
Dans le domaine de l’évaluation psychologique, des neurosciences cognitives et de la modélisation statistique avancée, la quantification précise des caractéristiques individuelles repose presque universellement sur la théorie de la distribution normale. Qu’il s’agisse d’évaluer le quotient intellectuel d’un enfant, de déterminer l’intensité d’un trouble anxieux ou de calibrer un test d’aptitude standardisé, les praticiens et chercheurs sont continuellement confrontés à la nécessité de situer une performance singulière au sein d’une population de référence. Au cœur de cette démarche se trouve le concept fondamental de score standardisé, communément désigné sous le terme de score Z, qui traduit la distance séparant une observation donnée de la moyenne du groupe en unités d’écart-type.
Toutefois, si la démarche directe consistant à convertir une note brute en score Z puis à en déduire une probabilité cumulée constitue un exercice classique pour tout étudiant en statistique, le problème inverse revêt une importance pratique et clinique considérablement plus stratégique. Savoir identifier le score Z exact correspondant à une aire prédéterminée sous la courbe normale standard représente la pierre angulaire de l’étalonnage psychométrique, de la définition des seuils nosographiques et de l’analyse décisionnelle. Lorsqu’un neuropsychologue cherche à circonscrire les 5 % d’individus présentant les déficits exécutifs les plus marqués, ou lorsqu’un psychologue du travail souhaite sélectionner les 10 % des candidats les plus performants, la problématique mathématique est identique : il s’agit de passer d’une proportion théorique, représentée par une surface géométrique sous la cloche de Gauss, à une valeur critique sur l’axe des abscisses.
Ce guide exhaustif a pour vocation d’exposer avec une rigueur absolue l’ensemble des fondements théoriques, des mécanismes mathématiques et des méthodologies opérationnelles permettant de résoudre le problème de l’aire inverse sous la distribution normale standard. À travers l’examen détaillé des tables statistiques imprimées, des algorithmes numériques intégrés dans les progiciels modernes de traitement de données et des commandes spécialisées des calculatrices scientifiques, ce document détaille pas à pas les procédures de calcul, les formules d’interpolation, les pièges conceptuels majeurs ainsi que les applications psychométriques concrètes indispensables à une pratique quantitative de haut niveau.
1. Introduction théorique : Les scores Z et l’aire sous la courbe normale en psychométrie
1.1 Définition mathématique et conceptuelle du score Z
Le score Z, ou variable normale centrée réduite, constitue le standard universel de mesure relative au sein des distributions quantitatives continues. D’un point de vue purement algébrique, le score Z opère une translation et une mise à l’échelle d’une observation brute issue d’une population parente caractérisée par une moyenne arithmétique et un écart-type définis. Cette transformation affine soustrait la moyenne du groupe de l’observation brute considérée, puis divise cette différence par l’écart-type de référence. L’effet géométrique et analytique de cette opération est fondamental : elle élimine totalement l’unité de mesure originale de la variable pour lui substituer une métrique adimensionnelle universelle, exprimée en fractions d’écart-type par rapport au centre de gravité de la distribution.
Dans le champ spécifique de l’évaluation psychologique et des sciences cognitives, la standardisation via le score Z résout l’épineux problème de l’incommensurabilité des instruments de mesure. Il est en effet scientifiquement impossible de comparer directement le nombre d’items réussis à un test de mémoire de travail avec le temps de réaction en millisecondes mesuré lors d’une tâche d’attention soutenue, ou encore avec le total de points obtenus sur une échelle d’évaluation de la dépression. En ramenant chaque performance brute à son écart relatif par rapport à un échantillon normatif représentatif, le score Z établit une échelle commune universelle. Une relation strictement bijective s’établit entre les valeurs de la variable aléatoire continue originale et la métrique standardisée, garantissant qu’aucune distorsion d’ordre ou de proportionnalité relative n’est introduite dans les données brutes initiales.
Sur le plan distributionnel formel, l’opération de centrage et de réduction confère à la nouvelle variable aléatoire des propriétés intrinsèques invariantes et remarquables. Quelle que soit la dispersion ou l’échelle de départ, la moyenne théorique d’une distribution de scores Z est rigoureusement égale à zéro, tandis que sa variance, et par conséquent son écart-type, est strictement égale à l’unité. Cette propriété de variance unitaire signifie qu’un score Z de +1,0 indique sans ambiguïté qu’un individu se situe exactement à un écart-type au-dessus de la moyenne de sa population de référence, tandis qu’un score de -2,0 traduit une performance s’affaissant à deux écarts-types en deçà du niveau central attendu. Cette métrique constitue ainsi le substrat indispensable à toute inférence probabiliste ultérieure.
1.2 La courbe normale standard comme distribution de probabilité
La distribution normale standard, souvent baptisée courbe en cloche de Gauss ou distribution de Laplace-Gauss, est une fonction de densité de probabilité continue dont l’expression mathématique fait intervenir la constante d’Euler et le nombre pi. Sur le plan structural, cette fonction se distingue par une symétrie axiale parfaite autour de son axe vertical passant par l’abscisse z = 0. En ce point central, la moyenne, la médiane et le mode de la distribution se trouvent rigoureusement confondus. La courbe s’étend de manière asymptotique vers l’infini positif et l’infini négatif, s’approchant indéfiniment de l’axe horizontal sans jamais le toucher, ce qui traduit la possibilité théorique d’observer des valeurs arbitrairement extrêmes, bien que leur probabilité d’occurrence décroisse exponentiellement à mesure que l’on s’éloigne du centre.
L’interprétation probabiliste de la distribution normale standard repose entièrement sur le calcul intégral. En vertu des axiomes fondamentaux de Kolmogorov régissant les théories des probabilités continues, la probabilité associée à une valeur ponctuelle isolée est rigoureusement nulle. En conséquence, les probabilités ne peuvent être définies que sur des intervalles continus de l’axe des réels, et correspondent géométriquement à l’aire délimitée par la courbe de densité, l’axe horizontal et les bornes verticales de l’intervalle considéré. L’intégrale définie de la fonction de densité de moins l’infini à plus l’infini est strictement égale à 1,0000, ce qui équivaut à la certitude absolue, soit 100 % de l’espace échantillonnal. Dès lors, toute portion de surface sous la courbe représente une probabilité cumulée bien définie.
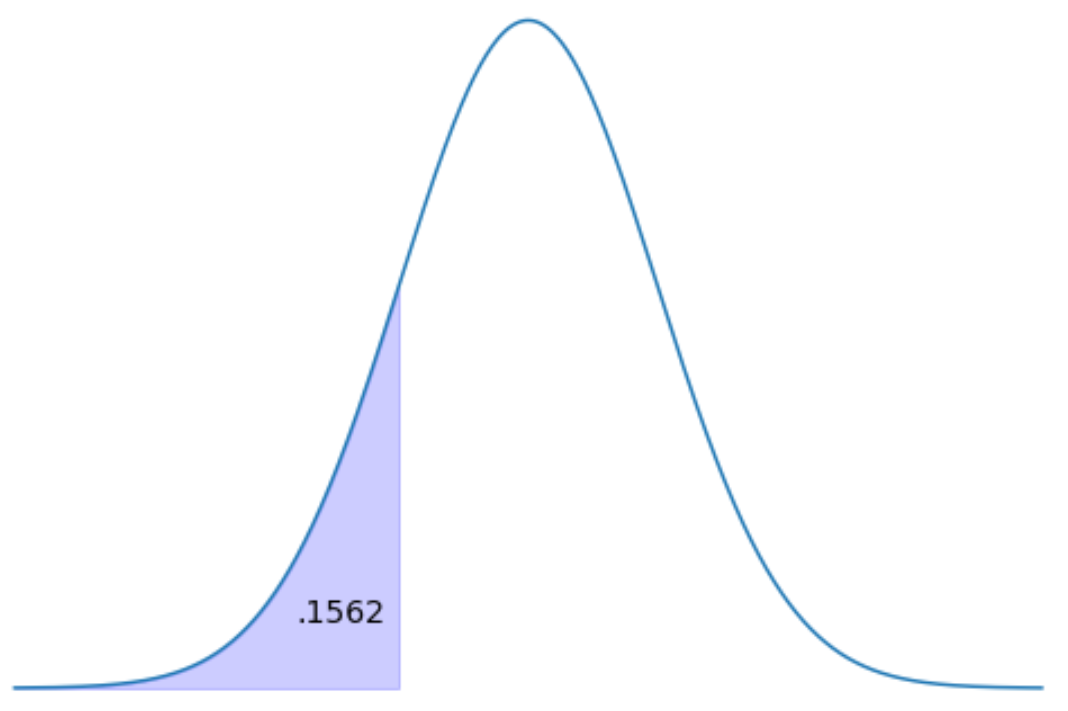
Il existe ainsi une équivalence formelle absolue entre l’aire géométrique sous la courbe, la probabilité cumulée et la notion psychométrique de rang percentile. Lorsqu’on affirme qu’une zone située sous la courbe normale entre moins l’infini et une abscisse spécifique représente une surface de 0,75, cela signifie mathématiquement que la probabilité d’observer un score inférieur ou égal à ce point est de 75 %. En psychométrie, cela correspond au 75e percentile, ce qui modélise avec une élégance remarquable la dispersion des traits latents, des compétences cognitives et des aptitudes psychophysiques au sein des populations biologiques et humaines, où les variations individuelles résultent de la sommation d’une infinité de micro-déterminants génétiques et environnementaux indépendants selon le théorème central limite.
1.3 Nécessité de la démarche inverse : de l’aire vers le score Z
L’utilisation pédagogique élémentaire des statistiques s’attache généralement au calcul direct : connaissant la valeur d’une observation brute, on calcule son score standardisé Z, puis l’on détermine, au moyen d’outils analytiques ou tabulaires, la probabilité cumulée ou le percentile correspondant. Cependant, dans la recherche empirique appliquée et dans la pratique clinique quotidienne, le paradigme est très fréquemment inversé. Le professionnel est confronté au problème du calcul inverse de fractile, également désigné sous le terme d’analyse de quantiles. Dans cette configuration, la probabilité ou le pourcentage de la population est le paramètre imposé a priori, et le praticien doit impérativement déduire la valeur critique Z qui délimite précisément cette proportion d’individus.
Cette approche descendante, allant de l’aire vers l’abscisse, constitue le mécanisme central de la standardisation des instruments psychométriques et du calibrage des tests diagnostiques. À titre d’illustration, l’identification d’une déficience intellectuelle ou d’un trouble spécifique des apprentissages ne repose pas sur une note brute arbitraire, mais sur la délimitation d’un seuil pathologique conventionnel fixé, par exemple, aux 2,28 % des scores les plus faibles de la population générale. Pour établir un tel diagnostic conformément aux critères nosographiques du DSM-5 ou de la CIM-11, le clinicien doit déterminer le score Z qui isole exactement cette aire inférieure de 0,0228. De même, les constructeurs d’outils d’évaluation ont constamment recours à cette inversion pour scinder les distributions en classes normatives standardisées : déciles (tranches de 10 % d’aire), quartiles (25 %), stanines (classes d’aires prédéterminées réparties sur l’échelle normale standard) ou percentiles individuels.
La précision numérique de cette démarche inverse conditionne directement la validité des décisions prises sur la base de ces scores. Une approximation trop grossière ou une confusion dans la gestion des aires peut conduire à classer erronément un sujet dans une catégorie psychopathologique ou, inversement, à méconnaître un déficit cognitif sévère méritant une compensation académique ou professionnelle. Dans les domaines hautement compétitifs du recrutement de cadres de haut niveau, de la sélection de pilotes de ligne ou de l’orientation scolaire spécialisée, quelques centièmes de déviation sur le score Z calculé à partir d’un pourcentage cible peuvent modifier drastiquement l’issue de l’évaluation, rendant indispensable la maîtrise absolue des différentes méthodes d’extraction de ce quantile.
2. Fondements mathématiques du problème de l’aire inverse
2.1 La fonction de répartition cumulée et son inverse quantile
Pour formaliser mathématiquement le passage d’une aire à un score Z, il est indispensable de manipuler la fonction de répartition de la loi normale standard, traditionnellement désignée par la lettre grecque majuscule Phi. Pour toute valeur réelle z, Phi(z) représente la probabilité cumulée que la variable aléatoire normale centrée réduite Z prenne une valeur inférieure ou égale à z. Cette fonction s’exprime sous la forme d’une intégrale définie de la fonction de densité gaussienne, s’étendant depuis la borne asymptotique inférieure jusqu’au point z :
Phi(z) = Intégrale de -infini à z de [ 1 / sqrt(2 * pi) ] * exp( – t^2 / 2 ) dt
Dans le problème de l’aire inverse, l’inconnue n’est plus la probabilité résultante, mais la borne supérieure d’intégration z elle-même. Soit une probabilité cumulée alpha appartenant à l’intervalle ouvert ]0, 1[, le problème mathématique consiste à résoudre l’équation fondamentale Phi(z) = alpha. La fonction réciproque qui associe à toute probabilité alpha le score z correspondant est la fonction quantile de la loi normale standard, également connue sous l’appellation mathématique et économétrique de fonction probit :
z = Phi^(-1)(alpha)
La complexité intrinsèque de cette opération réside dans le fait mathématique formel qu’il n’existe aucune fonction élémentaire (composée d’une combinaison finie de polynômes, exponentielles, logarithmes ou fonctions trigonométriques) permettant d’exprimer la primitive de la densité gaussienne. L’intégrale de Gauss ne possédant pas de forme close analytique simple, il est tout aussi impossible d’écrire une formule directe exacte pour sa réciproque. Par conséquent, l’évaluation de la fonction probit requiert obligatoirement le recours à des méthodes d’analyse numérique avancées. Historiquement, les mathématiciens ont développé des développements en séries entières, des fractions continues et des approximations asymptotiques complexes, telles que l’approximation de Hastings ou l’algorithme AS 241 de Wichura, capables de calculer le score z avec une précision relative oscillant entre dix et seize décimales significatives selon les besoins algorithmiques.
2.2 Gestion de la symétrie et de la directionnalité de l’aire
L’application rigoureuse des concepts de probabilité géométrique exige une compréhension parfaite de la directionnalité de la surface considérée sous la cloche de Gauss. Par convention universelle établie en statistique mathématique, l’aire standardisée désignée par la fonction de répartition Phi(z) est strictement une aire cumulée à gauche. Cela signifie qu’elle quantifie la probabilité totale associée à l’intervalle semi-infini ]-infini, z]. Cette convention géométrique découle naturellement de la construction de l’intégrale de Lebesgue et des fonctions de répartition cumulatives monotones croissantes.
Cependant, les problèmes pratiques imposent fréquemment la manipulation d’aires situées à droite de la valeur z recherchée, c’est-à-dire dans la queue supérieure de la distribution. En vertu du théorème des probabilités totales, l’aire totale sous la densité valant exactement 1, l’aire cumulée à droite, représentant la probabilité que Z soit strictement supérieur à z, est rigoureusement égale au complément à l’unité de l’aire à gauche :
P(Z > z) = 1 – P(Z <= z) = 1 – Phi(z)
D’autre part, la propriété de symétrie axiale parfaite de la courbe normale autour de l’ordonnée z = 0 implique une relation fondamentale liant directement les quantiles symétriques. Pour toute probabilité alpha, le score Z associé à une probabilité (1 – alpha) est exactement l’opposé arithmétique du score Z associé à la probabilité alpha :
Phi^(-1)(1 – alpha) = – Phi^(-1)(alpha)
Cette propriété de parité miroir engendre une règle directionnelle absolue gouvernant le signe du score Z en fonction de la valeur de l’aire cumulée à gauche. Le point médian de la distribution, marquant la médiane parfaite, correspond à une aire cumulative exactement égale à 0,5000, pour laquelle z = 0,00. Par voie de conséquence, toute aire cumulée à gauche strictement inférieure à 0,5000 est nécessairement associée à un score Z négatif, situant l’observation dans la moitié inférieure de la population. À l’inverse, toute aire cumulée à gauche strictement supérieure à 0,5000 correspond impérativement à un score Z positif. La maîtrise de ces relations d’inversion et de symétrie est indispensable, car une méconnaissance de ces principes élémentaires constitue la source la plus fréquente d’erreurs lors de l’utilisation des tables imprimées ou des fonctions programmées.
3. Méthode 1 : Utilisation approfondie de la table statistique normale standard
3.1 Structure et lecture inversée de la table Z classique
La table statistique de la loi normale standard demeure l’instrument pédagogique fondamental d’apprentissage et de calcul manuel. Bien qu’il existe diverses variantes typologiques de cette table, la configuration la plus répandue et la plus universellement adoptée présente l’aire cumulée depuis moins l’infini jusqu’à la valeur z (tables de surface unilatérale à gauche). Certaines éditions scindent cette présentation en deux feuillets distincts : une première page dédiée aux scores Z négatifs (couvrant les probabilités de 0,0001 à 0,4999) et une seconde page dédiée aux scores Z positifs (couvrant les probabilités de 0,5000 à 0,9999). D’autres ouvrages ne fournissent que la portion positive de la table, contraignant l’utilisateur à appliquer les règles de symétrie susmentionnées pour déduire les valeurs négatives.
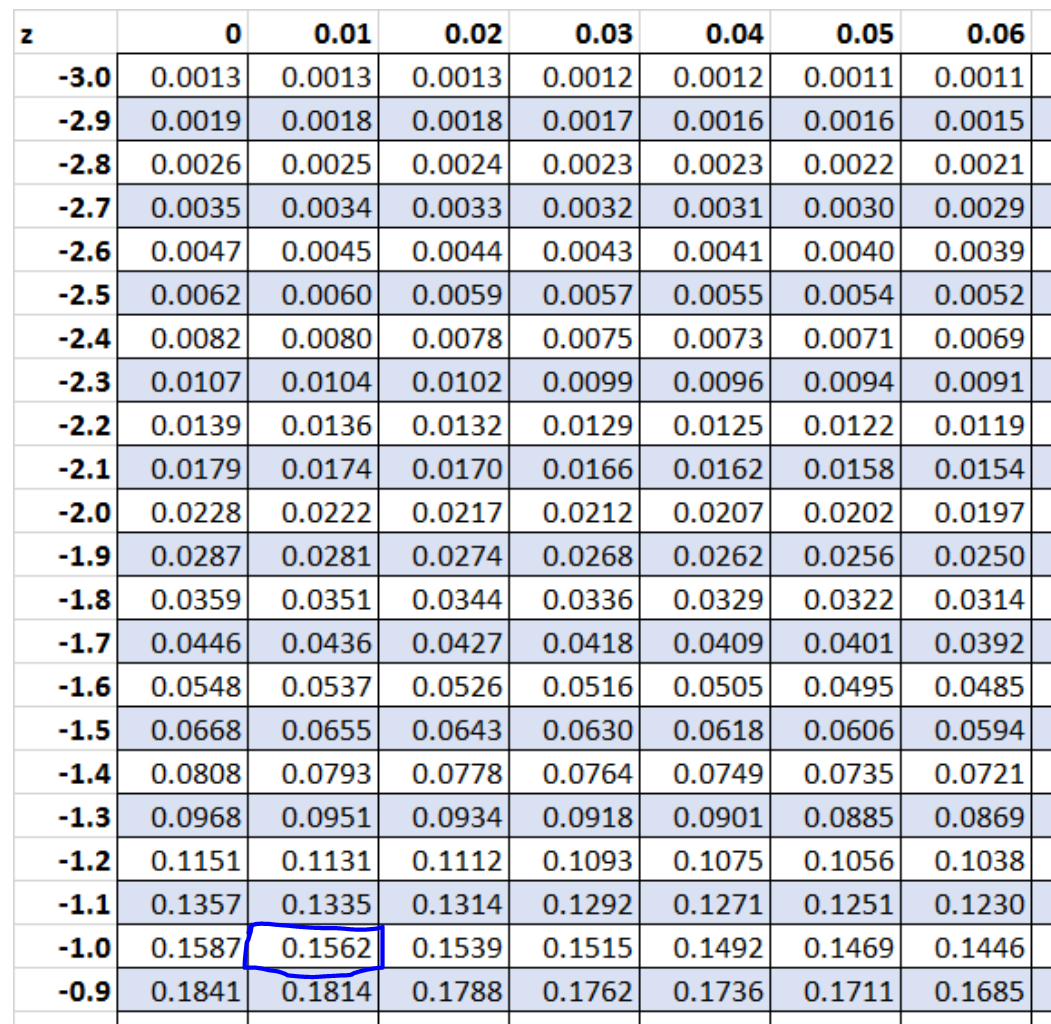
Dans sa structure matricielle, une table Z présente en marge gauche (les en-têtes de lignes) la partie entière du score Z ainsi que sa première décimale (par exemple : -1,9 ; -0,4 ; 0,0 ; 1,2 ; 2,5). L’en-tête supérieur (les colonnes) décline la seconde décimale, s’étendant de 0,00 à 0,09. L’intersection d’une ligne spécifique et d’une colonne donnée révèle, au cœur du corps tabulaire, une valeur décimale à quatre ou cinq chiffres représentant l’aire cumulée exacte sous la courbe, c’est-à-dire la probabilité Phi(z).
Pour réaliser la lecture inversée de la table afin d’identifier un score Z à partir d’une aire connue, la démarche analytique s’effectue de l’intérieur vers l’extérieur :
- L’utilisateur doit d’abord s’assurer que l’aire disponible correspond rigoureusement à l’aire cumulée à gauche de la valeur recherchée. Si l’énoncé fournit une aire à droite, il est impératif de soustraire préalablement cette valeur de 1,0000.
- L’utilisateur scrute le corps intérieur de la table afin de repérer le nombre décimal qui coïncide le plus fidèlement possible avec la probabilité cible.
- Une fois cette cellule isolée, l’utilisateur projette son regard horizontalement vers la marge de gauche pour lire la première composante du score Z (la partie entière et la première décimale).
- Il projette ensuite son regard verticalement vers le haut pour extraire la seconde décimale correspondante.
- Le score Z final est alors reconstitué par l’addition arithmétique simple de la valeur de ligne et de la valeur de colonne, en veillant scrupuleusement à conserver le signe négatif si l’analyse s’est opérée sur la section inférieure de la distribution.
3.2 Technique d’interpolation linéaire pour les valeurs intermédiaires
Étant donné que les tables imprimées fournissent des probabilités discrétisées avec un pas d’incrémentation de 0,01 sur la variable Z, il est extrêmement fréquent que l’aire recherchée ne figure pas de manière exacte au sein de la matrice numérique. Dans cette situation, deux approches sont envisageables : pour un calcul rapide d’ordre indicatif, on retient simplement la cellule la plus proche. Cependant, dès lors qu’une précision académique ou clinique est exigée, le recours à la méthode d’interpolation linéaire devient impératif pour estimer une troisième décimale significative.
La technique d’interpolation linéaire postule localement que la fonction de répartition présente un comportement quasi-rectiligne sur un intervalle extrêmement restreint de largeur delta z = 0,01. La démarche se déroule en plusieurs phases rigoureuses. En premier lieu, on encadre l’aire cible A par les deux probabilités tabulaires adjacentes les plus proches : une valeur immédiatement inférieure notée A1 (associée au score Z1) et une valeur immédiatement supérieure notée A2 (associée au score Z2). Le score Z final recherché s’obtient alors par l’application de la formule algébrique suivante :
z = z1 + [ (A – A1) / (A2 – A1) ] * (z2 – z1)
Puisque la distance séparant z1 et z2 sur la table est invariablement de 0,01, l’expression se simplifie sous la forme :
z = z1 + 0,01 * [ (A – A1) / (A2 – A1) ]
Considérons à titre d’exemple la recherche du score Z associé à une probabilité cumulée à gauche de 0,9755. Dans une table standard à quatre décimales, nous repérons les valeurs encadrantes suivantes : à z1 = 1,96 correspond l’aire A1 = 0,9750, et à z2 = 1,97 correspond l’aire A2 = 0,9756. L’écart entre les deux bornes tabulaires est A2 – A1 = 0,9756 – 0,9750 = 0,0006. La distance séparant notre valeur cible de la borne inférieure est A – A1 = 0,9755 – 0,9750 = 0,0005. Le ratio de proportionnalité vaut 0,0005 / 0,0006 = 5/6, soit environ 0,8333. En appliquant la formule, le score Z interpolé s’établit à :
z = 1,96 + (0,01 * 0,8333) = 1,9683
Cette méthodologie permet de réduire l’erreur systématique inhérente au format papier. Néanmoins, il convient de garder à l’esprit que la fonction de répartition normale n’étant pas linéaire mais sigmoïdale, l’interpolation introduit une minime erreur d’approximation de second ordre. Pour une table à quatre décimales, cette erreur résiduelle est généralement négligeable devant l’incertitude d’arrondi des données brutes.
3.3 Précautions indispensables lors de l’usage des tables papier
L’utilisation des tables statistiques imprimées, bien qu’apparemment mécanique, recèle de nombreux pièges méthodologiques susceptibles de compromettre la validité des calculs. La première précaution fondamentale consiste à identifier impérativement la convention topologique adoptée par l’auteur de la table consultée. Si la majorité des manuels modernes proposent l’aire cumulée intégrale depuis moins l’infini, certains ouvrages classiques utilisent des tables dites centrales, qui indiquent l’aire comprise entre l’axe médian z = 0 et l’abscisse z (couvrant une amplitude de 0,0000 à 0,4999). D’autres manuels anglo-saxons présentent des tables de dépassement unilatéral supérieur, fournissant l’aire située strictement dans la queue droite. Tenter d’extraire un quantile à partir d’une aire sans avoir préalablement vérifié le schéma explicatif placé en exergue de la table engendre inévitablement des erreurs grossières.
La seconde erreur classique, remarquablement fréquente chez les praticiens non statisticiens, réside dans la confusion cognitive entre l’aire recherchée et la valeur Z elle-même. Confronté à une demande d’identification du quantile pour une probabilité de 0,40, un utilisateur inexpérimenté cherche souvent le nombre 0,40 sur la marge extérieure des scores Z (lisant ainsi l’aire correspondant à z = 0,40, soit 0,6554) au lieu de localiser la probabilité 0,4000 dans la matrice interne pour remonter vers le score Z de -0,25. Cette méprise inverse totalement le sens de la relation fonctionnelle.
Enfin, la gestion des signes arithmétiques requiert une vigilance absolue lorsque l’on manipule des tables ne reproduisant que le versant positif de la courbe. Face à une aire cumulée à gauche de 0,0500, la table positive ne contient évidemment aucune cellule affichant 0,0500. L’opérateur doit d’abord calculer l’aire symétrique supérieure par complémentation (1 – 0,0500 = 0,9500), localiser le score correspondant (z = 1,645), puis obligatoirement lui assigner manuellement le signe négatif (z = -1,645). L’oubli de cette inversion de signe aboutirait à situer l’individu dans la frange supérieure de la population alors même que son score initial traduisait une performance extrêmement dégradée.
4. Méthode 2 : Calculatrices logicielles de percentiles et progiciels statistiques
4.1 Fonctionnement des convertisseurs percentile-score Z
À l’ère du traitement informatisé des données, les praticiens et chercheurs ont largement délaissé les tables imprimées au profit de convertisseurs logiciels et d’outils statistiques en ligne. Ces applications numériques reposent sur des algorithmes programmés exécutant des approximations rationnelles de haute précision pour résoudre la fonction quantile normale inverse. Parmi les architectures algorithmiques les plus renommées figure l’algorithme AS 241 publié par Michael J. Wichura dans la revue Applied Statistics. Cet algorithme fractionne le domaine de probabilité en plusieurs sous-régions (le centre et les queues extrêmes) et applique des approximations rationnelles polynomiales de type minimax (conçues selon la méthode de Remez) capables de restituer la valeur du score Z avec une exactitude atteignant la précision machine en double précision standard IEEE 754 (soit environ 16 chiffres significatifs).
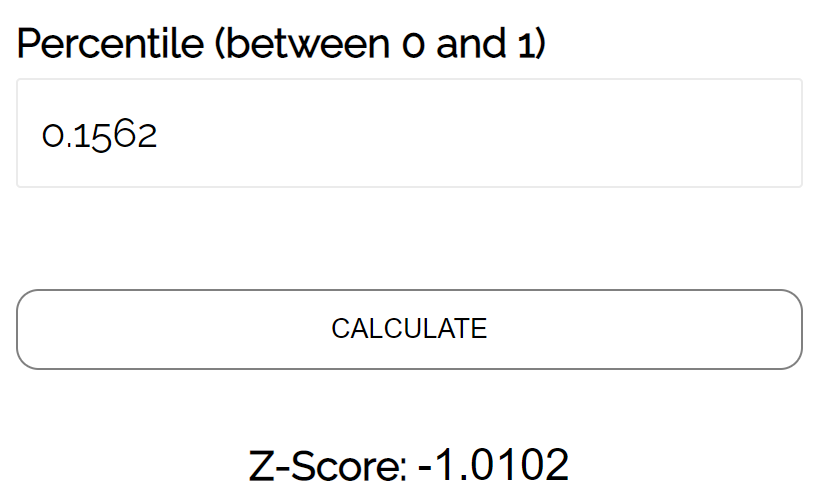
L’exploitation de ces convertisseurs interactifs exige toutefois une rigueur méthodologique dans la saisie des paramètres. La première étape impose de convertir systématiquement tout percentile ou pourcentage en une fraction décimale normalisée comprise strictement entre 0 et 1. Un percentile d’aptitude cognitive établi à 85 doit être saisi sous la valeur de proportion 0,8500. De surcroît, la plupart des convertisseurs modernes offrent la possibilité de spécifier les paramètres distributionnels de la population d’intérêt : la moyenne (notée mu) et l’écart-type (noté sigma). Pour obtenir un score Z pur standardisé, ces champs doivent impérativement demeurer fixés à leurs valeurs normalisées conventionnelles, à savoir mu = 0 et sigma = 1.
L’avantage prépondérant de ces solveurs numériques réside dans leur capacité à éliminer intégralement les imprécisions d’arrondi et les erreurs manuelles d’interpolation linéaire. Alors qu’une table papier restreint la recherche à des paliers de centièmes d’abscisse et des probabilités à quatre décimales, le convertisseur logiciel traite avec une fluidité absolue des probabilités complexes telles que 0,156238, renvoyant instantanément un score Z d’une fidélité mathématique parfaite, indispensable lors de l’établissement d’équations structurelles ou de protocoles normatifs standardisés.
4.2 Implémentation sous R et Python pour les sciences du comportement
Dans l’écosystème de la recherche empirique en psychologie et en sciences comportementales, les environnements de programmation statistique R et Python constituent les standards de référence incontournables. La manipulation computationnelle de la fonction quantile normale y est implémentée de manière native via des fonctions ultra-optimisées.
Dans l’environnement de calcul statistique R, la fonction dédiée à l’évaluation de l’inverse de la fonction de répartition normale est qnorm(). Sa syntaxe générale s’articule autour de plusieurs arguments formels :
- p : vecteur numérique des probabilités cibles pour lesquelles le quantile doit être déterminé.
- mean : paramètre de localisation, fixé par défaut à 0 pour la distribution normale standard.
- sd : paramètre de dispersion, fixé par défaut à 1 pour la distribution standard.
- lower.tail : variable booléenne logique. Lorsque cet argument est fixé à TRUE (comportement par défaut), la fonction interprète p comme l’aire cumulée à gauche (P(Z z)).
Par exemple, pour extraire le score Z délimitant une aire inférieure de 15,62 %, la commande s’écrit simplement qnorm(0.1562) et renvoie immédiatement la valeur -1.010047. Si l’on souhaite identifier le score Z isolant les 5 % supérieurs sans effectuer manuellement la soustraction, l’instruction qnorm(0.05, lower.tail = FALSE) retourne instantanément +1.644854.
Dans l’écosystème de programmation Python, la même opération mathématique s’exécute au travers de la célèbre bibliothèque de calcul scientifique SciPy, plus spécifiquement via le module de distributions probabilistes scipy.stats. La méthode appropriée est la fonction d’évaluation des points de pourcentage (Percent Point Function), abrégée en ppf(). La syntaxe opérationnelle s’organise comme suit :
On importe d’abord l’objet de distribution avec l’instruction from scipy.stats import norm. L’exécution de norm.ppf(0.1562) renvoie précisément la valeur flottante -1.010046903332143. Tout comme sous R, la distribution peut être paramétrée pour manipuler directement des variables non centrées réduites en renseignant les arguments de position et d’échelle loc et scale, bien que la conservation des valeurs par défaut loc=0 et scale=1 soit requise pour isoler les scores Z purs. L’automatisation permise par ces langages permet d’appliquer cette inversion vectorielle sur des cohortes cliniques de dizaines de milliers de sujets en une fraction de seconde.
4.3 Formules natives sous tableur (Excel et Google Sheets)
Pour la majorité des praticiens, analystes et psychologues en milieu hospitalier ou institutionnel, les tableurs tels que Microsoft Excel ou Google Sheets représentent l’outil de gestion de bases de données le plus immédiatement accessible. Les versions contemporaines de ces applications intègrent des fonctions statistiques de pointe, remplaçant avantageusement les anciennes commandes héritées des décennies antérieures.
La formule standard moderne intégrée pour calculer le score Z inverse est :
=LOI.NORMALE.STANDARD.INVERSE.N(probabilité)
Dans les versions antérieures d’Excel ou dans les environnements configurés avec une nomenclature historique, la formule équivalente s’intitulait LOI.NORMALE.STANDARD.INVERSE(), tandis que dans les versions anglophones du logiciel ou sur Google Sheets configuré en anglais, la commande prend la forme universelle :
=NORM.S.INV(probability)
Le paramètre unique requis par cette fonction est une valeur de probabilité continue strictement comprise entre 0 et 1 (excluant formellement 0 et 1, pour lesquels les scores Z tendent vers l’infini négatif et positif, générant une erreur d’argument `#NOMBRE!`). La fonction accepte indifféremment des saisies directes (comme =NORM.S.INV(0,85)) ou des références matricielles dynamiques vers d’autres cellules contenant les centiles transformés (par exemple =NORM.S.INV(A2/100)).
Sur le plan de l’architecture numérique, Microsoft a entièrement refondu ses algorithmes de calcul statistique à compter d’Excel 2010. Alors que les versions historiques (Excel 2003 et antérieures) souffraient d’imprécisions notoires et d’instabilités de troncature lors de l’évaluation des quantiles pour des probabilités situées dans les queues ultra-extrêmes (inférieures à 0,000001 ou supérieures à 0,999999), les versions actuelles implémentent des approximations de type Wichura garantissant une concordance parfaite jusqu’à la huitième décimale avec les calculatrices R et SciPy. Une telle précision élimine définitivement les divergences qui existaient jadis entre les tables imprimées et les traitements sur tableur.
5. Méthode 3 : La fonction invNorm() sur calculatrice graphique TI-84
5.1 Navigation et paramétrage du menu de distribution
Au sein des cursus universitaires de psychologie, de médecine, de biologie et d’ingénierie, la gamme des calculatrices graphiques Texas Instruments, en particulier les modèles de la série TI-84 Plus (comprenant les versions TI-84 Plus Silver Edition et TI-84 Plus CE à écran couleur), s’impose comme un standard matériel quasi institutionnel. Ces calculatrices disposent d’un sous-système de calcul dédié aux distributions probabilistes, capable d’exécuter des conversions d’aire en score Z de manière autonome, sans nécessiter de connexion à un terminal informatique.
Pour accéder à la fonction de calcul de l’aire inverse, la séquence de navigation matérielle requiert une manipulation rigoureuse :
- L’utilisateur allume l’appareil et presse consécutivement la touche bleue [2nd] puis la touche [VARS]. Cette combinaison permet d’activer le menu secondaire supérieur labellisé [DISTR] (abréviation de Distributions).
- L’écran affiche alors une liste ordonnée de fonctions probabilistes continues et discrètes. L’élément numéro 3, désigné explicitement sous l’intitulé 3: invNorm( (ou FracNorm( sur les versions dotées d’un système d’exploitation intégralement francisé), constitue la routine algorithmique recherchée.
- L’utilisateur sélectionne cette option en pressant directement la touche numérique [3] ou en déplaçant le curseur de sélection à l’aide des flèches directionnelles avant de valider via la touche [ENTER].
Sur les calculatrices modernes équipées du système d’exploitation TI-OS version 2.55MP ou ultérieure, l’écran bascule vers une interface interactive de saisie guidée (Wizard). Cette interface présente une série de champs consécutifs qu’il s’agit de renseigner : le champ area (l’aire de probabilité), le champ mu (la moyenne de la distribution), le champ sigma (l’écart-type) et, sur les modèles récents, un sélecteur de positionnement de queue (tail). Pour déterminer un score Z standardisé pur, l’utilisateur doit impérativement veiller à ce que les valeurs des paramètres d’échelle soient configurées à mu = 0 et sigma = 1, toute modification de ces grandeurs entraînant la conversion directe vers une note brute non standardisée.
5.2 Gestion des options de direction de queue (LEFT, RIGHT, CENTER)
L’une des innovations ergonomiques les plus remarquables introduites sur les systèmes TI-84 Plus modernes (spécifiquement les versions TI-84 Plus C Silver Edition et TI-84 Plus CE) réside dans l’apparition du paramètre de directionnalité de queue d’intégration, libellé Tail. Cette fonctionnalité offre trois alternatives géométriques qui modifient fondamentalement l’interprétation de l’aire saisie :
- Option LEFT (Queue à gauche) : Il s’agit du mode opératoire par défaut, parfaitement synchronisé avec la fonction de répartition classique Phi(z). Lorsque LEFT est sélectionné, la calculatrice interprète la valeur entrée dans le champ area comme l’aire cumulée s’étendant depuis moins l’infini jusqu’au score Z recherché. Ce mode est privilégié pour tous les problèmes formulés en termes de percentiles ou de seuils d’infériorité relative.
- Option RIGHT (Queue à droite) : Ce réglage indique à l’algorithme que la valeur numérique d’aire spécifiée correspond à la surface située sous la queue supérieure, c’est-à-dire entre le score Z recherché et plus l’infini. Cette option est extrêmement utile lors de l’étude de populations exceptionnelles, d’aptitudes supérieures ou de seuils critiques de rejet unilatéral droit, dispensant l’utilisateur d’effectuer manuellement la soustraction préalable (1 – Aire).
- Option CENTER (Queue centrale) : Cette option hautement sophistiquée modélise les problématiques d’intervalles symétriques de dispersion ou d’intervalles de confiance. Lorsque l’option CENTER est activée avec une aire de 0,90 par exemple, la calculatrice déduit automatiquement que les 90 % de surface spécifiés doivent être centrés exactement autour de la moyenne mu = 0, et renvoie un couple de deux bornes symétriques {-1,64485 ; 1,64485}.
Il est fondamental de souligner que sur les modèles plus anciens de la gamme (tels que la TI-83 classique ou les premières révisions de la TI-84 Plus dotées d’un firmware antérieur), l’option Tail est totalement absente. Sur ces appareils, l’interpréteur de commande impose une syntaxe textuelle directe en ligne de commande de la forme invNorm(aire, [mu], [sigma]) et fonctionne exclusivement et irrévocablement sous la convention LEFT. L’utilisateur d’un modèle non actualisé doit dès lors appliquer rigoureusement les transformations analytiques manuelles (1 – Aire pour la queue droite, et (1 – Aire)/2 pour la délimitation inférieure d’une aire centrale) avant de valider sa commande.
5.3 Erreurs courantes de saisie sur TI-84
L’exploitation de la calculatrice TI-84 en conditions d’examen ou d’évaluation clinique est fréquemment émaillée de bévues de saisie élémentaires qui compromettent la validité des résultats numériques. L’erreur la plus prévalente réside sans conteste dans la saisie directe d’un pourcentage sous sa forme entière au lieu de sa transcription décimale. Si un clinicien cherche le score Z marquant le 25e percentile et renseigne invNorm(25, 0, 1), le microprocesseur de la calculatrice déclenche immédiatement une interruption d’exécution matérialisée par l’affichage d’un message d’erreur fatal : ERR:DOMAIN. Cette alerte indique que l’argument soumis viole le domaine de définition de la fonction de répartition, lequel est strictement borné à l’intervalle ouvert ]0, 1[. L’aire doit obligatoirement être saisie sous la forme décimale 0.25.
Une seconde défaillance, plus pernicieuse car ne déclenchant aucune interruption logicielle, résulte de l’omission de réinitialisation des paramètres mu et sigma. Lorsqu’un praticien utilise temporairement sa machine pour analyser des données psychométriques brutes (par exemple en configurant mu = 100 et sigma = 15 pour étudier l’échelle du QI de Wechsler) et omet par la suite de rétablir les valeurs standard mu = 0 et sigma = 1, toutes les commandes ultérieures destinées à extraire des scores Z renverront en réalité des notes composites d’intelligence. L’opérateur non averti peut ainsi se retrouver avec un score supposé être un score Z affichant une valeur de 85 au lieu de -1,00, générant des contresens analytiques destructeurs.
Enfin, l’usage de la virgule typographique française au lieu du point décimal anglophone constitue un piège classique sur le clavier physique de la TI-84. La touche virgule située au-dessus de la touche [7] sert exclusivement de séparateur d’arguments syntaxiques dans les commandes complexes. L’encodage d’un nombre décimal doit impérativement s’effectuer via la touche du point décimal située sur la rangée inférieure, à gauche de la touche [ENTER], sous peine de déclencher une erreur syntaxique bloquante (ERR:SYNTAX).
6. Exemple pratique 1 : Trouver un score Z à partir d’une aire à gauche
6.1 Énoncé du problème et contexte psychologique
Afin d’ancrer ces développements théoriques dans la réalité opérationnelle de la pratique évaluative, considérons une situation clinique standardisée au sein d’un centre de diagnostic neuropsychologique de l’adulte. Une équipe de cliniciens procède à l’évaluation standardisée d’une cohorte d’individus suspectés de présenter des troubles de l’attention soutenue à l’aide d’une batterie informatisée mesurant les temps de réaction stables. Les scores de vitesse de traitement, convenablement normalisés à l’échelle de la population générale adulte, suivent une distribution normale continue.
Le protocole nosographique adopté stipule qu’une anomalie significative du profil cognitif est suspectée dès lors qu’un patient présente un niveau d’efficience le situant parmi les 15,62 % des profils les plus lents de la population de référence. La problématique psychométrique se résume ainsi à une interrogation univoque : quelle est la valeur critique exacte du score Z qui délimite rigoureusement cette zone de vigilance clinique, c’est-à-dire qui isole les 15,62 % inférieurs de la distribution globale ?
Sur le plan formel des probabilités, l’énoncé définit une aire cumulée à gauche de 0,1562. La recherche consiste à identifier la valeur scalaire z telle que :
P(Z <= z) = 0,1562, ce qui revient à poser z = Phi^(-1)(0,1562).
Avant d’engager le moindre calcul numérique instrumental, une anticipation logique fondamentale s’impose : l’aire cumulée étant strictement inférieure au seuil médian de 0,5000 (représentant 50 % de la population), le score Z recherché se situe incontestablement dans l’hémisphère inférieur de la distribution. Il doit par conséquent arborer un signe strictement négatif.
6.2 Résolution détaillée via la table Z
Procédons à la résolution du problème par l’intermédiaire de la méthode manuelle traditionnelle exploitant une table Z d’aire cumulée unilatérale gauche standardisée. L’observateur se munit du feuillet dédié aux scores Z négatifs. Son regard parcourt les rangées internes de la matrice de données décimales pour localiser la valeur la plus proche de 0,1562.
En analysant méthodiquement la section comprise entre les lignes z = -1,1 et z = -1,0, le parcours révèle les cellules suivantes :
- Sur la ligne indexée à -1,0, sous la colonne d’en-tête 0,00, la table indique l’aire : 0,1587.
- Sur cette même ligne indexée à -1,0, en glissant vers la colonne d’en-tête 0,01, la table révèle précisément la probabilité : 0,1562.
- Sur la colonne suivante d’en-tête 0,02, la valeur affichée est : 0,1539.
La convergence tabulaire est ici exceptionnellement parfaite : la valeur 0,1562 figure textuellement au croisement exact de la ligne -1,0 et de la colonne 0,01. La reconstitution arithmétique de la coordonnée d’abscisse s’opère donc de manière immédiate :
z = -1,0 + (-0,01) = -1,01
Sur le plan géométrique, ce résultat signifie que l’abscisse z = -1,01 délimite une surface sous la courbe, depuis l’extrémité asymptotique gauche jusqu’à cette coordonnée, équivalant rigoureusement à 15,62 % de la superficie intégrale totale sous la fonction de densité gaussienne standard.
6.3 Résolution via convertisseur de percentile et calculatrice TI-84
Vérifions et consolidons ce résultat par le biais des instruments de calcul automatisés contemporains.
Lors de l’utilisation d’un convertisseur logiciel ou d’un progiciel statistique sous R, nous saisissons directement l’instruction :
qnorm(0.1562)
La machine renvoie avec une précision algorithmique étendue le résultat suivant : -1.0100469…, confirmant que le score tronqué à deux décimales est rigoureusement z = -1,01.
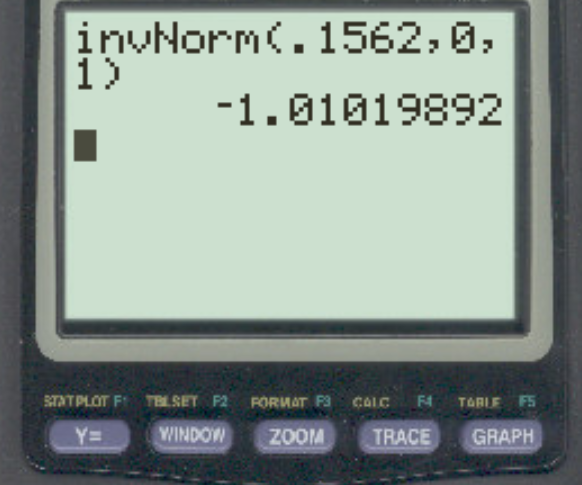
Sur une calculatrice graphique TI-84 Plus, la manipulation s’exécute selon les étapes systématiques suivantes :
- Pression sur [2nd] puis [VARS] pour ouvrir le catalogue des distributions.
- Sélection de l’option 3: invNorm(.
- Renseignement rigoureux des paramètres affichés à l’écran :
- area: 0.1562
- mu: 0
- sigma: 1
- Tail: LEFT (sur les modèles dotés de l’option de queue).
- Surbrillance de la commande Paste et validation via [ENTER]. L’écran principal affiche la formulation syntaxique complète : invNorm(0.1562, 0, 1, LEFT).
- Une seconde pression sur [ENTER] génère l’affichage immédiat du résultat numérique : -1.010046903.
La concordance absolue entre les trois démarches (table papier, solveur numérique et calculatrice graphique) atteste de l’exactitude de la résolution. Sur le plan de la décision clinique, le neuropsychologue conclut que tout patient dont le score Z standardisé est égal ou inférieur à -1,01 bascule dans la frange des 15,62 % des profils caractérisés par une lenteur anormale de traitement de l’information.
7. Exemple pratique 2 : Trouver un score Z à partir d’une aire à droite
7.1 Problématique et ajustement mathématique préliminaire
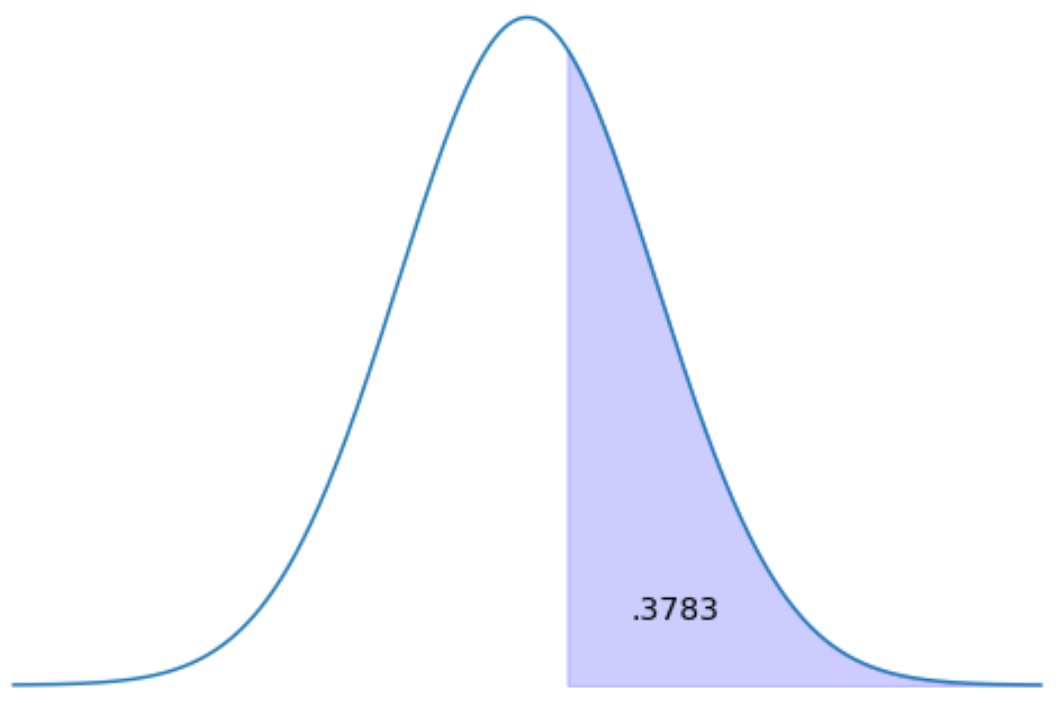
Examinons à présent une situation fréquente d’évaluation positive où la zone de sélection d’intérêt se trouve située non pas dans la portion inférieure, mais dans la portion supérieure droite de la distribution normale standard. Supposons qu’un organisme académique responsable de l’admission dans un cursus universitaire d’excellence médicale souhaite définir son seuil d’admissibilité de manière à ne retenir que les candidats constituant les 37,83 % les plus brillants au test d’aptitude logique général.
Le paramètre fourni est une aire unilatérale supérieure (aire à droite) égale à 37,83 %, soit une probabilité :
P(Z >= z) = 0,3783
L’utilisation directe de cette valeur au sein d’une table Z standard cumulée à gauche ou d’une fonction logicielle non paramétrée constitue une faute méthodologique rédhibitoire qui conduirait à déterminer un score erroné. Pour exploiter la table standard ou les fonctions natives, un ajustement algébrique préliminaire fondé sur la règle de l’événement complémentaire est absolument obligatoire :
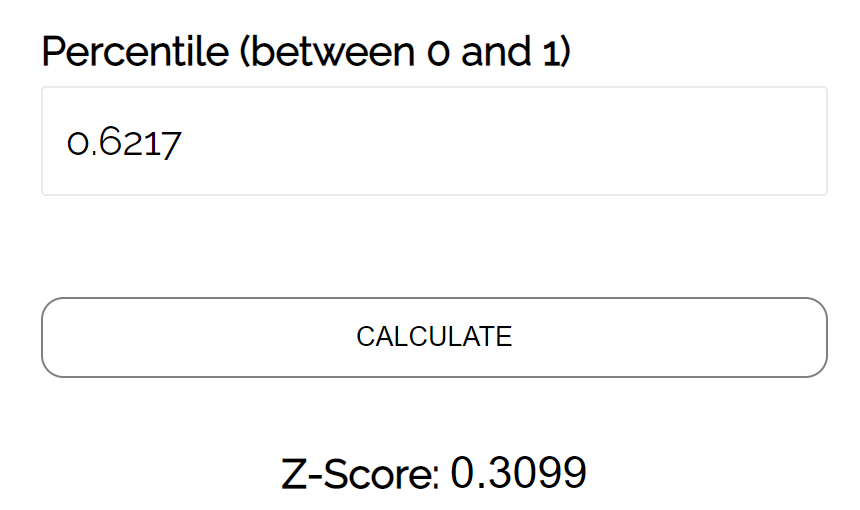
P(Z = z) = 1 – 0,3783 = 0,6217
L’aire cumulée à gauche associée au score Z recherché est donc rigoureusement égale à 0,6217. L’amplitude de cette aire cumulative étant strictement supérieure à 0,5000, le score Z attendu est indiscutablement de signe positif, situant la ligne de démarcation au-dessus de la moyenne de la cohorte générale.
7.2 Application des trois méthodes sur l’aire transformée
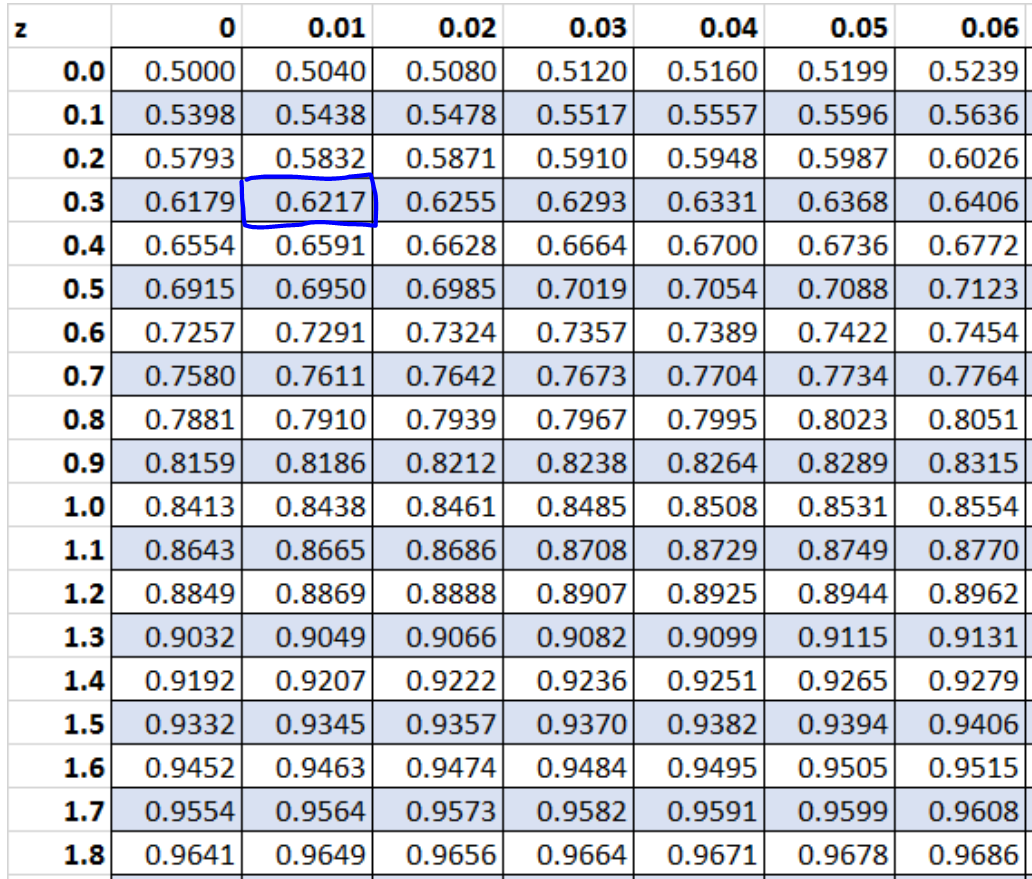
1. Résolution manuelle via la table Z standard : Muni du feuillet des scores Z positifs d’une table cumulée à gauche, l’utilisateur scrute le corps interne des probabilités à la recherche de la valeur décimale 0,6217. En parcourant la table :
- Sur la ligne indexée à 0,3, sous la colonne 0,00, la valeur affichée est 0,6179.
- En poursuivant sur cette ligne 0,3 jusqu’à la colonne 0,01, la cellule indique précisément 0,6217.
- La colonne adjacente 0,02 affiche quant à elle 0,6255.
L’identification est immédiate et exacte : l’aire 0,6217 correspond précisément à l’intersection de la ligne 0,3 et de la colonne 0,01. Le score Z recherché s’établit donc rigoureusement à :
z = +0,31
2. Résolution logicielle (R / Python / Excel) : En exploitant l’argument de queue unilatérale droite sous R, nous pouvons éviter la soustraction préalable en saisissant :
qnorm(0.3783, lower.tail = FALSE)
La console renvoie sans délai la valeur 0.3100063… De façon strictement équivalente sous Microsoft Excel, la formulation intégrant la conversion de surface s’écrit =LOI.NORMALE.STANDARD.INVERSE.N(1 – 0,3783), produisant un score de 0,3100.
3. Résolution sur calculatrice TI-84 Plus : Deux stratégies d’encodage sont offertes selon la génération du matériel :
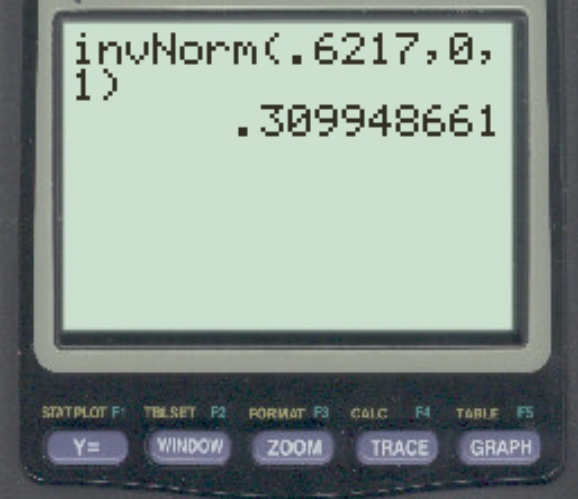
- Sur une TI-84 Plus CE récente : L’utilisateur saisit area: 0.3783, mu: 0, sigma: 1, et positionne impérativement le sélecteur Tail: sur RIGHT. La validation de invNorm(0.3783, 0, 1, RIGHT) restitue immédiatement 0.3100063073.
- Sur un modèle TI-84 traditionnel (sans option de queue) : L’opérateur encode manuellement l’expression du complément au sein de l’argument de surface : invNorm(1 – 0.3783, 0, 1), aboutissant rigoureusement au même résultat positif z = 0,31.
7.3 Interprétation quantitative du seuil supérieur
L’interprétation quantitative de ce résultat démontre avec clarté la rigueur de la théorie distributionnelle. Le fait que l’aire située dans la queue droite (37,83 %) soit inférieure à 50 % confirme sur le plan géométrique que le seuil de sélection doit surpasser la moyenne arithmétique de la population, ce que matérialise sans équivoque la positivité du score Z (+0,31).
Dans le contexte concret de la sélection universitaire, cela indique que le comité d’admissibilité doit fixer sa barre d’admission à un score Z de +0,31. Tout candidat obtenant un résultat supérieur ou égal à cette valeur critique se classe parmi les 37,83 % des meilleurs postulants et franchit victorieusement l’étape éliminatoire. Cette transformation garantit que le ratio de sélection est respecté avec une stabilité mathématique absolue, immunisée contre les variations d’étalonnage subjectif des correcteurs.
8. Exemple pratique 3 : Trouver les scores Z délimitant une aire centrale symétrique
8.1 Décomposition mathématique de l’intervalle de confiance central
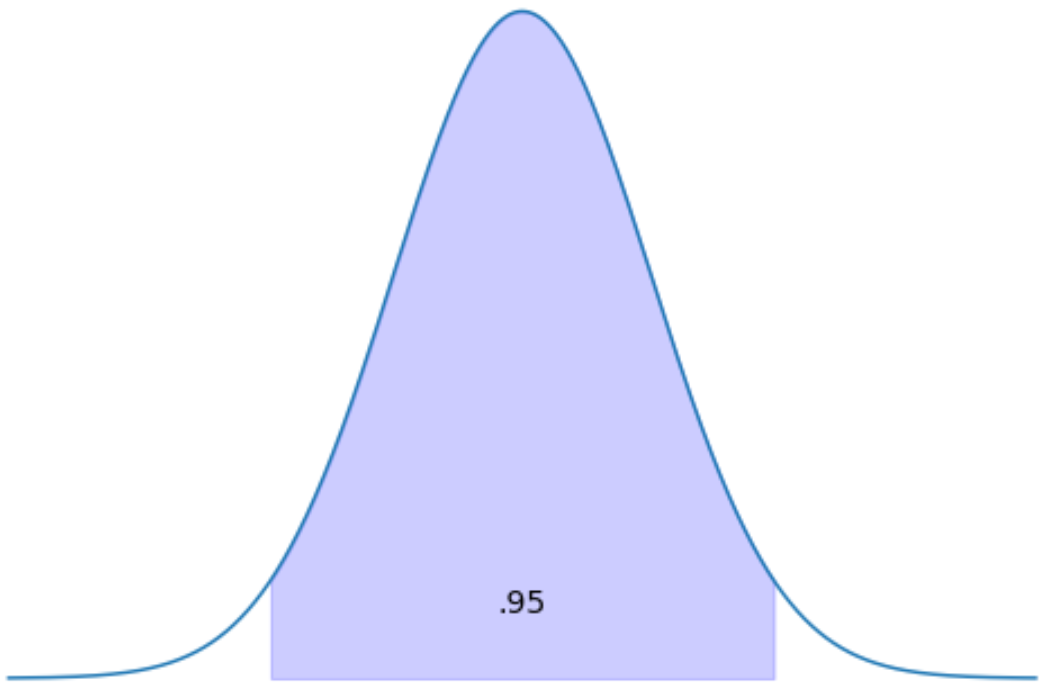
L’une des opérations les plus courantes en inférence statistique, dans la construction des intervalles de confiance et dans l’étalonnage psychologique des normes de rendement moyen, consiste à déterminer les deux scores Z symétriques délimitant une aire centrale prédéfinie. Soit une proportion centrale gamma appartenant à l’intervalle ]0, 1[ (souvent fixée conventionnellement à 80 %, 90 %, 95 % ou 99 %), il s’agit d’identifier les deux bornes opposées [-z_critique ; +z_critique] englobant précisément cette masse probabiliste centrale.
La résolution de cette configuration exige une décomposition rigoureuse de la distribution en trois zones géométriques disjointes : la bande centrale d’aire gamma, la queue inférieure gauche d’aire alpha1, et la queue supérieure droite d’aire alpha2. La symétrie parfaite de la fonction de densité gaussienne impose l’égalité stricte des deux queues résiduelles :
alpha1 = alpha2 = (1 – gamma) / 2
Dès lors, la recherche des bornes se ramène à la détermination de deux quantiles spécifiques :
- La borne inférieure (-z_critique) correspond au score Z dont l’aire cumulée à gauche est exactement égale à la fraction résiduelle d’une queue, soit : alpha / 2 = (1 – gamma) / 2.
- La borne supérieure (+z_critique) correspond au score Z dont l’aire cumulée à gauche englobe à la fois la queue inférieure et l’aire centrale, soit : 1 – (alpha / 2) = (1 + gamma) / 2.
Par les propriétés fondamentales de parité de la loi normale, ces deux scores Z possèdent impérativement la même valeur absolue, ne différant que par leur polarité algébrique.
8.2 Résolution pas à pas pour un intervalle central de 90 %
Appliquons rigoureusement cette modélisation à la recherche des scores Z délimitant les 90 % centraux de la distribution normale standard (gamma = 0,90).
Étape 1 : Calcul de l’aire des queues d’extrémité.
La masse probabiliste exclue de l’intervalle central est :
alpha = 1 – 0,90 = 0,10 (soit 10 % au total).
Cette probabilité se répartissant de manière strictement équiprobable entre les deux extrémités, l’aire de chaque queue s’établit à :
alpha / 2 = 0,10 / 2 = 0,0500 (soit 5 % par queue).
Étape 2 : Consultation de la table Z et interpolation.
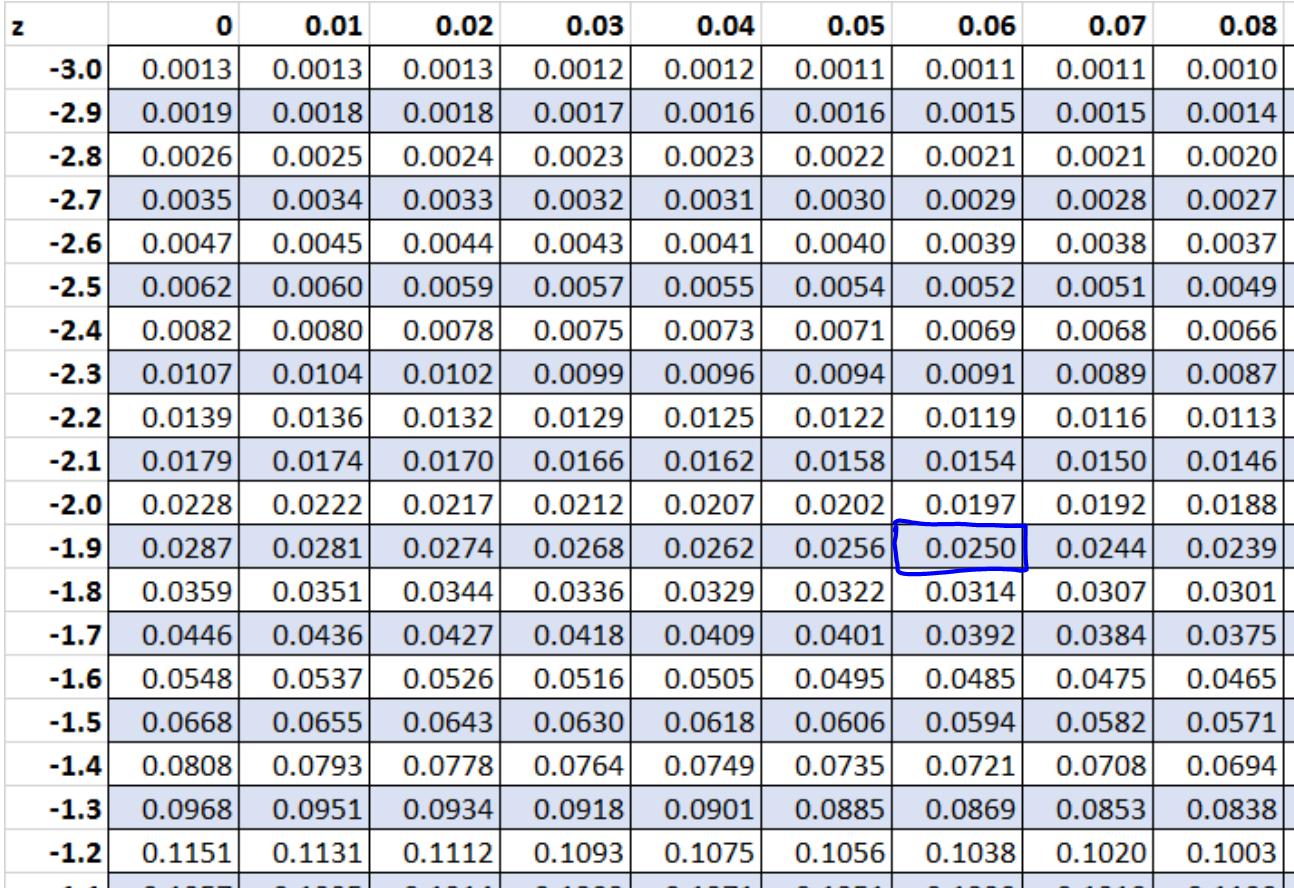
Pour identifier la borne inférieure -z_critique, nous recherchons l’aire 0,0500 au sein de la table normale négative. L’examen minutieux de la ligne z = -1,6 révèle :
- Sous la colonne 0,04, l’aire cumulée vaut : 0,0505.
- Sous la colonne 0,05, l’aire cumulée vaut : 0,0495.
La probabilité visée 0,0500 se trouve positionnée à équidistance absolue entre 0,0505 et 0,0495 (distance de 0,0005 de part et d’autre). L’application de la formule d’interpolation linéaire produit :
z = -1,64 + [ (0,0500 – 0,0505) / (0,0495 – 0,0505) ] * ( -1,65 – (-1,64) ) = -1,64 + 0,5 * (-0,01) = -1,645
Par symétrie axiale, la borne supérieure se situe à z = +1,645.
Étape 3 : Résolution via les outils technologiques.
Sous R, la détermination s’effectue via qnorm(0.05) produisant -1.644854 et qnorm(0.95) produisant +1.644854.
Sur la calculatrice TI-84 Plus CE, l’opération s’exécute avec une élégance remarquable en sélectionnant la configuration centrale :
- area: 0.90
- mu: 0
- sigma: 1
- Tail: CENTER
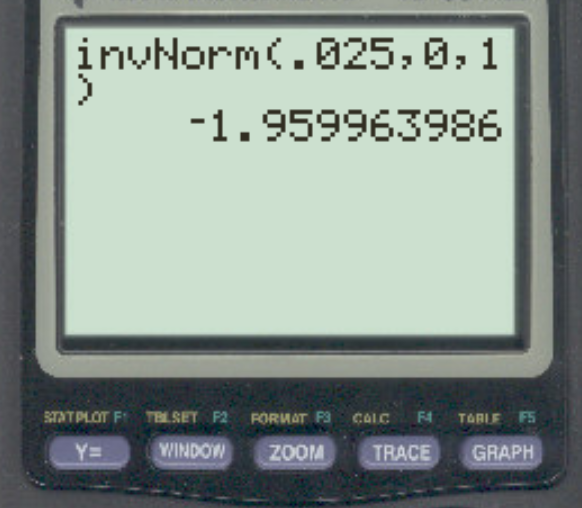
La validation de la commande invNorm(0.90, 0, 1, CENTER) renvoie instantanément sur l’écran la liste des deux valeurs : {-1.644853626, 1.644853626}.
L’intervalle central de 90 % est donc rigoureusement circonscrit par les bornes [-1,645 ; +1,645].
8.3 Application psychologique : Intervalles de normalité clinique
Dans l’évaluation psychométrique contemporaine, la délimitation d’un intervalle central de 90 % ou 95 % remplit une fonction fondamentale : établir la frontière nosologique entre la variabilité intra-individuelle normale et la déviance pathologique. Les concepteurs de batteries cognitives majeures (telles que les échelles de Wechsler pour enfants ou adultes) structurent fréquemment la zone de rendement intellectuel moyen autour de l’intervalle central englobant les fractions majoritaires de la population.
Lorsqu’un intervalle de normalité est calibré sur les 90 % médians, cela postule formellement que tout individu dont le score standardisé se maintient à l’intérieur de l’espace [-1,645 ; +1,645] manifeste des performances cognitives conformes aux attentes statistiques normatives. À l’inverse, l’effondrement d’un résultat en dessous de la borne critique de -1,645 signale sans équivoque que le sujet s’isole au sein des 5 % les plus déficitaires de son groupe de référence, fournissant un indice clinique majeur plaidant en faveur de l’existence d’une altération fonctionnelle significative.
9. Exemple pratique 4 : Trouver un score Z pour des aires extrêmes et seuils critiques
9.1 Cas des probabilités infimes (p < 0,01 et p < 0,001)
L’analyse des profils exceptionnels, qu’il s’agisse de la haute douance intellectuelle, des déficits cognitifs profonds consécutifs à des traumatismes crâniens majeurs ou des événements rarissimes en épidémiologie comportementale, confronte l’analyste à la quantification de probabilités infimes, fréquemment inférieures à 0,01, voire à 0,001. Dans ces zones extrêmes des queues de distribution, les tables papier révèlent leurs limites intrinsèques.
La plupart des tables normales standardisées imprimées interrompent en effet leur maillage matriciel aux alentours de z = 3,09 ou z = 3,50, zone où l’aire cumulée atteint 0,9998. Face à une aire cumulée à gauche extrêmement ténue comme p = 0,001 (représentant 1 individu sur 1 000 dans la queue inférieure) ou p = 0,0005, la table papier devient incapable de fournir une lecture précise sans extrapolations mathématiques hasardeuses.
Le recours aux solveurs algorithmiques informatisés devient alors incontournable. L’exploitation des fonctions quantiles programmées renvoie les valeurs critiques suivantes :
- Pour une aire de queue unilatérale alpha = 0,01 (1 %) : le score Z vaut z = -2,3263 (ou +2,3263 pour la queue supérieure).
- Pour une aire de queue unilatérale alpha = 0,005 (0,5 %, correspondant à un intervalle central bilatéral de 99 %) : le score Z s’établit précisément à z = -2,5758.
- Pour une aire de queue unilatérale alpha = 0,001 (0,1 %, soit un sujet sur 1 000) : le score Z atteint z = -3,0902.
- Pour une probabilité de queue unilatérale alpha = 0,0005 (bilatéral de 99,9 %) : le score Z s’élève à z = -3,2905.
La manipulation de ces grandeurs exige une extrême précision dans la saisie des décimales zéro. Une simple erreur d’inattention substituant l’aire 0,01 à l’aire 0,001 modifie la valeur du score Z d’un bond d’amplitude colossal de 0,76 écart-type, faussant totalement l’interprétation diagnostique du phénomène investigué.
9.2 Seuils décisionnels en psychopathologie expérimentale
Dans les protocoles de recherche en psychopathologie expérimentale et lors des essais cliniques randomisés évaluant l’efficacité d’une nouvelle thérapie cognitive, la démarche de calcul de l’aire inverse s’identifie formellement à la détermination des seuils critiques de décision statistique liés au risque de première espèce (le risque alpha). Avant d’engager le recueil de données, le chercheur fige a priori le seuil d’erreur alpha toléré (généralement 5 % ou 1 % en test unilatéral ou bilatéral).
Pour un test bilatéral avec un seuil de significativité alpha fixé conventionnellement à 0,05, la région critique de rejet de l’hypothèse nulle est scindée en deux queues latérales d’aire alpha / 2 = 0,025 chacune. La résolution numérique de Phi^(-1)(0,025) identifie immédiatement la valeur critique célèbre z_critique = +-1,9600. Dès lors, toute statistique empirique Z calculée sur l’échantillon expérimental qui dépasse en valeur absolue le seuil de 1,96 permet de rejeter l’hypothèse nulle d’absence d’effet au profit de l’efficacité démontrée de l’intervention thérapeutique.
Si la rigueur expérimentale impose de resserrer le seuil alpha à 0,01 bilatéral (alpha / 2 = 0,005), le calcul inverse établit la valeur critique à z_critique = +-2,576. La démarche d’inversion d’aire apparaît ainsi comme l’arbitre mathématique universel régissant l’inférence scientifique en psychologie quantitative.
10. Analyse comparative, précision algorithmique et limites des trois méthodes
10.1 Comparatif systématique : Vitesse, accessibilité et précision
L’existence de trois voies méthodologiques distinctes pour convertir une aire en score Z (la table statistique imprimée, les logiciels d’analyse statistique et la calculatrice graphique scientifique) impose une mise en perspective comparative de leurs propriétés respectives, synthétisées dans la matrice fonctionnelle ci-dessous.
Le recours à la table statistique papier conserve une valeur didactique et pédagogique indéniable. Elle matérialise physiquement la structure discrète de la distribution et contraint l’opérateur à maîtriser intellectuellement les propriétés de symétrie et de directionnalité. Néanmoins, sa précision est structurellement bridée par un affichage à deux décimales pour l’abscisse et quatre décimales pour les probabilités, limitant dramatiquement son utilité dès lors qu’il s’agit de traiter des percentiles non entiers ou des queues de distribution au-delà de trois écarts-types.
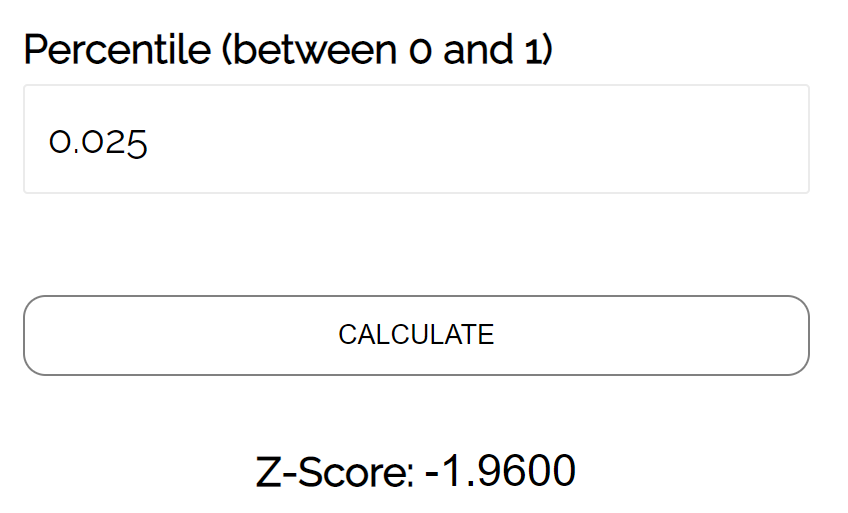
Les convertisseurs en ligne et progiciels statistiques (R, Python, Excel) se démarquent par une vitesse computationnelle instantanée, une flexibilité d’intégration logicielle totale et une exactitude numérique absolue atteignant la double précision machine. Ils constituent l’outil incontournable de la recherche contemporaine et du traitement de cohortes massives de données psychométriques. Leur unique limitation réside dans la dépendance matérielle à un ordinateur ou un terminal connecté.
La calculatrice graphique portable (TI-84) incarne le compromis opérationnel idéal pour l’évaluation en cabinet clinique, le travail sur le terrain ou les examens universitaires encadrés. L’implémentation de sélecteurs de queues géométriques (LEFT, RIGHT, CENTER) sur les éditions modernes combine la haute fidélité des algorithmes de calcul formel avec l’ergonomie d’un boîtier autonome.
- Table Z Imprimée : Précision limitée à 2 décimales (3 avec interpolation) | Risque d’erreur humaine élevé (confusion de colonne/ligne, omission de signe) | Vitesse d’exécution modérée | Aucune dépendance technologique.
- Progiciels (R / Python / Excel) : Précision absolue (jusqu’à 16 chiffres significatifs) | Risque d’erreur quasi nul une fois la commande codifiée | Vitesse fulgurante (vectorisation instantanée) | Nécessite un environnement informatique.
- Calculatrice TI-84 : Haute précision (10 chiffres significatifs) | Faible risque d’erreur sous réserve de configuration des queues | Vitesse très rapide | Matériel autonome standardisé.
10.2 Sources de divergences numériques et propagation d’erreurs
Bien que les trois démarches reposent fondamentalement sur la même entité mathématique sous-jacente (la fonction quantile gaussienne), des divergences numériques mineures sont fréquemment observées entre les sorties tabulaires et les calculs informatiques. Il est primordial pour le statisticien rigoureux d’en comprendre l’étiologie exacte afin d’éviter la propagation d’erreurs en cascade lors d’analyses psychométriques complexes.
La cause première de divergence réside dans le tronquage prématuré des probabilités d’entrée. Considérons un praticien convertissant un rang percentile empirique de 15,6238 %. Si ce dernier arrondit l’aire à 0,156 avant de consulter sa table, il extrait un score Z de -1,01. En revanche, si la probabilité intégrale 0,156238 est traitée par l’algorithme qnorm(), le score Z exact généré est de -1,00989. Si cette valeur doit ultérieurement être multipliée par un coefficient d’échelle important (comme dans le calcul des notes composites d’échelles globales), cet arrondi prématuré engendre un biais systématique non négligeable.
La seconde cause procède de l’erreur d’interpolation linéaire manuelle. Comme explicité précédemment, la fonction de répartition présente une courbure sigmoïde intrinsèque. L’interpolation linéaire postule une variation affine à taux constant sur l’intervalle [z1, z2]. Bien que l’erreur absolue résiduelle induite n’excède généralement pas 0,0005 sur le score Z dans les zones centrales, elle tend à s’amplifier sensiblement dans les zones de courbure maximale ou dans le début des queues de distribution, créant des disparités perceptibles face aux valeurs issues d’approximations rationnelles de type Remez déployées par les calculatrices logicielles.
11. Applications psychométriques : Du score Z aux notes composites de tests
11.1 Transformation linéaire du score Z vers les échelles psychométriques usuelles
Dans la pratique clinique, de neuropsychologie ou de psychologie du travail, les scores Z purs ne sont presque jamais communiqués directement aux patients ou aux commissions décisionnelles, principalement en raison de la présence déroutante pour les profanes de valeurs négatives et décimales. Les psychométriciens ont donc standardisé un ensemble de transformations linéaires affines permettant de projeter le score Z vers des métriques conventionnelles dotées d’une moyenne et d’un écart-type arbitraires strictement positifs, sans altérer en aucune manière les propriétés distributives de la mesure originale.
La transformation affine générale prend la forme mathématique suivante :
Note Standardisée = Moyenne_cible + (Écart-type_cible * Score Z)
Les métriques conventionnelles les plus répandues dans la littérature psychologique internationale comprennent :
- L’échelle de Quotient Intellectuel Standard (Échelles de Wechsler – WAIS, WISC) : Cette métrique de référence adopte une moyenne fixée à 100 et un écart-type unitaire étalonné à 15 :
QI = 100 + 15 * Z - L’échelle des Notes T (très usitée dans les inventaires de personnalité tels que le MMPI-2, MMPI-3 ou le BASC) : Elle calibre la moyenne à 50 et l’écart-type à 10 :
Note T = 50 + 10 * Z - L’échelle des Notes Standard de sous-tests (Wechsler) : Utilisée pour calibrer chaque sous-épreuve individuelle, elle fixe la moyenne à 10 et l’écart-type à 3 :
Note de sous-test = 10 + 3 * Z - L’échelle des Sten (Standard Ten) : Largement mobilisée en sélection professionnelle et ressources humaines, elle décompose l’espace en dix classes avec une moyenne de 5,5 et un écart-type de 2 :
Sten = 5,5 + 2 * Z - L’échelle des Stanines (Standard Nines) : Échelle historique en 9 classes, de moyenne 5 et d’écart-type 2.
L’invariance topologique fondamentale de ces transformations affines préserve scrupuleusement les proportions de surface sous la courbe. Identifier un individu au 2e percentile de la distribution normale revient à isoler un score Z de -2,054, qui se transpose mathématiquement et rigoureusement en un QI de 69,2 ou une note T de 29,5.
11.2 Étude de cas intégrée : Diagnostic clinique à partir d’un percentile
Illustrons la séquence intégrale de raisonnement clinique à travers une étude de cas neuropsychologique détaillée. Un patient adulte de 42 ans, consultant à la suite d’un accident vasculaire cérébral focal, réalise une évaluation approfondie de sa mémoire de travail visuo-spatiale au moyen du test des blocs de Corsi informatisé. Les normes d’étalonnage de l’épreuve sont exprimées en rangs percentiles par tranche d’âge.
Le dépouillement standardisé de la performance du patient situe sa capacité de mémorisation visuo-spatiale au 2e percentile de son groupe de référence d’âge.
Le neuropsychologue applique le protocole décisionnel quantitatif en trois étapes :
Étape 1 : Détermination de l’aire et du score Z correspondant.
Le 2e percentile traduit formellement une aire cumulée à gauche de :
p = 0,0200.
L’exécution de la fonction inverse sous R (qnorm(0.02)) ou sur TI-84 (invNorm(0.02, 0, 1)) calcule le score Z normé :
z = -2,0537 (arrondi à z = -2,05).
Étape 2 : Conversion vers la métrique composite standardisée de Wechsler.
Afin de comparer ce déficit avec le fonctionnement intellectuel global du patient évalué par la WAIS-IV, le score Z est converti sur l’échelle de score composite (M = 100, ET = 15) :
QI équivalent = 100 + 15 * (-2,0537) = 100 – 30,8055 = 69,19.
Étape 3 : Conclusion diagnostique et décision clinique.
Sur le plan diagnostique formel, la nosographie internationale des déficits cognitifs (notamment les critères diagnostiques du trouble neurocognitif majeur selon le DSM-5) impose l’objectivation d’un fléchissement de performance d’au moins deux écarts-types en deçà de la moyenne attendue (soit un score Z <= -2,00). Avec un score Z de -2,05 (correspondant à une note composite de 69), le seuil nosologique critique des 2 écarts-types est formellement franchi. Le clinicien peut ainsi conclure avec une certitude statistique absolue à l'existence d'un déficit mnésique de travail massif justifiant la mise en œuvre prioritaire d'un protocole de remédiation cognitive ciblée.
11.3 Détermination des rangs percentiles normatifs en population clinique
La démarche inverse intervient également de façon critique lors de la conception même et de l’étalonnage de nouveaux instruments d’évaluation clinique. Lorsqu’un laboratoire de recherche psychométrique développe une échelle d’évaluation de l’anxiété sociale ou du stress post-traumatique, les scores bruts recueillis lors de la phase de validation doivent être découpés en niveaux de sévérité gradués : absence de trouble, sévérité légère, sévérité modérée, et sévérité sévère.
Ces classifications nosologiques ne sont jamais posées arbitrairement. Elles découlent d’une segmentation standardisée de la courbe normale de distribution. Par exemple, la catégorie « sévérité clinique sévère » est conventionnellement assignée aux individus se positionnant au-delà des 95 % de la population générale (queue supérieure d’aire alpha = 0,05). Le constructeur du test calcule le score Z critique via Phi^(-1)(0,95) = +1,645, puis convertit ce fractile en note brute d’échelle via les paramètres empiriques de la cohorte d’étalonnage. Cette standardisation garantit que le nouvel outil diagnostique présentera des propriétés métrologiques invariantes et hautement reproductibles lors de son déploiement à grande échelle.
12. Guide méthodologique : Pièges fréquents et bonnes pratiques d’analyse
12.1 Erreurs conceptuelles majeures lors du calcul inverse
L’analyse des pratiques en statistique appliquée révèle la persistance de biais d’interprétation récurrents qu’il convient d’identifier avec rigueur :
- La non-vérification de la convention directionnelle : L’erreur la plus destructive consiste à saisir directement une aire sans avoir déterminé si celle-ci représente une queue à droite, une queue à gauche ou un intervalle central. Assimiler une aire de queue droite de 20 % à une probabilité cumulée de 0,20 au lieu d’utiliser son complément 0,80 conduit à transformer un résultat d’excellence (z = +0,84) en un résultat déficitaire (z = -0,84).
- L’attribution erronée d’un score Z positif à une aire cumulée inférieure à 0,50 : Tout score Z positif correspond impérativement à une aire cumulée à gauche supérieure à la moitié de la distribution. Si un calcul impliquant une performance située au 30e percentile renvoie un score Z positif, une erreur de signe a indubitablement été commise lors de l’inversion manuelle.
- L’assimilation abusive d’une distribution asymétrique à une loi normale : L’ensemble des procédures de calcul inverse exposées dans ce guide repose sur le postulat fondamental de normalité de la distribution parente. L’application de la fonction quantile normale sur des distributions manifestant une asymétrie marquée (skewness élevé) ou un aplatissement anomal (kurtosis prononcé) — situations très fréquentes dans l’évaluation de symptômes psychopathologiques rares où les données suivent une loi de Poisson ou une loi log-normale — engendre des distorsions diagnostiques sévères. Avant d’engager tout calcul de score Z sur des données empiriques, il est rigoureusement indispensable d’éprouver la normalité de la distribution au moyen de tests d’adéquation statistiques robustes, tels que le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov.
12.2 Protocole systématique de vérification en recherche empirique
Pour garantir une fiabilité méthodologique absolue lors de la résolution de problématiques d’aires inverses, il est fortement conseillé de déployer un protocole d’analyse systématique articulé en cinq étapes séquentielles :
- Étape 1 : Modélisation graphique descriptive. Avant toute manipulation d’un outil de calcul, esquisser systématiquement à main levée une courbe de Gauss standardisée. Tracer une ligne verticale approximative pour matérialiser le seuil recherché et hachurer visuellement la zone de surface mentionnée dans l’énoncé en identifiant formellement son orientation (queue gauche, queue droite ou intervalle central symétrique).
- Étape 2 : Détermination heuristique du signe et de la magnitude. Poser a priori l’intervalle attendu du score Z : sera-t-il positif, négatif ou nul ? Se situera-t-il dans une zone standard (entre -2 et +2) ou dans une zone extrême ? Cette prévision mentale immunise immédiatement contre les erreurs de manipulation logicielle majeures.
- Étape 3 : Calcul numérique instrumenté. Exécuter l’inversion d’aire en appliquant la méthode la plus appropriée au contexte opérationnel (table avec interpolation pour un examen académique, fonction qnorm() ou LOI.NORMALE.STANDARD.INVERSE.N() pour une analyse computationnelle, invNorm() sur TI-84).
- Étape 4 : Validation croisée par la démarche directe réciproque. Une fois le score Z calculé, injecter immédiatement cette coordonnée numérique au sein de la fonction de répartition directe (par exemple via la commande pnorm(z) sous R ou normalcdf(-1E99, z) sur la calculatrice TI-84). Si la probabilité cumulée restituée coïncide fidèlement avec l’aire initiale du problème, l’exactitude de la résolution est définitivement validée.
- Étape 5 : Contextualisation théorique et interprétation diagnostique. Transposer le score Z validé dans la métrique psychométrique ou clinique requise, et formuler l’interprétation diagnostique stricte dans le respect des cadres nosographiques et des standards de mesure en sciences du comportement.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
Beasley, J. D., & Springer, S. G. (1977). Algorithm AS 111: The percentage points of the normal distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 26(1), 118-121. https://doi.org/10.2307/2346889
Gregoire, J. (2019). L’évaluation clinique de l’intelligence de l’adulte : Guide pratique du clinicien pour la WAIS-IV. Mardaga.
Hastings, C. (1955). Approximations for digital computers. Princeton University Press.
Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
Texas Instruments. (2020). Guide de référence des calculatrices graphiques de la famille TI-84 Plus. Texas Instruments Incorporated. https://education.ti.com
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
Wichura, M. J. (1988). Algorithm AS 241: The percentage points of the normal distribution. Journal of the Royal Statistical Society. Series C (Applied Statistics), 37(3), 477-484. https://doi.org/10.2307/2347330