
La quantification des phénomènes psychologiques et comportementaux constitue l’un des défis méthodologiques les plus complexes des sciences humaines contemporaines. Contrairement aux grandeurs physiques directement observables telles que la masse, la longueur ou la température, les construits psychologiques — à l’instar de l’efficience intellectuelle, des traits de personnalité, de l’anxiété état ou des aptitudes mnésiques — constituent des entités latentes inaccessibles à une mesure métrologique directe. Pour appréhender ces dimensions intangibles avec rigueur et objectivité, la psychométrie et les statistiques quantitatives s’appuient sur la modélisation mathématique des distributions de probabilité continues. Au cœur de cet édifice théorique repose une interrogation fondamentale : comment dériver une probabilité d’occurrence rigoureuse à partir de deux paramètres descriptifs synthétiques que sont la moyenne et l’écart-type d’une population de référence ?
Cette démarche probabiliste ne relève pas d’un simple exercice de calcul algébrique désincarné. Elle incarne le socle opérationnel sur lequel reposent le diagnostic clinique, la prise de décision en neuropsychologie, la sélection d’individus au sein des organisations et l’évaluation de l’efficacité d’interventions thérapeutiques. En transformant un score brut individuel en une probabilité standardisée, le praticien ou le chercheur parvient à s’émanciper des contingences arbitraires d’un instrument de mesure particulier pour situer l’individu au sein d’une topographie comportementale universelle. Cette opération fait appel aux propriétés mathématiques de la distribution normale, également désignée sous le nom de loi de Gauss-Laplace, dont la découverte et l’application ont profondément refondu l’épistémologie des sciences empiriques.
Le présent article propose une exploration intégrale, méthodique et exhaustive du processus permettant de déterminer une probabilité à partir d’une moyenne et d’un écart-type. Nous aborderons successivement les soubassements théoriques des distributions continues en psychologie, l’architecture formelle de la densité gaussienne, la mécanique de standardisation par le score z, les protocoles opératoires unilatéraux et bilatéraux, ainsi que les méthodes inverses d’estimation de seuils critiques. Enfin, une attention scrupuleuse sera accordée aux écueils de calcul, aux biais interprétatifs fréquents et aux exigences méthodologiques régissant la validité écologique et clinique de ces inférences statistiques fondamentales.
1. 1. Introduction théorique aux distributions continues en psychologie quantitative
1.1 1.1. L’importance de la modélisation probabiliste en sciences psychologiques
La modélisation probabiliste représente le fondement épistémologique indispensable à l’analyse scientifique des traits latents et des conduites humaines. Dans le champ de la psychométrie moderne, un trait latent se définit comme une disposition psychologique sous-jacente non mesurable directement, dont l’existence est inférée à partir d’indicateurs comportementaux ou de réponses manifestes à un ensemble standardisé d’items. Qu’il s’agisse de mesurer la flexibilité cognitive, l’extraversion selon le modèle en cinq facteurs ou l’intensité d’un affect dépressif, l’attribution d’un score brut constitue toujours une approximation empirique bruitée, sujette aux aléas de l’échantillonnage et aux erreurs de mesure inhérentes à l’instrumentation humaine.
Afin de conférer une valeur informative à une observation isolée, il est impératif de situer la performance ou le profil d’un sujet au sein d’une population de référence clairement délimitée. Un score brut de 42 à une échelle d’évaluation de la mémoire de travail est rigoureusement dénué de signification clinique ou diagnostique intrinsèque tant qu’il n’est pas confronté à la distribution des scores obtenus par les pairs de même classe d’âge, de même niveau socioculturel ou partageant les mêmes conditions nosologiques. C’est ici qu’intervient la modélisation probabiliste : elle permet d’attribuer une fréquence d’apparition théorique à chaque configuration de score, transformant une valeur absolue arbitraire en une position relative probabilisée.
Ce paradigme nécessite une transition conceptuelle fondamentale entre la variable discrète empirique et le modèle continu théorique. Bien qu’un test psychométrique fournisse par nature des données discrètes — souvent des nombres entiers résultant du décompte de réponses correctes ou d’échelons de Likert — la modélisation formelle postule que le construit latent sous-jacent varie de manière continue sur un continuum sans rupture. Adopter une distribution de probabilité continue permet de dépasser les granularités grossières du recueil empirique et d’appliquer l’appareil analytique du calcul infinitésimal, conférant une puissance prédictive et inférentielle inégalée aux conclusions psychologiques.
1.2 1.2. Rôle structurant de la moyenne et de l’écart-type
Dans le cadre de la théorie statistique classique, la structure d’une distribution normale est intégralement déterminée par deux métriques synthétiques : la moyenne populationnelle et l’écart-type. La moyenne, conventionnellement désignée par la lettre grecque mu (μ), agit en tant qu’indicateur de tendance centrale attendue. Elle reflète le barycentre de la distribution des performances au sein du groupe de référence. Sur le plan psychométrique, la moyenne incarne la norme descriptive du collectif : elle capture le niveau d’accomplissement typique ou la manifestation comportementale médiane observée lorsque les multiples sources de variation interindividuelle s’équilibrent mutuellement.
L’écart-type, symbolisé par la lettre sigma (σ), constitue quant à lui la mesure paramétrique fondamentale de la variabilité et de la dispersion interindividuelle. Il quantifie l’amplitude moyenne selon laquelle les observations individuelles s’écartent de la tendance centrale. Alors que deux populations distinctes peuvent partager une moyenne rigoureusement identique lors d’une épreuve cognitive, l’hétérogénéité de leurs profils peut différer substantiellement selon la valeur de σ. Un écart-type restreint traduit une grande homogénéité des comportements au sein du groupe, où la majorité des individus gravitent étroitement autour de la norme. À l’inverse, un écart-type volumineux signale une forte disparité interindividuelle, élargissant l’éventail des performances considérées comme courantes.
Il est crucial de comprendre la dépendance absolue de l’échelle d’évaluation vis-à-vis de ces deux paramètres fondamentaux. Un score brut n’a aucune dimension universelle : il demeure prisonnier du nombre d’items, du barème de cotation et de la difficulté propre à l’instrument. La moyenne et l’écart-type constituent les ancrages dimensionnels indispensables qui permettent d’étalonner l’outil de mesure. En l’absence d’une estimation exacte et robuste de μ et de σ, toute tentative de dérivation d’une probabilité d’occurrence est vouée à produire des inférences erronées, susceptibles de biaiser dramatiquement l’appréciation des compétences ou des vulnérabilités d’un individu.
1.3 1.3. La loi normale comme modèle de distribution de référence
L’omniprésence de la loi normale dans les sciences quantitatives du comportement ne découle pas d’une simple convention de commodité arithmétique, mais trouve sa justification fondamentale dans le théorème central limite. Ce théorème mathématique majeur énonce que la somme, ou la résultante combinée, d’un grand nombre de variables aléatoires indépendantes et de variances finies converge inéluctablement vers une distribution gaussienne, indépendamment de la forme de la distribution de chacune des composantes individuelles. Or, les aptitudes cognitives complexes, les traits de tempérament ou les conduites humaines résultent précisément de la convergence synergique d’une myriade de micro-déterminants génétiques, neurobiologiques, éducatifs et environnementaux agissant de concert de façon additive.
Sur le plan morphologique, la loi normale se caractérise par une symétrie axiale parfaite autour de son centre de gravité. Au point d’inflexion maximal se superposent rigoureusement la moyenne (μ), la médiane (la valeur séparant l’échantillon en deux moitiés équiprobables) et le mode (la valeur enregistrant la densité de probabilité maximale). Cette unicité du mode combinée à une déclinaison progressive et harmonieuse des fréquences de part et d’autre du centre confère à la courbe sa forme caractéristique en cloche. Les scores modérés sont intrinsèquement les plus probables, tandis que la probabilité d’observer des scores très faibles ou très élevés diminue de façon continue à mesure que l’on s’éloigne du centre.
Enfin, les propriétés asymptotiques fondamentales de la fonction de densité gaussienne confèrent au modèle sa cohérence mathématique globale. La courbe s’étend théoriquement sur un support infini, de l’infini négatif à l’infini positif, sans jamais toucher l’axe des abscisses. Cette caractéristique asymptotique signifie que, bien que la probabilité d’observer des scores situés à une distance immense de la moyenne tende inexorablement vers zéro, elle ne s’annule jamais absolument. Ce comportement limite fournit un cadre analytique élégant pour modéliser des événements exceptionnels tout en préservant la continuité mathématique requise par le calcul des probabilités.
2. 2. Fondements mathématiques de la loi normale et ses paramètres
2.1 2.1. Fonction de densité de probabilité gaussienne
La formulation analytique de la loi normale repose sur l’équation différentielle de Gauss-Laplace, qui régit la fonction de densité de probabilité notée f(x). Pour une variable aléatoire continue X distribuée selon des paramètres de moyenne μ et d’écart-type σ — formalisée conventionnellement par la notation X ~ N(μ, σ2) — l’expression mathématique exacte s’écrit :
f(x) = (1 / (σ √(2π))) * exp(- (x – μ)2 / (2σ2))
Cette expression intègre des constantes universelles de l’analyse mathématique, à savoir la base des logarithmes népériens e et le nombre pi (π). Le terme préliminaire, 1 divisé par le produit de l’écart-type et de la racine carrée de deux pi, constitue la constante de normalisation indispensable garantissant que l’aire totale délimitée sous la courbe soit rigoureusement égale à un. Le facteur exponentiel décroît proportionnellement au carré de la distance euclidienne relative séparant la valeur x de la moyenne populationnelle μ.
L’impact de la moyenne sur la représentation graphique de cette fonction correspond à une simple translation horizontale rigide. Toute modification de μ translate l’intégralité de la courbe le long de l’axe des abscisses, sans altérer sa morphologie, son étalement ou son aplatissement. Le sommet de la cloche se positionne immanquablement au point d’abscisse x = μ. Inversement, l’effet de la variance (σ2) ou de l’écart-type (σ) modifie directement la forme de la cloche : un σ élevé étire horizontalement la courbe, abaissant son sommet pour compenser l’expansion latérale (courbe platykurtique). À l’opposé, un σ faible comprime horizontalement la distribution, engendrant un pic central très aiguisé et des flancs abrupts (courbe leptokurtique).
2.2 2.2. L’aire sous la courbe comme mesure de probabilité
Dans l’univers des variables aléatoires continues, le concept intuitif de probabilité subit une révision théorique fondamentale par rapport aux probabilités discrètes. En effet, il est mathématiquement impossible d’évaluer la probabilité ponctuelle exacte qu’une variable continue prenne une valeur numérique rigoureusement déterminée. Puisqu’il existe une infinité indénombrable de nombres réels entre deux valeurs arbitraires, la probabilité que la variable X prenne exactement la valeur x s’écrit : P(X = x) = 0. Une observation ponctuelle correspond géométriquement à un segment vertical de largeur infinitésimale nulle, dont la surface est par définition égale à zéro.
Dès lors, la probabilité n’acquiert de consistance mathématique qu’à travers la notion d’intervalle, modélisée par l’aire géométrique délimitée sous la courbe de la fonction de densité entre deux bornes déterminées. La probabilité qu’une observation se situe entre une valeur a et une valeur b correspond rigoureusement à l’intégrale définie de la fonction f(x) sur l’intervalle [a, b] :
P(a ≤ X ≤ b) = ∫ab f(x) dx
La propriété cardinale régissant cette métrique réside dans le principe d’intégrabilité unitaire totale. Si l’on intègre la fonction de densité de Gauss-Laplace sur l’ensemble de son domaine de définition, allant de moins l’infini à plus l’infini, l’aire totale résultante est impérativement égale à 1 (soit 100 % de certitude statistique). Ainsi, toute portion d’aire située sous la courbe au-dessus d’une région donnée de l’axe réel représente exactement la proportion de la population présentant des valeurs comprises dans cet intervalle, fondant l’analogie structurelle absolue entre aire géométrique et probabilité cumulée.
2.3 2.3. La règle empirique des 68-95-99,7
Avant d’engager des résolutions analytiques complexes ou de recourir aux tables statistiques, les praticiens utilisent couramment un outil d’heuristique probabiliste dérivé des propriétés intégrales de la distribution normale : la règle empirique des 68-95-99,7 (souvent qualifiée de règle des trois sigmas). Cette règle décrit la proportion constante d’observations contenues à l’intérieur d’intervalles symétriques centrés sur la moyenne et définis par des multiples entiers de l’écart-type.
Dans un premier temps, l’intervalle délimité par une déviation standard de part et d’autre de la moyenne — formalisé par [μ – 1σ ; μ + 1σ] — englobe approximativement 68,26 % de l’ensemble de la population de référence. Cela signifie que plus de deux tiers des individus manifestent des caractéristiques regroupées dans cette bande centrale étroite. Lorsque l’intervalle est élargi à deux écarts-types — soit [μ – 2σ ; μ + 2σ] — l’aire sous la courbe atteint environ 95,44 %. Cette délimitation joue un rôle de jalon diagnostique central en psychopathologie et en psychologie clinique : les individus se situant au-delà de ces deux bornes ne représentent qu’environ 4,56 % de la population globale (soit 2,28 % dans chaque queue de distribution), désignant immédiatement des profils atypiques méritant un approfondissement anamnestique.
Enfin, l’extension de l’intervalle à trois écarts-types — [μ – 3σ ; μ + 3σ] — circonscrit 99,74 % des observations empiriques. Moins de 0,26 % de la population totale échappe à cette enclave, situant les cas extérieurs à une probabilité unilatérale inférieure à 0,13 %. En psychologie quantitative, cette heuristique permet un calibrage diagnostique préliminaire instantané. Elle permet d’estimer mentalement la vraisemblance d’une performance avant tout calcul instrumentalisé et d’identifier sans délai les anomalies d’étalonnage ou les erreurs flagrantes de saisie de données.
3. 3. Le concept fondamental et le calcul du score z
3.1 3.1. Définition et principe du score standardisé
La diversité des épreuves d’évaluation en sciences humaines confronte constamment le chercheur et le clinicien à une multiplicité chaotique d’échelles de cotation. Une batterie neuropsychologique peut comporter des épreuves dont le score maximal est fixé à 30 points (comme le MMSE), des temps de réaction mesurés en millisecondes, et des indices d’efficience globale standardisés sur une échelle de moyenne 100. Comparer ou agréger directement ces scores bruts relève d’une impossibilité méthodologique majeure due à l’incommensurabilité des unités de mesure. C’est pour transcender cette impasse que s’impose la nécessité conceptuelle du score standardisé, ou score z.
Le score z convertit une mesure brute dotée d’une métrique spécifique vers une échelle d’abstraction pure, universelle et dénuée d’unité physique de mesure. Il modélise de façon continue la distance algébrique relative séparant une observation donnée x de la moyenne arithmétique de son groupe de référence, en exprimant cet écart au moyen de l’étalon naturel de variabilité de la population : l’écart-type. Le score standardisé ne mesure donc pas une grandeur intrinsèque, mais positionne l’observation sur une échelle d’éloignement relatif à la norme.
Cette échelle possède une sémiotique mathématique claire. Un score z rigoureusement égal à zéro indique que la performance du sujet coïncide parfaitement avec la moyenne populationnelle. Un score z positif stipule une performance supérieure à la moyenne, la valeur numérique précisant le nombre exact d’écarts-types séparant le sujet du centre de la distribution. Inversement, une valeur z négative indique un déficit relatif par rapport à la moyenne du groupe, alertant immédiatement le clinicien sur la direction et l’intensité du décalage par rapport au comportement modal attendu.
3.2 3.2. Formule analytique de standardisation
L’opération de standardisation repose sur une formulation analytique élémentaire sur le plan algébrique, mais aux implications conceptuelles profondes. Pour une variable aléatoire continue X de moyenne μ et d’écart-type σ, le score standardisé z correspondant à une réalisation x s’obtient par la relation :
z = (x – μ) / σ
Cette équation se décompose en deux opérations mathématiques successives assurant chacune une fonction transformationnelle spécifique :
- Le centrage au numérateur (x – μ) : Cette soustraction retranche la moyenne d’origine à chaque observation. Sur le plan géométrique, elle opère une translation rigide de l’ensemble de la distribution vers l’origine des axes de coordonnées cartésiennes. Après cette opération, la nouvelle moyenne de la variable décalée devient rigoureusement égale à zéro, neutralisant les effets de décalage d’échelle ou de niveau de base inhérents à l’instrument.
- La réduction au dénominateur (/ σ) : La division du résidu centré par l’écart-type effectue une mise à l’échelle homothétique. Elle compresse ou étire la distribution de telle sorte que la dispersion des scores soit calibrée selon une échelle unitaire. La variance et l’écart-type de la variable transformée deviennent mathématiquement égaux à un, abolissant l’unité de mesure initiale au profit d’un coefficient dimensionnel pur.
Cette articulation du centrage et de la réduction confère au score z une neutralité métrique absolue. Que l’on analyse des potentiels évoqués cognitifs mesurés en microvolts ou des temps d’inhibition stroop mesurés en centièmes de seconde, la standardisation projette ces données hétérogènes dans un espace métrique commun directement comparable.
3.3 3.3. Propriétés métriques de la loi normale centrée réduite
L’application systématique de la transformation en score z à l’ensemble des éléments d’une distribution normale générale N(μ, σ2) engendre une distribution normale spécifique qualifiée de loi normale centrée réduite, conventionnellement formalisée par N(0, 1). Sa fonction de densité de probabilité, notée usuellement φ(z), présente une formulation allégée où les paramètres μ et σ disparaissent au profit de leurs valeurs canoniques 0 et 1 :
φ(z) = (1 / √(2π)) * exp(- z2 / 2)
L’une des propriétés les plus remarquables de cette transformation réside dans la conservation stricte de l’ordre relatif des rangs et de la proportionnalité des aires sous la courbe. La standardisation est une transformation linéaire monotone croissante. Elle ne modifie en aucune manière les relations d’ordre entre les sujets : le participant ayant obtenu le score brut le plus élevé conserve rigoureusement le score z le plus grand. Plus encore, la forme de la distribution demeure strictement invariante ; aucune distorsion de type asymétrie ou tassement non linéaire n’est introduite.
Cette invariance structurelle garantit que la proportion de surface délimitée sous la courbe gaussienne d’origine N(μ, σ2) entre deux points x1 et x2 est rigoureusement identique à l’aire délimitée sous la loi normale centrée réduite N(0, 1) entre les scores standardisés z1 et z2 correspondants. Cette conservation d’isomorphisme géométrique est le pilier opérationnel qui permet d’utiliser une table numérique universelle unique pour résoudre des problèmes probabilistes issus d’une infinité de distributions empiriques distinctes.
4. 4. Protocole méthodique en deux étapes pour déterminer une probabilité
4.1 4.1. Étape 1 : Calcul méthodique du score z
La résolution rigoureuse de tout problème d’estimation probabiliste à partir d’une moyenne et d’un écart-type débute impérativement par une étape d’extraction paramétrique et de standardisation algébrique. Cette phase initiale requiert une méticulosité absolue dans l’identification des données sources. Le praticien ou l’analyste doit extraire avec exactitude la valeur observée x (la performance ou le seuil d’intérêt), la moyenne de référence μ et l’écart-type σ issus des tables d’étalonnage psychométrique ou de la littérature épidémiologique pertinente.
Une attention fondamentale doit être portée à l’homogénéité dimensionnelle des unités de mesure. Si la moyenne d’un temps de réaction est exprimée en secondes (par exemple 1,2 seconde) tandis que la dispersion est documentée en millisecondes (par exemple 300 millisecondes), une conversion préalable dans une unité partagée est indispensable sous peine de corrompre irrémédiablement le ratio de standardisation. Le calcul de z = (1,2 – 1,2) / 300 n’a aucun sens mathématique sans un alignement des grandeurs (ici x = 1200 ms, μ = 1200 ms, σ = 300 ms).
Par ailleurs, la gestion arithmétique des arrondis lors de cette étape conditionne directement la fidélité du résultat final. La distribution cumulative normale étant particulièrement sensible aux variations d’abscisse, un arrondi prématuré du score z à une seule décimale est susceptible d’introduire un décalage substantiel lors de la conversion en probabilité. Il est méthodologiquement recommandé de conserver au minimum quatre à cinq décimales lors des calculs intermédiaires, pour n’arrondir le score z qu’à deux décimales (au centième près) au moment exact de la consultation des tables statistiques traditionnelles.
4.2 4.2. Étape 2 : Consultation de la distribution cumulée
Une fois le score z déterminé avec la précision requise, la seconde étape consiste à extraire la probabilité cumulée associée en consultant la fonction de répartition universelle de la loi normale centrée réduite, notée usuellement par la lettre grecque majuscule Phi (Φ). La fonction Φ(z) est définie formellement par l’intégrale suivante :
Φ(z) = P(Z ≤ z) = ∫-∞z (1 / √(2π)) * exp(- t2 / 2) dt
En pratique, cette intégrale ne possédant aucune primitive exprimable sous forme de fonctions analytiques élémentaires, son évaluation numérique a historiquement été compilée sous forme de tables statistiques imprimées. L’utilisation de ces tables repose sur une lecture bidimensionnelle croisée particulièrement intuitive. La marge verticale gauche du tableau liste les valeurs du score z incluant sa partie entière et son premier chiffre décimal (les dixièmes, de 0,0 à 3,9). La bordure horizontale supérieure présente quant à elle le second chiffre décimal (les centièmes, de 0,00 à 0,09).
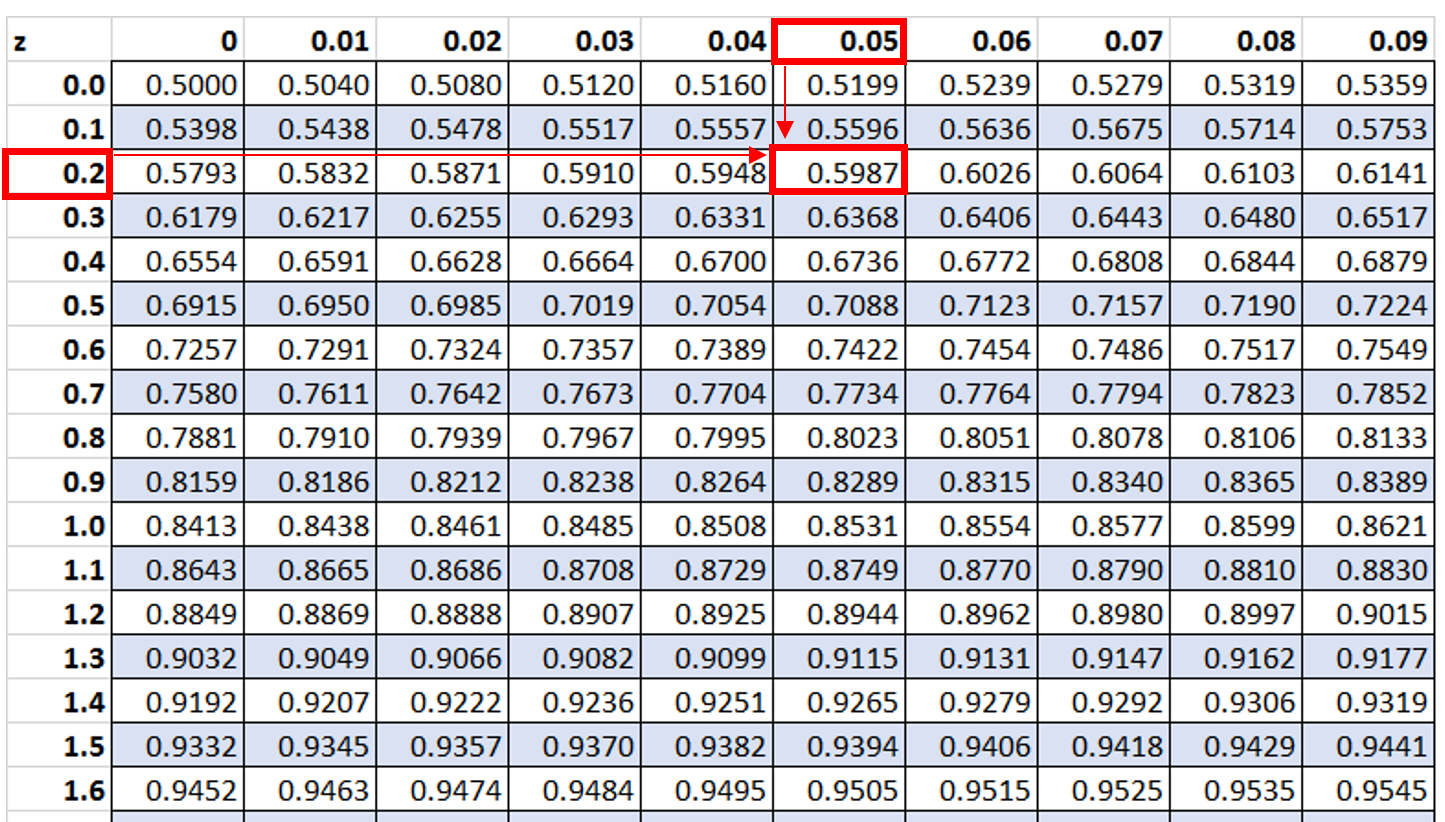
Pour déterminer la probabilité associée à un score z de 1,42, l’évaluateur repère la ligne indicée 1,4 dans la colonne de gauche, puis progresse horizontalement jusqu’à l’intersection avec la colonne surmontée du chiffre 0,02. La valeur numérique inscrite à cette cellule matricielle exacte correspond précisément à la valeur de Φ(1,42) — en l’occurrence 0,9222. Cette donnée tabulée se traduit immédiatement en probabilité d’occurrence empirique : il y a une probabilité de 0,9222 (soit 92,22 %) qu’un individu extrait aléatoirement de cette population présente un score inférieur ou égal à la valeur x ayant généré ce score z.
4.3 4.3. Articulation formelle entre géométrie et algèbre probabiliste
L’exécution mécanique du calcul algébrique ne doit jamais s’affranchir d’un contrôle de cohérence conceptuel fondé sur la géométrie de la courbe de Gauss. Il est impératif pour tout évaluateur de matérialiser graphiquement la zone de probabilité recherchée sous la courbe en esquissant systématiquement l’allure de la cloche, en positionnant la moyenne au centre et en hachurant la surface délimitée par la borne z calculée.
Cette démarche graphique permet une vérification immédiate de plausibilité entre le signe arithmétique du score z et le rang percentile anticipé. En vertu de la symétrie parfaite de la loi normale, une valeur x rigoureusement supérieure à la moyenne (μ) génère obligatoirement un score z positif. Par conséquent, l’aire cumulée unilatérale gauche située sous ce point doit impérativement être strictement supérieure à 0,50 (50 %). Si un praticien obtient un score z de +1,20 et extrait par inadvertance une probabilité de 0,1151, la contradiction manifeste entre le signe positif de z et une surface inférieure à la moitié de la cloche signale immédiatement une confusion dans l’utilisation de la table statistique.
À l’inverse, tout score brut x inférieur à la moyenne μ engendre nécessairement un score z négatif, contraignant l’aire cumulée gauche Φ(z) à osciller obligatoirement entre 0,00 et 0,50. L’ancrage de la réflexion dans l’espace topologique de la courbe gaussienne agit ainsi comme un mécanisme d’auto-correction puissant, prévenant les erreurs de transcription avant toute interprétation diagnostique ou prise de décision clinique formelle.
5. 5. Calcul de la probabilité d’obtenir une valeur inférieure à un seuil donné : P(X < x)
5.1 5.1. Formulation théorique de la probabilité unilatérale gauche
Le calcul de la probabilité d’observer une valeur strictement inférieure (ou inférieure ou égale) à un seuil critique prédéfini x constitue la configuration la plus classique en évaluation psychologique, formalisée par l’expression P(X ≤ x). Cette quantité mathématique correspond directement à la fonction de répartition cumulative de la variable aléatoire X, désignée par F(x). Elle mesure l’intégralité de la masse de probabilité accumulée depuis l’asymptote négative extrême (-∞) jusqu’à la limite supérieure définie par l’observation x.
Il importe de souligner à nouveau l’équivalence formelle absolue entre l’inégalité stricte et l’inégalité large dans le traitement d’une variable aléatoire continue :
P(X < x) = P(X ≤ x) = F(x) = Φ((x – μ) / σ)
Dans la mesure où la probabilité ponctuelle P(X = x) est strictement égale à zéro, la présence ou l’absence du signe d’égalité au seuil de démarcation ne modifie aucunement la valeur numérique de l’intégrale. Sur le plan pratique, cette formulation unilatérale gauche traduit directement le concept fondamental de percentile (ou rang centile) largement employé dans le champ de la psychométrie. Le percentile indique la proportion de pairs appartenant à la population de référence dont les performances se situent en deçà du résultat atteint par le sujet examiné.
5.2 5.2. Exemple psychométrique pratique : score à un test cognitif
Considérons une situation d’évaluation neuropsychologique concrète dans laquelle un clinicien administre une épreuve de raisonnement fluide abstrait. Le manuel d’étalonnage psychométrique de l’épreuve indique que, pour la tranche d’âge du patient, les performances se distribuent normalement avec une moyenne populationnelle μ fixée à 82 points et un écart-type σ établi à 8 points. Le sujet examiné obtient à l’issue de la passation une performance brute x = 84 points. Le clinicien cherche à quantifier la probabilité précise qu’un individu extrait au hasard de la population générale obtienne un score inférieur ou égal à cette performance.
En application rigoureuse du protocole méthodique, la première opération consiste à standardiser la mesure empirique brute :
z = (x – μ) / σ = (84 – 82) / 8 = 2 / 8 = 0,25
Le score z obtenu est positif, avec une valeur exacte de 0,25 écart-type au-dessus de la tendance centrale du groupe de normalisation. L’étape subséquente implique la consultation de la table cumulative de la loi normale centrée réduite pour extraire la probabilité unilatérale gauche Φ(0,25).
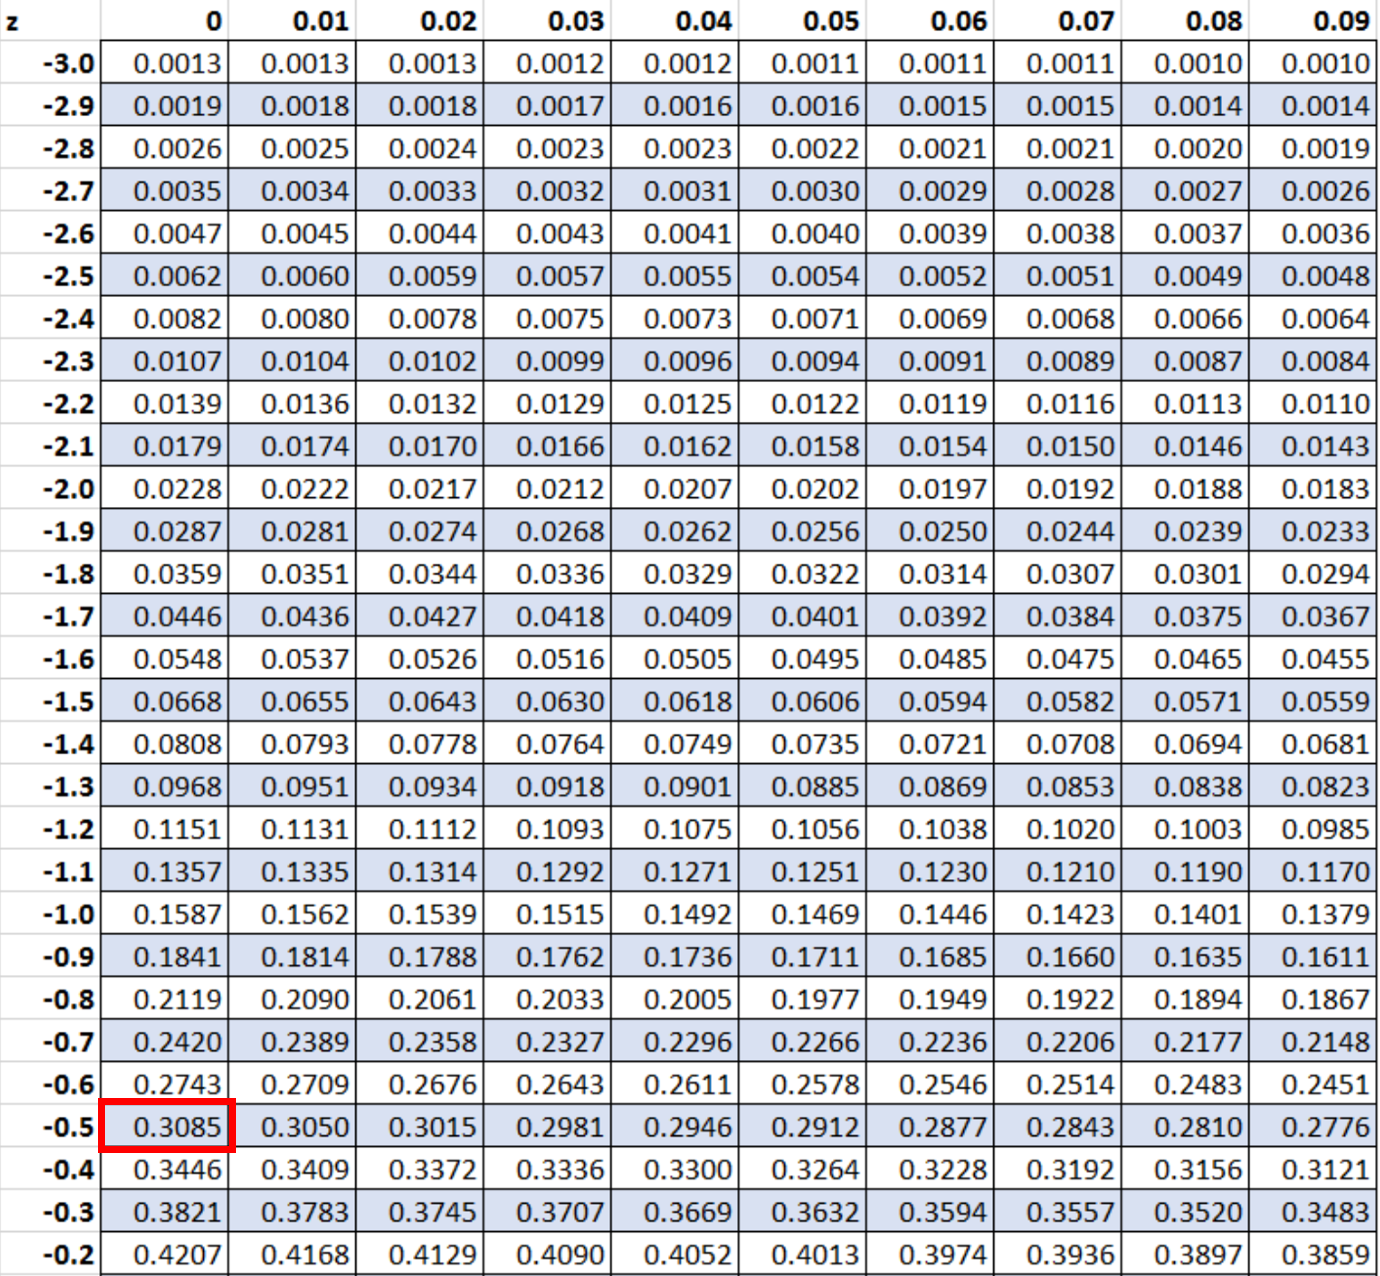
En localisant la ligne correspondant à 0,2 dans la colonne indicatrice verticale et la colonne 0,05 le long de l’axe supérieur horizontal, la table statistique fournit la valeur de répartition : Φ(0,25) = 0,5987. Par conséquent, la probabilité recherchée s’établit formellement comme suit :
P(X ≤ 84) = Φ(0,25) = 0,5987
5.3 5.3. Interprétation clinique et psychométrique du résultat
L’obtention d’une valeur de probabilité de 0,5987 doit faire l’objet d’une traduction sémantique rigoureuse débarrassée de toute ambiguïté statistique. Cette valeur signifie très précisément qu’environ 59,87 % de la population parente de référence obtient un score cognitif inférieur ou égal à 84 lors de cette épreuve. Réciproquement, ce résultat situe le patient examiné exactement au 60e percentile de sa cohorte d’âge (en arrondissant conventionnellement le rang centile à l’entier le plus proche).
Sur le plan du diagnostic cognitif, ce résultat positionne l’individu dans la zone de normalité moyenne, légèrement au-dessus de la médiane attendue (qui correspondrait exactement à 50 % ou à un score z de 0,00). Cette performance ne met en évidence aucun déficit fonctionnel, mais ne permet pas non plus de conclure à une supériorité cognitive cliniquement significative. L’écart de 0,25 écart-type relève d’une fluctuation tout à fait commune au sein de la variabilité interindividuelle habituelle.
Lors de la restitution du compte-rendu aux proches ou aux professionnels de santé non statisticiens, il convient d’exprimer ces résultats sans induire de biais interprétatifs majeurs. Expliquer simplement que le score de 84 place le sujet « dans la moyenne supérieure, surpassant environ 60 personnes sur un groupe représentatif de 100 individus » permet d’offrir une image claire et fidèle de la réalité psychométrique, évitant à la fois la dramatisation d’un score non exceptionnel et la sous-estimation de ses réelles capacités adaptatives.
6. 6. Calcul de la probabilité d’obtenir une valeur supérieure à un seuil donné : P(X > x)
6.1 6.1. La règle du complément pour la queue unilatérale droite
Dans de nombreuses circonstances cliniques, l’intérêt de l’évaluateur ne se focalise pas sur la proportion d’individus surpassés par le sujet, mais au contraire sur la rareté statistique des scores exceptionnellement élevés situés dans la queue unilatérale droite de la distribution, notée P(X > x). C’est le cas lors de l’évaluation de la sévérité d’une symptomatologie psychiatrique, où des scores hauts signalent une détresse aiguë, ou lors de l’identification d’individus à très haut potentiel intellectuel.
La plupart des tables statistiques et des fonctions informatiques standards documentent exclusivement la fonction de répartition cumulative gauche Φ(z). Pour contourner cette limite structurelle, l’analyste applique l’axiome fondamental de probabilité totale (axiome de Kolmogorov), selon lequel la probabilité de l’univers certain est unitairement égale à 1. Tout événement et son complémentaire sont mutuellement exclusifs et exhaustifs, ce qui permet d’énoncer la règle du complément :
P(X > x) = 1 – P(X ≤ x) = 1 – Φ((x – μ) / σ) = 1 – Φ(z)
L’omission de cette soustraction à l’unité constitue sans doute l’erreur la plus récurrente commise par les étudiants et praticiens néophytes. Consulter la table pour un score z positif élevé et retenir directement la valeur Φ(z) revient à quantifier la proportion d’individus se situant en deçà du seuil, opérant un contresens logique complet sur la nature du calcul engagé.
6.2 6.2. Illustration empirique appliquée aux échelles d’anxiété
Afin de concrétiser cette règle du complément, examinons l’administration d’un inventaire clinique d’anxiété validé en psychopathologie de l’adulte. Supposons que l’échelle présente une distribution normale au sein de la population générale, avec une moyenne étalonnée μ = 50 et un écart-type σ = 10. Un patient se présente en consultation avec un score brut particulièrement élevé x = 65. Le clinicien désire évaluer la probabilité qu’un individu non pathologique atteigne ou dépasse un tel niveau d’anxiété, c’est-à-dire P(X > 65).
Le protocole analytique se déploie selon les étapes suivantes :
- Calcul du score z correspondant à la valeur seuil :
z = (65 – 50) / 10 = 15 / 10 = 1,50 - Consultation de la table de répartition cumulative de la loi normale centrée réduite pour la valeur z = 1,50 :
Φ(1,50) = 0,9332 - Application rigoureuse de la règle du complément unilatéral droit :
P(X > 65) = 1 – Φ(1,50) = 1 – 0,9332 = 0,0668
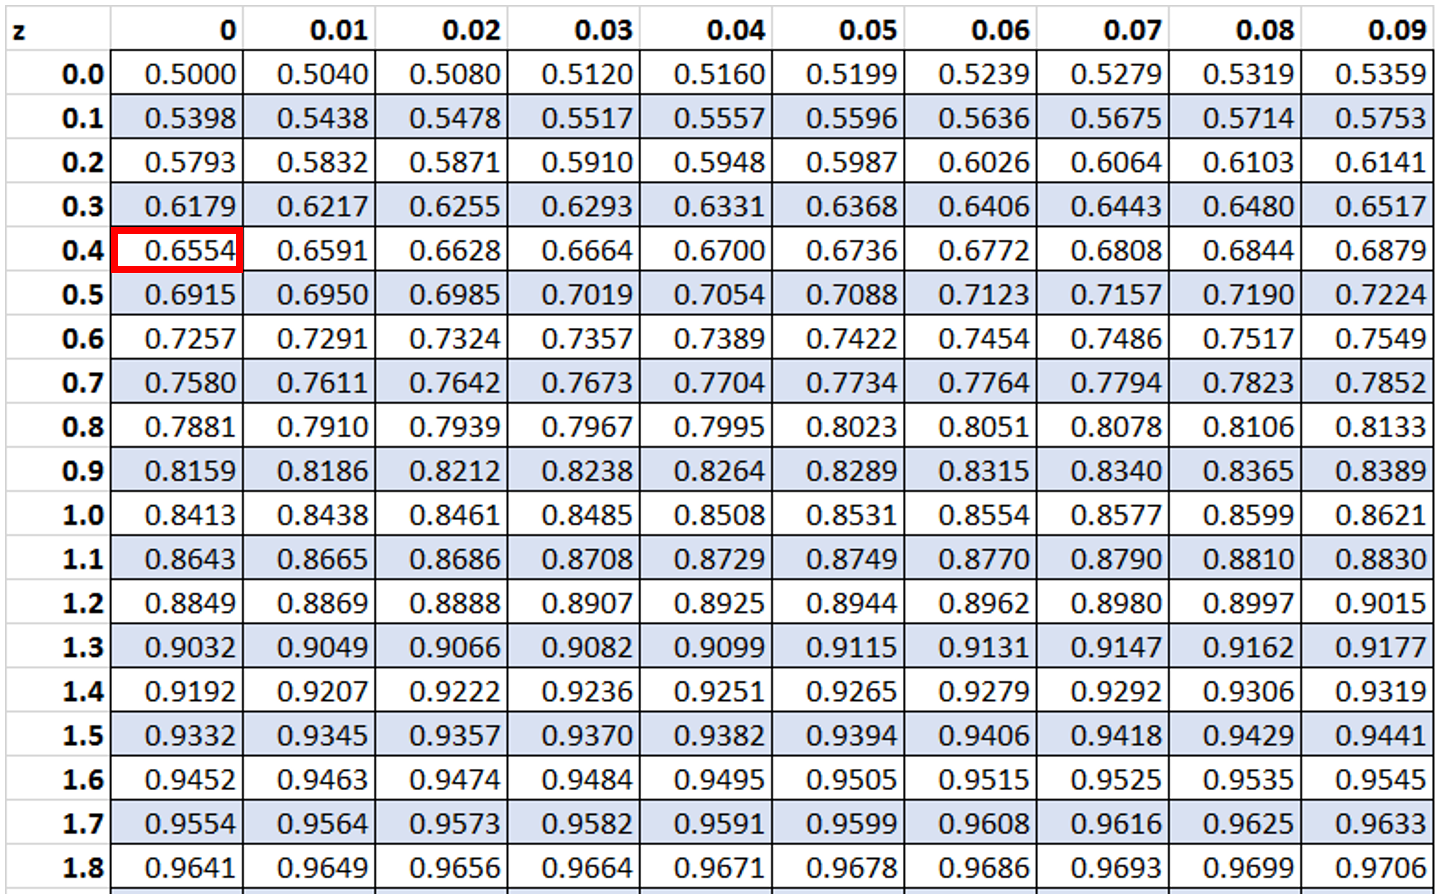
L’aire sous la courbe délimitée à droite de l’abscisse z = 1,50 représente une proportion exacte de 0,0668, démontrant la relative rareté statistique d’une telle intensité symptomatique dans la population générale non clinique.
6.3 6.3. Enjeux dans le dépistage et l’identification de profils atypiques
Ce calcul de probabilité supérieure constitue le pivot méthodologique du dépistage clinique et de la nosologie différentielle. Dans notre exemple, une probabilité de dépassement de 0,0668 atteste que seulement 6,68 % de la population globale éprouve des manifestations anxieuses d’intensité équivalente ou supérieure à celles du patient examiné. Bien que substantiellement élevé, ce niveau ne franchit pas encore le seuil conventionnel classique d’atypicité clinique sévère, souvent fixé par les manuels de psychiatrie quantitative à deux écarts-types au-dessus de la moyenne (z ≥ 2,00, soit une probabilité supérieure résiduelle inférieure à 2,28 %).
La détermination précise de cette probabilité de dépassement permet de calibrer les seuils d’intervention thérapeutique tout en mesurant précisément le risque de générer des résultats faux positifs. En fixant un critère d’inclusion diagnostique trop bas (par exemple à un écart-type de la moyenne, z = 1,00, P(X > x) = 15,87 %), les systèmes de soins s’exposent à médicaliser indûment des réactions de stress ordinaires touchant près d’un individu sur six. À l’opposé, un seuil d’extrême sévérité trop rigide risque d’engendrer un nombre inacceptable de faux négatifs, privant des patients vulnérables d’une prise en charge précoce.
L’évaluation mathématique de la queue supérieure offre ainsi aux cliniciens un ancrage statistique probabiliste objectif pour étayer leur jugement clinique qualitatif, transformant un sentiment intuitif de gravité en un indice de rareté nosographique standardisé et reproductible.
7. 7. Calcul de la probabilité entre deux bornes spécifiques : P(x1 < X < x2)
7.1 7.1. Décomposition par différence de fonctions cumulées
Dans la pratique quantitative quotidienne, l’investigation se limite rarement à l’examen d’un seul versant de la distribution. Il est extrêmement fréquent d’avoir à quantifier la probabilité qu’une variable continue s’inscrive à l’intérieur d’une plage de valeurs délimitée par deux bornes numériques distinctes, x1 et x2 (avec x1 < x2). Ce cas de figure analytique modélise la recherche de la proportion de sujets appartenant à une catégorie intermédiaire donnée, comme les classes de performances moyennes ou modérées.
Sur le plan géométrique, déterminer P(x1 ≤ X ≤ x2) équivaut à calculer l’aire sous la fonction de densité de probabilité comprise strictement entre les droites verticales d’abscisses x1 et x2. En vertu des propriétés fondamentales de l’intégrale de Riemann, cette surface s’obtient par la décomposition différentielle de deux fonctions cumulatives unilatérales gauches intégrées depuis l’infini négatif :
P(x1 ≤ X ≤ x2) = P(X ≤ x2) – P(X ≤ x1) = Φ(z2) – Φ(z1)
où z1 = (x1 – μ) / σ et z2 = (x2 – μ) / σ. Cette formulation géométrique impose une règle de cohérence arithmétique fondamentale : la probabilité cumulée associée à la borne supérieure Φ(z2) doit impérativement être supérieure ou égale à celle de la borne inférieure Φ(z1), garantissant que le résultat probabiliste final demeure rigoureusement positif ou nul, conformément aux axiomes cardinaux de la théorie des probabilités.
7.2 7.2. Cas pratique en psychométrie : la zone de normalité moyenne
L’application la plus emblématique de ce calcul concerne la définition de la « zone de normalité moyenne » lors de l’évaluation du quotient intellectuel (QI) au moyen des échelles de Wechsler (telles que la WAIS-IV ou le WISC-V). Par construction psychométrique standardisée, les scores de QI sont calibrés selon une loi normale théorique de moyenne μ = 100 et d’écart-type σ = 15 points. Les manuels cliniques définissent traditionnellement l’intelligence « moyenne » comme l’intervalle de scores bruts oscillant entre 90 et 110 points. Quelle est la probabilité exacte qu’un sujet prélevé aléatoirement dans la population générale présente un QI s’inscrivant dans cette plage ?
Pour répondre à cette problématique fondamentale, convertissons simultanément les deux bornes en scores standardisés z :
- Borne inférieure (x1 = 90) :
z1 = (90 – 100) / 15 = -10 / 15 ≈ -0,67 - Borne supérieure (x2 = 110) :
z2 = (110 – 100) / 15 = +10 / 15 ≈ +0,67
L’étape suivante consiste à extraire les probabilités cumulées respectives au moyen de la table normale. Pour la borne supérieure : Φ(+0,67) = 0,7486. Pour la borne inférieure, en utilisant les règles de symétrie de la loi normale détaillées plus loin (ou la table directe) : Φ(-0,67) = 1 – Φ(0,67) = 1 – 0,7486 = 0,2514.
La probabilité d’obtenir un score compris dans cet intervalle s’obtient par la soustraction différentielle :
P(90 ≤ X ≤ 110) = Φ(0,67) – Φ(-0,67) = 0,7486 – 0,2514 = 0,4972
Ainsi, exactement 49,72 % de la population globale (soit pratiquement un individu sur deux) présente un fonctionnement cognitif standardisé s’inscrivant au cœur de cette zone de performance moyenne.
7.3 7.3. Applications diagnostiques des intervalles de confiance individuels
La quantification probabiliste entre deux bornes trouve un prolongement clinique fondamental dans la modélisation des intervalles de confiance entourant les scores observés des patients. En psychométrie scientifique, un score observé ne reflète jamais fidèlement le niveau réel absolu d’un trait psychologique en raison de l’erreur de mesure inhérente à l’échantillonnage des items et à la variabilité physiologique du sujet. La théorie classique des tests postule que le score observé X est la résultante additive du score vrai V et d’une composante d’erreur aléatoire E (X = V + E).
Pour délimiter la fourchette à l’intérieur de laquelle se situe le score vrai d’un patient avec un niveau de certitude probabiliste prédéterminé (souvent 90 % ou 95 %), le psychométricien calcule l’erreur type de mesure (ETM = σ * √(1 – rxx), où rxx symbolise le coefficient de fidélité du test). Dès lors, la distribution des fluctuations d’échantillonnage autour du score du sujet suit une loi normale d’écart-type égal à cette ETM.
L’évaluation entre deux bornes permet alors d’authentifier les évolutions cliniques réelles lors de suivis longitudinaux ou d’interventions thérapeutiques. En comparant les bornes de performance temporelle avant et après remédiation cognitive (évaluation à T1 et T2), le calcul probabiliste permet de vérifier si l’intervalle de progression transcende la simple fluctuation d’échantillonnage aléatoire, documentant avec rigueur l’efficacité objective de l’approche thérapeutique engagée.
8. 8. Lecture et utilisation avancée des tables de probabilité de la loi normale
8.1 8.1. Typologie structurelle des tables de la loi normale
L’utilisation autonome et correcte de la littérature statistique et des manuels psychométriques nécessite une maîtrise approfondie de la morphologie des tables de distribution normale. Contrairement à une idée reçue, il n’existe pas un modèle unique de table z, mais trois architectures typologiques majeures éditées au fil de l’histoire des mathématiques :
- La table de répartition cumulative globale (-∞ à z) : C’est le standard moderne international prévalant dans l’enseignement et les suites logicielles. Elle répertorie l’intégralité de l’aire sous la courbe cumulée depuis l’asymptote négative extrême jusqu’au point d’abscisse z. Pour z = 0, la probabilité tabulée est rigoureusement égale à 0,5000, et pour z > 0, les valeurs oscillent de 0,5000 à 1,0000.
- La table d’aire centrale symétrique (0 à z) : Fréquemment rencontrée dans les manuels de statistique anglo-saxons plus anciens ou dans certains traités d’ingénierie, cette table mesure uniquement la surface comprise entre le centre de gravité de la cloche (z = 0) et le score z positif considéré. Pour z = 0, la table affiche 0,0000 ; pour obtenir la probabilité cumulée globale à partir d’une telle table, il est impératif d’ajouter systématiquement la constante 0,5000 à la valeur lue.
- La table de dépassement unilatéral (z à +∞) : Souvent qualifiée de table de queue supérieure, elle consigne directement l’aire résiduelle située à droite de la valeur z positive (la probabilité de dépassement). Pour z = 0, elle indique 0,5000, et décroît asymptotiquement vers zéro à mesure que z progresse vers les valeurs positives extrêmes.
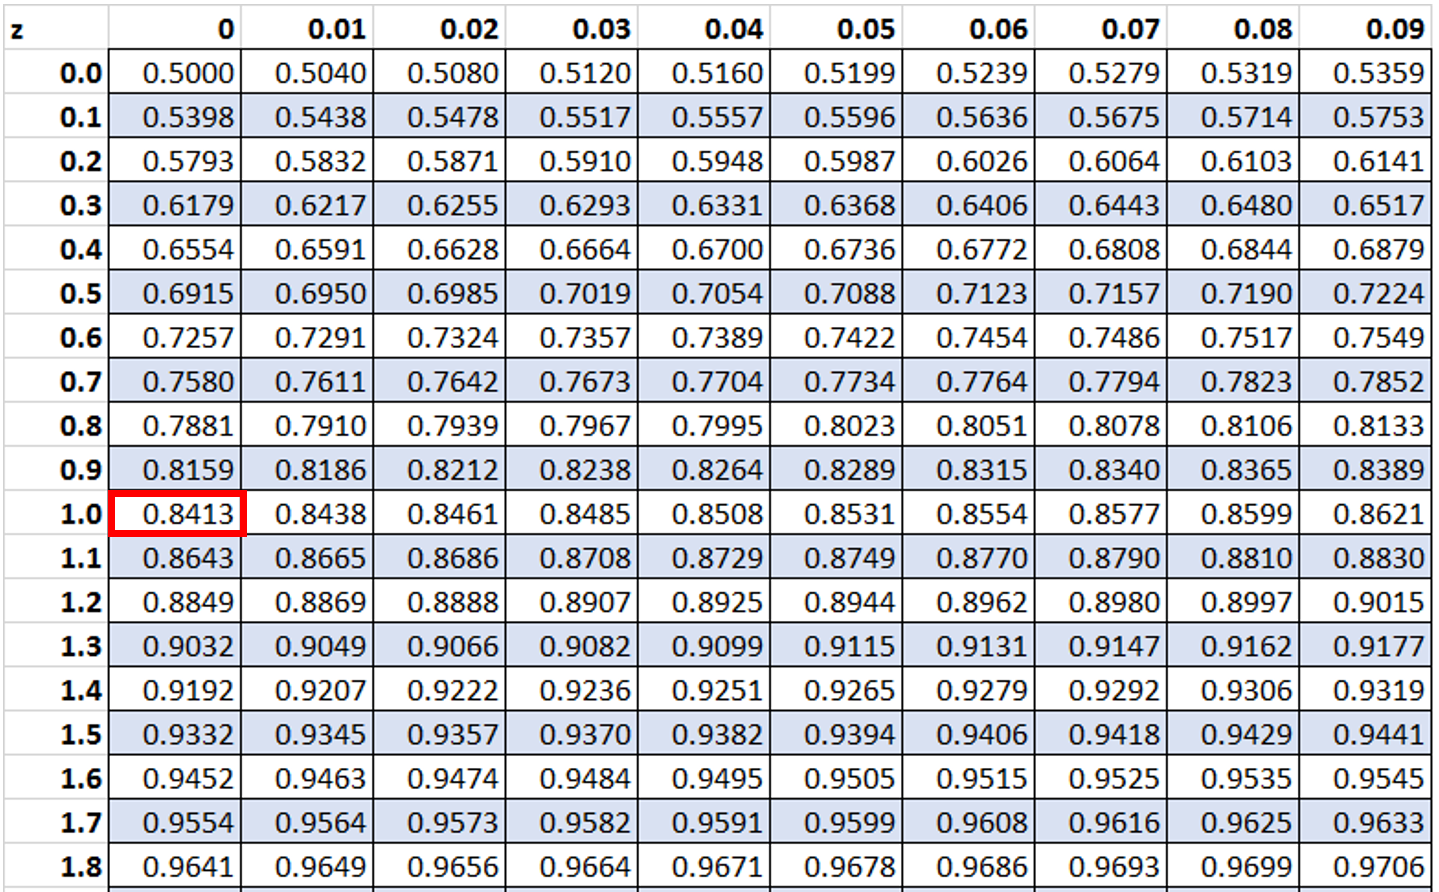
Il est donc d’une importance capitale d’examiner le cartouche descriptif et le schéma géométrique illustratif figurant invariablement en en-tête d’une table imprimée avant d’extraire la moindre donnée numérique, sous peine de commettre un décalage systématique de 0,50 sur l’ensemble des probabilités estimées.
8.2 8.2. Gestion mathématique des scores z négatifs
Par souci de compacité éditoriale, de nombreuses tables statistiques publiées dans les manuels omettent délibérément les pages consacrées aux valeurs négatives du score z, ne détaillant que la portion positive de la distribution (z ≥ 0). Cette restriction n’entrave en rien le calcul probabiliste pour les scores négatifs, à la condition expresse de mobiliser les propriétés de symétrie axiale parfaite de la fonction de densité gaussienne.
En vertu de cette symétrie autour de l’axe central d’abscisse z = 0, la surface située dans la queue gauche à gauche d’une valeur négative -z est géométriquement et numériquement identique à la surface située dans la queue droite à droite de la valeur positive symétrique +z. En appliquant la règle du complément unilatéral à cette identité, on déduit le théorème fondamental suivant pour les scores négatifs :
Φ(-z) = 1 – Φ(z)
Supposons qu’un clinicien doive calculer la probabilité cumulée associée à un score z = -1,85 à partir d’une table ne comportant que des entrées positives. La procédure se déroule sans difficulté :
- Considérer la valeur absolue positive : |z| = +1,85
- Lire la probabilité cumulée correspondante dans la table positive : Φ(1,85) = 0,9678
- Appliquer le principe de symétrie : Φ(-1,85) = 1 – Φ(1,85) = 1 – 0,9678 = 0,0322
La probabilité qu’un sujet obtienne un score standardisé inférieur ou égal à -1,85 écart-type est donc très précisément de 0,0322 (3,22 %). Le report graphique systématique de cette opération permet de prévenir toute erreur de signe lors de l’application de cette complémentarité axiale.
8.3 8.3. Interpolation linéaire pour scores intermédiaires
Bien que les tables imprimées fournissent un découpage fin au centième près (avec un pas de 0,01 pour z), les calculs de standardisation empirique génèrent fréquemment des valeurs intermédiaires possédant trois décimales ou davantage. Lorsqu’un niveau de rigueur métrique élevé est requis en l’absence de moyens informatiques, le recours à l’interpolation linéaire permet d’approximer la probabilité cumulée avec une précision remarquable.
Considérons un score z calculé égal à 0,724. La table statistique standard fournit les valeurs encadrantes discrètes suivantes :
- Pour za = 0,72 : Φ(0,72) = 0,7642
- Pour zb = 0,73 : Φ(0,73) = 0,7673
Le score cible z = 0,724 se situe précisément à une distance relative de 4 dixièmes (ou 40 %) du segment séparant 0,72 de 0,73. L’interpolation linéaire postule une progression locale affine de la fonction de répartition sur cet intervalle infinitésimal, et s’exprime formellement par l’équation :
Φ(z) ≈ Φ(za) + [(z – za) / (zb – za)] * (Φ(zb) – Φ(za))
En substituant nos valeurs numériques empiriques :
Φ(0,724) ≈ 0,7642 + [(0,724 – 0,72) / (0,73 – 0,72)] * (0,7673 – 0,7642)
Φ(0,724) ≈ 0,7642 + [0,004 / 0,01] * 0,0031 = 0,7642 + (0,4 * 0,0031) = 0,7642 + 0,00124 = 0,76544
La probabilité estimée par interpolation s’établit à 0,7654. L’erreur d’approximation inhérente à cette linéarisation locale par rapport à la valeur analytique exacte calculée par intégration numérique est infinitésimale (inférieure à 10-5), conférant à cette technique manuelle une fiabilité méthodologique totale pour les analyses psychométriques de haute exigence.
9. 9. Calcul inverse : déterminer une valeur seuil x à partir d’une probabilité donnée
9.1 9.1. Formulation du problème inverse en évaluation psychologique
Dans de nombreuses configurations de recherche et d’exercice clinique, le problème se pose dans le sens rigoureusement inverse de celui examiné jusqu’à présent. L’évaluateur ne cherche pas à dériver la probabilité associée à une performance brute observée x, mais dispose d’un pourcentage ou d’un rang centile théorique cible et souhaite déterminer le score brut seuil correspondant. Ce processus porte le nom de calcul de quantile ou problème de la fonction quantile (fonction probit), notée formellement comme l’inverse de la fonction de répartition : Φ-1(p).
Cette approche inverse intervient dès lors qu’il s’agit d’établir une ligne de démarcation opérationnelle a priori : quel score brut minimal un candidat doit-il atteindre pour faire partie des 10 % les plus performants ? Quel score seuil à une échelle de dépistage de l’autisme isole les 2 % d’enfants manifestant les comportements les plus atypiques ?
Le protocole mathématique de résolution du problème inverse s’articule en deux étapes séquentielles :
- Identification du score standardisé critique zp tel que Φ(zp) = p, en effectuant une recherche inverse à l’intérieur du corps de la table normale (recherche matricielle de la probabilité la plus proche pour lire en marge le score z correspondant).
- Inversion algébrique de la formule de standardisation canonique. Partant de z = (x – μ) / σ, l’isolement du terme x aboutit à la relation fondamentale suivante :
x = μ + (z * σ)
Cette équation reconstitue le score brut seuil en translatant la moyenne de référence d’un facteur proportionnel au score z critique pondéré par l’écart-type de la population.
9.2 9.2. Application au recrutement et à la sélection psychologique
Pour illustrer ce calcul inverse dans le contexte de la psychologie organisationnelle et du travail, considérons une entreprise d’ingénierie aérospatiale ouvrant une procédure de recrutement hautement sélective. Le service des ressources humaines administre un test standardisé de raisonnement mécanique spatio-temporel. L’étalonnage national du test indique une distribution normale avec une moyenne μ = 115 points et un écart-type σ = 18 points. L’organisation arrête pour critère d’admissibilité de ne convoquer en entretien individuel que les candidats appartenant au décile supérieur d’excellence, soit les 5 % les plus performants (le top 5 % de la cohorte).
Quel est le score brut minimal xseuil requis pour être sélectionné ?
Le fait d’appartenir au groupe des 5 % supérieurs signifie que la probabilité d’obtenir un score inférieur ou égal au seuil critique doit être exactement de 1 – 0,05 = 0,95 (95e percentile). L’évaluateur consulte donc la table statistique en explorant le corps des probabilités cumulées pour localiser la valeur la plus proche possible de 0,9500.
Dans la table, les valeurs les plus approchantes se situent à :
- Φ(1,64) = 0,9495
- Φ(1,65) = 0,9505
La valeur de probabilité 0,9500 réside à équidistance exacte entre ces deux bornes. Le score z critique conventionnel retenu est donc zcritique = 1,645. Il suffit désormais d’appliquer la formule d’inversion métrique :
x = μ + (z * σ) = 115 + (1,645 * 18) = 115 + 29,61 = 144,61 points
Puisque les épreuves psychométriques attribuent généralement des scores entiers discrets, l’entreprise retiendra un seuil de coupure fixé à 145 points. Tout candidat obtenant un score égal ou supérieur à 145 points sera garanti d’appartenir au décile d’excellence des 5 % supérieurs de la population de référence.
9.3 9.3. Établissement des seuils d’inclusion en recherche expérimentale
Le calcul inverse constitue également un pilier méthodologique strict dans les protocoles de recherche en neurosciences cognitives, en psychiatrie biologique ou en psychopharmacologie expérimentale. Dans ces contextes scientifiques, la puissance statistique des comparaisons dépend directement de la pureté phénotypique des groupes expérimentaux contrastés. Les chercheurs ont fréquemment recours à un design par groupes extrêmes (extreme groups design), consistant à isoler méthodologiquement des cohortes présentant des caractéristiques hautement divergentes vis-à-vis d’une dimension psychologique continue, par exemple l’anhédonie sociale ou la suggestibilité hypnotique.
Afin de prévenir tout arbitraire méthodologique menaçant la reproductibilité des résultats, les seuils d’inclusion doivent être calculés a priori en utilisant les quantiles inverses de la loi normale. Les chercheurs fixent conventionnellement des critères de sélection stricts, tels que l’inclusion dans le groupe « hypo-réactif » des sujets dont le score se situe sous le 10e percentile (z ≤ -1,28) et dans le groupe « hyper-réactif » de ceux dépassant le 90e percentile (z ≥ +1,28), les sujets intermédiaires étant exclus du protocole.
Ce protocole assure que les groupes expérimentaux ainsi constitués soient standardisés selon des métriques de dispersion universellement comparables entre laboratoires indépendants, assurant ainsi la rigueur et la validité scientifique des méta-analyses subséquentes.
10. 10. Automatisation du calcul : logiciels statistiques et tableurs
10.1 10.1. Fonctions intégrées dans les tableurs usuels
Si la compréhension des mécanismes manuels de consultation des tables statistiques est essentielle à la maîtrise conceptuelle des probabilités, l’exercice professionnel contemporain s’appuie massivement sur des environnements informatisés. Les logiciels de tableurs grand public (tels que Microsoft Excel, LibreOffice Calc ou Google Sheets) intègrent des bibliothèques d’algorithmes numériques permettant de résoudre instantanément les problèmes directs et inverses sans recourir à l’approximation des tables imprimées.
Pour le calcul direct de la probabilité cumulée unilatérale gauche P(X ≤ x) à partir de scores bruts non standardisés, la fonction fondamentale s’intitule :
=LOI.NORMALE.N(x; moyenne; ecart_type; VRAI)
L’argument booléen « VRAI » est d’une importance capitale : il ordonne au moteur de calcul d’évaluer la fonction de répartition cumulative intégrée (l’aire sous la courbe depuis -∞). L’utilisation erronée de l’argument « FAUX » renverrait uniquement la valeur ponctuelle de la fonction de densité de probabilité f(x), c’est-à-dire la hauteur d’ordonnée de la courbe au point d’abscisse x, ce qui ne représente en aucun cas une probabilité utilisable.
Lorsque le score standardisé z a déjà été calculé manuellement, le praticien peut mobiliser la fonction canonique centrée réduite :
=LOI.NORMALE.STANDARD.N(z; VRAI)
Pour résoudre le problème inverse consistant à dériver le score seuil brut x à partir d’une probabilité cumulée unilatérale gauche p, le tableur fournit la syntaxe :
=LOI.NORMALE.INVERSE.N(probabilite; moyenne; ecart_type)
Ces outils suppriment tout risque d’erreur d’arrondi intermédiaire et permettent le traitement séquentiel de cohortes massives de données en quelques millisecondes.
10.2 10.2. Programmation statistique avec R et Python
Dans l’écosystème de la recherche quantitative et de la science des données, les environnements open source de référence que sont le langage R et le langage Python (via l’écosystème SciPy) offrent des syntaxes hautement optimisées et vectorisées pour la modélisation probabiliste gaussienne.
Dans l’environnement de base du logiciel R, la famille des fonctions de la distribution normale s’articule autour du suffixe norm, combiné à des préfixes opérationnels mnémoniques :
pnorm(q, mean, sd, lower.tail = TRUE): Calcule la probabilité cumulée unilatérale gauche associée au quantile q. L’argument cruciallower.tail = FALSEpermet de calculer directement la probabilité unilatérale droite P(X > x) sans avoir à effectuer manuellement la soustraction à l’unité, évitant ainsi les erreurs d’arrondi numérique sur les queues extrêmes.qnorm(p, mean, sd, lower.tail = TRUE): Résout le problème inverse en extrayant le quantile exact associé à la probabilité p.dnorm(x, mean, sd): Évalue la densité de probabilité au point x.rnorm(n, mean, sd): Génère un échantillon aléatoire de n observations simulées selon les paramètres de la distribution normale spécifiés.
Au sein de l’environnement Python, ces fonctionnalités mathématiques sont implémentées au travers du sous-module scipy.stats, qui encapsule la distribution normale continue sous la classe norm :
scipy.stats.norm.cdf(x, loc=mu, scale=sigma): Évalue la fonction de répartition cumulative (Cumulative Distribution Function).scipy.stats.norm.sf(x, loc=mu, scale=sigma): Évalue la fonction de survie (Survival Function), équivalente à 1 – cdf, pour le calcul direct de la queue supérieure P(X > x).scipy.stats.norm.ppf(q, loc=mu, scale=sigma): Évalue la fonction quantile (Percent Point Function), assurant la résolution inverse.
Ces implémentations garantissent une précision numérique conforme au standard de calcul en virgule flottante double précision (IEEE 754), indispensable pour estimer la probabilité d’occurrences d’événements hautement exceptionnels situés à plus de 5 ou 6 écarts-types de la moyenne.
10.3 10.3. Traitement dans les suites psychométriques spécialisées
Au-delà des environnements de programmation polyvalents, les progiciels statistiques dédiés aux sciences sociales et biomédicales — tels qu’IBM SPSS Statistics, JASP ou Jamovi — intègrent ces calculs probabilistes au cœur de leurs modules d’analyse descriptive et d’étalonnage psychométrique. Lors de la saisie d’une série de scores bruts issus d’un échantillon d’étalonnage, ces plateformes offrent des fonctionnalités automatisées de calcul et de transformation de variables.
Dans SPSS, par exemple, la procédure descriptive permet d’activer l’option « Enregistrer les valeurs standardisées dans des variables », qui génère instantanément pour chaque observation de la matrice le score standardisé z correspondant, en appliquant les moyennes et écarts-types calculés sur l’échantillon. Conjointement, le calculateur de variables permet d’appeler les fonctions CDF.NORMAL et IDF.NORMAL pour obtenir en quelques clics les percentiles théoriques dérivés et les indices de rareté clinique.
De surcroît, les interfaces modernes comme JASP fournissent des modules d’évaluation visuelle dynamique : en modifiant les bornes d’intérêt sur un panneau graphique interactif, l’utilisateur observe instantanément la mise à jour de la surface ombrée sous la courbe gaussienne accompagnée de sa valeur de probabilité exacte. Cette intégration visuelle et analytique renforce la fiabilité diagnostique en minimisant les erreurs manuelles d’encodage et de lecture des tables tabulées.
11. 11. Pièges fréquents, biais d’interprétation et erreurs de calcul
11.1 11.1. Confusions fréquentes dans l’utilisation des queues de distribution
L’expérience pédagogique et l’audit de rapports psychologiques révèlent que les erreurs de calcul probabiliste ne découlent que rarement d’une mauvaise maîtrise de l’arithmétique élémentaire, mais résultent principalement de confusions conceptuelles quant à l’orientation des queues de distribution. L’erreur la plus classique consiste à omettre la soustraction unitaire lors du calcul d’une probabilité de dépassement supérieur P(X > x). L’évaluateur calcule correctement le score z = +2,00, lit dans la table la probabilité cumulée standard de 0,9772 et conclut par inadvertance que le sujet a une probabilité de 97,72 % d’atteindre ce niveau d’excellence, alors qu’il s’agit précisément de la proportion d’individus surpassés, la probabilité réelle de dépassement n’étant que de 1 – 0,9772 = 0,0228 (2,28 %).
Un deuxième piège récurrent concerne l’interversion accidentelle des bornes lors de l’estimation de la probabilité d’un intervalle P(x1 ≤ X ≤ x2). En soustrayant la probabilité de la borne supérieure de celle de la borne inférieure (Φ(z1) – Φ(z2)), l’analyste obtient un résultat de signe négatif. Face à cette impossibilité probabiliste, l’erreur consiste souvent à simplement inverser arbitrairement le signe final du résultat sans réexaminer la construction logique de la soustraction, occultant potentiellement d’autres erreurs sous-jacentes dans le choix des scores z de référence.
Enfin, la gestion des scores négatifs situés sous la moyenne génère de nombreuses confusions. Face à un score brut inférieur à μ, certains praticiens omettent le signe négatif du score z lors de la standardisation (en posant par exemple z = (μ – x) / σ pour forcer un résultat positif). Dès lors, la consultation de la table renvoie une probabilité supérieure à 0,50, attribuant paradoxalement un rang centile élevé à une performance déficitaire. Le strict respect de l’ordre des termes dans la formule de centrage (x – μ) demeure le garant absolu de la validité directionnelle du score z.
11.2 11.2. Confusion entre pourcentage brut et percentile probabiliste
Une dérive interprétative majeure en psychométrie clinique concerne l’assimilation trompeuse entre le pourcentage de réussite brute à une épreuve et le rang percentile probabiliste dérivé de la loi normale. Cette confusion traduit une méconnaissance de la différence entre une échelle de rapport absolue et une échelle ordinale ou d’intervalle relative à un groupe de pairs.
Considérons un test neuropsychologique composé de 100 items évaluant les praxies constructives. Si un patient réussit 80 items sur 100, son pourcentage de réussite brute est indéniablement de 80 %. Toutefois, cela ne préjuge aucunement de sa position probabiliste au sein de sa population de référence :
- Si l’épreuve est exceptionnellement difficile pour la cohorte d’âge (avec une moyenne populationnelle μ = 50 et un écart-type σ = 15), un score de 80 points engendre un score z = (80 – 50) / 15 = +2,00, plaçant le patient au 98e percentile (performance exceptionnellement brillante surpassant 97,7 % des pairs).
- Si, à l’inverse, l’épreuve est très facile (effet de facilité généralisé, μ = 95 et σ = 5), le même score de 80 items réussis conduit à un score standardisé z = (80 – 95) / 5 = -3,00, reléguant le patient sous le 1er percentile (témoignant d’un déficit constructif sévère).
Confondre ces deux métriques lors de la transmission d’un compte-rendu d’évaluation clinique est susceptible d’induire le médecin prescripteur en erreur, en interprétant par exemple un score brut de 70 % comme une performance convenable alors qu’il peut désigner une anomalie statistique majeure au regard de la distribution de référence.
11.3 11.3. Erreurs d’arrondi et instabilité numérique
La fonction de répartition cumulative normale présente une allure sigmoïdale dont la dérivée est maximale au centre et décroît de façon exponentielle vers les asymptotes. Cette morphologie non linéaire implique que la sensibilité de la probabilité aux variations du score z n’est pas uniforme sur l’ensemble de la distribution.
Dans la zone centrale de la courbe (pour des scores z compris entre -1,00 et +1,00), la pente est particulièrement abrupte. Au voisinage immédiat de la moyenne (z = 0,00), une variation minime de 0,05 unité sur le score z engendre un décalage de près de 2 % sur le rang centile cumulé (Φ(0,00) = 0,5000 ; Φ(0,05) = 0,5199). Un arrondi hâtif ou une troncature sauvage du score z (par exemple arrondir 0,048 à 0,00 au lieu de 0,05) introduit une imprécision métrique non négligeable.
Inversement, dans les régions extrêmes de la distribution (au-delà de |z| > 2,50), ce sont les probabilités résiduelles de queue qui manifestent une extrême instabilité relative face aux arrondis. Une infime variation d’arrondi sur un score z situé à 3,10 peut doubler ou diviser par deux la probabilité de dépassement unilatérale estimée. La règle méthodologique d’excellence impose donc d’exécuter l’intégralité des calculs algébriques intermédiaires en conservant la précision de calcul maximale de l’ordinateur ou de la calculatrice, et de ne pratiquer l’arrondi décimal qu’au stade ultime de la présentation des conclusions diagnostiques.
12. 12. Limites méthodologiques et vérification des conditions d’application
12.1 12.1. Vérification rigoureuse de l’hypothèse de normalité univariée
L’ensemble de l’architecture probabiliste exposée dans cet ouvrage repose sur un postulat mathématique fondamental et non négociable : la variable empirique sous-jacente doit se conformer rigoureusement à une distribution normale au sein de la population parente. L’utilisation mécanique de la moyenne et de l’écart-type pour extraire des probabilités à partir des tables gaussiennes sans contrôle préalable de cette hypothèse d’adéquation relève d’une négligence méthodologique majeure susceptible d’invalider l’ensemble des inférences diagnostiques.
L’évaluation rigoureuse de la normalité univariée d’une distribution repose sur la triangulation méthodique de plusieurs indices statistiques complémentaires :
- Les tests formels d’adéquation distributionnelle : Le test de Shapiro-Wilk constitue le test le plus puissant et recommandé pour les échantillons de taille modeste à modérée (N < 50). Pour de vastes cohortes de standardisation, le test de Kolmogorov-Smirnov avec correction de Lilliefors ou le test d’Anderson-Darling permettent de tester l’hypothèse nulle d’adéquation à la loi normale. Tout rejet de l’hypothèse nulle (p < 0,05) signale une déviation structurelle par rapport au modèle gaussien idéal.
- Les coefficients de forme (asymétrie et aplatissement) : L’asymétrie (skewness) quantifie le déport des observations vers la gauche ou la droite de la moyenne. L’aplatissement (kurtosis) mesure l’épaisseur des queues et la concentration des valeurs autour du mode. Dans une distribution gaussienne parfaite, ces coefficients théoriques sont nuls. En pratique psychométrique, des valeurs standardisées oscillant au-delà de l’intervalle [-1,0 ; +1,0] indiquent une distorsion incompatible avec l’utilisation directe des tables de la loi normale.
- L’inspection visuelle des diagrammes quantile-quantile (Q-Q plots) : Le Q-Q plot projette les quantiles empiriques observés de l’échantillon en regard des quantiles théoriques d’une distribution normale attendue. Si les points s’alignent fidèlement le long de la bissectrice diagonale, l’adéquation est confirmée. Tout infléchissement en forme de « S » ou courbure systématique trahit une anomalie distributionnelle qu’aucun calcul fondé sur le score z ne saurait compenser.
12.2 12.2. L’impact des effets de plancher et de plafond
Dans la pratique psychologique empirique, l’asymétrie d’une distribution trouve souvent sa genèse dans des contraintes physiques ou instrumentales désignées sous les termes d’effet de plancher et d’effet de plafond. Ces anomalies surviennent lorsque l’épreuve présente un niveau de difficulté inadapté aux compétences réelles de la cohorte évaluée :
- L’effet de plafond : L’épreuve est trop aisée pour la population testée. Une proportion massive de participants réussit la quasi-totalité des items et obtient le score maximal autorisé par l’instrument. La distribution empirique se comprime brutalement contre la borne supérieure, engendrant une asymétrie négative prononcée. Dans ce contexte, l’écart-type est artificiellement restreint et la moyenne artificiellement rehaussée. L’application mécanique du modèle normal sous-estime dramatiquement la probabilité d’obtenir des scores élevés et surévalue artificiellement la rareté des scores moyens.
- L’effet de plancher : L’épreuve est trop ardue ou conçue pour discriminer des pathologies sévères lorsqu’elle est administrée à une population générale saine. Une grande majorité des sujets cumule des scores nuls ou voisins de zéro, provoquant une accumulation artificielle de données sur la borne inférieure (asymétrie positive marquée).
Lorsque ces distorsions sont manifestes, les praticiens doivent impérativement proscrire la conversion linéaire par score z. Les solutions méthodologiques appropriées imposent alors le recours à des étalonnages non paramétriques basés sur les rangs centiles empiriques directs, ou l’application préalable de transformations mathématiques non linéaires stabilisatrices (transformations logarithmiques, puissances de Box-Cox) visant à normaliser la structure des résidus avant toute inférence probabiliste.
12.3 12.3. Représentativité et validité de l’étalonnage psychométrique
Enfin, la validité de toute probabilité estimée à partir d’une moyenne et d’un écart-type est strictement tributaire de la représentativité et de l’actualité de l’échantillon d’étalonnage ayant permis d’estimer ces deux paramètres cardinaux. La moyenne μ et l’écart-type σ ne constituent en aucun cas des vérités absolues ou intemporelles : ils ne sont que des estimations statistiques dérivées d’un groupe d’individus mesuré à une époque historique donnée et dans des conditions socioculturelles spécifiques.
L’une des illustrations les plus marquantes de cette variabilité temporelle est documentée sous le nom d’effet Flynn. Découvert par le politologue James Flynn, ce phénomène met en évidence une progression constante et séculaire des scores moyens aux tests d’efficience intellectuelle tout au long du XXe siècle dans les nations industrialisées (avec un gain moyen oscillant autour de 3 points de QI par décennie). En conséquence de cette dynamique, l’utilisation d’une table d’étalonnage obsolète conçue vingt ans auparavant conduit à utiliser une moyenne μ nettement sous-évaluée par rapport au niveau réel actuel de la population. Dès lors, le score z calculé pour un individu moderne sera artificiellement surestimé, attribuant une probabilité de rareté cognitive erronée à une performance qui est devenue sociologiquement courante.
De surcroît, la validité des paramètres μ et σ impose un appariement démographique scrupuleux vis-à-vis des facteurs modérateurs majeurs que sont l’âge chronologique, le niveau d’instruction formel, la maîtrise de la langue du test et le contexte culturel d’appartenance. Confronter les données brutes d’une personne âgée de 80 ans à un étalonnage établi sur une cohorte de jeunes adultes universitaires de 20 ans constitue un contresens métrologique absolu. La probabilité d’occurrence qui en résulterait n’aurait aucune consistance diagnostique et traduirait uniquement un artéfact méthodologique préjudiciable à la prise en charge éclairée de la personne.
En synthèse, la dérivation d’une probabilité à partir d’une moyenne et d’un écart-type représente un instrument analytique d’une puissance exceptionnelle pour les sciences psychologiques et comportementales. Toutefois, sa pertinence clinique et scientifique demeure subordonnée à la compréhension intime de ses axiomes mathématiques, à l’application rigoureuse d’un protocole opératoire méthodique, et à une vigilance épistémologique constante quant à la représentativité des normes de référence mobilisées.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anastasi, A., & Urbina, S. (1997). Psychological testing (7th ed.). Prentice Hall.
- Flynn, J. R. (1987). Massive IQ gains in 14 nations: What IQ tests really measure. Psychological Bulletin, 101(2), 171–191. https://doi.org/10.1037/0033-2909.101.2.171
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Laplace, P. S. (1812). Théorie analytique des probabilités. Vve Courcier.
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). Pearson Assessment.