
Dans le domaine des sciences du comportement, de la biométrie et de la psychométrie quantitative, la standardisation des observations empiriques constitue le socle indispensable à toute inférence diagnostique ou expérimentale. Lorsque des chercheurs, des cliniciens ou des analystes de données recueillent des mesures brutes issues d’instruments d’évaluation — qu’il s’agisse de tests d’efficience cognitive, d’échelles de personnalité ou d’épreuves de mémoire —, ces valeurs demeurent fondamentalement incommensurables sans une mise en relation rigoureuse avec une distribution de référence. Le score Z, ou cote standardisée centrée réduite, matérialise cette passerelle mathématique en convertissant un score individuel en unités d’écart-type par rapport à la moyenne de la population normée. Néanmoins, si la métrique Z s’avère optimale pour le traitement algébrique et la modélisation statistique avancée, elle présente une abstraction conceptuelle qui en limite l’intelligibilité immédiate lors de la communication des résultats aux praticiens, aux éducateurs ou aux patients eux-mêmes.
C’est précisément ici qu’intervient la conversion d’un score Z en rang percentile. Le percentile exprime la position relative d’un individu au sein d’une cohorte standardisée sous la forme d’un pourcentage cumulé d’observations se situant en deçà de la performance observée. Cette transformation d’une échelle d’intervalles vers une échelle ordinale normée repose sur l’intégration de la fonction de densité de la loi normale standard. Historiquement tributaire de volumineuses tables statistiques imprimées sujettes aux approximations d’interpolation, cette opération bénéficie aujourd’hui de la puissance de calcul embarquée des calculatrices graphiques de la gamme Texas Instruments, et plus particulièrement de la famille TI-84 (standard, Silver Edition et Plus CE). Cet outil technologique intègre des algorithmes d’approximation numérique de haute précision permettant d’obtenir instantanément des valeurs de probabilités cumulées à partir de n’importe quel point de la distribution gaussienne.
Le présent article constitue un traité méthodologique et pratique exhaustif dédié à l’évaluation, au calcul et à l’interprétation clinique des percentiles dérivés de scores Z au moyen de la calculatrice TI-84. En explorant successivement les fondements théoriques de la distribution normale en psychométrie, la syntaxe interne de la fonction normalcdf, les protocoles opératoires appliqués aux scores négatifs et positifs, la gestion des arrondis et les pièges syntaxiques récurrents, ce guide s’adresse aux étudiants universitaires, aux chercheurs en neuropsychologie et aux cliniciens désireux d’asseoir leur pratique calculatoire sur une rigueur mathématique irréprochable.
1. Fondements théoriques : Scores Z et distribution normale en psychométrie
1.1 Définition et formalisation mathématique du score Z
Le score Z, désigné sous l’appellation canonique de variable normale centrée réduite, constitue l’une des transformations linéaires les plus fondamentales de la théorie statistique classique des tests. D’un point de vue formel, pour une variable aléatoire continue $X$ suivant une distribution normale de paramètres d’espérance mathématique $\mu$ et de variance $\sigma^2$ (notée conventionnellement $X \sim \mathcal{N}(\mu, \sigma^2)$), la transformation en score Z s’opère selon l’équation mathématique élémentaire :
$$z = \frac{x – \mu}{\sigma}$$
Dans ce formalisme, le numérateur $(x – \mu)$ quantifie la déviation absolue du score brut par rapport au barycentre de la distribution de référence, tandis que le dénominateur $\sigma$ normalise cette différence en employant l’écart-type comme étalon d’échelle universel. Cette opération de standardisation confère à la nouvelle variable aléatoire $Z$ les propriétés strictes de la distribution normale standardisée, notée $\mathcal{N}(0, 1)$, caractérisée par une moyenne nulle ($\mu_z = 0$) et un écart-type unitaire ($\sigma_z = 1$). L’écart-type cesse dès lors d’être une mesure exprimée dans l’unité physique ou psychométrique du test (comme le nombre d’items réussis ou le temps de réaction en millisecondes) pour devenir une unité adimensionnelle pure. En vertu de cette propriété, un score $z = +1,50$ indique sans la moindre ambiguïté que l’observation se situe exactement à un écart-type et demi au-dessus de la moyenne de l’échantillon normatif, indépendamment de l’amplitude métrique originelle du protocole d’évaluation.
L’importance de l’invariance d’échelle induite par la distribution normale standardisée est prépondérante dans le champ de la psychométrie contemporaine. Comme l’ont explicité les travaux fondateurs réunis au sein des Standards for Educational and Psychological Testing édictés par l’American Psychological Association (APA), la comparaison directe de performances issues d’instruments hétérogènes est intrinsèquement invalide sans cette standardisation. La transformation z permet de neutraliser la variance arbitraire des formats d’épreuves et confère aux données une métrique stable autorisant les opérations de comparaison, de sommation pondérée et de modélisation mathématique linéaire.
1.2 Lien structurel entre les cotes Z et les percentiles
Le passage structural entre une cote Z et un percentile relève du calcul intégral appliqué à la théorie des probabilités. La distribution normale standardisée est régie par sa fonction de densité de probabilité, désignée par la lettre grecque $phi(z)$, dont la formulation analytique s’écrit :
$$\phi(z) = \frac{1}{\sqrt{2\pi}} e^{-\frac{z^2}{2}}$$
Le rang percentile associé à une valeur spécifique de $z$, noté $P_z$, correspond à la probabilité cumulative qu’une variable aléatoire $Z$ suivant cette loi prenne une valeur inférieure ou égale à $z$, transposée sur une échelle ordinale bornée conventionnellement entre 0 et 100. Cette relation s’établit formellement via la fonction de répartition cumulative, traditionnellement notée $Phi(z)$ :
$$\Phi(z) = P(Z le z) = \int_{-\infty}^{z} \frac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}} , dt$$
Le percentile formel s’exprime donc sous la forme :
$$\text{Percentile}(z) = \Phi(z) \times 100$$
Il est impératif de souligner la distinction critique entre un « pourcentage de score » et un « rang percentile ». Un pourcentage de score reflète simplement la proportion d’items réussis lors d’un test (par exemple, 70 réponses correctes sur 100 questions équivaut à 70 %), ce qui ne fournit aucune information quant à la rareté relative de cette performance au sein de la population. En revanche, le rang percentile traduit la position relative d’un score au sein d’une population normée ordonnée : se situer au 70e percentile signifie que la performance de l’individu dépasse celle de 70 % des membres du groupe de comparaison. La symétrie parfaite de la courbe de Gauss implique des équivalences fondamentales : le centre de la distribution, caractérisé par $z = 0$, correspond rigoureusement à l’aire sous la courbe d’exactement 0,5000, ce qui équivaut sans équivoque au 50e percentile, marquant le point médian exact où la cohorte est scindée en deux moitiés égales.
1.3 Utilité méthodologique en sciences cognitives et psychologie quantitative
Dans les disciplines neuroscientifiques et l’évaluation psychologique standardisée, les praticiens manipulent quotidiennement des échelles d’intelligence universellement répandues, telles que les échelles de Wechsler pour adultes (WAIS-IV) ou pour enfants (WISC-V). Ces batteries standardisées expriment généralement les indices composites sous forme de quotients intellectuels (QI) standardisés, configurés selon une moyenne arbitraire de 100 et un écart-type de 15. À un niveau plus granulaire, les épreuves individuelles (sous-tests) recourent fréquemment à des « notes standard » caractérisées par une moyenne de 10 et un écart-type de 3. La conversion continue en scores Z constitue le pivot algébrique obligatoire permettant d’harmoniser ces métriques disparates.
Lors de la démarche diagnostique, qu’elle vise à objectiver un trouble neurodéveloppemental, une détérioration mnésique d’étiologie neurodégénérative ou, à l’inverse, une précocité intellectuelle (haut potentiel cognitif), l’appréciation du degré de déviation normative est indispensable. Un neuropsychologue confronté à une batterie comportant des scores bruts hétérogènes (temps d’évocation lexicale, nombre d’omissions au test d’attention soutenue, nombre d’erreurs persévératives au Wisconsin Card Sorting Test) convertit systématiquement ces valeurs en scores Z. La transformation subséquente de ces scores Z en percentiles permet ensuite de synthétiser le profil fonctionnel de l’individu sous une modalité unifiée, directement compréhensible lors de la restitution des bilans interdisciplinaires avec les équipes médicales et pédagogiques.
2. Compréhension du concept de percentile dans l’évaluation psychologique
2.1 Définition et propriétés des rangs percentiles
Sur le plan opérationnel, un rang percentile $k$ désigne la valeur sur une échelle d’évaluation en dessous de laquelle se classe un pourcentage $k$ d’observations de la population de référence. Dès lors qu’un sujet se positionne au 84e percentile, cela signifie que 84 % des individus composant la population d’étalonnage affichent un rendement inférieur ou égal au sien, tandis que 16 % manifestent un rendement supérieur. Cette modélisation s’appuie sur une structure strictement ordinale : elle classe les sujets les uns par rapport aux autres sans postuler que la distance métrique séparant deux percentiles adjacents demeure constante le long de la distribution.
La caractéristique mathématique la plus déterminante des rangs percentiles réside dans leur non-linéarité fondamentale lorsqu’ils sont projetés sur une distribution normale. La fonction de densité de Gauss possède une configuration en cloche, caractérisée par une concentration massive de la masse de probabilité autour du mode (qui coïncide avec la moyenne et la médiane). En conséquence, une faible variation en termes de score Z au centre de la courbe engendre un déplacement considérable en termes de percentiles. À l’inverse, vers les extrémités (les « queues » de la distribution), une variation substantielle du score Z ne produit qu’une modification infinitésimale du percentile. Ce phénomène de compression périphérique et de dispersion centrale interdit formellement de concevoir le percentile comme une échelle d’intervalles constants.
2.2 Interprétation quantitative et seuils d’importance clinique
Dans la pratique neuropsychologique et diagnostique standardisée, l’interprétation des performances fait appel à des conventions statistiques rigoureuses déterminant les zones de normalité, de fragilité et d’atypicité clinique avérée. L’analyse des propriétés de l’intégrale de Gauss permet d’identifier des seuils pivots :
- Zone de normalité moyenne : Comprise traditionnellement entre $z = -1,00$ et $z = +1,00$, cette plage englobe environ 68,26 % de la population générale, ce qui se traduit par des rangs percentiles s’étalant du 15,87e au 84,13e percentile. Tout score s’inscrivant dans cet intervalle est qualifié de moyen ou typique.
- Zone limite ou de vigilance : Située généralement entre $z = -1,00$ et $z = -1,65$ (du 15,87e au 5e percentile) ou jusqu’à $z = -2,00$ selon les nomenclatures nosographiques, cette zone signale une performance modérément affaiblie nécessitant une surveillance attentive.
- Zone d’atypicité clinique (déficit significatif) : Définie usuellement par un score $z le -2,00$, elle ne correspond qu’à 2,28 % de la population générale (le 2,28e percentile). Dans de nombreux systèmes de classification (comme le DSM-5 pour le diagnostic du trouble du développement intellectuel), l’obtention d’un résultat situé à deux écarts-types sous la moyenne sur des mesures standardisées constitue l’un des critères psychométriques requis pour poser un diagnostic de sévérité.
L’utilisation de ces seuils impose néanmoins une grande prudence quant au risque inhérent de faux positifs, particulièrement lors de l’administration de protocoles composites comprenant de multiples sous-tests intercorrélés.
2.3 Limites inhérentes à l’usage des percentiles sans le score Z sous-jacent
Bien que le percentile constitue une métrique de communication exceptionnelle par son accessibilité intuitive, son usage exclusif en recherche ou en analyse clinique quantitative présente des biais méthodologiques majeurs. Le premier de ces écueils réside dans l’interdiction mathématique d’effectuer des opérations arithmétiques directes sur des percentiles. En raison de la non-linéarité précédemment démontrée, il est rigoureusement non valide de calculer la moyenne arithmétique de trois percentiles pour déterminer le niveau moyen d’un individu dans un domaine cognitif. Faire la moyenne entre le 50e et le 90e percentile ne correspond pas mathématiquement au 70e percentile en termes d’unités de variance sous-jacente.
De surcroît, le percentile efface l’ampleur exacte des écarts interindividuels dans les zones extrêmes de la distribution. La distance statistique réelle qui sépare un score $z = -3,00$ (0,13e percentile) d’un score $z = -2,00$ (2,28e percentile) est d’un écart-type complet, soit une différence de magnitude similaire à celle qui sépare un score $z = 0$ (50e percentile) d’un score $z = +1,00$ (84e percentile). Pourtant, sur l’échelle des percentiles, la première différence ne paraît être que de 2,15 points de pourcentage, alors que la seconde s’élève à 34 points de pourcentage. Pour toute modélisation statistique avancée, prédiction actuarielle ou analyse de régression, le maintien du score Z sous-jacent est donc impératif.
3. Présentation de l’environnement statistique de la calculatrice TI-84
3.1 Architecture logicielle de la TI-84 pour le calcul de probabilités
La gamme des calculatrices graphiques TI-84 (incluant la TI-84 Plus, la TI-84 Plus Silver Edition et les déclinaisons modernes TI-84 Plus CE dotées d’écrans rétroéclairés haute résolution) repose sur une architecture matérielle pilotée par les microprocesseurs de la série Zilog Z80 ou eZ80. Au sein de son système d’exploitation propriétaire, Texas Instruments a implémenté un sous-système de calcul dédié aux mathématiques probabilistes et aux statistiques inférentielles d’une robustesse éprouvée. Ce module traite les lois de probabilité discrètes (binomiale, poissonienne, géométrique) et continues (normale, de Student, de Fisher-Snedecor, du Chi-deux).
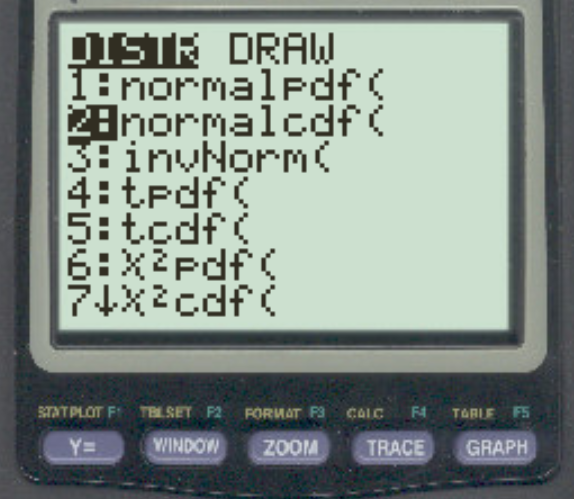
L’accès à ces fonctionnalités s’opère par l’intermédiaire du menu matériel DISTR (accessible en exécutant la séquence de frappe [2nd] puis [VARS]). Ce menu structure les commandes statistiques selon trois typologies fonctionnelles : les fonctions de densité de probabilité (suffixées par pdf pour probability density function), les fonctions de répartition cumulée (suffixées par cdf pour cumulative distribution function), et les fonctions de quantification inverse (préfixées par inv). L’évaluation des intégrales continues sur la TI-84 s’appuie sur des algorithmes d’approximation polynomiale de Tchebychev et des séries de fractions continues de haute précision, garantissant un résultat exact jusqu’à au moins 10 à 12 chiffres significatifs, ce qui surpasse largement les exigences habituelles de la psychométrie appliquée.
3.2 Distinction technique entre normalpdf, normalcdf et invNorm
L’une des sources de confusion les plus fréquentes chez les néophytes manipulant l’environnement TI-84 réside dans le choix erroné de la fonction de calcul dans le sous-menu DISTR. Il est essentiel de distinguer précisément le rôle mathématique de chacune des trois fonctions dédiées à la loi normale :
| Fonction TI-84 | Désignation mathématique | Objet du calcul produit | Applicabilité pour les percentiles |
|---|---|---|---|
| normalpdf( | Densité de probabilité $phi(x)$ | Calcule l’ordonnée (la hauteur de la courbe) pour une abscisse précise. Ne calcule aucune probabilité surfacique. | Inapplicable (la probabilité d’un point continu isolé est rigoureusement nulle). |
| normalcdf( | Répartition cumulative $Phi(x)$ | Calcule l’intégrale définie (aire sous la courbe) entre une borne inférieure et une borne supérieure. | Fonction exclusive requise pour le calcul d’un rang percentile. |
| invNorm( | Fonction quantile $\Phi^{-1}(p)$ | Prend en entrée une aire cumulative (probabilité) et retourne le score Z correspondant. | Opération réciproque (utile pour trouver un score Z à partir d’un percentile). |
L’usage exclusif de la commande normalcdf pour la recherche d’un percentile découle directement de la définition probabiliste : le percentile étant une aire cumulée s’étendant depuis l’extrême gauche de la courbe ($-\infty$) jusqu’au score considéré $z$, seule une fonction d’intégration numérique cumulative permet de quantifier cette proportion.
4. La fonction normalcdf : Syntaxe et paramètres fondamentaux
4.1 Syntaxe formelle de l’instruction normalcdf
La commande normalcdf accepte jusqu’à quatre arguments séparés par des virgules dans sa syntaxe interne brute. La signature universelle de l’instruction se décline comme suit :
normalcdf(lower_bound, upper_bound, [μ], [σ])
Dans ce formalisme algorithmique :
lower_bound: correspond à la limite inférieure de l’intervalle d’intégration le long de l’axe des abscisses.upper_bound: correspond à la limite supérieure de cet intervalle d’intégration.μ(paramètre optionnel) : désigne l’espérance mathématique (la moyenne) de la distribution normale considérée. Sa valeur par défaut dans le système est $0$.σ(paramètre optionnel) : représente l’écart-type de la population. Sa valeur par défaut dans le système est $1$.
Lorsque le praticien travaille directement sur des scores Z — qui sont, par construction méthodologique, déjà centrés et réduits —, il peut omettre les paramètres $\mu$ et $\sigma$ sur la ligne de commande, le processeur affectant automatiquement les valeurs canoniques $\mu = 0$ et $\sigma = 1$. Toutefois, que l’on utilise l’interface directe en ligne de commande ou l’assistant interactif (Stat Wizards), l’omission ou la saisie explicite de $(0, 1)$ aboutit à un résultat strictement identique.
4.2 Gestion de la borne inférieure pour le calcul du percentile standard
L’évaluation mathématique d’un percentile requiert l’intégration de la fonction de densité de $-\infty$ jusqu’au score Z ciblé. Les systèmes de calcul numérique à virgule flottante ne pouvant pas traiter l’infini formel comme une grandeur computationnelle directe, il est nécessaire d’assigner à la borne inférieure (lower_bound) une valeur numérique arbitrairement négative et suffisamment éloignée du centre pour que l’aire résiduelle omise soit mathématiquement indétectable par la machine.
Dans la littérature pédagogique et appliquée relative aux calculatrices Texas Instruments, deux conventions coexistent :
- La convention abrégée : Saisie de la valeur
-99. Sur une distribution $\mathcal{N}(0, 1)$, se situer à 99 écarts-types sous la moyenne place le point à une distance phénoménale du centre. L’aire sous la courbe normale située à gauche de $z = -99$ est de l’ordre de $10^{-2130}$, ce qui excède largement les capacités d’affichage de la machine (bornées à $10^{-99}$) et garantit une précision absolue sur l’ensemble des décimales visibles. - La convention scientifique rigoureuse : Saisie de la valeur
-1E99(obtenue en combinant le signe négatif, le chiffre 1 et la touche de notation exponentielle[EE]). Cette notation représente mathématiquement $-1 \times 10^{99}$, soit la borne inférieure absolue de la mémoire à virgule flottante de la TI-84.
Ces deux approches aboutissent rigoureusement au même résultat pratique pour le calcul de percentiles psychométriques. L’erreur d’approximation numérique induite par l’usage de -99 au lieu de $-\infty$ est de 0,000000000000 %, rendant la distinction purement académique dans le cadre d’une application pratique.
4.3 Conversion du résultat décimal de probabilité en percentile formel
Lors de l’exécution de la commande normalcdf(-1E99, z, 0, 1), le processeur de la TI-84 renvoie un nombre réel décimal compris dans l’intervalle ouvert $]0, 1[$. Par exemple, pour un score $z = 0$, la machine affiche 0.5. Ce résultat constitue la probabilité d’occurrence cumulée $P(Z le z)$.
Pour transformer cette probabilité brute en rang percentile standardisé, le calcul nécessite une multiplication par 100 :
$$\text{Percentile} = P \times 100$$
Sur le plan des directives de transcription psychométrique (normes APA), le niveau de précision requis pour le compte rendu d’un percentile dépend de sa position sur la distribution et de la finalité du bilan :
- Dans la zone centrale de la distribution (entre le 5e et le 95e percentile), la pratique universelle prescrit un arrondi à l’entier le plus proche (par exemple, une probabilité de $0,7123$ se transcrit par « 71e percentile ») ou, au maximum, à une décimale unique ($71,2$e).
- Aux extrêmes de la distribution (en deçà du 5e percentile ou au-delà du 95e percentile), l’arrondi à l’entier supprime une information clinique critique. Par exemple, un score situé au 0,2e percentile traduit un déficit bien plus marqué qu’un score au 2e percentile. La préservation de deux décimales devient alors indispensable pour éviter d’assimiler faussement une performance atypique à une pathologie sévère ou à un résultat nul.
5. Procédure détaillée pas à pas : Accéder et exécuter la fonction sur TI-84
5.1 Accès séquentiel aux commandes via le clavier matériel
L’accès aux routines statistiques de la loi normale sur les calculatrices de la famille TI-84 fait appel à une séquence opératoire matérielle standardisée. Il convient de respecter scrupuleusement l’ordre de manipulation suivant :
- Allumer l’appareil en appuyant sur la touche
[ON]située à l’angle inférieur gauche du clavier matériel. Si la calculatrice est déjà active sur un écran graphique ou une table de données, appuyer préalablement sur[2nd]puis[QUIT](associé à la touche[MODE]) afin de revenir à l’écran de calcul principal (Home Screen). - Appuyer sur la touche jaune ou bleue
[2nd](située en haut à gauche sous l’écran). Cette action active les fonctions secondaires des touches physiques. - Appuyer sur la touche
[VARS](localisée sur la troisième rangée de touches, sous les flèches directionnelles). Au-dessus de cette touche figure en lettres capitales colorées l’inscriptionDISTR. La pression combinée ouvre le menuDISTR(Distributions). - Dans la liste déroulante numérotée qui apparaît à l’écran, observer la disposition des commandes :
1: normalpdf(2: normalcdf(3: invNorm(
- Pour sélectionner la seconde commande, presser directement la touche numérique
[2]ou utiliser la flèche directionnelle vers le bas[▼]pour mettre en surbrillance l’item2: normalcdf(, puis valider en appuyant sur la touche[ENTER].
5.2 Saisie des paramètres dans l’interface Stat Wizards
Sur les calculatrices TI-84 dotées d’un système d’exploitation moderne (OS 2.55MP et versions ultérieures pour la TI-84 Plus, ou toutes versions de la TI-84 Plus CE), l’activation de la commande déclenche l’affichage d’un formulaire de saisie guidé nommé Stat Wizards. Ce menu interactif présente quatre champs de saisie consécutifs :
- lower : Ce champ accueille la borne inférieure. Si le champ contient une valeur préexistante (souvent
-1E99par défaut sur les systèmes récents), on peut la conserver. Si le champ est vierge ou erroné, saisir la négation unaire via la touche[(-)](attention, ne pas utiliser la touche de soustraction[-]), puis taper99ou bien1suivi de[2nd][,](qui affiche la lettre typographique majusculeE) puis99. - upper : Déplacer le curseur vers le bas à l’aide de la touche
[▼]. Taper ici la valeur exacte du score Z à analyser (par exemple1.44ou-0.85en utilisant impérativement la touche du point décimal[.]). - μ : Descendre au champ suivant. S’assurer que la valeur affichée est
0. Si une autre valeur est présente, la remplacer par0. - σ : Descendre au champ suivant. S’assurer que la valeur affichée est
1. Si une autre valeur est présente, la remplacer par1. - Paste : Descendre avec la flèche
[▼]sur l’optionPaste, puis presser la touche[ENTER]. L’assistant convertit les paramètres saisis sous la forme d’une ligne d’instruction syntaxique et la colle directement sur l’écran de calcul principal sans l’exécuter immédiatement. Il suffit alors de presser une ultime fois[ENTER]pour déclencher le calcul de l’intégrale numérique.
5.3 Exécution manuelle en ligne de commande (mode non-Wizard)
Sur les modèles de TI-84 Plus plus anciens ou lorsque le mode Stat Wizards est volontairement désactivé (option WIZARD OFF dans le menu [MODE]), la sélection de l’instruction 2: normalcdf( colle immédiatement le libellé textuel normalcdf( sur l’écran principal, sans afficher de formulaire intermédiaire. L’utilisateur doit dès lors saisir manuellement les arguments selon une syntaxe rigoureuse :
- Après la parenthèse ouvrante générée automatiquement
normalcdf(, taper la borne inférieure : presser la touche de négation[(-)]puis saisir99. - Insérer la virgule typographique de séparation des arguments en pressant la touche virgule
[,](située au centre du clavier matériel, immédiatement au-dessus de la touche numérique[7]). - Saisir la borne supérieure, correspondant à la valeur du score Z. S’il s’agit d’une valeur négative, précéder obligatoirement le nombre par la touche
[(-)]. - Insérer une nouvelle virgule en pressant
[,]. - Taper
0pour la moyenne, suivi d’une virgule[,], puis1pour l’écart-type. (Note méthodologique : Comme précisé précédemment, la saisie de,0,1est facultative en ligne de commande pure ; l’instructionnormalcdf(-99, Z)sera interprétée par défaut avec $\mu = 0$ et $\sigma = 1$). - Fermer la syntaxe en pressant la touche de parenthèse fermante
[)](située au-dessus de la touche[9]). Bien que le moteur d’interprétation de la TI-84 tolère l’omission de la parenthèse finale avant l’exécution, sa fermeture constitue une bonne pratique pour prévenir d’éventuels conflits d’opérateurs dans des formules composites. - Exécuter le calcul en pressant la touche
[ENTER].
6. Détermination du percentile pour un score Z négatif : Méthode et cas pratique
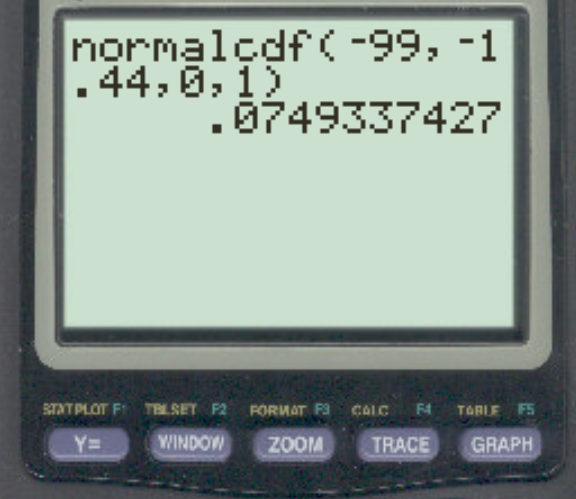
6.1 Résolution pas à pas pour un score Z = -1,44
Afin de concrétiser le protocole algorithmique, considérons l’évaluation d’un sujet obtenant un score standardisé $z = -1,44$ lors d’une épreuve standardisée de flexibilité mentale. L’objectif consiste à déterminer la probabilité cumulée $P(Z le -1,44)$, c’est-à-dire l’intégrale définie suivante :
$$\Phi(-1,44) = \int_{-\infty}^{-1,44} \frac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}} , dt$$
La transcription pas à pas de cette requête mathématique sur la TI-84 s’articule comme suit :
- Accéder au menu :
[2nd][VARS]$\rightarrow$2: normalcdf(. - Dans l’interface Wizard :
- Renseigner
lower:-99 - Renseigner
upper:-1.44(en employant[(-)]puis[1][.][4][4]) - Vérifier
μ: 0etσ: 1 - Sélectionner
Pasteet presser[ENTER].
- Renseigner
- La ligne de commande affichée à l’écran indique rigoureusement :
normalcdf(-99,-1.44,0,1). - Appuyer sur
[ENTER]pour finaliser le traitement algorithmique. - La machine retourne la valeur décimale brute :
0.074929.... - Pour convertir ce résultat décimal en rang percentile formel, multiplier immédiatement cette grandeur par 100 : presser la touche de multiplication
[×](l’écran affiche automatiquementAns*) puis taper100et[ENTER]. Le résultat numérique produit est7.49295.... - Selon les conventions psychométriques usuelles, cette performance équivaut formellement au 7,49e percentile (ou au 7e percentile si l’on applique l’arrondi standard à l’entier).
6.2 Analyse de la position relative dans la distribution
L’obtention du 7,49e percentile pour un score $z = -1,44$ appelle une analyse géométrique et statistique immédiate. Sur la courbe de Gauss, la médiane correspond à $z = 0$ (50e percentile) et le premier écart-type négatif se situe à $z = -1,00$ (15,87e percentile). Un score de $-1,44$ s’inscrit donc profondément dans le quart inférieur gauche de la distribution.
L’explication clinique de ce résultat se formalise selon une double perspective complémentaire :
- Perspective ascendante (infériorité) : Exactement 7,49 % des sujets constituant l’échantillon normatif obtiennent un résultat identique ou inférieur à cette performance. Autrement dit, un individu affichant ce profil se situe parmi les 7,5 % les moins performants de la cohorte d’étalonnage.
- Perspective descendante (dépassement) : Par soustraction complémentaire à l’aire totale ($100 – 7,49 = 92,51$), on déduit que 92,51 % des sujets de la population de référence surpassent ce niveau de rendement.
Dans un rapport d’évaluation neuropsychologique, une telle donnée confirme la présence d’une fragilité cognitive modérée, mais qui ne satisfait pas encore formellement au critère de déficit sévère (usuellement établi au-delà de deux écarts-types, soit $z le -2,00$).
6.3 Application à un score Z sévèrement négatif (z = -2,50)
Examinons à présent le cas d’une performance sévèrement compromise, caractérisée par un score $z = -2,50$ obtenu lors d’un test d’apprentissage verbal associatif. La démarche calculatoire sur la TI-84 implique la saisie de l’expression :
normalcdf(-99, -2.5, 0, 1)
Le résultat généré par le moteur de calcul est le suivant : 0.006209.... Multiplié par 100, ce résultat correspond au 0,62e percentile. Dans cette configuration, appliquer un arrondi mécanique à l’entier le plus proche conduirait à arrondir ce score à « 1 % » ou à « 0 % », ce qui masquerait la réalité quantitative du positionnement de l’individu. Arrondir à 1 % multiplierait artificiellement par près de deux la prévalence de ce profil dans la population, tandis qu’arrondir à 0 % suggérerait l’inexistence mathématique de ce résultat.
Sur le plan psychopathologique et nosologique, un score situé au 0,62e percentile démontre une altération cognitive massive : moins de 1 % de la population normale générale (approximativement 6 individus sur 1 000) présente des résultats aussi effondrés. Ce constat corrobore une détérioration pathologique manifeste sous réserve que les critères de validité écologique et de coopération du sujet durant l’examen soient rigoureusement satisfaits.
7. Détermination du percentile pour un score Z positif : Méthode et interprétation clinique
7.1 Résolution pas à pas pour un score Z = +0,56
Considérons maintenant l’évaluation d’un score standardisé supérieur à la moyenne normative, avec $z = +0,56$, obtenu sur une échelle d’aptitude visuo-spatiale. Il s’agit de calculer la probabilité cumulative $P(Z le +0,56)$, traduisant l’aire sous la courbe normale comprise entre $-\infty$ et $+0,56$ :
- Accéder au menu des distributions :
[2nd][VARS]puis sélectionner2: normalcdf(. - Au sein de l’interface Wizard :
- Paramétrer
lower:-99 - Paramétrer
upper:0.56 - Conserver
μ: 0etσ: 1 - Descendre sur
Pasteet appuyer sur[ENTER].
- Paramétrer
- L’instruction textuelle
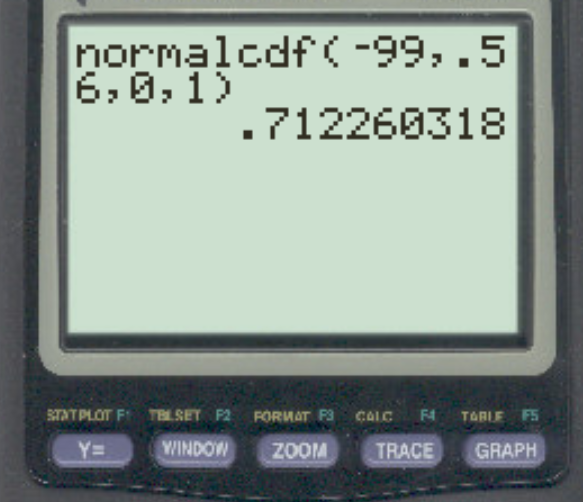
normalcdf(-99,0.56,0,1)apparaît sur l’écran principal. - Valider l’exécution en pressant la touche
[ENTER]. - Le processeur délivre la valeur décimale :
0.712260.... - En procédant à la multiplication par 100, on obtient le score ordonné de
71.226..., ce qui s’arrondit conventionnellement au 71,23e percentile (ou au 71e percentile).
7.2 Compréhension de la répartition au-dessus de la médiane
Tout score Z strictement positif ($z > 0$) implique logiquement et mathématiquement un rang percentile supérieur à 50. La décomposition géométrique de l’aire sous la courbe pour $z = +0,56$ met en lumière la structure cumulative de la mesure :
- L’intégrale de $-\infty$ à $0$ représente exactement $0,5000$ (soit 50 % de la population globale).
- L’intégrale comprise entre la moyenne $z = 0$ et le score observé $z = +0,56$ représente $0,2123$ (soit 21,23 % de la population).
- L’addition de ces deux aires ($50 % + 21,23 % = 71,23 %$) confirme que l’individu dépasse les 50 % des sujets situés sous la moyenne, auxquels s’ajoutent les 21,23 % d’individus situés entre la moyenne et son propre score.
Le pourcentage résiduel d’individus surpassant cette performance s’obtient aisément en calculant le complémentaire à 100 :
$$100 – 71,23 = 28,77%$$
Ce rendement se classe indéniablement au sein de la normalité moyenne supérieure, traduisant une intégrité cognitive totale sans pour autant constituer une performance exceptionnelle.
7.3 Application à un score Z élevé (z = +2,15)
Dans le cadre de l’évaluation de la douance cognitive, du très haut potentiel intellectuel ou de talents académiques exceptionnels, les psychométriciens traquent les scores situés dans le décile supérieur extrême. Considérons un sujet présentant un score standardisé $z = +2,15$ à l’épreuve de raisonnement fluide d’une batterie cognitive contemporaine.
La programmation sur la TI-84 de la formule :
normalcdf(-99, 2.15, 0, 1)
génère une probabilité cumulative de 0.984222..., ce qui correspond rigoureusement au 98,42e percentile. Dans ce registre d’excellence cognitive, seulement $1,58 %$ de la population d’étalonnage réalise une performance supérieure à ce niveau ($100 – 98,42 = 1,58$).
Ce résultat met en relief la grande sensibilité de la TI-84 aux variations décimales sur les extrêmes droits de la distribution : un score $z = +2,00$ correspond au 97,72e percentile, tandis qu’un score $z = +2,33$ atteint le 99,01e percentile. Cette non-linéarité prononcée justifie l’obligation d’une précision de calcul algorithmique rigoureuse, les tables papier synthétiques ne fournissant que rarement le détail des centièmes pour chaque subdivision décimale dans les zones d’extrême déviation.
8. Spécificités techniques selon les modèles de TI-84
8.1 TI-84 Plus standard versus TI-84 Plus Silver Edition
Bien que le noyau de calcul mathématique demeure fonctionnellement compatible sur l’ensemble de la gamme TI-84, des divergences d’ergonomie et de rapidité d’exécution existent entre les modèles historiques et contemporains. La TI-84 Plus classique fonctionne avec un microprocesseur Zilog Z80 cadencé à 15 MHz, disposant de 480 Ko de mémoire Flash ROM et de 24 Ko de mémoire vive RAM. La TI-84 Plus Silver Edition bénéficie quant à elle d’un processeur commutable pouvant atteindre 15 MHz mais dispose d’une mémoire Flash élargie à 1,5 Mo.
Sur le plan du traitement des scores Z, les versions de système d’exploitation antérieures à la version 2.53MP ne possédaient pas l’architecture MathPrint ni les assistants Stat Wizards. Sur ces anciens appareils, l’utilisateur est contraint d’utiliser exclusivement la saisie en ligne de commande pure normalcdf(-99, Z). Il est vivement conseillé de mettre à jour le système d’exploitation de ces unités matérielles via le logiciel utilitaire officiel TI Connect CE afin de bénéficier des derniers correctifs algorithmiques et d’accéder aux menus interactifs modernes qui réduisent considérablement les risques de coquilles d’encodage.
8.2 TI-84 Plus CE et modèles à écran couleur
L’introduction sur le marché de la TI-84 Plus CE a marqué une évolution technologique majeure pour la gamme Texas Instruments. Équipée d’un processeur eZ80 cadencé à 48 MHz et d’un écran couleur rétroéclairé d’une résolution de $320 \times 240$ pixels, la TI-84 Plus CE optimise considérablement la visualisation géométrique des concepts statistiques.
Outre la fonction de calcul numérique direct normalcdf, la TI-84 Plus CE intègre dans le sous-menu [2nd] [VARS] $\rightarrow$ DRAW un outil pédagogique et diagnostique nommé 1: ShadeNorm(. La syntaxe de cette instruction est calquée sur celle de normalcdf :
ShadeNorm(lower, upper, [μ], [σ])
Lors de son exécution, la calculatrice trace dynamiquement la courbe de Gauss sur l’écran couleur et hachure en temps réel l’aire exacte sous la courbe correspondant à l’intégrale calculée, tout en affichant au bas de l’écran la valeur de l’aire (la probabilité cumulée) ainsi que les bornes inférieure et supérieure. Cette fonctionnalité offre une validation visuelle immédiate permettant d’éviter les erreurs d’interprétation grossières (comme la confusion entre l’aire à gauche et l’aire à droite d’un score Z).
8.3 Configuration des modes de calcul généraux
Le comportement de la TI-84 lors du rendu des percentiles dépend directement du paramétrage global accessible via la touche [MODE]. Pour garantir un travail psychométrique optimal, certains réglages doivent faire l’objet d’une vérification préalable :
- Notation numérique (Normal / Sci / Eng) : Le mode
Normaldoit impérativement être sélectionné par défaut. Le passage accidentel en modeSci(scientifique) contraint l’affichage systématique de tous les résultats sous forme de puissances de dix (ex. : $7,12 \times 10^{-1}$ au lieu de $0,712$), ce qui complique inutilement la lecture des probabilités ordinaires. - Gestion des arrondis (Float) : Sur la deuxième ligne du menu
[MODE], l’optionFloatpermet de contrôler le nombre de décimales affichées. Il est recommandé de maintenir le réglage surFloatlibre (et non fixé à un nombre spécifique tel que0 1 2 3 4 5 6 7 8 9). Un verrouillage sur2décimales, par exemple, arrondirait un résultat brut de $0,0062$ à $0,01$, détruisant la précision critique nécessaire à l’évaluation des percentiles extrêmes. - Stat Wizards (ON / OFF) : Sauf impératif particulier d’évaluation académique interdisant les assistants, maintenir cette option sur
ONminimise substantiellement les inversions de syntaxe.
9. Rigueur mathématique : Analyse des valeurs limites et simulation de l’infini
9.1 Comparaison méthodologique entre -99 et -1E99
La simulation d’une borne d’intégration infinie ($-\infty$) dans un registre numérique fini soulève d’intéressantes considérations théoriques. L’analyse mathématique rigoureuse de la loi normale démontre que la fonction d’erreur associée à la queue de distribution converge vers zéro à une vitesse exponentielle régie par le facteur $e^{-z^2/2}$. Le tableau ci-dessous explicite l’amplitude des probabilités résiduelles omises en fonction de la borne inférieure adoptée :
| Borne inférieure saisie | Distance en écarts-types | Probabilité résiduelle omise $P(Z < \text{borne})$ | Incidence sur les percentiles |
|---|---|---|---|
-5 |
5 $\sigma$ | $\approx 2,86 \times 10^{-7}$ | Négligeable (erreur au millionième de %) |
-10 |
10 $\sigma$ | $\approx 7,61 \times 10^{-24}$ | Nulle à l’échelle de précision machine |
-99 |
99 $\sigma$ | $\approx 10^{-2130}$ | Totalement nulle (dépasse la capacité physique d’adressage) |
-1E99 |
$10^{99}$ $\sigma$ | Strictement $0$ dans le compilateur | Borne physique absolue de la TI-84 |
Ce tableau démontre que le choix pédagogique standard de -99 offre une garantie absolue de fidélité numérique : l’omission d’une fraction d’aire de l’ordre de $10^{-2130}$ est strictement équivalente à zéro pour l’ensemble des registres décimaux gérés par le processeur arithmétique de la calculatrice. L’avantage méthodologique de -1E99 réside principalement dans l’élégance de sa rigueur mathématique, car elle correspond à la plus petite valeur flottante adressable par le bus de données de l’appareil.
9.2 Impact sur la précision des décimales critiques
Un examen comparatif exécuté sur un microprocesseur de TI-84 Plus CE confirme que le calcul de :
normalcdf(-99, -2, 0, 1)
et le calcul de :
normalcdf(-1E99, -2, 0, 1)
retournent une chaîne numérique strictement indiscernable sur l’écran : 0.0227501319. La divergence mathématique théorique entre les deux approches n’intervient qu’au-delà de la milliardième décimale, soit infiniment plus loin que le dixième ou le centième de percentile utilisé dans les rapports cliniques ou les thèses doctorales. Néanmoins, pour des modélisations de distributions théoriques à queues épaisses ou lors de l’application de transformations non-linéaires complexes, l’emploi de -1E99 demeure la convention académique formellement recommandée.
9.3 Calcul de probabilités entre deux scores Z
La fonction normalcdf ne se cantonne pas au calcul unilatéral des percentiles depuis $-\infty$. Sa polyvalence autorise la détermination immédiate du pourcentage de la population s’inscrivant entre deux bornes normatives quelconques, modélisée par l’intégrale :
$$P(z_1 le Z le z_2) = \int_{z_1}^{z_2} \frac{1}{\sqrt{2\pi}} e^{-\frac{t^2}{2}} , dt = \Phi(z_2) – \Phi(z_1)$$
Cette approche s’avère particulièrement utile pour évaluer la proportion d’individus situés au sein de tranches de classification psychométrique spécifiques. Par exemple, pour quantifier le pourcentage exact de sujets se situant dans la « moyenne faible » ou zone limite (comprise rigoureusement entre $z = -2,00$ et $z = -1,00$), il suffit de renseigner :
normalcdf(-2, -1, 0, 1)
La machine délivre instantanément le résultat décimal 0.135905..., démontrant sans équivoque que 13,59 % de la population générale s’établit dans cet intervalle de performance. De manière analogue, le calcul du pourcentage de sujets s’inscrivant dans la zone de normalité centrale ($z$ compris entre $-1,00$ et $+1,00$) s’effectue via normalcdf(-1, 1, 0, 1), retournant les célèbres 0.682689... (soit 68,27 %).
10. Diagnostic et résolution des erreurs fréquentes sur la TI-84
10.1 Confusion entre le signe moins de soustraction et le signe négatif
L’erreur la plus récurrente rencontrée par les utilisateurs non avertis de la TI-84 lors de la saisie d’un score Z négatif ou de la borne d’intégration inférieure est le déclenchement de l’interruption logicielle :
ERR:SYNTAX
Cette défaillance provient de la distinction fondamentale opérée par l’architecture Texas Instruments entre deux touches du clavier matériel qui partagent le même symbole graphique dans l’écriture manuscrite :
- La soustraction binaire
[-]: Située sur la colonne de droite au-dessus de l’addition, cette touche matérialise l’opérateur arithmétique de soustraction liant deux grandeurs ($A – B$). Si l’utilisateur tapenormalcdf(-99, ...)en employant cette touche pour amorcer le nombre-99, le processeur interprète l’instruction comme une soustraction dépourvue de premier opérande, ce qui invalide l’analyse lexicale. - La négation unaire
[(-)]: Située sur la rangée inférieure, à gauche de la touche[ENTER]. Cette touche associe le signe de négativité au nombre qui lui succède immédiatement sans exécuter d’opération binaire.
Pour résoudre cette erreur, lors de l’apparition de l’écran ERR:SYNTAX, sélectionner l’option 2:Goto. Le système replace alors immédiatement le curseur clignotant sur le caractère fautif, permettant de substituer le tiret de soustraction par le véritable signe négatif [(-)].
10.2 Inversion involontaire des bornes inférieure et supérieure
Une anomalie procédurale classique consiste à inverser l’ordre des arguments dans la commande, en renseignant par exemple :
normalcdf(1.5, -99, 0, 1)
Sur le plan mathématique, l’intégration de la borne $b$ à la borne $a$ (avec $a < b$) s'avère être l'opposée de l'intégrale orientée conventionnelle de $a$ à $b$. Toutefois, l'algorithme interne de Texas Instruments a été programmé pour parer à cette incohérence géométrique : face à une inversion explicite, la TI-84 retourne une valeur strictement égale à 0 (ou dans certains cas un résultat aberrant lié à l'inversion d'orientation d'intégration).
Une variante plus subtile de cette inversion consiste à saisir le score Z en borne inférieure et la valeur $+99$ en borne supérieure, par exemple normalcdf(0.56, 99, 0, 1). Dans ce cas, la machine calcule l’intégrale cumulée de la queue supérieure, c’est-à-dire la probabilité de dépassement $P(Z ge 0,56)$, qui est égale à $0,2877$ (28,77 %). L’analyste qui confond ce résultat avec le percentile commet une erreur d’interprétation majeure en attribuant un rang du 28e percentile à un sujet qui se classe en réalité au 71e percentile. La règle cardinale demeure immuable : pour trouver un percentile, la borne inférieure doit toujours être la simulation de $-\infty$ (soit -99).
10.3 Paramétrage erroné de la moyenne et de l’écart-type
Une autre source d’artefacts calculatoires découle de la rémanence de paramètres statistiques personnalisés au sein de la fonction normalcdf. Lorsqu’un utilisateur travaille consécutivement sur des données brutes (non standardisées) ayant une moyenne $\mu = 100$ et un écart-type $\sigma = 15$ (comme les indices de QI), ces valeurs peuvent demeurer enregistrées dans les champs du menu Stat Wizards.
Si l’analyste saisit ultérieurement un score Z (par exemple $z = 1,00$) tout en conservant par mégarde les paramètres résiduels $\mu = 100$ et $\sigma = 15$, la commande exécutée devient :
normalcdf(-99, 1, 100, 15)
Le processeur calcule alors la probabilité d’obtenir un score brut inférieur ou égal à 1 sur une distribution dont la moyenne est de 100 avec un écart-type de 15. Le résultat retourné sera un nombre infinitésimal de l’ordre de $10^{-11}$, laissant faussement croire que le percentile associé est virtuellement nul. Une vérification systématique s’impose : dès lors que la valeur saisie dans le champ upper est une cote Z, les champs $\mu$ et $\sigma$ doivent être respectivement configurés sur 0 et 1.
11. Applications empiriques en recherche psychologique et neuropsychologie
11.1 Conversion des scores z d’épreuves cognitives en rangs normatifs
L’utilité clinique de la TI-84 se révèle pleinement lors de l’analyse conjointe d’un profil neuropsychologique complexe. Prenons l’exemple d’un patient de 45 ans reçu en consultation à la suite d’un traumatisme crânien, chez qui l’on administre l’épreuve de mémoire de travail arithmétique. Le score brut obtenu, après étalonnage selon les tables normatives stratifiées par âge et niveau d’études, génère un score standardisé $z = -1,15$.
L’introduction des données sur la calculatrice via l’instruction :
normalcdf(-99, -1.15, 0, 1)
fournit une probabilité cumulée de 0.12507..., soit le 12,51e percentile. Dans le compte-rendu d’évaluation neuropsychologique destiné au médecin prescripteur et à la famille du patient, le clinicien traduit cette métrique avec précision :
« Les capacités de manipulation mentale active d’informations numériques chez le patient se positionnent au 12,5e percentile. Ce rendement indique qu’environ 87,5 % des individus du même groupe d’âge et de formation académique comparable manifestent des compétences supérieures dans cette modalité d’évaluation. Ce niveau de performance s’inscrit dans la zone de fragilité modérée, sans atteindre le seuil pathologique avéré. »
Cette approche permet en outre d’articuler aisément ce score Z avec d’autres échelles de notation standards employées en psychopathologie, telles que l’échelle T de McCall ($T = 50 + 10z$, où un $z = -1,15$ correspond à un score $T = 38,5$) ou l’échelle des stanines.
11.2 Exploitation dans les profils de dispersion intra-individuelle
En pratique clinique avancée, l’évaluation isole rarement un score de manière décontextualisée. Le diagnostic différentiel — par exemple entre une variante comportementale de démence fronto-temporale et une maladie d’Alzheimer au stade prodromal — repose sur la mise en évidence d’une « dissociation » fonctionnelle entre plusieurs processus cognitifs au sein du même sujet (analyse de dispersion intra-individuelle).
Supposons qu’un même patient obtienne :
- En mémoire épisodique verbale (rappel libre différé) : un score $z = -2,20$. Sur la TI-84,
normalcdf(-99, -2.20, 0, 1)$\rightarrow$ 1,39e percentile. - En raisonnement perceptif visuel abstrait : un score $z = +0,85$. Sur la TI-84,
normalcdf(-99, 0.85, 0, 1)$\rightarrow$ 80,23e percentile.
La confrontation de ces deux percentiles dérivés objective immédiatement un écart de dispersion massif : le fonctionnement mnésique du patient se classe parmi les 1,4 % les plus détériorés de la population d’étalonnage, tandis que ses fonctions de logique visuo-spatiale surpassent plus de 80 % de cette même population. Cet écart inter-fonctions de plus de trois écarts-types ($|\Delta z| = 3,05$) exclut l’hypothèse d’une baisse globale et non spécifique du rendement psychologique (qui découlerait d’une anxiété d’évaluation ou d’un manque d’effort) et signe une dissociation cognitive hautement pathognomonique en faveur d’une atteinte mnésique sélective.
11.3 Conformité avec les directives psychométriques internationales
L’utilisation de la calculatrice TI-84 pour déterminer les percentiles doit s’inscrire dans le respect scrupuleux des standards méthodologiques édictés par les sociétés savantes internationales, au premier rang desquelles l’APA et la Commission internationale des tests (ITC). Ces organismes prescrivent la plus grande transparence quant aux outils de dérivation mathématique exploités dans les publications scientifiques et les dossiers cliniques.
Lors de la rédaction des sections méthodologiques de travaux de recherche empirique, l’auteur ne peut se contenter d’affirmer que « les percentiles ont été dérivés des scores Z ». Les directives actuelles préconisent de documenter :
- L’algorithme de conversion utilisé (en l’espèce, l’intégration numérique de la fonction de répartition cumulative normale $\mathcal{N}(0, 1)$).
- Le matériel et l’environnement logiciel mobilisés (par exemple : calculatrice graphique TI-84 Plus CE, OS version 5.6).
- La politique de traitement des arrondis appliquée systématiquement (par exemple : conservation de deux décimales pour les percentiles extrêmes $P 95$, arrondi à l’entier le plus proche pour l’intervalle intermédiaire).
Cette rigueur méthodologique garantit la parfaite reproductibilité des calculs statistiques par des évaluateurs indépendants, un impératif éthique et scientifique au cœur des bonnes pratiques de l’évaluation psychométrique contemporaine.
12. Validation des résultats de la TI-84 : Comparaisons avec les tables z et les logiciels statistiques
12.1 Confrontation avec les tables statistiques traditionnelles
Pendant des décennies, les statisticiens et psychologues ont été tributaires des tables papier de la loi normale centrée réduite imprimées en annexe des manuels universitaires. Une table statistique conventionnelle fournit l’aire sous la courbe normale pour des valeurs de $z$ échelonnées de centième en centième (par pas de 0,01). La comparaison entre ces tables statiques et le moteur numérique de la TI-84 met en lumière la supériorité opérationnelle manifeste de la calculatrice :
- Résolution du biais d’interpolation : Lorsqu’un score standardisé présente une précision excédant deux décimales (par exemple $z = 1,446$), la lecture d’une table imprimée classique impose de recourir à une interpolation linéaire manuelle fastidieuse entre la valeur de $z = 1,44$ et $z = 1,45$. Or, la fonction de Gauss étant strictement non-linéaire, l’interpolation linéaire introduit une erreur d’approximation inhérente. La TI-84 calcule quant à elle directement l’intégrale analytique pour la valeur exacte $1,446$, retournant sans approximation intermédiaire
0.925925...(92,59e percentile). - Élimination des erreurs de parallaxe et de typographie : La manipulation manuelle de tables denses imprimées sur de multiples colonnes génère un risque majeur d’erreur de lecture visuelle (confusion de lignes ou de colonnes), écueil totalement écarté par la programmation séquentielle de la TI-84.
12.2 Validation croisée avec les environnements logiciels modernes (R, SPSS, Python)
Afin d’attester de la validité de calcul de la TI-84, il est pertinent de confronter ses résultats aux standards computationnels déployés dans les progiciels statistiques de référence utilisés dans les laboratoires universitaires et l’industrie biostatistique. Considérons le cas d’un score standardisé $z = -1,644853$ (correspondant théoriquement au seuil unilatéral alpha de 5 %).
Examinons les instructions équivalentes au sein des principaux écosystèmes contemporains :
- Sous langage de programmation R :
L’instruction native d’intégration cumulative normale estpnorm(). L’exécution de la commande :
pnorm(-1.6448536, mean = 0, sd = 1) * 100
retourne :4.999999...(soit exactement le 5e percentile). - Sous IBM SPSS Statistics :
Au sein de la syntaxe de transformation de variables, l’évaluation fait appel à la fonctionCDF.NORMAL:
COMPUTE Percentile = CDF.NORMAL(-1.6448536, 0, 1) * 100.
Le résultat stocké dans la matrice est strictement de 5,000. - Sous Python (bibliothèque SciPy) :
Dans l’environnement scientifique Python, la modélisation statistique s’appuie sur le sous-modulescipy.stats:
from scipy import stats
stats.norm.cdf(-1.6448536, 0, 1) * 100
Le compilateur retourne4.999999999999999. - Sur calculatrice TI-84 :
La saisie denormalcdf(-99, -1.6448536, 0, 1) * 100retourne sur l’écran LCD :
5.0000003....
Cette concordance démontre une équivalence numérique quasi parfaite entre le processeur embarqué de la TI-84 et les bibliothèques d’analyse de données les plus pointues du monde scientifique contemporain.
12.3 Synthèse procédurale et guide de référence rapide pour l’utilisateur
Pour accompagner le praticien ou l’étudiant dans sa démarche d’évaluation au quotidien, la synthèse suivante récapitule de manière condensée et univoque l’ensemble des règles opératoires à appliquer sur la calculatrice TI-84 :
| Objectif psychométrique visé | Syntaxe TI-84 à exécuter | Traitement du résultat brut affiché |
|---|---|---|
| Trouver le percentile d’un score Z | normalcdf(-99, Z, 0, 1) |
Multiplier par 100. Arrondir à l’entier le plus proche (ou à 2 décimales si $Z le -2$ ou $Z ge +2$). |
| Trouver le pourcentage de dépassement ($P > Z$) | normalcdf(Z, 99, 0, 1) |
Multiplier par 100. Indique le pourcentage de la population surpassant ce score. |
| Pourcentage entre deux scores ($Z_1$ et $Z_2$) | normalcdf(Z1, Z2, 0, 1) |
Multiplier par 100. Indique la proportion de la population située entre ces deux seuils. |
| Retrouver un score Z depuis un percentile (Inverse) | invNorm(Percentile / 100, 0, 1) |
Fournit directement le score Z correspondant sur l’échelle continue. |
Avant toute validation définitive d’un rapport psychologique ou statistique fondé sur des calculs réalisés sur TI-84, il est vivement conseillé de passer en revue la liste de contrôle suivante :
- [ ] La borne inférieure utilisée est-elle bien
-99ou-1E99, précédée de la négation unaire[(-)]et non de la soustraction[-]? - [ ] Les paramètres de distribution sont-ils scrupuleusement paramétrés sur $\mu = 0$ et $\sigma = 1$ ?
- [ ] Le score décimal produit par la machine a-t-il bien été multiplié par 100 avant d’être formulé en tant que percentile ?
- [ ] La cohérence clinique globale est-elle validée (un score Z négatif donne impérativement un percentile inférieur à 50 ; un score Z positif donne obligatoirement un percentile supérieur à 50) ?
La maîtrise de ces protocoles garantit une exploitation rigoureuse, rapide et exempte de tout biais computationnel de la calculatrice TI-84, érigeant cet outil technologique en allié méthodologique pérenne pour l’ensemble des praticiens de la mesure humaine.
Références
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for Educational and Psychological Testing. American Educational Research Association. https://www.apa.org/science/programs/testing/standards
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Grégoire, J. (2019). L’évaluation clinique de l’intelligence de l’adulte : Pratique du WAIS-IV. Mardaga.
- Hart, J. F., Cheney, E. W., Lawson, C. L., Maehly, H. J., Mesztenyi, C. K., Rice, J. R., Thacher, H. C., & Witzgall, C. (1968). Computer Approximations. John Wiley & Sons.
- Howell, D. C. (2016). Méthodes statistiques en sciences humaines (M. Rogier, Trad. ; 3e éd.). De Boeck Supérieur.
- International Test Commission. (2014). ITC Guidelines on Quality Control in Scoring, Test Analysis, and Reporting of Test Scores. International Journal of Testing, 14(3), 195–217. https://doi.org/10.1080/15305058.2014.918042
- Lezak, M. D., Howieson, D. B., Bigler, E. D., & Tranel, D. (2012). Neuropsychological Assessment (5th ed.). Oxford University Press.
- Texas Instruments. (2020). Guide de référence pour la technologie graphique TI-84 Plus CE. Texas Instruments Incorporated. https://education.ti.com
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV) Administration and Scoring Manual. Pearson.