
Dans le champ de l’analyse quantitative et de la modélisation statistique appliquée aux sciences humaines, la détermination précise de la significativité d’un résultat constitue le pivot de la démarche inférentielle. Lorsque les chercheurs s’interrogent sur la véracité d’une différence observée entre deux conditions expérimentales ou sur la conformité d’une moyenne échantillonnale à une norme théorique, la distribution t de Student s’impose comme l’outil mathématique par excellence. Conçue pour pallier les déficiences intrinsèques de la loi normale lorsque la variance de la population demeure inconnue et que les effectifs observés sont restreints, cette loi probabiliste continue structure une part prépondérante des tests d’hypothèses contemporains.
Toutefois, en dépit de l’omniprésence des progiciels de traitement de données qui automatisent le calcul numérique, la maîtrise intellectuelle de la lecture de la table de distribution t demeure une compétence méthodologique fondamentale. Comprendre les mécanismes sous-jacents qui permettent d’extraire ou d’encadrer une p-valeur à partir d’une table imprimée ne relève pas d’un anachronisme pédagogique, mais d’une exigence épistémologique. Cette démarche offre au chercheur et au praticien une vision transparente de la géométrie de la décision statistique, démystifiant la nature de la p-valeur en la reliant directement aux surfaces délimitées sous la courbe de densité de probabilité.
Le présent guide a pour vocation de détailler, de manière exhaustive et didactique, l’ensemble des étapes nécessaires pour localiser, encadrer et interpréter la p-valeur au moyen de la table de Student. En explorant ses fondements théoriques, sa configuration géométrique et ses applications empiriques en psychologie et en sciences du comportement, cet ouvrage fournit les clés analytiques indispensables pour naviguer avec rigueur entre les degrés de liberté, la statistique observée et les seuils critiques de probabilité.
1. Fondements théoriques de la distribution t de Student en recherche quantitative
Pour appréhender pleinement la manipulation technique de la table de distribution t, il convient d’abord d’examiner les principes mathématiques et le contexte historique qui ont présidé à son élaboration. L’inférence statistique moderne repose sur une tension permanente entre la réalité empirique observée sur un échantillon fini et les paramètres inobservables de la population parente.
1.1 Origine historique et justification mathématique de William Sealy Gosset
L’histoire de la statistique retient souvent le pseudonyme de « Student », mais derrière cette signature modeste se trouve William Sealy Gosset, un chimiste et mathématicien britannique employé au tournant du XXe siècle par la célèbre brasserie Guinness à Dublin. Confronté à des problèmes concrets de contrôle de qualité liés à la fermentation de l’orge et aux matières premières agricoles, Gosset devait travailler sur des échantillons d’une taille extrêmement réduite, souvent inférieurs à une dizaine d’unités d’observation. Dans de telles conditions, les outils statistiques classiques de l’époque, fondés principalement sur la loi normale et les travaux de Karl Pearson, révélaient de sévères dysfonctionnements opérationnels.
La limite majeure de la distribution normale standard (ou loi Z) réside dans son exigence fondamentale : elle suppose connue la variance de la population générale, traditionnellement notée σ2. Or, dans la quasi-totalité des contextes de recherche empirique, ce paramètre est rigoureusement inaccessible. Les chercheurs sont alors contraints d’estimer la dispersion de la population à partir de la variance calculée sur l’échantillon, notée s2. Gosset démontra mathématiquement que la substitution directe de l’écart-type d’échantillon s à l’écart-type théorique σ au dénominateur du ratio de standardisation introduit une variabilité stochastique supplémentaire qui n’est pas prise en compte par la loi normale standard.
Parce que la brasserie Guinness interdisait formellement à ses scientifiques de publier des articles sous leur véritable identité afin de protéger leurs secrets industriels contre les concurrents, Gosset publia sa découverte révolutionnaire en 1908 dans la revue Biometrika sous le nom de plume « Student ». Son article, intitulé The Probable Error of a Mean, formalisa pour la première fois la distribution exacte du ratio lorsque le paramètre de dispersion est lui-même une variable aléatoire estimée. Il prouva également que lorsque la taille de l’échantillon croît vers l’infini, la distribution de ce ratio converge asymptotiquement vers la loi normale, conformément aux principes directeurs énoncés par le théorème central limite.
1.2 Caractéristiques morphologiques de la courbe t
D’un point de vue morphologique, la fonction de densité de la distribution t de Student présente une ressemblance frappante avec la courbe en cloche de Gauss, caractérisée par une parfaite symétrie axiale autour de son espérance mathématique, qui est égale à zéro. Cependant, une analyse plus rigoureuse de ses moments d’ordre supérieur met en lumière des divergences géométriques cruciales qui conditionnent directement le calcul des probabilités critiques.
La distribution t se distingue par son phénomène de leptocurticité relative par rapport aux queues de distribution : elle possède des « queues épaisses » (souvent désignées sous l’anglicisme heavy tails). Cette particularité signifie qu’une proportion plus importante de la probabilité totale se trouve concentrée dans les régions extrêmes, loin du centre de la distribution, tandis que le sommet de la courbe est légèrement plus aplati que celui de la loi normale centrée réduite. Mathématiquement, cette propriété reflète l’incertitude induite par l’estimation de l’écart-type échantillonnal : des fluctuations importantes de la statistique de test sont plus probables sous la loi t que sous la loi Z lorsque l’hypothèse nulle est vraie.
La morphologie exacte de la courbe dépend d’un paramètre fondamental et unique : le nombre de degrés de liberté (noté ddl ou df pour degrees of freedom). Lorsque le nombre de degrés de liberté est faible, la dispersion est très large et les queues sont particulièrement volumineuses. Au fur et à mesure que les degrés de liberté augmentent, la variance de la distribution t — qui est égale à ddl / (ddl – 2) pour un ddl supérieur à 2 — tend progressivement vers 1, qui est la variance théorique de la loi normale standard. Cette sensibilité dynamique de la courbe aux degrés de liberté modifie l’ordonnée et l’aire cumulée sous chaque intervalle de valeurs critiques.
1.3 Pertinence méthodologique en sciences psychologiques
Dans le domaine des sciences du comportement, de la psychologie cognitive et de la neuropsychologie clinique, le recours à la distribution t constitue une nécessité méthodologique quotidienne. Les contraintes déontologiques, la rareté de certains tableaux cliniques ou la lourdeur des protocoles d’évaluation expérimentale empêchent fréquemment la constitution de larges cohortes de participants. Travailler sur des échantillons comptant entre 10 et 30 sujets est une situation fréquente, dans laquelle l’assimilation hâtive de l’échantillon à une loi normale fausserait gravement le calcul du risque d’erreur.
Un atout fondamental de la statistique t de Student réside dans sa robustesse démontrée face aux déviations modérées par rapport au postulat de normalité des données. Les travaux de simulation de Monte Carlo ont largement mis en évidence que, tant que les distributions ne présentent pas une asymétrie (skewness) sévère ou une présence excessive de valeurs aberrantes, les probabilités nominales fournies par la distribution t demeurent étonnamment précises. Cette résilience en fait l’outil privilégié des devis quasi-expérimentaux et des études de validation thérapeutique de type pré-test/post-test.
Enfin, la distribution t joue un rôle pivot dans les démarches d’évaluation de l’efficacité d’interventions psychologiques innovantes. Qu’il s’agisse de mesurer la réduction des scores d’anxiété après une thérapie cognitive ou d’évaluer les gains mnésiques consécutifs à un entraînement attentionnel, la quantification de l’incertitude via la loi de Student permet d’établir si le changement observé dépasse raisonnablement le bruit statistique imputable aux fluctuations d’échantillonnage.
2. Anatomie structurelle de la table de distribution t
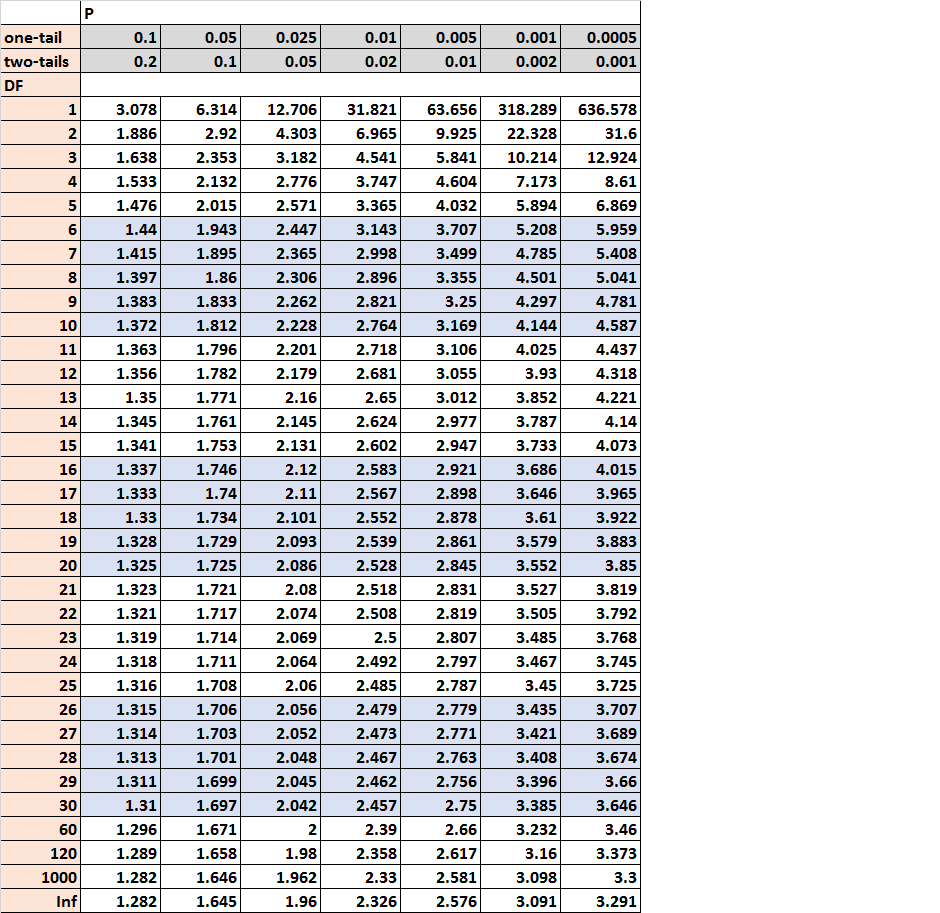
La table statistique de la distribution t se présente sous la forme d’une matrice bidimensionnelle conçue pour condenser, sous un format compact et aisément consultable, les intégrales de la fonction de densité de probabilité. L’acquisition d’une parfaite aisance dans la lecture de cette grille suppose d’en décomposer l’organisation architecturale.
2.1 Organisation des axes : degrés de liberté et niveaux de signification
L’architecture matricielle de la table repose sur une disposition géométrique conventionnelle : l’axe vertical (les lignes) est systématiquement alloué aux degrés de liberté, tandis que l’axe horizontal (les colonnes) répertorie les niveaux de probabilité ou seuils de signification. Chaque cellule à l’intersection d’une ligne et d’une colonne contient une valeur numérique critique de la statistique t.
La colonne de gauche, généralement intitulée df, ddl ou ν, égrène les entiers naturels débutant habituellement à 1 pour progresser unitairement jusqu’à des valeurs intermédiaires (comme 30 ou 40), avant de présenter des incréments plus larges. Quant aux en-têtes de colonnes, ils affichent des valeurs de probabilités décroissantes (par exemple 0,10 ; 0,05 ; 0,025 ; 0,01 ; 0,005 ; 0,001), qui correspondent à la surface de l’aire sous la courbe située au-delà de la valeur critique tabulée.
Cette disposition impose une logique de lecture bidirectionnelle. Le chercheur peut adopter une démarche descendante s’il dispose d’un risque d’erreur α prédéterminé et de son nombre de degrés de liberté afin de trouver la valeur seuil que sa statistique observée doit surpasser pour rejeter l’hypothèse nulle. Inversement — et c’est le cœur de notre propos —, il peut adopter une démarche ascendante : en partant de sa statistique calculée au sein de la ligne appropriée, il navigue horizontalement pour situer sa valeur empirique et remonter vers les probabilités associées afin d’extraire la p-valeur correspondante.
2.2 Différenciation des en-têtes : test unilatéral versus bilatéral
L’une des sources d’erreurs les plus courantes chez les analystes débutants réside dans la confusion entre les en-têtes unilatéraux (one-tailed ou test à une queue) et bilatéraux (two-tailed ou test à deux queues). La surface totale sous la courbe de Student valant par définition 1, l’attribution de la zone de rejet influence directement la correspondance mathématique entre l’abscisse et l’intégrale délimitée.
Dans un test unilatéral, l’aire de rejet correspondant au risque α est intégralement positionnée à l’une des deux extrémités de la distribution (soit exclusivement dans la queue droite pour une hypothèse prédisant une supériorité, soit dans la queue gauche pour une infériorité). En revanche, dans un test bilatéral, cette même probabilité d’erreur est équitablement scindée en deux parts d’aire égale à α / 2, situées symétriquement de part et d’autre de l’origine. Il en découle la relation fondamentale de conversion :
$$\alpha_{\text{bilatéral}} = 2 \times \alpha_{\text{unilatéral}}$$
Les tables contemporaines de référence, comme celles publiées par l’American Psychological Association ou figurant dans les manuels de biométrie avancée, résolvent cette ambiguïté en affichant un double système d’en-têtes superposés. La première ligne d’en-tête spécifie les seuils unilatéraux, tandis que la ligne immédiatement inférieure indique les seuils bilatéraux équivalents. Il est impératif de vérifier rigoureusement quelle ligne d’en-tête est mobilisée avant d’extraire une quelconque déduction probabiliste.
2.3 Nature discrète de la table et absence de continuité parfaite
Contrairement aux logiciels informatiques qui procèdent à une intégration numérique continue en temps réel pour renvoyer une p-valeur exacte à quatre ou cinq décimales, la table de papier est par essence discrète et discontinue. L’espace physique d’une page imprimée impose de limiter le nombre de colonnes à quelques valeurs remarquables de probabilité (le plus souvent 5 à 8 colonnes standards) et d’espacer la granularité des degrés de liberté dès que ces derniers dépassent le seuil de 30.
Ainsi, il est classique d’observer sur une table standard des sauts par dizaines, voire par vingtaines (ex. 30, 40, 60, 120), suivis du symbole de l’infini (∞). Ce fractionnement de l’information a pour corollaire immédiat l’impossibilité d’obtenir, par une simple lecture directe, la valeur exacte de la p-valeur lorsque la statistique observée se positionne entre deux bornes tabulées. L’utilisateur doit impérativement s’orienter vers une stratégie d’encadrement par intervalles d’inégalité.
Il est fascinant de remarquer que la dernière ligne de la table, désignée par le symbole infini (∞) ou z, correspond trait pour trait aux quantiles critiques de la loi normale centrée réduite. Par exemple, pour un risque bilatéral de 0,05, la ligne infinie affiche la valeur immuable de 1,960. Cela illustre concrètement l’asymptotisme de Student vers Gauss à mesure que la taille d’échantillon neutralise le biais de l’estimation de l’écart-type.
3. Les trois paramètres cardinaux pour interroger la table t
L’extraction rigoureuse d’une p-valeur à partir d’une distribution tabulaire ne s’improvise pas. Elle nécessite l’identification préalable et sans équivoque de trois paramètres méthodologiques structurants, fixés lors de l’élaboration du protocole de recherche.
3.1 Le seuil de signification théorique (Alpha)
Le paramètre α représente le seuil de signification fixé a priori par le chercheur, c’est-à-dire le risque maximal toléré de commettre une erreur de type I (rejeter à tort l’hypothèse nulle H0 alors qu’elle est en réalité vraie dans la population). Ce seuil exprime une limite probabiliste en deçà de laquelle l’observateur considère qu’un écart ne peut plus être raisonnablement attribué aux simples aléas du tirage d’échantillon.
En psychologie et en sciences sociales, des conventions séculaires introduites en grande partie par Ronald Fisher ont consacré les seuils de 0,05 (5 %), 0,01 (1 %) et 0,001 (0,1 %). Ces paliers constituent les points d’ancrage conventionnels des colonnes de nos tables de distribution. Le débat contemporain sur la crise de réplication a conduit certains méthodologistes à préconiser un abaissement systématique du seuil α à 0,005 pour les découvertes novatrices, mais le seuil de 0,05 demeure la norme standard de publication.
Il ne faut pas confondre le risque α, qui est une borne décisionnelle invariante déterminée avant toute collecte de données, avec la p-valeur observée, qui est une quantité probabiliste fluctuante calculée a posteriori à partir des données recueillies. La comparaison entre cette p-valeur et le seuil α constitue le socle du verdict statistique.
3.2 Le calcul précis des degrés de liberté selon le devis de recherche
Le deuxième paramètre indispensable pour sélectionner la ligne correcte de la table est le nombre de degrés de liberté (ddl). Sa formule de calcul dépend intimement de l’architecture expérimentale mise en œuvre :
- Test t pour échantillon unique : Le devis compare la moyenne d’un groupe à une valeur théorique connue. Le degré de liberté vaut simplement la taille de l’échantillon diminuée d’une unité :
$$ddl = n – 1$$
La perte de ce degré de liberté découle de l’estimation préalable de la moyenne arithmétique de l’échantillon pour calculer la variance. - Test t pour deux échantillons indépendants (variances homogènes) : Lorsque deux groupes distincts de participants sont comparés et que le postulat d’homogénéité des variances (homoscédasticité) est respecté, les degrés de liberté s’additionnent :
$$ddl = (n_1 – 1) + (n_2 – 1) = n_1 + n_2 – 2$$ - Correction de Welch-Satterthwaite (variances inégales) : Si les variances des deux groupes sont hétérogènes, le test t classique devient invalide. On utilise alors la correction de Welch, qui génère un nombre de degrés de liberté souvent fractionnaire, calculé selon une équation pondérant les variances et les tailles respectives de chaque groupe. Pour la lecture manuelle sur table, ce nombre fractionnaire impose une règle d’arrondi conservatoire spécifique.
- Test t pour échantillons appariés (mesures répétées) : Dans les protocoles où les mêmes sujets sont mesurés à deux reprises (par exemple avant et après traitement), la statistique porte sur le vecteur des différences individuelles. Dès lors, le degré de liberté dépend du nombre de paires de données :
$$ddl = N_{\text{paires}} – 1$$
3.3 L’orientation de l’hypothèse de recherche : unilatérale ou bilatérale
L’orientation de la recherche dicte la façon dont la zone de rejet de l’hypothèse nulle est configurée dans la géométrie de la courbe. Cette spécification doit être rigoureusement formulée avant toute inspection des données pour des raisons d’intégrité déontologique.
Une hypothèse bilatérale (non directionnelle) postule l’existence d’une différence ou d’un effet, sans présupposer le sens de cette variation :
$$H_0 : \mu_1 = \mu_2 \quad \text{contre} \quad H_1 : \mu_1 \neq \mu_2$$
L’aire critique est scindée entre l’extrémité inférieure et l’extrémité supérieure de la distribution. En revanche, une hypothèse unilatérale (directionnelle) postule explicitement le sens de la relation empirique :
$$H_1 : \mu_1 > \mu_2 \quad \text{ou} \quad H_1 : \mu_1 < \mu_2$$
Dans ce cas, l'intégralité du risque d'erreur est concentrée dans une unique queue.
Retenir une hypothèse unilatérale présente l’avantage statistique d’abaisser la valeur critique nécessaire pour déclarer un résultat significatif à un seuil α donné, augmentant ainsi la puissance statistique du test. Néanmoins, ce choix méthodologique exige une justification théorique préalable solide. Si un chercheur opte pour un test unilatéral après avoir observé ses données simplement pour transformer un résultat non significatif en un résultat publiable, il commet une faute méthodologique majeure assimilable au p-hacking.
4. Procédure méthodique pour encadrer la p-valeur dans la table t
Une fois les trois paramètres cardinaux explicités, l’opérateur peut procéder à l’interrogation physique de la table de distribution. L’encadrement méthodique de la p-valeur suit un protocole logique décomposé en trois étapes successives.
4.1 Étape 1 : Localisation de la ligne des degrés de liberté
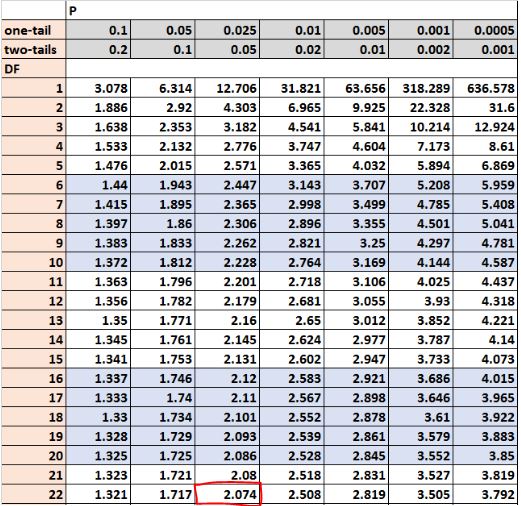
La première démarche opérationnelle consiste à parcourir la première colonne de la table pour y repérer le chiffre correspondant aux degrés de liberté du devis de recherche. Si la valeur exacte du ddl figure dans la table (ce qui est systématiquement le cas pour les entiers compris entre 1 et 30), il suffit d’isoler mentalement la rangée horizontale correspondante.
En revanche, lorsque l’échantillon est de taille intermédiaire ou importante (par exemple avec un ddl de 47) et que la table saute de 40 à 50, une décision rigoureuse doit être prise. La convention scientifique impose la règle du conservatisme statistique : en l’absence de la valeur exacte, l’analyste doit systématiquement sélectionner le degré de liberté immédiatement inférieur disponible dans la table (dans notre exemple, la ligne correspondant à 40).
Cette règle prudentielle s’explique par la géométrie même de la distribution t : plus le degré de liberté est bas, plus les queues de la distribution sont épaisses et plus les valeurs critiques requises pour atteindre un seuil de significativité donné sont élevées. Par conséquent, retenir le ddl inférieur revient à durcir artificiellement le critère de rejet de l’hypothèse nulle, éliminant tout risque d’inflation indue de l’erreur de type I. Sélectionner par mégarde la ligne supérieure conduirait à être indûment libéral, ce qui est proscrit par l’éthique de la recherche empirique.
4.2 Étape 2 : Positionnement de la statistique t empirique observée
La statistique t observée (tobs ou tcalc) découle du calcul mathématique appliqué aux données expérimentales. Avant de confronter cette valeur aux chiffres alignés sur la rangée sélectionnée, il convient d’appliquer une règle simplificatrice issue de la symétrie parfaite de la loi de Student : ignorer le signe algébrique en considérant la valeur absolue $|t_{\text{obs}}|$. Que le résultat calculé soit positif ou négatif, la surface sous la queue correspondante est rigoureusement identique.
L’opérateur balaie ensuite visuellement les valeurs critiques ordonnées de façon strictement croissante de gauche à droite sur la ligne de son ddl. L’objectif est d’insérer sa valeur empirique entre deux bornes consécutives de la grille :
$$t_{\text{\inf}} le |t_{\text{obs}}| le t_{\text{\sup}}$$
Trois configurations morphologiques peuvent alors se manifester :
- Configuration standard : La valeur calculée s’intercale harmonieusement entre deux nombres de la ligne (par exemple, 2,15 se positionne entre 2,064 et 2,492).
- Configuration sous-critique : La valeur calculée est inférieure au tout premier nombre listé sur la ligne (souvent associé à la probabilité la plus large, comme α = 0,10 ou 0,20).
- Configuration hautement significative : La valeur calculée est strictement supérieure au dernier nombre critique tabulé à l’extrémité droite de la ligne (couramment associé à α = 0,001 ou 0,0005).
4.3 Étape 3 : Déduction de l’intervalle de la p-valeur
L’encadrement numérique étant établi au niveau de la ligne des degrés de liberté, la phase conclusive consiste à remonter verticalement le long des colonnes correspondantes pour lire les valeurs de probabilité situées dans les en-têtes au sommet de la page. C’est à ce stade précis que l’orientation directionnelle fixée lors de l’étape préparatoire devient décisive.
Si la recherche teste une hypothèse bilatérale, l’observateur relève les probabilités indiquées sur la rangée d’en-tête « Deux queues » (two-tailed). En raison de la relation inverse qui lie l’amplitude de la statistique t et la surface résiduelle sous la courbe, l’inégalité s’inverse : plus la statistique t s’éloigne du centre, plus l’aire sous la queue (la p-valeur) se contracte. Ainsi, si l’on a :
$$t_1 < |t_{\text{obs}}| < t_2$$
L'intervalle de probabilité s'énonce mathématiquement de la manière suivante :
$$p_2 < p < p_1$$
Où $p_1$ est la probabilité associée à $t_1$ et $p_2$ celle associée à $t_2$.
Dans un rapport de recherche classique, ce résultat se formule sous la forme d’un encadrement strict, tel que $0,01 < p < 0,025$ ou $0,02 < p 0,10$. Si elle dépasse le seuil maximal de la table correspondant à la colonne $0,001$, on rédigera l’assertion définitive sous la forme d’une inégalité unilatérale : $p < 0,001$.
5. Comparaison approfondie : approche par valeur critique contre p-valeur
L’inférence statistique moderne telle qu’elle est pratiquée aujourd’hui résulte de l’agrégation, parfois conflictuelle, de deux paradigmes historiques distincts : la démarche décisionnelle binaire de Jerzy Neyman et Egon Pearson, et la logique inductive continue de Ronald Aylmer Fisher.
5.1 L’approche décisionnelle classique de Neyman-Pearson
L’approche conceptualisée par Jerzy Neyman et Egon Sharpe Pearson au cours des années 1930 s’enracine dans une vision comportementale et opérationnelle de la science. Selon cette perspective, le test statistique n’est pas conçu pour mesurer la plausibilité intrinsèque d’une théorie, mais pour fournir une règle de décision mécanique permettant de choisir entre deux actions incompatibles, tout en contrôlant les taux d’erreurs à long terme.
Dans cette architecture, l’expérimentateur détermine a priori son risque d’erreur de première espèce α (conventionnellement fixé à 0,05). En croisant ce seuil préétabli avec les degrés de liberté de l’échantillon dans la table t, il isole une unique valeur seuil dénommée valeur critique (notée $t_{\text{crit}}$). Cette coordonnée partitionne l’ensemble de l’espace d’échantillonnage en deux régions hermétiques :
- La région de non-rejet de l’hypothèse nulle (si $|t_{\text{obs}}| < t_{\text{crit}}$) ;
- La région critique ou région de rejet (si $|t_{\text{obs}}| ge t_{\text{crit}}$).
La règle décisionnelle s’avère binaire et impersonnelle : sitôt que la statistique observée franchit la frontière tracée par $t_{\text{crit}}$, l’hypothèse nulle est formellement rejetée au bénéfice de l’hypothèse alternative H1. L’avantage méthodologique majeur réside dans la clarté opératoire et le contrôle simultané de l’erreur α et du risque d’erreur de type II (β, la probabilité de manquer un effet réel), dont découle la puissance statistique ($1 – \beta$).
5.2 L’approche probatoire continue selon Fisher
À l’opposé de la mécanique prescriptive de Neyman et Pearson, Sir Ronald Fisher envisageait le test de signification comme un instrument purement probatoire, destiné à quantifier la force empirique de la preuve apportée par les données à l’encontre d’une hypothèse de référence nulle unique ($H_0$). Dans l’épistémologie de Fisher, il n’existe pas d’hypothèse alternative formalisée, ni de contrôle formel de l’erreur de seconde espèce β.
Pour Fisher, la valeur p représente un indice continu gradué le long de l’intervalle $[0, 1]$. Plus cette probabilité conditionnelle est infinitésimale, plus la divergence entre le modèle théorique d’absence d’effet et les observations de laboratoire est substantielle. Une p-valeur de 0,049 n’a absolument pas la même signification scientifique qu’une p-valeur de 0,0001, alors que dans le schéma binaire de Neyman-Pearson, toutes deux conduisent mécaniquement à la même décision binaire de rejet au seuil 0,05.
La synthèse contemporaine couramment désignée sous le vocable d’« approche hybride NHST » (Null Hypothesis Significance Testing) tente de concilier ces deux visions en comparant la p-valeur continue calculée selon la logique fisherienne à un seuil d’exclusion α fixé selon les préceptes de Neyman-Pearson. L’extraction de l’intervalle de p sur la table de Student participe directement de cette volonté d’évaluer la sévérité du désaccord entre les données et le modèle nul.
5.3 Cohérence mathématique entre les deux stratégies
Bien que divergentes dans leurs fondements philosophiques et interprétatifs, l’approche par valeur critique et l’approche par p-valeur s’avèrent strictement isomorphes et conduisent invariablement à des décisions empiriques identiques. La congruence mathématique sous-jacente est absolue :
$$|t_{\text{obs}}| ge t_{\text{crit}} iff p le \alpha$$
Si la statistique t empirique calculée à partir des données dépasse la valeur seuil répertoriée dans la colonne α = 0,05 de la rangée de vos degrés de liberté, cela garantit obligatoirement que la surface résiduelle située au-delà de cette coordonnée (la p-valeur) est inférieure ou égale à 0,05. Réciproquement, si la statistique observée échoue à franchir le seuil tabulé, la surface résiduelle englobera nécessairement une probabilité supérieure à 0,05.
En pratique clinique ou en recherche translationnelle, disposer de l’encadrement précis de la p-valeur apporte néanmoins une information bien plus informative que la simple assertion « résultat significatif ». Savoir que la p-valeur est comprise entre 0,001 et 0,01 plutôt que simplement « inférieure à 0,05 » renseigne sur la solidité du signal statistique extrait au milieu du bruit biologique ou psychométrique.
6. Application empirique 1 : Test t pour échantillon unique en psychologie cognitive
Afin d’illustrer la mise en œuvre pratique de cette procédure tabulaire, considérons un premier cas d’étude ancré dans le domaine des neurosciences cognitives et de l’étude des temps de traitement de l’information perceptive.
6.1 Mise en situation expérimentale et formulation des hypothèses
Un laboratoire de psychologie expérimentale s’intéresse à l’impact potentiel d’une tâche d’interférence visuo-spatiale complexe sur la rapidité de traitement de stimuli lumineux élémentaires. La norme standardisée de référence sur ce type de tâche élémentaire au sein de la population générale adulte est établie de longue date à un temps de réaction moyen de référence μ0 = 500 millisecondes (ms).
L’équipe recrute un groupe de 23 jeunes adultes volontaires sains ($n = 23$) soumis à un protocole de surcharge attentionnelle cognitive. Les chercheurs ne sachant pas à l’avance si le dispositif d’interférence induira un ralentissement attentionnel (augmentation du temps de réaction) ou au contraire un état d’hyper-vigilance transitoire (diminution du temps de réaction), ils arrêtent formellement une hypothèse de recherche bilatérale :
- Hypothèse nulle ($H_0$) : La moyenne de la population sous surcharge attentionnelle demeure égale à la norme de référence, soit $\mu = 500\text{ ms}$.
- Hypothèse alternative ($H_1$) : La moyenne de la population sous surcharge attentionnelle diffère significativement de la référence, soit $\mu \neq 500\text{ ms}$.
Le seuil de décision α est fixé à 0,05. Le nombre de degrés de liberté associé à cet échantillon unique se calcule immédiatement :
$$ddl = n – 1 = 23 – 1 = 22$$
6.2 Calcul de la statistique t et repérage tabulaire
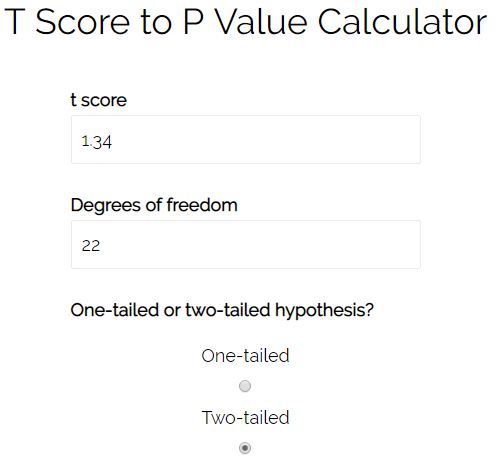
Après passation des épreuves et recueil des chronométries individuelles, l’analyse descriptive fournit une moyenne d’échantillon observée de $\bar{x} = 518\text{ ms}$ et un écart-type empirique non biaisé de $s = 64,5\text{ ms}$. L’erreur-type de la moyenne ($SE$) s’établit dès lors à :
$$SE = \frac{s}{\sqrt{n}} = \frac{64,5}{\sqrt{23}} = \frac{64,5}{4,7958} \approx 13,45\text{ ms}$$
Le calcul de la statistique de test t donne :
$$t_{\text{obs}} = \frac{\bar{x} – \mu_0}{SE} = \frac{518 – 500}{13,45} = \frac{18}{13,45} \approx 1,338$$
Arrondissons cette statistique observée à $t_{\text{obs}} = 1,34$.
L’analyste se saisit d’une table de distribution t de Student. Dans un premier temps, il descend le long de la colonne verticale des degrés de liberté jusqu’à localiser la ligne $ddl = 22$. En examinant cette rangée horizontale spécifique, les valeurs critiques successives tabulées pour les différents niveaux d’en-tête bilatéraux se présentent de la façon suivante :
- Pour $\alpha_{\text{bilat}} = 0,20$, la table indique : $t = 1,321$
- Pour $\alpha_{\text{bilat}} = 0,10$, la table indique : $t = 1,717$
- Pour $\alpha_{\text{bilat}} = 0,05$, la table indique : $t = 2,074$
- Pour $\alpha_{\text{bilat}} = 0,01$, la table indique : $t = 2,819$
L’insertion de notre statistique observée $|t_{\text{obs}}| = 1,34$ permet de constater avec précision qu’elle se positionne entre 1,321 et 1,717 :
$$1,321 < 1,34 < 1,717$$
6.3 Interprétation statistique et conclusion clinique
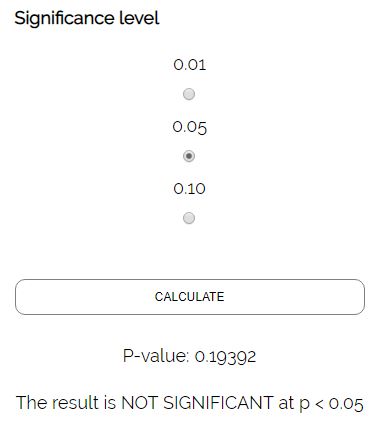
En remontant verticalement vers la ligne d’en-tête correspondant au devis bilatéral (two-tailed), nous déduisons directement l’inégalité encadrant la probabilité associée :
$$0,10 < p < 0,20$$
La p-valeur observée est donc strictement supérieure à 0,10 et strictement inférieure à 0,20.
La règle décisionnelle stipule que pour rejeter l’hypothèse nulle $H_0$ au seuil de risque choisi de $\alpha = 0,05$, il est impératif que la p-valeur soit strictement inférieure à 0,05 (ou, de manière équivalente, que la statistique t observée surpasse la valeur critique bilatérale $t_{\text{crit}} = 2,074$). Or, notre valeur empirique $t_{\text{obs}} = 1,34$ demeure nettement en deçà du seuil critique, et notre encadrement de p montre que la probabilité d’obtenir une telle déviation sous l’hypothèse d’absence d’effet se situe entre 10 % et 20 %.
La conclusion statistique est nette : on échoue à rejeter l’hypothèse nulle. Sur le plan cognitif, les résultats ne permettent pas d’affirmer que la tâche de surcharge attentionnelle testée induit une modification significative des temps de réaction par rapport à la norme standard ($t(22) = 1,34 ; p in ]0,10 ; 0,20[$). Les 18 millisecondes de divergence constatées s’expliquent raisonnablement par les simples fluctuations d’échantillonnage.
7. Application empirique 2 : Test t pour deux échantillons indépendants
Le devis inter-sujets comparant deux groupes randomisés constitue l’étalon d’or de l’évaluation méthodologique en psychopharmacologie et en psychothérapie. Voyons comment la lecture tabulaire s’articule dans ce cadre.
7.1 Protocole d’intervention en psychologie clinique
Une équipe de recherche en psychologie clinique souhaite évaluer l’efficacité d’un nouveau protocole de thérapie cognitive et comportementale (TCC) ciblant le trouble d’anxiété généralisée (TAG). Un échantillon de 30 patients diagnostiqués est recruté puis scindé par randomisation simple en deux groupes de taille strictement égale :
- Groupe expérimental ($n_1 = 15$) : Suivi d’un programme TCC intensif de 8 semaines ;
- Groupe témoin ($n_2 = 15$) : Placement sur liste d’attente active avec soutien téléphonique hebdomadaire.
À l’issue de l’intervention, la sévérité de la symptomatologie anxieuse est mesurée via l’échelle d’anxiété de Hamilton (HAM-A). Conformément à l’abondante littérature préexistante démontrant la supériorité des TCC sur l’absence de thérapie, l’équipe formule une hypothèse de recherche unilatérale directionnelle : le groupe TCC affichera une moyenne de score de Hamilton significativement inférieure à celle du groupe liste d’attente. Formellement :
$$H_0 : \mu_1 ge \mu_2 \quad \text{contre} \quad H_1 : \mu_1 < \mu_2$$
Le niveau de risque α est assigné à la valeur classique de 0,05.
Considérant que le test de Levene aura préalablement attesté de l’égalité des variances entre les deux populations, les degrés de liberté combinés du système se calculent selon :
$$ddl = n_1 + n_2 – 2 = 15 + 15 – 2 = 28$$
7.2 Navigation tabulaire et extraction de la probabilité
Les données terminales recueillies auprès des patients fournissent pour le groupe TCC une moyenne $\bar{x}_1 = 14,2$ ($s_1 = 3,8$) et pour le groupe témoin une moyenne $\bar{x}_2 = 18,1$ ($s_2 = 4,6$). L’estimation de la variance combinée (pooled variance) et le calcul subséquent de l’erreur-type de la différence intergroupes aboutissent à la statistique expérimentale suivante :
$$t_{\text{obs}} = -2,467$$
Conformément aux directives méthodologiques énoncées précédemment, le chercheur s’intéresse à la valeur absolue : $|t_{\text{obs}}| = 2,467$. Il se rend sur la table de Student et se positionne sur la rangée correspondant à $ddl = 28$. Il examine les valeurs critiques inscrites le long de cette ligne :
- Pour une probabilité unilatérale $\alpha_{\text{uni}} = 0,05$ : $t = 1,701$
- Pour une probabilité unilatérale $\alpha_{\text{uni}} = 0,025$ : $t = 2,048$
- Pour une probabilité unilatérale $\alpha_{\text{uni}} = 0,01$ : $t = 2,467$
- Pour une probabilité unilatérale $\alpha_{\text{uni}} = 0,005$ : $t = 2,763$
Fait remarquable : la statistique calculée $t_{\text{obs}} = 2,467$ correspond trait pour trait à la coordonnée critique tabulée pour la colonne associée au seuil unilatéral 0,01 !
7.3 Validation substantielle des résultats thérapeutiques
La lecture de la table fournit dans ce cas exceptionnel une valeur exacte : la p-valeur unilatérale associée à cette expérimentation est précisément égale à 0,01 :
$$p_{\text{unilatérale}} = 0,01$$
Si l’équipe avait préalablement opté pour une posture bilatérale conservatrice, la consultation de la ligne d’en-tête bilatérale pour cette même abscisse de 2,467 aurait indiqué :
$$p_{\text{bilatérale}} = 0,02$$
La p-valeur observée de 0,01 étant strictement inférieure au seuil de significativité nominal $\alpha = 0,05$, l’hypothèse nulle est rejetée avec force. Les données empiriques corroborent l’hypothèse clinique d’un bénéfice supérieur du protocole TCC comparativement à la condition témoin.
Toutefois, la seule significativité statistique ne renseigne nullement sur la pertinence concrète de la réduction symptomatique observée. Pour compléter cette analyse conformément aux exigences scientifiques actuelles, il est indispensable de calculer la taille d’effet standardisée au moyen du d de Cohen :
$$d = \frac{\bar{x}_1 – \bar{x}_2}{s_{\text{pooled}}} = \frac{14,2 – 18,1}{4,22} = -0,92$$
Ce résultat met en évidence un effet thérapeutique de magnitude élevée ($|d| > 0,80$), conférant à la significativité statistique une réelle portée clinique pour les praticiens.
8. Application empirique 3 : Test t pour échantillons appariés
Le recours à un plan à mesures répétées (intra-sujet) permet d’éliminer la part de variance imputable aux différences interindividuelles stables, augmentant substantiellement la sensibilité statistique du test de Student.
8.1 Devis pré-test post-test en psychologie de la santé
Un service de santé au travail déploie un programme novateur de réduction du stress basé sur la pleine conscience (MBSR) auprès de professionnels soignants exerçant au sein d’unités de soins palliatifs. L’objectif est d’évaluer l’impact direct de ce cursus intensif de 6 semaines sur le niveau perçu d’épuisement professionnel.
Un effectif de 18 soignants volontaires ($n = 18$) participe à l’intégralité du stage. Chaque soignant remplit l’Inventaire d’Épuisement Professionnel de Maslach (MBI, sous-échelle d’épuisement émotionnel) à deux moments clés :
- Le premier jour, avant toute séance d’initiation ($T_1$) ;
- Le lendemain de la dernière session pratique ($T_2$).
Le devis s’articule autour d’une hypothèse bilatérale, tenant compte de l’éventualité qu’une prise de conscience émotionnelle brutale puisse temporairement accroître le sentiment de détresse :
$$H_0 : \mu_D = 0 \quad \text{contre} \quad H_1 : \mu_D \neq 0$$
Où $\mu_D$ désigne la moyenne populationnelle théorique des différences individuelles $D_i = X_{T2, i} – X_{T1, i}$.
Le nombre de degrés de liberté s’établit sur la base du nombre de paires de scores appariés :
$$ddl = N_{\text{paires}} – 1 = 18 – 1 = 17$$
8.2 Exploitation de la table pour une valeur t élevée
L’analyse des scores de différence individuelle fait apparaître une atténuation moyenne de l’épuisement de $\bar{D} = -6,83$ points, associée à un écart-type des différences $s_D = 7,94$. L’erreur-type associée s’élève à :
$$SE_D = \frac{s_D}{\sqrt{n}} = \frac{7,94}{\sqrt{18}} = \frac{7,94}{4,2426} \approx 1,871$$
Ce qui engendre la statistique t appariée suivante :
$$t_{\text{obs}} = \frac{\bar{D} – 0}{SE_D} = \frac{-6,83}{1,871} \approx -3,65$$
En valeur absolue, nous obtenons : $|t_{\text{obs}}| = 3,65$.
L’investigateur consulte la table de distribution t à la ligne dédiée aux 17 degrés de liberté. En balayant horizontalement cette rangée, il constate la progression suivante des quantiles :
- $\alpha_{\text{bilat}} = 0,05 implies t = 2,110$
- $\alpha_{\text{bilat}} = 0,02 implies t = 2,567$
- $\alpha_{\text{bilat}} = 0,01 implies t = 2,898$
- $\alpha_{\text{bilat}} = 0,002 implies t = 3,646$
- $\alpha_{\text{bilat}} = 0,001 implies t = 3,965$
La statistique observée $|t_{\text{obs}}| = 3,650$ se positionne immédiatement au-dessus de la valeur 3,646 associée à l’en-tête bilatéral 0,002, tout en restant inférieure à la borne extrême de 3,965 associée à 0,001 :
$$3,646 < 3,650 < 3,965$$
8.3 Implications déontologiques et interprétation des bénéfices
L’inspection des colonnes permet d’encadrer la p-valeur bilatérale avec une remarquable finesse :
$$0,001 < p < 0,002$$
Ce résultat atteste d'une divergence extrême entre les données observées et l'hypothèse nulle d'invariance temporelle. Il existe moins de deux chances sur mille d'observer une telle baisse des scores d'épuisement émotionnel par pur hasard sous le modèle nul.
Le rejet de $H_0$ est incontestable. Toutefois, la déontologie méthodologique impose d’éclairer ces conclusions statistiques à la lumière des limites inhérentes à la validité interne du protocole. En l’absence d’un groupe contrôle n’ayant pas bénéficié de la formation (plan quasi-expérimental pré-post à groupe unique), une part de l’effet significatif mesuré pourrait résulter d’artéfacts expérimentaux non spécifiques, tels qu’un effet Hawthorne ou une simple régression statistique vers la moyenne.
Néanmoins, la puissance du test statistique ($p < 0,002$) adossée à une amplitude d'effet majeure justifie pleinement la mise en place d'un essai clinique randomisé et contrôlé (ECR) à plus grande échelle, tout en offrant aux gestionnaires hospitaliers un argument préliminaire solide pour pérenniser ces actions préventives du burn-out.
9. Techniques d’approximation fine : l’interpolation linéaire entre valeurs tabulaires
Si la stratégie de l’encadrement par intervalles satisfait aux exigences de la quasi-totalité des travaux académiques, certaines situations requièrent une estimation ponctuelle plus précise d’une p-valeur non répertoriée dans la grille standard.
9.1 Fondement mathématique de l’interpolation linéaire locale
L’interpolation linéaire repose sur l’hypothèse simplificatrice selon laquelle, sur un intervalle d’abscisse très resserré $[t_{\text{\inf}}, t_{\text{\sup}}]$, la fonction de répartition de la distribution de Student peut être localement assimilée à une droite affine. Bien que la courbe de densité soit intrinsèquement non linéaire en raison de sa courbure leptocurtique, l’erreur d’approximation introduite par la linéarisation locale reste négligeable tant que l’écart entre les bornes tabulées demeure étroit.
La démarche consiste à établir une règle de trois proportionnelle entre la distance relative séparant la statistique observée de ses bornes critiques et l’intervalle de probabilité correspondant aux colonnes de la table. La formule générale de l’interpolation linéaire s’énonce comme suit :
$$p_{\text{estimée}} = p_{\text{\inf}} + \frac{|t_{\text{obs}}| – t_{\text{\inf}}}{t_{\text{\sup}} – t_{\text{\inf}}} \times (p_{\text{\sup}} – p_{\text{\inf}})$$
Il est fondamental de veiller scrupuleusement au sens de variation des grandeurs : à mesure que la coordonnée t progresse numériquement, la probabilité cumulée de queue décroît. Ainsi, si l’on note $t_{\text{\inf}} p(t_{\text{\sup}})$).
9.2 Démonstration calculatoire détaillée sur un cas pratique
Reprenons le cas d’un test t bilatéral conduit avec 14 degrés de liberté ($ddl = 14$), pour lequel l’analyse empirique engendre une statistique observée de $t_{\text{obs}} = 2,35$.
La consultation de la ligne $ddl = 14$ de la table de Student fait apparaître les bornes bilatérales suivantes :
- Pour $\alpha_{\text{bilat}} = 0,05$ : $t_{\text{\inf}} = 2,145$
- Pour $\alpha_{\text{bilat}} = 0,02$ : $t_{\text{\sup}} = 2,624$
Notre valeur empirique $2,35$ s’insère nettement entre ces deux seuils : $2,145 < 2,35 < 2,624$.
Procédons par étapes au calcul de l’interpolation :
- Calculons l’écart critique total sur la ligne des t :
$$\Delta t = t_{\text{\sup}} – t_{\text{\inf}} = 2,624 – 2,145 = 0,479$$ - Calculons la distance relative entre notre valeur observée et la borne inférieure :
$$\text{Distance} = t_{\text{obs}} – t_{\text{\inf}} = 2,350 – 2,145 = 0,205$$ - Déterminons le ratio de parcours proportionnel ($R$) :
$$R = \frac{0,205}{0,479} \approx 0,4280 \quad (42,80,%)$$ - Calculons l’amplitude de l’intervalle de probabilité :
$$\Delta p = p_{\text{\sup}} – p_{\text{\inf}} = 0,02 – 0,05 = -0,03$$ - Appliquons le déplacement proportionnel pour extraire la p-valeur estimée :
$$p \approx p(t_{\text{\inf}}) + [R \times \Delta p] = 0,05 + [0,4280 \times (-0,03)] = 0,05 – 0,01284 = 0,03716$$
L’interpolation manuelle permet ainsi d’avancer une p-valeur approchée de $p \approx 0,037$. Si nous interrogeons un progiciel algorithmique pour calculer la probabilité exacte sous une loi de Student à 14 degrés de liberté avec un $t$ de 2,35, l’algorithme renvoie $p = 0,0340$. L’écart absolu entre l’approximation manuelle et le calcul matriciel exact n’est que de 0,003, ce qui démontre l’excellente précision de cette technique lors d’évaluations méthodologiques sur table.
9.3 Quand l’interpolation devient-elle indispensable ?
Cette méthodologie d’approximation s’avère particulièrement utile dans les contextes académiques formels, tels que les examens universitaires de biostatistique ou les soutenances de thèses cliniques réalisées hors connexion informatique. Elle permet au candidat d’apporter une preuve de maîtrise quantitative approfondie, dépassant la simple lecture d’encadrement.
Elle devient également précieuse lorsqu’un résultat expérimental se situe à la lisière immédiate du seuil critique de significativité (par exemple une statistique produisant un $p$ très proche de 0,05). Estimer si la valeur se situe vraisemblablement à 0,048 ou à 0,053 permet de calibrer la rigueur de la discussion scientifique.
Néanmoins, l’analyste doit reconnaître les limites de cet outil. L’interpolation linéaire perd rapidement de sa fiabilité dès lors que les données s’aventurent dans les queues extrêmes de distribution (au-delà de $\alpha = 0,005$), où la convexité de la courbe de Student s’accentue dramatiquement. Dans ces zones périphériques, une modélisation logarithmique des probabilités serait théoriquement requise pour maintenir la précision.
10. Biais d’interprétation et écueils courants autour de la p-valeur
L’usage de la p-valeur fait l’objet d’intenses débats épistémologiques dans l’ensemble des sciences quantitatives. Nombre d’erreurs méthodologiques récurrentes proviennent d’une mauvaise appréhension conceptuelle de sa définition mathématique.
10.1 L’erreur de transposition conditionnelle (Sophisme du procureur)
Le piège intellectuel le plus répandu consiste à interpréter la p-valeur comme la probabilité que l’hypothèse nulle soit vraie compte tenu des données recueillies, soit $P(H_0 mid \text{Données})$. Cette interprétation constitue un contresens logique formel, fréquemment qualifié de « sophisme du procureur » ou d’inversion des probabilités conditionnelles.
Par définition mathématique stricte, la p-valeur mesure la probabilité d’observer un résultat au moins aussi extrême que celui enregistré dans l’échantillon, sous l’hypothèse impérative que l’hypothèse nulle soit rigoureusement exacte dans la population :
$$p = P(\text{Statistique} ge t_{\text{obs}} mid H_0)$$
Inverser les termes de cette condition revient à confondre la probabilité d’avoir de la fièvre lorsque l’on est atteint d’une pneumonie avec la probabilité d’avoir une pneumonie dès lors que l’on présente de la fièvre. Obtenir une p-valeur de 0,03 ne signifie en aucune manière qu’il y a 3 % de chances que l’hypothèse nulle soit vraie (et par conséquent 97 % de chances que la théorie alternative soit exacte). Pour calculer la probabilité épistémique d’une hypothèse au vu des faits observés, il est théoriquement indispensable d’adopter le cadre de l’inférence bayésienne, qui intègre les probabilités a priori via le théorème de Bayes.
10.2 L’assimilation trompeuse entre significativité et amplitude de l’effet
Un deuxième écueil méthodologique omniprésent est l’amalgame entre la significativité statistique d’un test (caractérisée par une faible p-valeur) et son importance pratique ou théorique (caractérisée par la taille d’effet). La statistique t dépend mécaniquement de deux variables distinctes : la magnitude de la différence entre les moyennes et la taille globale de l’échantillon $n$.
Comme le dénominateur de la statistique t (l’erreur-type) est inversement proportionnel à $\sqrt{n}$, il suffit d’augmenter massivement le nombre d’observations pour réduire ce dénominateur vers zéro et gonfler artificiellement la valeur de t. Dès lors, sur un échantillon constitué de 20 000 participants, une différence microscopique et cliniquement insignifiante de 0,2 point sur une échelle de bien-être mental produira une statistique produisant un $p < 0,0001$. Inversement, une étude pilote menée sur un échantillon clinique restreint ($n = 10$) peut révéler une amélioration symptomatologique massive, tout en affichant un $p = 0,08$ en raison d'un manque de puissance statistique.
C’est pour conjurer cette dérive qu’aucun rapport statistique moderne ne saurait être validé sans l’adjonction systématique d’indices d’amplitude standardisés, tels que le d de Cohen ou le g de Hedges pour les contrastes de moyennes, ainsi que des intervalles de confiance à 95 % délimitant l’incertitude de l’estimation.
10.3 Les dérives du p-hacking et la crise de réplication
L’obligation institutionnelle de franchir le seuil fatidique de $p < 0,05$ pour accéder à la publication dans les revues indexées a favorisé l'émergence de pratiques de recherche contestables regroupées sous la bannière du p-hacking (ou manipulation de significativité).
Ces dérives opérationnelles englobent une multitude de micro-décisions analytiques opportunistes :
- Tester de multiples variables dépendantes et ne rapporter dans l’article final que celle affichant par chance un seuil significatif ;
- Procéder à des analyses en sous-groupes exploratoires sans appliquer de correction formelle pour les comparaisons multiples (telle que la correction de Bonferroni) ;
- Arrêter prématurément le recrutement des sujets au moment exact où la p-valeur franchit le seuil de 0,05 (collecte séquentielle non déclarée) ;
- Basculer rétrospectivement d’un test bilatéral vers un test unilatéral après avoir constaté que le $p$ bilatéral stagnait à 0,08.
Ces manipulations méthodologiques ont eu des répercussions désastreuses sur la réplicabilité des études empiriques au cours des deux dernières décennies. La maîtrise de la lecture de la table de Student permet de restaurer une hygiène scientifique saine, en rappelant que la zone critique d’un test dépend de contraintes théoriques arrêtées en amont et non d’ajustements opportunistes réalisés post hoc.
11. Résolution des cas limites et spécificités numériques de la table t
Lors de la manipulation quotidienne des tables physiques de distribution, le chercheur est fréquemment confronté à des configurations numériques limites qui soulèvent des questions pratiques de résolution.
11.1 Gestion des degrés de liberté non répertoriés
Lorsque la taille d’échantillon implique un nombre de degrés de liberté important (par exemple $ddl = 75$) et que la table statistique présente des paliers espacés sautant de 60 à 120, le recours au conservatisme par arrondi inférieur (retenir la ligne 60) garantit la rigueur décisionnelle. Toutefois, ce conservatisme peut parfois sembler trop sévère en pénalisant excessivement la statistique observée.
Dans ce cadre, une technique mathématique élégante consiste à recourir à l’interpolation harmonique. Parce que la convergence de la distribution t vers la loi normale standard s’opère de façon non pas linéaire mais inversement proportionnelle aux degrés de liberté, l’interpolation gagne considérablement en précision si elle est effectuée sur l’inverse arithmétique des degrés de liberté :
$$\frac{1}{ddl}$$
Si l’on cherche la valeur critique $t$ pour $ddl = 75$ entre la ligne $ddl_1 = 60$ et la ligne $ddl_2 = 120$, on calcule :
$$w = \frac{\frac{1}{75} – \frac{1}{60}}{\frac{1}{120} – \frac{1}{60}} = \frac{0,01333 – 0,01667}{0,00833 – 0,01667} = \frac{-0,00334}{-0,00834} \approx 0,40$$
La valeur critique estimée correspondra alors à :
$$t_{75} = t_{60} + w \times (t_{120} – t_{60})$$
Cette méthode fournit une précision remarquable, évitant de biaiser excessivement le seuil de décision.
11.2 Comportement asymptotique lorsque l’échantillon tend vers l’infini
La dernière rangée des tables de Student, fréquemment identifiée par le symbole de l’infini ($\infty$) ou par la mention explicite de la loi normale centrée réduite Z, formalise la limite asymptotique énoncée par Gosset. À mesure que les degrés de liberté dépassent la centaine, la dispersion d’échantillonnage de la variance $s^2$ devient tellement restreinte que la variance estimée coïncide quasiment avec la variance paramétrique théorique $\sigma^2$.
Il est instructif de mémoriser les valeurs critiques universelles affichées sur cette ligne d’horizon asymptotique pour les risques bilatéraux courants :
- Pour $\alpha = 0,10$ (bilatéral) : $z = 1,645$
- Pour $\alpha = 0,05$ (bilatéral) : $z = 1,960$
- Pour $\alpha = 0,01$ (bilatéral) : $z = 2,576$
- Pour $\alpha = 0,001$ (bilatéral) : $z = 3,291$
Au-delà de 120 degrés de liberté, le différentiel numérique entre la valeur critique d’un t de Student et celle de la loi normale Z devient inférieur à 0,015 pour un seuil à 5 %. C’est pourquoi, sur de vastes échantillons (par exemple $n > 500$), l’analyste peut sans préjudice méthodologique majeur mobiliser directement les quantiles de la loi normale standard.
11.3 Que faire face à des valeurs t extrêmes hors table ?
Il n’est pas rare, lors d’expérimentations comportant des effets massifs ou des dispersions intra-groupes infimes, d’aboutir à des statistiques observées très élevées, par exemple un $t_{\text{obs}} = 5,42$ ou $t_{\text{obs}} = 8,10$. Or, sur la quasi-totalité des tables physiques, la dernière colonne s’interrompt aux alentours de $\alpha = 0,001$ ou $\alpha = 0,0005$ (associée à des valeurs critiques oscillant généralement entre 3,20 et 4,00 selon les ddl).
Face à une telle configuration, l’analyste ne peut évidemment plus encadrer sa valeur entre deux bornes. L’attitude méthodologique standard consiste à formuler une inégalité unilatérale calée sur la borne la plus sévère figurant sur la table :
$$p < 0,001$$
Sous aucune circonstance un chercheur ne doit consigner dans son rapport scientifique la mention mathématiquement fausse $p = 0,000$. En théorie des probabilités continues, la surface sous la cloche s'étend jusqu'à l'infini par ses asymptotes horizontales ; la probabilité résiduelle n'est donc jamais rigoureusement nulle, quel que soit l'éloignement de la statistique de test observée.
12. Transition numérique : de la table papier aux logiciels statistiques et normes APA
Si la lecture manuelle de la table de distribution t demeure l’exercice formateur par excellence, la recherche contemporaine exploite des environnements logiciels computationnels et des normes de publication standardisées.
12.1 Extraction algorithmique de la p-valeur sous R, SPSS et Python
Les suites logicielles actuelles abandonnent les approximations tabulaires pour déterminer la p-valeur par calcul numérique direct d’équations intégrales de la loi de Student. Il est très éclairant de constater comment chaque environnement formalise cette extraction :
- Le langage R : L’environnement statistique de référence permet d’extraire la surface résiduelle exacte grâce à la fonction de répartition cumulative
pt(). Pour un test bilatéral avec un $t$ de 2,35 et 14 degrés de liberté, l’exécution de la commande :
2 * (1 - pt(2.35, df = 14))
renvoie immédiatement la valeur continue :0.03396884. De manière plus automatisée, la fonction nativet.test()délivre l’ensemble des métriques d’inférence au sein d’une restitution synthétique. - IBM SPSS Statistics : Le progiciel affiche ses résultats sous la forme de matrices standardisées. La p-valeur y figure sous l’en-tête « Sig. (2-tailed) » (Signification bilatérale). Une vigilance s’impose : lorsque la p-valeur est extrêmement faible, SPSS affiche la chaîne typographique
.000. Il incombe à l’analyste de corriger cette notation lors de la rédaction de ses manuscrits pour la convertir enp < .001. - Python (SciPy) : Au sein de l’écosystème Python, le module
scipy.statsconstitue la référence computationnelle. L’implémentation de la fonction de surviestats.t.sf()(qui correspond mathématiquement à $1 – \text{CDF}$) permet d’obtenir directement les probabilités de queue :
2 * stats.t.sf(abs(2.35), df=14)
Tandis que la commandestats.ttest_ind()prend en charge l’exécution intégrale du test d’hypothèses sur deux échantillons indépendants.
12.2 Formalisation des résultats selon les normes de l’American Psychological Association (APA)
La transmission rigoureuse des analyses statistiques dans les publications internationales obéit à des conventions typographiques et structurelles strictes, codifiées au sein du manuel de style de l’APA (7e édition). La restitution d’un test t de Student doit respecter une séquence normalisée comportant la lettre de la statistique en italique, les degrés de liberté entre parenthèses, la valeur calculée arrondie à deux décimales, la p-valeur exacte et la taille d’effet :
$$\textit{t}(\text{ddl}) = \text{valeur}, \textit{p} = \text{valeur}, \textit{d} = \text{valeur}$$
Voici trois formulations académiques exemplaires illustrant cette standardisation selon la nature des résultats :
- Pour un résultat statistiquement significatif au moyen d’un logiciel :
« L’analyse révèle une diminution significative du niveau d’anxiété post-thérapeutique dans le groupe expérimental comparativement au groupe témoin, t(28) = 2,47, p = ,020, d = 0,92, IC à 95 % [0,78 ; 7,02]. » - Pour un résultat non significatif encadré par table :
« La vitesse de traitement des participants sous surcharge attentionnelle ne diffère pas de manière statistiquement significative de la norme de référence, t(22) = 1,34, p > ,10, d = 0,28. » - Pour une statistique hautement extrême hors table :
« L’intervention induit une amélioration substantielle et robuste des scores mnésiques, t(17) = 5,89, p < ,001, d = 1,39. »
Conformément aux directives de l’APA, lorsque la p-valeur est exprimée numériquement, le zéro initial précédant la virgule décimale doit être omis (écrire p = ,042 et non p = 0,042), car une probabilité ne peut par essence mathématique jamais excéder la valeur 1.
12.3 Le mouvement Open Science et l’avenir de l’inférence statistique
L’inférence quantitative contemporaine traverse une mutation épistémologique profonde sous l’impulsion du mouvement pour la science ouverte (Open Science). Les défaillances de réplication documentées au cours de la dernière décennie ont mis en évidence la nécessité d’assortir les tests de Student de pratiques garantissant l’intégrité de la démarche scientifique.
Le pré-enregistrement systématique des protocoles de recherche sur des plateformes institutionnelles comme l’Open Science Framework (OSF) s’impose progressivement comme une norme d’excellence. En déclarant formellement le choix de l’orientation du test (unilatéral ou bilatéral), la règle d’arrêt de collecte des données et les critères d’exclusion des observations aberrantes avant même d’entamer le recueil expérimental, le pré-enregistrement élimine le risque d’altération opportuniste de la décision statistique.
Parallèlement, la diffusion croissante des approches bayésiennes invite les chercheurs à compléter l’usage du test t traditionnel par le calcul du Facteur de Bayes ($BF_{10}$). Ce dernier présente l’avantage considérable de quantifier de manière symétrique la force probante des données en faveur de l’hypothèse alternative ou, à l’inverse, d’apporter la preuve directe de la validité de l’hypothèse nulle d’absence d’effet, une prouesse que le cadre fréquentiste classique fondé sur la table de Student ne saurait rigoureusement accomplir.
Néanmoins, loin de rendre obsolète la distribution imaginée par William Sealy Gosset, ces innovations confirment son rôle fondateur. La compréhension intime de la table de Student demeure la pierre angulaire de la formation méthodologique, offrant aux chercheurs un socle d’alphabétisation statistique sans lequel aucune évaluation critique des résultats scientifiques contemporains ne saurait être valablement menée.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108