
L’analyse empirique et la modélisation quantitative constituent le socle de la démarche scientifique moderne, traversant l’ensemble des disciplines depuis l’économétrie jusqu’aux sciences cognitives et à la psychométrie. Au cœur de cette quête d’intelligibilité des phénomènes naturels et humains réside l’impératif de synthétiser des relations bivariées complexes au moyen de fonctions mathématiques rigoureuses et interprétables. La droite d’ajustement, communément désignée sous le vocable anglophone de line of best fit ou droite de régression linéaire, matérialise cette ambition épistémologique en offrant une passerelle formelle entre l’observation brute et l’abstraction prédictive.
Dans le paysage contemporain des outils de traitement de données, les environnements infonuagiques ont démocratisé des capacités computationnelles jadis réservées à des progiciels statistiques spécialisés. Parmi ces outils, Google Sheets s’est imposé comme une solution incontournable, combinant accessibilité collaborative, puissance de calcul algorithmique et flexibilité graphique. Toutefois, la facilité apparente avec laquelle un utilisateur peut tracer une trajectoire linéaire à travers un nuage de points occulte fréquemment les hypothèses stochastiques sous-jacentes et les exigences méthodologiques indispensables à une interprétation valide des résultats.
Ce guide encyclopédique se propose d’explorer de manière exhaustive l’art et la science de la détermination de la droite d’ajustement dans Google Sheets. En alliant une rigueur mathématique sans compromis aux réalités pratiques de la manipulation logicielle, ce document guide l’analyste, le chercheur ou l’étudiant avancé à travers chaque étape du processus : depuis les fondements théoriques de l’estimation par les moindres carrés jusqu’aux protocoles avancés de diagnostic des résidus, d’analyse matricielle et de publication académique selon les normes internationales.
1. Introduction théorique et épistémologique à la droite d’ajustement
1.1 Définition statistique de la droite de meilleur ajustement
Sur le plan fondamental, la droite d’ajustement représente l’expression géométrique et analytique de la tendance centrale régissant la covariation entre deux grandeurs quantitatives continues. Lorsque des paires d’observations sont projetées au sein d’un repère cartésien bidimensionnel, la distribution spatiale qui en résulte — le nuage de points — manifeste rarement une cohérence parfaite en raison des fluctuations d’échantillonnage, des erreurs de mesure inhérentes aux instruments et de la variabilité biologique ou comportementale propre aux sujets d’étude. La droite de meilleur ajustement intervient précisément pour extraire le signal structural sous-jacent au milieu de ce bruit stochastique.
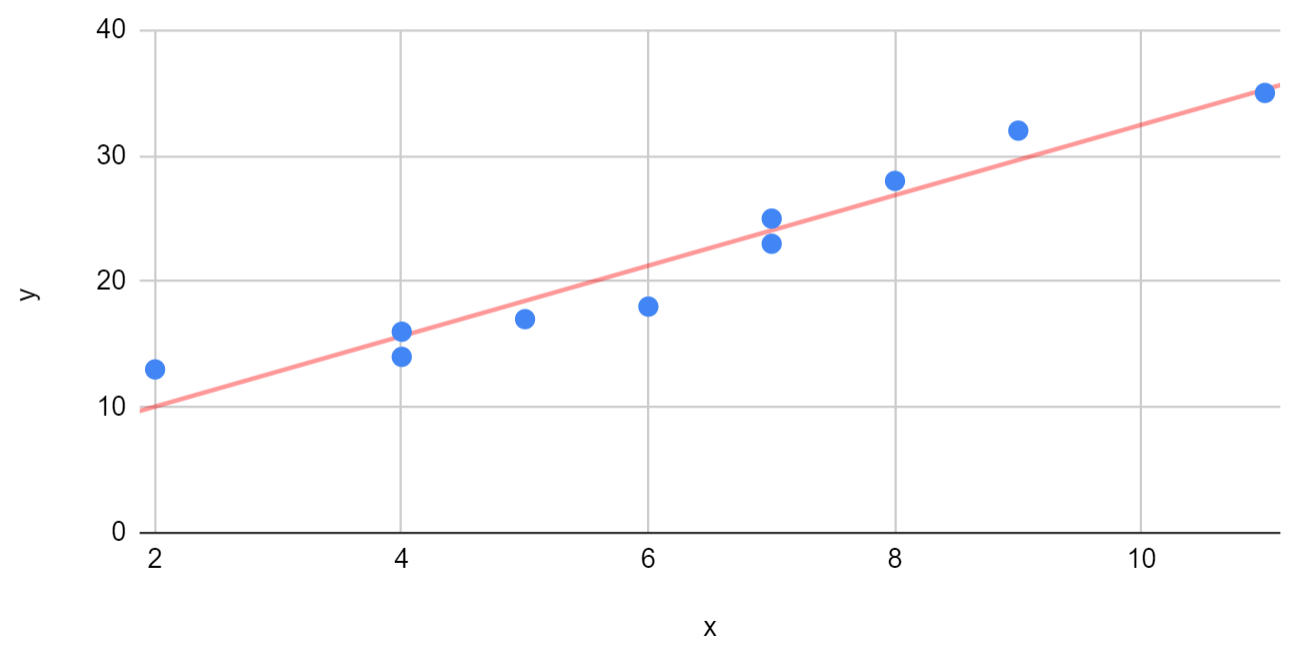
D’un point de vue géométrique, cette droite est déterminée de manière à minimiser la somme des écarts verticaux séparant chaque point de données empirique de la trajectoire modélisée correspondante. Contrairement à une distance euclidienne orthogonale qui mesurerait l’écart le plus court entre le point et la droite dans toutes les directions de l’espace, la régression univariée classique privilégie l’asymétrie fonctionnelle : l’abscisse est postulée comme exempte d’erreur de mesure ou fixée par l’expérimentateur, tandis que l’ordonnée concentre l’ensemble de l’aléa résiduel. Cette minimisation directionnelle traduit une posture téléologique précise, orientée vers l’optimisation de la prédiction de la variable dépendante conditionnellement aux valeurs de la variable explicative.
Il convient d’établir une démarcation épistémologique nette entre un modèle déterministe et un modèle stochastique. Dans un cadre déterministe, issu des lois fondamentales de la physique classique, une valeur d’entrée conduit de manière invariable et exacte à une valeur de sortie unique selon une relation invariante. En revanche, le modèle de régression linéaire appliqué aux données observationnelles s’inscrit dans un paradigme stochastique : il ne prétend nullement prédire l’emplacement exact d’une observation singulière, mais caractérise plutôt l’espérance conditionnelle d’une population statistique. La droite constitue ainsi le lieu géométrique des moyennes espérées de la variable critère pour chaque graduation théorique de la variable prédictive.
Dans le continuum de l’investigation scientifique, cette construction remplit un rôle pivot à l’intersection de l’analyse exploratoire des données, telle que conceptualisée par John Tukey, et de l’analyse confirmatoire dévolue aux tests d’hypothèses formels. En phase exploratoire, elle permet de détecter des gradients, de repérer des tendances globales et de calibrer visuellement des intuitions morphologiques. En phase confirmatoire, elle fournit les paramètres quantifiés indispensables au calcul des tailles d’effet, à l’inférence des intervalles de confiance et à l’arbitrage théorique entre modèles concurrents.
1.2 Fondements mathématiques : la méthode des moindres carrés ordinaires (MCO)
La dérivation formelle de la droite d’ajustement repose traditionnellement sur la méthode des moindres carrés ordinaires, conceptualisée indépendamment par Carl Friedrich Gauss et Adrien-Marie Legendre au tournant du XIXe siècle. Soit un ensemble de $n$ couples d’observations empiriques notés $(x_i, y_i)$ pour $i in {1, 2, dots, n}$. Le modèle postule une relation fonctionnelle affine augmentée d’un terme d’erreur résiduel, telle que :
$$y_i = \beta_0 + \beta_1 x_i + \varepsilon_i$$
Dans cette formulation mathématique, $\beta_0$ représente l’ordonnée à l’origine (ou constante), $\beta_1$ désigne le coefficient de pente (ou gradient de régression), et $\varepsilon_i$ incarne l’erreur stochastique inhérente à la $i$-ième observation. Afin d’estimer de manière optimale les paramètres de la population à partir de l’échantillon, notés respectivement $b_0$ et $b_1$, les moindres carrés ordinaires établissent une fonction de perte quadratique, désignée sous le terme de somme des carrés des résidus (notée couramment Residual Sum of Squares ou $RSS$) :
$$S(b_0, b_1) = \sum_{i=1}^n e_i^2 = \sum_{i=1}^n (y_i – \hat{y}_i)^2 = \sum_{i=1}^n (y_i – (b_0 + b_1 x_i))^2$$
Le recours à une pénalisation quadratique présente des propriétés analytiques majeures : il garantit la différentiabilité de la fonction sur l’ensemble du domaine réel et sanctionne de façon exponentielle les déviations majeures, décourageant ainsi l’éloignement excessif du modèle vis-à-vis des observations distantes. La résolution de ce problème d’optimisation sans contrainte s’opère par l’annulation conjointe des dérivées partielles de la fonction de perte par rapport à chacun des deux estimateurs cibles :
$$\frac{\partial S}{\partial b_0} = -2 \sum_{i=1}^n (y_i – b_0 – b_1 x_i) = 0$$
$$\frac{\partial S}{\partial b_1} = -2 \sum_{i=1}^n x_i (y_i – b_0 – b_1 x_i) = 0$$
Ce système d’équations, désigné sous l’appellation d’équations normales de Gauss, conduit par réarrangement algébrique direct aux expressions fermées des estimateurs optimaux. L’estimateur de la pente $b_1$ s’exprime comme le ratio de la covariance empirique entre $X$ et $Y$ sur la variance empirique de $X$ :
$$b_1 = \frac{\sum_{i=1}^n (x_i – \bar{x})(y_i – \bar{y})}{\sum_{i=1}^n (x_i – \bar{x})^2} = \frac{\mathrm{Cov}(X, Y)}{\mathrm{Var}(X)}$$
Consécutivement, l’ordonnée à l’origine $b_0$ se déduit immédiatement en contraignant la droite à transiter obligatoirement par le centre de gravité gravitationnel de la distribution bivariée, défini par le point cartésien de coordonnées $(\bar{x}, \bar{y})$ :
$$b_0 = \bar{y} – b_1 \bar{x}$$
En vertu du théorème de Gauss-Markov, ces estimateurs possèdent la propriété cardinale d’être sans biais et à variance minimale parmi l’ensemble des estimateurs linéaires sans biais (propriété désignée par l’acronyme BLUE : Best Linear Unbiased Estimator), sous réserve que les erreurs satisfassent les hypothèses d’homoscédasticité, d’indépendance mutuelle et d’espérance nulle. Néanmoins, la structure quadratique de la fonction de perte induit une hypersensibilité mécanique aux valeurs extrêmes, car une observation déviante unique possède le pouvoir de modifier substantiellement la trajectoire de la droite pour minimiser son résidu spécifique élevé au carré.
1.3 Pertinence méthodologique en sciences comportementales et psychologie
L’application de la régression linéaire et l’ajustement de lignes directrices revêtent une dimension fondamentale dans le domaine des sciences comportementales, de la neuropsychologie et de l’épidémiologie sociale. Dans ces champs disciplinaires, les chercheurs sont confrontés à la nécessité d’opérationnaliser des construits théoriques latents — tels que le niveau d’anxiété, la mémoire de travail, l’intelligence fluide ou le bien-être subjectif — en métriques observables continues recueillies au moyen de batteries psychométriques ou de dispositifs chronométriques de précision.
La droite d’ajustement permet de tester formellement l’existence et l’intensité d’une association directionnelle entre une variable indépendante manipulée expérimentalement (par exemple, la posologie d’un principe actif nootropique ou la durée d’une privation de sommeil) et un score comportemental résultant. Elle offre la possibilité d’estimer avec précision le gradient de transformation théorique liant deux entités psychologiques, permettant ainsi d’évaluer dans quelle mesure l’accroissement standardisé d’un construit entraîne une altération concomitante et mesurable de l’autre.
Toutefois, la manipulation de ces modèles statistiques impose une vigilance épistémologique constante face au risque récurrent de confusion entre corrélation empirique et imputation causale. La démonstration d’une pente de régression hautement significative entre deux variables comportementales ne constitue en aucun cas une preuve suffisante de causalité unidirectionnelle. Des phénomènes de causalité inverse, d’influence de tierces variables non contrôlées (variables confondantes) ou de mécanismes de rétroaction systémique peuvent engendrer des droites d’ajustement à l’allure impeccable qui ne traduisent pourtant qu’un artefact d’observation.
2. Préparation et structuration rigoureuse du jeu de données dans Google Sheets
2.1 Organisation matricielle des variables indépendantes et dépendantes
La réussite computationnelle d’une modélisation linéaire au sein d’un tableur dépend en premier lieu de la rigueur de l’architecture matricielle initiale. Contrairement à un logiciel de statistique à syntaxe pure où l’agencement spatial importe peu, Google Sheets tire parti de conventions d’organisation spatiale pour automatiser l’assignation des axes dans ses modules de visualisation graphique.
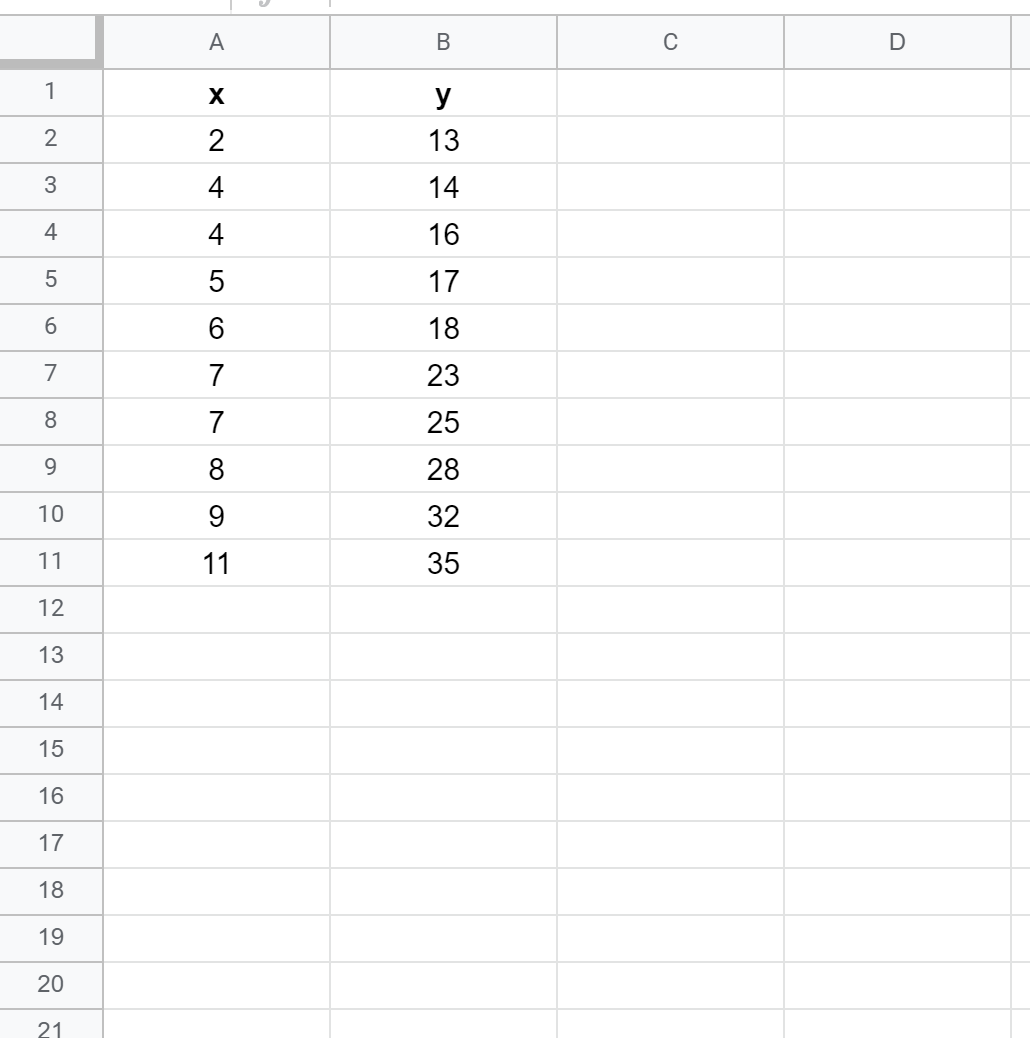
La règle méthodologique prédominante impose de disposer les données sous la forme d’un tableau rectangulaire strict où chaque ligne représente une unité d’échantillonnage singulière (sujet expérimental, séance d’essai, unité géographique) et chaque colonne matérialise une variable unidimensionnelle continue. Par convention logicielle et pour faciliter les interactions avec les algorithmes d’autodétection de Google Sheets, il est vivement recommandé d’implanter la variable indépendante ($X$, prédictive) dans la colonne située immédiatement à gauche de la colonne hébergeant la variable dépendante ($Y$, critère). Ainsi, la plage de cellules $A2:A100$ contiendra typiquement les valeurs de l’axe des abscisses, tandis que la plage contiguë $B2:B100$ hébergera les valeurs correspondantes de l’axe des ordonnées.
L’étiquetage des colonnes requiert une clarté absolue. La ligne 1 doit être systématiquement réservée aux en-têtes textuels explicites, stipulant la nature exacte du construit et son unité de mesure (par exemple, Temps_Reaction_ms ou Dose_Cafeine_mg). Cette pratique prévient les ambiguïtés lors de la génération automatisée des légendes par le tableur. Il est impératif de veiller à la typologie native des données : Google Sheets aligne par défaut les valeurs numériques reconnues à droite de la cellule, tandis que les chaînes textuelles demeurent alignées à gauche. Toute inadvertance typographique conduisant à l’insertion d’un caractère non numérique convertit l’intégralité de la cellule en chaîne de caractères, excluant cette ligne des calculs de régression.
2.2 Nettoyage préliminaire et détection des valeurs aberrantes
L’intégrité de la droite d’ajustement est conditionnée par l’assainissement préalable du tableau de données. La présence d’erreurs de saisie cléricales, de zéros malencontreux résultant de pannes d’enregistrement matériel ou de valeurs biologiquement invraisemblables est susceptible de distordre lourdement l’estimation des moindres carrés. L’activation des filtres conditionnels natifs (via le menu Données > Créer un filtre) constitue la première étape d’inspection, autorisant le tri instantané des colonnes par ordre croissant et décroissant afin de repérer les seuils aberrants.
Le traitement des données manquantes représente un enjeu méthodologique déterminant. Lorsqu’une cellule est laissée vierge au sein d’un couple $(x_i, y_i)$, Google Sheets adopte un comportement d’omission casuelle (listwise deletion) lors de la génération visuelle de la ligne de tendance, tout en adaptant dynamiquement les plages de calcul de ses formules scalaires. L’analyste doit choisir de manière documentée entre l’exclusion systématique des paires incomplètes ou l’application d’une méthode d’imputation méthodique (telle que l’imputation par la moyenne conditionnelle ou une modélisation par algorithme EM), afin de ne pas introduire un biais de sélection si l’absence d’observation n’est pas distribuée de manière purement aléatoire (mécanisme Missing Completely at Random).
Les scores extrêmes, communément désignés sous le terme d’outliers, méritent un examen rigoureux fondé sur des métriques objectives. L’application d’une mise en forme conditionnelle signalant les valeurs dont l’écart à la moyenne excède trois écarts-types ($\pm 3\sigma$) ou franchissant 1,5 fois l’intervalle interquartile au-delà des quartiles $Q_1$ et $Q_3$ permet d’isoler visuellement les observations hautement suspectes avant tout engagement dans la modélisation graphique.
2.3 Standardisation des unités et formats de mesure
L’interopérabilité internationale de Google Sheets introduit des écueils fréquents liés à la gestion des séparateurs décimaux. En fonction des paramètres régionaux configurés dans la feuille (accessibles sous Fichier > Paramètres), le logiciel utilise soit la virgule (norme francophone et européenne continentale), soit le point (norme anglo-saxonne). Une inadéquation entre le format de collage de données externes et la localisation du tableur génère instantanément des erreurs silencieuses, les nombres étant interprétés comme des libellés textuels inertes.
Dans de nombreuses configurations de recherche avancée, notamment lorsque les variables sont exprimées sur des échelles métriques sans commune mesure (par exemple, des millisecondes confrontées à des scores discrets d’inventaires de personnalité), il s’avère judicieux d’opérer une standardisation mathématique par le calcul de scores centrés-réduits, dits scores Z. Cette opération s’exécute aisément dans Google Sheets en adjoignant deux colonnes de transformation via la formule suivante appliquée à la cellule cible :
$A$2:$A$100)) / STDEV($A$2:$A$100)} »>$$z_i = \frac{x_i – \bar{x}}{s_x} \quad long\rightarrow \quad \text{Formule : } texttt{=(A2 – AVERAGE($A$2:$A$100)) / STDEV($A$2:$A$100)}$$
L’utilisation de variables standardisées transforme le coefficient de pente de la droite d’ajustement en l’exact équivalent du coefficient de corrélation linéaire de Bravais-Pearson, ramenant l’ordonnée à l’origine strictement à zéro. Cette standardisation facilite grandement la comparabilité transdisciplinaire des intensités d’effets observées au sein du modèle.
3. Génération du nuage de points (Scatterplot) préliminaire
3.1 Sélection de la plage de cellules et insertion de l’élément visuel
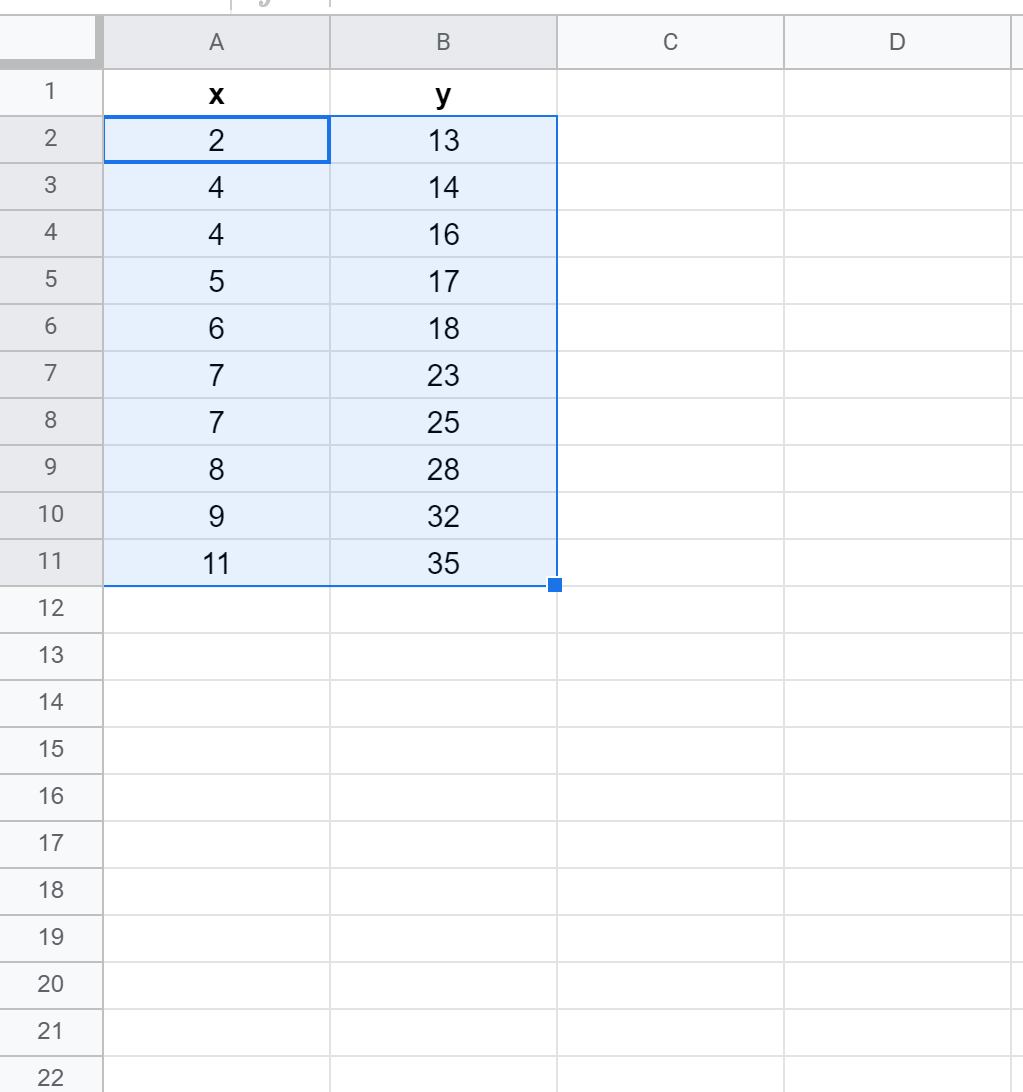
L’adage méthodologique formulé par le statisticien Francis Anscombe souligne qu’aucun calcul de régression ne devrait jamais être entrepris sans un examen visuel préalable de la dispersion spatiale des observations. Pour initier ce processus au sein de Google Sheets, l’opérateur doit sélectionner la matrice de données avec une précision chirurgicale, en incluant impérativement les cellules d’en-tête de la première ligne. Par exemple, la sélection recouvrira la plage rectangulaire continue $A1:B101$.
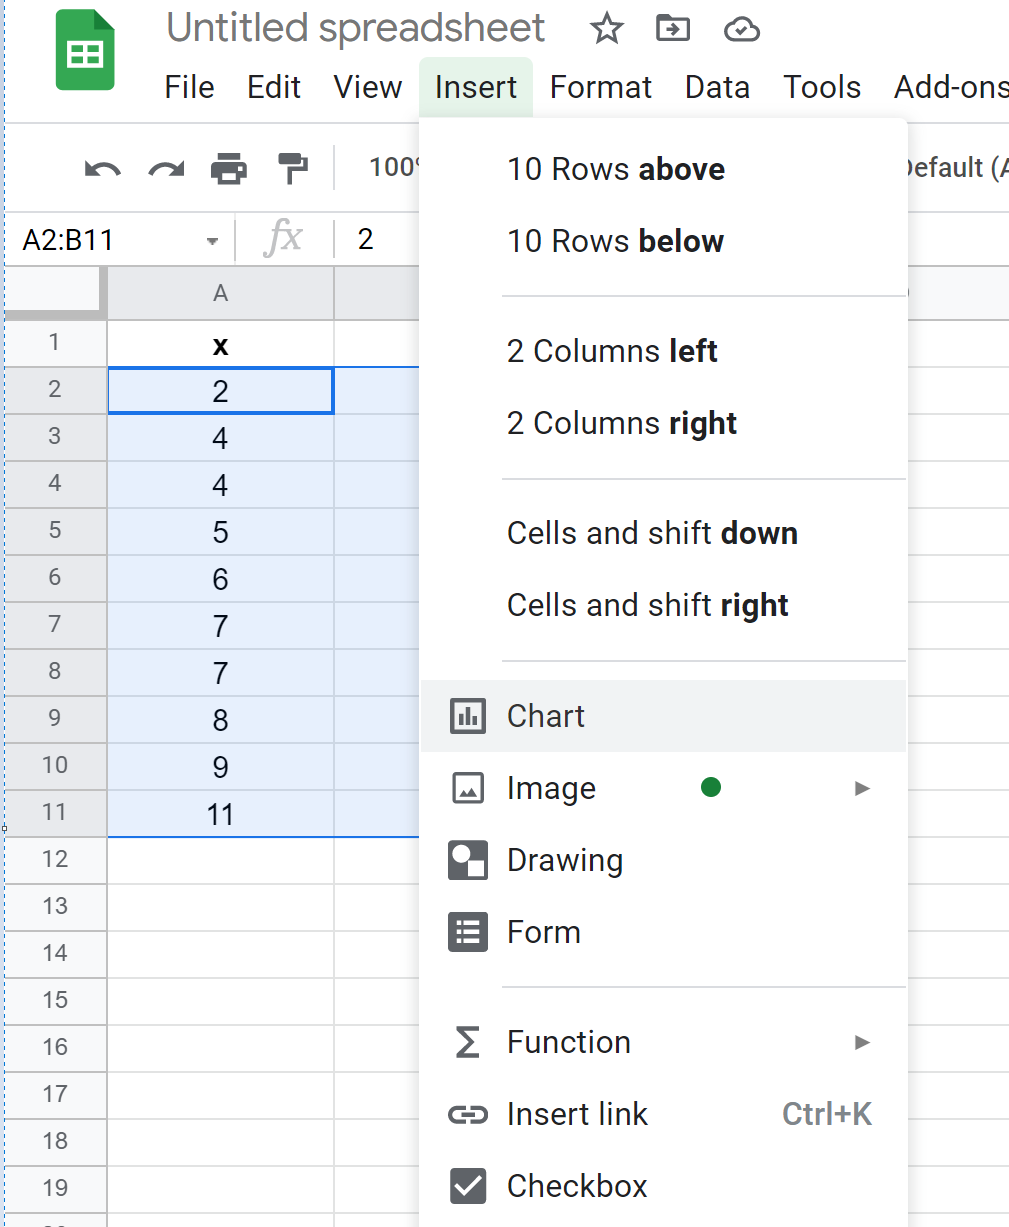
Une fois les coordonnées numériques circonscrites par le curseur, la génération de l’objet graphique s’effectue en accédant au ruban supérieur :
- Cliquer sur le menu textuel Insertion situé dans la barre d’outils principale.
- Sélectionner l’élément Graphique dans la liste contextuelle déroulante.
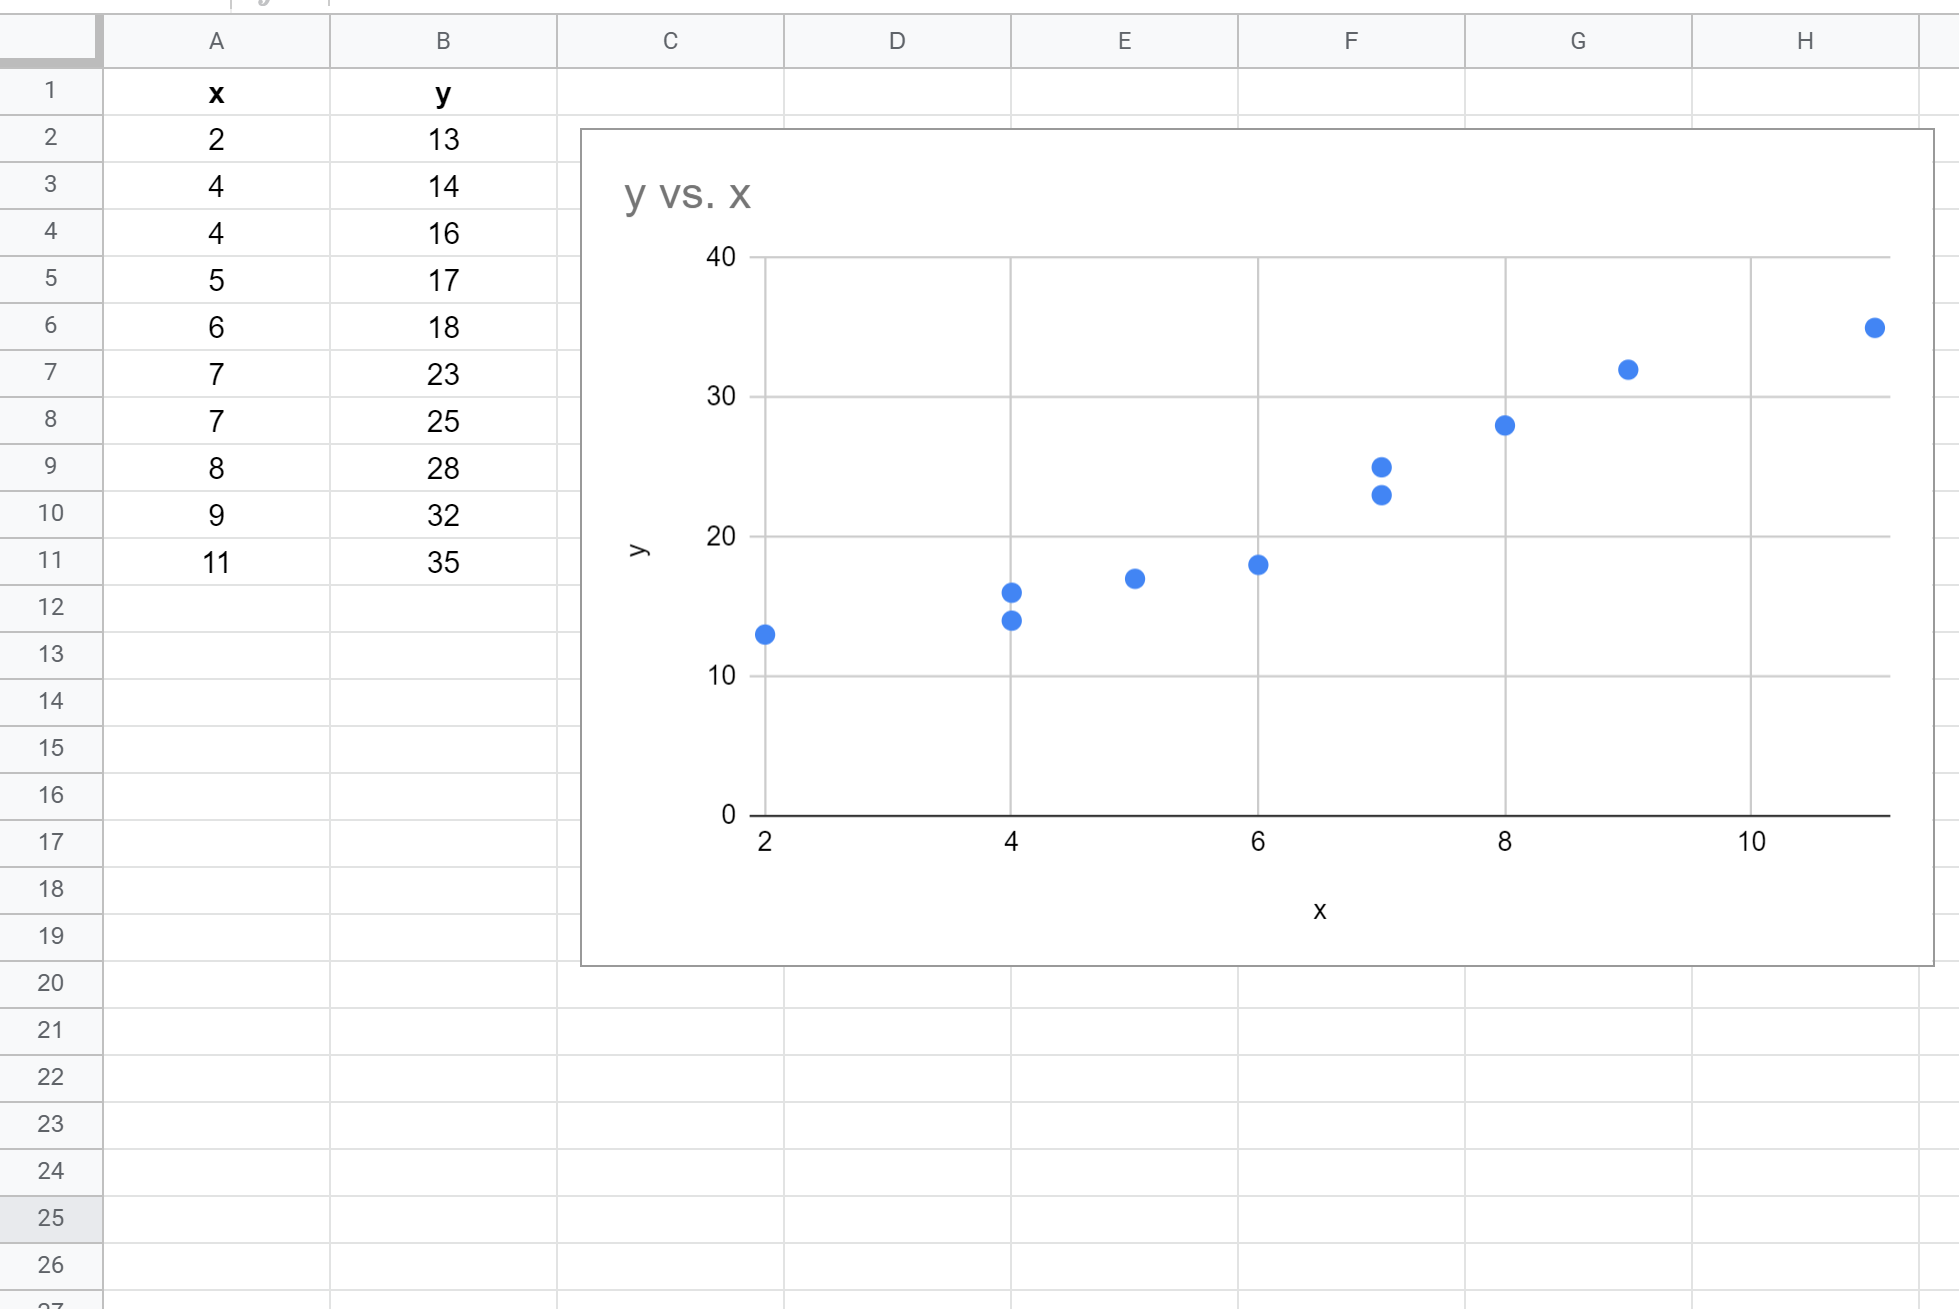
À cet instant, le moteur d’intelligence heuristique de Google Sheets analyse la structure matricielle fournie. Si le tableau est ordonné selon la convention susmentionnée, le logiciel déploie immédiatement un canevas graphique au sein de la feuille active tout en ouvrant, sur le flanc droit de l’espace de travail, le panneau interactif intitulé Éditeur de graphiques. Cependant, l’algorithme d’inférence logicielle choisit parfois erronément de représenter les données sous forme d’histogrammes verticaux ou de graphiques linéaires chronologiques, ce qui impose une reconfiguration immédiate.
3.2 Configuration du type de tracé dans l’éditeur de graphiques
Pour contraindre Google Sheets à afficher une véritable relation bivariée sans interpolation linéaire temporelle artificielle, l’analyste doit impérativement configurer le type de tracé approprié au sein du panneau latéral :
- Cliquer sur le premier onglet principal nommé Configuration au sommet de l’éditeur de graphiques.
- Dérouler le menu sélecteur sous l’intitulé Type de graphique.
- Parcourir les catégories graphiques jusqu’à la section intitulée Autres ou Nuage de points, puis cliquer explicitement sur l’icône Graphique en nuage de points (Scatter plot).
L’interface restructure instantanément le rendu cartésien. Il demeure indispensable de vérifier scrupuleusement l’assignation des axes opérée par le logiciel. Dans la sous-section Axe X, le champ doit mentionner de façon univoque la plage référençant votre variable prédictive (ex. A1:A100). Directement en dessous, dans la section Séries, doit figurer la variable critère (ex. B1:B100).
Deux cases à cocher déterminantes exigent une validation rigoureuse au bas du panneau de configuration :
- Utiliser la ligne 1 comme en-têtes : cette option doit être cochée pour transformer les libellés de la première rangée en titres automatiques d’axes et de légendes, évitant ainsi que le premier point de mesure soit confondu avec une coordonnée numérique égale à zéro.
- Utiliser la colonne A comme libellés : cette case permet d’ancrer de manière irrévocable la colonne initiale en tant que variable graduant l’abscisse horizontale.
3.3 Contrôle de la distribution empirique initiale
L’affichage du nuage de points sans aucun artifice géométrique ouvre une étape diagnostique primordiale : le contrôle visuel des postulats d’ajustabilité linéaire. L’œil humain constitue un détecteur de formes particulièrement performant, capable d’identifier instantanément des singularités mathématiques qu’un calcul algorithmique global dissimulerait sous un score agrégé flatteur.
L’analyste doit procéder à un balayage oculaire méthodique selon trois axes d’évaluation :
- L’homogénéité de la dispersion spatiale : le nuage présente-t-il une densité constante sur l’ensemble de son étendue, ou observe-t-on des conglomérats denses isolés les uns des autres (signe potentiel d’un échantillonnage stratifié non contrôlé) ?
- La monotonicité et la forme générale : la relation globale s’inscrit-elle raisonnablement dans une trajectoire rectiligne monotone, ou met-elle en évidence une courbure parabolique, une inflexion sigmoïdale ou une saturation asymptotique ? Si la courbure est manifeste, forcer une droite d’ajustement de premier degré constituerait une grave erreur de spécification théorique.
- L’identification visuelle des ruptures de variance : l’épaisseur verticale du nuage s’évase-t-elle de façon prononcée à mesure que $X$ croît ? Ce phénomène, indicateur précoce d’hétéroscédasticité, signale que la fiabilité de la modélisation variera selon l’intervalle de prédiction considéré.
4. Activation et personnalisation de la droite d’ajustement dans Google Sheets
4.1 Accès aux options de modélisation de la série de données
Dès lors que le nuage de points confirme l’admissibilité d’une trajectoire monotone linéaire, la phase d’adjonction computationnelle de la droite peut débuter au cœur de l’environnement interactif de Google Sheets. Pour appeler le panneau de paramétrage avancé si celui-ci s’est refermé, il suffit d’effectuer un double-clic vigoureux sur n’importe quel espace vierge du graphique cartésien, ou de cliquer sur les trois points verticaux logés dans l’angle supérieur droit du graphique pour sélectionner l’item Modifier le graphique.
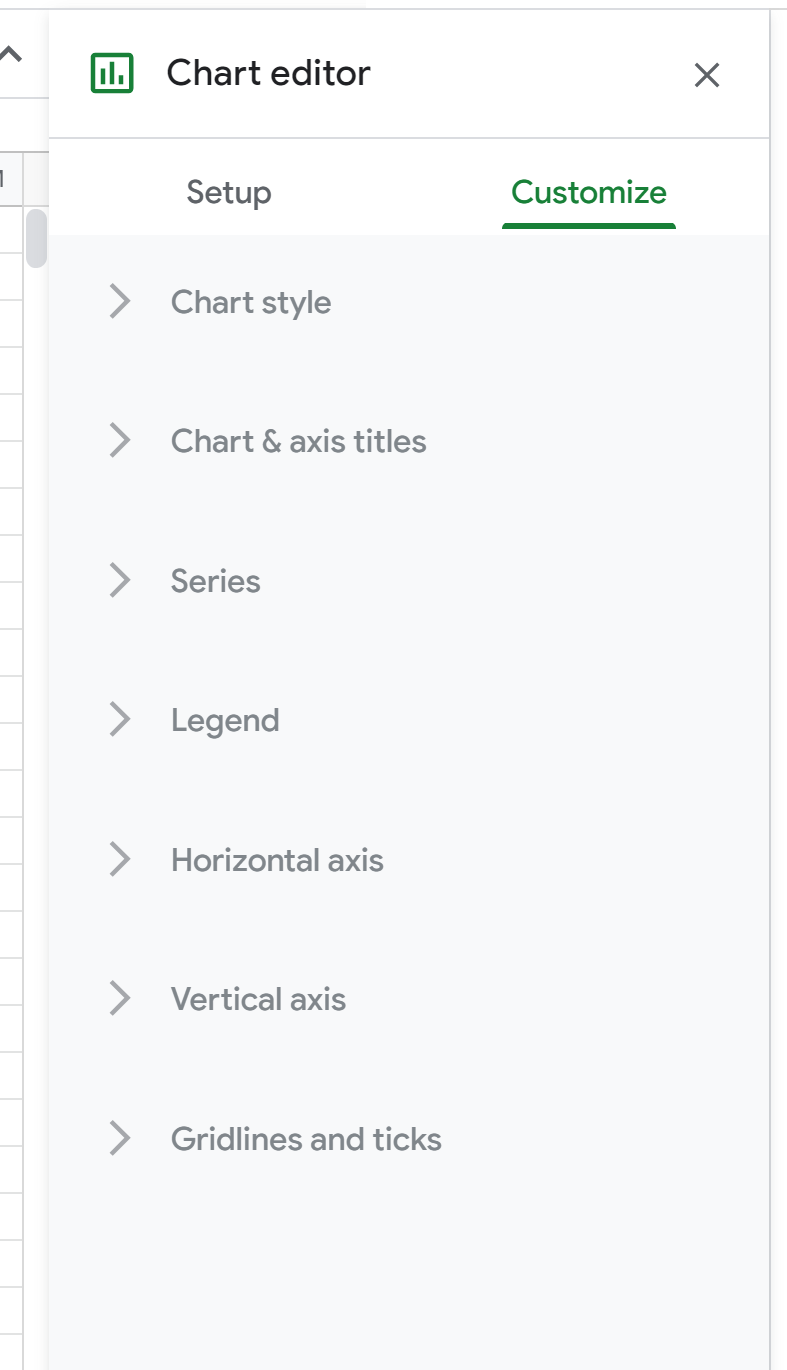
Dans l’éditeur qui surgit sur la droite de l’écran, l’attention méthodologique doit basculer de l’onglet structurel vers l’onglet cosmétique et analytique :
- Sélectionner l’onglet supérieur droit intitulé Personnaliser.
- Repérer et déployer le menu accordéon nommé Séries en cliquant sur la flèche adjacente.
La section Séries renferme l’ensemble des moteurs de modification paramétrique régissant l’apparence des marqueurs individuels, le traitement des barres d’erreur expérimentales et, fondamentalement, les fonctionnalités de modélisation asymptotique et tendancielle disponibles au sein de la suite bureautique infonuagique.
4.2 Application de la ligne de tendance linéaire
L’implémentation effective de la droite d’ajustement requiert le positionnement méthodique de plusieurs bascules logicielles au sein de ce volet Séries :
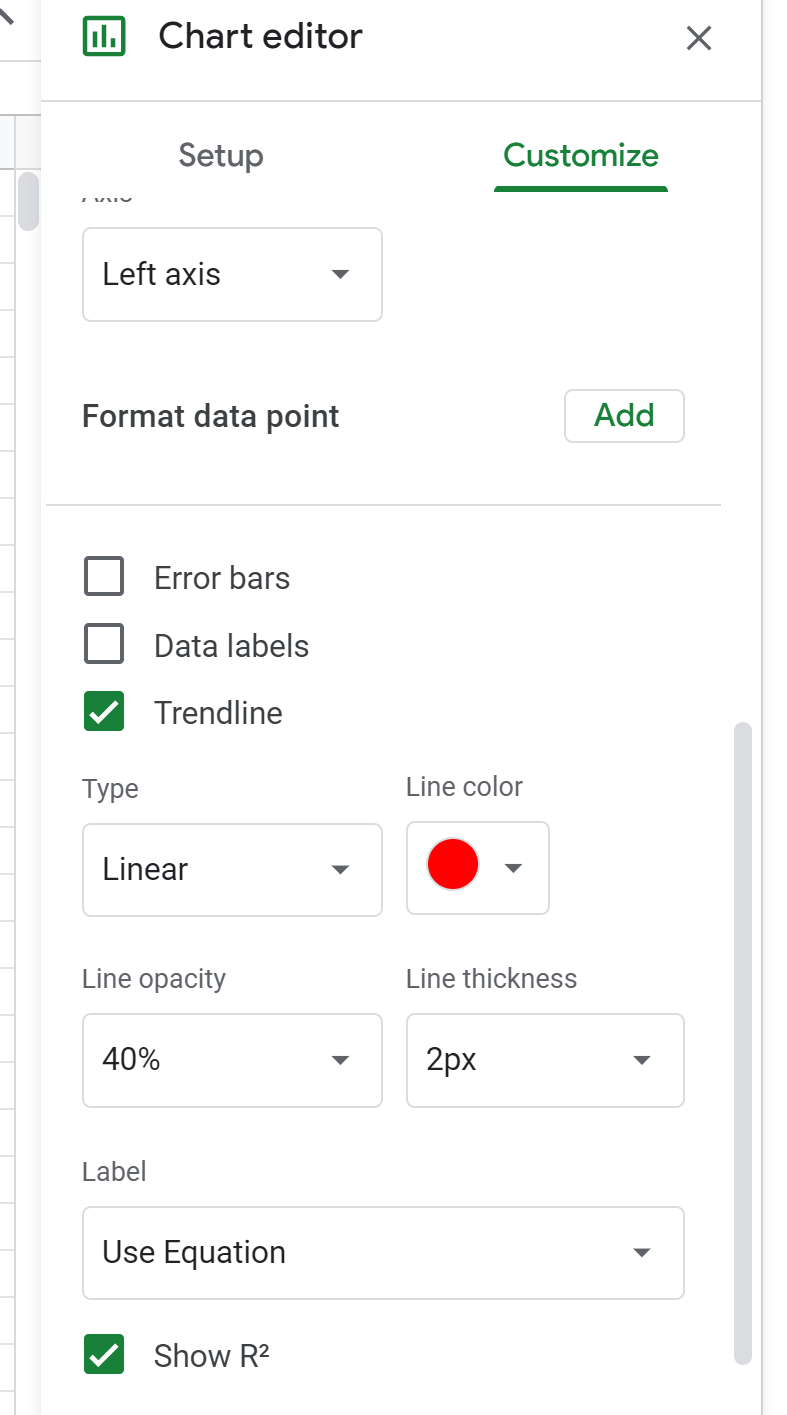
- Faire défiler le panneau vers le bas jusqu’à localiser la case à cocher intitulée Ligne de tendance (Trendline).
- Cocher cette case d’un clic gauche. Instantanément, le moteur graphique de Google Sheets injecte une droite traversant de part en part le plan cartésien du graphique.
- Vérifier immédiatement la liste déroulante subsidiaire qui vient d’apparaître sous l’intitulé Type de ligne de tendance. Par défaut, le logiciel sélectionne l’option Linéaire. Il convient de veiller à ce que ce paramètre soit fermement maintenu pour répondre au cadre d’une modélisation polynomiale d’ordre un régie par les moindres carrés ordinaires.
Cette action provoque l’exécution en arrière-plan d’une routine d’optimisation numérique calculant instantanément les coefficients optimaux $b_0$ et $b_1$ selon les formules d’équations normales démontrées à la section 1.2, et matérialise visuellement la réponse moyenne espérée pour chaque abscisse comprise entre la plus petite et la plus grande coordonnée empirique observée.
4.3 Modulation des attributs graphiques de la droite
Afin de préserver la lisibilité du document et de satisfaire aux canons rigoureux de la communication scientifique, la ligne de tendance ne doit pas entrer en conflit perceptif avec les points de dispersion sous-jacents. Google Sheets met à disposition de l’expérimentateur un ensemble complet de curseurs de modulation géométrique situés immédiatement sous le sélecteur du type de tendance :
- Couleur de la ligne de tendance : il est impératif d’opter pour une teinte offrant un contraste suffisant vis-à-vis des marqueurs de données. Si vos observations empiriques sont représentées par des disques bleu nuit ou gris acier, configurez la ligne de tendance dans une tonalité vermillon, carmin ou noir profond afin de détacher nettement la structure théorique des variations empiriques.
- Opacité de la ligne : accessible via le menu déroulant d’opacité (gradué de 0% à 100%). Un calibrage à 80% ou 100% confère une autorité visuelle nette au modèle, tandis qu’une valeur abaissée à 60% s’avère stratégique lorsque les densités d’observations sous la droite requièrent de demeurer parfaitement discernables par transparence.
- Épaisseur du trait : paramétrable de 1 pixel à 8 pixels. Une épaisseur de 2 à 4 pixels est préconisée par les chartes graphiques universitaires : un trait de 1 pixel présente une fragilité visuelle susceptible de disparaître à l’impression papier, tandis qu’un calibre de 8 pixels induit une illusion d’épaisseur masquant l’imprécision statistique de l’estimation.
5. Extraction et formalisation de l’équation mathématique du modèle
5.1 Activation de l’affichage de l’équation sur le graphique
L’intégration géométrique de la ligne de tendance au sein du canevas cartésien demeure scientifiquement insuffisante tant que les valeurs scalaires des paramètres régissant sa translation et son inclinaison n’ont pas été formellement extraites. Google Sheets propose une passerelle directe permettant d’afficher l’équation mathématique affine sans nécessiter la saisie manuelle de calculs annexes :
- En demeurant au sein du sous-menu Ligne de tendance (onglet Personnaliser > Séries), faire défiler les options jusqu’au champ intitulé Libellé (Label).
- Par défaut, ce paramètre arbore la valeur restrictive Aucun. Dérouler le menu contextuel et cliquer sur l’option Utiliser l’équation.
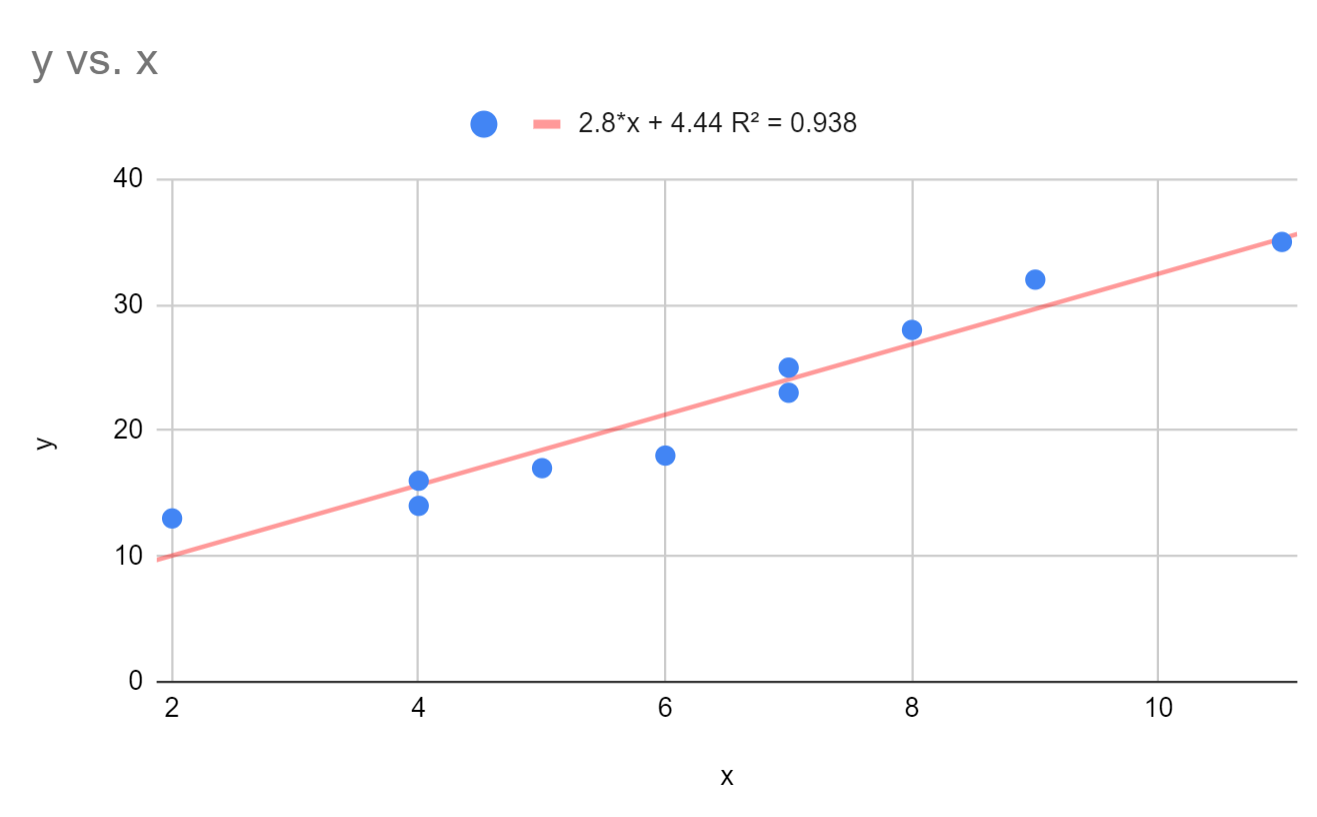
Dès cette validation effectuée, le logiciel génère une expression typographique dynamique qu’il positionne automatiquement au sein du pavé de légende, généralement situé au sommet de l’espace graphique. Cette formule adopte la typologie syntaxique standardisée des tableurs, reflétant en temps réel l’état exact des coordonnées de votre matrice de données brute.
5.2 Décomposition de la structure fonctionnelle affine (y = ax + b)
L’expression textuelle renvoyée par le module graphique se conforme rigoureusement à la syntaxe classique d’une équation de droite affine, transcrite sous la forme algorithmique suivante :
$$y = a*x + b \quad \text{ou plus exactement} \quad Y = b_1 X \pm b_0$$
Il est fondamental de décomposer minutieusement chaque terme typographique pour éviter tout contresens lors de la rédaction de rapports expérimentaux :
- Le premier coefficient numérique juxtaposé au symbole de la variable indépendante * x représente la pente ($b_1$, ou gradient). Ce nombre quantifie précisément la vitesse ou le taux d’accroissement de la variable dépendante par incrément unitaire strict de la variable explicative.
- L’opérateur arithmétique d’addition ou de soustraction qui lui succède commande le signe de l’ajustement.
- La grandeur scalaire finale constitue l’ordonnée à l’origine ($b_0$, ou intercepte). Elle désigne la valeur exacte extrapolée à laquelle la droite d’ajustement vient cisailler l’axe vertical d’ordonnée lorsque l’abscisse $X$ adopte une valeur rigoureusement égale à zéro.
Une précaution typographique s’impose : l’interface de Google Sheets utilise le caractère astérisque * pour marquer la multiplication algébrique entre le coefficient scalaire et la variable $x$. Lors du transfert de ces données dans un manuscrit académique, le chercheur veillera à convertir cette écriture informatique brute vers les normes de publication internationales de l’American Psychological Association, sous la forme épurée : $\hat{Y} = 2{,}45X + 12{,}80$.
5.3 Interprétation contextuelle des coefficients estimés
L’interprétation de ces coefficients estimés doit s’ancrer dans le champ paradigmatique de l’expérimentation conduite :
Le signe de la pente renseigne instantanément sur l’orientation ontologique du lien empirique. Une pente positive traduit une synergie proportionnelle (l’augmentation de $X$ s’accompagne d’une progression prévisible de $Y$). Inversement, une pente négative signale un processus d’inhibition, d’usure ou d’amortissement fonctionnel. Si le coefficient de pente s’avère égal ou statistiquement indiscernable de zéro, cela dénote une imperméabilité complète de la variable critère vis-à-vis des variations du prédicteur, invalidant ainsi l’hypothèse de travail linéaire.
L’ordonnée à l’origine exige une prudence épistémologique accrue. Dans de nombreux protocoles écologiques, l’évaluation de $X = 0$ relève d’une abstraction mathématique dénuée de faisabilité physique (par exemple, un être humain présentant une masse corporelle ou une pression artérielle nulle). Dans ces contextes précis, l’intercepte ne doit nullement faire l’objet d’une surinterprétation phénoménologique : elle n’agit que comme un paramètre de calage spatial indispensable à l’ancrage correct du modèle au sein du plan cartésien dans la fenêtre d’observation expérimentale.
6. Affichage et interprétation analytique du coefficient de détermination (R²)
6.1 Paramétrage du coefficient R² dans le panneau graphique
L’équation de droite renseigne sur l’orientation et l’inclinaison de l’ajustement, mais demeure muette quant à la représentativité effective de ce modèle vis-à-vis de l’éparpillement réel des données. Pour combler ce déficit informationnel, Google Sheets intègre un module computationnel automatisant le calcul du coefficient de détermination, universellement symbolisé par la métrique $R^2$ :
- Localiser, toujours au sein de l’onglet Personnaliser > Séries > Ligne de tendance, la case à cocher intitulée Afficher R² (Show R²), positionnée directement sous le sélecteur du libellé d’équation.
- Cocher cette option. Le moteur graphique adjoint instantanément à l’équation textuelle mentionnée précédemment une chaîne d’information supplémentaire formulée sous la forme synthétique : $R^2 = 0{,}842$ (valeur dépendante de votre jeu de données).
Cette valeur bénéficie d’une synchronisation dynamique totale : toute révision typographique, suppression de point aberrant ou insertion de nouveaux cas au sein des colonnes matricielles sources recalcule de façon synchrone le score du coefficient de détermination affiché sur le tracé.
6.2 Signification statistique de la variance expliquée
Sur le plan de l’inférence statistique, le coefficient de détermination représente le ratio fondamental décomposant la structure de la variance totale de la variable d’étude. La décomposition de la somme totale des carrés ($TSS$) s’établit formellement selon le théorème d’orthogonalité des projections :
$$TSS = ESS + RSS \quad iff \quad \sum_{i=1}^n (y_i – \bar{y})^2 = \sum_{i=1}^n (\hat{y}_i – \bar{y})^2 + \sum_{i=1}^n (y_i – \hat{y}_i)^2$$
Le coefficient $R^2$ s’énonce alors formellement comme la proportion de la variabilité globale de la variable dépendante $Y$ qui se trouve mécaniquement absorbée et « expliquée » par la variation linéaire de la variable prédictive $X$ à travers la droite de régression :
$$R^2 = \frac{ESS}{TSS} = 1 – \frac{RSS}{TSS} = 1 – \frac{\sum_{i=1}^n (y_i – \hat{y}_i)^2}{\sum_{i=1}^n (y_i – \bar{y})^2}$$
Cette grandeur statistique est obligatoirement bornée sur l’intervalle continu fermé $[0, 1]$ :
- Un $R^2$ égal à $0{,}00$ indique que la droite d’ajustement adoptée ne présente aucune supériorité prédictive par rapport à l’assignation de la simple moyenne arithmétique $\bar{y}$ à l’ensemble des individus de l’échantillon.
- Un $R^2$ culminant à $1{,}00$ caractérise une adéquation géométrique absolue : l’intégralité des observations empiriques se trouve rigoureusement alignée sur la trajectoire sans le moindre écart résiduel, signant un ajustement déterministe parfait.
- Une valeur intermédiaire, par exemple $R^2 = 0{,}64$, informe le statisticien que 64% de la variance observée chez les participants est directement structurée par le modèle linéaire proposé, tandis que les 36% résiduels relèvent de facteurs externes non mesurés ou d’erreurs de mesure stochastiques.
6.3 Écueils d’interprétation et limites du R²
L’apparente simplicité d’interprétation du coefficient $R^2$ dissimule de redoutables pièges d’inférence pour le praticien imprudent. La première faute méthodologique réside dans la croyance qu’un $R^2$ élevé constitue une preuve de la linéarité du phénomène. En réalité, un jeu de données présentant une courbure non linéaire hautement prononcée peut néanmoins générer un $R^2$ de $0{,}85$ sous un ajustement linéaire forcé, le modèle captant l’orientation générale tout en manquant systématiquement la structure fonctionnelle réelle.
La seconde vulnérabilité majeure du $R^2$ réside dans sa fragilité face aux observations possédant un fort effet de levier. Une observation unique, artificiellement déportée sur l’axe des abscisses par rapport au bloc principal des données et alignée de manière fortuite avec la tendance, est capable de propulser un $R^2$ médiocre de $0{,}20$ vers un score artificiellement spectaculaire de $0{,}75$.
Enfin, il demeure primordial de rappeler qu’un $R^2$ élevé ne garantit en rien la validité écologique ou théorique d’un lien. Deux séries chronologiques totalement déconnectées causalement (comme l’évolution de la consommation d’un produit alimentaire et le nombre de diplômes délivrés dans un pays sur la même décennie) génèrent fréquemment des $R^2$ supérieurs à $0{,}90$ du fait d’une tendance démographique partagée. Cette situation illustre le phénomène classique de la corrélation illusoire (spurious correlation).
7. Calcul de la droite d’ajustement par les formules statistiques de Google Sheets
7.1 Extraction directe des paramètres avec PENTE et ORDONNEE.ORIGINE
Si la modélisation graphique fournit une appréciation visuelle instantanée, la conduite d’analyses automatisées, de boucles de traitement récursives ou de prédictions dynamiques exige de stocker les coefficients directeurs au sein de cellules dédiées de la feuille de calcul. Google Sheets dispose pour ce faire d’un arsenal de fonctions scalaires d’une remarquable simplicité opératoire.
L’extraction de la pente $b_1$ s’effectue via l’invocation de la fonction PENTE (ou SLOPE dans la nomenclature anglophone). La syntaxe impose impérativement de déclarer les données dépendantes avant les données indépendantes :
$$texttt{=PENTE(données_Y; données_X)} \quad long\rightarrow \quad texttt{=PENTE(B2:B100; A2:A100)}$$
L’inversion de l’ordre des arguments constitue l’une des fautes les plus répandues chez les utilisateurs de tableurs : inverser les plages de données équivaut à calculer la droite de régression inverse de $X$ en fonction de $Y$, laquelle n’est nullement la réciproque mathématique de la première en présence d’aléa stochastique.
Simultanément, la capture de l’ordonnée à l’origine $b_0$ mobilise la formule dédiée ORDONNEE.ORIGINE (ou INTERCEPT) selon une architecture d’arguments rigoureusement identique :
$$texttt{=ORDONNEE.ORIGINE(données_Y; données_X)} \quad long\rightarrow \quad texttt{=ORDONNEE.ORIGINE(B2:B100; A2:A100)}$$
Ces cellules scalaires permettent ensuite de reconstruire mathématiquement des équations prédictives modulables ou d’automatiser des tests statistiques sans dépendre de l’affichage de l’objet graphique sur la feuille.
7.2 Analyse matricielle avancée via la fonction DROITEREG
Pour l’analyste exigeant une caractérisation statistique exhaustive du modèle dépassant les simples valeurs ponctuelles de la pente et de l’intercepte, Google Sheets propose une fonction matricielle d’une envergure professionnelle : la fonction DROITEREG (désignée sous le vocable LINEST en version anglaise).
Cette fonction exécute une régression linéaire multivariée par résolution matricielle des moindres carrés et renvoie, sous forme de tableau dynamique expansif (formule matricielle ou array formula), l’intégralité des indicateurs inférentiels associés. Sa syntaxe générale s’articule comme suit :
$$texttt{=DROITEREG(données_Y; [données_X]; [calculer_constante]; [calculs_statistiques])}$$
Pour déployer une analyse inférentielle complète sur le jeu de données localisé en colonnes A et B :
- Sélectionner une cellule vide disposant d’un espace dégagé suffisant d’au moins 2 colonnes par 5 rangées sous elle.
- Saisir précisément l’instruction :
=DROITEREG(B2:B100; A2:A100; VRAI; VRAI). - Valider par la touche Entrée. Le logiciel génère alors une matrice rectangulaire d’ordre $5 \times 2$.
La lecture de ce bloc matriciel s’opère selon une nomenclature codifiée :
- Rangée 1 : Pente empirique ($b_1$) en colonne 1 ; Ordonnée à l’origine ($b_0$) en colonne 2.
- Rangée 2 : Erreur type de la pente ($SE_{b1}$) en colonne 1 ; Erreur type de l’ordonnée ($SE_{b0}$) en colonne 2.
- Rangée 3 : Coefficient de détermination ($R^2$) en colonne 1 ; Erreur type de l’estimation ($\sigma_{\varepsilon}$) en colonne 2.
- Rangée 4 : Statistique $F$ de Fisher-Snedecor en colonne 1 ; Degrés de liberté du modèle ($df = n – 2$) en colonne 2.
- Rangée 5 : Somme des carrés de la régression ($ESS$) en colonne 1 ; Somme des carrés des résidus ($RSS$) en colonne 2.
La disponibilité de ces métriques avancées permet notamment de dériver manuellement les valeurs critiques du test de Student ($t = b_1 / SE_{b1}$) et de calculer les probabilités associées (p-values), transformant Google Sheets en un véritable banc d’essai biométrique et économétrique.
7.3 Calcul du coefficient de corrélation linéaire de Pearson
L’estimation de la droite d’ajustement est intrinsèquement liée à l’analyse de corrélation linéaire. Google Sheets permet d’évaluer la force du couplage linéaire univarié via la formule standard COEFFICIENT.CORRELATION (ou indifféremment PEARSON), mobilisant la formulation :
$$texttt{=COEFFICIENT.CORRELATION(données_Y; données_X)}$$
Le résultat obtenu constitue le coefficient $r$ de Pearson, borné de manière directionnelle sur l’intervalle $[-1, +1]$. Il existe une passerelle mathématique directe reliant cet indice au coefficient de détermination explicité plus haut :
$$R^2 = r^2 = (\mathrm{Corr}(X, Y))^2$$
L’équivalence arithmétique est absolue dans le cadre strict d’une régression univariée simple : élever le coefficient $r$ de Pearson au carré restitue au centième près la valeur du $R^2$ projetée sur le graphique de Google Sheets. Il est crucial de maintenir la distinction structurelle entre les deux indicateurs : $r$ exprime le degré d’association normalisé et sans dimension entre les grandeurs, tandis que la pente $b_1$ exprime le taux de variation physique d’une métrique exprimée dans l’unité de $Y$ pour chaque fraction unitaire de l’unité de $X$.
8. Diagnostics statistiques et vérification des postulats de linéarité
8.1 Analyse visuelle et computationnelle des résidus
La validation formelle d’une droite de régression ne s’achève pas à l’affichage d’un modèle graphique : elle exige la vérification des postulats théoriques régissant la validité des moindres carrés. Le premier devoir de l’analyste consiste à modéliser et isoler les résidus expérimentaux. Un résidu se définit comme l’écart algébrique vertical séparant chaque point mesuré de la prédiction formulée par la droite :
$$e_i = y_i – \hat{y}_i = y_i – (b_0 + b_1 x_i)$$
Pour matérialiser cette distribution au sein de Google Sheets :
- Créer dans la colonne C une série intitulée
Y_Predit, en implémentant dans la cellule $C2$ la formule d’inférence directe faisant référence aux coefficients extraits :=$F$1*A2 + $G$1(où $F1$ stocke la pente et $G1$ l’ordonnée à l’origine). Étendre cette formule sur l’ensemble de la colonne. - Créer dans la colonne D la variable
Residus, régie en $D2$ par la formule différentielle :=B2 - C2.
Une fois les écarts quantifiés, générer un second nuage de points plaçant les valeurs prédites $\hat{Y}$ sur l’axe des abscisses et les résidus $e_i$ sur l’axe des ordonnées. L’examen de ce graphique constitue le test de référence de conformité du modèle : un ajustement linéaire valide doit restituer un nuage résiduel purement aléatoire, évoquant un semis de points sans orientation directrice, oscillant symétriquement autour de l’axe horizontal $e = 0$. Tout motif distinctif — présence d’une arche parabolique, d’un entonnoir ou d’une sinusoïde — signale un défaut d’ajustement structurel imposant l’abandon du modèle linéaire pur.
8.2 Examen de l’homoscédasticité et de la normalité
Les théorèmes d’inférence statistique (intervalles de confiance des coefficients, seuils de significativité) reposent sur le postulat d’homoscédasticité, stipulant que la variance de l’erreur stochastique $\varepsilon_i$ demeure rigoureusement stationnaire sur l’ensemble du continuum des valeurs de la variable explicative : $\mathrm{Var}(\varepsilon_i | X = x_i) = \sigma^2 = \text{constante}$.
Sur le graphique des résidus explicité précédemment, l’hétéroscédasticité se trahit par l’apparition d’une structure morphologique en mégaphone ou en entonnoir : les résidus sont très regroupés pour les petites valeurs de prédiction, puis s’écartent drastiquement à mesure que les scores augmentent. Cette configuration pathologique ne biaise pas l’estimation des coefficients de pente en tant que tels, mais invalide complètement le calcul de leurs erreurs standards, rendant illégitimes les conclusions tirées des valeurs de significativité statistique ($p$-values) fournies par DROITEREG.
Parallèlement, la distribution des résidus doit satisfaire à l’hypothèse de normalité gaussienne. L’analyste peut contrôler ce critère dans Google Sheets en compilant un histogramme de fréquence des résidus calculés en colonne D (via Insertion > Graphique > Graphique d’histogramme). L’obtention d’une courbe en cloche symétrique confirme la normalité des erreurs et valide l’assise probabiliste nécessaire à la généralisation inférentielle du modèle à la population globale.
8.3 Détection des points leviers et des valeurs influentes
L’estimation par les moindres carrés présente une fragilité structurelle bien connue : sa non-robustesse face aux observations singulières dotées d’un levier excessif. En statistique mathématique, le potentiel de levier d’un point ($h_{ii}$, pour hat-value) mesure l’éloignement d’une observation $x_i$ par rapport à la moyenne $\bar{x}$ des prédicteurs. Une observation distante du barycentre dispose d’un bras de levier disproportionné sur l’inclinaison finale de la trajectoire d’ajustement.
Lorsqu’un point cumule un fort effet de levier et un résidu élevé (c’est-à-dire qu’il dévie nettement de la trajectoire suggérée par les autres observations), il est qualifié de point influent. De telles mesures peuvent altérer radicalement le positionnement de la droite :
- Il est recommandé d’identifier ces entités par le calcul de l’écart-type résiduel studentisé ou, de manière pragmatique, en observant le basculement géométrique de la droite lors de l’exclusion provisoire de la mesure contestée.
- La découverte d’une observation influente ne justifie pas son élimination arbitraire : l’investigateur doit vérifier minutieusement les protocoles d’acquisition pour identifier s’il s’agit d’une coquille matérielle évidente (valeur fausse devant être purgée) ou au contraire d’une réaction comportementale atypique authentique méritant une documentation théorique approfondie.
9. Exploration des modèles d’ajustement curvilignes et non linéaires
9.1 L’ajustement polynomial pour les dynamiques curvilinéaires
L’univers empirique ne se réduisant pas à des dynamiques proportionnelles simples, de nombreux phénomènes naturels exhibent des cinétiques curvilignes. Dans de telles configurations, forcer une ligne droite conduirait à un biais de modélisation inacceptable. Google Sheets pallie cette contrainte en intégrant, dans son menu déroulant des lignes de tendance (Personnaliser > Séries > Ligne de tendance > Type), le modèle Polynomial.
L’ajustement polynomial permet de tracer des fonctions d’ordre supérieur gouvernées par l’équation canonique :
$$Y = b_0 + b_1 X + b_2 X^2 + b_3 X^3 + dots + b_k X^k$$
L’opérateur peut en calibrer le Degré (de 2 à 6) directement dans l’interface logicielle :
- Un degré 2 (quadratique) génère une trajectoire parabolique classique, particulièrement adaptée aux lois biologiques décrivant des optimums fonctionnels (comme la célèbre loi de Yerkes-Dodson reliant la performance cognitive à l’activation émotionnelle sous une forme de U inversé).
- Un degré 3 (cubique) introduit un point d’inflexion autorisant la formalisation de cinétiques sigmoïdales ou biphasiques.
L’élévation inconsidérée du degré polynomial (degrés 4, 5 ou 6) constitue toutefois un piège méthodologique majeur : le surajustement (overfitting). Bien que le coefficient $R^2$ croisse mécaniquement vers des valeurs proches de 1, le modèle perd toute validité externe : la droite s’ondule excessivement pour capturer chaque résidu stochastique individuel, détruisant la capacité de généralisation prédictive du modèle à de nouveaux échantillons.
9.2 Modèles exponentiels et logarithmiques dans l’interface
Le panneau de modélisation de Google Sheets offre des alternatives fonctionnelles complémentaires adaptées à des cinétiques théoriques spécifiques :
Le modèle Exponentiel ($\hat{Y} = a \cdot e^{bX}$) est préconisé pour les phénomènes traduisant une dynamique d’amplification cumulative constante, tels que la croissance initiale d’une colonie bactérienne ou la propagation virale précoce. Ce type d’ajustement s’obtient instantanément en sélectionnant l’option éponyme dans le menu déroulant Type de la ligne de tendance. Dans cette modélisation, le paramètre $b$ ne représente plus un accroissement absolu, mais un taux de croissance proportionnel continu par unité de $X$.
Le modèle Logarithmique ($\hat{Y} = a \cdot \ln(X) + b$) modélise les dynamiques d’atténuation progressive, de saturation ou de rendement marginal décroissant. Ce modèle trouve une pertinence majeure dans l’étude des processus d’apprentissage comportemental et des seuils perceptifs sensoriels décrits par la psychophysique classique (telle que la loi de Fechner-Weber). La fonction enregistre une croissance initiale abrupte avant d’amorcer un écrasement asymptotique régulier traduisant la fatigabilité ou la saturation des récepteurs biologiques du sujet.
9.3 Critères comparatifs de sélection du meilleur ajustement
La sélection raisonnée du modèle d’ajustement le plus adéquat repose sur un arbitrage épistémologique fondamental entre qualité de l’ajustement statistique et parcimonie conceptuelle (le principe classique du rasoir d’Ockham). L’analyste confronté à plusieurs modèles concurrents sous Google Sheets doit structurer son évaluation selon trois directives formelles :
Premièrement, l’élévation du coefficient $R^2$ doit être interprétée avec circonspection : l’adjonction de paramètres mathématiques additionnels augmente systématiquement et artificiellement cette valeur. Un gain infinitésimal de variance expliquée (par exemple, un $R^2$ passant de $0{,}82$ en linéaire à $0{,}83$ en polynomial d’ordre 3) ne légitime en rien la complexification du modèle.
Deuxièmement, l’analyse comparative des résidus (telle qu’exposée en section 8.1) doit prévaloir. Le modèle d’ajustement optimal est celui qui parvient à blanchir intégralement le nuage de résidus, en éradiquant toute dynamique structurée des écarts sans mobiliser de composantes fonctionnelles superflues.
Enfin, l’impératif de plausibilité théorique demeure souverain : une fonction mathématique ne doit jamais être adoptée sous la seule justification de sa convergence graphique. Elle doit s’enraciner dans les fondements mécanistiques régissant la discipline concernée. Si la théorie sous-jacente postule une cinétique de saturation métabolique, le choix d’un modèle logarithmique ou asymptotique s’impose, même si un modèle polynomial d’ordre 4 délivre accidentellement une concordance de calcul supérieure sur l’échantillon d’observation disponible.
10. Applications pratiques et études de cas en méthodologie expérimentale
10.1 Étude de cas 1 : Stress environnemental et efficience cognitive
Afin de concrétiser l’ensemble des procédures exposées au sein d’un protocole empirique complet, examinons une investigation conduite en laboratoire d’ergonomie cognitive. L’objectif de la recherche réside dans la quantification de l’impact d’une élévation contrôlée du stress environnemental (mesuré par le niveau de décibels sonores ambiants, variable $X$, allant de 40 à 90 dB) sur la vitesse d’exécution lors d’une tâche d’inhibition motrice de type Go/No-Go (mesurée par le temps de réaction en millisecondes, variable $Y$).
Le protocole opératoire sous Google Sheets s’exécute selon la séquence suivante :
- Disposition des données : les niveaux de décibels sont saisis dans la plage $A2:A41$ (40 participants testés), et les temps de réaction associés sont collés dans la colonne contiguë $B2:B41$.
- Génération graphique : sélection de la plage $A1:B41$, appel du menu Insertion > Graphique, et sélection rigoureuse du tracé en Nuage de points.
- Paramétrage analytique : bascule dans l’onglet Personnaliser > Séries, validation de la case Ligne de tendance, sélection du modèle Linéaire, affectation du paramètre Libellé > Utiliser l’équation et activation de l’option Afficher R².
L’interface graphique projette l’expression mathématique suivante :
$$y = 5{,}23*x + 185{,}40 \quad \text{a\vec un score associé de } R^2 = 0{,}714$$
L’interprétation méthodologique de ces coefficients se formalise comme suit :
L’ordonnée à l’origine ($b_0 = 185{,}40\text{ ms}$) représente le temps de réaction moyen théorique espéré pour un niveau sonore nul ($0\text{ dB}$), extrapolation purement formelle ici en dehors de la fenêtre de mesure effective. La pente empirique ($b_1 = 5{,}23$) révèle que chaque décibel additionnel injecté dans l’environnement expérimental induit un ralentissement moyen prévisible du temps de réaction de $5{,}23\text{ millisecondes}$. Le coefficient de détermination ($R^2 = 0{,}714$) indique que plus de 71% de la variance interindividuelle observée dans les vitesses d’inhibition motrice est directement tributaire de la sévérité du stress sonore subi par les opérateurs, conférant au modèle linéaire une excellente capacité descriptive au sein de la plage d’exposition explorée.
10.2 Étude de cas 2 : Validité psychométrique d’un instrument d’évaluation
Dans le domaine du développement psychométrique, l’introduction d’un nouvel instrument de mesure abrégé (par exemple, un inventaire de dépression auto-administré en 10 items) exige l’établissement rigoureux de sa validité concourante vis-à-vis d’un outil clinique standardisé de référence (par exemple, un questionnaire diagnostique complet en 60 items administré par un clinicien qualifié).
Une cohorte de validation de 120 patients reçoit successivement les deux épreuves d’évaluation :
- La colonne $A$ répertorie les scores bruts issus de l’outil étalon de référence ($X$), tandis que la colonne $B$ consigne les résultats compilés sur la nouvelle échelle abrégée ($Y$).
- Le déploiement de la droite d’ajustement au sein de Google Sheets permet de vérifier visuellement et analytiquement la transposabilité des scores.
- L’équation extraite délivre la structure : $\hat{Y} = 0{,}98X + 1{,}05$, assortie d’un coefficient de détermination atteignant $R^2 = 0{,}884$.
Dans ce contexte psychométrique, la valeur du coefficient directeur ($b_1 = 0{,}98$) est particulièrement informative : étant très proche de l’unité ($1{,}00$), elle démontre une stricte équivalence de calibration des échelles métriques respectives, signifiant qu’un point de gravité acquis sur l’instrument canonique correspond précisément à un gain unitaire sur la forme synthétique abrégée. Concomitamment, le $R^2$ excédant le seuil standard de $0{,}80$ confirme la validité concourante de l’outil, autorisant son déploiement pragmatique dans des contextes de dépistage où le temps clinique disponible s’avère sévèrement restreint.
10.3 Extrapolation et prédiction de nouvelles observations
L’intérêt opératoire d’une droite de régression s’exprime pleinement dans sa mobilisation prédictive pour estimer des données non observées empiriquement. Google Sheets facilite cette mise en application directe au moyen de formules d’évaluation arithmétique simples :
Soit la relation modélisée dans l’étude de cas n°1 ($\hat{Y} = 5{,}23X + 185{,}40$). Supposons que l’équipe de recherche souhaite estimer le temps de réaction prévisible d’un personnel exposé à un nouveau palier sonore fixé à $75\text{ dB}$. Il suffit d’implanter la formule d’inférence dans une cellule quelconque du tableur :
$$texttt{=F1*75 + G1} \quad long\rightarrow \quad \hat{Y} = (5{,}23 \times 75) + 185{,}40 = 577{,}65\text{ ms}$$
Toutefois, une vigilance épistémologique impérative s’impose quant à la démarcation entre interpolation et extrapolation :
- L’interpolation s’exécute au sein du spectre des mesures effectivement recueillies par le protocole expérimental (dans notre exemple, entre $40\text{ dB}$ et $90\text{ dB}$). Sous réserve que le postulat de linéarité ait été validé par l’inspection des résidus, la valeur interpolée présente une haute probabilité de conformité empirique.
- L’extrapolation s’aventure au-delà des frontières de l’échantillonnage initial (par exemple, prédire le comportement cognitif à $130\text{ dB}$). Cette pratique est hautement risquée : nul ne peut postuler que le comportement du système biologique demeure linéaire dans des conditions d’exposition extrêmes, où des ruptures d’échelle physiques, des états de tétanie sensorielle ou des détresses physiologiques aiguës viennent invalider la validité de la trajectoire estimée.
11. Biais d’interprétation, erreurs méthodologiques et limites logicielles
11.1 Le piège de la fausse causalité et le paradoxe de Simpson
Le principal écueil guettant les utilisateurs de modélisations statistiques linéaires réside dans la tentation de transformer une covariance empirique en affirmation causale affirmative. Deux variables peuvent exhiber un alignement quasi déterministe sous une droite d’ajustement sans qu’aucun mécanisme causal n’opère entre elles. Outre les variables cachées ou de confusion (qui créent des corrélations fortuites en influençant simultanément $X$ et $Y$), le statisticien doit redouter un phénomène mathématique redoutable : le paradoxe de Simpson.
Ce paradoxe méthodologique se manifeste lorsqu’une corrélation d’une intensité ou d’une orientation donnée émerge lors de l’analyse globale d’un échantillon, mais se trouve totalement inversée lorsque la population d’étude est segmentée en sous-groupes structurels pertinents :
- L’analyste observant un nuage de points aggloméré au sein de Google Sheets peut tracer une droite de tendance générale affichant une pente positive significative ($b_1 > 0$).
- Toutefois, si les observations procèdent en réalité de deux cohortes distinctes non identifiées dans la saisie (par exemple, des classes d’âge ou des conditions expérimentales contrastées), l’ajustement exécuté isolément sur chaque strate peut mettre en lumière des pentes résolument négatives ($b_1 < 0$).
- L’effet agrégé flatteur visualisé sur le graphique ne traduit alors qu’un artefact d’échantillonnage, la trajectoire globale reflétant uniquement l’écart d’espérance entre les sous-populations et non la cinétique interne du phénomène étudié.
11.2 Interprétation abusive des coefficients dans des échantillons restreints
L’estimation des coefficients de régression par les moindres carrés ordinaires s’appuie asymptotiquement sur la loi des grands nombres. Dans des configurations expérimentales fragiles reposant sur des échantillons restreints ($n < 15$), les métriques délivrées par Google Sheets doivent être accueillies avec une réserve méthodologique rigoureuse.
Dans un effectif de petite taille, le coefficient de détermination subit une inflation mathématique systématique : plus le ratio entre le nombre de prédicteurs et la taille d’échantillon $n$ est élevé, plus le $R^2$ brut surestime la variance véritablement expliquée dans la population parente. Pour corriger ce biais d’optimisme statistique, il est nécessaire de calculer le $R^2$ ajusté ($R^2_{adj}$), que Google Sheets n’affiche malheureusement pas sur son tracé graphique et qui doit être recalculé manuellement en cellule via la formulation canonique :
$$R^2_{adj} = 1 – \left[ \frac{(1 – R^2)(n – 1)}{n – k – 1} \right]$$
où $n$ caractérise la taille de l’effectif et $k$ le nombre total de prédicteurs (égal à 1 en régression univariée simple). En outre, la variance d’échantillonnage de la pente est inversement proportionnelle à la taille d’échantillon, ce qui signifie qu’une réplication ultérieure du protocole expérimental menée sur un échantillon restreint identique est susceptible de fournir une pente radically divergente sous l’effet des seules fluctuations aléatoires d’échantillonnage.
11.3 Contraintes techniques spécifiques à l’environnement Google Sheets
Bien que Google Sheets constitue un tableur accessible, polyvalent et collaboratif, ses fonctionnalités de modélisation biométrique et économétrique accusent plusieurs limitations structurelles en comparaison d’outils statistiques dédiés tels que R, SPSS, SAS ou Jamovi :
- Absence de bandes de confiance visuelles : Google Sheets s’avère incapable d’intégrer nativement les fuseaux hyperboliques d’intervalles de confiance à 95% encadrant la droite d’ajustement, ni les intervalles de prédiction individuelle, laissant l’observateur dans l’ignorance visuelle de la perte d’efficience prédictive à mesure que l’on s’écarte du barycentre $(\bar{x}, \bar{y})$.
- Inexistence d’outils de pondération analytique : l’environnement graphique natif ne permet pas de réaliser des régressions aux moindres carrés pondérés (Weighted Least Squares) lorsque l’hétéroscédasticité est constatée et impose de pondérer chaque observation par l’inverse de sa variance.
- Impossibilité de modéliser des systèmes d’équations simultanées ou des modèles mixtes à effets aléatoires au sein des panneaux graphiques classiques.
Pour dépasser ces limites logicielles, le chercheur aguerri peut toutefois recourir à l’environnement d’automatisation intégré Google Apps Script. La conception de scripts en langage JavaScript exécutés côté serveur permet d’automatiser des procédures de rééchantillonnage de type bootstrap, d’extraire les métriques de Cook ou de dériver rigoureusement les intervalles de confiance point par point pour les réinjecter sous forme de barres d’erreur personnalisées sur le canevas cartésien.
12. Standardisation graphique académique et intégration dans un manuscrit
12.1 Mise en conformité du graphique avec les normes APA (7e édition)
L’élaboration d’un graphique au sein de Google Sheets constitue la première phase du travail de valorisation scientifique ; son inclusion dans un manuscrit soumis aux pairs requiert sa mise en conformité formelle avec les prescriptions typographiques de la 7e édition du manuel de l’American Psychological Association (APA) :
- Éradication du bruit visuel non informatif : les normes académiques proscrivent les arrière-plans colorés ou grisés et les quadrillages denses. Dans l’éditeur de Google Sheets (onglet Personnaliser > Quadrillage et graduations), il convient de désactiver systématiquement les lignes de quadrillage majeures et mineures pour épurer le rapport données/encre théorisé par Edward Tufte.
- Sobriété des axes et typographie unifiée : appliquer une typographie sobre, uniforme et sans empattement (telle qu’Arial ou Calibri) calibrée entre 10 et 12 points. Les axes cartésiens doivent être explicitement matérialisés par des traits pleins noirs ou gris anthracite d’un point d’épaisseur.
- Étiquetage rigoureux des axes : chaque axe doit mentionner sans équivoque le nom complet de la variable suivi de son unité de mesure normalisée placée entre parenthèses, selon la formule :
Intensité sonore (dB)ouTemps de réaction (ms). L’affichage d’un simple symbole mathématique isolé (comme un $X$ ou un $Y$) est formellement proscrit. - Gestion de la légende : dans un graphique univarié simple, la légende automatique superflue doit être supprimée pour éviter toute redondance visuelle, les paramètres de l’équation de droite et du $R^2$ devant être intégrés préférentiellement dans la note narrative explicative disposée sous la figure.
12.2 Procédures d’exportation et conservation de la résolution vectorielle
L’incorporation d’un graphique issu de Google Sheets dans un traitement de texte scientifique (comme LaTeX ou Microsoft Word) requiert de préserver scrupuleusement la netteté et la précision des tracés vectoriels originaux :
- Cliquer sur l’icône matérialisée par trois points verticaux logée dans l’angle supérieur droit du canevas graphique.
- Naviguer vers le menu contextuel Télécharger.
- Sélectionner impérativement le format Graphisme vectoriel évolutif (.svg) ou le format Document PDF (.pdf) pour toute finalité d’impression typographique ou d’édition académique. Contrairement aux images matricielles compressées, les formats vectoriels garantissent une résolution infinie sans pixellisation, assurant un rendu chirurgical des marqueurs et des droites de régression quel que soit le facteur d’agrandissement typographique retenu.
- Si le protocole éditorial exige exclusivement une matrice d’image (pour des présentations diaporama ou des prévisualisations rapides), exporter au format Image PNG (.png) en veillant à redimensionner au préalable le graphique dans le tableur afin d’obtenir une résolution native supérieure ou égale à 300 points par pouce (DPI).
Dans le cadre d’une rédaction collaborative menée conjointement sous l’écosystème Google Docs, privilégier la commande Insertion > Graphique > À partir de Sheets : cette passerelle native autorise l’intégration dynamique de l’élément visuel tout en préservant un lien bidirectionnel actif, permettant d’actualiser la figure dans le manuscrit d’un simple clic dès que le jeu de données du tableur source fait l’objet d’une révision expérimentale.
12.3 Documentation méthodologique et reproductibilité du tableur
L’exigence éthique et déontologique de reproductibilité scientifique, consacrée par le mouvement international de la Science Ouverte (Open Science), impose que le classeur Google Sheets hébergeant la modélisation ne soit pas un objet opaque, mais un protocole d’analyse transparent et auditable par n’importe quel évaluateur indépendant.
La pérennité méthodologique du fichier repose sur plusieurs protocoles d’organisation interne :
- Compartimentation des espaces de travail : dédier le premier onglet du classeur exclusivement aux
Donnees_Brutesprotégées en écriture, héberger les transformations mathématiques et le nettoyage dans un second ongletDonnees_Calculees, et regrouper les graphiques de dispersion, équations et sorties diagnostiques au sein d’un troisième onglet de synthèse nomméModeles_Graphiques. - Documentation des métadonnées (Codebook) : associer à chaque colonne du tableau une note textuelle contextuelle explicite détaillant l’origine de l’instrument d’évaluation, les seuils d’admissibilité des données et la formule spécifique appliquée pour standardiser les mesures.
- Archivage pérenne des calculs : doubler impérativement les représentations visuelles des équations de droite par les extractions computationnelles scalaires (via
PENTE,ORDONNEE.ORIGINEetDROITEREG), afin que l’ensemble des estimateurs demeure accessible par programmation sans requérir l’intermédiation manuelle de l’interface graphique. - Partage scientifique : lors de la mise à disposition publique du fichier au sein d’entrepôts de données certifiés (comme l’Open Science Framework ou Zenodo), configurer les droits d’accès en mode « Lecture seule » via un lien pérenne, garantissant ainsi l’intégrité intégrale de la chaîne computationnelle ayant concouru à l’ajustement du modèle publié.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Google. (2024). Éditeur de graphiques : Ajouter et modifier des courbes de tendance dans Google Sheets. Centre d’aide Google. https://support.google.com/docs/answer/63824
- Legendre, A. M. (1805). Nouvelles méthodes pour la détermination des orbites des comètes. F. Didot.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0