
La représentation simultanée de plusieurs séries temporelles ou trajectoires longitudinales au sein d’un même espace graphique constitue l’une des tâches fondamentales de l’analyse exploratoire et confirmatoire de données. Que ce soit pour comparer l’évolution de cohortes cliniques au cours d’un essai thérapeutique, analyser les dynamiques d’indices macroéconomiques concurrents, ou disséquer les cinétiques d’apprentissage en psychologie cognitive, le tracé multilignes permet d’appréhender d’un seul coup d’œil les phénomènes de synchronisation, d’inversion de tendance ou de divergence structurelle. L’environnement statistique R offre une plasticité exceptionnelle pour accomplir cette tâche, en proposant une dualité méthodologique remarquable entre les moteurs graphiques procéduraux historiques et les frameworks déclaratifs contemporains fondés sur une grammaire rigoureuse des graphiques.
Toutefois, la superposition de trajectoires multiples ne se résume pas à un acte technique trivial d’empilement de segments vectoriels. Elle soulève des défis conceptuels, ergonomiques et statistiques profonds. L’enchevêtrement excessif de courbes engendre rapidement le syndrome bien connu du graphique en spaghettis, où le bruit visuel oblitère le signal sous-jacent et sature la charge cognitive du lecteur. Dès lors, le chercheur ou l’analyste de données doit maîtriser non seulement les rouages programmatiques de la restructuration matricielle et de la géométrie vectorielle, mais également les canons de l’intégrité visuelle, de la théorie de la perception graphique et de l’accessibilité chromatique pour produire des visualisations à forte valeur probatoire.
Ce guide exhaustif a pour vocation d’explorer l’ensemble des paradigmes, architectures de données et protocoles techniques permettant de superposer harmonieusement plusieurs séries de données en R. En décomposant pas à pas les approches natives de Base R, la puissance expressive de ggplot2, les stratégies d’étiquetage direct, la quantification de l’incertitude et les extensions interactives modernes, cet ouvrage de référence fournit aux praticiens les clés théoriques et empiriques nécessaires pour concevoir des figures conformes aux exigences les plus strictes de la publication scientifique internationale.
1. Fondements conceptuels et importance de la visualisation multilignes en R
1.1 Représentation de données multivariées et profils longitudinaux
La visualisation simultanée de trajectoires individuelles et de tendances agrégées est au cœur des sciences empiriques contemporaines. Lorsqu’un protocole expérimental implique des mesures répétées dans le temps, la projection bidimensionnelle standard — associant l’abscisse temporelle à l’ordonnée quantitative — doit s’enrichir d’une dimension catégorielle ou individuelle pour distinguer les différentes unités statistiques observées. Cette modélisation graphique permet d’examiner la variabilité interindividuelle tout en préservant la perception de la trajectoire intra-individuelle, révélant ainsi l’hétérogénéité des réponses thérapeutiques ou comportementales qui échapperait à de simples résumés tabulaires.
Dans le domaine des protocoles expérimentaux, notamment en psychophysique, en neurosciences et en économie comportementale, le suivi de séries multiples permet d’identifier visuellement des phénomènes dynamiques complexes tels que la convergence asymptotique, l’oscillation périodique ou l’instabilité transitoire. L’observateur peut évaluer de façon qualitative l’émergence d’interactions statistiques d’ordre supérieur : une divergence progressive entre deux courbes de traitement suggère une interaction temps-groupe, tandis que des trajectoires strictement parallèles témoignent d’effets additifs stables. Cette intuition graphique guide ensuite la spécification mathématique des modèles mixtes linéaires ou des régressions longitudinales.
Par ailleurs, la prise en compte des covariables dépendantes ou indépendantes du temps exige une articulation graphique soignée. En représentant conjointement le comportement d’un groupe contrôle et de multiples bras expérimentaux, le graphique multilignes met en lumière les ruptures de pente consécutives à une intervention précise. L’examen minutieux de ces profils continus prévient les erreurs de sur-simplification inhérentes aux comparaisons binaires statiques pré-test et post-test, restituant toute la richesse de la chronobiologie ou de la cinétique des données observées.
1.2 Comparaison des paradigmes graphiques : Base R versus ggplot2
L’écosystème R héberge deux philosophies graphiques fondamentalement divergentes pour le tracé de séries multiples. Le moteur historique, communément désigné sous le terme de Base R, repose sur un paradigme impératif et procédural. L’utilisateur agit à la manière d’un peintre sur une toile blanche : chaque commande applique des primitives graphiques séquentielles (pixels, lignes, points, polygones) sur un canevas dont les limites sont fixées lors de l’initialisation. Ce contrôle pas à pas confère une grande liberté d’exécution et une exécution algorithmique extrêmement véloce, mais impose une gestion manuelle fastidieuse des échelles, des légendes et du recalcul des bornes extrêmes.
À l’opposé, le package ggplot2, conçu par Hadley Wickham d’après les travaux théoriques de Leland Wilkinson, implémente une grammaire déclarative des graphiques. Dans ce paradigme, une visualisation est définie comme une composition formelle reliant des données structurées à des attributs esthétiques (position spatiale, couleur, forme, taille) au travers de couches géométriques superposées. L’utilisateur ne décrit pas la séquence motrice de dessin, mais déclare la relation fonctionnelle entre les variables mathématiques et leur encodage visuel. Cette formalisation garantit une cohérence interne absolue, une gestion automatisée des échelles et une reproductibilité académique optimale.
Sur le plan de l’ingénierie logicielle et de l’efficience algorithmique, le choix entre ces deux approches dépend largement du contexte d’utilisation. Si Base R demeure imbattable pour des représentations matricielles brutes ultra-rapides sur des volumes massifs ne nécessitant aucun prétraitement, ggplot2 s’intègre de manière organique dans les pipelines de manipulation de données modernes articulés autour du tidyverse. La composition par couches facilite la maintenance du code, la modification modulaire des thèmes et la portabilité des scripts au sein de publications scientifiques collaboratives.
1.3 Considérations ergonomiques et intégrité visuelle
Le traçage de lignes multiples confronte immédiatement l’analyste aux limites physiologiques du système visuel humain. La surcharge cognitive survient dès lors que le nombre de séries concurrentes excède les capacités de la mémoire de travail visuelle, fixées empiriquement à environ quatre ou cinq entités distinctes selon les principes de la psychologie cognitive de la forme (Gestalt). Lorsque des dizaines de lignes s’entrecroisent sans hiérarchisation perceptive, l’œil est incapable de segmenter les motifs individuels, et le graphique perd toute capacité heuristique pour ne devenir qu’un amas indéchiffrable de bruit visuel.
Pour préserver l’intégrité de l’affichage, il est impératif de se référer aux préceptes formulés par Edward Tufte concernant le ratio données-encre (Data-Ink Ratio). Chaque goutte d’encre numérique présente sur la figure doit correspondre à une variation informative réelle du jeu de données sous-jacent. L’élimination des fioritures décoratives superflues, des bordures lourdes, des arrière-plans saturés et des quadrillages intrusifs permet de maximiser la visibilité des lignes de tendance. L’esthétique graphique n’est pas un ornement cosmétique, mais un vecteur de clarté fonctionnelle destiné à diriger l’attention du lecteur vers les gradients de variation critiques.
L’accessibilité visuelle constitue un autre impératif déontologique et méthodologique. Une proportion substantielle de la population mondiale présente des déficiences de la vision chromatique (deutéranopie, protanopie, tritanopie). L’usage exclusif de contrastes rouge-vert pour différencier des courbes expérimentales compromet formellement la diffusion universelle des découvertes scientifiques. Il convient dès lors d’adopter des palettes perceptuellement uniformes et de combiner systématiquement le codage couleur avec d’autres canaux visuels redundants, tels que les motifs de tiretages discontinus, ou d’arbitrer courageusement en faveur d’une décomposition spatiale en sous-graphiques sériels.
2. Structuration et préparation des données pour le traçage multilignes
2.1 Typologie des formats de données : large (wide) versus long (long)
La réussite architecturale d’un graphique multilignes dans R dépend intrinsèquement de l’organisation matricielle du tableau de données en amont de toute invocation graphique. Historiquement, les analystes manipulent des données agencées sous ce que la littérature nomme le format large (wide format). Dans cette configuration, chaque série temporelle ou condition expérimentale occupe une colonne distincte dédiée, tandis qu’une colonne initiale unique consigne les coordonnées temporelles ou ordinales. Cette structure tabulaire s’avère intuitive pour la saisie humaine manuelle sur tableur et correspond exactement aux attentes fonctionnelles des fonctions vectorielles primitives de Base R.
À l’inverse, le format long (long format ou tidy data) décompose l’information en triplets élémentaires respectant la règle fondamentale selon laquelle chaque ligne représente une observation unitaire et chaque colonne une variable conceptuelle unique. Dans un format long adapté aux séries multiples, une colonne unique réunit la variable temporelle continue, une seconde colonne rassemble l’ensemble des valeurs numériques mesurées indépendamment de la condition, et une troisième colonne catégorielle sert de clé d’identification explicite spécifiant à quelle série ou cohorte se rattache chaque point d’évaluation.
Cette distinction morphologique gouverne impérativement le choix de l’outil de traçage. Tandis que les routines matricielles traditionnelles comme matplot() exigent expressément une matrice de format large où chaque colonne représente une ligne géométrique tracée à l’écran, le moteur déclaratif de ggplot2 est programmé pour n’opérer de façon optimale que sur des structures strictement longues. Tenter de forcer l’usage d’un tableau large dans ggplot2 aboutit inévitablement à un code verbeux, redondant et impossible à maintenir, soulignant l’obligation de maîtriser les outils de pivotement bidirectionnel.
2.2 Transformation des données avec le package tidyr
Le package tidyr, composant central du tidyverse, fournit les primitives d’ingénierie transformationnelle permettant de convertir sans friction des structures larges en structures longues exploitables par la grammaire des graphiques. La fonction pivotale est pivot_longer(), qui déploie une syntaxe hautement expressive pour faire basculer un ensemble arbitraire de colonnes de métriques vers une disposition verticale unifiée. La maîtrise de ses arguments cardinaux — notamment cols, names_to et values_to — permet de documenter sémantiquement les nouvelles variables créées lors de l’opération de pivotement.
Considérons l’exemple archétypal d’un relevé d’expression génique mesuré sur quatre points de temps à travers trois lignées cellulaires disposées initialement en colonnes distinctes. Par le biais d’un appel rigoureusement paramétré à pivot_longer(), l’analyste spécifie les colonnes cibles via des sélecteurs contextuels, nomme la variable catégorielle réceptrice (par exemple, names_to = "Lignee_Cellulaire") et formalise la colonne d’amplitude résultante (par exemple, values_to = "Niveau_Expression"). Cette conversion préserve scrupuleusement les index temporels ou les identifiants de réplicats, assurant une parfaite traçabilité des données d’origine.
Inversement, le passage du format long au format large s’effectue au moyen de pivot_wider(), opération fréquemment requise lorsqu’on souhaite alimenter des fonctions d’algèbre matricielle, calculer des matrices de covariance entre séries, ou générer des tracés ultra-rapides sous Base R. Cette réversibilité algorithmique confère au praticien une flexibilité absolue pour adapter instantanément la structure topologique de ses données aux exigences idiosyncratiques de chaque moteur de rendu visuel sous R.
2.3 Gestion préalable des valeurs manquantes et types de variables
La continuité mathématique et topologique d’une ligne sur un graphique dépend étroitement de la continuité des données numériques sous-jacentes. La présence de valeurs manquantes (codées sous la constante NA dans l’environnement R) altère fondamentalement le rendu des segments vectoriels. Par défaut, la plupart des moteurs graphiques interrompent physiquement le tracé de la ligne à l’endroit exact de l’omission de donnée, créant des ruptures visuelles béantes qui peuvent induire le lecteur en erreur en suggérant une suspension de l’observation plutôt qu’une absence de mesure ponctuelle.
Face aux valeurs manquantes, l’analyste doit choisir méthodologiquement entre trois postures distinctes : la suppression par omission (qui nécessite une interpolation visuelle consciente), l’imputation statistique préliminaire (par régression locale, interpolation spline ou méthodes de moyennes mobiles) pour restaurer la contiguïté de la trajectoire, ou le maintien explicite de l’interruption spatiale pour notifier fidèlement la non-disponibilité de la donnée. Ce choix éditorial doit impérativement être consigné et documenté de manière transparente dans la légende explicative de la figure académique.
De surcroît, le typage strict des variables constitue un prérequis incontournable pour éviter les aberrations d’affichage. L’axe des abscisses requiert fréquemment la conversion de chaînes textuelles arbitraires en véritables objets de classe Date, POSIXct ou vecteurs numériques continus, sous peine de voir le moteur graphique traiter des ordonnées temporelles comme des catégories discrètes équidistantes sans cohérence d’échelle. De même, les variables d’identification des séries doivent être converties en facteurs ordonnés ou nominaux explicites pour autoriser un contrôle déterministe de leur ordonnancement dans les guides visuels et les échelles de couleurs.
3. Tracé de séries multiples avec Base R via la fonction matplot()
3.1 Mécanique opérationnelle et syntaxe matricielle de matplot()
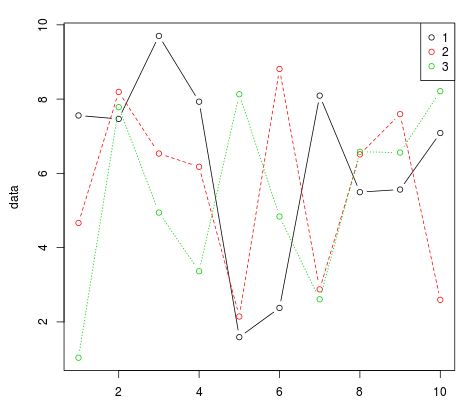
Pour les utilisateurs privilégiant la rapidité d’exécution sans dépendances logicielles tierces, la fonction primitive matplot() constitue l’outil le plus puissant du sous-système graphique Base R pour projeter simultanément une collection de séries numériques. Sa conception remonte aux origines mathématiques du langage S : matplot() est explicitement optimisée pour prendre en entrée une matrice numérique où chaque vecteur-colonne est automatiquement interprété comme une série distincte à tracer en fonction d’un vecteur d’abscisse commun, ou même d’une seconde matrice de dimensions identiques fournissant des coordonnées d’abscisse individualisées.
Lorsqu’un tableau de données (data.frame) se présente sous un format large standard, il doit généralement être converti ou extrait sous forme de matrice numérique pure via l’instruction as.matrix() appliquée sur les colonnes d’intérêt. Par défaut, matplot() trace les colonnes de la matrice en utilisant les numéros des colonnes comme glyphes discrets. Il est donc indispensable d’intervenir sur l’argument capital type. En spécifiant type = "l", la fonction remplace les symboles textuels par des lignes vectorielles continues raccordant les points de mesure consécutifs de chaque colonne.
Le contrôle de l’axe des abscisses s’effectue en passant un premier argument vectoriel x dont la longueur coïncide strictement avec le nombre de lignes de la matrice y. Si cet argument est omis, matplot() génère automatiquement une graduation discrète allant de 1 jusqu’au nombre total de lignes observables. Dès cette étape élémentaire, l’espace cartésien global est automatiquement dimensionné pour englober la valeur minimale absolue et la valeur maximale absolue détectées au sein de l’ensemble cumulé des colonnes matricielles soumises au traçage.
3.2 Paramétrage vectoriel : styles, épaisseurs et symboles
La force cardinale de matplot() réside dans sa capacité à exploiter la nature intrinsèquement vectorielle du langage R pour appliquer des cycles de propriétés graphiques différenciées à travers l’ensemble des colonnes tracées. Plutôt que de déclarer individuellement la mise en forme de chaque courbe, l’utilisateur passe des vecteurs de paramètres dont les éléments sont assignés séquentiellement à chacune des séries représentées, avec un mécanisme de recyclage automatique si la dimension du vecteur d’options est inférieure au nombre total de colonnes.
La modulation des teintes repose sur l’argument col, qui accepte un vecteur de noms de couleurs littéraux (tels que c("navy", "firebrick", "forestgreen")) ou de codes hexadécimaux stricts. Pour garantir la lisibilité au-delà de la seule pigmentation chromatique, le paramètre lty (line type) permet d’attribuer des motifs de tracé géométrique distinctifs : la valeur 1 correspond à une ligne pleine, 2 à des tirets longs, 3 à des pointillés fins, et 4 à une alternance point-tiret, conférant ainsi à chaque courbe une signature structurelle unique.
L’épaisseur relative de chaque segment se calibre par l’entremise de l’argument lwd (line width), acceptant des multiplicateurs scalaires positifs. De plus, si l’on opte pour un affichage combinant segments continus et symboles de mesure discrets via type = "b" (pour both) ou type = "o" (pour overlay), l’argument pch (plotting character) intervient pour désigner les glyphes géométriques assignés à chaque série (cercles évidés, triangles pleins, losanges ou croix). Cet étagement paramétrique vectoriel confère à matplot() une redoutable efficacité pour générer en une unique ligne de commande une synthèse graphique hautement contrastée.
3.3 Intégration d’une légende explicative avec legend()
Un tracé multilignes dépourvu de clé de lecture demeure scientifiquement inopérant. Contrairement aux moteurs graphiques déclaratifs plus modernes, la fonction matplot() n’élabore aucune légende de façon automatique ; la composition de cette dernière incombe intégralement à l’analyste au travers d’un appel subséquent explicite à la fonction legend(). Cette séparation procédurale exige une rigueur méthodique absolue pour prévenir toute désynchronisation entre les attributs visuels des courbes et les libellés correspondants.
Le positionnement spatial de la légende s’opère soit au moyen de coordonnées cartésiennes précises sur le plan (x, y), soit via des descripteurs toponymiques standardisés tels que "topright", "bottomleft", "topleft" ou "right". Pour assurer la correspondance sémantique stricte, les vecteurs passés aux arguments col, lty, lwd et éventuellement pch au sein de l’instruction legend() doivent être rigoureusement identiques à ceux préalablement déclarés dans l’instruction originelle de matplot(), tandis que l’argument legend reçoit le vecteur textuel des noms de séries (souvent extrait par colnames(matrice)).
L’ergonomie de la boîte de légende se peaufine ensuite grâce à une suite de micro-paramètres esthétiques. Le paramètre bty = "n" supprime la bordure rectangulaire pour aérer l’espace graphique, tandis que bg = "white" garantit un fond opaque protégeant le texte contre le croisement inopportun de lignes de données sous-jacentes. L’échelle globale de la légende peut être ajustée via l’argument scalaire cex (character expansion), évitant ainsi que le cartouche explicatif ne vienne phagocyter une surface excessive du canvas empirique.
4. Approche itérative en Base R avec plot() et lines()
4.1 Initialisation du canvas graphique avec plot()
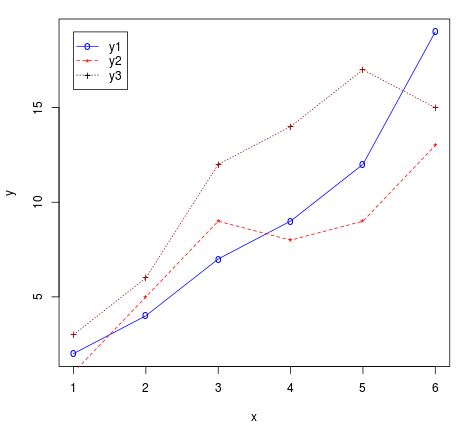
L’alternative artisanale la plus répandue au sein de l’environnement Base R consiste à bâtir une visualisation séquentielle en combinant une instruction primaire plot() suivie d’injections successives via la primitive lines(). Cette approche dite itérative ou incrémentale offre un contrôle chirurgical sur chaque millimètre carré du canevas, mais requiert une anticipation mathématique méticuleuse de la part du programmeur, en particulier concernant le bornage initial des axes cartésiens.
Lorsqu’on invoque plot() sur une première série de données, le moteur graphique calcule automatiquement les limites de l’espace de coordonnées (les arguments xlim et ylim) en se basant exclusivement sur les valeurs extrêmes de cette seule série fondatrice. Si l’une des séries secondaires tracées ultérieurement dépasse ces bornes initiales, ses segments seront purement et simplement tronqués et invisibilisés en dehors de la fenêtre d’affichage. Il est donc indispensable d’évaluer préalablement l’amplitude globale de l’ensemble des séries à représenter via les fonctions vectorielles range(), et d’injecter explicitement ces limites maximales dans les paramètres xlim et ylim de l’appel initial à plot().
Une technique académique éprouvée consiste à initialiser le canvas avec l’argument type = "n". Cette commande instancie l’ensemble du système de coordonnées euclidiennes, trace les axes, gradue les échelles, applique le titre principal via main et labellise les axes via xlab et ylab, mais s’abstient volontairement de projeter la moindre donnée visuelle. Le canevas demeure immaculé, parfaitement calibré sur les maxima globaux, prêt à recevoir la superposition ordonnée des différentes couches de tracés sans risque d’amputation dimensionnelle.
4.2 Superposition séquentielle de courbes avec lines() et points()
Une fois le cadre cartésien formellement verrouillé par l’instruction plot() primitive, l’analyste procède à l’empilement séquentiel des différentes trajectoires à l’aide de la fonction de bas niveau lines(). Contrairement à son homologue primaire, lines() ne recrée aucun nouveau graphique et n’altère en rien les échelles préexistantes ; elle projette directement de nouveaux segments vectoriels sur le dispositif graphique actif, reliant les couples de coordonnées (x, y) qui lui sont transmis en paramètres.
Chaque appel successif à lines() autorise une individualisation totale des propriétés stylistiques de la série concernée. Il devient ainsi possible d’attribuer une couleur singulière, une épaisseur personnalisée (lwd) ou une texture géométrique spécifique (lty) à une courbe d’intérêt expérimental majeur, tout en maintenant les séries secondaires de référence dans un style visuellement subordonné. Si les conditions expérimentales nécessitent l’adjonction de marqueurs discrets pour identifier formellement les instants précis d’échantillonnage empirique, la fonction complémentaire points() peut être appelée immédiatement après pour apposer des glyphes spécifiques au droit de chaque observation.
Dans ce mode opératoire, l’ordre chronologique d’exécution des lignes de code régit directement l’ordre de superposition physique (le plan d’occlusion en profondeur ou z-index) des tracés à l’écran. Les séries dessinées en premier se retrouvent reléguées au plan arrière, tandis que les lignes exécutées en fin de script viennent recouvrir physiquement les tracés antérieurs. L’analyste doit donc ordonner ses instructions avec discernement, en veillant à projeter d’abord les trajectoires de fond ou de référence, et en réservant les dernières couches d’exécution aux courbes stratégiques devant émerger avec un maximum de netteté perceptive.
4.3 Automatisation programmatique via boucles et structures conditionnelles
Bien que l’écriture manuelle séquentielle d’instructions lines() convienne pour deux ou trois trajectoires isolées, cette démarche devient rapidement ingérable, propice aux erreurs de typographie et viole le principe fondamental de non-redondance du génie logiciel (DRY : Don’t Repeat Yourself) dès lors qu’une cohorte comporte de multiples séries. L’automatisation programmatique au moyen de boucles itératives for ou de primitives fonctionnelles issues de la famille apply constitue la réponse architecturale idoine sous Base R.
Pour déployer une telle itération, l’analyste isole d’abord les colonnes numériques d’un tableau au format large. Une palette chromatique vectorielle est générée dynamiquement en amont, par exemple via des générateurs natifs tels que palette.colors(), rainbow() ou des fonctions dérivées de hcl.colors(). Une boucle for (i in 1:ncol(donnees_mat)) parcourt ensuite systématiquement chaque colonne : à chaque itération, la commande lines() extrait la i-ème colonne, sélectionne la i-ème couleur correspondante, et injecte le vecteur au sein de l’espace cartésien préalablement instancié.
Cependant, cette mécanique algorithmique itérative en Base R exhibe rapidement ses limites intrinsèques face à des structures de données complexes conditionnées par de multiples variables de stratification. La gestion manuelle de la correspondance des légendes, la réécriture fastidieuse de blocs conditionnels pour moduler l’affichage selon le sous-groupe expérimental et l’absence totale de flexibilité pour scinder le canevas en facettes automatisées rendent ce paradigme impératif excessivement lourd comparé à l’expressivité déclarative d’une véritable grammaire des graphiques.
5. Fondamentaux de la grammaire des graphiques avec ggplot2 pour séries multiples
5.1 L’association esthétique : aes(color), aes(linetype) et aes(group)
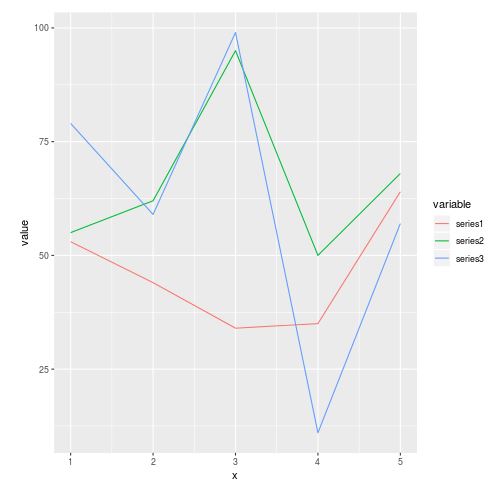
Le saut conceptuel opéré par ggplot2 réside dans la formalisation de la liaison esthétique (aesthetic mapping) via la fonction aes(). Pour tracer une pluralité de trajectoires, le praticien ne pilote pas manuellement des boucles d’itération graphique : il déclare formellement qu’une variable catégorielle présente dans un tableau de données au format long doit être traduite par le moteur graphique en un attribut visuel spécifique. L’association fondamentale s’établit au travers de aes(x = Temps, y = Valeur, color = Groupe), où le moteur se charge d’isoler automatiquement chaque modalité du facteur Groupe, d’attribuer une teinte distinctive et d’édifier de façon autonome la légende correspondante.
Un mécanisme fondamental, souvent mal compris des débutants, concerne le rôle déterminant du paramètre structurel aes(group = ...). Par défaut, lorsque la variable assignée à color ou linetype est un facteur discret, ggplot2 partitionne implicitement les observations en groupes géométriques disjoints. Cependant, si l’on souhaite représenter des trajectoires individuelles (par exemple des dizaines de patients suivis dans le temps) tout en colorant l’ensemble de ces courbes selon une macro-variable binaire (par exemple, le bras thérapeutique Traité versus Placebo), la liaison esthétique doit impérativement déclarer aes(group = Identifiant_Patient, color = Bras_Traitement). Sans cette explicitation du groupement unitaire, le moteur tente de relier chronologiquement tous les points appartenant à une même classe thérapeutique, engendrant des zébrures géométriques aberrantes à l’écran.
L’expressivité de cette grammaire autorise également des couplages esthétiques multivariés sophistiqués. Il est parfaitement licite d’associer simultanément une première variable de groupe au canal chromatique aes(color = Facteur_A) et une seconde variable qualitative orthogonale au canal textural aes(linetype = Facteur_B). Cette redondance ou ce croisement d’encodages perceptifs permet de transmettre une structure factorielle croisée au sein d’une unique figure plane, tout en garantissant que chaque combinaison de facteurs demeure immédiatement isolable par l’observateur.
5.2 Superposition de couches géométriques : geom_line() et geom_point()
L’architecture de ggplot2 repose sur un empilement modulaire de couches géométriques (geoms) reliées par l’opérateur d’addition unaire +. Pour construire une représentation multilignes canonique, la couche matricielle première est fournie par geom_line(). Cette géométrie prend en charge l’agencement chronologique des coordonnées : elle trie automatiquement les données le long de l’axe des abscisses pour chaque sous-groupe identifié, puis projette des segments continus raccordant rigoureusement les coordonnées successives selon les associations esthétiques déclarées dans le constructeur ggplot() parent.
Lorsque la densité temporelle des mesures est modérée ou irrégulière, la visualisation gagne immensément en transparence scientifique en superposant à la couche continue une couche discrète formalisée par geom_point(). L’adjonction de geom_point() matérialise l’ancrage empirique réel de chaque observation le long de la ligne théorique, empêchant le lecteur de supposer une interpolation continue là où des données n’ont pas été effectivement enregistrées. De surcroît, cette géométrie ponctuelle peut recevoir ses propres correspondances esthétiques, telles que aes(shape = Condition), enrichissant d’un degré supplémentaire la résolution informative globale.
La distinction entre paramètres esthétiques variables (situés à l’intérieur de l’appel aes()) et constantes esthétiques statiques (déclarées en dehors de aes()) constitue une règle syntaxique intangible. Si l’on souhaite attribuer une transparence globale uniforme à l’ensemble des trajectoires pour désaturer la scène, on déclare geom_line(alpha = 0.6). De même, l’épaisseur constante de tous les segments vectoriels se gouverne statiquement par l’argument dimensionnel moderne geom_line(linewidth = 0.8). La hiérarchie d’héritage assure que les géométries filles adoptent les assignations formulées au sommet de l’arbre syntaxique dans ggplot(), tout en préservant la possibilité de les surcharger localement au sein de chaque couche isolée.
5.3 Agrégation et représentation des tendances moyennes de cohortes
Dans de nombreuses disciplines scientifiques, la projection exclusive de dizaines de trajectoires individuelles désordonnées obscurcit la trajectoire centrale représentative de la population d’étude. Une stratégie visuelle et statistique particulièrement robuste consiste à conjuguer la granularité individuelle fine avec la modélisation agrégée d’une tendance centrale. Cette approche permet de visualiser l’amplitude de dispersion empirique tout en marquant avec force l’espérance mathématique conditionnelle du phénomène observé.
La réalisation pratique de ce paradigme au sein de ggplot2 s’articule élégamment par l’empilement de deux sources de données au sein du même graphe. La première couche geom_line() puise dans le jeu de données brut au format long, en associant chaque sujet à l’esthétique de groupe avec une forte transparence statique (par exemple, alpha = 0.2, linewidth = 0.4, color = "grey60"). En arrière-plan, ces faisceaux de courbes dessinent l’enveloppe de dispersion naturelle de la cohorte sans saturer l’espace visuel.
Par-dessus cet arrière-plan atténué, une seconde couche geom_line() est injectée en alimentant son argument local data avec un tableau préalablement agrégé au moyen de pipelines dplyr (calculant la moyenne empirique ou la médiane conditionnelle à chaque pas de temps pour chaque bras expérimental). Cette courbe centrale de synthèse se voit conférer une épaisseur accentuée (linewidth = 1.4) et une pigmentation saturée contrastée. Ce contraste structural et hiérarchique immédiat guide instinctivement le regard de l’observateur vers la dynamique globale de la cohorte tout en conservant une honnêteté scientifique totale quant à l’hétérogénéité des trajectoires individuelles sous-jacentes.
6. Personnalisation chromatique et esthétique avancée sous ggplot2
6.1 Palettes de couleurs scientifiques et accessibilité
L’arbitrage chromatique appliqué à un graphique multilignes conditionne directement sa validité méthodologique. Les palettes arc-en-ciel historiques (telles que la sinistre palette jet) sont désormais formellement bannies de la littérature académique rigoureuse en raison de leurs gradients de luminance non linéaires qui créent des artefacts perceptifs et des frontières visuelles artificielles là où les données physiques ne présentent aucune discontinuité. La recherche moderne en visualisation de données impose le recours à des échelles perceptuellement uniformes et universellement accessibles.
Dans l’écosystème ggplot2, la famille d’échelles scale_color_viridis_d() incarne la référence absolue pour le codage de facteurs qualitatifs discrets. Développées initialement pour la bibliothèque Python Matplotlib puis portées sous R, les palettes Viridis (ainsi que ses variantes Magna, Plasma, Inferno et Cividis) maintiennent une progression de luminance strictement monotone de l’état sombre à l’état clair. Cette propriété garantit une discernabilité parfaite des trajectoires aussi bien pour les personnes atteintes de diverses formes de dyschromatopsie que lors d’une restitution matérielle dégradée sous forme d’impression monochrome en niveaux de gris.
Pour les besoins spécifiques nécessitant des séparations catégorielles distinctes issues d’études psychologiques approfondies de la vision humaine, l’échelle scale_color_brewer(palette = "Set1") ou scale_color_brewer(palette = "Dark2"), dérivée des travaux fondateurs de Cynthia Brewer, offre des harmonies visuelles incomparables. Lorsque les exigences institutionnelles imposent une charte graphique propriétaire stricte, la fonction scale_color_manual(values = c(...)) autorise l’injection déterministe d’un vecteur de codes hexadécimaux étalonnés au spectromètre, conférant à la figure une finition professionnelle conforme aux normes des plus grands éditeurs scientifiques internationaux.
6.2 Modulation des styles de traits et niveaux d’opacité
Bien que la chromaticité demeure le principal vecteur de discrimination visuelle, son efficience décroît drastiquement dès que le nombre de trajectoires superposées s’élève ou que des courbes viennent à s’entrecroiser de façon frénétique. Pour lever toute ambiguïté de lecture, l’ingénierie visuelle contemporaine recommande de coupler systématiquement la couleur à la modulation de la texture géométrique du trait grâce à l’échelle scale_linetype_manual(). En assignant des motifs distincts (continu, tireté moyen, pointillés denses, alternance longue-courte) aux différents niveaux du facteur d’intérêt, l’analyste permet une identification bi-modale immédiate de chaque série de données.
Le contrôle précis du paramètre de transparence vectorielle alpha constitue une arme décisive contre le phénomène d’occlusion géométrique. L’opacité numérique, comprise entre 0 (invisibilité totale) et 1 (opacité absolue), permet de moduler la densité d’information projetée sur l’écran. Dans un graphique regroupant plusieurs dizaines de séries temporelles, appliquer un coefficient alpha = 0.25 aux trajectoires secondaires atténue considérablement l’intensité optique des croisements de segments. La superposition répétée de lignes semi-transparentes engendre de manière endogène des zones plus denses en pixels sombres, révélant intuitivement à l’œil les corridors de convergence où s’accumule préférentiellement la majorité des trajectoires empiriques.
L’utilisation concertée de l’épaisseur de ligne via l’argument linewidth contribue également à l’établissement d’une hiérarchie visuelle fonctionnelle. En réservant des épaisseurs substantielles (par exemple linewidth = 1.2) à une trajectoire expérimentale critique ou à un profil cible, tout en réduisant concomitamment les profils contrôles à une dimension plus filiforme (par exemple linewidth = 0.5), l’analyste réalise un guidage attentionnel cognitif de premier ordre, neutralisant d’emblée la sensation d’indifférenciation chaotique inhérente aux séries d’intensités visuelles homogènes.
6.3 Habillage typographique et thèmes conformes aux normes académiques
La puissance de communication d’un tracé multivarié ne saurait être dissociée de la rigueur de son écrin contextuel. Le thème visuel par défaut de ggplot2, reconnaissable à son fond grisâtre emblématique maillé d’un quadrillage blanc, bien qu’étudié initialement pour maintenir une comparaison de contrastes équilibrée, est généralement proscrit au sein des publications savantes formelles. Les éditeurs académiques prescrivent quasi universellement des toiles de fond parfaitement blanches, exemptes de toute réfraction parasite.
L’application d’un thème canonique épuré tel que theme_classic() ou theme_minimal(base_size = 12, base_family = "sans") permet d’assainir instantanément la scène graphique en substituant au masque gris un canevas immaculé de haute pureté typographique. L’ajustement du paramètre base_size assure une mise à l’échelle homothétique et proportionnelle de l’ensemble des éléments textuels de la figure, évitant les polices microscopiques illisibles une fois la figure insérée sur deux colonnes au sein d’un article imprimé.
Pour répondre strictement aux directives éditoriales les plus exigeantes, à l’instar des normes de l’American Psychological Association (APA 7th edition), la fonction de bas niveau theme() offre une granularité de configuration absolue. Elle permet d’épurer totalement le maillage d’arrière-plan via panel.grid = element_blank(), de tracer des axes cartésiens nets et robustes grâce à axis.line = element_line(color = "black", linewidth = 0.5), et d’ajuster l’interlignage, l’angle de rotation et la justification typographique des titres d’axes pour livrer une œuvre graphique d’un professionnalisme irréprochable.
7. Gestion avancée des légendes et stratégies d’étiquetage direct
7.1 Contrôle précis des guides et légendes dans ggplot2
Dans l’architecture déclarative de ggplot2, les clés de lecture et échelles sont gérées sous le concept fédérateur de guides graphiques. Si le positionnement par défaut de la légende sur le flanc droit du graphique convient aux visualisations simples, il dégrade fréquemment le ratio hauteur/largeur d’un tracé chronologique multilignes en amputant inutilement l’axe temporel de précieux centimètres horizontaux. L’analyste averti intervient dès lors sur la topologie spatiale de ces guides via la directive theme(legend.position = "bottom") ou theme(legend.position = "top") pour rééquilibrer la dynamique géométrique globale de la figure.
L’agencement interne du cartouche explicatif se gouverne via la fonction dédiée guides(). Celle-ci autorise la redéfinition précise des attributs fonctionnels de chaque esthétique mobilisée. Par le truchement de guides(color = guide_legend(nrow = 2, byrow = TRUE)), il devient trivial de réorganiser une énumération linéaire encombrante de séries en une grille matricielle compacte et élégante positionnée au bas du canevas. De surcroît, si la même variable catégorielle a été rigoureusement assignée à la fois à l’esthétique color et à l’esthétique linetype, ggplot2 réalise une fusion conceptuelle élégante des deux guides en une légende synthétique unique, à la stricte condition que les libellés et titres passés aux échelles respectives soient rigoureusement identiques au caractère près.
Dans les contextes où l’encombrement graphique atteint un seuil critique, ou lorsque l’analyste opte pour une stratégie d’étiquetage in situ direct, la légende conventionnelle devient redondante et contre-productive. Sa désactivation définitive s’obtient simplement par l’adjonction de l’instruction ciblée theme(legend.position = "none") ou en passant guide = "none" au sein de la fonction d’échelle chromatique considérée, purgeant le graphique de toute armature explicative latérale non essentielle.
7.2 Techniques de Direct Labeling pour éliminer les allers-retours visuels
Sur le plan de l’ergonomie visuelle et des sciences cognitives, la présence d’une légende désolidarisée impose à l’observateur un effort d’attention partagée particulièrement délétère : le lecteur est contraint d’effectuer d’incessants allers-retours oculaires (phénomène saccadique de navette visuelle) entre la ligne observée au cœur du tracé et le cartouche textuel déporté sur le côté pour identifier l’identité de la série. Cette friction perceptive s’élimine magistralement par la pratique de l’étiquetage direct (direct labeling), qui consiste à apposer le nom de chaque série au contact physique immédiat de l’extrémité droite de son tracé.
La mise en œuvre élégante de l’étiquetage direct en R s’appuie principalement sur l’extension spécialisée ggrepel, complétée par une extraction méthodique du dernier instant temporel enregistré pour chaque trajectoire. En isolant le sous-ensemble de données via une opération dplyr du type data %>% group_by(Serie) %>% filter(Temps == max(Temps)), on injecte ce sous-tableau terminal dans la géométrie avancée geom_text_repel() ou geom_label_repel(). Ces fonctions déploient des algorithmes d’optimisation par recuit simulé pour repousser intelligemment les libellés textuels les uns des autres ainsi que des segments de données, évitant de façon déterministe toute superposition typographique même lorsque les courbes convergent vers un point final identique.
Une alternative fonctionnelle classique réside dans l’emploi du package directlabels, pionnier historique en la matière. Au moyen d’une unique instruction telle que direct.label(graphique_ggplot, method = "last.points"), la librairie inspecte la topologie vectorielle des courbes et ancre les étiquettes textuelles de façon automatisée en bordure de canvas. Cette simplification d’accès rend l’expérience de lecture infiniment plus fluide, l’observateur associant instantanément et sans charge mentale résiduelle l’identité nominale à la cinétique de chaque courbe tracée.
7.3 Intégration d’annotations contextuelles et lignes de référence
Un tracé de données pures gagne une force démonstrative décuplée lorsqu’il est confronté graphiquement à des repères normatifs, des seuils de significativité théorique ou des jalons contextuels historiques. La grammaire de ggplot2 offre à cet effet une collection de primitives dédiées à l’ancrage de références invariantes, décorrélées des variations stochastiques des séries empiriques observées.
L’introduction de repères d’ordonnées ou d’abscisses critiques s’effectue au travers des fonctions geom_hline(yintercept = ...) et geom_vline(xintercept = ...). Que l’on souhaite matérialiser un seuil de toxicité clinique, un seuil d’alerte économique, ou l’instant précis d’inoculation d’un principe actif au sein d’une série chronologique, ces instructions permettent d’insérer des lignes directrices transversales discrètes, généralement stylisées sous forme de pointillés grisés (linetype = "dashed", color = "grey50"), pour situer instantanément la dynamique des courbes par rapport aux repères cardinaux du domaine scientifique étudié.
De surcroît, l’explicitation de plages temporelles structurales — telles qu’une phase de confinement sanitaire, une période de récession ou une fenêtre d’administration pharmacologique prolongée — se matérialise idéalement par l’insertion préliminaire d’un rectangle ombré via la couche geom_rect() positionnée à la racine du graphe. Enrichie d’annotations ponctuelles formulées via l’instruction universelle annotate("text", x = ..., y = ..., label = "..."), la visualisation multilignes transcende le statut de simple tracé descriptif pour s’ériger en un véritable document narratif explicatif, articulant données empiriques brutes et causalité contextuelle.
8. Visualisation de séries multiples avec intervalles d’incertitude
8.1 Calcul préalable des indices de variabilité statistique
La présentation académique rigoureuse de séries longitudinales multiples interdit formellement d’exposer de simples moyennes d’échantillons dénuées de l’expression quantifiable de leur variabilité ou de leur marge d’erreur. Selon les postulats distributionnels et la nature du design de recherche, la dispersion empirique autour de la trajectoire centrale s’exprime soit au moyen de l’écart-type (Standard Deviation, SD) pour documenter la variabilité interindividuelle brute, soit au travers de l’erreur standard de la moyenne (Standard Error of the Mean, SEM) ou d’intervalles de confiance (Confidence Intervals, IC à 95 %) dérivés de distributions paramétriques (loi de Student) ou d’estimations non paramétriques robustes par ré-échantillonnage bootstrap.
Le calcul de ces métriques d’incertitude doit impérativement intervenir en amont de la construction géométrique, au sein d’un pipeline de manipulation rigoureux orchestré par dplyr. À partir d’une table d’observations longitudinales répétées, l’analyste groupe les données par modalité factorielle et par temps d’évaluation via group_by(Condition, Temps), puis condense l’information par summarise(). Ce bloc opératoire dérive formellement la moyenne centrale, calcule la SEM par le ratio empirique de l’écart-type sur la racine carrée de l’effectif effectif non manquant (sd(y) / sqrt(sum(!is.na(y)))), et formalise explicitement les deux bornes critiques attendues par la grammaire visuelle : la borne inférieure ymin et la borne supérieure ymax.
Cette discipline méthodologique protège l’expérimentateur contre toute ambiguïté interprétative. La structure résultante, parfaitement ordonnée au format long, contient l’ensemble des coordonnées géométriques nécessaires pour projeter en parfaite adéquation spatiale la dynamique centrale et l’enveloppe de dispersion stochastique associée à chaque cohorte expérimentale suivie dans le temps.
8.2 Représentation sous forme de rubans ombrés avec geom_ribbon()
Lorsque la dimension temporelle de l’axe des abscisses est continue, l’encodage visuel de l’incertitude le plus esthétique et le plus informatif réside indiscutablement dans l’usage de rubans d’incertitude continus (shaded error bands) orchestrés par la couche geom_ribbon(). Cette géométrie cartographie spatialement l’espace bidimensionnel borné à chaque instant par les coordonnées vectorielles ymin et ymax, érigeant une gaine continue entourant la trajectoire centrale d’estimation.
L’implémentation de rubans d’incertitude superposés pour plusieurs séries simultanées exige toutefois une maîtrise sans faille de la transparence optique sous peine de générer des zones de chevauchement complètement opaques et illisibles. Il convient de lier le facteur de cohorte à l’attribut de remplissage surfacique via aes(fill = Condition) au sein de geom_ribbon(), tout en calibrant l’argument scalaire d’opacité à un niveau résolument ténu (par exemple alpha = 0.15 à 0.20). Cette semi-transparence préserve la visibilité transversale des rubans qui se croisent, permettant d’identifier immédiatement les périodes chronologiques où les intervalles de confiance se recouvrent (absence de différence statistiquement discernable) et les fenêtres de divergence où les rubans se découplent formellement.
L’ordre de déclaration au sein du script revêt ici une importance géométrique capitale. La couche geom_ribbon() doit être obligatoirement positionnée chronologiquement avant la couche geom_line() dans le flux d’instructions ggplot2. En agençant le ruban sous la ligne, l’analyste s’assure que le tracé principal de la trajectoire moyenne demeure impeccablement dessiné au premier plan, avec une netteté de contour parfaite non obscurcie par le remplissage du ruban polygonal.
8.3 Affichage alternatif via barres d’erreur discrètes
Dans les contextes expérimentaux où l’axe chronologique n’est pas appréhendé comme un continuum physique ininterrompu mais correspond à des points d’étape discrets et formalisés (par exemple des visites cliniques protocolaires calibrées à J0, J7, J28 et M6), la représentation continue par ruban ombré peut s’avérer trompeuse en suggérant une trajectoire d’incertitude continue entre les sessions. Dans ce cadre épistémologique précis, l’affichage traditionnel par barres d’erreur discrètes s’impose comme le standard méthodologique de rigueur.
La mobilisation de geom_errorbar() permet de projeter des segments verticaux délimitant la marge d’erreur calculée à chaque jalon d’échantillonnage. Néanmoins, l’application naïve de cette géométrie sur des séries multiples superposées déclenche un écueil visuel majeur : au même point d’abscisse temporelle, les barres d’erreur des différents groupes viennent se superposer exactement, aboutissant à un fouillis vectoriel inextricable où il devient impossible de déterminer à quelle courbe se rattache chaque segment terminal. L’argument capital pour dénouer ce conflit géométrique est le recours délibéré à position = position_dodge(width = ...).
L’opérateur position_dodge() applique un décalage spatial horizontal artificiel infime et symétrique aux éléments partageant la même abscisse nominale. En appliquant une valeur de décalage rigoureusement identique à la fois à la couche de barres d’erreur geom_errorbar(position = position_dodge(0.3), width = 0.2), à la couche de points de mesure geom_point(position = position_dodge(0.3)) et à la couche de liaison geom_line(position = position_dodge(0.3)), l’ensemble du système graphique se décale de concert avec une cohérence parfaite. Chaque série dispose d’une micro-colonne spatiale distincte, garantissant une lecture immédiate et sans collision de l’amplitude exacte de son incertitude statistique respective.
9. Décomposition en facettes : alternative aux graphiques surchargés
9.1 Théorie des Small Multiples d’Edward Tufte
Lorsque le volume de séries de données simultanées croît substantiellement — dépassant typiquement le seuil critique de cinq à six courbes concurrentes —, l’espace cartésien bidimensionnel unique atteint inexorablement ses limites d’encodage perceptif, quelle que soit la virtuosité chromatique déployée. L’enchevêtrement des tracés induit une occlusion mutuelle constante, transformant la visualisation en un labyrinthe indéchiffrable. Face à cette impasse structurelle, la théorie de la visualisation de données propose une parade magistrale théorisée par Edward Tufte sous le concept de « petits multiples » (Small Multiples).
Le principe des petits multiples postule que la décomposition d’un graphique saturé complexe en une série ordonnée de petits sous-graphiques simples, partageant rigoureusement les mêmes axes et la même échelle dimensionnelle, constitue la stratégie cognitive la plus efficiente pour comparer visuellement de multiples distributions ou séries chronologiques. En isolant chaque trajectoire (ou chaque sous-groupe logique) au sein de son propre compartiment spatial dédié, la dispersion vectorielle est éliminée, restaurant instantanément la pureté géométrique de chaque cinétique unitaire.
L’acuité analytique est décuplée par le maintien scrupuleux de l’alignement des repères : l’œil humain, remarquablement efficient pour détecter de faibles variations le long d’horizontales et de verticales partagées, effectue des comparaisons inter-panneaux d’une précision chirurgicale sans avoir à lutter contre les interférences optiques générées par les croisements de tracés adjacents. Cette technique résout définitivement la surcharge visuelle tout en amplifiant la capacité de détection des patterns idiosyncratiques propres à chaque condition expérimentale.
9.2 Mise en œuvre pratique avec facet_wrap()
L’implémentation opérationnelle de cette décomposition en sous-graphiques sériels atteint des sommets de concision et d’élégance algorithmique sous ggplot2 grâce à la fonction facet_wrap(). Cette directive prend en charge l’automatisation complète du processus de partitionnement : l’analyste se contente de spécifier la variable catégorielle de découpage sous forme de formule mathématique standard, à l’instar de facet_wrap(~ Identifiant_Sujet) ou facet_wrap(~ Pathologie).
Le moteur graphique calcule de façon totalement autonome le nombre de lignes et de colonnes nécessaires pour encapsuler l’ensemble des modalités du facteur, mais l’utilisateur conserve un contrôle direct sur l’agencement topologique via les arguments géométriques nrow et ncol. Par exemple, imposer ncol = 3 réorganise une collection de douze trajectoires longitudinales en une matrice ordonnée de quatre rangées par trois colonnes de panneaux, parfaitement calibrée pour l’impression sur un format de page scientifique standard en orientation portrait.
La scénographie textuelle des bandeaux de titres surplombant chaque compartiment (les strip labels) se personnalise avec une flexibilité totale. Au moyen du paramètre labeller, il est aisé d’injecter des étiquettes enrichies ou des équations mathématiques formatées, tandis que les directives theme(strip.background = ..., strip.text = ...) permettent de purger les cartouches de toute coloration distrayante pour instaurer une typographie épurée conforme aux critères graphiques académiques les plus stricts.
9.3 Structures matricielles avec facet_grid() et échelles libres
Lorsque le protocole de recherche explore les interactions dynamiques générées par le croisement strict de deux facteurs qualitatifs indépendants (par exemple, trois niveaux de Posologie pharmacologique combinés orthogonalement à deux profils de Sexe biologique), la simple décomposition unidimensionnelle de facet_wrap() s’efface au profit de la structure matricielle bidimensionnelle instaurée par facet_grid(). Cette fonction matérialise une table cartésienne rigoureuse où les lignes de la grille graphique correspondent aux modalités du premier facteur et les colonnes à celles du second facteur, formulée syntaxiquement sous la forme canonique facet_grid(Sexe ~ Posologie).
Dans ce canevas matriciel croisé, chaque cellule héberge la sous-série correspondante, offrant un panorama exhaustif et ordonné des variations du signal à travers l’ensemble de l’espace combinatoire expérimental. Par défaut, facet_grid() verrouille de manière immuable l’ensemble des axes d’ordonnées et d’abscisses sur des bornes universellement identiques, garantissant une comparabilité quantitative sans biais à travers l’ensemble des panneaux de la matrice.
Toutefois, dans certaines situations empiriques extrêmes où les amplitudes de signal oscillent à travers des ordres de grandeur hétérogènes entre les sous-groupes, le maintien d’une échelle commune peut écraser visuellement les séries de faible magnitude au point de les rendre plates et illisibles. Pour remédier à cette contrainte dimensionnelle, ggplot2 offre l’argument scales = "free_y" (ou scales = "free"). Il convient cependant d’user de cette liberté avec une réserve méthodologique extrême dans le cadre de publications scientifiques : la libération des échelles d’ordonnées compromet l’immédiateté de la comparaison visuelle inter-panneaux et peut induire en erreur un lecteur distrait en lui faisant percevoir des amplitudes identiques là où réside en réalité un écart substantiel de plusieurs ordres de grandeur.
10. Gestion des axes temporels et échelles chronologiques spécialisées
10.1 Formatage des variables chronologiques avec lubridate
La représentation temporelle rigoureuse de séries longitudinales au sein de l’environnement R exige une discipline formelle quant à la nature ontologique des données chronologiques manipulées. L’injection brute de vecteurs textuels contenant des dates (par exemple sous la chaîne "2023-04-15") sans instanciation de type formel constitue une source récurrente de dysfonctionnements majeurs : ggplot2 traitera invariablement ces chaînes comme des niveaux catégoriels discrets équidistants, annihilant toute proportionnalité physique entre la distance spatiale sur le graphique et l’écoulement réel de la durée temporelle.
L’utilisation du package spécialisé lubridate, intégré harmonieusement à l’écosystème du tidyverse, procure un arsenal de fonctions de conversion particulièrement robustes face à la diversité des formats d’encodage chronologique. Les commandes canoniques telles que ymd(), dmy() ou ymd_hms() convertissent instantanément des chaînes de caractères hétérogènes en objets formels de classe temporelle native Date ou POSIXct. Cette transmutation typologique fondamentale confère à la variable une continuité euclidienne mesurable, prenant rigoureusement en compte les irrégularités calendaires, les années bissextiles et la distribution stochastique réelle des pas d’échantillonnage temporel.
De surcroît, dans les études cliniques ou les protocoles comportementaux où les sujets ne sont pas examinés à la même date absolue du calendrier civil mais selon un temps relatif écoulé depuis leur inclusion individuelle, lubridate excelle dans le calcul d’intervalles et de durées standardisées. L’établissement d’une variable de temps relatif unifiée — définie rigoureusement comme le temps zéro (T0) centré sur l’événement thérapeutique d’intérêt — permet d’aligner parfaitement des séries asynchrones sur un axe d’abscisse commun, condition préalable indispensable au tracé comparatif de leurs trajectoires respectives.
10.2 Configuration des axes temporels avec scale_x_date()
Dès lors qu’une variable instanciée sous une véritable classe chronologique alimente l’axe horizontal d’un modèle ggplot2, le moteur substitue automatiquement l’échelle numérique linéaire générique par une échelle temporelle spécialisée, personnalisable en profondeur via l’instruction dédiée scale_x_date() (ou scale_x_datetime() pour les enregistrements horodatés à haute résolution).
La modulation des graduations principales et secondaires de l’axe s’effectue avec une fluidité exceptionnelle par l’intermédiaire de l’argument date_breaks. En déclarant des expressions sémantiques intuitives telles que date_breaks = "2 weeks", date_breaks = "3 months" ou date_breaks = "1 year", l’analyste calibre avec une précision absolue la densité des repères temporels le long du canevas, prévenant l’engorgement ou l’indigence des graduations d’abscisse.
La typographie formelle des étiquettes temporelles se gouverne quant à elle via le paramètre date_labels, qui accepte les spécificateurs de conversion standards conformes à la norme internationale POSIX. Ainsi, la chaîne de formatage date_labels = "%b %Y" convertira une coordonnée temporelle brute en une mention textuelle abrégée du type « Avr 2023 », optimisant l’espace spatial disponible. Si la densité textuelle demeure trop contraignante, la rotation mécanique des étiquettes le long du plan horizontal s’obtient simplement par l’adjonction de la directive theme(axis.text.x = element_text(angle = 45, hjust = 1)), assurant une lisibilité sans faille exempte de tout chevauchement typographique.
10.3 Lissage non paramétrique et modélisation de trajectoires (geom_smooth)
Face à des séries longitudinales multiples caractérisées par un bruit stochastique dense ou des fluctuations aléatoires à haute fréquence, le raccordement vectoriel brut de point à point via geom_line() aboutit fréquemment à un tracé erratique et heurté masquant la signature tendancielle globale. Dans ce cadre d’exploration analytique, l’adjonction d’une couche d’ajustement semi-paramétrique ou non paramétrique via geom_smooth() permet d’extraire et de projeter la tendance cinétique sous-jacente propre à chaque cohorte.
La couche geom_smooth() intègre nativement une gamme étendue de modélisations statistiques avancées. Pour des jeux de données denses comportant moins de mille observations, l’algorithme déploie par défaut une régression polynomiale pondérée locale (lissage LOESS, method = "loess"), particulièrement redoutable pour épouser les courbures non linéaires locales sans imposer d’hypothèse fonctionnelle rigide a priori. Pour des volumes massifs de données, le moteur bascule harmonieusement vers des modèles additifs généralisés (GAM, method = "gam", formule associant des fonctions de splines de régression pénalisées), garantissant une efficience algorithmique optimale et une flexibilité fonctionnelle maximale.
Par défaut, geom_smooth() calcule et affiche sous forme de ruban ombré l’intervalle de confiance à 95 % associé à la trajectoire estimée. Si la présence conjointe de ces rubans pour de multiples séries tend à saturer l’espace graphique, l’affichage de l’incertitude peut être neutralisé de façon déterministe via l’argument scalaire se = FALSE. L’observateur bénéficie alors d’un jeu de trajectoires tendancielles parfaitement pures et épurées, idéales pour discerner les points d’inflexion critiques et les phases d’accélération ou de décélération de chaque série de données.
11. Visualisations interactives pour séries multiples : plotly et extensions
11.1 Passerelle directe via la fonction ggplotly()
La diffusion croissante de la communication scientifique au format numérique — par le biais d’articles scientifiques interactifs, de plateformes web analytiques ou de tableaux de bord exécutifs — a profondément transformé les attentes entourant la visualisation des données. Pour l’exploration dynamique de trajectoires multiples entremêlées, l’interactivité abolit instantanément la friction cognitive de l’occlusion statique. L’écosystème R propose une passerelle logicielle magistrale entre la grammaire statique et le monde du web dynamique au travers du package plotly et de sa fonction passerelle ggplotly().
Le tour de force algorithmique de la fonction ggplotly() réside dans sa capacité à ingérer un objet graphique statique standard élaboré exhaustivement avec ggplot2, et à le traduire instantanément en un composant web interactif manipulable dans n’importe quel navigateur moderne via la technologie client JavaScript. La fidélité géométrique, chromatique et typographique du rendu original est scrupuleusement préservée, tout en dotant immédiatement le canevas d’un ensemble complet de commandes d’exploration vectorielle : zoom rectangulaire dynamique, translation panoramique, réinitialisation instantanée du cadre et capture instantanée d’images vectorielles haute définition.
De surcroît, le moteur interactif métamorphose fondamentalement l’utilité ergonomique du cartouche de légende. Par simple clic interactif sur un élément de la légende numérique, l’utilisateur final peut masquer temporairement une série spécifique ou, par un double-clic résolu, isoler une trajectoire singulière en occultant instantanément toutes les autres courbes de l’affichage. Cette manipulation à la volée résout radicalement le problème de surcharge des séries multiples, conférant au lecteur le pouvoir de désaturer la scène selon ses propres priorités d’exploration analytique.
11.2 Fonctionnalités avancées d’exploration dynamique
Au-delà de la simple conversion passive, l’articulation de plotly autorise un enrichissement sémantique considérable de l’expérience d’exploration multivariée. L’un des raffinements fonctionnels les plus probants concerne la personnalisation méticuleuse des fenêtres d’information contextuelles au survol du curseur (tooltips). En déclarant un argument esthétique dédié au sein du modèle déclaratif originel — par exemple aes(..., text = paste("Patient :", Id, " —, puis en spécifiant
Valeur :", round(Score, 2)))ggplotly(tooltip = "text"), l’infobulle flottante restitue l’intégralité du profil clinique de chaque point de mesure sans jamais encombrer le champ visuel statique.
Une autre configuration dynamique d’une pertinence analytique majeure pour les tracés multilignes consiste à unifier le mode d’inspection chronologique au moyen de la directive de mise en page layout(hovermode = "x unified"). Sous ce mode opératoire, le passage du pointeur le long de l’axe des abscisses projette une fine ligne verticale de visée qui traverse instantanément l’ensemble des courbes superposées, faisant apparaître un cartouche unique consolidé récapitulant les amplitudes exactes de toutes les séries au même instant temporel. L’exercice de comparaison transversale entre séries à un instant T précis atteint ici une efficacité et une précision mathématique inégalables sur support statique.
Pour les séries chronologiques de longue durée, l’injection d’un sélecteur interactif d’étendue temporelle (rangeslider) au bas du graphique déploie un ruban de contrôle tactile particulièrement fluide. L’utilisateur peut contracter, étendre ou translater manuellement la fenêtre d’observation temporelle à travers les années ou les décennies, scrutant les micro-variations à l’échelle de la journée tout en conservant une vision d’ensemble de la cinétique macroscopique séculaire.
11.3 Considérations de performance face aux données volumineuses
L’intégration d’interactivité dynamique n’est toutefois pas exempte de contraintes informatiques et matérielles. Contrairement à un tracé statique exporté sous forme d’image matricielle dont le poids mémoire est indépendant du nombre d’observations sous-jacentes, un graphique interactif instancié sous plotly intègre l’intégralité des coordonnées vectorielles sous forme d’une structure JSON interprétée côté client par le moteur JavaScript du navigateur de l’utilisateur final. Dès lors que l’on tente de tracer simultanément des centaines de séries comprenant chacune des dizaines de milliers de pas de temps, le navigateur subit un effondrement de fluidité, voire un gel complet d’exécution dû à l’épuisement des ressources mémoire.
Face à des séries massives issues d’enregistrements physiologiques continus (tels que des électroencéphalogrammes multivoies ou des métriques boursières haute fréquence à la milliseconde), il devient impératif de mettre en œuvre des techniques algorithmiques de décimation intelligente en amont de toute restitution interactive. L’application d’algorithmes de simplification de tracés géométriques, à l’instar de l’algorithme de Ramer-Douglas-Peucker ou de la méthode du Largest Triangle Three Buckets (LTTB), permet de réduire le volume de points vectoriels d’un facteur 100 à 1000 sans aucune perte perceptive discernable de la morphologie des trajectoires.
Par ailleurs, pour les flux de données chronologiques massifs, l’alternative technique offerte par le package spécialisé dygraphs — wrapper R de la bibliothèque JavaScript éponyme ultra-optimisée — surpasse largement les performances brutes de Plotly. Conçu expressément pour absorber des millions de coordonnées temporelles continues avec une fluidité de défilement constante, dygraphs s’impose comme le choix d’ingénierie privilégié lors du déploiement d’applications analytiques haute performance sous l’environnement Shiny.
12. Bonnes pratiques académiques, pièges d’interprétation et export pour publication
12.1 Résolution du syndrome du « graphique en spaghettis » (Spaghetti Plot)
Le syndrome du graphique en spaghettis désigne l’état de dégradation visuelle pathologique où la superposition indifférenciée de dizaines ou de centaines de lignes continues génère un enchevêtrement chaotique évoquant un plat de pâtes emmêlées. Dans une telle situation, l’intégrité sémiotique du graphique est totalement annihilée : l’observateur ne peut extraire aucune structure signifiante, les identités individuelles des courbes se dissolvent dans un magma de pixels superposés, et la figure échoue lamentablement dans sa mission de transmission intelligible du savoir empirique.
La solution méthodologique la plus spectaculaire et la plus élégante pour conjurer ce syndrome s’appuie sur la technique de la mise en exergue sélective (highlighting), implémentée magistralement dans l’écosystème R par le package spécialisé gghighlight. Cette approche postule que toutes les séries ne portent pas une pertinence scientifique identique. En intégrant la fonction gghighlight() au pipeline de rendu de ggplot2, l’analyste spécifie une condition logique discriminante — par exemple mettre en lumière les trajectoires dont la valeur terminale dépasse un seuil d’alerte, ou celles appartenant à un sous-groupe phénotypique d’intérêt majeur.
De façon entièrement automatisée, gghighlight relègue l’ensemble des séries non sélectionnées dans un arrière-plan désaturé uniforme, matérialisé par des segments minces d’un gris neutre discret, tout en projetant les trajectoires cibles au tout premier plan dans des teintes vives et saturées, enrichies d’étiquettes d’identification directes positionnées sans collision à leurs extrémités. L’observateur conserve ainsi la perception globale de la variabilité d’ensemble de la cohorte grâce au nuage gris d’arrière-plan, tout en analysant sans effort cognitif les trajectoires discriminées au premier plan.
Dans les cas où aucune sous-série n’émerge a priori, une approche statistique rigoureuse consiste à procéder préalablement à une classification non supervisée des courbes (par exemple un clustering fonctionnel ou l’algorithme des k-means appliqué aux coefficients de décomposition temporelle). Le graphique n’affiche alors plus l’ensemble des données individuelles brutes, mais uniquement les profils moyens représentatifs (les prototypes ou centres de gravité de clusters) associés à leurs enveloppes de dispersion respectives, réduisant une collection chaotique de mille trajectoires empiriques à une typologie claire et hautement intelligible de trois ou quatre patterns morphologiques fondamentaux.
12.2 Le piège des doubles axes Y et solutions alternatives rigoureuses
Face à la nécessité de projeter simultanément deux séries temporelles exprimées dans des unités physiques radicalement différentes (par exemple, modéliser le taux de chômage exprimé en pourcentage et le produit intérieur brut exprimé en milliards de devises monétaires), les concepteurs de graphiques cèdent fréquemment à la tentation méthodologiquement toxique du double axe des ordonnées (l’axe vertical gauche et l’axe vertical droit dotés d’échelles différentes sur le même canevas). La communauté scientifique et les experts en intégrité visuelle dénoncent avec force cette pratique en raison de son potentiel de manipulation perceptive destructeur.
L’écueil fondamental réside dans l’arbitraire absolu présidant à l’étalonnage relatif et au centrage vertical des deux axes indépendants. En modifiant légèrement l’échelle d’amplitude ou le point zéro de l’axe secondaire droit, l’auteur d’un graphique à double axe peut manipuler à sa guise la position relative des tracés, créant de toutes pièces des points d’intersection visuels totalement factices, induisant artificiellement une impression visuelle de corrélation ou synchronisation causale étroite entre des séries qui ne partagent en réalité aucune covariation tangible. Les créateurs de ggplot2 ont d’ailleurs délibérément restreint l’usage d’un second axe d’ordonnées en imposant que ce dernier ne soit obligatoirement qu’une stricte transformation affine mathématique directe de l’axe premier.
Pour s’affranchir de ce piège déontologique sans renoncer à la richesse de l’analyse, deux alternatives scientifiques rigoureuses s’imposent :
- La standardisation statistique des métriques sur un axe d’ordonnées commun : Avant tout affichage, les deux séries sont converties mathématiquement soit en scores standardisés Z (centrés-réduits par soustraction de la moyenne et division par l’écart-type), soit en indices d’évolution en pourcentage relatifs à une base 100 fixée à un temps zéro partagé. Les trajectoires évoluent dès lors sur une échelle sans dimension commune universellement comparable, matérialisant fidèlement leurs déviations relatives sans distorsion visuelle subjective.
- La juxtaposition en facettes empilées verticalement : En décomposant les deux séries au sein de deux panneaux distincts verticalement empilés partageant rigoureusement le même axe horizontal temporel, chaque série conserve son axe propre d’unités physiques sur son propre compartiment. L’observateur compare instantanément les cinétiques et les inflexions temporelles le long de la verticale commune sans qu’aucune collision visuelle ni manipulation d’intersection arbitraire ne vienne fausser le jugement scientifique.
12.3 Exportation vectorielle haute définition pour les revues scientifiques
L’aboutissement ultime de la production d’un tracé multivarié consiste en son extraction du logiciel de calcul vers un fichier physique conforme aux guides stricts aux auteurs édictés par les éditeurs scientifiques internationaux (tels que Nature, Science, Elsevier ou Springer). Une erreur technique majeure consiste à exporter les figures par simple capture d’écran ou sous des formats d’encodage matriciel compressés à faible résolution (tels que JPEG standard), condamnant le graphique à une pixellisation dégradée, des flous typographiques rédhibitoires et une pixellisation destructrice lors des opérations de mise en page pré-presse.
La commande incontournable au sein de l’écosystème déclaratif est la fonction d’exportation de haut niveau ggsave(). Celle-ci intègre un contrôle déterministe absolu des dimensions géométriques physiques d’exportation. Il est impératif de déclarer explicitement les dimensions spatiales de la figure via les arguments dimensionnels d’échelle réelle width et height, en adéquation absolue avec l’unité spécifiée par units = "cm" ou units = "in". Une figure destinée à occuper une colonne simple d’un journal académique doit être calibrée sur une largeur physique stricte comprise entre 8 et 9 centimètres, tandis qu’une planche étalée sur une double colonne requiert un calibrage dimensionnel rigide d’environ 17 à 18 centimètres.
Pour les restitutions matricielles exigeant une compression sans perte (principalement le format TIFF ou PNG de haute qualité), le paramètre de résolution spatiale doit être formellement verrouillé au minimum à dpi = 300 pour les illustrations en demi-teinte et jusqu’à dpi = 600 à 1200 pour les dessins aux traits vectoriels épurés. Toutefois, le standard absolu de publication demeure indiscutablement le format vectoriel pur — principalement le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics) formulé par device = cairo_pdf ou device = "svg". Dans ce format d’export vectoriel, les lignes géométriques, les glyphes de points et les polices de caractères typographiques sont encodés sous forme d’instructions mathématiques de courbes de Bézier pures et d’éléments typographiques vectorisés, garantissant un piqué typographique parfait et une netteté de tracé infinie, quel que soit le niveau de grossissement d’impression optique ou d’affichage sur écran haute résolution.
Références
- Brewer, C. A. (2015). Designing better maps: A guide for GIS users (2nd ed.). Esri Press.
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Grolemund, G., & Wickham, H. (2011). Dates and times made easy with lubridate. Journal of Statistical Software, 40(3), 1–25. https://doi.org/10.18637/jss.v040.i03
- R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Sievert, C. (2020). Interactive web-based data visualization with R, plotly, and shiny. Chapman and Hall/CRC. https://plotly-r.com/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0