
La modélisation statistique des variables aléatoires continues restreintes à un intervalle fini constitue un défi méthodologique fondamental dans de nombreuses disciplines quantitatives, tout particulièrement au sein des sciences cognitives, de la psychométrie, de la biométrie et de l’économétrie. Contrairement à la distribution gaussienne qui postule un support infini s’étendant de l’infini négatif à l’infini positif, de nombreux phénomènes empiriques sont par nature intrinsèquement bornés. Qu’il s’agisse de proportions, de taux d’exactitude, d’indices de précision motrice, de scores normalisés ou d’estimations subjectives de probabilités, ces mesures évoluent rigoureusement dans l’intervalle unitaire standardisé. Tenter d’ajuster des modèles linéaires classiques ou de superposer des densités normales sur de tels registres expose l’analyste à des aberrations théoriques manifestes, notamment la prédiction de probabilités négatives ou excédant l’unité, ainsi qu’à une violation systématique de l’hypothèse d’homoscapédasticité en raison de la compression de la variance aux abords des frontières.
Dans ce contexte analytique, la distribution Bêta s’impose comme le cadre mathématique de référence en raison de son exceptionnelle plasticité morphologique et de son support compact naturellement borné entre zéro et un. Caractérisée par deux hyperparamètres de forme régissant conjointement sa tendance centrale, sa dispersion, son asymétrie et son aplatissement, cette loi offre un pouvoir d’ajustement sans équivalent pour épouser des profils empiriques hautement diversifiés, allant de distributions rigoureusement symétriques en cloche à des formes en U, en J, exponentielles ou strictement uniformes. En outre, au sein du paradigme de l’inférence bayésienne, la loi Bêta jouit d’un statut privilégié en tant que distribution conjuguée canonique pour les modèles de vraisemblance binomiale, simplifiant considérablement le calcul analytique des distributions a posteriori régissant l’estimation de proportions.
Le langage et environnement statistique R fournit un écosystème computationnel particulièrement puissant pour appréhender, modéliser et visualiser la loi Bêta. Cependant, la transition entre la théorie mathématique abstraite et la production de visualisations graphiques rigoureuses, conformes aux standards académiques et aux exigences éditoriales internationales, requiert une maîtrise approfondie des fonctions analytiques sous-jacentes, des contraintes d’approximation numérique et des moteurs de rendu graphique, qu’il s’agisse du système graphique de base (R Base Graphics) ou de la grammaire des graphiques structurée via l’extension ggplot2. Ce guide exhaustif a pour vocation d’articuler pas à pas les concepts mathématiques fondamentaux, l’architecture logicielle de R et les techniques avancées de rendu visuel pour permettre aux chercheurs et analystes de tracer, personnaliser et interpréter la distribution Bêta avec une précision scientifique irréprochable.
1. Fondements théoriques et mathématiques de la distribution Bêta
1.1 Définition analytique et fonction de densité de probabilité
Sur le plan de l’analyse mathématique, la distribution Bêta est une loi de probabilité continue définie de manière rigoureuse sur le support compact unitaire fermé, ou plus fréquemment sur l’intervalle ouvert ]0, 1[ lorsque l’on souhaite exclure les singularités asymptotiques aux bornes. Pour une variable aléatoire continue $X$, sa fonction de densité de probabilité (FDP) s’exprime analytiquement sous la formulation suivante :
$$f(x; \alpha, \beta) = \frac{1}{\mathrm{B}(\alpha, \beta)} x^{\alpha – 1} (1 – x)^{\beta – 1} \quad \text{pour } x in ]0, 1[$$
Dans cette équation formelle, le terme $\mathrm{B}(\alpha, \beta)$ représente la fonction Bêta d’Euler, qui agit comme constante de normalisation analytique garantissant que l’intégrale de la densité sur l’ensemble du domaine de définition soit rigoureusement égale à un. Cette intégrale d’Euler de première espèce s’articule directement avec la fonction Gamma d’Euler selon l’identité remarquable :
$$\mathrm{B}(\alpha, \beta) = \int_0^1 u^{\alpha – 1} (1 – u)^{\beta – 1} , \mathrm{d}u = \frac{\Gamma(\alpha)\Gamma(\beta)}{\Gamma(\alpha + \beta)}$$
Cette paramétrisation standard s’appuie sur deux hyperparamètres fondamentaux de forme, conventionnellement notés $\alpha$ (alpha) et $\beta$ (bêta), qui doivent impérativement appartenir à l’ensemble des réels strictement positifs ($\mathbb{R}_+^*$). La flexibilité remarquable de la loi Bêta découle de l’interaction multiplicative entre le terme $x^{\alpha – 1}$, qui contrôle la pente et le comportement de la densité au voisinage de zéro, et le terme $(1 – x)^{\beta – 1}$, qui détermine la dynamique asymptotique ou l’annulation de la fonction au voisinage de l’unité.
L’exploration des moments statistiques de la loi Bêta permet d’appréhender de manière analytique la structure de cette distribution. L’espérance mathématique, qui représente le barycentre probabiliste de la densité, dépend exclusivement du ratio pondéré des deux hyperparamètres :
$$\mathbb{E}[X] = \frac{\alpha}{\alpha + \beta}$$
La variance, mesurant l’étalement ou la dispersion de la masse probabiliste autour de cette tendance centrale, fait intervenir la somme totale des hyperparamètres, fréquemment désignée sous le terme de paramètre de précision ou taille d’échantillon équivalente ($\kappa = \alpha + \beta$) :
$$\mathbb{V}\mathrm{ar}(X) = \frac{\alpha\beta}{(\alpha + \beta)^2 (\alpha + \beta + 1)}$$
Les moments d’ordre supérieur révèlent les caractéristiques de déformation de la courbe. L’asymétrie statistique (coefficient de skewness) est formalisée par :
$$\gamma_1 = \frac{2(\beta – \alpha)\sqrt{\alpha + \beta + 1}}{(\alpha + \beta + 2)\sqrt{\alpha\beta}}$$
Cette expression démontre formellement que lorsque $\alpha = \beta$, l’asymétrie s’annule rigoureusement ($\gamma_1 = 0$), conférant à la distribution une symétrie axiale parfaite autour de la médiane $x = 0{,}5$. Si $\alpha < \beta$, le coefficient est strictement positif, traduisant un étalement de la queue de distribution vers la droite (asymétrie positive), tandis que si $\alpha > \beta$, le coefficient devient négatif, indiquant une queue prédominante dirigée vers la gauche. Enfin, l’aplatissement (kurtosis excédentaire) permet de quantifier la leptocurticité ou la platycurticité du profil en fonction de l’intensité conjointe des deux paramètres, mettant en lumière la propension de la distribution à générer des queues épaisses ou au contraire une concentration modale aplanie.
1.2 Pertinence de la loi Bêta dans les sciences du comportement
Dans l’investigation empirique des sciences cognitives, de la psychologie différentielle, des neurosciences et des sciences comportementales, la distribution Bêta constitue un instrument de modélisation particulièrement adapté aux contraintes phénoménologiques des données expérimentales. Les chercheurs sont en effet confrontés de manière quasi permanente à des métriques dont l’espace d’échantillonnage est naturellement contraint par des bornes rigides indépassables. Les taux d’exactitude à des batteries d’évaluations mnésiques, les proportions de clics corrects lors de paradigmes d’inhibition motrice de type Go/No-Go, ou encore les pourcentages de réussite à des épreuves de raisonnement logique ne peuvent structurellement descendre en deçà de 0 % ni excéder 100 %.
Au-delà de ces métriques de performance objective, la psychologie cognitive s’intéresse en profondeur aux degrés de croyance subjective et aux mécanismes d’attribution de confiance métacognitive. L’évaluation par un sujet de la probabilité qu’un stimulus visuel masqué appartienne à une catégorie cible constitue une variable continue intrinsèquement bornée dans l’intervalle $[0, 1]$. De même, l’allocation relative des temps d’attention au cours d’enregistrements oculométriques (mesurée par la proportion de temps de fixation sur une région d’intérêt par rapport à la durée globale de l’essai) répond aux postulats fondamentaux de la loi Bêta. Modéliser ces grandeurs à l’aide de distributions gaussiennes induit inéluctablement des prédictions théoriques aberrantes en dehors des limites physiques du monde réel, problème que le support compact de la loi Bêta résout par construction de manière élégante et mathématiquement cohérente.
Dans le domaine de la psychométrie et de la modélisation statistique avancée, la distribution Bêta remplit une fonction méthodologique fondamentale en tant que distribution a priori conjuguée dans l’inférence bayésienne appliquée aux modèles binomiaux psychométriques. Lorsqu’un protocole expérimental évalue la probabilité de succès $\theta$ d’un individu à une série d’épreuves de Bernoulli indépendantes, l’attribution d’une distribution a priori Bêta($\alpha_0, \beta_0$) à ce paramètre latent conduit, après l’observation empirique de $k$ succès parmi $n$ essais, à une distribution a posteriori appartenant rigoureusement à la même famille fonctionnelle, à savoir Bêta($\alpha_0 + k, \beta_0 + n – k$). Cette propriété de conjugaison facilite non seulement l’analyse computationnelle en évitant le recours systématique aux algorithmes d’échantillonnage de Markov à chaînes (MCMC) pour les architectures simples, mais confère également aux hyperparamètres une interprétation psychologique intuitive en termes d’expériences virtuelles ou d’évidence préalable.
Enfin, l’opérationnalisation quantitative impose régulièrement de normaliser des scores composites issus d’échelles de Likert ou de questionnaires d’auto-évaluation multidimensionnels vers un continuum probabiliste standardisé. Les transformations linéaires de type min-max appliquées à des échelles de personnalité (comme celles mesurant le névrosisme ou l’extraversion) compriment les réponses brutes dans l’espace $[0, 1]$. La loi Bêta fournit alors un substrat probabiliste permettant d’ajuster des régressions continues directes tout en capturant l’hétérogénéité des variations individuelles et les effets de seuil (effets de plancher ou de plafond) fréquemment observés au sein des populations cliniques ou atypiques.
1.3 Morphologie de la distribution selon les valeurs des paramètres
La puissance d’expression de la distribution Bêta réside dans sa métamorphose géométrique spectaculaire au fur et à mesure que les hyperparamètres $\alpha$ et $\beta$ balayent le demi-plan des réels strictement positifs. Une typologie exhaustive des comportements morphologiques permet de catégoriser la distribution selon différentes classes qualitatives fondamentales, conférant au statisticien une grille de lecture visuelle immédiate pour identifier les processus générateurs sous-jacents.
Le premier régime morphologique concerne les distributions symétriques unimodales, caractérisées par l’égalité $\alpha = \beta > 1$. Dans cette configuration paramétrique, la courbe adopte un profil en cloche régulier, rigoureusement symétrique par rapport à l’abscisse centrale $x = 0{,}5$. La valeur modale coïncide parfaitement avec l’espérance et la médiane statistique. Lorsque la valeur commune de ces paramètres croît (par exemple $\alpha = \beta = 5$, puis $\alpha = \beta = 20$), la variance diminue de façon monotone, provoquant un resserrement drastique de la masse de probabilité autour du centre. À la limite asymptotique où ces hyperparamètres tendent vers l’infini, la distribution converge ponctuellement vers une masse de Dirac centrée en 0,5.
À l’opposé diamétral de ce comportement d’accumulation centrale se trouve le régime morphologique en forme de U, qui émerge de manière systématique lorsque les deux hyperparamètres sont strictement inférieurs à l’unité ($\alpha < 1$ et $\beta < 1$). Dans cette situation hautement singulière, la fonction de densité diverge vers l’infini positif aux deux frontières du support :
$$\lim_{x to 0^+} f(x) = +\infty \quad \text{et} \quad \lim_{x to 1^-} f(x) = +\infty$$
La distribution présente alors un minimum local unique (un antimode) en $x = (\alpha – 1) / (\alpha + \beta – 2)$. Un cas d’école éminemment célèbre de cette famille est la distribution dite d’Arcsinus, obtenue rigoureusement pour $\alpha = 0{,}5$ et $\beta = 0{,}5$, couramment exploitée en théorie des processus stochastiques pour caractériser les temps d’occupation des mouvements browniens au-dessus de zéro. Sur le plan psychologique, ce profil en U illustre parfaitement les phénomènes de polarisation extrême, où les individus adoptent massivement des comportements ou des opinions aux deux antipodes d’une échelle, délaissant les positions de consensus modérées.
Un cas particulier fondamental de la loi Bêta est incarné par la loi uniforme continue sur $[0, 1]$, obtenue lorsque les deux hyperparamètres valent exactement l’unité ($\alpha = 1$ et $\beta = 1$). Les puissances s’annulent ($x^0 = 1$ et $(1-x)^0 = 1$), et la fonction Bêta d’Euler $\mathrm{B}(1, 1)$ étant égale à 1, la densité devient rigoureusement constante et égale à 1 sur l’intégralité du domaine. Cette configuration incarne l’absence totale d’information directionnelle, souvent mobilisée comme distribution a priori non informative de Bayes-Laplace.
Dès lors qu’une asymétrie numérique s’installe entre les deux hyperparamètres ($\alpha \neq \beta$), la distribution bascule vers des profils asymétriques directionnels. Si $\alpha > 1$ et $\beta > 1$ avec $\alpha > \beta$, le mode analytique, donné par l’équation générale :
$$\text{Mode} = \frac{\alpha – 1}{\alpha + \beta – 2}$$
se déplace vers la droite du support ($> 0{,}5$), engendrant une asymétrie négative avec une queue qui s’allonge vers la gauche. Inversement, si $\alpha < \beta$, le mode migre vers la gauche ($< 0{,}5$), provoquant une asymétrie positive avec une longue queue s’étendant vers l’extrémité supérieure. Lorsque l’un des paramètres est inférieur ou égal à l’unité tandis que l’autre est strictement supérieur, la distribution abandonne sa forme en cloche pour prendre une allure en J ou en J inversé, caractérisée par une monotonie stricte (décroissance stricte si $\alpha le 1 < \beta$ ou croissance stricte si $\beta le 1 < \alpha$). Cette incroyable plasticité structurelle fait de la loi Bêta un instrument de représentation mathématique sans équivalent pour épouser fidèlement les régularités empiriques observées sur le terrain.
2. L’écosystème fonctionnel de la distribution Bêta dans l’environnement R
2.1 Anatomie de la famille de fonctions dbeta, pbeta, qbeta et rbeta
L’implémentation de la théorie des probabilités dans le langage statistique R obéit à une logique architecturale rigoureusement standardisée et cohérente. Chaque famille de distributions paramétriques est encapsulée au travers d’un ensemble de quatre fonctions élémentaires partageant une racine mnémonique commune, préfixée par les lettres d, p, q et r. Pour la loi Bêta, le radical linguistique retenu est beta, structurant ainsi le quatuor computationnel : dbeta(), pbeta(), qbeta() et rbeta().
La fonction dbeta() (pour density) constitue la clé de voûte de toute démarche de représentation graphique. Elle a pour mission d’évaluer ponctuellement ou vectoriellement la hauteur mathématique de l’ordonnée de la fonction de densité de probabilité $f(x)$ pour n’importe quelle valeur de l’abscisse $x$ positionnée sur le support. Il est impératif de souligner sur le plan conceptuel que l’ordonnée renvoyée par dbeta() ne correspond nullement à une probabilité brute (la probabilité ponctuelle d’une variable continue étant rigoureusement nulle), mais bien à une densité différentielle, susceptible par conséquent d’excéder largement l’unité lorsque la distribution présente une forte concentration de masse sur un intervalle étroit.
La fonction pbeta() (pour probability) correspond à la fonction de répartition cumulative (FDC), notée $F(x) = \mathbb{P}(X le x)$. Elle calcule l’intégrale définie de la fonction de densité depuis l’origine théorique zéro jusqu’à une valeur de coupure spécifique $x$. Cette primitive analytique, régie par la fonction Bêta incomplète régularisée $I_x(\alpha, \beta)$, est indispensable pour calculer des p-valeurs, estimer des risques d’erreur de première espèce ou évaluer la masse probabiliste confinée au sein d’une région délimitée par deux bornes arbitraires.
La fonction qbeta() (pour quantile) représente l’opérateur inverse de la fonction de répartition ($F^{-1}(p)$). En lui fournissant en entrée une probabilité cumulée $p in [0, 1]$, qbeta() renvoie le quantile exact de la distribution en deçà duquel s’accumule précisément cette proportion de masse probabiliste. Cette fonction joue un rôle capital dans la détermination des intervalles de crédibilité bayésiens à haute densité ou des bornes critiques d’intervalles de confiance unilatéraux ou bilatéraux.
Enfin, la fonction rbeta() (pour random) incarne le moteur de génération de nombres pseudo-aléatoires. Elle tire des réalisations stochastiques indépendantes et identiquement distribuées selon la spécification paramétrique Bêta($\alpha, \beta$). Basée en arrière-plan sur des algorithmes de rejet sophistiqués ou sur le ratio de variables Gamma indépendantes générées via des générateurs à congruence linéaire haute période, rbeta() s’avère incontournable pour les simulations de Monte-Carlo, le bootstrap paramétrique et la vérification empirique des modèles psychométriques.
2.2 Spécification technique des arguments de la fonction dbeta()
L’exploitation rigoureuse de la fonction dbeta() nécessite une compréhension exhaustive de sa signature computationnelle au sein de l’environnement de base de R. L’appel formel de la fonction expose la syntaxe suivante :
dbeta(x, shape1, shape2, ncp = 0, log = FALSE)
Le premier argument, x, désigne le vecteur numérique des quantiles pour lesquels la densité doit être calculée. En vertu de la définition formelle du support compact, toute valeur injectée dans ce vecteur doit théoriquement se trouver dans l’intervalle $[0, 1]$. Si l’utilisateur transmet des valeurs négatives ou strictement supérieures à l’unité, le moteur interne de R ne renvoie pas d’erreur d’exécution bloquante mais retourne silencieusement la valeur 0, conformément à la définition standard prolongeant la densité par zéro en dehors du support.
Les arguments shape1 et shape2 correspondent respectivement aux hyperparamètres de forme $\alpha$ et $\beta$. R impose une contrainte stricte de non-négativité : ces deux paramètres doivent être des nombres réels strictement supérieurs à zéro. Si l’analyste introduit par mégarde une valeur négative ou nulle, R produit immédiatement un avertissement formel (warning message: NaNs produced) et assigne des valeurs NaN (Not a Number) à l’ensemble des ordonnées calculées.
L’argument optionnel ncp (non-centrality parameter), configuré par défaut à zéro, introduit la distribution Bêta non centrale. Cette extension mathématique avancée intervient principalement lors de l’analyse de puissance statistique dans les tests d’hypothèses linéaires multivariés (MANOVA) et les calculs de puissance sous l’hypothèse alternative non nulle. Pour la quasi-totalité des représentations graphiques standards et des modélisations de base de proportions, cet argument doit être maintenu à sa valeur par défaut nulle, désignant ainsi la distribution Bêta centrale canonique.
Enfin, l’argument logique log, initialisé par défaut à FALSE, offre la possibilité de requérir le logarithme népérien de la densité de probabilité ($ln f(x)$). Ce commutateur technique revêt une importance capitale lors de la manipulation d’algorithmes d’optimisation par maximum de vraisemblance ou d’intégration numérique. Calculer directement $ln f(x)$ au niveau de la couche arithmétique compilée en C sous-jacente permet de prévenir efficacement les phénomènes de sous-dépassement arithmétique (numerical underflow), qui surviennent inévitablement lorsque des densités infinitésimales situées dans les queues de distribution sont multipliées entre elles, générant des zéros arithmétiques destructeurs dans la mémoire de la machine.
2.3 Gestion des singularités aux bornes du domaine
La restitution numérique de la distribution Bêta sur une machine à virgule flottante standard (norme IEEE 754) se heurte à des contraintes computationnelles sévères lorsque les hyperparamètres de forme sont inférieurs à un. Lorsque $\alpha < 1$, le terme $x^{\alpha – 1}$ implique une puissance négative. Lorsque l’abscisse $x$ s’approche de zéro par valeurs supérieures, la valeur théorique diverge vers l’infini. À l’évaluation exacte en $x = 0$, l’opération conduit mathématiquement à une division par zéro, incitant le moteur de R à retourner Inf. Une dynamique rigoureusement identique se produit à la frontière supérieure $x = 1$ lorsque $\beta < 1$, en raison du comportement du terme $(1 – x)^{\beta – 1}$.
Si la présence de valeurs infinies (Inf) au sein d’un vecteur d’ordonnées constitue une description mathématiquement exacte du comportement asymptotique de la distribution, elle génère des dysfonctionnements majeurs lors de l’appel aux primitives graphiques. Les fonctions de tracé comme plot() ou les moteurs de géométrie de ggplot2 peinent à déterminer dynamiquement les échelles des axes cartésiens lorsque l’étendue des ordonnées englobe l’infini, aboutissant fréquemment à l’écrasement complet de la structure informationnelle de la courbe au bas du graphique ou au masquage pur et simple du tracé.
Pour parer méthodologiquement à cet écueil sans introduire de biais d’interprétation, la pratique recommandée consiste à appliquer une troncature infinitésimale au domaine d’évaluation discrétisé. En substituant aux bornes rigides $0$ et $1$ les valeurs corrigées $varepsilon$ et $1 – varepsilon$, où $varepsilon$ représente une constante arbitrairement petite (par exemple $10^{-4}$ ou $10^{-5}$), l’analyste préserve la continuité visuelle du tracé tout en plafonnant les ordonnées à des grandeurs finies manipulables par les moteurs graphiques. Cette approche garantit que la vectorisation interne de R s’exécute avec une fluidité absolue sans lever d’exceptions arithmétiques.
3. Préparation du domaine continu et discrétisation pour le tracé graphique
3.1 Construction d’un maillage régulier avec la fonction seq()
La représentation visuelle d’une loi de probabilité continue sur un support d’affichage numérique impose une discrétisation préalable de l’abscisse. L’ordinateur ne pouvant calculer une infinité non dénombrable de coordonnées continues, la procédure consiste à générer un maillage unidimensionnel dense composé d’un nombre fini de nœuds d’évaluation régulièrement espacés. Au sein du système R, l’outil élémentaire dédié à cette tâche est la fonction seq().
Pour instancier ce vecteur d’abscisses, la formulation canonique standard s’écrit de la façon suivante :
p <- seq(from = 0, to = 1, length.out = 1000)
Le paramètre length.out gouverne la granularité et la finesse du rendu graphique. Le choix de la dimension de ce vecteur d’échantillonnage représente un compromis direct entre l’acuité visuelle et la charge mémoire computationnelle. Pour la majorité des représentations statiques destinées à des revues scientifiques imprimées ou des écrans haute résolution, un maillage comportant entre 500 et 1 000 points d’évaluation s’avère optimal. Une discrétisation trop lâche (par exemple $N = 50$) produit des segments polygonaux perceptibles à l’œil nu brisant l’illusion de courbure continue, tout particulièrement dans les régions de forte dérivée seconde situées aux abords des modes étroits. À l’inverse, générer un maillage de $10^6$ points n’apporte aucun gain d’acuité visuelle perceptible tout en ralentissant inutilement le calcul vectoriel et en alourdissant considérablement les fichiers d’exportation vectoriels de type PDF ou SVG.
Comme énoncé précédemment lors de l’analyse des singularités aux bornes, si la configuration paramétrique explorée implique des valeurs d’hyperparamètres strictement inférieures à 1 ($\alpha < 1$ ou $\beta < 1$), la spécification des bornes de seq() doit être ajustée pour éviter l’évaluation en 0 et en 1. L’instruction prendra alors la forme prudente :
p <- seq(from = 0.001, to = 0.999, length.out = 1000)
Cette discrétisation rigoureuse sur l’intervalle ouvert garantit l’intégrité du système de coordonnées tout en permettant de capter de manière saisissante l’élévation vertigineuse de la densité aux confins du domaine.
3.2 Vectorisation et calcul instantané de la densité théorique
L’un des atouts architecturaux les plus puissants du langage R réside dans son paradigme de vectorisation native. Contrairement aux langages de bas niveau requérant la mise en œuvre de boucles explicites d’itération (boucles for ou while) pour traiter séquentiellement chaque élément d’un ensemble, les fonctions mathématiques de base de R appliquent leurs calculs de manière globale et simultanée sur l’intégralité des éléments d’un vecteur, en exploitant des bibliothèques arithmétiques hautement optimisées compilées en Fortran et en C.
Par conséquent, l’évaluation de la densité théorique sur l’ensemble du maillage préparé s’accomplit en une seule instruction intuitive :
densite <- dbeta(p, shape1 = 2, shape2 = 10)
Sous cette syntaxe concise, R prend en charge de façon transparente la propagation vectorielle. L’objet résultant densite est un vecteur numérique d’une longueur rigoureusement identique à celle de l’abscisse p, stockant en correspondance biunivoque chaque valeur d’ordonnée $f(x_i)$. Cette efficience computationnelle permet d’évaluer des millions de points de densité en quelques fractions de milliseconde, facilitant l’exploration interactive des formes distributionnelles.
Pour assurer une conduite d’analyse irréprochable au sein de chaînes de traitement automatisées, il est impératif d’intégrer une étape intermédiaire de validation d’intégrité numérique avant de transmettre ces vecteurs aux routines d’affichage graphique. Cette vérification préventive s’opère par le biais de tests logiques ciblés :
any(is.na(densite))
any(is.infinite(densite))
La présence inattendue de valeurs manquantes (NA) peut trahir une spécification invalide des paramètres de forme, tandis que l’existence de valeurs infinies (Inf) signale une évaluation imprudente sur une borne singulière. La structuration conjointe de ces deux vecteurs au sein d’un tableau de données rectangulaire standard (data.frame) constitue la dernière étape méthodologique avant la phase de tracé, assurant l’interopérabilité immédiate avec les fonctions graphiques modernes.
4. Tracé élémentaire d’une distribution Bêta avec le moteur R Base
4.1 Implémentation pas-à-pas de la commande plot() standard
L’environnement graphique de base de R (R Base Graphics), piloté par le package standard graphics, constitue une infrastructure visuelle légère, remarquablement véloce et universellement accessible sans nécessiter l’installation de bibliothèques tierces. Sa commande maîtresse, plot(), opère par polymorphisme en adaptant automatiquement son rendu en fonction de la nature des objets qui lui sont passés en argument.
Pour matérialiser le tracé d’une loi Bêta, l’appel minimaliste requiert la transmission conjointe des vecteurs d’abscisses et d’ordonnées préalablement générés, en spécifiant de manière impérative le type de restitution géométrique souhaité :
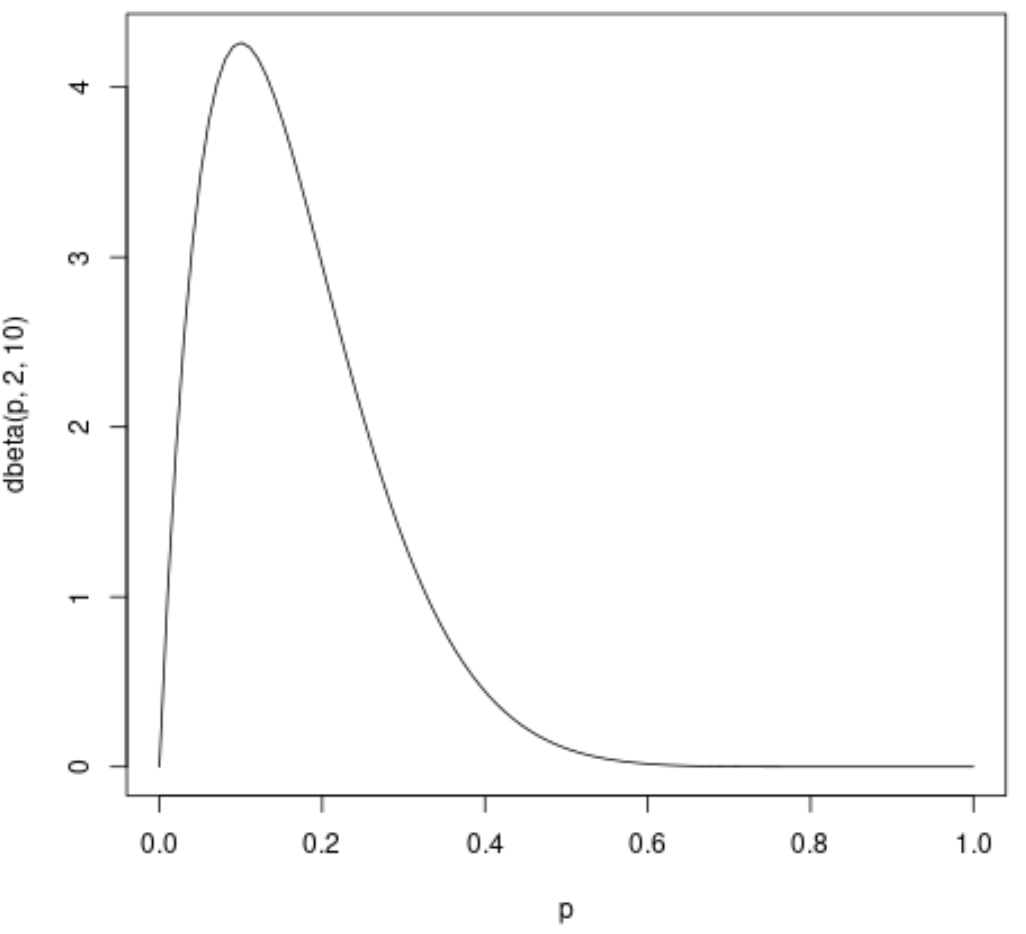
plot(x = p, y = densite, type = "l")
La précision de l’argument type = "l" (pour line) s’avère absolument déterminante sur le plan sémiotique. Par défaut, la commande plot() adopte un comportement de nuage de points (type = "p"), ce qui produirait une juxtaposition discontinue de centaines de symboles circulaires le long du profil mathématique. L’argument "l" ordonne au moteur de tracer un chemin continu en reliant linéairement chaque coordonnée $(x_i, y_i)$ à sa suivante consécutive. En vertu de la finesse du maillage discrétisé en amont, la segmentation polygonale devient imperceptible, restituant fidèlement l’impression d’une courbe continue différentiable.
Lors de cette invocation élémentaire, R détermine de manière entièrement automatisée l’étendue des axes cartésiens en calquant les dimensions du cadre sur les valeurs minimales et maximales observées au sein des données fournies. L’abscisse est ainsi automatiquement ajustée entre 0 et 1, tandis que l’axe vertical s’élève exactement jusqu’au sommet du mode de la distribution calculée. Si cette automatisation s’avère pratique lors d’analyses exploratoires préliminaires, elle engendre un rendu austère, marqué par des dénominations d’axes purement techniques réutilisant les noms des variables (par exemple x = p et y = densite), ce qui motive la mise en place d’une personnalisation académique approfondie.
4.2 Analyse empirique de la configuration asymétrique Bêta(2, 10)
Pour illustrer la pertinence de ce premier tracé au sein d’une problématique scientifique concrète, analysons en détail le comportement géométrique de la paramétrisation spécifique $\alpha = 2$ et $\beta = 10$. Cette configuration asymétrique est particulièrement célèbre en recherche comportementale, car elle formalise avec une grande justesse les métriques soumises à un phénomène d’échec récurrent ou à des compétences en phase précoce d’apprentissage.
Sur le plan analytique, le mode de cette distribution se calcule directement :
$$\text{Mode} = \frac{\alpha – 1}{\alpha + \beta – 2} = \frac{2 – 1}{2 + 10 – 2} = \frac{1}{10} = 0{,}10$$
L’espérance mathématique, quant à elle, s’établit à :
$$\mathbb{E}[X] = \frac{2}{2 + 10} = \frac{2}{12} \approx 0{,}167$$
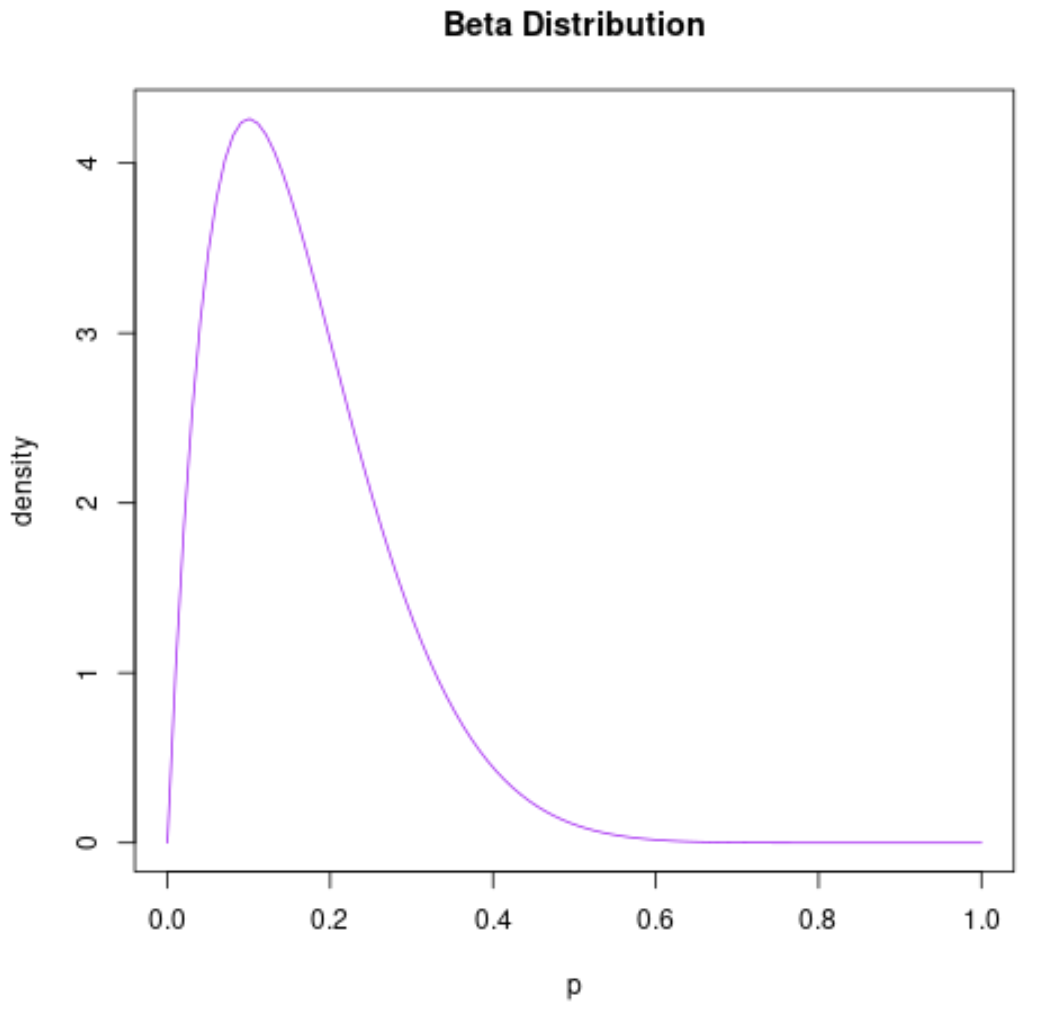
Cette configuration produit un décalage structurel marqué : le pic de la densité de probabilité se situe de façon très prononcée vers la gauche du repère, à seulement 10 % de la frontière inférieure du support unitaire. La courbe s’élève rapidement depuis zéro (puisque $\alpha = 2 > 1$, la densité démarre précisément à zéro en $x = 0$ avec une dérivée positive), atteint son acmé en $x = 0{,}10$, puis amorce une décroissance progressive qui s’étire sur une vaste étendue horizontale en direction de l’unité.
Cette morphologie illustre de manière spectaculaire une asymétrie positive robuste ($\gamma_1 > 0$). La queue de distribution s’étend loin vers la droite, visualisant le fait statistique que la vaste majorité des observations empiriques se concentrent entre 0,02 et 0,35, tandis qu’une infime proportion d’individus parvient à générer des scores supérieurs à 0,50. Une telle distribution correspond parfaitement à des paradigmes de détection de cibles hautement dégradées au sein de tests de vigilance psychophysique, où la performance de base de la population générale est comprimée vers le plancher, quelques participants exceptionnels parvenant seuls à émerger dans la région supérieure du continuum.
5. Personnalisation esthétique et rigueur académique du graphique R Base
5.1 Typographie des axes, titres et notations formelles
La publication d’une figure dans une revue scientifique à comité de lecture internationale requiert une rigueur typographique sans compromis. L’affichage d’identifiants informatiques bruts sur les axes d’un graphique constitue une négligence méthodologique inacceptable. Le système graphique de base de R intègre une interface complète permettant de spécifier des étiquettes sémantiques claires et d’intégrer des expressions mathématiques sophistiquées conformes aux standards éditoriaux.
La configuration de la description textuelle des axes cartésiens s’opère par le biais des arguments xlab (x-axis label) et ylab (y-axis label). Au lieu de laisser transparaître des noms d’objets informatiques, il convient de spécifier la nature exacte de la grandeur physique ou psychométrique mesurée ainsi que son unité, par exemple : xlab = "Proportion de réponses correctes (u03b8)" et ylab = "Densité de probabilité théorique f(u03b8)".
Pour porter la rigueur formelle à son niveau d’excellence, R met à disposition la puissante fonction expression(), qui interprète des constructions syntaxiques similaires au langage de composition mathématique TeX/LaTeX. Ainsi, pour afficher dans le titre principal la formulation exacte de la loi avec ses paramètres d’ajustement sans recourir à des approximations de texte brut, l’analyste peut implémenter :
main = expression(paste("Densité théorique de la loi ", Beta(alpha == 2, beta == 10))))
Cette commande génère un rendu typographique parfait où la lettre grecque Bêta s’affiche sous sa graphie formelle, les indices de paramètres étant rigoureusement ordonnés.
Parallèlement, la lisibilité quantitative des graduations numériques dépend étroitement des paramètres cex.axis (contrôlant le facteur d’agrandissement d’échelle de la police numérique des axes) et las (gouvernant l’orientation angulaire des étiquettes). La convention académique préconise l’utilisation de las = 1, qui force l’orientation strictement horizontale de toutes les étiquettes numériques, y compris celles de l’axe des ordonnées. Cette configuration épargne au lecteur l’effort ergonomique consistant à pencher la tête pour déchiffrer des valeurs verticales, améliorant instantanément le confort de lecture cognitif.
5.2 Stylisation de la ligne de densité : couleur, épaisseur et texture
Une fois le cadre typographique consolidé, l’attention méthodologique doit se focaliser sur la sémantique visuelle de la courbe elle-même. Dans la grammaire de base de R, trois paramètres gouvernent l’apparence physique du tracé vectoriel : col (couleur), lwd (line width, épaisseur du trait) et lty (line type, texture du tracé).
L’argument col permet de dépasser la monotonie du noir par défaut en adoptant des palettes chromatiques harmonieuses, professionnelles et universellement lisibles, notamment pour les personnes présentant des déficiences de vision des couleurs (daltonisme). L’injection de codes hexadécimaux professionnels (tels que col = "#1F77B4" pour un bleu acier académique ou col = "#2CA02C" pour une teinte forestière) confère d’emblée à la figure une tonalité éditoriale contemporaine conforme aux directives visuelles de l’American Psychological Association (APA).
L’épaisseur du trait, régie par lwd, exige un ajustement précis. La valeur par défaut (lwd = 1) génère une ligne souvent excessivement fine qui perd toute consistance visuelle lorsqu’elle est réduite pour être insérée dans une colonne de texte imprimé d’un article de recherche. L’affectation d’une épaisseur calibrée à lwd = 2.5 ou lwd = 3 assure une présence typographique robuste, améliorant la netteté et contrastant impeccablement avec le maillage du repère.
Enfin, l’argument lty pilote la géométrie structurelle de la ligne. Les valeurs entières ou textuelles standards acceptées incluent la ligne continue (lty = 1 ou "solid"), la ligne en tirets réguliers (lty = 2 ou "dashed"), et la ligne pointillée fine (lty = 3 ou "dotted"). Cette diversification texturale ne poursuit pas un but purement cosmétique : elle assure un codage redondant vital garantissant que même si la figure scientifique est reproduite en noir et blanc ou photocopiée sur support physique dégradé, l’intégrité de la distinction analytique demeure pleinement opérationnelle.
5.3 Contrôle millimétré des marges et du système de coordonnées
La mise en page globale d’un graphique sous le moteur R Base est régie par la fonction par(), qui orchestre les paramètres de bas niveau de l’environnement graphique actif. Parmi ces leviers techniques, l’ajustement du vecteur des marges externes via par(mar = c(bottom, left, top, right)) conditionne l’équilibre architectural de l’ensemble de la figure.
Par défaut, R alloue des marges généreuses (conventionnellement c(5.1, 4.1, 4.1, 2.1) lignes de texte). Dans le cadre d’un rapport de synthèse à haute densité d’information, ces espacements induisent un gaspillage spatial conséquent. Un calibrage chirurgical de la forme :
par(mar = c(4.5, 4.5, 3, 1.5))
permet de redistribuer l’espace utile au profit exclusif de la fenêtre cartésienne tout en ménageant l’espace strictement nécessaire pour éviter le chevauchement des étiquettes descriptives et des titres formels.
Concomitamment, le verrouillage rigide des bornes du système de coordonnées constitue une garantie méthodologique contre les distorsions visuelles. Par le biais des arguments xlim = c(0, 1) et ylim = c(0, max_y), l’analyste interdit au moteur d’étendre artificiellement le cadre au-delà du support mathématiquement valide de la distribution. Plus particulièrement, la fixation explicite de la borne inférieure de l’axe vertical à zéro élimine l’effet indésirable par défaut de R qui fait flotter la ligne de base au-dessus de l’axe horizontal, ancrant ainsi solidement la fonction de densité de probabilité sur son socle naturel.
6. Superposition de multiples lois Bêta pour l’analyse comparative
6.1 Usage séquentiel de la fonction lines() sur un canvas existant
L’intérêt de la modélisation statistique s’exprime pleinement lors de la comparaison systématique de sous-groupes ou de conditions expérimentales distinctes. Superposer plusieurs courbes de densité Bêta au sein d’une même fenêtre de rendu graphique permet d’objectiver instantanément des décalages de tendance centrale ou des rétrécissements de dispersion sous l’effet d’un traitement cognitif ou pharmacologique.
Le modèle opérationnel de R Base Graphics repose sur le concept de canvas incrémental. La commande initiale plot() crée de toute pièce le repère cartésien, trace les axes, affiche les étiquettes textuelles et dessine la première courbe de données. Une fois ce repère verrouillé, tout appel subséquent à la commande plot() écraserait irrémédiablement le canevas précédent en ouvrant une nouvelle page. Pour surimposer de nouvelles courbes sans perturber le repère existant, il est obligatoire de recourir à la fonction bas niveau lines(), qui se contente d’injecter des segments continus au sein du système de coordonnées déjà déployé.
Cependant, cette approche séquentielle recèle un piège technique majeur : le premier appel à plot() calcule l’échelle de l’axe vertical exclusivement sur la base de la première distribution transmise. Si une distribution superposée ultérieurement via lines() possède un pic modale plus élevé que la courbe d’origine, le sommet de cette nouvelle courbe sera tronqué au-delà du bord supérieur du graphique, ruinant la validité visuelle de la démonstration scientifique. Pour contourner systématiquement ce risque d’écrasement, l’analyste doit préalablement calculer l’ordonnée maximale absolue parmi l’ensemble des distributions destinées à coexister sur la figure :
max_y <- max(dbeta(p, a1, b1), dbeta(p, a2, b2), dbeta(p, a3, b3))
Cette borne maximale globale est alors injectée dès l’ouverture du canevas dans le paramètre de cadrage : plot(..., ylim = c(0, max_y * 1.05)). Le facteur d’amortissement de 5 % assure un dégagement supérieur suffisant pour accueillir confortablement les lignes de densité et la légende sans aucun risque de collision graphique.
6.2 Conception d’une légende scientifique exhaustive
Un graphique comparatif comportant une pluralité de courbes non identifiées est scientifiquement inutilisable. L’intégration d’une légende rigoureusement construite s’avère donc indispensable pour décoder la sémantique de l’agencement visuel. La fonction legend() fournit le protocole logiciel pour matérialiser cette boussole interprétative.
Le positionnement spatial de la légende au sein du canevas cartésien peut s’effectuer au moyen de coordonnées cartésiennes explicites $(x, y)$ ou par l’intermédiaire de mots-clés d’ancrage automatiques, tels que "topright", "topleft", "top" ou "center". Pour éviter que le bloc textuel ne vienne recouvrir de manière intempestive une zone informationnelle critique d’une distribution, l’analyste doit examiner la géométrie globale des courbes : sur des distributions décalées vers la gauche (asymétrie positive), l’ancrage en "topright" est généralement idéal, ménageant une lisibilité optimale dans l’espace sous-jacent inoccupé.
L’argument legend lui-même doit recevoir un vecteur d’expressions textuelles ou mathématiques renseignant scrupuleusement la valeur des hyperparamètres assignés à chaque courbe superposée. En combinant expression() avec des vecteurs de couleurs (col), d’épaisseurs (lwd) et de textures de traits (lty) rigoureusement synchronisés avec ceux utilisés lors des appels respectifs à plot() et lines(), la correspondance sémiotique devient instantanée et exempte d’ambiguïté :
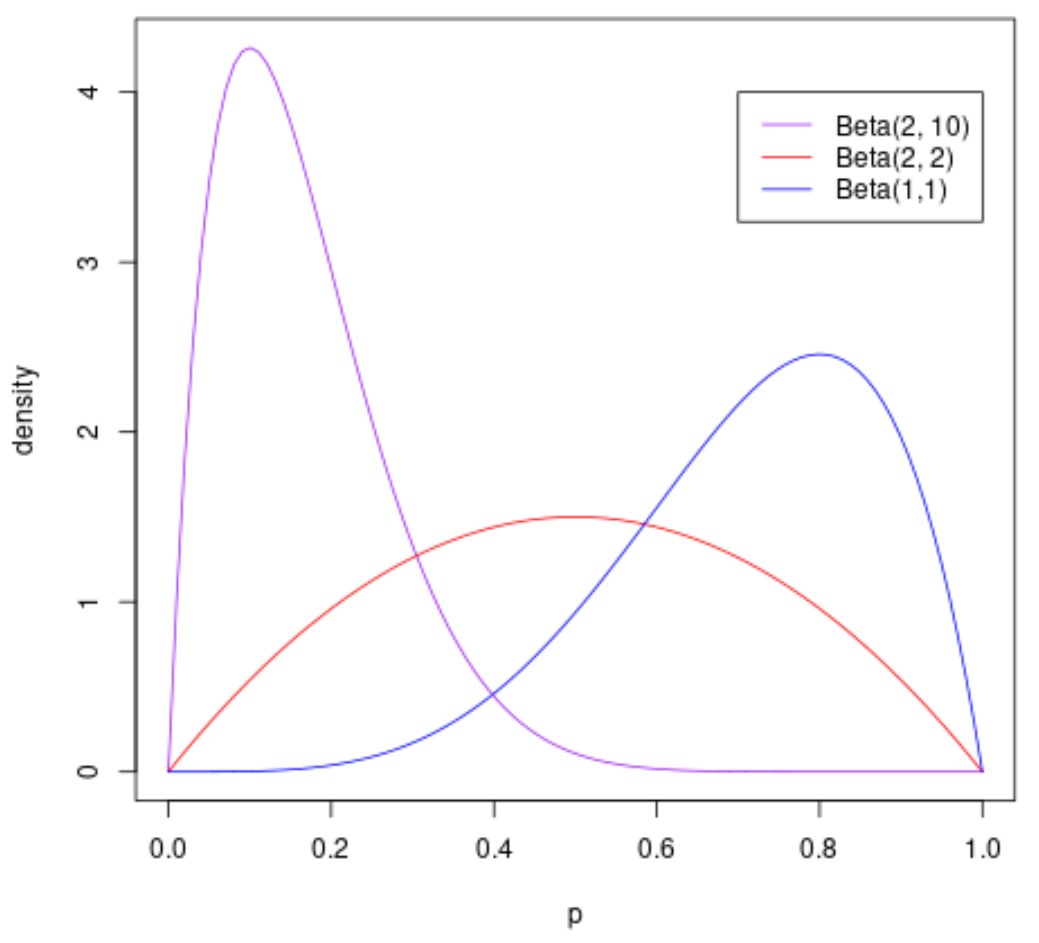
legend("topright", legend = c(expression(paste(alpha==2, ", ", beta==10)), expression(paste(alpha==2, ", ", beta==2)), expression(paste(alpha==5, ", ", beta==2))), col = c("#E41A1C", "#377EB8", "#4DAF4A"), lwd = 2.5, lty = c(1, 2, 4), bty = "n")
L’argument terminal bty = "n" (box type = none) constitue une recommandation stylistique académique majeure : en supprimant la bordure rectangulaire rigide entourant traditionnellement la légende, il allège considérablement la charge graphique inutile (ink-to-data ratio théorisé par Edward Tufte), instaurant une esthétique moderne et épurée.
6.3 Étude de cas comparative : Bêta(2, 10), Bêta(2, 2) et Bêta(5, 2)
Afin de concrétiser graphiquement la polyvalence morphologique de la loi Bêta, l’étude conjointe de trois profils aux topologies radicalement divergentes fournit une démonstration didactique d’une rare éloquence. Considérons la confrontation simultanée des configurations : Bêta(2, 10), Bêta(2, 2) et Bêta(5, 2).
La première courbe, issue de Bêta(2, 10), se matérialise comme une distribution asymétrique positive culminant à $x = 0{,}10$ avant de plonger rapidement vers une longue queue résiduelle droite. Elle incarne le profil caractéristique d’une tâche d’évaluation cognitive à très haute difficulté où la majorité de la cohorte plafonne à un taux d’exactitude très réduit.
La deuxième courbe, régie par Bêta(2, 2), se caractérise par une symétrie axiale irréprochable autour de l’axe $x = 0{,}5$. Les deux hyperparamètres étant identiques et strictement supérieurs à 1, la fonction forme une parabole inversée adoucie, traduisant une situation d’ambivalence expérimentale ou une performance médiane où la proportion de succès gravite équitablement autour de la performance du hasard, avec une variabilité importante modélisant une incertitude significative.
La troisième courbe enfin, spécifiée par Bêta(5, 2), inverse la topologie du premier cas. L’inégalité $\alpha > \beta$ déplace le mode analytique vers le haut :
$$\text{Mode} = \frac{5 – 1}{5 + 2 – 2} = \frac{4}{5} = 0{,}80$$
L’asymétrie devient strictement négative, la queue s’étirant cette fois vers la gauche jusqu’à zéro. Ce profil s’ajuste parfaitement à des données comportementales mesurées chez des participants experts ou dans des protocoles simples présentant un effet d’entraînement massif, la majorité des individus consolidant leur taux de maîtrise au voisinage de 80 à 90 % d’exactitude.
La juxtaposition directe de ces trois courbes sur une même échelle normalisée fournit aux chercheurs une illustration immédiate de la manière dont la modification ciblée des paramètres de forme permet de basculer de façon continue et cohérente d’un régime comportemental à un autre, tout en préservant l’intégrité formelle des frontières probabilistes sur l’intervalle $[0, 1]$.
7. Tracé moderne et reproductible de la distribution Bêta avec ggplot2
7.1 Structuration des données sous forme de tibble ou data frame
L’avènement du paradigme Tidyverse et du moteur graphique standard ggplot2 a profondément refondu les pratiques de programmation et de visualisation de données dans l’écosystème R contemporain. Fondé sur la formalisation théorique de The Grammar of Graphics développée par Leland Wilkinson, ggplot2 requiert une rupture méthodologique claire avec l’approche procédurale séquentielle de R Base : le tracé n’est plus une succession d’injonctions impératives sur un canevas de pixels, mais la déclaration sémantique d’associations projectives (aesthetic mappings) entre des colonnes de données structurées et des attributs géométriques visuels.
Pour exploiter toute la puissance expressive de cette approche lors du tracé comparatif de distributions de probabilité, la première phase consiste à organiser les données sous la forme d’un tableau rectangulaire au format long (tidy long format). Chaque ligne du tableau doit représenter une observation computationnelle unique, associant l’abscisse d’évaluation $x$, l’ordonnée de densité théorique calculée $y$, et une variable factorielle identifiant sans équivoque le groupe paramétrique d’appartenance.
L’orchestration de cette structuration s’accomplit avec une remarquable élégance en combinant le moteur tibble et les verbes fonctionnels de manipulation du package dplyr. En générant un maillage d’abscisses étendu, l’analyste peut instancier directement une table de données exhaustive à l’aide de liaisons de lignes ordonnées :
p <- seq(0.001, 0.999, length.out = 500)
df_beta <- bind_rows(

  tibble(x = p, densite = dbeta(p, 2, 10), groupe = "Beta(2, 10)"),

  tibble(x = p, densite = dbeta(p, 2, 2), groupe = "Beta(2, 2)"),

  tibble(x = p, densite = dbeta(p, 5, 2), groupe = "Beta(5, 2)")

)
Cette architecture en format long garantit une découplabilité totale entre la structure des données et leur mise en scène visuelle, rendant l’ensemble de la chaîne analytique auditable, extensible et reproductible selon les canons les plus stricts de la science ouverte.
7.2 Utilisation conjointe de geom_line() et de stat_function()
Lorsqu’il s’agit de projeter une distribution théorique au sein de l’univers ggplot2, deux voies programmatiques d’égale valeur méthodologique s’offrent au statisticien, chacune présentant des compromis distincts en matière de flexibilité et de concision syntaxique.
La première méthode, désignée sous le nom d’approche explicite par données précalculées, exploite la couche géométrique standard geom_line() appliquée directement sur le tableau de données rectangulaire élaboré précédemment :
ggplot(data = df_beta, aes(x = x, y = densite, color = groupe, linetype = groupe)) +

  geom_line(linewidth = 1.2)
Cette syntaxe explicite présente un avantage technique inestimable : l’ensemble des transformations numériques ayant été exécuté en amont au sein du tableau de données, l’utilisateur conserve une visibilité arithmétique absolue sur les coordonnées exactes, facilitant l’inspection des données, le calcul immédiat d’indicateurs de position ou l’injection de couches d’annotations textuelles sans rupture de contexte.
La seconde méthode, particulièrement prisée pour les démonstrations rapides et les scripts concis, repose sur l’exploitation de la couche fonctionnelle directe stat_function(). Cette primitive spécialisée affranchit l’analyste de l’obligation de créer un tableau de données volumineux : elle prend en charge de façon autonome la discrétisation interne du domaine et l’évaluation de la fonction de densité spécifiée :
ggplot(data = tibble(x = c(0, 1)), aes(x = x)) +

  stat_function(fun = dbeta, args = list(shape1 = 2, shape2 = 10), aes(color = "Beta(2, 10)"), linewidth = 1.2) +

  stat_function(fun = dbeta, args = list(shape1 = 2, shape2 = 2), aes(color = "Beta(2, 2)"), linewidth = 1.2) +

  stat_function(fun = dbeta, args = list(shape1 = 5, shape2 = 2), aes(color = "Beta(5, 2)"), linewidth = 1.2)
Cette approche fonctionnelle optimise la fluidité du code pour le prototypage exploratoire, ggplot2 se chargeant en interne d’ajuster le maillage de discrétisation pour lisser parfaitement les segments de courbe en fonction de la résolution de la fenêtre d’affichage active.
7.3 Raffinements thématiques selon les standards éditoriaux APA
L’apparence par défaut de ggplot2, bien que visuellement reconnaissable avec son fond gris quadrillé de blanc, ne correspond pas aux normes de publication académiques prescrites par les manuels de style éditoriaux tels que ceux de l’APA. La standardisation internationale requiert des figures d’une grande sobriété, dépourvues d’artéfacts visuels superflus, sur un fond blanc immaculé rehaussé par des lignes de repère d’une grande discrétion.
L’application du thème clé en main theme_classic() ou theme_bw() constitue la première étape d’assainissement ergonomique. Le fond grisâtre est immédiatement éradiqué, instaurant un contraste optique maximal indispensable pour l’impression papier. Pour parachever la mise en conformité typographique, la fonction theme() permet d’ajuster millimétriquement chaque composant structurel de l’affichage graphique :
theme_classic(base_size = 14, base_family = "sans") +

theme(

  plot.title = element_text(face = "bold", size = 16, hjust = 0.5, margin = margin(b = 10)),

  axis.title.x = element_text(face = "bold", margin = margin(t = 10)),

  axis.title.y = element_text(face = "bold", margin = margin(r = 10)),

  legend.position = "top",

  legend.title = element_blank(),

  legend.background = element_blank(),

  axis.line = element_line(linewidth = 0.8, color = "black")

)
Concomitamment, la gestion de l’espace chromatique doit être confiée à des modules de colorimétrie vectorielle éprouvés, tels que scale_color_brewer(palette = "Set1") ou une spécification manuelle déterministe via scale_color_manual(). En associant des contrastes de saturation adaptés à un encadrement textuel harmonieux, l’analyste produit des figures de qualité éditoriale native, prêtes à être insérées sans retouche ultérieure dans les manuscrits scientifiques les plus exigeants.
8. Visualisation avancée des aires de probabilité et intégration cumulative
8.1 Coloration des régions sous la courbe avec polygon() en R Base
Au-delà du simple tracé du contour d’une fonction de densité, la mise en évidence d’aires de probabilité sous la courbe constitue une démarche pédagogique et analytique fondamentale. En vertu des principes du calcul infinitésimal, la probabilité qu’une variable continue $X$ s’insère dans un intervalle délimité $[a, b]$ correspond rigoureusement à l’intégrale définie de sa densité entre ces deux bornes :
$$\mathbb{P}(a le X le b) = \int_a^b f(x; \alpha, \beta) , \mathrm{d}x$$
Dans l’écosystème graphique de R Base, l’instrument géométrique dédié au remplissage chromatique de surfaces délimitées est la fonction polygon(). Pour fonctionner correctement, cette primitive exige la spécification d’un chemin de contournement fermé continu défini par une suite ordonnée de coordonnées cartésiennes $(x, y)$ formant une boucle complète.
La construction méthodologique de ce polygone s’effectue en concaténant chronologiquement trois segments géométriques :
- La ligne de base inférieure longeant l’axe horizontal depuis la borne supérieure $b$ jusqu’à la borne inférieure $a$, où l’ordonnée est identiquement nulle ($y = 0$).
- Le segment vertical montant reliant $(a, 0)$ à $(a, f(a))$.
- La trajectoire incurvée de la fonction de densité épousant le profil de la courbe depuis $a$ jusqu’à $b$.
Sur le plan programmatique, cette logique d’encapsulation se traduit par :
x_sub <- seq(from = a, to = b, length.out = 200)
y_sub <- dbeta(x_sub, shape1, shape2)
polygon(x = c(a, x_sub, b), y = c(0, y_sub, 0), col = rgb(0.2, 0.4, 0.8, alpha = 0.4), border = NA)
L’argument col mobilisant la fonction rgb() avec son paramètre d’atténuation de transparence alpha (calibré ici à 0,4) joue un rôle visuel prépondérant : il permet d’ombrer délicatement la zone probabiliste sans masquer les graduations sous-jacentes du repère ni la netteté du contour de la distribution.
8.2 Remplissage conditionnel sous ggplot2 avec geom_ribbon()
La transposition de cette technique de mise en valeur sous l’environnement ggplot2 s’opère par le biais de la couche géométrique geom_ribbon(). Conçue à l’origine pour matérialiser des bandes de confiance ou des enveloppes d’erreur autour de trajectoires temporelles, cette fonction excelle dans le remplissage d’aires probabilistes lorsqu’on contraint sa borne inférieure à zéro.
L’élaboration de ce tracé commence par le découpage analytique du tableau de données en extrayant la fraction spécifique du domaine sur laquelle porte l’inférence. Si l’on souhaite par exemple colorer l’intervalle de crédibilité centré à 95 % délimité par les quantiles $q_{0{,}025}$ et $q_{0{,}975}$ d’une loi Bêta(5, 5), la procédure s’articule comme suit :
q_low <- qbeta(0.025, shape1 = 5, shape2 = 5)
q_high <- qbeta(0.975, shape1 = 5, shape2 = 5)
df_complet <- tibble(x = seq(0, 1, length.out = 1000), y = dbeta(x, 5, 5))
df_zone <- df_complet %>% filter(x >= q_low & x <= q_high)
La composition de la figure combine ensuite la courbe intégrale et la nappe de remplissage conditionnelle :
ggplot(df_complet, aes(x = x, y = y)) +

  geom_ribbon(data = df_zone, aes(ymin = 0, ymax = y), fill = "#3182BD", alpha = 0.5) +

  geom_line(linewidth = 1.1, color = "#08519C") +

  geom_vline(xintercept = c(q_low, q_high), linetype = "dashed", color = "#08519C", linewidth = 0.8)
L’adjonction de lignes de démarcation verticales via geom_vline() ancre visuellement les seuils critiques exacts du quantile. L’observateur appréhende ainsi simultanément la densité différentielle locale via la silhouette de la courbe et la masse probabiliste intégrée totale via la saturation optique de l’aire colorée, éliminant tout risque d’incompréhension séquentielle.
8.3 Représentation conjointe de la densité et de la fonction cumulative
Pour parfaire la maîtrise didactique de la distribution Bêta, il est particulièrement instructif de concevoir une visualisation conjointe associant la fonction de densité de probabilité (FDP) issue de dbeta() et la fonction de répartition cumulative (FDC) issue de pbeta(). Tandis que la première met en lumière les concentrations relatives de masse et l’emplacement des modes, la seconde dévoile la dynamique d’accumulation monotone de la probabilité sous la forme d’une courbe en S (sigmoïde), facilitant la lecture directe des centiles.
L’intégration modulaire de ces deux graphiques complémentaires au sein d’une seule figure composite se réalise de manière transparente grâce à l’extension spécialisée patchwork. Considérons l’implémentation de cette synchronisation spatiale :
p1 <- ggplot(df_complet, aes(x = x, y = y)) +

  geom_line(color = "#E6550D", linewidth = 1.2) +

  labs(title = "Densité de probabilité (PDF)", y = "f(x)", x = "x") +

  theme_classic()
p2 <- ggplot(df_complet, aes(x = x, y = pbeta(x, 5, 5))) +

  geom_line(color = "#31A354", linewidth = 1.2) +

  labs(title = "Probabilité cumulée (CDF)", y = "F(x) = P(X <= x)", x = "x") +

  theme_classic()
p1 + p2
L’opérateur arithmétique +, surchargé par le package patchwork, juxtapose horizontalement les deux graphiques en alignant automatiquement leurs repères cartésiens. L’analyste peut ainsi tracer mentalement une ligne de projection verticale reliant n’importe quel point d’inflexion ou mode de la densité supérieure avec la pente maximale de la sigmoïde inférieure, visualisant concrètement le théorème fondamental de l’analyse reliant l’intégration cumulative à la dérivée de la fonction de répartition.
9. Exploration visuelle systématique de l’espace des hyperparamètres
9.1 Cartographie matricielle des familles de distributions Bêta
L’appréhension exhaustive des métamorphoses topologiques de la loi Bêta exige de dépasser l’examen isolé de quelques cas particuliers pour embrasser une vue panoramique de l’espace bidimensionnel des hyperparamètres $(\alpha, \beta)$. La technique de facettage en grille (matrix faceting) offerte par ggplot2 via facet_grid() permet de construire une matrice graphique systématique dressant la morphologie de la distribution en fonction des permutations croisées des paramètres de forme.
Pour concrétiser cette cartographie matricielle, on commence par concevoir un plan factoriel croisant plusieurs niveaux cardinaux d’hyperparamètres, par exemple $\alpha in {0{,}5; 1; 2; 5}$ et $\beta in {0{,}5; 1; 2; 5}$. Un maillage bidimensionnel complet est généré par expansion factorielle au moyen de la fonction expand.grid() ou de l’utilitaire tidyr::crossing() :
grille_params <- crossing(

  p = seq(0.005, 0.995, length.out = 200),

  alpha = c(0.5, 1, 2, 5),

  beta = c(0.5, 1, 2, 5)

) %>%

mutate(densite = dbeta(p, alpha, beta))
L’instruction graphique déploie ensuite une matrice $4 \times 4$ d’une éloquence visuelle remarquable :
ggplot(grille_params, aes(x = p, y = densite)) +

  geom_line(color = "#2B8CBE", linewidth = 1) +

  facet_grid(rows = vars(alpha), cols = vars(beta), labeller = label_both) +

  coord_cartesian(ylim = c(0, 4)) +

  theme_bw() +

  labs(x = "Support (x)", y = "Densité f(x)")
L’observation synoptique de cette matrice révèle immédiatement les lois de symétrie et les régularités structurelles de la loi :
- Sur la diagonale principale reliant le coin supérieur gauche ($\alpha = 0{,}5, \beta = 0{,}5$) au coin inférieur droit ($\alpha = 5, \beta = 5$), les paramètres sont rigoureusement égaux, illustrant la métamorphose continue depuis la forme en U d’Arcsinus jusqu’à la cloche leptocurtique étroite, en passant par le plateau rectangulaire parfait de la loi uniforme ($\alpha = 1, \beta = 1$).
- De part et d’autre de cette diagonale principale, les sous-graphiques symétriques reflètent une invariance miroir parfaite : la cellule $(\alpha = 2, \beta = 5)$ présente l’exact reflet spéculaire inversé de la cellule $(\alpha = 5, \beta = 2)$, confirmant graphiquement la propriété fondamentale $f(x; \alpha, \beta) = f(1 – x; \beta, \alpha)$.
- L’augmentation conjointe de la somme $\alpha + \beta$ le long de n’importe quel ratio fixe agit visiblement comme un puissant facteur de réduction de la variance, visualisant de façon limpide le rôle de la somme des hyperparamètres comme indicateur absolu de précision ou de taille d’échantillon informationnelle.
9.2 Représentation dynamique et animations des variations de forme
Si la cartographie matricielle statique structure l’espace paramétrique en classes discrètes, la restitution cinétique sous forme d’animations continues permet de percevoir avec une acuité intuitive inégalée la dynamique d’écoulement et de déformation de la masse probabiliste lorsque les hyperparamètres varient de façon différentielle. L’extension spécialisée gganimate étend la grammaire standard de ggplot2 en introduisant des opérateurs d’interpolation temporelle capables de fluidifier la transition entre états paramétriques successifs.
Considérons la modélisation dynamique de l’accumulation continue de preuves empiriques au sein d’une tâche d’apprentissage moteur. Imaginons un apprenant qui débute avec un a priori Bêta(1, 1) uniforme, et dont les performances progressent pas à pas à travers 50 itérations d’ajustement jusqu’à culminer dans une distribution resserrée Bêta(25, 5). En construisant un tableau de données paramétré par un identifiant d’étape séquentielle frame, le rendu cinétique s’amorce comme suit :
df_anim <- map_dfr(1:50, function(step) {

  a <- 1 + (24 * (step / 50))

  b <- 1 + (4 * (step / 50))

  tibble(x = seq(0.001, 0.999, length.out = 300), densite = dbeta(x, a, b), frame = step, a_val = round(a, 1), b_val = round(b, 1))

})
anim <- ggplot(df_anim, aes(x = x, y = densite)) +

  geom_line(color = "#E41A1C", linewidth = 1.3) +

  geom_area(fill = "#E41A1C", alpha = 0.2) +

  labs(title = "Dynamique d'apprentissage : Etape {frame}/50",

       subtitle = "Parametres : Alpha = {current_frame}", x = "Taux de maitrise (x)", y = "Densite") +

  transition_manual(frame)
La compilation via la fonction animate() produit un fichier GIF ou une vidéo vectorielle MP4 visualisant l’érection progressive du mode depuis un plateau plat initial jusqu’à un pic élancé et pointu migrant vers l’extrême droite. Cet instrument pédagogique s’avère particulièrement pertinent lors de présentations en séminaires de recherche, de conférences ou pour des supports d’enseignement universitaire en statistiques cognitives, rendant tangibles les notions abstraites de convergence asymptotique et de mise à jour bayésienne.
10. Applications empiriques en recherche psychologique et sciences cognitives
10.1 Modélisation des taux de réussite et de l’exactitude aux tâches cognitives
Pour attester de l’utilité pratique de la loi Bêta sur des données comportementales réelles, examinons le cas concret d’une cohorte clinique de $N = 250$ participants soumis à un protocole neuropsychologique informatisé évaluant la flexibilité cognitive (par exemple une version adaptative du Wisconsin Card Sorting Test). La métrique primaire collectée pour chaque participant correspond à la proportion brute de réponses catégorielles correctes $Y in ]0, 1[$.
Pour modéliser la structure distributionnelle de ces proportions observées, la première démarche analytique consiste à estimer les hyperparamètres optimaux $\hat{\alpha}$ et $\hat{\beta}$ par la méthode du maximum de vraisemblance (MLE) ou par la méthode des moments. À partir de la moyenne empirique $\bar{y}$ et de la variance d’échantillonnage $s^2$, la méthode des moments fournit les estimateurs préliminaires explicites suivants :
$$\hat{\alpha}_{\text{mom}} = \bar{y} \left( \frac{\bar{y}(1 – \bar{y})}{s^2} – 1 \right)$$
$$\hat{\beta}_{\text{mom}} = (1 – \bar{y}) \left( \frac{\bar{y}(1 – \bar{y})}{s^2} – 1 \right)$$
Une fois ces hyperparamètres estimés (par exemple $\hat{\alpha} = 6{,}4$ et $\hat{\beta} = 2{,}8$), le diagnostic visuel de la qualité de l’ajustement empirique requiert la superposition simultanée de l’histogramme à densité des fréquences réelles observées et de la fonction théorique calibrée :
ggplot(donnees_cognitives, aes(x = taux_succes)) +

  geom_histogram(aes(y = after_stat(density)), bins = 20, fill = "#BDC9E1", color = "white") +

  stat_function(fun = dbeta, args = list(shape1 = 6.4, shape2 = 2.8), color = "#045A8D", linewidth = 1.3) +

  labs(title = "Ajustement d'une loi Beta sur les taux d'exactitude cognitive", x = "Proportion de reussite", y = "Densite") +

  theme_classic()
L’utilisation de la directive after_stat(density) au sein de la couche geom_histogram() est ici impérative : elle force le moteur graphique à normaliser la hauteur des barres discrètes de telle sorte que leur aire totale sous-jacente somme exactement à 1, rendant l’histogramme directement commensurable avec l’ordonnée de la courbe continue continue injectée par stat_function(). Si la ligne théorique traverse harmonieusement le sommet de chaque rectangle sans déviation systématique unilatérale, l’adéquation distributionnelle est visuellement validée.
10.2 Visualisation de distributions a priori et a posteriori bayésiennes
L’illustration canonique du théorème de Bayes appliqué à des données de proportions constitue l’un des domaines où la visualisation de distributions Bêta est la plus féconde sur le plan épistémologique. La formalisation de la mise à jour bayésienne s’écrit de façon épurée :
$$p(\theta mid \text{données}) propto p(\theta) \times p(\text{données} mid \theta)$$
Considérons un chercheur analysant l’efficacité d’un nouveau protocole de remédiation cognitive pour des patients amnésiques. Avant le début de l’expérimentation, les données préliminaires publiées dans la littérature suggèrent un taux de succès moyen modéré de 30 %, avec un degré d’incertitude substantiel. Cette croyance préalable est formalisée par une distribution a priori Bêta(3, 7). Au cours du nouvel essai clinique mené en double aveugle, une série de 20 essais standardisés est administrée à un patient, qui réalise avec succès 16 épreuves (vraisemblance binomiale : $k = 16, n = 20$).
En exploitant la conjugaison mathématique, la distribution a posteriori actualisée se calcule de manière analytique instantanée :
$$\alpha_{\text{post}} = \alpha_{\text{prio}} + k = 3 + 16 = 19$$
$$\beta_{\text{post}} = \beta_{\text{prio}} + (n – k) = 7 + (20 – 16) = 11$$
La puissance pédagogique du raisonnement bayésien s’exprime pleinement lors de la mise en scène graphique simultanée de ces trois entités : la distribution a priori Bêta(3, 7), la fonction de vraisemblance normalisée (mise à l’échelle pour s’intégrer unitairement sur $[0, 1]$, équivalente à une Bêta(17, 5)), et la distribution finale a posteriori Bêta(19, 11) :
p <- seq(0, 1, length.out = 500)
df_bayes <- tibble(

  theta = rep(p, 3),

  densite = c(dbeta(p, 3, 7), dbeta(p, 17, 5), dbeta(p, 19, 11)),

  composante = factor(rep(c("A priori: Beta(3, 7)", "Vraisemblance (normalisee): Beta(17, 5)", "A posteriori: Beta(19, 11)"), each = 500),

                      levels = c("A priori: Beta(3, 7)", "Vraisemblance (normalisee): Beta(17, 5)", "A posteriori: Beta(19, 11)"))

)
ggplot(df_bayes, aes(x = theta, y = densite, color = composante, linetype = composante)) +

  geom_line(linewidth = 1.2) +

  scale_color_manual(values = c("#7570B3", "#D95F02", "#1B9E77")) +

  labs(title = "Actualisation Bayesienne du taux d'efficacite therapeutique", x = "Parametre de succes (u03b8)", y = "Densite de probabilite") +

  theme_classic()
Le tracé résultant rend tangible l’arbitrage bayésien : la distribution a posteriori verte se positionne comme un compromis optimal entre l’a priori violet et les observations empiriques oranges. Sa dispersion considérablement réduite illustre visuellement le rétrécissement drastique de l’incertitude épistémique consécutif à l’acquisition de données expérimentales rigoureuses.
10.3 Calibration visuelle des modèles de régression Bêta
Lorsque les taux de réussite ou les proportions ne sont plus analysés de manière globale mais conditionnellement à une série de variables prédictives continues ou catégorielles (âge des sujets, niveau d’anxiété, durée de traitement), le cadre canonique d’analyse n’est plus le modèle linéaire classique mais la régression Bêta (Ferrari & Cribari-Neto, 2004), implémentée sous R au sein de l’incontournable bibliothèque betareg.
Le modèle de régression Bêta opère une reparamétrisation standard élégante de la distribution en substituant aux hyperparamètres $(\alpha, \beta)$ la moyenne conditionnelle $\mu = \alpha / (\alpha + \beta)$ et le paramètre de précision $\phi = \alpha + \beta$. Les prédicteurs linéaires agissent alors sur la moyenne via une fonction de lien canonique, le plus souvent la fonction logit :
$$\text{logit}(\mu_i) = \ln\left(\frac{\mu_i}{1 – \mu_i}\right) = \mathbf{x}_i^top boldsymbol{\beta}$$
Après ajustement du modèle au moyen de l’instruction modele <- betareg(taux ~ age + anxiete, data = df), la calibration et l’évaluation diagnostique reposent sur des visualisations bivariées superposant la courbe de prédiction moyenne conditionnelle $\hat{\mu}(x)$ et des bandes d’intervalles de prédiction ajustées aux percentiles 2,5 % et 97,5 % calculés dynamiquement via la fonction qbeta() :
newdata <- tibble(age = seq(20, 80, length.out = 100))
pred_mu <- predict(modele, newdata = newdata, type = "response")
pred_phi <- predict(modele, newdata = newdata, type = "precision")
newdata <- newdata %>% mutate(

  mu = pred_mu,

  phi = pred_phi,

  a = mu * phi,

  b = (1 - mu) * phi,

  q_inf = qbeta(0.025, shape1 = a, shape2 = b),

  q_sup = qbeta(0.975, shape1 = a, shape2 = b)

)
En projetant cette bande de prédiction curviligne asymétrique au-dessus du nuage de points des observations empiriques réelles, le chercheur met en évidence l’adéquation phénoménologique du modèle, démontrant visuellement comment la variance se contracte de manière cohérente lorsque la moyenne s’approche asymptotiquement de la frontière supérieure du domaine unitaire.
11. Résolution des problèmes graphiques récurrents et pièges de calcul
11.1 Écueils liés aux asymptotes verticales et divisions par zéro
Le premier écueil technique qui piège fréquemment les praticiens novices réside dans la gestion computationnelle des asymptotes verticales associées aux distributions Bêta dont au moins un hyperparamètre est inférieur à l’unité. Considérons une loi Bêta(0,2, 0,8) tracée naïvement sur le domaine standard généré par seq(0, 1, length.out = 1000). L’évaluation de dbeta(0, shape1 = 0.2, shape2 = 0.8) produit immédiatement la valeur Inf.
Lors de l’appel subséquent à plot() ou à ggplot(), le moteur d’échelle tente de déterminer la limite supérieure du repère cartésien en évaluant max(densite), ce qui retourne irrémédiablement Inf. Selon les versions et les configurations internes, R lève alors un message d’erreur d’échelle (Error in plot.window(…): need finite ‘ylim’ values) ou produit un graphique entièrement blanc dont l’axe vertical est invisible. Pour corriger de façon robuste ce comportement sans dénaturer la présentation théorique, deux mesures programmatiques conjointes doivent être systématiquement appliquées :
- Appliquer une troncature interne microscopique du maillage de discrétisation, par exemple
p <- seq(1e-4, 1 - 1e-4, length.out = 1000). Ce filtrage préserve le calcul fini des ordonnées à des fractions de millimètre des frontières. - Plafonner manuellement et explicitement l’étendue de l’axe vertical par le biais de l’argument
ylim = c(0, Y_MAX)sous R Base oucoord_cartesian(ylim = c(0, Y_MAX))sousggplot2(en fixant par exempleY_MAX = 5ou10). Ce plafonnement empêche le pic asymptotique d’écraser l’ensemble de la masse informationnelle de la courbe au bas de la figure, restituant avec clarté la dynamique de descente de la fonction de densité.
11.2 Discordance d’échelles lors de superpositions multiples
Le deuxième piège méthodologique récurrent concerne la discordance d’échelles verticales lors de la superposition séquentielle de distributions présentant des variances très hétérogènes. Lorsqu’une distribution diffuse Bêta(2, 2) (dont le sommet culmine à $f(0{,}5) = 1{,}5$) est superposée à une distribution hautement concentrée Bêta(100, 100) (dont le sommet modale s’élève vertigineusement à plus de $f(0{,}5) \approx 11{,}3$), un tracé non calibré débouche sur un désastre visuel : si la première distribution a défini le canevas d’origine, le pic de la seconde est intégralement sectionné aux neuf dixièmes de sa hauteur.
Pour immuniser les scripts d’analyse contre ce biais récurrent, l’analyste doit impérativement concevoir une routine d’extraction globale du supremum analytique ou numérique avant toute instruction de tracé. Sous R Base, l’utilisation de structures vectorielles dynamiques permet d’automatiser cette calibration :
parametres <- list(c(2, 2), c(20, 20), c(100, 100))
p_eval <- seq(0.001, 0.999, length.out = 1000)
plafond_y <- max(sapply(parametres, function(par) max(dbeta(p_eval, par[1], par[2]))))
plot(p_eval, dbeta(p_eval, 2, 2), type = "l", ylim = c(0, plafond_y * 1.05))
Sous ggplot2, ce problème est structurellement atténué, car le moteur calcule automatiquement l’enveloppe convexe englobante de l’ensemble des couches géométriques déclarées. Néanmoins, une vigilance rigoureuse s’impose lors de l’utilisation conjointe de facet_wrap() ou facet_grid() : l’argument par défaut scales = "fixed" doit être préservé si l’on souhaite maintenir la comparabilité directe de la hauteur des densités entre facettes, tandis que la configuration scales = "free_y" ne doit être tolérée que si l’objectif exclusif réside dans l’examen morphologique interne sans prétention comparative de la dispersion relative.
11.3 Reproductibilité et vectorisation haute définition pour publication
Le troisième piège concerne la dégradation de la résolution graphique lors de l’exportation et de l’intégration des visualisations au sein de manuscrits académiques ou de rapports de recherche. Exporter une figure sous la forme d’une simple capture d’écran matricielle ou d’un fichier JPEG compressé à basse résolution engendre des artéfacts de pixellisation destructeurs, dégradant la netteté typographique des axes et brisant l’aspect lisse des lignes de densité.
La règle éditoriale d’or en recherche quantitative réside dans l’exploitation prioritaire des formats vectoriels haute fidélité, au premier rang desquels figurent les formats PDF (Portable Document Format), EPS (Encapsulated PostScript) ou SVG (Scalable Vector Graphics). Contrairement aux matrices de points fixes des formats bitmap, les formats vectoriels encodent mathématiquement les segments, les courbes de Bézier et les glyphes typographiques, garantissant une netteté absolue et infinie quel que soit le niveau de zoom appliqué lors de l’impression ou de la consultation numérique.
L’exportation programmatique rigoureuse sous format vectoriel s’opère par l’ouverture d’un périphérique dédié sous R Base :
pdf(file = "Figure_Beta_Academique.pdf", width = 8, height = 6, useDingbats = FALSE)
# ... instructions de trace R Base ...
dev.off()
Sous l’environnement ggplot2, la commande standardisée ggsave() offre un contrôle similaire de haut niveau :
ggsave("Figure_Beta_Academique.pdf", plot = mon_graphique, width = 8, height = 6, units = "in", dpi = 600)
Si la revue exige impérativement un format matriciel (de type TIFF non compressé ou PNG haute résolution), le paramètre de résolution d’échantillonnage doit être impérativement verrouillé à un minimum strict de 300 à 600 DPI (dots per inch). Concomitamment, l’incorporation vectorielle des polices typographiques institutionnelles peut être pérennisée via l’utilisation des packages R spécialisés extrafont ou showtext, assurant l’intégrité de la restitution sur n’importe quel système d’exploitation sans altération des symboles grecs ou des indices mathématiques.
12. Perspective comparative : tracer la loi Bêta face à d’autres distributions théoriques
12.1 Distinction visuelle entre distribution Bêta et loi Normale tronquée
Un réflexe récurrent chez de nombreux analystes formés au cadre linéaire classique consiste à substituer à la distribution Bêta une loi normale conventionnelle dont on ampute artificiellement les extrémités en dehors de l’intervalle $[0, 1]$, donnant naissance à la distribution dite normale tronquée. Bien que séduisante de prime abord par sa familiarité conceptuelle, cette approximation présente des faiblesses théoriques majeures que la comparaison visuelle superposée met en relief de façon éclatante.
Considérons une distribution Bêta symétrique Bêta(5, 5), caractérisée par une moyenne $\mu = 0{,}5$ et une variance :
$$\sigma^2 = \frac{5 \times 5}{(10)^2 \times 11} = \frac{25}{1100} \approx 0{,}0227 implies \sigma \approx 0{,}1508$$
Ajustons en vis-à-vis une distribution normale $N(0{,}5; 0{,}1508^2)$ rigoureusement contrainte et renormalisée sur l’intervalle $[0, 1]$. En superposant les deux profils à l’aide de stat_function() sous ggplot2 :
ggplot(tibble(x = c(0, 1)), aes(x = x)) +

  stat_function(fun = dbeta, args = list(shape1 = 5, shape2 = 5), aes(color = "Beta(5, 5)"), linewidth = 1.2) +

  stat_function(fun = function(x) dtruncnorm(x, a = 0, b = 1, mean = 0.5, sd = 0.1508), aes(color = "Normale tronquee"), linewidth = 1.2, linetype = "dashed") +

  scale_color_manual(values = c("Beta(5, 5)" = "#1F78B4", "Normale tronquee" = "#E31A1C")) +

  labs(title = "Divergence structurale : Beta vs Normale tronquee", x = "Support unitaire", y = "Densite") +

  theme_classic()
L’examen minutieux des queues de distribution révèle la distinction fondamentale : tandis que la loi Bêta s’éteint de manière organique et fluide en atteignant zéro aux frontières du domaine avec une courbure asymptotique naturelle dictée par les exposants $(\alpha – 1)$ et $(\beta – 1)$, la loi normale tronquée subit une rupture mécanique brutale, sa fonction de densité butant abruptement contre la frontière avec une valeur strictement positive non nulle interrompue de façon artificielle. Cette discontinuité mathématique aux limites disqualifie la loi normale tronquée dès lors que des phénomènes physiques ou psychométriques impliquent un ralentissement progressif de la densité aux abords des seuils critiques.
12.2 Approximation continue de la loi Binomiale
La deuxième perspective comparative cardinale concerne l’articulation mathématique et visuelle unissant la distribution Bêta continue à la distribution discrète Binomiale. En vertu des principes de l’échantillonnage bernoullien, le nombre de succès $K$ obtenu au cours de $n$ essais indépendants gouvernés par une probabilité fixe $p$ obéit à la loi discrète $\mathcal{B}(n, p)$. Inversement, si le nombre de succès observés $k$ est fixé et que l’on s’interroge sur la distribution de vraisemblance du paramètre continu sous-jacent $p$, la fonction résultante adopte précisément la formulation fonctionnelle de la loi Bêta.
Pour visualiser cette dualité fondamentale au sein d’une même figure sous R, l’analyste peut juxtaposer la fonction de masse probabiliste discrète de la loi Binomiale (représentée par des impulsions verticales ou des barres d’aiguilles via geom_segment() ou type = "h") et la densité continue d’une loi Bêta adéquatement calibrée :
n <- 20; k <- 7

p_vals <- seq(0, 1, length.out = 500)

dens_beta <- dbeta(p_vals, shape1 = k + 1, shape2 = n - k + 1)
plot(p_vals, dens_beta, type = "l", col = "#2B83BA", lwd = 2.5, xlab = "Probabilite de succes (p)", ylab = "Densite / Masse normalisee", main = "Convergence d'echelle : Loi Binomiale et Loi Beta")
points(x = (0:n)/n, y = dbinom(0:n, size = n, prob = k/n) * (n + 1), type = "h", col = "#D7191C", lwd = 2)
points(x = (0:n)/n, y = dbinom(0:n, size = n, prob = k/n) * (n + 1), pch = 19, col = "#D7191C")
Le facteur multiplicatif $(n + 1)$ appliqué à la masse discrète binomiale opère une mise à l’échelle dimensionnelle nécessaire pour superposer des probabilités ponctuelles discrètes sur un axe d’ordonnées de densité continue. La figure met en lumière la congruence spectaculaire des deux lois, illustrant graphiquement le théorème de Bayes et démontrant que la distribution Bêta constitue le prolongement continu naturel de la combinatoire binomiale discrète sur l’espace probabiliste unitaire.
12.3 Synthèse procédurale et aide-mémoire des scripts R
Afin d’offrir aux chercheurs et data scientists une référence méthodologique immédiatement opérationnelle, le tableau synoptique suivant récapitule les correspondances conceptuelles et fonctionnelles entre les deux moteurs d’affichage graphique majeurs de l’environnement R pour la visualisation de la distribution Bêta :
| Objectif de visualisation | Implémentation R Base (graphics) | Implémentation moderne (ggplot2) |
|---|---|---|
| Tracé d’une courbe élémentaire | plot(p, dbeta(p, a, b), type = "l") |
stat_function(fun = dbeta, args = list(a, b)) |
| Superposition multi-courbes | Appels successifs à lines(p, dbeta(p, ...)) |
Mappage esthétique aes(color = groupe) |
| Coloration des aires critiques | Primitive fermée via polygon(x, y, col) |
Couche géométrique geom_ribbon(aes(ymin, ymax)) |
| Repères de seuils critiques | Lignes directrices via abline(v = quantile) |
Lignes orthogonales geom_vline(xintercept) |
| Structuration matricielle | Matrice de paramètres graphiques par(mfrow) |
Facettage dimensionnel facet_grid(alpha ~ beta) |
| Typographie mathématique | Arguments formels expression(Beta(alpha, beta)) |
Labels mathématiques label_parsed ou latex2exp |
Pour conclure cette architecture procédurale, le script modèle autonome suivant intègre l’ensemble des préceptes théoriques, ergonomiques et esthétiques établis tout au long de cette monographie, permettant de générer une figure comparative multi-courbes prête pour l’insertion dans une publication académique internationale de premier rang :
library(ggplot2)
library(dplyr)
library(tidyr)
# 1. Preparation du maillage continu vectorise
p <- seq(from = 0.001, to = 0.999, length.out = 1000)
# 2. Elaboration du tibble structure au format long
donnees_publication <- bind_rows(

  tibble(p = p, densite = dbeta(p, 2, 8), Configuration = "Beta(2, 8) : Asymetrique positive"),

  tibble(p = p, densite = dbeta(p, 5, 5), Configuration = "Beta(5, 5) : Symetrique unimodale"),

  tibble(p = p, densite = dbeta(p, 8, 2), Configuration = "Beta(8, 2) : Asymetrique negative"),

  tibble(p = p, densite = dbeta(p, 0.5, 0.5), Configuration = "Beta(0.5, 0.5) : Profil en U")

) %>% mutate(Configuration = factor(Configuration, levels = unique(Configuration)))
# 3. Generation du rendu graphique vectoriel conforme aux normes APA
figure_finale <- ggplot(donnees_publication, aes(x = p, y = densite, color = Configuration, linetype = Configuration)) +

  geom_line(linewidth = 1.1) +

  coord_cartesian(xlim = c(0, 1), ylim = c(0, 4.5)) +

  scale_color_manual(values = c("#E41A1C", "#377EB8", "#4DAF4A", "#984EA3")) +

  scale_linetype_manual(values = c("solid", "dashed", "dotdash", "twodash")) +

  labs(

    title = "Morphologie comparee des distributions Beta sur support unitaire",

    subtitle = "Illustration des comportements asymetriques, symetriques et singuliers",

    x = "Score standardise / Taux de reussite (u03b8)",

    y = "Densite de probabilite f(u03b8)"

  ) +

  theme_classic(base_size = 12) +

  theme(

    plot.title = element_text(face = "bold", size = 13, hjust = 0.5),

    plot.subtitle = element_text(size = 10, hjust = 0.5, margin = margin(b = 15)),

    axis.title = element_text(face = "bold"),

    legend.position = "bottom",

    legend.title = element_blank(),

    legend.box = "horizontal",

    legend.text = element_text(size = 9)

  )
# 4. Impression et sauvegarde haute resolution
print(figure_finale)
# ggsave("Figure_Publication_Beta.pdf", plot = figure_finale, width = 9, height = 6.5, units = "in")
Ce protocole algorithmique complet clôture notre itinéraire théorique et technique. En intégrant de manière rigoureuse ces concepts mathématiques, ces raffinements computationnels et ces conventions graphiques, les chercheurs en psychologie, sciences cognitives et data science disposent d’un arsenal méthodologique complet pour explorer, modéliser et valoriser visuellement l’ensemble des phénomènes bornés propres à l’investigation empirique du comportement.
Références
- Ferrari, S., & Cribari-Neto, F. (2004). Beta regression for modelling rates and proportions. Journal of Applied Statistics, 31(7), 799-815. https://doi.org/10.1080/0266476042000214501
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b16018
- Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate discrete distributions (3rd ed.). John Wiley & Sons.
- Kruschke, J. K. (2014). Doing Bayesian data analysis: A tutorial with R, JAGS, and Stan (2nd ed.). Academic Press.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer.