
La modélisation visuelle des données constitue l’un des piliers méthodologiques de l’inférence scientifique moderne et de l’analyse exploratoire contemporaine. Dans le cadre de la recherche quantitative, l’examen brut de distributions numériques massives s’avère fréquemment insuffisant pour appréhender la complexité des dynamiques relationnelles unissant deux variables continues. C’est précisément au confluent de la statistique mathématique et de la sémiologie graphique que s’établit la pertinence du traçage des lignes de tendance. L’environnement de programmation statistique R, enrichi par son écosystème Tidyverse, a redéfini les standards de la visualisation scientifique grâce au package ggplot2, conçu d’après les principes théoriques fondamentaux de la grammaire des graphiques formulés originellement par Leland Wilkinson.
L’intégration d’une ligne d’ajustement au sein d’un nuage de points ne relève pas d’un simple artifice esthétique destiné à enjoliver une planche descriptive. Elle matérialise une hypothèse de recherche, capture un signal déterministe immergé dans un bruit stochastique, et permet au chercheur d’opérationnaliser visuellement des concepts d’estimation paramétrique ou non paramétrique. Que l’on cherche à valider une relation linéaire issue des moindres carrés ordinaires, à explorer des courbures non linéaires par lissage local, ou à évaluer l’hétérogénéité structurelle entre différentes strates d’une population expérimentale, la fonction de lissage statistique constitue l’opérateur analytique par excellence de la sémiologie computationnelle contemporaine.
Cet article se propose d’explorer de manière exhaustive, systématique et rigoureuse les mécanismes sous-jacents au traçage, à la personnalisation et à l’interprétation des lignes de tendance au sein du formalisme graphique de ggplot2. En articulant la rigueur théorique des modèles de régression à l’élégance technique des couches syntaxiques, nous parcourrons chaque dimension fonctionnelle nécessaire à la production de figures analytiques de calibre universitaire, prêtes pour la diffusion dans les revues académiques les plus exigeantes.
1. Introduction à la modélisation visuelle des tendances avec ggplot2
1.1 Fondements théoriques de la droite de régression en analyse de données
Dans le domaine de l’analyse statistique bivariée, l’investigation empirique cherche fréquemment à établir si les variations d’une variable réponse dépendante peuvent être expliquées ou prédites par les fluctuations systématiques d’une variable explicative indépendante. L’ajustement linéaire classique constitue l’ancrage paradigmatique de cette quête épistémologique. D’un point de vue algébrique, une observation discrète se compose d’une valeur observée ponctuelle, issue d’un acte de mesure entaché d’incertitude ou de variabilité naturelle. En contrepoint, la droite de tendance représente une fonction continue qui projette l’espérance conditionnelle de la variable réponse sur l’ensemble du continuum de la variable prédictive.
La distinction entre l’observation discrète, matérialisée géométriquement par un point sur le plan cartésien, et l’estimation de tendance continue s’avère capitale pour éviter tout sophisme méthodologique. Tandis que l’échantillon d’observations reflète fidèlement la variabilité d’échantillonnage, la ligne de tendance formalise le comportement asymptotique du phénomène étudié, filtrant les résidus aléatoires pour ne conserver que la trajectoire structurelle. Ce passage de la singularité de la mesure ponctuelle à la généralité de la fonction continue repose sur la minimisation de critères d’erreur mathématiques bien définis, tels que la somme des résidus au carré dans le cadre des moindres carrés ordinaires.
L’avènement de la grammaire des graphiques de Wilkinson a profondément renouvelé la manière dont les statisticiens conçoivent cette articulation. En décomposant un graphique en composantes indépendantes mais harmonisées (données, esthétiques, géométries, transformations statistiques et échelles), cette approche théorique permet de superposer sans ambiguïté une couche statistique inférentielle sur une couche descriptive brute. L’analyste ne modifie pas la nature intrinsèque des données sources, mais leur adjoint un estimateur géométrique qui enrichit instantanément l’interprétation globale de l’expérimentation.
1.2 Structure syntaxique générale de ggplot2 et fonction geom_smooth()
L’implémentation logicielle de la grammaire des graphiques au sein de ggplot2 repose sur une logique cumulative où chaque instruction enrichit l’objet graphique au moyen de l’opérateur d’addition. Le tracé d’un diagramme de dispersion enrichi d’un ajustement analytique nécessite l’articulation fondamentale de trois couches syntaxiques interdépendantes : l’instanciation de l’environnement graphique via la fonction principale ggplot(), la projection discrète des données par geom_point(), et le calcul de la trajectoire estimée orchestré par la fonction geom_smooth().
L’affectation des variables d’intérêt s’opère par le biais de la fonction aes(), qui définit les relations esthétiques globales reliant les colonnes du tableau de données matriciel aux axes de coordonnées cartésiennes. Lorsqu’une variable est associée à l’axe des abscisses x et qu’une seconde variable est projetée sur l’axe des ordonnées y au sein de la fonction englobante, ces correspondances s’appliquent de manière récursive et descendante à toutes les géométries ultérieures. De ce fait, geom_point() utilise ces coordonnées pour disperser les glyphes individuels, tandis que geom_smooth() mobilise exactement ces mêmes variables pour instancier ses calculs statistiques sous-jacents.
La puissance conceptuelle de geom_smooth() réside dans son statut hybride : elle combine au sein d’une unique commande syntaxique une transformation statistique interne (stat_smooth) et un rendu géométrique polyvalent (combinant une ligne médiane et un polygone d’intervalle). Par défaut, sans paramétrage explicite, la fonction évalue la volumétrie de l’échantillon pour sélectionner l’algorithme d’estimation le plus adapté. Face à des effectifs inférieurs à un millier d’observations, elle applique automatiquement un lissage non paramétrique de type LOESS (Locally Estimated Scatterplot Smoothing), introduisant d’emblée une modélisation locale souple qui transcende les limitations des approches purement rigides.
1.3 Objectifs scientifiques et rigueur méthodologique de la représentation
Dans l’investigation empirique, la représentation graphique n’est pas un substitut simplificateur à l’analyse formelle, mais son précurseur diagnostique indispensable. L’évaluation visuelle des dynamiques relationnelles au travers d’une ligne de tendance permet d’apprécier la monotonicité, la stabilité locale de la variance résiduelle et la présence éventuelle de régimes de rupture structurelle au sein des données. Elle permet au chercheur d’anticiper la validité des modèles d’économétrie ou de biostatistique avant même d’engager des procédures d’estimation matricielle lourdes.
Cependant, l’introduction d’un ajustement graphique impose une rigueur méthodologique exemplaire pour prévenir les distorsions cognitives et les artefacts perceptifs. Une modification inconsidérée du ratio d’aspect des axes ou un recadrage artificiel des échelles cartésiennes peut exacerber artificiellement une pente presque nulle ou, à l’inverse, aplatir une relation pourtant critique sur le plan opérationnel. L’observateur humain ayant une propension innée à identifier des alignements déterministes même au sein de bruits purement gaussiens, la visualisation de la tendance doit impérativement s’accompagner d’une quantification rigoureuse de son incertitude statistique.
L’analyse exploratoire de données (EDA), formalisée historiquement par John Tukey, confère à la courbe de régression visuelle un statut de boussole heuristique. Avant d’arrêter les spécifications d’un modèle inférentiel paramétrique, l’observation minutieuse de l’écart systématique entre les points empiriques et la ligne ajustée permet d’interroger la forme fonctionnelle postulée a priori. Si les points dévient de manière cohérente et unilatérale par rapport à une trajectoire rectiligne, le statisticien est immédiatement alerté de la nécessité d’envisager des termes polynomiaux, des fonctions splines ou des transformations d’échelle non linéaires.
2. Préparation de l’environnement de calcul et données empiriques
2.1 Chargement des bibliothèques nécessaires
L’élaboration d’un flux de travail reproductible dans l’écosystème R exige une gestion méthodique de l’environnement d’exécution logicielle. Pour mener à bien les procédures graphiques et statistiques qui vont suivre, l’installation préalable et le chargement explicite de ggplot2 s’avèrent indispensables. Il est fréquent d’adopter une stratégie plus holistique en chargeant la méta-bibliothèque tidyverse, laquelle englobe non seulement ggplot2 pour la grammaire visuelle, mais également des modules d’ingénierie des données comme dplyr, tibble et tidyr.
L’invocation programmatique s’effectue via l’instruction library(ggplot2) ou library(tidyverse). Dans le cadre d’un rapport technique d’envergure, il est recommandé de monitorer rigoureusement la version des packages utilisés via l’instruction sessionInfo(). Cette précaution élimine les divergences de comportement algorithmique susceptibles de survenir entre les versions successives des librairies, notamment concernant le paramétrage des fonctions de lissage par défaut ou le rendu vectoriel des motifs graphiques. La stabilité de l’environnement garantit ainsi l’immuabilité temporelle de la production graphique scientifique.
Outre les outils graphiques purs, certaines modélisations avancées requièrent des extensions statistiques spécialisées. L’appel à la bibliothèque MASS pour l’estimation de régressions linéaires robustes, ou au package mgcv pour l’ajustement de modèles additifs généralisés de haute dimension, illustre l’interopérabilité native de ggplot2 avec l’écosystème algorithmique de R. La préparation adéquate des bibliothèques constitue ainsi le socle opérationnel garantissant la fluidité du pipeline analytique.
2.2 Création du jeu de données de référence
Afin d’illustrer les nuances méthodologiques du tracé des lignes de tendance avec une maîtrise parfaite des propriétés probabilistes sous-jacentes, il convient de générer un jeu de données synthétique mais biologiquement réaliste. En contrôlant le processus générateur de données (Data Generating Process), le chercheur peut évaluer avec précision la capacité de chaque variante de lissage à retrouver les paramètres structurels sous-jacents, tout en affrontant une composante stochastique hétérogène.
Considérons une situation expérimentale où l’on observe la concentration sérique d’un biomarqueur (notée comme variable dépendante continue) en fonction du temps d’exposition à un principe actif (variable indépendante continue). Nous pouvons concevoir un tableau de données rectangulaire au moyen de la structure data.frame ou de son équivalent moderne tibble. Dans ce cadre, la variable explicative x peut être définie comme une séquence régulière d’observations couvrant un intervalle continu allant de 5 à 50 unités temporelles, comprenant par exemple 150 points d’échantillonnage.
La variable dépendante y est construite en combinant une fonction linéaire théorique, dotée d’une constante de base égale à 12.5 et d’une pente directionnelle de 0.85, à laquelle s’additionne un vecteur de perturbations résiduelles gaudo-aléatoires généré par la fonction rnorm(). La structure interne de cet objet sera immédiatement auscultée à l’aide des fonctions fondamentales str() et summary(). Cet examen préliminaire valide la non-dégénérescence des moments statistiques fondamentaux (moyenne, écart-type, étendue interquartile) et assure qu’aucune valeur manquante non déclarée ne viendra compromettre le pipeline géométrique ultérieur.
2.3 Inspection préliminaire de la dispersion des observations
Avant d’apposer la moindre courbe d’ajustement, la déontologie scientifique impose la visualisation exclusive des données brutes au moyen d’un nuage de points non altéré. La tentation de masquer la variabilité intrinsèque des mesures sous une droite directrice synthétique peut conduire à des erreurs d’interprétation tragiques, occultant par exemple des bifurcations de trajectoire ou des concentrations bimodales dissimulées dans la distribution conjointe.
L’assemblage graphique originel repose sur l’appel ggplot(data = donnees_ref, aes(x = temps, y = biomarqueur)) associé à l’adjonction élémentaire du geom_point(). Cette première figure offre une perspective pure sur la dispersion empirique, permettant de calibrer intuitivement le rapport signal sur bruit. Le statisticien observe la dispersion des résidus le long du gradient horizontal, examine si l’amplitude de la variance demeure stable (homoscédasticité) ou si elle s’accroît avec la valeur de l’abscisse (hétéroscédasticité), et traque la présence d’éventuelles valeurs aberrantes extrêmes.
Cette étape exploratoire conditionne directement le choix du formalisme de tendance. Si la distribution des points manifeste une linéarité constante sans courbure perceptible ni rupture de continuité, l’application ultérieure d’un modèle des moindres carrés ordinaires s’en trouvera méthodologiquement justifiée. Si, à l’inverse, une inflexion quadratique ou une asymptote de saturation transparaît sous le regard critique du chercheur, l’utilisation aveugle d’une régression linéaire simple sera immédiatement disqualifiée au profit de formulations plus souples.
3. Tracé d’une ligne de tendance linéaire fondamentale
3.1 Paramétrage explicite de l’argument method = ‘lm’
Pour forcer l’ajusteur géométrique à adopter une trajectoire strictement rectiligne correspondant à un modèle linéaire univarié standard, il est impératif de stipuler explicitement l’argument method = « lm » au sein des paramètres formels de geom_smooth(). L’acronyme lm renvoie directement à la fonction native d’ajustement par les moindres carrés ordinaires (Linear Model) du moteur d’analyse de R, assurant une concordance algorithmique parfaite entre l’estimation graphique et la modélisation statistique théorique.
Par défaut, l’omission de cet argument incite ggplot2 à utiliser un lissage local pondéré (LOESS) pour les séries de taille modérée. Bien que le LOESS offre une flexibilité appréciable en phase exploratoire, il produit une ligne ondulatoire qui dévie subtilement d’une rectitude géométrique parfaite, ce qui s’avère méthodologiquement inadéquat lorsque l’hypothèse nulle du chercheur postule une dépendance proportionnelle constante. La fixation de method = « lm » neutralise cette flexibilité non paramétrique et impose à l’algorithme d’estimer un hyperplan de dimension un, caractérisé par un unique coefficient directeur et une ordonnée à l’origine universelle.
Le code d’implémentation minimaliste associe ainsi le socle de base au composant de modélisation linéaire :
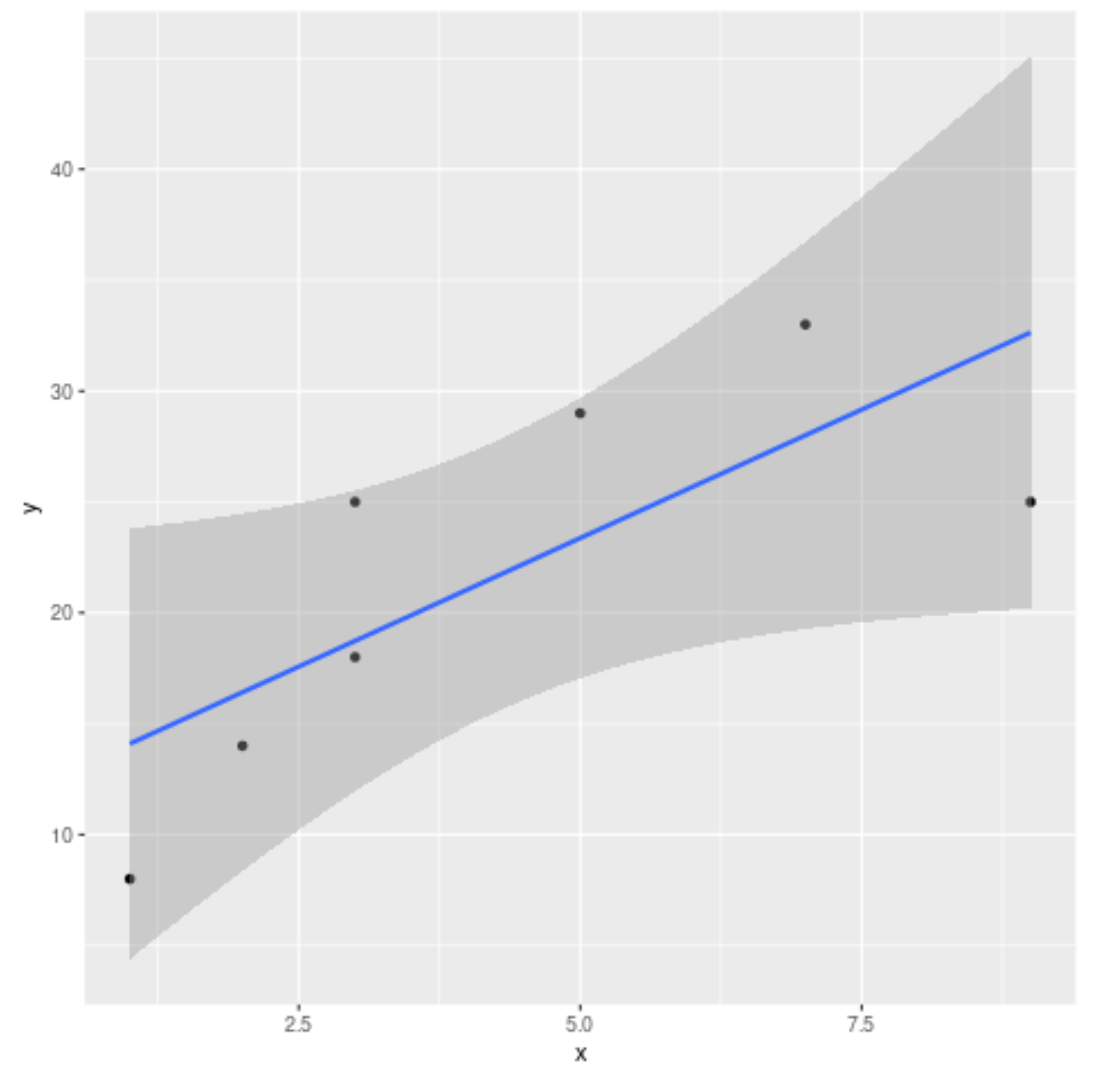
L’exécution de la commande ggplot(donnees_ref, aes(x = temps, y = biomarqueur)) + geom_point() + geom_smooth(method = « lm ») génère immédiatement la droite canonique superposée au nuage de points. Cette formulation concise exécute en arrière-plan la régression mathématique formelle, calcule la droite optimale qui minimise la somme géométrique des écarts verticaux au carré, et projette le segment résultant sur l’étendue exacte des données observées.
3.2 Interprétation analytique de la trajectoire observée
L’observation de la droite d’ajustement linéaire tracée sur le canevas graphique appelle une interprétation conjointe de ses propriétés spatiales et de ses soubassements statistiques. L’inclinaison de la ligne, traduite par la pente géométrique sur le plan euclidien, reflète le coefficient de régression estimé : pour chaque incrément unitaire le long de l’axe horizontal, la variable dépendante varie en moyenne de la quantité prescrite par la pente. Une orientation ascendante de gauche à droite certifie une corrélation empirique positive, tandis qu’une déclivité descendante trahirait une dynamique d’inhibition ou de décroissance inversement proportionnelle.
L’intersection projetée de cette droite avec l’axe vertical, correspondant à l’abscisse zéro, matérialise l’ordonnée à l’origine théorique du système. Il convient toutefois de veiller à ce que l’origine zéro possède un sens physique ou expérimental tangible avant de surinterpréter la hauteur initiale de la courbe. Par ailleurs, la qualité de l’ajustement global (souvent synthétisée par le coefficient de détermination R²) s’apprécie visuellement par la proximité relative du nuage de points vis-à-vis de l’axe rectiligne. Lorsque les observations s’agglomèrent étroitement autour du segment tracé, le modèle linéaire explique l’essentiel de la variance expérimentale ; une dispersion clairsemée et diffuse signale au contraire la prédominance de facteurs résiduels non contrôlés.
La ligne de tendance linéaire matérialise donc une synthèse mathématique élégante mais réductrice de la réalité expérimentale. Elle offre une simplification cognitive nécessaire pour communiquer un effet d’ensemble, tout en servant d’ancrage visuel à partir duquel les déviations individuelles peuvent être quantifiées et discutées méthodiquement au fil de la démonstration scientifique.
4. Modulation et contrôle des intervalles de confiance
4.1 Fonctionnement de l’enveloppe de confiance standard
L’un des apports majeurs de la fonction geom_smooth() réside dans son affichage systématique et automatisé d’un ruban d’incertitude enveloppant la ligne de tendance médiane. Cette bande ombrée semi-transparente ne doit sous aucun prétexte être confondue avec un intervalle de prédiction individuelle, qui engloberait la dispersion des futures observations singulières. Elle représente rigoureusement l’intervalle de confiance asymptotique à 95 % associé à l’espérance conditionnelle de la prédiction moyenne.
Sur le plan computationnel, cet intervalle est calculé à partir de l’erreur-type de la prédiction moyenne pour chaque valeur discrète de x échantillonnée le long de l’axe. La variance de cette prédiction dépend directement de la taille de l’échantillon, de la variance des erreurs résiduelles du modèle, ainsi que de l’écartement euclidien par rapport à la moyenne globale de la variable prédictive. Cette formulation algébrique explique pourquoi le ruban présente invariablement une morphologie incurvée en diabolo ou en sablier : l’enveloppe est la plus resserrée au niveau du centre de gravité des observations, là où l’information empirique est la plus dense, et s’évase progressivement à mesure que l’on s’approche des marges extrêmes du domaine expérimental.
Cette visualisation directe de la variabilité d’échantillonnage offre au praticien une mise en garde immédiate contre l’illusion de certitude absolue. Même si la pente observée paraît marquée, un ruban d’incertitude excessivement large, englobant potentiellement une ligne horizontale plane dans son enveloppe supérieure ou inférieure, signale immédiatement au chercheur un manque de puissance statistique ou une indétermination expérimentale majeure qu’une simple droite nue aurait totalement dissimulée.
4.2 Ajustement du niveau de confiance par le paramètre level
Bien que le seuil de significativité bilatéral de 95 % (correspondant à alpha = 0.05) constitue la convention dominante dans la littérature biomédicale et socio-économique, certaines disciplines requièrent des standards de preuve plus drastiques ou, au contraire, adoptent des seuils d’exploration plus permissifs. L’architecture de geom_smooth() permet de piloter directement la couverture probabiliste de ce ruban au moyen de l’argument explicite level.
Pour implémenter un intervalle de confiance hautement conservateur, calibré à 99 % conformément aux protocoles stricts de certains essais cliniques ou analyses de physique expérimentale, l’utilisateur adjoint simplement la mention level = 0.99 dans les parenthèses d’appel. Algébriquement, cette modification élargit le multiplicateur critique issu de la distribution de Student ou de la loi normale standard, ce qui se traduit graphiquement par une dilatation instantanée de l’épaisseur du ruban ombré. À l’inverse, l’ajustement à level = 0.90 restreint l’enveloppe visuelle en acceptant un risque d’erreur de première espèce plus élevé.
La comparaison visuelle entre plusieurs niveaux de confiance permet d’apprécier la stabilité géométrique de la conclusion empirique. Si, même au seuil ultra-conservateur de 99 %, la totalité du ruban d’incertitude conserve une inclinaison positive sans jamais intercepter une trajectoire horizontale, le chercheur dispose d’une preuve visuelle robuste de la significativité statistique de la relation bivariée observée, renforçant la crédibilité de ses conclusions analytiques.
4.3 Suppression intégrale de l’ombrage d’incertitude
En dépit de son utilité diagnostique incontestable, l’enveloppe d’incertitude peut, dans certaines configurations de présentation, surcharger inutilement le champ visuel de la figure. C’est particulièrement le cas lorsque l’analyste cherche à superposer simultanément un grand nombre de trajectoires issues de cohortes multiples, ou lorsqu’il s’agit d’intégrer le graphique au sein d’une publication exiguë dont l’impression papier tolère mal les dégradés d’ombrage complexes.
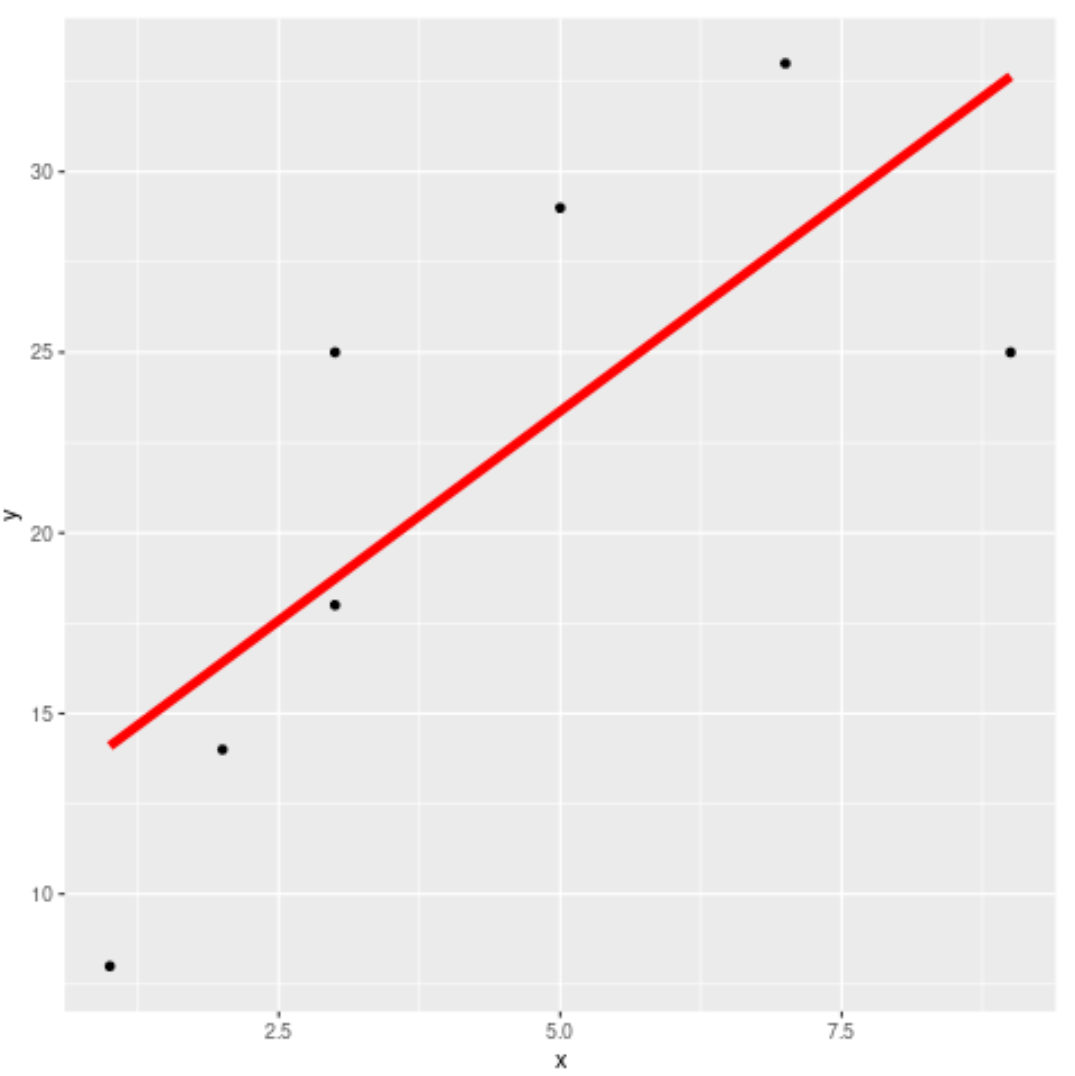
Pour épurer la figure et ne restituer que la trajectoire géométrique du modèle linéaire, il suffit de désactiver le calcul et l’affichage du ruban d’erreur par le truchement du paramètre logique se = FALSE (où se renvoie à standard error). En recevant cette instruction, la routine interne désactive le calcul des erreurs-types prédictives et omet la génération du polygone spatial associé, réduisant la consommation de mémoire graphique et restituant un tracé filaire strict.
L’écriture syntaxique de cette épuration s’énonce comme suit : geom_smooth(method = « lm », se = FALSE). Cette pratique s’avère hautement recommandable lorsque le nuage de points sous-jacent est particulièrement volumineux (plusieurs dizaines de milliers de données) et que la quasi-totalité de l’incertitude est infinitésimale. Dans un tel contexte de convergence asymptotique, l’épaisseur du ruban à 95 % deviendrait inférieure à la largeur physique du trait de crayon, rendant sa représentation visuelle superflue et potentiellement trompeuse.
5. Personnalisation esthétique de la droite de régression
5.1 Contrôle chromatique de la ligne et du ruban
L’optimisation de l’impact sémiotique d’une figure de publication passe par une sélection chromatique rigoureuse, guidée à la fois par les exigences de hiérarchisation de l’information et par les standards d’accessibilité visuelle universelle, notamment vis-à-vis du daltonisme. Par défaut, ggplot2 attribue une teinte bleue standard (#3366FF) à la ligne d’ajustement et un gris translucide au ruban d’incertitude. Ces paramètres par défaut peuvent être intégralement réécrits via les arguments scalaires passés à geom_smooth().
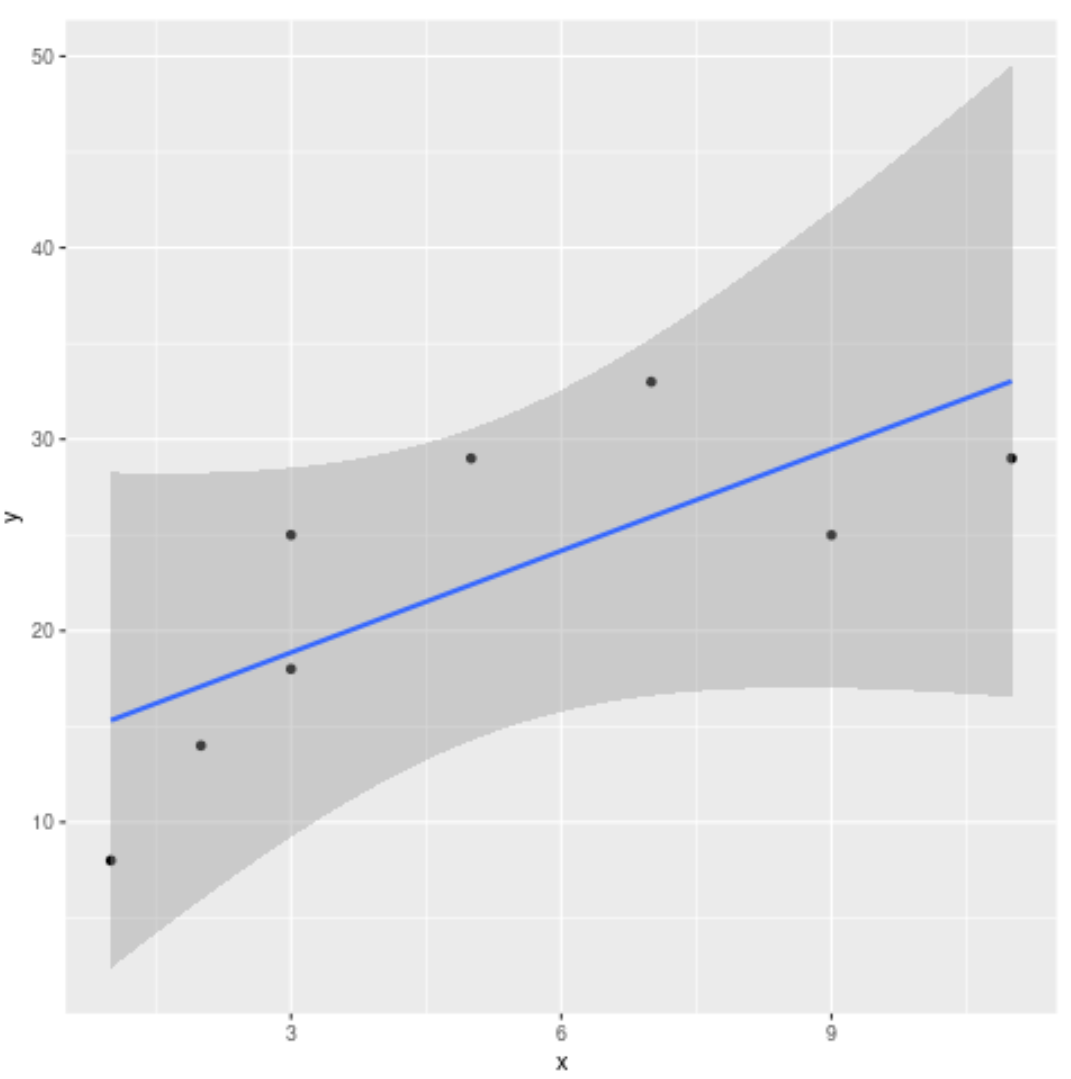
Il importe de distinguer formellement l’argument color, qui contrôle la pigmentation du tracé filaire unidimensionnel, de l’argument fill, qui gouverne le remplissage surfacique du polygone bidimensionnel délimitant l’intervalle de confiance. En assignant des valeurs hexadécimales standardisées ou des dénominations de couleurs universelles, le chercheur peut par exemple spécifier color = « firebrick » pour conférer une visibilité maximale à la trajectoire estimée, tout en sélectionnant fill = « grey70 » pour que l’enveloppe d’incertitude s’intègre discrètement dans le fond du graphique sans saturer le regard.
Cette dissociation chromatique est fondamentale dans l’élaboration de figures destinées aux revues internationales à comité de lecture. Une palette monochrome savamment dosée, alternant un tracé noir franc et un ruban d’incertitude gris perle, assure une lisibilité absolue y compris lorsque les lecteurs consultent l’article sur des tirages physiques en niveaux de gris, garantissant ainsi l’intégrité de la transmission de l’information statistique.
5.2 Modification de la texture et de la largeur du trait
La distinction visuelle entre plusieurs types d’estimations au sein d’un même repère cartésien ne doit pas reposer exclusivement sur le code couleur. La modification de la texture géométrique du trait, pilotée par l’argument linetype, offre une dimension de différenciation immédiate et robuste. Les options usuelles incluent des styles tels que « solid » (trait continu par défaut), « dashed » (tiret régulier), « dotted » (ligne de points denses), ou encore « longdash » (tirets allongés).
L’attribution d’un style tireté à une ligne de régression permet de signaler intuitivement qu’il s’agit d’une estimation modélisée, abstraite et conjecturale, par opposition à une ligne reliant séquentiellement des mesures physiques observées en série temporelle. Conjointement, le paramètre linewidth (ayant supplanté l’ancien paramètre size dans les versions récentes de ggplot2) permet de calibrer au dixième de point près l’épaisseur physique de la ligne. Une valeur de linewidth = 1.2 confère une présence marquée à la droite sans noyer pour autant les observations individuelles qui transitent à proximité immédiate.
L’ajustement harmonieux de ces attributs géométriques participe activement à la mise en place d’une hiérarchie visuelle efficiente. En réduisant légèrement le diamètre des points du nuage via geom_point(size = 1.5, alpha = 0.4) et en augmentant symétriquement la corpulence de la tendance centrale via linewidth = 1.1, l’analyste guide instinctivement l’attention du récepteur vers le modèle structurel tout en préservant le contexte stochastique des variations locales.
5.3 Gestion de la transparence pour éviter la sursaturation
L’un des écueils majeurs lors de l’adjonction d’une enveloppe de confiance est l’oblitération des données primaires situées au centre du nuage de dispersion. Si le polygone d’incertitude est rendu de manière complètement opaque (alpha = 1), les observations empiriques qui s’écartent faiblement de la moyenne deviennent totalement invisibles, faussant radicalement l’évaluation visuelle de la concentration des résidus.
La régulation fine du canal de transparence s’opère par l’argument alpha inséré directement dans geom_smooth(). Cette valeur scalaire s’étend sur une échelle normalisée de 0 (transparence intégrale, invisibilité absolue) à 1 (opacité totale et imperméable). L’expérience pratique de la publication scientifique montre qu’une valeur comprise entre alpha = 0.15 et alpha = 0.25 constitue un équilibre optimal. Ce réglage confère au ruban d’incertitude la consistance d’un voile léger qui délimite sans équivoque la zone de plausibilité statistique tout en laissant transparaître avec une clarté cristalline chaque observation individuelle sous-jacente.
Cet équilibrage de la densité visuelle globale prend une acuité encore supérieure lorsque l’on juxtapose plusieurs régressions sur un même graphique. Grâce à une gestion judicieuse de la transparence alpha, les intersections de rubans d’incertitude multiples se traduisent par des superpositions chromatiques décelables qui informent directement le chercheur sur les zones d’indécidabilité expérimentale où les deux cohortes présentent des comportements moyens statistiquement indiscernables.
6. Modélisations non linéaires et lissages locaux alternatifs
6.1 Ajustement non paramétrique via l’algorithme LOESS
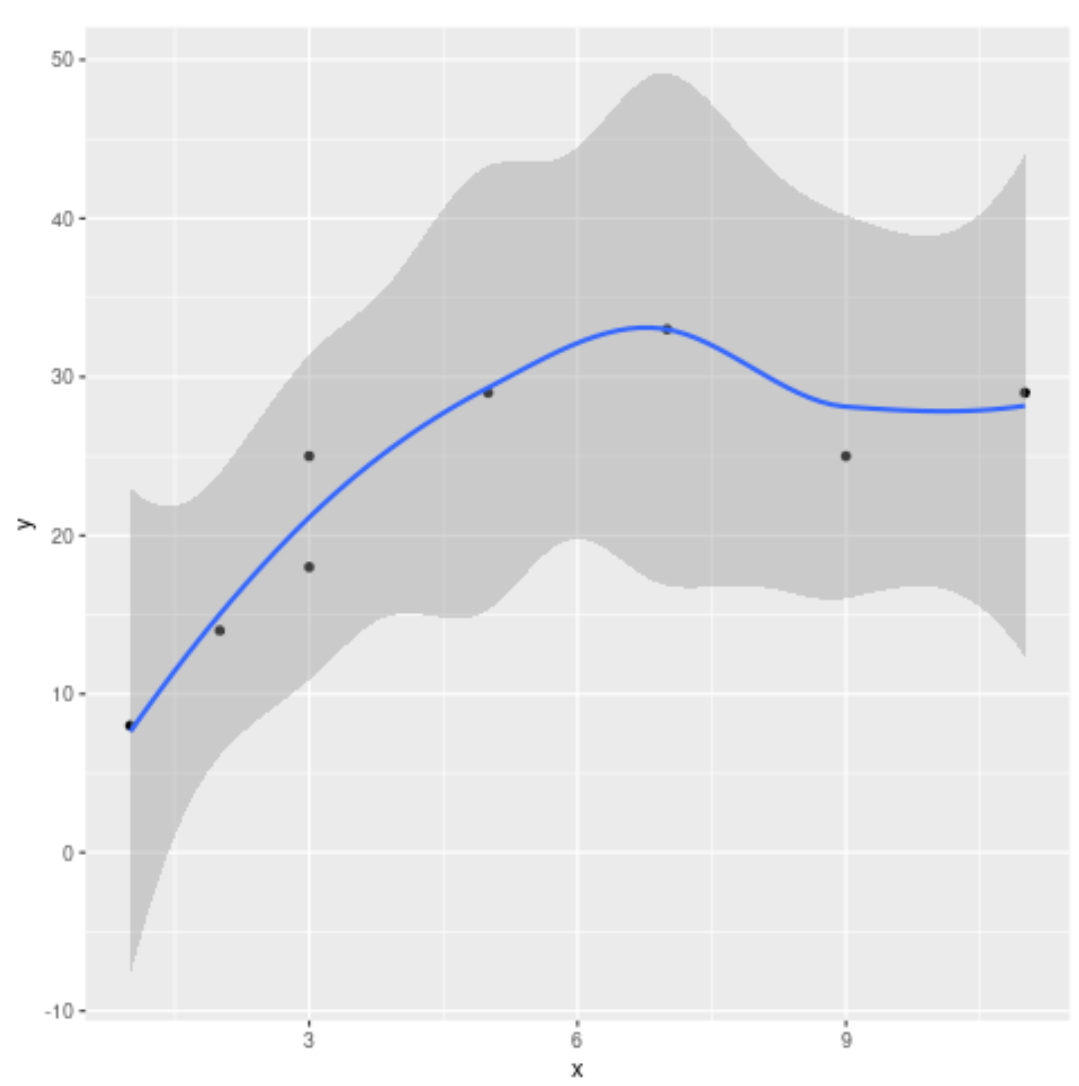
La réalité empirique des phénomènes naturels, sociologiques et biologiques refuse fréquemment de se plier à la contrainte rectiligne d’une droite de régression linéaire classique. L’algorithme LOESS (Locally Estimated Scatterplot Smoothing) constitue le standard de référence pour l’analyse exploratoire non supervisée de ces trajectoires complexes. Au lieu de contraindre l’ensemble des données dans un moule paramétrique global unique, LOESS ajuste une succession de modèles polynomiaux pondérés de bas degré sur des fenêtres locales glissantes le long du gradient de la variable indépendante.
Pour instancier explicitement ce mode de lissage, le chercheur stipule method = « loess » au sein de geom_smooth(). L’élément clé qui pilote le comportement mathématique de cette estimation réside dans l’argument span. Ce paramètre, compris théoriquement entre 0 et 1, définit la proportion de données du voisinage local employée pour calibrer chaque ajustement polynomial ponctuel. Une valeur de span resserrée (par exemple 0.25) octroie une immense liberté d’adaptation à la courbe, lui permettant de réagir vivement à chaque inflexion locale du nuage de points, au risque toutefois de surajuster le bruit stochastique (overfitting).
À l’inverse, une valeur de span élevée (telle que 0.85 ou 0.95) impose une régularisation sévère qui lisse impitoyablement les fluctuations locales mineures pour ne restituer que la courbure macroscopique fondamentale. Dans la recherche exploratoire, le statisticien alterne méthodiquement différentes calibrations du span pour évaluer la persistance des points d’inflexion : une structure ondulatoire qui subsiste sous un span élargi reflète généralement une véritable propriété déterministe du système, tandis qu’une ondulation éphémère qui disparaît immédiatement trahit une fluctuation d’échantillonnage aléatoire.
6.2 Intégration de termes polynomiaux dans la formule de régression
Lorsqu’une théorie scientifique prédit explicitement une relation non linéaire spécifique (par exemple une loi de décélération quadratique ou une dynamique de croissance cubique avec saturation intermédiaire), il est méthodologiquement préférable de conserver l’architecture rigoureuse du modèle linéaire ordinaire tout en enrichissant son espace fonctionnel au moyen d’un polynôme d’ordre supérieur. Cette opération se réalise au sein de geom_smooth() en combinant method = « lm » et l’argument explicite formula.
Par défaut, la relation fonctionnelle implicitement estimée par l’algorithme correspond à l’expression formula = y ~ x. Pour capturer une courbure parabolique sans abandonner le cadre paramétrique des moindres carrés, il suffit de reformuler cette syntaxe sous la forme formula = y ~ poly(x, degree = 2). La fonction native poly() génère alors des polynômes orthogonaux le long de la variable prédictive, ce qui permet d’éviter l’instabilité numérique associée à la colinéarité artificielle des puissances directes de x. Pour une dynamique à double inflexion, le degré peut être élevé à degree = 3.
Il convient néanmoins de manier l’ordre polynomial avec une circonspection méthodologique aiguë. L’accroissement inconsidéré des degrés polynomiaux (par exemple un degré 5 ou 6) engendre presque inévitablement le tristement célèbre phénomène de Runge, caractérisé par des oscillations anarchiques de l’estimateur aux extrémités du domaine expérimental. La formulation polynomiale doit donc toujours demeurer adossée à une rationalité théorique préexistante et être préférée à des approches splines adaptatives uniquement lorsque les coefficients du polynôme possèdent une interprétation physique concrète.
6.3 Modèles additifs généralisés (GAM)
Pour les bases de données massives (comprenant des dizaines de milliers ou des millions de relevés) ou pour les relations morphologiques hautement complexes dont aucune équation analytique simple ne peut rendre compte, les modèles additifs généralisés (Generalized Additive Models, GAM) représentent le compromis absolu entre puissance paramétrique et flexibilité adaptative. L’écosystème ggplot2 intègre une connexion native avec le célèbre moteur algorithmique du package mgcv en invoquant method = « gam ».
Dans cette configuration, l’ajustement s’appuie généralement sur une formule intégrant des fonctions splines pénalisées, telle que formula = y ~ s(x, bs = « cs »). La lettre s symbolise l’opérateur de lissage spline, tandis que bs = « cs » instancie une spline cubique de régression avec pénalisation de courbure. Le grand triomphe mathématique des modèles GAM réside dans leur capacité à déterminer de manière autonome et objective le degré optimal de courbure par validation croisée généralisée (GCV) ou par estimation du maximum de vraisemblance restreint (REML). L’algorithme arbitre lui-même le compromis entre fidélité aux données et régularité du tracé, éliminant l’arbitraire humain associé au calibrage manuel du paramètre span du LOESS.
L’utilisation de method = « gam » devient d’ailleurs la recommandation par défaut opérée automatiquement par ggplot2 dès lors que le nombre total d’observations dépasse le seuil critique de 1 000 points. Cette transition logicielle fluide protège l’ordinateur contre l’explosion combinatoire des temps de calcul inhérents au LOESS sur les grands volumes de données, tout en garantissant au chercheur une courbe de tendance lissée mathématiquement irréprochable et statistiquement défendable.
7. Tracé de tendances stratifiées par groupes catégoriels
7.1 Conditionnement esthétique par couleur et forme
L’analyse empirique s’intéresse rarement à des populations entièrement homogènes. Dans la quasi-totalité des dispositifs expérimentaux, les sujets ou les échantillons sont partitionnés selon des facteurs qualitatifs précis : groupes de traitement versus placebo, cohortes démographiques, souches génétiques ou zones géographiques distinctes. L’incorporation de cette dimension catégorielle au cœur de l’analyse visuelle de tendance constitue l’une des prouesses conceptuelles les plus élégantes de ggplot2.
En assignant une variable factorielle à l’esthétique générale de couleur ou de forme au sein de l’instruction d’initialisation, comme par exemple ggplot(donnees_ref, aes(x = temps, y = biomarqueur, color = groupe)), la grammaire graphique partitionne automatiquement l’ensemble du pipeline computationnel. Non seulement geom_point() génère des points dotés de teintes distinctes pour chaque modalité, mais geom_smooth() exécute de manière totalement autonome autant de régressions statistiques indépendantes qu’il existe de sous-groupes discrets au sein de la variable catégorielle.
Cette stratification automatisée produit une lecture comparative instantanée : chaque groupe se voit doté de sa propre droite de régression et de son propre ruban d’incertitude chromatique, tandis qu’une légende descriptive standardisée est injectée sur la marge droite du panneau. Le statisticien peut ainsi évaluer d’un seul coup d’œil si les trajectoires évolutives des différents groupes partagent des caractéristiques similaires ou si elles divergent substantiellement sous l’effet des conditions expérimentales spécifiques.
7.2 Désolidarisation des esthétiques globales et locales
Si la partition automatique par groupe s’avère infiniment productive, un cas d’usage scientifique particulièrement fréquent impose une asymétrie de représentation : le chercheur souhaite fréquemment visualiser les points individuels colorés en fonction de leur appartenance catégorielle, tout en superposant une unique tendance linéaire agrégée qui capture la trajectoire moyenne de l’ensemble de la population, transcendant les sous-groupes.
Pour atteindre cette dissociation géométrique, il est nécessaire de comprendre la cascade d’héritage des esthétiques dans ggplot2. Les déclarations logées au sein de ggplot() sont universelles et se transmettent à l’ensemble des couches sous-jacentes, tandis que les esthétiques déclarées localement au sein d’une géométrie spécifique sont strictement circonscrites à cette dernière. Ainsi, en déclarant l’association x et y au niveau global, puis en assignant localement color = groupe au sein de geom_point(), les points se colorent en fonction des catégories sans que geom_smooth() ne soit fragmenté en régressions multiples.
Il devient dès lors possible de pousser l’artifice analytique encore plus loin en superposant simultanément une tendance globale et des tendances locales au sein du même repère. L’instruction syntaxique associera alors une première couche geom_smooth(aes(color = groupe), method = « lm », se = FALSE) pour les dynamiques spécifiques, puis une seconde couche geom_smooth(method = « lm », color = « black », linewidth = 1.5) pour la macro-tendance. Cette confrontation visuelle entre comportements désagrégés et trajectoire globale constitue un instrument de communication scientifique d’une formidable efficacité démonstrative.
7.3 Analyse visuelle des effets d’interaction
D’un point de vue inférentiel, la comparaison graphique de droites de régression stratifiées par groupe constitue l’incarnation spatiale de l’analyse des effets d’interaction dans les modèles linéaires généraux. Lorsque les droites associées aux différents sous-groupes se déploient de manière rigoureusement parallèle le long du gradient expérimental, l’analyste en déduit l’absence d’effet modérateur : l’impact de la variable continue sur la réponse est strictement identique quelle que soit la modalité factorielle considérée.
À l’inverse, dès lors que les segments de régression présentent une divergence angulaire marquée, voire une intersection franche au sein de la plage d’échantillonnage, le graphique apporte l’indice visuel immédiat d’une interaction statistique significative. Une telle configuration démontre que l’ampleur, voire la direction même de la relation dépend étroitement du contexte catégoriel de l’observation. La visualisation permet d’identifier précocement ces phénomènes de croisement (crossovers) dont l’omission dans une modélisation additive classique conduirait à des biais de spécification majeurs.
Toutefois, une précaution méthodologique élémentaire s’impose lors de l’examen de ces pentes stratifiées. Il arrive fréquemment que les sous-groupes expérimentaux soient marqués par des déséquilibres d’effectifs massifs. Un groupe marginal comprenant un faible nombre d’observations manifestera un ruban d’incertitude disproportionnellement évasé et sera susceptible d’afficher une pente instable, hautement sensible aux aléas d’échantillonnage. Le regard critique du chercheur doit constamment confronter l’inclinaison des droites à l’étendue de leurs rubans d’erreur respectifs pour éviter de décréter l’existence d’une interaction physiologique là où ne réside qu’un artifice causé par l’indigence numérique d’une sous-cohorte.
8. Segmentation par facettage graphique
8.1 Multiplication des panneaux avec facet_wrap()
Lorsque la complexité factorielle d’un protocole expérimental augmente, la superposition de multiples droites et rubans d’incertitude sur un plan cartésien unique engendre rapidement une saturation visuelle préjudiciable, souvent qualifiée d’enchevêtrement perceptif. Pour préserver une lisibilité analytique optimale, la grammaire des graphiques propose le principe fondamental du facettage (trellis display), qui consiste à scinder l’espace graphique en une matrice ordonnée de sous-graphiques autonomes partageant la même structure métrique.
La commande canonique facet_wrap() permet de distribuer les sous-échantillons d’une variable catégorielle le long d’un ruban de panneaux séquentiels réorganisés en lignes et colonnes. La syntaxe repose sur une formule univariée explicite, telle que facet_wrap(~ condition_experimentale, ncol = 3). Au sein de chaque facette ainsi individualisée, ggplot2 exécute de manière hermétique le tracé des points empiriques et le calcul de la régression statistique dédiée, préservant ainsi la pureté géométrique de chaque dynamique unitaire.
L’avantage scientifique de cette décomposition en panneaux multiples réside dans la clarté absolue avec laquelle les disparités de comportement peuvent être examinées. En affranchissant les trajectoires individuelles de l’encombrement spatial mutuel, le facettage permet d’inspecter les subtilités locales propres à chaque sous-cohorte sans jamais sacrifier la cohérence de l’échelle d’évaluation globale, condition indispensable à toute comparaison inter-groupes valide.
8.2 Croisement bivarié via facet_grid()
Dans les dispositifs factoriels complets où deux variables qualitatives indépendantes se croisent systématiquement (par exemple, le sexe des sujets croisé avec différentes classes d’âge ou différents protocoles thérapeutiques), la fonction facet_grid() constitue l’outil de partitionnement bidimensionnel par excellence. Sa formulation syntaxique adopte la structure rigoureuse d’une table matricielle : facet_grid(facteur_ligne ~ facteur_colonne).
Cette disposition orthogonale génère une véritable grille analytique dans laquelle chaque cellule matérialise l’interaction spécifique de deux modalités expérimentales. En apposant geom_smooth(method = « lm ») sur cette matrice graphique, l’analyste trace un réseau complet de régressions qui permet de balayer du regard la stabilité des trajectoires d’une ligne à l’autre et d’une colonne à l’autre. On peut ainsi détecter si l’effet de la variable continue s’érode progressivement lorsque l’on progresse dans les strates d’un second facteur modérateur.
L’extrême rigueur structurelle de facet_grid() s’avère particulièrement précieuse dans la rédaction d’articles académiques de synthèse. Elle condense en une planche unique et immédiatement déchiffrable l’équivalent de plusieurs dizaines de tableaux de régression bivariés, transformant une masse ardue de paramètres statistiques en un tableau d’évidences géométriques coordonnées.
8.3 Arbitrage entre échelles fixes et échelles libres
Le comportement par défaut du système de facettage dans ggplot2 impose des échelles spatiales rigoureusement fixes et identiques sur l’intégralité des panneaux (scales = « fixed »). Cette contrainte métrique stricte garantit que la pente physique perçue visuellement par l’observateur correspond rigoureusement à la même valeur algébrique quel que soit le volet examiné. Une pente de quarante-cinq degrés dans le panneau supérieur gauche possède la même portée quantitative qu’une inclinaison similaire dans le panneau inférieur droit.
Il est toutefois possible de libérer cette contrainte en déclarant scales = « free », scales = « free_x » ou scales = « free_y ». L’adoption d’échelles libres permet au moteur graphique d’ajuster automatiquement les limites cartésiennes de chaque panneau à la dispersion locale spécifique des données qui s’y trouvent confinées. Cette flexibilité offre l’avantage évident d’optimiser l’occupation surfacique de chaque facette, éliminant les espaces vides lorsque certaines catégories affichent des valeurs beaucoup plus modestes que d’autres.
Néanmoins, sur le plan méthodologique, la libération des échelles lors de la comparaison de lignes de tendance constitue un piège interprétatif d’une extrême dangerosité. Dès lors que l’axe des ordonnées varie d’un panneau à l’autre, des pentes géométriquement identiques à l’œil peuvent correspondre à des gradients statistiques d’ordres de grandeur radicalement divergents. La prescription académique commande ainsi de conserver impérativement scales = « fixed » chaque fois que l’objectif principal réside dans la comparaison inter-groupes des coefficients d’ajustement, réservant les échelles libres aux situations où seule compte l’analyse morphologique interne de chaque strate indépendamment des autres.
9. Extraction et communication des indicateurs statistiques sous-jacents
9.1 Extraction programmatique des métriques du modèle linéaire
Bien que la commande geom_smooth(method = « lm ») accomplisse l’exploit de calculer et d’afficher instantanément la droite d’ajustement sur le canevas graphique, elle adopte une philosophie de boîte noire visuelle qui n’imprime pas les métriques d’estimation au sein de la console de travail. Pour le statisticien consciencieux, il est indispensable de vérifier la stricte concordance numérique entre l’ajustement visuel restitué par ggplot2 et les résultats formels fournis par le moteur de régression de R.
Cette validation s’effectue en formulant conjointement le modèle sous forme analytique via la fonction fondatrice lm(). En exécutant modele_lineaire <- lm(biomarqueur ~ temps, data = donnees_ref), le chercheur génère un objet d'estimation complet. L'application de la fonction summary() sur cet objet livre alors le trésor d'informations inférentielles canoniques : la valeur exacte de l'ordonnée à l'origine (intercept), le coefficient angulaire précis de la pente, les erreurs-types asymptotiques associées, les statistiques t de Student, la p-valeur bilatérale testant l'hypothèse de nullité, ainsi que le coefficient de détermination R² et sa version ajustée.
Cette double démarche programmatique certifie l’intégrité de la communication scientifique. L’analyste s’assure ainsi que le ruban d’incertitude affiché par la fonction graphique correspond fidèlement aux marges d’erreur matricielles calculées par le modèle formel, éliminant tout risque de discordance numérique entre le texte discursif d’un manuscrit et la figure qui vient en appuyer les conclusions.
9.2 Inclusion d’annotations textuelles scientifiques sur le graphique
Une figure scientifique aboutie doit pouvoir se suffire à elle-même (principe d’auto-suffisance graphique). Le lecteur d’un rapport ou d’une publication ne devrait pas être contraint d’effectuer des allers-retours fastidieux entre le corps de l’article et la planche descriptive pour localiser la valeur de l’équation de la droite ou le niveau de significativité statistique de la relation bivariée observée.
Pour résoudre cette exigence de communication, ggplot2 met à disposition la fonction de placement universelle annotate(). Cette commande permet d’ancrer chirurgicalement des blocs de texte, des segments directionnels ou des rectangles de surbrillance en des coordonnées cartésiennes précises du plan. L’incorporation d’une formule typographique s’exprime typiquement selon la syntaxe suivante : annotate(« text », x = coord_x, y = coord_y, label = « R² = 0.74, p < 0.001", size = 4.5, family = "serif", fontface = "italic").
Pour un rendu mathématique supérieur, conforme aux standards typographiques internationaux, il est particulièrement recommandé d’activer l’évaluation d’expressions formelles en injectant l’argument parse = TRUE. Cette fonctionnalité autorise l’écriture de syntaxes conformes au formalisme plotmath de R, permettant d’afficher des symboles grecs impeccables (tels que beta ou alpha), des indices subordonnés ou des superpositions exponentielles élégantes. L’annotation textuelle transcende ainsi le statut de simple commentaire pour devenir une composante intégrée et rigoureuse du dispositif probatoire graphique.
10. Diagnostic visuel des postulats et robustesse de l’estimation
10.1 Sensibilité de la droite aux observations aberrantes
La régression des moindres carrés ordinaires, sur laquelle repose la méthode method = « lm », est tristement réputée pour son absence totale de robustesse face aux contaminations d’échantillonnage. En raison de la minimisation quadratique des écarts, une unique valeur aberrante (outlier) située à l’extrême périphérie du domaine expérimental exerce un bras de levier (high leverage point) disproportionné sur l’estimation globale, capable à lui seul de faire pivoter dramatiquement la droite de régression et d’inverser artificiellement le signe d’une pente par ailleurs stable.
Le diagnostic visuel de cette vulnérabilité s’avère primordial. Lorsqu’une observation empirique s’écarte verticalement de plusieurs écarts-types de la trajectoire dominante tout en occupant une position horizontale périphérique, l’analyste doit immédiatement soupçonner une distorsion d’ajustement. Ce phénomène se traduit par une droite qui semble littéralement attirée par le point aberrant, délaissant le cœur dense du nuage de points au détriment de la représentativité statistique globale.
L’inspection visuelle des résidus par l’affichage d’un nuage de dispersion conjointement à la droite de tendance permet d’identifier précocement ces observations pathologiques. L’évaluation de l’influence potentielle d’un tel artefact commande alors d’interroger la nature de cette observation : s’agit-il d’une erreur triviale de saisie informatique ou de mesure d’un instrument défectueux (justifiant son exclusion motivée), ou bien de l’expression rare mais authentique d’un phénomène stochastique à queue lourde réclamant une alternative d’estimation plus appropriée ?
10.2 Implémentation de droites de régression robuste
Face à la présence inévitable ou soupçonnée de valeurs extrêmes au sein d’un jeu de données biologiques ou financières, la substitution du modèle linéaire classique par un algorithme de régression linéaire robuste constitue une exigence méthodologique majeure. L’approche M-estimateur, popularisée par Peter Huber, pondère itérativement les observations pour atténuer l’influence des points affichant des résidus massifs, empêchant ainsi la droite de dévier de sa trajectoire structurelle principale.
La mise en œuvre de cette stratégie robuste au sein de ggplot2 s’exécute avec une remarquable fluidité grâce à la compatibilité de geom_smooth() avec des fonctions d’estimation externes. En invoquant la commande method = MASS::rlm (issue de la célèbre bibliothèque MASS), le moteur de lissage remplace l’algorithme des moindres carrés par un processus itératif par moindres carrés repondérés (IRLS). Les points aberrants se voient assigner un poids décroissant à mesure qu’ils s’éloignent de la tendance centrale, garantissant une estimation imperméable aux distorsions marginales.
L’exercice le plus démonstratif consiste à superposer sur un même graphique la droite des moindres carrés ordinaires en style pointillé rouge et la droite robuste issue de rlm en trait continu vert foncé. Cette confrontation visuelle offre au lecteur un témoignage immédiat de la résilience du modèle : si les deux droites coïncident parfaitement, les éventuelles valeurs extrêmes n’exerçaient aucune distorsion critique ; si les deux trajectoires divergent significativement, l’estimation robuste s’impose incontestablement comme la seule référence analytique digne de foi.
11. Finalisation graphique pour la publication scientifique
11.1 Application de thèmes académiques épurés
Le thème par défaut déployé par ggplot2 (theme_grey()), caractérisé par une grille blanche matricée sur un fond gris neutre, a été initialement conceptualisé pour faciliter l’identification des contrastes colorés lors des phases exploratoires rapides. Néanmoins, ce fond grisé s’avère unanimement proscrit au sein des périodiques scientifiques internationaux de premier plan, où la sobriété, l’économie d’encre et la clarté typographique constituent des impératifs éditoriaux non négociables.
Pour hisser une figure au niveau des standards de publication les plus pointilleux, la substitution du thème natif par des fonctions thématiques dédiées s’impose comme une nécessité immédiate. L’appel à theme_classic() élimine d’un trait tout arrière-plan superflu et purge le repère des grilles secondaires pour ne préserver que les axes perpendiculaires fondamentaux x et y munis de leurs graduations fines, restituant l’esthétique intemporelle des figures classiques des grandes revues de sciences de la nature. Pour une approche alternative garantissant un repérage spatial minimal des coordonnées, la fonction theme_bw() offre un cadre rectangulaire épuré sur un fond rigoureusement blanc immaculé.
La personnalisation du thème peut ensuite être poussée vers un niveau d’excellence chirurgical grâce à la fonction englobante theme(). Celle-ci permet d’ajuster individuellement la famille de polices de caractères (par exemple l’utilisation d’une police sans empattement universelle comme Helvetica ou Arial, ou d’une police sérifée pour s’harmoniser avec la typographie du corps de texte), l’épaisseur des traits de graduation, la position de la légende (souvent logée à l’intérieur même du graphique pour optimiser l’occupation surfacique), et les marges périphériques de la figure.
11.2 Personnalisation intégrale des axes et étiquettes
Une rigueur scientifique exemplaire proscrit formellement l’utilisation des dénominations brutes de colonnes informatiques comme étiquettes des axes cartésiens. Des mentions laconiques et elliptiques telles que temps_sec ou conc_biomark_ng_ml trahissent une absence de soin dans la finalisation du travail d’analyse. La fonction d’habillage labs() constitue l’opérateur exclusif de cette régulation descriptive.
Chaque axe doit être pourvu d’un libellé explicite, débutant par une majuscule typographique, décrivant sans ambiguïté la dimension mesurée et mentionnant rigoureusement entre parenthèses ou entre crochets les unités du Système international appropriées (par exemple : labs(x = « Temps d’exposition (heures) », y = « Concentration sérique (ng/mL) »)). Les arguments title et subtitle doivent être réservés aux communications orales ou aux affichages poster, les articles académiques déléguant traditionnellement la contextualisation détaillée de l’expérience à la légende narrative située sous la figure.
En complément, le calibrage précis des coupures et de l’étendue des coordonnées se gère au moyen des fonctions d’échelle telles que scale_x_continuous() et scale_y_continuous(). L’utilisation conjointe des arguments breaks (permettant de définir explicitement l’espacement régulier des graduations majeures) et limits (délimitant la plage visible sans supprimer les données du calcul sous-jacent, à condition de manipuler prudemment l’environnement de coordonnées cartésiennes) assure une lisibilité géométrique absolue et prévient tout tassement arbitraire des graduations marginales.
11.3 Exportation vectorielle haute définition avec ggsave()
La conception d’une figure irréprochable au sein de la session de travail R ne garantit pas automatiquement sa restitution fidèle sur les épreuves finales d’un journal scientifique si l’étape d’exportation graphique n’a pas été méticuleusement configurée. La fonction d’enregistrement native ggsave() constitue le vecteur de déploiement privilégié pour préserver la netteté et l’intégrité sémiotique des tracés.
Il est de règle académique absolue de privilégier les formats vectoriels pérennes, au premier rang desquels figurent le PDF (Portable Document Format) et le SVG (Scalable Vector Graphics). Contrairement aux formats matriciels constitués de pixels discrets, les formats vectoriels codent géométriquement chaque point, segment et polygone sous la forme d’équations mathématiques scalaires. Il en résulte que le tracé de la droite de régression et l’enveloppe de confiance conservent une résolution infinie et une netteté chirurgicale, quel que soit le niveau de grossissement opéré par le lecteur ou les exigences de mise en page de l’éditeur.
Lorsque les exigences éditoriales imposent formellement un rendu matriciel rastérisé (par exemple pour des fichiers de type TIFF ou PNG), l’analyste doit impérativement paramétrer une résolution spatiale minimale de 300 à 600 DPI (dots per inch) via l’argument dpi = 300, tout en stipulant précisément les dimensions physiques de la planche en centimètres ou en pouces (width = 18, height = 12, units = « cm »). Cette rigueur dimensionnelle assure que la taille finale des polices et l’épaisseur proportionnelle des lignes de tendance ne subiront aucune compression destructrice lors de la photocomposition typographique finale.
12. Synthèse critique, écueils interprétatifs et bonnes pratiques
12.1 Pièges fréquents dans l’usage des lignes de tendance
L’apparente simplicité syntaxique avec laquelle ggplot2 permet d’ajouter une ligne de tendance à n’importe quel ensemble d’observations dissimule un piège méthodologique et épistémologique majeur : l’illusion d’intelligibilité causale. L’apparition d’une droite de régression magnifiquement ajustée, affichant un ruban d’incertitude resserré et une inclinaison vertigineuse, ne constitue en aucun cas la preuve formelle d’un mécanisme de causalité déterministe reliant la variable d’abscisse à celle d’ordonnée. La confusion proverbiale entre corrélation empirique et relation de cause à effet demeure le premier écueil guettant le chercheur inattentif.
Le second péril analytique réside dans l’extrapolation abusive au-delà de la plage observée des valeurs de la variable explicative. La droite tracée par method = « lm » possède une nature mathématique virtuellement infinie ; cependant, projeter mentalement ou graphiquement cette droite en deçà du minimum observé ou au-delà du maximum expérimenté revient à formuler l’hypothèse téméraire que le comportement du système demeure rigoureusement invariant dans des territoires où aucune donnée empirique n’a jamais été collectée. Dans les systèmes biologiques et socio-économiques, les régimes de non-linéarité, les seuils de saturation ou les phénomènes d’effondrement s’activent précisément aux marges des domaines explorés, rendant toute extrapolation linéaire caduque et potentiellement trompeuse.
Enfin, l’imposition aveugle d’une trajectoire monotone ou linéaire sur des distributions intrinsèquement cycliques, discontinues ou bifurcatives relève d’une erreur d’homogénéisation statistique majeure. Le statisticien consciencieux doit constamment garder en mémoire le célèbre quartet d’Anscombe, rappelant que des distributions aux structures géométriques radicalement dissemblables peuvent générer des droites de régression, des coefficients directeurs et des valeurs de R² strictement indiscernables. L’inspection attentive du nuage de points et des résidus doit donc systématiquement primer sur la fascination pour la régularité de la droite.
12.2 Directives déontologiques pour la visualisation de données de recherche
La pratique contemporaine de la recherche quantitative exige une adhésion inébranlable aux principes de reproductibilité computationnelle et de transparence déontologique. Pour répondre à ces exigences, toute visualisation intégrant une ligne de tendance doit impérativement s’accompagner d’une divulgation sans réserve de la dispersion des données sous-jacentes. Dissimuler le nuage de points pour ne donner à voir que la droite d’ajustement constitue une faute sémiotique grave, privant la communauté scientifique de son droit légitime à évaluer par elle-même l’adéquation du modèle aux observations empiriques.
Une bonne pratique recommandée consiste à enrichir la figure de distributions marginales projetées sur les bordures des axes (via des diagrammes de densité ou des boîtes à moustaches annexes), permettant ainsi au récepteur d’évaluer conjointement la densité univariée de chaque variable et la structure bivariée de leur relation. De plus, la documentation explicite du code R source ayant présidé à la génération de la figure (incluant la fixation de la graine pseudo-aléatoire via set.seed() lors de procédures de sous-échantillonnage ou de simulations) garantit que l’expérience graphique pourra être réitérée et auditée de manière totalement indépendante.
En conclusion de ce panorama méthodologique, nous proposons une grille de vérification synthétique destinée à guider le praticien avant la finalisation de tout livrable scientifique :
- Pertinence fonctionnelle : Le choix entre régression linéaire simple, modélisation polynomiale, algorithme LOESS ou modèle GAM est-il justifié à la fois par la morphologie empirique des résidus et par les postulats théoriques de la discipline ?
- Explicitation de l’incertitude : Le ruban de confiance d’erreur standard est-il maintenu, documenté quant à son seuil probabiliste (généralement 95 %), et sa transparence alpha est-elle calibrée pour ne pas occulter les mesures empiriques directes ?
- Contrôle de la sensibilité : La pente de la droite a-t-elle été immunisée contre l’effet destructeur d’éventuels points aberrants à fort effet de levier, au besoin en recourant à une estimation linéaire robuste (rlm) ?
- Sobriété sémiotique et accessibilité : Le thème graphique adopté est-il épuré, exempt d’artéfacts visuels encombrants, doté d’étiquettes d’axes métrologiquement complètes avec unités formelles, et déployé selon des palettes chromatiques compatibles avec le daltonisme et l’impression monochrome ?
- Pérennité vectorielle : L’exportation finale a-t-elle été opérée selon des formats vectoriels haute définition (PDF, SVG) ou dans une résolution matricielle minimale de 300 DPI garantissant l’intégrité visuelle lors de la diffusion savante ?
En observant scrupuleusement ces canons techniques et théoriques, l’analyste de données élève le tracé d’une ligne de tendance dans ggplot2 d’une simple manipulation logicielle à un acte authentique de communication et d’intégrité scientifique, alliant l’éloquence de l’art graphique à l’inflexible rigueur de la preuve mathématique.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cleveland, W. S. (1979). Robust locally weighted regression and scatterplot smoothing. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279