
L’analyse exploratoire et l’inférence statistique dans les sciences empiriques modernes reposent de façon prépondérante sur l’évaluation de la forme distributionnelle des variables quantitatives. Dans le champ de la recherche contemporaine, la distribution normale — ou loi gaussienne de Laplace-Gauss — occupe une place épistémologique et méthodologique centrale. Qu’il s’agisse de modéliser des caractéristiques biométriques, des traits psychométriques sous-jacents ou les résidus d’un modèle linéaire généralisé, la compréhension de la dispersion des observations autour de leur tendance centrale constitue le premier jalon indispensable à toute modélisation quantitative valide. La mauvaise appréciation d’une non-normalité peut en effet induire des biais systématiques dans l’estimation des paramètres, compromettre la puissance statistique des tests d’hypothèse et mener à des inférences erronées.
Face aux exigences croissantes de reproductibilité et de rigueur formelle imposées par l’évaluation par les pairs, la visualisation graphique des données ne se résume plus à une simple étape descriptive préliminaire. Elle constitue un puissant outil diagnostique capable de révéler des singularités structurelles que les seuls indicateurs d’asymétrie ou d’aplatissement échouent souvent à isoler. L’écosystème scientifique du langage Python s’est imposé comme une référence internationale pour relever ce défi. Au sein de cet environnement, la bibliothèque Seaborn, conçue sur les fondations robustes de Matplotlib, propose une architecture de haut niveau spécifiquement orientée vers la cartographie statistique et la représentation probabiliste des données complexes.
L’objectif de cet article est de fournir un guide méthodologique et technique exhaustif dédié à la représentation graphique rigoureuse de la distribution normale à l’aide de Seaborn. À travers une progression détaillée reliant les fondements mathématiques de la densité gaussienne aux techniques computationnelles les plus avancées, nous examinerons comment générer des histogrammes optimisés, ajuster des estimations de densité par noyau non paramétriques, superposer des densités théoriques exactes et mener des diagnostics visuels approfondis conformes aux normes de publication scientifique les plus strictes.
1. Fondements théoriques de la distribution normale et visualisation avec Seaborn
1.1 Définition mathématique et propriétés de la loi gaussienne
La distribution normale univariée, historiquement formalisée par Carl Friedrich Gauss et Pierre-Simon de Laplace, constitue la distribution de probabilité continue la plus universellement exploitée en théorie statistique. Mathématiquement, une variable aléatoire continue X suit une loi normale d’espérance μ (représentant la moyenne de la population) et de variance σ2 (le carré de l’écart-type σ, avec σ > 0), ce que l’on note conventionnellement X ~ N(μ, σ2). Sa fonction de densité de probabilité, notée f(x), est définie sur l’ensemble des réels par l’expression analytique suivante :
f(x) = (1 / (σ √(2π))) × exp(- (x – μ)2 / (2σ2))
Dans cette formulation, le paramètre μ localise le centre géométrique de la distribution, qui correspond simultanément à sa moyenne, sa médiane et son mode en raison de la parfaite symétrie axiale par rapport à la droite x = μ. Le paramètre σ régit la dispersion, dictant l’écartement des deux points d’inflexion situés exactement à μ – σ et μ + σ. En ces points précis, la dérivée seconde de la fonction s’annule, marquant la transition entre la concavité centrale et la convexité des queues de distribution.
L’omniprésence empirique de cette loi s’explique théoriquement par le théorème central limite. Ce théorème fondamental stipule que la somme (ou la moyenne arithmétique standardisée) d’un nombre élevé de variables aléatoires indépendantes et identiquement distribuées, dotées d’une variance finie, converge en loi vers une distribution normale standard, indépendamment de la forme de la distribution d’origine des variables sous-jacentes. En sciences expérimentales, toute mesure observable résultant d’une multitude d’influences infinitésimales et additives tendra ainsi naturellement vers un profil gaussien.
Sur le plan des moments d’ordre supérieur, la loi normale présente une valeur d’asymétrie (ou skewness de Fisher) rigoureusement égale à zéro, attestant l’équilibre absolu des déviations positives et négatives. Son coefficient d’aplatissement (ou kurtosis non centrée) est exactement égal à 3, ce qui correspond à un excès de kurtosis nul dans la standardisation de Fisher. Toute déviation observée dans un échantillon empirique par rapport à ces valeurs de référence suggère une non-gaussicité potentielle nécessitant des investigations quantitatives et visuelles minutieuses.
1.2 Importance de la modélisation gaussienne en sciences psychologiques et cognitives
Dans les sciences du comportement, la psychométrie et les neurosciences cognitives, l’hypothèse de normalité constitue l’ancrage structural de la quantification des traits latents. Les instruments de mesure standardisés, à l’image des échelles d’intelligence de Wechsler ou des inventaires de personnalité, sont délibérément étalonnés pour projeter les scores bruts sur des échelles gaussiennes standardisées. Par exemple, le quotient intellectuel est calibré de façon opérationnelle selon une moyenne fixée à 100 et un écart-type de 15 points. Cette conversion postule que la capacité cognitive générale se distribue de manière continue et symétrique au sein de la population générale, structurant les décisions diagnostiques relatives au haut potentiel ou aux déficits intellectuels.
Dans l’investigation des processus chronométriques et des paradigmes de psychophysique, la distribution des temps de réponse pose un défi d’interprétation constant. Bien que les temps de réponse bruts présentent intrinsèquement une forte asymétrie positive due à des contraintes physiologiques incompressibles, les modèles cognitifs décomposent fréquemment ces latences en composantes gaussiennes sous-jacentes via des distributions ex-gaussiennes ou des transformations logarithmiques normalisantes. L’adéquation d’un protocole expérimental repose souvent sur la vérification que les composantes décisionnelles pures se conforment à une dispersion symétrique prédictible.
De surcroît, l’édifice de la modélisation statistique paramétrique — incluant l’analyse de variance univariée et multivariée, les régressions linéaires multiples et la modélisation par équations structurelles — repose de façon critique sur l’hypothèse de normalité des résidus d’échantillonnage. Si les estimateurs des moindres carrés ordinaires demeurent sans biais en cas de violation modérée sous réserve du respect du théorème de Gauss-Markov, la validité des tests de signification (tests F et t) ainsi que l’exactitude des intervalles de confiance calculés sont directement compromises en présence d’anomalies de distribution sévères, particulièrement au sein d’échantillons de taille modeste.
1.3 Rôle de la bibliothèque Seaborn dans l’analyse exploratoire de données
La bibliothèque logicielle Python Seaborn, conçue par Michael Waskom, s’est imposée comme une référence majeure dans l’écosystème de la science des données pour combler le fossé entre la puissance bas niveau de Matplotlib et les impératifs analytiques de la modélisation statistique. Tandis que Matplotlib impose la gestion explicite de chaque élément graphique élémentaire (tracés, axes, délimitations, échelles), Seaborn intègre nativement une couche d’abstraction statistique de haut niveau qui lie directement les structures de données tabulaires (telles que les DataFrames de Pandas) aux principes de la grammaire des graphiques statistiques.
L’architecture moderne de Seaborn se distingue par sa capacité à appréhender les distributions probabilistes comme des entités analytiques complètes et non comme de simples ensembles géométriques de rectangles ou de segments. Les fonctions dédiées aux distributions procèdent de façon automatisée à des opérations computationnelles sophistiquées en coulisses : estimation de densités par noyau avec bandes passantes optimales, calcul adaptatif du découpage d’intervalles de classes selon des estimateurs robustes, et normalisation rigoureuse des surfaces sous les courbes de probabilité.
Pour la recherche quantitative reproductible, Seaborn présente l’avantage déterminant de standardiser les visualisations au moyen d’appels fonctionnels concis, prédictibles et robustes. L’automatisation du calcul des estimations d’incertitude et la cohérence de l’encodage sémantique permettent aux chercheurs de consacrer leur attention intellectuelle à l’interprétation substantielle des données plutôt qu’aux contingences de programmation graphique. Cette efficience computationnelle garantit la traçabilité complète des analyses, de l’échantillonnage brut jusqu’au tracé final destiné à la publication académique.
2. Configuration de l’environnement Python et préparation computationnelle
2.1 Installation et importation des bibliothèques scientifiques nécessaires
L’établissement d’un environnement de calcul rigoureux et reproductible constitue la condition préalable à toute démarche scientifique assistée par ordinateur. L’écosystème Python exploite un ensemble de bibliothèques complémentaires et interdépendantes. Pour mener à bien l’analyse distributionnelle, quatre bibliothèques fondamentales doivent être importées : NumPy pour le calcul matriciel et la génération aléatoire vectorisée, SciPy pour les fonctions de distribution statistique théorique, Matplotlib pour le contrôle typographique et architectural des figures, et Seaborn pour la production des graphiques statistiques de haut niveau.
La gestion stricte des dépendances logicielles s’avère indispensable pour neutraliser tout risque d’obsolescence ou de divergence de comportement entre différentes versions des paquets. L’analyse détaillée des distributions via les fonctions modernes de Seaborn requiert impérativement une version égale ou supérieure à 0.11.0, version marquant l’introduction de l’interface refondue d’exploration distributionnelle (notamment la famille de fonctions articulée autour de displot). L’utilisation d’environnements virtuels isolés (tels que ceux fournis par Conda, venv ou Poetry) garantit le gel précis des métadonnées logicielles associées aux scripts d’analyse.
Dans le cadre de l’exploitation au sein d’environnements interactifs comme JupyterLab, Jupyter Notebook ou les environnements de développement intégrés modernes (Visual Studio Code, PyCharm), la configuration du backend graphique graphique revêt une importance méthodologique critique. L’activation de moteurs de rendu vectoriels interactifs ou l’assignation de contextes de rendu à haute densité de pixels prévient toute pixellisation des éléments fins lors de l’exploration préliminaire, assurant que les artefacts visuels éventuels soient imputables aux propriétés des données et non à des limitations de trame graphique de l’affichage local.
2.2 Contrôle du générateur de nombres pseudo-aléatoires
La génération numérique d’échantillons probabilistes repose sur des algorithmes déterministes désignés sous le terme de générateurs de nombres pseudo-aléatoires. Afin de garantir l’exactitude de la reproductibilité scientifique — principe selon lequel un tiers exécutant le même code computationnel doit obtenir des résultats et des représentations graphiques strictement identiques au pixel près —, le contrôle de l’état initial du générateur pseudo-aléatoire est une étape incontournable.
Historiquement, les utilisateurs de Python recouraient massivement à l’appel de la fonction numpy.random.seed(). Bien qu’efficace, cette méthode ancienne modifiait l’état global partagé de l’interpréteur, introduisant des risques d’interférences collatérales dans des environnements d’exécution complexes ou multi-fils. L’architecture moderne de NumPy privilégie désormais l’instanciation explicite d’un générateur dédié au moyen de l’instruction numpy.random.default_rng(), qui encapsule un algorithme de pointe (par défaut, le générateur de permutations congruentielles PCG64). L’attribution d’un entier fixe comme graine (seed) à cette fonction permet d’isoler hermétiquement le flux stochastique propre à l’expérience computationnelle.
La stochasticité inhérente à l’échantillonnage exerce une influence majeure sur l’apparence des distributions tracées. Pour une même loi normale théorique sous-jacente, deux tirages aléatoires distincts de taille modeste peuvent présenter des asymétries locales ou des variations d’aplatissement purement accidentelles. Documenter scrupuleusement la graine aléatoire permet aux pairs d’inspecter les figures en sachant précisément distinguer les fluctuations aléatoires d’échantillonnage des tendances structurelles modélisées.
2.3 Génération d’échantillons gaussiens à l’aide de NumPy
Une fois le générateur de nombres pseudo-aléatoires initialisé de façon déterministe, la création d’échantillons continus conformes à une distribution gaussienne s’opère par le biais de la méthode normal du générateur. Cette fonction vectorisée requiert trois paramètres essentiels : le paramètre loc qui définit la moyenne théorique (μ), le paramètre scale correspondant à l’écart-type théorique (σ), et le paramètre size qui régit le volume et la dimensionnalité du tableau de données généré.
Pour appréhender l’impact de la taille de l’échantillon sur la convergence graphique vers la forme normale idéale, il est méthodologiquement éclairant de synthétiser des cohortes d’effectifs contrastés, par exemple N = 100, N = 1 000 et N = 10 000 observations. Chez un échantillon de 100 individus — dimension courante dans les expérimentations en psychologie cognitive en laboratoire —, les fluctuations d’échantillonnage produisent fréquemment des profils irréguliers présentant de légères asymétries locales. À mesure que l’effectif s’accroît vers 10 000 sujets, la distribution empirique converge de façon quasiment parfaite vers la courbe théorique continue conformément à la loi forte des grands nombres.
Avant d’engager toute procédure de tracé graphique, il est indispensable de procéder à une validation descriptive systématique du tenseur synthétisé. L’évaluation de la moyenne empirique, de l’écart-type non biaisé, ainsi que des estimateurs d’asymétrie et de kurtosis calculés sur l’échantillon permet de confirmer que les propriétés empiriques de la cohorte virtuelle se situent dans les marges de tolérance stochastique attendues autour des paramètres cibles injectés au générateur.
3. Méthode 1 : Tracer un histogramme de distribution normale avec sns.displot()
3.1 Implémentation de base et syntaxe fondamentale
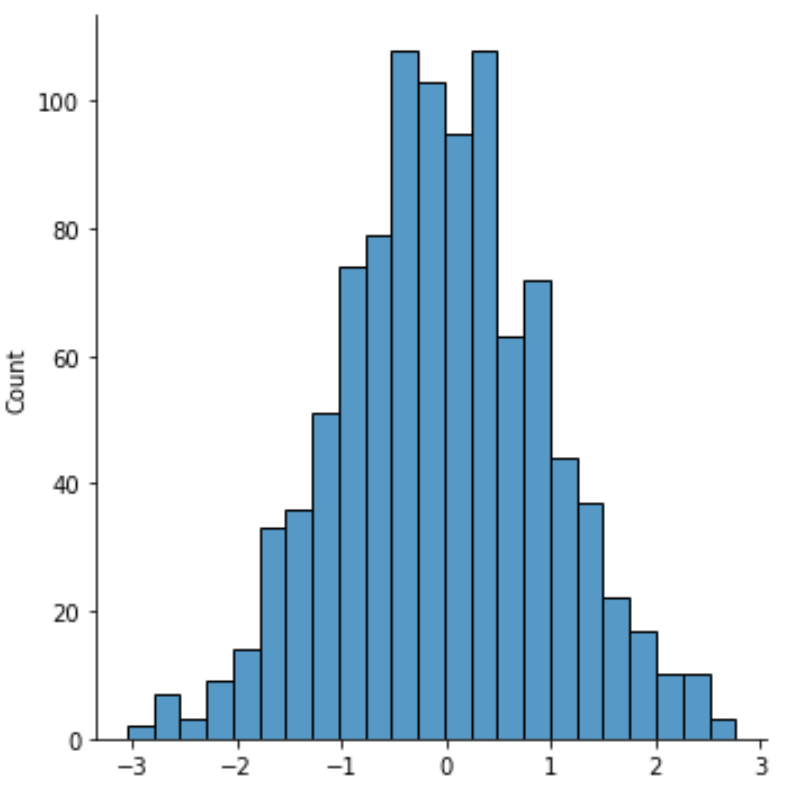
La méthode la plus immédiate et intuitive pour représenter visuellement la distribution d’une variable continue consiste à construire un histogramme. Dans l’écosystème Seaborn contemporain, la fonction sns.displot() constitue la porte d’entrée générale pour l’ensemble des figures dédiées à la visualisation des distributions univariées et bivariées. Appelée sur un vecteur de données unidimensionnel ou sur une colonne spécifique d’un tableau structuré, elle produit par défaut une représentation sous forme d’histogramme de fréquences.
Sur le plan structurel, sns.displot() est une fonction dite de « niveau figure » (figure-level). Contrairement aux fonctions graphiques élémentaires qui dessinent directement sur un objet d’axes existant, cette fonction orchestre l’instanciation autonome d’un conteneur global de classe FacetGrid. Cette classe supervise non seulement le tracé effectif des barres de l’histogramme, mais gère également la totalité des dimensions de la figure, l’allocation des marges, ainsi que le positionnement automatique des étiquettes et des légendes associées.
L’implémentation minimale consiste à passer le vecteur de données au paramètre principal data (ou comme premier argument positionnel). Seaborn procède alors de manière entièrement automatique à l’évaluation de l’étendue des données, à la partition de cette étendue en un ensemble fini d’intervalles contigus disjoints, et au dénombrement précis des observations numériques s’insérant dans chacun de ces intervalles, projetant le résultat sous la forme de barres verticales jointives dont la base correspond aux bornes des classes.
3.2 Optimisation des intervalles de classes (binning)
L’aspect visuel d’un histogramme et sa capacité à refléter fidèlement la symétrie gaussienne dépendent de façon critique du paramètre de découpage en classes, couramment désigné par le terme de binning. Un découpage inadapté peut fausser dramatiquement l’interprétation clinique ou scientifique de la distribution : un nombre excessif d’intervalles induit une hyper-fragmentation de la surface graphique, créant une impression trompeuse de bimodalité ou de bruit haute fréquence ; inversement, un nombre trop restreint de classes engendre un sur-lissage délétère qui dissimule les éventuelles asymétries et tronque les queues de distribution.
La littérature statistique fondamentale a formalisé plusieurs règles heuristiques d’optimisation mathématique du nombre d’intervalles k en fonction de l’effectif N et de la dispersion des observations :
- La règle de Sturges : définie par k = 1 + log2(N). Très répandue dans les logiciels grand public, elle postule implicitement une normalité absolue mais sous-estime systématiquement le nombre de classes optimal dès lors que l’effectif N dépasse quelques centaines d’observations.
- La règle de Scott : qui calibre la largeur optimale des intervalles h selon l’expression h = 3.49 × σ × N-1/3. Cette formulation minimise l’erreur quadratique moyenne intégrée entre l’histogramme et la densité théorique normale sous-jacente.
- La règle de Freedman-Diaconis : fondée sur une approche non paramétrique robuste qui remplace l’écart-type par l’intervalle interquartile (IQR) selon la formule h = 2 × IQR(X) × N-1/3. Elle présente l’avantage décisif d’être totalement insensible à la présence de valeurs aberrantes situées dans les queues extrêmes.
Dans Seaborn, le comportement de ce découpage est paramétrable avec une grande finesse via l’argument bins, qui accepte soit un entier explicite fixant le nombre total de classes, soit une chaîne de caractères spécifiant l’heuristique statistique souhaitée (par exemple bins='fd' pour Freedman-Diaconis). En complément, les paramètres binwidth et binrange permettent de figer manuellement la largeur absolue des intervalles et les bornes géométriques extrêmes de la partition, offrant un contrôle absolu pour l’alignement précis de séries de mesures comparatives.
3.3 Interprétation de l’axe vertical : fréquences versus densités
La nature de la grandeur projetée sur l’axe vertical d’un histogramme conditionne directement la signification mathématique de la figure. Par défaut, la fonction sns.displot() configure l’axe des ordonnées pour afficher le dénombrement brut des occurrences (stat='count'). Si cette modalité s’avère parfaitement intuitive pour apprécier l’effectif absolu d’un groupe expérimental unique, elle souffre d’une limitation majeure : la hauteur des barres dépend intrinsèquement de la taille totale de l’échantillon N et de la largeur choisie pour les intervalles de classes, interdisant toute comparaison visuelle directe entre cohortes d’effectifs inégaux.
Pour surmonter cette restriction méthodologique, Seaborn propose via le paramètre stat d’autres modes de normalisation rigoureux. En configurant stat='density', l’algorithme normalise la hauteur des barres de telle sorte que la somme totale des surfaces de tous les rectangles composant l’histogramme soit exactement égale à l’unité (1). Dès lors, la surface de chaque barre représente la proportion de la population contenue dans l’intervalle correspondant, et la hauteur de la barre devient directement assimilable à une ordonnée de densité de probabilité continue.
Cette normalisation en densité est une exigence mathématique incontournable dès lors que l’on envisage de superposer une courbe continue (telle qu’une fonction de densité théorique ou une estimation par noyau) sur l’histogramme. L’alternative stat='probability' calibre quant à elle la hauteur des rectangles pour que leur somme arithmétique simple vaille 1, ce qui traduit la probabilité discrète associée à chaque intervalle mais modifie la compatibilité d’échelle dimensionnelle lors d’une superposition continue.
4. Méthode 2 : Tracer une courbe d’estimation de densité par noyau (KDE)
4.1 Principe mathématique de l’estimation par noyau
L’estimation de densité par noyau (communément abrégée en KDE pour Kernel Density Estimation) représente l’approche non paramétrique par excellence pour reconstruire la fonction de densité de probabilité continue d’une variable aléatoire à partir d’un échantillon fini de points discrets. Contrairement à l’histogramme, dont le profil dépend de manière arbitraire du choix de l’origine et de la largeur des intervalles de classes, l’estimation par noyau s’affranchit des découpages discontinus pour fournir un profil continûment dérivable.
Le principe fondamental consiste à positionner, au-dessus de chaque observation individuelle xi de l’échantillon, une petite fonction continue symétrique appelée « noyau » (notée K), intégrable à l’unité. L’estimateur de Rosenblatt-Parzen évalue ensuite la densité globale en tout point x de l’espace continu en effectuant la moyenne arithmétique de la somme de tous ces noyaux individuels, selon la formulation mathématique suivante :
f̂h(x) = (1 / (N × h)) × ∑i=1..N K((x – xi) / h)
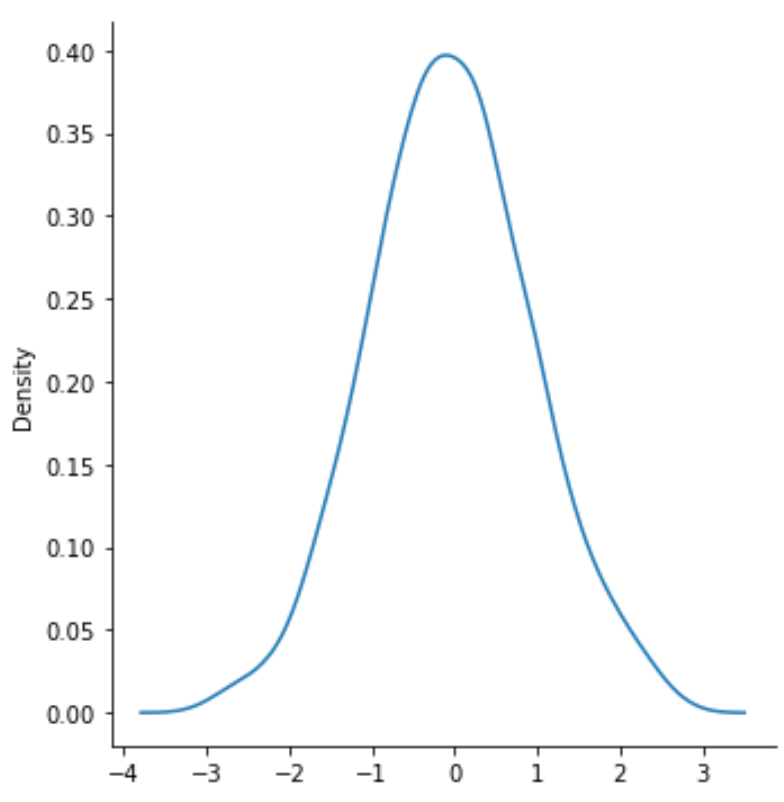
Dans cette équation, h désigne la largeur de bande passante (ou bandwidth), qui joue le rôle de paramètre d’échelle régissant l’étalement de chaque noyau élémentaire. Dans la quasi-totalité des applications pratiques en sciences quantitatives, le noyau K sélectionné est un noyau gaussien standard centré réduit. Dès lors, la densité estimée en tout point résulte d’une superposition harmonieuse de cloches gaussiennes microscopiques centrées sur les points de mesure effectifs, produisant une courbe d’une remarquable fluidité visuelle.
4.2 Application avec sns.displot(x, kind=’kde’)
Pour générer un tracé d’estimation par noyau dans Seaborn sans recourir à l’histogramme intermédiaire, il convient de spécifier l’argument kind='kde' au sein de la fonction sns.displot(). Cette instruction redirige l’exécution computationnelle interne vers les algorithmes d’estimation continue, projetant une courbe unique, lisse et fermée délimitant la densité estimée de la distribution normale sous-jacente.
Le contrôle de la largeur de bande passante h s’opère principalement par le biais du paramètre bw_adjust. Ce coefficient multiplicateur, dont la valeur par défaut est fixée à 1.0, vient moduler l’estimateur de bande passante automatique implémenté (fondé usuellement sur la règle empirique de Silverman ou de Scott). L’ajustement de ce paramètre requiert un discernement méthodologique rigoureux :
- Une valeur de
bw_adjustsubstantiellement inférieure à 1.0 (par exemple 0.3) induit un phénomène de sous-lissage ou de sur-ajustement (overfitting). La courbe s’adapte excessivement aux fluctuations d’échantillonnage locales, générant des ondulations parasites qui miment fallacieusement une multimodalité absente de la population mère. - Une valeur de
bw_adjustnettement supérieure à 1.0 (par exemple 2.5) conduit à un sur-lissage prononcé (underfitting). L’étalement excessif des noyaux écrase le sommet de la distribution normale et gonfle artificiellement l’épaisseur des queues de distribution, masquant d’éventuelles particularités structurelles réelles.
Par ailleurs, Seaborn offre les paramètres cut et clip pour maîtriser le comportement de la courbe aux extrémités du domaine. Le paramètre cut spécifie la distance, mesurée en unités de largeur de bande, au-delà de laquelle la courbe continue ne doit plus être projetée après l’observation extrême. Le paramètre clip permet de verrouiller rigoureusement des frontières physiques ou théoriques absolues (telles qu’un score qui ne peut mathématiquement descendre sous la valeur zéro), empêchant la courbe lissée d’empiéter illicitement sur des domaines de valeurs impossibles.
4.3 Lecture et interprétation des ordonnées de densité
Une erreur d’interprétation fréquente chez les praticiens non statisticiens consiste à assimiler directement l’ordonnée d’une courbe de densité par noyau à une probabilité exacte. Pour une variable aléatoire continue, la probabilité ponctuelle d’observer exactement une valeur infiniment précise P(X = x) est mathématiquement nulle. L’axe vertical f(x) ne quantifie pas une probabilité discrète, mais une densité différentielle de probabilité, exprimée en unités inverses de la variable mesurée (1 / unité de mesure).
La probabilité réelle ne se manifeste géométriquement que sous la forme d’une surface bidimensionnelle sous la courbe. Elle correspond à l’intégrale définie de la fonction de densité calculée entre deux bornes finies a et b :
P(a ≤ X ≤ b) = ∫a..b f(x) dx
Dans l’évaluation visuelle d’une distribution normale, la lecture des ordonnées doit donc s’orienter vers l’appréciation globale des rapports de proportionnalité et de morphologie. La hauteur relative du sommet par rapport à la dispersion latérale constitue un indicateur visuel de la kurtosis (l’aplatissement de la distribution). Une courbe s’élevant très haut avec des flancs étroits traduit un profil leptokurtique (concentré autour de la moyenne), tandis qu’un dôme aplati aux flancs larges signale un comportement platykurtique, s’écartant du standard mésokurtique de la loi normale pure.
5. Méthode 3 : Superposition de l’histogramme et de la courbe KDE avec kde=True
5.1 Mise en œuvre conjointe : sns.displot(x, kde=True)
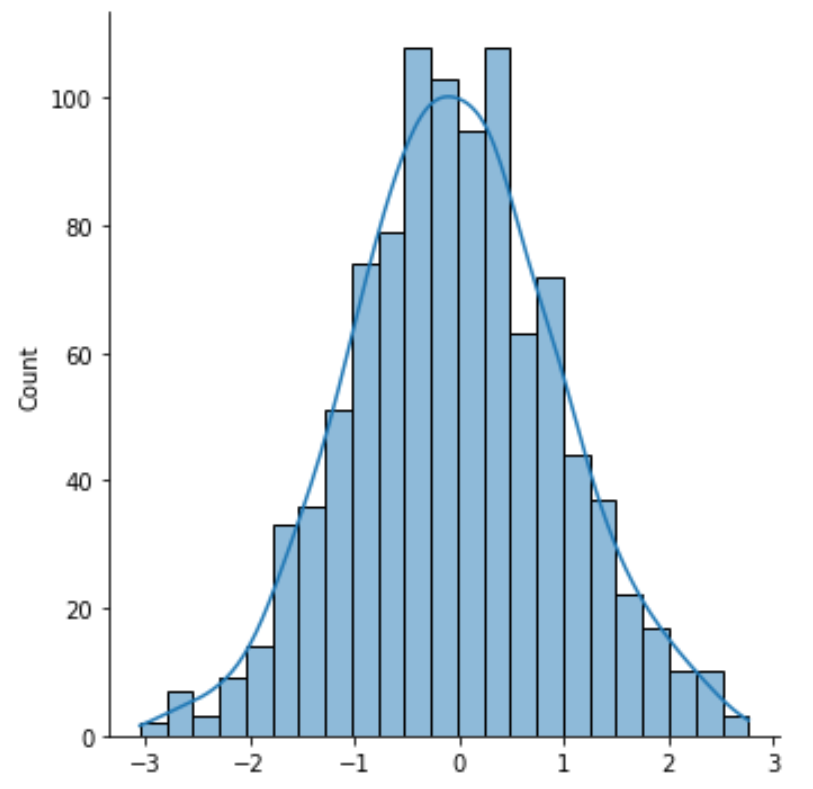
Si l’histogramme et l’estimation par noyau possèdent chacun des vertus descriptives spécifiques, leur combinaison au sein d’une unique représentation graphique offre la synthèse visuelle la plus complète et la plus rigoureuse pour l’exploration d’une distribution normale. Seaborn autorise cette intégration conjointe avec une grande simplicité d’écriture grâce à l’argument booléen kde=True passé à l’appel par défaut de sns.displot().
Lorsque cette option est activée, Seaborn bascule automatiquement le mode de calcul et de projection de l’histogramme vers une échelle normalisée de densité (équivalente à stat='density'). Cette adaptation est mathématiquement indispensable pour assurer la cohérence d’échelle entre les barres polygonales discontinues et la trajectoire de la courbe continue, évitant ainsi toute discordance dimensionnelle d’axes.
Cette représentation hybride permet au chercheur d’effectuer une confrontation optique permanente et immédiate entre l’information brute partitionnée et le modèle lissé sous-jacent. Les déviations locales des barres de l’histogramme par rapport à la courbe continue mettent en exergue les fluctuations stochastiques d’échantillonnage, tout en offrant à l’œil un guide continu pour juger de la symétrie globale et de la régularité du profil gaussien observé.
5.2 Personnalisation des composantes conjointes
La puissance expressive d’un graphique conjointe réside dans la clarté de sa hiérarchie visuelle. Une figure dense où les barres opaques de l’histogramme entreraient en conflit visuel avec la ligne de l’estimateur de densité aboutirait à une surcharge cognitive préjudiciable à la lisibilité. Seaborn permet de paramétrer indépendamment chacune des composantes au sein du même appel graphique.
L’argument kde_kws (pour KDE keywords) accepte un dictionnaire de configurations transmis directement à l’algorithme d’estimation continue. Ce mécanisme permet de stipuler la largeur du tracé (par exemple linewidth=2.5), le style de la ligne (trait continu ou discontinu) ou encore les paramètres de lissage spécifiques évoqués précédemment. Parallèlement, les propriétés intrinsèques des rectangles de l’histogramme se contrôlent via les arguments conventionnels de couleur et de texture : l’application d’un coefficient de transparence alpha (par exemple alpha=0.4) et la spécification de bordures contrastées autour des rectangles délimitent nettement les classes sans masquer le cheminement de la courbe de densité sous-jacente.
Il convient de veiller à maintenir un contraste suffisant entre la teinte de remplissage de l’histogramme et la couleur attribuée au tracé de la KDE. L’utilisation d’une nuance sombre et saturée pour la ligne continue superposée à une trame pastel translucide pour les barres assure une distinction instantanée des deux modes de représentation, favorisant une lecture multiniveau des données.
5.3 Avantages didactiques pour la publication scientifique
Dans le contexte de la communication scientifique et de la diffusion des résultats dans des revues à comité de lecture, la figure combinant histogramme et KDE s’impose désormais comme un standard d’excellence didactique. Ce consensus repose sur une exigence de transparence épistémologique : publier exclusivement une courbe KDE présente le risque de dissimuler le caractère discret ou la rareté effective des données dans certaines régions de l’espace échantillonnal, trompant potentiellement les évaluateurs sur la consistance réelle des effectifs étudiés.
Inversement, soumettre un histogramme isolé expose le lectorat aux artefacts perceptifs liés au découpage contingent des intervalles de classes. En affichant conjointement les barres discrètes normalisées et la ligne d’estimation par noyau, l’auteur fournit simultanément la preuve empirique non déformée de ses observations et le patron théorique continu abstrait qui guide son interprétation analytique.
Cette approche graphique duale permet d’apprécier d’un simple coup d’œil trois dimensions critiques de la normalité : la centralité unimodale (marquée par la coïncidence du sommet de l’histogramme et de l’apogée de la courbe), l’équilibre bilatéral de la dispersion (vérifiable par la décroissance symétrique des barres de part et d’autre de la moyenne), et la finesse asymptotique des queues de distribution, essentielles pour diagnostiquer la présence d’effets de seuil ou de scores aberrants.
6. Distinction essentielle entre fonctions au niveau figure et au niveau axes
6.1 Comprendre l’architecture de Seaborn : Figure-level vs Axes-level
L’un des fondements conceptuels les plus cruciaux pour maîtriser Seaborn réside dans la dichotomie structurelle entre les fonctions opérant au niveau de la figure complète (figure-level functions) et celles agissant directement à l’échelle des axes graphiques individuels (axes-level functions). Une incompréhension de cette distinction technique constitue la source la plus récurrente de dysfonctionnements lors de l’intégration de graphiques de distribution au sein de compositions multi-panneaux complexes.
La fonction sns.displot() appartient sans équivoque à la catégorie des fonctions au niveau figure. Lors de son exécution, elle ne se contente pas de dessiner sur un axe existant : elle prend le contrôle de l’ensemble de l’objet graphique, instancie en son sein un objet de classe FacetGrid issu de Matplotlib, et organise de façon centralisée l’allocation spatiale, le découpage en facettes éventuel selon des variables catégorielles, ainsi que les marges périphériques. À l’opposé, les fonctions spécialisées telles que sns.histplot() et sns.kdeplot() sont des fonctions au niveau axes. Elles se comportent comme des opérateurs de bas niveau conçus pour tracer exclusivement leurs éléments géométriques au sein d’un objet matplotlib.axes.Axes spécifiquement désigné.
Cette divergence architecturale implique des modalités de manipulation logicielle radicalement différenciées :
- Les fonctions de niveau figure (
displot) créent et encapsulent leur propre canevas, ce qui restreint leur intégration directe dans des structures de sous-graphiques arbitraires préexistantes, mais offre une gestion élégante des grilles multi-conditions via des arguments déclaratifs commecolourow. - Les fonctions de niveau axes (
histplot,kdeplot) s’insèrent naturellement dans n’importe quel maillage géométrique conçu préalablement via Matplotlib, acceptant explicitement une cible de tracé par le paramètreax.
6.2 Intégration dans des sous-graphiques Matplotlib (plt.subplots)
Dans la rédaction d’un manuscrit scientifique de haut niveau, il est d’usage courant de regrouper plusieurs visualisations au sein d’une figure composite à panneaux multiples (par exemple, confronter côte à côte la distribution des scores cognitifs avant et après une intervention clinique). Pour concrétiser cette disposition avec une liberté totale d’agencement, il est impératif d’utiliser les fonctions au niveau axes en conjonction avec la méthode matplotlib.pyplot.subplots().
Dans ce paradigme de développement, le chercheur commence par instancier une matrice de sous-graphiques en définissant le nombre de lignes et de colonnes souhaité, ce qui génère une figure globale et un tableau d’objets d’axes Matplotlib. Ensuite, lors de l’invocation des fonctions Seaborn — telles que sns.histplot() ou sns.kdeplot() —, il convient d’assigner l’identifiant de l’axe cible via le paramètre ax=axes[i]. Cette approche garantit une intégration chirurgicale, chaque composante distributionnelle venant se loger précisément dans l’espace alloué sans perturber les panneaux adjacents.
Tenter de forcer l’argument ax au sein d’une fonction de niveau figure comme sns.displot() constitue une erreur d’architecture logicielle : displot ignore traditionnellement ce paramètre ou lève une exception formelle, car sa vocation première est d’engendrer sa propre grille plutôt que de s’inféoder à un conteneur externe. La règle empirique consiste donc à réserver displot pour des visualisations autonomes ou des facettages simples, et à recourir au tandem histplot/kdeplot couplé à plt.subplots() dès lors qu’un contrôle topologique rigoureux est requis.
6.3 Contrôle dimensionnel et résolution d’exportation
La standardisation des figures destinées aux périodiques académiques impose un contrôle millimétrique des dimensions spatiales et une netteté de tracé irréprochable. L’ajustement géométrique des tracés s’opère selon des logiques différentes selon que l’on manipule une figure autonome générée par sns.displot() ou une construction personnalisée basée sur Matplotlib.
Pour la fonction sns.displot(), le dimensionnement ne se définit pas par la largeur et la hauteur absolues de la figure, mais par les paramètres coordonnés height et aspect. Le paramètre height stipule la hauteur verticale de chaque facette individuelle en pouces (inches), tandis que le paramètre aspect définit le rapport largeur/hauteur (ratio géométrique). Ainsi, la configuration height=5, aspect=1.3 produit un panneau unique d’une hauteur de 5 pouces et d’une largeur effective de 6,5 pouces. Cette approche garantit la préservation rigoureuse des proportions géométriques, quel que soit le nombre ultérieur de facettes adjointes.
En matière d’exportation numérique, la densité de points par pouce (DPI pour dots per inch) régit la résolution spatiale finale de l’image matricielle. Les standards internationaux des éditeurs scientifiques (tels que l’APA, Elsevier ou Springer) exigent une résolution minimale de 300 DPI pour les rendus en demi-teinte et jusqu’à 600 ou 1 200 DPI pour les tracés au trait pur. Lors de l’appel final à plt.savefig(), la spécification d’un DPI élevé couplée à l’argument bbox_inches='tight' garantit l’élimination automatique des marges résiduelles superflues et prévient tout rognage accidentel des légendes ou des titres d’axes mathématiques.
7. Superposition de la distribution normale théorique idéale sur des données empiriques
7.1 Calcul analytique de la densité gaussienne théorique
L’estimation non paramétrique par noyau (KDE), bien qu’extrêmement informative, présente l’inconvénient inhérent de s’adapter aux données observées sans fournir de référence normative absolue quant à ce que devrait être une loi normale parfaite. Pour apprécier rigoureusement le degré d’adéquation d’un échantillon empirique à la loi gaussienne, la démarche méthodologique la plus formelle consiste à superposer sur l’histogramme empirique la courbe analytique exacte de la densité de probabilité normale théorique, calculée à partir des paramètres estimés sur l’échantillon.
Cette modélisation analytique requiert deux étapes statistiques successives :
- L’estimation non biaisée des paramètres d’état : à partir du tableau d’observations empiriques, on calcule la moyenne arithmétique de l’échantillon (qui sert d’estimateur du paramètre μ) ainsi que l’écart-type d’échantillon corrigé avec N – 1 degrés de liberté (servant d’estimateur sans biais du paramètre σ).
- La génération d’une grille continue de coordonnées d’évaluation : on instancie un vecteur d’abscisses linéaire dense et uniformément espacé (via
numpy.linspace()), couvrant l’ensemble de l’étendue des données observées depuis μ – 4σ jusqu’à μ + 4σ.
Chaque point de ce vecteur d’abscisses est ensuite évalué analytiquement en appliquant la fonction de densité de probabilité gaussienne exacte, implémentée de manière hautement optimisée au sein du module statistique de SciPy via la fonction scipy.stats.norm.pdf(). Contrairement à la KDE qui résulte d’une sommation d’artéfacts locaux d’échantillonnage, la courbe ainsi obtenue représente la projection mathématique parfaite de la loi normale théorique possédant la même moyenne et la même variance que les données empiriques recueillies.
7.2 Tracé simultané sur le graphique Seaborn
La matérialisation visuelle de cette confrontation théorique s’effectue en associant la puissance descriptive de Seaborn pour l’histogramme normalisé et la précision de Matplotlib pour le tracé de la fonction théorique. Après avoir généré l’histogramme de densité via sns.histplot(data, stat='density'), la courbe théorique calculée est projetée directement sur le même axe graphique au moyen d’un appel standard à plt.plot().
Pour conférer à la figure une lisibilité diagnostique immédiate, il est méthodologiquement recommandé d’attribuer une identité visuelle distincte et contrastée à chacune des deux entités graphiques. La courbe théorique peut par exemple être habillée d’une teinte chromatique tranchant avec la palette générale (telle qu’un rouge carmin ou un noir profond face à des barres d’histogramme gris bleuté), assortie d’un tracé discontinu en tirets d’épaisseur suffisante (linestyle='--', linewidth=2).
La finalisation rigoureuse de la figure requiert la mise en place d’une légende explicite et non ambiguë. Chaque tracé doit comporter une étiquette sémantique formelle : l’histogramme désigné sous la mention « Densité empirique observée » et la courbe continue comme « Densité normale théorique N(μ̂, σ̂2) ». Cette séparation visuelle nette permet au lecteur d’évaluer instantanément les régions où les observations réelles épousent le modèle théorique et celles où se manifestent des distorsions empiriques tangibles.
7.3 Quantification de l’adéquation visuelle
L’inspection optique de la courbe théorique projetée sur l’histogramme d’échantillonnage autorise un diagnostic qualitatif de l’adéquation distributionnelle particulièrement sensible. Ce processus d’examen visuel s’articule autour de trois foyers d’observation prioritaires :
- Le diagnostic de la symétrie centrale : un décalage horizontal systématique entre le sommet de la courbe théorique (l’espérance estimée) et le barycentre des barres de plus forte fréquence signale la présence d’une asymétrie empirique. Si les barres s’étirent de façon démesurée vers les valeurs positives au détriment des fréquences centrales, on conclut à une asymétrie positive (right-skewed) caractéristique, par exemple, des scores d’anxiété au sein d’une cohorte non clinique.
- L’évaluation de la dispersion et de l’aplatissement (kurtosis) : si l’histogramme empirique dépasse verticalement la pointe du dôme théorique tout en affichant un déficit systématique d’observations dans les régions médianes (flancs), la distribution est leptokurtique. À l’inverse, un histogramme plus large et écrasé que la courbe théorique reflète un profil platykurtique.
- L’inspection des queues de distribution (fat tails) : la persistance de barres de fréquences au-delà des zones où la courbe théorique s’annule virtuellement (généralement au-delà de 3 écarts-types) met en lumière des phénomènes de sur-dispersion ou la présence d’observations aberrantes potentielles susceptibles de fausser les estimateurs paramétriques ultérieurs.
Cette inspection morphologique constitue le préalable heuristique indispensable à toute démarche d’inférence formelle. Elle guide le chercheur dans le choix des tests d’adéquation statistiques appropriés et prévient les erreurs de diagnostic aveugle souvent induites par une application machinale des seuils de p-valeurs.
8. Personnalisation esthétique et respect des standards graphiques académiques
8.1 Configuration des styles et contextes Seaborn pour les publications
La publication scientifique obéit à des normes d’ergonomie cognitive exigeantes. Une visualisation de données efficace doit éliminer toute charge visuelle superflue (ce qu’Edward Tufte désigne sous le concept d’encre inutile ou chartjunk) pour focaliser l’attention du lecteur exclusivement sur le signal statistique d’intérêt. Seaborn propose un système global de gestion thématique particulièrement adapté à ces contraintes institutionnelles.
Le contrôle de l’arrière-plan s’opère par l’instruction sns.set_theme() en sélectionnant le style style='ticks' ou style='whitegrid'. Dans la majorité des éditeurs scientifiques internationaux, le style sur fond blanc pur avec marques de graduation externes (ticks) est rigoureusement privilégié, car il évite les trames grises d’arrière-plan susceptibles d’altérer la lisibilité lors d’impressions papier en noir et blanc. En conjonction avec ce style, la fonction sns.despine() permet de supprimer de façon automatisée les bordures supérieures et droites du cadre graphique, allégeant instantanément l’architecture visuelle sans perte d’information géométrique.
Le calibrage de l’échelle typographique et de l’épaisseur relative des tracés s’ajuste quant à lui au moyen du paramètre de contexte : sns.set_context('paper'). Cette configuration prédéfinie réduit proportionnellement la taille des polices de caractères, l’épaisseur des axes et le calibre des marques de graduation pour les adapter précisément au ratio d’échelle standard des colonnes d’articles académiques, garantissant que les étiquettes ne paraissent ni disproportionnées ni illisibles une fois la figure insérée dans la mise en page finale de la revue.
8.2 Typographie, étiquetage rigoureux et notation mathématique
L’une des signatures de l’excellence académique réside dans la précision terminologique des étiquetages et la conformité des annotations aux standards formels de l’édition scientifique. Un graphique dont les axes affichent le nom brut des variables informatiques (par exemple var_score_t1) contrevient aux principes de lisibilité universelle et dégrade la portée scientifique du document.
L’intégration de la bibliothèque Matplotlib sous-jacente permet à Seaborn d’interpréter directement les expressions typographiques formattées en LaTeX. Ainsi, les axes et les légendes peuvent arborer des notations mathématiques conventionnelles parfaites : les paramètres peuvent être explicitement désignés par leurs symboles grecs respectifs μ et σ, et les estimations indiquées par leurs coiffes normatives (μ̂ et σ̂). Les axes des abscisses doivent systématiquement préciser le nom complet du concept mesuré suivi de son unité de mesure explicite entre parenthèses, tandis que l’axe des ordonnées doit formellement stipuler s’il s’agit d’une fréquence absolue, d’une proportion relative ou d’une densité de probabilité.
L’adjonction d’annotations textuelles ciblées au sein même de l’espace graphique enrichit considérablement la portée didactique de la figure. Par le truchement de la fonction plt.axvline(), il est judicieux de matérialiser la position exacte de la moyenne par une fine ligne verticale ponctuée, accompagnée d’un texte d’annotation indiquant la valeur numérique précise ainsi que la taille totale de l’échantillon N. Ces repères visuels ancrent l’interprétation du lecteur dans les données quantitatives fondamentales du protocole expérimental.
8.3 Choix des palettes de couleurs adaptées et accessibles
L’équité d’accès à l’information scientifique et le respect des normes d’accessibilité visuelle imposent désormais de concevoir des graphiques lisibles sans ambiguïté par les individus atteints d’anomalies de la vision des couleurs (telles que la protanopie, la deutéranopie ou la tritanopie). L’usage de contrastes chromatiques non discriminants, comme la confrontation brutale entre rouge et vert, doit être rigoureusement banni des publications savantes.
Seaborn propose une palette dédiée universellement éprouvée pour l’accessibilité : la palette palette='colorblind'. Cette déclinaison chromatique réajuste les contrastes de teinte et de luminosité pour assurer une discrimination optimale, quelle que soit la forme de daltonisme du lecteur. Alternativement, le recours à des palettes perceptuellement uniformes et séquentielles issues du projet Viridis (notamment viridis, magma ou cividis) présente l’avantage scientifique remarquable de maintenir une progression tonale strictement linéaire, y compris en cas de conversion intégrale de la figure en niveaux de gris pour l’impression papier.
Enfin, au-delà de la perception chromatique, la robustesse graphique gagne à s’appuyer sur des encodages visuels redondants. Lorsqu’une figure superpose ou juxtapose plusieurs distributions normales associées à des conditions expérimentales distinctes, l’utilisation conjointe de variations de couleur, de textures de hachures distinctes et de styles de traits différenciés (traits continus, tirets longs, pointillés) garantit que l’interprétation demeure totalement préservée en l’absence absolue de restitution des couleurs.
9. Diagnostics graphiques complémentaires de la normalité
9.1 Construction d’un diagramme quantile-quantile (Q-Q Plot)
Bien que l’histogramme et l’estimation par noyau constituent des outils intuitifs de premier niveau, ils ne permettent pas de détecter avec une sensibilité maximale les écarts de normalité logés spécifiquement dans les queues extrêmes de distribution. Le diagramme quantile-quantile, ou Q-Q plot, constitue l’outil graphique par excellence pour scruter la concordance fine entre la distribution d’un échantillon empirique et une loi gaussienne de référence.
Le fondement mathématique du Q-Q plot repose sur la mise en relation bi-univoque des quantiles théoriques attendus d’une loi normale standard avec les quantiles effectivement observés au sein du jeu de données expérimental. Si l’échantillon analysé est rigoureusement issu d’une population gaussienne, les points de coordonnées formés par les couples de quantiles viennent s’aligner de manière parfaitement rectiligne le long d’une droite de référence théorique passant par l’origine.
Dans l’écosystème Python, la construction conjointe d’un histogramme Seaborn et d’un Q-Q plot s’opère en articulant Seaborn avec la méthode scipy.stats.probplot(). L’interprétation sémiotique des courbures observées sur le Q-Q plot livre des informations diagnostiques d’une précision inaccessible au seul histogramme :
- Les queues lourdes (leptokurtose) : se manifestent graphiquement par une déviation caractéristique en forme de « S inversé » aux deux extrémités de la droite, indiquant que les quantiles extrêmes observés sont plus éloignés du centre que ne le prédit la théorie normale.
- Les queues légères (platykurtose) : engendrent une courbure inverse en « S régulier », signalant une coupure abrupte des valeurs extrêmes.
- La dissymétrie (skewness) : se traduit par une inflexion systématique convexe ou concave de l’ensemble de la trajectoire des points par rapport à la droite de référence, révélant immédiatement si la masse de distribution est désaxée vers la gauche ou vers la droite.
9.2 Représentation conjointe avec boîtes à moustaches (Boxplots) et diagrammes en violon
Pour parachever l’exploration de la géométrie distributionnelle, l’adjonction d’une boîte à moustaches (boxplot) ou d’un diagramme en violon (violin plot) fournit une vision synthétique hautement complémentaire de la structure de dispersion et de la localisation des valeurs aberrantes potentielles. Ces graphiques permettent d’isoler instantanément des propriétés de centralité ordinale qui complètent l’histogramme continu.
En exploitant les capacités d’agencement spatial de Matplotlib et de Seaborn, il est particulièrement instructif de concevoir une figure bipartite où un histogramme avec KDE occupe le panneau principal supérieur et une boîte à moustaches horizontale alignée sur le même axe des abscisses est projetée dans un panneau subordonné inférieur. Dans cette perspective, la boîte à moustaches délimite précisément la médiane et l’intervalle interquartile (contenant les 50 % centraux des observations), tandis que ses moustaches matérialisent les frontières de Tukey (généralement 1,5 fois l’IQR au-delà des quartiles). Tout point s’individualisant au-delà de ces bornes apparaît sous forme de glyphe isolé, alertant le chercheur sur des déviations extrêmes incompatibles avec une gaussienne idéale.
Le diagramme en violon (sns.violinplot()) quant à lui opère une fusion conceptuelle élégante en intégrant la boîte à moustaches interne au cœur d’une estimation de densité par noyau symétrique bilatérale. Cette visualisation permet d’apprécier la symétrie bivariée de la distribution tout en conservant les repères médians, offrant une robustesse diagnostique élevée face aux risques de contaminations de l’échantillon couramment rencontrés dans les passations d’épreuves psychométriques.
9.3 Corrélation entre diagnostic visuel et tests formels d’adéquation
Une démarche méthodologique exempte de biais exige de conjuguer harmonieusement l’exploration graphique et l’inférence formelle par tests d’hypothèse. Se fier exclusivement à la perception oculaire expose l’analyste au risque d’illusion paréidolique ou à des biais de confirmation subjectifs, particulièrement lorsque la taille de l’échantillon est réduite et que les fluctuations d’échantillonnage induisent une rugosité superficielle trompeuse.
L’inspection des graphiques Seaborn gagne à être systématiquement articulée avec l’exécution de tests statistiques d’adéquation de référence, disponibles dans le module scipy.stats :
- Le test de Shapiro-Wilk (
shapiro) : universellement considéré comme le test le plus puissant et le plus robuste pour évaluer l’hypothèse nulle de normalité sur des échantillons de petite et moyenne taille (N < 50). - Le test d’Anderson-Darling (
anderson) : une variante sophistiquée du test de Kolmogorov-Smirnov qui accorde une pondération spécifique aux queues de distribution, domaine où les violations de la normalité sont les plus préjudiciables aux modélisations ultérieures. - Le test de D’Agostino-Pearson (
normaltest) : fondé sur l’évaluation conjointe des coefficients d’asymétrie et de kurtosis empiriques, fournissant un bilan quantitatif direct des propriétés morphologiques scrutées sur l’histogramme.
Il importe toutefois de souligner le paradoxe inhérent à la puissance statistique liée aux grands effectifs. Dès lors que N excède plusieurs milliers d’individus, les tests formels acquièrent une puissance computationnelle telle qu’ils rejettent systématiquement l’hypothèse de normalité au moindre écart infinitésimal et sans aucune conséquence pratique. Dans ce contexte précis de données massives, le diagnostic visuel via Seaborn reprend une primauté décisionnelle absolue, car il permet de juger si la déviation détectée formellement présente une amplitude clinique et pratique suffisante pour invalider les modèles paramétriques.
10. Cas d’étude appliqués aux données de la recherche en psychologie
10.1 Étude de cas 1 : Étalonnage des scores d’un test psychométrique d’anxiété
Pour illustrer concrètement la démarche diagnostique, considérons une première situation empirique issue de l’évaluation psychométrique en santé mentale. Une équipe de chercheurs administre une échelle d’anxiété constituée de 20 items de type Likert (cotés de 1 à 5) à un échantillon normatif non clinique de N = 450 étudiants universitaires. Les scores totaux agrégés génèrent une variable quantitative théoriquement continue bornée entre 20 et 100 points.
Lors de la projection de cet échantillon au moyen de sns.displot(scores, kde=True, stat='density'), la figure obtenue révèle un phénomène clinique très classique : l’effet plancher (floor effect). Au sein d’une population saine, la majorité des individus éprouve des niveaux d’anxiété minimes, concentrant les masses de fréquences au voisinage de la borne inférieure de l’instrument. La superposition de la courbe normale théorique calculée sur la base de la moyenne et de l’écart-type de la cohorte met immédiatement en relief une dissymétrie positive spectaculaire (right skewness), la courbe KDE s’étirant vers les scores d’anxiété sévère tandis que le sommet de l’histogramme se situe très en deçà de la moyenne apparente.
Ce diagnostic visuel permet d’alerter le psychologue quantitative sur l’inadéquation radicale d’une standardisation classique fondée sur la moyenne et l’écart-type. L’application mécanique de seuils à ± 2 σ mènerait à une surestimation dramatique des diagnostics pathologiques et à une troncature statistique préjudiciable. La visualisation documente objectivement la nécessité d’orienter le traitement psychométrique soit vers un étalonnage non paramétrique en rangs percentiles, soit vers une modélisation par théorie de réponse aux items (TRI) adaptée aux échelles polytomiques asymétriques.
10.2 Étude de cas 2 : Distribution des temps de réponse dans une tâche d’attention soutenue
Un deuxième cas emblématique des sciences cognitives réside dans l’enregistrement chronométrique de la vitesse de traitement de l’information. Dans une épreuve d’attention soutenue de type psychomotrice (PVT), 1 200 essais de temps de réaction sont collectés auprès d’un groupe expérimental. Les latences de réponse brutes, exprimées en millisecondes, présentent structurellement une barrière physique incompressible aux temps courts (due aux délais de conduction neuronale axonale) et une longue queue de distribution vers les temps longs résultant des lapses attentionnels passagers.
La visualisation de ces données brutes à l’aide de Seaborn met en évidence une distribution hautement leptokurtique et asymétrique, s’écartant de façon indiscutable de la morphologie gaussienne. Face à cette violation caractérisée qui prohibe l’usage immédiat d’une analyse de variance (ANOVA), le chercheur applique une transformation logarithmique népérienne standard aux latences observées.
La génération d’une figure comparative à deux panneaux juxtaposés (conçue via plt.subplots(1, 2) et sns.histplot(ax=axes[...])) permet de tracer côte à côte la distribution brute originale et la distribution transformée log(TR). Sur le second panneau, la superposition de la normale théorique démontre visuellement que la transformation logarithmique a parfaitement résorbé l’asymétrie positive, ramenant les observations au sein d’une cloche parfaitement symétrique et homoscédastique. La figure constitue la preuve expérimentale directe et irréfutable de la validité distributionnelle autorisant la poursuite des analyses inférentielles paramétriques planifiées.
10.3 Étude de cas 3 : Comparaison multi-groupes de distributions de scores cognitifs
La troisième application méthodologique porte sur la confrontation expérimentale de plusieurs sous-groupes cliniques au sein d’un même devis de recherche. Supposons une étude en neuropsychologie évaluant les capacités de mémoire de travail chez trois cohortes de sujets : un groupe témoin sain, un groupe de patients présentant des troubles cognitifs légers (MCI), et un groupe diagnostiqué au stade précoce de la maladie d’Alzheimer (chaque cohorte comptant N = 120 participants).
Pour inspecter simultanément la distribution normale relative de ces trois populations sans multiplier inutilement les graphiques isolés, Seaborn offre la puissance sémantique de son paramètre hue. En exécutant sns.displot(data=df, x='score_memoire', hue='groupe', kind='kde', fill=True, common_norm=False), la fonction procède à l’estimation de la densité par noyau de manière conditionnelle et distincte pour chacun des trois groupes.
La spécification cruciale de common_norm=False garantit que chaque courbe KDE est normalisée de façon autonome à l’unité en fonction de son propre effectif interne, prévenant toute distorsion d’échelle induite par des variations marginales de taille de cohorte. Le graphique résultant affiche trois courbes de densité superposées, délimitées par des aplats de couleurs translucides distinctes. Cette visualisation livre un diagnostic clinique et statistique d’une grande clarté : elle permet de vérifier simultanément le décalage progressif des moyennes (baisse des capacités mnésiques le long de la trajectoire clinique), le maintien ou l’altération de la symétrie gaussienne interne au sein de chaque pathologie, ainsi que la conformité à l’hypothèse d’homogénéité des variances (homoscédasticité), identifiable graphiquement par l’équivalence de la largeur d’étalement des dômes de densité.
11. Erreurs fréquentes, pièges méthodologiques et résolutions
11.1 Mauvaise interprétation de la KDE sur de petits échantillons
L’un des pièges computationnels les plus pernicieux dans l’analyse exploratoire de données réside dans l’application acritique de l’estimation de densité par noyau sur des échantillons de très faible effectif (typiquement lorsque N < 30). Par construction algorithmique, le processus de lissage par convolution gaussienne produit inéluctablement une courbe fluide, continue et d’allure harmonieuse, même lorsque les données sous-jacentes sont issues d’un tirage uniforme, discret ou erratique.
Cette particularité mathématique peut créer une véritable illusion de normalité. L’œil humain, naturellement enclin à rechercher des régularités géométriques, tend à interpréter la cloche continue de la KDE comme la confirmation empirique d’une distribution gaussienne sous-jacente, alors même que cette morphologie résulte exclusivement de la fonction de noyau imposée par le logiciel. De surcroît, sur des effectifs restreints, l’estimation statistique de la largeur de bande optimale (bandwidth) devient particulièrement instable, un seul point excentré suffisant à gonfler artificiellement la variance globale estimée.
Pour conjurer cet écueil méthodologique lors de l’étude de petites cohortes, il est fortement préconisé d’adjoindre systématiquement un tracé de tapis de données (rug plot) à la représentation continue, activable via l’argument rug=True dans sns.displot(). Ce paramètre projette de fines marques de graduation individuelles sur l’axe horizontal, révélant la position physique de chaque observation réelle. La visualisation conjointe de ces tirets discrets rappelle instantanément à l’observateur la sparsité effective des données et prévient toute sur-interprétation de la courbe lissée.
11.2 Artefacts causés par un nombre inadapté de classes dans l’histogramme
L’apparente simplicité de l’histogramme dissimule une fragilité géométrique considérable liée au choix du découpage des classes (binning). Deux pathologies graphiques symétriques sont fréquemment observées dans les rapports de recherche préliminaires :
- La création artificielle de bimodalité ou de rugosité parasite : causée par la sélection d’un pas de classe excessivement étroit (par exemple en assignant manuellement une valeur arbitraire démesurée à
bins=100pour un échantillon de 150 sujets). Les barres d’histogramme se vident aléatoirement sous l’effet du bruit d’échantillonnage, mimant des creux et des pics multiples qui ne correspondent à aucune réalité populationnelle. - Le masquage d’hétérogénéités structurelles : engendré à l’inverse par un découpage grossier (par exemple
bins=5). Un tel regroupement agrège indûment des sous-populations distinctes, écrase les queues de distribution et arrondit artificiellement une distribution asymétrique, lui conférant une fausse apparence de symétrie gaussienne normale.
Pour neutraliser ces artefacts, le chercheur doit adopter une démarche de validation itérative. Il convient de tester systématiquement la stabilité morphologique de l’histogramme face aux différentes règles heuristiques reconnues (Sturges, Scott et Freedman-Diaconis). Si la structure globale (unimodalité, centre de gravité, symétrie des flancs) demeure invariante sous ces différents régimes computationnels, la fidélité de la représentation graphique peut être tenue pour scientifiquement robuste.
11.3 Conflits d’échelle et distorsions d’axes
La géométrie perceptive d’une figure statistique exerce une influence majeure sur l’interprétation clinique ou empirique qui en est extraite. Une manipulation malencontreuse ou involontaire des échelles et des limites d’axes peut altérer dramatiquement la lecture des propriétés d’une distribution normale.
Le piège le plus élémentaire, mais néanmoins dévastateur, réside dans la troncature injustifiée de l’axe vertical des ordonnées. Sur un histogramme de fréquences ou de densités, l’axe vertical doit impérativement trouver son origine absolue à la valeur zéro. L’élévation arbitraire de l’origine de l’axe (qui couperait par exemple les barres à mi-hauteur) déforme de manière inacceptable le rapport de proportionnalité des aires sous-jacentes, exagérant visuellement les écarts de fréquence minimes et transformant artificiellement une dispersion gaussienne modérée en une fracture bimodale abrupte.
De même, sur l’axe horizontal des abscisses, il convient de veiller à ce que l’étendue visualisée ne comprime ni n’étire excessivement le dôme distributionnel. L’imposition d’un ratio hauteur/largeur disproportionné (paramètre aspect dévoyé) peut aplatir visuellement une distribution normale pour lui conférer une allure platykurtique, ou à l’opposé l’étirer verticalement vers un profil leptokurtique aigu. Enfin, le recours à des échelles logarithmiques ou exponentielles sur l’un des axes sans justification théorique ni documentation explicite doit être proscrit, sous peine de détruire purement et simplement la géométrie gaussienne originelle de la variable étudiée.
12. Directives de synthèse et bonnes pratiques pour la science ouverte
12.1 Structuration d’un script d’analyse reproductible
Dans le paradigme contemporain de la science ouverte (Open Science), la production de visualisations statistiques ne peut plus être dissociée de la traçabilité intégrale de la chaîne computationnelle qui en a permis l’émergence. Pour satisfaire aux exigences de reproductibilité absolue des revues internationales de premier rang, le code source Python ayant servi à générer chaque tracé de distribution normale doit être articulé de manière rigoureusement modulaire et documenté de bout en bout.
Un script d’analyse statistique exemplaire s’articule canoniquement en quatre blocs programmatiques distincts et hermétiques :
- Le bloc d’initialisation de l’environnement : recensant l’ensemble des bibliothèques mobilisées, le gel de la graine pseudo-aléatoire du générateur NumPy (seed), et la configuration des thèmes globaux et des contextes de publication de Seaborn.
- Le bloc de curation et transformation des données : englobant l’importation brute, le filtrage documenté des données manquantes, le calcul des scores composites agrégés et l’application éventuelle de transformations normalisantes.
- Le bloc de modélisation analytique : calculant formellement les paramètres d’échantillon, les quantiles théoriques, les coordonnées de densités continues et les tests formels d’adéquation de normalité.
- Le bloc de rendu et d’exportation graphique : exécutant le tracé unifié, l’application des légendes et annotations LaTeX, et la sauvegarde vectorielle multiformat.
Ce script, idéalement partagé sous forme de calepin électronique Jupyter interactif ou de module Python autonome, a vocation à être déposé publiquement sur des infrastructures ouvertes pérennes, à l’image du réseau Open Science Framework (OSF), de Zenodo ou de GitHub. Cette pratique garantit la transparence méthodologique totale du processus d’inférence visuelle auprès des évaluateurs et de la communauté scientifique élargie.
12.2 Exportation vectorielle haute définition
L’étape ultime de la production d’une figure de distribution consiste en son exportation numérique en vue de l’insertion pré-presse dans le manuscrit scientifique final. Trop de chercheurs commettent encore l’erreur d’exporter leurs représentations sous forme d’images matricielles compressées (fichiers PNG ou JPEG à basse résolution), ce qui se traduit inévitablement par une perte de piqué optique, des phénomènes de pixellisation des polices de caractères et une dégradation des lignes fines lors de la mise en page finale par l’éditeur.
Pour assurer une préservation absolue de la qualité graphique quel que soit le facteur d’agrandissement, il est impératif d’exporter les figures Seaborn dans des formats vectoriels universels, au premier rang desquels figurent le format PDF (Portable Document Format), le format SVG (Scalable Vector Graphics) ou le format EPS (Encapsulated PostScript). Dans ces formats, chaque barre d’histogramme, chaque segment de courbe théorique et chaque glyphe typographique sont encodés sous forme d’instructions géométriques et mathématiques pures et non de matrices de pixels finies.
Lors de l’appel à la méthode plt.savefig('distribution_normale.pdf', format='pdf', bbox_inches='tight'), le développeur gagne également à configurer le paramètre pdf.fonttype = 42 dans les spécifications rcParams de Matplotlib. Cette instruction technique garantit que les polices de caractères vectorielles (notamment les symboles mathématiques grecs de la notation normale) soient intégralement incorporées en polices TrueType natives au sein du fichier généré, évitant ainsi toute substitution typographique indésirable ou altération d’encodage lors du traitement par les systèmes d’imprimerie académiques internationaux.
12.3 Liste récapitulative des étapes décisionnelles pour le chercheur
Afin de structurer le flux de travail de l’analyste face à une distribution quantitative empirique, le tableau décisionnel suivant résume les choix méthodologiques et fonctionnels recommandés dans Seaborn en fonction de l’objectif scientifique et des caractéristiques de l’échantillon :
- Échantillon modeste (N < 50) : Proscrire l’usage isolé d’une courbe KDE lissée. Recourir prioritairement à
sns.histplot(stat='density', bins='auto')combiné systématiquement avec l’argumentrug=Truepour afficher chaque point d’observation. Superposer analytiquement la densité théoriquescipy.stats.norm.pdfet adjoindre un diagramme Q-Q plot de contrôle formel. - Échantillon intermédiaire standard (50 ≤ N ≤ 1 000) : Utiliser la combinaison hybride de référence
sns.displot(x, kde=True, stat='density', bins='fd'). Cette configuration équilibre de façon optimale la transparence des barres d’histogramme (selon l’heuristique de Freedman-Diaconis) et l’information continue de l’estimation de densité par noyau. - Échantillon volumineux ou données massives (N > 1 000) : L’histogramme devenant potentiellement très dense, une courbe de densité pure via
sns.displot(x, kind='kde', bw_adjust=1.0)s’avère particulièrement pertinente, la taille d’échantillon garantissant la stabilité mathématique du lissage non paramétrique. - Confrontation de multiples groupes expérimentaux : Exploiter la puissance du facettage ou du partitionnement sémantique de
sns.displot(x, hue='groupe', kind='kde', common_norm=False)pour inspecter visuellement l’homogénéité des variances et la stabilité de la normalité à travers les conditions expérimentales. - Préparation pour la soumission académique : Appliquer systématiquement le thème
sns.set_theme(style='ticks'), dégraisser la figure parsns.despine(), étiqueter les axes en notation LaTeX rigoureuse, et exporter le fichier final au format vectoriel PDF à haute résolution.
En observant scrupuleusement ces directives méthodologiques et computationnelles, le chercheur s’assure que ses représentations de la distribution normale sous Seaborn constituent non seulement des visualisations esthétiquement irréprochables, mais surtout des instruments diagnostiques rigoureux au service de la validité et de la reproductibilité de l’inférence scientifique.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472
- Rosenblatt, M. (1956). Remarks on some non-parametric estimates of a density function. The Annals of Mathematical Statistics, 27(3), 832–837. https://doi.org/10.1214/aoms/1177728190
- Scott, D. W. (1979). On optimal and data-based histograms. Biometrika, 66(3), 605–610. https://doi.org/10.1093/biomet/66.3.605
- Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall. https://doi.org/10.1201/9781315140919
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), Article 3021. https://doi.org/10.21105/joss.03021