
Dans le domaine de l’ingénierie logicielle et du traitement analytique des données massives, le système SAS (Statistical Analysis System) demeure une référence institutionnelle incontournable au sein des industries bancaires, pharmaceutiques, épidémiologiques et assurantielles. La manipulation efficace des structures tabulaires constitue le socle fondamental sur lequel reposent l’intégrité, la robustesse et la rapidité des calculs statistiques. L’opération de sous-ensemble, communément désignée par le terme anglophone subsetting, représente l’un des mécanismes les plus critiques de cette chaîne de traitement. Elle consiste à extraire de manière déterministe une sous-partie congrue d’une table maîtresse, soit en isolant des variables pertinentes, soit en filtrant des observations selon des critères logiques rigoureux.
Une gestion non optimisée des sous-ensembles de données engendre fréquemment des goulots d’étranglement majeurs, caractérisés par une saturation de la mémoire vive et une sollicitation excessive des opérations d’entrée-sortie (I/O) sur disque. Lorsque les jeux de données atteignent des dizaines de gigaoctets ou des centaines de millions d’enregistrements, l’incapacité à restreindre précocement le volume d’informations traitées pénalise lourdement les performances globales de l’infrastructure informatique. L’ingénieur décisionnel et le biostatisticien doivent par conséquent maîtriser avec une exactitude chirurgicale les rouages internes de l’étape DATA de SAS, ainsi que le comportement intime du vecteur de données du programme (Program Data Vector, ou PDV).
Ce traité technique a pour vocation d’exposer de manière exhaustive, méthodique et documentée la théorie et la pratique du partitionnement de données au sein de l’écosystème SAS. À travers l’analyse méticuleuse d’un jeu de données de référence normalisé, nous décortiquerons trois approches canoniques : l’extraction de variables par l’instruction KEEP, l’éviction ciblée de colonnes via l’instruction DROP, et l’exclusion conditionnelle d’observations fondée sur la clause IF-THEN DELETE. Nous élargirons ensuite cette analyse aux instructions WHERE, au subsetting IF, ainsi qu’aux options de tables, tout en intégrant les impératifs méthodologiques propres à la recherche quantitative.
1. Introduction aux principes du sous-ensemble de données dans SAS
1.1 Définition et importance de la réduction dimensionnelle des données
Dans l’architecture de données relationnelle et tabulaire de SAS, le partitionnement ou sous-ensemble se scinde en deux dimensions géométriques complémentaires : la réduction verticale et la réduction horizontale. La réduction verticale correspond à la sélection exclusive des colonnes, attributs ou variables indispensables à l’étude envisagée, éliminant ainsi les dimensions superflues qui alourdissent inutilement la largeur de chaque enregistrement. À l’inverse, la réduction horizontale relève du filtrage des lignes ou observations, ne conservant que les unités statistiques répondant formellement à un faisceau de critères logico-mathématiques prédéfinis.
L’importance de cette double réduction s’évalue au regard des contraintes physiques des systèmes informatiques. Bien que les architectures modernes bénéficient de capacités d’adressage mémoire étendues, l’empreinte spatiale d’une table influe directement sur les cycles CPU nécessaires à son balayage séquentiel et sur la taille des blocs de transfert entre les sous-systèmes de stockage et la mémoire cache. Selon les standards architecturaux définis par l’Organisation internationale de normalisation en matière d’efficacité logicielle, la limitation précoce du périmètre des données constitue le premier levier de fiabilisation d’un pipeline analytique.
Dans la perspective de la modélisation statistique avancée (régressions multivariées, analyses factorielles, modèles à équations structurelles), la constitution d’une matrice épurée prévient les erreurs d’alignement dimensionnel et simplifie considérablement la phase d’audit. Une table allégée réduit le risque de redondance d’information, limite la présence de valeurs aberrantes ou manquantes non documentées, et garantit que seules les covariables validées sur le plan théorique participent à l’ajustement des paramètres.
1.2 Structure générale de l’étape DATA et cycle d’exécution
L’étape DATA représente le moteur procédural et transformationnel fondamental du langage SAS. Contrairement aux procédures pré-paramétrées (telles que PROC REG, PROC MEANS ou PROC FREQ) dont l’exécution repose sur des algorithmes matriciels figés, l’étape DATA offre un environnement de programmation itératif et séquentiel d’une grande granularité. Sa vocation première réside dans l’ingestion, le nettoyage, la restructuration et la persistance de l’information sous la forme de nouvelles tables SAS propriétaires.
Au cœur de cette étape se trouve l’instruction SET, qui agit comme le connecteur logique vers une ou plusieurs tables SAS préalablement matérialisées sur le disque dur ou dans une bibliothèque temporaire (généralement la bibliothèque WORK). L’instruction SET prend en charge l’ouverture de la table source, la lecture séquentielle des descripteurs de métadonnées, ainsi que le chargement successif de chaque enregistrement physique dans les zones tampons du compilateur SAS.
Le cycle d’exécution de l’étape DATA obéit à une boucle implicite strictement régulée. À chaque itération de la boucle, l’environnement SAS exécute de haut en bas l’intégralité des instructions programmées par l’utilisateur. Dès que le pointeur atteint la fin structurelle de l’étape DATA (marquée par le mot-clé RUN;), le système déclenche une écriture automatique des valeurs courantes dans la table de destination, réinitialise les zones mémoires non persistantes, puis incrémente son compteur interne avant de charger l’observation suivante issue de l’instruction SET. Ce mécanisme de boucle implicite perdure jusqu’à ce que le pointeur d’entrée atteigne le marqueur de fin de fichier (EOF, End-Of-File).
1.3 Objectifs pédagogiques et aperçu des trois méthodes fondamentales
L’objectif de cet exposé est de doter le programmeur, le biostatisticien et l’analyste de données d’une grille de lecture rigoureuse concernant l’impact algorithmique de ses choix de syntaxe. Trop souvent, les instructions de sélection sont employées de façon interchangeable sans une compréhension claire de leurs répercussions sur l’architecture mémoire du système. Nous nous proposons de décomposer la logique formelle de trois opérations canoniques afin de lever toute ambiguïté opérationnelle.
La première méthode analysée s’articule autour de l’instruction KEEP. Dédiée à la sélection affirmative des colonnes, cette instruction permet de déclarer expressément la liste des variables dont la présence est requise dans la table résultante. Elle incarne le principe de sécurité par défaut : toute variable non mentionnée est irrévocablement exclue de la sortie définitive, prémunissant ainsi le système contre la persistance involontaire de variables sensibles ou parasites.
La deuxième méthode repose sur l’usage symétrique de l’instruction DROP. Utilisée pour l’élagage ciblé, elle spécifie nominativement les variables qui doivent être rejetées de la table finale, tout en maintenant automatiquement l’ensemble des autres colonnes définies dans la table source. Cette approche s’avère particulièrement ergonomique lorsqu’une fraction négligeable du dictionnaire de données doit être éliminée.
La troisième méthode aborde la réduction horizontale à travers la construction conditionnelle IF-THEN DELETE. Ce paradigme combine l’évaluation d’un prédicat booléen et le déclenchement d’une rupture immédiate de l’itération courante. Lorsqu’une observation échoue au test logique, l’instruction DELETE ordonne au système d’avorter l’écriture de l’enregistrement dans la table cible et de réorienter instantanément le pointeur d’exécution vers l’en-tête de la boucle de l’étape DATA pour traiter la ligne suivante.
2. Architecture interne du Program Data Vector (PDV) et flux de données
2.1 Le rôle du Program Data Vector lors de la compilation
L’étape DATA ne s’exécute pas de manière interprétée directe ; elle subit préalablement une phase de compilation formelle au cours de laquelle SAS construit une structure mémoire dédiée appelée le Program Data Vector (PDV). Le PDV représente la zone de travail en mémoire vive (RAM) où sont matérialisées les colonnes de données lors du traitement de chaque observation. Durant cette phase de compilation, le compilateur lit le code séquentiellement afin d’identifier l’ensemble des variables déclarées, de déterminer leur type (numérique ou caractère) et d’allouer la longueur en octets requise pour chacune d’elles.
En sus des variables explicites issues des tables sources ou créées par le programmeur, le compilateur SAS injecte systématiquement deux variables automatiques au sein du PDV : _N_ et _ERROR_. La variable _N_ fonctionne comme un compteur d’itérations de l’étape DATA, débutant à la valeur 1 et s’incrémentant à chaque retour au sommet de la boucle logique. La variable _ERROR_ agit comme un drapeau d’intégrité binaire, prenant la valeur 0 en régime normal et passant à la valeur 1 dès lors qu’une anomalie intervient en cours d’exécution (conversion de type invalide, division par zéro, ou débordement mathématique).
Il est impératif de souligner que les variables automatiques _N_ et _ERROR_ possèdent des attributs internes particuliers : elles sont temporaires et ne sont jamais écrites sur le disque dans la table SAS finale. Le PDV agit ainsi comme une interface de conversion entre les flux d’octets bruts persistants et les environnements d’évaluation algébrique du processeur.
2.2 Comportement du PDV durant la phase d’exécution
Une fois la phase de compilation achevée avec succès, l’étape DATA bascule dans sa phase d’exécution. Le flux logique s’ouvre par l’initialisation des variables du PDV. Dans le cas d’une lecture via l’instruction SET, les emplacements mémoires assignés aux variables importées sont alimentés par la lecture séquentielle du bloc de données source situé sur le disque. Chaque appel à SET lit un enregistrement physique unique et en copie les valeurs dans les slots correspondants du PDV.
Contrairement aux variables calculées localement (qui sont réinitialisées à la valeur manquante à chaque début d’itération, sauf si elles font l’objet d’une instruction RETAIN), les variables issues d’une instruction SET bénéficient d’une persistance naturelle tout au long du cycle de vie de l’itération courante. Les calculs mathématiques, transformations textuelles ou réassignations logiques s’opèrent alors directement sur les valeurs hébergées temporairement dans le PDV.
L’aboutissement normal du cycle d’exécution survient lorsque le compilateur atteint l’instruction implicite ou explicite OUTPUT. À cet instant précis, le gestionnaire d’écriture prend une photographie des données contenues dans le PDV et les transfère dans la mémoire tampon de sortie, en vue de leur sérialisation définitive sur le support de stockage. Dès cette écriture consignée, le PDV est réinitialisé selon les règles de gestion de l’étape DATA, préparant la structure mémoire pour l’itération subséquente.
2.3 Point d’intervention des instructions de sous-ensemble
La compréhension du point d’intervention temporel des instructions de sous-ensemble au sein du cycle de vie du PDV est indispensable pour prévenir toute erreur de logique architecturale. Les instructions KEEP et DROP n’agissent pas sur la présence des variables à l’intérieur du PDV durant la phase de calcul ; elles fonctionnent comme des masques de filtrage appliqués au moment strict du déversement du PDV vers la table cible finale.
Ainsi, lorsqu’une instruction DROP points; est formulée, la variable points est bel et bien allouée dans le PDV lors de la compilation, et elle est lue depuis la table source durant l’exécution. Elle demeure totalement accessible pour effectuer des tests logiques ou des calculs dérivés au sein de l’étape DATA. Ce n’est qu’au moment précis de l’appel à l’écriture (OUTPUT) que le système SAS consulte le dictionnaire des métadonnées, constate la présence de la directive d’éviction, et ignore physiquement la colonne lors de la création du fichier binaire de sortie.
À l’inverse, l’instruction DELETE (notamment dans la séquence IF condition THEN DELETE;) intervient activement en amont de l’écriture. Lorsqu’elle est déclenchée, elle interrompt immédiatement le fil séquentiel des instructions restantes pour l’itération en cours. L’instruction OUTPUT implicite située à la fin de l’étape DATA est tout simplement court-circuitée. Le PDV est alors vidé de ses valeurs transitoires, la ligne courante est définitivement rejetée, et le système incrémente _N_ pour procéder sans délai à la lecture de l’enregistrement source suivant.
3. Présentation et initialisation du jeu de données de référence
3.1 Structure syntaxique de l’étape DATA d’initialisation
Afin d’illustrer rigoureusement les concepts développés dans ce mémoire, nous instancions un environnement expérimental contrôlé à travers un jeu de données sportif canonique. Ce jeu de données synthétise les performances offensives et défensives de plusieurs franchises de basket-ball professionnel nord-américain. Sa création repose sur la combinaison conventionnelle d’une étape DATA d’affectation et de l’instruction d’ingestion directe DATALINES.
La formulation syntaxique de ce bloc d’instanciation se structure selon le standard suivant :
data original_data;

input team $ points rebounds;

datalines;

Warriors 28 12

Wizards 18 9

Rockets 22 10

Celtics 21 8

Thunder 31 14

Spurs 27 11

Nets 26 7

;

run;
Dans ce segment de code, l’instruction data original_data; ordonne au compilateur d’allouer les structures descripteurs d’une nouvelle table enregistrée dans la bibliothèque temporaire WORK. L’instruction input définit la grille de lecture du flux textuel brut : le modificateur alphanumérique dollar ($) informe le compilateur que l’attribut team doit être configuré comme une chaîne de caractères de longueur standard, tandis que les variables points et rebounds reçoivent le type numérique flottant par défaut (double précision, standard IEEE 754).
3.2 Détail des variables et métadonnées du modèle
Le jeu de données de référence original_data est modélisé selon une matrice rectangulaire de dimension sept par trois, totalisant ainsi sept observations indépendantes réparties sur trois variables homogènes. Chaque dimension représente un axe d’évaluation quantitatif ou qualitatif univoque :
- team : Identifiant nominal de l’entité sportive observée. Cette variable catégorielle stocke le nom usuel de la franchise (ex. Warriors, Wizards, Rockets). Sur le plan des métadonnées, elle est encodée comme une séquence de caractères d’une longueur par défaut de 8 octets.
- points : Indicateur de performance offensive individuel ou collectif. Cet attribut quantitatif continu enregistre le volume de points marqués au terme de la séquence de jeu sous analyse.
- rebounds : Indicateur de performance défensive et d’occupation spatiale sous le cercle. Cet attribut quantitatif discret mesure le nombre de rebonds captés au cours de la même période.
Ce schéma tridimensionnel équilibré constitue un laboratoire parfait pour nos expérimentations. Il comporte des variables textuelles et numériques, un volume de lignes restreint permettant une traçabilité visuelle immédiate de chaque enregistrement dans le journal d’exécution (SAS Log), tout en présentant une variabilité suffisante pour implémenter des prédicats conditionnels sans ambiguïté analytique.
3.3 Validation de l’intégrité des données avec PROC PRINT
La compilation et l’exécution du bloc d’initialisation requièrent une validation formelle d’intégrité avant d’entamer la moindre manipulation dimensionnelle. Cette étape de contrôle qualité s’effectue via l’invocation de la procédure d’affichage standardisée PROC PRINT, paramétrée comme suit :
proc print data=original_data;

run;
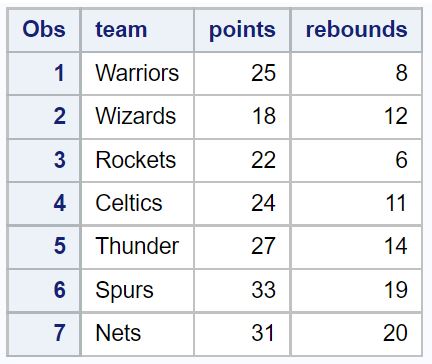
L’exécution de cette procédure déclenche l’affichage d’un tableau récapitulatif structuré dans la fenêtre de sortie standard ou au format HTML via l’Output Delivery System (ODS). Le résultat attendu se présente sous la configuration matricielle suivante :
| Obs | team | points | rebounds |
|---|---|---|---|
| 1 | Warriors | 28 | 12 |
| 2 | Wizards | 18 | 9 |
| 3 | Rockets | 22 | 10 |
| 4 | Celtics | 21 | 8 |
| 5 | Thunder | 31 | 14 |
| 6 | Spurs | 27 | 11 |
| 7 | Nets | 26 | 7 |
L’inspection du journal d’exécution SAS permet de vérifier qu’aucun message d’avertissement (WARNING) ni d’erreur de syntaxe (ERROR) n’a été émis. Le système confirme formellement que la table WORK.ORIGINAL_DATA comprend exactement 7 observations et 3 variables, scellant ainsi la validité structurelle de notre point de départ expérimental.
4. Exemple 1 : Sélection sélective des colonnes avec l’instruction KEEP
4.1 Syntaxe formelle et logique d’implémentation de KEEP
L’instruction KEEP est une directive déclarative interne à l’étape DATA qui instruit le moteur de stockage de SAS quant aux variables précises qui doivent être inscrites dans la table finale issue du traitement. Contrairement à une instruction exécutable (telle qu’une affectation arithmétique ou une conditionnelle), KEEP agit dès la phase de compilation pour configurer les drapeaux de sortie du dictionnaire de données.
Pour extraire exclusivement les variables team et points de notre table de base original_data et générer une nouvelle table dérivée intitulée new_data, la mise en œuvre programmatique s’énonce comme suit :
data new_data;

set original_data;

keep team points;

run;
Dans ce schéma opératoire, l’instruction set original_data; établit un pont de transmission avec la table source. L’instruction keep team points; dresse une barrière sélective ne laissant filtrer que les deux colonnes explicitement nommées. Il importe de relever que l’ordre des variables spécifiées dans l’instruction KEEP n’altère en rien l’ordre physique des colonnes dans la table résultante ; l’ordonnancement structurel demeure dicté par la séquence historique d’apparition des variables au sein du PDV lors de la lecture du descripteur source.
4.2 Analyse de la persistance des données au niveau du PDV
Pour appréhender la mécanique profonde de l’instruction KEEP, il est capital de lever un contresens récurrent : l’instruction KEEP n’empêche nullement la lecture des variables omises depuis la table source vers le PDV. Lorsque le bloc set original_data; s’exécute, SAS lit l’intégralité du descripteur de la table d’entrée. En conséquence, la variable rebounds est bel et bien transférée du disque vers l’espace mémoire alloué au PDV à chaque itération de la boucle.
Cela signifie concrètement que si le programmeur avait inséré une instruction intermédiaire telle que total = points + rebounds; avant l’instruction KEEP, l’opération mathématique se serait déroulée sans la moindre anomalie arithmétique. Le PDV conserve la plénitude de ses états opérationnels pendant toute la durée d’évaluation des expressions logiques.
Le filtrage intervient exclusivement au point d’ancrage de la commande OUTPUT implicite. À cette étape finale, le compilateur applique le masque défini par KEEP : seules les cases mémoire correspondant à team et points sont recopiées dans la mémoire tampon d’écriture (output buffer). La case mémoire associée à rebounds est simplement ignorée lors du flush binaire vers le disque dur, puis écrasée lors de l’itération suivante. Cette mécanique garantit une flexibilité algorithmique absolue tout en atteignant l’objectif de réduction dimensionnelle ciblée.
4.3 Inspection des résultats et sortie tabulaire
La validation empirique du sous-ensemble obtenu s’opère par l’invocation de la procédure PROC PRINT appliquée à la table de sortie new_data :
proc print data=new_data;

run;
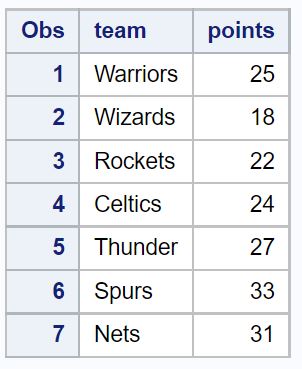
Le traitement génère l’état tabulaire suivant au niveau du rapport d’exécution :
| Obs | team | points |
|---|---|---|
| 1 | Warriors | 28 |
| 2 | Wizards | 18 |
| 3 | Rockets | 22 |
| 4 | Celtics | 21 |
| 5 | Thunder | 31 |
| 6 | Spurs | 27 |
| 7 | Nets | 26 |
L’observation attentive de cette sortie confirme le respect scrupuleux des spécifications logiques. La table compte toujours rigoureusement sept observations (aucune réduction horizontale n’ayant été ordonnée), mais la dimension colonne a été amputée de l’attribut rebounds. Le journal SAS consigne de manière transparente : The data set WORK.NEW_DATA has 7 observations and 2 variables, certifiant l’amincissement structurel de la table de données.
5. Exemple 2 : Exclusion des variables redondantes avec l’instruction DROP
5.1 Syntaxe formelle et cas d’usage de l’instruction DROP
L’instruction DROP représente le pendant négatif et complémentaire de l’instruction KEEP. Au lieu d’énumérer de façon limitative les composantes à conserver, l’ingénieur SAS dresse la liste des variables dont l’élimination est expressément requise. Cette approche s’impose comme la stratégie de codage préférentielle lorsqu’une table comporte un nombre massif de colonnes (par exemple plusieurs centaines d’attributs de mesure) dont seule une fraction résiduelle s’avère inutile pour les phases de modélisation ultérieures.
Considérons l’hypothèse où la variable points doit être expurgée de la table d’analyse, tout en préservant l’entité nominative de l’équipe ainsi que ses métriques de rebonds. L’implémentation syntaxique au sein de l’étape DATA s’écrit de la façon suivante :
data new_data;

set original_data;

drop points;

run;
Par cette écriture, le compilateur intègre la directive de rejet ciblant l’attribut points. L’ensemble des autres variables présentes dans le PDV — qu’elles proviennent directement de la table source ou qu’elles aient été calculées au fil du script — sont automatiquement incluses dans le flux de persistance de la table résultante new_data.
5.2 Mécanique d’éviction lors de l’écriture sur disque
À l’instar de l’instruction KEEP, l’instruction DROP n’exerce aucune action d’éviction préventive au sein du PDV lors de la lecture des données. La variable points est rigoureusement lue par l’instruction SET et demeure pleinement résidente en mémoire vive tout au long de l’évaluation du script pour chaque observation individuelle.
Cette propriété architecturale confère une liberté totale au programmeur. Il demeure parfaitement valide d’utiliser la variable écartée dans des structures conditionnelles complexes ou des dérivations mathématiques en aval de l’instruction DROP. Par exemple, la ligne de code if points > 20 then elite_offense = 1; s’exécutera avec un succès total, quand bien même la variable points aura été marquée du sceau de l’éviction pour la table finale.
L’éviction physique n’intervient qu’au moment précis où SAS s’apprête à sérialiser le contenu du PDV dans le bloc de données de sortie. Le pointeur d’écriture consulte le vecteur d’indicateurs de colonnes, constate la présence du drapeau de rejet sur la variable points, et omet délibérément le transfert des octets correspondants. La table new_data est ainsi matérialisée sur le disque avec un schéma restreint ne contenant que les colonnes team et rebounds.
5.3 Validation empirique par inspection du SAS Log
La confirmation opérationnelle de la validité de l’opération s’effectue systématiquement par un examen croisé du journal d’exécution (SAS Log) et de l’affichage produit par la procédure PROC PRINT :
proc print data=new_data;

run;
Le journal SAS renvoie un message sans équivoque attestant du bon déroulement de l’opération :
NOTE: There were 7 observations read from the data set WORK.ORIGINAL_DATA.
NOTE: The data set WORK.NEW_DATA has 7 observations and 2 variables.
NOTE: DATA statement used (Total process time): real time 0.01 seconds cpu time 0.00 seconds.
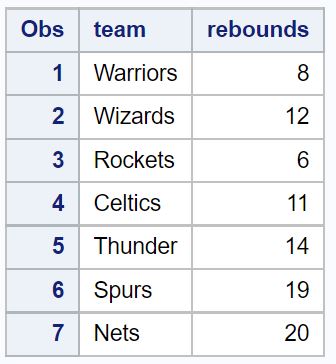
La sortie tabulaire générée illustre parfaitement la persistance de l’intégrité matricielle sur les attributs préservés :
| Obs | team | rebounds |
|---|---|---|
| 1 | Warriors | 12 |
| 2 | Wizards | 9 |
| 3 | Rockets | 10 |
| 4 | Celtics | 8 |
| 5 | Thunder | 14 |
| 6 | Spurs | 11 |
| 7 | Nets | 7 |
La variable quantitative points a été totalement éradiquée de la structure finale, tandis que le volume d’enregistrements (N=7) et l’alignement des valeurs de la colonne rebounds demeurent strictement conformes à l’état originel de la source.
6. Analyse comparative : Stratégie de choix entre KEEP et DROP
6.1 Critères de sélection fondés sur la volumétrie des variables
Le choix technique entre l’implémentation d’une instruction KEEP ou d’une instruction DROP ne répond pas à des critères de goût subjectif mais obéit à des règles d’ingénierie logicielle gouvernées par le principe de concision et la taille relative du dictionnaire de métadonnées. L’objectif cardinal consiste à minimiser la charge cognitive lors de la relecture du code tout en réduisant le risque statistique d’omission ou d’inclusion involontaire.
La règle empirique généralement admise s’articule comme suit : si le nombre de variables à conserver est strictement inférieur au nombre de variables à rejeter, le choix de l’instruction KEEP est méthodologiquement impératif. À titre d’illustration, face à une table épidémiologique comportant 300 variables démographiques et cliniques dont seules 5 métriques biologiques doivent être extraites pour une modélisation logistique, spécifier un KEEP de 5 éléments est infiniment plus économique et lisible que de rédiger une liste exhaustive de 295 variables sous une clause DROP.
Réciproquement, lorsqu’une table nettoyée ne nécessite que l’élimination marginale d’une poignée de variables techniques de travail (telles que des clés d’indexation temporaires, des compteurs de boucle ou des drapeaux booléens intermédiaires), l’instruction DROP s’avère parfaitement indiquée. Elle évite d’alourdir inutilement le script par la déclaration formelle de dizaines de variables pérennes qui n’ont subi aucune modification.
6.2 Robustesse et maintenabilité du code SAS en production
Au-delà de la concision brute, la sécurité applicative dans les environnements de production hautement réglementés (tels que ceux soumis aux normes de la Food and Drug Administration pour les essais cliniques) exige une analyse poussée de la résilience du code face aux évolutions du schéma amont. Dans ces contextes industriels, l’instruction KEEP offre une robustesse structurelle nettement supérieure à celle de l’instruction DROP.
Considérons l’hypothèse où la structure de la table source original_data vient à être modifiée en amont par l’intégration inopinée de trois nouvelles colonnes d’audit non sollicitées. Si l’étape DATA aval exploite une clause DROP, ces trois nouvelles variables vont mécaniquement traverser le filtre et persister dans la table new_data. Cette contamination du schéma peut briser des procédures analytiques ultérieures ou violer des protocoles stricts de minimisation des données (ex. Règlement général sur la protection des données).
À l’opposé, si le programmeur a sécurisé son pipeline à l’aide de l’instruction KEEP, l’injection imprévue de nouvelles colonnes dans la source demeurera sans le moindre impact sur la structure de sortie. Le descripteur de new_data demeurera rigoureusement immuable, garantissant une stabilité contractuelle des interfaces logicielles en production. Dans les environnements critiques, KEEP représente donc une barrière de confinement prédictible et auditée.
6.3 Impact comparatif sur l’utilisation des ressources système
Sur le plan de l’allocation brute de la mémoire vive au sein de l’étape DATA, les instructions KEEP et DROP appliquées sous forme d’instructions autonomes (instructions globales au sein de l’étape DATA) génèrent une empreinte système rigoureusement identique. Dans les deux cas, le compilateur SAS provisionne l’intégralité des variables de la table source dans le PDV, impliquant une charge mémoire proportionnelle à la somme des longueurs des variables lues.
Toutefois, la divergence de performance se manifeste avec acuité lors de la phase de sérialisation définitive sur le sous-système d’écriture (I/O). La taille du fichier binaire .sas7bdat généré dépend strictement du nombre de variables conservées et de leur longueur cumulée en octets. Un élagage dimensionnel sévère opéré par KEEP ou DROP réduit drastiquement la bande passante requise pour enregistrer les données sur disque, allège l’occupation des volumes de stockage partagés et accélère de manière exponentielle les opérations de lecture lors des étapes ultérieures du workflow analytique.
Il est à noter que la taille du bloc descripteur (l’en-tête de la table SAS hébergeant les métadonnées relatives aux formats, labels et attributs de colonnes) se trouve également contractée lorsque le dictionnaire de colonnes est purgé de ses éléments superflus, optimisant ainsi les requêtes d’introspection de métadonnées pilotées par les procédures de catalogage.
7. Exemple 3 : Filtrage conditionnel des lignes avec IF et DELETE
7.1 Syntaxe de l’expression conditionnelle IF-THEN DELETE
L’opération de sous-ensemble ne saurait se limiter à la simple sélection de colonnes ; l’élimination des observations non conformes à des critères empiriques représente la clé de voûte de la préparation des données. L’une des constructions algorithmiques les plus explicites pour opérer cette purge horizontale repose sur l’association de l’instruction d’évaluation logique IF-THEN et de l’ordre impératif DELETE.
Supposons que nous souhaitions restreindre notre jeu de données expérimental aux seules franchises de basket-ball faisant preuve d’une efficacité offensive notable, matérialisée par un seuil minimal de 25 points inscrits. Tout enregistrement affichant un score strictement inférieur à 25 doit être proscrit de la table finale new_data. Le code SAS formalisant cette exigence s’énonce comme suit :
data new_data;

set original_data;

if points < 25 then delete;

run;
La syntaxe se compose de trois éléments moteurs : l’évaluation du prédicat d’inégalité stricte points < 25, l’opérateur de déclenchement THEN, et l’instruction de contrôle de flux DELETE. Lorsque la condition est validée (évaluation booléenne vraie), l’instruction DELETE stoppe instantanément l’exécution séquentielle pour la ligne en cours et retourne immédiatement au début de l’étape DATA pour consommer l’enregistrement suivant, prévenant toute écriture sur le support de sortie.
7.2 Dynamique d’élimination des observations non conformes
Pour saisir l’élégance de cette dynamique, retraçons le comportement pas à pas du moteur SAS lors de l’exécution séquentielle des sept observations de notre table de base original_data :
- Observation 1 (Warriors) :
points = 28. L’évaluation28 < 25est fausse. L’actionDELETEest ignorée. Le flux franchit la ligne, atteint le bas de l’étape DATA et déclenche l’écriture de l’enregistrement dansnew_data. - Observation 2 (Wizards) :
points = 18. L’évaluation18 < 25est vraie. L’actionDELETEest exécutée. L’itération s’interrompt instantanément. Aucune écriture n’a lieu. - Observation 3 (Rockets) :
points = 22. L’évaluation22 < 25est vraie. Interruption immédiate et élimination de l’observation. - Observation 4 (Celtics) :
points = 21. L’évaluation21 < 25est vraie. Élimination de l’observation. - Observation 5 (Thunder) :
points = 31. L’évaluation31 < 25est fausse. Écriture confirmée. - Observation 6 (Spurs) :
points = 27. L’évaluation27 < 25est fausse. Écriture confirmée. - Observation 7 (Nets) :
points = 26. L’évaluation26 < 25est fausse. Écriture confirmée.
Ce traitement séquentiel illustre le caractère implacable du filtrage par rupture de flux. Les équipes des Wizards, des Rockets et des Celtics sont irrémédiablement écartées du processus de restitution, tandis que les Warriors, le Thunder, les Spurs et les Nets franchissent avec succès le crible de sélection.
7.3 Vérification des sorties et validation de la conformité
L’inspection du résultat tabulaire s’effectue par l’appel à la procédure de visualisation PROC PRINT :
proc print data=new_data;

run;
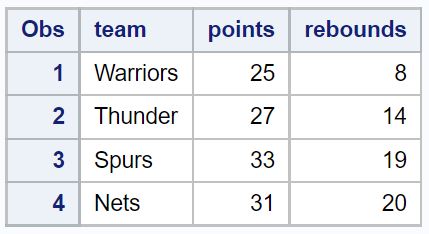
Le rapport de compilation reflète fidèlement la sélection opérée en ne présentant que les quatre entités sportives ayant satisfait au seuil de performance :
| Obs | team | points | rebounds |
|---|---|---|---|
| 1 | Warriors | 28 | 12 |
| 2 | Thunder | 31 | 14 |
| 3 | Spurs | 27 | 11 |
| 4 | Nets | 26 | 7 |
La confirmation d’intégrité au niveau du journal d’exécution affiche désormais : NOTE: There were 7 observations read from the data set WORK.ORIGINAL_DATA. NOTE: The data set WORK.NEW_DATA has 4 observations and 3 variables. L’intégrité des trois variables a été préservée dans leur totalité, tandis que le vecteur des lignes a été congruement réduit aux unités statistiques d’intérêt.
8. L’alternative de conservation positive : L’instruction IF sous-ensemble
8.1 Fonctionnement de l’instruction IF sans clause THEN (Subsetting IF)
Dans l’arsenal syntaxique de SAS, il existe une alternative extrêmement puissante et concise à la formulation IF-THEN DELETE : il s’agit de l’instruction conditionnelle directe, historiquement formalisée sous l’appellation de Subsetting IF (ou instruction IF de sous-ensemble). Cette instruction se singularise par l’absence délibérée de clause d’action THEN.
La formulation générique du Subsetting IF répond au schéma suivant : if condition_booleenne;. Sa sémantique interne inverse la logique d’éviction pour adopter une approche d’inclusion affirmative : si l’évaluation de l’expression booléenne retourne la valeur vraie (valeur non nulle et non manquante en arithmétique SAS), l’exécution du programme se poursuit de manière linéaire vers l’instruction suivante pour la ligne courante. À l’inverse, si l’expression booléenne est évaluée comme fausse ou manquante, l’exécution s’arrête net, et l’enregistrement est immédiatement écarté du flux de sortie.
Cette construction est strictement équivalente sur le plan fonctionnel à l’écriture if not (condition_booleenne) then delete;. Néanmoins, elle élimine le bruit syntaxique lié à l’inversion de la condition logique, simplifiant drastiquement l’écriture des prédicats d’inclusion complexes.
8.2 Comparaison syntaxique appliquée à notre jeu de données
Reprenons l’exigence métier de l’Exemple 3, consistant à ne retenir que les franchises affichant une performance égale ou supérieure à 25 points. L’implémentation par le Subsetting IF s’articule avec une remarquable économie de moyens :
data new_data;

set original_data;

if points >= 25;

run;
En juxtaposant ce bloc avec la solution précédente (if points < 25 then delete;), la symétrie conceptuelle apparaît avec évidence :
- Dans l’approche
IF-THEN DELETE, le programmeur formule la condition de rejet (l’événement pathologique ou non désiré :points < 25) pour ordonner la destruction de la ligne. - Dans l’approche Subsetting IF, le programmeur énonce directement la condition d’acceptation (l’événement recherché :
points >= 25).
Les deux codes produisent rigoureusement la même table physique sur le disque (mêmes observations, mêmes variables, même ordre). Toutefois, le Subsetting IF présente l’avantage stylistique d’exprimer positivement l’hypothèse de travail, ce qui réduit considérablement le risque d’erreur cognitive lors de la manipulation d’opérateurs booléens imbriqués.
8.3 Critères d’élégance algorithmique et d’auditabilité
En matière d’audit de code et de revue par les pairs au sein des équipes de biostatistique, la clarté algorithmique représente un impératif éthique et opérationnel. Le recours systématique aux conditions affirmatives via le Subsetting IF est largement préconisé par les guides de style officiels de SAS Institute. En effet, l’accumulation de doubles négations induite par l’association d’opérateurs négatifs et de clauses DELETE engendre une complexité cyclomatique néfaste.
Par exemple, tester la présence d’une pathologie tout en écartant des critères d’exclusion multiples devient vite illisible sous la forme : if not (pathologie=1 and age > 18 and exclusion=0) then delete;. La formulation par sous-ensemble direct : if pathologie=1 and age > 18 and exclusion=0; restitue immédiatement l’intention clinique sous une forme transparente et directement traçable par rapport au protocole d’essai clinique.
En outre, le Subsetting IF s’intègre harmonieusement avec d’autres instructions procédurales au sein de l’étape DATA, permettant d’enchaîner des filtres horizontaux successifs qui agissent comme des tamis progressifs au fur et à mesure que les transformations de colonnes sont opérées.
9. L’instruction WHERE : Filtrage en amont de la construction du PDV
9.1 Mécanisme fondamental de l’instruction WHERE
Bien que l’instruction conditionnelle IF et le Subsetting IF remplissent parfaitement leur rôle de filtrage, ils partagent une caractéristique architecturale commune : ils s’exécutent au sein de l’étape DATA, après que l’enregistrement a été physiquement extrait de la table source et chargé dans le Program Data Vector. Pour transcender cette limite mécanique, le système SAS propose une instruction hautement optimisée : l’instruction WHERE.
L’instruction WHERE ne relève pas de la logique itérative du PDV ; elle s’adresse directement au moteur d’accès aux données (le moteur de base de données SAS ou le moteur d’ingestion SQL via SAS/ACCESS). Son rôle fondamental consiste à conditionner la transmission des enregistrements avant même qu’ils ne soient injectés dans le PDV. La syntaxe canonique au sein d’une étape DATA s’établit comme suit :
data new_data;

set original_data;

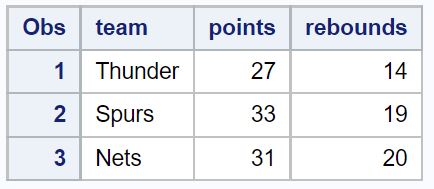
where points >= 25;

run;
Sous cette configuration, le moteur SAS évalue le prédicat points >= 25 dès la lecture des blocs de stockage physique. Les lignes qui échouent au test (Wizards, Rockets, Celtics) ne sont même pas acheminées vers le PDV. Cette mécanique d’interception précoce engendre une économie substantielle de cycles CPU et de bande passante bus mémoire, particulièrement manifeste lorsque les tables traitées hébergent des dizaines de millions de lignes.
9.2 Différences conceptuelles et opératoires entre WHERE et IF
L’assimilation superficielle entre WHERE et IF constitue l’un des pièges les plus répandus chez les développeurs SAS intermédiaires. Bien que le résultat final puisse sembler indiscernable sur de petits volumes de données, leurs principes de fonctionnement divergent fondamentalement :
- Disponibilité des variables calculées : L’instruction
WHEREne peut opérer que sur des variables préexistantes dans la table source mentionnée dans l’instructionSET. Il est rigoureusement impossible d’utiliser une clauseWHEREsur une variable calculée localement au sein de la même étape DATA. Par exemple, le coderatio = points/rebounds; where ratio > 2;déclenchera une erreur fatale de compilation indiquant que la variableration’existe pas dans le jeu de données source. Dans une telle situation, seul le Subsetting IF est légitime. - Exploitation des index : L’instruction
WHEREest la seule capable de tirer parti des index SAS (simples ou composites) préalablement créés sur les tables de données. Lorsqu’un index existe sur la colonnepoints, l’instructionWHEREpermet au moteur d’accéder directement aux enregistrements ciblés par recherche arborescente (B-Tree), sans procéder à un balayage linéaire complet (table scan) de la table. L’instructionIF, quant à elle, requiert impérativement la lecture séquentielle intégrale de tous les enregistrements. - Gestion des valeurs manquantes : Dans les expressions comparatives impliquant des opérateurs d’inégalité, l’instruction
WHEREet l’instructionIFadoptent des comportements d’une grande rigueur mais dont la logique booléenne doit être surveillée, notamment lors de l’usage d’opérateurs spécialisés tels quebetween andouis not missing.
9.3 Utilisation de WHERE dans les procédures statistiques directes
L’un des atouts prééminents de l’instruction WHERE réside dans son universalité d’application. Contrairement aux instructions KEEP, DROP ou IF qui sont structurellement inféodées à l’étape DATA, l’instruction WHERE peut être directement injectée au sein de quasiment toutes les procédures SAS (famille PROC).
Cette faculté permet d’exécuter des analyses statistiques descriptives ou inférentielles sur des sous-populations sans nécessiter la création intermédiaire d’une nouvelle table physique sur le disque. Considérons l’exemple où l’on désire afficher uniquement les statistiques des équipes franchissant le seuil des 25 points sans polluer la bibliothèque WORK par une table dérivée temporaire :
proc print data=original_data;

where points >= 25;

run;
De même, l’intégration de la clause where points >= 25; au sein d’une procédure PROC MEANS ou PROC FREQ permet de calculer instantanément les moyennes, écarts-types ou tables de contingence du sous-groupe cible. Cette pratique élimine les étapes de matérialisation redondantes, préserve l’espace disque sur les serveurs analytiques partagés et assure une exécution hautement rationalisée.
10. Options de table de données : Optimisation via (KEEP=), (DROP=) et (WHERE=)
10.1 Options associées à l’instruction SET (Filtrage en entrée)
Le langage SAS transcende la rigidité des instructions globales grâce au concept extraordinairement flexible des options de table de données (data set options). Ces options s’adjoignent directement entre parenthèses immédiatement après le nom de la table ciblée, aussi bien en lecture (sur l’instruction SET) qu’en écriture (sur l’instruction DATA).
L’application d’options de filtrage sur l’instruction SET matérialise le concept de filtrage en entrée (input filtering). Examinons la syntaxe suivante :
data new_data;

set original_data(keep=team points where=(points >= 25));

run;
L’impact architectural de cette écriture est colossal. Grâce à l’option keep=team points, la variable rebounds n’est même pas allouée au sein du Program Data Vector lors de la compilation de l’étape DATA ! Elle est complètement occultée dès la phase de lecture sur le support de stockage. Simultanément, la clause where=(points >= 25) garantit que seules les observations validant la condition franchissent le tampon d’ingestion. Le PDV est ainsi configuré avec une compacité optimale, n’hébergeant que les octets rigoureusement indispensables à l’opération.
10.2 Options associées à l’instruction DATA (Filtrage en sortie)
À l’autre extrémité de la chaîne de transmission, les options appliquées au niveau de l’instruction DATA régulent le filtrage en sortie (output filtering). Cette approche permet de moduler précisément la structure des tables finales créées, notamment lorsqu’une étape DATA produit simultanément plusieurs jeux de données divergents à partir d’une source unique.
Considérons le scénario où une organisation souhaite scinder une table maîtresse en deux tables distinctes spécialisées : une table dédiée aux métriques d’attaque et une table dédiée aux métriques défensives, tout en conservant l’identifiant de l’équipe dans les deux entités :
data offense_data(keep=team points) defense_data(keep=team rebounds);

set original_data;

run;
Dans cet exemple, toutes les variables sont lues et coexistent harmonieusement dans le PDV au cours de l’itération. Lors du déversement physique de la mémoire vers le stockage, le moteur SAS applique les masques de sortie différenciés spécifiés par chaque option de table. La table offense_data ne recevra que les colonnes team et points, tandis que la table defense_data n’enregistrera que team et rebounds. Cette prouesse architecturale s’accomplit en une seule passe séquentielle sur la table source, maximisant l’efficience computationnelle.
10.3 Combinaison matricielle des options de table pour un contrôle granulaire
Le plein potentiel de l’ingénierie de données SAS s’exprime dans la combinaison matricielle et synergique de ces différentes options au sein d’une étape DATA complexe. Il devient envisageable d’associer un filtrage d’entrée agressif pour soulager la mémoire, d’exécuter des transformations analytiques lourdes, puis d’appliquer des filtres de sortie spécialisés.
Le tableau comparatif suivant synthétise les propriétés respectives des différentes modalités d’intervention pour la sélection des colonnes et des lignes :
| Mécanisme | Type de réduction | Point d’action temporel | Présence dans le PDV | Usage dans les procédures |
|---|---|---|---|---|
| Instruction KEEP/DROP | Verticale (colonnes) | Écriture finale (Output) | Oui (pleinement active) | Non (étape DATA uniquement) |
| Option (KEEP=/DROP=) sur SET | Verticale (colonnes) | Lecture initiale (Input) | Non (variable non allouée) | Oui |
| Instruction IF / Subsetting IF | Horizontale (lignes) | Au sein de l’étape DATA | Oui (chargée avant test) | Non (étape DATA uniquement) |
| Instruction WHERE | Horizontale (lignes) | Avant l’entrée dans le PDV | Non pour les rejets | Oui (universelle) |
La règle d’or pour l’ingénieur de données consiste à pousser le filtrage au point le plus précoce possible de la chaîne d’exécution (fail-early principle). Chaque colonne non allouée et chaque ligne interceptée en amont du PDV se traduit par une économie de ressources système immédiatement mesurable.
11. Application contextuelle : Préparation de sous-ensembles en recherche quantitative
11.1 Sélection d’échelles et de sous-dimensions psychométriques
Dans le domaine des sciences du comportement, de la psychométrie et de la recherche en santé publique, les protocoles de collecte déploient fréquemment des questionnaires standardisés comprenant des centaines d’items individuels (échelles de Likert mesurant la résilience, l’anxiété ou la qualité de vie). La préparation de la matrice d’analyse requiert impérativement un sous-ensemble vertical rigoureux avant toute analyse factorielle exploratoire ou confirmatoire.
Grâce aux instructions et options de type KEEP, le biostatisticien isole les items spécifiques constitutifs d’une sous-dimension validée (par exemple les questions 12 à 24 associées au construit d’anxiété cognitive), tout en rejetant formellement via DROP les métadonnées techniques générées par les plateformes de recueil en ligne (horodatages de clics, adresses IP des répondants, drapeaux d’interruption temporaire). Cette sélection systématique garantit que la matrice de covariance soumise aux algorithmes d’estimation matricielle ne souffre d’aucune singularité mathématique imputable à des colonnes artéfactuelles.
La formulation explicite des variables retenues assure en outre la parfaite traçabilité du dictionnaire de données dans le rapport de recherche, condition indispensable pour satisfaire aux critères de reproductibilité scientifique exigés par la communauté académique internationale.
11.2 Filtrage d’échantillons cliniques selon des critères d’inclusion
Dans la recherche clinique et épidémiologique, la conformité absolue avec le protocole d’essai clinique enregistré (ex. sur ClinicalTrials.gov) impose la constitution de sous-ensembles de population méthodologiquement inattaquables. Les critères d’éligibilité stipulent fréquemment des bornes d’âge d’inclusion, des seuils de biomarqueurs biologiques et l’obligation d’un consentement éclairé validé.
Le filtrage conditionnel via l’instruction WHERE ou le Subsetting IF constitue le levier formel par lequel le statisticien dérive la population en intention de traiter (ITT) ou la population per-protocole (PP) à partir de la base de recrutement globale. Par exemple, une instruction telle que where age >= 18 and score_inclusion >= 50 and statut_consentement = 'VALIDE'; matérialise l’algorithme d’inclusion avec une rigueur mathématique irréfutable.
L’inspection minutieuse des métriques de sortie dans le journal SAS (nombre d’enregistrements rejetés à chaque étape du tamisage) fournit la matière brute nécessaire à l’élaboration du diagramme de flux CONSORT (Consolidated Standards of Reporting Trials), documentant pas à pas l’attrition de la cohorte depuis l’enrôlement initial jusqu’à la phase d’analyse définitive.
11.3 Nettoyage des valeurs aberrantes et conformité déontologique
La robustesse des inférences quantitatives repose également sur l’assainissement systématique des jeux de données, notamment par l’éviction contrôlée des valeurs aberrantes (outliers) et des observations entachées d’irrégularités chronométrées (temps de réponse aberrants suggérant une passation automatisée frauduleuse ou un défaut d’attention du sujet).
L’implémentation de filtres conditionnels combinés à des bornes statistiques dérivées (par exemple l’écart interquartile ou des seuils de distance de Mahalanobis calculés préalablement) permet d’éliminer les unités contaminantes à l’aide de la clause IF condition_aberrante THEN DELETE;. Ce filtrage préserve la normalité résiduelle des distributions et prévient les distorsions majeures des estimateurs des moindres carrés ordinaires.
Sur le plan déontologique et réglementaire, le sous-ensemble constitue le premier instrument de mise en conformité avec les réglementations relatives à la protection de la vie privée. L’exclusion catégorique des colonnes d’identification directe (nom, prénom, numéro de sécurité sociale) par une instruction DROP rigoureuse garantit la création d’un jeu de données de travail dûment pseudonymisé, assurant qu’aucun personnel d’analyse non habilité ne puisse être exposé à des données à caractère personnel sensibles.
12. Synthèse méthodologique, pièges courants et recommandations d’experts
12.1 Erreurs fréquentes lors du sous-ensemble et stratégies de résolution
L’expérience cumulée sur les systèmes industriels SAS révèle une récurrence systématique de certains pièges algorithmiques dont l’ingénieur de données doit impérativement se prémunir :
- La confusion fonctionnelle entre instruction globale et option de table : Rédiger
drop team;au corps de l’étape DATA laisse la variable accessible au calcul au sein du PDV. En revanche, écrireset original_data(drop=team);empêche totalement le chargement deteamdans le PDV. L’utilisation subséquente deteamdans une clause conditionnelle entraînera la création involontaire d’une variable vide initialisée à la valeur manquante, altérant silencieusement la logique du programme. - Le piège de la valeur manquante dans les comparaisons d’inégalité : En syntaxe SAS, la valeur manquante numérique (représentée par un point
.) est conceptuellement assimilée à l’infini négatif (soit la valeur numérique la plus petite envisageable). Par voie de conséquence, l’instructionif points < 25 then delete;aura pour effet d’éliminer impitoyablement toutes les observations dont la variablepointsest manquante ! Si la volonté métier consiste à conserver les valeurs non renseignées pour un imputage ultérieur, la clause doit être réécrite ainsi :if points < 25 and points ne . then delete;. - L’écrasement involontaire de la table source : Déclarer
data original_data; set original_data;combiné avec un filtre erroné détruit instantanément la table de référence sur le disque. Il est impératif de toujours sérialiser les sous-ensembles dans des tables cibles distinctes (new_data) lors de la phase de prototypage.
12.2 Diagnostic approfondi à l’aide des procédures d’audit
La validation d’un programme SAS de création de sous-ensembles ne s’arrête jamais à l’absence de message d’erreur dans le journal. Elle exige une démarche d’audit actif mobilisant les procédures d’introspection structurelle fournies par le système.
La procédure reine pour certifier l’architecture d’un sous-ensemble est PROC CONTENTS. Sa formulation méthodique :
proc contents data=new_data varnum;

run;
L’option varnum ordonne l’impression des variables selon leur ordre logique physique dans la table. Le rapport émis détaille la liste exhaustive des attributs, leurs types, leurs longueurs, ainsi que le nombre officiel d’observations certifiées. La confrontation de ce rapport avec le dictionnaire de données théorique permet de valider avec une certitude absolue que seules les colonnes attendues subsistent.
Parallèlement, pour les sous-ensembles horizontaux, la procédure PROC FREQ ou la procédure PROC UNIVARIATE appliquée sur les variables de filtrage permet de vérifier qu’aucune valeur en dehors des bornes spécifiées (par exemple des scores inférieurs à 25) n’a subsisté clandestinement dans la table dérivée finale.
12.3 Guide décisionnel pour l’ingénieur de données SAS
Afin de structurer le processus de décision de l’ingénieur et de garantir une uniformité méthodologique au sein des équipes de développement, nous formalisons le guide décisionnel suivant sous la forme de règles algorithmiques univoques :
- Cas 1 : Réduction verticale d’une minorité de colonnes. Utilisez l’instruction déclarative
DROPou l’option de sortie(DROP=)si vous préservez plus de 80 % des variables initiales. - Cas 2 : Isolation sélective d’un cœur de colonnes restreint. Privilégiez systématiquement l’instruction
KEEPou l’option d’entrée(KEEP=)pour garantir l’étanchéité du schéma final face aux modifications amont imprévues. - Cas 3 : Filtrage horizontal fondé sur des variables existantes dans la source. Employez l’instruction
WHEREou l’option de table(WHERE=)dès la lecture viaSETpour économiser les transferts de mémoire et solliciter les index matériels disponibles. - Cas 4 : Filtrage horizontal conditionné par des variables créées localement. Recourez exclusivement au Subsetting IF (
if condition;) formulé de manière positive pour une auditabilité logicielle optimale. - Cas 5 : Production simultanée de sous-ensembles hétérogènes. Déployez les options de table en sortie (
data table1(keep=...) table2(keep=...);) dans une unique étape DATA afin de rentabiliser le temps d’accès au fichier source et minimiser les cycles CPU globaux.
En observant scrupuleusement ces standards de développement, l’analyste de données élève ses programmes SAS au plus haut niveau d’efficience, de maintenabilité et de rigueur scientifique, garantissant une exploitation pérenne et irréprochable des patrimoines informationnels d’entreprise.
Références
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer, Sixth Edition. SAS Institute Inc. https://support.sas.com/en/books.html
- SAS Institute Inc. (2021). SAS® 9.4 Statements: Reference, Fifth Edition. SAS Institute Inc. https://documentation.sas.com
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS, Third Edition. SAS Institute Inc. https://support.sas.com/en/books.html
- Horstman, D. W. (2017). Methods of Subsetting Data in SAS: Efficiency and Elegance. Proceedings of the SAS Global Forum 2017 Conference. https://www.sas.com/en_us/events/sas-global-forum.html
- International Organization for Standardization. (2023). Systems and software engineering — Systems and software Quality Requirements and Evaluation (SQuaRE) — System and software quality models (ISO/IEC Standard No. 25010:2023). https://www.iso.org/standard/78176.html
- Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: updated guidelines for reporting parallel group randomised trials. BMJ, 340, c869. https://doi.org/10.1136/bmj.c869