
Dans l’écosystème de l’ingénierie des données et de l’analyse statistique avancée, le système SAS (Statistical Analysis System) demeure une référence institutionnelle majeure, plébiscitée tant pour sa robustesse transactionnelle que pour sa capacité à traiter des volumes colossaux d’informations au sein d’environnements réglementés. Toutefois, la manipulation de structures tabulaires sous SAS repose sur des paradigmes d’exécution singuliers qui diffèrent fondamentalement des approches purement déclaratives propres au langage SQL standard ou des structures dynamiques en mémoire que l’on observe communément sous Python (Pandas) ou R (Tidyverse). Parmi les exigences récurrentes qui jalonnent le cycle de vie de la préparation des données, l’agencement ordonné et la disposition séquentielle des colonnes constituent un enjeu opérationnel déterminant, influençant non seulement la lisibilité humaine des rapports d’extraction, mais conditionnant également la performance des opérations de fusion ultérieures et la conformité des tables livrées aux organismes de contrôle.
Contrairement aux représentations relationnelles classiques où l’ordre des colonnes est théoriquement considéré comme dépourvu de signification sémantique en vertu des axiomes de Codd, l’architecture interne des tables de données SAS (fichiers d’extension propriétaire .sas7bdat) accorde une importance physique et logique de premier plan à l’agencement séquentiel des variables. Cet ordonnancement est régi par le mécanisme interne du vecteur de données de programme, désigné sous l’acronyme PDV (Program Data Vector), dont la configuration structurelle se fige dès la phase initiale de compilation d’une étape DATA. Dès lors, réordonner les variables d’une table existante exige une compréhension fine des interactions entre les instructions déclaratives et exécutables, au premier rang desquelles figure l’instruction RETAIN, trop souvent méconnue ou réduite à sa seule fonction de persistance scalaire inter-observations.
Le présent article propose une exploration méthodique, exhaustive et rigoureuse des mécanismes permettant de réorganiser les colonnes d’une table SAS. À travers un jeu de données empirique standardisé et reproductible, nous analyserons les fondements théoriques de l’allocation mémoire au sein du PDV, avant de détailler les trois variantes d’application de l’instruction RETAIN, les alternatives basées sur la procédure PROC SQL, l’automatisation dynamique via les tables dictionnaires du métamodèle SAS, ainsi que les écueils syntaxiques et les impacts de performance associés au traitement de volumétries massives. Cette monographie vise à doter les statisticiens, biostatisticiens et ingénieurs de données d’un cadre méthodologique pérenne garantissant l’intégrité absolue de leurs métadonnées au fil des processus d’assainissement et de structuration.
1. Introduction à l’organisation structurelle des variables dans SAS
1.1 Fondements de l’architecture des tables de données SAS
L’architecture interne d’un fichier de données SAS au format .sas7bdat repose sur une structure binaire hybride, rigoureusement compartimentée entre un en-tête descriptif (le bloc descripteur) et une zone de stockage séquentiel des enregistrements physiques (les pages de données). Le bloc descripteur consigne l’ensemble des métadonnées régissant la table, à savoir le nombre total d’observations, la longueur fixe de chaque enregistrement exprimée en octets, ainsi que la table de correspondance des attributs des variables. Au sein de cette table de descripteurs, chaque colonne se voit assigner un identifiant numérique de position relative, communément appelé variable number ou ordre de compilation, qui détermine l’emplacement précis (décalage ou offset binaire) à partir duquel la valeur de cette variable est enregistrée pour chaque ligne d’observation.
Cette disposition séquentielle n’est pas un artefact cosmétique de présentation : elle découle directement de l’ordre chronologique d’introduction des variables lors de la phase de compilation du script générateur initial. Lorsque le moteur d’exécution SAS alloue l’espace sur le support de stockage physique, il sérialise les attributs dans le strict respect de cette séquence d’enregistrement. Par conséquent, il convient d’opérer une distinction méthodologique fondamentale entre l’ordre physique de stockage des données au sein des pages du fichier binaire et l’ordre de restitution visuelle offert par les procédures d’impression ou les interfaces graphiques. Si certains outils modernes permettent de réordonner l’affichage côté client sans altérer le support persistant, la modification pérenne de la table sous-jacente requiert une réécriture orchestrée qui reconstruit l’en-tête de description et redistribue les décalages binaires au sein de chaque bloc physique d’enregistrement.
1.2 Justifications méthodologiques du réordonnancement des colonnes
D’un point de vue opérationnel et analytique, le positionnement réfléchi des variables dans une table de données ne répond pas uniquement à des exigences esthétiques, mais participe directement à la fiabilisation des flux de traitement et à l’accroissement de la productivité des analystes. En premier lieu, lors des phases d’inspection exploratoire des bases, l’émission de sorties tabulaires via la procédure PROC PRINT ou au travers de visualiseurs interactifs devient nettement plus intelligible lorsque les attributs fondamentaux — tels que les identifiants uniques de sujets, les codes de centres d’investigation ou les horodatages critiques — sont positionnés immédiatement sur les colonnes les plus à gauche de l’écran ou de la page imprimée. Cette proximité visuelle immédiate limite les erreurs d’interprétation lors des audits de contrôle qualité.
En second lieu, l’harmonisation de l’ordre des colonnes constitue un prérequis structural impératif préalablement à l’exécution de certaines opérations de concaténation ou de fusion verticale d’envergure. Bien que l’instruction SET combinant plusieurs tables tolère des divergences dans l’ordre des variables en effectuant un alignement nominal lors de la compilation, l’uniformisation structurelle en amont prévient les anomalies de typage masquées et facilite l’utilisation de listes de variables contiguës par plage lexicale (les syntaxes utilisant l’opérateur double tiret varA--varZ). De surcroît, dans le cadre d’études cliniques ou épidémiologiques strictement encadrées par des standards internationaux tels que le modèle d’onglets de données d’études cliniques (SDTM) élaboré par le consortium CDISC, l’ordre précis d’apparition des variables (par exemple l’identifiant de l’étude STUDYID, suivi du domaine DOMAIN, puis de l’identifiant unique du sujet USUBJID) fait l’objet de règles de conformité non négociables dont le non-respect invalide la soumission réglementaire.
1.3 Aperçu général des solutions de réordonnancement
Pour modifier l’ordre des variables d’une table de données, l’environnement SAS propose plusieurs paradigmes d’ingénierie logicielle, chacun présentant des compromis spécifiques entre verbosité syntaxique, performance de traitement et flexibilité face à des schémas de données dynamiques. La méthode prépondérante, reconnue par la communauté académique comme le standard d’efficience au sein de l’étape DATA, repose sur l’exploitation détournée de l’instruction déclarative RETAIN. En mentionnant les variables cibles avant toute lecture séquentielle via l’instruction SET, le développeur force l’inscription précoce de ces attributs au sein de la mémoire tampon de travail, établissant ainsi une nouvelle topologie des colonnes sans requérir de traitements algorithmiques complexes.
Parallèlement à cette approche programmatique classique, il est envisageable de solliciter la procédure PROC SQL. À travers l’instruction CREATE TABLE et une clause SELECT énumérant explicitement les descripteurs, l’analyste peut recomposer l’agencement structurel de sa table en exploitant une syntaxe normalisée familière aux praticiens formés aux systèmes de gestion de bases de données relationnelles (SGBDR). Enfin, pour les architectures de traitement automatisées confrontées à des volumétries imposantes ou à des métadonnées volatiles, le couplage entre les vues dictionnaires du système (notamment la table SASHELP.VCOLUMN) et le processeur macro de SAS offre un niveau d’abstraction supérieur. Cette approche dynamique permet d’ordonnancer automatiquement des centaines de variables selon des critères logiques prédéfinis (ordre alphabétique, typologie de stockage, conventions de nommage) sans nécessiter la moindre intervention manuelle sur le code source.
2. Mécanisme sous-jacent : Le vecteur de données de programme (PDV)
2.1 Fonctionnement détaillé du Program Data Vector (PDV)
Pour appréhender avec exactitude la logique qui gouverne le réordonnancement des colonnes sous SAS, il est indispensable de disséquer le fonctionnement interne du vecteur de données de programme, communément désigné sous son acronyme anglophone PDV (Program Data Vector). Le PDV est une zone tampon allouée en mémoire vive par le système SAS lors de l’initialisation d’une étape DATA. Son rôle architectural consiste à héberger l’ensemble des valeurs des variables pour une observation unique au cours de son cycle de traitement, agissant comme un pont computationnel entre la lecture des enregistrements depuis le disque dur et leur sérialisation physique dans la table de destination finale.
Le cycle de traitement d’une étape DATA est scindé en deux phases chronologiques distinctes : la phase de compilation et la phase d’exécution. C’est durant la phase de compilation que l’architecture structurelle du PDV se construit de manière irrévocable. Dès que le compilateur SAS lit le script de l’étape DATA de haut en bas et de gauche à droite, il consigne chaque nouvelle variable rencontrée dans une table des symboles et réserve un créneau séquentiel contigu dans le PDV. L’ordre définitif dans lequel les colonnes apparaîtront dans la table physique de sortie correspond exactement à l’ordre d’enregistrement initial des noms de variables dans le PDV au cours de cette phase de compilation. Une fois qu’une variable a été insérée dans le PDV, sa position relative ne peut plus être modifiée par les instructions subséquentes lors de la phase d’exécution.
2.2 Le rôle structurel de l’instruction RETAIN
Dans l’arsenal syntaxique de l’étape DATA, l’instruction RETAIN est originellement conçue pour modifier le comportement de réinitialisation des variables de calcul d’une itération à la suivante. Par défaut, le processeur d’exécution SAS réinitialise à la valeur manquante (missing value) toutes les variables calculées au début de chaque cycle d’exécution du PDV. L’instruction RETAIN neutralise cette remise à zéro automatique, permettant par exemple l’agrégation continue de sommes cumulées ou la préservation de compteurs séquentiels.
Cependant, sur le plan strictement structurel, RETAIN est avant tout une instruction de nature déclarative, évaluée exclusivement lors de la phase de compilation du programme. Lorsque le compilateur SAS rencontre une instruction telle que retain variable_cible;, il vérifie si ladite variable figure déjà dans le dictionnaire du PDV. Si elle n’a pas encore été répertoriée, le compilateur l’inscrit immédiatement à la position courante dans le PDV, réservant son espace mémoire avant même d’avoir examiné la moindre source de données sous-jacente. Il existe donc une dualité fondamentale : tandis que sa fonction d’exécution concerne la persistance de l’état mémoire d’une ligne à l’autre, son impact structurel lors de la compilation réside dans la priorisation absolue de l’allocation spatiale des colonnes. C’est cette propriété mécanique précise qui fait de RETAIN le levier canonique de réordonnancement des variables dans SAS.
2.3 Comportement de l’instruction SET vis-à-vis du PDV
L’articulation entre l’instruction RETAIN et l’instruction SET constitue le cœur algorithmique du réordonnancement. Lorsque l’instruction SET est compilée, le compilateur SAS analyse les métadonnées de la table d’entrée référencée. Il examine séquentiellement chaque colonne présente dans le fichier source et l’ajoute au PDV si et seulement si cette variable n’a pas déjà été enregistrée par une instruction déclarative antérieure.
Si une variable a préalablement été déclarée via une instruction RETAIN positionnée en amont de l’instruction SET, le compilateur identifie que l’attribut est déjà logé dans le PDV à un rang d’offset défini. Il se contente alors d’associer les caractéristiques de métadonnées de la table source (le type de données numérique ou alphanumérique, la longueur d’octet de stockage, le label descriptif ainsi que les formats et informats associés) à l’emplacement mémoire préexistant sans en altérer la position relative. À l’inverse, toutes les variables de la table source qui n’ont pas été mentionnées dans le RETAIN préalable sont ajoutées au PDV à la suite immédiate des variables pré-déclarées, dans le strict respect de leur ordre d’apparition primitif au sein de la table d’origine. Enfin, lors de l’exécution, l’instruction SET lit physiquement l’enregistrement disque et vient écraser les segments mémoires correspondants du PDV, garantissant une intégrité transactionnelle absolue des valeurs sans aucune altération de données.
3. Présentation du jeu de données expérimental de référence
3.1 Construction du jeu de données brut via DATALINES
Afin d’illustrer les protocoles de manipulation structurelle avec une rigueur empirique vérifiable, nous établissons un jeu de données expérimental représentatif, contextualisé autour de métriques de performances sportives issues d’une ligue professionnelle de basket-ball. Ce jeu de données, arbitrairement nommé original_data, contient à la fois une variable catégorielle identifiant l’équipe d’appartenance et quatre métriques quantitatives fondamentales : les points marqués, les rebonds captés, les passes décisives distribuées et les interceptions réalisées.
La matérialisation de cette table s’effectue au moyen d’une étape DATA standard combinant l’instruction de saisie interne DATALINES et l’affectation explicite des descripteurs via l’instruction INPUT. L’utilisation du modificateur de format alphanumérique $ sur la variable team alloue une chaîne de caractères, tandis que les autres mesures statistiques sont instanciées comme des variables numériques à virgule flottante double précision sous le format standard IEEE de 8 octets propre à l’architecture SAS sous environnement 64 bits :
data original_data;

    input team $ points rebounds assists steals;

    datalines;

A 25 8 5 2

B 18 12 3 1

C 32 4 8 3

D 15 10 2 0

E 28 6 7 4

F 22 9 4 2

G 30 5 6 1

;

run;
Ce protocole instancie un échantillon équilibré de sept observations d’athlètes ou d’équipes distinctes, exempt de valeurs aberrantes ou manquantes. Il constitue un cadre expérimental idéal pour suivre l’évolution des structures de stockage sans introduire de biais analytiques liés à la validité des contenus scalaires.
3.2 Diagnostic de la structure initiale avec PROC PRINT et PROC CONTENTS
Dès l’exécution du script de génération, il convient d’établir un audit formel de la topologie de la table créée à travers les outils d’inspection canoniques du moteur SAS. L’exécution élémentaire de la procédure PROC PRINT permet de restituer visuellement les enregistrements tels qu’ils sont interprétés par le système de présentation :
proc print data=original_data noobs;

run;
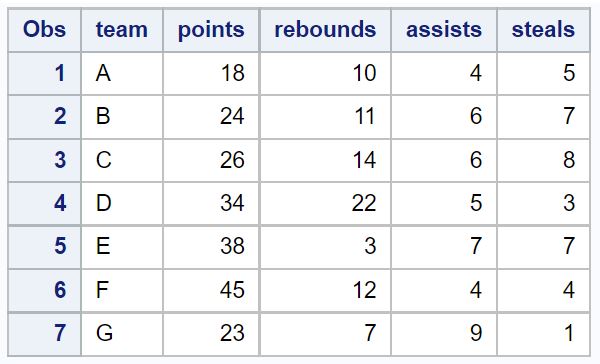
Cette commande génère une grille bidimensionnelle dont les colonnes s’affichent dans l’ordre rigoureusement identique à celui de leur formulation au sein de l’instruction INPUT : team, points, rebounds, assists, et steals. Cependant, l’examen visuel via PROC PRINT ne constitue qu’une projection superficielle. Pour auditer la structure intime des métadonnées et attester de la position binaire réelle de chaque descripteur dans l’en-tête de la table, il est impératif d’interroger la procédure d’analyse des descripteurs PROC CONTENTS, en spécifiant l’option VARNUM (abrégée pour Variable Number Order) :
proc contents data=original_data varnum;

run;
Dans le rapport technique produit par cette procédure, la section intitulée Variables in Creation Order consigne formellement le tableau des métadonnées de position : la variable team se voit attribuer le rang cardinal 1, points le rang 2, rebounds le rang 3, assists le rang 4 et steals le rang 5. Cet audit dimensionnel fige notre situation de départ. L’objectif des sections subséquentes consistera à manipuler ce modèle d’agencement pour répondre à divers impératifs métiers de restructuration tabulaire.
4. Méthode 1 : Réorganisation intégrale de l’ensemble des variables
4.1 Syntaxe formelle et positionnement stratégique du RETAIN
La première méthodologie opérationnelle, et la plus exhaustive, consiste à redéfinir intégralement l’ordre de l’ensemble des colonnes constitutives de la table de données. Ce procédé s’applique typiquement lorsque l’ingénieur souhaite aligner une base hétéroclite sur une maquette de rapport formelle ou sur un protocole standardisé exigeant une chronologie d’attributs strictement prédéterminée. Pour réussir cette recomposition, la règle syntaxique cardinale réside dans le placement rigoureux de l’instruction RETAIN en amont immédiat de l’instruction de lecture SET.
D’un point de vue programmatique, l’instruction RETAIN accepte une énumération linéaire de variables, séparées par de simples espaces blancs, sans délimiteur de ponctuation intercalaire en dehors du point-virgule terminal. Le langage SAS étant insensible aux retours chariots et aux tabulations au sein d’un même énoncé logique, il est fortement recommandé, dans une perspective d’ingénierie logicielle durable, de scinder les longues listes de descripteurs sur plusieurs lignes indentées. Cela améliore considérablement la maintenabilité du code tout en prévenant les omissions accidentelles de colonnes :
data new_data;

    retain team rebounds assists steals points;

    set original_data;

run;
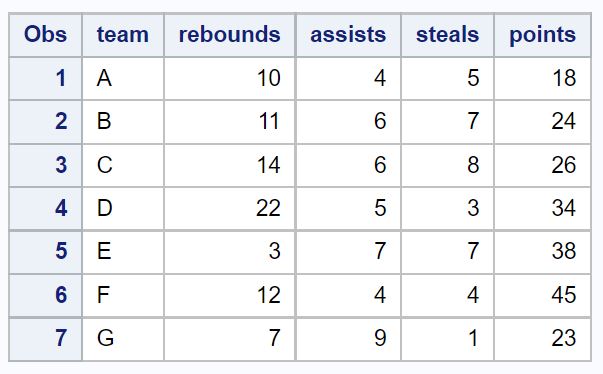
Dans cette structure, dès lors que le compilateur SAS lit la première ligne, il inscrit successivement dans le PDV les descripteurs team (position 1), rebounds (position 2), assists (position 3), steals (position 4) et points (position 5). Lorsque l’instruction set original_data; est ensuite interprétée, le compilateur constate que toutes les variables de la source existent déjà dans son registre de compilation. Il ne modifie donc aucun rang et valide cet ordonnancement pour l’écriture finale du fichier de données new_data.
4.2 Application pratique : Transformation complète du jeu de données
L’exécution de la séquence précédente applique concrètement cette réorganisation intégrale sur notre référentiel expérimental. Dans la table original_data, la métrique offensive points apparaissait immédiatement après l’identification de l’équipe (en deuxième position), devançant les indicateurs défensifs et organisationnels. Dans la nouvelle table produite, new_data, nous observons une relégation délibérée de la variable points en toute fin de structure tabulaire.
Pour certifier scientifiquement que la mutation structurelle a opéré sans la moindre perte d’intégrité volumétrique ou scalaire, nous procédons à une double vérification associant l’affichage tabulaire et l’extraction des métadonnées de création :
proc print data=new_data noobs;

run;
proc contents data=new_data varnum;
run;
La sortie de la procédure PROC PRINT matérialise visuellement la nouvelle séquence des colonnes : pour l’équipe A, nous lisons de gauche à droite la séquence team = A, rebounds = 8, assists = 5, steals = 2, et finalement points = 25. Aucune donnée n’a été corrompue : la valeur de 25 points demeure rigoureusement associée à l’équipe A. Parallèlement, le rapport de PROC CONTENTS sous l’option VARNUM confirme que la variable points a migré de la position physique numéro 2 à la position numéro 5. Ce cas démontre la parfaite efficience de la méthode pour les schémas d’attributs entièrement maîtrisés.
4.3 Gestion des grands volumes de colonnes
Lorsque le schéma de données sous-jacent comprend plusieurs dizaines ou centaines d’attributs, la rédaction manuelle et exhaustive de chaque nom de variable dans l’instruction RETAIN devient une opération fastidieuse, génératrice d’erreurs humaines par inadvertance et particulièrement pénible à auditer. Dans cette configuration, le langage SAS offre des mécanismes de syntaxe abrégée extrêmement puissants qui permettent de compacter la formulation de l’instruction RETAIN tout en conservant une précision chirurgicale sur l’ordonnancement du PDV.
La première syntaxe repose sur les listes numériques indexées. Si un ensemble de variables partage un préfixe lexical commun et se termine par un incrément arithmétique strictement continu (par exemple question1, question2, …, question50 ou score1-score100), le compilateur SAS supporte la notation abrégée par tiret simple : retain id date score1-score100 total;. Cette syntaxe déploie automatiquement les cent variables dans l’ordre séquentiel de leurs indices numériques au sein du PDV.
La seconde syntaxe fait appel aux plages lexicales fondées sur l’ordre physique initial de la table source, identifiées par le double tiret : retain team var_premiere--var_derniere points;. Cette notation ordonne au compilateur d’insérer toutes les colonnes comprises entre var_premiere et var_derniere dans le strict ordre où elles apparaissent actuellement dans la table source. Néanmoins, en dépit de ces raccourcis d’écriture, la méthode d’ordonnancement exhaustive montre ses limites d’extensibilité lorsque les tables subissent des évolutions fréquentes de schéma (ajout imprévu de nouvelles colonnes lors d’extractions automatisées), nécessitant alors de basculer vers des stratégies de déclaration sélective ou partielle.
5. Méthode 2 : Déplacement d’une variable unique en tête de table
5.1 Principe de la déclaration partielle anticipée
Dans un contexte d’ingénierie analytique, il est fréquent que l’analyste ne souhaite pas redéfinir l’ordonnancement complet de cinquante variables, mais désire simplement promouvoir une colonne critique en tête de structure afin qu’elle devienne le descripteur primaire visible dès l’ouverture du jeu de données. Il peut s’agir typiquement d’un horodatage d’événement, d’une clé de partitionnement ou d’un identifiant patient anonymisé qui se retrouvait initialement isolé en milieu ou en fin de table à la suite de fusions successives.
Le comportement architectural du compilateur SAS autorise une manipulation particulièrement élégante : la déclaration partielle anticipée. Si l’instruction RETAIN ne contient qu’un seul nom de variable, le compilateur procède immédiatement à l’inscription de cette unique variable à la position numéro 1 du PDV. Subséquemment, lorsque l’instruction SET est compilée, le moteur SAS lit la table source et constate que la variable spécifiée dans le RETAIN possède déjà son allocation mémoire au sommet de la pile. En conséquence, le compilateur inspecte les variables restantes du fichier d’entrée et les incorpore dans le PDV, de manière purement séquentielle, à la suite de la variable privilégiée, en préservant scrupuleusement leur ordre relatif d’origine.
5.2 Application concrète : Mise en avant de la variable steals
Considérons à titre d’expérimentation concrète la volonté de promouvoir la variable steals (les interceptions), initialement confinée à la cinquième et dernière position de notre table original_data, pour en faire le premier attribut de consultation dans la table résultante, tout en conservant scrupuleusement la séquence relative des quatre autres descripteurs (team, points, rebounds, assists).
L’implémentation de cette stratégie exige une économie syntaxique remarquable. Il suffit d’énoncer le nom de la variable cible dans un bloc RETAIN minimaliste précédant l’instruction SET :
data promoted_steals;

    retain steals;

    set original_data;

run;
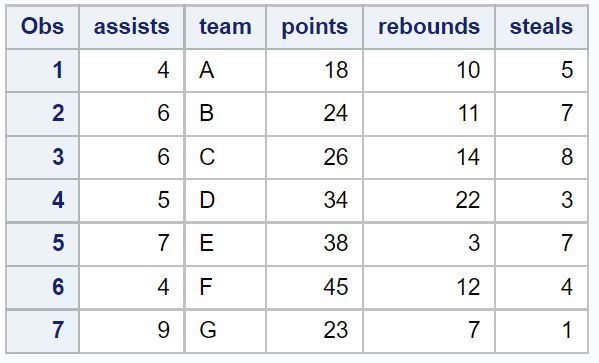
L’exécution de cette étape DATA instancie la table promoted_steals. L’inspection des enregistrements au moyen de l’instruction proc print data=promoted_steals noobs; run; révèle immédiatement l’efficacité de la structure obtenue : la colonne steals trône désormais en première position sur le flanc gauche de la matrice de données. Elle est immédiatement suivie par team, puis points, rebounds et assists. Le compilateur a mécaniquement absorbé la variable steals en position 1 lors de la rencontre de l’instruction RETAIN, puis a complété le PDV avec les attributs de la table source dans leur ordre relatif historique. L’intégrité des couples d’enregistrements demeure inaltérée : l’équipe A affiche fièrement ses 2 interceptions en première colonne, suivies de son identification et de ses 25 points.
5.3 Conséquences opérationnelles et gains d’efficience
L’adoption systématique de la déclaration partielle anticipée procure des avantages substantiels sur le plan de la maintenance applicative et de la robustesse des chaînes de production de données. Premièrement, cette approche allège de façon drastique le volume de code rédigé. Pour une table comportant quatre-vingts attributs, inscrire un seul mot-clé après RETAIN plutôt que de reproduire manuellement les quatre-vingts identificateurs élimine un risque significatif de fautes de frappe susceptibles de faire échouer la compilation.
Deuxièmement, cette méthode confère une résilience remarquable aux programmes d’intégration. Si, lors d’une extraction mensuelle ultérieure, la table source original_data vient à s’enrichir de nouvelles métriques non prévues lors du développement initial (telles que le pourcentage de tirs réussis ou le temps de jeu effectif), le script continuera de s’exécuter avec succès sans nécessiter la moindre refactorisation : la variable spécifiée dans le RETAIN demeurera positionnée au premier rang, tandis que toutes les nouvelles colonnes intégrées par l’instruction SET s’agrégeront naturellement en fin de structure. Cette robustesse opérationnelle est un critère de choix pour les architectures de traitement de données pérennes.
6. Méthode 3 : Déplacement d’un sous-ensemble spécifique de variables en tête
6.1 Technique de projection ciblée multi-variables
Prolongeant la logique de la déclaration partielle unitaire, la troisième méthode structurelle traite du scénario où une équipe de recherche doit mettre en exergue un sous-ensemble homogène de variables métiers, tout en se désintéressant de l’agencement minutieux des dizaines d’autres colonnes de métadonnées secondaires qui composent la base. Cette approche, qualifiée de projection ciblée multi-variables, combine la sélectivité de l’étape DATA avec la prévisibilité séquentielle de l’instruction RETAIN.
Le principe opérationnel repose sur la spécification ordonnée d’un vecteur restreint de n colonnes au sein du RETAIN initial. Le compilateur SAS applique le principe d’allocation séquentielle de gauche à droite pour les éléments désignés : la première variable déclarée occupera la position 1 du PDV, la deuxième occupera la position 2, et ainsi de suite jusqu’à la n-ième variable. Dès la rencontre de l’instruction SET, le moteur complète les positions résiduelles à partir du rang n + 1 en important toutes les colonnes sources absentes du RETAIN, en respectant rigoureusement leur chronologie native. Cette démarche offre un contrôle prédictif parfait sur la segmentation primaire de la table finale.
6.2 Étude de cas détaillée : Isolement des métriques défensives
Illustrons cette technique par une étude de cas statistique appliquée à notre jeu de données expérimental. Supposons qu’un analyste spécialisé dans l’efficacité défensive souhaite restructurer la table de référence pour analyser prioritairement les capacités de rebond et d’interception, reléguant les attributs organisationnels et le volume de points marqués au second plan analytique. L’objectif structurel consiste à imposer la séquence prioritaire rebounds suivie de steals, tout en préservant l’agencement passif des colonnes résiduelles (team, points, assists).
Le code SAS d’implémentation répond à une structure limpide et compacte :
data defensive_focus;

    retain rebounds steals;

    set original_data;

run;
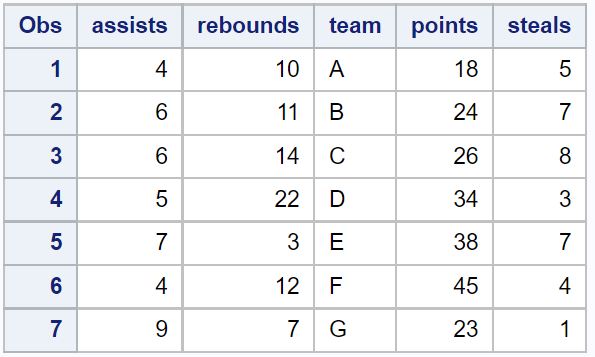
Durant la phase de compilation de cette étape DATA, le compilateur initialise le PDV en inscrivant rebounds en position numéro 1, puis steals en position numéro 2. Lors de la lecture subséquente des métadonnées de original_data par l’instruction SET, le compilateur identifie que team n’a pas encore été inscrite ; elle est donc logée en position numéro 3. Ensuite, la variable points est assignée à la position numéro 4. Le compilateur rencontre ensuite rebounds dans la source : constatant sa présence effective en position 1, il se borne à cartographier ses attributs sans modifier son rang. Le même mécanisme s’applique à steals (position 2). Enfin, la variable résiduelle assists est rattachée en position numéro 5.
Une exécution de contrôle via proc print data=defensive_focus noobs; run; matérialise avec éclat cette topologie : la grille tabulaire expose désormais la succession horizontale rebounds, steals, team, points, puis assists. Les observations d’origine conservent une conformité scalaire absolue (l’équipe B exhibe fièrement ses 12 rebonds et son unique interception avant de mentionner son nom d’équipe et ses 18 points).
6.3 Scénarios typiques d’application analytique
La projection ciblée multi-variables représente une pratique d’excellence dans de nombreux cadres d’ingénierie statistique avancée. L’un des cas d’usage les plus universels concerne l’isolation formelle des identifiants primaires et temporels. Dans les cohortes épidémiologiques longitudinales, où les tables comportent fréquemment des centaines de paramètres cliniques et biologiques relevés à des visites successives, il est d’usage d’imposer un préambule structurel unifié sous la forme retain ID_PATIENT CODE_CENTRE DATE_VISITE NUM_CYCLE;. Cette standardisation garantit que, quelle que soit la provenance de la table source ou l’ordre interne de ses mesures biologiques, les quatre colonnes pivots de stratification se situeront invariablement aux quatre premières positions de stockage.
Un autre scénario récurrent concerne la ségrégation fonctionnelle entre les prédicteurs exogènes majeurs et les covariables d’ajustement secondaire avant l’injection de la table dans des procédures de modélisation prédictive ou d’apprentissage automatique (telles que PROC LOGISTIC ou PROC GLMSELECT). En plaçant en tête de table la variable dépendante d’intérêt suivie immédiatement des variables explicatives cardinales, le statisticien simplifie l’écriture ultérieure de ses macros de validation et accélère la lisibilité des diagnostics de régression lors des phases de prototypage algorithmique.
7. Approches alternatives : Restructuration via PROC SQL
7.1 Ordonnancement explicite via la clause SELECT
Bien que l’étape DATA demeure le cœur battant du traitement procédural sous SAS, l’environnement intègre un moteur relationnel puissant à travers la procédure SQL (PROC SQL), qui offre une syntaxe déclarative conforme au standard ANSI SQL. Dans ce paradigme, la restructuration de l’ordre des colonnes ne s’opère plus par manipulation anticipée d’une zone tampon comme le PDV, mais par la formulation explicite d’une projection relationnelle au sein d’une clause SELECT subordonnée à une instruction de création de table CREATE TABLE.
Dans ce modèle d’ingénierie, l’analyste spécifie nommément chaque colonne dans l’ordre rigoureux souhaité pour la table cible, en séparant chaque élément par une virgule, conformément aux standards du langage SQL :
proc sql;

    create table sql_reordered as

    select team, rebounds, assists, steals, points

    from original_data;

quit;
Lors de l’évaluation de cette requête, le moteur de la procédure SQL parse l’énoncé, interroge le dictionnaire de la table original_data pour en extraire les attributs de format, de label et de typage de chaque variable citée, puis génère une nouvelle table physique sql_reordered dont le bloc descripteur reproduit scrupuleusement la séquence énoncée dans la projection du SELECT. Les données scalaires sont ensuite transférées ligne à ligne depuis la source vers la cible avec une fidélité transactionnelle complète.
7.2 Comparaison technique : Étape DATA RETAIN versus PROC SQL
L’arbitrage entre l’emploi de l’instruction RETAIN au sein de l’étape DATA et le recours à la procédure PROC SQL soulève des considérations techniques majeures en matière de performance computationnelle, de consommation de mémoire tampon et de flexibilité syntaxique. Le tableau comparatif suivant synthétise les propriétés opérationnelles intrinsèques à chaque modalité d’implémentation :
- Exhaustivité de l’énumération : Sous
PROC SQL, il est formellement impossible de déplacer une unique variable en tête de table sans réécrire l’intégralité exhaustive de toutes les autres colonnes. L’usage du caractère générique étoile (SELECT steals, *) aboutit à une erreur d’exécution ou à une duplication redondante de la colonnestealsdans la table produite, ce qui viole les règles de modélisation relationnelle. À l’opposé, l’instructionRETAINen étape DATA permet une manipulation unitaire ou partielle d’une concision exemplaire. - Ressources CPU et entrées/sorties (I/O) : L’étape DATA s’avère systématiquement plus efficiente lors de l’exécution sur des tables massives de plusieurs dizaines de millions d’enregistrements. Le moteur de l’étape DATA interagit au plus près des couches de bas niveau du système de fichiers SAS, minimisant les surcoûts d’évaluation syntaxique. La procédure
PROC SQL, quant à elle, introduit une couche d’abstraction supplémentaire via son optimiseur de requêtes, ce qui engendre une surconsommation mesurable de cycles processeur. - Gestion des métadonnées étendues : Alors que l’étape DATA préserve nativement l’intégralité des formats utilisateurs, informats et labels descriptifs sans la moindre altération,
PROC SQLpeut occasionnellement réinitialiser certains attributs spécifiques ou modifier le statut de compression des tables si les options de sous-système ne sont pas explicitement reconfigurées.
7.3 Cas d’usage pertinents pour l’approche SQL
En dépit de sa verbosité obligatoire pour les réorganisations simples, l’approche PROC SQL s’avère particulièrement pertinente et méthodologiquement supérieure dès lors que la restructuration des colonnes s’inscrit au sein d’une transformation relationnelle plus vaste impliquant des opérations de jointure ou d’agrégation d’indicateurs statistiques. Si une table doit simultanément subir une jointure externe gauche (LEFT JOIN) avec une table dimensionnelle de référence, calculer une moyenne pondérée et réordonner ses attributs finaux, l’accomplir au sein d’une unique requête PROC SQL évite la multiplication d’étapes DATA intermédiaires consommatrices d’écritures disques.
De plus, PROC SQL offre une souplesse incomparable pour effectuer simultanément un réordonnancement et un renommage de variables ou un transtypage via des alias et des fonctions de conversion (telles que put() ou input() intégrées directement dans la liste de sélection). Enfin, dans les organisations informatiques polyglottes où les équipes de développement partagent des bases de code communes entre SAS, Oracle, Snowflake et PostgreSQL, la syntaxe SQL présente l’avantage d’une lisibilité universelle immédiate pour les développeurs non initiés aux subtilités internes du PDV de l’étape DATA.
8. Réordonnancement dynamique à l’aide des tables dictionnaires et macros
8.1 Interrogation des métadonnées dans SASHELP.VCOLUMN
L’un des défis d’ingénierie les plus sophistiqués survient lorsque le réordonnancement des variables ne peut pas être codé « en dur » dans les programmes, soit parce que le nombre et le nom des colonnes varient à chaque livraison de données, soit parce qu’une règle institutionnelle impose un ordonnancement algorithmique systématique, tel que le tri alphabétique rigoureux de toutes les covariables après les identifiants primaires. Pour répondre à cette exigence d’automatisation, SAS intègre un répertoire de métadonnées dynamique accessible en lecture seule via la bibliothèque système SASHELP, et plus particulièrement la vue SASHELP.VCOLUMN.
La vue SASHELP.VCOLUMN consigne l’état structurel de l’intégralité des tables chargées au cours de la session de travail. Chaque ligne de cette vue correspond à une variable unique d’une table donnée, et fournit une riche batterie d’attributs de contrôle, parmi lesquels la bibliothèque d’attachement (LIBNAME), le nom du membre ou de la table (MEMNAME), le nom exact de la colonne (NAME), son rang de position physique d’origine (VARNUM), son type technique (TYPE) ainsi que sa longueur de stockage en octets (LENGTH). En filtrant cette vue par une requête ciblée sur les métadonnées de notre table d’intérêt, nous extrayons programmariquement la structure intime de notre schéma sans dépendre d’aucune hypothèse statique préalable.
8.2 Création automatique de listes ordonnées par PROC SQL INTO
La passerelle technique unissant le dictionnaire de métadonnées et l’exécution dynamique de l’instruction RETAIN réside dans l’utilisation de la clause SELECT ... INTO :macro_variable SEPARATED BY disponible sous PROC SQL. Cette syntaxe permet de capturer le résultat d’une requête portant sur les noms de colonnes et de sérialiser ces chaînes textuelles au sein d’une variable d’environnement globale du macroprocesseur, délimitées par des espaces blancs.
Considérons l’exigence méthodologique consistant à réordonner de manière strictement alphabétique l’ensemble des métriques de notre jeu de données expérimental original_data, tout en garantissant que l’attribut d’identification team demeure impérativement positionné au rang 1. Le macro-programme suivant opérationnalise cette logique de tri automatique :
%macro alphabetiser_variables(lib=, dsn=, out_dsn=, pivot=);

    /* 1. Extraction et ordonnancement alphabétique des variables hors pivot */

    proc sql noprint;

        select name into :varlist separated by ' '

        from sashelp.vcolumn

        where libname = upcase("&lib")

          and memname = upcase("&dsn")

          and upcase(name) ne upcase("&pivot")

        order by name asc;

    quit;
/* 2. Injection de la macro-variable ordonnée dans l'instruction RETAIN */
data &out_dsn;
retain &pivot &varlist;
set &lib..&dsn;
run;
%mend alphabetiser_variables;
/* Appel applicatif de la macro */
%alphabetiser_variables(lib=WORK, dsn=ORIGINAL_DATA, out_dsn=DATA_ALPHABETIQUE, pivot=team);
Lors de l’exécution de cette routine, la clause SQL interroge SASHELP.VCOLUMN, exclut le pivot désigné (team), trie les colonnes restantes selon la table de collation lexicographique ASCII/EBCDIC, puis concatène la chaîne résultante assists points rebounds steals dans la macro-variable système &varlist. Lors de la phase de résolution du macroprocesseur pour l’étape DATA, l’instruction compilée s’expanse fidèlement en retain team assists points rebounds steals;. L’inspection finale valide que la table DATA_ALPHABETIQUE est structurée avec le pivot en tête, suivi d’un déroulement rigoureusement alphabétique de toutes ses mesures chiffrées.
8.3 Avantages dans les chaînes de traitement automatisées
L’intégration de macro-commandes dynamiques adossées aux vues dictionnaires confère un niveau de sophistication et de fiabilité indispensable aux environnements de production industrielle de données (tels que les pipelines ETL d’entrepôts de données décisionnels ou les plateformes de biostatistique pharmaceutique). En éliminant toute dépendance vis-à-vis d’une saisie manuelle des noms d’attributs, cette architecture neutralise intégralement les défaillances induites par des erreurs typographiques humaines.
De surcroît, cette approche garantit une standardisation documentaire absolue à travers l’entreprise : chaque table générée par un processus applicatif peut subir une passe d’uniformisation automatisée appliquant les normes de l’institution (par exemple, ségrégation stricte des identifiants au début, suivis des variables cliniques ordonnées par ordre alphabétique, puis des métadonnées d’audit système telles que l’utilisateur de saisie et la date de dernière mise à jour reléguées en fin de structure). Cette résilience algorithmique face à des schémas de données évolutifs réduit de façon spectaculaire les coûts de maintenance logicielle.
9. Interaction avec d’autres instructions : FORMAT, KEEP, DROP et RENAME
9.1 Rôle de l’instruction FORMAT dans l’initialisation du PDV
Une caractéristique méconnue du compilateur SAS réside dans le fait que l’instruction RETAIN n’est pas le seul énoncé déclaratif susceptible d’influencer la topologie initiale du PDV lors de la phase de compilation. L’instruction FORMAT, ainsi que les instructions associées ATTRIB, LENGTH ou INFORMAT, possèdent également la capacité structurelle d’instancier des variables dans le PDV si elles sont positionnées stratégiquement en amont de l’instruction SET.
Si un programmeur déclare une instruction de mise en forme telle que format steals points 8.2; avant d’appeler l’instruction set original_data;, le compilateur rencontre les descripteurs steals et points pour la première fois lors de l’évaluation de cette ligne de formatage. En conséquence directe, le compilateur alloue immédiatement les positions relatives 1 et 2 du PDV à ces deux variables, leur assignant le format d’affichage spécifié, avant de compléter le PDV avec les variables lues dans la source. Bien que cette propriété puisse être exploitée pour réordonner des colonnes, il est méthodologiquement déconseillé de l’utiliser comme substitut d’un véritable RETAIN : mélanger la logique esthétique d’attribution de formats d’affichage avec la logique structurelle de disposition binaire introduit des confusions de lecture au sein des équipes de développement et accroît le risque d’appliquer involontairement des masques de saisie inappropriés à certains attributs.
9.2 Combinaison avec KEEP et DROP
La manipulation de l’ordre des colonnes s’accompagne quasi systématiquement d’opérations de filtrage horizontal ou vertical visant à éliminer les variables non pertinentes via les instructions KEEP ou DROP, ou leurs équivalents sous forme d’options de table ((keep=...) et (drop=...)). La combinaison de ces commandes avec une instruction RETAIN de réordonnancement exige une rigueur théorique absolue quant à l’ordre d’évaluation du compilateur pour éviter des comportements aberrants.
Il est fondamental de distinguer l’option de table appliquée à l’instruction d’entrée (par exemple set original_data(keep=team points);) de l’instruction globale KEEP énoncée au sein du corps de l’étape DATA. Si une variable est mentionnée dans l’instruction déclarative RETAIN (ex. : retain rebounds;), mais que l’option de table en entrée restreint l’importation (set original_data(drop=rebounds);), le compilateur instanciera tout de même la variable rebounds dans le PDV en vertu du RETAIN, mais l’instruction SET ne viendra jamais alimenter son espace mémoire depuis la source disque. Il en résultera une colonne rebounds physically présente en tête de la table de sortie, mais entièrement peuplée de valeurs manquantes (missing values). En revanche, l’application de filtres d’exclusion en sortie (data new_data(drop=assists); retain team points; set original_data; run;) garantit un flux de traitement rigoureux : les attributs souhaités sont correctement ordonnancés en tête, et la variable superflue est expurgée de la table finale au moment de la sérialisation sans interférer avec la cohérence du PDV.
9.3 Gestion des conflits lors de renommages avec RENAME
L’interaction entre l’instruction de réordonnancement RETAIN et la redéfinition des identificateurs au moyen de l’instruction RENAME est une source intarissable d’incompréhension et d’erreurs d’exécution pour les développeurs SAS de niveau intermédiaire. Cette complexité découle du cycle de vie du nom de la variable entre la phase de traitement interne au sein du PDV et l’étape finale d’écriture des descripteurs dans le fichier disque.
Lorsque l’instruction RENAME est utilisée sous sa forme déclarative globale au sein du corps de l’étape DATA (ex. : rename points = score_total;), cette modification n’opère qu’au moment précis où l’enregistrement quitte le PDV pour être couché sur le disque dur. Cela implique formellement que durant toute la phase de compilation et de calcul à l’intérieur du PDV, la variable continue d’exister sous son identité d’origine points. Par conséquent, l’instruction RETAIN préliminaire doit impérativement référencer le nom primitif :
data renamed_data;

    retain team points rebounds; /* Référence obligatoire au nom d'origine */

    set original_data;

    rename points = score_total; /* Renommage effectif lors de l'écriture */

run;
Si le programmeur commet l’erreur d’écrire retain team score_total rebounds;, le compilateur ne trouvant pas la variable score_total dans la table d’entrée original_data via le SET, considérera qu’il s’agit d’une nouvelle variable indépendante. Il créera une colonne score_total vide en tête de table, puis importera points depuis la source, pour finalement tenter de la renommer en score_total, ce qui déclenchera immédiatement une erreur de collision de noms fatale au sein du journal SAS (SAS Log), interrompant le traitement.
À l’inverse, si le renommage est opéré via une option de table directement adossée à l’instruction d’entrée SET (ex. : set original_data(rename=(points=score_total));), la mutation nominale s’effectue avant même l’ingestion de la donnée dans le PDV. Dans ce cas précis, et uniquement dans celui-ci, l’instruction RETAIN doit mentionner le nouveau descripteur score_total pour garantir un ordonnancement sans faille :
data renamed_data_alt;

    retain team score_total rebounds; /* Référence au nom immédiatement transformé */

    set original_data(rename=(points=score_total));

run;
10. Considérations de performance et intégrité des métadonnées
10.1 Impact computationnel sur les tables massives (Big Data)
Dans un contexte d’ingénierie traitant de giga-octets ou de téra-octets de données, le recours mécanique à une étape DATA pour réordonner des colonnes ne doit jamais être considéré comme une opération anodine. Bien que l’instruction RETAIN ne consomme quasiment aucun cycle d’instruction algorithmique lors de la phase de calcul du microprocesseur, le processus contraint le sous-système de stockage à effectuer une opération complète d’entrée-sortie (I/O) séquentielle : chaque page de données du fichier d’origine doit être lue depuis le stockage physique, décompressée en mémoire vive si la table source utilise l’algorithme de compression SAS (option COMPRESS=YES), restructurée au sein du PDV, puis réécrite bloc par bloc dans un nouveau fichier sur disque.
Pour contourner ce coût computationnel rédhibitoire lorsque la modification de l’ordre des variables n’est requise qu’à des fins d’analyse temporaire ou de restitution visuelle, il est architecturalement recommandé de substituer à la création d’une table physique l’instanciation d’une vue de données de l’étape DATA (DATA Step View). Une vue ne stocke aucun enregistrement physique sur disque et n’engendre aucune duplication de données, mais sauvegarde uniquement la logique de compilation dans le catalogue système :
data v_reordered_data / view=v_reordered_data;

    retain team rebounds assists steals points;

    set original_data;

run;
La compilation de cette vue est quasi instantanée (quelques millisecondes), et son empreinte disque additionnelle est strictement nulle. Lorsque des procédures d’analyse statistique ou des modèles prédictifs interrogent v_reordered_data, le moteur SAS lit les enregistrements directement depuis la table parente original_data et orchestre la redistribution des flux de colonnes à la volée dans le PDV sans solliciter d’opérations d’écriture sur le disque de stockage.
10.2 Préservation des attributs descriptifs des variables
L’un des atouts déterminants qui hisse l’environnement SAS au rang de standard dans les industries régulées est sa gouvernance rigoureuse des dictionnaires de métadonnées associés aux variables. Chaque colonne ne se résume pas à son étiquette textuelle et son vecteur de valeurs : elle encapsule un label descriptif étendu (pouvant atteindre 256 caractères), un format d’affichage (ex. : DATE9., COMMA12.2), un format de lecture ou informat, ainsi qu’une longueur physique de réservation d’octets (LENGTH).
Lors de l’application de la méthode de réordonnancement par RETAIN, une vigilance absolue s’impose quant à la syntaxe utilisée afin de ne pas détériorer accidentellement ces métadonnées fondamentales. En énonçant simplement retain variable_a variable_b;, le programmeur laisse le soin au compilateur d’hériter l’intégralité des métadonnées de la table source lors de la lecture ultérieure de l’instruction SET. Les labels, formats et informats demeurent rigoureusement préservés, sans la moindre troncature ni distorsion.
Cependant, l’introduction imprudente d’une déclaration implicite de format ou de longueur au sein de l’instruction RETAIN elle-même peut engendrer des régressions catastrophiques. Par exemple, si un développeur rédige retain team $ 2; en pensant simplement expliciter le type alphanumérique de la colonne, il force le compilateur à contraindre la longueur physique de stockage de la variable team à deux octets seulement. Si la table d’entrée contenait des libellés d’équipes de vingt caractères, toutes les valeurs textuelles seront impitoyablement tronquées à deux caractères lors du transfert dans le PDV, entraînant une perte irrémédiable de données scalaires sans qu’aucune erreur bloquante n’interrompe le programme. La règle d’or pour un réordonnancement sécurisé consiste donc à ne jamais adjoindre de spécificateurs de longueur, de type ou de valeur d’initialisation au sein de la liste de variables de l’instruction RETAIN.
11. Erreurs fréquentes, pièges syntaxiques et dépannage
11.1 Erreur classique : Placement du RETAIN après l’instruction SET
De très loin, l’erreur de programmation la plus répandue lors des tentatives de restructuration tabulaire sous SAS consiste à positionner physiquement l’instruction RETAIN postérieurement à l’instruction SET dans le corps de l’étape DATA :
/* EXEMPLE INCORRECT - ÉCHEC DE RÉORDONNANCEMENT */

data failed_reorder;

    set original_data;

    retain team rebounds assists steals points;

run;
L’observation du journal SAS (SAS Log) à l’issue de l’exécution de ce script erroné ne signale aucun message d’erreur (ERROR), ni même d’avertissement (WARNING) : la compilation et l’exécution se concluent avec un code de retour parfait. Pourtant, l’inspection tabulaire via PROC PRINT ou PROC CONTENTS révèle que l’ordre des variables dans la table failed_reorder demeure strictement identique à celui de la table d’origine (team, points, rebounds, etc.). L’instruction RETAIN n’a produit rigoureusement aucun effet structurel.
La justification de cet échec réside intégralement dans la chronologie de passage du compilateur à travers le texte source : lorsque le compilateur SAS lit la ligne set original_data;, il découvre en premier lieu les variables de la source et alloue immédiatement l’intégralité des positions du PDV selon la séquence native de la table d’entrée. Lorsque le compilateur descend ensuite à la ligne suivante et rencontre retain ...;, toutes les variables citées figurent déjà dans la table des symboles du PDV. Comme mentionné dans notre section théorique, le compilateur ne modifie jamais l’emplacement d’une variable préexistante. L’instruction est donc purement ignorée sur le plan structurel. La règle méthodologique intangible s’impose d’elle-même : pour modifier l’architecture du PDV, l’instruction de réordonnancement doit impérativement trôner sur la première ligne d’exécution logique de l’étape DATA.
11.2 Effets secondaires involontaires de persistance de valeur
Un autre piège pernicieux réside dans la nature hybride de l’instruction RETAIN. Comme nous l’avons explicité, au-delà de son rôle d’allocation précoce dans le PDV lors de la compilation, RETAIN est initialement conçue pour désactiver la remise à blanc des variables d’une observation à la suivante lors de la phase d’exécution. Si cette dualité est parfaitement neutralisée pour les colonnes directement alimentées par l’instruction SET (puisque l’opération d’ingestion physique écrase systématiquement les octets du PDV avec la nouvelle ligne lue depuis le support de stockage), elle peut engendrer des effets de bord dévastateurs si le développeur introduit simultanément de nouvelles colonnes calculées au sein de la même étape DATA.
Considérons le scénario pathologique où un analyste souhaite créer une variable d’indicateur binaire high_scorer, et écrit naïvement :
/* COMPORTEMENT PATHOLOGIQUE DE FUITE INTER-OBSERVATIONS */

data corrupted_data;

    retain team high_scorer rebounds assists steals points;

    set original_data;

    if points > 25 then high_scorer = 1;

run;
Dans ce cas d’école, la variable high_scorer n’existe pas dans la table original_data : elle est donc instanciée par le RETAIN en position 2. Si la première observation (équipe A, 25 points) ne valide pas la condition points > 25, high_scorer est évaluée à la valeur manquante. Mais dès qu’une observation franchit le seuil (équipe C, 32 points), high_scorer prend la valeur scalaire 1. En raison de l’instruction RETAIN qui neutralise la réinitialisation, la valeur 1 va persister indûment pour toutes les observations suivantes (équipes D, E, F, G), quand bien même leur total de points serait inférieur à 25 ! La contamination des valeurs se propage ainsi silencieusement d’une ligne à l’autre.
Pour immuniser les chaînes de traitement contre cette anomalie grave, le principe de précaution en ingénierie logicielle SAS impose d’adjoindre une instruction explicite de réinitialisation conditionnelle (else high_scorer = .;) ou de ségréger strictement les opérations : une première étape DATA dédiée à la dérivation et au calcul des métriques métiers, suivie d’une seconde étape DATA minimale et dénuée de toute logique conditionnelle, exclusivement vouée au réordonnancement structurel via RETAIN.
11.3 Typographie et variables introuvables
L’environnement SAS est réputé pour sa tolérance syntaxique permissive, mais cette flexibilité peut se muer en vulnérabilité critique lors de l’utilisation non encadrée de l’instruction RETAIN. Si un développeur commet une faute d’orthographe ou une erreur typographique en renseignant le nom d’une colonne dans l’énumération du RETAIN (par exemple en écrivant rebounds_totaux au lieu de rebounds), le système réagit d’une façon qui peut surprendre les analystes issus d’autres environnements de programmation.
Au lieu d’interrompre immédiatement la compilation par un message d’erreur fatal d’attribut inexistant, le compilateur SAS considère de bonne foi que le développeur a l’intention de déclarer une toute nouvelle variable au sein du programme. En conséquence, il inscrit rebounds_totaux au sommet du PDV. Lors de la lecture par l’instruction SET, le système charge fidèlement les vraies colonnes depuis la source, y compris la variable originale rebounds. À la fin de l’étape, la table générée comporte une colonne supplémentaire « fantôme » (rebounds_totaux), positionnée au rang privilégié mais entièrement vide de données, tandis que la véritable colonne rebounds se retrouve reléguée en fin de structure.
Pour prévenir cette dérive silencieuse, il est impératif d’intégrer dans les scripts de production industrielle les options d’environnement strictes de vérification des dictionnaires :
options dkricond=error dkrocond=error;
Ces directives ordonnent au superviseur SAS de convertir toute anomalie de déréférencement de variable ou d’écrasement de descripteur au sein des options de table en erreur bloquante (ERROR), provoquant l’arrêt immédiat du traitement et empêchant la génération d’une table corrompue dans les entrepôts de données décisionnels. Parallèlement, un protocole d’assurance qualité doit systématiquement inclure une lecture automatisée du journal SAS (via des expressions régulières recherchant les chaînes textuelles uninitialized ou missing) à l’issue de chaque exécution de pipeline.
12. Protocoles de validation et bonnes pratiques institutionnelles
12.1 Vérification automatisée de conformité structurelle
Au sein d’infrastructures de recherche biomédicale, bancaire ou assurantielle soumises à des audits d’organismes de tutelle externes (tels que la FDA, l’EMA ou l’ACPR), une transformation technique telle que la réorganisation de variables doit faire l’objet d’une preuve formelle de non-régression validant que l’intégrité de la base est demeurée absolue. Le premier pilier de cette validation repose sur l’exploitation approfondie de la procédure de comparaison PROC COMPARE.
La procédure PROC COMPARE permet de confronter rigoureusement deux tables de données (une table de référence base et une table cible compare) sur le plan de leurs métadonnées et de leurs enregistrements scalaires. En spécifiant les options adaptées, il est possible de certifier mathématiquement que les valeurs des variables n’ont subi aucune altération en dépit de la modification physique de l’ordre des colonnes :
proc compare base=original_data compare=new_data noobs method=absolute criterion=1E-9;

run;
Dans son rapport d’analyse comparative, PROC COMPARE isole la dimension structurelle de la dimension scalaire. Il notifiera de manière transparente que l’ordre des variables diffère entre les deux tables (divergence de métadonnées), tout en confirmant, par la présence de la mention institutionnelle No unequal values were found, que chaque cellule de données est demeurée strictement identique pour l’ensemble des observations. Ce diagnostic formel certifie qu’aucune troncature, perte de précision à virgule flottante ou décalage matriciel ne s’est produit au cours de la restructuration.
Parallèlement, une extraction programmatique de conformité peut être automatisée en archivant les métadonnées de PROC CONTENTS dans des tables de sortie au moyen de l’instruction out= :
proc contents data=new_data out=meta_check(keep=name varnum) noprint;

run;
proc sort data=meta_check;
by varnum;
run;
Cette table meta_check peut être immédiatement confrontée à une grille de spécifications de données (Data Transfer Agreement ou dictionnaire SDTM) pour valider automatiquement par assertions logiques que la variable team occupe bien la position 1, rebounds la position 2, etc., scellant ainsi la conformité de la livraison au sein d’un banc de tests unitaires automatisé.
12.2 Standardisation du code et lisibilité des programmes
Au-delà de la rigueur mathématique et de l’efficience algorithmique, la durabilité d’un patrimoine logiciel statistique repose de manière déterminante sur l’adoption de conventions stylistiques strictes et standardisées partagées par l’ensemble des membres d’une organisation. La réorganisation des variables, bien qu’élémentaire dans son principe, est trop souvent codée de manière opportuniste et anarchique au fil des scripts, nuisant à la relecture par les pairs.
Les bonnes pratiques institutionnelles requièrent d’adopter des règles de mise en page standardisées pour chaque étape DATA manipulant l’architecture du PDV :
- Indentation et alignement vertical : Les variables spécifiées sous l’instruction
RETAINdoivent être documentées et alignées de manière lisible. Pour les tables comprenant plus de dix colonnes, il est recommandé de scinder la déclaration en groupes fonctionnels d’attributs (identifiants, dates d’événements, variables de résultats primaires, biomarqueurs secondaires), chaque groupe occupant sa propre ligne d’indentation. - Commentaires explicatifs d’intention : Tout déplacement de variable doit être précédé d’un bloc de commentaires précisant expressément la justification méthodologique de la manœuvre (ex. : respect de la norme CDISC v3.3, alignement pour export vers un visualiseur décisionnel, harmonisation avant concaténation). L’intention du développeur ne doit jamais être laissée à la libre interprétation du relecteur.
- Encapsulation modulaire : Lorsqu’une séquence de réorganisation a vocation à être appliquée de manière récurrente à travers de multiples programmes d’une même étude ou d’un même département, il est impératif d’encapsuler cette logique au sein d’un macro-programme d’entreprise réutilisable et versionné sous un gestionnaire de code source (ex. : Git), plutôt que de dupliquer des blocs de déclarations statiques à travers des dizaines de fichiers indépendants.
En synthèse définitive, la maîtrise du réordonnancement des variables dans SAS constitue un marqueur d’excellence technique qui sépare le praticien profane de l’ingénieur de données aguerri. En appréhendant avec acuité le fonctionnement interne du vecteur de données de programme (PDV), en articulant rigoureusement les instructions déclaratives RETAIN en amont des instructions de lecture SET, et en exploitant avec discernement les alternatives SQL et macro-dynamiques selon les contraintes de volumétrie, le développeur s’assure d’une gouvernance optimale de ses actifs de données, alliant une élégance syntaxique irréprochable à une performance d’exécution maximale.
Références
CDISC. (2021). Study Data Tabulation Model Implementation Guide: Human Clinical Trials (Version 3.3). Clinical Data Interchange Standards Consortium. https://www.cdisc.org/standards/foundational/sdtm
Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
SAS Institute Inc. (2020). SAS® 9.4 Language Reference: Concepts, Sixth Edition. SAS Institute Inc. https://documentation.sas.com
SAS Institute Inc. (2021). SAS® 9.4 Statements: Reference, Fifth Edition. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/ledsref/titlepage.htm
SAS Institute Inc. (2022). Base SAS® 9.4 Procedures Guide, Seventh Edition. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/proc/titlepage.htm
SAS Institute Inc. (2023). SAS® 9.4 SQL Procedure User’s Guide, Fifth Edition. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/sqlproc/titlepage.htm