
Dans l’écosystème du traitement analytique et de la biostatistique, la structuration des données constitue le socle sur lequel repose l’intégrité de toute inférence scientifique. Au sein de cet environnement, le logiciel SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme la référence incontournable au sein des industries pharmaceutiques, des institutions financières et des organismes de recherche publique. La conduite d’analyses statistiques complexes nécessite une manipulation experte des tables de données, opération au sein de laquelle la modification des métadonnées — et tout particulièrement le renommage des variables — représente une étape charnière. Bien que cette tâche puisse sembler élémentaire à première vue, elle sous-tend des mécanismes internes fondamentaux liés à la gestion de la mémoire vive, au cycle de compilation des étapes de données et à la structure des descripteurs de fichiers sur disque.
Une dénomination inadéquate ou anarchique des colonnes d’un tableau d’analyse engendre inévitablement des surcoûts cognitifs majeurs, favorise l’introduction d’erreurs de programmation difficilement décelables et compromet la conformité réglementaire des projets de recherche. À l’inverse, l’application rigoureuse d’une stratégie de renommage méthodique permet de transformer des vecteurs bruts hétérogènes en structures d’information standardisées, transparentes et directement exploitables par des algorithmes d’analyse multivariée ou des procédures d’apprentissage automatique. Ce processus ne se limite pas à une simple substitution lexicale : il exige la compréhension des contextes d’exécution propres à SAS, qu’il s’agisse de l’évaluation séquentielle dans le vecteur de données du programme (Program Data Vector) ou de la modification directe des dictionnaires de métadonnées sans réécriture physique des enregistrements.
Ce guide méthodologique exhaustif a pour vocation d’explorer l’ensemble des paradigmes offerts par SAS pour procéder au renommage de variables. À travers l’examen détaillé des options de l’étape DATA, de l’utilisation spécialisée de la procédure PROC DATASETS, de l’intégration du langage déclaratif PROC SQL et de l’automatisation avancée permise par l’environnement macro, cet article propose une synthèse théorique et opérationnelle destinée aux data scientists, biostatisticiens et analystes de données soucieux de concilier rigueur scientifique, élégance algorithmique et optimisation des ressources de calcul.
1. Introduction méthodologique au renommage des variables dans SAS
1.1 Importance de la nomenclature normalisée en analyse de données
L’harmonisation des désignations au sein de bases de données volumineuses ou issues d’études longitudinales représente un impératif méthodologique de premier ordre. Dans le cadre d’enquêtes épidémiologiques ou d’essais cliniques multicentriques s’étendant sur plusieurs années, les cohortes de sujets font l’objet d’évaluations répétées à des intervalles temporels définis. L’absence d’une charte de nommage formelle et systématique conduit invariablement à la dispersion sémantique : une même mesure physiologique ou biologique peut ainsi être désignée sous les vocables disparates au fil des campagnes de recueil. Une telle disparité complique considérablement le travail de fusion des tables transversales et augmente de façon exponentielle le risque d’erreurs lors de l’assemblage des matrices d’analyse.
La conformité avec les standards de rigueur scientifique et de reproductibilité, tels que prescrits par les recommandations internationales et les consortiums de standardisation des données biomédicales comme le Consortium CDISC (Clinical Data Interchange Standards Consortium), impose que chaque variable dispose d’un identifiant stable, univoque et universellement compréhensible. Cette normalisation systématique réduit drastiquement les biais cognitifs et les fautes d’interprétation humaine qui surviennent lorsque des analystes manipulent des vecteurs aux dénominations ambiguës ou tronquées. Dans les équipes de recherche multidisciplinaires où collaborent biostatisticiens, cliniciens, épidémiologistes et ingénieurs de données, une nomenclature claire fluidifie la communication et garantit que l’objet de l’observation statistique demeure parfaitement corrélé avec sa représentation informatique sous-jacente.
Enfin, la standardisation lexicale des colonnes facilite l’intégration de routines de traitement automatisées. Les scripts d’épuration, d’imputation des données manquantes et d’analyse exploratoire gagnent en généricité dès lors que les variables respectent une nomenclature cohérente. La réduction du temps consacré à la maintenance des programmes et la pérennisation des flux de traitement analytique dépendent directement de cette discipline initiale apportée à la définition et à la refonte des en-têtes de colonnes.
1.2 Principes fondamentaux du système SAS pour l’identification des colonnes
Le moteur de traitement des données de SAS applique des règles syntaxiques formelles et immuables régissant la validité des noms de variables. Depuis l’introduction de l’architecture SAS Version 8 et la pérennisation de la Version 9, un nom de variable standard peut comporter jusqu’à 32 octets de longueur. Il doit obligatoirement débuter par une lettre de l’alphabet latin (non accentuée) ou par un caractère de soulignement (underscore). Les caractères subséquents peuvent inclure des lettres non accentuées, des chiffres de zéro à neuf ou des traits de soulignement. Bien que le système SAS ne soit pas sensible à la casse pour la résolution des noms lors des phases d’évaluation — traitant indifféremment les majuscules et les minuscules lors de l’appel d’un identifiant —, il préserve la casse typographique originelle telle qu’elle a été déclarée lors de la création de la variable au niveau du dictionnaire de métadonnées.
Il convient d’établir une distinction conceptuelle fondamentale entre le nom technique d’une variable et son libellé descriptif, désigné sous le terme de Label dans le vocabulaire SAS. Le nom de la variable constitue l’identifiant programmatique formel manipulé par le compilateur, le système de fichiers et les expressions mathématiques. Le libellé, quant à lui, est une chaîne textuelle explicative pouvant atteindre une longueur de 256 caractères, acceptant les espaces, les lettres accentuées et les caractères typographiques complexes. Trop souvent, les analystes débutants tentent d’incorporer une somme excessive d’informations sémantiques au sein du nom technique, alors que la bonne pratique architecturale commande de maintenir un nom technique concis, standardisé et mnémonique, tout en confiant l’exhaustivité de la description sémantique au libellé associé.
Les métadonnées relatives aux variables sont consignées au sein du bloc descripteur de chaque table SAS hébergée dans une bibliothèque spécifique. Ce bloc descripteur contient l’ensemble des spécifications structurelles du jeu de données : la liste ordonnée des variables, leur typage strict (numérique ou caractère), leur longueur allouée en octets, leur position physique relative au sein du vecteur d’enregistrement, ainsi que les formats et informats qui leur sont rattachés. Renommer une variable revient à intervenir sur ce registre de métadonnées, selon des modalités techniques dont le coût opérationnel varie radicalement d’une approche à une autre.
1.3 Panorama des approches : étape DATA versus procédures spécialisées
Pour modifier l’identifiant d’une ou plusieurs variables au sein de l’écosystème SAS, le développeur dispose d’un éventail d’approches méthodologiques qui se scindent principalement en deux paradigmes distincts : la réécriture séquentielle via l’étape DATA et l’altération directe des en-têtes sans duplication physique des données via les procédures système spécialisées. Le choix d’une méthode dépend intimement du volume de la table, des contraintes d’entrées-sorties (I/O) sur les disques de stockage, de la charge supportée par la mémoire temporaire et de la nécessité éventuelle de réaliser des calculs conjoints sur les valeurs vectorielles.
L’étape DATA, qu’elle exploite l’option de jeu de données RENAME= ou l’instruction autonome RENAME, repose sur la reconstruction séquentielle du tableau d’enregistrements. Dans cette configuration, chaque ligne est chargée depuis la source, traitée en mémoire centrale par le vecteur de données du programme (Program Data Vector ou PDV), puis intégralement réécrite dans une nouvelle table cible sur le disque. Si cette méthode offre une flexibilité totale en permettant d’opérer des transformations mathématiques, des recodages conditionnels et des filtrages d’observations au moment précis du renommage, elle induit un coût computationnel considérable. Sur des volumes massifs atteignant des dizaines de gigaoctets ou des centaines de millions de lignes, cette réplication intégrale consomme inutilement des cycles processeur et une quantité massive d’espace temporaire dans la bibliothèque WORK.
À l’opposé, les procédures spécialisées, au premier rang desquelles trône la procédure PROC DATASETS avec son instruction MODIFY, agissent exclusivement sur le bloc descripteur de la table sans jamais déplacer, lire ou réécrire le moindre enregistrement de données. Cette manipulation sur place (in-place) présente une efficacité algorithmique maximale : l’opération est quasi instantanée, indépendamment du nombre d’observations présentes dans la table. De son côté, la procédure PROC SQL offre une passerelle déclarative conforme aux standards de l’algèbre relationnelle, autorisant le renommage à la volée lors de projections ou de modifications structurelles par le biais de l’instruction ALTER TABLE. Le tableau conceptuel ci-dessous synthétise les propriétés distinctives de ces diverses options analytiques.
- Option RENAME= dans l’instruction SET : Réécriture complète de la table ; modification appliquée au chargement dans le vecteur de mémoire ; idéale lors de filtrages ou de calculs simultanés.
- Instruction autonome RENAME dans l’étape DATA : Réécriture complète de la table ; modification effective en fin d’étape lors de l’écriture sur disque ; exige une rigueur particulière lors du référencement des variables dérivées.
- Procédure PROC DATASETS : Altération pure des métadonnées du descripteur ; temps d’exécution quasi nul ; aucune réécriture d’enregistrements ; méthode préconisée pour les grands volumes de données.
- Procédure PROC SQL : Syntaxe relationnelle déclarative ; renommage ponctuel lors de la sélection ou modification structurelle permanente via ALTER TABLE.
2. Syntaxe fondamentale de l’option RENAME dans l’étape DATA
2.1 Mécanisme de l’option RENAME=(ancien=nouveau) dans l’instruction SET
L’utilisation de l’option de jeu de données RENAME= adossée à l’instruction SET constitue l’une des techniques les plus répandues et les plus fiables pour modifier l’appellation d’une variable au sein d’une étape DATA. Grammaticalement, cette option se positionne immédiatement après le nom de la table source entre parenthèses, selon la formulation typique : SET table_source(RENAME=(ancien_nom=nouveau_nom));. Cette syntaxe spécifie une règle de transformation en entrée (Input Data Set Option). Elle indique au moteur de traitement de SAS que, dès le moment où le fichier source est ouvert en lecture, la colonne anciennement étiquetée sous l’identifiant d’origine doit être immédiatement intégrée dans le système sous sa nouvelle désignation.
Le moment exact où cette substitution intervient est déterminant pour la logique du programme. Étant une option d’entrée, le renommage prend effet avant même que le vecteur de données du programme (PDV) ne rende la ligne accessible aux instructions de programmation situées en aval dans l’étape DATA. En conséquence, l’ancien nom de la variable cesse immédiatement d’exister pour le reste de l’étape DATA en cours d’exécution. Toute tentative de faire référence à l’ancienne désignation dans une condition logique WHERE, un test conditionnel IF-THEN, ou une équation d’assignation provoquera inévitablement une interruption de la compilation pour variable inexistante.
Cette particularité opérationnelle confère une grande cohérence au code : les développeurs peuvent ainsi concevoir des algorithmes en utilisant d’emblée la nomenclature harmonisée. Lorsqu’il s’agit de fusionner des tables dont les clés d’appariement diffèrent nominativement mais correspondent conceptuellement au même identifiant de patient ou d’observation, l’application de l’option RENAME= dans l’instruction SET permet de standardiser la clé avant même que les instructions de fusion ne soient évaluées par le processeur logique de SAS.
2.2 Cycle de compilation SAS et comportement du vecteur de données (PDV)
Pour appréhender pleinement les subtilités du renommage au sein de l’étape DATA, il est indispensable de disséquer le cycle de vie interne d’un programme SAS, structuré en deux phases distinctes et consécutives : la phase de compilation et la phase d’exécution. Lors de la phase de compilation, SAS analyse la grammaire des instructions, alloue les zones de mémoire vive requises et érige la structure interne du Program Data Vector (PDV). Le PDV est une zone tampon séquentielle en mémoire volatile qui héberge l’ensemble des variables déclarées, leurs indicateurs d’absence, ainsi que deux variables automatiques fondamentales du système, à savoir _N_ (le compteur d’itérations de l’étape) et _ERROR_ (le drapeau de signalement des anomalies d’exécution).
Lorsque l’option RENAME= est placée sur l’instruction SET, le compilateur lit les en-têtes de la table source, identifie la variable cible, et réserve un emplacement dans le PDV sous le nouveau nom spécifié. Aucune adresse mémoire n’est attribuée à l’ancien nom. En revanche, si l’option RENAME= est appliquée à l’instruction DATA — c’est-à-dire en sortie (Output Data Set Option), selon la forme DATA table_cible(RENAME=(ancien_nom=nouveau_nom)); —, le comportement interne est radicalement différent. Durant toute la compilation et l’exécution de l’étape DATA, la variable réside dans le PDV sous son ancien nom. C’est sous cet ancien nom qu’elle doit obligatoirement être référencée dans toutes les instructions de calcul ou de filtrage. Le renommage ne s’opère qu’à l’extrême fin du processus, à la fraction de seconde où les données résidant dans le PDV sont déversées et transcrites sur le disque dur au sein de la table de sortie.
La confusion entre le renommage en entrée (sur l’instruction SET) et le renommage en sortie (sur l’instruction DATA) est l’une des causes les plus fréquentes d’erreurs logiques chez les développeurs. Une maîtrise rigoureuse de la mécanique du PDV permet d’éviter l’écrasement intempestif de données et d’assurer que les variables créées ou transformées au sein de l’étape sont adressées sous leur appellation valide au moment opportun du flux séquentiel.
2.3 Instruction autonome RENAME versus option de jeu de données RENAME=
En complément des options de jeux de données associées aux instructions DATA ou SET, le langage SAS met à disposition une instruction autonome intitulée RENAME. Cette instruction s’inscrit directement au sein du bloc d’instructions de l’étape DATA sans être adossée à une parenthèse de table. Sa forme générale obéit au modèle : RENAME ancienne_variable = nouvelle_variable ;. Bien que fonctionnellement proche de l’option de sortie de jeu de données, cette instruction présente des caractéristiques d’évaluation propres qui méritent une clarification rigoureuse.
L’instruction RENAME informe le compilateur SAS qu’une substitution de métadonnées devra être effectuée sur la table finale issue de l’étape DATA. Cependant, à l’instar de l’option placée sur l’instruction DATA, l’instruction RENAME autonome n’altère en rien le nom de la variable au cours de l’exécution interne de l’étape DATA dans le PDV. Ainsi, au fil des calculs arithmétiques, des concaténations de chaînes et des embranchements conditionnels menés à l’intérieur du bloc de code, l’analyste doit impérativement continuer d’utiliser l’ancien nom de la variable. Si une expression tente d’utiliser le nouveau nom défini exclusivement dans une instruction RENAME autonome, le compilateur émettra une alerte indiquant que la variable n’est pas initialisée, affectant une valeur manquante (missing value) à tout calcul dépendant de celle-ci.
Ce paradoxe apparent constitue un piège régulier lors de la création de variables dérivées. Par exemple, si l’on souhaite renommer une mesure brute de tension artérielle en tension_initiale tout en calculant un écart par rapport à une valeur de référence, l’utilisation de l’instruction RENAME impose de formuler le calcul avec l’ancien nom. Pour éviter ces confusions cognitives et sécuriser l’écriture du code, de nombreux architectes logiciels recommandent d’employer prioritairement l’option RENAME= directement sur l’instruction SET lorsque les données préexistent, limitant l’instruction autonome RENAME aux seules variables synthétisées ex nihilo au sein de l’étape DATA courante.
3. Cas pratique 1 : Renommer une seule variable
3.1 Mise en place de la table d’expérimentation de référence
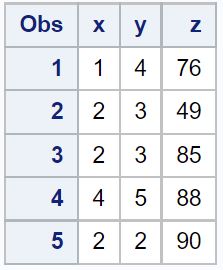
Afin d’illustrer de manière empirique et reproductible les principes exposés, il convient d’établir une table de travail expérimentale contenant un jeu de mesures quantitatives élémentaires. Pour ce faire, nous exploitons l’étape DATA couplée à l’instruction d’entrée de données en ligne DATALINES (ou CARDS), méthode canonique pour instancier des données au sein de la bibliothèque temporaire de travail de SAS, conventionnellement nommée WORK. Cette table de départ, que nous baptiserons original_data, servira de banc d’essai pour nos premières manipulations syntaxiques.
Le bloc de code ci-dessous procède à l’initialisation de notre environnement expérimental en déclarant trois vecteurs continus dénommés arbitrairement x, y et z. Ces variables représentent, par exemple, des coordonnées tridimensionnelles issues d’un capteur de biomécanique ou des concentrations sanguines de divers biomarqueurs mesurées chez un échantillon de sujets. L’intégrité du typage numérique et la validité des valeurs introduites sont scrupuleusement établies dès cette phase.
Dans l’environnement de programmation SAS, la construction de cette structure s’articule comme suit :
DATA original_data;
INPUT x y z;
DATALINES;
10.5 22.1 104.3
11.2 24.5 106.8
14.8 21.0 101.2
09.9 26.3 110.5
12.4 23.8 108.1
;
RUN;
L’exécution de ce segment de code produit une table SAS comportant cinq observations et trois variables numériques standards de huit octets chacune. Dès lors que cette table de référence est instanciée et validée dans l’espace de stockage de travail, il devient possible d’opérer une première mutation structurelle visant à substituer à la variable x une dénomination analytiquement plus signifiante.
3.2 Implémentation du renommage unitaire par l’étape DATA
L’objectif de cette première manipulation consiste à transformer la colonne anonyme x en une variable explicitement identifiée sous le terme mesure_biometrique_x, tout en maintenant parfaitement inaltérées les colonnes compagnes y et z. En appliquant la recommandation méthodologique privilégiant l’option de jeu de données en entrée sur l’instruction SET, nous assurons une intégration propre et lisible au sein du flux de compilation.
La formulation syntaxique de cette opération s’établit de la manière suivante :
DATA new_data;
SET original_data(RENAME=(x=mesure_biometrique_x));
RUN;
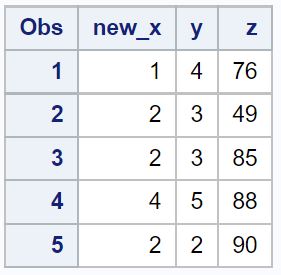
À l’issue de la soumission de ce bloc, une lecture rigoureuse du journal d’exécution (SAS Log) s’avère indispensable. Le journal doit consigner que la table WORK.ORIGINAL_DATA a été lue avec succès, comptabilisant cinq observations, et que la table WORK.NEW_DATA a été générée avec un volume strictement identique de lignes et de colonnes. Aucune alerte de type WARNING ni aucun message d’erreur syntaxique (ERROR) ne doit entacher ce compte rendu. Les variables y et z demeurent rigoureusement intactes dans leur position et leur contenu, tandis que l’adresse vectorielle dévolue à x est désormais officiellement associée à l’identifiant mesure_biometrique_x.
3.3 Contrôle empirique des résultats par les procédures d’inspection
En programmation scientifique, une modification n’est réputée valide qu’après avoir été formellement auditée par des outils d’inspection empiriques. Dans l’environnement SAS, deux procédures standards remplissent cette fonction d’audit avec un niveau d’exhaustivité complémentaire : la procédure PROC PRINT et la procédure PROC CONTENTS.
La procédure PROC PRINT permet d’éditer le contenu tabulaire brut afin de s’assurer visuellement du bon ordonnancement des observations et de l’affichage du nouvel en-tête de colonne :
PROC PRINT DATA=new_data NOOBS;
RUN;
Cette instruction restitue les cinq lignes d’enregistrements où la première colonne apparaît désormais sous le nom mesure_biometrique_x, affichant fidèlement les valeurs numériques d’origine (10.5, 11.2, 14.8, 09.9 et 12.4), confirmant l’absence de perte ou d’altération de précision flottante au cours de l’opération.
Néanmoins, l’inspection la plus déterminante s’effectue au moyen de la procédure PROC CONTENTS, conçue pour décortiquer le dictionnaire des descripteurs de la table :
PROC CONTENTS DATA=new_data;
RUN;
L’analyse du rapport émis par PROC CONTENTS atteste de la conformité structurelle de la nouvelle table : la liste alphabétique des variables recense désormais mesure_biometrique_x, y et z. Le rapport démontre également que les attributs physiques fondamentaux — à savoir le type numérique, la longueur de stockage fixée par défaut à 8 octets sous environnement 64 bits, ainsi que les éventuels formats d’affichage ou informats de lecture préexistants — ont été rigoureusement préservés. Le renommage unitaire a ainsi été conduit dans le respect absolu de l’intégrité des métadonnées du système.
4. Cas pratique 2 : Renommer simultanément plusieurs variables
4.1 Syntaxe séquentielle sans séparateur par virgule
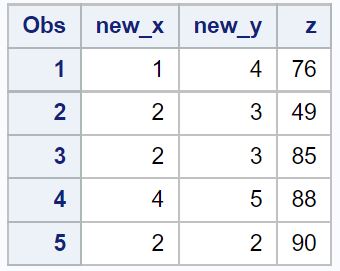
Dans la pratique réelle du traitement de données, le besoin de renommer une unique variable est marginal comparativement à la nécessité d’ajuster simultanément des cohortes entières d’indicateurs au sein d’une même table. L’option RENAME= offre la capacité de traiter une multiplicité de couples de variables au sein d’une seule et même clause de déclaration. Cependant, cette flexibilité s’accompagne d’une règle syntaxique impérative propre au compilateur SAS qui déroute fréquemment les utilisateurs familiers du langage SQL standard ou de langages modernes tels que R ou Python : les paires de renommage doivent être séparées exclusivement par des espaces blancs, et en aucun cas par des virgules.
La grammaire canonique s’énonce comme suit : RENAME=(ancien1=nouveau1 ancien2=nouveau2 ancien3=nouveau3). L’insertion intempestive d’une virgule entre les termes — par exemple sous la forme RENAME=(ancien1=nouveau1, ancien2=nouveau2) — provoque un arrêt immédiat de la compilation SAS, l’analyseur lexical interprétant la virgule comme le séparateur d’une nouvelle option de table inexistante, ce qui génère une erreur de syntaxe bloquante dans le journal système.
Cette séquence sans délimiteur de ponctuation s’applique avec une stricte uniformité, que les colonnes ciblées soient de nature numérique, alphanumérique ou temporelle. Le traitement conjoint de variables hétérogènes au sein d’une unique étape permet d’optimiser le pipeline d’exécution en mutualisant le cycle de lecture et d’écriture des enregistrements sur le support physique de stockage.
4.2 Application à des batteries de mesures psychométriques
Considérons à présent une application concrète issue du champ de la psychométrie ou de la psychiatrie observationnelle. Lors de l’administration d’un questionnaire standardisé évaluant la santé mentale d’une population d’étude — tel que l’échelle Hospital Anxiety and Depression Scale (HADS) —, les systèmes d’acquisition automatisés stockent fréquemment les réponses sous des identifiants alphanumériques opaques et anonymes tels que item_01, item_02, item_03, item_04. Ces désignations brutes s’avèrent impropres à la communication scientifique et compliquent l’interprétation directe des coefficients lors des modélisations par équations structurelles ou des régressions logistiques.
Supposons une table initiale dénommée psychometrie_brute contenant les identifiants abstraits des réponses fournies par les sujets d’une cohorte clinique. Pour préparer la phase d’analyse factorielle, le biostatisticien doit catégoriser explicitement chaque item selon sa dimension sous-jacente (par exemple l’anxiété versus l’état dépressif) tout en spécifiant son rang d’évaluation. L’étape DATA suivante applique un renommage simultané structuré :
DATA psychometrie_normalisee;
SET psychometrie_brute(RENAME=(
item_01 = anxiete_tension_intérieure
item_02 = depression_perte_plaisir
item_03 = anxiete_peur_panique
item_04 = depression_ralentissement_moteur
));
RUN;
Par cette formulation séquentielle fluide et lisible, le jeu de données subit une transmutation sémantique intégrale. Les variables résultantes renseignent immédiatement le chercheur sur la construction conceptuelle sous-jacente sans qu’il soit nécessaire de consulter perpétuellement le dictionnaire de codage externe. La cohérence des agrégats statistiques s’en trouve renforcée dès l’étape initiale du traitement analytique.
4.3 Diagnostic des anomalies lexicales courantes
Lors de la manipulation de listes étendues de variables au sein de l’option RENAME=, l’analyste s’expose à diverses anomalies lexicales susceptibles de compromettre le bon déroulement du script. La défaillance la plus courante réside dans le déséquilibre des paires d’assignation, souvent qualifié d’erreur d’appariement impaire. Cette situation survient lorsqu’un opérateur omet par inadvertance le signe d’égalité ou le nom de la variable de destination au sein d’une chaîne complexe, par exemple : RENAME=(var1=new_var1 var2 var3=new_var3). Dans cette conjoncture, le moteur d’analyse syntaxique de SAS se trouve dans l’incapacité d’associer le token isolé var2 à un vecteur de réception, provoquant un arrêt critique du script accompagné du message d’erreur formel stipulant une anomalie grammaticale dans l’expression RENAME.
Une seconde erreur fréquente concerne la gestion des parenthèses englobantes. L’option RENAME exige un double niveau de parenthétisation : le premier délimite l’option de jeu de données elle-même, tandis que le second circonscrit l’ensemble des égalités d’affectation : (RENAME=(ancien=nouveau)). L’omission de la parenthèse intérieure ou de la parenthèse extérieure génère une ambiguïté lexicale majeure qui conduit le compilateur à invalider l’instruction SET dans son intégralité.
L’examen minutieux du fichier journal constitue le remède fondamental face à ces déconvenues. Le journal SAS fournit généralement un indicateur de positionnement textuel — représenté par un point d’interrogation ou un tiret soulignant le caractère incriminé — signalant précisément l’endroit où la rupture grammaticale a été décelée. Le développeur doit alors vérifier systématiquement la stricte parité des identifiants déclarés et l’absence totale de tout caractère de ponctuation non autorisé au sein de la liste des couples de variables.
5. Cas pratique 3 : Ajout systématique de préfixes ou de suffixes
5.1 Standardisation par préfixe pour le suivi longitudinal
Dans le domaine des protocoles expérimentaux longitudinaux, tels que les études cliniques comparatives de type pré-test/post-test ou les études épidémiologiques de suivi de cohortes sur plusieurs décennies, les mêmes indicateurs biologiques, psychologiques ou économiques sont mesurés de manière itérative aux mêmes individus. Lors de la structuration de ces données sous un format horizontal ou large (wide format), où chaque ligne correspond à un sujet unique et chaque colonne à une mesure effectuée à un instant précis, il devient indispensable de préfixer rigoureusement les variables pour différencier les fenêtres temporelles de collecte.
Imaginons un essai clinique mesurant la pression artérielle systolique (PAS), le cholestérol total (CHOL) et l’indice de masse corporelle (IMC) lors de la visite d’inclusion (Baseline ou Temps 0), puis lors d’une visite de suivi à douze mois (Temps 1). Pour éviter toute collision d’identifiants lors de la fusion horizontale des deux tables d’évaluation, les colonnes doivent être affublées d’un préfixe temporel univoque :
DATA suivi_longitudinal;
MERGE evaluation_inclusion(RENAME=(PAS=T0_PAS CHOL=T0_CHOL IMC=T0_IMC))
evaluation_suivi_12m(RENAME=(PAS=T1_PAS CHOL=T1_CHOL IMC=T1_IMC));
BY identifiant_patient;
RUN;
L’adjonction méthodique de ces préfixes garantit le maintien absolu de la traçabilité temporelle des enregistrements. Elle autorise ensuite la formulation de calculs différentiels immédiats au sein de modèles d’analyses de variance pour mesures répétées (ANOVA) ou de régressions linéaires mixtes, éliminant tout risque de confusion entre l’état initial du participant et son évolution sous traitement pharmacologique.
5.2 Application systématique d’un suffixe d’unité ou de métrique
La documentation de la nature métrologique des variables au sein même de leur appellation technique constitue une excellente pratique d’ingénierie des données. L’adjonction de suffixes standardisés documentant l’échelle de mesure, l’unité de compte ou la transformation mathématique subie par la variable brute confère une transparence immédiate aux modélisations statistiques ultérieures.
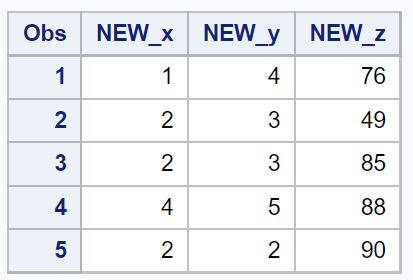
Lorsqu’un chercheur procède à des transformations non linéaires — telles que la normalisation logarithmique de concentrations d’enzymes hépatiques asymétriques ou la standardisation z-score de scores cognitifs —, la conservation des noms de colonnes originaux constitue une source d’erreurs d’interprétation désastreuse. L’intégration de suffixes explicites résout définitivement cette ambiguïté :
DATA biomarqueurs_transformes;
SET donnees_biologiques(RENAME=(
bilirubine = bilirubine_mgdl
transaminase = transaminase_ui
creatinine = creatinine_umol
));
bilirubine_log = log(bilirubine_mgdl);
transaminase_log = log(transaminase_ui);
RUN;
Cette rigueur terminologique permet à quiconque explore la table finale de connaître sans ambiguïté l’unité physique ou l’échelle mathématique du vecteur examiné, facilitant l’évaluation par les pairs et garantissant que les coefficients de régression estimés seront interprétés dans leurs unités de mesure légitimes.
5.3 Extraction programmatique des noms existants avec SASHELP.VCOLUMN
Lorsque la structure d’une table comporte plusieurs dizaines, voire plusieurs centaines de variables à suffixer ou préfixer de manière homogène, la saisie manuelle de chaque instruction d’affectation au sein de l’option RENAME= devient impraticable, source inévitable de fautes de frappe et d’omissions. Le système SAS dispose d’un mécanisme hautement élégant pour contourner cette contrainte : l’interrogation directe des tables du dictionnaire de métadonnées, accessibles en lecture seule via la bibliothèque système SASHELP, et tout particulièrement la vue SASHELP.VCOLUMN.
La vue SASHELP.VCOLUMN consigne de manière exhaustive l’ensemble des caractéristiques de toutes les colonnes présentes dans l’ensemble des tables allouées au sein de la session SAS active (nom de la bibliothèque, nom de la table, nom de la colonne, type, longueur, position, etc.). En combinant une requête déclarative via la procédure PROC SQL et l’interrogation de cette vue, il devient aisé de construire dynamiquement la chaîne textuelle correspondant à l’ensemble des paires de renommage requises :
PROC SQL NOPRINT;
SELECT CATX(‘=’, name, CATS(‘PRE_’, name))
INTO :liste_renommage SEPARATED BY ‘ ‘
FROM sashelp.vcolumn
WHERE libname = ‘WORK’ AND memname = ‘COHORTE_INITIALE’
AND name NOT IN (‘ID_PATIENT’, ‘CENTRE_INCLUSION’);
QUIT;
L’exécution de cette requête SQL extrait tous les noms de colonnes de la table cible (à l’exclusion des clés d’identification préservées), concatène à chacun le préfixe désiré à l’aide des fonctions de manipulation de chaînes CATX et CATS, et agrège l’ensemble de ces déclarations au sein d’une unique macro-variable globale nommée liste_renommage, séparées par des espaces. Dès lors, l’étape DATA ultérieure se simplifie de manière spectaculaire :
DATA cohorte_prefixee;
SET cohorte_initiale(RENAME=(&liste_renommage));
RUN;
Cette approche programmatique élimine toute intervention manuelle dans la déclaration des variables, offrant un gain de productivité considérable et garantissant l’exactitude absolue du processus de standardisation sur les bases de données à haute dimensionnalité.
6. Renommage en place sans duplication physique : PROC DATASETS
6.1 Architecture et efficacité computationnelle de PROC DATASETS
L’un des défis majeurs auxquels sont confrontés les gestionnaires de données réside dans l’optimisation des performances de calcul et la préservation des capacités d’entrées-sorties (I/O) lors du traitement de référentiels massifs (communément désignés sous le terme de Big Data). Comme exposé précédemment, la mise en œuvre d’une étape DATA pour effectuer un simple renommage de colonnes impose au sous-système de stockage de relire séquentiellement l’intégralité des octets de la table source et de les réécrire intégralement dans une nouvelle table cible ou d’écraser la table initiale via un fichier temporaire intermédiaire. Sur une base de données de plusieurs centaines de millions d’enregistrements représentant des dizaines de gigaoctets, cette réplication stérile peut requérir plusieurs dizaines de minutes de calcul processeur et saturer les canaux de communication disque.
La procédure PROC DATASETS constitue la réponse d’ingénierie optimale développée par l’Institut SAS pour surmonter cette inefficience structurelle. Contrairement à l’étape DATA, PROC DATASETS est une procédure utilitaire de gestion de bibliothèque qui opère exclusivement au niveau du bloc descripteur (l’en-tête de la table de données SAS hébergé sur le support de stockage). Les tables SAS sont composées de deux strates logiques : le descripteur, qui encapsule les métadonnées et la structure de la table, et le bloc d’enregistrements, qui abrite les données brutes sous forme matricielle continue.
Lorsque PROC DATASETS est invoquée pour renommer une variable, le moteur de fichiers localise l’en-tête du fichier sur le disque, modifie les octets alloués à la chaîne textuelle du nom de la variable dans le catalogue de descripteurs, et valide immédiatement la mise à jour sans jamais accéder aux lignes de données proprement dites. L’opération s’exécute ainsi en une fraction infime de seconde, quelle que soit la volumétrie de la table sous-jacente — qu’elle compte dix observations ou plusieurs milliards de lignes —, ce qui en fait l’outil d’élection absolu dans les environnements de production industrielle à hautes contraintes de performance.
6.2 Syntaxe formelle de l’instruction MODIFY et de la sous-instruction RENAME
L’exploitation de la procédure PROC DATASETS pour le renommage de variables obéit à une séquence syntaxique spécifique et hautement codifiée. Elle fait intervenir la déclaration de la bibliothèque d’accueil, le ciblage de la table au moyen de l’instruction MODIFY, et l’énonciation des transformations par la sous-instruction RENAME. L’option NOLIST est généralement adjointe à l’en-tête de procédure afin de désactiver l’impression automatique du catalogue de la bibliothèque dans les sorties du système, allégeant ainsi le journal d’exécution.
Le bloc opérationnel type se structure selon les déclarations suivantes :
PROC DATASETS LIBRARY=work NOLIST;
MODIFY grande_table_analytique;
RENAME ancien_identifiant = nouvel_identifiant
autre_variable_source = autre_variable_cible;
RUN;
QUIT;
Plusieurs éléments critiques doivent être scrupuleusement notés au sein de cette construction. En premier lieu, la sous-instruction RENAME s’applique directement à la table spécifiée par l’instruction MODIFY immédiatement précédente. Les paires d’assignation sont séparées par des espaces ou des retours à la ligne, et l’instruction se conclut formellement par un point-virgule. En second lieu, il est impératif d’inclure à la fois l’instruction RUN et l’instruction QUIT. La procédure PROC DATASETS est une procédure interactive : elle demeure active en mémoire d’exécution tant qu’une instruction QUIT formelle ne lui a pas signifié sa clôture définitive. L’omission du mot-clé QUIT laisse la procédure ouverte en arrière-plan, ce qui peut bloquer le flux séquentiel des scripts automatisés subséquents.
6.3 Impacts sur les verrous de fichiers et l’espace de stockage
La modification directe sur place des métadonnées d’une table confère à PROC DATASETS des implications architecturales majeures qu’il convient de maîtriser pour prévenir tout incident d’exploitation. La première conséquence positive concerne l’occupation de l’espace de stockage physique. Étant donné qu’aucune copie temporaire ou définitive du jeu de données n’est générée lors de l’opération, la consommation additionnelle d’espace dans le répertoire temporaire SASWORK est strictement nulle. Dans les contextes où l’espace alloué au dossier temporaire de travail est restreint par les administrateurs système, l’usage de l’étape DATA pour renommer des colonnes sur une table volumineuse conduit fréquemment à une interruption prématurée du traitement pour cause de dépassement de quota disque (code d’erreur système Out of Space). PROC DATASETS élimine définitivement ce facteur de vulnérabilité technique.
Néanmoins, cette modification sur place requiert impérativement l’obtention d’un verrou exclusif d’écriture (exclusive file lock) sur le fichier SAS concerné. Si la table ciblée est simultanément ouverte en consultation par une autre session utilisateur, lue par un visualiseur de données ou verrouillée par un processus analytique concurrent, le moteur de fichiers SAS rejettera immédiatement la demande de modification du descripteur, déclenchant une erreur de verrouillage (Locked File Error) dans le journal d’exécution.
Sur le plan du temps processeur (CPU Time) et du temps d’attente système (Real Time), les gains obtenus par PROC DATASETS sont vertigineux. Les tests comparatifs démontrent que sur une table de 50 millions de lignes et 100 colonnes, une étape DATA requiert plusieurs dizaines de secondes de lecture et d’écriture séquentielles mobilisant une bande passante disque considérable, alors que PROC DATASETS réalise l’opération de renommage en moins de 0,05 seconde, sans sollicitation mesurable du sous-système de disques.
7. Renommage de variables via le langage SQL (PROC SQL)
7.1 Renommage à la volée avec l’alias de projection (Clause AS)
L’intégration du langage d’interrogation structuré au sein de l’environnement SAS par le truchement de la procédure PROC SQL fournit une alternative d’une grande élégance déclarative pour renommer des variables. Cette méthodologie s’avère particulièrement naturelle pour les ingénieurs de données et analystes formés aux environnements de bases de données relationnelles (tels qu’Oracle, PostgreSQL ou Microsoft SQL Server). Dans le paradigme SQL, le renommage ponctuel d’une colonne s’opère canoniquement lors de la phase de projection à travers l’utilisation de l’alias de colonne régi par le mot-clé AS au sein de la clause SELECT.
L’implémentation pratique de ce mécanisme s’illustre par la requête suivante :
PROC SQL;
CREATE TABLE donnees_reformatees AS
SELECT identifiant AS id_sujet,
score_brut AS score_ajuste,
date_test AS date_evaluation
FROM table_source;
QUIT;
Cette approche crée une nouvelle table physique dans laquelle les colonnes sélectionnées adoptent immédiatement leurs nouveaux identifiants. Cependant, l’une des forces architecturales les plus remarquables de PROC SQL réside dans la capacité à substituer à la création d’une table physique la génération d’une vue relationnelle virtuelle via la syntaxe CREATE VIEW. En remplaçant CREATE TABLE par CREATE VIEW dans la requête précédente, SAS enregistre uniquement la logique de la projection dans le descripteur de vue sans allouer le moindre octet de stockage pour les données. Chaque fois que la vue est appelée par une procédure d’analyse statistique subséquente, le renommage s’exécute dynamiquement à la volée, offrant une solution idéale pour présenter des interfaces de données normalisées sans consommer d’espace disque additionnel.
7.2 Modification structurelle permanente avec ALTER TABLE et RENAME
Outre les capacités d’aliasing projectif offertes par la clause SELECT, la procédure PROC SQL intègre un sous-ensemble d’instructions relevant du langage de définition de données (Data Definition Language ou DDL). Parmi ces commandes figure l’instruction ALTER TABLE, spécifiquement conçue pour modifier l’architecture structurelle d’une table relationnelle existante sans réécrire l’ensemble du fichier de données. Dans le dialecte PROC SQL de SAS, la clause ALTER TABLE autorise le renommage direct de colonnes au moyen de la sous-instruction RENAME.
La syntaxe opératoire de cette modification structurelle permanente se formule comme suit :
PROC SQL;
ALTER TABLE base_epidemiologique
RENAME code_insee TO commune_residence,
statut_tabac TO exposition_tabagique;
QUIT;
L’exécution de cette requête DDL modifie la structure de la table base_epidemiologique de manière définitive et en place. Le moteur SQL interne de SAS interagit avec les couches de stockage de manière similaire à PROC DATASETS, adaptant les définitions de colonnes au sein du descripteur de table. Contrairement à l’étape DATA classique, les paires de renommage dans la clause ALTER TABLE de PROC SQL utilisent le mot-clé de transition TO (et non le signe d’égalité =) et sont rigoureusement délimitées par des virgules, conformément aux conventions lexicales de la norme SQL ANSI.
Il existe néanmoins des restrictions structurelles à l’usage de cette instruction sous PROC SQL : l’opération échouera si la table cible est assujettie à des contraintes d’intégrité référentielle complexes non suspendues ou si elle réside dans un moteur de base de données distant dont le pilote SAS/ACCESS sous-jacent ne supporte pas la répercussion directe des ordres DDL de renommage.
7.3 Évaluation comparative : PROC SQL versus étape DATA
L’arbitrage technique entre la mobilisation de PROC SQL et le recours à l’étape DATA pour l’opération de renommage doit être guidé par une appréciation fine des flux de travail et des transformations concomitantes. Si l’opération de renommage s’inscrit au sein d’une chaîne logique impliquant des agrégations relationnelles, des jointures multi-tables via la clause JOIN, ou l’extraction de métriques synthétiques par des fonctions d’agrégation (telles que SUM ou AVG), l’utilisation de PROC SQL est hautement recommandée en raison de son expressivité déclarative et de l’optimisation interne de l’optimiseur de requêtes SQL (Cost-Based Optimizer).
En revanche, lorsque le renommage de variables est associé à des manipulations séquentielles ligne par ligne — telles que l’accès aux valeurs de la ligne précédente par la fonction LAG, l’évaluation de conditions impératives complexes à plusieurs embranchements, ou l’exécution de boucles itératives —, l’étape DATA demeure incontournable en matière d’efficacité d’exécution et de flexibilité fonctionnelle. Sur le strict plan du benchmarking de renommage pur avec réécriture complète, les performances de temps de réponse entre une étape DATA optimisée et un CREATE TABLE sous PROC SQL s’avèrent comparables sur des jeux de données de taille moyenne. Toutefois, dès lors qu’aucune manipulation additionnelle de données n’est requise, la suprématie de la procédure PROC DATASETS demeure absolue, surpassant systématiquement tant l’étape DATA que PROC SQL par son absence totale de recours aux opérations d’entrées-sorties d’enregistrements.
8. Automatisation avancée par la macro-programmation SAS
8.1 Génération dynamique d’expressions de renommage via CALL SYMPUTX
Dans les pipelines de traitement de données d’entreprise et les architectures analytiques de pointe, la programmation statique montre rapidement ses limites face à la variabilité des données entrantes. L’automatisation dynamique du renommage de variables s’impose dès lors que les structures tabulaires évoluent ou que les identifiants de colonnes sont transmis dynamiquement par des sources externes sans intervention humaine directe. L’environnement macro de SAS, combiné à la routine système CALL SYMPUTX au sein d’une étape DATA d’extraction, offre un mécanisme robuste pour concrétiser cette exigence d’automatisation.
Le principe fondamental consiste à interroger les métadonnées système — telles que la table SASHELP.VCOLUMN ou une table de correspondance préalablement définie par un dictionnaire d’entreprise —, puis d’assembler dynamiquement la chaîne d’affectation au format ancien=nouveau et de l’injecter au sein d’une macro-variable d’environnement. La routine CALL SYMPUTX est spécifiquement privilégiée ici par rapport à l’ancienne routine CALL SYMPUT en raison de sa gestion automatique du décapage des espaces résiduels (trimming) et de la conversion implicite sécurisée des types.
L’architecture de ce traitement automatisé s’articule comme suit :
DATA _NULL_;
LENGTH instruction_renommage $32767;
RETAIN instruction_renommage »;
SET dictionnaire_de_renommage END=fin_de_fichier;
instruction_renommage = CATX(‘ ‘, instruction_renommage, CATX(‘=’, ancienne_var, nouvelle_var));
IF fin_de_fichier THEN DO;
CALL SYMPUTX(‘chaine_renommage_globale’, instruction_renommage, ‘G’);
END;
RUN;
Grâce à cette routine, la macro-variable globale chaine_renommage_globale héberge l’intégralité de la directive syntaxique requise. L’étape de production consécutive n’a plus qu’à résoudre cette variable macro au sein de son option RENAME=, permettant une mise à l’échelle industrielle totalement indépendante du nombre de colonnes à traiter et immunisée contre les risques d’omission humaine.
8.2 Boucles macro-itératives (%DO) pour séries de variables standardisées
Dans de nombreuses disciplines scientifiques — notamment en psychométrie, en génomique ou lors du traitement de questionnaires d’évaluation de la qualité de vie —, les données brutes sont constituées de séries massives d’items indicés séquentiellement, par exemple des questions numérotées de 1 à 100 sous la forme Q1 à Q100. Si la nomenclature cible exige de transformer ces identifiants sommaires en une structure indicée normalisée comportant un formatage textuel strict (par exemple item_eval_001 à item_eval_100 avec préservation d’un remplissage par zéros à gauche), le recours aux boucles itératives du macro-langage SAS via l’instruction %DO constitue la solution algorithmique la plus appropriée.
L’élaboration d’un bloc de pré-compilation macro exploitant les fonctions de formatage textuel système %SYSFUNC permet d’engendrer instantanément cette série d’égalités formelles sans aucune saisie fastidieuse :
%MACRO generer_chaine_indices(nb_variables=);
%LOCAL i resultat;
%LET resultat = ;
%DO i = 1 %TO &nb_variables;
%LET resultat = &resultat Q&i = item_eval_%SYSFUNC(PUTN(&i, Z3.));
%END;
&resultat
%MEND generer_chaine_indices;
En invoquant cette macro-fonction au sein d’une option de jeu de données — sous la forme SET table_source(RENAME=(%generer_chaine_indices(nb_variables=100))); —, le processeur macro de SAS substitue dynamiquement au texte d’appel l’ensemble exhaustif des cent couples d’affectation dûment ordonnés. La fonction interne Z3. assure que chaque chiffre inférieur à cent est automatiquement doté des zéros de tête requis (001, 002, …, 100), assurant un tri alphanumérique rigoureux des colonnes dans tous les outils de reporting ultérieurs.
8.3 Développement et déploiement d’une macro modulaire %RENAME_VAR
Pour conférer à un laboratoire de biostatistique ou à une direction des études un haut niveau d’efficience opérationnelle, il est particulièrement pertinent de concevoir une macro-commande modulaire d’entreprise dédiée au renommage, encapsulant les mécanismes d’intégrité, la gestion des exceptions et l’auditabilité des opérations. La macro paramétrique dénommée %RENAME_VAR présentée ci-dessous illustre cette démarche d’ingénierie logicielle avancée.
Cette routine accepte en arguments d’entrée le nom de la table source, le nom de la table de sortie, l’ancien nom de la variable et le nouveau nom de la variable, tout en intégrant des vérifications préventives garantissant l’existence préalable du fichier et la consignation formelle du succès opérationnel au sein du journal d’audit :
%MACRO RENAME_VAR(table_in=, table_out=, old_name=, new_name=);
%IF %SYSFUNC(EXIST(&table_in)) = 0 %THEN %DO;
%PUT %STR(ERR)OR: [MACRO RENAME_VAR] La table d’origine &table_in est introuvable.;
%RETURN;
%END;
DATA &table_out;
SET &table_in(RENAME=(&old_name = &new_name));
RUN;
%IF &SYSERR = 0 %THEN %DO;
%PUT %STR(NOTE): [MACRO RENAME_VAR] Renommage avec succes de &old_name en &new_name.;
%END;
%ELSE %DO;
%PUT %STR(ERR)OR: [MACRO RENAME_VAR] Echec critique lors de l’etape de renommage.;
%END;
%MEND RENAME_VAR;
Le déploiement centralisé d’un tel module garantit une exécution harmonisée sur l’ensemble des postes de travail d’une organisation. La vérification conditionnelle basée sur la fonction système %SYSFUNC(EXIST(…)) empêche le déclenchement d’étapes de calcul destructrices en cas d’absence de la ressource source, tandis que l’évaluation du code d’erreur automatique système &SYSERR assure une traçabilité totale du flux de travail au sein des journaux de production.
9. Interaction du renommage avec les autres déclarations SAS
9.1 Gestion des interactions avec DROP et KEEP
Dans la conduite des flux d’épuration de données sous SAS, il est très fréquent d’associer le renommage de certaines variables au filtrage sélectif des colonnes au moyen des instructions ou options DROP (exclusion) et KEEP (rétention). Toutefois, l’interaction simultanée de ces déclarations au sein d’une même étape DATA obéit à un ordre d’évaluation logique rigoureux régi par l’architecture du compilateur SAS, dont la méconnaissance provoque des erreurs systématiques d’exécution.
Lorsque l’option RENAME= cohabite avec l’option KEEP= ou DROP= sur la même instruction d’entrée SET — par exemple : SET table_source(KEEP=var1 var2 RENAME=(var1=nouvelle_var1)); —, le compilateur évalue impérativement les options dans l’ordre fonctionnel interne suivant : DROP/KEEP sont analysées en tout premier lieu, avant toute autre substitution. En conséquence, la variable doit obligatoirement être désignée sous son ancien nom au sein de la clause KEEP ou DROP. Si l’analyste commet l’erreur d’inscrire le nouveau nom au sein de la clause KEEP adossée à l’instruction SET, le compilateur échoue en signalant que la variable n’existe pas dans la table source, car le renommage n’a pas encore été consommé lors de l’établissement du filtre d’extraction.
À l’inverse, si les options DROP ou KEEP sont positionnées en sortie sur l’instruction DATA — ou invoquées sous la forme d’instructions autonomes dans le corps du programme alors que le renommage a été opéré dans l’instruction SET —, c’est le nouveau nom qui doit obligatoirement être référencé. L’ancien nom ayant été évincé du PDV lors de la phase de chargement, toute tentative d’exclusion ou de conservation basée sur l’ancienne désignation résultera en une erreur bloquante. La maîtrise de cette chronologie d’évaluation interne constitue une compétence essentielle pour tout programmeur SAS chevronné.
9.2 Préservation des métadonnées associées : Labels, Formats et Informats
L’altération de l’identifiant technique d’une colonne soulève immédiatement la question de la pérennité de ses métadonnées périphériques, à savoir ses étiquettes descriptives (Labels), ses règles d’affichage à l’écran (Formats) et ses modèles d’interprétation lors de la lecture (Informats). Dans la conception du noyau SAS, le descripteur d’une variable stocke ces attributs sous forme de propriétés attachées au vecteur de métadonnées de la colonne. Lorsque l’on procède au renommage d’une variable par l’option RENAME= (que ce soit dans l’étape DATA ou via PROC DATASETS), le système assure par défaut la transmission intégrale et transparente de l’ensemble des formats et libellés existants au nouvel identifiant.
Cependant, des discordances sémantiques peuvent surgir à la suite d’un renommage. Par exemple, si une variable originellement nommée age_brut possédait un format personnalisé de tranches d’âges (créé via PROC FORMAT) et un label explicatif stipulant « Âge du patient en années révolues », mais que l’analyste la renomme en age_standardise_zscore après transformation mathématique, le maintien aveugle des anciens formats et libellés produit une anomalie documentaire majeure : la table contiendra des valeurs numériques centrées-réduites affublées d’un libellé et d’un masque de mise en forme totalement inappropriés.
Dans cette perspective, il incombe au développeur de réaffecter explicitement les attributs lorsque la nature de la variable a évolué, en associant à l’instruction de renommage les instructions LABEL et FORMAT adéquates :
DATA donnees_epurees;
SET donnees_sources(RENAME=(poids=poids_mesure));
LABEL poids_mesure = ‘Masse corporelle evaluee en kilogrammes (balance calibree)’;
FORMAT poids_mesure 8.2;
RUN;
Cette démarche garantit que le nouvel identifiant s’accompagne d’une documentation descriptive parfaitement synchronisée, prévenant toute méprise lors de l’exportation des données vers des tiers ou de la confection de rapports automatisés au moyen de procédures telles que PROC REPORT ou PROC TABULATE.
9.3 Impact du renommage sur les fusions par concordance (MERGE / BY)
L’un des cas d’usage les plus critiques du renommage de variables intervient lors de l’appariement déterministe de jeux de données relationnels disjoints au moyen de l’instruction MERGE adossée à la clause de concordance BY. Pour que le moteur d’exécution de SAS puisse synchroniser horizontalement les lignes de deux tables distinctes, les colonnes servant de critères de jonction (les variables de fusion BY) doivent obligatoirement porter des noms strictement identiques dans chacune des tables appelées, tout en partageant un même type fondamental (numérique ou caractère).
Or, dans la réalité des systèmes d’information hospitaliers ou transactionnels, il arrive couramment que la clé primaire d’un sujet soit désignée sous l’identifiant numero_dossier dans la table démographique, alors qu’elle figure sous le nom id_patient dans la table des examens de biologie médicale. Sans une harmonisation préalable, l’instruction MERGE échoue irrémédiablement. L’application de l’option RENAME= directement dans l’instruction d’appel SET résout ce conflit de manière immédiate :
DATA dossier_clinique_consolide;
MERGE donnees_demographiques(RENAME=(numero_dossier=id_patient))
resultats_laboratoire;
BY id_patient;
RUN;
Il existe un corollaire tout aussi fondamental : la prévention de l’écrasement involontaire de variables non destinées à la fusion. Si les deux tables partagent une variable portant un nom identique mais représentant des concepts différents — par exemple une colonne date désignant la date de naissance dans la table démographique et la date du prélèvement dans la table de biologie —, la procédure MERGE écrasera silencieusement la valeur de la première table par celle de la seconde lors de l’écriture dans le PDV. L’utilisation préventive de l’option RENAME= pour renommer ces colonnes homonymes (en date_naissance et date_prelevement) constitue la seule garantie architecturale contre la corruption silencieuse des enregistrements au cours de la fusion.
10. Renommage itératif basé sur des tableaux (Arrays)
10.1 Limites inhérentes à l’instruction ARRAY pour le renommage structurel
Une incompréhension récurrente chez les programmeurs abordant les concepts avancés du langage SAS concerne l’utilisation de l’instruction ARRAY à des fins de renommage. L’instruction ARRAY est couramment perçue comme un outil de manipulation matricielle universel, conduisant fréquemment à la tentative erronée d’utiliser des boucles DO OVER pour tenter d’altérer les noms de variables en mémoire. Il est crucial d’affirmer avec rigueur la réalité architecturale : l’instruction ARRAY ne permet en aucun cas de modifier directement les métadonnées d’une variable ni son appellation technique.
Dans l’écosystème SAS, un ARRAY n’est pas une structure de données physique ni un objet de stockage persistant ; il s’agit d’un simple pointeur temporaire d’exécution, d’un regroupement mnémotechnique qui attribue des indices numériques transitoires à un ensemble de variables résidant déjà dans le Program Data Vector. Par conséquent, les tableaux SAS opèrent exclusivement sur les valeurs stockées dans les variables au cours de la phase d’exécution de l’étape DATA, et n’ont strictement aucune prise sur le descripteur de table qui fige les noms de ces variables lors de la phase de compilation. La barrière entre la structure des métadonnées (établie lors de la compilation) et l’évaluation matricielle des enregistrements (qui s’opère durant l’exécution) est étanche.
10.2 Stratégie de transposition et d’assignation indirecte
Puisqu’il est impossible de renommer structurellement des colonnes via un ARRAY, la stratégie algorithmique de contournement consiste à employer un paradigme d’assignation indirecte par transfert de vecteurs. Ce procédé élégant s’articule autour de la déclaration conjointe de deux tableaux distincts au sein de l’étape DATA : un tableau source pointant vers les colonnes d’origine, et un tableau récepteur pointant vers un ensemble de variables cibles nouvellement instanciées sous leur nomenclature définitive.
Le mécanisme s’exécute séquentiellement : pour chaque observation chargée dans le PDV, une boucle itérative transcrit les valeurs scalaires du premier tableau vers le second, dupliquant temporairement l’information sous les nouveaux identifiants. Une fois cette transmission de valeurs achevée, l’instruction DROP intervient pour purger intégralement les anciennes colonnes de la structure finale de la table, ne laissant subsister sur le disque que les nouvelles variables peuplées :
DATA matrice_renommee;
SET table_initiale;
ARRAY sources(3) mesure_a mesure_b mesure_c;
ARRAY cibles(3) variable_finale_1 variable_finale_2 variable_finale_3;
DO i = 1 TO 3;
cibles(i) = sources(i);
END;
DROP i mesure_a mesure_b mesure_c;
RUN;
Bien que cette méthode implique une allocation transitoire de mémoire pour héberger simultanément les deux tableaux dans le PDV, elle offre une souplesse exceptionnelle lorsqu’il est nécessaire de coupler le renommage à une logique d’imputation, de filtrage des valeurs aberrantes ou de transformation mathématique continue sur des dizaines de mesures simultanées.
10.3 Cas concret : Traitement par lot d’items d’échelles de personnalité
Pour matérialiser la puissance de cette approche par double tableau, considérons l’analyse d’un inventaire de personnalité clinique (par exemple basé sur le modèle du Big Five ou de l’inventaire NEO-PI). Les questionnaires psychologiques comportent fréquemment des items inversés conçus pour contrôler les biais d’acquiescement chez les répondants. Lors du dépouillement, le chercheur doit simultanément inverser le barème de cotation (sur une échelle de Likert de 1 à 5, transformer un score de 1 en 5, 2 en 4, etc.) et renommer les identifiants d’items pour expliciter cette inversion avant d’agréger les scores factoriels.
L’implémentation par double tableau ARRAY permet d’opérer cette double manipulation avec une concision et une clarté remarquables :
DATA inventaire_personnalite_traite;
SET reponses_brutes_questionnaire;
ARRAY items_bruts(5) q03 q07 q12 q18 q24;
ARRAY items_inverses(5) extraversion_rev_item3 neuroticisme_rev_item7
agreabilite_rev_item12 consciencieusite_rev_item18
ouverture_rev_item24;
DO k = 1 TO 5;
IF items_bruts(k) NE . THEN DO;
items_inverses(k) = 6 – items_bruts(k);
END;
ELSE DO;
items_inverses(k) = .;
END;
END;
DROP k q03 q07 q12 q18 q24;
RUN;
Grâce à ce patron de programmation, la formule algorithmique (6 – note brute) est appliquée séquentiellement à chaque item valide, les valeurs manquantes sont rigoureusement préservées, les anciennes variables brutes sont écartées de la structure de sortie et les nouvelles colonnes apparaissent immédiatement avec des identifiants scientifiques standardisés, documentant explicitement la nature inversée de la métrique recueillie.
11. Bonnes pratiques méthodologiques et gouvernance des données
11.1 Règles de dénomination académique et conformité réglementaire
L’attribution de nouveaux noms de variables ne doit jamais relever d’un choix esthétique arbitraire laissé à la discrétion individuelle du développeur ; elle doit s’inscrire au sein d’un cadre de gouvernance des données formel, aligné sur les préconisations des instances de régulation et les conventions de publication scientifique internationale. Dans le domaine de la recherche académique, les directives de l’American Psychological Association (APA) ainsi que les standards de la communauté biomédicale recommandent l’adoption stricte de typographies uniformes facilitant la lecture automatisée par des scripts de méta-analyse.
Deux conventions de casse se partagent principalement les faveurs des architectes de données :
- Le Snake_case : Les mots sont séparés par un caractère de soulignement (underscore) et sont rédigés préférentiellement en minuscules (ex. : taux_cholesterol_plasmatique). Cette approche présente l’immense avantage d’offrir une lisibilité optimale sur les écrans de terminaux et de s’intégrer sans ambiguïté dans les moteurs d’analyse de données actuels.
- Le CamelCase (ou UpperCamelCase / lowerCamelCase) : Les mots sont agglutinés sans espace en marquant l’initiale de chaque segment sémantique par une majuscule (ex. : TauxCholesterolPlasmatique).
Au-delà de la syntaxe formelle, l’adéquation réglementaire impose des contraintes éthiques impératives. Dans le cadre de la manipulation de données de santé ou de données à caractère personnel régies par le Règlement Général sur la Protection des Données (RGPD) en Europe ou la loi HIPAA aux États-Unis, le renommage de variables joue un rôle direct dans les protocoles de pseudonymisation. Il est formellement interdit de maintenir dans les tables d’analyse des identifiants directs (tels que noms, prénoms ou adresses) ; ces variables doivent être éliminées ou substituées par des identifiants chiffrés neutres (ex. : code_inclusion_anonymise) dès les premières étapes du pipeline de traitement statistique.
11.2 Documentation systématique du dictionnaire de données
Toute intervention altérant la structure des métadonnées d’une table d’investigation scientifique doit être consignée au sein d’un registre de traçabilité immuable (audit trail). Dans le cadre de soumissions réglementaires auprès d’agences sanitaires — telles que la Food and Drug Administration (FDA) américaine ou l’Agence Européenne des Médicaments (EMA) —, l’incapacité d’un promoteur à fournir la chaîne complète de transformation reliant chaque identifiant de la base finale aux questions des cahiers d’observation initiaux (Case Report Forms ou CRF) peut entraîner le rejet catégorique du dossier clinique.
Pour assurer cette conformité, l’ingénieur de données doit générer et archiver un dictionnaire de correspondance des données (Data Dictionary) chaque fois qu’un renommage par lot est opéré. Ce dictionnaire est généralement structuré sous la forme d’un tableau synthétique répertoriant l’ancien nom de la variable, son nouveau nom, son type technique, son libellé descriptif complet, la justification méthodologique de la modification et l’horodatage de l’opération.
Ce tableau documentaire peut être exporté automatiquement vers des formats pérennes ouverts — tels que des fichiers CSV normés, des feuilles de calcul ou des documents PDF certifiés — à l’aide des procédures SAS de reporting (ODS – Output Delivery System). Ce registre constitue une preuve opposable attestant devant les auditeurs et les examinateurs scientifiques du respect absolu des processus de gestion de la qualité des données.
11.3 Vérification automatisée de l’intégrité après renommage
Dans un processus de validation analytique rigoureux, la confirmation du bon déroulement d’une opération de renommage ne peut reposer sur une simple inspection visuelle humaine, par nature faillible. Il est impératif d’intégrer des procédures d’assurance qualité automatisées au sein des programmes. La procédure PROC COMPARE constitue la référence ultime pour vérifier qu’une opération de renommage s’est déroulée sans introduire la moindre dérive ou corruption de contenu.
PROC COMPARE confronte de manière exhaustive deux tables SAS (la table de référence initiale et la table modifiée) sur le plan des observations, des variables et de leurs valeurs respectives. Lorsque les variables ont été renommées, l’instruction RENAME peut être adjointe au sein de l’appel de comparaison pour réaligner les en-têtes et attester que les cellules numériques et caractères n’ont subi aucun déplacement ou altération de valeur :
PROC COMPARE BASE=table_initiale COMPARE=table_renommee(RENAME=(nouvelle_var=ancienne_var)) CRIT=1E-12;
RUN;
Si les deux jeux de données sont rigoureusement identiques au niveau de leurs observations, la procédure consigne dans le journal la mention formelle attestant qu’aucune disparité n’a été décelée (No unequal values were found). Parallèlement, des tests d’assertion programmés sous forme de macros conditionnelles permettent de valider automatiquement, avant toute étape de modélisation mathématique, que les nouveaux noms de variables sont bien présents dans la table cible et que les anciens identifiants en ont été définitivement exclus, sécurisant ainsi l’intégralité du pipeline analytique.
12. Guide de dépannage et résolution des erreurs de renommage
12.1 Résolution de l’erreur « Variable not found »
L’alerte d’exécution signalant qu’une variable est introuvable (ERROR: Variable … not found) représente incontestablement l’incident le plus fréquemment rencontré lors de la manipulation des directives de renommage. L’origine structurelle de cette anomalie réside presque systématiquement dans une désynchronisation temporelle entre la phase de compilation du programme et sa phase d’exécution au sein du vecteur de données (PDV).
Le diagnostic de cette erreur commande d’analyser précisément l’emplacement de l’option RENAME= :
- Cas de figure A (RENAME sur l’instruction DATA) : L’analyste écrit DATA out(RENAME=(x=new_x)); SET in; calcul = new_x * 2; RUN;. L’erreur « Variable new_x not found » surgit immédiatement. Comme exposé lors de l’analyse du PDV, l’option positionnée sur l’instruction DATA n’agit qu’au moment du déversement de la ligne sur le disque. Durant tout le traitement du corps de l’étape, la colonne s’appelle encore x. Le calcul aurait donc dû être écrit calcul = x * 2;.
- Cas de figure B (RENAME sur l’instruction SET) : L’analyste écrit DATA out; SET in(RENAME=(x=new_x)); calcul = x * 2; RUN;. Cette fois, c’est l’erreur « Variable x not found » qui apparaît dans le log. Dès lors que l’option RENAME est attachée à l’instruction SET, la variable x a cessé d’exister dès son franchissement de la table source. Le PDV ne connaît que new_x, qui devait impérativement être employée dans l’expression d’assignation.
Pour résoudre méthodiquement cette divergence, le programmeur doit tracer méticuleusement la chronologie de passage de chaque identifiant dans le flux de calcul. La règle cardinale se résume ainsi : sur l’instruction SET, on utilise le nouveau nom dans le corps de l’étape ; sur l’instruction DATA (ou avec l’instruction globale RENAME), on utilise impérativement l’ancien nom dans le corps de l’étape.
12.2 Gestion des collisions de noms et doublons au sein du jeu de données
Une situation conflictuelle majeure survient lorsqu’une tentative de renommage introduit une collision lexicale avec une colonne déjà préexistante au sein de la table de données cible. Supposons une table contenant deux indicateurs : une variable nommée tension et une autre nommée tension_systolique. Si une directive de renommage formule l’instruction RENAME=(tension=tension_systolique), le système SAS fait face à un doublon d’identifiant au sein du descripteur de sortie, ce qui viole le principe fondamental de l’unicité des colonnes dans une table relationnelle.
Face à une telle collision, le compilateur émet un message d’erreur bloquant dans le journal d’exécution et interrompt immédiatement la création de la table pour prévenir tout écrasement accidentel de données. Pour surmonter cette entrave sans perte d’information, l’analyste doit procéder par étapes coordonnées de désambiguïsation :
- Attribuer préalablement un nom transitoire unique et temporaire à la variable préexistante (par exemple tension_systolique_brute).
- Appliquer ensuite le renommage définitif à la variable source cible.
- Procéder, le cas échéant, à l’élimination sélective (DROP) de la colonne obsolète une fois la vérification de conformité effectuée.
Ces collisions de noms se rencontrent fréquemment lors de la consolidation de données issues d’études multicentriques où des hôpitaux partenaires utilisent des nomenclatures concurrentes pour enregistrer des mesures similaires. L’élaboration préalable d’une matrice de cartographie lexicale (Mapping Matrix) élimine en amont ces risques d’interférence.
12.3 Diagnostic des alertes (WARNINGS) et anomalies silencieuses
Si les erreurs (ERROR) provoquent une rupture visible et immédiate de l’exécution, les avertissements (WARNING) émis par SAS méritent une vigilance tout aussi scrupuleuse, car ils dissimulent fréquemment des anomalies silencieuses susceptibles de vicier les analyses ultérieures sans interrompre le traitement informatique.
Parmi les avertissements récurrents figure l’alerte de troncature d’identifiant. Conformément aux spécifications du moteur SAS standard, un nom de variable ne peut excéder 32 octets. Si une routine macro tente d’assigner un nom dépassant ce seuil critique — par exemple une chaîne explicative comportant 38 caractères —, le compilateur tronque silencieusement la chaîne aux 32 premiers octets et émet une alerte dans le journal (WARNING: The name … is too long for a SAS name and will be truncated). Si deux variables distinctes partagent les mêmes 32 premiers octets et ne diffèrent que par leurs caractères terminaux, cette troncature automatique engendre une collision de noms immédiate.
Un autre cas insidieux d’anomalie concerne l’application simultanée d’options RENAME sur l’instruction SET et sur l’instruction DATA au sein de la même étape sans une maîtrise absolue des transferts d’identifiants intermédiaires. Bien que le journal d’exécution n’affiche parfois qu’un simple avertissement d’incohérence, les variables peuvent se retrouver inversées ou écrasées en mémoire, générant des biais substantiels lors des analyses factorielles ou des tests d’hypothèses subséquents.
La règle d’or d’une programmation de niveau professionnel sous SAS impose de maintenir impérativement un journal de bord exempt du moindre WARNING et de la moindre ERROR. L’analyse systématique et exhaustive du SAS Log constitue l’unique garantie d’une science des données reproductible, robuste et exempte de tout artefact computationnel.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Clinical Data Interchange Standards Consortium. (2021). Study Data Tabulation Model Implementation Guide: Human Clinical Trials (Version 3.3). CDISC. https://www.cdisc.org/standards/foundational/sdtm
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 Statements: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lestmtsref/titlepage.htm
- SAS Institute Inc. (2021). Base SAS 9.4 Procedures Guide (7th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/proc/titlepage.htm
- SAS Institute Inc. (2022). SAS 9.4 SQL Procedure User’s Guide (4th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/sqlproc/titlepage.htm
- SAS Institute Inc. (2023). SAS 9.4 Macro Language: Reference (6th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/mcrolref/titlepage.htm