
Dans le domaine du traitement des données massives et de l’analyse biostatistique ou actuarielle, le système SAS (Statistical Analysis System) demeure une référence technologique fondamentale en raison de sa robustesse, de sa rigueur mathématique et de sa gestion optimisée des ressources de calcul. Cependant, l’un des défis permanents auxquels sont confrontés les ingénieurs de données, les statisticiens et les data scientists réside dans la gestion rigoureuse des données lacunaires. Dans un environnement opérationnel, l’apparition de champs non renseignés découle d’une multitude de facteurs, allant des ruptures de captation de signaux instrumentaux aux omissions volontaires dans les questionnaires psychométriques ou épidémiologiques, en passant par des anomalies structurelles survenues lors des processus d’extraction, de transformation et de chargement (ETL).
Le traitement des valeurs manquantes ne saurait se réduire à un simple choix esthétique d’affichage. Au sein de SAS, l’omission d’une valeur numérique déclenche des comportements algorithmiques prédéterminés qui, s’ils ne sont pas convenablement anticipés et maîtrisés, peuvent conduire à l’éviction massive d’observations lors des régressions multivariées, à la propagation silencieuse de valeurs indéfinies dans les chaînes d’opérations scalaires, ou encore à des distorsions conceptuelles majeures lors des agrégations sommatoires. Remplacer ces vides par la valeur zéro constitue ainsi une pratique extrêmement répandue, légitimée par de nombreux cadres d’affaires et impératifs méthodologiques. Cette décision implique néanmoins une compréhension intime des mécanismes internes du moteur SAS, en particulier du vecteur d’observation en mémoire vive, ainsi qu’une conscience aiguë des retombées statistiques sous-jacentes.
Cet ouvrage d’analyse approfondie a pour vocation d’explorer l’intégralité du spectre technique et théorique lié à la substitution des valeurs manquantes par zéro dans l’écosystème SAS. De la syntaxe conditionnelle élémentaire exécutée au sein de l’étape DATA jusqu’aux approches vectorisées à hautes performances permises par la procédure STDIZE, en passant par la manipulation experte des tableaux de mémoire temporaire (ARRAY), l’usage fonctionnel de COALESCE et les opérations relationnelles sous PROC SQL, l’ensemble des paradigmes programmatiques sera décortiqué. En outre, une attention particulière sera portée à la sémantique singulière des valeurs manquantes spéciales propres à SAS, aux considérations relatives à la théorie de l’imputation probabiliste de Donald Rubin, ainsi qu’aux protocoles d’assurance qualité et d’optimisation d’entrées-sorties sur les très grands volumes de données.
1. Fondements et contexte du remplacement des valeurs manquantes par zéro dans SAS
1.1 Nature des valeurs manquantes dans les environnements quantitatifs
Dans toute architecture informationnelle dédiée à la modélisation statistique, il convient de distinguer conceptuellement l’absence d’information de l’enregistrement d’une grandeur nulle. Une valeur manquante traduit l’inaccessibilité, l’inapplicabilité ou l’indétermination d’une mesure à un instant précis de la collecte. À l’inverse, le zéro représente un point précis sur l’axe des réels, indiquant une magnitude nulle, une absence de survenue d’un phénomène mesurable ou un équilibre thermodynamique, économique ou biologique parfaitement calibré. Confondre l’absence de mesure avec une mesure de magnitude nulle expose l’analyste à des erreurs fondamentales d’interprétation.
D’un point de vue computationnel, l’omission d’une donnée déclenche des conséquences pénalisantes au sein du moteur arithmétique de SAS. Lorsqu’une opération d’addition ou de multiplication élémentaire intègre une valeur non définie, le résultat retourné par le système est systématiquement une valeur manquante. Cette propagation stricte découle de l’axiome d’inconnaissance : si une composante d’une somme scalaire est inconnue, la somme globale est rigoureusement indéterminable. Dès lors, dans des contextes financiers ou logistiques où l’absence de saisie d’un flux de trésorerie ou d’un mouvement d’inventaire signifie en réalité qu’aucune transaction n’a eu lieu, l’absence de conversion vers le zéro détruit la capacité de calcul du système sur les cumuls périodiques.
La substitution déterministe par zéro se justifie sur le plan théorique et opérationnel dès lors que le processus générateur de données sous-jacent confère à l’absence la signification objective de l’inexistence du phénomène. Dans un registre de sinistres d’assurance, par exemple, un assuré n’ayant déclaré aucun accident présentera une ligne vide pour le montant des remboursements. La transformation de cette absence en une valeur monétaire égale à zéro n’est pas un artifice statistique abusif, mais une restitution fidèle de l’état économique de l’assuré vis-à-vis de l’assureur. L’enjeu technique réside dans la capacité à implémenter cette conversion avec une efficience maximale sans corrompre les métadonnées afférentes.
1.2 Représentation interne des données manquantes dans le système SAS
Le système SAS implémente une gestion native hautement spécialisée des valeurs manquantes pour les variables de type numérique. Contrairement à d’autres langages qui recourent à des valeurs sentinelles arbitraires ou au concept d’indétermination de type NaN (Not a Number) défini par la norme IEEE 754, SAS modélise la valeur manquante numérique standard par le symbole typographique du point (.). Ce point correspond, sur le plan physique de l’architecture binaire en virgule flottante, à une configuration spécifique de bits que le processeur d’évaluation SAS identifie immédiatement comme une valeur indéfinie.
Sur le plan comparatif et relationnel, le compilateur SAS adopte une règle critique qui diverge profondément des conventions mathématiques classiques : la valeur manquante numérique (.) est formellement ordonnée comme étant strictement inférieure à n’importe quel nombre réel concevable, y compris l’infini négatif théorique. Par conséquent, dans le cadre d’une évaluation booléenne non typée, l’expression conditionnelle évaluant si une variable est inférieure à un seuil positif arbitraire, ou même négatif, renvoie la valeur logique vraie si la variable contient un point. Cette particularité interne constitue l’un des pièges les plus redoutables pour les développeurs SAS non avertis.
Cette hiérarchisation a des répercussions directes lors des tris de tables (PROC SORT) et de l’application de clauses de filtrage (instructions WHERE ou IF). Par défaut, une procédure de tri ascendant positionnera systématiquement l’ensemble des enregistrements incomplets au tout début du jeu de données résultant. De même, un filtre cherchant à isoler des soldes de comptes débiteurs inférieurs à zéro capturera de manière parasite les valeurs manquantes, à moins qu’une exclusion explicite ne soit articulée. L’absence d’un traitement préalable d’uniformisation ou de conversion vers le zéro engendre donc des distorsions massives dans la sélection des cohortes analytiques.
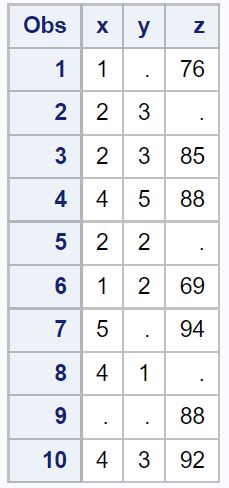
1.3 Objectifs analytiques de la conversion systématique vers le zéro
L’un des moteurs fondamentaux justifiant la conversion systématique des valeurs manquantes vers le zéro réside dans la préservation du pouvoir informatif des tables lors des agrégations arithmétiques. Au sein de l’étape DATA, l’opérateur d’addition unaire (+) échoue dès qu’un point standard est rencontré. Si l’on recourt à la fonction SUM(), celle-ci tolère les valeurs manquantes en les ignorant, mais si la totalité des arguments d’une ligne est manquante, le résultat demeure une valeur manquante. Remplacer explicitement les données absentes par zéro garantit que la structure matricielle résultante se comporte de façon totalement prévisible face aux opérateurs mathématiques, sans interruption ni propagation d’indéterminations.
Au-delà des calculs élémentaires, la normalisation des matrices de covariance et de corrélation représente un objectif méthodologique déterminant. Dans des disciplines telles que la psychométrie ou l’économétrie, le calcul d’une matrice de variance-covariance exige des vecteurs d’observations complets. Si un algorithme procède à l’élimination des observations incomplètes (« listwise deletion »), la perte d’effectifs peut être dévastatrice pour la puissance statistique des tests. Dans les contextes où l’absence d’observation correspond effectivement à un score nul sur une échelle d’évaluation comportementale, imputer le zéro permet de préserver la taille d’échantillon nécessaire à la convergence des estimateurs.
Enfin, la stabilisation des algorithmes prédictifs contemporains et des modèles linéaires généralisés (GLM) dépend largement de l’intégrité matricielle. Les procédures de modélisation prédictive, qu’il s’agisse de régressions logistiques, de modèles de survie ou de techniques d’arbres de décision régularisés, excluent fréquemment les vecteurs contenant des valeurs manquantes à moins d’avoir configuré des sous-routines complexes de substitution. Assigner le zéro de manière contrôlée supprime ce phénomène d’attrition artificielle des données, garantissant ainsi que l’ensemble du volume d’apprentissage participe à l’estimation des coefficients prédictifs du système.
2. La méthode élémentaire : Remplacement conditionnel via l’instruction IF-THEN
2.1 Syntaxe de base de l’instruction IF-THEN au sein de l’étape DATA
L’étape DATA de SAS repose sur une boucle itérative implicite qui traite séquentiellement chaque enregistrement de la table source. Au cœur de cette architecture se trouve le vecteur d’observation du programme, universellement désigné par l’acronyme Program Data Vector (PDV). Le PDV agit comme une zone tampon en mémoire vive où les colonnes sont allouées, alimentées, transformées puis écrites vers le jeu de données de sortie. L’instruction logique IF-THEN constitue le moyen le plus direct et fondamental d’interagir avec les valeurs résidant dans ce vecteur.
La structure formelle de la déclaration conditionnelle dédiée au remplacement s’articule traditionnellement autour du prédicat vérifiant la présence du point standard : if variable = . then variable = 0;. Lors de l’exécution, le compilateur évalue pour chaque ligne la concordance entre l’état binaire du champ dans le PDV et la constante représentative de la valeur manquante. Si la proposition logique est vérifiée, l’adresse mémoire associée à la variable est immédiatement réaffectée avec la représentation binaire du zéro en virgule flottante double précision.
Il est primordial d’optimiser l’écriture de ces instructions pour préserver les cycles d’horloge du processeur. Bien que l’instruction simple suffise, sur des tables contenant des dizaines de millions d’enregistrements, la réassignation ne doit s’opérer qu’en cas d’absolue nécessité. L’absence de branche conditionnelle alternative (clause ELSE) est ici appropriée, car lorsque la condition n’est pas remplie, la valeur valide déjà présente dans le PDV doit demeurer strictement inchangée. L’instruction conditionnelle évite ainsi toute altération parasite des valeurs légitimes non nulles.
2.2 Application à une variable numérique isolée
L’implémentation de cette logique sur une variable unitaire constitue l’archétype de la manipulation de nettoyage de données. Pour illustrer la cinétique opérationnelle, considérons un scénario d’analyse de rétention client où la variable mesurant le nombre de réclamations déposées au cours du dernier trimestre comporte des absences de données. Ces absences proviennent du fait que les opérateurs de saisie n’enregistrent aucun formulaire pour les clients sans incident. La table source, désignée conventionnellement sous le nom d’activité, nécessite une normalisation avant son exploitation par les algorithmes de segmentation.
Le bloc programmatique fondamental se déploie comme suit au sein de l’éditeur de code SAS :
data travail.activite_nettoyee;

    set source.activite;

    if reclamations = . then reclamations = 0;

run;
L’inspection de la table transformée par le truchement de la procédure PROC PRINT révèle la modification immédiate : les enregistrements qui affichaient préalablement le point d’indétermination arborent désormais le zéro numérique. Il convient de souligner que cette opération préserve scrupuleusement l’ensemble des métadonnées originelles de la variable. Le format d’affichage, le label informatif et la longueur de stockage en octets définis préalablement dans l’en-tête de la table SAS demeurent rigoureusement intacts au sein du PDV, garantissant une continuité absolue dans le dictionnaire des variables.
2.3 Remplacement séquentiel sur plusieurs colonnes ciblées
Lorsque la problématique de données lacunaires s’étend à plusieurs variables quantitatives distinctes au sein du même jeu de données, la réponse intuitive consiste à multiplier les instructions conditionnelles indépendantes les unes après les autres. Dans une base de données de facturation médicale comportant des colonnes dédiées aux montants de pharmacie, de radiologie et d’hospitalisation, l’analyste peut choisir de juxtaposer les blocs logiques de façon linéaire au fil de l’étape DATA.
data travail.facturation_complete;

    set source.facturation;

    if montant_pharmacie = . then montant_pharmacie = 0;

    if montant_radiologie = . then montant_radiologie = 0;

    if montant_hospitalisation = . then montant_hospitalisation = 0;

run;
Si cette approche séquentielle offre une lisibilité directe pour un nombre très restreint de colonnes, elle atteint très rapidement des limites méthodologiques sévères. Dès lors que le traitement concerne dix, vingt ou cinquante colonnes, la prolifération des lignes d’instructions expose le code à un risque élevé d’erreurs typographiques, d’omissions involontaires de variables et d’hétérogénéités de traitement. La maintenance applicative devient complexe et la lisibilité globale s’en trouve lourdement dégradée.
Sur le plan computationnel, l’évaluation successive de multiples blocs conditionnels IF non vectorisés force le moteur d’exécution à évaluer séquentiellement chaque condition logique pour chaque ligne du jeu de données. Même si l’impact sur une table modeste de quelques milliers de lignes est négligeable, la pénalité de performance devient sensible sur des volumes massifs de données transactionnelles. Cette limite a conduit les concepteurs de SAS à développer des mécanismes d’abstraction plus performants et élégants pour le traitement itératif de collections de variables.
3. Automatisation globale : Utilisation des tableaux ARRAY et de la variable _NUMERIC_
3.1 Principes fondamentaux de la structure ARRAY dans SAS
Pour s’affranchir de la répétition fastidieuse des instructions conditionnelles univariées, le langage SAS met à la disposition des développeurs la structure de tableau désignée par l’instruction ARRAY. Contrairement aux tableaux matriciels que l’on rencontre dans des langages compilés tels que C++ ou Fortran, un ARRAY en SAS ne constitue pas une nouvelle structure de stockage physique de données en mémoire ni un objet indépendant. Il s’agit fondamentalement d’un mécanisme de référencement symbolique temporaire qui crée un alias mnémonique pointant vers un ensemble de variables préexistantes dans le vecteur d’observation (PDV).
L’instanciation d’un tableau SAS établit une table de correspondance interne permettant d’adresser séquentiellement des colonnes via un indice positionnel. La déclaration s’effectue exclusivement à l’intérieur de l’étape DATA et son existence s’éteint dès la finalisation de la compilation de cette dernière. La syntaxe générale repose sur le mot-clé ARRAY, suivi du nom arbitraire attribué à la référence, de la dimension du tableau entre parenthèses, crochets ou accolades, et de la liste ordonnée des variables associées.
L’intérêt conceptuel majeur de cette abstraction réside dans l’unification des opérations : toute modification appliquée à un élément indicé du tableau s’applique immédiatement et directement à la variable physique correspondante dans le PDV. Cette liaison dynamique offre un cadre idéal pour la construction de boucles de traitement systématiques, réduisant des centaines de lignes potentielles de code conditionnel à une structure algorithmique condensée, élégante et parfaitement pérenne.
3.2 Exploitation du mot-clé spécial _NUMERIC_ pour un balayage exhaustif
Dans les architectures de bases de données hautement dénormalisées ou les tables d’analyse multidimensionnelle, identifier nommément chaque colonne numérique susceptible de contenir une valeur manquante représente une tâche fastidieuse et vulnérable aux évolutions de structure. Pour pallier cette contrainte, SAS intègre des variables de raccourci spéciales pilotées par le compilateur, parmi lesquelles le mot-clé universel _NUMERIC_ joue un rôle prépondérant.
L’association de l’instruction ARRAY avec le raccourci _NUMERIC_ instruit le compilateur de parcourir le dictionnaire de la table d’entrée et d’agréger automatiquement sous une même ombrelle indicée la totalité des colonnes dont le type interne est numérique. La déclaration s’effectue typiquement sous la forme suivante :
array ensemble_num {*} _NUMERIC_;
L’astérisque positionné entre les accolades signifie au système que la dimension du tableau n’a pas besoin d’être calculée manuellement par le programmeur ; SAS détermine lui-même le cardinal exact du groupe en comptant les variables numériques identifiées lors de la phase de compilation du PDV.
Cette technique confère une robustesse exceptionnelle aux programmes d’intégration. Si le dictionnaire de données en amont s’enrichit de nouvelles métriques numériques lors d’un cycle de mise à jour mensuel, le code SAS demeure totalement invariant tout en intégrant nativement ces nouveaux champs dans le périmètre de nettoyage. Par ailleurs, cette construction offre une protection absolue contre les erreurs de typage : les variables de type caractère présentes dans la table sont intrinsèquement et silencieusement ignorées par ce mot-clé, éliminant tout risque de conflit de conversion logique.
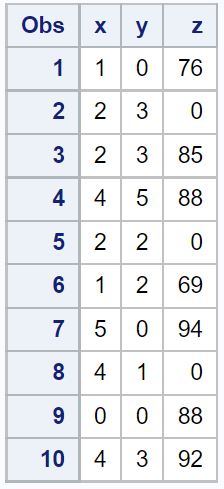
3.3 Implémentation de la boucle DO OVER pour la modification itérative
Pour procéder à la substitution itérative sans devoir déclarer formellement une variable d’incrémentation de boucle, SAS propose la structure syntaxique historique DO OVER. Cette instruction s’emploie conjointement avec un tableau à dimension implicite ou défini par astérisque. Elle instruit l’interpréteur de parcourir de manière transparente chaque composante du tableau, du premier au dernier élément, en positionnant automatiquement le pointeur interne sur la variable active.
L’architecture complète du script de traitement global par DO OVER se structure de la manière suivante :
data travail.donnees_imputees;

    set source.donnees_brutes;

    array tab_num {*} _NUMERIC_;

    do over tab_num;

        if tab_num = . then tab_num = 0;

    end;

run;
Lors de l’exécution, pour chaque ligne du jeu de données, SAS initialise la boucle et évalue successivement la condition d’absence sur chacune des colonnes numériques référencées par tab_num. Dès qu’un point standard est intercepté, la valeur 0 est injectée dans la mémoire vive de l’élément correspondant. L’analyse du journal d’exécution (SAS Log) confirme la fluidité de cette opération : aucune variable auxiliaire n’est créée dans la table finale et la consommation de mémoire centrale demeure restreinte à la seule gestion des pointeurs du PDV.
4. Ciblage séquentiel et contrôlé : Tableaux explicites avec boucles itératives DO
4.1 Déclaration explicite de tableaux avec indexation numérique
Bien que le balayage exhaustif via _NUMERIC_ séduise par sa concision, la pratique professionnelle impose fréquemment de circonscrire l’imputation par zéro à un sous-ensemble rigoureusement délimité de variables. Dans de nombreuses applications médicales ou industrielles, certaines variables numériques modélisent des constantes physiques ou des rapports de toxicité pour lesquels la substitution par zéro constituerait une aberration scientifique majeure. Il devient alors indispensable de recourir à une déclaration explicite désignant nominativement les variables cibles.
La syntaxe d’instanciation d’un tableau explicite s’articule comme suit :
array metriques_cibles {*} score_satisfaction temps_reponse solde_impaye;
Cette écriture lie de manière déterministe le tableau metriques_cibles aux trois variables énumérées. L’utilisation de l’astérisque préserve la flexibilité dimensionnelle, permettant à l’analyste d’ajouter ou de retirer ultérieurement des variables de la liste sans avoir à recalculer manuellement la borne supérieure du tableau. Les variables ainsi regroupées doivent obligatoirement partager la même nature de type élémentaire, ce qui est strictement respecté dès lors que l’on traite de grandeurs quantitatives destinées à l’arithmétique.
Cette méthodologie garantit une étanchéité absolue : seules les variables expressément nommées dans la clause de tableau subissent la logique d’imputation. Les autres colonnes numériques de la table source traversent le vecteur d’observation sans subir la moindre altération, conservant intactes leurs valeurs manquantes originelles pour les traitements ultérieurs appropriés.
4.2 Construction de la boucle itérative indicée standard
Pour parcourir un tableau explicite avec un niveau de rigueur optimal, l’emploi de la boucle indicée classique gouvernée par la fonction DIM() représente le standard absolu de programmation SAS. Contrairement à la boucle implicite, l’approche indicée fait intervenir une variable scalaire qui sert de compteur d’itération numérique, variant de l’unité jusqu’à la dimension totale du tableau évaluée dynamiquement.
Le canevas programmatique d’une telle implémentation s’établit ainsi :
data travail.cohortes_traitees;

    set source.cohortes;

    array tab_cible {*} score_satisfaction temps_reponse solde_impaye;

    do i = 1 to dim(tab_cible);

        if tab_cible{i} = . then tab_cible{i} = 0;

    end;

    drop i;

run;
La fonction DIM() interroge les métadonnées internes du tableau tab_cible et renvoie instantanément un entier égal à 3 dans ce cas précis. Au sein de la boucle, l’accès à la composante s’effectue via l’opérateur d’indexation tab_cible{i}. Une vigilance rigoureuse doit être accordée à la gestion de la variable indicatrice i. Étant créée au sein de l’étape DATA, elle intègre par défaut le vecteur d’observation et se retrouverait sauvegardée dans la table finale sur disque si l’instruction DROP i; n’était pas appliquée pour la purger avant l’écriture définitive.
4.3 Comparaison fonctionnelle entre DO OVER et boucle indicée explicite
L’arbitrage entre l’emploi de la directive historique DO OVER et l’usage de la boucle indicée DO i = 1 TO DIM() relève à la fois de considérations de pérennité du code et de flexibilité fonctionnelle. Bien que DO OVER offre une économie d’écriture appréciable en éliminant la déclaration et l’élimination explicite du compteur d’itération, elle est considérée par SAS Institute comme une syntaxe héritée de versions anciennes. Dans certains environnements stricts de production régulés par les autorités sanitaires (FDA) ou financières, l’usage de syntaxes formellement indicées est souvent imposé par les normes de codage internes en raison de leur non-ambiguïté absolue.
Sur le plan fonctionnel, la boucle indicée offre un contrôle granulaire infiniment supérieur. L’accès explicite à l’indice i permet d’exécuter des opérations conditionnelles asymétriques au sein du même tableau. Il devient par exemple aisé d’appliquer une substitution par zéro sur les premiers éléments du tableau, tout en appliquant une logique d’imputation différente ou un calcul de prorata sur les éléments de rang supérieur. Cette modularité est difficilement envisageable avec DO OVER, qui impose un traitement rigoureusement uniforme et opaque à chaque élément balayé.
Pour le travail collaboratif à grande échelle, la structure indicée explicite documente avec une clarté limpide la dynamique d’exécution algorithmique. Tout programmeur externe relisant le script appréhende instantanément les limites dimensionnelles du vecteur, la variable de boucle manipulée et le champ exact des colonnes impactées, assurant une maintenabilité logicielle pérenne dans les organisations de recherche clinique ou d’actuariat.
5. Approche fonctionnelle : Exploitation de la fonction COALESCE
5.1 Mécanisme opérationnel de la fonction COALESCE
Le langage SAS intègre dans sa bibliothèque native un ensemble étendu de fonctions scalaires hautement optimisées en langage bas niveau (C), conçues pour simplifier les opérations récurrentes de manipulation de données. Parmi celles-ci, la fonction COALESCE occupe une place centrale dans le traitement des valeurs indéfinies. Inspirée des standards de l’algèbre relationnelle et du langage SQL, la fonction COALESCE prend en arguments une liste indéterminée d’expressions numériques et renvoie invariablement la première valeur non manquante rencontrée lors de l’évaluation séquentielle de gauche à droite de ses paramètres.
La substitution déterministe d’une valeur manquante par zéro trouve dans cette fonction une concrétisation syntaxique d’une pureté remarquable. L’expression se formalise par l’affectation scalaire directe :
solde_ajuste = coalesce(solde_original, 0);
Dans cette construction, le moteur d’exécution examine la variable solde_original. Si celle-ci héberge une valeur numérique valide, positive ou négative, COALESCE la restitue immédiatement, interrompant le parcours des arguments. Si, en revanche, solde_original contient un point d’indétermination standard ou une valeur manquante spéciale, la fonction évalue l’argument subséquent, à savoir la constante numérique 0, et renvoie cette dernière comme résultat d’assignation. Cette approche élimine totalement le recours aux structures de branchement conditionnel explicites IF-THEN, rendant le code compact, lisible et exempt de risques de ruptures logiques.
5.2 Création de nouvelles variables versus remplacement sur place
L’exploitation de la fonction COALESCE soulève un arbitrage fondamental en matière d’architecture de données : la distinction entre la génération d’une nouvelle variable d’analyse et l’écrasement en place de la colonne préexistante dans le vecteur d’observation (PDV).
La création d’un nouvel identifiant, illustrée par l’expression revenu_impute = coalesce(revenu_declare, 0);, répond à une exigence majeure de gouvernance des données : l’auditabilité et la non-destructivité de l’information source. Dans les protocoles de recherche biomédicale ou les contextes de modélisation du risque de crédit, il est impératif de pouvoir tracer l’état originel des données brutes en vis-à-vis des valeurs imputées pour des besoins d’audit ou de recalibrage méthodologique. Toutefois, cette approche engendre un dédoublement de l’espace de stockage mémoire pour la variable considérée, augmentant l’empreinte disque de la table SAS finale.
À l’opposé, le remplacement en place via l’instruction réassignée revenu_declare = coalesce(revenu_declare, 0); conserve l’économie spatiale du jeu de données en modifiant directement le contenu binaire de la variable d’origine au sein du PDV. Cette technique est vivement recommandée lors du traitement d’immenses entrepôts de données où chaque octet supplémentaire démultiplié par des centaines de millions d’enregistrements s’avère coûteux en temps d’entrées-sorties (I/O). En outre, l’écrasement en place conserve automatiquement les métadonnées préexistantes attachées à la colonne originelle, notamment son étiquette descriptive (LABEL) et ses attributs de formatage (FORMAT), qui risqueraient d’être altérés ou perdus lors de la déclaration d’une nouvelle variable non formatée.
5.3 Combinaison de COALESCE avec les boucles ARRAY
La concision fonctionnelle de COALESCE prend toute sa dimension lorsqu’elle est conjuguée avec la puissance vectorielle des tableaux ARRAY. Cette synthèse programmatique permet d’éliminer totalement la clause conditionnelle IF au cœur de l’itération, compressant le corps de la boucle en une ligne unique d’instruction mathématique d’une clarté exemplaire.
Le modèle algorithmique combiné s’articule comme suit :
data travail.mesures_consolidees;

    set source.mesures_laboratoire;

    array tab_analyses {*} concentration_a concentration_b concentration_c;

    do i = 1 to dim(tab_analyses);

        tab_analyses{i} = coalesce(tab_analyses{i}, 0);

    end;

    drop i;

run;
Sur le plan des performances informatiques, la substitution du test logique IF ... THEN par un appel direct à la fonction COALESCE au sein de la boucle produit des résultats très compétitifs. En exploitant les optimisations vectorielles sous-jacentes du compilateur SAS, le processeur évite la pénalité de saut de branchement conditionnel (branch misprediction) susceptible d’apparaître sur des architectures matérielles modernes lorsque la survenue de données manquantes est hautement stochastique. L’opération devient purement computationnelle et prévisible pour les registres d’exécution de la machine.
6. Traitement vectoriel par procédure dédiée : Utilisation de PROC STDIZE
6.1 Architecture et fonctionnalités spécifiques de PROC STDIZE
Bien que la majorité des transformations de données au sein de l’environnement SAS soient traditionnellement dévolues à l’étape DATA, l’utilisation de procédures spécialisées hautement optimisées permet d’atteindre des niveaux d’efficience opérationnelle remarquables. La procédure PROC STDIZE relève originellement du module SAS/STAT ou de la couche analytique de base, sa mission première étant le centrage et la réduction des distributions statistiques par soustraction de paramètres de position (moyenne, médiane) et division par des mesures d’échelle (écart-type, écart interquartile).
Toutefois, les concepteurs de SAS ont intégré dans l’architecture algorithmique de cette procédure une fonctionnalité d’imputation déterministe dédiée, pilotée par l’option stratégique REPONLY (Replace Only). Lorsqu’elle est adjointe à l’instruction d’invocation, cette option ordonne à la procédure d’inhiber intégralement ses modules de calcul statistique de standardisation. Le moteur n’applique aucune déviation d’échelle ni aucun centrage ; il consacre l’intégralité de sa bande passante computationnelle à la seule substitution des valeurs manquantes selon la constante mathématique assignée par le paramètre d’imputation.
Cette déviation fonctionnelle de PROC STDIZE transforme une procédure d’analyse multivariée en un utilitaire d’imputation de données ultra-rapide. Elle présente l’avantage majeur de s’exécuter sans nécessiter la compilation d’une étape DATA explicite, éliminant ainsi la phase d’écriture manuelle des boucles, la gestion des pointeurs de mémoire PDV et les déclarations d’instructions DROP ou ARRAY.
6.2 Configuration des paramètres de remplacement par zéro
La mise en œuvre pratique de cette procédure pour la remise à zéro des données manquantes repose sur une syntaxe remarquablement compacte et standardisée. La configuration optimale pour un traitement exhaustif s’illustre par l’appel suivant :
proc stdize data=source.transactions out=travail.transactions_zero reponly missing=0;

run;
Dans ce bloc opératoire, l’option reponly verrouille les grandeurs observées non manquantes dans leur état strictly original. L’instruction missing=0 précise sans équivoque la constante de substitution à appliquer en lieu et place des points d’indétermination. En l’absence de clause de restriction, PROC STDIZE sélectionne par introspection dynamique la totalité des variables de type numérique présentes dans la table source, réalisant une couverture intégrale comparable au mot-clé _NUMERIC_ de l’étape DATA.
Si l’analyste souhaite restreindre l’action d’imputation à un sous-ensemble déterminé de métriques sans altérer les autres colonnes numériques du fichier, il suffit d’adjoindre l’instruction déclarative VAR :
proc stdize data=source.transactions out=travail.transactions_zero reponly missing=0;

    var montant_remise volume_ventes penalite_retard;

run;
La table résultante, exportée dans la bibliothèque de travail sous l’étiquette transactions_zero, intègre l’ensemble des colonnes originelles, seules les variables listées dans l’instruction VAR ayant subi la transformation vers le zéro.
6.3 Évaluation des performances sur les mégadonnées (Big Data)
L’intérêt fondamental du recours à PROC STDIZE réside dans son comportement computationnel sur des volumes de données gigantiques, typiques des entrepôts de données d’entreprises bancaires ou de télécommunications. Le code sous-jacent à PROC STDIZE a été compilé en C natif avec des directives d’optimisation poussées pour le traitement séquentiel en mémoire de flux massifs d’octets. Par conséquent, son exécution surpasse très fréquemment celle d’une étape DATA standard contenant des structures itératives complexes.
Dans une étape DATA utilisant des tableaux ARRAY, la machine virtuelle SAS doit gérer l’interpréteur de code, contrôler la progression des indices et gérer l’allocation séquentielle de chaque élément du PDV. En revanche, PROC STDIZE exécute des lectures de blocs binaires continues directement depuis le sous-système de stockage, applique le filtre de remplacement au niveau le plus bas du pipeline processeur, et réécrit les pages de données avec un minimum d’interruptions d’horloge. Cette mécanique se traduit par une réduction substantielle du temps CPU global consommé.
Néanmoins, cette vélocité brute s’accompagne d’une rigidité algorithmique incontournable. PROC STDIZE est un outil déterministe d’application uniforme : il est totalement incapable d’évaluer des règles logiques croisées (business rules), telles que le remplacement d’une valeur manquante par zéro sous réserve qu’une autre variable de la même ligne vérifie un statut contractuel spécifique. Dès lors qu’une logique d’imputation conditionnelle non linéaire est exigée par le cahier des charges analytique, l’étape DATA ou la procédure relationnelle SQL redeviennent impératives.
7. L’approche relationnelle : Remplacement par zéro via PROC SQL
7.1 Implémentation de l’instruction standard COALESCE en SQL SAS
L’intégration étroite du moteur relationnel au sein de la plateforme SAS via la procédure PROC SQL permet aux analystes et ingénieurs de concevoir des flux de préparation de données conformes aux standards internationaux ANSI/ISO SQL. Cette approche s’avère particulièrement naturelle pour les équipes évoluant dans des environnements technologiques mixtes, conjuguant des entrepôts de données relationnels (Oracle, PostgreSQL, Teradata, Snowflake) et des serveurs de calcul SAS.
Au sein de l’interpréteur PROC SQL, la fonction COALESCE s’emploie selon une sémantique rigoureusement identique aux standards de l’industrie des bases de données. L’opération de projection s’exprime dans une clause de sélection unitaire créant une nouvelle vue ou matérialisant une nouvelle table :
proc sql;

    create table travail.ventes_consolidees as

    select id_client, code_region, coalesce(montant_achat, 0) as montant_achat

    from source.ventes;

quit;
Cette construction garantit une intégration fluide dans les chaînes de traitement ETL complexes. En résolvant l’imputation directement lors des phases d’interrogation, de jointure ou d’agrégation groupée (clause GROUP BY), le développeur s’affranchit de la nécessité d’intercaler une étape DATA intermédiaire de nettoyage. Le flux de travail gagne en concision architecturale et en clarté déclarative.
7.2 Utilisation de la structure CASE WHEN pour un contrôle affiné
Lorsque l’imputation par zéro nécessite d’être adossée à une expression logique plus explicite ou enrichie de clauses alternatives, la structure conditionnelle déclarative standard CASE WHEN offre une lisibilité syntaxique incomparable. Au sein du processeur PROC SQL, la détection d’une valeur absente peut s’opérer aussi bien via le prédicat SQL conventionnel IS MISSING que par l’idiome relationnel universel IS NULL, l’interpréteur SAS assurant une parfaite passerelle sémantique entre ces notions.
L’expression d’une logique de normalisation s’établit de la façon suivante :
proc sql;

    create table travail.actifs_valides as

    select id_compte,

           case

               when solde_courant is missing then 0

               else solde_courant

           end as solde_courant

    from source.actifs;

quit;
L’atout prépondérant de l’opérateur CASE WHEN réside dans sa capacité intrinsèque à combiner des prédicats logiques multivariés au sein du même bloc décisionnel. L’analyste peut aisément subordonner la substitution par zéro à l’évaluation simultanée d’autres attributs, comme l’état de validation d’un contrat ou la nature d’un segment démographique, offrant un niveau de personnalisation fonctionnelle inaccessible à un simple appel unilatéral de COALESCE.
7.3 Mise à jour en place via l’instruction UPDATE de PROC SQL
L’un des différentiateurs fonctionnels majeurs de la procédure SQL réside dans sa capacité à réaliser des modifications physiques directes au sein d’une table sans générer une copie intégrale de la structure de données. Alors que l’étape DATA classique lit une table d’entrée pour en écrire une nouvelle sur disque (même lorsqu’elle écrase le nom de la table source), l’instruction UPDATE de PROC SQL modifie les enregistrements ciblés au niveau des blocs physiques existants.
Cette opération de mise à jour s’exécute selon le schéma suivant :
proc sql;

    update travail.grands_comptes

    set montant_impaye = 0

    where montant_impaye is missing;

quit;
Cette méthodologie s’avère particulièrement efficiente lorsque seule une proportion infinitésimale de lignes présente des valeurs lacunaires au sein d’une table d’un volume volumétrique colossal. Le moteur SQL SAS localise les blocs d’octets spécifiques et substitue les points d’indétermination par la signature binaire du zéro sans avoir à dupliquer des millions de lignes valides.
Toutefois, cette pratique exige des mesures d’assurance qualité draconiennes. L’instruction UPDATE modifiant de façon irréversible la table physique sous-jacente, toute erreur de ciblage dans la clause WHERE entraîne la destruction définitive de l’information préalable sans possibilité d’annulation (rollback) si des mécanismes stricts de sauvegarde n’ont pas été configurés au niveau du système de fichiers ou du moteur SAS/SHARE.
8. Prise en compte des valeurs manquantes spéciales (.A à .Z et ._)
8.1 Typologie et finalité sémiotique des valeurs manquantes spéciales
L’une des fonctionnalités les plus avancées et méconnues de l’architecture numérique du système SAS réside dans sa prise en charge des valeurs manquantes spéciales (special missing values). Conscient que l’absence d’une information quantitative peut procéder de causes ontologiques radicalement différentes, SAS enrichit la valeur manquante standard (.) de 27 représentations alternatives identifiées par les lettres majuscules précédées d’un point : .A, .B, …, .Z, ainsi que le caractère de soulignement ._.
Cette typologie permet aux méthodologues et concepteurs d’études d’encoder la sémantique de l’absence directement dans le champ numérique, sans requérir de colonnes textuelles additionnelles. À titre d’illustration dans les protocoles d’enquêtes épidémiologiques ou sociologiques :
.Aest fréquemment alloué pour spécifier le refus délibéré de répondre d’un sujet (Refusal)..Bdocumente l’inapplicabilité intrinsèque de la question liée au profil du répondant (Not Applicable)..Dsignale une rupture technique de l’instrumentation de mesure (Device Failure)..Nmatérialise l’omission involontaire ou la perte d’un échantillon biologique.
Sur le plan strictement arithmétique, ces valeurs spéciales se comportent de manière totalement comparable au point standard : toute tentative d’évaluation computationnelle scalaire ordinaire propage une valeur manquante. Cependant, leur présence dans le jeu de données requiert une rigueur programmatique absolue lors des phases d’imputation, sous peine d’altérer gravement la cohérence logique du traitement.
8.2 Pièges logiques lors de la détection par simple égalité
L’erreur la plus insidieuse commise par les développeurs SAS confrontés à des valeurs manquantes spéciales consiste à maintenir l’usage du test logique d’égalité unitaire : if variable = . then variable = 0;.
Sur le plan de la logique interne du compilateur SAS, le point standard (.) et les points spéciaux (.A à .Z, ._) représentent des entités binaires distinctes qui disposent chacune d’un rang propre dans l’ordre de tri machine. SAS positionne la valeur ._ comme étant la plus petite valeur concevable, suivie immédiatement par le point standard (.), puis par les lettres .A jusqu’à .Z, lesquelles demeurent toutes strictement inférieures au premier nombre réel négatif. Par conséquent, l’égalité logique stricte variable = . ne sera évaluée à « vrai » que si et seulement si la variable contient rigoureusement le point standard.
Si une variable héberge le code .A (dénotant un refus de réponse) ou .B (non applicable), l’instruction if variable = . then variable = 0; évaluera la condition à « faux ». La ligne traversera l’étape DATA sans être modifiée, laissant subsister la valeur manquante spéciale dans la table finale. Ce phénomène engendre une sous-estimation systématique et silencieuse du volume réel de données lacunaires à imputer, faussant l’intégralité des analyses quantitatives subséquentes sans générer le moindre avertissement d’erreur dans le journal d’exécution (log).
8.3 Stratégie de substitution par zéro adaptée aux valeurs spéciales
Pour capturer avec une infaillibilité absolue la totalité des configurations de données manquantes, qu’elles soient représentées par le point standard ou par l’un des 27 codes spéciaux, il est impératif d’abandonner l’opérateur d’égalité simple au profit de la fonction intrinsèque MISSING().
L’implémentation universelle d’une remise à zéro s’établit selon la syntaxe suivante :
if missing(variable) then variable = 0;
La fonction MISSING() évalue l’argument numérique qui lui est soumis et retourne systématiquement la valeur booléenne 1 (vrai) dès lors que le champ correspond à un point standard ou à n’importe quelle valeur manquante spéciale comprise entre ._ et .Z. Elle élimine instantanément le risque d’omission d’une catégorie particulière d’absence.
Toutefois, dans un cadre méthodologique raffiné, l’analyste peut souhaiter opérer une imputation sélective. Supposons une étude où l’absence non motivée (point standard) doive être assimilée à une consommation nulle (0), tandis que l’inapplicabilité structurelle (code .B) doive être impérativement préservée pour exclure ultérieurement le patient du dénominateur d’un taux d’incidence. Le code SAS tirera alors profit de la distinction interne :
if variable = . then variable = 0;

/* Le code .B est volontairement préservé sans être converti en zéro */
Inversement, si l’on souhaite exclure une plage précise de codes spéciaux de la conversion, la syntaxe comparée de SAS permet des expressions d’une grande finesse :
if missing(variable) and variable ne .B then variable = 0;
Ce haut niveau de discernement souligne la nécessité impérieuse de documenter rigoureusement dans le cahier d’observation statistique (SAP – Statistical Analysis Plan) le destin assigné à chaque déclinaison sémantique des données manquantes.
9. Remplacement contextuel et conditionnel basé sur des règles métier
9.1 Imputation conditionnée par l’état d’une variable tierce
Dans les architectures d’entreprise réelles, la remise à zéro d’une donnée manquante ne saurait s’opérer de manière isolée sans interroger le contexte systémique de l’observation. La valeur prise par une colonne est intrinsèquement tributaire des caractéristiques portées par d’autres attributs de la même entité d’analyse. Ce principe de cohérence contextuelle impose la mise en œuvre d’imputations conditionnées par l’état logique d’une ou plusieurs variables tierces.
Considérons le secteur de l’enseignement supérieur où une table centralise les résultats académiques d’étudiants. Une variable quantitative enregistre la note obtenue à un examen optionnel d’informatique avancée. Pour les étudiants inscrits dans la filière littéraire pour lesquels cette option n’existe pas au programme, l’absence de note représente une inapplicabilité fondamentale qui doit impérativement demeurer manquante. En revanche, pour les étudiants de la filière scientifique inscrits d’office à l’épreuve, l’absence d’enregistrement d’une note traduit l’absence injustifiée à l’évaluation, justifiant l’application réglementaire de la note zéro.
L’implémentation de cette règle métier s’opère par la combinaison de connecteurs booléens au sein de l’étape DATA :
data travail.academique_normalise;

    set source.academique;

    if filiere = 'Sciences' and missing(note_informatique) then note_informatique = 0;

run;
L’usage conjoint de l’opérateur relationnel et de la fonction MISSING() garantit que la variable note_informatique ne sera convertie vers le zéro que si et seulement si l’étudiant appartient au segment ciblé. La valeur manquante des étudiants de la filière littéraire est ainsi sanctuarisée, préservant la représentativité statistique des distributions d’échantillonnage pour chaque cohorte académique.
9.2 Traitement différentiel selon des seuils ou des groupes d’observations
La modélisation de données longitudinales ou de panels de suivi temporel requiert fréquemment d’articuler l’imputation par zéro autour de repères événementiels spécifiques. Dans de telles configurations, une mesure ne doit adopter la valeur zéro qu’à partir du moment exact où une étape charnière est franchie dans l’histoire de l’individu ou du système suivi, toute mesure antérieure devant conserver son statut indéfini pour refléter l’état de pré-inclusion.
Pour orchestrer ce traitement séquentiel hautement contrôlé, le recours aux variables automatiques FIRST. et LAST. générées par l’instruction BY de SAS constitue l’outil par excellence. Considérons une cohorte de patients suivis mensuellement pour le dosage d’un biomarqueur après l’administration d’une thérapie expérimentale :
proc sort data=source.suivi_patients out=travail.suivi_ordonne;

    by id_patient date_suivi;

run;
data travail.suivi_impute;
set travail.suivi_ordonne;
by id_patient date_suivi;
retain traitement_debute 0;
if first.id_patient then traitement_debute = 0;
if indicateur_administration = 1 then traitement_debute = 1;
if traitement_debute = 1 and missing(dosage_biomarqueur) then dosage_biomarqueur = 0;
run;
Dans cette logique élaborée, l’instruction RETAIN maintient l’état de l’indicateur binaire d’une ligne à l’autre au sein du même sujet. Avant l’administration du traitement, les éventuelles valeurs manquantes demeurent intouchées. Dès l’instant où l’administration est validée, l’indicateur bascule et active la règle d’imputation par zéro pour tous les points de mesure ultérieurs du patient. Cette méthodologie garantit une fidélité chronologique irréprochable et prévient l’introduction d’artéfacts de mesure dans les analyses de survie ou les modèles mixtes longitudinaux.
9.3 Gestion des interactions entre types de variables numériques et caractères
Dans de nombreuses architectures de capture de données mal normalisées, des grandeurs fondamentalement quantitatives se trouvent malencontreusement intégrées sous forme de variables alphanumériques (type caractère). Ce cas de figure survient fréquemment lors de l’ingestion de fichiers plats délimités (fichiers CSV) où des champs vides cohabitent avec des mentions textuelles hétérogènes (telles que « N/A », « NULL », ou des espaces multiples) pour exprimer l’absence de mesure.
Tenter d’appliquer une substitution numérique par zéro directement sur une variable textuelle sans conversion préalable expose le programmeur à des dysfonctionnements critiques. Si le développeur écrit char_var = 0;, le compilateur SAS exécute une conversion implicite automatique qui surcharge inutilement le processeur et pollue le journal d’exécution d’avertissements explicites (« NOTE: Character values have been converted to numeric values »). Pire encore, une variable alphanumérique affectée avec la chaîne « 0 » ne se comportera jamais comme un zéro mathématique lors des procédures analytiques futures.
La résolution élégante et robuste de ce défi exige une conversion explicite structurée en deux phases via les fonctions INPUT et PUT. Le patron de conception standard pour transmuter une colonne texte lacunaire en une variable numérique nettoyée et remise à zéro s’établit de la manière suivante :
data travail.donnees_assainies(drop=montant_str);

    set source.donnees_sources(rename=(montant=montant_str));

    montant_num = input(montant_str, ?? comma12.2);

    if missing(montant_num) then montant = 0;

    else montant = montant_num;

    drop montant_num;

run;
L’emploi du modificateur de suppression d’erreurs ?? adjoint à la fonction INPUT instruit le moteur SAS d’inhiber la génération d’alertes dans le journal lorsqu’il rencontre des chaînes textuelles non convertibles en nombres (telles que « INDETERMINE » ou « REFUS »). Ces configurations sont instantanément converties en points manquants standards (.), lesquels sont ensuite capturés en toute sécurité par la fonction MISSING() pour être réassignés à la valeur zéro au sein de la nouvelle variable numérique montant. L’utilisation conjointe des clauses RENAME et DROP assure une parfaite substitution d’en-tête sans déstabiliser les programmes aval.
10. Implications méthodologiques, statistiques et psychométriques de l’imputation par zéro
10.1 Distorsion des paramètres de tendance centrale et de dispersion
L’imputation déterministe d’une valeur constante au sein d’une distribution statistique, en particulier lorsqu’il s’agit du zéro, n’est jamais un acte neutre sur le plan fondamental. Sur le plan descriptif, le remplacement de valeurs manquantes par zéro engendre une baisse mécanique et systématique de la moyenne arithmétique de la variable étudiée, sous réserve que la moyenne des valeurs originellement observées soit positive. En augmentant arbitrairement le dénominateur de la somme sans modifier le numérateur (puisque l’ajout de zéros n’incrémente pas la masse globale), la position de l’estimateur de tendance centrale est inexorablement tirée vers le bas.
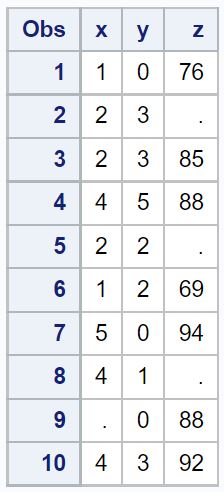
Concernant les paramètres de dispersion, l’impact est doublement paradoxal. D’une part, l’introduction artificielle d’une masse de probabilité ponctuelle au point zéro tend à comprimer la variance si les données observées gravitent déjà naturellement autour de zéro. D’autre part, si la distribution des valeurs valides se situe sur un registre d’échelle élevé (par exemple, des salaires annuels compris entre 40 000 et 120 000 euros), l’adjonction d’enregistrements à zéro gonfle artificiellement l’écart-type de manière vertigineuse en créant des distances d’écart quadratique considérables par rapport à la moyenne recalculée.
En outre, les moments d’ordre supérieur de la distribution subissent des distorsions structurelles massives. L’asymétrie (skewness) est fortement altérée vers la droite en présence d’une masse artificielle au zéro, conférant à la courbe empirique une longue traîne positive. Simultanément, le coefficient d’aplatissement (kurtosis) subit une poussée leptokurtique extrême, caractérisée par une pointe centrale hyper-concentrée au point d’imputation qui viole formellement l’hypothèse de normalité univariée sous-jacente à la vaste majorité des méthodes paramétriques classiques.
10.2 Altération des coefficients d’association et d’inférence
Sur le plan des statistiques bivariées et multivariées, l’imputation non contrôlée par zéro produit des effets délétères sur l’estimation des coefficients de corrélation linéaire de Pearson ainsi que sur les rangs de Spearman. En créant un groupe artificiel d’observations partageant exactement la même coordonnée sur l’axe des abscisses, l’analyste induit un phénomène de troncation artificielle ou d’atténuation des covariances réelles. Si la variable conjointe présente des valeurs dispersées face à cette concentration de zéros, le coefficient d’association linéaire tend mécaniquement vers zéro, occultant des relations fonctionnelles sous-jacentes pourtant fortes.
Dans le contexte des modèles de régression linéaire multiple estimés par la méthode des moindres carrés ordinaires (MCO), l’intégration de prédicteurs imputés déterministement par zéro biaise de manière irréversible les coefficients de régression partiels ($\beta$). L’estimateur perd sa propriété fondamentale de non-biais à variance minimale (propriété BLUE issue du théorème de Gauss-Markov). Les erreurs types des coefficients se trouvent artificiellement sous-estimées du fait de l’inflation non représentative de la taille apparente de l’échantillon ($N$), conduisant à une multiplication dramatique des erreurs de type I : l’analyste conclut à la significativité statistique de prédicteurs qui, en réalité, ne le sont pas.
Dans les domaines de la psychométrie et de la recherche comportementale faisant appel à l’analyse factorielle confirmatoire (CFA) ou aux modèles d’équations structurelles (SEM), la remise à zéro anarchique des items de questionnaires détruit la matrice de corrélation polychorique ou de covariance. Les algorithmes d’optimisation numérique (tels que le maximum de vraisemblance) rencontrent de graves difficultés de convergence en raison de l’apparition de matrices quasi-singulières ou non définies positives, conduisant à des solutions aberrantes de Heywood (variances d’erreur négatives) et invalidant l’ajustement global des modèles théoriques testés.
10.3 Typologie de Rubin : MCAR, MAR et MNAR face au zéro déterministe
Pour appréhender avec rigueur la validité scientifique d’une substitution par zéro, il convient d’analyser le problème à travers le prisme de la taxonomie fondamentale des mécanismes d’absence établie par le statisticien Donald Rubin. Cette typologie classe les données manquantes en trois régimes distincts :
- MCAR (Missing Completely at Random) : L’absence est rigoureusement indépendante de toute variable observée ou inobservée de l’étude.
- MAR (Missing at Random) : La probabilité d’absence dépend systématiquement d’autres variables observées dans le système, mais demeure indépendante de la valeur sous-jacente de la variable manquante elle-même.
- MNAR (Missing Not at Random) : La probabilité qu’une valeur soit manquante est directement corrélée à la magnitude de cette valeur.
L’application d’un zéro déterministe sous un régime MCAR constitue une dégradation artificielle de données valides. Si des données de tension artérielle sont manquantes en raison d’une panne stochastique d’imprimante thermique à l’hôpital, leur imputer la valeur zéro introduit une fausseté biologique absurde au sein de l’échantillon. En régime MAR, l’imputation par zéro est tout aussi préjudiciable à moins d’intégrer formellement les covariables conditionnantes dans une modélisation stochastique ou une procédure d’imputation multiple par équations chaînées (MICE), facilement accessible via la procédure native PROC MI de SAS.
Le seul cas où le remplacement déterministe par zéro se justifie pleinement sur le plan épistémologique réside dans certaines configurations spécifiques relevant formellement de la catégorie MNAR, où le processus physique de génération fait coïncider l’absence avec la valeur nulle. C’est le cas emblématique des « zéros comportementaux » : dans un sondage sur la consommation hebdomadaire de tabac, un non-fumeur laisse fréquemment la case du nombre de cigarettes fumées en blanc. La probabilité d’absence est ici intrinsèquement liée au fait que la consommation est rigoureusement égale à zéro. Dans ce cadre précis, l’imputation par zéro n’est pas un biais d’estimation, mais l’assignation exacte du statut réel du phénomène modélisé.
11. Validation empirique, contrôle qualité et traçabilité après imputation
11.1 Vérification exhaustive de l’élimination des valeurs manquantes
La rigueur de la programmation scientifique en environnement SAS exige que toute phase de manipulation de données soit immédiatement suivie d’une phase de validation empirique documentée. Il est exclu de postuler la parfaite réussite d’un script d’imputation sans en administrer la preuve analytique formelle. Le moyen le plus direct et complet d’attester de la disparition totale des points standard et spéciaux consiste à mobiliser la procédure PROC MEANS avec l’option statistique spécialisée NMISS.
L’audit de validation se déploie selon le canevas suivant :
proc means data=travail.donnees_imputees n nmiss min mean max;

    var _NUMERIC_;

run;
L’examen attentif du rapport généré dans l’interface de sortie SAS Results doit confirmer de manière irréfutable que la colonne Nmiss affiche la valeur zéro pour l’ensemble des variables soumises au protocole. Parallèlement, l’inspection de la statistique Min permet de s’assurer qu’aucune valeur négative aberrante n’a été introduite involontairement et que le zéro constitue désormais, le cas échéant, le nouveau plancher de la distribution.
Pour des variables discrètes ou catégorielles encodées numériquement ayant subi une remise à zéro, la procédure PROC FREQ assortie de l’option / MISSING fournit un contrôle d’une granularité supérieure :
proc freq data=travail.donnees_imputees;

    tables variable_cible / missing;

run;
L’option / MISSING ordonne à PROC FREQ de comptabiliser les valeurs manquantes comme des catégories d’affichage à part entière. Le rapport d’exécution final doit obligatoirement attester d’un effectif strictement égal à zéro pour les catégories indéfinies, tout en affichant l’accroissement exact de l’effectif associé à la modalité 0, confirmant l’intégrité de la bascule de population.
11.2 Création d’indicateurs de traçabilité (variables sentinelles / Shadow Variables)
Dans le contexte des Bonnes Pratiques Cliniques (BPC) et des exigences de traçabilité des autorités d’inspection réglementaire (FDA, EMA), écraser irrévocablement une valeur manquante par une constante sans conserver la mémoire de l’état originel constitue une non-conformité majeure de gouvernance. Il est vivement prescrit d’implémenter des indicateurs binaires de traçabilité, couramment qualifiés de variables sentinelles ou « variables d’ombre » (shadow variables).
Ces variables sentinelles agissent comme des drapeaux booléens (flags 0/1) signalant si la valeur finale a été mesurée de façon empirique ou si elle découle d’un algorithme de substitution déterministe. Leur génération doit obligatoirement précéder l’opération d’imputation au sein de l’étape DATA :
data travail.analyse_tracable;

    set source.analyse_brute;

    /* Instanciation de la variable sentinelle */

    flag_imput_dose = missing(dose_administree);
/* Application de la substitution par zéro */
if flag_imput_dose = 1 then dose_administree = 0;
run;
L’évaluation logique directe de l’expression missing(dose_administree) affecte la valeur 1 à flag_imput_dose si la mesure était originellement absente, et 0 dans le cas contraire. L’existence de ce marqueur offre des avantages considérables pour la suite du cycle d’analyse : elle permet aux biostatisticiens de mener des analyses de sensibilité poussées (tipping-point analyses) en comparant les paramètres du modèle selon que les enregistrements imputés sont maintenus ou exclus de l’échantillon d’inférence, conférant à la recherche une transparence méthodologique absolue.
11.3 Comparaison avant/après par visualisations et résumés numériques
L’évaluation de la qualité des données assainies passe obligatoirement par une confrontation synthétique des profils de distribution avant et après l’intervention logicielle. L’emploi de la procédure PROC UNIVARIATE offre une plateforme idéale pour quantifier l’effet de ce traitement sur la morphologie des séries statistiques.
L’interrogation comparative s’articule par l’exécution séquentielle sur les tables d’amont et d’aval :
proc univariate data=source.analyse_brute noprint;

    histogram score_clinique / normal;

run;
proc univariate data=travail.analyse_tracable noprint;
histogram score_clinique / normal;
run;
La confrontation des représentations graphiques met immédiatement en exergue le phénomène structural d’« inflation de zéros » (zero-inflation). Alors que l’histogramme initial présentait une densité continue et tronquée, la distribution finale exhibe une barre hyper-fréquente positionnée rigoureusement à l’origine, illustrant la métamorphose de la loi de probabilité vers une distribution mixte discrète-continue.
La consignation de ces résumés numériques (moyenne, médiane, écart interquartile, coefficient d’asymétrie) au sein des carnets de laboratoire électronique ou des rapports de validation de pipelines de données constitue un jalon fondamental du contrôle qualité. Cette documentation permet aux comités de relecture et aux auditeurs externes d’appréhender sans ambiguïté l’impact mécanique de la manipulation informatique sur les degrés de liberté et les propriétés de variance du jeu de données final.
12. Optimisation des performances et recommandations pour les tables massives
12.1 Minimisation des accès disque (I/O) et compression de table
Lors du déploiement de scripts de nettoyage sur des infrastructures d’entreprise manipulant des volumes de l’ordre de plusieurs téraoctets, le principal goulet d’étranglement informatique n’est presque jamais le cycle processeur (CPU), mais la bande passante du sous-système de disques (Entrées/Sorties – I/O). Dans ce contexte d’échelle massive, la stratégie conventionnelle consistant à lire une table volumineuse pour en réécrire une version complète modifiée dans une étape DATA génère des temps de latence et des transferts réseau prohibitifs.
Pour juguler cette contrainte matérielle, il est hautement pertinent d’utiliser l’étape DATA combinée avec l’instruction de modification directe MODIFY au lieu de l’instruction SET. L’emploi de MODIFY permet de mettre à jour les enregistrements in situ, sans duplication physique du jeu de données et sans nécessiter le doublement de l’espace de stockage alloué au sein du système de stockage de la bibliothèque SAS :
data travail.table_massive;

    modify travail.table_massive;

    array tab_num {*} _NUMERIC_;

    do i = 1 to dim(tab_num);

        if tab_num{i} = . then tab_num{i} = 0;

    end;

run;
Par ailleurs, l’introduction délibérée d’une grande quantité de zéros transforme souvent une table dense en une matrice partiellement creuse. Cette caractéristique morphologique doit impérativement être exploitée par l’activation de l’option de compression de blocs COMPRESS=YES ou COMPRESS=BINARY. En compressant les séries successives de zéros binaires sur le disque physique, le volume global du fichier est considérablement réduit, ce qui diminue proportionnellement le nombre de pages physiques que le moteur SAS doit transférer du stockage vers la mémoire vive lors des lectures ultérieures.
Enfin, le calibrage fin des paramètres d’exécution système relatifs aux tampons de mémoire vive via les options BUFSIZE (taille des pages de lecture) et BUFNO (nombre de tampons alloués simultanément par le processeur) permet de maximiser le débit de traitement séquentiel en mémoire, éliminant les micro-temps d’attente d’accès au stockage.
12.2 Création de macros réutilisables pour automatiser le traitement
Afin d’industrialiser les processus de préparation des données et d’asseoir une uniformité opérationnelle au sein des équipes de développement, la factorisation de la logique de remplacement par zéro sous la forme d’une macro SAS robuste et paramétrée représente une démarche d’ingénierie logicielle indispensable. Une macro d’entreprise moderne ne doit pas se borner à répliquer un code fixe ; elle doit interroger dynamiquement les métadonnées de la table pour opérer avec une adaptabilité totale.
L’exploitation des vues du dictionnaire de métadonnées du système SAS, notamment la table SASHELP.VCOLUMN, permet de détecter automatiquement les variables numériques cibles avant d’injecter leur liste dans l’étape d’exécution :
%macro ImputerZero(table_in=, table_out=);

    /* Extraction dynamique des colonnes de type numérique */

    proc sql noprint;

        select name into :liste_vars separated by ' '

        from sashelp.vcolumn

        where libname = upcase(scan("&table_in", 1, '.'))

          and memname = upcase(scan("&table_in", 2, '.'))

          and type = 'num';

    quit;
/* Exécution optimisée par PROC STDIZE */
%if &sqlobs > 0 %then %do;
proc stdize data=&table_in out=&table_out reponly missing=0;
var &liste_vars;
run;
%put NOTE: Imputation par zéro achevée avec succès pour la table &table_in.;
%end;
%else %do;
%put AVERTISSEMENT: Aucune variable numérique détectée dans &table_in.;
%end;
%mend ImputerZero;
Cette macro encapsule la rigueur du dictionnaire de données et tire profit de l’efficacité de calcul de PROC STDIZE. Elle immunise le pipeline contre toute erreur humaine d’inventaire de variables et assure une standardisation irréprochable des procédures d’assurance qualité au travers des différents services d’un organisme de recherche clinique, d’une direction des risques ou d’un institut national de statistiques.
12.3 Synthèse comparative des différentes méthodes abordées
Le choix de l’approche algorithmique pour substituer les données manquantes par zéro dans l’écosystème SAS dépend d’un faisceau complexe de contraintes associant la volumétrie des tables, la complexité des règles de gestion, l’architecture globale du pipeline d’ingestion et les objectifs d’auditabilité. Le tableau synthétique ci-dessous récapitule les caractéristiques déterminantes des cinq méthodologies examinées tout au long de cette monographie :
| Méthode | Flexibilité Logique | Performance Computationnelle | Empreinte Mémoire / Disque | Cas d’Usage Recommandé |
|---|---|---|---|---|
| IF-THEN Simple | Très élevée (conditions univariées arbitraires) | Modérée (dégradation si multiplication des blocs IF) | Standard (réassignation en place dans le PDV) | Traitements ad-hoc sur un nombre très restreint de colonnes (1 à 3). |
| ARRAY avec DO Indicée | Élevée (accès séquentiel contrôlé par indice) | Excellente (boucle vectorielle unifiée) | Optimisée (structure de mémoire temporaire) | Standard de production pour sous-ensembles spécifiques de variables. |
| Fonction COALESCE | Faible à moyenne (opérateur d’évaluation scalaire) | Excellente (compilation C optimisée sans sauts) | Flexible (in-place ou création de variable de suivi) | Assignations directes, simplifications de code au sein d’ARRAY. |
| PROC STDIZE (REPONLY) | Nulle (substitution globale et uniforme) | Maximale (moteur C optimisé pour Big Data) | Excellente (lecture et écriture par blocs binaires) | Tables massives exigeant une remise à zéro exhaustive de toutes les colonnes. |
| PROC SQL (UPDATE / COALESCE) | Moyenne à élevée (algèbre relationnelle et CASE WHEN) | Variable (très rapide sur UPDATE ciblé, plus lente sur vue) | Minimale avec UPDATE (modification in situ sans copie) | Pipelines de transformation ETL intégrés et entrepôts de données relationnels. |
En conclusion, la manipulation des données lacunaires dans l’environnement SAS illustre avec force la dualité fondamentale de l’ingénierie quantitative : la pure maîtrise syntaxique de l’outil informatique doit obligatoirement s’adosser à une conscience aiguë des postulats méthodologiques et statistiques sous-jacents.
Si le remplacement systématique d’une valeur manquante par zéro apparaît superficiellement comme une formalité de nettoyage élémentaire, l’analyse approfondie menée dans cet ouvrage démontre qu’elle touche aux fondations mêmes de l’architecture du système (vecteur d’observation, gestion des types en virgule flottante, codes manquants spéciaux) tout en impactant profondément la validité des inférences statistiques futures. En adaptant rigoureusement le choix de leurs patrons de conception logicielle aux caractéristiques de leurs données, les professionnels de l’écosystème SAS garantissent la construction de socles analytiques pérennes, performants et scientifiquement irréprochables.
Références
- Allison, P. D. (2001). Missing Data. SAGE Publications. https://doi.org/10.4135/9781412985079
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3e éd.). SAS Institute.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6e éd.). SAS Institute.
- Little, R. J. A., & Rubin, D. B. (2019). Statistical Analysis with Missing Data (3e éd.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- SAS Institute Inc. (2020). SAS(R) 9.4 Statements: Reference. SAS Institute. https://documentation.sas.com
- SAS Institute Inc. (2021). SAS/STAT(R) 15.2 User’s Guide: The STDIZE Procedure. SAS Institute. https://documentation.sas.com
- Schafer, J. L. (1997). Analysis of Incomplete Multivariate Data. Chapman & Hall/CRC. https://doi.org/10.1201/9781439821862