
Dans le domaine de l’ingénierie des données et de la biostatistique, la manipulation des chaînes de caractères représente une composante fondamentale du prétraitement analytique. L’écosystème logiciel développé par le SAS Institute s’est imposé depuis plusieurs décennies comme un standard industriel au sein des environnements hautement régulés, tels que la recherche clinique, le secteur bancaire et l’épidémiologie. Au sein de cet environnement, les données textuelles non structurées ou semi-structurées requièrent des procédures d’assainissement rigoureuses pour garantir que les variables catégorielles, les identifiants textuels et les nomenclatures scientifiques répondent à des critères d’intégrité absolue avant toute phase de modélisation inférentielle.
Le remplacement d’un motif textuel ou de caractères isolés dans une variable alphanumérique constitue une tâche programmatique quotidienne pour les développeurs SAS. Qu’il s’agisse de corriger des coquilles typographiques récurrentes issues d’une saisie manuelle décentralisée, de standardiser des acronymes médicaux ou d’épurer des identifiants d’essais cliniques, la maîtrise des fonctions natives dédiées au traitement des chaînes s’avère indispensable. La fonction TRANWRD se positionne au cœur de cette panoplie d’outils, offrant un mécanisme déterministe pour substituer des segments textuels sans altérer la cohérence syntaxique globale de l’observation.
Cet article propose une exploration méthodique, conceptuelle et pratique des mécanismes de substitution textuelle sous SAS. En articulant théorie algorithmique du vecteur de données de programme (Program Data Vector ou PDV) et études de cas appliquées, ce guide détaille l’utilisation de la fonction TRANWRD, ses interactions avec les fonctions d’épuration spatiale telles que COMPBL et STRIP, ainsi que ses distinctions fondamentales avec des instructions alternatives comme TRANSLATE et PRXCHANGE. Chaque concept est étayé par des implémentations complètes conçues pour optimiser les performances de traitement sur des tables de production à large échelle.
1. Introduction au traitement des chaînes de caractères en SAS et à la fonction TRANWRD
1.1 Fondements de la manipulation de texte dans l’écosystème SAS
Dans l’architecture du langage SAS, les données se divisent fondamentalement en deux types primitifs : le type numérique et le type caractère. Si les calculs matriciels et les modélisations stochastiques reposent sur les variables numériques, les variables textuelles constituent la trame contextuelle indispensable à la catégorisation, au partitionnement et à l’interprétation des phénomènes observés. L’intégrité des chaînes de caractères s’avère critique : une discordance minime, telle qu’une variation orthographique mineure ou la présence d’un espace parasite, scinde artificiellement une classe statistique en plusieurs strates disjointes lors de l’exécution de procédures de fréquence telles que la PROC FREQ.
Le stockage en mémoire des variables textuelles s’effectue sous un modèle de longueur fixe au sein du vecteur de données du programme. Lorsqu’une variable alphanumérique est allouée dans une étape DATA, SAS réserve une plage continue d’octets. Si la chaîne stockée est plus courte que l’espace alloué, le système comble le vide par des espaces de remplissage à droite (trailing blanks). Cette particularité architecturale impose une vigilance constante lors des opérations de concaténation et de substitution, afin d’éviter la génération involontaire de chaînes démesurées ou, à l’inverse, la troncature brutale d’informations signifiantes.
Le nettoyage textuel préalable s’inscrit ainsi comme une phase pivot de la gouvernance des données. Les fonctions de manipulation de chaînes ne constituent pas de simples commodités syntaxiques ; elles représentent les filtres déterministes par lesquels les données brutes hétérogènes sont converties en attributs standardisés, conformes aux exigences strictes des dictionnaires de données institutionnels.
1.2 Présentation générale et vocation de la fonction TRANWRD
La fonction TRANWRD (abréviation de Translate Word) a été conçue pour résoudre une problématique récurrente : rechercher toutes les occurrences d’un motif textuel continu au sein d’une chaîne source et les remplacer par une séquence de substitution désignée. Introduite pour pallier la lourdeur des routines d’extraction et de recombinaison manuelles, TRANWRD prend en charge de façon autonome le calcul des décalages d’indices et la réallocation des sous-chaînes.
Il convient de marquer une distinction opératoire fondamentale entre la substitution d’une suite de caractères ordonnée et la transposition de caractères isolés. Contrairement aux fonctions qui opèrent caractère par caractère, TRANWRD considère la cible comme un bloc indivisible d’octets. Si la chaîne cible est composée de cinq lettres, l’algorithme ne déclenche l’opération que lorsqu’il détecte ces cinq lettres consécutives dans le même ordre exact. La souplesse de cette fonction réside également dans le fait que la chaîne de remplacement ne requiert pas d’avoir une longueur identique à celle de la chaîne cible.
Historiquement, les programmeurs SAS recouraient à des combinaisons complexes combinant les fonctions INDEX et SUBSTR pour localiser la position d’un motif, découper la chaîne en segments périphériques et reconstruire l’observation par concaténation. L’introduction de TRANWRD a permis d’encapsuler cette logique itérative dans une routine en code compilé C sous-jacent, diminuant le nombre de lignes de code nécessaires et réduisant drastiquement le risque d’erreurs de décalage d’index (off-by-one errors).
1.3 Cas d’application fréquents dans le traitement de données empiriques
L’exploitation pratique de TRANWRD s’observe dans une multitude de domaines industriels et académiques. Dans la recherche épidémiologique et les essais cliniques régis par les normes du consortium CDISC (Clinical Data Interchange Standards Consortium), la standardisation des événements indésirables requiert l’harmonisation de formulations variées saisies par les investigateurs médicaux. Par exemple, la conversion systématique des termes tels que « céphalée aiguë » ou « maux de tête » vers une nomenclature unifiée conforme au dictionnaire MedDRA repose fréquemment sur des tables de correspondances exécutées via TRANWRD.
Un deuxième cas d’usage prédominant concerne l’éradication des anomalies de saisie au sein des entrepôts de données transactionnels. Des erreurs systématiques causées par des défaillances de lecteurs optiques, des saisies au clavier désynchronisées ou des transpositions de formats de dates peuvent être interceptées et neutralisées à l’échelle de millions d’enregistrements. TRANWRD permet de corriger des segments erronés récurrents sans affecter le reste des données textuelles associées.
Enfin, les exigences contemporaines en matière de protection de la vie privée, notamment sous l’égide du RGPD en Europe ou de la loi HIPAA aux États-Unis, imposent des protocoles stricts d’anonymisation et de pseudonymisation. TRANWRD facilite le masquage systématique d’identifiants directs, tels que des préfixes de numéros de sécurité sociale, des noms d’institutions ou des dénominations de sites géographiques sensibles, en substituant ces mentions par des balises génériques d’anonymisation.
2. Syntaxe fondamentale et paramètres opératoires de la fonction TRANWRD
2.1 Décomposition de la signature de la fonction TRANWRD
La mise en œuvre de la fonction TRANWRD repose sur une signature formelle stricte comportant trois arguments positionnels obligatoires. La syntaxe canonique s’énonce comme suit au sein d’une expression d’assignation dans l’étape DATA :
nouvelle_variable = tranwrd(source, cible, remplacement);
Le premier paramètre, désigné par le terme source, représente la variable de type caractère ou l’expression littérale au sein de laquelle la recherche doit être opérée. Il s’agit du vecteur textuel de référence qui sera parcouru par le moteur de recherche interne de SAS. Ce paramètre n’est pas modifié en place dans le stockage initial, car SAS applique un paradigme fonctionnel pur où la variable d’origine demeure intacte sauf si elle est explicitement réassignée.
Le deuxième argument, nommé cible (ou target string), spécifie la sous-chaîne exacte dont on souhaite repérer la présence. Cette cible peut être fournie sous la forme d’une constante littérale entre apostrophes ou guillemets, ou provenir d’une autre variable textuelle. Le troisième paramètre, nommé remplacement (ou replacement string), définit la séquence de caractères qui viendra se substituer à chaque occurrence de la cible identifiée. Il convient de souligner que sous SAS, l’usage des guillemets simples ou doubles doit faire l’objet d’une rigueur absolue : l’utilisation de guillemets doubles est requise lorsque la chaîne implique la résolution préalable d’une variable macro, tandis que les guillemets simples sont préconisés pour les chaînes statiques afin d’éviter toute surcharge d’interprétation par le processeur macro.
2.2 Sensibilité à la casse et gestion des correspondances partielles
L’algorithme sous-jacent à la fonction TRANWRD applique une politique rigoureuse de sensibilité à la casse (case sensitivity) basée sur la valeur binaire des octets sous le codage de session (qu’il s’agisse d’ASCII, d’EBCDIC ou d’UTF-8). En conséquence, le terme textuel « SAS » ne présente aucune équivalence avec « sas » ou « Sas ». Cette distinction stricte signifie que si la cible spécifiée dans la fonction ne respecte pas scrupuleusement la configuration majuscule/minuscule de l’observation source, la substitution échouera silencieusement, laissant la chaîne source inchangée sans générer d’avertissement dans le journal (SAS Log).
Pour neutraliser ce risque lors du traitement de données issues d’entrées manuelles non contrôlées, les ingénieurs SAS adoptent une stratégie d’harmonisation morphologique préalable. Cette approche consiste à encapsuler la variable source ou la cible dans les fonctions UPCASE ou LOWCASE. Ainsi, en convertissant temporairement ou définitivement l’ensemble de la chaîne en lettres capitales avant l’évaluation par TRANWRD, le programmeur garantit un appariement déterministe, indépendamment des variations de saisie introduites par les opérateurs humains.
Il importe également de considérer la problématique des correspondances partielles non désirées. Étant donné que TRANWRD recherche des motifs séquentiels sans vérifier les limites de mots (contrairement à une analyse lexicale avancée), cibler la séquence « car » dans une chaîne provoquera indifféremment la modification des mots isolés « car », mais également des sous-composantes incluses dans « pancarte », « carton » ou « encadrer ». La prévention de ces effets collatéraux impose d’encadrer la cible par des espaces délibérés ou de recourir à des expressions régulières lorsque le contexte sémantique exige l’isolation stricte des frontières lexicales.
2.3 Mécanisme d’exécution séquentiel lors de la compilation de l’étape Data
Pour appréhender pleinement le fonctionnement de TRANWRD, il est nécessaire de détailler le comportement du moteur d’exécution lors du cycle itératif de l’étape DATA. L’analyse de la chaîne s’opère selon un balayage linéaire de gauche à droite, octet par octet. Dès que la tête de lecture détecte une séquence de caractères correspondant bit à bit à l’argument cible, elle interrompt la progression, extrait la sous-chaîne cible, insère l’intégralité de la chaîne de remplacement dans la mémoire tampon intermédiaire, puis reprend son analyse immédiatement après le dernier caractère substitué.
Ce mode opératoire séquentiel protège l’algorithme contre les boucles infinies lors de substitutions auto-référentielles. Par exemple, si l’on demande à TRANWRD de remplacer la lettre « A » par la séquence « AA », la fonction remplacera le premier « A » par « AA », puis déplacera son pointeur d’analyse après le second « A ». Elle ne réévaluera pas les caractères nouvellement insérés. Ce principe préserve la stabilité de l’exécution et assure un temps de calcul prévisible, proportionnel à la longueur de la chaîne d’origine.
Toutefois, la présence d’occurrences multiples au sein d’une même observation est gérée de manière exhaustive : chaque répétition du motif cible subira la substitution sur l’ensemble de la longueur textuelle disponible dans la variable. L’opération s’arrête uniquement lorsque le curseur atteint la fin de la variable source ou la limite maximale d’octets allouée à la variable de réception dans le vecteur PDV.
3. Méthode 1 : Remplacement d’une séquence textuelle par une nouvelle chaîne
3.1 Principe théorique de la substitution directe de motifs
Le scénario opératoire canonique de TRANWRD réside dans le remplacement d’un mot ou d’un syntagme par une nouvelle formulation sémantique. Du point de vue théorique, cette opération réalise une transduction textuelle locale : elle préserve rigoureusement les segments périphériques situés en amont (préfixe textuel) et en aval (suffixe textuel) du point d’impact, tout en modifiant dynamiquement la section centrale ciblée.
Lorsque la chaîne de remplacement présente un nombre d’octets différent de celui de la cible, SAS orchestre une translation physique des caractères subséquents. Si la chaîne de substitution est plus volumineuse que la cible, l’ensemble des caractères postérieurs est décalé vers la droite, réduisant d’autant les espaces de remplissage disponibles en fin de chaîne. Inversement, si le terme de remplacement est plus court, les caractères postérieurs sont translatés vers la gauche, et le système insère des espaces supplémentaires à l’extrémité droite pour maintenir la dimension fixe assignée à la variable dans la table de données.
Ce mécanisme garantit le maintien absolu de la syntaxe globale des phrases ou des codes composites traités. Les délimiteurs de champs, la ponctuation périphérique et les structures syntaxiques non visées par le motif de recherche demeurent inchangés, assurant une parfaite reproductibilité des transformations au fil des observations successives.
3.2 Implémentation d’une nouvelle variable au sein de l’étape Data
Dans la pratique de programmation statistique, il est vivement déconseillé de réécrire directement le résultat d’une transformation textuelle sur la variable source d’origine. Une telle pratique écrase l’information brute et interdit toute traçabilité ou audit des données en aval. La convention méthodologique reconnue consiste à déclarer une nouvelle variable réceptrice au sein de l’étape DATA pour accueillir le résultat produit par la fonction TRANWRD.
L’assignation prend ainsi la forme analytique suivante :
libelle_standardise = tranwrd(libelle_brut, 'ANCIEN_TERME', 'NOUVEAU_TERME');
L’un des pièges les plus critiques lors de cette implémentation concerne la gestion implicite de la longueur d’allocation mémoire par SAS. Par défaut, si aucune instruction de dimensionnement préalable n’a été spécifiée pour la variable libelle_standardise, le compilateur SAS peut lui attribuer la longueur de la variable source, ou une longueur par défaut de 200 octets selon le contexte de l’expression. Si le motif de remplacement est nettement plus long que le motif cible et que les données initiales occupent une part importante de l’espace alloué, le résultat final peut subir une troncature silencieuse désastreuse. Il est donc formellement impératif d’adjoindre une instruction LENGTH explicite en amont de toute manipulation textuelle par TRANWRD.
3.3 Exemples conceptuels de restructuration sémantique
Considérons la gestion de nomenclatures organisationnelles ou hospitalières évolutives au fil du temps. Dans le cadre d’une étude observationnelle menée sur une décennie, les identifiants textuels de certains services hospitaliers changent fréquemment de dénomination officielle. Un service historiquement étiqueté « Unité de Soins Intensifs 1 » peut avoir été rebaptisé « Département de Réanimation Médicale ».
L’utilisation de TRANWRD permet d’harmoniser les historiques sans dénaturer les sous-identifiants de lits ou de pavillons inclus dans la même chaîne. De même, la gestion des acronymes techniques bénéficie directement de cette flexibilité : remplacer systématiquement le terme abrégé « HTA » par « Hypertension Artérielle » permet de préparer des rapports automatisés destinés à un lectorat médical non spécialisé, sans obliger le statisticien à disséquer la chaîne par des fonctions complexes de parsing positionnel.
Un autre cas représentatif concerne la modernisation de classifications nosologiques obsolètes au sein de bases médico-administratives historiques. Lorsqu’une terminologie diagnostique est réévaluée au cours du cycle de vie d’un registre épidémiologique, l’insertion de TRANWRD au sein des scripts d’importation permet de garantir que les séries temporelles d’indicateurs demeurent parfaitement comparables d’une cohorte à l’autre.
4. Méthode 2 : Suppression de motifs par substitution d’espaces vides
4.1 Substitution d’un terme par une chaîne nulle (suppression logique)
Une fonctionnalité particulièrement puissante mais parfois mal comprise de TRANWRD réside dans sa capacité à opérer l’effacement pur et simple d’un motif textuel. Cette suppression logique s’obtient en fournissant une chaîne vide en guise de troisième argument opérationnel. Dans la syntaxe du langage SAS, la chaîne vide est représentée par deux apostrophes consécutives sans aucun caractère intermédiaire ('') ou deux guillemets doubles non espacés ("").
L’instruction s’articule comme suit :
chaine_epuree = tranwrd(chaine_source, 'MOTIF_A_SUPPRIMER', '');
Sur le plan mécanique, dès que la fonction identifie la cible spécifiée, elle l’élimine du flux textuel sans insérer le moindre octet de substitution. Les caractères contigus situés immédiatement à droite du motif cible sont alors immédiatement rattachés aux caractères situés immédiatement à gauche. Il est crucial de distinguer cette opération d’effacement de l’insertion d’un espace typographique (' '). Spécifier un espace entre les guillemets n’efface pas le motif : cela le remplace par un blanc d’espacement, ce qui produit un impact structurel radicalement distinct sur la géométrie de la chaîne.
4.2 Gestion des artéfacts et espaces résiduels consécutifs
Bien que l’effacement par substitution d’une chaîne nulle soit syntaxiquement élégant, il engendre fréquemment des effets secondaires au niveau de la typographie textuelle. L’artefact le plus classique se manifeste lorsque le motif supprimé correspondait à un mot médian complet au sein d’une phrase. Dans une telle circonstance, le mot éliminé était originellement précédé et suivi d’un espace de séparation lexical.
La suppression directe du mot cible sans élimination concomitante de ses délimiteurs laisse subsister les deux espaces adjacents, lesquels se retrouvent désormais juxtaposés. Il en résulte un double espace résiduel (double blank) au cœur de la chaîne de caractères. De même, si le motif extrait se situait au début ou à la fin absolue de la chaîne, l’opération génère des espaces parasites de bordure (espaces de tête ou de queue).
Ces espaces résiduels ne constituent pas seulement une imperfection esthétique sur les rapports de sortie : ils risquent d’altérer les opérations ultérieures de partitionnement basées sur des délimiteurs simples (comme les fonctions SCAN ou INDEX) et de fausser le décompte exact du nombre d’unités lexicales. Par conséquent, toute stratégie de suppression de motif via TRANWRD doit obligatoirement s’accompagner d’une phase de post-traitement dédiée à la normalisation des blancs.
4.3 Cas d’usage : Purge de préfixes et suffixes récurrents
La suppression ciblée de sous-chaînes via TRANWRD trouve une utilité pratique majeure dans l’assainissement d’identifiants administratifs encombrés de préfixes techniques redondants. Dans de nombreux systèmes de gestion hospitalière ou bancaire, les identifiants d’enregistrements sont préfixés par des codes d’application tels que « ID_PROD_ » ou « CLIENT_NUM_ ».
Lorsque ces identifiants doivent être convertis en clés de jointure standardisées ou exportés vers des systèmes relationnels externes, la suppression systématique de ces préfixes se révèle indispensable. L’application séquentielle de TRANWRD ciblant ces balises fixes permet de ramener l’identifiant à sa composante strictement signifiante, réduisant au passage l’encombrement volumétrique de la variable en mémoire.
Cette approche s’applique identiquement au nettoyage des suffixes de versions de documents (tels que « _v1_final », « _rev2 ») au sein des métadonnées de suivi d’essais cliniques, facilitant le regroupement automatique de documents appartenant au même protocole fondamental indépendamment de leurs itérations de rédaction.
5. Démonstration pratique : Création et inspection du jeu de données expérimental
5.1 Génération de la table originale via l’étape Data et DATALINES
Afin d’illustrer concrètement les comportements décrits ci-dessus, nous élaborons un jeu de données expérimental structuré simulant un registre de dénominations d’équipes de compétition sportive. Ce scénario classique permet de manipuler des chaînes combinant des adjectifs qualificatifs récurrents et des noms d’animaux, présentant des variations lexicales contrôlées propices aux tests de substitution textuelle.
L’étape DATA suivante procède à la création de la table initiale désignée sous le nom de ORIGINAL_TEAMS. Elle exploite l’instruction INPUT associée au descripteur de format alphanumérique direct $1-20, garantissant que chaque ligne du bloc DATALINES est lue de façon rigoureusement reproductible sur une largeur fixe de 20 octets :
data original_teams;

  input team $1-20;

datalines;

Wild Mustangs

Angry Bees

Wild Cheetahs

Kind Panthers

Wild Aardvarks

;

run;
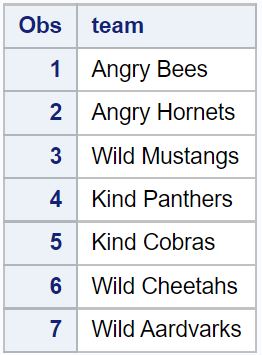
L’instruction DATALINES permet d’intégrer directement le corpus de test au sein du script SAS, éliminant ainsi toute dépendance à un fichier plat externe pour cette démonstration. Le jeu de données généré comporte cinq observations distinctes, intégrant trois occurrences du terme cible « Wild » au début des chaînes de caractères, ainsi que deux observations de contrôle (« Angry Bees » et « Kind Panthers ») qui permettront de valider la neutralité de l’algorithme face aux modalités non ciblées.
5.2 Validation du jeu de données à l’aide de PROC PRINT
Préalablement à toute transformation algorithmique, une bonne pratique de programmation SAS consiste à valider empiriquement la structure et le contenu de la table de départ à l’aide de la procédure générique PROC PRINT. Cette étape confirme que les données ont été ingérées sans décalage de colonne et que l’espace mémoire alloué correspond exactement aux spécifications requises.
Le code SAS d’inspection s’exécute simplement :
proc print data=original_teams noobs;

  title 'Inspection de la Table Originale des Équipes';

run;
L’option noobs est ici spécifiée pour supprimer l’affichage du numéro d’observation par défaut, fournissant une sortie épurée axée exclusivement sur le vecteur textuel étudié. L’examen attentif du journal SAS confirme la création de la table WORK.ORIGINAL_TEAMS avec 5 observations et 1 variable. Cette validation documentaire établit la référence par rapport à laquelle le différentiel d’état post-transformation sera mesuré.
5.3 Analyse structurelle des données d’exemple
L’analyse morphologique du corpus met en évidence plusieurs propriétés essentielles. Premièrement, la cible « Wild » est positionnée de manière répétitive en début absolu de chaîne (indices 1 à 4). Deuxièmement, les noms de créatures qui lui succèdent présentent des longueurs très disparates : « Mustangs » compte 8 caractères, « Cheetahs » en compte 8, tandis que « Aardvarks » en compte 9.
Cette variabilité de longueur au sein du second mot permet de vérifier que la substitution opérée sur le premier segment n’entraîne aucune corruption de pointeur sur le segment terminal, quel que soit l’encombrement lexical de ce dernier. Par ailleurs, la présence de noms composés démontre la capacité de la table à tester le maintien des délimiteurs intermédiaires (les espaces simples séparant l’adjectif du substantif animalier).
Enfin, les deux enregistrements neutres contenant les qualificatifs « Angry » et « Kind » permettent de vérifier l’absence d’effets de bord, s’assurant que la fonction ne produit pas d’assignation erronée ou de valeur manquante lorsqu’un enregistrement ne présente pas l’empreinte textuelle recherchée.
6. Cas pratique d’application : Substitution lexicale ciblée au sein d’une variable
6.1 Mise en œuvre du remplacement du motif ‘Wild’ par ‘Fast’
Nous abordons désormais l’exécution concrète de la substitution lexicale. L’objectif analytique consiste à standardiser la nomenclature sportive en remplaçant systématiquement le qualificatif « Wild » par la désignation moderne « Fast », tout en préservant l’intégrité intégrale de l’animal totémique associé. Pour mener à bien cette opération, une nouvelle étape DATA est initiée, lisant la table original_teams et créant la table dérivée new_teams_data.
L’instruction fondamentale s’implémente comme suit :
data new_teams_data;

  set original_teams;

  length new_team $ 25;

  new_team = tranwrd(team, 'Wild', 'Fast');

run;
Lors de l’exécution séquentielle, SAS lit chaque observation de la table source une à une et la charge dans le vecteur PDV. La fonction TRANWRD inspecte le contenu de la variable team. Lorsqu’elle identifie le segment « Wild », elle effectue la substitution par « Fast ». Il importe de noter qu’en termes de comptage de caractères, « Wild » et « Fast » présentent exactement le même nombre d’octets (4 caractères). Il s’agit donc d’une substitution isomorphe en longueur, ce qui simplifie la gestion spatiale, bien que l’instruction length new_team $ 25; ait été judicieusement déclarée en amont par précaution méthodologique.
6.2 Contrôle des résultats par inspection du nouveau jeu de données
Pour attester formellement de la conformité du traitement appliqué, une procédure d’impression analytique est exécutée sur la table nouvellement créée :
proc print data=new_teams_data noobs;

  title 'Validation de la Substitution Lexicale Ciblée';

run;
L’inspection du tableau de sortie confirme la parfaite réussite de l’algorithme. Les trois entités d’intérêt ont été modifiées de façon chirurgicale : « Wild Mustangs » s’est métamorphosé en « Fast Mustangs », « Wild Cheetahs » est devenu « Fast Cheetahs », et « Wild Aardvarks » a été converti en « Fast Aardvarks ».
Parallèlement, les observations de contrôle ont fait preuve d’une résilience structurelle absolue : « Angry Bees » et « Kind Panthers » n’ont subi aucune modification, ni altération de format, ni déplacement spatial. Cette inspection visuelle et programmatique valide le comportement déterministe de la fonction TRANWRD dans le cadre de transformations lexicales sous SAS.
6.3 Interprétation analytique du comportement sélectif de SAS
Le succès de cette opération repose sur l’orthogonalité de l’évaluation textuelle sous SAS. Si l’on décompose le flux de traitement de la ligne d’affectation, la fonction TRANWRD ne réévalue pas l’intégralité du contexte sémantique ; elle se borne à vérifier une correspondance binaire stricte. L’invariance des observations neutres démontre que le mécanisme ne produit aucun effet de bord non documenté.
Sur le plan du dimensionnement mémoire, le choix délibéré d’utiliser deux termes de longueur identique (4 octets chacun) a permis de préserver exactement l’emplacement des espaces de queue originels. La structure du vecteur de données n’a subi aucune distorsion d’alignement. Cette stabilité est précieuse lors de traitements industriels massifs impliquant plusieurs dizaines de millions de lignes, car elle évite au moteur de pagination de SAS d’avoir à recalculer dynamiquement des adresses mémoire complexes pour les variables de sortie.
Cette sélectivité opératoire confère à TRANWRD une fiabilité supérieure pour les pipelines ETL (Extract, Transform, Load) automatisés, où l’introduction involontaire de valeurs manquantes dues à des défaillances de parsing textuel constitue un risque opérationnel majeur.
7. Gestion des espaces résiduels et normalisation des chaînes avec COMPBL et STRIP
7.1 Problématique des espaces doubles après suppression par TRANWRD
Lorsque la fonction TRANWRD est employée pour supprimer un terme sans le remplacer par une nouvelle séquence (en utilisant la chaîne vide ''), une dysharmonie spatiale émerge inévitablement au sein de la chaîne de sortie. Supposons une variable contenant la mention « Protocole Bêta Phase III ». Si une directive méthodologique impose la suppression du qualificatif intermédiaire « Bêta », l’application stricte de tranwrd(source, 'Bêta', '') produira la chaîne suivante : « Protocole Phase III ».
L’examen minutieux de ce résultat met en évidence un espace double au niveau de la zone de suppression. L’espace qui précédait « Bêta » et l’espace qui lui succédait n’ont pas été absorbés par l’opération de suppression ; ils demeurent contigus dans la chaîne de caractères réceptrice. Cet espacement anarchique constitue une anomalie gênante tant pour l’esthétique des rapports destinés aux comités de pilotage que pour la rigueur des requêtes SQL ultérieures, où la condition d’égalité stricte libelle = 'Protocole Phase III' échouera lamentablement face à une observation contenant deux espaces intermédiaires.
Ce phénomène s’aggrave lorsque des suppressions multiples sont enchaînées au sein d’une même instruction : des agrégats de trois ou quatre espaces consécutifs peuvent se former, transformant la chaîne en une structure textuelle fragmentée particulièrement instable.
7.2 Application combinée de la fonction COMPBL pour compresser les blancs
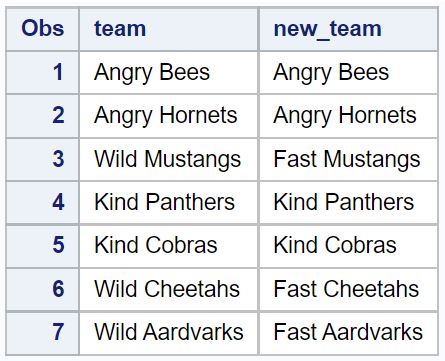
Pour remédier élégamment à cette détérioration spatiale sans recourir à des boucles conditionnelles fastidieuses, l’écosystème SAS met à disposition la fonction COMPBL (contraction de Compress Blanks). Le rôle algorithmique unique de COMPBL consiste à balayer la chaîne de caractères et à réduire instantanément toute séquence de plusieurs espaces consécutifs en un seul et unique espace typographique.
L’imbrication syntaxique de ces deux outils offre un motif de conception particulièrement puissant et compact dans l’étape DATA :
chaine_propre = compbl(tranwrd(source, 'MOTIF', ''));
Dans ce modèle d’exécution, la fonction interne TRANWRD opère en premier lieu, extrayant le mot ciblé et laissant temporairement des espaces doubles ou triples dans la mémoire tampon. Immédiatement après, la fonction externe COMPBL prend en charge le résultat intermédiaire, collapse l’ensemble des blancs redondants en espaces simples, et délivre une chaîne parfaitement cadencée sur le plan lexical. Cette composition de fonctions s’exécute de façon atomique au sein du processeur, garantissant une efficacité computationnelle maximale.
7.3 Élimination des espaces de bordure via TRIM, STRIP et LEFT
Si la fonction COMPBL résout impeccablement l’écueil des espaces intermédiaires redondants, elle ne traite pas de manière exhaustive le problème des espaces situés aux extrémités d’une chaîne. En effet, si le mot supprimé par TRANWRD se situait au début absolu de la variable, la chaîne résultante débutera par un espace d’indentation. Si le mot se situait à la fin, elle comportera un espace résiduel avant les espaces de bourrage système.
Pour assainir intégralement les frontières de la chaîne, les programmeurs disposent d’un ensemble de fonctions de cadrage spatial :
- LEFT : décale la totalité de la chaîne vers la gauche de manière à ce que le premier caractère signifiant occupe la première position en mémoire, déplaçant tous les espaces initiaux vers la fin de la variable.
- TRIM : supprime logiquement les espaces de fin (trailing blanks) lors de concaténations ultérieures, bien qu’au sein du vecteur fixe d’une table SAS, les espaces de fin réapparaissent si la variable réceptrice possède une longueur déclarée supérieure.
- STRIP : combine les actions de LEFT et de TRIM, éliminant simultanément les espaces initiaux et finaux en une seule passe algorithmique.
La règle d’or pour un assainissement textuel irréprochable consiste ainsi à ériger un pipeline de fonctions imbriquées :
libelle_final = strip(compbl(tranwrd(libelle_brut, 'MOTIF', '')));
Cette instruction condensée garantit que le motif est éradiqué, que les éventuels espaces doubles internes sont réduits à des espaces simples, et qu’aucun espace parasite ne subsiste en marge gauche ou droite de l’enregistrement finalisé.
8. Analyse comparative : TRANWRD versus TRANSLATE dans l’environnement SAS
8.1 Divergence de paradigme : Remplacement de chaînes vs substitution de caractères
Une confusion sémantique extrêmement répandue parmi les analystes juniors sous SAS réside dans l’assimilation erronée entre la fonction TRANWRD et la fonction TRANSLATE. Bien que leurs dénominations respectives évoquent un concept fonctionnel similaire de traduction ou de substitution, leurs architectures fondamentales reposent sur des paradigmes radicalement opposés.
La fonction TRANWRD traite les chaînes en tant qu’unités sémantiques continues de longueur arbitraire. Elle substitue un bloc par un autre bloc. En revanche, la fonction TRANSLATE opère exclusivement une transposition positionnelle caractère par caractère (au niveau d’octets isolés). TRANSLATE ne comprend pas la notion de mot : elle lit une liste de caractères individuels et les remplace systématiquement par une autre liste de caractères individuels selon un ordre d’indice strict.
Confondre ces deux fonctions peut engendrer des corruptions de données catastrophiques. Si un programmeur cherche à remplacer l’acronyme « US » par « UK » en utilisant par inadvertance TRANSLATE au lieu de TRANWRD sur une chaîne longue, la fonction ne cherchera pas le mot « US » : elle transformera chaque lettre « U » rencontrée dans la phrase en la lettre « U » de remplacement correspondante, et chaque lettre « S » isolée sera systématiquement convertie en « K ». Le mot « STATUS » deviendrait ainsi « STATUK », illustrant la dénaturation lexicale engendrée par cette méprise.
8.2 Syntaxe et cas d’école pour la fonction TRANSLATE
La signature de TRANSLATE diffère également de celle de TRANWRD par l’ordre de ses arguments, ce qui constitue une source additionnelle de fautes de programmation :
variable_corrigee = translate(source, to_chars, from_chars);
Dans cette syntaxe, le paramètre source reste la chaîne initiale, mais le deuxième argument représente les caractères d’arrivée (to_chars) et le troisième argument regroupe les caractères d’origine à convertir (from_chars). L’alignement est strictement positionnel : le premier caractère de from_chars est converti dans le premier caractère de to_chars, le deuxième dans le deuxième, et ainsi de suite.
Le cas d’école optimal pour l’emploi de TRANSLATE réside dans l’éradication des caractères diacritiques ou accents dans les environnements non-Unicode, ou la normalisation des séparateurs décimaux et typographiques. Par exemple, pour transformer tous les caractères accentués français en leurs équivalents stricts sans accent, TRANSLATE surpasse TRANWRD en termes de rapidité et d’élégance :
sans_accents = translate(nom, 'eeeeaiuoc', 'éèêëàîûôç');
Cette instruction unique réalise neuf substitutions distinctes en une seule passe processeur au niveau de chaque caractère du vecteur, une prouesse qui nécessiterait neuf appels imbriqués distincts si l’on devait l’exécuter à l’aide de TRANWRD.
8.3 Tableau décisionnel : Quelle fonction employer selon le contexte ?
Afin de structurer le processus de décision logicielle au sein des équipes de développement SAS, le tableau comparatif ci-dessous synthétise les propriétés discriminantes des deux instructions :
| Critère de comparaison | Fonction TRANWRD | Fonction TRANSLATE |
|---|---|---|
| Unité de traitement | Chaîne continue, sous-chaîne ou mot indivisible | Caractères isolés analysés unitairement (1 à 1) |
| Longueur des motifs | Variable (la cible et le remplacement peuvent avoir des tailles différentes) | Fixe (chaque caractère ciblé est remplacé par un caractère correspondant) |
| Sensibilité à la casse | Strictement sensible à la casse par défaut | Strictement sensible à la casse par défaut |
| Ordre des arguments | (source, cible_originale, nouveau_remplacement) | (source, nouveaux_caractères, caractères_originaux) |
| Cas d’usage préférentiel | Harmonisation de nomenclatures, d’acronymes ou de phrases | Suppression d’accents, substitution de délimiteurs de ponctuation |
| Complexité computationnelle | Modérée (balayage d’empreintes textuelles et décalages) | Extrêmement faible (transposition de table d’octets directe) |
Le choix architectural entre ces deux commandes découle ainsi de la nature granulaire de la cible : dès lors que le motif implique une relation ordonnée de plusieurs lettres dont le sens dépend de leur adjacence, TRANWRD est impérative ; dès lors qu’il s’agit de nettoyer une classe de caractères épars sans considération d’ordre lexical, TRANSLATE s’impose.
9. Utilisation avancée des expressions régulières avec les fonctions PRX (PRXCHANGE)
9.1 Limites inhérentes à TRANWRD face à la complexité des motifs
En dépit de sa remarquable simplicité et de son efficacité sur des motifs déterministes, la fonction TRANWRD atteint rapidement ses limites structurelles face à la variabilité inhérente aux données textuelles naturelles. En premier lieu, TRANWRD est incapable de gérer les métacaractères, les quantificateurs ou les conditions logiques alternatives. Il est impossible avec TRANWRD de définir un motif tel que « remplacer tout nombre comportant entre 3 et 5 chiffres suivi d’une lettre majuscule ».
De surcroît, la prise en charge des variantes morphologiques (telles que les formes plurielles, les accords de genre ou les préfixes alternatifs) exigerait avec TRANWRD une cascade d’appels répétitifs dégradant la lisibilité du code et la charge machine. Enfin, l’incapacité de TRANWRD à détecter nativement des frontières de mots (word boundaries) expose l’analyste au risque permanent de substitutions collatérales indésirables au sein de vocables plus longs contenant fortuitement la sous-chaîne ciblée.
Pour franchir ce palier fonctionnel, le langage SAS intègre le moteur de compilateur d’expressions régulières compatible Perl (Perl Regular Expressions, ou PRX), dont la fonction d’interfaçage principale pour les substitutions textuelles est PRXCHANGE.
9.2 Syntaxe opérationnelle de PRXCHANGE pour les substitutions complexes
La fonction PRXCHANGE adopte la notation classique de substitution de l’écosystème Perl, introduite par la lettre directive s, suivie d’un délimiteur (usuellement la barre oblique /), du motif de recherche, du délimiteur, de la chaîne de substitution, d’un ultime délimiteur et de modificateurs d’exécution optionnels. La syntaxe canonique s’exprime ainsi :
variable_resultat = prxchange('s/motif_regex/remplacement/options', nombre_occurrences, source);
Le paramètre nombre_occurrences spécifie le plafond d’itérations autorisées au sein de la ligne (-1 indiquant que toutes les occurrences valides doivent être substituées de manière exhaustive). L’option d’insensibilité à la casse i (pour case-insensitive) résout instantanément la rigidité typographique de TRANWRD sans exiger la modification de la casse du texte original par UPCASE.
Illustrons cette puissance avec un exemple médical : supposons qu’une variable contienne des identifiants patients formalisés sous des formats hétérogènes (tels que « PAT-123 », « Pat.456 », ou « patient_789 ») et que l’on désire unifier cette structure sous la désignation standardisée « ID-XXXX » :
format_standard = prxchange('s/pat(ient)?[._-](d+)/ID-$2/i', -1, id_brut);
Grâce à la capture par parenthèses et aux références arrières (backreferences matérialisées par $2), PRXCHANGE préserve dynamiquement la composante numérique tout en normalisant le préfixe et le délimiteur. Une telle prouesse algorithmique demeure totalement inaccessible à la fonction TRANWRD.
9.3 Comparatif technique : Performances et lisibilité entre TRANWRD et PRXCHANGE
L’arbitrage entre TRANWRD et PRXCHANGE soulève des considérations essentielles de rentabilité algorithmique et de maintenance logicielle à long terme. Le moteur PRX repose sur une machine à états finis non déterministe (NFA) qui nécessite la compilation du motif regex en mémoire (via la fonction PRXPARSE) avant d’exécuter la phase d’appariement. Cette machinerie algorithmique sophistiquée implique une surcharge computationnelle (CPU overhead) non négligeable.
Dans un contexte où les données volumineuses comptent des centaines de millions d’enregistrements, l’exécution d’un motif PRX complexe peut être de 3 à 8 fois plus lente que l’exécution d’un TRANWRD compilé en langage C de bas niveau, si le motif de recherche est une chaîne parfaitement fixe. Si le besoin de traitement se limite à remplacer « SARL » par « SOCIÉTÉ », l’emploi de PRXCHANGE relève de la sur-ingénierie préjudiciable aux performances du cluster de calcul SAS.
En matière de lisibilité et de maintenance, la syntaxe épurée de TRANWRD permet une reprise immédiate du code par n’importe quel biostatisticien ou data engineer sans prérequis avancé en théorie des langages formels, tandis que les expressions régulières denses génèrent régulièrement des incompréhensions ou des vulnérabilités de parsing lors des révisions de scripts.
10. Gestion de la mémoire, de la longueur des variables et troncature avec LENGTH
10.1 Attribution implicite de la longueur par SAS lors de l’usage de TRANWRD
L’un des comportements les plus insidieux du langage SAS lors de l’utilisation de fonctions de manipulation textuelle concerne l’attribution automatique de la longueur des variables dans le vecteur PDV. Lorsqu’une variable est créée pour la première fois dans une étape DATA par le biais d’une affectation directe impliquant la fonction TRANWRD, le compilateur doit figer sa dimension physique dans le dictionnaire de la table avant même de lire la moindre ligne de données.
Si la variable source possède une longueur explicitement typée, SAS attribue généralement à la nouvelle variable la longueur exacte de cette variable source, ou une limite conventionnelle de 200 octets si l’expression fait intervenir des opérations imbriquées non résolues. Or, considérons un scénario où la variable source a une longueur dimensionnée au plus juste à 15 octets pour contenir des chaînes telles que « Ville de Paris ».
Si l’on décide d’utiliser TRANWRD pour substituer le mot « Ville » par « Agglomération Urbaine Préfectorale », la nouvelle chaîne nécessiterait environ 40 octets pour s’épanouir intégralement. Mais la variable de réception ayant hérité implicitement de la longueur originelle de 15 octets, SAS tronquera brutalement le résultat final au 15ème caractère. Cette troncature s’effectue souvent sans lever d’erreur fatale susceptible d’interrompre l’étape DATA, laissant les données irrémédiablement corrompues.
10.2 Définition proactive de la longueur avec l’instruction LENGTH
Pour éliminer définitivement ce danger systémique, le principe fondamental d’ingénierie logicielle sous SAS impose la déclaration explicite de la structure de données en tête d’étape DATA. L’instruction déclarative LENGTH doit impérativement figurer avant la première assignation logique de la variable réceptrice.
L’implémentation rigoureuse adopte la forme suivante :
data reporting_standard;

  length libelle_complet $ 250;

  set donnees_sources;

  libelle_complet = tranwrd(libelle_court, 'Ctre Hosp', 'Centre Hospitalier Universitaire Régional');

run;
En spécifiant length libelle_complet $ 250; avant l’instruction SET ou l’instruction d’affectation, le développeur force l’allocateur de mémoire du compilateur à réserver un buffer de 250 octets dans le vecteur PDV. Ainsi, quelles que soient les extensions longitudinales provoquées par les substitutions textuelles de TRANWRD, aucune troncature ne viendra amputer la sémantique de l’enregistrement de sortie.
10.3 Optimisation des ressources de stockage dans les tables de production
Bien que la précaution de surdimensionner la longueur d’une variable garantisse la préservation intégrale des données contre la troncature, cette stratégie peut se révéler dispendieuse en termes d’espace disque et de mémoire tampon d’entrées/sorties (I/O). Si une table de production contient cent millions d’enregistrements et que l’on alloue une variable de 200 octets alors que la chaîne la plus longue n’en occupera jamais plus de 50, des gigaoctets entiers d’espaces de remplissage vides sont inutilement alloués et transférés à travers le réseau de stockage.
Pour concilier intégrité et sobriété matérielle, le programmeur averti procède en deux temps sur les grands jeux de données. Lors de la phase de transformation initiale, une taille conservatrice est accordée pour autoriser l’expansion textuelle. Par la suite, une procédure d’analyse dimensionnelle employant les fonctions LENGTHC (longueur d’allocation totale) et LENGTHN (longueur réelle ignorant les espaces de queue) permet d’identifier la valeur maximale effectivement atteinte par la variable :
proc sql;

  select max(lengthn(libelle_complet)) as longueur_optimale

  from reporting_standard;

quit;
La valeur maximale identifiée permet ensuite d’exécuter une passe d’optimisation via la procédure PROC DATASETS, redimensionnant au plus juste l’empreinte physique de la colonne sans recompiler l’intégralité du dataset, préservant ainsi à la fois la bande passante I/O et les coûts d’infrastructure d’hébergement.
11. Traitement conditionnel et substitutions massives sur plusieurs colonnes
11.1 Substitutions ciblées sous conditions logiques (IF-THEN / WHERE)
Dans les pipelines de traitement de données à grande échelle, appliquer systématiquement la fonction TRANWRD sur chaque ligne et chaque observation peut induire une dépense inutile de cycles d’horloge du processeur. Lorsqu’un motif de recherche n’est présent que dans une sous-population statistiquement rare de la table, il est particulièrement judicieux d’adjoindre un filtre logique conditionnel à l’opération de substitution.
Cette approche tire parti de la fonction INDEX ou FIND au sein d’une structure conditionnelle IF-THEN :
if find(diagnostic, 'DIAB') > 0 then do;

  diagnostic_std = tranwrd(diagnostic, 'DIAB', 'Diabète de Type');

end;

else do;

  diagnostic_std = diagnostic;

end;
La fonction FIND vérifie rapidement l’existence du sous-motif via un algorithme de recherche rapide de type Boyer-Moore. Si l’empreinte n’est pas détectée (retour d’indice 0), le bloc DO de TRANWRD est entièrement ignoré, épargnant au système le cycle d’allocation dynamique et de reconstruction de chaîne. Sur un ensemble de données médicales hétérogène de plusieurs dizaines de millions de lignes, cette conditionalisation peut réduire le temps d’exécution global de manière significative.
11.2 Automatisation des remplacements à l’aide de tableaux (ARRAYS)
Les tables SAS du secteur biomédical ou financier comportent fréquemment une collection étalée de colonnes textuelles analogues, telles que des variables de questionnaires répétées (ex : symptome_1, symptome_2, …, symptome_20). Répéter manuellement vingt assignations TRANWRD successives au sein de l’étape DATA nuit à l’élégance de la base de code, viole le principe de modularité DRY (Don’t Repeat Yourself) et multiplie les risques de coquilles d’assignation.
L’utilisation des tableaux vectoriels SAS (ARRAY) offre une réponse architecturale à cette contrainte. En encapsulant l’ensemble des colonnes d’intérêt au sein d’une structure indicée éphémère, le développeur peut itérer sur l’ensemble des champs textuels au moyen d’une boucle itérative séquentielle DO OVER ou DO i = 1 TO dim() :
data harmonisation_enquetes;

  set questionnaire_brut;

  array questions{*} qtext_1 - qtext_20;

  do i = 1 to dim(questions);

    questions{i} = tranwrd(questions{i}, 'N/A', 'Non Applicable');

    questions{i} = strip(compbl(questions{i}));

  end;

  drop i;

run;
Cette approche permet d’appliquer une batterie complète de règles de nettoyage textuel et de normalisation spatiale sur des dizaines de colonnes de manière homogène et hautement condensée, assurant la cohérence transversale du dictionnaire de données en aval.
11.3 Écriture de macro-programmes SAS pour la substitution paramétrique
Pour garantir la portabilité des routines de nettoyage au sein de pipelines de données institutionnels complexes, il est recommandé d’encapsuler la logique de substitution au sein du langage macro de SAS. La compilation d’une macro-commande réutilisable autorise l’injection dynamique des noms de tables, des variables cibles et des couples de valeurs de substitution sans réécriture du code source DATA :
%macro substituer_lexique(table_in=, table_out=, var_texte=, cible=, remplacement=);

  data &table_out;

    length &var_texte._nettoyee $ 200;

    set &table_in;

    &var_texte._nettoyee = tranwrd(&var_texte, "&cible", "&remplacement");

    &var_texte._nettoyee = strip(compbl(&var_texte._nettoyee));

  run;

%mend substituer_lexique;
L’appel unifié de cette routine standardisée s’opère par une simple instruction paramétrique :
%substituer_lexique(table_in=clinique_data, table_out=clinique_clean, var_texte=statut_visite, cible=ANNUL, remplacement=Annulation Validée);
L’automatisation macro permet d’intégrer des validations de paramètres complexes, de gérer des dictionnaires externes de métadonnées et de standardiser les processus de gouvernance de données à travers des départements analytiques entiers.
12. Synthèse méthodologique, diagnostics d’erreurs et meilleures pratiques en SAS
12.1 Diagnostics des erreurs fréquentes et interprétation du journal SAS (SAS Log)
La phase de débogage constitue une dimension inséparable du cycle de vie du développement sous SAS. Le journal d’exécution (SAS Log) contient des indices diagnostiques précieux qu’il convient de savoir interpréter face à des comportements inattendus de la fonction TRANWRD. L’une des erreurs les plus fréquentes survient lorsqu’un argument fourni à la fonction est d’un type numérique alors qu’une chaîne était attendue.
Dans ce scénario, le compilateur SAS n’interrompt pas brutalement l’exécution de l’étape DATA, mais applique une conversion implicite d’attribut en insérant une note d’avertissement caractéristique dans le journal :
NOTE: Numeric values have been converted to character values at the places given by: (Line):(Column).
Cette conversion implicite convertit le nombre en une chaîne cadrée à droite d’une longueur par défaut de 12 caractères, générant des espaces initiaux inattendus qui empêchent toute correspondance avec le motif cible. La résolution impose de recourir formellement à la fonction PUT(variable, format.) pour maîtriser explicitement la forme textuelle injectée dans TRANWRD.
Un deuxième point de vigilance concerne la gestion des encodages de caractères (ex : UTF-8 versus WLATIN1). Lorsqu’une session SAS configurée en UTF-8 traite des données textuelles accentuées, un caractère accentué tel que « é » occupe deux octets physiques et non un seul. Si une chaîne est découpée ou substituée par des routines inappropriées, des octets de continuation peuvent être brisés, générant des corruptions d’encodage (symbolisées par des glyphes de remplacement ou des erreurs de troncature multi-octets dans la session). Le développeur doit s’assurer que la longueur déclarée via LENGTH intègre une marge suffisante pour les octets multi-octets propres aux environnements Unicode contemporains.
12.2 Matrice de validation et protocole de test post-transformation
La validation empirique d’un processus de substitution textuelle ne saurait se limiter à l’inspection aléatoire de quelques lignes via PROC PRINT. L’adoption d’un protocole de validation statistique rigoureux s’impose avant tout déploiement en production. La procédure de référence pour contrôler l’intégrité de la transformation est la procédure PROC FREQ exécutée en table croisée sur les variables avant et après traitement :
proc freq data=new_teams_data;

  tables team * new_team / list missing;

run;
L’affichage sous forme de liste unifiée (/ list) permet d’inspecter l’exhaustivité des correspondances bijectives créées par l’algorithme. Tout enregistrement où la variable modifiée afficherait une valeur vide, une anomalie typographique ou une absence de concordance attendue apparaît immédiatement avec sa fréquence exacte d’occurrence au sein de la table globale.
En parallèle, l’extraction dédiée des lignes suspectes au moyen d’une clause WHERE dans une procédure PROC PRINT permet de capturer les valeurs aberrantes résiduelles pour analyse approfondie :
proc print data=new_teams_data;

  where find(new_team, 'Wild') > 0 or new_team = ' ';

  title 'Détection des Défaillances de Remplacement ou Valeurs Vides';

run;
Ce double filtre analytique garantit une auditabilité intégrale du pipeline de nettoyage textuel avant transmission aux équipes d’analyse statistique ou de biostatistique décisionnelle.
12.3 Recommandations formelles et arbre décisionnel pour les opérations de substitution
Pour pérenniser la qualité logicielle et la lisibilité des programmes développés au sein des départements analytiques, une synthèse des meilleures pratiques peut être formalisée sous la forme d’un arbre décisionnel d’implémentation :
- Règle 1 : Typologie de la substitution. Si l’opération consiste à convertir un jeu de caractères épars un à un (ex : transposition d’accents ou neutralisation de caractères spéciaux de ponctuation), employer impérativement TRANSLATE.
- Règle 2 : Substitutions de motifs déterministes. Si l’opération cible un mot précis, un acronyme ou une locution continue fixe, employer systématiquement TRANWRD couplée à STRIP et COMPBL pour assainir l’espace typographique résiduel.
- Règle 3 : Motifs polymorphiques ou basés sur des règles syntaxiques complexes. Si la détection du motif dépend de masques numériques, de jokers ou de métacaractères dynamiques, recourir aux fonctions d’expressions régulières PRXCHANGE.
- Règle 4 : Prévention de la troncature. Déclarer systématiquement la longueur maximale requise pour la variable réceptrice via une instruction LENGTH placée en tête de l’étape DATA, en prévoyant une marge suffisante pour les environnements de codage UTF-8.
- Règle 5 : Préservation de l’historique brut. Ne jamais réécrire sur la colonne d’origine dans les tables de premier niveau ; créer systématiquement une nouvelle variable dérivée explicitement documentée.
En observant scrupuleusement ces directives méthodologiques, les analystes de données, biostatisticiens et ingénieurs logiciels s’assurent de produire un code SAS hautement performant, pérenne, conforme aux exigences de validation des agences de régulation internationales et garantissant une intégrité absolue des données textuelles traitées.
Références
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc. https://support.sas.com/en/books.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc. https://www.sas.com/store/books/categories/usage-and-reference/the-little-sas-book-a-primer-sixth-edition/prodBK_69044_en.html
- Horstman, D. W. (2017). Manipulating Data with SAS Functions: A Step-by-Step Guide. SAS Institute Inc. https://support.sas.com/resources/papers/proceedings17/0458-2017.pdf
- SAS Institute Inc. (2021). SAS(R) 9.4 Functions and CALL Routines: Reference, Fifth Edition. SAS Documentation. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lefunctionsref/titlepage.htm
- SAS Institute Inc. (2023). Character String Functions in the SAS Data Step. SAS Technical Papers. https://support.sas.com/resources/papers/