
L’analyse des données catégorielles constitue l’un des piliers méthodologiques les plus anciens et les plus fondamentaux des sciences quantitatives modernes, particulièrement en psychologie expérimentale, en sociologie computationnelle et en biométrie. Alors que les méthodes paramétriques traditionnelles telles que l’analyse de variance ou la régression linéaire reposent sur des postulats stricts de normalité distributionnelle et d’homoscédasticité au niveau des échelles d’intervalles ou de rapports, le chercheur ou l’analyste se trouve fréquemment confronté à des données discrètes, nominales ou ordinales. Ces données traduisent des choix comportementaux, des appartenances typologiques, des réponses dichotomiques ou des distributions de fréquences qui échappent par nature aux métriques continues. Dans ce cadre épistémologique, l’inférence statistique nécessite un appareil formel capable d’évaluer si une configuration empirique observée reflète un mécanisme sous-jacent singulier ou si elle n’est que l’expression du bruit stochastique inhérent à tout échantillonnage aléatoire.
Le test du khi-deux d’adéquation (souvent désigné sous l’anglicisme goodness-of-fit test) conçu par Karl Pearson à l’aube du XXe siècle répond avec une élégance mathématique remarquable à cette exigence d’objectivation empirique. Bien que l’informatique contemporaine permette d’exécuter ces procédures en quelques millisecondes via des logiciels spécialisés tels que R, SPSS ou Python, l’exécution manuelle de ce test demeure un exercice pédagogique et heuristique irremplaçable. Elle dévoile l’architecture intime de l’inférence non paramétrique, démystifie le concept de résidu statistique et ancre durablement la compréhension de la métrique d’écart quadratique standardisé. Réaliser un test du khi-deux à la main permet de s’affranchir de l’illusion de la « boîte noire » computationnelle et confère au praticien une intuition aiguë de la sensibilité des données, de l’impact de la taille de l’échantillon et de la topologie de l’erreur d’échantillonnage.
Ce guide exhaustif a pour vocation de décomposer, avec une rigueur mathématique et méthodologique absolue, l’intégralité du processus menant du recueil des données brutes à la prise de décision statistique formalisée selon les standards académiques internationaux. À travers l’examen d’un cas pratique fil rouge issu du contrôle métrologique et de la psychologie décisionnelle — l’évaluation de l’équiprobabilité des faces d’un dé à six faces —, nous franchirons pas à pas chacune des huit étapes canoniques du test. Nous aborderons non seulement l’arithmétique exacte des fréquences attendues et des sommes de carrés normalisées, mais également les fondements distributionnels asymptotiques, les calculs de taille d’effet par le w de Cohen et le V de Cramer, les règles de décision épistémologiques et les normes typographiques de l’American Psychological Association (APA).
1. Fondements théoriques et épistémologiques du test du khi-deux d’adéquation
1.1 Origine et utilité du test du khi-deux de Pearson en sciences du comportement
L’acte de naissance de la statistique inférentielle moderne appliquée aux variables catégorielles est indissociable de la publication historique de Karl Pearson en 1900 dans le Philosophical Magazine. Confronté aux limites des distributions gaussiennes pour modéliser des phénomènes biologiques et anthropométriques asymétriques ou discontinus, Pearson élabora un critère universel permettant de mesurer la divergence globale entre une distribution de fréquences observées dans un échantillon fini et une distribution de probabilité théorique postulée a priori. Cette innovation conceptuelle a profondément transformé les sciences du comportement en fournissant le tout premier outil rigoureux de réfutation empirique appliqué aux sciences humaines naissantes.
Dans l’arsenal contemporain de la psychométrie et de la méthodologie expérimentale, il convient d’établir une distinction opérationnelle stricte entre deux déclinaisons fondamentales de la statistique de Pearson : le test du khi-deux d’adéquation (ou de conformité) et le test du khi-deux d’indépendance (ou d’homogénéité). Le test d’adéquation s’applique à une unique variable catégorielle discrète articulée en k modalités mutuellement exclusives. Son objectif consiste à éprouver l’adéquation d’un échantillon empirique à un modèle théorique unidimensionnel (par exemple, une distribution uniforme, binomiale, génétique mendélienne ou conforme à des prévalences épidémiologiques connues). À l’inverse, le test d’indépendance traite simultanément deux variables qualitatives croisées au sein d’un tableau de contingence bidimensionnel afin d’évaluer l’existence d’une association non aléatoire entre elles.
Le test d’adéquation relève du paradigme de l’inférence non paramétrique dans la mesure où il ne requiert aucune hypothèse préalable relative aux paramètres de position (moyenne) ou de dispersion (variance) d’une population parente continue. Il s’avère irremplaçable pour l’évaluation des biais cognitifs, des heuristiques de jugement, des préférences des consommateurs ou des paradigmes de choix forcé en psychophysique, où les réponses des participants se manifestent sous la forme d’occurrences nominales plutôt que de scores continus.
1.2 Logique mathématique sous-jacente à la comparaison fréquencielle
La mécanique fondamentale de la statistique de Pearson repose sur l’évaluation de la distance géométrique et probabiliste existant entre ce qui a été effectivement observé sur le terrain et ce qui aurait dû être observé si le modèle théorique sous-jacent décrivait fidèlement la réalité. Pour chaque modalité ou catégorie i constitutive de la variable étudiée, l’expérimentateur relève une fréquence observée, conventionnellement désignée par la notation $O_i$, et détermine par calcul probabiliste une fréquence théorique attendue (ou espérée), notée $E_i$. L’écart brut $(O_i – E_i)$ représente le résidu d’observation.
Néanmoins, la simple sommation arithmétique de ces écarts bruts est inopérante car les déviations positives et négatives s’annulent structurellement, la somme des fréquences observées étant par définition strictement égale à la somme des fréquences attendues, toutes deux équivalant à la taille totale de l’échantillon $N$. Pour pallier cette compensation systématique, la méthode de Pearson procède à l’élévation au carré de ces résidus, transformant ainsi chaque écart en une grandeur strictement positive $(O_i – E_i)^2$. Cette transformation quadratique accorde en outre une pénalité exponentielle aux divergences d’ampleur importante, traduisant le postulat qu’une grande déviation ponctuelle remet plus gravement en cause le modèle théorique que plusieurs fluctuations mineures.
Ces carrés des résidus doivent ensuite être pondérés ou normalisés. Un écart absolu de 10 unités ne possède pas la même signification statistique selon qu’il s’exprime par rapport à un effectif attendu de 12 unités ou de 10 000 unités. Dans le premier cas, la déviation est spectaculaire ; dans le second, elle est infinitésimale. La division par l’effectif attendu $E_i$ standardise cette déviation relative. Pearson a démontré par le théorème central limite que lorsque la taille totale de l’échantillon croît vers l’infini, la distribution d’échantillonnage de cette somme finie de variables aléatoires discrètes standardisées et élevées au carré converge asymptotiquement vers une loi de probabilité continue connue sous le nom de loi du khi-deux ($\chi^2$).
1.3 Présentation du cas pratique fil rouge : Le contrôle de l’équité d’un dé
Afin de guider notre développement d’une manière résolument concrète et opérationnelle, nous adopterons tout au long de cet ouvrage un protocole expérimental classique : le contrôle de l’équité d’un dé standard à six faces. Supposons qu’un laboratoire de psychologie cognitive s’intéresse à la production de séquences aléatoires par des sujets humains et décide, pour étalonner son protocole comparatif, de vérifier le comportement mécanique d’un générateur physique représenté par un dé cubique manufacturé. Le dé est lancé de façon parfaitement mécanique et standardisée un total de $N = 60$ fois dans des conditions environnementales contrôlées afin d’éliminer toute influence extérieure liée aux rebonds sur la piste feutrée.
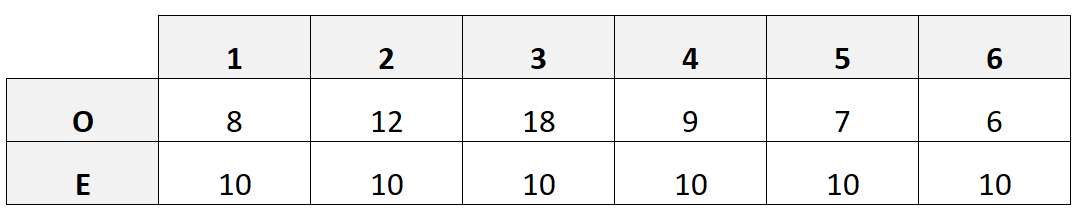
Au terme des 60 lancers séquentiels, le dénombrement rigoureux des occurrences observées pour chacune des faces se décline comme suit : la face 1 a été enregistrée 8 fois ; la face 2 a été observée 12 fois ; la face 3 est apparue à 18 reprises ; la face 4 a été relevée 9 fois ; la face 5 s’est manifestée 7 fois ; enfin, la face 6 a été constatée 6 fois. Ce décompte empirique présente à première vue une asymétrie apparente : la face 3 semble surreprésentée avec 18 apparitions, tandis que la face 6 présente une fréquence moitié moindre. La question fondamentale de l’inférence statistique se pose alors de façon éclatante : ces fluctuations résultent-elles uniquement des aléas de l’échantillonnage stochastique ou apportent-elles la preuve empirique suffisante que le dé présente un déséquilibre physique intrinsèque le rendant non équitable ?
Ce cas pratique d’école constitue une métaphore directe et parfaite des dispositifs expérimentaux à choix forcé à 6 modalités (tels que les tests d’identification visuelle sélective, les protocoles de catégorisation lexicale ou les mesures d’affects émotionnels différentiels selon l’hexagone de Paul Ekman). La méthode arithmétique que nous déploierons sur ces données physiques s’applique sans la moindre modification à ces paradigmes méthodologiques humains.
2. Conditions d’application et postulats méthodologiques préalables
2.1 Nature de l’échantillonnage et indépendance des observations
Avant d’engager la moindre opération arithmétique, le chercheur doit impérativement s’assurer que le protocole de recueil des données respecte les postulats stochastiques qui garantissent la validité inférentielle du test de Pearson. Le premier postulat, fondamental et non négociable, exige que les observations soient strictement indépendantes les unes des autres. Sur le plan de la conception expérimentale, cela signifie que le classement d’une observation spécifique dans une catégorie déterminée ne doit en aucun cas dépendre, influencer ou conditionner le classement des autres observations du corpus.
Cette condition implique le principe de non-redondance ou d’assignation mutuellement exclusive : chaque sujet expérimental, événement ou mesure élémentaire ne peut être comptabilisé qu’une seule et unique fois dans l’ensemble de la table catégorielle. En psychologie, une erreur méthodologique gravissime consisterait à administrer un questionnaire à un même groupe de participants à plusieurs moments longitudinaux différents (mesures répétées) et à agréger naïvement l’ensemble des réponses dans les cellules d’un test du khi-deux d’adéquation standard. Une telle violation introduirait une corrélation intra-classe substantielle qui réduirait artificiellement la variance d’échantillonnage résiduelle, provoquant une inflation incontrôlable du risque d’erreur de première espèce (rejet intempestif de l’hypothèse nulle alors qu’elle est vraie).
De surcroît, le mode d’échantillonnage doit répondre aux critères de l’échantillonnage aléatoire simple au sein de la population parente cible. Chaque unité expérimentale doit disposer d’une probabilité d’inclusion strictement non nulle et équivalente. Dans notre cas pratique du dé à six faces, l’indépendance stochastique est garantie par le protocole de lancer : le résultat d’un jet de dé à l’instant t n’exerce absolument aucun effet causal ni physique sur le résultat du jet subséquent à l’instant $t+1$, excluant tout phénomène d’hystérésis ou de mémoire du support expérimental.
2.2 Règle de Cochran et effectifs théoriques minimaux
Le second ensemble de conditions préalables découle de la nature asymptotique de la distribution du khi-deux. Rappelons que la variable statistique calculée $\chi^2$ est issue de l’agrégation de variables multinomiales discrètes. Sa conformité mathématique avec la fonction de densité continue du khi-deux théorique repose sur une approximation probabiliste qui n’est valide que si la taille de l’échantillon est suffisante au sein de chaque classe envisagée. Lorsque les effectifs sont excessivement clairsemés, la distribution discrète empirique diverge brutalement de la courbe lisse du modèle de Pearson, rendant les tables de probabilité critiques caduques.
Pour prévenir ces distorsions inférentielles, le statisticien William Gemmell Cochran a formalisé dans les années 1950 une série de règles empiriques unanimement adoptées par la communauté scientifique internationale, connues sous le nom de règles de Cochran :
- Règle générale pour les petits tableaux : Aucun effectif théorique attendu ($E_i$) ne doit être inférieur à 5. Si une seule cellule théorique descend sous le seuil strict de 5, l’approximation asymptotique continue est compromise.
- Tolérance pour les grands tableaux : Dans les configurations présentant un nombre substantiel de degrés de liberté (généralement lorsque le nombre de catégories k excède 4 ou 5), la règle s’assouplit : il est admissible qu’au maximum 20 % des catégories présentent un effectif attendu compris entre 1 et 5, à la condition impérative qu’absolument aucun effectif attendu ne soit inférieur à 1.
Lorsque ces critères ne sont pas remplis, l’analyste se trouve contraint d’appliquer des solutions de remédiation méthodologique. La première consiste à fusionner logiquement et conceptuellement des catégories contiguës ou sémantiquement proches afin d’accroître mécaniquement l’effectif espéré par cellule combinée. La seconde solution, privilégiée dans les analyses biomédicales contemporaines, consiste à abandonner l’approximation de Pearson au profit de méthodes de rééchantillonnage computationnelles ou du test exact multinomial (généralisation du test exact de Fisher), qui calcule de manière combinatoire la probabilité exacte d’apparition de la matrice observée sans recourir à une loi asymptotique continue.
2.3 Vérification des conditions de validité pour notre exemple numérique
Appliquons rigoureusement cette grille d’audit méthodologique à notre cas d’étude du dé à six faces afin d’établir la légitimité de la poursuite des calculs manuels. Notre échantillon comprend un effectif total de $N = 60$ observations réparties sur $k = 6$ modalités nominales distinctes (les faces 1 à 6). Chaque résultat de lancer correspond à une observation discrète, autonome, mutuellement exclusive des cinq autres et non répétée sur le plan des interactions physiques.
Sous l’hypothèse de référence stipulant que le dé est parfaitement régulier, la probabilité théorique d’apparition de chaque face individuelle est rigoureusement identique et s’établit à $p_i = \frac{1}{6}$ pour tout $i$ appartenant à l’ensemble ${1, 2, 3, 4, 5, 6}$. Par conséquent, l’effectif théorique attendu pour chacune des faces se calcule sans ambiguïté par l’application du produit de la taille totale de l’échantillon par la probabilité marginale de la classe :
$$E_i = N \times p_i = 60 \times \frac{1}{6} = 10$$
Chacune des 6 modalités présente un effectif théorique rigoureusement égal à 10 observations. Nous constatons de manière indiscutable que :
- 100 % des effectifs théoriques sont strictement supérieurs à 5 ($10 ge 5$).
- Aucun effectif théorique n’est nul ou inférieur à 1.
- L’indépendance probabiliste inter-observations est assurée par le dispositif de tirage aléatoire physique standardisé.
Toutes les exigences probabilistes et méthodologiques formulées par Cochran et Pearson étant scrupuleusement satisfaites, le modèle asymptotique du khi-deux s’avère parfaitement légitime pour traiter notre ensemble de données numériques.
3. Étape 1 – Formulation rigoureuse des hypothèses statistiques
3.1 Définition formelle de l’hypothèse nulle ($H_0$)
Toute démarche d’inférence statistique néoclassique s’enracine dans le cadre épistémologique du falsificationnisme poppérien : le chercheur ne cherche jamais à « prouver » directement la véracité de sa conjecture de recherche, mais s’efforce de rejeter, avec un risque d’erreur quantifiable, une hypothèse par défaut désignée sous le vocable d’hypothèse nulle et symbolisée par $H_0$. Dans le périmètre spécifique du test d’adéquation, l’hypothèse nulle postule formellement une identité parfaite entre la distribution de probabilité théorique spécifiée par le modèle et la distribution réelle des probabilités au sein de la population parente d’où provient l’échantillon.
Sur le plan conceptuel, $H_0$ affirme que les divergences observées sur le terrain entre les fréquences constatées et les fréquences théoriques ne constituent rien d’autre que des fluctuations stochastiques aléatoires attribuables à l’échantillonnage. Dans le cadre de notre contrôle métrologique de l’équité du dé, l’hypothèse nulle postule que le dé physique est exempt de biais de masse, d’irrégularité géométrique ou d’asymétrie de densité sur ses faces. Elle s’énonce mathématiquement sous la forme d’un système d’égalités strictes liant l’ensemble des probabilités élémentaires d’occurrence :
$$H_0 : P_1 = P_2 = P_3 = P_4 = P_5 = P_6 = \frac{1}{6}$$
où $P_i$ représente la probabilité d’apparition de la face $i$ dans la population infinie des lancers possibles du dé testé. D’un point de vue épistémique, tant que l’ampleur de la déviation empirique n’atteint pas un seuil critique d’invraisemblance statistique, l’hypothèse $H_0$ doit être provisoirement conservée en tant que modèle explicatif le plus parcimonieux de l’expérience.
3.2 Définition formelle de l’hypothèse alternative ($H_1$)
L’hypothèse alternative, conventionnellement désignée par $H_1$, formalise la rupture avec le modèle théorique postulée en amont de l’expérience. Une caractéristique fondamentale et souvent mal comprise du test du khi-deux d’adéquation réside dans sa nature d’épreuve statistique non directionnelle et omnibus. L’hypothèse alternative ne cible pas une modalité particulière de manière privilégiée et n’indique pas le sens des déviations (surreprésentation ou sous-représentation) ; elle postule simplement l’hétérogénéité de la distribution globale par rapport aux canons du modèle de référence.
Sur le plan mathématique, $H_1$ est formulée comme la négation logique rigoureuse de la conjonction d’égalités sous-tendant $H_0$. Elle stipule qu’au moins l’une des égalités probabilistes n’est pas vérifiée :
$$H_1 : \exists , i in {1, 2, 3, 4, 5, 6} \quad \text{tel que} \quad P_i ne \frac{1}{6}$$
Sur le plan méthodologique, cette formulation omnibus signifie que le rejet de l’hypothèse nulle autorisera à conclure que le dé n’est pas équitable dans son ensemble, mais ne permettra pas, à lui seul, d’affirmer de manière formelle que la face 3 est structurellement favorisée au détriment des autres. La localisation précise des foyers de non-conformité nécessite le déploiement d’analyses post-hoc complémentaires ou l’inspection détaillée des résidus standardisés ajustés.
3.3 Fixation a priori du seuil de signification alpha
Le seuil de signification, universellement désigné par la lettre grecque $\alpha$, quantifie la tolérance maximale admise par l’expérimentateur à l’égard de l’erreur de première espèce (ou risque de faux positif). Commettre une erreur de première espèce consiste à rejeter l’hypothèse nulle $H_0$ et à conclure à l’existence d’une anomalie ou d’un effet expérimental réel, alors que les déviations observées n’étaient en réalité produites que par le pur hasard de l’échantillonnage.
En conformité avec les conventions méthodologiques dominantes introduites par Ronald Aylmer Fisher dans les sciences biologiques et humaines, le seuil de signification est fixé de manière stricte et immuable avant l’amorce de tout calcul numérique à :
$$\alpha = 0{,}05$$
Ce niveau de risque implique que nous acceptons de déclarer le dé biaisé par erreur statistique au maximum dans 5 % des réplications potentielles de notre expérience de 60 lancers sous l’hypothèse d’une parfaite équité du matériel. Dans les contextes de haute sécurité métrologique, d’essais cliniques pharmacologiques ou de recherche génomique à très haut débit, ce seuil est couramment resserré à $\alpha = 0{,}01$ voire $\alpha = 0{,}001$ afin de conjurer le risque de faux positifs résultant de comparaisons multiples. Dans notre cas d’espèce, la norme conventionnelle académique de 5 % constitue le compromis optimal entre le contrôle rigoureux du risque alpha et la préservation de la puissance de détection du test face à un échantillon de taille modérée ($N = 60$).
4. Étape 2 – Structuration des données et inventaire des fréquences observées
4.1 Recueil et classification des données brutes en psychométrie
L’étape de structuration constitue la passerelle critique entre le protocole expérimental empirique et le formalisme arithmétique. Dans tout protocole de recherche en psychométrie ou en sciences sociales, les données brutes se présentent sous la forme d’un vecteur ou d’une liste désordonnée de réalisations individuelles (par exemple, la séquence temporelle brute : face 3, puis face 2, puis face 3, puis face 6…). L’opération préliminaire indispensable consiste à réduire ces données brutes par une opération de tri et de pointage afin de consolider la distribution empirique en fréquences observées absolues.
Pour notre expérimentation portant sur 60 lancers de dé, le dépouillement minutieux de la feuille de relevé produit la distribution empirique des effectifs observés, conventionnellement notés $O_i$, répertoriés dans le tableau synthétique suivant :
| Face du dé ($i$) | Désignation de la modalité | Fréquence empirique observée ($O_i$) |
|---|---|---|
| 1 | Modalité $C_1$ | 8 |
| 2 | Modalité $C_2$ | 12 |
| 3 | Modalité $C_3$ | 18 |
| 4 | Modalité $C_4$ | 9 |
| 5 | Modalité $C_5$ | 7 |
| 6 | Modalité $C_6$ | 6 |
| Somme totale des observations ($\sum O_i$) | 60 | |
La règle d’or arithmétique de cette étape d’inventaire réside dans le contrôle de complétude de la série : l’analyste doit impérativement valider l’égalité formelle $\sum_{i=1}^{k} O_i = N$. Dans notre cas :
$$\sum_{i=1}^{6} O_i = 8 + 12 + 18 + 9 + 7 + 6 = 60$$
Toute discordance numérique à ce stade traduirait l’omission d’une donnée brute ou une double comptabilisation, ce qui invaliderait l’ensemble de la chaîne inférentielle ultérieure.
4.2 Conception d’une matrice de calcul manuel standardisée
Pour exécuter un test du khi-deux à la main sans s’exposer au risque endémique d’erreur arithmétique ou d’inattention, il est hautement recommandé d’abandonner les calculs épars et d’adopter une organisation tabulaire rigoureuse. La matrice de calcul manuel standardisée organise les opérations algébriques en colonnes séquentielles qui épousent fidèlement l’architecture de la formule mathématique du khi-deux.
Cette matrice se compose de six colonnes canoniques :
- Colonne 1 – Modalité ($i$) : Indexation formelle de chacune des $k$ catégories exclusives constituant la variable catégorielle analysée.
- Colonne 2 – Fréquence observée ($O_i$) : Effectifs empiriques bruts dénombrés lors de l’expérimentation.
- Colonne 3 – Fréquence théorique attendue ($E_i$) : Effectifs espérés calculés sous l’égide stricte du modèle théorique de $H_0$.
- Colonne 4 – Déviation brute résiduelle ($O_i – E_i$) : Mesure de l’écart direct linéaire entre l’observation et la prédiction théorique.
- Colonne 5 – Déviation quadratique résolue ($(O_i – E_i)^2$) : Carré de l’écart brut destiné à éliminer la contrainte de signe négatif.
- Colonne 6 – Ratio standardisé normalisé ($\frac{(O_i – E_i)^2}{E_i}$) : Contribution individuelle unitaire de la modalité $i$ à la statistique globale du test.
Cette méthode tabulaire standardisée permet une vérification croisée à chaque étape intermédiaire et prévient la majorité des confusions arithmétiques lors des calculs à la pointe du crayon.
5. Étape 3 – Calcul mathématique rigoureux des fréquences théoriques attendues
5.1 Application de la formule canonique des fréquences attendues
Le calcul des fréquences attendues incarne l’opération par laquelle le modèle probabiliste abstrait prend corps dans les unités concrètes de l’échantillon. La formule canonique générale permettant de déterminer la fréquence théorique attendue $E_i$ pour toute modalité $i$ s’exprime par le produit universel :
$$E_i = N \times p_i$$
où $N$ correspond à la taille de l’échantillon total empiriquement collecté et $p_i$ représente la probabilité mathématique unitaire d’apparition de la modalité considérée, strictement dérivée du cadre d’hypothèse nulle $H_0$.
Dans notre cas fil rouge, l’hypothèse de pure équité mécanique implique une distribution théorique parfaitement uniforme sur l’ensemble des faces. Chacune des six faces possède une probabilité intrinsèque théorique d’apparition équivalente à :
$$p_1 = p_2 = p_3 = p_4 = p_5 = p_6 = \frac{1}{6} \approx 0{,}166667$$
En injectant la taille globale de notre échantillon ($N = 60$) dans cette équation, nous déterminons l’effectif théorique associé à chaque modalité :
$$E_1 = 60 \times \frac{1}{6} = 10$$
$$E_2 = 60 \times \frac{1}{6} = 10$$
$$E_3 = 60 \times \frac{1}{6} = 10$$
$$E_4 = 60 \times \frac{1}{6} = 10$$
$$E_5 = 60 \times \frac{1}{6} = 10$$
$$E_6 = 60 \times \frac{1}{6} = 10$$
L’analyste doit impérativement procéder à la vérification de la propriété fondamentale de conservation des masses fréquentielles : la sommation des effectifs attendus sur l’ensemble des modalités doit restituer exactement l’effectif global $N$ :
$$\sum_{i=1}^{k} E_i = 10 + 10 + 10 + 10 + 10 + 10 = 60 = N$$
Cette égalité stricte $\sum E_i = \sum O_i = N$ constitue un théorème d’invariance arithmétique qui ne tolère aucune exception théorique.
5.2 Cas particuliers : distributions théoriques non uniformes
Bien que notre exemple d’application s’appuie sur une distribution équiprobable, le test du khi-deux d’adéquation ne se cantonne aucunement à ce cas d’école. Dans un large éventail de recherches psychologiques et sociologiques, la distribution théorique de référence $H_0$ n’est pas uniforme mais reflète des proportions différentielles prédéterminées. Ces proportions théoriques peuvent découler de données démographiques issues de recensements nationaux (par exemple, la distribution de la population par tranches d’âge ou par catégories socio-professionnelles), de prévalences épidémiologiques établies par l’Organisation Mondiale de la Santé, ou encore de théories morphogénétiques et génétiques (telles que les fameux ratios mendéliens 9:3:3:1 de la ségrégation des allèles dihybrides).
Considérons à titre d’illustration méthodologique une étude en psychologie sociale s’intéressant à la répartition des types de personnalité dans un échantillon de 200 individus recrutés dans un environnement clinique spécifique. Si les données épidémiologiques nationales établissent que la population générale se compose de 50 % de profils de Type A ($p_1 = 0{,}50$), 30 % de profils de Type B ($p_2 = 0{,}30$) et 20 % de profils de Type C ($p_3 = 0{,}20$), les effectifs attendus sous $H_0$ ne seraient plus identiques mais proportionnels aux poids respectifs :
- $E_1 = 200 \times 0{,}50 = 100$
- $E_2 = 200 \times 0{,}30 = 60$
- $E_3 = 200 \times 0{,}20 = 40$
La sommation vérifie de nouveau le critère : $100 + 60 + 40 = 200 = N$. Lors de calculs manuels impliquant des proportions asymétriques ou des fractions rationnelles non entières, les effectifs théoriques attendus comportent couramment des décimales. Il convient d’observer une rigueur absolue : il ne faut jamais arrondir les $E_i$ à des nombres entiers. L’arrondi prématuré dégrade l’estimation mathématique et vicie la statistique finale du test. Les calculs manuels doivent conserver un minimum de deux à quatre décimales significatives tout au long du tableau analytique.
6. Étape 4 – Calcul des écarts bruts et de leur élévation au carré
6.1 Quantification des déviations brutes individuelles ($O_i – E_i$)
La quatrième colonne de notre matrice analytique a pour objet l’isolement algébrique des résidus bruts d’observation, formalisés par l’expression $(O_i – E_i)$. Cette opération élémentaire consiste à soustraire systématiquement l’effectif théorique attendu de l’effectif empirique observé, en conservant avec une vigilance totale le signe arithmétique résiduel (positif ou négatif).
Appliquons cette soustraction face par face à nos données expérimentales :
- Pour la face 1 : $O_1 – E_1 = 8 – 10 = -2$
- Pour la face 2 : $O_2 – E_2 = 12 – 10 = +2$
- Pour la face 3 : $O_3 – E_3 = 18 – 10 = +8$
- Pour la face 4 : $O_4 – E_4 = 9 – 10 = -1$
- Pour la face 5 : $O_5 – E_5 = 7 – 10 = -3$
- Pour la face 6 : $O_6 – E_6 = 6 – 10 = -4$
L’observation du signe permet une interprétation phénoménologique immédiate : les valeurs négatives signalent un déficit de réalisations empiriques par rapport aux espérances théoriques (la face 1 est sous-représentée de 2 lancers, la face 6 de 4 lancers), tandis que les valeurs positives mettent en évidence un excédent de réalisations (la face 3 affiche un surplus substantiel de 8 lancers).
À cette étape, l’analyste dispose d’un moyen de contrôle arithmétique absolu. En vertu du postulat de conservation des effectifs totaux démontré précédemment, la sommation algébrique des écarts bruts simples sur l’ensemble des modalités doit obligatoirement être égale à zéro :
$$\sum_{i=1}^{k} (O_i – E_i) = \sum_{i=1}^{k} O_i – \sum_{i=1}^{k} E_i = N – N = 0$$
Vérifions sur nos données :
$$\sum_{i=1}^{6} (O_i – E_i) = (-2) + (+2) + (+8) + (-1) + (-3) + (-4) = 0$$
Ce pointage rigoureux garantit qu’aucune erreur de soustraction ne s’est glissée dans le dispositif avant d’entamer la phase de transformation quadratique.
6.2 Neutralisation des signes par l’élévation au carré ($(O_i – E_i)^2$)
Comme évoqué lors de l’examen des fondements théoriques, l’information contenue dans les résidus bruts ne peut être exploitée directement sous sa forme linéaire sous peine d’auto-annulation mathématique universelle. Pour neutraliser l’obstacle des signes opposés, la méthodologie de Pearson impose l’élévation de chaque écart brut individuel à la puissance 2. Cette opération confère une nature strictement positive ou nulle à l’ensemble des termes résultants.
Exécutons les calculs quadratiques pour chaque catégorie :
- Pour la face 1 : $(-2)^2 = -2 \times (-2) = 4$
- Pour la face 2 : $(+2)^2 = 2 \times 2 = 4$
- Pour la face 3 : $(+8)^2 = 8 \times 8 = 64$
- Pour la face 4 : $(-1)^2 = -1 \times (-1) = 1$
- Pour la face 5 : $(-3)^2 = -3 \times (-3) = 9$
- Pour la face 6 : $(-4)^2 = -4 \times (-4) = 16$
L’inspection des grandeurs quadratiques ainsi obtenues met en relief la morphologie interne de la déviation expérimentale. Nous identifions instantanément que la modalité relative à la face 3 génère un terme quadratique majeur ($64$), éclipsant l’ensemble des autres déviations. À ce stade, nous possédons la numérisation brute de la distance au carré séparant nos observations empiriques de la trajectoire idéale formulée par l’hypothèse nulle.
7. Étape 5 – Pondération des écarts quadratiques et sommation de la statistique Khi-deux
7.1 Normalisation des déviations quadratiques par catégorie : $\frac{(O_i – E_i)^2}{E_i}$
L’avant-dernière opération arithmétique consiste à standardiser chaque écart quadratique en le divisant par sa fréquence théorique attendue respective. Cette normalisation transforme l’écart absolu au carré en une métrique d’écart relatif proportionnel. Cette pondération est requise pour assurer la comparabilité des contributions lorsque les cellules du tableau reposent sur des probabilités théoriques divergentes.
Dans notre cas pratique, l’opération s’avère particulièrement fluide puisque tous les effectifs théoriques sont uniformément égaux à $E_i = 10$. La division par 10 s’opère par un simple décalage de la virgule décimale :
- Pour la face 1 : $\frac{(O_1 – E_1)^2}{E_1} = \frac{4}{10} = 0{,}4$
- Pour la face 2 : $\frac{(O_2 – E_2)^2}{E_2} = \frac{4}{10} = 0{,}4$
- Pour la face 3 : $\frac{(O_3 – E_3)^2}{E_3} = \frac{64}{10} = 6{,}4$
- Pour la face 4 : $\frac{(O_4 – E_4)^2}{E_4} = \frac{1}{10} = 0{,}1$
- Pour la face 5 : $\frac{(O_5 – E_5)^2}{E_5} = \frac{9}{10} = 0{,}9$
- Pour la face 6 : $\frac{(O_6 – E_6)^2}{E_6} = \frac{16}{10} = 1{,}6$
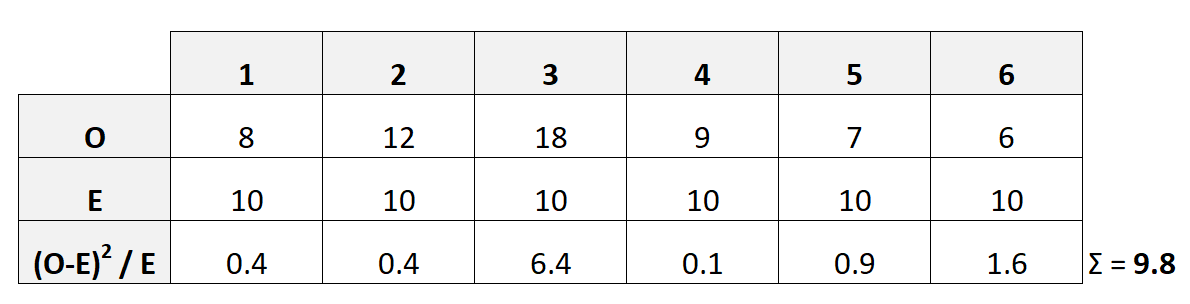
Ces quotients unitaires représentent les valeurs individuelles de khi-deux partiel associées à chaque cellule expérimentale. Nous pouvons dorénavant agréger l’ensemble de notre tableau d’analyse dans une synthèse matricielle définitive parfaitement exhaustive :
| Face ($i$) | $O_i$ | $E_i$ | $O_i – E_i$ | $(O_i – E_i)^2$ | $\frac{(O_i – E_i)^2}{E_i}$ |
|---|---|---|---|---|---|
| Face 1 | 8 | 10 | -2 | 4 | 0,4 |
| Face 2 | 12 | 10 | +2 | 4 | 0,4 |
| Face 3 | 18 | 10 | +8 | 64 | 6,4 |
| Face 4 | 9 | 10 | -1 | 1 | 0,1 |
| Face 5 | 7 | 10 | -3 | 9 | 0,9 |
| Face 6 | 6 | 10 | -4 | 16 | 1,6 |
| Total | 60 | 60 | 0 | — | $\chi^2 = 9{,}8$ |
7.2 Agrégation finale de la valeur empirique $\chi^2$ calculée
L’agrégation finale de la statistique empirique du test du khi-deux (souvent notée $\chi^2_{\text{obs}}$ ou $\chi^2_{\text{calc}}$) s’opère par l’addition séquentielle des ratios standardisés calculés dans la dernière colonne de notre matrice. La formule sommative canonique de Karl Pearson s’exprime dans toute sa plénitude :
$$\chi^2_{\text{calc}} = \sum_{i=1}^{k} \frac{(O_i – E_i)^2}{E_i}$$
Réalisons la sommation manuelle de nos six termes partiels :
$$\chi^2_{\text{calc}} = 0{,}4 + 0{,}4 + 6{,}4 + 0{,}1 + 0{,}9 + 1{,}6$$
Procédons par regroupements arithmétiques pour garantir une précision absolue :
- $(0{,}4 + 0{,}4) = 0{,}8$
- $0{,}8 + 6{,}4 = 7{,}2$
- $7{,}2 + 0{,}1 = 7{,}3$
- $7{,}3 + 0{,}9 = 8{,}2$
- $8{,}2 + 1{,}6 = 9{,}8$
La statistique du khi-deux observée pour notre expérience de 60 lancers de dé s’élève donc de manière indiscutable à :
$$\chi^2_{\text{calc}} = 9{,}80$$
Ce résultat scalaire condense en un indicateur synthétique unique l’intégralité des déviations fréquentielles constatées entre l’expérience réelle et le modèle théorique d’équiprobabilité.
7.3 Analyse exploratoire des contributions individuelles au $\chi^2$
Bien que le test du khi-deux soit fondamentalement une statistique globale (omnibus), il est d’une grande pertinence clinique et expérimentale de ne pas se borner à la contemplation du résultat global de 9,80 et d’effectuer une décomposition proportionnelle de la contribution relative de chaque catégorie à cette somme. La contribution relative d’une cellule $i$, exprimée en pourcentage de la statistique totale, se formalise par l’équation :
$$C_i = \left( \frac{\frac{(O_i – E_i)^2}{E_i}}{\chi^2_{\text{calc}}} \right) \times 100$$
Calculons ces contributions individuelles :
- Contribution de la face 1 : $\frac{0{,}4}{9{,}8} \times 100 \approx 4{,}08 %$
- Contribution de la face 2 : $\frac{0{,}4}{9{,}8} \times 100 \approx 4{,}08 %$
- Contribution de la face 3 : $\frac{6{,}4}{9{,}8} \times 100 \approx 65{,}31 %$
- Contribution de la face 4 : $\frac{0{,}1}{9{,}8} \times 100 \approx 1{,}02 %$
- Contribution de la face 5 : $\frac{0{,}9}{9{,}8} \times 100 \approx 9{,}18 %$
- Contribution de la face 6 : $\frac{1{,}6}{9{,}8} \times 100 \approx 16{,}33 %$
Cette analyse de décomposition fournit un éclairage méthodologique déterminant : à elle seule, l’anomalie constatée sur la face 3 (l’apparition excédentaire de 18 tirages pour une attente théorique de 10) est responsable de plus de 65 % de la valeur globale de la statistique de Pearson. En combinant la face 3 et la face 6 (cette dernière étant en déficit avec 6 apparitions), nous rendons compte de plus de 81 % de la variance totale d’écart. Cet audit diagnostique oriente directement l’expérimentateur vers les causes physiques potentielles du déséquilibre (par exemple, un défaut d’usinage sur l’axe reliant les faces opposées 3 et 4 ou 1 et 6).
8. Étape 6 – Détermination des degrés de liberté du modèle statistique
8.1 Concept et calcul mathématique des degrés de liberté (ddl)
La statistique scalaire calculée $\chi^2_{\text{calc}} = 9{,}80$ ne possède aucune signification décisionnelle intrinsèque si elle n’est pas mise en perspective avec la distribution d’échantillonnage théorique appropriée. Or, la loi du khi-deux ne constitue pas une courbe unique et invariable à l’instar de la loi normale centrée réduite, mais représente une famille infinie de lois de probabilité asymétriques entièrement indexées par un paramètre fondamental : les degrés de liberté (communément abrégés par $ddl$ en français ou $df$ pour degrees of freedom dans la littérature anglo-saxonne standard).
Sur le plan conceptuel et géométrique, le nombre de degrés de liberté quantifie le nombre d’éléments indépendants ou d’informations mathématiques libres de varier au sein du système statistique, une fois soumises aux contraintes linéaires imposées par la structure de l’échantillon. Dans le cadre précis d’un test du khi-deux d’adéquation portant sur un tableau de fréquences unidimensionnel à $k$ modalités sans estimation de paramètres internes, la formule de détermination des degrés de liberté s’établit simplement à :
$$ddl = k – 1$$
La justification formelle de cette soustraction d’une unité découle de la contrainte d’invariance de l’effectif global : $\sum_{i=1}^{k} O_i = N$. Si nous connaissons la taille totale de l’échantillon ($N = 60$) et que nous fixons arbitrairement les effectifs observés des cinq premières modalités ($O_1 = 8, O_2 = 12, O_3 = 18, O_4 = 9, O_5 = 7$), l’effectif de la sixième modalité ($O_6$) n’est plus libre de fluctuer. Il se trouve rigoureusement et arithmétiquement déterminé par différence :
$$O_6 = N – \sum_{i=1}^{5} O_i = 60 – (8 + 12 + 18 + 9 + 7) = 60 – 54 = 6$$
Dans notre étude pratique portant sur un dé possédant $k = 6$ faces :
$$ddl = 6 – 1 = 5$$
Notre statistique empirique devra impérativement être confrontée à la distribution théorique du khi-deux à 5 degrés de liberté.
8.2 Impact de l’estimation de paramètres sur les degrés de liberté
Une mise en garde épistémologique majeure doit être formulée quant à la généralisation de cette formule élémentaire $k – 1$. L’équation $ddl = k – 1$ n’est rigoureusement exacte que dans la situation où le modèle théorique sous $H_0$ est entièrement spécifié a priori de manière extrinsèque aux données expérimentales (comme l’équiprobabilité physique du dé, issue de considérations géométriques élémentaires indépendantes des lancers réels).
En revanche, lorsque les probabilités théoriques $p_i$ nécessaires au calcul des effectifs théoriques $E_i$ ne sont pas connues d’avance et doivent être estimées directement à partir de l’échantillon empirique via des statistiques descriptives d’échantillon (estimateurs du maximum de vraisemblance), chaque paramètre populationnel estimé impose une contrainte linéaire supplémentaire au système mathématique, amputant d’autant les degrés de liberté disponibles. La formule généralisée canonique formulée par Ronald Fisher s’écrit alors :
$$ddl = k – 1 – m$$
où $m$ représente le nombre strict de paramètres populationnels estimés à partir des données observées. Illustrons ce principe fondamental : si un chercheur souhaite tester l’adéquation d’une distribution de fréquences empiriques à une loi normale théorique discrétisée en $k$ classes, il est contraint d’estimer à partir de son échantillon à la fois la moyenne empirique ($\bar{x}$) et l’écart-type empirique ($s$), ce qui équivaut à estimer $m = 2$ paramètres. Les degrés de liberté du test d’adéquation ne s’élèvent plus alors à $k – 1$, mais chutent drastiquement à $k – 1 – 2 = k – 3$.
Il importe également de ne pas confondre le test d’adéquation avec le test d’indépendance du khi-deux appliqué aux tables de contingence croisées à deux facteurs comprenant $r$ lignes et $c$ colonnes, où les degrés de liberté sont régis par le produit marginal $ddl = (r – 1)(c – 1)$. Dans notre cas de figure métrologique portant sur le dé, aucun paramètre interne n’ayant été estimé ($m = 0$), nous confirmons définitivement que nos calculs opèrent sous $ddl = 5$.
9. Étape 7 – Lecture et extraction des seuils dans la table critique du Khi-deux
9.1 Structure et fonctionnement d’une table statistique de Pearson
La statistique du khi-deux résultant d’une modélisation continue asymptotique, l’obtention de la probabilité exacte associée à une valeur scalaire donnée nécessiterait la résolution manuelle d’une intégrale complexe de la fonction eulérienne gamma incomplète, ce qui s’avère irréalisable au crayon sur le terrain sans assistance informatique. C’est la raison pour laquelle les chercheurs et statisticiens s’appuient depuis plus d’un siècle sur des tables numériques de valeurs critiques précalculées.
La table statistique académique de la loi du khi-deux s’organise selon un repère matriciel à double entrée rigoureusement standardisé :
- L’axe vertical (lignes) : Répertorie de manière croissante les degrés de liberté ($ddl$ ou $\nu$), généralement échelonnés de 1 à 30, puis progressant par pas plus larges jusqu’à 100.
- L’axe horizontal (colonnes) : Affiche les niveaux de probabilité de dépassement critique standardisés, correspondant aux risques d’erreur alpha conventionnels ($\alpha = 0{,}10$, $\alpha = 0{,}05$, $\alpha = 0{,}025$, $\alpha = 0{,}01$, $\alpha = 0{,}001$). Dans les tables de distribution cumulative unilatérale supérieure (les plus usuelles), la colonne $\alpha = 0{,}05$ indique la valeur de l’abscisse au-delà de laquelle ne se situe que très exactement 5 % de la surface sous la courbe de densité de probabilité.
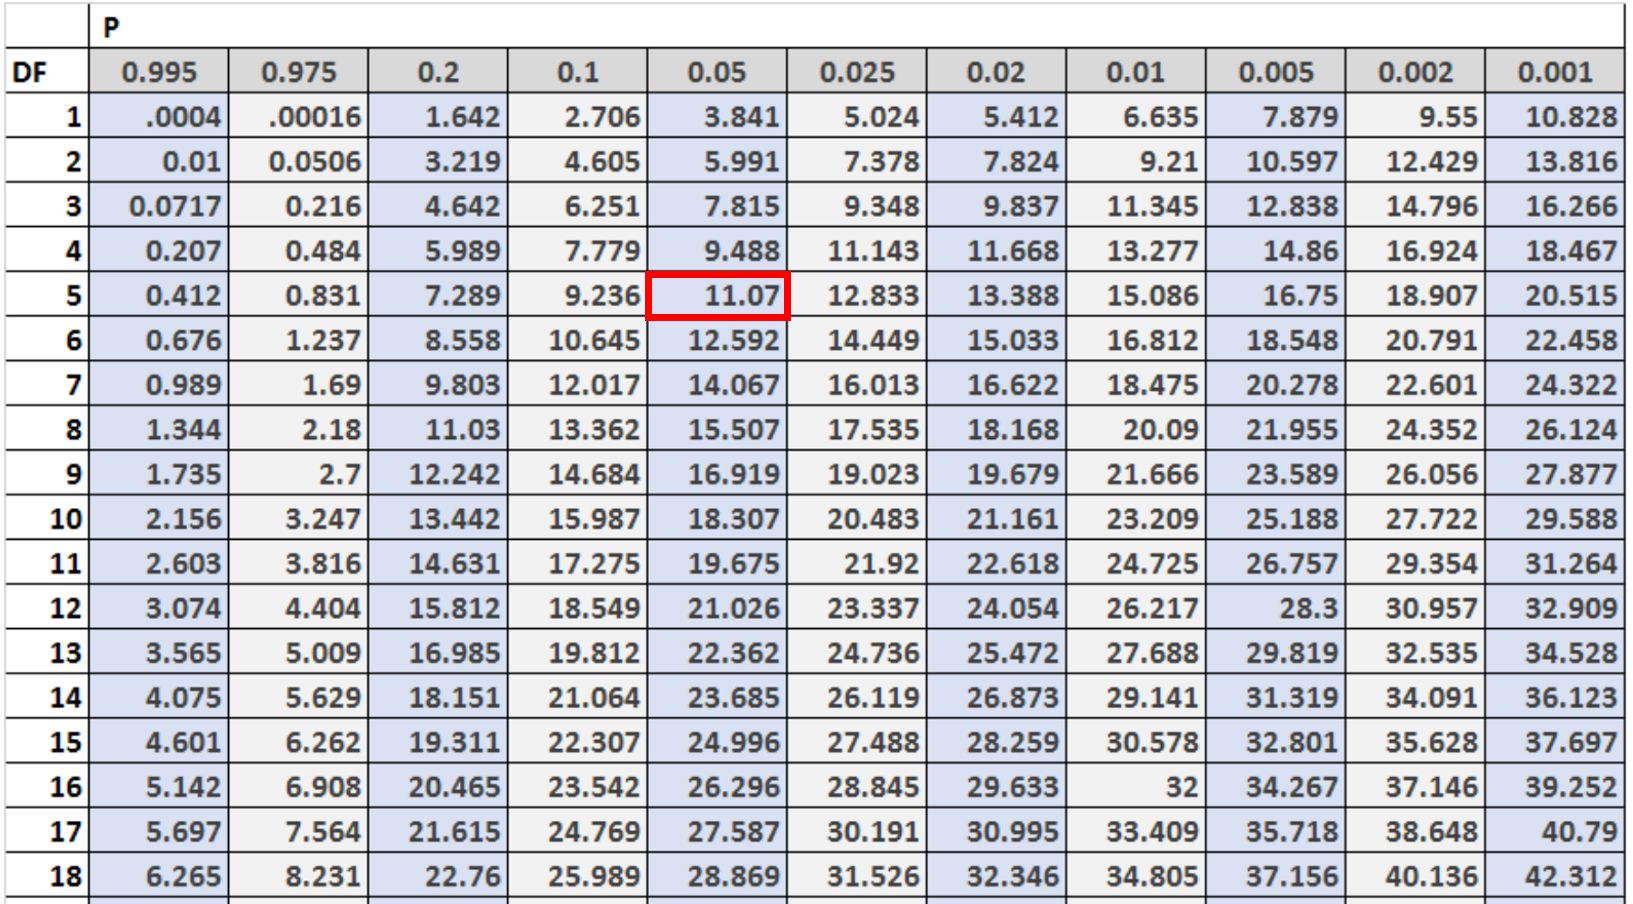
Le protocole d’extraction consiste à repérer la rangée correspondant exactement au nombre de degrés de liberté de l’expérience (soit la ligne $ddl = 5$), puis à projeter le regard orthogonalement jusqu’à l’intersection avec la colonne du niveau de risque prédéterminé ($\alpha = 0{,}05$).
9.2 Extraction de la valeur critique seuil pour notre analyse
Consultons un extrait canonique de la table de distribution critique de Pearson pour situer avec une précision mathématique totale l’environnement probabiliste de notre expérience à $ddl = 5$ :
| Degrés de liberté ($ddl$) | $\alpha = 0{,}10$ | $\alpha = 0{,}05$ | $\alpha = 0{,}025$ | $\alpha = 0{,}01$ | $\alpha = 0{,}001$ |
|---|---|---|---|---|---|
| 1 | 2,706 | 3,841 | 5,024 | 6,635 | 10,828 |
| 2 | 4,605 | 5,991 | 7,378 | 9,210 | 13,816 |
| 3 | 6,251 | 7,815 | 9,348 | 11,345 | 16,266 |
| 4 | 7,779 | 9,488 | 11,143 | 13,277 | 18,467 |
| 5 | 9,236 | 11,070 | 12,833 | 15,086 | 20,515 |
| 6 | 10,645 | 12,592 | 14,449 | 16,812 | 22,458 |
À l’intersection rigoureuse de la ligne $ddl = 5$ et de la colonne associée au risque d’erreur consenti $\alpha = 0{,}05$, la valeur critique extraite de la table s’établit de manière définitive à :
$$\chi^2_{\text{critique}} (5 ,;, 0{,}05) = 11{,}070$$
Si nous avions choisi un seuil de rigueur scientifique plus exigeant à $\alpha = 0{,}01$, la valeur critique aurait été de $15{,}086$. La valeur critique $11{,}070$ délimite sur le continuum de la loi du khi-deux la frontière exacte séparant la « région de non-rejet » (qui concentre 95 % de la masse de probabilité sous l’hypothèse nulle) de la « région de rejet critique » (située dans la queue unilatérale droite supérieure, englobant les 5 % de configurations empiriques les plus extrêmes et improbables sous $H_0$).
10. Étape 8 – Formulation de la règle de décision et conclusion statistique
10.1 Confrontation directe entre statistique calculée et valeur critique
L’acte décisionnel en inférence statistique repose sur l’application mécanique d’une règle de décision binaire asymétrique universelle :
- Règle de rejet de l’hypothèse nulle : Si la statistique calculée empiriquement est supérieure ou égale à la valeur critique tabulée ($\chi^2_{\text{calc}} ge \chi^2_{\text{critique}}$), l’écart entre la réalité et la théorie est trop massif pour être raisonnablement imputé au seul hasard. En conséquence, l’hypothèse nulle $H_0$ est formellement rejetée au seuil de risque $\alpha$.
- Règle de non-rejet de l’hypothèse nulle : Si la statistique calculée empiriquement est strictement inférieure à la valeur critique tabulée ($\chi^2_{\text{calc}} < \chi^2_{\text{critique}}$), la déviation constatée s'inscrit pleinement dans la marge des fluctuations stochastiques prévisibles. Par conséquent, il est formellement impossible de rejeter l'hypothèse nulle $H_0$.
Confrontons nos grandeurs numériques obtenues pas à pas :
$$\chi^2_{\text{calc}} = 9{,}80$$
$$\chi^2_{\text{critique}} (5 ,;, 0{,}05) = 11{,}070$$
$$9{,}80 < 11{,}070 implies \chi^2_{\text{calc}} < \chi^2_{\text{critique}}$$
Nous constatons que notre statistique observée n’atteint pas le seuil d’admissibilité dans la région de rejet critique. En examinant plus finement la table de distribution pour $ddl = 5$, nous repérons que $9{,}80$ se situe entre la valeur critique à $\alpha = 0{,}10$ ($9{,}236$) et la valeur critique à $\alpha = 0{,}05$ ($11{,}070$). Nous pouvons donc encadrer manuellement la p-valeur (probabilité d’obtenir une statistique au moins aussi extrême sous $H_0$) dans l’intervalle strict :
$$0{,}05 < p < 0{,}10$$
Une résolution algorithmique exacte nous révélerait une p-valeur précise de $p = 0{,}081$. Cette probabilité étant strictement supérieure à notre seuil alpha décisionnel ($\alpha = 0{,}05$), la décision méthodologique s’impose d’elle-même.
10.2 Prise de décision méthodologique et interprétation
La règle décisionnelle nous conduit formellement au non-rejet de l’hypothèse nulle $H_0$ au seuil conventionnel de significativité de 5 %. Cette conclusion réclame toutefois une mise au point épistémologique majeure : en statistique inférentielle, l’absence de preuve ne constitue en aucun cas la preuve de l’absence. Échouer à rejeter l’hypothèse nulle ne démontre absolument pas que le dé est intrinsèquement et ontologiquement équitable à la perfection micrométrique.
Dans le paradigme épistémique orthodoxe formalisé par Karl Popper, nous concluons sobrement que les données empiriques recueillies au cours de cette expérience de 60 lancers ne fournissent pas d’éléments de preuve suffisamment robustes pour réfuter l’hypothèse d’équiprobabilité des faces. L’amplitude de la déviation constatée, bien que visible à l’œil nu (notamment avec la fréquence élevée de 18 tirages sur la face 3), est susceptible de survenir spontanément par simple fluctuation d’échantillonnage dans plus de 8 % des cas lors de séries de 60 lancers avec un dé parfait. Le chercheur doit s’abstenir de déclarer le dé structurellement vicié sur la base exclusive de cette série de mesures.
10.3 Gestion du risque d’erreur de type II ($\beta$) et puissance statistique
La prudence méthodologique imposée par le non-rejet de $H_0$ soulève immédiatement la problématique symétrique de l’erreur de seconde espèce (notée $\beta$) : le risque de ne pas rejeter l’hypothèse nulle alors qu’elle est factuellement fausse dans la réalité du monde physique. En clair, le dé testé présente-t-il un déséquilibre mécanique authentique que notre protocole expérimental a été incapable de certifier statistiquement en raison d’une puissance statistique déficiente ?
La puissance d’un test statistique, définie par la quantité $(1 – \beta)$, représente la probabilité de rejeter à juste titre une hypothèse nulle fausse. Elle est directement gouvernée par trois facteurs :
- Le seuil alpha choisi ($\alpha = 0{,}05$).
- La taille réelle de la divergence dans la population (taille de l’effet).
- La taille totale de l’échantillon d’observation ($N$).
Dans notre étude, la taille de l’échantillon ($N = 60$) est relativement modeste. Si le dé possède un vice de fabrication induisant un biais réel mais modéré, 60 répétitions ne confèrent qu’une puissance statistique limitée pour franchir le seuil d’admissibilité critique de $11{,}070$. Pour illustrer ce phénomène mathématique de dépendance d’échelle, supposons que nous répliquions le test en lançant le dé 600 fois au lieu de 60, et que nous observions exactement les mêmes proportions empiriques marginales relatives (c’est-à-dire : 80 fois la face 1 ; 120 fois la face 2 ; 180 fois la face 3 ; 90 fois la face 4 ; 70 fois la face 5 ; 60 fois la face 6).
Les effectifs théoriques attendus passeraient tous à $E_i = 100$. Les écarts quadratiques seraient multipliés par 100 tandis que les dénominateurs seraient multipliés par 10. Mécaniquement, la statistique du khi-deux serait multipliée par un facteur d’échelle proportionnel égal à 10 :
$$\chi^2_{\text{nouveau}} = 10 \times 9{,}80 = 98{,}00$$
Avec $ddl = 5$, la valeur critique au seuil $\alpha = 0{,}05$ demeurerait rigoureusement inchangée à $11{,}070$. La confrontation deviendrait : $98{,}00 gg 11{,}070$, ce qui engendrerait un rejet massif et indiscutable de l’hypothèse nulle ($p < 0{,}0000001$). Cet exemple théorique démontre la sensibilité mécanique absolue du test du khi-deux à la taille de l'échantillon global $N$. C'est précisément pour dissocier la pure significativité statistique (dépendante de $N$) de l'intensité intrinsèque de l'écart expérimental qu'il s'avère indispensable de quantifier systématiquement l'amplitude de l'effet.
11. Quantification de l’amplitude de l’effet à la main : V de Cramer et W de Cohen
11.1 Limites de la seule significativité statistique et intérêt de la taille d’effet
Depuis plusieurs décennies, les instances méthodologiques internationales telles que l’American Psychological Association ou le comité éditorial de l’Association for Psychological Science dénoncent vigoureusement la dépendance exclusive des chercheurs à l’égard de la seule valeur de p. Une p-valeur ne mesure en aucun cas l’amplitude, l’intensité clinique ou la pertinence pratique d’un phénomène expérimental ; elle ne fait qu’arbitrer un niveau de compatibilité stochastique entre un échantillon de taille $N$ et un modèle théorique $H_0$.
Avec un échantillon gigantesque de plusieurs dizaines de milliers d’observations, la moindre déviation infinitésimale et physiquement insignifiante franchira le seuil de significativité ($p 0{,}05$) par manque de puissance statistique. La taille de l’effet (ou effect size) constitue une métrique standardisée affranchie de l’influence mécanique de la taille totale de l’échantillon $N$. Elle permet de quantifier directement l’ampleur géométrique de la rupture avec le modèle théorique et autorise les comparaisons directes à travers différentes études au sein de méta-analyses quantitatives.
11.2 Calcul pas à pas du W de Cohen pour le test d’adéquation
Pour le test d’adéquation unidimensionnel du khi-deux, la mesure canonique de la taille d’effet introduite par le statisticien et psychologue Jacob Cohen est l’indice $w$ de Cohen (parfois noté $w_{\text{Cohen}}$). Cet indice mesure la distance globale normalisée entre deux distributions discrètes.
La formule universelle permettant de calculer à la main le $w$ de Cohen à partir de la statistique empirique du khi-deux s’exprime avec une concision mathématique élégante :
$$w = \sqrt{\frac{\chi^2_{\text{calc}}}{N}}$$
Appliquons cette formule canonique à notre cas pratique numérique :
$$w = \sqrt{\frac{9{,}80}{60}}$$
Décomposons les opérations arithmétiques séquentielles :
- Calcul du quotient intérieur :
$$\frac{9{,}80}{60} = \frac{98}{600} = \frac{49}{300} \approx 0{,}163333$$ - Extraction manuelle de la racine carrée :
$$w = \sqrt{0{,}163333} \approx 0{,}4041$$
L’indice $w$ de Cohen s’établit donc approximativement à $w \approx 0{,}40$.
Pour donner du sens à cette grandeur scalaire, nous mobilisons la grille d’interprétation conventionnelle formulée par Jacob Cohen dans son ouvrage de référence Statistical Power Analysis for the Behavioral Sciences :
- Effet de faible amplitude ($w = 0{,}10$) : La divergence entre la distribution empirique et la distribution théorique est ténue, requérant des effectifs volumineux pour être mise en évidence de façon reproductible.
- Effet d’amplitude moyenne ($w = 0{,}30$) : La déviation présente une intensité modérée mais nettement perceptible lors d’investigations standardisées en sciences humaines.
- Effet de forte amplitude ($w ge 0{,}50$) : La rupture avec la distribution théorique est majeure, traduisant une distorsion distributionnelle massive.
Avec un indice calculé de $w = 0{,}404$, notre expérimentation se positionne fermement entre un effet moyen et un grand effet statistique. Cette donnée éclaire notre décision de l’étape précédente : bien que le test d’adéquation n’ait pas atteint le seuil de rejet critique formel ($p = 0{,}081$), la taille d’effet substantielle démontre que la déviation empirique n’est pas insignifiante. Le non-rejet découle principalement de l’effectif modéré ($N = 60$). Dans une perspective de réplication expérimentale, ce résultat inciterait fortement le chercheur à reconduire l’épreuve sur une série plus longue (par exemple $N = 120$ ou $N = 180$) afin de déterminer si cette tendance d’effet moyen à fort se confirme au-delà du seuil de significativité critique.
11.3 Calcul et interprétation du V de Cramer pour variables nominales
Une métrique alternative fréquemment rapportée dans la littérature méthodologique pour quantifier la force de liaison ou la déviation catégorielle est le $V$ de Harald Cramér. Alors que le $V$ de Cramér trouve son domaine d’élection au sein des tables de contingence bidimensionnelles ($r \times c$), il peut également être appliqué aux épreuves d’adéquation unidimensionnelles composées de $k$ modalités mutuellement exclusives.
La formule d’estimation manuelle du $V$ de Cramér s’articule comme suit :
$$V = \sqrt{\frac{\chi^2_{\text{calc}}}{N \times (k – 1)}}$$
Remarquons que le terme $(k – 1)$ situé au dénominateur correspond précisément au nombre de degrés de liberté de la variable d’adéquation. Remplaçons les variables par nos données empiriques calculées :
$$V = \sqrt{\frac{9{,}80}{60 \times (6 – 1)}} = \sqrt{\frac{9{,}80}{60 \times 5}} = \sqrt{\frac{9{,}80}{300}}$$
Exécutons l’arithmétique sous le radical :
- Division :
$$\frac{9{,}80}{300} \approx 0{,}032667$$ - Extraction de la racine carrée :
$$V = \sqrt{0{,}032667} \approx 0{,}1807$$
Le $V$ de Cramér s’établit ainsi à $V \approx 0{,}18$.
La divergence d’échelle entre le $w$ de Cohen ($0{,}40$) et le $V$ de Cramér ($0{,}18$) trouve son explication dans le mode de pondération mathématique intrinsèque : le $V$ de Cramér divise l’énergie totale d’écart par le nombre de degrés de liberté libres de fluctuer dans le système ($k – 1 = 5$), ce qui amortit la statistique lorsque le nombre de catégories croît. Le $V$ de Cramér est strictement borné sur l’intervalle $[0 ,;, 1]$, où 0 indique une conformité théorique absolue et 1 indique une concentration maximale de la totalité de l’échantillon sur une classe théoriquement marginale. Dans le contexte de notre analyse à 6 modalités, une valeur de $0{,}18$ caractérise une association ou une distorsion globale faible à modérée.
12. Bonnes pratiques, erreurs communes et rédaction aux normes APA
12.1 Erreurs méthodologiques et arithmétiques fréquentes lors du calcul à la main
L’exécution manuelle du test de Pearson expose l’analyste à des pièges classiques répertoriés dans les manuels de métrologie et d’analyse des données comportementales. Connaître ces écueils permet de sécuriser la démarche analytique :
- L’omission de la standardisation divisionnaire par $E_i$ : C’est l’erreur computationnelle la plus récurrente lors des calculs à la main. Elle consiste à sommer directement les carrés des résidus bruts $\sum (O_i – E_i)^2$ en omettant de diviser chaque terme par l’effectif attendu $E_i$. Dans notre exemple, cette omission produirait une somme brute de $4 + 4 + 64 + 1 + 9 + 16 = 98$, ce qui conduirait à une conclusion fallacieuse d’une significativité extrême au regard de la table critique.
- L’injection intempestive de fréquences relatives (pourcentages) : Le test du khi-deux repose formellement sur la loi multinomiale discrète appliquée à des comptages entiers bruts. Il est formellement prohibé d’introduire des pourcentages (par exemple 30 % ou 0,30) à la place des effectifs $O_i$ et $E_i$ dans l’équation de sommation. Agir de la sorte fausse l’intégralité du calcul en fixant artificiellement $N = 100$ ou $N = 1$, ce qui détruit la validité de la convergence asymptotique.
- La violation du postulat d’indépendance (données longitudinales ou appariées) : Utiliser le test du khi-deux de Pearson standard pour comparer les réponses pré-test et post-test des mêmes sujets constitue une erreur méthodologique grave. Cette configuration de mesures répétées relève exclusivement du test de McNemar ou des modèles mixtes logistiques à effets aléatoires.
- L’arrondi prématuré des effectifs attendus : Arrondir les effectifs théoriques à des entiers sous prétexte qu’une fréquence humaine ou physique ne peut être fractionnée altère l’équilibre de la somme $\sum E_i = N$ et vicie le calcul des résidus.
12.2 Correction de continuité de Yates : pertinence et application
Dans l’histoire du traitement des données catégorielles discrètes, le statisticien Frank Yates a introduit en 1934 une modification algorithmique connue sous le nom de correction de continuité de Yates. Cette correction vise à compenser l’erreur d’approximation résultant de l’ajustement d’une distribution discrète multinomiale par une loi de probabilité continue du khi-deux. Elle consiste à soustraire systématiquement une demi-unité ($0{,}5$) à la valeur absolue de chaque déviation brute avant de l’élever au carré :
$$\chi^2_{\text{Yates}} = \sum \frac{(|O_i – E_i| – 0{,}5)^2}{E_i}$$
Il est impératif d’énoncer clairement la règle méthodologique régissant son utilisation : la correction de Yates ne s’applique exclusivement qu’aux tables de contingence ou d’adéquation ne possédant qu’un seul et unique degré de liberté ($ddl = 1$), c’est-à-dire les tables $2 \times 2$ ou les épreuves binomiales à deux modalités ($k = 2$). Appliquer la correction de Yates à un test d’adéquation comportant 5 degrés de liberté, comme dans notre cas pratique du dé à six faces, constitue une erreur de spécification théorique majeure. La correction induit dans ce cas un conservatisme excessif qui réduit artificiellement la statistique du khi-deux et détruit la puissance statistique du test.
Pour notre modèle à $ddl = 5$, la fidélité de l’inférence asymptotique est pleinement garantie par le simple respect des critères d’effectifs attendus de Cochran ($E_i ge 5$), rendant superflue toute modification de continuité.
12.3 Protocole de rédaction des résultats selon les normes académiques de l’APA
La communication scientifique des analyses quantitatives est rigoureusement codifiée par les normes de l’American Psychological Association (Publication Manual of the APA, 7e édition). La formalisation canonique d’un test du khi-deux d’adéquation impose une séquence typographique standardisée :
$$\chi^2(ddl, , N = \text{taille totale}) = \text{valeur calculée}, , p = \text{p-valeur}, , \text{taille d’effet}$$
Les règles typographiques et d’arrondi exigent :
- La lettre grecque chi ($\chi$) ou la mention Chi-deux en italique, suivie immédiatement de l’exposant 2.
- L’indication des degrés de liberté ($ddl$) entre parenthèses, accompagnés de la taille totale de l’échantillon ($N$).
- La présentation de la statistique du khi-deux avec deux décimales significatives.
- L’expression de la p-valeur avec trois décimales. Si la probabilité exacte est accessible, elle doit être rapportée fidèlement (par exemple $p = 0{,}081$). Si seuls des calculs manuels sur table sont mobilisés, l’encadrement par rapport au seuil alpha est formulé (par exemple $p > 0{,}05$ ou $0{,}05 < p < 0{,}10$). La p-valeur ne prend jamais de zéro initial en typographie anglophone stricte (.081), mais conserve sa virgule décimale en typographie francophone normalisée ($0{,}081$).
- Le rapport systématique de la taille d’effet standardisée ($w$ de Cohen ou $V$ de Cramér).
Voici le modèle de paragraphe académique synthétique prêt à être intégré dans la section « Résultats » d’une publication scientifique évaluée par les pairs :
« Un test du khi-deux d’adéquation de Pearson a été réalisé afin de déterminer si la distribution des fréquences observées lors de 60 lancers d’un dé à six faces déviait significativement de l’hypothèse théorique d’équiprobabilité ($p_i = 1/6$). Les effectifs théoriques attendus ($E_i = 10$) respectaient scrupuleusement les postulats méthodologiques de Cochran. L’analyse révèle que la distribution empirique ne diffère pas de manière statistiquement significative de la distribution uniforme théorique, $\chi^2(5, , N = 60) = 9{,}80$, $p = 0{,}081$, $w = 0{,}40$. Par conséquent, l’hypothèse nulle d’équité du matériel ne peut être rejetée au seuil conventionnel $\alpha = 0{,}05$. Néanmoins, la mise en évidence d’une taille d’effet substantielle ($w = 0{,}40$) et la concentration de plus de 65 % de la variance d’écart sur la seule face 3 invitent à mener une étude de réplication sur un échantillon plus large afin de prévenir le risque d’erreur de type II lié à la puissance statistique modérée de notre série initiale. »
Références
- Cochran, W. G. (1952). The $\chi^2$ test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cochran, W. G. (1954). Some methods for strengthening the common $\chi^2$ tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Fisher, R. A. (1922). On the interpretation of $\chi^2$ from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Greenwood, P. E., & Nikulin, M. S. (1996). A guide to chi-squared testing. John Wiley & Sons.
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Yates, F. (1934). Contingency tables involving small numbers and the $\chi^2$ test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604