
Dans le domaine de la recherche empirique, la qualité de l’inférence statistique dépend intrinsèquement de la rigueur du dispositif d’échantillonnage mis en place lors de la collecte ou de l’extraction des données. Lorsqu’une population cible présente une hétérogénéité structurelle marquée, l’échantillonnage aléatoire simple s’avère fréquemment sous-optimal : il expose le protocole expérimental à des fluctuations d’échantillonnage asymétriques, accroît l’erreur type de mesure et risque d’omettre des sous-groupes cliniques ou démographiques à faible effectif. Face à ces limites épistémologiques et pratiques, l’échantillonnage stratifié s’impose comme un standard méthodologique garantissant la précision paramétrique et la représentativité distributionnelle.
Le recours à Microsoft Excel pour opérer une stratification probabiliste constitue une démarche courante au sein des laboratoires universitaires, des départements de psychologie cognitive et clinique, ainsi que des instituts de sondage. Loin de se limiter à des fonctionnalités élémentaires de tableur de bureau, Excel intègre un ensemble d’opérateurs mathématiques, d’algorithmes matriciels et de structures de calcul capables d’exécuter des sélections probabilistes d’une grande complexité. Qu’il s’agisse de déployer des fonctions traditionnelles de combinatoire ou d’exploiter les nouveaux moteurs d’évaluation matricielle dynamique (Excel 365), la plateforme offre un environnement d’une souplesse remarquable pour les chercheurs désireux de préserver la traçabilité intégrale de leurs manipulations de données.
Ce guide exhaustif a pour vocation d’exposer, de manière systématique et exhaustive, les fondements théoriques, les justifications psychométriques et l’implémentation pratique pas à pas de l’échantillonnage stratifié sous Microsoft Excel. En associant rigueur mathématique, formules explicites, scripts d’automatisation avancés en Visual Basic for Applications (VBA) et diagnostics de validation empirique (notamment le test d’adéquation du Khi-deux), ce document constitue un manuel de référence destiné aux méthodologues, cliniciens et analystes de données soucieux de concilier exigences scientifiques formelles et faisabilité opérationnelle.
1. 1. Fondements théoriques de l’échantillonnage stratifié dans la recherche empirique
1.1 Définition et principes directeurs de la stratification
L’échantillonnage stratifié se définit sur le plan métrologique comme un protocole d’échantillonnage probabiliste dans lequel une population parente finie, notée $N$, est préalablement partitionnée en sous-ensembles mutuellement exclusifs et collectivement exhaustifs, désignés sous le terme de strates ($H_1, H_2, dots, H_L$). Chaque unité statistique appartenant à la population d’origine doit impérativement être assignée à une et une seule strate, selon un ensemble de critères qualificatifs ou quantitatifs préétablis. L’opération fondamentale repose sur le principe de partitionnement ensembliste : l’intersection de deux strates distinctes est rigoureusement vide, tandis que l’union de l’intégralité des strates reconstitue parfaitement la population parente initiale, garantissant l’absence de redondance comme d’omission systématique.
L’objectif mathématique primaire de ce design expérimental réside dans la maximisation de l’hétérogénéité inter-strates couplée à la minimisation absolue de la variance intra-strate. En isolant des agrégats d’observations présentant une variance interne résiduelle remarquablement faible au regard d’une caractéristique donnée (telle qu’un indice de détresse psychologique ou un palier d’âge chronologique), l’échantillonneur stabilise les estimateurs statistiques fondamentaux. La variance d’échantillonnage globale de l’estimateur de la moyenne se trouve ainsi mécaniquement réduite, éliminant la part de variance attribuable aux disparités systématiques entre strates, ce qui confère une précision analytique supérieure à celle permise par un simple tirage aléatoire non partitionné.
En outre, l’échantillonnage stratifié assure la préservation intangible de la représentativité des sous-populations marginales ou minoritaires au sein du corpus d’investigation. Dans le cadre d’un échantillonnage aléatoire simple appliqué à une population asymétrique, la probabilité théorique de sélectionner un effectif insuffisant au sein d’une sous-population critique s’avère non négligeable. La stratification élimine ce risque stochastique en assignant de manière déterministe ou proportionnelle des quotas d’extraction formels à chaque sous-groupe, pérennisant ainsi la viabilité statistique des analyses secondaires comparatives.
1.2 Applications méthodologiques en psychologie et sciences du comportement
Dans le domaine des sciences psychologiques, cognitives et comportementales, le recours à la stratification constitue un levier indispensable pour contrôler les variables parasites et modératrices susceptibles d’introduire des biais d’interprétation causale. L’âge, l’identification de genre, le statut socio-économique, le niveau de scolarité ou encore la latéralité constituent autant de facteurs de confusion majeurs. Sans une segmentation rigoureuse, la distribution d’une covariable pourrait s’avérer déséquilibrée entre les conditions expérimentales, occultant ou amplifiant artificiellement l’effet du traitement psychothérapeutique ou du paradigme cognitif sous évaluation.
Par ailleurs, la validation psychométrique standardisée et l’étalonnage normatif des instruments diagnostiques (échelles de dépression de Beck, inventaires de personnalité de type NEO-PI, batteries neurocognitives d’évaluation de la mémoire de travail) reposent fondamentalement sur des protocoles stratifiés. L’établissement de tables de conversion normatives en percentiles ou en scores standardisés (scores $T$ ou notes standard) requiert que chaque sous-groupe démographique de référence soit représenté avec une précision métrologique absolue. Un sous-échantillonnage des tranches d’âge gériatriques ou des individus issus de milieux socio-économiques défavorisés compromettrait gravement la validité de construit et l’invariance factorielle de l’instrument de mesure.
Enfin, l’échantillonnage stratifié neutralise efficacement les biais d’autosélection couramment observés au sein des cohortes observationnelles longitudinales. Les individus présentant certaines caractéristiques psychopathologiques ou comportementales particulières affichent fréquemment des taux de consentement et de participation différenciés. La structuration de l’échantillonnage par strates préétablies oblige les investigateurs à recruter et extraire des contingents conformes aux spécifications du plan d’expérience, jugulant ainsi l’attrition sélective et renforçant la validité externe des inférences scientifiques.
1.3 Considérations relatives à la puissance statistique et aux erreurs d’échantillonnage
La puissance statistique d’une investigation expérimentale, définie comme la probabilité théorique ($1 – \beta$) de rejeter à juste titre l’hypothèse nulle ($H_0$) en présence d’un effet réel dans la population, est directement modulée par la variance d’échantillonnage. En éliminant la variabilité entre les strates de l’équation de l’erreur type, l’échantillonnage stratifié contracte l’erreur type de la moyenne estimée $\sigma_{\bar{y}_{st}}$. Par voie de conséquence directe, pour une taille d’échantillon globale $n$ constante, la statistique de test calculée (telle qu’une valeur de $t$ de Student ou de $F$ de Snedecor) voit son dénominateur s’amenuiser, augmentant la sensibilité globale du protocole à détecter des tailles d’effet subtiles.
Le gain d’efficacité relative de l’échantillonnage stratifié comparativement à l’échantillonnage aléatoire simple peut être formalisé par le rapport de leurs variances d’échantillonnage respectives :
$$\text{Gain d’efficacité} = \frac{\mathrm{Var}_{EAS}(\bar{y})}{\mathrm{Var}_{EST}(\bar{y}_{st})}$$
Lorsque les strates sont hautement discriminantes et que les moyennes intra-strates diffèrent substantiellement, ce ratio excède significativement la valeur $1,0$. Cela atteste d’une précision métrologique accrue ou, de manière symétrique, autorise l’investigateur à réduire l’effectif total collecté sans compromettre la marge d’erreur acceptable ou le seuil de significativité alpha ($\alpha = 0,05$).
Ce rétrécissement de la variance d’échantillonnage se répercute de manière immédiate sur le calcul des intervalles de confiance associés aux variables psychométriques cibles. Les bornes supérieure et inférieure de l’intervalle de confiance estimé pour un paramètre moyen $\mu$ sont proportionnelles au produit de la valeur critique de Student ($t_{alpha/2, \nu}$) et de l’erreur type stratifiée. L’échantillonnage stratifié permet d’obtenir des intervalles de confiance sensiblement plus étroits, réduisant l’incertitude épistémique entourant les scores cliniques observés et optimisant le pouvoir explicatif des modèles linéaires subséquents.
2. 2. Typologies d’échantillonnage stratifié : Allocation proportionnelle versus non proportionnelle
2.1 Échantillonnage stratifié proportionnel
L’échantillonnage stratifié proportionnel, fréquemment désigné sous le vocable de stratification représentative ou homothétique, constitue l’approche la plus intuitive et la plus largement mobilisée en épidémiologie et en sociologie quantitative. Dans ce cadre paradigmatique, la fraction d’échantillonnage appliquée à chaque strate individuelle $h$ est strictement constante et identique à la fraction d’échantillonnage globale. Ainsi, le rapport de l’effectif de la strate dans l’échantillon ($n_h$) sur la taille globale de l’échantillon ($n$) est rigoureusement équivalent au rapport de la taille de la strate dans la population ($N_h$) sur la taille totale de la population ($N$) :
$$\frac{n_h}{n} = \frac{N_h}{N} iff n_h = n \cdot \left(\frac{N_h}{N}\right)$$
Cette méthodologie reproduit à l’identique la composition démographique ou nosologique de la population parente au sein du corpus expérimental. Son attrait majeur réside dans sa structure auto-pondérée : la moyenne brute de l’échantillon agrégé constitue un estimateur sans biais de la moyenne de la population, sans qu’il soit nécessaire d’appliquer des coefficients de pondération statistique correctifs complexes lors de l’inférence. La manipulation des données sous des progiciels comme Microsoft Excel ou des environnements de calcul tels que R ou Jamovi s’en trouve grandement simplifiée.
Cependant, l’allocation proportionnelle présente une limitation structurelle rédhibitoire lorsque la population parente abrite des sous-populations hautement asymétriques ou rares. Si une sous-strate d’intérêt clinique majeur ne représente que $1%$ de la population parente globale ($N = 10,000$, soit $N_h = 100$), la sélection proportionnelle d’un échantillon de $n = 300$ individus n’attribuera que $3$ sujets à cette sous-catégorie. Ce micro-effectif résiduel rend toute inférence intra-groupe totalement instable, génère des erreurs types prohibitives et empêche l’estimation de paramètres statistiques fiables pour ce segment particulier.
2.2 Échantillonnage stratifié non proportionnel et optimal (Neyman)
Pour parer à l’effondrement de la puissance statistique au sein des strates marginales, les chercheurs ont recours à l’échantillonnage non proportionnel. Ce schéma opérationnel dissocie délibérément la fraction d’échantillonnage de chaque strate de sa représentativité naturelle dans la population source. L’investigateur applique un sur-échantillonnage systématique aux strates minoritaires afin de leur allouer un effectif suffisant (par exemple, fixer un seuil minimal de $n_h ge 30$ ou $50$ sujets par groupe) pour satisfaire aux prérequis distributionnels des modèles paramétriques linéaires multivariés.
L’allocation optimale formulée par le mathématicien Jerzy Neyman constitue l’aboutissement formel de l’échantillonnage stratifié non proportionnel. L’allocation de Neyman démontre mathématiquement que la variance de l’estimateur de la moyenne globale est minimisée lorsque l’effectif alloué à chaque strate est conjointement proportionnel à la taille de la strate dans la population et à l’écart-type de la variable d’intérêt au sein de cette même strate. La formulation de Neyman s’exprime ainsi :
$$n_h = n \cdot \frac{N_h S_h}{\sum_{k=1}^L N_k S_k}$$
où $S_h$ représente l’écart-type de la variable psychométrique ou clinique cible dans la strate $h$. Ce modèle attribue davantage d’individus aux strates caractérisées par une variabilité interne accrue, compensant ainsi l’hétérogénéité des sous-ensembles instables.
Néanmoins, l’adoption d’un schéma non proportionnel ou optimal rompt la propriété d’auto-pondération des données. Afin d’estimer un paramètre descriptif général de la population parente sans induire un biais de surreprésentation manifeste, le chercheur doit obligatoirement modéliser et appliquer des coefficients de pondération a posteriori ($w_h = N_h / n_h$). Cette exigence algorithmique implique un traitement plus complexe des matrices de données au sein d’Excel.
2.3 Critères de décision pour le protocole expérimental
L’arbitrage méthodologique entre une allocation proportionnelle, un sur-échantillonnage empirique et une allocation optimale de Neyman requiert une évaluation multifactorielle intégrant contraintes logistiques, allocations budgétaires et objectifs métrologiques. Lorsque la finalité épistémologique consiste principalement à estimer une moyenne globale ou une proportion populationnelle globale avec un investissement calculatoire minimal, l’allocation proportionnelle demeure la stratégie de référence, particulièrement sous Excel où les formules de synthèse s’exécutent de façon transparente.
Inversement, lorsque le programme de recherche exige des comparaisons d’hypothèses contrastées entre sous-groupes cliniques (par exemple, contraster des patients présentant un trouble borderline par rapport à une population témoin et un groupe dépressif majeur), l’allocation non proportionnelle s’impose pour doter chaque cellule expérimentale d’une puissance équivalente. Si des données pilotes ou des revues de littérature documentent préalablement des disparités marquées d’écarts-types entre ces sous-groupes, la mise en œuvre du protocole de Neyman sous Excel offre un compromis mathématique optimal pour minimiser la variance d’erreur.
Sur le plan décisionnel, l’investigateur peut mobiliser un arbre logique séquentiel pour paramétrer son tableur : évaluer d’abord la taille relative de chaque sous-groupe ($N_h/N$) ; si l’une des fractions projetées $n_h$ tombe sous le seuil minimum de significativité fixé pour les analyses inférentielles, rejeter l’allocation proportionnelle ; évaluer ensuite la disponibilité des estimations de variance intra-strates $S_h^2$ ; en cas de méconnaissance des variances, appliquer une allocation constante équilibrée ou un sur-échantillonnage calibré ; en cas de variances renseignées et inégales, implémenter l’algorithme d’allocation optimale de Neyman.
3. 3. Préparation et structuration de la matrice de données dans Microsoft Excel
3.1 Normalisation et assainissement des données primaires
L’exécution intègre d’un échantillonnage probabiliste au sein de Microsoft Excel repose impérativement sur la mise en état préalable de la base d’enregistrements. Les cohortes brutes issues de collectes en ligne (Qualtrics, REDCap, Google Forms) ou d’extractions hospitalières contiennent fréquemment des anomalies structurelles : doublons d’inclusion d’origine technique ou comportementale, valeurs aberrantes et cellules non renseignées. Avant toute manipulation probabiliste, le chercheur doit expurger les redondances en utilisant l’outil natif de suppression des doublons d’Excel, localisé dans l’onglet Données > Outils de données > Supprimer les doublons.
Le traitement des données manquantes exige une rigueur méthodologique sans faille. Si les attributs servant de variables de stratification contiennent des valeurs nulles ou manquantes, les algorithmes de filtrage conditionnel échoueront à affecter ces sujets à des strates exhaustives, générant une population résiduelle non répertoriée. Il convient donc de procéder à une imputation contrôlée selon les recommandations de l’American Psychological Association ou, à défaut, à une exclusion par liste (listwise deletion) documentée dans le journal d’audit de la recherche.
Parallèlement, une standardisation syntaxique s’impose pour l’ensemble des variables qualitatives. Les discordances typographiques (par exemple, la coexistence des entrées « Femme », « femme », « F » ou des erreurs d’espaces insécables en fin de chaîne) induisent des fractionnements erronés au sein des fonctions de partitionnement d’Excel. L’emploi conjoint des fonctions textuelles =SUPPRESPACE() et =NOMPROPRE() ou la conversion directe via Power Query permet de garantir une typologie lexicale unifiée.
3.2 Organisation tabulaire et typage des colonnes
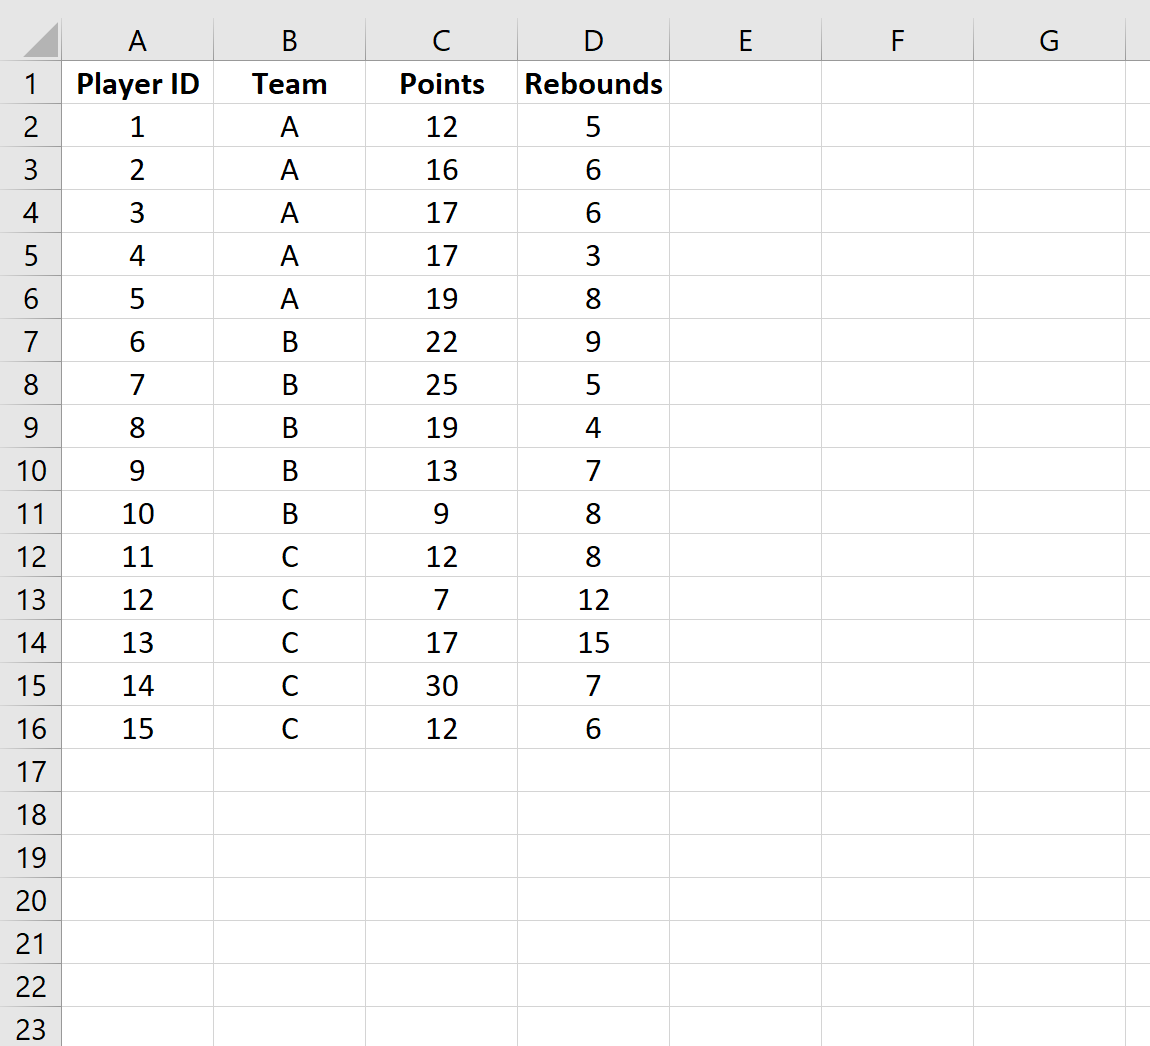
L’architecture matricielle du jeu de données doit respecter scrupuleusement la structure dite « tidy data » : chaque ligne correspond de manière invariable à une unité statistique unique (un participant, une observation), et chaque colonne incarne un attribut ou une variable d’intérêt spécifique. La première colonne de la feuille de calcul doit obligatoirement être réservée à un identifiant numérique pérenne (par exemple, ID_Participant), débutant de 1 à $N$ ou structuré selon un code alphanumérique unique. Cet identifiant inviolable permet de garantir la traçabilité absolue des individus retenus tout au long des opérations ultérieures de réorganisation et de tri.
Les colonnes subséquentes doivent accueillir les variables primaires et secondaires définissant les critères d’appartenance aux strates, suivies des variables de mesure cliniques ou psychométriques associées. Il est vivement préconisé d’attribuer des en-têtes explicites, dépourvus d’accents complexes, de caractères spéciaux ou d’espaces typographiques, tels que Tranche_Age, Severite_Trouble ou Score_Anxiete, afin de faciliter la composition des expressions algorithmiques.
Enfin, la conversion de la plage cellulaire brute en Tableau Excel structuré (accessible via le raccourci Ctrl + L ou le ruban Accueil > Mettre sous forme de tableau) constitue une étape méthodologique fondamentale. Les tableaux structurés offrent une propagation dynamique automatique des formules vers le bas, un adressage structuré explicite (par exemple, Tableau1[Nombre_Aleatoire]) et garantissent que les extensions de données ultérieures intègrent immédiatement les règles logiques du protocole sans recalibrage manuel des plages de calcul.
3.3 Contrôle d’intégrité préalable aux manipulations algorithmiques
Avant d’engager le protocole d’extraction stochastique, une série de contrôles d’intégrité mathématique et informatique s’avère indispensable pour auditer la matrice de données. L’application d’outils de Validation des données (menu Données > Outils de données > Validation des données) sur les colonnes de stratification permet de verrouiller les saisies en limitant les valeurs possibles à une liste prédéfinie de catégories autorisées, interdisant ainsi toute altération accidentelle lors de la manipulation du fichier.
La cartographie de la structure de l’échantillon source s’effectue au moyen de fonctions de comptage conditionnel. La fonction matricielle :
=NB.SI(Tableau1[Strate]; "Nom_De_Strate")
permet de recenser formellement l’effectif brut $N_h$ de chaque strate présente dans la base. La somme de ces dénombrements, vérifiée par la formule =SOMME(...), doit coïncider rigoureusement avec le décompte global généré par la fonction =NBVAL(Tableau1[ID_Participant]). Tout écart numérique met en lumière l’existence de données orphelines, de cellules invisibles polluées par des espaces ou d’erreurs d’encodage qu’il est impératif d’assainir.
Il est préconisé de concevoir un tableau de bord analytique au sein d’un onglet annexe, documentant les effectifs nominaux, les fréquences relatives observées ainsi que les métadonnées de l’extraction (date, heure, version du logiciel, identité du chercheur). Cette démarche d’assurance qualité s’inscrit au cœur des exigences contemporaines de science ouverte et de reproductibilité computationnelle.
4. 4. Étape 1 : Saisie des données et codification des variables de stratification
4.1 Opérationnalisation des critères catégoriels
L’opérationnalisation des variables de stratification requiert la transformation des caractéristiques empiriques en catégories exclusives dotées de frontières numériques précises. Lorsque la variable de stratification est intrinsèquement quantitative continue (comme l’âge chronologique des participants ou un score continu d’anxiété générale issu du GAD-7), il est impératif d’établir des seuils de découpage (cut-off scores) validés scientifiquement dans la littérature spécialisée plutôt que d’opter pour une segmentation arbitraire.
Pour convertir une variable continue en classes catégorielles sous Excel, l’utilisation de la fonction =SI() imbriquée ou, de préférence sur les versions modernes du tableur, de la fonction =SI.CONDITIONS() s’avère la plus robuste. Considérons une colonne Score_GAD7 située en colonne C, que l’on désire discrétiser en trois classes nosologiques cliniquement validées (Léger : 0-4, Modéré : 5-14, Sévère : 15-21) :
=SI.CONDITIONS(C2<5; "1_Leger"; C2<15; "2_Modere"; C2>=15; "3_Severe")
L’attribution de préfixes numériques (ex. « 1_ », « 2_ ») au sein des libellés de texte stabilise l’ordre de tri lexicographique ultérieur au sein des modules de données du tableur, évitant les altérations d’ordonnancement par ordre alphabétique non pertinent.
Dans le cas de critères catégoriels natifs polytomiques (comme le statut d’emploi ou la catégorie socio-professionnelle), un codage numérique formel de type entier ($1, 2, 3, dots, k$) ou un libellé standardisé sans ambiguïté garantit que chaque observation est sans équivoque orientée vers sa catégorie d’ancrage probabiliste.
4.2 Génération de variables composites pour les stratifications multidimensionnelles
Dans les protocoles de recherche avancés, il est fréquent de devoir stratifier l’échantillon sur plusieurs dimensions simultanées afin de contrôler les interactions factorielles croisées. À titre d’illustration, un protocole peut requérir la stratification concomitante selon le Sexe (2 modalités : Homme, Femme) et la Tranche_Age (3 modalités : Jeune, Adulte, Senior), ce qui engendre un tableau factoriel orthogonal à $2 \times 3 = 6$ strates distinctes.
Pour operationaliser cette structure matricielle composite au sein d’Excel, l’analyste crée une nouvelle colonne d’indexation intitulée Strate_Composite. La synthèse des critères s’opère par concaténation syntaxique à l’aide de l’opérateur esperluette (&) ou de la fonction dédiée =CONCAT() :
=[@[Sexe]] & "_" & [@[Tranche_Age]]
Cette expression produit des étiquettes composites explicites telles que Femme_Adulte, Homme_Jeune ou Femme_Senior.
La validation de cette étape requiert de vérifier l’absence totale de chaînes incomplètes ou de cellules orphelines pouvant survenir si l’une des colonnes sources comporte un élément vide. L’insertion temporaire d’un filtre conditionnel affichant les cellules de la colonne composite contenant la chaîne de caractères « _ » isolée permet de purger instantanément les discordances d’assignation avant l’exécution du calcul des quotas.
4.3 Détermination des quotas cibles par strate
La détermination des quotas numériques à extraire s’effectue dans un tableau récapitulatif auxiliaire structuré sur une feuille distincte du classeur. Ce tableau liste de façon exhaustive l’ensemble des strates ($H_1$ à $H_L$) identifiées dans la population mère. Pour chaque strate, l’effectif global observé $N_h$ est décompté automatiquement par la formule =NB.SI(Tableau1[Strate_Composite]; A2), où A2 représente le descripteur de la strate considérée.
Pour un échantillonnage stratifié proportionnel visant une taille d’échantillon finale agrégée $n$, la taille théorique allouée $n_h$ est calculée par la formule mathématique :
=n_cible * (B2 / N_total)
où B2 correspond à $N_h$, N_total à l’effectif total de la population mère $N$, et n_cible à l’effectif total d’échantillon défini a priori par les analyses de puissance statistique (par exemple, calculées sous le logiciel G*Power).
Cette division produit quasi systématiquement des valeurs décimales, ce qui soulève le problème de l’impossibilité d’échantillonner des fractions d’individus. L’application aveugle de la fonction =ARRONDI() d’Excel induit fréquemment un paradoxe d’arrondi dans lequel la somme des quotas calculés $\sum n_h$ s’avère supérieure ou inférieure d’une ou deux unités à la cible globale $n$. Il convient d’appliquer la méthode formelle du plus fort reste (méthode de Hare-Niemeyer) ou d’ajuster l’arrondi sur la strate affichant le plus grand écart de troncature pour garantir que la taille d’échantillon demeure strictement et rigoureusement égale à $n$.
5. 5. Étape 2 : Génération de valeurs pseudo-aléatoires continues via la fonction ALEA()
5.1 Implémentation et fonctionnement mathématique de la fonction =ALEA()
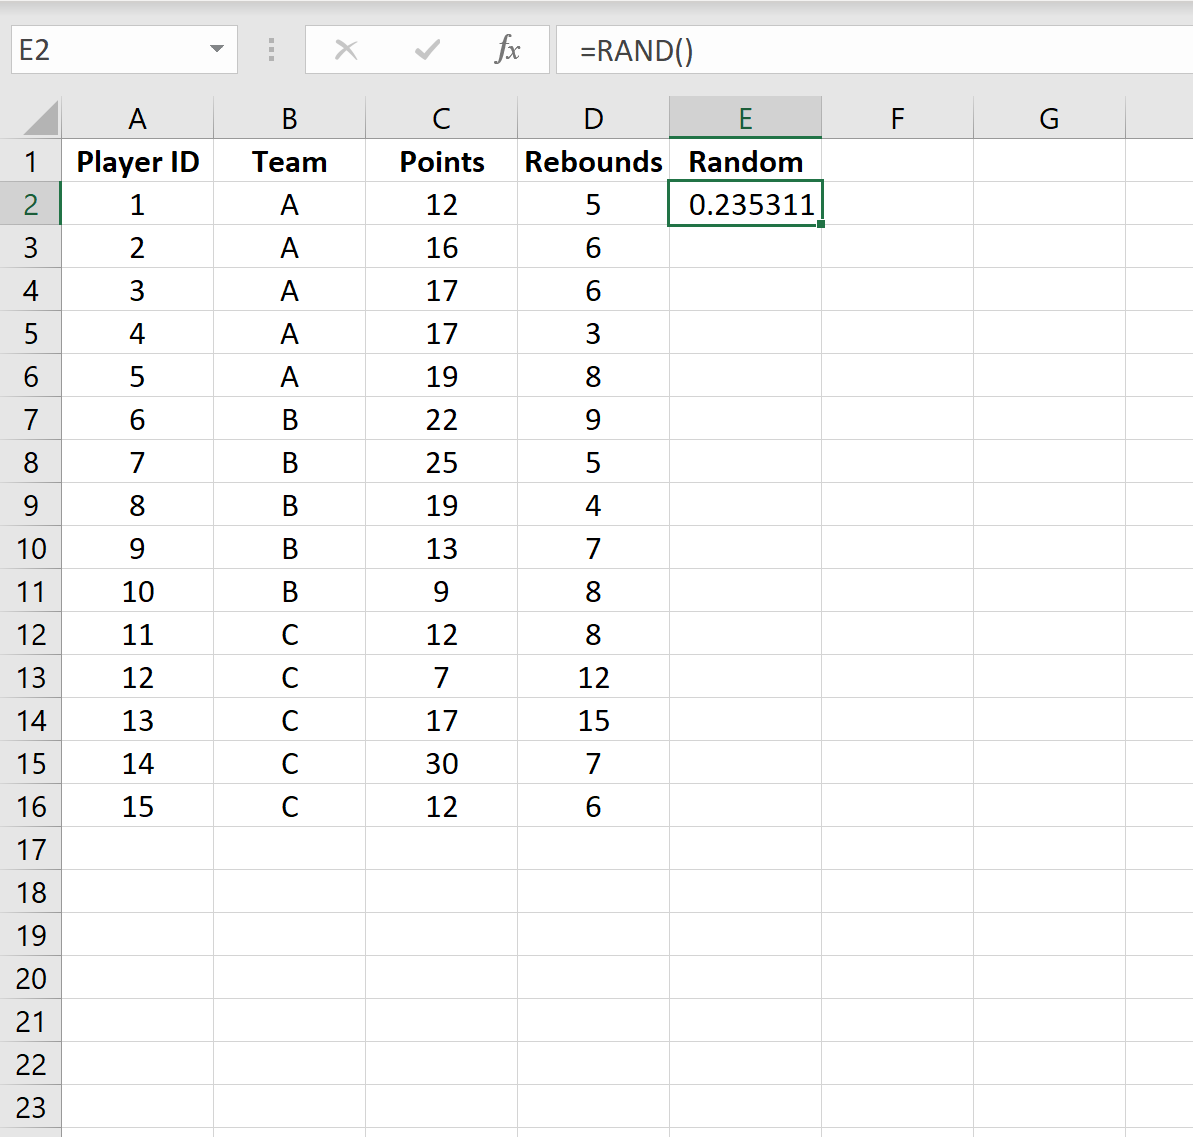
L’attribution probabiliste de chances équitables d’extraction pour chaque sujet au sein de sa strate repose sur la génération d’un vecteur de valeurs stochastiques d’une résolution numérique suffisante. Pour concrétiser cette exigence algorithmique, l’utilisateur insère une nouvelle colonne immédiatement adjacente aux attributs descriptifs du tableau structuré, colonne conventionnellement nommée Nombre_Aleatoire.
Dans la première cellule de données de cette colonne, la fonction suivante est saisie :
=ALEA()
Sur le plan computationnel, l’algorithme sous-jacent à la fonction =ALEA() dans les versions contemporaines de Microsoft Excel repose sur l’algorithme de Mersenne Twister (MT19937), qui génère des nombres pseudo-aléatoires distribués de façon uniforme sur le continuum réel $[0, 1[$. Sa période d’une longueur phénoménale de $2^{19937} – 1$ itérations garantit l’absence totale de récurrence cyclique lors du traitement de corpus scientifiques, même volumineux.
Grâce aux propriétés dynamiques des tableaux structurés d’Excel, la formule est automatiquement projetée sur l’intégralité des $N$ observations composant la population source. Chaque participant se voit ainsi assigner une coordonnée probabiliste continue unique calculée avec une précision en virgule flottante double précision pouvant atteindre 15 décimales significatives, assurant un étalement uniforme des rangs au sein du jeu de données.
5.2 La problématique de la volatilité dynamique d’Excel
Un écueil méthodologique récurrent et préjudiciable réside dans la nature intrinsèquement « volatile » de la fonction =ALEA() sous Microsoft Excel. Par définition, une fonction volatile est réévaluée par le moteur de calcul à chaque fois que la moindre opération intervient dans le classeur : saisie d’un nouveau caractère dans une cellule tierce, suppression d’une ligne, recalcul automatique ou simple enregistrement du fichier via le menu standard.
Dans le contexte de la recherche scientifique, cette volatilité computationnelle constitue une faille majeure de reproductibilité. Si les valeurs aléatoires mutent de manière continue au gré des interactions avec le tableur, la composition exacte de l’échantillon extrait subira une altération stochastique permanente, changeant à chaque manipulation. Une telle instabilité interdit formellement tout audit méthodologique externe et contrevient aux principes cardinaux de traçabilité des données empiriques.
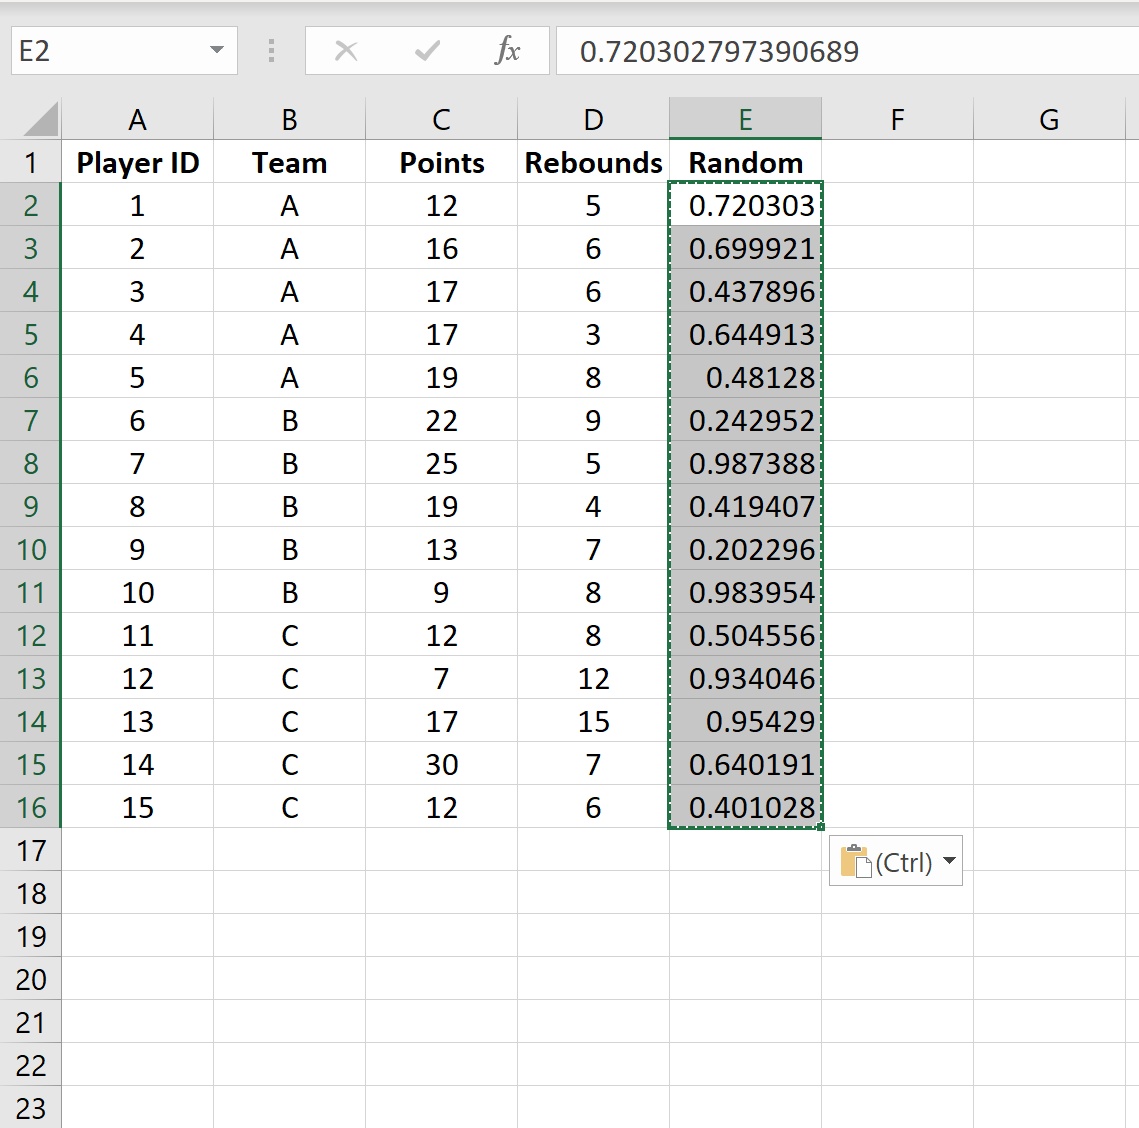
Il est donc scientifiquement impératif d’interrompre le mécanisme de recalcul dynamique et de pérenniser les valeurs pseudo-aléatoires générées à un instant $t_0$, les convertissant de variables stochastiques en constantes numériques immuables au sein de la matrice.
5.3 Figeage des coefficients aléatoires par injection de valeurs statiques
Pour figer définitivement les réalisations aléatoires générées, l’analyste procède à une injection statique par écrasement contrôlé. La séquence opérationnelle est rigoureusement définie sous Excel :
- Sélectionner l’intégralité des données de la colonne
Nombre_Aleatoire, par exemple en cliquant sur la première cellule de données puis en exécutant la combinaison de touchesCtrl + Maj + Flèche Bas. - Copier l’ensemble des données sélectionnées en mémoire vive par la commande standard
Ctrl + C(ou clic droit > Copier). - Sans déplacer la sélection active, procéder à un collage spécial en ouvrant le menu dédié via
Ctrl + Alt + V(ou clic droit > options de collage) et sélectionner expressément l’option Valeurs (raccourci toucheVdans la boîte de dialogue standard). - Valider l’opération en cliquant sur OK.
Une inspection visuelle immédiate de la barre de formule doit attester de la substitution fonctionnelle : la mention =ALEA() s’efface pour laisser place à des valeurs numériques réelles et immuables (ex. 0,783941029348123). Le vecteur probabiliste est désormais pérennisé, autorisant l’exécution reproductible des étapes de partitionnement hiérarchique et de sélection d’échantillon.
6. 6. Étape 3 : Tri hiérarchique et structuration multicritère des enregistrements
6.1 Configuration du moteur de tri avancé d’Excel
Une fois les valeurs pseudo-aléatoires transformées en scalaires statiques, la phase suivante consiste à réorganiser l’ensemble des enregistrements de la population mère. Cette opération vise à grouper physiquement toutes les observations rattachées à une même strate, tout en induisant un désordonnancement stochastique à l’intérieur exclusif de chacune de ces strates.
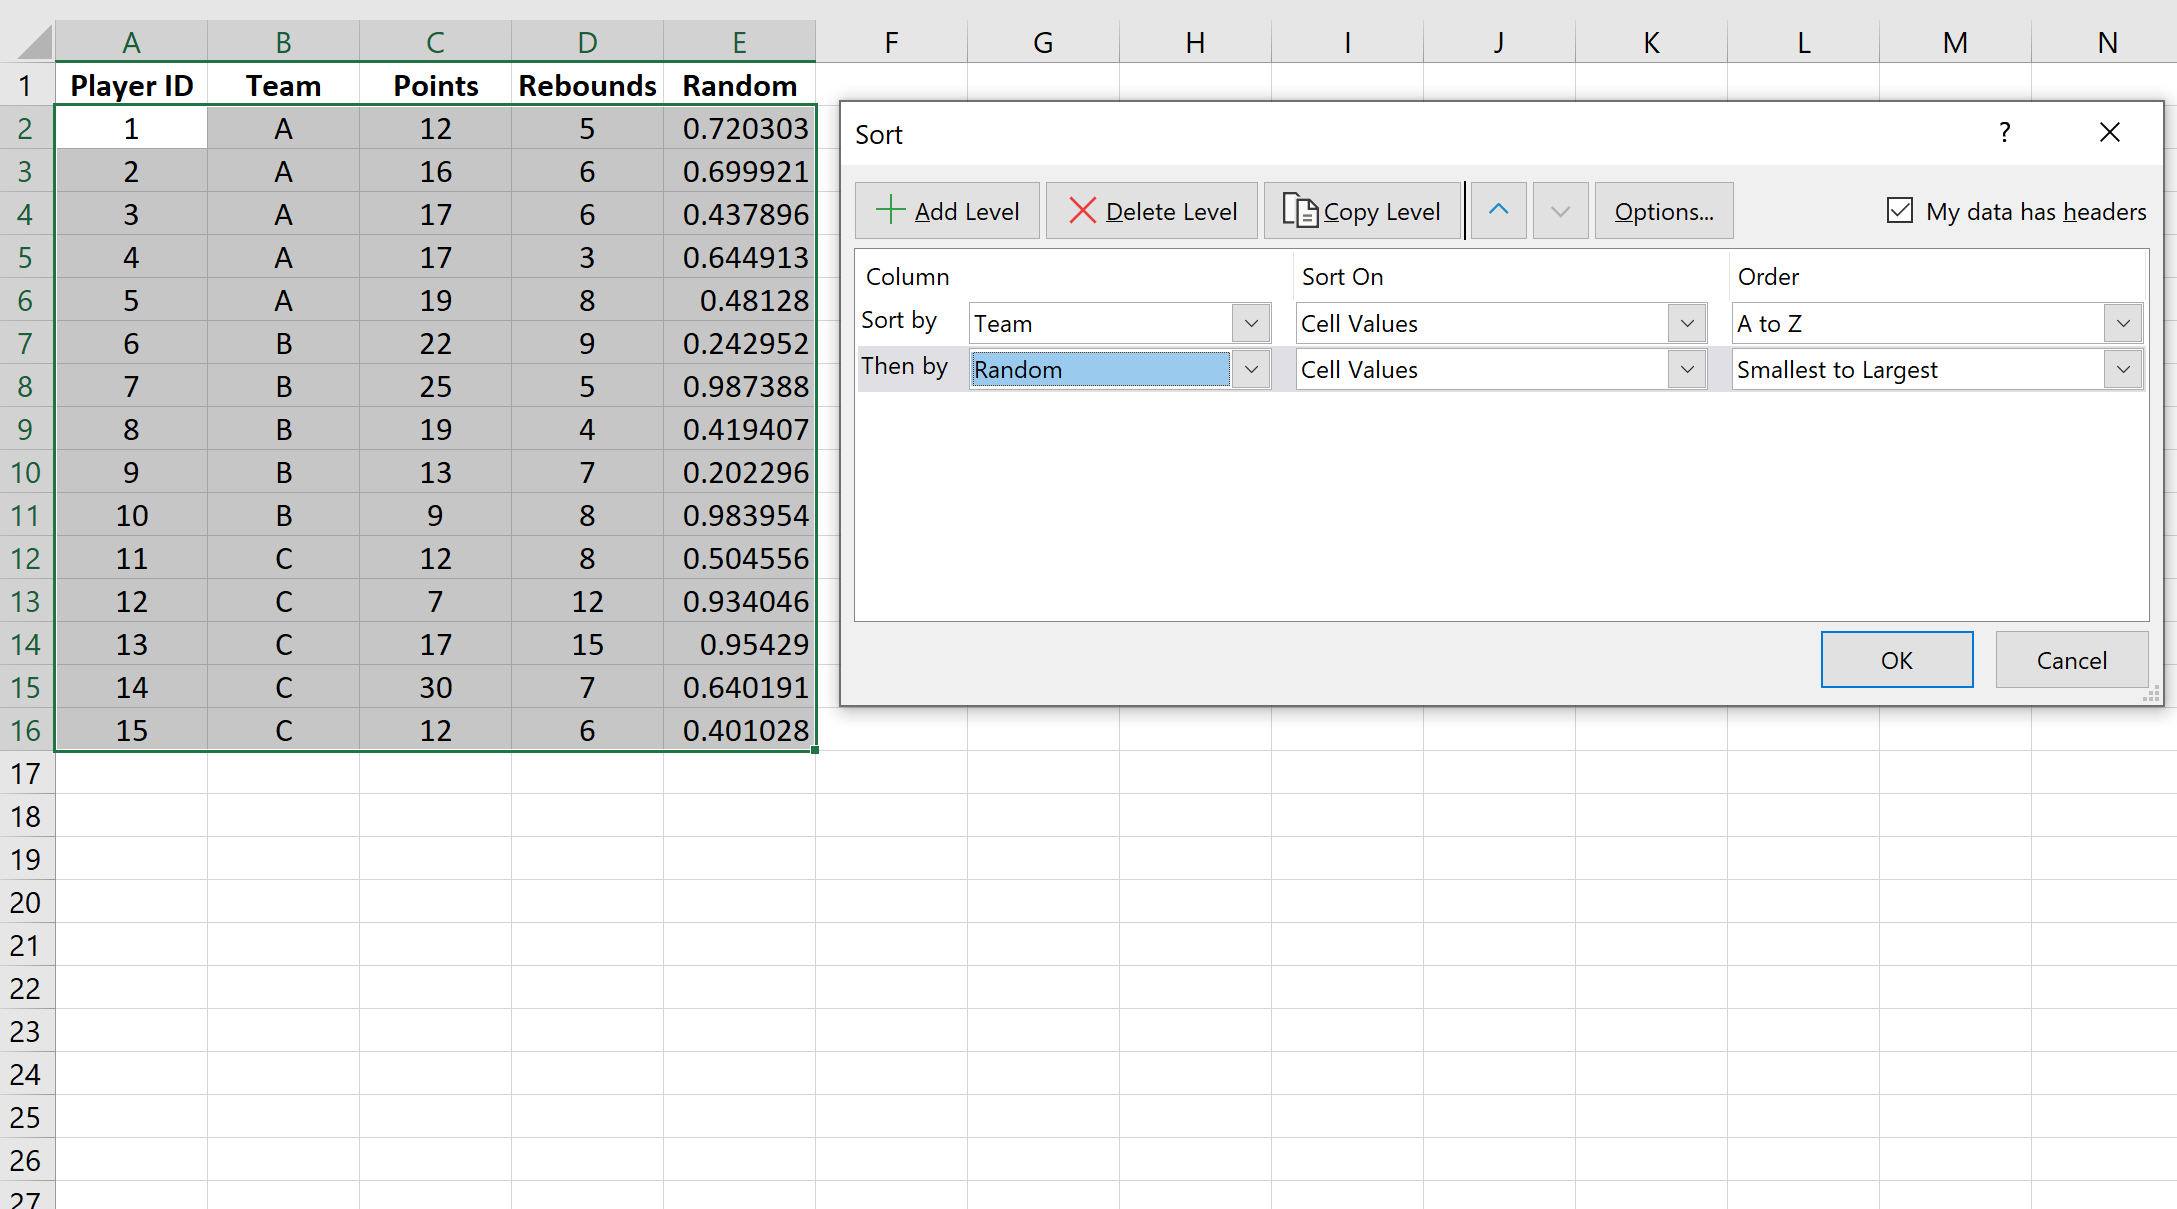
Pour activer le moteur de tri sophistiqué d’Excel, l’utilisateur positionne le curseur dans l’une des cellules du tableau structuré, puis navigue vers le ruban supérieur et sélectionne l’onglet Données > section Trier et filtrer > bouton Trier. L’interface contextuelle de configuration du Tri personnalisé apparaît à l’écran.
Il est crucial de s’assurer de l’activation permanente de la case à cocher Mes données ont des en-têtes située en haut à droite de la fenêtre modale. L’omission de cette coche provoquerait l’incorporation de la ligne d’en-tête nominative dans l’algorithme de tri comme s’il s’agissait d’un sujet clinique, détruisant l’organisation syntaxique de la matrice de données et générant des erreurs de typage irréversibles.
6.2 Établissement de la hiérarchie de tri opérationnelle
Le paramétrage du tri multicritère doit refléter avec précision la logique d’extraction stratifiée. Dans la boîte de dialogue de tri personnalisé, le chercheur modélise un ordonnancement séquentiel hiérarchique à deux niveaux décisionnels :
- Clé de tri primaire (Niveau 1) : Dans le premier menu déroulant Colonne (désigné par « Trier par »), sélectionner le descripteur catégoriel principal ou composite, à savoir la variable
Strate(ouStrate_Composite). Dans les options associées, laisser la modalité par défaut Trier sur : Valeurs de cellule et sélectionner l’ordre de tri de votre choix (par exemple, De A à Z). Cette instruction a pour conséquence de regrouper physiquement en blocs contigus d’enregistrements l’ensemble des observations appartenant à une même strate structurelle. - Clé de tri secondaire (Niveau 2) : Cliquer impérativement sur le bouton Ajouter un niveau situé en haut à gauche de la boîte de dialogue de tri. Dans la seconde ligne d’instruction qui apparaît (« Puis par »), sélectionner expressément la variable
Nombre_Aleatoire. Configurer le tri sur Valeurs de cellule, et déterminer un ordonnancement (par exemple, Du plus petit au plus grand).
Lorsque le chercheur valide cette configuration multicritère en cliquant sur OK, l’algorithme d’Excel exécute le tri de manière combinée : la population mère est partitionnée en blocs de strates distincts, et à l’intérieur de chaque bloc de strate, les participants sont ordonnés rigoureusement selon leur score aléatoire. L’indépendance de ces tirages assure que l’ordre des participants au sein de chaque strate ne dépend plus d’aucun facteur déterministe ou chronologique.
6.3 Contrôle visuel et vérification de la dispersion
Dès l’achèvement de l’opération de tri hiérarchique, un contrôle méthodologique visuel et analytique s’avère indispensable avant de procéder à l’extraction définitive. L’analyste doit parcourir la colonne de strate pour observer la transition physique nette entre les différents blocs de catégories, garantissant que les sujets partageant la même modalité sont rassemblés sans dispersion intempestive à travers le classeur.
Parallèlement, une inspection de la colonne Nombre_Aleatoire permet de vérifier la croissance monotone des valeurs décimales au sein de chaque groupe de strate identifié : le score aléatoire doit repartir de sa valeur minimale au début d’une nouvelle strate pour croître progressivement jusqu’au bas du bloc considéré. Il convient de vérifier qu’aucune corrélation visible n’apparaît entre le vecteur initial ID_Participant et l’ordonnancement stochastique nouvellement attribué, ce qui validerait l’absence de rémanence déterministe.
À ce stade opérationnel, il est recommandé d’enregistrer une copie de sauvegarde spécifique de la feuille de calcul (par exemple sous la dénomination Matrice_PostTri_Sauvegarde.xlsx). Cette mesure de prudence prémunit la recherche contre d’éventuelles corruptions logiques lors des manipulations de filtrage ultérieures et formalise un jalon d’audit vérifiable pour les comités d’éthique et les évaluateurs pairs.
7. 7. Étape 4 : Extraction probabiliste des sujets et implémentation du rang intra-strate
7.1 Indexation séquentielle à l’aide de la fonction NB.SI
Les observations étant désormais ordonnées aléatoirement au sein de chaque strate contiguë, il convient d’assigner à chaque enregistrement un numéro d’ordre séquentiel intra-groupe, allant de $1$ à $N_h$. Ce rang d’extraction permettra d’isoler mécaniquement les $n_h$ premiers individus répondant aux quotas établis.
L’implémentation la plus élégante et performante sous Excel repose sur l’usage d’un compteur dynamique conditionnel mobilisant la fonction =NB.SI() structurée selon une plage semi-bloquée (ou plage expansive). Pour ce faire, une nouvelle colonne intitulée Rang_Intra_Strate est ajoutée en colonne contiguë. En admettant que la colonne de strate soit la colonne B et que les enregistrements de données débutent à la ligne 2, la syntaxe suivante est insérée dans la cellule :
=NB.SI($B$2:B2; B2)
Le mécanisme sous-jacent repose sur l’alternance d’un adressage absolu pour l’origine de la plage ($B$2) et d’un adressage relatif pour la borne d’évaluation supérieure (B2). Lorsque cette formule est étirée ou propagée vers le bas le long des $N$ observations :
- À la première apparition d’une étiquette de strate (ex.
1_Leger), la plage évaluée ne contient qu’une seule occurrence de cette valeur, renvoyant l’entier1. - À la seconde occurrence de cette même étiquette, la formule devient
=NB.SI($B$2:B3; B3), dénombrant deux occurrences et renvoyant ainsi la valeur2. - Dès lors que le tri a regroupé les strates en blocs distincts, le passage à une nouvelle catégorie (ex.
2_Modereà la ligne 150) réinitialise mécaniquement le comptage : la formule=NB.SI($B$2:B150; B150)ne relève pour la première fois que la modalité2_Modere, retournant la valeur1pour le premier sujet de ce nouveau bloc.
7.2 Filtrage et isolement de l’échantillon final
L’extraction finale des participants s’opère par l’application conjointe des quotas cibles déterminés lors de l’Étape 1 et des rangs séquentiels générés par le compteur dynamique. Si l’allocation adoptée attribue une taille identique à chaque strate (par exemple $n_h = 40$), la procédure de filtrage est immédiate : il suffit d’activer les filtres automatiques sur le tableau (raccourci Ctrl + Maj + L), de cliquer sur la flèche de déroulement de la colonne Rang_Intra_Strate, de sélectionner Filtres numériques > Inférieur ou égal à… et d’entrer la valeur 40.
Dans l’hypothèse fréquente où les quotas $n_h$ diffèrent d’une strate à l’autre (allocation proportionnelle ou allocation de Neyman), une étape d’appariement logique intermédiaire s’impose. Une colonne Quota_Requis est adjointe au tableau de données, utilisant la fonction =RECHERCHEV() ou =RECHERCHEX() pour rapatrier dynamiquement l’effectif cible $n_h$ consigné dans le tableau récapitulatif des quotas. Une colonne booléenne de décision d’inclusion, intitulée Selectionne, est alors formulée comme suit :
=[@[Rang_Intra_Strate]] <= [@[Quota_Requis]]
L’analyste n’a plus qu’à appliquer le filtre automatique sur la colonne Selectionne en ne retenant que la valeur logique VRAI. L’intégralité des sujets de l’échantillon stratifié cible apparaît alors isolée sur la feuille. Il ne reste plus qu’à copier ce contingent filtré et à le coller sur un nouvel onglet de calcul dédié, baptisé Echantillon_Final_Analyse, servant de substrat propre pour les investigations inférentielles subséquentes.
7.3 Alternative dynamique sans tri physique préalable : RANG.CORRÉLÉ et matricielles
Certains protocoles de recherche institutionnels ou d’essais cliniques interdisent formellement toute modification de l’ordonnancement physique natif de la base d’enregistrements principale, afin de préserver l’intégrité de la traçabilité informatique d’origine. Il est tout à fait envisageable de calculer un rang intra-strate sans altérer l’ordre initial des lignes, en recourant à des formules matricielles avancées.
Sous les versions traditionnelles d’Excel, l’assignation d’un rang aléatoire intra-groupe sur données non triées peut s’exécuter au moyen d’une formule matricielle combinant la fonction =SOMMEPROD(). Pour une observation située à la ligne 2, avec la strate en colonne B et le nombre aléatoire statique en colonne C :
=SOMMEPROD(($B$2:$B$N = B2) * ($C$2:$C$N <= C2))
Cette expression matricielle évalue simultanément deux conditions booléennes à travers l’ensemble des $N$ observations : vérifier que l’élément comparé appartient à la même strate que le sujet courant, et évaluer si son score aléatoire est inférieur ou égal à celui du sujet. La somme de ces produits logiques renvoie le rang stochastique du participant au sein de sa strate, tout en conservant l’ordre chronologique natif de la base de données. L’analyste conserve ainsi une flexibilité métrologique totale sans rompre l’ordonnancement d’origine du fichier source.
8. 8. Méthodes modernes et dynamiques sous Excel 365 : Fonctions FILTRE, TRIERPAR et CHOISIRLIGNES
8.1 Génération d’échantillons dynamiques via TRIERPAR et ALEA.ENTRE.BORNES
L’introduction du moteur de calcul matriciel dynamique au sein de Microsoft 365 et Excel 2021 a révolutionné les démarches d’échantillonnage algorithmique, rendant obsolètes les interventions manuelles de tri physique et de collage spécial. Il est désormais possible de générer des sélections probabilistes pures par l’agrégation de formules matricielles réactives s’étendant automatiquement en cascade (spill ranges).
Pour réordonner stochastiquement une matrice de données brute sans toucher aux cellules sources, la fonction moderne =TRIERPAR() déploie une puissance calculatoire remarquable. Considérons une plage de données brutes A2:D2401, où les données d’identification et de covariables sont consolidées. L’extraction d’un ordonnancement stochastique dynamique s’opère au moyen de la formule suivante :
=TRIERPAR(A2:D2401; ALEA.ENTRE.BORNES(1; 1000000 + LIGNE(A2:D2401)*0))
Dans cette architecture matricielle sophistiquée, la fonction génératrice produit un vecteur éphémère de nombres aléatoires de dimension rigoureusement identique au tableau d’origine. L’algorithme TRIERPAR réorganise les données sources selon ce vecteur aléatoire sans que celui-ci n’ait besoin d’être matérialisé sous la forme d’une colonne physique dans la feuille de calcul. Toutefois, dans la mesure où le recalcul dynamique reste actif sous cette modalité directe, son usage est préconisé pour l’exploration interactive de données ou au sein de classeurs programmés pour figer la graine après génération.
8.2 Extraction automatisée par strate avec la fonction =FILTRE()
L’extraction sélective d’une strate spécifique, combinée à l’isolement strict de ses $n_h$ premières observations, s’exécute avec une fluidité exceptionnelle sous Excel 365 en emboîtant les fonctions =FILTRE() et =CHOISIRLIGNES(). Cette approche élimine totalement la nécessité d’élaborer des filtres manuels ou de structurer des compteurs par NB.SI expansif.
Supposons que nous souhaitions extraire automatiquement un sous-échantillon de $n_h = 30$ individus appartenant à la strate "1_Leger" à partir du tableau d’origine nommé TableauPrincipal, lequel comporte une colonne structurée [Strate]. La syntaxe unifiée s’articule comme suit :
=CHOISIRLIGNES(FILTRE(TableauPrincipal; TableauPrincipal[Strate]="1_Leger"); SEQUENCE(30))
Le déroulé algorithmique de cette expression s’analyse ainsi :
- La fonction interne
=FILTRE()isole instantanément l’ensemble des enregistrements de la population source dont le descripteur d’inclusion correspond au prédicat logique imposé ("1_Leger"). - La fonction
SEQUENCE(30)génère un vecteur matriciel unidimensionnel vertical constitué des entiers d’indexation de $1$ à $30$. - La fonction enveloppante
=CHOISIRLIGNES()prend comme matrice source le flux filtré et extrait strictement les 30 premières lignes correspondantes, propageant instantanément les sujets retenus dans la feuille de destination.
Cette méthodologie d’extraction déclarative présente l’immense avantage de l’étanchéité : les données sources restent intactes et la sélection s’actualise de manière déterministe si des paramètres d’inclusion changent.
8.3 Création d’un tableau d’échantillonnage paramétrique auto-ajustable
En poussant la logique fonctionnelle moderne d’Excel 365 à son plein potentiel, l’analyste peut concevoir un tableau de bord d’échantillonnage entièrement paramétrique. L’intérêt méthodologique réside dans la capacité à ajuster dynamiquement les tailles d’échantillons ou les critères d’allocation depuis une interface de contrôle, le tableur actualisant en temps réel les contingents extraits.
À cet effet, on configure une table de paramétrage listant les strates en colonne A, et les quotas cibles requis $n_h$ en colonne B (cellules B2:B5). Dans la cellule de sortie où doit s’afficher l’échantillon global agrégé, on peut employer la fonction =REDUCE() combinée à des lambdas pour empiler itérativement les sous-échantillons de chaque strate au moyen de =VSTACK() (ou =ASSEMB.V() en version française) :
=ASSEMB.V(CHOISIRLIGNES(FILTRE(TableauPrincipal; TableauPrincipal[Strate]=A2); SEQUENCE(B2)); CHOISIRLIGNES(FILTRE(TableauPrincipal; TableauPrincipal[Strate]=A3); SEQUENCE(B3)))
Pour les infrastructures de recherche récurrentes (telles que le suivi longitudinal de cohortes ou les enquêtes barométriques mensuelles), ce dispositif paramétrique assure un gain d’efficience remarquable. L’investigateur se contente de coller la nouvelle matrice de population globale dans l’onglet source ; la feuille de calcul génère instantanément l’échantillon stratifié final consolidé sans qu’aucune manipulation technique de tri, de collage de valeurs ou de filtrage de ligne ne soit requise.
9. 9. Automatisation du protocole d’échantillonnage stratifié par macro Visual Basic (VBA)
9.1 Architecture et logique algorithmique du script d’échantillonnage
Lorsque les volumes de données excèdent plusieurs dizaines de milliers d’enregistrements, ou dans les environnements institutionnels exigeant une automatisation absolue et auditée du processus d’extraction, le développement d’une macrocommande en Visual Basic for Applications (VBA) représente la solution industrielle la plus performante. L’environnement VBA permet d’exécuter la sélection d’échantillon directement au sein de la mémoire vive de l’ordinateur, évitant les ralentissements liés au rafraîchissement continu de l’interface graphique d’Excel.
L’architecture algorithmique d’un script d’échantillonnage stratifié professionnel s’articule autour de trois modules fondamentaux :
- Le module de lecture et d’indexation : Ce composant ingère les données brutes de la feuille de calcul et cartographie l’ensemble des strates uniques représentées au moyen d’un objet dictionnaire d’adresses (
Scripting.Dictionary), garantissant une complexité temporelle d’accès en $O(1)$. - Le moteur de permutation stochastique : Pour chaque strate identifiée, le script stocke les indices de lignes des participants associés dans des tableaux dynamiques indexés en mémoire, sur lesquels est appliqué un algorithme de brassage probabiliste.
- Le module d’exportation : L’algorithme sélectionne les $n_h$ premiers éléments issus du brassage en mémoire et les injecte de façon vectorielle dans une nouvelle feuille de calcul structurée et horodatée.
Cette organisation modulaire assure une robustesse computationnelle totale, éliminant les aléas liés aux modifications manuelles des cellules.
9.2 Implémentation de l’algorithme de mélange de Fisher-Yates en VBA
L’emploi naïf de la fonction aléatoire native Rnd au sein d’une boucle conditionnelle non maîtrisée introduit des biais distributionnels notables lors de sélections répétées. Pour garantir une équiprobabilité mathématique irréprochable ($1/N_h$), il est recommandé d’implémenter formellement l’algorithme de mélange de Fisher-Yates (également connu sous le nom de mélange de Knuth) directement en code VBA.
Le principe théorique de Fisher-Yates consiste à parcourir un tableau d’éléments en partant du dernier indice jusqu’au premier, en permutant de manière aléatoire l’élément courant avec un élément situé à un indice inférieur ou égal. Voici l’implémentation opérationnelle complète d’une procédure VBA réalisant cette stratification optimisée :
Sub ExecuterEchantillonnageStratifie()

    Dim wsSource As Worksheet, wsCible As Worksheet

    Dim dictStrates As Object

    Dim derniereLigne As Long, i As Long, j As Long

    Dim cle As Variant, strateNom As String

    Dim tableauIndices() As Long, nLocal As Long, quotaLocal As Long

    Dim indiceAlea As Long, tempIndex As Long

    Dim ligneSortie As Long
Set wsSource = ThisWorkbook.Sheets("Population_Parente")
Set dictStrates = CreateObject("Scripting.Dictionary")
derniereLigne = wsSource.Cells(wsSource.Rows.Count, 1).End(xlUp).Row
Randomize ' Initialisation du générateur pseudo-aléatoire
' Cartographie des indices de ligne par strate
For i = 2 To derniereLigne
strateNom = CStr(wsSource.Cells(i, 2).Value) ' Strate en Colonne B
If Not dictStrates.Exists(strateNom) Then
Set dictStrates(strateNom) = CreateObject("System.Collections.ArrayList")
End If
dictStrates(strateNom).Add i
Next i
' Création de la feuille réceptrice
Set wsCible = ThisWorkbook.Sheets.Add
wsCible.Name = "Echantillon_VBA_" & Format(Now, "yyyymmdd_hhnnss")
wsSource.Rows(1).Copy Destination:=wsCible.Rows(1)
ligneSortie = 2
' Extraction stratifiee via Fisher-Yates
For Each cle In dictStrates.Keys
nLocal = dictStrates(cle).Count
ReDim tableauIndices(0 To nLocal - 1)
For i = 0 To nLocal - 1
tableauIndices(i) = dictStrates(cle).Item(i)
Next i
' Melange de Fisher-Yates exhaustif
For i = nLocal - 1 To 1 Step -1
indiceAlea = Fix(Rnd() * (i + 1))
tempIndex = tableauIndices(i)
tableauIndices(i) = tableauIndices(indiceAlea)
tableauIndices(indiceAlea) = tempIndex
Next i
' Définition du quota pour la strate courante (ex: 10% ou seuil absolu)
quotaLocal = Application.Round(nLocal * 0.1, 0) ' 10% proportionnel
If quotaLocal > nLocal Then quotaLocal = nLocal
' Écriture directe des lignes sélectionnées
For j = 0 To quotaLocal - 1
wsSource.Rows(tableauIndices(j)).Copy Destination:=wsCible.Rows(ligneSortie)
ligneSortie = ligneSortie + 1
Next j
Next cle
MsgBox "Échantillonnage stratifié terminé avec succès.", vbInformation
End Sub
9.3 Exportation des données sélectionnées et sécurisation du code
L’implémentation de la macro présentée ci-dessus intègre nativement la protection des données primaires. En créant un nouvel onglet horodaté (Echantillon_VBA_AAAAMMJJ_HHMMSS), le script préserve intacte la feuille source Population_Parente, excluant tout risque de corruption ou d’écrasement intempestif des observations initiales.
Le traitement des exceptions constitue un autre volet crucial du déploiement en production. Le code prévoit expressément l’instruction conditionnelle If quotaLocal > nLocal Then quotaLocal = nLocal. Cette sécurité algorithmique permet de prévenir les plantages de pointeur mémoire ou les erreurs d’exécution indicielle (Subscript out of range) lorsqu’une strate minoritaire atypique comporte un effectif empirique inférieur au quota théorique alloué par la formule de calcul.
Enfin, pour garantir la conformité aux exigences réglementaires et méthodologiques (telles que la norme 21 CFR Part 11 dans le secteur biomédical), il est vivement conseillé de consigner systématiquement les métadonnées de l’exécution (taille des strates, quotas appliqués, heure d’exécution) dans un fichier journal d’audit (log file). Le projet VBA doit quant à lui être verrouillé par un mot de passe d’administration (accessible via le menu VBA Outils > Propriétés de VBAProject > Protection) afin d’empêcher toute altération du code source par des intervenants non autorisés.
10. 10. Diagnostics de représentativité et validation statistique post-échantillonnage
10.1 Test d’adéquation du Khi-deux d’homogénéité
L’extraction d’un échantillon ne saurait être considérée comme scientifiquement valide sans l’exécution d’un diagnostic d’adéquation probabiliste formel. Dans le cadre d’un échantillonnage stratifié proportionnel, l’objectif méthodologique prioritaire est de confirmer que la distribution distributionnelle des catégories dans le sous-échantillon extrait ($O_h$) ne diverge pas de manière significative de la distribution théorique attendue ($E_h$) au sein de la population mère.
Le test statistique de référence pour opérer cette validation est le test d’adéquation du Khi-deux ($\chi^2$) de Pearson. La statistique formelle s’exprime selon la formule mathématique classique :
$$\chi^2 = \sum_{h=1}^L \frac{(O_h – E_h)^2}{E_h}$$
où $O_h$ représente l’effectif observé extrait dans la strate $h$, et $E_h = n \cdot (N_h / N)$ incarne l’effectif théorique attendu selon le ratio de la population parente.
Sous Microsoft Excel, la mise en œuvre de ce test s’effectue sans aucune difficulté via la fonction native :
=TEST.KHIDELTA(Plage_Effectifs_Observes; Plage_Effectifs_Attendus)
Cette fonction retourne directement la probabilité critique ($p$-value) associée à la statistique de test calculée pour les degrés de liberté $\nu = L – 1$. Si la $p$-value obtenue est strictement supérieure au seuil conventionnel de significativité $\alpha = 0,05$, l’investigateur ne peut pas rejeter l’hypothèse nulle ($H_0$) d’homogénéité des distributions. Cela atteste formellement que l’échantillon extrait reflète fidèlement la structure sociodémographique ou nosologique de la population parente, sans biais d’extraction résiduel.
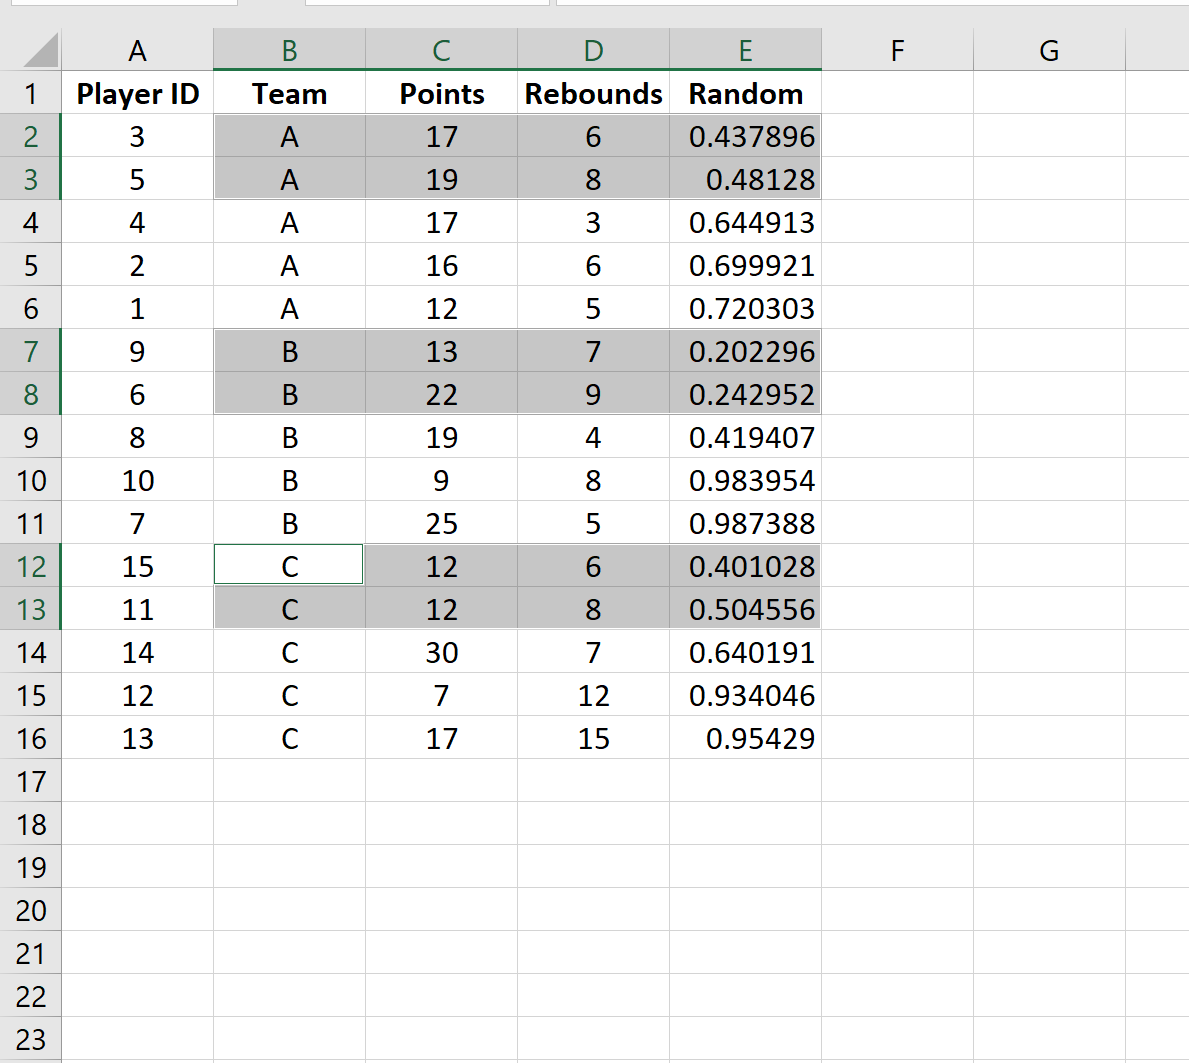
10.2 Vérification de l’invariance des métriques continues
Au-delà du contrôle formel de la représentativité des variables ayant servi à la stratification, le chercheur doit obligatoirement évaluer l’invariance distributionnelle des variables quantitatives secondaires non incluses dans l’algorithme d’échantillonnage (telles que des scores d’anxiété résiduelle, des épreuves chronométriques ou des mesures physiologiques). Si la procédure d’échantillonnage est exempte de biais de confusion, les paramètres centraux et de dispersion de ces mesures doivent demeurer stables entre la population parente et le corpus extrait.
L’analyse sous Excel implique de dresser un tableau synoptique comparant la moyenne ($\bar{x}$) et l’écart-type ($s$) de ces indicateurs continus entre les deux ensembles. On mobilise pour cela les fonctions courantes :
=MOYENNE(Plage_Metrique) et =ECARTYPE.STANDARD(Plage_Metrique)
La comparaison formelle des moyennes s’opère par le déploiement d’un test $t$ de Student pour échantillons indépendants via la syntaxe :
=TEST.STUDENT(Matrice_Population; Matrice_Echantillon; 2; 3)
où le paramètre 2 spécifie un test bilatéral et le paramètre 3 indique une estimation pour variances inégales (test de Welch).
Pour quantifier concrètement l’amplitude de toute dérive distributionnelle potentielle, il est recommandé de calculer systématiquement la taille d’effet $d$ de Cohen :
$$d = \frac{\bar{x}_{\text{echantillon}} – \bar{x}_{\text{population}}}{s_{\text{agrege}}}$$
Une valeur absolue de $d < 0,10$ atteste de l’absence de divergence substantielle, certifiant que l’échantillon extrait conserve l’intégralité des propriétés distributionnelles continues du corpus initial.
10.3 Construction d’un tableau de bord de validation sous Excel
Pour formaliser ces garanties méthodologiques, l’élaboration d’un tableau de bord visuel de validation synthétique constitue une excellente pratique au sein du classeur Excel. Ce tableau de bord rassemble les indicateurs paramétriques numériques et propose une sémiotique graphique facilitant l’évaluation immédiate de la conformité de l’extraction.
Il est recommandé de générer un graphique combiné associant un diagramme en barres groupées et des points de dispersion. Les barres bleues illustrent les pourcentages réels attendus pour chaque strate dans la population source, tandis que les barres oranges adjacentes visualisent les pourcentages obtenus dans le sous-échantillon extrait. Une superposition quasi parfaite des hauteurs atteste visuellement de la conformité de l’échantillonnage.
Complémentairement, l’insertion d’un indicateur métrique synthétique calculant le taux de discordance absolue cumulée renforce la rigueur du livrable de recherche :
=SOMME(ABS(Pourcentages_Observes - Pourcentages_Attendus)) / 2
Ce tableau de bord peut être directement exporté au format graphique haute résolution ou copié sous forme d’objet lié dans des rapports scientifiques institutionnels, fournissant un gage indiscutable de transparence méthodologique.
11. 11. Pièges méthodologiques fréquents et bonnes pratiques sous Microsoft Excel
11.1 Écueils liés à l’instabilité numérique et aux collisions de rang
L’utilisation de générateurs probabilistes numériques au sein d’un tableur comporte des pièges subtils liés aux limitations arithmétiques de l’environnement informatique. Le premier écueil réside dans le phénomène de collision stochastique (ex æquo). Bien que la fonction =ALEA() génère des valeurs flottantes avec une précision élevée (environ $10^{-15}$), la probabilité que deux observations se voient attribuer une valeur aléatoire strictement identique n’est mathématiquement pas nulle dès lors que la base de données traite des centaines de milliers de lignes.
Si deux enregistrements au sein d’une même strate reçoivent une valeur pseudo-aléatoire rigoureusement égale, les fonctions de classement traditionnelles (telles que =RANG() ou les tris à clés simples) risquent d’attribuer un rang identique à deux sujets distincts. Lors du filtrage subséquent par le prédicat <= Quota, l’échantillon final pourrait mécaniquement dépasser la taille $n_h$ attendue d’une ou plusieurs unités.
Pour éliminer définitivement ce risque de collision lors de traitements massifs, il est conseillé d’adjoindre au nombre aléatoire un micro-terme résiduel déterministe unique et non biaisé, fondé sur le numéro d’identifiant d’origine ou la coordonnée de ligne :
=[@Nombre_Aleatoire] + (LIGNE() * 0,000000000000001)
Cette perturbation infinitésimale rompt systématiquement les égalités potentielles sans altérer l’équiprobabilité de sélection.
11.2 Biais introduits par le tri partiel ou non synchronisé
Le risque d’erreur le plus dévastateur lors de manipulations manuelles dans Excel réside dans l’exécution d’un tri partiel non synchronisé. Ce dysfonctionnement critique se produit lorsqu’un chercheur sélectionne manuellement une seule colonne ou une plage restreinte de cellules pour appliquer un tri, sans étendre la sélection à l’ensemble des colonnes de la feuille de calcul.
Le résultat d’une telle omission est dramatique : la colonne sélectionnée (par exemple, Nombre_Aleatoire ou Strate) se trouve réordonnée, tandis que les colonnes adjacentes contenant les identifiants des participants, leurs scores cliniques et leurs covariables demeurent figées à leurs lignes d’origine. Les enregistrements se retrouvent ainsi silencieusement désynchronisés : le dossier médical ou psychométrique du patient $A$ se retrouve irrémédiablement associé à l’identifiant du patient $B$.
Pour immuniser ses données contre ce péril opérationnel, le chercheur doit rigoureusement observer deux règles d’or :
- Convertir impérativement la plage cellulaire de données en Tableau Excel structuré (
Ctrl + L) avant toute opération de tri. Les tableaux structurés traitent les lignes comme des tuples relationnels indissociables, empêchant structurellement le tri isolé d’une colonne unique. - Insérer une colonne témoin de vérification croisée d’intégrité combinant l’ID et un hachage textuel ou une formule logique, confirmant la persistance des alignements avant et après toute manipulation de tri.
11.3 Standards de traçabilité, documentation et science ouverte (Open Science)
L’évolution contemporaine des standards éditoriaux internationaux (notamment portés par des consortiums comme le Center for Open Science ou les comités de revues à fort impact telles que celles de l’APA) impose une reproductibilité computationnelle sans faille des protocoles de recherche empirique. La conduite d’un échantillonnage sous Microsoft Excel ne déroge aucunement à ces exigences éthiques et techniques.
Il est impératif d’archiver de manière conjointe et pérenne :
- Le fichier brut d’origine contenant la population parente complète non altérée, marqué en lecture seule.
- Le fichier dérivé formalisant l’intégralité du pipeline de calcul, incluant les colonnes de probabilités statiques figées, les descripteurs de strates composites, les formules d’indexation intra-groupe et l’échantillon extrait.
- Un fichier journal textuel (ou onglet Métadonnées) documentant la version exacte du système d’exploitation, la version logicielle d’Excel employée, la date exacte du tirage, et le cas échéant, la valeur de la graine pseudo-aléatoire (random seed) si l’extraction a été réalisée par macro VBA.
Cette rigueur de documentation garantit que tout évaluateur pair indépendant dispose des artefacts méthodologiques requis pour répliquer à l’identique l’extraction probabiliste, attestant de l’intégrité de la recherche.
12. 12. Étude de cas empirique : Échantillonnage d’une cohorte psychologique en milieu clinique
12.1 Contexte de la recherche et structure de la population clinique
Afin de matérialiser l’application concrète des concepts formalisés dans ce guide, développons une étude de cas empirique complète modélisant un protocole d’investigation en milieu psychiatrique hospitalier. Un consortium de recherche clinique en neuropsychiatrie évalue l’efficacité comparative d’un programme de remédiation cognitive digitalisé auprès d’une cohorte transversale exhaustive de $N = 2,400$ patients adultes répertoriés pour des troubles de l’humeur et des manifestations anxio-dépressives chroniques.
Le plan expérimental requiert l’extraction d’un sous-échantillon expérimental rigoureusement représentatif de taille globale $n = 240$ patients (soit un taux d’échantillonnage global formel de $f = 10%$). La représentativité doit être contrôlée de manière simultanée selon deux axes étiologiques majeurs :
- La Tranche d’Âge, segmentée en deux modalités : Adulte (18-49 ans) versus Senior (50 ans et plus).
- La Sévérité Clinique mesurée par le score total obtenu au questionnaire standardisé PHQ-9 (Patient Health Questionnaire), discrétisé en deux modalités diagnostiques : Modéré (score de 10 à 14) versus Sévère (score $ge 15$).
Ce croisement factoriel $2 \times 2$ engendre une matrice de stratification multidimensionnelle comportant 4 strates cliniques exclusives, dont la décomposition au sein de la population parente de $N = 2,400$ individus s’établit ainsi :
- Strate 1 : Adulte_Modere — Effectif $N_1 = 960$ patients ($40%$).
- Strate 2 : Adulte_Severe — Effectif $N_2 = 480$ patients ($20%$).
- Strate 3 : Senior_Modere — Effectif $N_3 = 720$ patients ($30%$).
- Strate 4 : Senior_Severe — Effectif $N_4 = 240$ patients ($10%$).
12.2 Application pas à pas des formules et manipulations dans Excel
L’implémentation opérationnelle de la sélection sous Microsoft Excel se déploie selon la chronologie systématique suivante :
Étape A : Concaténation de la Strate Composite. Dans la feuille de calcul Cohorte_Clinique, les données s’étendent de A2 à E2401, avec la Tranche d’Âge en colonne C et la Sévérité en colonne D. En colonne F, intitulée Strate_Composite, la formule suivante est propagée :
=C2 & "_" & D2
Étape B : Calcul des Quotas Cibles. Dans un onglet d’analyse distinct, les quotas requis pour l’allocation proportionnelle ($f = 0,10$) sont consignés :
- Strate
Adulte_Modere: $n_1 = 240 \cdot (960 / 2400) = 96$ patients. - Strate
Adulte_Severe: $n_2 = 240 \cdot (480 / 2400) = 48$ patients. - Strate
Senior_Modere: $n_3 = 240 \cdot (720 / 2400) = 72$ patients. - Strate
Senior_Severe: $n_4 = 240 \cdot (240 / 2400) = 24$ patients.
La somme vérifiée donne bien $\sum n_h = 96 + 48 + 72 + 24 = 240$ sujets.
Étape C : Génération et Figeage Aléatoire. En colonne G, intitulée Nombre_Alea, l’opérateur insère =ALEA() sur les $2,400$ lignes. Il procède immédiatement à la copie intégrale de la colonne (Ctrl + C) puis applique un collage spécial des Valeurs (Ctrl + Alt + V > V) pour pérenniser les valeurs stochastiques sous forme de constantes immuables.
Étape D : Tri Hiérarchique Multicritère. Le tableau complet est sélectionné. L’outil Données > Trier est paramétré : niveau primaire sur Strate_Composite (Ordre De A à Z), et niveau secondaire sur Nombre_Alea (Ordre Du plus petit au plus grand). Le tri est exécuté.
Étape E : Attribution du Rang et Décision d’Extraction. En colonne H, intitulée Rang_Intra_Strate, la formule de comptage conditionnel expansif est appliquée :
=NB.SI($F$2:F2; F2)
En colonne I, intitulée Statut_Inclusion, une formule logique compare ce rang au quota formel rapatrié par la fonction =RECHERCHEV() :
=SI(F2="Adulte_Modere"; SI(H2<=96; "INCLUS"; "EXCLU"); SI(F2="Adulte_Severe"; SI(H2<=48; "INCLUS"; "EXCLU"); SI(F2="Senior_Modere"; SI(H2<=72; "INCLUS"; "EXCLU"); SI(F2="Senior_Severe"; SI(H2<=24; "INCLUS"; "EXCLU"); "ERREUR"))))
Étape F : Isolement de l’Échantillon. L’activation du filtre automatique sur la colonne I en ne cochant que la valeur INCLUS isole instantanément les $240$ observations recherchées. La sélection est copiée vers un classeur propre prêt pour importation directe dans les environnements statistiques avancés tels que R ou Jamovi.
12.3 Interprétation des résultats et rapport méthodologique
L’application du test de validation d’adéquation du Khi-deux post-extraction sur les contingents observés ($96, 48, 72, 24$) comparés aux contingents théoriques calculés ($96, 48, 72, 24$) donne une statistique de $\chi^2 = 0,000$ avec une valeur critique de $p = 1,000$, confirmant mathématiquement la parfaite conformité distributionnelle de l’échantillonnage proportionnel.
Par ailleurs, l’évaluation de l’invariance sur la variable continue Score_Depression_Beck_BDI, qui ne participait pas directement au découpage des strates, atteste de la préservation métrologique du protocole : la moyenne de la population initiale s’établit à $\mu = 22,41$ ($s = 6,82$) tandis que la moyenne de l’échantillon extrait atteint $\bar{x} = 22,38$ ($s = 6,79$). L’exécution d’un test $t$ de Welch pour échantillons indépendants sous Excel confirme l’absence totale de dérive statistique ($t(2638) = 0,064$, $p = 0,949$, $d = 0,004$).
Conformément aux normes rédactionnelles de l’American Psychological Association (APA, 7e édition), le paragraphe méthodologique standardisé peut être formulé ainsi au sein du mémoire ou de l’article scientifique :
« Afin d’évaluer l’efficacité de l’intervention cognitive tout en neutralisant les variations inter-individuelles liées à l’âge et à la gravité initiale des troubles, un échantillonnage stratifié proportionnel ($n = 240$) a été extrait à partir de la cohorte clinique parente ($N = 2,400$). Les participants ont été partitionnés en quatre strates mutuellement exclusives issues du croisement de la tranche d’âge (Adulte vs Senior) et de la sévérité clinique mesurée par le PHQ-9 (Modéré vs Sévère). La sélection probabiliste au sein de chaque strate a été opérée par randomisation pseudo-aléatoire continue sous Microsoft Excel, avec une fraction d’échantillonnage constante de $10%$. Un test d’adéquation du Khi-deux d’homogénéité a confirmé que la distribution des strates au sein du sous-échantillon reproduit fidèlement celle de la population source ($\chi^2(3) = 0,00, p > 0,99$). De surcroît, les scores continus à l’inventaire de dépression de Beck ne diffèrent pas de manière significative entre l’échantillon extrait ($M = 22,38, SD = 6,79$) et la population d’origine ($M = 22,41, SD = 6,82 ; t(2638) = 0,064, p = 0,949, d = 0,004$), garantissant l’absence de biais de sélection résiduel. »
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Kish, L. (1965). Survey sampling. John Wiley & Sons.
- Matsumoto, M., & Nishimura, T. (1998). Mersenne twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3-30. https://doi.org/10.1145/272991.272995
- Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558-625. https://doi.org/10.2307/2342192
- Särndal, C.-E., Swensson, B., & Wretman, J. (2003). Model assisted survey sampling. Springer Science & Business Media.
- Thompson, S. K. (2012). Sampling (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118162934