
L’analyse de variance, universellement désignée sous l’acronyme ANOVA, constitue depuis les travaux fondateurs de Sir Ronald Aylmer Fisher l’un des piliers méthodologiques les plus sollicités en sciences quantitatives, particulièrement en psychologie cognitive, sociale et clinique. Sa finalité réside dans la modélisation statistique de la variabilité observée d’une variable dépendante continue au travers des modalités d’une ou plusieurs variables indépendantes catégorielles. Dans la tradition pédagogique et la pratique empirique classique, les protocoles de recherche ont longtemps privilégié les plans dits équilibrés, caractérisés par une égalité stricte des effectifs au sein de chaque groupe expérimental. Cette symétrie garantit des propriétés géométriques et probabilistes optimales, notamment l’orthogonalité parfaite des contrastes, une puissance statistique maximale et une robustesse remarquable face à d’éventuelles entorses mineures aux postulats sous-jacents du modèle linéaire général.
Cependant, la réalité empirique du terrain de recherche contemporain s’éloigne fréquemment de cet idéal symétrique. Qu’il s’agisse de l’attrition différentielle inhérente aux suivis longitudinaux, de l’accès contingent à des populations cliniques spécifiques, de rejets de données fondés sur des critères de qualité du signal électrophysiologique ou de non-réponses non intentionnelles, le chercheur se trouve confronté à des matrices de données caractérisées par des effectifs inégaux. Cette configuration, couramment qualifiée de plan déséquilibré, suscite des interrogations légitimes quant à la validité des inférences statistiques déduites de l’application standard du test F de Fisher. Des idées reçues persistent dans la littérature, assimilant parfois l’inégalité d’effectifs à une invalidation pure et simple de l’analyse univariée ou conduisant à des pratiques méthodologiquement contestables telles que l’élimination artificielle de sujets valides pour rétablir l’équilibre numérique.
L’objectif de cet article est de déconstruire les mécanismes mathématiques, méthodologiques et inférentiels régissant l’ANOVA univariée et multivariée face à des échantillons de tailles divergentes. Nous examinerons les conditions formelles d’existence du ratio de variance, dissèquerons les impacts concrets du déséquilibre sur la puissance statistique et l’erreur de Type I, expliciterons les querelles techniques entourant les différentes décompositions des sommes des carrés, et proposerons des recommandations opérationnelles complètes intégrant les alternatives modernes telles que l’ANOVA de Welch, les corrections post-hoc adaptées et leur implémentation rigoureuse dans les principaux environnements de calcul statistique contemporains.
1. Introduction à l’ANOVA unidirectionnelle et au postulat d’effectifs égaux
1.1 Fondements théoriques de l’analyse de variance
L’analyse de variance à un facteur repose sur la décomposition analytique de la variabilité globale observée au sein d’un échantillon en composantes mutuellement exclusives et exhaustives. Sur le plan théorique, la somme totale des carrés des écarts à la moyenne générale est scindée en deux vecteurs orthogonaux : la somme des carrés inter-groupes, qui capture les fluctuations attribuables aux différences de moyennes entre les modalités du traitement, et la somme des carrés intra-groupes ou résiduelle, traduisant l’hétérogénéité non expliquée, assimilée à l’erreur d’échantillonnage aléatoire. Le modèle linéaire univarié sous-jacent postule formellement que chaque observation individuelle s’exprime comme la somme d’une constante globale, d’un effet propre au niveau de facteur assigné et d’un résidu aléatoire théoriquement distribué selon une loi normale centrée d’espérance nulle.
La dérivation rigoureuse de la statistique de test requiert le respect de trois postulats canoniques : la normalité des erreurs résiduelles au sein de chaque population parente, l’indépendance statistique des observations individuelles (fondée sur un échantillonnage probabiliste ou une randomisation stricte), et l’homoscédasticité, désignant l’homogénéité stricte des variances résiduelles à travers l’ensemble des modalités du facteur étudié. Lorsque ces conditions sont réunies, le quotient du carré moyen inter-groupes par le carré moyen intra-groupes suit fidèlement une loi F de Fisher-Snedecor paramétrée par les degrés de liberté appropriés, autorisant un test d’hypothèse probabiliste portant sur l’égalité stricte des paramètres de localisation des populations mères.
Il importe de distinguer avec netteté les concepts de plans équilibrés, où la cardinalité des sous-ensembles d’observations est strictement identique pour toute condition expérimentale, et de plans déséquilibrés, où ces cardinaux oscillent. Une idée reçue tenace dans l’enseignement préliminaire des statistiques consiste à ériger l’égalité numérique des échantillons en un postulat mathématique d’existence du modèle linéaire. Or, sur le plan strictement déductif, la théorie de l’estimation par les moindres carrés ordinaires s’applique rigoureusement quelle que soit la distribution des effectifs par modalité. L’égalité des effectifs n’a jamais constitué une condition nécessaire à la dérivation de l’estimateur de Gauss-Markov, mais représente plutôt une condition de confort conférant au test des propriétés de robustesse et d’optimalité analytique qui s’évanouissent lorsque le déséquilibre s’installe.
1.2 Validité formelle de l’ANOVA en cas de déséquilibre
D’un point de vue mathématique formel, le calcul du ratio F en présence de tailles d’échantillons variables procède d’une généralisation pondérée directe des formules classiques. Chaque moyenne de groupe se voit attribuer un poids statistique strictement proportionnel à son effectif spécifique dans l’estimation de la moyenne générale et dans le calcul de la somme des carrés inter-groupes. Les degrés de liberté associés aux termes de variance demeurent invariablement fixés à k moins un pour le numérateur, où k représente le nombre de modalités du traitement, et à la somme totale des observations moins k pour le dénominateur résiduel. L’algèbre matricielle sous-jacente au modèle de projection sur le sous-espace vectoriel défini par les colonnes de la matrice d’expérience ne souffre d’aucune indétermination structurelle tant que la matrice d’information demeure de rang plein.
Sous les conditions d’homoscédasticité et de normalité préservées, les propriétés de convergence asymptotique de la statistique F demeurent rigoureusement garanties par la théorie asymptotique des grands échantillons. L’estimateur de la variance combinée des erreurs converge en probabilité vers la variance résiduelle populationnelle unique, assurant que le quotient standardisé conserve une loi limite F exacte sous l’hypothèse nulle. Ainsi, l’analyste qui dispose d’effectifs inégaux mais dont les variances résiduelles sont rigoureusement identiques ne commet aucune infraction aux lois de la probabilité en exécutant une ANOVA univariée classique, car la distribution de la statistique de test respecte scrupuleusement la distribution théorique tabulée.
Néanmoins, la vulnérabilité intrinsèque du modèle linéaire général se manifeste avec acuité dès lors que l’on quitte le domaine des hypothèses idéalisées. La robustesse légendaire de l’ANOVA face aux entorses modérées de la normalité et de l’homoscédasticité constitue une propriété asymptotique largement dépendante de la symétrie de la matrice de conception. En l’absence d’effectifs égaux, les marges de tolérance mathématique se contractent drastiquement. Dès lors, le comportement du modèle linéaire devient excessivement sensible à l’hétérogénéité des variances ou à la présence de données atypiques localisées, faisant voler en éclats le bouclier théorique qui protégeait traditionnellement le chercheur contre les biais décisionnels.
2. Origines et prévalence des échantillons déséquilibrés en psychologie
2.1 Facteurs expérimentaux et attrition différentielle
Dans la recherche expérimentale et translationnelle en psychologie, le déséquilibre des échantillons constitue la norme pragmatique plutôt que l’exception méthodologique. L’une des sources prépondérantes de cette asymétrie réside dans les phénomènes d’attrition différentielle observés au cours des protocoles longitudinaux ou d’interventions thérapeutiques répétées. Au sein des essais contrôlés randomisés évaluant l’efficacité d’une psychothérapie ou d’un entraînement cognitif informatisé, le taux de désistement ne se répartit que très rarement de manière homogène entre le groupe expérimental soumis à une charge cognitive astreignante et le groupe témoin bénéficiant d’une condition contrôle passive ou d’une liste d’attente exempte d’efforts substantiels.
L’émergence d’effets indésirables, la lassitude cognitive induite par des tâches expérimentales répétées ou la perception d’un manque d’efficacité thérapeutique provoquent une déperdition sélective des participants dans les conditions les plus exigeantes. Ce phénomène d’abandon prématuré génère non seulement un différentiel d’effectifs entre les bras de l’étude, mais introduit une contamination potentielle de la validité interne du protocole. Il devient impératif de dissocier le mécanisme de données manquantes totalement aléatoires, qualifié de Missing Completely at Random (MCAR), du mécanisme de données manquantes aléatoires conditionnelles (MAR) ou non aléatoires (MNAR), ces derniers altérant la représentativité des sous-échantillons finaux résiduels.
La non-réponse systématique à des batteries d’évaluation psychométrique ou l’élimination a posteriori de tracés électroencéphalographiques contaminés par des artéfacts oculaires massifs contribuent également à une érosion inégale des tailles d’échantillons. Les chercheurs se trouvent confrontés à un dilemme opérationnel : conserver l’intégralité des observations valides au risque de composer avec une matrice déséquilibrée, ou tronquer délibérément les groupes pour rétablir une parité artificielle. Comme nous le démontrerons ultérieurement, la suppression d’observations saines constitue une aberration statistique majeure qui dilapide l’information brute et dégrade la puissance du protocole sans apporter de bénéfice correcteur probant.
2.2 Contraintes écologiques et plans quasi-expérimentaux
Au-delà des incidents de parcours inhérents aux protocoles expérimentaux, les contraintes écologiques de la recherche en psychologie clinique, différentielle et sociale imposent structurellement des plans déséquilibrés. Dans l’investigation des psychopathologies rares, telles que la schizophrénie à début précoce, les troubles du spectre de l’autisme sévères ou certaines démences neurodégénératives focales, le vivier de recrutement clinique s’avère restreint par la prévalence épidémiologique intrinsèque de ces affections au sein de la population générale. À l’inverse, la constitution d’un groupe contrôle constitué d’individus neurotypiques ne souffre généralement d’aucune contrainte de volume équivalente.
Dans ce contexte, contraindre le plan expérimental à une égalité numérique stricte imposerait de restreindre la taille du groupe témoin au dénominateur commun le plus faible fixé par la cohorte clinique. Une telle décision restreindrait drastiquement la précision de l’estimation de la moyenne et de la variance du groupe contrôle, ce qui s’avère méthodologiquement contre-productif. Il apparaît infiniment plus pertinent d’optimiser le recrutement en intégrant un ratio asymétrique, par exemple deux à quatre participants contrôles pour chaque patient clinique, afin de stabiliser la variance de référence, bien que cette stratégie exige des ajustements analytiques appropriés pour l’inférence ultérieure.
Les investigations menées en milieu organisationnel, scolaire ou communautaire relèvent généralement de cadres quasi-expérimentaux où les unités d’échantillonnage préexistent sous la forme de classes scolaires, de services hospitaliers ou d’équipes de travail préconstituées. Les effectifs de ces grappes ne sont jamais rigoureusement uniformes. L’égalisation artificielle par tirage au sort et exclusion d’individus valides poserait des dilemmes éthiques intolérables, notamment dans les contextes pédagogiques ou thérapeutiques où l’accès à une intervention prometteuse ne saurait être arbitrairement refusé au simple motif de préserver l’élégance géométrique d’un plan factoriel équilibré.
3. Premier enjeu critique : La réduction de la puissance statistique
3.1 Mécanisme mathématique de la perte de puissance
La conséquence immédiate de l’asymétrie des effectifs réside dans la dégradation de la puissance statistique du test d’hypothèse globale. La sensibilité d’une analyse de variance à rejeter l’hypothèse nulle lorsque celle-ci est fausse dépend crucialement de l’erreur type associée aux contrastes de moyennes. Pour une comparaison univariée élémentaire entre deux moyennes, l’erreur type de la différence est formulée comme la racine carrée du produit de la variance d’échantillonnage combinée par la somme des inverses des tailles respectives des deux groupes. Cette quantité est directement dépendante de la moyenne harmonique des effectifs plutôt que de leur moyenne arithmétique.
Sur le plan analytique, la moyenne harmonique d’une série de nombres est systématiquement inférieure ou égale à leur moyenne arithmétique, l’égalité stricte n’étant obtenue que si et seulement si l’ensemble des termes sont identiques. Par conséquent, pour un nombre total N de participants fixé et mobilisé dans une recherche, la configuration qui minimise rigoureusement l’erreur type et qui, par ricochet, maximise la valeur du paramètre de non-centralité de la loi F correspond sans équivoque à la partition équilibrée. Tout écart à cette égalité entraîne une réduction mécanique de la moyenne harmonique et, par extension, un élargissement automatique des intervalles de confiance entourant l’estimation des paramètres de localisation.
À titre d’illustration théorique, considérons un protocole mobilisant un total de 100 participants répartis en deux conditions. Dans un plan parfaitement équilibré de 50 sujets par condition, la somme des inverses des effectifs équivaut à 1/50 plus 1/50, soit 0,04. Si ce même échantillon total est partitionné de manière asymétrique en un groupe de 90 individus et un second groupe de 10 individus, la somme des inverses devient 1/90 plus 1/10, ce qui équivaut approximativement à 0,111. L’erreur type de la différence de moyennes se trouve ainsi multipliée par un facteur supérieur à 1,66, ce qui dilue considérablement la probabilité d’atteindre le seuil de significativité conventionnel en présence d’une amplitude d’effet déterminée.
3.2 Conséquences sur l’erreur de type II
L’inflation de l’erreur type induite par la chute de la moyenne harmonique produit un accroissement direct de la probabilité de commettre une erreur de Type II, conventionnellement notée bêta. L’erreur de Type II survient lorsque le chercheur échoue à rejeter l’hypothèse nulle alors qu’il existe un effet réel de l’intervention ou du facteur étudié au sein de la population. Dans les paradigmes expérimentaux en psychologie cognitive ou clinique, où la magnitude réelle des effets se situe couramment dans des fourchettes faibles à modérées, cette érosion de la sensibilité s’avère particulièrement préjudiciable et concourt à la non-réplicabilité des résultats empiriques.
La vulnérabilité analytique s’avère particulièrement exacerbée au niveau des sous-groupes restreints au sein desquels s’effectuent les contrastes spécifiques. Si l’évaluation d’un effet principal au sein d’une ANOVA peut parfois demeurer significative grâce à la contribution cumulative d’un vaste groupe de référence, la détection des contrastes linéaires ou des interactions impliquant les cellules expérimentales minoritaires subit une chute drastique de puissance. Un contraste planifié impliquant une condition à faible effectif affichera un intervalle de confiance démesurément étendu, masquant potentiellement des variations phénotypiques d’une pertinence théorique cruciale.
Cette réalité géométrique souligne l’importance des calculs de puissance a priori confrontés aux déséquilibres prévisibles. Les chercheurs s’appuient fréquemment sur des progiciels de planification statistique en postulant une distribution uniforme des effectifs, pour constater ultérieurement que l’attrition a dégradé la puissance effective de leur devis. Il est donc indispensable d’intégrer dans les modèles d’allocation optimale des ressources des ratios de déséquilibre conservateurs dès la phase d’élaboration du protocole, en sur-dimensionnant le recrutement global afin de garantir que la moyenne harmonique finale des sous-échantillons préserve le niveau de puissance statistique ciblé, généralement fixé à 80 % ou 90 %.
4. Second enjeu critique : La vulnérabilité à l’hétéroscédasticité
4.1 Perte de robustesse à la violation de l’homoscédasticité
Si la réduction de puissance constitue un écueil d’efficacité statistique, la combinaison d’effectifs inégaux et d’une hétérogénéité des variances résiduelles représente une menace directe et létale pour la validité inférentielle de l’ANOVA classique. Sous un plan rigoureusement équilibré, le test F de Fisher bénéficie d’une propriété de robustesse exceptionnelle face à la violation du postulat d’homogénéité des variances. Même en présence de variances intra-groupes divergeant dans un ratio de un à quatre, le taux effectif d’erreur de Type I dans un plan équilibré demeure remarquablement stable et proche de son niveau nominal théorique fixé à alpha égal 0,05.
Cet amortissement mathématique provient du fait que dans une configuration symétrique, l’estimateur combiné de la variance résiduelle, calculé comme la simple moyenne arithmétique non pondérée des variances intra-groupes, compense exactement les déviations : la sous-estimation de la variance issue d’un groupe est neutralisée par la surestimation provenant d’un autre. En revanche, dès lors que les tailles d’échantillons diffèrent, l’estimateur de la variance combinée devient une moyenne pondérée par les degrés de liberté spécifiques de chaque groupe, accordant une influence prépondérante et disproportionnée aux conditions expérimentales disposant des effectifs les plus massifs.
Il en résulte un effondrement complet des propriétés de robustesse de l’ANOVA standard. La statistique F calculée cesse de suivre sa distribution théorique sous l’hypothèse nulle. La distorsion ne se manifeste pas de manière uniforme ou aléatoire, mais obéit à une directionnalité prévisible régie par le sens de l’association entre les magnitudes des variances et les tailles respectives des sous-échantillons, confrontant l’analyste soit à un laxisme statistique trompeur, soit à un conservatisme paralysant.
4.2 Directions du biais selon la corrélation variance-effectif
Le premier scénario, qualifié de situation libérale, se matérialise lorsqu’il existe une corrélation négative entre la taille des échantillons et l’amplitude de leurs variances résiduelles respectives. Dans ce cas de figure, les groupes expérimentaux caractérisés par les effectifs les plus restreints présentent les variances les plus volumineuses, tandis que les groupes massifs affichent une faible variabilité interne. L’estimateur combiné de la variance intra-groupes se trouve alors écrasé et sous-estimé car dominé par les petits écarts-types des grands groupes. Le dénominateur du ratio F devenant artificiellement réduit, la statistique de test est mécaniquement gonflée au-delà de sa valeur théorique légitime.
Les conséquences inférentielles de cette configuration libérale s’avèrent catastrophiques pour le contrôle de l’erreur de Type I. Les modélisations empiriques par simulations de Monte-Carlo démontrent sans ambiguïté que le taux réel de faux positifs peut s’envoler pour atteindre 10 %, 20 % voire plus de 30 %, alors même que le chercheur a fixé son seuil de décision nominal à 5 %. Des différences de moyennes totalement fortuites, issues de pures fluctuations d’échantillonnage sous l’hypothèse nulle, sont alors déclarées statistiquement significatives avec une régularité alarmante, induisant la publication d’artefacts expérimentaux faussement concluants.
Le second scénario, qualifié de situation conservatrice, survient à l’inverse lorsqu’une corrélation positive associe les effectifs élevés aux variances résiduelles les plus amples. L’estimateur combiné se trouve alors démesurément surévalué, captif de la dispersion des grands contingents d’observations. Le dénominateur du test F s’en trouve artificiellement gonflé, précipitant la statistique F vers des valeurs anormalement réduites. Le taux effectif d’erreur de Type I s’effondre alors très en-deçà du seuil nominal de 0,05, parfois jusqu’à des valeurs négligeables de 0,01 ou 0,005. Si cette situation protège contre les faux positifs, elle détruit littéralement la puissance statistique du test, garantissant la survenue massive d’erreurs de Type II et condamnant des effets réels à demeurer indétectés.
5. La typologie des sommes des carrés dans les plans non orthogonaux
5.1 Perte d’orthogonalité et chevauchement de variance
La transition d’un plan univarié simple à un plan factoriel croisé impliquant deux facteurs ou davantage fait émerger une complexité mathématique fondamentale liée à la structure géométrique des données. Dans un plan factoriel équilibré, la conception expérimentale bénéficie d’une propriété d’orthogonalité parfaite. Sur le plan vectoriel, les sous-espaces linéaires engendrés par les effets principaux du facteur A, les effets principaux du facteur B et les termes d’interaction A par B sont rigoureusement perpendiculaires au sein de l’espace euclidien des données. Cette indépendance géométrique garantit que la somme des carrés totale se partitionne de manière unique, additive et sans ambiguïté en composantes distinctes d’information.
Dès lors que les effectifs deviennent inégaux d’une cellule à l’autre de la matrice expérimentale, cette orthogonalité s’effondre irrémédiablement. Les facteurs du plan deviennent interdépendants et corrélés au sens de la régression multiple. Il en résulte un chevauchement substantiel de la variance expliquée : une fraction non négligeable de la dispersion des données peut être simultanément attribuée soit au facteur A, soit au facteur B, sans qu’un critère géométrique univoque ne permette de trancher naturellement cette affectation. La décomposition de la somme des carrés perd son caractère d’additivité élémentaire, posant le problème de la partition de cette variance partagée entre les prédicteurs.
Face à cette redondance informationnelle, les statisticiens ont formalisé différentes stratégies algébriques de hiérarchisation et de partitionnement de la variance, conventionnellement répertoriées sous les dénominations de Sommes des Carrés de Type I, Type II et Type III. Le choix entre ces métriques structurelles ne relève pas d’une simple divergence cosmétique ou d’une préférence de logiciel, mais engage une posture épistémologique quant aux hypothèses scientifiques que le chercheur entend soumettre à l’épreuve empirique.
5.2 Comparaison technique : Type I, Type II et Type III
Les Sommes des Carrés de Type I reposent sur un partitionnement strictement séquentiel et hiérarchique. Dans cette procédure, chaque facteur est introduit successivement dans le modèle de régression, et sa somme des carrés mesure l’accroissement spécifique de variance expliquée au-delà de l’ensemble des termes qui le précèdent chronologiquement. Si un chercheur spécifie l’ordre d’entrée A suivi de B, le facteur A recevra l’intégralité de la variance qui lui est propre ainsi que la totalité de la variance partagée avec B, tandis que B ne sera testé que pour sa contribution résiduelle marginale. Les Sommes des Carrés de Type I sont par conséquent hypersensibles à l’ordre formel d’écriture des facteurs dans la syntaxe d’analyse, une caractéristique qui les rend généralement inadaptées aux plans factoriels en psychologie où aucune préséance théorique absolue ne justifie de privilégier un facteur au détriment d’un autre.
Les Sommes des Carrés de Type II adoptent une approche marginale hiérarchique qui respecte le principe d’inclusion des modèles linéaires. Chaque effet principal est ajusté pour tous les autres effets principaux présents dans le modèle, mais sans être ajusté pour les termes d’interaction d’ordre supérieur dans lesquels il intervient. Cette méthodologie s’avère particulièrement puissante et statistiquement appropriée lorsque le chercheur a préalablement vérifié l’absence formelle d’interaction significative entre les facteurs étudiés. Elle maximise la puissance d’évaluation des effets principaux en utilisant l’ensemble de l’information disponible sous la contrainte d’invariance d’échelle.
Les Sommes des Carrés de Type III, introduites historiquement par les architectures de modélisation du progiciel SAS et devenues la référence prédominante sous SPSS et dans les publications relevant de l’American Psychological Association (APA), mettent en œuvre un ajustement marginal intégral. Chaque terme du modèle, qu’il s’agisse d’un effet principal ou d’une interaction d’ordre supérieur, est évalué en mesurant sa contribution unique une fois contrôlés l’intégralité de tous les autres termes du modèle sans exception. Ce procédé teste formellement l’égalité des moyennes non pondérées des cellules, accordant un poids identique à chaque condition expérimentale indépendamment des effectifs empiriques réels.
L’emploi valide des Sommes des Carrés de Type III exige impérativement que les variables catégorielles soient paramétrées à l’aide d’un codage de contrastes orthogonaux, usuellement désigné sous le terme d’effets de somme (sum-to-zero coding ou orthogonal polynomial coding), et non par un simple codage de traitement par référence (dummy coding). Si cette précaution algébrique est ignorée dans des logiciels comme R, les tests associés au Type III perdent leur propriété d’invariance et fournissent des résultats discordants qui n’évaluent plus les véritables hypothèses marginales souhaitées.
6. Protocole de diagnostic et vérification préalable des hypothèses
6.1 Évaluation de la normalité intra-groupe
L’administration rigoureuse d’une analyse de variance face à des échantillons de tailles divergentes commande la mise en place d’un protocole diagnostique approfondi des distributions intra-groupes. L’évaluation de la normalité ne doit en aucun cas être réalisée sur l’ensemble aggloméré de la variable dépendante sans tenir compte de la structuration en modalités, ce qui constituerait une faute méthodologique grossière en agrégeant artificiellement des sous-populations aux moyennes divergentes. La conformité à la loi normale doit être investiguée séparément à l’intérieur de chaque sous-échantillon ou, plus élégamment, sur la distribution globale des résidus standardisés extraits du modèle linéaire général estimé.
L’arsenal statistique privilégie le test de Shapiro-Wilk, largement reconnu pour sa puissance omnibus supérieure face aux alternatives telles que le test de Kolmogorov-Smirnov corrigé par Lilliefors. Toutefois, dans les sous-groupes à effectifs particulièrement restreints, le test de Shapiro-Wilk souffre d’un déficit de puissance manifeste, incapable de rejeter l’hypothèse nulle même en présence d’asymétries perceptibles. À l’inverse, au sein des sous-échantillons massifs, ce même test devient excessivement sensible, signalant comme hautement significatives des déviations infimes et dénuées de toute pertinence pratique pour le modèle linéaire.
Cette asymétrie de sensibilité statistique impose de subordonner les tests formels à une inspection visuelle experte reposant sur l’examen des diagrammes quantile-quantile (Q-Q plots) et l’estimation quantitative des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Une distribution intra-groupe dont les résidus s’alignent fidèlement sur la diagonale théorique d’un diagramme quantile-quantile sera légitimement jugée conforme, même si un test formel automatisé renvoie une significativité marginale imputable au volume de l’échantillon. En présence de déviations prononcées dans un sous-groupe minoritaire, des transformations de variables stabilisatrices (logarithmique, racine carrée ou transformation de Box-Cox) pourront être explorées avant d’envisager des alternatives méthodologiques non paramétriques.
6.2 Tests formels d’homogénéité des variances
Le diagnostic de l’homoscédasticité constitue l’étape la plus critique du protocole préliminaire lorsque les effectifs sont inégaux, en raison de l’extrême instabilité de l’erreur de Type I documentée précédemment. Le test historique de Bartlett, fondé sur une statistique du rapport de vraisemblance corrigée, possède certes une excellente puissance analytique sous l’hypothèse d’une normalité parfaite des populations sous-jacentes. Cependant, ce test s’avère hypersensible à la moindre entorse de la normalité, confondant régulièrement une distribution modérément leptokurtique avec une hétérogénéité des variances. Son application en psychologie empirique est par conséquent formellement déconseillée en présence de données réelles potentiellement imparfaites.
Le standard contemporain repose sur la famille des tests de Levene. La formulation originelle du test de Levene repose sur une analyse de variance exécutée sur les déviations absolues de chaque score individuel par rapport à la moyenne arithmétique de son groupe. Bien que plus robuste que le test de Bartlett, cette variante conserve une sensibilité résiduelle face aux distributions asymétriques. C’est pourquoi la variante optimisée par Brown et Forsythe, qui substitue la médiane du groupe à la moyenne arithmétique dans le calcul des déviations absolues, s’impose comme la procédure diagnostique la plus sûre et la plus robuste, offrant un contrôle rigoureux du taux d’erreur nominal même sous des lois parentes fortement asymétriques.
L’interprétation de l’homogénéité des variances ne saurait toutefois se cantonner à la lecture binaire d’une p-valeur issue du test de Levene. Dans les grands échantillons, des différences mineures de variances sont déclarées statistiquement significatives sans compromettre la validité inférentielle de l’analyse. Inversement, dans les petits échantillons, des écarts de dispersion colossaux peuvent échapper à la significativité statistique par manque de puissance. L’analyste averti articulera systématiquement le test formel avec le ratio empirique de variance maximale sur variance minimale. Une règle empirique éprouvée en biométrie suggère que si ce ratio de variance dépasse un seuil critique d’environ 4:1 (ou un ratio des écarts-types excédant 2:1) en conjonction avec un déséquilibre marqué des effectifs, l’ANOVA classique doit être impérativement récusée au profit de modélisations robustes.
6.3 Détection et traitement des observations aberrantes
La vulnérabilité structurelle des plans déséquilibrés s’exprime également à travers l’influence disproportionnée que peuvent exercer des observations atypiques ou aberrantes (outliers) isolées. Dans le cadre de l’estimation par les moindres carrés ordinaires, la fonction de perte quadratique accorde un bras de levier exponentiel aux points de données distants du centre de gravité de la distribution. Cette sensibilité devient critique lorsqu’une valeur extrême réside au sein d’une modalité expérimentale à faible effectif. Dans cette configuration, une unique observation aberrante possède le pouvoir mathématique de modifier radicalement la moyenne du sous-groupe tout en gonflant artificiellement sa variance résiduelle, altérant de facto l’ensemble de l’estimation combinée du modèle.
Le repérage de ces points influents mobilise des métriques diagnostiques avancées issues de l’économétrie et de la régression diagnostique. Les résidus studentisés désélectionnés (externally studentized residuals) permettent d’isoler les observations dont l’éloignement résiduel excède les seuils critiques probabilistes conventionnels, usuellement fixés au-delà de plus ou moins 2,5 ou 3 écarts-types. Conjointement, le calcul de la distance de Cook quantifie le déplacement global du vecteur des paramètres estimés induit par la suppression séquentielle de chaque observation individuelle. Tout point dont la distance de Cook excède le seuil de 4 divisé par le nombre de degrés de liberté résiduels doit faire l’objet d’une investigation méthodique méticuleuse.
Face à une observation aberrante validée, la décision méthodologique doit être dictée par une stricte transparence scientifique. S’il s’agit d’une anomalie technique avérée (erreur d’encodage, dysfonctionnement matériel, non-respect avéré des consignes expérimentales), la suppression pure et simple de la donnée est formellement justifiée. En revanche, s’il s’agit d’une manifestation biologique ou psychologique authentique de la variabilité interindividuelle, l’éviction arbitraire de la donnée constitue une forme insidieuse de manipulation des résultats empiriques. L’analyste se tournera alors vers des stratégies d’imputation robuste, de winsorisation contrôlée, ou privilégiera l’adoption d’estimateurs robustes fondés sur les M-estimateurs de Huber ou des procédures d’ANOVA sur moyennes tronquées.
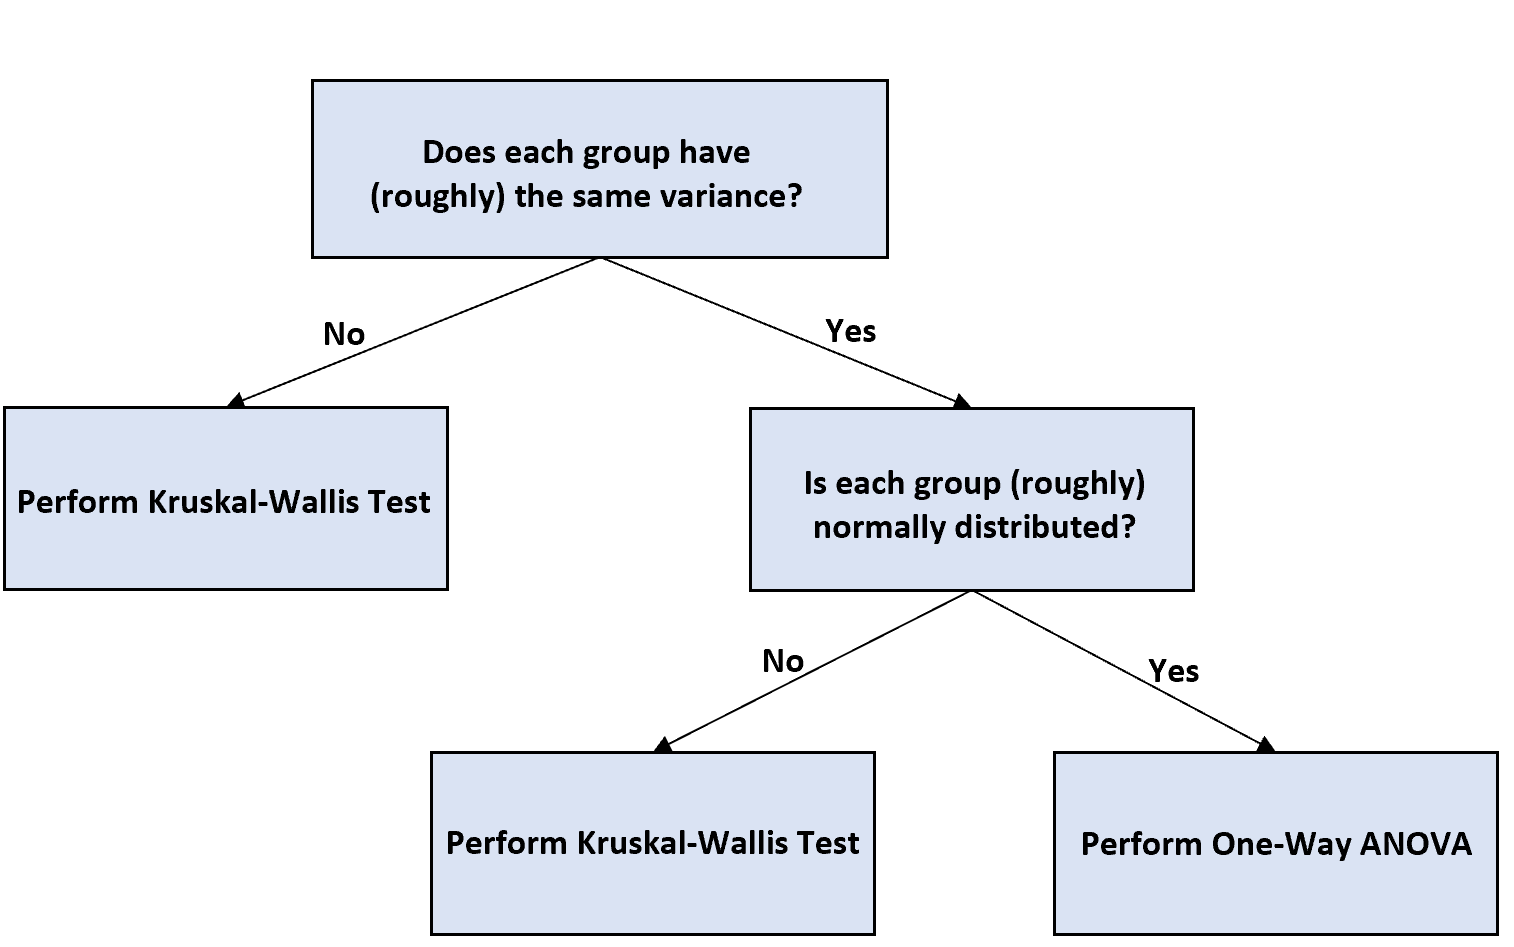
7. Alternatives paramétriques robustes : Welch et Brown-Forsythe
7.1 L’ANOVA de Welch comme standard méthodologique
Lorsque le protocole expérimental cumule de manière concomitante un déséquilibre des tailles d’échantillons et une violation substantielle de l’homoscédasticité, l’ANOVA de Welch s’impose incontestablement comme la solution méthodologique optimale. Conçue initialement par le statisticien Bernard Lewis Welch en 1951 comme une généralisation élégante du problème de Behrens-Fisher pour k populations indépendantes, cette procédure paramétrique émancipe le modèle univarié de la contrainte d’une variance résiduelle unique et partagée. Au lieu d’agréger les variances intra-groupes dans un estimateur combiné pondéré par les effectifs, le test de Welch traite chaque variance de modalité comme un paramètre autonome spécifique.
Le principe théorique de l’ANOVA de Welch réside dans l’application d’un schéma de pondération inverse. Dans l’estimation de la moyenne générale de référence et dans la formalisation de la statistique F ajustée, chaque moyenne de groupe est affectée d’un coefficient de pondération égal à l’inverse de sa variance d’échantillonnage spécifique, soit l’effectif divisé par la variance empirique de la modalité. Ce mécanisme d’ingénierie statistique neutralise l’impact délétère des cellules hautement variables : un groupe caractérisé par une dispersion excessive se verra automatiquement attribuer un poids statistique minoré dans la décision globale, prévenant ainsi toute distorsion artificielle du numérateur de la statistique de test.
Parallèlement, la statistique F de Welch incorpore une correction sophistiquée des degrés de liberté du dénominateur, dérivée des approximations de Satterthwaite relatives aux combinaisons linéaires de distributions du chi-deux indépendantes. Les degrés de liberté résiduels ne correspondent plus à un entier algébrique standard mais deviennent une fonction continue non entière dépendant étroitement de la distribution relative des variances et des effectifs empiriques. Cette souplesse confère à l’ANOVA de Welch une robustesse exceptionnelle. Une pléthore d’études par simulations informatiques a formellement démontré que le test de Welch maintient le taux d’erreur de Type I à son seuil nominal exact de 0,05 sous une variété extrême de configurations hétéroscédastiques et déséquilibrées, tout en préservant une puissance statistique remarquable, souvent équivalente voire supérieure à celle de l’ANOVA classique.
Ces performances théoriques et empiriques remarquables ont conduit d’éminents méthodologistes en psychologie et biométrie à recommander l’abandon de l’arbre décisionnel classique conditionnel. Traditionnellement, les praticiens procédaient à un test préliminaire de Levene pour décider de recourir soit à l’ANOVA standard, soit au test de Welch. Cette démarche en deux étapes est aujourd’hui sévèrement critiquée par les statisticiens, car le test conditionnel modifie le taux d’erreur global de l’expérience et souffre d’un manque de puissance diagnostique dans les petits effectifs. La recommandation méthodologique moderne préconise d’adopter l’ANOVA de Welch par défaut comme test univarié standard d’égalité des moyennes, dans la mesure où le test de Welch converge fidèlement vers l’ANOVA classique lorsque les variances s’avèrent homogènes, tout en garantissant une immunité absolue dès lors qu’un déséquilibre hétéroscédastique surgit inopinément dans les matrices de données.
7.2 Le test d’égalité des moyennes de Brown-Forsythe
Une seconde alternative paramétrique majeure est constituée par le test d’égalité des moyennes de Brown-Forsythe, formalisé en 1974. Bien que partageant une appellation commune avec le test d’homogénéité des variances évoqué précédemment, il s’agit ici d’un test omnibus visant spécifiquement à éprouver l’égalité des paramètres de localisation des k populations. À l’instar de la procédure de Welch, la formulation de Brown-Forsythe s’affranchit de l’hypothèse de variances homogènes en n’opérant pas de combinaison linéaire classique des sommes des carrés résiduelles.
La divergence mathématique entre Welch et Brown-Forsythe se situe dans la structure d’estimation de la variance globale de référence et l’attribution des degrés de liberté résiduels. Alors que Welch procède à une pondération directe par les variances d’échantillonnage, le test de Brown-Forsythe évalue la variabilité des moyennes en utilisant les effectifs bruts pondérés au numérateur, tout en ajustant le dénominateur par une somme des produits des variances de groupe et de leurs degrés de liberté respectifs corrigés. La dérivation des degrés de liberté du dénominateur mobilise également une approximation de type Satterthwaite, générant une valeur fractionnaire adaptée aux discordances de variances constatées.
Les investigations comparatives de robustesse démontrent que les tests de Welch et de Brown-Forsythe affichent des comportements différentiels subtils en fonction des distributions parentes. Le test de Welch surpasse généralement celui de Brown-Forsythe en termes de puissance statistique sous des conditions de normalité exacte ou lorsque les déviations de variances coïncident avec des distributions symétriques. En revanche, le test de Brown-Forsythe tend à manifester un contrôle de l’erreur de Type I légèrement plus conservateur et robuste lorsque les distributions intra-groupes dévient de la normalité en affichant des queues épaisses ou un aplatissement leptokurtique prononcé. Dans la pratique courante en psychologie, le test de Welch demeure néanmoins la référence privilégiée pour sa flexibilité mathématique et son implémentation unifiée dans les principaux packages logiciels modernes.
8. Approches non paramétriques et méthodes de rééchantillonnage
8.1 Le test de Kruskal-Wallis et ses limites
Face à une violation combinée des postulats de normalité et d’homoscédasticité au sein de données déséquilibrées, les chercheurs se tournent couramment vers le test non paramétrique de Kruskal-Wallis. Cette procédure procède à une transformation intégrale des scores bruts de l’ensemble de l’échantillon en rangs ordinaux ascendants, neutralisant de facto les effets d’asymétrie distributionnelle ou la présence d’observations aberrantes extrêmes. La statistique de test H est ensuite dérivée de la comparaison des sommes de rangs observées au sein de chaque condition expérimentale par rapport aux espérances mathématiques calculées sous l’hypothèse nulle d’indépendance.
Cependant, une confusion conceptuelle majeure imprègne la littérature quant à la portée exacte et aux postulats stricts du test de Kruskal-Wallis. Il est souvent enseigné que ce test s’émancipe de toute hypothèse distributionnelle préalable, ce qui est formellement faux. Pour que le test de Kruskal-Wallis constitue un test valide de l’égalité des médianes des populations mères, il postule impérativement que les distributions des k groupes présentent rigoureusement la même forme géométrique, incluant une variance et une asymétrie identiques, et ne diffèrent éventuellement que par une simple translation spatiale de leur centre de localisation.
Par conséquent, dès lors que l’hétéroscédasticité contamine des échantillons aux effectifs inégaux, le test de Kruskal-Wallis subit un effondrement inférentiel comparable à celui de l’ANOVA classique. Les travaux de recherche en simulation statistique ont amplement documenté que la statistique H gonfle démesurément lorsque de petites tailles de groupes sont couplées à de fortes dispersions de rangs, conduisant à une inflation substantielle de l’erreur de Type I. Substituer machinalement une ANOVA classique par un test de Kruskal-Wallis en présence d’une hétéroscédasticité avérée sur des effectifs asymétriques ne résout aucunement le problème de validité probabiliste et peut induire des conclusions tout aussi fallacieuses.
8.2 Techniques de bootstrapping et tests de permutation
Pour contourner les limites conjointes des tests paramétriques standards et des alternatives ordinales, les méthodologies computationnelles intensives de rééchantillonnage représentent une voie d’analyse d’une robustesse exceptionnelle. Parmi celles-ci, le bootstrapping non paramétrique stratifié permet de s’affranchir totalement de l’hypothèse de normalité tout en préservant scrupuleusement la structure inégale des données empiriques. Dans une stratification bootstrap, les tirages avec remise sont exécutés séparément à l’intérieur de chaque modalité expérimentale en respectant strictement l’effectif exact spécifique attribué à chacune d’elles.
Cette architecture de rééchantillonnage garantit que l’inégalité structurelle des cellules n’introduit aucun biais d’allocation probabiliste au cours de l’itération. À partir d’un nombre élevé de réplicats, typiquement 5 000 à 10 000 échantillons bootstrap, il devient aisé de construire une distribution empirique d’échantillonnage pour la statistique de test d’intérêt. L’estimation des intervalles de confiance robustes pour les différences de moyennes ou les tailles d’effet s’appuiera préférentiellement sur les intervalles corrigés du biais et accélérés, désignés sous l’acronyme BCa (Bias-Corrected and Accelerated), qui ajustent simultanément l’asymétrie distributionnelle et le paramètre de non-linéarité de l’estimateur.
Les tests de permutation exacte ou de randomisation constituent une alternative computationnelle tout aussi performante pour tester formellement l’hypothèse nulle d’invariance d’affectation. En réassignant de manière aléatoire les scores observés à travers les différentes conditions expérimentales tout en maintenant fixes les tailles inégales des groupes, on génère la distribution combinatoire exacte de la statistique de test sous l’hypothèse nulle. La p-valeur empirique déduite de la proportion de permutations fournissant une statistique plus extrême que la valeur originale ne requiert aucune supposition distributionnelle sur la population parente, conférant aux tests de permutation un statut de référence décisionnelle absolue pour les jeux de données complexes et déséquilibrés.
9. Procédures de comparaisons multiples et tests post-hoc adaptés
9.1 Adaptation de Tukey : La procédure de Tukey-Kramer
L’identification d’un effet omnibus statistiquement significatif au sein d’une ANOVA à k modalités ne clôt pas l’investigation empirique : elle impose de localiser avec précision la nature des divergences inter-groupes par le biais de comparaisons par paires. Dans un cadre équilibré classique sous homoscédasticité, la procédure de la plus petite différence significative honnête de Tukey (HSD – Honestly Significant Difference) constitue le standard de référence pour contrôler le taux d’erreur par famille (FWER – Family-Wise Error Rate) à son seuil nominal de 0,05 à travers l’ensemble des comparaisons par paires possibles, en mobilisant la distribution de l’étendue standardisée de Student (Studentized Range q).
Toutefois, la formule originelle de Tukey exige une symétrie parfaite des effectifs. Face à des échantillons de tailles divergentes, la procédure doit être impérativement adaptée sous la forme de l’algorithme de Tukey-Kramer, formalisé indépendamment par Clyde Kramer en 1956. La modification fondamentale apportée par Kramer consiste à substituer à la taille uniforme d’échantillon la moyenne harmonique spécifique calculée pour chaque paire de groupes examinée. L’erreur type de la différence de moyennes entre le groupe i et le groupe j devient alors fonction directe de la racine carrée de la moitié du produit du carré moyen résiduel par la somme des inverses de l’effectif n_i et de l’effectif n_j.
La démonstration de Hayter en 1984 a définitivement assis la validité mathématique de la procédure de Tukey-Kramer en prouvant de manière rigoureuse que cette adaptation garantit un contrôle conservateur du taux d’erreur par famille. Autrement dit, pour tout ensemble d’effectifs inégaux, le FWER effectif de la méthode de Tukey-Kramer est garanti inférieur ou rigoureusement égal au niveau alpha nominal sélectionné, à condition expresse que le postulat d’homogénéité des variances soit scrupuleusement respecté. Elle constitue donc la méthode post-hoc optimale dans les plans déséquilibrés homoscédastiques.
9.2 Post-hoc sous hétéroscédasticité : Procédure de Games-Howell
Lorsque le plan expérimental conjugue simultanément des effectifs inégaux et une hétérogénéité avérée des variances intra-groupes, la procédure de Tukey-Kramer perd instantanément sa validité et affiche un taux d’erreur par famille incontrôlé, reproduisant les travers libéraux documentés pour l’ANOVA standard. Dans cette situation méthodologiquement périlleuse, la procédure post-hoc de Games-Howell s’impose comme la solution universellement plébiscitée par les comités de rédaction des revues scientifiques de premier rang.
La méthodologie de Games-Howell transpose l’approche de Welch-Satterthwaite au domaine des comparaisons multiples de moyennes par paires. Elle s’émancipe totalement de l’utilisation d’une variance résiduelle combinée globale issue de l’ensemble du modèle. Pour chaque comparaison individuelle impliquant le groupe i et le groupe j, Games-Howell calcule une erreur type spécifique reposant exclusivement sur les variances empiriques et les effectifs propres à ces deux seuls sous-échantillons. Simultanément, les degrés de liberté sont recalculés de manière autonome pour chaque paire à l’aide de l’équation de Welch-Satterthwaite, générant un seuil critique ajusté pour chaque comparaison bilatérale.
Les investigations systématiques démontrent que la méthode de Games-Howell parvient à maintenir un contrôle irréprochable de l’erreur de Type I dès lors que la taille des plus petits groupes excède environ cinq ou six observations. Elle combine cette rigueur probabiliste avec une puissance d’inférence très supérieure aux corrections grossières basées sur l’inégalité de Bonferroni. Bien qu’elle puisse se révéler modérément conservatrice lorsque les effectifs sont extrêmement réduits, Games-Howell représente le prolongement post-hoc naturel et incontournable de l’ANOVA omnibus de Welch.
9.3 Ajustements conservateurs : Bonferroni, Holm et Benjamini-Hochberg
Au-delà des procédures omnibus d’étendue standardisée, l’arsenal méthodologique met à la disposition du chercheur des algorithmes d’ajustement correcteurs applicables à n’importe quelle série de contrastes univariés ou de tests t indépendants, indépendamment de la structure sous-jacente des effectifs. La plus élémentaire et la plus restrictive est la correction classique de Bonferroni, qui divise arithmétiquement le seuil alpha nominal par le nombre total de comparaisons planifiées ou exécutées. Si cette méthode garantit une protection absolue contre l’erreur de Type I, son conservatisme draconien dilue dramatiquement la puissance statistique, multipliant le risque d’omettre des effets réels dès que le nombre de contrastes dépasse trois ou quatre.
Une alternative séquentielle infiniment supérieure réside dans la procédure de Holm-Bonferroni (ou méthode de Holm). Cet algorithme ordonne préalablement les p-valeurs brutes observées par ordre croissant d’amplitude, puis applique un ajustement séquentiel dégressif, le test le plus significatif étant évalué au seuil alpha divisé par le nombre total de tests k, le suivant à alpha divisé par k moins un, et ainsi de suite jusqu’à rupture de significativité. La méthode de Holm domine mathématiquement celle de Bonferroni dans la mesure où elle contrôle rigoureusement le FWER au même niveau théorique tout en offrant une puissance statistique systématiquement supérieure, quel que soit le déséquilibre des effectifs analysés.
Dans les contextes de recherche exploratoire comportant une multiplicité massive de conditions expérimentales, la focalisation exclusive sur le FWER peut s’avérer contre-productive en paralysant la découverte scientifique. Il devient alors pertinent d’adopter le paradigme du taux de fausses découvertes, formalisé par le critère du False Discovery Rate (FDR) selon la méthode de Benjamini-Hochberg. Contrairement au FWER qui cherche à éliminer la moindre survenue d’un faux positif, le FDR contrôle la proportion attendue de fausses découvertes parmi l’ensemble des tests déclarés significatifs. Cette flexibilité offre un compromis optimal entre risque de Type I et de Type II, autorisant la mise en lumière de structures empiriques émergentes dans des protocoles volumineux et déséquilibrés.
10. Mise en œuvre pratique sur logiciels statistiques (R, SPSS, Python)
10.1 Exécution sous l’environnement R
L’environnement de calcul statistique R constitue un écosystème d’une rigueur absolue pour l’analyse des plans factoriels déséquilibrés, à condition d’en maîtriser la logique algorithmique interne. Par défaut, la fonction générique aov() ou l’application de anova(lm(...)) exécute une décomposition séquentielle des sommes des carrés correspondant strictement au Type I. L’utilisation naïve de ces fonctions standards sur un plan factoriel déséquilibré aboutit inévitablement à des estimations biaisées dépendantes de la position syntaxique des prédicteurs dans la formule de régression.
Pour exécuter une analyse factorielle rigoureuse mobilisant les sommes des carrés de Type III, l’analyste doit impérativement solliciter le package spécialisé car (Companion to Applied Regression) au travers de sa fonction Anova() (dont l’initiale majuscule la distingue de la commande de base). Préalablement à l’ajustement du modèle linéaire, il est indispensable de paramétrer explicitement les contrastes de traitement sous une forme orthogonale sommative via la commande options(contrasts = c("contr.sum", "contr.poly")). L’estimation du modèle linéaire exécutée ensuite via lm() pourra alors être passée en argument à Anova(modele, type = "III"), garantissant l’extraction exacte des sommes des carrés marginales conformes aux standards méthodologiques internationaux.
Pour l’analyse univariée simple sous hétéroscédasticité et déséquilibre d’effectifs, R propose nativement la fonction oneway.test(). L’assignation de l’argument var.equal = FALSE déclenche automatiquement l’implémentation complète de l’ANOVA de Welch avec correction continue des degrés de liberté de Satterthwaite. En ce qui concerne la phase des comparaisons multiples post-hoc, l’extension rstatix met à disposition la fonction games_howell_test(), tandis que le package de référence emmeans autorise la dérivation d’estimations marginales de moyennes et de contrastes par paires ajustés de manière cohérente avec la matrice de covariance sous-jacente.
10.2 Configuration dans IBM SPSS Statistics
Le progiciel IBM SPSS Statistics a historiquement été conçu pour paramétrer automatiquement les décompositions marginales adaptées aux plans non orthogonaux. Lors de l’utilisation du module du Modèle Linéaire Général via le menu Analyser > Modèle linéaire général > Univarié, SPSS configure par défaut le calcul des sommes des carrés selon la méthode du Type III. Ce réglage automatique protège l’utilisateur profane contre le risque d’évaluer séquentiellement ses facteurs, assurant une conformité immédiate avec les normes de publication des disciplines comportementales.
Toutefois, pour accéder aux alternatives paramétriques robustes face à l’hétérogénéité des variances, l’analyste doit emprunter un cheminement procédural distinct au sein du logiciel. Il convient de se diriger vers le menu Analyser > Comparer les moyennes > ANOVA à un facteur. Dans la boîte de dialogue contextuelle, le clic sur le sous-menu Options permet de cocher explicitement les tests de Welch et de Brown-Forsythe, qui seront calculés et restitués dans un tableau récapitulatif dédié, séparé de l’affichage de l’ANOVA classique de Fisher.
Au sein de cette même interface d’ANOVA à un facteur, l’onglet Post Hoc présente une organisation dichotomique claire et didactique des procédures de comparaisons multiples. La section supérieure répertorie les tests opérant sous le postulat d’homogénéité des variances, incluant la variante de Tukey (qui exécute automatiquement la correction de Tukey-Kramer en présence d’effectifs inégaux). La section inférieure rassemble spécifiquement les méthodes d’inférence applicables en cas de variances inégales, au premier rang desquelles figure le test de Games-Howell, complété par les procédures de Tamhane T2 et de Dunnett T3, offrant ainsi un panel complet d’outils analytiques robustes.
10.3 Implémentation sous Python (statsmodels et pingouin)
L’essor fulgurant du langage de programmation Python dans le champ de la science des données et des neurosciences computationnelles s’est accompagné du développement de bibliothèques statistiques hautement spécialisées. La bibliothèque historique statsmodels permet de répliquer rigoureusement les analyses linéaires factorielles. En formulant le modèle à travers la syntaxe de type Patsy via la fonction ols() de statsmodels.formula.api, l’utilisateur peut paramétrer ses contrastes et solliciter ensuite la fonction anova_lm() du module statsmodels.stats.anova en lui adjoignant l’argument explicite typ=3 pour obtenir le partitionnement des sommes des carrés de Type III.
Cependant, pour l’analyste recherchant une ergonomie moderne alliée à une rigueur académique irréprochable, le package pingouin s’impose désormais comme la référence incontournable en psychométrie sous Python. Développé spécifiquement pour combler les lacunes de scipy.stats en matière de modélisation statistique avancée, pingouin offre une fonction dédiée pingouin.welch_anova() qui calcule instantanément l’ANOVA de Welch univariée à partir d’un DataFrame Pandas, retournant les valeurs précises de la statistique F, des degrés de liberté fractionnaires et de la p-valeur corrigée.
Pour le déploiement des comparaisons post-hoc sous cette même bibliothèque, l’exécution s’avère particulièrement concise et intuitive grâce à la fonction pingouin.pairwise_gameshowell(). Cette méthode prend en charge nativement les tableaux de données asymétriques et renvoie un tableau détaillé synthétisant les différences de moyennes brutes, les erreurs types individualisées, les degrés de liberté de Satterthwaite, les intervalles de confiance à 95 % et les p-valeurs ajustées. Pour des contrastes homoscédastiques sous Tukey-Kramer, la fonction pingouin.pairwise_tukey() applique automatiquement la pondération harmonique des effectifs, garantissant une cohérence théorique totale.
11. Calcul et interprétation de la taille d’effet avec effectifs inégaux
11.1 Biais de l’Eta-carré et supériorité de l’Oméga-carré
La publication d’une analyse de variance ne saurait aujourd’hui se satisfaire de la simple déclaration de la significativité statistique, assujettie aux fluctuations arbitraires de la taille de l’échantillon global. L’évaluation de l’amplitude pratique et de la pertinence clinique de l’effet étudié requiert impérativement la quantification standardisée de la taille d’effet. Dans ce domaine, le coefficient de détermination global historiquement le plus répandu est l’Eta-carré (noté $\eta^2$), qui mesure le ratio de la somme des carrés de l’effet sur la somme des carrés totale. Malgré sa simplicité intuitive, l’Eta-carré constitue un estimateur purement descriptif qui présente un biais mathématique systématique orienté vers la surestimation de la variance expliquée dans les populations de recherche restreintes.
Ce biais de surévaluation d’échantillonnage est d’autant plus violent que les tailles de groupes sont modestes et dissymétriques. Pour pallier cette tare structurelle, le statisticien William Hays a formalisé l’estimateur de l’Oméga-carré (noté $\omega^2$). L’Oméga-carré est un estimateur non biaisé qui dérive la proportion de variance populationnelle en retranchant de la somme des carrés de l’effet le produit de ses degrés de liberté par le carré moyen résiduel de l’erreur, le tout rapporté à la somme des carrés totale incrémentée de la variance résiduelle. Par cette soustraction, l’Oméga-carré neutralise rigoureusement le bruit d’échantillonnage résiduel et fournit une estimation loyale de l’impact réel du traitement.
Une variante tout aussi pertinente mais moins connue est constituée par l’Epsilon-carré (noté $\epsilon^2$), introduit à l’origine par Truman Lee Kelley en 1935. L’Epsilon-carré applique un ajustement fondé sur la correction standard des degrés de liberté de la régression, offrant une convergence très proche de celle de l’Oméga-carré tout en se montrant remarquablement résistant face aux écarts d’effectifs modérés. Dans toute restitution académique portant sur des plans déséquilibrés, les chercheurs sont vivement encouragés à abandonner l’Eta-carré classique au profit de l’Oméga-carré partiel ou généralisé afin de préserver l’intégrité cumulative des méta-analyses contemporaines.
11.2 Tailles d’effet pour contrastes par paires (d de Cohen ajusté)
La quantification de la magnitude des contrastes spécifiques entre deux modalités d’un facteur mobilise de manière quasi universelle la métrique du d de Cohen. Le d de Cohen standard exprime la différence brute observée entre deux moyennes d’échantillons divisée par une estimation de l’écart-type résiduel combiné de la population. Dans un cadre équilibré, cet écart-type combiné correspond à la racine carrée de la moyenne arithmétique des deux variances d’échantillons. Toutefois, l’application de cette formule symétrique à des effectifs inégaux introduit une erreur d’estimation sensible en ignorant le volume relatif d’information apporté par chaque cellule.
Face à des effectifs divergents $n_1$ et $n_2$, l’écart-type combiné (usuellement désigné sous le terme de pooled standard deviation, $s_{pooled}$) doit impérativement être calculé comme une moyenne pondérée par les degrés de liberté respectifs des deux groupes, soit la racine carrée de la somme des carrés des déviations divisée par la somme totale de $n_1$ et $n_2$ diminuée de deux. Néanmoins, même avec cette précaution algébrique, le d de Cohen combiné conserve une propriété de surestimation positive systématique lorsque les effectifs totaux sont faibles (typiquement inférieurs à vingt participants par condition).
Il devient dès lors rigoureusement obligatoire d’adopter la correction proposée par Larry Hedges, connue sous la dénomination de g de Hedges. Le g de Hedges applique un facteur de correction multiplicatif dépendant du nombre total de degrés de liberté résiduels au d de Cohen pondéré, ce qui neutralise le biais d’échantillonnage des petits effectifs. L’interprétation de ces métriques standardisées de contraste (valeurs conventionnelles de 0,2 pour un effet faible, 0,5 pour un effet modéré et 0,8 pour un effet fort) doit être contextualisée en regard du champ spécifique investigué : en psychologie clinique, un effet modeste de 0,3 peut s’avérer déterminant pour la santé publique, tandis qu’en psycholinguistique cognitive, des contrastes de temps de réaction robustes franchissent couramment les seuils standardisés les plus élevés.
12. Directives de rédaction académique selon les normes de l’APA
12.1 Transparence méthodologique et justification du déséquilibre
La rédaction scientifique selon les normes éditoriales de l’American Psychological Association (Publication Manual of the APA, 7e édition) impose un impératif catégorique de clarté et de transparence méthodologique. L’époque où les chercheurs pouvaient masquer des asymétries numériques en ne rapportant que des effectifs globaux est définitivement révolue. Au sein de la section Méthode, sous le paragraphe dédié aux participants et au devis expérimental, l’analyste doit impérativement cartographier l’ensemble des flux d’échantillonnage, en explicitant le nombre initial de participants recrutés, les taux de désistement constatés au fil du protocole, ainsi que les effectifs finaux exactement inclus dans chaque modèle analytique.
Toute disparité d’effectifs entre les conditions expérimentales exige une explication causale détaillée. L’auteur doit formaliser si le déséquilibre procède d’une contrainte écologique inhérente aux groupes naturels (par exemple, prévalence différentielle d’un trouble neuropsychiatrique), d’un mécanisme de randomisation par blocs incomplets, ou d’une attrition différentielle survenue en cours d’intervention. Si des observations ont été écartées pour des motifs techniques (valeurs aberrantes validées, contaminations artéfactuelles), les critères d’exclusion standardisés adoptés doivent être explicités a priori avec une absolue rigueur.
De surcroît, le choix des estimateurs et des modèles statistiques doit faire l’objet d’une justification théorique étayée. L’adoption d’un partitionnement des sommes des carrés de Type III dans un plan factoriel, le recours préventif à l’ANOVA de Welch en lieu et place du test de Fisher classique, ou l’utilisation de tests post-hoc de Games-Howell doivent être explicitement argumentés en faisant référence aux diagnostics de variance et aux propriétés de robustesse face aux asymétries de tailles d’échantillons documentées dans la section méthodologique.
12.2 Formatage des résultats statistiques dans le texte et les tableaux
La transcription formelle des résultats statistiques au sein de la section Résultats répond à des conventions typographiques strictes standardisées par l’APA. La statistique de test F doit être introduite en lettres italiques, immédiatement suivie de ses degrés de liberté associés placés entre parenthèses, du symbole égal, de la valeur calculée de la statistique arrondie à deux décimales, de la p-valeur exacte rapportée à trois décimales (sans zéro précédant la virgule pour les grandeurs probabilistes bornées par l’unité), et de l’indicateur de taille d’effet accompagné de son intervalle de confiance à 95 %.
Dans le cas d’une ANOVA de Welch, la modification des degrés de liberté du dénominateur doit être formellement reflétée par une valeur décimale non entière. Par exemple, une restitution textuelle conforme prendra la tournure suivante : « L’ANOVA de Welch a révélé un effet principal significatif de la condition cognitive, F(2, 28.43) = 5.84, p = .008, $\omega^2$ = .14, IC à 95 % [.02, .31]. » Les comparaisons multiples par paires exécutées a posteriori devront systématiquement mentionner la procédure spécifique mobilisée, les écarts de moyennes ajustés, les p-valeurs corrigées pour la multiplicité des tests et l’amplitude de l’effet standardisé en g de Hedges.
L’intégration des résultats au sein d’un tableau récapitulatif synthétique demeure l’approche la plus efficiente pour présenter un ensemble dense de comparaisons. Le tableau doit obligatoirement inclure, pour chaque condition expérimentale, l’effectif final analysé ($n$), la moyenne arithmétique ($M$) et l’écart-type empirique ($SD$). Les notes de bas de tableau expliciteront la nature des corrections appliquées, garantissant au lecteur une lisibilité immédiate et une traçabilité intégrale de la chaîne d’inférence statistique déployée par les auteurs.
Références
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal n’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Hayter, A. J. (1984). A proof of the conjecture that the Tukey-Kramer multiple comparisons procedure is conservative. The Annals of Statistics, 12(1), 61–75. https://doi.org/10.1214/aos/1176346392
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001466
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579