
L’analyse quantitative contemporaine repose sur le traitement de corpus empiriques hétérogènes dont les variables constitutives présentent des échelles de mesure, des ordres de grandeur et des unités physiques profondément dissemblables. Dans les disciplines d’observation telles que la psychologie computationnelle, l’épidémiologie, les neurosciences comportementales et la science des données, les praticiens se trouvent régulièrement confrontés à l’obligation méthodologique de comparer, d’agréger ou de soumettre à des algorithmes d’apprentissage des descripteurs dont les amplitudes numériques oscillent entre des fractions infinitésimales et plusieurs milliers d’unités. L’absence d’harmonisation de ces métriques engendre des biais computationnels considérables, accordant de manière fallacieuse une prépondérance statistique aux variables dotées de la variance brute la plus étendue.
La normalisation unitaire, couramment désignée sous le vocable de mise à l’échelle Min-Max ou de re-scalage linéaire entre 0 et 1, constitue l’un des piliers méthodologiques fondamentaux de la phase de prétraitement des données. Loin d’être une simple opération de convenance arithmétique, cette transformation affine opère une translation et une contraction d’échelle rigoureuses, préservant la structure relationnelle interne de chaque distribution tout en la projetant sur un segment fermé unifié. Cette opération confère aux variables continues une comparabilité immédiate, optimise le conditionnement mathématique des surfaces d’optimisation numérique et garantit l’équité dimensionnelle requise par les fonctions de perte des modèles d’apprentissage automatique.
Le présent traité expose de manière exhaustive les fondements épistémologiques, les dérivations algébriques, les applications empiriques et les répercussions calculatoires de la normalisation unitaire. À travers l’examen minutieux de jeux de données psychométriques, l’analyse comparative vis-à-vis des protocoles de standardisation stochastique et la description détaillée des implémentations au sein des écosystèmes informatiques de pointe, cet article offre au chercheur comme à l’ingénieur une feuille de route rigoureuse pour maîtriser l’art et la science du re-scalage de données entre zéro et un.
1. Introduction conceptuelle à la mise à l’échelle des données empiriques
1.1 Définition formelle de la mise à l’échelle dans l’analyse quantitative
Dans l’architecture de la recherche quantitative, la mise à l’échelle désigne l’ensemble des transformations mathématiques destinées à modifier le domaine de définition et l’amplitude de dispersion des variables quantitatives sans en corrompre l’information topologique fondamentale. La nécessité d’ajuster des variables continues hétérogènes vers un référentiel partagé découle de la nature même des instruments de collecte scientifique. Lorsqu’un protocole expérimental enregistre simultanément des potentiels évoqués mesurés en microvolts, des latences comportementales exprimées en millisecondes et des scores psychométriques calibrés sur des échelles discrètes arbitraires, les matrices d’observations brutes souffrent d’une asymétrie dimensionnelle structurelle. Cette disparité compromet toute tentative d’évaluation globale conjointe.
D’un point de vue épistémologique, le recalibrage des métriques d’observation interroge la légitimité de la commensurabilité des phénomènes empiriques. Transformer une mesure revient à modifier son ancrage empirique originel pour l’inscrire dans une géométrie vectorielle abstraite. Cette transposition méthodologique est pourtant indispensable : en physique théorique comme en psychométrie, la signification d’un intervalle numérique dépend intrinsèquement de l’espace métrique dans lequel il s’insère. Modifier l’échelle d’une variable permet d’isoler la variance relative de celle-ci, la séparant du poids purement numérique conféré par le choix contingent de l’unité de mesure retenue par l’expérimentateur.
L’amplitude différentielle des descripteurs exerce une influence majeure sur les modélisations statistiques avancées. Dans le cadre de régressions pénalisées par les normes Ridge ou Lasso, de décompositions en composantes principales ou d’architectures de réseaux neuronaux profonds, la présence d’une variable dont l’échelle est mille fois supérieure à ses voisines induit une distorsion algorithmique délétère. Le modèle statistique interprète erronément la magnitude absolue des valeurs brutes comme un signal de pertinence explicative, écrasant ainsi la contribution explicative de prédicteurs cruciaux dotés d’amplitudes modestes. La mise à l’échelle unitaire neutralise ce biais d’attribution computationnel.
1.2 Rôle de la normalisation unitaire dans les protocoles de recherche empirique
L’application d’un re-scalage unitaire, bornant rigoureusement les variables au sein de l’intervalle semi-ouvert ou fermé compris entre zéro et un, joue un rôle structurant dans l’harmonisation des inventaires psychométriques présentant des échelles divergentes. En psychologie différentielle et en sociologie quantitative, il est fréquent de combiner des instruments validés reposant pour les uns sur des échelles de Likert en cinq points, et pour les autres sur des échelles visuelles analogiques continues graduées de 0 à 100 millimètres. La conversion de l’intégralité de ces mesures vers le segment zéro-un permet l’alignement immédiat des profils individuels au sein d’une métrique commune, rendant intelligibles les trajectoires comparées des sujets examinés.
L’un des avantages conceptuels déterminants de cette méthode réside dans la préservation absolue des rapports proportionnels régissant les observations individuelles. Contrairement aux transformations non linéaires susceptibles de modifier l’espacement relatif des quantiles, la projection sur l’intervalle unitaire applique une transformation strictement affine. Cela signifie que si le score d’un individu A surpassait initialement celui d’un individu B d’un tiers de l’amplitude totale observée chez les participants, cet écart relatif exact subsiste rigoureusement intact au terme de l’opération. L’intégrité ordinale et les distances relatives normalisées demeurent parfaitement conservées.
Dans la conduite des protocoles expérimentaux randomisés, la standardisation unitaire des variables dépendantes facilite considérablement l’analyse conjointe des réponses comportementales et physiologiques. En contraignant l’espace de réponse au sein d’un intervalle fixe et standardisé, les chercheurs s’assurent que les coefficients de régression associés aux traitements expérimentaux peuvent être directement confrontés en termes de fraction de l’étendue maximale réalisable. Cela simplifie la synthèse méta-analytique des résultats, offrant un cadre d’interprétation harmonisé à travers des laboratoires employant des variantes d’instrumentation différentes.
1.3 Objectifs analytiques de la borne stricte comprise entre 0 et 1
L’instauration délibérée d’une frontière numérique compacte délimitée par 0 et 1 répond à plusieurs impératifs théoriques et calculatoires. Sur le plan de la modélisation statistique, cette contrainte permet d’attribuer une interprétation quasi probabiliste ou relative aux scores transformés. Une valeur de 0,75 s’interprète sans ambiguïté comme l’atteinte de 75 % du gradient empirique total de la cohorte étudiée, le point 0 incarnant l’infimum observé et le point 1 désignant le supremum. Cette lecture standardisée dissout la complexité inhérente aux unités de mesure physiques brutes au profit d’un positionnement univoque sur l’axe d’évaluation.
D’autre part, la conformité avec les exigences computationnelles des algorithmes d’apprentissage automatique constitue une motivation prépondérante. De multiples fonctions d’activation non linéaires, à l’instar de la fonction logistique sigmoïde ou de la fonction softmax employées massivement dans les architectures connexionnistes de Scikit-Learn, affichent des asymptotes horizontales ou des gradients significatifs précisément sur des intervalles de magnitude réduite. L’injection d’entrées non bornées engendre le phénomène redouté de saturation des gradients, immobilisant l’apprentissage par rétropropagation. Le confinement des descripteurs dans le segment unitaire assure une dynamique d’optimisation fluide et stable le long des surfaces d’erreur.
Enfin, cette borne standardisée simplifie considérablement la lecture transversale des gradients de réponse au sein des études comportementales longitudinales. L’évolution d’un participant au fil du temps peut être visualisée sous la forme d’un vecteur dont les coordonnées évoluent à l’intérieur d’un hypercube unitaire, dont chaque sommet représente les configurations extrêmes possibles des états observés. Cette modélisation unitaire confère à l’analyste un cadre géométrique particulièrement propice à l’application de métriques spatiales, à la détection de singularités comportementales et à la formulation de diagnostics quantitatifs rigoureux.
2. Déconstruction mathématique de la formule de normalisation Min-Max
2.1 Analyse structurelle des composantes algébriques de l’équation
La transformation Min-Max, bien que d’apparence élémentaire, constitue une application affine canonique projetant un sous-ensemble compact des nombres réels vers le segment fermé [0, 1]. Pour toute série statistique observée, notée sous la forme d’un vecteur fini X = (x_1, x_2, …, x_n), la valeur normalisée associée à chaque réalisation individuelle x_i s’exprime formellement par l’équation fondamentale suivante :
z_i = (x_i – x_min) / (x_max – x_min)
Dans cette formulation, le terme résultant z_i représente une grandeur scalaire rigoureusement adimensionnelle, c’est-à-dire dépourvue de toute unité de mesure physique (qu’il s’agisse de kilogrammes, de millisecondes ou de points bruts de questionnaire). Cette caractéristique d’adimensionnalité est impérative pour garantir l’indépendance de l’analyse vis-à-vis du système de mesure retenu lors de la collecte initiale.
Le numérateur de l’expression, formalisé par la différence (x_i – x_min), accomplit une opération géométrique de translation vectorielle. En retranchant systématiquement la borne inférieure observée x_min à chaque observation, l’opérateur décale l’ensemble du domaine empirique vers la droite de l’axe réel, ancrant de facto l’élément le plus faible de la distribution exactement sur l’origine zéro. L’ensemble des valeurs translatées adopte par conséquent un statut de réels positifs ou nuls.
Le dénominateur, défini par la quantité (x_max – x_min), correspond rigoureusement à l’étendue ou à l’amplitude globale de l’échantillon empirique, couramment désignée sous le terme de « range ». Sa fonction opératoire réside dans une homothétie ou re-scalage d’échelle. En divisant la déviation locale (x_i – x_min) par l’étendue totale de la distribution, le dénominateur normalise cette déviation par la variabilité maximale disponible dans le corpus, garantissant mathématiquement que la valeur maximale réalisable ne puisse en aucun cas excéder l’unité.
2.2 Comportement analytique des bornes extrêmes théoriques
L’évaluation des propriétés asymptotiques et des conditions limites de l’équation Min-Max démontre la rigueur déterministe de sa projection. Considérons en premier lieu le cas singulier où la valeur individuelle x_i coïncide strictement avec la valeur minimale observée de la cohorte, c’est-à-dire x_i = x_min. En substituant cette égalité au sein du numérateur de la formule, nous obtenons l’expression (x_min – x_min) / (x_max – x_min) = 0 / (x_max – x_min). Dès lors que l’étendue est non nulle, le résultat converge avec une exactitude arithmétique absolue vers zéro, formalisant la borne inférieure du nouvel espace de mesure.
Réciproquement, examinons le comportement de l’opérateur lorsque la valeur observée x_i atteint le sommet absolu de la distribution échantillonnée, à savoir x_i = x_max. Le calcul prend alors la forme canonique (x_max – x_min) / (x_max – x_min). Toute quantité scalaire non nulle divisée par elle-même étant strictement égale à 1, la projection garantit que l’observation maximale du jeu de données se voit assigner la valeur numérique exacte de 1. L’ensemble des points d’évaluation intermédiaires se distribuent de manière harmonieuse sur le segment [0, 1].
Par ailleurs, la fonction de normalisation f(x) = (x – x_min) / (x_max – x_min) présente une dérivée première continue par rapport à x sur l’ensemble de son domaine de validité. Cette dérivée s’écrit f'(x) = 1 / (x_max – x_min). Puisque x_max est par définition strictement supérieur à x_min dans une distribution non dégénérée, la dérivée est strictement positive et constante sur l’intégralité du domaine. Cette stricte positivité démontre que la transformation Min-Max est une fonction strictement monotone croissante. Elle préserve par voie de conséquence de manière intégrale l’ordre stochastique : pour tout couple d’observations tel que x_a < x_b, la relation f(x_a) < f(x_b) demeure formellement vérifiée.
2.3 Hypothèses et contraintes préalables au calcul
L’application rigoureuse du re-scalage unitaire est tributaire de conditions méthodologiques et d’hypothèses de consistance numérique qu’il convient de contrôler préalablement à toute chaîne de traitement. La contrainte primordiale réside dans l’exigence absolue d’une étendue strictement supérieure à zéro (x_max – x_min > 0). Si un vecteur de données présente une variance nulle, traduisant une série de constantes invariantes où chaque élément x_i équivaut à x_min, le dénominateur s’annule mathématiquement, induisant une indétermination algébrique par division par zéro. Tout système automatisé de traitement de données doit impérativement intégrer une règle d’exception gérant ces distributions dégénérées en assignant arbitrairement une constante, telle que 0 ou 0,5, ou en écartant la caractéristique stationnaire du modèle.
Une seconde contrainte structurelle concerne l’extrême sensibilité du domaine normalisé aux fluctuations d’échantillonnage entre différents sous-groupes ou lors de la scission d’un corpus global. Étant donné que les paramètres de centrage et de dispersion reposent exclusivement sur des statistiques d’ordre extrêmes (le minimum absolu et le maximum absolu), toute variation accidentelle dans la détection de ces valeurs fausse la comparabilité entre sous-cohortes. Si deux échantillons indépendants issus d’une même population parente présentent des extrêmes divergents en raison de la taille de leurs échantillons respectifs, l’application de la normalisation Min-Max intra-échantillon créera un désalignement insidieux des grandeurs normalisées.
Enfin, le calcul postule implicitement une stabilité asymptotique des extrema au sein de la population parente étudiée. Si le chercheur destine son modèle à des prédictions prospectives en conditions réelles, l’apparition inévitable de nouvelles observations excédant les bornes initialement identifiées constitue une violation directe du cadre unitaire. Une observation future supérieure à x_max générera une projection strictement supérieure à 1, tandis qu’une mesure inférieure à x_min franchira la frontière inférieure vers les nombres négatifs. La modélisation doit anticiper cette vulnérabilité soit par un écrêtage (« clipping »), soit par l’adoption d’un paradigme de distribution compacte théorique préétablie.
3. Application empirique pas à pas sur un jeu de données réel
3.1 Extraction des paramètres descriptifs fondamentaux
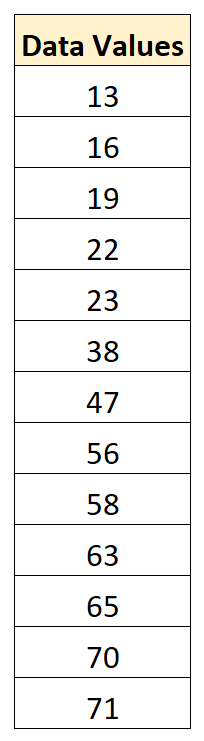
Afin d’ancrer ces développements théoriques dans la réalité pratique de l’investigation empirique, considérons une cohorte expérimentale de dix participants soumis à une épreuve neuropsychologique évaluant la flexibilité cognitive. Les scores bruts d’efficacité cognitive enregistrés pour ces dix sujets se répartissent selon la série d’observations quantitatives discrètes suivante : 13, 16, 19, 28, 35, 42, 49, 58, 64, et 71. Ce corpus restreint offre une lisibilité arithmétique idéale tout en incarnant fidèlement la dispersion observée au sein des batteries de tests cliniques standardisées.
La première phase du processus analytique consiste à explorer la distribution pour identifier formellement les paramètres extrêmes de positionnement. Un examen méthodique du vecteur ordonné permet d’isoler l’observation de magnitude la plus faible, désignée comme borne d’ancrage inférieure :
x_min = 13
Conjointement, l’analyse isole l’observation atteignant le sommet de la distribution empirique, qui constitue la borne d’ancrage supérieure :
x_max = 71
Dès lors que ces deux paramètres cardinaux sont formellement isolés, l’opérateur statistique procède à la soustraction différentielle fondamentale destinée à quantifier l’étendue globale de l’échantillon d’évaluation. L’opération s’énonce ainsi :
Étendue = x_max – x_min = 71 – 13 = 58
Le nombre 58 représente le dénominateur commun qui s’appliquera invariablement à chaque calcul individuel au sein de cette batterie d’observations.
3.2 Démonstration des calculs séquentiels d’échantillonnage
Muni des paramètres structurels identifiés, l’analyste déploie l’algorithme pas à pas sur les éléments constitutifs de l’échantillon. Examinons en premier lieu l’observation liminaire associée au premier participant, dont la performance brute se chiffre à 13. L’application de l’équation de transformation donne :
z_1 = (13 – 13) / 58 = 0 / 58 = 0,0000
Le premier sujet est ainsi précisément positionné à l’origine du référentiel unitaire, matérialisant le point plancher de la performance observée.
Poursuivons la démonstration avec le deuxième participant, dont le score brut s’élève à 16. La translation soustrait le minimum de base, avant d’opérer la division normalisante par l’étendue totale :
z_2 = (16 – 13) / 58 = 3 / 58 ≈ 0,0517
Ce résultat indique avec une grande finesse que le deuxième individu a parcouru approximativement 5,17 % de l’amplitude totale de performance cognitive manifestée par le groupe.
Pour le troisième point de mesure, caractérisé par un score brut de 19, le protocole séquentiel applique le même opérateur mathématique :
z_3 = (19 – 13) / 58 = 6 / 58 ≈ 0,1034
Il apparaît immédiatement que la distance relative entre le point 1 (0) et le point 2 (0,0517) est de 0,0517, et que celle entre le point 2 et le point 3 (0,1034) s’établit également à 0,0517. Cette constance traduit parfaitement la stricte linéarité de l’opération, la différence brute sous-jacente étant de 3 points d’évaluation dans les deux cas (16 – 13 = 3, et 19 – 16 = 3).
3.3 Vérification de la projection systématique sur l’intervalle unité
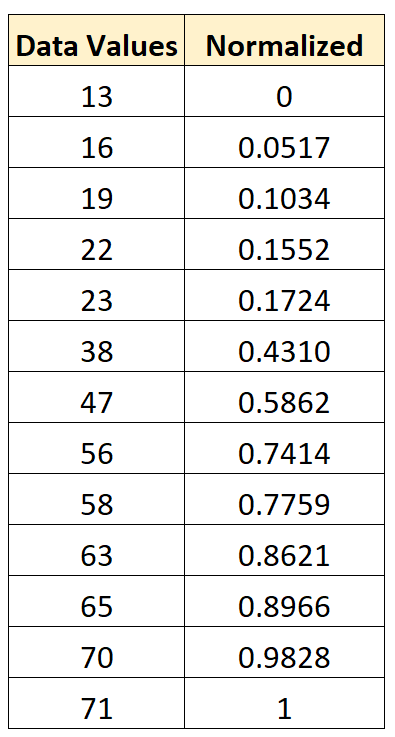
En poursuivant l’application de la formule sur l’intégralité des dix participants de l’étude neuropsychologique, nous obtenons la séquence complète des valeurs transformées. Le tableau d’équivalence analytique se dresse de la manière suivante : pour x = 13, z = 0,0000 ; pour x = 16, z ≈ 0,0517 ; pour x = 19, z ≈ 0,1034 ; pour x = 28, z = (28 – 13)/58 = 15/58 ≈ 0,2586 ; pour x = 35, z = 22/58 ≈ 0,3793 ; pour x = 42, z = 29/58 = 0,5000 ; pour x = 49, z = 36/58 ≈ 0,6207 ; pour x = 58, z = 45/58 ≈ 0,7759 ; pour x = 64, z = 51/58 ≈ 0,8793 ; et pour l’observation terminale x = 71, z = 58/58 = 1,0000.
Un audit d’assurance qualité statistique s’impose à ce stade pour valider le respect des contraintes axiomatiques du re-scalage. Le premier contrôle vise l’alignement ordinal : en comparant la série originelle et la série transformée, on vérifie que l’ordre des rangs demeure invariablement préservé du premier au dernier sujet. Aucun chevauchement ni inversion de rang ne peut survenir lors d’une transformation affine positive.
Le second contrôle confirme qu’absolument aucune valeur numérique ne franchit le segment borné [0, 1]. Le point médian de l’étendue, correspondant au score 42, produit exactement la valeur normalisée 0,5000, ce qui atteste du centrage parfait de la dispersion autour de sa moyenne géométrique d’intervalle. Les scores transformés fournissent ainsi une lecture standardisée de la performance, exploitable immédiatement pour des analyses multivariées ultérieures sans risque d’artéfact d’échelle.
4. Propriétés statistiques et préservation de la distribution
4.1 Caractère linéaire et conservation des propriétés géométriques
L’une des vertus épistémologiques fondamentales de la normalisation Min-Max réside dans sa nature strictement linéaire. D’un point de vue de la géométrie analytique, une transformation affine d’une variable continue préserve l’intégrité de la morphologie de sa fonction de densité de probabilité. Les rapports spatiaux, les points d’inflexion, la présence éventuelle de multimodalités et la structure globale des groupements d’observations ne subissent aucune déformation élastique ou distorsion compressive locale.
Sur le plan des moments statistiques d’ordre supérieur, cette linéarité se traduit par l’invariance mathématique absolue des coefficients d’asymétrie (skewness). L’asymétrie étant définie comme le troisième moment centré normalisé par le cube de l’écart-type, toute transformation de type Y = aX + b (où a > 0 représente le facteur d’homothétie 1/(x_max – x_min) et b la translation -x_min/(x_max – x_min)) multiplie le troisième moment centré par a^3 et le dénominateur par (a^2)^(3/2) = a^3. Les coefficients scalaires s’annulent rigoureusement, laissant le coefficient d’asymétrie de la variable transformée strictement identique à celui de la variable d’origine.
Il en va rigoureusement de même pour le degré d’aplatissement (kurtosis), mesuré par le quatrième moment centré divisé par le carré de la variance. Les facteurs d’échelle s’annulent de manière analogue au numérateur et au dénominateur par un ratio de a^4 sur a^4. Par conséquent, si la distribution initiale des données présentait une allure leptokurtique prononcée ou une queue de distribution épaisse, cette signature morphologique est intégralement préservée au terme de la normalisation entre 0 et 1. La transformation se contente d’ajuster le repère de lecture sans modifier la dynamique géométrique sous-jacente.
4.2 Impact sur les corrélations et les covariances
L’évaluation des relations bivariées constitue un pan essentiel de l’analyse méthodologique. Sous l’effet du re-scalage unitaire appliqué séparément à deux variables continues distinctes X et Y, le coefficient de corrélation linéaire de Pearson demeure strictement invariant. Mathématiquement, la corrélation de Pearson s’avère invariante à toute transformation linéaire positive des variables considérées. Le numérateur, qui correspond à la covariance, est multiplié par le produit des pentes scalaires des deux variables, tandis que le dénominateur, constitué du produit de leurs écarts-types individuels, est multiplié par ce même facteur scalaire conjoint. L’amplitude et la significativité du lien associatif mesuré entre les phénomènes empiriques demeurent par conséquent absolument inaltérées.
En revanche, la matrice de variance-covariance subit une altération quantitative délibérée et proportionnelle. Dans la mesure où la variance de chaque variable normalisée se voit multipliée par le facteur quadratique 1 / (x_max – x_min)^2, les amplitudes absolues des variances et des covariances brutes s’en trouvent substantiellement réduites. Cette contraction globale est un objectif recherché : elle garantit qu’aucune variable ne présente une variance disproportionnée susceptible d’influencer artificiellement les projections factorielles ou les distances géométriques au sein des modèles statistiques multivariés.
Cette propriété garantit la neutralité du re-scalage Min-Max lors de la conduite d’analyses factorielles exploratoires linéaires ou d’analyses en composantes principales fondées sur les matrices de corrélation. En revanche, si une analyse factorielle est exécutée à partir de la matrice de covariance brute sans standardisation préalable, la normalisation unitaire harmonisera l’impact des différents items d’évaluation sans pour autant conférer une variance égale à 1 à chaque variable, préservant ainsi la variance relative interne de chaque descripteur par rapport à son étendue naturelle.
4.3 Limites de la transformation face à la dispersion relative
Malgré ses remarquables propriétés de conservation morphologique, la normalisation Min-Max présente des vulnérabilités méthodologiques considérables lorsqu’elle est confrontée à des problèmes de dispersion relative non bornée. La limite la plus prégnante provient de la dépendance structurelle de l’écart-type transformé vis-à-vis de l’étendue globale observée. Contrairement à une standardisation par le score Z qui contraint formellement l’écart-type à l’unité (sigma = 1), l’écart-type d’une série normalisée entre 0 et 1 s’établit à s_normalisé = s_brut / (x_max – x_min). La variance résultante dépend donc exclusivement du ratio entre la variabilité interne et l’amplitude maximale de l’échantillon.
Cette particularité induit une altération potentielle des rapports de distances relatives perçues lorsque l’on juxtapose plusieurs variables dotées de dynamiques d’étalement différentes. Deux variables présentant initialement le même écart-type mais des étendues disparates en raison de points extrêmes isolés n’auront pas la même dispersion au sein de l’hypercube unitaire. La variable affichant la plus vaste étendue verra sa variance globale comprimée de manière bien plus vigoureuse que celle présentant une distribution compacte exempte d’asymétrie.
De surcroît, le système pâtit d’une instabilité rédhibitoire des distances relatives en cas d’adjonction ultérieure d’observations marginales. Si une nouvelle vague de mesures introduit un individu présentant un score nettement supérieur au x_max préexistant, la recalibration de l’échelle contractera immédiatement l’ensemble des scores des participants antérieurs. Les positions spatiales relatives des sujets au sein de l’espace unitaire se trouveront alors redéfinies, ce qui soulève de vives interrogations méthodologiques quant à la comparabilité temporelle des évaluations individuelles.
5. Applications concrètes en psychométrie et sciences comportementales
5.1 Harmonisation des échelles de Likert et questionnaires psychologiques
En psychométrie expérimentale, les cohortes d’évaluation sont fréquemment soumises à des batteries de tests hétérogènes conçues par des auteurs différents au fil de décennies de recherche. Par exemple, un inventaire de détresse psychologique peut reposer sur une échelle de Likert graduée en 4 modalités (de 0 à 3), tandis qu’un questionnaire d’estime de soi s’étalonne sur une échelle en 7 points (de 1 à 7). L’agrégation directe de ces mesures dans un modèle d’équations structurelles ou un score composite global engendre une pondération implicite fallacieuse, la mesure en 7 points possédant une étendue numérique brute de 6 contre seulement 3 pour l’outil concurrent.
La mise à l’échelle unitaire résout avec élégance cette distorsion de calibrage. Pour l’échelle d’estime de soi dont les extrema théoriques sont x_min = 1 et x_max = 7, un score de 4 est projeté selon la formule : (4 – 1) / (7 – 1) = 3 / 6 = 0,5000. Pour l’échelle de détresse psychologique dont les extrema sont 0 et 3, un score de 1,5 est transformé selon : (1,5 – 0) / (3 – 0) = 1,5 / 3 = 0,5000. Les deux instruments de mesure se trouvent ainsi parfaitement étalonnés sur une échelle continue équivalente de 0 à 1, autorisant le chercheur à calculer un indice composite non biaisé ou à exécuter des comparaisons directes de profils sans artefact dimensionnel.
Cette harmonisation permet également de combiner des sous-échelles divergentes au sein d’instruments composites unifiés pour le diagnostic clinique. Dans le cadre de l’évaluation multidimensionnelle de l’épuisement professionnel (burnout), un investigateur peut agréger les dimensions d’épuisement émotionnel, de dépersonnalisation et d’accomplissement personnel — bien que ces dimensions présentent initialement des nombres d’items et des métriques d’ancrage inégaux — en accordant à chaque domaine clinique un poids normatif rigoureusement équivalent au sein de l’évaluation finale.
5.2 Traitement unifié des temps de réaction et des scores cognitifs
Les protocoles de psychologie cognitive expérimentale exigent souvent la réconciliation méthodologique de variables dont la nature physique s’avère radicalement opposée. L’un des dilemmes les plus prégnants réside dans la coexistence de données de précision de réponse (fréquemment formalisées sous la forme de ratios de succès binaires compris entre 0 et 100 %) et de latences motrices ou temps de réaction comportementaux, enregistrés en millisecondes et fluctuant couramment entre 300 et 2500 ms.
L’application d’un re-scalage unitaire aux temps de réaction permet de concevoir des indices d’efficacité cognitive intégrés, neutralisant le compromis vitesse-précision (« speed-accuracy trade-off »). Afin de rendre les variables directionnellement convergentes, le chercheur peut appliquer une normalisation inverse aux latences cognitives. En soustrayant le score normalisé unitaire de 1, une latence extrêmement rapide (proche du minimum temporel) se voit réattribuée une valeur proche de 1, traduisant une excellente efficacité motrice. Les latences tardives convergent en revanche vers 0.
Une fois les deux descripteurs recalibrés au sein du segment [0, 1] avec une valence conceptuelle alignée, il devient méthodologiquement recevable de calculer un indice composite d’efficacité cognitive par simple moyenne arithmétique ou pondérée des scores normalisés. Les distorsions d’unités de mesure s’effacent, permettant d’évaluer de manière robuste la performance globale du participant au cours de tâches attentionnelles complexes ou d’épreuves de mémoire de travail chronométrées.
5.3 Mesures physiologiques et marqueurs neurofonctionnels
L’intégration de la psychophysiologie dans l’analyse comportementale contemporaine expose les chercheurs à des séries de données continues caractérisées par une variabilité interindividuelle et intra-individuelle majeure. Considérons l’enregistrement de la réponse électrodermale ou conductance cutanée (Skin Conductance Level, SCL), mesurée en microsiemens (µS). L’épaisseur de l’épiderme, l’hydratation basale et la densité glandulaire engendrent des disparités considérables de niveau tonique moyen d’un sujet à l’autre, bien que la dynamique phasique liée aux stimuli émotionnels soit comparable.
Pour éliminer ce bruit de fond physiologique propre à chaque participant, la mise à l’échelle unitaire est appliquée au niveau intra-individuel. En identifiant pour chaque sujet sa conductance minimale et maximale au cours d’une session expérimentale donnée, les enregistrements de conductance cutanée brute sont projetés sur l’intervalle [0, 1]. Cette normalisation individualisée isole l’amplitude relative des réponses autonomes induites par les stimuli psycho-émotionnels, rendant les activations physiologiques directement comparables à travers l’ensemble de la cohorte expérimentale indépendamment des disparités anatomiques basales.
Ce protocole trouve une application identique dans le traitement de la variabilité de la fréquence cardiaque (HRV) ainsi que dans l’électroencéphalographie quantitative (qEEG). Lors de l’analyse des densités de puissance spectrale des bandes de fréquences cérébrales (ondes Delta, Thêta, Alpha, Bêta), la normalisation unitaire des puissances spectrales de chaque électrode le long du scalp permet de comparer les topographies fonctionnelles sans que la magnitude globale du signal, tributaire de la résistance du tissu crânien, ne masque les asymétries hémisphériques ou les réorganisations spatiales d’intérêt.
6. Analyse comparative : Normalisation Min-Max versus Standardisation Z-Score
6.1 Fondements mathématiques divergents des deux approches
Dans l’arsenal du statisticien, deux méthodes de prétraitement prédominent : la normalisation Min-Max et la standardisation stochastique par le score Z (ou centrage-réduction). Si ces démarches partagent l’objectif commun d’éliminer les effets d’échelle brute, leurs fondations algébriques et leurs propriétés épistémologiques obéissent à des logiques profondément divergentes qu’il convient de distinguer avec clarté.
La normalisation Min-Max relève d’une logique purement déterministe et compacte. Elle ancre l’ajustement sur les valeurs extrêmes empiriquement identifiées (x_min et x_max) et projette les observations vers un segment fermé, strict et borné [0, 1]. À l’inverse, la standardisation par le score Z repose sur une approche stochastique fondée sur la théorie des probabilités et le calcul des moments :
z = (x – mu) / sigma
où mu représente l’espérance mathématique (ou moyenne arithmétique empirique) et sigma désigne l’écart-type de la distribution.
L’espace géométrique résultant du score Z constitue un ensemble ouvert infini non borné, s’étendant formellement de moins l’infini à plus l’infini. Tandis que la normalisation unitaire garantit l’absence totale de valeurs au-delà des limites 0 et 1 pour la cohorte analysée, le score Z centre la distribution autour d’une moyenne nulle (mu = 0) avec une variance unitaire (sigma^2 = 1). Il en résulte qu’une observation atypique située à cinq écarts-types de la moyenne générera un score Z de 5,0, conservant sa nature d’extrême non borné dans l’espace transformed.
6.2 Critères méthodologiques de sélection de l’outil approprié
Le choix entre ces deux paradigmes de transformation ne saurait être le fruit du hasard ou d’une routine algorithmique irréfléchie ; il engage la cohérence du protocole expérimental et de l’architecture d’analyse en aval. Le premier critère de discernement concerne l’adhésion de la variable empirique au modèle gaussien normal. Lorsque les descripteurs sous-jacents suivent approximativement une loi normale exempte d’asymétrie sévère, la standardisation Z est hautement recommandée en raison de sa connexion naturelle avec la théorie de l’échantillonnage gaussien et les tests paramétriques d’inférence.
Cependant, lorsque les données ne présentent aucune propension à la normalité — par exemple dans le cas de variables uniformes, bimodalement réparties ou restreintes par nature à des intervalles physiques compacts (comme des pourcentages de saturation d’oxygène ou des scores bornés de performance) — la normalisation Min-Max s’avère conceptuellement supérieure. Elle ne postule aucune hypothèse distributionnelle sous-jacente et respecte l’amplitude délimitée du phénomène d’intérêt sans imposer artificiellement un centrage stochastique dénué de pertinence écologique.
Un autre critère décisif repose sur la nature de l’interprétation recherchée par le praticien. La normalisation Min-Max s’impose avec force lorsqu’une interprétation phénotypique directe en termes de pourcentage de complétion d’un continuum est requise. En revanche, le score Z convient prioritairement lorsque l’objectif fondamental consiste à quantifier la rareté statistique ou la déviation relative d’un sujet par rapport à la norme d’une population de référence, formalisée en unités d’écart-type.
6.3 Conséquences décisionnelles sur l’inférence statistique
L’impact de la méthode de prétraitement sur les résultats de l’inférence statistique constitue une préoccupation constante en sciences comportementales. Dans le contexte de la modélisation linéaire classique, telle que la régression linéaire ordinaire (OLS), la normalisation Min-Max et la standardisation Z-Score conduisent rigoureusement aux mêmes décisions d’inférence statistique concernant la significativité globale du modèle (valeur F) et le coefficient de détermination R^2. De même, les statistiques de Student associées aux coefficients de régression ainsi que leurs valeurs p respectives demeurent strictement identiques, ces deux méthodes opérant de pures transformations affines préservant la colinéarité vectorielle.
Néanmoins, l’interprétation concrète des coefficients de pente bêta diverge profondément. Dans une régression reposant sur des variables normalisées par Min-Max, le coefficient de régression indique l’accroissement attendu de la variable dépendante lorsque le prédicteur passe de son minimum absolu (0) à son maximum absolu (1), c’est-à-dire traverse l’intégralité de son étendue observée. Dans une régression sur scores standardisés Z, le coefficient de régression (coefficient bêta standardisé) reflète la variation prédite pour une hausse d’un seul écart-type du prédicteur.
En présence de multicolinéarité modérée, la standardisation Z offre l’avantage traditionnel de réduire la corrélation artificielle induite entre les termes linéaires et leurs termes polynomiaux ou d’interaction lors de régressions quadratiques ou modérées. La normalisation unitaire ne supprime pas cette corrélation de structure de manière aussi efficiente, car le produit de variables bornées entre 0 et 1 génère des distributions résolument asymétriques tendant vers zéro, ce qui peut compliquer l’estimation non biaisée des effets d’interaction de haut niveau sans centrage préalable.
7. Implémentation technique et calculatoire dans l’environnement Python
7.1 Programmation native et vectorielle avec la bibliothèque NumPy
L’implémentation d’une fonction de normalisation unitaire au sein du langage NumPy permet d’appréhender avec limpidité les opérations d’algèbre linéaire sous-jacentes tout en tirant parti de la vectorisation matérielle. La conception d’un algorithme sans dépendance logicielle excessive constitue une compétence méthodologique essentielle pour le déploiement de chaînes de traitement légères et véloces.
Sur le plan technique, la vectorisation s’appuie sur le mécanisme de diffusion (« broadcasting ») des tableaux multidimensionnels. L’écriture d’une fonction personnalisée implique d’extraire simultanément les vecteurs de minima et de maxima le long d’un axe spécifié (généralement axis=0 afin de traiter les colonnes de prédicteurs de façon indépendante). L’expression algorithmique s’articule autour des fonctions natives np.min et np.max, suivie de l’évaluation séquentielle du numérateur et du dénominateur :
On définit une fonction qui reçoit une matrice multidimensionnelle en entrée. Cette fonction extrait le minimum de chaque colonne via la commande interne de recherche de borne inférieure, puis le maximum respectif par la commande homologue. Le calcul s’exécute ensuite par simple soustraction matricielle, divisée par la différence absolue des deux extrema. Le mécanisme interne de NumPy projette ces opérations sur l’ensemble des éléments scalaires sans recourir à des boucles explicites lentes, garantissant des temps de traitement microscopiques même sur des matrices comprenant des centaines de milliers de lignes d’enregistrement expérimental.
La gestion rigoureuse des dimensions exige une attention particulière lors de l’utilisation de l’argument keepdims=True au sein des fonctions d’extraction d’extrema. Ce paramètre préserve la dimensionalité matricielle d’origine (transformant un tableau 2D en vecteurs lignes de dimension compatible), empêchant tout repliement vectoriel inattendu lors de l’application de la division matricielle broadcasée.
7.2 Traitement de cohortes avec les DataFrames Pandas
Dans l’écosystème de la science des données biomédicales, la manipulation des corpus d’études s’effectue préférentiellement au travers de la structure en tableau de données de la bibliothèque Pandas. L’avantage prépondérant de cette structure réside dans la préservation systématique des étiquettes sémantiques, des indexations temporelles fines et des identifiants anonymisés des participants au fil des calculs.
Pour appliquer la transformation unitaire à une sélection rigoureuse de colonnes d’intérêt représentant des échelles psychométriques ou des scores physiologiques, tout en laissant inaltérées les métadonnées qualitatives (telles que le groupe clinique, le sexe biologique ou l’identifiant du patient), la méthodologie privilégie les opérations vectorielles groupées. L’isolation préalable des colonnes quantitatives continues s’opère par sélection de sous-ensembles typés. L’expression s’appuie ensuite sur les méthodes natives associées à la série ou au DataFrame, calculant le minimum et le maximum de manière instantanée sur les axes verticaux.
L’un des défis récurrents réside dans la manipulation adéquate des données manquantes (notées NaN pour « Not a Number »). Pandas intègre par défaut une politique d’exclusion implicite (skipna=True) lors de l’évaluation des extrema x_min et x_max. Cela garantit que la présence de cellules vides au sein d’un descripteur n’empêche pas l’identification correcte des frontières de dispersion de la cohorte. Les cases manquantes demeurent naturellement positionnées sous forme de valeurs non renseignées après transformation unitaire, sans corrompre les calculs associés aux observations complètes.
7.3 Utilisation industrielle avec MinMaxScaler de Scikit-Learn
Pour les projets nécessitant une standardisation rigoureuse de niveau industriel et une intégration sans faille dans des pipelines de modélisation prédictive, le transformateur MinMaxScaler du module de prétraitement de Scikit-Learn constitue l’outil de référence absolu. Sa supériorité méthodologique repose sur son adhérence stricte au paradigme architectural de l’apprentissage statistique articulé autour des méthodes d’ajustement (« fit ») puis de projection (« transform »).
Ce paradigme sépare délibérément l’étape d’apprentissage des paramètres statistiques de l’étape d’application mathématique. L’instruction fit explore la distribution assignée afin d’extraire, d’enregistrer et de verrouiller en mémoire les attributs fondamentaux nommés data_min_ et data_max_, ainsi que le coefficient d’échelle interne scale_. Une fois cette calibration figée, l’instruction transform utilise ces paramètres immuables pour convertir la matrice de données. Cette séparation évite toute corruption des structures d’évaluation lors de la scission des cohortes.
De surcroît, le transformateur offre des paramètres avancés d’un grand intérêt pratique. L’argument feature_range permet de définir des intervalles d’arrivée arbitraires différents du segment unitaire classique, tels que [-1, 1], requis par certaines fonctions d’activation neuronales comme la tangente hyperbolique (tanh). Le paramètre clip=True, introduit dans les versions contemporaines de l’outil, autorise l’écrêtage automatique des données prédictives futures, forçant toute observation dépassant accidentellement les extrema de référence à s’aligner rigidement sur 0 ou 1, évitant ainsi la génération de valeurs aberrantes hors-bornes lors des phases de déploiement clinique prospectif.
8. Implémentation computationnelle dans l’environnement de calcul R
8.1 Développement de fonctions scalaires et vectorielles en langage R de base
Dans les laboratoires académiques et les unités de recherche biostatistique, le langage de programmation statistique R demeure une plateforme de choix pour l’analyse fine des protocoles expérimentaux. L’implémentation canonique d’une fonction de normalisation unitaire en R de base s’appuie sur la richesse de ses fonctions primitives internes d’optimisation numérique.
La conception d’une fonction générique robuste requiert la prise en compte explicite de la gestion des données manquantes et du contrôle d’intégrité vectorielle. Une fonction élémentaire peut être formulée de la manière suivante :
On programme une routine nommée normaliser_min_max qui accepte un vecteur atomique numérique x et un argument booléen na.rm régulant l’exclusion des valeurs absentes. La fonction exécute la primitive range() afin d’extraire simultanément, au sein d’un vecteur compact à deux éléments, la borne inférieure et la borne supérieure du descripteur. Après avoir extrait ces deux scalaires, l’étendue est calculée par simple soustraction. Si l’étendue s’avère nulle (signalant une variance inexistante), la fonction renvoie un vecteur de zéros ou avertit l’analyste par un message d’alerte, évitant ainsi le piège computationnel du résultat indéfini (NaN).
L’application de cette fonction sur des structures matricielles ou des jeux de données rectangulaires bidimensionnels s’opère naturellement sans boucle explicite grâce à l’usage de la famille fonctionnelle apply. L’instruction apply(matrice, 2, normaliser_min_max) applique l’opérateur de manière récursive sur chacune des colonnes de la matrice statistique, restituant un format multidimensionnel parfaitement re-scalé avec un coût computationnel marginal.
8.2 Intégration au flux de travail moderne Tidyverse
L’avènement du paradigme Tidyverse a profondément rénové les standards de manipulation des données en sciences comportementales en promouvant une syntaxe lisible, modulaire et structurée selon le principe des données ordonnées (« tidy data »). Au sein de cet écosystème, l’orchestration de la normalisation unitaire à grande échelle s’exécute de façon privilégiée via les extensions de la bibliothèque dplyr.
En combinant les verbes d’action structurants mutate() et across(), l’analyste exécute le re-scalage simultané d’une vaste pluralité de variables sélectionnées selon des prédicats sémantiques ou typologiques précis. Il devient aisé de spécifier que toutes les colonnes numériques, ou toutes les variables dont le nom contient un préfixe d’item psychométrique (par exemple starts_with(« item_ »)), doivent être re-scalées en appliquant la fonction unitaire. Cette approche garantit une traçabilité exemplaire du code au sein des carnets de laboratoire reproductibles (R Markdown ou Quarto).
Conjointement, l’association de dplyr avec le moteur graphique ggplot2 offre une opportunité remarquable pour le contrôle visuel des distributions pré- et post-normalisation. La projection simultanée de graphiques d’estimation de la densité par noyau (« density plots ») ou de diagrammes en boîte à moustaches (« boxplots ») permet à l’expérimentateur d’attester visuellement de l’invariance absolue des profils de densité, confirmant que seule la graduation de l’axe des abscisses a été comprimée pour s’insérer docilement entre 0 et 1, sans la moindre altération morphologique de la variance de cohorte.
8.3 Automatisation avancée via les packages caret et recipes
Pour les chercheurs impliqués dans la modélisation prédictive supervisée complexe ou l’apprentissage automatique clinique, la gestion manuelle du prétraitement présente des risques majeurs d’erreurs méthodologiques. L’emploi d’architectures d’ingénierie statistique spécialisées, telles que caret (Classification And REgression Training) ou l’écosystème moderne tidymodels via le package recipes, formalise la chaîne d’opérations sous la forme d’un protocole entièrement encapsulé.
Avec le package caret, la standardisation s’orchestre au travers de la fonction prédictive preProcess, en spécifiant l’option method = « range ». Cette directive demande au moteur d’extraire automatiquement l’amplitude empirique des prédicteurs d’entraînement et d’ajuster une structure de projection réutilisable sur tout jeu de données externe ou sous-échantillon de validation croisée.
Le module recipes de tidymodels offre une flexibilité de niveau supérieur en décomposant les étapes préparatoires en une véritable « recette de laboratoire ». L’utilisation du mot-clé step_range() permet de définir la projection unitaire sur des groupes de prédicteurs spécifiques, d’ajuster finement les bornes cibles (par défaut min = 0, max = 1), et de figer ces transformations au sein d’une recette préparée (« prep ») prête à être cuite (« bake ») sur des données nouvelles. Cette approche élimine toute possibilité d’interférence humaine lors de l’exécution séquentielle des calculs, assurant une conformité rigoureuse avec les standards de la science ouverte et reproductible.
9. Vulnérabilité aux données aberrantes et variantes de normalisation robuste
9.1 Effet d’écrasement de la variance induit par les outliers
En dépit de son élégance mathématique et de sa simplicité calculatoire, la normalisation Min-Max souffre d’un point faible structurel bien documenté par les statisticiens : son extrême vulnérabilité face aux données aberrantes ou atypiques, couramment désignées sous le terme d’outliers. Cette fragilité découle directement de son équation constitutive, dont le dénominateur repose intégralement sur les statistiques d’ordre les plus instables d’un échantillon aléatoire, à savoir le premier et le dernier quantile extrême.
Lorsqu’un jeu de données héberge ne serait-ce qu’une seule observation isolée présentant une magnitude disproportionnée — qu’il s’agisse d’une erreur d’encodage instrumental, d’un artéfact de mesure expérimental ou d’un profil biologique ultra-rare —, la valeur x_max se trouve catapultée à un niveau d’élévation anormal. En conséquence, l’étendue globale (x_max – x_min) subit une dilatation artificielle colossale. Ce phénomène déclenche ce que la littérature nomme « l’effet d’écrasement de la variance » (« variance compression »).
Puisque le dénominateur devient démesurément vaste, l’ensemble des observations empiriques légitimes constituant le cœur de la cohorte d’étude se retrouve projeté et comprimé au sein d’une minuscule fraction du segment unitaire, par exemple entre 0,00 et 0,05. Le pouvoir discriminant de la variable normalisée s’en trouve quasi totalement anéanti. Les disparités subtiles mais cliniquement informatives qui distinguaient les participants réguliers sont gommées par l’écrasement de l’échelle, neutralisant l’aptitude des modèles de régression ou de segmentation à exploiter la variance sous-jacente.
9.2 Techniques préliminaires de nettoyage et de troncature statistique
Pour immuniser la normalisation unitaire contre ce risque dévastateur sans abandonner la compacité pratique de l’intervalle [0, 1], plusieurs protocoles de prétraitement et de nettoyage statistique préliminaires peuvent être déployés en amont de l’application de la formule.
La première stratégie repose sur la troncature statistique ou winsorisation empirique. Au lieu d’ancrer le calcul sur les extrema absolus bruts de la série, le méthodologiste redéfinit conventionnellement les bornes en sélectionnant des percentiles critiques, tels que le 1er percentile pour le point bas et le 99e percentile pour le point haut (ou les 5e et 95e percentiles dans les contextes hautement bruités). Toute valeur observée au-delà de ces frontières se voit réassignée à la valeur exacte du seuil correspondant avant d’exécuter le re-scalage Min-Max. La variabilité centrale est ainsi préservée de l’effet d’étirement provoqué par les queues de distribution lourdes.
Une alternative robuste consiste à fonder la détection et l’élagage des aberrations sur l’écart absolu à la médiane (Median Absolute Deviation, MAD). Contrairement à l’écart-type classique, la médiane et la MAD affichent un point de rupture élevé de 50 %, ce qui signifie que jusqu’à la moitié des données peuvent être contaminées par des valeurs extrêmes sans que ces estimateurs ne perdent leur représentativité centrale. En définissant des seuils de cohérence clinique fondés sur un multiple de la MAD, les valeurs empiriquement impossibles peuvent être identifiées, corrigées ou filtrées en amont du calcul de l’étendue globale.
9.3 Alternatives robustes : la normalisation quantile et l’échelle robuste
Lorsque la nature intrinsèque des phénomènes étudiés génère structurellement des queues de distribution épaisses et asymétriques qu’il est scientifiquement injustifiable d’élaguer arbitrairement, le chercheur doit se tourner vers des variantes méthodologiques avancées de mise à l’échelle robuste.
L’une des alternatives reconnues est le re-scalage interquartile robuste (Robust Scaling), implémenté notamment par le transformateur RobustScaler. Cette approche substitue la moyenne par la médiane, et remplace l’étendue totale par l’étendue interquartile (Interquartile Range, IQR), définie comme la différence arithmétique entre le 75e percentile (Q3) et le 25e percentile (Q1) :
z = (x – Médiane) / IQR
Bien que cette métrique ne contraigne pas formellement les valeurs à s’inscrire à l’intérieur d’un intervalle fermé [0, 1], elle préserve efficacement la variance centrale de la contamination par les valeurs marginales.
Pour réconcilier robustesse statistique et confinement unitaire strict, une approche sophistiquée réside dans l’application combinée d’une transformation non linéaire par fonction logistique sigmoïde standardisée suivie d’une projection unitaire, ou dans l’usage de la normalisation par transformation quantile uniforme (QuantileTransformer avec distribution de sortie uniforme). Cette dernière applique une transformation non paramétrique fondée sur la fonction de répartition empirique, redistribuant uniformément l’ensemble des rangs individuels sur l’intervalle [0, 1]. Cette procédure dissout totalement l’impact des outliers, bien qu’elle sacrifie au passage la stricte linéarité de l’espacement original au profit d’un étalement uniforme des rangs.
10. Impact de la normalisation sur les architectures de modélisation prédictive
10.1 Optimisation des algorithmes basés sur la descente de gradient
Dans le domaine computationnel contemporain, la performance des algorithmes d’apprentissage automatique supervisé et non supervisé dépend de façon critique du conditionnement géométrique des surfaces d’erreur optimisées par la descente de gradient, sous ses variantes stochastiques ou adaptatives (Adam, RMSprop). L’absence de normalisation des entrées conduit à la formation de vallées de coût profondément anisotropiques, caractérisées par des contours elliptiques démesurément étirés.
Lorsque les coordonnées d’un espace de paramètres présentent des amplitudes disparates, le gradient spatial oscille violemment le long des dimensions dotées des plus fortes variations numériques tout en progressant avec une lenteur exaspérante sur les dimensions à faible magnitude. Ce phénomène contraint l’expérimentateur à adopter un pas d’apprentissage (« learning rate ») excessivement réduit afin d’éviter l’explosion numérique des calculs, au détriment dramatique du temps de convergence algorithmique.
La normalisation unitaire Min-Max restaure une symétrie sphérique harmonieuse sur la topographie des fonctions de coût, régularisant le conditionnement hessien du système. L’homogénéisation des gradients sur chaque axe directionnel autorise l’utilisation de taux d’apprentissage optimaux, accélère de plusieurs ordres de grandeur la convergence vers les minima globaux et atténue substantiellement les risques de disparition ou d’explosion du gradient au sein des couches cachées des réseaux neuronaux profonds appliqués aux signaux comportementaux.
10.2 Influence déterminante sur les métriques de distance multidimensionnelle
Une vaste famille de méthodes statistiques et de classification non supervisée repose sur la mesure de proximités géométriques ou de dissimilarités spatiales au sein d’un espace vectoriel à d dimensions. C’est le cas emblématique du partitionnement par l’algorithme des K-moyennes (K-means clustering), de la classification par les K-plus-proches voisins (KNN), de la méthode des machines à vecteurs de support (SVM) à noyau de base radiale (RBF) et du positionnement multidimensionnel (MDS).
Toutes ces architectures s’appuient principalement sur le calcul de la distance euclidienne canonique entre deux vecteurs d’observations p et q, formulée par la racine carrée de la somme des écarts quadratiques :
d(p, q) = sqrt( sum_{k=1}^d (p_k – q_k)^2 )
Si une variable k possède une échelle brute oscillant entre 0 et 50 000 tandis qu’une dimension compagne varie entre 0 et 1, la somme des écarts quadratiques sera mathématiquement dominée à 99,99 % par la première composante. La distance spatiale n’aura de proximité que le nom : elle se réduira dans les faits à l’évaluation unidimensionnelle de la caractéristique à forte variance brute, ignorant purement et simplement les variations du second descripteur.
En projetant chaque dimension k sur le segment unifié [0, 1], la normalisation Min-Max assure à chaque prédicteur une contribution théorique strictement équilibrée à l’édification de l’espace métrique. Les algorithmes de partitionnement peuvent ainsi agréger des individus sur la base d’une similarité multidimensionnelle équitable, garantissant que les typologies ou profils cliniques identifiés reflètent l’ensemble des domaines de compétences évalués plutôt qu’un artéfact dimensionnel arbitraire.
10.3 Sensibilité comparée des modèles arborescents et non paramétriques
Il est scientifiquement fondamental d’observer que l’impératif de mise à l’échelle des descripteurs n’affecte pas l’ensemble des paradigmes d’apprentissage de façon uniforme. Les modèles fondés sur les arbres de décision hiérarchiques — qu’il s’agisse des arbres de classification et de régression simples (CART), des forêts aléatoires (Random Forests) ou des algorithmes de gradient boosting sur arbres (XGBoost, LightGBM) — manifestent une invariance structurelle absolue face aux transformations monotones des variables explicatives.
Cette invariance découle directement de la méthode de scission séquentielle opérée par les nœuds d’un arbre. Pour isoler le seuil de coupure optimal d’un descripteur, l’algorithme analyse l’ordonnancement séquentiel des observations plutôt que leur magnitude vectorielle continue. Dès lors qu’une transformation mathématique préserve rigoureusement la monotonie d’ordre — ce qui est le cas avéré de la normalisation unitaire f(x) = (x – x_min)/(x_max – x_min) dont la dérivée est strictement positive —, le seuil optimal identifié sur la série brute se transpose avec une fidélité isomorphe parfaite sur la série re-scalée. La géométrie des partitions décisionnelles demeure rigoureusement identique.
Par conséquent, pour les architectures reposant exclusivement sur des ensembles d’arbres décisionnels, l’exécution d’une normalisation Min-Max n’apporte aucun gain d’exactitude empirique ni d’accélération d’apprentissage prédictif. L’analyste peut s’épargner cette étape computationnelle, consacrant ses ressources de calcul à des phases d’ingénierie plus fécondes, sous réserve de n’intégrer dans son flux prédictif aucune composante sensible aux métriques de distance ou de gradient régularisé.
11. Bonnes pratiques méthodologiques et prévention des biais d’analyse
11.1 Prévention stricte du phénomène de fuite de données (Data Leakage)
L’écueil méthodologique le plus insidieux et dévastateur lors de la mise en œuvre de transformations d’échelle au sein de protocoles prédictifs ou d’apprentissage automatique réside dans la fuite d’information ou fuite de données (« data leakage »). Cette faute méthodologique majeure survient lorsque des informations issues de l’ensemble d’évaluation (jeu de validation ou de test) s’infiltrent subrepticement dans la phase d’apprentissage du modèle statistique, générant une surestimation illusoire et non reproductible de ses performances réelles.
La règle déontologique et méthodologique fondamentale stipule que l’extraction des paramètres d’échelle x_min et x_max doit impérativement et exclusivement s’effectuer à partir des données constitutives du sous-ensemble d’entraînement (« training set »). Calculer le minimum et le maximum globaux sur l’intégralité d’un corpus avant de procéder à sa scission aléatoire entre sous-ensemble d’entraînement et sous-ensemble de test constitue une violation formelle de l’indépendance des échantillons. En opérant ainsi, les extrema du jeu de test influencent directement le centrage et la dilatation des prédicteurs d’entraînement.
La procédure orthodoxe impose de calibrer l’opérateur de transformation uniquement sur les matrices d’entraînement. Ces paramètres d’ancrage fixes sont ensuite appliqués de manière aveugle aux données de validation et de test. Si le jeu de test présente ultérieurement des réalisations empiriques inférieures au x_min d’entraînement ou supérieures au x_max d’entraînement, le système doit accepter de projeter ces points en dehors du segment [0, 1] strict (donnant des valeurs négatives ou supérieures à l’unité), ou appliquer une politique délibérée d’écrêtage contrôlé, sous peine de falsifier la validité externe des conclusions scientifiques.
11.2 Calcul de la transformation inverse pour l’interprétabilité clinique
Si la projection unitaire facilite grandement le traitement algorithmique et l’optimisation mathématique des modèles, elle s’avère profondément défavorable à l’interprétabilité humaine directe et à la communication translationnelle des résultats auprès des praticiens, cliniciens ou décideurs publics. Présenter à un médecin une prédiction de temps de sédation de 0,382 ou annoncer à un patient un indice d’anxiété de 0,714 n’offre aucune intelligibilité immédiate quant à la gravité ou à la réalité physique du pronostic.
Il est donc méthodologiquement impératif de maîtriser et d’intégrer dans ses chaînes de traitement l’inversion algébrique exacte de la transformation, couramment appelée dé-normalisation. Partant de la formule canonique de base, l’expression de la réciproque s’obtient aisément en isolant la variable brute originale x_i par simple inversion des opérations arithmétiques :
x_i = z_i * (x_max – x_min) + x_min
Le score normalisé z_i est en premier lieu multiplié par l’étendue originale retenue lors de la phase de calibration, réattribuant à la grandeur sa variance physique d’origine, avant de se voir additionner la borne minimale originale x_min pour restaurer le point d’ancrage naturel du repère d’observation.
Cette dé-normalisation systématique des prédictions finales permet de restituer la significativité clinique complète des résultats. Les prédictions redeviennent lisibles dans leurs unités d’origine — milligrammes par litre, millisecondes, ou points de score diagnostique standardisés —, autorisant le calcul d’intervalles de confiance concrets et facilitant une prise de décision éclairée et éthiquement responsable en milieu appliqué.
11.3 Documentation méticuleuse et reproductibilité de la recherche
Dans le contexte de la crise internationale de la reproductibilité scientifique qui traverse les sciences comportementales et biomédicales, la rigueur appliquée à la documentation des étapes de prétraitement numérique est devenue un critère d’évaluation prépondérant de la qualité des publications. Trop d’investigations omettent de consigner explicitement les constantes scalaires employées pour calibrer leurs transformations, rendant impossible la réplication indépendante de leurs conclusions statistiques.
Chaque protocole d’analyse quantitative publiant des résultats dérivés de variables normalisées doit scrupuleusement consigner et archiver au sein de ses répertoires de données ouvertes (tels que l’Open Science Framework ou Zenodo) les valeurs scalaires exactes des bornes x_min et x_max exploitées pour chaque prédicteur. Cette consigne s’applique avec une acuité accrue lorsque la normalisation a reposé sur des extrema théoriques d’instruments de mesure plutôt que sur les minima et maxima empiriques de la cohorte d’étude.
De même, l’exhaustivité méthodologique exige la publication intégrale et sans altération des scripts computationnels de transformation rédigés en R, Python ou tout autre langage formel. Ces scripts doivent expliciter la gestion réservée aux données manquantes, les éventuelles politiques d’écrêtage mises en œuvre, ainsi que le positionnement exact de l’opération dans le flux d’analyse par rapport aux étapes d’imputation ou de partitionnement transversal, assurant ainsi une auditabilité irréprochable de la démarche computationnelle.
12. Synthèse théorique et guide de décision pour le chercheur contemporain
12.1 Arbre décisionnel pour l’adoption du re-scalage Min-Max
Afin de guider le chercheur contemporain dans les dédales des choix méthodologiques préparatoires, la décision d’opter pour la normalisation unitaire Min-Max plutôt que pour une méthode concurrente peut être formalisée au travers d’un cheminement décisionnel logique rigoureux et exhaustif.
La première interrogation structurante interroge la compacité théorique de l’espace de mesure : la variable observée possède-t-elle des frontières naturelles strictes et infranchissables (par exemple un ratio, une proportion physique bornée ou une échelle psychométrique fermée) ? Si la réponse est affirmative, la normalisation unitaire représente le choix le plus élégant et conforme à l’ontologie du phénomène. Si la variable s’inscrit au contraire dans un continuum théoriquement infini sujet à des dérives imprédictibles, une standardisation probabiliste doit être envisagée avec circonspection.
La seconde étape décisionnelle examine la présence et la plausibilité des observations extrêmes au sein de la distribution : le jeu de données présente-t-il des queues épaisses contaminées par des valeurs aberrantes massives ? Si ces aberrations ne peuvent être éliminées sur des critères biologiques ou expérimentaux stricts, la normalisation Min-Max brute doit être formellement rejetée au profit d’une mise à l’échelle robuste (RobustScaler) ou d’une winsorisation préliminaire rigoureuse pour esquiver l’écrasement de variance.
Enfin, le troisième pivot décisionnel évalue les exigences mathématiques du modèle analytique situé en aval de la chaîne de traitement. Si le projet mobilise des algorithmes d’optimisation basés sur la descente de gradient, des architectures neuronales saturables, des métriques spatiales euclidiennes ou requiert une interprétation en fraction d’amplitude totale, la mise à l’échelle entre 0 et 1 constitue le standard d’excellence méthodologique incontournable.
12.2 Grille d’évaluation critique de la qualité de la transformation
Préalablement à l’injection définitive de matrices de données normalisées dans des architectures prédictives ou des modèles inférentiels de haut niveau, le chercheur se doit d’exécuter une batterie systématique de tests d’intégrité numérique servant de grille d’évaluation critique de l’opération.
Le premier point de contrôle réside dans la vérification de la fermeture de l’intervalle numérique d’arrivée : l’opérateur doit certifier qu’aucune valeur générée sur l’ensemble d’entraînement ne se situe en deçà de 0,0000 ni au-delà de 1,0000, et que les extrema numériques réels du vecteur transformé coïncident rigoureusement avec 0 et 1 (à la précision machine près, excluant les erreurs infinitésimales d’arrondi en virgule flottante). Sur les jeux de données de test prospectifs, l’ampleur d’éventuels débordements hors-bornes doit être quantifiée avec exactitude.
Le second contrôle porte sur l’audit d’intégrité ordinale et de colinéarité : le coefficient de corrélation de rang de Spearman entre le vecteur brut originel et le vecteur unitaire final doit obligatoirement être égal à 1,0000 avec une valeur p infinitésimale. Toute divergence par rapport à cette égalité parfaite trahirait une corruption catastrophique de l’algorithme ou l’intervention inopinée d’une non-linéarité non maîtrisée au cours de la chaîne de traitement.
12.3 Perspectives futures dans le traitement des biomarqueurs comportementaux
L’avènement récent de la santé numérique, de la psychiatrie computationnelle et des dispositifs de captation physiologique en continu (montres intelligentes, capteurs ambulatoires électrodermaux, évaluation écologique momentanée sur smartphone ou EMA) confronte la théorie de la normalisation à des défis conceptuels inédits qui redéfinissent les frontières de la discipline.
Le paradigme traditionnel du re-scalage statique sur des jeux de données clos s’avère structurellement inopérant face à des flux de données massifs générés en continu et en temps réel (« streaming data »). Dans de tels contextes, les extrema x_min et x_max ne constituent plus des paramètres figés mais des variables stochastiques dynamiques sujettes à des dérives temporelles et circadiennes majeures. Cela stimule le développement d’algorithmes de normalisation adaptative glissante (« online dynamic scaling »), capables de réactualiser récursivement les coefficients d’échelle le long d’une fenêtre temporelle exponentiellement pondérée.
De surcroît, la standardisation des biomarqueurs comportementaux longitudinaux soulève des questions éthiques et épistémologiques fondamentales touchant à l’individualisation des métriques. Contraindre le niveau d’anxiété subjectif ou la variabilité motrice d’un individu au sein d’une échelle normalisée universelle risque d’effacer les idiosyncrasies phénotypiques d’un patient au profit d’une uniformisation trompeuse. La science des données comportementales de demain s’oriente vers des architectures hiérarchiques mixtes, conjuguant une normalisation locale centrée sur la trajectoire personnalisée du sujet avec des ancrages globaux de cohorte, garantissant ainsi l’expression optimale de la complexité du comportement humain.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Geron, A. (2022). Hands-on machine learning with Scikit-Learn, Keras, and TensorFlow: Concepts, tools, and techniques to build intelligent systems (3rd ed.). O’Reilly Media.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Kuhn, M., & Johnson, K. (2013). Applied predictive modeling. Springer. https://doi.org/10.1007/978-1-4614-6849-3
- Kuhn, M., & Wickham, H. (2020). Tidymodels: a collection of packages for modeling and machine learning using tidyverse principles. https://www.tidymodels.org
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Van Rossum, G., & Drake, F. L. (2009). Python 3 reference manual. CreateSpace.
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686