
L’évaluation quantitative des déterminants de santé et des dynamiques psychopathologiques repose sur la capacité des chercheurs et des cliniciens à modéliser précisément les liens d’association entre des expositions spécifiques et l’émergence d’issues cliniques données. Dans le champ vaste de l’épidémiologie clinique, des neurosciences translationnelles et des sciences comportementales, la mesure de la force de ces associations constitue un impératif méthodologique incontournable. Parmi les indices d’effet les plus fréquemment mobilisés, le risque relatif (RR) occupe une place fondamentale. Il offre une grille de lecture intuitive et robuste pour évaluer à quel point l’exposition à un facteur biopsychosocial amplifie ou atténue la probabilité d’occurrence d’un trouble ou d’une modification comportementale au sein d’une population définie.
Toutefois, en dépit de son apparente simplicité arithmétique, le risque relatif demeure l’une des métriques statistiques les plus fréquemment mal interprétées, tant dans les publications académiques que dans les synthèses cliniques et les médias de vulgarisation. Les écueils conceptuels sont légion : confusion entre risques absolus et relatifs, assimilation erronée de l’association statistique à une causalité mécanique, méconnaissance des contraintes imposées par les devis de recherche, ou encore confusion récurrente avec le rapport de cotes (l’odds ratio). De telles méprises ne sont pas sans conséquences : elles peuvent conduire à une appréciation erronée de l’efficacité d’un protocole psychothérapeutique, à une surestimation alarmiste du danger inhérent à un facteur de vulnérabilité, ou à l’élaboration de politiques de santé publique mal calibrées face aux réalités épidémiologiques du terrain.
Le présent article propose une analyse approfondie, didactique et rigoureusement formalisée du risque relatif, adaptée aux exigences de la recherche contemporaine en psychologie et en psychiatrie. À travers l’exploration de ses fondements probabilistes, la décomposition de son appareillage mathématique, l’examen détaillé d’études de cas cliniques et l’explicitation de ses liens avec la prise de décision thérapeutique, ce guide a vocation à outiller les chercheurs, praticiens et étudiants d’une compréhension exhaustive de cet indicateur. En appréhendant non seulement le calcul ponctuel du risque relatif mais également l’évaluation de son incertitude statistique et les biais méthodologiques susceptibles d’en altérer la valeur, le lecteur disposera d’un cadre d’analyse complet pour décoder avec discernement les données probantes issues de la littérature internationale.
1. Fondements conceptuels du risque relatif en psychologie et sciences comportementales
1.1 Définition statistique et cadre épistémologique
D’un point de vue épistémologique, la caractérisation du risque relatif s’inscrit au cœur du paradigme de la causalité probabiliste, développé pour formaliser les relations d’interdépendance au sein de systèmes complexes où le déterminisme strict s’avère inapplicable. En psychologie empirique et en psychiatrie, les phénomènes observés ne répondent que très rarement à des modèles de causalité linéaire directe ; ils résultent de convergences multifactorielles impliquant des prédispositions génétiques, des facteurs neurobiologiques, des trajectoires développementales et des contextes environnementaux singuliers. Dans ce cadre épistémique, le risque relatif est défini comme le rapport de l’incidence d’un événement clinique ou comportemental donné survenant dans un groupe exposé à un facteur spécifique, par rapport à l’incidence de ce même événement observée dans un groupe de comparaison non exposé, au cours d’une période d’observation déterminée.
La formalisation probabiliste du risque suppose la définition rigoureuse d’une population cible et d’un échantillon représentatif au sein duquel chaque individu possède une probabilité non nulle, mais strictement inférieure à un, de présenter l’issue étudiée. Le risque, au sens épidémiologique, n’est pas un concept abstrait : il s’agit d’une proportion, comprise entre 0 et 1, estimant la probabilité qu’un événement survienne au sein d’une cohorte d’individus initialement indemnes dudit événement. Cette approche permet de conceptualiser le risque relatif non comme une simple manipulation numérique, mais comme un instrument d’inférence permettant d’appréhender le rôle joué par un facteur d’exposition dans la chaîne étiopathogénique d’un trouble.
Pour appréhender cette mécanique, il est indispensable de différencier clairement la probabilité marginale de la probabilité conditionnelle. La probabilité marginale correspond à la probabilité globale d’apparition d’un événement au sein de l’ensemble de la population, indépendamment de toute stratification liée à une exposition particulière. À l’inverse, l’analyse du risque relatif repose exclusivement sur la manipulation de probabilités conditionnelles : il s’agit de calculer la probabilité de l’événement conditionnée par la présence de l’exposition, notée classiquement P(Événement | Exposition), et de la rapporter à la probabilité de ce même événement conditionnée par l’absence d’exposition, notée P(Événement | Non-exposition). Cette distinction conditionnelle est le fondement méthodologique qui autorise la comparaison objective de deux trajectoires épidémiologiques distinctes.
1.2 Distinction entre risque absolu, risque relatif et cote (odds)
L’un des prérequis cardinaux à l’interprétation rigoureuse du risque relatif réside dans sa différenciation d’avec le risque absolu et la cote (ou odds). Le risque absolu représente la mesure de l’incidence brute au sein d’un groupe spécifique. Il indique directement la proportion d’individus qui développent une issue psychologique au cours d’un intervalle temporel donné. Par exemple, observer un risque absolu de 0,05 signifie simplement que 5 % des individus d’un groupe suivi ont présenté l’événement clinique considéré. Le risque absolu fournit l’ampleur brute du phénomène à l’échelle de la cohorte, ce qui constitue une information indispensable pour estimer la charge globale de morbidité au sein d’un système de soins.
À l’inverse, le risque relatif ne renseigne aucunement sur l’incidence brute sous-jacente : il n’exprime qu’un ratio de proportions, c’est-à-dire une comparaison relative entre deux risques absolus. De ce fait, un risque relatif identique peut masquer des réalités cliniques radicalement divergentes. Un doublement du risque (RR = 2,0) peut correspondre à une transition d’une incidence de 0,0001 % à 0,0002 % pour une pathologie neurodégénérative rarissime, ou à une transition de 20 % à 40 % pour un état de détresse psychologique consécutif à un stress aigu. Cette insensibilité intrinsèque du risque relatif à la ligne de base du risque absolu impose une vigilance clinique constante, car l’impact concret d’une exposition sur la santé publique dépend prioritairement du niveau initial de vulnérabilité de la population examinée.
La cote, quant à elle, conceptualise la probabilité sous une forme différente : elle ne rapporte pas le nombre de cas au total des individus observés, mais met en relation la probabilité qu’un événement survienne avec la probabilité qu’il ne survienne pas. Le rapport de ces cotes (désigné sous le vocable d’odds ratio) diverge mathématiquement du rapport de proportions qu’est le risque relatif. Bien que ces deux indices soient parfois utilisés de manière interchangeable par inadvertance, ils répondent à des logiques algébriques distinctes et à des contraintes méthodologiques strictes dictées par le type de devis de recherche employé. L’appréciation erronée de ces différences constitue l’une des sources majeures de distorsion dans la restitution des données scientifiques.
1.3 Applications critiques en psychopathologie et santé mentale
L’application du risque relatif en psychopathologie offre un cadre précieux pour décortiquer l’influence des expositions environnementales et des traumatismes précoces sur le développement ultérieur des affections mentales. Grâce aux devis prospectifs, les chercheurs peuvent quantifier avec rigueur l’élévation du risque de développer des troubles de l’humeur, des troubles anxieux ou des états de stress post-traumatique chez des sujets exposés à des violences durant l’enfance par rapport à des cohortes témoins non exposées. Ce type de quantification permet d’étayer empiriquement les modèles diathèse-stress en démontrant dans quelle mesure un stresseur modifie substantiellement la probabilité de survenue d’une décompensation psychopathologique au cours du cycle de vie.
Dans le domaine des essais cliniques et des études d’intervention, le risque relatif s’avère tout aussi central pour mesurer l’efficacité des protocoles thérapeutiques qu’ils soient psychopharmacologiques ou psychothérapeutiques. Lorsqu’un traitement vise à prévenir un événement péjoratif — tel qu’une rechute dépressive, une réhospitalisation psychiatrique ou une tentative de suicide —, le risque relatif permet de mesurer la réduction de la morbidité obtenue sous le protocole actif comparativement au groupe témoin sous placebo ou sous prise en charge standard (treatment as usual). Dans ce cas précis, une valeur de risque relatif significativement inférieure à l’unité atteste objectivement du rôle protecteur de l’intervention testée.
Enfin, l’analyse des trajectoires développementales et des phénomènes de comorbidité psychiatrique mobilise largement le risque relatif. Il permet notamment de cartographier comment la présence précoce d’un trouble des conduites ou d’un déficit de l’attention avec hyperactivité (TDAH) modifie le risque d’évolution vers un trouble lié à l’usage de substances psychoactives à l’âge adulte. En fournissant un indice standardisé et comparable d’une étude à l’autre, le risque relatif facilite la hiérarchisation des cibles de prévention primaire et secondaire au sein des politiques de santé mentale publique.
2. Formulation mathématique et méthodologie de calcul
2.1 L’équation standard du risque relatif
L’estimation ponctuelle du risque relatif repose sur une formalisation algébrique rigoureuse, issue du calcul des probabilités. Si l’on désigne par la variable aléatoire binaire $Y$ la survenue de l’événement clinique d’intérêt ($Y = 1$ en présence de la pathologie, $Y = 0$ en son absence) et par la variable binaire $X$ le statut d’exposition ($X = 1$ pour le groupe exposé, $X = 0$ pour le groupe non exposé), l’expression mathématique standard du risque relatif s’écrit formellement comme le ratio de deux probabilités conditionnelles :
$$RR = \frac{P(Y = 1 mid X = 1)}{P(Y = 1 mid X = 0)}$$
Dans cette formulation, le numérateur représente la proportion d’incidence de l’événement au sein de la strate exposée, tandis que le dénominateur correspond à la proportion d’incidence de ce même événement au sein de la strate non exposée. Sur le plan des propriétés mathématiques, le risque relatif est un estimateur non linéaire contraint à un espace strictement positif : son domaine de variation s’étend de zéro à l’infini théorique ($RR in [0, +\infty[$). L’absence de symétrie arithmétique autour de la valeur neutre 1 constitue une caractéristique structurelle fondamentale de cette métrique. En effet, un effet protecteur (réduction du risque) se trouve comprimé dans l’intervalle fini $[0, 1[$, tandis qu’un effet délétère ou facteur de vulnérabilité (augmentation du risque) se déploie sur l’intervalle infini $]1, +\infty[$.
Cette asymétrie d’échelle implique des considérations analytiques fondamentales, particulièrement lors de la modélisation statistique avancée et de la construction des intervalles de confiance. L’estimateur ponctuel du risque relatif ne suit pas une loi de distribution normale dans les échantillons de taille modérée ; sa distribution d’échantillonnage présente une asymétrie positive marquée, caractérisée par un étalement important vers les valeurs élevées. Il en découle que tout traitement inférentiel du risque relatif nécessite une transformation préalable visant à rétablir la symétrie de la distribution, le plus souvent par le recours au logarithme népérien de la métrique.
2.2 Structuration et exploitation de la table de contingence 2×2
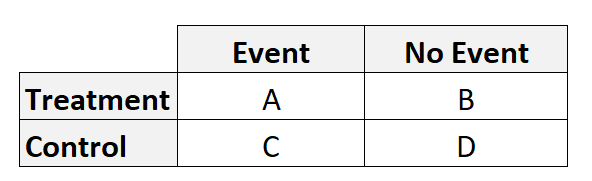
Dans la pratique épidémiologique et clinique, les données brutes issues d’une étude prospective ou d’un essai randomisé sont classiquement synthétisées sous la forme d’une table de contingence bivariée à quatre cellules, communément appelée table 2×2. Cette matrice met en regard le statut d’exposition croisé avec le statut de la maladie ou du comportement examiné. Par convention internationale, la disposition des effectifs s’établit selon la nomenclature suivante :
- Cellule a : Nombre de sujets exposés ayant développé l’événement (vrais positifs de l’exposition).
- Cellule b : Nombre de sujets exposés n’ayant pas développé l’événement.
- Cellule c : Nombre de sujets non exposés ayant développé l’événement.
- Cellule d : Nombre de sujets non exposés n’ayant pas développé l’événement.
À partir de cette matrice fondamentale, il est aisé d’extraire les totaux marginaux. Le total marginal de la ligne supérieure, noté $(a + b)$, correspond à l’effectif global des individus soumis au facteur d’exposition. De même, le total marginal de la ligne inférieure, noté $(c + d)$, représente l’effectif global de la cohorte non exposée. La somme de la première colonne, $(a + c)$, quantifie le nombre total de cas observés au terme du suivi, tandis que la seconde colonne, $(b + d)$, réunit l’ensemble des individus demeurés indemnes. L’effectif total de l’échantillon analysé est désigné par $N = a + b + c + d$.
L’algorithme de calcul du risque relatif s’opère directement par dérivation des taux d’incidence cumulée au sein des deux sous-groupes définis par les lignes du tableau. L’incidence chez les exposés s’écrit $I_e = a / (a + b)$, et l’incidence chez les non-exposés correspond à $I_0 = c / (c + d)$. L’expression algébrique calculée à partir des effectifs observés de la table s’énonce ainsi :
$$RR = \frac{\frac{a}{a + b}}{\frac{c}{c + d}} = \frac{a(c + d)}{c(a + b)}$$
La validation de cette équation exige impérativement de vérifier la cohérence interne des données tabulées. Aucun effectif marginal ne doit être négatif, et les sommes des cellules doivent être parfaitement concordantes avec les données brutes initiales.
2.3 Calculs des probabilités conditionnelles sous-jacentes
L’estimation ponctuelle de la proportion d’incidence au sein du groupe expérimental ou exposé repose sur l’opération $a / (a + b)$. Ce ratio quantifie directement la probabilité empirique conditionnelle qu’un individu quelconque appartenant à ce groupe développe le trouble au cours de la période d’observation. De la même manière, la proportion d’incidence calculée au sein du groupe témoin ou non exposé, via le rapport $c / (c + d)$, établit la probabilité de base ou de référence face à laquelle l’effet du facteur sera mis en perspective. Ces deux estimations conditionnelles sont soumises à la variabilité d’échantillonnage inhérente à toute observation empirique : des fluctuations aléatoires d’échantillons de faible taille peuvent altérer significativement les proportions observées et générer des distorsions notables du ratio final.
Une problématique méthodologique fréquente concerne la survenue d’une cellule nulle au sein de la table de contingence. Si aucun événement clinique ne se produit dans le groupe exposé ($a = 0$), le numérateur s’annule, aboutissant à un risque relatif estimé ponctuellement à 0,00. Bien que cela indique empiriquement une absence totale d’événement sous exposition, cette valeur est souvent trompeuse et instable en petit échantillon. Inversement, si la cellule $c$ prend une valeur nulle ($c = 0$), le dénominateur de l’équation s’annule, ce qui rend le risque relatif indéterminé ou théoriquement infini.
Pour remédier à cette contrainte calculatoire sans exclure l’étude de l’analyse statistique, les épidémiologistes recourent couramment à une correction de continuité empirique, telle que l’ajustement de Haldane-Anscombe. Cette méthode consiste à ajouter une constante fractionnaire (généralement 0,5) à chacune des quatre cellules de la table de contingence. Cette correction prévient l’effondrement de la formule du risque relatif et permet le calcul de sa variance logarithmique, tout en minimisant les biais d’estimation lorsque les effectifs d’événements observés sont particulièrement faibles.
3. Principes fondamentaux de l’interprétation des valeurs du risque relatif
3.1 La valeur nulle : Comprendre la signification de RR = 1
Dans l’évaluation statistique du risque relatif, la valeur 1,00 constitue la valeur nulle de référence, incarnant l’absence stricte d’association statistique entre l’exposition examinée et l’issue psychopathologique considérée. Lorsque l’égalité formelle $RR = 1,00$ est observée, elle atteste que la proportion d’incidence observée au sein du groupe exposé est rigoureusement identique à celle observée au sein du groupe témoin : $P(Y = 1 mid X = 1) = P(Y = 1 mid X = 0)$. Sur le plan théorique, cette équivalence démontre que la survenue du trouble est statistiquement indépendante du statut d’exposition, ce qui conduit à réfuter l’hypothèse d’une modulation du risque induite par cette variable spécifique.
Sur le plan clinique, l’obtention d’un risque relatif égal à l’unité peut signifier l’innocuité absolue d’un facteur environnemental suspecté d’être nocif, ou l’inefficacité thérapeutique d’un protocole d’intervention psychologique censé prévenir un état de détresse mentale. Toutefois, les chercheurs doivent se garder d’assimiler hâtivement l’absence d’association statistique observée à la preuve définitive d’une absence d’effet dans la réalité clinique. La validation d’une hypothèse nulle d’équivalence exige des conditions méthodologiques strictes, au premier rang desquelles figure une puissance statistique adéquate.
Une distinction fondamentale doit ainsi être établie entre l’absence d’effet statistique avéré et un manque de puissance méthodologique imputable à un échantillon sous-dimensionné. Lorsqu’une étude est menée sur un échantillon trop restreint, la variance d’échantillonnage est considérable ; l’estimation ponctuelle peut osciller autour de 1,00 ou s’en écarter légèrement sans parvenir à rejeter l’hypothèse nulle en raison de l’imprécision métrique. Il est donc impératif d’examiner l’intervalle de confiance encadrant la valeur 1,00 avant de formuler une conclusion catégorique quant à l’inutilité d’un protocole ou à la parfaite innocuité d’une exposition.
3.2 Effet protecteur : Interprétation d’un RR inférieur à 1
Lorsque la valeur estimée du risque relatif est strictement comprise entre 0 et 1 ($0 < RR < 1$), les données probantes indiquent l'existence d'une association inverse entre l'exposition et l'événement psychopathologique. Dans ce cas, la proportion d'individus développant l'issue clinique est moins élevée chez les sujets exposés que chez les sujets non exposés. En psychologie clinique, une telle valeur désigne le facteur d'exposition comme un facteur protecteur, ou atteste de l'efficacité préventive d'un traitement thérapeutique, d'un programme psychoéducatif ou d'une intervention psychosociale visant la diminution d'un comportement délétère.
Pour exprimer de manière intelligible l’ampleur clinique de cet effet protecteur, il est d’usage de calculer la réduction relative du risque (RRR). Cette dérivation algébrique mesure la proportion de réduction du risque de base attribuable à l’exposition au facteur protecteur. La formule canonique de calcul s’exprime ainsi :
$$RRR = 1 – RR$$
Multipliée par 100, la réduction relative du risque permet de formuler des conclusions claires pour les praticiens et les usagers de soins. Par exemple, une étude évaluant un protocole de remédiation cognitive qui rapporte un risque relatif de dépression de $RR = 0,65$ chez les sujets bénéficiaires par rapport aux témoins s’interprète par une réduction relative du risque de $RRR = 1 – 0,65 = 0,35$, soit une diminution de 35 % de l’incidence du trouble au sein du groupe traité par rapport au groupe témoin. Cette formulation synthétique facilite la communication des bénéfices thérapeutiques sans masquer la logique comparative de la mesure.
3.3 Facteur de vulnérabilité : Interprétation d’un RR supérieur à 1
À l’inverse, l’obtention d’une valeur de risque relatif strictement supérieure à l’unité ($RR > 1$) caractérise une association positive entre l’exposition et la survenue de l’issue clinique. Les sujets exposés au facteur présentent une probabilité conditionnelle plus importante de développer la condition psychopathologique que leurs homologues préservés de cette même exposition. Dès lors, le facteur d’exposition est identifié comme un facteur de risque, un stresseur étiologique ou un marqueur de vulnérabilité biopsychosociale amplifiant la survenue du trouble.
Pour quantifier explicitement l’excès de risque généré par cette exposition, les épidémiologistes calculent l’augmentation relative du risque (ARR, pour Absolute/Relative Risk Increase, ici désigné comme accroissement relatif). Cette métrique se dérive par la soustraction de l’unité à la valeur observée du risque relatif :
$$ARR = RR – 1$$
Si l’on observe un risque relatif de $RR = 2,40$ associant l’exposition au harcèlement scolaire à l’émergence d’un trouble anxieux généralisé à l’adolescence, l’augmentation relative s’élève à $ARR = 2,40 – 1 = 1,40$. Exprimé en pourcentage, ce résultat démontre une augmentation de 140 % du risque de trouble anxieux chez les adolescents victimes de harcèlement comparativement aux adolescents non harcelés. Sur le plan de la gradation de la force de l’association, la littérature épidémiologique et méthodologique classe généralement les risques relatifs compris entre 1,1 et 1,5 comme des effets faibles, ceux situés entre 1,5 et 3,0 comme des effets modérés, tandis que les valeurs excédant 3,0 (ou a fortiori 5,0) signalent des associations puissantes témoignant d’une vulnérabilité étiologique majeure.
4. Interprétation d’un risque relatif inférieur à 1 : Études de cas empiriques
4.1 Cas pratique 1 : Activité physique et prévention de la dépression majeure
Afin d’illustrer concrètement l’interprétation d’un risque relatif protecteur au sein de la recherche contemporaine, considérons une vaste étude prospective de cohorte examinant l’influence de l’activité physique modérée à intense sur l’apparition d’un épisode dépressif caractérisé (EDC) chez des adultes initialement sains suivis sur une période de 5 ans. L’échantillon comprend deux groupes distincts : une cohorte d’individus s’adonnant à une pratique sportive régulière (au moins 150 minutes hebdomadaires, constituant le groupe exposé au facteur d’activité) et une cohorte de sujets sédentaires (groupe non exposé servant de référence comparative). Chaque bras de l’étude comprend 500 participants rigoureusement appariés sur leurs caractéristiques sociodémographiques de base.
Au terme des 5 années de suivi longitudinal standardisé, les évaluations diagnostiques conduites selon les critères du Manuel diagnostique et statistique des troubles mentaux (DSM-5) révèlent la survenue d’un EDC chez 140 individus au sein du groupe actif ($a = 140$ sur $a + b = 500$), ce qui correspond à une proportion d’incidence brute de $I_e = 140 / 500 = 0,28$ (soit 28 %). Au sein du groupe sédentaire, les cliniciens identifient 250 cas de dépression majeure ($c = 250$ sur $c + d = 500$), traduisant une incidence cumulée de $I_0 = 250 / 500 = 0,50$ (soit 50 %). Le calcul formel du risque relatif s’opère selon l’équation de base :
$$RR = \frac{0,28}{0,50} = 0,56$$
La dérivation de la réduction relative du risque s’établit à $RRR = 1 – 0,56 = 0,44$. La restitution narrative de ces résultats s’énonce ainsi : les adultes maintenant une activité physique régulière présentent une réduction de 44 % du risque de développer un épisode dépressif caractérisé sur 5 ans comparativement aux adultes sédentaires. L’activité physique se configure donc ici comme un déterminant protecteur substantiel face à la morbidité dépressive en population générale.
4.2 Cas pratique 2 : Thérapie basée sur la pleine conscience et rechute addictive
Examinons à présent un devis expérimental interventionnel : un essai contrôlé randomisé (ECR) mené en addictologie clinique pour évaluer l’efficacité de la thérapie cognitive basée sur la pleine conscience pour la prévention de la rechute (MBRP) face à une prise en charge standard (TAU) chez des patients sevrés de l’alcool. Les patients sont aléatoirement assignés soit au groupe MBRP ($n = 200$), soit au groupe témoin sous prise en charge usuelle ($n = 200$). L’issue clinique évaluée est la rechute alcoolique sévère, mesurée à un horizon de 12 mois post-intervention.
À l’échéance de l’année d’observation, les données cliniques indiquent que 64 patients ont rechuté dans le groupe MBRP ($a = 64$), établissant l’incidence conditionnelle à $I_e = 64 / 200 = 0,32$ (32 %). Dans le bras témoin TAU, 112 patients ont connu un épisode de rechute caractérisée ($c = 112$), représentant une proportion d’incidence de $I_0 = 112 / 200 = 0,56$ (56 %). Le risque relatif de rechute associé au suivi du protocole de pleine conscience se quantifie comme suit :
$$RR = \frac{0,32}{0,56} \approx 0,571$$
L’estimation de la réduction relative du risque est de $RRR = 1 – 0,571 = 0,429$, soit environ 43 %. Ces données indiquent que l’intégration du protocole MBRP permet de diminuer de près de 43 % le risque de rechute à 12 mois par rapport au traitement usuel seul. La portée psychologique d’un tel résultat met en lumière l’intérêt clinique du renforcement des compétences métacognitives et de régulation émotionnelle pour moduler les automatismes de craving chez les usagers souffrant de dépendance sévère.
4.3 Méthode d’interprétation pour les cliniciens et chercheurs
Lorsqu’ils sont confrontés à une estimation de risque relatif attestant d’un effet protecteur ($RR < 1$), les chercheurs et praticiens doivent déployer une démarche d'évaluation critique avant de traduire ces données dans la pratique clinique. La première étape consiste à valider la plausibilité théorique et neurobiologique du mécanisme d'action postulé : la diminution de l'incidence observée s'articule-t-elle avec les connaissances contemporaines relatives à la régulation du stress, aux processus de neuroplasticité ou aux théories comportementales de l'apprentissage ?
La seconde étape méthodologique impose d’examiner avec minutie les niveaux d’observance thérapeutique et la fidélité au protocole délivré. Une intervention psychologique présentant un risque relatif séduisant de 0,50 dans un essai aux conditions contrôlées peut voir son bénéfice s’effondrer en milieu réel si la lourdeur des séances ou le taux d’abandon (attrition) n’ont pas été pris en compte. Enfin, la rédaction des synthèses cliniques doit impérativement éviter le sensationnalisme en formulant des conclusions équilibrées. Il convient d’exposer conjointement la baisse relative et les données de risque absolu, afin d’éviter toute distorsion dans l’appréciation du gain thérapeutique réel pour le patient individuel.
5. Interprétation d’un risque relatif supérieur à 1 : Facteurs d’exposition et psychopathologie
5.1 Cas pratique 1 : Traumatismes de l’enfance et trouble panique à l’âge adulte
L’étude des facteurs de vulnérabilité développementale fournit une illustration archétypale des risques relatifs élevés. Considérons une cohorte longitudinale prospective suivant des individus de la petite enfance jusqu’à l’âge de 30 ans afin de modéliser le retentissement des expériences négatives de l’enfance (définies ici par la survenue documentée d’abus physiques ou émotionnels sévères avant l’âge de 12 ans) sur l’apparition ultérieure d’un trouble panique avec ou sans agoraphobie.
L’étude suit une cohorte de 400 individus exposés à des traumatismes précoces et un groupe témoin de 600 individus n’ayant rapporté aucune expérience traumatique durant l’enfance. À l’évaluation clinique menée à l’âge adulte, les données épidémiologiques révèlent que 72 sujets du groupe exposé ont développé un trouble panique caractérisé ($a = 72$), ce qui établit l’incidence de morbidité à $I_e = 72 / 400 = 0,18$ (soit 18 %). Dans le groupe témoin préservé de traumatismes, 36 sujets ont manifesté cette même pathologie ($c = 36$), générant une proportion d’incidence de base de $I_0 = 36 / 600 = 0,06$ (soit 6 %). Le calcul du risque relatif est le suivant :
$$RR = \frac{0,18}{0,06} = 3,00$$
L’augmentation relative du risque s’établit à $ARR = 3,00 – 1 = 2,00$, ce qui correspond à un accroissement de 200 %. Dans une formulation clinique rigoureuse, ces résultats établissent que les individus exposés à des traumatismes sévères dans l’enfance présentent un risque de développer un trouble panique à l’âge adulte trois fois supérieur à celui des individus non exposés. Cette augmentation de 200 % de l’incidence atteste du statut d’agresseur neurodéveloppemental majeur conféré au stress toxique précoce dans la dérégulation pérenne de l’axe hypothalamo-hypophyso-surrénalien et des circuits cérébraux de la peur conditionnée.
5.2 Cas pratique 2 : Usage précoce de substances et décompensation psychotique
Un autre cas paradigmatique concerne la modélisation de l’association entre la consommation régulière de cannabis à l’adolescence (exposition initiée avant l’âge de 15 ans avec fréquence hebdomadaire documentée) et la survenue ultérieure d’un premier épisode psychotique au cours des dix années suivantes. Dans une cohorte prospective regroupant 1 000 adolescents consommateurs précoces et 2 000 adolescents non consommateurs, le suivi psychiatrique standardisé identifie 40 décompensations psychotiques dans la cohorte d’usagers ($a = 40$), fixant l’incidence cumulée à $I_e = 40 / 1000 = 0,04$ (4 %).
Dans la cohorte témoin n’ayant jamais consommé de substances durant l’adolescence, 20 épisodes psychotiques sont recensés sur la même période ($c = 20$), établissant une incidence brute de $I_0 = 20 / 2000 = 0,01$ (soit 1 %). L’application de la formule fondamentale génère l’estimation suivante :
$$RR = \frac{0,04}{0,01} = 4,00$$
Ce résultat démontre un sur-risque épidémiologique d’un facteur 4, traduisant une élévation relative de 300 % ($ARR = 4,00 – 1 = 3,00$) de la décompensation psychotique chez les usagers précoces. Toutefois, l’interprétation épidémiologique de ce risque relatif élevé impose d’introduire des nuances majeures quant à l’hétérogénéité génétique sous-jacente. L’impact délétère du cannabis ne s’exerce pas de manière uniforme dans la population : il interagit avec des vulnérabilités polygéniques préexistantes (telles que les polymorphismes liés aux gènes COMT ou AKT1), soulignant que le risque relatif capture l’effet moyen d’une population globale sans refléter l’aléa spécifique propre à chaque sous-profil génomique individuel.
5.3 Seuils d’importance clinique des valeurs de RR élevé
La qualification de l’importance clinique d’un risque relatif élevé requiert l’articulation des repères statistiques traditionnels avec les critères d’impact en santé mentale. Bien que les indices de taille d’effet de Cohen ou de Rosenthal aient été conçus pour des contextes d’analyses paramétriques spécifiques (comme les différences de moyennes standardisées), leur logique de gradation s’applique conceptuellement à l’évaluation des ratios épidémiologiques. Un risque relatif de 1,20, bien que potentiellement statistiquement significatif dans une méga-cohorte de 100 000 sujets, peut n’avoir qu’une portée translationnelle négligeable pour le clinicien au chevet d’un patient particulier.
À l’inverse, des valeurs de risque relatif excédant 2,0 ou 3,0 signalent généralement des facteurs méritant une vigilance de premier plan. Néanmoins, les chercheurs doivent rigoureusement distinguer une causalité étiologique directe d’un simple marqueur indirect de vulnérabilité. Un risque relatif élevé peut découler de mécanismes de confusion non mesurés ou d’une causalité inversée (par exemple, une automédication précoce précédant le diagnostic formel du trouble). Enfin, la transposition d’un risque relatif élevé issu d’une étude populationnelle à la trajectoire pronostique d’un patient singulier constitue une faute méthodologique connue sous le nom de sophisme écologique : le risque probabiliste de groupe ne préjuge jamais de la fatalité d’une trajectoire clinique individuelle.
6. Évaluation de l’incertitude : Intervalles de confiance du risque relatif
6.1 Théorie de l’intervalle de confiance à 95 % (IC 95 %)
L’estimation ponctuelle du risque relatif issue d’un échantillon ne représente qu’une approximation ponctuelle soumise à l’aléa d’échantillonnage. En inférence statistique fréquentiste, il est impératif de modéliser cette incertitude aléatoire en calculant un intervalle de confiance, couramment calibré au seuil de 95 % (IC 95 %). Cet intervalle définit une plage de valeurs plausibles construite de telle manière que, si l’on répétait l’expérience d’échantillonnage un nombre infini de fois dans des conditions méthodologiques identiques, 95 % des intervalles ainsi calculés contiendraient la véritable valeur paramétrique du risque relatif de la population parente.
Comme souligné précédemment, la distribution d’échantillonnage de l’estimateur ponctuel du risque relatif présente une asymétrie positive marquée, car les valeurs sont bornées inférieurement par zéro mais illimitées vers le haut. Cette configuration interdit l’application directe des formules standard fondées sur l’addition symétrique de marges d’erreur gaussiennes ($RR \pm 1,96 \times SE$). Pour surmonter cette entrave technique, la théorie asymptotique statistique impose d’opérer une transformation mathématique en appliquant le logarithme népérien au risque relatif :
$$\ln(RR) = \ln\left(\frac{I_e}{I_0}\right)$$
Sur cette échelle logarithmique, la distribution de la métrique $ln(RR)$ converge vers une loi normale symétrique, ce qui autorise l’estimation rigoureuse de l’erreur-type et des bornes de confiance à l’aide des lois de probabilité usuelles.
6.2 Algorithme d’estimation de l’erreur-type et des bornes
L’estimation de l’erreur-type du logarithme du risque relatif, notée $SE(ln(RR))$, repose sur la méthode delta développée en statistique asymptotique. À partir des effectifs de la table de contingence 2×2, la formule d’approximation de l’erreur-type s’énonce comme suit :
$$SE(\ln(RR)) = \sqrt{\frac{1}{a} – \frac{1}{a + b} + \frac{1}{c} – \frac{1}{c + d}} = \sqrt{\frac{b}{a(a + b)} + \frac{d}{c(c + d)}}$$
Une fois cette erreur-type calculée, les bornes inférieure ($L_{\inf}$) et supérieure ($L_{\sup}$) de l’intervalle de confiance à 95 % sont déterminées sur l’échelle logarithmique en utilisant le quantile d’ordre 0,975 de la loi normale centrée réduite ($Z_{1 – alpha/2} \approx 1,96$) :
$$\ln(RR)_{\inf} = \ln(RR) – 1,96 \times SE(\ln(RR))$$
$$\ln(RR)_{\sup} = \ln(RR) + 1,96 \times SE(\ln(RR))$$
Pour rétablir l’intervalle de confiance sur l’échelle naturelle du risque relatif et le rendre interprétable cliniquement, il suffit d’appliquer la fonction exponentielle réciproque aux bornes logarithmiques obtenues :
$$IC_{95%} = \left[ \exp(\ln(RR)_{\inf}) , ; , \exp(\ln(RR)_{\sup}) \right]$$
À titre d’illustration numérique, reprenons le cas pratique sur les traumatismes de l’enfance ($a = 72$, $b = 328$, $c = 36$, $d = 564$). Nous avions $RR = 3,00$, d’où $\ln(3,00) \approx 1,0986$. Le calcul de l’erreur-type donne :
$$SE(\ln(RR)) = \sqrt{\frac{1}{72} – \frac{1}{400} + \frac{1}{36} – \frac{1}{600}} = \sqrt{0,01389 – 0,0025 + 0,02778 – 0,00167} = \sqrt{0,0375} \approx 0,1936$$
Les bornes sur l’échelle logarithmique sont $\ln(RR)_{\inf} = 1,0986 – (1,96 \times 0,1936) = 0,7191$ et $\ln(RR)_{\sup} = 1,0986 + (1,96 \times 0,1936) = 1,4781$. En appliquant l’exponentielle, nous obtenons l’intervalle final : $IC_{95%} = [\exp(0,7191) ; \exp(1,4781)] = [2,05 ; 4,38]$. L’estimation du risque relatif est donc rigoureusement formulée : $RR = 3,00$, $IC_{95%} [2,05 ; 4,38]$.
6.3 Interprétation statistique conjointe de l’IC 95 % et de la valeur p
L’analyse conjointe de l’intervalle de confiance à 95 % et de la valeur $p$ associée fournit une double grille de lecture évaluant simultanément la significativité statistique et la précision de l’estimation. La règle de décision fondamentale stipule que si l’intervalle de confiance à 95 % exclut la valeur nulle d’indépendance ($RR = 1,00$), l’association observée est formellement déclarée statistiquement significative au seuil canonique de $\alpha = 0,05$ (ce qui correspond à une valeur de $p < 0,05$). Dans notre exemple précédent, l'intervalle $[2,05 ; 4,38]$ est entièrement situé au-dessus de 1,00, ce qui permet de rejeter l'hypothèse nulle sans ambiguïté.
Au-delà du simple rejet de l’hypothèse nulle, la largeur intrinsèque de l’intervalle de confiance est un indicateur direct de la précision statistique de l’étude. Un intervalle très étroit (par exemple $[1,45 ; 1,55]$) dénote une excellente puissance statistique liée à un échantillonnage substantiel, ce qui permet de cerner avec précision l’ampleur probable de l’effet dans la population cible. À l’inverse, un intervalle excessivement large (par exemple $[1,05 ; 9,80]$), bien que statistiquement significatif au sens du seuil $p < 0,05$, traduit une imprécision majeure qui invite à une grande réserve clinique quant à la magnitude réelle du phénomène.
L’examen minutieux des intervalles de confiance permet ainsi de démasquer les études sous-dimensionnées qui échouent à détecter un effet pourtant cliniquement significatif en raison d’un manque de puissance (erreur de type II). De même, il rappelle aux cliniciens que la significativité statistique n’est pas synonyme de pertinence clinique : un facteur présentant un $RR = 1,05$ statistiquement significatif avec un intervalle $[1,02 ; 1,08]$ dans une méga-cohorte de 500 000 sujets peut s’avérer dénué de tout intérêt pratique pour la prise en charge thérapeutique individuelle.
7. Risque relatif versus Odds Ratio (Rapport de cotes) dans les plans expérimentaux
7.1 Divergence théorique et algébrique entre RR et OR
La confusion entre le risque relatif ($RR$) et l’odds ratio ou rapport de cotes ($OR$) représente l’une des erreurs les plus persistantes de la littérature biomédicale et comportementale. Bien que ces deux indices quantifient l’association entre une exposition et une variable d’issue binaire, leurs fondements algébriques reposent sur des rapports mathématiques distincts. Alors que le risque relatif constitue un ratio de proportions mesurant la probabilité brute de survenue de l’événement sur l’ensemble de la population à risque, l’odds ratio est défini comme le rapport de deux cotes d’exposition :
$$OR = \frac{\frac{P(Y = 1 mid X = 1)}{1 – P(Y = 1 mid X = 1)}}{\frac{P(Y = 1 mid X = 0)}{1 – P(Y = 1 mid X = 0)}} = \frac{\frac{a}{b}}{\frac{c}{d}} = \frac{a \times d}{b \times c}$$
Sur le plan mathématique formel, dès lors que l’événement clinique présente une incidence non nulle, l’odds ratio présente une tendance systématique à s’éloigner de la valeur nulle 1,00 plus fortement que ne le fait le risque relatif. Dès que le risque relatif dépasse l’unité ($RR > 1$), l’odds ratio surestime systématiquement son amplitude ($OR > RR$). Réciproquement, lorsque l’association est protectrice ($RR < 1$), l'odds ratio sous-estime la valeur en étant plus proche de zéro ($OR < RR$). Cette divergence géométrique s'accroît d'autant plus que l'incidence du trouble dans la population d'étude est élevée.
Une divergence méthodologique majeure concerne les contraintes imposées par les devis de recherche. Dans les études cas-témoins rétrospectives, le ratio des sujets atteints de la pathologie (les cas) et des sujets indemnes (les témoins) est fixé artificiellement par le chercheur au moment de la constitution de l’échantillon. En conséquence, les totaux marginaux des colonnes sont arbitraires, rendant impossible le calcul d’une incidence brute dans le groupe exposé ou non exposé. Le calcul direct du risque relatif y est donc mathématiquement prohibé. Dans un devis cas-témoins, l’odds ratio s’impose comme la seule métrique directement calculable pour évaluer l’effet de l’exposition.
7.2 L’hypothèse des maladies rares et la convergence des métriques
Il existe une condition statistique bien précise sous laquelle l’odds ratio constitue une approximation fidèle du risque relatif : l’hypothèse de la maladie rare (rare disease assumption). D’un point de vue algébrique, si l’incidence de l’événement étudié est très faible au sein de la population examinée, la probabilité d’absence d’événement ($1 – P$) tend vers 1 pour les deux groupes ($a ll b$ et $c ll d$). Par conséquent, les dénominateurs des proportions d’incidence cumulée se simplifient : $(a + b) \approx b$ et $(c + d) \approx d$. Dans cette configuration de basse fréquence, l’équation du risque relatif converge asymptotiquement vers celle de l’odds ratio :
$$RR = \frac{\frac{a}{a + b}}{\frac{c}{c + d}} \approx \frac{\frac{a}{b}}{\frac{c}{d}} = \frac{ad}{bc} = OR$$
En pratique épidémiologique, cette équivalence est généralement admise lorsque l’incidence cumulée du phénomène psychopathologique est strictement inférieure à 10 %, ou idéalement inférieure à 5 % sur la durée totale du suivi. Si cette condition est respectée, comme c’est le cas pour certains troubles psychiatriques d’apparition rare (tels que la schizophrénie à début très précoce ou la maladie de Huntington), les cliniciens peuvent interpréter l’odds ratio issu d’une régression logistique comme un substitut acceptable du risque relatif.
Néanmoins, en psychologie et en santé mentale, cette hypothèse de rareté est fréquemment violée. Les troubles majeurs tels que la dépression caractérisée, les troubles anxieux ou les états de détresse psychologique consécutifs à des crises sociétales présentent des prévalences et des incidences cumulées dépassant fréquemment 15 %, 20 % voire 30 % dans les cohortes cliniques. Dès lors que l’incidence s’écarte du seuil des 10 %, l’odds ratio s’écarte significativement du risque relatif réel et amplifie artificiellement l’ampleur de l’effet d’association mesuré.
7.3 Erreurs d’interprétation communes dans la littérature scientifique
L’une des dérives les plus fréquentes au sein des articles scientifiques consiste à rapporter un odds ratio de 2,00 ou 3,00 issu d’un modèle de régression logistique multivariée, et à l’énoncer sous la forme linguistique : « les sujets exposés présentent deux (ou trois) fois plus de risque de développer le trouble ». Cette affirmation constitue une violation des règles de l’inférence épidémiologique lorsque l’affection n’est pas rare. Si l’incidence de base chez les témoins est de 30 % et que l’odds ratio vaut 3,00, le risque relatif sous-jacent réel n’est en réalité que de 1,76. Interpréter l’OR comme un RR génère donc ici une surestimation dramatique de 70 % de l’ampleur du sur-risque présumé.
Pour corriger cette distorsion sans renoncer aux analyses multivariées, les chercheurs peuvent mobiliser la formule de correction établie par Zhang et Yu (1998). Cette méthode permet d’approximer le risque relatif à partir de l’odds ratio ajusté ($OR$) et de la proportion d’incidence brute observée chez les sujets non exposés ($P_0 = c / (c + d)$) :
$$RR_{corrigé} = \frac{OR}{(1 – P_0) + (P_0 \times OR)}$$
L’application rigoureuse de cette équation permet de redresser les métriques issues des modèles logistiques et de rétablir une description non inflationniste de la réalité clinique. La diffusion de ces bonnes pratiques rédactionnelles constitue un enjeu majeur pour préserver l’intégrité de la littérature scientifique et assurer une communication transparente envers les praticiens du champ de la santé mentale.
8. Biais méthodologiques et facteurs de confusion influençant le risque relatif
8.1 Biais de sélection et d’information en psychologie clinique
La validité interne d’une estimation de risque relatif dépend directement du contrôle des erreurs systématiques susceptibles d’altérer la structure des données empiriques recueillies. Les biais de sélection surviennent lorsque les modalités de recrutement ou de maintien des sujets dans la cohorte créent une distorsion systématique de la relation entre l’exposition et l’issue psychopathologique. L’un des biais de sélection les plus insidieux dans les études prospectives en psychologie est le biais d’attrition, caractérisé par la perte de vue non aléatoire de participants au cours du suivi. Si les sujets les plus sévèrement déprimés du groupe exposé abandonnent prématurément le protocole d’observation en raison de leur apragmatisme, le risque d’incidence dans ce groupe sera sous-estimé, induisant une distorsion majeure du risque relatif calculé.
Les biais d’information (ou biais de mesure) résultent quant à eux d’une classification erronée de l’exposition, de l’issue clinique, ou des deux variables combinées. Le biais de rappel constitue un écueil particulièrement fréquent dans les recherches explorant les antécédents développementaux : les adultes souffrant actuellement d’un trouble de l’humeur ont une propension mnésique involontaire à rapporter davantage d’événements traumatiques vécus durant leur jeunesse que des sujets témoins asymptomatiques. Cette dysmétrie d’évaluation génère une surévaluation systématique de la proportion d’exposés parmi les malades, produisant un risque relatif artificiellement gonflé.
Pour se prémunir de ces distorsions systématiques, les protocoles de recherche doivent standardiser l’administration des instruments de mesure, mobiliser des questionnaires diagnostiques structurés (tels que la SCID ou le MINI) administrés en aveugle du statut d’exposition, et planifier des stratégies d’échantillonnage probabilistes permettant de limiter les biais de classification différentielle et non différentielle au sein des populations évaluées.
8.2 Facteurs de confusion et paradoxe de Simpson
Un facteur de confusion est une variable extrinsèque associée à la fois au facteur d’exposition étudié et à la pathologie d’intérêt, sans pour autant constituer un maillon intermédiaire dans la chaîne de causalité unissant ces deux entités. En psychopathologie clinique, les déterminants socio-économiques, l’adversité psychosociale globale ou encore la consommation concomitante d’autres substances représentent des facteurs de confusion fréquents. L’omission du contrôle de ces variables parasites fausse l’estimation du risque relatif, pouvant créer une association illusoire ou occulter une relation réelle.
Le cas extrême de cette distorsion est incarné par le paradoxe de Simpson. Ce phénomène mathématique et épidémiologique se manifeste lorsqu’une association statistique observée au niveau global d’une population se trouve totalement inversée, ou annulée, lorsque l’on analyse les données de manière stratifiée en fonction d’un facteur de confusion majeur. Par exemple, une étude brute non ajustée pourrait suggérer qu’une approche psychothérapeutique innovante est associée à une élévation apparente du risque d’échec clinique ($RR > 1$). Néanmoins, si cette nouvelle thérapie a été administrée préférentiellement aux patients présentant une sévérité initiale extrême, la stratification selon la gravité de la pathologie révélera que dans chaque sous-groupe homogène, la thérapie engendre en réalité une baisse significative du risque d’échec ($RR < 1$).
Ce paradoxe illustre la nécessité de distinguer conceptuellement la confusion statistique d’autres interactions telles que la modération (modification de l’effet) ou la médiation psychologique (mécanisme d’action séquentiel intermédiaire). Une analyse épidémiologique brute non ajustée présente donc une valeur inférentielle fragile en santé mentale.
8.3 Techniques statistiques d’ajustement multivarié
Pour neutraliser l’impact délétère des facteurs de confusion et extraire une estimation non biaisée du risque relatif, plusieurs approches statistiques avancées sont mobilisées dans la littérature contemporaine. La méthode historique repose sur la technique de standardisation de Mantel-Haenszel. Cette procédure consiste à partitionner les données de la cohorte en plusieurs strates définies par les modalités des variables de confusion suspectées, à estimer un risque relatif propre à chaque sous-strate, puis à calculer une estimation globale pondérée par la taille et la variance des strates individuelles.
Dans les contextes d’analyses complexes impliquant de multiples covariables continues et catégorielles, la modélisation multivariée s’avère indispensable. Alors que la régression logistique modélise les cotes (générant des odds ratios nécessitant une correction ultérieure), la régression log-binomiale permet d’estimer directement des risques relatifs ajustés à partir d’un modèle linéaire généralisé avec fonction de lien logarithmique. Toutefois, la régression log-binomiale présente l’inconvénient d’échouer fréquemment à converger sur le plan numérique lorsque les solutions prédictives approchent les limites de l’espace des probabilités ($P > 1$).
Pour contourner ces écueils de non-convergence, l’alternative méthodologique standardisée consiste à utiliser la régression de Poisson modifiée avec un estimateur de variance robuste (variance sandwich de Huber-White), comme l’ont validé Zou (2004) et Spiegelman et Hertzmark (2005). En appliquant une loi de Poisson à des variables binaires et en redressant l’erreur-type par l’estimateur sandwich robuste, ce modèle produit des estimations ponctuelles et des intervalles de confiance non biaisés pour le risque relatif ajusté, consolidant ainsi la robustesse des conclusions cliniques.
9. Risque relatif et prise de décision clinique : La perspective appliquée
9.1 Conversion en Nombre de Sujets à Traiter (NNT) et à Nuire (NNH)
Si le risque relatif renseigne les chercheurs sur la force théorique d’une association, il demeure insuffisant à lui seul pour guider la décision du clinicien au chevet du patient. Pour opérationnaliser l’utilité pratique d’une intervention, les principes de la médecine et de la psychologie fondées sur les données probantes préconisent la conversion de l’effet relatif en métriques d’impact clinique absolu : le Nombre de Sujets à Traiter (NNT, pour Number Needed to Treat) et son pendant pour les effets délétères, le Nombre de Sujets à Nuire (NNH, pour Number Needed to Harm).
Le NNT quantifie le nombre d’individus qu’il est nécessaire de soumettre au protocole d’intervention thérapeutique plutôt qu’au traitement de référence pour prévenir la survenue d’un événement clinique péjoratif supplémentaire. Il se définit mathématiquement comme la réciproque de la réduction absolue du risque (RAR) :
$$RAR = I_0 – I_e$$
$$NNT = \frac{1}{RAR} = \frac{1}{I_0 – I_e}$$
La relation algébrique liant conjointement le risque relatif ($RR$) et le NNT met en lumière le rôle déterminant du niveau d’incidence de base ($I_0$) :
$$NNT = \frac{1}{I_0 \times (1 – RR)}$$
Cette formalisation démontre qu’un risque relatif protecteur constant ($RR = 0,50$, soit une réduction relative de 50 %) produira un NNT radicalement distinct selon la sévérité clinique de la cohorte ciblée. Si le risque de rechute de base est de 40 % ($I_0 = 0,40$), le NNT est de $1 / (0,40 \times 0,50) = 5$ : il suffit de traiter 5 patients pour éviter une rechute. En revanche, si ce risque de base n’est que de 2 % ($I_0 = 0,02$), le NNT grimpe à $1 / (0,02 \times 0,50) = 100$. Le clinicien doit donc traiter 100 individus pour obtenir le même gain prophylactique unitaire, ce qui modifie l’évaluation du ratio coût/bénéfice du protocole thérapeutique.
9.2 L’illusion de l’effet majeur : Piège du risque relatif sans risque absolu
La communication exclusive d’un risque relatif sans mention de l’incidence absolue sous-jacente génère fréquemment ce que les psychologues cognitivistes nomment « l’illusion de l’effet majeur ». Il s’agit d’une distorsion de jugement conduisant les cliniciens, les usagers et les décideurs institutionnels à surestimer considérablement l’impact réel d’une exposition ou d’un traitement en focalisant leur attention sur un pourcentage relatif sensationnel.
Pour illustrer ce piège récurrent, considérons une étude révélant que l’exposition à un polluant environnemental est associée à un risque relatif spectaculaire de $RR = 3,00$ pour le développement d’une pathologie neuropsychiatrique sévère, traduisant une hausse de 200 % du risque. Présentée sous cette seule forme, l’information suscite une anxiété légitime au sein de la population. Or, si l’incidence brute initiale de ce trouble dans la population non exposée est rarissime, par exemple de 1 cas sur 100 000 individus ($I_0 = 0,00001$), l’exposition au toxique porte l’incidence cumulée à 3 cas sur 100 000 ($I_e = 0,00003$). L’augmentation absolue du risque n’est en réalité que de 2 cas additionnels pour 100 000 personnes exposées.
D’un point de vue éthique et déontologique, la présentation simultanée du risque absolu et du risque relatif constitue une obligation méthodologique préconisée par l’ensemble des institutions internationales de santé, dont la collaboration Cochrane. Omettre le risque absolu prive le praticien des données indispensables pour peser rationnellement les bénéfices escomptés d’un protocole en regard des risques d’effets secondaires, du fardeau financier et de l’observance attendue.
9.3 Communication des risques au patient en thérapie cognitivo-comportementale
En pratique psychothérapeutique, notamment dans le cadre des thérapies cognitivo-comportementales (TCC), la psychoéducation constitue une composante centrale de la prise en charge. La transmission d’estimations statistiques de risque aux patients souffrant de troubles anxieux ou de dépression est souvent entravée par des biais cognitifs de traitement de l’information, tels que le biais de négativité ou le saut aux conclusions (jumping to conclusions). L’énoncé d’une élévation relative du risque peut amplifier des schémas de catastrophisme chez un patient anxieux.
Les recherches menées en psychologie de la décision, notamment par Gerd Gigerenzer et son équipe, démontrent que le recours aux pourcentages relatifs et aux fractions probabilistes complexes favorise l’erreur d’interprétation chez les patients comme chez les praticiens. Pour favoriser une compréhension clinique transparente, il est vivement recommandé de traduire les risques relatifs sous la forme de « fréquences naturelles » et de supports graphiques (tels que des iconographies ou pictogrammes représentant une matrice de 100 ou 1 000 individus).
Plutôt que d’affirmer à un patient : « ce protocole thérapeutique réduit votre risque d’échec de 40 % », l’explication gagne en clarté sous la forme : « Sur un groupe de 100 personnes présentant les mêmes symptômes initiaux que vous, 50 connaissent habituellement une persistance des troubles sans notre protocole. Avec le suivi complet de notre thérapie, ce chiffre tombe à 30 personnes. Cela signifie que 20 patients sur 100 tirent un bénéfice direct et durable de la démarche ». Cette formulation descriptive permet au patient de contextualiser rationnellement le gain attendu et consolide l’alliance thérapeutique au sein d’un modèle de décision médicale partagée.
10. Risque relatif dans les études longitudinales et cohortes prospectives
10.1 Incidence cumulée versus taux d’incidence
La temporalité constitue une dimension essentielle dans l’évaluation des liens étiologiques en santé mentale. Selon la façon dont le facteur temps est intégré dans le recueil des données cliniques, deux métriques distinctes de morbidité peuvent être calculées pour dériver un risque relatif : l’incidence cumulée et le taux d’incidence (ou densité d’incidence). La compréhension de cette distinction est capitale pour interpréter avec justesse la nature de l’effet rapporté.
L’incidence cumulée correspond à une proportion fermée : elle mesure le nombre de nouveaux cas apparus au cours d’une période temporelle fixe, divisé par le nombre total de personnes initialement exemptes de la maladie au début du protocole de suivi. Le ratio de ces proportions constitue le risque relatif proprement dit (désigné en anglais sous l’appellation de Risk Ratio ou Cumulative Incidence Ratio). Cette approche postule implicitement que tous les sujets sont observés sur une durée strictement identique et qu’aucun individu ne quitte l’étude avant son terme sans avoir développé la condition.
En revanche, dans les cohortes longitudinales ouvertes au suivi prolongé, les individus présentent des durées d’observation inégales en raison d’inclusions échelonnées dans le temps, d’abandons prématurés ou de décès survenus par d’autres causes. Dans ce cadre, la mesure adéquate de l’incidence est le taux d’incidence, qui rapporte le nombre de cas diagnostiqués à la somme des temps d’observation effectifs de chaque individu (exprimée en unités personnes-temps). Le ratio de deux taux d’incidence définit ainsi le rapport de taux d’incidence (appelé Rate Ratio ou Incidence Rate Ratio, IRR), qui incorpore directement la dimension dynamique du temps d’exposition.
10.2 Calcul de l’Incidence Rate Ratio (IRR) et notion de personnes-années
L’unité d’observation personne-temps (classiquement formulée en personnes-années ou personnes-mois) représente la somme consolidée des périodes individuelles durant lesquelles chaque participant a contribué au suivi en demeurant à risque de développer l’issue psychopathologique. Si une cohorte suit 100 individus sur 10 ans sans aucune perte, elle totalise 1 000 personnes-années d’observation. Si un sujet développe le trouble au bout de 3 ans, sa contribution au dénominateur temporel s’arrête à 3 personnes-années, date à laquelle il cesse d’appartenir à la population à risque.
Considérons une étude prospective en santé au travail analysant l’impact de la surcharge professionnelle chronique (exposition au modèle de Karasek) sur l’apparition d’un syndrome d’épuisement professionnel sévère (burnout clinique) au sein de deux cohortes d’employés suivies sur plusieurs années. Dans le groupe soumis à une surcharge chronique, les chercheurs enregistrent 60 cas de burnout pour un total agrégé de 3 000 personnes-années de suivi, ce qui donne un taux d’incidence de :
$$T_e = \frac{60}{3000} = 0,020 \text{ cas par personne-année}$$
Dans la cohorte témoin évoluant sous une charge de travail modérée, 20 cas sont observés pour un volume cumulé de 4 000 personnes-années, produisant un taux d’incidence de :
$$T_0 = \frac{20}{4000} = 0,005 \text{ cas par personne-année}$$
L’Incidence Rate Ratio se calcule par le ratio de ces deux densités d’incidence :
$$IRR = \frac{0,020}{0,005} = 4,00$$
L’interprétation clinique de cet IRR établit que la vitesse de survenue de l’épuisement professionnel est 4 fois supérieure au sein du personnel surchargé par rapport au groupe témoin, chaque tranche de temps d’exposition générant un quadruplement du risque instantané d’émergence de la pathologie d’épuisement.
10.3 Gestion de la censure et de l’attrition des données
L’un des défis méthodologiques majeurs des cohortes prospectives en psychopathologie réside dans la gestion des données censurées. Un individu est considéré comme censuré à droite lorsqu’il quitte le protocole de suivi avant la survenue de l’événement (perte de vue, déménagement, refus de poursuivre) ou lorsque l’étude s’achève alors qu’il n’a pas encore présenté le trouble d’intérêt. Si cette censure s’opère de manière informative — c’est-à-dire que les abandons sont corrélés à l’aggravation subclinique des symptômes ou à l’effet indésirable de l’exposition —, les calculs standards du risque d’incidence se trouvent profondément biaisés.
Pour modéliser rigoureusement le risque relatif en présence d’attrition et de censure droite, l’analyse de survie longitudinale constitue l’outil statistique de référence. Le modèle à risques proportionnels de Cox permet d’estimer des risques relatifs instantanés, désignés sous le terme de rapports de risques instantanés (Hazard Ratios, HR). L’estimateur du HR s’interprète de manière analogue au risque relatif, en quantifiant l’augmentation ou la diminution de la probabilité instantanée de survenue de l’issue clinique à tout instant de l’intervalle d’observation sous condition d’être demeuré indemne jusqu’alors.
La validité d’un modèle de Cox repose sur le respect impératif du postulat de proportionnalité des risques au cours du temps. Si l’effet du facteur d’exposition s’estompe ou s’amplifie avec les années de suivi, le modèle doit être enrichi de covariables dépendantes du temps pour éviter toute distorsion dans l’interprétation du risque instantané calculé.
11. Risque relatif dans les méta-analyses psychologiques et psychiatriques
11.1 Agrégation statistique des risques relatifs individuels
L’accumulation des données empiriques au sein de multiples protocoles de recherche impose le recours à la méta-analyse quantitative pour dégager une estimation consolidée de l’effet d’une intervention ou de la nocivité d’une exposition. L’agrégation statistique de risques relatifs provenant d’études indépendantes ne s’opère jamais par une simple moyenne arithmétique brute des indices individuels. Les procédures méta-analytiques reposent sur des techniques de pondération mathématique rigoureuses, où chaque étude est pondérée proportionnellement à sa précision statistique, classiquement définie par l’inverse de la variance du logarithme de son risque relatif ($w_i = 1 / v_i$, où $v_i = SE(\ln(RR_i))^2$).
Deux grands modèles mathématiques président à cette synthèse de données probantes : le modèle à effets fixes et le modèle à effets aléatoires. Le modèle à effets fixes postule l’existence d’une taille d’effet véritable unique et universelle au sein de la population globale, les divergences observées d’une étude à l’autre étant attribuables exclusivement à l’erreur d’échantillonnage aléatoire interne ($v_i$). La méthode standard de Mantel-Haenszel ou l’inverse de la variance sont classiquement employées pour calculer l’estimateur combiné sous cette hypothèse.
Néanmoins, en psychiatrie et en sciences comportementales, la diversité des caractéristiques sociodémographiques des patients, des protocoles thérapeutiques administrés et des critères de mesure utilisés rend l’hypothèse d’une valeur paramétrique unique théoriquement invraisemblable. Le modèle à effets aléatoires de DerSimonian et Laird s’impose alors comme la méthode préférentielle. Ce modèle intègre un terme de variance supplémentaire ($\tau^2$, ou tau-carré) représentant la variabilité réelle de l’effet clinique d’une étude à l’autre. Le poids attribué à chaque recherche est alors ajusté en fonction de la somme de la variance intra-étude et de la variance inter-études ($w_i^* = 1 / (v_i + \tau^2)$), aboutissant à une estimation globale combinée plus conservatrice et plus représentative de l’hétérogénéité des contextes cliniques.
11.2 Évaluation de l’hétérogénéité entre études empiriques
L’interprétation de l’estimation globale d’un risque relatif issu d’une méta-analyse est indissociable de l’analyse statistique rigoureuse de l’hétérogénéité inter-études. La première mesure conventionnelle est la statistique $Q$ de Cochran, fondée sur la somme pondérée des écarts au carré entre les risques relatifs de chaque étude individuelle et l’estimation globale combinée. Un test de signification fondé sur une loi du chi-deux informe sur la présence d’une hétérogénéité excédant ce que le seul hasard d’échantillonnage permettrait d’anticiper.
Cependant, en raison de la sensibilité excessive de la statistique $Q$ à la taille de l’échantillon, la métrique contemporaine de choix est l’indice $I^2$ développé par Higgins et Thompson. Ce coefficient quantifie le pourcentage de la variabilité globale observée parmi les tailles d’effet qui est attribuable à une véritable hétérogénéité clinique ou méthodologique plutôt qu’à l’erreur d’échantillonnage fortuite :
$$I^2 = \max\left(0, , \frac{Q – df}{Q}\right) \times 100%$$
Une valeur d’$I^2$ proche de 25 % reflète une hétérogénéité modérée, 50 % signale une hétérogénéité substantielle, tandis qu’une valeur supérieure à 75 % indique une divergence majeure entre les résultats des études agrégées. Lorsqu’un niveau d’hétérogénéité très élevé est identifié, les synthèses de données probantes doivent renoncer à interpréter un risque relatif global unique comme une vérité absolue. Elles doivent impérativement mobiliser des analyses de sous-groupes stratifiées ou des modèles de méta-régression afin d’identifier les variables modératrices (durée du suivi, posologie psychothérapeutique, âge moyen des cohortes) modulant la magnitude du risque relatif au fil des publications.
11.3 Représentation visuelle et identification des biais
La synthèse des risques relatifs au sein d’une méta-analyse se visualise traditionnellement par un graphique en forêt (Forest Plot). Cette représentation graphique aligne verticalement l’ensemble des études incluses. Pour chaque publication, l’estimation ponctuelle du risque relatif est figurée par un carré dont la superficie est directement proportionnelle au poids méthodologique attribué à l’étude dans le modèle. Une ligne horizontale traversant le carré matérialise l’étendue de l’intervalle de confiance à 95 %.
Au bas du Forest Plot, un losange (ou diamant synthétique) illustre l’estimation globale consolidée : le centre géométrique du losange correspond à la valeur moyenne pondérée du risque relatif méta-analytique, tandis que sa largeur transversale délimite précisément l’intervalle de confiance à 95 % combiné. Si ce diamant ne coupe pas l’axe vertical d’indépendance passant par la valeur nulle 1,00, l’effet global consolidé est formellement déclaré statistiquement significatif au seuil conventionnel.
Pour garantir la validité des conclusions, les auteurs doivent également évaluer l’existence éventuelle d’un biais de publication via la construction d’un graphique en entonnoir (Funnel Plot). En l’absence de biais, la distribution des logarithmes des risques relatifs en fonction de leur précision statistique (ou erreur-type inverse) prend l’aspect d’un entonnoir inversé symétrique. Une asymétrie marquée — matérialisée par l’absence d’études de petite taille rapportant des effets nuls ou délétères — alerte sur une rétention sélective des résultats défavorables. Le test de régression linéaire d’Egger permet de tester formellement cette asymétrie, tandis que la procédure itérative de remplissage de Duval et Tweedie (Trim and Fill) permet de recalculer un risque relatif global ajusté en simulant l’intégration des études manquantes non publiées.
12. Guide pratique et erreurs récurrentes d’interprétation du risque relatif
12.1 Confusions sémantiques et sophismes de causalité
L’écueil conceptuel le plus pernicieux dans l’interprétation du risque relatif consiste à basculer subrepticement de la description d’une association statistique à l’affirmation péremptoire d’un lien de cause à effet direct. Ce glissement relève du sophisme classique désigné en logique sous l’adage cum hoc ergo propter hoc (« avec ceci, donc à cause de ceci »). Démontrer qu’une population exposée présente un risque relatif de $RR = 2,50$ de manifester un comportement pathologique atteste formellement d’une covariation temporelle, mais ne prouve aucunement que l’exposition constitue le déterminant causal univoque du phénomène.
Pour qu’une valeur de risque relatif puisse s’intégrer légitimement dans un plaidoyer de causalité, les épidémiologistes et les cliniciens doivent éprouver les données empiriques à l’aune des neuf critères fondamentaux de causalité formalisés par Sir Austin Bradford Hill :
- La force de l’association : Des valeurs de risque relatif très élevées (ex. $RR > 4,0$) rendent moins plausible l’explication exclusive par un facteur de confusion non contrôlé.
- La constance des observations : L’effet doit être répliqué au sein de populations géographiques et socioculturelles distinctes au moyen de devis méthodologiques variés.
- La spécificité de l’association : Une exposition donnée génère une issue clinique singulière, bien que ce critère soit rarement strictement vérifié dans le champ complexe de la psychopathologie.
- La temporalité : L’exposition doit incontestablement précéder l’émergence des manifestations prodromiques du trouble d’intérêt.
- Le gradient biologique (ou relation dose-réponse) : L’élévation de la magnitude du risque relatif doit suivre l’intensité ou la fréquence de l’exposition au facteur d’étude.
- La plausibilité biologique et psychologique : Le lien mesuré doit faire sens au regard des connaissances actuelles issues des neurosciences et de la psychologie empirique.
- La cohérence : Les données épidémiologiques ne doivent pas entrer en contradiction flagrante avec l’histoire naturelle de la pathologie.
- La preuve expérimentale : L’interruption de l’exposition doit théoriquement entraîner une diminution de la fréquence de survenue du trouble.
- L’analogie : Des mécanismes similaires ont déjà été validés pour d’autres facteurs de risque comparables.
Dans la rédaction académique contemporaine, les chercheurs doivent proscrire les termes d’implication causale directe (tels que « le facteur provoque », « l’intervention déclenche ») lorsqu’ils commentent des devis observationnels, pour leur préférer des formulations prudentes : « l’exposition est significativement associée à une élévation de l’incidence du trouble », soulignant le statut d’indicateur ou de marqueur de vulnérabilité biopsychosociale.
12.2 Erreurs d’arithmétique et inversions de référence
L’estimation et l’interprétation numérique du risque relatif sont jalonnées d’erreurs d’arithmétique récurrentes dont l’impact peut altérer la restitution des conclusions scientifiques. L’une des bévues les plus fréquentes réside dans l’inversion involontaire du groupe de référence servant de dénominateur à l’équation. Si le ratio initial compare les sujets exposés aux non-exposés et produit un $RR = 0,25$, désigner par inadvertance le groupe exposé comme référence inverse l’équation ($RR_{inversé} = 1 / 0,25 = 4,00$). Cette méprise modifie radicalement la perception de l’amplitude de l’effet, transformant une réduction de 75 % du risque en une majoration apparente de 300 % du phénomène selon la façon dont les colonnes ont été libellées.
Une seconde erreur largement documentée réside dans la confusion linguistique et mathématique entre « points de pourcentage » absolus et « pourcentage de variation relative ». Considérons une situation où l’incidence passe de 2 % chez les non-exposés à 4 % chez les exposés. L’augmentation absolue est de 2 points de pourcentage ($4% – 2% = 2%$). En revanche, l’augmentation relative du risque s’établit à 100 % ($RR = 0,04 / 0,02 = 2,00$, soit $ARR = 1,00$). Formuler cette observation sous la phrase « le traitement augmente le risque de 2 % » constitue une déformation clinique majeure, car cela masque le fait que l’incidence a en réalité doublé au plan relatif.
Enfin, la méconnaissance de l’asymétrie de l’échelle du risque relatif conduit souvent à des raisonnements erronés sur l’équivalence des amplitudes d’effet. Un risque relatif de 0,50 (qui correspond à une diminution de moitié du risque) est mathématiquement symétrique à un risque relatif de 2,00 (doublement du risque) sur l’échelle logarithmique, mais aucunement sur l’échelle naturelle. Pour prévenir ces dérives calculatoires, il est impératif d’auditer systématiquement les scripts d’analyse sous les environnements statistiques reconnus (tels que le langage R avec les packages epitools ou metafor, ou Python avec statsmodels), en vérifiant l’attribution des modalités binaires (0 = référence indemne, 1 = exposé/malade) au sein des tables de contingence.
12.3 Grille d’évaluation critique pour la lecture d’articles académiques
Afin d’outiller les cliniciens et chercheurs lors de la lecture critique de publications biomédicales et psychologiques rapportant des risques relatifs, nous formalisons une liste de contrôle méthodologique standardisée articulée en six étapes logiques d’audit :
- Étape 1 : Vérification de la compatibilité du devis de recherche. Le plan expérimental retenu est-il une étude prospective de cohorte ou un essai randomisé permettant le recueil direct de l’incidence ? Si l’étude est de nature rétrospective de type cas-témoins, l’utilisation du risque relatif est a priori invalide et doit être disqualifiée au profit de l’odds ratio.
- Étape 2 : Identification formelle des groupes et de la ligne de base. Le groupe de référence non exposé est-il clairement défini et indemne du trouble au temps zéro ? Le niveau de risque absolu de base ($I_0$) est-il explicitement chiffré dans les tableaux de résultats descriptifs ?
- Étape 3 : Examen de la précision statistique et des bornes de l’IC 95 %. L’intervalle de confiance est-il rapporté ? Exclut-il la valeur nulle 1,00 ? Quelle est son étendue ? Un intervalle excessivement étalé signale-t-il un manque de puissance statistique compromettant la solidité des inférences cliniques ?
- Étape 4 : Audit des biais méthodologiques potentiels. Les taux de suivi et d’attrition longitudinale sont-ils documentés ? Les évaluateurs cliniques étaient-ils rigoureusement placés en aveugle du statut d’exposition des patients ? Des biais de mémoire ou de classification différentielle sont-ils susceptibles de biaiser la proportion observée ?
- Étape 5 : Examen de la stratégie d’ajustement multivarié. Le risque relatif présenté est-il une valeur brute ou une estimation ajustée sur les facteurs de confusion majeurs ? Les auteurs ont-ils mobilisé des régressions log-binomiales ou de Poisson modifiée robustes plutôt qu’une extrapolation abusive à partir d’un odds ratio ?
- Étape 6 : Évaluation de la pertinence translationnelle clinique. Les auteurs ont-ils pris le soin de convertir le risque relatif en réduction absolue du risque (RAR) et en Nombre de Sujets à Traiter (NNT) ? L’interprétation narrative proposée dans la discussion est-elle exempte d’affirmations causales hâtives non étayées par les critères épidémiologiques standardisés ?
L’application rigoureuse et systématique de cette grille d’analyse méthodologique garantit une intégration judicieuse des données de la recherche internationale dans l’élaboration des politiques de santé mentale et le choix des stratégies psychothérapeutiques individualisées.
Références
- Altman, D. G. (1998). Confidence intervals for the number needed to treat. BMJ, 317(7168), 1309–1312. https://doi.org/10.1136/bmj.317.7168.1309
- Bradford Hill, A. (1965). The environment and disease: Association or causation? Proceedings of the Royal Society of Medicine, 58(5), 295–300. https://doi.org/10.1177/003591576505800503
- DerSimonian, R., & Laird, N. (1986). Meta-analysis in clinical trials. Controlled Clinical Trials, 7(3), 177–188. https://doi.org/10.1016/0197-2456(86)90046-2
- Gigerenzer, G., Gaissmaier, W., Kurz-Milcke, E., Schwartz, L. M., & Woloshin, S. (2007). Helping doctors and patients make sense of health statistics. Psychological Science in the Public Interest, 8(2), 53–96. https://doi.org/10.1111/j.1539-6053.2007.00033.x
- Higgins, J. P. T., & Thompson, S. G. (2002). Quantifying heterogeneity in a meta-analysis. Statistics in Medicine, 21(11), 1539–1558. https://doi.org/10.1002/sim.1186
- Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern Epidemiology (3rd ed.). Lippincott Williams & Wilkins.
- Sackett, D. L., Richardson, W. S., Rosenberg, W., & Haynes, R. B. (1997). Evidence-based medicine: How to practice and teach EBM. Churchill Livingstone.
- Spiegelman, D., & Hertzmark, E. (2005). Easy SAS calculations for risk or prevalence ratios and differences. American Journal of Epidemiology, 162(3), 199–200. https://doi.org/10.1093/aje/kwi188
- Szklo, M., & Nieto, F. J. (2014). Epidemiology: Beyond the basics (3rd ed.). Jones & Bartlett Learning.
- Zhang, J., & Yu, K. F. (1998). What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA, 280(19), 1690–1691. https://doi.org/10.1001/jama.280.19.1690
- Zou, G. (2004). A modified poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090