
Dans le champ foisonnant des sciences quantitatives, de la recherche biomédicale contemporaine et de la psychologie clinique, l’évaluation rigoureuse des associations statistiques constitue la pierre angulaire de l’inférence scientifique. Qu’il s’agisse d’estimer l’effet d’une psychothérapie innovante sur la rémission d’un état de stress post-traumatique, d’identifier des facteurs de vulnérabilité cognitive face aux troubles dépressifs majeurs ou de quantifier l’impact de marqueurs génétiques sur l’apparition de conduites addictives, les chercheurs se heurtent inévitablement à la nécessité de mesurer la force d’un lien entre une exposition et un événement dichotomique. Parmi l’arsenal d’indicateurs développés par la biométrie et la statistique inférentielle, l’Odds Ratio (OR), communément désigné sous le terme français de « rapport de cotes », occupe une place prépondérante, à la fois célébrée pour ses vertus mathématiques invariantes et redoutée pour son opacité interprétative.
Malgré sa diffusion universelle dans les revues internationales à comité de lecture, le rapport de cotes demeure l’une des métriques les plus fréquemment travesties dans la littérature académique et la vulgarisation scientifique. Il n’est pas rare de voir des investigateurs chevronnés, trompés par des intuitions probabilistes naïves, assimiler sans précaution méthodologique un rapport de cotes à un risque relatif, multipliant ainsi artificiellement la perception de l’amplitude d’un phénomène de santé ou d’un effet thérapeutique. Cette confusion sémantique et conceptuelle engendre des répercussions considérables, pouvant orienter de manière fallacieuse des décisions de politique publique, biaiser l’allocation de ressources en santé mentale ou fausser les conclusions de méta-analyses majeures. Comprendre la nature intrinsèque de l’Odds Ratio requiert donc une déconstruction minutieuse des mécanismes algébriques qui séparent la simple probabilité de la cote, ainsi qu’une immersion lucide dans les contextes de modélisation où cette métrique règne sans partage.
Ce guide exhaustif a pour vocation de fournir aux chercheurs, cliniciens, statisticiens et étudiants avancés les clés théoriques, méthodologiques et pratiques indispensables à l’interprétation infaillible du rapport de cotes. En explorant ses fondements probabilistes, sa mécanique computationnelle sur table de contingence, son intégration au sein des modèles de régression logistique binaire, ainsi que ses divergences critiques avec le risque relatif, cet ouvrage de référence se propose d’éradiquer les confusions conceptuelles récurrentes. À travers des démonstrations mathématiques claires, des exemples cliniques contextualisés en psychopathologie cognitive et des protocoles de rédaction conformes aux exigences les plus strictes de l’American Psychological Association (APA), le lecteur acquerra une maîtrise souveraine de cet indicateur fondamental de la recherche empirique moderne.
1. Introduction fondamentale : Du concept de probabilité aux rapports de cotes
1.1 Définition conceptuelle de la probabilité en recherche quantitative
La probabilité constitue le socle axiomatique sur lequel repose l’édifice de l’inférence statistique. Formellement théorisée par Andreï Kolmogorov en 1933 à travers la théorie de la mesure, la probabilité classique ou fréquentiste se définit comme le rapport mathématique strict entre le nombre d’occurrences favorables à un événement donné et le nombre total d’événements élémentaires mutuellement exclusifs et équiprobables constituant l’univers des possibles, noté traditionnellement Ω. Dans le cadre d’un protocole d’échantillonnage clinique, si un ensemble d’individus présente un phénotype psychopathologique spécifique noté A, la probabilité P(A) d’observer cet état correspond à la limite de sa fréquence relative lorsque la taille de la cohorte tend vers l’infini :
P(A) = n(A) / N
où n(A) représente le nombre de sujets exhibant la condition clinique et N l’effectif total de l’échantillon analysé. Cette métrique est intrinsèquement bornée dans l’intervalle réel fermé [0, 1]. Une probabilité de 0 dénote l’impossibilité théorique ou empirique absolue de la survenue de l’événement, tandis qu’une valeur unitaire de 1 scelle sa certitude déterministe.
Sur le plan épistémologique, la recherche comportementale oscille régulièrement entre cette approche fréquentiste objective — où la probabilité reflète une propriété physique stable et mesurable d’un système biologique ou social soumis à des tirages indépendants et identiquement distribués — et la perspective bayésienne ou subjective, au sein de laquelle la probabilité quantifie le degré de croyance rationnelle d’un observateur à l’égard d’une hypothèse, conditionné par l’information disponible a priori. Quelle que soit l’école de pensée adoptée, la métrique probabiliste brute s’avère indispensable pour quantifier la charge de morbidité, l’incidence cumulée d’un trouble ou la prévalence ponctuelle au sein d’une population cible.
Toutefois, en dépit de sa simplicité intuitive et de sa manipulabilité directe, la probabilité brute révèle de sévères limitations structurelles dès lors qu’il s’agit d’analyser des relations d’association complexes ou de comparer des dynamiques d’occurrence entre plusieurs cohortes distinctes soumises à des facteurs environnementaux hétérogènes. La contrainte d’additivité et le bornage obligatoire entre zéro et un imposent des verrous mathématiques rigides qui compliquent l’estimation d’effets multivariés indépendants sans engendrer de prédictions aberrantes se situant en dehors du domaine de définition probabiliste valide.
1.2 Émergence et pertinence de la notion de cote (Odds)
Afin de s’émanciper des contraintes géométriques inhérentes à la probabilité, la théorie de la décision statistique et les sciences actuarielles ont formalisé un concept alternatif, historiquement forgé dans l’univers des jeux de hasard et des paris hippiques britanniques : la cote, universellement désignée par le terme anglo-saxon odds. Alors que la probabilité classique évalue la fraction de l’événement cible par rapport à la totalité des possibles (succès rapportés à l’ensemble succès plus échecs), la cote opère une rupture paradigmatique en confrontant directement la fréquence de survenue d’un événement à la fréquence de sa non-survenue.
Analytiquement, la cote associée à un événement A dont la probabilité d’occurrence est P(A) s’énonce comme le ratio de cette probabilité sur son complémentaire arithmétique 1 – P(A), ce dernier représentant la probabilité d’échec ou d’absence de l’événement :
Cote(A) = P(A) / [1 – P(A)]
Cette transformation modifie fondamentalement les propriétés algébriques de la mesure. Si la probabilité reste captive du segment unitaire [0, 1], l’échelle des cotes se déploie de manière asymétrique sur le demi-axe réel positif [0, +∞[. Lorsque la survenue d’un phénomène est hautement improbable (par exemple, P(A) = 0,001), le dénominateur est approximativement égal à l’unité, de sorte que la cote est quasi identique à la probabilité brute (0,001 / 0,999 ≈ 0,001001). En revanche, lorsque la probabilité s’approche de la certitude (P(A) = 0,95), la cote subit une accélération non linéaire majeure (0,95 / 0,05 = 19). La cote exprime alors qu’il y a 19 chances d’observer l’événement pour une seule chance d’observer son absence.
Cette structure mathématique confère à la cote une souplesse exceptionnelle dans les jeux d’inférence. Elle supprime la frontière supérieure fixe, permettant ainsi de concevoir des fonctions de liaison continues requises pour la régression statistique avancée. En confrontant l’occurrence à la non-occurrence, elle transforme une proportion fermée en un rapport vectoriel d’intensités rivales.
1.3 Nécessité de l’Odds Ratio dans les sciences psychologiques et comportementales
Dans les sciences psychologiques, psychiatriques et cognitives, les investigateurs explorent couramment des variables latentes, des profils de personnalité et des tableaux nosographiques dont l’étiologie multifactorielle défie les modélisations linéaires classiques fondées sur l’homoscédasticité et la normalité des résidus. Lorsque le critère de jugement clinique est fondamentalement binaire — présence versus absence d’un épisode dépressif caractérisé, rechute versus maintien de l’abstinence tabagique, tentative de suicide versus absence de passage à l’acte —, comparer les simples différences de proportions absolues entre deux groupes s’avère méthodologiquement insuffisant et souvent biaisé.
La différence de risques absolus dépend drastiquement de la prévalence basale du trouble au sein des populations interrogées. Elle ne permet pas de capturer de façon robuste l’intensité intrinsèque de l’association étiologique à travers des contextes sociodémographiques variés. De surcroît, les protocoles expérimentaux randomisés ne constituent qu’une fraction marginale des devis de recherche disponibles en psychopathologie pour des raisons éthiques évidentes : on ne saurait exposer délibérément des sujets à des maltraitances infantiles ou à des traumatismes de guerre pour en observer les conséquences cliniques longitudinales. La discipline recourt donc massivement à des devis observationnels rétrospectifs, notamment les études cas-témoins (case-control studies).
Dans un protocole cas-témoins, le chercheur sélectionne a posteriori des individus manifestant le trouble mental (les cas) et les apparie à des individus indemnes (les témoins), avant d’explorer rétrospectivement leur niveau d’exposition antérieur à un facteur de risque hypothétique. Dans ce paradigme particulier, le taux de prévalence générale ou l’incidence réelle du trouble ne peut pas être calculé, car la proportion de cas est arbitrairement fixée par le chercheur (par exemple, un ratio strict d’un cas pour un témoin). Dès lors, le calcul du Risque Relatif conventionnel devient strictement impossible. C’est ici que l’Odds Ratio s’impose comme un invariant structurel indispensable : de par ses propriétés mathématiques singulières, le rapport des cotes de l’événement selon l’exposition est rigoureusement équivalent au rapport des cotes d’exposition selon le statut clinique du sujet. L’OR transcende ainsi l’architecture du devis d’étude et s’érige en pierre angulaire de la quantification des liens d’association en santé mentale et en épidémiologie comportementale.
2. Distinction mathématique essentielle : Probabilité, cote et rapport de cotes
2.1 Comparaison arithmétique rigoureuse entre probabilité et cote
Pour appréhender la mécanique intime de l’Odds Ratio, il est impératif de dissiper toute ambiguïté théorique entre la probabilité et la cote au moyen d’une analyse comparative formelle. Considérons une population clinique au sein de laquelle la probabilité P d’émergence d’un état d’anxiété généralisée varie le long du spectre théorique. Le tableau ci-dessous explicite la non-linéarité fondamentale qui gouverne la conversion de la probabilité en cote :
| Probabilité (P) | Complément (1 – P) | Formule de la cote (P / [1 – P]) | Valeur de la cote | Interprétation discursive |
|---|---|---|---|---|
| 0,01 | 0,99 | 0,01 / 0,99 | 0,0101 | Environ 1 contre 99 |
| 0,10 | 0,90 | 0,10 / 0,90 | 0,1111 | 1 contre 9 |
| 0,20 | 0,80 | 0,20 / 0,80 | 0,2500 | 1 contre 4 |
| 0,50 | 0,50 | 0,50 / 0,50 | 1,0000 | 1 contre 1 (équicote) |
| 0,80 | 0,20 | 0,80 / 0,20 | 4,0000 | 4 contre 1 |
| 0,90 | 0,10 | 0,90 / 0,10 | 9,0000 | 9 contre 1 |
| 0,99 | 0,01 | 0,99 / 0,01 | 99,0000 | 99 contre 1 |
L’observation attentive de ces valeurs démontre que la cote n’est pas proportionnelle à la probabilité. Alors que la probabilité passe de 0,50 à 0,99 (soit un facteur multiplicatif d’à peine 1,98 sur l’échelle des probabilités), la cote explose, passant de 1,0 à 99,0 (soit une multiplication par 99). Lorsque la probabilité tend asymptotiquement vers 1, la cote diverge vers l’infini positif (+∞). Inversement, lorsque P s’approche de 0, la cote converge vers 0, maintenant une quasi-équivalence avec la probabilité brute.
Cette divergence exponentielle est la source première de confusions massives chez les chercheurs inexpérimentés. Confondre une cote de 4 avec une probabilité de 4 (ce qui serait mathématiquement absurde, les probabilités étant limitées à 1,0) ou déduire d’une cote de 4 une probabilité de 80 % (0,80 / [1 – 0,80] = 4) exige une gymnastique mentale rigoureuse qui fait trop souvent défaut dans la restitution narrative des résultats empiriques.
2.2 Formulation algébrique précise de l’Odds Ratio (OR)
L’Odds Ratio, ou rapport de cotes, représente par définition le quotient arithmétique de deux cotes indépendantes associées à deux modalités distinctes d’une variable explicative ou d’une condition clinique. Soient deux groupes indépendants, le Groupe 1 (par exemple, des patients exposés à un événement de vie hautement stressant) et le Groupe 2 (des sujets non exposés ou soumis à un protocole témoin neutre). Notons P1 la probabilité de survenue du trouble mental dans le Groupe 1, et P2 la probabilité d’occurrence du même trouble dans le Groupe 2.
La cote d’apparition du trouble au sein du Groupe 1 s’établit à :
Cote1 = P1 / (1 – P1)
De même, la cote d’apparition du trouble dans le Groupe 2 s’exprime par :
Cote2 = P2 / (1 – P2)
L’Odds Ratio univarié est formellement défini comme :
OR = Cote1 / Cote2 = [P1 / (1 – P1)] / [P2 / (1 – P2)]
Cette métrique possède une propriété de symétrie réciproque tout à fait remarquable. Si l’on inverse l’ordre des groupes ou si l’on redéfinit l’issue en termes de « non-maladie » (guérison ou absence de trouble), le nouvel Odds Ratio obtenu correspond exactement à l’inverse arithmétique de l’OR originel (1 / OR). Pour linéariser cette mesure et restaurer une symétrie parfaite autour de zéro, la statistique biomédicale recourt universellement à la transformation logarithmique naturelle de l’Odds Ratio, dénommée log-odds ratio ou fonction logit :
ln(OR) = ln(Cote1) – ln(Cote2) = logit(P1) – logit(P2)
Sur l’échelle logarithmique, un OR de 1 devient égal à 0 (absence totale d’effet), un OR de 2 correspond à ln(2) ≈ +0,693, tandis qu’un OR de 0,5 se traduit par ln(0,5) ≈ -0,693. Cette distribution log-normale symétrique joue un rôle instrumental dans le calcul des erreurs types et des tests d’inférence.
2.3 Illustration par cas canonique : Tirage de boules et modèles de décision
Pour appréhender la métrique sans le parasitage des biais cliniques, analysons un modèle canonique à base d’urnes stochastiques, couramment mobilisé dans l’étude des processus de décision heuristique en psychologie expérimentale.
Imaginons deux urnes opaques contenant des billes rouges (symbolisant la manifestation d’un dysfonctionnement neurocognitif) et des billes blanches (symbolisant un fonctionnement standard). L’Urne A (représentant la condition d’exposition cognitive délétère) contient 40 billes rouges et 10 billes blanches, pour un total de 50 billes. L’Urne B (représentant la condition contrôle neutre) renferme 20 billes rouges et 80 billes blanches, soit 100 billes au total.
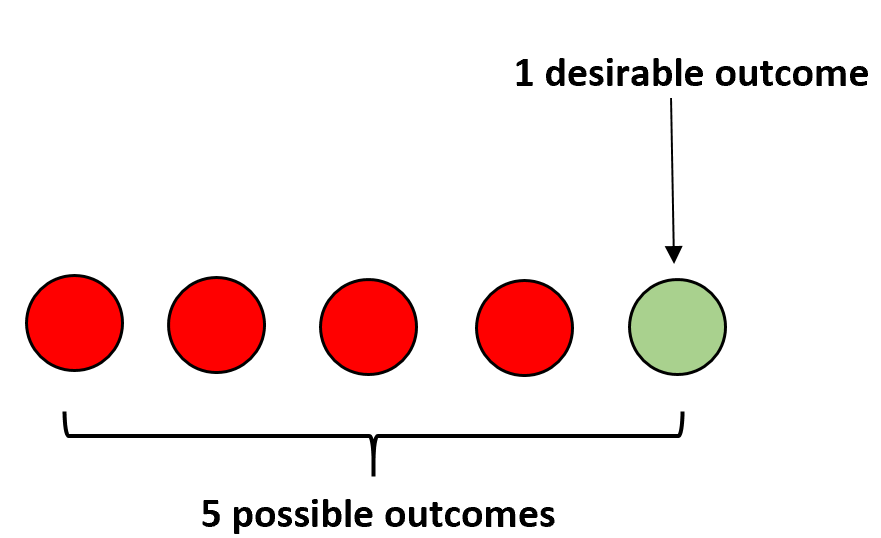
Calculons séquentiellement les métriques associées au tirage d’une bille rouge :
- Probabilités marginales :
- Pour l’Urne A : PA = 40 / 50 = 0,80 (soit 80 % de billes rouges).
- Pour l’Urne B : PB = 20 / 100 = 0,20 (soit 20 % de billes rouges).
- Risque Relatif (RR) :
- RR = PA / PB = 0,80 / 0,20 = 4,00. Le tirage d’une bille rouge est 4 fois plus probable dans l’Urne A que dans l’Urne B.
- Cotes élémentaires (Odds) :
- Pour l’Urne A : CoteA = 0,80 / (1 – 0,80) = 0,80 / 0,20 = 4,00 (il y a 4 billes rouges pour chaque bille blanche).
- Pour l’Urne B : CoteB = 0,20 / (1 – 0,20) = 0,20 / 0,80 = 0,25 (il y a 0,25 bille rouge par bille blanche, soit 1 bille rouge pour 4 blanches).
- Odds Ratio (OR) :
- OR = CoteA / CoteB = 4,00 / 0,25 = 16,00.
L’analyse de ces chiffres met en lumière une fracture numérique éclatante : alors que la probabilité n’augmente que d’un facteur 4, la cote est quant à elle multipliée par 16. L’Odds Ratio quantifie ici la supériorité de la confrontation binaire. Si un sujet doit parier sur la couleur de la bille tirée, le ratio de ses espérances relatives de gain est modifié d’un facteur 16 lors du passage de l’Urne B à l’Urne A. Transposé à la psychologie du choix sous incertitude, ce modèle illustre comment une modification de l’environnement cognitif peut exercer un effet démultiplicateur spectaculaire sur les cotes de sélection d’une alternative comportementale.
3. Méthodologie de calcul du rapport de cotes à partir de tables de contingence
3.1 Structure matricielle d’un tableau croisé 2×2
En épidémiologie clinique et dans la recherche comportementale observationnelle, le point de départ classique du calcul d’association bivariée réside dans l’élaboration d’une matrice croisée de dimension 2×2. Cette table de contingence organise les effectifs empiriques observés selon deux axes orthogonaux : le statut d’exposition à un facteur de risque environnemental ou génétique (placé conventionnellement en lignes) et le statut de survenue d’un critère clinique ou psychopathologique (positionné en colonnes).
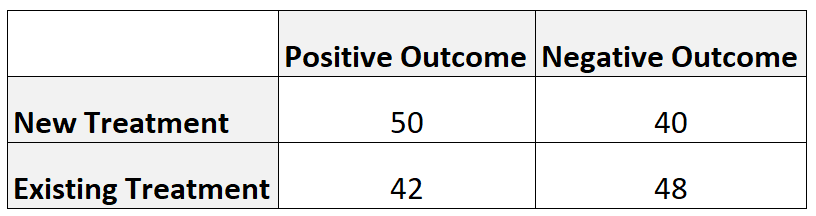
La codification internationale standardise la nomenclature des cellules au moyen des lettres minuscules a, b, c, d, comme modélisé ci-après :
| Exposition / Prédicteur | Événement Présent (Cas) | Événement Absent (Témoins) | Total Marginal |
|---|---|---|---|
| Exposés (E+) | a (Vrais Positifs) | b (Faux Positifs d’exposition) | a + b (Total Exposés) |
| Non-Exposés (E-) | c (Faux Négatifs d’exposition) | d (Vrais Négatifs) | c + d (Total Non-Exposés) |
| Total Marginal | a + c (Total Cas) | b + d (Total Témoins) | N = a + b + c + d |
L’intégrité de la table impose le respect de conditions préalables strictes. L’échantillon global N doit résulter d’un schéma d’échantillonnage valide, et les observations individuelles doivent satisfaire au critère d’indépendance mutuelle stochastique (aucun sujet ne peut appartenir simultanément à deux cellules). En outre, pour garantir la validité asymptotique des estimations ultérieures, les effectifs marginaux théoriques attendus sous l’hypothèse d’indépendance — calculés pour chaque cellule par la formule (Total Ligne × Total Colonne) / N — doivent impérativement être supérieurs ou égaux à 5 dans au moins 80 % des cellules, aucune cellule théorique ne devant être strictement inférieure à 1.
3.2 Application de la formule du produit croisé (Cross-Product Ratio)
À partir de cette formalisation matricielle, l’extraction de l’Odds Ratio se prête à une simplification algébrique d’une remarquable élégance. Reprenons les formules fondamentales de la cote chez les exposés et chez les non-exposés en utilisant les effectifs réels observés :
La probabilité d’être malade chez les exposés est PE+ = a / (a + b). Dès lors, la probabilité complémentaire d’être sain chez les exposés s’élève à 1 – PE+ = b / (a + b). La cote d’événement chez les exposés correspond donc au quotient de ces deux valeurs :
CoteE+ = [a / (a + b)] / [b / (a + b)] = a / b
Selon une démarche rigoureusement superposable, la probabilité d’être malade chez les non-exposés est PE- = c / (c + d), et son complément vaut 1 – PE- = d / (c + d). La cote d’événement chez les sujets non exposés devient alors :
CoteE- = [c / (c + d)] / [d / (c + d)] = c / d
L’Odds Ratio s’obtient immédiatement en divisant la première cote par la seconde :
OR = (a / b) / (c / d) = (a × d) / (b × c)
Cette relation fondamentale porte le nom historique de rapport des produits croisés (cross-product ratio). Les dénominateurs marginaux s’annulent intégralement lors de la simplification algébrique, conférant à la formule une robustesse exceptionnelle. Pour quantifier la dispersion statistique de cette estimation ponctuelle, la méthode asymptotique introduite par Barnet Woolf en 1955 permet de calculer la variance empirique du logarithme naturel de l’OR selon la formule additive suivante :
Var[ln(OR)] = (1 / a) + (1 / b) + (1 / c) + (1 / d)
Dans les configurations méthodologiques délicates où l’une des cellules empiriques présente un effectif strictement nul (0), le calcul brut aboutit à un dénominateur nul ou à un numérateur nul, rendant l’OR soit indéfini, soit infini. Dans cette situation, la correction de continuité standard de Haldane-Anscombe s’impose : elle préconise d’ajouter systématiquement la constante 0,5 à l’ensemble des quatre cellules matricielles de la table avant de dériver l’Odds Ratio et son erreur type asymptotique.
3.3 Exemple pratique appliqué à un trouble psychologique
Afin de concrétiser l’application computationnelle de ces équations, examinons une investigation transversale menée auprès d’une cohorte de 450 étudiants universitaires en période d’examens académiques. L’objectif consiste à évaluer l’impact d’une exposition avérée à un niveau de stress perçu chronique sévère (mesuré via la Perceived Stress Scale) sur le déclenchement d’un épisode dépressif caractérisé modéré à sévère (évalué selon les critères diagnostiques du DSM-5 via le Patient Health Questionnaire-9).
Les données quantitatives récoltées se structurent ainsi :
- Parmi les 150 étudiants exposés au stress chronique (E+) : 60 présentent un épisode dépressif avéré (a = 60), et 90 en sont indemnes (b = 90).
- Parmi les 300 étudiants non exposés ou présentant un stress modéré/faible (E-) : 45 manifestent un épisode dépressif (c = 45), et 255 demeurent asymptomatiques (d = 255).
Vérifions les totaux marginaux : effectif global N = 450. Total des dépressifs = 60 + 45 = 105. Total des sains = 90 + 255 = 345. Les conditions d’effectifs minimaux étant largement respectées, appliquons la formule du produit croisé :
OR = (a × d) / (b × c) = (60 × 255) / (90 × 45)
OR = 15 300 / 4 050 ≈ 3,778
Déterminons ensuite la variance asymptotique du log-odds ratio :
Var[ln(OR)] = (1 / 60) + (1 / 90) + (1 / 45) + (1 / 255) ≈ 0,01667 + 0,01111 + 0,02222 + 0,00392 = 0,05392
L’erreur type (Standard Error, SE) s’obtient par la racine carrée de cette variance :
SE[ln(OR)] = √(0,05392) ≈ 0,2322
Ce résultat chiffré brut indique préliminairement que la cote de présenter un état dépressif est presque quatre fois supérieure chez les étudiants subissant un stress chronique comparativement à leurs pairs préservés. Il convient désormais d’en décoder la signification théorique et clinique profonde.
4. Les principes fondamentaux de l’interprétation numérique de l’Odds Ratio
4.1 Signification théorique de la valeur pivot unitaire (OR = 1)
Dans l’univers des rapports de cotes, le chiffre 1,00 constitue la borne pivotale sacrée : la valeur de référence sous l’hypothèse nulle (H0). D’un point de vue probabiliste et algébrique rigoureux, obtenir un Odds Ratio exactement égal à 1 signifie que la cote d’apparition de l’événement au sein du groupe exposé est parfaitement identique à la cote observée au sein du groupe témoin (Cote1 = Cote2, d’où Cote1 / Cote2 = 1,00).
Sur le plan de l’inférence clinique, cette valeur pivot traduit une stricte indépendance statistique entre la variable prédictive et le critère nosographique étudié. L’exposition n’augmente ni ne diminue la cote de survenue de l’affection mentale considérée. Dans le contexte de l’évaluation d’un essai clinique randomisé comparant un psychotrope ou une thérapie cognitive informatisée à un placebo pur, un OR empirique égal à 1 signifie que l’intervention évaluée présente une efficacité rigoureusement équivalente à la condition témoin, signant la neutralité absolue de l’effet thérapeutique.
Il est toutefois capital de rappeler une distinction épistémologique chère à la statistique méthodologique : l’obtention d’un rapport de cotes ponctuel dont l’intervalle d’incertitude englobe l’unité ne constitue en aucun cas la « preuve d’une absence d’effet », mais simplement « l’absence de preuve d’un effet » statistiquement détectable compte tenu de la puissance de l’échantillon analysé. La nuance sépare un constat de robustesse de la simple incapacité empirique à rejeter l’hypothèse nulle.
4.2 Décodage des valeurs supérieures à l’unité (OR > 1)
Lorsque la valeur calculée de l’Odds Ratio excède strictement l’unité (OR > 1,00), elle formalise une association positive entre le facteur d’exposition et le critère de jugement clinique. L’exposition est ainsi classée préliminairement comme un facteur de risque potentiel, une variable aggravante ou, dans le cadre d’un protocole d’intervention psychologique axé sur la rémission, un facteur favorisant la guérison si l’événement codé 1 est la rémission.
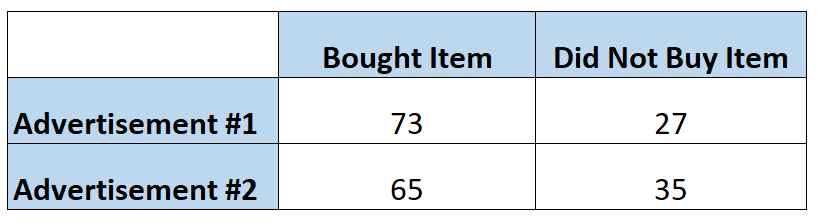
Pour convertir de manière rigoureuse ce coefficient multiplicatif en une variation proportionnelle facilement appréhendable par la communauté médicale, on utilise conventionnellement la formule de conversion en pourcentage d’augmentation de la cote :
Pourcentage d’augmentation de la cote = (OR – 1) × 100
Reprenons le résultat de notre simulation sur le stress chronique et la dépression, où OR ≈ 3,78 :
(3,78 – 1) × 100 = +278 %
L’expression discursive scientifiquement irréprochable s’énonce ainsi : « L’exposition au stress chronique perçu est associée à une augmentation de 278 % de la cote d’apparition d’un épisode dépressif caractérisé », ou encore : « La cote de développer un état dépressif est multipliée par 3,78 chez les étudiants soumis au stress chronique par rapport aux non-exposés ». L’erreur fatale consisterait à affirmer que le « risque » ou la « probabilité » de dépression a augmenté de 278 %, ou que les exposés ont 3,78 fois plus de risque de contracter le trouble, glissement verbal inadmissible dont les ravages seront disséqués à la Section 8.
4.3 Décodage des valeurs inférieures à l’unité (OR < 1)
À l’inverse, lorsqu’un Odds Ratio prend une valeur comprise dans l’intervalle ouvert ]0, 1[, il traduit une relation inverse ou négative entre le prédicteur et l’événement cible. Dans ce scénario, la cote d’apparition du phénomène indésirable est plus faible chez les individus exposés que chez les sujets témoins : le facteur examiné se comporte comme un facteur protecteur, un agent prophylactique ou un inhibiteur clinique.
La formulation discursive de cette réduction relative de cote requiert une opération algébrique de soustraction :
Pourcentage de réduction de la cote = (1 – OR) × 100
Considérons, à titre d’illustration, une investigation évaluant l’effet protecteur d’une pratique régulière de la méditation de pleine conscience (Mindfulness-Based Stress Reduction, MBSR) face au risque de rechute addictive chez des patients sevrés de l’alcool. Supposons que l’analyse rapporte un OR = 0,35 en faveur du groupe pratiquant la méditation comparé au groupe de suivi usuel :
Pourcentage de réduction de la cote = (1 – 0,35) × 100 = 65 %
On énoncera formellement que la pratique régulière de la pleine conscience est associée à une diminution de 65 % de la cote de rechute alcoolique comparativement au suivi standard. Pour lever l’asymétrie de perception cognitive liée aux nombres décimaux inférieurs à 1 (le cerveau humain interprétant mal les fractions), il est vivement recommandé d’effectuer la transformation inverse arithmétique :
ORinverse = 1 / OR = 1 / 0,35 ≈ 2,86
Cette manipulation parfaitement légitime permet de déclarer en inversant les groupes de comparaison : « La cote de rechute alcoolique est 2,86 fois plus élevée chez les patients ne pratiquant pas la pleine conscience que chez ceux bénéficiant de l’intervention », une formule cognitivement plus accessible pour le praticien hospitalier.
5. Inférence statistique, intervalles de confiance et tests d’hypothèses
5.1 Rôle déterminant de l’intervalle de confiance à 95 % (IC 95 %)
L’estimation ponctuelle d’un Odds Ratio issue d’un échantillon empirique ne reflète qu’une approximation sujette aux fluctuations de l’échantillonnage aléatoire. Isolé de son contexte probabiliste, un OR ponctuel est scientifiquement inutilisable. L’estimation d’un intervalle de confiance à 95 % constitue l’exigence minimale absolue permettant de situer, avec une probabilité conventionnelle de 95 %, la véritable valeur paramétrique de l’Odds Ratio au sein de la population cible parente.
Comme l’Odds Ratio brut suit une distribution asymétrique fortement étirée vers la droite sur son échelle naturelle [0, +∞[, la théorie statistique impose d’opérer le calcul de l’intervalle de confiance sur l’échelle des logarithmes népériens, où la distribution asymptotique converge vers une loi normale centrée par le théorème central limite. Pour un niveau de confiance bilatéral standard de 95 %, le quantile critique de la distribution normale standard Z1 – α/2 est fixé à 1,96. Les bornes inférieure et supérieure du logarithme de l’Odds Ratio s’énoncent formellement :
ln(OR)inf = ln(OR) – [1,96 × SE(ln(OR))]
ln(OR)sup = ln(OR) + [1,96 × SE(ln(OR))]
Une fois ces bornes logarithmiques obtenues, on leur applique la fonction exponentielle inverse pour restaurer l’échelle naturelle de l’Odds Ratio :
IC 95 % = [ exp(ln(OR)inf) ; exp(ln(OR)sup) ]
Reprenons notre exemple pratique de la Section 3.3 où OR = 3,778 et SE[ln(OR)] = 0,2322 :
ln(3,778) = 1,329
ln(OR)inf = 1,329 – (1,96 × 0,2322) = 1,329 – 0,455 = 0,874
ln(OR)sup = 1,329 + (1,96 × 0,2322) = 1,329 + 0,455 = 1,784
En prenant les exponentielles :
Borne inférieure = exp(0,874) ≈ 2,40
Borne supérieure = exp(1,784) ≈ 5,95
Ainsi, OR = 3,78, IC 95 % [2,40 ; 5,95]. La règle de décision fondamentale s’applique alors avec une clarté limpide : si l’intervalle de confiance exclut strictement la valeur pivot 1,00 (comme c’est le cas ici, la borne inférieure étant à 2,40), l’association observée est déclarée statistiquement significative au seuil alpha bilatéral de 5 % (p < 0,05). La largeur géométrique de l’intervalle traduit directement la précision métrologique : un échantillon massif resserrera l’intervalle, tandis qu’un effectif squelettique générera un intervalle excessivement béant (par exemple [1,02 ; 14,80]), attestant d’une extrême imprécision de l’estimation sous-jacente.
5.2 Articulation entre intervalle de confiance et valeur p
La statistique contemporaine a engagé un combat vigoureux contre l’hégémonie de la simple « valeur p » (p-value), rappelant qu’une valeur p inférieure au seuil arbitraire de 0,05 ne certifie nullement l’existence d’un effet cliniquement pertinent ou de forte magnitude. L’intervalle de confiance offre une information infiniment plus riche que la valeur p : il combine simultanément la meilleure estimation de la magnitude de l’effet et la mesure tangible de l’incertitude expérimentale due au bruit d’échantillonnage.
Le test de Wald, couramment mobilisé pour dériver la valeur p associée à un Odds Ratio dans les logiciels statistiques, repose sur le ratio entre le log-odds ratio et son erreur type :
z = ln(OR) / SE[ln(OR)]
Dans notre étude sur le stress : z = 1,329 / 0,2322 ≈ 5,72. La comparaison de cette statistique à la distribution de Gauss produit une valeur p < 0,0001. Cependant, la significativité statistique est intrinsèquement tributaire de la taille de l’échantillon N. Avec un échantillon titanique de 500 000 participants, un Odds Ratio trivial de 1,02 (représentant une élévation infinitésimale de la cote de 2 %, cliniquement imperceptible en thérapie) affichera une valeur p hautement significative (p < 0,001), mais son intervalle de confiance [1,01 ; 1,03] informera immédiatement le chercheur de la futilité substantielle de l’effet. Inversement, une étude pilote menée sur 25 patients traumatisés pourra révéler un OR prometteur de 4,50 dont l’intervalle [0,85 ; 23,82] inclut l’unité simplement par manque de puissance statistique. L’articulation conjointe de l’OR et de son IC 95 % empêche le chercheur de confondre puissance statistique et pertinence clinique.
5.3 Tests d’association bivariés associés aux tables 2×2
L’estimation de l’Odds Ratio au sein d’une table de contingence bivariée s’articule directement avec les tests d’hypothèses d’indépendance classiques. Le test du Chi-carré (χ²) de Pearson constitue la méthode d’inférence canonique appliquée aux matrices 2×2. Il évalue la divergence globale entre les fréquences observées (Oij) dans chaque cellule et les fréquences théoriques attendues sous H0 (Eij) :
χ² = ∑ [(Oij – Eij)² / Eij]
Dans une table 2×2 à un degré de liberté (dl = 1), le rejet de l’hypothèse nulle d’indépendance au seuil de 5 % (χ² ≥ 3,841) coïncide rigoureusement avec le fait que l’intervalle de confiance à 95 % de l’Odds Ratio exclut la valeur unitaire.
Néanmoins, lorsque les effectifs de l’échantillon sont ténus ou que la distribution des événements est rare, induisant des effectifs théoriques inférieurs à 5 dans certaines cellules, l’approximation continue de la loi du Chi-carré perd sa validité probabiliste. Il est alors méthodologiquement impératif de recourir au test exact de Ronald Fisher. Fondé sur la distribution hypergéométrique, le test exact de Fisher calcule la probabilité combinatoire exacte d’observer la table empirique observée, ou toute autre configuration plus extrême, en maintenant strictement constants les totaux marginaux des lignes et des colonnes :
P = [ (a + b)! (c + d)! (a + c)! (b + d)! ] / [ N! a! b! c! d! ]
Dans les modèles statistiques avancés impliquant des analyses emboîtées, le test du rapport de vraisemblance (Likelihood Ratio Test, LRT) supplante le Chi-carré de Pearson : il compare le logarithme de la vraisemblance d’un modèle incluant le paramètre d’intérêt à celui d’un modèle restreint sous l’hypothèse nulle, fournissant une évaluation particulièrement robuste de la déviance expliquée.
6. L’Odds Ratio dans la régression logistique binaire en psychologie
6.1 Fondements du modèle logit et relation avec l’Odds Ratio
Dans la recherche contemporaine en psychologie cognitive et clinique, les investigateurs explorent rarement des relations strictement bivariées. Les phénomènes psychopathologiques sont le produit d’interactions complexes entre facteurs génétiques, traits tempéramentaux, antécédents biographiques et stresseurs actuels. La régression logistique binaire développée par le statisticien David Cox constitue le cadre de modélisation paramétrique de référence lorsque la variable dépendante Y est de nature dichotomique (codée 1 pour la présence de l’affection et 0 pour son absence).
Tenter d’appliquer un modèle de régression linéaire par moindres carrés ordinaires à une variable binaire violerait les postulats d’homoscédasticité et de normalité des résidus, tout en produisant des prédictions mathématiquement absurdes situées au-delà des frontières probabilistes [0, 1]. Pour contourner cette impasse, la régression logistique opère une transformation sigmoïde de la probabilité conditionnelle π(x) = P(Y = 1 | X = x) en appliquant la fonction de liaison logit :
logit(π(x)) = ln[ π(x) / (1 – π(x)) ] = β0 + β1X1 + β2X2 + … + βkXk
La beauté mathématique de cette formulation réside dans le fait que la fonction logit n’est rien d’autre que le logarithme népérien de la cote de survenue de l’événement. Par conséquent, chaque coefficient de régression estimé β (bêta) par la méthode du maximum de vraisemblance représente directement la variation du logarithme de la cote (le log-odds ratio) pour chaque incrément d’une unité de la variable prédictive associée, en maintenant fixes toutes les autres variables du modèle. Pour rétablir l’Odds Ratio standard à partir du coefficient estimé par le logiciel statistique (R, SPSS, Jamovi ou SAS), il suffit de procéder à son exponentiation :
OR = exp(β)
Le modèle logistique est donc un modèle multiplicatif d’effets sur les cotes, où chaque addition unitaire sur l’axe des prédicteurs se traduit par une multiplication géométrique de la cote basale de l’événement par le facteur exp(β).
6.2 Interprétation des prédicteurs dichotomiques
Dans le cas le plus accessible, considérons un prédicteur dichotomique codé de manière binaire (0 ou 1). Imaginons un essai clinique interventionnel mené auprès de patients souffrant d’anxiété sociale généralisée, où la variable explicative X identifie le protocole thérapeutique suivi : les sujets du groupe de référence (codés 0) sont placés sur liste d’attente avec suivi empathique de base, tandis que les sujets du groupe interventionnel (codés 1) reçoivent une psychothérapie cognitivo-comportementale (TCC) informatisée standardisée. La variable d’issue Y est binaire : atteinte de la rémission clinique après 12 semaines (1 = oui, 0 = non).
Supposons que la régression logistique binaire univariée produise les sorties informatiques suivantes :
- Coefficient intercept β0 = -1,386
- Coefficient du prédicteur TCC β1 = +1,099 ; Erreur type SE = 0,285 ; Statistique de Wald = 14,84 ; p < 0,001
L’exponentiation du coefficient β1 livre l’Odds Ratio associé à l’intervention :
OR = exp(1,099) ≈ 3,00
Le calcul de l’intervalle de confiance à 95 % donne : exp(1,099 ± 1,96 × 0,285) = [exp(0,540) ; exp(1,658)] = [1,72 ; 5,25].
L’interprétation formelle selon les standards académiques s’articule comme suit : « Les patients ayant bénéficié de la TCC informatisée ont une cote d’atteindre la rémission clinique 3,00 fois plus élevée (IC 95 % [1,72 ; 5,25], p < 0,001) comparativement aux patients assignés à la liste d’attente ». Notons l’importance capitale du choix de la modalité de référence : si l’analyste avait inversé le codage en plaçant la TCC comme référence (codée 0) et la liste d’attente en 1, le coefficient aurait été de β = -1,099 et l’Odds Ratio aurait valu exp(-1,099) ≈ 0,33, traduisant une réduction de 67 % de la cote de rémission pour les sujets sur liste d’attente par rapport au groupe traité. La réalité statistique sous-jacente demeure rigoureusement identique, seule la perspective sémantique change.
6.3 Interprétation des prédicteurs quantitatifs continus
L’immense majorité des instruments d’évaluation psychométrique livre des scores quantitatifs continus ou semi-continus issus d’échelles d’auto-évaluation (par exemple l’Inventaire de Dépression de Beck, le score d’attachement anxieux ou l’indice de réactivité émotionnelle). L’intégration d’un prédicteur continu dans une équation logistique enrichit l’analyse, mais complexifie subtilement l’interprétation de l’Odds Ratio associé.
Soit un modèle logistique visant à prédire l’abandon thérapeutique prématuré (drop-out, codé 1) en fonction du score total obtenu à une échelle d’alexithymie (notée sur une échelle continue s’étendant de 20 à 100 points). Supposons que l’analyse fournisse un coefficient β = +0,050 (p = 0,012). L’Odds Ratio unitaire s’obtient par :
ORunitaire = exp(0,050) ≈ 1,051
Ce chiffre indique que pour chaque augmentation incrémentale d’un point supplémentaire sur l’échelle d’alexithymie, la cote d’abandon thérapeutique prématuré s’accroît de 5,1 % ([1,051 – 1] × 100). Cependant, une augmentation d’un seul point sur une échelle psychométrique de 100 unités est souvent dénuée de sens clinique perceptible. Que se passe-t-il si l’on souhaite apprécier le changement de cote induit par une augmentation de 10 points (soit approximativement un écart-type de l’échelle) ?
De par la nature multiplicative de la logistique, l’Odds Ratio cumulé pour un accroissement arbitraire de k unités ne correspond pas à la multiplication de l’OR par k, mais à son élévation à la puissance k :
OR(k unités) = exp(k × β) = [ORunitaire]k
Pour un accroissement clinique substantiel de 10 points d’alexithymie :
OR(10 points) = exp(10 × 0,050) = exp(0,50) ≈ 1,649
Le clinicien peut ainsi expliciter : « Une élévation de 10 points du niveau d’alexithymie basale d’un patient est associée à une multiplication par 1,65 de sa cote d’abandon prématuré de la prise en charge ». Pour faciliter la comparaison entre des prédicteurs quantitatifs d’étendues métriques dissemblables, la statistique préconise de standardiser préalablement les variables continues sous forme de scores réduits (z-scores : moyenne = 0, écart-type = 1). Dès lors, l’Odds Ratio résultant exprime la variation de la cote pour une déviation d’un écart-type complet, autorisant des comparaisons d’effet directes entre des échelles psychométriques hétérogènes.
7. Rapports de cotes bruts vs ajustés : Prise en compte de la confusion
7.1 Définition méthodologique du biais de confusion en psychologie
L’un des périls majeurs guettant le chercheur dans l’interprétation des données observationnelles réside dans l’illusion d’une association directe causale, alors que le lien constaté est le sous-produit parasite d’une tierce variable agissant en coulisses : le facteur de confusion (confounder). En épidémiologie comportementale et psychologique, un facteur C ne peut être scientifiquement qualifié de variable de confusion avérée que s’il satisfait simultanément à trois critères méthodologiques cumulatifs stricts :
- Le facteur C doit être statistiquement et causalement associé à l’exposition d’intérêt X au sein de la population étudiée.
- Le facteur C doit être un prédicteur direct et indépendant de la variable d’issue clinique Y, tant chez les exposés que chez les non-exposés.
- Le facteur C ne doit pas être un chaînon intermédiaire situé sur la trajectoire causale unissant l’exposition X à l’issue Y (dans quel cas il s’agirait d’une variable médiatrice et non de confusion).
Pour cartographier et neutraliser ces biais, la recherche s’appuie désormais sur les diagrammes causaux acycliques (Directed Acyclic Graphs, DAG). Imaginons une enquête épidémiologique observant un Odds Ratio brut substantiel entre la consommation journalière de caféine et le déclenchement d’attaques de panique (ORbrut = 2,80). Un examen superficiel conclurait à la forte toxicité anxiogène du café. Or, une proportion majeure de gros consommateurs de café présente un tabagisme chronique sévère et un niveau élevé de privation de sommeil, deux déterminants majeurs et indépendants de l’hyperexcitabilité autonome favorisant la panique. Le tabagisme et la dette de sommeil agissent ici comme de puissants facteurs de confusion qui gonflent artificiellement l’association constatée.
7.2 Mécanique du contrôle statistique dans la régression multiple
La modélisation par régression logistique multivariée permet de s’affranchir de l’influence déformante de ces covariables en produisant des rapports de cotes ajustés (notés aOR pour adjusted Odds Ratio). Lorsqu’une équation logistique intègre simultanément le prédicteur central X1 et un ensemble de covariables de contrôle C1, C2, …, Cm :
logit(P) = β0 + β1X1 + γ1C1 + γ2C2 + … + γmCm
Le paramètre aOR1 = exp(β1) exprime la modification de la cote d’apparition de l’événement induite par une variation d’une unité de l’exposition X1, toutes choses étant égales par ailleurs (ceteris paribus), c’est-à-dire en maintenant rigoureusement constantes les valeurs des covariables d’ajustement incluses dans le modèle. La comparaison arithmétique entre l’OR brut (issu du modèle univarié) et l’aOR (issu du modèle multivarié) constitue l’outil diagnostique cardinal de l’amplitude du biais :
Pourcentage de changement de l’OR = [ (ORbrut – aOR) / ORbrut ] × 100
Si la valeur numérique de l’OR se modifie de plus de 10 % à 15 % après l’inclusion de la covariable, celle-ci exerce une confusion empirique avérée. Si l’aOR s’effondre jusqu’à englober la valeur 1,00, l’association brute initiale était intégralement factice (spurious). Soulignons toutefois un piège méthodologique pernicieux : la non-collapsibilité intrinsèque de l’Odds Ratio. Contrairement au risque relatif ou à la différence de risques, l’OR ajusté peut diverger de l’OR brut même en l’absence totale de biais de confusion, du simple fait de la nature mathématique non linéaire de la fonction logit dès lors qu’un prédicteur indépendant de l’issue est introduit.
7.3 Interprétation des termes d’interaction et modération
Dans de nombreuses configurations psychopathologiques, l’effet d’une exposition environnementale ne s’applique pas de manière uniforme à l’ensemble des individus : il est conditionné ou modulé par une tierce variable, telle qu’une prédisposition génétique, un type de personnalité ou le genre du sujet. On parle alors d’effet d’interaction statistique ou de modération. Dans le formalisme logistique, l’effet modérateur est opérationnalisé par l’insertion d’un terme produit unissant l’exposition X et le modérateur M :
logit(P) = β0 + β1X + β2M + β3(X × M)
Dans ce modèle, l’Odds Ratio associé à l’exposition X n’est plus unique : il devient conditionnel au niveau pris par le modérateur M. Lorsque M = 0, l’Odds Ratio de X vaut exp(β1). En revanche, lorsque M = 1, l’Odds Ratio régissant l’effet de X se transforme en :
ORX | M=1 = exp(β1 + β3) = exp(β1) × exp(β3)
Le terme exp(β3) représente mathématiquement le rapport des rapports de cotes (Ratio of Odds Ratios, ROR). Il quantifie le facteur multiplicatif par lequel l’Odds Ratio de l’exposition est altéré lors du passage de la condition M = 0 à la condition M = 1.
Illustrons cette mécanique par l’étude de l’interaction gène-environnement dans la dépression. Soit l’exposition X un traumatisme infantile sévère (1 = oui, 0 = non), et le modérateur génétique M la présence de l’allèle court du promoteur du transporteur de la sérotonine (5-HTTLPR, codé 1 pour les porteurs de l’allèle à risque, 0 pour les homozygotes longs). Supposons que l’analyse multivariée révèle un β1 = 0,693 (d’où exp(β1) = 2,00) et un coefficient d’interaction β3 = 0,916 (d’où exp(β3) = 2,50). L’interprétation rigoureuse s’énonce ainsi : chez les individus porteurs du profil génétique résilient (M = 0), le traumatisme infantile double la cote de dépression (OR = 2,00). En revanche, chez les individus génétiquement vulnérables (M = 1), l’effet traumatique est démultiplié d’un facteur 2,50 additionnel : leur cote de dépression n’est pas doublée, mais quintuplée (OR = 2,00 × 2,50 = 5,00). L’Odds Ratio d’interaction permet de valider empiriquement des modèles de vulnérabilité diathèse-stress d’une haute complexité étiologique.
8. Odds Ratio versus Risque Relatif : Différences critiques et risques de confusion
8.1 Divergence conceptuelle fondamentale entre risque et cote
L’erreur la plus ubiquitaire et la plus dévastatrice relevée dans la littérature biomédicale et psychologique consiste à substituer verbalement le mot « risque » au mot « cote », en traitant un Odds Ratio comme s’il s’agissait d’un Risque Relatif (RR). Le Risque Relatif s’énonce comme le quotient pur de deux probabilités (incidences cumulées ou risques absolus) au sein de deux cohortes suivies longitudinalement :
RR = P1 / P2
Alors que le Risque Relatif opère dans le domaine strict des proportions comparées [0, +∞[, l’Odds Ratio compare des cotes élémentaires :
OR = [P1 / (1 – P1)] / [P2 / (1 – P2)] = RR × [ (1 – P2) / (1 – P1) ]
L’observation attentive de ce lien formel éclaire la relation géométrique reliant les deux indices. Le rapport (1 – P2) / (1 – P1) agit comme un facteur d’amplification d’échelle. Dès lors que l’exposition accroît la probabilité de l’événement (P1 > P2), le terme (1 – P1) devient nécessairement plus petit que (1 – P2). Par voie de conséquence directe, la fraction (1 – P2) / (1 – P1) devient strictement supérieure à l’unité : l’Odds Ratio s’éloigne systématiquement plus de la valeur pivot 1,00 que ne le fait le Risque Relatif.
Le tableau ci-dessous explicite cette divergence numérique en fonction de l’incidence basale de l’événement étudié :
| Risque Témoin (P2) | Risque Exposé (P1) | Risque Relatif (P1 / P2) | Odds Ratio (Cote1 / Cote2) | Écart d’inflation (OR / RR) |
|---|---|---|---|---|
| 0,01 (1 %) | 0,03 (3 %) | 3,00 | 3,06 | +2,0 % (Divergence minime) |
| 0,05 (5 %) | 0,15 (15 %) | 3,00 | 3,35 | +11,7 % (Inflation modérée) |
| 0,10 (10 %) | 0,30 (30 %) | 3,00 | 3,86 | +28,7 % (Surestimation notable) |
| 0,20 (20 %) | 0,60 (60 %) | 3,00 | 6,00 | +100,0 % (Doublement pur) |
| 0,30 (30 %) | 0,90 (90 %) | 3,00 | 21,00 | +600,0 % (Distorsion massive) |
Ce tableau met en exergue une vérité mathématique implacable : pour un même Risque Relatif constant de 3,00, l’Odds Ratio s’emballe de manière vertigineuse dès que l’affection n’est plus un événement exceptionnel, culminant à une valeur de 21,00 lorsque l’événement touche une large proportion de la population.
8.2 L’hypothèse des maladies rares (Rare Disease Assumption)
La seule circonstance méthodologique au sein de laquelle l’Odds Ratio peut être légitimement considéré comme une approximation directe et fidèle du Risque Relatif est connue sous le nom canonique d’hypothèse des maladies rares (rare disease assumption). D’un point de vue analytique, lorsque la probabilité globale de survenue de l’événement est très faible dans la population générale — conventionnellement fixée en épidémiologie à un seuil d’incidence cumulée ou de prévalence inférieur à 10 % (P < 0,10), et idéalement inférieur à 5 % —, les dénominateurs des cotes tendent vers l’unité :
Si P1 ≈ 0 et P2 ≈ 0 ⇒ (1 – P1) ≈ 1 et (1 – P2) ≈ 1
Dans ce contexte strict, le facteur d’ajustement (1 – P2) / (1 – P1) ≈ 1, ce qui implique arithmétiquement :
OR ≈ RR
Cette convergence explique pourquoi, historiquement, l’Odds Ratio a été acclamé par les pères fondateurs de l’épidémiologie moderne comme Jerome Cornfield : dans les études cas-témoins portant sur des cancers rarissimes ou des affections génétiques exceptionnelles, l’Odds Ratio obtenu permettait d’estimer sans distorsion le Risque Relatif étiologique inconnu.
Toutefois, en psychologie, en psychiatrie générale et en sciences sociales, cette hypothèse est quasi systématiquement violée. Les états de détresse psychologique, l’anxiété, le burn-out professionnel ou les troubles dépressifs modérés affichent des taux de prévalence en population clinique qui oscillent fréquemment entre 15 % et 40 %. Dans de telles conditions, appliquer aveuglément l’hypothèse des affections rares relève d’une faute méthodologique majeure : l’OR gonfle artificiellement l’effet réel de l’exposition.
Pour remédier à cette inflation lorsque l’on souhaite dériver le Risque Relatif à partir d’un modèle logistique multivarié ayant fourni un Odds Ratio ajusté, le biostatisticien peut mobiliser l’algorithme de conversion de Zhang et Yu (1998) :
RR ≈ aOR / [ (1 – P0) + (P0 × aOR) ]
où P0 symbolise l’incidence ou la proportion de survenue de l’événement au sein du groupe de référence non exposé. Cette correction arithmétique ramène l’estimation à des proportions épidémiologiques réalistes et prévient les hallucinations d’amplitude.
8.3 Le piège de la mauvaise interprétation sémantique
La déformation de l’Odds Ratio dans le discours scientifique contemporain ne relève pas simplement d’une approximation théorique, mais d’une contamination lexicale préoccupante. Décrire un OR = 2,5 par la proposition : « Les sujets exposés ont 2,5 fois plus de risque de développer la pathologie » constitue une affirmation factuellement erronée dès lors que la prévalence est notable.
Supposons qu’au cours d’un protocole en psychologie du travail, un indice de surcharge professionnelle livre un OR = 3,0 pour le diagnostic de syndrome d’épuisement professionnel (burn-out), avec un taux basale d’atteinte de 40 % chez les collaborateurs non surchargés (P0 = 0,40). Si les ressources humaines et les médias s’emparent de ce résultat en affirmant que les salariés surchargés ont « trois fois plus de risque de s’effondrer », ils commettent une aberration mathématique. En effet, tripler un risque basale de 40 % aboutirait à une probabilité théorique de 120 % (3 × 0,40 = 1,20), ce qui heurte de plein fouet les axiomes probabilistes élémentaires.
En appliquant la formule de correction de Zhang et Yu :
RR = 3,0 / [ (1 – 0,40) + (0,40 × 3,0) ] = 3,0 / [ 0,60 + 1,20 ] = 3,0 / 1,80 ≈ 1,67
Le risque absolu réel des salariés exposés à la surcharge n’est pas de 120 %, mais de 66,7 % (P1 = 0,40 × 1,67). L’augmentation réelle du risque n’est pas un triplement (facteur 3), mais une hausse relative de 67 % (facteur 1,67). Les comités éditoriaux des plus grandes revues internationales exigent désormais une stricte discipline lexicale : tout auteur rapportant un Odds Ratio doit bannir le terme « risque » de ses conclusions et mobiliser exclusivement le lexique de « la cote » (odds), ou recourir à des modèles directs de régression modélisant les risques relatifs, tels que la régression log-binomiale ou la régression de Poisson avec variance robuste.
9. Taille d’effet, pertinence clinique et signification pratique en psychologie
9.1 Grilles de référence pour évaluer la magnitude d’un Odds Ratio
Disposer d’un Odds Ratio assorti d’une significativité statistique indiscutable (p < 0,001) ne renseigne nullement le chercheur sur l’amplitude substantive de l’effet mis en lumière. Dans le domaine des sciences comportementales, l’évaluation de la taille d’effet (effect size) constitue une norme impérative. Afin d’harmoniser l’appréciation quantitative des rapports de cotes avec les métriques conventionnelles de la psychométrie, les travaux de Chen, Cohen et Chen (2010) ont établi des seuils heuristiques rigoureux permettant de classer la magnitude d’un Odds Ratio en trois catégories standards : faible, modérée ou forte.
Ces classifications s’appuient sur l’équivalence mathématique liant le logarithme de l’Odds Ratio au fameux d de Cohen (différence standardisée de moyennes), validée à l’origine par Hasselblad et Hedges :
d = [ ln(OR) × √3 ] / π ≈ ln(OR) / 1,814
En miroir, l’Odds Ratio s’exprime en fonction du d de Cohen par :
OR = exp( d × π / √3 ) ≈ exp( 1,814 × d )
Sur la base des seuils classiques de Cohen pour les sciences humaines (d = 0,20 pour un effet faible, d = 0,50 pour un effet modéré, et d = 0,80 pour un effet fort), la table d’équivalence biométrique se formalise ainsi :
| Magnitude conventionnelle | d de Cohen équivalent | Odds Ratio (Effet Aggravant : OR > 1) | Odds Ratio (Effet Protecteur : OR < 1) |
|---|---|---|---|
| Effet négligeable / Trivial | < 0,20 | 1,00 à 1,43 | 0,70 à 1,00 |
| Effet faible (Small) | 0,20 à 0,49 | 1,44 à 2,47 | 0,41 à 0,69 |
| Effet modéré (Medium) | 0,50 à 0,79 | 2,48 à 4,26 | 0,23 à 0,40 |
| Effet fort (Large) | ≥ 0,80 | ≥ 4,27 | ≤ 0,23 |
L’application mécanique de ces grilles de lecture doit néanmoins demeurer contextuelle. Dans le domaine du pronostic du passage à l’acte suicidaire ou de l’émergence d’épisodes psychotiques aigus, un Odds Ratio modeste de 1,35 peut représenter une découverte clinique d’une portée capitale pour la santé publique, dès lors que l’exposition concerne des dizaines de millions de personnes (par exemple, la précarité socio-économique ou l’isolement relationnel).
9.2 Conversion de l’Odds Ratio en Nombre de Sujets à Traiter (NNT)
Pour le médecin psychiatre, le psychologue clinicien ou le responsable de santé publique, l’Odds Ratio demeure une abstraction géométrique ardue à traduire en actes concrets de soin. Pour surmonter ce fossé entre la métrique statistique et la décision clinique au chevet du patient, la médecine fondée sur les preuves (Evidence-Based Medicine) privilégie le Nombre de Sujets à Traiter (Number Needed to Treat, NNT). Le NNT quantifie le nombre théorique d’individus devant recevoir l’intervention expérimentale plutôt que le protocole témoin pour observer la guérison ou prévenir un événement clinique défavorable supplémentaire chez un patient donné.
Le calcul du NNT à partir d’un Odds Ratio issu d’un essai thérapeutique impose impérativement la prise en compte du niveau de risque basale sans traitement (Patient Expected Event Rate, PEER, noté P0). L’algorithme computationnel s’articule comme suit :
Tout d’abord, on dérive le risque absolu attendu chez les sujets traités (noté P1) en réarrangeant la formulation de l’Odds Ratio d’intervention bénéfique (où OR < 1 pour la survenue de l’événement péjoratif) :
P1 = [ OR × P0 ] / [ (1 – P0) + (OR × P0) ]
La Réduction Absolue du Risque (RAR, ou Absolute Risk Reduction) correspond à la simple différence arithmétique :
RAR = P0 – P1
Le Nombre de Sujets à Traiter est alors rigoureusement défini comme l’inverse de la Réduction Absolue du Risque :
NNT = 1 / RAR = 1 / (P0 – P1)
Supposons un essai clinique portant sur une psychothérapie de groupe brève réduisant les rechutes dépressives, avec un OR = 0,40. Si l’on applique cette thérapie dans un centre ambulatoire lourd où le risque basale de rechute annuelle est très élevé (P0 = 0,50) :
P1 = (0,40 × 0,50) / [ (1 – 0,50) + (0,40 × 0,50) ] = 0,20 / (0,50 + 0,20) = 0,20 / 0,70 ≈ 0,286
RAR = 0,50 – 0,286 = 0,214
NNT = 1 / 0,214 ≈ 4,67 ⇒ arrondi à 5 patients.
En revanche, si l’on déploie cette même thérapie dans une population de prévention primaire en milieu professionnel où le risque basale de dépression n’est que de 5 % (P0 = 0,05), le calcul révèle :
P1 = (0,40 × 0,05) / [ (1 – 0,05) + (0,40 × 0,05) ] = 0,02 / (0,95 + 0,02) = 0,02 / 0,97 ≈ 0,0206
RAR = 0,05 – 0,0206 = 0,0294
NNT = 1 / 0,0294 ≈ 34 patients.
Cet exemple magistral démontre l’illusion des métriques purement relatives : un Odds Ratio protecteur invariant de 0,40 implique de traiter seulement 5 patients hospitaliers pour éviter une rechute, mais exige de mobiliser des ressources pour traiter 34 individus dans la communauté. La focalisation isolée sur l’OR masque cette réalité économique et clinique décisive.
9.3 Traduction de l’OR en termes d’utilité clinique et pronostique
Dans l’évaluation des outils psychométriques de dépistage nosographique ou des biomarqueurs en psychiatrie biologique, l’Odds Ratio s’incarne sous une déclinaison métrologique spécialisée : le Rapport de Cotes Diagnostique (Diagnostic Odds Ratio, DOR). Le DOR synthétise en une valeur scalaire unique le pouvoir discriminant intrinsèque d’un test clinique dichotomisé. Il s’exprime formellement par le quotient du rapport de vraisemblance positif (Positive Likelihood Ratio, LR+) sur le rapport de vraisemblance négatif (Negative Likelihood Ratio, LR-) :
DOR = LR+ / LR- = [ Sensibilité / (1 – Spécificité) ] / [ (1 – Sensibilité) / Spécificité ] = (Sensibilité × Spécificité) / [ (1 – Sensibilité) × (1 – Spécificité) ]
Le DOR présente l’immense supériorité d’être totalement indépendant du taux de prévalence du trouble au sein des cohortes examinées, ce qui autorise des comparaisons transculturelles robustes des instruments psychométriques. Un DOR de 1 indique que le test est dénué de la moindre valeur discriminante (l’attribution du statut diagnostique s’apparente à un tirage à pile ou face). Des valeurs de DOR supérieures à 25 signalent généralement d’excellentes performances de tri nosologique.
Toutefois, une vigilance épistémologique stricte s’impose : un Odds Ratio étiologique élevé identifié lors d’une régression logistique multivariée ne confère aucunement à la variable d’exposition la qualité d’un test diagnostique performant. Un facteur environnemental peut quintupler la cote d’une maladie rare sans pour autant permettre d’identifier individuellement les futurs malades, car la quasi-totalité des individus exposés demeureront parfaitement asymptomatiques. Les courbes ROC (Receiver Operating Characteristic) et le calcul de l’aire sous la courbe (AUC / C-index) constituent le seul arbitre fiable de la valeur diagnostique individuelle, interdisant toute extrapolation hâtive d’un OR associatif vers la prédiction unitaire.
10. L’Odds Ratio dans les méta-analyses et revues systématiques
10.1 Agrégation statistique des rapports de cotes entre études
Au sommet de la pyramide des preuves scientifiques en médecine factuelle trônent les revues systématiques avec méta-analyse. Lorsqu’une synthèse quantitative compile une multitude d’essais cliniques indépendants ou d’études observationnelles ayant mesuré des issues dichotomiques, l’Odds Ratio s’impose comme l’unité métrique standard d’agrégation internationale. Sa non-dépendance envers les schémas d’échantillonnage et ses propriétés log-normales idéales en font l’indicateur universel par excellence.
L’agrégation computationnelle repose sur la méthode de pondération par l’inverse de la variance (Inverse-Variance Method). Pour chaque étude primaire i, on extrait le logarithme du rapport de cotes yi = ln(ORi) et sa variance asymptotique vi = Var[ln(ORi)]. Le poids statistique wi alloué à l’étude i est rigoureusement défini comme l’inverse arithmétique de sa variance :
wi = 1 / vi
Dans le modèle à effets fixes de Mantel-Haenszel, qui postule que l’ensemble des études primaires partage une taille d’effet paramétrique unique sous-jacente θ, le log-odds ratio combiné poolé s’établit par la moyenne pondérée :
ln(OR)poolé = ∑ (wi × yi) / ∑ wi
Dans la recherche psychologique et comportementale, cette hypothèse d’un effet fixe universel est presque toujours intenable en raison des variations méthodologiques, sociodémographiques et d’implémentation entre les laboratoires. Les méta-analystes privilégient donc le modèle à effets aléatoires de DerSimonian et Laird. Ce modèle postule l’existence d’une distribution de vraies tailles d’effet à travers les contextes cliniques. Le calcul du poids intègre dès lors une composante supplémentaire quantifiant la variance inter-études (τ², tau au carré) :
wi* = 1 / (vi + τ²)
Le résultat méta-analytique final est synthétisé visuellement sur un diagramme en forêt (Forest Plot), où chaque étude primaire est matérialisée par un carré dont la surface est proportionnelle à son poids d’inférence, encadré par les moustaches de son intervalle de confiance, tandis que l’OR combiné final est représenté par un losange (le « diamant ») dont la largeur figure l’IC 95 % global de la littérature mondiale disponible.
10.2 Évaluation de l’hétérogénéité statistique des OR
L’interprétation clinique d’un Odds Ratio poolé perd toute légitimité scientifique si les résultats des différentes investigations s’avèrent contradictoires ou d’une dispersion disproportionnée au regard des seules fluctuations d’échantillonnage. L’exploration de l’hétérogénéité statistique constitue donc une étape préalable indispensable avant toute validation d’un OR global.
Le test canonique repose sur la statistique Q de Cochran, distribuée sous H0 selon une loi du Chi-carré avec k – 1 degrés de liberté (où k figure le nombre d’études primaires incluses) :
Q = ∑ [ wi × (yi – ln(OR)poolé)² ]
Comme le test Q manque cruellement de puissance statistique lorsque le nombre d’études est limité, la biométrie recourt universellement à la métrique complémentaire I² formulée par Higgins et Green :
I² = max [ 0 ; ((Q – (k – 1)) / Q) × 100 ]
L’indice I² s’exprime sous forme de pourcentage borné entre 0 % et 100 %. Il quantifie la part de la variabilité globale observée entre les Odds Ratios primaires imputable à une hétérogénéité substantielle réelle (différences d’instruments psychométriques, caractéristiques des patients, doses d’exposition) plutôt qu’au simple hasard statistique :
- I² ≤ 25 % : Hétérogénéité négligeable ou faible. L’agrégation des OR est méthodologiquement sûre.
- 25 % < I² ≤ 75 % : Hétérogénéité modérée. L’Odds Ratio combiné doit être interprété avec une réserve critique prudente.
- I² > 75 % : Hétérogénéité massive. Présenter un Odds Ratio moyen unique devient méthodologiquement fallacieux. L’équipe de recherche doit renoncer à l’agrégation aveugle et s’orienter vers des méta-régressions multivariées ou des analyses en sous-groupes prédéfinies pour identifier les variables modératrices qui conditionnent l’amplitude de l’effet.
10.3 Détection et impact des biais de publication
Un risque mortel pour la validité de l’Odds Ratio méta-analytique réside dans le phénomène bien documenté du « tiroir de bureau » (file-drawer effect) et des biais de publication. Dans l’écosystème académique compétitif, les études mettant en évidence des résultats positifs statistiquement probants (des Odds Ratios significativement supérieurs ou inférieurs à 1,00) sont considérablement plus susceptibles d’être rédigées, soumises et acceptées dans des revues prestigieuses que les investigations rigoureuses observant des OR parfaitement neutres oscillant autour de 1,00.
Cette censure sélective produit une hémiplégie de la littérature, créant une surestimation dramatique de l’OR combiné final. Pour déceler cette anomalie, l’analyste construit un graphique en entonnoir (Funnel Plot), qui projette graphiquement l’ampleur de l’effet de chaque étude (ln(OR) en abscisse) en regard de sa précision métrologique ou de la taille de son effectif (l’erreur type ou l’inverse de l’erreur type en ordonnée). En l’absence de biais de diffusion sélective, les nuages de points se distribuent symétriquement selon la forme d’un cône inversé entourant la taille d’effet moyenne globale. L’absence sélective d’études à petits effectifs situées dans le quadrant de neutralité ou d’effets contradictoires crée une asymétrie flagrante de l’entonnoir.
Cette observation optique est formellement soumise à des tests statistiques d’asymétrie, notamment le test de régression linéaire de Matthias Egger (portant sur l’ordonnée à l’origine du ratio de déviance standardisé) et le test de corrélation des rangs de Colin Begg. Lorsque le biais est objectivé, la méthode de redressement non paramétrique dite du « Trim and Fill » de Duval et Tweedie permet d’imputer algorithmiquement les études « manquantes » suspectées afin de recalculer un Odds Ratio méta-analytique corrigé. Dans de multiples occurrences de la psychopharmacologie, cette imputation a conduit à l’effondrement pur et simple de l’efficacité présumée de psychotropes, transformant un OR initialement triomphant en une neutralité clinique absolue.
11. Erreurs courantes, sophismes statistiques et pièges d’interprétation
11.1 Le sophisme de la mauvaise interprétation causale
L’illusion d’une équivalence fonctionnelle entre force de l’association statistique et lien de causalité directe incarne le sophisme le plus tenace de l’analyse quantitative. Un Odds Ratio monumental de 8,50 liant un biomarqueur salivaire ou un profil d’utilisation des réseaux sociaux à la dépression ne prouve en aucun cas que la variable indépendante est la cause opérante du désordre psychologique observé.
Toute assertion causale dérivée d’un rapport de cotes empirique doit impérativement être tamisée à travers les critères épistémologiques formels établis par Sir Austin Bradford Hill en 1965 :
- La temporalité : L’exposition a-t-elle indiscutablement précédé l’émergence de l’affection ? Dans les devis transversaux, la causalité inverse représente une menace permanente (les conduites addictives sont-elles la cause ou la tentative d’automédication désespérée d’une dépression latente non diagnostiquée ?).
- Le gradient biologique ou dose-réponse : Observe-t-on une augmentation monotone de l’Odds Ratio à mesure que l’intensité ou la durée de l’exposition croît ?
- La plausibilité biologique et psychologique : Le mécanisme postulable est-il corroboré par les neurosciences et la psychologie expérimentale fondamentale ?
- La cohérence et la réplicabilité : L’Odds Ratio se maintient-il stablement à travers des cultures et des protocoles diversifiés ?
Ignorer ces balises épistémologiques expose le chercheur à concevoir des interventions curatives chimériques ciblant des corrélats épiphénoménaux dénués de tout pouvoir de levier thérapeutique causal.
11.2 Le paradoxe de Simpson et ses répercussions sur l’OR
Le paradoxe de Simpson représente l’une des aberrations de distribution les plus déroutantes de l’analyse multivariée : il formalise la situation vertigineuse au sein de laquelle une association statistique observée de manière globale au niveau de la population générale s’inverse totalement ou disparaît purement et simplement lorsque la cohorte est partitionnée en sous-strates homogènes conditionnées par une tierce variable.
Considérons une simulation numérique canonique portant sur l’évaluation d’un nouveau protocole de psychothérapie cognitive brève comparativement au traitement habituel, menée sur 400 patients souffrant d’anxiété sévère, stratifiés selon la sévérité du trauma d’enfance :
| Sous-groupe analysé | Succès TCC (Cas / Total) | Succès Témoin (Cas / Total) | Cote TCC | Cote Témoin | Odds Ratio de succès TCC |
|---|---|---|---|---|---|
| Strate 1 : Trauma sévère | 30 / 100 (30 %) | 8 / 40 (20 %) | 30 / 70 ≈ 0,429 | 8 / 32 = 0,250 | OR = 1,714 (Favorable TCC) |
| Strate 2 : Pas de trauma | 80 / 100 (80 %) | 112 / 160 (70 %) | 80 / 20 = 4,000 | 112 / 48 ≈ 2,333 | OR = 1,714 (Favorable TCC) |
| Population Globale Agrégée | 110 / 200 (55 %) | 120 / 200 (60 %) | 110 / 90 ≈ 1,222 | 120 / 80 = 1,500 | OR = 0,815 (Défavorable TCC !) |
Cette démonstration numérique coupe le souffle du statisticien candide : au sein de la strate des sujets traumatisés, la thérapie novatrice multiplie la cote de succès par 1,71. Au sein de la strate des sujets indemnes de trauma, elle multiplie exactement de la même manière la cote de succès par 1,71. Pourtant, dès que le chercheur aveugle agglomère les effectifs au sein d’une table 2×2 brute non stratifiée, l’Odds Ratio chute à 0,81, concluant faussement que la thérapie dégrade les chances de guérison !
L’explication arithmétique réside dans la disparité majeure de répartition des patients : les thérapeutes ont alloué prioritairement les patients les plus sévèrement traumatisés (pronostic intrinsèque très sombre de 30 % de guérison) au groupe expérimental, créant une confusion de distribution massive. Cet écueil démontre l’obligation absolue de ne jamais s’en remettre aveuglément à des Odds Ratios bivariés bruts sans exploration systématique de la stratification et contrôle multivarié.
11.3 Problèmes de sparsité et séparation complète des données
Dans la conduite de régressions logistiques complexes incluant de multiples covariables continues et dichotomiques sur des échantillons de taille modeste, le modélisateur se heurte fréquemment à un fléau algorithmique discret : le problème de sparsité ou de quasi-séparation complète (complete separation ou quasi-complete separation).
Ce phénomène survient lorsqu’une variable indépendante ou une combinaison linéaire de prédicteurs prédit avec une perfection absolue le statut de la variable dépendante d’issue. Par exemple, si au sein d’une cohorte, la totalité des 22 patients ayant des antécédents d’hospitalisation psychiatrique ont rechuté (zéro cas de non-rechute dans cette catégorie), l’algorithme d’estimation du maximum de vraisemblance (Newton-Raphson) tente de déterminer la valeur de β telle que P(Y=1) = 1,00. Sur l’échelle de la fonction logit, une probabilité unitaire impose d’atteindre l’infini positif :
logit(1,00) = ln(1 / 0) = +∞
Face à cette impossibilité numérique, le logiciel statistique entre en panique computationnelle : le processus itératif échoue à converger formellement. Les symptômes caractéristiques de cette faillite sur les sorties informatiques sont indiscutables : le coefficient β grimpe à des valeurs aberrantes (par exemple β = 18,4 ou -24,8), l’erreur type explose de manière grotesque (SE = 1450,2), et l’Odds Ratio qui en découle affiche des valeurs hallucinatoires du type OR = 98 450 120 assorti d’un intervalle de confiance démesuré [0,000 ; +∞[, souvent accompagné d’une valeur p égale à 0,999 ou 1,000 en raison de la dilatation de l’erreur type dans le test de Wald.
Ignorer cette pathologie de modélisation en recopiant passivement ces chiffres dans un mémoire académique décrédibilise instantanément le chercheur. La résolution rigoureuse impose d’abandonner l’estimation du maximum de vraisemblance standard pour déployer la régression pénalisée de David Firth. Fondée sur la fonction de vraisemblance pénalisée par l’information de Jeffreys, la méthode de Firth injecte un biais asymptotique correcteur inverse qui garantit la convergence vers des estimations finies robustes d’Odds Ratios et d’intervalles de confiance crédibles, même en présence de tables creuses ou de zéros structurels.
12. Guide pratique de rédaction et restitution des résultats selon les normes APA
12.1 Structure formelle du compte-rendu statistique selon l’APA 7e édition
L’écriture académique en psychologie et en sciences comportementales obéit à un ensemble de canons formalisés avec une minutie extrême par le Publication Manual of the American Psychological Association (7e édition). La restitution d’un Odds Ratio exige le respect rigoureux de conventions typographiques universelles. L’acronyme doit impérativement figurer en lettres capitales (OR), sans point abréviatif. Tout paramètre statistique désigné par une lettre de l’alphabet latin (tels que p, z, N, ou dl) doit être composé en italique strict. En revanche, les abréviations métrologiques standardisées comme OR, IC 95 %, exp(β) ou AIC demeurent en caractères romains droits.
Les normes de précision décimale imposent d’arrondir les coefficients β, les erreurs types, les Odds Ratios et les bornes des intervalles de confiance à deux décimales (parfois trois décimales si une extrême finesse métrologique le requiert). La valeur p s’arrondit quant à elle à trois décimales (par exemple p = 0,024), sans jamais faire précéder le séparateur décimal d’un zéro dans la littérature anglophone (règle du zéro initial supprimé lorsque le nombre ne peut mathématiquement jamais excéder 1,00, soit .024), bien que la typographie académique francophone maintienne conventionnellement le zéro initial (0,024). Les valeurs inférieures à 0,001 s’écrivent obligatoirement sous forme d’inégalité : p < 0,001 (bannir définitivement l’aberration p = 0,000 générée par les sorties machine d’anciennes versions de SPSS).
La formulation narrative canonique d’une relation logistique multivariée doit intégrer conjointement : l’identification sans équivoque de la variable dépendante et de sa catégorie cible, la désignation des catégories d’exposition avec explicitation du groupe de référence, la statistique de Wald ou de déviance du prédicteur, le degré de liberté, la valeur p exacte, l’Odds Ratio ponctuel et impérativement les bornes de son intervalle de confiance à 95 %. Un modèle d’énoncé académique exemplaire s’articule ainsi :
« Une analyse de régression logistique binaire multivariée a été conduite afin de prédire l’émergence d’une phobie spécifique au cours de l’adolescence. Après ajustement statistique contrôlant pour l’âge, le genre biologique et le statut socio-économique parental, la présence d’une inhibition comportementale précoce durant la petite enfance est demeurée significativement associée à l’éclosion du trouble phobique, Wald χ²(1, N = 642) = 18,47, p < 0,001. La cote de développer une phobie spécifique chez les adolescents présentant des antécédents d'inhibition comportementale sévère est 3,14 fois supérieure à celle des adolescents sans antécédent d'inhibition (aOR = 3,14, IC 95 % [1,87 ; 5,28]). »
12.2 Conception de tableaux synthétiques pour la régression logistique
Lorsqu’un protocole empirique explore simultanément plusieurs prédicteurs au sein de blocs successifs de modélisation logistique hiérarchique, la mise en page sous forme de tableau standardisé constitue la méthode de restitution la plus claire et la plus dense. Un tableau de régression conforme aux exigences strictes de l’APA 7e édition proscrit formellement les quadrillages verticaux et ne tolère qu’un nombre minimal de bordures horizontales (trois lignes principales : sous le titre du tableau, sous les intitulés de colonnes et sous la rangée finale fermant le corpus de données).
Le tableau ci-dessous modélise la présentation professionnelle d’un modèle logistique prédisant la réponse thérapeutique complète chez des patients déprimés majeurs :
| Prédicteurs cliniques | B | SE B | Wald χ² | dl | p | OR | IC 95 % |
|---|---|---|---|---|---|---|---|
| Constante | -0,85 | 0,31 | 7,52 | 1 | 0,006 | 0,43 | — |
| Âge chronologique (années) | -0,01 | 0,01 | 1,12 | 1 | 0,290 | 0,99 | [0,97 ; 1,01] |
| Genre | — | — | — | — | — | — | — |
| Homme (Réf.) | 0,00 | — | — | — | — | 1,00 | — |
| Femme | 0,28 | 0,18 | 2,42 | 1 | 0,120 | 1,32 | [0,93 ; 1,88] |
| Alliance thérapeutique basale (score z) | 0,64 | 0,12 | 28,44 | 1 | < 0,001 | 1,90 | [1,50 ; 2,41] |
| Comorbidité de personnalité | — | — | — | — | — | — | — |
| Absente (Réf.) | 0,00 | — | — | — | — | 1,00 | — |
| Présente | -0,92 | 0,24 | 14,69 | 1 | < 0,001 | 0,40 | [0,25 ; 0,64] |
Note. N = 412. La variable dépendante est la rémission complète (1 = oui, 0 = non). B = coefficient logistique non standardisé ; SE B = erreur type du coefficient ; Wald χ² = statistique de Wald ; p = degré de signification bilatéral ; OR = Odds Ratio univarié/multivarié (exp[B]) ; IC 95 % = intervalle de confiance à 95 % du rapport de cotes. Réf. = modalité désignée comme catégorie de référence. Qualité globale de l’ajustement : Test d’Hosmer-Lemeshow χ²(8) = 6,24, p = 0,620 ; R² pseudo de Cox & Snell = 0,182 ; R² pseudo de Nagelkerke = 0,251.
L’insertion rigoureuse des indicateurs d’adéquation globale (goodness-of-fit) en note de bas de tableau est impérative. Un test d’Hosmer-Lemeshow non significatif (p > 0,05) signale que le modèle s’ajuste harmonieusement aux données empiriques, l’écart entre probabilités prédites et observées n’étant pas significativement divergent. L’adjonction des pseudo-coefficients de détermination (particulièrement le R² de Nagelkerke, dont l’échelle s’étend théoriquement jusqu’à 1,00) offre une estimation tangible de la part de déviance logistique absorbée par l’ensemble des régresseurs du modèle.
12.3 Check-list méthodologique pour la relecture critique d’articles
Pour parachever ce traité et armer les chercheurs, évaluateurs pairs (peer-reviewers) et cliniciens face à l’avalanche de manuscrits quantitatifs, nous proposons ci-dessous une check-list de validation critique synthétisant les garde-fous épistémologiques développés tout au long de ce guide :
- Cohérence de l’architecture du devis : Le recours à l’Odds Ratio est-il dicté par la nature des données ? S’il s’agit d’une étude de cohorte prospective ou d’un essai randomisé évaluant une affection fréquente (> 10 %), les auteurs ont-ils justifié pourquoi ils n’ont pas rapporté directement un Risque Relatif ou une régression log-binomiale ?
- Étanchéité lexicale et sémantique : Les auteurs ont-ils proscrit tout glissement fallacieux assimilant l’Odds Ratio à une « multiplication du risque » ? Le terme « cote » (odds) est-il rigoureusement respecté dans le corps du texte, les figures et les résumés analytiques ?
- Transparence systématique des intervalles de confiance : Tout Odds Ratio rapporté s’accompagne-t-il indiscutablement de son IC 95 % ? Les auteurs ont-ils évité de focaliser leur discussion exclusivement sur le seuil p < 0,05 pour analyser la largeur et l’imprécision métrologique de l’intervalle géométrique ?
- Neutralisation des facteurs de confusion : Les auteurs présentent-ils côte à côte les OR bruts et les aOR ajustés ? Le protocole de sélection des covariables est-il théoriquement étayé (de préférence via des graphes causaux DAG) afin d’éviter l’inclusion catastrophique de variables médiatrices dans les équations logistiques ?
- Vigilance face aux anomalies algorithmiques : Le tableau de résultats ne dissimule-t-il aucun coefficient monstrueux ou erreur type hypertrophiée trahissant un écueil de séparation complète ? Si des cellules d’effectifs nuls étaient présentes, les corrections de continuité appropriées (Haldane-Anscombe ou régression pénalisée de Firth) ont-elles été expressément déclarées ?
- Différenciation ferme entre taille d’effet et précision diagnostique : Si l’article promeut un marqueur ou une échelle, les auteurs se sont-ils abstenus de conclure à une efficacité de dépistage individuel sur le simple fondement d’un OR statistique significatif, sans fournir de courbes ROC et de rapports de cotes diagnostiques (DOR) validés ?
En soumettant systématiquement toute publication biomédicale ou psychologique à ces critères d’une intransigeance scientifique totale, la communauté scientifique s’assurera de préserver l’intégrité de ses conclusions, érigeant l’Odds Ratio non plus en vecteur d’illusions d’optique probabilistes, mais en un instrument exemplaire de rigueur et de clairvoyance empirique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2021). Introduction to meta-analysis (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119558378
- Chen, H., Cohen, P., & Chen, S. (2010). How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies. Communications in Statistics – Simulation and Computation, 39(4), 860–864. https://doi.org/10.1080/03610911003650383
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cornfield, J. (1951). A method of estimating comparative rates from clinical data; applications to cancer of the lung, breast, and cervix. Journal of the National Cancer Institute, 12(6), 1269–1275. https://doi.org/10.1093/jnci/12.6.1269
- Cox, D. R. (1958). The regression analysis of binary sequences. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), 215–232. https://doi.org/10.1111/j.2517-6161.1958.tb00292.x
- DerSimonian, R., & Laird, N. (1986). Meta-analysis in clinical trials. Controlled Clinical Trials, 7(3), 177–188. https://doi.org/10.1016/0197-2456(86)90046-2
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27–38. https://doi.org/10.1093/biomet/80.1.27
- Glas, A. S., Lijmer, J. G., Prins, M. H., Bonsel, G. J., & Bossuyt, P. M. (2003). The diagnostic odds ratio: A single indicator of test performance. Journal of Clinical Epidemiology, 56(11), 1129–1135. https://doi.org/10.1016/S0895-4356(03)00177-X
- Higgins, J. P. T., Thompson, S. G., Deeks, J. J., & Altman, D. G. (2003). Measuring inconsistency in meta-analyses. BMJ, 327(7414), 557–560. https://doi.org/10.1136/bmj.327.7414.557
- Hill, A. B. (1965). The environment and disease: Association or causation? Proceedings of the Royal Society of Medicine, 58(5), 295–300. https://doi.org/10.1177/003591576505800505
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern epidemiology (3rd ed.). Lippincott Williams & Wilkins.
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01339.x
- Zhang, J., & Yu, K. F. (1998). What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA, 280(19), 1690–1691. https://doi.org/10.1001/jama.280.19.1690