
L’analyse par régression linéaire constitue depuis des décennies l’un des piliers méthodologiques les plus robustes et les plus sollicités au sein des sciences psychologiques, cognitives et comportementales. Qu’il s’agisse d’évaluer l’efficacité différentielle d’une intervention psychothérapeutique, d’isoler les prédicteurs cognitifs du déclin mnésique ou de modéliser les dynamiques motivationnelles en milieu organisationnel, les chercheurs recourent fréquemment aux moindres carrés ordinaires pour quantifier les relations entre variables observées. Cependant, la puissance inférentielle de ces modèles repose sur une série de postulats théoriques stricts dont la violation, souvent sous-estimée, menace directement la validité interne et la réplicabilité des découvertes scientifiques.
Parmi ces hypothèses fondamentales, la constance de la variance des erreurs conditionnelles — plus communément désignée sous le terme d’homoscédasticité — occupe une place prépondérante. Lorsque cette variance fluctue systématiquement en fonction des niveaux des variables prédictrices, le phénomène d’hétéroscédasticité s’installe, compromettant silencieusement l’estimation des erreurs-types, faussant les intervalles de confiance et augmentant de manière alarmante le risque d’erreurs de type I ou de type II. Pour prémunir les chercheurs contre ces biais pernicieux, les outils d’inspection visuelle offrent un diagnostic d’une finesse incomparable, bien supérieure à celle des simples indicateurs numériques globaux.
Le graphique Scale-Location (également dénommé graphique d’échelle-localisation ou Spread-Location plot) s’impose comme le dispositif diagnostique de référence pour examiner avec une acuité maximale la stabilité de la variance des résidus. En convertissant les résidus standardisés sous une échelle stabilisée et en les projetant contre les valeurs ajustées par le modèle, cet outil graphique permet de démasquer les moindres motifs d’hétéroscédasticité, de déceler les effets de seuil ou de plafond et d’identifier les observations atypiques. Ce guide exhaustif a pour vocation de décortiquer les fondements mathématiques, les règles d’interprétation empirique, les illustrations concrètes et les protocoles de remédiation liés à ce graphique indispensable, afin d’armer les chercheurs et cliniciens d’une rigueur analytique irréprochable.
1. Introduction aux graphiques diagnostiques de régression en psychologie
1.1 Le rôle crucial des postulats de la régression linéaire
Dans l’écosystème de la recherche psychologique contemporaine, le recours au modèle linéaire généralisé représente une démarche quasi omniprésente pour éprouver des hypothèses expérimentales et corrélationnelles. Toutefois, l’application rigoureuse des modèles de régression par les moindres carrés ordinaires (Ordinary Least Squares, OLS) ne se résume pas à l’obtention d’un coefficient de détermination (R^2) flatteur ou de valeurs p statistiquement significatives. Les théorèmes mathématiques qui sous-tendent ces analyses, notamment le théorème fondamental de Gauss-Markov, posent des conditions strictes sans lesquelles les estimations produites perdent toute propriété d’optimalité. En psychométrie et en psychologie quantitative, la vérification de ces postulats n’est pas une simple formalité technique, mais une condition sine qua non de la validité scientifique des inférences.
L’ignorance ou la minimisation de ces conditions préalables engendre des répercussions directes sur l’ensemble de l’édifice empirique. Lorsqu’un modèle viole le postulat de variance constante des erreurs, les coefficients estimés demeurent formellement non biaisés, mais leur variance est inexactement estimée. Cela conduit inévitablement à un calcul erroné des erreurs-types, qui constituent pourtant le dénominateur de tous les ratios t de Student et des statistiques F de Fisher. Par voie de conséquence, les seuils de significativité deviennent fallacieux, poussant les chercheurs à conclure à l’existence d’effets thérapeutiques, cognitifs ou comportementaux qui ne sont en réalité que des artefacts statistiques induits par la dispersion hétérogène des données.
Pendant longtemps, la pratique standard s’est cantonnée à l’inspection d’indices synthétiques ou de métriques globales sommaires. Pourtant, le passage d’une démarche purement numérique vers un diagnostic visuel systématique et approfondi marque une évolution méthodologique majeure. Les représentations graphiques possèdent cette capacité unique de révéler la morphologie sous-jacente des erreurs, là où un chiffre condensé masque souvent des anomalies locales substantielles. Dans les études comportementales, où les variables sont par nature soumises à une forte variabilité humaine et à des imprécisions de mesure inhérentes aux questionnaires, l’évaluation visuelle des résidus demeure la méthode la plus sûre pour s’assurer que les inférences finales reflètent la réalité psychologique plutôt qu’une distorsion mathématique non maîtrisée.
1.2 Présentation générale du graphique Scale-Location
Au sein de la panoplie des outils diagnostiques développés par les statisticiens pour sonder l’intégrité des modèles linéaires, le graphique Scale-Location, couramment désigné dans la littérature anglo-saxonne sous le terme de Spread-Location plot ou graphique d’échelle-localisation, occupe une fonction singulière et irremplaçable. Alors que d’autres graphiques évaluent la linéarité globale ou la normalité distributionnelle, le Scale-Location est spécifiquement paramétré pour explorer la structure de la variance résiduelle à travers l’éventail complet des prédictions générées par le modèle.
Sa fonction première est d’offrir une détection visuelle hautement sensible de l’hétéroscédasticité au sein des résidus. Dans un modèle parfaitement calibré répondant aux critères d’homoscédasticité, la dispersion des termes d’erreur doit être rigoureusement identique, quel que soit le score ajusté attendu pour un individu. Le graphique Scale-Location permet d’isoler cette propriété en éliminant le signe positif ou négatif des résidus et en stabilisant leur échelle, transformant ainsi l’examen délicat d’un nuage de points dispersé verticalement en une évaluation simple de l’horizontalité et de la régularité spatiale.
Dans les environnements statistiques modernes tels que le logiciel libre R, ce graphique fait partie intégrante du quatuor diagnostique canonique généré automatiquement lors de l’appel de la commande de base dédiée aux objets linéaires. Occupant traditionnellement la troisième position dans cette séquence (auprès du graphique des résidus en fonction des valeurs ajustées, du diagramme quantile-quantile normal et du graphique des résidus en fonction du levier), il fournit aux chercheurs un éclairage complémentaire ciblé sur la dimension d’échelle (scale), élément charnière pour valider ou réfuter les postulats inférentiels.
1.3 Importance méthodologique dans les sciences du comportement
Les sciences psychologiques et les disciplines comportementales connexes sont confrontées à des défis d’échantillonnage et de mesure d’une complexité singulière. La variabilité interindividuelle, loin d’être un bruit de fond anodin, reflète souvent des processus psychologiques complexes : différences individuelles d’anxiété, capacités de mémoire de travail disparates ou profils de personnalité idiosyncrasiques. Cette nature intrinsèque des construits psychologiques rend les données empiriques particulièrement vulnérables aux ruptures de variance constante, car certains sous-groupes de participants présentent naturellement une dispersion comportementale nettement plus vaste que d’autres.
Un enjeu majeur réside dans la gestion des effets de seuil (floor effects) et de plafond (ceiling effects), omniprésents lors de l’utilisation d’échelles d’auto-évaluation de type Likert ou de batteries d’évaluation neuropsychologiques standardisées. Lorsqu’une tâche cognitive est trop aisée, les scores des sujets performants s’agglutinent autour du score maximal avec une variance résiduelle quasi nulle, tandis que les sujets en difficulté se distribuent sur une large plage de scores. Ce déséquilibre structurel engendre mécaniquement une hétéroscédasticité prononcée qui invalide les conclusions des régressions naïves. Le graphique Scale-Location permet d’identifier avec une clarté immédiate ces zones d’écrasement ou d’expansion anormale de la variance.
Pour les praticiens, les cliniciens et les chercheurs appelés à formuler des recommandations fondées sur des preuves empiriques (evidence-based practice), l’exactitude des tests de significativité revêt une dimension éthique et appliquée déterminante. Déclarer qu’un trait de personnalité prédit significativement la réussite académique ou que le niveau de stress parental influence le développement émotionnel de l’enfant requiert l’assurance que les intervalles de confiance ne sont ni artificiellement resserrés ni indûment élargis. La maîtrise du diagnostic par le graphique Scale-Location constitue ainsi une compétence méthodologique indispensable pour garantir l’intégrité de la recherche en psychologie.
2. Définition et fondements théoriques du graphique Scale-Location
2.1 Les composantes mathématiques de l’axe des ordonnées
Pour comprendre pleinement la puissance diagnostique du graphique Scale-Location, il convient d’analyser la formulation mathématique précise de son axe vertical. Contrairement au graphique standard des résidus qui projette les résidus bruts (e_i = y_i – hat{y}_i), l’axe des ordonnées du Scale-Location applique une double transformation mathématique hautement spécialisée. La métrique représentée est la racine carrée de la valeur absolue des résidus standardisés, couramment exprimée par la formule mathématique suivante :
[ text{Ordonnée} = sqrt{|r_i|} quad text{où} quad r_i = frac{e_i}{hat{sigma} sqrt{1 – h_{ii}}} ]
Dans cette formulation, (r_i) désigne le résidu standardisé (ou résidu studentisé interne) de la (i)-ème observation, (e_i) représente le résidu brut, (hat{sigma}) l’estimation de l’écart-type des erreurs du modèle, et (h_{ii}) la valeur de levier (leverage) associée à l’observation via la matrice chapeau. La division par le terme (sqrt{1 – h_{ii}}) est primordiale, car elle corrige le fait que les observations présentant un levier élevé possèdent intrinsèquement des résidus bruts de plus petite variance, assurant ainsi que tous les (r_i) possèdent théoriquement une variance unitaire sous l’hypothèse de validité du modèle.
La transformation par la valeur absolue (|r_i|) élimine délibérément le signe de l’erreur, repliant l’ensemble de la dispersion résiduelle dans le domaine des nombres positifs. L’application consécutive de la racine carrée constitue l’élément déterminant : elle a pour propriété mathématique de contracter la queue de distribution et de symétriser la loi des écarts. Sous l’hypothèse de normalité des résidus, la variable (|r_i|) suit une distribution demi-normale (half-normal), qui présente une asymétrie positive marquée. En appliquant la transformation racine carrée, la distribution de (sqrt{|r_i|}) se rapproche étroitement d’une distribution symétrique, réduisant considérablement l’influence visuelle excessive des valeurs résiduelles extrêmes et permettant à l’œil humain de juger objectivement de la stabilité de l’échelle sans être distrait par des valeurs aberrantes isolées.
2.2 La métrique de l’axe des abscisses
L’axe des abscisses du graphique Scale-Location est constitué des valeurs ajustées ou prédites par le modèle linéaire, conventionnellement notées (hat{y}_i). Ces valeurs correspondent à la combinaison linéaire optimale des covariables multipliées par leurs coefficients de régression respectifs, augmentée de la constante :
[ hat{y}_i = hat{beta}_0 + hat{beta}_1 x_{i1} + hat{beta}_2 x_{i2} + dots + hat{beta}_p x_{ip} ]
La projection des résidus standardisés transformés contre les valeurs ajustées permet de cartographier la dispersion des erreurs tout au long du spectre des scores prévus par le modèle. Cette disposition est d’une grande efficacité méthodologique : plutôt que de scruter séparément chaque variable prédictrice dans des régressions multiples complexes comportant dix ou quinze covariables, les valeurs prédites synthétisent l’espace multidimensionnel des prédicteurs en une unique dimension ordonnée représentative du signal principal.
Cette configuration permet d’identifier immédiatement s’il existe une corrélation fonctionnelle entre l’ampleur moyenne de la réponse attendue et la variabilité de l’erreur commise. Par exemple, si le modèle prédit des scores de dépression allant de 0 à 60, l’observation de l’axe horizontal permet de vérifier instantanément si l’incertitude du modèle est identique pour les individus dont le score estimé est de 10 que pour ceux dont le score s’élève à 50. La métrique des abscisses ancre ainsi l’évaluation de la variance au cœur du continuum clinique ou comportemental exploré.
2.3 La courbe de tendance lissée (ligne rouge LOESS)
L’interprétation d’un nuage de points bruts peut s’avérer ardue, particulièrement en présence d’échantillons de taille modeste ou au contraire très denses, où la superposition des observations peut tromper la perception visuelle. Pour surmonter cet écueil cognitif, le graphique Scale-Location intègre de manière standard une courbe de tendance non paramétrique, matérialisée par une ligne rouge continue issue d’un algorithme de lissage de régression locale (LOESS ou LOWESS).
Le principe du lissage LOESS repose sur l’ajustement de régressions polynomiales pondérées au sein de fenêtres glissantes le long de l’axe des abscisses. Pour chaque valeur ajustée (hat{y}), l’algorithme calcule une estimation locale de la moyenne conditionnelle de (sqrt{|r|}), en accordant un poids prépondérant aux points géographiquement proches et un poids décroissant aux points plus éloignés selon une fonction de noyau robuste. Cette approche ne présuppose aucune forme géométrique prédéterminée (linéaire, quadratique ou exponentielle) et épouse fidèlement les inflexions réelles des données.
Sur le graphique Scale-Location, cette courbe rouge agit comme un baromètre visuel objectif : elle matérialise la trajectoire moyenne de la dispersion résiduelle à travers tout le domaine de prédiction. Si la variance demeure constante, la valeur attendue de (sqrt{|r_i|}) reste invariante, et la ligne LOESS trace une trajectoire horizontale parfaite. En revanche, toute déviation systématique de cette ligne — qu’il s’agisse d’une pente ascendante, descendante ou ondulatoire — offre une indication incontestable que la dispersion fluctue, signalant ainsi la présence sous-jacente d’une hétéroscédasticité qu’il appartiendra au chercheur de quantifier et de corriger.
3. L’hypothèse fondamentale d’homoscédasticité en recherche comportementale
3.1 Cadre conceptuel de l’homoscédasticité
L’homoscédasticité, étymologiquement issue du grec homo (identique) et skedasis (dispersion), formalise la condition selon laquelle la variance des termes d’erreur stochastiques (varepsilon_i) est constante pour chaque niveau possible des variables explicatives conditionnantes. Sur le plan formel, cette condition s’exprime par l’égalité d’espérance conditionnelle suivante :
[ operatorname{Var}(varepsilon_i mid X_1 = x_{i1}, X_2 = x_{i2}, dots, X_p = x_{ip}) = sigma^2 ]
Cette hypothèse centrale constitue la clé de voûte du théorème de Gauss-Markov. Ce dernier stipule que, sous réserve de la linéarité du modèle, d’une espérance nulle des erreurs et de l’absence de colinéarité parfaite et d’autocorrélation, les estimateurs issus des moindres carrés ordinaires sont les meilleurs estimateurs linéaires sans biais (propriété désignée par l’acronyme anglais BLUE : Best Linear Unbiased Estimator). La notion de « meilleur » renvoie explicitement à la précision : l’estimateur OLS est celui qui minimise la variance parmi tous les estimateurs linéaires non biaisés possibles.
Il importe de clarifier une confusion récurrente dans les manuscrits scientifiques entre les résidus bruts observés et les résidus conditionnels. L’homoscédasticité n’exige nullement que la variable dépendante (Y) soit uniformément dispersée dans la population brute. Elle exige spécifiquement que, une fois que l’effet systématique des variables prédictrices a été pris en compte et soustrait par le modèle, l’incertitude résiduelle restante (le bruit blanc aléatoire) affiche une variabilité parfaitement homogène sur l’ensemble de l’espace des covariables.
3.2 Impact de l’hétéroscédasticité sur les inférences statistiques
Lorsque le postulat d’homoscédasticité est transgressé, les conséquences sur l’architecture statistique de la régression sont insidieuses mais profondes. Contrairement à ce que l’on pourrait intuitivement redouter, les coefficients de régression (hat{beta}_j) calculés par la méthode OLS demeurent formellement non biaisés et convergents : en moyenne, sur un nombre infini de réplications expérimentales, ils ciblent la véritable valeur du paramètre populationnel. En revanche, l’estimation classique de la matrice de variance-covariance des coefficients devient structurellement erronée.
Dans la formule standard de l’erreur-type (SE(hat{beta}) = sigma sqrt{(X^T X)^{-1}}), la variance unique supposée (sigma^2) est remplacée par une approximation globale qui s’avère fausse si la variance locale oscille. Par conséquent, les erreurs-types calculées par les logiciels statistiques conventionnels sont biaisées. Dans la majorité des configurations empiriques en sciences sociales, ces erreurs-types sont substantiellement sous-estimées, ce qui gonfle de manière artificielle la valeur absolue du ratio (t = hat{beta} / SE(hat{beta})) et écrase la valeur p associée.
Cette distorsion mathématique déclenche une inflation dramatique du taux d’erreur de type I : le chercheur rejette l’hypothèse nulle à tort et conclut à l’existence d’un effet psychologique qui n’est en fait qu’un mirage généré par une variance non contrôlée. Dans d’autres contextes, une surestimation de l’erreur-type conduit à des erreurs de type II, masquant des relations réelles mais rejetées par manque de puissance statistique apparente. Dans le contexte actuel de la crise de la reproductibilité en psychologie expérimentale, l’hétéroscédasticité non corrigée représente l’un des moteurs discrets mais dévastateurs de la prolifération de faux positifs dans la littérature indexée.
3.3 Origines fréquentes de l’hétéroscédasticité en psychologie
Dans le domaine des sciences humaines et du comportement, l’hétéroscédasticité n’est pas une anomalie rare mais une conséquence logique de la dynamique des processus cognitifs, émotionnels et sociaux. L’une des sources les plus documentées réside dans l’hétérogénéité intrinsèque des sous-populations au sein des échantillons cliniques. Par exemple, lorsqu’on modélise l’efficacité cognitive en fonction de l’âge, les jeunes adultes affichent généralement des scores homogènes et resserrés autour de la moyenne, tandis que les cohortes de sujets âgés présentent une variabilité considérable, certains individus conservant d’excellentes capacités exécutives alors que d’autres manifestent un déclin cognitif marqué.
Une seconde cause majeure découle des erreurs de mesure cumulatives inhérentes aux instruments psychométriques. Lors de l’administration d’inventaires d’évaluation de la symptomatologie psychopathologique (comme l’échelle d’anxiété de Hamilton ou l’inventaire de dépression de Beck), les individus présentant des niveaux pathologiques élevés ont tendance à manifester une fluctuation de réponse beaucoup plus volatile d’une séance à l’autre que les témoins asymptomatiques, induisant une hétéroscédasticité proportionnelle à la sévérité du trouble.
Enfin, les plans expérimentaux à mesures répétées et les protocoles d’apprentissage comportemental sont structurellement vulnérables à ce phénomène. Au début d’une phase d’apprentissage moteur ou linguistique, les temps de réaction et les taux d’erreurs varient fortement entre les participants selon leurs aptitudes de départ. À mesure que les essais se succèdent et que la compétence se consolide, la performance s’automatise, provoquant un rétrécissement massif de la variance interindividuelle au fil de l’expérience, générant ainsi un profil hétéroscédastique typique.
4. Anatomie détaillée et composantes graphiques
4.1 L’alignement géométrique des points
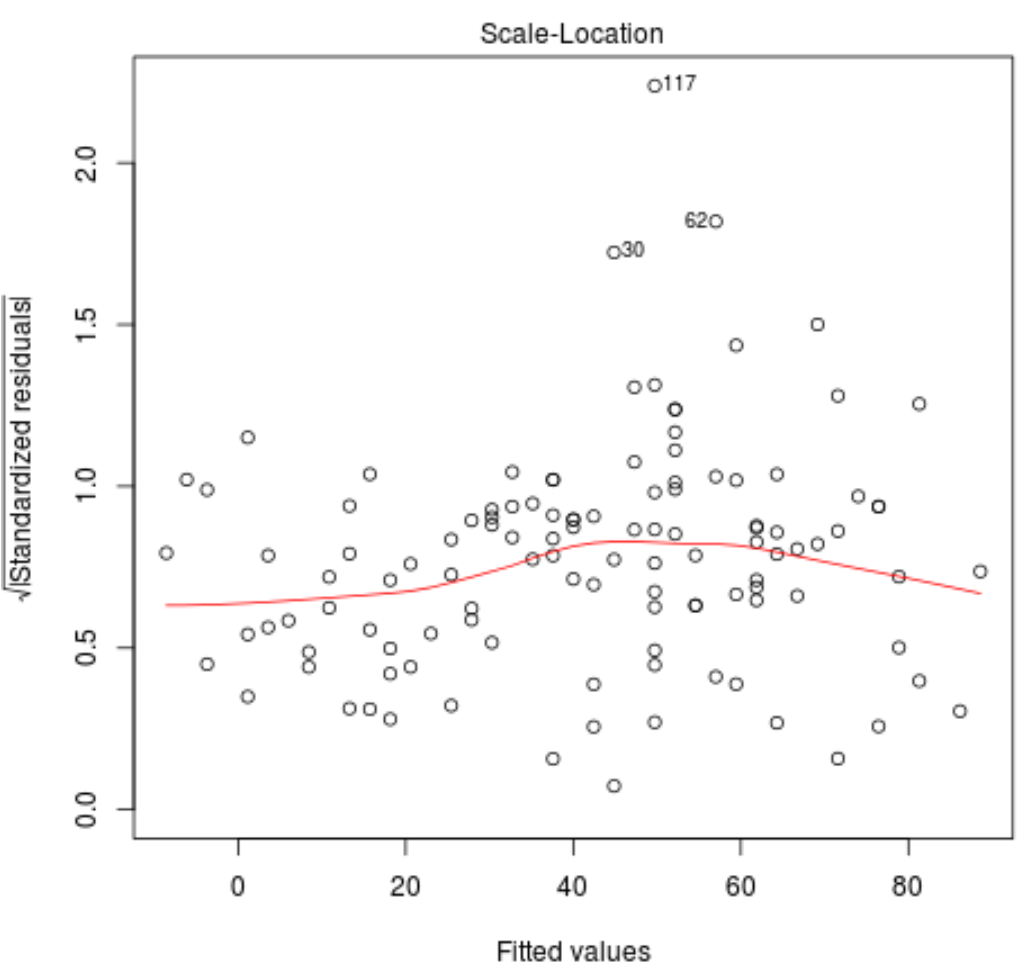
Chaque point projeté sur le graphique Scale-Location représente une observation unique issue de l’échantillon empirique analysé, qu’il s’agisse d’un participant dans une étude expérimentale, d’un patient en suivi psychologique ou d’une unité organisationnelle. La compréhension de la topographie de ce graphique requiert de décomposer avec minutie la façon dont les coordonnées spatiales de ces points sont définies.
La position horizontale (abscisse) d’un point est strictement dictée par le score prédictif (hat{y}_i) calculé par l’équation de régression. Cela signifie que l’axe des X segmente les participants selon le niveau de réponse que le modèle théorique leur assigne sur la base de leurs variables explicatives. Des observations situées sur le flanc gauche correspondent à des individus pour lesquels le modèle anticipe des valeurs faibles, tandis que les observations ancrées sur l’extrême droite rassemblent les individus gratifiés d’estimations élevées.
La position verticale (ordonnée) traduit l’amplitude absolue du résidu standardisé transformé (sqrt{|r_i|}). Un point situé tout près de la ligne de base (ordonnée proche de zéro) désigne une observation pour laquelle le modèle a prédit le comportement réel avec une exactitude quasi chirurgicale, l’écart observé étant infime. Inversement, plus un point s’élève vers le sommet du graphique, plus la divergence entre le score réel observé chez ce participant et la prédiction théorique du modèle est marquée. La dispersion géométrique verticale matérialise donc directement l’ampleur de l’incertitude prédictive locale.
4.2 Interprétation de la ligne rouge de référence
L’élément central vers lequel le regard du méthodologiste doit prioritairement converger est la courbe de régression locale non paramétrique tracée en rouge à travers le nuage d’observations. Dans des conditions idéales d’homoscédasticité parfaite et d’erreurs normalement distribuées, cette ligne de lissage adopte une trajectoire rigoureusement plane et parfaitement parallèle à l’axe des abscisses.
La hauteur théorique à laquelle cette ligne horizontale idéale doit se stabiliser n’est pas arbitraire. Sachant que pour une distribution normale standard, l’espérance mathématique de la racine carrée de la valeur absolue d’un écart réduit est donnée par (E(sqrt{|Z|}) = Gamma(3/4) cdot 2^{1/4} / sqrt{pi} approx 0{,}822), la ligne LOESS doit idéalement osciller autour d’une ordonnée moyenne proche de 0,8 à 0,85. Une ligne parfaitement horizontale mais anormalement élevée signalerait une variance globale mal estimée ou un manque général d’ajustement du modèle, tandis qu’une ligne basse indiquerait un surajustement (overfitting).
Il est capital de souligner la sensibilité différentielle de cette courbe aux extrémités de la distribution. En vertu du fonctionnement mathématique des fenêtres de lissage LOESS, les bords extrêmes du graphique (les prédictions les plus basses et les plus hautes) reposent sur un nombre plus restreint d’observations adjacentes. Dès lors, une légère flexion de la courbe à ses marges terminales ne doit pas nécessairement être surinterprétée comme une rupture pathologique d’homoscédasticité si elle est induite par un ou deux points périphériques isolés.
4.3 Indexation des observations influentes
Dans les implémentations logicielles standards, notamment celles générées nativement par R, le graphique Scale-Location intègre un système d’étiquetage numérique automatique des observations présentant les déviations résiduelles les plus sévères. Typiquement, les trois ou quatre points occupant les altitudes les plus élevées sur l’axe des ordonnées sont annotés avec leur numéro d’identifiant dans la matrice de données d’origine (par exemple, les points étiquetés « 42 », « 118 » ou « 205 »).
Cette indexation ne signifie pas automatiquement que ces observations doivent être éliminées du jeu de données. Elle vise à alerter le chercheur sur l’existence de cas atypiques méritant une inspection qualitative approfondie. Une distinction conceptuelle nette doit être opérée entre un point aberrant résiduel (un participant dont le score s’écarte radicalement de la prédiction du modèle sans pour autant modifier la trajectoire de la régression) et un point de levier influent (qui tire à lui seul la droite de régression et déforme artificiellement les estimations).
Sur le graphique Scale-Location, un point étiqueté au sommet reflète une variabilité résiduelle exceptionnelle. Si plusieurs de ces points extrêmes sont regroupés dans une région spécifique de l’axe des abscisses, ils peuvent à eux seuls induire une distorsion locale de la ligne LOESS et créer une apparence trompeuse d’hétéroscédasticité générale. L’analyste doit impérativement croiser cette information avec le graphique de la distance de Cook pour évaluer si ces observations déstabilisent unilatéralement la variance du modèle.
5. Les deux règles fondamentales pour une interprétation valide
5.1 Règle n°1 : L’horizontalité absolue de la ligne LOESS
La première règle d’or pour attester de la validité du postulat d’homoscédasticité réside dans l’examen minutieux de la rectitude géométrique de la ligne rouge de lissage LOESS. L’observateur doit exiger de cette courbe une horizontalité quasi parfaite d’une extrémité à l’autre de l’axe des valeurs prédites. L’absence de toute pente globale — qu’elle soit positive et ascendante ou négative et descendante — fournit la confirmation visuelle directe que l’espérance de la dispersion d’erreur demeure rigoureusement invariable, quel que soit le niveau prédit par le modèle.
Il convient toutefois de tempérer cette exigence théorique par le pragmatisme statistique : sur des données empiriques réelles issues d’échantillons psychologiques de taille modérée (par exemple, (N = 100) à (200)), la ligne rouge n’adoptera jamais la rectitude géométrique absolue d’un trait tracé à la règle. Des micro-ondulations locales, de légères sinuosités ou des déviations marginales sans tendance générale directionnelle sont inévitables et constituent le produit naturel des fluctuations d’échantillonnage aléatoires.
Le critère d’alerte méthodologique réside dans la présence d’une inclinaison soutenue, monotone et persistante. Si la ligne rouge s’élève de manière continue sur une part substantielle de l’axe X, ou si elle subit une déclinaison marquée, l’hypothèse d’homoscédasticité doit être formellement rejetée. L’analyste doit prêter une attention particulière à la stabilité de la ligne dans la zone centrale du nuage, où réside la plus forte densité d’observations et où l’estimation de la variance conditionnelle est la plus fiable.
5.2 Règle n°2 : L’absence de structure ou de pattern dans les points
La seconde règle impérative, indissociable de la première, concerne la distribution spatiale des points qui composent le nuage d’observations. L’analyste doit vérifier l’absence totale de motifs géométriques, de structures morphologiques ou d’agencements non aléatoires au sein du graphique. Les résidus standardisés transformés doivent être répartis de façon homogène, fluide et continue dans une bande rectangulaire d’épaisseur constante tout au long de l’axe des valeurs ajustées.
Cette régularité spatiale implique que la largeur verticale de la bande formée par les points ne doit ni s’amincir ni s’épaissir à mesure que l’on se déplace de gauche à droite sur l’axe des abscisses. La présence de regroupements segmentés, de grappes distinctes de points séparées par des « clairières » vides, ou d’alignements linéaires obliques trahit de graves défaillances de spécification. De tels alignements suggèrent fréquemment qu’une variable modératrice catégorielle ou une discontinuité structurelle dans le protocole n’a pas été intégrée dans le modèle.
De surcroît, la densité spatiale des points doit demeurer proportionnellement constante au volume d’observations projeté. Un examen attentif doit confirmer que les observations ne se concentrent pas exclusivement près de la ligne de base dans certaines portions du graphique tout en s’éparpillant vers des sommets verticaux dans d’autres portions. Le respect simultané de cette dispersion uniforme et de l’horizontalité de la ligne LOESS constitue la preuve graphique la plus solide en faveur de l’homoscédasticité.
6. Typologie des anomalies visuelles et de l’hétéroscédasticité
6.1 Le profil en entonnoir (mégaphone)
Le profil en entonnoir, souvent désigné sous l’appellation de profil en mégaphone, constitue l’anomalie visuelle la plus fréquemment rencontrée dans la recherche comportementale. Sur le plan morphologique, cette figure se caractérise par un resserrement très compact des observations le long de l’axe vertical pour les faibles valeurs ajustées, suivi d’un élargissement progressif, continu et dramatique de la bande de dispersion des résidus à mesure que l’on progresse vers les valeurs prédites élevées.
Cette géométrie traduit directement une augmentation de la variance des résidus proportionnelle à l’amplitude de la variable dépendante modélisée. Dans cette configuration, la ligne rouge LOESS abandonne son horizontalité pour adopter une pente ascendante prononcée et spectaculaire vers le coin supérieur droit du graphique. Ce profil est l’illustration archétypale d’une hétéroscédasticité multiplicative, où l’incertitude de la prédiction croît conjointement avec le phénomène mesuré.
En psychologie cognitive, un exemple paradigmatique s’observe lors de l’étude des temps de réaction dans des tâches motrices complexes chez des populations présentant divers degrés d’atteinte neurologique. Pour les sujets rapides et préservés, les temps de réponse sont courts et extrêmement stables d’un essai à l’autre (faible variance résiduelle). En revanche, chez les patients souffrant d’un ralentissement cognitif sévère, les temps de réaction moyens sont longs et fluctuent considérablement d’un moment à l’autre, générant cet élargissement en entonnoir sur le graphique Scale-Location.
6.2 Le profil en cône inversé
À l’opposé exact de la morphologie précédente, le profil en cône inversé (ou entonnoir descendant) se manifeste par une variance résiduelle très étendue pour les faibles valeurs prédites sur la gauche du graphique, laquelle se contracte de manière continue pour devenir extrêmement étroite et comprimée au fur et à mesure que les scores ajustés augmentent sur la droite. La ligne rouge LOESS décrit alors une pente descendante marquée, glissant des altitudes élevées vers la base du graphique.
Ce patron visuel singulier est presque invariablement la signature d’un effet de plafond sévère au sein de l’instrument de mesure utilisé. Lorsque les participants approchent du score maximal permis par une échelle d’évaluation psychométrique ou un test de compétences psychologiques, la marge de variation des réponses est mécaniquement écrasée par la limite supérieure de l’outil. Les sujets ayant des compétences très élevées obtiennent tous un score identique ou quasi identique, compressant artificiellement le résidu brut vers zéro.
À l’inverse, pour les participants dont les niveaux attendus sont faibles ou moyens, l’échelle conserve toute sa sensibilité discriminative, permettant aux erreurs de mesure et à la variabilité interindividuelle de s’exprimer pleinement. Le profil en cône inversé constitue une mise en garde explicite : il indique au chercheur que le modèle linéaire échoue à capturer la réalité asymptotique du phénomène psychologique et qu’une modélisation par régression tronquée (modèle Tobit) ou logistique ordonnée serait méthodologiquement plus appropriée.
6.3 Les profils curvilinéaires et non linéaires
L’hétéroscédasticité ne se limite pas à des patrons monotones d’élargissement ou de contraction. Le graphique Scale-Location révèle fréquemment des anomalies structurelles plus complexes, se matérialisant sous la forme de lignes de lissage LOESS hautement curvilinéaires, adoptant des morphologies caractéristiques en forme de « U », de cloche inversée ou de vagues sinusoïdales. Dans ce type de figure, la variance résiduelle apparaît minimale au centre de la distribution des prédictions, mais s’embrase aux deux extrémités extrêmes (ou vice-versa).
Cette configuration curvilinéaire est rarement le reflet d’une hétéroscédasticité pure et indépendante ; elle traduit le plus souvent une erreur de spécification du modèle mathématique. La violation la plus courante réside dans l’omission d’un terme polynomial d’ordre supérieur (comme un effet quadratique (X^2)) ou dans l’ignorance d’un terme d’interaction modérateur ((X_1 times X_2)) crucial reliant les prédicteurs au critère d’évaluation.
En psychologie du travail, par exemple, la loi classique de Yerkes-Dodson reliant le niveau d’éveil (ou stress) à la performance cognitive adopte une forme en U inversé. Si un chercheur tente naïvement d’ajuster une régression purement linéaire sur cette relation, les résidus seront massivement sous-estimés aux niveaux intermédiaires d’éveil et surestimés aux extrêmes. Sur le graphique Scale-Location, cette distorsion se projettera sous la forme d’une ligne de tendance profondément incurvée, prouvant que ce qui semblait de prime abord être une anomalie de variance n’est que la conséquence directe d’une sous-spécification de la relation fonctionnelle moyenne.
7. Génération et configuration du graphique dans l’environnement R
7.1 Utilisation des fonctions de base de R
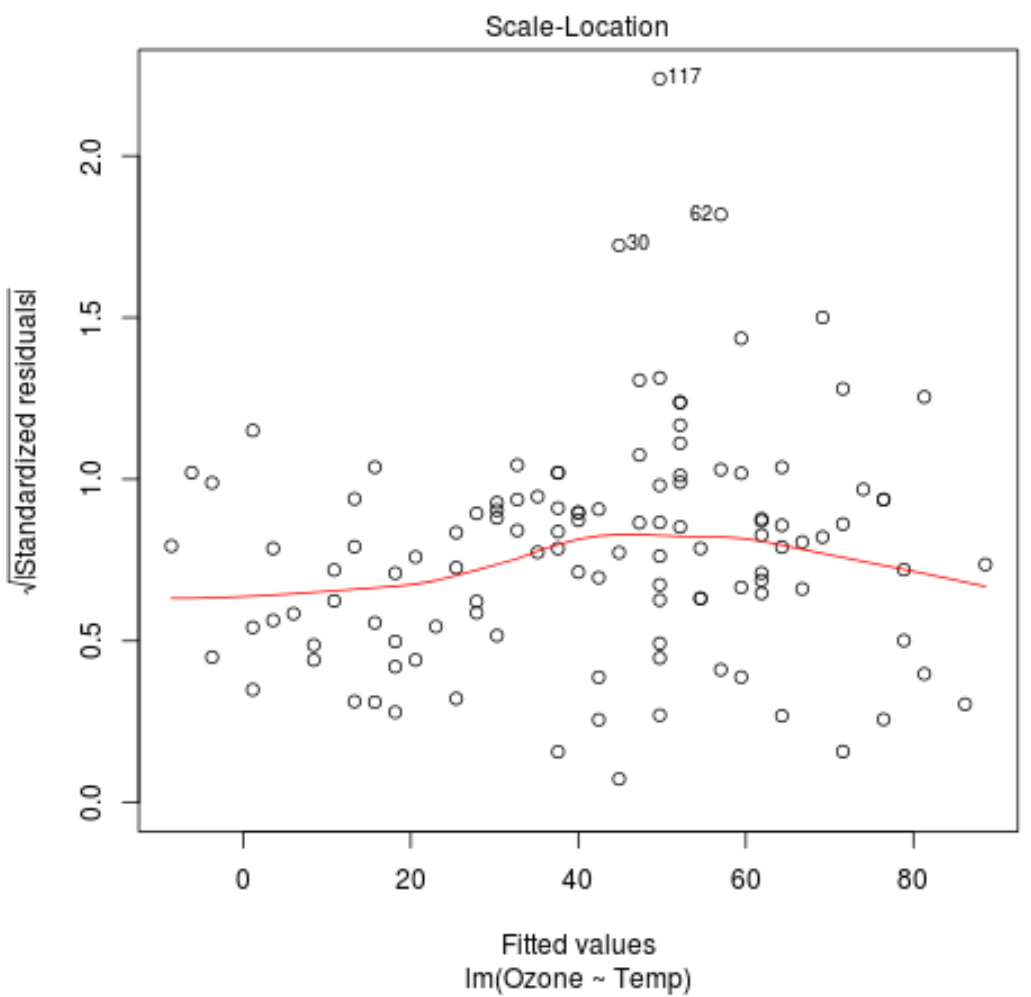
L’environnement statistique de programmation R offre une infrastructure d’une rare élégance pour produire de manière instantanée et standardisée les diagnostics de régression indispensables. Une fois un modèle linéaire ajusté à l’aide de la fonction canonique lm(), il suffit de solliciter la méthode générique plot() appliquée à l’objet de régression résultant pour accéder à la batterie de vérifications graphiques. L’argument spécifique which = 3 isole directement le graphique Scale-Location, évitant ainsi le défilement inutile des autres représentations.
La syntaxe de base s’articule de façon minimaliste et limpide :
modele <- lm(Performance ~ Stress + Sommeil, data = donnees_psy)
plot(modele, which = 3)
Par défaut, cette instruction trace sur le périphérique graphique actif les valeurs ajustées en abscisse, la racine carrée des résidus standardisés en ordonnée, le nuage de points enrichi des identifiants des trois observations les plus atypiques, ainsi que la courbe rouge LOESS paramétrée de façon robuste. L’analyste peut personnaliser cette visualisation à l’aide des arguments graphiques conventionnels (main, xlab, ylab, col, pch, lwd) afin d’adapter l’esthétique aux exigences visuelles de son analyse.
Au-delà de la représentation graphique passive, R permet d’extraire directement les valeurs numériques sous-jacentes à ce tracé. Grâce aux fonctions fitted(modele) et rstandard(modele), le chercheur peut récupérer la matrice exacte des coordonnées :
y_ajuste <- fitted(modele)
residus_transf <- sqrt(abs(rstandard(modele)))
Cette extraction programmatique offre une flexibilité totale pour procéder à des filtrages conditionnels, calculer des métriques descriptives sur la dispersion selon des quantiles de prédiction ou archiver les scores pour des protocoles d’assurance qualité rigoureux.
7.2 Visualisation moderne avec ggplot2 et ggfortify
Bien que les graphiques de base de R soient remarquablement fonctionnels pour l’exploration rapide, la rédaction d’articles scientifiques selon les standards éditoriaux les plus stricts requiert souvent la flexibilité typographique et stylistique offerte par l’écosystème tidyverse et son extension phare ggplot2. Deux voies méthodologiques s’ouvrent à l’analyste pour générer un graphique Scale-Location au rendu moderne.
La voie la plus directe consiste à mobiliser le package spécialisé ggfortify. En chargeant cette bibliothèque, la commande autoplot() reconnaît nativement les objets de classe lm et produit instantanément des représentations vectorielles stylisées basées sur le moteur graphique de ggplot2. En spécifiant l’argument which = 3, l’utilisateur obtient un tracé intégrant une palette chromatique harmonieuse, une grille de lecture épurée et des étiquettes textuelles automatisées via l’algorithme de répulsion :
library(ggfortify)
autoplot(modele, which = 3, colour = 'steelblue', smooth.colour = 'firebrick')
Pour un contrôle absolu de chaque composant graphique, la seconde approche consiste à déstructurer le modèle à l’aide de la fonction augment() issue du package broom. Cette commande annexe directement les valeurs ajustées (.fitted) et les résidus standardisés (.std.resid) au jeu de données d’origine sous la forme d’un tableau propre (tibble). Il devient dès lors trivial de composer le graphique par strates déclaratives successives :
library(ggplot2)
library(broom)
donnees_diag <- augment(modele)
ggplot(donnees_diag, aes(x = .fitted, y = sqrt(abs(.std.resid)))) +
geom_point(alpha = 0.6, color = "#2c3e50") +
geom_smooth(method = "loess", color = "#e74c3c", se = FALSE) +
labs(title = "Graphique Scale-Location Personnalisé", x = "Valeurs Ajustées", y = expression(sqrt("|Résidus Standardisés|"))) +
theme_minimal()
Cette granularité permet de modifier la sensibilité de la courbe en ajustant le paramètre de portée (span) du lisseur LOESS, d’intégrer des bandes d’intervalle de confiance et d’exporter le fichier dans des formats haute résolution vectoriels (PDF, SVG, TIFF à 300 DPI) parfaitement conformes aux directives des revues internationales de psychologie.
7.3 Diagnostics automatisés avec le package performance
Ces dernières années ont vu émerger l’initiative easystats, un ensemble unifié de packages R conçu pour démocratiser l’accès aux analyses quantitatives de pointe tout en garantissant des pratiques statistiques exemplaires. Au sein de cet écosystème, la bibliothèque performance se distingue par sa capacité à condenser en quelques lignes de commande l’intégralité du protocole diagnostique d’un modèle linéaire.
La commande maîtresse check_heteroscedasticity(modele) constitue une avancée méthodologique majeure. Elle exécute instantanément un diagnostic croisé, associant le calcul d’un test inférentiel formel (variante du test de Breusch-Pagan) à une interprétation sémantique automatisée en langage clair (« Warning: Heteroscedasticity (non-constant error variance) detected » ou « OK: Error variance appears to be homoscedastic »). L’analyste s’affranchit ainsi de l’ambiguïté interprétative en disposant d’un verdict algorithmique immédiat.
Pour une synthèse visuelle exhaustive, la fonction check_model(modele) génère automatiquement une planche composite rassemblant six graphiques diagnostiques modernisés, incluant une version optimisée du Scale-Location sous la bannière explicite « Homogeneity of Variance ». La force de cette implémentation réside dans la présence de zones de tolérance colorées précalculées : une bande verte horizontale guide l’œil du chercheur, matérialisant visuellement les limites dans lesquelles la ligne rouge de référence doit s’inscrire pour que l’homoscédasticité soit considérée comme préservée. Ce couplage visuel et formel immédiat constitue aujourd’hui le standard d’or pour des flux d’analyse rigoureux, transparents et hautement reproductibles.
8. Exemple pratique n°1 : Modèle valide en psychologie de la santé
8.1 Présentation du jeu de données et formulation du modèle
Afin d’ancrer ces développements théoriques dans la réalité empirique du laboratoire, examinons un premier exemple pratique issu du champ de la psychologie de la santé. Imaginons une recherche prospective menée auprès d’une cohorte de (N = 250) soignants exerçant au sein de services d’urgence hospitaliers, particulièrement exposés à l’épuisement professionnel. L’objectif théorique de l’étude consiste à modéliser le niveau de résilience psychologique globale des praticiens (évaluée au moyen de l’échelle validée CD-RISC de Connor-Davidson, score continu s’étendant de 0 à 100) en fonction de deux prédicteurs fondamentaux : le score moyen de stress perçu au travail (évalué par le questionnaire PSS-10 de Cohen) et la quantité moyenne d’heures de sommeil de qualité recueillie quotidiennement par actimétrie sur une période de trois semaines consécutives.
La distribution univariée initiale des scores ne révèle aucun effet d’écrasement ni d’asymétrie pathologique, et la taille de l’échantillon garantit une puissance statistique largement suffisante pour détecter des effets de taille modérée ((f^2 = 0{,}15)). Le chercheur formalise l’équation de régression multiple suivante :
[ text{Résilience}_i = beta_0 + beta_1 cdot text{Stress}_i + beta_2 cdot text{Sommeil}_i + varepsilon_i ]
Dans l’environnement R, le modèle est immédiatement estimé :
modele_sante <- lm(Resilience ~ Stress + Sommeil, data = donnees_soignants)
summary(modele_sante)
Les résultats statistiques initiaux affichent un coefficient de détermination robuste ((R^2 = 0{,}44), (F(2, 247) = 97{,}03), (p < 0{,}001)), le stress exerçant un impact négatif significatif ((hat{beta}_1 = -0{,}62), (p < 0{,}001)) et le sommeil un effet protecteur majeur ((hat{beta}_2 = 3{,}14), (p < 0{,}001)). Toutefois, avant de communiquer ces coefficients comme des vérités scientifiques consolidées, l’inspection impérative du graphique Scale-Location est déployée via l’instruction plot(modele_sante, which = 3).
8.2 Inspection pas à pas du graphique Scale-Location obtenu
L’ouverture de la fenêtre graphique révèle une configuration visuelle exemplaire, matérialisant point par point les critères d’un modèle conforme aux postulats de Gauss-Markov. Dès le premier regard porté sur l’axe des ordonnées, la trajectoire de la ligne rouge de lissage LOESS s’impose par sa remarquable horizontalité. D’un bout à l’autre du continuum des valeurs prédites de résilience — qui s’échelonnent sur l’axe horizontal d’un score estimé de 35 points pour les profils les plus vulnérables jusqu’à 85 points pour les praticiens les plus préservés —, la courbe ne présente aucune inclinaison directionnelle systématique.
Elle se maintient de manière rectiligne autour d’une hauteur médiane stabilisée approximativement à 0,82, s’alignant sur l’espérance théorique attendue pour des erreurs normalement distribuées. Les deux extrémités du domaine de prédiction ne manifestent que d’infimes oscillations d’une amplitude inférieure à 0,05 unité, attribuables aux variations stochastiques naturelles d’échantillonnage dans les régions à plus faible densité d’observations.
L’analyse morphologique du nuage de points confirme ce diagnostic d’homoscédasticité optimale. Les résidus standardisés transformés se distribuent de manière uniforme au sein d’une bande géométrique rectangulaire d’une parfaite régularité spatiale. Il n’existe aucun phénomène d’élargissement progressif évoquant un entonnoir, ni aucun amincissement pouvant faire suspecter un effet d’échelle tronquée. Bien que le système d’étiquetage automatique de R mette en exergue trois observations légèrement plus déviantes (les participants n° 14, 89 et 192, dont l’ordonnée atteint 1,8), ces points demeurent isolés et ne polarisent en rien l’équilibre structurel du graphique. Le postulat d’homoscédasticité est pleinement validé sur le plan de l’évaluation visuelle.
8.3 Validation croisée avec les tests statistiques inférentiels
Bien que l’évaluation visuelle experte demeure l’arbitre méthodologique ultime en raison de son insensibilité aux biais de puissance propres aux tests d’hypothèses nuls, il est de bonne pratique académique de corroborer ce diagnostic par des tests inférentiels formels de variance. L’analyste soumet alors le modèle au test de Breusch-Pagan via la bibliothèque spécialisée lmtest :
library(lmtest)
bptest(modele_sante)
L’exécution de la commande retourne une statistique de test de Studentisée (BP = 1{,}84) associée à 2 degrés de liberté, générant une valeur p largement supérieure au seuil critique conventionnel ((p = 0{,}398)). L’hypothèse nulle d’homoscédasticité des résidus ne peut donc pas être rejetée. Afin d’évaluer d’éventuelles formes d’hétéroscédasticité non linéaires dépendant des termes au carré ou des produits croisés des prédicteurs, le test de White est également exécuté, fournissant une conclusion identique de non-significativité ((p = 0{,}472)).
Cette convergence totale entre la rectitude de la ligne LOESS sur le graphique Scale-Location, la dispersion rectangulaire homogène des points et la non-significativité des tests statistiques confirme formellement que la variance des erreurs est constante. Le chercheur peut affirmer avec une rigueur absolue que les erreurs-types calculées par OLS sont exactes, que les intervalles de confiance à 95 % ne sont pas distordus et que les inférences tirées quant au rôle protecteur du sommeil sur la résilience hospitalière reposent sur un modèle mathématiquement irréprochable.
9. Exemple pratique n°2 : Modèle avec hétéroscédasticité avérée en neuropsychologie
9.1 Contexte de recherche : Temps de réaction et charge cognitive
Pour illustrer la situation inverse et analyser la morphologie d’une défaillance structurelle de modèle, tournons-nous vers une expérimentation menée en neuropsychologie cognitive expérimentale. Un laboratoire étudie les effets d’une privation de sommeil contrôlée et de la charge mentale sur la vitesse de traitement de l’information. Un échantillon de (N = 180) jeunes adultes a été soumis à une tâche informatisée de temps de réaction à choix multiples comportant une charge cognitive paramétrique croissante (variant de 1 à 8 stimuli simultanés à discriminer en mémoire active).
La variable dépendante analysée est le temps de réponse moyen (exprimé en millisecondes, (ms)), prédit par l’indice continu de charge cognitive imposée lors de la session de test. Dès la conception expérimentale, un fait clinique bien documenté aurait dû alerter les expérimentateurs : si les individus réagissent tous de façon rapide et avec une quasi-synchronie face à une tâche simple (faible charge cognitive), l’accroissement de la complexité cognitive induit une divergence exponentielle des capacités de traitement individuel. Certains sujets conservent une efficacité remarquable alors que d’autres s’effondrent sous le poids de la surcharge mentale, produisant des temps de réponse hautement erratiques.
Ignorant temporairement cette réalité différentielle, l’analyste spécifie un modèle linéaire ordinaire par les moindres carrés :
modele_neuro <- lm(Temps_Reaction ~ Charge_Cognitive, data = donnees_neuro)
summary(modele_neuro)
L’estimation indique que la charge cognitive prédit massivement l’augmentation des temps de réponse ((hat{beta} = 84{,}2), (t = 14{,}62), (p < 0{,}001), (R^2 = 0{,}54)). Persuadé d’avoir isolé un effet expérimental éclatant, le chercheur génère le graphique Scale-Location via plot(modele_neuro, which = 3) pour finaliser son diagnostic.
9.2 Détection visuelle des anomalies graphiques
Le graphique obtenu offre une illustration flagrante et sans équivoque d’une violation radicale du postulat d’homoscédasticité. Au premier coup d’œil, la géométrie du tracé se déploie sous la forme caractéristique d’un mégaphone ou d’un entonnoir largement évasé vers la droite, marquant l’incompétence du modèle à maintenir une variance stable.
Pour les faibles valeurs ajustées sur la gauche du graphique (temps de réponse prédits autour de 400 à 500 ms, correspondant aux tâches simples), le nuage de points est comprimé de manière spectaculaire le long de l’axe horizontal, aucun point ne dépassant l’altitude de 0,6 unité. En revanche, au fur et à mesure que l’on glisse vers la droite le long des valeurs ajustées supérieures (temps de réponse atteignant 1000 à 1200 ms sous forte charge), la bande de dispersion s’ouvre de façon exponentielle, projetant des résidus transformés à des altitudes dépassant 2,2 unités.
Sous l’influence directe de cette explosion locale de la variance, la ligne rouge de lissage LOESS abandonne toute velléité d’horizontalité. Elle s’infléchit brutalement à partir du tiers gauche de l’axe pour entamer une ascension continue, abrupte et soutenue, passant d’un plancher anormal de 0,35 à un sommet culminant au-delà de 1,45. De surcroît, le logiciel indexe plusieurs observations extrêmes (les cas n° 52, 107 et 164) qui se détachent au sommet droit du graphique, confirmant que la volatilité de la mesure devient extrême sous forte charge cognitive. Le diagnostic visuel est formel et irrévocable : le modèle souffre d’une hétéroscédasticité structurelle majeure.
9.3 Conséquences empiriques directes sur l’interprétation des résultats
La confirmation formelle de ce diagnostic visuel est immédiatement ratifiée par le test de Breusch-Pagan, qui affiche une statistique hautement significative : (BP = 48{,}72), (p < 0{,}0001). Les répercussions de cette violation sur les inférences du laboratoire sont immédiates et critiques.
Puisque la variance des erreurs augmente conjointement avec les valeurs de la variable prédictrice, les formules conventionnelles des moindres carrés ordinaires sous-estiment gravement l’erreur-type réelle du coefficient associé à la charge cognitive. Dans ce cas précis, l’erreur-type affichée par la commande standard de R est de (SE(hat{beta}) = 5{,}76), générant un ratio (t) artificiellement gonflé de 14,62. La modélisation a créé une illusion de précision chirurgicale qui ne correspond en rien à la réalité de la dispersion des données humaines sous contrainte cognitive.
Si ce modèle était publié en l’état, l’intervalle de confiance calculé à 95 % autour de la pente d’apprentissage ou de surcharge cognitive serait drastiquement trop resserré, induisant la communauté scientifique en erreur sur la certitude de l’effet. De surcroît, l’utilisation de ce modèle à des fins pronostiques ou cliniques individuelles serait particulièrement hasardeuse : les intervalles de prédiction pour les individus soumis à une charge mentale élevée seraient sous-dimensionnés, ignorant le fait que leur comportement est par nature hautement imprévisible. La communication des résultats en l’état est méthodologiquement irrecevable, exigeant une restructuration analytique immédiate.
10. Différenciation : Scale-Location versus autres graphiques de résidus
10.1 Scale-Location vs Residuals vs Fitted
Il règne fréquemment chez les étudiants gradués et les chercheurs une confusion quant à la complémentarité fonctionnelle existant entre le graphique Residuals vs Fitted (résidus bruts en fonction des valeurs prédites, graphique n°1 dans R) et le graphique Scale-Location (graphique n°3). Bien que ces deux représentations partagent un axe des abscisses strictement identique (les valeurs ajustées (hat{y})), la divergence fondamentale réside dans la nature de l’axe des ordonnées et l’objectif diagnostique ciblé.
Le graphique Residuals vs Fitted trace sur son axe vertical les résidus bruts ordinaires (e_i), préservant scrupuleusement leur signe positif ou négatif de part et d’autre de la ligne horizontale du zéro. Sa mission primordiale n’est pas d’examiner la dispersion des variances, mais de contrôler la linéarité de la relation sous-jacente. Si le modèle linéaire capture adéquatement la tendance déterministe, la courbe de lissage rouge LOESS de ce premier graphique doit rester collée à la ligne du zéro. Si elle s’incurve en cloche ou en parabole, c’est la structure linéaire moyenne du modèle qui est invalidée.
En revanche, le graphique Scale-Location plie l’ensemble des résidus dans le domaine positif en prenant leur valeur absolue et en les comprimant par la racine carrée. Cette transformation délibérée neutralise l’impact de la direction de l’erreur pour focaliser l’attention exclusivement sur son amplitude (l’échelle ou la variance). Le Scale-Location est infiniment supérieur pour démasquer l’hétéroscédasticité, car sur le premier graphique, l’œil humain peine souvent à juger si l’épaisseur verticale d’un nuage de points disséminé au-dessus et en dessous de zéro reste constante. En rabattant tous les points dans un même demi-plan stabilisé, le Scale-Location rend tout motif d’expansion de variance instantanément perceptible.
10.2 Scale-Location vs Normal Q-Q Plot
Une autre distinction conceptuelle cruciale oppose le graphique Scale-Location au diagramme Normal Q-Q (Quantile-Quantile plot, graphique n°2 dans la suite diagnostique de R). Le tracé quantile-quantile normal est exclusivement dédié à l’évaluation du postulat de normalité distributionnelle des termes d’erreur, en projetant les quantiles empiriques des résidus standardisés contre les quantiles théoriques d’une loi normale gaussienne standard (N(0, 1)).
Il est fondamental de rappeler la totale indépendance théorique entre la normalité des résidus et l’homoscédasticité. Un modèle de régression peut parfaitement présenter des résidus rigoureusement gaussiens à l’échelle globale de l’échantillon tout en souffrant d’une hétéroscédasticité dramatique (par exemple, si la variance des erreurs gaussiennes double entre le début et la fin de l’axe des prédictions). Inversement, un modèle peut être rigoureusement homoscédastique (la variance reste invariante sur tout le domaine X) mais posséder des résidus qui suivent une loi logistique, une loi de Laplace ou une distribution bimodale à queues lourdes.
De surcroît, le graphique Normal Q-Q est totalement aveugle aux valeurs ajustées : il agrège tous les résidus dans une urne globale sans conserver la moindre mémoire de la position d’un participant sur l’axe des prédicteurs. Le graphique Scale-Location, à l’inverse, préserve l’agencement conditionnel des données, permettant de diagnostiquer si la volatilité du modèle dépend du niveau de réponse estimé. Ces deux graphiques examinent donc deux propriétés stochastiques distinctes et non interchangeables.
10.3 Scale-Location vs Residuals vs Leverage
Enfin, le dernier graphique canonique de la régression linéaire, le tracé Residuals vs Leverage (résidus standardisés en fonction du levier statistique, graphique n°5 dans R), poursuit une finalité diagnostique orientée vers l’isolement des cas influents et des valeurs aberrantes extrêmes. Ce graphique associe le levier statistique ((h_{ii}), mesurant à quel point les valeurs des covariables d’un sujet sont éloignées du centre de gravité multivarié des prédicteurs) à la magnitude du résidu standardisé, tout en superposant les courbes de niveau de la distance de Cook.
La nuance avec le Scale-Location est déterminante pour orienter la décision méthodologique du chercheur. Le graphique Scale-Location met en évidence une pathologie globale et structurelle du modèle : l’incapacité de l’équation linéaire à maintenir une incertitude homogène à travers différentes tranches de la population étudiée. Il évalue la viabilité du postulat de Gauss-Markov à l’échelle du groupe.
Le graphique Residuals vs Leverage, quant à lui, opère une surveillance microscopique et individuelle. Il isole le participant spécifique qui, combinant un levier élevé et un résidu marqué, exerce un couple de torsion mécanique disproportionné sur les paramètres estimés, risquant de faire basculer la droite de régression à lui seul. Alors que l’hétéroscédasticité détectée par le Scale-Location appelle des modifications de modélisation (transformations, régressions pondérées), la détection d’un point influent via le graphique de levier impose une réflexion clinique sur la validité de l’observation incriminée (erreur de saisie, profil pathologique atypique hors-champ de la population cible).
11. Stratégies de remédiation en cas d’hétéroscédasticité constatée
11.1 Transformation mathématique des variables dépendantes
Lorsqu’un profil manifeste d’hétéroscédasticité (comme l’entonnoir classique) est décelé sur le graphique Scale-Location, la première stratégie corrective — historiquement la plus employée — réside dans l’application d’une transformation mathématique non linéaire à la variable dépendante (Y). L’objectif est de comprimer de manière différentielle les hautes valeurs de l’échelle afin de stabiliser la variance globale des résidus.
Pour les distributions présentant une hétéroscédasticité multiplicative croissante, la transformation logarithmique s’impose comme la solution canonique :
[ Y^* = ln(Y) quad text{ou} quad Y^* = ln(Y + 1) text{ en présence de valeurs nulles} ]
Dans d’autres configurations empiriques, notamment lorsque les données comportementales sont des données de comptage (nombre d’erreurs commises, fréquence d’apparition d’un symptôme), la transformation racine carrée ((Y^* = sqrt{Y})) ou la transformation inverse ((Y^* = 1 / Y), courante pour transformer des temps de latence en vitesses d’exécution) apportent une stabilisation spectaculaire de la variance.
Pour déterminer de manière algorithmique et sans arbitraire la transformation optimale, la méthode de transformation paramétrique de Box-Cox constitue l’approche méthodologique la plus élégante. En estimant par le maximum de vraisemblance le paramètre d’élévation à la puissance (lambda) :
[ Y^{(lambda)} = begin{cases} dfrac{Y^lambda – 1}{lambda} & text{si } lambda neq 0 ln(Y) & text{si } lambda = 0 end{cases} ]
La commande boxcox() du package MASS permet d’identifier graphiquement la valeur de (lambda) qui maximise la vraisemblance du modèle et restaure l’homoscédasticité. Une fois la variable transformée, l’analyste doit impérativement réajuster la régression et tracer un nouveau graphique Scale-Location pour attester que la ligne rouge LOESS a retrouvé son horizontalité régulatrice.
11.2 Recours aux erreurs-types robustes à l’hétéroscédasticité (HC)
Bien que les transformations de variables soient efficaces sur le plan mathématique, elles comportent un écueil interprétatif majeur : elles altèrent l’échelle de mesure d’origine. En psychologie clinique ou en neuropsychologie, interpréter des coefficients de régression exprimés en « log-millisecondes » ou en « racines carrées de points d’anxiété » s’avère particulièrement ardu pour les praticiens et complique considérablement la communication des grandeurs d’effets réelles.
Une alternative moderne consiste à conserver le modèle linéaire OLS sur les données brutes — préservant ainsi l’intégrité et la lisibilité immédiate des coefficients (hat{beta}) originaux —, tout en corrigeant formellement l’estimation des erreurs-types au moyen d’un estimateur robuste de variance-covariance de type « sandwich », initié historiquement par Halbert White. Ces estimateurs, communément désignés sous le sigle HC (Heteroscedasticity-Consistent), remplacent la matrice de covariance standard par une formulation qui intègre directement les résidus observés individuels :
[ operatorname{Var}_{HC}(hat{beta}) = (X^T X)^{-1} (X^T hat{Omega} X) (X^T X)^{-1} ]
Dans la littérature méthodologique moderne, les variantes HC3 (proposée par Davidson et MacKinnon) et HC4 (développée par Cribari-Neto) sont vigoureusement recommandées, particulièrement sur des échantillons de petite à moyenne taille où l’estimateur original HC0 de White tend à se montrer excessivement libéral. Dans l’environnement R, le calcul de ces erreurs-types corrigées et des tests de significativité associés s’opère aisément grâce aux packages sandwich et lmtest :
library(sandwich)
library(lmtest)
coeftest(modele_neuro, vcov = vcovHC(modele_neuro, type = "HC3"))
Cette approche ajuste automatiquement les ratios (t) et les valeurs p en fonction de l’hétéroscédasticité réelle identifiée sur le Scale-Location, immunisant l’analyste contre les fausses découvertes sans altérer la clarté clinique des scores d’origine.
11.3 Méthodes avancées : Régression pondérée (WLS) et modèles mixtes
Lorsque l’hétéroscédasticité découle d’un mécanisme de génération de variance parfaitement connu ou théoriquement modélisable, le chercheur peut s’orienter vers des méthodes d’estimation plus sophistiquées que les OLS. La première méthode est la régression par les moindres carrés pondérés (Weighted Least Squares, WLS). Le principe repose sur l’attribution d’un poids analytique (w_i) inversement proportionnel à la variance de l’erreur propre à chaque observation :
[ w_i = frac{1}{sigma_i^2} ]
Sous cette pondération, les observations appartenant aux strates où la dispersion résiduelle est immense et instable reçoivent un poids atténué dans l’ajustement du modèle, tandis que les observations issues de contextes de mesure stables et précis pèsent plus lourdement dans la détermination des coefficients. Les estimateurs WLS retrouvent alors la pleine propriété d’optimalité BLUE garantie par le théorème de Gauss-Markov.
Dans les contextes de données hiérarchiques ou longitudinales (patients imbriqués dans des hôpitaux, mesures répétées au fil du temps), les modèles linéaires mixtes (déployés via le package nlme) offrent une plasticité méthodologique exceptionnelle. Grâce à l’argument weights = varFunc(), il est possible de spécifier explicitement une structure de variance hétérogène (par exemple varIdent pour modéliser une variance distincte selon le genre, ou varPower pour modéliser une variance croissant comme une puissance d’une variable continue).
Enfin, les modèles additifs généralisés pour l’emplacement, l’échelle et la forme (GAMLSS) incarnent la frontière la plus avancée de la modélisation statistique contemporaine. Au lieu de considérer la variance comme une simple nuisance à stabiliser, les modèles GAMLSS permettent de modéliser simultanément et conjointement la moyenne (mu) (le score attendu) et l’échelle (sigma) (la variabilité individuelle) par des équations de régression distinctes, offrant un éclairage scientifique sur les facteurs qui augmentent ou diminuent l’inconsistance comportementale des participants.
12. Bonnes pratiques méthodologiques et normes de publication APA
12.1 Standardisation du reporting selon les normes APA 7
L’American Psychological Association (APA), dans la 7e édition de son manuel de publication, accorde une importance cruciale à la transparence analytique et à la divulgation exhaustive des démarches de vérification des postulats statistiques. Il ne suffit plus d’affirmer de manière lapidaire que « les postulats de la régression linéaire ont été vérifiés ». Le manuscrit scientifique doit expliciter avec précision les instruments diagnostiques mobilisés, les anomalies décelées et les mesures correctives adoptées.
Dans la section Méthode (sous-section Analyses statistiques), le chercheur doit mentionner systématiquement le recours aux graphiques diagnostiques des résidus, en nommant explicitement le graphique Scale-Location pour l’examen de l’homoscédasticité. Dans la section Résultats, le texte doit détailler le résultat de cette inspection. Voici un modèle canonique de formulation rédactionnelle conforme aux normes APA 7 :
« Préalablement à l’évaluation des hypothèses inférentielles, les postulats du modèle linéaire généralisé ont fait l’objet d’un examen systématique. L’homoscédasticité de la variance des résidus a été évaluée visuellement à l’aide du graphique Scale-Location (Spread-Location plot). La constance de la variance conditionnelle a été attestée par l’horizontalité de la ligne de régression locale LOESS et par l’absence d’agencement structurel dans la dispersion des résidus standardisés transformés. Ce diagnostic visuel a été confirmé par le test de Breusch-Pagan, qui n’a révélé aucune violation significative de l’homoscédasticité, (BP(2) = 1{,}84), (p = 0{,}398). Les erreurs-types conventionnelles ont par conséquent été retenues pour l’ensemble des inférences statistiques. »
Si une correction pour hétéroscédasticité a dû être déployée, la démarche doit être consignée avec la même limpidité :
« L’inspection du graphique Scale-Location a révélé un profil d’hétéroscédasticité en entonnoir prononcé, caractérisé par une élévation substantielle de la ligne LOESS sous forte charge cognitive. Cette rupture d’homoscédasticité étant confirmée par le test de Breusch-Pagan ((BP = 48{,}72), (p < 0{,}001)), les coefficients de régression OLS ont été rapportés en appliquant l’estimateur d’erreurs-types robustes HC3 de Davidson-MacKinnon (package sandwich v3.0). Les degrés de liberté et les statistiques (t) ajustés ont été utilisés pour dériver les intervalles de confiance à 95 %. »
12.2 Écueils fréquents à éviter pour les chercheurs
L’expérience de l’évaluation par les pairs révèle une série d’erreurs méthodologiques récurrentes commises par les chercheurs lors de l’interprétation de la variance résiduelle. Le premier écueil réside dans la dépendance exclusive aux tests statistiques formels (tels que le test de Breusch-Pagan, de Koenker ou de White) au détriment de l’analyse visuelle sur le graphique Scale-Location. Les tests inférentiels souffrent d’une limitation majeure liée à la puissance statistique : sur de très grands échantillons ((N > 1000)), ils deviennent hypersensibles et rejettent systématiquement l’hypothèse nulle pour d’infimes fluctuations de variance parfaitement négligeables sur le plan pratique. Inversement, sur de petits échantillons ((N < 50)), ils manquent cruellement de puissance et échouent à détecter des hétéroscédasticités massives visibles au premier regard sur le graphique.
Le second écueil, hautement dommageable pour la déontologie scientifique, consiste en l’amputation hâtive d’observations aberrantes. Face à un graphique Scale-Location où la ligne LOESS fléchit sous le poids de deux ou trois observations étiquetées aux sommets de l’axe vertical, certains analystes cèdent à la tentation de supprimer purement et simplement ces participants sans justification théorique préalable, dans le seul but « d’aplanir » la courbe. Cette pratique, assimilable à une altération illégitime des données (p-hacking), doit être bannie. Les observations extrêmes doivent être investiguées pour comprendre leur signification psychologique plutôt que d’être opportunément effacées.
Enfin, le troisième écueil réside dans l’absence de contrôle post-transformation. Nombre d’auteurs appliquent une transformation logarithmique sur leur variable dépendante suite à un diagnostic d’hétéroscédasticité, puis rapportent immédiatement leur nouvelle régression sans jamais prendre la peine de régénérer un graphique Scale-Location sur le nouveau modèle. Or, une transformation mathématique mal calibrée peut non seulement échouer à stabiliser la variance, mais parfois induire une hétéroscédasticité inverse (transformer un entonnoir ascendant en un cône descendant). L’itération diagnostique est une obligation méthodologique incontournable.
12.3 Synthèse procédurale pour l’analyste de données
Pour ancrer ces recommandations dans une pratique quotidienne reproductible, il est hautement bénéfique pour le chercheur de suivre un arbre décisionnel séquentiel standardisé lors de chaque ajustement de régression linéaire :
- Étape 1 : Spécification et ajustement initial. Modéliser la relation théorique par OLS avec
lm()en veillant à la sélection adéquate des covariables et des termes d’interaction pertinents. - Étape 2 : Extraction et visualisation diagnostique. Générer le graphique Scale-Location via
plot(modele, which = 3)ouperformance::check_model(). - Étape 3 : Évaluation de la ligne de référence LOESS.
- Si la ligne rouge est approximativement plane et horizontale autour de l’ordonnée 0,8 : l’homoscédasticité moyenne est confirmée.
- Si la ligne s’élève de manière monotone vers la droite : présence d’une hétéroscédasticité croissante (profil en entonnoir).
- Si la ligne plonge de manière monotone : présence d’une hétéroscédasticité décroissante ou effet de plafond.
- Si la ligne présente une courbure en U ou en cloche : suspecter une mauvaise spécification (non-linéarité ou interaction omise).
- Étape 4 : Évaluation de la régularité spatiale des observations. S’assurer que le nuage de points remplit uniformément une bande rectangulaire sans discontinuités de densité spatiale ni évasement bilatéral.
- Étape 5 : Arbitrage et remédiation.
- Si le graphique est conforme : conserver les erreurs-types OLS standard et documenter l’inspection visuelle selon les normes APA 7.
- Si l’hétéroscédasticité est modérée à sévère et que l’interprétabilité directe des scores d’origine est requise : substituer les erreurs-types conventionnelles par les erreurs-types robustes HC3 ou HC4 via les fonctions
vcovHC()etcoeftest(). - Si la variance croît manifestement avec l’échelle de mesure et que la métrique s’y prête : tester une transformation Box-Cox ou logarithmique, réestimer le modèle et réitérer le contrôle graphique depuis l’Étape 2.
L’intégration systématique et rigoureuse de ce protocole au sein des scripts d’analyse reproductibles (via R Markdown ou Quarto) garantit une recherche quantitative d’une robustesse méthodologique irréprochable. En érigeant le graphique Scale-Location en un garde-fou incontournable de l’analyse linéaire, les chercheurs en sciences psychologiques et comportementales s’assurent que leurs conclusions reposent sur des bases statistiques solides, contribuant de manière tangible à la fiabilité, à la crédibilité et à l’avancement durable de leur discipline.
Références
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829–836. https://doi.org/10.1080/01621459.1979.10481038
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cribari-Neto, F. (2004). Asymptotic inference under heteroskedasticity of unknown form. Computational Statistics & Data Analysis, 45(2), 215–233. https://doi.org/10.1016/S0167-9473(02)00366-3
- Davidson, R., & MacKinnon, J. G. (1993). Estimation and inference in econometrics. Oxford University Press.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). Performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.
- Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10