
Dans le champ de l’évaluation psychologique, de la neuropsychologie et de la psychiatrie contemporaine, la prise de décision diagnostique repose continuellement sur la transformation de dimensions latentes continues en classifications cliniques binaires. Qu’il s’agisse de déterminer si un patient présente un épisode dépressif majeur à partir d’un score d’auto-évaluation, de statuer sur la présence d’un déficit neurocognitif débutant ou de quantifier le risque de passage à l’acte suicidaire, le clinicien se heurte inévitablement à la nature probabiliste de la mesure psychométrique. Les frontières du normal et du pathologique ne constituent que rarement des ruptures franches et discrètes au sein des distributions de scores ; elles forment au contraire des zones de chevauchement complexe où chaque déplacement de la valeur seuil modifie la nature et le coût des erreurs d’attribution.
Face à cet impératif de précision diagnostique, l’analyse par les courbes caractéristiques de fonctionnement de l’opérateur, couramment désignées sous le sigle anglophone ROC (Receiver Operating Characteristic), s’est imposée comme le standard méthodologique absolu. Conçue initialement comme un outil de traitement du signal, cette approche graphique et probabiliste transcende les limites inhérentes aux simples métriques d’exactitude globale, lesquelles demeurent excessivement vulnérables aux fluctuations de la prévalence des troubles dans la population cible. En dissociant la performance intrinsèque de discrimination d’un instrument psychométrique des critères de décision adoptés par l’évaluateur, la courbe ROC offre une cartographie exhaustive du compromis permanent entre la capacité à détecter les individus réellement atteints et le risque d’assigner indûment un statut pathologique à des individus sains.
Le présent article propose une exploration approfondie de la théorie, de la modélisation mathématique et de l’interprétation clinique des courbes ROC en psychologie et en santé mentale. À travers une déconstruction minutieuse de ses composantes structurelles, l’examen détaillé des critères d’optimisation des seuils de coupure, l’exposition d’études de cas écologiques appuyées par des données empiriques précises, et l’analyse de ses prolongements méthodologiques les plus sophistiqués, ce guide s’adresse aux chercheurs, psychométriciens et praticiens soucieux de consolider la rigueur épistémologique et l’éthique de leurs démarches diagnostiques.
1. Fondements théoriques et genèse de la courbe ROC en psychométrie
1.1 Origine historique et transfert vers les sciences comportementales
L’émergence de la courbe ROC s’enracine dans les impératifs technologiques et militaires de la Seconde Guerre mondiale. À la suite des bombardements aériens de la bataille d’Angleterre en 1940, les ingénieurs britanniques et américains ont été confrontés à un problème d’ingénierie critique : comment distinguer, sur les récepteurs radar naissants, les échos électromagnétiques faibles renvoyés par les escadrons de bombardiers ennemis du bruit de fond généré par les perturbations atmosphériques, la réverbération marine ou les vols d’oiseaux. L’opérateur humain devait décider si une fluctuation du signal lumineux constituait un avion réel ou une interférence aléatoire. La théorie de la détection du signal (TDS), formalisée par Peterson, Birdsall et Fox en 1954, permit alors de modéliser mathématiquement cette décision sous incertitude en postulant que la détection dépend à la fois de la force relative du signal par rapport au bruit et du critère décisionnel adopté par l’opérateur.
Très rapidement, les pionniers de la psychophysique et de la psychologie cognitive, à l’instar de Green et Swets (1966), comprirent que ce modèle mathématique constituait une avancée majeure pour les sciences comportementales. Jusqu’alors, la psychologie expérimentale peinait à isoler la sensibilité perceptive sensorielle brute des tendances subjectives de l’observateur, telles que la prudence, l’audace ou l’anxiété de commettre une bévue. En transposant la théorie de la détection du signal à l’étude des seuils sensoriels auditifs et visuels, les chercheurs disposaient enfin d’un paradigme séparant rigoureusement la capacité discriminative intrinsèque de l’organisme, notée sous le paramètre d’ (d-prime), du biais de réponse individuel, noté sous le paramètre β (bêta) ou c.
Au cours des années 1970 et 1980, cette formalisation conceptuelle opéra une seconde migration décisive, passant des laboratoires de perception sensorielle aux services de psychiatrie clinique et de psychométrie hospitalière. Dans le diagnostic de pathologies telles que la schizophrénie, les troubles de l’humeur ou les lésions neurodégénératives, la question n’était plus de percevoir un stimulus lumineux dans la pénombre, mais de repérer la constellation de symptômes sémiologiques signalant la présence d’une affection psychiatrique au sein du flux complexe de la souffrance psychologique ordinaire. La courbe ROC s’érigea en instrument méthodologique privilégié, autorisant l’évaluation de la validité de critère des tests psychométriques sans que cette dernière ne fût biaisée par l’attitude conservatrice ou libérale du clinicien face aux seuils diagnostiques.
1.2 Définition formelle et utilité dans l’évaluation psychologique
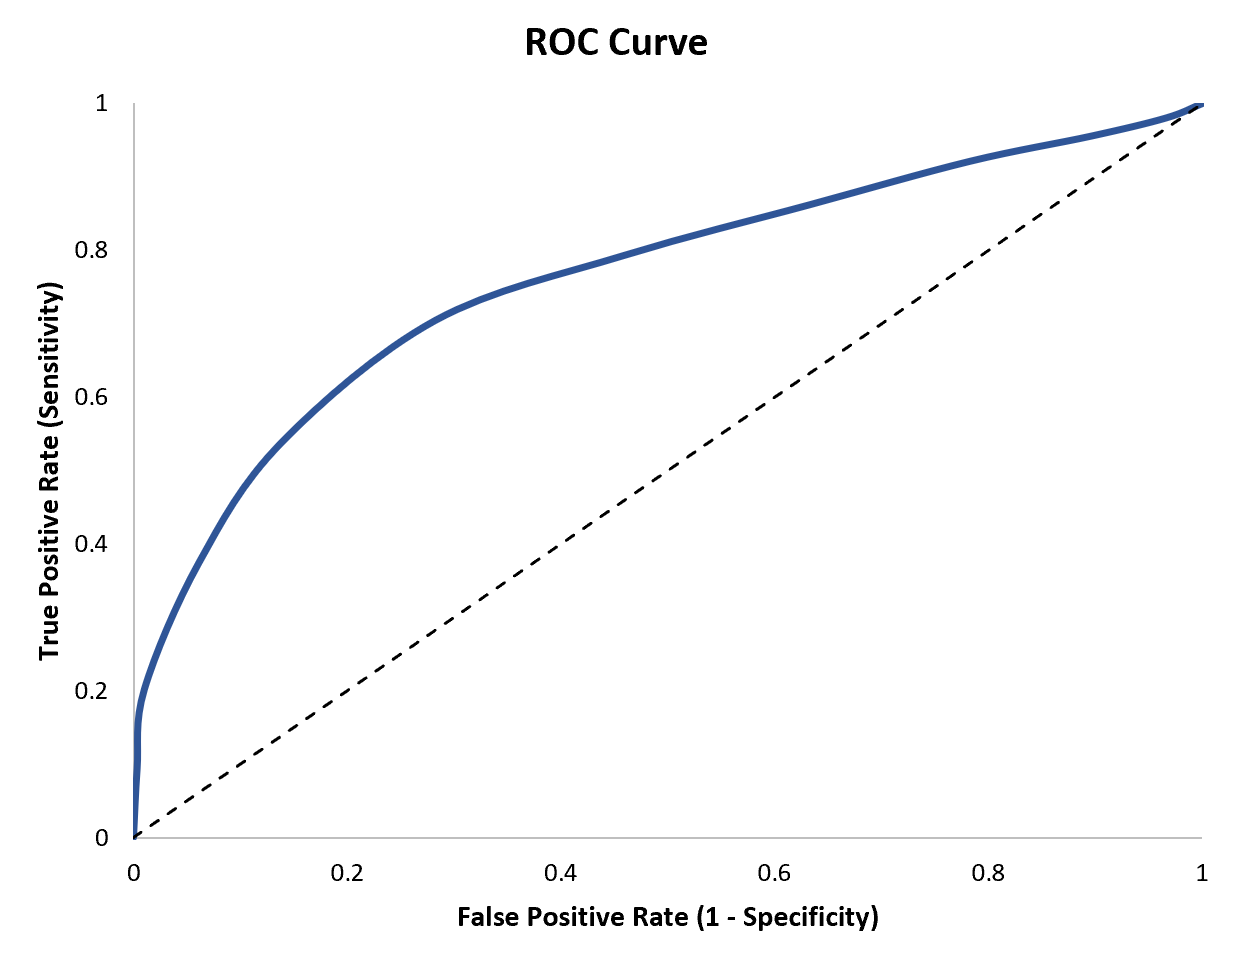
Sur le plan formel, la courbe ROC constitue une représentation géométrique bidimensionnelle décrivant l’ensemble des configurations opérationnelles d’un système de classification binaire au fur et à mesure que son seuil de décision parcourt l’intégralité du continuum des scores possibles. Dans le cadre de l’évaluation psychologique, un test mesure le plus souvent un construit latent — qu’il s’agisse de l’intensité de la symptomatologie anxieuse, de l’altération des fonctions exécutives ou de traits de personnalité pathologiques — qui s’exprime par une valeur numérique ordinale ou continue. La courbe ROC reporte en ordonnée la sensibilité de l’épreuve et en abscisse le complémentaire de la spécificité (1 – spécificité) pour chaque score observé.
L’utilité fondamentale de la courbe ROC réside dans sa neutralité totale vis-à-vis des distributions statistiques sous-jacentes. Contrairement aux approches fondées sur la comparaison des moyennes ou l’analyse de variance, qui exigent des distributions strictement gaussiennes et l’homoscédasticité des variances entre les groupes cliniques et témoins, la courbe ROC non paramétrique repose uniquement sur les rangs des observations. Elle examine dans quelle mesure l’ensemble des scores des sujets présentant le trouble clinique se distribue à un niveau supérieur à celui des sujets indemnes de la pathologie. Cette propriété garantit une résistance analytique exceptionnelle face aux asymétries de distribution et aux effets de plancher ou de plafond, omniprésents dans la mesure des traits psychopathologiques.
En outre, l’analyse ROC remplit un rôle central dans la standardisation transculturelle et l’étalonnage international des instruments d’évaluation. Lorsqu’une échelle de dépistage élaborée dans un pays anglo-saxon est traduite et adaptée pour une population francophone, il est fréquent que les normes descriptives se modifient en raison de variations d’expression stylistique, de réticences culturelles ou de formulations syntaxiques. La courbe ROC permet de réévaluer objectivement l’efficacité discriminative du nouvel étalonnage, de vérifier l’invariance de sa validité concourante et de calibrer de nouveaux seuils de décision adaptés aux spécificités épidémiologiques et sociolinguistiques de la population cible, garantissant ainsi l’équivalence métrique du test.
1.3 Articulation avec la régression logistique binaire
L’intersection entre la psychométrie computationnelle et la modélisation statistique avancée s’incarne de manière privilégiée dans l’articulation entre la courbe ROC et la régression logistique binaire. Dans de nombreux protocoles de recherche psychopathologique, l’appartenance à un groupe clinique ne dépend pas d’un score unique, mais d’une combinaison linéaire de plusieurs indices psychométriques, de covariables sociodémographiques et de biomarqueurs physiologiques. La régression logistique modélise le logarithme népérien du rapport des cotes (le logit) que la variable dépendante prenne la modalité 1 (présence du trouble) en fonction des variables prédictives continues ou catégorielles.
Une fois le modèle estimé par le maximum de vraisemblance, chaque sujet se voit attribuer une probabilité prédite d’appartenance diagnostique, nécessairement comprise dans l’intervalle ouvert ]0, 1[ grâce à la fonction sigmoïde. C’est précisément sur cette distribution continue de probabilités individuelles prédites que la courbe ROC est ensuite générée. Dans ce contexte, l’analyse ROC n’évalue plus directement un test isolé, mais mesure la capacité globale du modèle multivarié à hiérarchiser correctement les sujets selon leur niveau de risque réel. Elle fait office d’instrument d’adéquation globale (goodness-of-fit) orienté vers le pouvoir prédictif discriminatif, offrant une perspective complémentaire aux indices classiques d’ajustement global tels que le test de Hosmer-Lemeshow ou le pseudo-R² de Nagelkerke.
Cette articulation offre également un cadre idéal pour la comparaison empirique de modèles statistiques emboîtés. Un chercheur souhaitant valider l’apport diagnostique incrémentiel d’un nouveau sous-test de mémoire de travail dans la détection précoce de la maladie d’Alzheimer peut modéliser une première équation logistique incluant uniquement l’âge et le niveau socio-éducatif, puis une seconde équation incorporant le nouveau score mnésique. La comparaison formelle des courbes ROC issues des deux modèles permet de démontrer empiriquement si l’adjonction de l’épreuve psychologique engendre un gain statistiquement significatif de discrimination, justifiant son intégration dans les protocoles d’investigation clinique de routine.
2. Anatomie et composantes structurelles d’une courbe ROC
2.1 L’axe des ordonnées : Taux de vrais positifs (Sensibilité)
L’ordonnée d’une courbe ROC représente graphiquement le Taux de Vrais Positifs (TVP), rigoureusement équivalent au concept biostatistique de sensibilité (Se). Sur le plan mathématique, pour une valeur de seuil de décision c donnée, la sensibilité correspond à la probabilité conditionnelle que le score Y mesuré par le test soit supérieur ou égal à c, sachant que l’individu appartient objectivement à la population atteinte du trouble cible (notée D = 1) :
Sensibilité = P(Y ≥ c | D = 1) = Vrais Positifs / (Vrais Positifs + Faux Négatifs)
Dans la pratique clinique, cette dimension quantifie l’exhaustivité de l’instrument d’évaluation. Une sensibilité de 0,90 indique que le test est en mesure de dépister correctement 90 % des sujets souffrant de la pathologie au sein de la cohorte analysée, laissant échapper les 10 % restants sous forme de faux négatifs. Sur le graphique, la sensibilité s’étend de la valeur minimale de 0,0 (situation où le seuil est placé à un niveau infiniment élevé, n’identifiant aucun cas) à la valeur asymptotique maximale de 1,0 (situation où le seuil est suffisamment bas pour inclure l’intégralité des individus malades sans exception).
La minimisation des faux négatifs revêt une portée déontologique et pronostique fondamentale. En psychopathologie, l’assignation d’un statut de faux négatif à un patient — par exemple l’absence d’identification d’un trouble bipolaire masqué ou la sous-estimation d’une détresse psychologique aiguë accompagnée d’idées de suicide — peut entraîner une privation d’accès aux soins d’urgence, un retard d’intervention thérapeutique cruciale et, dans les situations les plus dramatiques, l’aboutissement fatal du geste auto-agressif. L’axe vertical d’une courbe ROC constitue ainsi la métrique visuelle directe de la sécurité clinique du processus de détection.
2.2 L’axe des abscisses : Taux de faux positifs (1 – Spécificité)
L’axe horizontal d’une courbe ROC est quant à lui dédié au Taux de Faux Positifs (TFP), qui correspond au complémentaire arithmétique strict de la spécificité clinique (noté 1 – Sp). La spécificité (Sp) mesurant la probabilité que le test fournisse un résultat négatif chez un sujet exempt du trouble, le taux de faux positifs traduit la probabilité conditionnelle inverse qu’un sujet sain obtienne un score égal ou supérieur au seuil critique retenu :
Taux de Faux Positifs = P(Y ≥ c | D = 0) = Faux Positifs / (Vrais Négatifs + Faux Positifs) = 1 – Spécificité
Cliniquement, cette métrique capture la propension de l’instrument à générer des alertes erronées chez des individus neurotypiques ou non atteints par le syndrome ciblé. Un taux de faux positifs fixé à 0,15 signifie que 15 % des sujets sains sont improprement étiquetés comme porteurs potentiels du trouble psychologique évalué. L’abscisse s’étend naturellement de 0,0 (absence totale de fausse alerte, obtenue lorsque le seuil est maximal) à 1,0 (classement de la totalité de la population saine dans la catégorie pathologique, provoqué par un seuil excessivement permissif).
Le taux de faux positifs est souvent désigné sous l’angle du coût sociopsychologique et institutionnel de l’évaluation. L’attribution indue d’une étiquette psychopathologique n’est jamais un acte neutre sur le plan clinique ; elle peut susciter une détresse anxieuse iatrogène majeure chez le patient et sa famille, encourager une surmédicalisation inappropriée, déclencher des procédures d’investigation lourdes et invasives, et saturer inutilement les structures de prise en charge spécialisées au détriment des patients nécessitant des soins prioritaires.
2.3 La diagonale de référence et les points cardinaux
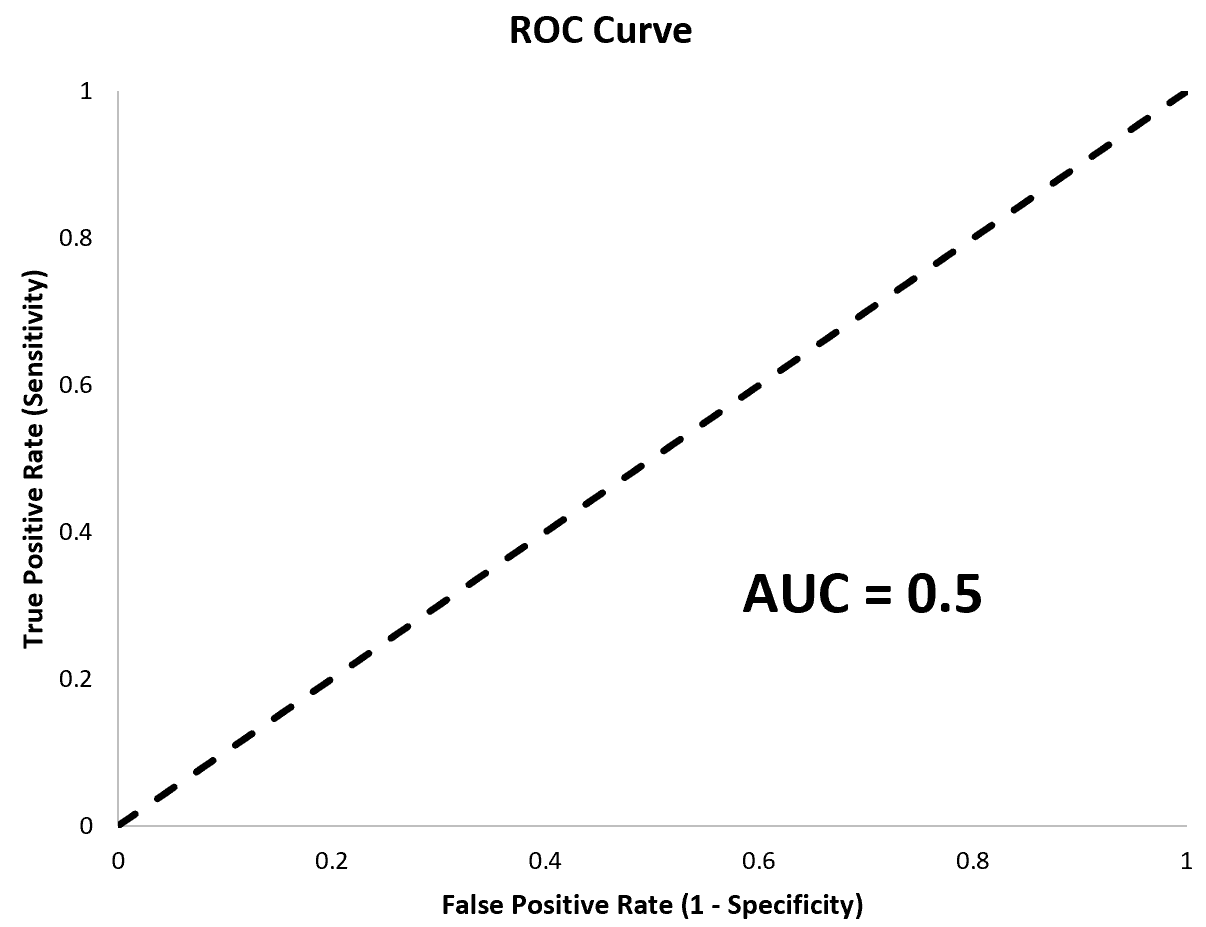
L’espace géométrique unitaire [0, 1] × [0, 1] dans lequel s’inscrit la courbe ROC comporte plusieurs repères cardinaux indispensables à sa lecture. Le premier repère est constitué par la diagonale reliant l’origine (0, 0) au sommet supérieur droit (1, 1), caractérisée par l’équation linéaire y = x. Cette ligne de référence représente l’indiscrimination statistique absolue, c’est-à-dire le comportement d’un test dont la performance ne dépasse en rien celle d’un tirage au sort à pile ou face. En tout point de cette diagonale, la probabilité d’attribuer un résultat positif est strictement identique que le sujet appartienne au groupe malade ou au groupe sain (TVP = TFP), rendant l’outil totalement dépourvu de validité discriminative.
Le point de coordonnées (0, 1), situé au sommet supérieur gauche du repère cartésien, constitue le point idéal ou parfait. Il incarne l’optimum théorique où la sensibilité atteint 1,0 (détection de 100 % des sujets malades) et le taux de faux positifs se maintient à 0,0 (spécificité de 100 %, aucun sujet sain classé à tort). Plus la trajectoire d’une courbe ROC s’incurve et s’approche de ce sommet idéal, plus le pouvoir de discrimination du test psychométrique est élevé. À l’inverse, l’origine (0, 0) traduit la configuration où aucun individu n’est diagnostiqué positif (sensibilité nulle, spécificité parfaite), tandis que le point (1, 1) traduit la configuration où l’ensemble des individus de l’échantillon sont déclarés positifs (sensibilité maximale, spécificité nulle).
Enfin, la présence d’une courbe empirique plongeant significativement sous la diagonale d’indiscrimination — évoluant dans le triangle inférieur délimité par les coordonnées (0, 0), (1, 0) et (1, 1) — traduit une anomalie méthodologique majeure ou une inversion conceptuelle du sens de cotation. Dans la majorité des échelles psychométriques, un score élevé dénote une gravité psychopathologique accrue. Si l’analyste applique par mégarde un algorithme de classification où les scores faibles sont supposés prédire la pathologie alors que le test mesure les compétences cognitives préservées, la courbe s’inverse mécaniquement. Une inversion symétrique par rapport à la diagonale restaure immédiatement la véritable capacité discriminante de l’outil.
3. Sensibilité et spécificité : Le compromis inhérent à l’évaluation clinique
3.1 La sensibilité clinique en pratique psychologique
En psychopathologie clinique et en santé publique, la recherche d’une sensibilité maximale répond à une doctrine de précaution guidée par l’asymétrie des risques. Dans certaines situations d’évaluation, le coût clinique, humain et légal lié à l’omission d’un cas pathologique outrepasse infiniment les désagréments passagers générés par une fausse alerte. L’exemple paradigmatique demeure l’évaluation du risque de passage à l’acte suicidaire aux urgences psychiatriques. Face à un patient en crise, le clinicien doit impérativement mobiliser une échelle de dépistage affichant une sensibilité approchant les 95 ou 98 %, garantissant que pratiquement aucun individu en situation de détresse létale imminente ne soit renvoyé à son domicile sans surveillance.
Cette priorité accordée à l’exhaustivité diagnostique s’avère tout aussi déterminante dans le déploiement des campagnes de dépistage de masse à l’échelle d’une population ou de milieux éducatifs et professionnels. Lorsqu’un protocole vise à repérer précocement les troubles du spectre de l’autisme chez le jeune enfant ou les épisodes psychotiques débutants chez l’adolescent, l’objectif premier de la phase initiale est de filtrer le plus largement possible la population générale afin d’inclure toute trajectoire développementale atypique. Les sujets identifiés par ce premier filtre ultra-sensible feront ensuite l’objet d’un examen approfondi de seconde intention, beaucoup plus contraignant mais capable d’éliminer les faux positifs.
Toutefois, cette quête d’hypersensibilité contraint le psychologue à tolérer une proportion parfois substantielle de sujets faussement alertés. Dans un service d’accueil des urgences pédiatriques, tolérer qu’un score de dépistage du trouble de stress post-traumatique présente une sensibilité de 0,95 au détriment d’une spécificité abaissée à 0,60 est un arbitrage délibéré, justifié par le fait que l’administration d’entretiens de confirmation ultérieurs représente un coût acceptable comparé au risque de laisser s’enkyster une souffrance psychique non prise en charge.
3.2 La spécificité clinique et la préservation de la norme
À l’opposé du spectre décisionnel, l’exigence d’une spécificité clinique élevée s’impose chaque fois que la confirmation du statut pathologique entraîne des conséquences thérapeutiques invasives, irréversibles ou potentiellement stigmatisantes. Dans l’investigation des démences et des affections neurodégénératives comme la démence à corps de Lewy, poser un diagnostic erroné chez une personne âgée présentant un simple déclin cognitif lié au vieillissement physiologique peut altérer dramatiquement sa qualité de vie, déclencher une perte d’autonomie précipitée, susciter une dépression réactionnelle majeure et conduire à la prescription injustifiée de molécules aux effets secondaires marqués.
Le maintien d’un niveau de spécificité élevé s’avère tout aussi capital au sein des contextes d’expertise psycholégale et médico-judiciaire. Lorsqu’un psychologue ou un neuropsychologue est mandaté par une cour de justice pour évaluer l’imputabilité pénale d’un prévenu, évaluer sa dangerosité criminologique ou statuer sur la mise sous tutelle renforcée d’un adulte vulnérable, le préjudice porté aux libertés individuelles par une fausse attribution pathologique est immense. Dans ces situations, le clinicien ne peut se satisfaire d’un instrument permissif ; il doit sélectionner un seuil opératoire garantissant un taux de faux positifs extrêmement faible (inférieur à 5 %, voire 1 %), ancrant la conclusion sur des indices indiscutables.
De surcroît, les contraintes macro-économiques et logistiques des institutions hospitalières renforcent la nécessité de préserver la spécificité. Les programmes de psychothérapie intensive — tels que les thérapies comportementales dialectiques en hospitalisation de jour pour le trouble de la personnalité borderline — disposent d’un ratio places/demandes très restreint. Admettre au sein de ces structures spécialisées des individus ne répondant pas aux critères complets du trouble désorganiserait les cohortes thérapeutiques et priverait de soins des patients en souffrance sévère pour lesquels ces protocoles spécifiques ont été conçus.
3.3 La dynamique d’arbitrage (Trade-off) et la matrice de confusion
L’articulation dialectique entre sensibilité et spécificité se matérialise dans la matrice de confusion 2 × 2, qui croise l’état réel de l’individu avec le verdict catégoriel issu du seuil décisionnel. Ce tableau de contingence ventile les observations cliniques selon quatre compartiments mutuellement exclusifs : les Vrais Positifs (VP), les Faux Positifs (FP), les Vrais Négatifs (VN) et les Faux Négatifs (FN).
| Diagnostic Réel / Test | Test Positif (Score ≥ c) | Test Négatif (Score < c) | Total |
|---|---|---|---|
| Sujets Pathologiques (D = 1) | Vrais Positifs (VP) | Faux Négatifs (FN) | Total Malades (VP + FN) |
| Sujets Sains (D = 0) | Faux Positifs (FP) | Vrais Négatifs (VN) | Total Sains (FP + VN) |
Cette matrice met en exergue la loi d’airain de l’évaluation diagnostique : le compromis antagoniste indépassable (trade-off). Étant donné un instrument de mesure dont les items et les qualités intrinsèques sont fixés, il est mathématiquement impossible d’accroître simultanément la sensibilité et la spécificité en modifiant simplement le seuil d’inclusion. Abaisser le seuil critique pour récupérer davantage de cas pathologiques (hausse de la sensibilité et diminution des FN) entraîne mécaniquement une transgression accrue sur la distribution des sujets sains, gonflant le contingent des fausses alertes (baisse de la spécificité et hausse des FP).
Sur le plan géométrique, cet arbitrage continu se traduit par la concavité descendante caractéristique de la trajectoire de la courbe ROC. Tout déplacement le long de cette frontière de décision correspond à l’application implicite d’une fonction de perte. Cette fonction pondère les coûts comparatifs des erreurs de classement. Définir le positionnement adéquat sur la courbe ne relève donc pas d’une simple gymnastique mathématique neutre, mais d’une décision éthique et clinique structurée, calibrant le ratio tolérable entre la gravité d’un faux négatif et celle d’un faux positif au regard des finalités thérapeutiques poursuivies.
4. Détermination et optimisation des seuils de décision (Cut-off Points)
4.1 Nature continue des scores et seuils opérationnels
La majorité des instruments psychométriques modernes — échelles d’évaluation des symptômes affectifs, inventaires de traits dysfonctionnels de personnalité, batteries de performance attentionnelle — génèrent des scores bruts étalés le long d’un continuum numérique. Pourtant, l’exercice de la décision clinique contraint le praticien à trancher de manière catégorielle : orienter vers une prise en charge pharmacologique ou s’abstenir, déclarer un conducteur apte ou inapte suite à un traumatisme crânien, accorder ou refuser une compensation d’invalidité. Le passage d’une variable latente continue à une action clinique discrète requiert la fixation d’un seuil opérationnel (cut-off point).
La variation infinitésimale de ce seuil modifie instantanément les ratios de vraisemblance positif (RV+) et négatif (RV-), qui caractérisent la force d’inférence diagnostique du test. Le ratio de vraisemblance positif correspond au rapport entre la probabilité d’un test positif chez les malades et cette même probabilité chez les non-malades [RV+ = Sensibilité / (1 – Spécificité)]. Plus le seuil est relevé, plus ce ratio tend vers des valeurs élevées (idéalement supérieures à 10), transformant un résultat positif en un argument de certitude quasi absolue en faveur de la présence de la pathologie. Réciproquement, le ratio de vraisemblance négatif [RV- = (1 – Sensibilité) / Spécificité] s’effondre lorsque le seuil est abaissé, offrant une puissance d’exclusion diagnostique totale dès lors qu’il descend sous le seuil de 0,10.
Dans de nombreuses situations cliniques, la dichotomie binaire brute s’avère trop réductrice pour refléter les nuances diagnostiques, conduisant les concepteurs d’échelles à définir des seuils multiples. On observe fréquemment l’établissement de deux valeurs bornes délimitant trois zones décisionnelles : un seuil d’exclusion hautement sensible en deçà duquel le trouble est rejeté avec un risque minime, un seuil d’inclusion hautement spécifique au-delà duquel la présence de l’affection est affirmée avec quasi-certitude, et une zone intermédiaire dite « grise » ou d’incertitude dans laquelle le score ne permet pas de trancher, imposant le recours à des examens complémentaires ou à une observation longitudinale.
4.2 L’indice de Youden (J) : Maximisation conjointe
Parmi les méthodes automatisées les plus fréquemment employées dans la littérature psychométrique pour isoler un seuil unique figure l'<a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″ target= »_blank » rel= »noopener »>indice de Youden, introduit par le biostatisticien William J. Youden en 1950. Cet indice, classiquement désigné par la lettre J, formalise mathématiquement la recherche du point de convergence optimale entre la sensibilité et la spécificité d’une échelle diagnostique :
J = Sensibilité + Spécificité – 1 = TVP – TFP
Sur le plan géométrique, l’indice de Youden correspond à la distance verticale maximale séparant la courbe ROC de la diagonale d’indiscrimination théorique. La valeur de J oscille théoriquement entre 0 (pour un test n’apportant aucun gain prédictif par rapport au hasard) et 1 (pour un test idéal offrant une séparation absolue entre les deux populations à un score donné). Le seuil empirique c* sélectionné par cette méthode est précisément celui qui maximise la valeur de cette fonction :
c* = argmax_{c} [Se(c) + Sp(c) – 1]
L’attrait prépondérant de l’indice de Youden réside dans sa simplicité algorithmique et son objectivité formelle, qui prévient tout tri arbitraire de la part du chercheur. Cependant, sa faiblesse méthodologique intrinsèque réside dans son hypothèse sous-jacente d’équivalence absolue : il postule implicitement que la sensibilité et la spécificité revêtent une importance strictement identique, et que le coût unitaire d’un faux positif équivaut point par point au coût d’un faux négatif. Dans les contextes psychopathologiques réels où l’omission d’un risque grave s’avère infiniment plus préjudiciable qu’une fausse alerte modérée, l’adoption machinale du seuil de Youden peut conduire à sous-estimer la sensibilité requise.
4.3 La méthode de la distance minimale au point idéal
Une alternative géométrique très usitée consiste à déterminer le point de la courbe ROC qui minimise la distance euclidienne le séparant du sommet supérieur gauche idéal de coordonnées (0, 1), souvent dénommé point de perfection diagnostique. Cette métrique, notée d ou distance au coin parfait, s’exprime par le calcul suivant :
d = sqrt{(1 – Sensibilité)^2 + (1 – Spécificité)^2} = sqrt{(1 – TVP)^2 + TFP^2}
Le score seuil optimal selon cette approche correspond à la coordonnée empirique qui minimise la valeur scalaire de d. L’optimisation vectorielle vise ici à rapprocher au plus près le comportement du test du scénario parfait où l’exhaustivité est intégrale et le bruit statistique totalement absent. Dans les configurations où la courbe ROC présente une morphologie parfaitement symétrique autour de la diagonale négative orientée de (0, 1) vers (1, 0), le seuil identifié par la distance euclidienne minimale coïncide rigoureusement avec celui désigné par l’indice de Youden.
Néanmoins, dès lors que la courbe ROC présente des distorsions asymétriques — situation fréquente en psychopathologie lorsque les variances des scores au sein des populations saines et cliniques sont inégales —, la méthode de la distance minimale peut désigner un seuil opérationnel légèrement distinct de celui fourni par le critère de Youden. La distance euclidienne pénalise de manière quadratique les écarts individuels par rapport à la perfection, accordant un désavantage prononcé aux configurations accusant un déficit marqué sur l’un des deux axes, même si la somme arithmétique globale de la sensibilité et de la spécificité y demeure élevée.
4.4 Ajustement économique et éthique selon la prévalence
Les indices de Youden et de distance euclidienne présentent le défaut d’opérer dans un univers mathématique idéalisé qui fait abstraction de deux paramètres cliniques capitaux : la prévalence réelle du trouble au sein de la population examinée et le ratio de gravité économique et humaine des erreurs diagnostiques. Pour pallier cette lacune, l’optimisation avancée des seuils intègre une formalisation bayésienne des fonctions de coût global, telle que modélisée à l’origine par Metz (1978).
Si l’on désigne par P la prévalence du trouble dans la cohorte d’intérêt, par C(FP) le coût associé à la classification erronée d’un sujet sain en sujet malade, et par C(FN) le coût induit par l’omission d’un sujet réellement pathologique (les coûts des décisions correctes étant posés comme nuls ou marginaux), la pente m de la tangente à la courbe ROC au seuil optimal est définie par l’équation d’iso-coût suivante :
Pente = m = frac{1 – P}{P} times frac{C(FP)}{C(FN)}
L’intersection entre la courbe ROC empirique et la droite de pente m tangente à sa frontière convexe supérieure isole le seuil décisionnel qui minimise formellement le coût attendu total par patient examiné. Cette équation met en lumière deux mécanismes majeurs :
- Lorsque la prévalence P devient extrêmement faible dans la population générale, le rapport (1 – P) / P augmente drastiquement, ce qui redresse fortement la pente m de la tangente et repousse le seuil optimal vers le coin inférieur gauche (haute spécificité), afin de contenir l’inondation de faux positifs.
- Si le coût d’un faux négatif C(FN) est jugé infiniment supérieur à celui d’une fausse alerte (cas du risque suicidaire imminent), le terme C(FP) / C(FN) tend vers zéro, aplatissant la pente de la droite d’iso-coût et déplaçant le seuil vers le sommet supérieur droit de la courbe, garantissant une sensibilité maximale quelles que soient les pertes collatérales en spécificité.
5. L’Aire sous la courbe (AUC) : Quantification de la performance globale
5.1 Interprétation probabiliste et mathématique de l’AUC
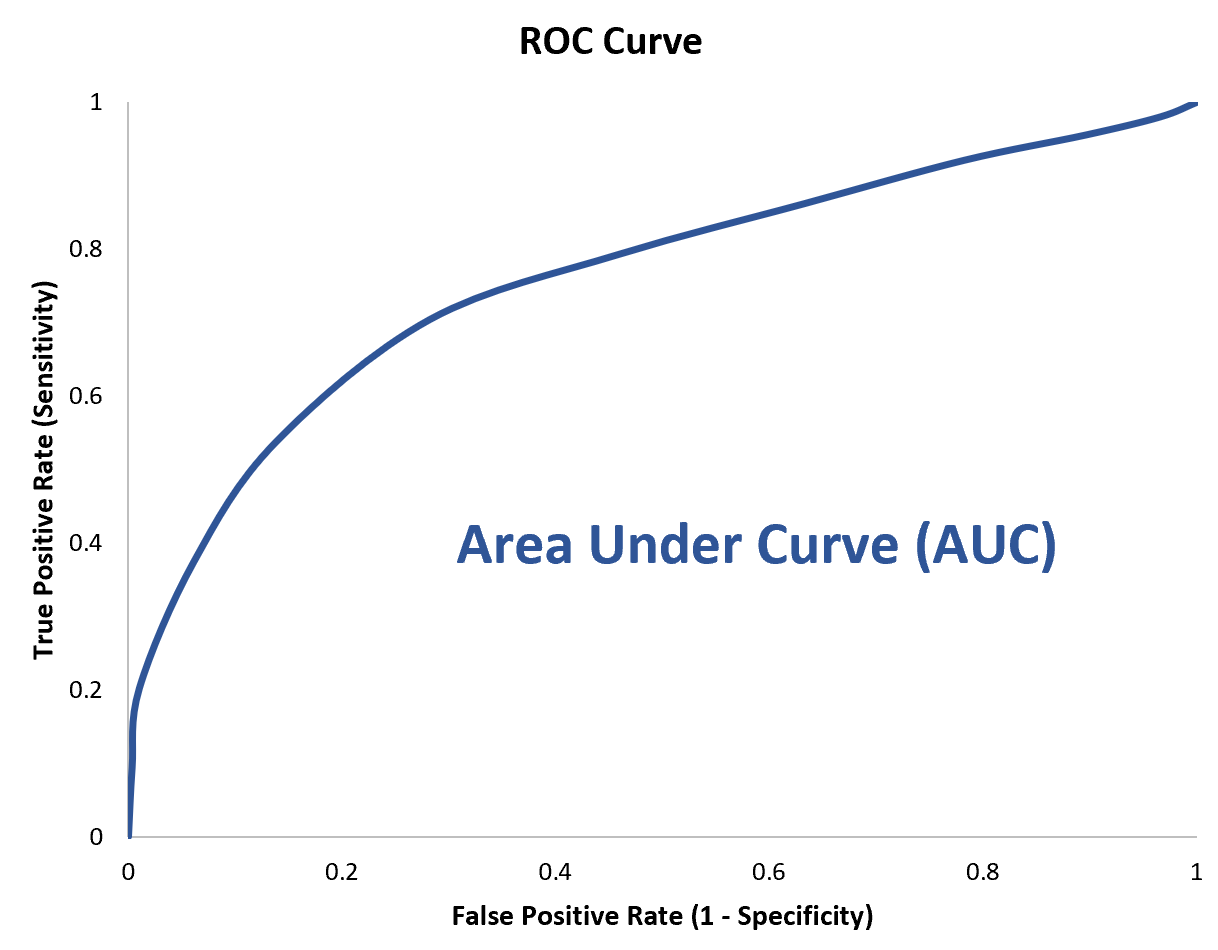
Si la trajectoire de la courbe ROC illustre visuellement la modulation continue des seuils, l’Aire sous la courbe (AUC, pour Area Under the Curve) résume en un scalaire unique la capacité discriminative globale d’un instrument psychométrique. Définie analytiquement par l’intégrale de la sensibilité sur l’ensemble de l’étendue du taux de faux positifs, sa valeur est rigoureusement bornée au sein de l’intervalle [0, 1] :
AUC = int_{0}^{1} Sensibilité(1 – Spécificité) , d(1 – Spécificité)
Sur le plan probabiliste, l’AUC possède une signification intuitive élégante : elle équivaut exactement à la probabilité qu’un individu tiré au sort de manière aléatoire au sein de la population pathologique obtienne un score psychométrique plus sévère (ou plus anormal) qu’un individu extrait au hasard au sein de la population indemne de la pathologie. Sur le plan de la théorie statistique non paramétrique, Bamber (1975) a démontré l’équivalence algébrique stricte entre l’AUC et la statistique normalisée U de Mann-Whitney-Wilcoxon :
AUC = frac{U}{n_1 times n_0}
où n1 et n0 représentent respectivement les effectifs des échantillons cliniques et sains. Pour des données discrètes, le calcul s’effectue communément par l’algorithme trapézoïdal non paramétrique, sommant les aires des trapèzes successifs formés sous chaque segment reliant deux points observés consécutifs. L’avantage majeur de l’AUC réside dans son indépendance absolue vis-à-vis d’un quelconque choix de seuil décisionnel ; elle livre un verdict sur le pouvoir séparateur intrinsèque de l’outil, avant toute contingence d’application opérationnelle.
5.2 Grille standard de qualification clinique des valeurs d’AUC
L’interprétation clinique et psychométrique d’une valeur scalaire d’AUC obéit à des conventions empiriques largement partagées dans la communauté scientifique internationale, formalisées notamment par Swets (1988) et réaffirmées en psychopathologie quantitative :
- AUC = 0,50 : Capacité de discrimination nulle. Le test est statistiquement indistinguable du hasard complet. Le résultat ne véhicule aucune information diagnostique.
- 0,50 < AUC < 0,70 : Précision discriminative faible à médiocre. Bien que la tendance soit statistiquement significative sur des cohortes volumineuses, l’épreuve s’avère inapte à guider une décision clinique individuelle en raison d’un recouvrement trop massif des distributions.
- 0,70 ≤ AUC < 0,80 : Pouvoir discriminant acceptable. L’instrument est adapté pour des protocoles de dépistage préliminaire à large spectre, à condition d’être couplé à des investigations diagnostiques plus robustes.
- 0,80 ≤ AUC < 0,90 : Excellente précision diagnostique. Le test assure une différenciation robuste et s’avère pleinement qualifié pour une utilisation en pratique clinique de routine afin d’orienter les choix thérapeutiques.
- AUC ≥ 0,90 : Précision discriminante exceptionnelle. Les scores séparent très nettement les deux populations avec une marge d’incertitude marginale. Une telle performance demeure rare dans la mesure de construits psychopathologiques complexes.
- AUC = 1,00 : Séparation absolue et parfaite. Il n’existe aucun chevauchement entre la distribution des sujets pathologiques et celle des sujets contrôles.
Il importe toutefois de souligner qu’en santé mentale, l’obtention d’une AUC supérieure à 0,95 doit susciter une vigilance méthodologique critique accrue plutôt qu’un enthousiasme aveugle. Une performance quasi parfaite dissimule fréquemment un biais d’incorporation sérologique ou clinique, une tautologie diagnostique (par exemple évaluer un test dont les items reproduisent fidèlement les critères du manuel diagnostique ayant servi de référence externe) ou un artéfact provoqué par la comparaison d’échantillons extrêmes artificiellement polarisés.
5.3 Inférence statistique et intervalles de confiance de l’AUC
L’estimation ponctuelle de l’AUC calculée sur un échantillon d’investigation ne constitue qu’une approximation de la performance réelle du test dans la population parente. Pour autoriser une généralisation scientifique valide, cette métrique doit systématiquement être assortie de son Erreur-Type (SE) et d’un Intervalle de Confiance bilatéral (généralement calculé au seuil de 95 %).
L’approche analytique pionnière de Hanley et McNeil (1982) a fourni une formule asymptotique permettant d’estimer l’erreur-type de l’AUC sans recourir à des calculs informatiques intensifs :
SE(AUC) = sqrt{frac{AUC(1 – AUC) + (n_1 – 1)(Q_1 – AUC^2) + (n_0 – 1)(Q_2 – AUC^2)}{n_1 times n_0}}
dans laquelle Q1 représente la probabilité que deux individus malades distincts obtiennent tous deux un score supérieur à un individu sain tiré au sort [approximée par Q1 = AUC / (2 – AUC)], et Q2 la probabilité qu’un individu malade obtienne un score supérieur à deux individus sains distincts [approximée par Q2 = 2 times AUC^2 / (1 + AUC)].
Dans la pratique psychométrique moderne, on privilégie souvent le recours aux méthodes computationnelles non paramétriques de rééchantillonnage avec remise (bootstrap). En générant plusieurs milliers d’itérations bootstrap de l’échantillon empirique, l’analyste dérive une distribution empirique de l’AUC et en extrait un intervalle de confiance par la méthode des percentiles corrigée du biais et accélérée (BCa). Ce procédé garantit des bornes valides même lorsque les effectifs cliniques sont restreints et que la distribution des scores s’écarte notablement de l’asymptote normale, permettant de tester avec rigueur l’hypothèse nulle d’indiscrimination formelle H0 : AUC = 0,50.
6. Protocole méthodologique pour construire et analyser une courbe ROC
6.1 Phase préparatoire : Sélection des variables et standard de référence
La validité scientifique de l’analyse d’une courbe ROC repose intégralement sur la qualité de sa phase préparatoire. L’exigence méthodologique première et indérogeable est l’existence d’un standard de référence externe — ou critère de référence (Gold Standard) — indépendant de l’instrument évalué. En psychopathologie, l’établissement de ce diagnostic de référence s’effectue généralement par le biais d’un entretien diagnostique standardisé et validé (tel que la SCID pour les troubles du DSM, ou la MINI) administré par des cliniciens chevronnés, idéalement appuyé par un consensus d’experts indépendants ayant accès à l’ensemble du dossier clinique anamnétique.
Il est impératif que l’évaluation du gold standard soit réalisée en double insu strict : les cliniciens posant le diagnostic de référence doivent ignorer totalement les scores obtenus par les sujets au test psychométrique à l’étude, et réciproquement. La violation de cette règle engendre un biais de vérification ou un biais d’incorporation, altérant artificiellement la validité apparente du test.
Par ailleurs, la sélection de l’échantillon d’inclusion doit impérativement reproduire le spectre clinique réel de la population auprès de laquelle le test sera ultérieurement appliqué dans les pratiques de soins, afin de contourner le pernicieux biais de spectre (spectrum bias). Confronter une échelle de détection de la schizophrénie en comparant uniquement 50 patients chroniques institutionnalisés de longue date à 50 étudiants universitaires parfaitement sains aboutit à une surestimation massive de l’AUC. L’échantillon expérimental doit au contraire inclure des formes cliniques modérées, des cas débutants, des diagnostics différentiels intriqués et des sujets témoins présentant des plaintes psychologiques non psychotiques, reproduisant ainsi l’ambiguïté inhérente à la consultation de première ligne.
6.2 Calcul séquentiel des matrices de confusion pour chaque score
Une fois les données cliniques recueillies, la confection algorithmique de la courbe ROC s’amorce par l’ordonnancement de l’ensemble des scores observés au sein de la cohorte consolidée, du score le plus bas au score le plus élevé. Soit un vecteur de scores {S1, S2, …, Sk} représentant les réalisations psychométriques des sujets sains et malades.
Le système computationnel exécute ensuite un balayage itératif systématique en considérant successivement chaque score observé comme un seuil de décision potentiel c. Pour chacune de ces valeurs, l’algorithme génère la matrice de confusion 2 × 2 correspondante en appliquant la règle de décision formelle : tout sujet dont le score Y satisfait Y ≥ c est classifié positif, et tout sujet dont le score vérifie Y < c est assigné à la catégorie négative. L’algorithme procède au dénombrement exhaustif des cellules empiriques :
- Nombre de Vrais Positifs : VP(c) = Σ I(Yi ≥ c et Di = 1)
- Nombre de Faux Négatifs : FN(c) = Σ I(Yi < c et Di = 1)
- Nombre de Vrais Négatifs : VN(c) = Σ I(Yi < c et Di = 0)
- Nombre de Faux Positifs : FP(c) = Σ I(Yi ≥ c et Di = 0)
À chaque itération du seuil c, l’algorithme dérive le couple de coordonnées cartésiennes [x(c), y(c)], où x(c) = 1 – Sp(c) = FP(c) / [VN(c) + FP(c)] et y(c) = Se(c) = VP(c) / [VP(c) + FN(c)]. Cette séquence produit un tableau ordonné de points discrets retraçant fidèlement l’évolution des performances discriminatives sur l’intégralité du domaine de mesure du test.
6.3 Tracé graphique et modélisation paramétrique vs non paramétrique
La dernière étape méthodologique consiste en la matérialisation graphique des coordonnées calculées au sein du plan unitaire. Deux philosophies d’ajustement s’opposent ici : l’approche non paramétrique empirique et l’approche paramétrique lissée.
L’approche non paramétrique — universellement intégrée dans les logiciels de statistique contemporains (tels que R avec les packages pROC ou ROCR, Python avec scikit-learn, ou SPSS) — relie directement les coordonnées empiriques calculées par des segments rectilignes, conférant à la courbe un tracé caractéristique en escalier. Ce procédé présente l’immense mérite de ne formuler aucun postulat sur la forme distributionnelle des variables sous-jacentes. Chaque « marche » verticale traduit le gain d’un vrai positif lors de la diminution du seuil, tandis que chaque palier horizontal signale l’irruption d’un faux positif.
À l’opposé, l’approche paramétrique classique s’appuie sur le modèle binormal développé originellement par Dorfman et Alf (1969). Elle postule que les scores du test (ou une transformation monotone croissante de ceux-ci) se distribuent selon des lois normales au sein des deux sous-populations : N(μ0, σ0²) pour le groupe sain et N(μ1, σ1²) pour le groupe pathologique. Sous ces hypothèses, la courbe ROC théorique adopte une trajectoire parfaitement curviligne et lisse régie par l’équation fonctionnelle :
Sensibilité = Phi(a + b times Phi^{-1}(1 – Spécificité))
où Φ représente la fonction de répartition de la loi normale centrée réduite, a = (μ1 – μ0) / σ1 capture la distance standardisée entre les moyennes des distributions, et b = σ0 / σ1 traduit le rapport de leurs écarts-types respectifs. Si l’ajustement binormal procure une estimation élégante et compense les artéfacts des petits échantillons, il recèle des périls considérables en psychométrie : en présence de données fortement asymétriques ou hétérogènes, le modèle binormal peut générer des artéfacts d’inflexion aberrants, tels que des courbes présentant une pente négative au voisinage de l’origine ou croisant inopportunément la ligne de chance.
7. Exemple clinique 1 : Dépistage de la dépression majeure avec le BDI-II
7.1 Contexte de l’étude et échantillon psychopathologique
Afin d’illustrer la mise en pratique opérationnelle de l’analyse ROC dans un cadre clinique d’évaluation, nous examinons une étude d’étalonnage diagnostique de l’Inventaire de Dépression de Beck – Seconde Édition (BDI-II) au sein d’une consultation universitaire d’évaluation psychologique. Le BDI-II est un auto-questionnaire standardisé comprenant 21 items cotés de 0 à 3, générant un score composite continu oscillant entre 0 et 63 points, où une cotation élevée traduit une intensité accrue de la sémiologie dépressive.
L’investigation a été menée auprès d’une cohorte clinique consécutive de 250 adultes âgés de 18 à 65 ans sollicitant une consultation psychologique. Le standard de référence (Gold Standard) a consisté en l’administration intégrale de l’entretien clinique structuré du DSM-5 (SCID-5-CV) par des psychologues cliniciens indépendants, tenus dans l’aveugle strict des scores au BDI-II. À l’issue des investigations diagnostiques de référence, l’échantillon se scinde en deux sous-groupes cliniques étanches :
- Un groupe pathologique (D = 1) composé de 100 individus recevant formellement le diagnostic d’Épisode Dépressif Majeur (EDM).
- Un groupe témoin (D = 0) rassemblant 150 participants n’affichant aucun critère d’épisode dépressif caractérisé (incluant des sujets sans trouble mental et des sujets présentant des troubles anxieux sans comorbidité thymique).
L’objectif psychométrique assigné à l’analyse ROC consiste à évaluer l’efficacité discriminante globale du BDI-II au sein de cette population tout-venant et à sélectionner le score seuil optimal pour calibrer un dispositif d’orientation vers une psychothérapie structurée.
7.2 Analyse empirique des seuils et tableau des coordonnées ROC
L’analyse statistique des données empiriques a permis d’extraire la distribution des performances diagnostiques pour l’ensemble des seuils observés. Le tableau ci-après consigne les résultats psychométriques obtenus pour plusieurs valeurs seuils pivots du BDI-II, illustrant les déplacements coordonnés de la sensibilité, de la spécificité, des taux d’erreurs et de l’indice de Youden correspondant :
| Score BDI-II (Seuil ≥ c) | Sensibilité (TVP) | Spécificité | 1 – Spécificité (TFP) | Indice de Youden (J) | Distance Idéale (d) |
|---|---|---|---|---|---|
| Score ≥ 10 | 0,99 | 0,42 | 0,58 | 0,41 | 0,58 |
| Score ≥ 14 | 0,94 | 0,68 | 0,32 | 0,62 | 0,33 |
| Score ≥ 19 (Optimum J) | 0,86 | 0,88 | 0,12 | 0,74 | 0,18 |
| Score ≥ 22 | 0,78 | 0,93 | 0,07 | 0,71 | 0,23 |
| Score ≥ 25 | 0,65 | 0,97 | 0,03 | 0,62 | 0,35 |
| Score ≥ 30 | 0,42 | 0,99 | 0,01 | 0,41 | 0,58 |
L’intégration numérique trapézoïdale de l’intégralité de la séquence empirique délivre une Aire sous la courbe (AUC) globale remarquable de 0,91. L’application de la méthode de calcul asymptotique de Hanley et McNeil produit une erreur-type de 0,020, débouchant sur un intervalle de confiance bilatéral à 95 % particulièrement resserré compris entre [0,87 et 0,95]. Le test de conformité statistique rejette vigoureusement l’hypothèse nulle d’indiscrimination (p < 0,0001), confirmant l’excellente validité concourante du BDI-II pour distinguer les sujets atteints d’un épisode dépressif caractérisé au sein de cette cohorte clinique.
7.3 Interprétation décisionnelle et choix du seuil opérationnel
L’examen des données numériques révèle que le score brut de 19 maximise formellement l’indice de Youden (J = 0,74) tout en minimisant la distance euclidienne au point idéal (d = 0,18). À cette valeur seuil, l’échelle affiche une sensibilité de 0,86 conjuguée à une spécificité de 0,88. Concrètement, si la structure ambulatoire applique ce seuil de 19 pour statuer sur l’orientation des usagers, elle diagnostiquera avec succès 86 des 100 patients dépressifs réels, tout en n’orientant par mégarde que 18 sujets sains sur les 150 consultations contrôles (12 % de faux positifs). Ce compromis apparaît remarquablement équilibré pour un service de consultation psychologique externe généraliste, où l’on cherche à éviter la saturation de l’unité tout en maintenant une détection satisfaisante.
Imaginons en revanche que ce même instrument soit déployé dans le cadre d’un protocole de prévention primaire en santé au travail visant à prévenir le désengagement professionnel ou l’émergence d’idées suicidaires chez des salariés à haut risque d’épuisement. Dans cette perspective préventive, l’arbitrage clinique doit privilégier la sensibilité pour éviter impérativement qu’un individu en détresse sévère ne soit refoulé du dispositif d’aide. Le psychologue du travail retiendra alors le seuil abaissé de 14. Ce réglage confère au test une sensibilité remarquable de 94 % (seulement 6 % de faux négatifs), au détriment d’une spécificité réduite à 68 %.
Ce choix délibéré implique que 32 % des sujets non dépressifs obtiendront un score positif à ce premier filtrage, générant environ 48 fausses alertes pour 150 personnes saines. Cependant, les entretiens de soutien psychologique de seconde ligne consécutifs au dépistage permettront de rassurer sans danger ces individus faussement étiquetés, tandis que la quasi-totalité des collaborateurs en détresse thymique clinique aura été sécurisée et orientée vers une prise en charge adaptée.
8. Exemple clinique 2 : Détection des troubles neurocognitifs légers avec le MoCA
8.1 Problématique neuropsychologique et critères d’évaluation
Le second cas pratique aborde le diagnostic précoce des troubles neurocognitifs légers (MCI, pour Mild Cognitive Impairment) chez les personnes âgées, un domaine où la frontière clinique avec le vieillissement cérébral normal s’avère particulièrement ténue. Dans cette étude de neuropsychologie clinique gériatrique, nous nous intéressons à l’efficacité diagnostique de l’Évaluation Cognitive de Montréal (MoCA), une échelle brève cotée sur 30 points évaluant les fonctions exécutives, visuospatiales, mnésiques, attentionnelles et le langage.
L’échantillon d’investigation réunit 180 adultes âgés de 65 à 85 ans adressés à un centre mémoire hospitalier pour bilan de plainte mnésique. Le standard diagnostique de référence ne repose pas sur le score à un test unique, mais sur un diagnostic syndromique collégial formulé à l’issue d’une batterie neuropsychologique approfondie de deux heures (incluant le RL/RI-16, la figure de Rey, les fluences verbales et les tests de Stroop et TMT), d’une imagerie cérébrale par résonance magnétique (IRM volumétrique hippocampique) et du dosage de biomarqueurs plasmatiques. Cette procédure sépare la cohorte en :
- 70 patients répondant rigoureusement aux critères diagnostiques de Petersen pour le trouble neurocognitif léger amnésique ou multidomaine (MCI).
- 110 sujets contrôles présentant une plainte cognitive subjective mais dont l’ensemble des performances psychométriques standardisées s’inscrit dans les limites de la norme statistique ajustée pour l’âge et la réserve cognitive.
8.2 Modélisation logistique et trajectoire de la courbe ROC
La particularité méthodologique des échelles neuropsychologiques réside dans l’inversion de l’orientation du signal : à la différence des inventaires de symptômes où un score élevé traduit une sévérité accrue, les épreuves de performance cognitive attribuent des scores faibles aux déficits pathologiques les plus marqués. Lors du paramétrage de l’analyse ROC, la condition positive (détection du MCI) doit impérativement être assignée à la règle Score ≤ Seuil. Omettre cette inversion conduirait à produire une courbe évoluant en miroir sous la diagonale d’indiscrimination.
L’analyse non ajustée du score brut MoCA produit une AUC de 0,83 (IC 95 % : [0,77 – 0,89]), témoignant d’une excellente capacité discriminative brute. Toutefois, l’observation détaillée de la trajectoire ROC révèle une chute brutale et prématurée de la spécificité dès que le seuil de score est légèrement relevé. Cette déformation morphologique résulte de la contamination des scores du MoCA par le niveau socio-éducatif des participants : des sujets neurotypiques sains possédant un faible niveau de scolarité commettent des erreurs formelles sur les items d’abstraction et de dénomination, imitant ainsi le profil de performance de patients MCI de haut niveau académique.
Pour neutraliser ce biais systématique, une régression logistique binaire est ajustée en modélisant la présence du trouble MCI par le score MoCA, l’âge chronologique et le nombre d’années d’études formalisées. La courbe ROC reconstruite sur les probabilités d’appartenance diagnostique prédites par ce modèle multivarié voit son AUC bondir de manière spectaculaire à 0,89 (IC 95 % : [0,84 – 0,94]). Cet accroissement met en évidence l’intérêt diagnostique d’intégrer le calcul ROC au sein d’une approche de modélisation multivariée combinant performances brutes et variables démographiques modulatrices.
8.3 Sélection d’un seuil à haute spécificité pour éviter l’anxiété iatrogène
Dans la validation historique originale du MoCA par Nasreddine et ses collaborateurs en 2005, un seuil brut de 26/30 avait été proposé pour dépister le MCI, avec une sensibilité rapportée avoisinant 90 %. Cependant, le transfert écologique de ce seuil à notre cohorte gériatrique hospitalière révèle une limite psychologique majeure : le seuil de 26 induit une spécificité médiocre de seulement 65 %, générant 35 % de faux positifs (soit près de 39 personnes saines erronément étiquetées comme déclinantes sur 110 témoins).
Sur le plan psychopathologique, l’annonce inconsidérée d’une suspicion de trouble neurocognitif dégénératif chez une personne âgée déclenche un traumatisme narcissique et une anxiété catastrophique iatrogène souvent dévastatrice. Pour l’équipe de consultation mémoire, la consigne clinique consiste à préserver formellement les sujets sains et à limiter au strict minimum ces fausses alertes anxiogènes. La priorité d’optimisation se déplace donc vers l’obtention d’une spécificité minimale garantie d’au moins 90 %.
L’interrogation de la courbe ROC guide la sélection vers un seuil révisé plus conservateur fixé à Score MoCA ≤ 24. À ce seuil :
- La spécificité atteint 91,8 %, restreignant le contingent de faux positifs à moins de 9 cas sur l’ensemble de la cohorte témoin.
- La sensibilité résultante s’établit à 74,3 % (permettant d’identifier correctement 52 des 70 patients MCI).
Bien que ce seuil révisé laisse échapper environ un quart des troubles légers au premier tamisage (qui feront l’objet d’un suivi de routine ultérieur lors de plaintes récurrentes), il sanctuarise le statut psychologique des personnes âgées saines et assure aux cliniciens que tout individu échouant sous la barre de 24/30 présente une très haute probabilité de déficit cognitif authentique, justifiant pleinement la mise en œuvre d’investigations étiologiques poussées.
9. Comparaison de tests psychométriques multiples par courbes ROC
9.1 Superposition graphique et analyse différentielle directe
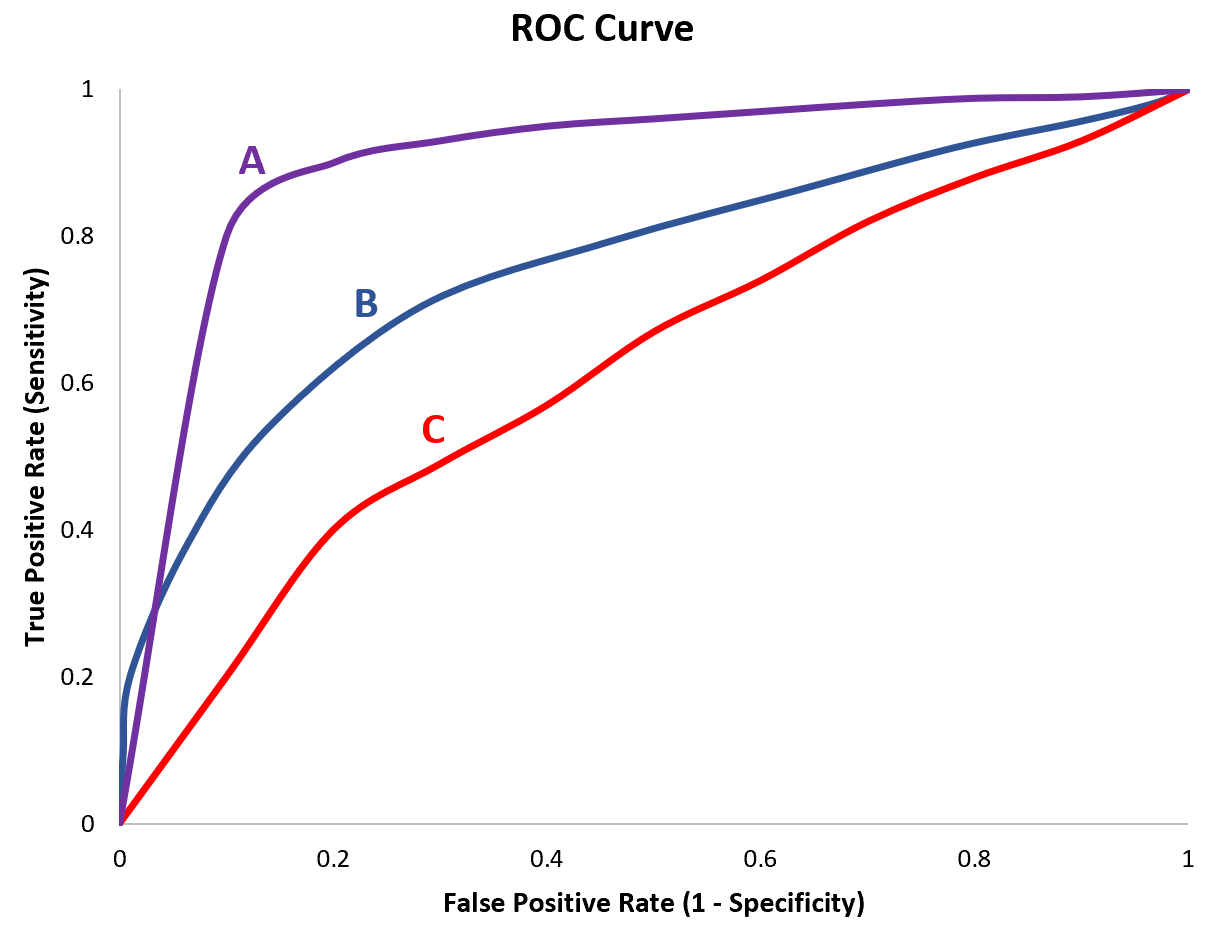
L’une des contributions méthodologiques les plus puissantes de l’analyse ROC réside dans sa faculté à départager empiriquement plusieurs instruments d’évaluation ou plusieurs sous-échelles concurrentes destinées à mesurer la même entité psychopathologique. La superposition graphique des trajectoires ROC au sein d’un même repère cartésien offre une appréciation visuelle immédiate de leurs mérites respectifs. Lorsqu’une courbe ROC enveloppe intégralement une autre courbe sans jamais la croiser — situation dite de dominance stochastique —, l’instrument supérieur affiche une sensibilité plus élevée pour chaque niveau concevable de spécificité, établissant sa supériorité diagnostique inconditionnelle.
Toutefois, la réalité empirique confronte régulièrement les psychométriciens au phénomène plus complexe des courbes sécantes. Dans ce cas de figure, la courbe de l’instrument A surpasse celle de l’instrument B dans les zones de haute sensibilité (partie supérieure droite du graphique), tandis que la courbe de l’instrument B prévaut dans les zones de haute spécificité (partie inférieure gauche). L’analyse globale des AUC peut alors masquer cette divergence locale et conclure à une apparente équivalence scalaire. Le clinicien doit dépasser la simple valeur globale de l’AUC et déterminer quel instrument offre la morphologie la plus conforme à son objectif : un outil ultra-sensible pour le dépistage initial ou un outil ultra-spécifique pour la confirmation clinique formelle.
Il est en outre exclu de décréter la supériorité d’une épreuve psychologique sur une autre sur la foi d’une simple inspection oculaire des courbes ou d’un écart arithmétique mineur entre leurs aires respectives. Un écart d’AUC de 0,84 contre 0,81 peut résulter exclusivement de fluctuations d’échantillonnage aléatoires. La validation d’une différence de performance exige impérativement le déploiement de tests d’hypothèse inférentiels adaptés aux propriétés statistiques des courbes ROC.
9.2 Le test statistique de DeLong pour échantillons appariés
Lorsque deux tests psychométriques distincts sont administrés à la même cohorte de participants pour prédire un diagnostic unique (plan d’échantillonnage intra-sujet ou apparié), les deux estimations d’AUC ne sont pas indépendantes ; elles sont corrélées en raison de la variance partagée liée aux caractéristiques propres des sujets. Pour tester formellement si la différence observée entre deux AUC appariées ΔAUC = AUC1 – AUC2 est statistiquement différente de zéro, la méthode de référence absolue est le test non paramétrique proposé par DeLong, DeLong et Clarke-Pearson (1988).
Le test de DeLong exploite la théorie des U-statistiques pour dériver une matrice de variance-covariance asymptotique non paramétrique des deux estimateurs d’AUC. En calculant les composantes structurelles de placement pour chaque sujet sain et pathologique vis-à-vis des scores des deux épreuves, la méthode permet d’obtenir une estimation robuste de la variance de la différence :
Var(AUC_1 – AUC_2) = Var(AUC_1) + Var(AUC_2) – 2 times Cov(AUC_1, AUC_2)
À partir de cette covariance estimée, la statistique de test Z suit asymptotiquement une loi normale centrée réduite sous l’hypothèse nulle d’égalité des performances discriminatives :
Z = frac{AUC_1 – AUC_2}{sqrt{Var(AUC_1 – AUC_2)}}
Ce test joue un rôle primordial lors du développement et de la validation d’échelles psychologiques abrégées. Lorsqu’une équipe de recherche conçoit une version ultracourte à 7 items pour remplacer un inventaire de personnalité exhaustif comportant 60 questions, l’administration concomitante des deux versions permet de tester via DeLong si la perte inhérente d’information psychométrique entraîne une dégradation statistiquement significative de l’AUC diagnostique. Si la valeur de p s’avère non significative, le clinicien dispose d’un argument statistique irréfutable pour privilégier l’outil le plus économe en temps d’administration sans sacrifier la validité de décision.
9.3 Combinaison de prédicteurs par régression logistique multivariée
L’évaluation psychologique moderne ne s’enferme plus dans l’usage monopolistique d’un test isolé. La démarche clinique d’évaluation intégrative procède par convergence d’indices combinant auto-évaluations subjectives, tests d’efficience cognitive objective, hétéro-évaluations anamnestiques et données biologiques ou génétiques. L’analyse ROC trouve une application privilégiée dans la quantification du gain diagnostique permis par ces architectures multiméthodes.
La méthodologie procède en calculant une courbe ROC synthétique à partir du modèle composite de régression logistique qui intègre l’ensemble de ces prédicteurs hétérogènes. L’amélioration du pouvoir de discrimination apportée par l’adjonction d’une variable psychométrique d’intérêt s’exprime par le Delta-AUC (ΔAUC) séparant le modèle de base (incluant uniquement les covariables standard) du modèle enrichi. L’évaluation de la signification statistique de ce gain peut être consolidée par des métriques complémentaires issues de l’épidémiologie moderne, à savoir l’Amélioration Nette de la Reclassification (Net Reclassification Improvement, NRI) et l’Indice d’Amélioration de la Discrimination Intégrée (Integrated Discrimination Improvement, IDI) développés par Pencina et collaborateurs (2008).
Cette formalisation permet de trancher avec rigueur des questions d’arbitrage médico-économique cruciales en santé mentale. Si l’adjonction d’un test neuropsychologique chronophage et coûteux — requérant 45 minutes de cotation par un professionnel qualifié — n’augmente l’AUC du diagnostic précoce de la schizophrénie que de manière marginale (par exemple un ΔAUC de +0,01 non significatif par rapport à un modèle fondé sur les prodromes cliniques et un auto-questionnaire rapide), la poursuite de son administration systématique en contexte de ressources hospitalières limitées perd sa justification empirique.
10. Limites critiques et écueils d’interprétation méthodologique
10.1 L’illusion de l’indépendance à la prévalence et les valeurs prédictives
L’un des arguments les plus couramment invoqués pour valoriser la courbe ROC réside dans l’invariance mathématique de ses composantes structurelles face aux fluctuations de la prévalence. Il est exact que la sensibilité et le taux de faux positifs constituent des probabilités conditionnelles formulées à l’intérieur des sous-populations spécifiques (respectivement D = 1 et D = 0). Sur le plan théorique, l’allure graphique d’une courbe ROC et la valeur scalaire de l’AUC demeurent rigoureusement inchangées, que la prévalence de la pathologie au sein de l’échantillon soit de 1 %, de 50 % ou de 80 %.
Cette neutralité arithmétique engendre cependant un piège d’interprétation clinique majeur, baptisé le paradoxe de la prévalence. Dans l’exercice effectif de sa consultation, le clinicien ne raisonne pas à partir des probabilités conditionnelles inversées (connaître le test sachant l’état pathologique), mais à partir de la question diagnostique concrète : « Sachant que mon patient obtient un score positif au test, quelle est la probabilité réelle qu’il présente authentiquement ce trouble psychiatrique ? ». Cette interrogation renvoie non pas à la sensibilité, mais à la Valeur Prédictive Positive (VPP), qui dépend inextricablement de la prévalence du trouble selon le théorème de Bayes :
VPP = frac{Sensibilité times Prévalence}{Sensibilité times Prévalence + (1 – Spécificité) times (1 – Prévalence)}
L’impact pratique de cette loi est colossal. Considérons une échelle de dépistage de la dépression dotée d’une sensibilité de 0,90 et d’une spécificité de 0,90 (affichant une AUC flatteuse voisine de 0,95). Si cette échelle est validée en service psychiatrique spécialisé où la prévalence de la dépression est de 50 %, sa VPP s’élève à un niveau rassurant de 90 % (9 tests positifs sur 10 identifient un cas réel). Mais si un praticien transpose directement le seuil de ce même test pour dépister la dépression en médecine générale ou en entreprise, où la prévalence n’excède pas 2 %, la VPP s’effondre dramatiquement à :
VPP = frac{0,90 times 0,02}{(0,90 times 0,02) + (0,10 times 0,98)} = frac{0,018}{0,018 + 0,098} approx 0,155 quad (soit ; 15,5,%)
Dans ce contexte épidémiologique à faible taux de base, près de 85 % des sujets identifiés comme positifs par le test seront en réalité des faux positifs. Isoler l’interprétation d’une courbe ROC de la prévalence réelle du milieu d’application constitue l’un des écueils les plus pernicieux de la psychométrie appliquée.
10.2 Le problème du standard imparfait en psychopathologie
L’architecture entière de la méthodologie ROC postule l’existence d’un étalon de vérité diagnostique omniscient et infaillible (le Gold Standard), scindant l’échantillon d’investigation en deux ensembles mutuellement exclusifs et parfaitement catégorisés. Or, la nosographie psychiatrique et psychologique ne dispose, pour l’immense majorité de ses entités — trouble anxieux généralisé, trouble de la personnalité limite, trouble de stress post-traumatique —, d’aucun biomarqueur biologique ou génétique irréfutable comparable à l’anatomopathologie en oncologie.
Le critère diagnostique de référence repose lui-même sur des entretiens cliniques et des jugements d’experts humains intrinsèquement vulnérables à des biais d’appréciation, à des fluctuations de subjectivité interprétative et à une fidélité inter-juges imparfaite (coefficients Kappa de Cohen oscillant fréquemment entre 0,65 et 0,80). Lorsque le standard externe de vérité est contaminé par des erreurs de classement aléatoires ou systématiques, les propriétés de la courbe ROC s’en trouvent lourdement viciées. Des démonstrations mathématiques ont prouvé qu’en présence d’un standard imparfait, l’AUC calculée subit une atténuation artificielle systématique : elle sous-estime structurellement la véritable capacité discriminante de l’outil à l’étude.
Pour contourner ce verrou méthodologique en l’absence de standard parfait, les psychométriciens avancés délaissent l’analyse ROC classique au profit de modélisations par analyse de classes latentes (Latent Class Analysis, LCA). Ces méthodes probabilistes infèrent l’état morbide latent non observé en croisant simultanément les réponses issues de multiples instruments imparfaits, permettant d’estimer conjointement la sensibilité et la spécificité de chaque épreuve sans conférer à aucune d’entre elles le statut abusif de critère absolu de vérité.
10.3 Courbes asymétriques, irrégulières et artéfacts d’échantillonnage
L’esthétique épurée et la courbure convexe harmonieuse présentées dans les manuels didactiques contrastent vivement avec la rugosité des courbes ROC empiriques issues de la recherche psychopathologique réelle. Les petites cohortes d’investigation (par exemple les études portant sur des affections cliniques rares réunissant moins de 30 patients) génèrent des courbes heurtées, composées de marches d’escalier démesurées et de vastes plateaux horizontaux ou verticaux où aucun changement de classement n’intervient sur plusieurs points d’échelle.
Ces artéfacts d’échantillonnage provoquent une forte instabilité stochastique des seuils optimaux. L’indice de Youden calculé sur un échantillon clinique restreint peut désigner un seuil spécifique simplement parce qu’un ou deux sujets aberrants ont fortuitement déplacé la ligne de quelques fractions de millimètres. La réplication d’un tel seuil sur une cohorte indépendante conduit invariablement au phénomène de surajustement (overfitting), caractérisé par un effondrement des performances diagnostiques effectives.
Un autre écueil morphologique réside dans l’asymétrie marquée des distributions de variances entre les groupes cliniques. En psychopathologie, il est fréquent que la distribution des scores du groupe témoin soit resserrée autour du plancher de l’échelle (faible variance), tandis que celle du groupe clinique s’étale sur une très vaste amplitude de sévérité (forte variance). Cette hétérogénéité des variances produit une courbe ROC asymétrique, dotée d’une très forte pente initiale suivie d’un écrasement prématuré vers l’asymptote horizontale. Dans de telles configurations, les indices synthétiques symétriques tendent à désigner des seuils cliniquement sous-optimaux, obligeant l’analyste à un examen scrupuleux de la dérivée locale de la courbe.
11. Extensions modernes : Précision-Rappel, ROC partielle et analyse de décision
11.1 Courbes Précision-Rappel (PRC) face aux données hautement déséquilibrées
Lorsque l’analyse prédictive aborde des événements psychopathologiques gravissimes mais statistiquement rares au sein de la population générale — tels que le suicide consommé (dont l’incidence annuelle avoisine 10 à 15 cas pour 100 000 habitants), les passages à l’acte homicide ou les décompensations psychotiques inaugurales —, l’échantillon d’analyse présente un déséquilibre de classes extrême. Dans ces configurations (par exemple 1 cas pathologique pour 1 000 sujets sains), la courbe ROC conventionnelle devient excessivement indulgente et peut susciter un optimisme trompeur.
Cette vulnérabilité provient de la formule de son axe horizontal : le taux de faux positifs (FP / [VN + FP]). Étant donné l’immensité de l’effectif des vrais négatifs VN dans les déséquilibres extrêmes, le dénominateur devient colossal. Par conséquent, la survenue de plusieurs centaines de faux positifs n’engendre qu’une augmentation imperceptible du taux de faux positifs, maintenant artificiellement la courbe ROC tout près de l’axe vertical et délivrant une AUC flatteuse supérieure à 0,90. Pourtant, sur le terrain clinique, l’équipe soignante est submergée par une déferlante de fausses alertes rendant le protocole d’évaluation totalement inopérant.
Pour surmonter cet écueil, l’épidémiologie computationnelle préconise l’emploi des courbes Précision-Rappel (Precision-Recall Curves, PRC). Cette représentation reporte en ordonnée la Précision — qui n’est autre que la Valeur Prédictive Positive [VP / (VP + FP)] — et en abscisse le Rappel — équivalent strict de la Sensibilité [VP / (VP + FN)]. La courbe PRC ignore complètement l’effectif des vrais négatifs ; elle focalise son intégration exclusivement sur la sous-population des prédictions positives. Dès lors que le nombre de faux positifs augmente, la précision s’effondre instantanément, dégradant impitoyablement l’Aire sous la courbe Précision-Rappel (PR-AUC). Face à des données psychopathologiques sévèrement asymétriques, l’évaluation par courbe PRC constitue le standard de rigueur incontournable.
11.2 L’Aire sous la courbe partielle (pAUC)
L’un des reproches conceptuels majeurs adressés à l’AUC classique concerne son mode d’agrégation holistique : elle intègre les performances du test sur l’intégralité du domaine [0, 1] du taux de faux positifs. Or, dans la quasi-totalité des applications en santé mentale, de vastes segments de la courbe ROC sont totalement dépourvus de toute applicabilité clinique concevable. Aucun responsable de centre de diagnostic ou d’institution hospitalière n’envisagerait d’adopter un seuil opérationnel tolérant un taux de faux positifs de 40, 50 ou 70 %.
L’analyse par l’Aire sous la courbe partielle (notée pAUC, pour Partial AUC), formalisée initialement par McClish (1989), répond à cette critique en restreignant délibérément le calcul de l’intégrale à la seule fenêtre de performance cliniquement admissible. L’analyste borne par exemple le calcul de l’aire au domaine où la spécificité demeure impérativement supérieure ou égale à 90 %, ce qui correspond à l’intervalle restreint d’intégration du taux de faux positifs [0 ≤ 1 – Sp ≤ 0,10] :
pAUC(e_0) = int_{0}^{e_0} Sensibilité(x) , dx
où e0 désigne le taux maximal de fausses alertes toléré par le protocole (ici 0,10). Afin d’autoriser des comparaisons intelligibles entre des instruments évalués sur des plages partielles diverses, McClish a introduit une standardisation normalisée de la pAUC, projetant la valeur obtenue sur une échelle équivalente comprise entre 0,5 (indiscrimination sur le segment) et 1,0 (séparation parfaite). Cette focalisation chirurgicale sur la zone d’intérêt décisionnel réel permet de départager des instruments psychométriques concurrents dont les trajectoires globales divergent précisément dans les tranches d’ultra-haute spécificité.
11.3 Analyse des courbes de décision (Decision Curve Analysis – DCA)
Bien que l’analyse ROC et ses variantes quantifient avec raffinement la précision diagnostique statistique, elles demeurent fondamentalement muettes sur une question clinique essentielle : « L’utilisation effective de ce test psychométrique améliore-t-elle concrètement les décisions de prise en charge et le pronostic des patients par rapport à une pratique de soins standard ? ». Pour combler le fossé entre statistique inférentielle et utilité clinique appliquée, Vickers et Elkin (2006) ont développé une méthodologie d’avant-garde : l’Analyse des Courbes de Décision (DCA).
La DCA repose sur le concept de Bénéfice Net (Net Benefit, noté NB). Elle postule que le seuil de probabilité diagnostique (pt) à partir duquel un praticien décide de prescrire un traitement ou une psychothérapie capture implicitement le rapport d’arbitrage subjectif entre le préjudice de ne pas traiter un sujet malade et les dommages d’administrer une thérapeutique à un sujet sain. Le calcul du bénéfice net s’exprime en unités de vrais positifs équivalents selon l’équation fondamentale :
Bénéfice Net = frac{VP}{N} – left(frac{FP}{N} times frac{p_t}{1 – p_t}right)
où N désigne la taille totale de la cohorte évaluée et pt la probabilité critique de décision. L’analyse trace graphiquement le Bénéfice Net en fonction d’un continuum de seuils décisionnels pt, et compare la courbe du modèle psychométrique évalué à deux stratégies décisionnelles par défaut universelles :
- La stratégie « Traiter tout le monde » (considérer l’ensemble des consultants comme atteints sans distinction).
- La stratégie « Ne traiter personne » (bénéfice net nul par définition).
Un instrument psychométrique ou un algorithme prédictif ne démontre une réelle utilité clinique que si sa courbe de décision se positionne nettement au-dessus des deux lignes de stratégies par défaut sur la plage des probabilités seuils considérées comme raisonnables par les praticiens. En santé mentale contemporaine, le couplage systématique d’une analyse ROC robuste et d’une courbe de décision DCA incarne l’état de l’art pour légitimer l’adoption d’un nouvel outil dans les référentiels de médecine factuelle (Evidence-Based Practice).
12. Recommandations rédactionnelles et déontologiques pour les rapports cliniques
12.1 Conformité aux directives de publication scientifique (STARD et APA)
La diffusion publique et la publication scientifique de travaux impliquant l’analyse de courbes ROC en psychologie exigent une conformité stricte aux standards méthodologiques internationaux. Les chercheurs et cliniciens sont instamment tenus d’appliquer les lignes directrices de la déclaration STARD (Standards for Reporting of Diagnostic Accuracy Studies), réactualisées pour garantir la transparence intégrale des protocoles de précision diagnostique, ainsi que les recommandations de l’American Psychological Association (APA 7th edition).
Toute communication de résultats psychométriques adossés à une courbe ROC doit rigoureusement rapporter :
- L’estimation ponctuelle précise de l’AUC, obligatoirement assortie de son Erreur-Type (SE) et de son Intervalle de Confiance bilatéral à 95 % (IC 95 %), en précisant explicitement l’algorithme d’estimation employé (trapézoïdal non paramétrique, binormal ou bootstrap avec nombre d’itérations documenté).
- La justification théorique et empirique du critère diagnostique externe ayant servi de Gold Standard, accompagnée de la démonstration formelle du respect de l’aveuglement bilatéral (masquage réciproque des résultats).
- La publication exhaustive de la matrice de confusion brute (effectifs de VP, FP, VN, FN) correspondant à chaque seuil d’intérêt clinique majeur retenu, afin de permettre aux pairs d’effectuer des méta-analyses indépendantes.
- La description transparente du flux d’inclusion des participants via un diagramme de flux conforme aux normes STARD, précisant le traitement appliqué aux données manquantes, aux abandons de protocole et aux résultats de tests techniquement ininterprétables.
12.2 Communication transparente des seuils aux équipes pluridisciplinaires
Dans l’environnement interdisciplinaire des centres de santé mentale — réunissant psychiatres, psychologues, infirmiers spécialisés, assistants sociaux et éducateurs —, le psychologue assume la responsabilité déontologique de traduire les métriques abstraites en implications thérapeutiques tangibles et intelligibles. Il est impératif d’écarter vigoureusement toute illusion de vérité mécanique associée à un score seuil.
Le praticien doit expliciter auprès de ses confrères qu’un seuil psychométrique n’isole pas une rupture ontologique absolue entre santé et maladie mentale, mais matérialise une frontière opérationnelle de gestion du risque probabiliste. Présenter un score seuil comme une sentence binaire infaillible expose les patients au risque d’une stigmatisation catégorielle prématurée ou, inversement, au refus de soins préjudiciable pour des individus dont la détresse est manifeste mais dont le score s’échoue à un point en dessous de la valeur critique retenue.
Dans les comptes rendus d’examen psychologique, la communication des scores étalonnés doit s’accompagner d’une mise en contexte qualitative et holistique. Le résultat chiffré doit s’intégrer harmonieusement à l’analyse sémiologique des dynamiques de personnalité, aux antécédents biographiques, aux capacités adaptatives globales du sujet et à la réalité de son écosystème relationnel. Le score psychométrique n’a pas vocation à se substituer à la sagacité du jugement clinique ; il constitue une balise probabiliste rigoureuse destinée à l’éclairer et à le consolider.
12.3 Check-list pratique de l’évaluateur avant validation d’un seuil
Avant d’entériner formellement l’implémentation opérationnelle d’un score de coupure issu d’une analyse ROC au sein d’une structure de diagnostic ou d’un protocole expérimental, l’évaluateur méthodique se doit de passer au crible de sa réflexion critique les quatre points cardinaux suivants :
- Vérification de l’adéquation épidémiologique : Le niveau de prévalence caractérisant la cohorte d’étalonnage initiale est-il comparable à la prévalence prévalant au sein de mon milieu clinique d’exercice ? Si l’écart de prévalence est marqué, ai-je procédé au recalcul des Valeurs Prédictives Positives et Négatives attendues via le modèle bayésien ?
- Validation croisée et prévention du surajustement : Le score seuil d’optimisation a-t-il été testé et répliqué sur un échantillon indépendant de validation externe, ou tout au moins soumis à un protocole rigoureux de validation croisée k-fold (k-fold cross-validation) afin d’écarter tout artéfact d’optimisation locale ?
- Évaluation de l’asymétrie éthique des coûts : Les conséquences humaines, psychosociales et médicales directes d’un Faux Négatif ont-elles été confrontées sans complaisance aux préjudices induits par un Faux Positif ? La pondération mathématique adoptée (Youden versus pente d’iso-coût) reflète-t-elle fidèlement ces impératifs déontologiques ?
- Contrôle du biais différentiel de mesure : Le seuil sélectionné fonctionne-t-il de manière équitable et invariante quelles que soient les sous-populations d’usagers, ou induit-il un taux de faux positifs asymétrique et discriminatoire en fonction du genre, de l’âge chronologique ou du capital socioculturel et linguistique des individus évalués ?
Références
- Bamber, D. (1975). The area above the ordinal dominance graph and the area below the receiver operating characteristic graph. Journal of Mathematical Psychology, 12(4), 387-415. https://doi.org/10.1016/0022-2496(75)90001-2
- Beck, A. T., Steer, R. A., & Brown, G. K. (1996). Manual for the Beck Depression Inventory-II. Psychological Corporation.
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837-845. https://doi.org/10.2307/2531595
- Dorfman, D. D., & Alf, E. (1969). Maximum-likelihood estimation of parameters of signal-detection theory and determination of confidence intervals—Rating-method data. Journal of Mathematical Psychology, 6(3), 487-496. https://doi.org/10.1016/0022-2496(69)90019-4
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29-36. https://doi.org/10.1148/radiology.143.1.7063747
- McClish, D. K. (1989). Analyzing a portion of the ROC curve. Medical Decision Making, 9(3), 190-195. https://doi.org/10.1177/0272989X8900900307
- Metz, C. E. (1978). Basic principles of ROC analysis. Seminars in Nuclear Medicine, 8(4), 283-298. https://doi.org/10.1016/S0001-2998(78)80014-2
- Nasreddine, Z. S., Phillips, N. A., Bédirian, V., Charbonneau, S., Whitehead, V., Collin, I., Cummings, J. L., & Chertkow, H. (2005). The Montreal Cognitive Assessment, MoCA: A brief screening tool for mild cognitive impairment. Journal of the American Geriatrics Society, 53(4), 695-699. https://doi.org/10.1111/j.1532-5415.2005.53221.x
- Pencina, M. J., D’Agostino, R. B., D’Agostino, R. B., & Vasan, R. S. (2008). Evaluating the added predictive ability of a new marker: From area under the ROC curve to reclassification and beyond. Statistics in Medicine, 27(2), 157-172. https://doi.org/10.1002/sim.2929
- Peterson, W. W., Birdsall, T. G., & Fox, W. C. (1954). The theory of signal detectability. Transactions of the IRE Professional Group on Information Theory, 4(4), 171-212. https://doi.org/10.1109/TIT.1954.1057460
- Swets, J. A. (1988). Measuring the accuracy of diagnostic systems. Science, 240(4857), 1285-1293. https://doi.org/10.1126/science.3287615
- Vickers, A. J., & Elkin, E. B. (2006). Decision curve analysis: A novel method for evaluating prediction models. Medical Decision Making, 26(6), 565-574. https://doi.org/10.1177/0272989X06295361
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32-35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3″ target= »_blank » rel= »noopener »>https://doi.org/10.1002/1097-0142(1950)3:13.0.co;2-3