
Dans le champ de la modélisation statistique et de l’apprentissage automatique, la régression logistique occupe une place singulière. Conçue initialement pour surmonter l’inadéquation structurelle des moindres carrés ordinaires face aux variables dépendantes qualitatives, elle s’est imposée comme l’outil privilégié d’analyse lorsque l’événement étudié est binaire. Qu’il s’agisse de prédire le défaut de paiement d’un emprunteur, la rémission clinique d’un patient sous protocole thérapeutique ou la décision d’achat d’un consommateur, la méthode transforme un problème de classification discret en une estimation probabiliste continue. Cette transition du discret au continu trouve son expression la plus éloquente dans la courbe sigmoïde, représentation géométrique emblématique dont la courbure capture précisément l’accélération puis la saturation de la probabilité d’occurrence d’un phénomène.
Pourtant, malgré l’omniprésence des bibliothèques de calcul en Python, le tracé rigoureux et esthétiquement irréprochable d’une courbe de régression logistique demeure une épreuve technique pour de nombreux analystes et chercheurs. Entre la simple ligne droite erronée tracée par inadvertance sur des données dichotomiques, l’absence de dispersion visuelle des observations marginales et les écueils liés au calcul des intervalles de confiance par rééchantillonnage, la visualisation d’un modèle logistique exige une maîtrise conjointe des fondements mathématiques et des subtilités d’implémentation. Une figure scientifique ne doit pas se contenter d’illustrer une tendance : elle doit expliciter la distribution des observations réelles, traduire l’incertitude paramétrique du modèle et communiquer sans ambiguïté les dynamiques non linéaires sous-jacentes.
Ce guide exhaustif a pour vocation d’articuler la rigueur mathématique du modèle logistique avec les capacités de visualisation offertes par l’écosystème Python moderne, notamment à travers Seaborn, Matplotlib, Scikit-Learn et Statsmodels. En explorant pas à pas les dimensions conceptuelles, programmatiques et sémiotiques du tracé sigmoïdal, cet article propose une référence méthodologique complète. De l’estimation par maximum de vraisemblance à la calibration des bandes de confiance bootstrap, de la résolution de la surimpression des points par gigue visuelle jusqu’aux extensions multivariées et aux diagnostics d’influence, chaque étape est disséquée afin de vous permettre de produire des représentations graphiques répondant aux exigences des revues académiques les plus strictes.
1. Fondements théoriques de la régression logistique et pertinence de sa représentation graphique
1.1 Principe mathématique de la fonction logistique et du rapport des cotes
La régression logistique repose sur la modélisation de la probabilité conditionnelle qu’une variable dépendante binaire $Y in {0, 1}$ prenne la valeur $1$, sachant un vecteur de variables explicatives $X$. Contrairement au modèle de probabilité linéaire, qui postule une relation purement affine entre le prédicteur et l’espérance mathématique de la réponse, le cadre logistique contraint intrinsèquement les valeurs prédites à demeurer dans l’intervalle ouvert $]0, 1[$. Cette propriété découle de l’utilisation de la fonction de répartition de la loi logistique standard, plus communément appelée fonction sigmoïde ou fonction logistique standard. Sur le plan formel, la probabilité modélisée s’exprime selon l’équation canonique :
$$P(Y=1|X) = \pi(X) = \frac{1}{1 + e^{-(\beta_0 + \beta_1 X)}}$$
Pour appréhender la mécanique interne de cette fonction, il est indispensable de formaliser le concept de cote, couramment désigné sous le vocable anglo-saxon d’odds. La cote se définit comme le ratio de la probabilité de survenue d’un événement sur la probabilité de sa non-survenue, soit $\frac{\pi(X)}{1 – \pi(X)}$. Alors que la probabilité est strictement bornée par $0$ et $1$, la cote évolue sur la demi-droite positive $[0, +\infty[$. En appliquant le logarithme népérien à ce ratio, on obtient la transformation logit :
$$\text{logit}(\pi(X)) = \ln\left(\frac{\pi(X)}{1 – \pi(X)}\right) = \beta_0 + \beta_1 X$$
Cette linéarisation du rapport des cotes logarithmiques permet d’estimer les paramètres $\beta_0$ (l’ordonnée à l’origine ou log-odds de base) et $\beta_1$ (la pente ou variation du log-odds par unité de prédicteur). L’estimation ne repose pas sur la minimisation d’une somme de carrés résiduels, mais sur la maximisation de la fonction de vraisemblance de Bernoulli via des algorithmes itératifs d’optimisation numérique tels que Newton-Raphson ou le quasi-Newton L-BFGS. Un élément géométrique et conceptuel cardinal de cette formulation est le point d’inflexion, situé précisément à la probabilité critique $\pi(X) = 0{,}5$. À cet endroit, la dérivée seconde de la fonction sigmoïde s’annule, ce qui marque le passage d’une phase de croissance convexe à une phase de croissance concave. Sur l’axe des abscisses, ce seuil correspond à la valeur $X = -\frac{\beta_0}{\beta_1}$, fréquemment interprétée comme la frontière de décision naturelle départageant les classes prédites.
1.2 Nécessité de la visualisation graphique en modélisation binaire
Le recours à la représentation graphique s’avère bien plus critique dans le cadre de la régression logistique que dans celui de la régression linéaire classique. Lorsqu’un praticien tente d’ajuster un modèle linéaire ordinaire sur des observations dichotomiques, le graphique révèle immédiatement les apories méthodologiques de la démarche : la droite d’ajustement dépasse fatalement les bornes logiques $0$ et $1$ pour des valeurs extrêmes du prédicteur, créant des « probabilités » négatives ou supérieures à cent pour cent, tout en violant de manière irréversible l’hypothèse d’homoscédasticité des résidus.
La visualisation de la courbe sigmoïde superposée aux observations réelles permet d’évaluer d’un simple coup d’œil l’ampleur du chevauchement empirique entre les deux groupes. Dans les situations réelles, les classes $0$ et $1$ ne sont que rarement séparées de façon nette le long de l’axe des abscisses ; il existe presque toujours une zone de transition au sein de laquelle coexistent des individus appartenant aux deux catégories. Le tracé de la sigmoïde matérialise visuellement la vitesse à laquelle la probabilité bascule d’un régime à un autre, la pente $\beta_1$ gouvernant la raideur de cette transition.
Au-delà de la vérification technique, le support visuel constitue un instrument de communication indispensable pour expliciter des résultats statistiques auprès d’audiences interdisciplinaires. Si le concept de « variation du logarithme du rapport des cotes » rebute régulièrement les décideurs cliniques ou managériaux, la lecture d’une courbe en S bornée entre $0$ et $1$ offre une intuitivité immédiate. Enfin, l’examen graphique permet d’identifier des anomalies locales que les métriques globales d’ajustement, telles que l’information d’Akaike (AIC) ou le pseudo $R^2$ de McFadden, échouent parfois à signaler : présence de points aberrants exerçant un levier disproportionné, zones de densité creuse dans l’échantillon, ou bifurcations comportementales suggérant une violation de la fonction de liaison logit.
1.3 Applications empiriques en sciences comportementales et psychologie quantitative
En psychologie expérimentale et dans les sciences du comportement, la régression logistique sert de fondement analytique à de nombreux paradigmes d’investigation. La modélisation de la décision humaine ou de l’apparition d’un symptôme clinique pathologique se heurte invariablement à des mesures binaires : succès ou échec à une épreuve cognitive, maintien ou arrêt d’un protocole d’abstinence, survenue ou absence d’une crise d’angoisse lors d’une tâche d’induction de stress. Le tracé de la courbe logistique permet aux chercheurs de modéliser la propension comportementale non pas comme un phénomène binaire réducteur, mais comme une vulnérabilité sous-jacente continue dont la matérialisation obéit à un seuil d’activation non linéaire.
Dans l’étude des seuils décisionnels sous charge mentale ou privation de sommeil, la sigmoïde illustre la dégradation abrupte des performances. Alors qu’une baisse modérée de vigilance n’altère que peu la probabilité d’erreur jusqu’à un certain plateau de compensation cognitive, le passage d’une valeur seuil entraîne une hausse exponentielle du risque d’omission, avant de plafonner à un niveau d’erreur incompressible. Tracer cette courbe permet d’objectiver avec précision le point de bascule opérationnel où l’intervention humaine devient critique.
De même, la psychométrie computationnelle s’appuie largement sur ce formalisme à travers la théorie de la réponse aux items (TRI). La courbe caractéristique d’un item (CCI), qui relie le niveau d’un trait latent inobservable (comme l’anxiété ou l’aptitude verbale) à la probabilité de donner une réponse positive à une question spécifique, n’est rien d’autre qu’une déclinaison théorique de la fonction logistique univariée. La représentation visuelle de cette courbe informe directement le psychomètre sur la difficulté de l’item (son point d’inflexion) et sur son pouvoir discriminant (sa pente au centre), validant ainsi la qualité métrologique des questionnaires standardisés utilisés à l’échelle internationale.
2. Environnement technique et préparation des bibliothèques Python
2.1 Configuration de l’écosystème scientifique
La mise en œuvre pratique de visualisations statistiques avancées en Python requiert l’assemblage cohérent de plusieurs bibliothèques complémentaires. L’environnement d’analyse s’articule autour de deux piliers structurants : NumPy pour le calcul matriciel et la manipulation efficace des tableaux multidimensionnels, et Pandas pour la manipulation tabulaire des jeux de données hétérogènes. Ces structures forment le socle indispensable sur lequel reposent tant les moteurs d’estimation statistique que les utilitaires de rendu graphique.
Concernant la production visuelle, la bibliothèque fondamentale Matplotlib, et plus particulièrement son interface procédurale `matplotlib.pyplot`, fournit le moteur de bas niveau autorisant un contrôle micrométrique sur chaque élément géométrique du graphique (axes, graduations, textes, bordures). Au-dessus de cette couche, la bibliothèque de haut niveau Seaborn déploie des fonctions statistiques spécialisées intégrant nativement des algorithmes d’ajustement et d’estimation d’incertitude par rééchantillonnage, simplifiant grandement le prototypage exploratoire.
Pour le calcul algorithmique des paramètres de régression, deux approches méthodologiques distinctes mais complémentaires doivent être intégrées à l’environnement : Scikit-Learn (via le module `linear_model.LogisticRegression`), privilégié pour sa rapidité d’exécution, son intégration dans des chaînes de traitement automatisées et ses solveurs régularisés, et Statsmodels (via `statsmodels.api.Logit`), incontournable pour l’inférence statistique formelle, le calcul exact des erreurs types asymptotiques et l’édition de bilans paramétriques détaillés. Dans les carnets de travail interactifs de type Jupyter ou Google Colab, il est primordial de verrouiller la reproductibilité de l’environnement en consignant les versions précises de ces dépendances, afin de prémunir les scripts contre les dépréciations d’arguments au fil des versions.
2.2 Paramétrage global des styles graphiques académiques
L’esthétique graphique ne relève pas d’une simple coquetterie cosmétique ; elle conditionne directement l’efficacité cognitive avec laquelle le lecteur assimile l’information quantitative. Pour conférer un aspect académique et professionnel aux représentations issues de Python, il convient d’établir dès le début du script un paramétrage global des propriétés de style. La fonction `seaborn.set_theme()` permet de définir une base épurée en adoptant par exemple le style `’ticks’` ou `’white’`, qui élimine la grille de fond omniprésente souvent considérée comme un bruit graphique superflu selon les préceptes de transmission de données établis par Edward Tufte.
La typographie, la taille des polices et la résolution globale doivent être calibrées en amont à travers les dictionnaires de paramètres `matplotlib.rcParams`. Fixer une taille de police par défaut de 11 ou 12 points pour les libellés d’axes et de 13 à 14 points pour les titres assure une lisibilité sans faille après réduction typographique dans le corps d’un article publié en double colonne. De même, la définition d’une résolution par défaut de 300 points par pouce (DPI) garantit la netteté des tracés lors des prévisualisations sur écran haute densité.
Enfin, le choix des palettes chromatiques doit respecter les critères modernes d’accessibilité visuelle. L’utilisation de contrastes nets et de palettes perceptuellement uniformes (comme Viridis, Cividis ou des déclinaisons sobres de bleu et de gris ardoise) garantit que les figures demeurent parfaitement interprétables pour les personnes atteintes de déficiences de la vision des couleurs (daltonisme). Ce choix préserve également la lisibilité du document lors d’une impression en noir et blanc, où les nuances de gris doivent suffire à distinguer la courbe théorique de la dispersion empirique des points.
3. Acquisition et structuration des données pour l’analyse logistique
3.1 Chargement et inspection initiale du jeu de données
Pour illustrer de manière concrète la modélisation logistique, le jeu de données économique et financier `Default`, popularisé par James, Witten, Hastie et Tibshirani dans leur ouvrage de référence An Introduction to Statistical Learning, constitue un support didactique idéal. Ce jeu de données synthétise le comportement de remboursement de dix mille clients bancaires, en consignant leur statut de défaut de paiement, leur solde débiteur moyen après paiement mensuel (`balance`), leur revenu annuel (`income`) et leur statut d’étudiant (`student`).
L’acquisition des données s’effectue traditionnellement via l’instruction `pandas.read_csv()`, ciblant un référentiel distant sécurisé ou un stockage local. Dès le chargement opéré, une inspection systématique de l’intégrité tabulaire s’impose. L’exécution de la méthode `head()` permet d’appréhender visuellement les premières lignes du corpus, tandis que l’appel combiné à `info()` et `describe()` fournit une cartographie exhaustive de la structure des colonnes, des types primitifs de données (flottants, entiers, objets) et des volumes scalaires.
Cette étape d’audit initial doit impérativement valider l’absence de valeurs manquantes (`NaN`), qui interrompraient les solveurs de maximisation de vraisemblance, ainsi que l’inexistence d’aberrations numériques manifestes, telles que des soldes bancaires strictement négatifs ou des revenus infiniment élevés qui fausseraient l’estimation de la pente logistique univariée.
3.2 Préparation et codage des variables explicatives et cibles
Les bibliothèques d’estimation statistique exigent une conformité stricte des types de données pour opérer sans friction. Dans le jeu de données `Default`, la variable cible désignant l’insolvabilité de l’individu est fréquemment enregistrée sous la forme de chaînes de caractères catégorielles (`’Yes’` et `’No’`). Pour autoriser le traitement mathématique, cette variable dichotomique doit être formellement recodée en valeurs binaires discrètes d’entiers naturels, où la modalité d’échec ou d’absence est fixée à $0$ (`’No’`), et celle d’intérêt — en l’occurrence la défaillance financière — est assignée à $1$ (`’Yes’`).
Cette transformation s’opère de façon transparente via une opération de mappage Pandas ou l’utilisation d’une instruction booléenne vectorisée. Parallèlement, la variable prédictive continue sélectionnée pour la modélisation univariée — ici, le solde bancaire résiduel `balance` — doit être isolée sous la forme d’une série numérique unidimensionnelle ou d’une matrice colonne.
Bien que la régression logistique à un seul prédicteur continue ne requière pas obligatoirement une standardisation préalable pour converger (contrairement aux modèles pénalisés par régularisation Ridge ou Lasso), il demeure essentiel de vérifier que la variable explicative se déploie sur une échelle numérique continue dépourvue de discontinuités artificielles. Dans le cas d’algorithmes d’optimisation sensibles aux échelles de grandeurs, une normalisation (soustraction de la moyenne et division par l’écart-type) peut être appliquée pour stabiliser le conditionnement de la matrice hessienne lors de l’inversion numérique des gradients.
3.3 Exploration descriptive de la distribution marginale
Avant d’ajuster le moindre modèle prédictif, il est primordial de mener une analyse descriptive de la répartition marginale des données. Le premier écueil analytique à quantifier est le déséquilibre de classe : dans le jeu de données `Default`, seule une infime minorité d’individus (environ 3,33 %) se retrouve en situation de défaut effectif de paiement. Cette dissymétrie prononcée entre la fréquence des zéros et celle des uns exerce une influence déterminante sur l’ordonnée à l’origine du modèle $\beta_0$, décalant massivement le point d’inflexion théorique vers les valeurs très élevées du prédicteur.
Pour apprécier visuellement la dynamique de séparation, l’analyste peut générer un graphique des densités conditionnelles de la variable explicative conditionnellement aux deux états de la variable cible. En projetant la fonction de densité de probabilité (estimée par noyau gaussien, ou KDE) du solde bancaire pour le sous-échantillon non défaillant face au sous-échantillon défaillant, on observe de manière flagrante un décalage substantiel vers la droite des individus insolvables. Les clients en défaut affichent quasi systématiquement des soldes bancaires considérablement plus élevés.
Cette dissociation spatiale des deux distributions marginales conforte l’hypothèse selon laquelle le solde bancaire constitue un prédicteur hautement discriminant, justifiant l’application d’un modèle sigmoïdal destiné à quantifier la probabilité croissante de défaut au fur et à mesure que le solde progresse le long de l’axe continu.
4. Traçage direct avec Seaborn : Exploitation optimale de regplot()
4.1 Syntaxe fondamentale et mécanisme sous-jacent
La bibliothèque Seaborn offre sans conteste l’interface la plus directe et concise pour tracer une courbe de régression logistique sans nécessiter l’instanciation préalable manuelle d’un estimateur algorithmique. Cette prouesse est matérialisée par la fonction `seaborn.regplot()`. Dans sa configuration standard destinée à l’analyse linéaire, cette fonction calcule et trace une droite par les moindres carrés. Cependant, la simple activation de l’argument booléen `logistic=True` métamorphose le comportement interne de la fonction, commandant le calcul d’un modèle logistique univarié complet.
Sous le capot, Seaborn ne réinvente pas la roue statistique : il délègue l’estimation des paramètres $\beta_0$ et $\beta_1$ au moteur inférentiel de Statsmodels. La fonction transmet les vecteurs spécifiés dans les arguments `x` et `y` à l’algorithme `statsmodels.api.Logit`, qui procède à l’ajustement par maximum de vraisemblance. Une fois les coefficients optimisés obtenus, Seaborn génère automatiquement une grille dense de points équidistants le long de l’étendue de l’axe des abscisses, calcule la probabilité prédite pour chacun de ces points selon la formule sigmoïde, puis trace la courbe résultante avec une remarquable fluidité géométrique.
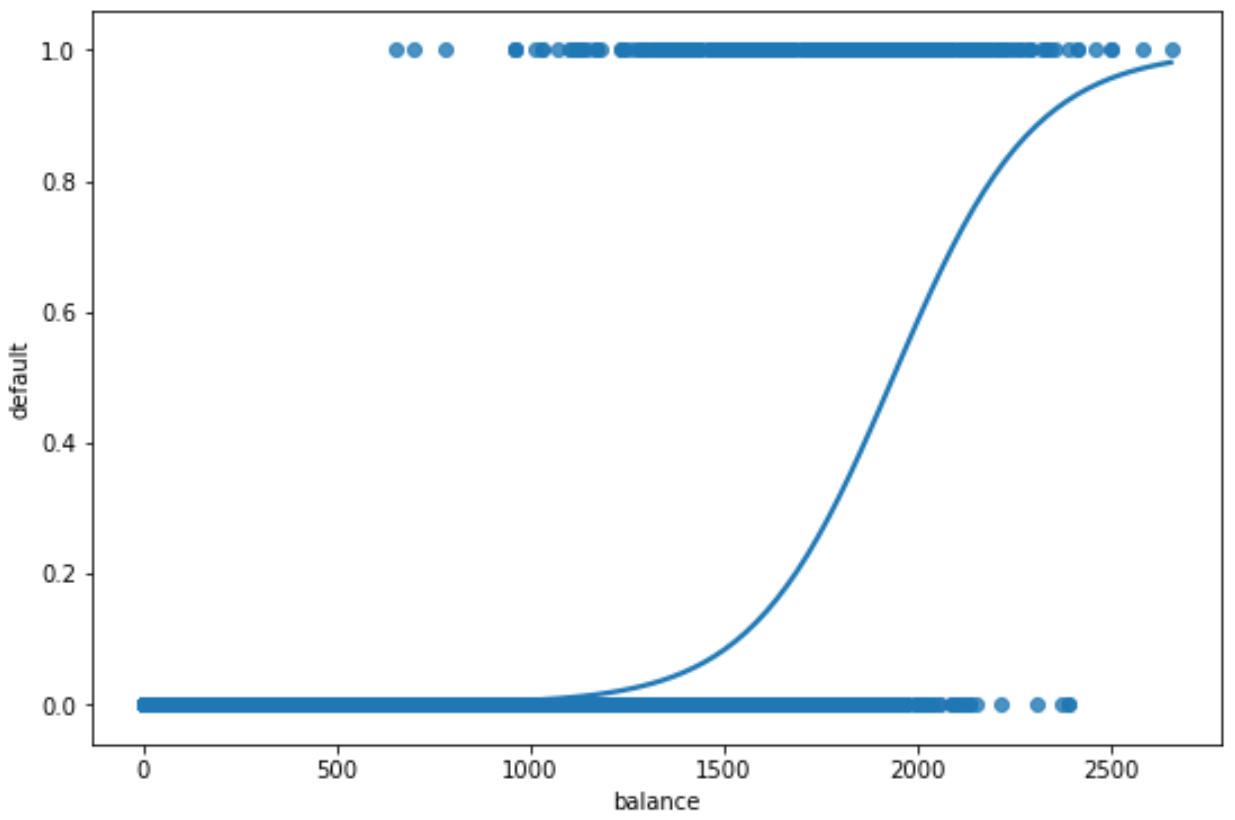
Simultanément, les données empiriques brutes sont projetées sur le canevas sous forme de nuage de points (`scatter`), matérialisant les occurrences effectives sur les deux rails horizontaux d’ordonnée $y = 0$ et $y = 1$. Cette dualité graphique — fusionnant dans un appel de fonction unique l’affichage des données observées discrètes et la trajectoire probabiliste théorique — fait de `regplot()` l’outil exploratoire le plus puissant de l’écosystème Python pour le diagnostic rapide d’une association logistique.
4.2 Résolution des conflits d’estimation et convergence
Bien que l’usage de `regplot(x=’balance’, y=’default’, data=df, logistic=True)` apparaisse d’une simplicité désarmante, son exécution pratique peut se heurter à des dysfonctionnements computationnels complexes. Le problème le plus fréquent réside dans l’apparition d’avertissements explicites d’optimisation émis par Statsmodels, signalant une non-convergence de l’algorithme ou un dépassement du nombre maximal d’itérations autorisées. Ce phénomène surgit généralement lorsque les données présentent une séparation quasi-complète (les valeurs d’une classe ne chevauchent presque pas l’autre), entraînant une divergence des coefficients vers l’infini numérique.
Une autre source majeure de blocage réside dans le volume de l’échantillon combiné à l’estimation des bandes d’incertitude. Par défaut, `regplot()` tente d’estimer l’intervalle de confiance autour de la courbe au moyen d’une procédure de rééchantillonnage bootstrap. Si le jeu de données comprend plusieurs dizaines de milliers d’observations, l’exécution répétée de centaines de régressions logistiques itératives via Statsmodels peut paralyser temporairement l’environnement d’exécution, donnant l’illusion d’un gel complet du script Python.
Pour prévenir ces écueils de convergence, l’analyste doit inspecter au préalable la distribution conjointe de ses variables afin de s’assurer d’un volume suffisant de cas positifs et négatifs sur l’ensemble du domaine de variation du prédicteur. Si le solveur de Statsmodels rencontre des difficultés numériques lors de l’inversion de la matrice d’information de Fisher, il devient nécessaire de filtrer les valeurs aberrantes extrêmes ou de désactiver temporairement les fonctionnalités de rééchantillonnage intensif afin de vérifier l’adéquation de la fonction de liaison logit sur les données brutes.
4.3 Exécution programmatique pas à pas
La mise en œuvre concrète d’une figure logistique minimale avec Seaborn se déroule selon une séquence d’instructions linéaire mais rigoureuse. L’analyste commence par importer les modules requis (`import matplotlib.pyplot as plt` et `import seaborn as sns`), puis prépare son canevas en instanciant une figure et un système d’axes via `plt.subplots(figsize=(9, 5))`. Cette étape préalable d’initialisation de l’objet `Axes` est cruciale, car elle permet de conserver une maîtrise absolue sur les dimensions physiques de la figure avant d’y injecter le tracé Seaborn.
L’appel à la fonction est ensuite formulé en rattachant explicitement la sortie graphique à l’axe nouvellement créé via l’argument `ax=ax`. Les paramètres nominaux spécifient la source de données tabulaire `data=df`, le nom de la colonne prédictive `x=’balance’` et la colonne binaire encodée `y=’default’`. En adjoignant `logistic=True`, la fonction déclenche les calculs décrits précédemment et restitue la composition graphique complète.
Dès l’affichage du rendu final au moyen de l’instruction `plt.show()`, l’analyste peut vérifier la cohérence visuelle globale. La courbe doit présenter une courbure asymptotique parfaite, s’étirant de manière tangente vers l’ordonnée zéro sur la gauche du graphique pour les soldes bancaires modestes, avant d’amorcer une remontée progressive et de s’infléchir vers l’ordonnée un lorsque le solde bancaire franchit des niveaux critiques situés au-delà de 1 500 à 2 000 unités monétaires. Ce premier résultat offre une confirmation visuelle immédiate de la validité de la spécification logistique.
5. Paramétrage avancé et gestion des intervalles de confiance avec regplot()
5.1 Estimation et affichage des bandes de confiance bootstrap
L’une des fonctionnalités les plus sophistiquées de `seaborn.regplot()` réside dans sa capacité à quantifier visuellement l’incertitude structurelle du modèle par l’adjonction d’une bande de confiance translucide ceignant la courbe sigmoïde. Par défaut, l’argument `ci=95` stipule le calcul d’un intervalle de confiance à 95 %. Contrairement aux méthodes analytiques linéaires standard qui exploitent directement la matrice de variance-covariance des paramètres, Seaborn applique une méthode non paramétrique de rééchantillonnage aléatoire avec remise (bootstrap).
À chaque itération de bootstrap, un nouvel échantillon de même taille que le jeu d’origine est synthétisé, un nouveau modèle logistique est ajusté, et une nouvelle courbe sigmoïde est évaluée. La bande ombrée représente l’intervalle interquartile empirique borné par les 2,5e et 97,5e percentiles des prédictions cumulées sur l’ensemble des réplications. Cette approche possède l’immense avantage de ne formuler aucune hypothèse préalable quant à la normalité asymptotique de la distribution d’échantillonnage des coefficients, ce qui la rend remarquablement robuste face aux échantillons asymétriques.
Toutefois, cette rigueur a un coût computationnel considérable. Si le temps de calcul devient prohibitif lors du traitement d’échantillons massifs, l’utilisateur peut calibrer le nombre d’itérations via le paramètre `n_boot` (par exemple `n_boot=500` au lieu de 1000), ou désactiver purement et simplement le calcul de l’incertitude en spécifiant explicitement `ci=None`. Cette désactivation libère instantanément les ressources processeur, permettant d’obtenir un tracé épuré et ultra-rapide lorsque seule l’estimation ponctuelle moyenne est recherchée.
5.2 Contrôle du jittering pour disperser les données binaires superposées
Un défaut graphique majeur inhérent à la représentation brute des modèles de classification binaire réside dans la surimpression massive des observations. Les données réelles ne pouvant prendre que les valeurs discrètes $0$ ou $1$, des milliers d’observations s’agglutinent sur deux lignes géométriquement infiniment fines aux extrémités supérieure et inférieure du repère. Cette superposition dense crée un écran d’opacité totale qui masque entièrement au lecteur la concentration locale et la densité relative des points.
Pour résoudre avec élégance cette occlusion visuelle, la fonction `regplot()` met à disposition l’argument `y_jitter`. Ce paramètre introduit une perturbation stochastique contrôlée — un bruit aléatoire uniforme ou gaussien — sur l’axe vertical des données affichées. En spécifiant une valeur scalaire modérée, par exemple `y_jitter=0.03`, les points discrets se dispersent délicatement autour des rails $y = 0$ et $y = 1$, s’étalant typiquement dans des couloirs compris entre $[-0.03, +0.03]$ et $[0.97, 1.03]$.
Il est fondamental de souligner que cette gigue artificielle (`jittering`) est purement graphique : elle n’altère en rien les valeurs numériques réelles transmises au solveur logistique et ne modifie nullement l’équation de la sigmoïde ajustée. En combinant judicieusement ce décalage spatial avec un coefficient de transparence des marqueurs réduit (argument `scatter_kws={‘alpha’: 0.15}`), les zones concentrant une forte densité d’observations apparaissent visuellement plus sombres et saturées, tandis que les régions d’occurrences sporadiques restent pâles, restituant fidèlement au regard la véritable topographie de l’échantillon.
5.3 Personnalisation des marqueurs et de la ligne de régression
Pour hisser une figure au niveau des standards éditoriaux les plus stricts, `seaborn.regplot()` permet de piloter indépendamment l’apparence des points d’observation et celle de la trajectoire sigmoïdale ajustée. Cette personnalisation fine s’effectue au moyen de dictionnaires d’arguments transmis respectivement aux paramètres `scatter_kws` (qui contrôle l’objet `PathCollection` des points) et `line_kws` (qui gouverne l’objet `Line2D` de la courbe).
La distinction visuelle entre le modèle mathématique continu et les mesures empiriques discrètes doit être immédiate. À ce titre, il est recommandé d’attribuer une teinte sombre et neutre aux observations réelles — telle qu’un gris anthracite ou un bleu nuit atténué — tout en réduisant leur diamètre via `scatter_kws={‘s’: 15, ‘alpha’: 0.2, ‘color’: ‘#4A5568’}`. Ce traitement efface la présence intrusive des milliers de points individuels pour ne laisser transparaître que leur distribution de masse globale.
À l’inverse, la courbe de régression logistique doit polariser l’attention du lecteur. On lui assignera une couleur saturée et contrastée (comme un bleu cobalt `#2B6CB0` ou un rouge carmin profond), associée à une épaisseur de trait affirmée (`line_kws={‘color’: ‘#C53030’, ‘linewidth’: 2.5}`). Ce contraste chromatique et dimensionnel hiérarchise instantanément l’image : l’œil identifie d’abord la tendance générale modélisée avant d’analyser dans un second temps la variabilité et les écarts des données sous-jacentes.
6. Approche manuelle et déterministe avec Scikit-Learn et Matplotlib
6.1 Ajustement explicite du modèle LogisticRegression
Si Seaborn séduit par son haut degré d’automatisation, la construction manuelle et déterministe d’une courbe de régression logistique via Scikit-Learn et Matplotlib offre un contrôle algorithmique incomparablement supérieur. Cette approche décorrèle totalement l’étape d’optimisation numérique de l’étape de rendu graphique, permettant d’inspecter, de manipuler et de valider les paramètres statistiques avant toute mise en image. La première phase consiste à instancier la classe `LogisticRegression` issue du sous-module `sklearn.linear_model`.
Le paramétrage de l’estimateur exige une attention rigoureuse. Par défaut, Scikit-Learn applique une pénalisation de norme $L_2$ régie par le terme d’hyperparamètre $C=1.0$. Pour émuler une régression logistique classique par maximum de vraisemblance non biaisée — identique à celle de la littérature statistique traditionnelle —, il convient de désactiver la régularisation en configurant `penalty=None` (ou en fixant $C$ à une valeur arbitrairement gigantesque comme `C=1e9` sur les versions antérieures). Le choix du solveur, tel que `solver=’lbfgs’`, assure une convergence rapide et numériquement stable.
L’ajustement s’opère via la méthode standard `.fit(X, y)`. Une contrainte technique impérative de Scikit-Learn est que la matrice des variables indépendantes $X$ doit être strictement bidimensionnelle, adoptant la forme `(n_samples, n_features)`. L’analyste doit ainsi convertir la série unidimensionnelle du solde bancaire en une matrice colonne au moyen de `df[[‘balance’]].values` ou `df[‘balance’].values.reshape(-1, 1)`. Une fois le modèle ajusté, l’extraction des grandeurs structurelles s’effectue via les attributs publics `model.intercept_[0]` (qui fournit le scalaire $\beta_0$) et `model.coef_[0][0]` (qui restitue la pente $\beta_1$).
6.2 Génération de la grille de prédiction continue
Une fois les paramètres du modèle logistique gravés dans la mémoire de l’estimateur, l’erreur classique du débutant consiste à vouloir tracer la courbe en appliquant directement les prédictions sur les points du jeu de données initial. Dans la mesure où les observations réelles ne sont ni triées par ordre croissant de solde bancaire ni uniformément distribuées le long du spectre, une telle tentative produit un tracé désordonné en « dents de scie » totalement inexploitable. Il est impératif de construire un espace géométrique synthétique supportant le tracé continu.
Cette grille s’élabore avec une grande élégance grâce à la fonction `numpy.linspace()`. L’analyste extrait la valeur minimale et la valeur maximale observées du prédicteur dans l’échantillon empirique, puis génère un vecteur unidimensionnel dense composé typiquement de 500 à 1000 points régulièrement espacés : `x_grid = np.linspace(df[‘balance’].min(), df[‘balance’].max(), 500)`. Cette densité assure que la courbe sigmoïde ne présentera aucune brisure polygonale perceptible à l’œil nu.
Ce vecteur synthétique est ensuite reformaté en matrice colonne bidimensionnelle (`x_grid.reshape(-1, 1)`) afin d’être soumis à la méthode d’inférence probabiliste `model.predict_proba()`. Cette méthode renvoie un tableau de dimension `(500, 2)` contenant les probabilités calculées pour chaque classe. La seconde colonne (`[:, 1]`) correspond exactement à l’estimation de $P(Y=1|X)$. L’analyste peut d’ailleurs vérifier la rigueur de cette inférence en recalculant ces probabilités manuellement par application directe de la formule mathématique : `1 / (1 + np.exp(-(model.intercept_[0] + model.coef_[0][0] * x_grid)))`. Les deux vecteurs ainsi obtenus coïncident à la précision machine près.
6.3 Composition graphique intégrale avec Matplotlib
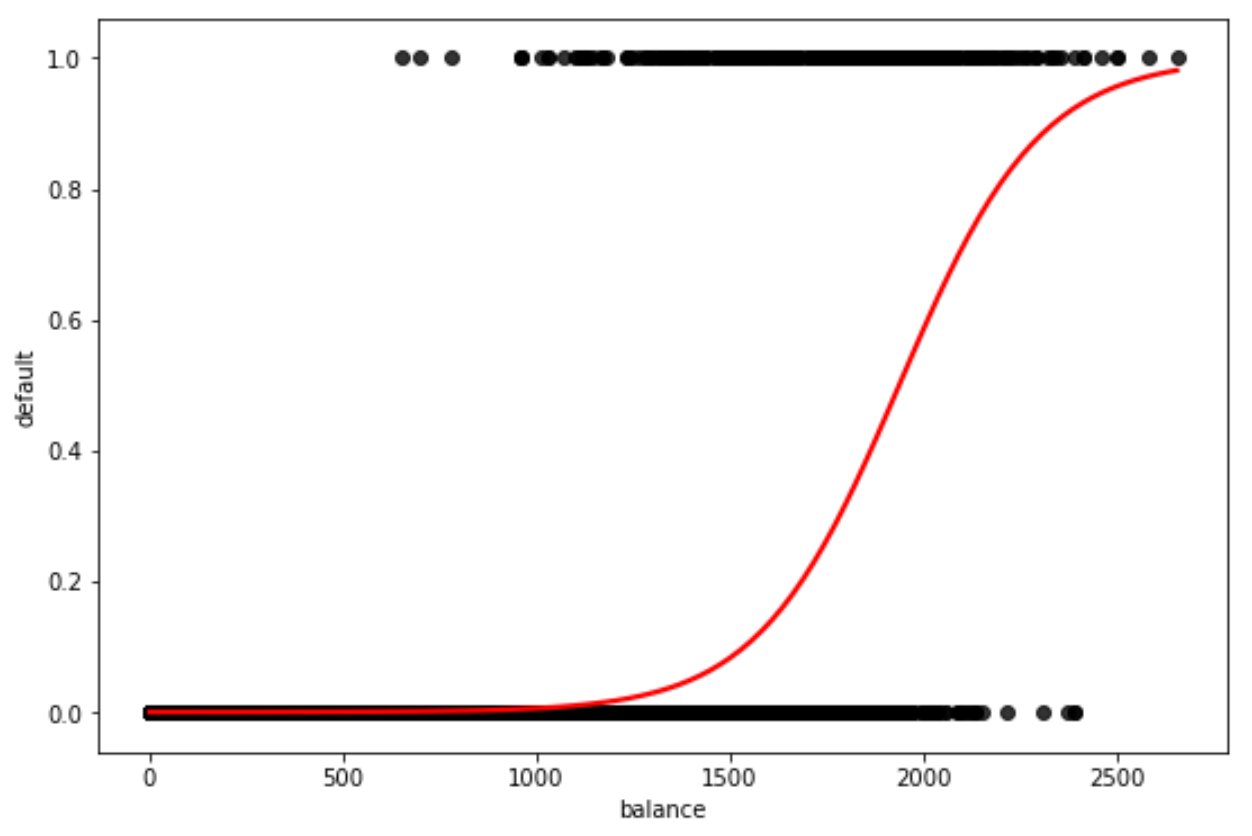
Disposant d’un côté des données d’observation brutes et de l’autre de la grille prédictive continue, l’assemblage géométrique s’orchestre directement au sein d’une figure Matplotlib de bas niveau. Cette décomposition procure une liberté créative totale dans l’agencement des calques visuels. La première couche graphique se compose du nuage de points expérimental généré par la fonction `ax.scatter()`, en appliquant manuellement une légère gigue verticale calculée avec `numpy.random.normal()` pour aérer les classes superposées :
La seconde couche, superposée à la première, accueille la courbe continue modélisée via l’instruction `ax.plot(x_grid, y_probs, color=’#0D47A1′, linewidth=2.5, label=’Probabilité logistique estimée’)`. La courbure mathématique apparaît alors dans toute sa pureté analytique, flottant au-dessus des observations réelles.
Pour parachever la lisibilité conceptuelle du modèle, il est hautement recommandé d’ajouter des repères géométriques contextuels. L’appel à `ax.axhline(y=0.5, color=’gray’, linestyle=’–‘, linewidth=1, alpha=0.7)` trace la ligne horizontale matérialisant le seuil critique d’équiprobabilité. De plus, en calculant la coordonnée transversale d’inflexion $x_{\text{seuil}} = -\frac{\beta_0}{\beta_1}$, l’analyste peut projeter une ligne verticale descendante `ax.axvline(x=x_seuil, color=’firebrick’, linestyle=’:’)`, reliant visuellement le point d’inflexion de la sigmoïde à la valeur pivot correspondante sur l’axe des abscisses. Cette triangulation graphique explicite instantanément la règle de décision bayésienne sous-jacente.
7. Modélisation statistique inférentielle et courbe sigmoïde avec Statsmodels
7.1 Ajustement par Maximum de Vraisemblance (Logit)
Tandis que Scikit-Learn privilégie une approche orientée prédiction et génie logiciel, la bibliothèque Statsmodels incarne la tradition de la statistique inférentielle rigoureuse. L’ajustement d’un modèle logistique via la classe `statsmodels.api.Logit` repose sur la formalisation matricielle classique des modèles linéaires généralisés (GLM). Une spécificité fondamentale de Statsmodels — qui déroute fréquemment les praticiens habitués à d’autres écosystèmes — est qu’il n’inclut pas d’ordonnée à l’origine par défaut. L’analyste doit explicitement enrichir sa matrice de conception avec une colonne unitaire constante au moyen de l’instruction `statsmodels.api.add_constant(X)`.
L’optimisation des paramètres s’exécute par l’appel de la méthode `.fit()`, qui met en œuvre un algorithme de Newton-Raphson standard et affiche dans la console les étapes itératives de minimisation de la log-vraisemblance négative. L’objet résultat renvoyé, conventionnellement nommé `results`, recèle un volume colossal d’informations diagnostiques condensées dans la méthode `results.summary()`. Ce tableau synthétique récapitule non seulement les valeurs estimées des coefficients $\beta_0$ et $\beta_1$, mais également leurs erreurs types asymptotiques (`std err`), les statistiques de test de Wald associées (`z`), les p-valeurs correspondantes (`P > |z|`) ainsi que les intervalles de confiance à 95 % des paramètres.
La lecture de ce sommaire permet de statuer formellement sur la significativité statistique de la variable prédictive : une p-valeur infinitésimale associée au solde bancaire apporte la preuve mathématique que la pente de la sigmoïde diffère significativement de zéro, réfutant l’hypothèse nulle d’indépendance stochastique entre l’endettement résiduel et la probabilité de défaillance financière.
7.2 Extraction des intervalles de confiance analytiques
L’un des apports majeurs de Statsmodels pour la représentation graphique réside dans la possibilité de calculer des intervalles de confiance asymptotiques parfaitement exacts et continus, sans recourir aux simulations stochastiques chronophages du bootstrap. La dérivation de ces bornes repose sur la méthode delta, qui projette la variance de l’estimateur de l’espace linéaire non borné du logit vers l’espace contraint des probabilités.
En pratique, l’analyste génère une matrice synthétique d’abscisses munie de sa colonne de constante unitaire, puis fait appel à la méthode `results.get_prediction(x_grid_with_const)`. L’objet de prédiction qui en résulte possède une méthode `summary_frame(alpha=0.05)` restituant un tableau structuré contenant pour chaque coordonnée : l’espérance mathématique de la probabilité prédite (`predicted`), l’erreur type associée, ainsi que les limites inférieures (`ci_lower`) et supérieures (`ci_upper`) de l’intervalle de confiance théorique au niveau requis.
Cette démarche confère une précision graphique chirurgicale. Pour matérialiser cette marge d’erreur analytique sur le repère Matplotlib, on utilise la fonction de remplissage surfacique :
`ax.fill_between(x_grid, pred_df[‘ci_lower’], pred_df[‘ci_upper’], color=’#1E88E5′, alpha=0.25, label=’Intervalle de confiance à 95 % (analytique)’)`
Cette zone ombrée épouse intimement la courbure sigmoïde, se rétrécissant dans les régions densément pourvues en observations empiriques pour s’élargir aux abords des frontières de l’échantillon où la variance d’échantillonnage s’accroît sous l’effet de la raréfaction des données.
7.3 Comparaison méthodologique : Seaborn, Scikit-Learn et Statsmodels
Face à la multiplicité des outils disponibles en Python pour tracer une régression logistique, le choix de la méthodologie appropriée dépend étroitement des objectifs scientifiques et computationnels poursuivis par le chercheur. Aucune bibliothèque ne surpasse universellement les autres ; chacune répond à un cahier des charges opérationnel distinct, comme le résume le tableau comparatif suivant :
- Seaborn (`regplot`) : Conçu pour l’exploration rapide et la visualisation descriptive. Ses atouts résident dans son écriture mono-ligne et l’intégration visuelle immédiate des bandes bootstrap. Ses limites apparaissent lors du traitement de très volumineux jeux de données où le bootstrap paralyse le système, ainsi que dans l’impossibilité d’extraire formellement les métriques d’inférence (erreurs types, p-valeurs) pour une tabulation textuelle.
- Scikit-Learn (`LogisticRegression`) : Optimisé pour la modélisation prédictive, le génie logiciel et les chaînes de traitement industrielles (`Pipelines`). Il offre des solveurs ultra-performants en C++, gère nativement la régularisation et s’intègre harmonieusement aux procédures de validation croisée. En revanche, il ignore totalement le calcul formel des p-valeurs et des intervalles de confiance analytiques, imposant un calcul manuel de la sigmoïde sur une grille Matplotlib.
- Statsmodels (`Logit` / `GLM`) : Érigé pour la rigueur académique et l’inférence hypothético-déductive. Il restitue l’intégralité des diagnostics économétriques et autorise le calcul direct d’intervalles de confiance asymptotiques via la méthode delta. Son utilisation s’avère toutefois plus verbeuse, contraignant l’utilisateur à manipuler manuellement les constantes matricielles et à orchestrer le tracé Matplotlib de A à Z.
8. Visualisation de la régression logistique multiple et effets modérateurs
8.1 Représentation de courbes conditionnelles multi-groupes
Dans la grande majorité des recherches empiriques, l’effet d’une variable continue ne s’exprime pas de façon isolée ; il est fréquemment conditionné ou modéré par un facteur catégoriel d’appartenance à un groupe. L’analyse conjointe du solde bancaire et du statut d’étudiant (`student`) dans la prédiction de la défaillance financière illustre parfaitement cette dynamique. Visualiser comment la courbe de régression logistique se translate ou s’infléchit différemment selon que l’individu est étudiant ou non constitue un enjeu analytique majeur.
La bibliothèque Seaborn résout ce problème de décomposition conditionnelle avec une élégance remarquable grâce à la fonction `seaborn.lmplot()`. En spécifiant l’argument de segmentation catégorielle `hue=’student’`, la fonction segmente instantanément le jeu de données en deux sous-populations distinctes, calcule deux régressions logistiques indépendantes en coulisses, et trace sur le même canevas deux courbes sigmoïdes arborant des codes chromatiques différenciés, chacune ceinte de sa propre bande de confiance bootstrap.
Cette visualisation multi-groupe met immédiatement en relief le paradoxe statistique sous-jacent : pour un solde bancaire rigoureusement identique, la courbe des étudiants se situe systématiquement en dessous de celle des non-étudiants, révélant un taux de défaillance conditionnel inférieur chez les étudiants à encours égal. L’examen des deux sigmoïdes parallèles ou sécantes renseigne également sur l’existence potentielle d’une interaction statistique : des trajectoires rigoureusement parallèles dans l’espace logit dénotent un effet purement additif, tandis que des pentes divergentes mettent en lumière un effet modérateur du facteur de groupe sur la sensibilité au solde résiduel.
8.2 Tracé de surfaces logistiques en trois dimensions
Lorsque le modèle logistique incorpore simultanément deux prédicteurs continus — par exemple le solde bancaire résiduel ($X_1$) et le revenu annuel de l’emprunteur ($X_2$) —, la représentation bidimensionnelle devient mathématiquement insuffisante pour restituer la dynamique prédictive conjointe. L’équation de la probabilité décrit alors une surface non linéaire tridimensionnelle s’élevant au-dessus du plan formé par les deux prédicteurs :
$$P(Y=1|X_1, X_2) = \frac{1}{1 + e^{-(\beta_0 + \beta_1 X_1 + \beta_2 X_2)}}$$
Pour matérialiser cette géométrie complexe en Python, l’analyste doit mobiliser le module d’extension tridimensionnelle `mpl_toolkits.mplot3d` conjointement avec la fonction matricielle `numpy.meshgrid()`. Après avoir ajusté un modèle bivarié avec Scikit-Learn ou Statsmodels, on synthétise deux grilles d’axes denses recouvrant l’ensemble du domaine de variation conjointe des deux covariables. La matrice des probabilités correspondantes est ensuite calculée sur l’intégralité du maillage bidimensionnel résultant.
Le tracé s’exécute au moyen de la méthode `ax.plot_surface(X1_grid, X2_grid, Z_probs, cmap=’viridis’, alpha=0.8, edgecolor=’none’)`. La surface sigmoïdale ainsi matérialisée ressemble à une nappe incurvée ondulante, glissant imperceptiblement d’un plancher d’équiprobabilité nulle vers un plateau supérieur d’occurrence certaine. Alternativement, pour une lecture quantitative plus directe sur support papier, cette topologie 3D peut être aplatie sous la forme d’un graphique de contours bidimensionnel via `ax.contourf()`, où les isolignes de probabilités (iso-lignes à 10 %, 30 %, 50 %, 70 %, 90 %) délimitent géographiquement les bassins de risque au sein de l’espace des prédicteurs.
8.3 Stratégie de marginalisation pour isoler un prédicteur d’intérêt
Dans un modèle multivarié comportant une multitude de covariables et de facteurs de confusion, l’analyste ne peut pas projeter l’ensemble des dimensions sur un seul axe. Il doit alors recourir à la stratégie méthodologique des prédictions marginales, également formalisée sous le concept d’effets marginaux ajustés. L’objectif consiste à isoler l’influence pure du prédicteur focal d’intérêt tout en neutralisant l’effet parasite des autres variables explicatives incluses dans l’équation.
La procédure standard consiste à figer artificiellement l’ensemble des covariables secondaires à une valeur de référence représentative — traditionnellement leur moyenne empirique ou leur médiane pour les variables quantitatives, et la modalité modale pour les facteurs discrets. L’analyste génère une matrice synthétique dans laquelle seule la variable focale varie sur une grille continue (comme le solde bancaire), tandis que les colonnes adjacentes (revenu, âge, statut) sont maintenues rigoureusement constantes à leurs valeurs moyennes respectives.
En projetant ensuite le modèle ajusté sur cette matrice conditionnelle, on obtient la trajectoire de la probabilité prédite « pour un individu moyen ». Cette courbe marginale permet d’interpréter sans ambiguïté l’impact du prédicteur focal sans que la dispersion des points ne soit brouillée par les variations concomitantes des autres variables du système. C’est précisément cette méthodologie de marginalisation qui est recommandée par les manuels de biostatistique et d’économétrie pour la publication des résultats de modèles logistiques multivariés complexes.
9. Personnalisation esthétique et rigueur académique selon les normes de publication
9.1 Conception d’étiquettes et d’annotations claires
La recevabilité d’une figure dans une revue scientifique à comité de lecture est conditionnée par son autonomie sémantique : le lecteur doit être en mesure d’appréhender l’intégralité du message quantitatif sans être contraint de se plonger laborieusement dans le texte de l’article. Cette exigence impose une rédaction méticuleuse de l’appareil textuel environnant le graphique. Les intitulés d’axes ne doivent jamais se contenter des identifiants techniques bruts des colonnes de données (comme `’balance’` ou `’def_flag’`), mais afficher des libellés explicites stipulant la grandeur mesurée et son unité physique ou monétaire, par exemple : « Solde bancaire moyen résiduel (en dollars américains) » et « Probabilité prédite de défaut de paiement ».
L’enrichissement didactique du repère gagne également à intégrer des annotations géométriques directes grâce à la fonction `ax.annotate()`. Au lieu de reléguer la compréhension du point d’inflexion dans une légende distante, une flèche fine pointant directement sur la coordonnée $(\hat{x}_{0.5}, 0.5)$ accompagnée d’un encadré textuel mentionnant la valeur numérique exacte du seuil de transition confère une valeur pédagogique immédiate au graphique.
Enfin, l’inscription discrète mais explicite de l’équation mathématique paramétrée au sein de la zone graphique — en exploitant les capacités de rendu LaTeX natives de Matplotlib (`ax.text(…, r’$\hat{P}(Y=1) = \frac{1}{1 + e^{-(-10.65 + 0.0055 \cdot X)}}$‘, fontsize=10)`) — permet aux pairs d’évaluer instantanément la plausibilité des coefficients estimés et de reproduire mentalement les calculs sans recourir à des tables annexes.
9.2 Hiérarchisation visuelle et mise en page
L’élégance formelle d’une visualisation académique découle de l’élimination systématique de tout artifice ornemental non porteur d’information, un principe fondamental formalisé par le ratio encre/données (data-ink ratio). Pour instaurer cette sobriété, l’analyste doit purger le système d’axes des bordures périphériques superflues. L’instruction `sns.despine(ax=ax, top=True, right=True)` supprime immédiatement les épines supérieure et droite du repère, dégageant l’espace visuel pour ne conserver que les échelles de graduation strictement nécessaires à la lecture.
Le paramétrage des axes (`ax.tick_params()`) mérite un réglage minutieux. Les graduations principales doivent être clairement orientées vers l’extérieur (`direction=’out’`), avec une épaisseur et une teinte harmonisées avec celles des axes principaux. L’axe vertical des ordonnées, qui matérialise les probabilités théoriques, doit impérativement être borné de façon stricte entre $0$ et $1$ (`ax.set_ylim(-0.05, 1.05)` avec la gigue visuelle, ou rigoureusement `[0, 1]` si les points bruts ne sont pas affichés), en matérialisant des paliers réguliers tous les 0,1 ou 0,2.
La légende doit être assemblée avec un soin d’architecte : positionnée dans un espace vide du repère pour ne jamais chevaucher la sigmoïde ou les nuages d’observations denses, elle doit être enclose dans un cadre aux bordures atténuées (`frameon=True`, `framealpha=0.9`, `edgecolor=’none’`). Chaque entrée de légende doit expliciter clairement la nature du tracé géométrique : données empiriques observées, estimation ponctuelle du modèle logistique, et enveloppe d’incertitude statistique délimitant l’intervalle de confiance.
9.3 Exportation haute résolution pour les revues scientifiques
La phase finale de la chaîne de production graphique réside dans la compilation et l’exportation du fichier image vers le disque dur. Un écueil fréquent consiste à copier-coller une prévisualisation basse résolution affichée à l’écran du carnet Jupyter, aboutissant à une figure pixellisée, floue et inexploitable pour l’impression professionnelle. Les directives techniques des maisons d’édition scientifiques (Elsevier, Springer, IEEE, APA) exigent des fichiers sources respectant des contraintes géométriques et typographiques extrêmement précises.
L’exportation doit être exécutée au moyen de l’instruction `plt.savefig()`, en sélectionnant rigoureusement le format d’encodage selon la finalité éditoriale. Pour les formats vectoriels — hautement recommandés car ils autorisent un agrandissement infini sans aucune dégradation de netteté des courbes et des polices —, les extensions `.pdf` ou `.svg` constituent le standard absolu. Pour les formats matriciels non compressés requis lors des soumissions de manuscrits finaux, le format `.tiff` ou `.png` haute densité doit être privilégié en fixant impérativement une résolution d’au moins 300 à 600 points par pouce :
`plt.savefig(‘figure1_logistic_regression.pdf’, dpi=300, bbox_inches=’tight’, transparent=False)`
L’adjonction systématique de l’argument `bbox_inches=’tight’` est fondamentale : elle ordonne à Matplotlib de recalculer dynamiquement la boîte englobante de l’image avant l’écriture binaire, évitant ainsi le rognage inopiné des libellés d’axes ou des titres longs situés à la périphérie du canevas.
10. Diagnostic graphique, détection des anomalies et qualité de l’ajustement
10.1 Visualisation des résidus et des points aberrants
L’ajustement visuel harmonieux d’une courbe sigmoïde sur un nuage de points ne garantit pas à lui seul l’adéquation structurelle du modèle mathématique aux réalités sous-jacentes du phénomène observé. La modélisation logistique requiert des procédures diagnostiques rigoureuses destinées à repérer les observations pathologiques exerçant une influence indue sur l’estimation des coefficients. En régression binaire, la définition des résidus s’avère toutefois plus complexe qu’en analyse linéaire ordinaire, en raison de la nature intrinsèquement discrète de la variable cible.
L’analyste dispose principalement de deux métriques résiduelles standardisées : les résidus de Pearson (qui divisent l’écart brut par l’écart-type binomial estimé) et les résidus de déviance (qui mesurent la contribution individuelle de chaque point à la log-vraisemblance globale du modèle). En traçant ces résidus standardisés en fonction des probabilités prédites ou de la variable explicative, l’analyste examine l’apparition de structures atypiques. Une courbe sigmoïde mal ajustée se traduit souvent par des résidus de déviance asymétriques dépassant les limites horizontales conventionnelles de $\pm 2$ ou $\pm 3$.
Parallèlement, la détection des points de levier influents s’appuie sur le calcul de la distance de Cook adaptée aux modèles logistiques. En représentant graphiquement la distance de Cook pour chaque individu de l’échantillon sous forme d’un graphique en tiges (`stem plot`), les observations qui dépassent les seuils critiques habituels apparaissent immédiatement. L’élimination temporaire ou la pondération de ces cas extrêmes permet de vérifier si la courbure de la sigmoïde observée ne découle pas simplement de quelques artéfacts statistiques isolés.
10.2 Courbes de calibration empirique
Un modèle logistique peut afficher un pouvoir discriminant remarquable tout en délivrant des probabilités prédites sévèrement décalées par rapport aux taux réels de survenue de l’événement ; on parle alors d’un déficit de calibration ou de fiabilité probabiliste. L’outil graphique privilégié pour diagnostiquer et communiquer cette dimension de performance est la courbe de calibration (ou diagramme de fiabilité), disponible dans Scikit-Learn via la fonction `sklearn.calibration.calibration_curve`.
Le principe opérationnel de ce tracé diagnostique repose sur une discrétisation par déciles. Les probabilités prédites par le modèle logistique pour l’ensemble des individus sont ordonnées et découpées en plusieurs intervalles réguliers (typiquement dix classes d’équiprobabilité). Pour chaque intervalle, on calcule la probabilité prédite moyenne, que l’on compare sur un graphique bidimensionnel à la proportion empirique réelle d’événements observés au sein de ce même sous-groupe.
Le tracé confronte ces points d’observation à la diagonale théorique parfaite à 45 degrés reliant les coordonnées $(0, 0)$ à $(1, 1)$. Si la courbe empirique épouse fidèlement la diagonale, le modèle est qualifié de parfaitement calibré : une prédiction de 30 % correspond rigoureusement à 30 cas positifs observés sur 100 individus. En revanche, si la courbe plonge systématiquement sous la diagonale, le modèle pèche par surconfiance (il surestime le risque réel), tandis qu’une courbe oscillant au-dessus signale une sous-estimation systématique, invitant l’analyste à réviser la structure de ses prédicteurs ou à appliquer une recalibration isotone.
10.3 Intégration de la courbe ROC et de l’indice de Youden
La trajectoire de la courbe de régression logistique entretient des liens mathématiques intimes avec la courbe ROC (Receiver Operating Characteristic), pierre angulaire de l’évaluation des classificateurs probabilistes. Alors que la sigmoïde trace l’évolution de la probabilité conditionnelle en fonction d’un prédicteur continu sur une échelle absolue, la courbe ROC projette l’ensemble des compromis opérationnels entre la sensibilité (taux de vrais positifs) et l’anti-spécificité (taux de faux positifs) obtenus en faisant glisser le seuil décisionnel de coupure de $0$ à $1$.
Grâce aux utilitaires `sklearn.metrics.roc_curve` et `roc_auc_score`, l’analyste trace cette trajectoire de performance globale au sein d’un graphique carré normé $[0, 1] \times [0, 1]$. L’aire sous la courbe (AUC) synthétise la capacité de discrimination globale du modèle logistique : une valeur de 0,5 correspond à un pouvoir prédictif nul équivalant au hasard pur, tandis qu’une valeur de 1,0 caractérise une séparation discriminante parfaite.
L’enrichissement visuel de ce diagnostic passe souvent par la matérialisation de l’indice de Youden ($J = \text{Sensibilité} + \text{Spécificité} – 1$). Le point géométrique de la courbe ROC qui maximise cet indice représente le seuil décisionnel d’arbitrage optimal en l’absence de coûts asymétriques d’erreur. En projetant la valeur critique de ce seuil optimal sur la courbe sigmoïde initiale, l’analyste relie directement l’abstraction matricielle du modèle de classification à sa déclinaison concrète dans l’espace physique du problème métier étudié.
11. Application concrète en sciences comportementales et analyse empirique
11.1 Mise en situation clinique : Prédiction de l’adhésion thérapeutique
Afin d’illustrer la puissance explicative et la pertinence pratique de l’ensemble des protocoles développés, déployons une étude de cas inspirée de la recherche en psychologie de la santé. Imaginons un essai clinique interventionnel portant sur l’adhésion thérapeutique de patients souffrant de troubles dépressifs chroniques majeurs. L’objectif consiste à modéliser la probabilité d’abandon prématuré du traitement médicamenteux ($Y = 1$ en cas d’abandon ou de rupture thérapeutique non concertée, $Y = 0$ en cas de persévérance et de suivi rigoureux du protocole) en fonction du score initial d’anxiété évalué à l’inclusion sur une échelle psychométrique standardisée continue graduée de 0 à 50.
Pour assurer la parfaite reproductibilité de l’expérimentation, synthétisons un échantillon expérimental réaliste de $N = 400$ patients via NumPy, en calibrant délibérément les paramètres générateurs afin d’émuler une réalité clinique documentée : une anxiété basale modérée chez les patients persévérants, et une hyper-réactivité anxieuse chez les individus interrompant leur prise médicamenteuse. Le modèle probabiliste sous-jacent est paramétré avec $\beta_0 = -4{,}2$ et $\beta_1 = 0{,}14$, ce qui déplace la zone de bascule décisionnelle au cœur de l’échelle clinique.
L’estimation logistique conduite sur ce jeu de données synthétique confirme la validité de l’inférence : l’augmentation unitaire du score d’anxiété s’accompagne d’une hausse significative des log-odds d’abandon, se traduisant graphiquement par une courbe sigmoïde s’étirant avec netteté entre les scores de 15 et 45, dessinant une transition comportementale d’une clarté exemplaire.
11.2 Interprétation contextuelle du graphique produit
L’examen minutieux de la courbe de régression logistique issue de ce cas clinique offre des enseignements opérationnels immédiats pour l’équipe médicale, bien au-delà de ce que permettrait la simple lecture d’un tableau de coefficients statistiques. Le graphique met en lumière l’existence de trois zones comportementales distinctes :
- Le plateau de stabilité basse (scores de 0 à 20) : La courbe évolue de façon quasi horizontale au ras de l’axe des abscisses, avec une probabilité d’abandon résiduelle inférieure à 10 %. Dans cette zone, les variations mineures du niveau d’anxiété n’exercent aucun impact déstabilisant mesurable sur l’adhésion du patient.
- La zone critique de transition non linéaire (scores de 20 à 40) : La pente de la sigmoïde s’accélère vigoureusement, le point d’inflexion critique ($\pi = 0{,}5$) se situant précisément à un score d’anxiété d’environ 30 points ($-\frac{-4{,}2}{0{,}14} = 30$). Dans ce couloir de vulnérabilité, une augmentation marginale de seulement 5 points d’anxiété majore la probabilité d’abandon de près de 35 %, faisant basculer l’individu d’un pronostic favorable vers une trajectoire de rupture thérapeutique hautement probable.
- Le plateau de saturation haute (scores de 40 à 50) : La courbe plafonne au-delà de 85 %, indiquant que pour ces niveaux d’angoisse massifs, l’échec de persévérance est quasi inéluctable en l’absence d’une prise en charge conjointe ciblée.
Cette sectorisation graphique fournit une recommandation clinique immédiate : les ressources préventives et les consultations de soutien psychologique renforcé ne doivent pas être allouées uniformément, mais concentrées de manière prioritaire sur les patients dont le score initial d’anxiété oscille entre 22 et 35 points, là où l’action préventive dispose du plus fort levier de basculement de la trajectoire d’adhésion.
11.3 Reproductibilité computationnelle du protocole
Pour ancrer ces pratiques dans la démarche de science ouverte et de recherche reproductible, l’ensemble de cette chaîne d’analyse et de tracé doit être encapsulé au sein d’une fonction Python paramétrable, documentée et modulaire. Cette fonction standardisée prend en arguments d’entrée le tableau de données Pandas, l’intitulé de la variable indépendante, celui de la variable dépendante binaire, ainsi que les spécifications esthétiques souhaitées.
La structure de cette fonction orchestre méthodiquement les étapes décrites précédemment : vérification de l’absence de valeurs nulles, typage strict des arguments, calcul du modèle d’ajustement via Scikit-Learn ou Statsmodels, génération de la grille linéaire déterministe, évaluation vectorisée des intervalles de confiance analytiques ou bootstrap, traçage des observations réelles avec dispersion contrôlée par gigue, et projection de la sigmoïde théorique munie de ses annotations contextuelles de seuil.
En mettant ce script automatisé à la disposition de la communauté scientifique ou de son équipe de recherche, l’analyste s’assure que chaque figure produite au sein du laboratoire respectera rigoureusement les mêmes critères de sémiotique graphique, d’exactitude mathématique et de calibrage dimensionnel, éliminant les disparités de style et garantissant une standardisation optimale des publications scientifiques.
12. Erreurs courantes, limites interprétatives et solutions programmatiques
12.1 Écueils fréquents lors de l’implémentation graphique
La pratique quotidienne de la modélisation statistique révèle la récurrence de plusieurs erreurs d’implémentation graphique qui compromettent la validité des analyses présentées. Le piège le plus élémentaire, mais néanmoins extrêmement répandu chez les utilisateurs débutants de Seaborn, réside dans l’omission involontaire du paramètre `logistic=True` au sein de l’instruction `sns.regplot(x=’x’, y=’y’, data=df)`. En l’absence de cet argument, la fonction applique mécaniquement sa configuration par défaut : une régression linéaire par les moindres carrés ordinaires. Le résultat est désastreux : une droite oblique traverse les classes $0$ et $1$, s’étendant sans retenue dans des zones de non-sens probabiliste (valeurs négatives ou supérieures à $1$).
Une seconde confusion conceptuelle majeure porte sur la distinction entre l’espace des cotes logarithmiques (log-odds) et l’espace des probabilités naturelles. Certains utilisateurs tracent l’expression linéaire directe $\beta_0 + \beta_1 X$ en lui adjoignant par erreur une étiquette de probabilité sur l’axe vertical, générant une incompréhension totale chez le lecteur confronté à des prédictions linéaires évoluant de $-\infty$ à $+\infty$. Il est impératif de s’assurer que la transformation logistique inverse a été rigoureusement appliquée avant de labelliser l’axe vertical comme une échelle de probabilité bornée sur $[0, 1]$.
Sur le plan purement programmatique avec Matplotlib, une bévue fréquente réside dans l’oubli du tri vectoriel lors de l’utilisation de `ax.plot()`. Si un utilisateur transmet les observations brutes du jeu de données désordonné à cette fonction en lieu et place d’une grille générée par `np.linspace()`, Matplotlib relie méthodiquement chaque point dans l’ordre arbitraire d’apparition dans le tableau, dessinant un enchevêtrement chaotique de lignes croisées en toile d’araignée. L’emploi systématique d’un vecteur synthétique strictement ordonné constitue la parade absolue contre cette défaillance.
12.2 Limites de la représentation bidimensionnelle
Aussi séduisante soit-elle, la représentation bidimensionnelle d’une courbe de régression logistique souffre de limites épistémologiques intrinsèques qu’il convient de garder à l’esprit lors de l’interprétation. En projetant un problème comportemental ou clinique sur un plan univarié unique $(X, Y)$, l’analyste opère une simplification drastique de la réalité. Si d’autres prédicteurs majeurs exercent une influence conjointe sur le phénomène, leur omission visuelle peut introduire un biais de confusion substantiel, masquant des hétérogénéités sous-jacentes majeures.
Ce phénomène se manifeste avec acuité en présence de multicolinéarité sévère entre variables explicatives. Deux covariables fortement corrélées peuvent donner lieu à des estimations univariées artificiellement instables, dont la projection sur une courbe unique ne permet pas d’apprécier la fragilité structurelle. De même, le célèbre paradoxe de Simpson peut frapper de plein fouet une analyse logistique bidimensionnelle : une pente globale apparaissant positive sur l’échantillon agrégé peut s’avérer strictement négative au sein de chaque sous-groupe stratifié, une réalité que seule une représentation décomposée multi-panneaux (via `sns.lmplot(…, col=’groupe’)`) est à même de dévoiler.
Enfin, la modélisation logistique standard projetée sur une courbe plane postule l’indépendance statistique stricte des observations. Dans les contextes de données hiérarchiques, longitudinales ou répétées — fréquents en psychologie où un même patient subit des évaluations successives —, la variabilité intra-sujet et les effets aléatoires de groupe ne peuvent pas être fidèlement reflétés par une sigmoïde déterministe unique, imposant le recours à des modèles linéaires mixtes généralisés (GLMM) bien plus complexes à synthétiser graphiquement.
12.3 Recommandations méthodologiques finales
Pour clore ce panorama exhaustif de la visualisation logistique en Python, plusieurs préceptes méthodologiques cardinaux doivent guider le travail du statisticien et du chercheur. En premier lieu, une courbe de régression ne doit jamais être publiée de façon isolée ; elle doit impérativement être accompagnée des métriques globales d’ajustement et de discrimination (pseudo $R^2$, critère d’information d’Akaike AIC, déviance résiduelle, score AUC de la courbe ROC) afin de fournir aux pairs un ancrage quantitatif rigoureux permettant de juger de la portée réelle du modèle présenté.
En second lieu, la transparence méthodologique sur la manipulation des variables constitue une obligation déontologique incontournable. Toute standardisation préalable, exclusion de points aberrants identifiés par la distance de Cook, imputation de valeurs manquantes ou application de bruits de dispersion artificielle (`jittering`) doit être explicitée sans détour dans la légende du graphique ou dans le paragraphe méthodologique afférent du manuscrit.
En adoptant cette discipline de travail — qui allie la rigueur de la théorie statistique, la puissance computationnelle des bibliothèques scientifiques Python et la finesse sémiotique des arts graphiques —, l’analyste transforme une simple procédure d’ajustement algorithmique en un véritable instrument d’investigation et de démonstration scientifique, capable d’éclairer les mécanismes décisionnels les plus subtils au sein des données complexes contemporaines.
Références
- Agresti, A. (2013). Categorical Data Analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1922-00a
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (Vol. 57, p. 61). https://doi.org/10.25080/Majora-92bf1922-011
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
- Waskom, M. L. (2021). Seaborn: statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021