
Dans le champ de l’ingénierie des données, de l’économétrie appliquée et de l’analyse scientifique quantitative, l’intégrité des séries chronologiques et des matrices d’observation constitue le postulat fondamental de toute inférence valide. L’occurrence de discontinuités empiriques, matérialisée par la présence de cellules vides ou de données manquantes au sein des feuilles de calcul, compromet systématiquement la robustesse des modèles d’évaluation statistique. Face à cette pathologie informationnelle récurrente dans les environnements professionnels et académiques, le tableur Microsoft Excel offre un écosystème d’ingénierie computationnelle d’une profondeur souvent sous-estimée, s’étendant des mécanismes natifs d’incrémentation déterministe jusqu’aux algorithmes avancés d’ajustement matriciel et de modélisation spline par code procédural.
L’acte d’interpoler ne doit en aucun cas être appréhendé comme une simple opération cosmétique destinée à masquer des lacunes tabulaires pour faciliter des représentations graphiques. Il s’agit d’une démarche de reconstruction mathématique rigoureuse, fondée sur l’hypothèse ontologique selon laquelle la trajectoire des variables observées obéit à des lois de régularité, de continuité et de dérivabilité sur des intervalles finis. Substituer une valeur artificielle à une absence exige une compréhension approfondie des mécanismes sous-jacents qui ont engendré la lacune, sous peine d’induire des biais d’estimation critiques, d’écraser la variance naturelle des phénomènes étudiés ou d’introduire des artefacts d’autocorrélation fallacieux dans les régressions ultérieures.
Ce traité exhaustif a pour vocation d’exposer, selon une rigueur méthodologique sans compromis, l’intégralité des paradigmes, formules algébriques, fonctions statistiques et architectures algorithmiques permettant d’interpoler avec exactitude les valeurs manquantes sous Excel. De la dérivation théorique des séries arithmétiques et géométriques jusqu’à l’implémentation de résolutions tridiagonales par l’algorithme de Thomas en Visual Basic for Applications (VBA), ce guide dote le modélisateur d’une grille de lecture critique et d’une boîte à outils opérationnelle exhaustive pour restaurer la complétude des données empiriques tout en préservant leur validité statistique interne et externe.
1. Fondements théoriques de l’interpolation des données manquantes dans Excel
1.1 Typologie épistémologique des données manquantes : MCAR, MAR et MNAR
L’analyse préalable de la nature probabiliste des données manquantes constitue une exigence épistémologique incontournable avant toute tentative de manipulation numérique sous Excel. Conformément à la taxonomie fondamentale formulée par Donald Rubin (1976), les lacunes au sein d’un échantillon relèvent de trois régimes distincts : les données manquantes complètement au hasard (Missing Completely at Random, MCAR), les données manquantes au hasard (Missing at Random, MAR) et les données manquantes de manière non aléatoire (Missing Not at Random, MNAR).
Le régime MCAR postule une indépendance stochastique stricte entre la probabilité d’occurrence d’une lacune et l’ensemble des variables observées et non observées du modèle. Dans cette configuration idéale, l’absence d’une mesure dans une cellule de la feuille de calcul n’est liée ni à la grandeur intrinsèque de la valeur omise, ni aux fluctuations des descripteurs concomitants. Sur le plan formel, si $Y$ désigne la variable cible et $R$ la variable indicatrice d’absence, le mécanisme MCAR impose $P(R=1|Y, X) = P(R=1)$. Dans cette situation spécifique, les données observées peuvent être considérées comme un sous-échantillon aléatoire parfait de la population initiale, ce qui immunise le modélisateur contre les biais de sélection systématiques, bien que la puissance statistique globale demeure diminuée.
À l’inverse, le paradigme MAR assouplit cette contrainte en admettant que la probabilité d’omission dépende systématiquement d’autres covariables observées dans le tableau de bord, mais demeure indépendante de la valeur sous-jacente de la variable lacunaire elle-même, soit $P(R=1|Y, X) = P(R=1|X)$. À titre illustratif, dans le cadre d’un protocole expérimental de métrologie thermique, un dysfonctionnement de capteur peut survenir plus fréquemment sous des tensions électriques instables (variable explicative $X$), sans que le niveau de température réel mesuré ($Y$) ne soit directement responsable de la panne. En régime MAR, l’omission d’une modélisation conditionnelle adéquate expose les calculs sous Excel à des distorsions paramétriques notables.
Le régime le plus critique demeure le MNAR, où la propension à l’absence est directement corrélée à la grandeur de la variable non observée : $P(R=1|Y, X)$ ne peut être réduite et dépend intrinsèquement de $Y$. L’interpolation séquentielle ou temporelle sous Excel s’avère particulièrement périlleuse face à des processus MNAR. Si une série de rendements financiers présente des cellules vides lors de phases de volatilité extrême précisément parce que les cotations ont été suspendues suite à un krach, l’application d’une continuité linéaire entre les bornes observables sous-estimera dramatiquement l’amplitude des pertes réelles. L’interpolation mathématique ne peut donc légitimement s’appliquer que sous réserve d’une vérification formelle de la plausibilité d’un mécanisme MCAR ou MAR localement contrôlé.
1.2 Distinction conceptuelle entre imputation statistique et interpolation mathématique
Il est impératif d’opérer une ligne de démarcation méthodologique rigoureuse entre l’imputation statistique et l’interpolation mathématique, deux démarches fréquemment confondues au sein des pratiques de gestion de données sous tableur. L’imputation statistique relève fondamentalement d’un paradigme stochastique : elle envisage la cellule manquante comme une variable aléatoire dont il s’agit d’estimer la distribution conditionnelle, soit par espérance-maximisation (algorithme EM), soit par des procédures d’imputation multiple par équations chaînées (MICE). L’imputation cherche à injecter de l’aléa contrôlé afin de préserver les propriétés de dispersion, les résidus d’erreur et les matrices de covariance globales du jeu de données.
L’interpolation mathématique, quant à elle, s’inscrit dans une logique purement déterministe. Elle mobilise les coordonnées de points d’ancrage connus — désignés sous le terme de nœuds — situés dans le voisinage topologique ou chronologique immédiat de la lacune, afin de reconstruire une trajectoire continue par le biais d’un opérateur fonctionnel prédéfini (linéaire, polynomial, spline ou géométrique). L’interpolation sous Excel ne prétend pas inférer la densité de probabilité de la valeur manquante, mais postule que le phénomène sous-jacent satisfait à des conditions strictes de régularité mathématique, notamment la continuité et la différentiabilité de la fonction génératrice sur l’intervalle d’investigation.
Cette distinction conceptuelle dicte le périmètre de pertinence de chaque méthode. L’interpolation préserve scrupuleusement l’ordre géométrique, la monotonicité locale et la séquentialité temporelle des observations, ce qui la rend irremplaçable pour le traitement de signaux continus, de cinétiques physiques ou de séries temporelles physiques et financières à haute fréquence. En contrepartie, elle impose l’acceptation d’un écrasement systématique de l’erreur aléatoire locale, puisque chaque valeur synthétisée se voit assignée directement sur la courbe analytique retenue, sans considération du terme de perturbation stochastique inhérent aux phénomènes empiriques.
1.3 Impact méthodologique des lacunes sur l’analyse de données empiriques
L’impact méthodologique de la présence de cellules vides au sein d’une matrice Excel s’étend bien au-delà de la gêne visuelle ou de l’incommodité lors de l’édition des calculs. Sur le plan de la statistique descriptive, la présence de lacunes altère substantiellement les estimateurs de tendance centrale et de dispersion. Lorsqu’un analyste exécute naïvement des fonctions standards telles que MOYENNE ou ECARTYPE sur des colonnes incomplètes, le moteur de calcul d’Excel procède par défaut à une suppression par observation (listwise deletion) au niveau ponctuel. Si l’échantillonnage n’est pas strictement MCAR, cette exclusion automatique induit un déplacement mécanique du barycentre des observations et fausse l’appréciation de l’asymétrie (skewness) et de l’aplatissement (kurtosis).
Dans la perspective de la statistique inférentielle et de la modélisation économétrique, les ruptures de séquentialité générées par des cellules vides provoquent une contraction sévère de la puissance statistique des tests d’hypothèses (tests de Student, analyses de variance, tests de stationnarité de Dickey-Fuller). Le rejet indu d’hypothèses nulles légitimes ou, à l’inverse, l’incapacité à déceler des relations causales effectives découle directement de la troncature des degrés de liberté. De surcroît, dans les études longitudinales, la discontinuité chronologique interdit l’application directe des opérateurs de décalage temporel (lags et leads) indispensables à l’estimation des modèles autorégressifs (ARIMA) ou à correction d’erreur (VECM).
L’établissement d’une procédure d’interpolation standardisée sous Excel répond dès lors à l’impératif de sauvegarde de la validité interne du protocole expérimental. En comblant les intervalles lacunaires selon des fonctions mathématiques adaptées à la dynamique du système, le praticien restaure la complétude structurelle de la matrice d’apprentissage. Toutefois, la robustesse de cette démarche repose intégralement sur la capacité de l’analyste à quantifier a posteriori les incertitudes d’interpolation et à auditer la matrice de données préalablement à toute substitution computationnelle.
2. Préparation rigoureuse et audit du jeu de données dans l’environnement Excel
2.1 Identification systématique des cellules vides par mise en forme conditionnelle
Avant d’exécuter le moindre algorithme d’interpolation, l’analyste doit procéder à une cartographie visuelle et structurelle exhaustive des discontinuités au sein de la feuille de calcul. L’outil privilégié pour matérialiser instantanément la morphologie des lacunes réside dans le moteur de mise en forme conditionnelle d’Excel. En appliquant une règle de surbrillance spécifique sur l’ensemble de la plage d’intérêt, il devient possible d’identifier immédiatement si les omissions se manifestent sous forme de cellules isolées, de grappes denses ou de plages continues de grande envergure, chaque motif exigeant une stratégie de remédiation différente.
Pour implémenter cette détection, sélectionnez la matrice de données observationnelles, naviguez vers le ruban Accueil, cliquez sur Mise en forme conditionnelle, puis sélectionnez Nouvelle règle. Dans la boîte de dialogue contextuelle, choisissez l’option Appliquer un format uniquement aux cellules qui contiennent, puis, dans le sélecteur de critères, modifiez la valeur par défaut pour désigner explicitement les Cellules vides. Il convient alors d’assigner un remplissage chromatique contrasté mais non agressif, tel qu’un aplat pastel, afin d’assurer une lisibilité optimale lors de l’inspection des tendances périphériques.
Cette approche graphique permet également d’opérer une distinction sémiotique fondamentale entre les valeurs nulles réelles (zéros arithmétiques) et les absences d’observation. Dans de nombreuses bases de données issues de progiciels de gestion intégrés (ERP) ou d’automates industriels, la valeur zéro est indûment substituée à une absence de signal, ou inversement. La mise en forme conditionnelle met en exergue les discontinuités de structure et alerte le modélisateur sur la nécessité de requalifier préalablement les faux zéros en véritables valeurs nulles pour éviter toute distorsion lors du calcul de la pente d’interpolation.
2.2 Audit quantitatif à l’aide des fonctions de diagnostic intégrées
L’évaluation quantitative du volume de données manquantes s’impose comme une métrique d’arbitrage essentielle pour déterminer la viabilité même de l’interpolation. Excel intègre des fonctions de diagnostic statistique permettant d’instrumenter un tableau de contrôle en amont des manipulations algébriques. Les fonctions canoniques NB.VIDE (déterminant le nombre absolu de cellules non renseignées dans une plage) et ESTVIDE (test logique unitaire renvoyant un booléen) constituent l’ossature de cet audit informationnel.
Il est recommandé de formaliser, en tête de colonne ou dans un onglet d’audit dédié, le calcul du ratio d’incomplétude $R_{inc}$, défini par l’expression algébrique :
$$R_{inc} = \frac{\text{NB.VIDE}(\text{Plage})}{\text{LIGNES}(\text{Plage})}$$
Si ce ratio dépasse un seuil critique conventionnel — généralement fixé à 15 % ou 20 % dans la littérature biométrique et économétrique —, toute interpolation déterministe risque d’engendrer une distorsion structurelle majeure de la série, incitant à privilégier l’abandon de la variable ou des méthodes d’imputation multiple sous des environnements de calcul plus évolués.
L’audit doit simultanément traquer les artefacts textuels invisibles qui polluent fréquemment les imports de fichiers plats (CSV ou flux de données texte). Très couramment, une cellule apparaissant vide contient en réalité une chaîne de caractères de longueur nulle (résultant d’une formule telle que ="") ou un espace insécable (code ASCII 160). Ces entités parasitaires font échouer la fonction ESTVIDE et génèrent des erreurs d’incompatibilité de type #VALEUR! lors de l’exécution d’interpolations mathématiques. L’emploi conjoint de formules de nettoyage telles que SUPPRESPACE, EPURAGE, combiné à la formule de validation matricielle SOMMEPROD(N(ESTTEXTE(Plage))), garantit la pureté arithmétique de la série avant son traitement.
2.3 Structuration et indexation chronologique des observations
L’exactitude mathématique de toute interpolation repose sur la relation fonctionnelle univoque entre une variable dépendante $Y$ (la grandeur à interpoler) et une variable indépendante $X$ (l’indice temporel ou séquentiel). Une erreur classique commise sous Excel consiste à tenter une interpolation linéaire en supposant implicitement que les lignes du tableur sont distribuées selon un pas constant, alors que les coordonnées de l’axe des abscisses présentent des écarts irréguliers. L’équidistance des intervalles constitue la condition sine qua non de la validité des méthodes natives d’Excel.
Pour garantir la rigueur de l’indexation, la série temporelle ou spatiale doit impérativement faire l’objet d’un tri méthodologique croissant strict en exploitant les outils du ruban Données > Trier. Les doublons sur la variable d’indexation $X$ doivent être rigoureusement éliminés via la commande Supprimer les doublons, car la présence de valeurs identiques pour une même abscisse violerait la définition mathématique d’une fonction, où à chaque valeur de $X$ ne peut correspondre qu’une seule image $Y$.
Par ailleurs, la normalisation des formats de date et d’heure requiert une vigilance absolue. Sous Excel, le temps est représenté sous forme de nombres ordinaux séquentiels où l’entier représente le nombre de jours écoulés depuis le 1er janvier 1900 et la partie décimale modélise la fraction de la journée. Les discordances typographiques — telles que le stockage de dates sous forme de chaînes textuelles non reconnues — brisent la continuité numérique requise pour l’évaluation des deltas d’abscisse $\Delta X = x_{i+1} – x_i$. L’application de la fonction DATEVAL ou CNUM permet de rétablir la nature scalaire des points d’ancrage préalablement au calcul des incréments.
3. Méthode native 1 : L’outil Série pour l’interpolation linéaire directe
3.1 Mécanisme opérationnel de la commande Remplissage > Série
Pour combler de manière directe et statique un vide informationnel situé entre deux bornes numériques connues, Excel dispose d’une fonctionnalité native hautement performante, logée dans son moteur de manipulation séquentielle : l’outil Série. Cette commande court-circuite la nécessité de rédiger manuellement des formules algébriques complexes pour les cas d’interpolation linéaire simple sur des intervalles discrets.
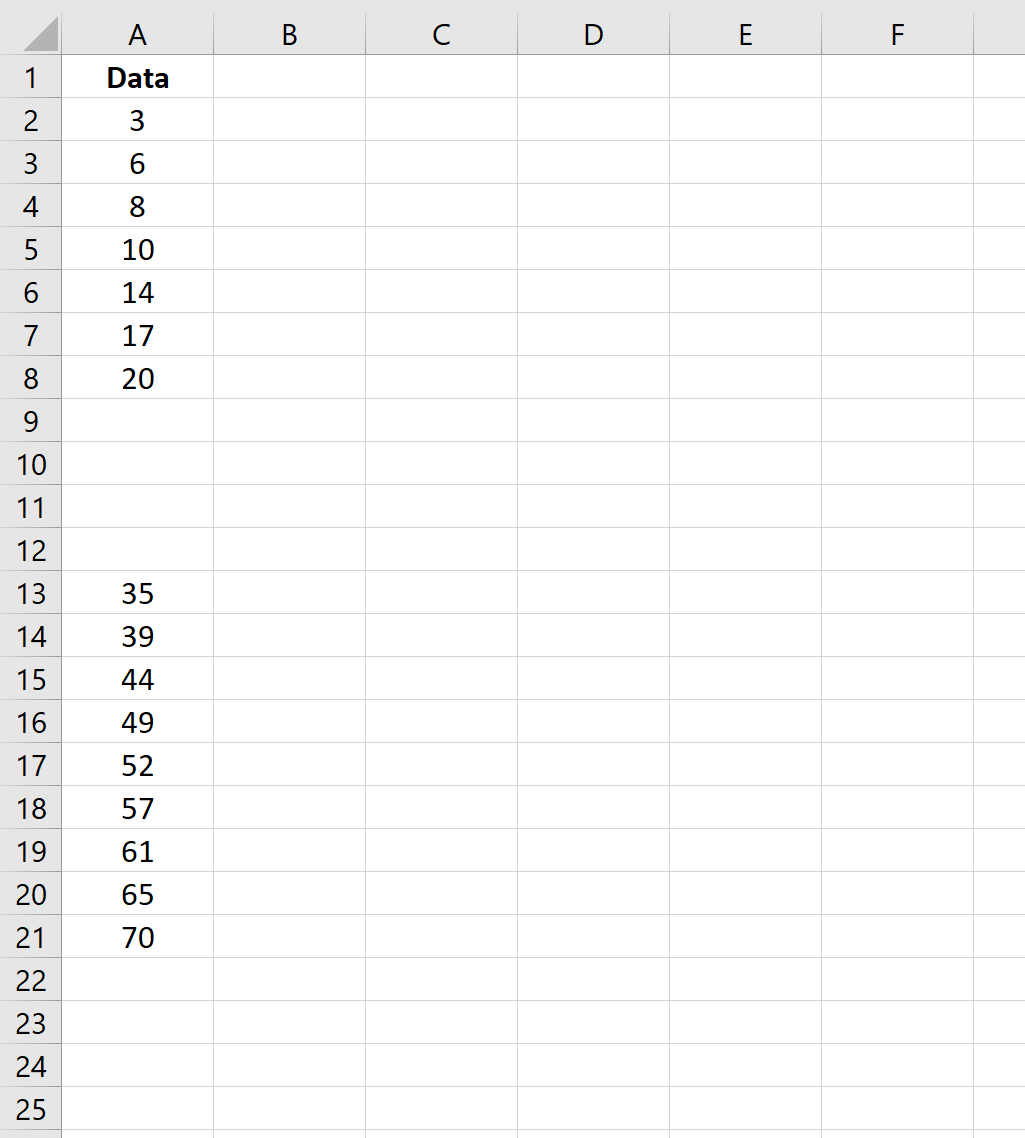
Le protocole opératoire requiert une sélection géométrique stricte au sein de la feuille de calcul. L’analyste doit impérativement sélectionner une plage continue débutant par la cellule contenant la borne inférieure connue (la valeur initiale $y_1$), englobant l’intégralité des cellules vides consécutives à interpoler, et se terminant exactement sur la cellule abritant la borne supérieure (la valeur finale $y_2$). Si la sélection n’englobe pas précisément ces deux ancrages numériques aux extrémités de la plage de cellules cibles, l’algorithme sous-jacent sera incapable d’extraire les paramètres d’extrapolation nécessaires à la fermeture de l’intervalle.
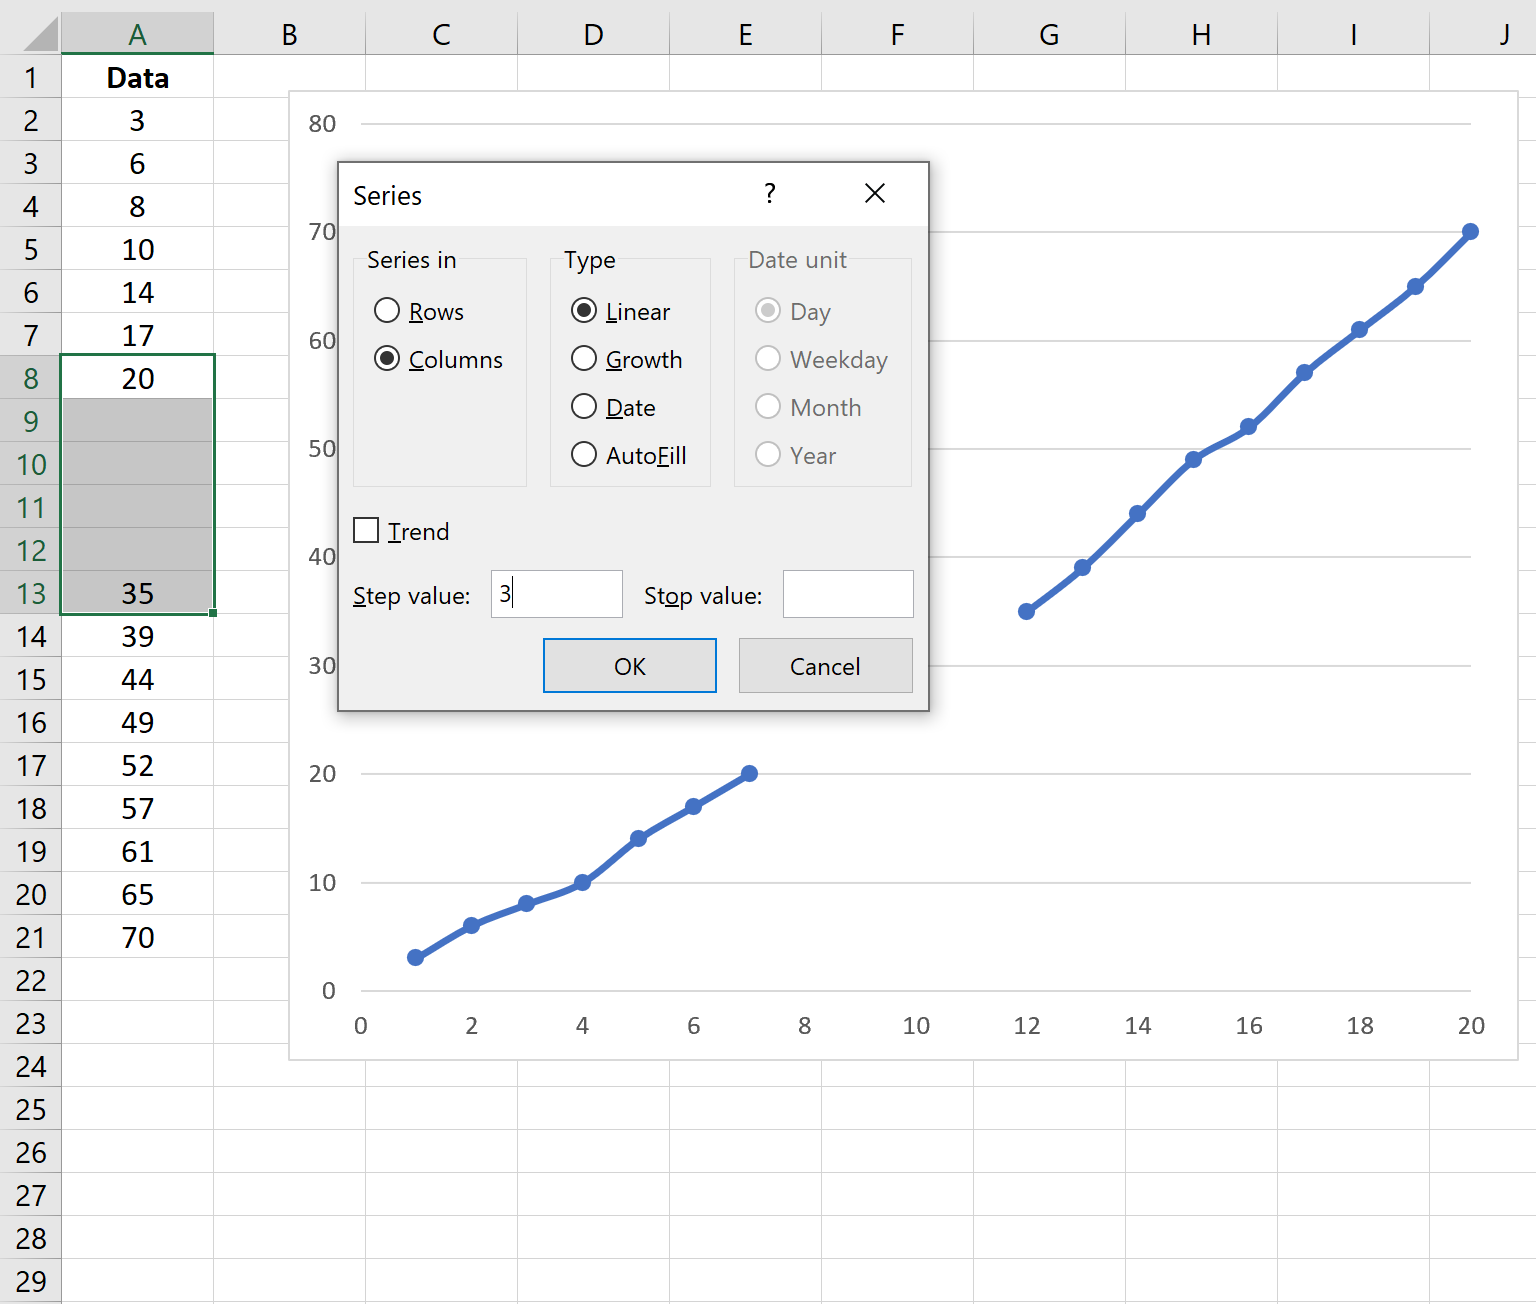
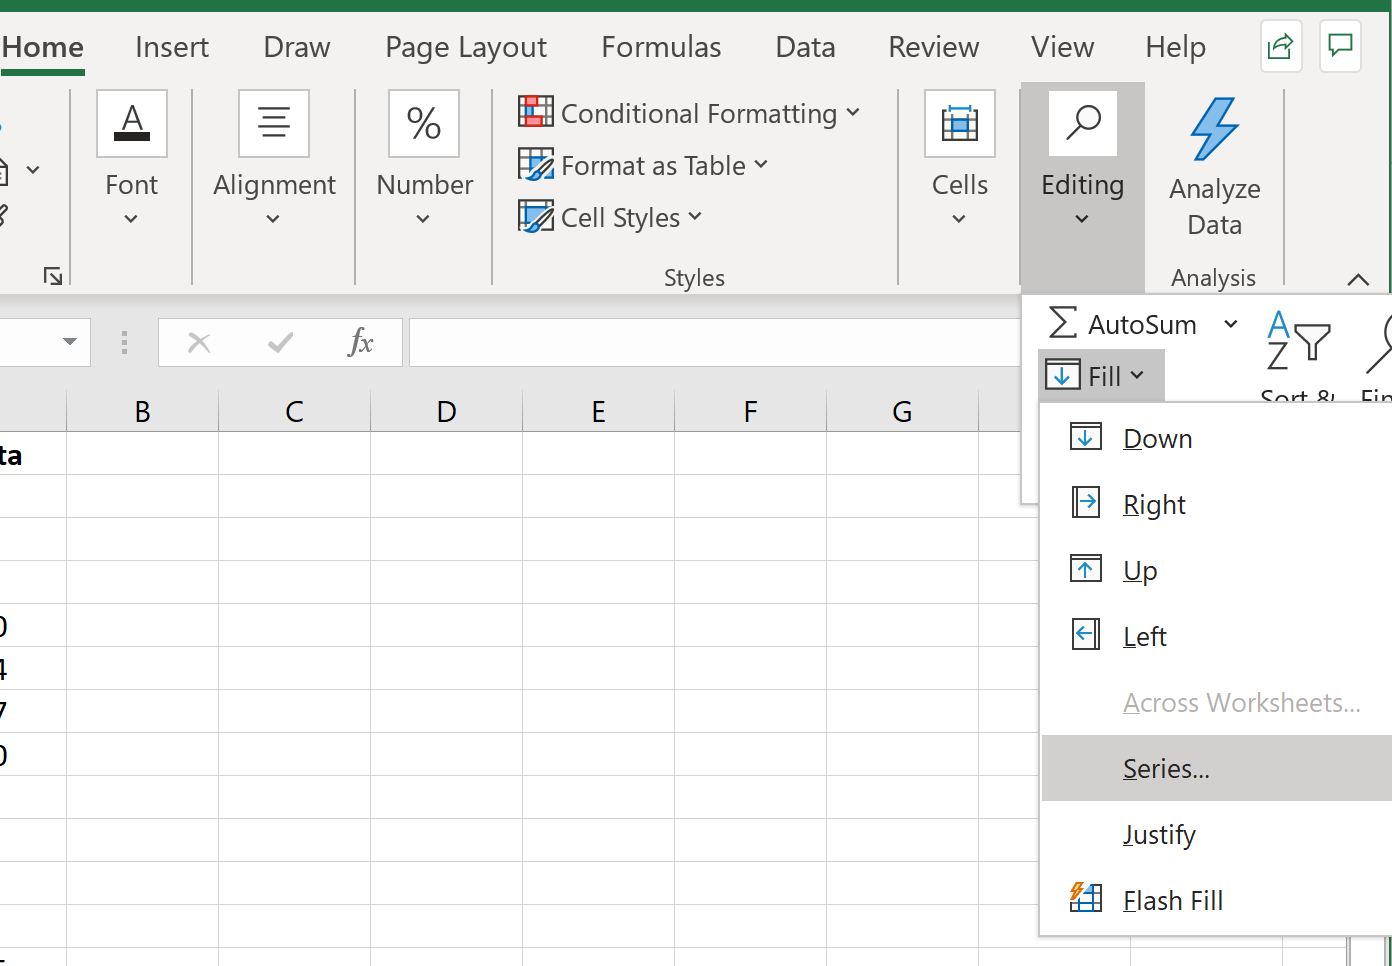
Une fois la plage rigoureusement mise en surbrillance, naviguez au sein de l’interface vers l’onglet Accueil, localisez le groupe fonctionnel Édition situé à l’extrémité droite du ruban, cliquez sur le menu déroulant Remplir, puis sélectionnez la commande Série…. Dans la boîte de dialogue qui se matérialise à l’écran, le modélisateur configure l’exécution : activez l’orientation correspondante (Colonnes si vos observations sont structurées verticalement, ce qui représente le standard le plus fréquent en science des données), définissez le type sur Linéaire, puis cochez impérativement la case intitulée Tendance. Cette dernière manipulation ordonne à Excel d’ignorer la valeur de pas manuelle et de dériver analytiquement le différentiel arithmétique reliant les deux bornes.
3.2 Dérivation mathématique du calcul automatique du pas d’incrémentation
Pour comprendre la précision de l’outil Série et éviter les erreurs d’interprétation, il convient de démonter la mécanique algorithmique qu’exécute silencieusement le moteur de calcul d’Excel lors de la validation de la boîte de dialogue. L’opérateur modélise la séquence sous-jacente comme une progression arithmétique finie définie par son premier terme $y_1$, son terme d’arrivée $y_2$, et un nombre $n$ de cellules intermédiaires non renseignées.
Le pas d’incrémentation constant, noté $\Delta y$, est calculé formellement par la dérivation suivante :
$$\Delta y = \frac{y_2 – y_1}{k + 1}$$
Dans cette formulation rigoureuse, $k$ représente le nombre strict de cellules vides situées entre les deux jalons. Le dénominateur $k + 1$ correspond mathématiquement au nombre de transitions d’intervalles nécessaires pour parcourir la distance séparant $y_1$ de $y_2$. Chaque point interpolé $y_{1+j}$ (pour $j in {1, 2, dots, k}$) est alors généré par l’application récursive de la loi arithmétique :
$$y_{1+j} = y_1 + j \times \Delta y = y_1 + j \times \left( \frac{y_2 – y_1}{k + 1} \right)$$
Cette logique algébrique garantit que la pente demeure rigoureusement invariante sur l’intégralité du segment interpolé. Le calcul gère de manière native et totalement transparente les valeurs initiales ou finales négatives, ainsi que les transitions de signe (traversée de l’axe zéro). Si $y_2 < y_1$, le différentiel $y_2 – y_1$ devient strictement négatif, induisant un pas d'incrémentation négatif qui assure une décroissance monotone parfaitement linéaire au sein de l'espace comblé.
3.3 Étude de cas pas à pas : Comblement d’un intervalle séquentiel simple
Afin de concrétiser ce déploiement dans un contexte opérationnel, considérons l’enregistrement expérimental de la pression barométrique d’un réacteur chimique, relevée toutes les heures. La série chronologique présente une défaillance de transmission entre la 3e et la 8e heure : la cellule B4 (correspondant à $T=3\text{h}$) indique une pression nominale de $102,4\text{ kPa}$, tandis que la cellule B9 ($T=8\text{h}$) affiche $108,9\text{ kPa}$. Les cellules intermédiaires B5, B6, B7 et B8 sont totalement vides, soit un déficit de $k = 4$ observations consécutives.
L’analyste sélectionne scrupuleusement la plage verticale B4:B9, incluant les deux données empiriques valides et les quatre vides. En appelant le menu Accueil > Remplir > Série…, en cochant Colonnes, Linéaire et l’option Tendance, le moteur d’Excel calcule instantanément la variation totale :
$$\Delta Y_{total} = 108{,}9 – 102{,}4 = 6{,}5\text{ kPa}$$
Le nombre de pas étant de $k + 1 = 4 + 1 = 5$, le pas arithmétique calculé s’établit exactement à :
$$\Delta y = \frac{6{,}5}{5} = 1{,}3\text{ kPa}$$
Le tableur remplit instantanément les cellules cibles avec les valeurs déterministes suivantes : B5 reçoit $103,7$ ($102,4 + 1,3$), B6 reçoit $105,0$ ($103,7 + 1,3$), B7 reçoit $106,3$ ($105,0 + 1,3$) et B8 reçoit $107,6$ ($106,3 + 1,3$). La validité du comblement est corroborée par le fait que l’addition subséquente du pas sur la cellule B8 aboutit précisément à $107,6 + 1,3 = 108,9\text{ kPa}$, soit la valeur exacte de la borne supérieure B9. Cette méthode offre une exécution instantanée, exempte de toute formule résiduelle, idéale pour figer des valeurs au sein de rapports statistiques statiques.
4. Méthode native 2 : L’interpolation géométrique pour les dynamiques multiplicatives
4.1 Justification théorique du modèle de croissance géométrique
L’application indistincte d’une interpolation linéaire à tous les profils de données représente une faute méthodologique majeure dans les disciplines où les phénomènes observés sont régis par des lois multiplicatives ou exponentielles. Dans des domaines tels que la démographie, la finance quantitative (capitalisation composée des intérêts), l’épidémiologie (propagation d’un agent pathogène) ou la pharmacocinétique, les variables évoluent proportionnellement à leur niveau actuel plutôt que par incréments additifs constants.
L’interpolation linéaire sur un processus exponentiel tend à sous-estimer de manière systématique les valeurs au cours des premières phases de l’intervalle et à biaiser la courbure globale de la dynamique. Dans ce cadre épistémologique, l’hypothèse de continuité impose de formaliser l’évolution selon une fonction puissance ou exponentielle continue de type $y(t) = y_0 \cdot e^{rt}$ ou $y(t) = y_0 \cdot q^t$. L’interpolation géométrique consiste donc à calculer une raison géométrique $q$ invariante sur la période lacunaire, de sorte que chaque observation intermédiaire soit le produit de la précédente par ce facteur d’échelle.
L’identification de ce besoin se déduit fréquemment de l’analyse de la distribution empirique : si la transformation logarithmique $ln(Y)$ linéarise la série observée, l’interpolation géométrique s’impose avec une force d’évidence mathématique. Elle garantit l’invariance du taux de croissance périodique tout au long du segment interpolé, offrant une fidélité dynamique infiniment supérieure à l’approximation par sécante arithmétique.
4.2 Configuration de l’option Géométrique dans la boîte de dialogue Série
Pour exécuter cette transition multiplicatrice sous Excel, le modélisateur mobilise à nouveau l’interface de commande native Série…, mais en substituant le modèle géométrique au modèle arithmétique conventionnel. La contrainte opératoire préalable impose que l’ensemble des données d’ancrage sélectionnées soient strictement positives ($y_1 > 0$ et $y_2 > 0$). La présence d’une valeur nulle ou négative engendre une aberration de calcul mathématique, la racine d’un produit négatif conduisant dans l’ensemble des nombres complexes, structure non prise en charge par l’outil natif Série d’Excel qui renvoie alors une erreur de calcul.
La sélection s’opère de manière analogue à la démarche linéaire : sélectionnez de façon contiguë la cellule d’ancrage initiale, l’ensemble des cellules vides consécutives, et la cellule de clôture terminale. En accédant au menu Accueil > Remplir > Série…, configurez la zone Type en cochant explicitement l’option Géométrique, tout en veillant à maintenir cochée la case Tendance.
L’algorithme interne d’Excel extrait alors la raison géométrique multiplicative $q$ reliant les deux bornes par l’extraction de la racine $(k+1)$-ième du ratio des observations :
$$q = \left( \frac{y_2}{y_1} \right)^{\frac{1}{k + 1}}$$
Dès lors, chaque cellule intermédiaire $j$ (avec $j$ variant de $1$ à $k$) est peuplée automatiquement selon la formule exponentielle discrète :
$$y_{1+j} = y_1 \times q^j = y_1 \times \left( \frac{y_2}{y_1} \right)^{\frac{j}{k + 1}}$$
Le facteur multiplicatif est appliqué avec une rigueur absolue, préservant ainsi la nature exponentielle de la trajectoire étudiée.
4.3 Analyse comparative : Trajectoire arithmétique versus géométrique
L’évaluation des écarts d’estimation induits par le choix entre le régime arithmétique et le régime géométrique peut être formalisée à travers une étude comparative sur une série à forte dynamique d’expansion. Considérons l’évaluation d’un portefeuille d’actifs technologiques dont la valorisation est mesurée à $10,000\text{ €}$ au mois $M_0$ et atteint $80,000\text{ €}$ au mois $M_3$, les mois intermédiaires $M_1$ et $M_2$ n’ayant pu être audités ($k = 2$ cellules manquantes).
Si l’analyste déploie l’interpolation linéaire (arithmétique), le pas d’incrémentation s’établit à :
$$\Delta y = \frac{80,000 – 10,000}{2 + 1} = \frac{70,000}{3} \approx 23,333{,}33\text{ €}$$
Les valeurs interpolées seront alors de $33,333{,}33\text{ €}$ pour $M_1$ et de $56,666{,}67\text{ €}$ pour $M_2$. Dans cette configuration, le taux de variation apparent s’effondre de manière totalement artificielle au fil du temps : la progression est de $+233{,}3%$ entre $M_0$ et $M_1$, puis chute à $+70%$ entre $M_1$ et $M_2$, pour finir à $+41{,}2%$ entre $M_2$ et $M_3$. Cette distorsion phénoménologique trahit la réalité sous-jacente du processus d’expansion du portefeuille.
À l’inverse, si l’on applique l’interpolation géométrique via l’outil Série, la raison géométrique s’établit exactement à :
$$q = \left( \frac{80,000}{10,000} \right)^{\frac{1}{3}} = 8^{\frac{1}{3}} = 2{,}0$$
Les estimations obtenues sous Excel sont de $20,000\text{ €}$ pour $M_1$ ($10,000 \times 2$) et de $40,000\text{ €}$ pour $M_2$ ($20,000 \times 2$), clôturant parfaitement à $M_3$ sur $80,000\text{ €}$ ($40,000 \times 2$). Le taux de croissance mensuel demeure strictement homogène à $+100%$ tout au long de la période de lacune. La divergence au centre de l’intervalle ($M_1$) entre l’évaluation linéaire ($33,333\text{ €}$) et géométrique ($20,000\text{ €}$) atteint un écart colossal de $66{,}6%$, illustrant le danger opérationnel d’une sélection inadéquate du modèle de reconstitution des données.
5. Interpolation linéaire algébrique par formules dynamiques
5.1 Formulation mathématique standard de l’interpolation linéaire ponctuelle
Bien que les fonctionnalités natives du menu Remplir fournissent une réponse opérationnelle élégante, elles souffrent d’une limitation majeure : leur nature statique. Toute modification ultérieure des valeurs d’ancrage aux bornes n’actualise pas automatiquement les cellules interpolées. Pour instaurer une réactivité computationnelle au sein du classeur, l’interpolation doit être transcrite sous forme de formules algébriques dynamiques.
La formulation analytique standard de l’interpolation linéaire ponctuelle découle directement de l’équation de la droite sécante reliant deux points cartésiens $P_1(x_1, y_1)$ et $P_2(x_2, y_2)$ dans le plan affine $\mathbb{R}^2$. Pour toute coordonnée cible $x$ comprise strictement dans l’intervalle fermé $[x_1, x_2]$, la valeur interpolée correspondante $y$ est donnée par la relation canonique :
$$y = y_1 + \left( \frac{x – x_1}{x_2 – x_1} \right) \cdot (y_2 – y_1)$$
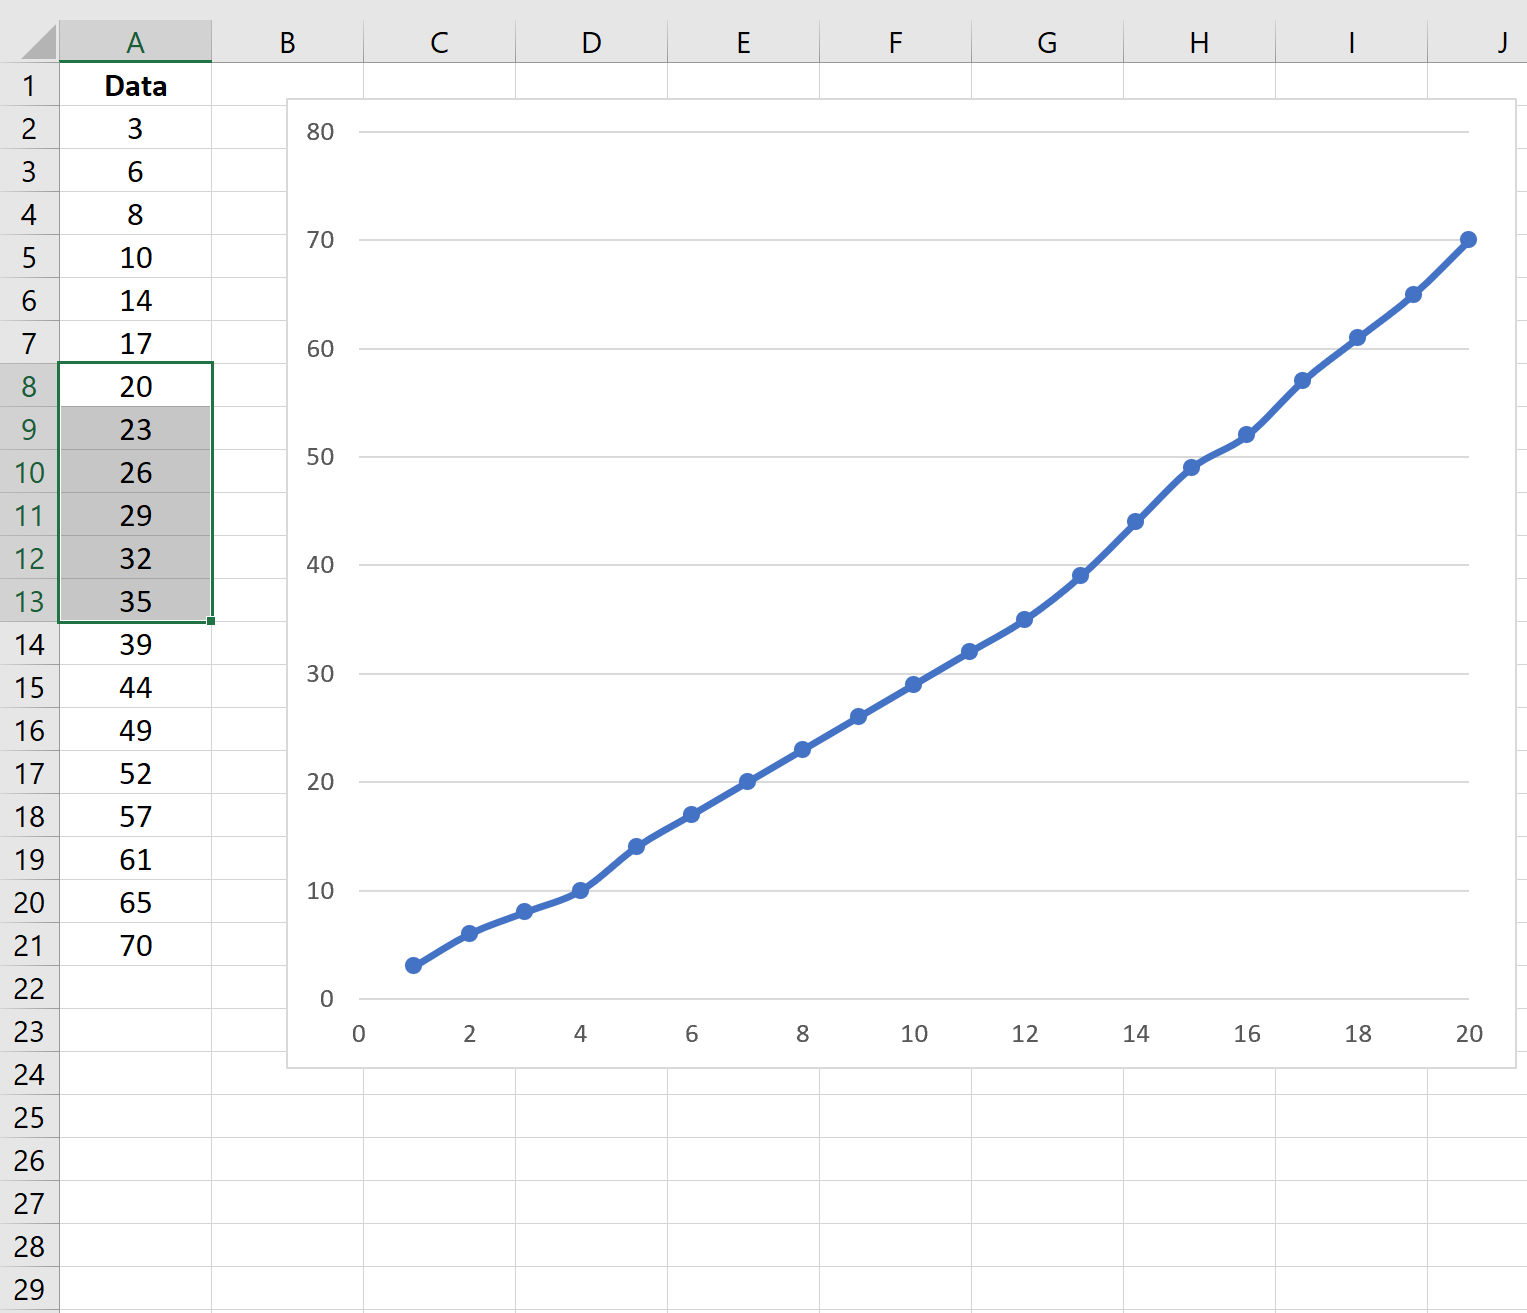
Cette expression peut être réécrite selon une structure de moyenne pondérée par les distances relatives aux bornes :
$$y = \left( \frac{x_2 – x}{x_2 – x_1} \right) y_1 + \left( \frac{x – x_1}{x_2 – x_1} \right) y_2$$
Les conditions strictes d’existence mathématique de cette solution imposent d’une part la non-coïncidence spatiale des abscisses ($x_2 \neq x_1$), excluant toute division par zéro, et d’autre part l’appartenance de la cible à l’enveloppe convexe formée par les nœuds d’interpolation. Au-delà de ces bornes, le modèle bascule formellement dans le régime de l’extrapolation, dont la variance résiduelle s’accroît proportionnellement à la distance par rapport aux observations réelles.
5.2 Construction d’une formule dynamique combinant INDEX et EQUIV
Le défi algorithmique dans l’environnement d’une feuille de calcul Excel consiste à localiser dynamiquement, pour une abscisse cible $x_i$ dont l’ordonnée est manquante, les coordonnées des bornes inférieure $(x_1, y_1)$ et supérieure $(x_2, y_2)$ au sein d’une table sans intervention manuelle de l’utilisateur. Cet objectif est atteint avec une robustesse exemplaire par la combinaison matricielle des fonctions de recherche INDEX et EQUIV.
Considérons un tableau structuré où la plage chronologique continue des abscisses est hébergée dans la plage A$2:A$100 et les observations correspondantes — ponctuées de cellules vides — dans la plage B$2:B$100. Pour une cellule cible située sur la ligne $i$, dont l’abscisse se lit en A20 mais dont la cellule d’observation B20 est vide, l’analyste implémente dans une colonne adjacente de traitement la formule matricielle suivante :
La recherche de la borne inférieure s’articule autour de la fonction EQUIV exploitée en mode d’encadrement descendant :
INDEX(B$2:B$100; EQUIV(A20; A$2:A$100; 1))
Cependant, pour contourner la présence de cellules vides dans la colonne $Y$ et isoler la dernière valeur numérique observée en amont, la logique matricielle contemporaine mobilise la formule avancée :
INDEX(B$2:B$100; MAX(SI((A$2:A$100 < A20)*(B$2:B$100 <> ""); LIGNE(B$2:B$100)-LIGNE(B$2)+1)))
De façon symétrique, l’identification de la borne supérieure aval requiert de localiser la première ligne postérieure non vide au moyen de la fonction MIN conditionnelle :
INDEX(B$2:B$100; MIN(SI((A$2:A$100 > A20)*(B$2:B$100 <> ""); LIGNE(B$2:B$100)-LIGNE(B$2)+1)))
En encapsulant ces extracteurs d’indices dynamiques au sein de la formule de sécante canonique explicitée au paragraphe 5.1, la feuille de calcul résout l’interpolation en temps réel. Dès qu’une valeur empirique est corrigée ou insérée dans la source brute, l’ensemble des segments interpolés s’ajuste instantanément par recalcul du graphe de dépendances d’Excel.
5.3 Traitement automatisé des séries complexes via les fonctions LET et LAMBDA
L’intégration des fonctions modernes dans Microsoft 365, spécifiquement LET et LAMBDA, révolutionne le traitement des formules d’interpolation dynamique sous Excel. Auparavant, la complexité des formules combinant INDEX, EQUIV, MAX et SI engendrait des expressions monolithiques redondantes, où les mêmes plages étaient réévaluées des dizaines de fois au sein d’une seule formule, plombant la bande passante du processeur lors de calculs sur des centaines de milliers de lignes.
La fonction LET permet de rationaliser l’architecture computationnelle en assignant des variables intermédiaires locales. La structure de l’interpolation se formalise avec une clarté algorithmique exceptionnelle :
=LET(xc; A20; X; A$2:A$100; Y; B$2:B$100; filtreInf; (X < xc)*(Y <> ""); filtreSup; (X > xc)*(Y <> ""); ligInf; MAX(SI(filtreInf; LIGNE(Y)-LIGNE(INDEX(Y;1;1))+1)); ligSup; MIN(SI(filtreSup; LIGNE(Y)-LIGNE(INDEX(Y;1;1))+1)); x1; INDEX(X; ligInf); y1; INDEX(Y; ligInf); x2; INDEX(X; ligSup); y2; INDEX(Y; ligSup); y1 + ((xc - x1) / (x2 - x1)) * (y2 - y1))
En portant cette abstraction à son apogée, l’analyste peut encapsuler cette syntaxe au sein du Gestionnaire de noms d’Excel pour forger une fonction personnalisée réutilisable, dénuée de tout code macroscopique VBA, par l’entremise de l’opérateur LAMBDA :
=LAMBDA(x_cible; vecteur_x; vecteur_y; LET(... formule complète ...))
En nommant cette entité INTERPOLER.LIN, l’utilisateur final n’a plus qu’à renseigner dans la feuille de calcul la commande concise =INTERPOLER.LIN(A20; A$2:A$100; B$2:B$100). Cette modularisation hisse Excel au niveau de langages de script de haut niveau comme Python NumPy ou R, tout en conservant l’interactivité visuelle native du tableur.
6. Exploitation des fonctions d’estimation statistique : PRÉVISION.LINÉAIRE et TENDANCE
6.1 Estimation ponctuelle par la fonction PRÉVISION.LINÉAIRE
Le moteur d’analyse statistique d’Excel propose des fonctions de régression directement mobilisables pour l’interpolation de coordonnées lacunaires, parmi lesquelles la fonction standard PRÉVISION.LINÉAIRE (qui succède à l’ancienne commande PRÉVISION) occupe une place centrale. Sa vocation originelle réside dans la prédiction prospective le long d’une tendance établie, mais sa syntaxe mathématique se prête idéalement à l’interpolation ponctuelle restreinte au voisinage immédiat d’une lacune.
La syntaxe canonique requiert trois arguments ordonnés :
PRÉVISION.LINÉAIRE(x; y_connus; x_connus)
Pour exploiter cette fonction en tant qu’interpolateur linéaire strict sans la polluer par les tendances globales de la série, la sélection des arguments y_connus et x_connus doit impérativement être circonscrite aux deux seuls points d’ancrage entourant immédiatement l’intervalle manquant. Si la lacune se déploie entre la ligne 12 et la ligne 15, les arguments vectoriels doivent cibler exclusivement les lignes 11 et 16.
Sous cette contrainte de délimitation locale bilatérale, l’ajustement par la méthode des moindres carrés ordinaires (MCO) exécuté par PRÉVISION.LINÉAIRE converge de façon exacte vers l’équation de la droite sécante. La pente statistique des moindres carrés $\hat{\beta} = \frac{\text{Cov}(X,Y)}{\text{Var}(X)}$ se réduit rigoureusement au ratio du pas arithmétique :
$$\hat{\beta} = \frac{y_2 – y_1}{x_2 – x_1}$$
L’estimation délivrée par la fonction à l’abscisse cible $x$ coïncide alors au bit près avec le résultat de la formule d’interpolation linéaire algébrique, offrant une formulation concise exempte de divisions manuelles complexes.
6.2 Déploiement matriciel global à l’aide de la fonction TENDANCE
Lorsque le jeu de données présente de multiples lacunes dispersées au sein d’une série où l’hypothèse sous-jacente est celle d’un profil de régression continue sur l’ensemble de l’échantillon, la fonction matricielle dynamique TENDANCE constitue un vecteur d’interpolation global d’une redoutable efficacité opérationnelle.
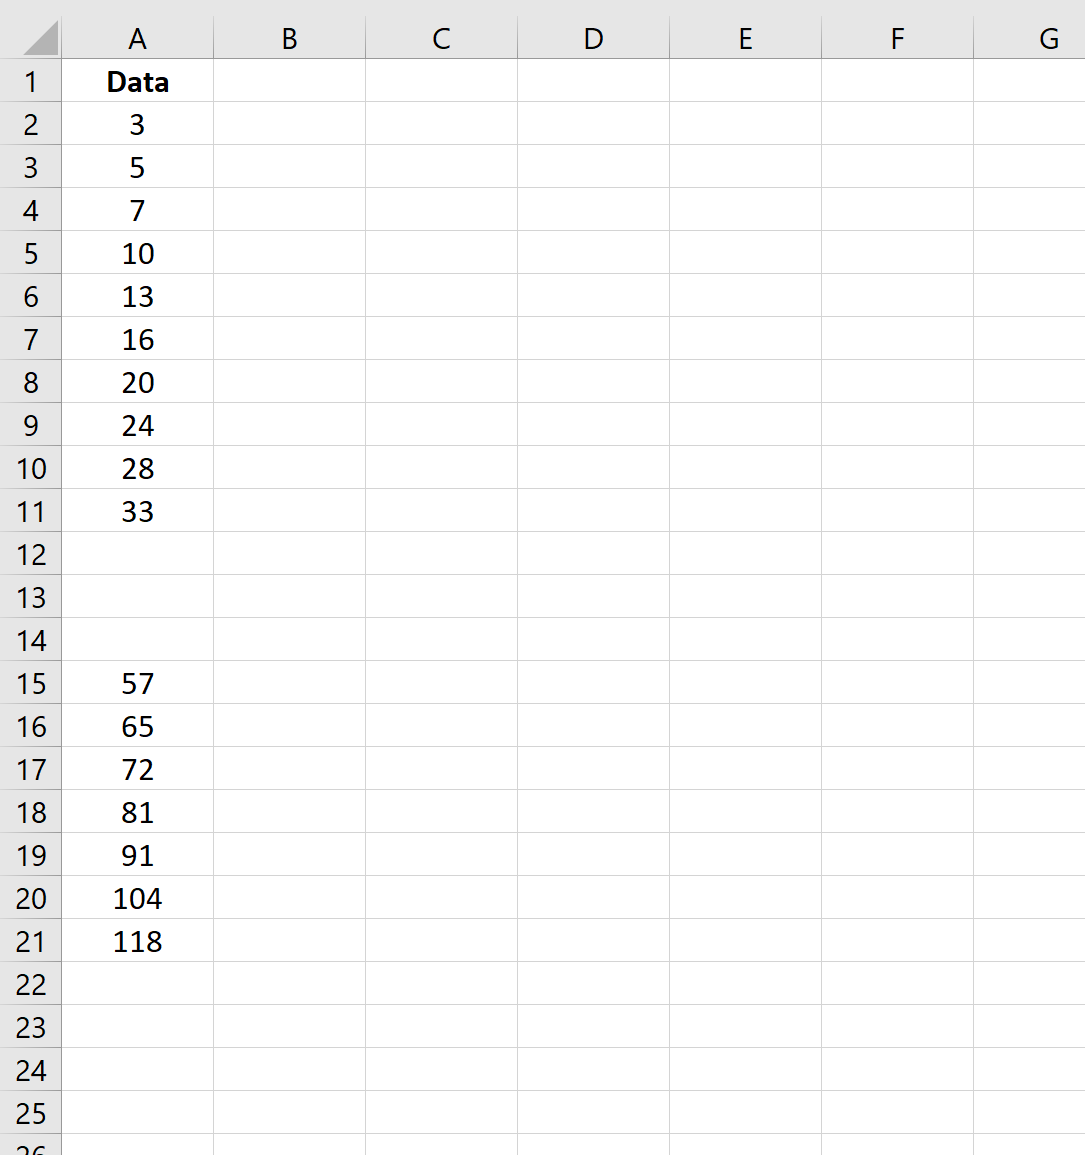
La signature structurelle de la commande se déploie selon les paramètres suivants :
TENDANCE(y_connus; [x_connus]; [nouveaux_x]; [constante])
Le mécanisme d’action matriciel de TENDANCE se distingue fondamentalement des interpolateurs purement locaux. En fournissant l’ensemble des ordonnées observées dans y_connus et leurs abscisses associées dans x_connus, puis en passant la plage complète des abscisses correspondant aux données manquantes dans nouveaux_x, la fonction génère par propagation dynamique l’ensemble des ordonnées reconstituées.
Il est critique de conceptualiser la bifurcation méthodologique ici à l’œuvre : TENDANCE n’impose pas que la droite interpolée passe exactement par les nœuds encadrant immédiatement la lacune. Elle assujettit la reconstruction à la trajectoire de la droite des moindres carrés ordinaires calculée sur l’ensemble du jeu de données. Il s’agit dès lors d’une régression globale appliquée au comblement de lacunes, particulièrement précieuse lorsque les mesures empiriques sont entachées d’un bruit de fond stochastique modéré que l’on désire filtrer au détriment du respect absolu des points d’observation locaux.
6.3 Limites de validité et écueils de la régression appliquée aux lacunes
L’exploitation des fonctions d’estimation statistique telles que TENDANCE ou PRÉVISION.LINÉAIRE pour pallier les déficits informationnels comporte des risques d’inférence sévères que l’analyste doit impérativement maîtriser. Le danger primordial réside dans la vulnérabilité intrinsèque de la régression linéaire aux points aberrants (outliers) et aux observations influentes (effet de levier mesuré par la distance de Cook).
Si une mesure erronée s’est glissée dans les y_connus, la droite d’ajustement global calculée par TENDANCE pivotera autour de ce point levier, propageant une distorsion systématique sur l’intégralité des cellules interpolées à travers le classeur. L’interpolation purement locale (INDEX/EQUIV ou outil Série) circonscrit l’erreur au seul sous-intervalle concerné, tandis que la modélisation régressive globale contamine l’ensemble de la série temporelle.
De plus, l’ajustement global présuppose l’homoscédasticité des résidus et l’absence d’autocorrélation, des conditions quasi systématiquement violées dans les séries chronologiques financières ou biologiques complexes. Remplacer une suite continue de cellules vides par les prédictions d’un modèle linéaire global sur un processus présentant en réalité des cycles saisonniers ou des sauts de régime engendre un écrasement de la variance locale résiduelle, induisant en erreur tout module ultérieur de contrôle de gestion ou d’analyse prédictive.
7. Interpolation non linéaire et polynomiale dans les feuilles de calcul
7.1 Extraction des paramètres polynomiaux via la fonction DROITEREG
Lorsque le phénomène sous-jacent présente une courbure structurelle prononcée — traduisant par exemple des lois physiques de décélération, des rendements d’échelle décroissants ou des comportements balistiques —, l’interpolation linéaire génère un biais d’approximation inacceptable. L’ajustement non linéaire via des polynômes de degré supérieur ($n ge 2$) permet d’épouser fidèlement la géométrie des observations disponibles.
La fonction matricielle DROITEREG d’Excel recèle une puissance algorithmique insoupçonnée pour extraire les coefficients d’un polynôme de degré arbitraire par la méthode des moindres carrés matricielle. Pour ajuster un modèle quadratique ($y = ax^2 + bx + c$) ou cubique ($y = ax^3 + bx^2 + cx + d$), il est impératif de construire une matrice explicite des puissances de la variable indépendante $x$.
Dans la syntaxe avancée d’Excel, cette dérivation s’opère directement au sein de la formule à l’aide de l’opérateur de vectorisation de constantes matricielles. Pour une régression cubique, la formule s’écrit de la manière suivante :
DROITEREG(plage_y; plage_x^{1; 2; 3}; VRAI; VRAI)
En validant cette expression matricielle, Excel renvoie un tableau horizontal contenant les estimateurs optimaux des coefficients d’ajustement : $[\hat{a}_3, \hat{a}_2, \hat{a}_1, \hat{a}_0]$. Le quatrième argument fixé à VRAI force la génération des statistiques de régression complémentaires, notamment le coefficient de détermination multivarié $R^2$, indispensable pour auditer la significativité mathématique de la courbure introduite avant de l’exploiter à des fins de calcul de comblement.
7.2 Reconstruction mathématique des valeurs lacunaires par évaluation polynomiale
Une fois les estimateurs matriciels des paramètres polynomiaux extraits par DROITEREG, la valeur interpolée associée à une abscisse lacunaire $x_k$ se calcule par l’évaluation directe de la fonction polynomiale estimée. Plutôt que de disperser les calculs de puissances dans de multiples colonnes auxiliaires de la feuille de calcul, la fonction SOMMEPROD permet d’évaluer vectoriellement la somme pondérée des coefficients de manière concise et performante.
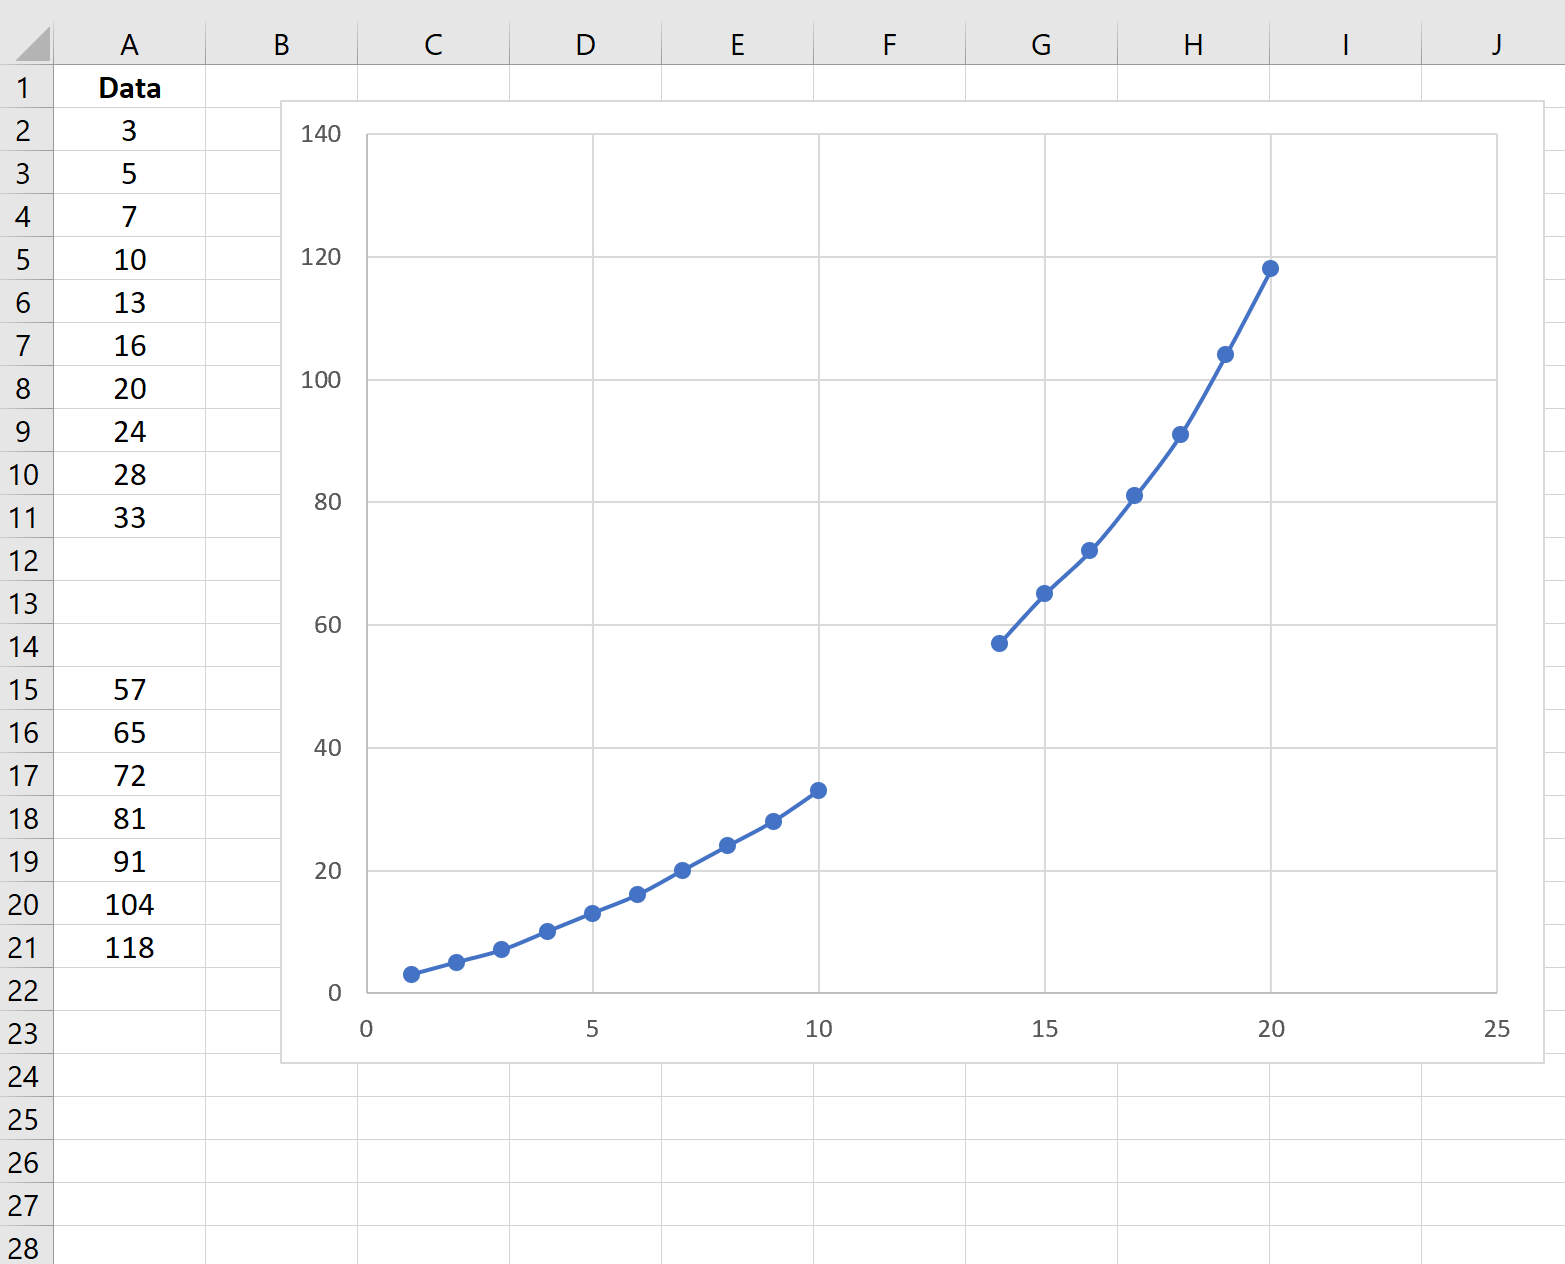
Si la plage horizontale E1:H1 héberge les quatre coefficients cubiques $[\hat{a}_3, \hat{a}_2, \hat{a}_1, \hat{a}_0]$ générés par l’expression DROITEREG, la valeur interpolée correspondant à une abscisse manquante située dans la cellule A15 s’obtient instantanément par l’injection de la syntaxe :
=SOMMEPROD(E$1:H$1; A15^{3; 2; 1; 0})
Cette approche vectorielle garantit une modularité totale. Si le modèle d’ajustement retenu est un polynôme quadratique de degré 2 hébergé dans E1:G1, la syntaxe se transpose sans friction en =SOMMEPROD(E$1:G$1; A15^{2; 1; 0}). Cette technique de calcul déploie toute sa pertinence dans la métrologie chimique ou industrielle, par exemple pour calibrer des courbes d’étalonnage de spectrométrie où l’atténuation du signal suit une décroissance parabolique connue, permettant de reconstruire les lacunes d’analyse avec une précision microscopique inaccessible aux estimateurs affines.
7.3 Gestion des risques d’instabilité : Phénomène de Runge et surajustement
L’enthousiasme pour la flexibilité des interpolations polynomiales d’ordre élevé doit être impérativement tempéré par la connaissance du phénomène de Runge. En analyse numérique, l’élévation du degré du polynôme d’interpolation ne garantit aucunement une convergence uniforme vers la fonction génératrice sous-jacente ; au contraire, au-delà du degré 3 ou 4, l’interpolation polynomiale globale produit des oscillations divergentes dramatiques à proximité immédiate des extrémités de l’intervalle.
Dans un classeur Excel, l’analyste qui chercherait à combler des cellules vides en forçant un ajustement de degré 5 ou 6 sur une douzaine de points expérimentaux constatera l’apparition de prédictions interpolées aberrantes — des valeurs calculées devenant massivement négatives sur des séries de grandeurs physiques strictement positives, ou des sommets oscillatoires totalement déconnectés de la réalité phénoménologique. Ce comportement traduit un surajustement (overfitting) pathologique où le modèle ajuste le bruit aléatoire plutôt que la tendance structurelle.
En conséquence, les règles de bonne pratique en matière d’ingénierie des données sous Excel dictent deux recommandations intangibles :
- Proscrire rigoureusement tout polynôme d’ajustement d’un ordre strictement supérieur à 3 pour des opérations d’interpolation de données réelles.
- Procéder systématiquement au partitionnement de la série en sous-intervalles locaux disjoints (interpolation polynomiale par morceaux) dès que le profil global présente des inversions de courbure multiples, plutôt que de tenter un ajustement global unique sur l’ensemble de la feuille de calcul.
8. Traitement graphique des données manquantes : Continuité visuelle et analyse
8.1 Configuration des paramètres de cellules masquées et vides dans les graphiques
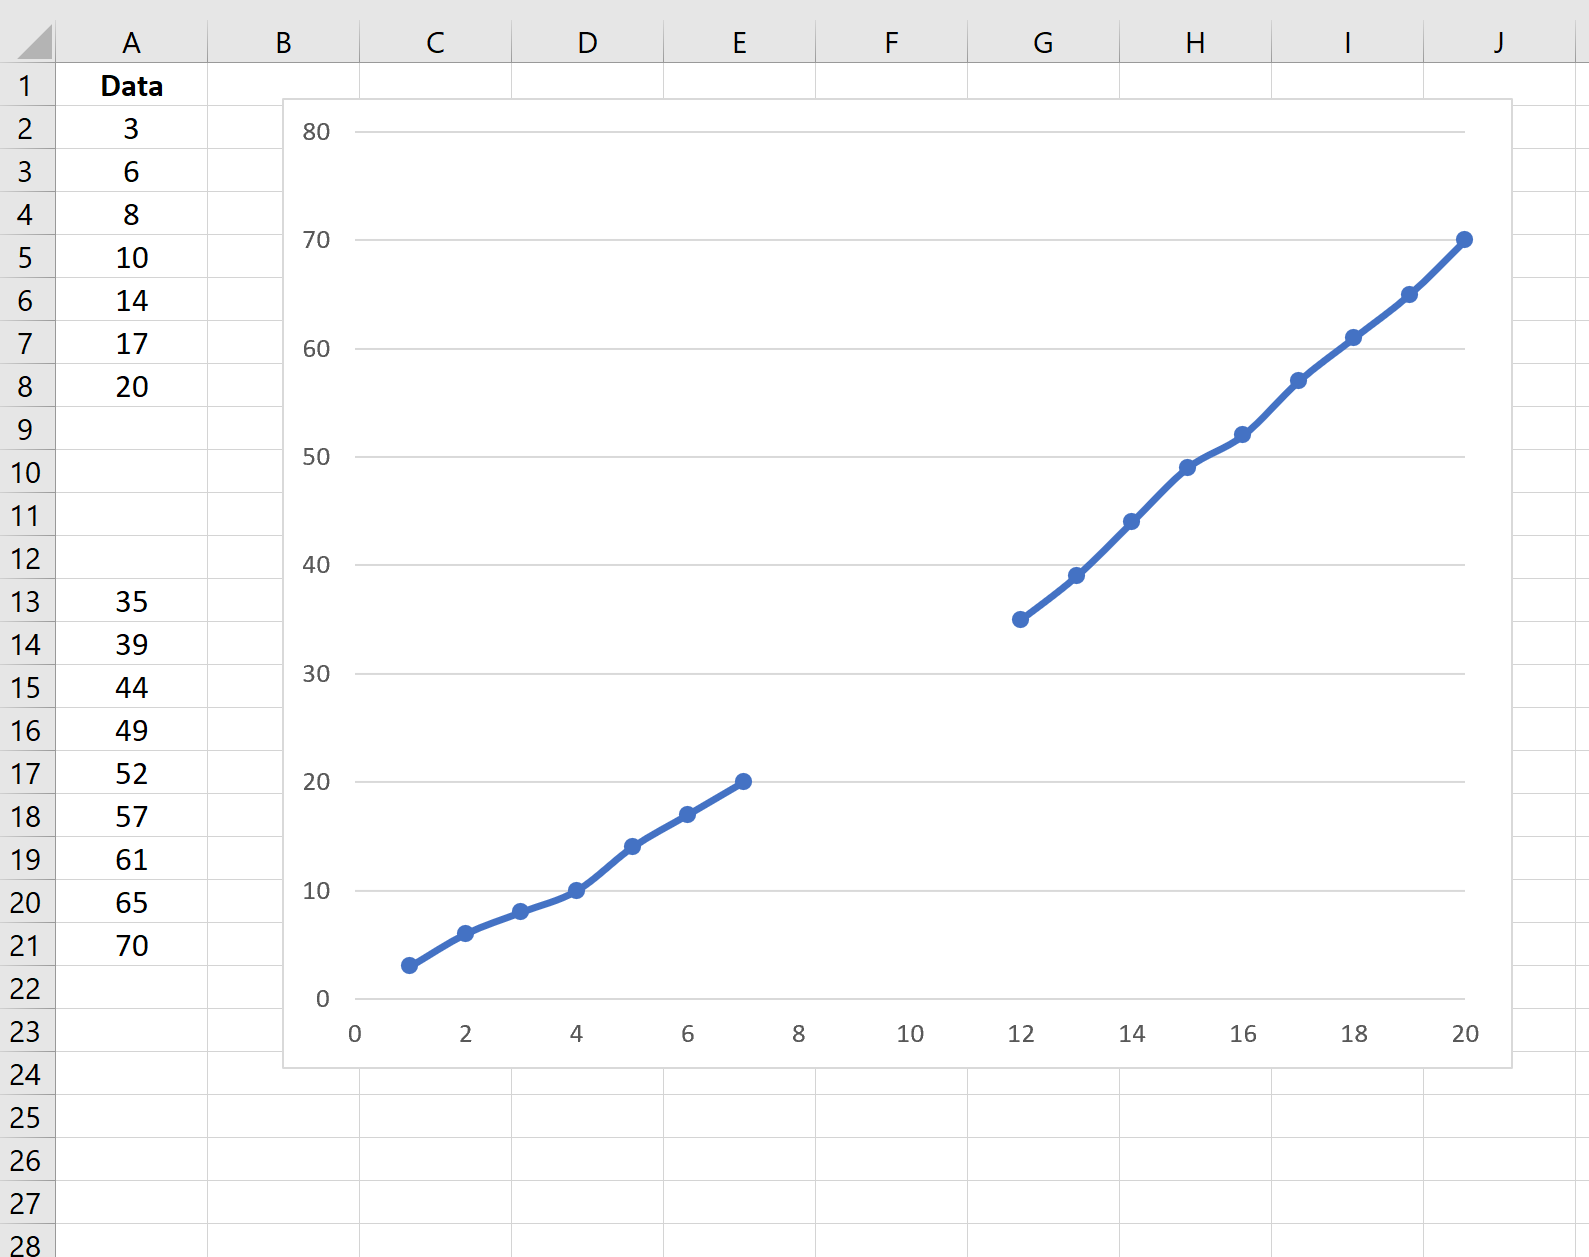
L’impact des cellules vides ne se cantonne pas aux calculs arithmétiques du tableur ; il affecte immédiatement la lisibilité des visualisations de synthèse. Par défaut, lorsqu’un graphique cartésien ou un nuage de points reliés par des segments de ligne est généré à partir d’une série temporelle lacunaire, Excel insère des ruptures physiques dans le tracé. La ligne de tendance se disloque en tronçons isolés, nuisant considérablement à l’intelligibilité de la communication exécutive.
Le moteur graphique d’Excel dissimule une fonctionnalité permettant de configurer le mode de restitution visuelle des lacunes sans modifier l’intégrité tabulaire des cellules sous-jacentes. Pour y accéder, sélectionnez le graphique concerné, faites un clic droit sur sa zone d’affichage et sélectionnez Sélectionner des données…. Au bas de la boîte de dialogue contextuelle, cliquez sur le bouton Cellules masquées et cellules vides.
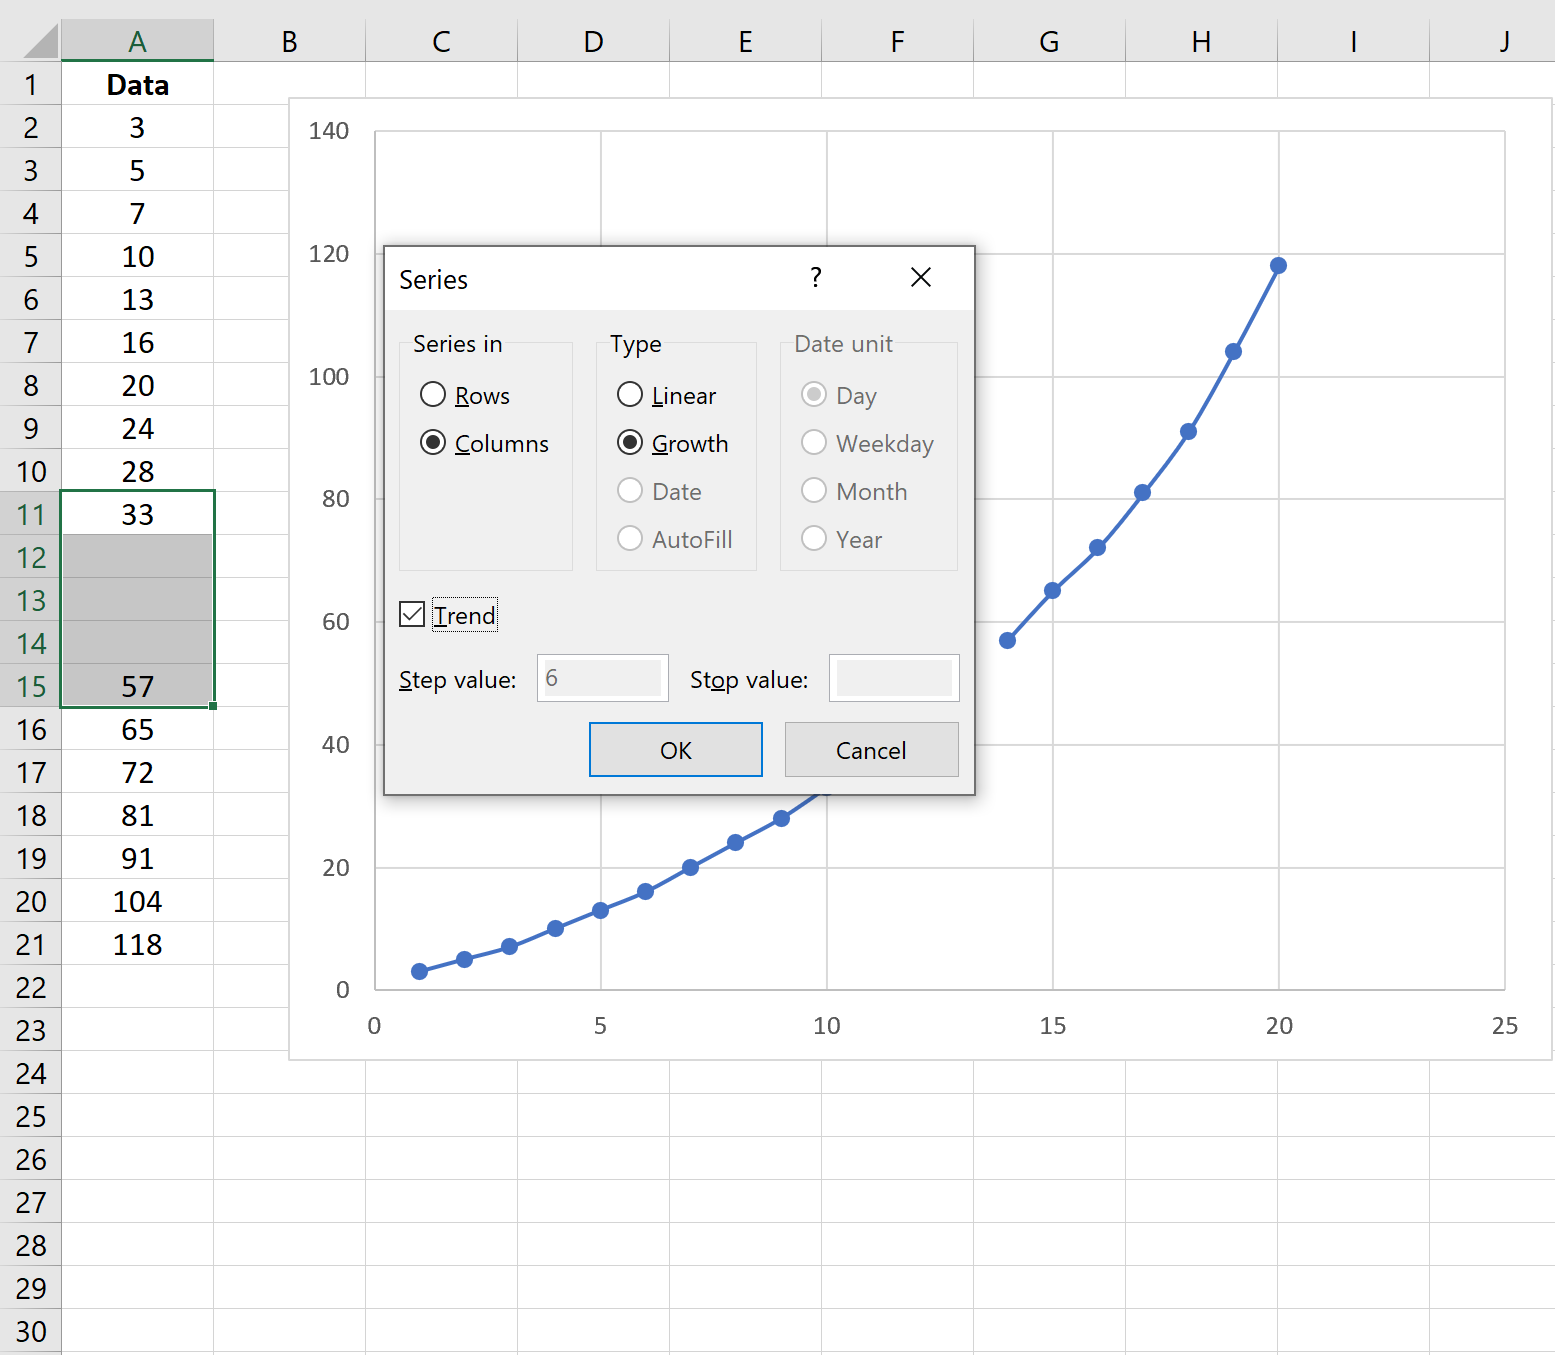
L’interface offre alors trois arbitrages structurants pour l’affichage des cellules vides :
- Espaces vides : Comportement standard maintenant des ruptures physiques continues au sein de la courbe tracée.
- Zéro : Assimile fallacieusement toute cellule vide à une ordonnée de zéro, précipitant artificiellement la courbe vers l’axe des abscisses lors de chaque omission d’enregistrement.
- Relier les points par une ligne : L’option cardinale pour l’analyse visuelle, qui applique une interpolation géométrique linéaire directe à l’écran, tirant un vecteur continu entre les nœuds adjacents connus.
8.2 Différenciation épistémologique entre continuité graphique et intégrité tabulaire
Il est fondamental de disséquer le piège épistémologique induit par l’activation de l’option Relier les points par une ligne. Cette commodité visuelle constitue une illusion d’optique computationnelle : la feuille de calcul ne contient rigoureusement aucune donnée synthétisée dans les cellules lacunaires du tableau source. Les cellules B5:B8 demeurent des vides informationnels au sens du système de typage d’Excel.
Cette divergence entre représentation phénoménologique et contenu structurel recèle des périls critiques en entreprise. Si un collaborateur exporte la série sous-jacente au format CSV ou la charge dans un progiciel de Business Intelligence (Power BI, Tableau) ou un moteur de calcul statistique (R, Python Pandas), les lacunes ressurgiront instantanément, provoquant l’échec des flux ETL ou des calculs de covariance. De surcroît, le calcul d’indicateurs agrégés dans Excel (tels que la moyenne ou l’écart-type de la série affichée) continuera d’ignorer ces segments, générant des incohérences fondamentales entre les chiffres rapportés dans le corps d’un rapport et la trajectoire lissée affichée par le graphique.
La déontologie scientifique impose donc une règle stricte : si un graphique recourt à l’option de liaison continue des points masqués, une mention méthodologique explicite doit figurer dans la légende ou les notes infrapaginales de la figure pour certifier que la continuité visuelle observée résulte d’un artéfact d’affichage et ne reflète pas une complétude empirique tabulaire.
8.3 Adjonction de courbes de tendance analytiques pour guider l’interprétation
Pour superposer à la série observée une dynamique continue sans pour autant altérer les cellules de travail, l’adjonction d’une Courbe de tendance algorithmique offre une alternative analytique robuste. En sélectionnant la série de données au sein du graphique et en activant l’outil contextuel Ajouter une courbe de tendance, le modélisateur a accès aux moteurs d’ajustement intégrés : linéaire, logarithmique, polynomial, puissance ou moyenne mobile.
Pour conférer à cette démarche une rigueur professionnelle incontestable, deux options du panneau de configuration latéral doivent systématiquement être activées :
- Afficher l’équation sur le graphique : Cette commande imprime la forme algébrique explicite de la fonction d’estimation $y = f(x)$, livrant à l’auditeur la clé mathématique exacte de la trajectoire visualisée.
- Afficher le coefficient de détermination (R²) sur le graphique : La restitution de cette métrique adimensionnelle informe immédiatement sur la proportion de la variance totale expliquée par le modèle d’ajustement choisi.
Cette approche permet en outre d’exploiter les paramètres de prévision En avant et En arrière intégrés à la courbe de tendance. En spécifiant un horizon temporel de plusieurs périodes, la courbe prolonge sa trajectoire analytique au-delà des bornes ou comble visuellement des intervalles lacunaires centraux en s’appuyant sur l’ensemble du corpus d’apprentissage, constituant une passerelle visuelle idéale avant d’entreprendre l’implémentation de modèles programmés en Visual Basic.
9. Interpolation avancée par Spline cubique via Visual Basic for Applications (VBA)
9.1 Fondements mathématiques des splines cubiques naturelles
Si l’interpolation linéaire brise la douceur de la trajectoire par des singularités angulaires au niveau des nœuds de raccordement (dérivée première non continue), et si l’interpolation polynomiale globale s’expose aux instabilités de Runge, l’interpolation par splines cubiques représente l’étalon-or absolu de l’analyse numérique pour la reconstruction de séries continues.
La méthode repose sur l’ajustement d’une famille de polynômes cubiques distincts par morceaux, notés $S_k(x)$, sur chaque sous-intervalle délimité par les nœuds successifs $[x_k, x_{k+1}]$ :
$$S_k(x) = a_k (x – x_k)^3 + b_k (x – x_k)^2 + c_k (x – x_k) + d_k$$
L’élégance de cette construction réside dans les conditions de raccordement imposées au niveau de chaque nœud interne :
- Continuité positionnelle de la fonction : $S_{k-1}(x_k) = S_k(x_k) = y_k$
- Continuité de la dérivée première (tangence univoque) : $S’_{k-1}(x_k) = S’_k(x_k)$
- Continuité de la dérivée seconde (courbure lisse sans à-coup) : $S »_{k-1}(x_k) = S »_k(x_k)$
Dans le cas des splines cubiques naturelles, une condition aux limites additionnelle force la dérivée seconde à s’annuler exactement aux deux extrémités de l’ensemble de la série : $S »(x_1) = S »(x_n) = 0$. La formalisation de ce système de contraintes différentielles aboutit à la résolution d’un système linéaire matriciel strictement tridiagonal, garantissant une stabilité numérique absolue et l’absence totale de dérive oscillatoire.
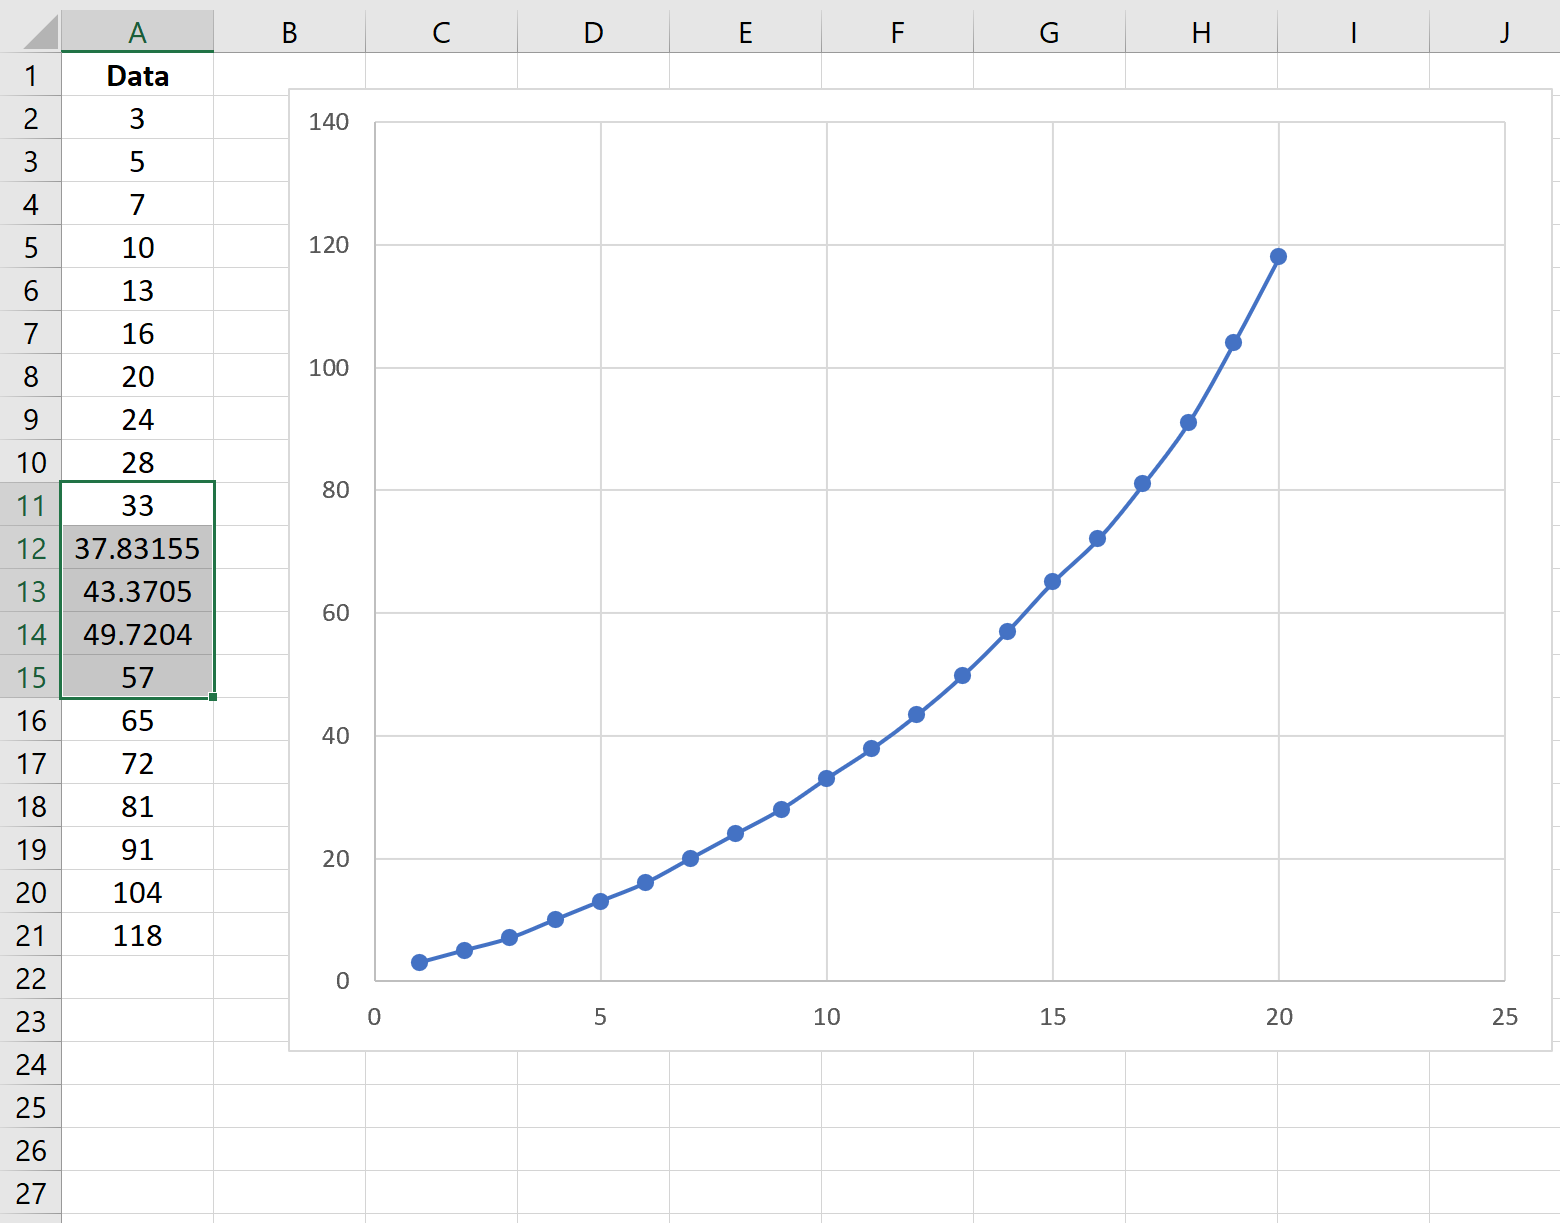
9.2 Architecture et codage d’une fonction personnalisée (UDF) en VBA
Excel ne dispose d’aucune fonction native permettant de calculer une spline cubique. Il est donc nécessaire de mobiliser l’environnement Visual Basic for Applications (VBA) pour enrichir le tableur d’une fonction personnalisée (User-Defined Function, UDF), que l’on nommera conventionnellement SplineInterpolation. L’architecture algorithmique mobilise l’algorithme de Thomas (élimination gaussienne spécialisée pour matrices tridiagonales), assurant une complexité computationnelle linéaire en temps $\mathcal{O}(n)$, infiniment plus rapide qu’une inversion matricielle générique.
Pour insérer cette routine, activez l’environnement de développement via la combinaison de touches ALT + F11, naviguez vers le menu Insertion > Module, et insérez l’architecture logicielle suivante :
La routine déclare d’abord la signature de la fonction utilisateur :
Function SplineInterpolation(x_cible As Double, Plage_X As Range, Plage_Y As Range) As Variant
L’algorithme se structure en plusieurs phases logiques séquentielles :
- Extraction et validation matricielle : Les plages de cellules d’entrée sont dimensionnées dans des tableaux de variables scalaires réelles en double précision. L’algorithme vérifie que la taille du vecteur d’abscisse coïncide rigoureusement avec celle du vecteur d’ordonnée, et que le nombre d’observations connues $n$ est strictement supérieur à 3.
- Vérification de la monotonicité : L’algorithme s’assure que la série des abscisses est classée dans un ordre strictement croissant ($x_{i+1} > x_i$), renvoyant une erreur standard
CVErr(xlErrNum)en cas de violation. - Construction du système tridiagonal : Le calcul dérive les espacements d’intervalles $h_i = x_{i+1} – x_i$, puis peuple les vecteurs diagonaux $[A]$, $[B]$, $[C]$ de la matrice ainsi que le vecteur constant $[D]$ représentant les dérivées secondes discrètes.
- Résolution par algorithme de Thomas : Le système tridiagonal est factorisé via une phase de descente éliminatoire suivie d’une phase de remontée substitutive, déterminant avec exactitude les valeurs des dérivées secondes $M_i$ à chaque nœud d’observation.
- Évaluation locale ponctuelle : L’algorithme localise le segment spécifique $[x_k, x_{k+1}]$ encadrant la valeur
x_cible, puis évalue l’ordonnée finale par l’évaluation cubique :
$$y(x) = \frac{M_k (x_{k+1} – x)^3 + M_{k+1} (x – x_k)^3}{6 h_k} + \left( \frac{y_k}{h_k} – \frac{M_k h_k}{6} \right)(x_{k+1} – x) + \left( \frac{y_{k+1}}{h_k} – \frac{M_{k+1} h_k}{6} \right)(x – x_k)$$
9.3 Exécution pratique et audit de performance de la macro
Une fois le module injecté et compilé au sein de l’environnement VBA, son exécution dans la feuille de calcul s’opère avec la même fluidité que n’importe quelle commande standard du répertoire Excel. L’analyste se positionne sur la cellule cible correspondant à une ligne dépourvue d’observation empirique et formule l’appel suivant :
=SplineInterpolation(A20; A$2:A$50; B$2:B$50)
L’évaluation comparative entre la courbe issue de la spline cubique et une interpolation linéaire classique démontre l’immense supériorité structurelle de l’approche algorithmique avancée. Les transitions au droit des nœuds d’inflexion cessent d’arborer des profils anguleux artificiels pour adopter une trajectoire fluide, éliminant les discontinuités de gradients qui faussent généralement les calculs de dérivées premières (vitesses, flux marginaux) ou de dérivées secondes (accélérations, convexités financières).
Sur le plan de l’intégrité logicielle, l’utilisation de modules de code impose la sauvegarde formelle du classeur au format prenant en charge les macros, arborant l’extension .xlsm. Si le document est stocké au format conventionnel .xlsx, le moteur d’enregistrement d’Excel détruira instantanément le code source du module VBA, anéantissant l’interactivité de la fonction et renvoyant des erreurs structurelles de nommage #NOM? lors de la réouverture subséquente du projet.
10. Validation statistique et métrologie de la qualité de l’interpolation
10.1 Protocoles de validation croisée par masquage artificiel de données
Déployer une interpolation sous Excel sans instrumenter un protocole d’évaluation métrologique rigoureux relève de l’empirisme aveugle. Pour certifier la validité scientifique d’un comblement de données, le modélisateur doit implémenter un protocole de validation croisée par masquage artificiel (également désigné sous l’appellation d’analyse de complétion aveugle ou back-testing métrologique).
Ce protocole consiste à sélectionner délibérément un sous-ensemble d’observations empiriques parfaitement connues et documentées au sein de la série temporelle originale, puis à occulter volontairement leurs valeurs en les copiant dans un onglet d’audit distinct et en purgeant les cellules correspondantes dans l’espace de calcul. Les différents algorithmes d’interpolation candidats (linéaire, géométrique, régression polynomiale, spline cubique VBA) sont alors appliqués pour reconstituer ces valeurs volontairement censurées.
En confrontant mathématiquement les valeurs synthétisées calculées par Excel face aux valeurs empiriques historiques réelles, l’analyste génère une distribution d’erreurs d’approximation résiduelles. Ce protocole immunise contre les hypothèses de complaisance et permet de sélectionner objectivement la méthode d’interpolation qui minimise les déviances sur le comportement dynamique spécifique de la série étudiée.
10.2 Calcul des indicateurs de performance d’ajustement dans Excel
Pour dépasser l’appréciation qualitative visuelle, Excel offre l’ensemble des opérateurs nécessaires pour formaliser les grands indicateurs de performance d’ajustement statistique sur les résidus d’interpolation. Trois métriques scalaires standard doivent être systématiquement dérivées dans un tableau d’évaluation comparatif :
L’Erreur Quadratique Moyenne (Root Mean Square Error, RMSE), qui pénalise sévèrement les grands écarts d’interpolation en raison de l’élévation au carré des résidus :
$$\text{RMSE} = \sqrt{ \frac{1}{N} \sum_{i=1}^{N} (y_i – \hat{y}_i)^2 }$$
Formule Excel correspondante : =RACINE(MOYENNE.SI.ENS((Plage_Reelle - Plage_Interpol)^2)) validée matriciellement.
L’Erreur Absolue Moyenne (Mean Absolute Error, MAE), traduisant l’amplitude moyenne brute des résidus sans distinction de signe :
$$\text{MAE} = \frac{1}{N} \sum_{i=1}^{N} |y_i – \hat{y}_i|$$
Formule Excel correspondante : =MOYENNE(ABS(Plage_Reelle - Plage_Interpol)).
L’Erreur Absolue Moyenne en Pourcentage (Mean Absolute Percentage Error, MAPE), délivrant une métrique adimensionnelle normalisée relative :
$$\text{MAPE} = \frac{100%}{N} \sum_{i=1}^{N} left| \frac{y_i – \hat{y}_i}{y_i} right|$$
On complétera avantageusement cette grille par le calcul du Coefficient d’efficacité de Nash-Sutcliffe (NSE), indicateur largement exploité en modélisation environnementale et hydrologique, défini par l’expression :
$$\text{NSE} = 1 – \frac{\sum (y_i – \hat{y}_i)^2}{\sum (y_i – \bar{y})^2}$$
Un NSE égal à 1 traduit une interpolation parfaite, tandis qu’un NSE inférieur ou égal à 0 démontre mathématiquement que l’interpolation appliquée est moins précise que la simple utilisation de la moyenne empirique globale $\bar{y}$ comme prédicteur.
10.3 Détection des dérives statistiques et déformation de la distribution
Le comblement massif de valeurs manquantes par interpolation altère insidieusement la forme intrinsèque de la distribution statistique des données au sein de la feuille Excel. L’analyste doit impérativement auditer la déformation des moments de la distribution avant et après l’opération d’interpolation.
La première déformation concerne l’écrasement de la dispersion. En calculant le rapport de variance $F = \frac{\text{Var}_{post}}{\text{Var}_{pre}}$ via la fonction VAR.S, on observe systématiquement une contraction de la dispersion, car l’interpolation positionne mécaniquement les données reconstituées au cœur des distributions locales sans réintroduire l’aléa résiduel. Si ce ratio s’effondre de manière excessive, les tests d’homoscédasticité ultérieurs perdront toute validité empirique.
Les dérives des moments d’ordre supérieur doivent être contrôlées via les fonctions intégrées :
COEFFICIENT.ASYMETRIE(Skewness) : Évalue si l’interpolation linéaire répétée n’a pas artificiellement équilibré des queues de distribution pourtant historiquement asymétriques.KURTOSIS(Aplatissement) : Mesure la concentration des valeurs autour du centre. Une hausse dramatique du kurtosis post-interpolation signale un phénomène d’hyper-lissage pathologique, indiquant que le tableur a inséré une masse trop importante d’estimations hyper-conformes qui neutralisent la détection des régimes de variabilité extrême.
11. Limites critiques, risques d’inférence et considérations déontologiques
11.1 Réduction artificielle de la variance et risque d’erreur de type I
L’intégration délibérée de séries temporelles interpolées dans des chaînes de traitement statistique avancées sans précaution méthodologique induit un piège d’inférence majeur : l’inflation trompeuse des degrés de liberté et l’effondrement artificiel des variances d’échantillonnage. En remplaçant formellement des cellules vides par des valeurs déterministes rigides, le modélisateur gonfle artificiellement la taille d’échantillon nominale $N$ au sein de sa feuille Excel.
Lors de l’application subséquente de tests d’hypothèses statistiques (tels que les tests de Student ou les régressions univariées exécutées par l’outil Utilitaire d’analyse d’Excel), le dénominateur de l’erreur-type de la moyenne, régi par l’expression $\sigma_{\bar{x}} = \frac{s}{\sqrt{N}}$, se trouve indûment contracté par la majoration de $N$. Simultanément, la variance d’échantillon $s^2$ se trouve comprimée par l’hyper-lissage déterministe.
Cette double distorsion engendre une explosion mathématique du risque d’erreur de type I (rejet à tort d’une hypothèse nulle vraie). Le chercheur ou l’analyste conclura péremptoirement à la significativité statistique éclatante d’un coefficient ou d’une corrélation d’affaires, alors que cette prétendue robustesse découle exclusivement de la rigidité arithmétique artificielle injectée par les formules d’interpolation d’Excel. En s’affranchissant du bruit stochastique réel de l’intervalle manquant, le tableur génère une certitude trompeuse qui viole les postulats de Gauss-Markov.
11.2 Situations pathologiques d’exclusion formelle de l’interpolation
La puissance computationnelle d’Excel ne saurait affranchir l’opérateur du discernement scientifique : il existe des configurations distributionnelles pathologiques où le recours à l’interpolation déterministe doit être formellement proscrit sous peine d’invalidation méthodologique absolue.
Le premier cas d’exclusion absolue concerne les processus stochastiques purs régis par des dynamiques de marche aléatoire (random walk) ou de bruit blanc. Sur une série de cotations d’actions liquides ou de taux de change à haute fréquence, l’espérance mathématique de la trajectoire entre deux points distants est dénuée de mémoire déterministe ; interpoler linéairement une lacune au cours d’une séance boursière revient à masquer des sauts de volatilité fondamentaux et à fabriquer une séquence de rendements nuls sans aucune consistance financière.
Le second périmètre d’exclusion réside dans la présence avérée de ruptures structurelles ou de transitions de phase au cœur de l’intervalle lacunaire. Si une cellule vide coïncide temporellement avec un choc macroéconomique exogène majeur, une refonte réglementaire ou une défaillance catastrophique de matériel, l’application d’un lissage (qu’il soit linéaire ou par spline) jette un voile de régularité artificielle sur une discontinuité fondamentale du système modélisé.
Enfin, la proportion relative de l’intervalle d’incomplétude constitue un critère d’exclusion éliminatoire. Lorsque la longueur de la plage de cellules consécutives manquantes excède l’échelle temporelle de la dynamique étudiée (par exemple, 10 mois consécutifs de vide au sein d’une série saisonnière annuelle), l’interpolation mathématique perd toute légitimité informationnelle et doit s’effacer devant des méthodes de reconstruction par modèles d’espace d’état ou l’admission pure et simple de l’indisponibilité des données.
11.3 Exigences de transparence scientifique et traçabilité des transformations
L’intégrité méthodologique exige une gouvernance rigoureuse de la traçabilité des modifications apportées aux classeurs. Modifier subrepticement les cellules d’origine en y injectant des valeurs interpolées, sans consigner formellement la genèse mathématique de ces données synthétisées, constitue une violation grave des normes de reproductibilité scientifique énoncées par les protocoles internationaux d’audit de données.
Tout projet sous Excel intégrant des processus d’interpolation doit impérativement instaurer un cloisonnement strict entre les données brutes immutables et les séries modélisées. Les relevés empiriques originels doivent être scellés au sein d’un onglet d’archive dédié, verrouillé en écriture, pour interdire tout écrasement destructif irréversible. L’interpolation doit impérativement s’exécuter dans des colonnes de traitement distinctes, clairement étiquetées par des conventions de nommage univoques (telles que Y_Interpol_Spline ou Y_Linear_Est).
Dans le domaine académique et les rapports techniques réglementaires, la transparence impose de documenter explicitement dans les métadonnées du classeur les paramètres algorithmiques mobilisés : formules exactes employées, versions logicielles, équations des polynômes d’ajustement, et justification phénoménologique du modèle continu adopté. Cette traçabilité garantit qu’un auditeur tiers puisse à tout instant isoler les véritables observations empiriques des artéfacts de calcul déterministes.
12. Protocole décisionnel et guide d’application standardisé sous Excel
12.1 Arbre de décision algorithmique pour le choix de la méthode idoine
Pour guider le praticien à travers le dédale des solutions logiques présentées dans ce manuel, nous formalisons ci-après un protocole d’arbitrage algorithmique structuré selon la typologie et les contraintes mathématiques de la série traitée.
L’orientation méthodologique s’articule selon une séquence ordonnée de jalons discriminants :
- Axe 1 : Exigence de dynamisme des calculs
- Si le classeur est un rapport analytique statique sans vocation de mise à jour : S’orienter vers les outils natifs de remplissage (Section 3 ou 4).
- Si le jeu de données est évolutif et sujet à des actualisations de nœuds : Mobiliser impérativement des solutions par formules (Sections 5, 6 ou 9).
- Axe 2 : Régime phénoménologique de la variable
- Processus à taux de variation proportionnel constant ($y > 0$) : Déployer l’interpolation Géométrique via l’outil Série ou une transposition logarithmique dynamique.
- Processus physique ou cinétique doux avec inversions de courbure : Exécuter la fonction Spline cubique naturelle VBA pour préserver la dérivabilité d’ordre 2.
- Relation affine stationnaire sur de petits intervalles : Déployer l’interpolation Linéaire locale par formules dynamiques
LET / INDEX / EQUIV. - Signal globalement bruité où l’on désire filtrer l’aléa : Utiliser la régression matricielle TENDANCE ou l’ajustement polynomial DROITEREG d’ordre maximal 3.
- Axe 3 : Contraintes dimensionnelles et environnementales
- Environnement d’entreprise sécurisé bloquant strictement l’exécution des macros VBA : Écarter les splines cubiques et se replier sur l’architecture dynamique
LET / LAMBDAnative d’Excel 365.
- Environnement d’entreprise sécurisé bloquant strictement l’exécution des macros VBA : Écarter les splines cubiques et se replier sur l’architecture dynamique
12.2 Canevas méthodologique séquentiel de comblement pas à pas
Pour assurer une exécution sans faille dans le cadre de projets d’analyse d’envergure, le traitement opérationnel des données manquantes sous Excel doit s’articuler scrupuleusement autour d’un canevas en quatre phases itératives :
Phase 1 : Audit structurel et sauvegarde intégrale
Dupliquez l’onglet original dans une feuille protégée nommée RAW_DATA. Exécutez l’audit d’intégrité à l’aide des fonctions NB.VIDE et ESTVIDE. Appliquez la mise en forme conditionnelle pour cartographier la distribution des vides. Nettoyez les chaînes de texte vides invisibles via des fonctions textuelles de conversion arithmétique.
Phase 2 : Évaluation sur échantillon témoin
Sélectionnez une plage contiguë de 10 à 20 observations empiriques complètes représentatives. Masquez artificiellement des sous-intervalles de longueur équivalente aux lacunes réelles constatées dans la base. Déployez en parallèle sur ce témoin la méthode linéaire, géométrique et spline. Calculez les métriques d’erreur RMSE et MAE. Figez le choix de la méthode qui minimise formellement l’écart quadratique.
Phase 3 : Déploiement computationnel
Implémentez l’outil ou la formule dynamique retenue sur l’ensemble de la série cible au sein d’une colonne dédiée distincte intitulée NomVariable_Reconstruite. Veillez à ce que les bornes inférieures et supérieures d’interpolation soient référencées avec des ancrages absolus adéquats pour éviter tout glissement d’intervalle lors de l’étirement des expressions mathématiques.
Phase 4 : Contrôle post-traitement et documentation
Vérifiez l’absence résiduelle d’erreurs logicielles (#VALEUR!, #REF!, #DIV/0!) sur la colonne résultante. Tracez la distribution des résidus et vérifiez que les moments de la série (variance, asymétrie) n’ont pas subi d’hyper-lissage destructeur. Insérez un bloc de métadonnées documentant la date du traitement, le modèle mathématique appliqué, et les métriques de validation associées.
12.3 Synthèse des bonnes pratiques pour assurer la reproductibilité scientifique
La pérennité des modèles quantitatifs élaborés sous Excel dépend de l’adhésion rigoureuse à des standards professionnels de développement bureautique. Pour hisser la pratique de l’interpolation à un niveau de fiabilité scientifique équivalent aux pipelines de données industriels, trois impératifs doivent être observés en permanence :
Premièrement, systématisez l’usage des Tableaux structurés Excel (via la commande Insertion > Tableau ou le raccourci CTRL + L). Les références structurées (telles que [@Date] ou [Valeur]) immunisent contre les erreurs classiques de décalage de plages d’adresses lors de l’insertion ultérieure de nouvelles lignes, tout en rendant les formules algébriques dynamiques immédiatement lisibles et auditables par un tiers.
Deuxièmement, normalisez vos fonctions personnalisées et constantes via le Gestionnaire de noms. Si vous concevez une routine de calcul combinant des fonctions LAMBDA, assignez-lui un nom explicite intégrant un préfixe distinctif (ex: MATH_INTERPOL_LIN). Commentez abondamment le code logique dans la description du nom afin que n’importe quel analyste exploitant ultérieurement le classeur comprenne instantanément les fondements théoriques de l’opérateur mobilisé.
Troisièmement, auditez systématiquement la compatibilité ascendante et descendante de votre classeur. L’emploi de formules matricielles dynamiques natives (comme LET ou le calcul de tableaux dynamiques transparents) limitera l’exploitation fonctionnelle du classeur aux utilisateurs disposant de Microsoft 365 ou d’Excel 2021+. Si le document est destiné à circuler dans des organisations exploitant des versions antérieures (Excel 2016 ou 2019), il conviendra de privilégier des formules matricielles classiques validées par CTRL + MAJ + ENTRÉE ou des macros procédurales VBA autonomes, garantissant ainsi l’universalité et la parfaite reproductibilité de vos résultats analytiques.
Références
- Barnett, V., & Lewis, T. (1994). Outliers in statistical data (3rd ed.). John Wiley & Sons.
- Burden, R. L., & Faires, J. D. (2010). Numerical analysis (9th ed.). Brooks/Cole, Cengage Learning.
- De Boor, C. (2001). A practical guide to splines (Rev. ed.). Springer-Verlag. https://doi.org/10.1007/978-1-4614-1406-3
- Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- Microsoft Corporation. (2024). Documentation sur les fonctions de feuille de calcul Excel. Microsoft Learn. https://learn.microsoft.com/fr-fr/office/vba/api/overview/excel
- Nash, J. E., & Sutcliffe, J. V. (1970). River flow forecasting through conceptual models part I — A discussion of principles. Journal of Hydrology, 10(3), 282-290. https://doi.org/10.1016/0022-1694(70)90255-6
- Press, W. H., Teukolsky, S. A., Vetterling, W. T., & Flannery, B. P. (2007). Numerical recipes: The art of scientific computing (3rd ed.). Cambridge University Press.
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-590. https://doi.org/10.1093/biomet/63.3.581
- Quarteroni, A., Sacco, R., & Saleri, F. (2007). Numerical mathematics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b98885
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.