
Dans le domaine de l’analyse statistique avancée, du traitement de données massives et de l’économétrie appliquée, l’environnement logiciel SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme une référence incontournable au sein des institutions de recherche, des agences gouvernementales et des grandes industries réglementées telles que la pharmacovigilance, la banque et l’assurance. La robustesse de ce système repose sur sa capacité à traiter de manière déterministe et rigoureuse des volumes considérables d’informations structurées, tout en offrant une traçabilité totale des flux de calcul. Néanmoins, la validité empirique et la fiabilité des conclusions inférentielles issues de ces analyses dépendent en premier lieu de la qualité intrinsèque du nettoyage des données, opération préalable indispensable dont la sélection des observations non nulles constitue l’un des piliers méthodologiques les plus critiques.
L’omniprésence des données incomplètes représente un défi récurrent pour les statisticiens et les ingénieurs de données. Qu’elles résultent d’un défaut de saisie, d’une non-réponse lors d’enquêtes démographiques, d’une panne d’instrumentation dans des dispositifs de captation continue ou de mécanismes d’attrition au cours d’essais cliniques longitudinaux, les valeurs manquantes imposent une vigilance particulière. En SAS, la gestion de cette vacuité informationnelle ne se limite pas à une simple exclusion mécanique : elle requiert une compréhension aiguë de l’architecture logicielle, des formats de stockage machine, des structures mémoire sous-jacentes et de la sémantique formelle régissant l’évaluation des conditions booléennes. Une manipulation imprudente des critères de sélection risque d’introduire des distorsions systématiques dans les distributions d’échantillonnage ou de provoquer des comportements computationnels imprévus.
Le présent article constitue une étude exhaustive et détaillée des méthodologies requises pour identifier, filtrer et extraire avec une rigueur absolue les observations non nulles au sein de l’écosystème SAS. En abordant successivement les fondements théoriques de la représentation binaire des données manquantes, les syntaxes comparées de l’étape DATA et du module PROC SQL, la gestion différentielle des types numériques et alphanumériques, ainsi que les stratégies d’optimisation algorithmique pour le traitement de volumétries massives, ce guide offre une référence complète destinée aux chercheurs, data scientists et biostatisticiens soucieux de garantir l’intégrité, l’efficience et la reproductibilité de leurs protocoles de programmation.
1. Introduction aux valeurs manquantes et non nulles dans l’environnement SAS
1.1 Typologie et représentation des données manquantes en SAS
L’architecture interne du système SAS repose sur une différenciation stricte et immuable entre deux catégories fondamentales de variables : les variables numériques et les variables alphanumériques (caractères). Cette distinction élémentaire engendre des conséquences architecturales profondes sur le mode d’encodage et la sémantique de l’absence d’information. Pour les grandeurs scalaires numériques, codées selon la norme de représentation en virgule flottante double précision sur huit octets (standard IEEE 754 adapté), l’absence de valeur ne se traduit pas par un pointeur nul ou un état indéfini généralisé, mais par une valeur binaire dédiée matérialisée à l’affichage par un point standard (.).
Ce point standard constitue la manifestation visible d’une configuration de bits spécifique dans laquelle l’exposant et la mantisse signalent au moteur analytique que la cellule est dépourvue de mesure observable. De surcroît, SAS enrichit cette notion par l’introduction de vingt-sept valeurs manquantes spéciales, désignées par le point suivi d’un caractère alphabétique (de .A à .Z) ou par un trait de soulignement (._). Cette taxonomie étendue permet aux chercheurs de classifier l’étiologie de l’absence de mesure, en distinguant par exemple un refus catégorique de réponse (.R) d’une omission accidentelle (.O) ou d’une inéligibilité structurelle du sujet (.I).
À l’inverse, le traitement des variables alphanumériques ne repose pas sur une valeur sentinelle numérique. Une chaîne de caractères absente est techniquement encodée sous la forme d’un vecteur d’octets exclusivement composé d’espaces simples (code ASCII 32, ou caractère hexadécimal 0x20). En vertu de la gestion des chaînes à longueur fixe inhérente à l’architecture historique de SAS, une variable de texte déclarée pour une longueur de vingt caractères contiendra exactement vingt espaces si aucune valeur significative ne lui est assignée. Cette dichotomie conceptuelle implique que le test de vacuité ne peut être appréhendé de façon identique selon la nature de la variable, les conditions booléennes devant s’adapter à la réalité binaire sous-jacente afin d’éviter toute évaluation erronée lors de la compilation et de l’exécution du code.
1.2 Enjeux épistémologiques et méthodologiques de la sélection de données complètes
D’un point de vue épistémologique, l’exclusion d’enregistrements présentant des données lacunaires ne constitue jamais un acte neutre sur le plan scientifique. Dans le cadre de l’inférence statistique et de l’estimation économétrique, la sélection d’un sous-ensemble d’observations dites « complètes » (communément désignée sous l’appellation d’analyse de cas complets ou complete case analysis) repose sur l’hypothèse sous-jacente forte que les mécanismes générateurs de l’absence de données relèvent d’un processus complètement aléatoire, théorisé dans la littérature sous le vocable de Missing Completely at Random (MCAR).
Lorsque cette condition d’indépendance statistique entre la probabilité de vacuité et les valeurs observées ou non observées n’est pas rigoureusement vérifiée, la suppression des observations incomplètes expose le protocole de recherche à un biais de sélection substantiel. Si les données manquantes dépendent de variables observées (Missing at Random, MAR) ou, plus gravement encore, de la valeur manquante elle-même (Missing Not at Random, MNAR), l’échantillon tronqué perd sa représentativité vis-à-vis de la population cible. Les estimateurs des moindres carrés ordinaires ou du maximum de vraisemblance perdent dès lors leurs propriétés asymptotiques de non-biais et de convergence.
Parallèlement, la réduction drastique de la taille effective de l’échantillon consécutive à l’éviction systématique de toute ligne non exhaustive diminue la puissance statistique des tests d’hypothèses, augmentant de manière exponentielle le risque d’erreur de type II (non-rejet à tort de l’hypothèse nulle). Il devient donc impératif, dans le cadre de bonnes pratiques de recherche auditables, de documenter précisément les règles de sélection de données non nulles, de chiffrer l’attrition de l’échantillon à chaque étape du pipeline et d’attester de la non-vacuité des variables selon des critères algorithmiques explicites et reproductibles.
1.3 Aperçu comparatif : PROC SQL versus étape DATA
L’architecture logicielle de SAS met à la disposition des programmeurs deux paradigmes fondamentaux pour l’interrogation et la manipulation des données : l’étape DATA séquentielle impérative et la procédure PROC SQL d’inspiration déclarative. L’étape DATA opère selon un modèle itératif explicite, matérialisé par le vecteur de données de programme (Program Data Vector ou PDV). Dans cette architecture, les observations sont lues, transformées et filtrées séquentiellement, une par une, au sein d’une boucle implicite régie par le moteur d’exécution séquentiel. Cette approche offre une granularité de contrôle maximale, permettant d’exécuter des instructions conditionnelles complexes, d’instancier des variables intermédiaires ou de diriger conditionnellement des flux vers des tables cibles multiples.
À l’opposé, la procédure PROC SQL implémente une variante robuste du standard SQL relationnel, reposant sur une philosophie purement déclarative. L’utilisateur y spécifie le résultat attendu — en définissant la projection des colonnes et les prédicats de restriction via les clauses SELECT et WHERE — sans décrire explicitement la procédure algorithmique de parcours des fichiers. L’optimiseur de requêtes SQL de SAS se charge alors d’élaborer un plan d’exécution optimal, tirant parti d’éventuels index et gérant de façon transparente les allocations de mémoire tampon.
Sur le plan de la portabilité, PROC SQL présente un avantage indéniable pour les équipes de recherche évoluant dans des infrastructures hétérogènes, dans la mesure où les instructions de filtrage de non-vacuité respectent les standards ISO/IEC 9075 SQL couramment exploités dans des systèmes de gestion de bases de données relationnelles comme Oracle, PostgreSQL ou Teradata. Néanmoins, l’étape DATA demeure structurellement supérieure dès lors qu’il s’agit d’exécuter des traitements de nettoyage en flux tendu sur des tables plates massives nécessitant des calculs vectorisés ou des lectures parallèles, grâce à une surcharge syntaxique minimale et une consommation prévisible des cycles processeur.
2. Fondements de la fonction MISSING() et son inversion logique
2.1 Mécanisme interne et universalité de la fonction MISSING()
Conscient des difficultés induites par la divergence d’encodage binaire entre grandeurs scalaires et chaînes de caractères, l’éditeur SAS a introduit dans son moteur de calcul la fonction polymorphique native MISSING(). Cette fonction constitue le standard algorithmique absolu pour tester la vacuité d’une variable ou d’une expression évaluée. Son mécanisme interne repose sur une analyse préliminaire de l’en-tête de métadonnées associé à l’argument transmis : que la variable soit déclarée comme un flottant de huit octets ou comme un champ textuel de longueur arbitraire, MISSING() applique la règle d’évaluation appropriée sans nécessiter de conversion explicite de type de la part du programmeur.
Lorsqu’elle traite un argument numérique, la fonction MISSING() examine les bits de configuration de la mantisse et de l’exposant. Elle renvoie le booléen entier 1 (représentant la valeur logique VRAI) si la valeur est le point standard (.) ou l’une quelconque des vingt-sept valeurs manquantes spéciales (._, .A, …, .Z). Si la cellule contient un nombre réel fini, qu’il soit négatif, nul ou positif, elle renvoie le booléen entier 0 (représentant FAUX). Lorsqu’elle reçoit un argument de type caractère, la fonction inspecte la séquence d’octets et vérifie si celle-ci est exclusivement constituée d’espaces ou si elle présente une longueur nulle, renvoyant 1 dans ces cas et 0 dès lors qu’un caractère non blanc est détecté.
Cette universalité fait de la fonction MISSING() un composant indispensable pour l’écriture d’un code source sécurisé, robuste et agnostique quant aux conventions d’encodage textuel sous-jacentes. Elle garantit une abstraction totale vis-à-vis des formats de représentation physique des données sur les supports de stockage secondaires.
2.2 L’inversion logique avec l’opérateur NOT
L’identification et l’extraction des données valides, utiles et exploitables exigent d’isoler le complémentaire mathématique de l’ensemble des données manquantes. Cette opération s’accomplit par l’application de l’opérateur unaire de négation logique NOT (ou son équivalent symbolique tilde ~ et point d’exclamation ! selon les configurations de table de caractères). L’expression syntactique résultante, NOT MISSING(variable), évalue la négation stricte du résultat fourni par la fonction sous-jacente.
Sur le plan de l’algèbre de Boole appliquée au moteur d’exécution SAS, cette expression se comporte de façon parfaitement bivalente : elle ne peut renvoyer que 1 (vrai) si la variable détient une valeur substantielle, ou 0 (faux) si elle est vide. En évaluant l’expression pour un enregistrement donné, le processeur de requêtes SAS détermine avec certitude si l’observation doit être retenue dans le cadre du filtrage. L’instruction formelle WHERE NOT MISSING(points); ou l’expression WHERE MISSING(points) = 0; neutralisent toute ambiguïté interprétative.
Cette approche par négation unaire évite les effets de bord fréquents qui se manifestent lors de l’utilisation d’opérateurs arithmétiques d’inégalité. Dans un système où les valeurs manquantes possèdent un statut ordinal au sein de l’architecture de calcul, l’inversion logique directe d’un prédicat de vacuité constitue la formulation la plus pure sur le plan sémantique, éliminant tout risque de faux positif ou de faux négatif découlant d’une conversion de type silencieuse.
2.3 Avantages comparatifs face aux opérateurs relationnels classiques
De nombreux programmeurs formés empiriquement ont pris l’habitude d’écrire des filtres d’exclusion basés sur des comparaisons directes, telles que var ^= . ou var > . pour les variables numériques, et chaine ^= '' ou chaine ^= ' ' pour les variables alphanumériques. Bien que ces formulations puissent sembler fonctionnelles dans des scénarios simplistes, elles souffrent de failles méthodologiques majeures susceptibles de corrompre l’intégrité de la sélection.
En premier lieu, l’expression var ^= . vérifie exclusivement l’inégalité par rapport au point standard. Dans le cas critique où une table de données épidémiologiques contient des valeurs manquantes spéciales telles que .A ou .N (utilisées pour désigner des mesures non réalisées), la comparaison var ^= . sera évaluée à VRAI, car dans l’ordre de classement interne de SAS, ces valeurs sont distinctes du point standard. En conséquence, l’observation lacunaire franchira le filtre et sera incluse à tort dans les calculs paramétriques, faussant les moyennes, variances et régressions ultérieures.
De même, pour les données alphanumériques, l’écriture chaine ^= '' dépend de la manière dont le système interprète une chaîne vide par rapport à un ensemble d’espaces insécables ou de caractères de contrôle. La fonction MISSING() combinée à l’opérateur NOT unifie ces deux paradigmes sous une signature unique, élimine le risque d’erreur humaine lié à la confusion entre types de variables, et assure une maintenabilité pérenne du code source au sein des équipes de développement.
3. Implémentation via PROC SQL : Syntaxe et cas d’usage canonique
3.1 Structure fondamentale de la requête de filtrage
La mise en œuvre d’un prédicat de sélection non nulle au sein de la procédure PROC SQL répond aux principes stricts de la grammaire SQL déclarative. La requête fondamentale s’articule autour de trois composants majeurs : la clause SELECT qui spécifie la liste des champs à projeter, la clause FROM identifiant la table source physique ou la vue logique interrogée, et la clause WHERE qui impose la condition de restriction booléenne en amont de toute phase d’agrégation ou de tri.
Dans cet environnement, la détection des lignes valides peut être formalisée soit au moyen du prédicat standard ANSI SQL IS NOT NULL, soit en faisant appel à la fonction native NOT MISSING() que le compilateur SQL de SAS reconnaît et exécute avec une parfaite efficacité. Il convient de clore impérativement la procédure par l’instruction QUIT; afin de libérer le contexte de thread associé et d’achever la transaction au sein de la session de travail active.
L’optimiseur de requêtes analyse la clause WHERE dès la phase d’analyse syntaxique. Si la colonne soumise au prédicat de non-vacuité dispose d’un index simple ou composé préexistant, le moteur SQL peut choisir de parcourir l’arbre d’indexation pour isoler instantanément les identifiants d’enregistrements (RID – Record Identifiers) qualifiés, évitant ainsi la lecture intégrale séquentielle (table scan) du jeu de données source.
3.2 Analyse pas à pas de l’exemple d’application
Afin d’illustrer de manière concrète l’exclusion des valeurs nulles dans une structure relationnelle SAS, considérons la construction d’une table d’expérimentation nommée DONNEES_TEST contenant l’évaluation quantitative des performances d’une série de sujets cliniques identifiés par leur code matricule. Certaines observations contiennent des valeurs manquantes standardisées sur la métrique cible score_clinique :
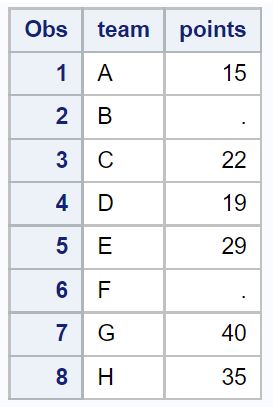
L’étape préliminaire de saisie génère une table comportant cinq enregistrements. Les sujets 101, 102 et 105 disposent d’un score numérique parfaitement valide (respectivement 45.5, 78.2 et 62.0), tandis que les sujets 103 et 104 présentent pour l’un un point d’absence standard (.) et pour l’autre une valeur manquante spéciale (.D pour mesure déviante).
L’application de la requête SQL d’extraction s’articule comme suit dans le journal d’exécution SAS :
L’instruction PROC SQL; initialise le compilateur. La déclaration SELECT identifiant, score_clinique FROM DONNEES_TEST WHERE NOT MISSING(score_clinique); instruit le moteur de n’extraire que les lignes pour lesquelles la fonction renvoie zéro avant inversion. Lors de l’exécution, les lignes correspondant aux sujets 103 et 104 sont rejetées de manière déterministe. Le résultat affiché dans le visualiseur de données ou exporté vers une table fille ne comportera rigoureusement que les trois observations complètes, attestant de la validité de l’exclusion.
3.3 Projection sélective versus projection globale
Lors de la rédaction de la clause SELECT, le choix d’utiliser l’astérisque globale (SELECT *) ou d’énumérer de manière exhaustive les colonnes pertinentes relève d’arbitrages de performance et de gouvernance informatique. La projection globale présente indéniablement un avantage de rapidité d’écriture dans les phases exploratoires d’analyse de données, puisqu’elle conserve l’intégralité du dictionnaire des variables sans exiger une saisie fastidieuse des noms de champs.
Cependant, dans un environnement de production ou lors du traitement de tables massives comptant plusieurs centaines de variables, la projection SELECT * induit un gaspillage massif de mémoire vive et de bande passante d’entrée/sortie (I/O). En forçant le système à charger dans la mémoire tampon (buffer pool) l’ensemble des colonnes de chaque observation filtrée, le temps d’exécution global de la requête peut croître de manière exponentielle, même si la condition de filtrage WHERE NOT MISSING() est elle-même très sélective.
La projection sélective, consistant à ne mentionner que les identifiants pivots et les covariables nécessaires aux analyses ultérieures, permet au moteur SAS de minimiser la taille de l’enregistrement logique transféré du disque vers la mémoire vive. Cette pratique garantit en outre la pérennité des scripts face à d’éventuelles évolutions ultérieures de la table source, telles que l’ajout inopiné de nouvelles colonnes volumineuses qui viendraient dégrader la performance globale des flux sans justification analytique.
4. Filtrage des données non nulles avec l’étape DATA
4.1 L’instruction WHERE au sein de l’étape DATA
L’instruction WHERE au sein d’une étape DATA constitue le mécanisme de filtrage le plus efficient de l’architecture séquentielle SAS. Son positionnement hiérarchique au sein du moteur d’exécution lui confère une propriété fondamentale : elle opère comme un filtre d’entrée de bas niveau, intervenant directement lors de la lecture des blocs de données sur le disque physique ou dans la mémoire tampon, avant même que l’enregistrement ne soit décodé et transféré dans le vecteur de données de programme (Program Data Vector ou PDV).
Sur le plan de l’optimisation des ressources computationnelles, cette pré-sélection procure une économie substantielle de cycles d’horloge du processeur central (CPU). Les observations qui ne satisfont pas la condition logique WHERE NOT MISSING(nom_variable); sont immédiatement ignorées par le sous-système d’accès aux fichiers, sans subir l’initialisation des variables, la réinitialisation des pointeurs ou le traitement séquentiel des instructions de transformation définies dans l’étape.
De plus, l’utilisation de l’instruction WHERE dans l’étape DATA bénéficie d’une compatibilité directe avec les mécanismes d’indexation SAS. Si un index existe sur la colonne testée, le moteur exploite les structures arborescentes de l’index pour cibler exclusivement les enregistrements pertinents, garantissant un débit de traitement maximal, en particulier lorsque le ratio d’observations non nulles par rapport à la population totale est faible.
4.2 L’instruction de sous-ensemble IF conditionnelle
À côté de l’instruction WHERE, l’étape DATA met à disposition l’instruction de sous-ensemble conditionnelle IF (communément appelée subsetting IF). Contrairement à WHERE, le IF conditionnel intervient de manière tardive dans le cycle de vie de l’itération, après que l’observation a été extraite de la source de données, copiée dans le PDV et soumise aux éventuels calculs arithmétiques ou logiques situés en amont dans le script.
L’évaluation IF NOT MISSING(variable_calculee); interrompt l’exécution de l’itération courante pour l’observation en cours si la condition est fausse, empêchant son écriture dans la table cible par l’instruction implicite OUTPUT située à la fin de l’étape, et ordonne au moteur de passer immédiatement à l’observation suivante (instruction implicite RETURN). Cette cinématique d’exécution post-lecture confère au IF une flexibilité absolue, car il permet de filtrer les données en se basant sur des variables dérivées dynamiquement au sein de l’étape courante, ce dont l’instruction WHERE est structurellement incapable.
Toutefois, cette souplesse s’accompagne d’un coût opérationnel non négligeable. Même si une observation est vouée à être rejetée, elle consomme des ressources de transfert de données et de traitement machine jusqu’au point d’évaluation de la condition IF. L’instruction ne peut en outre tirer aucun parti des index SAS existants sur les tables sources, contraignant systématiquement le système à un balayage linéaire exhaustif de la table d’entrée.
4.3 Étude comparative approfondie : WHERE versus IF
Le choix entre l’instruction WHERE et l’instruction IF sous-ensemble doit être guidé par une analyse rigoureuse de la provenance des variables et de la structure du traitement. Le tableau mental suivant résume les divergences structurelles entre ces deux opérateurs essentiels :
D’un côté, WHERE s’applique impérativement à des variables préexistantes dans les tables d’entrée déclarées dans les instructions SET, MERGE ou MODIFY. Il est totalement inopérant pour filtrer une variable générée par une affectation interne à l’étape DATA courante (par exemple, le ratio de deux colonnes brutes). Tenter d’utiliser une variable dynamique dans une clause WHERE génère immédiatement une erreur de compilation dans le journal SAS : « ERROR: Variable nom_var is not on file WORK.TABLE ».
D’un autre côté, lorsque le filtrage porte sur une colonne native de la table d’origine, l’usage de WHERE NOT MISSING(var) surpasse systématiquement l’instruction IF en matière de temps processeur et de réduction des opérations d’entrées/sorties (I/O). La recommandation méthodologique prédominante dans le cadre de projets industriels ou académiques consiste donc à filtrer le plus en amont possible au moyen de l’instruction WHERE pour expurger les lignes incomplètes, et à réserver l’instruction IF de sous-ensemble aux seuls cas où la condition de non-vacuité dépend d’un calcul intermédiaire complexe ou de l’évaluation de variables automatiques système (telles que _N_ ou FIRST.variable).
5. Distinctions critiques entre types numériques et chaînes de caractères
5.1 Traitement rigoureux des variables numériques
L’évaluation des grandeurs scalaires numériques au sein du système SAS est conditionnée par un principe de tri et de comparaison hérité de sa conception initiale : dans l’ordre séquentiel des valeurs réelles, toutes les valeurs manquantes sont considérées comme étant inférieures au plus petit nombre réel négatif concevable sur l’architecture machine.
L’ordonnancement interne strict adopté par le moteur SAS respecte la hiérarchie ascendante suivante :
._ < . < .A < .B < ... < .Z < -1E308 < ... < 0 < ... < +1E308
Cette relation d’ordre engendre un piège classique mais dévastateur pour les programmeurs imprudents. Si un analyste tente de sélectionner les observations positives ou non nulles en rédigeant l’instruction apparemment intuitive WHERE valeur >= 0;, le résultat sera formellement exact car toutes les valeurs manquantes étant inférieures à zéro, elles seront rejetées. En revanche, si la condition vise à sélectionner toutes les observations différentes de zéro au moyen de l’expression WHERE valeur ^= 0; ou WHERE valeur > -9999;, l’ensemble des données manquantes (point standard et lettres spéciales) satisfera la condition logique et sera incorporé dans la table finale.
De même, l’écriture fréquente WHERE valeur > .; présente un défaut critique : si elle exclut le point standard (.) et la valeur de soulignement (._), elle inclut en revanche toutes les valeurs manquantes spéciales de .A à .Z, puisque celles-ci sont classées comme supérieures au point standard. Seule l’utilisation rigoureuse de la formulation WHERE NOT MISSING(valeur); garantit l’exclusion absolue et inconditionnelle de la totalité des représentations de la vacuité numérique.
5.2 Gestion des chaînes de caractères et des espaces blancs
La nature du stockage des chaînes de caractères en SAS — champs à longueur prédéfinie complétés à droite par des espaces blancs de remplissage — requiert des précautions méthodologiques spécifiques lors de l’évaluation de leur statut de vacuité. Une variable alphanumérique déclarée d’une longueur de dix octets ne peut jamais être « vide » au sens d’un pointeur nul ou d’une chaîne de longueur zéro comme dans les langages C ou Python : elle contient intrinsèquement dix caractères.
Si la chaîne ne contient que des espaces standards (code ASCII 32), la fonction MISSING(chaine) renvoie la valeur 1, identifiant adéquatement la cellule comme vacante. Néanmoins, les données textuelles importées depuis des fichiers plats, des extractions Web ou des fichiers bureautiques non normalisés contiennent fréquemment des caractères invisibles parasites : tabulations horizontales (code ASCII 09), sauts de ligne (ASCII 10 et 13), ou espaces insécables (ASCII 160). Face à ces séquences d’octets, la fonction MISSING() standard peut être mise en échec et renvoyer 0, considérant à tort le champ comme une observation textuelle informative.
Pour immuniser les protocoles de nettoyage contre cette pathologie des données textuelles, la pratique recommandée consiste à associer la fonction MISSING() aux fonctions de normalisation de chaînes STRIP() ou COMPBL(). La fonction STRIP() purge de manière exhaustive les espaces situés en tête et en queue de chaîne. L’expression WHERE NOT MISSING(STRIP(variable_texte)) procure une assurance méthodologique absolue quant au fait que seules les observations détenant un contenu textuel réel et sémantiquement porteur d’information seront sélectionnées.
5.3 Comportement des variables dérivées et calculées
L’évaluation des observations non nulles devient plus complexe dès lors que les données analysées proviennent d’expressions arithmétiques intermédiaires exécutées au fil de l’eau. Dans l’architecture SAS, toute opération arithmétique élémentaire (addition, soustraction, multiplication, division, exponentiation) impliquant au moins un opérande manquant produit immédiatement et silencieusement une valeur manquante standard (.) comme résultat.
Par exemple, l’affectation arithmétique score_composite = var_a + var_b; renverra inévitablement une valeur manquante si var_b est absente, même si var_a détient une valeur numérique valide. Un filtrage postérieur appliqué sur score_composite via WHERE NOT MISSING(score_composite) provoquera l’élimination de la totalité de l’enregistrement, entraînant une perte d’information qui aurait pu être évitée par l’utilisation de fonctions d’agrégation d’étape DATA telles que SUM(var_a, var_b), laquelle ignore nativement les valeurs manquantes pour sommer les termes renseignés.
Par ailleurs, les opérations mathématiques dont le résultat est indéterminé au plan analytique, comme la division d’un nombre par zéro (taux = numerateur / denominateur; lorsque denominateur = 0), ne suspendent pas l’exécution du programme. SAS consigne un message d’avertissement dans le journal, assigne une valeur manquante à la variable résultat, et poursuit son itération. L’analyste doit impérativement anticiper ces mécanismes d’écrasement silencieux afin de concevoir des prédicats de sélection capables de distinguer une donnée originellement manquante d’un artefact arithmétique provoqué par une singularité computationnelle.
6. Sélection multivariée : Gestion conjointe de multiples colonnes non nulles
6.1 Conjonction stricte avec l’opérateur logique AND
Dans la majorité des protocoles expérimentaux ou des études observationnelles quantitatives, les modèles statistiques tels que les régressions multivariées ou les analyses en composantes principales exigent que l’ensemble des dimensions de l’espace des covariables soit simultanément et rigoureusement documenté pour chaque unité statistique. Cette contrainte se traduit algorithmiquement par une conjonction stricte de prédicats de non-vacuité reliés par l’opérateur booléen AND.
La formalisation d’une telle sélection s’exprime sous la forme :
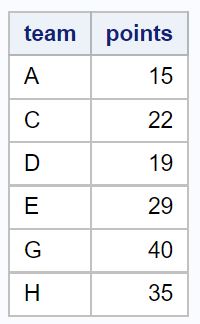
WHERE NOT MISSING(age) AND NOT MISSING(pression_arterielle) AND NOT MISSING(taux_cholesterol);
Cette condition impose que l’enregistrement doit comporter une valeur définie pour chacune des métriques listées pour franchir le filtre. Dès lors qu’une seule des variables présente une absence de donnée, l’expression globale bascule vers l’état logique FAUX, entraînant le rejet de l’observation.
L’impact de la conjonction stricte sur l’attrition de l’échantillon d’analyse peut être colossal. Dans un jeu de données contenant cinquante covariables présentant chacune seulement 2 % de données manquantes distribuées de façon indépendante, l’application d’un filtre conjonctif strict sur l’intégralité des variables peut conduire à l’éviction de plus de 63 % de l’échantillon initial (selon la loi binomiale $(1 – 0.02)^{50} \approx 0.364$). Ce phénomène met en exergue l’importance de cibler avec parcimonie les seules variables véritablement requises par le modèle conceptuel lors de l’application de filtres AND exhaustifs.
6.2 Disjonction inclusive via l’opérateur OR
Dans des contextes d’investigation différents, notamment lors de l’analyse de dossiers médicaux partagés ou de données d’enquêtes complexes à filtres de questionnement multiples, la règle de sélection exige souvent de retenir une observation dès lors qu’elle comporte au moins une modalité ou une mesure significative parmi un ensemble d’indicateurs potentiels. Ce cas d’usage relève de la disjonction inclusive opérée au moyen de l’opérateur OR.
L’implémentation syntaxique s’écrit de manière analogue :
WHERE NOT MISSING(telephone_fixe) OR NOT MISSING(telephone_mobile) OR NOT MISSING(adresse_courriel);
Cette structure permet de conserver l’enregistrement si au moins un moyen de communication a été collecté, garantissant que l’unité statistique demeure joignable dans le cadre d’un protocole de suivi longitudinal.
L’utilisation conjointe des opérateurs AND et OR exige une vigilance extrême quant à la précédence des opérateurs logiques au sein du compilateur SAS. Conformément aux règles d’évaluation formelle, l’opérateur AND possède une priorité intrinsèque supérieure à celle de l’opérateur OR. Ainsi, l’instruction WHERE condA OR condB AND condC est implicitement analysée comme WHERE condA OR (condB AND condC). L’absence d’encadrement explicite au moyen de parenthèses appropriées risque d’altérer profondément le périmètre des données retenues, faussant la représentativité statistique du sous-ensemble final sans qu’aucun message d’erreur syntaxique ne vienne alerter le chercheur dans le journal.
6.3 Utilisation des fonctions vectorielles NMISS, CMISS et N
Lorsque le périmètre de sélection s’étend à un nombre élevé de variables (par exemple dans le traitement de batteries psychométriques ou de panels génomiques), l’écriture répétitive de prédicats NOT MISSING() combinés par des opérateurs booléens devient source d’alourdissement du code et accroît le risque d’erreurs d’inattention. Pour pallier cette contrainte, le système SAS propose une famille de fonctions vectorielles spécialisées : N(), NMISS() et CMISS().
La fonction NMISS() calcule le nombre total d’arguments numériques manquants parmi une liste de variables passée en paramètre. Son invocation vectorielle simplifiée permet de condenser une clause de sélection complexe en une écriture compacte et élégante :
WHERE NMISS(OF score1-score20) = 0;
Cette clause impose que la quantité de variables manquantes parmi les vingt colonnes de la série soit rigoureusement nulle, matérialisant une conjonction stricte de complétude. Inversement, l’instruction WHERE NMISS(OF score1-score20) < 20; équivaut à exiger qu’au moins une des vingt variables soit documentée (disjonction inclusive).
La fonction N() réalise le décompte inverse pour les variables numériques, en renvoyant le nombre exact de paramètres dotés d’une valeur réelle non manquante. L’expression WHERE N(OF var_a var_b var_c) >= 2; offre ainsi la possibilité de filtrer les observations sur un critère de complétude partielle, en imposant qu’au moins deux grandeurs sur trois soient documentées.
Enfin, la fonction CMISS() apporte une flexibilité supérieure en acceptant indifféremment des arguments de type numérique et de type caractère au sein de la même liste vectorielle. Elle évalue l’état de vacuité de chaque argument selon son type respectif et totalise le nombre d’éléments non renseignés. Cette fonction s’avère particulièrement puissante pour établir des métriques de qualité globales au sein d’enregistrements hétérogènes sans nécessiter de conversion préalable des formats de données.
7. Quantification et dénombrement des observations non nulles
7.1 Agrégation par COUNT() dans PROC SQL
Avant ou après l’extraction d’un sous-ensemble d’observations, l’audit de qualité des données requiert fréquemment de dénombrer avec précision le volume de lignes complètes par rapport à la volumétrie brute. Au sein de la procédure PROC SQL, la fonction d’agrégation COUNT() présente une dualité sémantique majeure qu’il convient de maîtriser rigoureusement pour éviter toute erreur de comptage.
Lorsque la fonction est invoquée avec l’astérisque globale sous la forme SELECT COUNT(*) FROM table;, le moteur SQL dénombre l’intégralité physique des lignes constituant la table, sans opérer la moindre inspection du contenu informationnel des colonnes. En revanche, lorsque le statisticien fournit le nom spécifique d’une colonne comme argument de la fonction, sous la forme SELECT COUNT(score_clinique) FROM table;, la sémantique formelle du langage SQL standard impose l’exclusion implicite de toutes les valeurs nulles. Le résultat renvoyé quantifie alors précisément le nombre d’observations détenant une valeur non nulle pour cette métrique précise.
La combinaison d’une clause WHERE NOT MISSING() avec la fonction d’agrégation permet par ailleurs de ventiler ces dénombrements par strates ou catégories sociodémographiques en introduisant une clause de regroupement GROUP BY. Cette formulation permet d’auditer en une passe unique les écarts de complétude relative entre différentes cohortes ou centres investigateurs au sein d’essais cliniques multicentriques.
7.2 Procédures d’inspection statistique : PROC FREQ et PROC MEANS
Pour l’analyse exploratoire et l’assurance qualité des jeux de données, les procédures analytiques natives de SAS fournissent des mécanismes d’inspection automatisés hautement informatifs. Pour les variables catégorielles ou qualitatives, la procédure PROC FREQ dresse le tableau exhaustif de distribution des fréquences. Par défaut, PROC FREQ exclut les valeurs manquantes du calcul des pourcentages d’échantillonnage, consignant en bas de tableau le volume total d’observations omises sous la mention « Frequency Missing ».
Si l’analyste souhaite analyser la structure des données manquantes en tant que modalité informative à part entière, l’option / MISSING adossée à l’instruction TABLES réintègre ces données au sein du tableau de contingence, permettant de mesurer précisément leur proportion relative. L’évaluation préalable de cette répartition guide la pertinence d’une étape ultérieure de sélection stricte par WHERE NOT MISSING().
Pour les variables quantitatives continues, la procédure PROC MEANS (ou son homologue PROC SUMMARY) génère automatiquement des métriques d’audit grâce aux mots-clés de statistiques descriptives N et NMISS. L’instruction suivante en fournit l’archétype analytique :
PROC MEANS DATA=source N NMISS MIN MEAN MAX; VAR score1 score2; RUN;
La métrique N certifie le volume d’enregistrements non nuls pris en compte pour l’estimation de la moyenne et des moments statistiques d’ordre supérieur, tandis que NMISS quantifie l’attrition. Ce diagnostic préalable est indispensable pour valider la représentativité d’un échantillon avant d’appliquer des filtres de non-vacuité drastiques.
7.3 Comptage algorithmique direct dans l’étape DATA
Bien que les procédures préprogrammées offrent une efficacité indéniable, il est des architectures de traitement en temps réel ou des chaînes de production de données où le décompte des observations valides doit être calculé de manière incrémentale directement au sein de l’étape DATA, sans générer de lectures de tables additionnelles.
Ce résultat est obtenu en recourant à l’instruction RETAIN, laquelle neutralise la réinitialisation automatique du PDV à chaque nouvelle itération de la boucle de lecture. Le mécanisme est formalisé par l’implémentation algorithmique d’un compteur incrémental :
Une variable compteur_non_nulles est déclarée et initialisée à zéro via l’instruction RETAIN compteur_non_nulles 0;. À chaque itération de l’étape DATA, l’évaluation conditionnelle est exécutée : IF NOT MISSING(metrique) THEN compteur_non_nulles = compteur_non_nulles + 1;. En exploitant l’option de détection de fin de fichier END=EOF sur l’instruction SET, le programmeur peut capturer l’ultime cycle de lecture (IF EOF THEN DO; ... END;) pour exporter la volumétrie globale consolidée vers le journal d’exécution via l’instruction PUT, ou pour diriger cette métrique vers une table d’audit dédiée.
Cette technique permet d’extraire la sous-population non nulle et d’obtenir simultanément sa quantification exacte au sein d’une unique traversée séquentielle du jeu de données brut, optimisant drastiquement les performances d’E/S sur les volumétries de l’ordre de plusieurs dizaines de gigaoctets.
8. Création de sous-ensembles de données permanents et temporaires
8.1 Matérialisation de tables épurées par PROC SQL
L’extraction d’observations complètes n’a pas seulement pour objet l’affichage dans un rapport de restitution : elle vise le plus souvent à matérialiser une nouvelle table épurée destinée à servir de socle aux étapes analytiques ultérieures. Dans PROC SQL, cette opération s’effectue via la directive de création de table CREATE TABLE couplée à la clause de restriction.
La syntaxe canonique s’articule comme suit :
PROC SQL; CREATE TABLE work.cohorte_valide AS SELECT id, traitement, resultat FROM work.source WHERE NOT MISSING(resultat); QUIT;
Cette instruction déclenche l’allocation d’un nouvel espace physique au sein de la bibliothèque temporaire WORK (ou d’une bibliothèque permanente si un identifiant de libellé spécifique tel que PERM. est utilisé). L’optimiseur SQL effectue le transfert des seules observations qualifiées, en reconstruisant un nouveau dictionnaire de colonnes débarrassé des enregistrements indésirables.
Il importe de souligner que cette création matérialise une copie physique des données. Si cette duplication assure l’indépendance totale de la table fille vis-à-vis des modifications futures de la table mère, elle implique une consommation proportionnelle d’espace disque. Dès lors, sur des bases de données massives, le recours à la sélection de colonnes strictes au lieu du SELECT * devient impératif pour ne pas saturer l’espace de stockage temporaire alloué à la session SAS.
8.2 Partitionnement conditionnel multiple dans l’étape DATA
L’étape DATA offre un avantage fonctionnel majeur sur PROC SQL : la possibilité de réaliser un partitionnement conditionnel simultané d’une table source vers de multiples tables cibles au cours d’un parcours de lecture unique. Dans le cadre de l’assurance qualité des flux de données, il est souvent exigé de ne pas simplement détruire les enregistrements nuls, mais de les isoler dans une table de quarantaine afin d’en analyser les causes profondes et d’assurer une traçabilité intégrale de l’attrition.
Ce partitionnement est mis en œuvre en déclarant plusieurs noms de tables sur l’instruction d’ouverture DATA, puis en aiguillant les observations via des instructions OUTPUT sous contrôle d’une structure décisionnelle :
L’instruction s’ouvre par DATA table_valides table_rejets; SET table_source;. La logique conditionnelle est ensuite formalisée : IF NOT MISSING(score_principal) THEN OUTPUT table_valides; ELSE OUTPUT table_rejets;. Le moteur SAS oriente chaque ligne de manière hermétique et déterministe vers l’un ou l’autre des conteneurs physiques sans doubler le temps de lecture de la source.
Cette méthodologie d’aiguillage constitue un standard incontournable dans les protocoles cliniques réglementés par la Food and Drug Administration (FDA), où la conservation exhaustive de la traçabilité des observations écartées est une condition sine qua non pour la recevabilité scientifique des dossiers d’enregistrement de nouveaux médicaments.
8.3 Gestion des formats et étiquettes lors du sous-ensemble
Lors de la création d’une sous-table épurée de ses valeurs nulles, la préservation des métadonnées de description associées aux variables est un enjeu de rigueur documentaire. Par défaut, qu’il s’agisse de PROC SQL ou de l’étape DATA, le compilateur SAS reporte fidèlement la plupart des attributs fondamentaux des colonnes : les étiquettes descriptives (labels), les longueurs de stockage physique (lengths) ainsi que les formats d’affichage externe (formats) et de lecture (informat).
Toutefois, certaines opérations d’extraction impliquant des transformations au vol ou des fonctions scalaires peuvent altérer ces métadonnées si elles ne sont pas explicitement gérées. Par exemple, l’application d’une fonction de conversion de chaîne sur une variable filtrée peut entraîner l’assignation d’une longueur par défaut excessive (souvent 200 octets), induisant une inflation inutile du volume du fichier résultat.
Il est dès lors recommandé d’expliciter la structure des métadonnées lors de la création de la table sous-ensemble en mobilisant les instructions ATTRIB, LABEL ou FORMAT :
L’intégration de directives telles que LABEL score_clinique = "Score clinique validé (sans données manquantes)"; garantit que la documentation sémantique de l’indicateur reflète fidèlement le processus d’épuration dont il a fait l’objet, éliminant tout risque d’équivoque pour les biostatisticiens appelés à manipuler secondairement les tables finales de modélisation.
9. Utilisation des vues SAS pour un filtrage dynamique sans duplication
9.1 Création de vues relationnelles avec PROC SQL
La matérialisation physique de sous-ensembles de données complets, bien qu’efficace sur le plan de l’isolation des processus, engendre des surcoûts majeurs en termes d’espace disque et introduit un risque de désynchronisation si la table de base subit des mises à jour incrémentales. Pour s’affranchir de ces limitations, l’architecture logicielle de SAS permet l’instanciation de vues dynamiques de données via la commande CREATE VIEW au sein de PROC SQL.
La déclaration formelle prend la structure suivante :
PROC SQL; CREATE VIEW work.vue_patients_complets AS SELECT identifiant, mesure_biologique FROM work.base_source WHERE NOT MISSING(mesure_biologique); QUIT;
Contrairement à une table standard, la vue ne contient aucun enregistrement physique sur le disque de stockage : elle n’enregistre au sein du catalogue que l’arbre syntaxique de la requête SQL compilée. Chaque fois qu’une procédure analytique ultérieure fait référence à work.vue_patients_complets, l’optimiseur de requêtes réexécute à la volée le filtre de non-vacuité.
Cette approche garantit une fraîcheur absolue des données sélectionnées : toute correction ou ajout d’enregistrement valide au sein de la table mère work.base_source se répercute instantanément dans les résultats de la vue, sans nécessiter d’opération de recalcul ou de maintenance manuelle des tables intermédiaires.
9.2 Vues de traitement séquentiel dans l’étape DATA
L’étape DATA offre une fonctionnalité analogue, souvent méconnue des praticiens mais redoutablement puissante pour l’élaboration de chaînes de traitement séquentiel complexes : la création de vues de données de type étape DATA. Cette construction s’opère par l’adjonction de l’option / VIEW=nom_vue sur l’instruction d’ouverture.
L’architecture de code correspondante s’écrit comme suit :
DATA work.vue_mesures_valides / VIEW=work.vue_mesures_valides; SET work.donnees_capteurs; WHERE NOT MISSING(valeur_pression); calcul_derive = log(valeur_pression); RUN;
Dans ce scénario, le code source de l’étape DATA est précompilé et conservé sous forme de pseudocode exécutable encapsulé dans une coquille de métadonnées. L’instruction WHERE NOT MISSING(valeur_pression); garantit que seules les valeurs autorisant le calcul logarithmique sans erreur numérique seront chargées dans le PDV lors des lectures ultérieures.
Cette modalité s’avère particulièrement pertinente au sein des architectures de modélisation statistique en continu, car elle autorise l’enchaînement de multiples étapes de filtrage et de transformation sans jamais écrire de tables intermédiaires temporaires sur le système de fichiers, soulageant ainsi substantiellement les sous-systèmes d’E/S des serveurs d’analyse.
9.3 Considérations architecturales et compromis de performance
Le recours aux vues dynamiques SAS impose néanmoins un arbitrage technique rigoureux entre la consommation de stockage physique et la sollicitation des unités de calcul arithmétique (CPU). Si les vues éliminent la duplication d’espace disque, elles déportent l’intégralité de la charge de calcul sur chaque procédure consommatrice qui les interroge.
Si un analyste utilise une vue de sélection non nulle comme source pour dix procédures successives (par exemple PROC MEANS, PROC FREQ, PROC REG, PROC GLM, etc.), le moteur SAS exécutera dix fois de manière consécutive l’intégralité du parcours séquentiel et du filtrage NOT MISSING() sur la table mère d’origine. Sur des jeux de données atteignant plusieurs centaines de millions de lignes, cette redondance computationnelle peut dégrader considérablement les temps d’exécution globaux par rapport à un scénario où la table aurait été matérialisée physiquement une fois pour toutes.
La règle empirique d’architecture applicative consiste à privilégier l’usage des vues lorsque la table source est volatile ou lorsque le pipeline de modélisation ne consomme la vue qu’au travers d’une unique procédure synthétique finale, et à préférer la création de tables physiques épurées permanentes lorsque les données complètes doivent faire l’objet de multiples explorations itératives lourdes.
10. Optimisation des performances et stratégies d’indexation
10.1 Rôle des index SAS sur les prédicats de sélection
L’optimisation des temps d’accès aux enregistrements non nuls constitue un enjeu critique dès lors que la volumétrie des tables franchit le seuil des dizaines de millions d’observations. Dans cette perspective, la mise en place d’un index SAS — structure physique auxiliaire en arbre binaire balancé (B-tree) stockée dans un fichier d’extension .sas7bndx — peut métamorphoser les performances d’extraction en permettant au moteur d’accéder directement aux lignes éligibles sans parcourir l’intégralité des blocs du fichier principal.
Toutefois, l’interaction entre les index et la sélection des valeurs non nulles présente des particularités comportementales déterminantes. Au sein d’un index SAS, les valeurs manquantes sont regroupées au tout début de la structure arborescente en vertu de leur ordre ordinal minimal. Si le jeu de données comporte une proportion écrasante de données manquantes (par exemple dans le cas de matrices creuses issues de logs télémétriques où 99 % des lignes sont vides), l’instruction WHERE NOT MISSING(variable) s’avère hautement sélective : l’optimiseur de requêtes SAS exploitera immédiatement l’index pour cibler le reliquat de 1 % d’enregistrements valides, réduisant le temps d’exécution d’un facteur cent.
À l’inverse, si la variable étudiée est quasiment exhaustive (par exemple 98 % d’observations non nulles), le coût d’accès dispersé aux enregistrements via les pointeurs de l’index devient très supérieur au coût d’un simple balayage séquentiel direct par blocs contigus de la table. Dans cette configuration, le moteur SAS choisira délibérément d’ignorer l’index existant pour privilégier une lecture séquentielle exhaustive (table scan), neutralisant ainsi l’investissement d’espace consenti pour la construction de l’index.
10.2 Paramétrage des mémoires tampons et accès disques
Lorsque le balayage séquentiel s’avère inévitable pour extraire les observations non nulles d’une table massive, l’optimisation des performances dépend principalement du réglage fin de l’allocation des mémoires tampons d’entrée/sortie régies par les options système BUFSIZE et BUFNO.
L’option BUFSIZE= contrôle la taille des pages physiques allouées pour les transferts de blocs entre le disque de stockage et l’espace d’adressage de la session SAS, tandis que l’option BUFNO= spécifie le nombre de tampons mémoire fonctionnant de concert. Lors de l’exécution d’un filtre massif de données complètes sur de très grandes tables, le paramétrage par défaut du système (souvent des tampons de 8 Ko ou 64 Ko) force le contrôleur d’E/S à effectuer des millions de micro-lectures disques hautement pénalisantes.
L’ajustement de ces paramètres via l’instruction système OPTIONS BUFSIZE=256K BUFNO=64; permet de configurer un pipeline de lecture par blocs massifs contigus. Combinée avec l’application de la clause WHERE NOT MISSING() qui purge les données au niveau le plus bas du pilote d’accès, cette allocation mémoire libère la bande passante du contrôleur et réduit drastiquement les temps de latence de lecture, assurant une saturation optimale des canaux de transfert de données sur les serveurs de calcul haute performance.
10.3 Traitement des volumes massifs de données (Big Data)
Dans les environnements modernes de mégadonnées d’entreprise, les tables d’enregistrement ne résident plus systématiquement au format natif SAS sur des disques locaux, mais sont hébergées au sein d’entrepôts de données distribués ou de bases relationnelles massives telles que Snowflake, Teradata, Oracle ou des clusters Apache Spark / Hadoop. Dans ce contexte, l’extraction de données non nulles par SAS doit impérativement s’appuyer sur la technologie d’optimisation SAS In-Database Processing.
Lorsqu’un analyste formule une requête PROC SQL ou une étape DATA avec une instruction WHERE NOT MISSING(colonne) à destination d’une table externe liée via une bibliothèque LIBNAME pourvue d’un moteur d’accès spécifique (SAS/ACCESS), le composant logiciel d’optimisation génère un mécanisme de délégation de requête (SQL Push-Down). La clause de sélection de non-vacuité est traduite instantanément dans le dialecte SQL natif de la base distante (généralement convertie en WHERE colonne IS NOT NULL) et transmise directement au moteur du serveur distant.
Cette cinématique garantit que le filtrage massif s’opère au sein du cluster de calcul distant hautement parallélisé. Seules les lignes satisfaisant rigoureusement le critère de non-vacuité transitent sur le réseau local vers la session SAS du chercheur. Ce principe prévient l’effondrement des performances d’infrastructure consécutif au transfert réseau de plusieurs téraoctets de données brutes composées majoritairement d’enregistrements nuls voués à être immédiatement supprimés dès leur réception.
11. Pièges courants, erreurs d’interprétation et débogage
11.1 Confusion fréquente entre zéro arithmétique et vacuité
L’une des défaillances conceptuelles les plus fréquentes en analyse de données consiste à assimiler la valeur numérique zéro (0) à une valeur manquante, ou inversement à imputer la valeur zéro à une cellule lacunaire de manière arbitraire. Cette confusion, particulièrement pernicieuse dans les études économiques ou épidémiologiques, peut altérer gravement la structure distributionnelle des données.
Sur le plan mathématique et informatique, le nombre 0 est une mesure scalaire valide, un point fixe sur l’axe des réels détenant une valeur d’information pleine et entière (par exemple, une glycémie nulle, bien que physiologiquement incompatible avec la vie, ou un revenu mensuel de zéro euro traduisant une absence de ressources déclarées). À l’opposé, une valeur manquante (.) signifie l’absence totale de mesure : le phénomène n’a pas été observé ou n’a pas pu être collecté.
Toute opération de sélection qui remplacerait silencieusement les valeurs nulles par des zéros via des fonctions de type COALESCE() avant d’appliquer des filtres de sélection introduit des distorsions massives : la moyenne d’échantillon est artificiellement décalée vers le bas, l’écart-type est faussé, et la significativité statistique des tests d’hypothèses est totalement compromise. La règle d’audit fondamentale impose de toujours vérifier empiriquement la distribution de la valeur zéro distinctement de celle du point d’absence avant d’arrêter définitivement les prédicats d’extraction dans l’étape de sélection.
11.2 Les espaces insoupçonnés dans les champs alphanumériques
L’univers des données textuelles héberge un piège récurrent lié à la présence de chaînes apparemment vides à l’œil nu lors de la visualisation sous SAS Enterprise Guide ou SAS Studio, mais qui abritent en réalité des caractères non imprimables. Le cas le plus insidieux réside dans les chaînes constituées de caractères d’espacement insécables ou de chaînes de longueur fixe renseignées uniquement avec des espaces protégés issus d’outils de saisie tiers.
Dans ce scénario, si l’analyste formule son exclusion sous la forme rudimentaire :
WHERE variable_texte ^= '';
Le moteur compare la colonne à un littéral de chaîne vide. Selon les options système d’alignement et de troncature de chaînes actives, cette condition peut évaluer à VRAI une cellule ne contenant qu’une tabulation ou un espace protégé. Dès lors, des dizaines d’observations privées de tout contenu analytique utile traversent indûment le filtre de sélection, causant des erreurs d’exécution ultérieures (notamment lors de tentatives de conversion de ces chaînes en formats temporels ou numériques).
L’écriture défensive systématique requiert le déploiement d’une chaîne de fonctions de nettoyage au sein du prédicat d’extraction :
WHERE NOT MISSING(STRIP(COMPRESS(variable_texte, '091013A0'x)));
Cette formulation sécurisée supprime préalablement tous les octets de tabulations, retours chariots et espaces insécables avant d’évaluer la vacuité par la fonction MISSING(), sanctuarisant ainsi la cohorte d’observations retenues.
11.3 Diagnostic des avertissements et anomalies dans le journal SAS
Le journal d’exécution (SAS Log) constitue le réceptacle absolu de vérité pour quiconque souhaite auditer la qualité d’une sélection de données. L’absence de message d’erreur bloquant (ERROR) ne garantit aucunement que le filtrage des observations non nulles s’est opéré conformément aux intentions de l’analyste.
Une anomalie particulièrement pernicieuse à surveiller est l’émission d’un message d’avertissement de conversion implicite : « NOTE: Numeric values have been converted to character values at the place given by… » ou inversement. Cet avertissement survient typiquement lorsqu’une variable numérique est testée par inadvertance contre une chaîne d’espaces (WHERE var_num ^= ' ';) ou qu’une variable textuelle est comparée au point standard numérique (WHERE var_char ^= .;). Bien que SAS procède automatiquement à un transcodage interne pour tenter de résoudre la condition, cette opération dégrade drastiquement les performances et aboutit très souvent à des assignations logiques erronées qui corrompent le sous-ensemble extrait.
Il est par conséquent indispensable d’instaurer des contrôles stricts du journal après l’exécution de toute étape de filtrage, en vérifiant que le nombre de lignes écrites dans la table cible (signalé par la ligne « NOTE: The data set WORK.CIBLE has X observations and Y variables ») correspond scrupuleusement aux dénombrements de complétude théoriques établis préalablement par les procédures d’inspection PROC FREQ ou PROC MEANS.
12. Applications avancées et automatisation dans les pipelines de recherche
12.1 Génération de filtres dynamiques via les macros SAS
Dans les infrastructures industrielles de recherche clinique ou d’évaluation actuarielle, les opérations de sélection ne portent pas sur une poignée de tables statiques mais sur des centaines de jeux de données dont le schéma d’agencement des colonnes est susceptible de varier selon les phases d’expérimentation. L’automatisation du filtrage des observations non nulles exige alors la conception de programmes macro dynamiques modulaires.
Le compilateur macro de SAS permet de requérir dynamiquement les tables de métadonnées du système — notamment la vue système DICTIONARY.COLUMNS (accessible également via SASHELP.VCOLUMN) — afin d’extraire la liste exhaustive des variables numériques ou de caractères associées à une table cible, puis d’assembler automatiquement une clause WHERE conjonctive ou disjonctive sans aucune intervention manuelle de l’utilisateur.
Un macro-programme archétypal peut ainsi recevoir en argument le nom d’une table source et une liste de colonnes d’intérêt. En recourant à la clause CALL SYMPUTX au sein d’une étape DATA d’inspection des métadonnées, le système stocke dans une variable macro globale une chaîne de caractères assemblant dynamiquement la séquence NOT MISSING(var1) AND NOT MISSING(var2) ... AND NOT MISSING(varN). Cette macro-variable est ensuite résolue au sein de l’instruction WHERE &clause_dynamique; de l’étape DATA de production, garantissant l’extensibilité et l’adaptabilité intégrale du pipeline face à toute modification du schéma relationnel sous-jacent.
12.2 Préparation de données pour la modélisation statistique avancée
L’extraction rigoureuse d’enregistrements exhaustifs constitue l’étape préparatoire obligatoire pour le déploiement de modèles économétriques sophistiqués, tels que les modèles linéaires généralisés à effets mixtes (PROC GLIMMIX), les modèles de survie à risques proportionnels de Cox (PROC PHREG) ou les algorithmes d’apprentissage statistique supervisé (arbres de décision, forêts aléatoires via PROC HPFOREST). La quasi-totalité de ces procédures computationnelles intègre un comportement par défaut d’exclusion par ligne (listwise deletion) dès lors qu’une seule des variables indépendantes ou dépendantes requises par la syntaxe du modèle fait défaut.
Si l’analyste laisse le modèle appliquer silencieusement cette suppression au moment de l’ajustement, les métriques d’information telles que le critère d’Akaike (AIC) ou le critère bayésien (BIC) ne peuvent plus être valablement comparées d’un modèle à l’autre si le périmètre des variables explicatives change, car les bases d’échantillonnage sous-jacentes varient en fonction des patterns de vacuité propres à chaque sous-ensemble de covariables. Pour garantir la comparabilité scientifique stricte des modèles emboîtés ou concurrents, la règle méthodologique impose de créer préalablement un jeu de données commun d’analyse d’où sont expurgées toutes les observations présentant la moindre vacuité sur l’ensemble du faisceau de variables candidates.
Cette standardisation du jeu de données en amont de l’estimation garantit en outre la convergence des algorithmes itératifs d’optimisation numérique (tels que Newton-Raphson ou Quasi-Newton), éliminant les instabilités de calcul induites par des sous-matrices de variances-covariances non définies positives générées par l’introduction fortuite de cellules vides dans les blocs d’itérations matricielles.
12.3 Intégration dans un cadre de reproductibilité scientifique
Dans un contexte international marqué par les exigences accrues de reproductibilité des protocoles de recherche (notamment impulsées par les directives FAIR – Findable, Accessible, Interoperable, Reusable), la sélection des données non nulles ne saurait être cantonnée à une série de manipulations ponctuelles et opaques. Elle doit faire partie intégrante d’un pipeline d’extraction de données auditable, documenté et reproductible à l’identique par des inspecteurs ou des comités d’éthique indépendants.
L’instauration d’un tel standard de gouvernance logicielle dans l’écosystème SAS repose sur la formalisation de scripts dédiés au contrôle qualité et à l’attrition. Chaque filtre de non-vacuité exécuté doit être consigné au sein d’un tableau d’audit traçant chronologiquement le volume d’enregistrements entrants, le nombre exact d’observations rejetées pour motif de vacuité sur chaque variable, le volume d’enregistrements finaux retenus, ainsi que la date et la signature cryptographique (hachage SHA-256) du script ayant opéré la sélection.
Cette discipline de développement assure la parfaite transparence des résultats de l’étude. En préservant la traçabilité intégrale de la logique de sélection — de l’instruction fondamentale WHERE NOT MISSING() jusqu’aux macro-programmes de contrôle d’intégrité référentielle — le chercheur protège ses travaux contre toute contestation méthodologique, fournissant à la communauté scientifique des bases d’échantillonnage saines, conformes aux exigences les plus sévères de l’inférence statistique contemporaine.
Références
- Allison, P. D. (2001). Missing Data (Quantitative Applications in the Social Sciences, Vol. 136). SAGE Publications. https://doi.org/10.4135/9781412985079
- Cody, R. (2018). Cody’s Data Cleaning Techniques Using SAS (3rd ed.). SAS Institute Inc. https://www.sas.com/store/books/categories/usage-and-reference/cody-s-data-cleaning-techniques-using-sas-third-edition/prodBK_69654_en.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc. https://support.sas.com/en/books/little-sas-book.html
- International Organization for Standardization. (2016). Information technology — Database languages — SQL — Part 2: Foundation (SQL/Foundation) (ISO/IEC Standard No. 9075-2:2016). https://www.iso.org/standard/63555.html
- Little, R. J. A., & Rubin, D. B. (2019). Statistical Analysis with Missing Data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- SAS Institute Inc. (2020). SAS(R) 9.4 Statements: Reference. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lestmtsref/titlepage.htm
- SAS Institute Inc. (2021). SAS(R) 9.4 SQL Procedure User’s Guide (4th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/sqlproc/titlepage.htm
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., … & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), 160018. https://doi.org/10.1038/sdata.2016.18