
L’analyse rigoureuse des données empiriques au sein des sciences quantitatives, de la gestion organisationnelle et de l’ingénierie décisionnelle repose fondamentalement sur la maîtrise des dynamiques chronologiques. Dans le cadre contemporain de la recherche assistée par ordinateur, les logiciels de feuilles de calcul tels que Google Sheets ont transcendé leur statut initial de simples grilles d’enregistrement comptable pour s’ériger en véritables moteurs de traitement matriciel et d’inférence statistique. Toutefois, l’intégrité épistémologique des conclusions tirées d’un corpus de données dépend de manière critique de la capacité de l’analyste à isoler avec exactitude des segments temporels pertinents sans altérer la cohérence globale de l’échantillon documentaire.
Le filtrage par plage de dates constitue l’opération pivot par laquelle une masse hétérogène et continue d’observations séquentielles est partitionnée en sous-ensembles analytiquement exploitables. Qu’il s’agisse d’évaluer l’impact d’une variable indépendante circonscrite à une période expérimentale précise, d’agréger des indicateurs de performance trimestriels ou de synchroniser des séries chronologiques complexes, l’extraction temporelle exige une conformité absolue aux règles de typage des données, aux spécifications logiques des opérateurs relationnels et aux spécificités architecturales du moteur d’exécution de Google Sheets. Une méconnaissance de ces principes fondamentaux expose inévitablement l’expérimentateur à des biais d’échantillonnage, des erreurs d’occultation ou des troncatures involontaires.
Ce traité exhaustif a pour vocation de formaliser de manière méthodique l’ensemble des approches théoriques, fonctionnelles et programmatiques permettant de filtrer un jeu de données selon un intervalle temporel défini. En explorant successivement les fondements séquentiels de l’encodage chronologique, les mécanismes graphiques natifs, les vues collaboratives isolées, les formulations matricielles déversées, la puissance du métalangage structuré et les perspectives offertes par l’automatisation scriptée, ce document propose un cadre référentiel destiné à pérenniser la reproductibilité scientifique et l’excellence opérationnelle dans la manipulation des tableurs de recherche.
1. Fondements conceptuels du filtrage temporel dans les tableurs de recherche
1.1 Pertinence de la structuration chronologique des données empiriques
L’ordonnancement séquentiel des observations constitue l’un des piliers de la méthode empirique moderne. Dans les protocoles de recherche en sciences sociales, biomédicales ou économiques, l’introduction de l’axe temporel permet de transformer un agrégat statique de mesures en une série temporelle dynamique, apte à révéler des tendances lourdes, des cycles périodiques ou des ruptures structurelles. La validité de ces analyses repose sur la fidélité de l’échantillonnage longitudinal, lequel exige que chaque observation soit indexée de façon univoque au moment précis de son occurrence dans le continuum temporel.
Dans la pratique analytique sur Google Sheets, circonscrire les données au sein d’une fenêtre chronologique délimitée est indispensable pour neutraliser les variables parasites exogènes. Lorsque des facteurs environnementaux, législatifs ou méthodologiques subissent une mutation à un instant précis, l’analyste doit impérativement restreindre son examen aux intervalles durant lesquels le système observé est demeuré dans un état d’équilibre stationnaire. L’opération de filtrage par intervalle temporel n’est donc pas une simple commodité visuelle, mais un acte méthodologique visant à garantir que les inférences tirées ne résultent pas de perturbations extérieures non contrôlées.
Par ailleurs, la standardisation des protocoles d’échantillonnage longitudinal sur les outils infonuagiques permet d’assurer la comparabilité inter-études. En documentant avec une rigueur mathématique les bornes temporelles d’une extraction, l’équipe de recherche rend ses démarches totalement auditables et reproductibles, conformément aux principes de la science ouverte promus notamment par l’Organisation internationale de normalisation. La discipline imposée dans le partitionnement chronologique conditionne ainsi la robustesse globale des chaînes de traitement analytique ultérieures.
1.2 La distinction fondamentale entre chaîne textuelle et numéro de série séquentiel
L’un des écueils majeurs rencontrés lors du traitement automatisé des séries chronologiques réside dans la confusion cognitive entre la représentation graphique d’une date et sa nature informatique interne. Pour l’esprit humain, la mention d’un jour sous la forme typographique traditionnelle constitue une suite de caractères porteurs de sens sémantique. Pour Google Sheets, en revanche, une date valide n’est jamais stockée sous la forme d’un texte, mais sous la forme d’un nombre décimal séquentiel continu, couramment désigné sous le terme de numéro de série séquentiel.
Le point d’origine temporel du système Google Sheets est conventionnellement fixé au 30 décembre 1899 à minuit, qui correspond à la valeur numérique zéro. Dès lors, chaque journée entière écoulée depuis cette date de référence incrémente le numéro de série d’une unité entière. À titre d’illustration, le 1er janvier 1900 est encodé par l’entier 2, tandis qu’une date contemporaine se traduit par un entier à cinq chiffres. Les fractions journalières sont quant à elles converties en décimales représentant la composante horaire : 0,5 correspond précisément à midi (12:00:00), 0,25 à six heures du matin (06:00:00), et ainsi de suite. Cette conception scalaire permet d’effectuer des opérations arithmétiques directes, telles que la soustraction de deux dates pour obtenir un intervalle exprimé en jours.
Lorsqu’une date est saisie ou importée par erreur sous forme de chaîne textuelle brute, le tableur perd sa capacité à mobiliser cette échelle numérique continue. Dès lors, l’application d’opérateurs d’inégalité logique tels que supérieur à ou inférieur à échoue systématiquement ou produit des aberrations de classement. Dans l’ordre lexicographique textuel, la chaîne « 15/01/2021 » sera considérée comme supérieure à « 02/12/2023 » simplement parce que le caractère typographique initial « 1 » précède le caractère « 0 ». La compréhension de cet encodage séquentiel est donc un prérequis absolu pour prévenir les défaillances silencieuses d’analyse.
1.3 Objectifs méthodologiques du filtrage par intervalle temporel
L’isolation sélective d’une fenêtre d’observation spécifique a pour objectif premier de concentrer les ressources cognitives et calculatoires sur un segment informatif pertinent, tout en préservant l’intégrité physique de la base de données source. Dans les architectures de données rigoureuses, la suppression pure et simple des enregistrements extérieurs à la période étudiée constitue une faute méthodologique majeure qui compromet l’irréversibilité du processus de recherche. Le filtrage opère une occultation contextuelle ou une extraction dérivée sans jamais altérer le corpus primaire.
L’optimisation de la charge cognitive lors de l’inspection visuelle de volumétries denses représente un deuxième impératif ergonomique. Face à des matrices contenant des dizaines de milliers d’enregistrements chronologiques, l’œil de l’expérimentateur et les interfaces graphiques subissent une saturation d’informations non pertinentes. En réduisant la vue aux seules occurrences comprises entre la borne initiale et la borne terminale sélectionnées, le filtrage temporel permet de dégager instantanément les régularités locales, d’identifier les anomalies d’acquisition ou de vérifier la complétude d’un protocole sans interférence cognitive.
Enfin, la traçabilité des données brutes se trouve consolidée par l’application de critères de filtrage transparents et paramétrables. Dans un cadre de recherche collaborative ou d’audit industriel, l’observateur doit pouvoir expliciter à tout instant la logique d’inclusion ou d’exclusion appliquée à l’échantillon. L’établissement de règles de sélection temporelle claires offre un cadre déterministe où chaque donnée affichée justifie son appartenance à l’ensemble mathématique délimité par l’intervalle d’investigation.
2. Préparation et normalisation des jeux de données chronologiques
2.1 Harmonisation des formats régionaux et paramètres linguistiques
La première phase préparatoire à toute manipulation temporelle sur Google Sheets concerne la synchronisation des paramètres régionaux de la feuille de calcul avec les conventions de notation employées dans le jeu de données. Le système d’interprétation contextuelle des chaînes saisies s’appuie directement sur la localisation linguistique définie dans les paramètres du classeur. Une discordance structurelle entre le modèle d’écriture francophone (Jour/Mois/Année) et le modèle anglo-saxon (Mois/Jour/Année) engendre inéluctablement des corruptions massives lors de la sérialisation des dates.
Pour ajuster ces conventions, l’utilisateur doit accéder aux paramètres internes via le menu Fichier, puis Paramètres, et configurer avec précision les menus déroulants « Paramètres régionaux » et « Fuseau horaire ». L’attribution d’un paramètre régional inadapté induit une inversion fatidique entre les jours et les mois pour toutes les valeurs dont le numéro de jour est inférieur ou égal à douze, transformant le 4 juillet en 7 avril, tout en rejetant les dates dont le jour excède douze sous forme de chaînes textuelles inexploitables, dans la mesure où le calendrier ne compte aucun mois supérieur à douze.
Afin de prémunir durablement les bases de recherche contre ces écueils transfrontaliers, il est vivement recommandé d’adopter formellement la norme internationale ISO 8601. Ce standard prescrit l’écriture des dates sous la structure descendante universelle AAAA-MM-JJ (Année-Mois-Jour). Cette nomenclature élimine toute ambiguïté sémantique entre les différentes sphères linguistiques mondiales et garantit une compatibilité native et pérenne avec les bases de données relationnelles et les syntaxes de requêtage les plus exigeantes.
2.2 Diagnostic et conversion des dates stockées sous forme de texte
Avant d’engager la moindre opération de filtrage, il est impératif de procéder à un diagnostic d’intégrité typologique sur la colonne contenant les marqueurs chronologiques. La fonction native TYPE() constitue l’outil diagnostique de référence dans cet environnement. Lorsqu’elle est appliquée à une cellule donnée, cette fonction renvoie la valeur numérique 1 si le contenu est un nombre réel (ce qui confirme la validité du numéro de série temporel) ou la valeur 2 s’il s’agit d’une chaîne textuelle arbitraire.
Lorsque le diagnostic révèle la présence de pseudo-dates textuelles, plusieurs techniques d’assainissement doivent être mobilisées. La méthode la plus élégante consiste à forcer une coercition mathématique unitaire à l’aide de l’opérateur double moins (–), ou en multipliant la valeur par le facteur un. Si la chaîne présente une syntaxe conventionnelle, Google Sheets opérera automatiquement la conversion vers son équivalent séquentiel continu. Alternativement, l’emploi de la fonction explicite DATEVAL() permet de parser la chaîne de caractères et de restituer le numéro de série sous-jacent avec une précision absolue.
Un examen minutieux doit également être porté sur les caractères invisibles parasites qui polluent fréquemment les jeux de données issus d’extractions externes ou de formulaires web. L’apostrophe initiale forcée, souvent invisible dans la grille mais affichée dans la barre d’édition des formules, impose arbitrairement le format texte à l’entrée. De même, les espaces insécables et les retours à la ligne résiduels doivent être purgés de façon systématique à l’aide de combinaisons algorithmiques associant les fonctions SUPPRESPACE() et EPURAGE(), sous peine de paralyser le moteur de reconnaissance typologique de la plateforme.
2.3 Structuration optimale de la table de données avant manipulation
L’efficacité du filtrage temporel repose sur l’adoption d’une topologie tabulaire stricte, calquée sur les principes de la normalisation relationnelle. La matrice de données doit impérativement s’ouvrir sur une unique ligne d’en-tête, contenant des descripteurs dimensionnels sans ambiguïté. L’utilisation de cellules fusionnées au niveau des en-têtes ou au sein de la zone des enregistrements doit être rigoureusement proscrite, car la fusion altère la géométrie de référence des cellules et interrompt la continuité vectorielle nécessaire aux algorithmes de tri et de filtrage.
La continuité géométrique des colonnes doit être préservée sur l’ensemble de la dimension verticale. L’insertion accidentelle de lignes entièrement vides ou de sous-totaux intercalés fragmente la base en segments discontinus, induisant le tableur en erreur quant à la véritable délimitation spatiale du registre d’observation. Chaque enregistrement individuel doit occuper une ligne singulière, et chaque colonne doit se voir assigner une variable sémantique exclusive.
Enfin, une ségrégation rigoureuse doit être instaurée entre les variables d’horodatage et les attributs métriques ou qualitatifs de l’expérience. La colonne temporelle ne doit contenir aucun libellé narratif ni commentaire circonstanciel mélangé aux numéros de série. Si des métadonnées contextuelles relatives à l’acquisition temporelle sont requises (telles que le nom de l’opérateur de saisie ou l’état de calibration de l’appareil de mesure), celles-ci doivent être déportées dans des colonnes subsidiaires dédiées afin de préserver l’intégrité scalaire absolue de l’attribut de datation.
3. La méthode native : Filtrage graphique standard par condition
3.1 Activation de l’outil de filtrage sur la matrice d’observation
L’approche la plus accessible et universellement mise en œuvre pour restreindre visuellement une table de données selon des critères de dates consiste à solliciter le moteur de filtrage graphique standard. L’initialisation de ce protocole exige une sélection rigoureuse de la zone matricielle couverte par l’investigation. L’opérateur doit s’assurer que la plage sélectionnée englobe intégralement la ligne d’en-tête ainsi que l’ensemble des colonnes d’enregistrements, sans omettre les éventuelles variables marginales situées aux extrémités droites de la table.
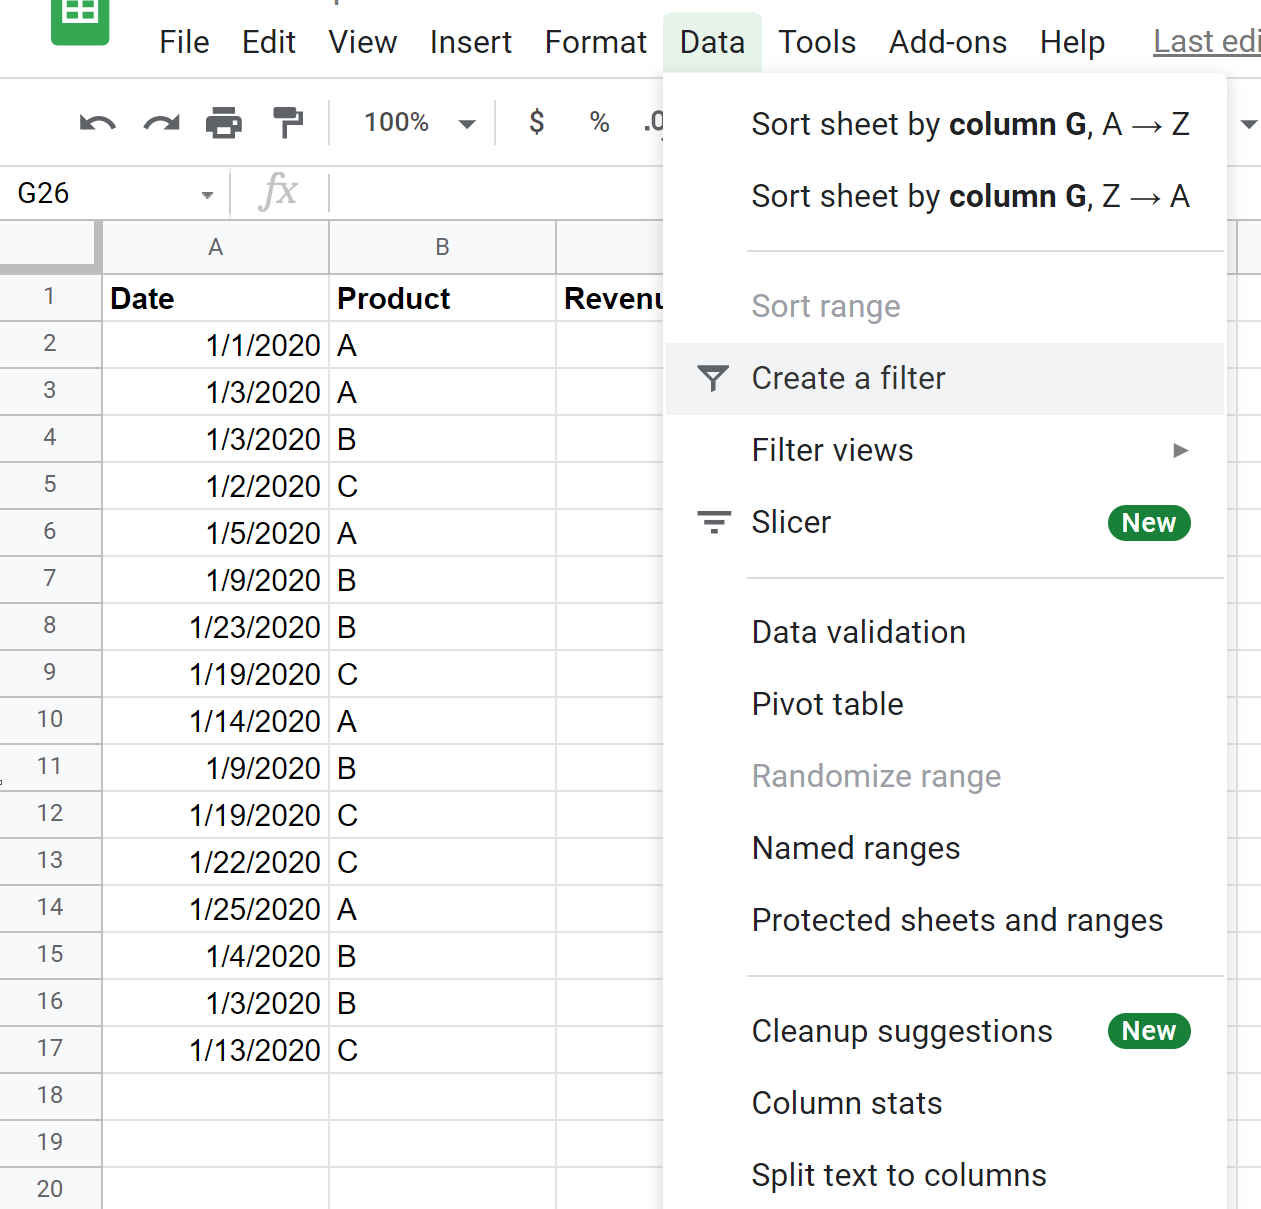
Le cheminement ergonomique s’opère via la barre de menus supérieure de Google Sheets, par la commande Données, suivie de l’instruction Créer un filtre. L’utilisateur peut également mobiliser l’icône standardisée en forme d’entonnoir présente dans la barre d’outils contextuelle. L’exécution de cette commande se matérialise immédiatement par l’apparition d’un glyphe géométrique caractéristique, représentant une pyramide inversée de lignes horizontales, apposé à l’extrémité droite de chaque cellule composant l’en-tête du registre.
La présence visible de cet entonnoir confirme que la matrice est désormais placée sous le contrôle direct du moteur de filtrage natif. Toute action exécutée à partir de ces interfaces contextuelles affectera l’état de visualisation global de la feuille courante, dissimulant instantanément les lignes qui dérogent aux clauses logiques formulées par l’expérimentateur, tout en conservant intacts les indices de lignes originaux en marge de l’espace de travail.
3.2 Configuration des critères logiques au sein de l’interface
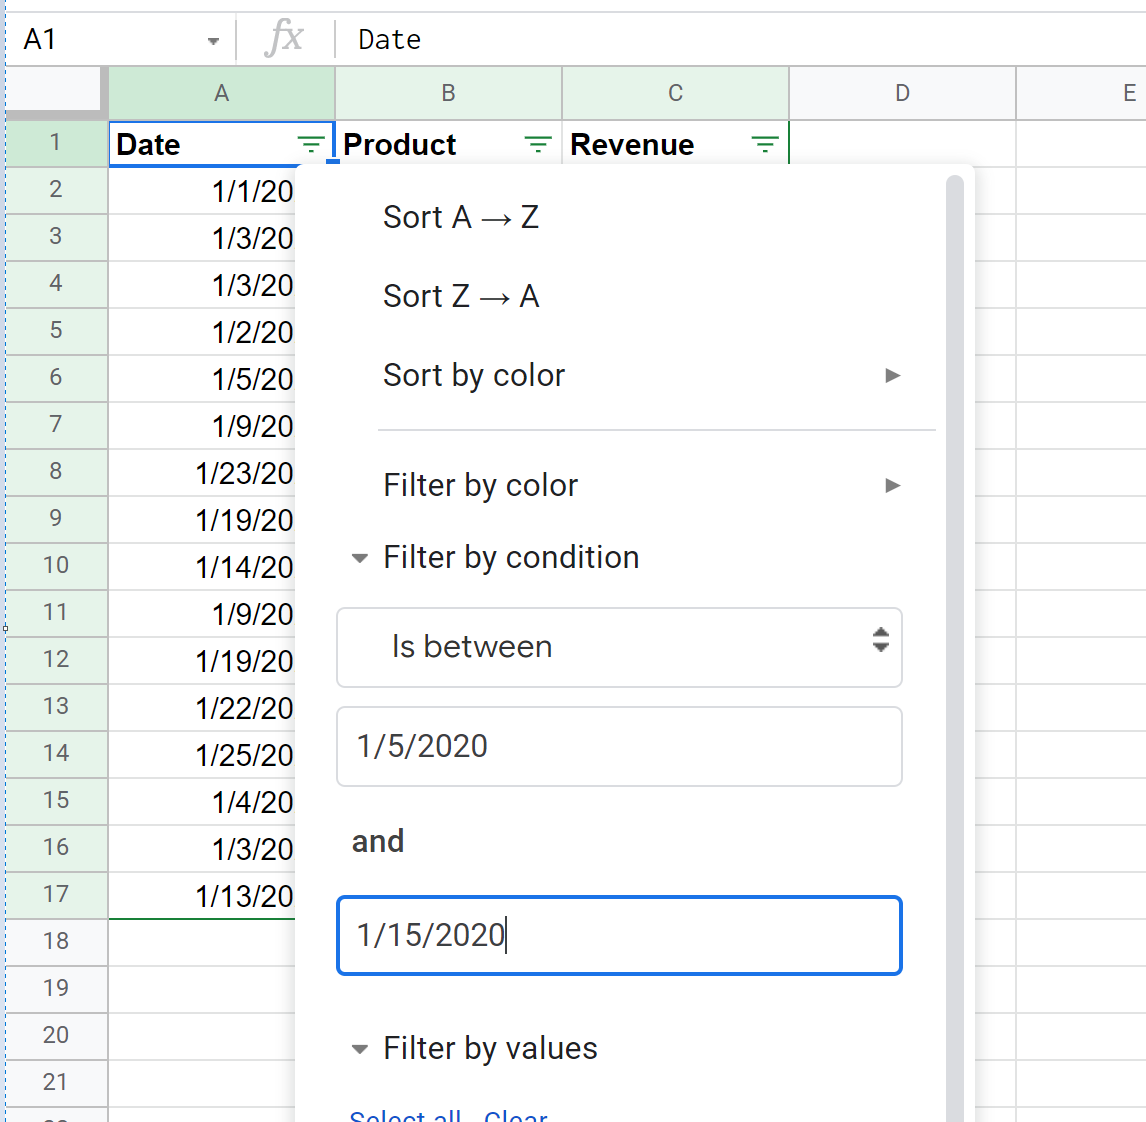
Pour paramétrer la fenêtre d’exclusion chronologique, l’opérateur doit déployer le menu contextuel en cliquant sur l’icône de filtrage située dans l’en-tête de la colonne des dates. Une palette modale s’affiche, offrant deux paradigmes de sélection distincts : le filtrage par valeurs et le filtrage par condition. Si le filtrage par valeurs permet de cocher individuellement des occurrences discrètes, il s’avère totalement inopérant et méthodologiquement prohibitif face à des séries continues s’étalant sur des centaines de journées distinctes.
L’expérimentateur doit impérativement basculer sur le paradigme supérieur en cliquant sur l’intitulé Filtrer par condition. L’activation de cette section déroule une liste exhaustive de prédicats logiques et relationnels configurés en usine. Ce sous-menu permet de s’affranchir de la singularité de chaque valeur pour formuler une loi mathématique générale régissant l’admissibilité des données au sein de la vue résultante.
Au sein de cette nomenclature logique, l’opérateur localise et sélectionne la règle intitulée explicitement « Est compris entre ». Ce prédicat constitue la formulation relationnelle idéale pour borner un intervalle temporel continu, car il active de manière synchrone une double vérification d’inégalité sans nécessiter la saisie manuelle de formules booléennes complexes dans le panneau contextuel.
3.3 Saisie rigoureuse des bornes inclusivement définies
La sélection du prédicat « Est compris entre » fait émerger immédiatement deux champs textuels paramétriques superposés au sein de la boîte de dialogue modale. Ces espaces de saisie sont dévolus à l’inscription formelle des limites temporelles de l’intervalle d’étude. Le premier champ accueille la date de départ, marquant l’ouverture de la fenêtre analytique, tandis que le second champ est assigné à la date de clôture, marquant le terme de la période d’observation.
La notation de ces valeurs doit respecter scrupuleusement le formatage régional du classeur ou, de préférence, s’effectuer selon la syntaxe standardisée AAAA-MM-JJ afin de prévenir tout aléa d’interprétation par le moteur graphique. Il est fondamental de souligner la nature mathématique du filtrage opéré par ce prédicat : il s’agit d’un intervalle fermé, ce qui implique que la comparaison logique s’effectue au sens large. Les enregistrements dont la date coïncide strictement avec la borne initiale ou avec la borne terminale sont réputés satisfaire la condition et demeurent pleinement inclus dans la vue résultante.
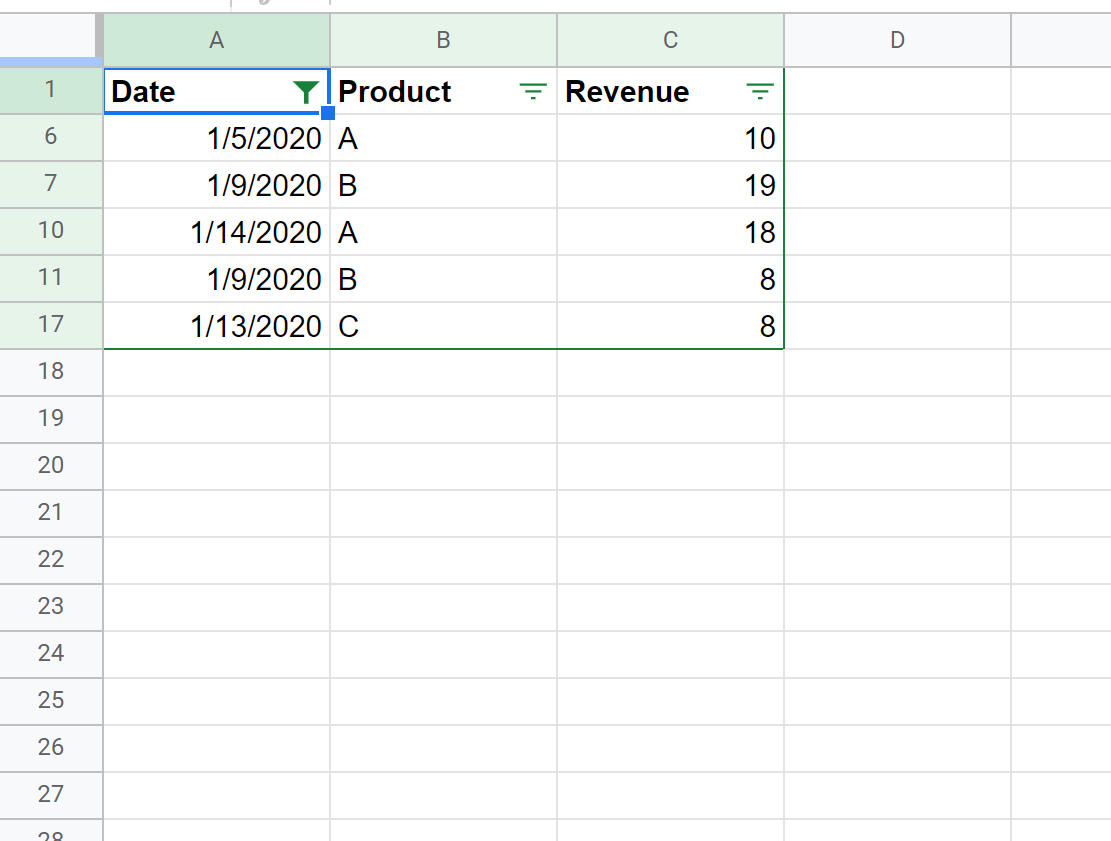
Dès la validation de la commande par l’appui sur le bouton vert « OK », Google Sheets recalcule l’état d’affichage de la matrice. Toutes les lignes dont l’indice temporel se situe strictement en deçà de la borne inférieure ou strictement au-delà de la borne supérieure sont instantanément soustraites au regard de l’analyste par repliement vertical des rangées. L’icône de la colonne ciblée mute alors visuellement pour adopter la silhouette d’un entonnoir plein, signalant à tout observateur la présence d’une restriction active sur cette variable.
4. Exécution empirique détaillée : Démonstration pas à pas sur un jeu témoin
4.1 Établissement du registre d’observation expérimental
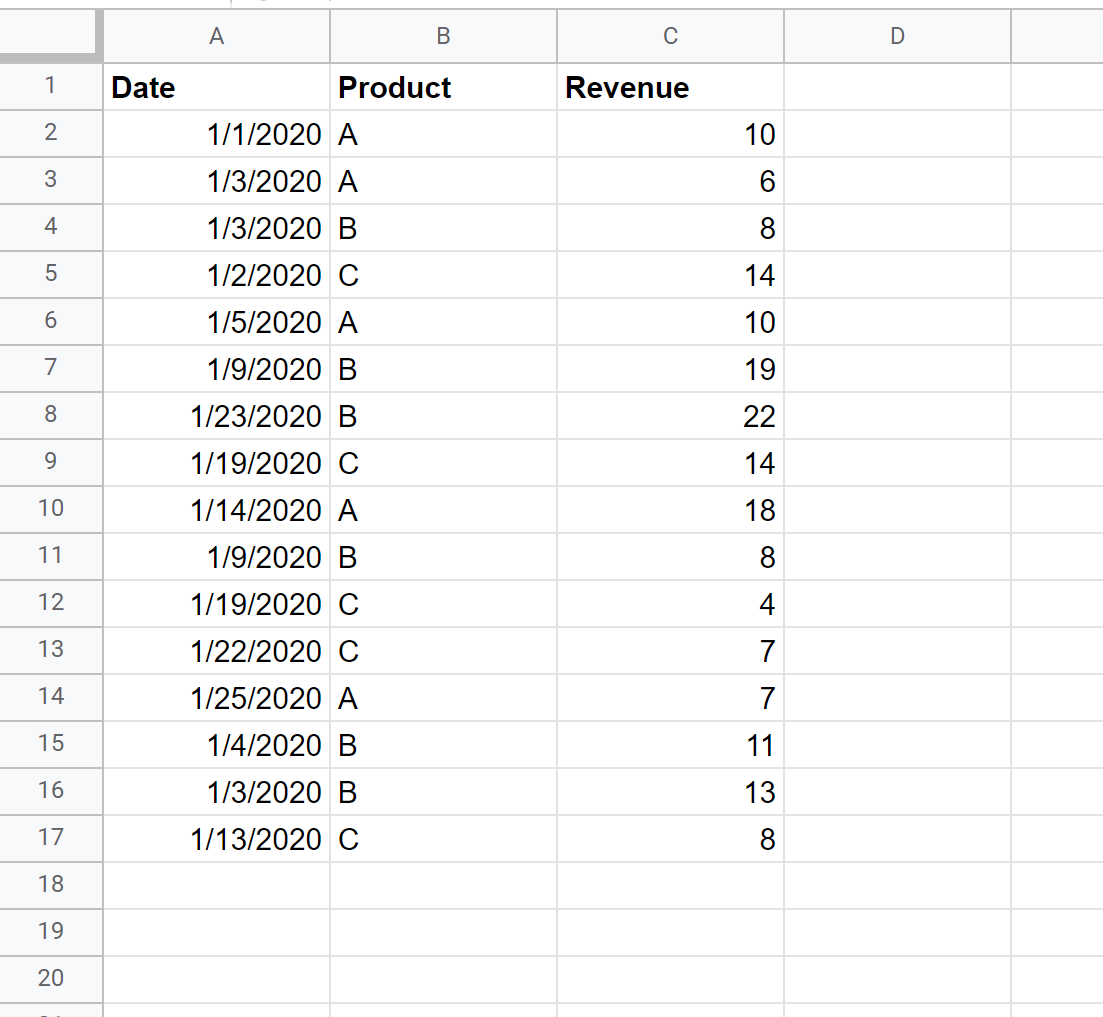
Afin d’illustrer la mécanique opérationnelle de ce protocole, considérons un jeu de données expérimental consignant des transactions de recherche ou des acquisitions biométriques s’étendant sur le mois de mai de l’année 2020. Cet échantillon témoin se structure en trois dimensions : l’Identifiant de l’observation (colonne A), la Date d’enregistrement de la mesure (colonne B) et la Valeur métrique mesurée (colonne C). Ce tableau est consigné sur la plage A1:C11 de la feuille de calcul active.
Le registre se compose des dix occurrences séquentielles suivantes :
- Ligne 2 : OBS-001 | 28/04/2020 | 14,2
- Ligne 3 : OBS-002 | 01/05/2020 | 18,7
- Ligne 4 : OBS-003 | 03/05/2020 | 22,1
- Ligne 5 : OBS-004 | 07/05/2020 | 19,5
- Ligne 6 : OBS-005 | 12/05/2020 | 25,3
- Ligne 7 : OBS-006 | 15/05/2020 | 21,8
- Ligne 8 : OBS-007 | 16/05/2020 | 17,4
- Ligne 9 : OBS-008 | 20/05/2020 | 30,2
- Ligne 10 : OBS-009 | 31/05/2020 | 15,9
- Ligne 11 : OBS-010 | 02/06/2020 | 11,6
Un diagnostic préalable confirme que toutes les entrées de la colonne B possèdent une valeur de type 1 selon la fonction TYPE(), certifiant leur encodage sous forme de numéros de série séquentiels continus. L’objectif analytique formalisé consiste à isoler exclusivement la première quinzaine du mois de mai 2020, soit la fenêtre chronologique s’étendant rigoureusement du 1er mai 2020 au 15 mai 2020 inclus.
4.2 Application séquentielle de la restriction temporelle
L’analyste sélectionne la matrice globale A1:C11 et actionne la création du filtre par le menu Données. En cliquant sur le sélecteur contextuel de la cellule B1 (l’en-tête de la colonne des dates), le menu modale se déploie. L’opérateur sélectionne Filtrer par condition, puis substitue la mention « Aucune » par le prédicat relationnel « Est compris entre » dans l’arborescence déroulante.
Dans le premier champ de saisie textuel qui apparaît, l’opérateur introduit la chaîne littérale 01/05/2020 (ou 2020-05-01). Dans le second champ, il introduit la valeur terminale 15/05/2020 (ou 2020-05-15). Dès confirmation par l’activation du bouton « OK », la feuille de calcul procède à l’évaluation booléenne de chaque rangée au regard de la double condition mathématique stipulée.
Le résultat observable est immédiat et déterministe. Les lignes 2, 8, 9, 10 et 11 sont occultées. Seules les lignes 3, 4, 5, 6 et 7 demeurent visibles à l’écran. La présence de la ligne 3 (01/05/2020) et de la ligne 7 (15/05/2020) atteste formellement du caractère inclusif du filtrage aux limites de l’intervalle. Les indices verticaux de la grille de calcul reflètent cette discontinuité en affichant une numérotation passant directement de 1 à 3, puis de 7 à 12, les bordures de lignes masquées étant soulignées par un liseré bleu distinctif propre à l’ergonomie de Google Sheets.
4.3 Restauration de la visibilité intégrale et réversibilité du processus
L’un des avantages cruciaux de la méthode native réside dans son absolue réversibilité. Les données soustraites à l’affichage n’ont subi aucune suppression physique ; elles demeurent résidentes en mémoire vive et peuvent être rétablies à l’état initial par de multiples cheminements opératoires, garantissant l’auditabilité permanente de la base d’origine.
Si l’analyste souhaite désactiver temporairement la restriction sans supprimer l’infrastructure du filtre, il lui suffit de rouvrir le panneau de condition sur la cellule B1, de repositionner le sélecteur d’opérateur logique sur « Aucune », puis de valider. L’ensemble des lignes 2 à 11 réapparaît instantanément dans leur ordre chronologique primitif. Les calculs statistiques matriciels globaux, s’ils ont été configurés en dehors de la zone de filtrage, retrouvent leur périmètre d’évaluation initial.
Pour démanteler intégralement le dispositif de filtrage graphique, l’utilisateur suit le cheminement Données, puis Supprimer le filtre, ou clique à nouveau sur l’icône d’entonnoir dans la barre d’outils. Les glyphes d’en-tête s’estompent, et la feuille de calcul retourne à son mode d’affichage universel standard. Ce processus démontre que le filtre natif graphique constitue une couche de présentation dynamique surimposée à la grille de données, sans aucune réécriture destructive des cellules sous-jacentes.
5. L’exploitation des vues filtrées : Coopération sans interférence
5.1 Mécanisme et utilité méthodologique des vues filtrées
Dans un contexte d’ingénierie collaborative synchrone, où plusieurs chercheurs, statisticiens ou auditeurs consultent et manipulent simultanément un même classeur partagé sur le cloud, le filtre graphique standard révèle une limitation structurelle rédhibitoire. Lorsqu’un opérateur applique un filtre standard, la modification de l’affichage est globale et s’impose en temps réel à l’ensemble des collaborateurs connectés à la feuille de calcul. Une telle interférence désorganise profondément le flux de travail des tiers, qui voient leurs propres zones d’inspection disparaître ou se comprimer de manière imprévisible.
Pour résoudre cette friction collaborative, Google Sheets dispose d’une fonctionnalité de découplage d’affichage hautement sophistiquée : les vues filtrées (Filter Views). Une vue filtrée permet d’isoler un paramétrage de tri et de filtrage spécifique au sein d’une bulle d’exécution visuelle locale. L’analyste qui active une vue filtrée peut restreindre la chronologie selon ses stricts besoins d’étude sans que la vue globale des autres intervenants ne subisse la moindre altération graphique.
Sur le plan de l’architecture logicielle, la vue filtrée agit comme un calque de requête indépendant adossé à la matrice principale. Elle préserve l’ordonnancement originel de la feuille tout en conférant à son initiateur l’intégralité des prérogatives d’investigation nécessaires au traitement de données chronologiques massives. Ce mécanisme constitue la réponse standard aux exigences d’intégrité opérationnelle dans les équipes de recherche pluridisciplinaires.
5.2 Création et configuration persistante d’une vue de plage de dates
La mise en œuvre d’une vue filtrée s’effectue par un protocole dédié. L’opérateur sélectionne la table d’observation, puis chemine à travers le menu supérieur en sélectionnant Données, puis Vues filtrées, et enfin Créer une vue filtrée. Instantanément, l’environnement graphique se modifie : la zone matricielle sélectionnée s’entoure d’un cadre sombre distinctif, et une barre contextuelle supérieure apparaît, indiquant la création d’un calque nommé par défaut « Filtre 1 ».
L’analyste est immédiatement invité à renommer ce calque dans le champ dédié de la barre contextuelle supérieure afin de conférer une lisibilité documentaire pérenne à la manipulation. Une nomenclature normalisée telle que « Cohorte_Mai_2020_Bornes_01_15 » permet à tout collaborateur d’identifier sans ambiguïté la nature de la sélection temporelle opérée. L’opérateur clique ensuite sur l’entonnoir associé à la variable de datation, configure la condition logique sur « Est compris entre », et assigne les valeurs scalaires des dates limites, conformément au processus examiné précédemment.
La particularité fondamentale de la vue filtrée réside dans sa persistance structurelle. Une fois configurée et fermée (en cliquant sur la croix située à l’extrémité droite du bandeau sombre), la vue ne disparaît pas. Elle demeure enregistrée dans les métadonnées internes du document. À tout moment, n’importe quel membre du projet peut réactiver ce filtre personnalisé en le sélectionnant directement dans le sous-menu des vues filtrées, ce qui réapplique instantanément la restriction temporelle sans nécessiter une nouvelle configuration paramétrique.
5.3 Transmission et partage direct d’une fenêtre d’observation
Au-delà de la préservation du confort collaboratif, les vues filtrées apportent une avancée majeure en matière de communication scientifique grâce à leur intégration dans le protocole de localisation des ressources en ligne. Dès qu’une vue filtrée est instanciée et activée sur Google Sheets, l’adresse web universelle (URL) affichée dans la barre de navigation du navigateur se transforme dynamiquement pour incorporer un paramètre d’identification unique, matérialisé par le suffixe &fvid=XXXXXXXXX (où X représente un identifiant numérique spécifique à la vue).
Cette propriété autorise la diffusion d’un hyperlien ciblé vers un tiers ou son inclusion dans un rapport de recherche externe. Lorsque le destinataire clique sur cet hyperlien, Google Sheets s’ouvre directement au sein de la vue filtrée désignée, appliquant instantanément la restriction par plage de dates définie par l’auteur, quelle que soit la disposition adoptée par d’autres utilisateurs au même instant. L’analyse gagne ainsi en précision et en reproductibilité contextuelle.
En outre, cette fonctionnalité fluidifie la gouvernance des droits d’accès. Même les utilisateurs dotés de prérogatives restreintes de simple consultation (rôle « Lecteur ») peuvent créer des vues filtrées temporaires pour inspecter les chronologies sans altérer la feuille source, ou consulter les vues filtrées publiques configurées par les éditeurs. La chaîne de transmission des données se trouve ainsi blindée contre toute manipulation involontaire ou toute dégradation accidentelle des filtres matriciels établis.
6. Filtrage dynamique par formules matricielles : La fonction FILTER
6.1 Syntaxe analytique et logique booléenne de la fonction FILTER
Bien que les interfaces graphiques natives et les vues filtrées offrent une commodité visuelle indéniable, elles demeurent limitées par leur incapacité à acheminer les résultats filtrés vers une structure analytique distincte sans intervention manuelle répétée. Pour édifier des tableaux de bord dynamiques, automatisés et résilients, l’emploi de fonctions de calcul matriciel déversé s’avère indispensable. Dans cette perspective, la fonction FILTER s’impose comme le moteur de sélection programmatique le plus performant et ergonomique de Google Sheets.
La signature syntaxique universelle de la fonction se décompose selon l’expression suivante :
=FILTER(plage_données; condition1; [condition2; ...])
Le premier argument, plage_données, délimite la matrice d’origine qui subira l’opération d’extraction sélective. Les arguments subséquents incarnent les vecteurs de test logique booléen. Chacun de ces vecteurs de condition doit impérativement posséder une dimension spatiale rigoureusement identique à la hauteur (ou à la largeur) de la matrice source, sous peine de déclencher une discordance de dimensionnement matriciel irréversible.
Le moteur d’évaluation de la fonction FILTER analyse chaque ligne de la plage source en lui appliquant simultanément l’ensemble des conditions formulées sous forme d’arguments distincts. Ces conditions séquentielles sont unies par un opérateur logique implicite de conjonction (ET booléen). La fonction génère alors une nouvelle matrice dynamique, déversée dans les cellules adjacentes libres à partir de la cellule réceptrice initiale, laissant la table source rigoureusement intouchée dans son espace d’origine.
6.2 Formulation formelle d’un intervalle clos à l’aide d’opérateurs
Pour formaliser un filtrage chronologique clos à l’aide de FILTER, l’analyste doit traduire l’appartenance à l’intervalle par la conjonction de deux inégalités algébriques ordonnées : la date de l’observation doit être à la fois supérieure ou égale à la borne initiale et inférieure ou égale à la borne terminale. Dans le cadre de notre jeu expérimental consigné sur la plage A2:C11, la formulation mathématique s’établit de la manière suivante au sein d’une cellule réceptrice indépendante :
=FILTER(A2:C11; B2:B11 >= DATE(2020;5;1); B2:B11 <= DATE(2020;5;15))
L’utilisation de la fonction constructrice DATE(année; mois; jour) au sein de la formule constitue une recommandation méthodologique de première importance. Elle garantit que les scalaires de référence sont convertis de manière univoque en numéros de série séquentiels par le moteur de calcul de Google Sheets, indépendamment des variations linguistiques du classeur ou des interprétations régionales locales des chaînes de caractères brutes. Recourir à une formulation littérale vulnérable telle que ">=01/05/2020" expose le traitement à des ruptures de cohérence si le fichier venait à être consulté sous une locale anglo-saxonne.
Cette expression matricielle se distingue par son dynamisme intrinsèque. Toute modification, insertion ou suppression d’un enregistrement intervenant au sein de la plage originelle A2:C11 est répercutée en temps réel au sein de la matrice déversée par FILTER, sans que l’opérateur n’ait à rafraîchir manuellement un quelconque outil graphique. L’intégration de bornes dynamiques ouvertes (par exemple en étendant la plage jusqu’à A2:C et B2:B) permet d’absorber automatiquement le flux continu de nouvelles mesures chronologiques au fil de l’avancement du protocole expérimental.
6.3 Traitement rigoureux des exceptions et des retours vides
Un principe fondamental de l’ingénierie logicielle appliquée aux tableurs stipule que toute formule matricielle doit être outillée pour gérer sereinement les cas de rupture logique ou d’absence de données conformes. Lorsque la fonction FILTER évalue un jeu de données au sein duquel aucun enregistrement ne vérifie l’ensemble des conditions formulées (par exemple, si aucune mesure n’a été collectée entre le 1er et le 15 mai 2020), le moteur d’exécution interrompt le calcul et renvoie une erreur typologique fatale de type #N/A, accompagnée de l’avertissement textuel « Le filtre n’a renvoyé aucune valeur ».
L’apparition non maîtrisée de cette erreur interrompt la chaîne de calcul en aval, provoquant des défaillances en cascade au niveau des fonctions statistiques qui tenteraient d’agréger les résultats déversés. Afin d’immuniser le modèle contre cette vulnérabilité, l’expérimentateur doit systématiquement encapsuler l’expression FILTER au sein d’une structure conditionnelle d’interception d’anomalie, telle que IFNA() ou la fonction plus généraliste IFERROR().
L’architecture défensive s’articule alors selon le schéma syntaxique suivant :
=IFNA(FILTER(A2:C11; B2:B11 >= DATE(2020;5;1); B2:B11 <= DATE(2020;5;15)); "Aucune observation dans la période")
Sous cette configuration stabilisée, l’absence de concordance temporelle n’engendre plus une rupture d’exécution, mais produit un message explicatif standardisé et univoque, préservant la stabilité architecturale des tableaux de bord et fournissant une information immédiate sur l’état d’échantillonnage de la plage ciblée.
7. Interrogation avancée de séries temporelles avec la fonction QUERY
7.1 Fondements du dialecte pseudo-SQL au sein de Google Sheets
Dans l’arsenal des fonctions de traitement de données matricielles, la fonction QUERY occupe un sommet d’expressivité et de puissance algorithmique. Elle intègre directement dans l’environnement Google Sheets une implémentation simplifiée du langage d’interrogation standardisé SQL (Structured Query Language), optimisée au travers de l’API Google Visualization. La fonction permet d’exécuter en une instruction déclarative unique des opérations complexes associant projection dimensionnelle, restrictions multicritères, agrégations statistiques et ordonnancement chronologique.
La structure syntaxique fondamentale de la fonction s’énonce comme suit :
=QUERY(données; requête; [en-têtes])
L’argument données spécifie la matrice source, tandis que l’argument requête se présente sous la forme d’une chaîne de commande textuelle régie par une grammaire formelle stricte faisant appel à des clauses telles que SELECT, WHERE, GROUP BY ou ORDER BY. Le dernier argument optionnel indique le nombre de rangées réservées aux en-têtes dimensionnels au sommet de la plage.
L’avantage cardinal de la fonction QUERY face à une imbrication de fonctions conventionnelles réside dans sa compacité et son découplage opératoire. Plutôt que de multiplier les colonnes intermédiaires ou de combiner FILTER, SORT et des prédicats logiques disparates, l’analyste formule une instruction d’interrogation unifiée, hautement lisible pour qui maîtrise le paradigme relationnel, assurant un traitement optimisé des volumétries d’enregistrements temporels denses.
7.2 Formatage obligatoire des littéraux de dates dans QUERY
La puissance de la fonction QUERY s’accompagne d’une rigueur syntaxique impitoyable, singulièrement en matière de manipulation des variables temporelles. Le moteur SQL interne de Google Visualization ignore totalement les formats d’affichage régionaux et n’interprète pas nativement les numéros de série séquentiels décimaux comme le font les fonctions standards de la feuille de calcul. Pour être reconnue et évaluée comme un vecteur temporel légitime au sein d’une clause conditionnelle WHERE, une date doit obligatoirement respecter deux contraintes structurelles fondamentales :
- Elle doit impérativement adopter la représentation typographique descendante conforme à la norme ISO 8601, soit la syntaxe
AAAA-MM-JJ. - Elle doit être précédée du mot-clé réservé
date, encadrée par des apostrophes droites (guillemets simples), signalant explicitement au compilateur interne qu’il s’agit d’un littéral typé de nature chronologique et non d’une simple chaîne de texte ou d’une opération arithmétique de division.
Ainsi, l’instruction littérale pure s’écrit formellement sous la forme :
=QUERY(A1:C11; "SELECT * WHERE B >= date '2020-05-01' AND B <= date '2020-05-15'"; 1)
Lorsque les bornes temporelles sont issues de cellules de paramétrage dynamiques (par exemple, la cellule E1 pour la date initiale et la cellule E2 pour la date finale), l’analyste doit procéder à une concaténation rigoureuse de la chaîne de requête en sollicitant la fonction TEXTE() afin de garantir la sérialisation descendante requise, quel que soit le format de saisie visuel appliqué par l’utilisateur :
=QUERY(A1:C11; "SELECT * WHERE B >= date '" & TEXTE(E1; "aaaa-mm-jj") & "' AND B <= date '" & TEXTE(E2; "aaaa-mm-jj") & "'"; 1)
L’alternance méticuleuse entre les guillemets doubles (qui délimitent les fragments textuels de la requête dans Google Sheets) et les guillemets simples (qui circonscrivent la date dans la grammaire de l’API) constitue le point critique dont dépend la validité formelle de l’instruction.
7.3 Exécution d’extractions combinées et de tris chronologiques
L’exploitation de la fonction QUERY révèle toute son efficacité méthodologique lorsqu’il devient nécessaire de coupler le filtrage temporel à des restrictions dimensionnelles transversales et à une réorganisation spatiale des résultats. Par exemple, si une base de données rassemble des mesures provenant de multiples centres expérimentaux répartis à l’échelle internationale, l’analyste peut souhaiter isoler la première quinzaine de mai 2020 pour un laboratoire spécifique tout en triant immédiatement les observations de la plus récente à la plus ancienne.
La formulation de cette requête combinée prend la forme suivante :
=QUERY(A1:D1000; "SELECT A, B, D WHERE B >= date '2020-05-01' AND B <= date '2020-05-15' AND C = 'Laboratoire_Alpha' ORDER BY B DESC"; 1)
Dans cet exemple, la clause SELECT opère une projection des seules colonnes utiles (identifiant, date, mesure), la clause WHERE filtre simultanément la chronologie et l’appartenance institutionnelle, et la clause ORDER BY impose un classement chronologique inverse via le modificateur DESC. L’ensemble de cette chaîne analytique s’exécute de façon atomique au niveau du moteur d’exécution, offrant des performances de calcul nettement supérieures à l’accumulation de fonctions natives dispersées sur de vastes cohortes de données.
8. Gestion des plages dynamiques relatives et horizons glissants
8.1 Automatisation des intervalles relatifs par la fonction TODAY()
Dans la surveillance continue de processus expérimentaux, d’indicateurs de performance médicale ou de métriques opérationnelles, les bornes de l’intervalle d’étude ne sont pas toujours figées dans un passé historique absolu, mais sont souvent indexées de façon relative par rapport au moment présent. La conception d’une fenêtre d’observation dynamique glissante permet d’automatiser l’actualisation continue des tableaux de bord décisionnels sans requérir d’ajustements manuels quotidiens.
L’élément moteur de cette dynamique est la fonction native TODAY (ou AUJOURDHUI() dans la configuration française). Cette fonction renvoie à chaque cycle de recalcul le numéro de série séquentiel correspondant à la date courante du système. En s’appuyant sur l’arithmétique des dates de Google Sheets, l’analyste peut modéliser avec précision une fenêtre rétrospective glissante de N jours par une simple soustraction algébrique.
Ainsi, pour extraire en temps réel toutes les observations enregistrées au cours des trente derniers jours révolus, l’expression matricielle FILTER se formule selon la structure suivante :
=FILTER(A2:C; B2:B >= TODAY() - 30; B2:B <= TODAY())
Chaque matin, à l’ouverture du classeur ou lors d’un déclenchement programmé, les bornes d’inclusion avancent d’une unité entière, intégrant naturellement les données nouvellement injectées la veille et expulsant les données devenues antérieures à l’horizon des trente jours écoulés. La même logique s’applique aux horizons prévisionnels prospectifs en employant l’addition arithmétique (TODAY() + N) pour surveiller le respect de jalons méthodologiques futurs.
8.2 Partitionnement par blocs calendaires périodiques
L’investigation temporelle requiert fréquemment d’aligner les fenêtres d’échantillonnage non pas sur un volume de jours glissants arbitraire, mais sur des subdivisions calendaires canoniques telles que le mois civil, le trimestre ou l’année fiscale. Pour opérer ce partitionnement sans contraindre l’utilisateur à saisir les bornes extrêmes de chaque période, l’analyste peut mobiliser les fonctions de décomposition chronologique ou d’arithmétique calendaire avancée.
Pour délimiter rigoureusement un mois civil donné, la fonction FIN.MOIS (ou EOMONTH en notation anglo-saxonne) offre une précision structurelle inégalée. En recevant une date de référence et un décalage mensuel, elle renvoie de manière déterministe le numéro de série du dernier jour du mois visé, neutralisant de fait les variations de longueur des mois (28, 29, 30 ou 31 jours) et les années bissextiles. Pour capturer l’intégralité du mois courant, les bornes inférieure et supérieure s’établissent élégamment comme suit :
- Borne initiale (premier jour du mois courant) :
=FIN.MOIS(TODAY(); -1) + 1 - Borne terminale (dernier jour du mois courant) :
=FIN.MOIS(TODAY(); 0)
La combinaison conjointe des fonctions MOIS() et ANNEE() permet quant à elle d’isoler un segment calendaire précis directement au sein d’une clause conditionnelle. Dans une requête de type FILTER, l’expression :
=FILTER(A2:C; MOIS(B2:B) = 5; ANNEE(B2:B) = 2020)
procède à l’extraction de l’ensemble des occurrences de mai 2020, indépendamment de toute considération sur le nombre exact de jours composant cet intervalle temporel.
8.3 Impact de la volatilité des fonctions temporelles sur le calcul matriciel
L’introduction de fonctions relatives dynamiques telles que TODAY() ou NOW() implique une vigilance méthodologique accrue quant aux ressources de calcul consommées par le tableur. Sur le plan de la théorie des compilateurs de feuilles de calcul, ces instructions sont classifiées comme des fonctions hautement volatiles. Contrairement à une fonction pure et déterministe (telle que DATE(2020;5;1)) dont la valeur de retour demeure immuable tant que ses arguments d’entrée ne changent pas, une fonction volatile force la réévaluation intégrale de son arbre de dépendances à chaque modification apportée à la feuille ou à chaque cycle périodique d’horloge.
Lorsque ces fonctions volatiles sont injectées dans des conditions matricielles évaluant des dizaines de milliers d’enregistrements via FILTER ou QUERY, l’impact sur la latence logicielle peut devenir critique. Le processeur du client ou les serveurs d’exécution de Google Workspace sont sollicités de façon continue pour recalculer des vérités logiques qui, la plupart du temps, demeurent stables durant une même journée d’analyse.
Pour pallier cette dégradation de performance, il est préconisé d’isoler l’appel à la fonction volatile dans une cellule de référence unique en marge de la feuille de calcul (par exemple en affectant =TODAY() à la cellule Z1), puis de faire pointer l’ensemble des formules matricielles vers cette cellule réceptrice. De plus, lors de l’archivage d’une cohorte expérimentale stabilisée, l’analyste averti veillera à figer les bornes par un copier-coller des valeurs brutes afin de désamorcer la chaîne de réévaluation volatile et de garantir l’immutabilité stricte des résultats historiques.
9. Conception d’une interface de filtrage interactive et paramétrique
9.1 Découplage strict entre couche de données et couche de contrôle
Dans l’ingénierie des systèmes d’information décisionnels basés sur tableur, l’intégration des paramètres de sélection directement à l’intérieur du code des formules constitue une mauvaise pratique universellement décriée sous le vocable de « codage en dur » (hard-coding). Cette approche contraint l’utilisateur à modifier manuellement la syntaxe des fonctions à chaque redéfinition de l’intervalle temporel, ce qui multiplie de façon exponentielle les risques de corruption accidentelle du modèle par effacement d’un opérateur, d’une parenthèse ou d’un séparateur d’arguments.
Une architecture logicielle rigoureuse exige un découplage conceptuel et spatial strict entre la couche de données (la matrice des enregistrements bruts), la couche de contrôle (le panneau ergonomique de commande où l’opérateur sélectionne les paramètres d’analyse) et la couche de présentation (l’espace où sont déversés les résultats filtrés). En dévoluant des cellules indépendantes et clairement balisées à la réception de la borne de début et de la borne de fin, l’analyste érige une interface hermétique et pérenne.
Cette ségrégation est renforcée par l’application systématique de règles de verrouillage et de protection des plages sur les cellules abritant le moteur de calcul. Les utilisateurs finaux, souvent non spécialistes de la syntaxe mathématique interne de Google Sheets, se voient attribuer l’accès exclusif aux cellules de commande, préservant ainsi la pérennité structurelle de l’infrastructure informationnelle contre toute erreur de manipulation.
9.2 Intégration d’outils de validation de saisie et mini-calendriers
Pour assurer la totale intégrité typologique des entrées introduites dans les cellules de commande, l’implémentation d’une couche de validation des données est impérative. Cette fonctionnalité contraint le moteur de saisie de Google Sheets à rejeter instantanément toute valeur qui dérogerait aux spécifications structurelles édictées par l’analyste.
Le paramétrage s’effectue en sélectionnant les cellules réceptrices des bornes (par exemple E1 pour le seuil minimal et F1 pour le seuil maximal), puis en suivant le chemin Données, puis Validation des données, et en instanciant une nouvelle règle. L’opérateur définit le critère sur « La date est une date valide » et configure le comportement d’exception sur « Refuser la saisie ». Dès lors, l’introduction d’un texte incohérent ou d’une date syntaxiquement erronée est immédiatement bloquée par le système, écartant le risque d’alimenter le moteur de filtrage avec des paramètres invalides.
L’activation de cette règle de validation confère en outre un avantage ergonomique majeur : elle déclenche l’apparition d’un sélecteur chronologique graphique interactif (mini-calendrier). Il suffit à l’opérateur d’effectuer un double-clic sur la cellule de commande pour voir s’afficher une interface modale de calendrier mensuel permettant de naviguer visuellement à travers les millésimes, les mois et les jours. La sélection d’une date injecte directement le numéro de série séquentiel adéquat dans la cellule, alliant ainsi confort d’utilisation et sécurité typologique absolue.
9.3 Liaison réactive des moteurs FILTER et QUERY aux cellules sources
Une fois la couche de contrôle paramétrée et sécurisée, la liaison réactive du moteur matriciel s’opère en substituant les expressions constantes par des références absolues pointant vers les cellules d’entrée. Dans le cadre d’un système articulé autour de FILTER, la formule maîtresse s’établit comme suit :
=FILTER(A2:C11; B2:B11 >= E1; B2:B11 <= F1)
Cette architecture confère une réactivité instantanée à la feuille de calcul : dès que l’opérateur modifie l’un des paramètres temporels via le mini-calendrier, l’arbre de calcul réévalue l’expression booléenne et actualise la matrice déversée sans la moindre latence perceptible.
Une modélisation sophistiquée doit également intégrer une vérification de la cohérence chronologique élémentaire, garantissant que la borne initiale E1 est rigoureusement antérieure ou égale à la borne finale F1, sous peine d’interdire l’exécution du calcul. De surcroît, la prise en charge de l’omission volontaire de l’une des bornes permet d’offrir une souplesse d’interrogation supplémentaire. En employant une structure conditionnelle matricielle élargie, l’analyste peut autoriser un filtrage semi-ouvert :
=FILTER(A2:C11; (B2:B11 >= E1 + ESTVIDE(E1)*(-99999)); (B2:B11 <= F1 + ESTVIDE(F1)*(99999)))
Grâce à cette formulation avancée, si l’opérateur laisse la cellule de fin F1 vide, l’expression neutralise mathématiquement le seuil maximal, extrayant ainsi de manière dynamique l’ensemble des données comprises depuis la date de début jusqu’à l’horizon temporel le plus éloigné consigné dans la matrice.
10. Dépannage méthodique des anomalies de filtrage chronologique
10.1 Résolution des interférences générées par l’horodatage masqué
L’un des dysfonctionnements les plus déroutants et fréquents observés lors du filtrage chronologique réside dans l’exclusion apparemment inexplicable d’enregistrements dont la date correspond exactement à la borne supérieure définie par l’opérateur. Ce phénomène d’occultation anormale trouve son origine physique dans la présence d’une composante horaire fractionnaire dissimulée par le format d’affichage de la cellule.
Comme explicité au cours des fondements théoriques de ce document, les heures, minutes et secondes sont encodées sous forme de fractions décimales de journée ajoutées au numéro de série entier. Si une cellule affiche la mention typographique « 15/05/2020 » alors que son contenu réel sous-jacent est 43966,625 (soit le 15 mai 2020 à 15:00:00), l’application d’un filtre comparatif formulé sous la condition B2:B11 <= DATE(2020;5;15) conclura irrémédiablement à l’exclusion de l’enregistrement. En effet, la fonction DATE() génère un numéro de série strict correspondant au début de la journée à minuit (43966,000), et le moteur relationnel constate légitimement que 43966,625 est strictement supérieur à 43966,000.
Pour neutraliser cette interférence chronologique sans altérer les données sources, l’analyste doit tronquer la composante décimale horaire au sein de l’instruction de comparaison. L’application de la fonction arithmétique ENTIER() (ou INT()) permet d’extraire la partie entière du numéro de série, ramenant virtuellement chaque mesure au point zéro temporel de sa journée d’acquisition :
=FILTER(A2:C11; B2:B11 >= E1; ENTIER(B2:B11) <= F1)
Sous cette formulation assainie, l’enregistrement horodaté à 15:00:00 est évalué selon sa seule valeur entière, rétablissant la conformité de l’extraction avec l’intention méthodologique initiale de l’expérimentateur.
10.2 Gestion des discordances de configuration régionale et d’importation
Les opérations de migration et d’intégration de données provenant de systèmes hétérogènes (fichiers CSV, extractions d’équipements de laboratoire, exports JSON d’APIs tierces) constituent le principal vecteur de corruption des séries temporelles. Le symptôme universel de cette détérioration est l’inversion involontaire entre le quantième du jour et le rang du mois, résultant d’un conflit d’interprétation entre le moteur source et la locale active de la feuille Google Sheets de destination.
Face à une colonne corrompue où coexistent des dates légitimes et des chaînes textuelles arbitraires issues d’une interprétation anglo-saxonne avortée, l’utilisation de l’outil natif accessible via le menu Données, puis Diviser le texte en colonnes, permet d’opérer une première dissociation physique des segments élémentaires en employant le séparateur oblique (/) ou le tiret (-). Une fois les trois composantes atomiques (jour, mois, année) isolées dans des colonnes subsidiaires, l’analyste reconstruit algorithmiquement un numéro de série séquentiel inviolable en mobilisant la fonction structurante DATE(année; mois; jour).
Dans les scénarios plus complexes où les chaînes de caractères incorporent des dénominations textuelles abrégées (telles que « 15-May-2020 »), l’emploi d’expressions régulières via la fonction REGEXEXTRACT() ou REGEXREPLACE() s’avère indispensable pour extraire les entités morphologiques et les faire correspondre, via une table de conversion matricielle (par exemple au moyen de RECHERCHEV), aux entiers mensuels correspondants. Ce processus de remédiation garantit que l’intégralité du corpus est rétablie dans son état séquentiel nominal avant l’activation des filtres.
10.3 Traitement des incohérences matricielles et erreurs #REF!
L’utilisation intensive des fonctions de calcul matriciel déversé telles que FILTER ou QUERY expose l’utilisateur à l’émergence d’erreurs d’extension spatiale, manifestées par l’apparition du code d’erreur critique #REF!. Cette défaillance ne découle pas d’une inexactitude logique dans les conditions de dates spécifiées, mais d’une entrave spatiale survenant au sein de la zone d’expansion de la matrice résultante.
Lorsqu’une formule matricielle évalue une requête dont le résultat comporte, par exemple, cinq cents lignes et quatre colonnes, elle tente d’occuper immédiatement cet espace rectangulaire à partir de la cellule d’ancrage. Si une seule cellule résidant dans cette trajectoire prévisionnelle de déversement contient une donnée textuelle, une constante numérique ou même un caractère d’espace résiduel, l’ensemble du processus de déversement est bloqué par mesure de sécurité pour prévenir tout écrasement destructif de données existantes. L’expérimentateur doit alors inspecter le message contextuel de l’erreur #REF!, qui précise les coordonnées exactes de la cellule conflictuelle, et purger cet obstacle pour permettre à la matrice de se déployer sans contrainte.
Une seconde cause d’erreur fondamentale réside dans l’asymétrie dimensionnelle entre la plage de données inspectée et les vecteurs de conditionnement. Si la formule tente d’exécuter l’instruction =FILTER(A2:C100; B2:B50 >= E1), le moteur d’exécution déclenche instantanément une erreur de divergence structurelle : le vecteur de condition B2:B50 ne couvrant que cinquante rangées alors que la matrice en compte quatre-vingt-dix-neuf, l’évaluation booléenne bijective devient mathématiquement impossible. L’alignement dimensionnel parfait des arguments vectoriels constitue une règle d’ingénierie formelle absolue.
11. Automatisation programmée du filtrage temporel via Google Apps Script
11.1 Architecture du modèle d’objet SpreadsheetApp pour les filtres
Lorsque la complexité des flux de données dépasse les capacités des interfaces interactives et exige une exécution asynchrone, récurrente ou événementielle, l’environnement de développement Google Apps Script offre un cadre programmatique complet adossé au langage standardisé JavaScript (moteur V8). L’API SpreadsheetApp expose l’ensemble des classes nécessaires pour instancier, manipuler et automatiser les critères de filtrage au niveau serveur.
Au sein du modèle d’objet Apps Script, la manipulation d’un filtre graphique repose sur l’interaction synchrone entre plusieurs entités canoniques :
- La classe
Sheet, représentant la feuille de calcul active sur laquelle opère l’opération matricielle. - La classe
Range, qui délimite avec exactitude l’étendue dimensionnelle de la table de données soumise au traitement. - La classe
Filter, qui encapsule l’état global du dispositif de filtrage sur la plage de référence. - La classe
FilterCriteriaBuilder, qui constitue l’atelier logiciel permettant d’élaborer formellement les règles de sélection, de conditionnement et d’exclusion applicables aux vecteurs colonnes.
L’exécution programmatique offre un avantage architectural décisif sur les opérations manuelles de l’utilisateur : elle permet d’appliquer des filtres de manière déterministe sur des volumes de données considérables sans subir la latence d’affichage du navigateur client, tout en autorisant l’enchaînement automatisé de tâches complexes telles que l’exportation PDF d’une cohorte périodique ou l’envoi d’extractions ciblées par courrier électronique.
11.2 Écriture d’un script d’automatisation de filtrage par intervalle
L’implémentation logicielle d’une procédure automatisée de filtrage chronologique exige d’instancier un objet de critères en mobilisant les méthodes de comparaison temporelle offertes par la classe SpreadsheetApp. Le script suivant illustre de manière exhaustive la mise en place d’une restriction par plage de dates fermée sur la colonne B d’une feuille de travail désignée, en extrayant les bornes dynamiquement configurées au sein des cellules de contrôle :
function appliquerFiltreChronologique() {

  var feuille = SpreadsheetApp.getActiveSpreadsheet().getSheetByName("Observations");

  var plageDonnees = feuille.getRange("A1:C1000");

  var dateDebut = feuille.getRange("E1").getValue();

  var dateFin = feuille.getRange("F1").getValue();
// Validation de l'intégrité des entrées comme instances de Date JavaScript
if (!(dateDebut instanceof Date) || !(dateFin instanceof Date)) {
SpreadsheetApp.getUi().alert("Erreur de typage : Les bornes doivent être des dates valides.");
return;
}
// Récupération du filtre existant ou instanciation sur la plage
var filtre = plageDonnees.getFilter();
if (filtre !== null) {
filtre.remove();
}
filtre = plageDonnees.createFilter();
// Élaboration des critères : supérieur ou égal à dateDebut ET inférieur ou égal à dateFin
var critere = SpreadsheetApp.newFilterCriteria()
.whenDateGreaterThanOrEqualTo(dateDebut)
.whenDateLessThanOrEqualTo(dateFin)
.build();
// Application du critère sur la colonne B (index 2 au sein de la plage)
filtre.setColumnFilterCriteria(2, critere);
}
Ce programme démontre la rigueur avec laquelle Apps Script gère les objets temporels. En s’appuyant sur l’objet universel Date de JavaScript, le script s’affranchit totalement des divergences de formatage textuel local et instancie un filtrage inclusif aux deux extrémités de l’intervalle avec une fiabilité absolue.
11.3 Déploiement de déclencheurs temporels et d’interfaces personnalisées
L’édification d’un script d’automatisation prend toute sa dimension méthodologique lorsqu’il est articulé à des déclencheurs événementiels autonomes. L’écosystème Google Apps Script permet de configurer des déclencheurs pilotés par le temps (time-driven triggers) qui s’exécutent de manière récurrente à un horaire préétabli, par exemple chaque nuit à minuit ou au premier jour ouvré de chaque mois.
Dans le cadre du suivi d’une cohorte longitudinale glissante, un déclencheur automatique peut être programmé pour mettre à jour quotidiennement les cellules de commande E1 et F1 avec les dates correspondant à l’horizon d’analyse souhaité, puis exécuter la fonction appliquerFiltreChronologique(). L’analyste accède ainsi chaque matin à une base de données parfaitement ordonnée et filtrée sur la fenêtre glissante des trente derniers jours sans avoir accompli la moindre intervention technique manuelle.
Pour conférer une accessibilité ergonomique aux utilisateurs non-programmeurs amenés à consulter la feuille de calcul, le développeur peut lier cette macrocommande à un composant graphique interactif. En insérant une forme géométrique stylisée via le menu Insertion puis Dessin, et en lui assignant le nom de la fonction JavaScript par un clic droit contextuel, l’expérimentateur transforme un simple dessin vectoriel en un bouton de commande interactif. Il suffit alors d’un clic pour déclencher l’actualisation algorithmique de la restriction chronologique sur l’ensemble de la feuille de calcul.
12. Synthèse comparative et cadre décisionnel pour le traitement des dates
12.1 Évaluation comparative des approches : Interface, formules et scripts
Face à la diversité des méthodologies exposées tout au long de cette étude, l’analyste de données doit disposer d’une grille d’arbitrage rationnelle permettant de sélectionner le paradigme le plus approprié à ses impératifs de recherche. Chaque famille de solutions techniques présente un profil d’avantages et de contraintes qu’il convient d’aligner avec le volume des données, les compétences des opérateurs et les objectifs de pérennité du projet.
| Méthodologie | Avantages opérationnels | Limitations structurelles | Cas d’usage préférentiels |
|---|---|---|---|
| Filtre graphique standard | Simplicité ergonomique immédiate ; aucune compétence algorithmique requise ; réversibilité visuelle totale. | Modification destructive de l’affichage partagé pour les tiers ; aucune automatisation possible ; risque d’erreur humaine. | Inspection exploratoire ponctuelle ; audit unitaire rapide sur des volumétries réduites. |
| Vues filtrées (Filter Views) | Isolation absolue des affichages collaboratifs ; partage direct par URL unique ; persistance des réglages nommés. | Ne déverse pas de données vers de nouveaux tableaux ; exige une discipline stricte dans l’utilisation du cadre sombre. | Travail d’équipe synchrone ; rapports multipartites sur des bases de données partagées en lecture/écriture. |
| Fonction FILTER | Réactivité dynamique en temps réel ; préserve la table source intacte ; liaison parfaite aux cellules de commande. | Sensible aux blocages spatiaux (#REF!) ; gestion nécessaire des retours vides via IFNA() ; syntaxe booléenne stricte. | Tableaux de bord dynamiques ; pipelines de modélisation mathématique déversée ; interfaces paramétriques. |
| Fonction QUERY | Puissance expressive pseudo-SQL ; projection, restriction et tri combinés en une instruction unique ; excellente scalabilité. | Grammaire syntaxique exigeante ; formatage rigide des dates ISO obligatoire ; verbosité de la concaténation de variables. | Extraction de données denses ; agrégations statistiques croisées ; architectures décisionnelles complexes. |
| Google Apps Script | Automatisation totale au niveau serveur ; déclencheurs programmés temporels ; intégration avec d’autres services cloud. | Nécessite des compétences en programmation ; temps d’exécution asynchrone ; gestion complexe des autorisations OAuth. | Traitement nocturne de cohortes massives ; reporting institutionnel périodique automatisé ; processus d’audit légal. |
12.2 Garantie de l’intégrité analytique et de la reproductibilité scientifique
L’application d’un filtre temporel ne constitue jamais un acte méthodologiquement neutre. En restreignant le champ d’observation, l’analyste modifie la distribution des données et influe directement sur les grandeurs statistiques qui en seront issues (moyenne, écart-type, corrélations). Il est donc d’une importance capitale de consigner de façon explicite et transparente les critères d’inclusion temporelle au sein des métadonnées associées au projet de recherche.
Le principal biais méthodologique guettant l’expérimentateur réside dans le positionnement arbitraire des bornes chronologiques visant, consciemment ou non, à conforter une hypothèse de recherche préconçue (pratique assimilable au p-hacking temporel). Afin de prémunir l’étude contre cette menace épistémologique, les bornes de l’intervalle doivent être fixées de manière a priori au sein d’un protocole d’enregistrement préalable (pre-registration), fondé sur des justifications théoriques ou événementielles documentées avant toute consultation des données métriques.
Enfin, la séparation absolue entre les jeux de données bruts primaires et les matrices secondaires de traitement filtrées constitue le garant inviolable de la reproductibilité scientifique. Un chercheur tiers ou un auditeur indépendant doit pouvoir recalculer à l’identique l’ensemble des résultats publiés en appliquant les filtres documentés à partir du corpus initial préservé dans son intégrité d’origine. Cette traçabilité descendante matérialise l’idéal de rigueur promu par les standards contemporains de la recherche quantitative.
12.3 Ressources complémentaires pour les opérations temporelles corrélées
La maîtrise approfondie du filtrage temporel ouvre naturellement la voie à des opérations mathématiques dérivées indispensables à l’analyse avancée des séries chronologiques. La première de ces opérations réside dans la quantification précise de la durée temporelle séparant les deux bornes d’un intervalle. À cet effet, l’utilisation de la fonction arithmétique standard JOURS(date_fin; date_debut) ou de la fonction historique DATEDIF(date_debut; date_fin; « D ») permet de mesurer sans ambiguïté le nombre exact de jours calendaires révolus au sein de la fenêtre d’investigation.
Pour les analyses focalisées sur les dynamiques organisationnelles ou professionnelles, il s’avère souvent indispensable de purger les week-ends et les jours fériés de l’intervalle temporel afin d’évaluer la charge productive réelle. La mobilisation conjointe des fonctions NB.JOURS.OUVRES() ou NB.JOURS.OUVRES.INTL() offre un raffinement méthodologique précieux, autorisant la prise en compte de calendriers institutionnels personnalisés pour pondérer le volume des données filtrées selon la densité des jours effectivement travaillés.
Enfin, la génération algorithmique de calendriers d’étude continus et standardisés constitue une ressource complémentaire de premier plan. En combinant la fonction SEQUENCE() avec une date initiale formatée selon le schéma =SEQUENCE(JOURS(date_fin; date_debut) + 1; 1; date_debut; 1), l’expérimentateur génère instantanément un axe temporel complet et ininterrompu. Cet étalon chronologique sert ensuite de socle invariant pour fusionner, aligner et filtrer des flux de données multidimensionnels hétérogènes avec une exactitude mathématique exemplaire.
Références
Google Workspace. (2023). Documentation officielle sur les fonctions de recherche et de matrices de Google Sheets. Google Support. https://support.google.com/docs/answer/3093197
Google Workspace. (2023). Utiliser des vues filtrées dans Google Sheets pour la collaboration. Google Support. https://support.google.com/docs/answer/3540681
Google Workspace. (2023). Manuel de référence du langage de requête Google Visualization API. Google Developers. https://developers.google.com/chart/interactive/docs/querylanguage
International Organization for Standardization. (2019). Date and time — Representations for information interchange (ISO Standard No. 8601-1:2019). https://www.iso.org/standard/70907.html
W3C Date and Time Formats Working Group. (1997). Date and Time Formats (W3C Note). World Wide Web Consortium. https://www.w3.org/TR/NOTE-datetime
Google Developers. (2023). Spreadsheet service reference in Google Apps Script (SpreadsheetApp API). Google Developers. https://developers.google.com/apps-script/reference/spreadsheet
Walkenbach, J. (2015). Excel 2016 Bible: The comprehensive tutorial resource. John Wiley & Sons.
McKinney, W. (2022). Python for data analysis: Data wrangling with Pandas, NumPy, and Jupyter (3e éd.). O’Reilly Media.