
Dans le paysage contemporain de l’analyse de données avancée, de la biostatistique et des sciences quantitatives, le progiciel SAS (Statistical Analysis System) s’est durablement imposé comme une référence institutionnelle pour le traitement de structures d’informations massives et complexes. Cependant, l’évolution rapide des écosystèmes technologiques et la démocratisation des plateformes libres d’analyse ont profondément redéfini les exigences méthodologiques liées à la gestion des données empiriques. La recherche scientifique et la prise de décision opérationnelle ne s’exécutent plus en vase clos au sein d’une architecture logicielle unique, mais requièrent au contraire des passerelles fluides, reproductibles et vérifiables entre des systèmes hétérogènes.
L’exportation de données stockées sous la forme de tables propriétaires SAS vers des fichiers texte structurés à valeurs séparées par des délimiteurs, communément désignés sous l’acronyme CSV (Comma-Separated Values), constitue l’une des démarches fondamentales garantissant cette continuité opérationnelle. Loin de représenter une simple opération technique subalterne, l’exportation vers le format CSV implique une compréhension fine de la sémantique sous-jacente des variables, du comportement du moteur d’exécution séquentiel de SAS, de la gestion de la mémoire vive et de la préservation des formats numériques et textuels. Une mauvaise configuration des paramètres d’exportation peut corrompre l’intégrité de jeux de données longitudinaux, altérer des variables de datation ou introduire des biais systématiques dans le cadre de modélisations ultérieures.
Cet article propose un examen méthodologique exhaustif des techniques d’exportation de données de l’environnement SAS vers le format CSV. À travers l’analyse de la procédure standardisée PROC EXPORT, l’exploration de la programmation de bas niveau via l’étape DATA et l’instruction FILE, ainsi que le déploiement d’architectures macro-analytiques automatisées, ce guide s’adresse aux biostatisticiens, psychométriciens, ingénieurs de données et chercheurs désireux de maîtriser la chaîne complète de transformation de leurs données avec un niveau d’exigence académique et professionnel optimal.
1. Introduction à l’exportation de données dans SAS : Contexte méthodologique et enjeux
1.1 Importance de l’interopérabilité des données dans la recherche quantitative
Au sein des laboratoires de recherche quantitative, des départements d’épidémiologie clinique et des unités d’évaluation psychométrique, la centralisation des données sous des formats propriétaires a longtemps constitué une norme pragmatique garantissant la performance computationnelle et la sécurité transactionnelle. Toutefois, l’essor des principes directeurs FAIR (Faciles à trouver, Accessibles, Interopérables et Réutilisables) a transformé la gouvernance de l’information empirique. Les protocoles scientifiques exigent désormais que les jeux de données bruts et dérivés puissent être audités, réanalysés et partagés sans dépendance exclusive envers une licence commerciale restrictive. La conversion des données SAS vers des formats ouverts devient ainsi le pivot central des politiques de transparence méthodologique et de reproductibilité computationnelle.
Le format CSV présente des propriétés architecturales singulières qui expliquent sa persistance en tant que standard universel d’échange. En tant que fichier plat (flat file) en mode texte brut, il s’affranchit des couches d’abstraction binaire et des métadonnées propriétaires. Cette neutralité structurelle garantit une longévité archivistique exceptionnelle : un fichier textuel demeure lisible à travers les décennies, indépendamment de l’obsolescence programmée des systèmes d’exploitation ou des logiciels spécialisés. En outre, la collaboration interdisciplinaire contemporaine implique fréquemment la mobilisation conjointe de chercheurs utilisant SAS pour le nettoyage de bases massives, d’équipes mobilisant R pour les modélisations d’équations structurelles, et de data scientists exploitant Python pour l’apprentissage automatique. Le fichier CSV agit alors comme le vecteur communicationnel de référence minimisant les frictions lors des transferts inter-logiciels.
À l’inverse, l’enfermement dans le format binaire propriétaire SAS, matérialisé par l’extension .sas7bdat, expose les consortiums de recherche à des contraintes structurelles sévères. L’ouverture directe de ces fichiers par des tiers non équipés de l’infrastructure SAS nécessite le recours à des modules d’ingestion spécialisés (comme les bibliothèques haven en R ou pyreadstat en Python), qui peuvent manifester des incompatibilités selon les sous-versions d’encodage du moteur SAS hôte. De surcroît, les mécanismes de sécurité institutionnels interdisent régulièrement l’installation d’outils de décodage binaire tiers dans des environnements de confiance hautement sécurisés. Ainsi, maîtriser l’exportation standardisée vers un format textuel délimité permet non seulement de préserver la souveraineté des données produites, mais garantit également la réplication exacte des résultats empiriques en éliminant toute incertitude liée au décodage de couches binaires propriétaires.
1.2 Panorama des approches d’exportation disponibles sous SAS
L’architecture modulaire du système SAS met à la disposition des analystes deux paradigmes principaux pour opérer l’extraction des données tabulaires vers un support externe délimité : l’approche déclarative et automatisée incarnée par la procédure PROC EXPORT, et l’approche procédurale de bas niveau matérialisée par l’étape DATA couplée aux instructions FILE et PUT. Chacune de ces méthodologies répond à des exigences distinctes d’arbitrage entre simplicité de mise en œuvre, consommation de ressources de calcul et finesse de contrôle sur la structure de sortie.
La procédure PROC EXPORT représente le mécanisme d’extraction le plus direct et le plus couramment documenté. Conçue comme un wrapper automatisé, elle interroge le descripteur de la table SAS source pour déterminer dynamiquement la liste des variables, leur type (numérique ou caractère), leur format d’affichage et leurs étiquettes associées. En quelques instructions élémentaires, elle génère un flux de données structuré respectant les conventions formelles du type de délimiteur choisi. Cette procédure masque la complexité algorithmique sous-jacente en prenant en charge de manière autonome l’inclusion des en-têtes, la délimitation des chaînes textuelles par des guillemets et la gestion basique des valeurs manquantes. Pour la grande majorité des traitements quotidiens et des flux de travail où la structure des tables est standardisée, PROC EXPORT constitue la solution optimale par son ergonomie et sa lisibilité syntaxique.
Cependant, face à des jeux de données hautement hétérogènes, des fichiers de taille extrême dépassant plusieurs dizaines de gigaoctets ou des contraintes strictes de formatage (telles que des alignements spécifiques, des masquages conditionnels de cellules ou l’absence totale de délimiteurs de chaînes pour des systèmes récepteurs archaïques), l’étape DATA offre une flexibilité algorithmique absolue. En mobilisant l’instruction FILE associée au modificateur DSD (Delimiter-Sensitive Data) et à la boucle itérative d’écriture pilotée par l’instruction PUT, le programmeur s’affranchit des règles implicites des modules pré-compilés de SAS. Cette approche permet de manipuler les flux d’octets de façon séquentielle, de conditionner l’écriture ligne par ligne, d’injecter des métadonnées dynamiques au sein du flux de données et de réduire drastiquement l’empreinte mémoire du traitement. Le choix entre ces deux approches ne relève donc pas d’une préférence stylistique, mais procède d’une analyse rigoureuse de la complexité volumétrique et qualitative des données à traiter.
2. Comprendre la procédure PROC EXPORT : Syntaxe de base et mécanique interne
2.1 Décomposition fondamentale de l’instruction PROC EXPORT
Pour exploiter rigoureusement la procédure PROC EXPORT, il convient de disséquer ses composants syntaxiques fondamentaux et d’appréhender la manière dont le compilateur SAS interprète chaque clause de l’instruction. Dans sa formulation la plus épurée, la procédure mobilise quatre éléments directeurs qui régissent l’intégralité du processus de sérialisation des données tabulaires :
PROC EXPORT DATA=bibliotheque.table_source

    OUTFILE="chemin/vers/fichier_cible.csv"

    DBMS=CSV

    REPLACE;

RUN;
L’argument DATA= définit de façon explicite la table SAS d’origine hébergée au sein de l’espace de stockage temporaire (bibliothèque WORK) ou permanent. Cet argument ne se limite pas à une simple désignation nominale : il autorise l’intégration immédiate d’options de table entre parenthèses, permettant d’altérer la structure des données en mémoire avant même que le moteur d’exportation n’engage l’écriture sur le disque. Cette propriété s’avère stratégique pour optimiser les performances en évitant des passes de calcul intermédiaires.
L’argument OUTFILE= désigne la cible physique d’écriture sur le système de fichiers hôte, sous la forme d’une chaîne de caractères représentant un chemin d’accès absolu ou relatif. La robustesse des architectures de production requiert l’usage systématique de chemins absolus normalisés ou l’exploitation de références dynamiques générées par des variables macro. La spécification de l’argument DBMS=CSV indique quant à elle au moteur sous-jacent le pilote de traitement à instancier. L’acronyme DBMS (Database Management System) informe SAS qu’il doit appliquer les conventions formelles du standard CSV, notamment l’emploi de la virgule comme séparateur par défaut de champs, l’adjonction systématique d’une ligne d’en-tête portant le nom des variables et l’encadrement par des guillemets doubles des chaînes de caractères renfermant des délimiteurs ou des caractères d’échappement. Enfin, l’instruction RUN; déclenche la soumission du bloc au compilateur séquentiel, scellant la frontière transactionnelle du module d’exportation.
2.2 Mécanisme d’exécution et génération des journaux de traitement
L’exécution de PROC EXPORT ne se réduit pas à une simple copie de flux d’informations : elle déclenche une série complexe d’opérations internes d’interrogation des métadonnées. Dans un premier temps, SAS ouvre la table source en mode de lecture partagée et accède à son bloc de descripteur (descriptor portion). Ce bloc contient la définition structurelle formelle de la table : le nombre d’observations, le vecteur des noms de colonnes, leurs formats d’affichage associés, les attributs d’encodage (par exemple UTF-8 ou WLATIN1) et la typologie stricte de chaque variable. À partir de ces éléments, la procédure génère en coulisse un script temporaire d’étape DATA optimisé, exploitant les instructions FILE et PUT, qu’elle compile et exécute immédiatement au sein du sous-système SAS.
Ce processus de compilation et de transcription se reflète de manière transparente au sein du journal d’exécution (le SAS Log), qui constitue l’unique garant de la conformité méthodologique du traitement. Un examen rigoureux du journal permet d’observer la succession des phases opérationnelles : l’instanciation de la cible de sortie, la confirmation du délimiteur utilisé, le volume exact de lignes injectées dans le fichier textuel et le temps d’exécution CPU et réel alloué à l’opération. L’apparition d’avertissements (WARNING) ou d’erreurs (ERROR) dans ce journal signale immédiatement des anomalies de troncature textuelle, des corruptions de conversion numérique ou des conflits de verrouillage de fichiers.
Dans les pipelines de traitement automatisés à haute fiabilité, la simple inspection visuelle du journal s’avère insuffisante. Les développeurs chevronnés interrogent systématiquement la variable d’environnement automatique &SYSCC (System Condition Code) immédiatement après l’instruction RUN;. Cette macro-variable capture l’état terminal de la dernière procédure exécutée : une valeur de 0 indique un succès parfait sans la moindre réserve structurelle, une valeur de 4 signale la présence d’avertissements méthodologiques nécessitant un audit, tandis qu’une valeur supérieure ou égale à 8 dénote un échec critique ayant interrompu l’écriture du fichier. L’évaluation conditionnelle de ce code de retour permet d’interrompre préventivement les chaînes d’analyse ultérieures en cas d’altération de l’exportation.
3. Paramètres essentiels de l’instruction PROC EXPORT pour les fichiers CSV
3.1 Écrasement et sécurisation des fichiers cibles : L’option REPLACE
L’administration des fichiers au sein d’environnements multi-utilisateurs et de serveurs d’analyse partagés exige une rigueur absolue quant à la persistance des livrables de données. Par défaut, si l’argument OUTFILE= pointe vers un fichier textuel préexistant sur le système de fichiers hôte, la procédure PROC EXPORT adopte une politique conservatrice : elle refuse d’altérer l’intégrité de l’élément existant, interrompt son traitement sans modifier la cible et consigne une erreur explicite dans le journal d’exécution. Bien que protecteur, ce comportement par défaut paralyse les flux de production itératifs, tels que les calculs statistiques nocturnes ou les pipelines d’intégration continue nécessitant l’actualisation périodique des extractions.
L’intégration de l’option REPLACE au sein de l’instruction principale PROC EXPORT neutralise cette restriction en autorisant explicitement l’écrasement de la ressource cible. Positionnée à la fin de l’instruction principale avant le point-virgule terminal, elle signale au système d’exploitation sous-jacent l’ouverture du fichier physique en mode de troncature puis d’écriture (mode w standard en langage C). Cependant, l’usage de cette option engage la responsabilité méthodologique de l’analyste. Dans des protocoles de recherche soumis à des exigences d’auditabilité stricte (tels que les essais cliniques régis par les normes de la FDA ou de l’EMA), l’écrasement silencieux d’un fichier de résultats peut détruire de manière irréversible une version historisée de référence.
De surcroît, le comportement de l’option REPLACE est tributaire des privilèges de sécurité du système d’exploitation hôte. Sous les environnements Microsoft Windows, si le fichier cible est simultanément ouvert en lecture exclusive par un logiciel tiers tel que Microsoft Excel, la tentative d’écrasement provoquera un échec critique de verrouillage (File Lock Violation), générant une exception SAS non récupérable. Sous les architectures UNIX et Linux, la réussite de l’écrasement dépend rigoureusement des masques d’autorisation POSIX (file permissions) assignés au répertoire parent et au fichier lui-même. Une conception robuste requiert donc d’isoler les répertoires d’exportation et de valider l’absence de processus concurrents avant toute écriture destructive.
3.2 Sélection des sous-ensembles d’observations et de variables
L’exportation brute d’une table analytique complète est fréquemment contre-productive et inefficace. Dans le cadre d’enquêtes psychologiques ou d’études épidémiologiques longitudinales, les tables SAS contiennent régulièrement des centaines de variables auxiliaires (variables de travail, indicateurs de contrôle, clés de jointure techniques) et des millions d’enregistrements dont seule une fraction restreinte s’avère requise pour les modélisations externes. L’application d’un filtrage en amont, directement orchestré au sein de l’option DATA=, constitue une bonne pratique fondamentale pour limiter l’empreinte mémoire et accélérer les temps de transfert I/O (Entrées/Sorties).
SAS permet d’adjoindre directement des options de table entre parenthèses à la suite du nom de la table source. Les options KEEP= et DROP= permettent de redéfinir sélectivement le vecteur des colonnes à transmettre au moteur d’exportation. L’option KEEP= spécifie de manière exhaustive les seules variables autorisées à intégrer le fichier CSV final, tandis que l’option DROP= exclut les variables déclarées superflues. L’évaluation de ces options s’opère avant la phase de sérialisation : les colonnes écartées ne sont jamais traitées par le descripteur d’exportation, ce qui allège considérablement la charge computationnelle du processeur.
Parallèlement au filtrage des attributs, la sélection dimensionnelle des observations s’effectue via l’option WHERE=. Cette clause accepte l’ensemble des opérateurs logiques et booléens supportés par le moteur SQL et l’étape DATA de SAS. Par exemple, l’expression suivante illustre une sélection conjointe hautement ciblée :
PROC EXPORT DATA=recherche.cohortes_psychometrie (KEEP=id_patient age score_anxiete statut_inclusion WHERE=(statut_inclusion=1 AND age >= 18))

    OUTFILE="/data/exports/echantillon_valide.csv"

    DBMS=CSV

    REPLACE;

RUN;
Cette approche chirurgicale garantit que seules les observations pertinentes d’adultes inclus sont extraites, tout en limitant le fichier texte aux colonnes essentielles. L’impact de cette optimisation sur les volumétries colossales est direct : le fichier CSV résultant ne souffre d’aucune surcharge textuelle superflue, facilitant son ingestion immédiate dans des langages comme Python ou Julia pour des traitements computationnels intensifs.
4. Exemple 1 : Exportation standard d’un jeu de données vers un fichier CSV avec les paramètres par défaut
4.1 Création du jeu de données expérimental et inspection initiale
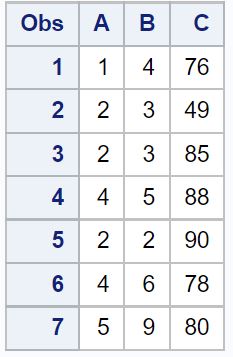
Afin de matérialiser concrètement les principes exposés, construisons une table SAS représentative d’une étude quantitative en psychologie clinique. Ce jeu de données, nommé EVAL_CLINIQUE, intègre des identifiants alphanumériques, des variables catégorielles textuelles, des mesures psychométriques continues issues d’échelles d’auto-évaluation et des scores composites comportant des valeurs décimales. La création s’effectue classiquement par une étape DATA alimentée par l’instruction DATALINES :
DATA work.eval_clinique;

    LENGTH Participant_ID $8 Diagnostic$15 Sexe $1;

    INPUT Participant_ID $ Age Sexe $ Score_BDI Score_STAI Poids_Kg;

    DATALINES;

SUBJ001 34 F 14.5 42.0 62.4

SUBJ002 45 M 28.0 55.5 81.2

SUBJ003 29 F  8.0 31.0 54.8

SUBJ004 52 M 32.5 61.0 95.0

SUBJ005 38 F 19.0 46.5 68.1

;

RUN;
Avant d’initier la moindre tentative d’exportation vers un support délimité externe, la rigueur méthodologique impose de valider la consistance de la table en mémoire. Pour ce faire, les procédures PROC CONTENTS et PROC PRINT doivent être systématiquement mobilisées. La procédure PROC CONTENTS révèle la structure interne du descripteur : elle certifie que les variables textuelles possèdent des longueurs statiques d’allocation convenables (évitant ainsi les gaspillages de mémoire) et que les variables numériques sont encodées selon la représentation binaire IEEE à virgule flottante sur 8 octets standard de SAS. L’inspection des cinq premières lignes via PROC PRINT permet d’attester l’absence de valeurs aberrantes immédiates ou de décalages de colonnes provoqués par une mauvaise lecture des délimiteurs dans DATALINES.
Cette phase de validation pré-exportation est primordiale : exporter une table sans avoir certifié son intégrité intrinsèque équivaut à propager des erreurs invisibles vers des systèmes tiers. Dès lors que la table est certifiée exempte d’anomalies de parsing, le processus d’extraction sérialisée peut être amorcé en toute sécurité.
4.2 Application du script standard PROC EXPORT
L’exportation standardisée de notre table EVAL_CLINIQUE s’opère par l’invocation de la procédure PROC EXPORT, en ciblant un répertoire dédié du système de fichiers local ou distant. Nous appliquons les paramètres conventionnels par défaut pour observer le comportement natif du moteur :
PROC EXPORT DATA=work.eval_clinique

    OUTFILE="/recherche/projets/output_standard.csv"

    DBMS=CSV

    REPLACE;

RUN;
À la soumission de ce bloc d’instructions, le journal SAS restitue une séquence d’informations attestant de la prise en charge du traitement. Le message clé consigné dans la console ressemble typiquement à la formulation suivante : « NOTE: /recherche/projets/output_standard.csv was successfully created. », assorti de la volumétrie précise du nombre d’enregistrements traités et du décompte temporel de l’opération. L’absence absolue de messages du type WARNING: Truncated record ou ERROR: File could not be locked confirme le succès transactionnel.
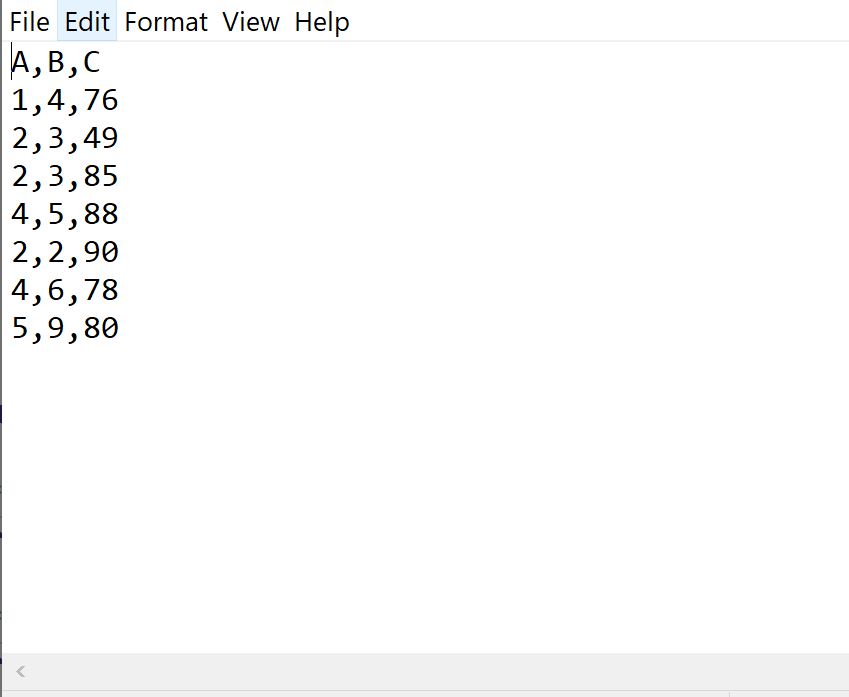
L’ouverture du fichier output_standard.csv généré, effectuée à l’aide d’un éditeur de texte brut non formateur (tel que Vim sous Linux, Notepad++ sous Windows ou TextEdit en mode texte pur sous macOS), permet de constater la matérialisation physique des données :
Participant_ID,Age,Sexe,Score_BDI,Score_STAI,Poids_Kg

SUBJ001,34,F,14.5,42,62.4

SUBJ002,45,M,28,55.5,81.2

SUBJ003,29,F,8,31,54.8

SUBJ004,52,M,32.5,61,95

SUBJ005,38,F,19,46.5,68.1
L’examen de cette sortie brute met en lumière l’application rigoureuse des règles par défaut de DBMS=CSV : la première ligne accueille fidèlement les noms des variables SAS issus du descripteur, servant d’en-tête de colonnes. Les champs numériques sont convertis en chaînes décimales utilisant le point typographique anglo-saxon. Aucun guillemet superflu n’est inséré autour des chaînes de caractères alphanumériques simples qui ne contiennent aucun espace ni caractère de rupture. La concordance structurelle entre l’objet résidant dans la bibliothèque SAS et le fichier plat sur disque est totale et prête pour l’ingestion externe.
5. Gestion des délimiteurs personnalisés et options spécifiques au format délimité (DBMS=DLM)
5.1 Substitution du séparateur virgule par le point-virgule ou la tabulation
L’usage de la virgule comme séparateur de champs, bien qu’universel dans les pays anglo-saxons et au sein des environnements d’apprentissage machine, pose des défis méthodologiques majeurs dans l’espace francophone et européen. Dans de nombreux pays d’Europe continentale, la norme typographique standard pour séparer la partie entière de la partie fractionnaire d’un nombre réel n’est pas le point, mais la virgule décimale. Par conséquent, lors de l’ouverture directe d’un fichier CSV standardisé sous une version européenne de Microsoft Excel, le moteur tableur tente d’interpréter les virgules comme des démarcations de colonnes, fragmentant les nombres décimaux en deux cellules distinctes et ruinant instantanément l’intégrité analytique du fichier.
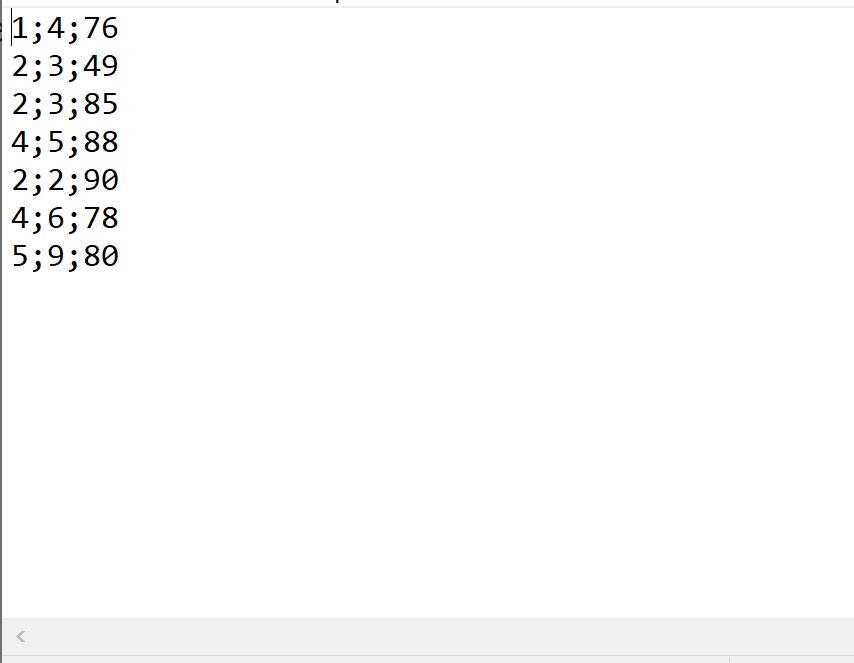
Pour parer à cette incompatibilité structurelle sans dénaturer la précision numérique, la procédure PROC EXPORT propose une flexibilité déterminante en autorisant la substitution du pilote DBMS=CSV par le pilote générique DBMS=DLM (pour Delimited). L’emploi de cet identifiant générique débloque l’instruction déclarative complémentaire DELIMITER=, au sein de laquelle l’analyste peut spécifier manuellement le caractère séparateur de son choix. Pour les environnements de travail européens, le point-virgule (;) constitue le standard de référence absolu :
PROC EXPORT DATA=work.eval_clinique

    OUTFILE="/recherche/projets/output_europe.csv"

    DBMS=DLM

    REPLACE;

    DELIMITER=';';

RUN;
Dans d’autres configurations informatiques de pointe, notamment lors du transfert de données massives vers des clusters de calcul distribué exploitant des frameworks de type Apache Hadoop ou Spark, le délimiteur tabulation (Tab-Separated Values ou TSV) est fréquemment exigé en raison de son absence quasi totale au sein des chaînes textuelles libres. SAS prend en charge cette variante de deux manières équivalentes : soit par l’utilisation de l’identifiant dédié DBMS=TAB, soit par la déclaration du code hexadécimal de la tabulation horizontale via DELIMITER='09'x; sous DBMS=DLM. Cette adaptabilité garantit une transition transparente vers n’importe quelle architecture cliente sans requérir d’outils de conversion de flux post-traitement.
5.2 Contrôle des guillemets d’encadrement des chaînes textuelles
Le traitement des données observationnelles en sciences humaines, sociales et médicales implique fréquemment la manipulation de variables textuelles qualitatives : verbatim de patients, comptes-rendus d’entretiens psychologiques ou commentaires cliniques libres. Ces observations ont la particularité intrinsèque de contenir des caractères qui entrent en collision directe avec la structure du fichier d’exportation : des virgules, des points-virgules, des apostrophes ou même des retours à la ligne imbriqués.
Le comportement conventionnel de la procédure PROC EXPORT repose sur un mécanisme d’encadrement adaptatif. Dès lors qu’une variable de type caractère renferme en son sein le caractère déclaré comme délimiteur de champs, le moteur insère automatiquement des guillemets doubles (") autour de la chaîne incriminée afin de signaler aux parseurs tiers que le délimiteur textuel fait partie intégrante de la donnée et ne marque pas un changement de colonne. Si la chaîne textuelle contient elle-même des guillemets doubles natifs, la procédure applique le standard d’échappement universel RFC 4180 en doublant le caractère d’échappement ("").
Toutefois, certains systèmes récepteurs ou pipelines d’ingestion SQL stricts exigent un encadrement systématique de toutes les colonnes de type caractère (quote-all policy), indépendamment de la présence ou de l’absence de caractères délimiteurs, afin d’éliminer toute ambiguïté lors de la détermination des types de données par inférence automatique. Inversement, d’autres systèmes archaïques rejettent catégoriquement la présence du moindre guillemet. Bien que PROC EXPORT offre un contrôle basique, la maîtrise chirurgicale fine de ces règles d’encadrement trouve ses limites sous ce module pré-compilé. Lorsqu’un contrôle absolu sur la politique de citation textuelle est requis par le cahier des charges, l’analyste doit délaisser la procédure automatisée au profit de l’étape DATA programmée avec l’instruction FILE, démontrant une nouvelle fois la complémentarité des approches disponibles sous SAS.
6. Contrôle précis des métadonnées : Gestion des noms de variables et des libellés (PUTNAMES et LABEL)
6.1 Inclusion ou suppression de l’en-tête de colonnes avec PUTNAMES
L’intégration de la première ligne au sein d’un fichier délimité, traditionnellement consacrée aux identifiants nominatifs des colonnes, constitue une convention standardisée mais non universelle. Dans de nombreux scénarios de gestion de données avancée, la présence d’une telle ligne d’en-tête est préjudiciable. C’est notamment le cas lorsque le fichier CSV généré est destiné à alimenter un processus d’ajout séquentiel (append mode) au sein d’un entrepôt de données relationnel préexistant, ou lorsqu’il s’agit de fragmenter une table gigantesque en dizaines de segments textuels partitionnés destinés à être concaténés au niveau binaire via des commandes systèmes telles que cat sous UNIX ou copy sous Windows.
Pour maîtriser ce comportement, la procédure PROC EXPORT expose l’instruction booléenne PUTNAMES. Par défaut, celle-ci est implicitement fixée à PUTNAMES=YES, forçant le moteur à lire les métadonnées de colonnes dans le descripteur et à les sérialiser sur la première ligne d’enregistrement. La déclaration explicite de PUTNAMES=NO; désactive instantanément cette mécanique :
PROC EXPORT DATA=work.eval_clinique

    OUTFILE="/recherche/projets/donnees_sans_entete.csv"

    DBMS=CSV

    REPLACE;

    PUTNAMES=NO;

RUN;
Le fichier CSV généré sous cette configuration commence directement à la première observation empirique de l’échantillon. Cette rigueur structurelle permet d’assurer une symétrie parfaite entre le nombre total de lignes inscrites dans le fichier physique (déterminé par des outils systèmes comme wc -l sous Linux) et le nombre d’observations effectives hébergées dans la table SAS source (observable dans la macro-variable &SYSNOBS). Cette stricte égalité numérique élimine les distorsions d’indexation lors des contrôles automatisés d’intégrité au sein des chaînes d’intégration continue.
6.2 Arbitrage entre noms de variables normalisés et libellés descriptifs (LABEL)
L’un des atouts conceptuels majeurs du système de métadonnées SAS réside dans la dissociation nette entre le nom technique de la variable (qui est traditionnellement restreint à 32 caractères alphanumériques sans espaces ni caractères spéciaux) et son étiquette textuelle descriptive (le LABEL), qui peut s’étendre jusqu’à 256 caractères et accueillir une description littéraire complète de la mesure. Dans les bases de données issues de questionnaires psychométriques complexes, le nom de la variable prend typiquement la forme d’un acronyme codé (par exemple BDI_ITEM_01), tandis que le libellé consigne l’énoncé exact présenté au répondant (« Je ne me sens pas triste au quotidien »).
Par défaut, l’instruction DBMS=CSV sérialise le nom technique de la variable en tête de fichier pour garantir la compatibilité computationnelle avec les langages de programmation en aval. Cependant, lorsque les fichiers CSV sont destinés à être transmis à des commanditaires d’études, des analystes métiers ou des auditeurs institutionnels ne maîtrisant pas le dictionnaire des variables, l’exportation des libellés descriptifs longs en lieu et place des noms techniques s’avère particulièrement pertinente. Pour activer cette substitution, l’analyste intègre l’option de procédure LABEL au sein de l’instruction PROC EXPORT :
PROC EXPORT DATA=work.eval_clinique

    OUTFILE="/recherche/projets/rapport_descriptif.csv"

    DBMS=CSV

    REPLACE;

    LABEL;

RUN;
Lorsque cette option est active, SAS vérifie pour chaque variable la présence d’un libellé associé au sein du descripteur. S’il existe, c’est ce texte descriptif qui est imprimé dans l’en-tête du fichier CSV ; dans le cas contraire, la procédure bascule par défaut sur le nom technique standard. Bien que cette pratique confère une lisibilité immédiate aux documents de synthèse, elle exige une vigilance méthodologique extrême : si les étiquettes de colonnes contiennent des virgules ou des caractères non conformes aux conventions syntaxiques des bases de données de destination, elles compliquent la rétro-ingénierie et l’indexation algorithmique ultérieure. L’arbitrage entre NAME et LABEL doit donc résulter d’une analyse des besoins de la phase de cycle de vie des données.
7. Exportation avancée avec l’étape DATA et l’instruction FILE (Alternative à PROC EXPORT)
7.1 Architecture fondamentale de l’instruction FILE pour le flux CSV
Bien que la procédure PROC EXPORT constitue une solution pratique et concise, elle dissimule les mécanismes d’écriture sous une couche d’abstraction qui prive l’ingénieur de données de tout contrôle microscopique. Lorsque les exigences opérationnelles imposent un formatage personnalisé à chaque cellule, une écriture conditionnelle ligne par ligne ou une optimisation extrême des performances I/O, le recours à l’étape DATA programmée représente l’approche architecturale reine. Au cœur de ce paradigme réside l’instruction FILE, couplée au modificateur syntaxique DSD (Delimiter-Sensitive Data).
L’instruction FILE redirige le canal de sortie standard du moteur SAS vers une destination physique externe. L’adjonction de l’option DSD modifie substantiellement la mécanique interne de traitement textuel du système :
- Elle assigne par défaut la virgule comme délimiteur physique de champs.
- Elle gère automatiquement l’encadrement des chaînes textuelles : toute variable caractère contenant un délimiteur de champs, des guillemets natifs ou des sauts de ligne est systématiquement encapsulée par des guillemets doubles.
- Elle traite avec rigueur les délimiteurs consécutifs comme des cellules vides, prévenant tout décalage d’indices de colonnes lors de la présence de valeurs manquantes.
- Elle élimine les guillemets superflus autour des variables alphanumériques simples, préservant ainsi la compacité volumétrique du flux textuel.
Pour introduire manuellement une ligne d’en-tête au sein d’une étape DATA séquentielle, l’analyste interroge la variable automatique _N_. Cette variable système interne, incrémentée de 1 à chaque itération de la boucle de l’étape DATA, permet d’exécuter un bloc d’instructions de manière unique lors de la lecture du tout premier enregistrement, garantissant ainsi l’impression unique des métadonnées de colonnes avant le début de l’injection des observations.
7.2 Programmation chirurgicale de la sortie avec l’instruction PUT
L’écriture effective des données au sein du flux physique est assurée par l’instruction PUT, agissant de concert avec le pointeur d’enregistrement du Program Data Vector (PDV). L’association de PUT et du mot-clé _ALL_ ou de la liste explicite des variables combinée à la notation de formatage nommée (named input/output) permet une liberté absolue de personnalisation. Considérons l’implémentation industrielle suivante, traduisant l’exportation d’une table clinique complexe :
DATA _NULL_;

    SET work.eval_clinique;

    FILE "/recherche/projets/export_chirurgical.csv" DSD DLM=';' LRECL=32767;
/* Écriture dynamique de l'en-tête à la première itération */
IF _N_ = 1 THEN DO;
PUT "IDENTIFIANT;AGE_ANNEES;GENRE;SCORE_DEPRESSION;SCORE_ANXIETE;POIDS_KG";
END;
/* Application conditionnelle et formatage explicite */
PUT Participant_ID
Age 3.
Sexe $1.
Score_BDI 6.2
Score_STAI 6.2
Poids_Kg 8.3;
RUN;
Plusieurs aspects méthodologiques de ce script méritent une attention approfondie. L’usage de la pseudo-table cible DATA _NULL_; constitue une règle d’or pour optimiser la mémoire : il indique à SAS qu’aucune nouvelle table binaire ne doit être compilée ou stockée dans la bibliothèque WORK, concentrant ainsi 100 % de la bande passante processeur et mémoire sur le streaming direct du flux textuel vers le disque. L’option LRECL=32767 (Logical Record Length) étend préventivement la capacité du tampon de ligne pour accueillir sans risque de troncature des chaînes textuelles très étendues. Enfin, le passage direct de spécifications de formats numériques (tels que 6.2 ou 8.3) dans l’instruction PUT permet de figer la précision décimale au moment exact de la sérialisation, éliminant les imprécisions d’arrondi binaire inhérentes aux représentations à virgule flottante.
8. Traitement des valeurs manquantes, des caractères spéciaux et du formatage numérique lors de l’export
8.1 Gestion rigoureuse des valeurs manquantes dans les analyses quantitatives
L’un des défis les plus redoutables de la manipulation de données quantitatives réside dans le traitement rigoureux de l’incomplétude informationnelle. Dans le moteur d’exécution interne de SAS, une observation numérique manquante n’est pas représentée par un état nul indéterminé ou une absence d’octets, mais par une valeur binaire spéciale matérialisée à l’affichage par un point standard (.), ou par l’un des 27 codes de valeurs manquantes spéciales (.A jusqu’à .Z et ._). Ces valeurs manquantes spéciales sont fréquemment mobilisées dans les études cliniques pour catégoriser la nature de l’absence (par exemple : .N = Non applicable, .R = Refus de répondre, .M = Donnée matérielle perdue).
Lors de l’application de PROC EXPORT avec le pilote DBMS=CSV, le comportement par défaut de SAS consiste à transcrire les valeurs manquantes numériques standards sous la forme d’un point littéral (.) ou d’un champ vide délimité par deux séparateurs successifs, selon la version logicielle et les options systèmes actives. L’injection d’un point textuel (.) au sein d’une colonne autrement purement numérique peut avoir des conséquences désastreuses lors de l’ingestion par des bibliothèques externes telles que Pandas en Python ou le package readr en R. Ces parseurs peuvent malencontreusement convertir l’intégralité de la colonne en type objet textuel (object ou string) pour accueillir ce caractère typographique, paralysant les calculs mathématiques subséquents.
Pour garantir une conformité méthodologique absolue lors de l’exportation via l’étape DATA, l’analyste neutralise l’option système globale des valeurs manquantes en configurant OPTIONS MISSING='';. Cette directive indique à SAS de ne sérialiser aucun caractère physique lorsqu’une variable numérique est manquante, produisant la séquence standard ...;valeur_precedente;;valeur_suivante;... attendue par l’ensemble des parseurs industriels. Si, au contraire, les codes de valeurs manquantes spéciales doivent être préservés à des fins d’imputation multiple, une transformation préalable des colonnes numériques en représentations alphanumériques explicites via la fonction PUT() devient obligatoire afin de traduire textuellement .R en "REFUS" ou "NA" avant le déclenchement de l’exportation.
8.2 Préservation de l’intégrité des dates, heures et nombres à virgule flottante
Dans l’écosystème SAS, les variables temporelles ne constituent pas un type de données physique distinct : les dates sont stockées sous la forme d’entiers représentant le nombre de jours écoulés depuis le 1er janvier 1960, tandis que les valeurs d’horodatage (DATETIME) quantifient le nombre de secondes depuis cette même date d’origine. Si une table contenant des variables temporelles est exportée sans l’application d’un format de présentation explicite, PROC EXPORT retranscrit directement ces nombres entiers sous-jacents. Le destinataire du fichier CSV se retrouve ainsi confronté à des identifiants scalaires tels que 23456 au lieu de la chaîne lisible correspondante, introduisant une confusion temporelle majeure.
Pour éliminer tout risque d’inversion sémantique, la règle méthodologique fondamentale consiste à figer les variables temporelles sous une norme universelle standardisée, prioritairement la norme internationale ISO 8601 (YYYY-MM-DD), avant l’exportation. Cette standardisation s’exécute avec élégance via l’instruction FORMAT :
PROC EXPORT DATA=work.cohortes (KEEP=patient_id date_visite score)

    OUTFILE="/recherche/projets/dates_normalisees.csv"

    DBMS=CSV

    REPLACE;

RUN;
En amont de cette procédure, il suffit d’avoir déclaré au sein de la table ou dans une étape transitoire FORMAT date_visite B8601DA10.; pour que le flux CSV contienne une structure strictement formatée sous la forme 2024-03-30. Cette précaution neutralise le risque récurrent de distorsion entre les conventions anglo-saxonnes (MM/DD/YYYY) et européennes (DD/MM/YYYY).
Concernant les mesures psychométriques fines, les calculs de latence d’électroencéphalographie ou les concentrations biochimiques, la précision des nombres à virgule flottante exige une surveillance tout aussi rigoureuse. L’utilisation de formats génériques par défaut de SAS (comme le format d’écriture automatique BEST12.) peut tronquer silencieusement des décimales significatives au-delà du huitième rang ou basculer inopinément les très petits nombres vers une notation scientifique exponentielle (ex. 1.45E-5). Si le système de réception ne supporte pas la notation exponentielle, l’analyste doit formellement assigner des formats d’extension numérique explicites (par exemple E8601DN16. ou des gabarits F12.6) pour sanctuariser la résolution numérique originelle des observations.
9. Gestion des encodages de caractères (UTF-8, Latin1) et compatibilité multiplateforme
9.1 Résolution des conflits d’encodage lors du transfert inter-systèmes
L’altération de données textuelles due à des disparités d’encodage binaire constitue l’une des sources d’erreurs les plus pernicieuses en science des données. Le symptôme le plus visible de cette friction est le phénomène de mojibake, où des caractères accentués courants de la langue française (tels que é, à, ç ou ê) se transforment lors de l’exportation en suites incohérentes de symboles (par exemple é ou â€TM). Cette corruption dégrade la qualité des annotations cliniques et peut invalider les analyses sémantiques ou de traitement du langage naturel (NLP).
Ce dysfonctionnement s’enracine dans la disparité entre la page de code native de la session SAS hôte et l’attente du système d’exploitation cible. Historiquement, les environnements SAS sous Windows fonctionnaient quasi exclusivement sous l’encodage mono-octet WLATIN1 ou ISO-8859-1, au sein duquel chaque caractère est codé sur un octet unique. Les architectures modernes, les bases de données réparties et les plateformes Web exigent désormais sans exception la norme universelle multi-octets UTF-8. Pour éviter toute distorsion textuelle, la procédure PROC EXPORT autorise la spécification impérative de l’encodage du fichier de sortie via l’option ENCODING= :
PROC EXPORT DATA=work.eval_clinique

    OUTFILE="/recherche/projets/donnees_utf8.csv"

    DBMS=CSV

    REPLACE;

    ENCODING="utf-8";

RUN;
L’introduction de ce paramètre déclenche l’appel aux bibliothèques de transcodage de l’International Components for Unicode (ICU) intégrées dans le runtime SAS. Chaque chaîne textuelle est transcodée à la volée depuis la page de code interne de la table source vers le format universel UTF-8 lors de son écriture sur disque. Cette standardisation garantit que le document CSV sera restitué de façon parfaitement transparente et identique sous n’importe quel système d’exploitation cible.
9.2 Gestion des fins de ligne selon l’environnement d’exploitation (CRLF vs LF)
Sous la surface d’un fichier textuel délimité, la matérialisation du saut marquant le passage à l’observation suivante varie substantiellement selon l’architecture matérielle et le système d’exploitation sous-jacent. Deux conventions prévalent historiquement dans l’industrie informatique :
- La convention Microsoft Windows, qui utilise deux octets de contrôle successifs : un retour chariot (Carriage Return, ASCII
13our) suivi d’un saut de ligne (Line Feed, ASCII10oun), séquence codée conventionnellement sous le sigleCRLF. - La convention UNIX, Linux et macOS contemporain, qui n’emploie qu’un unique octet de saut de ligne :
LF(ASCII10oun).
Cette divergence invisible à l’œil nu peut paralyser des infrastructures de traitement distribué. Si un script SAS exécuté sur un serveur central UNIX exporte un fichier CSV destiné à être traité par un outil Windows obsolète, ce dernier peut être incapable de segmenter les lignes et interpréter l’intégralité du document comme un enregistrement unique colossal. Réciproquement, la présence de caractères CR résiduels sous Linux peut perturber les scripts d’analyse shell ou l’ingestion au sein de clusters haute performance.
Dans le cadre d’un export avancé orchestré via l’étape DATA et l’instruction FILE, le contrôle de cette séquence de terminaison s’effectue via l’option TERMSTR= (Termination String). Cette directive permet de forcer la convention de fin de ligne indépendamment du système d’exploitation hébergeant la session SAS :
/* Exportation sous Linux avec obligation de compatibilité Windows */

DATA _NULL_;

    SET work.eval_clinique;

    FILE "/recherche/projets/target_windows.csv" DSD DLM=',' TERMSTR=CRLF;

    PUT Participant_ID Age Sexe Score_BDI Score_STAI Poids_Kg;

RUN;
L’utilisation explicite de TERMSTR=CRLF ou TERMSTR=LF sanctuarise le formatage physique des sauts d’enregistrements et supprime toute dépendance envers les conversions implicites du système hôte, consolidant ainsi la portabilité globale des fichiers d’extraction.
10. Optimisation des performances lors de l’exportation de volumineux ensembles de données
10.1 Allocation mémoire et réduction des opérations d’entrée/sortie (I/O)
Lorsque la taille des bases de données à exporter passe de quelques milliers à des dizaines ou des centaines de millions d’observations (comme c’est fréquemment le cas dans les registres nationaux de santé ou les bases transactionnelles financières), les opérations d’entrée/sortie sur disque (I/O) deviennent le goulot d’étranglement prédominant de l’infrastructure. Une procédure d’exportation non configurée peut immobiliser des ressources de calcul massives pendant des heures simplement en attendant le rafraîchissement des tampons d’écriture physique.
Le levier d’optimisation principal réside dans l’ajustement de la taille et du nombre de mémoires tampons allouées au sous-système de gestion de fichiers via les options système globales BUFSIZE= et BUFNO=. L’option BUFSIZE détermine la taille en octets d’un bloc de transfert de données entre le disque dur et la mémoire vive, tandis que BUFNO dicte le nombre de pages de cache maintenues simultanément en mémoire. En accroissant temporairement ces métriques pour la durée du traitement, l’analyste permet à SAS de charger des blocs massifs de données et d’exécuter des écritures groupées séquentielles, réduisant radicalement les appels systèmes (system calls) et la latence mécanique ou réseau :
/* Optimisation des tampons mémoires pour l'exportation massive */

OPTIONS BUFSIZE=64K BUFNO=32;
PROC EXPORT DATA=grands_registres.biomarqueurs_massifs
OUTFILE="/stockage_rapide/biomarqueurs_complets.csv"
DBMS=CSV
REPLACE;
RUN;
/* Restauration des paramètres par défaut */
OPTIONS BUFSIZE=DEFAULT BUFNO=DEFAULT;
Par ailleurs, l’existence d’index secondaires (fichiers .sas7bndx) associés à la table source peut dégrader les performances d’exportation si le moteur tente de maintenir la synchronisation des pointeurs. Une bonne pratique consiste à désactiver temporairement les index ou à s’assurer que la lecture de la table s’effectue dans l’ordre séquentiel physique naturel (ordre d’insertion) sans forcer de tri mémoire artificiel.
10.2 Stratégies d’exportation en flux direct (Streaming) sans surcharge disque
L’un des pièges récurrents dans la gestion de données volumineuses réside dans la création de tables temporaires intermédiaires au sein de la bibliothèque WORK pour préparer un sous-ensemble d’exportation. Cette pratique entraîne une duplication inutile de l’information : les données sont lues sur le stockage permanent, réécrites sous forme binaire temporaire dans l’espace WORK, puis relues pour être finalement sérialisées dans le fichier CSV. Cette redondance sature l’espace disque scratch des serveurs partagés et dégrade les performances globales.
La solution d’ingénierie optimale consiste à substituer les tables intermédiaires temporaires par des vues de données SAS (créées via l’instruction DATA ... / VIEW=... ou par une instruction PROC SQL CREATE VIEW ... AS). Une vue SAS ne stocke physiquement aucune observation sur le disque : elle sauvegarde uniquement la logique algorithmique de transformation sous forme compilée. Lors de l’appel ultérieur de PROC EXPORT, ce dernier consomme directement la vue comme s’il s’agissait d’une table matérielle :
/* Création d'une vue logique sans duplication physique sur disque */

PROC SQL;

    CREATE VIEW work.vue_export_optimale AS

    SELECT

        id_sujet,

        score_total,

        (score_total / variance_score) AS score_standardise

    FROM entrepot.donnees_massives

    WHERE annee_recueil >= 2020;

QUIT;
/* Exportation en flux continu depuis la vue */
PROC EXPORT DATA=work.vue_export_optimale
OUTFILE="/data/exports/donnees_recentes_stream.csv"
DBMS=CSV
REPLACE;
RUN;
Dans ce scénario, les calculs de dérivation (tels que la standardisation du score) et le filtrage chronologique s’exécutent en mémoire vive à la volée, au fur et à mesure que les lignes sont projetées dans le fichier CSV. Aucun espace de stockage disque intermédiaire n’est consommé, préservant l’intégrité de l’infrastructure logicielle sur les serveurs institutionnels tels que SAS Studio ou SAS Enterprise Guide.
11. Résolution des anomalies courantes et erreurs de syntaxe dans PROC EXPORT
11.1 Diagnostic des erreurs de chemin, de verrous et de permissions de fichiers
L’exploitation quotidienne de la procédure PROC EXPORT confronte régulièrement les analystes à des interruptions d’exécution dont les causes ne relèvent pas de la validité algorithmique du script, mais des interactions conflictuelles avec le système d’exploitation sous-jacent. Trois familles d’erreurs structurelles dominent les rapports d’incidents :
La première famille d’anomalies concerne les erreurs de chemin physique et de syntaxe de répertoires. Les architectures hybrides modernes impliquent fréquemment l’utilisation d’un client graphique hébergé sous Microsoft Windows connecté à un serveur de calcul distant tournant sous Red Hat Enterprise Linux. L’utilisation maladroite d’antislashs () caractéristiques de Windows au lieu de slashs (/) conformes aux standards POSIX au sein de l’argument OUTFILE= provoque un rejet catégorique : ERROR: Physical file does not exist. De surcroît, SAS ne dispose pas par défaut de la faculté de créer dynamiquement des arborescences de dossiers inexistantes : le chemin cible doit préexister dans sa totalité avant la soumission de la procédure, sous peine de voir l’opération avorter.
La seconde anomalie récurrente est le conflit de verrouillage partagé (File Locking Contention). Lorsqu’un utilisateur a préalablement ouvert une version antérieure du fichier CSV dans un logiciel de bureau comme Microsoft Excel, celui-ci verrouille le fichier physique via un mécanisme de verrouillage exclusif d’écriture. Lors de la soumission de PROC EXPORT, le compilateur SAS échoue à obtenir le handle d’écriture sur le fichier et consigne dans le journal le message redouté : ERROR: File is in use by another user or application. La résolution de ce conflit requiert l’arrêt immédiat du processus verrouillant ou l’attribution d’un nom dynamique unique au fichier de sortie afin de contourner l’occupation de la ressource.
Enfin, la question des privilèges d’accès (Permissions Denied) survient fréquemment dans les environnements de production sécurisés. Si le compte de service sous lequel s’exécute le démon SAS ne détient pas formellement les droits d’écriture (droit POSIX w) sur le répertoire distant ciblé, la tentative d’exportation est stoppée net. Le protocole de débogage rigoureux impose de tester l’accessibilité du répertoire à l’aide de la fonction système interne FILEXIST() ou via l’instruction d’interrogation de variables logiques %SYSFUNC(FILENAME(...)) avant de soumettre un traitement d’exportation massif.
11.2 Correction des tronquages de chaînes et des désalignements de colonnes
Le deuxième ordre de dysfonctionnements critiques concerne l’altération structurelle du contenu interne des fichiers délimités générés. Ces anomalies se manifestent typiquement sous deux formes : la troncature silencieuse des chaînes textuelles longues et le décalage brutal des alignements de colonnes lors de la relecture externe.
La troncature textuelle intervient principalement lorsque la variable caractère source a été définie avec une longueur insuffisante dans l’étape DATA parente ou lorsque le moteur d’exportation présume une longueur de tampon par défaut trop étriquée (souvent 256 octets). Si une variable de commentaire clinique comporte 800 caractères, toute la fraction excédant la longueur déclarée est irréversiblement perdue lors de la sérialisation, sans nécessairement déclencher d’erreur bloquante dans le journal. Pour pallier ce risque, il convient de déclarer explicitement des longueurs étendues via l’instruction LENGTH (par exemple LENGTH variable_texte $2000;) et de vérifier attentivement le dimensionnement du paramètre LRECL= (Logical Record Length) pour garantir que la capacité d’accueil de la ligne d’exportation n’est pas saturée.
Le décalage de colonnes (column shifting) résulte quant à lui presque exclusivement de la présence pernicieuse de caractères de contrôle textuels résiduels enfouis au sein des données : tabulations non déclarées, retours chariot (r) ou sauts de ligne (n) injectés lors de la saisie manuelle de questionnaires d’évaluation. Lorsqu’un fichier CSV contient une observation avec un saut de ligne non encapsulé, le parseur récepteur présume le démarrage immédiat d’une nouvelle observation. Les données se retrouvent alors désalignées, des valeurs textuelles se positionnant dans des colonnes de score numérique, ruinant l’analyse statistique subséquente.
Pour éliminer définitivement ce risque, une phase de nettoyage préventif doit être intégrée dans le pipeline en amont de l’exportation. L’emploi de la fonction COMPBL() pour réduire les espaces multiples ou de la fonction d’expression régulière PRXCHANGE() permet de purger systématiquement les caractères non imprimables :
DATA work.eval_purgee;

    SET work.eval_clinique;

    /* Élimination des retours à la ligne internes (ASCII 10 et 13) */

    Diagnostic = COMPRESS(Diagnostic, '0A0D'x);

RUN;
Cette étape de remédiation assure la rectitude géométrique parfaite du fichier d’arrivée, garantissant que chaque enregistrement physique corresponde rigoureusement à une unique observation conceptuelle.
12. Automatisation et industrialisation : Utilisation des macros SAS pour exporter plusieurs tables en CSV
12.1 Conception d’une macro-commande paramétrée pour exports itératifs
Dans un contexte d’industrialisation des chaînes analytiques, la soumission manuelle d’instructions répétitives PROC EXPORT pour chaque table d’un projet de recherche représente une régression méthodologique majeure, source d’erreurs humaines et d’inconsistances de maintenance. L’encapsulation de la logique d’extraction au sein du puissant Macro-Langage SAS permet d’ériger des modules d’exportation réutilisables, modulaires et robustes.
La conception d’une telle macro-commande repose sur le passage de paramètres dynamiques permettant de faire varier le jeu de données d’origine, le répertoire de stockage de sortie, le format du séparateur et l’application éventuelle de sous-sélections conditionnelles. Examinons la construction d’un composant d’infrastructure hautement résilient :
%MACRO ExporterVersCSV(

    TableSource = ,

    RepertoireSortie = ,

    Separateur = %STR(,),

    Remplacer = YES

);
/* Validation préventive des paramètres d'entrée */
%IF %SYSFUNC(EXIST(&TableSource)) = 0 %THEN %DO;
%PUT %STR(ERR)%STR(OR): La table source "&TableSource" est introuvable.;
%RETURN;
%END;
/* Extraction dynamique du nom de fichier pur */
%LOCAL NomFichier;
%IF %INDEX(&TableSource, .) > 0 %THEN
%LET NomFichier = %SCAN(&TableSource, 2, .);
%ELSE
%LET NomFichier = &TableSource;
/* Déclenchement conditionnel de l'exportation */
PROC EXPORT DATA=&TableSource
OUTFILE="&RepertoireSortie/&NomFichier..csv"
DBMS=DLM
%IF %UPCASE(&Remplacer) = YES %THEN REPLACE;;
DELIMITER="&Separateur";
PUTNAMES=YES;
RUN;
/* Vérification formelle du code conditionnel système */
%IF &SYSCC > 4 %THEN %DO;
%PUT %STR(WAR)%STR(NING): L'exportation de la table &TableSource a généré des anomalies critiques.;
%END;
%ELSE %DO;
%PUT %STR(NOTE): Exportation réussie de &TableSource vers &NomFichier..csv.;
%END;
%MEND ExporterVersCSV;
Cette macro-commande matérialise une démarche de conception défensive : elle valide l’existence de la table avant l’appel à la procédure via la fonction %SYSFUNC(EXIST()), isole le nom de la table sans son préfixe de bibliothèque pour forger un nom de fichier propre, contrôle l’application de l’option REPLACE et interroge la variable d’erreur &SYSCC pour notifier le système de monitoring de la bonne exécution du livrable. L’analyste peut ainsi soumettre des blocs d’exportation en une ligne de code lisible et auditable.
12.2 Exportation par lot à partir des métadonnées du dictionnaire SAS (SASHELP.VTABLE)
L’apogée de l’automatisation dans l’environnement SAS réside dans l’extraction dynamique guidée par les métadonnées. Plutôt que de déclarer manuellement chaque table à exporter, les ingénieurs peuvent interroger directement le dictionnaire interne du système via la vue SASHELP.VTABLE. Cette table de métadonnées recense l’intégralité des objets tabulaires instanciés au sein de l’ensemble des bibliothèques actives au cours de la session courante.
En combinant l’interrogation de cette vue avec la puissante instruction de commande procédurale CALL EXECUTE, il devient possible d’instancier dynamiquement une chaîne séquentielle d’exportations pour des dizaines de tables sans rédiger la moindre ligne de code répétitif. Considérons le cas d’usage où l’intégralité des tables hébergées dans la bibliothèque d’étude CLINIQUE doit être extraite sous forme de fichiers CSV individuels horodatés pour archivage pérenne :
DATA _NULL_;

    SET sashelp.vtable (WHERE=(libname = 'CLINIQUE'));
/* Génération dynamique d'une estampille temporelle */
LENGTH Horodatage $10 Commande$1000 CheminFichier $500;
Horodatage = PUT(TODAY(), YYMMDDN8.);
/* Construction du chemin d'accès absolu unique */
CheminFichier = CATS('/archives/csv/clinique_', memname, '_', Horodatage, '.csv');
/* Assemblage de la chaîne de syntaxe PROC EXPORT */
Commande = CATS(
'PROC EXPORT DATA=', libname, '.', memname, ' ',
'OUTFILE="', CheminFichier, '" ',
'DBMS=CSV REPLACE; ',
'PUTNAMES=YES; ',
'RUN;'
);
/* Transmission de l'instruction au tampon d'exécution du superviseur */
CALL EXECUTE(Commande);
RUN;
Le fonctionnement interne de ce script reflète toute la puissance de l’architecture méta-programmatique de SAS. L’étape DATA _NULL_ s’itère sur chaque enregistrement de SASHELP.VTABLE correspondant au critère libname = 'CLINIQUE'. Pour chaque table identifiée, elle assemble dynamiquement une chaîne de caractères contenant une instruction PROC EXPORT complète, intégrant le nom de la table (memname) et un horodatage systématique au format YYYYMMDD. L’instruction CALL EXECUTE pousse ensuite cette chaîne directement dans le tampon de commande global de SAS, qui l’exécute séquentiellement dès la clôture de l’étape DATA.
Cette approche élimine tout risque d’omission lors de l’archivage de bases multi-tables complexes. Chaque table dérivée, table d’audit ou registre d’événements indésirables se voit automatiquement projeté sur le système de stockage pérenne sous une dénomination normalisée et traçable. L’intégration de tels pipelines d’exportation automatisée garantit aux organisations de recherche une intégrité méthodologique absolue, réduisant la charge de travail manuel et assurant une parfaite transition des connaissances tout au long du cycle de vie des données.
Références
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer, Sixth Edition. SAS Institute Inc. https://support.sas.com/en/books/little-sas-book.html
- Peng, R. D. (2015). Report writing for data science in R. Leanpub. https://leanpub.com/reportwriting
- SAS Institute Inc. (2020). SAS® 9.4 Statements: Reference, Fifth Edition. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lestmtsref/titlepage.htm
- SAS Institute Inc. (2021). Base SAS® Procedures Guide, Version 9.4. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/proc/titlepage.htm
- Shafer, Y. (2017). PROC EXPORT and the DATA Step: The Dynamic Duo for Creating CSV Files. Proceedings of the SAS Global Forum 2017 Conference. SAS Institute Inc. https://www.sas.com/content/dam/SAS/support/en/sas-global-forum-proceedings/2017/0402-2017.pdf
- Wickham, H., & Grolemund, G. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media. https://r4ds.had.co.nz/
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., … & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), 1-9. https://doi.org/10.1038/sdata.2016.18