
Dans le paysage contemporain du traitement statistique et de la science des données, l’écosystème logiciel développé par le SAS Institute demeure une référence incontournable au sein des institutions académiques, des laboratoires de recherche clinique et des grandes organisations industrielles. Doté d’une robustesse éprouvée pour la manipulation de volumétries massives et l’exécution d’analyses inférentielles sophistiquées, SAS structure ses calculs autour d’un format propriétaire hautement optimisé, le fichier SAS7BDAT. Cependant, l’isolement technique des environnements de calcul haute performance entre souvent en tension avec les impératifs de dissémination, de révision collaborative et de communication pluridisciplinaire qui caractérisent la recherche empirique moderne. C’est précisément à cette jonction critique que s’impose l’utilisation des tableurs électroniques, au premier rang desquels figure Microsoft Excel, instrument omniprésent d’exploration visuelle et d’échange d’informations tabulaires.
L’exportation de données depuis SAS vers Microsoft Excel ne représente pas une simple opération mécanique de conversion de format, mais constitue une étape méthodologique fondamentale dans la chaîne de valeur du traitement des données. Transférer un jeu de données implique de garantir une fidélité absolue de la structure tabulaire, de préserver la typologie exacte des variables quantitatives et catégorielles, de maintenir la cohérence temporelle des formats calendaires et de documenter avec une rigueur irréprochable les métadonnées associées. Toute altération non maîtrisée lors de cette passerelle logicielle risque d’engendrer des erreurs de calcul ultérieures, des décalages d’indexation ou des pertes d’information susceptibles de compromettre la reproductibilité des résultats scientifiques et la validité des conclusions publiées.
Le présent traité méthodologique a pour vocation de fournir un guide exhaustif, exhaustif et rigoureusement documenté sur les techniques d’exportation de données depuis l’environnement SAS vers Microsoft Excel. En abordant successivement les fondements syntaxiques de la procédure PROC EXPORT, le paramétrage avancé des pilotes d’accès aux bases de données, l’architecture multi-feuilles, le traitement délicat des valeurs manquantes et des jeux de caractères étendus, ainsi que les alternatives offertes par le système de restitution ODS (Output Delivery System), ce document offre aux biostatisticiens, chercheurs et analystes de données les compétences nécessaires pour concevoir des flux de travail robustes, automatisés et conformes aux plus hauts standards d’intégrité numérique.
1. Introduction méthodologique à l’exportation de données SAS vers Microsoft Excel
1.1 Nécessité de l’interopérabilité entre SAS et les tableurs dans la recherche
Le rôle pivot dévolu à la suite logicielle SAS dans les infrastructures de recherche internationales repose sur sa capacité à exécuter des procédures mathématiques complexes, à manipuler des modèles linéaires généralisés à effets mixtes et à traiter des données d’essais cliniques sous des protocoles de conformité particulièrement rigoureux, à l’image des normes établies par la Food and Drug Administration (FDA) des États-Unis. Néanmoins, la complexité intrinsèque de l’interface de programmation SAS et le coût substantiel de ses licences logicielles limitent naturellement son déploiement à un groupe restreint de statisticiens spécialisés. À l’inverse, le tableur Microsoft Excel bénéficie d’une universalité quasi absolue au sein de la communauté scientifique, offrant une interface graphique intuitive, une manipulation directe des matrices de cellules et des capacités de visualisation rapide adaptées aux réunions d’arbitrage méthodologique et aux revues d’avancement de projets.
Les besoins de diffusion des résultats auprès de chercheurs, de cliniciens, de gestionnaires de projets et de collaborateurs non programmeurs imposent la mise en place d’une passerelle fluide et bidirectionnelle. Les destinataires finaux des synthèses quantitatives requièrent fréquemment des données sous une forme immédiatement manipulable, leur permettant d’effectuer des tris ad hoc, de concevoir des graphiques exploratoires ou d’intégrer des tableaux récapitulatifs dans des manuscrits scientifiques. L’exportation de données SAS vers des classeurs Excel répond à cet impératif de démocratisation analytique tout en déchargeant le statisticien principal des requêtes d’interrogation récurrentes de premier niveau.
Ce transfert ne saurait toutefois s’effectuer au détriment de l’intégrité des structures tabulaires. Le passage d’un environnement strictement typé, régi par le moteur de base de données relationnelle interne de SAS, à une grille de cellules semi-structurée propre à Excel présente des risques méthodologiques manifestes. La préservation de l’atomicité des champs, la distinction claire entre valeurs numériques et chaînes alphanumériques, ainsi que la conservation de l’ordre d’ordonnancement des observations constituent des impératifs absolus. La transition doit s’opérer sans injection d’artefacts d’arrondi, sans modification des délimiteurs décimaux et sans corruption des identifiants alphanumériques, dont la troncature éventuelle fausserait l’appariement ultérieur des données.
Enfin, les exigences contemporaines de la science ouverte et de la reproductibilité computationnelle impliquent que l’archivage sous des formats universellement consultables soit rigoureusement documenté. Bien que le format propriétaire SAS7BDAT soit pérenne au sein de son propre écosystème, le format de feuille de calcul normalisé, standardisé sous la spécification internationale ISO/IEC 29500 (Office Open XML), garantit une accessibilité multi-plateforme à long terme. Cette standardisation assure que des données colligées dans le cadre de protocoles longitudinaux demeurent déchiffrables et auditables par des évaluateurs indépendants, indépendamment de la disponibilité immédiate d’une station de travail SAS opérationnelle.
1.2 Vue d’ensemble des approches programmatiques d’exportation
Pour orchestrer le transfert des structures tabulaires vers l’environnement Excel, le programmeur SAS dispose principalement de deux paradigmes conceptuels distincts : la procédure d’échange de données universelle, matérialisée par la commande PROC EXPORT, et le sous-système de restitution graphique et tabulaire, désigné sous l’acronyme ODS (Output Delivery System). Ces deux architectures répondent à des finalités méthodologiques radicalement divergentes et mobilisent des moteurs internes dissemblables. Comprendre cette dichotomie structurelle s’avère indispensable pour sélectionner la stratégie d’exportation optimale en fonction des contraintes de production et des objectifs d’analyse.
La procédure PROC EXPORT a été spécifiquement conçue comme un composant d’extraction, de transformation et de chargement (ETL). Son objectif primaire réside dans la sérialisation directe du contenu brut d’une table SAS sous la forme d’un tableau à deux dimensions dans un fichier externe. Elle se caractérise par une vitesse d’exécution élevée, une consommation minimale de mémoire tampon et une adhérence stricte aux schémas de données. À l’opposé, le système ODS, et en particulier sa destination ODS EXCEL, opère au niveau de la présentation visuelle. ODS intercepte le flux de sortie des procédures analytiques (telles que PROC MEANS, PROC FREQ ou PROC REG) pour générer des classeurs élaborés, enrichis de formats typographiques, de styles chromatiques, d’en-têtes hiérarchiques et de métadonnées visuelles. Tandis que PROC EXPORT extrait la matrice de données sous-jacente, ODS formalise un rapport de synthèse destiné à la lecture humaine.
L’évaluation comparative des formats cibles constitue le second axe décisionnel. Historiquement, SAS prenait en charge le format binaire propriétaire Microsoft Excel 97-2003 (.xls), structuré selon la norme BIFF8 (Binary Interchange File Format). Ce format ancien s’accompagne de contraintes sévères, notamment un plafonnement strict à 65 536 lignes par feuille. À l’inverse, le format contemporain .xlsx repose sur une archive compressée de fichiers XML normalisés, autorisant jusqu’à 1 048 576 lignes et offrant une compatibilité totale avec les systèmes 64 bits. Enfin, le format texte délimité par des virgules (.csv) représente l’alternative d’interopérabilité maximale, s’affranchissant de toute dépendance vis-à-vis des composants logiciels Microsoft, bien qu’il sacrifie les fonctionnalités avancées telles que la gestion des feuilles multiples au sein d’un fichier unique.
Les considérations relatives aux versions du logiciel SAS conditionnent également le choix des instructions. Sous SAS 9.4 (notamment à partir de la version de maintenance 9.4M2), l’intégration du moteur natif XLSX a considérablement fluidifié l’exportation en éliminant le recours obligatoire aux composants tiers Microsoft Access Database Engine (ACE). Dans les architectures infonuagiques distribuées, telles que SAS Viya, l’abstraction de la couche de stockage modifie la gestion des chemins de fichiers, exigeant une manipulation prudente des bibliothèques de serveurs de données (caslibs). Pour les utilisateurs de SAS OnDemand for Academics, l’exécution s’effectue sur des serveurs distants sous environnement Linux, ce qui impose de composer avec des arborescences de répertoires virtualisées et des contraintes strictes d’accès aux systèmes de fichiers de l’utilisateur distant.
2. Fondements et syntaxe canonique de la procédure PROC EXPORT
2.1 Décomposition élémentaire de la commande PROC EXPORT
La syntaxe de la procédure PROC EXPORT obéit à un agencement déclaratif strict, conçu pour expliciter sans ambiguïté la table de données source, le réceptacle physique externe et les modalités de transmission. L’instruction initiale débute invariablement par l’invocation du mot-clé PROC EXPORT, immédiatement suivi de paramètres positionnels ou nommés définissant le périmètre de la transaction. Cette structure déclarative garantit la prévisibilité de l’opération et permet à l’interpréteur de commandes SAS de valider l’existence des objets en mémoire avant d’initier toute écriture sur le sous-système de disques.
L’argument DATA= joue un rôle névralgique en désignant la table SAS source qui doit faire l’objet de l’extraction. Cette table peut résider au sein de la bibliothèque de travail temporaire WORK (auquel cas la spécification d’un préfixe est facultative, bien que formellement recommandée sous la forme DATA=WORK.MaTable), ou provenir d’une bibliothèque permanente préalablement assignée via une instruction LIBNAME (par exemple, DATA=Projet.Patients). L’instruction accepte également des options de table intégrées entre parenthèses, permettant d’appliquer des filtres d’observations ou des sélections de colonnes directement à la source avant l’exécution du processus d’exportation.
L’option OUTFILE= explicite la trajectoire physique complète et le nommage du fichier qui sera créé ou modifié sur le système de stockage hôte. Cette chaîne de caractères doit impérativement être délimitée par des guillemets doubles ou simples et comporter l’extension de fichier adéquate correspondant au pilote retenu. L’absence de guillemets ou l’omission de l’extension de fichier déclenche des erreurs de syntaxe fatales au niveau de l’analyseur lexical de SAS, interrompant prématurément le traitement séquentiel du programme.
À l’instar de la majorité des procédures procédurales de SAS, le bloc de commande doit obligatoirement être clos par l’instruction RUN. Cette commande ordonne au compilateur d’achever la phase de résolution macro-structurelle, de verrouiller les ressources d’entrée-sortie et d’exécuter l’écriture sur le disque. En amont immédiat de cette exécution, une gouvernance rigoureuse des permissions du système hôte s’avère indispensable : l’utilisateur exécutant la session SAS doit disposer de privilèges explicites d’écriture et de modification sur le répertoire de destination spécifié dans l’argument OUTFILE=, sous peine d’interruption abrupte du programme assortie de messages d’erreur d’accès refusé au niveau du journal d’exécution.
2.2 Maîtrise des options REPLACE et SHEET
La flexibilité et la sécurité transactionnelle de la procédure PROC EXPORT reposent en grande partie sur l’utilisation conjointe des options structurelles REPLACE et SHEET. L’option REPLACE indique au moteur d’exportation qu’il est formellement autorisé à écraser une ressource physique préexistante portant un nom identique à celui spécifié dans l’argument OUTFILE=. Si l’instruction REPLACE est omise et que le fichier cible est déjà présent sur le support de stockage, SAS refuse d’altérer le fichier d’origine et consigne une alerte critique dans le journal système (SAS Log), suspendant l’exportation pour prévenir toute destruction accidentelle de données antérieures.
Le comportement de l’option REPLACE présente toutefois une nuance capitale lorsqu’elle est combinée avec le pilote DBMS=XLSX. Dans ce contexte précis, REPLACE n’efface pas systématiquement l’intégralité du classeur Excel préexistant s’il contient plusieurs onglets : elle réinitialise spécifiquement l’onglet désigné par l’instruction SHEET=, laissant les autres feuilles intactes, sauf si le fichier n’existait pas préalablement, auquel cas un nouveau classeur est intégralement instancié. Cette subtilité opérationnelle permet d’utiliser l’option REPLACE de manière sélective pour mettre à jour une section précise d’un classeur analytique sans corrompre les feuilles adjacentes dédiées à d’autres métriques statistiques.
L’argument SHEET= détermine avec précision le libellé de l’onglet récepteur au sein du classeur Excel. La désignation s’effectue via une chaîne de caractères encadrée de guillemets, respectant les normes nominales de Microsoft Excel (longueur maximale de 31 caractères, interdiction des caractères réservés tels que les deux-points, les barres obliques ou les points d’interrogation). En l’absence de l’instruction SHEET=, le comportement par défaut de SAS consiste à baptiser la feuille de calcul créée du nom exact de la table SAS d’origine, ou sous l’identifiant générique « Sheet1 » selon les versions et pilotes sous-jacents mobilisés.
La prévention des pertes de données accidentelles lors d’exécutions successives d’un même script analytique requiert une planification rigoureuse de ces deux arguments. Lors de flux de travail itératifs ou de traitements par lots (batch processing), l’omission involontaire de l’option SHEET= couplée à un emploi systématique de REPLACE peut conduire à des écrasements séquentiels destructeurs, où seule la dernière table traitée subsiste dans le document final. Maîtriser l’articulation entre l’écrasement global du fichier et la mise à jour granulaire des onglets garantit la cohérence structurelle des livrables sans risque de régression informationnelle.
3. Paramétrage technique de l’instruction OUTFILE et gestion des chemins d’accès
3.1 Syntaxe des chemins sous Windows, Linux et architectures infonuagiques
La configuration de la chaîne de caractères assignée à l’option OUTFILE= exige une compréhension approfondie des particularités structurales des systèmes d’exploitation sous-jacents hébergeant le moteur SAS. Une erreur fréquente commise par les analystes réside dans la transposition naïve de chemins de répertoires sans égard pour les conventions de nommage propres à chaque environnement. Sous les systèmes d’exploitation Microsoft Windows, l’arborescence des fichiers repose historiquement sur l’utilisation de lettres de lecteur suivies de barres obliques inverses (antislashs), comme l’illustre la syntaxe typique « C:RechercheProjetAResultats.xlsx ».
À l’opposé, les architectures de type Unix et les distributions Linux — sur lesquelles s’appuient la grande majorité des serveurs d’entreprise SAS et les environnements infonuagiques modernes — emploient exclusivement des barres obliques conventionnelles (slashs) partant de la racine du système, adoptant une structure telle que « /sas/data/recherche/projet_a/resultats.xlsx ». Il convient de souligner que SAS sous Windows tolère généralement les barres obliques conventionnelles au sein des chaînes d’accès aux fichiers, ce qui constitue une bonne pratique de programmation portable permettant d’assurer la compatibilité transversale du code entre différents systèmes sans nécessiter de refactorisation textuelle.
L’utilisation de la plateforme pédagogique et de recherche SAS OnDemand for Academics introduit un niveau d’abstraction supplémentaire. L’utilisateur opère au sein d’une session de virtualisation hébergée dans le nuage informatique de SAS Institute. Dans ce contexte, l’arborescence de stockage est strictement cloisonnée et les chemins de fichiers doivent obligatoirement refléter la structure interne du compte utilisateur distant, matérialisée sous la forme « /home/uXXXXXX/mon_repertoire/sortie.xlsx », où « uXXXXXX » correspond à l’identifiant unique assigné lors de l’enregistrement de l’accès. Tenter de spécifier un chemin pointant vers un disque dur local (tel qu’un lecteur « C: ») au sein d’une session SAS OnDemand aboutit immanquablement à une rupture d’exécution, le serveur distant n’ayant aucune passerelle d’accès direct au sous-système de stockage de la machine cliente.
Par ailleurs, la distinction entre chemins absolus et chemins relatifs mérite une attention singulière. Si un chemin absolu garantit un pointage univoque vers l’emplacement physique du fichier sur le serveur, il présente l’inconvénient majeur de fragiliser le script face à tout déplacement de l’arborescence globale. Les chemins relatifs, calculés par rapport au répertoire de travail courant défini dans la session, offrent une plus grande modularité mais exigent une vérification rigoureuse du répertoire actif via la fonction système GETOPTION(‘WORK’) ou des commandes de navigation d’environnement. Enfin, la présence d’espaces typographiques ou de caractères diacritiques (accents, cédilles) au sein des noms de répertoires constitue une source récurrente d’instabilité logicielle. L’encadrement scrupuleux des chemins par des guillemets et l’adoption d’une nomenclature normalisée reposant sur des traits d’union bas (underscores) s’imposent pour prémunir les scripts contre les rejets de lecture.
3.2 Utilisation des références globales et macro-variables de chemin
Afin de maximiser la maintenabilité, l’évolutivité et l’élégance architecturale des programmes SAS, l’ancrage direct en dur (hard-coding) des chemins d’accès au sein de l’instruction OUTFILE= doit être formellement banni au profit de l’utilisation de macro-variables d’environnement. L’instruction %LET constitue à cet égard l’outil fondamental permettant de centraliser la définition des répertoires cibles au sommet des programmes analytiques. En déclarant une macro-variable globale dédiée, telle que %LET RepSortie = /sas/projets/etude_clinique/livrables;, le développeur circonscrit l’intégralité des dépendances de chemins à une unique ligne de configuration modifiable à volonté.
L’injection de cette macro-variable au sein de la procédure PROC EXPORT s’effectue par substitution lexicale au moyen du symbole perluète (&). Il est alors impératif d’encadrer la valeur de l’argument OUTFILE= de guillemets doubles (« &RepSortie/Rapport_Final.xlsx ») plutôt que de guillemets simples. Dans le système de compilation SAS, les chaînes délimitées par des apostrophes ou guillemets simples sont traitées de manière purement littérale, empêchant le processeur macro de résoudre la référence symbolique, ce qui conduit à la recherche infructueuse d’un fichier dont le nom contiendrait textuellement le caractère « & ».
Cette modularité s’avère particulièrement précieuse lors des phases de migration de code entre des environnements de développement, de pré-production et de production industrielle, ou lors du partage de scripts entre chercheurs collaborant sur des stations de travail hétérogènes. La modification d’une unique variable d’ancrage en tête de script permet de réadapter instantanément l’intégralité du pipeline d’extraction, réduisant à néant les risques d’omissions manuelles au sein des blocs procéduraux dispersés dans le corps du document.
Pour parfaire l’industrialisation du processus, il est hautement recommandé d’intégrer un contrôle programmatique préalable de l’existence physique du répertoire récepteur. L’utilisation combinée du macro-langage et de la fonction système SAS FILEEXIST permet de tester la validité du conteneur avant de déclencher l’écriture des données. Si l’interrogation du chemin révèle l’absence du répertoire d’accueil, le script peut alors déclencher dynamiquement l’instanciation de l’arborescence manquante via la commande système CALL SYSTEM ou interrompre l’exécution de manière contrôlée via l’instruction %ABORT, consignant un message circonstancié dans le journal système et empêchant ainsi la génération d’erreurs en cascade dues à un chemin invalide.
4. Rôle et sélection des pilotes DBMS pour les formats tabulaires
4.1 Le pilote DBMS=XLSX : avantages et compatibilité native
Le paramètre DBMS= (Database Management System) de la procédure PROC EXPORT indique à l’interpréteur SAS le sous-système de conversion et le protocole binaire à mobiliser pour sérialiser les données vers le support externe. Parmi l’ensemble des moteurs disponibles dans les versions modernes de SAS, l’instruction DBMS=XLSX s’affirme comme le standard de référence absolu pour l’ensemble des développements contemporains. Ce pilote assure une passerelle native vers la spécification OpenXML régissant les fichiers Microsoft Excel modernes portant l’extension homonyme .xlsx.
Le bénéfice architectural majeur de DBMS=XLSX réside dans son autonomie logicielle complète. Contrairement aux solutions historiques, ce pilote ne requiert l’installation d’aucun composant tiers Microsoft Office, d’aucune bibliothèque ODBC/OLE DB dédiée et ne dépend aucunement du moteur redistribuable Microsoft Access Database Engine (ACE). SAS génère et assemble directement les flux XML sous-jacents compressés au sein du conteneur ZIP qui structure tout fichier XLSX moderne. Cette indépendance totale élimine d’emblée les conflits logiciels traditionnels, permettant une exécution d’une stabilité absolue sur les serveurs distants opérant sous des distributions Unix, Linux ou AIX, où l’écosystème applicatif Microsoft est par nature inexistant.
En outre, l’implémentation native 64 bits de DBMS=XLSX éradique les incompatibilités récurrentes qui entravaient fréquemment les flux d’exportation sur les postes de travail dotés d’une version 64 bits de SAS cohabitant avec une suite bureautique Office compilée en architecture 32 bits. Le pilote dialogue directement avec le système de fichiers hôte, maximisant les débits de transfert de données et autorisant la gestion transparente d’écritures directes volumineuses sans saturer la pile de mémoire applicative.
Enfin, DBMS=XLSX offre un support considérablement optimisé pour la préservation des métadonnées de colonnes étendues. Il prend en charge nativement les chaînes de caractères longues sans appliquer la troncature arbitraire à 255 caractères qui caractérisait les anciens protocoles tabulaires, et gère avec une précision chirurgicale l’alignement des types scalaires. La rapidité d’exécution et la fidélité de restitution offertes par ce moteur en font le choix préférentiel et exclusif de toute chaîne de traitement de données pérenne.
4.2 Alternatives historiques : DBMS=EXCEL et DBMS=XLS
L’exploration du patrimoine méthodologique et des bases de code SAS anciennes met fréquemment en lumière l’utilisation des pilotes DBMS=EXCEL et DBMS=XLS. Comprendre les fondements et les limites de ces options historiques s’avère crucial pour tout analyste confronté à des opérations de maintenance logicielle ou de rétro-ingénierie, bien que leur emploi dans des développements neufs soit désormais formellement déconseillé par les architectes de systèmes d’information.
L’option DBMS=EXCEL a longtemps constitué le moyen privilégié de dialogue entre SAS et Microsoft Excel sous environnement d’exploitation Windows. Son fonctionnement reposait cependant sur une dépendance critique vis-à-vis des composants d’accès aux données de Microsoft, successivement matérialisés par le moteur Jet Engine puis par l’Access Database Engine (ACE). Cette dépendance technique imposait une concordance architecturale rigoureuse entre la version de SAS et celle de Microsoft Office. Si un utilisateur exploitait une version 64 bits de SAS aux côtés d’une version 32 bits d’Excel — configuration historiquement très répandue en milieu d’entreprise pour des raisons de rétrocompatibilité des macros VBA —, l’appel à DBMS=EXCEL échouait systématiquement, confronté à l’incapacité d’établir une liaison dynamique inter-processus hétérogène (32/64 bits).
De son côté, le pilote DBMS=XLS s’adressait spécifiquement à la génération de fichiers binaires respectant la spécification BIFF8 propre à Microsoft Excel versions 97 à 2003. La contrainte la plus invalidante de cette norme réside dans son plafond volumétrique structurel indépassable : une feuille de calcul au format XLS ne peut mathématiquement héberger plus de 65 536 lignes d’observations et se trouve restreinte à un maximum de 256 colonnes. Toute tentative d’exportation d’un jeu de données statistique contemporain excédant ces seuils dimensionnels entraîne l’avortement immédiat de la procédure et une troncation irrémédiable des informations.
Ces deux pilotes souffrent aujourd’hui d’une dépréciation technique prononcée. Les évolutions continues du noyau logiciel SAS et les durcissements des politiques de sécurité des systèmes d’exploitation modernes ont accentué les risques d’instabilité liés à leur utilisation. Le maintien de ces instructions au sein de scripts en production expose les infrastructures à des ruptures de service inopinées lors de la mise à jour des parcs applicatifs. Dès lors, la conversion systématique des flux historiques vers le moteur DBMS=XLSX constitue un impératif de gestion des risques informatiques.
5. Exemple pratique 1 : Exportation d’une table unique vers une feuille de calcul
5.1 Construction du jeu de données expérimental SAS
Afin de concrétiser les concepts théoriques exposés, nous allons développer un premier exemple empirique centré sur l’exportation d’une table unique. Dans le cadre de ce cas pratique, nous simulons la constitution d’une cohorte d’évaluation psychométrique colligeant diverses métriques cognitives et physiologiques chez des sujets soumis à des protocoles d’entraînement distincts. Ce protocole nous permettra d’étudier le comportement du moteur d’exportation face à des types de données hétérogènes.
L’étape de programmation DATA initialise une table temporaire nommée EVALUATION_COGNITIVE au sein de la bibliothèque de travail WORK. Nous déclarons des variables identifiantes de type caractère (Patient_ID), des variables continues issues d’échelles standardisées (Score_PreTest, Score_PostTest), un indicateur temporel rigoureusement formaté (Date_Evaluation) et une variable catégorielle assignant les sujets à un bras expérimental spécifique (Condition_Traitement). L’étape DATA utilise des fonctions de distribution aléatoire et des assignations directes pour peupler un échantillon représentatif de sujets, en veillant à incorporer délibérément des particularités structurelles telles que des décimales précises et des dates calendaires.
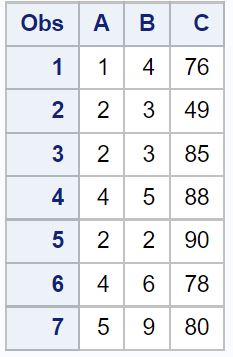
Une fois la table instanciée en mémoire, une inspection préalable de son intégrité dimensionnelle et scalaire s’impose avant tout transfert externe. Cette validation préliminaire est réalisée au moyen de la procédure PROC CONTENTS, qui renseigne le dictionnaire complet de la table (nombre d’enregistrements, longueur des chaînes, formats attribués), complétée par un appel à la commande PROC PRINT pour visualiser les premières observations de contrôle. Cette étape de vérification garantit que le flux entrant dans le pipeline d’exportation est rigoureusement conforme aux attentes statistiques et ne contient aucune anomalie cryptique d’indexation.
5.2 Implémentation et exécution du script PROC EXPORT
L’implémentation de la procédure PROC EXPORT pour cette première table fait appel à la combinaison canonique des arguments directeurs. La table source EVALUATION_COGNITIVE est déclarée via l’argument DATA=, tandis que la trajectoire du livrable est consignée dans l’argument OUTFILE=. Nous sélectionnons explicitement le pilote moderne DBMS=XLSX, complété de l’option REPLACE afin de garantir que les itérations successives du script puissent s’exécuter sans interruption de blocage, tout en personnalisant le libellé de l’onglet de destination sous l’appellation « Donnees_Brutes » via l’instruction SHEET=.
L’exécution du script s’accompagne d’un examen approfondi du journal d’exécution (SAS Log), qui constitue le panneau de diagnostic de référence de l’analyste. Lors du traitement de l’instruction RUN, le moteur SAS compile le flux, initialise l’interpréteur XLSX, instancie l’arborescence compressée du classeur cible et procède à l’écriture séquentielle des blocs d’enregistrements. Le journal consigne avec précision le nombre de lignes et de colonnes effectivement transférées, tout en confirmant la trajectoire absolue du fichier écrit sur le disque dur hôte.
L’analyste doit impérativement scruter le journal système pour détecter l’apparition éventuelle de messages d’avertissement (WARNING) ou de signalements d’erreur (ERROR). Une exécution réussie se traduit systématiquement par une mention explicite confirmant que le fichier a été créé avec succès et que la table WORK.EVALUATION_COGNITIVE a été convertie dans le format spécifié. Toute divergence entre le volume de données attendu et le décompte affiché dans le journal révèle une anomalie structurelle dans le processus de transmission.
5.3 Validation post-exportation dans l’interface Excel
La clôture du protocole d’exportation ne saurait être validée sans une démarche méthodique d’audit a posteriori au sein de l’environnement applicatif récepteur, à savoir Microsoft Excel. Cette étape d’assurance qualité logicielle consiste à ouvrir le classeur généré afin de confronter visuellement et fonctionnellement la structure de données restituée par le tableur avec la table mère gérée dans le référentiel SAS.
Le premier point de contrôle porte sur l’ordonnancement séquentiel des colonnes et la conformité des en-têtes. Il convient de vérifier que les variables Patient_ID, Score_PreTest, Score_PostTest, Date_Evaluation et Condition_Traitement occupent les positions respectives définies lors de l’étape de programmation, et qu’aucun décalage vectoriel n’a été introduit. L’intégrité des cellules est ensuite inspectée : les valeurs numériques continues doivent être reconnues par Excel comme des nombres réels autorisant immédiatement des calculs arithmétiques, et non comme du texte brut aligné à gauche de la cellule — anomalie classique traduisant un mauvais couplage de format lors de l’exportation.
Une attention spécifique doit être portée aux formats temporels et calendaires. La variable Date_Evaluation doit apparaître sous une graphie chronologique directement interprétable (par exemple JJ/MM/AAAA) et être sous-tendue par une valeur sérielle valide au sens du calendrier interne d’Excel. Enfin, l’absence totale de décalages d’indexation — phénomène qui survient lorsque des délimiteurs internes ou des caractères non imprimables corrompent la rupture des cellules — garantit que l’isolation matricielle des données a été scrupuleusement respectée d’une extrémité à l’autre de la passerelle logicielle.
6. Exemple pratique 2 : Structuration d’un classeur multi-feuilles à partir de plusieurs tables
6.1 Préparation de multiples tables statistiques corrélées
Dans les contextes d’analyse avancée, la diffusion des résultats de recherche sous la forme d’un fichier Excel requiert rarement le transfert d’une table unique et isolée. Les exigences de reporting scientifique imposent le plus souvent de structurer les livrables sous la forme d’un classeur d’analyse cohérent, agrégeant au sein d’une même entité physique des niveaux d’information hiérarchisés : les caractéristiques démographiques individuelles de la cohorte, les synthèses de statistiques descriptives univariées et les paramètres d’estimation issus de la modélisation statistique inférentielle.
Pour illustrer ce cas d’école multi-dimensionnel, nous instancions dans l’environnement de calcul SAS trois tables de données distinctes mais conceptuellement corrélées. La première, désignée sous le nom DEMOGRAPHIE, rassemble les attributs pérennes des participants à l’étude (identifiant du sujet, classe d’âge, genre biologique, centre de recrutement). La deuxième table, intitulée STATS_DESCRIPTIVES, est produite à l’aide de la procédure PROC MEANS et contient les métriques d’agrégation classiques (moyenne arithmétique, écart-type, médiane, quartiles et étendue) calculées sur les différents marqueurs évalués. Enfin, la troisième table, nommée MODELES_ANALYSE, capture les estimateurs de régression, les erreurs types associées, les valeurs du test statistique de Wald et les p-values résultant de l’exécution d’une procédure PROC REG ou PROC GLM.
En amont de toute démarche d’exportation, l’architecture relationnelle de ces trois tables doit faire l’objet d’un audit de cohérence strict. Les identifiants primaires doivent être rigoureusement harmonisés afin d’éliminer toute divergence typographique ou scalaire. De même, les nomenclatures des variables d’agrégation doivent être unifiées pour écarter tout risque de collision sémantique lors de la lecture transversale du classeur final par les équipes de recherche destinataires.
6.2 Règles d’enchaînement de PROC EXPORT pour alimenter un fichier unique
La consolidation de plusieurs tables SAS au sein d’un classeur Excel unique doté d’onglets multiples obéit à une mécanique procédurale d’une grande rigueur. L’erreur la plus dévastatrice observée dans ce scénario réside dans l’utilisation répétée et indistincte de l’option REPLACE lors de chaque appel à la procédure PROC EXPORT. Si l’analyste spécifie systématiquement l’option REPLACE au cours d’une chaîne d’exportations pointant vers le même fichier physique, chaque exécution successive a pour effet de réinitialiser le document cible, détruisant instantanément les onglets injectés par les étapes précédentes pour ne conserver finalement que la dernière table traitée.
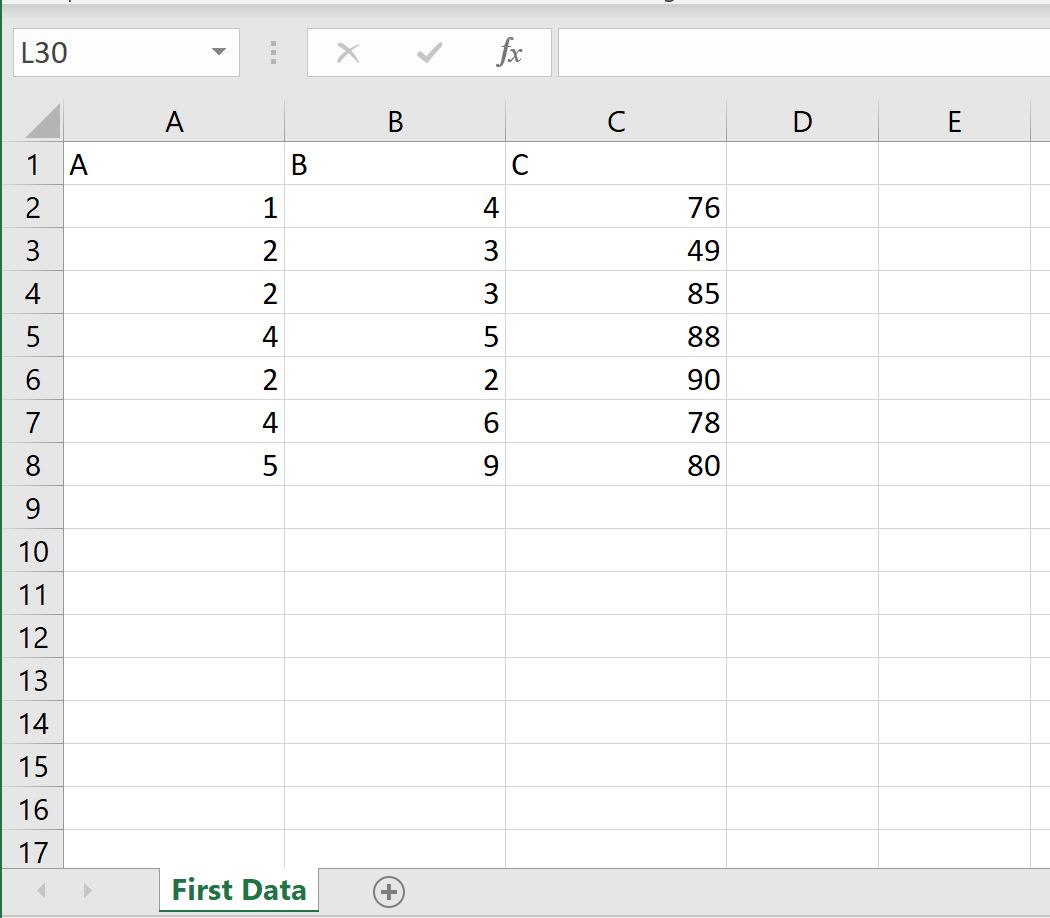
La règle d’or d’ingénierie SAS repose donc sur l’asymétrie de configuration entre la première transaction et les opérations subséquentes. Le premier bloc PROC EXPORT, destiné à écrire la table DEMOGRAPHIE dans la feuille ‘Demographie’, doit impérativement comporter l’option REPLACE afin de purger d’éventuels artéfacts issus d’exécutions antérieures et d’initialiser proprement le conteneur physique de stockage sur le disque hôte. Ce premier appel déploie la fondation du document OpenXML.
Dès la deuxième transaction d’exportation (concernant la table STATS_DESCRIPTIVES dirigée vers l’onglet ‘Statistiques’) ainsi que pour la troisième (dédiée à la table MODELES_ANALYSE vers la feuille ‘Modeles’), la stratégie doit être scrupuleusement ajustée. L’instruction SHEET= assigne le nom d’onglet exclusif correspondant à chaque domaine de données, garantissant une séparation étanche des flux. Grâce à la robustesse du moteur DBMS=XLSX, SAS inspecte la structure du conteneur existant, y insère les nouveaux flux XML correspondant à la feuille additionnelle, met à jour le dictionnaire de relations internes du classeur et sauvegarde le document sans altérer la substance des feuilles préexistantes.
Une vigilance constante doit être accordée au risque de collision nominale : si un appel ultérieur spécifie un nom d’onglet rigoureusement identique à un onglet déjà présent au sein du classeur (par exemple ‘Demographie’ à nouveau), le comportement de SAS consistera à écraser spécifiquement cet onglet particulier, ce qui illustre toute la puissance mais également les risques inhérents à une gestion imprécise des libellés de feuilles de calcul.
6.3 Vérification de l’architecture finale du classeur
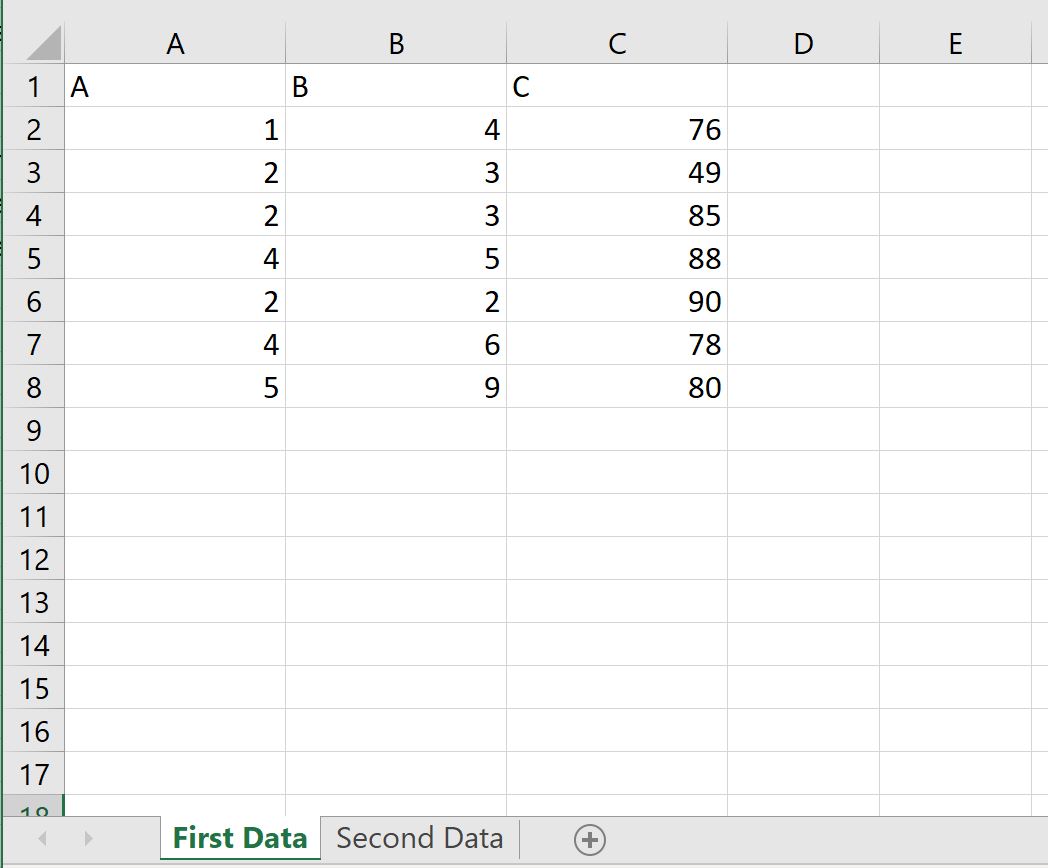
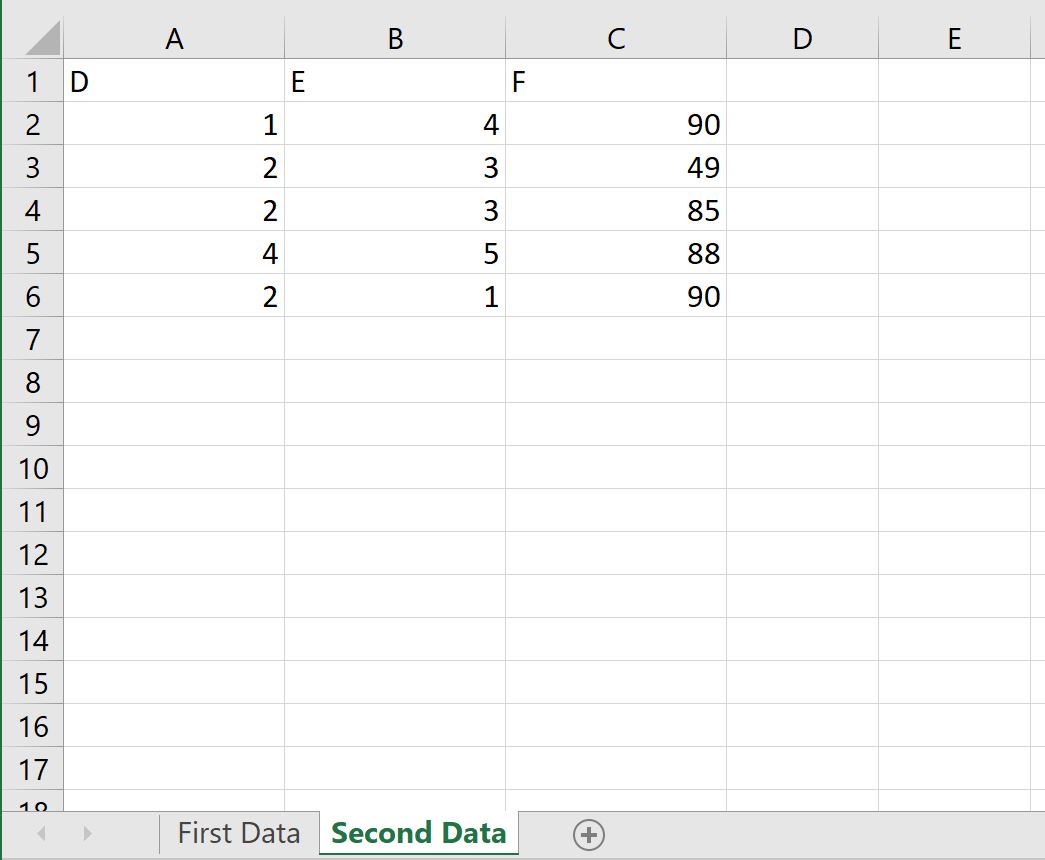
L’aboutissement de la séquence d’instructions multi-tables impose une vérification minutieuse de l’architecture finale du livrable consolidé. L’analyste doit procéder à l’ouverture du classeur Excel pour valider visuellement et fonctionnellement la coexistence des trois onglets indépendants au sein de la barre de navigation inférieure du logiciel : ‘Demographie’, ‘Statistiques’ et ‘Modeles’. Chacun de ces onglets doit encapsuler exclusivement le périmètre de données qui lui a été alloué, attestant de l’étanchéité des transactions d’écriture successives.
Au-delà de la confirmation visuelle, un audit de traçabilité volumétrique doit être conduit. Le nombre d’enregistrements présent dans l’onglet ‘Demographie’ doit correspondre rigoureusement au décompte d’observations issu de la table mère SAS, majoré de la ligne d’en-tête. La même comparaison rigoureuse doit être appliquée aux feuilles ‘Statistiques’ et ‘Modeles’, en s’assurant qu’aucune troncature de libellé de paramètre ou de valeur statistique n’est survenue lors du processus d’assemblage séquentiel.
Cette validation structurelle garantit l’intégrité référentielle des données exportées par lots. Le classeur Excel devient un artefact d’analyse autosuffisant, documenté et prêt pour la phase de diffusion auprès des évaluateurs externes ou des partenaires institutionnels, tout en conservant une concordance parfaite avec les tables analytiques résidant au sein de l’environnement sécurisé SAS.
7. Gestion des étiquettes de variables, des formats et des valeurs manquantes
7.1 Exportation des noms de variables versus étiquettes (Labels)
L’une des distinctions fondamentales au sein du dictionnaire de données SAS repose sur la dichotomie entre le nom canonique d’une variable et son étiquette descriptive (LABEL). Le nom de variable est assujetti à des règles syntaxiques restrictives : il ne peut excéder 32 caractères dans les versions actuelles, doit impérativement débuter par une lettre ou un trait d’union bas et exclut l’usage d’espaces et de caractères accentués. À l’inverse, l’étiquette descriptive offre un champ de contextualisation sémantique étendu pouvant comporter jusqu’à 256 caractères, incluant une ponctuation élaborée et des caractères diacritiques, ce qui en fait le vecteur idéal pour documenter précisément la signification clinique ou expérimentale d’une colonne.
Par défaut, le comportement opérationnel de la procédure PROC EXPORT avec le pilote DBMS=XLSX consiste à extraire les noms techniques de variables pour constituer la ligne d’en-tête de la feuille Excel générée. Si cette modalité satisfait les exigences des pipelines d’automatisation informatique destinés à une réimportation ultérieure dans des bases de données relationnelles, elle s’avère fréquemment sous-optimale pour la production de rapports destinés à des utilisateurs non techniciens, qui privilégient la lisibilité d’étiquettes textuelles soignées telles que « Tension Artérielle Systolique (mmHg) » au détriment de désignations compactes telles que « TAS_mmHg_V1 ».
Pour modifier ce comportement par défaut et forcer la procédure PROC EXPORT à substituer les étiquettes descriptives aux noms de variables au sein de la ligne d’en-tête du fichier cible, le développeur doit mobiliser l’option d’environnement système LABEL. Cette configuration est activée en amont de l’appel procédural au moyen de l’instruction OPTIONS LABEL;. Couplée à l’instruction d’exportation, cette directive ordonne au moteur XLSX de sonder le dictionnaire de la table SAS : si une étiquette descriptive a été préalablement assignée à la colonne, elle est injectée dans l’en-tête du classeur Excel ; en l’absence d’étiquette explicite, le nom canonique de la variable est conservé à titre de repli technique. Cette flexibilité permet d’adapter parfaitement l’esthétique du classeur à son public cible.
7.2 Préservation des formats personnalisés et dates
La gestion des dates et des variables chronologiques constitue l’un des écueils méthodologiques les plus critiques lors de la transition entre SAS et Microsoft Excel. Cette difficulté trouve son origine dans la divergence profonde des calendriers sériels internes régissant ces deux plateformes logicielles. SAS quantifie les dates sous la forme d’un nombre entier représentant le nombre de jours écoulés depuis le point d’ancrage historique fixé au 1er janvier 1960. À l’opposé, Microsoft Excel utilise par défaut un système de référence chronologique prenant pour origine le 1er janvier 1900 (ou le 1er janvier 1904 sur certaines configurations historiques de systèmes Macintosh).
En l’absence d’application préalable d’un format calendaire adéquat au sein de l’environnement SAS, une valeur de date sera irrémédiablement exportée sous la forme de son entier sériel brut d’origine 1960. Par exemple, la date du 15 octobre 2023, qui correspond à la valeur sérielle 23300 dans le système SAS, sera insérée telle quelle dans la cellule Excel ; le tableur, interprétant ce nombre selon son propre calendrier 1900, affichera alors la date erronée du 29 octobre 1963, introduisant une altération temporelle majeure susceptible de vicier gravement des analyses longitudinales.
Pour prémunir le pipeline analytique contre cette désynchronisation, il est impératif d’assigner rigoureusement un format de date SAS explicite (tel que DATE9., YYMMDD10. ou DDMMYY10.) à la variable avant de lancer l’instruction d’exportation, soit au sein d’une étape DATA intermédiaire, soit via une instruction FORMAT encapsulée. Le pilote DBMS=XLSX intercepte ces formats calendaires standardisés et assure la translation mathématique requise vers l’échelle chronologique d’Excel tout en configurant la propriété d’affichage de la cellule réceptrice. Une logique analogue s’applique aux formats monétaires (DOLLAR., EURO.) et numériques décimaux (PERCENT., COMMA.), garantissant que l’attribut visuel transmis à Excel respecte fidèlement les conventions typographiques sans dénaturer la précision numérique sous-jacente.
7.3 Traitement des valeurs manquantes et caractères spéciaux
La structure des données empiriques se heurte inévitablement à la problématique des observations lacunaires ou non collectées. Au sein du système SAS, l’absence de mesure pour une variable numérique est signalée par défaut par le symbole du point régulier (.), qui représente la valeur manquante standard. Le compilateur SAS propose également une fonctionnalité analytique puissante matérialisée par les valeurs manquantes spéciales, désignées par un point immédiatement suivi d’une lettre majuscule (.A jusqu’à .Z) ou d’un trait de soulignement (._), permettant aux chercheurs de catégoriser la nature précise de l’absence de donnée (par exemple : .N pour « Non applicable », .R pour « Refus de réponse » ou .D pour « Donnée perdue »).
Lors de l’exportation vers un classeur Excel, la transcription de ces valeurs manquantes exige une vigilance singulière. Par défaut, le moteur DBMS=XLSX convertit les valeurs manquantes numériques standards (.) en cellules intégralement vides au sein de la feuille de calcul. Ce comportement s’avère généralement vertueux, dans la mesure où les formules arithmétiques internes d’Excel (telles que MOYENNE ou SOMME) ignorent nativement les cellules vides lors de leurs évaluations scalaires, alors que la présence d’un point textuel forcerait le tableur à traiter la cellule comme une chaîne de caractères, générant des messages d’erreur de typage arithmétique de type #VALEUR! lors de l’exécution de formules dépendantes.
En revanche, le traitement des valeurs manquantes spéciales (.A à .Z) peut conduire à l’inscription de ces codes sous une forme textuelle au sein des cellules Excel correspondantes. L’analyste doit impérativement cartographier ces comportements et documenter la signification de ces identifiants dans un dictionnaire de métadonnées annexé à l’export, afin d’éviter que des évaluateurs non avertis ne confondent une variable manquante catégorisée avec une chaîne de caractères valide.
Enfin, la gestion des caractères spéciaux et de l’alphabet étendu francophone (lettres accentuées telles que é, è, ê, cédilles, ligatures) implique une maîtrise sans faille des encodages de caractères. Si la session SAS est initialisée sous un encodage mono-octet restreint (tel que Latin1 / Wlatin1) et dialogue avec un système d’exploitation cible opérant sous une variante différente de l’Unicode, des artefacts de sérialisation désignés sous le terme de mojibake peuvent apparaître au sein des libellés de cellules Excel (se traduisant par des symboles aberrants tels que « é »). L’initialisation systématique des environnements SAS modernes sous l’encodage universel UTF-8 constitue le bouclier le plus efficace pour éradiquer définitivement ces corruptions de transcodage.
8. Automatisation et dynamisation des exports via le langage macro SAS
8.1 Création d’une macro-commande paramétrable pour l’exportation
Dans un contexte opérationnel caractérisé par la récurrence des opérations de modélisation et la nécessité de livrer périodiquement des résultats actualisés, l’écriture séquentielle et répétitive de blocs de commandes PROC EXPORT devient une source d’inefficience et de vulnérabilité logicielle. L’encapsulation de la logique d’exportation au sein d’une macro-commande SAS standardisée et paramétrable constitue la réponse méthodologique idéale pour élever le niveau de fiabilité et de modularité du code d’analyse.
Une macro-commande robuste, que l’on pourra désigner sous le nom formel de %ExportExcel, doit être conçue de manière à accepter des paramètres nommés définissant l’intégralité de ses dimensions d’action : la table source en mémoire (table=), la trajectoire de stockage cible (chemin=), le libellé de l’onglet de destination (feuille=) ainsi qu’un commutateur booléen contrôlant l’autorisation d’écrasement (remplacer=OUI). L’architecture interne de la macro structure l’évaluation de ces arguments et orchestre la composition dynamique de l’instruction procédurale sous-jacente.
L’avantage cardinal de cette approche réside dans la possibilité d’intégrer des règles de validation préventives directement au sein du corps de la macro. Au moyen des directives conditionnelles du macro-langage (%IF-%THEN-%ELSE), la macro peut vérifier l’absence d’arguments obligatoires, tester la validité structurelle des paramètres passés en revue et consigner des messages d’erreur explicites au sein du journal SAS avant même de tenter d’instancier la moindre ressource d’entrée-sortie. Ce niveau de contrôle programmatique transforme un simple script d’extraction en un module applicatif pérenne, réutilisable sans friction au travers de multiples projets de recherche.
8.2 Génération de noms de fichiers dynamiques et horodatés
Le contrôle de version et l’archivage rigoureux des données constituent des piliers cardinaux de la gouvernance de l’information statistique. L’écrasement continu d’un fichier portant un nom statique (tel que « Resultats.xlsx ») expose les équipes à des pertes irrémédiables d’historique analytique et empêche l’audit rétrospectif de l’évolution des calculs au cours des différentes phases d’un protocole expérimental. La dynamique temporelle doit donc être injectée directement dans le nom de fichier généré par le moteur d’exportation.
Le macro-processeur SAS offre pour cela des fonctionnalités avancées d’interrogation du temps système au travers de la fonction macro %SYSFUNC, capable de mobiliser les fonctions scalaires du langage de base. En combinant %SYSFUNC avec les fonctions TODAY() et TIME(), associées à des formats calendaires et horaires compacts ne contenant aucun caractère prohibé par les systèmes de fichiers (tels que YYMMDDN8. ou TOD6.), le développeur peut extraire une estampille chronologique univoque sous la forme « 20231025_143022 ».
L’assemblage de cette estampille au sein d’une macro-variable d’horodatage permet de formater dynamiquement la chaîne passée à l’argument OUTFILE=. Un livrable portera ainsi automatiquement la nomenclature contextualisée « Export_Donnees_2023_10_25.xlsx ». Cette technique garantit que chaque exécution programmée du pipeline d’analyse produira un nouvel artefact physique autonome, parfaitement identifiable chronologiquement, facilitant le suivi longitudinal des bases de données de recherche et instaurant une traçabilité native des cycles de traitement sans intervention humaine manuelle.
8.3 Exportation itérative d’une collection de tables via une boucle macro
Les protocoles analytiques de grande envergure requièrent fréquemment l’exportation simultanée de plusieurs dizaines, voire de plusieurs centaines de tables de résultats issues de procédures de modélisation sérielles ou de découpages par sous-groupes populationnels. Rédiger manuellement des dizaines d’occurrences de la commande PROC EXPORT s’avérerait intolérablement fastidieux et hautement propice aux erreurs de copier-coller. L’automatisation itérative par boucle macro s’impose dans ce contexte comme une nécessité impérieuse.
Le fondement de cette stratégie repose sur l’exploitation des tables de métadonnées du système SAS, et plus particulièrement de la vue SASHELP.VTABLE. Cette vue dictionnaire expose l’inventaire en temps réel de l’ensemble des tables de données hébergées au sein des bibliothèques actives de la session. En exécutant une requête SQL via la procédure PROC SQL ciblant la vue SASHELP.VTABLE, filtrée sur une bibliothèque spécifique (par exemple WHERE libname = ‘RESULTATS’), l’analyste peut capturer automatiquement la liste exhaustive des noms de tables à exporter et charger cette collection au sein d’une série de macro-variables indexées, ou générer un décompte total via l’instruction INTO :liste_tables SEPARATED BY ‘ ‘.
Il suffit dès lors de concevoir une boucle macro itérative, régie par l’instruction %DO index = 1 %TO &NombreTotalDeTables;, pour balayer séquentiellement chaque élément de la liste. À chaque itération de la boucle, la macro résout le nom de la table courante, instancie l’appel à la procédure PROC EXPORT en redirigeant le flux vers un onglet individualisé ou vers une série de classeurs distincts, et consigne la progression de la transaction dans le journal système. Cette automatisation industrielle décuple la productivité du statisticien, lui permettant d’évacuer des volumes massifs de données tabulaires vers Excel au travers d’un flux de traitement à la fois élégant, robuste et totalement autonome.
9. Utilisation alternative du système ODS (Output Delivery System) Excel
9.1 Introduction à la destination ODS EXCEL
Bien que la procédure PROC EXPORT demeure l’outil d’élection pour le transfert de données tabulaires brutes destinées à des recalculs, le système de livraison des sorties SAS Output Delivery System (ODS) offre une approche conceptuelle radicalement différente, centrée sur la publication de rapports hautement stylisés. Introduite pour succéder à l’ancienne destination expérimentale ODS TAGSETS.EXCELXP, la destination native ODS EXCEL permet de concevoir des classeurs électroniques dotés d’un degré de sophistication graphique et structurelle que la procédure PROC EXPORT ne saurait structurellement atteindre.
Le principe opérationnel d’ODS EXCEL repose sur l’interception des flux de sortie produits par n’importe quelle procédure procédurale SAS (qu’il s’agisse de tableaux de statistiques descriptives issus de PROC TABULATE, d’arbres d’estimation produits par des modèles mixtes ou de graphiques statistiques générés par PROC SGPLOT). L’architecture syntaxique repose sur un encadrement strict de la séquence analytique : l’instruction ODS EXCEL FILE= »chemin/Rapport.xlsx » OPTIONS(…) procède à l’ouverture du canal de communication vers le fichier cible, après quoi les différentes procédures SAS s’exécutent normalement en envoyant leurs rendus visuels dans ce tuyau virtuel, avant que la commande ODS EXCEL CLOSE ne vienne sceller l’archive OpenXML et achever l’écriture sur le disque hôte.
Cette approche permet de transcender les frontières du tableau de données standard. ODS EXCEL offre la faculté unique de mixer au sein d’une même feuille de calcul des blocs d’informations composites : des titrages éditoriaux riches, des tableaux de contingence stylisés, des paragraphes de commentaires méthodologiques et des représentations graphiques vectorielles haute résolution intégrées directement au cœur de la grille de calcul, créant ainsi des livrables de restitution prêts à être présentés aux instances de décision.
9.2 Personnalisation avancée de la mise en page
Le véritable potentiel de la destination ODS EXCEL réside dans sa capacité de paramétrage typographique et ergonomique extrêmement fine, pilotée au travers d’une multitude d’options de sous-système déclarées au sein de l’instruction d’ouverture ou modulées par des commandes intermédiaires. L’analyste peut ainsi rompre avec l’austérité visuelle des tables brutes pour adopter des chartes graphiques sophistiquées conformes aux standards institutionnels les plus exigeants.
L’option STYLE= permet de sélectionner des modèles de mise en forme prédéfinis au sein du référentiel SAS (tels que les styles Journal, Statistical, HTMLBlue ou Daisy), ou de concevoir des styles totalement personnalisés via la procédure PROC TEMPLATE. Ces styles régissent la famille de polices de caractères, les dimensions scalaires des textes, l’alternance chromatique des lignes de données (effet de zébrage facilitant la lecture optique des grands tableaux) ainsi que la coloration conditionnelle des cellules de bordures.
Au-delà de l’esthétique pure, les options de mise en page permettent de maîtriser avec précision l’expérience utilisateur au sein de Microsoft Excel. L’instruction sub-ordonnée OPTIONS(SHEET_INTERVAL=’PAGE’) permet de dicter au moteur SAS les conditions précises de génération d’un nouvel onglet, créant automatiquement une nouvelle feuille à chaque nouvelle procédure exécutée ou à chaque rupture d’une variable de groupe spécifiée dans une clause BY. De même, des fonctionnalités avancées telles que l’ajustement automatique de la largeur des colonnes aux dimensions de leur contenu textuel le plus étendu (AUTOFIT_HEIGHT=’YES’), le figeage des lignes d’en-tête supérieures pour maintenir la lisibilité lors du défilement vertical (FROZEN_HEADERS=’YES’), ou l’insertion programmatique de métadonnées d’impression dans les pieds de page du classeur confèrent aux documents générés une finition professionnelle irréprochable.
9.3 Arbitrage méthodologique : Quand privilégier ODS par rapport à PROC EXPORT
Face à la dualité méthodologique incarnée par PROC EXPORT d’un côté et le système ODS EXCEL de l’autre, le biostatisticien et l’ingénieur de données doivent exercer un arbitrage éclairé en fonction des objectifs assignés au livrable et des contraintes computationnelles de l’environnement de production. Choisir aveuglément l’un ou l’autre de ces canaux d’exportation sans évaluer le cas d’usage conduit invariablement à des inefficacités opérationnelles ou à des déconvenues ergonomiques.
La procédure PROC EXPORT doit être impérativement privilégiée dès lors que l’objectif principal du transfert concerne l’extraction de données brutes destinées à alimenter des pipelines de transformation ultérieurs (ETL), à être intégrées dans des bases de données relationnelles ou à servir de matériau matriciel pour des réanalyses ad hoc dans d’autres environnements logiciels. Sa vitesse d’exécution est sans égale, sa consommation de ressources processeur (CPU) et d’espace temporaire de mémoire vive demeure minimale, et elle garantit une absence totale d’interférences visuelles (styles de bordures superflus, fusions de cellules gênantes pour les formules matricielles) au sein des tables sérialisées.
À l’opposé, la destination ODS EXCEL s’impose avec force dès lors que le destinataire du classeur est un comité de pilotage, un panel d’évaluateurs cliniques ou une équipe managériale exigeant un rapport de synthèse directement diffusable, lisible et mis en forme. La possibilité de compiler des tableaux croisés dynamiques préformatés, d’insérer des notes méthodologiques en bas de page et d’intégrer des courbes de survie ou des graphiques de régression confère à ODS une supériorité incontestable sur le plan de la communication scientifique.
Cet arbitrage esthétique doit toutefois être tempéré par des considérations d’empreinte mémoire. Le système ODS construit l’arbre hiérarchique de l’ensemble du document en mémoire tampon avant d’opérer la sérialisation OpenXML définitive. Sur des volumétries d’observations considérables (dépassant plusieurs centaines de milliers de lignes), ODS EXCEL engendre une surconsommation drastique de mémoire vive pouvant provoquer des blocages du sous-système de calcul ou des temps de génération exponentiels. Dans de tels contextes de volumétrie critique, la sobriété mécanique de PROC EXPORT s’affirme comme le seul choix techniquement viable.
10. Résolution des erreurs courantes et gestion des verrous de fichiers
10.1 L’erreur de verrouillage de fichier (File Lock Error)
Au panthéon des incidents techniques interrompant abruptement l’exécution des programmes d’exportation de données SAS vers Excel, l’erreur de verrouillage de ressource (File Lock Error) occupe incontestablement le premier rang par sa fréquence de survenue. Cette défaillance se manifeste dans le journal système par un message d’alerte sans équivoque : « ERROR: Resource temporarily unavailable », « ERROR: Permission denied » ou encore « ERROR: A lock is not available for file… ».
L’étiologie de cette panne informatique réside dans la gestion exclusive des droits d’accès aux fichiers par les systèmes d’exploitation modernes, et plus singulièrement sous Microsoft Windows. Lorsqu’un utilisateur ouvre un classeur Excel au sein de l’application bureautique pour en examiner le contenu, le système d’exploitation attribue un verrou exclusif en écriture au processus EXCEL.EXE afin d’empêcher que deux applications concurrentes ne corrompent simultanément l’intégrité binaire du fichier. Si, dans le même intervalle temporel, une session SAS tente d’exécuter un script PROC EXPORT doté de l’option REPLACE ciblant exactement ce même fichier physique, le sous-système d’entrée-sortie de SAS se heurte à une fin de non-recevoir catégorique de la part du système hôte, provoquant l’interruption immédiate de la transaction.
La résolution de cette impasse opérationnelle requiert des stratégies adaptées au contexte de travail. Sur un poste de travail individuel sous environnement Windows, le premier réflexe de dépannage consiste naturellement à fermer scrupuleusement toute instance active du classeur cible au sein de l’interface Microsoft Excel avant de relancer l’exécution du code SAS. Toutefois, il advient fréquemment qu’une session Excel soit fermée visuellement par l’utilisateur mais qu’un processus résiduel fantôme demeure actif en arrière-plan au sein de la table des tâches du système d’exploitation, maintenant indûment le verrouillage binaire sur le fichier. Dans ce cas de figure, l’analyste doit inspecter le Gestionnaire des tâches de Windows et procéder à l’arrêt forcé du processus EXCEL.EXE orphelin.
Dans les environnements multi-utilisateurs hébergés sur des serveurs distants ou sous des distributions Linux, la libération des verrous orphelins implique le recours à des commandes administratives spécialisées au niveau du terminal système, telles que l’utilitaire fuser ou la commande lsof (List Open Files), permettant d’identifier le processus utilisateur spécifique retenant le descripteur de fichier et d’ordonner sa terminaison contrôlée via l’instruction kill. L’adoption d’une discipline de développement stricte, dissociant systématiquement les répertoires d’écriture de production des répertoires de consultation partagés, prévient en amont la survenue de ces conflits d’accès concurrents.
10.2 Dépassement des limites dimensionnelles et troncature
Une cause majeure d’échec ou d’altération silencieuse des données lors de l’exportation réside dans la confrontation directe avec les limites physiques et structurelles inhérentes à la norme des tableurs. Bien que la transition du format binaire obsolète XLS vers le format OpenXML moderne XLSX ait considérablement repoussé les frontières dimensionnelles, celles-ci demeurent finies et continuent de contraindre rigoureusement la manipulation de grands jeux de données statistiques.
La norme technique actuelle de Microsoft Excel plafonne mathématiquement l’architecture d’une feuille de calcul à un maximum absolu de 1 048 576 lignes d’observations et de 16 384 colonnes de variables. Si une procédure PROC EXPORT est appelée sur une table SAS dont la volumétrie excède ce contingent critique (par exemple une base de données de pharmacovigilance ou de transactions de santé regroupant 1,5 million d’enregistrements), le moteur DBMS=XLSX est incapable de loger le surplus d’enregistrements au sein de la feuille désignée. Selon la révision de maintenance du logiciel, SAS consigne une erreur fatale dans le journal système ou interrompt l’écriture au franchissement de la 1 048 576ème ligne, amputant la table de son résidu sans que l’utilisateur non averti ne s’en rende immédiatement compte s’il ne consulte pas le journal d’exécution.
Une problématique tout aussi insidieuse concerne la troncature scalaire des chaînes de caractères textuelles volumineuses. Au sein d’une cellule de tableur Excel, la spécification logicielle limite la longueur d’une chaîne de texte à un plafond de 32 767 caractères, dont seuls les 1 024 premiers peuvent être affichés visuellement de manière fluide au sein de la grille sans activation de la barre de formule étendue. Si la table SAS contient des variables de texte libres (notes d’investigateurs cliniques, verbatims d’enquêtes ou séquences bio-informatiques sérialisées de très grande longueur), tout dépassement de ces seuils dimensionnels expose la cellule à une troncature pure et simple du message au-delà du seuil critique, détruisant irréversiblement une fraction de la métadonnée textuelle lors de la conversion OpenXML.
10.3 Incohérences de formats et d’encodage de caractères
L’internationalisation des projets de recherche et l’utilisation continue d’alphabets comportant des signes diacritiques complexes (accents aigus, graves, circonflexes, cédilles propres à la langue française ou caractères non latins) révèlent fréquemment des dysfonctionnements subtils lors du passage de SAS vers Microsoft Excel, désignés sous l’appellation d’incohérences d’encodage de caractères.
Ce phénomène prend racine dans la confrontation entre les tables de correspondances numériques des jeux de caractères (code pages). Lorsqu’une station de travail SAS fonctionne sous un encodage mono-octet traditionnel hérité du monde mainframe ou des premiers systèmes Windows (tel que WINDOWS-1252 ou ISO-8859-1 / Latin1), chaque glyphe est codé sur un octet unique. Or, le format contemporain .xlsx s’appuie structurellement sur le standard universel de l’Unicode, et plus précisément sur la transformation multioctets UTF-8 pour sérialiser ses documents XML internes. Si le sous-système de conversion de SAS ne procède pas à une translittération propre des points de code lors de l’exportation, l’ouverture du classeur au sein d’Excel dévoilera des séquences typographiques corrompues (par exemple, « Décès » au lieu de « Décès »).
Pour résoudre méthodologiquement ces discordances et garantir l’intégrité orthographique des libellés scientifiques, plusieurs leviers doivent être actionnés. En premier lieu, il est recommandé de standardiser l’environnement d’exécution de la session SAS sous l’encodage natif UTF-8, configuration qui est désormais le standard des architectures analytiques modernes. En second lieu, au niveau de la procédure PROC EXPORT ou de l’étape de préparation des données, l’utilisation explicite de l’option ENCODING=’UTF-8′ ou de fonctions scalaires de transcodage de chaîne telles que KCVT permet de forcer la conversion des flux textuels vers la nomenclature cible, éradiquant les rejets de lignes consécutifs aux caractères non résolus dans le fichier journal.
Enfin, les erreurs de rejet de lignes au sein du journal d’exécution trouvent parfois leur source dans la présence de caractères de contrôle non imprimables (tels que les tabulations horizontales, les retours chariot ASCII 13 ou les sauts de ligne ASCII 10) involontairement intégrés au sein de variables de type caractère lors de saisies manuelles d’opérateurs. L’application préventive de la fonction de nettoyage COMPBL ou de l’expression régulière PRXCHANGE au sein d’une étape DATA d’assainissement préalable permet de purger la table de tout caractère corrupteur avant le déclenchement de la procédure d’exportation vers le tableur.
11. Optimisation des performances pour l’exportation de données volumineuses
11.1 Filtrage et sélection en amont dans l’étape d’export
Dans le domaine du traitement de données quantitatives, l’optimisation des flux de traitement repose sur un axiome fondamental d’économie computationnelle : la réduction de l’empreinte volumétrique doit être opérée le plus en amont possible au sein du pipeline d’exécution. Exporter l’intégralité d’une table d’entrepôt de données statistiques contenant plusieurs dizaines de millions d’octets et des centaines de colonnes techniques pour n’en exploiter finalement qu’une poignée au sein d’un classeur Excel constitue une gabegie de ressources de calcul et de bande passante d’entrée-sortie.
La procédure PROC EXPORT offre une flexibilité remarquable en autorisant l’utilisation immédiate des options de table SAS directement au sein de la déclaration de l’instruction DATA=. L’analyste peut ainsi encapsuler entre parenthèses les options de sélection de variables DROP= ou KEEP= afin d’élaguer drastiquement le schéma relationnel transmis au moteur d’exportation. En spécifiant par exemple DATA=Projet.Cohorte(KEEP=Patient_ID Age Sexe Statut_Clinique), seules les quatre variables explicitement désignées seront mobilisées en mémoire vive et acheminées vers le constructeur OpenXML, déchargeant le processeur de la gestion de toutes les colonnes intermédiaires résidant dans la table mère.
De même, l’injection de l’option de filtrage conditionnel WHERE= permet de restreindre chirurgicalement le périmètre des observations exportées sans exiger la création préalable d’une table SAS temporaire sur le disque. Une instruction formulée sous la forme DATA=Projet.Mesures(WHERE=(Annee_Suivi = 2023 AND Statut_Validation = ‘COMPLET’)) ordonne au sous-système de lecture de SAS de filtrer les flux d’enregistrements à la volée. Cette approche d’ingénierie réduit de manière drastique l’empreinte mémoire avant même l’écriture sur le disque, limitant le livrable Excel aux strictes observations requises pour la diffusion et préservant les performances globales du serveur de calcul.
11.2 Gestion des index et de la mémoire tampon de SAS
L’optimisation des débits de transfert lors de l’exportation de tables d’envergure intermédiaire ou massive implique une configuration fine des mécanismes d’entrée-sortie (I/O) du moteur SAS et une gouvernance avisée des sous-systèmes de mémoire tampon. La vitesse à laquelle SAS lit les blocs de données sur le stockage sous-jacent et les réencode sous forme de structures XML compressées est directement tributaire du dimensionnement des tampons de communication.
L’utilisation judicieuse de l’option système IBUFSIZE (Index Buffer Size) et de l’option BUFSIZE permet d’ajuster la taille des blocs de transfert de données. Sur des systèmes traitant des volumétries substantielles, assigner une valeur de tampon de lecture plus généreuse (par exemple via OPTIONS BUFSIZE=64K ou BUFSIZE=128K) permet au sous-système de stockage de procéder à des lectures séquentielles par blocs massifs, réduisant considérablement le nombre total d’accès physiques aux têtes de lecture des disques durs ou minimisant la surcharge de requêtes réseau sur les baies de stockage de type SAN ou NAS.
Une attention méticuleuse doit également être accordée à l’interaction entre la compression native des tables SAS et le processus d’exportation. Lorsqu’une table de données est stockée sous une forme compressée dans SAS via l’option COMPRESS=YES (ou COMPRESS=BINARY), le moteur de données SAS doit décompresser chaque page d’enregistrement en mémoire vive avant de pouvoir transmettre les scalaires au pilote DBMS=XLSX. Ce mécanisme de décompression consomme des cycles de processeur substantiels. Si les performances d’exportation s’avèrent critiques, il peut être judicieux de séquencer le flux analytique en décompressant préalablement les données dans une zone de mémoire volatile haute performance avant d’initier la commande de conversion externe.
Enfin, la surveillance de l’espace de stockage alloué à la bibliothèque temporaire SASWORK demeure impérative. Durant la compilation et la constitution de l’archive ZIP encapsulant les fichiers XML constitutifs du classeur XLSX, le pilote DBMS=XLSX instancie des fichiers temporaires volumineux au sein de cet espace de travail. Une saturation inopinée du volume de disque alloué à SASWORK en plein cours d’écriture provoquera l’interruption cataclysmique de la session SAS, ruinant l’opération d’exportation et contraignant à une réinitialisation intégrale des processus.
11.3 Alternative du format délimité pour le Big Data
En dépit des optimisations algorithmiques continues intégrées au sein du pilote DBMS=XLSX, il existe un seuil volumétrique critique au-delà duquel l’utilisation du conteneur Microsoft Excel (.xlsx) cesse d’être méthodologiquement viable ou informatiquement pertinente. Lorsque les tables d’analyse franchissent la barre des plusieurs centaines de milliers d’enregistrements, la charge de traitement imposée par la génération de millions de balises XML textuelles au sein de la structure compressée du fichier XLSX induit une dégradation exponentielle des temps de calcul et une surchauffe de la charge CPU.
Dès lors que la volumétrie approche ou dépasse le million d’enregistrements, l’analyste rigoureux doit abandonner le format de classeur enrichi pour se tourner vers l’alternative universelle offerte par les fichiers texte délimités, au premier rang desquels figure le format CSV (Comma-Separated Values). L’invocation de la procédure PROC EXPORT avec l’argument DBMS=CSV déploie une mécanique d’une efficacité brute inégalée : le moteur écrit séquentiellement les flux d’octets sur le disque avec une surcharge protocolaire quasi nulle, sans compression complexe et sans instanciation de schémas de styles superflus.
Le fichier CSV généré s’affranchit de facto du plafond dimensionnel des 1 048 576 lignes d’Excel, pouvant comporter des dizaines de millions d’observations sans la moindre instabilité logicielle. L’intégration de ces flux de données massives au sein de l’environnement bureautique Microsoft ne s’effectue plus dès lors par une ouverture directe du fichier dans la grille classique du tableur — ce qui provoquerait une troncature immédiate —, mais par l’intermédiaire du composant Microsoft Power Query intégré à Excel.
Power Query ingère les flux de données CSV délimités directement au sein de son modèle relationnel interne en mémoire (technologie VertiPaq / PowerPivot), court-circuitant totalement les limitations dimensionnelles de la grille de calcul bidimensionnelle traditionnelle. L’utilisateur final bénéficie ainsi de la puissance d’exploration analytique et de conception de tableaux croisés dynamiques d’Excel tout en s’appuyant sur un flux d’exportation SAS d’une vélocité et d’une résilience incomparables, scellant la fusion harmonieuse de la performance industrielle et de l’accessibilité décisionnelle.
12. Bonnes pratiques de traçabilité, de conformité et d’intégrité des données
12.1 Documentation systématique du journal d’exécution (Log)
Dans le cadre des protocoles de recherche soumis à des exigences réglementaires strictes — telles que les Bonnes Pratiques Cliniques (BPC) régies par l’ICH ou les normes d’intégrité des données électroniques dictées par le titre 21 CFR Part 11 de la FDA américaine —, une opération de traitement ou de conversion informatique ne possède aucune valeur probante si elle n’est pas assortie d’une preuve d’audit irréfutable attestant de son déroulement sans faille. La documentation systématique du journal d’exécution SAS (SAS Log) constitue le socle fondamental de cette exigence d’imputabilité.
Le journal système ne doit sous aucun prétexte demeurer un artefact volatil affiché temporairement à l’écran de l’environnement de développement avant d’être écrasé par la session suivante. Il convient d’ordonner la sauvegarde programmatique pérenne de ce flux au moyen de l’instruction PROC PRINTTO. En déclarant en amont du pipeline la commande PROC PRINTTO LOG= »/repertoire/journaux/Export_Audit_20231025.log » NEW; puis en rétablissant la redirection standard via PROC PRINTTO; à l’issue de l’exécution, l’intégralité des transactions système, des horodatages à la milliseconde, des décomptes d’enregistrements transférés et des éventuels signaux d’alerte se trouve figée sur un support inaltérable.
Pour parachever l’assurance de non-altération des valeurs de mesures expérimentales entre la base source et le classeur généré, il est hautement recommandé d’implémenter des algorithmes de réconciliation automatisée reposant sur des sommes de contrôle numériques (checksums) ou des totaux de contrôle de variables clés. En calculant au sein de SAS la somme arithmétique globale d’une variable quantitative pivot et en venant confronter programmatiquement ce total de contrôle avec la somme calculée a posteriori sur la feuille Excel, l’analyste apporte la preuve mathématique que la passerelle logicielle n’a induit aucune dérive de précision scalaire, aucun arrondi arbitraire et aucune perte résiduelle d’information au cours du transit numérique.
12.2 Protection et gouvernance des données exportées
La dissémination de jeux de données au travers de tableurs électroniques présente des risques majeurs en matière de sécurité de l’information et de conformité réglementaire. Alors qu’un système analytique SAS d’entreprise bénéficie d’une infrastructure de gouvernance robuste — caractérisée par une authentification centralisée, des contrôles d’accès basés sur les rôles (RBAC) et des pistes d’audit immuables —, un classeur Microsoft Excel exporté sur un poste de travail ou déposé sur un serveur de partage devient un conteneur éminemment mobile, aisément duplicable et hautement vulnérable aux fuites de données accidentelles ou malveillantes.
Dès lors, l’exportation de données statistiques doit être rigoureusement subordonnée au respect des cadres législatifs de protection de la vie privée, au premier rang desquels figure le Règlement Général sur la Protection des Données (RGPD) en vigueur au sein de l’Union européenne, ainsi que la législation HIPAA aux États-Unis pour les informations de santé nominatives. Avant d’engager toute procédure PROC EXPORT, le biostatisticien a l’obligation éthique et légale de procéder à l’anonymisation ou à la pseudonymisation stricte du jeu de données au sein d’une étape de préparation SAS préalable.
Ce protocole implique la purge définitive de toute variable directement identifiante (noms patronymiques, prénoms, adresses postales précises, numéros de sécurité sociale ou coordonnées de contact) au moyen de l’option DROP=. Les variables quasi-identifiantes (telles que les dates de naissance complètes ou les identifiants hospitaliers natifs) doivent être converties en données agrégées (classes d’âge décennales) ou hachées au moyen d’algorithmes cryptographiques irréversibles (tels que la fonction SHA256 intégrée à SAS) couplés à un sel cryptographique sécurisé. Seules les données rigoureusement nécessaires à l’analyse sollicitée doivent franchir la frontière de l’environnement sécurisé SAS vers le tableur de consultation.
12.3 Établissement d’un protocole standardisé d’exportation de laboratoire
La pérennité organisationnelle d’un laboratoire de recherche ou d’un département de biostatistique repose sur sa capacité à s’affranchir des habitudes de programmation disparates propres à chaque individu pour instaurer une culture d’excellence opérationnelle formalisée. L’établissement d’une Procédure Opérationnelle Standardisée (Standard Operating Procedure – SOP) dédiée à l’exportation des données tabulaires constitue la pierre angulaire de cette gouvernance scientifique.
Ce protocole standardisé doit consigner sans ambiguïté les règles d’architecture applicative applicables à tout projet analytique : interdiction formelle des pilotes obsolètes (DBMS=XLS), obligation d’utiliser le pilote DBMS=XLSX nativement documenté, standardisation des conventions de nommage des répertoires et des macro-variables d’ancrage, et vérification scrupuleuse des formats calendaires et décimaux. Tout script analytique destiné à la production d’un livrable officiel doit obligatoirement intégrer le cadre de macro-commandes standardisé du laboratoire, garantissant l’homogénéité structurelle de l’ensemble des productions documentaires de l’équipe.
De surcroît, le protocole de laboratoire doit exiger que chaque classeur Excel exporté soit systématiquement accompagné d’un dictionnaire de données exhaustif (codebook). Ce dictionnaire, qui peut constituer le premier onglet introductif du classeur généré via une étape programmée, détaille de manière chirurgicale la nomenclature de chaque colonne, le type de variable sous-jacent, les unités de mesure physiques associées, la signification univoque de chaque code catégoriel ainsi que la codification retenue pour les valeurs manquantes. Enfin, l’ensemble de ce pipeline analytique, depuis l’ingestion de la donnée brute jusqu’à la sérialisation finale du classeur de restitution, doit être méticuleusement consigné et versionné au sein du Plan de Gestion des Données (Data Management Plan – DMP) du projet de recherche, scellant l’alignement irréprochable de la démarche scientifique avec les principes fondamentaux de transparence, de traçabilité et de reproductibilité de la science contemporaine.
Références
Alliance for Clinical Trials in Oncology. (2020). Best practices for data management and transfer in multi-center clinical trials. Duke University Clinical Research Institute.
Commission Nationale de l’Informatique et des Libertés. (2018). Règlement général sur la protection des données (RGPD) : Guide méthodologique de la sécurité des données personnelles. Éditions des Journaux Officiels. https://www.cnil.fr/fr/reglement-europeen-protection-donnees
International Organization for Standardization. (2016). Information technology — Document description and processing languages — Office Open XML File Formats — Part 1: Fundamentals and Markup Language Reference (ISO/IEC Standard No. 29500-1:2016). https://www.iso.org/standard/71691.html
Microsoft Corporation. (2023). Spécifications et limites relatives à Microsoft Excel. Microsoft Support Documentation. https://support.microsoft.com/fr-fr/office/
SAS Institute Inc. (2019). SAS/ACCESS 9.4 Interface to PC Files: Reference, Fifth Edition. SAS Institute Inc.
SAS Institute Inc. (2021). SAS 9.4 Output Delivery System: User’s Guide, Fifth Edition. SAS Institute Inc. https://documentation.sas.com
SAS Institute Inc. (2022). Base SAS 9.4 Procedures Guide, Seventh Edition. SAS Institute Inc.
U.S. Food and Drug Administration. (2019). Providing regulatory submissions in electronic format: Standardized study data. Center for Drug Evaluation and Research (CDER).
Venable, P. R. (2017). Exchanging data between SAS and Microsoft Excel: Beyond the basics of PROC IMPORT and PROC EXPORT. Proceedings of the SAS Global Forum 2017 Conference, Orlando, FL.
Zender, A. S. (2018). Demystifying the ODS destination for Excel: How to create presentation-ready workbooks without Microsoft Office. Proceedings of the Western Users of SAS Software Conference, Sacramento, CA.