
L’analyse statistique moderne et la science des données reposent sur un écosystème d’outils hautement spécialisés, au sein duquel le langage de programmation statistique R occupe une place prépondérante. Réputé pour sa puissance algorithmique, son extensibilité et sa rigueur mathématique, R permet de manipuler, de modéliser et de visualiser des structures de données complexes avec une précision remarquable. Cependant, l’activité de recherche ne se déroule pas en vase clos : elle s’inscrit au sein d’équipes pluridisciplinaires, d’institutions cliniques, de laboratoires universitaires et d’organisations industrielles où les compétences techniques sont hétérogènes. Dans cet environnement collaboratif, le pont jeté entre les environnements de calcul de pointe et les outils bureautiques traditionnels constitue une composante stratégique du travail analytique.
Le tableur Microsoft Excel demeure le vecteur d’échange d’informations quantitatives le plus universellement répandu dans le tissu professionnel et académique. Bien que les statisticiens privilégient la rigueur non destructive et l’automatisation offertes par les scripts R, la restitution des résultats sous forme de classeurs structurés au format OpenXML (.xlsx) s’avère fréquemment indispensable. Cette exigence pose un défi méthodologique fondamental : comment exporter des structures rectangulaires de données matricielles — communément désignées sous le terme de data frames — depuis R vers des fichiers Excel sans altérer l’intégrité numérique, sans corrompre les métadonnées qualitatives, et tout en maintenant un niveau irréprochable de reproductibilité computationnelle ?
Le présent article propose une analyse approfondie et exhaustive des mécanismes d’exportation de data frames vers des classeurs Excel dans l’environnement R. En explorant tant les considérations conceptuelles liées à la sérialisation des structures tabulaires que les solutions algorithmiques offertes par les bibliothèques logicielles modernes telles que writexl et openxlsx, ce guide offre aux chercheurs, biostatisticiens et analystes de données un protocole méthodique pour fiabiliser leurs flux de travail. Chaque section détaille les étapes techniques, les écueils d’encodage, la gestion des systèmes d’exploitation hôtes et les exigences de standardisation indispensables à la diffusion de résultats scientifiques intègres et pérennes.
1. Introduction et fondements méthodologiques de l’exportation de données sous R
1.1 Le rôle du format Excel dans la communication scientifique et clinique
Dans l’écosystème de la recherche contemporaine, la communication des résultats empiriques représente une étape aussi critique que le recueil des observations ou l’application des modèles inférentiels. Si le langage R offre un cadre idéal pour l’analyse computationnelle grâce à sa capacité à documenter chaque transformation au sein de scripts déterministes, il se heurte régulièrement à une barrière d’accessibilité dès lors qu’il s’agit de partager des données brutes, des résumés statistiques ou des cohortes de patients avec des parties prenantes non initiées à la programmation. Les cliniciens, les décideurs institutionnels, les comités de régulation et les partenaires industriels s’appuient quasi exclusivement sur les tableurs pour examiner les données, effectuer des filtres exploratoires rapides ou intégrer des tableaux dans des rapports exécutifs.
L’interopérabilité entre les logiciels d’analyse quantitative et les tableurs généralistes transcende la simple commodité technique : elle constitue un impératif de transmission du savoir. L’utilisation du format Microsoft Excel (.xlsx), normalisé à l’échelle internationale sous le standard ISO/IEC 29500 (Office Open XML), garantit que les observations compilées dans l’espace de travail vectoriel de R puissent être inspectées instantanément sans nécessiter l’installation d’environnements d’exécution volumineux ou de compilateurs spécialisés. Cette accessibilité universelle réduit les frictions lors des audits cliniques et accélère les processus de prise de décision fondés sur les preuves empiriques.
Néanmoins, cette transition entre un environnement programmatique rigide et un support interactif exige un compromis méthodologique méticuleux. L’analyste doit préserver la fidélité de ses analyses quantitatives tout en fournissant une restitution synthétique ergonomique. L’enjeu consiste à concevoir une procédure d’exportation qui ne sacrifie ni la précision numérique des estimateurs statistiques, ni la clarté taxonomique des variables observées, instaurant ainsi un dialogue fluide entre la complexité de l’environnement R et la flexibilité d’Excel.
1.2 Panorama des formats de sérialisation : CSV contre formats natifs Excel
Pour exporter des structures de données tabulaires, les praticiens sont fréquemment confrontés au choix binaire entre les fichiers texte délimités, principalement les formats Comma-Separated Values (CSV), et les formats binaires ou compressés natifs tels que le format .xlsx. Les fichiers CSV ont longtemps constitué l’étalon-or de la portabilité en raison de leur extrême simplicité structurelle : de simples flux de caractères ASCII ou UTF-8 séparés par des virgules ou des points-virgules. Cependant, cette simplicité même engendre des limitations fonctionnelles sévères lorsque la complexité du protocole expérimental augmente.
La première contrainte des fichiers CSV réside dans leur incapacité intrinsèque à supporter le partitionnement multi-tables au sein d’un document unifié. Là où un classeur Excel permet d’organiser logiquement plusieurs feuilles de calcul (par exemple, pour héberger séparément les données démographiques, les dosages biologiques et le dictionnaire des variables), le format CSV impose la multiplication de fichiers textuels isolés. Cette dispersion physique augmente substantiellement le risque de désynchronisation des versions ou de perte accidentelle d’une partie du jeu de données lors des transferts par voie électronique.
En second lieu, la préservation de la typologie des colonnes s’avère particulièrement vulnérable lors de l’ouverture d’un fichier CSV par un tableur. Les logiciels comme Microsoft Excel appliquent des heuristiques d’inférence de type automatiques lors de l’importation de texte brut, conduisant fréquemment à des altérations catastrophiques : conversion involontaire d’identifiants génétiques en dates calendaires, suppression des zéros non significatifs initiaux au sein des codes postaux ou des numéros d’inclusion, ou interprétation erronée des séparateurs décimaux en fonction de la localisation linguistique du système hôte. À l’inverse, le conteneur .xlsx encapsule des définitions explicites de types de cellules au sein de son architecture XML zippée, offrant une protection substantiellement plus robuste contre ces réinterprétations arbitraires.
1.3 Objectifs du protocole d’exportation et reproductibilité de la recherche
Dans le contexte actuel de la crise de la reproductibilité qui traverse les sciences empiriques, l’exportation des données ne doit jamais être reléguée au rang d’opération administrative secondaire exécutée à la hâte. Un pipeline de traitement de données rigoureux requiert que chaque étape, depuis l’acquisition initiale jusqu’à la livraison finale des classeurs, soit entièrement automatisée, documentée et reproductible. Les manipulations manuelles réalisées a posteriori dans un tableur — telles que l’ajustement interactif de colonnes, la suppression manuelle de lignes erronées ou la copie de segments tabulaires — introduisent des sources directes d’erreur humaine impossibles à tracer dans un cahier de laboratoire électronique.
La standardisation du protocole d’exportation via des fonctions programmatiques programmées dans R élimine ces interventions opportunistes. En codifiant explicitement les paramètres de sortie — la nomenclature des feuilles, la gestion des codes d’absence et la structure des variables —, l’analyste crée un flux déterministe. Chaque exécution du script engendre un document strictement identique, garantissant ainsi l’alignement absolu entre les résultats exposés dans les publications et les données sources distribuées.
De surcroît, la transparence méthodologique exige que l’exportation intègre non seulement les données numériques primaires, mais également des métadonnées contextuelles. Un protocole reproductible vise à produire des classeurs autonomes (self-contained workbooks) contenant leur propre documentation méthodologique, limitant ainsi les risques d’interprétations erronées de la part des collaborateurs externes. Cette rigueur algorithmique constitue le garant fondamental de la confiance accordée aux conclusions scientifiques qui émergent de ces flux analytiques.
2. Anatomie d’un Data Frame en R et préparation préalable à l’exportation
2.1 Typage des variables et cohérence interne des vecteurs atomiques
Avant d’initier la moindre opération de sérialisation vers un fichier externe, il est impératif de procéder à un examen structurel approfondi de l’objet R manipulé. Au niveau interne, un data frame standard (classe data.frame) ou un tibble moderne (classe tbl_df issu de l’écosystème Tidyverse) est une liste de vecteurs atomiques de même longueur, dotée d’attributs de noms de colonnes et de noms de lignes. La première étape de l’audit préparatoire concerne la cohérence du typage de ces vecteurs atomiques : vecteurs réels (double), entiers (integer), logiques (logical), chaînes de caractères (character) et facteurs (factor).
Les variables catégorielles encapsulées sous forme de facteurs méritent une attention spécifique. Dans le modèle de données de R, un facteur est stocké de manière compacte sous la forme d’un vecteur d’entiers sous-jacents associé à un vecteur d’étiquettes textuelles (attribut levels). Si l’on ne prend pas la précaution de clarifier le comportement attendu lors de l’exportation, certaines fonctions de conversion rudimentaires peuvent exporter la valeur numérique de l’indice plutôt que le libellé textuel correspondant, ce qui altère gravement l’intelligibilité des groupes cliniques ou expérimentaux. Une conversion explicite via la fonction as.character() s’impose si l’on souhaite garantir la persistance textuelle des modalités, à moins que la bibliothèque d’exportation utilisée ne prenne en charge nativement cette déréférenciation.
De manière similaire, les vecteurs temporels constituent un foyer classique d’incohérences. R implémente deux classes fondamentales pour la gestion chronologique : la classe Date (représentant le nombre de jours écoulés depuis le 1er janvier 1970) et la classe POSIXct (représentant le nombre de secondes écoulées depuis la même date de référence, avec gestion intégrée du fuseau horaire). Lors du transfert vers Excel, ces horodatages doivent être validés pour éviter qu’ils ne soient traduits en de simples entiers arithmétiques. Il convient de s’assurer que les valeurs temporelles sont normalisées dans un fuseau de référence clair (idéalement le temps universel coordonné, UTC) avant la phase d’écriture physique sur disque.
2.2 Harmonisation des identifiants et des métadonnées de variables
L’intégrité de la présentation tabulaire dépend substantiellement de la propreté formelle des identifiants de colonnes. En R, les règles syntaxiques relatives aux noms de variables sont relativement permissives, autorisant des caractères spéciaux, des espaces ou des points si les identifiants sont délimités par des accents graves. Toutefois, le transfert vers un tableur tiers impose une discipline de nommage rigoureuse. L’utilisation de caractères diacritiques non standard (accents, cédilles) ou de caractères de contrôle dans les en-têtes de colonnes est susceptible d’engendrer des corruptions de schéma lors de l’importation de ces classeurs dans d’autres plateformes de bio-informatique ou des bases de données relationnelles (SQL).
Une recommandation éprouvée consiste à adopter une convention de casse uniforme, telle que le snake_case (par exemple, pression_arterielle_systolique) ou le camelCase, en proscrivant les espaces intercalaires et les barres obliques. L’application de fonctions d’assainissement syntaxique, à l’image des utilitaires fournis par le package janitor, permet de transformer automatiquement des intitulés désordonnés en vecteurs lexicaux fiables.
Un autre point de friction réside dans le traitement des noms de lignes (row.names). Historiquement, les data frames de R conservent des étiquettes d’identification des observations au sein d’un attribut dédié qui ne constitue pas une colonne de données explicite. Cette convention est source de nombreuses confusions lors de l’exportation vers Excel, car la plupart des protocoles modernes négligent purement et simplement cet attribut, entraînant la perte des identifiants de sujets si ceux-ci n’ont pas été explicitement convertis en une variable autonome. L’analyste doit impérativement migrer les row.names vers une colonne formalisée (exécutable via la fonction tibble::rownames_to_column() ou une extraction basique df$identifiant <- rownames(df)) afin de sanctuariser la traçabilité de chaque enregistrement.
2.3 Création d’un ensemble de données empirique représentatif pour les démonstrations
Afin de concrétiser les démonstrations méthodologiques tout au long de cette étude, nous définissons un jeu de données empirique synthétique, représentatif d’une cohorte clinique en psychométrie et neurosciences cognitives. Cet ensemble d’observations comporte des variables quantitatives continues, des indices discrets, des facteurs nominaux et ordinaux, des dates d’évaluation et des valeurs manquantes sciemment positionnées pour tester la robustesse des protocoles d’exportation.
Considérons une cohorte longitudinale comprenant cinquante sujets évalués sur des épreuves de mémoire de travail et d’attention sélective, répartis entre un groupe témoin et deux bras d’intervention thérapeutique. Les variables enregistrées incluent l’identifiant unique du patient (chaîne textuelle normalisée), l’âge chronologique (valeur entière), le sexe biologique (facteur à deux niveaux), la date précise de passation des tests (classe Date), le score standardisé au test psychométrique (valeur continue flottante), le statut de conformité au protocole (booléen) et une évaluation clinique globale (facteur ordonné).
L’inspection structurelle systématique de cet objet à l’aide des fonctions standards du système R de base — notamment str() pour révéler l’architecture interne des vecteurs et summary() pour examiner la dispersion et la présence éventuelle de non-valeurs — constitue le prérequis obligatoire avant tout ordre d’exportation. Cette validation préliminaire permet également de certifier l’absence de colonnes complexes imbriquées (list-columns) ou d’objets matrices multidimensionnels qui briseraient la rectangularité stricte indispensable à l’écriture au sein d’un feuillet Excel standard.
3. Le package writexl : Architecture, avantages et spécificités techniques
3.1 Indépendance vis-à-vis des environnements Java et bibliothèques tierces
Pendant de nombreuses années, l’exportation de données vers des formats propriétaires ou semi-propriétaires de la suite bureautique Microsoft constituait une épreuve technique notoire pour la communauté R. Les solutions historiques s’appuyaient principalement sur des couches logicielles intermédiaires, au premier rang desquelles figurait le package xlsx, qui reposait lui-même sur une interface de liaison avec la machine virtuelle Java (via le package rJava) et la bibliothèque Apache POI. Ce paradigme architectural entraînait une instabilité systémique considérable.
Les difficultés récurrentes d’alignement entre les versions 32-bit et 64-bit de la machine Java Runtime Environment (JRE), les blocages de compilation sur les distributions Linux de calcul haute performance, et les alertes de sécurité récurrentes relatives aux liaisons dynamiques ont motivé le développement d’une nouvelle génération d’outils. C’est dans ce contexte de refonte que le package writexl, développé par Jeroen Ooms sous l’égide du consortium rOpenSci, s’est imposé comme une révolution technique majeure.
L’avantage décisif de writexl réside dans son autonomie absolue : il est entièrement dépourvu de dépendances logicielles externes lourdes. Le package ne requiert ni l’installation de Java, ni la présence de Microsoft Excel ou de bibliothèques tierces sur la machine hôte. Son architecture repose sur une intégration étroite en C natif avec la bibliothèque légère libxlsxwriter, conçue spécifiquement pour la création déterministe et ultra-rapide de classeurs au format Excel 2007+ XLSX. Cette conception épurée garantit une portabilité sans faille, que le script soit exécuté sur un poste de travail sous macOS, une machine Windows ou un conteneur Docker orchestré sur un cluster distant.
3.2 Architecture fonctionnelle de la commande write_xlsx()
Le package writexl se caractérise par une interface de programmation délibérément minimaliste, focalisée sur une mission unique accomplie avec un niveau d’optimisation exceptionnel : l’écriture de données tabulaires. Le cœur opérationnel du package est concentré dans une fonction principale unique : write_xlsx(). Cette signature compacte évite la surcharge cognitive associée à des frameworks plus volumineux et minimise la surface d’erreurs potentielles dans les scripts d’analyse.
La fonction accepte principalement trois arguments structurants : le paramètre x, qui désigne le data frame individuel ou la liste nommée de data frames à exporter ; le paramètre path, qui spécifie le chemin du fichier cible sur le disque dur ; et le paramètre col_names, un opérateur booléen déterminant si la première ligne du classeur doit héberger les intitulés des variables. D’autres arguments avancés, tels que format_headers, permettent d’indiquer si les en-têtes doivent être stylisés avec une graisse renforcée et une mise en page spécifique conforme aux conventions de lecture humaine.
Sur le plan mécanique, lors de l’appel de write_xlsx(), les structures de données vectorielles de R sont immédiatement transférées à la couche C sous-jacente sans passer par une sérialisation textuelle intermédiaire. Chaque vecteur atomique est converti de manière déterministe dans le type de cellule OpenXML équivalent : les nombres réels deviennent des cellules numériques standard (permettant aux utilisateurs d’Excel d’appliquer immédiatement des formules sans avertissement de conversion textuelle), les chaînes deviennent des éléments de chaînes partagées (Shared Strings) pour minimiser la redondance textuelle dans le fichier compressé, et les booléens sont transcrits en valeurs logiques natives.
3.3 Efficacité mémoire et vitesse d’exécution comparée
L’un des arguments techniques les plus probants en faveur de l’adoption de writexl réside dans sa gestion exemplaire des ressources système, en particulier de la mémoire vive (RAM). La sérialisation de jeux de données massifs — comprenant plusieurs centaines de milliers de lignes — provoque fréquemment des saturations brutales de mémoire lorsque les outils intermédiaires instancient de multiples copies des données sous forme d’arborescences Document Object Model (DOM) en mémoire vive avant de les consigner sur disque.
La bibliothèque libxlsxwriter intégrée dans writexl fonctionne sur un principe de flux continu (streaming). Les enregistrements tabulaires sont convertis et compressés au format ZIP/XML de manière incrémentale au fur et à mesure de l’itération à travers le data frame R. Cette approche en flux direct permet de maintenir une empreinte mémoire volatile extrêmement basse, indépendante de la profondeur d’échantillonnage de la matrice à exporter. Le ramasse-miettes (garbage collector) de R n’est ainsi soumis à aucune pression anormale pendant l’opération d’écriture.
Les bancs d’essai comparatifs (benchmarks) démontrent systématiquement que writexl surpasse ses concurrents historiques d’un ordre de grandeur en termes de temps d’exécution cpu pur. Alors que l’ancien package xlsx pouvait nécessiter plusieurs minutes pour exporter une table de 100 000 lignes tout en risquant une exception de type OutOfMemoryError liée au tas de la machine virtuelle Java, writexl accomplit la même tâche en quelques fractions de seconde, garantissant une intégration sans ralentissement au sein des pipelines d’intégration continue et des rapports automatisés.
4. Mise en œuvre fondamentale : Installation et première exportation avec writexl
4.1 Procédure d’installation et chargement de l’environnement de travail
L’initialisation d’un environnement de travail dédié à l’exportation de données implique l’acquisition propre du package depuis le Comprehensive R Archive Network (CRAN). La commande d’installation standard s’exécute de manière triviale dans la console ou au sein d’un script d’approvisionnement d’environnement :
install.packages(« writexl »)
Dans un contexte d’infrastructure gérée ou d’utilisation en entreprise, il est fortement conseillé de consigner explicitement la version installée pour préserver l’immuabilité du comportement logiciel dans le temps. Une fois les binaires déployés dans la bibliothèque locale de l’interpréteur, le chargement de l’espace de noms s’opère conventionnellement à l’aide de l’instruction library(writexl).
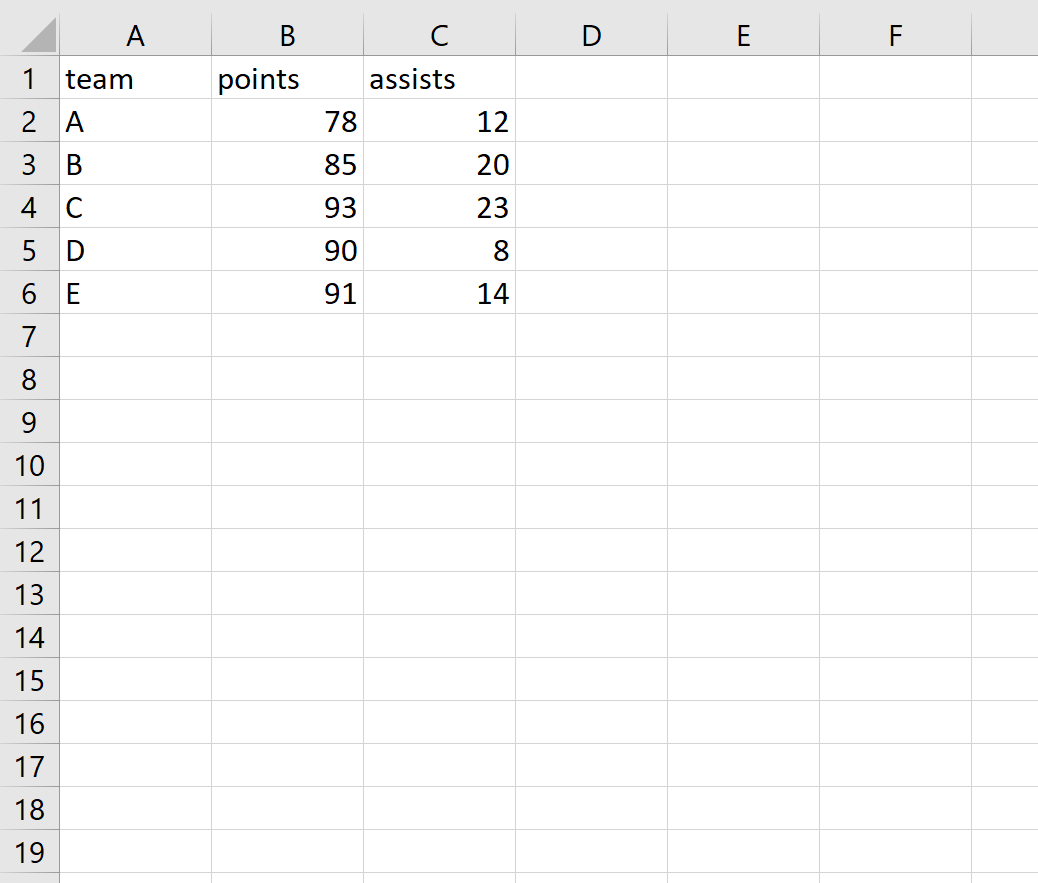
Pour assurer la rigueur du processus d’analyse, il est recommandé de travailler dans une session R propre, débarrassée de résidus mémoriels d’exécutions antérieures. L’analyste s’assurera également que l’environnement de travail de base (working directory) est formellement identifié via la fonction getwd(), évitant ainsi toute dispersion involontaire des artéfacts générés dans des dossiers système imprévus.
4.2 Exécution d’une exportation basique pas à pas
Une fois l’environnement configuré et le data frame de démonstration chargé en mémoire vive, l’exportation s’effectue par une instruction unitaire et directe. Supposons que notre tableau de données cliniques soit stocké dans une variable nommée donnees_cliniques. La sérialisation vers le répertoire de travail actuel est déclenchée par la syntaxe suivante :
write_xlsx(x = donnees_cliniques, path = « resultats_cliniques.xlsx »)
Cette commande exécute séquentiellement plusieurs opérations de bas niveau. Elle valide l’existence du chemin spécifié, alloue les structures de la bibliothèque C, parcourt l’ensemble des colonnes atomiques du data frame R pour en déduire les balises XML appropriées, et assemble l’archive conteneur sous la norme OpenXML avant de finaliser l’écriture sur le disque de la machine hôte.
Dès l’achèvement de l’appel de fonction, l’intégrité de l’artéfact produit doit être contrôlée de manière programmatique. L’interrogation du système de fichiers à l’aide de la fonction R de base file.exists("resultats_cliniques.xlsx") permet de certifier l’existence physique du document. Il est également salutaire de vérifier immédiatement la taille du fichier via file.info("resultats_cliniques.xlsx")$size afin de s’assurer que le fichier ne présente pas une taille anormale de zéro octet, symptôme d’un verrouillage système au moment du vidage du tampon d’écriture.
4.3 Contrôle des paramètres par défaut de mise en page
Le comportement intrinsèque de write_xlsx() a été conçu pour produire un résultat directement exploitable par un lecteur humain sans nécessiter de retouches manuelles subséquentes. Par défaut, la fonction active l’argument format_headers = TRUE. Cette option stylise automatiquement la ligne d’en-tête du classeur en appliquant une typographie en graisse renforcée (bold) et en délimitant les cellules supérieures d’une bordure inférieure discrète, différenciant visuellement la nomenclature des champs du corps des observations quantitatives.
Un autre avantage majeur réside dans la gestion des séparateurs décimaux. Au sein du format XLSX généré par writexl, les valeurs numériques flottantes sont consignées selon la représentation binaire IEEE 754 standardisée sous les spécifications OpenXML. En conséquence, l’affichage des décimales (qu’il s’agisse d’un point décimal anglo-saxon ou d’une virgule décimale européenne) n’est pas codé en dur sous forme de texte, mais s’adapte dynamiquement aux paramètres régionaux du système d’exploitation de l’utilisateur final qui ouvre le fichier dans Microsoft Excel, Apple Numbers ou LibreOffice Calc.
Enfin, la casse d’origine des intitulés de colonnes est rigoureusement préservée. Contrairement à certains outils d’exportation historiques qui convertissaient arbitrairement les en-têtes en majuscules ou remplaçaient les caractères non alphabétiques par des points, writexl garantit une homologie stricte entre les chaînes de caractères déclarées dans le vecteur names(df) et les cellules de la première ligne du classeur.
5. Gestion rigoureuse des chemins d’accès et particularités des systèmes d’exploitation
5.1 Désambiguïsation des séparateurs de répertoires sous Microsoft Windows
La désignation de l’emplacement de sauvegarde d’un fichier constitue l’une des sources les plus courantes d’échec d’exécution dans les scripts R, tout particulièrement lors du déploiement d’analyses sur des plateformes Microsoft Windows. L’origine de cette vulnérabilité réside dans la divergence fondamentale des conventions de séparation des dossiers au sein de l’arborescence des systèmes de fichiers.
Alors que les systèmes de la famille UNIX — incluant les distributions Linux et Apple macOS — utilisent exclusivement la barre oblique (slash, /) pour délimiter les répertoires, l’architecture Windows exploite historiquement la barre oblique inversée (backslash, ). Or, dans la syntaxe formelle de R, l’antislash est un caractère d’échappement sémantique réservé, utilisé pour définir des séquences spéciales (telles que n pour le saut de ligne ou t pour la tabulation).
Par conséquent, l’inclusion littérale d’un chemin copié directement depuis l’explorateur Windows, tel que path = "C:UsersAnalysteDocumentsexport.xlsx", provoque une erreur de compilation immédiate lors de l’analyse syntaxique du script :
Error: ‘U’ used without hex digits in character string starting « »C:U »
Pour contourner ce piège, l’analyste doit impérativement adopter l’une des deux solutions suivantes : soit doubler systématiquement chaque barre oblique inversée pour annuler l’échappement (path = "C:UsersAnalysteDocumentsexport.xlsx"), soit, de manière largement préférable, adopter universellement la barre oblique simple (path = "C:/Users/Analyste/Documents/export.xlsx"). Le moteur d’exécution de R sous Windows est nativement conçu pour traduire de manière transparente les barres obliques simples en appels système compatibles avec les API Win32 sous-jacentes.
5.2 Construction dynamique et robuste des arborescences de fichiers
L’écriture en dur de chemins absolus (hardcoding) au sein des scripts de recherche représente une violation caractérisée des bonnes pratiques de programmation scientifique. Un script contenant une référence statique à un disque local spécifique devient instantanément inopérant dès lors qu’il est exécuté sur la machine d’un confrère ou au sein d’une infrastructure d’intégration continue distante.
La construction sémantique des arborescences doit être déléguée à des fonctions spécialisées d’abstraction de chemins d’accès. La commande R de base file.path() permet de concaténer des chaînes de caractères représentant des répertoires successifs en intercalant automatiquement le séparateur approprié au système d’exploitation en cours d’utilisation :
dossier_sortie <- file.path(« analyses », « livrables », « cohortes »)
chemin_fichier <- file.path(dossier_sortie, « tableau_final.xlsx »)
Pour une robustesse encore plus poussée, l’intégration du package here est hautement préconisée dans le cadre de projets structurés sous RStudio ou Git. La fonction here::here("analyses", "livrables", "tableau_final.xlsx") détermine dynamiquement la racine du projet à partir de la présence de fichiers sentinelles (tels qu’un fichier .Rproj ou un dossier caché .git), rendant le pipeline d’exportation totalement indépendant de l’emplacement physique du répertoire racine sur l’ordinateur de l’utilisateur.
Préalablement à toute tentative d’écriture, l’analyste consciencieux vérifiera toujours l’existence programmatique du répertoire de destination à l’aide de dir.exists(). Si le répertoire cible s’avère absent, l’invocation conditionnelle de dir.create(dossier_sortie, recursive = TRUE) permet d’engendrer l’ensemble des branches manquantes de l’arborescence, empêchant ainsi la levée d’une exception fatale d’écriture lors de l’exécution de la fonction write_xlsx().
5.3 Droits d’accès, permissions système et blocages de fichiers ouverts
Même lorsque la syntaxe du chemin est irréprochable, l’interaction avec le système d’exploitation hôte peut se heurter à des restrictions d’E/S (Entrées/Sorties) au moment de l’accès aux blocs de stockage physique. L’écueil le plus fréquent en milieu professionnel survient lorsqu’un analyste tente d’écraser un classeur Excel existant alors que ce même fichier est simultanément ouvert en lecture ou édition dans l’application Microsoft Excel locale.
Contrairement aux systèmes d’exploitation de type POSIX qui autorisent sous certaines conditions la réécriture ou la suppression de descripteurs de fichiers actifs, l’environnement Windows applique un verrouillage exclusif strict (file locking) sur tout classeur ouvert par la suite logicielle Office. Si R tente d’exécuter un appel d’écriture sur ce fichier ciblé, le système hôte rejettera l’opération et déclenchera une erreur explicite :
Error: Failed to open file … for writing: Permission denied
Il est donc essentiel d’anticiper cette contrainte au sein des scripts automatisés. Une démarche défensive consiste à isoler l’appel d’écriture au sein d’une structure de capture d’erreur de type tryCatch(). Si l’accès est refusé en raison d’un verrouillage actif, le script peut alors soit émettre un message explicatif invitant l’utilisateur à clore son instance d’Excel, soit dériver dynamiquement le flux d’exportation vers un nom de fichier horodaté alternatif pour éviter la perte des données calculées en mémoire vive.
Enfin, lors d’exécutions sur des serveurs d’établissement, des lecteurs réseau d’entreprise (montages SMB/NFS) ou des zones de stockage cloud synchronisées (SharePoint, OneDrive, Dropbox), des mécanismes de synchronisation asynchrones peuvent interférer avec la création de fichiers binaires. L’attribution correcte des privilèges de lecture/écriture dans le répertoire hôte et la prise en compte des délais de latence réseau représentent des précautions indispensables à la stabilité du protocole d’exportation.
6. Techniques avancées avec writexl : Feuilles multiples et métadonnées
6.1 Exportation coordonnée de tables multiples dans un classeur unique
L’un des avantages compétitifs majeurs d’un classeur au format .xlsx réside dans sa structure modulaire en onglets multiples. Dans le cadre d’un essai comparatif ou d’une recherche observationnelle, il est courant de vouloir segmenter les différents niveaux d’abstraction analytique au sein d’un document unifié : par exemple, le jeu complet des données individuelles brutes dans une première feuille, les statistiques descriptives univariées dans une seconde, et les estimations des coefficients d’un modèle de régression dans une troisième.
Le package writexl répond à cette exigence méthodologique avec une élégance algorithmique remarquable grâce à l’exploitation des listes nommées (named lists) du langage R. Lorsque l’argument x transmis à la fonction write_xlsx() n’est plus un data frame unique, mais une liste contenant plusieurs tables de données, la fonction interprète chaque élément de la liste comme une feuille de calcul indépendante :
classeur_recherche <- list(
« Donnees_Brutes » = table_individus,
« Statistiques_Descriptives » = table_resumes,
« Modeles_Regresseurs » = table_parametres
)
write_xlsx(x = classeur_recherche, path = « Rapport_Analytique_Global.xlsx »)
Le mécanisme sous-jacent utilise impérativement les étiquettes textuelles de la liste (les clés associées à chaque élément) pour nommer les onglets correspondants dans l’arborescence OpenXML du classeur. Si l’analyste transmet une liste anonyme (dépourvue de noms d’attributs), writexl attribuera par défaut des libellés génériques de type « Sheet1 », « Sheet2 », réduisant substantiellement la clarté du livrable.
6.2 Configuration des colonnes et ajustements de présentation intégrés
Bien que le rôle principal de writexl soit de maximiser la vitesse d’écriture sans complexité de mise en forme superflue, la fonction met à disposition des commutateurs de configuration qui améliorent grandement le confort visuel du document final. L’argument col_names, positionné par défaut à TRUE, peut être désactivé si l’on souhaite exporter des matrices numériques pures sans étiquettes d’en-tête, ce qui s’avère parfois nécessaire pour alimenter des logiciels de calcul tiers qui attendent des grilles homogènes d’observations continues.
L’optimisation ergonomique passe également par la prévention des chevauchements textuels. Dans un fichier Excel généré sans soin particulier, les colonnes adoptent une largeur standardisée invariable, ce qui contraint l’utilisateur final à double-cliquer manuellement sur les séparateurs d’en-têtes pour lire les libellés de variables longs ou les phrases qualitatives détaillées. Dans ses versions récentes, writexl intègre un algorithme d’inférence de largeur qui ajuste automatiquement la dimension horizontale des colonnes à la longueur maximale des chaînes de caractères détectées, assurant une lisibilité immédiate dès l’ouverture du fichier.
Une bonne pratique académique incontournable consiste à inclure, au sein du classeur multi-feuilles, un onglet dédié explicitement au dictionnaire des variables (Codebook). Cette feuille méthodologique consigne la définition opérationnelle de chaque colonne présente dans le classeur, les unités de mesure physiques correspondantes (ex. milligrammes par décilitre, millisecondes), les seuils de normalité clinique et les abréviations utilisées. En encapsulant ces métadonnées directement aux côtés des données quantitatives, l’analyste élimine l’ambiguïté sémantique et sécurise l’exploitation de ses résultats par les chercheurs tiers.
6.3 Contrôle de l’ordre d’apparition des sous-ensembles de variables
La hiérarchie spatiale au sein d’un document quantitatif n’est jamais neutre : elle dicte la cinématique de lecture et guide la compréhension cognitive des évaluateurs. L’ordonnancement des feuilles dans le classeur final reflète fidèlement la disposition séquentielle des objets au sein de la liste R sous-jacente. Il incombe donc à l’analyste de trier méthodiquement les éléments de sa liste en amont de l’appel d’écriture.
Une structure de communication optimale place généralement la feuille de synthèse ou le dictionnaire des variables en position inaugurale (premier onglet visible à l’ouverture du document), suivi des tableaux agrégés des résultats principaux, puis, en dernière position, du registre complet des données brutes micro-économiques ou individuelles. Cette structuration s’obtient aisément en R par réindexation explicite du vecteur des clés de liste :
ordre_onglets <- c(« Documentation », « Synthese_Regroupement », « Enregistrements_Detailles »)
classeur_ordonne <- classeur_source[ordre_onglets]
write_xlsx(classeur_ordonne, « Etude_Structuree.xlsx »)
De surcroît, la cohérence interne des observations individuelles à l’intérieur de chaque feuille doit être verrouillée. Tout tri d’observation — par exemple, un classement chronologique selon la date d’inclusion ou un tri hiérarchique par centre hospitalier investigateur et identifiant patient — doit être impérativement exécuté en mémoire vive sous R (via la fonction order() ou le verbe arrange() de dplyr) préalablement à la phase de compilation. Cette précaution garantit que la disposition des lignes n’est pas laissée au hasard de l’ordre d’indexation interne de la machine hôte.
7. L’alternative openxlsx : Contrôle stylistique et manipulation programmatique fine
7.1 Présentation du paradigme objet et architecture d’openxlsx
Tandis que le package writexl privilégie une philosophie fonctionnaliste d’exécution unitaire sans dépendances, certains protocoles de valorisation des données exigent un contrôle esthétique et typographique complet sur le classeur généré. La production de tableaux de bord financiers, de documents soumis aux autorités sanitaires ou de tables directement publiables selon les normes de l’American Psychological Association (APA) nécessite d’intervenir sur les bordures, le tramage des cellules, l’alignement typographique et les formats numériques conditionnels.
Pour répondre à ces exigences sophistiquées, le package openxlsx constitue une solution de référence. Tout comme writexl, il s’affranchit totalement de Java en s’appuyant sur des modules natifs C++ (via Rcpp) pour la génération des structures OpenXML. Toutefois, son architecture logicielle se distingue par l’adoption d’un paradigme orienté objet. Au lieu d’écrire directement un data frame sur le disque en un seul appel fonctionnel, openxlsx permet de construire et de manipuler un objet en mémoire représentant le classeur dans son intégralité : la classe Workbook.
Ce modèle procédural s’articule en une succession d’étapes programmatiques maîtrisées :
- Création d’un objet classeur vierge via l’instruction
wb <- createWorkbook(). - Allocation séquentielle de feuilles de calcul au moyen de la fonction
addWorksheet(wb, "Nom_Onglet"). - Injection chirurgicale de sous-ensembles de données ou de matrices à des coordonnées cellulaires précises via
writeData()ouwriteDataTable(). - Application de couches de styles typographiques préalablement compilées sur des plages de cellules spécifiées (
addStyle()). - Sérialisation et persistance finale de l’objet manipulé sur disque avec
saveWorkbook(wb, "chemin.xlsx", overwrite = TRUE).
7.2 Application de styles typographiques, bordures et formats numériques
La véritable puissance de travail déployée par openxlsx réside dans sa capacité à paramétrer des styles granulaires. À l’aide de la fonction createStyle(), le chercheur dispose d’une latitude totale pour configurer l’apparence des cellules : sélection de polices de caractères institutionnelles (ex. Calibri, Times New Roman, Arial), calibrage précis de la taille de police, activation de la graisse ou de l’italique, justification textuelle et coloration des fonds cellulaires via des codes hexadécimaux RVB standardisés.
Les bordures de cellules, indispensables à la structuration formelle des tables scientifiques, peuvent être configurées pour respecter scrupuleusement les canons visuels académiques : bordures horizontales épaisses pour encadrer la ligne d’en-tête et la ligne terminale de totalisation, et absence de bordures verticales intérieures, conformément aux chartes graphiques de publications biomédicales renommées. L’application de ces bordures se réalise en ciblant des zones matricielles par leurs coordonnées de lignes (rows) et de colonnes (cols).
Un autre atout fondamental concerne le formatage numérique explicite. Sans modifier la valeur mathématique sous-jacente stockée dans la cellule Excel (ce qui préserve l’exactitude des calculs futurs), openxlsx permet d’imposer un masque de présentation typographique :
style_decimale <- createStyle(numFmt = « 0.000 »)
addStyle(wb, sheet = 1, style = style_decimale, rows = 2:51, cols = 4, gridExpand = TRUE)
Cette commande assure que les scores statistiques ou les p-valeurs affichent systématiquement trois décimales après la virgule, y compris lorsque les derniers chiffres sont des zéros non significatifs, respectant ainsi rigoureusement les préconisations métrologiques internationales sans recourir à des arrondis destructeurs dans les données R sources.
7.3 Insertion d’éléments graphiques et d’annotations calculées
Au-delà de la manipulation textuelle et numérique brute, openxlsx transcende les capacités des outils conventionnels d’exportation en permettant l’intégration transparente de figures visuelles et de logiques calculatoires internes au sein des classeurs OpenXML.
Sur le plan de l’illustration graphique, les diagrammes conçus avec le moteur de rendu graphique vectoriel ggplot2 peuvent être insérés directement sur n’importe quel onglet du classeur sans passer par des copies manuelles fastidieuses. La fonction insertPlot() intercepte le dispositif graphique actif de la session R et projette l’image compilée au format vectoriel ou raster à un emplacement de cellule précisément déterminé (spécification de la ligne de départ startRow et de la colonne de départ startCol), produisant ainsi des livrables de haute tenue qui unifient analyses quantitatives et représentations géométriques de dispersion.
Concernant les formules de calcul, l’analyste peut déléguer des évaluations arithmétiques au moteur de calcul interne de Microsoft Excel. À l’aide de l’instruction writeFormula(), il est envisageable d’injecter des expressions textuelles telles que SUM(C2:C50) ou AVERAGE(D2:D50) au bas des colonnes de données. Ces formules seront évaluées dynamiquement dès l’ouverture du fichier par le destinataire, permettant une actualisation immédiate des agrégats si l’utilisateur modifie interactivement certaines observations.
Enfin, openxlsx offre des fonctions de gouvernance des données, incluant la protection sélective des feuilles de calcul par mot de passe via protectWorksheet(). Cette fonctionnalité permet de verrouiller les cellules contenant des formules ou des données d’essais cliniques certifiées tout en laissant certaines zones accessibles à la saisie de commentaires, dressant un rempart efficace contre les modifications involontaires de tiers.
8. Comparatif technique des bibliothèques R dédiées aux formats tabulaires
8.1 writexl versus openxlsx : Critères objectifs de sélection
Le choix entre writexl et openxlsx ne doit pas être guidé par des préférences subjectives, mais par un arbitrage méthodique fondé sur les spécifications techniques de chaque projet d’analyse. Ces deux bibliothèques logicielles adoptent des postulats architecturaux distincts qui répondent à des contraintes opérationnelles différenciées.
Le package writexl s’affirme comme le standard absolu dès lors que la priorité est accordée à la vitesse d’exécution, à l’économie maximale des ressources computationnelles et à la simplicité de maintenance du code. Dans les architectures de traitement de flux massifs de données (batch processing), les pipelines d’analyses bio-informatiques à haut débit ou les micro-services conteneurisés où la mémoire vive allouée est strictement plafonnée, l’intégration minimale de libxlsxwriter en C garantit une robustesse inégalée. Le code nécessaire à l’exportation tient en une ligne unique, réduisant considérablement la dette technique des scripts.
À l’opposé, openxlsx est l’outil préférentiel lorsque le classeur généré est destiné à une interaction humaine directe exigeante, nécessitant une mise en page typographique élaborée, l’imbrication de formules natives, l’insertion de figures ggplot2 ou l’application de formatages conditionnels colorés pour alerter sur des valeurs critiques. Ce contrôle stylistique étendu s’accompagne néanmoins d’une complexité accrue : les scripts deviennent plus longs, nécessitant de nombreuses lignes pour allouer, ordonnancer et styliser chaque composante de l’objet classeur.
8.2 L’approche historique du package xlsx et ses contraintes rJava
Pour apprécier la supériorité des solutions actuelles, il est pertinent d’analyser d’un œil critique le package historique xlsx. Conçu au début des années 2010, ce package représentait à l’époque une avancée notable en comblant l’absence de support natif pour les formats Microsoft au sein de l’environnement R. Cependant, son socle technologique présentait des fragilités structurelles majeures dues à sa dépendance étroite envers la bibliothèque rJava et l’infrastructure Apache POI.
L’intégration de la machine virtuelle Java au sein d’un processus R implique une coexistence complexe entre deux environnements d’exécution dotés de leurs propres politiques d’allocation de mémoire et de ramasse-miettes distincts. La configuration des variables d’environnement telles que JAVA_HOME a constitué un écueil récurrent pour des cohortes entières d’analystes, provoquant des pannes d’exécution silencieuses lors des migrations de versions de systèmes d’exploitation. De plus, la mémoire allouée au tas Java (heap space) est bridée par défaut, exigeant l’injection manuelle de directives de compilation obscures (telles que options(java.parameters = "-Xmx4g")) avant même le chargement du package pour éviter des saturations mémorielles brutales.
D’un point de vue méthodologique contemporain, le maintien de dépendances envers xlsx ou rJava pour de simples tâches de sérialisation tabulaire est désormais considéré comme un anti-patron de conception logicielle (anti-pattern). Les coûts de maintenance, les risques d’incompatibilités entre architectures et la lenteur relative des transferts de données inter-environnements justifient pleinement le délaissement de cette filière au profit d’outils modernes en C ou C++ compilés.
8.3 Tableau synoptique des fonctionnalités et performances
Afin de guider objectivement les biostatisticiens et ingénieurs de données dans la sélection de leur panoplie logicielle, le tableau descriptif ci-dessous résume les caractéristiques fondamentales des principales solutions logicielles disponibles sur le CRAN pour l’exportation de données vers le format Excel :
- Package writexl :
- Langage du moteur interne : C pur (libxlsxwriter).
- Dépendance externe Java : Aucune (indépendance absolue).
- Vitesse d’écriture sérielle : Extrêmement rapide (optimisation de flux).
- Empreinte mémoire volatile : Minimale (consommation constante en streaming).
- Personnalisation esthétique et styles : Rudimentaire (uniquement mise en valeur standard des en-têtes).
- Prise en charge multi-feuilles : Oui (via la manipulation de listes nommées de data frames).
- Insertion d’éléments graphiques : Non prise en charge.
- Cas d’usage recommandés : Calculs intensifs, pipelines de production, déploiement sur serveurs, tables volumineuses.
- Package openxlsx :
- Langage du moteur interne : C++ (via Rcpp).
- Dépendance externe Java : Aucune.
- Vitesse d’écriture sérielle : Modérée à rapide.
- Empreinte mémoire volatile : Modérée (stockage temporaire de l’arborescence du classeur en RAM).
- Personnalisation esthétique et styles : Complète (polices, bordures, formats numériques, couleurs hexadécimales).
- Prise en charge multi-feuilles : Oui (via des primitives procédurales directes).
- Insertion d’éléments graphiques : Oui (intégration directe des tracés vectoriels et raster de ggplot2).
- Cas d’usage recommandés : Rapports décisionnels, tableaux de bord interactifs, protocoles de publications académiques normées.
- Package xlsx (historique) :
- Langage du moteur interne : Java (via rJava et Apache POI).
- Dépendance externe Java : Requise (nécessite l’installation d’une JRE spécifique sur la machine hôte).
- Vitesse d’écriture sérielle : Faible (surcharge de pontage inter-processus).
- Empreinte mémoire volatile : Très élevée (gestion complexe du tas de mémoire Java, risques d’écrasement de pile).
- Personnalisation esthétique et styles : Étendue mais syntaxiquement complexe.
- Prise en charge multi-feuilles : Oui.
- Insertion d’éléments graphiques : Complexe et sujette à des instabilités de mémoire.
- Cas d’usage recommandés : Obsolète pour les nouveaux développements ; maintenance exclusive de systèmes patrimoniaux.
9. Normalisation des données et encodage linguistique avant exportation
9.1 Préservation stricte de l’encodage UTF-8 et gestion des diacritiques français
La transmission de fichiers de données textuelles ou biomédicales au sein de la francophonie et des espaces multilingues se heurte inévitablement à la problématique de l’encodage des caractères diacritiques (accents aigus, graves, circonflexes, cédilles, trémas). Une défaillance dans la chaîne de préservation de l’encodage linguistique engendre le phénomène bien connu d’mojibake, au sein duquel une chaîne telle que « Évaluation clinique après thérapie » se trouve irrémédiablement altérée en « Évaluation clinique après thérapie ».
L’origine fondamentale de ce désordre textuel réside dans le décalage historique entre l’encodage par défaut de nombreuses installations Windows francophones (la table de codage Windows-1252 ou ISO-8859-1) et le standard universel contemporain adopté par l’ensemble du web et du calcul scientifique : l’encodage UTF-8. Alors que le moteur de R sur les systèmes récents (notamment depuis R version 4.2 sous Windows, qui a adopté l’encodage UTF-8 comme standard de session UCRT) traite nativement les caractères multilingues, des corruptions peuvent survenir lors du transfert de chaînes natives vers des formats binaires si les marqueurs d’encodage sont équivoques.
Pour immuniser les flux de données contre toute corruption visuelle, l’analyste doit assainir explicitement les vecteurs de chaînes de caractères avant la phase d’exportation. L’utilisation systématique de la fonction enc2utf8() sur les colonnes textuelles garantit que chaque chaîne porte le drapeau d’encodage UTF-8 déclaré. L’emploi conjoint de la bibliothèque stringi offre des outils de validation avancés pour identifier, normaliser (selon la forme canonique NFC) et certifier la parfaite conformité linguistique des observations textuelles avant leur sérialisation dans l’archive OpenXML.
9.2 Standardisation sémantique des chaînes qualitatives et réponses ouvertes
Les variables issues de questionnaires qualitatifs, d’enquêtes épidémiologiques ou de champs de réponses ouvertes présentent fréquemment des anomalies typographiques invisibles à l’œil nu lors d’un affichage en console R, mais génératrices de distorsions importantes dans l’environnement d’un tableur. Parmi ces parasites textuels figurent les espaces insécables redondants, les tabulations accidentelles insérées par collage de texte, ainsi que les sauts de ligne intempestifs (caractères n ou rn).
Dans Microsoft Excel, la présence d’un saut de ligne dissimulé au sein d’une chaîne de caractères provoque l’élargissement vertical spectaculaire de la ligne concernée si l’option d’ajustement automatique du texte est activée, perturbant considérablement l’alignement ergonomique du tableau. L’application d’un nettoyage préliminaire via les fonctions vectorisées de stringr s’avère hautement profitable :
donnees$commentaires <- stringr::str_squish(donnees$commentaires)
La commande str_squish() opère une purge méthodique en supprimant les espaces de début et de fin de chaîne, tout en réduisant toute séquence interne d’espaces, de tabulations ou de sauts de ligne multiples à une espace typographique unique.
Un autre impératif de sécurité informatique concerne la prévention des attaques ou anomalies d’injection de formules dans les tableurs (CSV/Formula Injection). Si un participant renseigne dans un formulaire de saisie une chaîne de texte débutant par un symbole opératoire tel que l’égalité (=), l’addition (+), la soustraction (-) ou l’arobase (@) — par exemple la chaîne "-2.5% d'amélioration" ou une commande malveillante programmée —, Excel peut interpréter cette chaîne comme une formule exécutable lors de l’ouverture du classeur. L’analyste préviendra cette faille en insérant systématiquement un guillemet simple d’échappement devant les chaînes qualitatives commençant par ces caractères spéciaux.
9.3 Audit de conformité des libellés de variables scientifiques
La nomenclature des variables constitue le squelette conceptuel de tout jeu de données. Lorsque ces libellés sont transférés vers un environnement ouvert tel qu’Excel, une vérification rigoureuse de leur unicité et de leur structure syntaxique est indispensable pour prévenir toute collision ou écrasement silencieux d’informations.
Il est fréquent, lors d’opérations d’assemblage (merging) ou de concaténation de tables hétérogènes en R, que deux colonnes partagent par inadvertance le même intitulé de variable. Si R tolère parfois des libellés dupliqués au sein de structures de base (en les annotant d’un suffixe numérique lors de manipulations strictes), les parseurs de fichiers Excel et les utilisateurs humains sont incapables de distinguer sans ambiguïté la provenance de colonnes homonymes. L’exécution préalable d’une vérification d’unicité via la commande any(duplicated(names(df))) constitue une barrière de contrôle qualité incontournable.
De plus, il convient de veiller à ce que la longueur textuelle des en-têtes de colonnes n’excède pas les capacités d’affichage optimales du tableur. Un intitulé de variable comportant plus d’une centaine de caractères nuit à la compacité de l’affichage tabulaire. L’analyste privilégiera l’attribution d’acronymes normalisés et concis pour les en-têtes de la table principale, tout en consignant la définition exhaustive et détaillée de ces descripteurs au sein de la feuille méthodologique de dictionnaire des variables (Codebook) évoquée précédemment.
10. Traitement des valeurs manquantes, types complexes et cas limites
10.1 Traduction des codes manquants : NA, NaN, NULL et espaces vides
L’omniprésence de données manquantes représente une caractéristique incontournable de la recherche empirique, qu’elle résulte d’abandons de suivi au sein d’essais cliniques, de défaillances de capteurs métrologiques ou du refus délibéré de participants de répondre à des items sensibles. Le langage R dispose d’un modèle formel très sophistiqué pour caractériser ces lacunes grâce à la constante logique NA (Not Available), qui possède des déclinaisons typées pour chaque vecteur atomique (NA_real_, NA_integer_, NA_character_).
Lors de l’exportation vers Microsoft Excel, la question de la sérialisation visuelle de ces non-valeurs est capitale. Par défaut, la bibliothèque writexl traduit les valeurs NA de R par des cellules vides (blank cells). Ce comportement correspond généralement aux souhaits des analystes, car une cellule vide n’interfère pas avec les calculs de moyennes arithmétiques exécutés par le tableur : la fonction Excel MOYENNE() exclut nativement les cellules vides de son dénominateur, préservant ainsi la validité des agrégats descriptifs.
Néanmoins, sur le plan épistémologique, il existe une différence fondamentale entre l’absence d’observation et une valeur arithmétique égale à zéro. Dans certains contextes de saisie réglementée, une cellule totalement vacante peut être interprétée comme un oubli de saisie plutôt que comme une valeur manquante répertoriée. Pour lever cette incertitude, certains protocoles imposent de matérialiser explicitement l’absence par un code textuel standardisé (tel que "NA", "NON_EVALUE" ou "MANQUANT"). Il convient toutefois d’être conscient que l’injection d’un libellé textuel dans une colonne initialement numérique transforme la colonne en un type hétérogène sous Excel, ce qui bloquera l’application des formules mathématiques sur cette plage de cellules.
De plus, la valeur NaN (Not a Number), qui sanctionne en R des opérations mathématiquement indéterminées telles que la division de zéro par zéro (0/0), doit être distinguée du simple NA. Si elle n’est pas corrigée, elle sera soit exportée sous forme de chaîne de caractères littérale, soit convertie en une erreur de formule Excel standard (#VALEUR! ou #NOMBRE!), perturbant la présentation du classeur.
10.2 Sérialisation des valeurs numériques atypiques et infinies
Dans les calculs statistiques impliquant des ratios de cotes (odds ratios), des logarithmes ou des régressions non linéaires, l’analyste peut voir émerger des grandeurs limites représentées en R par les constantes Inf et -Inf. Ces valeurs surviennent typiquement lors de divisions d’un scalaire strictement positif ou négatif par zéro (par exemple, log(0) ou 1/0).
Le standard OpenXML sous-jacent à Microsoft Excel ne possède pas de représentation primitive pour la notion mathématique d’infini positif ou négatif selon la norme IEEE 754. Par conséquent, les bibliothèques d’exportation adoptent des comportements d’arbitrage variables lorsqu’elles rencontrent ces entités. La tentative d’écriture directe d’un scalaire Inf au sein d’une cellule attendue comme numérique peut provoquer l’interruption prématurée du processus d’encodage ou contraindre la bibliothèque à sérialiser la constante sous la forme d’une chaîne de caractères brute "Inf".
Cette conversion silencieuse en chaîne altère la cohérence interne du tableau et expose les utilisateurs finaux à des calculs erronés lors de la réimportation des données dans d’autres plateformes. Un protocole analytique rigoureux impose un audit systématique de fin de calcul pour intercepter et traiter ces valeurs atypiques avant l’exportation :
donnees_nettoyees <- do.call(data.frame, lapply(donnees, function(col) {
if(is.numeric(col)) {
col[is.infinite(col)] <- NA
}
return(col)
}))
Ce traitement substitue de manière déterministe les entités infinies par des valeurs manquantes standardisées NA, évitant ainsi toute rupture de type ou levée d’exception lors de la constitution physique de l’archive binaire du classeur.
10.3 Résolution des colonnes de listes et variables imbriquées
Avec l’avènement des structures de données modernes portées par le Tidyverse et l’exploitation courante de données semi-structurées issues d’API web (au format JSON), il est devenu très fréquent de manipuler des tables de données intégrant des list-columns. Une colonne de liste est une variable dont chaque élément unitaire n’est pas un scalaire atomique simple, mais un vecteur de longueur variable, un autre data frame imbriqué ou même un objet complexe tel qu’un résumé de modèle linéaire (objet de classe lm).
Bien que ce paradigme apporte une flexibilité d’encapsulation extraordinaire au sein de l’environnement R, il entre en contradiction totale avec le principe de rectangularité fondamentale propre aux tableurs tels qu’Excel. Une cellule de feuille de calcul est incapable d’héberger nativement un vecteur multidimensionnel ou un sous-tableau dynamique. Si l’on transmet un data frame contenant une colonne de type liste à write_xlsx(), la fonction interrompra son exécution en levant une erreur d’incompatibilité structurelle :
Error: Column `nom_colonne` is a list-column. Converting to excel is not supported.
Pour exporter avec succès ce type de données, l’analyste doit opérer une transformation d’aplatissement (flattening). Deux démarches méthodologiques s’offrent alors à lui :
- La concaténation scalaire textuelle : Si la liste contient de simples vecteurs de chaînes courtes (par exemple, la liste des antécédents médicaux d’un patient), il est possible de fondre ces éléments en une chaîne unique séparée par un délimiteur sémantique explicite (comme le point-virgule), à l’aide de la fonction
sapply(colonne_liste, paste, collapse = "; "). La colonne redevient ainsi un vecteur atomique textuel régulier parfaitement sérialisable. - La désimbrication relationnelle (dénormalisation) : Si la structure imbriquée héberge des tables de dimensions substantielles, l’approche la plus rigoureuse consiste à déployer la table à l’aide des fonctions
tidyr::unnest()pour dupliquer les lignes d’identifiants au prorata des éléments imbriqués, ou, plus élégamment, à extraire les structures hiérarchiques pour les exporter dans des onglets dédiés distincts au sein du même classeur, en établissant une clé de jointure commune (identifiant primaire / clé étrangère).
11. Automatisation et intégration dans des protocoles de recherche reproductibles
11.1 Itération et génération automatique de fichiers en série via purrr et lapply
Dans le cadre d’études épidémiologiques d’envergure multicentrique ou d’analyses de panels industriels, l’analyste est fréquemment amené à générer non pas un classeur unique, mais des dizaines, voire des centaines de classeurs individualisés correspondant aux strates de son échantillon (par exemple, un classeur de suivi indépendant par centre investigateur ou par région géographique). L’exécution manuelle de ces opérations est proscrite en raison du risque inhérent de bévues de manipulation.
L’utilisation concertée des outils de programmation fonctionnelle du langage R — incarnés par la famille des fonctions lapply() ou par les utilitaires du package purrr — permet d’automatiser ce flux de production avec une précision chirurgicale. Le protocole s’articule autour d’une partition initiale de la table mère, suivie d’une itération d’écriture vectorisée :
donnees_scindees <- split(donnees_globales, donnees_globales$centre_hospitalier)
purrr::iwalk(donnees_scindees, function(sous_table, nom_centre) {
nom_fichier <- paste0(« Rapport_Activité_ », nom_centre, « _ », Sys.Date(), « .xlsx »)
chemin_complet <- file.path(« livrables_centres », nom_fichier)
writexl::write_xlsx(sous_table, path = chemin_complet)
})
L’opérateur iwalk() applique l’écriture en boucle sur chaque sous-ensemble en associant dynamiquement le data frame partitionné avec son étiquette nominale. L’inclusion programmée de l’instruction Sys.Date() au sein du nommage des artéfacts physiques constitue une bonne pratique fondamentale de traçabilité, assurant un horodatage immuable qui prévient tout risque d’écrasement accidentel lors des réitérations analytiques ultérieures.
11.2 Insertion de la phase d’exportation dans les pipelines R Markdown et Quarto
L’essor des technologies de publication scientifique dynamique, portées par R Markdown et son successeur unifié Quarto, a transformé la rédaction des rapports de recherche. Ces frameworks permettent d’entrelacer du code informatique exécutable et de la prose académique au sein d’un document source unique (fichiers .Rmd ou .qmd), compilé ultérieurement sous forme de manuscrits PDF, de pages web ou de présentations diaporama.
L’intégration de la phase d’exportation de classeurs Excel au sein d’un document Quarto répond à une double exigence : fournir un rapport synthétique hautement rédigé pour les décideurs, tout en compilant automatiquement les annexes de données sous-jacentes sous forme de tableurs directement téléchargeables. Cette architecture unifiée crée un écosystème de diffusion transparent :
Pour insérer cette étape sans perturber le flux visuel du rapport final, le bloc de code (chunk) dédié à l’exportation doit être configuré avec des options d’exécution strictes, telles que echo = FALSE, warning = FALSE et message = FALSE. L’opération d’écriture sur disque s’exécute ainsi de manière silencieuse en coulisses pendant la compilation du document principal. Le texte du rapport peut alors intégrer un lien hypertexte relatif pointant directement vers le fichier .xlsx nouvellement généré au sein de la même arborescence, permettant aux lecteurs d’accéder d’un clic aux données ayant servi à tracer les graphiques du document.
11.3 Validation automatisée post-exportation et contrôle de conformité
Un protocole scientifique déterministe ne saurait considérer l’appel de la commande write_xlsx() comme le point final du flux de travail sans instaurer un mécanisme d’audit de clôture (post-export validation). Il s’agit de s’assurer de l’isomorphisme strict entre la structure résidant initialement dans la mémoire vive de R et le fichier binaire physiquement matérialisé sur le support de stockage.
Cette vérification de conformité implique une procédure de relecture immédiate via une bibliothèque dédiée telle que readxl. En réimportant immédiatement le fichier créé dans une variable éphémère (donnees_relectes <- readxl::read_xlsx("resultats.xlsx")), l’analyste peut procéder à des tests unitaires automatisés à l’aide du package testthat :
- Vérification de la dimensionnalité : Vérifier que
nrow(donnees_relectes) == nrow(donnees_sources)et quencol(donnees_relectes) == ncol(donnees_sources). Une discordance signale une troncature inattendue lors de l’écriture. - Vérification de la cohérence de somme de contrôle (checksum) : Calculer la somme des variables continues d’intérêt (par exemple,
sum(donnees_sources$score, na.rm = TRUE)comparée àsum(donnees_relectes$score, na.rm = TRUE)) pour garantir l’absence de toute altération de précision d’arrondi décimal ou de conversion textuelle accidentelle. - Audit des identifiants : Confirmer l’absence d’inversion ou de décalage dans la séquence des clés d’identification des individus.
Le déclenchement d’une alerte bloquante (via l’instruction stopifnot()) en cas de divergence constatée constitue le rempart ultime contre la propagation d’artéfacts corrompus vers les destinataires finaux de la recherche.
12. Dépannage méthodique, erreurs courantes et optimisation des performances
12.1 Diagnostic et résolution des erreurs de syntaxe et de chemin d’accès
L’exploitation quotidienne des pipelines de données confronte régulièrement les ingénieurs à des défaillances récurrentes lors des tentatives d’écriture sur disque. L’approche méthodique face à une exception impose de décomposer le problème selon ses composantes environnementales et syntaxiques.
Le tableau des incidents est largement dominé par l’erreur d’interdiction d’accès (Permission denied). Dès la survenue de ce message, le réflexe immédiat doit être d’interroger la table des processus du système d’exploitation hôte pour déterminer si une instance de l’application Microsoft Excel verrouille le fichier cible. L’analyste s’assurera également que l’utilisateur exécutant la session R dispose des privilèges administratifs requis pour modifier le répertoire visé, tout particulièrement lors du travail sur des répertoires montés sur des volumes réseau d’entreprises ou au sein d’environnements universitaires restreints.
Une autre pathologie fréquente concerne le dépassement de la longueur maximale autorisée pour les chemins d’accès (MAX_PATH limit). Sous certaines versions de Windows, un chemin complet excédant 260 caractères provoque une rupture de sérialisation immédiate. L’adoption d’arborescences de sous-dossiers concises et l’évitement de nomenclatures de fichiers démesurément expansives constituent les remèdes les plus élémentaires pour pallier cette restriction historique du système d’exploitation.
12.2 Contournement des limites physiques imposées par le format .xlsx
Bien que le format OpenXML moderne présente des capacités d’hébergement largement supérieures à l’ancien format binaire Excel 97-2003 (.xls), il est impératif de rappeler que le classeur Excel n’est pas une base de données relationnelle et qu’il demeure bridé par des contraintes architecturales physiques strictes codées dans les spécifications ISO de Microsoft :
- Plafond vertical absolu : 1 048 576 lignes au maximum par feuille de calcul.
- Plafond horizontal absolu : 16 384 colonnes au maximum par feuille de calcul.
- Plafond de chaîne cellulaire : 32 767 caractères au maximum au sein d’une cellule unique.
Lorsque les données manipulées franchissent ces seuils critiques — ce qui se produit fréquemment dans le séquençage génomique à haut débit, l’enregistrement de signaux électrophysiologiques continus ou les flux de mégadonnées d’observatoires spatiaux —, la commande d’exportation échoue fatalement. Tenter d’injecter une table de 1 500 000 lignes dans une feuille unique sous writexl provoquera une levée d’erreur directe de la bibliothèque C libxlsxwriter.
Pour circonvenir à cette contrainte, deux stratégies méthodologiques s’imposent :
Si la transmission sous forme de classeur Excel demeure formellement contractuelle, l’analyste peut procéder à un partitionnement vertical de son data frame en tranches de 1 000 000 de lignes réparties séquentiellement sur plusieurs onglets du même classeur (ex. Feuille_Partie_1, Feuille_Partie_2). Cependant, cette solution n’est qu’un pis-aller ergonomique.
Dès lors que les volumes de données atteignent ces ordres de grandeur, le choix du format Excel devient intrinsèquement inadapté. L’analyste se doit d’orienter sa restitution vers des conteneurs de données massives dédiés, standardisés et hautement compressés, au premier rang desquels figure le format tabulaire colonnaire Apache Parquet (manipulable sous R via le package arrow) ou vers des bases de données relationnelles compactes unifiées telles que SQLite (via le package RSQLite). Ces architectures offrent des performances de compression et des vitesses de requêtage infiniment supérieures sans être assujetties aux plafonds de dimensionnement des tableurs bureautiques.
12.3 Synthèse des bonnes pratiques pour un pipeline de données académique et pérenne
Pour clore ce protocole méthodique, il est utile de synthétiser les recommandations fondamentales qui doivent guider tout praticien du langage R soucieux de pérenniser ses procédures d’exportation vers des formats tabulaires. La rigueur analytique repose sur l’adoption d’une discipline de codage constante et d’un contrôle qualité préalable à toute distribution extérieure.
Voici la liste de contrôle (checklist) en dix points indispensables pour certifier la conformité de vos classeurs de données :
- Vérification du typage : Contrôler que chaque colonne possède un type de vecteur atomique approprié et convertir explicitement les facteurs nominaux ou ordinaux en chaînes textuelles si nécessaire.
- Traitement des noms de lignes : Extraire et transformer systématiquement les
row.namesen une colonne d’identifiants unique explicite. - Assainissement des libellés : Normaliser les noms de variables en proscrivant les espaces intercalaires, les barres obliques et les caractères accentués non standard.
- Encodage linguistique : Forcer la normalisation UTF-8 sur l’ensemble des champs qualitatifs pour prévenir toute altération d’affichage sur les systèmes d’exploitation étrangers.
- Nettoyage des parasites textuels : Supprimer les sauts de ligne internes et les tabulations au moyen de fonctions de nettoyage sémantique.
- Prévention des injections : Échapper tout caractère opératoire initial susceptible d’être interprété par inadvertance comme une formule de calcul interactive par Excel.
- Gestion des valeurs limites : Intercepter et recoder préalablement les grandeurs mathématiques atypiques (
Inf,-Inf,NaN). - Aplatissement structurel : Veiller à l’absence totale de colonnes de listes imbriquées brisant la rectangularité formelle de la grille tabulaire.
- Construction robuste des arborescences : Éviter les chemins d’accès absolus écrits en dur et privilégier l’utilisation de fonctions de résolution dynamique portables.
- Audit d’intégrité de sortie : Exécuter une réimportation de contrôle immédiate pour certifier l’isomorphisme de dimensionalité et la fidélité numérique du fichier stocké.
L’inclusion systématique de la commande sessionInfo() au terme des scripts d’analyse permet de documenter précisément les versions exactes du système d’exploitation, de l’interpréteur R et des packages de sérialisation utilisés. Cette documentation contextuelle sanctuarise le caractère pérenne et rigoureux de l’analyse, autorisant la traçabilité intégrale du protocole de calcul bien des années après la publication inaugurale des résultats scientifiques.
Références
Grolemund, G., & Wickham, H. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media. https://r4ds.had.co.nz/
International Organization for Standardization. (2016). Information technology — Document description and processing languages — Office Open XML File Formats (ISO/IEC 29500-1:2016). ISO. https://www.iso.org/standard/71691.html
Ooms, J. (2023). writexl: Export Data Frames to Excel ‘xlsx’ Format (Version 1.4.2) [Logiciel informatique]. CRAN. https://cran.r-project.org/package=writexl
Peng, R. D. (2016). Report Writing for Data Science in R. Leanpub. https://leanpub.com/reportwriting
R Core Team. (2024). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Schauberger, P., & Walker, A. (2023). openxlsx: Read, Write and Edit xlsx Files (Version 4.2.5.2) [Logiciel informatique]. CRAN. https://cran.r-project.org/package=openxlsx
Wickham, H. (2019). Advanced R (2e éd.). Chapman and Hall/CRC. https://adv-r.hadley.nz/
Wickham, H., & Bryan, J. (2023). readxl: Read Excel Files (Version 1.4.3) [Logiciel informatique]. CRAN. https://cran.r-project.org/package=readxl