
Dans le champ des sciences humaines, de la psychopathologie et des neurosciences comportementales, les chercheurs sont constamment confrontés à la modélisation de phénomènes qualitatifs discrets. Qu’il s’agisse de prédire la rémission clinique d’un trouble dépressif majeur, l’abandon prématuré d’une psychothérapie, l’échec scolaire ou l’émergence d’une conduite addictive, l’issue clinique ou comportementale prend fréquemment la forme d’un événement binaire. Face à une telle variable dépendante dichotomique, l’utilisation des modèles d’analyse traditionnels, tels que la régression linéaire par les moindres carrés ordinaires (MCO), se heurte à des limites conceptuelles et mathématiques fondamentales. C’est précisément pour surmonter ces contraintes que la régression logistique binaire s’est imposée comme le paradigme statistique de référence dans la recherche biomédicale et comportementale contemporaine.
Le logiciel IBM SPSS Statistics constitue l’un des environnements informatiques les plus puissants et les plus largement adoptés pour implémenter cette famille de modèles linéaires généralisés. Bien que son interface graphique intuitive permette d’exécuter une analyse logistique en quelques clics, la rigueur scientifique exige une maîtrise approfondie des postulats sous-jacents, des algorithmes d’estimation itératifs, des diagnostics résiduels et de l’interprétation des indices d’association métriques tels que l’Odds Ratio. Une exécution mécanique de la procédure, dissociée d’une compréhension probabiliste rigoureuse, expose l’investigateur à des erreurs méthodologiques substantielles : surajustement des paramètres, méconnaissance des violations de linéarité du logit, surinterprétation de covariables collinéaires ou encore mauvaise calibration clinique des probabilités estimées.
Ce guide exhaustif a été conçu pour accompagner le chercheur, l’étudiant doctoral et le clinicien à travers toutes les étapes de la conduite d’une régression logistique binaire dans SPSS. Depuis l’ancrage théorique des distributions de Bernoulli jusqu’à la restitution finale des données selon les exigences de la 7e édition des normes de l’American Psychological Association (APA 7), cet article décortique chaque mécanisme paramétrique, chaque boîte de dialogue logicielle et chaque tableau de résultats. En articulant formalisation statistique, captures des subtilités algorithmiques et exemples appliqués en psychologie clinique, ce document fournit une référence méthodologique complète pour quiconque souhaite explorer les relations complexes entre un ensemble de covariables et la survenue d’un état psychologique ou comportemental catégoriel.
1. Fondements théoriques de la régression logistique binaire en psychologie
1.1 Nature et spécificité de la variable dépendante dichotomique
La modélisation d’une issue binaire impose une rupture épistémologique avec le modèle linéaire classique. Dans une régression linéaire standard par les moindres carrés ordinaires, la variable dépendante Y est postulée continue, normalement distribuée et caractérisée par une homoscédasticité de ses résidus sur l’ensemble du continuum des valeurs prédites. Or, lorsque la variable dépendante est dichotomique (ou binaire), elle ne peut prendre que deux valeurs discrètes mutuellement exclusives, conventionnellement codées 0 et 1. Appliquer une droite de régression linéaire standard à une telle variable engendre un « modèle de probabilité linéaire » qui viole immédiatement les axiomes fondamentaux de la statistique inférentielle : les valeurs prédites Ŷ ne sont pas contraintes dans l’intervalle [0, 1] et peuvent ainsi générer des probabilités aberrantes, négatives ou supérieures à 100 %, totalement dépourvues de validité clinique et probabiliste.
Sur le plan distributionnel, une variable dépendante binaire suit une loi de Bernoulli, dont la variance est une fonction directe de la moyenne : Var(Y) = p(1 – p), où p représente la probabilité de survenue de l’événement d’intérêt P(Y = 1). Cette dépendance structurelle implique une hétéroscédasticité intrinsèque : la variance des résidus varie inévitablement en fonction de la valeur des prédicteurs, ce qui invalide l’estimation des erreurs types et fausse l’ensemble des tests de significativité statistique basés sur la distribution de Student ou de Fisher. En psychologie empirique, où le codage standard assigne la valeur 0 à l’absence d’un trouble, à l’échec ou à la non-récidive, et la valeur 1 à la présence d’une pathologie, au succès thérapeutique ou à la survenue d’une rechute, la relation liant les prédicteurs continus (par exemple, le score d’anxiété ou l’âge) à la probabilité d’occurrence de l’événement n’est pas linéaire, mais suit une courbe sigmoïde en forme de S (courbe logistique), caractérisée par des effets de saturation aux extrémités du spectre.
1.2 La fonction logit et le concept d’Odds Ratio
Pour modéliser mathématiquement cette relation non linéaire tout en maintenant une structure paramétrique interprétable, la régression logistique opère une transformation en deux temps de la variable dépendante. La première étape consiste à convertir la probabilité p en une « cote » (communément désignée par le terme anglophone odds). La cote représente le rapport entre la probabilité de survenue de l’événement et la probabilité de son non-avènement : Odds = p / (1 – p). Alors qu’une probabilité est strictement bornée entre 0 et 1, la cote s’étend quant à elle sur un intervalle allant de 0 à l’infini positif. Si la probabilité d’un décrochage thérapeutique est de 0,80, la probabilité de persistance est de 0,20, conférant une cote de 0,80 / 0,20 = 4,0, ce qui signifie que l’abandon thérapeutique est quatre fois plus probable que la poursuite de la thérapie.
La seconde étape résout le problème de l’asymétrie et de la non-linéarité par l’application du logarithme népérien à la cote, générant la fonction logit : logit(p) = ln[p / (1 – p)]. La transformation logit projette l’intervalle semi-infini [0, +∞[ sur la droite réelle complète ]-∞, +∞[, créant ainsi une variable continue non bornée qui peut être modélisée linéairement par une combinaison de variables prédictives : logit(p) = β₀ + β₁X₁ + β₂X₂ + … + βₖXₖ. C’est cette transformation qui permet la linéarisation de la relation. L’indicateur pivot qui en découle est le rapport des cotes, ou Odds Ratio (OR), calculé en appliquant l’exponentielle au coefficient de régression : OR = exp(β). L’Odds Ratio quantifie la modification proportionnelle de la cote de survenue de l’événement pour chaque incrément d’une unité sur le prédicteur considéré, jouant un rôle analytique majeur pour déterminer l’ampleur de l’effet clinique.
1.3 Estimation par le maximum de vraisemblance (Maximum Likelihood)
Contrairement aux modèles de régression linéaire où les paramètres β sont obtenus analytiquement en résolvant directement les équations normales par la méthode des moindres carrés ordinaires, les coefficients d’une régression logistique ne disposent pas d’une solution fermée directe. L’estimation statistique repose donc sur la méthode du maximum de vraisemblance (Maximum Likelihood Estimation, MLE). Le postulat théorique de cette approche consiste à identifier les valeurs des coefficients β qui maximisent la probabilité (la vraisemblance) d’observer les données empiriquement recueillies dans l’échantillon clinique ou expérimental.
En pratique, pour simplifier les calculs mathématiques, l’algorithme ne maximise pas directement la fonction de vraisemblance L, mais son logarithme népérien, ce qui aboutit à la fonction de log-vraisemblance (Log-Likelihood, LL). Pour des raisons de commodité d’interprétation statistique et d’analogie avec la somme des carrés résiduels, cette valeur est multipliée par -2, produisant la statistique -2LL, également qualifiée de déviance. Une valeur de -2LL plus faible indique un meilleur ajustement du modèle aux données. L’algorithme utilisé par SPSS met en œuvre une procédure itérative de type Newton-Raphson. Le logiciel démarre à partir de valeurs initiales arbitraires pour les coefficients, calcule la déviance, puis réajuste les paramètres pas à pas jusqu’à ce que la différence d’estimation entre deux itérations consécutives devienne infinitésimale. C’est ce que l’on nomme la convergence algorithmique, régie par des critères d’arrêt stricts (par défaut, une modification du logit inférieure à 0,00001 ou un nombre maximal de 20 itérations dans SPSS).
2. Conditions d’application et postulats méthodologiques
2.1 Taille d’échantillon et règle des événements par variable (EPV)
L’estimation par le maximum de vraisemblance est une méthode asymptotique, ce qui signifie que ses propriétés statistiques optimales (absence de biais, normalité asymptotique et efficacité des estimations) ne sont garanties que pour des tailles d’échantillon suffisamment vastes. En régression logistique binaire, la taille brute globale de l’échantillon (N) n’est pas le paramètre déterminant ; l’attention méthodologique doit prioritairement se porter sur la fréquence de la modalité la moins représentée de la variable dépendante, désignée sous le terme d’« événements » (ou groupe minoritaire).
Le standard méthodologique le plus largement reconnu est la règle empirique de Peduzzi et al. (1996), complétée par les travaux de Vittinghoff et McCulloch (2007), dite règle des Events Per Variable (EPV). Cette recommandation stipule qu’il convient de disposer d’un minimum absolu de 10 à 20 événements pour chaque paramètre indépendant estimé dans le modèle (y compris chaque niveau indicé d’une variable nominale polytomique). Par exemple, si une étude sur l’épuisement professionnel compte 40 individus en burnout avéré (Y = 1) et 360 individus indemnes (Y = 0), le nombre maximal de prédicteurs pouvant être introduits sans compromettre la stabilité du modèle est de 40 / 10 = 4 régresseurs. Le non-respect de ce critère expose directement l’analyse au surajustement (overfitting) : les erreurs types des coefficients gonflent artificiellement, la puissance statistique des tests de Wald s’effondre et le modèle devient incapable de se généraliser à de nouvelles populations cliniques.
2.2 Absence de multicollinéarité parmi les variables indépendantes
La présence d’une forte intercorrélation linéaire entre les variables prédictives constitue une menace sévère pour l’intégrité de la régression logistique. Bien que la collinéarité n’invalide pas la capacité globale du modèle à prédire l’événement binaire, elle distord dramatiquement l’estimation des coefficients partiels B. Lorsque deux covariables partagent une redondance conceptuelle ou empirique élevée (par exemple, la dépression mesurée par le BDI et l’anxiété mesurée par le STAI), la matrice d’information devient mal conditionnée, ce qui accroît démesurément la variance d’échantillonnage des coefficients associés.
Le module de régression logistique de SPSS ne fournissant pas directement d’indices diagnostiques de collinéarité dans ses sorties natives, l’investigateur doit impérativement exécuter au préalable une régression linéaire auxiliaire fictive en utilisant la même liste de prédicteurs et une variable dépendante continue arbitraire (ou la variable binaire elle-même). Il examine alors le facteur d’inflation de la variance (VIF) et l’indice de Tolérance. Un seuil empirique couramment admis en méthodologie psychologique indique qu’une Tolérance inférieure à 0,20 (correspondant à un VIF supérieur à 5), voire une Tolérance inférieure à 0,10 (VIF > 10), signale une multicollinéarité problématique. Les solutions consistent alors à éliminer l’un des régresseurs redondants, à les agréger au sein d’un score composite via une analyse en composantes principales, ou à employer des techniques d’estimation pénalisée.
2.3 Linéarité du logit pour les variables continues
Si la régression logistique s’affranchit du postulat de linéarité reliant directement les prédicteurs à la probabilité brute de l’événement, elle impose impérativement que chaque variable indépendante continue entretienne une relation strictement linéaire avec le logarithme népérien des cotes (le logit). La violation de cette condition conduit à une sous-estimation substantielle de la force de l’association, à une perte de puissance statistique et, dans les cas extrêmes, à une distorsion du sens clinique de l’Odds Ratio.
La vérification empirique de ce postulat repose sur la procédure formalisée par Box et Tidwell (1962). Ce test consiste à introduire dans le modèle de régression logistique, pour chaque covariable continue X, un terme d’interaction composé du produit de la variable par son propre logarithme naturel, soit X * ln(X). Si le coefficient associé à ce terme d’interaction s’avère statistiquement significatif au seuil conventionnel p < 0,05 (ou à un seuil corrigé de Bonferroni pour pallier l’inflation de l’erreur de type I liée à la multiplication des tests), le postulat de linéarité du logit est formellement rejeté. Pour remédier à cette non-linéarité, le chercheur peut appliquer des transformations mathématiques à la variable (racine carrée, échelle logarithmique, termes polynomiaux) ou, à défaut, la segmenter en catégories cliniques ordinales (par exemple des quartiles), bien que cette dernière pratique entraîne une perte inhérente d’information métrique.
2.4 Indépendance des observations et absence de quasi-séparation
L’architecture inférentielle de la régression logistique requiert l’indépendance mutuelle stricte de l’ensemble des observations formant le corpus de données. Les mesures répétées dans le temps sur les mêmes sujets (données longitudinales), les structures de données appariées ou les échantillonnages en grappes (élèves nichés dans des classes scolaires, patients nichés chez des thérapeutes) violent ce postulat d’indépendance. Dans ces contextes écologiques, l’utilisation de la régression logistique binaire standard sous-estime systématiquement les erreurs types ; il devient impératif de recourir aux équations d’estimation généralisées (GEE) ou aux modèles mixtes généralisés (GLMM) hiérarchiques.
Un écueil computationnel additionnel réside dans le phénomène de séparation complète ou quasi-séparation des données (Albert & Anderson, 1984). La quasi-séparation survient lorsqu’une variable indépendante (ou une combinaison linéaire de variables) prédit parfaitement l’issue binaire pour un sous-groupe d’individus. Par exemple, si aucun des patients ayant un niveau de soutien social élevé ne rechute, la probabilité prédite pour cette case conditionnelle est rigoureusement de 0 %, ce qui correspond à un logit de -∞. Incapable de calculer une valeur numérique finie, l’algorithme de Newton-Raphson diverge. Dans la table SPSS intitulée « Variables in the Equation », ce dysfonctionnement se manifeste par un signal d’alarme sans équivoque : des coefficients B anormalement gigantesques (ex. B = 28,45) associés à des erreurs types (S.E.) astronomiques (ex. S.E. = 1450,82) et une valeur p fallacieusement proche de 1,000.
3. Préparation et codage des données dans l’interface de SPSS
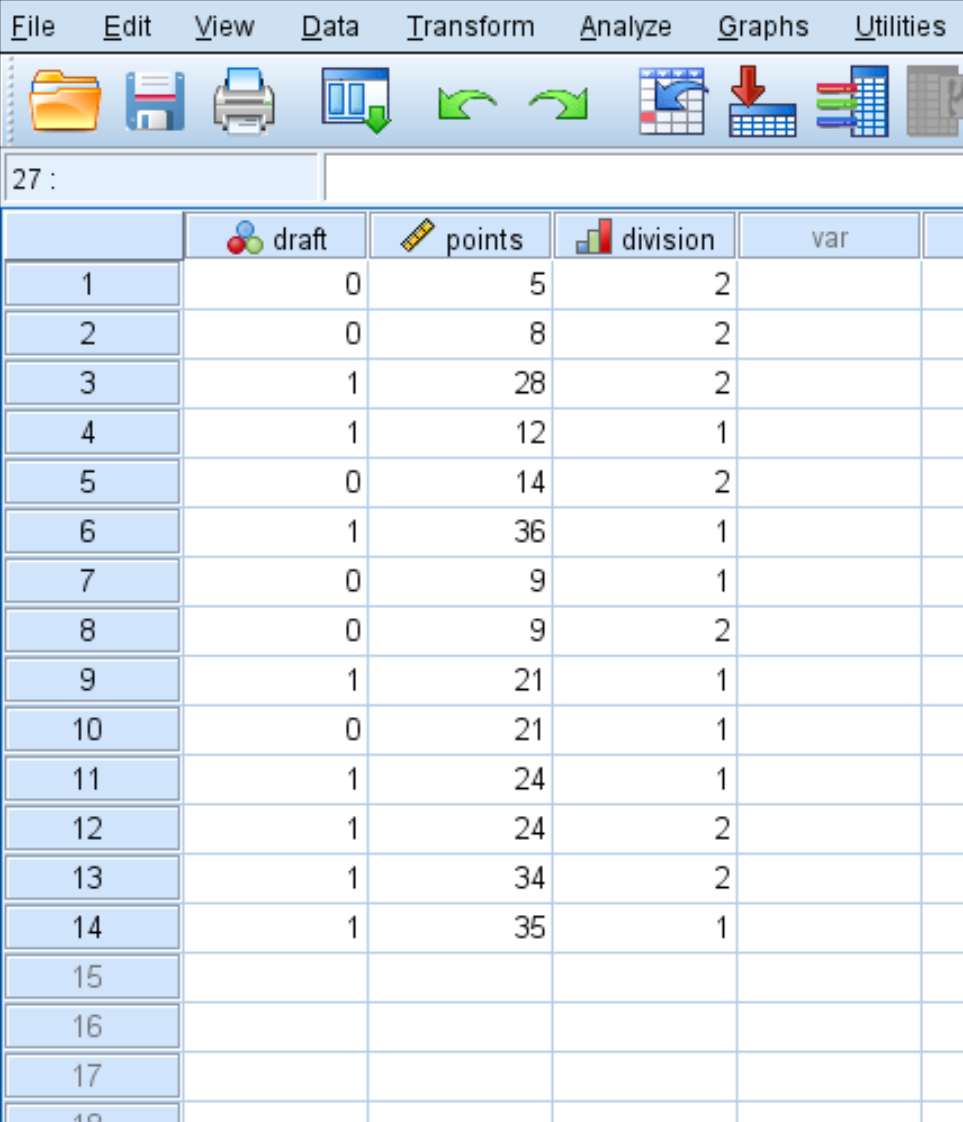
3.1 Configuration du dictionnaire des variables dans SPSS
Avant d’engager toute procédure de modélisation mathématique, une structuration rigoureuse du dictionnaire des variables dans la vue « Variable View » (Affichage des variables) de SPSS est une condition indispensable à la validité des analyses ultérieures. Chaque colonne de la matrice de données doit être minutieusement paramétrée sur le plan métrique. La variable dépendante doit impérativement être configurée avec le type de mesure Nominal, tandis que les covariables doivent être rigoureusement distinguées entre Échelle (pour les prédicteurs continus tels que les scores psychométriques sommés), Ordinal (pour les échelles de Likert ou stades cliniques hiérarchisés) et Nominal (pour les facteurs qualitatifs non ordonnés).
La documentation textuelle via le champ « Label » (Étiquette) et surtout le champ « Values » (Valeurs) prévient les confusions d’interprétation lors de l’exportation des sorties. Pour la variable critère binaire, il est impératif d’assigner formellement : 0 = Absence de trouble / Réussite et 1 = Présence de trouble / Échec. Parallèlement, le traitement des valeurs manquantes doit être paramétré dans la colonne « Missing » (Manquant). SPSS distingue les valeurs manquantes système (cases vides, symbolisées par un point) des valeurs manquantes définies par l’utilisateur (codes numériques explicites tels que 999 ou -9). Si ces codes numériques ne sont pas formellement déclarés comme manquants dans le dictionnaire, le logiciel les traitera comme des valeurs quantitatives réelles, induisant un biais dévastateur dans l’ajustement de la fonction de log-vraisemblance.
3.2 Recodage des prédicteurs qualitatifs et création de variables indicatrices
Les variables indépendantes qualitatives polytomiques (comportant trois modalités ou davantage, telles que le statut matrimonial, le groupe ethnoculturel ou le type de protocole psychothérapeutique) ne peuvent pas être insérées telles quelles comme prédicteurs continus dans l’équation de régression. Leur intégration requiert un codage disjonctif complet en variables indicatrices, universellement désigné sous le terme de dummy coding. Si une variable nominale possède k modalités, elle doit être décomposée en exactement k – 1 variables indicatrices binaires (prenant les valeurs 0 ou 1), l’une des modalités étant impérativement réservée comme catégorie de référence.
Le choix de la catégorie de référence n’est pas anodin ; il doit reposer sur des justifications théoriques solides et représenter une condition clinique témoin, le groupe standard ou la modalité affichant l’effectif le plus représentatif afin de stabiliser l’estimation des erreurs types. Bien que SPSS propose un sous-menu automatisé pour paramétrer ces contrastes catégoriels (contrastes de type « Indicateur ») lors de l’appel de la procédure, il est fréquemment recommandé dans les protocoles de recherche avancés de créer manuellement ces variables muettes via le menu Transformer > Recoder dans des variables différentes ou par syntaxe SPSS. Cette formalisation explicite garantit une transparence totale sur l’attribution des contrastes et prévient les erreurs d’inversion de modalité de référence fréquemment commises dans l’interface interactive.
3.3 Nettoyage préliminaire et exploration des distributions
Une étape préparatoire incontournable consiste à cribler la base de données pour caractériser la structure distributionnelle des variables sélectionnées. Le chercheur doit débuter par l’examen des fréquences univariées (menu Analyser > Statistiques descriptives > Fréquences) afin de détecter d’éventuels effectifs marginaux excessivement réduits. Toute modalité d’un prédicteur catégoriel qui rassemblerait moins de 5 à 10 observations représente un danger immédiat d’instabilité numérique pour l’algorithme du maximum de vraisemblance, justifiant souvent le regroupement raisonné de plusieurs catégories sous une étiquette conceptuelle plus large.
Dans un second temps, le croisement systématique de chaque prédicteur qualitatif avec la variable dépendante au moyen de tableaux de contingence croisés (Analyser > Statistiques descriptives > Tableaux croisés), assorti du test du Chi-carré d’indépendance de Pearson et de l’analyse des résidus ajustés, permet de déceler la présence de cellules vides (effectifs égaux à 0), annonciatrices de quasi-séparation. Concernant les prédicteurs quantitatifs continus, l’investigateur examinera les indices d’asymétrie (skewness) et d’aplatissement (kurtosis). L’application d’un centrage sur la moyenne (soustraction de la moyenne générale à chaque score individuel) ou d’une standardisation en scores Z est vivement conseillée, en particulier si l’analyse envisage l’introduction ultérieure de termes d’interaction, afin d’atténuer la multicolinéarité structurelle induite par les produits de variables.
4. Navigation et configuration de l’analyse dans SPSS
4.1 Accès au module de régression logistique binaire
L’exécution d’une régression logistique binaire au sein de l’environnement graphique de SPSS s’effectue en déroulant la barre des menus principaux : cliquez successivement sur Analyser, puis positionnez le curseur sur Régression, et sélectionnez enfin Logistique binaire.... Cette action déclenche l’ouverture de la boîte de dialogue principale, qui constitue le centre de contrôle algorithmique de la procédure.
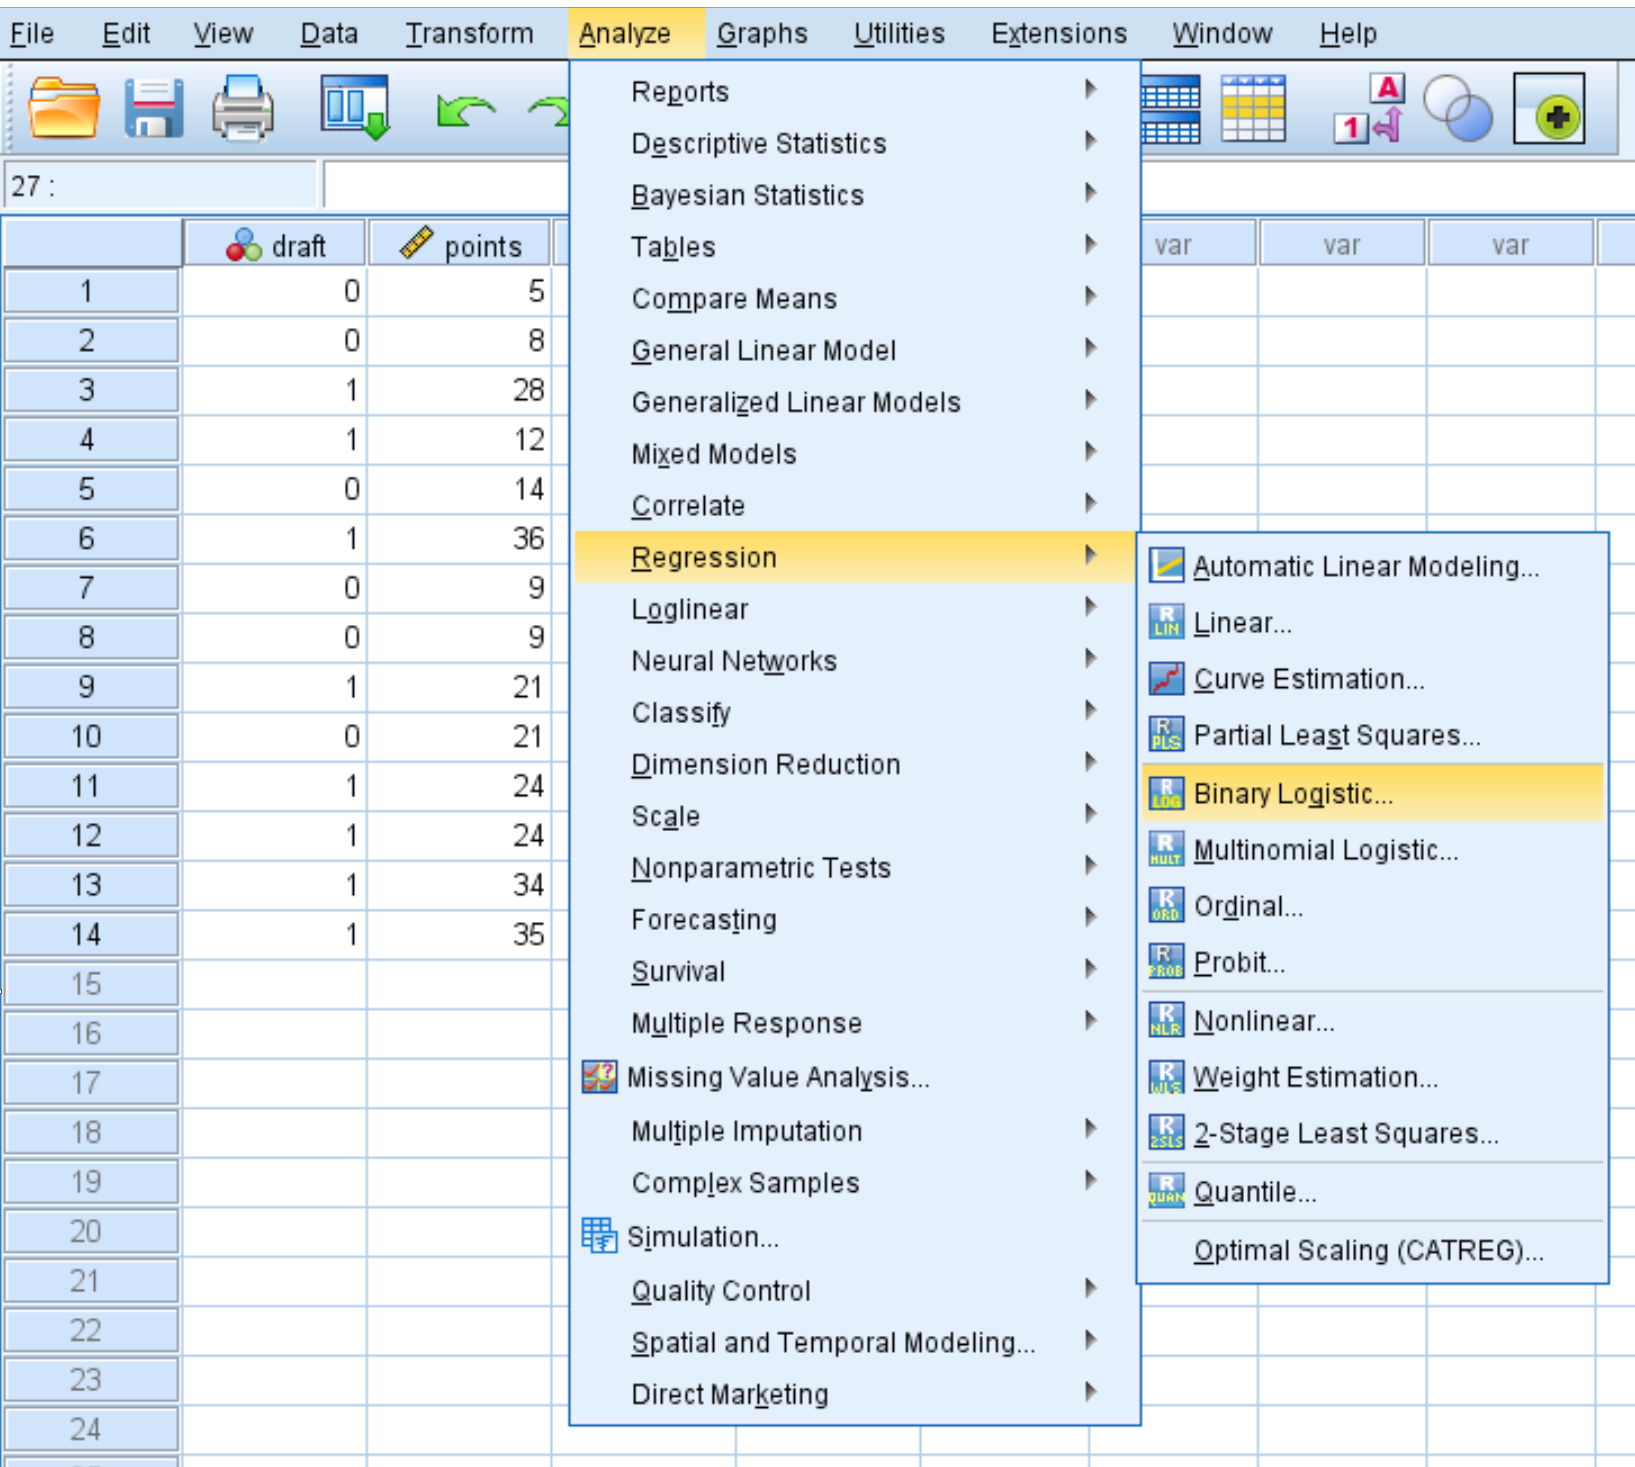
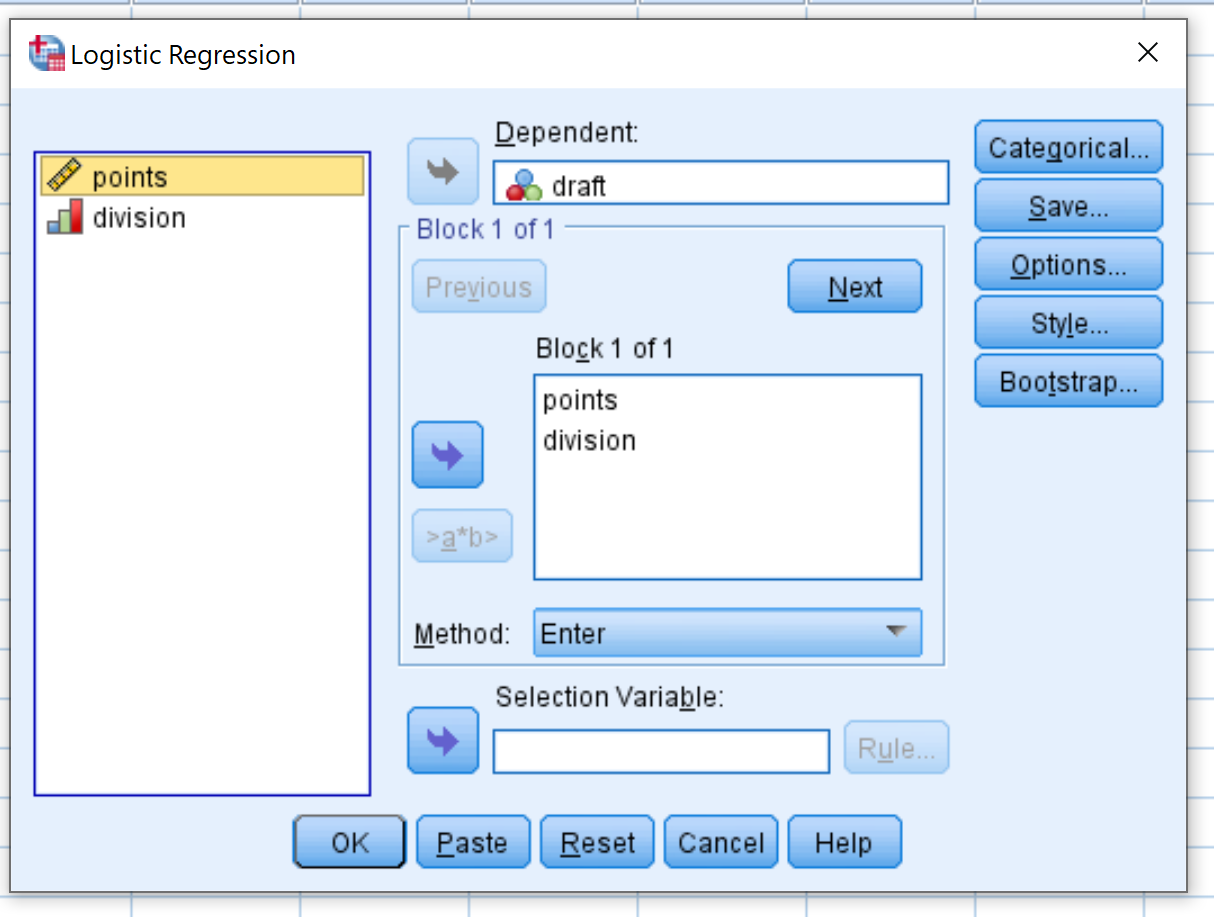
La première opération technique réside dans le transfert de la variable critère binaire depuis la liste des variables disponibles vers le champ intitulé Dépendante :. Il est primordial de se rappeler que SPSS modélise par défaut la probabilité d’occurrence de la modalité codée avec la valeur numérique la plus élevée (en règle générale la modalité 1). Dans un second temps, l’ensemble des variables prédictives — qu’il s’agisse de métriques continues, ordinales ou qualitatives — doit être sélectionné et transféré dans le panneau central intitulé Covariables :, rattaché au « Bloc 1 de 1 ». À ce stade, la boîte de sélection déroulante « Méthode : » affiche l’option « Entrée » par défaut, qui correspond à la méthode d’insertion simultanée de l’ensemble des covariables dans l’équation de régression.
4.2 Configuration des variables catégorielles via la sous-fenêtre dédiée
Lorsque le modèle statistique incorpore des prédicteurs qualitatifs nominaux ou ordinaux, leur simple présence dans le champ des covariables demeure insuffisante. SPSS requiert une déclaration formelle de leur statut pour générer automatiquement le système de variables indicatrices sous-jacent. Pour ce faire, il convient de cliquer sur le bouton Catégorielle… situé sur le flanc droit de la boîte de dialogue principale.
Dans la fenêtre secondaire qui se superpose alors, l’utilisateur transfère les variables qualitatives depuis la liste de gauche vers l’espace intitulé Covariables catégorielles :. Dès ce transfert opéré, la section inférieure « Changer de contraste » devient active. Le paramètre par défaut est le contraste « Indicateur ». L’attention méthodologique doit se focaliser sur l’option Catégorie de référence, qui propose deux options d’arbitrage : Dernier (par défaut, la valeur numérique maximale sert de référence) ou Premier (la valeur numérique la plus basse sert de référence). Après avoir sélectionné l’option en cohérence avec vos hypothèses cliniques, il est absolument indispensable de cliquer sur le bouton Changer. Une omission fréquente consiste à modifier le bouton radio sans valider par « Changer » ; dans ce cas, SPSS conserve l’ancien paramétrage, induisant une inversion silencieuse de la référence lors de l’estimation de l’Odds Ratio.
4.3 Sélection des options d’exportation et statistiques descriptives
Afin d’obtenir une sortie analytique complète, conforme aux standards de publication académique, il est impératif de configurer les options avancées de calcul. Depuis la boîte de dialogue principale, cliquez sur le bouton Options… pour accéder aux paramétrages des sorties tabulaires et des critères d’arrêt mathématiques.
Dans cette sous-fenêtre, cochez impérativement la case Intervalles de confiance pour exp(B) : et vérifiez que le seuil est configuré à 95%. Cette étape est cruciale, car sans cette activation explicite, SPSS ne produit que l’estimation ponctuelle de l’Odds Ratio sans son intervalle d’incertitude inférentielle. Dans le groupe de statistiques d’ajustement global, sélectionnez Qualité de l’ajustement de Hosmer-Lemeshow, outil diagnostique incontournable pour évaluer l’étalonnage des probabilités attendues par rapport aux probabilités observées. Il est également recommandé de cocher Historique des itérations pour vérifier la convergence algorithmique et s’assurer de l’absence de quasi-séparation, ainsi que Corrélations des corrélations (qui génère la matrice de corrélation asymptotique des paramètres estimés B). Enfin, assurez-vous que la probabilité d’affectation (« Fréquence de coupure » ou classification cutoff) est fixée à 0.5 avant de cliquer sur Poursuivre.
5. Stratégies d’introduction des prédicteurs et modélisation hiérarchique
5.1 Méthode d’entrée simultanée standard (Entrée)
La méthode d’entrée simultanée, désignée sous le terme d’inclusion forcée ou méthode Entrée (Enter) dans la nomenclature de SPSS, constitue le paradigme d’estimation le plus conservateur, le plus robuste et le plus préconisé dans le champ de la recherche confirmatoire en psychologie. Dans cette approche, la totalité des variables prédictives sélectionnées a priori par l’investigateur est introduite simultanément dans l’équation de régression en une unique étape computationnelle, indépendamment de leur niveau respectif de significativité bivariée.
Ce protocole analytique garantit le contrôle strict de l’erreur de type I globale (taux de faux positifs) à l’échelle de l’étude. En évaluant chaque régresseur en présence de tous les autres, la méthode « Entrée » produit des estimations de coefficients résolument partiels : l’effet de chaque prédicteur représente son apport unique et incrémental sur le logit, une fois neutralisée la variance partagée avec l’ensemble des autres covariables du modèle. Elle s’oppose aux dérives exploratoires guidées par les seules fluctuations de l’échantillon, et demeure l’étalon-or lorsque la modélisation s’adosse à un corpus théorique bien charpenté prédisant un rôle spécifique pour chaque déterminant psychosocial.
5.2 Procédures pas à pas (Stepwise) : Forward et Backward
SPSS met à disposition une batterie d’algorithmes de sélection automatisée par étapes, scindés en méthodes ascendantes (Forward Selection) et descendantes (Backward Elimination). Dans l’algorithme ascendant, le modèle débute avec la seule constante, puis incorpore un à un les prédicteurs dont l’apport statistique est le plus prononcé, selon le test du score de Rao ou le ratio de vraisemblance. Inversement, l’algorithme descendant (particulièrement la méthode Descendante : Wald ou Descendante : RV) débute avec l’ensemble des covariables, puis retranche séquentiellement les prédicteurs les moins informatifs dont la contribution n’atteint pas le seuil de rétention (fixé par défaut à p = 0,10).
Bien que séduisantes pour des démarches purement exploratoires de data mining ou d’ingénierie de données massives, ces approches algorithmiques pas à pas font l’objet de critiques méthodologiques majeures dans la littérature statistique contemporaine (Harrell, 2015). Leurs faiblesses inhérentes incluent la capitalisation excessive sur la chance (les algorithmes sélectionnent des prédicteurs sur la base de variations aléatoires d’échantillonnage), l’inflation massive de l’erreur de type I, l’estimation sévèrement biaisée vers le haut des coefficients B et des Odds Ratios (phénomène de la malédiction du vainqueur), et l’instabilité flagrante des modèles retenus, où la suppression d’une seule observation peut bouleverser la liste des prédicteurs finaux.
5.3 Régression logistique hiérarchique par blocs séquentiels
La régression logistique hiérarchique (à ne pas confondre avec les modèles multiniveaux) représente une approche de modélisation théoriquement guidée par blocs successifs. L’utilisateur structure sa modélisation en définissant des blocs conceptuels via le bouton Suivant dans SPSS. Cette procédure permet de tester des modèles emboîtés (nested models) pour évaluer rigoureusement l’apport incrémental d’un groupe spécifique de variables psychologiques, au-delà de l’effet exercé par des covariables de contrôle.
Un design méthodologique classique consistera à introduire, dans le Bloc 1, les caractéristiques sociodémographiques structurelles ou facteurs de confusion (âge, sexe, niveau socio-économique). Dans le Bloc 2, l’investigateur ajoutera les facteurs de vulnérabilité biologique ou historique clinique. Enfin, dans le Bloc 3, il intégrera les prédicteurs psychologiques ciblés (styles d’attachement, scores de résilience, schémas cognitifs). L’intérêt statistique pivot réside dans l’analyse de la variation du Chi-carré de déviance (Δ-2LL ou Chi-square change) entre deux blocs emboîtés. Si l’adjonction du Bloc 3 s’accompagne d’une réduction statistiquement significative de la déviance globale, le chercheur démontre de manière irréfutable la valeur ajoutée et la validité incrémentale de ses construits psychologiques sur l’issue dichotomique.
6. Interprétation des résultats : Qualité globale et ajustement du modèle
6.1 Statistique du Chi-carré Omnibus et déviance du modèle
L’évaluation de la performance du modèle s’articule initialement autour de l’examen de la sortie SPSS intitulée « Omnibus Tests of Model Coefficients » (Tests omnibus des coefficients de modèle). Ce tableau statistique formalise le test du rapport de vraisemblance (Likelihood Ratio Test), qui compare l’adéquation du modèle saturé incorporant l’ensemble de vos régresseurs par rapport au modèle nul (ou modèle de base du Bloc 0, ne contenant que le terme constant).
Le Chi-carré Omnibus évalue l’hypothèse nulle fondamentale stipulant que l’ensemble des coefficients de régression associés aux prédicteurs sont simultanément nuls dans la population parente : H₀ : β₁ = β₂ = … = βₖ = 0. Ce test s’appuie sur la différence d’ajustement : χ² = (-2LL_modèle_nul) – (-2LL_modèle_complet), associée à un nombre de degrés de liberté (dl) rigoureusement équivalent au nombre de prédicteurs ajoutés. Une valeur de p inférieure au seuil alpha critique de 0,05 conduit au rejet sans ambiguïté de l’hypothèse nulle. Cela atteste que la prise en compte des variables indépendantes améliore significativement l’estimation probabiliste de la variable critère par rapport à une assignation uniforme basée sur la seule prévalence marginale.
6.2 Coefficients de pseudo-R² : Cox & Snell et Nagelkerke
En régression linéaire conventionnelle, le coefficient de détermination R² possède une interprétation géométrique directe et limpide : il reflète la proportion de variance de la variable dépendante expliquée par l’ensemble des prédicteurs. Dans le contexte de la régression logistique, la nature discrète de la distribution de Bernoulli exclut l’existence d’un équivalent exact fondé sur la partition de la somme des carrés. Pour pallier cette absence, les statisticiens ont développé des métriques d’association de substitution désignées sous le vocable générique de pseudo-R².
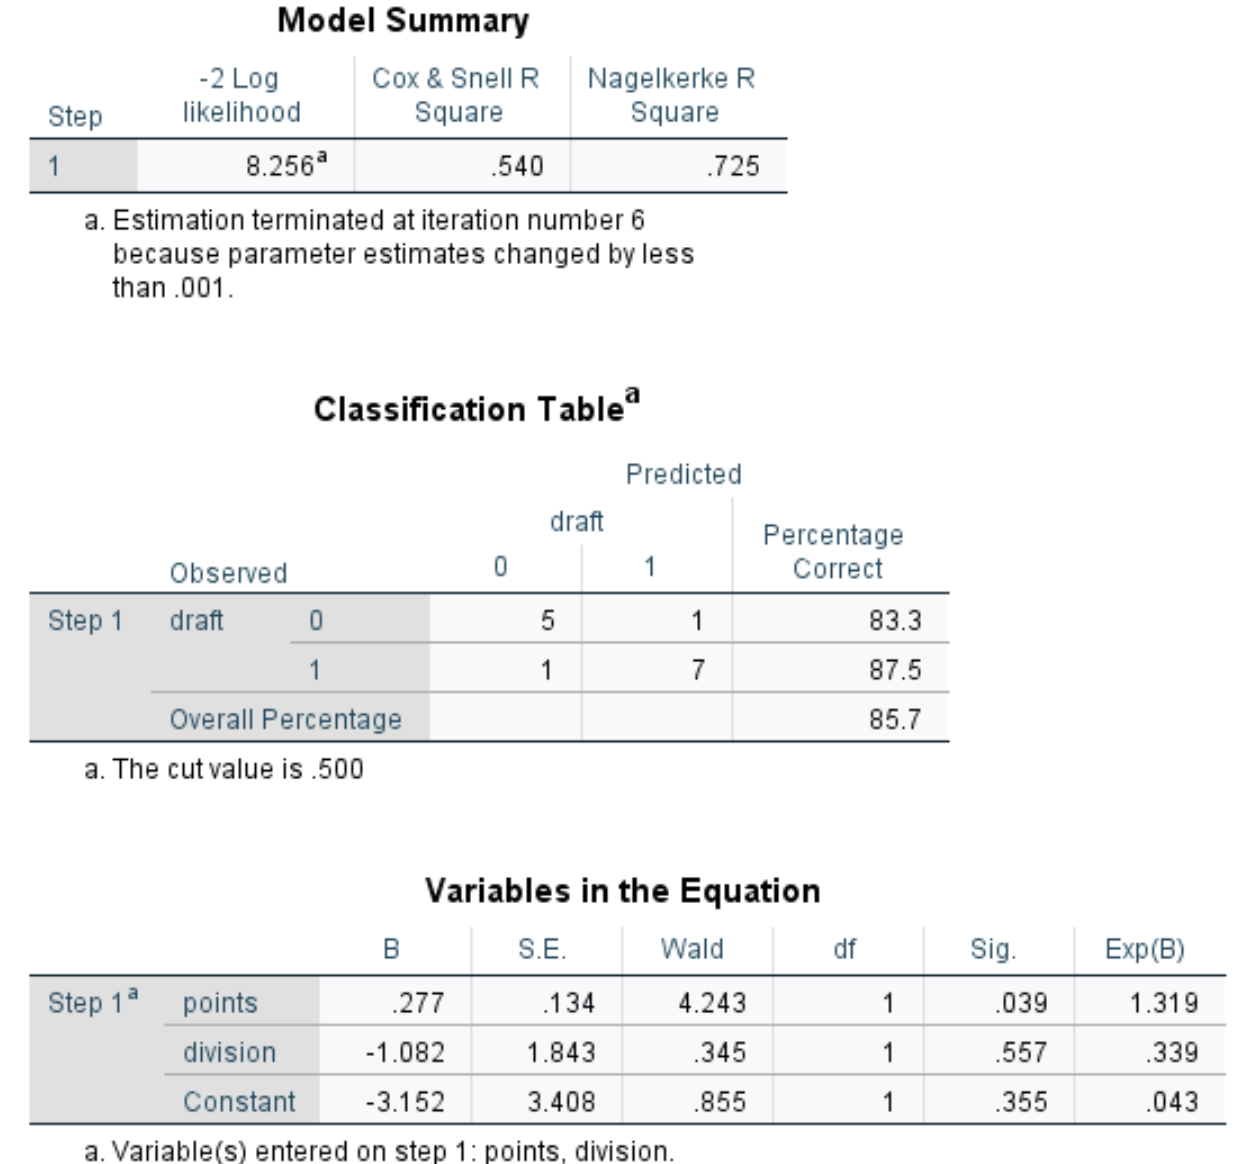
Le tableau « Model Summary » (Récapitulatif des modèles) généré par SPSS restitue deux indices fondamentaux :
- Le pseudo-R² de Cox et Snell : Reposant directement sur le rapport des log-vraisemblances entre le modèle nul et le modèle testé, cet indice quantifie le gain informationnel. Cependant, sa faiblesse majeure réside dans le fait que sa borne supérieure théorique n’atteint jamais 1,00, plafonnant typiquement à 1 – [L(Modèle Nul)]^(2/N), ce qui en complique singulièrement la lisibilité clinique.
- Le pseudo-R² de Nagelkerke : Constitue une ré-estimation normée du coefficient de Cox et Snell. En divisant l’indice précédent par sa borne maximale théorique, Nagelkerke crée une échelle standardisée s’étirant parfaitement de 0 à 1 (soit de 0 % à 100 %). Un pseudo-R² de Nagelkerke de 0,38 signifie que le modèle complet explique approximativement 38 % de la pseudo-variance de l’événement psychologique étudié.
6.3 Test d’adéquation globale de Hosmer-Lemeshow
Alors que le Chi-carré Omnibus teste la significativité globale de la régression, il ne renseigne aucunement sur l’étalonnage ou le calibrage clinique (goodness-of-fit) des prédictions. C’est précisément l’objet du test d’adéquation de Hosmer-Lemeshow. Le principe mathématique de ce test consiste à sérier l’ensemble des sujets de l’échantillon par ordre croissant de leurs probabilités prédites d’occurrence de l’événement, puis à partitionner ces observations en groupes ordonnés d’effectifs égaux, traditionnellement dix segments désignés sous le terme de déciles de risque.
Au sein de chaque décile, le test compare les fréquences empiriquement observées de survenue de l’événement (Y = 1) et de non-survenue (Y = 0) avec les fréquences attendues théoriques dérivées du modèle mathématique. Une statistique de type Chi-carré de Pearson de concordance est alors calculée, reposant typiquement sur g – 2 = 10 – 2 = 8 degrés de liberté. L’interprétation du test de Hosmer-Lemeshow impose une vigilance conceptuelle rigoureuse car la règle décisionnelle y est inversée par rapport aux usages habituels :
- Une valeur de p > 0,05 (non significative) atteste que les écarts entre les fréquences observées et les valeurs attendues sont négligeables, confirmant un excellent ajustement global du modèle aux données.
- Une valeur de p < 0,05 (statistiquement significative) indique un mauvais ajustement (misfit), signifiant que le modèle déforme systématiquement les probabilités de risque au sein de certains segments de la population d’étude.
7. Interprétation des paramètres individuels et de l’Odds Ratio
7.1 Coefficients non standardisés B et erreur type
L’investigation de la contribution analytique de chaque variable prédictive individuelle s’opère dans la table maîtresse de SPSS intitulée « Variables in the Equation » (Variables dans l’équation). La première colonne, libellée B, contient les coefficients de régression partiels non standardisés. Le coefficient B traduit la variation du logarithme népérien des cotes (le logit) pour chaque accroissement d’une unité métrique sur la variable prédictive considérée, lorsque tous les autres régresseurs du modèle sont maintenus rigoureusement constants.
Le signe mathématique de la pente B indique immédiatement la directionnalité de l’effet clinique :
- Un coefficient B positif (B > 0) dénote qu’une augmentation du score du prédicteur entraîne une élévation conjointe du logit, augmentant consécutivement la probabilité de survenue de l’événement binaire d’intérêt (par exemple, un risque accru de décrochage thérapeutique).
- Un coefficient B négatif (B < 0) atteste d’un effet protecteur, chaque hausse unitaire du prédicteur diminuant le logit et réduisant par conséquent la probabilité de survenue de l’événement.
La colonne S.E. (Standard Error) quantifie l’erreur type de l’estimation, reflétant la variabilité attendue du coefficient au fil des échantillonnages répétés. Le ratio de ces deux grandeurs génère la statistique de Wald : Wald = (B / S.E.)², distribuée asymptotiquement selon une loi du Chi-carré à 1 degré de liberté. La colonne Sig. fournit la valeur p bilatérale associée. Cependant, il convient de souligner que le test de Wald tend à devenir anormalement conservateur (induisant une inflation de l’erreur de type II) lorsque la valeur absolue du coefficient B devient très élevée.
7.2 L’exposant de B : Exp(B) et son interprétation clinique
En raison du caractère abstrait de l’échelle des logits pour les cliniciens et praticiens, la colonne Exp(B) constitue l’indice métrique le plus important de l’analyse : elle représente la transformation exponentielle directe du coefficient B, ce qui équivaut rigoureusement à l’Odds Ratio (OR) ou rapport des cotes. Cet indice fournit une mesure directe de la force d’association clinique entre le prédicteur et l’issue dichotomique :
- Si Exp(B) = 1,00 : Le prédicteur n’exerce strictement aucun effet sur la cote de survenue de l’événement (absence totale d’association).
- Si Exp(B) > 1,00 : Le prédicteur accroît la cote de l’événement. Par exemple, un Exp(B) = 1,45 pour une échelle d’évaluation du stress indique que chaque point additionnel sur l’échelle majore la cote de décompensation anxieuse de 45 % (calculé par la formule : [Exp(B) – 1] × 100), toutes choses étant égales par ailleurs.
- Si Exp(B) < 1,00 : Le prédicteur diminue la cote de survenue de l’événement (effet protecteur). Ainsi, un Exp(B) = 0,72 pour un score d’alliance thérapeutique indique que chaque élévation d’une unité sur l’échelle d’alliance réduit la cote de rechute de 28 % (calculé par : [1 – Exp(B)] × 100).
Pour les variables indépendantes catégorielles contrastées via le dummy coding, la lecture d’Exp(B) s’interprète de façon comparative et relative : elle traduit le ratio des cotes entre la modalité indicée spécifique et la catégorie désignée comme référence d’analyse.
7.3 Intervalles de confiance à 95% de l’Odds Ratio
L’estimation ponctuelle d’un Odds Ratio n’a que peu de valeur scientifique si elle n’est pas assortie de l’évaluation explicite de sa précision d’échantillonnage via les colonnes 95% C.I. for EXP(B) (Intervalle de confiance à 95 % de l’Odds Ratio, délimité par ses bornes inférieure et supérieure). Les bornes de cet intervalle sont dérivées exponentiellement de l’intervalle de confiance du logit : IC 95% = exp[B ± 1,96 × S.E.(B)].
L’interprétation de l’intervalle de confiance est soumise à deux impératifs décisionnels :
- Le critère de significativité inférentielle : L’investigateur doit scruter si la valeur 1,00 (valeur d’absence d’effet pour un rapport multiplicatif) se trouve englobée à l’intérieur des bornes de l’intervalle. Si l’intervalle de confiance intègre la valeur 1,00 (par exemple, IC 95% [0,94 ; 1,82]), le test n’est pas significatif au seuil conventionnel p > 0,05, indiquant que l’échantillon ne permet pas d’écarter l’hypothèse nulle. À l’inverse, si l’intervalle exclut entièrement le chiffre 1 (par exemple, IC 95% [1,12 ; 2,45] ou IC 95% [0,41 ; 0,85]), l’effet est statistically significatif à p < 0,05.
- L’amplitude de l’intervalle : La largeur de l’intervalle de confiance reflète le degré de précision de l’estimation. Un intervalle excessivement large (ex. IC 95% [1,05 ; 15,30]) révèle une fragilité méthodologique aiguë, fréquemment imputable à une taille d’échantillon insuffisante ou à un nombre trop restreint d’événements dans les sous-groupes (faible valeur d’EPV).
8. Analyse de la matrice de classification et performance prédictive
8.1 Matrice de confusion et seuil de coupure standard (Cut-off 0.50)
Au-delà de la significativité statistique des covariables, l’investigateur doit impérativement évaluer la capacité du modèle mathématique à classer correctement les individus concrets de l’échantillon. Cette analyse clinique s’appuie sur le tableau de classification (communément appelé matrice de confusion dans les sciences computationnelles), restitué par SPSS pour le modèle initial sans prédicteurs (Bloc 0) puis pour le modèle complet final (Bloc 1).
Par défaut, l’algorithme convertit la probabilité prédite continue p̂ calculée pour chaque individu en une prédiction d’appartenance catégorielle discrète en utilisant une fréquence de coupure (classification cut-off) conventionnellement arrêtée à 0,50. Si la probabilité prédite par l’équation de régression pour un sujet dépasse 0,50, l’individu est prédit comme devant expérimenter l’événement (Ŷ = 1) ; si elle s’avère inférieure ou égale à ce seuil, il est classé dans l’état indemne (Ŷ = 0). La confrontation croisée entre le diagnostic réellement observé et le pronostic théorique généré par le modèle fournit le pourcentage global de classification correcte (Overall Percentage). Toutefois, ce chiffre brut peut être trompeur en présence de données asymétriques : si la prévalence de l’événement n’est que de 10 %, un modèle nul affectant arbitrairement l’ensemble des sujets à l’état 0 affichera d’emblée un taux d’exactitude factice de 90 % sans posséder la moindre compétence prédictive.
8.2 Sensibilité, spécificité et valeurs prédictives
L’évaluation rigoureuse des propriétés diagnostiques du modèle statistique impose d’extraire de la matrice de confusion des indices métriques standardisés empruntés à l’épidémiologie clinique :
- La sensibilité (Taux de vrais positifs) : Elle quantifie la proportion d’individus présentant effectivement l’état pathologique ou l’événement clinique (Y = 1) qui ont été adéquatement identifiés comme tels par l’équation logistique. Une sensibilité clinique défaillante signifie que le modèle engendre un volume élevé de faux négatifs (des patients vulnérables non détectés).
- La spécificité (Taux de vrais négatifs) : Elle mesure la proportion de sujets exempts de la condition clinique (Y = 0) qui sont correctement classés comme indemnes par le modèle mathématique. Une faible spécificité se solde par une profusion clinique de faux positifs, induisant des prises en charge injustifiées.
- Les valeurs prédictives positive (VPP) et négative (VPN) : La VPP indique la probabilité qu’un sujet soit réellement porteur du trouble lorsqu’il est étiqueté positif par l’algorithme logistique. La VPN indique la probabilité d’être effectivement sain lorsque l’algorithme formule un pronostic négatif. Contrairement à la sensibilité et à la spécificité, ces grandeurs prédictives dépendent étroitement de la prévalence basale de l’événement au sein de la population cible étudiée.
8.3 Optimisation des seuils décisionnels et courbe ROC dans SPSS
Le maintien rigide du seuil de coupure standard à 0,50 n’est que rarement optimal en contexte clinique appliqué, en particulier lorsque les coûts associés aux erreurs de diagnostic sont asymétriques (par exemple, omettre de détecter un risque suicidaire s’avère infiniment plus préjudiciable que de déclencher une surveillance préventive par excès). L’optimisation empirique de ce seuil de décision passe par la modélisation de la courbe ROC (Receiver Operating Characteristic).
Pour implémenter cette analyse dans SPSS, le chercheur doit d’abord cocher l’option Probabilités dans la boîte de dialogue Enregistrer... de la régression logistique binaire, ce qui insère une nouvelle variable continue (étiquetée par défaut PRE_1) au sein du fichier de données. Dans un second temps, il sélectionne le menu Analyser > Courbe ROC..., place la variable des probabilités prédites PRE_1 dans le champ « Variable du test », affecte la variable critère binaire d’origine dans le champ « Variable d’état », et précise la valeur 1 comme code du groupe d’intérêt. SPSS génère alors la trajectoire graphique reliant la sensibilité en ordonnée au complément de la spécificité (1 – spécificité) en abscisse pour l’ensemble des seuils de coupure continus possibles. L’indice pivot issu de cette sortie est l’aire sous la courbe (AUC) :
- AUC = 0,50 : Performance purement aléatoire, équivalente au hasard d’un tirage à pile ou face.
- 0,70 ≤ AUC < 0,80 : Capacité discriminante acceptable.
- 0,80 ≤ AUC < 0,90 : Excellente discrimination clinique.
- AUC ≥ 0,90 : Capacité discriminante exceptionnelle.
L’examen approfondi des coordonnées de la courbe permet à l’investigateur de sélectionner manuellement le seuil décisionnel (ex. p = 0,32) qui maximise l’indice de Youden (Sensibilité + Spécificité – 1), équilibrant au mieux les compromis de détection selon les exigences éthiques et cliniques du protocole.
9. Diagnostics résiduels et détection des observations influentes
9.1 Résidus standardisés, déviance et résidus de Pearson
Un modèle affichant d’excellents indices d’ajustement global peut néanmoins dissimuler des défaillances locales substantielles ou être indûment façonné par un nombre restreint d’observations atypiques. L’examen des résidus constitue donc une étape diagnostique incontournable. Dans le menu Enregistrer... de la logistique binaire sous SPSS, plusieurs indicateurs de discordance résiduelle peuvent être exportés sous forme de variables additionnelles dans la matrice de données.
Le résidu de Pearson standardise l’écart brut entre la valeur empirique binaire observée yᵢ et la probabilité théorique estimée p̂ᵢ en divisant cette différence par l’écart-type théorique : eᵢ = (yᵢ – p̂ᵢ) / √[p̂ᵢ(1 – p̂ᵢ)]. Le résidu standardisé (ou studentisé) réajuste cette valeur en tenant compte de l’effet de levier exercé par le profil des covariables de l’individu. Les observations présentant un résidu standardisé dont la valeur absolue excède 2,58 (écart statistiquement significatif au seuil p < 0,01), ou a fortiori 3,00, doivent être isolées et minutieusement inspectées par l’investigateur. Ces cas signalent des anomalies prédictives prononcées : par exemple, un patient qui, en dépit d’une constellation exhaustive de facteurs de risque lourds culminant dans une probabilité prédite de rechute de 98 % (p̂ = 0,98), n’a pas rechuté (y = 0), générant un résidu particulièrement divergent.
9.2 Points de levier et statistique de distance de Cook
Un résidu élevé signale une mauvaise qualité d’ajustement pour une observation donnée, mais cela ne signifie pas nécessairement que cette dernière altère à elle seule les paramètres globaux de l’équation mathématique. Pour identifier les données exerçant une traction disproportionnée sur la solution statistique, il convient de croiser la discordance résiduelle avec l’effet de levier (leverage), enregistré sous le label de variable LEV_1 ou valeurs chapeaux (hat values, hᵢᵢ) dans SPSS.
L’effet de levier quantifie l’éloignement vectoriel d’un profil de covariables par rapport au centroïde moyen de l’ensemble des prédicteurs dans l’échantillon. Un sujet porteur de scores extrêmes et isolés sur plusieurs covariables simultanées aura un levier très élevé. Pour quantifier l’impact conjoint du résidu et du levier sur l’ensemble des coefficients de régression, la métrique maîtresse est la distance de Cook (enregistrée sous la variable COO_1 dans SPSS). Adaptée par Pregibon (1981) aux modèles linéaires généralisés, la distance de Cook mesure l’ampleur du déplacement multidimensionnel de l’ensemble des coefficients B si l’observation venait à être intégralement retranchée de l’échantillon. Selon les standards méthodologiques usuels, toute valeur de distance de Cook approchant ou dépassant le seuil de 1,00 indique une observation hautement influente dont la présence biaise unilatéralement la trajectoire du modèle.
9.3 DFBETA et sensibilité des coefficients individuels
Tandis que la distance de Cook synthétise la distorsion globale opérée sur l’ensemble de l’équation, la procédure diagnostique du DFBETA affine l’exploration en évaluant l’impact spécifique exercé par une observation singulière sur chaque coefficient de régression individuel pris isolément. Lors de la configuration de l’analyse, cocher l’option DFBETA(s) dans la boîte de dialogue d’enregistrement génère autant de nouvelles colonnes de données qu’il y a de paramètres estimés dans le modèle (un DFBETA pour la constante et un pour chaque prédicteur).
Sur le plan mathématique, le DFBETA standardisé d’un individu i pour un prédicteur j correspond à la différence arithmétique entre l’estimation du coefficient Bⱼ dérivée de l’échantillon complet et celle ré-estimée après élimination du sujet i, standardisée par l’erreur type : DFBETAᵢⱼ = (Bⱼ – Bⱼ₍ᵢ₎) / SE(Bⱼ). L’investigateur examinera les colonnes de DFBETA à la recherche de valeurs absolues excédant 1,00 pour les échantillons de taille modeste, ou excédant le seuil ajusté 2 / √N pour les échantillons cliniques plus volumineux. L’identification d’un DFBETA pathologique ne légitime pas l’exclusion aveugle et opportune du cas ; elle impose une revue critique : s’agit-il d’une erreur matérielle de saisie numérique (qui doit être corrigée), d’un profil psychopathologique authentique mais singulier, ou d’une violation grave des critères d’inclusion qui justifierait une analyse de sensibilité (comparant le modèle avec et sans l’observation déviante).
10. Modélisation des termes d’interaction et effets non linéaires
10.1 Création et intégration de termes d’interaction dans SPSS
L’investigation des hypothèses de modération en psychologie postule que la magnitude ou le sens de l’impact exercé par un prédicteur focal X₁ sur la survenue de l’issue clinique binaire Y varie continûment ou par paliers selon le niveau d’une troisième variable régulatrice, appelée modérateur X₂ (par exemple, l’efficacité d’un traitement en fonction de la sévérité du trauma initial). Dans la régression logistique, la modération se formalise mathématiquement par l’adjonction d’un terme de produit croisé multiplicatif : β₃(X₁ × X₂).
L’environnement de SPSS autorise l’implémentation directe de ces effets sans manipulation manuelle préalable de la base. Pour générer un terme d’interaction dans la boîte de dialogue Logistique binaire :
- Maintenez la touche clavier
Ctrlenfoncée et cliquez successivement sur les deux variables candidates au sein de la liste des variables d’entrée pour les mettre en surbrillance simultanée. - Cliquez sur le bouton interactif a*b positionné entre la liste des variables et le champ des covariables. Le produit syntactique
Var1*Var2s’inscrit immédiatement dans la boîte d’analyse.
Il est impératif, avant toute insertion d’interaction, de procéder préalablement au centrage sur la moyenne de l’ensemble des variables continues impliquées dans le produit afin d’éliminer la multicollinéarité artificielle inhérente aux termes d’ordre supérieur et de préserver la signification clinique intelligible des effets d’ordre principal (main effects).
10.2 Interprétation des effets d’interaction sur l’échelle logistique
L’évaluation statistique de l’existence d’une modération s’opère directement par l’examen de la ligne associée au produit croisé dans le tableau des variables de l’équation : si le test de Wald associé au coefficient d’interaction B₃ affiche une valeur de p < 0,05, l’hypothèse de modération est validée. Toutefois, l’interprétation substantielle de l’Odds Ratio Exp(B) associé à ce terme d’interaction exige une immense prudence et ne saurait être assimilée à celle d’un régresseur simple.
Dans un modèle interactif, l’Odds Ratio associé à X₁ n’est plus constant : il devient conditionnel à la valeur précise prise par le modérateur X₂, obéissant à la formulation : OR(X₁) = exp(B₁ + B₃X₂). Pour dénouer cliniquement la nature de cette dynamique, l’investigateur doit calculer les effets simples conditionnels (simple slopes analysis), traditionnellement évalués pour trois points d’ancrage représentatifs du modérateur : la moyenne empirique, un écart-type en dessous de la moyenne (-1 SD), et un écart-type au-dessus de la moyenne (+1 SD). La transposition de ces équations sous forme de tracés graphiques illustrant la probabilité prédite d’événement (en ordonnée) en fonction des niveaux du prédicteur (en abscisse) stratifiés selon les lignes de profil du modérateur constitue le moyen de restitution le plus accessible et le plus rigoureux pour des publications spécialisées.
11. Présentation des résultats selon les normes académiques APA 7
11.1 Structure textuelle standardisée pour le rapport des résultats
La rédaction de la section des résultats d’une régression logistique binaire au sein d’une revue affiliée à l’American Psychological Association obéit à une architecture canonique rigoureuse, proscrivant toute ambiguïté sur les paramètres rapportés. La description textuelle doit s’articuler en trois temps séquentiels :
- Rapport de l’ajustement global du modèle : L’investigateur débute par stipuler la significativité omnibus du modèle statistique en mentionnant expressément la valeur du Chi-carré, ses degrés de liberté, sa significativité exacte, ainsi que les indices d’amplitude d’effet : χ²(dl) = XX,XX, p = ,XXX, assorti des pseudo-R² de Cox & Snell et de Nagelkerke, et du test de calibration de Hosmer-Lemeshow : χ²_HL(dl) = XX,XX, p = ,XXX.
- Description des performances prédictives : Il convient d’exposer synthétiquement le pourcentage global de reclassement adéquat obtenu sur la matrice de confusion, en stipulant explicitement la sensibilité et la spécificité clinique constatées au seuil décisionnel retenu.
- Exposé détaillé des prédicteurs individuels : Pour chaque covariable statistiquement significative ou théoriquement fondamentale, le texte doit préciser de manière exhaustive la direction clinique de l’association, la valeur non standardisée de la pente B, l’erreur type SE, la statistique de test Wald (avec son dl), la valeur exacte de p, l’Odds Ratio OR (correspondant à l’Exp(B) de SPSS), et enfin, impérativement, son intervalle de confiance à 95 % : 95% IC [Borne Inférieure, Borne Supérieure].
11.2 Élaboration d’un tableau récapitulatif aux normes APA 7
Conformément aux normes typographiques de l’APA 7e édition, les tableaux de régression doivent adopter une mise en page épurée proscrivant formellement l’usage de bordures verticales. Seules trois lignes horizontales principales doivent structurer l’affichage : sous le titre du tableau, sous la ligne d’en-tête descriptive des colonnes, et immédiatement à la base du tableau au-dessus des notes méthodologiques de bas de page. Toutes les valeurs numériques décimales dépourvues de possibilité théorique d’excéder le chiffre 1 (comme les valeurs de p) doivent être rédigées sans zéro préliminaire (ex. p = ,012 et non 0,012).
| Variable prédictive | B | SE B | Wald (1) | p | OR | 95% IC OR |
|---|---|---|---|---|---|---|
| Âge du patient (années) | -0,03 | 0,01 | 5,76 | ,016 | 0,97 | [0,95 ; 0,99] |
| Genre (Réf : Féminin) | ||||||
| Masculin | 0,45 | 0,22 | 4,18 | ,041 | 1,57 | [1,02 ; 2,42] |
| Sévérité dépressive (BDI-II) | 0,08 | 0,02 | 16,00 | < ,001 | 1,08 | [1,04 ; 1,12] |
| Alliance thérapeutique (WAI) | -0,12 | 0,03 | 16,00 | < ,001 | 0,89 | [0,84 ; 0,94] |
| Constante | 0,52 | 0,48 | 1,17 | ,279 | 1,68 | — |
Note. N = 340. Dépendante codée : 0 = Maintien en thérapie, 1 = Décrochage précoce. B = coefficient non standardisé ; SE B = erreur type du coefficient ; Wald = statistique de Wald ; p = significativité bilatérale ; OR = Odds Ratio (Exp(B)) ; IC = intervalle de confiance. χ²(4) = 48,62, p < ,001 ; R² de Cox & Snell = ,133 ; R² de Nagelkerke = ,194 ; Test de Hosmer-Lemeshow χ²(8) = 6,24, p = ,620.
11.3 Exemple pratique rédigé d’une régression logistique en psychologie
Pour illustrer concrètement la formalisation textuelle au sein d’une section académique de résultats, voici un modèle standardisé directement transposable basé sur les données d’une cohorte clinique en ambulatoire (Tableau 1) :
« Une régression logistique binaire par méthode d’entrée simultanée a été réalisée afin d’évaluer la capacité de l’âge, du genre, de la sévérité initiale de la dépression (BDI-II) et de la qualité précoce de l’alliance thérapeutique (WAI) à prédire l’abandon thérapeutique prématuré (codé 1 = décrochage, 0 = maintien) chez 340 patients suivis pour un épisode dépressif majeur. L’analyse des diagnostics préliminaires a confirmé l’absence de multicollinéarité critique (l’ensemble des valeurs de VIF demeurant strictement inférieures à 1,45) et le respect du postulat de linéarité du logit via les tests de Box-Tidwell pour les variables continues (p > ,15). L’évaluation de l’ajustement global démontre que le modèle incluant l’ensemble des prédicteurs se révèle statistiquement très significatif comparativement au modèle constant seul, χ²(4, N = 340) = 48,62, p < ,001. La déviance résiduelle globale indique une réduction substantielle de l’erreur d’ajustement, le modèle rendant compte d’une part appréciable de la variance de l’abandon avec des indices de pseudo-R² satisfaisants (Cox & Snell R² = ,133 ; Nagelkerke R² = ,194). Le test d’adéquation globale de Hosmer-Lemeshow s’avère non significatif, χ²(8) = 6,24, p = ,620, confirmant un calibrage probabiliste adéquat entre les fréquences d’abandon observées et les valeurs attendues par le modèle à travers l’ensemble des déciles de risque. La matrice de confusion révèle un taux d’exactitude de classification globale de 74,4 % (avec une sensibilité diagnostique de 68,2 % et une spécificité clinique de 78,5 % pour un seuil de coupure standard configuré à ,50).
L’analyse des paramètres individuels (Tableau 1) met en évidence que l’ensemble des covariables intégrées exercent une contribution statistiquement significative sur le pronostic de décrochage. La sévérité dépressive initiale constitue un prédicteur de risque indépendant, B = 0,08, SE = 0,02, Wald(1) = 16,00, p < ,001, OR = 1,08, 95% IC [1,04 ; 1,12], indiquant que chaque augmentation unitaire sur le score du BDI-II accroît la cote d’abandon de 8 %. Inversement, la perception de l’alliance thérapeutique précoce agit comme un puissant facteur protecteur contre l’attrition, B = -0,12, SE = 0,03, Wald(1) = 16,00, p < ,001, OR = 0,89, 95% IC [0,84 ; 0,94], chaque point additionnel sur l’échelle WAI diminuant la cote de décrochage de 11 %. Concernant les caractéristiques sociodémographiques, l’avancée en âge s’accompagne d’une réduction modérée du risque d’abandon (OR = 0,97, p = ,016), tandis que les hommes présentent une cote d’attrition 1,57 fois supérieure à celle des femmes (OR = 1,57, 95% IC [1,02 ; 2,42], p = ,041), neutralisant l’influence concomitante des facteurs psychopathologiques. »
12. Résolution des erreurs fréquentes et diagnostics avancés dans SPSS
12.1 Gestion des messages d’avertissement de quasi-séparation
Lors de l’ajustement d’un modèle logistique, le journal d’exécution (Log) de SPSS affiche parfois des messages d’avertissement alarmants tels que : « The parameter covariance matrix cannot be computed » ou « Estimation terminated at iteration number 20 because maximum iterations has been reached ». Ces alertes signalent invariablement la présence d’une séparation complète ou quasi-complète des données dans l’espace multidimensionnel des covariables, rendant l’algorithme du maximum de vraisemblance standard incapable de converger vers un optimum fini.
Face à ce blocage numérique, plusieurs voies de remédiation méthodologique s’offrent au chercheur :
- Le regroupement de classes (Collapsing categories) : Si la quasi-séparation découle du croisement d’un prédicteur catégoriel clairsemé avec la variable critère, il convient de fusionner la modalité problématique avec une catégorie conceptuellement adjacente afin d’éliminer les effectifs marginaux nuls (cellules à zéro).
- La suppression prudente du prédicteur : Si une covariable dichotomique prédit à 100 % l’événement sans aucune exception clinique, elle représente un déterminant déterministe absolu plutôt qu’un facteur de risque probabiliste, et peut devoir être extraite de la modélisation statistique.
- L’estimation par vraisemblance pénalisée (Méthode de Firth) : Lorsque l’effectif réduit empêche tout réaménagement empirique, la solution analytique la plus élégante consiste à recourir à la régression logistique pénalisée de Firth (introduisant un terme de pénalité de Jeffreys sur la fonction de score). Bien que non intégrée de base dans les menus interactifs standards, la procédure de Firth peut être implémentée dans SPSS en exécutant la commande d’extension
SPSSINC FIRTHLOGpréalablement téléchargée via le hub d’extensions.
12.2 Traitement des prédicteurs redondants et matrices singulières
Une autre complication algorithmique classique survient lorsque le journal des sorties indique qu’une ou plusieurs variables ont été automatiquement exclues du modèle mathématique par le logiciel avec la mention : « Redundant variables have been removed ». Ce comportement protecteur automatique de SPSS se déclenche lorsque la matrice d’information hessienne devient singulière (non inversible), phénomène directement imputable à une collinéarité linéaire parfaite entre les prédicteurs.
Ce cas de figure surgit typiquement lors d’erreurs de programmation humaine :
- L’investigateur a introduit simultanément les scores partiels de plusieurs sous-échelles ainsi que le score composite global obtenu par la sommation exacte arithmétique de ces mêmes sous-échelles.
- L’utilisateur a manuellement créé des variables indicatrices muettes (dummy variables) pour l’intégralité des k modalités d’une variable qualitative en omettant de retrancher la catégorie de référence (piège classique de la dummy variable trap). Dans cette situation, la somme de l’ensemble des indicatrices équivaut rigoureusement au terme constant du modèle (le vecteur de 1), créant une singularité matricielle absolue.
La résolution impose une restructuration préalable de l’ensemble des prédicteurs : vérifiez les équations arithmétiques liant vos covariables, supprimez les redondances additives, et assurez-vous qu’exactement k – 1 indicatrices sont soumises à l’analyse pour chaque facteur nominal à k modalités.
12.3 Biais d’estimation liés aux données manquantes
Par défaut, l’architecture computationnelle de la régression logistique binaire sous SPSS applique un filtre d’exclusion radical pour gérer les valeurs incomplètes : la suppression par liste complète, communément désignée sous le vocable de listwise deletion. Si un individu présente une valeur manquante sur une seule des douze covariables insérées dans le modèle, l’algorithme élimine purement et simplement ce sujet de l’intégralité de la procédure d’ajustement global.
Cette approche par défaut génère deux dérives méthodologiques sévères : une réduction spectaculaire de la taille effective de l’échantillon (qui contracte le ratio d’événements par variable et effondre la puissance statistique), et surtout l’introduction d’un biais d’estimation systématique déformant la valeur des Odds Ratios si le mécanisme d’absence des données n’est pas strictement aléatoire au sens de Rubin (Missing Completely at Random, MCAR).
Avant de lancer définitivement l’analyse de régression logistique, il est de bonne pratique de diagnostiquer la nature des patrons de données manquantes via le menu Analyser > Analyse des valeurs manquantes... (test MCAR de Little). Si l’hypothèse de données manquantes de manière aléatoire (Missing at Random, MAR) est retenue, l’investigateur doit proscrire la suppression par liste et privilégier la technique de l’imputation multiple, accessible via le menu dédié Analyser > Imputation multiple dans SPSS. Cette procédure génère plusieurs matrices complétées indépendantes (typiquement 5 à 20 bases imputées) qui sont ensuite analysées séparément par la procédure de régression logistique binaire. SPSS combine alors automatiquement l’ensemble des coefficients et erreurs types selon les règles de Rubin, garantissant une inférence statistique non biaisée et pleinement représentative de la variabilité clinique initiale.
Références
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1-10. https://doi.org/10.1093/biomet/71.1.1
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E., & Tidwell, P. W. (1962). Transformation of the independent variables. Technometrics, 4(4), 531-550. https://doi.org/10.1080/00401706.1962.10490038
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27-38. https://doi.org/10.1093/biomet/80.1.27
- Harrell, F. E. (2015). Regression modeling strategies: With applications to linear models, logistic and ordinal regression, and survival analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- IBM Corporation. (2021). IBM SPSS Statistics 28 Brief Guide. IBM Corp. https://www.ibm.com/docs/fr/spss-statistics
- Nagelkerke, N. J. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691-692. https://doi.org/10.1093/biomet/78.3.691
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373-1379. https://doi.org/10.1016/s0895-4356(96)00236-3
- Pregibon, D. (1981). Logistic regression diagnostics. The Annals of Statistics, 9(4), 705-724. https://doi.org/10.1214/aos/1176345513
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Vittinghoff, E., & McCulloch, C. E. (2007). Relaxing the rule of ten events per variable in logistic and Cox regression. American Journal of Epidemiology, 165(6), 710-718. https://doi.org/10.1093/aje/kwk052