
L’analyse de variance à un facteur, universellement désignée sous l’acronyme anglophone ANOVA (Analysis of Variance), représente l’un des piliers méthodologiques et inférentiels les plus fondamentaux des sciences quantitatives contemporaines. Développée initialement pour répondre aux exigences de l’agronomie expérimentale, elle a trouvé en psychologie expérimentale, en neurosciences cognitives et en sciences de l’éducation un terreau d’application d’une fécondité exceptionnelle. Comprendre l’ANOVA ne consiste pas simplement à mémoriser une séquence d’opérations sur un logiciel commercial tel que SPSS, R ou SAS ; cela exige d’appréhender intimement la mécanique géométrique et mathématique qui sous-tend la décomposition de la variabilité d’un ensemble empirique d’observations.
L’exécution manuelle d’une ANOVA à un facteur constitue un exercice pédagogique et intellectuel irremplaçable pour quiconque aspire à maîtriser la statistique inférentielle. L’immersion directe dans le calcul pas à pas des sommes de carrés, des degrés de liberté et des variances estimées permet de lever le voile opaque de la boîte noire informatique. L’analyste prend alors conscience de la manière dont les écarts individuels s’agrègent, comment le bruit aléatoire propre à l’hétérogénéité humaine se sépare du signal expérimental induit par les manipulations du chercheur, et selon quels principes probabilistes une décision d’inférence causale peut être légitimement proclamée. Ce processus confère une rigueur conceptuelle indispensable à l’interprétation critique des publications scientifiques.
Ce guide exhaustif a pour vocation de vous accompagner, étape par étape, dans la réalisation intégrale d’une analyse de variance unidirectionnelle à la main, sans recourir à un quelconque outil automatisé autre qu’une calculatrice arithmétique de base. À travers un protocole expérimental complet issu de la recherche en psychologie cognitive portant sur l’efficacité comparée de plusieurs méthodes pédagogiques, chaque formule mathématique sera explicitée, démontrée et appliquée avec une transparence arithmétique totale. De l’élaboration épistémologique des hypothèses nulles et alternatives jusqu’au calcul de la taille d’effet et aux tests d’ajustement post-hoc, vous découvrirez les rouages mathématiques profonds de cet outil d’évaluation scientifique majeur.
1. Fondements théoriques et épistémologiques de l’ANOVA à un facteur en psychologie
1.1 Définition et principe de l’analyse de variance unidirectionnelle
L’analyse de variance unidirectionnelle inter-sujets (ou ANOVA à un facteur contrôlé) tire son origine historique des travaux séminaux du statisticien et généticien britannique Ronald Aylmer Fisher dans les années 1920. Confronté à la nécessité d’évaluer la productivité de différentes variétés de cultures soumises à de multiples engrais sur les parcelles de la station expérimentale de Rothamsted, Fisher conçut une armature théorique révolutionnaire visant à comparer simultanément plusieurs distributions empiriques sans dégrader la robustesse du contrôle probabiliste. L’ANOVA constitue formellement l’extension mathématique directe du test t de Student appliqué à deux échantillons indépendants : lorsque le nombre de modalités d’un facteur expérimental dépasse deux, le test t devient structurellement inapplicable de manière isolée sans violer des postulats stochastiques fondamentaux.
Le principe fondamental de l’ANOVA repose sur un paradoxe apparent d’une singulière élégance conceptuelle : pour tester si des moyennes de populations sont égales entre elles, la méthode ne compare pas directement les moyennes sous forme d’écarts absolus, mais procède à l’évaluation et au partitionnement de la variance totale observée au sein de l’ensemble des scores individuels. L’architecture de Fisher postule que l’hétérogénéité globale des observations mesurées sur une échelle continue est la résultante additive de deux sources distinctes et mutuellement exclusives : d’une part, la variabilité existant entre les différents groupes expérimentaux (variabilité inter-groupes ou Between-groups variance), et d’autre part, la variabilité régnant au sein même de chaque groupe (variabilité intra-groupe ou Within-groups variance).
D’un point de vue épistémologique, la variabilité inter-groupes capture l’amplitude des déviations systématiques produites par la manipulation expérimentale opérée par le chercheur (le traitement ou l’intervention psychologique), additionnée à d’inévitables fluctuations d’échantillonnage. En miroir, la variabilité intra-groupe reflète le bruit stochastique, c’est-à-dire l’ensemble des fluctuations individuelles non contrôlées, les idiosyncrasies biologiques, psychologiques ou motivationnelles des participants, ainsi que l’erreur de mesure inhérente à tout instrument psychométrique. Si l’effet du traitement expérimental est réel, la dispersion des moyennes des sous-échantillons autour du barycentre général des données sera substantiellement supérieure à la dispersion interne des individus autour de la moyenne de leur condition respective.
1.2 Nécessité de l’ANOVA face à la multiplication des tests t
Une interrogation récurrente chez l’apprenti chercheur réside dans la tentation apparente de décomposer une comparaison à $k$ groupes (où $k ge 3$) en une série de tests t de Student appliqués à chaque paire d’échantillons envisageable. Cette démarche, bien qu’intuitive, conduit à une impasse méthodologique majeure connue sous le nom d’inflation du risque d’erreur de première espèce (erreur de type I, symbolisée conventionnellement par la lettre grecque $\alpha$). Le risque $\alpha$ correspond à la probabilité de rejeter à tort l’hypothèse nulle ($H_0$), c’est-à-dire de conclure faussement à l’existence d’une différence significative entre deux conditions alors que cette divergence n’est qu’un artéfact imputable aux fluctuations aléatoires de l’échantillonnage.
Lorsqu’un chercheur réalise une série de $c$ tests d’hypothèses indépendants, le taux global d’erreur par famille (family-wise error rate, ou FWER) ne demeure plus confiné au seuil nominal désiré (généralement $\alpha = 0{,}05$), mais croît de manière exponentielle selon la loi binomiale des probabilités combinées. La formule mathématique définissant la borne supérieure de ce risque d’erreur cumulé s’écrit formellement :
$$\alpha_{\text{global}} = 1 – (1 – \alpha)^c$$
Dans cette relation, $c$ représente le nombre total de comparaisons binaires distinctes requises pour épuiser toutes les combinaisons possibles entre $k$ modalités, déterminé par le coefficient binomial :
$$c = \frac{k(k – 1)}{2}$$
Ainsi, dans une expérience impliquant seulement quatre conditions expérimentales distinctes ($k = 4$), le nombre de comparaisons par paires s’élève à $c = 4(3)/2 = 6$. Si chaque test est conduit au seuil standard $\alpha = 0{,}05$, le risque effectif de commettre au moins une fausse déclaration positive s’établit à :
$$\alpha_{\text{global}} = 1 – (1 – 0{,}05)^6 = 1 – (0{,}95)^6 \approx 1 – 0{,}7351 = 0{,}2649$$
Le chercheur s’expose alors à un risque supérieur à 26,49 % de rapporter une découverte fallacieuse, rendant les conclusions expérimentales totalement caduques. L’ANOVA remédie à ce fléau par l’intermédiaire d’une procédure omnibus unique : elle évalue l’ensemble des données dans un cadre mathématique global unifié, garantissant de façon inconditionnelle le respect strict du seuil nominal de significativité $\alpha$ pour l’ensemble du protocole avant toute analyse ciblée ultérieure.
1.3 Cadre conceptuel des variables indépendantes et dépendantes
L’opérationnalisation d’une ANOVA à un facteur exige une structuration rigoureuse du plan d’expérience en distinguant sans ambiguïté les statuts fonctionnels des variables mobilisées. La Variable Indépendante (VI), fréquemment désignée sous le vocable de facteur ou de prédicteur nominal, est une variable catégorielle discrète comportant $k$ niveaux ou modalités mutuellement exclusives. Dans le cadre d’un plan inter-sujets (ou plan à mesures indépendantes), chaque participant ou unité statistique est assigné à une et une seule modalité du facteur. Ces modalités peuvent correspondre soit à des catégories naturelles observées (comme des tranches d’âge ou des sous-types cliniques prédéterminés), soit à des conditions de traitement manipulées activement par l’expérimentateur (comme l’administration de divers dosages pharmacologiques ou de différents protocoles de remédiation cognitive).
À l’opposé, la Variable Dépendante (VD) représente l’indicateur mesuré chez les sujets afin d’estimer l’impact potentiel du facteur expérimental. Par nature, la VD doit obligatoirement être quantitative et continue, ou à tout le moins mesurée sur une échelle d’intervalles ou de rapports pour que les opérations d’addition, de calcul de moyennes arithmétiques et d’élévation au carré conservent un sens mathématique et métrologique plein. En psychologie comportementale, cette variable peut être un temps de réaction en millisecondes, le score d’efficience à une batterie d’évaluation neuropsychologique standardisée, ou encore le taux de rétention mémorielle.
La validité interne du dispositif repose de façon décisive sur les procédures d’échantillonnage probabiliste et de randomisation. L’assignation aléatoire intégrale des participants aux différents groupes de traitement constitue la garantie mathématique que les caractéristiques individuelles non contrôlées (intelligence globale, stabilité émotionnelle, statut socio-économique) se distribuent de manière uniforme entre les conditions. Cette équivalence initiale permet d’évacuer les biais de confusion systématiques et confère à l’ANOVA la puissance d’une véritable inférence causale. Dans les dispositifs quasi-expérimentaux où la randomisation est impossible (par exemple lors de la comparaison de groupes d’individus porteurs de traumatismes cérébraux spécifiques), l’analyste doit redoubler de vigilance épistémologique : les différences de moyennes constatées ne pourront être imputées univoquement au facteur sans une discussion approfondie des variables parasites concomitantes.
2. Formulation rigoureuse des hypothèses statistiques et choix du seuil alpha
2.1 Définition de l’hypothèse nulle (H0) et de l’hypothèse alternative (H1)
La mécanique inférentielle de l’ANOVA s’inscrit pleinement dans le cadre néo-fisherien et de Neyman-Pearson du test de signification d’hypothèse nulle (NHST). La première démarche indispensable consiste à expliciter formellement les propositions théoriques sous une forme mathématique non ambiguë. L’hypothèse nulle, notée $H_0$, postule l’absence totale d’effet de la variable indépendante sur la variable dépendante au sein de la population parente dont sont extraits les échantillons. Autrement formulé, elle pose l’identité stricte des paramètres de tendance centrale pour l’ensemble des $k$ populations sous-jacentes :
$$H_0 : \mu_1 = \mu_2 = dots = \mu_k$$
Dans cette équation, $\mu_j$ symbolise la moyenne paramétrique théorique de la population exposée à la $j$-ième modalité du traitement expérimental. Sous la véracité de $H_0$, toute différence observable entre les moyennes empiriques d’échantillons $\bar{X}_1, \bar{X}_2, dots, \bar{X}_k$ ne relève exclusivement que de l’aléa de l’échantillonnage et de l’erreur d’estimation.
L’hypothèse alternative, notée $H_1$, ne postule pas simplement que toutes les moyennes diffèrent mutuellement les unes des autres de façon ordonnée. Elle stipule avec précision qu’au moins une des moyennes de population dévie des autres, ce qui s’écrit de manière formelle :
$$H_1 : \exists , (i, j) \quad \text{tel que} \quad \mu_i \neq \mu_j \quad (\text{a\vec } i \neq j)$$
Il est capital de souligner le caractère fondamentalement non directionnel et omnibus du test d’analyse de variance. À ce stade du raisonnement statistique, $H_1$ ne fournit aucune indication sur l’architecture précise des disparités : elle ne précise pas quel groupe domine l’autre, ni si l’écart est concentré sur un contraste particulier ou distribué sur toutes les conditions. Le rejet de $H_0$ autorise seulement le chercheur à affirmer, avec un risque probabiliste maîtrisé, que le modèle fondé sur l’égalité globale est insoutenable au vu des preuves empiriques accumulées.
2.2 Fixation et justification du seuil de signification statistique
La fixation du seuil de signification statistique $\alpha$ doit impérativement intervenir a priori, c’est-à-dire en amont immédiat de la collecte des données et de l’engagement des opérations arithmétiques, afin de prémunir l’expérimentateur contre tout biais de confirmation post-hoc. En psychologie et en sciences sociales, la convention universelle héritée de Fisher établit ce seuil critique à la valeur $\alpha = 0{,}05$, bien que des seuils plus conservateurs, tels que $\alpha = 0{,}01$ ou $\alpha = 0{,}001$, soient fréquemment requis dans les recherches biomédicales ou translationnelles à fort enjeu clinique.
D’un point de vue décisionnel, le choix du seuil $\alpha$ matérialise l’arbitrage théorique et philosophique opéré entre le risque d’erreur de première espèce et le risque d’erreur de deuxième espèce (noté $\beta$). Ce dernier quantifie la probabilité d’échouer à rejeter l’hypothèse nulle $H_0$ alors que cette dernière est en réalité fausse dans le monde réel (manque de sensibilité ou faux négatif). La grandeur complémentaire, définie par $1 – \beta$, constitue la puissance statistique du test, qui mesure l’aptitude effective de l’investigation empirique à identifier un effet réel d’une magnitude donnée. Réduire aveuglément $\alpha$ de 0,05 à 0,001 diminue certes drastiquement l’occurrence de faux positifs, mais gonfle mécaniquement l’erreur $\beta$ et compromet la capacité du chercheur à détecter des effets authentiques mais d’intensité modérée.
L’estimation a priori de la taille d’échantillon nécessaire à l’aide d’analyses de puissance statistique (mobilisant des logiciels dédiés comme G*Power) constitue le complément indispensable de la fixation du seuil alpha. En anticipant la taille de l’effet escomptée à travers la littérature scientifique antérieure, le chercheur calcule le volume d’observations requis par condition afin d’assurer une puissance minimale conventionnelle de $1 – \beta = 0{,}80$, seuil en deçà duquel la recherche souffre d’une fragilité méthodologique rédhibitoire.
3. Conditions d’application et postulats fondamentaux de l’ANOVA
3.1 Normalité de la distribution de la variable dépendante
L’édifice mathématique de l’analyse de variance repose sur une dérivation formelle qui implique que la variable dépendante continue se distribue selon une loi normale au sein de chacune des $k$ sous-populations étudiées. En d’autres termes, pour chaque modalité $j$ de la variable indépendante, les scores individuels $Y_{ij}$ doivent suivre une distribution gaussienne paramétrée par la moyenne spécifique $\mu_j$ et une variance théorique commune $\sigma^2$, ce qui s’exprime sous la forme :
$$Y_{ij} \sim \mathcal{N}(\mu_j, \sigma^2)$$
D’un point de vue opérationnel et résiduel, cette condition équivaut à exiger que les résidus du modèle linéaire sous-jacent (définis par la soustraction $e_{ij} = Y_{ij} – \bar{Y}_j$) soient distribués selon une loi normale centrée en zéro d’écart-type résiduel constant : $e_{ij} \sim \mathcal{N}(0, \sigma^2)$.
En dépit de cette exigence formelle, l’ANOVA est traditionnellement réputée pour sa remarquable robustesse statistique face aux déviations modérées vis-à-vis de la normalité. Cette résilience théorique s’explique principalement par le théorème central limite, lequel garantit que la distribution des moyennes d’échantillonnage tend asymptotiquement vers une loi gaussienne à mesure que la taille des effectifs augmente, même si les observations brutes manifestent une légère asymétrie. Dans le cadre de calculs conduits à la main ou d’évaluations préliminaires sans logiciel complexe, le chercheur examine la distribution des scores à travers la construction de diagrammes de dispersion, l’inspection visuelle de tracés quantiles-quantiles (Q-Q plots) ou la vérification empirique du coefficient d’asymétrie (skewness) et du coefficient d’aplatissement (kurtosis).
Néanmoins, lorsque les distributions présentent une asymétrie extrême (par exemple lors de l’étude de temps de latence fortement étirés vers la droite) ou des profils multimodaux marqués sur des échantillons de faibles dimensions ($n < 15$), la forme théorique de la distribution d'échantillonnage de la statistique $F$ est corrompue. Les taux d'erreur effectifs dérivent alors significativement du seuil $\alpha$ théorique fixé par l'analyste, rendant impératif le recours à des transformations d'échelle (logarithmique, racine carrée) ou à des alternatives non paramétriques comme le test de Kruskal-Wallis.
3.2 Homogénéité des variances ou homoscédasticité
Le second postulat cardinal de l’analyse de variance unidirectionnelle classique réside dans l’hypothèse d’homogénéité des variances, techniquement qualifiée d’homoscédasticité. Cette règle impose que la dispersion interne des observations autour de leur moyenne de groupe respective soit rigoureusement identique à travers l’ensemble des $k$ sous-populations examinées. Formellement, les variances théoriques doivent vérifier l’égalité :
$$\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2 = \sigma^2$$
Cette condition d’égalité est indispensable car la formule canonique de l’ANOVA regroupe (ou « mutualise », en anglais pools) les différentes variances intra-groupes calculées pour former un unique estimateur sans biais du bruit aléatoire global $\sigma^2$. Si les variances des populations d’origine divergent de manière substantielle (situation d’hétéroscédasticité), cette mutualisation produit une distorsion arithmétique globale, attribuant indûment un poids égal à des groupes présentant des instabilités stochastiques foncièrement différentes.
Dans un contexte de traitement manuel, l’évaluation de l’homoscédasticité peut être menée avec célérité par l’intermédiaire du ratio de Hartley (désigné sous le terme de test $F_{\max}$). Ce critère d’inspection pragmatique se calcule en divisant la plus grande des variances échantillonnales obtenues par la plus faible d’entre elles :
$$F_{\max} = \frac{s^2_{\max}}{s^2_{\min}}$$
Ce ratio empirique est ensuite comparé aux valeurs seuils tabulées par H. O. Hartley en fonction du nombre de groupes $k$ et des degrés de liberté de l’échantillon. En règle générale, au sein de plans dits « équilibrés » comportant des effectifs rigoureusement identiques dans chaque condition ($n_1 = n_2 = dots = n_k$), l’analyse de variance manifeste une très forte tolérance aux écarts d’homogénéité : tant que le ratio $F_{\max}$ ne franchit pas le seuil de 3 ou 4, le taux d’erreur empirique de type I demeure confiné aux abords immédiats du seuil de 5 %. À l’inverse, dès lors que les effectifs de groupe deviennent disparates (plans non équilibrés), la conjonction d’hétéroscédasticité et d’inégalité d’effectifs détruit la fiabilité du test : si les groupes les plus restreints présentent les variances les plus massives, le taux d’erreur de première espèce s’envole de manière incontrôlable bien au-delà de la tolérance nominale.
3.3 Indépendance des observations et des erreurs de mesure
S’il existe un postulat dont la violation s’avère totalement fatale pour l’ANOVA, c’est indiscutablement celui de l’indépendance statistique des observations et de leurs erreurs résiduelles associées. Mathématiquement, la covariance stochastique entre deux erreurs quelconques $e_{ij}$ et $e_{i’j’}$ doit être rigoureusement nulle pour toute paire d’observations distinctes :
$$operatorname{Cov}(e_{ij}, e_{i’j’}) = 0 \quad \text{pour tout } (i, j) \neq (i’, j’)$$
Ce postulat impose que la performance ou le score manifesté par un participant donné ne subisse aucune forme de dépendance, d’influence, de contagion ou de corrélation vis-à-vis du score produit par un quelconque autre individu de la cohorte. Contrairement aux postulats de normalité et d’homoscédasticité, pour lesquels des approximations et des compensations robustes existent, l’analyse de variance ne possède aucune immunité face à la non-indépendance. La plus infime corrélation positive non contrôlée entre les observations au sein d’une même modalité entraîne une sous-estimation massive du dénominateur d’erreur résiduelle, provoquant une explosion artificielle de la statistique $F$ observée et générant des taux de faux positifs pouvant atteindre 30 % à 50 % pour un seuil nominal théoriquement assigné à 5 %.
La garantie de l’indépendance ne relève pas d’une correction mathématique post-hoc mais d’un contrôle méthodologique intransigeant lors de l’exécution empirique du protocole. Elle requiert une administration scrupuleuse évitant les effets d’entraînement de groupe (par exemple, des étudiants testés collectivement dans une même salle où des réactions murmurées peuvent s’interconnecter), une séparation spatiale et temporelle des passations, et une attribution strictement randomisée des unités statistiques aux diverses conditions. Il convient en outre de distinguer catégoriquement les protocoles inter-sujets (mesures indépendantes) des protocoles intra-sujets (mesures répétées sur les mêmes individus), ces derniers nécessitant des aménagements mathématiques radicalement distincts (ANOVA à mesures répétées intégrant des corrections spécifiques de sphéricité).
4. Protocole expérimental et données chiffrées de l’étude de cas
4.1 Contexte de recherche : comparaison de trois méthodes d’apprentissage
Afin d’incarner de manière concrète l’intégralité des calculs manuels qui vont suivre, nous élaborons une expérimentation pédagogique fictive mais rigoureusement représentative des protocoles en psychologie cognitive et en sciences de l’éducation. Un laboratoire universitaire s’intéresse à l’optimisation des performances d’acquisition et de restitution mnésique de concepts complexes en biologie cellulaire chez des étudiants de premier cycle universitaire. L’équipe d’enseignants-chercheurs souhaite comparer l’efficacité de trois dispositifs didactiques distincts.
Le protocole comporte un unique facteur inter-sujets (la méthode d’apprentissage) décliné en trois modalités exclusives ($k = 3$) :
- Programme A (Méthode passive) : Les étudiants assistent à un cours magistral standardisé d’une durée de deux heures, dispensé sous forme de monologue magistral traditionnel avec projection passive de diapositives d’illustrations statiques.
- Programme B (Méthode active) : Les participants sont placés dans un environnement d’apprentissage dynamique fondé sur la résolution coopérative de problèmes cliniques, l’interrogation socratique réciproque et l’auto-évaluation formative continue durant deux heures.
- Programme C (Méthode mixte / hybride) : Ce protocole alterne une phase d’exposition théorique condensée de quarante-cinq minutes et une heure et quart d’ateliers interactifs et de manipulation de cartes conceptuelles numériques.
Trente étudiants ($N = 30$) volontaires et n’ayant jamais suivi de module d’immunologie ou de cytologie sont sélectionnés et assignés aléatoirement, à l’aide d’une table de nombres aléatoires, à l’un des trois programmes à raison de dix participants par condition ($n_1 = n_2 = n_3 = 10$). Le plan d’expérience est donc parfaitement équilibré. Au terme de l’intervention pédagogique respective, l’ensemble des participants subit une épreuve d’évaluation standardisée anonyme, notée de 0 à 20, comprenant des questions d’intégration conceptuelle de haut niveau taxonomique. Ce score constitue la Variable Dépendante quantitative continue de notre étude.
4.2 Tableau exhaustif des scores bruts obtenus par groupe
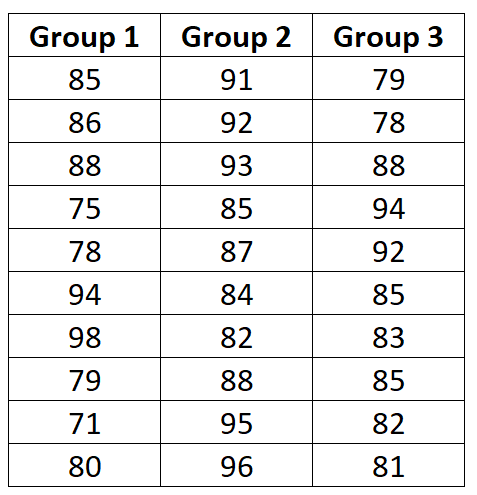
L’intégrité de la démarche manuelle impose de disposer des données individuelles brutes sous leur forme originale non condensée. Le tableau ci-après présente les notes sur vingt recueillies de manière indépendante auprès des trente participants répartis au sein des trois cohortes expérimentales.
| Numéro d’ordre ($i$) | Groupe 1 : Programme A (Passif) | Groupe 2 : Programme B (Actif) | Groupe 3 : Programme C (Mixte) |
|---|---|---|---|
| Participant 1 | 8 | 13 | 12 |
| Participant 2 | 9 | 14 | 13 |
| Participant 3 | 10 | 16 | 15 |
| Participant 4 | 11 | 15 | 14 |
| Participant 5 | 10 | 17 | 16 |
| Participant 6 | 12 | 15 | 13 |
| Participant 7 | 9 | 14 | 15 |
| Participant 8 | 8 | 16 | 14 |
| Participant 9 | 11 | 15 | 13 |
| Participant 10 | 12 | 15 | 15 |
L’inspection des données initiales révèle une structuration claire : les étudiants soumis à la modalité magistrale passive semblent plafonner autour de valeurs moyennes inférieures à 12, tandis que les approches dynamiques et combinées génèrent des distributions manifestement translatées vers le haut de l’échelle d’évaluation. Il appartient désormais aux opérations d’inférence de déterminer si ces disparités descriptives excèdent ce qui peut résulter du seul jeu de l’erreur fortuite.
4.3 Calculs préliminaires : sommes et sommes des carrés individuelles
Pour mener à bien une ANOVA manuelle sans s’épuiser dans des réitérations fastidieuses de soustractions élémentaires, la stratégie de calcul la plus robuste consiste à établir immédiatement les totaux de groupe, symbolisés par $T_j = \sum_{i=1}^{n_j} X_{ij}$, ainsi que la somme de chaque valeur brute individuellement élevée au carré au sein de chaque modalité, notée $\sum_{i=1}^{n_j} X_{ij}^2$.
Procédons scrupuleusement au décompte pour le Groupe 1 (Programme A) :
$$T_1 = \sum X_{i1} = 8 + 9 + 10 + 11 + 10 + 12 + 9 + 8 + 11 + 12 = 100$$
$$\sum X_{i1}^2 = 8^2 + 9^2 + 10^2 + 11^2 + 10^2 + 12^2 + 9^2 + 8^2 + 11^2 + 12^2$$
$$\sum X_{i1}^2 = 64 + 81 + 100 + 121 + 100 + 144 + 81 + 64 + 121 + 144 = 1,020$$
Exécutons les mêmes opérations pour le Groupe 2 (Programme B) :
$$T_2 = \sum X_{i2} = 13 + 14 + 16 + 15 + 17 + 15 + 14 + 16 + 15 + 15 = 150$$
$$\sum X_{i2}^2 = 13^2 + 14^2 + 16^2 + 15^2 + 17^2 + 15^2 + 14^2 + 16^2 + 15^2 + 15^2$$
$$\sum X_{i2}^2 = 169 + 196 + 256 + 225 + 289 + 225 + 196 + 256 + 225 + 225 = 2,262$$
Appliquons enfin la procédure au Groupe 3 (Programme C) :
$$T_3 = \sum X_{i3} = 12 + 13 + 15 + 14 + 16 + 13 + 15 + 14 + 13 + 15 = 140$$
$$\sum X_{i3}^2 = 12^2 + 13^2 + 15^2 + 14^2 + 16^2 + 13^2 + 15^2 + 14^2 + 13^2 + 15^2$$
$$\sum X_{i3}^2 = 144 + 169 + 225 + 196 + 256 + 169 + 225 + 196 + 169 + 225 = 1,974$$
Synthétisons les grandeurs macroscopiques transversales indispensables aux étapes suivantes :
Le Grand Total ($G$), représentant la somme arithmétique globale de l’intégralité des trente mesures, vaut :
$$G = \sum_{j=1}^{k} T_j = T_1 + T_2 + T_3 = 100 + 150 + 140 = 390$$
La somme globale de tous les scores individuels élevés au carré dans l’ensemble de l’expérience s’élève à :
$$\sum_{\text{total}} X^2 = \sum X_{i1}^2 + \sum X_{i2}^2 + \sum X_{i3}^2 = 1,020 + 2,262 + 1,974 = 5,256$$
L’effectif total d’observations collectées est formalisé par :
$$N = \sum_{j=1}^{k} n_j = 10 + 10 + 10 = 30$$
Ces totaux vérifiés constituent l’assise chiffrée définitive sur laquelle reposera l’ensemble de notre démonstration analytique.
5. Étape 1 : Calcul manuel des moyennes de groupes et de la moyenne globale
5.1 Détermination des moyennes arithmétiques d’échantillon
L’amorce de la procédure analytique réside dans l’extraction des indicateurs de tendance centrale propres à chaque sous-échantillon expérimental. La moyenne d’un groupe, désignée universellement par $\bar{X}_j$, s’obtient en divisant la somme cumulée des scores dudit groupe par son effectif d’observations correspondant :
$$\bar{X}_j = \frac{T_j}{n_j} = \frac{\sum_{i=1}^{n_j} X_{ij}}{n_j}$$
Pour le Groupe 1 (Programme A – Pédagogie passive) :
$$\bar{X}_1 = \frac{100}{10} = 10{,}00$$
La cohorte exposée au format magistral traditionnel obtient ainsi une moyenne exacte de 10 sur 20, se positionnant tout juste au seuil de validation académique standard.
Pour le Groupe 2 (Programme B – Pédagogie active) :
$$\bar{X}_2 = \frac{150}{10} = 15{,}00$$
Les étudiants formés par les approches interactives de coopération et de résolution de cas enregistrent une performance moyenne substantiellement supérieure, culminant à 15 sur 20.
Pour le Groupe 3 (Programme C – Approche hybride) :
$$\bar{X}_3 = \frac{140}{10} = 14{,}00$$
Le groupe ayant bénéficié d’une combinaison magistrale et pratique atteint une moyenne arithmétique de 14 sur 20, démontrant une progression très nette par rapport à l’écoute passive, bien que légèrement en deçà de l’immersion active intégrale.
Ce premier niveau descriptif montre une divergence d’amplitude remarquable, avec un écart maximal de 5 points entiers entre les programmes A et B sur une échelle bornée à 20. Toutefois, cette disparité manifeste d’échantillon ne constitue pas en soi une preuve statistique : il reste impératif de confronter cette dispersion à la variabilité aléatoire interne des sujets.
5.2 Calcul de la moyenne générale (Grand Mean)
La moyenne globale ou « grande moyenne » (désignée dans la littérature anglophone sous l’appellation Grand Mean et symbolisée formellement par $\bar{X}_{\text{globale}}$ ou $\bar{\bar{X}}$) représente le centre de gravité arithmétique absolu de l’ensemble des données expérimentales combinées, indépendamment de toute considération relative aux modalités de traitement.
D’une façon générale, lorsque les tailles d’échantillons varient d’une condition à l’autre, la grande moyenne doit être impérativement calculée sous forme d’une moyenne pondérée des moyennes de groupes :
$$\bar{X}_{\text{globale}} = \frac{\sum_{j=1}^{k} n_j \bar{X}_j}{N}$$
Dans notre étude de cas, le plan expérimental étant strictement équilibré ($n_1 = n_2 = n_3 = 10$), cette formule pondérée coïncide rigoureusement avec la simple moyenne arithmétique non pondérée des moyennes de groupes :
$$\bar{X}_{\text{globale}} = \frac{\bar{X}_1 + \bar{X}_2 + \bar{X}_3}{k} = \frac{10{,}00 + 15{,}00 + 14{,}00}{3} = \frac{39{,}00}{3} = 13{,}00$$
Alternativement, l’obtention de cette valeur par division du grand total d’observations par l’effectif total d’individus offre une confirmation arithmétique instantanée :
$$\bar{X}_{\text{globale}} = \frac{G}{N} = \frac{390}{30} = 13{,}00$$
Cette grandeur charnière ($\bar{X}_{\text{globale}} = 13{,}00$) joue un rôle structural décisif dans l’ANOVA : elle incarne le point de référence central, l’origine métrique par rapport à laquelle s’évalueront les déviations de nos trois sous-groupes (au titre de la variabilité inter-groupes) ainsi que la dispersion générale de l’ensemble des trente étudiants (au titre de la variabilité globale).
6. Étape 2 : Calcul de la somme des carrés inter-groupes (SSB / SSR)
6.1 Compréhension conceptuelle de la variabilité expliquée par le modèle
La somme des carrés inter-groupes (symbolisée par $SS_{\text{inter}}$, $SSB$ pour Sum of Squares Between, ou encore $SSR$ pour Sum of Squares due to Treatment / Regression) représente le cœur mathématique de l’effet expérimental. Elle quantifie précisément l’intensité avec laquelle les moyennes des différents groupes s’écartent et oscillent autour de la grande moyenne générale.
Conceptuellement, si l’hypothèse nulle était rigoureusement exacte au centième près au niveau de la population générale, et s’il n’existait aucune fluctuation aléatoire d’échantillonnage, les moyennes de chaque condition convergeraient parfaitement vers une valeur unique : nous aurions alors $\bar{X}_1 = \bar{X}_2 = \bar{X}_3 = \bar{X}_{\text{globale}}$. Dans cette configuration idéale, la différence $(\bar{X}_j – \bar{X}_{\text{globale}})$ s’annulerait pour chaque groupe, et la valeur de $SSB$ serait strictement égale à zéro. Plus l’impact spécifique de la variable manipulée (les programmes d’enseignement) est puissant, plus les étudiants réagissent différemment d’une condition à l’autre, et plus les moyennes de groupe s’éloignent du barycentre général, entraînant une amplification directe de la grandeur de $SSB$.
La $SSB$ matérialise donc la variabilité dite « expliquée » par le modèle d’analyse. Elle correspond à la part de l’hétérogénéité totale des notes qui est directement imputable au fait d’avoir été assigné au programme passif, actif ou hybride plutôt qu’à une distribution purement contingente du hasard.
6.2 Application pas à pas de la formule de définition
La formulation théorique fondamentale de la somme des carrés inter-groupes stipule que l’on doit calculer l’écart séparant chaque moyenne empirique de groupe de la grande moyenne globale, élever cette déviation au carré afin d’en neutraliser la polarité (les écarts négatifs s’annulant sinon avec les écarts positifs), multiplier ce carré par l’effectif du groupe considéré pour pondérer son importance, et enfin sommer ces termes pondérés pour l’ensemble des $k$ groupes :
$$SSB = \sum_{j=1}^{k} n_j (\bar{X}_j – \bar{X}_{\text{globale}})^2$$
Développons explicitement chaque terme numérique pour nos trois conditions :
Pour le Groupe 1 :
$$\text{Déviation} = \bar{X}_1 – \bar{X}_{\text{globale}} = 10{,}00 – 13{,}00 = -3{,}00$$
$$\text{Déviation au carré} = (-3{,}00)^2 = 9{,}00$$
$$\text{Terme pondéré } n_1 (\bar{X}_1 – \bar{X}_{\text{globale}})^2 = 10 \times 9{,}00 = 90{,}00$$
Pour le Groupe 2 :
$$\text{Déviation} = \bar{X}_2 – \bar{X}_{\text{globale}} = 15{,}00 – 13{,}00 = +2{,}00$$
$$\text{Déviation au carré} = (2{,}00)^2 = 4{,}00$$
$$\text{Terme pondéré } n_2 (\bar{X}_2 – \bar{X}_{\text{globale}})^2 = 10 \times 4{,}00 = 40{,}00$$
Pour le Groupe 3 :
$$\text{Déviation} = \bar{X}_3 – \bar{X}_{\text{globale}} = 14{,}00 – 13{,}00 = +1{,}00$$
$$\text{Déviation au carré} = (1{,}00)^2 = 1{,}00$$
$$\text{Terme pondéré } n_3 (\bar{X}_3 – \bar{X}_{\text{globale}})^2 = 10 \times 1{,}00 = 10{,}00$$
La sommation des trois contributions élémentaires délivre la valeur finale exacte de la somme des carrés inter-groupes :
$$SSB = 90{,}00 + 40{,}00 + 10{,}00 = 140{,}00$$
6.3 Démonstration de la formule de calcul direct
Bien que la formule conceptuelle soit parfaitement transparente lorsque les moyennes d’échantillons tombent sur des entiers parfaits, elle engendre d’importantes erreurs d’arrondi dès que les valeurs moyennes comportent de multiples décimales récurrentes. Pour cette raison, les statisticiens privilégient la formule de calcul direct (ou formule machine), fondée exclusivement sur les totaux de groupe $T_j$ et le grand total $G$. Cette formulation s’énonce ainsi :
$$SSB = \left( \sum_{j=1}^{k} \frac{T_j^2}{n_j} \right) – \frac{G^2}{N}$$
Le second terme, $\frac{G^2}{N}$, est traditionnellement dénommé « terme de correction » ou « facteur de correction » ($CF$, pour Correction Factor). Calculons isolément ce terme correctif pour notre dispositif :
$$CF = \frac{G^2}{N} = \frac{(390)^2}{30} = \frac{152,100}{30} = 5,070{,}00$$
Évaluons à présent le premier terme regroupant la somme des carrés des totaux de groupes divisés par leurs effectifs :
$$\sum_{j=1}^{k} \frac{T_j^2}{n_j} = \frac{T_1^2}{n_1} + \frac{T_2^2}{n_2} + \frac{T_3^2}{n_3} = \frac{(100)^2}{10} + \frac{(150)^2}{10} + \frac{(140)^2}{10}$$
$$\sum_{j=1}^{k} \frac{T_j^2}{n_j} = \frac{10,000}{10} + \frac{22,500}{10} + \frac{19,600}{10} = 1,000 + 2,250 + 1,960 = 5,210{,}00$$
Il ne reste plus qu’à opérer la soustraction :
$$SSB = 5,210{,}00 – 5,070{,}00 = 140{,}00$$
Nous constatons avec une satisfaction arithmétique totale la concordance absolue des deux approches ($SSB = 140{,}00$), ce qui certifie l’exactitude de nos calculs intermédiaires.
7. Étape 3 : Calcul de la somme des carrés intra-groupes (SSW / SSE)
7.1 Fondement conceptuel de la variabilité d’erreur résiduelle
La somme des carrés intra-groupes (désignée par $SS_{\text{intra}}$, $SSW$ pour Sum of Squares Within, ou encore $SSE$ pour Sum of Squares Error) incarne la variabilité inexpliquée ou résiduelle. Elle mesure l’ampleur de la dispersion des scores individuels à l’intérieur même de chaque modalité de traitement, par rapport à la moyenne spécifique de cette modalité.
L’assise épistémologique de cette grandeur mérite une attention particulière : les dix étudiants composant le Groupe 1 ont tous suivi rigoureusement le même enseignement magistral, dans les mêmes conditions matérielles, avec les mêmes supports et la même durée d’exposition. Pourtant, leurs scores ne sont pas tous uniformément égaux à 10 : certains obtiennent 8, d’autres 9, 11 ou 12. Dès lors que la variable indépendante est parfaitement constante au sein de ce sous-groupe, ces écarts individuels ne peuvent en aucune manière être imputés au programme d’enseignement.
Cette dispersion intra-groupe puise son origine dans les différences interindividuelles préexistantes (capacités mnésiques initiales, état de fatigue lors de l’examen, motivation intrinsèque) et dans l’erreur de mesure non systématique. Elle constitue le « bruit » de fond de l’expérience. L’ANOVA fait le postulat que cette dynamique de bruit s’exprime librement et indépendamment à l’intérieur de chacune des conditions expérimentales, et que l’agrégation de ces variances internes permettra de mesurer la précision basale de l’univers d’étude.
7.2 Calcul manuel des écarts individuels par rapport à leur moyenne de groupe
La formulation conceptuelle de la somme des carrés intra-groupes nécessite de mesurer la déviation de chaque score individuel $X_{ij}$ par rapport à la moyenne de son groupe de rattachement $\bar{X}_j$, d’élever cette déviation au carré, et de sommer l’ensemble des carrés obtenus à travers tous les individus de tous les groupes :
$$SSW = \sum_{j=1}^{k} \sum_{i=1}^{n_j} (X_{ij} – \bar{X}_j)^2$$
Détaillons scrupuleusement cette opération cohorte par cohorte.
Pour le Groupe 1 (Moyenne $\bar{X}_1 = 10{,}00$) :
- Participant 1 : $(8 – 10)^2 = (-2)^2 = 4$
- Participant 2 : $(9 – 10)^2 = (-1)^2 = 1$
- Participant 3 : $(10 – 10)^2 = (0)^2 = 0$
- Participant 4 : $(11 – 10)^2 = (1)^2 = 1$
- Participant 5 : $(10 – 10)^2 = (0)^2 = 0$
- Participant 6 : $(12 – 10)^2 = (2)^2 = 4$
- Participant 7 : $(9 – 10)^2 = (-1)^2 = 1$
- Participant 8 : $(8 – 10)^2 = (-2)^2 = 4$
- Participant 9 : $(11 – 10)^2 = (1)^2 = 1$
- Participant 10 : $(12 – 10)^2 = (2)^2 = 4$
Somme des carrés pour le Groupe 1 ($SS_1$) :
$$SS_1 = 4 + 1 + 0 + 1 + 0 + 4 + 1 + 4 + 1 + 4 = 20{,}00$$
Pour le Groupe 2 (Moyenne $\bar{X}_2 = 15{,}00$) :
- Participant 1 : $(13 – 15)^2 = (-2)^2 = 4$
- Participant 2 : $(14 – 15)^2 = (-1)^2 = 1$
- Participant 3 : $(16 – 15)^2 = (1)^2 = 1$
- Participant 4 : $(15 – 15)^2 = (0)^2 = 0$
- Participant 5 : $(17 – 15)^2 = (2)^2 = 4$
- Participant 6 : $(15 – 15)^2 = (0)^2 = 0$
- Participant 7 : $(14 – 15)^2 = (-1)^2 = 1$
- Participant 8 : $(16 – 15)^2 = (1)^2 = 1$
- Participant 9 : $(15 – 15)^2 = (0)^2 = 0$
- Participant 10 : $(15 – 15)^2 = (0)^2 = 0$
Somme des carrés pour le Groupe 2 ($SS_2$) :
$$SS_2 = 4 + 1 + 1 + 0 + 4 + 0 + 1 + 1 + 0 + 0 = 12{,}00$$
Pour le Groupe 3 (Moyenne $\bar{X}_3 = 14{,}00$) :
- Participant 1 : $(12 – 14)^2 = (-2)^2 = 4$
- Participant 2 : $(13 – 14)^2 = (-1)^2 = 1$
- Participant 3 : $(15 – 14)^2 = (1)^2 = 1$
- Participant 4 : $(14 – 14)^2 = (0)^2 = 0$
- Participant 5 : $(16 – 14)^2 = (2)^2 = 4$
- Participant 6 : $(13 – 14)^2 = (-1)^2 = 1$
- Participant 7 : $(15 – 14)^2 = (1)^2 = 1$
- Participant 8 : $(14 – 14)^2 = (0)^2 = 0$
- Participant 9 : $(13 – 14)^2 = (-1)^2 = 1$
- Participant 10 : $(15 – 14)^2 = (1)^2 = 1$
Somme des carrés pour le Groupe 3 ($SS_3$) :
$$SS_3 = 4 + 1 + 1 + 0 + 4 + 1 + 1 + 0 + 1 + 1 = 14{,}00$$
7.3 Agrégation de la somme des carrés des erreurs
Pour obtenir la somme des carrés intra-groupes globale ($SSW$), il suffit d’additionner arithmétiquement les sommes de carrés internes calculées au sein de chacune des trois cohortes :
$$SSW = SS_1 + SS_2 + SS_3 = 20{,}00 + 12{,}00 + 14{,}00 = 46{,}00$$
Il est fondamental de noter que l’application de la formule de calcul direct permet d’obtenir ce résultat de manière quasi instantanée en exploitant les sommes de carrés brutes déterminées lors des calculs préliminaires de la section 4.3 :
$$SS_j = \sum_{i=1}^{n_j} X_{ij}^2 – \frac{T_j^2}{n_j}$$
Vérifions cette identité pour chaque condition :
$$SS_1 = 1,020 – \frac{(100)^2}{10} = 1,020 – 1,000 = 20{,}00$$
$$SS_2 = 2,262 – \frac{(150)^2}{10} = 2,262 – 2,250 = 12{,}00$$
$$SS_3 = 1,974 – \frac{(140)^2}{10} = 1,974 – 1,960 = 14{,}00$$
La somme donne invariablement : $SSW = 20 + 12 + 14 = 46{,}00$. Cette grandeur de 46,00 mesure la quantité totale d’erreur d’estimation pure présente dans notre protocole, constituant l’étalon de comparaison face auquel devra être jugée l’ampleur de la $SSB$ de 140,00.
8. Étape 4 : Calcul de la somme des carrés totale (SST) et validation croisée
8.1 Calcul de la variabilité globale de l’échantillon
La somme des carrés totale (notée $SS_{\text{total}}$ ou $SST$) quantifie la dispersion intégrale de l’ensemble des données numériques de l’expérience, sans tenir aucun compte de la partition en trois groupes distincts. Elle envisage les trente participants comme formant un seul et unique grand échantillon d’observations extrait de la population étudiante générale.
La formule définitionnelle de la $SST$ correspond formellement au numérateur de la formule canonique de la variance totale de l’échantillon. Elle consiste à calculer la déviation de chaque score individuel $X_{ij}$ par rapport à la grande moyenne générale $\bar{X}_{\text{globale}}$, à élever chacun de ces trente écarts au carré, puis à en opérer la sommation exhaustive :
$$SST = \sum_{j=1}^{k} \sum_{i=1}^{n_j} (X_{ij} – \bar{X}_{\text{globale}})^2$$
Bien que cette procédure conceptuelle permette de toucher du doigt la signification physique de la dispersion totale, son évaluation manuelle directe requerrait le calcul rébarbatif de trente soustractions consécutives face à la grande moyenne (13,00) et leur élévation respective à la puissance deux. Pour des raisons évidentes de célérité et de fiabilité arithmétique, l’usage de la formule machine est systématiquement privilégié lors de l’exécution manuelle.
8.2 Application de la formule machine de la somme totale
La formule directe ou machine de la somme des carrés totale exploite la somme globale de tous les scores individuels préalablement élevés au carré ($\sum X^2$) et retranche de ce total le facteur de correction global $CF = \frac{G^2}{N}$ calculé à l’étape 6.3 :
$$SST = \left( \sum_{\text{total}} X^2 \right) – \frac{G^2}{N}$$
En reprenant les données macroscopiques établies avec précision lors des calculs préliminaires :
$$\sum_{\text{total}} X^2 = \sum X_{i1}^2 + \sum X_{i2}^2 + \sum X_{i3}^2 = 1,020 + 2,262 + 1,974 = 5,256{,}00$$
$$CF = \frac{G^2}{N} = \frac{(390)^2}{30} = 5,070{,}00$$
L’exécution de la soustraction fournit immédiatement la valeur définitive de la dispersion totale :
$$SST = 5,256{,}00 – 5,070{,}00 = 186{,}00$$
La variabilité globale absolue de l’expérience s’établit donc rigoureusement à 186,00 unités carrées.
8.3 Contrôle de fermeture : la loi de conservation de la variance
Le théorème fondamental de décomposition de l’analyse de variance, formulé avec brio par Fisher, énonce une propriété géométrique remarquable d’orthogonalité dans l’espace euclidien à $N$ dimensions. Ce principe affirme que la variabilité globale observée est exactement égale à la somme arithmétique de la variabilité inter-groupes et de la variabilité intra-groupe, sans perte ni surplus d’information :
$$SST = SSB + SSW$$
Ce résultat constitue ce que les praticiens qualifient de « contrôle de fermeture » ou de validation croisée. Il offre à l’analyste un test infaillible de son travail arithmétique : toute discordance, même minime, signale sans équivoque une erreur de calcul, d’arrondi ou de transcription intervenue à l’une des étapes précédentes.
Injectons nos résultats numériques pour vérifier l’intégrité de la décomposition :
$$SSB + SSW = 140{,}00 + 46{,}00 = 186{,}00$$
$$SST = 186{,}00$$
L’égalité $186{,}00 = 186{,}00$ se vérifie avec une précision parfaite. Cette confirmation garantit de façon inconditionnelle que l’intégralité des calculs de dispersion manuels exécutés jusqu’ici est exempte de toute coquille arithmétique, nous autorisant à aborder sereinement la transition vers l’espace des degrés de liberté.
9. Étape 5 : Détermination des degrés de liberté et calcul des carrés moyens
9.1 Calcul des degrés de liberté pour chaque source de variation
Les sommes de carrés ($SSB$, $SSW$, $SST$) mesurent des quantités cumulées de dispersion, mais elles sont mécaniquement dépendantes du nombre d’observations agrégées : plus un échantillon compte d’individus, plus sa somme de carrés gonfle, sans que cela n’implique nécessairement une plus grande instabilité intrinsèque. Pour transformer ces sommes en estimateurs de variance non biaisés comparables, il est impératif de les diviser par leurs degrés de liberté respectifs (notés conventionnellement $df$, pour degrees of freedom).
Les degrés de liberté quantifient le nombre d’éléments d’information indépendants restant libres de varier après que certaines contraintes statistiques (en l’occurrence, l’estimation des moyennes) ont été imposées aux données.
Pour la variabilité inter-groupes, la contrainte imposée est l’alignement sur la grande moyenne générale. Sachant que nous comparons $k$ groupes, les degrés de liberté inter-groupes valent :
$$df_{\text{inter}} = k – 1$$
Dans notre protocole impliquant $k = 3$ méthodes pédagogiques :
$$df_{\text{inter}} = 3 – 1 = 2$$
Pour la variabilité intra-groupe (résiduelle), chaque sous-échantillon $j$ perd un degré de liberté en raison de l’estimation de sa propre moyenne $\bar{X}_j$, conservant $(n_j – 1)$ degrés de liberté. En sommant ces libertés sur les $k$ groupes, nous obtenons les degrés de liberté résiduels globaux :
$$df_{\text{intra}} = \sum_{j=1}^{k} (n_j – 1) = N – k$$
Pour notre cohorte de 30 participants répartis en 3 conditions :
$$df_{\text{intra}} = 30 – 3 = 27$$
Pour la variabilité totale, une seule contrainte est imposée à l’ensemble des 30 observations : la grande moyenne $\bar{X}_{\text{globale}}$. Dès lors, les degrés de liberté totaux s’élèvent à :
$$df_{\text{total}} = N – 1 = 30 – 1 = 29$$
Tout comme les sommes de carrés, les degrés de liberté vérifient une propriété stricte d’additivité arithmétique :
$$df_{\text{total}} = df_{\text{inter}} + df_{\text{intra}} implies 29 = 2 + 27$$
La règle d’additivité est rigoureusement respectée.
9.2 Calcul du carré moyen inter-groupes (MSB / MSR)
Le carré moyen inter-groupes (désigné par $MSB$ pour Mean Square Between, ou $MSR$ pour Mean Square Regression / Treatment) constitue l’estimation de la variance entre les groupes. Il s’obtient formellement en divisant la somme des carrés inter-groupes par ses degrés de liberté associés :
$$MSB = \frac{SSB}{df_{\text{inter}}} = \frac{SSB}{k – 1}$$
Exécutons l’opération arithmétique avec nos valeurs :
$$MSB = \frac{140{,}00}{2} = 70{,}00$$
L’interprétation théorique de la valeur de $MSB$ est fondamentale pour comprendre l’inférence de l’ANOVA. Sur le plan de l’espérance mathématique, $MSB$ estime simultanément deux grandeurs combinées : la variance d’erreur aléatoire de la population ($\sigma^2$) et l’effet différentiel réel du traitement expérimental pondéré par la taille des échantillons, ce que les modélisateurs écrivent :
$$E(MSB) = \sigma^2 + \frac{\sum n_j \alpha_j^2}{k – 1}$$
Si la variable indépendante n’exerce aucune influence réelle sur les notes des étudiants (hypothèse nulle vérifiée), les paramètres d’effet $\alpha_j$ s’annulent tous, et le second terme disparaît purement et simplement : $MSB$ ne représente plus alors qu’une estimation non biaisée du bruit aléatoire résiduel $\sigma^2$. En revanche, si les programmes d’enseignement provoquent des apprentissages réels d’efficience différente, $MSB$ s’accroît d’une grandeur proportionnelle à la puissance de cet impact pédagogique.
9.3 Calcul du carré moyen intra-groupes (MSW / MSE)
Le carré moyen intra-groupe (désigné par $MSW$ pour Mean Square Within, ou $MSE$ pour Mean Square Error) représente la variance d’erreur résiduelle mutualisée (pooled error variance). Il se calcule en divisant la somme des carrés intra-groupes par ses degrés de liberté résiduels :
$$MSW = \frac{SSW}{df_{\text{intra}}} = \frac{SSW}{N – k}$$
Injectons nos données expérimentales :
$$MSW = \frac{46{,}00}{27} \approx 1{,}7037$$
Sur le plan structural, l’espérance mathématique du carré moyen intra-groupe ne dépend jamais de l’effet du traitement. Que l’hypothèse nulle soit parfaitement exacte ou dramatiquement fausse, $MSW$ constitue invariablement un estimateur convergent et sans biais de la variance d’erreur pure au sein des populations mères :
$$E(MSW) = \sigma^2$$
Cette estimation ($MSW \approx 1{,}7037$) représente donc le bruit de mesure aléatoire incompressible propre à notre dispositif. C’est elle qui servira de terme d’étalonnage et de dénominateur stabilisateur dans la balance inférentielle de Fisher.
10. Étape 6 : Calcul de la statistique F de Fisher-Snedecor
10.1 Construction du rapport de variance F
La pierre angulaire de l’analyse de variance culmine dans la construction de la statistique de décision $F$, baptisée en hommage direct à Ronald Fisher par le statisticien américain George Snedecor. Cette statistique se définit comme le ratio précis entre la variance inter-groupes estimée et la variance intra-groupe résiduelle :
$$F_{\text{observé}} = \frac{MSB}{MSW}$$
L’architecture de ce ratio illustre la pureté de la logique de Fisher :
- Au numérateur ($MSB$) : Nous avons une estimation composite contenant le bruit aléatoire ($\sigma^2$) plus l’effet systématique éventuel de la variable indépendante.
- Au dénominateur ($MSW$) : Nous avons une estimation pure du bruit aléatoire ($\sigma^2$), totalement imperméable à l’effet de traitement.
Dès lors, la déduction mathématique sous-jacente est d’une clarté lumineuse : si l’hypothèse nulle $H_0$ est vraie (absence totale de supériorité pédagogique d’un programme sur un autre), le terme d’effet systématique au numérateur s’évanouit. Le ratio se réduit alors au quotient de deux estimateurs indépendants d’une même et unique grandeur sous-jacente ($\sigma^2 / \sigma^2$) : sous $H_0$, la valeur théorique attendue de la statistique $F$ fluctue donc au voisinage immédiat de 1.
À l’inverse, dès lors que les méthodes d’apprentissage induisent des modifications substantielles de la mémorisation chez les étudiants, le numérateur s’accroît considérablement tandis que le dénominateur demeure stable. La statistique $F_{\text{observé}}$ s’éloigne alors de 1 pour atteindre des magnitudes élevées. Plus $F$ est massif, plus il devient statistiquement improbable d’attribuer une telle déviation aux seules vicissitudes du hasard d’échantillonnage.
10.2 Calcul numérique pas à pas du F observé
Calculons avec une haute précision arithmétique la statistique empirique issue des données de notre protocole didactique :
$$F_{\text{observé}} = \frac{MSB}{MSW} = \frac{70{,}00}{\frac{46}{27}} = \frac{70{,}00 \times 27}{46} = \frac{1,890}{46} \approx 41{,}086956dots$$
Conformément aux normes typographiques et scientifiques internationales édictées par l’American Psychological Association (APA), les statistiques de test s’arrondissent usuellement à deux ou trois décimales. Nous retenons la valeur canonique :
$$F_{\text{observé}} = 41{,}09$$
Une observation qualitative immédiate de cette grandeur révèle qu’elle dépasse de manière spectaculaire le point d’équilibre unitaire théorique ($F = 1$). La variance observée entre les modalités d’apprentissage se révèle plus de 41 fois supérieure à la variance résiduelle interne attribuable aux fluctuations aléatoires entre étudiants d’un même groupe. Ce résultat préliminaire suggère avec une force éclatante l’existence d’une hétérogénéité pédagogique radicale.
11. Étape 7 : Détermination de la valeur critique et prise de décision statistique
11.1 Utilisation et lecture des tables statistiques de distribution F
Disposer d’une statistique $F_{\text{observé}} = 41{,}09$ ne permet pas, à elle seule, de décréter formellement la significativité sans confronter ce score à la distribution théorique continue de Snedecor sous l’hypothèse nulle. Cette distribution d’échantillonnage est paramétrée par deux valeurs distinctes de degrés de liberté : les degrés de liberté du numérateur (notés $df_1 = df_{\text{inter}} = 2$) et les degrés de liberté du dénominateur (notés $df_2 = df_{\text{intra}} = 27$).
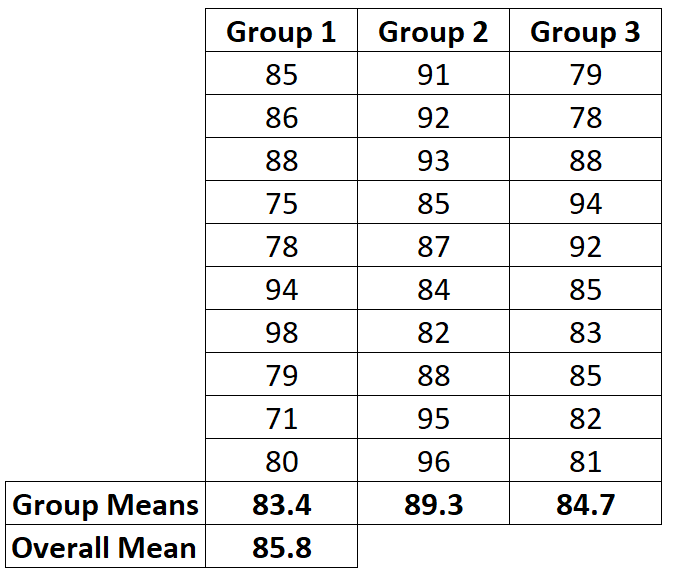
La recherche de la valeur seuil ou critique, symbolisée par $F_{\text{critique}}(\alpha ; df_1, df_2)$, s’opère dans une table statistique de Fisher standardisée correspondant au seuil alpha fixé en amont de notre démarche ($\alpha = 0{,}05$) :
- Repérez la colonne correspondant aux degrés de liberté du numérateur : $df_1 = 2$.
- Descendez le long de cette colonne jusqu’à la ligne associée aux degrés de liberté du dénominateur : $df_2 = 27$.
À l’intersection de la colonne 2 et de la ligne 27 de la table à $\alpha = 0{,}05$, nous extrayons la valeur critique théorique exacte :
$$F_{\text{critique}}(0{,}05 ; 2, 27) \approx 3{,}354$$
Cette valeur seuil de 3,35 constitue la frontière géométrique de la zone de rejet : sous l’hypothèse nulle, la probabilité d’obtenir fortuitement par pur hasard d’échantillonnage une statistique $F$ supérieure ou égale à 3,354 est strictement bornée à 5 % (soit $p = 0{,}05$). Toute valeur franchissant ce seuil critique bascule mathématiquement dans la région critique de non-compatibilité avec $H_0$.
11.2 Règle de décision statistique et conclusion inférentielle
La règle d’inférence de Neyman-Pearson s’énonce selon un formalisme binaire déterministe dépourvu de toute ambiguïté subjective :
- Si $F_{\text{observé}} le F_{\text{critique}}$, nous échouons à rejeter l’hypothèse nulle ($H_0$ est conservée faute de preuves suffisantes).
- Si $F_{\text{observé}} > F_{\text{critique}}$, nous rejetons catégoriquement l’hypothèse nulle au profit de l’hypothèse alternative $H_1$.
En comparant nos valeurs empiriques et théoriques :
$$F_{\text{observé}} = 41{,}09 \quad \text{et} \quad F_{\text{critique}} = 3{,}354$$
$$41{,}09 > 3{,}354$$
La décision statistique est sans appel : nous rejetons formellement l’hypothèse nulle $H_0$ au seuil de risque $\alpha = 0{,}05$.
L’interprétation psychologique contextualisée peut alors être formulée avec une rigueur scientifique absolue : les résultats expérimentaux recueillis apportent une preuve empirique hautement convaincante d’un impact direct de la nature des dispositifs didactiques sur la réussite à l’examen de biologie cellulaire. Les moyennes des trois cohortes ne peuvent être considérées comme mutuellement équivalentes au sein de la population parente d’étudiants. L’efficacité pédagogique est tributaire de l’architecture active, passive ou mixte du programme d’apprentissage dispensé.
11.3 Notion de p-valeur associée et estimation manuelle
La p-valeur (ou probabilité critique empirique) correspond à la probabilité exacte d’observer, sous la supposition inconditionnelle que l’hypothèse nulle $H_0$ soit vraie, une statistique de test au moins aussi extrême que la valeur empiriquement mesurée dans notre échantillon. Dans le traitement automatisé par logiciel, cette valeur est calculée par intégration numérique directe de la fonction de densité de probabilité de Snedecor. Dans le cadre d’un calcul manuel sans ordinateur, le chercheur procède à un encadrement probabiliste rigoureux en consultant successivement les tables statistiques établies pour des seuils de significativité de plus en plus stricts.
Consultons la table statistique de la loi $F$ de Fisher aux seuils $\alpha = 0{,}01$ et $\alpha = 0{,}001$ pour $df_1 = 2$ et $df_2 = 27$ :
- Pour $\alpha = 0{,}01$ : $F_{\text{critique}}(0{,}01 ; 2, 27) \approx 5{,}488$
- Pour $\alpha = 0{,}001$ : $F_{\text{critique}}(0{,}001 ; 2, 27) \approx 9{,}019$
Notre statistique empirique ($F_{\text{observé}} = 41{,}09$) excède de très loin le seuil hautement conservateur de 9,019. Nous pouvons donc déclarer manuellement, avec une certitude absolue :
$$p < 0{,}001$$
En pratique, l’intégration numérique exacte révélerait une p-valeur infinitésimale de l’ordre de $p = 2{,}83 \times 10^{-9}$. Il convient toutefois d’alerter le jeune chercheur contre les interprétations fallacieuses qui pullulent parfois dans la littérature : une p-valeur infime ne signifie en aucune façon que l’hypothèse de recherche est « vraie à 99,999 % », ni que la différence observée possède une portée clinique ou éducative titanesque. Elle indique simplement qu’il est quasiment inconcevable d’observer de tels contrastes de moyennes sous le règne exclusif du hasard stochastique.
12. Synthèse tabulaire, quantification de la taille d’effet et étapes ultérieures
12.1 Construction du tableau récapitulatif officiel de l’ANOVA
L’aboutissement standardisé de toute analyse de variance réside dans l’élaboration de son tableau récapitulatif d’évaluation (ANOVA Summary Table). Ce document synthétique condense dans une mise en forme normalisée et universellement lisible l’ensemble des grandeurs arithmétiques établies tout au long de notre parcours manuel. Sa présentation est régie par les conventions éditoriales de l’APA.
| Source de variation | Somme des Carrés ($SS$) | Degrés de liberté ($df$) | Carré Moyen ($MS$) | Statistique $F$ | Valeur de $p$ |
|---|---|---|---|---|---|
| Inter-groupes (Traitement didactique) | 140,00 | 2 | 70,00 | 41,09 | < 0,001 |
| Intra-groupe (Erreur résiduelle) | 46,00 | 27 | 1,70 | — | — |
| Total | 186,00 | 29 | — | — | — |
La formulation synthétique normalisée pour la rédaction finale dans un article scientifique s’énonce textuellement selon le canon suivant : « Une analyse de variance unidirectionnelle à mesures indépendantes a révélé un effet statistiquement significatif du format pédagogique sur les performances aux examens, $F(2, 27) = 41{,}09, p < 0{,}001$. »
12.2 Calcul de la taille d’effet : Eta-carré (η²) et Eta-carré partiel
La déclaration de la seule significativité statistique ($p 1,000$), révélant des effets infinitésimaux et dépourvus de pertinence écologique sur le terrain. Il s’avère donc impératif de quantifier la magnitude substantielle du phénomène à travers un indice de taille d’effet standardisé.
L’indicateur princeps le plus couramment employé dans le cadre de l’ANOVA est l’Eta-carré ($\eta^2$, analogue direct du coefficient de détermination $R^2$ en régression linéaire). Il représente la proportion exacte de variance de la variable dépendante qui est directement expliquée ou prédite par la variable indépendante :
$$\eta^2 = \frac{SSB}{SST}$$
Calculons cet indice pour notre étude didactique :
$$\eta^2 = \frac{140{,}00}{186{,}00} \approx 0{,}752688dots \approx 0{,}753$$
Ce chiffre indique que 75,27 % de la variance totale des scores des étudiants est directement imputable au format d’enseignement dispensé. Selon la nomenclature conventionnelle établie par Jacob Cohen dans ses travaux de métrologie psychologique :
- $\eta^2 \approx 0{,}01$ correspond à un effet de faible magnitude.
- $\eta^2 \approx 0{,}06$ reflète un effet moyen.
- $\eta^2 ge 0{,}14$ qualifie un effet de forte amplitude.
Notre résultat ($\eta^2 = 0{,}753$) caractérise un effet d’une puissance colossale. Néanmoins, l’Eta-carré classique présente le défaut structural de souffrir d’un biais d’optimisme sur les petits échantillons (il surestime systématiquement la variance expliquée dans la population). Afin de corriger ce biais d’échantillonnage, les statisticiens recommandent fréquemment le calcul de l’Oméga-carré ($\omega^2$), estimateur corrigé non biaisé défini par la relation :
$$\omega^2 = \frac{SSB – (df_{\text{inter}} \times MSW)}{SST + MSW}$$
Injectons nos résultats dans cette formule de correction :
$$\omega^2 = \frac{140{,}00 – (2 \times 1{,}7037)}{186{,}00 + 1{,}7037} = \frac{140{,}00 – 3{,}4074}{187{,}7037} = \frac{136{,}5926}{187{,}7037} \approx 0{,}7277$$
Même après purge rigoureuse du biais d’échantillonnage, l’Oméga-carré confirme que près de 72,77 % de la variance de la population générale étudiante est régie par l’approche pédagogique déployée.
12.3 Nécessité et principes des comparaisons multiples post-hoc
L’aboutissement à une statistique omnibus significative ($F = 41{,}09, p < 0{,}001$) certifie qu'au moins une des trois méthodes d'apprentissage produit des scores différents de ses homologues. En revanche, le test global est structuralement incapable d'indiquer avec précision où résident ces disparités : la méthode active surpasse-t-elle significativement la méthode hybride ? Ou bien est-ce uniquement la méthode passive traditionnelle qui s’effondre de manière isolée par rapport aux deux autres ?
Pour résoudre cette question sans réintroduire le péril de l’inflation du risque d’erreur $\alpha$ mentionné à la section 1.2, l’analyste doit engager des procédures de comparaisons multiples post-hoc spécialement adaptées au calcul manuel. Trois approches majeures dominent le paysage méthodologique :
1. La Différence Minimale Significative de Fisher avec ajustement de Bonferroni : La méthode la plus intuitive à la main consiste à effectuer des tests t bilatéraux standards sur chaque paire de groupes, mais en divisant le seuil alpha par le nombre total de comparaisons envisagées ($c = 3$). Pour conserver un risque global de 0,05, chaque contraste binaire est ainsi évalué au seuil hyper-conservateur :
$$\alpha_{\text{ajusté}} = \frac{0{,}05}{3} \approx 0{,}0167$$
2. Le test HSD de Tukey (Honestly Significant Difference) : Cette méthode calcule la différence absolue minimale que doivent manifester deux moyennes d’échantillon pour être déclarées significativement divergentes. Sa formulation repose sur la distribution de l’étendue studentisée ($q$) :
$$\text{HSD} = q_{\text{critique}} \times \sqrt{\frac{MSW}{n}}$$
Dans notre étude, pour $k = 3$ et $df = 27$ au seuil $\alpha = 0{,}05$, la table de l’étendue studentisée donne $q \approx 3{,}506$. Dès lors :
$$\text{HSD} = 3{,}506 \times \sqrt{\frac{1{,}7037}{10}} = 3{,}506 \times \sqrt{0{,}17037} = 3{,}506 \times 0{,}41276 \approx 1{,}447$$
Toute paire de moyennes présentant un écart arithmétique absolu strictement supérieur à 1,45 point sera donc déclarée significativement différente. Évaluons nos trois paires :
- Programme B vs Programme A : $|\bar{X}_2 – \bar{X}_1| = |15 – 10| = 5{,}00 > 1{,}45$ $implies$ Différence statistiquement significative.
- Programme C vs Programme A : $|\bar{X}_3 – \bar{X}_1| = |14 – 10| = 4{,}00 > 1{,}45$ $implies$ Différence statistiquement significative.
- Programme B vs Programme C : $|\bar{X}_2 – \bar{X}_3| = |15 – 14| = 1{,}00 < 1{,}45$ $implies$ Différence non significative.
3. Le test de Scheffé : Procédure la plus robuste et la plus conservatrice de l’arsenal statistique, elle permet de tester non seulement les comparaisons simples par paires mais également n’importe quel contraste complexe non planifié (par exemple, la comparaison de la méthode passive face à la combinaison simultanée des méthodes active et mixte).
Cette analyse post-hoc manuelle boucle magistralement l’investigation empirique : elle démontre que si les programmes B (actif) et C (mixte) surclassent tous deux très largement le format passif traditionnel, ils ne se démarquent pas de manière statistiquement distincte l’un de l’autre au sein de la présente cohorte d’étude. La maîtrise totale de cette chaîne de déductions, conduite intégralement à la main, consacre l’émancipation méthodologique définitive du chercheur en sciences humaines et quantitatives.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates. https://www.worldcat.org/title/statistical-power-analysis-for-the-behavioral-sciences/oclc/17877467
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd. https://psychclassics.yorku.ca/Fisher/Methods/
- Hartley, H. O. (1950). The use of range in analysis of variance. Biometrika, 37(3/4), 271–280. https://doi.org/10.2307/2332378
- Howell, D. C. (2012). Statistical methods for psychology (8e éd.). Cengage Learning. https://www.cengage.com
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4e éd.). Pearson Prentice Hall. https://www.pearson.com
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3e éd.). Routledge. https://doi.org/10.4324/9781315642956
- Snedecor, G. W., & Cochran, W. G. (1989). Statistical methods (8e éd.). Iowa State University Press. https://www.wiley.com
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913