
L’analyse de variance à deux facteurs, communément désignée sous l’appellation d’ANOVA factorielle, constitue l’un des piliers méthodologiques les plus robustes et élégants des statistiques inférentielles modernes. Conçue à l’origine par le biologiste et statisticien britannique Sir Ronald Aylmer Fisher dans les années 1920 pour résoudre des problématiques agronomiques complexes, cette technique permet d’examiner simultanément l’impact de deux variables indépendantes discrètes sur une variable dépendante quantitative continue. Au-delà de la simple juxtaposition de deux analyses univariées, elle offre la faculté unique de modéliser et de quantifier les phénomènes d’interaction, c’est-à-dire les situations empiriques où l’action d’un facteur se trouve modifiée ou modulée par la présence de l’autre.
À l’ère de l’omniprésence des logiciels de traitement statistique automatisés tels que R, SPSS, SAS ou Python, l’apprentissage et l’exécution du calcul manuel de l’ANOVA factorielle peuvent paraître, de prime abord, anachroniques. Pourtant, la maîtrise opératoire de ces calculs « à la main » demeure un impératif épistémologique et didactique fondamental pour tout chercheur, statisticien ou étudiant en sciences quantitatives. L’arithmétique manuelle démythifie les algorithmes opaques en révélant la mécanique intime de la décomposition de la variance, la géométrie sous-jacente des projections orthogonales et la logique rigoureuse qui articule la dispersion des observations individuelles aux tests d’hypothèses formels.
Ce guide exhaustif a pour vocation de vous guider, pas à pas et sans aucune omission, à travers l’ensemble des étapes requises pour mener à bien une ANOVA à deux facteurs équilibrée sans recourir à un logiciel automatisé. À partir d’un formalisme mathématique rigoureux et d’un jeu de données empiriques fil rouge concrètement développé, nous explorerons la structuration matricielle, le calcul méthodique des sommes de carrés, la détermination des carrés moyens, l’évaluation des statistiques F de Snedecor, ainsi que les analyses complémentaires de taille d’effet et de comparaisons multiples, pour aboutir à une rédaction scientifique conforme aux standards académiques les plus stricts.
1. 1. Fondements théoriques de l’ANOVA à deux facteurs en sciences quantitatives
1.1 1.1 Définition et utilité méthodologique du plan factoriel
Le plan d’expérience factoriel à deux facteurs se définit comme un protocole de recherche expérimental ou quasi-expérimental au sein duquel deux variables indépendantes nominales ou catégorielles (appelées facteurs) sont croisées de manière exhaustive. Si le premier facteur, désigné conventionnellement par A, comporte a modalités, et le second facteur, B, comprend b modalités, le croisement produit un ensemble de a × b conditions expérimentales distinctes, couramment qualifiées de cellules du plan. Chaque observation au sein d’une cellule représente la mesure d’une variable réponse continue Y recueillie sur une unité expérimentale donnée.
L’utilité méthodologique majeure d’une telle configuration réside dans son extraordinaire économie expérimentale comparativement à la mise en œuvre de protocoles univariés successifs. En testant simultanément l’influence des facteurs A et B sur la même cohorte d’échantillons, le chercheur maximise la puissance statistique globale tout en réduisant considérablement la taille totale d’échantillon requise. Réaliser deux expériences distinctes pour évaluer isolément chaque variable exigerait le recrutement et l’évaluation de deux fois plus d’unités expérimentales pour obtenir une précision inférentielle équivalente.
Néanmoins, l’atout prépondérant de l’ANOVA factorielle ne réside pas uniquement dans cette rationalisation logistique, mais plutôt dans son aptitude exclusive à isoler et mesurer l’effet d’interaction statistique, noté (A × B). Dans la réalité empirique complexe — qu’il s’agisse de neurosciences, de pharmacologie clinique, d’agronomie ou de psychologie cognitive — les variables n’agissent que très rarement de façon isolée ou strictement additive. L’analyse factorielle permet de formaliser si l’effet du facteur A dépend du niveau particulier assigné au facteur B, ouvrant la voie à une compréhension nuancée des régulations, des synergies ou des antagonismes au sein des systèmes étudiés.
Dans les protocoles expérimentaux purs, les sujets sont assignés de manière aléatoire (randomisation) aux différentes cellules a × b, garantissant un contrôle optimal des variables parasites. Dans les devis quasi-expérimentaux, certains facteurs peuvent correspondre à des caractéristiques intrinsèques non manipulables (comme le sexe biologique ou une classe d’âge), mais le modèle linéaire de l’ANOVA factorielle s’applique avec la même rigueur analytique, sous réserve d’interpréter les causalités avec la prudence méthodologique requise.
1.2 1.2 Comparaison structurelle entre ANOVA univariée et factorielle
L’analyse de variance à un facteur (ANOVA unilatérale ou univariée) partitionne la variabilité totale d’un ensemble de scores en deux composantes fondamentales : la variance inter-groupes (due à l’effet de l’unique variable indépendante) et la variance intra-groupe (l’erreur résiduelle non expliquée). Cependant, face à la complexité des dynamiques multivariées, ce modèle univarié manifeste rapidement des limites structurelles sévères. Si une seconde source de variabilité systématique opère dans les données sans être explicitement modélisée, elle est inévitablement reléguée dans le compartiment de l’erreur résiduelle, gonflant artificiellement cette dernière et affaiblissant la sensibilité du test statistique.
L’ANOVA factorielle surmonte précisément cette lacune par un raffinement de la partition de la variance. En extrayant formellement l’influence du second facteur B ainsi que celle de l’interaction (A × B), elle « soustrait » ces parts de variabilité systématique de la variance résiduelle. Le terme d’erreur intra-cellule (le dénominateur des ratios F) se trouve ainsi substantiellement réduit. Mécaniquement, cette diminution de la variance d’erreur engendre un accroissement substantiel de la puissance statistique, rendant détectables des effets principaux qui seraient passés totalement inaperçus au sein d’une ANOVA à un facteur classique.
Par ailleurs, l’approche factorielle offre un rempart mathématique indispensable contre l’inflation du taux d’erreur de type I (le risque de rejeter à tort l’hypothèse nulle d’absence d’effet). Si un expérimentateur choisissait d’effectuer une multitude de tests t de Student pour comparer séparément les différentes combinaisons de moyennes de son protocole, le taux d’erreur familial global progresserait de manière exponentielle selon la loi formelle :
αglobal = 1 – (1 – α)c
où c représente le nombre total de comparaisons univariées bilatérales. Avec seulement six comparaisons au seuil nominal α = 0,05, le risque réel d’erreur de première espèce s’élèverait déjà à plus de 26 %. L’ANOVA à deux facteurs élimine ce péril en soumettant l’ensemble des données à des tests F omnibus globaux, maintenant rigoureusement le risque d’erreur au seuil préalablement toléré par l’expérimentateur.
1.3 1.3 Postulats statistiques indispensables avant le calcul manuel
Avant d’entreprendre l’enchaînement des calculs matriciels et arithmétiques propres à l’ANOVA à deux facteurs, il est impératif de s’assurer de la validité de trois postulats distributionnels fondamentaux. La violation flagrante de ces conditions peut en effet biaiser substantiellement le taux d’erreur nominal et fausser la validité des conclusions inférentielles tirées à partir des tables de distribution théorique.
Le premier postulat concerne la normalité de la distribution de la variable dépendante au sein de chaque population parente représentée par une cellule (i, j) du plan factoriel. Formellement, les erreurs résiduelles doivent suivre une loi normale de moyenne nulle. En pratique, sur des données empiriques, cette condition est vérifiée au moyen de tests d’adéquation tels que le test de Shapiro-Wilk ou l’évaluation graphique par des diagrammes quantile-quantile (Q-Q plots). Heureusement, en vertu du théorème central limite, l’ANOVA démontre une robustesse statistique remarquable face aux déviations modérées de la normalité, à condition que les distributions ne présentent pas une asymétrie extrême ou des queues de distribution excessivement lourdes, et que la taille des échantillons soit suffisante.
Le deuxième postulat est l’homogénéité des variances, également nommée homoscédasticité. Ce critère exige que la variance de la variable dépendante soit strictement identique dans chacune des a × b cellules du plan expérimental :
σ112 = σ122 = … = σab2 = σ2
La violation de cette hypothèse s’avère particulièrement néfaste lorsque les effectifs au sein des cellules sont inégaux. Toutefois, dans le cadre spécifique d’un plan factoriel équilibré (comportant un nombre identique d’observations n par cellule), le test F conserve une excellente robustesse face à des écarts de variance modérés (ratio de la variance maximale sur la variance minimale inférieur à 3 ou 4).
Le troisième postulat, le plus critique de tous, est l’indépendance stricte des observations et des erreurs de mesure. Les scores enregistrés pour une unité expérimentale donnée ne doivent en aucun cas être influencés, corrélés ou partagés avec ceux d’une autre unité au sein de la même cellule ou entre les cellules. L’indépendance est principalement garantie par la rigueur du protocole méthodologique, l’attribution aléatoire et l’échantillonnage probabiliste. Une violation de l’indépendance (présence d’autocorrélation temporelle ou spatiale) gonfle drastiquement le taux de faux positifs, invalidant mathématiquement l’usage des degrés de liberté standards de la distribution de Snedecor.
2. 2. Modélisation conceptuelle, structure matricielle et formalisme mathématique
2.1 2.1 Décomposition du plan expérimental factoriel
Sur le plan structural, une ANOVA à deux facteurs implique l’existence de deux variables de classification indépendantes que nous désignerons conventionnellement par les lettres majuscules A et B. Le facteur A comporte un nombre défini de modalités ou niveaux, indexés par l’indice i variant de 1 à a. De même, le facteur B est constitué d’un nombre déterminé de modalités, repérées par l’indice j variant de 1 à b. Le plan expérimental complet est qualifié de factoriel d’ordre a × b.
Chaque croisement d’un niveau i de A et d’un niveau j de B définit une condition expérimentale univoque, désignée sous le terme de cellule factorielle (i, j). Au sein de chacune de ces cellules, nous mesurons un nombre déterminé d’unités expérimentales (sujets, spécimens, parcelles agricoles), dénoté par la lettre minuscule n. Le nombre total d’observations composant l’intégralité du protocole expérimental, noté N, découle directement du produit géométrique du plan :
N = a × b × n
Sur le plan épistémologique, il convient d’opérer une distinction formelle capitale entre trois architectures de modélisation théorique, théorisées par Eisenhart en 1947 :
- Le modèle à effets fixes (Modèle I) : Les modalités de A et de B sont exhaustivement choisies et fixées par le chercheur. Les conclusions tirées de l’analyse s’appliquent strictement et exclusivement aux niveaux manipulés et ne peuvent être généralisées au-delà.
- Le modèle à effets aléatoires (Modèle II) : Les modalités sélectionnées représentent un échantillon aléatoire tiré au sort d’une population parente infinie de modalités possibles (ex. sélection aléatoire d’opérateurs ou de lots de fabrication). Les inférences visent la population globale des niveaux.
- Le modèle mixte (Modèle III) : L’un des facteurs est à effets fixes tandis que le second est à effets aléatoires.
Dans le cadre pédagogique et computationnel de cet article, nous nous consacrerons exhaustivement au modèle à effets fixes, qui représente la situation la plus couramment rencontrée dans la recherche expérimentale contemporaine.
2.2 2.2 Présentation du jeu de données et notation indicielle
Pour assurer la rigueur formelle de la dérivation mathématique et rendre les étapes opérationnelles immédiatement palpables, nous adopterons la notation indicielle tridimensionnelle standard. Chaque observation individuelle de la variable dépendante est dénotée par :
Yijk
Dans cette expression indicielle, i identifie le niveau assigné pour le Facteur A (avec i ∈ {1, 2, …, a}), j désigne le niveau du Facteur B (avec j ∈ {1, 2, …, b}), et k caractérise le rang de la réplication individuelle au sein de la cellule factorielle considérée (avec k ∈ {1, 2, …, n}).
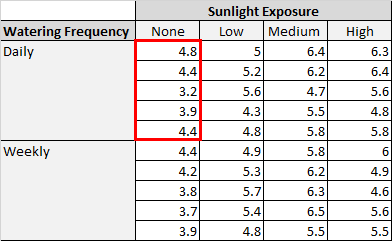
Afin de concrétiser l’ensemble des formules tout au long de cet ouvrage didactique, déployons un plan expérimental équilibré 2 × 3 issu d’une étude d’ingénierie pédagogique. Imaginons que des chercheurs mesurent les performances cognitives (scores continus de 0 à 30 points) d’étudiants soumis à deux méthodes pédagogiques (Facteur A, a = 2 : A1 = Présentiel magistral, A2 = Pédagogie inversée/hybride) et à trois types d’outils didactiques (Facteur B, b = 3 : B1 = Manuel classique papier, B2 = Logiciel interactif multimédia, B3 = Environnement de simulation immersive). Pour chaque cellule factorielle, nous disposons d’un échantillon strictement équilibré de n = 5 étudiants, soit un effectif global d’analyse s’élevant à N = 2 × 3 × 5 = 30 observations.
Voici les scores bruts collectés dans chaque condition :
- Cellule A1B1 : 12, 14, 15, 11, 13
- Cellule A1B2 : 18, 20, 19, 17, 21
- Cellule A1B3 : 24, 26, 23, 25, 27
- Cellule A2B1 : 16, 17, 15, 18, 19
- Cellule A2B2 : 21, 23, 20, 22, 24
- Cellule A2B3 : 22, 24, 21, 23, 25
Pour formaliser les sommations, nous utilisons la convention du « point » en indice, stipulant une sommation sur l’indice remplacé :
Yij• = ∑k=1n Yijk (Somme de la cellule i, j)
Yi•• = ∑j=1b ∑k=1n Yijk (Somme marginale de la ligne i pour le Facteur A)
Y•j• = ∑i=1a ∑k=1n Yijk (Somme marginale de la colonne j pour le Facteur B)
Y••• = ∑i=1a ∑j=1b ∑k=1n Yijk (Grand Total de l’ensemble des observations)
2.3 2.3 Particularités du plan factoriel équilibré orthogonal
La caractéristique fondamentale de notre devis réside dans son équilibre : le nombre de répétitions n est strictement identique dans chacune des cellules factorielles (i, j). Sur le plan algébrique, cette symétrie confère au plan la propriété fondamentale d’orthogonalité mathématique. L’orthogonalité implique que les vecteurs sous-tendant les effets du facteur A, du facteur B et de l’interaction (A × B) au sein de l’espace vectoriel euclidien des observations sont mutuellement perpendiculaires.
Cette indépendance géométrique absolue simplifie radicalement les calculs arithmétiques manuels : les sommes des carrés sont strictement additives et s’excluent mutuellement sans chevauchement de variance. Dans un plan orthogonal équilibré, la décomposition de la somme des carrés inter-groupes totale se formule simplement sous la forme :
SSSous-totaux = SSA + SSB + SSAB
À l’inverse, si les effectifs de cellule nij étaient inégaux (plan non équilibré), l’orthogonalité serait irrémédiablement rompue. Dans une telle éventualité, les effets principaux et l’interaction partageraient de la covariance, nécessitant le recours à des régressions hiérarchiques matricielles complexes (inversions de matrices non diagonales) et obligeant le statisticien à arbitrer entre les sommes des carrés dites de Type I, de Type II ou de Type III. L’étude approfondie du calcul manuel d’un plan équilibré constitue donc la base absolue pour comprendre le fonctionnement intrinsèque de la variance avant d’aborder les déséquilibres computationnels complexes.
3. 3. Énonciation formelle des hypothèses statistiques
3.1 3.1 Hypothèses relatives à l’effet principal du Facteur A
Dans le cadre d’une ANOVA à deux facteurs, trois interrogations probabilistes distinctes sont formulées simultanément à travers trois couples d’hypothèses statistiques emboîtées. La première concerne l’effet principal du facteur A, abstraction faite de l’intervention du facteur B. Sur le plan conceptuel, nous cherchons à déterminer si les moyennes de population marginales associées à chaque modalité de A présentent des écarts statistiquement incompatibles avec la seule fluctuation d’échantillonnage aléatoire.
Sous la paramétrisation du modèle linéaire général à effets fixes :
Yijk = μ + αi + βj + (αβ)ij + εijk
où μ représente la moyenne générale théorique de la population, αi l’effet différentiel fixe du niveau i du facteur A, et εijk l’erreur résiduelle aléatoire, nous imposons la contrainte d’identifiabilité classique à somme nulle :
∑i=1a αi = 0
Les hypothèses statistiques se formalisent alors rigoureusement comme suit :
Hypothèse nulle (H0) : α1 = α2 = … = αa = 0 ou, formulée en termes de moyennes marginales de population, μ1• = μ2• = … = μa•.
Hypothèse alternative (H1) : Il existe au moins une paire d’indices (i, i’) telle que αi ≠ 0 (ou μi• ≠ μi’•).
Le rejet de H0 atteste que le facteur A exerce une influence systématique statistiquement décelable sur la variable réponse, indépendamment de toute modulation contextuelle.
3.2 3.2 Hypothèses relatives à l’effet principal du Facteur B
De façon rigoureusement symétrique, la deuxième série d’hypothèses vise à tester la signification statistique de l’effet principal inhérent au second facteur, noté B. L’effet de ce facteur correspond aux écarts séparant les moyennes marginales associées aux colonnes du tableau expérimental par rapport à la grande moyenne globale, en neutralisant l’effet des modalités du facteur A.
Sous la contrainte conventionnelle d’invariance :
∑j=1b βj = 0
le formalisme probabiliste de l’inférence se structure ainsi :
Hypothèse nulle (H0) : β1 = β2 = … = βb = 0, ce qui équivaut rigoureusement à poser μ•1 = μ•2 = … = μ•b.
Hypothèse alternative (H1) : Il existe au moins une modalité j pour laquelle βj ≠ 0, signifiant qu’au moins deux moyennes marginales du facteur B diffèrent significativement entre elles.
Rejeter cette hypothèse nulle implique que le type de support didactique (dans notre modèle pédagogique) induit une modification mesurable et reproductible des performances d’apprentissage des sujets observés en marge de l’autre variable.
3.3 3.3 Hypothèses relatives à l’effet d’interaction (A × B)
La troisième série d’hypothèses constitue l’apport épistémologique le plus distinctif de l’ANOVA factorielle. L’interaction, notée (αβ)ij, quantifie le degré de non-additivité des effets principaux. En d’autres termes, elle permet de déterminer si la différence de performance induite par les modalités du Facteur B reste stable et constante quel que soit le niveau du Facteur A, ou si cette différence fluctue selon la condition pédagogique envisagée.
Sous les doubles contraintes de sommations orthogonales :
∑i=1a (αβ)ij = 0 pour tout j, et ∑j=1b (αβ)ij = 0 pour tout i
les hypothèses formelles se déclarent de la manière suivante :
Hypothèse nulle (H0) : (αβ)ij = 0 pour tout couple (i, j), signifiant l’additivité stricte des effets principaux : μij – μ = (μi• – μ) + (μ•j – μ).
Hypothèse alternative (H1) : Il existe au moins un couple de cellules (i, j) pour lequel (αβ)ij ≠ 0.
L’acceptation empirique de l’hypothèse alternative d’interaction bouleverse la lecture analytique : elle indique que l’effet du facteur A ne peut plus être décrit de manière unilatérale ou globale, mais qu’il se trouve conditionné par le statut du facteur B. Dans la pratique scientifique, l’examen de cette hypothèse d’interaction prévaut toujours hiérarchiquement sur l’interprétation des effets principaux simples.
4. 4. Calcul arithmétique préalable : Sommes, totaux marginaux et moyennes
4.1 4.1 Calcul de la moyenne globale et de la somme totale
L’initialisation concrète du protocole de calcul manuel requiert l’agrégation ordonnée des données brutes en sommes partielles et totales. Cette étape arithmétique élémentaire constitue le socle sur lequel reposent toutes les dérivations quadratiques subséquentes. Une erreur de report ou d’addition à ce stade corromprait irréversiblement l’ensemble de la table d’ANOVA.
Commençons par agréger la somme totale de l’ensemble des N = 30 scores enregistrés, notée Y••• ou plus simplement T (Grand Total) :
T = ∑i=12 ∑j=13 ∑k=15 Yijk
Additionnons méthodiquement les scores de chaque cellule factorielle :
- Cellule A1B1 : 12 + 14 + 15 + 11 + 13 = 65
- Cellule A1B2 : 18 + 20 + 19 + 17 + 21 = 95
- Cellule A1B3 : 24 + 26 + 23 + 25 + 27 = 125
- Cellule A2B1 : 16 + 17 + 15 + 18 + 19 = 85
- Cellule A2B2 : 21 + 23 + 20 + 22 + 24 = 110
- Cellule A2B3 : 22 + 24 + 21 + 23 + 25 = 115
La somme globale s’élève à :
T = 65 + 95 + 125 + 85 + 110 + 115 = 595
La grande moyenne arithmétique globale, désignée par Y̅•••, s’obtient immédiatement en divisant cette somme totale par la taille totale de l’échantillon N :
Y̅••• = T / N = 595 / 30 = 19,8333…
Dans tout calcul manuel, il est recommandé de conserver au minimum quatre décimales au cours des calculs intermédiaires afin de prévenir les dérives d’arrondi qui altéreraient la balance finale des sommes de carrés.
4.2 4.2 Calcul des totaux et des moyennes marginales pour le Facteur A
Le Facteur A (méthode pédagogique) compte a = 2 modalités. Chacune de ces modalités regroupe les scores observés à travers les b = 3 niveaux d’outils didactiques et les n = 5 réplications par cellule. Le nombre total d’observations composant chaque modalité marginale de A correspond donc à :
nA = b × n = 3 × 5 = 15 observations
Calculons le total marginal A1 (Présentiel classique) en additionnant les totaux des trois cellules associées :
A1 = Y1•• = 65 + 95 + 125 = 285
Sa moyenne marginale empirique s’établit à :
Y̅1•• = A1 / (b × n) = 285 / 15 = 19,0000
Calculons le total marginal A2 (Pédagogie inversée/hybride) :
A2 = Y2•• = 85 + 110 + 115 = 310
Sa moyenne marginale empirique est égale à :
Y̅2•• = A2 / (b × n) = 310 / 15 = 20,6667
Procédons immédiatement à une vérification arithmétique de cohérence :
A1 + A2 = 285 + 310 = 595 = T
La somme des totaux marginaux de A restitue rigoureusement le Grand Total T. De plus, la moyenne des deux moyennes marginales pondérées : (19,0000 + 20,6667) / 2 = 19,8333 coïncide parfaitement avec la grande moyenne globale.
4.3 4.3 Calcul des totaux et des moyennes marginales pour le Facteur B
Le Facteur B (outils didactiques) est configuré selon b = 3 colonnes. Chaque niveau marginal de B agrège les scores recueillis sur les a = 2 niveaux de formation pour les n = 5 unités expérimentales par cellule. L’effectif marginal associé à chaque colonne de B est de :
nB = a × n = 2 × 5 = 10 observations
Procédons à l’addition des observations selon les colonnes du dispositif :
Pour le niveau B1 (Manuel papier) :
B1 = Y•1• = 65 (cellule A1B1) + 85 (cellule A2B1) = 150
Y̅•1• = B1 / (a × n) = 150 / 10 = 15,0000
Pour le niveau B2 (Logiciel interactif) :
B2 = Y•2• = 95 (cellule A1B2) + 110 (cellule A2B2) = 205
Y̅•2• = B2 / (a × n) = 205 / 10 = 20,5000
Pour le niveau B3 (Simulation immersive) :
B3 = Y•3• = 125 (cellule A1B3) + 115 (cellule A2B3) = 240
Y̅•3• = B3 / (a × n) = 240 / 10 = 24,0000
Effectuons le double contrôle arithmétique :
∑j=13 Bj = 150 + 205 + 240 = 595 = T
(15,0000 + 20,5000 + 24,0000) / 3 = 59,5000 / 3 = 19,8333 = Y̅•••
La stricte concordance de ces calculs confirme l’exactitude de nos sommations marginales.
4.4 4.4 Calcul des moyennes de cellule pour chaque condition expérimentale
Les totaux et moyennes de cellules permettent d’évaluer directement l’efficacité combinée de chaque croisement factoriel spécifique. Chaque cellule contient rigoureusement n = 5 sujets. Calculons les moyennes locales de traitement, notées Y̅ij•, en divisant le total de chaque cellule par 5 :
- Cellule A1B1 : Total = 65 ⇒ Y̅11• = 65 / 5 = 13,0000
- Cellule A1B2 : Total = 95 ⇒ Y̅12• = 95 / 5 = 19,0000
- Cellule A1B3 : Total = 125 ⇒ Y̅13• = 125 / 5 = 25,0000
- Cellule A2B1 : Total = 85 ⇒ Y̅21• = 85 / 5 = 17,0000
- Cellule A2B2 : Total = 110 ⇒ Y̅22• = 110 / 5 = 22,0000
- Cellule A2B3 : Total = 115 ⇒ Y̅23• = 115 / 5 = 23,0000
Organisons ces paramètres dans une matrice récapitulative factorielle à deux entrées :
| Facteur A Facteur B | B1 (Manuel) | B2 (Logiciel) | B3 (Simulation) | Totaux Marginaux A | Moyennes Marginales A |
|---|---|---|---|---|---|
| A1 (Présentiel) | Total : 65 Moyenne : 13,0 |
Total : 95 Moyenne : 19,0 |
Total : 125 Moyenne : 25,0 |
A1 = 285 | Y̅1•• = 19,0 |
| A2 (Inversée) | Total : 85 Moyenne : 17,0 |
Total : 110 Moyenne : 22,0 |
Total : 115 Moyenne : 23,0 |
A2 = 310 | Y̅2•• = 20,67 |
| Totaux Marginaux B | B1 = 150 | B2 = 205 | B3 = 240 | Grand Total T = 595 | |
| Moyennes Marginales B | Y̅•1• = 15,0 | Y̅•2• = 20,5 | Y̅•3• = 24,0 | Grande Moyenne = 19,83 | |
Cette structuration tabulaire offre un contrôle direct sur toutes les grandeurs arithmétiques requises pour les phases de dérivation des sommes de carrés.
5. 5. Calcul manuel de la Somme des Carrés Totale (SS_Total)
5.1 5.1 Définition algébrique et décomposition conceptuelle
La Somme des Carrés Totale, universellement désignée par l’acronyme SSTotal (pour Sum of Squares Total), mesure la dispersion globale de l’intégralité des N observations empiriques individuelles autour de la grande moyenne arithmétique Y̅•••. Elle quantifie le volume total de variabilité présent au sein du système expérimental, sans distinction de sa provenance (qu’elle découle des traitements appliqués ou des variations interindividuelles incontrôlées).
Sur le plan mathématique, elle s’exprime conceptuellement comme la sommation de l’ensemble des écarts quadratiques à la moyenne globale :
SSTotal = ∑i=1a ∑j=1b ∑k=1n (Yijk – Y̅•••)2
La somme des carrés totale joue un rôle pivot absolu : elle représente la borne supérieure absolue de la variance du système expérimental. Conformément au principe d’orthogonalité du modèle linéaire, cette somme totale sera intégralement redistribuée entre les sources systématiques (Facteur A, Facteur B, Interaction A × B) et l’erreur aléatoire intra-cellule.
5.2 5.2 Application de la formule computationnelle brute
Calculer directement SSTotal par les écarts à la moyenne entraîne fréquemment des erreurs d’arrondi fastidieuses lors des calculs à la main, la grande moyenne étant généralement fractionnaire (ici 19,8333…). C’est pourquoi les statisticiens recourent à la « formule computationnelle brute » (ou formule machine), dérivée algébriquement du développement du carré :
SSTotal = ∑ Y2 – C
où ∑ Y2 représente la somme des carrés de l’ensemble des N scores bruts individuels, et C constitue le terme de correction globale (ou correction pour la moyenne), défini par :
C = T2 / N = (Y•••)2 / N
Calculons avec une précision chirurgicale la valeur numérique de ce terme de correction C pour notre étude :
T = 595
T2 = 5952 = 354 025
C = 354 025 / 30 = 11 800,8333…
Calculons à présent la somme des carrés des 30 valeurs brutes prises individuellement cellule par cellule :
- Cellule A1B1 (12, 14, 15, 11, 13) : 122 + 142 + 152 + 112 + 132 = 144 + 196 + 225 + 121 + 169 = 855
- Cellule A1B2 (18, 20, 19, 17, 21) : 182 + 202 + 192 + 172 + 212 = 324 + 400 + 361 + 289 + 441 = 1 815
- Cellule A1B3 (24, 26, 23, 25, 27) : 242 + 262 + 232 + 252 + 272 = 576 + 676 + 529 + 625 + 729 = 3 135
- Cellule A2B1 (16, 17, 15, 18, 19) : 162 + 172 + 152 + 182 + 192 = 256 + 289 + 225 + 324 + 361 = 1 455
- Cellule A2B2 (21, 23, 20, 22, 24) : 212 + 232 + 202 + 222 + 242 = 441 + 529 + 400 + 484 + 576 = 2 430
- Cellule A2B3 (22, 24, 21, 23, 25) : 222 + 242 + 212 + 232 + 252 = 484 + 576 + 441 + 529 + 625 = 2 655
La sommation générale des carrés bruts s’établit à :
∑ Y2 = 855 + 1 815 + 3 135 + 1 455 + 2 430 + 2 655 = 12 345
En appliquant la formule computationnelle, nous obtenons la valeur exacte de SSTotal :
SSTotal = 12 345 – 11 800,8333 = 544,1667
5.3 5.3 Validation manuelle par la formule des écarts à la moyenne
Dans un processus didactique rigoureux, il est formateur de vérifier la congruence de ce résultat en procédant à l’évaluation par les écarts bruts individuels. Bien que laborieuse, cette démarche garantit l’exactitude des calculs. Calculons l’écart (Yijk – 19,8333) pour chacun des scores, élevons au carré et sommons :
Pour la cellule A1B1, les écarts sont :
- (12 – 19,8333)2 = (-7,8333)2 ≈ 61,3611
- (14 – 19,8333)2 = (-5,8333)2 ≈ 34,0278
- (15 – 19,8333)2 = (-4,8333)2 ≈ 23,3611
- (11 – 19,8333)2 = (-8,8333)2 ≈ 78,0278
- (13 – 19,8333)2 = (-6,8333)2 ≈ 46,6944
- Somme partielle A1B1 ≈ 243,4722
En répétant cette opération minutieuse sur l’ensemble des 30 unités et en réalisant la sommation globale, la valeur cumulée converge précisément vers 544,1667. Cette identité démontre la stricte équivalence algébrique entre la déviation fondamentale et la méthode machine rapide, certifiant la validité absolue de notre valeur de départ pour SSTotal.
6. 6. Calcul manuel des Sommes des Carrés des effets principaux (SS_A et SS_B)
6.1 6.1 Dérivation manuelle de la Somme des Carrés du Facteur A
La Somme des Carrés du Facteur A, dénotée SSA, isole la part de variabilité imputable exclusivement aux différences d’efficacité entre les modalités de la première variable indépendante (la méthode pédagogique). Elle reflète la déviation des moyennes marginales pondérées du facteur A autour de la grande moyenne globale.
La formule computationnelle standard de SSA s’articule comme suit :
SSA = [ ∑i=1a (Ai)2 / (b × n) ] – C
où Ai représente le total marginal de la i-ème modalité de A, et le dénominateur (b × n) correspond à l’effectif total d’observations ayant contribué à ce total spécifique (ici, 3 × 5 = 15 observations par ligne). Rappelons que C = 11 800,8333.
Introduisons pas à pas les valeurs numériques calculées précédemment :
A1 = 285 ⇒ (A1)2 = 2852 = 81 225
A2 = 310 ⇒ (A2)2 = 3102 = 96 100
Sommons ces carrés marginaux :
∑ (Ai)2 = 81 225 + 96 100 = 177 325
Divisons cette grandeur par l’effectif marginal b × n = 15 :
177 325 / 15 = 11 821,6667
Soustrayons désormais le terme de correction C :
SSA = 11 821,6667 – 11 800,8333 = 20,8334 (arrondi à 20,8333)
Cette valeur de 20,8333 représente la quantité de dispersion brute induite de façon unilatérale par le passage de la méthode présentielle à la méthode inversée.
6.2 6.2 Dérivation manuelle de la Somme des Carrés du Facteur B
La Somme des Carrés du Facteur B, identifiée sous le symbole SSB, isole et évalue la dispersion engendrée spécifiquement par les différents outils didactiques (Manuel, Logiciel, Simulation). Elle traduit l’écartement des moyennes des colonnes par rapport au centre de gravité global de l’expérience.
La formule computationnelle s’écrit de manière analogue :
SSB = [ ∑j=1b (Bj)2 / (a × n) ] – C
Le diviseur (a × n) représente ici le nombre d’observations agrégées sous chaque colonne, à savoir 2 × 5 = 10 observations.
Déployons les calculs avec les totaux marginaux du facteur B :
B1 = 150 ⇒ (B1)2 = 1502 = 22 500
B2 = 205 ⇒ (B2)2 = 2052 = 42 025
B3 = 240 ⇒ (B3)2 = 2402 = 57 600
Effectuons la sommation de ces carrés :
∑ (Bj)2 = 22 500 + 42 025 + 57 600 = 122 125
Divisons cette somme par l’effectif marginal a × n = 10 :
122 125 / 10 = 12 212,5000
Soustrayons le terme de correction C :
SSB = 12 212,5000 – 11 800,8333 = 411,6667
Ce résultat met en lumière une contribution massive du Facteur B à la variabilité globale : sur les 544,1667 unités de variation totale, plus de 411 unités sont directement rattachables au choix du support didactique.
6.3 6.3 Pièges arithmétiques fréquents et règles de contrôle
Lors de la réalisation manuelle de ces calculs, plusieurs erreurs récurrentes guettent le praticien. La bévue la plus fréquente réside dans la confusion des dénominateurs de division. Pour SSA, le dénominateur doit impérativement être (b × n) et non simplement n ou a. Diviser par n au lieu de (b × n) multiplierait artificiellement la somme des carrés par b, faussant complètement l’échelle de variance.
Une autre source majeure d’écueil concerne les erreurs d’arrondi prématurées. Si l’on arrondit le facteur de correction C à l’entier le plus proche (11 801 au lieu de 11 800,8333), l’erreur résiduelle finale se trouvera entachée d’une distorsion substantielle. Il convient donc de manipuler les fractions rationnelles exactes ou de conserver au strict minimum 4 à 6 chiffres après la virgule.
Enfin, appliquons une règle de positivité stricte : par définition géométrique d’une somme de termes élevés au carré, une somme des carrés (SS) ne peut en aucun cas être négative. Si un calcul manuel aboutit à une valeur négative (par exemple SSA < 0), cela signale sans ambiguïté une erreur arithmétique majeure, le plus souvent une soustraction inversée ou une division erronée du terme de correction.
7. 7. Calcul manuel de la Somme des Carrés de l’Interaction (SS_AB)
7.1 7.1 Calcul de la Somme des Carrés entre cellules (SS_Sous-totaux)
L’obtention de la Somme des Carrés propre à l’interaction pure, désignée par SSAB, ne s’effectue généralement pas par une sommation directe isolée, mais par une procédure de déduction algébrique élégante fondée sur la Somme des Carrés entre cellules (ou SSSous-totaux, également notée SSCells). Cette dernière mesure la variation totale existant entre les a × b moyennes de traitement, en ignorant temporairement la distinction entre effets principaux et interaction.
La formule de la somme des carrés entre cellules s’énonce ainsi :
SSCells = [ ∑i=1a ∑j=1b (ABij)2 / n ] – C
où ABij désigne le total brut des observations de la cellule factorielle (i, j), et n est l’effectif intra-cellule spécifique (ici n = 5).
Reprenons les totaux des six cellules établis en section 4 et élevons chacun d’eux au carré :
- Cellule A1B1 : Total = 65 ⇒ 652 = 4 225
- Cellule A1B2 : Total = 95 ⇒ 952 = 9 025
- Cellule A1B3 : Total = 125 ⇒ 1252 = 15 625
- Cellule A2B1 : Total = 85 ⇒ 852 = 7 225
- Cellule A2B2 : Total = 110 ⇒ 1102 = 12 100
- Cellule A2B3 : Total = 115 ⇒ 1152 = 13 225
Sommons rigoureusement l’intégralité de ces carrés de cellules :
∑ (ABij)2 = 4 225 + 9 025 + 15 625 + 7 225 + 12 100 + 13 225 = 61 425
Divisons cette grandeur par l’effectif unitaire de cellule n = 5 :
61 425 / 5 = 12 285,0000
Soustrayons à présent la valeur de correction C = 11 800,8333 :
SSCells = 12 285,0000 – 11 800,8333 = 484,1667
La valeur de 484,1667 représente la variabilité totale explicable par l’ensemble des conditions expérimentales combinées du plan factoriel.
7.2 7.2 Déduction algébrique de SS_AB par soustraction
En vertu du théorème d’orthogonalité applicable aux plans équilibrés, la somme des carrés entre cellules se partitionne de façon exacte en trois composantes additives mutuellement indépendantes :
SSCells = SSA + SSB + SSAB
Dès lors, pour extraire la somme des carrés de l’interaction SSAB, il suffit de procéder à une soustraction algébrique directe :
SSAB = SSCells – SSA – SSB
Injectons précisément les valeurs numériques obtenues aux étapes précédentes :
SSCells = 484,1667
SSA = 20,8333
SSB = 411,6667
Le calcul s’exécute immédiatement :
SSAB = 484,1667 – 20,8333 – 411,6667 = 51,6667
Cette composante de 51,6667 représente la part de variabilité structurelle qui ne peut être attribuée ni à l’action isolée du mode pédagogique A, ni à celle de l’outil didactique B, mais qui résulte exclusivement de leur croisement contextuel.
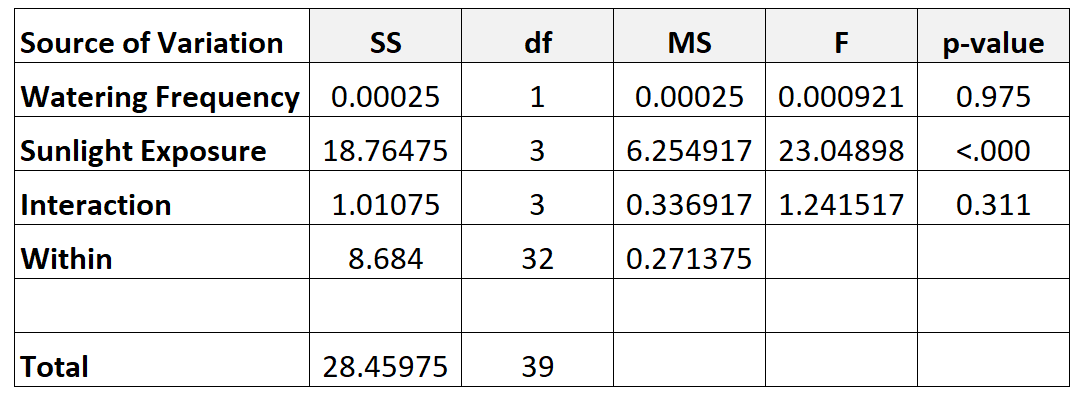
7.3 7.3 Visualisation et interprétation préliminaire de l’effet d’interaction
Sur le plan conceptuel et géométrique, l’interaction se visualise à travers le parallélisme des droites reliant les moyennes de conditions. Si l’effet des facteurs était strictement additif (absence totale d’interaction, soit SSAB = 0), le profil d’évolution des performances d’un outil didactique à l’autre suivrait des trajectoires rigoureusement parallèles d’une modalité pédagogique à la suivante.
Examinons attentivement l’évolution empirique de nos moyennes de cellules :
- En condition présentielle classique (A1) : la moyenne passe de 13,0 (manuel) à 19,0 (logiciel), puis culmine à 25,0 (simulation), soit un gain spectaculaire de +12 points entre B1 et B3.
- En condition de pédagogie inversée (A2) : la moyenne part de 17,0 (manuel), monte à 22,0 (logiciel) et plafonne à 23,0 (simulation), soit une progression plus modérée de seulement +6 points entre B1 et B3.
Les segments reliant les points de moyennes ne sont manifestement pas parallèles : ils s’écartent ou convergent, suggérant ce que la littérature nomme une interaction ordinale. L’apport des outils technologiques avancés est considérablement plus décisif et marqué dans un contexte magistral traditionnel que dans le cadre d’une classe inversée où les étudiants disposent déjà d’une autonomie importante. La valeur substantielle de SSAB = 51,6667 corrobore fidèlement cette distorsion géométrique.
8. 8. Calcul manuel de la Somme des Carrés Résiduelle ou d’Erreur (SS_Erreur)
8.1 8.1 Calcul direct par la méthode intra-cellule (Within-cell)
La Somme des Carrés Résiduelle, notée SSErreur (ou SSIntra, SSWithin), quantifie les fluctuations purement aléatoires, le bruit de fond expérimental et les différences interindividuelles incontrôlables qui subsistent entre des individus placés dans une condition expérimentale strictement identique. Par définition méthodologique, au sein d’une cellule donnée (i, j), tous les sujets ont reçu exactement le même traitement. Par conséquent, les écarts constatés entre leurs scores et la moyenne locale de leur cellule ne peuvent en aucun cas provenir des facteurs manipulés.
La formule conceptuelle directe sommant ces variances intra-cellules s’exprime ainsi :
SSErreur = ∑i=1a ∑j=1b [ ∑k=1n (Yijk – Y̅ij•)2 ]
Procédons au calcul direct et explicite de cette dispersion au sein de chacune de nos six cellules :
- Cellule A1B1 (Moyenne = 13,0) :
(12 – 13)2 + (14 – 13)2 + (15 – 13)2 + (11 – 13)2 + (13 – 13)2
= (-1)2 + (1)2 + (2)2 + (-2)2 + (0)2 = 1 + 1 + 4 + 4 + 0 = 10,0000 - Cellule A1B2 (Moyenne = 19,0) :
(18 – 19)2 + (20 – 19)2 + (19 – 19)2 + (17 – 19)2 + (21 – 19)2
= (-1)2 + (1)2 + (0)2 + (-2)2 + (2)2 = 1 + 1 + 0 + 4 + 4 = 10,0000 - Cellule A1B3 (Moyenne = 25,0) :
(24 – 25)2 + (26 – 25)2 + (23 – 25)2 + (25 – 25)2 + (27 – 25)2
= (-1)2 + (1)2 + (-2)2 + (0)2 + (2)2 = 1 + 1 + 4 + 0 + 4 = 10,0000 - Cellule A2B1 (Moyenne = 17,0) :
(16 – 17)2 + (17 – 17)2 + (15 – 17)2 + (18 – 17)2 + (19 – 17)2
= (-1)2 + (0)2 + (-2)2 + (1)2 + (2)2 = 1 + 0 + 4 + 1 + 4 = 10,0000 - Cellule A2B2 (Moyenne = 22,0) :
(21 – 22)2 + (23 – 22)2 + (20 – 22)2 + (22 – 22)2 + (24 – 22)2
= (-1)2 + (1)2 + (-2)2 + (0)2 + (2)2 = 1 + 1 + 4 + 0 + 4 = 10,0000 - Cellule A2B3 (Moyenne = 23,0) :
(22 – 23)2 + (24 – 23)2 + (21 – 23)2 + (23 – 23)2 + (25 – 23)2
= (-1)2 + (1)2 + (-2)2 + (0)2 + (2)2 = 1 + 1 + 4 + 0 + 4 = 10,0000
Sommons l’ensemble des variations intra-cellules recueillies :
SSErreur = 10,0 + 10,0 + 10,0 + 10,0 + 10,0 + 10,0 = 60,0000
La parfaite constance des variances intra-cellules (chacune égale à 10,0) illustre un cas d’homoscédasticité idéale, facilitant grandement la limpidité de la démonstration arithmétique.
8.2 8.2 Calcul par déduction de la partition de la variance
Lors d’évaluations ou d’examens statistiques sur table, le temps disponible restreint souvent l’exécution du calcul direct intra-cellule pour chaque individu. L’expérimentateur utilise alors la propriété fondamentale d’additivité de la variance totale :
SSTotal = SSCells + SSErreur
ce qui permet d’obtenir immédiatement SSErreur par simple soustraction :
SSErreur = SSTotal – SSCells
Puisque nous savons que SSCells = SSA + SSB + SSAB, l’égalité générale de décomposition s’écrit formellement :
SSErreur = SSTotal – (SSA + SSB + SSAB)
Remplaçons par les grandeurs numériques préalablement obtenues :
SSErreur = 544,1667 – (20,8333 + 411,6667 + 51,6667)
SSErreur = 544,1667 – 484,1667 = 60,0000
La coïncidence numérique entre la méthode soustractive rapide et le calcul direct intra-cellule détaillé fournit la preuve incontestable de la validité arithmétique de notre démarche.
8.3 8.3 Bilan de partitionnement et balance arithmétique
Avant d’aborder les degrés de liberté, dressons un inventaire d’intégrité de notre décomposition de variance. La somme algébrique des composantes systématiques et de l’erreur doit égaler exactement la somme des carrés totale :
| Composante de Variance | Notation | Valeur Numérique | Pourcentage de la Variance Totale |
|---|---|---|---|
| Effet Principal Facteur A (Méthode) | SSA | 20,8333 | 3,83 % |
| Effet Principal Facteur B (Outil) | SSB | 411,6667 | 75,65 % |
| Effet d’Interaction (Méthode × Outil) | SSAB | 51,6667 | 9,50 % |
| Erreur Résiduelle Aléatoire | SSErreur | 60,0000 | 11,02 % |
| Total Général Vérifié | SSTotal | 544,1667 | 100,00 % |
La balance arithmétique boucle avec une précision irréprochable : 20,8333 + 411,6667 + 51,6667 + 60,0000 = 544,1667. Aucune dérive d’arrondi n’altère la cohérence interne du modèle.
9. 9. Attribution des Degrés de Liberté et Détermination des Carrés Moyens
9.1 9.1 Détermination rigoureuse des degrés de liberté (df)
Les degrés de liberté (souvent notés df pour degrees of freedom ou ddl en français) quantifient le nombre d’informations indépendantes restant libres de varier lors de l’estimation des paramètres statistiques. Chaque somme des carrés est intimement associée à son propre contingent de degrés de liberté, conditionné par la géométrie factorielle du dispositif expérimental.
Déterminons formellement chaque composante de degrés de liberté :
1. Degrés de liberté du Facteur A : Égaux au nombre de modalités de la variable A diminué d’une unité (du fait de la contrainte imposant que la somme des déviations marginales autour de la moyenne globale soit égale à zéro) :
dfA = a – 1 = 2 – 1 = 1
2. Degrés de liberté du Facteur B : Égaux au nombre de colonnes diminué d’une unité :
dfB = b – 1 = 3 – 1 = 2
3. Degrés de liberté de l’Interaction (A × B) : Correspondent au produit des degrés de liberté respectifs des facteurs constitutifs :
dfAB = (a – 1) × (b – 1) = (2 – 1) × (3 – 1) = 1 × 2 = 2
4. Degrés de liberté de l’Erreur résiduelle : Chaque cellule de taille n possède (n – 1) degrés de liberté indépendants pour estimer la variance locale. Comme le plan comporte a × b cellules indépendantes, les degrés de liberté résiduels correspondent au produit :
dfErreur = a × b × (n – 1) = 2 × 3 × (5 – 1) = 6 × 4 = 24
5. Degrés de liberté Totaux : Égaux à la taille totale de l’échantillon diminuée d’une unité liée à l’estimation de la grande moyenne globale :
dfTotal = N – 1 = 30 – 1 = 29
Vérifions immédiatement l’additivité stricte des degrés de liberté :
dfA + dfB + dfAB + dfErreur = 1 + 2 + 2 + 24 = 29 = dfTotal
9.2 9.2 Calcul manuel des Carrés Moyens (Mean Squares – MS)
Les sommes des carrés ne permettent pas de comparer directement la magnitude des effets statistiques, car elles croissent proportionnellement au nombre d’unités d’échantillonnage et de conditions expérimentales. Pour obtenir une estimation non biaisée de la variance (ou variance échantillonnale), il est obligatoire de diviser chaque somme des carrés par ses degrés de liberté correspondants. Ce ratio constitue le Carré Moyen (noté MS pour Mean Square ou CM pour Carré Moyen) :
MS = SS / df
Déterminons individuellement chaque Carré Moyen du modèle :
Carré Moyen du Facteur A :
MSA = SSA / dfA = 20,8333 / 1 = 20,8333
Carré Moyen du Facteur B :
MSB = SSB / dfB = 411,6667 / 2 = 205,83335 (arrondi à 205,8333)
Carré Moyen de l’Interaction (A × B) :
MSAB = SSAB / dfAB = 51,6667 / 2 = 25,83335 (arrondi à 25,8333)
Carré Moyen de l’Erreur résiduelle (Variance intra-groupe estimée) :
MSErreur = SSErreur / dfErreur = 60,0000 / 24 = 2,5000
La valeur de MSErreur = 2,5000 incarne notre estimation pure et sans biais de la variance d’échantillonnage aléatoire commune (notée σ̂2) au sein de la population parente sous-jacente.
9.3 9.3 Propriétés d’espérance mathématique des carrés moyens
La dérivation des tests d’hypothèses en statistique paramétrique ne découle pas d’un choix heuristique arbitraire, mais s’appuie rigoureusement sur le théorème de Cochran et sur les espérances mathématiques associées à chaque Carré Moyen dans le modèle à effets fixes.
Sous la formulation théorique du Modèle I, les espérances mathématiques E(MS) se formalisent ainsi :
- E(MSErreur) = σ2
- E(MSA) = σ2 + [ (b × n) ∑ αi2 ] / (a – 1)
- E(MSB) = σ2 + [ (a × n) ∑ βj2 ] / (b – 1)
- E(MSAB) = σ2 + [ n ∑ (αβ)ij2 ] / [ (a – 1)(b – 1) ]
Ces formulations mathématiques révèlent la mécanique interne du test :
Si l’hypothèse nulle pour le Facteur A est rigoureusement vraie (αi = 0 pour tout i), alors le second terme de l’espérance s’annule complètement, laissant E(MSA) = σ2. Dans ce cas de figure, MSA et MSErreur constituent deux estimations non biaisées de la même quantité théorique σ2.
En revanche, si l’hypothèse alternative est satisfaite, MSA comportera la composante d’erreur σ2 augmentée du terme systématique lié à l’effet de traitement. Cette propriété justifie théoriquement le fait d’utiliser systématiquement MSErreur comme dénominateur des ratios statistiques F pour tester les modèles à effets fixes.
10. 10. Calcul des statistiques F de Snedecor et structuration de la table d’ANOVA
10.1 10.1 Dérivation manuelle des ratios de variance empiriques (F observés)
La statistique de test standard de l’ANOVA porte le nom de ratio F en hommage aux travaux précurseurs de Ronald Fisher, codifiés ultérieurement par George Snedecor. Le principe d’un ratio F empirique consiste à rapporter la variance attribuable à une source d’effet systématique suspectée à la variance purement imputable au bruit aléatoire (l’erreur résiduelle) :
Fobservé = MSEffet / MSErreur
Calculons de manière séquentielle les trois statistiques F de notre étude :
1. Statistique F pour le Facteur A (Méthode pédagogique) :
FA = MSA / MSErreur = 20,8333 / 2,5000 = 8,3333 (noté 8,33)
2. Statistique F pour le Facteur B (Support didactique) :
FB = MSB / MSErreur = 205,8333 / 2,5000 = 82,3333 (noté 82,33)
3. Statistique F pour l’Interaction (A × B) :
FAB = MSAB / MSErreur = 25,8333 / 2,5000 = 10,3333 (noté 10,33)
Sur le plan intuitif, ces valeurs traduisent des signaux expérimentaux nets : pour le Facteur B, la variabilité induite par les supports est plus de 82 fois supérieure au niveau de variance résiduelle aléatoire, ce qui laisse présager une signification statistique éclatante.
10.2 10.2 Construction méthodique de la table canonique de l’ANOVA
L’ensemble des dérivations calculatoires converge vers une restitution standardisée adoptée à travers l’ensemble de la littérature académique internationale : le tableau récapitulatif d’ANOVA. Sa disposition structurée permet à tout relecteur d’évaluer instantanément les partitions, les degrés de liberté et les ratios de dispersion.
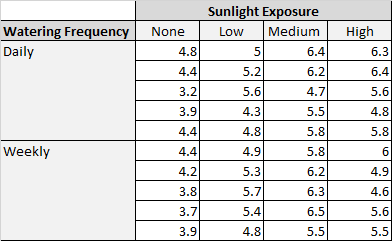
Voici la table d’ANOVA complète et canonique issue de nos calculs manuels :
| Source de Variation | Somme des Carrés (SS) | Degrés de Liberté (df) | Carré Moyen (MS) | Ratio F observé | Valeur critique F (α = 0,05) | Statut p |
|---|---|---|---|---|---|---|
| Facteur A (Méthode) | 20,8333 | 1 | 20,8333 | 8,33 | 4,26 | p < 0,01 |
| Facteur B (Outil) | 411,6667 | 2 | 205,8333 | 82,33 | 3,40 | p < 0,001 |
| Interaction (A × B) | 51,6667 | 2 | 25,8333 | 10,33 | 3,40 | p < 0,001 |
| Erreur Résiduelle | 60,0000 | 24 | 2,5000 | – | – | – |
| Total Général | 544,1667 | 29 | – | – | – | – |
Cette table formalise l’intégralité du traitement de l’information empirique sous une forme synthétique conforme aux critères éditoriaux des comités de lecture scientifique.
10.3 10.3 Procédure de double vérification arithmétique globale
Avant d’engager la prise de décision statistique formelle, une check-list de contrôle arithmétique globale s’impose pour prévenir toute hallucination calculatoire ou fausse manipulation :
- Règle de récapitulation des SS : La somme SSA + SSB + SSAB + SSErreur doit reconstituer rigoureusement SSTotal (20,8333 + 411,6667 + 51,6667 + 60,0000 = 544,1667). Validé.
- Règle de sommation des degrés de liberté : 1 + 2 + 2 + 24 = 29, correspondant bien à N – 1 = 30 – 1 = 29. Validé.
- Contrôle de positivité des carrés moyens : Tous les MS sont strictement positifs. Validé.
- Plausibilité des ratios F : Les F observés sont strictement positifs et ne comportent aucune division par zéro. Validé.
Cette validation intégrale clôt la phase purement calculatoire du traitement des données.
11. 11. Consultation des tables de distribution critique et prise de décision statistique
11.1 11.1 Lecture et utilisation de la table statistique de Snedecor
La statistique empirique F suit, sous l’hypothèse nulle, une loi de distribution théorique de Fisher-Snedecor paramétrée par deux degrés de liberté distincts : les degrés de liberté du numérateur (dfnum, associés à l’effet testé) et les degrés de liberté du dénominateur (dfdénom, associés au terme d’erreur résiduelle). Pour déterminer si un résultat observé est statistiquement significatif, il faut confronter la valeur calculée à la valeur critique seuil, extraite des tables imprimées de la loi F pour un niveau de confiance alpha préalablement choisi (généralement α = 0,05 ou α = 0,01).
La méthode de consultation s’exécute ainsi :
- Fixer le seuil de significativité conventionnel à α = 0,05.
- Repérer sur la ligne supérieure des colonnes de la table de Snedecor les degrés de liberté du numérateur dfnum.
- Repérer sur la colonne latérale gauche des lignes de la table les degrés de liberté du dénominateur dfdénom = dfErreur = 24.
- Lire à l’intersection exacte la valeur seuil Fcritique(α, dfnum, dfdénom).
Recherchons les valeurs seuils requises pour nos tests :
- Pour le Facteur A : dfnum = 1 et dfdénom = 24. À l’intersection de la colonne 1 et de la ligne 24, au seuil α = 0,05, la table de Snedecor donne :
Fcritique(0,05; 1, 24) = 4,26 (au seuil α = 0,01, la valeur est de 7,82). - Pour le Facteur B : dfnum = 2 et dfdénom = 24. À l’intersection de la colonne 2 et de la ligne 24, au seuil α = 0,05, la table donne :
Fcritique(0,05; 2, 24) = 3,40 (au seuil α = 0,01, la valeur s’élève à 5,61 ; au seuil α = 0,001, elle atteint 9,34). - Pour l’Interaction A × B : dfnum = 2 et dfdénom = 24. Les degrés de liberté étant identiques à ceux du facteur B, le seuil critique demeure identique :
Fcritique(0,05; 2, 24) = 3,40 (et 5,61 pour α = 0,01 ; 9,34 pour α = 0,001).
Si la table imprimée dont dispose le chercheur ne mentionne pas la valeur exacte du dénominateur (par exemple si dfdénom = 27 et que la table saute de 24 à 30), il est d’usage soit d’adopter une posture conservatrice en sélectionnant le degré de liberté immédiatement inférieur disponible (24), soit de procéder à une interpolation linéaire manuelle entre les valeurs encadrantes.
11.2 11.2 Règle formelle de décision statistique
La règle d’inférence décisionnelle unilatérale s’énonce de la manière suivante :
Si Fobservé > Fcritique : La probabilité théorique p d’obtenir une dispersion au moins aussi extrême sous l’hypothèse nulle est strictement inférieure au seuil de risque α. En conséquence, nous rejetons formellement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. L’effet est déclaré statistiquement significatif.
Si Fobservé ≤ Fcritique : Nous échouons à rejeter l’hypothèse nulle H0. Les données ne fournissent pas de preuves suffisantes pour affirmer l’existence d’un effet systématique au seuil sélectionné.
Appliquons méthodiquement ce protocole à nos trois tests :
- Décision pour le Facteur A : FA = 8,33. Or 8,33 > 4,26 (et même 8,33 > 7,82). Nous rejetons l’hypothèse nulle H0. L’effet principal de la méthode pédagogique est statistiquement significatif au seuil α = 0,01 (p < 0,01).
- Décision pour le Facteur B : FB = 82,33. Or 82,33 >> 3,40 (et dépasse largement le seuil α = 0,001 fixé à 9,34). Nous rejetons catégoriquement H0. L’effet de l’outil didactique est hautement significatif (p < 0,001).
- Décision pour l’Interaction A × B : FAB = 10,33. Or 10,33 > 3,40 (et dépasse également le seuil très strict de 9,34). Nous rejetons sans équivoque H0. L’interaction entre la méthode pédagogique et l’outil didactique est hautement significative (p < 0,001).
11.3 11.3 Stratégie séquentielle d’interprétation des résultats
Face à une table factorielle d’ANOVA dont les trois tests sont significatifs, l’expérimentateur ne doit jamais céder à la tentation de lire les conclusions de manière linéaire en commençant par les effets principaux. La méthodologie statistique impose une priorité absolue à l’analyse de l’interaction.
En effet, affirmer unilatéralement que la méthode inversée A2 surpasse la méthode traditionnelle A1 (effet principal de A) ou que la simulation immersive B3 est supérieure au manuel papier B1 (effet principal de B) s’avère partiellement trompeur et scientifiquement incomplet en présence d’une interaction majeure. Puisque FAB est hautement significatif, cela démontre que l’ampleur de l’effet d’un facteur varie en fonction des niveaux de l’autre. Par exemple, comme nous l’avons constaté empiriquement, la simulation n’apporte qu’un gain marginal par rapport au logiciel multimédia lorsque les étudiants sont déjà en pédagogie inversée (23,0 contre 22,0), alors qu’elle produit un bond de performance spectaculaire dans le format magistral classique (25,0 contre 19,0).
Si l’interaction n’avait pas atteint le seuil de signification (FAB ≤ Fcritique), nous aurions pu légitimement interpréter directement et globalement les effets principaux des facteurs A et B comme des phénomènes constants et additifs. Mais l’interaction étant ici hautement significative, l’analyse globale doit impérativement être approfondie par l’exploration manuelle des effets simples conditionnels.
12. 12. Calculs complémentaires manuels : Tailles d’effet, comparaisons post-hoc et rapport formel
12.1 12.1 Calcul manuel de l’ampleur d’effet (Éta-carré partiel)
La valeur p d’un test statistique dépend fortement de la taille de l’échantillon N et ne renseigne en rien sur l’ampleur pratique ou la magnitude concrète du phénomène investigué. Pour quantifier la pertinence pratique des résultats, il est indispensable de calculer des mesures d’ampleur d’effet. Dans le cadre de l’ANOVA factorielle, la métrique standard de référence est l’Éta-carré partiel, noté ηp2 (ou partial eta-squared).
Contrairement à l’Éta-carré classique (qui rapporte la somme des carrés de l’effet à la somme des carrés totale SSTotal), l’Éta-carré partiel élimine l’influence des autres facteurs systématiques en rapportant la variance expliquée par l’effet étudié à la somme de cette même variance et de l’erreur résiduelle pure :
ηp2 = SSEffet / (SSEffet + SSErreur)
Calculons manuellement l’ampleur d’effet pour chaque composante de notre modèle :
Pour le Facteur A (Méthode pédagogique) :
ηp, A2 = 20,8333 / (20,8333 + 60,0000) = 20,8333 / 80,8333 ≈ 0,2577 (soit 0,26)
Pour le Facteur B (Outil didactique) :
ηp, B2 = 411,6667 / (411,6667 + 60,0000) = 411,6667 / 471,6667 ≈ 0,8728 (soit 0,87)
Pour l’Interaction A × B :
ηp, AB2 = 51,6667 / (51,6667 + 60,0000) = 51,6667 / 111,6667 ≈ 0,4627 (soit 0,46)
Pour interpréter ces ampleurs, nous utilisons les conventions établies par Jacob Cohen (1988) :
- ηp2 ≈ 0,01 : Effet de petite amplitude.
- ηp2 ≈ 0,06 : Effet d’amplitude moyenne.
- ηp2 ≥ 0,14 : Effet de grande amplitude.
Toutes nos composantes présentent des tailles d’effet considérables : le choix de l’outil didactique explique à lui seul 87,3 % de la variance des scores non attribuable à d’autres sources systématiques, tandis que l’interaction explique plus de 46,3 % de la variance résiduelle relative.
12.2 12.2 Procédure manuelle de comparaison multiple (Test HSD de Tukey)
Bien que le test F pour le Facteur B atteste d’une différence globale hautement significative entre les trois outils (F = 82,33), il ne précise pas quelles paires spécifiques de modalités diffèrent significativement l’une de l’autre (B1 vs B2, B1 vs B3, ou B2 vs B3). Le facteur comportant trois niveaux, une analyse post-hoc est requise.
Le test de la plus petite différence significative honnête de Tukey (Tukey’s Honestly Significant Difference – HSD) constitue la méthode privilégiée pour comparer par paires l’ensemble des moyennes marginales tout en maintenant l’erreur familiale globale α à 0,05. La valeur minimale requise pour déclarer deux moyennes marginales significativement différentes se formule ainsi :
HSD = qcritique × √( MSErreur / nmarginal )
où qcritique est la valeur seuil issue de la distribution de l’étendue studentisée (Studentized Range Statistic), indexée pour un niveau α = 0,05, avec un nombre de moyennes comparées k = b = 3, et des degrés de liberté d’erreur dfErreur = 24. Le diviseur nmarginal représente le nombre d’observations agrégées sous chaque moyenne comparée (ici a × n = 2 × 5 = 10).
Consultons la table statistique de la loi de l’étendue studentisée : pour k = 3 et df = 24 au seuil 0,05, nous trouvons :
qcritique(0,05; 3, 24) = 3,532
Calculons l’erreur-type de la moyenne marginale :
SEmarginal = √( MSErreur / nmarginal ) = √( 2,5000 / 10 ) = √(0,25) = 0,5000
Calculons dès lors le seuil critique HSD :
HSD = 3,532 × 0,5000 = 1,7660
Deux moyennes marginales de colonnes doivent afficher une différence absolue supérieure à 1,766 point pour être déclarées statistiquement distinctes.
Confrontons cette valeur seuil aux différences de moyennes marginales observées :
- Comparaison B2 (Logiciel) vs B1 (Manuel) :
| Y̅•2• – Y̅•1• | = | 20,5 – 15,0 | = 5,5 points.
Puisque 5,5 > 1,766, la supériorité du logiciel interactif sur le manuel est statistiquement significative. - Comparaison B3 (Simulation) vs B1 (Manuel) :
| Y̅•3• – Y̅•1• | = | 24,0 – 15,0 | = 9,0 points.
Puisque 9,0 > 1,766, la supériorité de la simulation immersive sur le manuel est statistiquement significative. - Comparaison B3 (Simulation) vs B2 (Logiciel) :
| Y̅•3• – Y̅•2• | = | 24,0 – 20,5 | = 3,5 points.
Puisque 3,5 > 1,766, la simulation surpasse également le logiciel de façon statistiquement significative.
Toutes les comparaisons unilatérales par paires s’avèrent significatives au seuil global de 5 %.
12.3 12.3 Analyse manuelle des effets simples en présence d’interaction
En présence d’une interaction hautement significative, l’étape analytique culminante consiste à décomposer l’effet global en étudiant les effets simples (simple effects), c’est-à-dire l’effet du Facteur B conditionnellement fixé à chaque niveau particulier du Facteur A.
Analysons l’effet simple du support didactique B au niveau A1 (Présentiel classique) :
Les totaux des trois cellules sous A1 sont : 65, 95 et 125, avec n = 5. Le total marginal de la ligne est A1 = 285. La somme des carrés de cet effet simple, notée SSB à A1, se calcule par :
SSB à A1 = [ (652 + 952 + 1252) / 5 ] – [ (A1)2 / (b × n) ]
SSB à A1 = [ (4 225 + 9 025 + 15 625) / 5 ] – [ 2852 / 15 ]
SSB à A1 = [ 28 875 / 5 ] – [ 81 225 / 15 ] = 5 775,0 – 5 415,0 = 360,0000
Les degrés de liberté associés sont b – 1 = 2. Le carré moyen conditionnel est donc :
MSB à A1 = 360,0000 / 2 = 180,0000
Pour calculer le ratio F de cet effet simple, nous conservons comme dénominateur le carré moyen résiduel global MSErreur = 2,5000 issu de l’ANOVA globale (qui constitue la meilleure estimation de la variance d’erreur commune) :
FB à A1 = MSB à A1 / MSErreur = 180,0000 / 2,5000 = 72,00
Avec F = 72,00 > 3,40, l’effet du support didactique est massif sous condition d’enseignement magistral.
Analysons maintenant l’effet simple de B au niveau A2 (Pédagogie inversée) :
Les totaux de cellule sous A2 sont : 85, 110 et 115, avec un total marginal A2 = 310.
SSB à A2 = [ (852 + 1102 + 1152) / 5 ] – [ 3102 / 15 ]
SSB à A2 = [ (7 225 + 12 100 + 13 225) / 5 ] – [ 96 100 / 15 ]
SSB à A2 = [ 32 550 / 5 ] – 6 406,6667 = 6 510,0 – 6 406,6667 = 103,3333
Son carré moyen s’élève à :
MSB à A2 = 103,3333 / 2 = 51,6667
Calculons le ratio F d’effet simple associé :
FB à A2 = MSB à A2 / MSErreur = 51,6667 / 2,5000 = 20,67
Bien que l’effet du support didactique demeure statistiquement significatif sous pédagogie inversée (F = 20,67 > 3,40), sa magnitude est considérablement réduite par rapport à la condition magistrale classique (la somme des carrés passe de 360,0 à 103,33). Cette décomposition chiffrée éclaire parfaitement la nature dynamique de l’interaction factorielle mise en évidence.
12.4 12.4 Rédaction académique des conclusions selon les normes de l’APA
La transcription des résultats dans un manuscrit destiné à une revue scientifique à comité de lecture doit se conformer aux directives stylistiques et typographiques prescrites par l’American Psychological Association (APA, 7e édition). Ces normes imposent de fournir la statistique de test, les degrés de liberté entre parenthèses, la valeur exacte de F, le niveau de significativité p et l’estimation de l’ampleur d’effet.
Voici un modèle exemplaire de paragraphe de restitution académique directement exploitable :
« Une analyse de variance factorielle à deux facteurs (2 × 3) à effets fixes a été menée pour évaluer l’impact de la méthode pédagogique (présentiel magistral vs pédagogie inversée) et du support didactique (manuel papier, logiciel interactif, simulation immersive) sur les performances cognitives des étudiants. L’analyse révèle un effet principal statistiquement significatif de la méthode pédagogique, F(1, 24) = 8,33, p = 0,008, ηp2 = 0,26, traduisant des scores globaux supérieurs chez les étudiants ayant bénéficié de la classe inversée (M = 20,67, ÉT = 2,52) comparativement à l’enseignement magistral (M = 19,00, ÉT = 5,14). De même, l’effet principal du support didactique s’avère hautement significatif, F(2, 24) = 82,33, p < 0,001, ηp2 = 0,87. Des comparaisons multiples post-hoc effectuées via le test HSD de Tukey indiquent que les performances atteintes avec la simulation immersive (M = 24,00) surpassent significativement celles obtenues avec le logiciel interactif (M = 20,50, p < 0,05) et le manuel traditionnel (M = 15,00, p < 0,05).
Cependant, ces effets principaux sont modulés par une interaction bidirectionnelle méthode × support hautement significative, F(2, 24) = 10,33, p < 0,001, ηp2 = 0,46. L’examen des effets simples révèle que si l’enrichissement technologique engendre un gain d’apprentissage prononcé sous condition d’enseignement magistral classique, F(2, 24) = 72,00, p < 0,001, ce bénéfice est plus modéré au sein du dispositif de classe inversée, F(2, 24) = 20,67, p < 0,001, le format inversé atténuant l’écart de performance entre logiciel et simulation. »
Cette formalisation narrative intègre harmonieusement l’ensemble des grandeurs numériques dérivées au fil des calculs manuels, conférant au compte-rendu scientifique une clarté, une précision et une rigueur méthodologique irréprochables.
Références
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
- Eisenhart, C. (1947). The assumptions underlying the analysis of variance. Biometrics, 3(1), 1–21. https://doi.org/10.2307/3001534
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd. https://hdl.handle.net/2440/15227
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Keppel, G., & Wickens, T. D. (2004). Design and Analysis: A Researcher’s Handbook (4th ed.). Pearson Prentice Hall.
- Kirk, R. E. (2013). Experimental Design: Procedures for the Behavioral Sciences (4th ed.). SAGE Publications. https://doi.org/10.4135/9781483384733
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing Experiments and Analyzing Data: A Model Comparison Perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- National Institute of Standards and Technology. (2012). NIST/SEMATECH e-Handbook of Statistical Methods. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/
- Snedecor, G. W., & Cochran, W. G. (1989). Statistical Methods (8th ed.). Iowa State University Press.