
Dans l’arsenal des méthodes quantitatives appliquées aux sciences humaines, économiques et comportementales, la régression linéaire multiple occupe une place prépondérante. Les chercheurs se trouvent fréquemment confrontés à la nécessité d’évaluer non seulement l’effet isolé d’une variable indépendante spécifique, mais également l’apport conjoint et incrémental d’un groupe cohérent de prédicteurs. Qu’il s’agisse de mesurer la plus-value explicative d’une batterie de tests cognitifs au-delà des facteurs sociodémographiques classiques, ou d’estimer l’impact global d’un ensemble de biomarqueurs sur une mesure de détresse psychologique, l’évaluation de modèles concurrents exige une rigueur méthodologique irréprochable. C’est précisément à cette fin qu’intervient le test F partiel, couramment désigné sous le terme de test de significativité du changement de variance ou test de modèles emboîtés.
Bien que des logiciels statistiques spécialisés tels que R, SPSS ou SAS automatisent ces calculs au travers de modules de régression hiérarchique, la maîtrise de cette procédure au sein d’un tableur universel comme Microsoft Excel demeure une compétence analytique inestimable. Excel offre une transparence totale sur la décomposition de la variance, permettant au praticien de s’affranchir de l’effet « boîte noire » propre aux environnements automatisés. En manipulant directement les sommes des carrés résiduels, les degrés de liberté et les distributions de probabilité associées, l’analyste acquiert une compréhension intime des équations sous-jacentes qui régissent l’arbitrage fondamental entre parcimonie et pouvoir explicatif d’un modèle statistique.
Ce guide exhaustif a pour vocation de détailler, avec le plus haut degré de rigueur académique et pratique, l’ensemble des étapes nécessaires à l’exécution d’un test F partiel dans Excel. Depuis les fondements mathématiques de l’algèbre linéaire matricielle jusqu’à la rédaction des conclusions selon les normes de l’American Psychological Association (APA 7e édition), en passant par l’exploitation avancée de l’Utilitaire d’analyse et de la fonction matricielle dynamique DROITEREG, chaque concept est ici disséqué. L’objectif est d’équiper le chercheur, l’étudiant avancé ou le data analyste d’un cadre méthodologique robuste, entièrement reproductible et exempt des biais numériques fréquemment rencontrés dans le traitement tabulaire des données.
1. Introduction conceptuelle au test F partiel en régression linéaire
1.1 Définition et rôle du test F partiel dans l’analyse quantitative
Le test F partiel, également documenté dans la littérature économétrique sous l’appellation de test de contrainte linéaire ou test d’exclusion de variables, est une procédure inférentielle conçue pour déterminer si l’adjonction conjointe d’un ensemble déterminé de variables indépendantes améliore significativement l’ajustement d’un modèle de régression linéaire par rapport à une spécification plus restrictive. Contrairement à l’analyse de régression simple où chaque variable est évaluée isolément, le test F partiel examine l’effet marginal partagé d’un bloc de prédicteurs, prenant explicitement en compte les corrélations mutuelles existant entre ces derniers et les covariables déjà présentes dans l’équation.
Dans les sciences comportementales et psychologiques, les phénomènes observés sont intrinsèquement multifactoriels et caractérisés par une forte interdépendance. Lorsqu’un chercheur tente d’expliquer la variance d’un construit latent, tel que la performance cognitive ou la réactivité émotionnelle, les prédicteurs appartiennent souvent à des niveaux conceptuels distincts : déterminants distaux (âge, niveau d’éducation, statut socio-économique) et déterminants proximaux (styles d’attachement, traits de personnalité, marqueurs neurobiologiques). Le test F partiel permet d’évaluer formellement si les prédicteurs proximaux fournissent une contribution explicative authentique, au-delà de ce qui est déjà capturé par les variables distales de contrôle.
Il importe de distinguer nettement le test F global du test F partiel. Le test F global, systématiquement fourni dans le tableau d’analyse de variance (ANOVA) standard d’une régression, teste l’hypothèse nulle selon laquelle l’ensemble de tous les coefficients de pente du modèle sont simultanément égaux à zéro. En revanche, le test F partiel isole un sous-ensemble spécifique de coefficients pour vérifier si leur contribution conjointe est statistiquement distincte du bruit aléatoire, tout en maintenant constants les effets de tous les autres prédicteurs préalablement intégrés. Cette spécificité en fait l’outil privilégié de la validation incrémentale.
1.2 La notion de modèles emboîtés (Nested Models)
L’application rigoureuse du test F partiel repose sur la condition sine qua non de l’emboîtement des modèles, désignée en anglais sous le vocable de nested models. Deux modèles statistiques sont dits strictement emboîtés lorsque le modèle le plus simple, qualifié de modèle restreint ou réduit (Reduced Model), peut être dérivé du modèle le plus complexe, qualifié de modèle complet (Full Model), en imposant une série de contraintes linéaires exactes sur les paramètres de ce dernier. Dans le contexte de l’exclusion de variables, ces contraintes consistent invariablement à fixer les coefficients de régression d’un sous-ensemble prédéfini de variables explicatives à une valeur théorique de zéro.
Considérons à titre d’illustration théorique une recherche psychométrique visant à prédire le niveau d’anxiété généralisée ($Y$). Le modèle complet peut intégrer quatre prédicteurs : l’âge ($X_1$), le niveau d’instruction ($X_2$), l’auto-efficacité émotionnelle ($X_3$) et la rumination cognitive ($X_4$). Le modèle restreint omettra, par exemple, les deux dernières variables ($X_3$ et $X_4$) pour ne conserver que les prédicteurs sociodémographiques ($X_1$ et $X_2$). Dans cette configuration, le modèle réduit est parfaitement emboîté dans le modèle complet, car il correspond exactement à la situation où les coefficients de population $\beta_3$ et $\beta_4$ sont simultanément contraints à la valeur nulle.
Sur le plan de la géométrie vectorielle sous-jacente à la méthode des moindres carrés ordinaires (MCO), le modèle complet projette le vecteur des observations dépendantes sur un sous-espace vectoriel de dimension $k$ défini par l’ensemble des régresseurs. Le modèle restreint, quant à lui, projette ce même vecteur sur un sous-espace de dimension strictement inférieure, disons $k – p$, où $p$ représente le nombre de paramètres éliminés. La validité du test dépend du fait que le sous-espace du modèle restreint soit un sous-espace vectoriel direct et complet de l’espace défini par le modèle complet, garantissant que l’augmentation de la somme des carrés résiduels résulte uniquement de la suppression des dimensions associées aux $p$ prédicteurs omis.
1.3 Applications pratiques en psychologie et sciences sociales
L’utilisation empirique du test F partiel est omniprésente dans les protocoles de recherche en psychologie clinique, différentielle et organisationnelle. L’une des applications fondamentales réside dans le contrôle méthodique des facteurs de confusion. Lors de l’étude de l’efficacité d’une nouvelle approche thérapeutique sur la réduction des symptômes dépressifs, il est impératif d’isoler l’effet du protocole clinique des variables parasites telles que la durée du trouble, les antécédents médicamenteux ou le revenu du foyer. Le chercheur spécifie un premier modèle contenant uniquement ces covariables, puis introduit les modalités thérapeutiques dans un second modèle. Le test F partiel quantifie alors avec précision si l’intervention clinique produit un gain statistique réel, indépendant du profil initial des participants.
Une autre application prépondérante concerne l’évaluation de la validité incrémentale d’un nouvel instrument psychométrique. Lorsqu’une équipe de recherche développe une nouvelle échelle destinée à mesurer l’agilité cognitive, il ne suffit pas de démontrer que cet outil corrèle significativement avec la performance professionnelle. Il est méthodologiquement requis de prouver que cette échelle prédit la performance au-delà des mesures standardisées d’intelligence générale ($g$) et des cinq grands traits de personnalité (Big Five). En soumettant l’échelle nouvelle au test F partiel en tant que prédicteur incrémental, les auteurs établissent formellement la nécessité ou la redondance théorique du nouveau construit.
Enfin, en épidémiologie comportementale et en neurosciences cognitives, le test F partiel est systématiquement employé pour juger de la pertinence de biomarqueurs neuroendocriniens ou génétiques dans la modélisation de vulnérabilités comportementales. L’adjonction simultanée de polymorphismes génétiques à des modèles prédictifs environnementaux permet de déterminer si les variables génomiques apportent une signature prédictive conjointe justifiable, prévenant ainsi la surinterprétation d’associations univariées fragiles ou dépendantes du bruit d’échantillonnage.
2. Fondements mathématiques et formulation des hypothèses
2.1 Énoncé rigoureux des hypothèses statistiques nulle et alternative
La formalisation du test F partiel s’opère par le biais d’un test d’hypothèses conjointes sur les paramètres d’un modèle linéaire général. Supposons la spécification d’un modèle de régression linéaire sous sa forme matricielle complète :
$$Y = \beta_0 + \beta_1 X_1 + dots + \beta_q X_q + \beta_{q+1} X_{q+1} + dots + \beta_k X_k + \varepsilon$$
Dans cette équation, les $q$ premières variables représentent l’ensemble de base conservé au sein du modèle réduit, tandis que les variables indicées de $q+1$ à $k$ constituent le bloc de prédicteurs additionnels dont on désire tester la pertinence collective. Le nombre de régresseurs additionnels est donc défini par $p = k – q$.
L’hypothèse nulle ($H_0$) postule la nullité simultanée et exacte de tous les coefficients de régression associés aux variables omises :
$$H_0 : \beta_{q+1} = \beta_{q+2} = dots = \beta_k = 0$$
L’hypothèse alternative ($H_A$ ou $H_1$) s’énonce comme la négation logique de cette conjonction de contraintes :
$$H_A : \exists , j in {q+1, dots, k} \quad \text{tel que} \quad \beta_j \neq 0$$
Il est fondamental de noter que l’hypothèse alternative n’exige pas que tous les coefficients additionnels soient simultanément non nuls. Il suffit qu’un seul prédicteur au sein du sous-ensemble apporte une contribution non négligeable pour rejeter formellement l’hypothèse nulle. Cette formulation matricielle s’exprime conventionnellement sous la forme $R\beta = 0$, où $R$ est une matrice de contrainte de dimensions $p \times (k+1)$. Le non-rejet de $H_0$ conclut à la validité de la restriction et justifie mathématiquement l’adoption du modèle le plus parcimonieux.
2.2 Dérivation de la statistique de test F partielle
La dérivation analytique du ratio de test repose sur l’évaluation de la variation de la somme des carrés des résidus (souvent désignée par RSS pour Residual Sum of Squares ou SSE pour Sum of Squared Errors) consécutive à l’imposition des contraintes linéaires sous l’hypothèse nulle. Par définition des moindres carrés ordinaires, restreindre des coefficients à zéro ne peut jamais diminuer l’erreur quadratique d’ajustement ; ainsi, la somme des carrés résiduels du modèle réduit ($RSS_{\text{réduit}}$) est invariablement supérieure ou égale à celle du modèle complet ($RSS_{\text{complet}}$).
La statistique F partielle mesure si l’accroissement de la variance inexpliquée résultant de l’exclusion des $p$ prédicteurs est substantiellement plus grand que l’erreur d’ajustement résiduelle non biaisée observée dans le modèle complet. L’équation canonique s’exprime comme suit :
$$F = \frac{\frac{RSS_{\text{réduit}} – RSS_{\text{complet}}}{p}}{\frac{RSS_{\text{complet}}}{n – k – 1}}$$
où $n$ désigne la taille absolue de l’échantillon, $k$ est le nombre total de prédicteurs dans le modèle complet (à l’exclusion de la constante), et $p$ représente le nombre exact de régresseurs exclus lors du passage au modèle réduit. Les degrés de liberté associés au numérateur correspondent à $p$, c’est-à-dire au nombre d’équations de contrainte imposées, tandis que les degrés de liberté du dénominateur sont égaux à $n – k – 1$, représentant la dimension de l’espace résiduel du modèle complet.
Sous les postulats standards de normalité, d’homoscédasticité et d’indépendance des erreurs, les deux formes quadratiques figurant au numérateur et au dénominateur suivent des distributions du khi-deux indépendantes une fois divisées par la variance résiduelle théorique de la population $\sigma^2$. En vertu du théorème de Fisher-Cochran, leur quotient suit rigoureusement une distribution de Fisher-Snedecor à $p$ et $n – k – 1$ degrés de liberté sous l’hypothèse nulle :
$$F \sim \mathcal{F}(p, , n – k – 1)$$
2.3 Équivalence avec le gain de variance expliquée (R² incrémentiel)
Une propriété remarquable du test F partiel réside dans son équivalence mathématique absolue avec le ratio basé sur la variation du coefficient de détermination ($R^2$). En rappelant que la somme des carrés totale ($TSS$) est strictement constante pour un échantillon de données invariant, les relations suivantes sont immédiatement établies :
$$RSS_{\text{réduit}} = TSS (1 – R^2_{\text{réduit}}) \quad \text{et} \quad RSS_{\text{complet}} = TSS (1 – R^2_{\text{complet}})$$
En substituant ces identités dans la formule du numérateur de la statistique de test F, on observe :
$$RSS_{\text{réduit}} – RSS_{\text{complet}} = TSS \left[ (1 – R^2_{\text{réduit}}) – (1 – R^2_{\text{complet}}) \right] = TSS (R^2_{\text{complet}} – R^2_{\text{réduit}}) = TSS \cdot \Delta R^2$$
De même, le dénominateur peut être réécrit sous la forme suivante :
$$\frac{RSS_{\text{complet}}}{n – k – 1} = \frac{TSS (1 – R^2_{\text{complet}})}{n – k – 1}$$
En simplifiant le terme scalaire invariant $TSS$ présent au numérateur et au dénominateur, la statistique F partielle s’exprime intégralement en termes de coefficients de détermination :
$$F = \frac{\frac{\Delta R^2}{p}}{\frac{1 – R^2_{\text{complet}}}{n – k – 1}} = \frac{\frac{R^2_{\text{complet}} – R^2_{\text{réduit}}}{p}}{\frac{1 – R^2_{\text{complet}}}{n – k – 1}}$$
Bien que cette seconde formulation présente un intérêt pédagogique manifeste en reliant directement le test à la notion d’accroissement de variance expliquée ($\Delta R^2$), la formulation exploitant directement les sommes des carrés résiduels ($RSS$) doit être formellement privilégiée lors des calculs numériques dans Excel. En effet, les valeurs de $R^2$ fournies dans les sorties de régression sont des grandeurs normalisées comprises entre 0 et 1, susceptibles d’être tronquées ou arrondies à quelques décimales par l’interface du logiciel. Manipuler les grandeurs brutes des sommes des carrés résiduels garantit la conservation intégrale de la précision numérique à double virgule flottante (IEEE 754) nativement implémentée dans le moteur de calcul d’Excel, éliminant tout risque d’erreur d’arrondi cumulatif.
3. Préparation et structuration des données psychologiques dans Excel
3.1 Organisation tabulaire et typologie des variables
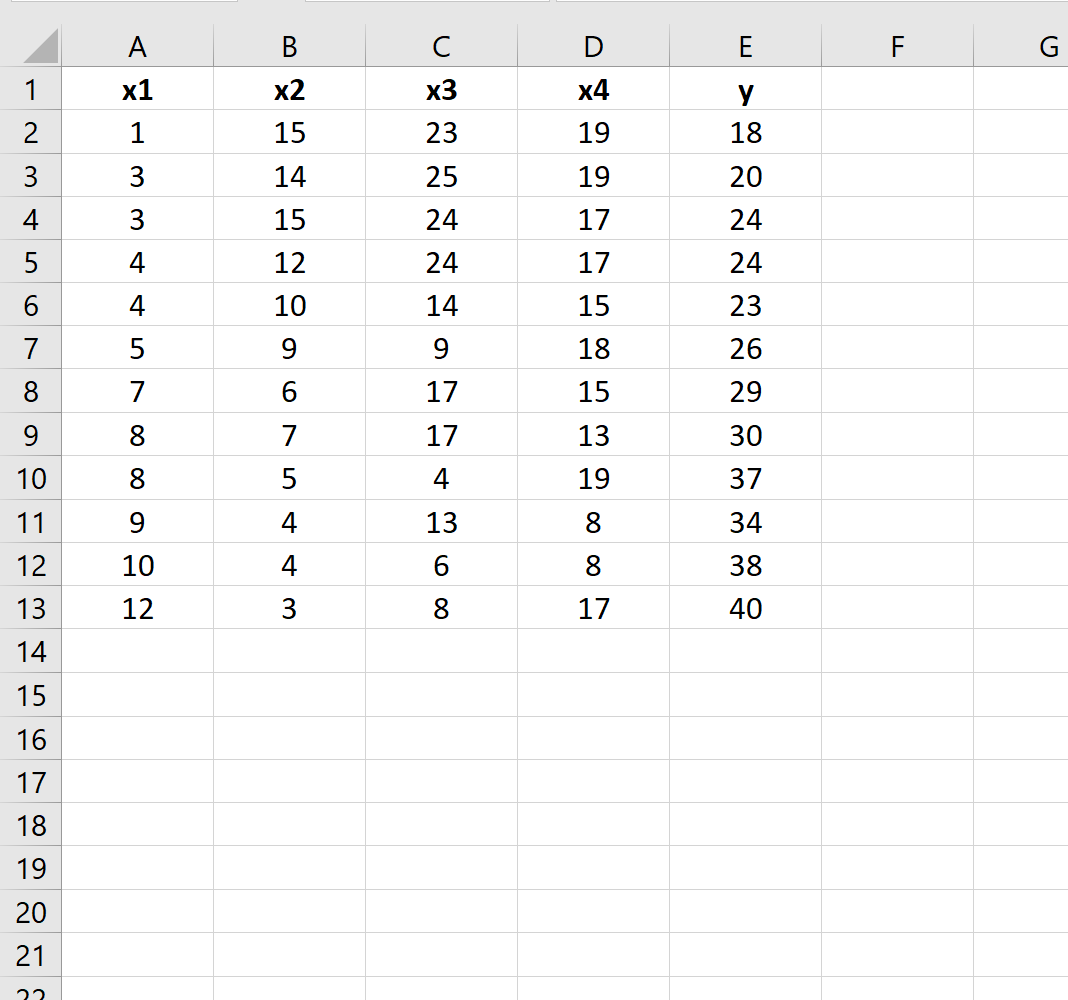
Avant toute implémentation statistique, l’organisation rigoureuse des données au sein du tableur Excel constitue une condition préalable impérative. Les règles fondamentales de structuration matricielle exigent que chaque ligne du tableau représente une unité d’observation distincte (par exemple, un participant ou un sujet clinique) et que chaque colonne corresponde sans ambiguïté à une variable unique. La première ligne du tableau doit impérativement être réservée aux étiquettes textuelles univoques identifiant les métriques (par exemple : ID, Score_Depression, Age, Sexe, Trait_Anxiete, Dysfonction_Cognitive).
La distinction entre variable dépendante ($Y$) et prédicteurs indépendants ($X$) doit être matérialisée dès la phase de conception du classeur. Dans la mesure où l’outil de régression d’Excel requiert la sélection d’une plage contiguë de colonnes pour les variables explicatives, il est hautement recommandé de regrouper les variables indépendantes côte à côte, en plaçant systématiquement la variable dépendante continue à l’extrémité gauche ou droite du bloc de données. Si le protocole comporte des prédicteurs qualitatifs à modalités discrètes (tels que le groupe d’appartenance clinique ou le niveau de formation catégorisé), ces derniers doivent être préalablement recodés sous forme de variables indicatrices binaires (variables muettes ou dummy variables prenant les valeurs 0 ou 1). Une variable nominale comportant $m$ modalités requiert impérativement la création de $m – 1$ variables indicatrices au sein de la matrice pour éviter toute colinéarité structurelle parfaite (piège des variables muettes).
Le nettoyage des données constitue un enjeu analytique majeur. Les logiciels bureautiques ne gèrent pas les données manquantes de manière homogène. L’analyste doit inspecter minutieusement le jeu de données pour détecter d’éventuelles cellules vides, des symboles non numériques aberrants (tels que des points, des tirets ou des mentions « NA » importées d’autres plateformes) et procéder à une suppression par liste (listwise deletion) uniforme pour toutes les variables intégrées dans l’ensemble des modèles à tester.
3.2 Vérification des postulats fondamentaux de la régression linéaire
L’inférence exacte issue du test F partiel n’est valide que dans la mesure où les postulats gaussiens sous-tendant la théorie des moindres carrés ordinaires sont respectés. Ces conditions incluent la linéarité du phénomène étudié, la normalité des termes d’erreur, l’homoscédasticité (constance de la variance résiduelle) et l’absence d’interdépendance sérielle ou spatiale entre les observations. Dans Excel, ces hypothèses peuvent être évaluées par des procédures d’inspection graphique directes.
L’évaluation de la normalité univariée des variables et de la distribution des résidus d’estimation peut être initialement conduite en calculant les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis) à l’aide des fonctions statistiques intégrées :
=COEFFICIENT.ASYMETRIE(plage_donnees) et =KURTOSIS(plage_donnees).
Des valeurs d’asymétrie s’écartant substantiellement de l’intervalle [-1, +1] suggèrent des déviations problématiques par rapport à la distribution normale théorique, justifiant d’éventuelles transformations mathématiques (logarithmiques ou racines carrées) des variables brutes.
L’homoscédasticité et la linéarité doivent être vérifiées en construisant un nuage de points croisant les résidus estimés (en ordonnée) et les valeurs prédites par le modèle complet (en abscisse). Une dispersion homogène et rectangulaire des résidus le long de l’axe horizontal atteste de la stabilité de la variance d’erreur. À l’inverse, l’observation d’un motif en entonnoir signale une hétéroscédasticité manifeste, laquelle peut distordre la probabilité de commettre une erreur de type I lors du calcul de la statistique F. Enfin, la détection de la multicolinéarité sévère impose d’examiner la matrice des corrélations bivariées entre prédicteurs via l’outil Corrélation d’Excel, en s’assurant qu’aucun coefficient de corrélation linéaire de Pearson ne franchit le seuil critique de 0,80 à 0,85.
3.3 Configuration de l’environnement Excel
Pour mener à bien ces régressions multiples, l’environnement de calcul de Microsoft Excel doit être configuré adéquatement. Le module analytique avancé n’étant pas toujours actif par défaut lors de l’installation du logiciel, il convient d’activer l’Utilitaire d’analyse (Analysis ToolPak). Cette opération s’effectue en accédant au menu Fichier, puis Options, sous-menu Compléments. Dans la liste déroulante inférieure relative à la gestion des compléments Excel, il faut cliquer sur Atteindre…, cocher la case Utilitaire d’analyse et valider par OK. Cette manipulation fait apparaître le groupe Analyse de données au sein de l’onglet Données du ruban principal.
Il est crucial de vérifier les paramètres régionaux d’Excel relatifs aux séparateurs décimaux. Selon les configurations linguistiques du système d’exploitation, le séparateur de décimales est défini soit par une virgule (norme francophone standard), soit par un point (norme anglo-saxonne). Une incompatibilité à ce niveau est susceptible d’altérer la reconnaissance numérique des colonnes, transformant subrepticement les nombres réels en chaînes textuelles inaptes aux calculs matriciels. Une méthode infaillible consiste à tester l’évaluation de la fonction =ESTNUM(cellule) sur plusieurs valeurs d’entrée.
Enfin, afin d’assurer l’intégrité et la clarté opérationnelle des formules ultérieures, il est vivement conseillé de structurer le classeur en plusieurs feuilles de calcul spécialisées : un premier onglet dénommé « Donnees_Brutes », un second nommé « Modele_Complet », un troisième nommé « Modele_Reduit » et un dernier intitulé « Synthese_Test_F ». L’attribution de noms explicites aux plages de cellules (par exemple, nommer la variable dépendante Y_Depression) via le Gestionnaire de noms constitue une excellente pratique limitant les erreurs de sélection spatiale lors des manipulations matricielles complexes.
4. Ajustement du modèle complet (Full Model) via l’Utilitaire d’analyse
4.1 Paramétrage de l’outil Régression pour l’ensemble des prédicteurs
La première phase calculatoire consiste à ajuster le modèle linéaire général incorporant la totalité des variables explicatives envisagées. En cliquant sur le bouton Analyse de données situé dans l’onglet Données, l’analyste sélectionne la ligne Régression puis valide par OK pour ouvrir la boîte de dialogue de configuration.
Le champ Plage d’entrée Y doit être renseigné avec les coordonnées de la colonne correspondant à la variable critère, en prenant soin d’inclure la première ligne contenant l’en-tête alphabétique (par exemple, $A$1:$A$151 pour un échantillon de 150 participants). Le champ Plage d’entrée X requiert quant à lui la sélection contiguë de la totalité des colonnes explicatives du modèle complet, incluant à la fois les variables de contrôle et les variables à tester (par exemple, $B$1:$F$151 pour cinq régresseurs). Il est impératif de cocher la case Intitulés afin d’indiquer à l’algorithme que la première rangée contient les étiquettes des variables, garantissant ainsi l’intelligibilité des sorties produites.
Par défaut, le champ Constante = Zéro doit demeurer décoché, sauf justification théorique absolue requérant le passage forcé de l’hyperplan par l’origine vectorielle (ce qui est exceptionnellement rare en sciences du comportement). Le niveau de confiance peut être maintenu à sa valeur conventionnelle de 95 %. Dans les options de sortie, il convient de sélectionner l’option Nouvelle feuille de calcul et de la nommer explicitement Modele_Complet. Une validation finale par le bouton OK déclenche instantanément l’exécution de l’algorithme d’inversion matricielle de Gauss-Jordan sous-jacent et génère le rapport statistique exhaustif.
4.2 Extraction des grandeurs clés de la table ANOVA du modèle complet
Le rapport de régression généré par Excel se décompose en trois sections distinctes : les statistiques de régression globales, la table d’analyse de variance (ANOVA) et le tableau détaillé des coefficients estimés. Pour l’implémentation du test F partiel, la table ANOVA constitue la structure informative essentielle. Cette table décompose la variation totale de la variable dépendante en deux composantes fondamentales : la variance attribuable à la régression et la variance résiduelle inhérente à l’erreur aléatoire.
L’analyste doit repérer sans la moindre ambiguïté la ligne intitulée Résidus (ou Residual selon la langue de la version). Dans cette rangée précise, trois valeurs doivent être identifiées :
- Les degrés de liberté résiduels, situés sous la colonne ddl (ou df), correspondant mathématiquement à la quantité $n – k – 1$.
- La somme des carrés résiduels, localisée sous la colonne SS (ou Somme des carrés). Cette cellule contient la valeur numérique exacte de $RSS_{\text{complet}}$, pierre angulaire du futur dénominateur de notre ratio.
- La moyenne des carrés résiduels, située sous la colonne MS (ou Moyenne des carrés), représentant la variance d’erreur estimée sans biais du modèle complet, formellement notée $MSE_{\text{complet}} = \frac{RSS_{\text{complet}}}{n – k – 1}$.
Il convient également d’enregistrer le coefficient de détermination multiple ($R^2$) figurant dans le tableau supérieur des Statistiques de la régression, ainsi que la significativité globale du modèle fournie par la cellule F critique (qui représente en réalité la p-valeur du test F global). Si le test F global s’avère non significatif au seuil préalablement arrêté (typiquement $\alpha = 0,05$), cela indique qu’aucun prédicteur du modèle complet n’entretient de relation linéaire stable avec le critère, limitant la portée heuristique de tout test partiel subséquent.
4.3 Archivage et sécurisation des sorties statistiques
L’intégrité analytique d’une démarche empirique repose sur la traçabilité des transformations appliquées aux données. Dès la génération de la feuille Modele_Complet, il est impératif d’en figer les paramètres pour prévenir toute altération consécutive à une manipulation erratique ou à l’écrasement involontaire de cellules de calcul. Une stratégie rigoureuse consiste à protéger la feuille en lecture seule ou à attribuer des couleurs d’accentuation nettes aux cellules critiques identifiées au point précédent.
Il est opportun d’ajouter une zone de documentation textuelle en regard des tableaux statistiques générés. Cette documentation interne doit lister avec précision la syntaxe des plages d’entrée utilisées lors de l’exécution de l’utilitaire, les noms explicites des $k$ variables incluses dans le modèle non restreint, ainsi que la date et l’horodatage de l’opération. Cette rigueur documentaire garantit que, lors de la transmission du classeur à des fins de révision par les pairs ou d’audit scientifique, la reproductibilité computationnelle du modèle complet demeure immédiate et incontestable.
En outre, il est formellement déconseillé de déplacer manuellement les cellules de sortie générées par l’Utilitaire d’analyse. Ces sorties ne sont pas des formules dynamiques, mais des valeurs numériques statiques calculées au moment de l’exécution. Tout déplacement de cellules risque d’induire des erreurs de référencement spatial lors des étapes de liaison dynamique avec la feuille de synthèse finale.
5. Ajustement du modèle réduit (Reduced Model) via l’Utilitaire d’analyse
5.1 Sélection des prédicteurs conservés et spécification du sous-modèle
L’étape suivante requiert la spécification et l’ajustement du modèle restreint, lequel découle directement des hypothèses théoriques formulées par le chercheur. La sélection des prédicteurs conservés ne doit jamais procéder d’une logique opportuniste guidée par les seules valeurs des p-valeurs observées (biais de sélection post-hoc ou p-hacking), mais doit refléter un modèle emboîté théoriquement justifiable. Le modèle restreint exclut formellement les $p$ variables dont on cherche à tester l’influence conjointe, tout en conservant l’exact ensemble des $q$ covariables de contrôle initiales.
L’une des contraintes structurelles majeures de l’outil Régression de Microsoft Excel réside dans l’obligation de désigner une plage contiguë pour les variables indépendantes d’entrée. Si les variables à exclure sont intercalées géographiquement entre des prédicteurs à conserver dans le tableau de données originel, l’outil refusera la sélection multiple par disjonction (la touche Contrôle étant inopérante pour fusionner des plages de régression disjointes). Pour contourner cette limitation technique sans dénaturer la base de données brute, il convient d’insérer une feuille de travail intermédiaire ou de réorganiser proprement les colonnes de prédicteurs au sein de la feuille d’analyse, de façon à regrouper les $q$ prédicteurs conservés dans un bloc spatialement ininterrompu.
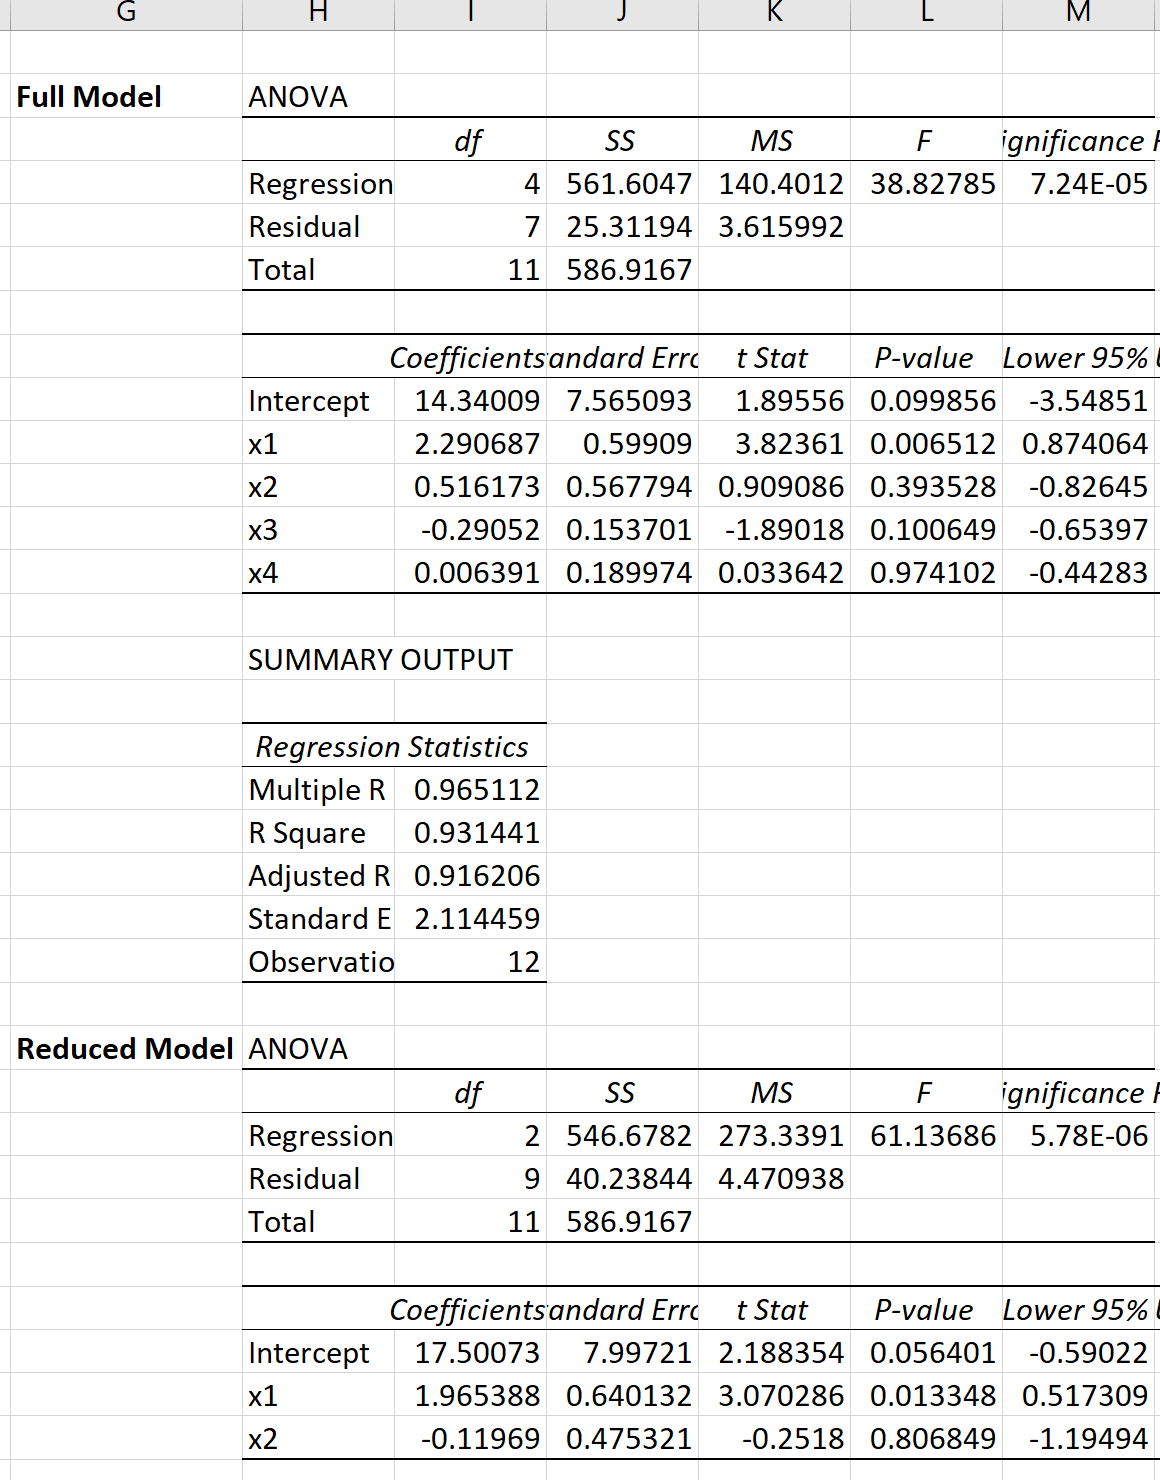
Une fois les variables réorganisées, la boîte de dialogue de régression est ouverte de nouveau. La Plage d’entrée Y demeure strictement identique à celle du modèle complet. La Plage d’entrée X est restreinte à la zone contiguë contenant exclusivement les $q$ covariables sélectionnées. Les options d’intitulés et de seuils de confiance sont maintenues de manière rigoureusement conforme à la configuration précédente. La sortie doit être dirigée vers une nouvelle feuille intitulée sans équivoque Modele_Reduit.
5.2 Extraction des paramètres critiques du modèle emboîté
L’analyse de variance du modèle réduit génère un nouveau tableau de décomposition de variance dans l’onglet dédié. L’analyste doit immédiatement se focaliser sur la rangée des Résidus afin de relever deux valeurs scalaires fondamentales :
- La somme des carrés résiduels du modèle réduit, formellement désignée par $RSS_{\text{réduit}}$.
- Les degrés de liberté résiduels associés à cette spécification restreinte, calculés mathématiquement par la formule $n – q – 1$.
À ce stade de la procédure, un contrôle logique élémentaire mais obligatoire doit être opéré par l’analyste. En raison de la propriété mathématique intrinsèque de la minimisation des moindres carrés, l’inégalité suivante doit être impérativement satisfaite :
$$RSS_{\text{réduit}} \geq RSS_{\text{complet}}$$
La suppression de prédicteurs d’une équation linéaire entraîne inévitablement une diminution ou, au mieux, une stagnation de la variance expliquée par l’hyperplan, ce qui se traduit mécaniquement par une augmentation (ou un maintien strict) de l’erreur quadratique résiduelle. Si, par suite d’une erreur d’aiguillage dans les cellules ou d’une inversion de colonnes, $RSS_{\text{réduit}}$ apparaissait inférieure à $RSS_{\text{complet}}$, l’analyste se trouverait en présence d’une anomalie procédurale rédhibitoire invalidant l’ensemble de la démarche empirique.
5.3 Gestion des pièges liés aux données manquantes non concordantes
L’un des écueils les plus pernicieux et les plus destructeurs de la validité interne d’un test F partiel dans Excel réside dans la variation involontaire de la taille de l’échantillon effectif ($n$) entre le modèle complet et le modèle réduit. Ce phénomène survient fréquemment lorsque l’analyste utilise une base de données non nettoyée contenant des observations manquantes disséminées.
L’Utilitaire d’analyse d’Excel gère les données manquantes en excluant la ligne entière lors de l’exécution de l’algorithme. Si les $p$ variables éliminées dans le modèle restreint contenaient des cellules vides que ne possédaient pas les $q$ variables conservées, l’outil réintègrera automatiquement ces lignes lors de l’ajustement du modèle restreint. En conséquence, le modèle réduit sera ajusté sur une taille d’échantillon supérieure ($n_{\text{réduit}} > n_{\text{complet}}$). Une telle divergence brise instantanément l’emboîtement des espaces vectoriels : les sommes des carrés totaux ($TSS$) diffèrent entre les deux modèles, rendant les sommes des carrés résiduels rigoureusement incommensurables.
Pour immuniser l’analyse contre cette erreur dévastatrice, il est strictement impératif de contrôler que le nombre total d’observations (indiqué sur la ligne Total de la table ANOVA par $n – 1$ degrés de liberté) est rigoureusement identique dans la feuille Modele_Complet et dans la feuille Modele_Reduit. L’application préalable d’un filtrage automatique éliminant toute ligne présentant au moins une valeur manquante sur l’ensemble de la batterie de prédicteurs ($X_1$ à $X_k$) et sur le critère ($Y$) garantit l’invariance absolue de l’échantillon d’analyse.
6. Extraction et comparaison des sommes des carrés résiduels (RSS)
6.1 Isolement méthodique des métriques dans une feuille de synthèse
Pour conférer au classeur Excel une architecture modulaire, professionnelle et transparente, les données analytiques dispersées dans les feuilles de résultats bruts doivent être consolidées au sein d’une table comparative unifiée dans l’onglet Synthese_Test_F. Cette feuille constitue le tableau de bord décisionnel où s’articulera le calcul de la statistique d’inférence.
Il convient de créer un tableau structuré présentant les colonnes suivantes :
- Spécification du modèle (Modèle Complet vs Modèle Réduit)
- Somme des carrés résiduels (RSS)
- Degrés de liberté résiduels (ddl_res)
- Variance résiduelle moyenne (MSE)
- Coefficient de détermination ($R^2$)
L’insertion des valeurs dans ces cellules ne doit en aucun cas résulter d’une saisie manuelle de nombres scalaires, sous peine d’induire des fautes de frappe indétectables et d’annihiler la dynamique d’actualisation du classeur. L’analyste doit formellement utiliser des liaisons de formules dynamiques pointant directement vers les cellules cibles des feuilles précédentes. Par exemple, si la somme des carrés résiduels du modèle complet réside dans la cellule C13 de la feuille Modele_Complet, la cellule correspondante de la feuille de synthèse comportera la formule :
=Modele_Complet!C13
Cette rigueur méthodologique garantit que si une modification ultérieure intervient sur le jeu de données d’origine et que les régressions sont régénérées aux mêmes emplacements, le tableau de synthèse reflétera immédiatement les valeurs rectifiées sans exiger de reconfiguration manuelle.
6.2 Comptabilisation exacte des paramètres et degrés de liberté
La robustesse mathématique du test F partiel dépend de l’attribution exacte des degrés de liberté au numérateur et au dénominateur de la fraction. Toute approximation dans le décompte des paramètres introduit un biais systématique sur la statistique de test et, par voie de conséquence, fausse intégralement la p-valeur associée.
Les degrés de liberté du numérateur, représentant la quantité $p$, correspondent sans exception au nombre exact de régresseurs exclus de l’équation lors de la restriction. Ce paramètre peut être calculé dynamiquement au sein de la feuille de synthèse en établissant la différence arithmétique entre les degrés de liberté résiduels du modèle réduit et ceux du modèle complet :
$$p = ddl_{\text{résiduel(réduit)}} – ddl_{\text{résiduel(complet)}}$$
Sous Excel, la cellule dédiée à $p$ recevra simplement la syntaxe :
=Cellule_ddl_Reduit - Cellule_ddl_Complet
Il est fondamental de vérifier que le décompte des paramètres du modèle complet ($k$) intègre correctement la totalité des pentes explicatives, en excluant l’ordonnée à l’origine (constante $\beta_0$) du dénombrement des prédicteurs mais en tenant compte de sa consommation d’un degré de liberté dans le total de l’échantillon. Les degrés de liberté du dénominateur sont rigoureusement définis par la dimension résiduelle non contrainte :
$$ddl_{\text{dénominateur}} = n – k – 1$$
qui équivaut très précisément à la valeur inscrite dans la cellule des degrés de liberté résiduels du modèle complet (Cellule_ddl_Complet).
6.3 Analyse du compromis parcimonie versus variance expliquée
L’examen des métriques consolidées permet de formaliser l’arbitrage canonique de la modélisation statistique : la balance entre le principe d’économie de paramètres (principe de parcimonie ou rasoir d’Ockham) et l’adéquation empirique aux données observées. Le passage du modèle complet au modèle restreint se solde systématiquement par une augmentation de l’erreur résiduelle, quantifiée par la métrique différentielle :
$$\Delta RSS = RSS_{\text{réduit}} – RSS_{\text{complet}}$$
Cette variation positive représente la part de variabilité de la variable dépendante qui était conjointement prise en charge par les $p$ variables éliminées, et qui est désormais rejetée dans la composante stochastique inexpliquée du modèle réduit. La question analytique fondamentale réside alors dans l’évaluation de cette grandeur : la dégradation de l’ajustement ($\Delta RSS$) est-elle substantielle et disproportionnée par rapport aux $p$ degrés de liberté économisés, ou est-elle suffisamment modeste pour être assimilée aux simples fluctuations d’échantillonnage ? La statistique F partielle apporte une réponse quantitative probabilisée à cette interrogation.
7. Calcul pas à pas de la statistique F partielle avec les formules Excel
7.1 Calcul du carré moyen additionnel (Numérateur)
Le numérateur de la statistique de test F partiel traduit la variance moyenne attribuable au bloc de prédicteurs exclus. Il s’obtient en divisant la variation de la somme des carrés résiduels par le nombre de contraintes linéaires imposées au système.
Dans la feuille de synthèse Synthese_Test_F, assignons des coordonnées conceptuelles claires aux cellules préalablement établies :
- Cellule
B4: $RSS_{\text{réduit}}$ - Cellule
B3: $RSS_{\text{complet}}$ - Cellule
C4: $ddl_{\text{résiduel(réduit)}}$ - Cellule
C3: $ddl_{\text{résiduel(complet)}}$ - Cellule
B6: Nombre de paramètres exclus ($p$), calculé par=C4-C3
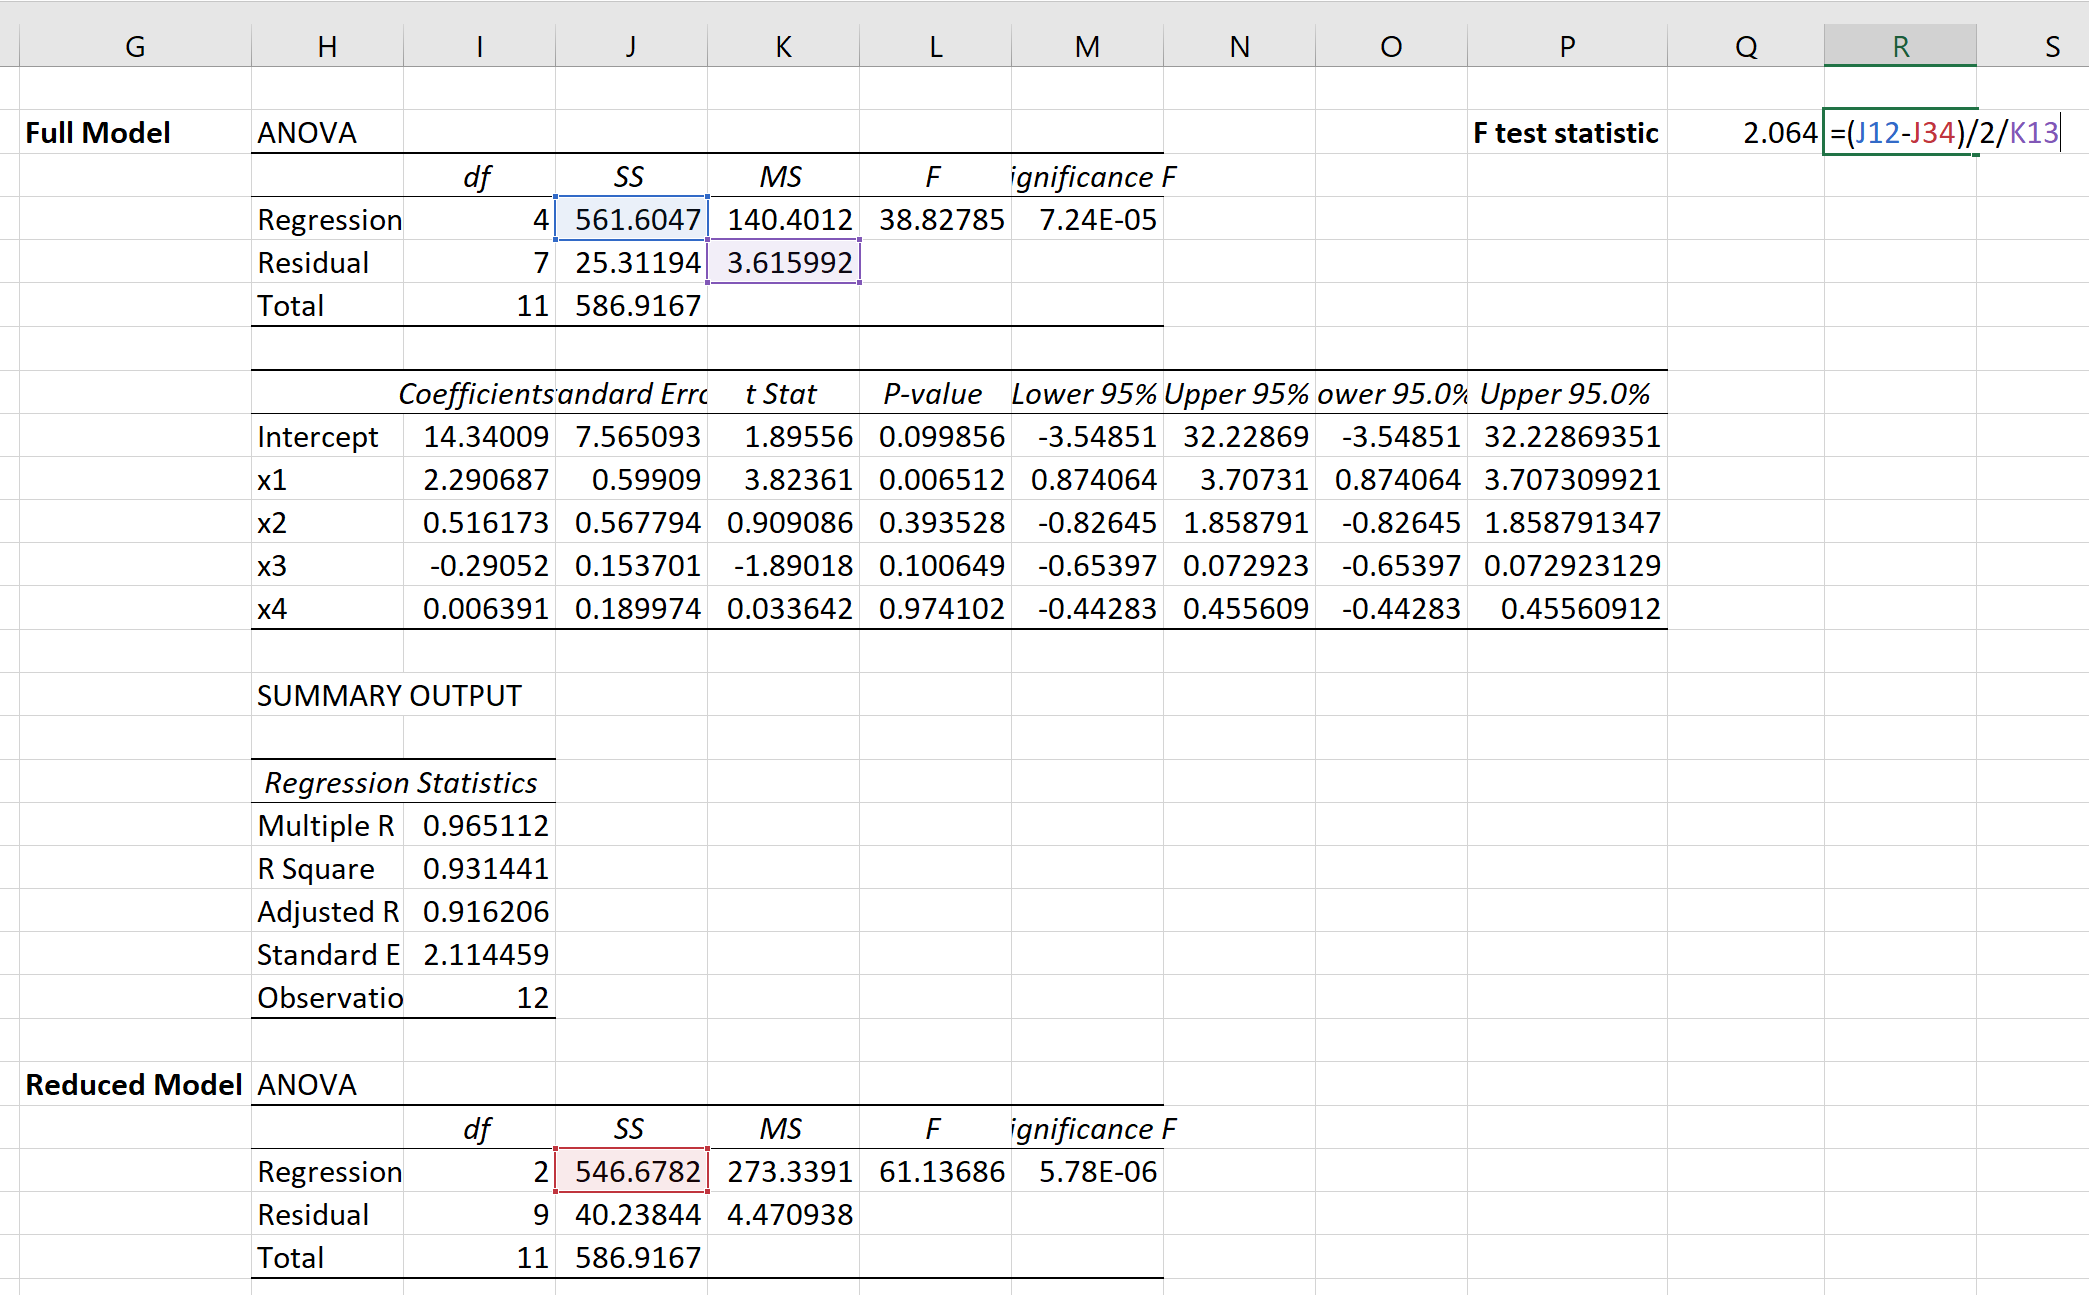
La cellule dédiée au calcul du carré moyen additionnel, que nous pouvons situer en B8 et étiqueter « Carré Moyen Additionnel (MS_Numérateur) », sera implémentée avec la formule arithmétique suivante :
=(B4 - B3) / B6
Cette formulation quantifie le saut d’ajustement marginal par paramètre omis. Si la soustraction (B4 - B3) retournait une valeur négative, cela mettrait en évidence une inversion de référencement entre les modèles complet et réduit, imposant une vérification immédiate de la source des cellules associées.
7.2 Calcul de la variance résiduelle non biaisée du modèle complet (Dénominateur)
Le dénominateur de la statistique F d’emboîtement sert d’estimateur de référence de la variance de l’erreur théorique ($\sigma^2$). Il est capital de souligner que cet estimateur doit provenir exclusivement du modèle complet non contraint, et en aucun cas du modèle réduit. Le modèle complet étant le plus riche, il fournit l’estimation la plus exempte de biais d’omission pour la variance du terme stochastique $varepsilon$.
Ce dénominateur correspond mathématiquement à l’erreur quadratique moyenne du modèle complet ($MSE_{\text{complet}}$) :
$$MSE_{\text{complet}} = \frac{RSS_{\text{complet}}}{n – k – 1}$$
Dans notre tableau de bord synthétique, cette quantité peut être extraite selon deux modalités parfaitement équivalentes :
- Soit par calcul direct dans la cellule
B9:=B3 / C3 - Soit par liaison dynamique directe pointant vers la colonne MS de la ligne des résidus dans la feuille ANOVA du modèle complet :
=Modele_Complet!D13
L’utilisation de la première formule assure une homogénéité interne parfaite en dérivant l’intégralité du ratio directement des deux colonnes mères de la table de synthèse.
7.3 Assemblage final du ratio F partiel
Dès lors que les deux composantes de la variance marginale et résiduelle sont formellement calculées dans les cellules B8 et B9, l’assemblage de la statistique de Fisher s’effectue avec une remarquable simplicité.
Dans la cellule B11, étiquetée « F partiel calculé », l’analyste renseigne le quotient canonique :
=B8 / B9
Pour les utilisateurs souhaitant condenser l’ensemble de l’opération au sein d’une expression algorithmique unifiée et exempte d’étapes intermédiaires, Excel permet l’écriture directe suivante :
=((B4 - B3) / (C4 - C3)) / (B3 / C3)
Cette formulation condensée encapsule l’intégralité de la logique du test F partiel en une unique expression vectorielle. La valeur résultante constitue la statistique empirique qui sera comparée aux valeurs de la loi théorique de Fisher-Snedecor. Il est recommandé de paramétrer le format d’affichage numérique de cette cellule pour présenter une précision minimale de trois à quatre décimales (par exemple : 4,8523), évitant ainsi les effets de seuil visuels lors de la confrontation avec la valeur critique théorique.
8. Détermination de la p-valeur et de la valeur critique à l’aide des fonctions Excel
8.1 Utilisation de la fonction LOI.F.DROITE pour le calcul de la p-valeur
La statistique $F$ observée n’a de valeur décisionnelle qu’une fois confrontée à la distribution théorique sous l’hypothèse nulle afin de quantifier la probabilité d’obtenir une valeur au moins aussi extrême du seul fait des aléas d’échantillonnage. Dans la mesure où le test F est intrinsèquement unilatéral à droite (seule une augmentation disproportionnée du numérateur par rapport au dénominateur conduit à rejeter $H_0$), c’est l’intégrale de la queue supérieure de la loi de Fisher qui doit être calculée.
Depuis la version 2010 d’Excel, la fonction standardisée hautement recommandée pour cette opération est LOI.F.DROITE (équivalent de F.DIST.RT dans les versions anglophones). La syntaxe rigoureuse s’énonce comme suit :
=LOI.F.DROITE(x; degres_liberte1; degres_liberte2)
Dans notre contexte de synthèse, les arguments sont mappés de la manière suivante :
x: la valeur de la statistique $F$ calculée (celluleB11).degres_liberte1: les degrés de liberté du numérateur ($p$, celluleB6ouC4 - C3).degres_liberte2: les degrés de liberté du dénominateur ($n – k – 1$, celluleC3).
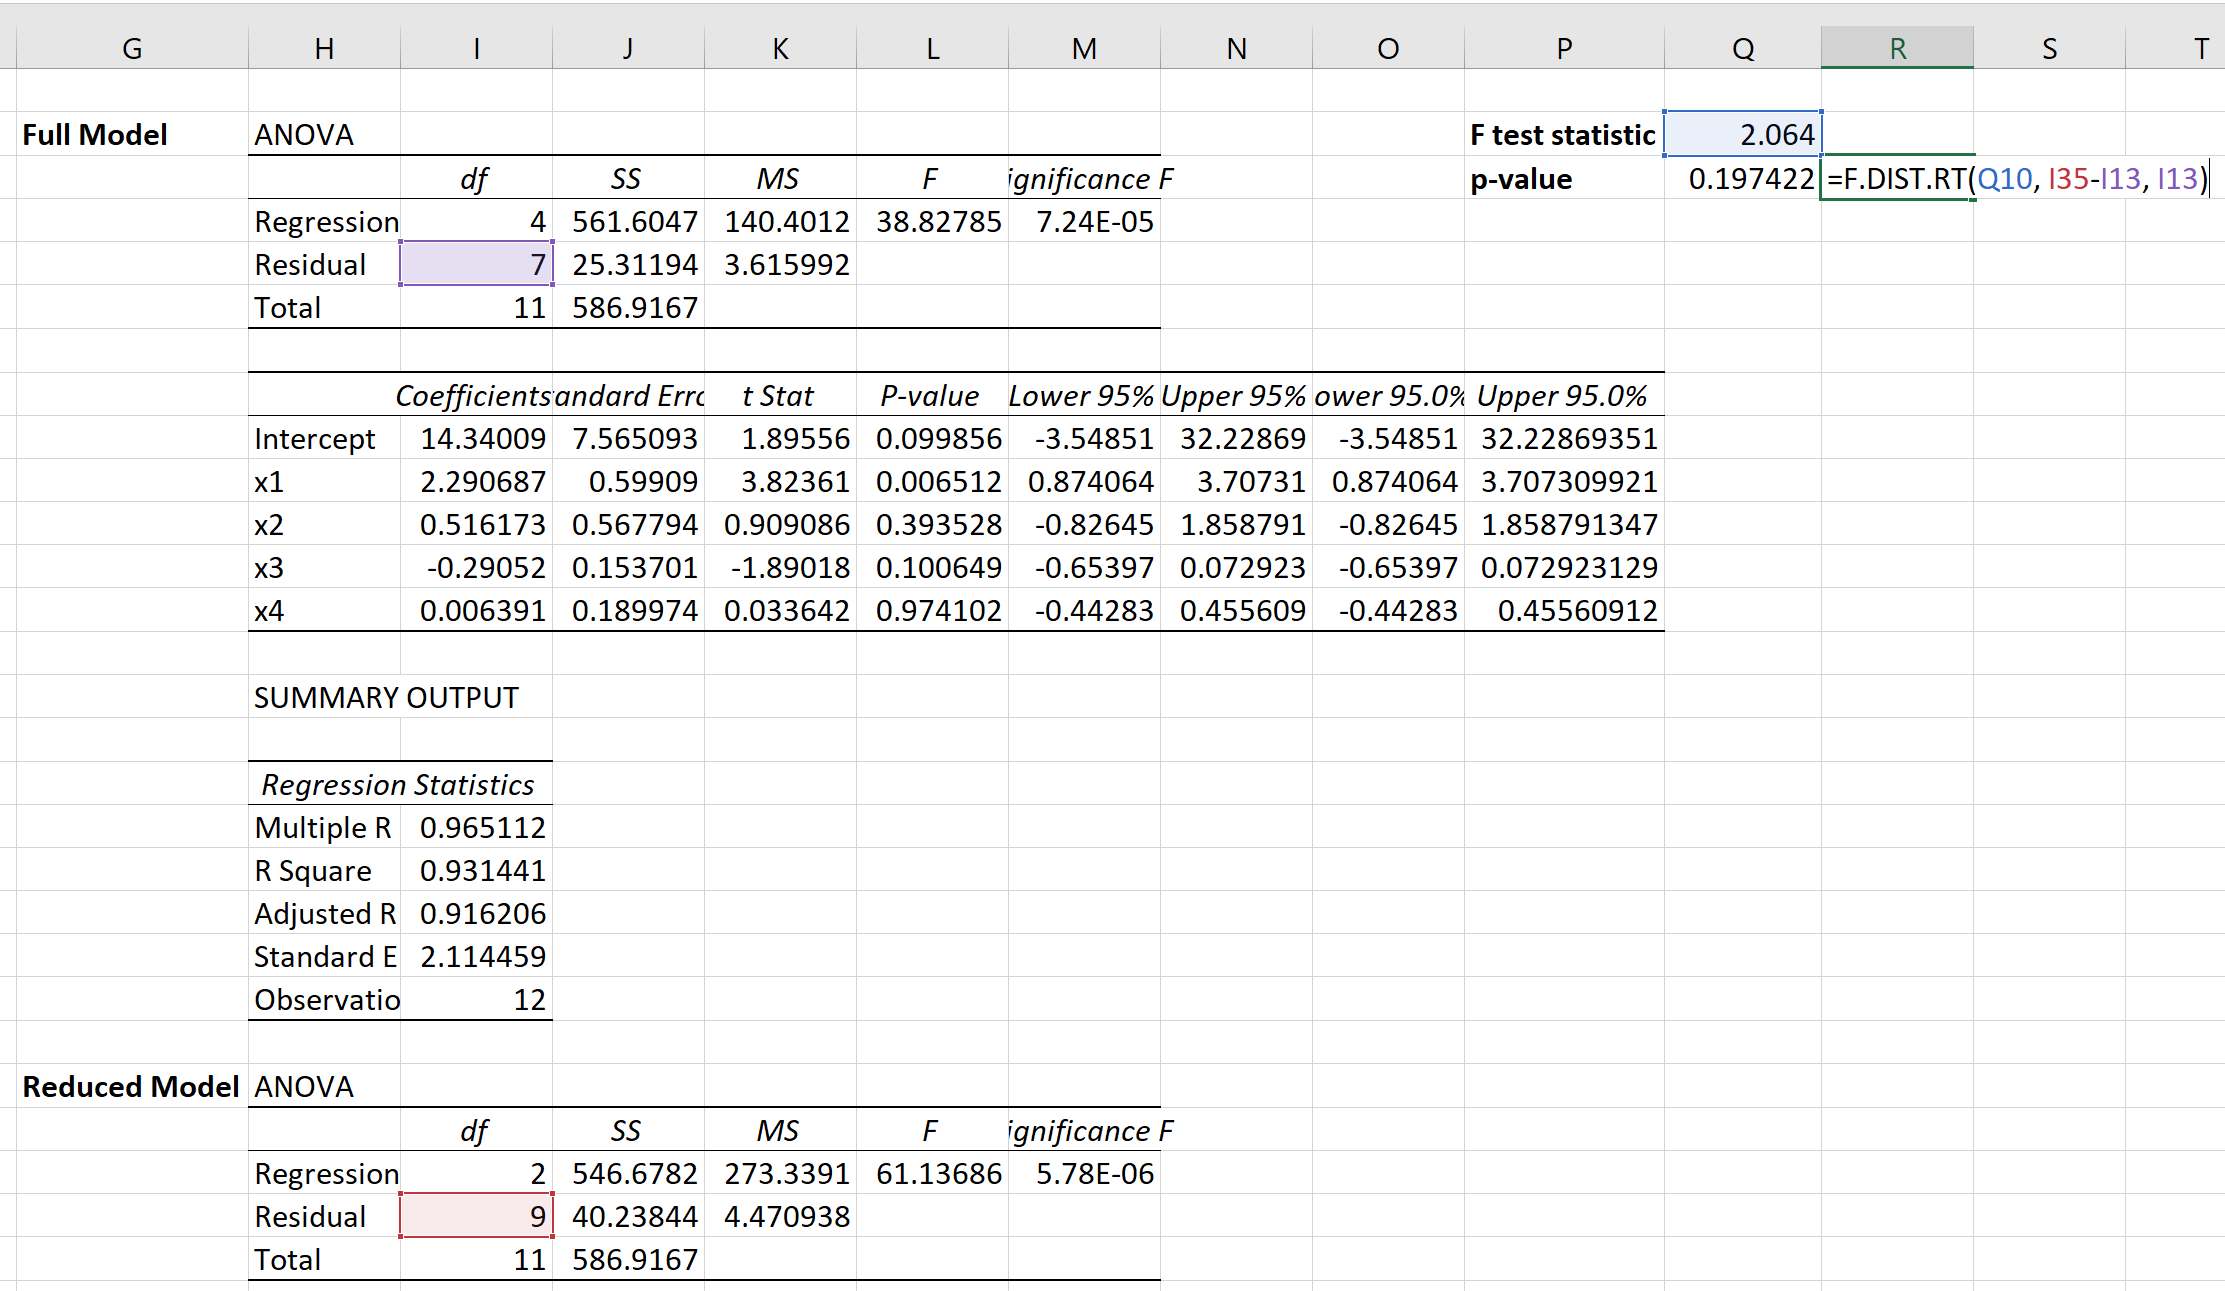
La formule intégrée dans la cellule B12 s’écrit par conséquent :
=LOI.F.DROITE(B11; B6; C3)
Pour assurer la rétrocompatibilité avec les versions historiques d’Excel (antérieures à 2010), l’ancienne fonction =LOI.F(x; degres_liberte1; degres_liberte2) calculait nativement la probabilité de la queue droite. Cependant, la syntaxe moderne LOI.F.DROITE doit être impérativement privilégiée afin de respecter les standards contemporains de développement d’algorithmes statistiques sous Office.
8.2 Calcul de la valeur critique avec la fonction INVERSE.LOI.F.DROITE
L’approche décisionnelle par la valeur critique constitue le pendant géométrique de la p-valeur. Elle consiste à délimiter sur l’axe des abscisses de la distribution de Fisher l’abscisse exacte au-delà de laquelle la surface sous la courbe correspond au risque d’erreur de première espèce choisi, conventionnellement fixé à $\alpha = 0,05$ ou $\alpha = 0,01$ dans la recherche académique en psychologie.
Pour extraire ce seuil critique sous Excel, il convient de recourir à la fonction INVERSE.LOI.F.DROITE (ou F.INV.RT en anglais). Sa structure d’appel se définit par :
=INVERSE.LOI.F.DROITE(probabilite; degres_liberte1; degres_liberte2)
Si la cellule B13 héberge le seuil nominal de significativité retenu (par exemple, 0,05), la cellule B14, étiquetée « Valeur Critique F », accueillera la syntaxe :
=INVERSE.LOI.F.DROITE(B13; B6; C3)
La région critique de rejet de l’hypothèse nulle est ainsi géométriquement établie : pour toute statistique empirique $F_{\text{calculé}}$ strictement supérieure à la valeur critique $F_{\text{critique}}$, le point d’échantillonnage tombe dans la zone de rejet unilatéral, attestant que la contribution du groupe de variables éliminées dépasse largement ce qui pourrait résulter des simples fluctuations stochastiques d’échantillonnage.
8.3 Automatisation de la règle de décision statistique
Afin de parachever le tableau de bord et de limiter toute méprise interprétative, la conclusion inférentielle formelle peut être automatisée au travers d’une structure logique conditionnelle. La décision d’accepter ou de rejeter l’hypothèse nulle obéit à deux conditions strictement isomorphes :
- Rejet de $H_0$ si : $\text{p-valeur} < \alpha$
- Rejet de $H_0$ si : $F_{\text{calculé}} \geq F_{\text{critique}}$
Dans la cellule B15, dédiée à la sentence inférentielle, l’analyste peut implémenter la formule conditionnelle suivante :
=SI(B12 < B13; "Rejet de H0 : Contribution incrémentale significative"; "Non-rejet de H0 : Absence de contribution significative (Modèle réduit privilégié)")
Pour un confort visuel optimal lors de la présentation des résultats à des comités scientifiques ou d’audit, cette cellule décisionnelle peut être couplée à une règle de Mise en forme conditionnelle. En appliquant un remplissage vert clair avec police verte foncée en cas de « Rejet de H0 » et un remplissage orange pâle en cas de « Non-rejet de H0 », l’analyste dote son classeur de recherche d’une signalétique ergonomique et immédiatement déchiffrable.
9. Interprétation statistique et psychométrique des résultats du test F partiel
9.1 Interprétation du rejet de l’hypothèse nulle
Sur le plan de l’inférence théorique, le rejet de l’hypothèse nulle ($p < \alpha$, $F_{\text{calculé}} \geq F_{\text{critique}}$) signifie que les prédicteurs omis dans le modèle restreint exercent, collectivement, une influence prédictive statistiquement non négligeable sur la variable dépendante, au-delà de la variance déjà absorbée par les covariables conservées. En d'autres termes, l'augmentation observée de la somme des carrés résiduels ($\Delta RSS$) est trop marquée pour être imputable au bruit aléatoire. Le chercheur en conclut formellement à la nécessité méthodologique de retenir le modèle complet, plus complexe mais significativement plus valide.
Dans les applications psychométriques, ce constat apporte la preuve empirique de la validité incrémentale d’un construit ou d’un instrument. Si l’on évaluait l’apport d’une batterie de tests de fonctions exécutives sur les compétences académiques en contrôlant le quotient intellectuel global, le rejet de $H_0$ attesterait que les fonctions exécutives capturent des facettes cognitives déterminantes non subsumées par la mesure standardisée du quotient intellectuel.
Néanmoins, l’analyste rigoureux doit systématiquement préserver une distinction imperméable entre la significativité statistique et la significativité pratique ou clinique. Dans le cas d’échantillons de très grande taille ($n > 1000$), le test F partiel acquiert une sensibilité statistique considérable, conduisant fréquemment au rejet de $H_0$ pour des gains de variance expliquée microscopiques (par exemple, $\Delta R^2 = 0,004$). Il appartient au chercheur de contextualiser ce résultat statistique en examinant attentivement l’ampleur concrète de l’effet incrémental.
9.2 Interprétation du non-rejet de l’hypothèse nulle
À l’inverse, l’absence de significativité statistique ($p \geq \alpha$, $F_{\text{calculé}} < F_{\text{critique}}$) conduit formellement au non-rejet de l'hypothèse nulle. Cette conclusion indique qu'en l'état des données observées, il est impossible de démontrer que les variables additionnelles contribuent à l'explication du critère au-delà de ce qui est déjà prédit par le modèle restreint. En vertu du canon épistémologique de parcimonie scientifique (canon de Morgan et rasoir d'Ockham), le modèle réduit doit être systématiquement préféré pour les modélisations futures et la prise de décision pratique.
Sur le plan rédactionnel, une extrême vigilance terminologique s’impose. En aucun cas le chercheur ne doit affirmer qu’il a « prouvé que les variables additionnelles n’ont aucun effet ». Une telle assertion constituerait une méconnaissance grave de la logique de Fisher et de Neyman-Pearson. Le non-rejet signifie simplement que la preuve de leur utilité incrémentale n’a pas été administrée au seuil de risque consenti. Cette absence de preuve peut découler soit d’une réelle absence d’effet dans la population sous-jacente, soit d’un manque criant de puissance statistique.
L’analyste doit ainsi examiner avec une prudence particulière les cas de non-rejet survenant dans des contextes d’échantillons de petite taille ($n < 50$) combinés à un nombre élevé de paramètres ($k$). Dans de telles configurations, l'erreur de type II ($\beta$) croît drastiquement, et l'incapacité de rejeter $H_0$ peut simplement refléter une incapacité technique à extraire le signal hors du bruit ambiant.
9.3 Calcul et interprétation de la taille d’effet incrémentale (f² de Cohen)
Pour parer aux limitations inhérentes à la dépendance de la p-valeur vis-à-vis de la taille d’échantillon, le rapportage scientifique moderne impose de quantifier la magnitude substantielle de l’apport incrémental par une mesure de taille d’effet standardisée. L’indice canonique préconisé dans les modèles linéaires généraux est le $f^2$ de Cohen (Cohen’s f²), spécifiquement formulé pour les comparaisons de modèles hiérarchiques emboîtés :
$$f^2 = \frac{R^2_{\text{complet}} – R^2_{\text{réduit}}}{1 – R^2_{\text{complet}}} = \frac{\Delta R^2}{1 – R^2_{\text{complet}}}$$
Cette métrique exprime la proportion de variance additionnelle captée par le bloc de nouvelles variables, rapportée à la proportion de variance demeurée inexpliquée par le modèle complet. L’implémentation de cette taille d’effet dans le tableau de bord Excel s’effectue directement par la syntaxe suivante :
=(Cellule_R2_Complet - Cellule_R2_Reduit) / (1 - Cellule_R2_Complet)
Jacob Cohen a établi des balises interprétatives conventionnelles, universellement citées dans la littérature en psychométrie et en sciences sociales :
- $f^2 \geq 0,02$ : Effet incrémental faible (small effect size)
- $f^2 \geq 0,15$ : Effet incrémental modéré (medium effect size)
- $f^2 \geq 0,35$ : Effet incrémental fort (large effect size)
Le rapport conjoint de la statistique $F$, des degrés de liberté exacts, de la p-valeur et du coefficient $f^2$ garantit une communication scientifique d’une transparence absolue, permettant d’apprécier la pertinence conjointe de la significativité mathématique et de l’amplitude psychologique du phénomène investigué.
10. Comparaison méthodologique : Test F partiel versus Test t de Student et critères d’information
10.1 Le test F partiel pour un prédicteur unique (p = 1) versus le test t individuel
Une interrogation récurrente chez les utilisateurs d’Excel concerne l’articulation entre le test F partiel et les tests t de Student affichés en regard de chaque coefficient de régression dans le tableau de sortie élémentaire. Il existe un lien mathématique rigoureux entre ces deux approches statistiques lorsque le bloc de prédicteurs exclus est restreint à une seule variable ($p = 1$).
Dans ce cas particulier d’un unique degré de liberté au numérateur, le carré de la statistique $t$ de Student associée au coefficient de la variable exclue dans le modèle complet est rigoureusement et strictement identique à la statistique $F$ calculée par la décomposition des sommes des carrés résiduels :
$$F_{\text{partiel (p=1)}} = (t_{\text{Student}})^2$$
De surcroît, la p-valeur bilatérale issue du test t individuel est rigoureusement égale à la p-valeur unilatérale à droite issue du test F partiel. L’analyste peut vérifier empiriquement cette égalité absolue dans Excel en élevant au carré la valeur de la colonne Stat t de la variable considérée dans le tableau des coefficients du modèle complet.
Dès lors que le bloc d’exclusion comporte au moins deux prédicteurs ($p \geq 2$), le test t individuel devient totalement inopérant pour juger de la pertinence collective du sous-ensemble. En effet, examiner séparément les coefficients par une succession de tests t unitaires expose le chercheur au péril de l’inflation de l’erreur de type I (accumulation du risque d’alpha à travers les tests multiples). Plus critique encore, en cas de multicolinéarité modérée entre les variables du bloc exclu, il est fréquent qu’aucun coefficient pris individuellement n’atteigne le seuil de significativité par test t, alors même que leur prise en compte conjointe est hautement significative au travers du test F partiel. C’est précisément dans cette capacité à agréger l’effet partagé que réside la supériorité structurelle du test F partiel.
10.2 Complémentarité avec les critères d’information d’Akaike et bayésien (AIC / BIC)
Bien que le test F partiel demeure la référence paradigmatique dans le cadre de l’inférence fréquentiste classique, il présente la limitation théorique d’exiger impérativement l’emboîtement formel des spécifications économétriques. Lorsqu’il s’agit de confronter des modèles non emboîtés ou d’arbitrer de manière plus stricte la pénalité liée au nombre de variables intégrées, les critères d’information basés sur la log-vraisemblance constituent une alternative indispensable.
Sous les postulats gaussiens de la régression linéaire par moindres carrés ordinaires, le critère d’information d’Akaike (AIC) et le critère d’information bayésien de Schwarz (BIC) peuvent être approchés directement dans Excel à partir de la somme des carrés des résidus ($RSS$), de la taille d’échantillon ($n$) et du nombre total de paramètres estimés ($K = k + 1$ en incluant la constante et la variance d’erreur) :
$$AIC \approx n \cdot \ln\left(\frac{RSS}{n}\right) + 2K$$
$$BIC \approx n \cdot \ln\left(\frac{RSS}{n}\right) + K \cdot \ln(n)$$
Dans Excel, ces critères se programment sans difficulté :
=n * LN(RSS / n) + 2 * K pour l’AIC
=n * LN(RSS / n) + K * LN(n) pour le BIC
Contrairement au test F partiel qui n’aboutit qu’à une décision binaire de rejet/non-rejet à un seuil $\alpha$ discrétionnaire, l’AIC et le BIC établissent un classement relatif d’efficacité : le modèle présentant la valeur de critère la plus faible est réputé optimal en termes de ratio information/complexité. Le BIC pénalisant la prolifération des paramètres plus lourdement que l’AIC dès lors que $ln(n) > 2$ (soit pour $n \geq 8$), son analyse conjointe avec le test F partiel prémunit le chercheur contre la surparamétrisation des modèles.
10.3 Test F partiel versus sélection automatisée pas à pas (Stepwise)
Il est fondamental d’opposer l’approche de sélection de modèles par régression hiérarchique guidée par la théorie — validée à chaque palier par des tests F partiels — aux algorithmes de sélection automatique aveugle pas à pas (Stepwise, Forward ou Backward regression). Bien que ces méthodes automatisées soient couramment implémentées dans certains progiciels, leur utilisation est sévèrement critiquée par la communauté statistique internationale.
Les algorithmes pas à pas effectuent des tests d’exclusion et d’inclusion basés sur des seuils statistiques locaux sans aucun ancrage conceptuel, provoquant une inflation catastrophique des fausses découvertes (erreurs de type I), un biais systématique d’estimation vers le haut des coefficients sélectionnés (paradoxe du gagnant ou winner’s curse) et des p-valeurs artificiellement trop petites dues à la multiplicité implicite des comparaisons. L’utilisation du test F partiel au sein d’une séquence de régressions hiérarchiques préspécifiées constitue la réponse scientifique légitime à ces dérives, garantissant que chaque palier d’inclusion découle d’un plan d’hypothèses rigoureusement motivé a priori.
11. Diagnostics des erreurs courantes et validation des postulats dans Excel
11.1 Erreurs méthodologiques et confusions fréquentes
L’implémentation du test F partiel sur tableur est particulièrement vulnérable à une série d’erreurs méthodologiques récurrentes qu’il convient de répertorier afin d’en verrouiller préventivement l’apparition. La première méprise, fréquemment observée chez les analystes novices, réside dans l’inversion des termes au numérateur du test. Calculer RSS_complet - RSS_reduit au lieu de l’ordre inverse génère une variation négative, débouchant sur une statistique F négative. Une valeur de Fisher négative est une aberration mathématique dans le cadre de la théorie des formes quadratiques définies positives, et signale invariablement une permutation fautive des cellules d’entrée.
La seconde faute classique concerne le décompte des degrés de liberté, en particulier l’omission ou la double comptabilisation de la constante de régression ($\beta_0$). Il convient de garder en mémoire que les degrés de liberté résiduels fournis par Excel déduisent déjà automatiquement la constante du total. Tenter de corriger manuellement cette valeur sans comprendre la formule interne aboutit à des décalages d’un point sur le dénominateur ($n – k$ au lieu de $n – k – 1$), faussant la précision des décimales de la p-valeur.
Une troisième erreur critique consiste à tenter d’appliquer la logique du test F partiel à des modèles non emboîtés (par exemple, comparer un modèle intégrant $X_1$ et $X_2$ à un modèle intégrant $X_3$ et $X_4$). Dans cette situation, aucun des modèles n’est une sous-variété de l’autre ; la somme des carrés résiduels de l’un n’est pas nécessairement contrainte par l’autre, ce qui invalide mathématiquement l’hypothèse de distribution conjointe selon la loi de Fisher. Seuls les critères AIC/BIC ou des tests spécifiques pour modèles non emboîtés (test J de Davidson-MacKinnon) sont autorisés dans ce cadre.
11.2 Erreurs de syntaxe et de manipulation dans Excel
Sur le plan purement logiciel, l’usage des fonctions de probabilité d’Excel requiert le respect scrupuleux de l’ordre positionnel des arguments. Une interversion entre les degrés de liberté du numérateur et ceux du dénominateur lors de l’appel de la fonction LOI.F.DROITE(B11; C3; B6) au lieu de LOI.F.DROITE(B11; B6; C3) modifie radicalement la forme de la distribution sous-jacente et génère une probabilité fallacieuse pouvant conduire à une conclusion inférentielle diamétralement opposée à la réalité des faits.
L’apparition de l’erreur d’exécution #VALEUR! signale presque toujours la présence d’un caractère textuel invisible au sein des plages numériques transmises à l’utilitaire de régression, ou l’inclusion par mégarde d’un libellé alphabétique dans une cellule supposée contenir un scalaire réel. Il importe également de veiller à ce que la cellule recevant la statistique F ne soit pas formatée en pourcentage ou en entier tronqué, ce qui masquerait la précision nécessaire aux calculs d’inférence fine.
Enfin, le piège le plus insidieux découle du copier-coller statique. Lorsqu’un chercheur réalise une régression, modifie subséquemment quelques valeurs aberrantes dans son échantillon brut, puis relance le modèle réduit sans réexécuter le modèle complet, les deux tables ANOVA se retrouvent désynchronisées. L’automatisation dynamique via les fonctions natives, détaillée dans la section subséquente, représente le remède définitif à cette vulnérabilité procédurale.
11.3 Techniques d’audit et de contrôle de validité de la feuille de calcul
Pour s’assurer de l’irréprochabilité méthodologique d’un classeur de recherche, l’analyste doit exploiter les fonctionnalités d’audit de formules intégrées à Microsoft Excel. Situées dans l’onglet Formules du ruban, les options Repérer les antécédents et Repérer les dépendants projettent des flèches graphiques visualisant sans ambiguïté les flux de données alimentant chaque cellule du test F partiel. Cette vérification optique confirme instantanément que le numérateur puise bien ses sources dans les deux modèles respectifs et que le dénominateur est exclusivement lié à l’erreur du modèle complet.
De plus, l’analyste rigoureux implémentera des assertions de contrôle logique (sanity checks) au sein de sa feuille de calcul. Par exemple, une cellule dédiée à la vérification structurelle peut héberger la formule logique suivante :
=SI(ET(B4 >= B3; C4 > C3; Modele_Complet!C16 = Modele_Reduit!C16); "Audit Validé : Spécification Conforme"; "ERREUR CRITIQUE : Vérifier emboîtement ou n")
Cette assertion teste automatiquement l’inégalité des sommes des carrés, la cohérence des degrés de liberté et l’égalité parfaite des tailles d’échantillon à travers les sommes des carrés totaux (cellule C16 dans l’exemple de table ANOVA standard), érigeant un rempart infranchissable contre les erreurs de manipulation humaine.
12. Automatisation avancée et modèle de feuille de calcul réutilisable pour la recherche
12.1 Exploitation de la fonction matricielle DROITEREG pour un calcul dynamique
L’Utilitaire d’analyse présente un inconvénient méthodologique sérieux pour la recherche reproductible : son exécution génère des valeurs statiques non réactives aux modifications des données. Pour pallier cette faiblesse et doter Excel d’une réactivité algorithmique comparable à celle des scripts R ou Python, l’exploitation de la fonction matricielle universelle DROITEREG (ou LINEST en version anglaise) s’avère hautement supérieure.
La fonction DROITEREG dispose d’un argument statistique dédié permettant de renvoyer directement la table ANOVA complète de la régression en mémoire vive. Sa syntaxe générale s’établit comme suit :
=DROITEREG(Y_connus; [X_connus]; [constante]; [statistiques])
Lorsque le quatrième argument [statistiques] est fixé à VRAI, la fonction produit une matrice de cinq lignes et de $k+1$ colonnes. Les valeurs requises pour le test F partiel se trouvent systématiquement aux coordonnées matricielles standardisées suivantes :
- Ligne 5, Colonne 1 : Somme des carrés de la régression ($SS_{\text{reg}}$)
- Ligne 5, Colonne 2 : Somme des carrés des résidus ($RSS$)
- Ligne 4, Colonne 2 : Degrés de liberté résiduels ($ddl_{\text{résiduel}}$)
- Ligne 3, Colonne 1 : Coefficient de détermination multiple ($R^2$)
Grâce à la combinaison élégante de la fonction d’extraction INDEX avec DROITEREG, il devient possible d’extraire dynamiquement la somme des carrés résiduels sans devoir déployer manuellement la matrice complète sur la feuille :
Pour le modèle complet :
=INDEX(DROITEREG(Plage_Y; Plage_X_Complet; VRAI; VRAI); 5; 2)
Pour le modèle réduit :
=INDEX(DROITEREG(Plage_Y; Plage_X_Reduit; VRAI; VRAI); 5; 2)
De même, les degrés de liberté résiduels du modèle complet s’extraient instantanément par :
=INDEX(DROITEREG(Plage_Y; Plage_X_Complet; VRAI; VRAI); 4; 2)
Cette méthodologie d’extraction avancée élimine totalement le recours à l’Utilitaire d’analyse : toute mise à jour, adjonction ou rectification de données brutes dans le tableau d’entrée répercute instantanément ses conséquences sur la statistique F et sur la p-valeur finale, garantissant un flux analytique parfaitement dynamique et transparent.
12.2 Conception d’une matrice d’analyse hiérarchique par blocs
Dans les protocoles empiriques sophistiqués, la recherche procède souvent par paliers successifs d’accumulation de prédicteurs (régression hiérarchique séquentielle à 3 ou 4 étapes). Une architecture matricielle ordonnée permet d’enchaîner harmonieusement ces comparaisons emboîtées au sein d’une feuille de travail automatisée réutilisable.
Le classeur peut être configuré sous forme de tableau séquentiel structuré selon la disposition suivante :
| Étape | Prédicteurs Introduits | $R^2$ | $\Delta R^2$ | $RSS$ | $ddl$ Rés. | $F$ Partiel | $ddl_1$ | $ddl_2$ | $p$-valeur | $f^2$ Cohen |
|---|---|---|---|---|---|---|---|---|---|---|
| Étape 1 | Démographie (Âge, Sexe) | 0,125 | 0,125 | 4520,3 | 147 | 10,50 | 2 | 147 | < 0,001 | 0,143 |
| Étape 2 | + Intelligence Générale (QI) | 0,284 | 0,159 | 3698,7 | 146 | 32,45 | 1 | 146 | < 0,001 | 0,222 |
| Étape 3 | + Fonctions Exécutives (3 tests) | 0,341 | 0,057 | 3402,1 | 143 | 4,16 | 3 | 143 | 0,007 | 0,086 |
Dans ce modèle d’architecture, chaque ligne compare le modèle du palier courant (faisant office de modèle complet) au modèle du palier précédent (faisant office de modèle restreint). Les formules configurées aux sections précédentes s’appliquent en cascade de façon relative le long des lignes du tableau. Cette matrice produit en temps réel une synthèse complète de la progression incrémentale de la puissance explicative du système théorique, signalant d’un coup d’œil les blocs apportant une contribution robuste et ceux dont l’intégration relève de la simple inflation de paramètres inefficaces.
12.3 Exportation et rédaction des résultats selon les normes académiques (APA 7)
L’aboutissement naturel de toute démarche analytique réside dans la communication rigoureuse de ses conclusions au sein de publications scientifiques arbitrées. L’American Psychological Association (APA 7e édition) définit des normes formelles strictes pour la consignation des tests de régression hiérarchique et des tests F de changement de modèle.
Sur le plan textuel, la rédaction doit impérativement stipuler la valeur de la statistique $F$, les degrés de liberté entre parenthèses (numérateur en premier, dénominateur en second, séparés par une virgule), la valeur exacte de la probabilité d’erreur ($p$) rapportée à trois décimales (sans zéro initial si la valeur ne peut théoriquement dépasser 1), ainsi que l’ampleur du changement de variance ($\Delta R^2$) ou la taille d’effet correspondante ($f^2$).
Un gabarit de rédaction canonique conforme aux normes APA s’énonce comme suit :
« Afin d’évaluer la validité incrémentale des fonctions exécutives au-delà des facteurs démographiques et du quotient intellectuel, une analyse de régression hiérarchique a été conduite. L’introduction du bloc des trois mesures de fonctions exécutives à la troisième étape du modèle explique une part de variance additionnelle significative de la performance académique, $\Delta R^2 = 0,057$, $F(3, 143) = 4,16$, $p = 0,007$, $f^2 = 0,086$. Ces résultats confirment l’apport prédictif spécifique et substantiel des fonctions exécutives, justifiant le maintien du modèle complet au détriment du modèle restreint. »
Sur le plan tabulaire, le tableau d’exportation doit présenter les coefficients de régression non standardisés ($B$), leurs erreurs types ($SE$), les coefficients standardisés ($\beta$), ainsi que les statistiques de changement à chaque étape ($\Delta R^2$, $F$ de changement, $p$). En structurant judicieusement les cellules sous Excel et en supprimant les quadrillages verticaux superflus conformément aux règles typographiques des revues internationales (seules des bordures horizontales discrètes délimitant l’en-tête et le pied de table étant tolérées), le chercheur génère un document immédiatement diffusable, garantissant la reproductibilité computationnelle intégrale de ses analyses.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Davidson, R., & MacKinnon, J. G. (1981). Several tests for model specification in the presence of alternative hypotheses. Econometrica, 49(3), 781–793. https://doi.org/10.2307/1911522
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Hocking, R. R. (2013). Methods and applications of linear models: Regression and the analysis of variance (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118514931
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Microsoft Corporation. (2023). Fonction DROITEREG – Support Microsoft. Microsoft Support. https://support.microsoft.com/fr-fr/office/droitereg
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.