
L’analyse des séries temporelles et la modélisation économétrique reposent traditionnellement sur le postulat d’invariance temporelle des paramètres. Les chercheurs supposent bien souvent que les relations fonctionnelles liant une variable dépendante à un ensemble de covariables demeurent immuables tout au long de la période d’observation. Néanmoins, l’histoire économique, les bouleversements technologiques, les modifications de cadres réglementaires ou les crises financières majeures démontrent avec acuité que la stabilité structurelle d’un modèle linéaire est fréquemment mise en défaut. Lorsqu’un changement de régime intervient au sein d’un échantillon, l’estimation d’une régression unique sur l’ensemble de la période engendre des estimateurs biaisés, une sous-estimation systématique de la variance des erreurs et des projections prédictives totalement erronées.
Face à cette problématique fondamentale, l’économétrie contemporaine mobilise des outils d’inférence rigoureux permettant d’évaluer la constance des coefficients de régression. Le test développé par l’économètre Gregory Chow en 1960 demeure la référence historique et théorique incontournable pour détecter une instabilité structurelle à une date prédéterminée. Conçu comme une extension du test de Fisher pour la comparaison de modèles emboîtés, le test de Chow confronte la performance globale d’un modèle restreint à celle de plusieurs sous-modèles sectorisés, apportant une réponse probabiliste rigoureuse à la question de la persistance des mécanismes de causalité observés dans les données empiriques.
L’environnement statistique R offre une infrastructure logicielle exceptionnelle pour implémenter, visualiser et approfondir le test de Chow. Grâce à des bibliothèques hautement spécialisées telles que strucchange ou car, ainsi qu’à la flexibilité native du langage pour l’algèbre matricielle et l’ajustement de modèles linéaires, les praticiens disposent d’un ensemble complet de méthodes diagnostiques. Ce guide exhaustif explore de façon approfondie l’ensemble des dimensions théoriques, mathématiques et informatiques requises pour maîtriser le test de Chow sous R, depuis la formalisation des hypothèses jusqu’au diagnostic post-estimation et au traitement des ruptures endogènes.
1. Introduction aux ruptures structurelles et fondements du test de Chow
1.1 Définition et genèse historique du test de Chow
La formalisation statistique des ruptures structurelles a connu son tournant fondateur avec la publication en 1960 de l’article séminal de Gregory Chow dans la revue Econometrica, intitulé « Tests of Equality Between Sets of Coefficients in Two Linear Regressions ». Dans un contexte macroéconomique d’après-guerre marqué par des débats intenses sur la stabilité de la fonction de consommation keynésienne et de la demande de monnaie, Chow s’est attelé à résoudre une interrogation méthodologique essentielle : comment certifier mathématiquement que la relation entre deux ou plusieurs grandeurs économiques ne s’est pas modifiée suite à un choc exogène, tel qu’une guerre, une réforme monétaire ou une dérégulation institutionnelle ?
Sur le plan formel, l’instabilité des paramètres dans un modèle linéaire se définit comme une altération non aléatoire du vecteur des coefficients de régression au fil des observations. Dans un modèle standard estimé par la méthode des moindres carrés ordinaires, on suppose que le vecteur de coefficients bêta demeure rigoureusement invariant pour l’ensemble des observations indicées de 1 à T. Une rupture structurelle implique que l’échantillon se scinde en deux ou plusieurs régimes distincts, chacun étant caractérisé par son propre vecteur de paramètres générateurs. Cette discontinuité peut affecter la constante du modèle, traduisant un saut de niveau de la variable expliquée, les pentes associées aux régresseurs, révélant une mutation de la sensibilité marginale, ou encore l’ensemble de ces composantes simultanément.
Il convient de dissocier formellement la variabilité stochastique ordinaire d’un changement de régime structurel pérenne. Les fluctuations d’échantillonnage aléatoires représentent des perturbations résiduelles de moyenne nulle qui n’affectent pas la loi de distribution fondamentale régissant les coefficients. À l’inverse, une rupture structurelle consacre une modification déterministe et durable du processus générateur de données sous-jacent. Ignorer une telle rupture en contraignant le modèle à adopter un vecteur de coefficients uniforme sur l’intégralité de la période équivaut à commettre une erreur d’agrégation temporelle majeure, annihilant la validité descriptive et explicative du travail de modélisation.
1.2 Pertinence méthodologique en modélisation quantitative
La détection des ruptures structurelles constitue un enjeu déterminant en modélisation quantitative appliquée. Lorsqu’une fracture structurelle est occultée, les propriétés d’optimalité théorique de l’estimateur des moindres carrés ordinaires s’effondrent. En premier lieu, l’estimation conjointe sur des données hétérogènes induit un biais d’omission de variable d’état, ce qui fausse irrémédiablement l’estimation de l’amplitude des coefficients. Les estimateurs obtenus ne convergent plus vers les vraies valeurs des paramètres de sous-périodes, mais vers une moyenne pondérée instable et dénuée de sens théorique réel, brouillant la lecture empirique des mécanismes analysés.
En second lieu, l’inférence statistique conventionnelle est invalidée de manière critique. La présence d’une rupture non spécifiée engendre une inflation substantielle de la variance estimée des résidus. Il en découle que les erreurs-types des coefficients sont artificiellement gonflées ou, à l’inverse, biaisées à la baisse en raison d’une fausse autocorrélation induite par le décalage de niveau. Les tests d’hypothèses univariés de Student perdent leur niveau de signification nominal : les intervalles de confiance s’avèrent erronés et la puissance des tests s’effondre. Au niveau prédictif, l’omission d’un point d’inflexion historique conduit à des erreurs de prévision hors échantillon considérables, les extrapolations projetant dans le futur un régime caduc qui n’a plus cours dans la réalité empirique.
Initialement circonscrite à la macroéconomie et à l’économétrie financière, l’analyse des ruptures structurelles s’est étendue avec succès à l’ensemble des disciplines quantitatives. Dans l’étude des séries temporelles climatiques, elle permet d’identifier l’accélération d’un réchauffement liée à des seuils anthropiques ou naturels. En marketing quantitatif et en analyse comportementale longitudinale, elle sert à quantifier l’impact immédiat du déploiement d’une nouvelle politique tarifaire ou d’une campagne médiatique disruptive sur l’élasticité de la demande. Dans les sciences biomédicales, elle permet d’évaluer la transition physiologique d’un groupe de patients suite à l’administration d’un traitement thérapeutique, confirmant le caractère universel de cette approche méthodologique.
1.3 Objectifs du protocole d’analyse sous R
Le déploiement d’un protocole d’analyse rigoureux sous R répond à des objectifs précis de validation méthodologique. L’intention première est d’examiner formellement l’existence d’un point de bascule temporel ou contextuel préalablement suspecté par la théorie ou l’histoire empirique. Qu’il s’agisse d’un événement institutionnel daté avec précision ou d’un choc macroéconomique identifié, le test permet d’arbitrer objectivement entre la thèse de la continuité paramétrique et celle de la rupture franche.
Le second objectif consiste à orchestrer une comparaison statistique directe entre le modèle global restreint, ajusté sur l’échantillon complet, et les sous-modèles partitionnés non restreints, ajustés séparément sur chaque sous-période. Le protocole sous R permet de quantifier avec une extrême précision géométrique la réduction de la somme des carrés des résidus induite par la segmentation de l’échantillon, et de déterminer si ce gain d’ajustement compense la perte de degrés de liberté inhérente à la duplication des paramètres estimés.
Enfin, le protocole vise à valider la stabilité temporelle des covariables individuelles. Au-delà d’un simple verdict global de rejet ou de non-rejet de l’hypothèse nulle, l’analyse menée dans l’environnement R autorise une décomposition fine des sources de l’instabilité. Elle permet d’isoler si la rupture est imputable à une translation parallèle de la droite de régression via son ordonnée à l’origine ou si elle découle d’une modification structurelle des pentes marginales traduisant un bouleversement dans la transmission des effets des régresseurs.
2. Fondements mathématiques et statistiques du test de Chow
2.1 Formulation des hypothèses statistiques
La mécanique inférentielle du test de Chow repose sur la formalisation rigoureuse d’hypothèses linéaires dans le cadre du modèle linéaire général. Considérons un échantillon global de taille T partitionné en deux sous-échantillons distincts comportant respectivement T1 et T2 observations, de telle sorte que la somme de T1 et T2 égale T. Pour chaque sous-période, le processus générateur s’exprime sous forme matricielle par l’équation suivante :
Pour le premier sous-échantillon, le vecteur des observations de la variable dépendante Y1 est modélisé par le produit de la matrice de conception X1 de dimension (T1 par k) et du vecteur de paramètres bêta 1 de dimension (k par 1), additionné du vecteur d’erreurs stochastiques epsilon 1. De même, pour le second sous-échantillon, le vecteur Y2 est modélisé par le produit de la matrice X2 de dimension (T2 par k) et du vecteur de paramètres bêta 2, additionné du vecteur d’erreurs epsilon 2. Le scalaire k représente ici le nombre total de régresseurs, incluant la colonne unitaire dédiée à la constante.
L’hypothèse nulle, notée H0, stipule l’égalité stricte des vecteurs de coefficients entre les deux régimes d’observation :
H0 : bêta 1 = bêta 2
Sous cette hypothèse de stabilité, il existe un vecteur unique bêta commun à l’ensemble des observations. L’hypothèse alternative, notée H1, postule l’existence d’une hétérogénéité structurelle telle que :
H1 : bêta 1 est différent de bêta 2
Cette hypothèse alternative admet plusieurs configurations théoriques. La rupture peut être totale, impliquant une divergence simultanée de l’ensemble des k coefficients. Elle peut être partielle, affectant exclusivement la constante sans modifier les pentes marginales, ce que l’on qualifie de rupture de niveau. Inversement, elle peut affecter une ou plusieurs pentes de régression tout en maintenant l’ordonnée à l’origine invariante, traduisant une modification exclusive de la sensibilité des variables explicatives.
2.2 Dérivation de la statistique de test F
La statistique de test proposée par Chow dérive directement du principe du test de rapport de vraisemblance appliqué aux résidus des moindres carrés ordinaires. La stratégie calculatoire requiert l’ajustement de trois régressions distinctes. En premier lieu, on ajuste le modèle restreint sur l’ensemble des T observations, ce qui permet d’extraire la somme des carrés des résidus restreinte, couramment désignée par l’acronyme SCRR (ou SSR_R). Ce modèle impose la contrainte stricte de l’hypothèse nulle en forçant les coefficients à demeurer constants sur toute la série.
En second lieu, on estime de manière totalement indépendante le premier sous-modèle sur les T1 premières observations, fournissant la première somme des carrés des résidus non restreinte, notée SCR1. Ensuite, le second sous-modèle est estimé sur les T2 observations restantes, produisant la seconde somme des carrés des résidus non restreinte, notée SCR2. La somme des carrés des résidus non restreinte globale, notée SCRNR (ou SSR_UR), est obtenue par l’addition scalaire directe de SCR1 et SCR2. En raison de la flexibilité conférée par l’ajustement séparé des paramètres, SCRNR est mathématiquement inférieure ou égale à SCRR.
La statistique de Fisher-Snedecor se structure à partir de l’accroissement relatif de la somme des carrés des résidus consécutif à l’imposition des contraintes d’invariance. Le numérateur de la statistique calcule la différence entre SCRR et SCRNR, normalisée par le nombre de restrictions linéaires testées, qui correspond exactement au nombre de paramètres k dans le cas d’un test global. Le dénominateur est constitué de la somme des carrés des résidus non restreinte SCRNR, normalisée par ses degrés de liberté résiduels, à savoir T moins 2k. L’expression de la statistique F s’écrit ainsi :
F = [ (SCRR – SCRNR) / k ] / [ SCRNR / (T – 2k) ]
Cette statistique mesure si l’amélioration de la qualité d’ajustement résultant de la liberté accordée aux coefficients de varier entre les sous-échantillons est statistiquement significative par rapport à la variance résiduelle non expliquée du modèle non restreint.
2.3 Propriétés asymptotiques et distribution d’échantillonnage
Sous la validité conjointe de l’hypothèse nulle et des hypothèses classiques du modèle de régression linéaire gaussien, la statistique de Chow suit exactement une loi théorique de Fisher-Snedecor à k degrés de liberté au numérateur et T moins 2k degrés de liberté au dénominateur. Cette propriété d’exactitude en échantillon fini confère au test une robustesse théorique remarquable, à condition que les résidus soient rigoureusement normaux et homoscédastiques.
Lorsque la taille de l’échantillon T tend vers l’infini, la statistique k multipliée par F converge en loi vers une distribution du Chi-carré à k degrés de liberté, en vertu des théorèmes centraux limites régissant les formes quadratiques des estimateurs des moindres carrés ordinaires. Néanmoins, l’efficacité asymptotique et la puissance du test en échantillon fini demeurent tributaires de la répartition relative des observations entre les sous-échantillons. Le ratio d’échantillonnage, défini par le rapport de T1 sur T, conditionne directement la précision de l’estimation de chaque sous-vecteur de paramètres.
Un déséquilibre sévère dans la taille des sous-groupes engendre des distorsions préjudiciables. Si la rupture suspectée se situe très près du début ou de la fin de l’échantillon (par exemple avec un T1 inférieur à k), le premier sous-modèle ne peut même pas être mathématiquement identifié par suite de l’indétermination du rang de la matrice des données. Même lorsque T1 excède légèrement k, la variance d’échantillonnage des coefficients bêta 1 sera extrêmement élevée. Ce manque de précision dégrade considérablement la puissance du test de Chow, augmentant substantiellement le risque d’erreur de type II consistant à échouer à rejeter l’hypothèse nulle alors qu’une fracture structurelle existe bel et bien.
3. Hypothèses sous-jacentes et conditions d’application statistique
3.1 Normalité et indépendance des termes d’erreur
La validité théorique stricte de la loi de Fisher attribuée à la statistique de Chow repose impérativement sur l’hypothèse de normalité multidimensionnelle des termes de perturbation stochastique. L’indépendance et la distribution gaussienne des résidus conditionnent le fait que la forme quadratique au numérateur et celle au dénominateur suivent des lois du Chi-carré indépendantes au sens du théorème de Cochran. En présence de déviations modérées par rapport à la normalité dans de grands échantillons, l’inférence asymptotique demeure approximativement valide, mais en petits échantillons, une forte asymétrie ou une leptocurtose prononcée fausse l’exactitude des valeurs critiques tabulées.
L’indépendance sérielle des erreurs constitue une condition tout aussi déterminante, particulièrement dans le cadre de données chronologiques séquentielles. La présence d’une autocorrélation positive des résidus entraîne une sous-estimation systématique de la variance résiduelle non restreinte. Cette distorsion gonfle artificiellement la statistique F calculée, conduisant l’économètre à rejeter l’hypothèse de stabilité structurelle alors même que l’instabilité apparente n’est que le reflet d’une dépendance temporelle des erreurs non modélisée.
Avant d’engager le calcul du test de Chow, un protocole exploratoire rigoureux exige l’évaluation empirique de ces conditions. La normalité des résidus s’examine au moyen de statistiques formelles telles que le test de Shapiro-Wilk pour les échantillons modestes ou le test de Jarque-Bera fondé sur les coefficients d’asymétrie et d’aplatissement. Parallèlement, l’absence d’autocorrélation d’ordre un est classiquement vérifiée via la statistique de Durbin-Watson ou, pour des ordres supérieurs, à l’aide du test du multiplicateur de Lagrange de Breusch-Godfrey.
3.2 Homoscédasticité inter-groupes et intra-groupes
L’une des hypothèses les plus critiques et les plus fréquemment méconnues du test de Chow traditionnel réside dans l’homogénéité parfaite de la variance des perturbations entre les deux sous-échantillons. Le modèle postule explicitement que la variance de l’aléa stochastique dans le régime 1 est strictement identique à la variance de l’aléa dans le régime 2, soit sigma 1 au carré égal à sigma 2 au carré. Cette condition d’homoscédasticité inter-régimes conditionne la factorisation de la variance commune hors des formes quadratiques lors de la dérivation du ratio de Fisher.
L’impact de la violation de cette hypothèse a été abondamment documenté dans la littérature économétrique, notamment par Toyoda en 1974 puis par Schmidt et Sickles en 1977. En présence d’une hétéroscédasticité inter-groupes prononcée (par exemple si les chocs subis après la rupture sont nettement plus volatils qu’avant), la statistique de Chow cesse de suivre une loi de Fisher, même sous l’hypothèse nulle d’égalité des pentes. Le niveau de signification réel du test diverge alors considérablement de son niveau nominal théorique. Si le sous-échantillon doté de la plus grande variance résiduelle est également le plus restreint en termes d’effectif, le taux de rejet à tort de l’hypothèse nulle explose, provoquant de fausses détections de ruptures de coefficients.
Face à ce défi de robustesse, le modélisateur doit impérativement tester l’égalité des variances résiduelles préalablement au test de Chow, en recourant au test de Goldfeld-Quandt ou au test de Breusch-Pagan partitionné. En présence d’hétéroscédasticité manifeste, le test de Chow classique doit être délaissé au profit d’alternatives robustes à la variance inégale, telles que l’approximation de Welch-Satterthwaite transposée aux régressions multivariées ou le test de Wald fondé sur des matrices de variance-covariance robustes de type White.
3.3 Exogénéité stricte et absence de colinéarité
L’estimation convergente et sans biais des modèles partitionnés repose sur l’hypothèse d’exogénéité stricte des régresseurs au sein de chaque sous-période. Cette condition stipule que l’espérance conditionnelle des perturbations par rapport à la matrice de conception est rigoureusement nulle pour tout indice temporel. Si un phénomène d’endogénéité émerge dans l’un des sous-échantillons — qu’il provienne d’une causalité inverse, d’une variable omise corrélée ou d’une erreur de mesure —, la divergence observée entre bêta 1 et bêta 2 ne reflétera pas une véritable rupture structurelle dans les paramètres fondamentaux, mais une variation de l’amplitude du biais d’endogénéité entre les deux périodes.
Par ailleurs, la stabilité structurelle du rang de la matrice de conception conditionne la faisabilité algébrique du test. La matrice X transposée multipliée par X doit être strictement inversible sur l’échantillon complet, mais également sur chaque partition sous-échantillonnée. Cette exigence implique qu’aucune variable explicative ne devienne invariante ou parfaitement colinéaire à une autre au sein de l’un des sous-groupes, ce qui survient fréquemment lorsque l’on introduit des variables qualitatives indicatrices qui ne prennent qu’une seule modalité sur une sous-période restreinte.
Le contrôle de la multicolinéarité s’opère par l’examen du facteur d’inflation de la variance (VIF) au sein de chaque sous-échantillon. Un VIF excédant les seuils conventionnels (couramment fixés à 5 ou 10) dans l’un des régimes indique que l’information disponible est insuffisante pour isoler les contributions individuelles des régresseurs sur cette fenêtre temporelle. Dans un tel contexte, le test de Chow global risque de manquer singulièrement de puissance ou de générer des instabilités numériques lors de l’inversion matricielle.
4. Préparation de l’environnement R et packages indispensables
4.1 Installation et chargement des bibliothèques spécialisées
Pour exécuter un test de Chow avec toute la rigueur méthodologique requise, l’environnement R doit être enrichi de bibliothèques spécialisées en économétrie appliquée et en analyse des ruptures structurelles. Le package central et incontournable pour cette analyse est sans conteste strucchange (Testing, Monitoring, and Dating Structural Changes), conçu par Achim Zeileis et ses coauteurs. Ce module propose une infrastructure algorithmique unifiée pour tester l’invariance paramétrique dans les modèles linéaires, couvrant aussi bien les tests sur points de rupture fixes que les procédures de détection endogène.
En complément de strucchange, la bibliothèque car (Companion to Applied Regression), développée par John Fox et Sanford Weisberg, s’avère indispensable. Elle offre la fonction linearHypothesis, qui permet de réaliser des tests d’hypothèses linéaires sous des formes arbitraires, incluant des formulations robustes à l’hétéroscédasticité particulièrement utiles pour contourner les limites du test de Chow ordinaire. Les packages de manipulation et d’affichage, notamment dplyr pour le filtrage élégant des sous-échantillons et ggplot2 pour la modélisation graphique vectorielle de haute qualité, viennent compléter cette panoplie d’outils analytiques.
L’installation s’effectue traditionnellement au moyen de la fonction install.packages appliquée à un vecteur de chaînes de caractères comprenant « strucchange », « car », « ggplot2 », « dplyr », « lmtest » et « sandwich ». Une fois le téléchargement des binaires complété depuis le dépôt CRAN, les fonctions sont intégrées dans la session active via l’instruction library pour chacun des modules. Il est fortement conseillé de vérifier l’absence de conflits de noms de fonctions lors du chargement, notamment entre les méthodes de manipulation de dplyr et les fonctions statistiques de base.
4.2 Configuration des options globales et reproductibilité
L’intégrité de toute analyse quantitative dépend de la stricte reproductibilité computationnelle de ses résultats. Dans le cadre de protocoles impliquant des données simulées ou des procédures de rééchantillonnage, la fixation d’un germe de génération pseudo-aléatoire au moyen de l’instruction set.seed s’impose comme une règle méthodologique absolue. L’assignation d’un entier spécifique garantit que l’ensemble des tirages d’erreurs stochastiques et des variations d’échantillonnage pourront être reproduits à l’identique par tout auditeur exécutant le script sur une autre machine.
L’optimisation de l’environnement RStudio requiert également un paramétrage adéquat des options d’affichage de la console. L’ajustement du paramètre global digits via la fonction options permet de fixer la précision des sorties numériques à quatre ou cinq décimales significatives, facilitant la lecture comparative des statistiques de test et des p-valeurs sans encombrer la mémoire visuelle. De même, la désactivation de la notation scientifique systématique au moyen de l’argument scipen calibré à une valeur modérée (par exemple options(scipen = 10)) prévient l’affichage d’exposants complexes lors de la restitution des probabilités critiques.
Enfin, la bonne gouvernance de projet commande la structuration d’un répertoire de travail dédié articulé autour d’un fichier de projet RStudio (extension .Rproj). Cette organisation isole les dépendances, évite le recours à des chemins d’accès absolus rigides qui compromettent la portabilité du code, et garantit que les jeux de données, les scripts d’analyse économétrique et les visualisations graphiques générées seront archivés de manière cohérente au sein d’une arborescence standardisée.
5. Création et structuration du jeu de données pour l’analyse
5.1 Génération programmatique des données d’exemple
Afin d’illustrer la mécanique interne du test de Chow de manière parfaitement contrôlée et didactique, la génération d’un jeu de données synthétique intégrant une rupture structurelle déterministe présente un intérêt pédagogique supérieur. Considérons un échantillon composé de T = 200 observations ordonnées chronologiquement, représentant une métrique continue x évoluant de manière uniforme et une variable dépendante y soumise à un choc structurel intervenant exactement à l’observation T1 = 100.
Le processus générateur sous-jacent est articulé autour de deux régimes paramétriques distincts. Pour les observations 1 à 100 (premier régime), la relation fonctionnelle est caractérisée par une constante fixée à 5 et une pente marginale unitaire égale à 2. À partir de l’observation 101 et jusqu’à la fin de la série (second régime), un événement structurel majeur modifie les conditions d’équilibre : la constante subit une contraction pour s’établir à 2, tandis que la pente marginale subit une amplification drastique, passant de 2 à 4,5. Les erreurs stochastiques sont générées selon une loi normale centrée réduite de variance unitaire, garantissant le respect temporaire des postulats d’homoscédasticité et de normalité.
L’assemblage informatique sous R s’opère par la création d’un vecteur de covariable généré via la fonction runif ou seq, suivi de la programmation vectorielle de la variable dépendante conditionnée par l’indice d’observation. Les deux segments sont ensuite fusionnés au sein d’un objet data.frame standardisé, incluant une variable d’index temporel direct. Cette structure tabulaire constitue la matrice empirique sur laquelle l’ensemble des régressions restreintes et partitionnées seront ensuite évaluées.
5.2 Inspection dimensionnelle et intégrité des données
Préalablement à toute démarche de modélisation, une phase d’audit dimensionnel des données s’avère indispensable. L’exécution de la fonction str permet de vérifier la typologie exacte des colonnes composant le jeu de données, confirmant que les prédicteurs et la variable réponse sont bien formatés sous forme de vecteurs numériques à double précision et non sous forme de chaînes de caractères ou de facteurs inadaptés aux régressions linéaires standard.
L’appel aux fonctions head et tail permet de vérifier visuellement la cohérence des bornes extrêmes de l’échantillon, tandis que l’instruction summary offre une première appréciation descriptive de la dispersion, de la moyenne et des étendues interquartiles des séries. Cette inspection descriptive permet d’attester de l’absence totale de valeurs manquantes (NA) ou infinies (Inf), qui viendraient altérer le calcul des degrés de liberté ou forcer l’omission asymétrique d’observations lors des estimations linéaires.
À cette étape, il est méthodologiquement judicieux de construire une variable catégorielle binaire explicite identifiant l’appartenance de chaque ligne au régime pré-rupture ou post-rupture. Cette variable indicatrice facilitera grandement l’encodage des modèles à interactions croisées lors des sections ultérieures, tout en offrant une clé de segmentation naturelle pour les opérations de visualisation comparative via les fonctions de partitionnement graphique.
6. Visualisation exploratoire des données et détection graphique des ruptures
6.1 Construction du nuage de points avec ggplot2
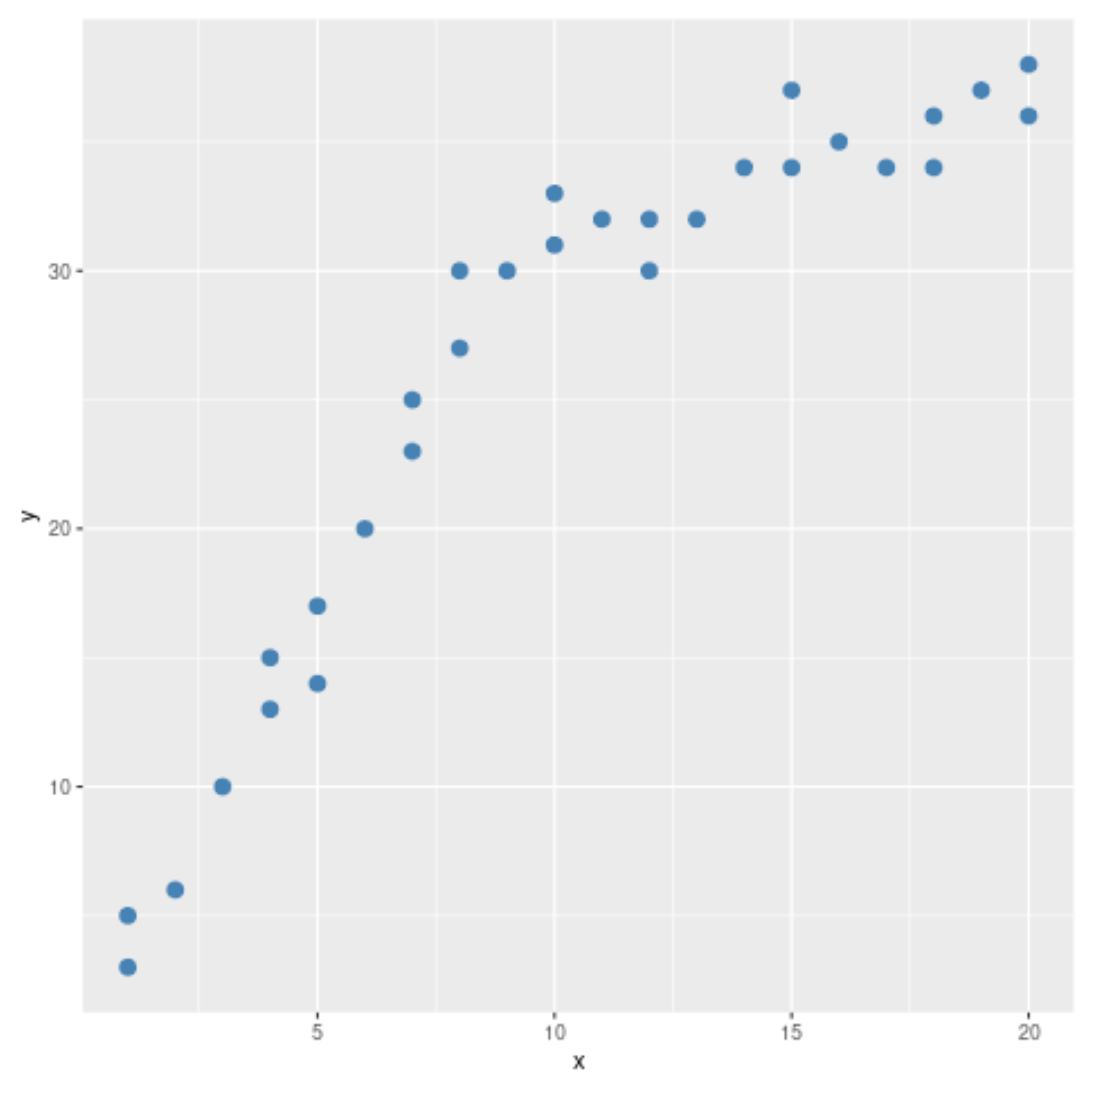
L’analyse exploratoire graphique constitue une phase préliminaire irremplaçable dans l’étude des ruptures de structure. Même les tests statistiques les plus sophistiqués ne sauraient se substituer à une inspection visuelle minutieuse de la forme fonctionnelle globale des données. L’écosystème graphique du package ggplot2 permet de construire une représentation cartésienne haute définition du nuage de points, en projetant la variable dépendante en ordonnée et la covariable explicative continue en abscisse.
L’agencement des éléments visuels doit être pensé pour maximiser la lisibilité des distributions locales. L’utilisation de points semi-transparents via l’argument alpha permet de prévenir la saturation optique causée par la superposition de points dans les zones à forte densité d’observations. L’enrichissement de l’esthétique par une échelle de couleur continue corrélée à l’indice temporel fournit un gradient visuel intuitif, révélant immédiatement à l’analyste si la trajectoire des observations glisse de manière continue ou si elle subit une bifurcation abrupte dans le plan cartésien à partir d’une certaine période.
Cette première modélisation géométrique permet fréquemment de poser un diagnostic visuel sur la nature du changement. Si l’on observe deux grappes de points étirées selon des axes de directions visiblement discordantes, l’intuition d’une altération de la pente marginale s’en trouve immédiatement confortée. À l’inverse, si les grappes demeurent rigoureusement parallèles mais décalées verticalement, l’hypothèse d’une simple rupture sur la constante gagne en crédibilité, guidant ainsi la formulation des futures hypothèses statistiques formelles.
6.2 Superposition de droites de régression distinctes
Pour matérialiser la rupture de façon tangible, la superposition graphique de modèles de régression alternatifs sur le nuage de points s’avère extrêmement puissante. Dans un premier temps, une droite de tendance linéaire globale, calculée sur l’ensemble des 200 observations, est projetée sur le graphique en utilisant la fonction geom_smooth avec la méthode linéaire (« lm ») sans scission de groupe. Cette courbe globale, généralement tracée en ligne pointillée sombre, illustre visuellement la contrainte de rigidité qu’impose le modèle restreint.
Dans un second temps, deux segments de régression distincts sont ajustés séparément sur les sous-ensembles temporellement partitionnés, en associant la couleur de la droite à la variable indicatrice de régime construite précédemment. Ce double ajustement local met en lumière l’inflexion fondamentale du système : la pente modérée du premier régime se détache de façon éclatante de la pente accentuée caractérisant le second segment. La zone de croisement ou de discontinuité spatiale entre les deux droites fournit une représentation visuelle directe de la rupture.
La confrontation immédiate entre la droite globale et les deux segments locaux démontre avec force l’incapacité du modèle unique à capturer la réalité sous-jacente des données. On constate visuellement que la droite restreinte sous-estime les valeurs réelles sur certaines plages tout en les surestimant systématiquement sur d’autres, traduisant graphiquement le concept théorique d’erreur de spécification par agrégation temporelle abusive.
6.3 Analyse graphique des résidus locaux
L’exploration visuelle gagne à être prolongée par l’examen de la distribution séquentielle des résidus issus du modèle restreint unique. En projetant sur un graphique linéaire l’évolution de ces résidus d’ajustement le long de l’axe temporel ou ordinal des observations, le modélisateur met en lumière d’éventuels schémas d’instabilité résiduelle. Une ligne de référence horizontale calée sur le zéro permet de contrôler le centrage de l’erreur.
En présence d’une rupture structurelle ignorée, le graphique des résidus ne présente pas l’aspect d’un bruit blanc stationnaire oscillant aléatoirement autour de zéro. Au contraire, on observe une dérive déterministe marquée : les résidus demeurent durablement positifs ou négatifs au cours du premier régime, avant de basculer brutalement dans la zone inverse suite à la date de rupture. Cette persistance non aléatoire fournit un indice visuel sans équivoque d’une violation du postulat d’indépendance et de moyenne nulle conditionnelle.
De surcroît, l’inspection des résidus permet d’évaluer la stabilité de leur variance le long du temps. Une dispersion visuellement accrue des résidus dans la seconde moitié de l’échantillon alerte immédiatement le chercheur sur l’émergence d’une hétéroscédasticité inter-régimes, condition qui invalide les propriétés de la distribution F classique et impose le recours à des ajustements robustes lors des tests formels ultérieurs.
7. Mise en œuvre du test de Chow avec le package strucchange
7.1 Utilisation de la fonction sctest pour le test de Chow
Le package strucchange constitue le cadre de référence sous R pour formaliser les tests de stabilité structurelle. Au sein de cette architecture, la fonction générique sctest (Structural Change Test) concentre l’ensemble des algorithmes d’inférence. Pour mobiliser spécifiquement le test de Chow conventionnel, la fonction requiert la déclaration de plusieurs arguments obligatoires rigoureusement ordonnés.
Le premier argument est constitué de la formule symbolique du modèle linéaire à évaluer, respectant la syntaxe usuelle y ~ x. Le deuxième argument fondamental est type, qui doit impérativement recevoir la chaîne de caractères « Chow » afin d’orienter le moteur d’inférence vers l’algorithme de partitionnement de Fisher. Enfin, l’argument point doit spécifier l’emplacement exact de la rupture candidate au sein de l’échantillon. La syntaxe formelle s’écrit ainsi : sctest(formule, type = « Chow », point = valeur_rupture, data = donnees).
Il est fondamental de noter que l’objet retourné par sctest hérite de la classe htset. Il encapsule de manière structurée l’ensemble des métriques d’intérêt : la valeur numérique de la statistique de Fisher, les degrés de liberté associés au numérateur et au dénominateur, la probabilité critique asymptotique ou exacte (p-valeur), ainsi qu’une description textuelle formelle de l’hypothèse alternative testée.
7.2 Exécution pas à pas sur les données simulées
L’application de la procédure sctest à notre jeu de données synthétique s’effectue en assignant le seuil de scission au centième point d’observation, correspondant rigoureusement à l’instant où nous avons injecté l’altération des coefficients dans le processus de simulation. Le code s’articule simplement en déclarant l’instruction : test_chow <- sctest(y ~ x, type = « Chow », point = 100, data = df_simule). L’exécution est quasi-instantanée, reflétant l’optimisation matricielle du package.
L’impression en console de l’objet test_chow produit une sortie académique standardisée. La section statistic affiche la valeur scalaire de la statistique F empirique, notée traditionnellement F de Chow. La section parameter restitue un vecteur contenant les deux degrés de liberté de la distribution théorique sous l’hypothèse nulle, à savoir df1 = 2 (le nombre de coefficients testés simultanément, constante et pente) et df2 = 196 (calculé par T – 2k = 200 – 4).
Enfin, la ligne p.value dévoile la métrique décisive pour la prise de décision statistique. Compte tenu de la magnitude de la rupture injectée dans notre simulation (passage de la pente de 2 à 4,5), la valeur de la statistique F empirique atteint un niveau extrêmement élevé, se chiffrant bien souvent à plusieurs centaines. En corollaire, la p-valeur associée se positionne sous la barre des 2,2e-16, conduisant à un rejet catégorique et hautement significatif de l’hypothèse de stabilité structurelle.
7.3 Variantes d’implémentation selon le positionnement de la rupture
La fonction sctest fait preuve d’une grande souplesse quant à la manière d’indexer l’emplacement de la rupture structurelle candidate. Le paramètre point peut être renseigné sous forme d’un nombre entier, compris entre 1 et T, traduisant directement l’indice de la ligne dans le tableau de données. Cette formulation convient parfaitement lorsque l’événement perturbateur est repéré par un numéro d’observation séquentiel précis.
Alternativement, le point de rupture peut être formulé sous forme d’un nombre décimal strict appartenant à l’intervalle ouvert ]0, 1[, désignant alors une proportion relative de l’échantillon total. Par exemple, assigner point = 0.5 équivaut rigoureusement à couper l’échantillon à sa médiane exacte, soit à l’observation 100 dans un échantillon de 200 individus. Cette convention s’avère particulièrement utile dans les méta-analyses ou les protocoles automatisés où la taille totale des séries fluctue d’un jeu de données à l’autre.
Une vigilance méthodologique s’impose toutefois quant aux valeurs extrêmes attribuées à l’argument point. Si l’utilisateur positionne la rupture trop près des bornes de l’échantillon, par exemple à point = 2 ou point = 199, l’algorithme génère une erreur d’exécution ou produit un résultat indéterminé. En effet, chaque sous-échantillon doit contenir un nombre d’observations strictement supérieur au nombre de paramètres k à estimer afin de garantir le rang plein des matrices locales, ce qui justifie l’application systématique d’une marge d’exclusion (ou trimming) aux extrémités temporelles.
8. Calcul manuel du test de Chow via les régressions linéaires (lm)
8.1 Estimation du modèle restreint global
Pour démystifier la boîte noire algorithmique de la fonction sctest et approfondir la compréhension économétrique du test, la reconstitution manuelle étape par étape via la fonction lm de base constitue un exercice formateur indispensable. La première étape réside dans l’ajustement du modèle global restreint sur l’intégralité du jeu de données, sans procéder à la moindre partition.
L’estimation s’écrit de façon canonique : modele_restreint <- lm(y ~ x, data = df_simule). Ce modèle part du principe contraignant que la relation fonctionnelle ne subit aucune déviation au fil du temps. Une fois le modèle estimé, l’économètre extrait la somme des carrés des résidus globale restreinte. Deux approches programmatiques équivalentes sont possibles sous R : l’utilisation de la fonction deviance(modele_restreint) ou la sommation explicite des résidus élevés au carré via sum(residuals(modele_restreint)^2).
Cette grandeur scalaire, désignée par SCRR, synthétise l’ensemble de la dispersion non expliquée par le modèle unique. Parallèlement, le nombre total de paramètres k est extrait en dénombrant la longueur du vecteur des coefficients via length(coef(modele_restreint)), qui est ici égal à 2 (l’ordonnée à l’origine et le coefficient de régression de la variable x).
8.2 Estimation des modèles partitionnés non restreints
La seconde étape opérationnelle consiste à estimer les modèles non restreints en scindant formellement l’échantillon de données en deux sous-groupes mutuellement exclusifs et exhaustivement complémentaires. Le premier sous-ensemble regroupe les observations indicées de 1 à 100, tandis que le second assemble les observations indicées de 101 à 200. Cette partition s’opère élégamment à l’aide de l’argument subset de la fonction lm ou par un découpage préalable du tableau de données.
On ajuste consécutivement les deux régressions indépendantes :
modele_1 <- lm(y ~ x, data = df_simule, subset = (1:100))
modele_2 <- lm(y ~ x, data = df_simule, subset = (101:200))
Chacun de ces modèles optimise ses propres coefficients bêta de façon à minimiser localement la variance résiduelle de son sous-échantillon respectif. On extrait ensuite la somme des carrés des résidus de chaque modèle partiel, notées respectivement SCR1 <- deviance(modele_1) et SCR2 <- deviance(modele_2). La somme des carrés des résidus non restreinte totale, désignée par SCRNR, s’obtient simplement par l’addition scalaire de ces deux grandeurs : SCRNR <- SCR1 + SCR2. Ce total représente la dispersion résiduelle incompressible lorsque l’on autorise une flexibilité structurelle totale des paramètres entre les deux époques.
8.3 Programmation algébrique de la statistique F sous R
Ayant isolé avec précision SCRR, SCRNR, le nombre de régresseurs k et la taille d’échantillon T, il devient aisé de programmer directement dans la console R l’équation matricielle de la statistique de Fisher-Snedecor déduite à la section 2.2. L’écriture du code s’exécute de manière limpide :
k_param <- length(coef(modele_restreint))
taille_T <- nrow(df_simule)
degres_num <- k_param
degres_den <- taille_T – 2 * k_param
F_chow_manuel <- ((SCRR – SCRNR) / degres_num) / (SCRNR / degres_den)
Une fois la statistique F_chow_manuel calculée, l’évaluation de sa p-valeur exacte sous l’hypothèse nulle requiert l’appel à la fonction de répartition de la loi de Fisher, disponible sous R via la fonction pf. Puisqu’il s’agit d’un test unilatéral à droite (seules des valeurs anormalement élevées de F conduisent au rejet de l’hypothèse nulle de stabilité), la probabilité critique s’obtient par le complément à l’unité : p_valeur_manuelle <- 1 – pf(F_chow_manuel, degres_num, degres_den), ou de façon numériquement plus stable pour les valeurs extrêmes via pf(F_chow_manuel, degres_num, degres_den, lower.tail = FALSE).
La confrontation directe de la valeur obtenue pour F_chow_manuel et p_valeur_manuelle avec les sorties générées à la section précédente par la commande sctest confirme une égalité numérique parfaite jusqu’à la dernière décimale. Cette concordance valide empiriquement l’équivalence stricte entre l’algorithme interne de strucchange et la dérivation géométrique des sommes de carrés résiduels de Gauss.
8.4 Approche équivalente par variables indicatrices et interactions
Il existe une troisième méthodologie, d’une élégance conceptuelle remarquable, permettant d’exécuter un test rigoureusement équivalent au test de Chow sans avoir à ajuster des régressions scindées : l’approche par variables muettes (dummy variables) et termes d’interaction croisée. Cette formulation unifiée au sein d’un seul modèle global permet de tester l’invariance via un test d’hypothèse linéaire général ou un tableau d’analyse de variance.
Pour mettre en œuvre cette méthode, on définit une variable indicatrice binaire D qui prend la valeur 0 pour les observations de la première sous-période et la valeur 1 pour celles de la seconde. On spécifie ensuite un modèle complet incluant la constante, la variable explicative x, la variable muette D, ainsi que le produit croisé entre D et x, programmé sous R sous la forme syntaxique y ~ x * D ou de façon développée y ~ x + D + I(x * D).
Dans cette paramétrisation, le coefficient associé à D mesure la rupture spécifique sur la constante (le saut de niveau), tandis que le coefficient associé au terme d’interaction croisée mesure la rupture sur la pente marginale (la variation de sensibilité). Le test de Chow global d’invariance paramétrique équivaut alors strictement au test de significativité conjointe de ces deux termes additionnels. En exécutant l’instruction anova(modele_restreint, modele_interaction), la statistique F d’analyse de variance renvoyée pour le sous-espace restreint est rigoureusement identique à la statistique de Chow calculée manuellement et par sctest. Cette approche offre en outre l’avantage immédiat de pouvoir tester individuellement la nullité de la rupture sur la pente ou sur l’ordonnée via les statistiques de Student figurant dans le summary habituel du modèle.
9. Interprétation rigoureuse des sorties statistiques et de la p-valeur
9.1 Critères de décision statistique
L’interprétation des résultats issus du test de Chow repose sur des règles de décision inférentielle strictes. Le premier indicateur d’arbitrage est la p-valeur générée par le test. Confrontée aux seuils de risque alpha conventionnels fixés a priori par le chercheur (généralement 5 %, 1 % ou 0,1 %), la règle statistique s’énonce sans ambiguïté : si la p-valeur est strictement inférieure au seuil alpha choisi, l’économètre rejette formellement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. On conclut alors à l’existence d’une instabilité structurelle significative à la date de rupture évaluée.
Une approche décisionnelle complémentaire consiste à confronter directement la statistique F empirique à la valeur critique théorique issue des tables de la loi de Fisher-Snedecor pour les degrés de liberté considérés, accessible sous R via l’instruction qf(1 – alpha, degres_num, degres_den). Lorsque la statistique F calculée excède la valeur critique tabulée, le point d’estimation s’inscrit dans la région critique de rejet, corroborant mathématiquement le diagnostic apporté par la p-valeur.
Il importe toutefois de se prémunir contre une interprétation purement binaire et mécanique des seuils de significativité. Dans les jeux de données contemporains massifs comportant plusieurs dizaines de milliers d’observations, la puissance statistique des tests de Fisher devient tellement phénoménale que la moindre divergence infinitésimale et substantiellement insignifiante dans les coefficients induit une p-valeur microscopique conduisant au rejet de H0. Le chercheur quantitatif doit impérativement conjuguer la significativité statistique avec l’évaluation de la pertinence empirique de la rupture.
9.2 Interprétation substantielle de la rupture
Au-delà du verdict probabiliste brut, le rôle de l’économètre réside dans la qualification économique et substantielle de la fracture mise en évidence. Il convient d’analyser la trajectoire directionnelle des coefficients estimés avant et après la coupure. Une élévation marquée de la pente marginale traduit une transmission amplifiée du choc de la variable explicative vers la variable dépendante, signalant une réactivité accrue des agents ou une mutation de l’environnement technologique ou concurrentiel.
L’analyse différentielle entre la constante et la pente s’avère particulièrement éclairante. Une rupture circonscrite à l’ordonnée à l’origine traduit un déplacement parallèle de la fonction de réponse : l’état moyen du système a été translaté vers le haut ou vers le bas sous l’effet de facteurs exogènes non modélisés, mais l’efficacité incrémentale de la variable explicative x est demeurée constante. À l’inverse, une rupture dominée par la pente révèle une transformation profonde dans les mécanismes d’élasticité ou de productivité marginale.
La quantification de l’ampleur économique du changement s’opère par le calcul des variations relatives de coefficients, par exemple en calculant le ratio de bêta post-rupture sur bêta pré-rupture. Cette analyse de magnitude permet de donner du sens au résultat : affirmer qu’une rupture est statistiquement significative à 1 % est une information technique nécessaire ; démontrer que la rentabilité marginale d’un investissement a chuté de 45 % suite à une modification réglementaire constitue la véritable conclusion à haute valeur ajoutée décisionnelle.
9.3 Reporting académique selon les normes scientifiques
La communication des résultats d’un test de Chow au sein d’une publication scientifique évaluée par des pairs exige le respect de normes de présentation standardisées, inspirées notamment des recommandations de l’American Psychological Association (APA) et de l’Econometric Society. Le reporting textuel ne doit jamais se limiter à mentionner une rupture sans étayer l’affirmation par le triptyque statistique complet : la métrique du test, les deux degrés de liberté associés et la p-valeur précise.
Le formatage rédactionnel canonique s’articule généralement ainsi : « L’évaluation de la stabilité structurelle du modèle a été réalisée au moyen du test de Chow à la date charnière de l’observation 100. Les résultats attestent d’une rupture hautement significative dans le vecteur des paramètres : F(2, 196) = 142,58, p < 0,001. » Cette formulation condense l’ensemble des éléments permettant au lecteur scientifique de situer instantanément l’échelle d’inférence employée.
Sur le plan tabulaire, il est fortement recommandé de présenter un tableau comparatif articulé en trois colonnes de coefficients : la première consacrée au modèle restreint global, la seconde au premier régime temporel, et la troisième au second régime. Chaque colonne doit faire figurer les coefficients estimés, leurs erreurs-types entre parenthèses, le coefficient de détermination ajusté (R² ajusté) ainsi que le nombre d’observations respectif. En bas de tableau, une section dédiée consigne la statistique de Chow, ses degrés de liberté et la probabilité critique associée, validant formellement l’utilité méthodologique de la partition tabulaire.
10. Diagnostic post-estimation et robustesse des modèles fractionnés
10.1 Validation des résidus au sein de chaque régime
Le rejet de l’hypothèse de stabilité structurelle et la décision consécutive d’adopter des modèles fractionnés imposent un retour rigoureux sur les résidus d’estimation de chacun des sous-modèles. Il est impératif de s’assurer que la scission de l’échantillon a effectivement restauré les propriétés d’optimalité stochastique attendues et qu’elle n’a pas masqué d’autres pathologies de spécification au sein des régimes individuels.
Pour chaque modèle partitionné (modele_1 et modele_2), le chercheur doit générer les quatre graphiques diagnostiques standards de la fonction plot(modele). L’examen du graphique des résidus en fonction des valeurs ajustées (Residuals vs Fitted) permet de vérifier l’absence de non-linéarité résiduelle locale. Le diagramme quantile-quantile normal (Normal Q-Q) confirme si la normalité des perturbations est préservée sur chaque sous-période, condition nécessaire à l’exactitude des futurs tests de Student individuels menés au sein de chaque régime.
Une attention méticuleuse doit être accordée à la détection des points d’influence disproportionnée via le calcul de la distance de Cook et l’analyse des points leviers (leverage). Il arrive fréquemment qu’une rupture structurelle apparente détectée par le test de Chow soit en réalité provoquée de manière factice par la présence d’une ou deux valeurs aberrantes extrêmes situées immédiatement après le point de scission. Si la suppression contrôlée de ces points atypiques résorbe la significativité du test de Chow, le modélisateur doit conclure à un problème de données aberrantes locales plutôt qu’à un authentique basculement de régime structurel.
10.2 Évaluation comparative des critères d’information
La segmentation d’un échantillon entraîne mécaniquement une augmentation du nombre total de paramètres estimés : au lieu d’un unique vecteur de k coefficients, le modélisateur en estime désormais 2k. Cette flexibilité paramétrique accrue engendre inévitablement une hausse artificielle du coefficient de détermination global (R²). Il est donc méthodologiquement fallacieux de justifier la partition temporelle sur la seule base de l’amélioration du R² ordinaire.
Pour arbitrer objectivement entre le gain d’ajustement empirique et le coût associé à la complexification paramétrique du modèle, le recours aux critères d’information d’Akaike (AIC) et bayésien de Schwarz (BIC) s’avère indispensable. Dans l’environnement R, le calcul de l’AIC du modèle restreint s’obtient par AIC(modele_restreint). Pour le modèle non restreint global, son AIC équivaut à la somme des log-vraisemblances des deux modèles scindés, ou plus simplement à l’AIC du modèle complet à interactions croisées programmé à la section 8.4 : AIC(modele_interaction).
La règle de décision favorise le modèle affichant la valeur du critère d’information la plus faible. Une diminution substantielle de l’AIC (communément admise comme supérieure à 10 unités) confirme que la réduction de la somme des carrés résiduels compense très largement la pénalité de parcimonie imposée par l’adjonction de k paramètres supplémentaires. Le critère BIC, plus sévère envers la surparamétrisation dans les grands échantillons, apporte une confirmation particulièrement robuste de l’utilité empirique de la segmentation.
10.3 Correction pour hétéroscédasticité en présence de variances inégales
Comme démontré dans les fondements théoriques (section 3.2), la présence d’hétéroscédasticité entre les deux sous-périodes invalide la distribution de Fisher du test de Chow standard. Si le test préliminaire de Goldfeld-Quandt ou de Breusch-Pagan révèle une divergence significative des variances résiduelles entre le régime 1 et le régime 2, le statisticien doit impérativement abandonner la statistique de Chow classique au profit d’une procédure robuste.
Sous R, la correction s’opère de manière remarquable en associant le package car et le package sandwich. En utilisant le modèle unifié à variables muettes et interactions (modele_interaction), on applique la fonction linearHypothesis en intégrant une matrice de variance-covariance robuste aux hétéroscédasticités hétérogènes de type White (HC3 ou HC1). La syntaxe s’articule ainsi :
linearHypothesis(modele_interaction, c(« D = 0 », « x:D = 0 »), vcov = vcovHC(modele_interaction, type = « HC3 »))
Cette approche substitue à la statistique F de Fisher ordinaire une statistique de Wald robuste corrigée de l’inégalité des variances inter-régimes. La distribution d’échantillonnage de cette forme quadratique robuste converge asymptotiquement vers une loi du Chi-carré à k degrés de liberté (ou une loi F corrigée selon les options logicielles). Si la significativité statistique persiste sous cette spécification robuste, le chercheur acquiert la certitude mathématique que le rejet de l’invariance paramétrique n’est pas un artefact provoqué par une modification de la variance résiduelle, mais traduit une véritable mutation des coefficients structurels bêta.
11. Applications avancées : points de rupture inconnus et tests alternatifs
11.1 Limites du test de Chow classique face aux dates inconnues
En dépit de sa prééminence historique, le test de Chow classique souffre d’une limitation épistémologique majeure : il exige que la date de la rupture soit connue a priori de manière exacte et déterministe, indépendamment des données analysées. Cette hypothèse est recevable lorsqu’un événement exogène historique précis peut être convoqué pour justifier la coupure (comme la date d’entrée en vigueur d’un traité international ou l’instauration d’un confinement sanitaire mondial). En revanche, elle s’avère totalement inopérante lorsque la rupture découle d’une dynamique économique endogène dont le calendrier exact est incertain ou diffus.
Face à une date inconnue, la tentation intuitive de calculer des tests de Chow successifs sur chaque observation de la série temporelle et de sélectionner la date qui maximise la statistique F empirique constitue une erreur méthodologique gravissime, constitutive de dragage de données (data snooping ou p-hacking). Cette sélection du maximum biaise profondément la distribution statistique : la valeur maximale d’une suite de statistiques de Fisher ne suit absolument plus une loi de Fisher standard. Utiliser les valeurs critiques usuelles dans ce contexte conduit à un effondrement du contrôle de l’erreur de type I, générant un taux de faux positifs pouvant excéder 60 % pour un seuil nominal de 5 %.
Par ailleurs, le test de Chow standard est totalement aveugle face aux mutations structurelles progressives ou douces. Il modélise exclusivement un basculement discontinu et instantané d’un vecteur de coefficients à un autre. Lorsqu’un système évolue par transition graduelle selon un modèle à transition lisse (Smooth Transition Autoregressive ou STAR), le test de Chow manque cruellement de puissance par rapport à des tests de non-linéarité dédiés.
11.2 Procédure de Quandt et test Sup-F de Andrews
Pour surmonter l’impasse méthodologique des dates de rupture non documentées a priori, l’économètre Richard Quandt a proposé dès 1960 le test du ratio de vraisemblance séquentiel, formalisé et validé sur le plan asymptotique par Donald Andrews en 1993 sous l’appellation de test Sup-F (ou test QLR pour Quandt Likelihood Ratio). Le principe consiste à calculer la statistique F de Chow pour l’ensemble des points de scission candidats situés au sein d’un intervalle central de l’échantillon, traditionnellement élagué de ses extrémités temporelles à hauteur de 15 % (paramètre de trimming usuel epsilon = 0,15).
La statistique du test d’Andrews correspond au supremum (la valeur maximale absolue) de l’ensemble des statistiques F obtenues sur cette fenêtre mobile : Sup-F = max F(tau). La distribution de cette statistique sous l’hypothèse nulle n’est pas une loi de Fisher, mais le supremum d’un pont brownien multidimensionnel (tied-down Bessel process), dont Andrews a tabulé les valeurs critiques asymptotiques par simulation numérique.
Sous R, cette procédure de pointe est directement accessible au sein du package strucchange au moyen de la fonction Fstats. En exécutant f_stats <- Fstats(y ~ x, from = 0.15, to = 0.85, data = df_simule), l’algorithme évalue l’ensemble des points de bascule potentiels. L’application de la fonction sctest sur cet objet f_stats applique automatiquement la distribution asymptotique d’Andrews pour calculer la p-valeur exacte, tandis que l’instruction breakpoints(f_stats) identifie mathématiquement la date exacte correspondant au sommet de la trajectoire F, localisant de façon entièrement endogène le point de rupture structurelle le plus vraisemblable de l’échantillon.
11.3 Processus CUSUM et détection de ruptures multiples
Une autre alternative puissante pour auditer la constance des paramètres le long du temps repose sur l’analyse des processus empiriques de fluctuation, dont les tests CUSUM (Cumulative Sum of Residuals) et MOSUM (Moving Sum of Residuals) constituent les représentants les plus célèbres, formalisés par Brown, Durbin et Evans en 1975. Plutôt que de segmenter explicitement le modèle, la démarche CUSUM analyse les déviations cumulées des résidus récursifs d’ajustement. Si les paramètres demeurent stables, la somme cumulée des erreurs oscille au voisinage de zéro à l’intérieur d’un couloir de confiance délimité par des frontières probabilistes divergentes.
La fonction efp (Empirical Fluctuation Process) du package strucchange permet d’estimer et de cartographier instantanément ces trajectoires stochastiques sous R. La déclaration efp_modele <- efp(y ~ x, type = « Rec-CUSUM », data = df_simule) instancie le calcul des résidus récursifs. La commande graphique associée plot(efp_modele) projette la trajectoire empirique superposée aux frontières de rejet critiques à 5 %. Tout franchissement des bornes par la courbe signale une instabilité paramétrique irréfutable, fournissant en outre un diagnostic temporel continu sur la zone d’amorce de la dérive.
Enfin, lorsque la série temporelle est suffisamment longue pour abriter non pas un seul choc, mais une pluralité de régimes successifs (par exemple lors de cycles économiques récurrents), l’économétrie moderne mobilise l’algorithme généralisé de Bai et Perron (1998, 2003). Cet algorithme sophistiqué résout le problème de la détermination conjointe et simultanée d’un nombre inconnu m de ruptures structurelles à dates inconnues en minimisant la somme globale des carrés des résidus par programmation dynamique. L’implémentation sous R s’exécute via la fonction breakpoints(y ~ x, data = df_simule, breaks = 5). Le recours au critère d’information BIC pénalisé extrait automatiquement le nombre optimal de régimes et date rigoureusement chaque segment temporel, hissant l’analyse structurelle bien au-delà des capacités du test de Chow binaire originel.
12. Erreurs courantes, limites méthodologiques et bonnes pratiques sous R
12.1 Pièges fréquents lors du codage et de l’exécution
La mise en œuvre informatique du test de Chow sous R expose les praticiens à plusieurs erreurs récurrentes d’encodage qu’il convient de répertorier méthodiquement. Le piège le plus fréquent réside dans la confusion entre l’indice de position d’une observation et la valeur textuelle ou numérique de la variable d’indexation temporelle. Lors de l’utilisation de l’argument point dans la fonction sctest, strucchange attend par défaut un entier représentant le rang d’ordre de la ligne dans le tableau de données (ou une proportion décimale), et non l’année civile calendaire. Transmettre une valeur calendaire brute (par exemple point = 2008 dans un jeu de données de 50 observations annuelles) déclenchera irrémédiablement une erreur d’indice hors limites (subscript out of bounds).
Une seconde maladresse courante concerne la manipulation des facteurs qualitatifs à multiples niveaux au sein des modèles scindés. Si un régresseur catégoriel présent dans l’échantillon global possède une modalité qui n’apparaît que très rarement (par exemple une modalité observée uniquement 2 fois sur 200 individus), il est hautement probable que cette modalité soit totalement absente de l’un des deux sous-échantillons après la partition. Lors de l’ajustement séparé via lm, R supprimera automatiquement cette colonne dans le sous-modèle concerné pour éviter une singularité. Cette asymétrie dimensionnelle modifie silencieusement les degrés de liberté et invalide le calcul manuel de la statistique F en faussant le décompte des paramètres non restreints.
Enfin, l’omission des vérifications d’intégrité préliminaires constitue une négligence analytique majeure. Lancer aveuglément un test de Chow sur un modèle sans s’être préalablement assuré de l’absence d’autocorrélation des résidus ou de multicolinéarité sévère conduit bien souvent à interpréter comme un changement de structure ce qui ne relève que d’une mauvaise spécification dynamique ou d’une forte instabilité d’inversion matricielle. Le diagnostic exploratoire n’est pas une option accessoire : il conditionne la véracité scientifique de l’ensemble de la démarche.
12.2 Limites théoriques intrinsèques au test de Chow
Sur le plan de l’épistémologie statistique, le test de Chow classique présente plusieurs limitations structurelles que le modélisateur doit toujours garder à l’esprit. En premier lieu, le postulat d’une transition abrupte et instantanée entre les régimes constitue une simplification souvent irréaliste des dynamiques réelles. Dans le monde économique et social, les agents ajustent rarement leurs anticipations et leurs comportements de façon synchrone et immédiate lors d’un choc réglementaire. Les changements s’opèrent fréquemment par diffusion progressive au fil de périodes de transition étendues, configuration pour laquelle la modélisation à régimes étanches du test de Chow constitue une approximation imparfaite.
En second lieu, le test est extrêmement sensible à l’omission de variables explicatives non linéaires. Si la véritable relation génératrice entre la variable dépendante et la covariable est une courbe quadratique ou logarithmique douce, mais que le chercheur impose une spécification linéaire univariée standard, le nuage de points s’écartera systématiquement de la droite globale. Le test de Chow partitionné conclura alors à une rupture structurelle hautement significative des pentes entre le début et la fin de l’échantillon, alors même que le processus générateur de données est demeuré parfaitement immuable, l’invariance n’étant rompue que par la mauvaise formulation fonctionnelle de la régression.
Enfin, la vulnérabilité du test face à l’hétéroscédasticité inter-régimes demeure son talon d’Achille théorique le plus critique. Comme explicité précédemment, une simple altération de la volatilité des chocs résiduels au fil du temps suffit à détruire l’exactitude de la loi de Fisher, entraînant une propension systématique au sur-rejet de l’hypothèse nulle d’invariance. Tout modélisateur rigoureux doit aborder les conclusions d’un test de Chow conventionnel avec une extrême circonspection tant que l’homoscédasticité des perturbations n’a pas été formellement corroborée.
12.3 Guide récapitulatif des bonnes pratiques méthodologiques
Afin de garantir un protocole d’analyse irréprochable lors de l’étude de la stabilité structurelle sous R, l’application d’un flux de travail (workflow) méthodique standardisé est vivement recommandée. Ce protocole systématique s’articule en six étapes séquentielles obligatoires :
- Étape 1 : Exploration graphique exhaustive. Construire systématiquement un nuage de points haute résolution avec ggplot2, enrichi de gradients temporels et d’une droite de régression globale restreinte, complété par l’analyse séquentielle des résidus pour repérer visuellement les inflexions ou dérives potentielles.
- Étape 2 : Audit diagnostique des conditions d’application. Évaluer formellement la normalité résiduelle (Shapiro-Wilk ou Jarque-Bera), l’absence d’autocorrélation sérielle (Durbin-Watson ou Breusch-Godfrey) et vérifier l’homoscédasticité inter-groupes (Goldfeld-Quandt) sur les partitions envisagées.
- Étape 3 : Exécution du test formel adapté. Si la date de bascule est exogène et connue a priori et que les résidus sont homoscédastiques, appliquer sctest avec le type « Chow » du package strucchange. Si une hétéroscédasticité est constatée, employer impérativement la formulation linéaire robuste via linearHypothesis et la matrice vcovHC du package car.
- Étape 4 : Détection endogène en cas d’incertitude temporelle. Si la date exacte fait débat, refuser catégoriquement le calcul empirique de tests de Chow multiples naïfs. Recourir au test Sup-F d’Andrews via la fonction Fstats et identifier le candidat optimal par la méthode breakpoints.
- Étape 5 : Validation post-estimation et arbitrage de parcimonie. Si la rupture est avérée, vérifier les résidus locaux de chaque modèle partiel (absence de points leviers ou d’observations aberrantes singulières) et certifier la pertinence de la partition au moyen des critères de pénalisation AIC et BIC.
- Étape 6 : Reproductibilité et traçabilité du script R. Rédiger un script entièrement reproductible, incluant set.seed au début de l’exécution, commentant la justification méthodologique de chaque seuil d’inférence, et formatant les sorties conformément aux standards académiques internationaux.
En observant scrupuleusement cette feuille de route économétrique, le praticien s’assure d’exploiter la puissance analytique du langage R dans le respect absolu des règles de validité inférentielle, transformant une simple commande informatique en une véritable démarche d’investigation scientifique rigoureuse.
Références
- Andrews, D. W. K. (1993). Tests for parameter instability and structural change with unknown change point. Econometrica, 61(4), 821–856. https://doi.org/10.2307/2951764
- Bai, J., & Perron, P. (1998). Estimating and testing linear models with multiple structural changes. Econometrica, 66(1), 47–78. https://doi.org/10.2307/2998540
- Bai, J., & Perron, P. (2003). Computation and analysis of multiple structural change models. Journal of Applied Econometrics, 18(1), 1–22. https://doi.org/10.1002/jae.659
- Brown, R. L., Durbin, J., & Evans, J. M. (1975). Techniques for testing the constancy of regression relationships over time. Journal of the Royal Statistical Society: Series B (Methodological), 37(2), 149–163. https://doi.org/10.1111/j.2517-6161.1975.tb01532.x
- Chow, G. C. (1960). Tests of equality between sets of coefficients in two linear regressions. Econometrica, 28(3), 591–605. https://doi.org/10.2307/1910133
- Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Quandt, R. E. (1960). Tests of the hypothesis that a linear regression system obeys two separate regimes. Journal of the American Statistical Association, 55(290), 324–330. https://doi.org/10.1080/01621459.1960.10482067
- Schmidt, P., & Sickles, R. (1977). Some further evidence on the use of the Chow test under heteroskedasticity. Econometrica, 45(5), 1293–1298. https://doi.org/10.2307/1914073
- Toyoda, T. (1974). Use of the Chow test under heteroscedasticity. Econometrica, 42(3), 601–608. https://doi.org/10.2307/1911798
- Zeileis, A., Leisch, F., Hornik, K., & Kleiber, C. (2002). strucchange: An R package for testing for structural change in linear regression models. Journal of Statistical Software, 7(2), 1–38. https://doi.org/10.18637/jss.v007.i02