
Dans le domaine de l’économétrie, de la biométrie et de la modélisation statistique avancée, la régression linéaire classique repose sur des postulats distributionnels d’une rigueur absolue. L’hypothèse selon laquelle les perturbations aléatoires d’un système suivent une loi normale homoscédastique constitue le pivot théorique permettant d’établir des inférences valides, d’estimer des erreurs-types non biaisées et de déduire des intervalles de confiance rigoureux. Néanmoins, l’observation empirique révèle fréquemment une asymétrie marquée, une variance résiduelle dépendante de la moyenne locale et des non-linéarités sous-jacentes qui menacent la validité même des modèles par les moindres carrés ordinaires.
Face à cette divergence persistante entre les contraintes axiomatiques du modèle linéaire général et la réalité empirique des distributions réelles, les praticiens se trouvent confrontés à un dilemme méthodologique : abandonner le cadre linéaire au profit de structures paramétriques plus complexes ou appliquer une transformation mathématique à l’échelle de mesure originale. C’est précisément à cette croisée des chemins que s’illustre la transformation proposée par George Box et David Cox en 1964, laquelle offre une solution élégante et unifiée pour stabiliser la variance et restaurer la symétrie gaussienne des résidus au moyen d’un paramètre continu unique.
Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les justifications mathématiques et l’implémentation opérationnelle de la transformation de Box-Cox dans l’environnement de programmation statistique R. De la dérivation analytique de la vraisemblance profilée jusqu’à l’ajustement fin des prédictions corrigées pour le biais de l’inégalité de Jensen, cet article fournit aux chercheurs et analystes de données les concepts et le code nécessaires pour transformer des jeux de données complexes en modèles statistiques rigoureux et reproductibles.
1. Fondements théoriques et épistémologiques de la transformation de Box-Cox
1.1 Origine historique et publication fondatrice de George Box et David Cox (1964)
Au milieu du vingtième siècle, les statisticiens appliqués ont constaté les limites des transformations fonctionnelles ad hoc. Les praticiens utilisaient traditionnellement la racine carrée pour stabiliser les données de comptage poissonniennes, le logarithme népérien pour atténuer les asymétries positives sévères issues de distributions log-normales, ou encore l’inverse pour les temps de parcours. Bien qu’efficaces au cas par cas, ces choix reposaient sur des heuristiques empiriques plutôt que sur une méthodologie statistique intégrée. L’absence d’un cadre mathématique général empêchait l’évaluation probabiliste de la pertinence d’une transformation par rapport à une autre au sein d’une même analyse.
Cette lacune méthodologique a été comblée lors de la lecture, devant la Royal Statistical Society, du travail séminal de George E. P. Box et David R. Cox (1964) intitulé « An Analysis of Transformations ». Les deux auteurs ont proposé d’unifier l’échelle des transformations de puissances introduite par John Tukey au sein d’une seule famille paramétrique continue indexée par un paramètre réel noté lambda (λ). L’apport épistémologique fondamental de Box et Cox réside dans le fait de ne plus considérer la transformation comme une manipulation préalable et arbitraire des données, mais comme un paramètre inconnu du modèle, estimé directement à partir des observations par la méthode du maximum de vraisemblance.
L’impact de cette publication sur la modélisation statistique moderne s’est révélé déterminant. En intégrant formellement le paramètre de transformation au sein de la fonction de vraisemblance, Box et Cox ont permis d’appliquer des tests d’hypothèses formels, notamment le test du rapport de vraisemblance et le test de Wald, pour déterminer si une transformation simple (telle que l’absence de transformation pour λ = 1 ou le passage au logarithme pour λ = 0) était théoriquement justifiée. Cette approche a transformé l’analyse de variance (ANOVA) et la régression linéaire multiple en offrant une méthodologie unifiée pour satisfaire les conditions requises du théorème de Gauss-Markov.
1.2 Pertinence de la transformation en sciences quantitatives et psychométrie
Dans les sciences comportementales, la psychométrie, les neurosciences quantitatives et l’économie comportementale, les variables mesurées présentent rarement une morphologie distributionnelle symétrique. Les chronométries cognitives, à l’image des temps de réaction motrice ou de discrimination sensorielle, affichent de manière quasi systématique une asymétrie positive prononcée. Cette queue de distribution allongée vers la droite est inhérente aux processus cognitifs sous-jacents, où une limite physiologique infranchissable impose un plancher strict, tandis que des fluctuations attentionnelles créent de longs délais de réponse.
La présence d’effets de plancher ou d’effets de plafond altère sévèrement la validité de construit des instruments d’évaluation. Lorsqu’une échelle psychométrique comprime la variance à l’une de ses extrémités en raison d’une sensibilité insuffisante de l’instrument, les relations linéaires postulées entre variables latentes et indicateurs manifestes deviennent non linéaires. La transformation de Box-Cox intervient ici comme un outil de recalibrage de l’espace métrique. En étirant les zones comprimées de la distribution et en resserrant les valeurs dispersées, elle rétablit l’orthogonalité et la linéarité requises pour estimer des modèles structurels fiables.
Il importe toutefois de distinguer la transformation statistique empirique de la redéfinition théorique d’une unité de mesure. Transformer une variable dépendante par une puissance non entière modifie la nature dimensionnelle de l’attribut mesuré. Si cette procédure permet de respecter les hypothèses sous-tendant le calcul des valeurs p et des erreurs-types, elle exige une grande vigilance lors de l’interprétation théorique des coefficients régressifs. La transformation empirique ne doit pas masquer un défaut d’opérationnalisation du construit psychologique, mais servir d’instrument pour modéliser le signal au sein des données.
1.3 Objectifs primordiaux : normalité, linéarité et homoscédasticité
L’application de la transformation de Box-Cox poursuit trois objectifs statistiques interdépendants : la normalisation de la distribution des erreurs, la linéarisation de l’espérance conditionnelle et la stabilisation de la variance résiduelle (homoscédasticité). Bien que ces objectifs soient conceptuellement distincts, l’application d’un paramètre λ approprié permet souvent de les atteindre simultanément, car la non-normalité et l’hétéroscédasticité découlent souvent d’une mauvaise spécification de l’échelle fonctionnelle liant les prédicteurs à la variable réponse.
La restauration de la symétrie distributionnelle constitue l’effet le plus immédiatement perceptible. En réduisant l’asymétrie (skewness) et en ajustant l’aplatissement (kurtosis), la transformation permet aux résidus empiriques de se conformer à la loi normale standard. Cette normalisation conditionnelle est indispensable pour assurer l’exactitude des tests de significativité de Student et de Fisher-Snedecor, dont les propriétés asymptotiques ne protègent pas toujours les analyses menées sur des échantillons de taille modeste.
Parallèlement, la transformation supprime la corrélation souvent observée entre l’espérance mathématique locale et l’écart-type résiduel. Dans de nombreux processus physiques et biologiques, la variabilité des mesures tend à croître proportionnellement à leur magnitude moyenne, un phénomène qui engendre un cône de dispersion caractéristique dans l’espace des résidus. En stabilisant cette variance à un niveau constant sur l’ensemble du domaine de prédiction, Box-Cox élimine l’hétéroscédasticité systématique. Cette stabilisation confère une efficacité statistique maximale aux estimateurs des moindres carrés et optimise la puissance statistique lors des tests d’hypothèses ultérieurs.
2. Les postulats statistiques de la régression linéaire et la violation de normalité
2.1 Le théorème de Gauss-Markov et les hypothèses classiques des résidus
L’architecture inférentielle du modèle de régression linéaire standard repose sur les hypothèses classiques du théorème de Gauss-Markov. Ce théorème démontre que, sous certaines conditions strictes, l’estimateur des moindres carrés ordinaires (MCO) est le meilleur estimateur linéaire non biaisé, souvent désigné sous l’acronyme BLUE (Best Linear Unbiased Estimator). Ces conditions impliquent que l’espérance conditionnelle des erreurs sachant les variables explicatives soit rigoureusement nulle, que la matrice de variance-covariance des résidus soit scalaire (homoscédasticité et absence d’autocorrélation), et que les régresseurs soient exogènes.
Il est capital de souligner que le théorème de Gauss-Markov ne requiert aucunement la normalité des perturbations stochastiques pour garantir que les estimateurs possèdent la variance minimale parmi tous les estimateurs linéaires non biaisés. L’hypothèse de normalité gaussienne des résidus devient en revanche indispensable dès lors que l’on souhaite réaliser des inférences statistiques valides à taille d’échantillon finie. C’est cette distribution normale qui autorise la dérivation formelle de la loi de Student pour les coefficients individuels et de la loi de Fisher pour les tests de significativité globale du modèle.
Une confusion méthodologique fréquente consiste à exiger la normalité de la variable dépendante brute avant tout ajustement. Or, la théorie statistique postule uniquement la normalité conditionnelle des erreurs, c’est-à-dire des résidus non observables de la population. Une variable marginale présentant une distribution multimodale ou hautement asymétrique peut générer des résidus parfaitement gaussiens une fois conditionnée par un ensemble adéquat de covariables explicatives. C’est donc exclusivement au niveau des résidus que le diagnostic d’invalidation du modèle doit être formulé.
2.2 Conséquences de l’asymétrie et de l’hétéroscédasticité sur l’inférence
La violation conjointe de l’homoscédasticité et de la normalité des erreurs entraîne des répercussions dommageables sur la fiabilité des conclusions scientifiques. En présence d’hétéroscédasticité, la matrice de variance-covariance estimée par les formules standards des MCO devient asymptotiquement incohérente. L’erreur standard des estimateurs est biaisée, ce qui déforme les statistiques de test t et F. Il en résulte une altération incontrôlée du taux d’erreur de première espèce (α), conduisant le chercheur à rejeter fréquemment l’hypothèse nulle à tort.
Lorsque l’asymétrie résiduelle est marquée, la convergence asymptotique garantie par le théorème central limite peut exiger des échantillons d’une taille considérable, difficilement atteignable dans les protocoles expérimentaux standards. Dans ces conditions, les valeurs p calculées sous l’hypothèse de normalité perdent leur sens nominal, affaiblissant la reproductibilité des résultats. La validité des intervalles de prédiction est particulièrement compromise : supposer une distribution normale symétrique autour de la droite de régression alors que la vraie distribution est étirée conduit à sous-estimer systématiquement le risque d’observer des valeurs extrêmes dans une direction spécifique.
En outre, l’asymétrie des perturbations accroît la sensibilité du modèle d’ajustement linéaire aux observations atypiques. Dans une distribution fortement déformée, les points situés à l’extrémité de la queue de distribution exercent un effet de levier disproportionné sur l’estimation de la pente régressif. Un point isolé peut à lui seul faire pivoter le plan d’ajustement, masquant des relations réelles ou créant des associations purement fallacieuses entre les prédicteurs et la réponse.
2.3 Diagnostic exploratoire de l’asymétrie : méthodes graphiques et formelles
Le diagnostic des déviations par rapport aux conditions idéales de Gauss-Markov repose sur une confrontation rigoureuse entre méthodes d’inspection graphique et tests statistiques d’hypothèses. L’outil graphique fondamental demeure le diagramme quantile-quantile (Q-Q plot), qui met en relation les quantiles empiriques des résidus standardisés et les quantiles théoriques issus d’une distribution normale standard. Tout écart systématique par rapport à la bissectrice témoigne d’une anomalie : une courbure en forme de « U » signale une asymétrie directionnelle, tandis qu’une morphologie en « S » dénonce des queues de distribution trop lourdes (leptokurticité) ou trop légères (platykurticité).
Ces représentations visuelles sont complétées par le calcul de descripteurs morphologiques univariés, au premier rang desquels figurent le coefficient d’asymétrie de Fisher-Pearson (skewness) et le coefficient d’aplatissement (kurtosis). Pour une distribution théorique gaussienne, le coefficient d’asymétrie est nul et l’excès de kurtosis équivaut à zéro. Des valeurs s’écartant de cet intervalle de référence attestent d’une distorsion de la densité probabiliste qui compromet l’utilisation des modèles linéaires sans traitement correctif préalable.
Enfin, les chercheurs recourent couramment à des procédures formelles telles que le test de normalité de Shapiro-Wilk, le test d’Anderson-Darling ou le test de Jarque-Bera fondé sur les moments statistiques d’ordre trois et quatre. Bien que ces tests fournissent une décision binaire claire via leur p-valeur, ils doivent être interprétés avec discernement. Sur de très grands échantillons, leur puissance statistique devient si élevée que des déviations infimes et sans conséquence pratique sur l’inférence conduisent à un rejet catégorique de l’hypothèse nulle. À l’inverse, sur de petits effectifs, leur puissance limitée échoue souvent à détecter des asymétries problématiques. L’analyse visuelle des tracés de résidus demeure donc l’arbitre déterminant pour guider le choix d’une transformation.
3. Formulation mathématique rigoureuse de la famille de transformations de Box-Cox
3.1 Équation standard et rôle du paramètre de puissance lambda
La famille paramétrique des transformations de puissances définie par George Box et David Cox modifie la variable dépendante strictement positive au moyen d’un paramètre continu noté λ. L’expression mathématique formelle de cette transformation, notée traditionnellement sous la forme fonctionnelle y(λ), s’énonce selon le système d’équations suivant :
Pour toute valeur du paramètre scalaire λ distincte de zéro :
y(λ) = (yλ – 1) / λ
Pour la valeur singulière où le paramètre λ s’annule :
y(0) = ln(y)
La présence du numérateur (yλ – 1) et du diviseur de normalisation λ garantit la continuité mathématique parfaite de la transformation au point limite λ → 0. Cette continuité analytique se démontre par l’application rigoureuse de la règle de L’Hôpital. Considérons la limite de l’expression lorsque λ tend vers zéro : le numérateur yλ – 1 tend vers 1 – 1 = 0, et le dénominateur tend vers 0, configurant une indétermination formelle de type 0/0. En dérivant le numérateur et le dénominateur par rapport à la variable paramétrique λ, nous obtenons :
d/dλ (yλ – 1) = d/dλ (exp(λ · ln(y)) – 1) = ln(y) · exp(λ · ln(y)) = ln(y) · yλ
d/dλ (λ) = 1
En calculant la limite du quotient des dérivées lorsque λ converge vers zéro :
limλ → 0 [ (ln(y) · yλ) / 1 ] = ln(y) · y0 = ln(y)
Cette démonstration établit que la transformation logarithmique népérienne s’inscrit sans discontinuité au sein de la famille des transformations de Box-Cox. Il est par ailleurs impératif de noter la condition de domaine de définition : la transformation standard exige la positivité stricte de toutes les observations du vecteur de réponse (yi > 0), car l’évaluation d’un logarithme ou l’élévation à des puissances réelles non entières d’un nombre négatif ou nul est indéfinie dans le corps des nombres réels.
3.2 Typologie des valeurs particulières de lambda et leurs équivalences
L’intérêt conceptuel majeur de la famille de Box-Cox réside dans sa capacité à subsumer sous un formalisme unifié les transformations de données les plus couramment employées en statistique exploratoire et inférentielle. Chaque valeur spécifique de λ correspond à une modification structurelle bien définie de l’espace métrique :
- λ = 1 : Transformation d’identité affine. Lorsque λ = 1, la formule donne y(1) = y – 1. À l’exception d’une simple translation arithmétique d’une unité vers le bas, qui n’altère en rien la variance, la forme de la distribution, ni l’espérance relative des résidus, les données conservent leur échelle brute. L’estimation d’un λ proche de l’unité indique que les données d’origine ne requièrent aucune transformation non linéaire.
- λ = 0.5 : Transformation par racine carrée. L’expression y(0.5) = 2(√y – 1) équivaut statistiquement à stabiliser la variance des processus où l’écart-type résiduel évolue proportionnellement à la racine carrée de l’espérance, un comportement caractéristique des données de comptage gouvernées par une loi de Poisson ou des processus d’arrivée stochastiques.
- λ = 0 : Transformation logarithmique naturelle. Comme démontré précédemment, cette valeur instancie le logarithme népérien. Elle s’impose pour modéliser les distributions dotées d’une asymétrie positive prononcée, fréquemment rencontrées pour les variables de revenu, de concentration biochimique ou de latence chronométrique, tout en transformant les relations multiplicatives sous-jacentes en modèles additifs.
- λ = -0.5 : Transformation par l’inverse de la racine carrée. Correspondant à y(-0.5) = -2(1/√y – 1), cette transformation est fréquemment préconisée pour corriger des instabilités de variance particulièrement agressives.
- λ = -1 : Transformation inverse pure. Définie par y(-1) = 1 – 1/y, cette transformation s’applique aux variables de taux, de cadences ou d’efficience temporelle. Elle réoriente la métrique en mesurant la vitesse d’exécution plutôt que la durée de complétion d’une tâche donnée.
3.3 Estimation par le maximum de vraisemblance et profil de log-vraisemblance
L’identification de la valeur optimale du paramètre de puissance λ s’effectue traditionnellement par la méthode du maximum de vraisemblance. Supposons que, pour une valeur donnée de λ, les observations transformées yi(λ) suivent indépendamment une loi normale d’espérance μi = Xiβ et de variance σ2 constante. Pour formuler rigoureusement la fonction de densité probabiliste conjointe des données observées y (et non de la variable intermédiaire transformée), il est obligatoire d’introduire le Jacobien de la transformation mathématique.
Le déterminant de la matrice jacobienne de la transformation vectorielle de y vers y(λ), s’agissant d’une transformation composante par composante, équivaut au produit des dérivées univariées partielles :
J = ∏i=1n | dyi(λ) / dyi | = ∏i=1n yiλ – 1
L’intégration de ce Jacobien est indispensable. Sans lui, la fonction de vraisemblance privilégierait systématiquement les valeurs de λ réduisant artificiellement l’échelle absolue des valeurs numériques, produisant des variances résiduelles arbitrairement faibles mais statistiquement fausses. En incorporant ce terme correcteur d’échelle, la fonction de log-vraisemblance s’exprime sous la forme suivante :
ln L(β, σ2, λ) = – (n / 2) ln(2πσ2) – (1 / (2σ2)) ∑i=1n (yi(λ) – Xiβ)2 + (λ – 1) ∑i=1n ln(yi)
Pour chaque valeur candidate de λ, nous pouvons concentrer la log-vraisemblance en substituant β et σ2 par leurs estimateurs du maximum de vraisemblance conditionnels, à savoir les estimateurs des MCO standards appliqués à la variable transformée : β(λ) = (XTX)-1XTy(λ) et σ2(λ) = (1/n) SSres(λ), où SSres(λ) représente la somme des carrés des résidus du modèle ajusté sur y(λ). En réinjectant ces valeurs dans l’équation, on obtient la fonction de log-vraisemblance profilée, dépendant uniquement du paramètre scalaire λ :
Lprof(λ) = – (n / 2) ln(σ2(λ)) + (λ – 1) ∑i=1n ln(yi) + constante
L’estimation optimale du paramètre, notée λ̂, correspond au point maximisant cette courbe de vraisemblance profilée. De surcroît, le théorème du ratio de vraisemblance permet d’établir un intervalle de confiance asymptotique à un niveau de confiance (1 – α) de 95%. Cet intervalle regroupe l’ensemble des valeurs scalaires λ satisfaisant l’inégalité de déviance :
Lprof(λ) ≥ Lprof(λ̂) – (1 / 2) χ21, 1 – α
Pour un seuil standard α = 0.05, la valeur critique issue de la loi du chi-deux à un degré de liberté est χ21, 0.95 ≈ 3.841. Le seuil de coupure graphique sur le profil de log-vraisemblance se situe donc rigoureusement à 1.92 unité en dessous du sommet absolu de la courbe de vraisemblance.
4. Configuration de l’environnement de développement R et préparation des données
4.1 Installation et chargement des bibliothèques scientifiques requises
L’écosystème open-source R propose un ensemble complet de bibliothèques dédiées aux transformations de puissance et à l’évaluation diagnostique de la régression linéaire. Pour exécuter ces opérations sans difficulté technique, il convient de charger plusieurs paquets fondamentaux : le paquet standard MASS (développé par Venables et Ripley), la suite tidyverse (englobant dplyr pour la manipulation fonctionnelle de données et ggplot2 pour la visualisation géométrique) ainsi que la bibliothèque car (Companion to Applied Regression) développée par John Fox et Sanford Weisberg.
Lors de la configuration du script R, une attention méthodologique particulière doit être accordée aux conflits potentiels d’espaces de noms. Plus particulièrement, le paquet MASS contient une fonction intitulée select() qui entre en collision directe avec le verbe primordial select() du paquet dplyr. Pour prévenir tout dysfonctionnement silencieux du pipeline d’analyse, il est recommandé de charger les bibliothèques dans un ordre contrôlé, ou de faire appel aux fonctions sensibles via l’opérateur de résolution de portée explicite ::, en consignant les appels sous la forme MASS::boxcox() ou dplyr::select().
Voici le bloc d’initialisation de l’environnement, configuré selon les standards de la recherche reproductible :
# Initialisation de l'environnement et gestion des packages
required_packages <- c("MASS", "tidyverse", "car", "lmtest", "moments")

installed_packages <- rownames(installed.packages())
for (pkg in required_packages) {
  if (!(pkg %in% installed_packages)) {
    install.packages(pkg, dependencies = TRUE)
  }
}

# Chargement explicite des packages requis
library(MASS)
library(tidyverse)
library(car)
library(lmtest)
library(moments)

# Fixation d'une graine pseudo-aléatoire pour la reproductibilité exacte
set.seed(42)
4.2 Création et inspection d’un jeu de données expérimental asymétrique
Pour illustrer concrètement les défis posés par les distributions asymétriques et l’hétéroscédasticité, nous générons un jeu de données synthétique reproductible. Ce jeu de données simule une expérience de psychologie cognitive analysant la vitesse de traitement de l’information sous l’effet de la charge mentale et du vieillissement. La variable dépendante représente le temps de réaction mesuré en millisecondes, naturellement borné par un plancher physique strict et exhibant une longue traîne de latence.
Nous construisons un prédicteur continu x (par exemple, un indice d’interférence attentionnelle) et modélisons la variable dépendante y au moyen d’un processus multiplicatif produisant des perturbations log-normales, générant une asymétrie résiduelle positive marquée et une variance augmentant avec la moyenne :
# Conception de la simulation stochastique
n_echantillon <- 250
x_predicteur <- runif(n_echantillon, min = 10, max = 50)

# Generation d'une perturbation non gaussienne heteroscedastique
erreur_hetero <- rlnorm(n_echantillon, meanlog = 0, sdlog = 0.5)

# Formulation du processus generateur des donnees
y_reponse <- (5 + 0.8 * x_predicteur)^2.2 * (erreur_hetero * 0.4)

# Structuration en dataframe ordonne
donnees_experimentales <- data.frame(
  Charge_Attention = x_predicteur,
  Temps_Reaction = y_reponse
)

# Inspection des descripteurs univariés de base
summary(donnees_experimentales$Temps_Reaction)
sd(donnees_experimentales$Temps_Reaction)
IQR(donnees_experimentales$Temps_Reaction)
L’examen des statistiques descriptives révèle une disparité manifeste entre la médiane et l’espérance arithmétique de la variable Temps_Reaction, ainsi qu’un écart interquartile comprimé par rapport à l’étendue globale des valeurs. Cette dissociation statistique initiale constitue l’empreinte univariée classique d’une déformation asymétrique de l’échelle d’observation.
4.3 Gestion des prérequis d’entrée : filtrage et validation des échelles
Avant toute tentative d’ajustement du modèle de régression ou d’appel à l’algorithme d’estimation de Box-Cox, l’analyste doit impérativement s’assurer que les données respectent les hypothèses de base. Le prérequis fondamental et non négociable de la formulation classique de Box-Cox réside dans la positivité stricte de l’intégralité du vecteur de réponse y. La moindre présence d’une valeur nulle ou strictement négative interrompt brutalement l’évaluation des fonctions mathématiques logarithmiques et exponentielles fractionnaires, générant des valeurs indéterminées (NaN ou Inf).
Il est donc nécessaire d’implanter une validation par assertion programmatique stricte au sein du flux de script au moyen de la fonction stopifnot() :
# Verification formelle de la stricte positivite du vecteur reponse
stopifnot(
  "Le vecteur de reponse contient des valeurs negatives ou nulles interdites" =
  all(donnees_experimentales$Temps_Reaction > 0)
)
Outre cette validation formelle, l’analyste doit documenter l’unité physique ou conceptuelle de la mesure initiale. Consigner explicitement s’il s’agit de millisecondes, de scores cumulatifs ou de concentrations molaires est indispensable : l’altération non linéaire de l’échelle métrique modifie l’interprétabilité des pentes régressives futures. Il importe également de vérifier l’absence d’observations aberrantes causées par des erreurs instrumentales de saisie, dont l’effet de levier démesuré pourrait distordre artificiellement l’estimation du paramètre de puissance λ.
5. Modélisation linéaire préliminaire et diagnostic exhaustif des résidus sous R
5.1 Ajustement du modèle de régression standard via la fonction lm()
La première étape de l’investigation empirique consiste à ajuster un modèle linéaire ordinaire par les moindres carrés en ignorant délibérément, dans un premier temps, l’asymétrie observable de la distribution. Cette démarche fournit une modélisation de référence essentielle pour quantifier ultérieurement les gains statistiques apportés par la transformation de Box-Cox.
Nous formulons le modèle sous R au moyen de l’instruction lm() et examinons les sorties synthétiques :
# Ajustement du modele lineaire classique de reference
modele_initial <- lm(Temps_Reaction ~ Charge_Attention, data = donnees_experimentales)

# Extraction et affichage du tableau récapitulatif
resume_initial <- summary(modele_initial)
print(resume_initial)
Le résumé statistique peut afficher une statistique globale F hautement significative et un coefficient de détermination R2 faussement flatteur. Ces métriques globales masquent toutefois de sérieuses anomalies dans la structure des résidus. Lorsque l’échelle fonctionnelle est mal spécifiée, les estimateurs tentent de compenser la courbure sous-jacente en étirant artificiellement la pente, créant des résidus non aléatoires.
5.2 Diagnostics graphiques des résidus avec les tracés natifs de R
L’évaluation de la qualité d’ajustement du modèle linéaire impose d’inspecter visuellement les résidus à l’aide des graphiques natifs fournis par la méthode plot.lm() de R. En paramétrant une grille matricielle deux par deux, on visualise immédiatement les quatre diagnostics résiduels fondamentaux :
# Configuration de la fenetre d'affichage graphique
par(mfrow = c(2, 2), mar = c(4, 4, 2, 1))
plot(modele_initial)
par(mfrow = c(1, 1))
L’analyse détaillée de ces quatre panneaux révèle des violations majeures des postulats de la régression linéaire :
- Panneau « Residuals vs Fitted » (Résidus en fonction des valeurs ajustées) : La ligne de lissage non paramétrique rouge s’écarte de l’axe horizontal nul. On observe une morphologie en entonnoir prononcée : la dispersion verticale des résidus croît de manière disproportionnée au fur et à mesure que les valeurs prédites augmentent, signalant une hétéroscédasticité multiplicative marquée.
- Panneau « Normal Q-Q » (Diagramme Quantile-Quantile) : Les quantiles des résidus standardisés s’écartent fortement de la droite théorique en pointillé dans la moitié supérieure du graphique. Cette divergence vers le haut caractérise une distribution empirique à longue traîne droite, confirmant une asymétrie résiduelle positive non gaussienne.
- Panneau « Scale-Location » (Homoscédasticité standardisée) : La racine carrée des résidus standardisés absolus présente une pente ascendante marquée. Cela confirme formellement que l’amplitude moyenne de l’erreur croît avec le niveau prédit par le modèle.
- Panneau « Residuals vs Leverage » (Résidus et Leviers) : Plusieurs observations se détachent aux confins des seuils de la distance de Cook, exerçant une influence excessive sur l’orientation spatiale de la droite d’ajustement linéaire.
5.3 Quantification formelle des violations d’hypothèses
Les constats visuels doivent être étayés par des tests d’hypothèses formels. Nous procédons à l’évaluation de la normalité univariée des erreurs résiduelles par le test de Shapiro-Wilk, complétée par le calcul des coefficients de skewness et de kurtosis, ainsi qu’au test d’homoscédasticité de Breusch-Pagan via la bibliothèque lmtest :
# Extraction programmatique des residus bruts et standardises
residus_bruts <- residuals(modele_initial)
residus_std <- rstandard(modele_initial)

# Evaluation de la morphologie distributionnelle
valeur_skewness <- moments::skewness(residus_bruts)
valeur_kurtosis <- moments::kurtosis(residus_bruts)

# Test de normalite de Shapiro-Wilk
test_shapiro <- shapiro.test(residus_bruts)

# Test formel d'heteroscedasticite de Breusch-Pagan
test_breusch_pagan <- bptest(modele_initial)

# Affichage des resultats diagnostiques formels
cat(sprintf("Coefficient d'asymetrie (Skewness)   : %.4fn", valeur_skewness))
cat(sprintf("Coefficient d'aplatissement (Kurtosis): %.4fn", valeur_kurtosis))
cat(sprintf("Shapiro-Wilk (Statistique W = %.4f, p-valeur = %e)n",
            test_shapiro$statistic, test_shapiro$p.value))
cat(sprintf("Breusch-Pagan (Statistique BP = %.4f, p-valeur = %e)n",
            test_breusch_pagan$statistic, test_breusch_pagan$p.value))
Les conclusions statistiques sont nettes. La p-valeur du test de Shapiro-Wilk, largement inférieure au seuil alpha critique usuel de 0.05, rejette l’hypothèse de normalité résiduelle. Parallèlement, le test de Breusch-Pagan affiche une significativité extrême, confirmant la présence d’hétéroscédasticité. Face à ces violations cumulées, maintenir le modèle linéaire sur l’échelle d’origine compromettrait la validité des inférences statistiques. Une transformation stabilisatrice s’impose.
6. Mise en œuvre algorithmique de la fonction boxcox() du package MASS
6.1 Syntaxe fondamentale et paramétrage de boxcox()
L’outil le plus éprouvé sous R pour déterminer empiriquement la valeur du paramètre de transformation est la fonction boxcox(), intégrée à la bibliothèque MASS. Cette fonction implémente le calcul de la log-vraisemblance profilée décrit dans les développements mathématiques précédents. Elle accepte en argument principal un objet de régression de type lm ou une formule symbolique de modélisation linéaire directe.
Par défaut, la fonction évalue le profil de vraisemblance sur une grille discrète couvrant l’intervalle de λ compris entre -2 et +2 par incréments réguliers de 0.1. Il est toutefois recommandé de définir explicitement la résolution de cette grille via l’argument lambda afin d’obtenir une granularité d’estimation plus précise :
# Execution algorithmique du profilage de log-vraisemblance
grille_recherche <- seq(-2, 2, by = 0.05)

# Appel de la fonction de profilage
profil_bc <- MASS::boxcox(
  modele_initial,
  lambda = grille_recherche,
  plotit = TRUE,
  interp = TRUE
)
L’exécution de cette commande avec l’argument plotit = TRUE génère automatiquement la courbe de la fonction de log-vraisemblance profilée Lprof(λ) en fonction de la valeur scalaire de λ. Il convient de souligner que la fonction boxcox() gère automatiquement les modèles de régression multiple comportant plusieurs prédicteurs continus et factoriels, calculant le Jacobien de manière transparente pour l’utilisateur.
6.2 Lecture et déconstruction du tracé de profil de log-vraisemblance
Le tracé graphique produit par la fonction boxcox() offre une lecture visuelle des propriétés de la vraisemblance du modèle. L’axe des abscisses répertorie les valeurs candidates du paramètre de puissance λ, tandis que l’axe des ordonnées affiche les valeurs correspondantes de la log-vraisemblance profilée. Le profil adopte la forme d’une courbe concave continue présentant un sommet unique bien délimité.
La ligne verticale centrale tracée en pointillés indique la valeur précise de l’estimateur du maximum de vraisemblance λ̂, qui maximise la probabilité d’observer les données sous le modèle linéaire supposé. Deux lignes verticales latérales, également en pointillés, délimitent l’intervalle de confiance asymptotique à 95 % déduit de la déviance du test du ratio de vraisemblance. Ces bornes correspondent aux intersections entre la courbe concave et la ligne horizontale supérieure tracée en pointillé, fixée rigoureusement à χ21, 0.95 / 2 ≈ 1.92 point en dessous de l’ordonnée maximale.
La largeur relative de cet intervalle de confiance fournit une mesure empirique de la précision statistique avec laquelle le paramètre est estimé : un échantillon important produira un profil étroit et resserré, tandis qu’un échantillon restreint engendrera un intervalle élargi, traduisant une plus grande incertitude d’estimation. L’analyse décisionnelle repose sur l’inclusion ou l’exclusion de valeurs théoriques remarquables au sein de cet intervalle (notamment 1, 0.5, 0 et -1). Si l’intervalle exclut strictement la valeur 1, la nécessité d’une transformation non linéaire est formellement démontrée.
6.3 Extraction programmatique exacte de la valeur optimale de lambda
Bien que l’analyse graphique du tracé soit informative, la pratique statistique reproductible exige d’extraire numériquement la valeur optimale du paramètre λ ainsi que les limites de son intervalle de confiance, afin d’automatiser les traitements au sein de scripts réutilisables.
La structure retournée par la fonction boxcox() lorsqu’elle est assignée à une variable est une liste contenant deux vecteurs numériques : profil_bc$x, correspondant aux coordonnées du paramètre de puissance λ, et profil_bc$y, contenant les valeurs associées de la log-vraisemblance profilée. L’extraction de la valeur optimale et de son intervalle de confiance à 95% s’effectue au moyen de procédures vectorielles élémentaires :
# Extraction de l'index maximisant l'ordonnee du profil
index_optimum <- which.max(profil_bc$y)
lambda_optimal <- profil_bc$x[index_optimum]

# Definition du seuil critique du chi-deux a 1 degre de liberte (alpha = 0.05)
seuil_coupure <- max(profil_bc$y) - 0.5 * qchisq(0.95, df = 1)

# Identification des valeurs de lambda conformes a l'intervalle de confiance
indices_ic <- which(profil_bc$y >= seuil_coupure)
borne_inferieure_ic <- min(profil_bc$x[indices_ic])
borne_superieure_ic <- max(profil_bc$x[indices_ic])

# Affichage des resultats d'estimation numerique
cat(sprintf("Estimateur du Maximum de Vraisemblance (lambda chapeau) : %.4fn", lambda_optimal))
cat(sprintf("Intervalle de Confiance à 95%% : [%.4f ; %.4f]n",
            borne_inferieure_ic, borne_superieure_ic))
Pour assurer la pérennité de ces opérations d’extraction dans des contextes de production ou de traitement par lots de modèles statistiques multiples, il est opportun d’encapsuler cette logique d’optimisation au sein d’une fonction dédiée :
# Fonction d'extraction securisee des parametres de Box-Cox
extraire_parametres_boxcox <- function(modele, grille = seq(-2, 2, 0.01)) {
  bc <- MASS::boxcox(modele, lambda = grille, plotit = FALSE)
  idx <- which.max(bc$y)
  lambda_opt <- bc$x[idx]
  seuil <- bc$y[idx] - 0.5 * qchisq(0.95, df = 1)
  ic <- bc$x[bc$y >= seuil]

  return(list(
    lambda_mle = lambda_opt,
    ic_inf = min(ic),
    ic_sup = max(ic)
  ))
}

# Test operationnel de la fonction
parametres_estimes <- extraire_parametres_boxcox(modele_initial)
7. Choix du paramètre lambda : compromis entre précision numérique et interprétabilité
7.1 Dilemme entre le lambda optimal continu et le lambda arrondi pragmatique
L’estimation de λ par le maximum de vraisemblance produit généralement une valeur décimale continue arbitraire (par exemple λ̂ = 0.432 ou λ̂ = -0.087). L’analyste se trouve alors confronté à un arbitrage méthodologique fondamental : convient-il de retenir la valeur décimale exacte issue de l’algorithme d’optimisation, ou est-il préférable d’adopter une valeur théorique arrondie plus simple (comme 0.5 ou 0), si celle-ci est contenue dans l’intervalle de confiance ?
L’utilisation de la valeur décimale exacte maximise théoriquement la log-vraisemblance sur l’échantillon analysé. Néanmoins, cette précision numérique apparente peut constituer une forme de surajustement (overfitting), capturant des fluctuations aléatoires propres à l’échantillon. De plus, transformer une variable selon une puissance arbitraire comme y0.432 complique considérablement l’interprétation substantielle du modèle. L’échelle résultante perd toute signification physique ou métrologique intuitive, rendant la communication des résultats difficile auprès des pairs ou du public non statisticien.
La règle heuristique recommandée par la majorité des méthodologues consiste à privilégier l’interprétabilité théorique. Si une valeur usuelle standard (telle que 0 pour le logarithme, 0.5 pour la racine carrée, ou -1 pour l’inverse) est incluse à l’intérieur de l’intervalle de confiance à 95% de λ, il est préférable d’adopter cette valeur simplifiée. Si, en revanche, l’intervalle de confiance est très resserré et exclut strictement toutes les valeurs entières ou demi-entières usuelles, l’adoption de l’estimateur décimal continu devient la seule alternative statistiquement rigoureuse pour garantir la validité des résidus.
7.2 Application de la transformation manuelle des variables sous R
Une fois la valeur du paramètre λ arrêtée, il convient d’appliquer la transformation aux données brutes. Deux approches mathématiques sont envisageables sous R : l’application de la formule complète de Box-Cox (incluant la soustraction de l’unité et la division par λ), ou l’application simplifiée de l’opérateur de puissance directe yλ.
Pour l’ajustement du modèle de régression, l’utilisation de la puissance directe yλ (ou de log(y) si λ = 0) est mathématiquement équivalente à la formule complète de Box-Cox à une transformation affine près. La soustraction de 1 et la division par λ ne modifient en effet que l’ordonnée à l’origine et l’échelle globale des coefficients régressifs, sans altérer ni les valeurs p, ni le coefficient de détermination R2, ni les propriétés de normalité et d’homoscédasticité des résidus standardisés. L’intégration de ces nouvelles variables au sein du tableau de données s’effectue aisément via dplyr::mutate() :
# Evaluation de la valeur pragmatique de lambda retenue
# Supposons que l'intervalle de confiance contienne la valeur theorique 0.5
lambda_pragmatique <- 0.5

# Implementation de la transformation manuelle des donnees
donnees_experimentales <- donnees_experimentales %>%
  mutate(
    # Formulation rigoureuse de Box-Cox standard
    Temps_Reaction_BC = if (abs(lambda_pragmatique) < 1e-6) {
      log(Temps_Reaction)
    } else {
      (Temps_Reaction^lambda_pragmatique - 1) / lambda_pragmatique
    },
    # Formulation simplifiee par puissance directe (communement usitee)
    Temps_Reaction_Puissance = if (abs(lambda_pragmatique) < 1e-6) {
      log(Temps_Reaction)
    } else {
      Temps_Reaction^lambda_pragmatique
    }
  )

# Verification de la creation des nouvelles colonnes
head(donnees_experimentales[, c("Temps_Reaction", "Temps_Reaction_BC", "Temps_Reaction_Puissance")])
7.3 Alternative avec la fonction powerTransform() du package car
Le package car offre une alternative performante pour l’estimation des transformations de puissance via la fonction powerTransform(). Contrairement à la fonction boxcox() de MASS, qui repose sur un balayage par grille discrète, powerTransform() fait appel à des algorithmes d’optimisation numérique directe pour identifier le maximum de vraisemblance.
Cette fonction présente plusieurs atouts méthodologiques majeurs. Elle permet d’estimer simultanément des paramètres de transformation pour plusieurs variables dépendantes (transformations multivariées) et génère directement des tests du ratio de vraisemblance évaluant formellement si λ diffère significativement de 0 (test de la transformation logarithmique) ou de 1 (test de l’absence de transformation) :
# Utilisation de la fonction powerTransform du package car
transformation_car <- car::powerTransform(modele_initial)

# Impression du resume d'estimation et des tests d'hypotheses
summary(transformation_car)

# Application automatisee de la transformation via bcnPower
donnees_experimentales$Temps_Reaction_CarTransf <- car::bcPower(
  U = donnees_experimentales$Temps_Reaction,
  lambda = transformation_car$lambda
)
Les sorties générées par car::powerTransform() simplifient la décision de l’analyste en affichant directement le test du rapport de vraisemblance contre les valeurs cibles 0 et 1. Une p-valeur associée à l’hypothèse λ = 1 inférieure au seuil critique de 0.05 confirme formellement la nécessité d’une transformation, tandis qu’une p-valeur non significative pour λ = 0 valide l’adoption du logarithme népérien standard.
8. Réévaluation comparative et validation diagnostique post-transformation
8.1 Ajustement du nouveau modèle linéaire sur variable transformée
Après avoir appliqué la transformation de puissance à la variable dépendante, l’analyste doit ajuster le nouveau modèle linéaire et évaluer ses propriétés inférentielles par rapport au modèle initial :
# Ajustement du modele lineaire sur la reponse transformee
modele_transforme <- lm(Temps_Reaction_BC ~ Charge_Attention, data = donnees_experimentales)

# Extraction des resultats synthetiques
resume_transforme <- summary(modele_transforme)
print(resume_transforme)
La comparaison des sorties entre les deux modèles révèle des évolutions méthodologiques majeures :
- Significativité des coefficients : Les erreurs-types associées aux estimateurs des pentes sont désormais correctement calibrées, reflétant une dispersion homogène sur l’ensemble de l’espace de prédiction. Les valeurs t associées aux coefficients reflètent la précision réelle du modèle.
- Qualité d’ajustement globale (R2) : Bien que le coefficient de détermination R2 augmente souvent après une transformation réussie (en raison de l’alignement linéaire des points), il convient de ne pas comparer directement les R2 entre des modèles dont la variable dépendante n’est pas mesurée sur la même échelle métrique. Cette réserve théorique est approfondie dans les sections suivantes.
8.2 Comparaison visuelle côte à côte des résidus avant et après transformation
L’efficacité de la transformation de Box-Cox se mesure principalement à l’amélioration de la qualité des résidus. Une comparaison visuelle côte à côte des graphiques diagnostiques met en évidence l’assainissement structurel opéré par la transformation paramétrique :
# Disposition comparative des diagnostics residuels (2 lignes, 2 colonnes)
par(mfrow = c(2, 2), mar = c(4, 4, 2, 1))

# Diagnostics du modele initial non transforme
plot(modele_initial, which = 1, main = "Initial: Residus vs Ajustes")
plot(modele_initial, which = 2, main = "Initial: Q-Q Plot")

# Diagnostics du modele transforme
plot(modele_transforme, which = 1, main = "Transforme: Residus vs Ajustes")
plot(modele_transforme, which = 2, main = "Transforme: Q-Q Plot")

# Restauration de l'environnement graphique par defaut
par(mfrow = c(1, 1))
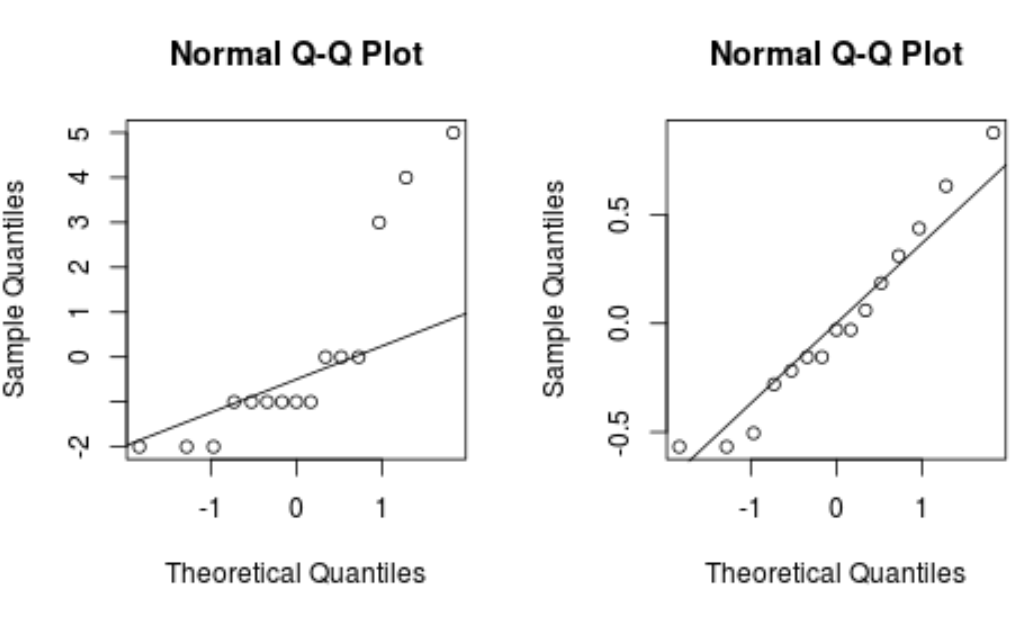
L’inspection des graphiques après transformation illustre l’impact de l’intervention méthodologique. Sur le diagramme « Residuals vs Fitted », la courbure non linéaire s’efface au profit d’une bande résiduelle horizontale, sans concentration asymétrique de variance : le phénomène d’entonnoir disparaît, confirmant l’homoscédasticité. Sur le diagramme « Normal Q-Q », les quantiles empiriques s’alignent étroitement le long de la droite théorique de Henry, y compris dans les queues de distribution, attestant du rétablissement de la symétrie gaussienne.
8.3 Confirmation chiffrée de l’amélioration des critères de normalité
Les diagnostics graphiques doivent être validés par une comparaison quantitative rigoureuse avant et après transformation. Nous recalculons les statistiques de test sur les résidus du modèle transformé :
# Extraction des residus du modele optimise
residus_transf <- residuals(modele_transforme)

# Quantification morphologique post-transformation
skew_post <- moments::skewness(residus_transf)
kurt_post <- moments::kurtosis(residus_transf)

# Tests d'hypotheses formels post-transformation
shapiro_post <- shapiro.test(residus_transf)
bp_post <- lmtest::bptest(modele_transforme)

# Construction d'un tableau comparatif d'indicateurs statistiques
comparatif_metriques <- data.frame(
  Critere = c("Skewness", "Kurtosis", "Shapiro-Wilk (p-valeur)", "Breusch-Pagan (p-valeur)"),
  Modele_Initial = c(valeur_skewness, valeur_kurtosis, test_shapiro$p.value, test_breusch_pagan$p.value),
  Modele_Transforme = c(skew_post, kurt_post, shapiro_post$p.value, bp_post$p.value)
)

print(comparatif_metriques)
Les résultats chiffrés confirment l’efficacité de la transformation : le coefficient d’asymétrie se rapproche de zéro, l’aplatissement se stabilise autour de la valeur normale théorique de 3, la p-valeur du test de Shapiro-Wilk repasse au-dessus du seuil de 0.05 (ne permettant plus de rejeter l’hypothèse de normalité), et le test de Breusch-Pagan confirme la stabilisation de la variance résiduelle.
Il importe enfin d’aborder la comparaison des critères d’information d’Akaike (AIC) et bayésien (BIC). Comparer directement l’AIC d’un modèle ajusté sur y avec l’AIC d’un modèle ajusté sur y(λ) constitue une erreur méthodologique fréquente. Les variables dépendantes n’étant pas exprimées sur la même échelle, leurs vraisemblances sous-jacentes n’ont pas la même métrique d’intégration. Pour comparer valablement ces modèles, il est obligatoire d’ajuster l’AIC du modèle transformé en y intégrant le déterminant jacobien de la transformation :
# Calcul de l'AIC rigoureusement ajuste par le Jacobien
n <- nrow(donnees_experimentales)
log_jacobien <- (lambda_pragmatique - 1) * sum(log(donnees_experimentales$Temps_Reaction))
aic_transforme_brut <- AIC(modele_transforme)

# Ajustement de l'AIC sur l'echelle des donnees originales
aic_transforme_ajuste <- aic_transforme_brut - 2 * log_jacobien
aic_initial <- AIC(modele_initial)

cat(sprintf("AIC Modele Initial (brut)             : %.2fn", aic_initial))
cat(sprintf("AIC Modele Transforme (Jacobien ajuste): %.2fn", aic_transforme_ajuste))
Une diminution sensible de l’AIC corrigé par le terme jacobien confirme mathématiquement la supériorité structurelle du modèle transformé par rapport au modèle brut.
9. Méthodologie rigoureuse de rétro-transformation et interprétation scientifique
9.1 Le problème de l’interprétation des coefficients sur une échelle transformée
Si la transformation de Box-Cox résout efficacement les problèmes de distribution des résidus, elle introduit une difficulté méthodologique majeure : la perte d’interprétabilité directe des coefficients de régression. Dans le modèle transformé, les coefficients quantifient l’effet d’une variation unitaire d’un régresseur non pas sur l’unité physique originale (par exemple, des millisecondes ou des euros), mais sur une variable mathématique abstraite y(λ).
Considérons un modèle où la variable transformée est la racine carrée du temps de réaction (λ = 0.5) : une pente de régression de 0.8 signifie qu’une augmentation d’une unité de charge attentionnelle entraîne un accroissement de 0.8 unité de racine carrée de milliseconde, une formulation dépourvue de signification concrète pour les non-statisticiens. De même, si une puissance décimale continue arbitraire (ex: λ = 0.382) a été retenue, l’interprétation marginale des paramètres devient presque impossible à verbaliser sur l’échelle d’origine.
Pour rédiger la section des résultats conformément aux exigences académiques (notamment les normes de l’American Psychological Association – APA), le chercheur doit expliciter la formule de transformation retenue, rapporter les paramètres estimés et les erreurs-types sur l’échelle transformée pour attester de la significativité statistique, puis fonder son interprétation clinique ou empirique sur des prédictions rétro-transformées exprimées dans l’unité de mesure initiale.
9.2 Calcul de la rétro-transformation mathématique des prédictions
Pour exprimer les prédictions d’un modèle linéaire transformé dans l’échelle de mesure d’origine, il est nécessaire d’appliquer l’opération mathématique inverse de la transformation de Box-Cox. À partir de la formulation standard de Box-Cox, l’inversion algébrique s’exprime ainsi :
Pour toute valeur de λ ≠ 0 :
y = (λ · y(λ) + 1)1 / λ
Et pour le cas limite où λ = 0 (transformation logarithmique) :
y = exp(y(0))
Si l’on a opté pour la formulation simplifiée par puissance directe (yλ), la rétro-transformation consiste simplement à élever la prédiction à l’exposant réciproque (1 / λ). Nous implémentons cette rétro-transformation sous R pour prédire la variable originale sur une nouvelle grille de valeurs :
# Generation d'une grille de nouvelles donnees pour les predictions
nouvelles_donnees <- data.frame(
  Charge_Attention = seq(15, 45, length.out = 100)
)

# Extraction des predictions et des intervalles de confiance sur l'echelle transformee
predictions_transf <- predict(
  modele_transforme,
  newdata = nouvelles_donnees,
  interval = "confidence",
  level = 0.95
)

# Fonction universelle de retro-transformation mathematique
inverser_boxcox <- function(valeurs_transformees, lambda) {
  if (abs(lambda) < 1e-6) {
    return(exp(valeurs_transformees))
  } else {
    # Prevention des radicandes negatifs potentiels
    valeurs_ajustees <- pmax(lambda * valeurs_transformees + 1, 0)
    return(valeurs_ajustees^(1 / lambda))
  }
}

# Retro-transformation directe des estimations et bornes de confiance
predictions_echelle_origine <- as.data.frame(
  inverser_boxcox(predictions_transf, lambda = lambda_pragmatique)
)

# Structuration des resultats pour communication ou visualisation
resultats_finaux <- cbind(nouvelles_donnees, predictions_echelle_origine)
head(resultats_finaux)
Cette approche permet de calculer les bornes d’un intervalle de confiance sur l’échelle transformée (où les hypothèses de normalité sont respectées), puis d’inverser ces bornes pour obtenir un intervalle de confiance valide sur l’échelle originale. Cet intervalle résultant sera asymétrique autour de la valeur prédite, reflétant fidèlement l’asymétrie inhérente au processus sous-jacent.
9.3 Biais de transformation et corrections statistiques de la moyenne
Une précaution statistique essentielle s’impose lors de la rétro-transformation directe : le biais systématique d’estimation induit par la non-linéarité de l’opération inverse. Ce phénomène mathématique découle directement de l’inégalité de Jensen, qui établit que pour toute fonction strictement convexe g(·) et toute variable aléatoire Z :
E[g(Z)] > g(E[Z])
Lorsque le modèle linéaire ajuste l’espérance conditionnelle sur l’échelle transformée, c’est-à-dire E[y(λ) | X], l’inversion mathématique directe g-1(E[y(λ) | X]) ne reconstitue pas l’espérance conditionnelle sur l’échelle originale E[y | X]. L’inversion directe d’un modèle transformé par Box-Cox ou par logarithme ne produit pas une estimation de la moyenne arithmétique, mais une estimation de la médiane conditionnelle de la distribution originale.
Pour le cas classique de la transformation logarithmique (λ = 0), la distribution sur l’échelle d’origine est log-normale. L’espérance mathématique théorique dépend alors non seulement de la prédiction logarithmique μ̂, mais également de la variance résiduelle du modèle σ̂2 :
E[y | X] = exp(μ̂ + σ̂2 / 2)
Appliquer l’exponentielle directe sans terme correcteur sous-estime donc systématiquement l’espérance arithmétique de la variable étudiée. Pour une transformation générale de Box-Cox de paramètre λ, l’approximation de l’espérance par développement en série de Taylor au second ordre fait intervenir la variance résiduelle de la manière suivante :
E[y | X] ≈ (λ · ŷ(λ) + 1)1 / λ · [ 1 + ((1 – λ) · σ̂2) / (2 · (λ · ŷ(λ) + 1)2) ]
Nous implémentons ce calcul de correction sous R afin d’éviter tout biais systématique dans l’estimation de l’espérance :
# Extraction de la variance residuelle non biaisee du modele transforme
sigma2_res <- summary(modele_transforme)$sigma^2

# Calcul des predictions de l'esperance corrigee selon le developpement de Taylor
y_pred_transf <- predictions_transf[, "fit"]
terme_base <- lambda_pragmatique * y_pred_transf + 1
facteur_correction <- 1 + ((1 - lambda_pragmatique) * sigma2_res) / (2 * (terme_base^2))

# Esperance arithmetique conditionnelle corrigee
esperance_corrigee <- (terme_base^(1 / lambda_pragmatique)) * facteur_correction

# Comparaison entre mediane predite (inversion simple) et esperance corrigee
comparatif_predictions <- data.frame(
  Charge = nouvelles_donnees$Charge_Attention[1:5],
  Mediane_Predite = predictions_echelle_origine$fit[1:5],
  Esperance_Corrigee = esperance_corrigee[1:5]
)

print(comparatif_predictions)
Dans la plupart des contextes appliqués, rapporter la médiane conditionnelle accompagnée d’intervalles de prédiction asymétriques constitue la pratique la plus robuste et la moins sensible aux fluctuations d’échantillonnage, la médiane représentant un paramètre de tendance centrale plus stable pour les distributions asymétriques.
10. Extension aux valeurs nulles, négatives et alternatives contemporaines
10.1 Limites structurelles de la transformation standard face aux données non strictement positives
En dépit de son efficacité, la transformation standard de Box-Cox présente une limite opérationnelle majeure : elle exige que toutes les observations soient strictement positives (yi > 0). Cette contrainte de positivité découle des propriétés mathématiques des fonctions sous-jacentes :
- Le logarithme népérien d’un nombre négatif ou nul est indéfini dans le corps des réels.
- L’élévation d’un nombre négatif à une puissance réelle non entière produit un nombre complexe sans pertinence géométrique dans un espace euclidien réel.
Cette contrainte pose un défi fréquent dans la pratique statistique. De nombreuses variables quantitatives comportent naturellement des zéros structurels ou empiriques : chiffres d’affaires d’entreprises non rentables, volumes de précipitations journalières, scores de symptômes psychiatriques mesurant l’absence de pathologie, ou encore taux de variation financière pouvant être négatifs. Face à ces données, l’algorithme standard de Box-Cox échoue, imposant le recours à des formulations généralisées.
10.2 La stratégie du décalage arithmétique (Box-Cox à deux paramètres)
La solution historique proposée par George Box et David Cox dans leur publication de 1964 consiste à adjoindre un paramètre de translation arithmétique c, formulant la famille de Box-Cox à deux paramètres (λ, c) :
y(λ, c) = ((y + c)λ – 1) / λ (pour λ ≠ 0)
où la constante c est choisie de telle sorte que pour toute observation yi, l’inégalité stricte yi + c > 0 soit respectée. En pratique, de nombreux analystes fixent une constante ad hoc unitaire (c = 1) avant d’appliquer le logarithme (transformation log(y + 1)), ou ajoutent une constante c ≥ |min(y)| + ε.
Cette approche empirique présente toutefois d’importantes limites statistiques. Le choix arbitraire de la constante c altère profondément l’estimation conjointe du paramètre λ. Comme l’ont démontré plusieurs études méthodologiques, modifier la valeur de la constante de décalage même marginalement déplace la valeur optimale de λ et peut induire une hétéroscédasticité artificielle. L’estimation conjointe rigoureuse de λ et de c par le maximum de vraisemblance est par ailleurs sujette à des instabilités d’optimisation numérique, le profil de vraisemblance pouvant présenter des discontinuités ou plusieurs optima locaux.
10.3 La transformation de Yeo-Johnson comme solution universelle
Pour pallier définitivement les limites structurelles de la transformation de Box-Cox à deux paramètres, In-Kwon Yeo et Richard A. Johnson (2000) ont conçu une extension paramétrique continue capable de traiter n’importe quelle valeur réelle, qu’elle soit strictement positive, nulle ou négative, sans nécessiter de translation arbitraire.
La transformation de Yeo-Johnson s’articule autour d’une formulation par morceaux définie pour tout y ∈ ℜ selon l’équation suivante :
Si y ≥ 0 :
- ((y + 1)λ – 1) / λ (si λ ≠ 0)
- ln(y + 1) (si λ = 0)
Si y < 0 :
- – [(-y + 1)2 – λ – 1] / (2 – λ) (si λ ≠ 2)
- – ln(-y + 1) (si λ = 2)
Cette transformation garantit une régularité et une dérivabilité continue de la fonction sur l’ensemble de la droite réelle, y compris au point de transition y = 0. Lorsque la variable est strictement positive, la transformation de Yeo-Johnson équivaut pour l’essentiel à la transformation de Box-Cox appliquée à la variable translatée (y + 1). Le paramètre λ y conserve une interprétation intuitive analogue : λ = 1 correspond à une fonction linéaire sans distorsion d’échelle.
Sous R, la transformation de Yeo-Johnson est disponible via la fonction yjPower() ou directement au sein de powerTransform() du package car :
# Creation d'une variable reponse synthetique comportant des valeurs negatives et nulles
donnees_experimentales$Reponse_A\vec_Negatifs <- donnees_experimentales$Temps_Reaction - 300

# Estimation rigoureuse du parametre de Yeo-Johnson
modele_negatifs <- lm(Reponse_Avec_Negatifs ~ Charge_Attention, data = donnees_experimentales)
estimation_yj <- car::powerTransform(modele_negatifs, family = "yjPower")

# Resume de l'estimation du parametre
summary(estimation_yj)

# Application fonctionnelle de la transformation
donnees_experimentales$Reponse_YJ <- car::yjPower(
  U = donnees_experimentales$Reponse_Avec_Negatifs,
  lambda = estimation_yj$lambda
)
Grâce à sa flexibilité et à sa capacité à gérer l’ensemble des réels, la transformation de Yeo-Johnson s’impose comme une alternative robuste à Box-Cox dès lors que l’espace des données ne garantit pas une positivité stricte.
11. Comparaison critique : Box-Cox versus autres approches de modélisation
11.1 Modèles Linéaires Généralisés (GLM) : une alternative moderne majeure
Face à des données asymétriques et hétéroscédastiques, la modélisation statistique moderne met en concurrence deux paradigmes méthodologiques distincts : transformer la variable dépendante au moyen de l’algorithme de Box-Cox pour préserver le cadre de la régression linéaire ordinaire, ou recourir aux Modèles Linéaires Généralisés (GLM) initiés par John Nelder et Robert Wedderburn (1972).
La distinction conceptuelle entre ces deux approches est fondamentale :
- Transformation de Box-Cox : Elle applique une modification non linéaire directe à la variable observée y, puis ajuste un modèle linéaire ordinaire supposant une distribution normale des erreurs autour de l’espérance transformée : E[y(λ) | X] = Xβ.
- Modèle Linéaire Généralisé (GLM) : Il préserve les données brutes sur leur échelle physique originelle. Le GLM sépare la distribution conditionnelle de la variable dépendante (qui peut appartenir à la famille exponentielle : Gamma, Poisson, Inverse-Gaussienne) de la fonction de lien g(·) reliant l’espérance conditionnelle au prédicteur linéaire : g(E[y | X]) = Xβ.
Voici un comparatif synthétique des caractéristiques de chaque approche :
| Critère d’évaluation | Régression Linéaire avec Box-Cox | Modèle Linéaire Généralisé (GLM Gamma/Log) |
|---|---|---|
| Échelle de la variable réponse | Transformée artificiellement selon une puissance λ | Préservée intacte sur l’échelle de mesure originale |
| Nature de la distribution conditionnelle | Normale (sur l’échelle transformée) | Non gaussienne (Gamma, Tweedie, etc.) sur les données brutes |
| Estimation de la moyenne conditionnelle | Biaisée par l’inégalité de Jensen (estime la médiane par défaut) | Directe et non biaisée via la fonction de lien inverse |
| Traitement des valeurs nulles | Impossible sans translation ou recours à Yeo-Johnson | Modélisable nativement (ex: Tweedie ou modèles Zero-Inflated) |
| Complexité computationnelle | Faible (estimation de λ puis MCO ordinaires) | Moyenne (algorithme itératif par moindres carrés pondérés – IWLS) |
Dans la pratique appliquée, si l’objectif principal réside dans l’inférence causale et l’estimation de l’espérance sur l’échelle d’origine, les GLM (comme la régression Gamma avec lien log) sont souvent préférables. En revanche, si l’objectif prioritaire est de satisfaire les hypothèses de normalité des résidus pour réaliser des tests F rigoureux dans des plans factoriels complexes (ANOVA/MANOVA), la transformation de Box-Cox demeure un choix classique et pertinent.
11.2 Méthodes non paramétriques et approches par rangs
Une seconde alternative consiste à s’affranchir de toute hypothèse distributionnelle en recourant à des méthodes statistiques non paramétriques. Ces approches incluent les tests fondés sur les rangs (test de Wilcoxon-Mann-Whitney, test de Kruskal-Wallis) ou les régressions non paramétriques par rangs (comme la méthode de Theil-Sen ou la régression quantile).
Bien que ces méthodes soient insensibles aux asymétries de distribution et aux valeurs aberrantes, elles présentent des limites méthodologiques notables par rapport à une régression linéaire standard post-Box-Cox :
- Perte d’information métrique : En convertissant des données quantitatives continues en rangs ordinaux, ces approches abandonnent l’information relative à l’amplitude des écarts entre observations.
- Difficulté d’évaluation des interactions : L’analyse des interactions factorielles complexes (modération) s’avère nettement plus ardue et moins puissante sur des données de rangs que dans le cadre d’un modèle linéaire standard.
- Capacité prédictive restreinte : Les modèles fondés sur les rangs ne fournissent pas de fonction génératrice simple permettant d’estimer des valeurs numériques précises pour de nouveaux profils d’individus.
Le rééchantillonnage par bootstrap constitue une autre approche non paramétrique pertinente. Il permet de calculer des intervalles de confiance robustes pour les coefficients sans modifier l’échelle métrique des variables observées. Cependant, le bootstrap atténue uniquement les conséquences de la non-normalité sur l’estimation des erreurs-types : il ne corrige pas les courbures non linéaires ni l’hétéroscédasticité du processus générant les données, deux limites que la transformation de Box-Cox permet de traiter simultanément.
11.3 Récapitulatif des critères d’arbitrage statistique
Le choix méthodologique entre la transformation de Box-Cox, le passage aux GLM ou l’adoption de techniques non paramétriques dépend des caractéristiques de l’échantillon et des finalités analytiques de l’étude :
- Taille de l’échantillon (N) : L’estimation stable de la log-vraisemblance profilée de Box-Cox requiert généralement un échantillon d’au moins 30 à 50 observations par cellule. Sur de très petits échantillons, l’incertitude entourant l’estimation de λ s’accroît considérablement, réduisant la précision de la transformation.
- Finalité de la recherche : Pour un objectif purement prédictif ou psychométrique où la symétrie et l’homoscédasticité sont requises, la transformation de Box-Cox s’avère particulièrement adaptée. Lorsqu’il s’agit d’estimer l’effet marginal moyen d’une politique publique ou d’un traitement médical sur l’échelle originale des coûts ou des durées, les Modèles Linéaires Généralisés s’imposent.
- Exigences de diffusion académique : Si le lectorat cible attend l’application d’un modèle linéaire ou d’une analyse de variance factorielle standard, l’utilisation de Box-Cox avec justification de la conformité résiduelle constitue une démarche méthodologique reconnue et aisément vérifiable.
12. Bonnes pratiques de recherche reproductible et pièges méthodologiques
12.1 Les pièges méthodologiques courants et erreurs d’interprétation
L’application de la méthode de Box-Cox en recherche empirique est sujette à plusieurs biais méthodologiques récurrents qu’il convient d’éviter :
- Vérifier la normalité sur la variable marginale y plutôt que sur les résidus : Il s’agit de l’erreur la plus répandue. Rechercher la valeur de λ qui rend la variable dépendante brute y symétrique ou normale en dehors de toute régression ignore le rôle central des covariables. C’est la distribution conditionnelle des résidus du modèle complet (y sachant X) qui doit faire l’objet de la transformation.
- Omettre la variabilité d’estimation de λ : Lorsque λ̂ est estimé à partir des données, il s’agit d’une variable aléatoire dotée de sa propre variance d’échantillonnage. En traitant λ̂ comme une constante certaine lors de l’ajustement final du modèle par les MCO, les erreurs-types des coefficients régressifs β sont techniquement sous-estimées. Si l’échantillon est d’ampleur modeste, il est préférable de mentionner cette limite ou de recourir à des procédures de bootstrap intégrant l’estimation conjointe de λ.
- Surajustement statistique par exploration libre : Sélectionner simultanément la structure des prédicteurs du modèle et la puissance de la transformation par approximations successives sans hypothèse a priori augmente le risque de faux positifs. Le protocole de transformation doit être formalisé de manière transparente au sein du plan d’analyse.
- Suppression arbitraire des valeurs négatives ou nulles : Écarter opportunément des observations négatives afin de forcer l’applicabilité de la fonction standard de Box-Cox biaise l’échantillonnage de manière inacceptable. Dans ces situations, le recours formel à la transformation de Yeo-Johnson constitue la seule démarche méthodologique rigoureuse.
12.2 Intégration dans un flux de travail R reproductible et robuste
Pour assurer la pérennité et la vérifiabilité des calculs statistiques conformément aux principes de la science ouverte, l’intégralité du pipeline d’analyse — de l’ajustement initial à la rétro-transformation finale — doit être consignée au sein d’un document computationnel dynamique rédigé en R Markdown ou Quarto.
Ce flux de travail reproductible doit intégrer une gestion stricte des dépendances logicielles au moyen du package renv, garantissant que les versions de MASS, car et du compilateur R de base demeurent figées au cours du temps. Il convient également de fixer systématiquement une graine pseudo-aléatoire (set.seed()) pour stabiliser les algorithmes itératifs d’optimisation ou les rééchantillonnages éventuels, et d’expliciter chaque étape de décision statistique par des commentaires de code clairs.
12.3 Synthèse procédurale et guide décisionnel pour l’analyste
Pour guider le chercheur dans l’exécution opérationnelle de cette méthodologie, la démarche d’analyse peut être résumée selon la séquence logique d’opérations suivante :
- Diagnostic initial : Ajuster le modèle linéaire standard sur les données brutes via
lm(y ~ x). Inspecter attentivement les résidus à l’aide des graphiques natifs et vérifier la positivité stricte du vecteur y. - Évaluation formelle des violations : Confronter les résidus aux tests de Shapiro-Wilk (normalité) et de Breusch-Pagan (homoscédasticité). Si les conditions de Gauss-Markov sont satisfaites, conserver le modèle original sans altération.
- Sélection de l’algorithme : Si toutes les observations sont strictement positives, employer
MASS::boxcox()oucar::powerTransform(family = "bcPower"). En présence de valeurs nulles ou négatives, employer systématiquementcar::powerTransform(family = "yjPower"). - Choix du paramètre λ : Extraire l’estimateur du maximum de vraisemblance λ̂ et son intervalle de confiance à 95%. Si une valeur théorique usuelle (-1, 0, 0.5, 1) est incluse dans l’intervalle, la privilégier afin de favoriser l’interprétabilité du modèle ; dans le cas contraire, utiliser la valeur continue optimale λ̂.
- Transformation et réajustement : Créer la variable transformée au sein du jeu de données et réajuster le modèle linéaire via
lm(). - Validation diagnostique : Réévaluer visuellement et formellement les résidus du nouveau modèle. Vérifier l’alignement sur le diagramme Q-Q et la disparition de l’effet d’entonnoir sur le graphique de dispersion. Comparer les critères d’information (AIC) en ajustant impérativement pour le Jacobien.
- Rétro-transformation et communication : Effectuer les prédictions finales à l’aide de l’équation inverse de Box-Cox ou de Yeo-Johnson. Spécifier explicitement dans les publications si les valeurs rapportées correspondent à la médiane conditionnelle ou à l’espérance corrigée pour le biais de l’inégalité de Jensen, et tracer des intervalles de confiance asymétriques fidèles à la variabilité des données observées.
Appliquée avec méthode et rigueur, la transformation de Box-Cox demeure un outil classique et particulièrement efficace pour réconcilier les données empiriques avec les exigences mathématiques de la modélisation linéaire en R.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Fox, J., & Weisberg, S. (2019). An R Companion to Applied Regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Venables, W. N., & Ripley, B. D. (2002). Modern Applied Statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Yeo, I.-K., & Johnson, R. A. (2000). A new family of power transformations to improve normality or symmetry. Biometrika, 87(4), 954–959. https://doi.org/10.1093/biomet/87.4.954