
Dans l’arsenal méthodologique du chercheur en sciences humaines et sociales, particulièrement en psychologie cognitive, sociale et clinique, l’analyse inférentielle des données discrètes occupe une place stratégique fondamentale. Lorsque les phénomènes investigués échappent aux échelles de mesure métriques continues et se manifestent sous la forme de taxinomies, de catégories diagnostiques ou de choix comportementaux mutuellement exclusifs, les modèles de régression linéaire classique ou les analyses de variance paramétriques deviennent structurellement inadéquats. C’est précisément dans cette brèche épistémologique et analytique que s’enracine le test du khi-carré d’indépendance, conceptualisé initialement par le mathématicien britannique Karl Pearson à l’aube du vingtième siècle. Cette épreuve non paramétrique universelle offre une modélisation probabiliste rigoureuse permettant de statuer sur l’existence d’une dépendance stochastique entre deux variables qualitatives mesurées au sein d’une même population.
Si la pratique contemporaine de l’analyse statistique tend à déléguer l’ensemble des procédures inférentielles à des progiciels spécialisés et opaques fonctionnant sur le mode de la « boîte noire » — tels que SPSS, SAS, Stata ou encore certains modules automatisés du langage R —, ce parti pris d’ingénierie logicielle s’accompagne trop souvent d’une atrophie de la compréhension mathématique sous-jacente. L’utilisation avertie d’un tableur comme Microsoft Excel se présente alors comme une démarche pédagogique et scientifique d’une efficacité remarquable. Loin d’être un simple carnet d’adresses ou un outil de comptabilité de gestion, le tableur permet de reconstruire manuellement, avec une granularité chirurgicale, chaque étape matricielle menant de l’observation empirique à l’évaluation probabiliste de l’hypothèse nulle.
Ce guide exhaustif a été conçu selon les standards académiques les plus exigeants pour accompagner les étudiants de troisième cycle, les chercheurs en psychologie et les statisticiens praticiens dans la maîtrise opérationnelle intégrale du test d’indépendance de Pearson sous Excel. En articulant la théorie probabiliste pure, le calcul matriciel des effectifs théoriques, l’analyse fine des résidus standardisés ajustés de Haberman, le calcul de la taille d’effet par le V de Cramér et la formalisation des résultats selon les normes de la septième édition de l’American Psychological Association (APA), ce texte constitue un manuel de référence exhaustif pour quiconque souhaite allier rigueur mathématique et manipulation transparente des données tabulaires.
1. Fondements théoriques du test du khi-carré d’indépendance en psychologie
1.1 Nature et propriétés des variables catégorielles en recherche quantitative
L’édifice de la statistique inférentielle repose sur la nature de l’échelle de mesure employée pour opérationnaliser les entités psychiques et comportementales. Dans la classification canonique établie par Stanley Smith Stevens, les variables qualitatives se subdivisent strictement entre les échelles nominales et les échelles ordinales. En psychologie empirique, une variable nominale polytomique désigne une catégorisation où les modalités ne peuvent faire l’objet d’aucune relation d’ordre mathématique naturelle, d’aucun gradient d’intensité ou de hiérarchie métrique sous-jacente. L’affiliation politique, le sous-type nosologique d’un trouble de l’humeur selon le DSM-5 ou la modalité sensorielle préférentielle constituent des archétypes de variables nominales.
L’opérationnalisation de ces construits psychologiques sous forme d’attributs discrets impose une contrainte logique absolue : le système de classification doit obligatoirement respecter les critères d’exhaustivité et d’exclusivité mutuelle. L’exhaustivité garantit que chaque individu de l’échantillon peut être classé dans l’une des catégories prévues par le protocole expérimental, tandis que l’exclusivité mutuelle empêche qu’un même participant ne soit comptabilisé simultanément dans deux compartiments distincts d’une même dimension. Lorsque ces conditions sont rigoureusement remplies, l’information collectée ne réside plus dans une grandeur continue, mais dans la fréquence d’apparition ou le dénombrement absolu d’occurrences au sein de chaque classe d’équivalence.
Dès lors, l’évaluation des relations entre sous-groupes cliniques ou démographiques interdit l’usage des coefficients de corrélation linéaire conventionnels comme le r de Pearson ou des comparaisons de moyennes de type test t de Student. La nature non linéaire et discontinue des taxonomies impose une approche analytique matricielle où l’on n’examine plus la covariation de grandeurs numériques, mais l’écart de distribution d’une variable à travers les différents niveaux de l’autre. Le test du khi-carré se profile alors comme la méthode d’élection pour cartographier ces configurations relationnelles non métriques sans trahir la structure qualitative des données empiriques.
1.2 Principe mathématique de l’indépendance stochastique
La théorie des probabilités formalise le concept d’indépendance stochastique entre deux événements aléatoires discrets à travers la règle de multiplication conjointe. Soient deux événements A et B appartenant à un espace probabilisé. Ces deux événements sont dits stochastiquement indépendants si et seulement si la probabilité de leur réalisation simultanée est égale au produit exact de leurs probabilités marginales respectives :
P(A ∩ B) = P(A) × P(B)
Transposé au paradigme d’une table de contingence croisant deux variables catégorielles X (possédant r modalités en lignes) et Y (possédant c modalités en colonnes), ce postulat d’indépendance implique que la probabilité conditionnelle d’observer une modalité spécifique de Y sachant la réalisation d’une modalité donnée de X demeure invariante quel que soit le niveau de X considéré. Autrement formulé, l’appartenance d’un sujet à une catégorie de la variable X n’apporte aucune information prédictive sur sa probabilité d’appartenir à une catégorie de la variable Y.
Sous l’hypothèse nulle d’indépendance stochastique, la fréquence théorique ou l’effectif attendu au sein de chaque cellule croisée (i, j) de la matrice correspond à l’espérance mathématique du dénombrement en situation d’absence totale d’association. Cet effectif théorique découle directement du produit des totaux marginaux de la ligne i et de la colonne j, normalisé par la taille totale de la cohorte d’observation.
La métrique fondamentale conçue par Pearson quantifie précisément la divergence globale entre la réalité empirique observée et ce modèle théorique de non-liaison. En calculant l’écart quadratique entre les effectifs observés et les effectifs attendus, puis en standardisant cet écart par l’effectif théorique attendu, on obtient une statistique synthétique qui mesure la distance statistique globale séparant les données réelles de la situation idéale d’indépendance pure. Si cette divergence quadratique dépasse ce qui peut être raisonnablement attribué aux simples fluctuations d’échantillonnage aléatoire, l’hypothèse d’indépendance stochastique est formellement révoquée.
1.3 Pertinence et portée opérationnelle du tableur Excel en analyse inférentielle
Dans le paysage contemporain des sciences comportementales, l’utilisation de Microsoft Excel à des fins d’inférence statistique fait souvent l’objet de préjugés injustifiés. Pourtant, sur le plan didactique et épistémologique, la décomposition pas à pas d’un test du khi-carré d’indépendance dans un tableur constitue le moyen le plus efficace d’échapper au syndrome de la boîte noire algorithmique. Alors qu’un progiciel statistique commercial produit instantanément des tableaux de sorties denses sans révéler la chaîne logique des calculs intermédiaires, le tableur oblige le chercheur à matérialiser chaque transition mathématique : calcul des marges, dérivation des matrices théoriques, élévation au carré des écarts et sommation résiduelle.
Cette transparence opérationnelle confère à l’analyste un contrôle cognitif total sur ses données. En manipulant directement les cellules du tableur, l’opérateur observe la genèse exacte de la statistique d’épreuve, saisit intuitivement la notion de degré de liberté via la disposition géométrique des marges et visualise sans artifice la provenance des résidus les plus prononcés. En outre, la possibilité de formuler dynamiquement des matrices d’écarts permet de détecter immédiatement les erreurs de saisie ou les incohérences arithmétiques qui demeureraient invisibles lors de l’exécution d’un script préprogrammé opaque.
Néanmoins, une rigueur scientifique impartiale exige de reconnaître les limites structurelles d’Excel. Si le logiciel d’ingénierie de données de Microsoft excelle dans le traitement de matrices de contingence d’ordre modeste à intermédiaire (typiquement des tableaux de 2×2 à 10×10 issus d’échantillons de quelques centaines à quelques dizaines de milliers de sujets), il montre des faiblesses notables face à des mégadonnées nécessitant des algorithmes d’optimisation non linéaires complexes ou des rééchantillonnages par bootstrapping intensifs. Pour l’analyse d’indépendance de contingences classiques en psychologie, Excel demeure toutefois un instrument d’une précision arithmétique irréprochable et d’une puissance pédagogique incomparable.
2. Conditions d’application et postulats méthodologiques préalables
2.1 Exigence d’échantillonnage aléatoire et d’indépendance des observations
L’édifice inférentiel du test du khi-carré repose sur un ensemble de postulats probabilistes stricts dont le non-respect invalide intégralement les conclusions statistiques. Le premier de ces postulats concerne l’indépendance mutuelle absolue de toutes les observations individuelles composant le jeu de données. Chaque sujet inclus dans l’étude ne doit être comptabilisé qu’une seule et unique fois dans l’ensemble de la table de contingence. Cette exigence structurelle découle de la nature de la distribution multinomiale qui sous-tend le calcul de la probabilité de Pearson.
Par conséquent, le test d’indépendance du khi-carré est formellement inapplicable aux plans expérimentaux à mesures répétées, aux études longitudinales mesurant le même individu à travers plusieurs pas temporels successifs, ou aux situations d’évaluation pré-test/post-test. Pour ces protocoles intra-sujets, des approches spécialisées telles que le test de McNemar (pour les tables 2×2 appariées) ou les modèles d’équations d’estimation généralisées (GEE) doivent impérativement être substituées au test de Pearson.
La violation de cette clause d’indépendance des unités d’observation — par exemple en intégrant dans la même table des données issues de couples dyadiques, de fratries ou d’élèves nichés au sein de mêmes classes scolaires sans modélisation multiniveau préalable — génère un phénomène délétère d’inflation massive de l’erreur de type I (rejet abusif d’une hypothèse nulle pourtant vraie). La pseudo-répétition artificielle des mesures contracte artificiellement la variance d’échantillonnage, induisant une significativité fallacieuse qui fausse irrémédiablement le jugement du psychologue chercheur.
2.2 Règles de décision de Cochran sur les effectifs théoriques
Le khi-carré de Pearson est une statistique d’épreuve dont la loi théorique continue n’est qu’une approximation asymptotique de la distribution discrète exacte des effectifs multinomiaux. Pour que cette approximation mathématique demeure robuste et valide, les effectifs théoriques attendus (et non les effectifs observés) doivent satisfaire à des seuils minimaux de densité d’information. Ces critères ont été formalisés par le statisticien William Gemmell Cochran dans une série de publications fondatrices qui font toujours autorité dans la communauté biométrique et psychologique internationale.
Les directives méthodologiques de Cochran s’articulent autour de deux critères cardinaux complémentaires :
- Dans les tables de contingence de dimension 2×2 (comportant un seul degré de liberté), aucun effectif théorique calculé ne doit être inférieur à 5. Certains auteurs ultra-conservateurs préconisent même un plancher minimal de 10 unités pour écarter tout risque de biais dans les queues de distribution.
- Dans les grands tableaux de contingence de dimensions supérieures (au minimum r × c ≥ 6, avec un nombre de degrés de liberté strictement supérieur à 1), une tolérance pragmatique est accordée : jusqu’à 20 % des cellules de la matrice théorique peuvent posséder un effectif attendu inférieur à 5, sous la condition absolue et non négociable qu’aucune cellule ne présente une valeur théorique strictement inférieure à 1.
L’impact d’une violation de ces seuils de Cochran sur la puissance statistique et la validité inférentielle est désastreux. Lorsque des effectifs attendus approchent de zéro, la division par une valeur infinitésimale lors du calcul de l’écart quadratique réduit produit une explosion artificielle de la statistique globale du khi-carré, ce qui conduit inévitablement à des décisions erronées de rejet de l’hypothèse nulle.
2.3 Gestion des violations méthodologiques sous Excel
Face à une table de contingence violant les postulats d’effectifs minimaux de Cochran, l’analyste sous Excel doit déployer des stratégies correctives rigoureuses pour assainir ses données avant de procéder à l’inférence. La méthode d’ingénierie statistique la plus courante et la plus pragmatique consiste à opérer un regroupement raisonné des modalités adjacentes ou conceptuellement homogènes d’une des variables en jeu. En fusionnant deux catégories cliniques proches ou deux échelons sociodémographiques minoritaires, on augmente substantiellement les effectifs marginaux correspondants, ce qui rehausse mécaniquement les effectifs théoriques calculés dans chaque case de la matrice fusionnée.
Cette opération d’agrégation catégorielle doit toutefois être guidée par des considérations théoriques solides et ne jamais être exécutée de manière opportuniste ou ad hoc dans le seul but d’obtenir une significativité artificielle (évitement du p-hacking). Si le regroupement de modalités s’avère épistémologiquement indéfendable ou impossible (notamment dans un tableau strict de dimension 2×2 où aucune réduction dimensionnelle n’est concevable), le chercheur se heurte à une limitation structurelle intrinsèque de Microsoft Excel : l’absence d’algorithme natif pour exécuter directement le test exact de Fisher sur des tables de dimensions arbitraires.
Si la formule native TEST.F d’Excel existe, elle se cantonne à l’analyse de variances de variables métriques et ne réalise en aucun cas le test exact hypergéométrique de Fisher pour matrices de contingence qualitatives. Dès lors, lorsque les critères de Cochran sont violés dans une table 2×2, ou qu’un grand tableau comporte trop de cellules quasi désertes non réductibles, le statisticien intègre doit documenter l’impasse dans son classeur Excel et réorienter méthodologiquement le jeu de données vers des environnements spécialisés (tels que R avec la fonction fisher.test() ou JASP) capables d’exécuter des permutations exactes ou des méthodes de Monte-Carlo.
3. Formulation rigoureuse du cadre d’hypothèses statistiques
3.1 Définition formelle de l’hypothèse nulle et de l’hypothèse alternative
La conduite d’une analyse inférentielle impose une clarification formelle des propositions théoriques rivales soumises à l’épreuve des faits. Dans le cadre du test du khi-carré de Pearson, le formalisme statistique s’articule autour d’une hypothèse nulle d’indépendance stochastique, conventionnellement notée H₀, et d’une hypothèse alternative d’association ou de dépendance, désignée par H₁.
L’hypothèse nulle postule rigoureusement que les deux attributs qualitatifs investigués sont totalement indépendants au sein de la population parente dont est issu l’échantillon expérimental. D’un point de vue mathématique, cela signifie que la distribution de probabilité conjointe correspond exactement au produit des distributions de probabilités marginales pour chaque paire d’indices (i, j) :
H₀ : P(X = i ∩ Y = j) = P(X = i) × P(Y = j), ∀ i ∈ {1, …, r} et ∀ j ∈ {1, …, c}
À l’opposé, l’hypothèse alternative H₁ ne postule pas une modalité d’interaction spécifique ou une directionnalité linéaire, mais énonce simplement la négation logique de la proposition précédente :
H₁ : ∃ (i, j) tel que P(X = i ∩ Y = j) ≠ P(X = i) × P(Y = j)
Il est primordial de souligner la nature fondamentalement non directionnelle (omnibus) et bilatérale du test du khi-carré d’indépendance. Contrairement à un test t de Student unilatéral où le chercheur peut formuler l’hypothèse a priori qu’une moyenne de groupe est strictement supérieure à une autre, le test du khi-carré évalue l’omnibus d’un écart structural global. Rejeter H₀ atteste l’existence d’une liaison statistiquement significative entre les variables sans pour autant révéler immédiatement quelles cellules spécifiques génèrent cette dépendance ou quel est le sens psychologique exact de cette attraction/répulsion catégorielle.
3.2 Détermination du seuil de significativité alpha
Le paramétrage du seuil de risque d’erreur, conventionnellement noté α (alpha), cristallise l’arbitrage épistémologique entre la propension à détecter des effets réels et le refus d’entériner des artefacts d’échantillonnage. En psychologie et dans les sciences du comportement, le standard universellement adopté depuis les travaux fondateurs de Ronald Fisher fixe ce seuil à 0,05 (soit un risque d’erreur consenti de 5 %). Adopter α = 0,05 signifie que le chercheur accepte de rejeter l’hypothèse nulle à tort dans 5 % des cas où celle-ci serait pourtant rigoureusement vérifiée dans la population générale.
Toutefois, ce calibrage standard ne doit pas être appliqué de façon mécanique ou décontextualisée. Dans les protocoles de recherche impliquant des tests d’hypothèses multiples menés simultanément sur les sous-groupes d’une même base de données, l’accumulation stochastique des risques d’erreur conduit inévitablement à un phénomène d’inflation du risque global de type I (taux d’erreur par famille). Si un chercheur multiplie les tableaux de contingence en croisant frénétiquement des dizaines de variables démographiques sans correction méthodologique, la probabilité d’obtenir au moins une association fallacieuse significative explose bien au-delà des 5 % nominaux.
Dans ce contexte, le recours à des procédures de contrôle strictes, telles que la correction conservatrice de Bonferroni (qui prescrit de diviser le seuil α par le nombre total de comparaisons indépendantes effectuées) ou la procédure de Holm-Bonferroni, devient obligatoire. Néanmoins, l’analyste sous Excel doit manipuler ces corrections avec une lucidité critique absolue : chaque diminution arbitraire du seuil α pour juguler l’erreur de type I détériore mécaniquement la puissance statistique (1 – β) de l’analyse, accroissant drastiquement le risque d’erreur de type II (non-rejet d’une hypothèse nulle pourtant fausse dans la réalité).
3.3 Contextualisation empirique : Étude de l’affiliation politique et du genre
Afin d’ancrer de manière didactique et opérationnelle l’intégralité des procédures de calcul qui seront développées dans ce manuel, nous définissons un scénario empirique complet issu de la psychologie politique et sociale contemporaine. Supposons une équipe de recherche souhaitant investiguer les déterminants psychosociaux des choix électoraux au sein d’une population d’adultes francophones. L’objectif consiste à évaluer s’il existe une association structurelle significative entre l’identité de genre déclarée par les individus et leur affiliation idéologique partisane.
La recherche mobilise un échantillon probabiliste rigoureusement stratifié de N = 500 participants majeurs ayant accepté de répondre anonymement à un questionnaire sociologique standardisé. Le protocole opérationnalise l’investigation à travers deux facteurs qualitatifs multinomiaux bien délimités :
- La variable indépendante (ou facteur prédicteur théorique) : Le « Genre » du répondant, conceptualisé ici selon deux modalités nominales exhaustives et mutuellement exclusives : Femme et Homme (disposition factorielle à 2 niveaux en lignes).
- La variable dépendante (ou critère de segmentation psychosociale) : L’« Affiliation politique », opérationnalisée selon trois grandes tendances doctrinales représentatives du spectre électoral : Gauche, Centre et Droite (disposition factorielle à 3 niveaux en colonnes).
Le croisement méthodique de ces deux attributs définit un espace géométrique d’observation sous la forme d’un tableau matriciel de contingence comportant 2 lignes et 3 colonnes (soit une matrice 2×3 comportant 6 cellules empiriques élémentaires). Sur le plan théorique, rejeter l’hypothèse nulle H₀ d’indépendance dans ce contexte expérimental reviendra à démontrer scientifiquement que le positionnement idéologique des individus n’est pas distribué de manière homogène entre les genres, suggérant l’influence de mécanismes de socialisation différentielle ou de représentations identitaires clivées dans l’orientation politique contemporaine.
4. Structuration et saisie de la matrice de contingence dans Excel
4.1 Disposition géométrique des données brutes observées
La première phase de la mise en œuvre pratique sous Excel réside dans l’organisation rigoureuse de l’espace de travail au sein de la feuille de calcul. Une structuration spatiale claire prévient les erreurs de référencement de cellules et optimise la traçabilité de la chaîne analytique. Il est fortement recommandé d’allouer la zone supérieure gauche du classeur à la table empirique des effectifs observés (communément dénommée table de contingence empirique).
Conformément aux conventions standardisées de l’analyse bidimensionnelle, positionnez systématiquement les modalités de la première variable catégorielle (le Genre, variable en lignes) le long de l’axe vertical, et les modalités de la seconde variable (l’Affiliation politique, variable en colonnes) le long de l’axe horizontal. Dans notre classeur modèle, nous réservons la cellule A3 pour l’intitulé de la première variable (« Genre ») et la plage A4:A5 pour ses deux modalités exclusives respectives : « Femme » en A4 et « Homme » en A5.
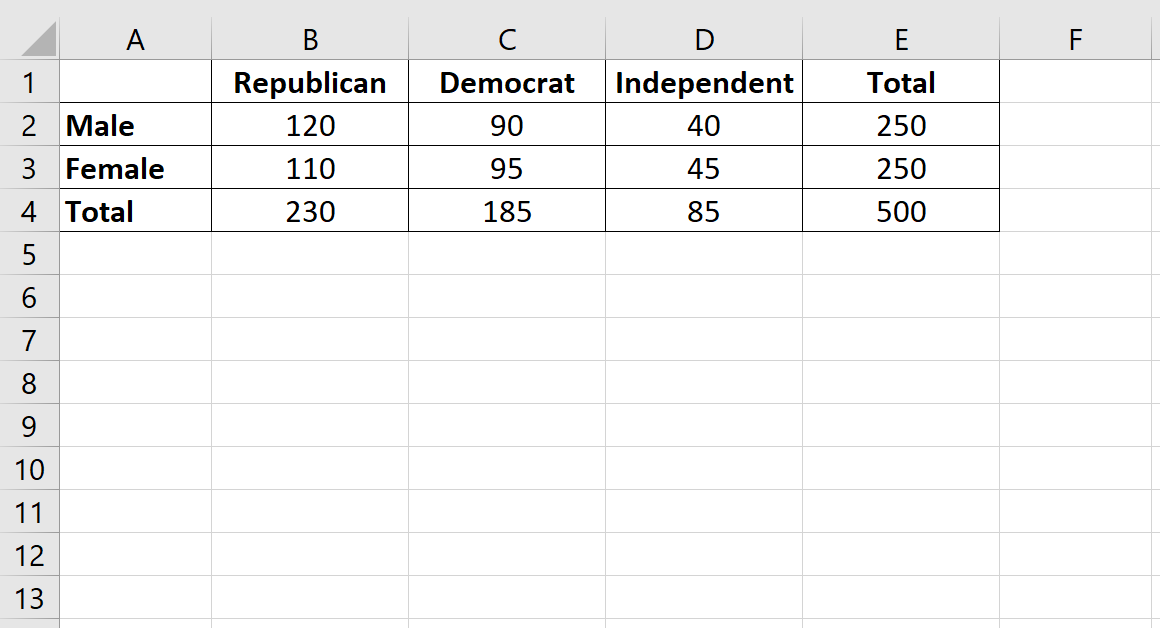
Sur le plan horizontal, la plage B3:D3 accueille les étiquettes des trois orientations politiques : « Gauche » en B3, « Centre » en C3 et « Droite » en D3. Dès lors, la plage centrale B4:D5 héberge les données d’observation issues du dénombrement des 500 sujets de notre étude empirique. Ces valeurs brutes observées, notées Oij, sont saisies manuellement sans aucune formule intermédiaire :
- Cellule
B4(Femmes de Gauche) : 120 - Cellule
C4(Femmes du Centre) : 80 - Cellule
D4(Femmes de Droite) : 60 - Cellule
B5(Hommes de Gauche) : 70 - Cellule
C5(Hommes du Centre) : 70 - Cellule
D5(Hommes de Droite) : 100
4.2 Calcul des totaux marginaux de lignes et de colonnes
Une fois les fréquences d’observation brutes renseignées dans le tableau matriciel, la construction des marges arithmétiques s’impose comme une étape incontournable. Les totaux marginaux représentent les distributions univariées d’échantillonnage de chaque variable prise isolément, sans considération de l’état de l’autre attribut. Dans Excel, ces grandeurs doivent être calculées au moyen de fonctions dynamiques natives afin de garantir l’actualisation automatique du modèle en cas de modification ultérieure des valeurs brutes.
Pour dériver les marges horizontales (totaux par modalité de genre), insérez l’étiquette « Total » dans la cellule E3. Dans la cellule E4, saisissez rigoureusement la formule sommatoire vectorielle suivante :
=SOMME(B4:D4)
Cette commande retourne la valeur 260, correspondant au nombre total de femmes constituant l’échantillon. Étirez cette formule vers le bas ou saisissez en E5 la commande =SOMME(B5:D5), qui délivre l’effectif marginal masculin équivalant à 240.
De manière symétrique, générez la ligne des marges verticales (totaux par modalité politique) en renseignant l’étiquette « Total » en A6. Dans la plage horizontale B6:D6, insérez les fonctions d’agrégation verticale correspondantes :
- En
B6:=SOMME(B4:B5), générant un total marginal de 190 électeurs de Gauche. - En
C6:=SOMME(C4:C5), fixant la marge centrale à 150 individus. - En
D6:=SOMME(D4:D5), matérialisant un effectif marginal de 160 électeurs de Droite.
Sur le plan ergonomique, il convient d’appliquer des bordures inférieures doubles et des bordures latérales épaisses aux cellules marginales afin d’éviter toute confusion visuelle entre les données brutes observées et les totaux d’agrégation.
4.3 Contrôle de cohérence de la taille totale de l’échantillon
L’intersection géométrique de la colonne marginale et de la ligne marginale (cellule E6) incarne le cardinal global de l’échantillon expérimental, universellement désigné par la lettre N. Cette cellule est le point d’ancrage névralgique de toute l’architecture de calcul subséquente. Pour s’assurer de l’absence absolue de corruption arithmétique ou d’omission lors de l’encodage des données, l’analyste doit impérativement instaurer un double contrôle de cohérence vectorielle.
Le grand total N peut être calculé indifféremment par l’addition des marges de lignes ou par l’addition des marges de colonnes. En E6, implémentez la somme des marges horizontales :
=SOMME(E4:E5)
Cette instruction renvoie précisément 500. Pour sanctuariser ce résultat et prévenir toute erreur de saisie masquée (telle qu’une omission de participant ou une incohérence de bordure), il est méthodologiquement judicieux d’introduire dans une cellule adjacente (par exemple en F6) une formule logique d’audit algorithmique :
=SI(SOMME(E4:E5)=SOMME(B6:D6); "Intégrité validée (N=" & E6 & ")"; "ERREUR D'INTÉGRITÉ")
Cette précaution garantit que la somme des colonnes marginales coïncide à l’unité près avec la somme des lignes marginales. Tant que ce feu vert algorithmique n’apparaît pas clairement sur la feuille de travail, toute tentative de dérivation des effectifs théoriques attendus demeure formellement prohibée, car elle propagerait un biais d’échelle dévastateur sur l’ensemble de la statistique d’épreuve.
5. Calcul matriciel des effectifs théoriques attendus dans Excel
5.1 Formalisation algébrique des fréquences attendues sous indépendance
L’étape de modélisation théorique constitue le cœur conceptuel de la démarche de Pearson. Il s’agit d’engendrer une seconde matrice, isomorphe à la matrice des observations brutes, décrivant la répartition idéale des 500 sujets si l’hypothèse nulle H₀ d’indépendance parfaite entre le Genre et l’Affiliation politique était strictement respectée. Dans ce monde hypothétique de non-liaison, la proportion d’individus adhérant à une orientation politique spécifique devrait être rigoureusement identique chez les femmes et chez les hommes, reflétant fidèlement le poids marginal de cette opinion dans l’échantillon global.
Soit Ri le total marginal de la ligne i (le nombre total de participants appartenant au genre i), Cj le total marginal de la colonne j (le nombre total d’individus partageant l’affiliation politique j), et N la taille globale de l’échantillon d’étude. La probabilité théorique conjointe d’appartenir simultanément à la cellule (i, j) est égale à :
P(i ∩ j) = P(Ligne i) × P(Colonne j) = (Ri / N) × (Cj / N)
L’effectif théorique attendu Eij (souvent noté fe pour expected frequency) s’obtient en multipliant cette probabilité conjointe par la taille globale de l’échantillon N :
Eij = N × [(Ri / N) × (Cj / N)] = (Ri × Cj) / N
Cette simplification algébrique démontre que l’effectif attendu sous indépendance est invariablement égal au produit du total marginal de sa ligne par le total marginal de sa colonne, le tout divisé par le grand effectif total. Il est impératif, à ce stade du processus dans Excel, de ne jamais arrondir les valeurs obtenues à l’entier le plus proche. Les effectifs théoriques représentent des espérances mathématiques continues et doivent conserver l’intégralité de leur précision décimale (au minimum 4 à 6 décimales dans le moteur de calcul du tableur) pour garantir la justesse de la statistique d’épreuve finale.
5.2 Utilisation stratégique des références absolues et relatives
La puissance d’automatisation d’Excel repose sur la maîtrise fondamentale de la notation par dollars ($) pour alterner judicieusement entre références relatives, mixtes et absolues. Dériver manuellement la formule de chaque cellule théorique serait fastidieux et source d’erreurs humaines substantielles. Une structuration algébrique optimale permet de concevoir une formule unique maîtresse au sein de la cellule initiale, que l’analyste peut ensuite recopier par simple glissement bidirectionnel sur l’intégralité de la matrice attendue.
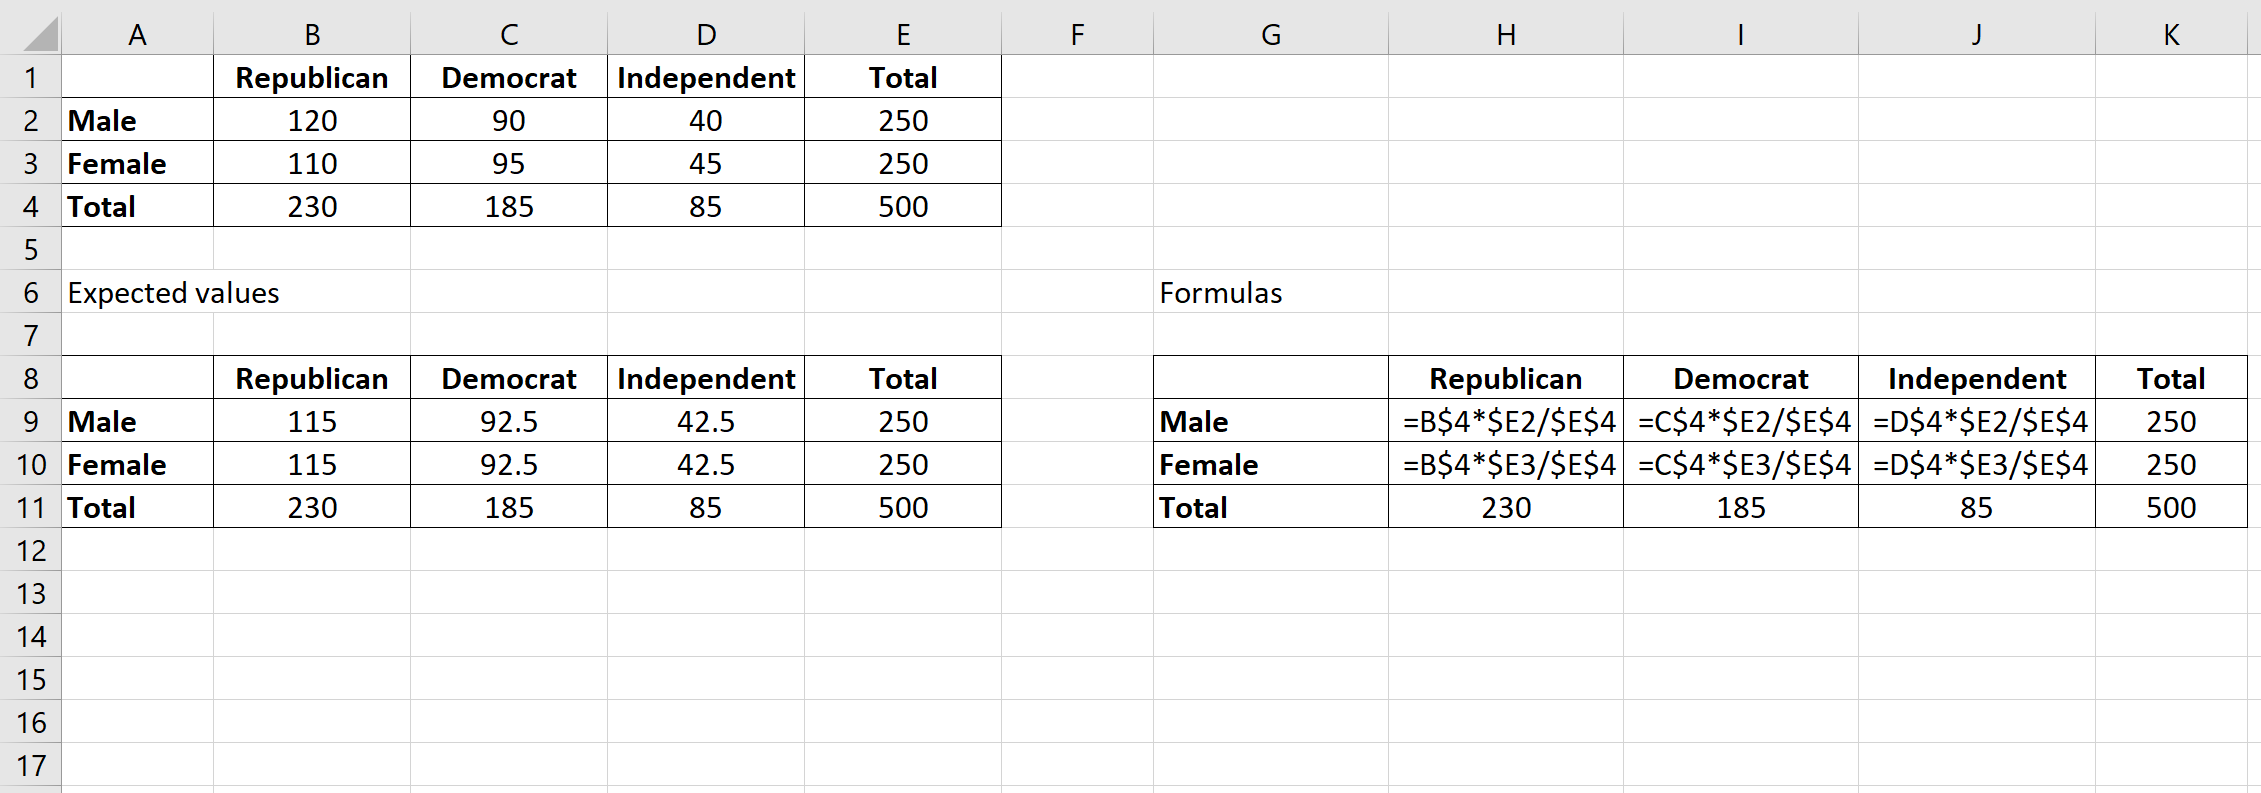
Construisons la table miroir des effectifs théoriques dans la zone inférieure de notre classeur. Laissons quelques lignes de séparation et positionnons les en-têtes identiques dans la plage A9:D11. Le Genre reste consigné en A10:A11 (« Femme », « Homme ») et la politique en B9:D9 (« Gauche », « Centre », « Droite »). La première cellule théorique à compléter est B10, qui modélise l’effectif attendu des « Femmes de Gauche ».
Pour implémenter la règle mathématique (Rligne 4 × Ccolonne B) / N, nous devons analyser les mouvements de translation de la formule lors de l’étirement matriciel :
- Le total marginal de la ligne féminine se trouve en
E4. Lors d’un étirement horizontal vers les colonnes du Centre et de la Droite, la référence doit rester scellée sur la colonne marginaleE, mais doit pouvoir descendre sur la ligne5lors d’un étirement vertical vers les hommes. Nous verrouillons donc la colonne par une référence mixte :$E4. - Le total marginal de la politique de Gauche réside en
B6. Lors d’un étirement horizontal, la formule doit se déplacer librement vers les colonnesCetD, mais doit rester scellée sur la ligne marginale6lors de l’étirement vers le bas. Nous verrouillons donc la ligne par une référence mixte :B$6. - Le grand effectif total N est immuablement localisé dans la cellule
E6. Son positionnement ne doit souffrir d’aucune dérive directionnelle. Nous appliquons un verrouillage absolu bilatéral intégral :$E$6.
Ainsi, la formule maîtresse unifiée à saisir dans la cellule B10 s’énonce impérativement comme suit :
=($E4*B$6)/$E$6
5.3 Génération de la table miroir des effectifs théoriques
Une fois la commande =($E4*B$6)/$E$6 encodée avec précision dans la cellule B10, l’analyste procède à la génération instantanée de l’ensemble de la table miroir. Cliquez sur le coin inférieur droit de la cellule B10 (la poignée de recopie incrémentée) et étirez la sélection horizontalement jusqu’à la cellule D10, puis, sans relâcher la logique matricielle, prolongez l’étirement vers le bas pour couvrir la plage B10:D11.
Le moteur de calcul d’Excel génère alors instantanément les valeurs théoriques suivantes (arrondies ici à deux décimales pour des motifs de lisibilité textuelle, mais conservées dans leur infinité flottante par le tableur) :
- Cellule
B10(Femmes de Gauche attendues) : (260 × 190) / 500 = 98,80 - Cellule
C10(Femmes du Centre attendues) : (260 × 150) / 500 = 78,00 - Cellule
D10(Femmes de Droite attendues) : (260 × 160) / 500 = 83,20 - Cellule
B11(Hommes de Gauche attendus) : (240 × 190) / 500 = 91,20 - Cellule
C11(Hommes du Centre attendus) : (240 × 150) / 500 = 72,00 - Cellule
D11(Hommes de Droite attendus) : (240 × 160) / 500 = 76,80
Deux protocoles d’audit immédiat doivent être exécutés :
- Sommation de validation : En calculant la somme totale de cette nouvelle matrice miroir par la commande
=SOMME(B10:D11), on doit obtenir rigoureusement 500,00. L’espérance totale des effectifs théoriques équivaut toujours indéfectiblement à l’effectif observé total de l’échantillon d’origine. - Audit de Cochran : Procédez à une inspection visuelle minutieuse de l’ensemble des 6 cellules théoriques générées. La plus petite valeur observée dans notre cas est de 72,00 (cellule
C11). Toutes les cellules théoriques sont donc largement supérieures au plancher critique de 5 imposé par les règles de décision de Cochran. Les postulats asymptotiques sont validés avec une marge de sécurité exceptionnelle.
6. Calcul pas à pas des écarts quadratiques réduits
6.1 Détermination des résidus bruts d’observation
L’estimation de la divergence statistique requiert une analyse différentielle directe entre le fait empirique observé et l’attente théorique modélisée. Cette confrontation commence par le calcul des résidus bruts d’observation, désignés par l’écart arithmétique simple (Oij – Eij) pour chaque compartiment catégoriel.
Dans un troisième tableau dimensionnel disposé sous les précédents (par exemple dans la plage B15:D16), nous pourrions formaliser ces différences en écrivant pour la première cellule la syntaxe =B4-B10. L’évaluation arithmétique révèle immédiatement l’orientation vectorielle du phénomène psychologique :
- Pour les Femmes de Gauche (
B4 - B10) : 120 – 98,80 = +21,20. Le signe positif atteste une surreprésentation empirique : les femmes de gauche sont nettement plus nombreuses dans l’échantillon que ce que prédirait le seul hasard stochastique. - Pour les Femmes de Droite (
D4 - D10) : 60 – 83,20 = -23,20. Le signe négatif indique une sous-représentation marquée des femmes dans l’électorat conservateur par rapport au modèle d’indépendance pure.
Il est fondamental de noter une propriété mathématique universelle inaltérable des matrices de contingence : la somme algébrique brute de l’ensemble des résidus simples Σ (Oij – Eij) sur l’ensemble de la table est obligatoirement égale à zéro (aux imprécisions de virgule flottante près). Les surreprésentations observées dans certains quadrants compensent mathématiquement les déficits constatés dans les autres. C’est précisément cette neutralisation par sommation nulle qui interdit l’usage direct des résidus simples pour mesurer l’écart global et contraint les statisticiens à opérer une transformation quadratique.
6.2 Élévation au carré et pondération par les effectifs attendus
Pour contourner l’annihilation mutuelle des résidus positifs et négatifs, l’ingénierie statistique pearsonienne applique deux opérations successives remarquables. En premier lieu, chaque résidu brut est élevé au carré : (Oij – Eij)². Cette opération géométrique présente le double avantage d’éliminer définitivement tous les signes négatifs (un nombre réel élevé au carré étant nécessairement positif) et d’amplifier de façon non linéaire le poids accordé aux écarts substantiels par rapport aux fluctuations mineures.
Toutefois, un écart quadratique brut de 100 n’a pas la même signification statistique selon qu’il survient au sein d’une catégorie mobilisant 20 individus théoriques ou dans un compartiment qui en rassemble 2 000. Pour obtenir une métrique sans dimension standardisée, Karl Pearson a établi qu’il fallait pondérer (diviser) chaque écart quadratique par l’effectif théorique attendu de la cellule sous-jacente. Cette normalisation transforme l’écart absolu en une grandeur standardisée appelée écart quadratique réduit ou contribution élémentaire au khi-carré :
χ²ij = (Oij – Eij)² / Eij
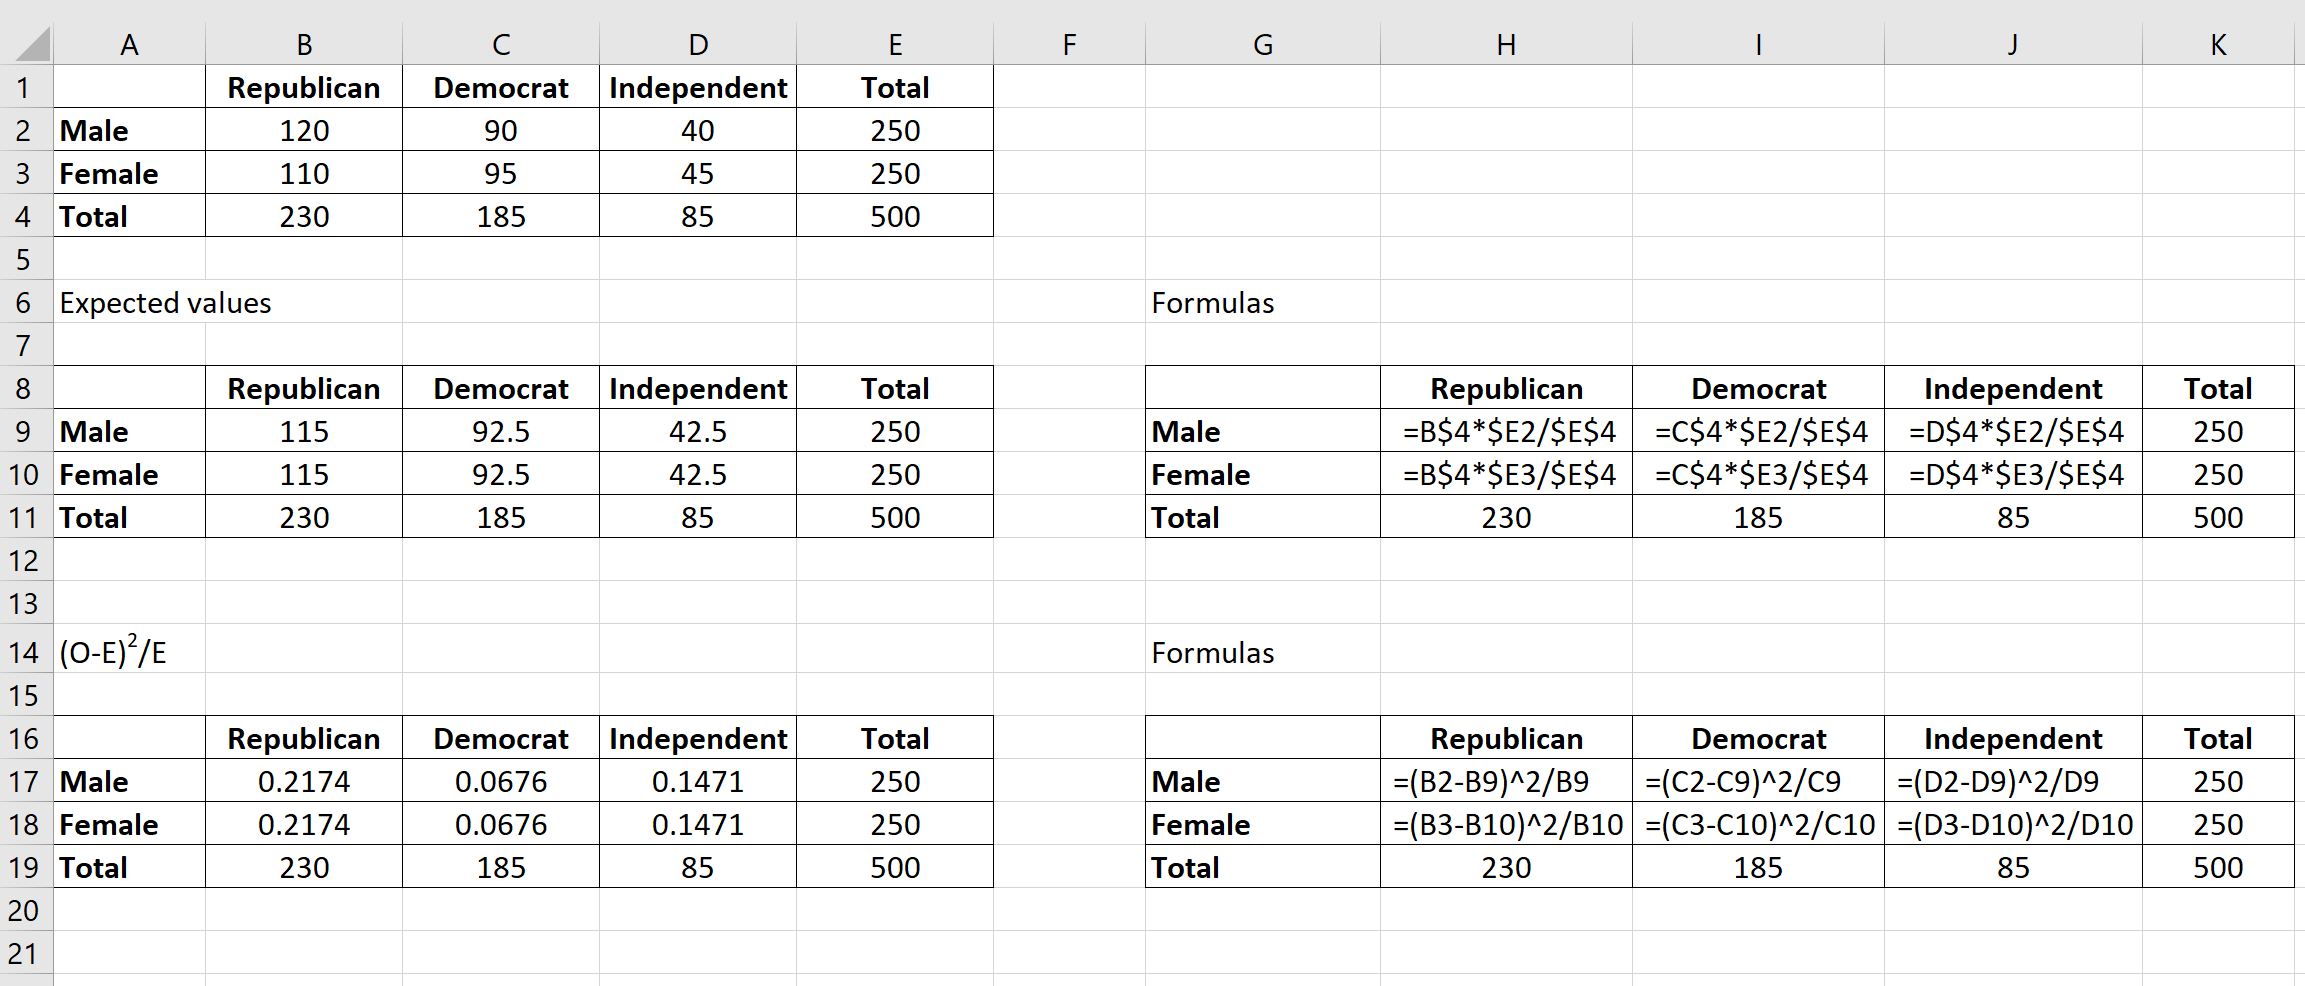
Dans notre feuille Excel, structurons la matrice terminale des contributions au khi-carré dans la plage B15:D16, avec les mêmes libellés de lignes (« Femme » en A15, « Homme » en A16) et de colonnes (« Gauche » en B14, « Centre » en C14, « Droite » en D14). Dans la cellule initiale B15, saisissez la formule synthétique combinée exploitant directement les coordonnées des deux tables matrices préalablement confectionnées :
=((B4-B10)^2)/B10
Recopiez ensuite cette formule par étirement incrémenté sur l’intégralité de la plage B15:D16.
6.3 Identification des cellules contribuant le plus à l’écart global
L’étirement de la formule matricielle dans la plage B15:D16 engendre les valeurs de contributions partielles suivantes :
- Cellule
B15(Femmes de Gauche) : (120 – 98,80)² / 98,80 = (21,20)² / 98,80 = 4,5486 - Cellule
C15(Femmes du Centre) : (80 – 78,00)² / 78,00 = (2,00)² / 78,00 = 0,0513 - Cellule
D15(Femmes de Droite) : (60 – 83,20)² / 83,20 = (-23,20)² / 83,20 = 6,4692 - Cellule
B16(Hommes de Gauche) : (70 – 91,20)² / 91,20 = (-21,20)² / 91,20 = 4,9281 - Cellule
C16(Hommes du Centre) : (70 – 72,00)² / 72,00 = (-2,00)² / 72,00 = 0,0556 - Cellule
D16(Hommes de Droite) : (100 – 76,80)² / 76,80 = (23,20)² / 76,80 = 7,0083
L’examen clinique de cette table intermédiaire livre des indications diagnostiques capitales que la simple lecture d’une p-valeur finale ne saurait révéler. On constate d’emblée que les deux cellules centrales (C15 et C16), relatives à l’électorat centriste, affichent des contributions infinitésimales (environ 0,05), ce qui atteste que l’orientation centriste est distribuée de manière quasi parfaitement proportionnelle entre les hommes et les femmes.
À l’inverse, les cellules D16 (Hommes de Droite, contribution = 7,01) et D15 (Femmes de Droite, contribution = 6,47), suivies par les cellules de l’électorat de Gauche, concentrent la quasi-totalité de l’écart au modèle d’indépendance. Pour sublimer cette lecture heuristique sous Excel, appliquez sur la plage B15:D16 une règle de mise en forme conditionnelle : sélectionnez Accueil > Mise en forme conditionnelle > Nuances de couleurs (en choisissant une palette allant du blanc ou vert clair pour les faibles valeurs vers le rouge cramoisi pour les valeurs élevées). Ce repérage visuel fait instantanément ressortir les foyers d’attraction et de répulsion catégorielle au sein de l’architecture matricielle.
7. Dérivation de la statistique globale du khi-carré et degrés de liberté
7.1 Sommation terminale de la matrice des résidus pondérés
L’obtention de la statistique d’épreuve globale du test de Pearson — formellement désignée par la lettre grecque chi élevée au carré (χ²) — s’accomplit par l’agrégation finale de l’ensemble des écarts quadratiques réduits calculés au sein de la matrice précédente. Mathématiquement, cette sommation bidimensionnelle s’exprime par la double intégration discrète sur les lignes et les colonnes de la table :
χ²obs = Σi=1..r Σj=1..c [ (Oij – Eij)² / Eij ]
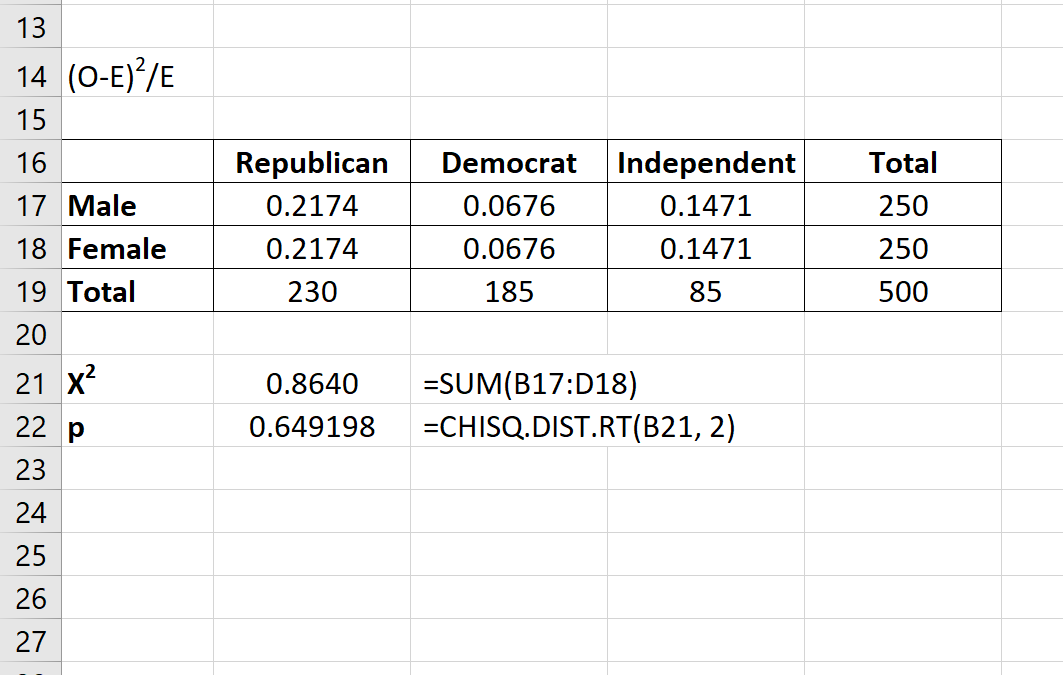
Dans notre classeur de modélisation, allouons une cellule dédiée et mise en exergue à cette valeur cardinale, par exemple la cellule B19, précédée en A19 de l’étiquette explicite « Statistique Khi-deux observée (χ²) ». Dans cette cellule B19, implémentez l’opérateur d’agrégation d’Excel :
=SOMME(B15:D16)
L’évaluation numérique délivre avec une précision chirurgicale :
χ²obs = 4,5486 + 0,0513 + 6,4692 + 4,9281 + 0,0556 + 7,0083 = 23,0611
Puisque chaque contribution élémentaire est issue d’un ratio de termes strictement positifs, la statistique globale du khi-carré est invariablement bornée inférieurement par zéro (χ² ≥ 0). Une valeur de zéro indiquerait une adéquation absolue et rigoureuse entre les effectifs observés et théoriques (une situation d’indépendance stochastique pure). Plus la grandeur numérique de χ²obs croît, plus l’écart structural entre la configuration empirique et l’hypothèse de neutralité s’accroît, rendant cette dernière de moins en moins plausible.
7.2 Calcul algorithmique des degrés de liberté associés
Une statistique du khi-carré ne possède aucune signification interprétable de manière isolée ; sa grandeur dépend intrinsèquement de la dimensionnalité de la table de contingence d’où elle émerge. Cette dimensionnalité est formalisée mathématiquement par la notion de degrés de liberté, universellement abrégée par ddl (ou df pour degrees of freedom). Les degrés de liberté représentent le nombre de cellules de la matrice d’observation qui peuvent être renseignées de manière totalement libre avant que toutes les autres ne soient mathématiquement et géométriquement verrouillées par l’obligation de respecter les totaux marginaux préétablis.
Pour une table de contingence croisant une variable à r lignes et une variable à c colonnes, le nombre de degrés de liberté est formulé invariablement par l’équation :
ddl = (r – 1) × (c – 1)
Dans notre étude empirique croisant le Genre (2 modalités) et l’Affiliation politique (3 modalités), nous obtenons :
ddl = (2 – 1) × (3 – 1) = 1 × 2 = 2
Afin de concevoir une feuille de calcul automatisée pérenne et réutilisable pour d’autres configurations matricielles, il est préférable de ne pas inscrire ce chiffre « 2 » en dur dans les formules, mais de le faire dériver algorithmiquement par Excel à l’aide des fonctions de dimensionnement vectoriel. En réservant la cellule B20 pour les degrés de liberté, implémentez la commande suivante :
=(LIGNES(B4:D5)-1)*(COLONNES(B4:D5)-1)
Cette syntaxe dynamique extrait directement le nombre d’enregistrements catégoriels de la matrice des observations brutes, assurant l’actualisation instantanée des degrés de liberté si le tableau venait à être redimensionné.
7.3 Propriétés distributionnelles de la statistique d’épreuve
La statistique du khi-carré suit sous l’hypothèse nulle une loi de probabilité continue théorique : la distribution du khi-carré, dont l’unique paramètre formel est précisément le nombre de degrés de liberté k. L’analyste doit impérativement comprendre les propriétés topologiques de cette loi pour interpréter correctement ses résultats sous tableur.
La distribution du khi-carré est une loi strictement asymétrique positive, définie exclusivement sur le domaine des nombres réels positifs [0, +∞[. Pour de faibles valeurs de degrés de liberté (comme ddl = 1 ou ddl = 2), la densité de probabilité est fortement étirée vers la droite, présentant une décroissance exponentielle rapide. L’espérance mathématique d’une loi du khi-carré est rigoureusement égale à son nombre de degrés de liberté E(χ²) = k, tandis que sa variance théorique est égale au double de ses degrés de liberté Var(χ²) = 2k.
Dans notre exemple empirique où ddl = 2, l’espérance mathématique théorique de la statistique sous l’hypothèse nulle d’absence d’effet est simplement de 2. Or, la valeur que nous avons empiriquement dérivée de nos observations s’élève à 23,0611. Ce constat intuitif préliminaire met en relief le gouffre statistique qui sépare notre résultat empirique de la valeur centrale attendue sous H₀. Au fur et à mesure que les degrés de liberté s’élèvent (au-delà de 30 à 50 ddl), le théorème central limite s’applique, et la distribution du khi-carré perd progressivement son asymétrie pour converger asymptotiquement vers une loi normale gaussienne standardisée.
8. Automatisation directe via les fonctions natives intégrées d’Excel
8.1 Syntaxe et fonctionnement de la fonction TEST.KHIDEUX
Parallèlement à la décomposition pédagogique matricielle, Microsoft Excel intègre des fonctions statistiques natives sophistiquées capables de court-circuiter l’intégralité des tableaux intermédiaires pour fournir instantanément la probabilité critique asymptotique du test. La fonction moderne de référence s’intitule TEST.KHIDEUX (correspondant à CHISQ.TEST dans les déclinaisons anglophones du tableur).
La syntaxe de cette commande requiert obligatoirement deux arguments matriciels disjoints d’égales dimensions :
=TEST.KHIDEUX(plage_données_réelles; plage_données_théoriques)
L’implémentation opérationnelle de cette fonction au sein de notre classeur modèle s’exécute en positionnant l’étiquette descriptive « p-valeur directe (TEST.KHIDEUX) » en cellule A22, puis en insérant en B22 la formulation rigoureuse suivante :
=TEST.KHIDEUX(B4:D5; B10:D11)
Une mise en garde méthodologique absolue doit être formulée ici : les plages sélectionnées comme arguments formels doivent strictement et exclusivement se limiter aux données élémentaires croisées, en excluant formellement les totaux marginaux de lignes, de colonnes ou le grand effectif global. Si par mégarde un utilisateur intégrait la ligne 6 ou la colonne E dans les arguments de TEST.KHIDEUX, l’algorithme sous-jacent traiterait ces totaux marginaux comme des données de fréquences supplémentaires, ce qui fausserait irrémédiablement le dimensionnement des degrés de liberté et corromprait l’intégrité de l’évaluation probabiliste.
8.2 Évolution terminologique et rétrocompatibilité des versions logicielles
L’histoire du moteur de calcul d’Excel a été marquée par une révision substantielle de sa bibliothèque de fonctions statistiques lors du déploiement de la version Office 2010. Les analystes travaillant sur des postes institutionnels hétérogènes ou échangeant des classeurs avec des collaborateurs évoluant sur des versions patrimoniales doivent maîtriser l’arbre des équivalences terminologiques.
Avant la refonte de 2010, le test d’indépendance était exécuté sous l’étiquette syntaxique CHITEST (en français comme en anglais dans certaines versions précoces, bien que francisé ultérieurement en TEST.PEARSON ou maintenu sous CHITEST). Cette ancienne formule est toujours supportée par Microsoft dans les versions récentes au titre de la compatibilité ascendante, mais elle ne fait plus l’objet d’aucune optimisation d’architecture logicielle. Il convient donc de proscrire définitivement son usage dans les nouvelles recherches scientifiques au profit de la syntaxe normalisée TEST.KHIDEUX.
Par ailleurs, pour les chercheurs collaborant dans des consortiums internationaux employant la version internationale en langue anglaise du logiciel, le tableau suivant synthétise les transpositions exactes des fonctions statistiques impliquées :
- Français :
TEST.KHIDEUX↔ Anglais :CHISQ.TEST - Français :
LOI.KHIDEUX.DROITE↔ Anglais :CHISQ.DIST.RT - Français :
LOI.KHIDEUX.INVERSE.DROITE↔ Anglais :CHISQ.INV.RT
L’avantage cardinal d’Excel réside dans le fait que lors de l’ouverture d’un fichier .xlsx configuré en français sur un ordinateur paramétré en langue anglaise (ou inversement), le moteur de traduction interne d’Office assure la mutation syntaxique automatique des fonctions sans altérer le fonctionnement matriciel du classeur.
8.3 Avantages comparés entre automatisation directe et calcul détaillé
Face à la possibilité d’obtenir instantanément la significativité statistique via une commande unifiée en une seule ligne, la pertinence de déployer l’intégralité des calculs matriciels détaillés développés dans les sections précédentes mérite d’être explicitée. L’automatisation directe par TEST.KHIDEUX présente des atouts opérationnels indéniables : une vitesse d’exécution fulgurante, l’économie d’espace sur la feuille de travail et l’éradication des risques d’erreurs de copie lors des manipulations de cellules intermédiaires.
Néanmoins, la fonction TEST.KHIDEUX présente une limite épistémologique majeure : elle ne délivre qu’un nombre unique isolé, la p-valeur finale. Elle ne renvoie ni la valeur numérique intermédiaire de la statistique χ²obs, ni le nombre de degrés de liberté associés, ni surtout la matrice différentielle des résidus quadratiques réduits. En se cantonnant à cette boîte noire, le psychologue se prive totalement de la capacité de disséquer l’anatomie de l’effet. Il sait que le test est globalement significatif, mais demeure incapable d’indiquer quelles sont les cellules d’attributs qui violent le postulat d’indépendance.
La doctrine d’excellence méthodologique recommande donc impérativement une approche mixte : construire rigoureusement l’édifice matriciel étape par étape pour des impératifs d’audit, de transparence analytique et de diagnostic des résidus locaux, tout en exploitant parallèlement la formule intégrée TEST.KHIDEUX comme un instrument de vérification arithmétique croisée destiné à confirmer l’exactitude de la chaîne de calculs.
9. Détermination de la valeur critique et extraction de la p-valeur
9.1 Calcul de la valeur critique théorique de rejet
Dans le cadre épistémologique de l’inférence décisionnelle neymano-pearsonienne, le rejet formel de l’hypothèse nulle s’opère par la délimitation préalable d’une région critique sur la distribution théorique du khi-carré. La valeur qui sépare la région d’acceptation (ou de non-rejet) de la zone de rejet unilatéral droit s’intitule la valeur critique, désignée par χ²critique. Cette valeur dépend exclusivement de deux paramètres : le seuil d’erreur consenti α et les degrés de liberté ddl.
Historiquement, les chercheurs devaient compulser manuellement d’arides tables statistiques imprimées en annexes des manuels d’économétrie pour localiser cette abscisse critique. Sous Excel, cette grandeur s’obtient instantanément grâce à la fonction de distribution inverse de queue droite : LOI.KHIDEUX.INVERSE.DROITE.
En réservant la cellule A24 pour le libellé « Seuil alpha (α) » (où l’on renseigne 0,05 en B24) et la cellule A25 pour « Valeur critique théorique (χ² critique) », inscrivez dans la cellule B25 la syntaxe suivante :
=LOI.KHIDEUX.INVERSE.DROITE(B24; B20)
Cette instruction interroge la fonction quantile de la distribution du khi-carré à 2 degrés de liberté pour une probabilité cumulée de queue droite égale à 0,05. Le résultat retourné par Excel est sans équivoque :
χ²critique = 5,9915
Ce chiffre matérialise la frontière décisionnelle infranchissable : toute statistique observée χ²obs qui excéderait 5,9915 conduira inéluctablement au rejet péremptoire de l’hypothèse nulle au seuil de confiance de 95 %.
9.2 Calcul et interprétation de la p-valeur exacte par décomposition
Tandis que la valeur critique borne l’espace géométrique de rejet, la probabilité critique exacte — universellement désignée sous le terme de p-valeur (ou asymptotic significance) — quantifie la probabilité stochastique précise d’observer, par le simple jeu du hasard de l’échantillonnage, une divergence globale au moins aussi extrême que celle mesurée au sein de notre cohorte empirique, sous l’hypothèse fondamentale où l’hypothèse nulle serait rigoureusement vraie.
Cette probabilité s’obtient en intégrant la fonction de densité du khi-carré depuis notre statistique d’épreuve observée jusqu’à l’infini positif. Dans Excel, cette intégration continue s’exécute au moyen de la fonction native LOI.KHIDEUX.DROITE. En cellule B26, renseignez la commande :
=LOI.KHIDEUX.DROITE(B19; B20)
En injectant notre statistique observée calculée manuellement (B19 = 23,0611) et nos degrés de liberté (B20 = 2), le moteur algorithmique d’Excel produit le résultat suivant :
p = 0,000009825… soit en notation scientifique standard : 9,83 × 10⁻⁶
Si l’analyste compare ce chiffre infinitésimal avec la valeur délivrée en cellule B22 par la fonction directe =TEST.KHIDEUX(B4:D5; B10:D11), il constatera une concordance absolue jusqu’à la dernière décimale. Ce double résultat apporte la preuve empirique définitive de l’exactitude mathématique de l’intégralité du tableau de calcul intermédiaire confectionné dans notre classeur.
9.3 Règle de décision statistique et arbitrage de l’hypothèse nulle
L’étape conclusive de la phase inférentielle réside dans la formalisation de la décision statistique. Deux heuristiques équivalentes permettent de trancher de manière incontestable :
- Approche par la statistique d’épreuve : Nous comparons χ²obs à χ²critique. Dans notre dispositif, 23,0611 > 5,9915. La statistique observée se situe profondément ancrée à l’intérieur de la région critique de rejet unilatéral droit.
- Approche par la probabilité critique : Nous confrontons la p-valeur au seuil nominal préétabli α = 0,05. Dans notre étude, p = 0,00000983 < 0,05 (et même p < 0,001).
Les deux voies convergent vers une même sentence méthodologique : L’hypothèse nulle d’indépendance stochastique H₀ est rejetée de manière hautement significative.
Pour parachever l’ergonomie de la feuille de travail sous Excel, il est particulièrement élégant d’intégrer en cellule B28 une formule logique synthétique formulant automatiquement le verdict textuel :
=SI(B26<B24; "Rejet formel de H0 : Dépendance significative constatée (p < " & B24 & ")"; "Non-rejet de H0 : Absence de relation significative démontrée")
Cette automatisation garantit une lisibilité immédiate du résultat pour les évaluateurs et sécurise le processus décisionnel contre toute mauvaise lecture des décimales exponentielles.
10. Mesure de la force de l’association : Calcul de la taille d’effet dans Excel
10.1 Limites inhérentes à la seule significativité statistique
Une défaillance majeure observée dans la littérature psychologique néophyte consiste à assimiler béatement une valeur p infinitésimale (comme notre p < 0,00001) à la démonstration d'un effet psychologique massif ou d'une dépendance théorique écrasante. Cette confusion trahit une incompréhension radicale des propriétés fondamentales de l'échantillonnage statistique.
La statistique du khi-carré de Pearson possède en effet une dépendance mathématique directe et linéaire vis-à-vis de la taille globale de l’échantillon N. Si l’on multiplie par dix l’effectif de chaque cellule d’un tableau de contingence tout en maintenant des proportions de sous-groupes strictement identiques, la valeur calculée de χ² sera exactement multipliée par dix, et la p-valeur s’effondrera exponentiellement vers zéro. Dès lors, sur des cohortes d’observation massives (constituées de dizaines de milliers de répondants), des fluctuations d’indépendance totalement triviales, négligeables et dénuées de la moindre pertinence théorique ou clinique atteindront systématiquement des seuils de significativité extrêmes.
C’est précisément pour juguler ce biais d’échelle que les commissions méthodologiques internationales et les manuels de publication les plus rigoureux imposent désormais de dissocier la significativité statistique (qui atteste simplement que l’effet n’est pas réductible au hasard d’échantillonnage) de la significativité substantielle ou pratique. Cette dernière s’évalue au moyen d’indices standardisés d’ampleur d’effet (effect size), totalement affranchis de l’influence mécanique du cardinal N.
10.2 Formulation et calcul du coefficient Phi pour les tables deux par deux
Lorsque la recherche mobilise une table de contingence strictement quadratique de dimension 2×2 (comportant 1 seul degré de liberté), l’indicateur standardisé conventionnel d’ampleur d’association est le coefficient Phi, universellement désigné par la lettre grecque minuscule φ. Ce coefficient a été conçu pour standardiser le khi-carré en le ramenant sur une échelle variant entre 0 (indépendance absolue) et 1 (dépendance fonctionnelle parfaite dans une table symétrique).
La définition algébrique formelle du coefficient Phi s’énonce comme la racine carrée du quotient de la statistique d’épreuve du khi-carré par l’effectif total d’observation :
φ = √( χ² / N )
Sur le plan conceptuel, le coefficient Phi est formellement équivalent au coefficient de corrélation produit-moment r de Pearson calculé sur deux variables dichotomiques artificiellement encodées sous forme d’indicateurs binaires {0, 1}. Bien que notre cas d’étude réel soit une table 2×3 interdisant l’usage direct de Phi (ce dernier risquant de dépasser l’unité théorique de 1 sur des matrices rectangulaires dissymétriques), la syntaxe unifiée pour le calculer sous Excel dans une table 2×2 positionnerait la formule suivante :
=RACINE(B19/E6)
Cette expression allie la fonction mathématique RACINE à l’extraction directe du ratio de nos deux grandeurs mères.
10.3 Implémentation du V de Cramér pour les matrices pluridimensionnelles
Pour mesurer la force de liaison au sein de tableaux de contingence de dimensions arbitraires supérieures à 2×2 (matrices r × c comme notre dispositif 2×3), le statisticien Harald Cramér a développé une extension généralisée remarquable de l’indice de Pearson : le V de Cramér (souvent désigné par la notation VC ou simplement V). Cet indice universel intègre un facteur géométrique d’ajustement dimensionnel afin de garantir que sa borne supérieure théorique ne dépasse jamais rigoureusement 1,00, quelle que soit la complexité dimensionnelle du tableau.
L’équation canonique du V de Cramér s’exprime comme suit :
V = √[ χ² / ( N × (k – 1) ) ]
Où N désigne l’effectif total de la cohorte et le terme k représente le minimum arithmétique absolu entre le nombre de lignes r et le nombre de colonnes c de la table matricielle empirique :
k = min(r, c)
Dans le cadre de notre étude empirique croisant le Genre (r = 2) et l’Affiliation politique (c = 3), la dimension minimale est manifestement k = min(2, 3) = 2. Dès lors, le facteur correcteur dimensionnel (k – 1) est égal à (2 – 1) = 1. Dans cette configuration particulière, l’équation se simplifie numériquement :
V = √[ 23,0611 / ( 500 × 1 ) ] = √[ 0,046122 ] = 0,2148
Pour sceller cette dérivation de manière totalement dynamique et universelle dans Excel — de sorte que la formule s’adapte automatiquement si l’on injecte ultérieurement une matrice 4×5 ou 3×3 —, inscrivons en cellule A30 le libellé « Taille d’effet (V de Cramér) » et implémentons en B30 la syntaxe matricielle imbriquée suivante :
=RACINE(B19 / (E6 * (MIN(LIGNES(B4:D5); COLONNES(B4:D5)) - 1)))
Cette commande sophistiquée extrait le minimum dimensionnel via la fonction MIN, soustrait l’unité obligatoire, multiplie par le grand total de la cohorte consigné en E6, divise notre statistique globale issue de B19, et applique enfin l’opérateur RACINE pour délivrer instantanément la valeur 0,215.
10.4 Grille de lecture psychométrique de l’intensité de l’association
La qualification qualitative d’une ampleur d’effet ne relève pas de l’appréciation subjective du chercheur, mais obéit aux critères psychométriques standardisés établis par Jacob Cohen dans son ouvrage de référence sur l’analyse de puissance statistique. Néanmoins, une subtilité méthodologique souvent méconnue impose d’ajuster les seuils critiques de Cohen en fonction des degrés de liberté effectifs de la dimension minimale de la matrice, conventionnellement dénotés ddlmin = min(r – 1; c – 1).
Lorsque la dimension minimale soustraite d’une unité vaut ddlmin = 1 (ce qui est précisément notre cas puisque min(2 – 1; 3 – 1) = 1), les repères conventionnels de Jacob Cohen pour le V de Cramér s’alignent rigoureusement sur les paliers canoniques des coefficients de corrélation bivariés r :
- Effet négligeable ou trivial : V < 0,10 (l'association explique moins de 1 % de la variance partagée).
- Effet de faible intensité : 0,10 ≤ V < 0,30 (liaison décelable empiriquement mais d'une portée concrète modeste).
- Effet d’intensité modérée : 0,30 ≤ V < 0,50 (association robuste marquant une différenciation nette entre sous-groupes).
- Effet de forte intensité : V ≥ 0,50 (dépendance catégorielle majeure structurant massivement les réponses).
Pour des matrices plus denses où ddlmin = 2 (par exemple un tableau 3×3 ou 3×4), les seuils de Cohen s’abaissent mécaniquement par compensation dimensionnelle à 0,07 pour un effet faible, 0,21 pour un effet moyen et 0,35 pour un effet fort. Dans notre dispositif empirique actuel, le V de Cramér calculé atteignant 0,215, nous concluons sans ambiguïté à l’existence d’une association catégorielle statistiquement significative mais d’une ampleur modeste à faible selon les standards de la psychologie différentielle.
11. Analyse des résidus ajustés et rédaction scientifique aux normes APA
11.1 Calcul matriciel des résidus ajustés standardisés de Haberman dans Excel
Statuer sur le rejet global de H₀ et quantifier la taille d’effet par le V de Cramér clôture l’évaluation globale omnibus, mais laisse entière la question de la localisation locale des écarts : au sein de quelles catégories précises les comportements observés dévient-ils significativement de l’attente théorique ? Pour répondre à cette exigence analytique avec le plus haut degré de rigueur mathématique, la simple consultation des résidus simples ou des contributions partielles est insuffisante. Il convient de calculer les résidus ajustés standardisés (souvent appelés résidus de Haberman).
Le résidu ajusté standardisé zij conçu par Shelby Haberman divise le résidu brut non seulement par l’écart-type d’échantillonnage théorique, mais incorpore une correction stochastique prenant en compte les proportions marginales respectives de la ligne et de la colonne concernées :
zij = (Oij – Eij) / √[ Eij × (1 – Ri / N) × (1 – Cj / N) ]
Cette formulation remarquable confère aux résidus ajustés une propriété distributionnelle exceptionnelle : sous l’hypothèse nulle d’indépendance, chaque résidu zij suit asymptotiquement une loi normale centrée réduite N(0, 1). Dès lors, les valeurs calculées peuvent être directement comparées aux seuils critiques canoniques de la loi normale univariée bilatérale :
- Si |zij| > 1,96, la cellule présente un écart statistiquement significatif au seuil α = 0,05.
- Si |zij| > 2,58, l’écart est significatif au seuil α = 0,01.
- Si |zij| > 3,29, l’écart atteint une significativité extrême au seuil α = 0,001.
Construisons dans Excel la matrice des résidus de Haberman dans la plage B34:D35. Dans la cellule B34 correspondant à la première case (Femmes de Gauche), implémentez la formule unifiée suivante :
=(B4-B10)/RACINE(B10*(1-($E4/$E$6))*(1-(B$6/$E$6)))
Par un étirement incrémenté sur l’ensemble de la matrice B34:D35, Excel dérive les valeurs standardisées suivantes :
- Femmes de Gauche (
B34) : +3,81 (valeur largement supérieure à +3,29 : surreprésentation féminine massive à gauche hautement significative à p < 0,001). - Femmes du Centre (
C34) : +0,41 (inférieure en valeur absolue à 1,96 : aucune spécificité de genre significative pour le centre). - Femmes de Droite (
D34) : -4,42 (valeur inférieure à -3,29 : sous-représentation féminine à droite hautement significative à p < 0,001). - Hommes de Gauche (
B35) : -3,81 (sous-représentation masculine significative à gauche, symétrique de celle des femmes). - Hommes du Centre (
C35) : -0,41 (conformité stricte au hasard pour le centre). - Hommes de Droite (
D35) : +4,42 (surreprésentation masculine massive et hautement significative dans l’électorat conservateur).
Ce diagnostic matriciel de Haberman apporte une profondeur interprétative chirurgicale : la rupture d’indépendance est exclusivement portée par la polarisation idéologique bipolaire Gauche/Droite, le Centre demeurant un espace de neutralité stochastique absolue vis-à-vis du genre.
11.2 Normes de formalisation typographique selon la septième édition de l’APA
La publication scientifique de résultats statistiques dans les revues affiliées à l’APA exige une soumission rigoureuse à des conventions graphiques, syntaxiques et typographiques hautement standardisées. Toute négligence dans ce domaine déprécie la crédibilité académique du manuscrit soumis. Les règles de la septième édition de l’APA imposent les exigences suivantes pour le test du khi-carré :
- La lettre grecque désignant la statistique d’épreuve doit être typographiée sous sa forme latine approchée en italique avec son exposant mathématique : χ².
- Les degrés de liberté associés au modèle matriciel doivent obligatoirement figurer entre parenthèses immédiatement après le symbole de la statistique, accolés de la taille globale de l’échantillon d’observation N : χ²(ddl, N = …).
- La valeur calculée de la statistique d’épreuve doit être arrondie à deux décimales exactes.
- La valeur de la probabilité critique (p-valeur) doit être rapportée avec trois décimales. Si la valeur calculée est strictement inférieure à 0,001 (comme c’est le cas dans notre étude où p ≈ 0,00001), il est formellement interdit d’écrire
p = 0,000(une probabilité ne pouvant jamais être mathématiquement nulle dans une loi continue asymptotique) ; la convention exige la mention explicite : p < ,001. - Les zéros initiaux précédant la virgule (ou le point décimal anglophone) doivent être supprimés pour toutes les grandeurs statistiques qui sont théoriquement bornées par l’unité (c’est-à-dire qui ne peuvent jamais dépasser 1,00). Cette règle s’applique impérativement à la p-valeur (écrire p < ,001 et non p < 0,001), au coefficient Phi et au V de Cramér (écrire V = ,21 et non V = 0,21). En revanche, la statistique χ² pouvant excéder 1,00, elle conserve son zéro initial si sa valeur est inférieure à l’unité.
- L’indice de taille d’effet doit être systématiquement adjoint à la statistique inférentielle, accompagné de ses résidus standardisés majeurs pour éclairer la direction clinique de l’effet.
11.3 Modèle de paragraphe de résultats pour une publication scientifique
Afin de concrétiser le passage direct de la feuille de calcul Excel à la rédaction finale du manuscrit académique, voici la formulation exemplaire, structurée selon les canons les plus stricts de la psychologie quantitative, rendant compte de l’ensemble des analyses que nous venons de modéliser :
« Un test du khi-carré d’indépendance de Pearson a été conduit afin d’examiner l’existence d’une relation structurelle entre le genre des participants et leur affiliation idéologique politique déclarée au sein de notre cohorte (N = 500). Les conditions d’application asymptotiques de Cochran ont été rigoureusement vérifiées, l’intégralité des cellules théoriques attendues affichant des effectifs substantiellement supérieurs au seuil minimal de 5 (valeurs attendues minimales = 72,00). Les analyses révèlent une rupture statistiquement hautement significative de l’hypothèse d’indépendance stochastique entre les deux construits, χ²(2, N = 500) = 23,06, p < ,001. L'ampleur de cette association globale, estimée par le coefficient du V de Cramér, s’établit à V = ,21, ce qui correspond, selon les critères conventionnels d’interprétation psychométrique de Cohen ajustés pour un degré de liberté minimal de 1, à un effet d’intensité modeste à faible.
L’analyse approfondie de la matrice des résidus ajustés standardisés de Haberman (z) permet d’élucider la dynamique directionnelle sous-tendant cet effet omnibus. La dispersion des choix envers le Centre politique ne présente aucune déviation significative vis-à-vis du hasard stochastique, tant chez les femmes (z = 0,41, effectif observé = 80, effectif théorique = 78,00) que chez les hommes (z = -0,41, effectif observé = 70, effectif théorique = 72,00). En revanche, la dépendance catégorielle est intégralement polarisée le long de l’axe idéologique bilatéral : les répondantes féminines manifestent une surreprésentation hautement significative au sein de l’affiliation de Gauche (z = 3,81, effectif observé = 120, effectif théorique = 98,80) associée à une sous-représentation marquée au sein de l’électorat de Droite (z = -4,42, effectif observé = 60, effectif théorique = 83,20). Symétriquement, les répondants masculins s’avèrent significativement sous-représentés à Gauche (z = -3,81, effectif observé = 70, effectif théorique = 91,20) et massivement surreprésentés au sein des formations de Droite (z = 4,42, effectif observé = 100, effectif théorique = 76,80). Ces constats empiriques corroborent l’hypothèse d’un clivage psychosocial des préférences électorales en fonction du genre dans notre population d’investigation. »
12. Diagnostic des erreurs d’analyse courantes et solutions sous tableur
12.1 Gestion des erreurs de syntaxe et de référence dans Excel
La pratique empirique sous tableur confronte régulièrement le chercheur à des messages d’erreur d’ingénierie logicielle qui peuvent entraver le bon déroulement de l’analyse inférentielle. L’apparition du code d’erreur classique #VALEUR! lors de l’exécution d’une formule matricielle signale presque invariablement une anomalie de typage de données. Elle survient typiquement lorsqu’une cellule composant la table des observations brutes héberge un caractère d’espacement masqué, une tabulation résiduelle ou une convention de séparateur décimal non conforme (par exemple l’encodage d’un point au lieu d’une virgule sous un environnement de système d’exploitation paramétré en langue française).
Pour éliminer définitivement ces scories numériques lors de l’importation de fichiers .csv bruts dans Excel, appliquez la fonction de nettoyage =EPURAGE(SUPPRESPACE(cellule)) ou auditez la nature des cellules suspectes au moyen de la commande logique =ESTNUM(cellule). Si cette dernière instruction renvoie FAUX, la donnée doit être impérativement convertie en valeur numérique via la fonction =CNUM().
Un autre dysfonctionnement ubiquitaire réside dans la prolifération de l’erreur #REF! ou dans la production de résultats manifestement aberrants (tels que des totaux théoriques cumulés ne coïncidant pas avec l’effectif N). Ce phénomène est l’expression directe d’une défaillance dans le positionnement des caractères de verrouillage absolu (le symbole dollar $). L’omission de figer la colonne marginale $E ou la ligne marginale $6 dans la formule maîtresse des effectifs théoriques =($E4*B$6)/$E$6 induit un glissement parasite des plages de référence lors de l’étirement matriciel horizontal ou vertical. L’analyste doit acquérir le réflexe d’activer l’affichage des formules dans la feuille de travail via le raccourci clavier Ctrl + Guillemet (Ctrl + ") ou le ruban Formules > Afficher les formules afin de vérifier visuellement l’ancrage immuable des vecteurs de totaux marginaux sur l’ensemble des cellules de la table miroir.
12.2 Confusion fréquente entre test d’adéquation et test d’indépendance
Sur le plan conceptuel et programmatique, une méprise épistémologique pernicieuse consiste à confondre le test du khi-carré d’adéquation (ou de conformité univariée, goodness-of-fit) avec le test du khi-carré d’indépendance (ou d’association bivariée). Si les deux épreuves partagent l’identité formelle de la métrique d’écart quadratique Σ (O – E)² / E, leurs structures sous-jacentes et leurs degrés de liberté divergent radicalement.
Le test d’adéquation s’applique à un vecteur univarié isolé comportant k catégories élémentaires et évalue la conformité des fréquences observées à une distribution théorique a priori préétablie (par exemple l’équiprobabilité théorique uniforme de 1/k ou les lois de distribution génétique mendéliennes). Dans ce cadre univarié, le nombre de degrés de liberté est rigoureusement fixé à ddl = k – 1.
À l’inverse, le test d’indépendance opère obligatoirement sur un produit cartésien matriciel croisant deux variables disjointes, et ses degrés de liberté sont contraints par les dimensions marginales bidimensionnelles (r – 1) × (c – 1). L’application erronée de la fonction native TEST.KHIDEUX sur deux colonnes de données individuelles sans agrégation préalable sous forme de table de contingence constitue l’erreur type de l’utilisateur inexpérimenté : la fonction retourne un résultat calculé sur les vecteurs bruts sans que l’analyste ne prenne conscience que le tableur a traité les identifiants de participants comme des fréquences matricielles, générant une p-valeur totalement dénuée de sens scientifique.
12.3 Limites structurelles d’Excel et transition vers les logiciels statistiques dédiés
Bien qu’Excel se révèle être un instrument pédagogique et opérationnel irremplaçable pour l’analyse transparente des tables de contingence canoniques, le chercheur intègre doit savoir identifier le seuil au-delà duquel le tableur atteint ses limites algorithmiques fondamentales. Le premier goulet d’étranglement concerne l’incapacité absolue d’Excel à réaliser des calculs de permutations exactes ou de rééchantillonnage par bootstrapping non paramétrique. Lorsqu’une table présente des effectifs théoriques dérisoires violant les conditions asymptotiques de Cochran, et que tout regroupement catégoriel s’avère méthodologiquement prohibé, l’exécution d’un test exact de Fisher étendu aux dimensions r × c devient indispensable.
De surcroît, le tableur de Microsoft ne dispose d’aucun module natif pour modéliser des dépendances multivariées plus complexes impliquant trois facteurs ou davantage. Si le protocole expérimental nécessite de contrôler l’effet d’une troisième variable modératrice ou confondante (par exemple l’âge des électeurs ou leur niveau d’éducation dans notre étude Genre/Politique), le cadre bidimensionnel du test de Pearson devient obsolète et doit céder le pas à l’analyse log-linéaire multivariée ou à la régression logistique polytomique ordonnée.
Dans de telles conjectures méthodologiques, l’analyste sous tableur doit utiliser Excel pour ce qu’il accomplit avec la plus grande excellence : le nettoyage préliminaire des données, la validation de la structure d’encodage, le contrôle d’intégrité vectorielle et la dérivation des premières matrices descriptives. Une fois ce travail préparatoire sanctuarisé, l’analyste exportera fluidement le jeu de données vers des progiciels académiques dédiés tels que le langage de programmation R (au moyen du paquet epitools pour les odds ratios ou vcd pour l’analyse visuelle des données catégorielles) ou JASP pour des analyses inférentielles bayésiennes et exactes de pointe.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1952). The χ² test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press. https://press.princeton.edu/books/paperback/9780691080048/mathematical-methods-of-statistics
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications. https://uk.sagepub.com/en-gb/eur/discovering-statistics-using-ibm-spss-statistics/book255948
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning. https://www.cengage.com
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677