
L’investigation empirique au sein des sciences contemporaines, et tout particulièrement dans le champ de la psychologie scientifique et des neurosciences comportementales, repose de manière fondamentale sur la quantification des relations unissant divers construits latents et manifestations observables. Qu’il s’agisse de mesurer le degré d’association entre l’anxiété situationnelle et l’efficacité de la mémoire de travail, ou d’évaluer la convergence psychométrique entre deux instruments d’évaluation clinique, l’analyse bivariée constitue le socle indispensable sur lequel s’édifient des théories plus complexes et des modélisations causales sophistiquées. Au cœur de cette démarche épistémologique réside le test de corrélation, un outil d’une élégance mathématique remarquable qui permet de synthétiser la covariation de deux ensembles de mesures en un indice standardisé unique.
Toutefois, la manipulation de ces concepts mathématiques requiert une rigueur méthodologique sans faille. Trop souvent, l’estimation d’un coefficient d’association est réduite à une simple routine logicielle, dépouillée de la vérification critique de ses postulats sous-jacents et déconnectée de la compréhension profonde de sa distribution d’échantillonnage. L’avènement de la crise de la réplicabilité dans les sciences comportementales a mis en lumière la nécessité impérieuse de maîtriser non seulement les fondements formels des tests statistiques, mais également les outils informatiques modernes qui garantissent la transparence, la robustesse et la reproductibilité des calculs.
À cet égard, le langage de programmation statistique R s’est imposé comme l’étalon-or international pour les chercheurs, les biostatisticiens et les analystes de données. En transcendant les interfaces graphiques opaques, R offre une traçabilité intégrale de l’analyse, depuis l’importation brute des données jusqu’à la modélisation probabiliste et la visualisation avancée. Ce guide exhaustif a pour vocation d’explorer en profondeur la théorie, l’implémentation algorithmique et l’interprétation critique des tests de corrélation sous R. En abordant successivement les approches paramétriques de Pearson, les alternatives de rangs de Spearman et de Kendall, ainsi que les diagnostics d’hypothèses et les visualisations publiables, cet article constitue une référence académique complète pour quiconque souhaite manier l’analyse de corrélation avec une expertise technique et conceptuelle absolue.
1. Introduction aux tests de corrélation en psychologie et en statistiques avec R
1.1 Définition de l’association linéaire et utilité dans la recherche psychométrique
L’association linéaire caractérise la manière dont deux variables quantitatives continues varient conjointement selon une dynamique proportionnelle constante. Sur le plan conceptuel, affirmer qu’il existe une telle relation implique que l’accroissement ou la diminution d’une unité sur une échelle de mesure s’accompagne d’une variation moyenne prévisible et unidirectionnelle sur une seconde échelle. Dans le domaine de la psychométrie, cette notion s’avère indispensable pour opérationnaliser des construits théoriques abstraits. Lorsque des chercheurs conçoivent des inventaires de personnalité ou des batteries d’évaluation neuropsychologique, ils doivent impérativement s’assurer que les scores obtenus reflètent fidèlement les dimensions psychologiques ciblées, ce qui nécessite la quantification standardisée de la covariation entre différents items ou entre des échelles concurrentes.
L’estimation de cette covariation prend tout son sens lors de l’établissement de la validité de construit. On distingue traditionnellement la validité convergente, qui requiert qu’un nouvel instrument montre une corrélation substantielle avec des mesures préexistantes validées évaluant le même phénomène, de la validité discriminante, qui exige au contraire des coefficients d’association proches de zéro avec des construits théoriquement orthogonaux. L’absence d’un indice standardisé rendrait impossible la comparaison directe entre des études utilisant des métriques hétérogènes. Sans une métrique commune, comparer l’effet d’une intervention cognitive mesurée par un temps de réaction en millisecondes avec une mesure de bien-être évaluée sur une échelle ordinale relèverait de l’impasse méthodologique.
Sur le plan historique, la formalisation de cette mesure découle des travaux pionniers menés à la fin du dix-neuvième siècle. Francis Galton, étudiant les phénomènes d’hérédité biologique et la transmission de la taille des parents à leurs descendants, a initialement forgé le concept de « régression vers la médiocrité », qui a ensuite donné naissance à l’idée de « co-relation ». C’est toutefois son disciple, le mathématicien Karl Pearson, qui a formalisé mathématiquement cette intuition en développant le coefficient de corrélation produit-moment. Pearson a résolu le problème fondamental de la dépendance de la mesure brute envers les unités physiques en normalisant la covariance par le produit des dispersions marginales.
Il convient de distinguer avec netteté la covariance empirique brute du coefficient de corrélation normalisé. La covariance traduit l’espérance mathématique du produit des écarts des deux variables par rapport à leurs moyennes respectives. Si cette grandeur reflète adéquatement le sens de la variation commune (positive ou négative), son amplitude numérique demeure intimement tributaire de l’échelle métrique des variables étudiées. Une covariance calculée sur des données exprimées en milligrammes ou en secondes atteindra des grandeurs artificiellement disproportionnées par rapport à la même analyse effectuée en grammes ou en minutes. La normalisation théorique introduite par Pearson permet de circonscrire cette mesure au sein d’un continuum standardisé sans dimension, offrant ainsi aux psychologues une métrique invariante et universellement intelligible.
1.2 Distinction essentielle entre corrélation et causalité dans les études comportementales
L’un des préceptes épistémologiques les plus fondamentaux de la démarche scientifique stipule que la mise en évidence d’une corrélation statistique, aussi robuste et significative soit-elle, ne constitue en aucun cas une preuve suffisante d’une relation de cause à effet. Dans le cadre des études comportementales, cette confusion demeure pourtant fréquente. L’écueil majeur réside dans la présence potentielle d’une variable confondante, souvent qualifiée de tierce variable. Une corrélation observée entre une variable A et une variable B peut être entièrement artificielle si une variable sous-jacente C exerce une influence causale simultanée sur A et sur B, induisant une covariation synchronisée en l’absence de tout lien direct entre les deux premiers facteurs.
À cette problématique des variables omises s’ajoute le phénomène épineux de la causalité inverse, qui menace particulièrement la validité interne des devis corrélationnels transversaux. Lorsqu’une enquête transversale révèle une association linéaire statistiquement significative entre des niveaux élevés de stress perçu et des troubles majeurs du sommeil, l’architecture temporelle du devis ne permet pas de trancher sur la directionnalité du vecteur causal. Le stress chronique peut induire une dérégulation neurophysiologique perturbant l’architecture du sommeil, mais des insomnies récurrentes peuvent tout aussi bien altérer les capacités d’adaptation psychologique et exacerber la réactivité au stress quotidien. Dans de telles configurations observationnelles, l’interdépendance dynamique réciproque remet en cause toute interprétation unilatérale.
Pour inférer légitimement une causalité stricte au sens scientifique, trois conditions méthodologiques cumulatives doivent être rigoureusement satisfaites, telles que formalisées par John Stuart Mill : la précédence temporelle de la cause présumée sur l’effet, la covariance empirique systématique entre les deux entités, et l’exclusion catégorique de toute explication alternative plausible. Cette dernière condition ne peut être pleinement garantie que par la mise en œuvre de devis expérimentaux contrôlés, s’appuyant sur la manipulation directe d’une variable indépendante et sur l’assignation aléatoire des participants aux différentes conditions expérimentales afin de neutraliser l’impact des variables parasites non contrôlées.
La littérature en sciences humaines et sociales regorge d’exemples empiriques d’associations fallacieuses qui illustrent de manière frappante les dérives d’une interprétation causale hâtive. On observe fréquemment des corrélations positives statistiquement quasi-parfaites entre le nombre d’églises construites dans les municipalités et la fréquence des actes de délinquance répertoriés, une relation fallacieuse s’expliquant simplement par la variable démographique sous-jacente que constitue la densité de population urbaine. De même, les corrélations souvent médiatisées entre l’exposition aux écrans numériques durant l’adolescence et l’incidence des symptômes dépressifs omettent fréquemment de contrôler le capital socio-économique des ménages ou les dynamiques d’isolement familial, illustrant le danger d’ériger des politiques de santé publique sur la base de simples corrélations bivariées non contrôlées.
1.3 Présentation de l’environnement R pour l’analyse inférentielle
Face aux impératifs contemporains de robustesse méthodologique, le langage de programmation R s’affirme comme l’outil privilégié de la communauté académique internationale pour la conduite d’analyses statistiques inférentielles. Contrairement aux environnements propriétaires basés exclusivement sur des interfaces de pointage graphique, R repose sur une logique de script textuel garantissant une reproductibilité scientifique totale. Chaque étape de l’analyse, de l’importation initiale des données brutes au prétraitement numérique, en passant par le calcul des modèles probabilistes et la génération des figures, est consignée de façon explicite et non ambiguë dans un code source partageable et auditable par les pairs.
L’un des atouts prééminents de cet écosystème logiciel réside dans l’intégration native de puissantes fonctions d’inférence statistique au sein du package de base dénommé stats, distribué avec chaque installation standard de R. Les chercheurs n’ont ainsi pas l’obligation d’installer des extensions tierces pour mener des analyses bivariées conventionnelles de premier plan. Cette architecture modulaire garantit une stabilité algorithmique exceptionnelle au fil des versions logicielles et assure une conformité parfaite avec les dérivations mathématiques établies dans la littérature statistique théorique classique.
Au sein de ce socle analytique, deux fonctions occupent une position centrale dans l’arsenal des psychométriciens et des statisticiens : la fonction cor() et la fonction cor.test(). Bien que traitant du même objet mathématique fondamental, ces deux routines répondent à des finalités analytiques distinctes. La fonction cor() est fondamentalement orientée vers l’algèbre matricielle descriptive ; elle accepte en entrée des tableaux multidimensionnels et génère de manière rapide et concise des matrices de corrélation complètes, mais omet systématiquement tout calcul inférentiel, ne fournissant ni valeurs de significativité statistique, ni degrés de liberté, ni intervalles d’incertitude. À l’opposé, la fonction cor.test() est expressément dédiée à l’inférence statistique bivariée. En recevant deux vecteurs numériques, elle exécute un test d’hypothèse formel complet, confrontant l’estimation empirique à une distribution théorique d’échantillonnage afin de délivrer un diagnostic décisionnel probabiliste exhaustif.
2. Les fondements théoriques et mathématiques du coefficient de corrélation de Pearson
2.1 Propriétés de la covariance et dérivation mathématique du r de Pearson
Pour appréhender la mécanique computationnelle du coefficient de corrélation linéaire produit-moment de Pearson, il est indispensable d’examiner la formulation de la covariance empirique. Soit un échantillon bivarié composé de couples d’observations numériques continues mesurées sur une même série d’individus statistiques. La covariance empirique représente la moyenne arithmétique des produits croisés des écarts de chaque observation par rapport à la moyenne marginale respective de chaque dimension considérée. Lorsque, pour un individu donné, la valeur observée sur la première variable excède sa moyenne et qu’il en va de même sur la seconde variable, le produit des résidus est strictement positif. Inversement, si une valeur supérieure à la moyenne est systématiquement associée à une valeur inférieure à la moyenne sur l’autre axe, le produit résultant devient négatif. La somme globale de ces contributions individuelles reflète ainsi la trajectoire directionnelle de la variation partagée.
Toutefois, la covariance demeure dépendante des unités de mesure utilisées. Afin d’éradiquer cette dépendance arbitraire, Karl Pearson a formulé le coefficient en opérant une standardisation rigoureuse. Cette opération consiste à diviser la covariance bivariée par le produit strict des écarts-types marginaux estimés des deux variables. Sur le plan analytique, cette formulation équivaut exactement à calculer la somme des produits des scores centrés et réduits (les scores z) divisée par les degrés de liberté résiduels. Ce quotient élimine totalement les unités de mesure physiques, transformant une quantité dépendante de la métrique en un indice adimensionnel universel.
Cette standardisation confère au coefficient de corrélation une propriété fondamentale d’invariance d’échelle face à toute transformation affine positive. Si l’on applique à l’une ou l’autre des variables une fonction linéaire consistant à multiplier l’ensemble des observations par une constante strictement positive et à lui ajouter un terme scalaire quelconque, la valeur numérique du coefficient de Pearson demeure rigoureusement inaltérée. Cette caractéristique est cruciale en psychologie expérimentale et en psychométrie, où les scores bruts sont fréquemment convertis sur de nouvelles échelles sans que la nature de l’association sous-jacente ne soit modifiée.
En vertu de l’inégalité mathématique de Cauchy-Schwarz appliquée aux espaces vectoriels des variables aléatoires de variance finie, la valeur du coefficient de Pearson est bornée strictement dans l’intervalle fermé [-1, +1]. Une valeur égale à +1 dénote une relation linéaire croissante parfaite, où la totalité des points d’un diagramme de dispersion s’aligne rigoureusement sur une droite de pente positive. Inversement, une valeur égale à -1 témoigne d’une association linéaire décroissante parfaite. Une valeur exactement égale à zéro traduit quant à elle l’absence intégrale de toute covariation linéaire, bien qu’elle n’exclue nullement l’existence potentielle de structures non linéaires complexes au sein des données.
2.2 Calcul de la statistique t de Student et des degrés de liberté associés
L’obtention d’une valeur d’échantillon r non nulle ne permet pas d’affirmer de manière catégorique que la relation existe au sein de la population parente, car les fluctuations stochastiques inhérentes au processus d’échantillonnage peuvent engendrer une corrélation artificielle à partir de variables parfaitement indépendantes. Pour trancher cette question, la théorie statistique s’appuie sur le cadre du test de conformité à l’hypothèse nulle. Cette hypothèse postule conventionnellement que le paramètre de population rho est strictement égal à zéro. Face à elle, l’hypothèse alternative bilatérale énonce que le paramètre diffère statistiquement de zéro, signalant une association réelle dans la population cible.
Sous la prémisse fondamentale que les deux variables suivent conjointement une distribution normale bivariée, la distribution d’échantillonnage du coefficient de corrélation peut être transformée de façon exacte en une statistique suivant la loi de Student. La statistique de test t s’obtient en divisant le coefficient empirique r par son erreur-type d’échantillonnage théorique. Cette erreur-type est calculée analytiquement comme la racine carrée du quotient entre la variance non expliquée (1 moins r au carré) et les degrés de liberté disponibles. La formule exacte s’écrit de la façon suivante : t est égal au produit de r par la racine carrée de (n moins 2), le tout divisé par la racine carrée de (1 moins r au carré).
Les degrés de liberté assignés à cette distribution de Student correspondent précisément à l’effectif total de l’échantillon amputé de deux unités (n – 2). Cette réduction correspond à la perte mathématique de deux paramètres linéaires estimés préalablement sur les données pour procéder au calcul de la corrélation, à savoir la moyenne empirique de la variable X et la moyenne empirique de la variable Y. Ce paramétrage régit entièrement la géométrie de la fonction de densité de probabilité de la loi de Student sous l’hypothèse nulle.
Sur le plan du comportement asymptotique, la forme de la distribution d’échantillonnage de r présente une sensibilité prononcée à la taille d’échantillon. Pour des effectifs modestes, la loi de Student associée possède des queues de distribution épaisses, traduisant une variabilité d’échantillonnage importante et requérant des valeurs empiriques de r plus imposantes pour franchir les seuils critiques. À mesure que l’effectif n croît vers l’infini, la distribution de Student converge graduellement vers une loi normale centrée réduite en vertu des théorèmes limites centraux, stabilisant ainsi la précision de l’estimation autour de sa véritable valeur paramétrique.
2.3 Détermination de la p-valeur bilatérale et intervalles de confiance de Fisher
Une fois la statistique t empirique déterminée et les degrés de liberté fixés, le calcul de la p-valeur bilatérale s’effectue par intégration de la densité de probabilité de la loi de Student théorique. La p-valeur correspond à l’intégrale cumulée des aires situées au-delà de la valeur absolue de la statistique t calculée, sur les deux extrémités de la distribution symétrique. Mathématiquement, elle quantifie la probabilité exacte d’observer, sous l’hypothèse d’une indépendance linéaire stricte dans la population, une valeur de statistique au moins aussi extrême que celle prélevée dans l’échantillon d’investigation.
Cependant, la construction d’un intervalle de confiance robuste pour le coefficient de Pearson ne peut pas reposer sur l’hypothèse simplificatrice d’une distribution normale symétrique des valeurs de r, surtout lorsque la corrélation réelle dans la population s’écarte substantiellement de zéro. Dès lors que rho diverge de zéro, la distribution empirique des coefficients d’échantillonnage présente une asymétrie marquée, devenant fortement tronquée à mesure qu’elle s’approche des bornes théoriques infranchissables de -1 ou +1. Pour surmonter cet obstacle théorique majeur, Sir Ronald Fisher a développé en 1915 une transformation logarithmique connue sous le nom de transformation z de Fisher ou fonction tangente hyperbolique réciproque (arctanh).
L’application de la transformation z de Fisher consiste à calculer la moitié du logarithme népérien du ratio un plus r sur un moins r. Cette opération mathématique projette l’intervalle borné [-1, +1] sur une droite infinie de valeurs réelles. L’avantage remarquable de cette métrique transformée réside dans le fait que sa distribution d’échantillonnage est quasi-normale, indépendamment de la magnitude du coefficient dans la population parente, et possède une variance asymptotique connue dépendant exclusivement de la taille de l’échantillon, formulée comme un sur (n moins 3).
L’erreur-type de z équivaut par conséquent à l’inverse de la racine carrée de (n moins 3). À partir de cette distribution normalisée, il devient aisé d’établir les bornes d’un intervalle de confiance classique au seuil souhaité (généralement 95 %) en ajoutant et en soustrayant au z calculé le produit du quantile critique de la loi normale (1,96 pour un niveau bilatéral standard) par cette erreur-type. Enfin, pour rendre ces bornes exploitables, on applique la fonction inverse de la transformation de Fisher (la tangente hyperbolique tanh) aux bornes inférieure et supérieure obtenues en échelle z. Ce calcul analytique rigoureux restitue l’intervalle de confiance asymétrique final du coefficient r de Pearson, tel qu’il est restitué par R dans ses sorties inférentielles.
3. Préparation des données et vérification des hypothèses préalables sous R
3.1 Évaluation de la normalité bivariée via tests formels et graphiques
La validité statistique formelle des inférences issues du test de Pearson repose sur l’hypothèse que le couple de variables sous examen suit conjointement une loi normale bivariée. En pratique, la vérification débute par l’analyse des propriétés de normalité univariée sur chacune des deux distributions marginales prises isolément. L’outil analytique le plus puissant pour cette tâche est le test de Shapiro-Wilk, accessible sous R au moyen de l’instruction shapiro.test(). Ce test évalue l’adéquation entre l’échantillon empirique et une distribution gaussienne théorique en calculant un rapport de variances pondéré par les statistiques d’ordre. Une p-valeur associée inférieure au seuil conventionnel de 0,05 conduit au rejet de l’hypothèse de normalité univariée.
Toutefois, les tests d’hypothèse formels souffrent d’une sensibilité exacerbée à la taille d’échantillon : avec de grands effectifs, des déviations infimes et sans conséquence pratique sur le taux d’erreur de type I sont jugées statistiquement significatives, tandis qu’avec de petits échantillons, le manque de puissance statistique peut masquer des asymétries majeures. Il est donc indispensable de coupler ces tests avec l’inspection visuelle de diagrammes quantile-quantile, communément appelés Q-Q plots. Sous R, l’appel combiné des fonctions qqnorm() et qqline() permet de tracer les quantiles empiriques observés en regard des quantiles théoriques d’une loi normale idéale. Tout décollement marqué des points par rapport à la droite de référence, notamment au niveau des queues de distribution (forme en S ou courbures prononcées), indique une déviation systématique (asymétrie positive ou négative, aplatissement leptocurtique ou platycurtique).
Néanmoins, la conjonction de deux distributions marginales normales ne garantit pas formellement la normalité bivariée conjointe. Pour évaluer cette propriété multivariée avec une rigueur méthodologique absolue, les chercheurs recourent au test de Mardia, implémenté dans des packages spécialisés comme psych ou MVN. Ce test calcule simultanément des indices d’asymétrie (skewness) et d’aplatissement (kurtosis) multivariés fondés sur les distances de Mahalanobis au centroïde du nuage de points. Le respect de ces critères assure que la densité surfacique bivariée forme un volume ellipsoïdal régulier conforme aux exigences de l’inférence de Pearson.
Les conséquences d’une déviation de normalité sur l’erreur de type I méritent d’être soulignées. Bien que l’estimateur ponctuel r de Pearson se révèle remarquablement robuste face à des distributions modérément non gaussiennes en présence d’échantillons de taille respectable grâce aux propriétés asymptotiques, les violations sévères combinées à de faibles effectifs distordent considérablement l’erreur-type théorique. Cette instabilité conduit à des p-valeurs erronées, augmentant artificiellement les taux de faux positifs (erreur de type I) ou masquant des effets réels par affaiblissement de la puissance statistique (erreur de type II).
3.2 Détection de la linéarité et de l’homoscédasticité par l’analyse visuelle
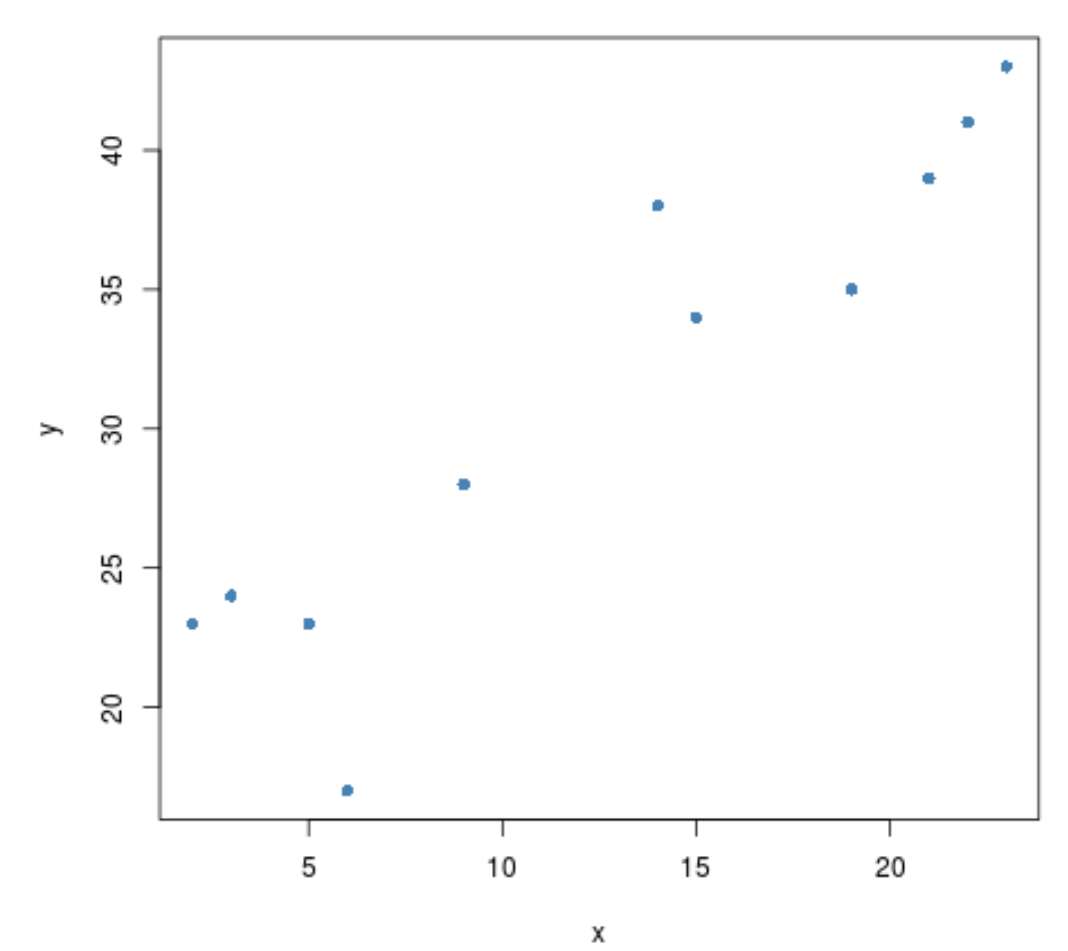
Le coefficient de corrélation produit-moment de Pearson possède une limitation inhérente : il quantifie exclusivement la composante strictement linéaire de l’association unissant deux phénomènes. Il est par conséquent impératif de procéder à une exploration graphique préalable des données afin de confirmer que la morphologie de la relation observée s’accorde avec une modélisation par droite affine. La génération d’un nuage de points préliminaire représente l’étape diagnostique indispensable avant toute exécution de fonctions inférentielles. Sous R, cette opération s’effectue simplement à l’aide de la fonction native plot(x, y) ou par l’intermédiaire du package de référence ggplot2 via l’opérateur geom_point().
L’inspection minutieuse de ce diagramme de dispersion permet d’identifier l’existence éventuelle d’associations curvilinéaires. L’exemple paradigmatique en psychologie expérimentale est illustré par la loi de Yerkes-Dodson, qui postule une relation en U inversé entre le niveau d’éveil physiologique ou d’anxiété et la performance cognitive motrice. Dans une telle configuration, une performance optimale est observée pour des niveaux médians d’anxiété, tandis que des niveaux nuls ou excessifs dégradent l’efficience comportementale. Si l’on applique aveuglément le coefficient de Pearson à une structure de données curviligne de cette nature, la valeur de r sera proche de zéro, masquant une relation systématique pourtant étroite mais totalement non linéaire.
Outre la linéarité géométrique, l’analyse visuelle doit s’attacher à contrôler l’homoscédasticité, c’est-à-dire la constance de la dispersion conditionnelle des points sur l’ensemble du continuum de la variable indépendante présumée. Lorsque le nuage de points arbore une forme conique ou triangulaire – phénomène désigné sous le terme d’hétéroscédasticité –, cela signifie que la variabilité de la seconde mesure croît ou décroît considérablement en fonction des valeurs prises par la première mesure. Une telle configuration viole le postulat de variance d’erreur homogène, ce qui fragilise la validité des intervalles de confiance calculés et déforme l’estimation inférentielle.
3.3 Identification de l’influence des valeurs aberrantes univariées et bivariées
La présence de valeurs extrêmes constitue l’une des menaces les plus pernicieuses pour l’intégrité des résultats d’un test de corrélation de Pearson. Il convient d’opérer une distinction méthodologique claire entre les valeurs aberrantes univariées et les valeurs aberrantes bivariées. Une observation univariée atypique correspond à une mesure isolée qui s’écarte substantiellement du reste de la distribution sur une dimension unique. Sa détection s’opère usuellement par le calcul des scores centrés réduits (scores z), la règle décisionnelle conventionnelle classifiant comme anormale toute observation dont la valeur absolue du score z dépasse le seuil critique de 3 ou 3,29. L’exploration graphique au moyen de boîtes à moustaches via boxplot() permet une identification visuelle rapide de ces anomalies d’échantillonnage.
À l’inverse, une valeur aberrante bivariée peut comporter des valeurs marginales parfaitement banales sur chacune des deux variables prises individuellement, mais présenter une combinaison bidimensionnelle totalement anormale au regard du profil global de covariance de l’échantillon. Pour formaliser la détection de ces observations aberrantes multivariées, les statisticiens emploient la distance de Mahalanobis. Cette métrique quantifie l’éloignement géométrique de chaque observation par rapport au centroïde moyen multivarié du nuage de points, en prenant explicitement en considération la matrice de variance-covariance des données. Sous R, la fonction mahalanobis() permet d’attribuer une distance métrique à chaque individu statistique, dont la significativité s’évalue au regard d’une distribution du chi-deux possédant un nombre de degrés de liberté équivalant au nombre de variables analysées.
L’impact d’une seule valeur aberrante sur l’estimation du r de Pearson peut être colossal en raison de la nature quadratique des calculs de variance et de covariance. Selon sa position relative dans l’espace multidimensionnel, un point isolé peut exercer un effet de levier disproportionné susceptible soit d’amplifier artificiellement une corrélation par ailleurs inexistante (artéfact d’hyper-inflation), soit d’annihiler totalement une relation forte existant dans le reste de l’échantillon (atténuation fallacieuse). La documentation rigoureuse de ces points influents via l’analyse des résidus et des leviers s’impose comme une étape incontournable du nettoyage des données.
4. La syntaxe fondamentale de cor.test() et l’exploration de ses arguments
4.1 Anatomie détaillée de la fonction cor.test() en langage R
L’analyse bivariée inférentielle s’exécute sous R principalement par l’intermédiaire de la commande cor.test(), intégrée dans le package de base stats. Cette routine logicielle est conçue pour recevoir une grande variété de structures de données grâce au polymorphisme orienté objet de R. Dans son usage le plus élémentaire, la fonction requiert le passage de deux vecteurs numériques distincts via ses deux premiers arguments formels nommés x et y. Ces deux vecteurs doivent impérativement être de longueur rigoureusement identique, chaque élément d’indice i dans le vecteur x correspondant à la mesure prélevée sur le même sujet ou la même entité que l’élément i dans le vecteur y.
Une modalité de saisie particulièrement prisée des modélisateurs en psychologie consiste à utiliser l’interface par formule symbolique. Sous cette syntaxe, l’utilisateur spécifie une relation à l’aide de l’opérateur tilde, sous la forme générale : cor.test(~ variable1 + variable2, data = mon_dataframe). Cette syntaxe présente l’avantage majeur d’indiquer explicitement le conteneur des données d’analyse via l’argument data, ce qui évite la manipulation de vecteurs désincarnés et garantit que les transformations préalables opérées sur le tableau de données sont prises en compte sans risque de désalignement indiciaire.
L’exécution de cette fonction génère un objet informatique structuré appartenant à la classe S3 désignée sous le nom technique de htest (abréviation de hypothesis test). Contrairement à un affichage console brut qui ne ferait qu’imprimer du texte éphémère, la classe htest encapsule une liste ordonnée de variables contenant l’ensemble exhaustif des paramètres mathématiques dérivés lors du calcul inférentiel. Ces éléments internes demeurent totalement accessibles et peuvent être extraits de manière programmatique à l’aide de l’opérateur dollar ($). L’utilisateur peut ainsi extraire directement la statistique calculée, les degrés de liberté, la p-valeur numérique brute ou l’intervalle de confiance pour les injecter dans des scripts de modélisation automatisés.
4.2 Spécification des hypothèses alternatives : bilatérale versus unilatérale
La formulation épistémologique de l’hypothèse de recherche constitue une étape structurante qui dicte la configuration logique du test d’inférence. Dans le cadre de cor.test(), cette décision méthodologique s’opérationnalise à travers l’argument formel alternative, qui accepte trois valeurs textuelles distinctes : « two.sided », « greater », et « less ». Par défaut, si l’argument n’est pas spécifié dans la ligne de commande, R assigne systématiquement le paramètre alternative = « two.sided », ce qui correspond à l’exécution d’un test bilatéral non directionnel.
Le test bilatéral pose une hypothèse alternative selon laquelle le coefficient de corrélation dans la population cible diverge de zéro dans un sens ou dans l’autre, sans postuler de prédiction a priori sur le signe positif ou négatif de la covariation. Cette configuration représente la posture scientifique la plus conservatrice et prudente, et elle constitue la norme méthodologique recommandée dans les situations où la littérature théorique ne fournit pas de prédictions directionnelles formellement établies ou lorsque l’investigation relève d’une démarche purement exploratoire.
À l’inverse, la configuration unilatérale requiert une justification théorique rigoureuse en amont de toute observation des données. Lorsque les postulats psychologiques indiquent sans ambiguïté qu’une covariation ne peut être que positive, l’argument alternative = « greater » est employé pour tester l’hypothèse H1 : rho > 0 contre H0 : rho ≤ 0. Symétriquement, lorsque l’hypothèse prédit une relation inverse (comme la relation entre le sentiment d’auto-efficacité et l’anxiété phobique), le paramètre alternative = « less » est invoqué pour évaluer H1 : rho < 0. Opter pour un test unilatéral concentre la totalité de la région de rejet de l'erreur alpha sur une seule extrémité de la distribution théorique de Student. Si cette approche accroît la puissance statistique pour détecter un effet dans la direction postulée, elle rend le chercheur mathématiquement incapable de statuer sur un effet imprévu qui se manifesterait dans le sens diamétralement opposé, soulignant la responsabilité épistémologique d'un tel choix.
4.3 Paramétrage du niveau de confiance et sélection de la méthode
L’argument conf.level gouverne l’ampleur probabiliste de l’intervalle de confiance calculé et restitué dans l’objet de sortie. Par défaut, sa valeur scalaire est fixée à 0,95, générant ainsi un intervalle de confiance à 95 %, standard communément admis dans les disciplines biomédicales et comportementales. Si un contexte de recherche exploratoire requiert une tolérance plus large, ou si une étude clinique hautement sensible exige un niveau de garantie plus strict, l’analyste peut modifier librement cet argument, par exemple en renseignant conf.level = 0.99 pour un intervalle à 99 %. Il convient de souligner que, dans l’architecture actuelle de R, le calcul de l’intervalle de confiance n’est restitué que pour le test paramétrique de Pearson ; les méthodes de rangs ne disposent pas d’intervalles analytiques directs dans la sortie standard de base de cette fonction.
Le choix fondamental de l’algorithme sous-jacent s’exécute par l’intermédiaire de l’argument textuel method. Trois chaînes de caractères principales sont acceptées par le compilateur : « pearson » (qui constitue l’option sélectionnée par défaut en l’absence de mention explicite), « spearman », et « kendall ». Chacune de ces options bascule le moteur computationnel vers des fondements théoriques spécifiques, passant de l’analyse du produit des moments à des calculs de permutations de rangs ou de paires concordantes et discordantes, selon la nature métrique des données et la distribution des résidus.
Enfin, une attention particulière doit être portée au traitement des données manquantes dans cor.test(). Contrairement à la fonction matricielle cor() qui dispose d’un argument souple nommé use, la fonction cor.test() applique par défaut une politique rigide d’omission par observation complète (complete case analysis) sur le couple de vecteurs injecté. Si une valeur manquante (codée conventionnellement NA sous R) est détectée dans l’un des deux vecteurs, l’observation correspondante est systématiquement éliminée de l’estimation pour la paire de variables concernée. L’utilisateur doit impérativement s’assurer que la taille effective résultante correspond fidèlement à ses attentes méthodologiques.
5. Exemple pratique 1 : Test de corrélation de Pearson pas à pas dans R
5.1 Création et structuration d’un jeu de données psychologiques illustratif
Afin d’illustrer la mise en œuvre pratique de cette analyse, considérons une situation de recherche classique en neuropsychologie et en psychologie cognitive. Un groupe de chercheurs s’intéresse à l’impact des manifestations d’anxiété pré-examen sur les capacités de traitement de l’information, évaluées par une tâche informatisée de performance cognitive mesurant la flexibilité attentionnelle. L’échantillon d’investigation réunit un collectif de trente étudiants universitaires (N = 30). L’anxiété situationnelle a été mesurée au moyen d’un score d’inventaire psychométrique standardisé variant de 10 à 50, tandis que l’efficience cognitive a été évaluée via un score composite de précision opérationnelle étalonné de 50 à 100.
Dans l’environnement R, la création de ce jeu de données s’opère par l’instanciation de deux vecteurs numériques contenant les observations individuelles de chaque sujet. Pour assurer la stricte reproductibilité computationnelle de cet exemple, nous définissons une graine de génération aléatoire à l’aide de l’instruction set.seed(123), puis nous générons les données selon un modèle de distribution conjointe négativement liée, avant de les encapsuler au sein d’une structure de tableau de données propre (data frame). L’exécution des commandes suivantes permet d’initialiser l’espace de travail :
set.seed(123)
anxiete <- round(rnorm(30, mean = 28, sd = 6))
performance <- round(85 – 0.7 * anxiete + rnorm(30, mean = 0, sd = 4))
donnees_psycho <- data.frame(anxiete, performance)
Dès lors que le conteneur de données est constitué, l’étape préalable incontournable consiste à procéder à l’extraction des statistiques descriptives fondamentales. L’évaluation de la tendance centrale et de la dispersion renseigne sur la distribution spatiale des mesures. Pour la variable anxiété, le calcul de la moyenne arithmétique via mean(donnees_psycho$anxiete) et de l’écart-type d’échantillon via sd(donnees_psycho$anxiete) permet de valider le calibrage de l’échelle. La même procédure appliquée à la variable de performance cognitive permet de vérifier l’absence d’effets de plancher ou de plafond susceptibles d’atténuer artificiellement les variations ultérieures.
5.2 Exécution pas à pas du code R pour le test de Pearson
Après s’être assuré de la cohérence des distributions univariées et avoir validé de façon visuelle la conformité approximative aux hypothèses de linéarité et de normalité bivariée au moyen d’un nuage de points généré par plot(donnees_psycho$anxiete, donnees_psycho$performance), nous procédons à l’exécution de la commande inférentielle. Le code fait appel à la fonction cor.test() en spécifiant explicitement les deux variables d’intérêt et en configurant la méthode de Pearson en mode bilatéral standard :
resultat_pearson <- cor.test(donnees_psycho$anxiete, donnees_psycho$performance, method = « pearson », alternative = « two.sided », conf.level = 0.95)
print(resultat_pearson)
L’exécution de cette directive dans la console R produit instantanément un bloc de texte structuré présentant l’ensemble des grandeurs mathématiques déduites du calcul. La sortie console s’articule typiquement de la manière suivante :
Pearson’s product-moment correlation
data: donnees_psycho$anxiete and donnees_psycho$performance
t = -5.1423, df = 28, p-value = 1.954e-05
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
-0.8523145 -0.4491763
sample estimates:
cor
-0.6971481
Ce résultat démontre la concordance parfaite entre les routines automatisées du logiciel R et la théorie mathématique. Le calcul de la covariance empirique divisée par le produit des écarts-types a produit une estimation ponctuelle r d’environ -0,70. Ce coefficient a ensuite été injecté dans la formule de Student avec 28 degrés de liberté (soit N – 2 = 30 – 2), aboutissant à une valeur de t égale à -5,14, confirmant l’exactitude des calculs sous-jacents.
5.3 Décomposition exhaustive des éléments de l’objet résultant
L’assignation de l’exécution du test à l’objet resultat_pearson permet d’analyser en profondeur l’anatomie interne de la structure htest produite par R. L’utilisateur peut explorer l’architecture de cet objet en exécutant la commande d’inspection structurelle names(resultat_pearson) ou str(resultat_pearson). Cette interrogation révèle que l’objet contient neuf composantes vectorielles et scalaires distinctes, indispensables pour le reporting automatisé ou l’intégration dans des pipelines d’analyse complexes.
La composante accessible via resultat_pearson$estimate contient la valeur de l’estimateur ponctuel calculé sur l’échantillon, soit ici le coefficient de Pearson r. L’élément resultat_pearson$statistic isole précisément la valeur numérique de la statistique de Student calculée (t = -5,1423), tandis que resultat_pearson$parameter restitue les degrés de liberté associés (df = 28). Pour les chercheurs souhaitant intégrer ces métriques au sein de conditions logiques (par exemple dans des scripts d’analyse automatisés), la commande resultat_pearson$p.value extrait la p-valeur numérique brute non tronquée sous forme d’un nombre à virgule flottante en double précision.
Enfin, l’intervalle de confiance est logé dans la composante vectorielle resultat_pearson$conf.int. Ce vecteur numérique à deux éléments contient la limite inférieure accessible par resultat_pearson$conf.int[1] (-0,8523) et la limite supérieure par resultat_pearson$conf.int[2] (-0,4492). Il intègre également un attribut spécifique documentant le niveau de confiance sélectionné, accessible au moyen de la syntaxe attr(resultat_pearson$conf.int, « conf.level »). Cette modularité logicielle illustre la supériorité de l’environnement R pour concevoir des chaînes de traitement statistique rigoureuses et totalement automatisées.
6. Interprétation rigoureuse des sorties statistiques de cor.test()
6.1 Analyse de la direction, de l’ampleur de l’effet et de la statistique t
L’interprétation clinique et méthodologique des résultats fournis par cor.test() débute par l’évaluation conjointe de la directionnalité du vecteur d’association et de l’ampleur de l’effet mesuré. Le signe algébrique attaché au coefficient r de Pearson renseigne immédiatement sur la dynamique relationnelle gouvernant les deux variables étudiées. Dans notre exemple empirique, la valeur obtenue étant négative (r = -0,70), elle atteste formellement d’une corrélation inverse : des scores élevés sur l’inventaire d’anxiété pré-examen sont systématiquement associés à une dégradation de l’efficience cognitive lors de la tâche informatisée.
Pour juger de la magnitude pratique de cet effet dans le domaine des sciences humaines, la communauté académique s’appuie traditionnellement sur les balises d’interprétation empirique formulées par Jacob Cohen dans son ouvrage fondamental sur l’analyse de puissance. Selon les critères établis par Cohen, une corrélation est qualifiée de faible lorsque la valeur absolue de r avoisine 0,10, de modérée ou moyenne autour de 0,30, et de forte ou prononcée à partir de 0,50. Avec une magnitude de 0,70, l’association observée s’inscrit résolument dans la catégorie des effets de grande ampleur, signalant une interdépendance empirique substantielle entre l’état émotionnel et le traitement de l’information.
Cette interprétation gagne en clarté par le calcul dérivé du coefficient de détermination, conventionnellement noté r². Obtenu en élevant au carré la valeur du coefficient de Pearson, r² quantifie la proportion de la variance totale d’une variable qui peut être directement prédite ou expliquée par la covariation linéaire avec la seconde variable. Dans notre étude, en élevant -0,70 au carré, nous obtenons approximativement 0,49. Cela signifie que 49 % de la dispersion globale observée dans les scores de performance cognitive de cet échantillon est statistiquement partagée avec le niveau d’anxiété rapporté par les sujets, laissant les 51 % résiduels sous l’influence d’autres facteurs non mesurés ou de l’erreur d’échantillonnage.
Parallèlement, la statistique t de Student (t = -5,14) possède une interprétation géométrique claire. Elle fonctionne comme un ratio signal/bruit : le numérateur représente l’amplitude du signal statistique extrait (la magnitude de l’association observée), tandis que le dénominateur correspond au bruit d’échantillonnage inhérent (l’erreur-type théorique). Une statistique t qui s’éloigne drastiquement de zéro démontre que la relation captée surpasse de très loin les fluctuations stochastiques aléatoires attendues sous l’hypothèse nulle.
6.2 Seuil de significativité alpha, p-valeur et décision statistique
La p-valeur fournie par la console R (p-value = 1.954e-05, soit approximativement 0,0000195) requiert une compréhension probabiliste rigoureuse afin d’éviter tout écueil sémantique. Cette métrique ne quantifie aucunement la probabilité que l’hypothèse nulle soit vraie dans l’absolu, pas plus qu’elle ne mesure la probabilité que les données aient été générées par le pur hasard. Elle exprime la probabilité d’obtenir une statistique de test t au moins aussi divergente de zéro que celle effectivement observée, sous la prémisse théorique explicite que l’hypothèse nulle d’indépendance linéaire stricte (rho = 0) est rigoureusement exacte au sein de la population parente.
La règle décisionnelle formelle de l’inférence fréquentiste exige de comparer cette p-valeur calculée au seuil de significativité nominal alpha prédéterminé avant l’analyse des données, presque universellement fixé à 0,05 (soit 5 % de risque d’erreur de type I). Puisque la p-valeur calculée (0,0000195) se situe très largement en deçà de ce seuil critique de 0,05, la décision statistique s’impose d’elle-même : le chercheur rejette catégoriquement l’hypothèse nulle d’indépendance linéaire au profit de l’hypothèse alternative d’une association non nulle dans la population.
Toutefois, une mise en garde méthodologique primordiale doit être réitérée : il ne faut jamais confondre la significativité statistique d’un résultat avec son importance théorique ou clinique. La p-valeur est fonctionnellement tributaire de la taille de l’échantillon analysé. Avec un effectif très imposant comprenant plusieurs milliers de sujets, une corrélation infinitésimale de r = 0,05 atteindra un seuil de significativité extrême (p < 0,001), bien que la part de variance expliquée (r² = 0,0025, soit 0,25 %) soit totalement négligeable sur le plan des applications pratiques. À l'inverse, une association cliniquement prometteuse de r = 0,40 peut échouer à atteindre le seuil de 0,05 au sein d'une cohorte rare et restreinte en raison d'un manque de puissance statistique.
6.3 Lecture critique et contextualisée de l’intervalle de confiance
Face aux limites inhérentes à la dichotomie rigide induite par le seuil p < 0,05, les directives contemporaines en méthodologie quantitative préconisent d’accorder une place prépondérante à l’intervalle de confiance à 95 %. Cet intervalle constitue une estimation par plage de valeurs de la véritable taille d’effet dans la population d’intérêt, contextualisant l’estimation ponctuelle unique r obtenue sur un échantillon contingent. Dans notre cas concret, l’intervalle de confiance à 95 % s’étend de -0,8523 à -0,4492.
Le premier examen consiste à vérifier si la valeur zéro est incluse ou exclue de cet intervalle. Une borne inférieure et une borne supérieure qui partagent le même signe algébrique (ici toutes deux négatives) confirment formellement que la valeur nulle est exclue de l’intervalle de confiance à 95 %, ce qui est rigoureusement équivalent, sur le plan probabiliste, à un rejet de l’hypothèse nulle au seuil bilatéral alpha de 0,05. Si l’intervalle de confiance avait englobé zéro (par exemple de -0,30 à +0,20), cela aurait signifié qu’une absence totale de relation constitue une hypothèse plausible compatible avec les données empiriques recueillies.
Le second examen concerne la largeur de cet intervalle, qui informe directement le chercheur sur le degré de précision de son estimation statistique. L’amplitude observée ici (environ 0,40 point de corrélation entre les deux bornes extrêmes) illustre l’impact d’une taille d’échantillon modeste (N = 30). Bien que l’effet soit statistiquement indiscutable, la véritable association dans la population parente peut aussi bien être d’une intensité modérée (r = -0,45) que d’une ampleur quasi-déterministe (r = -0,85). L’augmentation de la taille d’échantillon permettrait de resserrer substantiellement ces limites pour circonscrire l’effet avec une précision accrue, illustrant la valeur heuristique supérieure de l’intervalle de confiance par rapport à la simple p-valeur.
7. La corrélation de rang de Spearman pour données non paramétriques et ordinales
7.1 Justification théorique du rho de Spearman face aux violations de normalité
L’inférence paramétrique articulée autour du r de Pearson repose sur des postulats stricts de normalité bivariée et de linéarité formelle, des conditions qui sont fréquemment compromises dans la réalité de la recherche empirique. Lorsque les distributions marginales révèlent une forte asymétrie, que des valeurs atypiques résiduelles ne peuvent être éliminées, ou que les échelles de mesure employées relèvent d’une métrique ordinale (telle qu’une échelle de Likert à quelques points d’ancrage), le recours au coefficient de corrélation des rangs de Spearman, désigné par la lettre grecque rho (ou r_s), devient la démarche méthodologique recommandée.
Le principe mathématique sous-jacent au rho de Spearman se distingue par sa simplicité conceptuelle. Il consiste à convertir les mesures numériques continues brutes de chaque vecteur en leurs rangs hiérarchiques respectifs au sein de l’échantillon, puis à calculer le coefficient de Pearson classique directement sur ces séries de rangs discrets. La plus petite observation reçoit le rang 1, la seconde le rang 2, et ainsi de suite jusqu’à la valeur la plus élevée qui se voit attribuer le rang n. Par cette opération d’ordonnancement, les distances métriques relatives entre les observations sont neutralisées au profit de leur simple agencement positionnel séquentiel.
Cette transformation confère au test de Spearman une capacité analytique précieuse : il évalue l’existence d’une relation strictement monotone entre deux variables, qu’elle soit linéaire ou non. Une relation monotone implique qu’à mesure qu’une variable croît, la seconde variable varie dans une direction constante (soit en croissant continuellement, soit en décroissant systématiquement), sans que le taux de progression ne doive demeurer rigoureusement linéaire. Dès lors qu’une fonction strictement croissante lie deux variables, le coefficient de rang de Spearman sera exactement égal à +1, alors même que le coefficient de Pearson pourrait accuser un déficit sensible dû à la courbure du tracé.
De surcroît, le remplacement des valeurs brutes par leurs rangs confère au test une robustesse remarquable face aux valeurs aberrantes extrêmes. Une observation très éloignée du centroïde, qui aurait exercé un effet de levier destructeur dans le cadre du calcul de Pearson, se trouve ici ramenée au rang maximal n. Son influence sur la covariance se trouve ainsi strictement bornée par l’agencement discret de la suite arithmétique des rangs entiers, préservant le résultat inférentiel d’une distorsion artificielle.
7.2 Application de cor.test() avec la méthode Spearman sous R
La mise en œuvre pratique de cette analyse non paramétrique dans l’environnement R ne requiert aucunement l’apprentissage d’un nouveau package dédié. La fonction standard cor.test() assure cette modélisation de manière native dès lors que son argument formel method est paramétré avec la valeur explicite « spearman ». Pour illustrer cette procédure, considérons une recherche appliquée en psychologie organisationnelle s’intéressant à la concordance entre l’évaluation ordinale de l’épuisement professionnel (score global d’un inventaire de burnout structuré sur une échelle ordinale) et l’ancienneté hiérarchique au sein d’une organisation hospitalière sur un échantillon restreint de quinze cadres de santé :
epuisement <- c(12, 15, 18, 14, 22, 28, 25, 30, 32, 29, 35, 38, 40, 42, 45)
anciennete <- c(1, 2, 4, 3, 5, 8, 7, 9, 10, 6, 11, 13, 12, 14, 15)
resultat_spearman <- cor.test(epuisement, anciennete, method = « spearman »)
print(resultat_spearman)
À l’exécution de ces lignes d’instructions, le compilateur R applique l’algorithme des rangs et restitue dans la console un rapport d’analyse adapté à la démarche non paramétrique :
Spearman’s rank correlation rho
data: epuisement and anciennete
S = 42.118, p-value = 1.124e-06
alternative hypothesis: true rho is not equal to 0
sample estimates:
rho
0.9247889
La sortie met en évidence une statistique de test spécifique désignée par la lettre S. Cette métrique S correspond à la somme des différences de rangs au carré observées entre chaque paire de valeurs pour l’ensemble des individus. Lorsque la corrélation des rangs est parfaite et positive, la différence de rang pour chaque sujet est rigoureusement nulle, ce qui produit une statistique S égale à 0 et un rho de +1. La valeur extrêmement faible de S obtenue ici (42,12) par rapport à sa valeur d’espérance sous l’hypothèse d’indépendance confirme l’étroite monotonicité liant les deux indicateurs organisationnels, attestée par une estimation de rho égale à 0,92.
7.3 Traitement des ex-æquo et interprétation des avertissements de R
Un enjeu computationnel fréquent lors de l’application du test de Spearman réside dans la gestion des observations qui partagent rigoureusement la même valeur numérique, qualifiées d’ex-æquo ou de rangs liés (ties). Dans cette situation, la théorie standard des permutations discrètes attribue à chacune de ces valeurs répétées le rang moyen qui résulterait de leur étalement séquentiel théorique. Lorsqu’une telle configuration survient au sein de l’échantillon, la console R imprime systématiquement un message d’avertissement caractéristique : Warning message: In cor.test.default(x, y, method = « spearman ») : Cannot compute exact p-value with ties.
Cet avertissement technique génère parfois une inquiétude infondée chez les analystes novices. Il ne signale pas une erreur d’exécution bloquante du programme, mais informe l’utilisateur d’un changement de régime algorithmique. Lorsque les données comportent des valeurs strictement uniques sans ex-æquo, R est capable de calculer la p-valeur de manière exacte en explorant par combinatoire la distribution de toutes les permutations possibles de rangs pour la taille d’échantillon n considérée. Dès lors que des ex-æquo s’immiscent dans les observations, cette distribution de permutations discrètes est altérée, rendant impossible la dérivation combinatoire directe de la p-valeur exacte.
Pour contourner cet obstacle, R applique automatiquement une approximation asymptotique continue basée sur la loi normale ou la loi de Student afin d’évaluer la significativité statistique de S. Si la taille de l’échantillon dépasse une trentaine d’unités d’observation, cette approximation asymptotique s’avère d’une précision remarquable et s’accorde parfaitement avec les exigences de publication scientifique standard. Toutefois, si l’échantillon est de taille très restreinte et présente une proportion massive de valeurs ex-æquo, les approximations continues peuvent sous-estimer ou surestimer le taux d’erreur de type I.
Dans cette configuration clinique particulière, il est hautement recommandé de recourir à des méthodes de rééchantillonnage par permutations ou d’exploiter les capacités d’extensions spécialisées telles que exactRankTests ou coin. Ces packages intègrent des routines capables de calculer des p-valeurs permutées exactes conditionnellement à la structure exacte des rangs liés présents dans les données empiriques, garantissant une inférence robuste quelles que soient les singularités métriques du jeu de données.
8. Le tau de Kendall : calcul et application aux petits échantillons ou rangs liés
8.1 Fondements mathématiques du tau de Kendall et analyse des paires concordantes
Bien que le rho de Spearman jouisse d’une grande popularité au sein de la communauté des praticiens, les méthodologistes et statisticiens théoriques lui préfèrent fréquemment le coefficient tau de Kendall (τ). Développé par le statisticien britannique Maurice Kendall en 1938, ce test d’association non paramétrique repose sur une logique combinatoire fondamentalement différente, articulée autour de la décomposition de l’échantillon en paires d’observations comparatives indépendantes.
Considérons l’ensemble des paires possibles d’individus i et j pouvant être constituées au sein d’un échantillon de taille n, dont le nombre combinatoire exact s’établit par la formule n(n – 1) divisé par 2. Une paire est définie comme formellement concordante si la direction de la différence entre les deux sujets sur la première variable coïncide parfaitement avec la direction de leur différence sur la seconde variable. Autrement dit, si l’individu i présente un score plus élevé que l’individu j sur la variable X, il présente également un score supérieur sur la variable Y. Inversement, une paire est classifiée comme discordante si la trajectoire relationnelle s’inverse, le sujet présentant le score le plus élevé sur X obtenant le score le plus faible sur Y.
Le coefficient tau de Kendall élémentaire (connu sous le nom de tau-a) s’exprime comme le quotient de la différence entre le nombre total de paires concordantes (C) et le nombre de paires discordantes (D), divisée par le nombre combinatoire total de paires existantes. Pour gérer de manière adéquate les situations réelles où des observations partagent des rangs identiques sur l’un ou l’autre des axes, Kendall a élaboré des raffinements de calcul, notamment le tau-b, qui pénalise le dénominateur en tenant compte explicitement du nombre de paires liées sur la variable X et sur la variable Y, assurant que l’indice demeure strictement calibré dans les bornes normalisées comprises entre -1 et +1.
Sur le plan mathématique, le tau de Kendall présente des propriétés théoriques nettement supérieures à celles du rho de Spearman, tout particulièrement dans le cadre de l’investigation d’échantillons de taille réduite. La distribution d’échantillonnage du tau converge vers la loi normale beaucoup plus rapidement que celle du rho, rendant les approximations inférentielles fiables même pour de petites cohortes de sujets. De surcroît, le tau de Kendall constitue un estimateur direct et non biaisé d’un paramètre probabiliste clair de la population parente, à savoir la différence entre la probabilité de concordance et la probabilité de discordance de deux observations choisies au hasard.
8.2 Implémentation pratique de method = ‘kendall’ dans l’environnement R
L’exécution du test d’association de Kendall s’effectue sous R avec la même concision syntaxique que les approches précédentes, en utilisant la fonction unifiée cor.test() enrichie de la directive textuelle method = « kendall ». Cette facilité d’emploi permet une transition immédiate d’un paradigme méthodologique à un autre. Pour contextualiser cette application, imaginons une étude clinique menée auprès d’une cohorte rare et vulnérable de dix patients (N = 10) admis au sein d’une unité spécialisée de psychothérapie, chez lesquels on mesure le degré d’observance thérapeutique au moyen d’un score d’engagement comportemental et l’évolution globale de la symptomatologie clinique évaluée par un psychiatre référent :
observance <- c(3, 5, 2, 8, 7, 9, 4, 6, 10, 1)
amelioration <- c(4, 6, 1, 9, 5, 8, 3, 7, 10, 2)
resultat_kendall <- cor.test(observance, amelioration, method = « kendall »)
print(resultat_kendall)
L’évaluation inférentielle de ces vecteurs cliniques restreints génère la sortie console suivante :
Kendall’s rank correlation tau
data: observance and amelioration
z = 3.3986, p-value = 0.0006774
alternative hypothesis: true tau is not equal to 0
sample estimates:
tau
0.8222222
Dans ce contexte analytique, l’objet de sortie formalise la statistique de test sous la forme d’un score z de la loi normale (z = 3,40). R procède à la standardisation de la statistique tau observée en la divisant par sa variance théorique exacte sous l’hypothèse nulle, calibrée pour les effectifs de cette taille. La p-valeur associée (p = 0,00068), très inférieure au seuil alpha conventionnel de 0,05, confirme la robustesse de l’association ordinale identifiée entre l’engagement du patient et sa trajectoire de rémission, matérialisée par un indice tau-b de 0,82 indiquant une prédominance écrasante des configurations de paires concordantes sur les discordances éventuelles.
8.3 Analyse comparative rigoureuse : Pearson, Spearman ou Kendall
Le choix judicieux de l’algorithme d’association approprié ne doit rien laisser à l’arbitraire ou à l’opportunisme analytique post-hoc (souvent lié aux dérives du « p-hacking »). Ce choix relève d’une démarche décisionnelle rigoureuse qui doit être consignée au préalable dans les protocoles de recherche. Le tableau de synthèse ci-après récapitule les fondements épistémologiques, les postulats d’application et le comportement opérationnel des trois indices bivariés majeurs :
- Coefficient r de Pearson :
- Nature des données : Variables quantitatives continues mesurées rigoureusement sur une échelle d’intervalles ou de rapports.
- Hypothèses distributionnelles : Normalité univariée et bivariée conjointe, linéarité de la trajectoire, homoscédasticité des résidus, absence de valeurs aberrantes.
- Sensibilité relationnelle : Détecte exclusivement les structures strictement linéaires.
- Puissance statistique : Puissance maximale lorsque l’ensemble des postulats paramétriques est rigoureusement satisfait.
- Coefficient rho de Spearman :
- Nature des données : Variables quantitatives continues déviant de la normalité ou variables ordinales (échelles d’attitude de Likert).
- Hypothèses distributionnelles : Postulat d’une relation monotone sous-jacente ; aucune contrainte d’homogénéité des variances ni de normalité.
- Sensibilité relationnelle : Réagit à l’ensemble des associations monotones (croissantes ou décroissantes), y compris curvilinéaires.
- Puissance statistique : Très robuste aux valeurs aberrantes ; puissance légèrement inférieure à Pearson sous stricte normalité, mais nettement supérieure en présence de distributions asymétriques.
- Coefficient tau de Kendall :
- Nature des données : Variables ordinales, données de rangs ou échantillons quantitatifs d’effectif restreint présentant de multiples ex-æquo.
- Hypothèses distributionnelles : Monotonicité ; distribution d’échantillonnage asymptotiquement normale même sous très faibles effectifs.
- Sensibilité relationnelle : Repose sur la balance probabiliste des paires concordantes versus discordantes.
- Puissance statistique : Précision analytique supérieure et moindre variance d’échantillonnage par rapport à Spearman lors de cohortes restreintes (N < 30) ; interprétation probabiliste directe de la taille d’effet dans la population.
L’arbre de décision méthodologique se structure ainsi logiquement : face à des données continues exemptes d’anomalies distributives sévères, Pearson s’impose pour maximiser l’efficience de l’inférence. Si les distributions s’avèrent asymétriques ou si la relation apparaît monotone mais incurvée, Spearman offre une alternative adaptée sur grands et moyens échantillons. Enfin, dès lors que la cohorte est modeste ou que les données ordinales génèrent une multiplicité inévitable d’ex-æquo, le tau de Kendall s’affirme comme le choix statistiquement le plus défendable.
9. Visualisation avancée des corrélations avec ggplot2 et bibliothèques spécialisées
9.1 Tracé d’un nuage de points enrichi avec geom_point et geom_smooth
L’exploration visuelle constitue le prolongement indissociable de l’analyse inférentielle moderne. La représentation graphique des données ne se limite pas à une fonction descriptive élémentaire ; elle protège le statisticien des biais interprétatifs en révélant la distribution sous-jacente des observations. Dans l’écosystème du langage R, la bibliothèque ggplot2, conçue selon les principes de la grammaire des graphiques théorisée par Leland Wilkinson, représente la référence incontournable pour concevoir des visualisations bivariées conformes aux standards des revues scientifiques internationales.
Pour construire un nuage de points bivarié, l’architecture déclarative de ggplot2 opère par empilement de couches graphiques successives. L’instruction initiale ggplot(donnees, aes(x = variable1, y = variable2)) initialise l’espace cartésien en liant les axes aux colonnes de données du data frame. La superposition de la couche géométrique geom_point() matérialise les observations individuelles sous forme de coordonnées discrètes dans l’espace bidimensionnel. Il est possible d’ajuster l’esthétique de ces points en modifiant leur opacité (argument alpha), leur diamètre (argument size) ou leur morphologie afin de prévenir les chevauchements visuels excessifs lorsque l’échantillon est dense.
La caractérisation de la tendance linéaire générale s’effectue par l’adjonction méthodique de la couche d’ajustement géométrique geom_smooth(). Pour représenter la droite de régression linéaire optimale correspondant au modèle d’estimation de Pearson, l’argument formel method = « lm » (pour linear model) doit être explicitement stipulé. Par défaut, cette fonction enrichit le tracé en matérialisant un ruban semi-transparent entourant la droite de régression, délimitant la zone d’incertitude standard correspondant à l’intervalle de confiance à 95 % de la trajectoire moyenne ajustée. L’analyste affine ensuite le rendu final en appliquant un thème typographique épuré comme theme_classic() ou theme_minimal(), et en formalisant la nomenclature complète des axes via la fonction labs().
9.2 Annotation directe des résultats statistiques sur le graphique
Pour conférer à une figure une autonomie interprétative totale au sein d’une communication académique, il est d’usage d’annoter directement dans l’espace graphique les coefficients statistiques issus du modèle d’inférence, notamment le r de Pearson, le degré de significativité p, et l’effectif total N de la cohorte analysée. Cette intégration peut s’effectuer manuellement par la fonction native annotate() de ggplot2, qui requiert de renseigner manuellement les coordonnées spatiales x et y du texte descriptif. Cependant, cette démarche manuelle présente le défaut de ne pas s’adapter dynamiquement aux modifications ultérieures du jeu de données.
Afin d’automatiser entièrement cette procédure tout en préservant la reproductibilité computationnelle, la bibliothèque spécialisée ggpubr offre une solution d’une remarquable efficacité via sa fonction stat_cor(). Cette directive logicielle s’interface nativement avec les objets ggplot et prend en charge l’exécution du test statistique en arrière-plan, procédant à l’extraction automatique des paramètres et à leur conversion en une chaîne typographique élégante positionnée au sein du graphique. La commande s’exécute typiquement sous la forme suivante :
library(ggplot2)
library(ggpubr)
ggplot(donnees_psycho, aes(x = anxiete, y = performance)) +
geom_point(color = « #2c3e50 », size = 2.5, alpha = 0.8) +
geom_smooth(method = « lm », color = « #e74c3c », se = TRUE, fill = « #e74c3c », alpha = 0.2) +
stat_cor(method = « pearson », label.x = 15, label.y = 85, p.accuracy = 0.001) +
theme_classic() +
labs(x = « Score d’Anxiété Pré-Examen », y = « Score de Performance Cognitive »)
Grâce à cette approche modulaire, toute variation dans le jeu de données sous-jacent met à jour instantanément la droite ajustée, l’intervalle d’incertitude et l’annotation statistique textuelle. Pour satisfaire aux contraintes techniques de soumission éditoriale des revues à fort facteur d’impact, la sauvegarde définitive du tracé s’opère par l’instruction ggsave(), qui permet de stipuler avec précision les dimensions physiques du fichier (en centimètres ou en pouces) ainsi que la résolution matricielle requise (typiquement 300 à 600 DPI au format TIFF) ou de générer directement un fichier vectoriel non pixellisé au format PDF.
9.3 Création de graphiques diagnostiques pour examiner la structure bivariée
Au-delà du simple tracé bivarié, des visualisations enrichies s’avèrent souvent nécessaires pour diagnostiquer simultanément la structure des distributions marginales et détecter d’éventuelles hétérogénéités sous-jacentes au sein de l’échantillon. Un outil d’une grande pertinence méthodologique est représenté par l’intégration d’histogrammes marginaux ou de densités univariées projetés directement sur les bordures supérieure et droite du diagramme de dispersion. Le package ggExtra matérialise cette exigence avec la fonction ggMarginal().
En encapsulant un tracé ggplot2 existant au sein de la fonction ggMarginal(mon_graphique, type = « density », fill = « transparent »), l’analyste fait apparaître instantanément les profils de distribution univariés des variables X et Y face aux axes correspondants. Cette disposition permet de visualiser d’un seul coup d’œil si l’asymétrie observée sur le nuage de points découle d’une anomalie marginale propre à l’une des deux mesures, optimisant ainsi la détection visuelle des écarts à la normalité bivariée.
De surcroît, ces visualisations avancées jouent un rôle déterminant pour révéler des configurations en grappes hétérogènes. Si l’échantillon intègre deux sous-populations distinctes (par exemple des groupes de patients présentant des profils nosologiques contrastés), l’attribution d’un paramètre esthétique de coloration catégorielle via aes(color = groupe) permettra d’identifier instantanément si la corrélation globale apparente ne traduit pas simplement un effet d’agglomération entre des moyennes de groupes décalées. Cette clarification graphique permet de déjouer les artefacts d’interprétation et prépare l’analyste aux modélisations multivariées plus avancées.
10. Gestion des données manquantes, des valeurs aberrantes et pièges méthodologiques
10.1 Stratégies de traitement des données manquantes dans les tests corrélationnels
La présence de valeurs manquantes (valeurs désignées sous le symbole NA dans l’environnement R) représente un défi récurrent lors du traitement des données empiriques issues de protocoles de recherche en sciences humaines. Les protocoles longitudinaux ou les batteries psychométriques longues enregistrent fréquemment des taux de non-réponse partiels qu’il convient de traiter avec une rigueur théorique constante. Deux stratégies algorithmiques classiques sont disponibles au sein des fonctions matricielles de base de R : la suppression par liste complète (listwise deletion, matérialisée par l’argument use = « complete.obs ») et la suppression par paires (pairwise deletion, paramétrée par use = « pairwise.complete.obs »).
La suppression par liste complète élimine systématiquement de l’ensemble des analyses tout individu statistique qui présente une valeur manquante sur au moins l’une des variables du tableau, indépendamment du fait que cette variable participe ou non au calcul de la corrélation bivariée ciblée. Si cette démarche assure que toutes les corrélations de la matrice résultante reposent strictement sur un échantillon commun et homogène, elle peut conduire à une réduction drastique de la taille d’échantillon globale effective et à un affaiblissement sensible de la puissance statistique. À l’opposé, la suppression par paires maximise l’usage des données disponibles en calculant chaque coefficient d’association sur l’ensemble des observations complètes disponibles pour la paire de variables concernée. Cette méthode engendre toutefois un écueil analytique : chaque cellule d’une matrice de corrélation peut alors reposer sur un effectif effectif différent, ce qui peut rendre la matrice résultante non définie positive et compromettre les analyses factorielles ou régressives ultérieures.
Sur le plan de la validité inférentielle, la licéité de ces approches d’amputation mécanique dépend entièrement du mécanisme probabiliste ayant engendré la perte de données, selon la typologie théorique formulée par Donald Rubin : données manquantes totalement au hasard (MCAR), données manquantes au hasard conditionnel (MAR), ou données manquantes non aléatoires (MNAR). Si le mécanisme sous-jacent est MAR ou MNAR, l’amputation brute des observations incomplètes biaise sévèrement l’estimation des coefficients d’association en tronquant sélectivement des segments précis de la population cible.
Face à ces limitations, les standards méthodologiques contemporains préconisent d’abandonner l’amputation mécanique au profit de techniques modernes d’imputation multiple adaptées aux corrélations, telles qu’implémentées dans le package R mice (Multivariate Imputation by Chained Equations). Cette méthodologie procède à la modélisation itérative des valeurs absentes en s’appuyant sur l’ensemble de l’information prédictive disponible dans le jeu de données, générant plusieurs jeux de données imputés complets. Les tests de corrélation sont ensuite exécutés sur chaque sous-échantillon reconstitué, puis les résultats sont agrégés au moyen des règles de combinaison de Rubin, préservant ainsi la puissance statistique tout en intégrant rigoureusement l’incertitude imputée dans l’estimation finale.
10.2 Phénomène de restriction d’étendue et paradoxe de Simpson
L’estimation d’une corrélation d’échantillon peut être substantiellement déformée par deux pièges méthodologiques redoutables fréquemment ignorés des praticiens : la restriction d’étendue et le paradoxe de Simpson. Le phénomène de restriction d’étendue survient lorsque l’échantillon analysé a été sélectionné de manière directe ou indirecte sur la base de critères restrictifs ayant pour effet d’homogénéiser artificiellement l’une des variables sous investigation. Cette contraction artificielle de la variance marginale observée entraîne inéluctablement une atténuation majeure de la grandeur du coefficient de corrélation empirique de Pearson, qui apparaîtra proche de zéro alors même que la relation est substantielle au sein de la population générale non tronquée.
Ce biais est typiquement observé dans les recherches consacrées à l’évaluation des instruments de sélection universitaire ou professionnelle. Lorsque l’on cherche à évaluer la corrélation liant les scores à un concours d’entrée très sélectif et les performances professionnelles ultérieures, l’analyse ne peut être menée que sur les candidats effectivement retenus, chez lesquels la variance des scores au concours est fortement réduite par rapport au vivier initial de candidats. Pour compenser ce biais d’échantillonnage, les psychométriciens recourent aux formules de correction de Thorndike, qui permettent de recalculer une estimation désatténuée de l’association en réajustant le coefficient empirique à partir du ratio de variance observé entre l’échantillon sélectionné et la population parente de référence.
Le paradoxe de Simpson constitue une aberration interprétative encore plus déstabilisante : il décrit une configuration mathématique où une association statistique observée de manière systématique au sein de plusieurs sous-groupes homogènes d’individus s’inverse totalement lorsque ces sous-groupes sont agrégés en un échantillon unique. Dans le domaine comportemental, imaginons une étude évaluant la relation entre le temps alloué à l’utilisation d’une plateforme d’apprentissage numérique et les performances cognitives mesurées auprès d’étudiants de deux niveaux académiques contrastés (licence débutante versus master spécialisé). Au sein de chaque niveau pris isolément, une corrélation positive marquée est identifiée : plus l’étudiant travaille sur la plateforme, plus ses scores s’améliorent.
Toutefois, si les étudiants de master ont globalement des scores moyens beaucoup plus hauts mais disposent de beaucoup moins de temps libre que les étudiants de licence, le nuage de points global agrégé montrera que les individus passant le plus d’heures (les étudiants de licence) obtiennent en moyenne les scores de performance les plus faibles. L’analyste imprudent exécutant une corrélation globale sur les données agrégées conclura à l’existence d’une corrélation négative fallacieuse. Ce paradoxe met en lumière le danger de traiter des cohortes agrégées sans tester préalablement l’homogénéité des pentes au sein des strates sous-jacentes à l’aide de modèles linéaires à effets mixtes ou de régressions stratifiées.
10.3 Approches de corrélation robuste pour contourner les valeurs atypiques
Lorsque la structure des données défie les postulats de normalité bivariée et présente des valeurs discordantes qui ne résultent pas d’erreurs manifestes de saisie mais reflètent une variabilité écologique authentique, les transformations de rangs ne constituent pas la seule alternative disponible. L’analyse statistique robuste offre un cadre théorique permettant d’estimer des coefficients d’association qui résistent à l’influence perturbatrice d’un pourcentage substantiel de points atypiques sans nécessiter l’abandon de l’échelle métrique d’origine.
Une première approche élémentaire repose sur le principe de la troncature ou de la « winsoirisation » des données, implémentée sous R au sein de diverses extensions comme DescTools. La winsoirisation consiste à remplacer les valeurs univariées extrêmes situées au-delà d’un centile déterminé (par exemple au-delà du 5e ou du 95e centile) par la valeur exacte de ce seuil. Le calcul du coefficient de Pearson opéré sur ces vecteurs préalablement régularisés permet de stabiliser l’estimation empirique en circonscrivant l’impact des queues de distribution épaisses.
Sur un plan théorique plus avancé, les biostatisticiens emploient fréquemment le coefficient bi-pondéré de Wilcox (biweight midcorrelation) ou les estimateurs robustes d’enveloppe elliptique, tels que le Minimum Covariance Determinant (MCD), largement accessibles via le package R WRS2 développé par Rand Wilcox. La corrélation bi-pondérée évalue l’association en attribuant dynamiquement un poids fonctionnel à chaque observation : les points proches du centre de gravité de la masse des données se voient assigner un poids unitaire maximal, tandis que les observations s’éloignant progressivement du centroïde voient leur influence décroître de manière fluide jusqu’à devenir totalement nulle au-delà d’une certaine distance critique. Cette technique assure une résistance théorique exceptionnelle face aux contaminations d’échantillon, garantissant une estimation inférentielle fiable là où l’estimateur de Pearson classique échoue.
11. Matrices de corrélation multiples et tests de significativité globale
11.1 Calcul simultané d’une matrice complète avec cor() et Hmisc::rcorr()
Dans la majorité des programmes de recherche empiriques, l’analyse ne se borne pas à l’exploration d’un unique couple de variables, mais requiert l’examen simultané des interrelations unissant une batterie complète d’échelles et de sous-dimensions comportementales. Le traitement unitaire au moyen d’appels successifs à cor.test() deviendrait alors fastidieux et peu lisible. Pour répondre à cet impératif, R propose la fonction matricielle native cor(), qui accepte en entrée directe un tableau de données multidimensionnel composé exclusivement de variables numériques et retourne instantanément une matrice symétrique de corrélation.
Cependant, ainsi que souligné précédemment, la fonction de base cor() omet le calcul des p-valeurs inférentielles associées à chaque croisement bivarié. Pour obtenir simultanément une vue synthétique des coefficients d’association et de leur significativité statistique sans développer de boucles itératives manuelles, les méthodologistes recourent couramment à la fonction rcorr() fournie par l’extension spécialisée Hmisc. Cette fonction exige que le data frame soit préalablement converti en une matrice pure via la commande as.matrix(), et accepte le paramétrage explicite du type d’analyse via l’argument type = c(« pearson », « spearman ») :
library(Hmisc)
matrice_donnees <- as.matrix(donnees_multidimensionnelles)
resultats_globaux <- rcorr(matrice_donnees, type = « pearson »)
L’objet structuré issu de cette commande fournit trois matrices imbriquées de dimensions identiques : resultats_globaux$r renferme l’ensemble des coefficients d’association calculés, resultats_globaux$n documente le nombre effectif d’observations exploitées pour chaque paire bivariée (reflétant le traitement par paires des valeurs manquantes), et resultats_globaux$P stocke les p-valeurs exactes associées à chaque test. Cette architecture permet d’extraire rapidement les informations clés en éliminant les calculs redondants de la matrice triangulaire supérieure.
11.2 Ajustement des p-valeurs pour le contrôle de l’erreur de type I globale
L’estimation simultanée d’un nombre élevé de tests d’hypothèses au sein d’une matrice de corrélation bivariée expose le chercheur à un biais méthodologique majeur : l’inflation systématique du risque d’erreur de type I globale (family-wise error rate). Lorsque l’on procède à l’évaluation d’un seul test au seuil nominal conventionnel alpha de 0,05, la probabilité de commettre un faux positif (rejeter l’hypothèse nulle à tort) est bornée à 5 %. Néanmoins, si l’on calcule une matrice reliant simultanément dix variables psychométriques distinctes, ce calcul implique l’évaluation de 45 tests de corrélation indépendants. Sans ajustement statistique, la probabilité globale d’observer au moins une p-valeur artificiellement significative par le simple jeu du hasard s’élève à 1 moins (1 – 0,05) puissance 45, soit une probabilité supérieure à 90 %.
Pour neutraliser ce risque et préserver la rigueur de l’inférence, il est méthodologiquement indispensable de procéder à un ajustement des p-valeurs. La fonction native de R p.adjust() a été conçue pour administrer ces corrections à partir d’un vecteur simple de p-valeurs brutes. La méthode la plus ancienne et la plus conservatrice est la procédure de Bonferroni, paramétrable par p.adjust(p_valeurs, method = « bonferroni »), qui consiste à diviser le seuil nominal alpha par le nombre total k d’hypothèses testées (ou, de manière équivalente, à multiplier chaque p-valeur calculée par k). Si cette approche garantit un contrôle absolu du risque d’erreur de type I, elle se révèle excessivement conservatrice lorsque la matrice intègre des dizaines de comparaisons, augmentant considérablement le risque d’erreur de type II en masquant des associations authentiques de moyenne amplitude.
Pour pallier cette perte de puissance, des solutions de compromis plus adaptées sont privilégiées dans la littérature moderne. La méthode séquentielle de Holm-Bonferroni (activable via method = « holm ») ordonne préalablement les p-valeurs de façon croissante et leur applique un critère d’évaluation échelonné, assurant un contrôle rigoureux du taux d’erreur familial avec une puissance statistique supérieure. Par ailleurs, dans les approches exploratoires ou transcriptomiques impliquant des centaines de variables corrélées, les chercheurs appliquent préférentiellement la procédure de Benjamini-Hochberg (accessible via method = « fdr »). Cette approche ne vise pas à contrôler le risque qu’une seule erreur survienne dans la famille globale, mais régule le taux de fausses découvertes (False Discovery Rate), garantissant un équilibre optimal entre sensibilité heuristique et fiabilité de l’inférence.
11.3 Visualisation de matrices de corrélation complexes avec corrplot
La communication synthétique d’une matrice intégrant un grand nombre d’indices statistiques bivariés devient rapidement confuse si elle demeure sous forme de tableau numérique. La transposition visuelle de cette structure matricielle sous la forme d’un « corrélogramme » facilite l’appréhension globale des interrelations au sein des données. Le package spécialisé corrplot s’est imposé comme l’un des standards les plus complets et élégants pour concevoir ce type de représentations sous R.
La routine corrplot() reçoit en entrée la matrice des coefficients numériques bruts préalablement extraite et offre une flexibilité de paramétrage typographique avancée. L’utilisateur peut spécifier la géométrie de restitution par l’argument method, choisissant de figurer les associations sous forme de cercles proportionnels (method = « circle »), d’ellipses orientées (method = « ellipse ») traduisant l’inclinaison de l’ajustement linéaire, ou de cellules carrées texturées. Une option d’une valeur heuristique majeure réside dans le regroupement automatique des variables : en renseignant l’argument order = « hclust », la fonction applique un algorithme de classification hiérarchique ascendante qui regroupe spatialement les variables présentant des profils de covariation hautement congruents le long de la diagonale, révélant la structure dimensionnelle sous-jacente des construits psychologiques.
De surcroît, le package corrplot permet d’intégrer une matrice de p-valeurs via son argument p.mat. Grâce au paramètre sig.level = 0.05 combiné avec insig = « blank » ou insig = « label_sig », l’analyste peut masquer automatiquement ou barrer d’une croix conventionnelle toute intersection qui échoue à franchir le seuil de significativité retenu après correction des tests multiples. En complétant cette configuration par une palette chromatique divergente adaptée aux daltoniens (évitant les contrastes stricts rouge-vert au profit d’échelles perceptuellement uniformes bleu-orange), le chercheur produit une figure synthétique publiable dans les meilleures revues de son champ disciplinaire.
12. Rédaction et communication des résultats selon les normes de l’APA en recherche psychologique
12.1 Directives typographiques et formelles de l’APA (7e édition)
La diffusion des résultats d’une analyse corrélationnelle dans le champ de la psychologie et des sciences comportementales doit impérativement se conformer aux standards typographiques et éditoriaux établis par l’American Psychological Association, dont la septième édition du Manuel de publication constitue la référence internationale en vigueur. Ces directives formalisent de manière extrêmement rigoureuse la typographie, l’arrondi décimal et l’agencement des paramètres statistiques, garantissant une uniformité de lecture et une comparabilité internationale des écrits scientifiques.
Sur le plan typographique, une règle fondamentale stipule que tout symbole statistique désigné par une lettre latine doit être rigoureusement composé en caractères italiques. Ainsi, le coefficient de corrélation de Pearson (r), le coefficient de rang de Spearman (rs), le tau de Kendall (τ), la statistique de test de Student (t), la statistique normale (z), la p-valeur (p) ainsi que la taille effective de l’échantillon (N pour la cohorte totale ou n pour un sous-groupe spécifique) doivent systématiquement être typographiés en italique. En revanche, les valeurs numériques qui leur sont associées, les opérateurs mathématiques d’égalité ou d’inégalité, ainsi que les lettres grecques (hormis le tau selon certaines configurations d’usage) demeurent en caractères romains droits conventionnels.
Une directive spécifique de l’APA relative aux notations numériques concerne la gestion de la décimale zéro initiale (le « leading zero »). La règle stipule qu’aucun zéro ne doit précéder le séparateur décimal (point typographique en anglais académique, ou virgule dans certaines adaptations francophones strictes) pour les grandeurs mathématiques qui, de par leur définition théorique, ne peuvent jamais excéder la valeur absolue de 1. Par conséquent, les coefficients d’association (r, rs, τ) ainsi que les p-valeurs (p) doivent impérativement s’écrire sans zéro initial : on rédigera ainsi formellement r = .42 ou p = .003, et jamais r = 0.42 ou p = 0.003. À l’inverse, pour les grandeurs pouvant théoriquement dépasser l’unité, telles que la statistique t de Student ou les distances de Mahalanobis, la présence du zéro initial demeure strictement obligatoire (par exemple t(28) = 5.14 ou t(28) = 0.84).
En matière d’arrondis numériques, les recommandations de l’APA préconisent d’arrondir systématiquement les coefficients d’association empiriques ainsi que les statistiques de test à deux décimales après la virgule. Les p-valeurs doivent quant à elles être rapportées avec une précision de trois décimales. Si une p-valeur se révèle inférieure à un millième (ce qui est fréquent sous R qui affiche par exemple 2.2e-16), il est proscrit de mentionner l’inégalité obsolète p = .000 ; il convient d’écrire rigoureusement p < .001. Enfin, la mention explicite des degrés de liberté associés à la statistique de Student entre parenthèses immédiates ainsi que la communication intégrale de l’intervalle de confiance à 95 % entre crochets sont désormais obligatoires pour toute soumission scientifique contemporaine.
12.2 Modèles de phrases types pour la rédaction des résultats empiriques
Pour assurer la fluidité de la communication académique tout en respectant l’exigence de précision requise par les pairs, la transcription textuelle des résultats doit s’articuler autour de modèles syntaxiques éprouvés. L’énoncé doit intégrer harmonieusement la direction de l’association, la magnitude de la taille d’effet, le diagnostic inférentiel probabiliste complet et la portée conceptuelle de l’effet démontré. Reprenons l’exemple bivarié développé à la section 5 évaluant la relation entre l’anxiété pré-examen et la performance cognitive pour illustrer une formulation académique exemplaire :
« Une analyse de corrélation produit-moment de Pearson a été conduite afin d’évaluer la relation linéaire unissant le niveau d’anxiété situationnelle pré-examen et l’efficience de la performance cognitive chez les étudiants universitaires (N = 30). L’examen préliminaire des distributions a confirmé la conformité globale aux postulats de linéarité et de normalité bivariée. Les résultats révèlent l’existence d’une corrélation négative statistiquement significative et de forte ampleur entre les deux construits, r(28) = -.70, p < .001, IC à 95 % [-.85, -.45]. L’anxiété explique approximativement 49 % de la variance globale des scores de performance cognitive (r² = .49). Conformément à notre hypothèse de recherche, des niveaux élevés d’anxiété situationnelle sont systématiquement associés à une dégradation de l’efficience cognitive. »
À titre de contraste pédagogique, considérons désormais la rédaction d’un résultat non significatif conduisant au non-rejet de l’hypothèse nulle :
« Le test de corrélation de Pearson n’a pas permis de mettre en évidence d’association linéaire statistiquement significative entre l’ancienneté dans l’organisation et le score d’engagement professionnel des employés, r(48) = .12, p = .412, IC à 95 % [-.16, .38]. La part de variance partagée s’avère négligeable (r² = .01). Ces données ne permettent pas de rejeter l’hypothèse nulle d’indépendance linéaire au sein de cette cohorte. »
Il est instructif d’identifier les maladresses de formulation fréquemment sanctionnées par les évaluateurs universitaires. Une formulation erronée classique consisterait à affirmer : « L’anxiété a provoqué une baisse significative de la performance cognitive (r = -0.70, p = 0.000) ». Cette phrase cumule trois fautes majeures : l’emploi du verbe causal « provoquer » totalement injustifiable dans un devis corrélationnel d’observation, l’omission des degrés de liberté et de l’intervalle de confiance, et l’usage fautif du zéro initial et du format d’affichage p = 0.000. Adopter une sémantique mesurée évoquant une « covariation » ou une « association » constitue le garant de la rigueur épistémologique du chercheur.
12.3 Construction de tableaux de corrélation publiables sous R
La présentation académique de matrices de corrélation au sein d’un manuscrit soumis pour publication ne se réalise jamais par la simple capture d’écran d’une console logicielle. Elle exige la composition d’un tableau formaté selon les normes typographiques strictes de l’APA : absence totale de lignes de séparation verticales, présence restreinte de trois bordures horizontales majeures (au sommet, sous l’en-tête des colonnes, et à la base du tableau), et positionnement clair des statistiques descriptives univariées associées.
Concevoir manuellement de tels tableaux dans un traitement de texte représente une tâche fastidieuse propice aux erreurs de transcription. Heureusement, l’écosystème R moderne intègre des bibliothèques dédiées à l’automatisation de ce processus éditorial, au premier rang desquelles figurent apaTables et rempsyc. L’utilisation du package apaTables offre une solution intégrée grâce à sa fonction apa.cor.table(). Cette routine logicielle calcule l’ensemble des coefficients de Pearson bivariés, formate la matrice sous une forme triangulaire inférieure, intègre les astérisques de significativité conventionnels (* p < .05, ** p < .01, *** p < .001), et adjoint sur la marge gauche les moyennes empiriques (M) et les écarts-types (SD) de chaque variable :
library(apaTables)
apa.cor.table(donnees_psycho_multi, filename = « Tableau_Correlations_APA.doc », table.number = 1)
L’exécution de cette commande génère directement sur le disque dur un document au format Word (.doc ou .docx) entièrement structuré selon les canons éditoriaux de l’APA, prêt pour la soumission. Pour les chercheurs désireux de disposer d’une personnalisation typographique plus fine au sein d’environnements de rédaction computationnelle comme Quarto ou R Markdown, le package rempsyc combiné à flextable fournit la commande nice_table(), capable d’insérer des matrices de corrélation interactives élégantes au sein de rapports HTML ou de manuscrits PDF générés via les moteurs de composition LaTeX. L’intégration de ces technologies logicielles parachève la chaîne de reproductibilité scientifique en reliant l’analyse inférentielle bivariée à la diffusion formelle des connaissances.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE Publications.
- Fisher, R. A. (1915). Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population. Biometrika, 10(4), 507–521. https://doi.org/10.2307/2331838
- Fisher, R. A. (1921). On the ‘probable error’ of a coefficient of correlation deduced from a small sample. Metron, 1, 3–32.
- Galton, F. (1888). Co-relations and their measurement, chiefly from anthropometric data. Proceedings of the Royal Society of London, 45(273-279), 135–145. https://doi.org/10.1098/rspl.1888.0082
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.2307/2332226
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1098/rspa.1970.0166
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3e éd.). Academic Press.