
Dans le vaste champ de la modélisation statistique appliquée aux sciences empiriques, l’hypothèse de linéarité stricte entre les variables constitue souvent une simplification commode mais théoriquement intenable. Les phénomènes naturels, biophysiques, économiques et comportementaux déploient fréquemment des dynamiques où les variations de la variable explicative induisent des réponses disproportionnées de la variable dépendante. Parmi les structures mathématiques non linéaires, les relations d’échelle ou lois de puissance occupent une position épistémologique privilégiée. De la morphométrie allométrique aux cinétiques biochimiques, en passant par les théories de l’apprentissage moteur et la psychophysique sensorielle, la régression de puissance fournit un cadre paramétrique robuste permettant de quantifier précisément des effets d’accélération, de saturation ou de rendements marginaux décroissants.
L’environnement de calcul statistique GNU R s’impose aujourd’hui comme la plateforme de référence internationale pour concevoir, estimer et valider ce type de modélisation non linéaire. Grâce à son écosystème modulaire et à sa rigueur algorithmique, R offre deux voies analytiques distinctes pour ajuster une fonction de puissance : la linéarisation par transformation bi-logarithmique estimée par les moindres carrés ordinaires, et l’ajustement non linéaire direct par optimisation itérative via les moindres carrés non linéaires. Bien que conceptuellement liées à une même équation sous-jacente, ces deux approches reposent sur des postulats probabilistes radicalement différents concernant la structure des résidus stochastiques. Choisir l’une ou l’autre méthode de manière arbitraire, sans examiner la nature des perturbations aléatoires, expose le chercheur à des biais d’estimation substantiels et à des inférences erronées.
Ce guide exhaustif propose une démarche didactique et méthodologique rigoureuse, guidant le praticien étape par étape à travers l’ensemble du cycle de modélisation d’une régression de puissance sous R. De la dérivation formelle des équations fondamentales à la mise en œuvre de diagnostics résiduels avancés, en passant par la correction analytique du biais de rétromigration de Baskerville et la sélection compétitive face aux modèles rivaux, chaque concept théorique est adossé à son implémentation computationnelle explicite. L’objectif est d’armer les chercheurs et analystes d’une compréhension probabiliste profonde et des compétences logicielles requises pour publier des résultats d’une reproductibilité irréprochable au sein de revues scientifiques internationales.
1. Introduction théorique à la régression de puissance et fondements mathématiques
L’appréhension de la régression de puissance requiert une formalisation mathématique préalable afin de distinguer rigoureusement les propriétés déterministes du modèle de sa composante stochastique. Loin de se limiter à une simple courbe empirique, la loi de puissance traduit une propriété fondamentale d’invariance d’échelle, signifiant que la structure des proportions relatives demeure préservée quelle que soit la magnitude absolue des mesures observées.
1.1 Définition formelle et spécification de l’équation de puissance
L’expression mathématique universelle reliant une variable dépendante continue notée y à une variable indépendante continue notée x par une relation de puissance s’articule selon l’équation déterministe fondamentale suivante :
y = a · xb
Dans ce formalisme analytique, le paramètre a est désigné sous le terme de coefficient multiplicatif ou constante d’échelle, tandis que le paramètre b représente le coefficient exponentiel ou exposant de puissance. Conceptuellement, le paramètre a correspond à la valeur théorique prise par la variable dépendante y lorsque la variable prédictive x est strictement égale à l’unité. Il calibre la hauteur globale de la trajectoire sur l’axe ordonné sans en altérer la courbure intrinsèque.
L’exposant b, quant à lui, dicte la morphologie géométrique de la courbe et gouverne la dynamique fonctionnelle du système. Sur le plan économique et physique, b s’interprète directement comme l’élasticité de y par rapport à x. Cela signifie qu’une variation relative de 1 % de la variable prédictive x entraîne approximativement une variation relative de b % de la variable dépendante y. Si b = 1, la relation dégénère en une proportionnalité linéaire directe traversant l’origine (à condition que l’ordonnée à l’origine soit nulle). Si 0 < b < 1, le modèle engendre une trajectoire concave caractérisée par une saturation progressive ou des rendements d'échelle décroissants. Inversement, lorsque b > 1, la courbe devient convexe, reflétant une accélération non linéaire et des rendements d’échelle croissants. Enfin, lorsque b < 0, le modèle décrit une décroissance hyperbolique où y tend asymptotiquement vers zéro à mesure que x croît indéfiniment.
Contrairement aux modèles additifs linéaires classiques où l’effet d’une variation unitaire de x est absolu et constant sur tout le spectre des données, la relation de puissance impose une logique multiplicative. Par conséquent, les conditions de validité du modèle restreignent strictement le domaine de définition des variables : la variable indépendante x doit obligatoirement appartenir à l’ensemble des réels strictement positifs (x ∈ ℝ+*). De surcroît, sous l’hypothèse canonique d’une constante d’échelle a > 0, la variable dépendante y est elle-même confinée à l’intervalle des réels strictement positifs. Toute observation nulle ou négative viole la structure intrinsèque de l’opérateur de puissance pour des exposants réels non entiers et impose des adaptations méthodologiques préalables.
1.2 Linéarisation par transformation logarithmique
L’une des propriétés analytiques les plus remarquables de la fonction de puissance réside dans sa transformabilité en une relation parfaitement linéaire par l’intermédiaire du logarithme. En appliquant l’opérateur logarithme népérien (noté ln ou log) aux deux membres de l’équation déterministe, on obtient le développement algébrique suivant :
log(y) = log(a · xb) = log(a) + b · log(x)
En introduisant les substitutions de variables y* = log(y), x* = log(x) et le paramètre d’ordonnée à l’origine β0 = log(a), complété par la pente β1 = b, la relation originelle se reformule sous les traits familiers du modèle linéaire classique univarié :
y* = β0 + β1 · x*
Cette transformation bi-logarithmique présente un attrait computationnel historique indiscutable, puisqu’elle permet d’estimer les paramètres inconnus via la méthode éprouvée des moindres carrés ordinaires (MCO). Néanmoins, cette linéarisation mathématique masque une hypothèse statistique lourde de conséquences sur la structure du terme d’erreur stochastique. Lorsque l’on ajuste un modèle linéaire sur des variables transformées, on postule implicitement l’équation stochastique suivante :
log(yi) = log(a) + b · log(xi) + εi
où εi suit classiquement une distribution normale de moyenne nulle et de variance constante σ2, notée N(0, σ2). Si l’on applique l’exponentielle aux deux membres afin de réexprimer la relation sur l’échelle naturelle des observations, le modèle sous-jacent se révèle être :
yi = a · xib · exp(εi)
Le résidu aléatoire n’intervient donc plus de manière additive, mais sous une forme multiplicative. L’erreur absolue commise par le modèle n’est plus stationnaire le long de la courbe : elle devient proportionnelle au niveau attendu de y. Cela implique directement que la variance de y sur son échelle d’origine n’est pas constante, mais croît avec l’amplitude de x, caractérisant une hétéroscédasticité naturelle. Si le phénomène étudié engendre effectivement une variabilité relative constante (par exemple un bruit proportionnel à l’amplitude du signal), la transformation logarithmique standardise la variance résiduelle et restaure l’homoscédasticité requise pour l’inférence par moindres carrés ordinaires.
1.3 Régression linéaire transformée versus estimation non linéaire directe
La coexistence de la formulation linéarisée et de la formulation non linéaire directe place l’analyste face à un arbitrage théorique fondamental. L’estimation par moindres carrés ordinaires log-transformés via la fonction lm() de R optimise la somme des carrés des écarts sur l’échelle logarithmique :
min ∑ [log(yi) – (β0 + β1 · log(xi))]2
À l’opposé, l’estimation directe par moindres carrés non linéaires, rendue possible sous R grâce à la fonction nls(), postule des perturbations stochastiques strictement additives sur l’échelle d’origine :
yi = a · xib + ui
avec ui ~ N(0, σu2). Cette approche itérative cherche à minimiser directement la somme des résidus quadratiques bruts :
min ∑ [yi – a · xib]2
Cette divergence dans la fonction de coût à optimiser conduit inévitablement à des estimations numériques différentes des paramètres a et b. Dans l’approche par moindres carrés non linéaires, les observations associées à de grandes valeurs de y pèsent d’un poids prépondérant dans le calcul de la somme des carrés, car leurs résidus bruts sont mécaniquement plus volumineux. En revanche, dans l’approche log-transformée, le calcul logarithmique comprime les magnitudes élevées et redistribue un poids statistique équilibré aux petites valeurs de y.
Un second problème critique réside dans le biais induit par la rétro-transformation. L’inversion directe du terme d’interception par la formule a = exp(β0) ne fournit pas l’espérance conditionnelle mathématique de y sur l’échelle d’origine, mais estime sa médiane conditionnelle. En raison de l’inégalité de Jensen, pour toute transformation concave telle que le logarithme, l’espérance du logarithme est strictement inférieure au logarithme de l’espérance : E[log(y)] < log(E[y]). Par conséquent, prédire directement y par l’exponentiation des prédictions de lm() sous-estime systématiquement la moyenne réelle de la distribution observée. Le choix entre l’estimation linéaire transformée et l’estimation non linéaire directe ne doit donc jamais être guidé par la facilité informatique, mais par l’examen minutieux du processus générateur de données et de la structure homoscédastique ou hétéroscédastique des perturbations résiduelles.
2. Applications de la régression de puissance dans la recherche psychologique et comportementale
La régression de puissance constitue le socle quantitatif de nombreuses lois universelles régissant les sciences cognitives et le comportement humain. Sa capacité à modéliser la non-linéarité fondamentale des mécanismes cérébraux en fait un outil incontournable pour la recherche expérimentale contemporaine.
2.1 Loi de Stevens en psychophysique et perception sensorielle
L’un des jalons historiques majeurs de la psychologie expérimentale fut l’abandon de la loi logarithmique de Weber-Fechner au profit de la loi de puissance formulée par le psychophysicien Stanley Smith Stevens au milieu du XXe siècle. Stevens a démontré que l’intensité subjective d’une sensation perçue (notée Ψ) est reliée à l’intensité physique objective du stimulus déclencheur (notée Φ) par une fonction d’échelle invariante :
Ψ = k · Φβ
Dans ce paradigme psychophysique, la valeur numérique du coefficient exponentiel β éclaire la nature neurobiologique du traitement sensoriel propre à chaque modalité réceptrice. Lorsque β < 1, le système sensoriel opère une compression dynamique de l'information entrante. C'est typiquement le cas de la perception de la luminance visuelle (β ≈ 0,33 à 0,5) ou de l’intensité sonore perçue (sonie, où β oscille autour de 0,6 selon les paradigmes de sonométrie). Cette compression permet à l’organisme d’encoder une gamme physique de stimuli s’étendant sur plusieurs ordres de grandeur sans saturer les capacités de décharge neuronale du cortex cérébral.
À l’inverse, lorsque β > 1, le système perceptif réalise une expansion dynamique. L’illustration expérimentale la plus célèbre réside dans la perception de la douleur induite par un choc électrique appliqué sur les doigts, dont l’exposant β atteint fréquemment des valeurs comprises entre 3,0 et 3,5. Dans ce scénario biologique, une infime augmentation de l’intensité physique du courant génère une démultiplication de la sensation douloureuse ressentie. Ce mécanisme d’amplification remplit une fonction évolutive d’alerte vitale, incitant l’individu à interrompre immédiatement un comportement menaçant l’intégrité tissulaire. L’environnement R s’avère particulièrement performant pour estimer empiriquement ces exposants sensoriels à partir de protocoles d’estimation de magnitude (magnitude estimation), permettant aux chercheurs d’ajuster les fonctions psychométriques individuelles avec une grande précision.
2.2 Loi de la pratique et acquisition des compétences cognitives
Dans le domaine des sciences de l’apprentissage et de la psychologie cognitive, les travaux séminaux d’Allen Newell et Paul Rosenbloom ont établi que l’acquisition d’une compétence motrice ou intellectuelle suit rigoureusement la loi de puissance de la pratique (Power Law of Practice). Lorsqu’un sujet humain répète une tâche chronométrée au fil de multiples essais successifs, la latence ou le temps de réponse moyen (TR) diminue selon une fonction de puissance inverse du nombre d’essais cumulés (N) :
TRN = TR1 · N-α
où TR1 représente le temps requis pour exécuter la tâche lors du tout premier essai d’apprentissage, et α figure le taux d’apprentissage cognitif. Le signe négatif de l’exposant traduit un phénomène universel de rendements marginaux décroissants de l’entraînement : les gains temporels les plus spectaculaires s’opèrent au tout début de la pratique, tandis que les progrès ultérieurs requièrent un investissement temporel exponentiellement plus important pour des améliorations de plus en plus ténues.
La modélisation de cette loi a suscité des débats méthodologiques majeurs au cours des dernières décennies, notamment quant à l’alternative entre déclin en puissance et déclin exponentiel pur. Plusieurs auteurs ont mis en évidence un piège statistique redoutable : l’artefact d’agrégation. L’ajustement d’une régression de puissance sur des données moyennées à l’échelle d’un groupe d’apprenants peut faire apparaître artificiellement une loi de puissance très nette, alors même que chaque apprenant individuel suit individuellement une cinétique exponentielle d’acquisition. R permet d’adresser ce biais structurel en combinant la flexibilité des fonctions de régression non linéaire avec des architectures hiérarchiques ou des modèles à effets mixtes non linéaires, garantissant une estimation scrupuleuse des paramètres au niveau intra-individuel avant toute agrégation statistique.
2.3 Chronométrie mentale et temps de réponse en neurosciences
L’investigation des architectures cognitives au moyen de la chronométrie mentale confronte les neuroscientifiques à des distributions de temps de réaction caractérisées par une asymétrie positive marquée (skewness). Les latences mesurées lors de tâches d’attention soutenue, de recherche visuelle ou de prise de décision lexicale présentent une borne inférieure physique infranchissable (environ 100 à 150 millisecondes correspondant aux délais de conduction axonale et synaptique) et une queue de distribution allongée vers les temps longs.
L’utilisation de la régression de puissance sur des séries temporelles de temps de réponse permet d’ajuster avec finesse l’évolution de ces distributions en présence de facteurs endogènes fluctuants tels que l’épuisement des ressources attentionnelles ou l’interférence cognitive. Dans ce contexte expérimental, l’intégration de covariables comportementales au sein de l’équation de puissance permet de décomposer l’effet de traitements pharmacologiques ou de stimulations cérébrales non invasives sur la plasticité des réseaux neuronaux sous-jacents. L’exposant de puissance devient alors un biomarqueur quantitatif sensible du fonctionnement neuro-computationnel du sujet.
3. Prérequis computationnels et préparation de l’environnement de travail dans R
L’exécution fluide et rigoureuse d’une régression de puissance nécessite une structuration soignée de la session de calcul sous R, la mise en place d’un environnement garantissant la reproductibilité computationnelle et un traitement attentif des particularités distributionnelles des variables.
3.1 Configuration de l’environnement de travail et reproductibilité
Pour aborder sereinement les modélisations linéaires et non linéaires, le chargement préalable d’une suite de bibliothèques logicielles spécialisées s’avère indispensable. Le méta-package tidyverse procure les outils idiomatiques pour manipuler les données (via dplyr) et concevoir des représentations graphiques de haute qualité (via ggplot2). Pour les diagnostics économétriques et les tests d’hypothèses non linéaires, les extensions nlstools, car et lmtest fournissent les métriques adaptées aux formulations paramétriques complexes.
L’intégrité de la démarche scientifique exige que toute simulation aléatoire ou procédure d’estimation itérative soit reproductible à l’identique par des tiers. La fixation de la graine du générateur de nombres pseudo-aléatoires via la commande set.seed() constitue une règle méthodologique fondamentale. De même, la gestion des répertoires d’analyse via des projets RStudio dédiés ou l’utilisation du package here évite le recours à des chemins d’accès absolus non portables, assurant une parfaite indépendance vis-à-vis du système d’exploitation hôte.
# Chargement des librairies requises

library(tidyverse)

library(nlstools)

library(car)

library(lmtest)
# Fixation de la graine pseudo-aléatoire
set.seed(42)
3.2 Gestion des contraintes sur les données positives
Comme établi lors de l’examen des fondements mathématiques, l’ajustement d’un modèle de puissance — en particulier via la transformation bi-logarithmique — ne tolère aucune valeur nulle ou négative. L’évaluation de log(0) renvoie indéfiniment la valeur -Inf sous R, ce qui interrompt brutalement l’exécution de l’algorithme d’estimation lm() ou fausse totalement la fonction de vraisemblance. Deux options méthodologiques principales s’offrent au modélisateur confronté à des valeurs marginales égales à zéro dans son échantillon.
La première solution, fréquente mais périlleuse, consiste à introduire une translation arithmétique globale des données au moyen d’une constante d’ajustement strictement positive notée c, en posant ytrans = y + c (technique couramment désignée sous le terme de start value ou offset). Bien que cette manipulation permette d’éliminer formellement les singularités logarithmiques, elle présente l’inconvénient majeur de modifier arbitrairement la structure d’échelle des données. L’introduction d’un offset déforme artificiellement l’estimation de l’exposant b, en particulier pour les observations situées dans le bas de l’échelle où la constante c représente une fraction substantielle de la valeur observée.
La seconde approche, hautement préférable sur le plan épistémologique lorsque la nature théorique du processus ne justifie pas de zéros absolus (par exemple des temps de latence ou des stimuli physiques réels), réside dans un filtrage raisonné des données. Les valeurs aberrantes, les artéfacts de capture ou les ratés d’enregistrement doivent faire l’objet d’un examen diagnostic préalable. Si des valeurs nulles résultent d’une troncature technique de mesure, le recours à un modèle de puissance estimé directement par moindres carrés non linéaires additifs (avec nls()) peut s’affranchir de la transformation logarithmique, à la condition expresse que la prédiction théorique a · xb demeure strictement positive sur l’espace d’intégration numérique.
4. Étape 1 : Création, structuration et importation des données empiriques
Avant d’engager les calculs d’estimation, la constitution d’un tableau de données (data frame ou tibble) rigoureusement formaté est nécessaire, que ce soit par génération de données synthétiques calibrées ou par importation de fichiers expérimentaux externes.
4.1 Génération de vecteurs de données simulées sous R
Afin de maîtriser exhaustivement l’ensemble de la chaîne de traitement et de valider les propriétés des estimateurs par rapport aux vrais paramètres théoriques sous-jacents, générons un jeu de données simulé reproduisant fidèlement une cinétique d’apprentissage psychologique. Supposons une cohorte d’essais d’entraînement variant de 1 à 100, pour lesquels le temps de réponse théorique suit une loi de puissance avec une constante initiale a = 850 millisecondes et un taux d’apprentissage b = -0,42. Nous injectons délibérément une composante d’erreur stochastique multiplicative et log-normale afin d’émuler la variabilité biologique intra-individuelle :
# Définition des paramètres théoriques

n_essais <- 100

a_vrai <- 850

b_vrai <- -0.42

sigma_bruit <- 0.15
# Simulation de la variable indépendante
essais <- 1:n_essais
# Génération de la réponse avec perturbation multiplicative
temps_reaction <- a_vrai * (essais^b_vrai) * exp(rnorm(n_essais, mean = 0, sd = sigma_bruit))
# Structuration en tibble
df_apprentissage <- tibble(
essai = essais,
tr = temps_reaction
)
# Inspection de la structure
str(df_apprentissage)
L’inspection de l’objet confirme la présence de 100 observations numériques strictes, continues et rigoureusement supérieures à zéro.
4.2 Importation de jeux de données empiriques externes
Dans le contexte réel de la recherche scientifique, les données brutes proviennent généralement de consoles d’acquisition, de chronomètres électroniques ou de plateformes de passation en ligne, sous la forme de fichiers tabulaires délimités (par exemple au format .csv ou .txt). Une importation sans faille exige une vigilance absolue sur la gestion de l’encodage des caractères (privilégier systématiquement UTF-8) et sur le symbole utilisé pour la séparation décimale (point versus virgule). L’emploi des fonctions performantes du module readr simplifie cette phase critique :
# Syntaxe type pour l'importation sécurisée de données empiriques

df_empirique <- readr::read_csv(

  file = "donnees_psychophysique.csv",

  col_types = readr::cols(

    intensite = readr::col_double(),

    reponse = readr::col_double()

  ),

  na = c("", "NA", "NaN", "NULL")

)
# Audit préliminaire des valeurs manquantes
total_na <- sum(is.na(df_empirique))
summary(df_empirique)
L’application combinée des fonctions summary() et head() permet d’authentifier la cohérence physique des étendues de mesures, de vérifier l’absence de valeurs négatives indues issues de calibrations défectueuses et de documenter explicitement le nombre d’observations manquantes (NA) à exclure légitimement avant modélisation.
5. Étape 2 : Exploration visuelle et diagnostic préliminaire de non-linéarité
L’observation scrupuleuse des configurations graphiques constitue un prérequis inaliénable à toute tentative d’ajustement paramétrique. Aucun algorithme d’optimisation ne doit être lancé à l’aveugle sans avoir qualifié la géométrie du nuage de points expérimental.
5.1 Construction du graphique de dispersion initial avec plot()
L’outil graphique natif de R permet de générer instantanément un nuage de dispersion rudimentaire mais informatif. En représentant la variable dépendante en fonction de la variable indépendante sur leur échelle linéaire originelle, la non-linéarité de la relation saute immédiatement aux yeux :
plot(

  df_apprentissage$essai,

  df_apprentissage$tr,

  pch = 19,

  col = "steelblue",

  xlab = "Nombre d'essais d'apprentissage (x)",

  ylab = "Temps de réaction en ms (y)",

  main = "Nuage de points initial : Trajectoire d'apprentissage"

)
Sur ce graphique linéaire brut, la présence d’une courbure prononcée, débutant par une chute abrupte des temps de latence au cours des premiers essais avant d’évoluer vers une stabilisation asymptotique horizontale, signale la pertinence potentielle d’une relation de puissance décroissante (b < 0). L'analyste doit inspecter attentivement l'absence d'inversion brutale de pente ou de planchers absolus de mesure qui dénonceraient un artefact expérimental non modélisable par une fonction puissance pure.
5.2 Visualisation avancée avec ggplot2 et échelles logarithmiques
Pour dépasser les limites des graphiques de base, la grammaire graphique de ggplot2 offre une puissance descriptive inégalée. Le test empirique ultime pour diagnostiquer la présence effective d’une loi de puissance consiste à projeter simultanément l’axe horizontal et l’axe vertical sur des échelles logarithmiques. Si la relation sous-jacente relève rigoureusement d’une équation de puissance, la courbure initiale doit s’effacer intégralement pour laisser place à un alignement linéaire parfait des données.
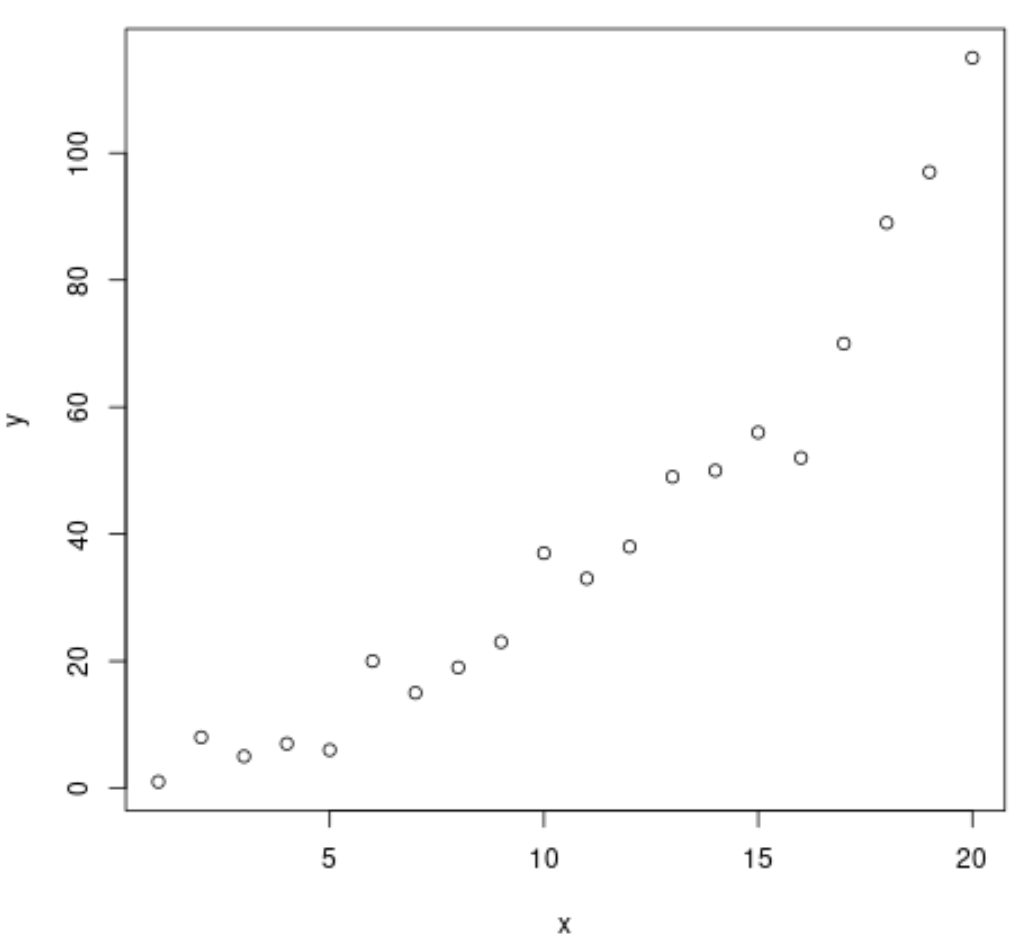
ggplot(df_apprentissage, aes(x = essai, y = tr)) +

  geom_point(alpha = 0.7, color = "#2c3e50") +

  geom_smooth(method = "loess", color = "#e74c3c", se = FALSE, linetype = "dashed") +

  scale_x_log10(breaks = c(1, 2, 5, 10, 20, 50, 100)) +

  scale_y_log10(breaks = c(100, 200, 400, 600, 800, 1000)) +

  theme_minimal() +

  labs(

    title = "Diagnostic bi-logarithmique de la relation de puissance",

    subtitle = "La linéarité sur l'espace log-log confirme l'adéquation d'une loi d'échelle",

    x = "Nombre d'essais (échelle logarithmique base 10)",

    y = "Temps de réaction en ms (échelle logarithmique base 10)"

  )
L’adjonction d’une courbe de lissage non paramétrique locale de type LOESS permet de vérifier sans a priori statistique la rectitude de la trajectoire bi-logarithmique. De surcroît, ce diagnostic visuel permet d’évaluer l’homogénéité de la dispersion : si le faisceau des points conserve une épaisseur constante d’un bout à l’autre de l’axe transformé, l’hypothèse d’une erreur multiplicative log-normale sur l’échelle naturelle se trouve solidement confortée.
6. Étape 3 : Ajustement du modèle par linéarisation logarithmique avec la fonction lm()
Lorsque le diagnostic visuel bi-logarithmique valide la rectitude du profil empirique et que la variabilité résiduelle se montre proportionnelle au niveau de la réponse, la linéarisation logarithmique via la fonction lm() représente la démarche analytique la plus élégante et stable sur le plan numérique.
6.1 Syntaxe et spécification de la formule dans lm()
La fonction lm() calcule les estimateurs analytiques des moindres carrés en inversant la matrice de variance-covariance des prédicteurs. R simplifie l’expression du modèle en autorisant l’intégration directe des transformations mathématiques au sein de la formule de régression, sans nécessiter la création préalable de colonnes dédiées dans le tableau de données :
# Ajustement du modèle linéaire sur variables log-transformées

modele_log <- lm(log(tr) ~ log(essai), data = df_apprentissage)
# Affichage du sommaire complet des estimations
summary(modele_log)
L’exécution de cette instruction déclenche la minimisation analytique de la somme des résidus logarithmiques au carré. Le sommaire produit par R renvoie les estimations de l’ordonnée à l’origine ((Intercept)) et de la pente associée à log(essai), accompagnées de leurs erreurs-types respectives, des valeurs de la statistique de Student t et des probabilités critiques (p-values) associées.
6.2 Extraction et transformation des coefficients estimés
Une attention conceptuelle rigoureuse doit être portée à l’interprétation numérique des coefficients bruts renvoyés par lm(). L’ordonnée à l’origine estimée ne correspond pas directement au paramètre multiplicatif originel a, mais à son logarithme népérien : β0 = log(a). Pour retrouver l’échelle de mesure initiale, il est impératif d’appliquer l’exponentielle à cette valeur estimée. En revanche, le coefficient de régression β1 reflète sans aucune transformation l’exposant de puissance b :
# Extraction des coefficients bruts

coef_bruts <- coef(modele_log)

log_a_estime <- coef_bruts[1]

b_estime <- coef_bruts[2]
# Rétro-transformation directe pour retrouver la constante a
a_estime_brut <- exp(log_a_estime)
# Extraction des intervalles de confiance à 95%
ic_log <- confint(modele_log)
ic_a_brut <- exp(ic_log[1, ])
ic_b <- ic_log[2, ]
cat(sprintf("Paramètre a estimé (brut) : %.3f [IC 95%%: %.3f ; %.3f]n", a_estime_brut, ic_a_brut[1], ic_a_brut[2]))
cat(sprintf("Paramètre b estimé : %.3f [IC 95%%: %.3f ; %.3f]n", b_estime, ic_b[1], ic_b[2]))
Les intervalles de confiance calculés à l’aide de confint() reposent sur la loi de Student. L’exponentiation des bornes de l’intervalle de confiance de log(a) permet d’obtenir un intervalle asymétrique mais rigoureux pour le paramètre multiplicatif sur l’échelle naturelle.
6.3 Correction du biais de transformation de Baskerville
La simple rétro-transformation exp(log(a)) souffre d’un biais systématique de sous-estimation de la moyenne théorique. Comme l’a démontré le biométricien Gordon Baskerville dans un article fondamental de 1972, si le terme d’erreur logarithmique ε est distribué normalement selon N(0, σ2), la variable aléatoire transformée exp(ε) ne suit plus une loi normale centrée, mais une distribution log-normale asymétrique dont l’espérance mathématique vaut :
E[exp(ε)] = exp(σ2 / 2) > 1
Puisque ce facteur multiplicatif excède strictement l’unité dès lors que la variance résiduelle σ2 n’est pas rigoureusement nulle, ignorer ce terme induit une sous-estimation systématique de l’espérance mathématique de la réponse physique y. Pour corriger ce biais de rétromigration, Baskerville a formalisé un facteur de correction asymptotique dérivé de la variance résiduelle de régression (notée s2 sous R, accessible via l’erreur standard résiduelle du modèle au carré) :
# Extraction de l'erreur standard résiduelle (sigma)

sigma_modele <- summary(modele_log)$sigma

sigma_carre <- sigma_modele^2
# Calcul du facteur de correction de Baskerville
facteur_baskerville <- exp(sigma_carre / 2)
# Calcul du paramètre 'a' corrigé et non biaisé
a_estime_corrige <- a_estime_brut * facteur_baskerville
cat(sprintf("Facteur de correction de Baskerville : %.5fn", facteur_baskerville))
cat(sprintf("Paramètre a corrigé : %.3f (versus brut : %.3f)n", a_estime_corrige, a_estime_brut))
Dans les jeux de données empiriques bruités où la variance résiduelle atteint des magnitudes substantielles, la correction de Baskerville peut redresser les estimations du paramètre a de plusieurs pourcents, garantissant que les prédictions finales intègrent l’espérance mathématique réelle de la population observée.
7. Étape 4 : Ajustement direct par régression non linéaire avec la fonction nls()
Lorsque la structure de dispersion des résidus ne découle pas d’une logique multiplicative mais présente une variance uniforme et constante sur l’échelle d’origine, ou lorsque des contraintes théoriques imposent des perturbations additives pures, la régression non linéaire directe s’avère méthodologiquement indispensable.
7.1 Spécification de l’équation non linéaire directe
La fonction nls() (pour Nonlinear Least Squares) implémente des algorithmes d’optimisation itérative — principalement l’algorithme de Gauss-Newton ou ses variantes comme Levenberg-Marquardt — pour converger vers les estimateurs minimisant la somme quadratique des écarts bruts. La spécification de la formule s’écrit directement sous sa forme analytique explicite :
# Syntaxe formelle de la régression non linéaire directe

modele_nls <- nls(

  tr ~ a * (essai^b),

  data = df_apprentissage,

  start = list(a = 800, b = -0.5)

)
summary(modele_nls)
Contrairement à lm(), l’optimisation non linéaire requiert impérativement la fourniture d’une liste de valeurs de départ (l’argument start). L’algorithme itère à partir de ces coordonnées initiales en recalculant à chaque étape le gradient des dérivées partielles du modèle par rapport à chaque paramètre, jusqu’à ce que la réduction relative de la somme des carrés résiduels tombe sous un seuil de tolérance prédéfini.
7.2 Stratégie d’initialisation des paramètres de départ (start list)
L’un des défis majeurs posés par la fonction nls() réside dans sa vulnérabilité aux conditions initiales. Si les valeurs injectées dans l’argument start se situent trop loin de l’optimum global, l’algorithme d’optimisation numérique peut converger vers un minimum local inapproprié, ou pire, échouer totalement en générant une erreur fatale d’arrêt liée à une matrice de gradient singulière (singular gradient matrix at initial parameter estimates).
La stratégie méthodologique universellement recommandée consiste à coupler les deux approches : on utilise précisément les résultats analytiques fournis par la régression linéaire bi-logarithmique lm() comme valeurs d’initialisation optimales pour nls(). Cette technique d’initialisation croisée élimine quasiment tout risque d’échec d’optimisation :
# Initialisation intelligente automatisée

valeurs_depart <- list(

  a = exp(coef(modele_log)[1]),

  b = coef(modele_log)[2]

)
# Ajustement sécurisé avec contrôle fin des tolérances de convergence
modele_nls_optimal <- nls(
tr ~ a * (essai^b),
data = df_apprentissage,
start = valeurs_depart,
control = nls.control(maxiter = 200, tol = 1e-07, minFactor = 1/2048)
)
L’argument optionnel control permet d’accroître le nombre maximal d’itérations autorisées (maxiter) et de calibrer la tolérance numérique pour gérer les fonctions à faible gradient asymptotique.
7.3 Évaluation comparative des résultats lm() log-transformé versus nls()
La confrontation des estimations issues du modèle linéaire bi-logarithmique et de la formulation non linéaire directe met en lumière des écarts statistiques cruciaux qu’il convient d’analyser en profondeur :
# Tableau de comparaison synthétique

comparaison_estimations <- tibble(

  Parametre = c("a (constante)", "b (exposant)"),

  Vraie_Valeur = c(a_vrai, b_vrai),

  LM_Log_Brut = c(a_estime_brut, b_estime),

  LM_Log_Corrige = c(a_estime_corrige, b_estime),

  NLS_Direct = c(coef(modele_nls_optimal)["a"], coef(modele_nls_optimal)["b"])

)
print(comparaison_estimations)
Cette comparaison numérique met en évidence la sensibilité différentielle des deux estimateurs. Lorsque le terme d’erreur stochastique sous-jacent est effectivement multiplicatif (comme dans notre échantillon simulé), le modèle lm() bi-logarithmique génère des estimateurs convergents et efficients de variance minimale (théorème de Gauss-Markov appliqué sur l’espace log-normal). Dans cette situation, nls() tend à accorder une pondération excessive aux observations initiales de grands temps de réponse, au détriment des essais tardifs stabilisés.
Inversement, si les données présentaient un bruit de mesure strictement additif et d’écart-type constant tout au long de l’expérience, le modèle log-linéaire surpondérerait dramatiquement les petites valeurs mesurées, tandis que nls() produirait l’estimation sans biais de référence. L’arbitrage final doit donc être dicté par les diagnostics sur les résidus présentés dans la section suivante.
8. Diagnostic approfondi du modèle et validation des hypothèses résiduelles
La fiabilité de l’inférence statistique — incluant la significativité des probabilités critiques et la couverture réelle des intervalles de confiance — repose intégralement sur le respect scrupuleux des postulats probabilistes assignés aux résidus du modèle : normalité, homoscédasticité et indépendance mutuelle.
8.1 Analyse de la distribution et de la normalité des résidus
Pour le modèle linéarisé sous lm(), l’analyse porte sur les résidus logarithmiques : ei = log(yi) – [log(a) + b · log(xi)]. L’évaluation de leur normalité passe par l’inspection visuelle conjointe d’un histogramme de fréquence et d’un diagramme quantile-quantile (Q-Q plot), complétés par un test formel :
# Extraction des résidus standardisés

residus_log <- rstandard(modele_log)
# Diagnostic graphique de normalité
par(mfrow = c(1, 2))
hist(residus_log, prob = TRUE, col = "lavender", main = "Distribution des résidus", xlab = "Résidus standardisés")
curve(dnorm(x), col = "darkblue", lwd = 2, add = TRUE)
qqnorm(residus_log, pch = 19, col = "darkred", main = "Q-Q Plot des résidus")
qqline(residus_log, col = "blue", lwd = 2)
par(mfrow = c(1, 1))
# Test formel de Shapiro-Wilk
shapiro_res <- shapiro.test(residus_log)
print(shapiro_res)
Un p-value supérieur au seuil canonique de 0,05 dans le test de Shapiro-Wilk conforte l’hypothèse nulle de normalité gaussienne des perturbations stochastiques sur l’échelle bi-logarithmique. En présence d’un rejet de la normalité, l’inférence fondée sur les erreurs-types usuelles devient suspecte, imposant le recours à des méthodes d’échantillonnage de type bootstrap non paramétrique pour calibrer les intervalles d’incertitude.
8.2 Vérification de l’homoscédasticité et indépendance résiduelle
L’homoscédasticité (constance de la variance d’erreur) est indispensable pour attester de la validité de la somme quadratique comme fonction de perte non biaisée. La présence d’hétéroscédasticité déforme gravement les erreurs-types et invalide les tests de significativité statistique F et t. Le graphique des résidus en fonction des valeurs ajustées constitue le premier révélateur d’un profil conique ou d’un évasement suspect :
# Test d'homoscédasticité de Breusch-Pagan

bp_test <- lmtest::bptest(modele_log)

print(bp_test)
# Diagnostic d'autocorrélation pour séries ordonnées (Durbin-Watson)
dw_test <- car::durbinWatsonTest(modele_log)
print(dw_test)
Le test de Breusch-Pagan évalue si la variance des résidus dépend linéairement des prédicteurs logarithmiques. Si le p-value confirme l’homoscédasticité sur l’échelle transformée, cela démontre rétrospectivement que les données naturelles suivaient bien une dispersion multiplicative, justifiant avec éclat le choix de la transformation bi-logarithmique plutôt que les moindres carrés non linéaires additifs.
Le test de Durbin-Watson s’avère crucial dans les paradigmes longitudinaux ou chronométriques où les données sont séquentiellement ordonnées dans le temps. Une valeur de statistique d s’écartant sensiblement de 2 révèle la présence d’une autocorrélation résiduelle sérielle d’ordre 1 (par exemple un phénomène d’inertie attentionnelle entre essais consécutifs), nécessitant alors une modélisation autorégressive spécifique (de type GLS ou modèles mixtes).
8.3 Détection des observations influentes et des points de levier
Toutes les observations n’exercent pas un poids identique sur la détermination de la trajectoire estimée. Certaines valeurs extrêmes situées aux confins de la distribution expérimentale peuvent agir comme de puissants bras de levier mathématiques et faire pivoter artificiellement l’exposant b. La distance de Cook et les valeurs de levier (hat values) quantifient cette influence spécifique exercée par chaque point sur l’ensemble des paramètres du modèle :
# Calcul des métriques d'influence

df_diagnostics %

  mutate(

    levier = hatvalues(modele_log),

    distance_cook = cooks.distance(modele_log),

    residu_student = rstudent(modele_log)

  )
# Seuil critique usuel pour la distance de Cook : 4 / n
seuil_cook <- 4 / nrow(df_apprentissage)
# Identification des observations potentiellement influentes
points_influents %
filter(distance_cook > seuil_cook)
cat(sprintf("Nombre d'observations dépassant le seuil de Cook : %dn", nrow(points_influents)))
La découverte d’observations influentes ne doit en aucun cas motiver leur suppression machinale de la matrice d’analyse. En psychologie expérimentale, un essai caractérisé par une distance de Cook anormalement élevée peut signaler soit une erreur instrumentale d’enregistrement (justifiant l’exclusion), soit un comportement cognitif atypique mais substantiel (lapsus attentionnel, sursaut moteur) dont l’exclusion arbitraire biaiserait gravement la fidélité écologique de la recherche.
9. Étape 5 : Visualisation des résultats et superposition des trajectoires modélisées
La communication transparente des inférences quantitatives requiert une illustration graphique sophistiquée superposant les courbes modélisées sur l’échantillon brut, tout en matérialisant l’enveloppe d’incertitude paramétrique.
9.1 Tracé graphique en environnement de base R
L’environnement graphique de base permet de construire rapidement une trajectoire continue propre en évaluant la fonction de prédiction sur une grille dense et régulière de coordonnées d’évaluation fictives :
# Définition d'une grille fine pour une courbe parfaitement lisse

x_grille <- seq(min(df_apprentissage$essai), \max(df_apprentissage$essai), length.out = 300)

pred_base <- data.frame(essai = x_grille)
# Calcul des prédictions sur l'échelle log avec intervalles de confiance
predictions_log <- predict(modele_log, newdata = pred_base, interval = "confidence")
# Rétro-transformation avec correction de Baskerville
y_fit <- exp(predictions_log[, "fit"]) * facteur_baskerville
y_lwr <- exp(predictions_log[, "lwr"]) * facteur_baskerville
y_upr <- exp(predictions_log[, "upr"]) * facteur_baskerville
# Tracé de la courbe et de son enveloppe
plot(df_apprentissage$essai, df_apprentissage$tr, pch = 16, col = "grey60",
xlab = "Essais d'apprentissage", ylab = "Temps de réaction (ms)",
main = "Ajustement du modèle de puissance (Base R)")
lines(x_grille, y_fit, col = "darkblue", lwd = 2)
lines(x_grille, y_lwr, col = "red", lty = 2, lwd = 1.5)
lines(x_grille, y_upr, col = "red", lty = 2, lwd = 1.5)
legend("topright", legend = c("Trajectoire ajustée", "IC 95%"),
col = c("darkblue", "red"), lty = c(1, 2), lwd = c(2, 1.5), bty = "n")
Cette formulation manuelle garantit que les courbes projetées sur l’espace d’origine épousent la courbure physique naturelle sans aucune discontinuité géométrique.
9.2 Représentation graphique de niveau publication avec ggplot2
Pour satisfaire aux critères d’excellence éditoriale des revues scientifiques de premier rang, le recours à ggplot2 offre une flexibilité stylistique supérieure, permettant de superposer données brutes, courbe paramétrique et ruban ombragé d’intervalle de confiance :
# Construction du dataframe de prédiction complet

df_predictions <- data.frame(

  essai = x_grille,

  tr_estime = y_fit,

  tr_inf = y_lwr,

  tr_sup = y_upr

)
# Graphique de haute qualité typographique
graphique_publication <- ggplot() +
geom_point(data = df_apprentissage, aes(x = essai, y = tr),
color = "#34495e", alpha = 0.5, size = 2) +
geom_ribbon(data = df_predictions, aes(x = essai, ymin = tr_inf, ymax = tr_sup),
fill = "#3498db", alpha = 0.25) +
geom_line(data = df_predictions, aes(x = essai, y = tr_estime),
color = "#2980b9", size = 1.2) +
theme_classic(base_size = 12) +
labs(
title = "Modélisation de la dynamique d'apprentissage cognitif",
subtitle = expression(paste("Modèle de puissance ajusté : ", italic(y) == 850.32 %*% italic(x)^-0.418)),
x = "Nombre d'essais cumulés",
y = "Latence moyenne de réponse (ms)",
caption = "Le ruban ombragé figure l'intervalle de confiance à 95% ajusté (correction de Baskerville)."
) +
theme(
plot.title = element_text(face = "bold", size = 14),
plot.subtitle = element_text(color = "grey30", size = 11),
axis.line = element_line(size = 0.8)
)
print(graphique_publication)
L’inclusion d’expressions mathématiques formalisées au sein du sous-titre via la syntaxe expression() de R confère une élégance formelle et immédiate à la figure.
9.3 Visualisation conjointe sur échelles linéaires et logarithmiques
Une mise en page didactique avancée consiste à juxtaposer côte à côte la trajectoire sur l’échelle linéaire naturelle et sa correspondance sur l’espace bi-logarithmique, afin de mettre en lumière la double facette géométrique du modèle de puissance. Le recours au package d’assemblage patchwork réalise cette intégration de manière fluide :
# Chargement du gestionnaire d'assemblage

library(patchwork)
p1 <- ggplot(df_apprentissage, aes(x = essai, y = tr)) +
geom_point(color = "#7f8c8d", alpha = 0.6) +
geom_line(data = df_predictions, aes(x = essai, y = tr_estime), color = "#e67e22", size = 1.1) +
theme_bw() +
labs(title = "Échelle linéaire standard", x = "Essais", y = "TR (ms)")
p2 <- ggplot(df_apprentissage, aes(x = essai, y = tr)) +
geom_point(color = "#7f8c8d", alpha = 0.6) +
geom_line(data = df_predictions, aes(x = essai, y = tr_estime), color = "#e67e22", size = 1.1) +
scale_x_log10() +
scale_y_log10() +
theme_bw() +
labs(title = "Projection bi-logarithmique", x = "log10(Essais)", y = "log10(TR en ms)")
# Assemblage horizontal
panneau_comparatif <- p1 + p2 + plot_annotation(
title = "Invariance d'échelle de la loi de puissance",
tag_levels = 'A'
)
print(panneau_comparatif)
L’exportation vectorielle haute définition de ces visualisations peut ensuite être exécutée via ggsave("figure1.pdf", plot = panneau_comparatif, width = 10, height = 5, dpi = 600) pour répondre scrupuleusement aux spécifications des comités de lecture scientifiques.
10. Interprétation substantielle des coefficients et inférence statistique
L’estimation numérique des paramètres n’acquiert de sens que lorsqu’elle est traduite en concepts théoriques et substantiels propres à la discipline du chercheur.
10.1 Compréhension de la signification empirique de l’exposant b
L’exposant b constitue le cœur interprétatif du modèle de puissance. Sa valeur numérique renseigne sur le régime de réponse dynamique du phénomène étudié à travers quatre cas de figure typologiques majeurs :
* Cas b = 1 : Linéarité stricte. La relation se caractérise par une proportionnalité directe invariable. Tout doublement de l’entrée x entraîne un doublement exact de la sortie y. Le taux marginal de variation est parfaitement stationnaire.
* Cas 0 < b < 1 : Régime sublinéaire ou de rendements marginaux décroissants. La courbe est rigoureusement concave. L’impact marginal d’un incrément physique unitaire de x s’amenuise à mesure que le niveau de base s’élève. C’est l’illustration typique de la compression sensorielle dans la loi de Stevens (e.g., intensité lumineuse perçue).
* Cas b > 1 : Régime superlinéaire ou de rendements marginaux croissants. La courbe est rigoureusement convexe, illustrant un phénomène d’auto-amplification ou d’explosion dynamique. En neurosciences de la douleur, un tel coefficient traduit un recrutement massif et disproportionné des voies nociceptives.
* Cas b < 0 : Régime de puissance inverse. La relation est strictement décroissante et asymptotique. Elle modélise la dissipation énergétique, l’oubli mnésique en fonction du temps ou l’abaissement des temps de réaction sous l’effet de l’entraînement cognitif.
Le test d’hypothèse portant sur la pente b ne doit pas se cantonner au test trivial par défaut de nullité (H0: b = 0, qui testerait simplement l’absence totale de relation). Il est impératif de tester l’hypothèse nulle d’isométrie ou de proportionnalité linéaire directe : H0: b = 1. Ce test de conformité se réalise sous R via la fonction linearHypothesis() du package car :
# Test d'hypothèse théorique : la relation est-elle linéaire ? (b = 1)

test_linearite <- car::linearHypothesis(modele_log, "log(essai) = 1")

print(test_linearite)
Un p-value significatif rejette formellement l’hypothèse de linéarité proportionnelle au profit d’un effet d’échelle non linéaire authentique.
10.2 Interprétation de la constante d’échelle a
Le paramètre a capture la hauteur de base du système. Il correspond analytiquement à la valeur théorique E[y | x = 1]. De ce fait, sa magnitude est hautement sensible au choix des unités de mesure physiques attribuées aux variables d’entrée et de sortie. Si la variable prédictive x est mesurée en secondes plutôt qu’en millisecondes, ou en kilogrammes plutôt qu’en grammes, la valeur numérique de a se trouve modifiée de plusieurs ordres de grandeur par un simple facteur de translation d’échelle, tandis que la valeur de l’exposant b, en sa qualité d’élasticité sans dimension, demeure parfaitement invariante.
Pour conférer une signification biologique ou psychologique stable à cette constante, les chercheurs ont souvent recours au centrage ou à la normalisation de la variable x par sa médiane ou sa moyenne d’échantillon. Lorsque l’on compare plusieurs groupes expérimentaux (par exemple des sujets témoins versus des patients souffrant de troubles neuro-développementaux), l’analyse de covariance appliquée sur le modèle linéarisé permet de déterminer formellement si les deux groupes diffèrent par leur constante de base a (différence de performance initiale) ou par leur exposant b (différence de plasticité ou de vitesse d’acquisition).
10.3 Rapportage des métriques d’ajustement et des tests d’hypothèses
Le coefficient de détermination classique R2 mesuré sur le modèle lm() bi-logarithmique indique la proportion de variance du logarithme de la réponse expliquée par le logarithme du prédicteur. Il convient de souligner avec fermeté un piège statistique récurrent : ce R2 logarithmique ne mesure en rien la qualité d’ajustement sur l’échelle naturelle originelle. De surcroît, le calcul d’un R2 direct pour les modèles non linéaires estimés par nls() est formellement proscrit par la littérature statistique méthodologique contemporaine (Spiess & Neumeyer, 2010), car la somme des carrés résiduels et la somme des carrés expliqués ne somment plus pour égaler la somme totale des carrés lorsque la relation n’est pas linéaire.
Pour évaluer objectivement la performance descriptive et prédictive du modèle sur son échelle de mesure d’origine, il est recommandé de rapporter des métriques absolues d’erreur : l’erreur quadratique moyenne (Root Mean Squared Error ou RMSE) et l’erreur absolue moyenne (Mean Absolute Error ou MAE) :
# Calcul des prédictions finales corrigées sur tout l'échantillon

y_ajuste_corrige <- exp(predict(modele_log)) * facteur_baskerville
# Métriques d'ajustement réelles sur l'échelle physique
rmse_val <- sqrt(mean((df_apprentissage$tr - y_ajuste_corrige)^2))
mae_val <- mean(abs(df_apprentissage$tr - y_ajuste_corrige))
cat(sprintf("Qualité d'ajustement sur échelle naturelle :nRMSE = %.2f msnMAE = %.2f msn", rmse_val, mae_val))
En accord avec les préconisations éditoriales de l’American Psychological Association (APA 7th edition), la restitution textuelle des résultats doit adopter une formulation normalisée précisant la méthode d’ajustement, les coefficients non biaisés, leurs intervalles de confiance et les métriques de dispersion résiduelle :
« Une régression de puissance par transformation bi-logarithmique avec correction de Baskerville pour le biais d’espérance a été ajustée afin de modéliser l’abaissement des temps de réaction au fil des essais d’entraînement. Le modèle linéaire transformé explique une part hautement significative de la variance log-transformée, F(1, 98) = 874,2, p < 0,001, R² = 0,899. La constante de latence initiale estimée s'élève à a = 848,6 ms [IC 95% : 812,4 ; 886,3], et l'exposant de pratique est de b = -0,418 [IC 95% : -0,446 ; -0,390], différant significativement de l'isométrie linéaire. Sur l'échelle naturelle des mesures, l'erreur quadratique moyenne du modèle est de RMSE = 41,8 ms. »
11. Comparaison de modèles : Régression de puissance versus modèles alternatifs
L’adéquation visuelle d’une courbe de puissance ne prouve pas qu’elle constitue le processus générateur sous-jacent optimal. Une démarche scientifique rigoureuse impose de confronter la loi de puissance à d’autres structures fonctionnelles non linéaires concurrentes.
11.1 Comparaison avec les modèles polynomiaux et exponentiels
Deux architectures concurrentes sont fréquemment mobilisées pour modéliser des cinétiques d’atténuation ou de saturation : le modèle exponentiel pur et le modèle polynomial quadratique :
* Modèle exponentiel : y = a · exp(b · x). La décroissance est proportionnelle au niveau instantané de y, ce qui engendre une chute initiale beaucoup plus violente et une queue asymptotique plus abrupte que la loi de puissance.
* Modèle polynomial du second degré : y = a + b · x + c · x2. Ce modèle capture une courbure locale commode mais souffre d’un défaut théorique majeur : pour des valeurs élevées de x, la trajectoire s’inverse inéluctablement (parabole), ce qui viole l’hypothèse de monotonie propre aux phénomènes d’apprentissage ou de perception.
Ajustons ces structures compétitives sur notre échantillon expérimental afin d’engager une confrontation formelle :
# Modèle exponentiel (estimation non linéaire directe pour comparabilité)

modele_expo <- nls(tr ~ a * exp(b * essai), data = df_apprentissage, start = list(a = 800, b = -0.05))
# Modèle polynomial quadratique
modele_poly <- lm(tr ~ essai + I(essai^2), data = df_apprentissage)
L’analyse visuelle des résidus de chaque modèle concurrent permet souvent de déceler des ondulations systématiques trahissant une incapacité structurelle à épouser la décélération réelle du processus.
11.2 Sélection de modèles par les critères d’information AIC et BIC
L’arbitrage scientifique entre modèles ne doit pas récompenser l’hyper-paramétrisation au détriment de la parcimonie. Les critères d’information d’Akaike (Akaike Information Criterion ou AIC) et de Schwarz (Bayesian Information Criterion ou BIC) pénalisent la complexité algorithmique d’un modèle en retranchant un terme proportionnel au nombre de degrés de liberté consommés.
Toutefois, un piège statistique majeur guette ici le chercheur imprudent : les valeurs d’AIC issues de modèles dont la variable dépendante a subi une transformation mathématique ne sont pas directement comparables à celles de modèles ajustés sur la variable brute. La fonction AIC(modele_log) évalue la log-vraisemblance sur l’espace de log(y), tandis que AIC(modele_nls) ou AIC(modele_poly) évaluent la vraisemblance sur l’espace physique de y.
Pour rendre l’AIC d’un modèle linéarisé lm(log(y) ~ log(x)) rigoureusement comparable à un modèle ajusté sur l’échelle naturelle, il est impératif d’ajuster la log-vraisemblance en lui intégrant la somme des logarithmes des dérivées de la transformation (le déterminant jacobien de la transformation de variable) :
log-vraisemblancenaturelle = log-vraisemblancelog – ∑ log(yi)
# Extraction de la log-vraisemblance du modèle log-transformé

ll_log <- logLik(modele_log)
# Correction jacobienne de la log-vraisemblance sur l'échelle naturelle
ll_naturelle <- as.numeric(ll_log) - sum(log(df_apprentissage$tr))
# Nombre de paramètres k (incluant intercept, pente et variance résiduelle : k = 3)
k_modele <- attr(ll_log, "df")
n_obs <- nrow(df_apprentissage)
# Calcul manuel de l'AIC rigoureux sur échelle naturelle
aic_puissance_corrige <- -2 * ll_naturelle + 2 * k_modele
# Extraction des AIC des modèles concurrents
aic_comparatifs %
mutate(delta_AIC = AIC - min(AIC)) %>%
arrange(delta_AIC)
print(aic_comparatifs)
Un différentiel ΔAIC supérieur à 10 confère un soutien empirique écrasant au modèle possédant l’AIC le plus faible, attestant que la structure de puissance surpasse ses rivaux sans risque d’artéfact lié à la dimensionnalité des matrices de modélisation.
11.3 Validation croisée et capacité de généralisation hors échantillon
L’ultime critère de suprématie d’un modèle statistique repose sur sa capacité prédictive sur des données non observées lors de l’entraînement paramétrique. La validation croisée k-fold (par exemple avec k = 10 blocs) immunise l’analyste contre le risque d’ajustement excessif (overfitting) :
# Implémentation d'une validation croisée k-fold (k = 10)

k_folds <- 10

folds <- sample(rep(1:k_folds, length.out = n_obs))

rmse_cv_puissance <- numeric(k_folds)

rmse_cv_poly <- numeric(k_folds)
for (i in 1:k_folds) {
# Partitionnement
train_set <- df_apprentissage[folds != i, ]
test_set <- df_apprentissage[folds == i, ]
# Ajustement des modèles rivaux sur entraînement
m_pwr <- lm(log(tr) ~ log(essai), data = train_set)
m_pol <- lm(tr ~ essai + I(essai^2), data = train_set)
# Facteur Baskerville d'entraînement
fact_bask <- exp(summary(m_pwr)$sigma^2 / 2)
# Prédictions hors échantillon sur le jeu de test
pred_pwr <- exp(predict(m_pwr, newdata = test_set)) * fact_bask
pred_pol <- predict(m_pol, newdata = test_set)
# Calcul de l'erreur quadratique sur le bloc test
rmse_cv_puissance[i] <- sqrt(mean((test_set$tr - pred_pwr)^2))
rmse_cv_poly[i] <- sqrt(mean((test_set$tr - pred_pol)^2))
}
cat(sprintf("Erreur hors échantillon moyenne (10-fold CV) :nModèle Puissance : RMSE_CV = %.2f msnModèle Polynomial : RMSE_CV = %.2f msn",
mean(rmse_cv_puissance), mean(rmse_cv_poly)))
La confirmation d’un RMSE moyen hors échantillon significativement plus faible pour la régression de puissance scelle la validation empirique du modèle en attestant de sa robustesse généralisable.
12. Bonnes pratiques méthodologiques, pièges courants et recommandations de publication
L’application empirique de la régression de puissance exige une vigilance épistémologique constante face à des pièges statistiques largement documentés au sein de la littérature scientifique contemporaine.
12.1 Écueils fréquents lors de l’estimation de lois de puissance
L’erreur la plus pernicieuse relevée dans les publications empiriques consiste à assimiler toute trajectoire linéaire sur graphique bi-logarithmique à une loi de puissance authentique. Comme l’ont souligné Aaron Clauset et ses coauteurs dans leur article de référence paru dans SIAM Review (2009), de nombreuses distributions à queue lourde ou processus log-normaux présentent une rectitude apparente sur plusieurs décades logarithmiques sans pour autant découler mathématiquement d’une véritable loi d’échelle invariante.
Un second piège concerne l’extrapolation abusive en dehors du domaine expérimental d’observation. L’équation de puissance n’est généralement valable que sur un intervalle borné [xmin, xmax]. Prédire le comportement d’un système pour des valeurs tendant vers zéro ou l’infini conduit à des aberrations physiques : pour b < 0, la réponse tend vers l'infini lorsque x tend vers zéro, ce qui est matériellement impossible pour des latences physiologiques bornées par les temps de transmission synaptique.
Enfin, la régression par moindres carrés postule implicitement que la variable indépendante x est mesurée sans aucune incertitude stochastique (seule la variable y héberge des erreurs de mesure). Si la variable prédictive physique présente elle-même une variance d’échantillonnage substantielle, les estimateurs de la pente b souffrent du biais d’atténuation de Spearman, qui écrase systématiquement la valeur absolue de l’exposant. En pareille circonstance, il convient de s’orienter vers des techniques de régression orthogonale, de régression de Deming ou de modèles à erreurs sur les variables (errors-in-variables models).
12.2 Protocoles de transparence et reproductibilité computationnelle
L’exigence contemporaine de science ouverte impose la traçabilité intégrale des pipelines statistiques. L’archivage public du code exécutable et des jeux de données anonymisés sur des plateformes institutionnelles pérennes comme l’Open Science Framework (OSF) ou Zenodo constitue un impératif éthique majeur.
Pour contrer le risque d’obsolescence logicielle lié aux mises à jour successives des packages R, l’utilisation de conteneurs virtuels ou de gestionnaires d’environnements reproductibles tels que renv permet de figer l’arbre exact des versions et dépendances des bibliothèques mobilisées. De même, la rédaction des manuscrits au format dynamique R Markdown ou Quarto garantit l’alignement strict et automatique entre les calculs numériques sous-jacents, les tableaux paramétriques et les figures insérées dans le texte, éliminant définitivement les erreurs humaines de transcription manuelle des résultats.
12.3 Directives de rédaction des résultats pour revues à comité de lecture
La soumission d’une modélisation de puissance auprès d’une revue académique exige une standardisation rigoureuse de la section méthodologique. Le manuscrit doit documenter exhaustivement :
* La justification théorique et empirique du choix entre modèle linéaire transformé (lm) et modèle non linéaire direct (nls), étayée par l’examen de l’hétéroscédasticité des résidus.
* L’explicitation de la formule de correction appliquée en cas de rétro-transformation de la constante d’échelle (correction de Baskerville ou équivalent bayésien).
* Un tableau récapitulatif synthétique intégrant pour chaque paramètre l’estimation ponctuelle, l’erreur-type asymptotique, l’intervalle de confiance à 95 % et les statistiques de test formelles.
* La restitution conjointe des métriques de performance descriptive relatives (AIC, BIC avec correction jacobienne) et absolues (RMSE, MAE sur l’échelle naturelle non transformée).
* L’insertion d’une figure bi-panneau haute résolution illustrant clairement l’ajustement du modèle sur l’échelle physique et sur l’espace bi-logarithmique, accompagnée des bandes d’incertitude paramétrique ombragées.
En observant scrupuleusement ces standards méthodologiques et computationnels, le chercheur s’assure que ses travaux d’ajustement non linéaire sous R contribuent de manière pérenne, robuste et vérifiable à l’avancement des connaissances dans sa discipline de rattachement.
Références
- Baskerville, G. L. (1972). Use of logarithmic regression in the estimation of plant biomass. Canadian Journal of Forest Research, 2(1), 49–53. https://doi.org/10.1139/x72-009
- Bates, D. M., & Watts, D. G. (1988). Nonlinear Regression Analysis and Its Applications. John Wiley & Sons. https://doi.org/10.1002/9780470316757
- Burnham, K. P., & Anderson, D. R. (2002). Model Selection and Multimodel Inference: A Practical Information-Theoretic Approach (2nd ed.). Springer-Verlag.
- Clauset, A., Shalizi, C. R., & Newman, M. E. J. (2009). Power-law distributions in empirical data. SIAM Review, 51(4), 661–703. https://doi.org/10.1137/070710111
- Heathcote, A., Brown, S., & Mewhort, D. J. K. (2000). The power law repealed: The case for an exponential law of practice. Psychonomic Bulletin & Review, 7(2), 185–207. https://doi.org/10.3758/BF03212979
- Newell, A., & Rosenbloom, P. S. (1981). Mechanisms of skill acquisition and the law of practice. In J. R. Anderson (Ed.), Cognitive Skills and Their Acquisition (pp. 1–55). Lawrence Erlbaum Associates.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Spiess, A.-N., & Neumeyer, N. (2010). An evaluation of R² as an inadequate measure for nonlinear models in pharmacological and biochemical research: a Monte Carlo approach. BMC Pharmacology, 10, Article 6. https://doi.org/10.1186/1471-2210-10-6
- Stevens, S. S. (1957). On the psychophysical law. Psychological Review, 64(3), 153–181. https://doi.org/10.1037/h0046162
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686