
L’analyse de régression constitue l’un des piliers méthodologiques fondamentaux de la modélisation statistique contemporaine en sciences quantitatives, allant de l’économétrie à l’ingénierie biomédicale, en passant par les sciences cognitives et la psychophysique expérimentale. Face à des données empiriques qui manifestent une dynamique non linéaire caractérisée par des variations initiales d’une grande intensité suivies d’une décélération progressive, l’ajustement linéaire classique par la méthode des moindres carrés ordinaires se révèle fondamentalement inadapté, voire conceptuellement trompeur. Dans ce contexte, la régression logarithmique offre un cadre formel élégant et robuste, permettant de capturer les phénomènes de rendement marginal décroissant et de saturation relative sans exiger l’introduction d’asymptotes horizontales strictes.
Au sein des environnements d’enseignement supérieur, des laboratoires de recherche appliquée et des programmes de formation scientifique avancée, la plateforme matérielle constituée par les calculatrices de la gamme Texas Instruments — plus particulièrement la famille TI-84 Plus, comprenant la TI-84 Plus Silver Edition et la TI-84 Plus CE — demeure un standard incontournable pour l’exploration interactive des données. Malgré sa miniaturisation matérielle relative, cette calculatrice graphique intègre des moteurs d’algèbre computationnelle et des primitives algorithmiques dédiées capables d’exécuter des régressions non linéaires complexes en un temps quasi instantané. Cependant, la rigueur méthodologique impose de ne pas considérer cet appareil comme une simple « boîte noire » distribuant des coefficients sans contrôle formel.
Le présent traité propose une exploration exhaustive, didactique et hautement formalisée du déploiement de la régression logarithmique sur la TI-84. En articulant les fondements mathématiques sous-jacents, les procédures séquentielles de configuration logicielle, les vérifications d’hypothèses diagnostiques par l’analyse des résidus et les arbitrages statistiques vis-à-vis des modèles concurrents, ce document a pour vocation d’armer les praticiens et les étudiants d’un protocole d’analyse complet. À travers une démarche pas à pas, exempte de raccourcis superficiels, nous aborderons chaque paramètre machine, chaque arbitrage numérique et chaque interprétation théorique nécessaires à l’exploitation optimale du modèle logarithmique.
1. Fondements théoriques et mathématiques de la régression logarithmique
1.1 Structure formelle du modèle logarithmique
La régression logarithmique univariée formalise une relation fonctionnelle dans laquelle la variable dépendante ou variable de réponse, notée conventionnellement y, est exprimée comme une transformation affine du logarithme népérien de la variable explicative indépendante, notée x. L’équation déterministe standard s’énonce selon l’expression canonique :
y = a + b * ln(x)
Dans ce modèle, le paramètre a représente l’ordonnée à l’origine théorique, correspondant à la valeur prédite de y lorsque la fonction logarithmique s’annule, c’est-à-dire précisément lorsque l’argument x est égal à l’unité (puisque ln(1) = 0). Le paramètre b constitue le coefficient directeur ou facteur d’échelle multiplicatif, régissant l’amplitude ainsi que le sens de la concavité de la courbe. D’un point de vue différentiel, la propriété cardinale de cette relation réside dans l’expression de sa dérivée première par rapport à x :
dy / dx = b / x
Cette dérivée révèle que le taux de variation instantané de la variable dépendante est inversement proportionnel à la magnitude absolue de la variable prédictive x. Lorsque x est faible, une variation unitaire engendre une modification substantielle de y ; inversement, à mesure que x croît vers l’infini, la dérivée tend asymptotiquement vers zéro, matérialisant un amortissement progressif sans jamais s’annuler strictement pour une valeur finie. Cette propriété différentielle restreint immédiatement le domaine de définition mathématique du modèle : l’argument du logarithme doit appartenir au demi-plan réel strictement positif, soit la condition x > 0. Toute tentative d’évaluation en x = 0 engendre une indétermination singulière (divergence vers l’infini négatif si b > 0), tandis que les valeurs négatives sont formellement exclues du corps des réels.
Il convient d’établir une distinction théorique nette entre le logarithme népérien (noté ln, de base mathématique e ≈ 2,71828) et le logarithme décimal (noté log, de base 10). Bien que la calculatrice TI-84 emploie explicitement la fonction ln au sein de son algorithme de régression LnReg, les deux formulations demeurent structurellement homomorphes par application du théorème de changement de base : log(x) = ln(x) / ln(10). Ainsi, une régression formulée en base 10 aboutirait à une estimation rigoureusement identique des propriétés explicatives, à une simple constante d’échelle multiplicative près appliquée au coefficient b (soit b’ = b * ln(10)). L’usage du logarithme népérien s’impose toutefois en calcul infinitésimal en raison de la simplicité analytique de sa dérivation, évitant l’introduction systématique de facteurs modulaires artificiels.
1.2 Morphologie des courbes de croissance et de décroissance
L’observation topologique d’une trajectoire logarithmique permet de caractériser sans ambiguïté sa signature morphologique au sein du repère cartésien. La fonction se distingue par une phase initiale d’accélération ou de décélération spectaculaire, suivie d’un coude structurel où le gradient d’évolution s’infléchit pour adopter une trajectoire presque horizontale, sans pour autant se stabiliser sur une asymptote finie. Cette morphologie traduit mathématiquement le principe fondamental de l’atténuation progressive de l’effet marginal, formalisé en psychologie expérimentale par la célèbre loi de Weber-Fechner. Selon cette loi, la sensation perçue par un organisme sensoriel croît comme le logarithme de l’intensité de la stimulation physique appliquée, expliquant pourquoi un surcroît d’énergie lumineuse ou sonore produit un impact perceptif de plus en plus discret à mesure que le niveau de base s’élève.
L’orientation générale de la trajectoire est strictement subordonnée au signe algébrique du paramètre de pente b. Lorsque b > 0, la fonction décrit une croissance logarithmique pure : la courbe est strictement monotone croissante et présente une concavité dirigée vers le bas (dérivée seconde d²y/dx² = -b / x² < 0 pour tout x > 0). C’est le modèle type de l’assimilation cognitive ou de la diffusion technologique précoce. À l’inverse, lorsque b < 0, la fonction caractérise une décroissance logarithmique : la trajectoire s’effondre abruptement à partir des petites valeurs de x, puis poursuit son déclin avec une lenteur croissante, la courbe arborant alors une convexité orientée vers le haut (d²y/dx² > 0). Ce cas de figure correspond typiquement aux dynamiques de dissipation d’énergie résiduelle ou de dégradation de la performance sous privation sensorielle.
La comparaison théorique de ce profil morphologique avec les autres familles de modèles d’ajustement couramment rencontrés met en exergue des différences conceptuelles majeures. Contrairement au modèle exponentiel (y = a * b^x ou y = a * e^(bx)), dont le taux de croissance relatif est rigoureusement constant et conduit à une explosion divergente rapide de la variable y, le modèle logarithmique présente une divergence extrêmement lente (la divergence harmonique du logarithme). Par rapport aux fonctions polynomiales de degré deux ou trois (paraboles ou courbes cubiques), le modèle logarithmique présente l’immense avantage théorique de préserver la monotonicité : il n’introduit aucun point d’inflexion parasite ni aucun extremum local artificiel (maximum ou minimum) qui viendrait contredire les lois de la physique ou de la biologie imposant une progression univoque. Enfin, il se différencie du modèle de puissance (y = a * x^b) en conservant une réponse additive aux ratios d’échelle multiplicatifs de la variable d’entrée.
1.3 Pertinence méthodologique en sciences quantitatives et psychométrie
L’intérêt de la régression logarithmique dépasse largement le cadre d’un simple ajustement numérique empirique ; elle incarne un mécanisme générateur sous-jacent propre à de nombreuses dynamiques comportementales et psychométriques. En premier lieu, elle trouve une illustration exemplaire dans l’analyse des courbes d’apprentissage et d’acquisition des habiletés motrices ou cognitives. Dans ces paradigmes, le temps d’exécution d’une tâche complexe ou le taux d’erreurs commises diminue de façon marquée lors des premières sessions d’entraînement, avant d’atteindre un palier de consolidation où chaque gain de performance marginal exige un investissement temporel exponentiellement supérieur.
En second lieu, le modèle formalise avec une remarquable précision la loi de Hick-Hyman en ergonomie cognitive. Cette loi stipule que le temps de réaction moyen d’un individu confronté à un choix multiple n’augmente pas linéairement avec le nombre d’alternatives discrètes disponibles, mais proportionnellement au logarithme du nombre d’options, reflétant la quantité d’information théorique (mesurée en bits d’entropie) qui doit être traitée par le système nerveux central. Dans une perspective connexe, la modélisation de la mémoire et de l’oubli initiée par Hermann Ebbinghaus démontre que le taux de rétention mémorielle d’items appris suit une cinétique de décroissance rapide dans les minutes suivant l’encodage, avant de se stabiliser sur un socle résiduel à long terme, dynamique qui se linéarise remarquablement lorsqu’elle est exprimée en fonction de l’échelle logarithmique du temps écoulé.
Enfin, en économie comportementale et en écologie comportementale, le traitement des phénomènes de rendement marginal décroissant constitue le champ d’élection de la régression logarithmique. Qu’il s’agisse de mesurer la satisfaction subjective d’un agent économique en regard de son revenu financier, ou de quantifier l’efficacité d’un temps de butinage chez un prédateur explorant une parcelle de ressources selon le théorème de la valeur marginale de Charnov, la transformation logarithmique permet d’isoler des invariants d’élasticité. Face à ces dynamiques, contraindre le jeu de données dans un modèle linéaire standard mènerait inévitablement à des biais de spécification majeurs, caractérisés par une non-normalité sévère des résidus et une perte substantielle de la puissance prédictive.
2. Préparation technique et configuration initiale de la calculatrice TI-84
2.1 Vérification du système d’exploitation et initialisation de la mémoire
Avant d’engager toute démarche d’analyse de données sur la calculatrice TI-84, une vérification scrupuleuse de l’environnement logiciel s’avère impérative pour garantir la reproductibilité des calculs et la stabilité des primitives statistiques. Les différentes déclinaisons matérielles de la série — qu’il s’agisse des anciens modèles TI-84 Plus standards fonctionnant sur un écran monochrome, de la TI-84 Plus Silver Edition, ou des récents modèles TI-84 Plus CE dotés d’un écran couleur rétroéclairé haute résolution — n’exécutent pas des versions strictement identiques de l’OS (Operating System). Sur les modèles CE, le système d’exploitation est numéroté en version 5.x, tandis que les architectures monochromes exploitent des versions stabilisées en 2.55MP. Pour inspecter la version installée, il suffit de presser successivement la touche [2nd] puis la touche [+] (qui donne accès au gestionnaire MEM), puis de sélectionner l’option 1:About. L’utilisateur visualisera immédiatement le numéro de version de l’OS ainsi que l’espace mémoire RAM libre.
Une étape préparatoire salutaire consiste à nettoyer l’espace de travail des résidus de calculs antérieurs susceptibles d’interférer avec le traitement statistique. Les variables matricielles résiduelles, les vecteurs de listes mal dimensionnés ou les fragments de programmes en arrière-plan peuvent saturer la mémoire vive (RAM) et provoquer des interruptions d’exécution intempestives. Pour effectuer une réinitialisation partielle des listes sans altérer les programmes archivés, on accède au menu mémoire par [2nd] puis [MEM], on choisit l’option 4:ClrAllLists, puis on valide par [ENTER]. La commande inscrit « Done » sur l’écran d’accueil, garantissant que les listes système standard de L1 à L6 sont désormais entièrement vidées de leurs données numériques passées.
Enfin, il convient de calibrer avec précision le format d’affichage numérique dans le menu des modes généraux de l’appareil. En pressant la touche [MODE], l’utilisateur accède à la matrice des paramètres fondamentaux du système. Il est impératif de s’assurer que la deuxième ligne, relative à l’arrondi décimal, est positionnée sur Float et non sur une valeur entière figée (telle que 0, 2 ou 3). Le mode Float permet à la calculatrice de conserver l’ensemble des décimales significatives (jusqu’à 14 chiffres de précision interne avec 10 chiffres affichés à l’écran), évitant ainsi des erreurs d’arrondi précoces susceptibles de dégrader la convergence de l’algorithme des moindres carrés appliqué aux logarithmes des prédicteurs.
2.2 Activation systématique des indicateurs statistiques (DiagnosticOn)
L’un des pièges les plus récurrents rencontrés par les utilisateurs de la calculatrice TI-84 réside dans l’absence spontanée d’affichage des coefficients de corrélation (r) et de détermination (r²) lors de l’exécution des fonctions de régression. Par défaut d’usine ou à la suite d’une réinitialisation matérielle globale de la RAM, le registre d’évaluation diagnostique de la machine est désactivé (état équivalent à l’instruction système DiagnosticOff). Dans cette configuration dégradée, l’exécution d’une commande de régression fournit exclusivement les paramètres de la droite ou de la courbe d’ajustement (les valeurs de a et de b), privant l’expérimentateur des métriques indispensables à l’évaluation de la qualité de l’adéquation empirique.
Pour remédier définitivement à cet écueil sur les calculatrices de génération classique (TI-84 Plus monochrome), la démarche canonique requiert l’accès au catalogue exhaustif des instructions système via la combinaison de touches [2nd] puis [0] (accès à l’étiquette CATALOG). Ce catalogue répertoriant alphabétiquement l’intégralité des primitives machine, l’utilisateur peut presser directement la touche alpha correspondant à la lettre « D » (située sur la touche [x⁻¹]) afin d’effectuer un saut direct dans la liste textuelle. Il convient ensuite de faire défiler les instructions vers le bas à l’aide de la flèche directionnelle jusqu’à localiser l’entrée textuelle DiagnosticOn. Une première pression sur [ENTER] copie l’instruction sur l’écran de calcul principal, et une seconde validation par [ENTER] déclenche l’exécution effective du script, confirmée par l’affichage univoque du message « Done ».
Sur les modèles plus récents, en particulier la TI-84 Plus CE dotée des versions logicielles 5.x, les concepteurs de Texas Instruments ont judicieusement simplifié cette procédure en déplaçant le commutateur au sein même du menu principal de configuration. Il suffit d’appuyer sur la touche [MODE], puis de faire défiler le curseur vers le bas de la liste des paramètres pour repérer la ligne intitulée STAT DIAGNOSTICS. Par défaut parfois positionné sur OFF, ce paramètre doit être basculé manuellement sur ON en plaçant le curseur clignotant sur l’option et en validant par [ENTER]. Dès lors que cette bascule est opérée, l’état persiste dans la mémoire de configuration non volatile, garantissant que toutes les régressions ultérieures afficheront systématiquement les statistiques d’adéquation associées.
2.3 Nettoyage préalable de l’éditeur de fonctions graphiques
L’analyse statistique bidimensionnelle ne se résume pas à l’obtention de métriques scalaires ; elle s’appuie fondamentalement sur la superposition graphique des données discrètes et du modèle continu calculé. Pour que cette représentation visuelle s’effectue sans distorsion ni artefact visuel, une purge méticuleuse de l’éditeur d’équations analytiques s’impose. En appuyant sur la touche [Y=] située à l’extrême gauche de la rangée supérieure sous l’écran, l’utilisateur découvre la liste des registres de fonctions mathématiques, graduée de Y1 jusqu’à Y0. Si des équations résiduelles d’algèbre générale ou de trigonométrie y subsistent, elles viendront se superposer au tracé statistique, polluant la lecture de la courbe de régression ou provoquant des ralentissements computationnels lors du rafraîchissement d’écran.
La neutralisation de ces équations parasites s’effectue en positionnant le curseur sur chaque ligne occupée et en appuyant sur la touche [CLEAR]. Si l’on souhaite préserver une équation complexe pour un usage ultérieur sans pour autant la tracer immédiatement, il est possible de désactiver son rendu en positionnant le curseur sur le signe d’égalité (« = ») associé à la fonction et en appuyant sur [ENTER]. Le surlignage noir du signe s’efface alors, signalant que la fonction est momentanément inactive. Simultanément, il est indispensable de vérifier l’état des tracés statistiques situés sur la rangée supérieure de ce même écran Y=, identifiés sous les étiquettes Plot1, Plot2 et Plot3. Seul le tracé dédié à l’étude courante devra être actif ; les autres doivent être désactivés pour éviter les collisions dimensionnelles entre listes de tailles discordantes.
Enfin, un contrôle rapide du format général d’affichage s’avère hautement profitable via le menu format accessible par la combinaison de touches [2nd] puis [ZOOM] (fonction FORMAT). Au sein de cet écran, l’utilisateur gagne à vérifier que les coordonnées cartésiennes sont bien activées (CoordOn), que les axes sont visibles (AxesOn), et que la grille de repérage est paramétrée selon la préférence de l’expérimentateur (idéalement GridDot ou GridLine sur les écrans couleur CE afin de faciliter la lecture visuelle des ordonnées). Une configuration initiale soignée de cet environnement d’affichage prévient toute déconvenue d’interprétation lors de la phase de rendu graphique.
3. Saisie méthodique des données empiriques dans l’éditeur de listes
3.1 Navigation et encodage au sein de l’éditeur STAT EDIT
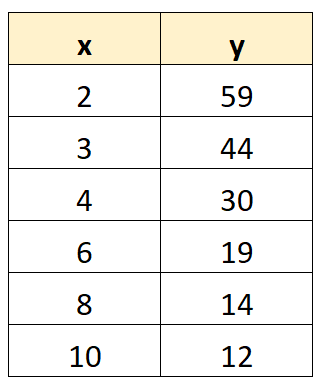
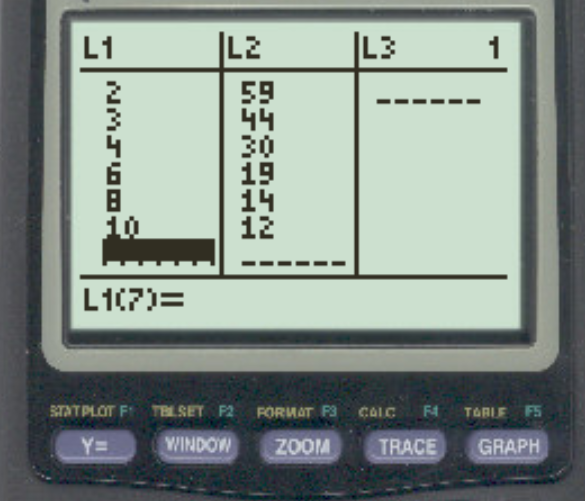
La saisie des observations constitue l’étape empirique déterminante qui conditionne l’exactitude des calculs matriciels subséquents. Pour accéder au tableur interne de la calculatrice TI-84, la séquence opératoire commence par une pression sur la touche dédiée [STAT], positionnée au centre de la moitié supérieure du clavier. Cette action ouvre le menu de gestion statistique articulé en trois onglets fondamentaux : EDIT, CALC et TESTS. Par défaut, le curseur pointe directement sur le premier onglet, et l’option 1:Edit... est pré-sélectionnée. Il suffit d’appuyer sur la touche [ENTER] pour pénétrer au cœur du gestionnaire tabulaire matriciel.
L’interface graphique présente un tableau structuré en colonnes verticales désignées par des identifiants système : L1, L2, L3, jusqu’à L6. Selon les conventions canoniques de l’analyse bivariée :
- La colonne L1 est réservée à l’encodage de la variable explicative indépendante (l’abscisse prédictive x).
- La colonne L2 reçoit la variable dépendante ou variable de réponse (l’ordonnée observée y).
L’encodage s’opère de manière séquentielle : l’utilisateur tape la valeur numérique à l’aide du pavé décimal, puis valide par [ENTER], ce qui décale automatiquement le curseur vers la cellule inférieure. Il est impératif d’utiliser le point décimal standard du clavier numérique pour séparer la partie entière de la partie fractionnaire, et non la virgule typographique qui constitue un séparateur d’arguments textuels. Une fois la colonne L1 intégralement garnie, une pression sur la flèche directionnelle droite déplace le curseur au sommet de la colonne L2, où les observations correspondantes sont encodées selon le même procédé.
Au terme de cette saisie, l’analyste doit impérativement procéder à une vérification dimensionnelle formelle : la parité stricte des listes. Chaque couple d’observation (x_i, y_i) doit être rigoureusement horizontalement aligné. La TI-84 ne tolère aucune asymétrie de structure : si la colonne L1 contient dix observations et que la colonne L2 n’en dénombre que neuf (ou inversement), l’exécution de la routine statistique provoquera une interruption immédiate assortie d’un message d’erreur bloquant (ERR:DIM MISMATCH). Un contrôle visuel rapide du bas de l’écran, qui indique systématiquement l’indice de l’élément sélectionné sous la forme L2(n) = , permet de s’assurer que la longueur totale de L2 concorde à l’unité près avec celle de L1.
3.2 Purge et réaffectation sécurisée des colonnes de données
Lors de la manipulation récurrente de jeux de données successifs, la purge préalable des colonnes antérieures représente une manipulation critique où de nombreux utilisateurs commettent une erreur structurelle préjudiciable. Il existe une différence fondamentale et absolue entre l’action de vider le contenu d’une liste et l’action de supprimer l’objet de liste du système d’affichage :
- Procédure correcte d’effacement : Il convient de faire monter le curseur à l’aide de la flèche vers le haut jusqu’à positionner la surbrillance sur le nom même de la colonne (par exemple sur l’en-tête L1). Dès que l’en-tête est en surbrillance, l’utilisateur doit presser la touche [CLEAR] (et surtout pas la touche [DEL]), puis valider par la touche [ENTER]. L’intégralité des cellules de la colonne est alors instantanément purgée, et le curseur revient sur une cellule vide prête à l’emploi.
- Erreur critique de suppression : Si l’utilisateur, ayant placé l’en-tête de liste en surbrillance, appuie par mégarde sur la touche [DEL] (Supprimer), la liste n’est pas simplement vidée : elle est physiquement retirée de l’affichage de l’éditeur tabulaire. La colonne L1 disparaît alors de la matrice visuelle, décalant immédiatement L2 à gauche, ce qui engendre une confusion extrême lors des saisies futures.
Dans l’éventualité où une liste système viendrait à être malencontreusement supprimée de l’éditeur, Texas Instruments a prévu une procédure de restauration native particulièrement simple. Il n’est nullement nécessaire de réinitialiser l’appareil. Il suffit de sortir de l’éditeur en appuyant sur [2nd] puis [QUIT] (sur la touche MODE), de presser la touche [STAT], de sélectionner dans le premier onglet l’option 5:SetUpEditor, puis de valider en appuyant sur [ENTER]. Cette commande système restructure automatiquement l’éditeur tabulaire en rétablissant l’ordre canonique des six listes par défaut (L1 à L6). Par ailleurs, pour des projets expérimentaux d’envergure, l’analyste peut également créer des listes personnalisées identifiées par des chaînes de caractères alphabétiques (par exemple TEMPS ou SCORE), en insérant une nouvelle colonne via la combinaison [2nd] puis [INS] sur un en-tête de liste et en saisissant le libellé souhaité.
3.3 Gestion des contraintes de domaine sur les prédicteurs
La singularité mathématique de la fonction logarithmique impose une rigueur d’ingénierie des données préalable à tout traitement numérique. Comme établi lors de l’exposé des fondements théoriques, la fonction ln(x) admet une asymptote verticale en zéro et n’est formellement pas définie pour des valeurs inférieures ou égales à zéro dans l’ensemble des réels. Si la liste L1 contient une seule valeur nulle (0) ou négative (par exemple -2,5), l’algorithme des moindres carrés échouera instantanément, renvoyant l’erreur fatale ERR:DOMAIN.
Dans de nombreux protocoles de laboratoire, notamment en chronométrie mentale ou lors du suivi de cinétiques chimiques, la première mesure est conventionnellement enregistrée au temps t = 0, marquant l’instant initial de la manipulation. Face à cette situation, l’expérimentateur ne doit pas supprimer arbitrairement le point d’observation, ce qui biaiserait la puissance statistique de l’échantillon, mais doit mettre en œuvre une stratégie formelle de translation linéaire de la variable indépendante :
x’ = x + c
La constante de translation c (souvent choisie égale à 1 dans le cadre de transformations classiques de type ln(x + 1), ou égale à la précision minimale de mesure telle que 0,01) garantit que l’intégralité des arguments transmis à la calculatrice respecte la condition stricte x’ > 0. Pour automatiser cette translation directement sur la TI-84 sans ressaisir manuellement l’intégralité des données, l’utilisateur peut exploiter le moteur vectoriel de la machine :
- Placer le curseur sur l’en-tête d’une colonne libre, par exemple L3.
- Saisir l’expression arithmétique vectorielle :
L1 + 1(le symbole L1 étant appelé par la touche [2nd] puis [1]). - Valider par [ENTER] : la colonne L3 se peuple instantanément des valeurs translatées.
Il est fondamental de noter que l’application d’une telle transformation linéaire sur les abscisses modifie la structure paramétrique du modèle estimé : le coefficient d’ordonnée à l’origine représentera désormais la valeur de y au point x + c = 1. Toute publication ou rapport d’évaluation quantitative doit documenter scrupuleusement la constante de décalage utilisée afin de préserver la validité de l’interprétation des résultats et permettre l’inversion mathématique ultérieure des prédictions.
4. Exploration visuelle préalable par le tracé du nuage de points
4.1 Configuration des paramètres de tracé (Stat Plot)
L’application aveugle d’une régression statistique sans inspection visuelle préalable du nuage de points représente une entorse grave aux bonnes pratiques de l’analyse exploratoire des données, conceptualisées notamment par le statisticien John Tukey. La TI-84 dispose d’un module graphique dédié, complètement distinct du traceur de fonctions d’analyse mathématique, baptisé STAT PLOT. Ce module permet de projeter les couples empiriques sous forme de diagramme de dispersion cartésien.
Pour configurer ce tracé statistique, la séquence opérationnelle est la suivante :
- Appuyer sur la combinaison de touches [2nd] puis [Y=] pour afficher le menu
STAT PLOTS. - Sélectionner l’option
1:Plot1...en appuyant sur [ENTER] pour entrer dans le paramétrage du premier tracé. - Positionner le curseur clignotant sur l’option
Onet valider par [ENTER] afin d’activer le traceur. - Descendre sur la ligne intitulée
Type:. Cette ligne propose six pictogrammes graphiques distincts. Le premier pictogramme, situé à l’extrême gauche et figurant une série de points isolés sans liaison continue, représente le nuage de points (Scatter Plot). Placer le curseur dessus et appuyer sur [ENTER]. - Définir explicitement les sources de données : sur la ligne
Xlist:, s’assurer que la référence est bien assignée àL1(accessible via [2nd] puis [1]). Sur la ligneYlist:, vérifier qu’elle pointe surL2(accessible via [2nd] puis [2]). - Choisir le symbole d’affichage (
Mark:) : la calculatrice propose généralement un petit carré évidé, un signe croix (+), ou un point minuscule. Le carré évidé offre la meilleure lisibilité visuelle sur les écrans à cristaux liquides en évitant que deux observations rapprochées ne se fondent en un pixel indéchiffrable. - Sur les modèles TI-84 Plus CE dotés d’écrans couleur, une option complémentaire
Color:permet d’attribuer une nuance chromatique spécifique (comme le bleu marine ou le rouge vif) pour distinguer ce nuage des tracés mathématiques ultérieurs.
4.2 Optimisation automatique et manuelle du repère cartésien
Une fois le tracé statistique configuré, une simple pression sur la touche [GRAPH] aboutit fréquemment à un écran vide ou tronqué, les bornes spatiales par défaut du repère (couramment restreintes à l’intervalle [-10, 10] sur les deux axes) ne coïncidant que très rarement avec la magnitude réelle des variables expérimentales. Pour contourner cette difficulté, la TI-84 embarque un algorithme d’optimisation contextuelle extrêmement performant : la fonction ZoomStat.
En appuyant sur la touche [ZOOM] située au centre de la rangée de commande graphique, l’utilisateur accède à la liste exhaustive des modes de cadrage. En faisant défiler la liste vers le bas ou en appuyant directement sur la touche numérique [9], on déclenche l’exécution de l’instruction 9:ZoomStat. L’algorithme interne de la calculatrice scanne alors instantanément les listes déclarées dans le traceur actif (L1 et L2), détermine la valeur minimale et la valeur maximale de chaque série, et redéfinit automatiquement les dimensions du champ visuel pour faire tenir l’ensemble des points d’observation à l’écran, avec une marge périphérique de sécurité d’environ 10 %.
Toutefois, la compréhension globale du phénomène exige souvent un ajustement manuel des bornes cartésiennes, accessible en pressant la touche [WINDOW]. Il est particulièrement recommandé d’ajuster manuellement la valeur de Xmin à une borne légèrement inférieure à l’unité (par exemple 0,1 ou 0,5 si les données débutent à 1), plutôt que de laisser le zoom automatique caler la fenêtre sur une valeur arbitraire. De surcroît, le paramètre d’échelle (Xscl et Yscl), qui contrôle l’espacement spatial entre deux graduations sur les axes, doit être ajusté pour éviter que les axes n’apparaissent comme d’épaisses bandes noires continues causées par une surcharge de graduations. Enfin, cet étalonnage spatial précis permet d’identifier visuellement d’éventuels points aberrants grossiers (outliers), découlant par exemple d’une coquille de frappe lors de la saisie numérique (tel qu’un point décimal omis transformant un 12,5 en 125).
4.3 Diagnostic graphique de la convexité logarithmique
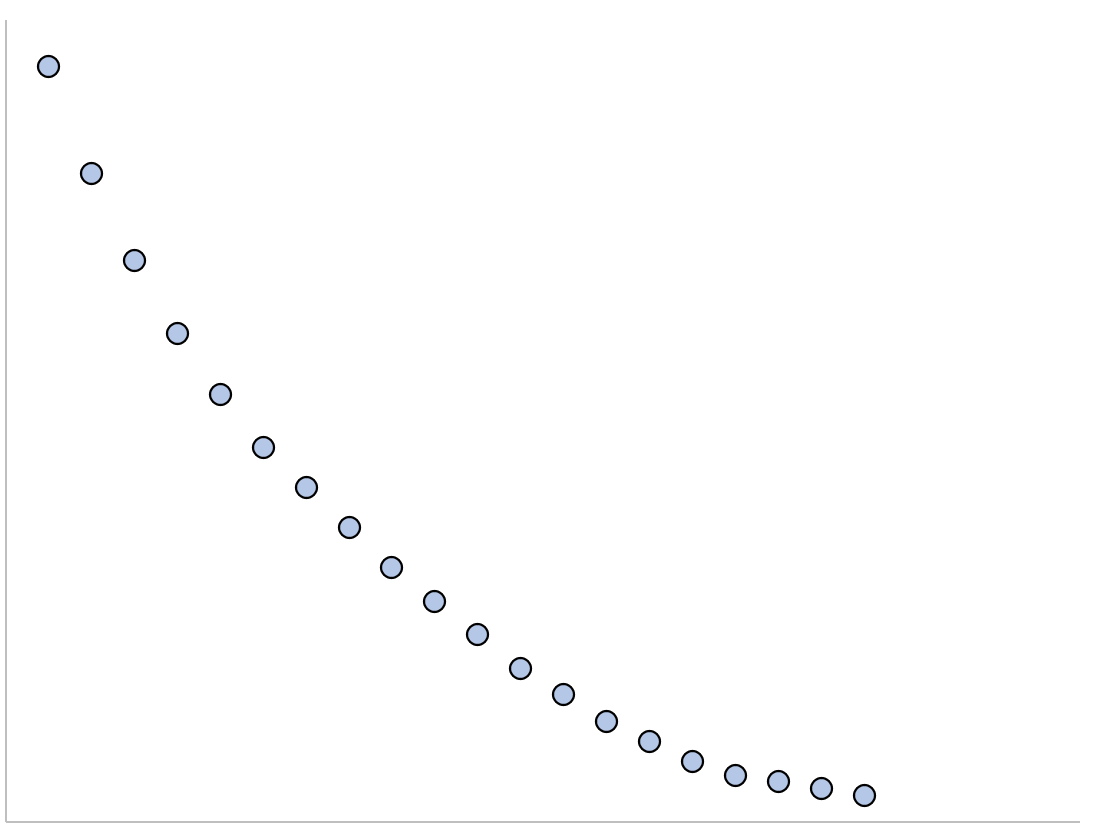
L’observation du nuage de points projeté sur l’écran fournit les éléments qualificatifs capitaux justifiant l’application d’un modèle de régression logarithmique. L’analyste doit procéder à une lecture morphologique attentive de la structure de dispersion spatiale. Deux caractéristiques géométriques majeures doivent obligatoirement se manifester :
- Une courbure de décélération continue : Aux faibles valeurs d’abscisse, la variation verticale observée entre deux points consécutifs doit être substantielle, dessinant une pente abrupte. Au fur et à mesure que l’on se déplace vers la droite du graphe le long de l’axe des abscisses, l’espacement vertical entre les points doit se réduire continuellement, matérialisant un net ralentissement du rythme d’évolution.
- L’absence absolue de point d’inflexion : La trajectoire empirique ne doit en aucun cas présenter une allure en « S » (caractéristique d’une dynamique sigmoïdale ou logistique). Dans un modèle logarithmique, la dérivée seconde conserve un signe constant sur l’ensemble de son domaine ; il ne saurait y avoir de transition entre une phase convexe et une phase concave.
Cette inspection visuelle permet d’écarter immédiatement des hypothèses de modélisation alternatives manifestement discordantes. Si le nuage de points présente une progression rectiligne uniforme, l’application d’un modèle linéaire classique (LinReg) sera privilégiée en vertu du principe de parcimonie. Si, au contraire, la croissance semble s’accélérer verticalement à mesure que l’on progresse vers la droite, c’est vers un modèle exponentiel (ExpReg) ou une fonction puissance de degré supérieur à un qu’il faudra se tourner. Dès lors que la morphologie confirme une décélération progressive sans asymptote apparente rigide, la décision d’engager le calcul de l’ajustement logarithmique (LnReg) est scientifiquement et méthodologiquement fondée.
5. Exécution pas à pas de l’algorithme de régression logarithmique (LnReg)
5.1 Localisation et sélection de la primitive LnReg sur la TI-84
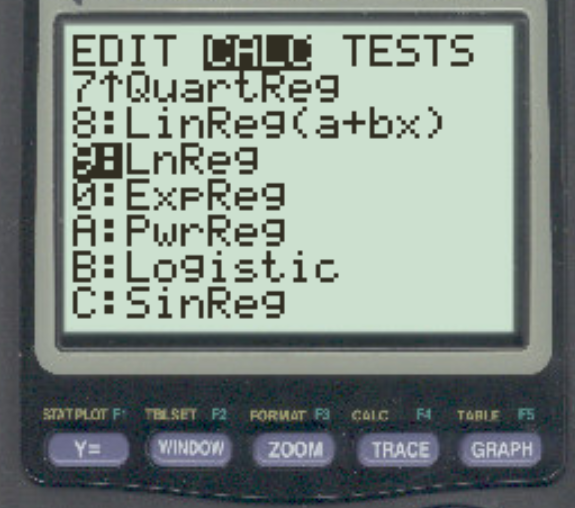
La bibliothèque logicielle intégrée de la calculatrice TI-84 contient une collection complète d’algorithmes d’ajustement matriciel par la méthode des moindres carrés. Pour exécuter spécifiquement la régression logarithmique, l’utilisateur doit accéder au sous-menu des calculs statistiques. L’opération débute par une pression sur la touche [STAT], suivie d’une pression sur la flèche directionnelle droite pour basculer sur l’onglet horizontal CALC.
Ce menu déroulant répertorie l’ensemble des estimateurs disponibles sur l’appareil. En faisant défiler la liste vers le bas au moyen de la flèche descendante, on localise la neuvième option, textuellement référencée sous la forme 9:LnReg. Il est possible de naviguer manuellement jusqu’à cette ligne et d’appuyer sur [ENTER], ou plus simplement de presser directement la touche numérique [9] du pavé de saisie pour déclencher immédiatement son appel.
Il importe d’insister sur la nécessité absolue de ne pas confondre cette commande avec deux autres primitives aux dénominations superficielles proches mais aux propriétés mathématiques radicalement divergentes :
- L’option
0:ExpReg(régression exponentielle), qui modélise des dynamiques de forme y = a * b^x, où c’est la variable x qui apparaît en exposant et non le logarithme qui lui est appliqué. - L’option
B:Logistic(régression logistique), qui calcule un ajustement sigmoïdal borné par deux asymptotes horizontales selon une formule de type y = c / (1 + a * e^(-bx)).
La commande 9:LnReg est l’unique routine de la TI-84 spécifiquement programmée pour exécuter le calcul linéaire sur la transformation logarithmique népérienne naturelle de l’argument d’abscisse.
5.2 Configuration des arguments sous l’interface moderne (TI-84 Plus CE / OS récent)
Sur les modèles récents dotés de l’environnement graphique à invite guidée (introduit sur les versions logicielles modernes de la TI-84 Plus et sur l’ensemble de la gamme TI-84 Plus CE), la sélection de l’option LnReg ne projette pas directement une ligne de commande sur l’écran d’accueil, mais ouvre une boîte de dialogue contextuelle paramétrique. Cet écran structure les arguments nécessaires sous forme d’une série de champs textuels successifs qu’il s’agit de compléter méthodiquement :
- Champ Xlist : Spécifie l’emplacement de stockage de la variable indépendante. Par défaut, la machine inscrit
L1. Si les données translatées ou spécifiques se situent dans une autre colonne, l’utilisateur peut modifier cette entrée en appelant la liste adéquate via la touche [2nd] suivie de la touche numérique associée (par exemple [2nd] puis [3] pour attribuer L3). - Champ Ylist : Spécifie la liste réceptrice de la variable de réponse. Ce paramètre doit être rigoureusement aligné sur la colonne correspondante, généralement
L2(accessible par [2nd] puis [2]). - Champ FreqList : Permet de prendre en considération une liste de pondération ou de fréquences absolues si chaque point représente une classe d’effectifs agrégés. Dans la très grande majorité des expérimentations scientifiques standard où chaque couple (x, y) constitue une observation univariée unique, ce champ doit impérativement être laissé entièrement vierge. Si un caractère quelconque y figure, il convient de l’effacer à l’aide de la touche [CLEAR].
- Champ Store RegEQ : Ce paramètre hautement stratégique permet d’indiquer le registre de fonction graphique dans lequel l’équation de régression calculée doit être automatiquement copiée sous forme analytique continue. La configuration précise de ce champ fait l’objet d’un développement approfondi dans la section suivante.
- Ligne Calculate : Constitue le déclencheur de l’opération. L’utilisateur y positionne le curseur clignotant à l’aide des flèches directionnelles et valide par une pression ferme sur la touche [ENTER].
5.3 Exécution en mode syntaxe de commande directe (Classique / OS antérieur)
Sur les modèles plus anciens de la gamme TI-84 Plus fonctionnant en mode classique (ou lorsque l’option d’assistance par menu contextuel a été désactivée dans les réglages système du mode), la sélection de la primitive statistique n’ouvre aucun formulaire d’invite. La calculatrice bascule immédiatement sur l’écran d’accueil textuel principal en y inscrivant simplement le nom de la primitive suivi d’un espace clignotant : LnReg _.
Dans ce contexte classique, l’utilisateur doit renseigner les arguments de calcul de façon manuelle en respectant scrupuleusement la syntaxe formelle de l’interpréteur de commandes de Texas Instruments. La syntaxe canonique exhaustive s’énonce comme suit :
LnReg [Xlist, Ylist, FreqList, Equation]
Pour un traitement classique reliant les abscisses de L1, les ordonnées de L2 et destiné à stocker l’équation dans la variable de fonction Y1, l’utilisateur doit saisir manuellement la chaîne d’instructions suivante directement à la suite du mot-clé LnReg :
- Appuyer sur [2nd] puis [1] pour insérer l’identifiant de liste
L1. - Appuyer sur la touche virgule [,] située impérativement au-dessus de la touche numérique [7]. Il est crucial de ne pas employer le point décimal sous peine de provoquer une erreur de syntaxe immédiate.
- Appuyer sur [2nd] puis [2] pour insérer l’identifiant de liste
L2. - Insérer une seconde virgule typographique [,].
- Omettre l’argument de fréquence en insérant directement la destination d’équation (ou en insérant une nouvelle virgule si le système réclame le saut d’argument), en appelant le jeton de fonction
Y1(via le menu des variables ou le raccourci clavier décrit au chapitre suivant).
La ligne textuelle finale affichée à l’écran doit présenter exactement la structure suivante : LnReg L1, L2, Y1. Une fois cette syntaxe validée par la touche [ENTER], le microprocesseur de la TI-84 engage les calculs d’inversion matricielle pour minimiser la somme des carrés des erreurs résiduelles.
6. Stockage automatique et superposition graphique du modèle d’ajustement
6.1 Assignation de l’équation estimée à une variable fonctionnelle (Store RegEQ)
L’une des manipulations les plus sous-estimées, mais dont la maîtrise distingue l’utilisateur expert de l’amateur, réside dans le transfert automatisé de l’expression mathématique estimée vers l’éditeur de fonctions. Trop fréquemment, les praticiens se contentent de noter manuellement sur un brouillon les coefficients a et b affichés à l’écran après calcul, pour aller ensuite les retaperLaborieusement dans le menu Y=. Cette mauvaise pratique engendre une double pénalisation : d’une part, elle introduit un risque non négligeable d’erreur de transcription humaine, et d’autre part, elle tronque sévèrement la précision intrinsèque des paramètres (réduisant une mantisse interne de quatorze chiffres à deux ou trois décimales arbitraires), ce qui induit des biais d’arrondi significatifs lors des extrapolations numériques futures.
L’utilisation judicieuse du paramètre Store RegEQ élimine totalement ce problème. La procédure d’assignation standard s’exécute comme suit :
- Lorsque le curseur se trouve positionné sur le champ
Store RegEQ(dans l’interface moderne) ou à la suite de la deuxième virgule de l’instruction textuelle (en mode classique), appuyer sur la touche [VARS] située sous les flèches de navigation. - Déplacer le curseur vers la droite pour surligner l’onglet horizontal supérieur
Y-VARS. - Sélectionner la première option
1:Function...et appuyer sur [ENTER]. - Une liste déroulante énumère l’ensemble des registres fonctionnels disponibles (de
1:Y1à0:Y0). Sélectionner1:Y1et appuyer sur [ENTER].
Sur l’ensemble des calculatrices de la série TI-84 Plus CE ainsi que sur les modèles TI-84 Plus équipés d’un système d’exploitation récent, il existe un raccourci clavier considérablement plus rapide : il suffit d’appuyer sur la touche [ALPHA] puis sur la touche de fonction [TRACE] (qui donne un accès direct au menu rapide F4). Une fenêtre contextuelle miniature s’ouvre instantanément, listant directement les variables Y1 à Y0. Une simple pression sur la touche numérique [1] insère immédiatement le symbole Y1 dans le champ d’assignation. Lorsque la régression est calculée, l’intégralité de la formule déterministe avec sa pleine précision en virgule flottante est injectée en mémoire vive dans le registre graphique ciblé.
6.2 Génération et rendu de la courbe ajustée sur le graphe
Une fois l’algorithme exécuté et les résultats numériques affichés sur l’écran principal, le tracé de la courbe modélisée ne réclame plus qu’une simple pression sur la touche [GRAPH]. Le moteur de rendu graphique de la TI-84 projette alors simultanément deux éléments visuels distincts au sein du même repère orthonormé :
- Les données discrètes du nuage de points issues de
Plot1, figurées par les marqueurs sélectionnés lors de la phase exploratoire. - La fonction d’ajustement continu issue du registre
Y1, matérialisée par une courbe lisse venant épouser la trajectoire tendancielle du nuage.
L’analyste est désormais en mesure d’apprécier la qualité de la superposition théorique. La courbe de régression logarithmique doit traverser le nuage de points de part en part, distribuant harmonieusement les observations au-dessus et en-dessous de sa trajectoire. Sur les modèles TI-84 Plus CE à écran couleur, l’esthétique du tracé peut être affinée dans le menu [Y=] : en déplaçant le curseur tout à fait à gauche de la ligne Y1, au-delà du signe égal, l’utilisateur peut appuyer sur [ENTER] pour modifier la couleur du trait (par exemple la basculer en magenta ou en noir pour trancher avec les points bleus) ou en accroître l’épaisseur structurelle afin d’optimiser le confort de lecture lors d’une présentation ou d’une capture d’écran pédagogique.
L’inspection visuelle doit également porter sur le comportement asymptotique aux frontières de la fenêtre cartésienne. À l’extrême gauche, au voisinage de l’axe des ordonnées, la trajectoire continue doit plonger abruptement vers le bas (ou monter vers le haut si b < 0), illustrant la singularité asymptotique en x = 0. À l’extrême droite, la courbe doit exhiber un tassement continu sans jamais basculer vers une pente négative (dans le cas d’une croissance où b > 0), confirmant visuellement le respect de la monotonie de la modélisation.
6.3 Exploration interactive via l’outil de traçage (TRACE)
L’un des atouts interactifs majeurs de la TI-84 réside dans la commande de traçage dynamique, accessible par la touche [TRACE] positionnée sur la rangée supérieure des commandes graphiques. Dès son activation, un curseur clignotant s’ancre sur l’un des objets géométriques affichés à l’écran, et les coordonnées numériques instantanées du point sélectionné (X et Y) s’affichent en temps réel dans la marge inférieure de l’écran.
Il est fondamental de noter que l’utilisateur peut basculer le curseur interactif entre le tracé discret des données empiriques et le tracé continu de la fonction de régression mathématique à l’aide des touches directionnelles haut et bas :
- Navigation sur le nuage de points : En sélectionnant le tracé
Plot1(l’identifiant figure dans l’angle supérieur gauche), les flèches gauche et droite permettent de sauter séquentiellement d’un point expérimental à l’autre selon l’ordre d’encodage des listes, affichant les coordonnées observées exactes issues de L1 et L2. - Navigation sur la courbe théorique : En pressant la flèche descendante, le curseur bascule sur la courbe continue modélisée issue de
Y1(l’équation formelle y = a + b * ln(x) s’inscrit au sommet de l’écran). Dès lors, le déplacement via les flèches directionnelles gauche et droite calcule et affiche les coordonnées théoriques prédites le long de la fonction continue.
De surcroît, lorsque le curseur est ancré sur la fonction théorique continue, l’utilisateur a la possibilité de saisir directement n’importe quelle valeur numérique d’abscisse au clavier. Par exemple, en tapant immédiatement la valeur 4.5 suivie de [ENTER], le curseur se téléporte instantanément sur la coordonnée correspondante et fournit l’évaluation prédite exacte du modèle, à la seule condition technique que la valeur saisie soit rigoureusement comprise entre les bornes d’affichage Xmin et Xmax définies dans le repère actif. Cette fonctionnalité procure un levier d’une efficacité redoutable pour procéder à des interpolations ponctuelles immédiates sans quitter l’interface visuelle.
7. Interprétation analytique et statistique des coefficients du modèle
7.1 Décomposition du coefficient constant d’intersection (a)
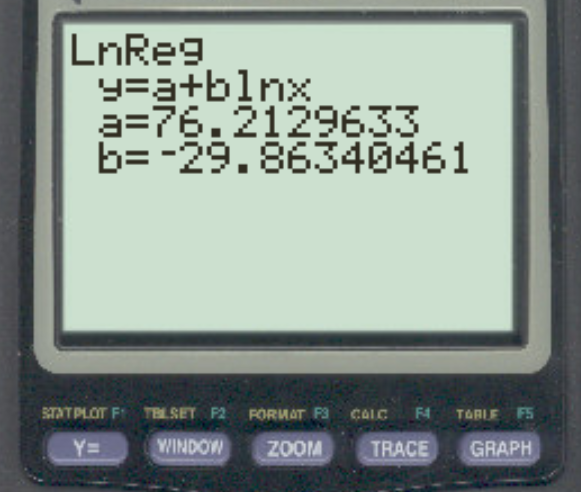
L’exécution de la routine LnReg fournit sur l’écran d’accueil un ensemble d’estimations numériques calées sur l’expression synthétique y = a + b*ln(x). L’interprétation méthodologique de ces valeurs scalaires impose une compréhension fine de leur signification géométrique et conceptuelle au sein du paradigme expérimental étudié.
Le terme constant a correspond formellement à la valeur attendue ou prédite de la variable de réponse y lorsque la composante logarithmique s’annule dans l’équation. Étant donné que la fonction ln(x) est strictement égale à zéro si et seulement si son argument vaut l’unité (ln(1) = 0), le paramètre a ne représente pas la valeur de départ à l’origine absolue (c’est-à-dire en x = 0, où la fonction est mathématiquement indéfinie), mais la valeur de la réponse au point d’abscisse unitaire x = 1 :
y(1) = a + b * ln(1) = a + b * 0 = a
Cette particularité confère au choix de l’unité de mesure assignée à la variable explicative une influence déterminante sur la magnitude de a. Si la variable prédictive représente un intervalle temporel, la valeur estimée de a dépendra entièrement du fait que le temps ait été encodé en secondes, en minutes ou en jours. Par exemple, si l’unité est la minute, a quantifie la performance prédite à la première minute d’expérimentation ; si les mêmes données sont réencodées en secondes sans translation préalable, l’abscisse x = 1 représentera désormais la première seconde, ce qui modifiera drastiquement l’ordonnée d’intersection estimée par la machine.
Sur le plan déontologique et méthodologique, l’analyste doit formellement proscrire toute tentative d’extrapolation visant à faire signifier au paramètre a « l’état initial avant toute stimulation ». Évaluer le modèle en x = 0 relève d’une aberration mathématique qui conduirait à une singularité infinie. Si le protocole expérimental requiert impérativement la prédiction d’un niveau de base au repos absolu, le recours à un modèle de régression différent (comme un modèle polynomial ou un modèle logistique à seuil inférieur défini) ou l’application documentée d’un décalage d’échelle de type x’ = x + 1 s’avère indispensable.
7.2 Décomposition du coefficient multiplicatif de pente (b)
Le paramètre multiplicateur b incarne l’élément dynamique central du modèle : il quantifie la sensibilité marginale de la variable dépendante par rapport aux variations d’échelle proportionnelles de la variable indépendante. Contrairement à une pente linéaire classique qui traduit une variation absolue constante de y pour une variation absolue unitaire de x (taux marginal dy/dx invariant), le coefficient b d’une régression logarithmique régit une variation absolue constante de y en réponse à une variation relative géométrique de x.
Sur le plan mathématique fondamental, le coefficient b exprime la variation absolue de la réponse y observée lorsque la variable explicative x est multipliée par la base népérienne e (≈ 2,718). En effet :
y(e * x) = a + b * ln(e * x) = a + b * (ln(e) + ln(x)) = a + b * (1 + ln(x)) = y(x) + b
Dans la pratique des sciences expérimentales et économiques appliquées, l’interprétation par multiplication par e étant peu intuitive, on recourt universellement à la règle de l’approximation relative à 1 %. Par dérivation différentielle, une variation relative de 1 % de la variable x engendre une variation absolue prévisible de la variable de réponse égale approximativement à :
Δy ≈ (b / 100)
Ainsi, si une étude évaluant l’acquisition de compétences cognitives aboutit à une estimation de b = 15,4, le chercheur peut affirmer de manière rigoureuse qu’une augmentation de 1 % du temps alloué à l’apprentissage se traduit en moyenne par un accroissement incrémental de 0,154 point sur l’échelle de performance mesurée. De la même manière, si le coefficient est négatif (b < 0), sa magnitude mesure directement le gradient de décroissance de l’efficacité d’un stimulus psychologique ou de l’oubli mémoriel. Enfin, sur le plan de l’inférence statistique formelle, un coefficient b dont l’intervalle de confiance encadre la valeur zéro indique l’absence totale de relation non linéaire significative entre les deux grandeurs, invalidant l’hypothèse d’une dynamique logarithmique au profit d’une hypothèse nulle d’indépendance.
7.3 Formalisation académique de l’équation finale
La transcription des sorties brutes fournies par l’écran de la TI-84 vers un rapport d’expertise, un mémoire de recherche universitaire ou une publication scientifique obéit à des normes typographiques et formelles strictes, édictées notamment par les standards de l’American Psychological Association (APA). L’écran de la calculatrice restitue les coefficients sous une typographie informatique brute, souvent encombrée de mantisses étendues et d’opérateurs textuels élémentaires (par exemple : y=a+b*ln(x) suivi de a=2.45187214 et b=0.87412953). L’analyste ne doit en aucun cas insérer une capture brute ou recopier l’équation sous cette graphie télégraphique.
Les règles académiques de transcription imposent :
- L’arrondi systématique des coefficients numériques estimés à deux ou trois décimales significatives stables (trois décimales étant la norme d’usage en psychométrie et biométrie), sauf impératif spécifique dicté par la précision des instruments de mesure originaux.
- L’omission explicite du signe de multiplication informatique (l’astérisque « * »), le produit d’un scalaire par une fonction transcendante s’écrivant traditionnellement par juxtaposition simple ou espacement fin.
- La substitution des variables génériques x et y par les acronymes ou les dénominations formelles des construits opérationnels mesurés.
Par exemple, si une modélisation évalue le temps d’accomplissement d’une épreuve psychomotrice (noté T, en secondes) en fonction du nombre de répétitions préalables (noté N), et que la machine fournit les estimations a = 48,2138 et b = -9,6542 avec un ajustement solide, la formalisation finale au sein du texte de recherche devra adopter la structure suivante :
« L’ajustement du temps d’exécution en fonction du volume d’entraînement suit une cinétique logarithmique formelle définie par l’équation prédictive : T̂ = 48,214 – 9,654 ln(N), où T̂ représente le temps moyen prédit en secondes. Le coefficient multiplicatif indique qu’à chaque doublement du volume de pratique (multiplication de N par 2), le temps d’accomplissement de la tâche diminue de manière prévisible d’environ 6,69 secondes (-9,654 * ln(2)). »
8. Évaluation de la qualité de l’ajustement : coefficients r et r²
8.1 Compréhension du coefficient de détermination (r²)
L’estimation des paramètres numériques par l’algorithme des moindres carrés garantit mathématiquement la minimisation de la somme des carrés des écarts verticaux entre le modèle et les données empiriques. Toutefois, cette optimalité locale ne garantit en rien que le modèle logarithmique soit intrinsèquement performant pour rendre compte de la dispersion globale du phénomène. Le coefficient de détermination, universellement noté r², constitue la métrique cardinale permettant d’évaluer la qualité d’adéquation globale (goodness-of-fit) du modèle estimé.
Sur le plan de l’analyse de la variance, r² quantifie la proportion de la variance totale de la variable dépendante y qui se trouve statistiquement expliquée ou prédite par la transformation logarithmique de la variable indépendante x. Sa formulation algébrique fondamentale repose sur la décomposition de la dispersion :
r² = SCE / SCT = 1 – (SCR / SCT)
où SCE représente la somme des carrés expliquée par le modèle, SCR désigne la somme des carrés des résidus inexpliqués, et SCT incarne la somme des carrés totale des écarts à la moyenne empirique de y. Le coefficient de détermination est un nombre réel sans dimension, rigoureusement contraint au sein de l’intervalle fermé [0, 1] :
- Un r² = 0 signifie que la connaissance du logarithme de x ne contribue en rien à réduire l’incertitude sur la variance de y, le modèle n’étant pas plus performant qu’une simple constante égale à la moyenne empirique.
- Un r² = 1 signale une adéquation déterministe parfaite : l’intégralité des points empiriques s’aligne rigoureusement sur la courbe logarithmique, sans le moindre écart résiduel.
Dans le domaine des sciences expérimentales et du comportement, les seuils conventionnels d’acceptabilité établis par la littérature méthodologique (notamment les critères de Jacob Cohen) considèrent généralement qu’un r² avoisinant 0,25 traduit un effet modéré, tandis qu’un r² ≥ 0,50 signale un ajustement robuste expliquant plus de la moitié de la variabilité totale. Il importe toutefois de mettre en garde l’analyste contre le risque d’une surinterprétation béate d’un r² excessivement élevé (par exemple 0,98) obtenu sur un très faible échantillon d’observations (par exemple n = 4 ou 5). Dans de telles configurations de sous-dimensionnement empirique, le nombre de degrés de liberté résiduels s’effondre, gonflant artificiellement le coefficient d’ajustement sans pour autant assurer la généralisabilité externe du modèle.
8.2 Analyse du coefficient de corrélation linéaire (r)
Directement corrélé au coefficient de détermination, le coefficient r restitué par la TI-84 correspond formellement au coefficient de corrélation linéaire de Bravais-Pearson calculé non pas entre x et y, mais de façon précise entre la transformation linéraire ln(x) et la variable observée y. Ce coefficient oscille au sein de l’intervalle fermé [-1, +1].
Le signe algébrique associé à r fournit immédiatement l’orientation de la dépendance monotone reliant les deux construits :
- Un r positif (0 < r ≤ 1) atteste d’une corrélation logarithmique positive, traduisant une dynamique de croissance où l’élévation de x s’accompagne d’une progression systématique de y, de concavité négative.
- Un r négatif (-1 ≤ r < 0) signale une corrélation logarithmique négative, matérialisant une dynamique de décadence ou d’atténuation où toute hausse de x accélère la baisse initiale de y.
Il est crucial de réitérer un avertissement épistémologique fondamental : la mise en évidence d’un coefficient r très proche de +1 ou de -1 démontre une stricte covariance mathématique d’ajustement, mais ne prouve en aucun cas l’existence d’un lien de causalité psychologique, physiologique ou mécanique direct entre les deux variables. Des facteurs de confusion sous-jacents ou des biais de covariation temporelle peuvent parfaitement générer un ajustement logarithmique artificiellement élevé. De surcroît, le coefficient r présente une vulnérabilité reconnue face aux relations non monotones : si la vraie trajectoire empirique montait puis s’effondrait brutalement, le coefficient de corrélation linéaire des logarithmes s’annulerait, masquant l’existence d’une dépendance déterministe sous-jacente.
8.3 Procédure de dépannage en cas de disparition des métriques r et r²
L’une des requêtes d’assistance les plus fréquentes formulées par les étudiants et chercheurs utilisant la TI-84 concerne la disparition soudaine des lignes r² et r de l’écran d’affichage des résultats après l’exécution de la commande LnReg. L’écran ne présente alors que la mention générique du modèle et la valeur des coefficients a et b, plongeant l’utilisateur dans l’incapacité d’évaluer la rigueur statistique de son modèle.
Cette situation ne découle nullement d’une défaillance matérielle de l’appareil ou d’un bogue algorithmique interne ; elle résulte exclusivement du basculement involontaire du registre statistique machine sur l’état inactif (DiagnosticOff). Cet événement survient typiquement lors d’un remplacement de piles, d’un crash de la mémoire vive suite à une boucle de programmation non terminée, ou d’une manipulation maladroite dans les sous-menus de l’appareil.
Pour réactiver immédiatement l’affichage des métriques sans altérer les jeux de données déjà encodés, l’utilisateur doit appliquer la routine de dépannage suivante :
- Accéder au catalogue global des commandes en pressant la combinaison de touches [2nd] puis [0] (
CATALOG). - Presser la touche [x⁻¹] (qui correspond au caractère alphabétique ‘D’) pour descendre instantanément dans l’arborescence des primitives.
- Faire défiler le curseur vers le bas jusqu’à repérer la commande
DiagnosticOn. - Appuyer sur [ENTER] pour appeler l’instruction sur l’écran d’accueil, puis appuyer une seconde fois sur [ENTER] pour exécuter la bascule. La machine affiche le mot « Done ».
- Sur les modèles TI-84 Plus CE, la méthode alternative consiste simplement à appuyer sur [MODE], descendre jusqu’à la ligne
STAT DIAGNOSTICSet valider l’optionON.
Étape obligatoire complémentaire : La réactivation du diagnostic n’actualise pas rétroactivement l’écran figé. L’analyste doit impérativement réexécuter la régression : appuyer sur [STAT], aller sur l’onglet CALC, sélectionner à nouveau 9:LnReg et relancer l’algorithme par [ENTER]. Les lignes r² et r réapparaissent alors immédiatement sous les coefficients a et b, et y demeureront tant que la mémoire de configuration ne sera pas réinitialisée.
9. Diagnostics avancés : analyse résiduelle sur la calculatrice
9.1 Génération et extraction de la liste des résidus (RESID)
L’évaluation globale de la pertinence d’un modèle mathématique ne saurait se cantonner à la seule contemplation d’un coefficient r² flatteur. Il est formellement établi en statistique appliquée qu’un modèle mathématiquement inadéquat ou mal spécifié peut fort bien exhiber un coefficient de détermination élevé tout en introduisant des biais prédictifs majeurs et systématiques. L’outil diagnostique par excellence pour sonder la validité interne d’une régression réside dans l’analyse des résidus.
Par définition, le résidu associé à la i-ième observation empirique, conventionnellement noté e_i, représente l’écart algébrique vertical entre la valeur réelle observée y_i et la valeur théorique prédite par l’équation estimée, notée ŷ_i :
e_i = y_i – ŷ_i = y_i – (a + b * ln(x_i))
La calculatrice TI-84 intègre un mécanisme d’ingénierie logicielle particulièrement sophistiqué : à chaque fois qu’une fonction de régression statistique (telle que LnReg) est exécutée sur l’appareil, le microprocesseur calcule automatiquement l’intégralité des résidus individuels associés à chaque point de la série et les injecte au sein d’une liste système protégée baptisée RESID.
Pour inspecter numériquement ces résidus ou les manipuler dans des calculs subséquents, il est hautement recommandé de copier cette variable système vers une colonne standard libre, telle que L3. La procédure d’extraction s’effectue comme suit :
- Accéder à l’éditeur tabulaire en pressant [STAT] puis [1:Edit].
- Faire monter le curseur jusqu’à placer en surbrillance l’en-tête de la colonne L3.
- Appuyer sur la commande d’appel des listes via les touches [2nd] puis [STAT] (fonction
LIST). - L’onglet horizontal
NAMESénumère toutes les listes stockées en mémoire. Descendre jusqu’à localiser l’entrée textuelleRESIDet appuyer sur [ENTER]. - La zone de saisie en bas d’écran affiche désormais
L3 = RESID. Une validation par la touche [ENTER] peuple instantanément l’intégralité de la colonne L3 avec les écarts résiduels exacts calculés par la machine.
L’inspection analytique de cette colonne permet de quantifier immédiatement l’amplitude des déviations locales, d’identifier quel individu expérimental subit la prédiction la plus dégradée, et de vérifier que la somme algébrique de ces résidus est rigoureusement nulle (aux erreurs de troncature en virgule flottante près), propriété mathématique intrinsèque de la méthode des moindres carrés.
9.2 Construction du diagramme de dispersion des résidus
L’exploration purement chiffrée d’un vecteur de résidus s’avérant fastidieuse sur un large échantillon, la construction de son diagramme de dispersion géométrique constitue l’étape diagnostique visuelle incontournable. Ce graphique met en relation les valeurs de la variable prédictive x en abscisse avec les résidus correspondants e en ordonnée.
La configuration de ce diagnostic visuel sur la TI-84 réclame le paramétrage d’un tracé statistique dédié :
- Accéder au gestionnaire des tracés statistiques en appuyant sur [2nd] puis [Y=] (
STAT PLOT). - Sélectionner
1:Plot1et s’assurer que le mode est toujours activé (On) et configuré en nuage de points (Scatter Plot). - Modifier l’affectation des axes : laisser la ligne
Xlist:configurée surL1(la variable explicative originelle). - Sur la ligne
Ylist:, substituer la liste initiale par la liste des résidus : presser [2nd] puis [STAT] (LIST), descendre surRESIDet valider par [ENTER] (ou taper directementL3si l’étape de transfert précédente a été exécutée). - Désactiver impérativement le tracé de la fonction continue dans le menu [Y=] pour éviter qu’une courbe de régression non centrée ne vienne barrer le diagramme des résidus.
- Appliquer le cadrage automatique optimal en appuyant sur [ZOOM] puis [9] (
ZoomStat).
Le graphique affiché présente les résidus distribués de part et d’autre de l’axe horizontal d’équilibre, qui représente le zéro théorique. L’analyste doit rechercher la manifestation de l’homoscédasticité : la variance des résidus doit demeurer constante et homogène sur l’ensemble de l’étendue du domaine de x. Les points doivent former une bande horizontale nébuleuse, distribuée de manière aléatoire et équilibrée sans tendance directionnelle.
Si, à l’inverse, le diagramme présente une structure géométrique en « entonnoir » ou en « mégaphone » (la dispersion étant très serrée pour les petits x puis s’évasant largement pour les grands x, ou vice versa), l’analyste se trouve confronté à un phénomène d’hétéroscédasticité. Ce constat signale que la fiabilité prédictive du modèle logarithmique se dégrade sélectivement sur certaines portions du domaine d’observation, remettant en cause la validité des intervalles de confiance standards.
9.3 Détection des déviations systématiques et des valeurs atypiques
Au-delà de la surveillance de l’homoscédasticité, le diagramme des résidus opère comme un détecteur impitoyable de mauvaise spécification mathématique globale. La présence d’une courbure résiduelle structurée constitue l’indice le plus flagrant de l’inadéquation du modèle logarithmique :
- Structure en « U » ou en « U inversé » : Si les résidus adoptent une trajectoire systématique débutant dans les valeurs positives, plongeant continûment dans les valeurs négatives au centre, puis remontant nettement dans les valeurs positives aux extrémités du repère, cette organisation non aléatoire démontre que la fonction logarithmique échoue à capturer la concavité réelle des données. Une telle structure indique qu’un modèle polynomial d’ordre supérieur ou une fonction logistique sigmoïdale s’avère mathématiquement indispensable.
- Identification des points aberrants et leviers (Outliers) : Un point isolé se projetant à une distance verticale disproportionnée de la bande centrale de dispersion matérialise une observation anormale. L’analyste doit déterminer si cette déviation résulte d’un artéfact expérimental (parasitage d’un capteur, distraction du sujet lors d’une mesure chronométrique) ou d’un comportement authentique mais exceptionnel.
L’existence de points situés aux extrémités de l’axe des abscisses (valeurs de x très faibles proches de zéro, ou valeurs de x extrêmement élevées) mérite une vigilance accrue. En raison de la forte courbure de la fonction ln(x) dans le voisinage de son origine, une observation atypique située à ce niveau exercera un effet de levier disproportionné sur la droite de linéarisation, faisant basculer l’estimation du paramètre b et faussant l’ajustement de l’ensemble des autres points. Dans le cas de séries temporelles expérimentales, l’analyste veillera également à repérer une éventuelle autocorrélation des résidus (les résidus successifs tendant à conserver le même signe), signe que des variables exogènes temporelles non prises en compte perturbent le phénomène étudié.
10. Exploitation prédictive du modèle : interpolation et extrapolation
10.1 Calcul de prédictions directes via l’environnement graphique
La finalité pratique d’un modèle d’ajustement réside dans sa capacité à opérer des prédictions fiables pour des valeurs de la variable explicative qui n’ont pas fait l’objet d’un recueil d’observation direct au sein du protocole expérimental. La calculatrice TI-84 propose un environnement computationnel graphique immédiat pour accomplir ces extrapolations ponctuelles.
Dès lors que l’équation a été sauvegardée dans le registre Y1 et que le tracé est affiché à l’écran via la touche [GRAPH], l’utilisateur peut mobiliser le sous-menu d’analyse fonctionnelle :
- Presser la touche [2nd] puis la touche [TRACE] pour faire surgir le menu d’analyse computationnelle
CALC(Calcul graphique). - La première commande proposée en tête de liste est
1:value. Valider son choix en pressant [ENTER]. - L’écran bascule à nouveau sur l’espace cartésien en affichant à la base de l’écran l’invite d’interrogation textuelle
X=avec un curseur clignotant. - Saisir directement la valeur numérique d’abscisse pour laquelle on souhaite évaluer le modèle (par exemple saisir
14.75), puis appuyer sur [ENTER].
Le moteur graphique calcule instantanément l’image mathématique via l’expression logarithmique stockée, déplace le curseur visuel exactement sur les coordonnées calculées le long de la courbe, et affiche en bas d’écran l’évaluation prédite sous la mention Y=.... Cette démarche procure une confirmation visuelle et spatiale immédiate du positionnement de l’estimation le long de la dynamique générale.
Une limitation technique majeure de cette routine réside dans sa stricte dépendance vis-à-vis des bornes de la fenêtre active : si l’abscisse X saisie par l’analyste se situe en dehors de l’intervalle spatial délimité par [Xmin, Xmax], la machine interrompt l’opération en déclenchant l’erreur bloquante ERR:INVALID ou en refusant la saisie. Si l’on désire effectuer une prédiction par extrapolation au-delà du champ d’observation, il est obligatoire d’ouvrir préalablement le menu [WINDOW] et d’élargir manuellement la valeur de Xmax pour y englober la cible prédictive avant d’appeler l’instruction 1:value.
10.2 Automatisation des évaluations tabulaires (TABLE)
Lorsque le protocole d’analyse réclame l’évaluation systématique d’une pluralité de prédictions sur une grille discrète ou pour un ensemble de valeurs cibles discontinues, l’évaluation individuelle via l’écran graphique s’avère fastidieuse. La TI-84 résout cette difficulté par son gestionnaire de tableaux numériques automatisés (TABLE).
L’exploitation de cet outil exige un étalonnage préalable au sein de l’utilitaire de configuration accessible par les touches [2nd] puis [WINDOW] (fonction TblSet pour Table Setup) :
- Mode incrémental régulier :
- Définir la valeur de départ sur la ligne
TblStart(par exemple1). - Définir le pas d’incrémentation régulier sur la ligne
ΔTbl(par exemple0.5ou10selon la magnitude des données). - S’assurer que les deux paramètres d’automatisation situés en bas d’écran (
Indpnt:etDepend:) sont configurés sur l’étatAuto.
- Définir la valeur de départ sur la ligne
- Mode d’interrogation dynamique personnalisé (Indpnt: Ask) :
- Si l’analyste possède une série de valeurs d’abscisses arbitraires non régulières (par exemple évaluer le modèle à x = 2,3 ; 7,8 ; 45 ; 120), il convient de positionner le paramètre de la variable indépendante
Indpnt:sur le modeAsken validant par [ENTER].
- Si l’analyste possède une série de valeurs d’abscisses arbitraires non régulières (par exemple évaluer le modèle à x = 2,3 ; 7,8 ; 45 ; 120), il convient de positionner le paramètre de la variable indépendante
Une fois le paramétrage validé, l’appel de l’écran tabulaire s’effectue par la combinaison de touches [2nd] puis [GRAPH] (fonction TABLE). Si le mode Auto a été retenu, l’écran présente un tableau à double entrée déroulant, où la colonne X s’incrémente selon le pas défini, tandis que la colonne Y1 affiche les ordonnées logarithmiques correspondantes calculées en continu. Si le mode Ask a été activé, la table se présente sous la forme d’une matrice vierge : l’utilisateur tape séquentiellement n’importe quelle valeur de X dans la première colonne et valide par [ENTER], voyant la prédiction Y1 se générer instantanément en regard. Cette méthode constitue le vecteur le plus véloce et le plus sécurisé pour extraire un jeu de prédictions sans risque d’erreur manuelle.
10.3 Résolution inverse : déterminer la valeur de x pour une réponse y cible
Dans de nombreuses applications d’ingénierie et de modélisation biomédicale, la problématique prédictive ne consiste pas à évaluer y à partir de x, mais à résoudre le problème réciproque : quelle magnitude de variable explicative x doit être mise en œuvre pour atteindre un niveau de réponse y préalablement ciblé ? (par exemple, déterminer le temps d’entraînement nécessaire pour abaisser le temps d’exécution d’une tâche sous un seuil critique déterminé).
La résolution de cette équation inverse peut être menée selon deux démarches distinctes sur la TI-84 :
1. L’approche graphique par intersection :
- Accéder au menu [Y=]. Conserver l’équation logarithmique dans le registre
Y1. - Descendre sur le registre
Y2et y encoder la valeur cible sous forme d’une fonction constante (par exemple taperY2 = 75si la réponse visée est 75). - Vérifier dans le menu [WINDOW] que l’intervalle
[Ymin, Ymax]englobe bien la valeur constante (dans notre exemple, que Ymax > 75), et queXmaxest suffisamment étendu pour contenir le point de croisement des deux courbes. - Afficher le graphe par la touche [GRAPH] : la droite horizontale Y2 vient couper la courbe logarithmique Y1.
- Appeler le menu des calculs graphiques par [2nd] puis [TRACE] (
CALC), et sélectionner la commande5:intersect. - La calculatrice sollicite successivement la désignation de la première courbe (
First curve?, valider par [ENTER]), de la seconde courbe (Second curve?, valider par [ENTER]), puis d’une estimation visuelle approchée (Guess?, déplacer le curseur près du croisement et valider par [ENTER]). - Le microprocesseur isole instantanément les coordonnées de convergence, fournissant l’abscisse exacte X correspondant à l’ordonnée cible en bas d’écran.
2. L’approche analytique via le solveur numérique :
L’autre modalité repose sur le solveur d’équations intégré accessible via la touche [MATH], option B:Solver... (ou Numeric Solver sur les OS récents). Il suffit d’y poser l’égalité 0 = Y1 - Target, de fournir une valeur de départ vraisemblable pour la variable X (en respectant la contrainte X > 0), et d’exécuter la résolution numérique par la combinaison [ALPHA] puis [ENTER] (instruction SOLVE).
Il est impératif d’émettre une mise en garde méthodologique fondamentale sur les dangers de l’extrapolation. En raison de la concavité amortie de la fonction logarithmique, la variable y croît avec une lenteur extrême pour les grands x. Par voie de conséquence, chercher à atteindre une valeur de y à peine supérieure aux maxima observés impose de projeter l’abscisse x à des ordres de grandeur exponentiellement gigantesques, largement au-delà des frontières empiriques éprouvées. Projeter des décisions expérimentales sur de telles extrapolations expose l’analyste à des erreurs prédictives colossales si le phénomène réel finit par bifurquer ou plafonner sous l’action d’une contrainte physique non modélisée.
11. Résolution des erreurs fréquentes et pièges computationnels sur TI-84
11.1 Traitement des erreurs fatales d’exécution courantes
L’utilisation de la calculatrice TI-84 en analyse statistique matricielle confronte régulièrement l’opérateur à des arrêts brutaux matérialisés par des écrans de défaut d’exécution (écrans d’erreurs système). L’interruption de la machine fournit un code d’erreur standardisé qu’il convient de décoder avec sang-froid pour apporter la correction immédiate appropriée :
- ERR:DOMAIN (Erreur de domaine d’évaluation) : Cette interruption fatale survient de manière quasi systématique lors de l’exécution de
LnReglorsque la liste déclarée en variable indépendante Xlist contient une valeur nulle (0) ou strictement négative. Le moteur de calcul matriciel ne pouvant calculer le logarithme népérien d’un nombre non strictement positif dans le corps des réels, il stoppe le processus. Pour résoudre cette anomalie, l’analyste doit choisir l’option2:Gotoproposée par l’écran d’erreur pour inspecter la cellule fautive, ou revenir dans l’éditeur de listes (STAT 1:Edit) pour purger la donnée aberrante ou appliquer la translation linéaire x’ = x + c détaillée à la section 3.3. - ERR:DIM MISMATCH (Discordance dimensionnelle) : Cette erreur signale formellement une rupture de parité dans la taille des vecteurs de données. L’algorithme des moindres carrés bivarié exige un appariement bivoque strict entre chaque valeur x_i et chaque valeur y_i. Si la colonne L1 compte quatorze entrées tandis que la colonne L2 n’en dénombre que treize, l’appareil bloque l’exécution. La résolution impose de parcourir les deux colonnes dans l’éditeur de listes pour identifier la ligne orpheline et rétablir la parité dimensionnelle absolue.
- ERR:STAT (Erreur d’incompatibilité de paramètres statistiques) : Ce message se manifeste principalement lors d’une tentative de tracé graphique. Il indique une contradiction logique dans la configuration de
STAT PLOT, telle que la désignation d’une liste système inexistante ou purgée, ou la tentative de tracer un diagramme de dispersion alors que les deux listes pointées n’ont pas les mêmes dimensions. - ERR:SYNTAX (Erreur de syntaxe textuelle) : Se produit exclusivement sur les OS classiques ou lors de la frappe manuelle d’instructions sur l’écran d’accueil. Elle traduit la présence d’un caractère non valide dans l’expression, le plus souvent l’usage malencontreux du point décimal à la place de la virgule de séparation d’arguments, ou l’oubli d’une parenthèse fermante dans un calcul vectoriel.
11.2 Anomalies d’affichage et collisions graphiques
Même lorsque les algorithmes s’exécutent sans renvoyer de code d’erreur textuel explicite, l’utilisateur peut être confronté à des comportements graphiques anormaux ou déconcertants qui compromettent la restitution visuelle de l’analyse :
- L’écran blanc lors de la commande GRAPH : L’utilisateur sollicite l’affichage graphique mais l’écran demeure désespérément vierge de tout point et de toute courbe. Cette anomalie résulte systématiquement d’un décalage total entre les coordonnées spatiales des données et le repère cartésien configuré dans
WINDOW. La parade universelle et immédiate consiste à appliquer la réinitialisation dynamique via l’instruction [ZOOM] puis [9] (ZoomStat), qui recalibre automatiquement la caméra graphique sur le barycentre des données. - La superposition de courbes parasites : Lors du tracé de la régression, une multitude de droites obliques, de paraboles ou de sinusoïdes viennent barrer l’écran en surchargeant l’affichage. Ce phénomène découle de la présence de fonctions résiduelles non effacées dans l’éditeur d’équations. L’analyste doit immédiatement se rendre dans le menu [Y=] et purger l’ensemble des registres inutilisés de
Y2àY0à l’aide de la touche [CLEAR]. - Le conflit d’affichage multi-plots : Si plusieurs tracés statistiques (par exemple
Plot1etPlot2) sont simultanément activés (On) alors que le second pointe vers des listes vides ou obsolètes, la machine déclenchera une erreur dès l’appui sur GRAPH. Il convient de vérifier dans le menu [2nd] puis [Y=] que seul le tracé effectivement assigné à l’étude courante est positionné surOn, tous les autres devant être basculés surOff. - Le blocage par boucle de calcul continue : Parfois, un petit indicateur pointillé clignote indéfiniment dans le coin supérieur droit de l’écran, signalant que la calculatrice est prise au piège d’un calcul différentiel lourd ou d’un tracé graphique ultra-dense. Pour forcer l’interruption immédiate de l’opération sans éteindre l’appareil, il suffit de presser avec insistance la touche [ON], qui joue le rôle d’interrupteur matériel d’interruption logicielle prioritaire (Break).
11.3 Précautions de précision et limitations de l’architecture matérielle
Bien que le système de calcul de la TI-84 fasse preuve d’une fiabilité remarquable pour les usages scientifiques courants, son architecture matérielle repose sur un microprocesseur Zilog Z80 cadencé à des fréquences modestes (15 MHz sur les versions monochromes, jusqu’à 48 MHz sur les modèles CE) et exploitant une arithmétique en virgule flottante propriétaire codée sur un nombre fini d’octets. Ces contraintes matérielles imposent plusieurs précautions d’emploi rigoureuses :
En premier lieu, la fonction logarithmique naturelle manifeste une instabilité numérique sévère au voisinage immédiat de zéro. Lorsque l’on fournit en argument des valeurs extrêmement petites (par exemple x = 10⁻¹⁰), la pente vertigineuse de l’asymptote entraîne une perte de précision sur les derniers chiffres significatifs lors de l’estimation de la matrice des moindres carrés. L’analyste veillera à normaliser ou rééchelonner ses données d’entrée si les valeurs empiriques embrassent des ordres de grandeur trop proches de la singularité.
En second lieu, il convient de souligner que l’algorithme LnReg de la TI-84 ne résout pas une régression non linéaire par optimisation itérative directe de Gauss-Newton ou de Levenberg-Marquardt dans l’espace originel, mais procède par linéarisation sous transformation bijective. La machine calcule intérieurement le vecteur translaté X’ = ln(X), puis lui applique la routine analytique fermée standard de la régression linéaire simple. Bien que cette approche soit mathématiquement exacte pour la fonction logarithmique (qui est intrinsèquement linéaire par rapport à ses paramètres a et b), elle implique que les écarts résiduels minimisés sont les écarts verticaux directs sur la variable y, ce qui rend l’estimation extrêmement sensible à la présence de bruit additif gaussien sur cette composante.
Enfin, sur le plan de la maintenance matérielle préventive, l’analyste manipulant des jeux de données d’envergure doit surveiller l’état de charge de l’accumulateur ou des piles alcalines. Un affaiblissement critique de la tension d’alimentation en plein cours d’inversion matricielle ou de sauvegarde sur la mémoire FLASH d’archivage peut provoquer une corruption irréversible de la table d’allocation de la mémoire vive, contraignant l’utilisateur à un effacement total de la RAM (Reset All) qui anéantirait l’ensemble des données encodées. Il est vivement conseillé d’archiver les listes critiques en mémoire non volatile FLASH (via la commande Archive List L1 accessible dans le menu MEM) une fois la saisie stabilisée.
12. Arbitrage méthodologique : comparer LnReg aux modèles concurrents
12.1 Comparaison structurelle avec la régression puissance (PwrReg)
L’une des ambiguïtés méthodologiques les plus courantes lors du traitement de données manifestant une croissance ralentie réside dans l’arbitrage entre une modélisation par régression logarithmique (LnReg) et un ajustement par régression de puissance (PwrReg). Bien que ces deux familles mathématiques traduisent une décélération de l’effet marginal, leurs fondements structurels et leurs trajectoires limites sont profondément divergents.
Les expressions fonctionnelles respectives mettent en relief cette disparité de structure :
- Modèle logarithmique : y = a + b * ln(x)
- Modèle de puissance : y = a * x^b
Lorsque le paramètre de puissance b est compris entre 0 et 1 (par exemple y = a * √x), la régression de puissance produit une courbe dont l’allure visuelle imite superficiellement celle du logarithme, affichant une courbure tournée vers le bas. Cependant, le comportement asymptotique à l’infini constitue un critère de discrimination physique majeur : la fonction logarithmique diverge avec une lenteur extrême, d’ordre sous-polynomial (elle croît plus lentement que n’importe quelle puissance positive de x, quelle que soit sa fraction). À l’inverse, une fonction de puissance avec b > 0 préserve une élévation beaucoup plus substantielle à long terme.
Sur le plan de l’invariance d’échelle, le modèle de puissance implique une élasticité constante : une augmentation de 1 % de la variable x se traduit par une variation relative constante de b % sur la variable y (relation élasticité log-log). Le modèle logarithmique, pour sa part, matérialise une relation de type semi-logarithmique, où une variation relative de x génère une variation absolue de y. L’analyste départagera ces deux modèles sur la calculatrice en comparant systématiquement leurs coefficients de détermination respectifs obtenus via LnReg et PwrReg, tout en soumettant les deux vecteurs de résidus à une analyse de variance comparative.
12.2 Comparaison avec la régression exponentielle (ExpReg) et logistique
La distinction méthodologique opposant la régression logarithmique aux modèles exponentiels et logistiques relève d’une importance capitale dans la modélisation des processus d’apprentissage et de maturation biologique.
L’opposition entre LnReg et ExpReg (y = a * b^x) est structurellement antinomique :
- Le modèle exponentiel caractérise des phénomènes d’auto-amplification à taux de croissance constant, engendrant une divergence explosive rapide sans la moindre saturation d’échelle. Il est rigoureusement incapable de modéliser un plafonnement ou un ralentissement des gains marginaux.
- Le modèle logarithmique traduit précisément l’inverse : une perte continue d’efficacité marginale du stimulus ou de l’effort consenti au fur et à mesure que l’échelle se dilate.
L’arbitrage s’avère nettement plus subtil lorsqu’il s’agit de départager la régression logarithmique et la régression logistique (Logistic). Cette dernière modélise une trajectoire en « S » contrainte par une capacité de charge maximale ou asymptote horizontale supérieure stricte :
y = c / (1 + a * e^(-bx))
En psychométrie de l’apprentissage moteur, si la tâche est bornée par une contrainte physiologique insurmontable (par exemple, le temps de réponse minimal incompressible déterminé par la vitesse de conduction axonale synaptique), le modèle logistique est conceptuellement supérieur car il interdit formellement à la performance de franchir cette barrière asymptotique. En revanche, le modèle logistique exige l’estimation de trois à quatre paramètres distincts (dont la capacité d’accueil c), ce qui réclame un volume substantiel d’observations pour garantir la convergence numérique. La régression logarithmique, économe avec ses deux seuls paramètres a et b, s’impose comme le modèle le plus robuste et le plus parcimonieux lorsque les données empiriques n’ont pas encore atteint la zone de saturation asymptotique finale, capturant avec une grande fidélité la phase de transition intermédiaire.
12.3 Procédure systématique de sélection du meilleur ajustement sur TI-84
Pour s’extraire de l’arbitraire subjectif dans le choix d’un modèle d’ajustement, l’analyste quantitativement rigoureux se doit d’appliquer une procédure séquentielle discriminatoire standardisée, entièrement réalisable au moyen des fonctionnalités de la calculatrice TI-84. Ce protocole systématique s’articule en quatre étapes coordonnées :
- Exécution séquentielle des modèles candidats sur le même jeu de données : L’utilisateur conserve les données sources fixes dans L1 et L2. Il exécute tour à tour les primitives statistiques concurrentes du menu
STAT CALC:4:LinReg(ax+b)(modèle linéaire de contrôle)9:LnReg(modèle logarithmique)0:ExpReg(modèle exponentiel)A:PwrReg(modèle puissance)
- Compilation d’une matrice comparative de performance : Pour chaque régression exécutée, l’analyste consigne sur une feuille de synthèse le coefficient de détermination r² ainsi que la somme des carrés résiduels (qui peut être calculée en évaluant la somme des carrés de la liste des résidus correspondante via l’instruction
sum(RESID²)accessible dans le menuLIST MATH). Le modèle affichant le r² le plus élevé et la SCR minimale détient un avantage empirique initial. - Filtrage par l’analyse résiduelle croisée : Un modèle affichant un r² légèrement supérieur peut néanmoins s’avérer vicieux s’il introduit une déformation systématique. Pour chaque modèle prometteur, l’utilisateur trace le diagramme des résidus correspondant (L1 contre RESID). Tout modèle qui fait apparaître une structure sinueuse en « U » ou un regroupement non aléatoire doit être éliminé sans hésitation, nonobstant la magnitude brute de son r².
- Arbitrage par le principe de parcimonie (Rasoir d’Ockham) : En présence de deux modèles présentant des qualités d’adéquation diagnostique et des distributions résiduelles statistiquement indiscernables, le principe épistémologique du rasoir d’Ockham impose de retenir systématiquement le modèle le plus simple, c’est-à-dire celui qui repose sur le plus petit nombre de paramètres libres et dont les fondements mécanistes s’accordent le plus directement avec les théories admises dans la discipline. La régression logarithmique
LnRegtriomphe fréquemment lors de cet arbitrage final en raison de son élégance mathématique univariée et de sa stabilité computationnelle éprouvée.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Charnov, E. L. (1976). Optimal foraging, the marginal value theorem. Theoretical Population Biology, 9(2), 129–136. https://doi.org/10.1016/0040-5809(76)90040-X
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Ebbinghaus, H. (1913). Memory: A contribution to experimental psychology (H. A. Ruger & C. E. Bussenius, Trans.). Teachers College, Columbia University. (Original work published 1885). https://doi.org/10.1037/10011-000
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Hick, W. E. (1952). On the rate of gain of information. Quarterly Journal of Experimental Psychology, 4(1), 11–26. https://doi.org/10.1080/17470215208416600
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
- Texas Instruments. (2015). TI-84 Plus CE reference guide. Texas Instruments Incorporated. https://education.ti.com/guides
- Texas Instruments. (2020). TI-84 Plus graphing calculator guidebook. Texas Instruments Incorporated. https://education.ti.com/guides
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.