
Dans le champ contemporain de l’ingénierie des données et de l’économétrie appliquée, la manipulation rigoureuse des bases relationnelles constitue une compétence analytique fondamentale. Au sein de l’environnement logiciel développé par le SAS Institute, la fusion d’entités tabulaires disparates représente une tâche opérationnelle quotidienne, conditionnant directement la fiabilité de l’ensemble de la chaîne de traitement statistique. Parmi la diversité des opérations ensemblistes mises à disposition des biostatisticiens et des scientifiques de données, la jointure externe gauche, universellement désignée sous l’appellation anglophone Left Join, occupe une position méthodologique singulière. Cette opération permet d’enrichir une population d’intérêt par des attributs complémentaires sans jamais compromettre l’exhaustivité de l’échantillon initial, préservant ainsi l’intégrité de la structure d’observation de référence.
Historiquement, le système SAS a privilégié une approche procédurale et séquentielle pour le traitement des données structurées, matérialisée par l’étape DATA et l’instruction MERGE. Toutefois, l’intégration progressive des standards de gestion de bases de données relationnelles a conduit à l’introduction d’un moteur SQL robuste, incarné par la procédure PROC SQL. Cette dualité architecturale au sein de SAS offre deux paradigmes fondamentaux : la programmation impérative du vecteur de données d’un côté, et la formulation déclarative de l’algèbre relationnelle de l’autre. La maîtrise de ces mécanismes d’appariement ne relève pas simplement d’un enjeu syntaxique élémentaire, mais d’une exigence méthodologique critique visant à neutraliser les biais de sélection, à éviter la prolifération silencieuse des erreurs d’asymétrie et à optimiser la charge computationnelle sur des volumétries massives.
Le présent article propose une exploration académique et pratique approfondie du Left Join dans l’environnement SAS. Nous décomposerons les fondements théoriques hérités de la théorie des ensembles et du modèle de Ted Codd, avant de décortiquer la grammaire syntaxique de la procédure SQL standard. À travers l’analyse d’un cas empirique reproductible, nous étudierons étape par étape la mise en œuvre de la jointure, le diagnostic des structures tabulaires sous-jacentes, les stratégies d’imputation des valeurs manquantes résultantes, ainsi que les alternatives hautement performantes telles que les objets de hachage en mémoire vive. Enfin, un accent particulier sera porté sur l’évitement des pièges relationnels classiques, notamment l’explosion cartésienne et l’inversion involontaire du prédicat de jointure par une mauvaise utilisation de la clause de filtrage.
1. Introduction aux opérations relationnelles et au Left Join dans l’environnement SAS
1.1 Définition formelle de la jointure externe gauche
La jointure externe gauche puise son origine conceptuelle directe dans l’algèbre relationnelle, formalisée pour la première fois en 1970 par le mathématicien et chercheur britannique Edgar F. Codd au sein de son article séminal sur les grands ensembles de données partagés. Dans la théorie classique des relations, une opération de jointure consiste à combiner les tuples de deux relations distinctes sur la base d’un critère de correspondance prédéfini, couramment désigné sous le terme de prédicat d’équi-jointure. Alors que la jointure interne (Inner Join) restreint strictement l’ensemble de sortie à l’intersection logique des deux tables — éliminant de facto toute observation ne possédant pas de contrepartie exacte dans la relation associée —, la jointure externe gauche introduit une règle de dissymétrie délibérée.
Dans le formalisme d’une jointure externe gauche unissant une relation de gauche $R$ et une relation de droite $S$, la totalité des tuples appartenant à la table de référence $R$ est formellement préservée au sein de l’espace relationnel d’arrivée. L’opération évalue chaque observation de $R$ au regard des prédicats établis vis-à-vis des tuples de $S$. Lorsqu’une concordance stricte est identifiée, les attributs de la relation $S$ sont adjoints horizontalement au tuple de la relation $R$. En revanche, en l’absence absolue de correspondance au sein de la relation secondaire $S$, l’observation issue de la table $R$ n’est nullement écartée du jeu de données résultant : les attributs provenant de $S$ sont simplement instanciés avec des marqueurs d’absence de données, matérialisés sous la forme de valeurs nulles ou manquantes.
Cette caractéristique fondamentale distingue substantiellement le Left Join de la jointure complète (Full Outer Join), laquelle conserve l’ensemble des éléments non appariés des deux relations simultanément, générant ainsi des cellules manquantes des deux côtés de l’espace produit. La jointure gauche impose ainsi une hiérarchisation épistémologique stricte : la table située à gauche de l’opérateur constitue la population matrice inaliénable, tandis que la table positionnée à droite n’agit que comme un réservoir d’enrichissement conditionnel, subordonné à l’existence préalable d’une clé d’identification dans la table principale.
1.2 Pertinence du Left Join en analyse de données et recherche empirique
Dans le contexte des sciences appliquées, de l’épidémiologie clinique, de l’économétrie et de l’analyse décisionnelle moderne, la préservation intégrale de la population source représente un impératif méthodologique incontournable. Toute perte accidentelle d’observations au cours de la phase de préparation des données risque d’introduire un biais de sélection destructeur, compromettant de fait la validité interne et externe des inférences statistiques subséquentes. Le recours au Left Join permet d’arrimer systématiquement des ensembles de covariables secondaires à une cohorte mère sans altérer son effectif de base.
Considérons, à titre d’illustration méthodologique, un registre national de patients atteints d’une pathologie chronique rare, représentant la cohorte source d’une étude d’observation longitudinale. Ce jeu de données central consigne l’ensemble des admissions hospitalières, les paramètres cliniques initiaux et les événements de santé primaires. Les investigateurs souhaitent enrichir cette base clinique au moyen d’un fichier annexe consignant les expositions environnementales moyennes par code géographique de résidence, collecté par un organisme public distinct. L’utilisation d’une jointure interne éliminerait sans sommation l’ensemble des patients résidant dans des circonscriptions non documentées ou rurales pour lesquelles les capteurs environnementaux faisaient défaut. Une telle démarche tronquerait l’échantillon de recherche en surreprésentant les zones urbaines hautement industrialisées.
En mobilisant une jointure externe gauche, l’analyste garantit le maintien strict du dénominateur d’origine. Les sujets dont les métriques d’exposition environnementale ne sont pas recensées demeurent présents dans la structure tabulaire finale. Leurs variables d’exposition seront légitimement marquées comme manquantes, permettant aux chercheurs d’appliquer ultérieurement des protocoles rigoureux d’imputation multiple, d’analyse de sensibilité ou de modélisation par équations structurelles tenant compte de l’attrition partielle. Le Left Join constitue par conséquent l’instrument de prédilection dès lors qu’il s’agit de garantir la traçabilité des unités statistiques élémentaires lors de consolidations multi-sources complexes.
1.3 L’écosystème SAS et la dualité DATA Step vs PROC SQL
L’architecture logicielle du système SAS se distingue par une dualité historique majeure dans le traitement des tables relationnelles. Durant les premières décennies de son déploiement institutionnel, SAS a fondé son paradigme de manipulation de données sur le concept d’étape séquentielle, l’étape DATA (DATA Step), articulée autour du mécanisme interne du vecteur de données du programme, ou Program Data Vector (PDV). Sous cette approche impérative, l’appariement de jeux de données requiert l’utilisation conjointe de l’instruction MERGE et de l’instruction BY, assujettissant impérativement l’exécution de la fusion à un tri physique préalable et exhaustif des deux tables sources selon les variables de regroupement.
Au début des années 1990, avec l’avènement et la standardisation industrielle du langage SQL normalisé par l’American National Standards Institute (ANSI), SAS a intégré dans son moteur analytique la procédure PROC SQL. Cette implémentation novatrice a radicalement transformé la manière dont les ingénieurs abordent la manipulation tabulaire au sein de l’environnement SAS. Contrairement à l’étape DATA qui oblige le développeur à décrire minutieusement la cinématique séquentielle du parcours des enregistrements ligne par ligne, la procédure SQL repose sur une programmation déclarative. L’analyste spécifie la nature de la relation désirée, les prédicats logiques d’association et les colonnes à projeter, laissant à l’optimiseur de requêtes sous-jacent la charge de déterminer l’algorithme d’exécution le plus efficient.
Cette modularité déclarative propre à PROC SQL présente des vertus méthodologiques indéniables, particulièrement dans le déploiement du Left Join. Elle affranchit le programmeur de la contrainte lourde et coûteuse en entrées/sorties disque (I/O) imposée par le tri préalable obligatoire du DATA Step. De surcroît, elle autorise des formulations relationnelles hautement complexes, impliquant des jointures conditionnelles dynamiques ou non équi-jointures, des liaisons multi-tables et des sous-requêtes imbriquées, le tout au sein d’une grammaire syntaxique standardisée, intelligible et universellement partagée par l’ensemble des praticiens de la science des données.
2. Fondements théoriques de l’algèbre relationnelle appliqués à SAS
2.1 Mécanisme ensembliste du produit cartésien restreint
Sur le plan strictement mathématique, l’exécution d’une jointure relationnelle au sein de SAS ne constitue pas une simple juxtaposition physique de colonnes, mais procède formellement d’une restriction logique appliquée à un produit cartésien. Soit une première table $R$ comportant $m$ enregistrements et $p$ attributs, et une seconde table $S$ constituée de $n$ enregistrements et $q$ attributs. Le produit cartésien $R \times S$ représente l’ensemble de tous les couples possibles $(r, s)$ où $r in R$ et $s in S$, générant théoriquement une matrice volumique intermédiaire comprenant une dimension de $m \times n$ lignes pour $p + q$ colonnes.
Dans le cas d’une jointure interne, l’opérateur applique un filtre booléen strict, appelé prédicat d’équi-jointure (formalisé dans la clause ON), qui retient exclusivement les combinaisons de lignes pour lesquelles l’égalité de la clé est vérifiée :
$$\sigma_{R.cle = S.cle}(R \times S)$$
Dans le cadre d’un Left Join, l’opérateur ensembliste étend ce produit cartésien restreint en y réinjectant l’ensemble des éléments de $R$ qui ont été exclus par le prédicat de filtrage. En termes algorithmiques, SAS parcourt chaque unité statistique de la relation de référence. Si une concordance est relevée dans la relation secondaire, le produit des tuples correspondants est généré. Si aucune concordance n’existe, l’unité est tout de même projetée, en associant une ligne fictive composée exclusivement d’attributs indéterminés pour la relation de droite.
La maîtrise de cette mécanique est fondamentale pour anticiper les variations de cardinalité relationnelle. Dans une relation de type un-à-un (1:1), chaque tuple de la table gauche ne possède au maximum qu’une seule et unique correspondance dans la table droite, garantissant que le nombre total de lignes résultant de la jointure sera strictement identique à l’effectif originel de la table gauche. Toutefois, dans les scénarios de cardinalité un-à-plusieurs (1:N), où une même entité de la table mère trouve plusieurs occurrences directes dans la relation secondaire, le produit cartésien restreint dupliquera inévitablement la ligne d’origine autant de fois qu’il existe de correspondances dans la table secondaire, entraînant une expansion verticale de la table résultante.
2.2 Traitement rigoureux des discordances relationnelles
L’un des défis opérationnels les plus déterminants de l’opération de jointure externe réside dans la gestion des discordances relationnelles, c’est-à-dire les situations où des unités d’observation documentées dans la relation de référence ne trouvent aucune résonance au sein de la table adjointe. Lorsqu’une clé primaire présente dans la table gauche n’existe pas dans la table droite, l’optimiseur relationnel de SAS génère systématiquement, au moment de l’assemblage horizontal, des marqueurs d’absence de données pour l’ensemble des colonnes dépendantes de la relation secondaire.
Au sein de l’environnement SAS, la représentation interne de ces discordances obéit à une typologie structurelle rigoureusement formalisée. Pour les variables de type numérique (numeric), l’absence de concordance se traduit automatiquement par l’injection d’un point standard (.), qui encode la donnée manquante par défaut. Pour les variables textuelles ou alphanumériques (character), cette absence est matérialisée par une chaîne de caractères vide (' '), équivalente à une série d’espaces selon la longueur déclarée de la colonne. Cette opération garantit une complétude dimensionnelle parfaite de la structure matricielle finale sans provoquer l’arrêt du programme ni lever d’exceptions d’exécution non gérées.
Néanmoins, la prolifération de ces valeurs manquantes induites n’est pas sans conséquence sur les étapes subséquentes de la modélisation statistique. Les procédures de statistique descriptive de base, telles que PROC MEANS ou PROC SUMMARY, traitent les valeurs manquantes numériques en les écartant de facto du calcul des mesures de tendance centrale (moyenne, médiane) et de dispersion (variance, écart-type). De même, les procédures de modélisation économétrique avancée, à l’instar de PROC REG ou PROC GLM, appliquent par défaut une suppression univariée ou multivariée stricte au niveau de l’observation (listwise deletion). Il en résulte qu’une inclusion mal maîtrisée de variables secondaires fragmentaires via un Left Join peut paradoxalement aboutir à une exclusion massive d’observations lors de la phase finale de régression statistique, annihilant précisément l’objectif premier d’exhaustivité recherché lors de la conception de la requête.
3. Anatomie de la syntaxe SQL standard dans PROC SQL pour le Left Join
3.1 Décomposition structurelle de l’instruction PROC SQL
L’intégration formelle du modèle relationnel au sein de l’environnement logiciel SAS s’effectue au travers du bloc déclaratif initié par la déclaration PROC SQL. Contrairement à la majorité des autres procédures SAS qui traitent un flux continu d’instructions délimité par l’ordre de fermeture classique RUN, la procédure PROC SQL constitue une procédure interactive. Elle demeure active en mémoire vive, en attente de soumissions de requêtes successives, jusqu’à ce que l’interpréteur rencontre explicitement l’instruction de terminaison formelle QUIT;.
L’exécution standard d’une jointure externe gauche requiert l’instanciation physique ou temporaire d’un nouveau jeu de données résultant, ce qui s’opère par le couplage de la directive CREATE TABLE suivie du nom de la table cible et du mot-clé AS. Le pipeline de traitement s’articule ensuite autour de trois clauses fondamentales :
- La clause
SELECT, définissant rigoureusement le vecteur de projection, c’est-à-dire la liste exhaustive des variables appelées à composer l’espace dimensionnel de sortie. - La clause
FROM, désignant la table de référence source qui occupera la position logique dominante à gauche de l’opérateur de liaison relationnelle. - La clause
LEFT JOIN, spécifiant la table adjointe subordonnée, positionnée à droite, dont les tuples viendront enrichir la table maîtresse.
Ce bloc syntaxique fondamental s’achève impérativement par le critère d’association logique stipulé au sein de la clause ON. La non-fermeture de l’environnement par l’instruction QUIT; peut entraîner le maintien de verrous d’écriture concurrentiels sur les bibliothèques SAS ouvertes, altérant de fait la reproductibilité des programmes exécutés en mode différé (batch).
3.2 L’importance des alias de tables et de la clause ON
Dans le développement de requêtes relationnelles complexes, la lisibilité du code et la précision sémantique reposent largement sur l’utilisation systématique des alias de tables. Un alias constitue un identifiant contextuel court, assigné immédiatement après la désignation d’un jeu de données dans les clauses FROM et LEFT JOIN. Par convention analytique, les tables sont fréquemment associées à des lettres uniques distinctes (par exemple x pour la table de gauche et y pour la table de droite) ou à des abréviations mnémoniques représentatives.
L’application de ces alias devient critique pour lever l’ambiguïté relationnelle via la notation pointée (dot notation). Lorsque la variable servant de pivot de liaison possède un nom strictement identique au sein des deux structures de données sources — ce qui constitue la norme dans les modèles entité-relation bien conçus —, l’omission du préfixe d’alias dans la clause ON ou la clause SELECT engendre une erreur d’ambiguïté signalée dans le journal d’exécution de SAS (SAS Log). La formulation rigoureuse ON x.identifiant = y.identifiant informe sans équivoque le compilateur SQL interne sur les champs constitutifs du test logique d’appariement.
Il est impératif de souligner la distinction conceptuelle et opérationnelle absolue existant entre la clause d’appariement ON et la clause de filtrage conditionnel WHERE. Dans une architecture Left Join, la clause ON intervient lors de la phase fondamentale de constitution de la jointure externe : si le prédicat énoncé dans le ON est évalué à faux pour une observation donnée de la table droite, l’observation de la table gauche est impérativement conservée et la ligne droite est complétée par des valeurs manquantes. Inversement, la clause WHERE opère un filtrage rétrospectif sur la table consolidée : toute condition restrictive formulée dans le WHERE qui évalue une variable de la table droite portera sur les valeurs résultantes, éliminant arbitrairement toutes les lignes où cette variable contient des valeurs nulles. Par conséquent, l’inclusion malavisée d’un critère d’admissibilité de la table secondaire au sein d’une clause WHERE dégrade silencieusement et involontairement la jointure externe gauche en une simple jointure interne.
3.3 Sélection des colonnes : astérisque versus projection explicite
Dans la pratique de programmation quotidienne, l’utilisation du sélecteur universel matérialisé par l’astérisque (SELECT *) est fréquemment observée en raison de sa concision apparente. Toutefois, au regard des normes académiques d’ingénierie logicielle et de gestion des ressources computationnelles, cette pratique doit être fermement proscrite dans le cadre d’un Left Join.
L’instruction SELECT * impose au système la lecture, l’allocation en mémoire et l’écriture physique de l’intégralité des variables présentes au sein des deux relations d’entrée. Lorsque les bases de données mobilisées intègrent plusieurs dizaines ou centaines d’attributs annexes inutiles pour l’analyse visée, cette approche génère un goulot d’étranglement majeur au niveau du bus d’entrées/sorties et sature inutilement l’espace de stockage de la bibliothèque temporaire WORK. De surcroît, le recours au sélecteur universel provoque une collision structurelle systématique sur la variable de jointure : la clé étant présente à la fois dans $R$ et dans $S$, SAS déclenche un mécanisme d’écrasement ou émet un avertissement formel dans le journal, retenant généralement les attributs de la première table rencontrée.
La stratégie méthodologiquement optimale consiste à définir une projection explicite et parcimonieuse. L’analyste désigne nommément chaque colonne requise pour les investigations empiriques, en préfixant impérativement chaque identifiant par son alias de provenance. Cette rigueur garantit une stabilité structurelle absolue du jeu de données résultant, prévient les collisions accidentelles de métadonnées et permet une allocation minimale et optimisée de la mémoire vive par le compilateur de requêtes de SAS.
4. Préparation et exploration empirique des jeux de données d’exemple
4.1 Définition programmatique du premier jeu de données (DATA1)
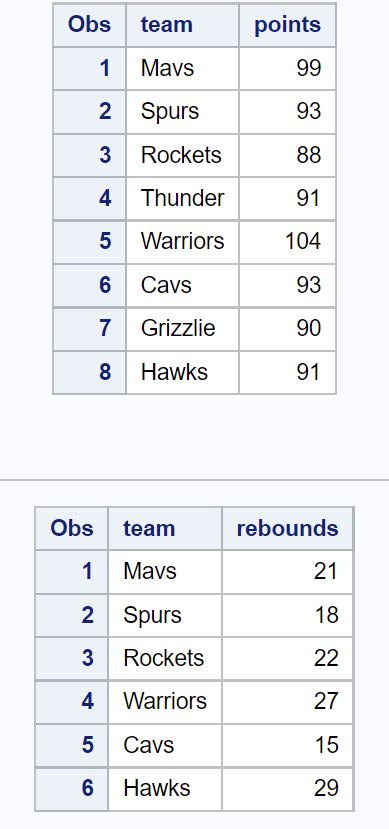
Afin de fonder nos démonstrations sur un support empirique concret, vérifiable et reproductible, nous concevons un scénario appliqué issu de l’économétrie du sport professionnel, discipline réputée pour ses structures tabulaires asymétriques. Considérons une table principale désignée sous le nom de DATA1, documentant les performances offensives globales d’une série de franchises de basket-ball professionnel nord-américain lors d’une phase de championnat régulier.
Cette première relation constitue la population matrice d’observation. Elle recense huit franchises sportives distinctes, identifiées par la variable textuelle team, ainsi que le volume agrégé des points marqués au cours de la période, stocké sous la variable numérique points. L’instanciation de cette structure est matérialisée au sein de l’environnement SAS par le script programmatique suivant :
Dans l’environnement SAS, le code permettant de matérialiser cette structure s’articule comme suit :
- Création de la table de travail principale
DATA1. - Définition de l’instruction
INPUTintégrant le modificateur de format textuel pour la saisie de chaînes de caractères. - Saisie directe via l’instruction
DATALINESde huit unités statistiques élémentaires représentant les équipes : Mavericks, Rockets, Spurs, Pistons, Thunder, Warriors, Cavaliers et Grizzlies.
Sur le plan technique, la variable team se voit attribuer une longueur par défaut de huit octets lors de la lecture séquentielle par SAS. Les observations intégrées illustrent une diversité d’équipes de référence, sans doublon sur la clé primaire nominale. L’intégrité de cette table mère devra demeurer totalement intangible lors de la consolidation relationnelle ultérieure : aucune équipe ne doit disparaître, quel que soit son statut au sein de la base secondaire.
4.2 Définition programmatique du second jeu de données (DATA2)
Concomitamment, nous générons une table secondaire, nommée DATA2, qui collige une métrique de performance défensive complémentaire : le nombre total de rebonds captés par match, stocké sous la variable rebounds. À des fins de démonstration méthodologique rigoureuse des propriétés de la jointure externe, ce jeu de données est volontairement configuré de manière asymétrique vis-à-vis de DATA1.
Cette seconde relation exclut délibérément deux franchises pourtant centrales dans la première table, en l’occurrence le Thunder et les Grizzlies, simulant une défaillance de collecte ou une absence temporaire de métriques avancées pour ces entités. Inversement, la table DATA2 intègre des équipes n’existant pas au sein de la table de référence DATA1, notamment les Lakers et les Raptors.
L’intersection théorique entre ces deux ensembles de données ne couvre donc que six franchises communes (Mavericks, Rockets, Spurs, Pistons, Warriors, Cavaliers). Ce scénario permet d’observer sans ambiguïté le comportement du moteur relationnel de SAS : validation du maintien des entités sans rebonds associés et exclusion sélective des franchises externes ne figurant pas dans la population mère initiale.
4.3 Vérification diagnostique initiale via PROC PRINT et PROC CONTENTS
Préalablement à toute opération d’assemblage relationnel sous SAS, un audit diagnostique rigoureux des tables sources s’avère impératif. La précipitation consistant à exécuter des jointures sans validation préalable des formats, des types de données et des codages mène immanquablement à des échecs d’exécution ou, pire encore, à des anomalies silencieuses au sein des données résultantes.
La procédure PROC PRINT est immédiatement mobilisée pour imprimer le contenu brut des deux tables dans la fenêtre de sortie standard ou dans l’interface de restitution SAS. Cette inspection visuelle primaire valide l’alignement des colonnes et la bonne lecture des flux DATALINES. Cependant, l’examen visuel demeure largement insuffisant pour garantir l’interopérabilité relationnelle. L’analyste doit impérativement recourir à la procédure PROC CONTENTS sur chacune des tables afin de sonder leurs métadonnées fondamentales :
- Contrôle strict de l’homogénéité du type de la variable de jointure : la colonne
teamdoit impérativement être déclarée sous le type caractère dans les deux relations. Toute divergence de type (un identifiant numérique dans une base et textuel dans l’autre) provoquerait l’avortement immédiat de la clauseONavec émission d’un message d’incompatibilité de type dans le journal. - Évaluation de la longueur déclarée (attribut
LENGTH) : une divergence de longueur d’encodage entre les deux clés peut susciter des dysfonctionnements, particulièrement si des chaînes sont tronquées ou si des espaces de remplissage modifient les signatures binaires de comparaison. - Examen de la séquence de classement (collation sequence) : indispensable pour vérifier que les règles de sensibilité à la casse (majuscules/minuscules) sont uniformément distribuées dans l’ensemble des environnements de stockage.
Ce protocole de vérification préliminaire garantit un cadre de calcul parfaitement intègre pour le déploiement de la syntaxe de jointure.
5. Implémentation pas à pas d’un Left Join avec PROC SQL dans SAS
5.1 Codage du script de jointure externe
La phase d’implémentation opérationnelle sous PROC SQL synthétise l’ensemble des règles de standardisation relationnelle formulées précédemment. L’objectif consiste à projeter une nouvelle table permanente ou temporaire, désignée conventionnellement sous l’identifiant FINAL_TABLE, en garantissant la préservation intégrale des huit observations de la table matricielle DATA1 enrichie par l’adjonction latérale de la variable rebounds de DATA2.
Le script structuré se déploie selon la syntaxe rigoureuse suivante :
Le bloc de programmation déclaratif s’agence ainsi :
- Ouverture de la procédure via
PROC SQL;. - Directive d’instanciation matérielle :
CREATE TABLE FINAL_TABLE AS. - Définition de la projection explicite avec désambiguïsation :
SELECT x.team, x.points, y.rebounds. - Désignation de la relation matrice gauche assortie de son alias :
FROM DATA1 AS x. - Déclaration de l’opérateur relationnel et de la relation adjointe droite :
LEFT JOIN DATA2 AS y. - Établissement du critère de correspondance stricte :
ON x.team = y.team;. - Terminaison absolue du bloc interactif :
QUIT;.
Dès la soumission de cette séquence d’instructions au compilateur SAS, l’analyste doit immédiatement reporter son attention sur le journal d’exécution (SAS Log). L’environnement consigne systématiquement un message informatif précisant le statut du traitement : le journal confirme la création de la table FINAL_TABLE, renseigne le nombre exact de lignes et de colonnes instanciées, et notifie l’absence formelle d’erreurs ou d’avertissements de troncature. Ce suivi de journal constitue la première ligne de défense de l’ingénierie des données sous SAS.
5.2 Analyse détaillée de la table résultante (FINAL_TABLE)
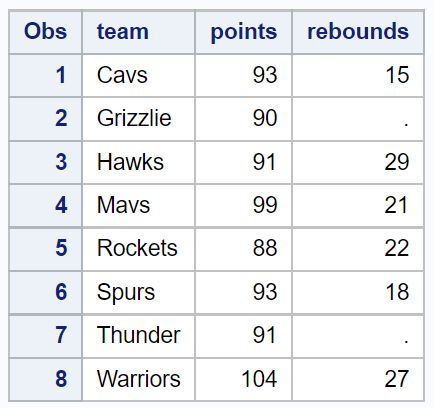
L’exécution de la procédure PROC PRINT DATA=FINAL_TABLE; RUN; permet d’objectiver empiriquement les conséquences algorithmiques directes du Left Join. L’examen des huit observations projetées apporte des éclairages méthodologiques cruciaux :
- Conservation de l’effectif intégral de la table de référence : La table résultante présente rigoureusement les huit franchises initialement consignées au sein de
DATA1. Aucune unité statistique n’a été évincée du traitement relationnel. - Association horizontale harmonieuse pour les entités communes : Les franchises Mavericks, Rockets, Spurs, Pistons, Warriors et Cavaliers voient leurs métriques respectives de
pointset dereboundsparfaitement associées sur chaque ligne. Les valeurs issues deDATA2ont été alignées sans altération de l’attribut numérique. - Production systématique de valeurs manquantes pour les discordances : Les franchises Thunder et Grizzlies, documentées dans
DATA1mais absentes des relevés deDATA2, apparaissent avec leurs scores de points respectifs intacts, tandis que la colonnereboundsaffiche explicitement le symbole du point d’indétermination (.). - Exclusion souveraine des enregistrements non appariés de la table secondaire : Les entités Lakers et Raptors, exclusivement présentes au sein de
DATA2, ont été intégralement écartées de l’espace de sortie. Leur exclusion valide l’asymétrie protectrice du Left Join, imperméable aux perturbations dimensionnelles induites par des tables secondaires non contrôlées.
Cette configuration matérialise l’exactitude de l’opération ensembliste : un enrichissement conditionnel parfait opérant sur un socle de population totalement préservé.
5.3 Validation systématique des métriques de conformité
L’obtention apparente d’un tableau de données ne saurait suffire à clore la procédure d’ingénierie relationnelle. Un audit de conformité doit systématiquement être diligenté afin de valider les propriétés formelles du résultat. Cet audit repose sur une série de contrôles quantitatifs précis :
En premier lieu, l’analyste procède à la vérification de la conservation stricte de la métrique cardinale de l’échantillon. Le nombre de lignes de la table de sortie doit être comparé à l’effectif originel de la table gauche. Cette comparaison peut être automatisée via la lecture de la macro-variable système &SQLOBS, qui enregistre le nombre d’observations sélectionnées ou affectées par la dernière requête SQL exécutée sous SAS. Si la table gauche est réputée posséder une clé primaire unique sans redondance, toute observation d’une valeur de &SQLOBS supérieure à l’effectif source signale une anomalie majeure : la présence pernicieuse de clés dupliquées au sein de la table secondaire droite, ayant provoqué une expansion cartésienne locale indésirable.
En second lieu, l’intégrité référentielle globale doit faire l’objet d’un examen minutieux. Il convient de s’assurer qu’aucun décalage structurel de colonnes n’a été produit, que les valeurs d’identification textuelles n’ont pas subi de suppression d’espaces préjudiciable et que la distribution globale de la variable appariée (rebounds) demeure cohérente avec les lois empiriques attendues, en dehors du volume quantifié de valeurs manquantes structurelles.
6. Gestion des valeurs manquantes et imputation post-jointure
6.1 Identification des valeurs manquantes générées par l’absence de correspondance
L’apparition de valeurs manquantes consécutivement à une opération de Left Join constitue un phénomène relationnel structurel et prévisible, qui se distingue ontologiquement de la présence de données non collectées ou de refus de réponse rencontrés lors de l’administration d’un questionnaire d’enquête. Dans le cadre de l’algèbre relationnelle, cette absence de valeur matérialise l’inapplicabilité logique d’une mesure à une unité statistique n’ayant pas été interceptée par le système de collecte secondaire.
Dans le système SAS, comme exposé précédemment, la dichotomie des types élémentaires gouverne la typologie des valeurs d’indétermination. Les colonnes numériques affichent un point standard (.), encodé sous forme d’une valeur à virgule flottante spécifique reconnue par le processeur arithmétique comme inférieure à tout nombre réel concevable (un point SAS est évalué comme étant plus petit que n’importe quel entier négatif dans les tests logiques d’inégalité). Pour les variables de type caractère, la donnée manquante correspond à une chaîne de blancs non imprimables.
Cette distinction conceptuelle entre une absence structurelle d’observation relationnelle et une mesure enregistrée à zéro prend une dimension cruciale dans le secteur financier ou biomédical. Si une franchise sportive n’apparaît pas dans la base de capture des rebonds, cela ne signifie nullement sur le plan empirique qu’elle a réalisé zéro rebond lors de la rencontre ; cela traduit simplement que sa performance n’a pas été soumise au protocole de mesure. Confondre l’absence de mesure et la valeur nulle constitue l’une des fautes d’interprétation les plus préjudiciables de l’analyse quantitative.
6.2 Techniques de remplacement conditionnel avec COALESCE et COALESCEC
Dans de nombreuses configurations opérationnelles ou industrielles, l’architecture analytique subséquente impose l’absence totale de cellules indéterminées, notamment lors de l’alimentation de tableaux de bord financiers ou d’algorithmes d’apprentissage automatique supervisé ne tolérant pas les entrées creuses. Pour remédier à cette contrainte sans altérer la logique du Left Join, le moteur PROC SQL met à la disposition des développeurs des fonctions hautement spécialisées de coalescence : la fonction COALESCE pour les vecteurs numériques et la fonction COALESCEC pour les chaînes de caractères.
La fonction COALESCE évalue de manière séquentielle, de gauche à droite, la liste des arguments qui lui sont transmis et renvoie le premier élément non manquant identifié. Au sein même de la projection SELECT d’un Left Join, cette fonction permet de substituer dynamiquement une valeur constante prédéfinie, par exemple zéro, à l’absence de données induite par la non-concordance de la table secondaire :
L’intégration s’opère formellement via la clause déclarative :
SELECT x.team, x.points, COALESCE(y.rebounds, 0) AS rebounds
Dans cette implémentation, si l’unité d’observation trouve une correspondance valide au sein de DATA2, la valeur native issue de y.rebounds est restituée sans altération. Dans le cas contraire, où y.rebounds contiendrait la valeur d’indétermination numérique (.), la fonction intercepte la lacune et injecte immédiatement la constante entière 0 dans la structure finale.
Pour les variables qualitatives ou catégorielles, la fonction homologue COALESCEC s’applique selon une logique rigoureusement analogue, autorisant le remplacement de chaînes vides par des marqueurs textuels explicites tels que 'NON_DOCUMENTE' ou 'INCONNU', normalisant ainsi les nomenclatures en vue des traitements séquentiels postérieurs.
6.3 Impact des données manquantes sur les procédures analytiques ultérieures
L’impact de l’injection massive de données manquantes via un Left Join ne doit jamais être sous-estimé lors de la transition vers la modélisation économétrique ou psychométrique avancée. L’analyste doit impérativement anticiper le comportement des moteurs statistiques canoniques de SAS face à cette matrice d’information partielle.
Au sein de procédures d’inférence causale telles que PROC REG, PROC LOGISTIC ou PROC MIXED, l’algorithme d’estimation procède par défaut à l’exclusion systématique de toute ligne comportant au moins une valeur manquante sur l’ensemble des régresseurs déclarés dans l’équation de modélisation (mécanisme de suppression univariée complète, ou complete-case analysis). Si un Left Join a été configuré sur une table secondaire souffrant d’un taux d’attrition de 40 %, l’échantillon effectivement exploité par le modèle économétrique final subira une amputation mécanique de 40 % de ses degrés de liberté, quand bien même la table de référence d’origine affichait une complétude absolue sur ses prédicteurs primaires.
Ce phénomène engendre deux risques méthodologiques majeurs :
- Une dégradation critique de la puissance statistique des tests de significativité des coefficients, augmentant substantiellement la probabilité de commettre une erreur de type II (non-rejet à tort de l’hypothèse nulle).
- L’introduction potentielle d’un biais d’attrition dévastateur si le mécanisme régissant l’absence de correspondance au sein de la table secondaire ne relève pas d’une absence complètement aléatoire (Missing Completely at Random, MCAR), mais répond à une causalité sous-jacente liée aux caractéristiques de l’unité (Missing Not at Random, MNAR).
Dans cette dernière hypothèse, les praticiens doivent substituer à l’analyse naïve des protocoles d’imputation multiple rigoureux via la procédure PROC MI et combiner les inférences au moyen de la procédure PROC MIANALYZE.
7. Résolution des ambiguïtés de colonnes et sélection sélective des variables
7.1 Le piège de la duplication de la clé de jointure lors de SELECT *
L’une des déviances de programmation les plus pernicieuses sous PROC SQL réside dans l’utilisation du sélecteur universel d’attributs SELECT * lors d’une jointure externe, mécanisme fréquemment adopté par les analystes débutants souhaitant embrasser l’ensemble des variables sans effort de formalisation. Cette habitude génère un phénomène de duplication et de conflit de nomenclature particulièrement insidieux sur la colonne de liaison relationnelle.
Considérons une situation où les deux tables sources possèdent une colonne pivot intitulée team. L’exécution de la directive SELECT * FROM DATA1 AS x LEFT JOIN DATA2 AS y ON x.team = y.team; contraint l’interpréteur SQL de SAS à traiter deux vecteurs homonymes distincts : x.team et y.team. Face à cette collision d’identifiants, le compilateur applique des règles de précédence arbitraires ou émet une série d’avertissements (WARNING) dans le journal d’exécution. Dans certains scénarios complexes, SAS résout le conflit en conservant les métadonnées de la première occurrence rencontrée, mais en écrasant ou tronquant les données sous-jacentes par celles de la table secondaire.
Le danger devient critique lorsqu’une observation de la table de référence $R$ ne possède pas d’équivalent dans la table secondaire $S$. Si le système venait à projeter la clé issue de la relation secondaire (y.team) plutôt que celle de la relation matrice (x.team), l’analyste observerait avec effroi que la colonne d’identification principale de son unité statistique est devenue manquante, alors même que l’unité existait bel et bien dans la table de gauche. Pour immuniser le système contre ce biais destructeur, l’ingénieur de données doit s’imposer la règle intangible de projeter systématiquement la clé primaire de la table de référence dominante, en spécifiant de manière univoque : SELECT x.team.
7.2 Renommage et attribution de labels au sein de PROC SQL
La modularité déclarative de PROC SQL offre une flexibilité remarquable pour la standardisation des métadonnées au moment même de la constitution des tables consolidées. Il est fréquent que les tables secondaires soient produites par des systèmes opérationnels hétérogènes employant des conventions de nommage cryptiques, redondantes ou contraires aux règles d’hygiène de code analytique en vigueur au sein de l’organisation de recherche.
L’instruction SQL permet de procéder au renommage unilatéral et immédiat de n’importe quel attribut à l’aide du mot-clé AS, tout en intégrant des étiquettes sémantiques explicites grâce au qualificateur LABEL. Cette démarche s’illustre dans le raffinement d’une requête de production :
Le bloc de projection s’enrichit alors de la manière suivante :
x.team AS Identifiant_Equipe LABEL='Franchise sportive de référence'x.points AS Score_Offensif LABEL='Total des points inscrits au cours de la saison'y.rebounds AS Prises_Defensives LABEL='Moyenne des rebonds captés par rencontre'
Cette standardisation in situ présente des vertus méthodologiques remarquables. Elle garantit que les métadonnées descriptives sont immédiatement encapsulées dans l’en-tête physique de la table SAS résultante, ce qui facilite grandement le travail collaboratif entre équipes de biostatisticiens et analystes décisionnels. Les restitutions générées subséquemment par les procédures d’édition graphique ou de synthèse tabulaire (PROC REPORT, PROC TABULATE) afficheront automatiquement ces labels exhaustifs et intelligibles, supprimant le besoin d’étapes intermédiaires laborieuses de reformatage de colonnes.
8. Approche comparative : Left Join via l’étape DATA (MERGE) vs PROC SQL
8.1 Syntaxe équivalente avec l’instruction MERGE et l’option IN=
La culture de programmation SAS repose historiquement sur une dualité profonde, matérialisée par la coexistence de la procédure PROC SQL et du moteur procédural séquentiel de l’étape DATA. L’exécution d’une jointure externe gauche peut être rigoureusement répliquée sous l’étape DATA au moyen de l’instruction MERGE, couplée obligatoirement à l’instruction de contrôle de tri BY et à l’exploitation des indicateurs logiques d’observation via l’option IN=.
Cependant, cette approche classique impose une contrainte mécanique absolue que PROC SQL évite : le tri physique préalable des deux tables sources selon la clé de fusion commune. L’implémentation algorithmique de cette méthode requiert une séquence en trois étapes majeures :
- Tri physique de la table matrice
DATA1selon la cléteamvia la procédurePROC SORT DATA=DATA1; BY team; RUN;. - Tri physique distinct de la table secondaire
DATA2selon la même variable pivot via la procédurePROC SORT DATA=DATA2; BY team; RUN;. - Déploiement de l’étape de fusion avec allocation de drapeaux booléens temporaires et filtrage conditionnel :
Le corps séquentiel de l’étape DATA prend alors la structure suivante :
DATA FINAL_MERGE;MERGE DATA1(IN=a) DATA2(IN=b);BY team;IF a;RUN;
Au cours de cette exécution, le système alloue en mémoire deux variables logiques temporaires, a et b, associées respectivement à la présence physique de l’observation courante dans DATA1 et DATA2. L’instruction de filtrage sélectif IF a; (sous-entendu IF a = 1;) conditionne la persistance de la ligne au sein de la table de sortie au seul fait que celle-ci appartienne originellement à la table gauche. Si a=1 et b=0, la ligne est projetée avec les variables de la table secondaire initialisées aux valeurs manquantes du vecteur de données (PDV), simulant parfaitement le comportement ensembliste d’un Left Join.
8.2 Comparatif technique : consommation de ressources et lisibilité
L’arbitrage entre l’étape DATA MERGE et la procédure PROC SQL pour l’orchestration d’une jointure externe gauche soulève des questions fondamentales d’optimisation computationnelle et d’architecture des systèmes d’information. Chaque méthode présente des profils de performance et de maintenabilité radicalement divergents.
Sur le plan de la consommation des ressources matérielles, l’étape DATA MERGE souffre du coût prohibitif imposé par les phases de tri préliminaires. La procédure PROC SORT requiert une allocation substantielle d’espace sur le disque de travail temporaire afin de manipuler les fichiers d’échange, générant un volume considérable d’opérations d’entrées/sorties (I/O) qui saturent fréquemment la bande passante des serveurs de données d’entreprise. Si les tables sont extrêmement volumineuses et ne sont pas nativement ordonnées selon les attributs de liaison, l’impact sur le temps CPU global s’avère particulièrement préjudiciable. En revanche, si les données sources sont d’ores et déjà triées ou indexées physiquement en amont, l’étape DATA MERGE offre une rapidité d’exécution en lecture séquentielle streaming quasiment imbattable, consommant un volume de mémoire vive minimal.
À l’inverse, PROC SQL offre une flexibilité méthodologique incomparable pour les travaux d’analyse ad-hoc et l’intégration continue. L’optimiseur relationnel intégré analyse la structure des requêtes et détermine dynamiquement la stratégie algorithmique optimale (tri interne temporaire, jointure par balayage séquentiel ou recours à une table de hachage volatile), sans exiger du développeur la création physique de versions ordonnées intermédiaires. De plus, sur le registre de la lisibilité et de la gouvernance du code, la syntaxe déclarative SQL constitue une norme universellement comprise au-delà de la seule communauté SAS, facilitant grandement la transférabilité des scripts vers des environnements de stockage distribués tels que Hadoop, Spark ou les entrepôts de données dans le cloud (Snowflake, BigQuery).
8.3 Tableau récapitulatif des divergences algorithmiques
Pour synthétiser les caractéristiques discriminantes de ces deux paradigmes au sein de SAS, le tableau méthodologique suivant récapitule les disparités opérationnelles et structurelles fondamentales :
- Prérequis d’ordonnancement physique :
- PROC SQL (Left Join) : Aucun ordonnancement préalable requis. Le compilateur évalue dynamiquement les stratégies d’accès selon les index ou ordonne les flux en mémoire de manière transparente.
- DATA Step (MERGE) : Tri physique absolu et préalable obligatoire selon l’ensemble des variables spécifiées dans l’instruction
BY, sous peine d’interruption fatale du programme (ERROR: By-variable out of order).
- Comportement face aux cardinalités plusieurs-à-plusieurs (N:N) :
- PROC SQL (Left Join) : Génération rigoureuse de l’ensemble du produit cartésien restreint. Toutes les combinaisons de correspondances sont intégralement projetées sous forme de lignes dupliquées.
- DATA Step (MERGE) : Comportement dangereux d’écrasement séquentiel partiel au sein du PDV sans expansion cartésienne complète, aboutissant à une corruption silencieuse des observations si la relation n’est pas univoque.
- Gestion des collisions de variables non-clés :
- PROC SQL (Left Join) : Conservation par défaut des valeurs de la table dominante de gauche ou obligation d’arbitrage explicite via des alias stricts de projection.
- DATA Step (MERGE) : Écrasement séquentiel mécanique : la variable de la seconde table lue écrase systématiquement la variable homonyme de la première table dans le PDV, entraînant des pertes d’attributs sans avertissement majeur.
- Complexité des critères de jointure :
- PROC SQL (Left Join) : Capacité native à intégrer des non-équi-jointures, des inégalités conditionnelles, des jointures avec prédicats arithmétiques ou des sous-requêtes corrélées.
- DATA Step (MERGE) : Restreint strictement à l’égalité parfaite des attributs déclarés au sein de la clause
BY.
Au terme de ce comparatif, il apparaît clairement que la procédure PROC SQL doit être désignée comme le standard d’ingénierie par défaut pour l’exécution des jointures externes gauches, reléguant l’étape DATA MERGE aux rares scénarios où les données sources bénéficient déjà d’un ordonnancement physique certifié et où la volumétrie surpasse drastiquement les capacités d’allocation de la mémoire vive du système.
9. Gestion des jointures avec clés multiples et types de données composites
9.1 Formulation de jointures composites à plusieurs prédicats
Dans les architectures relationnelles du monde réel, l’identification univoque d’une entité statistique ne repose que rarement sur un attribut unique. En recherche épidémiologique, en socio-démographie ou lors du traitement de panels économiques longitudinaux, les tables mobilisent fréquemment des clés composites, associant par exemple un identifiant d’individu, un code de centre hospitalier et une date d’inclusion protocolaire.
Au sein de PROC SQL, la formulation d’une jointure externe gauche sur des dimensions composites s’opère de façon remarquablement fluide par l’interconnexion logique des prédicats au sein de la clause ON, au moyen de l’opérateur booléen AND. L’architecture de la requête s’articule comme suit :
Le prédicat de jointure composite s’énonce selon la logique formelle suivante :
ON x.patient_id = y.patient_id AND x.visit_date = y.visit_date AND x.site_code = y.site_code
Cette formulation impose au moteur d’évaluation l’exacte synchronisation simultanée de l’ensemble des critères d’appariement. Si un patient a été reçu à une date donnée mais au sein d’un centre alternatif non indexé dans la table secondaire, la condition globale est évaluée à faux, et l’enregistrement de référence de la table gauche est scrupuleusement maintenu avec l’injection des valeurs manquantes requises. La vigilance méthodologique doit être maximale : l’omission d’un seul des composants de la clé composite (par exemple, omettre la variable visit_date) dégrade instantanément l’appariement en une relation un-à-plusieurs débridée, provoquant une multiplication anarchique des tuples en sortie et détruisant la granularité spatio-temporelle de l’étude.
9.2 Harmonisation des attributs de clés avant l’exécution
L’échec technique le plus fréquent lors de la consolidation de données massives issues de sources disparates résulte de l’hétérogénéité structurelle des variables pivots de liaison. Il est classique de constater que des entités conceptuellement identiques sont enregistrées sous forme de chaînes de caractères au sein d’un entrepôt opérationnel et sous forme d’identifiants numériques entiers au sein d’un registre administratif central.
Si un analyste tente d’exécuter directement un Left Join entre deux variables de types divergents (par exemple ON x.id_char = y.id_num), SAS bloque net l’exécution de la requête avec un message d’erreur d’incompatibilité de type. Bien que l’on puisse être tenté d’intégrer des fonctions de conversion à la volée directement au sein de la clause ON (en utilisant les fonctions PUT ou INPUT), cette pratique dégrade sévèrement les performances computationnelles en neutralisant la possibilité pour SAS d’exploiter les index existants.
La bonne pratique d’ingénierie impose d’harmoniser formellement les métadonnées de liaison en amont :
- Pour convertir une chaîne de caractères en valeur numérique, on appliquera la fonction
INPUT(chaine, informat.)au sein d’une étape de préparation dédiée. - Pour transformer un identifiant numérique en variable caractère standardisée, l’application de la fonction
PUT(numerique, format.)permettra de maîtriser précisément l’alignement et les éventuels zéros de tête. - Sur les chaînes textuelles, le nettoyage rigoureux des espaces parasites avant la jointure constitue un prérequis incontournable : l’utilisation conjointe des fonctions
STRIP()ouTRIM()élimine les espaces résiduels de début et de fin de chaîne, tandis que la fonctionUPCASE()uniformise la casse typographique (majuscules/minuscules), neutralisant les ruptures d’appariement découlant de simples artefacts de saisie manuelle.
10. Optimisation des performances, indexation et traitement des volumétries massives
10.1 Indexation stratégique des variables de jointure
Lorsque le volume des tables relationnelles franchit le cap de plusieurs millions d’enregistrements — ce qui constitue la norme dans les environnements de facturation bancaire ou les bases médico-administratives —, le temps d’exécution d’un Left Join peut croître de manière exponentielle si l’accès aux données n’est pas optimisé. L’indexation stratégique des variables de jointure représente le levier de performance le plus puissant offert par l’architecture sous-jacente de SAS.
Un index SAS est une structure de données arborescente (généralement un arbre B ou B+) stockée séparément de la table physique de données, qui consigne les valeurs des clés associées à des pointeurs d’adresses d’enregistrements directs. La création préalable d’un index simple ou composite sur la variable de liaison de la table secondaire droite permet à l’optimiseur de requêtes de PROC SQL d’abandonner le balayage séquentiel intégral (full table scan) de la base secondaire au profit d’un accès direct par recherche indexée index scan.
L’instanciation programmatique d’un tel index s’opère de manière déclarative au travers de l’instruction CREATE INDEX :
La syntaxe d’optimisation d’accès se matérialise comme suit :
PROC SQL;CREATE INDEX team ON DATA2(team);QUIT;
Le gain computationnel est spectaculaire : au lieu de parcourir les millions de lignes de DATA2 pour chaque individu de DATA1, l’interpréteur interroge directement l’index en mémoire vive en un temps algorithmique logarithmique $\mathcal{O}(\log n)$, réduisant drastiquement les opérations de lecture sur disque et divisant le temps de réponse global de la jointure par un ordre de grandeur significatif.
10.2 Options de mémoire vive et configurations système
Au-delà de la structuration physique des fichiers de données, la gouvernance de l’environnement matériel par le paramétrage des options système de SAS conditionne directement l’efficacité d’un Left Join sur de grands volumes de données. Deux options fondamentales doivent faire l’objet d’un dimensionnement rigoureux par l’architecte de données : MEMSIZE et SORTSIZE.
L’option système MEMSIZE détermine le plafond absolu de mémoire vive physique que le système d’exploitation alloue à la session SAS active pour l’ensemble de ses structures de calcul. Pour des traitements massifs, il est indispensable de configurer cette option à des valeurs substantielles (par exemple MEMSIZE=16G ou MEMSIZE=32G selon les capacités matérielles du serveur), prévenant ainsi les débordements intempestifs vers le disque. Concomitamment, l’option SORTSIZE gouverne la quantité maximale de mémoire vive allouée spécifiquement aux opérations de tri et d’assemblage relationnel interne opérées par PROC SQL.
En parallèle, l’emplacement physique de la bibliothèque temporaire WORK revêt une importance critique. L’optimiseur de requêtes de PROC SQL génère fréquemment des structures de travail volatiles durant l’évaluation des équi-jointures. L’assignation de la bibliothèque WORK sur des disques à semi-conducteurs haute vitesse (SSD NVMe) ou sur des systèmes de fichiers en mémoire vive montés (RAM-disk) permet d’éradiquer la latence d’entrées/sorties qui constitue, dans plus de 80 % des cas documentés, le véritable facteur limitant de la performance des jointures SAS.
10.3 Technique de hachage en mémoire (Hash Objects) comme alternative haute performance
Pour les architectures critiques où la rapidité d’exécution constitue une contrainte absolue, l’environnement SAS propose une alternative méthodologique de pointe surpassant à la fois l’étape DATA MERGE et la procédure PROC SQL : l’utilisation des objets de hachage en mémoire vive (Hash Objects) au sein de l’étape DATA.
Un objet de hachage est une classe d’objet orientée objet nativement intégrée au compilateur SAS, permettant d’importer l’intégralité de la table secondaire droite directement au sein d’une table de hachage volatile logée dans la mémoire vive centrale. Cette table utilise des fonctions de hachage sophistiquées pour mapper les clés de liaison à des adresses directes, assurant un temps d’accès théorique unitaire en $\mathcal{O}(1)$.
L’implémentation opérationnelle d’un Left Join via un objet de hachage se formule par l’instanciation programmatique suivante :
Le bloc de traitement par objet de hachage s’organise selon la cinématique suivante :
- Ouverture de l’étape
DATA FINAL_HASH;. - Lecture séquentielle exclusive de la table de référence gauche :
SET DATA1;. - Condition d’initialisation de l’objet en mémoire active au premier enregistrement :
IF _N_ = 1 THEN DO;. - Déclaration et instanciation du constructeur de hachage chargeant la table secondaire :
DECLARE HASH h(DATASET: 'DATA2');. - Définition de la clé de correspondance :
h.DEFINEKEY('team');. - Définition des variables d’attributs à adjoindre :
h.DEFINEDATA('rebounds');. - Finalisation formelle de l’instanciation :
h.DEFINEDONE(); END;. - Tentative de recherche directe par la méthode
rc = h.FIND();. - Gestion explicite de l’absence de correspondance pour forcer la complétude de la jointure externe :
IF rc ne 0 THEN CALL MISSING(rebounds);. - Suppression de la variable technique de code retour :
DROP rc;. - Fermeture par
RUN;.
Cette architecture supprime purement et simplement toute contrainte de tri préalable physique de la table gauche et s’affranchit des mécanismes de verrouillage de PROC SQL. Pour des tables de gauche comptant plusieurs dizaines de millions d’enregistrements et des tables de droite relativement denses mais tenant en mémoire vive, l’objet de hachage constitue la solution algorithmique la plus robuste et la plus rapide disponible dans l’ensemble de l’écosystème SAS.
11. Erreurs courantes, pièges diagnostiques et validation de l’intégrité des données
11.1 Multiplication non désirée des observations (explosion cartésienne)
L’un des pièges méthodologiques les plus destructeurs rencontrés dans la mise en œuvre empirique d’un Left Join réside dans l’apparition silencieuse d’une multiplication non contrôlée des observations de la table de référence, communément désignée dans la littérature informatique sous le concept d’explosion cartésienne.
Cette dérive algorithmique survient dès lors que l’analyste suppose implicitement que la relation d’appariement relève d’une cardinalité stricte d’un-à-un (1:1), alors que la table secondaire de droite dissimule en réalité des occurrences multiples de la variable de jointure (cardinalité un-à-plusieurs, 1:N). Lorsqu’un individu documenté une seule fois dans la table de gauche trouve trois enregistrements distincts partageant le même identifiant au sein de la table de droite, le moteur relationnel SQL n’effectue aucun arbitrage arbitraire : il projette obligatoirement trois lignes distinctes pour cette même unité dans la table résultante.
Ce phénomène vicieux altère fondamentalement l’intégrité de l’échantillon de recherche. Les dénominateurs statistiques sont instantanément faussés, ce qui gonfle artificiellement le nombre total de degrés de liberté de l’analyse, biaise la distribution des poids d’échantillonnage et altère gravement le calcul des variances. Pour prémunir le pipeline analytique contre ce risque, un audit d’unicité formel de la table droite doit être déployé de manière impérative avant toute opération de fusion :
Cet audit de contrôle s’exécute couramment via la syntaxe de diagnostic suivante :
PROC SQL;SELECT team, COUNT(*) AS frequence FROM DATA2 GROUP BY team HAVING COUNT(*) > 1;QUIT;
Si cette requête renvoie ne serait-ce qu’une seule ligne, la table secondaire doit impérativement faire l’objet d’un processus préalable de déduplication ou d’agrégation statistique au niveau de granularité pertinent avant d’être soumise au Left Join.
11.2 Incohérences de filtrage dans la clause WHERE au lieu de ON
L’erreur d’architecture la plus insidieuse, documentée de manière récurrente au sein des équipes d’analystes, réside dans l’incompréhension des séquences d’évaluation logique séparant la clause ON de la clause WHERE lors de l’application de critères de sélection supplémentaires sur la relation secondaire.
Supposons que l’analyste souhaite réaliser un Left Join entre la table des équipes DATA1 et la table des rebonds DATA2, tout en ne retenant les informations de rebonds que si ceux-ci dépassent le seuil critique de 10 unités. Une formulation erronée classique consiste à rédiger la requête comme suit :
Syntaxe viciée provoquant la régression relationnelle :
PROC SQL;CREATE TABLE ERREUR_TABLE ASSELECT x.team, x.points, y.reboundsFROM DATA1 AS xLEFT JOIN DATA2 AS y ON x.team = y.teamWHERE y.rebounds > 10;QUIT;
Sur le plan logique, le compilateur de SAS évalue la clause WHERE de manière rétrospective sur la matrice consolidée issue de la jointure externe. Les unités statistiques de DATA1 qui ne trouvaient pas de correspondance dans DATA2 (ou dont les rebonds étaient nuls) possèdent un point d’indétermination numérique (.) pour l’attribut y.rebounds. Or, dans l’arithmétique relationnelle SAS, une valeur manquante est évaluée comme étant inférieure à 10. Par conséquent, la clause WHERE éradique sans distinction l’ensemble de ces lignes de la table finale. L’analyste a involontairement transformé son Left Join en une jointure interne stricte, détruisant l’exhaustivité de sa cohorte matrice d’origine.
Pour préserver intégralement les observations de la table gauche tout en conditionnant l’enrichissement secondaire, la restriction doit impérativement être intégrée au sein même de la clause d’appariement ON :
Syntaxe méthodologiquement certifiée :
PROC SQL;CREATE TABLE VALIDE_TABLE ASSELECT x.team, x.points, y.reboundsFROM DATA1 AS xLEFT JOIN DATA2 AS y ON x.team = y.team AND y.rebounds > 10;QUIT;
Dans cette implémentation, le prédicat y.rebounds > 10 fait partie intégrante du test d’équi-jointure : si l’équipe n’atteint pas ce seuil, le test échoue, mais la franchise est maintenue avec une valeur manquante, préservant ainsi l’intégrité de la structure de l’échantillon source.
11.3 Techniques avancées de validation et journalisation
L’assurance qualité des flux de données dans les infrastructures analytiques modernes impose l’automatisation systématique des contrôles de complétude. Un ingénieur SAS ne saurait se fier à une inspection passive du journal d’exécution ; le code de traitement doit intégrer des assertions défensives capables de stopper le pipeline en cas de dérive relationnelle.
Ces contrôles reposent sur l’interrogation programmatique des variables automatiques du système SAS :
- La macro-variable
&SQLOBS, consignée immédiatement à l’issue de l’exécution dePROC SQL, renvoie le volume précis de lignes instanciées par la dernière requête. - La macro-variable
&SQLRC, qui stocke le code retour d’exécution du moteur SQL (une valeur de 0 attestant d’une exécution formellement parfaite, tandis qu’une valeur non nulle signale une violation de contrainte d’intégrité ou un arrêt prématuré). - La macro-variable globale
&SYSCC, qui enregistre le niveau de gravité cumulé des erreurs du système SAS.
Au sein des pipelines industriels, il est hautement recommandé d’encapsuler le Left Join dans une macro d’audit automatisée. Cette macro compare formellement le volume de la table résultante à celui de la table de départ. Si une divergence est constatée ($N_{\text{final}} ne N_{\text{source}}$), une macro-routine d’alerte émet une exception critique dans le flux de log et consigne l’anomalie dans une table d’audit dédiée, suspendant la mise en production avant que des modèles décisionnels erronés ne soient alimentés par des données corrompues.
12. Applications avancées en modélisation analytique et conclusion méthodologique
12.1 Cas d’usage : enrichissement de cohortes cliniques ou longitudinales
L’application par excellence du Left Join en recherche épidémiologique et en biostatistique clinique réside dans l’arrimage de données environnementales, génomiques ou socio-démographiques annexes à un essai clinique contrôlé ou à une cohorte hospitalière longitudinale.
Imaginons une étude observationnelle évaluant la survie à long terme de patients admis en milieu hospitalier pour décompensation cardiaque aiguë. La table matrice de cohorte regroupe les identifiants uniques de sujets suivis pendant dix années. Les investigateurs souhaitent tester l’hypothèse selon laquelle l’exposition chronique aux particules fines atmosphériques ($PM_{2.5}$) agit comme un facteur de confusion environnemental aggravant la mortalité cardiovasculaire. Les données de pollution sont acquises via un modèle de dispersion atmosphérique satellite fournissant des moyennes annuelles rattachées au code postal d’habitation.
L’obligation d’utiliser un Left Join relève ici de l’éthique de la recherche scientifique. Les patients ayant déménagé dans des zones frontalières mal cartographiées ou dont l’adresse postale présente des anomalies de codage ne doivent sous aucun prétexte être retranchés de l’analyse globale de survie. En intégrant les données d’exposition via un Left Join, l’équipe préserve l’effectif intégral de la cohorte prospective. Dans les modèles de régression à risques proportionnels de Cox qui seront construits ultérieurement, ces sujets perdus de vue au plan environnemental demeureront informatifs pour l’estimation des taux de survie de base, permettant ainsi de maintenir la puissance statistique globale du protocole expérimental sans biaiser artificiellement l’estimation de l’effet d’intérêt.
12.2 Chaînage de Left Joins multiples dans des modèles relationnels complexes
Dans les entrepôts de données architecturés selon des schémas en étoile (star schemas) ou en flocon de neige (snowflake schemas), la modélisation analytique impose fréquemment de consolider une table de faits centrale au moyen de multiples dimensions d’analyse secondaires. PROC SQL excelle dans l’orchestration de ces fusions en cascade, permettant le chaînage fluide de plusieurs clauses LEFT JOIN successives au sein d’une seule et unique déclaration déclarative.
La structure syntaxique d’une telle imbrication multi-dimensionnelle s’articule comme suit :
Le chaînage relationnel multi-tables se formalise ainsi :
PROC SQL;CREATE TABLE COHORTE_CONSOLIDEE ASSELECTx.patient_id, x.age, x.sexe,y.taux_cholesterol, y.pression_arterielle,z.indice_defavorisation,w.statut_vitalFROM TABLE_PATIENTS AS xLEFT JOIN BASE_BIOMARQUEURS AS y ON x.patient_id = y.patient_idLEFT JOIN GEO_DEPRIVATION AS z ON x.code_postal = z.code_postalLEFT JOIN REGISTRE_DECES AS w ON x.patient_id = w.patient_id;QUIT;
Dans cette dynamique ensembliste, chaque étape de jointure évalue séquentiellement sa clause ON respective, enrichissant progressivement la table de base tout en garantissant que le dénominateur fondamental, matérialisé par TABLE_PATIENTS, ne soit jamais amputé. La lisibilité de ce code repose intégralement sur une indentation rigoureuse et une nomenclature univoque des alias, démontrant la supériorité expressive de PROC SQL par rapport à l’empilement complexe d’étapes DATA MERGE intermédiaires.
12.3 Synthèse des bonnes pratiques de programmation SAS
Pour clore cette analyse approfondie consacrée à la jointure externe gauche au sein de l’environnement SAS, il convient de cristalliser les préceptes méthodologiques essentiels sous forme d’une charte de bonnes pratiques à destination des analystes et des ingénieurs de données :
- Adoption systématique de la projection explicite : Proscrire irrévocablement l’usage de
SELECT *dans les jointures relationnelles. Déclarer individuellement chaque colonne requise en préfixant explicitement chaque nom par son alias de table afin d’éliminer toute ambiguïté structurelle. - Sécurisation absolue de la clé de référence : Projeter systématiquement la clé primaire issue de la table de gauche (
SELECT x.cle) pour empêcher la prolifération de valeurs manquantes artificielles sur l’identifiant unitaire de l’observation. - Audit d’unicité préalable : Vérifier méticuleusement l’absence de doublons non anticipés sur la variable de liaison au sein de la table secondaire droite avant toute fusion, afin de neutraliser tout risque d’explosion cartésienne.
- Positionnement rigoureux des critères conditionnels : Placer impérativement les filtres portant sur la table secondaire dans la clause d’appariement
ONet non dans la clauseWHERE, afin d’éviter la dégradation accidentelle du Left Join en jointure interne. - Arbitrage technologique rationnel : Privilégier la modularité et la sécurité conceptuelle de
PROC SQLpour l’immense majorité des applications analytiques régulières. Réserver l’étapeDATA MERGEaux rares scénarios où les données bénéficient d’un ordonnancement préexistant certifié, et mobiliser les objets de hachage (Hash Objects) dès lors que les exigences de performance computationnelle sur de très grandes volumétries l’imposent.
En observant scrupuleusement ces règles de gouvernance technique et méthodologique, les praticiens de la science des données garantissent à leurs traitements une robustesse absolue, une reproductibilité scientifique irréprochable et une efficacité computationnelle optimale au cœur de l’écosystème SAS.
Références
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://doi.org/10.1145/362384.362685
- Date, C. J. (2004). An Introduction to Database Systems (8th ed.). Addison-Wesley.
- SAS Institute Inc. (2020). SAS® 9.4 SQL Procedure User’s Guide (4th ed.). SAS Institute. https://documentation.sas.com
- SAS Institute Inc. (2021). SAS® 9.4 Language Reference: Concepts (6th ed.). SAS Institute. https://documentation.sas.com
- Secosky, J. (2007). Merging vs. Joining: Comparing the DATA Step with PROC SQL. Proceedings of the SAS Global Forum 2007 Conference, Paper 032-2007. https://support.sas.com
- Vorfeld, H. (2012). Tips and Tricks for Using PROC SQL for Data Manipulation. PharmaSUG 2012 Proceedings, Paper CC12. https://www.lexjansen.com