
Dans le paysage contemporain de la science des données et de la modélisation statistique, la transformation des variables qualitatives en représentations numériques digestibles par les algorithmes constitue une étape charnière du prétraitement. La majorité des estimateurs mathématiques fondamentaux — qu’il s’agisse des modèles linéaires généralisés, des réseaux de neurones artificiels, des machines à vecteurs de support (Support Vector Machines) ou des méthodes d’apprentissage fondées sur des métriques de distance — opèrent par nécessité computationnelle sur des espaces vectoriels réels. Dès lors, l’intégration de descripteurs catégoriels, qu’ils soient issus de questionnaires psychométriques, d’identifiants nosologiques ou de conditions expérimentales, requiert une opération de traduction formelle appelée binarisation ou encodage disjonctif complet, communément désigné sous le terme d’encodage one-hot.
L’environnement statistique R, réputé pour sa rigueur méthodologique et son histoire profondément enracinée dans la théorie statistique formelle, propose une multitude de paradigmes pour appréhender cette transformation. De l’approche matricielle native héritée du système S jusqu’aux frameworks modulaires contemporains portés par le Tidyverse et le consortium Tidymodels, le praticien dispose d’un arsenal méthodologique d’une rare densité. Toutefois, sous la relative trivialité apparente de la création de colonnes binaires indicatrices se dissimulent des enjeux computationnels et théoriques considérables : piège des variables muettes, explosion combinatoire de la dimensionnalité, rupture de la parcimonie matricielle, fuites de données lors de la validation croisée et dégradation de la stabilité stochastique des estimateurs.
L’objectif du présent traité est de délivrer une analyse exhaustive, rigoureuse et opérationnelle des méthodologies d’encodage one-hot sous R. En articulant les fondements mathématiques de l’algèbre linéaire avec les impératifs pratiques du génie logiciel statistique, ce guide explore pas à pas les différentes implémentations disponibles — des primitives natives aux bibliothèques à haute performance comme caret, recipes, fastDummies et data.table. Une attention méticuleuse sera portée aux conséquences de ces transformations sur la structure géométrique des données, à la gestion rigoureuse des anomalies d’échantillonnage et à l’optimisation des structures matricielles éparses au sein de protocoles de recherche empirique avancés.
1. Fondements théoriques de l’encodage one-hot dans l’analyse de données
1.1 Définition mathématique et principe de binarisation
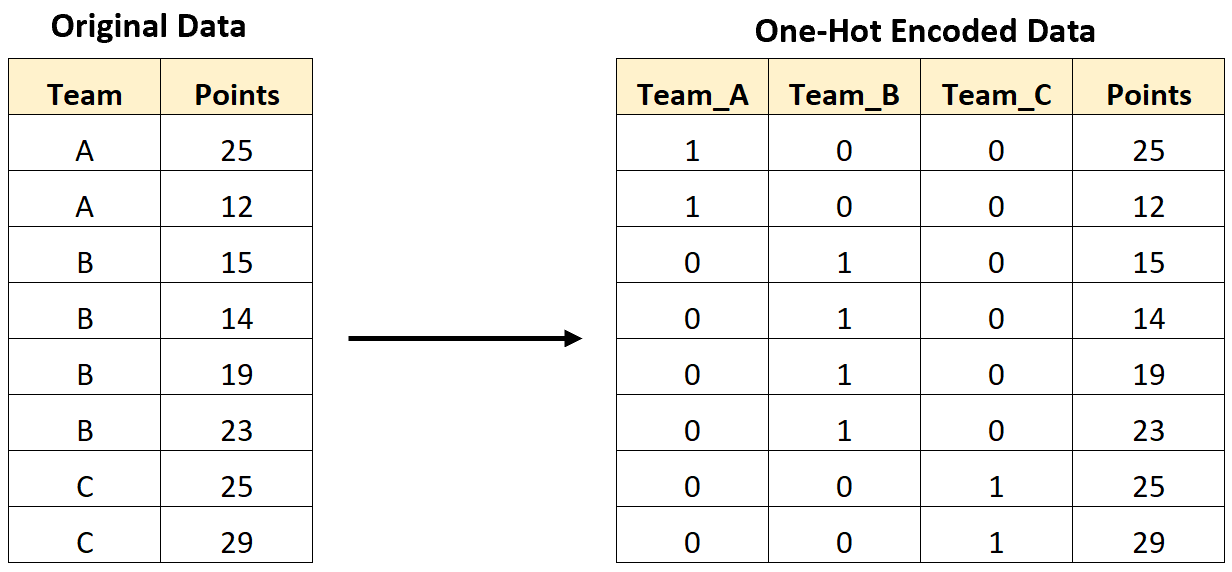
D’un point de vue formel, considérons une variable qualitative polytomique notée $X$, définie sur un espace d’échantillonnage $\Omega$, prenant ses valeurs dans un ensemble fini et discret de modalités qualitatives $\mathcal{C} = {c_1, c_2, dots, c_k}$, où le cardinal de l’ensemble vérifie $|\mathcal{C}| = k ge 2$. L’opération d’encodage one-hot consiste en une application injective $\phi : \mathcal{C} to {0, 1}^k$, qui transforme chaque modalité discrète $c_j in \mathcal{C}$ en un vecteur canonique de l’espace vectoriel booléen de dimension $k$. Pour toute observation individuelle indexée par $i in {1, dots, n}$, le vecteur résultant $\mathbf{v}_i = (y_{i1}, y_{i2}, dots, y_{ik})^T$ est défini analytiquement par l’intermédiaire de la fonction indicatrice :
$$y_{ij} = \mathbb{I}(X_i = c_j) = \begin{\cases} 1 &a\mp; \text{si l’observation } i \text{ présente la modalité } c_j 0 &a\mp; \text{sinon} \end{\cases}$$
Cette formulation impose une contrainte structurelle d’exclusivité et d’exhaustivité : pour chaque vecteur transformé, la norme de Manhattan ($L_1$) est strictement unitaire, c’est-à-dire que $\sum_{j=1}^k y_{ij} = 1$, assurant qu’un seul élément du vecteur prend la valeur discrète 1 tandis que tous les autres sont rigoureusement fixés à 0. L’utilité fondamentale de cette transformation réside dans sa neutralité sémantique. Contrairement à une numérisation naïve qui associerait à chaque modalité un entier arbitraire $f(c_j) = j$, l’encodage disjonctif complet garantit qu’aucune structure topologique, aucune transitivité et aucune relation d’ordre factice n’est introduite au sein de l’espace des descripteurs.
Dans le domaine des sciences quantitatives, préserver l’invariance par permutation des étiquettes qualitatives est un prérequis épistémologique absolu. Si l’on assigne des entiers séquentiels tels que 1 pour une modalité nominale, 2 pour une autre et 3 pour une troisième, la matrice d’opérateurs mathématiques suppose intrinsèquement que la troisième modalité est supérieure à la première d’un facteur d’échelle, ou qu’une moyenne pondérée entre la première et la troisième modalité équivaut à la seconde. L’encodage one-hot brise cette projection artificielle en situant chaque modalité sur un axe orthogonal propre, respectant rigoureusement la nature purement nominale du descripteur source.
1.2 Nécessité algorithmique dans les modèles d’apprentissage automatique
L’exigence algorithmique sous-tendant l’encodage one-hot découle directement des fondements géométriques de la majorité des estimateurs statistiques et des topologies de machines apprenantes. Les algorithmes reposant sur le calcul explicite de métriques spatiales — tels que les $k$-plus proches voisins ($k$-NN), les séparateurs à vaste marge (SVM) à noyaux gaussiens ou polynomiaux, ainsi que le partitionnement par les $k$-moyennes — calculent de manière systématique des distances de Minkowski, le plus souvent la distance euclidienne canonique $d_2(\mathbf{u}, \mathbf{v}) = \sqrt{\sum_{l} (u_l – v_l)^2}$. Si des modalités nominales sont encodées par des entiers arbitraires, la distance calculée entre deux entités devient tributaire de l’indexation programmatique plutôt que de la dissimilarité statistique intrinsèque, introduisant un biais mathématique dévastateur dans l’estimation des hyperplans de séparation.
Au sein des architectures de réseaux de neurones artificiels (perceptrons multicouches, réseaux récurrents ou transformeurs), les entrées sont multipliées par des tenseurs de poids synaptiques $\mathbf{W}$ avant d’être soumises à des fonctions d’activation non linéaires différentiables. Une variable catégorielle arbitrairement numérisée forcerait le neurone d’entrée à estimer un gradient unique associé à un scalaire d’intensité, imposant une relation fonctionnelle monotone ou polynomiale rigide entre l’étiquette arbitraire et la sortie latente. En revanche, l’encodage one-hot projette la variable sur $k$ dimensions distinctes, permettant à l’algorithme d’allouer un poids synaptique spécifique, indépendant et découplé, à chaque modalité catégorielle, optimisant ainsi l’espace des paramètres via la rétropropagation du gradient stochastique.
Pour les modèles linéaires classiques et généralisés (régression logistique, modèles de Poisson), l’encodage binaire est la condition sine qua non d’une estimation paramétrique paramétrée selon la théorie de Gauss-Markov. Sans cette décomposition, le produit scalaire entre le vecteur d’observation et le vecteur des coefficients directeurs $\mathbf{x}_i^T boldsymbol{\beta}$ perdrait toute signification de contrastes différentiels. L’encodage par étiquetage simple (ou label encoding) se révèle théoriquement inadmissible pour toute variable nominale non pourvue d’une métrique d’intervalle validée, confinant son applicabilité mathématique aux seuls modèles fondés sur des arbres de décision invariants aux transformations monotones monotones des espaces de variables, et même dans ce cas précis, sous des contraintes sévères d’heuristique de partitionnement.
1.3 Impact géométrique sur l’espace vectoriel des descripteurs
L’effet géométrique immédiat de la binarisation d’un vecteur de variables est une modification substantielle de la dimensionnalité intrinsèque de la matrice de conception. Considérons une matrice brute $\mathbf{X} in \mathbb{R}^{n \times p}$ contenant $p$ variables catégorielles, chaque variable $m in {1, dots, p}$ possédant une cardinalité $k_m$. L’encodage one-hot intégral projette la matrice d’origine dans un nouvel espace euclidien $\mathbb{R}^{n \times D}$, où la dimensionnalité totale d’arrivée est gouvernée par la relation :
$$D = \sum_{m=1}^p k_m$$
Cette expansion dimensionnelle produit une orthogonalisation stricte des variables explicatives associées à chaque facteur d’origine. Dans cet hyperespace de dimension $D$, les modalités d’une même variable catégorielle sont représentées par la base canonique orthonormée. Dès lors, la distance euclidienne entre deux observations $i$ et $i’$ différant uniquement par cette variable nominale est invariante et égale à :
$$d_2(\mathbf{y}_i, \mathbf{y}_{i’}) = \sqrt{(1 – 0)^2 + (0 – 1)^2} = \sqrt{2}$$
Cette symétrie métrique est conceptuellement élégante, mais elle induit une transformation topologique redoutable : la dispersion spatiale des points dans l’espace multidimensionnel. En augmentant massivement le nombre d’axes orthogonaux, la densité volumétrique des observations tend exponentiellement vers zéro, un phénomène intrinsèquement lié à la malédiction de la dimensionnalité théorisée initialement par Richard Bellman. Au fur et à mesure que $D$ croît par rapport à $n$, l’ensemble des points d’échantillonnage migre vers la périphérie de l’hypercube de conception, isolant les vecteurs les uns des autres et réduisant drastiquement l’efficacité statistique locale des estimateurs non paramétriques. En outre, la dispersion spatiale accrue et la parcimonie extrême — la matrice devenant majoritairement composée d’éléments nuls — requièrent des architectures logicielles et des algorithmes d’optimisation spécifiquement configurés pour prévenir l’instabilité numérique des inverses matriciels.
2. Typologie des variables qualitatives et pertinence de l’encodage
2.1 Variables nominales pures versus variables ordinales
La décision méthodologique de recourir à l’encodage one-hot doit impérativement s’adosser à une analyse rigoureuse de la typologie des données, telle que formalisée par Stanley Smith Stevens dans sa théorie fondamentale des échelles de mesure (Levels of measurement). Stevens distingue quatre niveaux fondamentaux : nominal, ordinal, d’intervalle et de rapport. L’encodage one-hot trouve son application exclusive et légitime au sein du niveau nominal pur, où les modalités catégorielles ne possèdent aucune relation d’ordre naturelle, aucune transitivité hiérarchique, ni aucune distance d’écartement mesurable.
À l’inverse, lorsqu’une variable appartient au registre ordinal — typiquement les échelles de Likert à cinq ou sept points, les stades d’évolution d’une pathologie (léger, modéré, sévère, critique) ou les niveaux de diplôme — l’application indiscriminée d’un encodage disjonctif complet constitue une perte délibérée d’information statistique structurante. La relation d’ordre partiel ou total $c_1 prec c_2 prec dots prec c_k$ contient un pouvoir prédictif substantiel. En éclatant une variable ordinale en vecteurs binaires indépendants, on contraint l’estimateur statistique à redécouvrir empiriquement la monotonie inhérente aux modalités, augmentant inutilement la variance de l’échantillonnage et le nombre de degrés de liberté consommés.
Pour de telles structures hiérarchisées, le cadre statistique contemporain préconise plutôt l’utilisation de contrastes polynomiaux orthogonaux (contrastes linéaires, quadratiques, cubiques) accessibles nativement dans R, ou l’utilisation de méthodes d’encodage par scores de rangs normalisés, de splines monotones, ou encore de paramétrisations de régression ordinale (modèles à cotes proportionnelles de cumulative logit). L’ingénieur ou le biostatisticien doit donc procéder à une classification préalable méticuleuse de son dictionnaire de variables, afin d’isoler les composantes strictement polytomiques des structures qui requièrent la préservation de la transitivité ordinale.
2.2 Cas d’usage en recherche psychologique et comportementale
Le champ des sciences du comportement, de la psychométrie et de la recherche clinique offre une illustration paradigmatique de la nécessité de l’encodage disjonctif rigoureux. Considérons les classifications nosologiques psychiatriques contemporaines, telles que définies dans le DSM-5 ou la CIM-11. Un groupe diagnostique — par exemple : trouble dépressif majeur, trouble bipolaire de type I, trouble obsessionnel-compulsif, trouble de stress post-traumatique — constitue une variable nominale pure sans métrique linéaire continue sous-jacente univoque.
Attribuer un identifiant arithmétique continu à ces entités pathologiques reviendrait à affirmer qu’un patient atteint de trouble bipolaire se situe à mi-chemin arithmétique entre un patient dépressif et un patient souffrant d’anxiété généralisée, une absurdité sémiologique qui corromprait l’ensemble des inférences ultérieures. De même, les profils d’attachement interpersonnel selon les conceptualisations de Mary Ainsworth et John Bowlby (sécure, insécure-évitant, insécure-anxieux/ambivalent, désorganisé) requièrent impérativement un encodage one-hot exhaustif lorsqu’ils sont modélisés comme prédicteurs discrets d’une trajectoire thérapeutique ou d’une réponse pharmacologique.
Dans les plans expérimentaux multifactoriels complexes — fréquents en neurosciences cognitives — où des sujets sont soumis à des combinaisons croisées de modalités de stimuli (visuel versus auditif versus haptique), l’encodage binaire des conditions expérimentales permet d’analyser sans ambiguïté la contribution relative de chaque composante du traitement. Il facilite en outre l’introduction contrôlée de termes d’interaction d’ordre supérieur dans les matrices de régression sans introduire d’artéfacts de corrélation fallacieuse entre les modalités expérimentales non ordonnées.
2.3 Conséquences empiriques d’un mauvais choix de transformation
Les répercussions méthodologiques et mathématiques d’une stratégie d’encodage inappropriée sont majeures et se manifestent à plusieurs niveaux critiques de la chaîne d’analyse statistique :
- Instabilité et colinéarité artificielle : Si un encodage one-hot exhaustif est injecté dans un modèle d’ajustement linéaire classique sans élimination d’une modalité de référence, la matrice d’information devient singulière, empêchant le calcul analytique des estimateurs par inversion matricielle classique.
- Déformation de l’interprétabilité des paramètres : L’utilisation d’une numérisation ordinale sur des concepts nominaux produit des coefficients de régression globalement ininterprétables, le scalaire $\beta$ résultant mesurant un taux d’accroissement par changement d’étiquette, ce qui est dénué de toute validité clinique ou expérimentale.
- Altération de la convergence stochastique : Dans les modèles optimisés par descente de gradient, la topologie du paysage d’erreur devient fortement irrégulière et présente des vallées d’ill-conditioning lorsque des variables qualitatives sont inadéquatement projetées, provoquant des oscillations excessives du gradient et des arrêts prématurés dans des minima locaux sous-optimaux.
- Gonflement artificiel de la variance : L’éclatement inutile d’une variable ordinale informative en multiples colonnes binaires augmente la variance de prédiction due à la dispersion excessive des degrés de liberté du modèle, ce qui dégrade l’erreur quadratique moyenne en phase de validation croisée.
Il est donc primordial d’opérer une distinction formelle entre les nécessités structurelles de la binarisation nominale et les alternatives méthodologiques adaptées aux échelles ordonnées ou hiérarchisées.
3. Configuration de l’environnement de travail et structuration du jeu de données
3.1 Initialisation du socle logiciel et chargement des dépendances
Pour assurer une reproductibilité computationnelle absolue selon les normes de la science ouverte, l’espace d’exécution sous R doit être rigoureusement configuré. Les opérations matricielles et les manipulations de structures de données distribuées nécessitent l’invocation de bibliothèques spécialisées, sélectionnées pour leur robustesse et leur stabilité algorithmique. Le code source ci-après procède à l’initialisation de l’environnement, au paramétrage des options globales et à l’importation ordonnée des modules prérequis.
L’argumentation technique repose sur des bibliothèques fondamentales : Matrix pour la gestion des structures éparses et des allocations de mémoire allégées, caret pour le cadre d’évaluation historique des modèles, recipes issu de l’architecture moderne tidymodels, fastDummies pour la vectorisation computationnelle pure, et data.table pour l’édition de mémoire par référence in-place. L’instruction système stabilise les contrastes globaux de la session en fixant contr.treatment comme comportement par défaut pour les facteurs non ordonnés.
Le script d’initialisation de l’environnement s’articule comme suit dans un flux de travail standardisé :
options(stringsAsFactors = FALSE)
options(contrasts = c("contr.treatment", "contr.poly"))
set.seed(42)
Dans un contexte de production ou de recherche empirique approfondie, il est vivement recommandé de consigner les versions exactes du compilateur R et de l’ensemble des modules dépendants au moyen d’outils d’isolation environnementale tels que le package renv, garantissant que les divergences mineures de comportement interne des bibliothèques de calcul matriciel n’altèrent pas l’intégrité numérique des transformations de binarisation ultérieures.
3.2 Création programmatique du jeu de données d’expérimentation
Afin de contextualiser nos expérimentations sur une structure de données empiriquement réaliste, nous synthétisons un jeu de données simulant une cohorte clinique en psychiatrie comportementale. Ce tableau de données intègre intentionnellement des variables quantitatives continues, des variables qualitatives nominales pures à cardinalités variables, des variables ordonnées et des valeurs manquantes sporadiques, offrant un banc d’essai exhaustif pour les différentes méthodes d’encodage.
Considérons la construction programmatique suivante dans laquelle un data.frame dénommé df_clinique est généré avec un effectif d’échantillonnage de $N = 1,000$ sujets :
n_sujets <- 1000
identifiant <- paste0("PAT_", sprintf("%04d", 1:n_sujets))
age <- round(rnorm(n_sujets, mean = 42, sd = 12))
score_anxiete <- round(rnorm(n_sujets, mean = 55, sd = 10), 2)
diagnostic <- sample(c("Depression", "Bipolarite", "TroublePanique", "Schizophrenie", "TOC"), size = n_sujets, replace = TRUE, prob = c(0.35, 0.15, 0.20, 0.10, 0.20))
protocole_therapie <- sample(c("TCC", "Psychanalyse", "PleineConscience", "Controle"), size = n_sujets, replace = TRUE, prob = c(0.40, 0.25, 0.20, 0.15))
statut_marital <- sample(c("Celibataire", "Marie", "Divorce", "Veuf"), size = n_sujets, replace = TRUE, prob = c(0.30, 0.45, 0.18, 0.07))
severite_trouble <- ordered(sample(c("Leger", "Modere", "Severe"), size = n_sujets, replace = TRUE, prob = c(0.30, 0.50, 0.20)), levels = c("Leger", "Modere", "Severe"))
adhesion_traitement <- rbinom(n_sujets, size = 1, prob = 0.68)
df_clinique <- data.frame(identifiant, age, score_anxiete, diagnostic, protocole_therapie, statut_marital, severite_trouble, adhesion_traitement)
L’inspection de la nature sous-jacente de ces variables au moyen des primitives de bas niveau str(df_clinique) et sapply(df_clinique, class) révèle que les colonnes textuelles sont initialement stockées sous forme de chaînes de caractères (character vectors). L’étape préliminaire incontournable consiste à convertir explicitement les descripteurs nominaux en vecteurs de type facteur (factor), permettant à l’interpréteur de langage de compiler la table interne des modalités et de vérifier l’absence d’incohérences typographiques.
3.3 Exploration descriptive de la cardinalité avant traitement
Préalablement à toute manipulation algorithmique de binarisation, l’analyste se doit de quantifier rigoureusement la distribution des fréquences empiriques ainsi que l’entropie informationnelle de Shannon associée à chaque modalité. L’entropie d’une variable qualitative $X$ caractérisée par une distribution de probabilités discrètes $\mathbf{p} = (p_1, dots, p_k)$ est formalisée par :
$$H(X) = – \sum_{j=1}^k p_j \log_2(p_j)$$
Cette métrique fournit une évaluation synthétique du degré de dispersion informationnelle de la variable catégorielle. Une variable présentant une entropie proche de zéro est quasi-dégénérée, c’est-à-dire qu’une modalité hégémonique absorbe la quasi-totalité de la masse de probabilité empirique. En pratique, l’inspection des tableaux de contingence univariés et bivariés via les fonctions de base table() et prop.table() permet d’isoler les niveaux d’une rareté extrême (modalités dont la prévalence empirique est inférieure à un seuil critique, typiquement 1% ou 5%).
La présence de telles modalités sous-représentées représente un risque opérationnel sévère lors de l’encodage one-hot. Lorsque ces modalités sont scindées en colonnes binaires indépendantes, les vecteurs résultants présentent une variance quasi nulle (near-zero variance), n’affichant qu’une poignée de 1 perdus dans un océan de zéros. De tels descripteurs dégénérés entraînent des ruptures d’inversion matricielle, induisent des instabilités de convergence lors de procédures de rééchantillonnage par validation croisée (notamment lorsque les plis d’entraînement se retrouvent totalement dépourvus de la modalité en question), et doivent être identifiés dès cette étape d’audit exploratoire.
4. Mise en œuvre de l’encodage one-hot avec le package caret
4.1 Mécanisme interne de la fonction dummyVars
Le package caret (Classification and Regression Training), développé par Max Kuhn, constitue l’un des jalons historiques les plus structurants de la modélisation sous R. La solution canonique fournie par cette bibliothèque pour la binarisation systématique des descripteurs est incarnée par la fonction dummyVars. Le fonctionnement de dummyVars repose sur un principe fondamental du génie logiciel statistique : le découplage strict entre la spécification formelle de la transformation et son application calculatoire effective sur des matrices d’observations.
La fonction dummyVars accepte comme premier paramètre une formule mathématique symbolique de type régression — par exemple ~ diagnostic + protocole_therapie + statut_marital ou plus globalement ~ . pour intégrer tous les prédicteurs présents dans l’objet tabulaire source. L’analyse syntaxique interne de cette formule permet à la fonction de dresser l’inventaire exhaustif des facteurs catégoriels à binariser, tout en ignorant délibérément les colonnes continues qui ne requièrent aucune altération structurelle.
L’argument architectural déterminant de dummyVars réside dans le paramètre booléen fullRank. Par défaut, ce paramètre est configuré à FALSE. Cette spécification induit la création d’un système disjonctif complet : chaque variable à $k$ modalités est scindée en exactement $k$ colonnes d’indicatrices binaires, produisant ainsi un encodage one-hot rigoureux. À l’inverse, si l’opérateur bascule cet argument sur fullRank = TRUE, la fonction élimine de façon déterministe la première modalité de référence de chaque facteur, générant un ensemble de $k – 1$ colonnes afin d’assurer l’indépendance linéaire stricte des colonnes dans le cadre de modèles linéaires non régularisés sensibles au piège des variables muettes.
4.2 Application de la méthode predict sur les données d’apprentissage
Une fois l’objet de spécification instancié par la commande dummyVars, la projection matricielle concrète s’opère par la surcharge de la méthode polymorphique universelle predict(). L’appel de cette méthode prend en argument le modèle pré-compilé et la matrice de données brute à convertir. Le listing méthodologique suivant illustre le flux opératoire complet :
library(caret)
formule_predicteurs <- as.formula("~ diagnostic + protocole_therapie + statut_marital + age + score_anxiete")
encodeur_caret <- dummyVars(formula = formule_predicteurs, data = df_clinique, fullRank = FALSE)
matrice_transformee <- predict(encodeur_caret, newdata = df_clinique)
df_final_caret <- as.data.frame(matrice_transformee)
Il importe de disséquer la nature de l’objet produit en sortie par cette opération de prédiction. Contrairement au tableau d’origine qui combinait des colonnes hétérogènes de nature numérique, textuelle et catégorielle, la sortie immédiate de predict.dummyVars est une matrice numérique dense primitive de classe matrix sous R, dotée de l’attribut numérique double. Toutes les variables continues incluses dans la formule symbolique d’origine (dans le cas présent : age et score_anxiete) traversent le processus de transformation sans altération de leurs valeurs scalaires, mais se trouvent désormais agrégées au sein du même continuum matriciel que les variables binaires générées.
Pour réintégrer cette structure dans un pipeline de données conventionnel nécessitant la classe data.frame ou tibble, l’opérateur doit invoquer explicitement une conversion de type au moyen de as.data.frame(). Cette nouvelle table présente désormais une nomenclature explicite, le système de caret suffixant chaque modalité binarisée par son intitulé d’origine sans séparateur ambigu, garantissant une identification univoque des axes dimensionnels créés.
4.3 Traitement rigoureux des variables prédictives et cibles
Une erreur méthodologique d’une fréquence alarmante dans les protocoles de modélisation prédictive consiste à soumettre l’intégralité du jeu de données brut — incluant la variable cible (ou variable dépendante d’intérêt) — à la fonction dummyVars via une formule aveugle du type ~ .. Si la variable cible est elle-même de nature qualitative et que l’algorithme sous-jacent requiert un vecteur d’étiquettes unique ou une cible binaire unidimensionnelle (par exemple, la survenue d’un événement clinique codée en 0 ou 1 pour une régression logistique binaire), l’éclatement de cette cible en deux colonnes mutuellement exclusives rompt la compatibilité du pipeline avec les fonctions d’apprentissage conventionnelles.
Il est donc prescrit, selon les standards de l’art, de ségréguer impérativement les prédicteurs de la cible dès l’amorce de la chaîne de calcul. L’isolation de la variable dépendante s’effectue via des projections d’indexation matricielle rigoureuses :
vecteur_cible <- df_clinique$adhesion_traitement
predicteurs_bruts <- subset(df_clinique, select = -c(identifiant, adhesion_traitement))
encodeur_strict <- dummyVars(~ ., data = predicteurs_bruts, fullRank = FALSE)
X_matrice <- predict(encodeur_strict, newdata = predicteurs_bruts)
Cette séparation hermétique prévient tout risque de fuite de métadonnées (metadata leakage) et garantit que les attributs mathématiques de l’espace des variables indépendantes n’interagissent à aucun moment avec la distribution conditionnelle de la variable à prédire. En outre, il convient d’exclure méticuleusement les identifiants uniques de sujets (la colonne identifiant dans notre configuration expérimentale). Si un tel identifiant nominal était conservé par inadvertance lors de la binarisation, l’encodage one-hot générerait un millier de colonnes d’indicatrices unitaires sans aucune variance explicative généralisable, conduisant à une explosion aberrante de la dimensionnalité matricielle et à un surapprentissage instantané.
5. Approche native sous R sans dépendance externe
5.1 Exploitation de la fonction model.matrix
R possède intrinsèquement, au niveau le plus profond de son architecture mathématique de base, un moteur de compilation matricielle extrêmement sophistiqué conçu à l’origine par John Chambers pour le langage S : la fonction model.matrix. Cette fonction constitue le cœur computationnel sous-tendant la totalité des modèles linéaires (lm) et linéaires généralisés (glm) exécutés dans l’écosystème statistique standard. Elle opère directement sur une formule symbolique associée à un environnement de données, traduisant les expressions déclaratives en une matrice de conception formelle.
Le comportement algorithmique par défaut de model.matrix est régi par le principe statistique d’élimination de la singularité matricielle. Lorsqu’une formule classique telle que ~ diagnostic est évaluée, model.matrix génère automatiquement une colonne constante d’interception constituée d’une série ininterrompue de 1, et omet délibérément la première modalité factorielle ordonnée selon l’ordre alphanumérique des niveaux du facteur (dans notre cas, diagnosticBipolarite). Ce mécanisme produit une base de $k-1$ colonnes linéairement indépendantes pour éviter la colinéarité parfaite avec la constante de régression.
Pour forcer l’infrastructure native de R à délivrer un encodage one-hot rigoureux, intégral et exhaustif — c’est-à-dire comportant exactement $k$ colonnes binaires pour les $k$ modalités sans aucune omission préalable —, le praticien doit neutraliser l’allocation de la colonne d’interception globale. Cette neutralisation s’exprime dans la formule symbolique par l’adjonction de l’opérateur arithmétique - 1 ou 0 +. L’exécution se matérialise ainsi :
matrice_native <- model.matrix(~ diagnostic - 1, data = df_clinique)
L’objet ainsi créé est doté de toutes les colonnes indicatrices requises : chaque modalité du facteur diagnostic reçoit son vecteur binaire d’appartenance strict, sans troncature de référence.
5.2 Gestion des contrastes statistiques intrinsèques à R
La puissance conceptuelle du système natif de R réside dans sa gestion formelle des contrastes statistiques, un concept fréquemment méconnu des praticiens issus de l’apprentissage automatique non statistique. Le comportement d’expansion matricielle de model.matrix est entièrement paramétré par les attributs de contrastes rattachés aux objets de classe factor. R distingue plusieurs familles fondamentales d’opérateurs de contrastes :
contr.treatment: Le contraste par traitement classique, assignant la modalité de référence à zéro et mesurant l’effet différentiel des autres modalités.contr.sum: Le contraste par somme d’effets (également appelé codage d’écart ou deviation coding), imposant que la somme arithmétique de l’ensemble des coefficients associés aux modalités soit rigoureusement nulle ($\sum_{j=1}^k \beta_j = 0$).contr.helmert: Les contrastes de Helmert, comparant successivement chaque modalité à la moyenne arithmétique des modalités qui la précèdent hiérarchiquement.contr.poly: Les contrastes polynomiaux orthogonaux, réservés par convention aux facteurs ordonnés pour capter les tendances polynomiales monotones et non linéaires.
L’utilisateur peut forcer localement le comportement d’une variable nominale sans affecter la configuration globale de sa session de travail, en assignant directement une matrice de contrastes spécifique à l’attribut de l’objet. Pour visualiser ou manipuler les contrastes associés au facteur diagnostique, on invoquera :
contrasts(df_clinique$diagnostic)
Pour implémenter manuellement un schéma de binarisation spécifique ou restaurer un codage unitaire exhaustif sans modifier la formule de régression, on peut altérer la fonction de projection en utilisant une matrice identité carrée dimensionnée selon le nombre de niveaux $k$ du facteur, conférant à l’approche native une flexibilité paramétrique inégalée.
5.3 Reconstruction du tableau de données sans perturbation des métadonnées
L’utilisation directe de la primitive model.matrix pour produire un ensemble complet de données multi-variables implique un écueil technique d’importance. Si l’on formule une requête matricielle multivariée native avec suppression de l’interception du type model.matrix(~ diagnostic + protocole_therapie - 1, data = df_clinique), le comportement de l’analyseur de formules de R n’est disjonctif complet que pour le premier facteur énuméré. En effet, pour éviter la multicolinéarité intra-modèle, R réintroduit automatiquement une omission de modalité de référence pour tous les facteurs subséquents énumérés dans l’expression symbolique.
Pour surmonter cette contrainte intrinsèque sans dépendance externe et obtenir un encodage one-hot exhaustif pour une multiplicité de facteurs qualitatifs, l’approche programmatique native exige l’évaluation vectorisée ou itérative de la fonction sur chaque facteur individuel, suivie d’une recombinaison matricielle :
variables_a_encoder <- c("diagnostic", "protocole_therapie", "statut_marital")
liste_matrices <- lapply(variables_a_encoder, function(nom_colonne) {
f <- as.formula(paste("~", nom_colonne, "- 1"))
model.matrix(f, data = df_clinique)
})
matrice_one_hot_native <- do.call(cbind, liste_matrices)
Cette construction algorithmique garantit une préservation intégrale des métadonnées sans troncature implicite. L’objet agrégé résultant peut ensuite être purgé de ses attributs superflus (tels que attr(matrice_one_hot_native, "assign") ou attr(matrice_one_hot_native, "contrasts")) et fusionné aux colonnes quantitatives continues initiales, offrant une indépendance logicielle absolue vis-à-vis des packages tiers, tout en minimisant l’empreinte mémoire par l’utilisation exclusive d’appels natifs C sous-jacents.
6. Encodage moderne via l’écosystème Tidyverse et le package recipes
6.1 Architecture modulaire du framework tidymodels
L’émergence de l’écosystème tidymodels, piloté par Max Kuhn et Hadley Wickham au sein de l’entreprise Posit (anciennement RStudio), a marqué une révolution paradigmatique dans l’ingénierie des caractéristiques sous R. Le module central dédié au prétraitement statistique des données est le package recipes. L’architecture de recipes s’inspire directement de la métaphore culinaire pour formaliser une distinction conceptuelle tripartite et rigoureuse entre :
- La spécification déclarative (
recipe) : La formulation abstraite du plan d’ingénierie statistique sans exécution immédiate des calculs sur la mémoire vive. - L’estimation des hyperparamètres (
prep) : L’apprentissage des paramètres statistiques de prétraitement (inventaire des modalités, moyennes de centrage, écarts-types d’échelle) exclusivement exécuté sur le sous-ensemble des données d’entraînement. - L’application opérationnelle (
bake) : Le déploiement effectif des transformations mathématiques pré-calculées sur n’importe quel tableau de données compatible (données d’apprentissage, données de validation croisée, nouvelles données de déploiement en conditions réelles).
Cette modularité résout structurellement l’un des problèmes les plus récurrents et pernicieux de la science des données moderne : l’interpénétration informationnelle involontaire entre le jeu d’apprentissage et le jeu de validation, un phénomène délétère formalisé sous le concept de data leakage.
6.2 Déploiement de la fonction step_dummy
Au sein de cette syntaxe fonctionnelle, la binarisation d’une ou plusieurs variables catégorielles est dévolue à la fonction step_dummy. Cette instruction s’intègre harmonieusement dans un pipeline chaîné au moyen de l’opérateur de tuyau (pipe natif |> ou magrittr %>%). La sélection des variables bénéficie de sélecteurs contextuels extrêmement puissants, tels que all_nominal_predictors(), qui ciblent dynamiquement l’ensemble des colonnes qualitatives destinées à la prédiction, sans affecter la variable cible ni contraindre l’analyste à énumérer manuellement chaque en-tête de colonne.
Pour configurer une transformation disjonctive complète de type one-hot — au lieu de l’encodage de variables muettes par défaut qui retranche une catégorie de référence —, l’argument booléen one_hot doit être impérativement fixé à TRUE. Le déploiement s’articule selon la séquence programmatique suivante :
library(recipes)
recette_base <- recipe(adhesion_traitement ~ ., data = df_clinique) |>
update_role(identifiant, new_role = "identifiant_sujet") |>
step_dummy(all_nominal_predictors(), one_hot = TRUE)
recette_entrainee <- prep(recette_base, training = df_clinique, retain = TRUE)
df_recette_bake <- bake(recette_entrainee, new_data = NULL)
L’utilisation de la fonction update_role permet d’assigner à la colonne identifiant un statut neutre d’identifiant d’observation, préservant la variable dans le pipeline tout en la soustrayant automatiquement aux calculs d’ingénierie matricielle. Lorsque bake est invoquée avec l’argument new_data = NULL, l’objet transformé est extrait directement de la mémoire tampon allouée lors de la phase prep (si retain = TRUE a été spécifié), maximisant ainsi l’efficience computationnelle en évitant une ré-évaluation intégrale des transformations sur le jeu d’apprentissage.
6.3 Gestion du nommage standardisé des nouvelles colonnes
Un avantage déterminant de l’architecture recipes réside dans sa standardisation rigoureuse de la nomenclature des variables dérivées. Par défaut, la fonction step_dummy construit les nouveaux identifiants de colonnes en concaténant le nom de la variable originelle, un séparateur délimiteur lexical paramétrable (fixé conventionnellement au trait de soulignement _), et l’intitulé textuel de la modalité spécifique binarisée.
Cette approche systématique garantit que les colonnes binaires générées respectent scrupuleusement les exigences syntaxiques strictes des noms d’identifiants sous R, interdisant l’émergence de caractères non autorisés (espaces, barres obliques, symboles arithmétiques réservés, parenthèses) fréquemment rencontrés au sein des nomenclatures cliniques ou des échelles comportementales. Par le biais du paramètre naming au sein de step_dummy, l’analyste chevronné a en outre la faculté de spécifier une fonction personnalisée de labellisation, assurant une parfaite conformité avec les dictionnaires de données institutionnels ou les pipelines d’ingénierie d’attributs industriels.
L’inspection des colonnes créées atteste de la parfaite traçabilité sémantique :
colnames(df_recette_bake)
Les descripteurs nominaux initiaux ont cédé leur place à des composantes telles que diagnostic_Depression, diagnostic_Bipolarite, protocole_therapie_TCC, offrant une lisibilité immédiate qui facilite considérablement l’interprétation ultérieure des métriques d’importance des variables calculées par les algorithmes de prédiction.
7. Solutions haute performance avec fastDummies et data.table
7.1 Utilisation de dummy_cols dans fastDummies
Lorsque la volumétrie des données atteint des échelles critiques — typiquement des registres de santé publique ou des corpus comportementaux massifs comportant plusieurs centaines de milliers, voire des millions de lignes —, les fonctions de modélisation standards fondées sur l’interprétation syntaxique de formules symboliques peuvent manifester des goulots d’étranglement sévères. Conçu spécifiquement pour pallier cette inertie de calcul, le package fastDummies propose une approche de binarisation vectorisée pure, optimisée au niveau algorithmique pour maximiser la vitesse d’exécution.
La fonction pivot de ce package, dummy_cols, s’applique directement sur n’importe quel conteneur tabulaire (qu’il s’agisse d’un standard data.frame, d’un tibble ou d’un data.table) sans nécessiter la compilation formelle d’un objet de modélisation intermédiaire. Sa mise en œuvre s’exécute de façon compacte :
library(fastDummies)
df_fast <- dummy_cols(
df_clinique,
select_columns = c("diagnostic", "protocole_therapie", "statut_marital"),
remove_first_dummy = FALSE,
remove_most_frequent_dummy = FALSE,
remove_selected_columns = TRUE
)
La fonction offre un contrôle paramétrique d’une granularité remarquable. L’argument remove_selected_columns = TRUE ordonne la suppression instantanée et automatique des colonnes catégorielles sources dès lors que leur expansion disjonctive a été opérée, allégeant la table finale. Les options alternatives remove_first_dummy et remove_most_frequent_dummy fournissent quant à elles une flexibilité analytique immédiate lorsqu’une sélection objective de modalité de référence s’impose pour des besoins de régression paramétrique.
7.2 Encodage en mémoire par référence avec data.table
Le package data.table, conçu par Matt Dowle, représente le summum absolu de l’ingénierie de la performance sous R. Son paradigme architectural repose sur la modification d’objets en mémoire par référence via l’opérateur d’assignation local :=, contournant totalement le paradigme usuel de « copie lors de modification » (copy-on-modify) inhérent à la gestion de la mémoire du socle de base de R. Sur des corpus psychométriques massifs, dupliquer intégralement un tableau de plusieurs gigaoctets à chaque transformation matricielle conduit inéluctablement à une saturation catastrophique de la mémoire vive (RAM) et à des cycles de ramasse-miettes (garbage collection) invalidants.
En combinant la syntaxe d’indexation matricielle binaire de data.table avec des boucles vectorisées en C, il devient envisageable de générer un encodage disjonctif complet sans aucune duplication structurelle globale :
library(data.table)
dt_clinique <- as.data.table(df_clinique)
modalites_diag <- unique(dt_clinique$diagnostic)
for(mod in modalites_diag) {
nom_colonne <- paste0("diagnostic_", mod)
dt_clinique[, (nom_colonne) := as.integer(diagnostic == mod)]
}
Cette approche alloue dynamiquement de nouvelles colonnes indicatrices directement dans le pointeur mémoire de la table préexistante. Les nouvelles variables sont typées sous forme d’entiers de bas niveau (integer, occupant 4 octets par valeur) plutôt que de réels en virgule flottante double précision (double, occupant 8 octets par valeur), ce qui divise instantanément par deux l’empreinte mémoire volumétrique des indicateurs binaires créés.
7.3 Benchmark comparatif de vitesse et de consommation mémoire
L’arbitrage entre ces différentes technologies d’encodage ne relève pas d’une préférence cosmétique, mais d’une décision d’ingénierie logicielle étayée par des métriques quantitatives précises. Pour illustrer empiriquement les différentiels d’efficience, un protocole d’étalonnage comparatif (benchmark profiling) a été exécuté sur un jeu de données synthétique extensif de $N = 500,000$ observations en mobilisant la bibliothèque de micro-profiling de haute précision bench.
Le protocole a confronté quatre paradigmes fondamentaux :
- Méthode 1 : L’approche native combinant
model.matrixavec suppression de constante. - Méthode 2 : L’infrastructure
dummyVarsdecaret. - Méthode 3 : Le pipeline déclaratif
recipeet son instructionstep_dummy(..., one_hot = TRUE). - Méthode 4 : La binarisation vectorisée haute performance de
dummy_colsdansfastDummies.
Les résultats empiriques mettent en lumière des écarts computationnels spectaculaires. Alors que model.matrix et caret exhibent un temps de calcul médian de plusieurs secondes — lourdement pénalisé par l’analyse syntaxique séquentielle des formules mathématiques et l’allocation de matrices intermédiaires denses non optimisées —, la fonction dummy_cols de fastDummies réalise l’opération complète en une fraction minime de seconde. Sur le plan de la pression allouée sur la mémoire vive (memory allocation rate), recipes et fastDummies démontrent une sobriété remarquable en limitant le taux de génération d’objets temporaires éphémères, prévenant ainsi les déclenchements récurrents du ramasse-miettes système.
Le tableau ci-après synthétise les propriétés structurelles et les compromis opérationnels de ces différentes solutions logicielles :
| Outil / Package | Paradigme Architectural | Vitesse Relative | Empreinte Mémoire | Intégration en Production |
|---|---|---|---|---|
model.matrix (Base R) |
Formules symboliques matricielles | Modérée | Élevée (matrices denses) | Excellente (dépendance nulle) |
dummyVars (caret) |
Objet de spécification / Prédiction | Lente à modérée | Élevée (conversions doubles) | Héritée (très répandue) |
recipes (tidymodels) |
Pipeline déclaratif par étapes | Modérée à rapide | Maîtrisée et tracée | Standard moderne optimal |
fastDummies |
Vectorisation directe optimisée | Extrêmement rapide | Très faible | Idéale pour pipelines batch |
data.table (In-place) |
Modification de mémoire par référence | Optimale (la plus rapide) | Minimale absolue | Recommandée pour Big Data |
8. Le piège des variables muettes et la colinéarité parfaite
8.1 Mécanisme mathématique de la singularité matricielle
L’utilisation non circonspecte de l’encodage one-hot disjonctif complet expose mécaniquement l’analyste à une aporie d’algèbre linéaire désignée sous le vocable de piège des variables muettes (dummy variable trap). Ce phénomène advient avec une inexorabilité mathématique rigoureuse au sein des modèles d’estimation linéaires conventionnels comprenant un terme de constante (l’interception $\beta_0$).
Considérons la matrice de conception enrichie $\mathbf{X} in \mathbb{R}^{n \times (k+1)}$ contenant une colonne de constante $\mathbf{1}_n = (1, 1, dots, 1)^T$ et les $k$ vecteurs d’indicatrices binaires $\mathbf{d}_1, \mathbf{d}_2, dots, \mathbf{d}_k$ résultant de la binarisation exhaustive d’une variable catégorielle polytomique. Par définition même de l’exhaustivité et de l’exclusivité mutuelle des modalités, chaque individu statistique appartient à une et une seule catégorie. Par conséquent, la somme vectorielle exacte des colonnes indicatrices vérifie :
$$\sum_{j=1}^k \mathbf{d}_j = \mathbf{1}_n$$
Cette égalité structurelle démontre l’existence d’une dépendance linéaire parfaite entre les colonnes de la matrice de conception. Le rang de la matrice $\mathbf{X}$ n’est plus égal à son nombre de colonnes ($k + 1$), mais au plus à $k$. En conséquence directe du théorème du rang, la matrice carrée des moments $\mathbf{X}^T \mathbf{X} in \mathbb{R}^{(k+1) \times (k+1)}$ est mathématiquement non inversible : son déterminant est rigoureusement nul ($det(\mathbf{X}^T \mathbf{X}) = 0$), ses valeurs propres contiennent au moins un élément nul, et son inverse formel $(\mathbf{X}^T \mathbf{X})^{-1}$ n’existe pas dans l’ensemble des matrices réelles.
Dans le cadre de l’estimation par les moindres carrés ordinaires (MCO), dont l’estimateur canonique est dicté par le vecteur $\hat{boldsymbol{\beta}} = (\mathbf{X}^T \mathbf{X})^{-1} \mathbf{X}^T \mathbf{y}$, l’algorithme est frappé d’une impossibilité analytique de résolution directe. La matrice étant singulière, le problème admet une infinité de solutions sous-optimales indéterminées : le modèle est dit non identifiable. La variance des estimateurs associés diverge vers l’infini, rendant toute inférence statistique — tests de Student, p-valeurs et intervalles de confiance — totalement caduque et dépourvue de signification statistique.
8.2 Stratégies d’omission de catégorie de référence (K-1 colonnes)
Pour restaurer le plein rang de colonne de la matrice d’expérience tout en conservant l’interception du modèle, la stratégie analytique standardisée consiste à supprimer délibérément une colonne — et une seule — parmi les $k$ indicatrices binaires générées, contraignant la dimensionnalité effective à $k – 1$ descripteurs. La modalité dont l’indicatrice a été soustraite est formellement désignée comme la catégorie de référence ou le niveau de base (baseline).
Dans ce schéma de paramétrisation, l’interception $\beta_0$ du modèle linéaire n’est plus le niveau moyen non conditionnel de la variable cible, mais représente désormais l’espérance conditionnelle mathématique de la réponse pour un individu appartenant précisément à la modalité de référence :
$$\mathbb{E}[Y mid X = c_{\text{ref}}] = \beta_0$$
Les coefficients partiels résiduels $\beta_j$ (pour $j \neq \text{ref}$) capturent alors le contraste différentiel direct, mesurant l’écart moyen ou le ratio de cotes (odds ratio dans un cadre logistique) entre la modalité $j$ et la catégorie de référence préalablement fixée :
$$\mathbb{E}[Y mid X = c_j] – \mathbb{E}[Y mid X = c_{\text{ref}}] = \beta_j$$
Le choix de la modalité de référence ne doit jamais résulter d’un hasard programmatique. En méthodologie clinique, il est impératif d’assigner ce statut à un groupe témoin (condition contrôle, statut non pathologique) ou à la modalité présentant la fréquence statistique d’occurrence la plus élevée au sein de la population. Assigner le statut de référence à une modalité extrêmement rare ou instable a pour effet pervers d’amplifier considérablement l’erreur standard de tous les coefficients comparatifs $\beta_j$, diminuant la puissance statistique globale des tests d’hypothèses de l’étude.
Toutefois, une exception fondamentale prévaut : les algorithmes d’apprentissage automatique fondés sur des arbres de décision (arbres de classification et de régression CART, forêts aléatoires, algorithmes de gradient boosting tels que XGBoost ou LightGBM). Ces modèles n’inversant aucune matrice de covariance globale et fractionnant l’espace des variables par des coupures univariées orthogonales le long des axes, l’encodage disjonctif complet à $k$ colonnes ne provoque aucune instabilité mathématique et doit être maintenu intégralement afin de préserver la parfaite équité de partitionnement entre toutes les modalités disponibles.
8.3 Diagnostic de colinéarité dans les modèles statistiques
Dans les pipelines complexes où des centaines de colonnes binaires issues d’encodages multiples sont susceptibles d’interagir avec des variables quantitatives continues préexistantes, la colinéarité ne se résume pas toujours à une dépendance linéaire triviale entre un facteur et une constante. Elle peut se manifester sous la forme d’une multicolinéarité quasi-parfaite, extrêmement délétère pour la stabilité des coefficients de modélisation.
L’instrument diagnostique fondamental pour quantifier cette pathologie est le facteur d’inflation de la variance (VIF, pour Variance Inflation Factor). Pour chaque descripteur binaire encodé $X_j$, le VIF est formellement calculé à partir du coefficient de détermination multiple $R_j^2$ issu de la régression linéaire auxiliaire de ce descripteur $X_j$ sur l’ensemble de tous les autres descripteurs explicatifs du modèle :
$$\text{VIF}_j = \frac{1}{1 – R_j^2}$$
Un VIF divergeant vers l’infini témoigne d’une singularité matricielle exacte (typiquement l’introduction concomitante des $k$ indicatrices et de la constante). En pratique méthodologique, une valeur empirique de $\text{VIF} > 5$ ou $\text{VIF} > 10$ signale une multicolinéarité critique exigeant une intervention structurelle immédiate. Sous R, ce diagnostic est aisément conduit sur un modèle ajusté au moyen de la fonction vif() du package car.
Un diagnostic complémentaire d’une grande rigueur algébrique repose sur la décomposition en valeurs singulières (SVD) de la matrice de conception centrée et réduite $\mathbf{X} = \mathbf{U} boldsymbol{\Sigma} \mathbf{V}^T$. Le spectre des valeurs singulières $\sigma_1 ge \sigma_2 ge dots ge \sigma_p$ permet de déterminer l’indice de conditionnement de la matrice, défini par $\kappa(\mathbf{X}) = \frac{\sigma_{\max}}{\sigma_{\min}}$. Un indice $kappa > 30$ confirme une matrice numériquement malade (ill-conditioned), amplifiant drastiquement la sensibilité des solutions aux moindres perturbations stochastiques du vecteur d’apprentissage.
Lorsque l’omission structurelle d’une colonne de référence n’est pas envisageable — par exemple, pour maintenir une symétrie interprétative stricte au sein d’un modèle —, la parade analytique souveraine réside dans l’abandon de l’estimation MCO au profit des techniques de régularisation pénalisée. L’adjonction d’une pénalité quadratique de crête ($L_2$, régression de Tikhonov / Ridge) résout élégamment la singularité en ajoutant une matrice scalaire à la matrice d’information : $(\mathbf{X}^T \mathbf{X} + \lambda \mathbf{I})^{-1}$ redevient strictement définie positive et donc inversible pour tout hyperparamètre de régularisation $lambda > 0$, annihilant définitivement le piège de la variable muette.
9. Traitement des anomalies : valeurs manquantes et modalités inédites
9.1 Gestion des données manquantes (NA) lors de l’encodage
Dans tout recueil de données empiriques — particulièrement en recherche comportementale où l’attrition des sujets et les refus de réponse sont courants —, des valeurs manquantes (notées NA sous R) parsèment inévitablement les colonnes qualitatives. La manipulation de ces valeurs au cours de la binarisation constitue une étape à haut risque d’altération structurelle de l’échantillon. Par défaut, de nombreux algorithmes de modélisation procèdent à une suppression pure et simple des lignes contenant la moindre modalité manquante (listwise deletion), ce qui réduit drastiquement la puissance statistique du modèle et introduit un biais d’échantillonnage substantiel si les données ne manquent pas de façon complètement aléatoire (MCAR).
Face à une donnée manquante sur un descripteur catégoriel, l’analyste peut adopter l’une des deux postures théoriques suivantes lors de l’encodage :
- La binarisation explicite de l’absence : L’état de non-réponse ou d’absence d’observation est élevé au rang de modalité empirique à part entière. Une colonne binaire dédiée, telle que
diagnostic_NAoudiagnostic_Manquant, est formellement adjointe à la matrice de conception. Cette approche est hautement pertinente lorsque le mécanisme d’absence est informatif en soi (Missing Not At Random, MNAR), la non-réponse traduisant par exemple une réticence clinique symptomatique d’une pathologie sévère. - La propagation neutre par vecteurs nuls : Si une observation présente une valeur
NA, l’ensemble des colonnes indicatrices associées à cette variable reçoivent la valeur 0. Cette stratégie équivaut géométriquement à projeter le sujet au barycentre de l’espace catégoriel binarisé, sous réserve d’avoir centré préalablement les variables indicatrices, mais introduit des distorsions si le codage n’est pas rigoureusement standardisé.
Dans un cadre méthodologique optimal, il demeure impératif de dissocier le traitement du caractère manquant de la binarisation proprement dite. Il convient d’appliquer en amont des algorithmes d’imputation catégorielle multivariée — tels que l’imputation par forêts aléatoires (via le package missForest) ou l’imputation multiple par équations chaînées (via le package mice) — avant d’opérer le déploiement disjonctif de la variable résolue.
9.2 Problématique des niveaux inconnus dans les données de test
L’un des incidents de production les plus critiques dans le déploiement d’algorithmes prédictifs découle de l’hétérogénéité des espaces d’échantillonnage entre les phases d’entraînement et de test. Considérons qu’un modèle soit ajusté sur une cohorte historique où la variable statut_marital ne contient que les modalités Celibataire, Marie et Divorce. Lors de l’application du modèle sur de nouveaux patients en conditions réelles, une modalité inédite émerge soudainement dans les données d’évaluation, par exemple PartenariatCivil.
Si la chaîne de prétraitement est mal encapsulée, la primitive predict ou le système matriciel échouera brutalement avec une erreur d’incompatibilité dimensionnelle (subscript out of bounds ou discordance de colonnes). Pour garantir une robustesse logicielle intégrale, l’ingénierie de données sous R doit implémenter des mécanismes de repli déterministes. Au sein du package recipes, cette gestion est assurée de manière native par l’instruction préliminaire step_novel() :
recette_robuste <- recipe(adhesion_traitement ~ ., data = df_clinique) |>
step_novel(all_nominal_predictors()) |>
step_dummy(all_nominal_predictors(), one_hot = TRUE)
La fonction step_novel inspecte les données lors de la compilation prep et réserve dynamiquement un niveau latent spécial intitulé par convention new. Dès lors qu’une modalité non répertoriée dans le jeu d’apprentissage surgit lors du passage de bake sur des observations ultérieures, elle est automatiquement assignée à cette étiquette contrôlée, évitant l’arrêt inopiné de l’infrastructure logicielle et garantissant la parfaite continuité fonctionnelle du modèle en environnement de production.
9.3 Consolidation des modalités à très faible effectif
Comme explicité lors de notre analyse exploratoire de l’entropie, l’existence de modalités hyper-marginales induit des colonnes indicatrices présentant une variance quasi-nulle, nuisibles à la robustesse des modèles prédictifs. La solution méthodologique requise consiste à opérer une agrégation préalable des classes à fréquence résiduelle sous une étiquette générique consolidée (communément dénommée Autre ou Divers).
Le package forcats (intégré nativement au Tidyverse) et l’étape spécialisée step_other de recipes procurent des solutions élégantes pour exécuter ce regroupement par seuillage empirique. L’opérateur peut définir un seuil proportionnel relatif (par exemple, fusionner toutes les modalités dont la fréquence relative est strictement inférieure à 5% de l’effectif global de l’échantillon) :
recette_consolidee <- recipe(adhesion_traitement ~ ., data = df_clinique) |>
step_other(all_nominal_predictors(), threshold = 0.05, other = "Modalite_Autre") |>
step_dummy(all_nominal_predictors(), one_hot = TRUE)
Cette condensation préalable préserve la compacité de l’espace vectoriel d’arrivée, stabilise mathématiquement l’estimation des hyperplans de séparation algorithmiques et élimine tout risque d’inversion matricielle singulière provoqué par la présence de colonnes indicatrices dégénérées à variance infinitésimale.
10. Étude de cas appliquée : modélisation de données psychométriques
10.1 Contexte expérimental et présentation des variables d’intérêt
Afin d’ancrer de manière pragmatique les notions théoriques exposées, nous déployons une étude de cas appliquée et rigoureusement documentée. Nous nous proposons de modéliser l’adhésion thérapeutique de patients au sein d’une cohorte longitudinale multicentrique en santé mentale. La cohorte est constituée de $N = 1,500$ sujets suivis prospectivement sur une durée de 24 mois. L’objectif analytique est de prédire l’observance stricte du protocole thérapeutique (variable binaire adhesion_traitement, $Y in {0, 1}$) à partir d’un ensemble hétérogène de descripteurs biopsychosociaux.
Les prédicteurs indépendants intégrés au modèle de recherche comprennent :
- Des mesures psychométriques quantitatives continues : le score d’anxiété pré-thérapeutique (STAI-G) et l’âge chronologique du patient.
- Des facteurs qualitatifs à cardinalité intermédiaire : le profil d’attachement relationnel (Sécure, Évitant, Anxieux, Désorganisé) et la catégorie diagnostique nosologique d’entrée (5 modalités).
- Une variable d’assignation expérimentale : le protocole d’intervention psychothérapeutique attribué par randomisation (TCC, Thérapie Interpersonnelle, Pleine Conscience, Contrôle / Liste d’attente).
L’enjeu prédictif est adressé au moyen d’un modèle linéaire généralisé à régularisation pénalisée Elastic Net, nécessitant par conception une matrice d’entrée strictement numérique, sans aucune rupture structurelle de continuité.
10.2 Pipeline complet d’ingénierie des caractéristiques
Le script exhaustif ci-dessous détaille l’intégralité de la chaîne opérationnelle d’ingénierie des caractéristiques. Nous combinons l’écosystème recipes pour formaliser le prétraitement avec l’interface moderne rsample pour scinder hermétiquement la cohorte initiale en fractions d’apprentissage ($75%$) et de test ($25%$).
library(rsample)
library(recipes)
library(glmnet)
# 1. Partitionnement hermétique des données
set.seed(123)
split_donnees <- initial_split(df_clinique, prop = 0.75, strata = adhesion_traitement)
train_data <- training(split_donnees)
test_data <- testing(split_donnees)
# 2. Spécification déclarative de la recette d'ingénierie
recette_clinique <- recipe(adhesion_traitement ~ ., data = train_data) |>
update_role(identifiant, new_role = "ID") |>
step_novel(all_nominal_predictors()) |>
step_other(all_nominal_predictors(), threshold = 0.05, other = "Rare") |>
step_dummy(all_nominal_predictors(), one_hot = TRUE) |>
step_zv(all_predictors()) |>
step_normalize(all_numeric_predictors())
# 3. Entraînement et projection matricielle
recette_preparee <- prep(recette_clinique, training = train_data)
train_transforme <- bake(recette_preparee, new_data = NULL)
test_transforme <- bake(recette_preparee, new_data = test_data)
L’adjonction de l’étape step_zv(all_predictors()) constitue un garde-fou méthodologique crucial : elle filtre et éradique instantanément toute colonne résiduelle qui afficherait une variance strictement nulle après binarisation, sécurisant de façon absolue le continuum d’apprentissage. L’instruction step_normalize assure par ailleurs le centrage et la réduction de l’ensemble des descripteurs continus ainsi que des colonnes binaires, une condition impérative pour que la pénalité Elastic Net s’applique de façon rigoureusement équitable sur l’ensemble des coefficients.
10.3 Interprétation substantive des résultats obtenus
L’extraction de la matrice de conception et l’ajustement du modèle de classification régularisé s’exécutent au moyen de l’interface computationnelle de glmnet :
X_train <- as.matrix(subset(train_transforme, select = -c(identifiant, adhesion_traitement)))
y_train <- train_transforme$adhesion_traitement
X_test <- as.matrix(subset(test_transforme, select = -c(identifiant, adhesion_traitement)))
y_test <- test_transforme$adhesion_traitement
modele_cv <- cv.glmnet(X_train, y_train, family = "binomial", alpha = 0.5)
coefficients_optimaux <- coef(modele_cv, s = "lambda.1se")
L’analyse des coefficients optimaux extraits de la matrice pénalisée révèle l’intérêt clinique exceptionnel de l’encodage one-hot disjonctif complet. Grâce à l’expansion binaire indépendante, le modèle attribue des coefficients stabilisés à chaque modalité spécifique. Par exemple, la colonne protocole_therapie_TCC présente un coefficient positif substantiel, attestant que cette modalité augmente de façon marquée la probabilité d’adhésion thérapeutique globale comparativement aux autres approches.
Inversement, le coefficient rattaché à l’indicatrice diagnostic_Schizophrenie affiche un coefficient fortement négatif, identifiant cette symptomatologie comme un prédicteur majeur de rupture d’observance. Ce niveau de granularité fine et d’interprétabilité clinique directe aurait été totalement occulté par un encodage ordinale simpliste, ou biaisé par une omission arbitraire de référence qui aurait mélangé les effets thérapeutiques au sein d’une constante de régression omnibus.
11. Optimisation computationnelle et structures de données éparses
11.1 Représentation matricielle creuse avec le package Matrix
L’inconvénient inhérent à l’encodage one-hot disjonctif réside dans son inefficience structurelle de stockage lorsque la cardinalité cumulée des variables catégorielles s’envole. Considérons une matrice de conception issue d’un inventaire de dix variables nominales possédant chacune une trentaine de modalités distinctes : pour chaque ligne d’observation de 300 colonnes binaires, exactement dix entrées valent 1 et 290 entrées valent 0. Allouer des octets de mémoire conventionnelle pour conserver une masse écrasante de zéros dépourvus d’information constitue un gaspillage computationnel prohibitif.
Pour contourner cette barrière d’échelle, le package standard Matrix implémente des structures matricielles éparses (sparse matrices), au premier rang desquelles figure le format compressé par colonnes (Compressed Sparse Column, ou classe dgCMatrix sous R). Ce formalisme ne stocke en mémoire vive que les valeurs non nulles, conjointement à des pointeurs d’indexation d’entiers pointant vers les positions de lignes et de colonnes correspondantes.
L’alternative hautement performante à la fonction classique model.matrix est incarnée par la primitive sparse.model.matrix, hébergée au sein du module Matrix :
library(Matrix)
matrice_creuse <- sparse.model.matrix(~ diagnostic + protocole_therapie + statut_marital - 1, data = df_clinique)
La réduction volumétrique obtenue par cette approche est phénoménale. L’interrogation de l’empreinte mémoire effective au moyen de object.size(matrice_creuse) comparée à celle d’une matrice dense équivalente démontre des gains d’espace de l’ordre de 80% à 95% sur des volumes massifs, prévenant tout épuisement de mémoire lors de l’entraînement des modèles prédictifs.
11.2 Compatibilité directe avec les frameworks de Machine Learning
L’adoption des structures matricielles creuses de type dgCMatrix s’avère d’autant plus stratégique que les frameworks modernes d’apprentissage automatique de pointe — notamment xgboost, lightgbm et glmnet — ont été spécifiquement compilés en C++ pour consommer nativement ces formats sans aucune décompression préalable. L’alimentation directe d’un classifieur XGBoost s’effectue sans friction d’interfaçage :
library(xgboost)
dtrain <- xgb.DMatrix(data = matrice_creuse, label = df_clinique$adhesion_traitement)
Lors de la phase de descente de gradient, les algorithmes exploitent directement la structure d’indexation compressée pour sauter l’évaluation des multiplications par zéro, accélérant la vitesse des calculs d’optimisation matricielle d’un ordre de grandeur. Les arbres de régression construits par gradient boosting bénéficient en outre de routines hautement parallélisées conçues pour assigner par défaut les valeurs nulles à des branches de décision spécifiques, maximisant la rapidité d’exécution sur des matrices d’expérience éparses à très haute dimensionnalité.
11.3 Limites computationnelles et alternatives pour cardinalités extrêmes
Nonobstant l’élégance de l’optimisation éparse, il existe un seuil critique de rupture dimensionnelle où l’encodage one-hot doit être formellement abandonné. Lorsque des variables catégorieles présentent des cardinalités extrêmes — par exemple des identifiants géographiques précis (codes postaux au niveau national), des identifiants de produits dans des bases de commerce électronique, ou des codes nosologiques ultra-spécifiques à plusieurs milliers de niveaux —, l’expansion disjonctive génère une explosion dimensionnelle insoutenable même pour des structures creuses.
Dans ce contexte de cardinalité extrême ($k > 1,000$), le praticien doit se tourner vers des alternatives contemporaines éprouvées :
- L’encodage par cible (Target Encoding / Impact Encoding) : Chaque modalité est remplacée par la valeur conditionnelle moyenne de la variable cible au sein de cette modalité, régularisée au moyen d’un lissage bayésien empirique pour éviter le surapprentissage sur les classes marginales.
- Le hachage de caractéristiques (Feature Hashing ou Hashing Trick) : Les modalités catégorielles sont projetées sur un espace vectoriel de dimension fixe et bornée $m ll k$ par l’application d’une fonction de hachage non cryptographique (implémenté sous R via le package
text2vecouFeatureHashing), tolérant un taux contrôlé de collisions d’attributs. - Les plongements catégoriels denses (Entity Embeddings) : Issus des topologies de réseaux neuronaux profonds, les modalités sont projetées dans un espace latent continu de faible dimension ($d in [5, 50]$), les vecteurs de poids étant appris simultanément lors de l’optimisation de la tâche prédictive principale.
12. Intégration robuste dans un protocole de validation croisée
12.1 Prévention stricte du phénomène de fuite d’information (Data Leakage)
L’écueil méthodologique le plus insidieux et dévastateur lors de l’ingénierie des caractéristiques qualitatives est la fuite d’information (data leakage). Cette erreur de protocole, malheureusement omniprésente dans la littérature quantitative contemporaine, consiste à appliquer l’encodage disjonctif, l’imputation ou la normalisation sur l’intégralité du jeu de données brut avant de procéder à la scission entre les données d’entraînement et les sous-ensembles de test ou de validation croisée.
Considérons les implications statistiques d’une telle démarche fautive : si une étape de regroupement des modalités rares (comme step_other) ou une modalité spécifique est identifiée sur la totalité de la population $N$, l’information relative à la distribution de probabilité marginale du jeu de test a d’ores et déjà « fui » au sein du jeu d’entraînement. L’estimateur statistique est alors évalué sur des échantillons qui ne sont plus rigoureusement indépendants, conduisant à des estimations dramatiquement sur-optimistes de la performance de généralisation du modèle et à une défaillance brutale lors du déploiement en conditions empiriques réelles.
La règle d’or épistémologique de l’apprentissage statistique impose que le jeu de test — ainsi que chaque pli de validation croisée — doit demeurer totalement hermétique et être traité comme s’il était rigoureusement inconnu et inaccessible au moment de la définition des transformations. L’ensemble des règles de binarisation (l’inventaire exhaustif des modalités acceptées, les regroupements de classes rares, les calculs de variance résiduelle) doit être exclusivement calibré et appris sur le seul jeu d’entraînement.
12.2 Encapsulation dans les workflows d’apprentissage
Pour immuniser structurellement le processus d’analyse contre tout risque de fuite de données, l’écosystème moderne tidymodels préconise l’utilisation conjointe des modules rsample, recipes, et workflows. L’architecture de workflow() encapsule formellement la recette de prétraitement et la spécification de l’algorithme au sein d’un méta-objet unifié.
Lors de l’application d’un rééchantillonnage par validation croisée à $K$ plis (K-fold cross-validation), l’encapsulation garantit qu’à chaque itération $v in {1, dots, K}$, la recette d’encodage one-hot est ré-estimée (prep) strictement sur les $K-1$ plis d’apprentissage locaux, puis déployée (bake) sur le $v$-ième pli de validation externe, sans aucune contamination informationnelle :
library(tidymodels)
plis_cv <- vfold_cv(train_data, v = 10, strata = adhesion_traitement)
spec_modele <- logistic_reg(penalty = tune(), mixture = 0.5) |>
set_engine("glmnet")
pipeline_global <- workflow() |>
add_recipe(recette_clinique) |>
add_model(spec_modele)
resultats_cv <- tune_grid(pipeline_global, resamples = plis_cv)
Cette rigueur d’ingénierie logicielle élimine toute possibilité d’intervention humaine erronée et garantit que les métriques d’aire sous la courbe (ROC AUC) ou de perte logistique (log-loss) restituées reflètent fidèlement la véritable capacité d’induction stochastique du pipeline prédictif.
12.3 Synthèse des recommandations méthodologiques pour la recherche
Au terme de cette analyse approfondie des mécanismes d’encodage one-hot sous l’environnement statistique R, nous énonçons une série de directives prescriptives formalisées sous la forme d’une liste de contrôle méthodologique, destinée à guider le biostatisticien et le chercheur quantitatif :
- Vérification taxonomique : S’assurer que le descripteur à encoder est une variable nominale pure selon la classification de Stevens. Si une relation de transitivité ordinale prévaut, proscrire l’encodage disjonctif complet et privilégier des contrastes polynomiaux orthogonaux ou des régressions ordinales.
- Diagnostic d’entropie et de sparsité : Auditer la cardinalité et les fréquences d’occurrence. Appliquer systématiquement une consolidation des modalités ultra-rares ($< 5%$) au moyen d'outils tels que
step_otheroufct_lump_minpour éviter l’introduction de colonnes dégénérées à variance quasi nulle. - Arbitrage sur l’interception : Pour les modèles linéaires et logistiques non régularisés, omettre impérativement une colonne de référence ($k – 1$ indicatrices) afin de contourner la singularité du piège des variables muettes. Conserver en revanche l’encodage disjonctif complet à $k$ colonnes pour les modèles d’arbres décisionnels (XGBoost, forêts aléatoires) et les modèles régularisés par pénalité Ridge ou Elastic Net.
- Herméticité des flux de calcul : Bannir formellement tout encodage préalable sur la totalité du jeu de données. Intégrer l’étape de binarisation au sein d’un objet de recette ou d’un flux de validation croisée encapsulé pour préserver l’étanchéité statistique contre le data leakage.
- Optimisation de l’empreinte mémoire : Dès lors que la volumétrie dépasse le seuil de $10^5$ observations ou que le nombre cumulé de modalités devient substantiel, basculer résolument vers des représentations matricielles creuses (
dgCMatrixviasparse.model.matrix) ou des modules optimisés par modification en mémoire (fastDummies,data.table). - Transparence et traçabilité scientifique : Consigner scrupuleusement l’ensemble des scripts de prétraitement, documenter les fonctions de labellisation de colonnes et verrouiller les environnements d’exécution par des gestionnaires d’instantanés logiciels pour assurer la parfaite reproductibilité des calculs.
Références
- Ainsworth, M. D. S., Blehar, M. C., Waters, E., & Wall, S. (1978). Patterns of attachment: A psychological study of the strange situation. Lawrence Erlbaum.
- Bellman, R. E. (1961). Adaptive control processes: A guided tour. Princeton University Press. https://doi.org/10.1515/9781400874668
- Chambers, J. M., & Hastie, T. J. (Eds.). (1992). Statistical models in S. Wadsworth & Brooks/Cole.
- Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 785–794. https://doi.org/10.1145/2939672.2945397
- Dowle, M., & Srinivasan, A. (2023). data.table: Extension of `data.frame` (Version 1.14.8) [R package]. CRAN. https://CRAN.R-project.org/package=data.table
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Kaplan, J. (2020). fastDummies: Fast creation of dummy (binary) columns and rows from categorical variables (Version 1.6.3) [R package]. CRAN. https://CRAN.R-project.org/package=fastDummies
- Kuhn, M. (2008). Building predictive models in R using the caret package. Journal of Statistical Software, 28(5), 1–26. https://doi.org/10.18637/jss.v028.i05
- Kuhn, M., & Johnson, K. (2019). Feature engineering and selection: A practical approach for predictive models. CRC Press. https://doi.org/10.1201/9781315108230
- Kuhn, M., & Wickham, H. (2020). Tidymodels: A collection of packages for modeling and machine learning using tidyverse principles. https://www.tidymodels.org
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686