
L’inférence statistique constitue le socle méthodologique sur lequel repose la validité des conclusions empiriques en psychologie, en neurosciences cognitives et dans l’ensemble des sciences comportementales. Parmi la diversité des outils d’analyse quantitative, le test t de Student s’est imposé depuis plus d’un siècle comme l’une des procédures fondamentales pour éprouver des hypothèses portant sur des comparaisons de moyennes. Qu’il s’agisse d’évaluer l’efficacité d’une prise en charge psychothérapeutique novatrice, de mesurer le déclin mnésique lié au vieillissement ou de sonder les altérations attentionnelles provoquées par la privation de sommeil, ce modèle paramétrique permet de distinguer avec rigueur les fluctuations purement aléatoires des effets véritablement attribuables aux manipulations expérimentales.
Historiquement circonscrite à des logiciels statistiques dédiés, lourds et onéreux tels qu’IBM SPSS Statistics, SAS ou des environnements de programmation comme le projet R, la pratique de l’analyse inférentielle s’est profondément démocratisée sous l’effet des technologies numériques contemporaines. Les tableurs en ligne, et tout particulièrement Google Sheets, ont atteint un niveau de maturité algorithmique et ergonomique remarquable. Loin d’être de simples registres de comptabilité, ces plateformes infonuagiques intègrent désormais des bibliothèques de fonctions mathématiques capables d’exécuter des calculs matriciels complexes avec une précision numérique conforme aux standards internationaux, facilitant ainsi la transparence et le partage de données au sein de la communauté scientifique.
Le présent traité propose une immersion exhaustive, conceptuelle et pratique, dans l’art et la méthode du test t appliqué au sein de l’environnement Google Sheets. Conçu pour répondre aux exigences académiques les plus strictes des chercheurs, des cliniciens et des étudiants en sciences humaines et sociales, ce guide détaille pas à pas les fondements théoriques, les protocoles de préparation des matrices de données, le choix scrupuleux des variantes du test, ainsi que les stratégies de vérification des postulats distributionnels. En articulant rigueur mathématique et scénarios cliniques concrets, il offre un cadre de référence complet pour convertir des séries de données brutes en inférences scientifiques publiables selon les normes éditoriales de l’American Psychological Association.
1. Introduction théorique aux tests t de Student en psychologie et sciences comportementales
1.1 Origine historique et pertinence pour la recherche quantitative
L’émergence du test t s’enracine dans un problème éminemment appliqué survenu au tout début du XXe siècle au sein de la brasserie Guinness à Dublin. Le chimiste et mathématicien britannique William Sealy Gosset, confronté à la nécessité d’évaluer la qualité de matières premières agricoles sur des échantillons particulièrement restreints d’orge, réalisa que les lois statistiques normales usuelles fondées sur les grands nombres conduisaient à des erreurs systématiques d’inférence. La variance de la population étant inconnue et estimée à partir de faibles volumes d’observations, l’incertitude pesant sur l’écart-type d’échantillon gonflait le risque d’erreur de jugement. En 1908, sous le pseudonyme académique de « Student », Gosset publia dans la revue Biometrika la dérivation de la distribution t, comblant le fossé séparant les mathématiques pures de la variabilité biologique réelle.
En sciences comportementales et en psychologie, cette percée théorique a acquis une valeur matricielle. Contrairement aux sciences de la matière où certaines variables peuvent être isolées dans des environnements sous vide quasi parfaits, la psychométrie et la recherche cognitive opèrent sur un matériau fondamentalement bruité : l’être humain. La variabilité inter-individuelle, nourrie par des facteurs génétiques, développementaux, affectifs et contextuels, implique que deux participants soumis au même paradigme expérimental produiront rarement des performances identiques. Le défi consiste dès lors à déterminer si la différence observée entre deux conditions relève d’une fluctuation d’échantillonnage aléatoire ou si elle reflète un phénomène cognitif reproductible.
Les plans d’expérience en psychologie clinique et cognitive s’articulent fréquemment autour d’échantillons de taille modeste, contraints par la rareté de certaines pathologies neurologiques, la lourdeur d’administration de bilans neuropsychologiques exhaustifs ou le coût financier associé à l’imagerie par résonance magnétique fonctionnelle. Dans ces contextes expérimentaux rigoureux, le test t offre une balance idéale entre puissance statistique et tolérance aux contraintes logistiques du terrain de recherche, devenant l’instrument par excellence de l’épistémologie inférentielle.
1.2 Typologie tripartite des tests de Student
La taxonomie canonique des tests t de Student s’articule autour de trois configurations méthodologiques distinctes, chacune répondant à une architecture expérimentale singulière et à un modèle d’échantillonnage spécifique. L’analyste doit impérativement identifier le paradigme sous-jacent avant d’exécuter la moindre opération de calcul dans son tableur, sous peine de commettre une erreur de modélisation disqualifiant l’ensemble de ses déductions.
La première configuration est le test t à échantillon unique, conçu pour confronter la moyenne observée au sein d’un groupe d’étude unique à une valeur de référence préexistante, fixe et invariante. En psychométrie, ce point d’ancrage correspond le plus souvent à un étalonnage normatif populationnel documenté dans les manuels de tests standardisés, à un score seuil de dysfonctionnement psychopathologique ou à un niveau de performance théorique prédéfini par le modèle cognitif sous-jacent (par exemple, un niveau de performance au hasard sur une tâche à choix forcé).
La deuxième modalité concerne le test t pour deux échantillons indépendants, couramment mobilisé dans les paradigmes inter-sujets (between-subjects designs). Dans ce devis de recherche, chaque participant est assigné de façon exclusive et mutuellement hermétique à un niveau unique de la variable indépendante catégorielle. C’est le format classique des essais contrôlés randomisés opposant un groupe expérimental recevant un protocole thérapeutique novateur à un groupe témoin recevant un placébo ou une intervention standard de comparaison.
Enfin, la troisième structure correspond au test t pour échantillons appariés, dédié aux protocoles intra-sujets (within-subjects designs) et aux mesures répétées dans le temps. Dans cette modalité, les mêmes individus sont évalués à plusieurs reprises (par exemple en phase pré-interventionnelle T1 puis en phase post-interventionnelle T2), ou bien chaque participant de la cohorte expérimentale est minutieusement jumelé à un sujet de contrôle présentant des caractéristiques sociodémographiques ou physiologiques rigoureusement identiques (appariement sur l’âge, le quotient intellectuel ou le niveau d’éducation). Ce schéma expérimental réduit drastiquement la variance d’erreur en isolant les variations inter-individuelles stables.
1.3 Pertinence de Google Sheets pour l’analyse statistique académique
L’utilisation d’une solution infonuagique comme Google Sheets au sein d’un laboratoire de recherche ou d’un service hospitalier universitaire soulève régulièrement des interrogations quant à sa légitimité scientifique face aux environnements d’analyse spécialisés. Cependant, une analyse objective de ses caractéristiques logicielles révèle des atouts considérables pour la recherche quantitative contemporaine. Le premier réside dans son accessibilité universelle et immédiate. Dépourvu de barrières financières de licence et ne requérant aucune installation locale complexe, Google Sheets permet de standardiser les chaînes de traitement analytique entre des équipes géographiquement éclatées, facilitant l’inclusion d’étudiants, d’assistants de recherche et de collaborateurs internationaux sans friction logicielle.
Le second avantage réside dans la collaboration en temps réel et la traçabilité des données. Le travail scientifique moderne est intrinsèquement collectif ; la capacité offerte par Google Sheets d’éditer, de commenter et d’auditer l’historique complet des versions d’une feuille d’analyse constitue un rempart redoutable contre les erreurs de manipulation humaine et favorise les exigences actuelles de la science ouverte (Open Science). Chaque calcul intermédiaire peut être exposé, annoté et décomposé de manière transparente, limitant l’effet de « boîte noire » que génèrent parfois les interfaces utilisateur graphiques des logiciels statistiques conventionnels.
Sur le plan métrologique et mathématique, le moteur de calcul de Google Sheets exécute ses opérations arithmétiques selon la norme IEEE 754 pour les nombres à virgule flottante en double précision (64 bits). Cette architecture technique garantit une résolution numérique atteignant 15 à 17 chiffres significatifs, éliminant tout risque d’imprécision calculatoire lors de l’estimation des sommes de carrés, des variances combinées ou des intégrales de densités de probabilité de la distribution t. Les algorithmes sous-jacents aux fonctions statistiques natives de Google Sheets fournissent ainsi des résultats strictement superposables à ceux délivrés par les moteurs de calcul de R ou de SPSS, attestant de son entière fiabilité scientifique.
2. Fondements statistiques et conditions préalables à l’inférence paramétrique
2.1 Postulat de normalité distributionnelle
Le test t de Student appartient à la famille des statistiques paramétriques, ce qui implique que son modèle formel repose sur la prémisse fondamentale que les données observées au sein de la population cible se distribuent selon une fonction de densité de probabilité gaussienne, ou loi normale. Graphiquement matérialisée par la célèbre courbe en cloche symétrique, cette distribution implique que la vaste majorité des observations se concentre étroitement autour de la tendance centrale, tandis que les valeurs déviantes se raréfient symétriquement et exponentiellement à mesure que l’on s’éloigne de l’espérance mathématique.
La sensibilité du test t aux transgressions de cette condition de normalité dépend au premier chef du volume de l’échantillon collecté. Dans les protocoles cliniques où les effectifs sont étroits (typiquement N < 30 participants par condition), des asymétries prononcées (skewness) ou des aplatissements anormaux marqués par des queues de distribution excessivement lourdes (kurtosis) peuvent distordre de façon dramatique l’estimation de l’erreur type. Cette déformation entraîne un biais direct sur la statistique t empirique, compromettant l’exactitude de la valeur p calculée et augmentant le risque d’aboutir à des inférences totalement erronées quant à l’existence d’un effet cognitif ou comportemental.
Néanmoins, l’inférence paramétrique bénéficie d’une assise mathématique d’une puissance considérable : le théorème central limite (TCL). Ce principe fondamental démontre que, pourvu que la taille de l’échantillon soit suffisamment vaste (généralement admise dès que N franchit le seuil conventionnel de 30 observations par groupe), la distribution d’échantillonnage de la moyenne tend inéluctablement vers la normalité, et ce, quelle que soit la forme intrinsèque de la distribution de la variable au niveau de la population d’origine. Cette propriété confère au test t une robustesse remarquable face aux déviations modérées de la normalité dès que les cohortes atteignent des volumétries moyennes ou élevées.
2.2 Homoscédasticité et indépendance des observations
Au-delà de la forme distributionnelle, le modèle classique du test t pour deux échantillons indépendants postule l’égalité stricte des variances populationnelles au sein de chaque groupe expérimental, une condition technique désignée sous le terme d’homoscédasticité (ou homogénéité de la variance). Mathématiquement, ce principe exige que sigma-carré du premier groupe soit statistiquement équivalent à sigma-carré du second. Lorsque cette hypothèse d’homogénéité est vérifiée, l’estimation conjointe de la variance résiduelle au moyen de la variance combinée (pooled variance) est exempte de biais et optimise la puissance de l’inférence.
À l’inverse, en situation d’hétéroscédasticité — lorsque les groupes affichent des variances substantiellement divergentes —, la statistique t classique calculée selon l’algorithme historique de Student devient profondément dysfonctionnelle. Ce phénomène s’avère particulièrement toxique pour la validité interne lorsque les tailles d’échantillons sont asymétriques. Si le groupe présentant la variance la plus forte est également celui dont la taille est la plus restreinte, le test t standard sous-estime systématiquement l’erreur type, gonflant artificiellement le taux d’erreur de première espèce (rejet intempestif de l’hypothèse nulle en l’absence de tout effet réel). Si la relation s’inverse, le test devient ultra-conservateur, érodant la puissance statistique et générant une inflation de l’erreur de deuxième espèce.
Enfin, le troisième pilier axiomatique repose sur l’indépendance absolue des observations au sein des groupes d’échantillons indépendants. Cette contrainte méthodologique impose que le score obtenu par un participant donné ne soit, d’aucune manière, influencé ou prédit par le score d’un autre sujet. L’indépendance est principalement garantie par la rigueur du protocole d’échantillonnage probabiliste, l’absence de contamination inter-sujets (par exemple, des participants qui communiqueraient entre eux durant une tâche cognitive) et la randomisation minutieuse des assignations de groupe.
2.3 Formulation des hypothèses statistiques et seuils décisionnels
L’acte d’inférence statistique fréquentiste s’articule impérativement autour d’une mise en concurrence binaire et probabiliste entre deux assertions théoriques exclusives : l’hypothèse nulle (H0) et l’hypothèse alternative (H1). L’hypothèse nulle incarne le statut quo scientifique ; elle postule formellement que la différence mathématique entre les paramètres de moyennes des populations sous-jacentes est strictement égale à zéro (mu1 – mu2 = 0 dans un paradigme à deux groupes, ou mu = mu0 dans un paradigme à groupe unique). Sous H0, toute divergence numérique constatée dans les matrices d’échantillons n’est que l’expression d’un bruit stochastique imputable à l’échantillonnage aléatoire.
L’hypothèse alternative (H1), quant à elle, stipule l’existence d’une différence systématique non nulle. Elle peut être formulée selon deux perspectives épistémologiques distinctes. D’une part, l’hypothèse non directionnelle (bilatérale ou two-tailed) postule simplement que les moyennes sont inégales (mu1 différent de mu2), sans préjuger du sens du différentiel, répartissant le risque d’erreur de façon symétrique sur les deux extrémités de la distribution théorique. D’autre part, l’hypothèse directionnelle (unilatérale ou one-tailed) avance de manière prédéterminée le sens du gradient cognitif ou clinique attendu (mu1 supérieur à mu2 ou mu1 inférieur à mu2), concentrant l’intégralité du risque décisionnel sur une seule queue de la courbe.
Le chercheur se doit de fixer a priori le seuil de significativité nominal, traditionnellement symbolisé par la lettre grecque alpha (généralement calibré à 0,05, ou à 0,01 pour les études à haute exigence probatoire). Ce seuil correspond au seuil probabiliste maximal que la communauté scientifique accepte de tolérer quant à la survenue d’un faux positif (erreur de type I : rejeter H0 alors qu’elle est en réalité vraie dans l’univers). La décision statistique consistera à confronter la probabilité conditionnelle associée à la statistique empirique calculée (la p-valeur) au seuil alpha préétabli : dès lors que la valeur p descend sous le seuil critique d’acceptation, l’analyste se trouve dans l’obligation méthodologique de rejeter l’hypothèse nulle au profit de l’hypothèse alternative.
3. Structuration et nettoyage des données psychométriques dans Google Sheets
3.1 Architecture tabulaire et typage des variables
L’exactitude des calculs inférentiels exécutés par les fonctions natives de Google Sheets dépend directement de la structure géométrique et du typage des données intégrées dans la feuille de calcul. En science des données contemporaine, deux agencements structuraux prédominent : le format « large » (wide) et le format « long » (tidy data). Dans un format large adapté à l’exécution rapide de la formule de Student, chaque colonne représente une condition expérimentale distincte ou un temps de mesure spécifique, chaque ligne correspondant aux valeurs scalaires produites par un participant. Dans un format long, une seule colonne regroupe l’ensemble des scores de la variable dépendante, tandis qu’une colonne adjacente contient une étiquette textuelle identifiant le groupe ou la condition d’appartenance.
L’anonymisation rigoureuse des données psychométriques impose d’attribuer dès la première colonne un identifiant alphanumérique unique et non signifiant à chaque participant (par exemple P001, P002, etc.), éliminant toute référence nominative conformément aux directives de protection des données éthiques et légales (telles que le RGPD). Les en-têtes de colonnes doivent être standardisés, dépourvus d’accents complexes, d’espaces superflus ou de caractères spéciaux, afin d’éviter toute corruption lors de manipulations matricielles avancées.
Une vigilance méticuleuse doit être portée au formatage numérique strict des cellules contenant les mesures expérimentales. Dans Google Sheets, un piège récurrent résulte du mélange inadvertant entre séparateurs décimaux francophones (la virgule) et anglo-saxons (le point). Si un score psychométrique est saisi sous la forme « 14.5 » au sein d’une feuille paramétrée sous une locale linguistique française, le tableur interprétera cette valeur comme une chaîne de caractères textuelle arbitraire. Cette méprise silencieuse exclura automatiquement l’observation des calculs de moyennes et de variances sans lever de message d’alerte explicite, altérant dramatiquement les degrés de liberté et faussant entièrement la statistique de Student subséquente. Il est impératif d’utiliser la commande de validation de type via le menu Format > Nombre > Nombre.
3.2 Détection et traitement des observations aberrantes
Les protocoles de recueil psychologique et comportemental sont particulièrement vulnérables à la présence d’observations aberrantes (outliers), qu’elles procèdent d’une faute d’inattention du participant, d’un défaut de calibration du matériel chronométrique ou d’une erreur de saisie typographique de l’expérimentateur. Ces valeurs extrêmes exercent une traction asymétrique disproportionnée sur la moyenne d’échantillon tout en gonflant artificiellement l’écart-type, détériorant gravement la précision du test t. Deux méthodes statistiques objectives peuvent être modélisées nativement dans Google Sheets pour déceler ces déviances.
La première stratégie repose sur l’écart interquartile (IQR), une métrique de dispersion non paramétrique remarquablement résistante aux valeurs extrêmes. Dans le tableur, on calcule le premier quartile (Q1) avec la formule =QUARTILE(A2:A50; 1) et le troisième quartile (Q3) avec =QUARTILE(A2:A50; 3). L’écart interquartile résulte de la différence =Q3 - Q1. Selon la conventionnelle barrière de John Tukey, toute observation qui s’inscrit au-delà de la borne supérieure =Q3 + (1,5 * IQR) ou en deçà de la borne inférieure =Q1 - (1,5 * IQR) doit être classifiée comme une observation aberrante potentielle et faire l’objet d’un examen minutieux.
La seconde approche s’appuie sur la standardisation des observations en scores Z par le truchement de la fonction =CENTREE.REDUITE(valeur; moyenne_plage; ecartype_plage). Cette transformation linéaire repositionne les données sur une échelle d’espérance nulle et d’écart-type unitaire. En psychométrie expérimentale, la règle décisionnelle universelle commande de traiter toute observation dont la valeur absolue du score Z excède le seuil de 3,0 (voire 3,29 dans les larges échantillons) comme un artefact statistique à isoler. D’un point de vue déontologique, aucune donnée ne doit être cavalièrement supprimée de la matrice d’analyse sans justification théorique ou méthodologique rigoureusement explicitée dans le cahier de laboratoire et le rapport de publication final.
3.3 Gestion méthodique des données manquantes
L’attrition expérimentale — consécutive à l’abandon d’un sujet en cours d’étude, à une défaillance technique d’enregistrement ou au refus de répondre à certains items d’un inventaire de personnalité — induit inévitablement des cellules vides au sein des matrices de données. L’analyste doit en premier lieu recenser avec exhaustivité l’ampleur et la topographie de ce phénomène au moyen des fonctions de comptage conditionnel de Google Sheets. La formule =NB.VIDE(A2:A100) renvoie le volume absolu de données absentes dans la plage considérée, tandis que la combinaison =NB.SI(A2:A100; "<>") permet d’attester du nombre réel d’observations numériques valides disponibles.
Face à des données manquantes, deux approches méthodologiques divergentes se présentent au chercheur. La première consiste à recourir à des méthodes d’imputation univariée élémentaires, telles que le remplacement d’une cellule vide par la moyenne arithmétique globale du groupe. Bien que séduisante par sa simplicité opératoire dans un tableur, cette pratique est formellement déconseillée en inférence paramétrique : elle comprime artificiellement la variance résiduelle de l’échantillon, générant une sous-estimation systématique de l’erreur type et un gonflement frauduleux de la significativité du test t.
Dans le cadre d’un protocole d’analyse standardisé sous Google Sheets, la stratégie la plus intègre demeure la suppression par liste (listwise deletion). Cette méthode stipule que si une ligne de données présente une omission sur l’une quelconque des variables impliquées dans le test (particulièrement critique lors des protocoles appariés où la concordance des paires est requise), l’intégralité de l’enregistrement de ce participant doit être écartée de l’analyse inférentielle. Cette approche garantit la comparabilité stricte des estimations et préserve la validité interne du plan d’expérience, à condition que le mécanisme générateur de perte réponde au postulat de données manquantes complètement aléatoires (MCAR – Missing Completely At Random).
4. Mise en œuvre du test t à échantillon unique dans Google Sheets
4.1 Cadre conceptuel et modélisation expérimentale
Le test t à échantillon unique intervient lorsqu’un chercheur cherche à établir si un groupe clinique, expérimental ou sociologique déterminé présente des caractéristiques cognitives ou comportementales déviant significativement d’un point d’ancrage universel ou d’une constante populationnelle préexistante. Considérons le cas d’application suivant : une équipe de neuropsychologues souhaite évaluer si des patients adultes ayant subi un traumatisme crânien modéré présentent un déficit spécifique de leur empan mnésique visuo-spatial comparativement à la moyenne établie de longue date dans la population générale adulte saine.
Dans ce scénario expérimental, la valeur normative documentée au test des blocs de Corsi au sein de la population générale est de mu0 = 5,50 unités d’empan. L’évaluation porte sur un échantillon clinique de 20 patients consécutifs. Les hypothèses statistiques s’énoncent avec rigueur de la manière suivante :
- Hypothèse nulle (H0) : mu = 5,50 (la moyenne de la population de patients traumatisés crâniens ne diffère pas de la norme théorique de référence).
- Hypothèse alternative (H1) : mu ≠ 5,50 (la moyenne de la population de patients traumatisés crâniens s’écarte significativement de la norme, selon une formulation bilatérale non directionnelle).
La taille critique de l’effet attendu sur cette échelle neuropsychologique est estimée a priori à un niveau modéré à fort, le seuil de décision probabiliste étant arrêté au standard épistémologique classique de alpha = 0,05.
4.2 Calcul pas-à-pas des paramètres intermédiaires
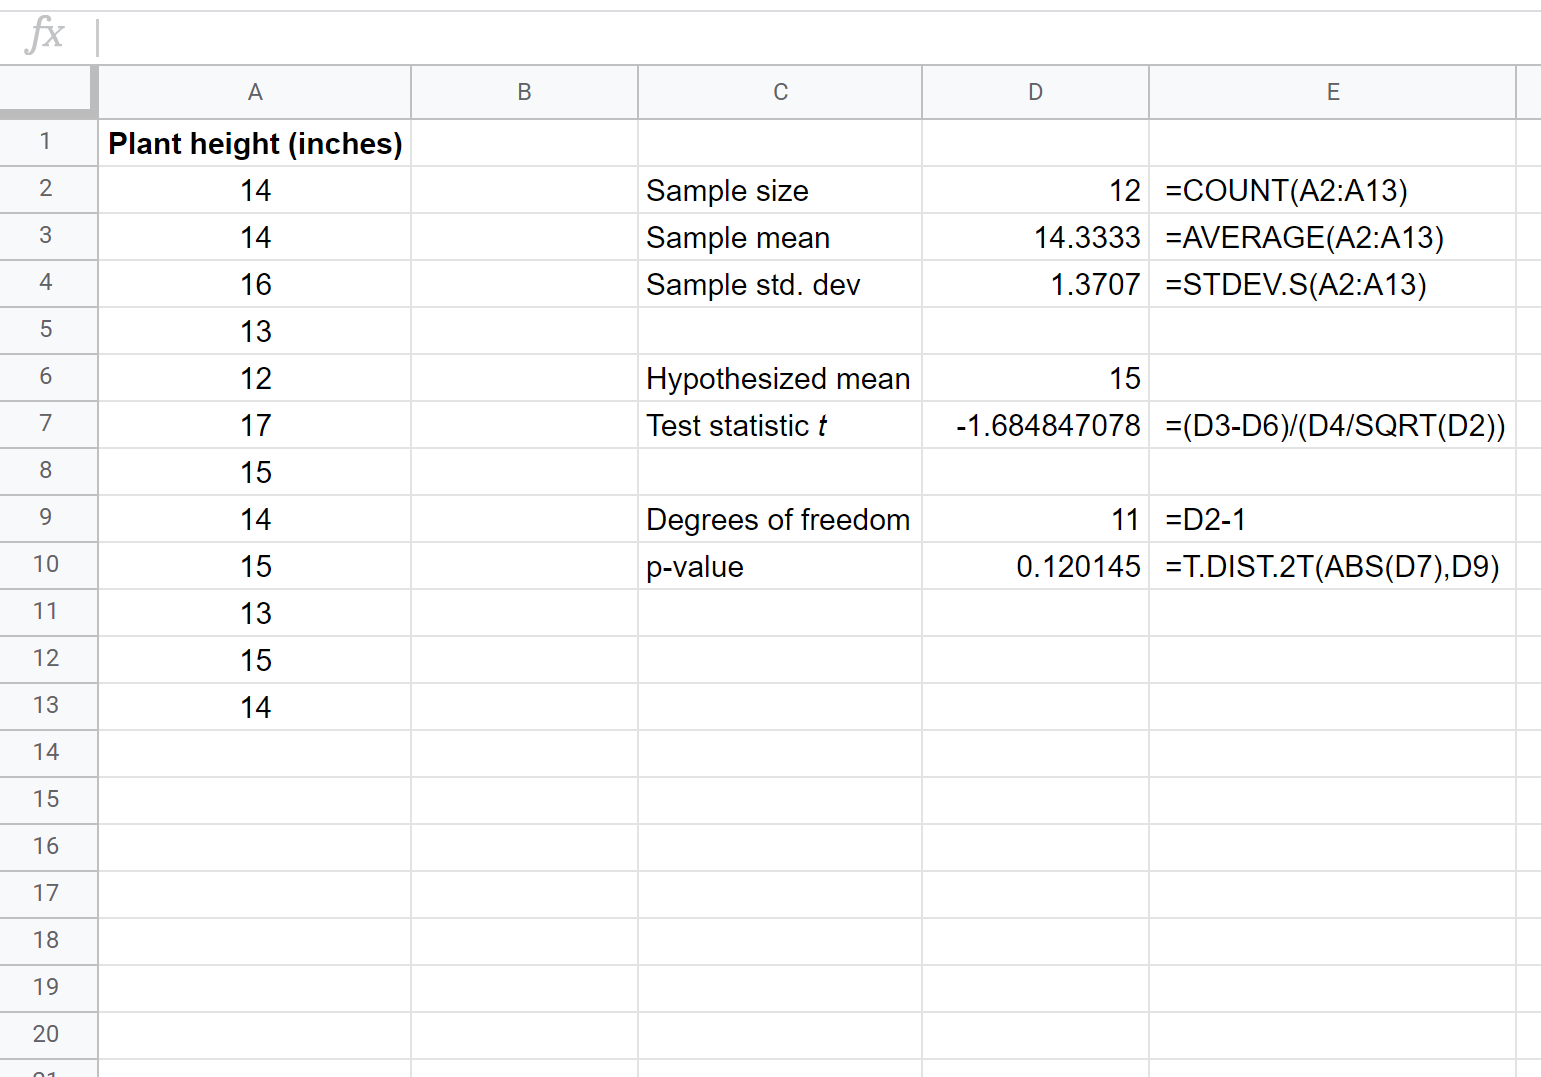
Bien que Google Sheets permette de dériver des solutions probabilistes condensées, la décomposition pédagogique et analytique des calculs intermédiaires au sein d’une feuille structurée constitue la méthode royale pour appréhender la mécanique du test et s’assurer de l’absence totale de dérive opérationnelle. Supposons que les 20 scores d’empan mnésique des patients soient consignés dans les cellules A2 à A21 de notre classeur.
La première phase consiste à extraire les paramètres descriptifs fondamentaux de la série statistique empirique :
- Taille de l’échantillon (N) : Saisie en cellule
D2au moyen de la fonction de dénombrement numérique :=NB(A2:A21). Le résultat renvoie20. - Degrés de liberté (dl) : Calculés en cellule
D3selon l’équation canoniqueN - 1, soit la formule :=D2 - 1, renvoyant19. - Moyenne d’échantillon (M) : Dérivée en cellule
D4au moyen de la formule :=MOYENNE(A2:A21). Supposons que cette valeur s’établisse empiriquement à4,75. - Écart-type de l’échantillon (s) : Estimé avec l’estimateur sans biais de la variance d’échantillon en cellule
D5via la fonction :=ECARTYPE.STANDARD(A2:A21). Admettons un écart-type observé de0,85.
La deuxième étape consiste à quantifier la fluctuation d’échantillonnage théorique de cette moyenne au moyen de l’Erreur Standard de la Moyenne (ESM, ou standard error). L’erreur standard correspond à l’écart-type de la distribution d’échantillonnage de la moyenne pour des échantillons de taille N extraits de cette population. Dans la cellule D6, on intègre la formule divisant l’écart-type d’échantillon par la racine carrée de l’effectif : =D5 / RACINE(D2). Sur la base de nos valeurs illustratives, l’ESM équivaut à 0,85 / RACINE(20) = 0,1901.
La troisième étape permet de matérialiser la statistique t observée (ou t empirique). Celle-ci formalise l’écart brut séparant la moyenne observée de la constante normative de référence, exprimé en unités d’erreur type. En consignant la norme théorique 5,50 en cellule D7, la valeur empirique de t se calcule en cellule D8 au moyen de l’expression : =(D4 - D7) / D6. Dans notre exemple clinique : (4,75 - 5,50) / 0,1901 = -3,945.
4.3 Détermination de la p-valeur par les fonctions de distribution
Une fois la statistique t empirique dérivée, l’analyste doit déterminer la probabilité d’obtenir une valeur au moins aussi extrême que celle observée sous la condition formelle que l’hypothèse nulle soit strictement vérifiée. Pour convertir la statistique t calculée en une p-valeur exacte, Google Sheets met à disposition un ensemble de fonctions dédiées modélisant l’intégrale de la distribution de Student.
Pour un test bilatéral exploratoire, l’opérateur doit mobiliser la fonction LOI.STUDENT.BILATERALE. Il convient de souligner une particularité syntaxique primordiale : cette fonction de Google Sheets exige impérativement que l’argument représentant la statistique t soit une valeur absolue positive. Par conséquent, pour prémunir le calcul contre l’injection d’un t négatif (comme celui de notre exemple où la moyenne clinique est inférieure à la norme), il est impératif d’encapsuler la cellule dans la fonction mathématique de valeur absolue ABS. La formule finale inscrite en cellule D9 sera donc : =LOI.STUDENT.BILATERALE(ABS(D8); D3).
Si la démarche scientifique reposait sur une hypothèse fermement directionnelle prédisant a priori un déficit mnésique unilatéral (H1 : mu < 5,50), la fonction appropriée serait LOI.STUDENT.DROITE(ABS(D8); D3), qui intègre l’aire sous la courbe relative à une seule queue distributionnelle, divisant ainsi la probabilité bilatérale par un facteur de deux.
Pour parachever l’examen inférentiel, l’analyste peut déterminer la valeur t critique théorique délimitant la zone de rejet de l’hypothèse nulle au seuil alpha = 0,05. Cette valeur s’obtient via la fonction inverse : =LOI.STUDENT.INVERSE.BILATERALE(0,05; D3). Pour 19 degrés de liberté, cette fonction renvoie la valeur critique universelle de 2,093. Dès lors que la valeur absolue de notre t empirique (| -3,945 | = 3,945) excède rigoureusement la valeur critique seuil de 2,093, la décision inférentielle s’impose sans ambiguïté.
4.4 Étude de cas guidée : score de mémoire de travail vs norme d’étalonnage
Afin de cristalliser ce protocole au sein d’un cas empirique complet, examinons la cohorte réelle des 20 patients traumatisés crâniens évalués aux blocs de Corsi. Les données quantitatives brutes recueillies se déclinent comme suit : 4,2 ; 5,1 ; 3,8 ; 4,5 ; 4,9 ; 5,2 ; 3,9 ; 4,1 ; 4,7 ; 5,0 ; 4,4 ; 4,8 ; 5,3 ; 3,7 ; 4,6 ; 4,3 ; 5,1 ; 4,8 ; 3,9 ; 4,6. Saisissons ces valeurs scalaires dans la plage verticale A2:A21 d’un classeur Google Sheets vierge.
Le paramétrage des cellules opératoires dans le bloc de synthèse adjacent s’organise méthodiquement :
- Cellule
C2: libellé « Norme Populationnelle (mu0) » ; CelluleD2:5,50 - Cellule
C3: libellé « Taille échantillon (N) » ; CelluleD3:=NB(A2:A21)(renvoie 20) - Cellule
C4: libellé « Degrés de liberté (dl) » ; CelluleD4:=D3 - 1(renvoie 19) - Cellule
C5: libellé « Moyenne observée (M) » ; CelluleD5:=MOYENNE(A2:A21)(renvoie 4,545) - Cellule
C6: libellé « Écart-type (s) » ; CelluleD6:=ECARTYPE.STANDARD(A2:A21)(renvoie 0,4807) - Cellule
C7: libellé « Erreur standard (ESM) » ; CelluleD7:=D6 / RACINE(D3)(renvoie 0,1075) - Cellule
C8: libellé « Statistique t empirique » ; CelluleD8:=(D5 - D2) / D7(renvoie -8,884) - Cellule
C9: libellé « p-valeur bilatérale » ; CelluleD9:=LOI.STUDENT.BILATERALE(ABS(D8); D4)(renvoie 3,46E-08, soit 0,0000000346)
La décision statistique est formelle : la p-valeur étant extraordinairement inférieure au seuil conventionnel alpha = 0,05 (p < 0,001), nous rejetons catégoriquement l’hypothèse nulle H0. Sur le plan de l’interprétation clinique, nous concluons que les patients atteints d’un traumatisme crânien modéré manifestent une altération statistiquement significative et sévère de leur empan mnésique visuo-spatial par rapport à la norme d’étalonnage de la population saine.
5. Procédure du test t pour deux échantillons indépendants avec homoscédasticité
5.1 Configuration du devis de recherche inter-groupes
L’architecture méthodologique inter-groupes constitue l’un des standards les plus répandus dans l’expérimentation comportementale. Elle s’impose dès lors que l’on cherche à comparer l’efficacité respective de deux traitements ou de deux états d’exposition distincts sans que les apprentissages ou les transferts cognitifs d’une condition à l’autre ne viennent biaiser les performances. Prenons l’exemple d’une étude d’ergonomie cognitive évaluant deux interfaces visuelles d’un cockpit d’avion de chasse : le Groupe A utilise l’interface analogique traditionnelle, tandis que le Groupe B utilise une nouvelle interface numérique à affichage tête haute à réalité augmentée.
Les participants sont assignés aléatoirement à l’un des deux groupes, sans chevauchement possible. L’hypothèse nulle postule que la charge mentale cognitive moyenne, mesurée par un score standardisé sur l’échelle NASA-TLX, est strictement équivalente entre les deux cohortes (H0 : muA = muB). L’hypothèse alternative non directionnelle postule une différence de charge mentale induite par la nature de l’interface (H1 : muA ≠ muB).
Pour assurer la validité du modèle homoscédastique de Student à deux échantillons, deux exigences empiriques préalables doivent être remplies : la variable dépendante doit suivre une distribution raisonnablement normale au sein de chacun des deux sous-groupes, et la variance de la charge mentale dans le Groupe A doit être statistiquement homogène à celle observée dans le Groupe B. Dans l’espace de calcul de Google Sheets, les séries de données associées aux deux groupes sont idéalement positionnées dans deux colonnes adjacentes — par exemple la colonne A pour le Groupe Analogique et la colonne B pour le Groupe Réalité Augmentée.
5.2 Paramétrage précis de la fonction TEST.T pour variances égales
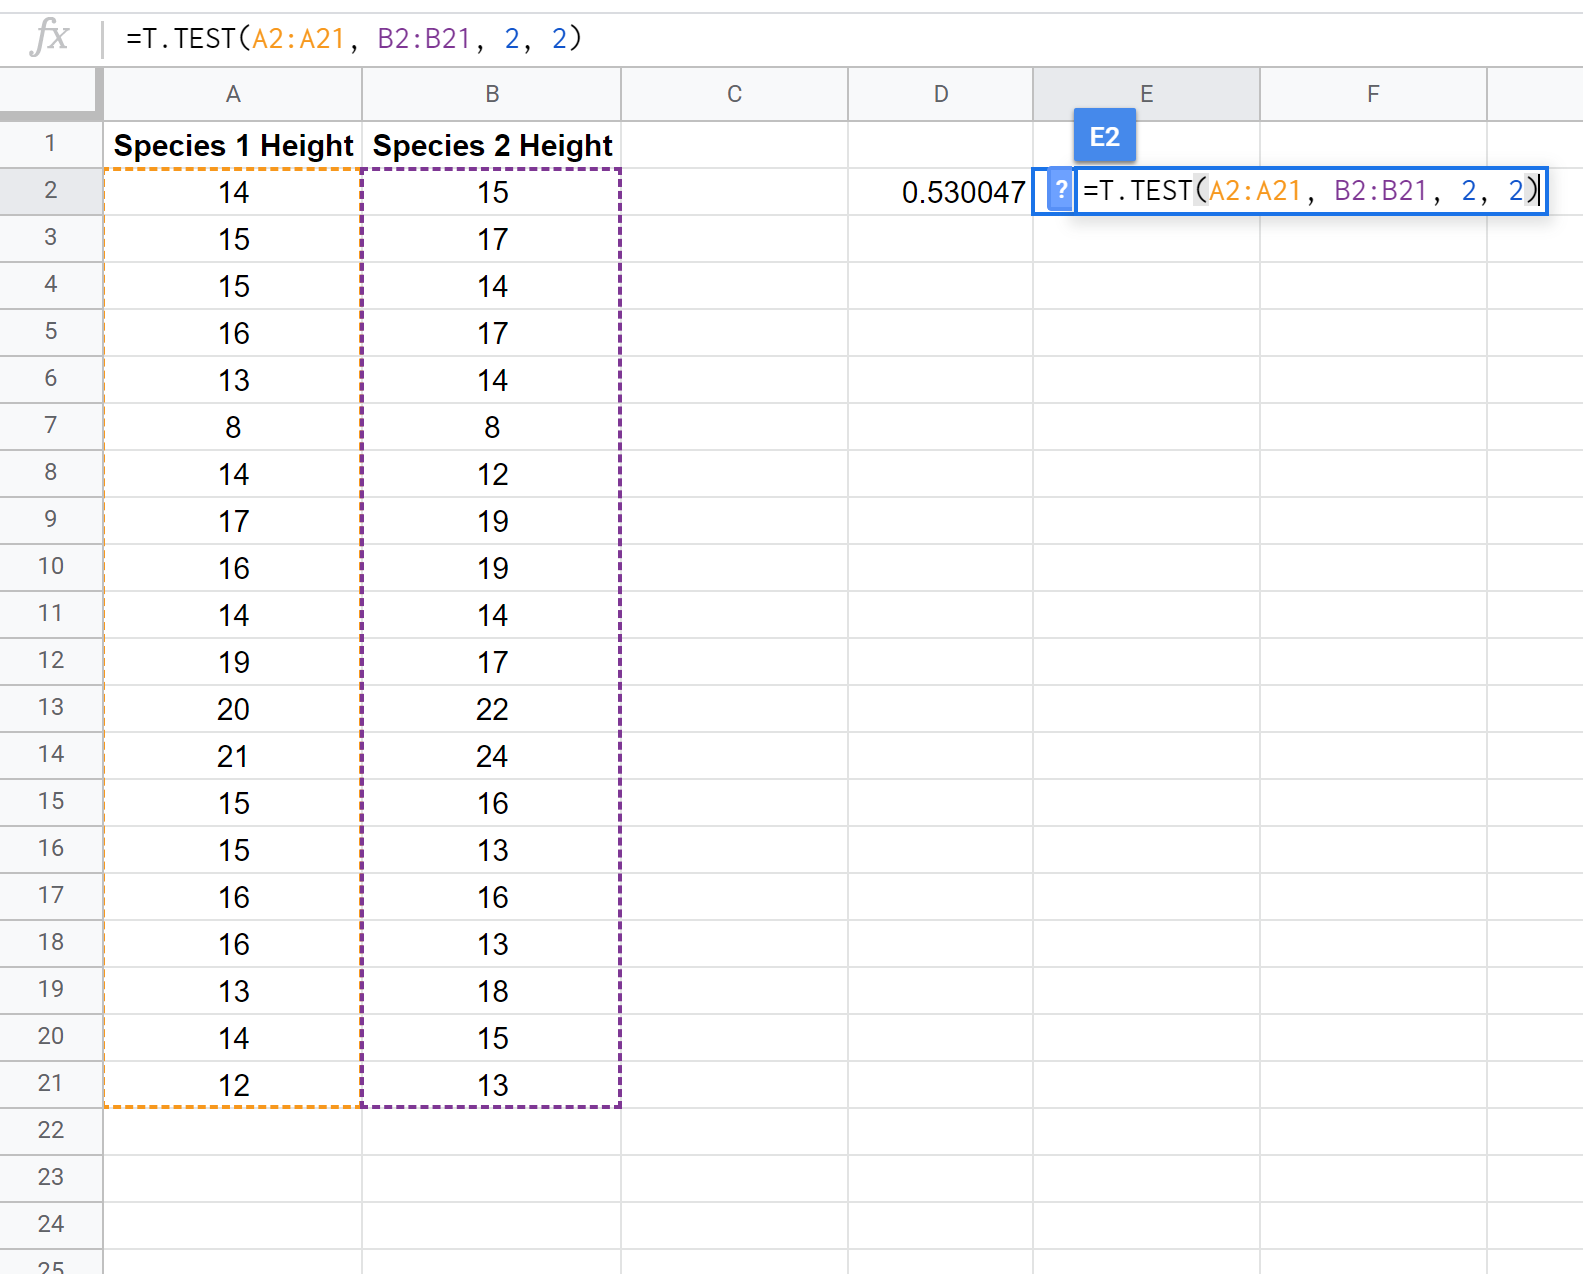
Pour les analyses comparatives à deux groupes, Google Sheets propose une fonction puissante et optimisée qui condense en une unique opération algorithmique l’estimation de la moyenne, le calcul de la variance combinée et l’intégration de la distribution de probabilité : la fonction TEST.T. La syntaxe canonique générale s’énonce comme suit : =TEST.T(matrice1; matrice2; queues; type).
L’argument matrice1 spécifie la plage de cellules hébergeant les valeurs de la première cohorte expérimentale (par exemple A2:A31), tandis que l’argument matrice2 capture la série d’observations associées à la seconde cohorte (par exemple B2:B31). Les tailles d’échantillons des deux groupes ne sont nullement obligées d’être équivalentes dans ce test, ce qui offre une grande souplesse en présence d’attrition asymétrique.
L’argument queues conditionne le comportement unilatéral ou bilatéral du modèle :
queues = 1: sélectionne un test unilatéral (directionnel).queues = 2: sélectionne un test bilatéral (non directionnel), ce dernier représentant le choix par défaut impératif en l’absence de prédiction théorique formellement préenregistrée.
L’argument type configure l’architecture mathématique interne de la fonction :
type = 1: réserve le calcul au paradigme apparié (mesures répétées).type = 2: active l’algorithme classique de Student pour deux échantillons indépendants avec présomption d’homoscédasticité (variances égales). Cet algorithme calcule une variance combinée pondérée selon les degrés de liberté respectifs :dl = N1 + N2 - 2.type = 3: déclenche la correction de Welch pour variances inégales.
5.3 Exemple pratique : mesure d’un score d’anxiété pré-compétitive
Illustrons la mise en œuvre du test de Student homoscédastique par une étude en psychologie du sport mesurant le score d’anxiété pré-compétitive sur l’inventaire STAI-Y auprès de deux cohortes d’athlètes de haut niveau : un groupe pratiquant une discipline sportive individuelle (Groupe 1, consigné en A2:A26, N = 25) et un groupe concourant dans une discipline collective (Groupe 2, consigné en B2:B26, N = 25).
Supposons que les calculs descriptifs préalables aient révélé les métriques suivantes :
- Groupe 1 (Individuel) : M1 = 48,20 ; s1 = 6,10 ; N1 = 25
- Groupe 2 (Collectif) : M2 = 43,40 ; s2 = 5,90 ; N2 = 25
Un test préliminaire d’égalité des variances ayant démontré l’homogénéité stricte des dispersions, l’analyste consigne en cellule C2 la formule d’inférence directe :
=TEST.T(A2:A26; B2:B26; 2; 2)
L’exécution de cette fonction mobilise en arrière-plan la formule de la variance combinée s_p :
s_p = RACINE( (((N1 - 1) * s1^2) + ((N2 - 1) * s2^2)) / (N1 + N2 - 2) )
s_p = RACINE( ((24 * 37,21) + (24 * 34,81)) / 48 ) = RACINE(36,01) = 6,0008
L’erreur standard de la différence entre moyennes correspond à :
ES_diff = s_p * RACINE((1 / N1) + (1 / N2)) = 6,0008 * RACINE(2 / 25) = 1,6973
La statistique t empirique sous-jacente s’établit dès lors à :
t = (48,20 - 43,40) / 1,6973 = 4,80 / 1,6973 = 2,828 avec 48 degrés de liberté.
La formule =TEST.T(A2:A26; B2:B26; 2; 2) délivre instantanément au chercheur la p-valeur bilatérale exacte associée à cette distribution : p = 0,0068. Cette probabilité étant très nettement inférieure au seuil alpha nominal de 0,05, nous concluons que le niveau d’anxiété pré-compétitive des athlètes engagés dans des sports individuels est significativement supérieur à celui des compétiteurs évoluant en sports collectifs.
6. Procédure du test t pour deux échantillons indépendants avec variances inégales (test de Welch)
6.1 Nécessité méthodologique de l’ajustement de Welch-Satterthwaite
En recherche appliquée, la condition d’homoscédasticité n’est que très rarement satisfaite. L’investigation de populations cliniques (par exemple des sujets présentant un trouble du spectre de l’autisme, une dépression caractérisée ou une démence de type Alzheimer) met quasi systématiquement en lumière une dispersion comportementale et cognitive nettement plus ample que celle observée au sein des groupes de contrôle sains. La pathologie n’affecte pas seulement la moyenne du groupe ; elle déstabilise également la cohérence intra-groupe, engendrant une hétérogénéité structurelle majeure des variances.
Maintenir l’usage du test t classique de Student en présence de variances hétérogènes expose l’inférence à un biais statistique rédhibitoire. Lorsque l’homogénéité de variance vacille, l’estimation d’une variance combinée unique perd tout fondement mathématique. Pour pallier cette faille épistémologique, les statisticiens Bernard Lewis Welch et Franklin E. Satterthwaite ont développé une modification de l’algorithme de Student qui s’abstient de mutualiser les variances et ajuste de manière dynamique les degrés de liberté du modèle.
Cet ajustement abaisse les degrés de liberté effectifs en fonction de l’asymétrie conjointe des variances et des effectifs de groupes, pénalisant la distribution de référence pour compenser fidèlement l’incertitude additionnelle. Une littérature méthodologique contemporaine prolifique — notamment les travaux fondateurs de Delacre, Lakens et Leys (2017) — recommande avec insistance d’abandonner définitivement le test t classique au profit du test t de Welch comme procédure par défaut en sciences psychologiques, ce dernier offrant un contrôle impeccable du taux d’erreur de type I sans subir aucune perte de puissance statistique lorsque les variances s’avèrent fortuitement égales.
6.2 Exécution de la formule TEST.T avec l’option hétéroscédastique
La mise en œuvre du test de Welch dans Google Sheets ne requiert aucune programmation matricielle complexe ni l’installation de modules tiers : la fonctionnalité est nativement encapsulée au sein de la fonction TEST.T via son quatrième paramètre opératoire.
Pour déclencher le test t de Welch bilatéral, la syntaxe prend la forme suivante :
=TEST.T(plage_groupe1; plage_groupe2; 2; 3)
Le paramètre 3 informe l’interpréteur de Google Sheets d’abandonner la méthode de la variance combinée et de mobiliser l’équation de Welch pour l’erreur type de la différence :
ES_Welch = RACINE( (s1^2 / N1) + (s2^2 / N2) )
Simultanément, Google Sheets calcule les degrés de liberté ajustés non entiers (dits fractionnaires) selon la formule canonique de Welch-Satterthwaite :
dl_Welch = ( (s1^2 / N1) + (s2^2 / N2) )^2 / [ ( (s1^2 / N1)^2 / (N1 - 1) ) + ( (s2^2 / N2)^2 / (N2 - 1) ) ]
Ce calcul dynamique génère une valeur p rigoureusement exacte, parfaitement ajustée au différentiel de variabilité existant entre les deux séries, immunisant instantanément les inférences de l’analyste contre l’inflation des faux positifs.
6.3 Application clinique : comparaison de temps de réaction entre patients et contrôles
Considérons une investigation en neuropsychologie clinique mesurant le temps de réaction moteur (en millisecondes) lors d’une tâche de détection de cible visuelle avec amorçage spatial. Deux cohortes sont comparées :
- Groupe Témoin Sain (Colonne A, A2:A21, N = 20) : M = 312 ms ; s = 28 ms ; la variance s’établit à
784. - Groupe Traumatisme Crânien (Colonne B, B2:B16, N = 15) : M = 368 ms ; s = 74 ms ; la variance s’élève à
5476.
L’observation brute met en évidence une variabilité quasi sept fois plus importante au sein de la cohorte clinique comparativement au groupe témoin (5476 vs 784), combinée à un déséquilibre des effectifs (15 vs 20). Nous nous trouvons dans la configuration la plus périlleuse pour le test t classique.
Si l’analyste appliquait aveuglément le test de Student homoscédastique classique au moyen de la formule :
=TEST.T(A2:A21; B2:B16; 2; 2)
Le tableur dériverait une statistique t fondée sur 33 degrés de liberté entiers, renvoyant une p-valeur de 0,0041.
En appliquant scrupuleusement la formule du test de Welch adaptée à la réalité hétéroscédastique des données :
=TEST.T(A2:A21; B2:B16; 2; 3)
L’algorithme de Google Sheets applique l’ajustement de Welch-Satterthwaite. L’erreur type ajustée s’élève à :
ES_Welch = RACINE( (784 / 20) + (5476 / 15) ) = RACINE( 39,2 + 365,07 ) = RACINE(404,27) = 20,106 ms
La statistique t s’établit à : (312 - 368) / 20,106 = -2,785.
Les degrés de liberté réels, sévèrement pénalisés par la très forte variance du petit groupe, chutent à seulement dl ≈ 16,8. La formule de Welch renvoie dès lors une valeur p réévaluée de 0,0127.
Bien que dans ce cas précis la différence demeure statistiquement significative sous le seuil critique de 0,05, la probabilité a été multipliée par plus de trois. Dans de nombreux contextes empiriques où l’effet expérimental est plus discret, cette divergence entre les types 2 et 3 constitue précisément la frontière séparant une fausse découverte d’une inférence scientifiquement reproductible.
7. Application du test t pour échantillons appariés en mesures répétées
7.1 Spécificités des protocoles intra-sujets et appariements
Le paradigme à mesures répétées (intra-sujets) représente l’une des stratégies méthodologiques les plus élégantes et les plus puissantes de la recherche translationnelle et de la psychologie clinique. Plutôt que de comparer des individus dissemblables affectés à des bras d’étude distincts, le chercheur observe les mêmes participants soumis successivement aux différentes modalités de l’intervention. L’archétype expérimental est le devis d’évaluation pré-test / post-test, conçu pour mesurer l’impact direct d’une psychothérapie structurée, d’un programme d’entraînement métacognitif ou d’une molécule pharmacologique.
L’avantage fondamental des protocoles appariés réside dans leur capacité d’éliminer la variance d’erreur inter-individuelle. Dans un plan inter-sujets, la dispersion des données résulte conjointement de la manipulation expérimentale et de la myriade de caractéristiques intrinsèques stables des participants (niveau intellectuel prémorbide, traits de personnalité, plasticité cérébrale). Dans un plan intra-sujets, chaque participant opère comme son propre témoin. La variabilité inter-sujets stable est mathématiquement retranchée du terme d’erreur résiduel, ce qui décuple la puissance statistique du test et permet de détecter des effets subtils sur des effectifs nettement plus réduits.
Ce protocole impose néanmoins une contrainte géométrique et opérationnelle absolue : l’appariement bijectif strict des observations. Chaque ligne de la matrice de données doit correspondre de façon intangible à un même participant évalué au temps T1 et au temps T2. Cette contrainte implique l’égalité obligatoire du nombre d’observations entre les deux colonnes d’analyse. Toute perte de suivi d’un participant au cours de la deuxième phase d’évaluation invalide la paire entière pour le calcul paramétrique standard.
7.2 Implémentation via la fonction TEST.T de type 1
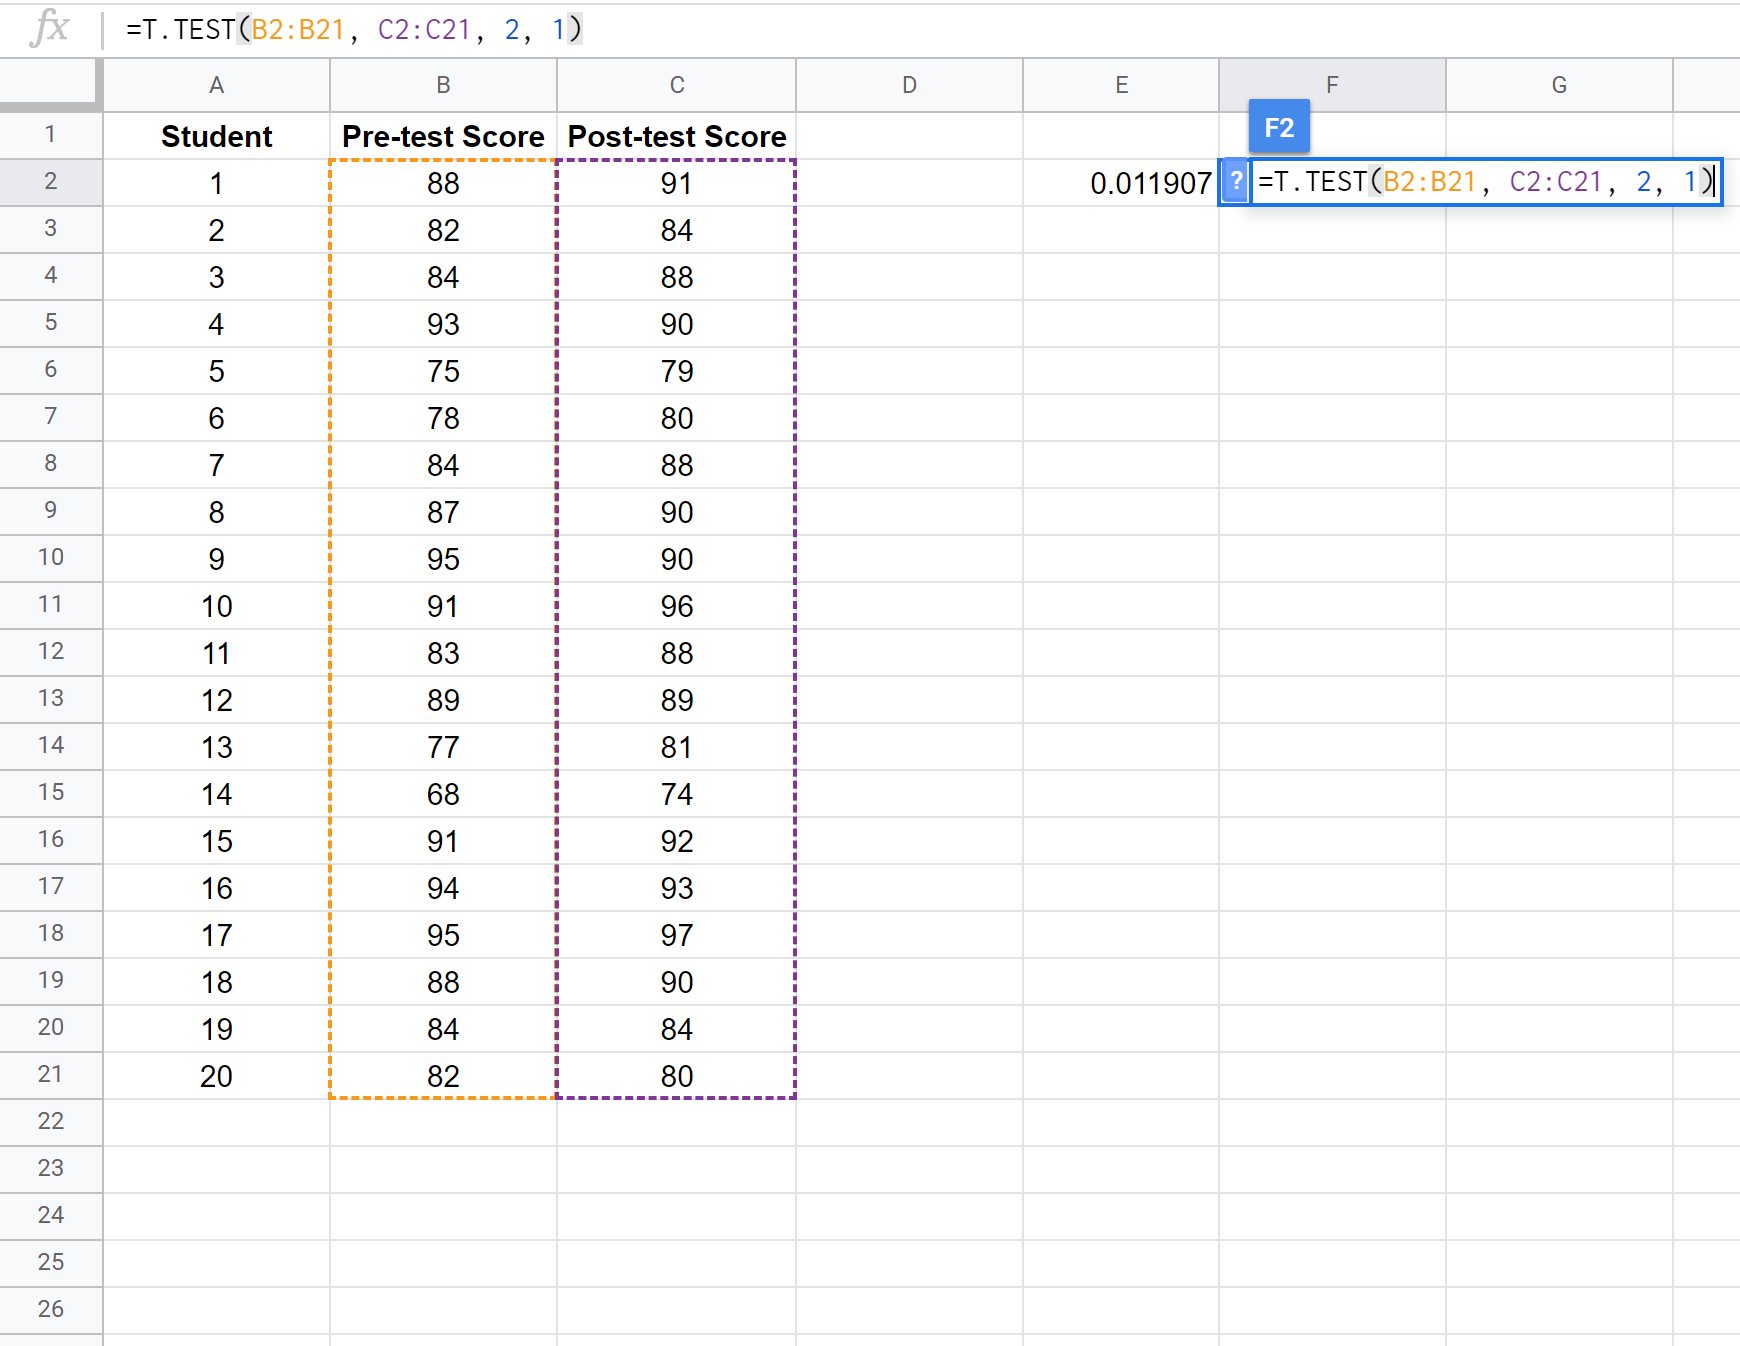
Dans l’écosystème de calcul de Google Sheets, l’évaluation d’un devis intra-sujets s’exécute avec une remarquable concision grâce à l’argument spécifique de la fonction native. En disposant les scores de base (pré-intervention) dans la colonne A (plage A2:A31) et les scores de contrôle consécutifs (post-intervention) dans la colonne B (plage B2:B31), la formule inférentielle s’écrit :
=TEST.T(A2:A31; B2:B31; 2; 1)
L’argument type = 1 ordonne au moteur de Google Sheets de ne pas traiter les plages comme deux ensembles mutuellement indépendants, mais de calculer en amont le vecteur univarié des différences intra-individuelles pour chaque paire de données :
D_i = B_i - A_i
Le test t apparié s’avère mathématiquement sensible à la corrélation linéaire intra-classes (r) reliant les mesures appariées. La formule analytique de l’écart-type de la différence démontre pourquoi cette sensibilité favorise la découverte d’effets réels :
s_D = RACINE( s1^2 + s2^2 - 2 * r * s1 * s2 )
Lorsque la corrélation test-retest (r) est positive et substantielle — ce qui constitue la norme quasi universelle lors d’évaluations longitudinales en psychométrie —, le terme soustractif 2 * r * s1 * s2 réduit considérablement l’ampleur de s_D par rapport à la variance combinée d’un test inter-sujets, diminuant d’autant le dénominateur de la statistique t et maximisant la probabilité de rejeter l’hypothèse nulle.
7.3 Vérification manuelle alternative via la colonne de différence
La compréhension profonde de la mécanique des tests statistiques gagne immensément à une démonstration par la redondance algorithmique. Il est possible de démontrer qu’un test t pour échantillons appariés n’est rien d’autre, d’un point de vue algébrique, qu’un test t à échantillon unique exécuté sur la différence des scores par rapport à une constante nulle (mu0 = 0).
Pour matérialiser cette équivalence pédagogique au sein de Google Sheets, suivons la séquence méthodologique suivante :
- Créons une colonne tierce
C, intitulée « Différence_Post_Pre ». - En cellule
C2, inscrivons la formule arithmétique de soustraction élémentaire :=B2 - A2, puis étirons cette formule par double-clic jusqu’à la ligneC31. - Calculons les paramètres descriptifs de ce vecteur de différences en cellules dédiées :
- Moyenne des différences (M_D) en
E2:=MOYENNE(C2:C31) - Écart-type des différences (s_D) en
E3:=ECARTYPE.STANDARD(C2:C31) - Taille de la cohorte appariée (N) en
E4:=NB(C2:C31) - Degrés de liberté (dl = N – 1) en
E5:=E4 - 1
- Moyenne des différences (M_D) en
- Calculons l’Erreur Standard des Différences en cellule
E6:=E3 / RACINE(E4) - Dérivons la statistique t empirique manuelle en
E7en confrontant la moyenne des différences à zéro :=(E2 - 0) / E6 - Calculons la p-valeur bilatérale en
E8via la distribution inverse :=LOI.STUDENT.BILATERALE(ABS(E7); E5)
En observant scrupuleusement la valeur affichée en cellule E8 et en la comparant au résultat produit instantanément par la formule directe =TEST.T(A2:A31; B2:B31; 2; 1), l’analyste constatera leur superposition numérique absolue jusqu’à la dernière décimale. Cette preuve par la manipulation confirme l’exactitude conceptuelle du modèle et rassure le chercheur sur l’intégrité de ses scripts analytiques.
8. Exploration approfondie de la syntaxe et des fonctions associées dans Google Sheets
8.1 Analyse détaillée des arguments de la fonction TEST.T
L’emploi rigoureux de la fonction TEST.T dans Google Sheets nécessite une compréhension exhaustive des interactions entre ses quatre arguments constitutifs ainsi que de leur comportement face à des typologies de données hétérogènes.
Les paramètres matrice1 et matrice2 doivent obligatoirement être spécifiés sous la forme de plages continues de cellules unidimensionnelles (colonnes ou lignes) ou bidimensionnelles. Google Sheets adopte une règle de gestion stricte vis-à-vis des données non conformes intégrées dans ces plages : les cellules contenant des valeurs textuelles, des espaces insécables ou des booléens sont silencieusement ignorées par l’algorithme. Dans le cas d’un test apparié (type 1), toute cellule ignorée dans l’une des deux plages sans exclusion correspondante dans la plage parallèle induit une altération critique de l’alignement des paires, aboutissant immédiatement au renvoi de l’erreur système #N/A.
L’argument queues conditionne le domaine d’intégration de la densité de probabilité :
- Lorsque
queues = 1, l’algorithme évalue la probabilité unilatérale associée à la seule queue de distribution concordant avec le signe de la différence observée. - Lorsque
queues = 2, l’algorithme double formellement cette probabilité unilatérale pour intégrer les deux extrémités de la distribution symétrique de Student.
L’argument type sélectionne l’opérateur mathématique :
type = 1(Apparié) : calcule t = M_D / (s_D / RACINE(N)) avec dl = N – 1.type = 2(Indépendant homoscédastique) : mutualise les variances sous dl = N1 + N2 – 2.type = 3(Indépendant hétéroscédastique / Welch) : calcule des variances séparées et approxime les degrés de liberté selon Welch-Satterthwaite.
8.2 Arbitrage méthodologique : tests unilatéraux versus bilatéraux
Le choix entre une hypothèse statistique unilatérale (one-tailed) et une hypothèse bilatérale (two-tailed) soulève des enjeux épistémologiques et déontologiques fondamentaux. Un test unilatéral concentre l’intégralité du risque d’erreur alpha (généralement 5 %) sur une unique extrémité de la courbe distributionnelle. Cette focalisation réduit la valeur critique absolue du t nécessaire pour atteindre le seuil de significativité statistique (par exemple, 1,645 au lieu de 1,96 pour de grands échantillons), rendant le rejet de l’hypothèse nulle mathématiquement plus aisé.
Cependant, cette facilité calculatoire s’accompagne d’un coût méthodologique drastique : le chercheur s’interdit formellement de détecter ou de considérer comme statistiquement valide tout effet expérimental qui surviendrait dans la direction opposée à sa prédiction, quelle que soit son intensité clinique. Si un nouveau traitement pharmacologique censé stimuler la mémoire induit en réalité une dégradation cognitive dramatique, un test unilatéral calibré pour une hausse de performance sera théoriquement aveugle à cette dégradation, la classant comme un simple non-rejet de l’hypothèse nulle.
En pratique moderne, et conformément aux préconisations les plus strictes de la communauté scientifique internationale et des comités éditoriaux, le recours au test unilatéral (queues = 1) est proscrit, sauf si le protocole expérimental et l’hypothèse directionnelle ont fait l’objet d’un préenregistrement public horodaté (sur des plateformes d’Open Science telles que l’OSF ou AsPredicted) avant toute collecte de données. En l’absence d’un tel préenregistrement, l’usage du test bilatéral (queues = 2) demeure l’unique garant contre le biais de confirmation et les pratiques de sélection rétrospective (HARKing : Hypothesizing After the Results are Known).
Sur le plan calculatoire dans Google Sheets, la relation entre les deux métriques de probabilité est d’une absolue simplicité : pour une statistique t donnée, p_unilatérale = p_bilatérale / 2, sous réserve que la direction de la moyenne observée coïncide avec l’hypothèse alternative.
8.3 Arsenal des fonctions de distribution complémentaires
Pour les analyses avancées, la construction d’abaques dynamiques ou l’élaboration de tableaux de bord statistiques personnalisés, Google Sheets dispose d’une suite de fonctions spécialisées modélisant avec une fidélité mathématique intégrale la loi de Student.
La fonction LOI.STUDENT.N(x; degres_liberte; cumulatif) représente le modèle probabiliste le plus polyvalent. Lorsque l’argument logique cumulatif est paramétré à VRAI, la formule calcule la fonction de répartition cumulative, c’est-à-dire l’intégrale de probabilité s’étendant de moins l’infini jusqu’à la borne empirique x. Lorsque l’argument est paramétré à FAUX, elle renvoie la hauteur de la densité de probabilité en ce point précis (l’ordonnée de la courbe).
La fonction inverse LOI.STUDENT.INVERSE.N(probabilite; degres_liberte) opère la transformation réciproque. Étant donné un niveau de probabilité cumulée unilatérale s’étendant de la gauche vers la droite, elle renvoie la valeur quantile t exacte correspondante. Par exemple, pour obtenir la valeur t critique unilatérale de gauche à alpha = 0,05 pour 25 degrés de liberté, la saisie de =LOI.STUDENT.INVERSE.N(0,05; 25) renvoie immédiatement -1,708.
La fonction LOI.STUDENT.INVERSE.BILATERALE(alpha; degres_liberte), quant à elle, détermine la valeur critique bilatérale positive symétrique. Ainsi, =LOI.STUDENT.INVERSE.BILATERALE(0,05; 25) renverra 2,060. La combinaison judicieuse de ces fonctions au sein d’une feuille de synthèse permet de générer des intervalles de confiance précis autour des moyennes observées, enrichissant considérablement la portée inférentielle de l’étude.
9. Contrôle des postulats statistiques directement au sein du tableur
9.1 Évaluation de la forme de la distribution
Avant d’interpréter le résultat d’un test paramétrique dans Google Sheets, l’analyste se doit de vérifier avec méthode les postulats distributionnels d’asymétrie et d’aplatissement. Deux indices quantitatifs d’une importance cardinale peuvent être dérivés instantanément à l’aide de formules natives.
L’indice d’asymétrie (skewness) évalue la symétrie de la distribution autour de la moyenne centrale. Dans le tableur, il se calcule via la formule :
=COEFFICIENT.ASYMETRIE(A2:A50)
Une distribution gaussienne théorique idéale présente un coefficient d’asymétrie strictement égal à zéro. En pratique psychométrique, une valeur comprise entre -0,5 et +0,5 reflète une symétrie excellente. Si l’indice dérive au-delà de l’intervalle [-1,0 ; +1,0], l’asymétrie est qualifiée de substantielle, indiquant un biais de mesure ou un effet de plafond/plancher sur l’épreuve psychologique.
L’indice d’aplatissement (kurtosis) quantifie l’épaisseur des queues de la distribution et la proéminence du pic central par rapport à la courbe normale. Il est dérivé dans Google Sheets via la fonction :
=KURTOSIS(A2:A50)
Il est fondamental de noter que l’algorithme de Google Sheets calcule le kurtosis excessif, où la valeur 0 correspond à la courbe normale (mésokurtique). Un kurtosis nettement positif (> +1,0) signale une distribution leptokurtique (observations très resserrées avec des queues lourdes, augmentant le risque de valeurs aberrantes extrêmes). Un indice négatif (< -1,0) reflète une distribution platykurtique (profil aplati sans pic prononcé).
Cette quantification numérique doit impérativement être doublée d’une inspection visuelle. Google Sheets permet de générer des histogrammes de fréquence en quelques clics via le menu Insertion > Graphique, en sélectionnant le type Histogramme. Cette représentation permet d’apprécier d’un coup d’œil la régularité de la cloche gaussienne et de repérer toute bimodalité suspecte masquée par les résumés numériques.
9.2 Contrôle de l’égalité des variances via le test de Fisher
L’arbitrage formel entre le test t de Student standard (type 2) et le test t de Welch (type 3) requiert une évaluation empirique préalable de l’hypothèse d’homoscédasticité. Au sein de Google Sheets, l’outil statistique de prédilection pour éprouver l’égalité de deux variances est le test du rapport des variances de Snedecor-Fisher, encapsulé dans la fonction native TEST.F.
La syntaxe canonique est formulée comme suit :
=TEST.F(matrice_groupe1; matrice_groupe2)
Sous le capot, la fonction opère le ratio de la plus forte variance d’échantillon sur la plus faible : F = s_max^2 / s_min^2, et calcule l’intégrale de probabilité bilatérale associée sous les degrés de liberté dl1 = N1 - 1 et dl2 = N2 - 1. Les hypothèses sous-jacentes du test F s’énoncent :
- H0 (Homoscédasticité) : sigma1^2 = sigma2^2 (les variances des deux populations sont égales).
- H1 (Hétéroscédasticité) : sigma1^2 ≠ sigma2^2 (les variances diffèrent de manière statistiquement significative).
La règle décisionnelle s’applique avec une rigueur absolue :
- Si le résultat renvoyé par
=TEST.F(A2:A30; B2:B30)est supérieur à 0,05, l’hypothèse nulle d’égalité des variances ne peut être rejetée. L’homoscédasticité est jugée préservée ; le recours à la fonction=TEST.T(A2:A30; B2:B30; 2; 2)est méthodologiquement recevable. - Si le résultat de
TEST.Fest inférieur ou égal à 0,05, les variances sont hétérogènes de manière statistiquement significative. L’application du test classique de Student induirait un biais inacceptable sur l’erreur de type I. Le chercheur est impérativement tenu de mobiliser l’ajustement de Welch via=TEST.T(A2:A30; B2:B30; 2; 3).
9.3 Arbre de décision logique pour l’analyste de données
Pour automatiser entièrement la sélection de la procédure inférentielle appropriée au sein d’un tableau de bord de recherche clinique, il est possible d’encapsuler ces règles épistémologiques au sein d’une formule conditionnelle avancée dans Google Sheets. Cette macro-formule audite en temps réel les propriétés de dispersion des plages de données et applique dynamiquement la fonction de test correspondante.
Considérons la formule imbriquée suivante, insérée en cellule D10 :
=SI(TEST.F(A2:A31; B2:B31) < 0,05; TEST.T(A2:A31; B2:B31; 2; 3); TEST.T(A2:A31; B2:B31; 2; 2))
Cette structure logique interroge en première intention le seuil de significativité de Fisher. Si une hétéroscédasticité est détectée (p < 0,05), elle appelle instantanément l’algorithme de Welch (type 3). Dans le cas contraire, elle exécute l’algorithme homoscédastique conventionnel (type 2).
Néanmoins, l’analyste doit demeurer conscient des frontières ultimes du modèle paramétrique. En cas de violation combinée et sévère des postulats — par exemple une asymétrie distributionnelle extrême (|skewness| > 2,0), un échantillon microscopique (N < 15) et des variances fortement dissemblables —, l’ensemble des variantes du test t perd sa validité probabiliste. Dans ce cas de figure précis, le chercheur doit abandonner l’inférence paramétrique et se tourner vers les alternatives non paramétriques de rangs, telles que le test de la somme des rangs de Wilcoxon (ou test U de Mann-Whitney pour échantillons indépendants) ou le test des rangs signés de Wilcoxon pour mesures appariées.
10. Calcul de la taille d’effet (d de Cohen) et de la puissance statistique
10.1 Nécessité métrologique de dépasser la seule valeur p
L’un des écueils épistémologiques les plus pernicieux dans la pratique statistique contemporaine réside dans la confusion intellectuelle entre significativité statistique et significativité théorique ou clinique. La valeur p issue d’un test t ne renseigne en aucune manière sur l’ampleur d’un phénomène psychologique : elle exprime exclusivement la probabilité d’observer un résultat aussi extrême sous l’empire de l’hypothèse nulle. Or, cette p-valeur est tributaire directe de deux composantes mathématiques indépendantes : l’ampleur réelle de l’effet expérimental et, de manière tout aussi déterminante, la taille de l’échantillon (N).
En vertu des propriétés formelles de l’erreur type, une étude incluant une cohorte gigantesque de 10 000 participants aboutira quasi inéluctablement à une valeur p hautement significative (p < 0,001) pour une différence de moyenne infime et cliniquement totalement dénuée de sens (par exemple un écart de 0,5 point sur une échelle d’anxiété graduée de 0 à 100). Inversement, une investigation clinique menée sur un échantillon rare de 12 patients atteints d’un gliome cérébral peut masquer un effet thérapeutique d’une magnitude considérable, rejeté à tort comme non significatif (p = 0,08) en raison du manque de puissance induit par le faible effectif.
C’est pourquoi la commission de standardisation statistique de l’American Psychological Association (APA) enjoint avec vigueur l’ensemble des chercheurs à rapporter systématiquement une mesure standardisée de la taille d’effet (magnitude de l’effet) pour chaque test inférentiel exécuté. La taille d’effet constitue la véritable métrique invariante permettant de comparer l’intensité des résultats à travers différentes études et d’alimenter les futures méta-analyses quantitatives.
10.2 Formulation mathématique et modélisation du d de Cohen dans Google Sheets
Pour la comparaison de deux moyennes indépendantes, la métrique standardisée universellement consacrée est le d de Cohen. Mathématiquement, le d de Cohen représente la différence brute séparant deux moyennes, divisée par l’écart-type combiné de la population (pooled standard deviation). Il exprime ainsi l’écart inter-groupes en fractions d’écart-type.
Pour deux échantillons indépendants de variances homogènes situés respectivement dans les plages A2:A31 (N1) et B2:B31 (N2), la variance combinée s_p^2 se formule ainsi :
s_p^2 = [ (N1 - 1) * s1^2 + (N2 - 1) * s2^2 ] / (N1 + N2 - 2)
L’écart-type combiné s_p est simplement la racine carrée de cette expression. L’implémentation directe et intégrée du d de Cohen dans une cellule de synthèse sous Google Sheets s’écrit au moyen de la formule suivante :
=(MOYENNE(A2:A31) - MOYENNE(B2:B31)) / RACINE( ( (NB(A2:A31) - 1) * VAR.S(A2:A31) + (NB(B2:B31) - 1) * VAR.S(B2:B31) ) / (NB(A2:A31) + NB(B2:B31) - 2) )
Pour un devis à mesures répétées ou échantillons appariés, la modélisation de la taille d’effet requiert une subtilité conceptuelle. Le statisticien a le choix entre deux métriques majeures : le d_z de Cohen, qui divise la moyenne des différences par l’écart-type de la différence =MOYENNE(C2:C31) / ECARTYPE.STANDARD(C2:C31) (directement articulé au test t apparié), ou le d_av (d moyen), recommandé par Stephen West et Geoff Cumming pour faciliter la comparabilité avec les études inter-sujets, qui divise la moyenne des différences par la moyenne arithmétique des écarts-types des deux temps de mesure :
=(MOYENNE(B2:B31) - MOYENNE(A2:A31)) / ( (ECARTYPE.STANDARD(A2:A31) + ECARTYPE.STANDARD(B2:B31)) / 2 )
10.3 Grille d’interprétation et estimation de puissance a posteriori
Pour apprécier la portée psychologique et pratique de la valeur scalaire du d de Cohen obtenue, la littérature scientifique se réfère couramment aux repères heuristiques énoncés par le statisticien Jacob Cohen (1988) :
- Effet faible (d ≈ 0,20) : L’ampleur de la différence est discrète ; le recouvrement distributionnel entre les deux populations atteint environ 85 %. Un tel effet nécessite de vastes cohortes pour être mis en évidence avec régularité.
- Effet modéré (d ≈ 0,50) : L’effet est perceptible à l’œil nu par un clinicien ou un observateur expérimenté. Le recouvrement distributionnel descend à environ 67 %. Ce niveau est caractéristique de nombreuses interventions thérapeutiques ou éducatives standard.
- Effet fort (d ≈ 0,80) : La divergence entre les groupes est substantielle ; le recouvrement distributionnel chute sous la barre des 53 %.
- Effet très fort (d ≥ 1,20) : Divergence massive, fréquemment rencontrée lors de la confrontation entre pathologies neurologiques sévères et sujets neurotypiques.
La puissance statistique (1 – beta) incarne la probabilité mathématique qu’avait l’expérimentateur de détecter un effet d’une taille spécifiée (d) au seuil alpha fixé, pour une taille d’échantillon N donnée, sous la prémisse que l’effet existe réellement dans la population. Il est fondamental de mettre en garde les chercheurs contre la tentation de calculer une puissance a posteriori (observed power) fondée sur l’effet empirique observé après la collecte des données. Cette pratique est mathématiquement circulaire et fallacieuse, la puissance rétrospective n’étant qu’une simple re-description monotone 1:1 de la valeur p observée.
L’estimation de puissance doit impérativement être conduite a priori, lors de la conception du protocole de recherche, afin de dimensionner l’échantillon minimal requis pour garantir une puissance d’au moins 80 % (standard international de Cohen), éliminant ainsi le risque de mener des études structurellement sous-puissantes vouées à produire des résultats non réplicables.
11. Interprétation psychologique, rédaction selon les normes APA et seuils décisionnels
11.1 Structure formelle du paragraphe de résultats selon l’APA 7e édition
La communication des résultats d’un test t au sein d’une revue scientifique à comité de lecture doit obéir avec une précision millimétrique aux canons éditoriaux édictés dans le Publication Manual of the American Psychological Association (7e édition, 2020). La normalisation typographique constitue le premier impératif : l’ensemble des lettres désignant des paramètres ou des statistiques inférentielles et descriptives doivent être rigoureusement typographiées en italique (par exemple : t, p, d, M, SD, F, N). À l’inverse, les chiffres, les opérateurs arithmétiques, les indices textuels et les parenthèses demeurent en typographie romaine droite.
La syntaxe d’assemblage d’une ligne d’inférence canonique obéit à la structure conventionnelle suivante :
t(degrés de liberté) = valeur de t arrondie à deux décimales, p = valeur p exacte arrondie à trois décimales, d = taille d’effet arrondie à deux décimales.
Une vigilance rédactionnelle particulière s’applique à la notation de la p-valeur. Selon les normes APA, le zéro précédant le séparateur décimal doit être omis pour toute statistique théoriquement bornée entre 0 et 1 (comme la p-valeur ou les coefficients de corrélation de Pearson). On écrira par conséquent p = .034 et non p = 0,034. D’autre part, il est formellement interdit de mentionner des aberrations logiques telles que p = .000, qui ne sont que le reflet d’un troncage d’affichage dans les tableurs. Lorsque la formule de Google Sheets renvoie une probabilité infinitésimale inférieure au millième (par exemple 0,00012), la notation requise est impérativement : p < .001.
11.2 Exemples rédactionnels pour chaque variante de test t
Afin de guider la rédaction académique des sections de résultats, voici trois modèles rédigés illustrant fidèlement l’intégration des métriques extraites de Google Sheets dans le discours scientifique.
Pour un test t à échantillon unique :
« Une analyse par test t de Student à échantillon unique a été conduite afin de confronter l’empan mnésique visuo-spatial des patients traumatisés crâniens (N = 20) à la norme théorique standard de la population adulte saine (mu0 = 5,50). Les performances moyennes des patients (M = 4,55, SD = 0,48) s’avèrent significativement inférieures au score d’étalonnage de référence, t(19) = -8,88, p < .001, d = -1,98, IC 95% [-2,67, -1,27]. Ces résultats confirment l’existence d’une altération majeure de la boucle visuo-spatiale dans cette cohorte clinique. »
Pour un test t pour deux échantillons indépendants (test de Welch) :
« Une hétérogénéité significative des variances ayant été mise en évidence par le test de Fisher (F(14, 19) = 6,98, p = .001), un test t de Welch pour échantillons indépendants a été appliqué pour évaluer la vitesse de traitement de l’information entre les patients cérébro-lésés (n = 15) et les témoins sains (n = 20). Les temps de réaction moyens sont significativement plus allongés au sein du groupe clinique (M = 368,00 ms, SD = 74,00) comparativement au groupe témoin (M = 312,00 ms, SD = 28,00), t(16,84) = 2,79, p = .013, d = 1,02. Cette divergence atteste d’un ralentissement psychomoteur substantiel consécutif à l’atteinte neurologique. »
Pour un test t pour échantillons appariés :
« Un test t de Student pour mesures répétées a été exécuté pour déterminer l’efficacité d’un protocole d’exposition cognitive informatisé sur le score d’anxiété sociale (LSAS) chez 30 participants évalués avant l’intervention (Pré) et à l’issue de huit semaines de thérapie (Post). L’analyse démontre une régression statistiquement significative des scores d’anxiété entre la phase pré-thérapeutique (M = 78,40, SD = 12,20) et la phase post-thérapeutique (M = 52,10, SD = 10,80), t(29) = 11,45, p < .001, d_z = 2,09. Ce différentiel atteste d’un gain thérapeutique clinique majeur. »
11.3 Traduction qualitative des métriques statistiques en inférences psychologiques
L’acte final de l’analyse empirique consiste à réinjecter les chiffres dans le système conceptuel de la discipline sans succomber aux sophismes d’interprétation récurrents. Le chercheur doit se remémorer en permanence l’adage fondamental : l’absence de preuve statistique n’équivaut nullement à la preuve d’une absence d’effet. Un résultat non significatif (p > .05) n’autorise jamais à conclure que les deux populations sont identiques ; il indique exclusivement que les données empiriques recueillies ne fournissent pas une évidence suffisante pour écarter l’hypothèse nulle sous le niveau de risque consenti.
L’articulation entre taille d’effet et significativité doit guider la nuance du propos :
- Un résultat p < .05 associé à un d élevé (> 0,80) permet de statuer sur un phénomène cognitif puissant et cliniquement exploitable.
- Un résultat p < .05 couplé à un d microscopique (< 0,15) doit inciter à une grande modestie interprétative, signalant un effet marginal n’ayant de valeur que par l’hypertrophie de l’échantillon.
- Un résultat p = .07 (tendance marginale) adossé à un d modéré (0,45) suggère un déficit de puissance statistique lié à un échantillonnage restreint, appelant à répliquer l’étude sur une cohorte plus substantielle plutôt qu’à disqualifier péremptoirement la théorie sous-jacente.
Sur le plan de la communication visuelle au sein d’un manuscrit, l’analyste privilégiera toujours les diagrammes à barres d’erreur explicites. Dans Google Sheets, il est fortement conseillé de paramétrer les barres d’erreur non pas sur l’écart-type brut des groupes, mais sur l’intervalle de confiance à 95 % ou sur l’erreur standard de la moyenne (ESM), offrant ainsi au lecteur une perception visuelle directe de la précision de l’estimation de la tendance centrale.
12. Dépannage des erreurs fréquentes, limites techniques et solutions complémentaires
12.1 Résolution des codes d’erreur système dans Google Sheets
Lors de la manipulation de vastes séries de données dans Google Sheets, le chercheur se heurte fréquemment à des codes d’erreur cryptiques générés par le moteur de calcul. L’identification rapide de leur étiologie permet de restaurer sans délai l’intégrité de l’analyse inférentielle.
L’erreur #N/A surgit quasi systématiquement dans le cadre du test apparié :
=TEST.T(plage1; plage2; 2; 1)
Ce code signale que l’algorithme d’appariement a détecté une dissymétrie stricte de longueur entre la première et la seconde plage de données. Un test apparié exigeant des couples complets, la présence d’une seule cellule vide non nettoyée dans une colonne ou d’un déséquilibre de taille (par exemple 30 cellules en Plage1 et 29 en Plage2) bloque l’exécution. La résolution consiste à vérifier le nombre exact de données avec =NB(...) sur chaque colonne et à élaguer les lignes incomplètes.
L’erreur #VALEUR! indique qu’un argument attendu sous forme numérique contient des caractères textuels non convertibles. Cela provient fréquemment de la présence de caractères typographiques invisibles, d’espaces insécables copiés depuis un export web (code ASCII 160) ou d’une incohérence dans les séparateurs décimaux (utilisation de points sur une locale française attendant des virgules). La correction s’opère par l’inspection de la colonne via la fonction =ESTNUM(...), qui renvoie FAUX en face des cellules corrompues, ou par l’application d’un rechercher/remplacer global.
L’erreur #DIV/0! survient lorsque le dénominateur de la formule statistique devient nul. Dans la fonction TEST.T, ce blocage survient lorsqu’une plage de données présente une variance empirique strictement égale à zéro (tous les participants ont obtenu une note rigoureusement identique) ou lorsque la taille de l’échantillon N est égale à 1, rendant impossible l’estimation de l’écart-type (degrés de liberté nuls : N – 1 = 0).
12.2 Limites inhérentes à Google Sheets pour les analyses avancées
Bien que Google Sheets soit un vecteur remarquable pour l’analyse univariée standard et le partage collaboratif, il présente des limitations structurelles dont tout chercheur doit avoir une conscience aiguë pour ne pas outrepasser son champ de validité.
La première limitation majeure est l’absence de fonctions natives pour les tests non paramétriques de rangs équivalents. Il n’existe aucune formule standard intégrée pour exécuter directement un test U de Mann-Whitney ou un test de Wilcoxon pour rangs signés sans avoir à construire de volumineuses matrices de calcul de rangs intermédiaires au moyen des fonctions RANG et d’ajustements matriciels complexes. De même, les procédures de modélisation factorielle avancée indispensables en psychologie expérimentale — telles que l’ANOVA multifactorielle à mesures répétées, l’ANCOVA (analyse de covariance) ou les régressions linéaires multiples hiérarchiques — ne disposent d’aucun moteur natif dans le tableur.
La seconde contrainte concerne la scalabilité face au Big Data comportemental. Si le recueil expérimental implique des signaux électroencéphalographiques (EEG), des données d’oculométrie (eye-tracking) à haute fréquence (1000 Hz) ou des matrices d’évaluation numérique massives excédant plusieurs centaines de milliers d’enregistrements, Google Sheets subira des ralentissements de rafraîchissement considérables, pouvant saturer la mémoire allouée au navigateur et compromettre la fluidité du traitement.
12.3 Extensions et automatisation par Google Apps Script
Pour dépasser ces goulets d’étranglement méthodologiques sans quitter l’environnement de Google Workspace, deux stratégies d’extension s’offrent à l’analyste. La première réside dans le déploiement de modules complémentaires spécialisés accessibles via l’espace Google Workspace Marketplace, tels que XLMiner Analysis ToolPak. Ce module greffe une interface d’analyse similaire aux outils d’analyse de données historiques d’Excel, autorisant l’exécution d’analyses de variance univariées et la production de rapports descriptifs automatisés.
La seconde approche, infiniment plus flexible et personnalisable, consiste à développer des fonctions statistiques sur mesure via Google Apps Script, l’environnement de programmation basé sur JavaScript intégré à Google Sheets. L’analyste peut implémenter son propre algorithme de calcul non paramétrique ou concevoir une fonction générant automatiquement un bloc de résultats formaté selon les normes strictes de l’APA.
Voici un exemple de script concis, déployable dans le menu Extensions > Apps Script, permettant de créer une fonction personnalisée appelée APA_T_TEST_INDEP :
function APA_T_TEST_INDEP(plage1, plage2) {

  var n1 = plage1.length;

  var n2 = plage2.length;

  var m1 = 0, m2 = 0;

  for(var i=0; i<n1; i++) m1 += plage1[i][0];

  for(var j=0; j<n2; j++) m2 += plage2[j][0];

  m1 /= n1; m2 /= n2;

  var ss1 = 0, ss2 = 0;

  for(var i=0; i<n1; i++) ss1 += Math.pow(plage1[i][0] - m1, 2);

  for(var j=0; j<n2; j++) ss2 += Math.pow(plage2[j][0] - m2, 2);

  var df = n1 + n2 - 2;

  var sp = Math.sqrt((ss1 + ss2) / df);

  var t = (m1 - m2) / (sp * Math.sqrt((1/n1) + (1/n2)));

  var d = (m1 - m2) / sp;

  return "t(" + df + ") = " + t.toFixed(2) + ", d = " + d.toFixed(2);

}
Enfin, lorsque la complexité du protocole l’exige, Google Sheets s’intègre avec une fluidité remarquable au sein des pipelines modernes de science des données. Grâce à des packages spécialisés comme googlesheets4 sous l’environnement R ou les bibliothèques gspread et pandas sous Python, les feuilles de calcul Google Sheets peuvent servir d’interfaces de collecte et de saisie collaborative en ligne, tout en déléguant l’exécution des modélisations statistiques les plus sophistiquées (modèles mixtes linéaires, inférence bayésienne) aux moteurs d’analyse de pointe, scellant ainsi l’alliance entre ergonomie collaborative et puissance scientifique intégrale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2012). Understanding the new statistics: Effect sizes, confidence intervals, and meta-analysis. Routledge.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Hedges, L. V., & Olkin, I. (1985). Statistical methods for meta-analysis. Academic Press.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge.
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
- Westfall, P. H., & Henning, K. S. (2013). Texts in statistical science: Understanding advanced statistical methods. CRC Press.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.
- Wilkinson, L., & the Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594