
Dans le champ contemporain des sciences de gestion et de l’ingénierie financière, la prise de décision stratégique ne saurait s’accommoder d’une vision univoque ou déterministe de l’avenir. L’instabilité macroéconomique, la volatilité des marchés financiers et la complexité inhérente aux chaînes logistiques mondiales exigent des décideurs qu’ils explorent des bifurcations prospectives multiples avant d’engager des capitaux matériels ou humains. Dans ce contexte, l’analyse d’hypothèses — traditionnellement désignée sous le vocable anglo-saxon de what-if analysis — constitue un ensemble méthodologique fondamental visant à mesurer la sensibilité d’un système numérique face aux perturbations délibérées de ses paramètres fondamentaux.
Longtemps réservée aux environnements logiciels spécialisés de recherche opérationnelle ou aux progiciels de planification intégrés d’entreprise, cette discipline de simulation quantitative a trouvé dans le tableur informatique son médium de vulgarisation le plus universel. L’avènement des écosystèmes infonuagiques, incarné de manière emblématique par Google Sheets, a transformé ce qui relevait autrefois d’un calcul statique et isolé en une dynamique collaborative en temps réel. Grâce à l’interconnexion instantanée des données et à la distribution décentralisée des calculs, la modélisation contrefactuelle s’est émancipée des silos analytiques traditionnels.
Toutefois, la manipulation rigoureuse de ces outils au sein d’un tableur moderne nécessite bien davantage que la simple saisie empirique de données numériques. Elle requiert une compréhension aiguë de l’architecture mathématique sous-jacente, une maîtrise formelle des graphes de dépendance cellulaire, ainsi qu’une vigilance épistémologique constante face aux heuristiques de jugement qui biaisent l’interprétation des résultats. Ce traité se propose d’explorer, de manière systématique et exhaustive, les fondements conceptuels, les mécaniques algorithmiques, les protocoles opératoires et les cadres de gouvernance indispensables pour conduire des analyses d’hypothèses de haute précision dans Google Sheets.
1. Fondements théoriques et épistémologie de l’analyse d’hypothèses
1.1 Définition conceptuelle et taxonomie de l’analyse d’hypothèses
L’analyse d’hypothèses peut être formellement définie comme une approche d’expérimentation contrefactuelle appliquée à un système formellement clos, où l’analyste modifie délibérément un ou plusieurs paramètres d’entrée afin d’observer la trajectoire consécutive des métriques de sortie. Dans l’environnement d’un tableur, cette démarche repose sur l’exploitation d’une fonction mathématique multivariée implicite, régie par les interconnexions de cellules. Loin d’être une simple commodité technique, la simulation prospective sur tableur matérialise une démarche heuristique puissante : elle permet d’éprouver la résilience structurelle d’un modèle économique ou logistique sans encourir les coûts réels inhérents aux erreurs de planification matérielle.
D’un point de vue taxonomique, il convient d’opérer une distinction sémantique et méthodologique rigoureuse entre trois piliers fondamentaux : l’analyse de sensibilité, la modélisation par scénarios et la recherche d’objectifs (ou rétro-ingénierie paramétrique). L’analyse de sensibilité explore le gradient de variation d’une variable dépendante sous l’effet de perturbations incrémentales appliquées à une ou deux variables indépendantes isolées. La modélisation par scénarios, en revanche, consiste en la permutation synchrone d’un vecteur complet de variables exogènes, capturant ainsi des conjonctures macroéconomiques ou opérationnelles globales (telles que des états nominaux, pessimistes ou optimistes). Enfin, la recherche d’objectifs inverse la causalité algorithmique : partant d’un état final prescrit pour la variable dépendante, elle mobilise des solveurs itératifs afin d’identifier la valeur exacte que doit adopter une variable indépendante cible pour satisfaire cette condition téléologique.
Cette taxonomie met en relief le rôle paradigmatique des variables exogènes et endogènes dans les systèmes de calcul matriciel. Les variables exogènes représentent des grandeurs imposées au modèle depuis son environnement extérieur (par exemple, un taux d’inflation, un cours de change ou un barème fiscal), tandis que les variables endogènes résultent exclusivement des équations internes de l’architecture cellulaire. Historiquement, les capacités de simulation stochastique, autrefois l’apanage de mainframes exécutant des simulations de Monte-Carlo au prix de programmations lourdes, ont migré progressivement vers les ordinateurs personnels via des solutions pionnières comme VisiCalc et Lotus 1-2-3, avant de trouver leur quintessence collaborative dans les moteurs de calcul asynchrones des tableurs contemporains hébergés en nuage.
1.2 Dimensions psychologiques et prise de décision sous incertitude
L’analyse d’hypothèses ne se résume pas à un agrégat de manipulations calculatoires ; elle s’inscrit au cœur de la cognition décisionnelle des organisations. L’incertitude managériale génère une anxiété cognitive substantielle chez les dirigeants, souvent confrontés à l’absence de visibilité quant aux externalités de leurs choix. La simulation chiffrée intervient ici comme un réducteur d’entropie psychologique : en visualisant concrètement l’éventail des possibles sous la forme de distributions de valeurs, le décideur transforme un inconnu non mesurable en un risque probabilisable, atténuant ainsi l’inhibition paralysante propre aux contextes hautement instables.
En outre, l’exploration systématique d’espaces de variables critiques joue un rôle crucial dans l’atténuation du biais d’excès de confiance (overconfidence bias). L’esprit humain a une propension documentée à sous-estimer la variance future et à postuler une linéarité rassurante des trajectoires économiques. En confrontant l’analyste à des scénarios de rupture générés algorithmiquement, le tableur met en lumière la fragilité intrinsèque des modèles déterministes. Cette dynamique renvoie directement aux postulats de la théorie des perspectives formulée par Daniel Kahneman et Amos Tversky, laquelle démontre que les agents économiques évaluent les gains et les pertes de manière asymétrique, avec une aversion marquée pour la perte relative à un point de référence donné. Dans le calcul des seuils de rentabilité, cette asymétrie psychologique se traduit par un impératif : identifier avec une rigueur absolue la marge de sécurité avant qu’une perturbation marginale ne précipite l’exploitation dans la zone des flux négatifs.
Le rôle heuristique de la rétroaction dynamique s’avère déterminant lors des choix stratégiques à hauts risques. Lorsqu’un gestionnaire observe en direct la recomposition instantanée de ses marges ou de son besoin en fonds de roulement sous l’impulsion d’une commande interactive ou d’un curseur logiciel, son schéma mental s’affine par apprentissage rétroactif immédiat. Cette plasticité cognitive renforce la compréhension systémique des interdépendances causales au sein de l’organisation, prévenant l’adoption de stratégies myopes qui optimiseraient un sous-ensemble local au détriment de la résilience globale de l’édifice économique.
1.3 Typologie des architectures de calcul applicables dans Google Sheets
L’exécution d’analyses contrefactuelles dans Google Sheets repose sur des infrastructures logiques différenciées qu’il convient de classifier selon la nature de leurs équations et la topologie de leur réseau cellulaire. La distinction cardinale oppose les modèles purement déterministes aux approches probabilistes ou stochastiques formulées en équations fermées. Un modèle déterministe postule une chaîne de causalité stricte où chaque intrant produit un extrant invariable et prévisible via des fonctions algébriques classiques. À l’inverse, l’intégration d’approches stochastiques mobilise des générateurs de pseudo-nombres aléatoires (tels que la fonction ALEA() ou ALEA.ENTRE.BORNES()) couplés à des fonctions de répartition inverse pour simuler des variables obéissant à des lois normales, log-normales ou de Poisson, transformant ainsi la feuille de calcul en un laboratoire de micro-simulations statistiques.
Sur le plan structurel, le moteur d’évaluation de Google Sheets modélise les relations entre les cellules sous la forme d’un graphe orienté acyclique (DAG, pour Directed Acyclic Graph). Dans cette armature topologique, chaque cellule constitue un sommet, et chaque référence formule constitue une arête orientée partant de la cellule antécédente vers la cellule dépendante. L’intégrité computationnelle de Google Sheets exige en principe l’absence de cycles, garantissant que l’ordonnancement topologique puisse déterminer un ordre d’évaluation sans ambiguïté. Lorsqu’un analyste déclenche une analyse d’hypothèses, le moteur invalide les nœuds modifiés et propage la mise à jour exclusivement le long des branches descendantes du graphe, garantissant une efficacité de calcul optimale.
Néanmoins, certaines modélisations complexes requièrent l’activation délibérée du calcul itératif pour traiter des conditions de bouclage circulaire contrôlé. Cette situation émerge notamment dans la modélisation financière lors du calcul simultané des intérêts de la dette et du solde de trésorerie disponible, où le paiement des intérêts dépend du tirage de crédit, qui dépend lui-même du déficit net induit par les intérêts. Google Sheets autorise la résolution de ces systèmes d’équations simultanées en suspendant l’interdiction des références circulaires et en instaurant un processus itératif récursif. Ce dernier est contraint par deux critères stricts : le nombre maximal d’itérations allouées et le seuil de convergence numérique (valeur epsilon), garantissant la terminaison formelle du calcul sans risque de divergence arithmétique infinie.
2. Préparation structurée et architecture des données matricielles
2.1 Conception rigoureuse du schéma tabulaire de simulation
La viabilité et la pérennité d’une analyse d’hypothèses reposent invariablement sur la discipline architecturale appliquée lors de la modélisation initiale du classeur. Une erreur méthodologique omniprésente chez les analystes novices réside dans la promiscuité spatiale des données : mélanger, au sein d’un même périmètre cellulaire non différencié, des valeurs empiriques statiques, des constantes structurelles et des formules analytiques dérivées. Pour conjurer les risques de corruption du modèle, il est impératif d’instaurer une ségrégation spatiale stricte divisant le classeur en trois territoires distincts : le bloc des paramètres d’entrée (input vector), le bloc des calculs intermédiaires et d’agrégation, et enfin le bloc de restitution des métriques d’impact stratégique (output dashboard).
La normalisation des plages de données s’avère tout aussi capitale afin de garantir la persistance et la non-corruption des pointeurs mémoires lors de l’extension dynamique du modèle. Cette démarche implique de concevoir des structures tabulaires orthogonales et continues, dépourvues de lignes blanches orphelines ou de cellules fusionnées anarchiques — ces dernières constituant des obstacles majeurs à la vectorisation des calculs et à l’exploitation des fonctions matricielles avancées. De surcroît, l’analyste chevronné adoptera systématiquement des nomenclatures conventionnelles et déploiera des plages nommées (via le menu Données > Plages nommées). L’attribution d’identifiants univoques tels que Cout_Acquisition_Client ou Taux_Actualisation_WACC en lieu et place de coordonnées arbitraires telles que B4 ou $K$12 clarifie instantanément la sémantique computationnelle et prévient les erreurs de glissement de références.
Enfin, cette architecture doit impérativement s’accompagner d’une couche de métadonnées documentaires intégrée. Dans un environnement partagé, aucune hypothèse ne doit subsister à l’état de variable muette. L’emploi systématique de notes de cellules, de volets documentaires réservés ou de colonnes d’explicitation méthodologique permet de documenter la source empirique, la date de révision et le degré d’incertitude associé à chaque paramètre exogène avant d’engager toute simulation d’impact à grande échelle.
2.2 Formulation mathématique et intégrité des équations sources
L’efficacité d’un modèle d’hypothèses dépend intrinsèquement de l’élégance et de la robustesse de ses équations sources. Les calculs doivent privilégier des architectures matricielles condensées plutôt que des cascades infinies d’opérations scalaires élémentaires. La combinaison de produits matriciels, notamment au travers de la fonction PRODMAT (ou MMULT en nomenclature internationale), et de sommes pondérées permet de compacter des logiques d’affaires hautement complexes au sein d’expressions mathématiques formellement vérifiables. Cette compacité réduit l’empreinte mémoire du classeur et diminue drastiquement la surface d’exposition aux erreurs humaines de recopie de formules.
Un audit topologique préventif du classeur est nécessaire pour éliminer sans concession toute référence circulaire involontaire. Contrairement aux boucles circulaires contrôlées évoquées précédemment, les références circulaires accidentelles résultent généralement de glissements de plages sommatoires englobant la cellule de résultat elle-même. Ces anomalies provoquent l’instabilité du graphe d’évaluation de Google Sheets et l’affichage d’erreurs d’invalidation (#REF!), rendant totalement caduque toute tentative d’analyse de sensibilité. L’audit exige une inspection minutieuse de la cohérence dimensionnelle des plages référencées et la vérification des bornes d’indexation.
Parallèlement, la validation préventive des types de données constitue une étape non négociable. Google Sheets possède un moteur d’inférence de type permissif, capable de convertir implicitement des chaînes textuelles contenant des chiffres en valeurs numériques lors de certaines opérations arithmétiques basiques. Cependant, cette permissivité devient une source critique de dysfonctionnement dans les calculs matriciels stricts ou les fonctions logiques avancées, où une chaîne de caractères non typée sera ignorée par une fonction SOMME ou rejetée par un solveur d’optimisation. L’analyste doit imposer des types rigides, nettoyer les espaces parasites à l’aide de la fonction SUPPRESPACE, et recourir à des fonctions d’assertion telles que ESTNUM pour garantir que seules des grandeurs arithmétiques réelles alimentent les formules mères.
2.3 Validation formelle et contraintes d’intégrité
Afin d’éviter que le modèle de simulation ne produise des résultats absurdes ou mathématiquement indéterminés lorsqu’il est soumis à des tests aux limites, l’application de règles de validation des données s’avère indispensable. Dans Google Sheets, la fonctionnalité accessible sous Données > Validation des données permet de circonscrire strictement les intervalles admissibles pour chaque variable indépendante. Il est ainsi possible d’imposer qu’un taux de conversion soit rigoureusement compris entre 0 et 1 (0 % et 100 %), qu’un volume de production soit un entier strictement positif, ou qu’un prix de vente unitaire ne descende jamais sous un plancher réglementaire ou marginal. Cette barrière préventive garantit que toute perturbation injectée lors de l’expérimentation contrefactuelle demeure dans un domaine de faisabilité physique et économique pertinent.
La traçabilité absolue des états antérieurs constitue une exigence fondamentale de l’analyse d’hypothèses en milieu professionnel. Lors des sessions de travail exploratoires, il est fréquent que les analystes modifient les données d’entrée de manière anarchique pour tester des hypothèses fugaces. Google Sheets intègre nativement une gestion de versions granulaire via Google Drive (Fichier > Historique des versions). Ce mécanisme offre la possibilité d’immortaliser des points de contrôle étiquetés — par exemple, « État de référence avant simulation d’inflation T3 » — permettant de restaurer instantanément la topologie initiale du modèle ou de comparer visuellement les deltas de données induits par les différentes itérations.
Enfin, l’intégrité du système repose sur la protection logicielle des cellules abritant les équations maîtresses. En verrouillant sélectivement les plages contenant les formules de calcul et les tableaux intermédiaires (via Données > Protéger les feuilles et les plages), l’architecte du modèle autorise uniquement la modification des cellules d’hypothèses désignées. Cette mesure préventive garantit que les utilisateurs ou les collaborateurs ne puissent altérer involontairement les liaisons fonctionnelles lors de l’exécution de leurs simulations, sanctuarisant ainsi la validité mathématique de l’infrastructure de calcul.
3. L’extension Goal Seek : Architecture technique et déploiement
3.1 Protocoles d’acquisition et permissions sécuritaires
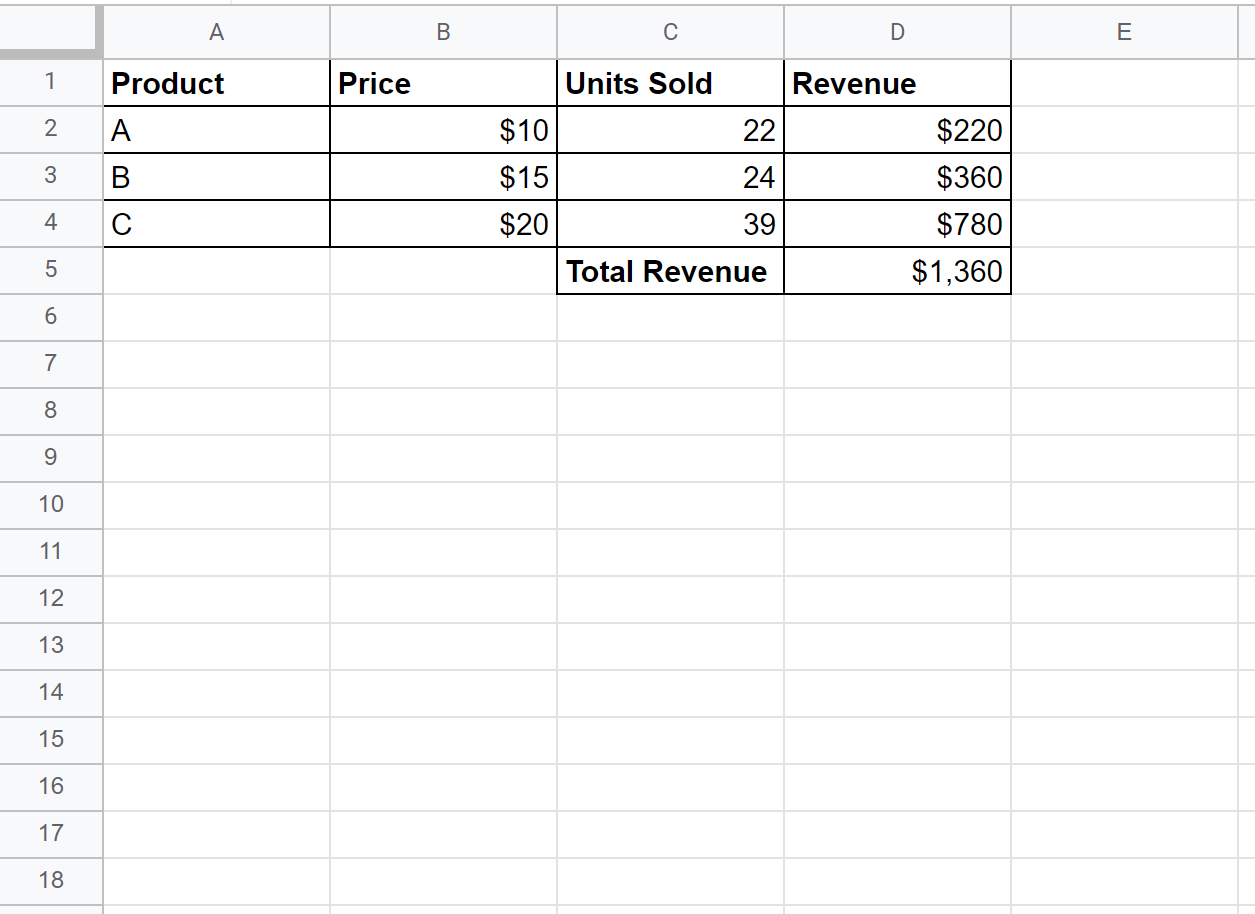
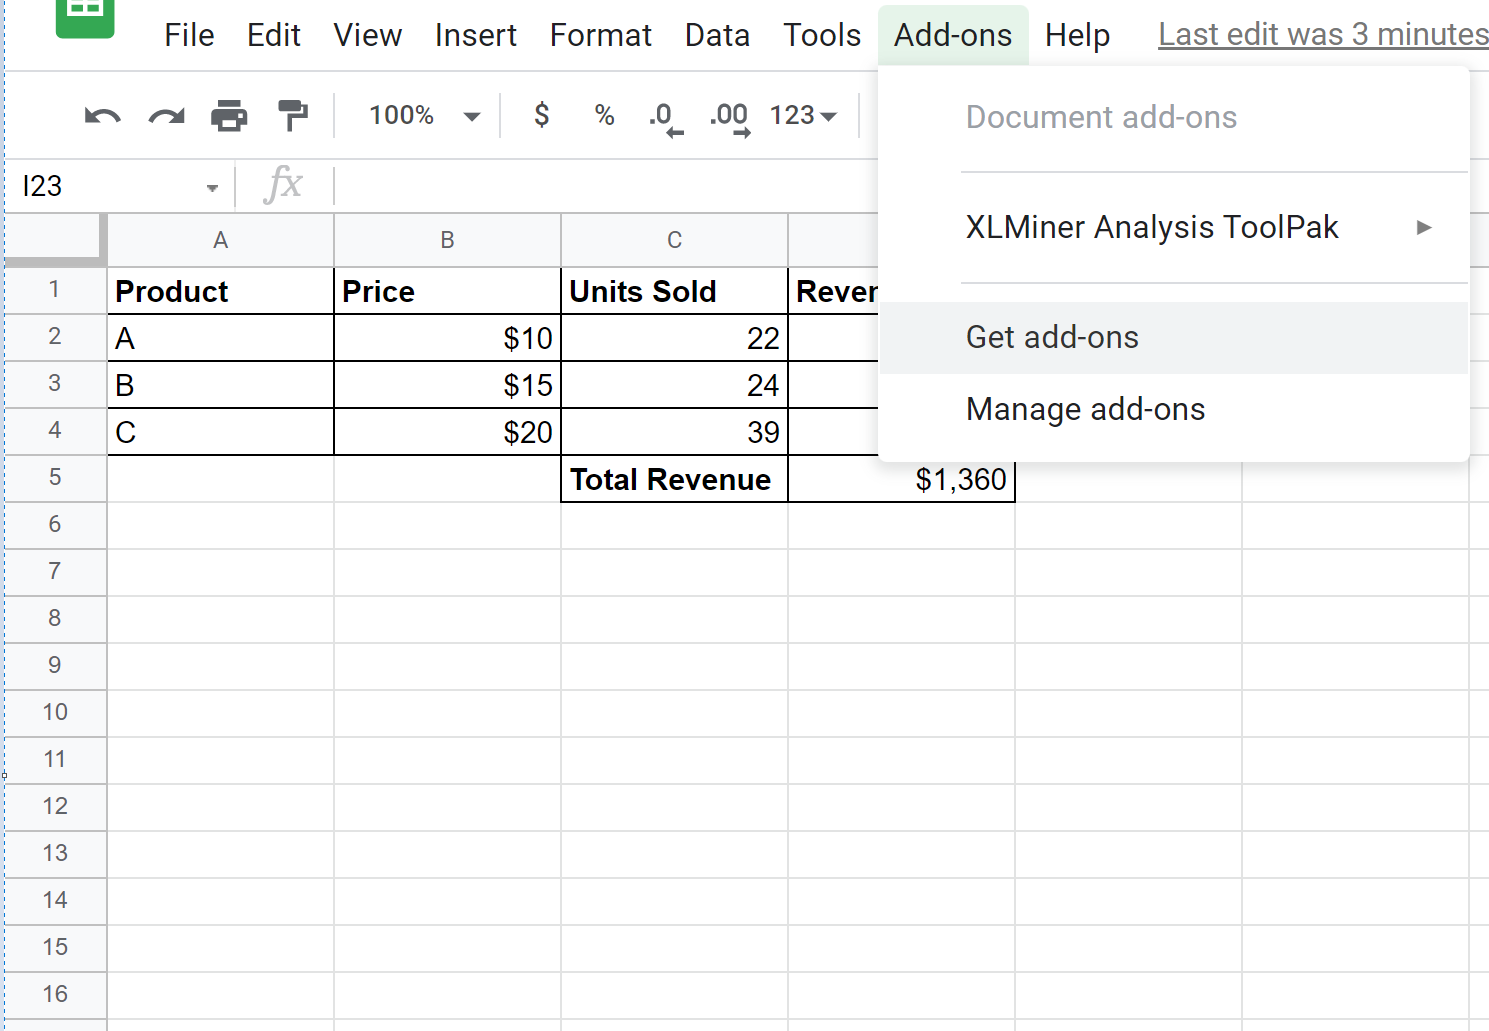
Bien que Google Sheets offre en natif un ensemble exceptionnel de fonctions d’analyse prospective, il est dépourvu par défaut de la fonction univariable automatisée de recherche d’objectifs présente historiquement dans les tableurs de bureau. Pour pallier cette absence, l’équipe d’ingénierie de Google Workspace a développé une extension officielle et dédiée, baptisée Goal Seek. L’acquisition de ce module s’effectue directement au travers du magasin applicatif hébergé au sein de l’interface : il suffit de parcourir Extensions > Modules complémentaires > Télécharger des modules complémentaires, puis de soumettre la requête correspondante dans le champ de recherche.
L’installation d’un tel module tiers ou propriétaire engage nécessairement une révision rigoureuse des privilèges sécuritaires et des protocoles d’autorisation. Lors du déploiement, Google Sheets sollicite le consentement de l’utilisateur via le protocole OAuth2. L’extension requiert l’accès en lecture et en écriture au document actif afin de pouvoir inspecter les formules des cellules, lire les valeurs intermédiaires et modifier de manière itérative la variable libre sélectionnée. Dans les organisations régies par des politiques de sécurité des systèmes d’information (PSSI) strictes, ces habilitations doivent faire l’objet d’un audit préalable : il convient de s’assurer que le script s’exécute strictement dans le contexte du document sans opérer d’exfiltration de métadonnées sensibles vers des serveurs externes non certifiés.
Dans un contexte d’entreprise ou d’institution académique, le déploiement individuel par les utilisateurs peut s’avérer inefficace ou contraire aux règles de gouvernance. Les administrateurs de la console Google Workspace possèdent la faculté de réaliser un déploiement centralisé à l’échelle du domaine ou d’une unité organisationnelle spécifique. Cette approche assure l’homogénéité des versions de l’outil à travers l’ensemble des collaborateurs, élimine les disparités de configuration et garantit que les classeurs de simulation partagés fonctionnent sans friction opérationnelle chez l’ensemble des destinataires de l’organisation.
3.2 Algorithmes sous-jacents du moteur Goal Seek
Pour appréhender les capacités et les vulnérabilités de l’extension Goal Seek, il est essentiel d’examiner le moteur mathématique qui régit son fonctionnement. Contrairement à une idée largement répandue, l’extension n’effectue pas un balayage aléatoire par force brute de l’espace des solutions, ce qui saturerait rapidement les temps de réponse réseau. Elle s’appuie sur une version numériquement discrétisée de la méthode de la sécante, un algorithme d’analyse numérique dédié à la localisation des racines d’une équation continue univariable de type ( f(x) – Y = 0 ), où ( Y ) représente la cible prescrite.
La méthode de la sécante constitue une variante de la célèbre méthode de Newton-Raphson. Cependant, là où Newton-Raphson exige le calcul formel ou symbolique de la dérivée première ( f'(x) ) de la fonction — une exigence impossible à satisfaire de manière générique au sein d’un graphe cellulaire complexe où les formules peuvent comporter des opérateurs logiques, des indexations conditionnelles et des calculs en chaîne non différentiables —, la méthode de la sécante contourne cette limitation en substituant à la dérivée une approximation par différences finies. L’algorithme évalue la fonction en deux points successifs, ( x_k ) et ( x_{k-1} ), puis calcule la pente de la droite sécante sécante traversant ces coordonnées pour projeter la prochaine estimation ( x_{k+1} ) selon la formule de récurrence :
[ x_{k+1} = x_k – f(x_k) cdot frac{x_k – x_{k-1}}{f(x_k) – f(x_{k-1})} ]
La terminaison formelle de ce processus numérique est gouvernée par deux critères essentiels : la tolérance résiduelle (seuil epsilon en dessous duquel l’écart absolu ( |f(x) – Y| ) est jugé mathématiquement négligeable) et le plafond itératif maximal (généralement configuré par défaut à 100 cycles d’évaluation). Si la fonction modélisée présente une courbure continue et une stricte monotonie dans le voisinage de la solution, l’algorithme démontre une convergence superlinéaire rapide d’ordre géométrique voisin de 1,618 (le nombre d’or). En revanche, face à des fonctions non monotones, présentant des points d’inflexion horizontaux ou des singularités discontinues, l’algorithme est susceptible d’entrer dans des cycles d’oscillation instable ou de diverger vers l’infini arithmétique.
3.3 Initialisation et disposition de l’interface utilisateur
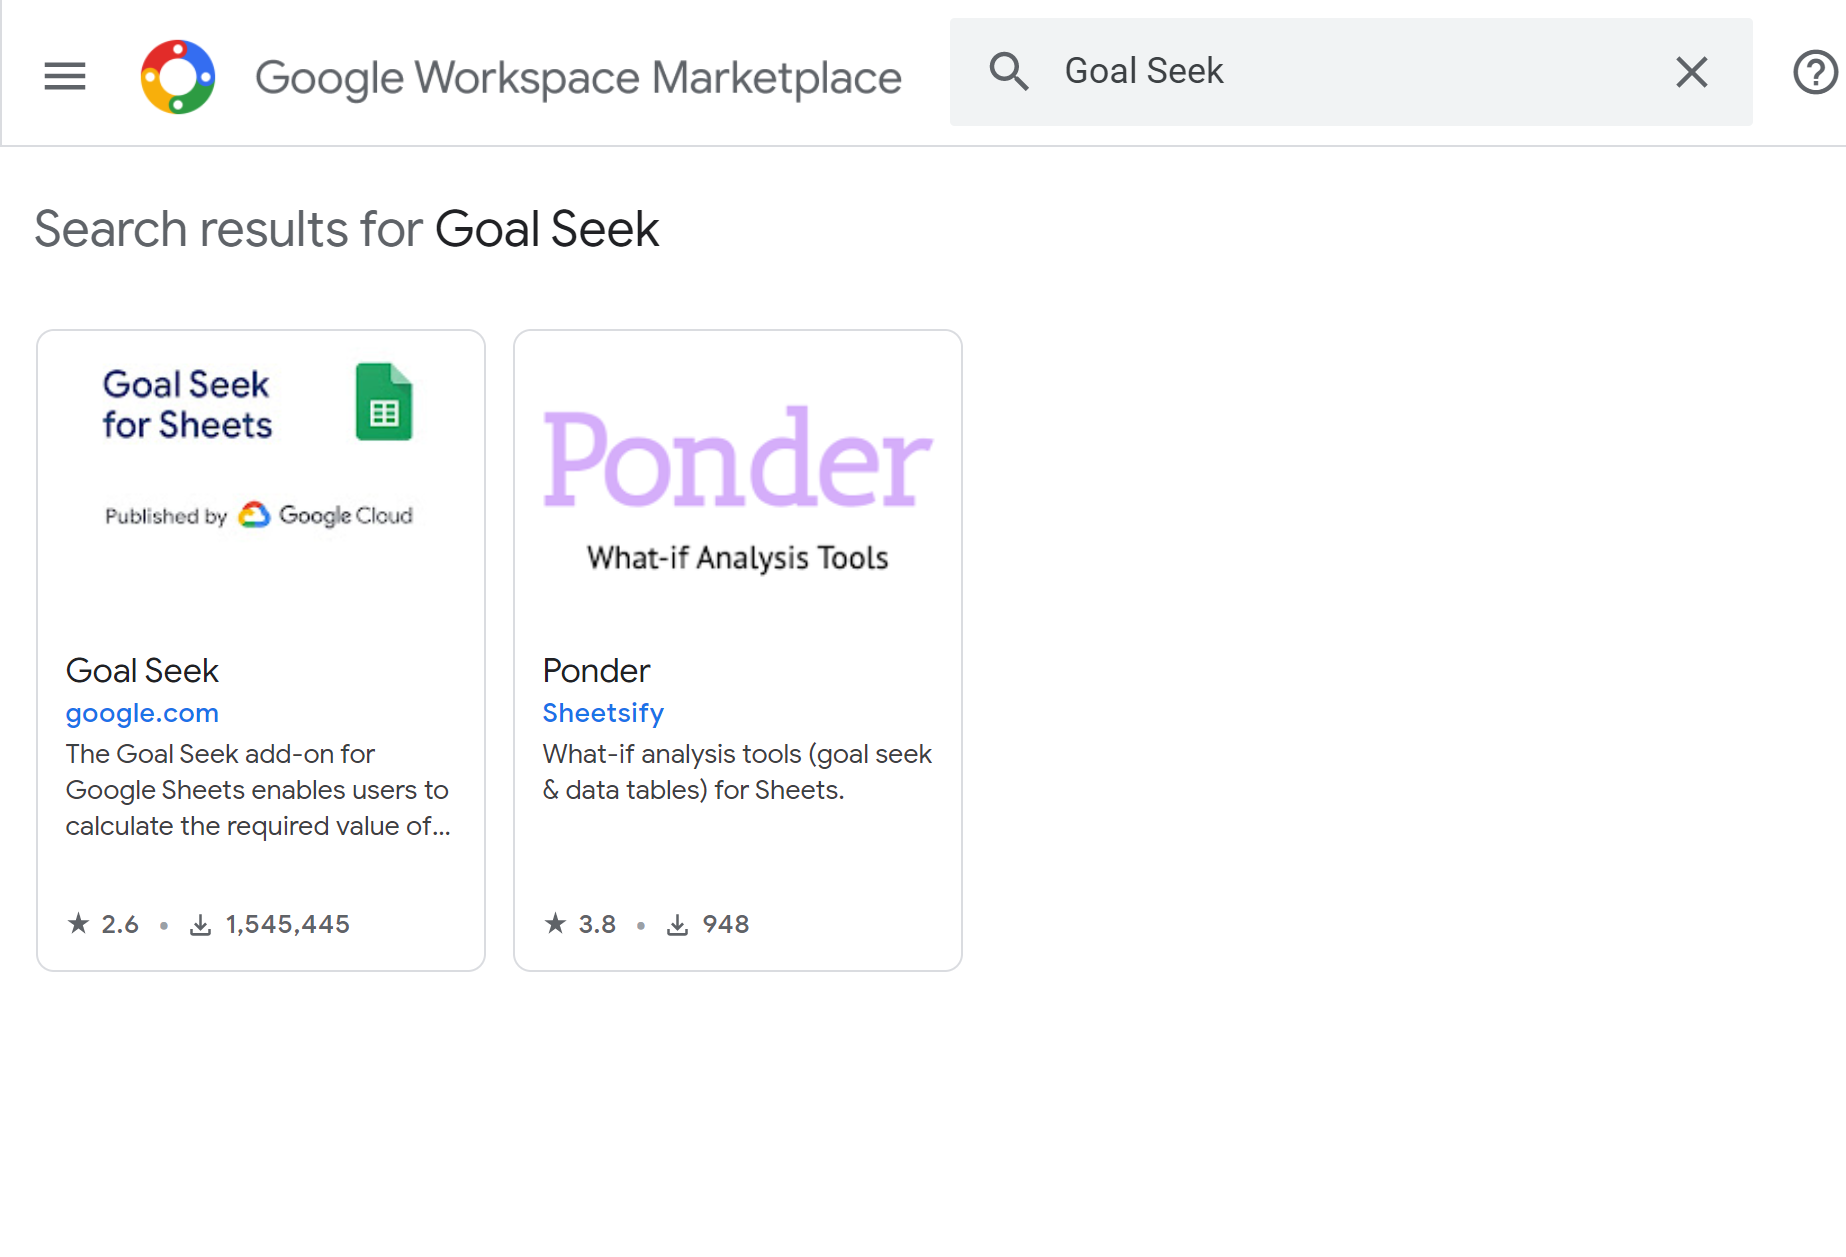
Une fois l’extension formellement déployée au sein du classeur, son activation s’effectue en déroulant le menu Extensions > Goal Seek > Open. Cette action déclenche l’ouverture d’un panneau latéral asynchrone intégré au canevas applicatif de Google Sheets. Ce choix d’ergonomie matérielle s’avère particulièrement pertinent : l’ancrage du module dans un volet latéral préserve l’intégralité du focus visuel sur les matrices de données centrales, permettant à l’analyste de suivre l’évolution cellulaire sans que la fenêtre de dialogue ne vienne masquer les coordonnées critiques de la modélisation.
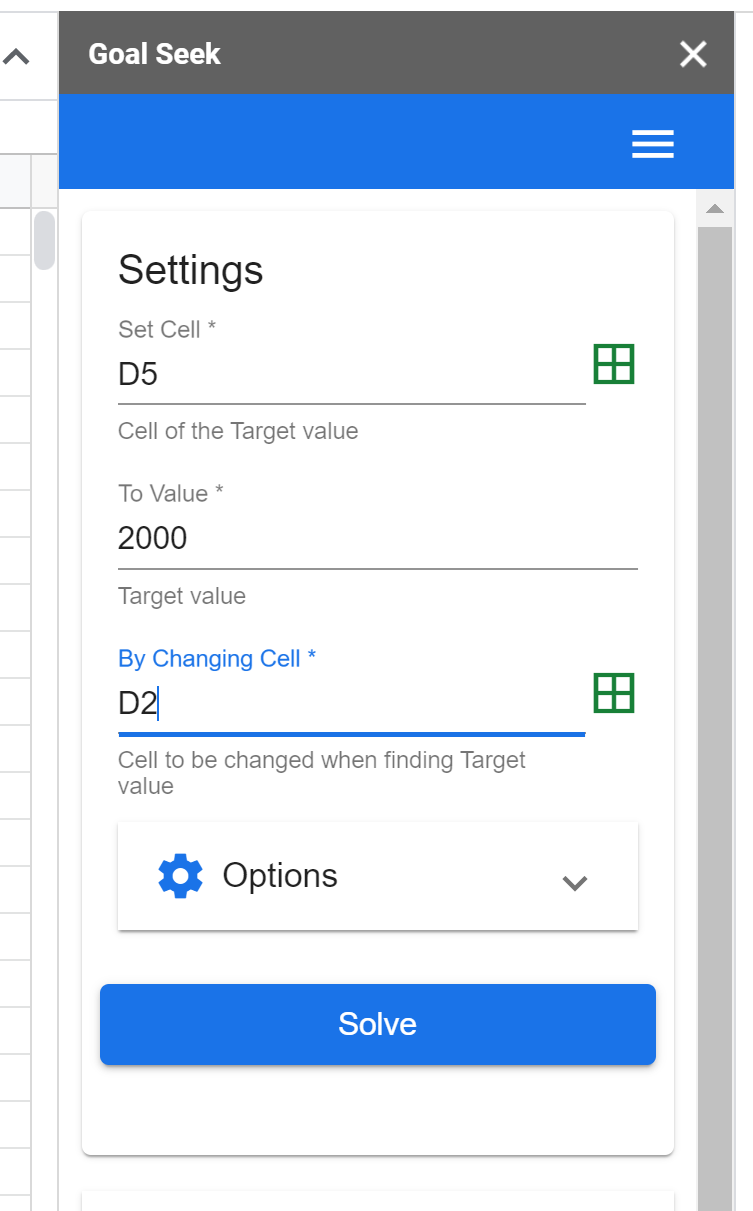
L’interface graphique de Goal Seek se distingue par un minimalisme fonctionnel pensé pour concentrer l’action décisionnelle sur trois paramètres d’entrée cardinaux :
- Set Cell : La cellule cible abritant l’équation dont on souhaite piloter la valeur de sortie.
- To Value : La constante scalaire rigide représentant l’objectif numérique à atteindre.
- By Changing Cell : La cellule indépendante recevant la perturbation itérative jusqu’à résolution complète du système.
Il importe de souligner la gestion de l’état asynchrone sous-tendant ce dispositif. Contrairement aux tableurs opérant en mémoire vive locale, Google Sheets exécute une partie de la logique transactionnelle au travers d’échanges sérialisés avec les serveurs de calcul de Google. Lorsque l’utilisateur valide l’analyse en cliquant sur le bouton Solve, l’extension prend le contrôle temporaire du flux de données, injectant des valeurs successives dans la variable libre, attendant l’évaluation par le moteur central du graphe de dépendance, puis recueillant l’extrant calculé pour ajuster l’itération suivante. Cette chorégraphie réseau implique une latence intrinsèque supérieure à celle des solveurs compilés en local, ce qui justifie une conception architecturale épurée évitant les calculs superflus au sein du classeur.
4. Protocole pas à pas pour l’analyse d’atteinte d’objectifs simples
4.1 Définition de la cellule d’évaluation finale (Set Cell)
L’amorce d’une analyse d’objectifs rigoureuse débute par la sélection sans ambiguïté de la cellule d’évaluation finale au sein du champ Set Cell. Cette cellule doit impérativement abriter une formule mathématique active — qu’elle soit élémentaire ou issue d’un enchaînement matriciel complexe — dont l’évaluation courante dépend, de manière directe ou indirecte, de la variable que l’on se propose d’ajuster. Désigner par erreur une cellule contenant une simple valeur scalaire statique constitue la cause première d’échec chez les utilisateurs inexpérimentés ; le solveur se retrouverait dans l’incapacité absolue d’ajuster le résultat, déclenchant un message d’erreur d’incompatibilité immédiat.
Avant d’engager le traitement algorithmique, il est indispensable d’auditer l’existence d’une chaîne causale descendante et ininterrompue reliant la cellule cible à la variable libre. Pour ce faire, l’analyste doit remonter la généalogie des formules pour s’assurer qu’aucun maillon de liaison n’a été brisé par l’écrasement intempestif d’une équation intermédiaire par une constante statique. La présence d’une rupture dans la dépendance rendrait la dérivée de la fonction nulle par rapport à la variable d’entrée, condamnant l’algorithme de la sécante à une division par zéro lors de l’estimation de la pente.
Les conséquences d’un ciblage incorrect s’étendent également aux performances et à la justesse typologique. Pointer vers une cellule contenant une macro personnalisée instable, une formule générant des requêtes externes (telle que GOOGLEFINANCE ou IMPORTXML) ou une expression renvoyant des données textuelles induit des lenteurs massives de résolution dues aux délais d’aller-retour réseau et expose l’utilisateur à des blocages d’exécution consécutifs à des erreurs de typage non gérées par le moteur séquentiel.
4.2 Spécification de la cible numérique (To Value)
Le second paramètre de configuration réside dans la zone de texte To Value, où l’opérateur doit consigner l’amplitude arithmétique précise du résultat recherché. Sur le plan de la conception logicielle de l’extension standard, cette entrée est assujettie à une contrainte structurelle rigide : elle n’accepte exclusivement que des scalaires numériques explicites (par exemple : 50000, -1250.75 ou 0.185). Il est rigoureusement impossible d’y injecter une référence cellulaire dynamique telle que =F12 ou une formule arithmétique telle que =B1*1.2 sans voir l’algorithme échouer ou interpréter la saisie comme une chaîne non traitable.
Cette particularité impose une vigilance accrue lors de l’adaptation aux contraintes dimensionnelles propres aux différentes métriques financières ou scientifiques. Si la cellule cible est formatée pour exprimer un pourcentage (par exemple, un taux de marge ou un taux de rentabilité interne TRI), l’opérateur ne doit pas inscrire la valeur entière sous peine de multiplier l’objectif par un facteur cent. Pour atteindre une rentabilité de 15 %, la chaîne introduite dans le champ To Value doit être strictement typée en fraction décimale, à savoir 0.15. De même, les notations monétaires doivent être dépouillées de tout symbole monétaire (€, $, £) ou d’espaces séparateurs de milliers, sous peine de corrompre l’analyseur lexical (parser) du champ de saisie.
Dans les scénarios requérant des simulations d’amortissement ou de désendettement, la manipulation de valeurs négatives exige une rigueur symétrique. Omettre le signe négatif devant une charge d’intérêt ou un déficit résiduel conduira le solveur à explorer des régions de calcul spatialement opposées aux équilibres recherchés, aboutissant soit au plafonnement prématuré du nombre d’itérations, soit à des préconisations de variables physiques inconcevables (telles que des volumes de production négatifs).
4.3 Sélection de la variable d’ajustement (By Changing Cell)
Le triptyque de configuration s’achève par le paramétrage du champ By Changing Cell, dédié à l’identification de la variable d’ajustement. Cette sélection doit porter sur une cellule unique et indivisible. L’extension Goal Seek pour Google Sheets ne disposant pas des mécanismes multivariables d’un solveur de programmation linéaire sous contraintes (tel que Simplex), toute tentative d’injection d’une plage vectorielle (par exemple C4:C8) se soldera par une invalidation immédiate de l’instruction d’exécution.
Une exigence fondamentale gouverne cette cellule modifiable : elle doit impérativement être vierge de toute formule préexistante et héberger uniquement une valeur scalaire brute. Si l’opérateur commet l’imprudence de sélectionner une cellule abritant une équation dépendante, le premier cycle de calcul de Goal Seek écrasera irrémédiablement ladite formule en y injectant une valeur numérique itérative brute. Cet écrasement brise de facto le graphe de dépendance acyclique du modèle et corrompt la validité structurelle de l’ensemble du classeur, obligeant à une restauration manuelle via l’historique des versions.
En outre, l’état numérique initial présent dans la cellule modifiable au moment où le solveur est initialisé exerce une influence critique sur la vitesse et le succès de la convergence. L’algorithme de la sécante ayant besoin de deux évaluations pour estimer sa pente initiale, il utilise généralement la valeur de départ comme premier point d’ancrage et lui applique une perturbation marginale pour définir le second. Si cette valeur initiale est trop éloignée de la racine réelle, ou si elle se situe dans un bassin d’attraction proche d’une division par zéro locale ou d’un extremum local à dérivée quasi nulle, le solveur risque d’errer dans des boucles de convergence lentes ou d’échouer prématurément. Choisir une valeur de départ rationnelle et proche de l’ordre de grandeur présumé de la solution représente une règle empirique d’une haute valeur pratique.
5. Étude de cas empirique : Analyse de rentabilité d’un catalogue produit
5.1 Modélisation de l’écosystème de vente multi-produits
Afin d’illustrer la mise en œuvre pratique de ces principes computationnels, considérons un cas d’école empirique représentatif des problématiques d’arbitrage commercial au sein d’une entreprise manufacturière distribuant un catalogue composé de trois produits phares désignés A, B et C. L’écosystème financier de cette entreprise est encapsulé dans une matrice de bord de tableau où chaque produit est caractérisé par un volume de vente estimé, un prix de vente unitaire catalogue et un coût unitaire direct de production et d’acheminement logistique.
Posons les bases quantitatives initiales au sein de notre feuille de calcul Google Sheets :
- Produit A : Volume initial de 500 unités, Prix unitaire fixé à 10,00 €, Coût variable unitaire de 4,00 €, générant un chiffre d’affaires sectoriel de 5 000,00 € et une marge brute unitaire de 6,00 €.
- Produit B : Volume initial de 300 unités, Prix unitaire fixé à 25,00 €, Coût variable unitaire de 15,00 €, générant un chiffre d’affaires sectoriel de 7 500,00 € et une marge brute unitaire de 10,00 €.
- Produit C : Volume initial de 150 unités, Prix unitaire fixé à 80,00 €, Coût variable unitaire de 50,00 €, générant un chiffre d’affaires sectoriel de 12 000,00 € et une marge brute unitaire de 30,00 €.
Le total des revenus consolidés s’établit initialement à 24 500,00 € par sommation des produits scalaires, et le montant total des coûts variables directs atteint 14 000,00 €. Pour compléter ce cadre comptable, l’entreprise supporte une structure de charges fixes incompressibles d’exploitation (amortissement des équipements, loyers des infrastructures de stockage, dépenses administratives et masse salariale fixe) qui s’élève à 9 000,00 €. La marge nette d’exploitation (EBIT) s’obtient alors par la déduction des charges fixes et variables du revenu brut total, établissant le bénéfice net de départ à :
[ text{Résultat d’exploitation initial} = (5,000 + 7,500 + 12,000) – (2,000 + 4,500 + 7,500) – 9,000 = 1,500,€ ]
5.2 Formulation de l’hypothèse de rupture de seuil financier
Le comité de direction, confronté à des exigences accrues de rémunération des actionnaires et à la nécessité de constituer une réserve de trésorerie de précaution, formule une exigence stratégique nouvelle : porter le résultat d’exploitation d’exploitation net à un seuil contractuel de 3 500,00 €, soit une augmentation absolue de 2 000,00 € de la rentabilité finale nette.
Une revue détaillée des contraintes opérationnelles sectorielles impose cependant des restrictions drastiques sur les leviers d’action mobilisables. Les capacités de production et la demande commerciale pour les produits B et C se trouvent actuellement au plafond de leur marché respectif ; leurs volumes de vente sont donc considérés comme strictement invariables à court terme (fixés invariablement à 300 et 150 unités). De surcroît, les prix de vente de l’ensemble du catalogue sont encadrés par des engagements contractuels annuels fermes interdisant toute indexation tarifaire unilatérale.
Dans ce contexte hautement contraint, l’unique variable décisionnelle résiduelle réside dans l’ajustement du volume de production et d’écoulement du produit A. L’analyste se trouve ainsi confronté à un problème contrefactuel univarié bien défini : à quel niveau précis le volume d’unités vendues du produit A doit-il être porté pour compenser le déficit de rentabilité et absorber la structure des charges d’exploitation, de manière à satisfaire exactement la cible d’EBIT de 3 500,00 € ?
5.3 Résolution algorithmique et examen des résultats itérés
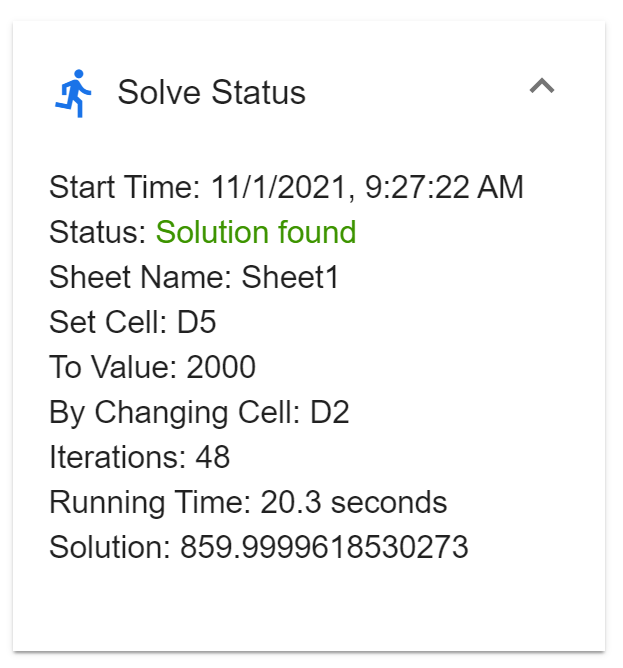
L’opérateur configure l’extension Goal Seek en assignant les pointeurs cellulaires correspondants : le champ Set Cell reçoit les coordonnées de la cellule abritant la formule de calcul de l’EBIT consolidé (par exemple E15), le champ To Value est instancié à la valeur cible 3500, et la zone By Changing Cell se voit assigner la cellule hébergeant le volume de vente du produit A (par exemple B4). Dès l’impulsion sur le bouton Solve, l’algorithme prend en charge le classeur : on observe à l’écran un défilement rapide des états matriciels au fur et à mesure que la méthode de la sécante affine ses extrapolations linaires successives.
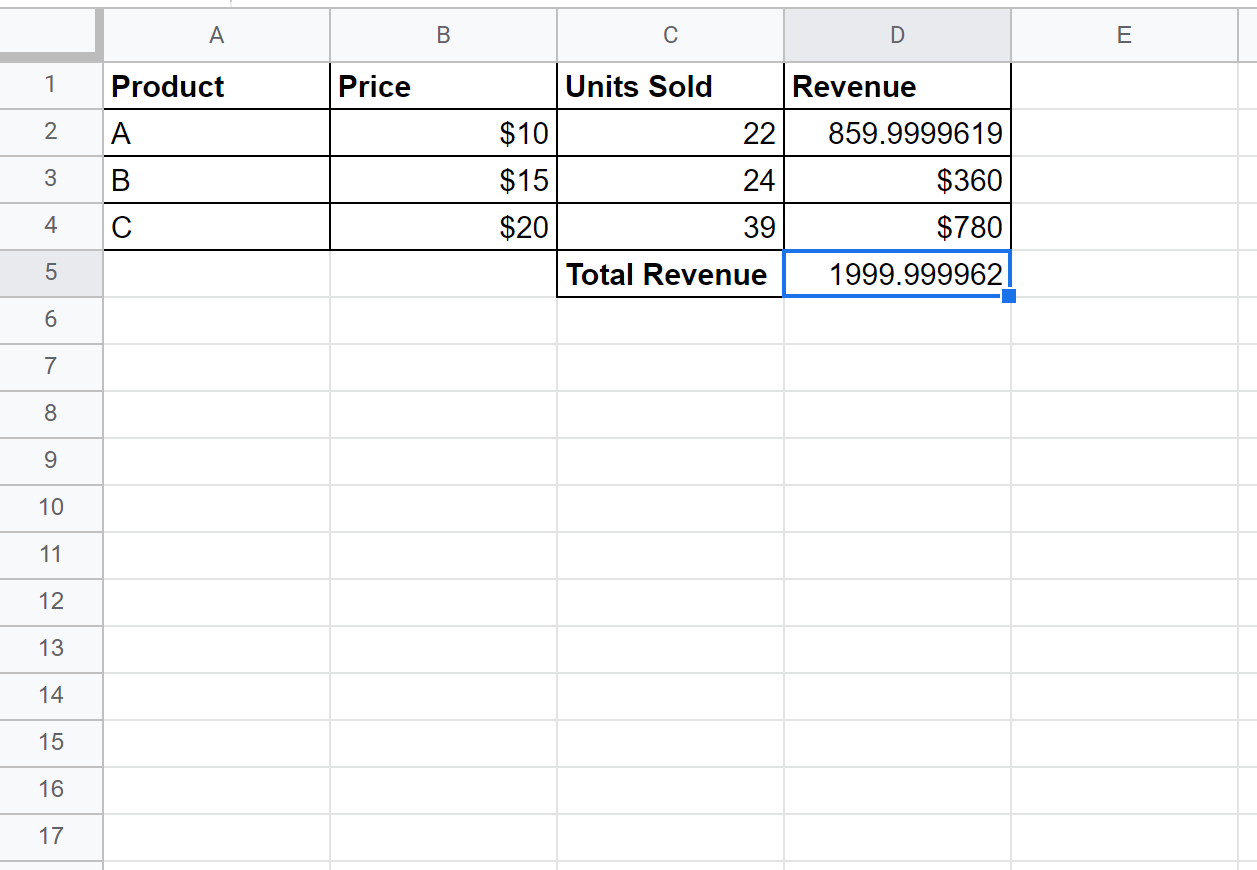
En quelques cycles d’itération, le moteur converge avec succès vers la valeur cible requise. L’algorithme fixe le volume d’unités du produit A à exactement 833,33 unités (soit une extrapolation arrondie au supérieur de 834 unités industrielles finies). L’injection de ce nouveau volume porte le chiffre d’affaires dérivé du produit A de 5 000,00 € à 8 333,33 €, générant une marge contributive unitaire supplémentaire consolidée de 2 000,00 € (( 333,33 times 6,00,€ )), ce qui compense rigoureusement l’écart et hisse l’EBIT final à l’objectif arithmétique rigoureux de 3 500,00 €.
Toutefois, l’expertise de l’analyste ne s’arrête pas au constat de la réussite du solveur mathématique : elle se déploie dans l’évaluation de la faisabilité commerciale opérationnelle au regard des capacités d’absorption du marché et de l’outil industriel. Une progression instantanée de 500 à 834 unités représente une augmentation de charge de 66,7 % pour la ligne de production dédiée au produit A. L’appareil de production peut-il absorber une telle charge sans engendrer de coûts de surchauffe (heures supplémentaires majorées, usure prématurée des outillages, recours à l’intérim) ? Le réseau logistique est-il dimensionné pour distribuer ces volumes sans dégrader les délais de livraison ? Le marché est-il en mesure d’absorber une telle quantité sans requérir de remises tarifaires de gros qui viendraient éroder la marge brute unitaire de 6,00 € ? Face à cette contradiction patente entre pure abstraction mathématique et réalités du terrain, l’arbitrage décisionnel consistera bien souvent à rejeter l’hypothèse univariée brute pour réexaminer une réallocation multifactorielle intégrant des économies de coûts fixes ou des ajustements marginaux de la gamme complète.
6. Modélisation de tables d’hypothèses à double entrée sans modules externes
6.1 Mécanique théorique des matrices de sensibilité bidimensionnelles
Si la recherche d’objectifs via solveur s’avère indispensable pour les résolutions inverses ciblées, la modélisation prospective bénéficie immensément de la spatialisation cartographique offerte par les matrices de sensibilité bidimensionnelles. Une table à double entrée permet d’abandonner l’analyse d’un événement isolé pour contempler un continuum cartésien structuré par l’interaction dynamique de deux inducteurs de performance indépendants (par exemple, le croisement de différents volumes d’activité en ligne avec une échelle de barèmes tarifaires en colonne).
La puissance conceptuelle de ce dispositif réside dans sa capacité à produire une évaluation simultanée, exhaustive et statique d’un espace de variabilité sans exiger le recours à des recalculs itératifs séquentiels. Contrairement aux approches par solveur qui contraignent l’analyste à attendre la terminaison de boucles algorithmiques pour chaque scénario unitaire, la table bidimensionnelle expose immédiatement sous le regard de l’observateur un tableau complet d’extrants. Cette vue synoptique facilite la lecture instantanée des convexités, des ruptures de pente et des zones de bascule financière, offrant ainsi une compréhension intuitive et globale du comportement du modèle face aux fluctuations conjointes de son environnement.
Par ailleurs, l’élaboration de ces matrices par le biais strict des fonctionnalités natives de Google Sheets confère une robustesse et une sécurité supérieures vis-à-vis des modules externes ou des scripts propriétaires. Les extensions et les scripts tiers demeurent assujettis à des limitations d’appels d’API, à des plafonds de quotas d’exécution temporelle et à des dépendances logicielles susceptibles d’être invalidées par les mises à jour des navigateurs ou les restrictions d’administration. Une architecture de calcul ancrée exclusivement dans le moteur d’évaluation matriciel natif du tableur assure une résilience absolue et une compatibilité multiplateforme sans défaillance.
6.2 Implémentation pratique avec les formules matricielles dynamiques
Pendant de nombreuses années, la construction de matrices de sensibilité au sein des tableurs traditionnels a reposé sur l’utilisation de commandes spécialisées de tables de données (l’instruction TABLE d’Excel). Dans Google Sheets, une modélisation particulièrement élégante et rapide consiste à exploiter la puissance des fonctions matricielles modernes de nouvelle génération, notamment ARRAYFORMULA, combinée à des opérations vectorielles rigoureusement formulées, ou le recours aux fonctions d’ordre supérieur introduites plus récemment telles que LAMBDA, MAP et MAKEARRAY.
Pour illustrer la mécanique native via les fonctions de génération dynamique, examinons l’instruction MAKEARRAY. Cette fonction permet de synthétiser une grille bidimensionnelle complète en calculant chaque cellule d’intersection à partir de ses indices de ligne et de colonne sans aucune recopie manuelle de formule. Supposons que nous souhaitions évaluer la sensibilité de la Valeur Actuelle Nette (VAN) d’un projet d’investissement en croisant une plage verticale de 5 taux d’actualisation différents (disposés en cellules A2:A6) avec une plage horizontale de 4 hypothèses de flux de trésorerie annuels constants (disposées en cellules B1:E1). La formule matricielle dynamique unique s’écrit de la manière suivante :
=MAKEARRAY(5; 4; LAMBDA(r; c; (INDEX(B1:E1; 1; c) * ((1 - (1 + INDEX(A2:A6; r; 1))^(-10)) / INDEX(A2:A6; r; 1))) - 100000))
Dans cette formulation fermée, la fonction MAKEARRAY parcourt une grille de dimension 5×4. Pour chaque intersection identifiée par la ligne r et la colonne c, l’abstraction LAMBDA extrait dynamiquement le taux d’actualisation correspondant via l’instruction INDEX(A2:A6; r; 1) et le flux de trésorerie associé via INDEX(B1:E1; 1; c), avant de calculer la valeur financière dérivée (ici l’actualisation d’une annuité sur 10 ans minorée de l’investissement initial de 100 000 €). Le résultat se déploie instantanément depuis une seule cellule sous la forme d’une matrice déversée (spill range), garantissant une intégrité mathématique absolue : aucune cellule individuelle de la plage générée ne peut être accidentellement éditée ou corrompue sans annuler le déversement complet de la structure matricielle.
6.3 Optimisation des performances et fluidité de recalcul
Bien que la manipulation des fonctions matricielles confère une flexibilité d’analyse remarquable, la dimensionnement inconsidéré des grilles de sensibilité peut impacter drastiquement la réactivité du logiciel et saturer les ressources du navigateur client. Le recalcul d’une table croisant 100 variations de prix avec 100 variations de coûts équivaut à la résolution instantanée de 10 000 évaluations fonctionnelles interconnectées. Dans les classeurs complexes comportant des dizaines de milliers de dépendances cellulaires, une telle charge computationnelle engendre une latence perceptible lors de chaque saisie, nuisant à l’expérience utilisateur.
Pour pallier ces dégradations de performance, des mesures de confinement architectural doivent être adoptées. L’analyste veillera à restreindre le nombre de points d’évaluation de la matrice aux seuls intervalles stratégiquement significatifs, éliminant les incréments infinitésimaux non pertinents pour l’arbitrage exécutif. Il est par ailleurs recommandé d’isoler les tables de sensibilité massives sur des feuilles de calcul dédiées au sein du classeur, évitant ainsi que les modifications courantes opérées sur les feuilles de saisie opérationnelle ne forcent une réévaluation permanente des blocs matriciels lourds.
Enfin, la gouvernance de ces tables impose une documentation méticuleuse de leurs coordonnées cartésiennes à destination des auditeurs internes. Les axes doivent être balisés sans ambiguïté par des en-têtes explicites spécifiant l’unité de mesure retenue (devises monétaires, pourcentages, indices de volume physique). De plus, la formule génératrice maîtresse doit faire l’objet d’un commentaire documentaire d’en-tête détaillant le rôle des variables passées en arguments, permettant à tout nouvel analyste d’appréhender le fonctionnement de la matrice de sensibilité sans devoir déchiffrer les imbrications fonctionnelles de la formule matricielle.
7. Gestion des scénarios alternatifs par commutateurs dynamiques
7.1 Architecture d’un commutateur de scénario centralisé
Lorsque la simulation contrefactuelle ne porte plus sur l’oscillation isolée d’un ou deux inducteurs indépendants, mais sur la mutation conjointe de multiples variables corrélées sous l’effet de changements de paradigme économique, l’analyste doit basculer vers la modélisation par scénarios alternatifs. L’état de l’art dans Google Sheets consiste à implémenter une cellule de pilotage centrale agissant comme un commutateur logique universel, connectée à un menu déroulant de validation de données (accessible via Données > Validation des données > Liste d’éléments).
Ce commutateur permet à l’utilisateur de sélectionner d’un simple clic parmi un éventail de profils conjoncturels archétypaux prédéfinis. Dans les standards de l’ingénierie financière et de la planification stratégique, la typologie classique s’articule généralement autour de trois configurations fondamentales :
- Le scénario nominal (ou Base Case) : Modélisant la trajectoire d’exploitation la plus probable selon le consensus des données prévisionnelles établies par les directions métiers.
- Le scénario pessimiste (ou Downside / Stress Case) : Intégrant une dégradation conjointe de l’environnement : contraction des volumes d’absorption, flambée des coûts des matières premières, allongement des délais de recouvrement de créances clients et hausse du loyer de l’argent.
- Le scénario optimiste (ou Upside Case) : Postulant un alignement macroéconomique favorable caractérisé par des gains d’efficacité industrielle, une surperformance des canaux de distribution et un apaisement de l’inflation des charges directes.
Sur le plan architectural, il est impératif d’opérer une séparation spatiale étanche entre la matrice des hypothèses statiques et le modèle de calcul actif. La matrice des hypothèses prend la forme d’un tableau de référence structurel où chaque ligne représente une variable exogène du modèle et chaque colonne héberge les coefficients spécifiques assignés à un scénario déterminé. Le commutateur de pilotage se contente alors d’ordonner au modèle dynamique de pointer vers la colonne active, garantissant une clarté conceptuelle totale et éliminant les risques de mélange entre les paramètres de référence et les formules opérationnelles.
7.2 Combinaison des fonctions SWITCH, CHOOSE et INDEX
L’orchestration technique du routage des données entre la matrice statique des scénarios et le modèle d’évaluation repose sur une sélection judicieuse des fonctions logiques de recherche et de sélection. Historiquement, les analystes recouraient à des imbrications massives de conditions logiques SI (Nested IF statements), une pratique aujourd’hui proscrite en raison de son illisibilité structurelle, de sa lourdeur de maintenance et de sa vulnérabilité aux erreurs d’échappement logique.
Dans les versions modernes de Google Sheets, l’emploi de la fonction SWITCH offre une syntaxe d’une limpidité remarquable pour distribuer les hypothèses à l’ensemble du classeur en fonction de la valeur textuelle sélectionnée dans la cellule de commande :
=SWITCH($B$1; "Pessimiste"; Hypotheses!C4; "Nominal"; Hypotheses!D4; "Optimiste"; Hypotheses!E4; Hypotheses!D4)
Dans cette formulation, si la cellule de pilotage $B$1 affiche l’état « Pessimiste », la formule renvoie immédiatement la valeur située en Hypotheses!C4. La dernière référence agit comme une clause d’échappement par défaut, garantissant le renvoi du scénario nominal si une valeur non reconnue ou un champ vide venait à être sélectionné dans la cellule pilote.
Pour les infrastructures de données plus vastes ou les répertoires de scénarios complexes comportant des dizaines de variantes, le couplage vectoriel des fonctions INDEX et EQUIV (ou la fonction moderne RECHERCHEX) s’avère nettement supérieur :
=INDEX(Hypotheses!$C$4:$G$50; EQUIV(A4; Hypotheses!$A$4:$A$50; 0); EQUIV($B$1; Hypotheses!$C$3:$G$3; 0))
Ce protocole bidimensionnel recherche l’identifiant exact de la variable le long de l’axe vertical tout en sélectionnant dynamiquement la colonne correspondant au scénario désigné en $B$1. Cette approche découple totalement la taille du catalogue d’hypothèses de la syntaxe des formules de calcul, autorisant l’adjonction de scénarios supplémentaires sans exiger la modification de la moindre ligne de code ou formule au sein du modèle financier opérationnel.
7.3 Analyse d’écarts statistiques inter-scénarios
La simple visualisation isolée des résultats d’un scénario unitaire ne saurait suffire à éclairer les comités de direction lors de décisions d’allocation de capital majeures. Une modélisation mature doit impérativement s’accompagner d’un bloc de consolidation mesurant de manière dynamique les deltas statistiques et les dispersions entre les différentes configurations simulées.
Ce bloc d’analyse d’écarts compile, pour chaque indicateur clé de performance (EBITDA, flux de trésorerie disponible, ratio d’endettement net), les écarts absolus et relatifs calculés par rapport à la référence du scénario nominal :
[ Delta_{text{absolu}} = Y_{text{simulé}} – Y_{text{nominal}} ]
[ Delta_{text{relatif}} = frac{Y_{text{simulé}} – Y_{text{nominal}}}{Y_{text{nominal}}} times 100 ]
Au-delà de ces calculs différentiels linéaires, l’analyste rigoureux introduira des indicateurs de dispersion statistique pour quantifier l’exposition globale au risque. Le calcul de la variance prévisionnelle et de l’écart-type inter-scénarios, exécuté à l’aide de la fonction ECARTYPE.STANDARD appliquée aux métriques consolidées des configurations simulées, permet d’établir un indice de volatilité intrinsèque du projet d’investissement. L’amorce d’une analyse probabiliste pondérée — où l’on assigne des coefficients de vraisemblance subjective (par exemple : 20 % Pessimiste, 60 % Nominal, 20 % Optimiste) au travers d’une formule matricielle SOMMEPROD — synthétise l’ensemble des futurs envisageables en une espérance mathématique unique et rigoureuse, fournissant ainsi une base solide pour l’aide à la décision.
8. Automatisation programmée des analyses d’hypothèses via Google Apps Script
8.1 Dépassement des limites natives de l’interface Goal Seek
Si l’extension Goal Seek et les formules matricielles dynamiques répondent avec brio aux problématiques prospectives courantes, elles se heurtent à des limitations fonctionnelles inhérentes dès lors que les exigences d’audit et de modélisation franchissent un seuil de complexité supérieur. L’interface Goal Seek ne peut traiter qu’une seule cible à la fois et requiert une intervention humaine manuelle pour chaque simulation, ce qui la rend totalement inopérante lorsqu’il s’agit d’exécuter des analyses de sensibilité exhaustives le long de séries temporelles étendues ou de calibrer simultanément des dizaines de budgets divisionnaires interdépendants.
L’accès à l’environnement de programmation Google Apps Script — une plateforme de développement infonuagique ancrée sur le standard JavaScript moderne ECMAScript — permet de lever ces verrous technologiques. Grâce à Apps Script, l’analyste financier et le modélisateur de données s’émancipent des contraintes des interfaces graphiques pour piloter de manière algorithmique le moteur de calcul du classeur.
Cette approche programmatique permet non seulement de résoudre des arbitrages multivariables séquentiels complexes inaccessibles aux modules standards, mais autorise également l’automatisation intégrale de l’exécution en arrière-plan (batch processing). Il devient ainsi possible d’écrire des scripts qui balaient des centaines de scénarios combinatoires, calculent les équilibres financiers sous-jacents, et exportent automatiquement les matrices de résultats sous forme d’instantanés statiques immuables au sein d’onglets d’archivage dédiés, sanctuarisant les pistes d’audit contre tout écrasement ultérieur.
8.2 Développement d’un algorithme de dichotomie personnalisé en Apps Script
Pour s’affranchir des dépendances aux extensions tierces et bénéficier d’une vitesse de convergence adaptée à des calculs déterministes monotones, l’analyste peut implémenter son propre algorithme de dichotomie (ou méthode de bissection) directement au sein de l’éditeur de scripts (accessible via Extensions > Apps Script). Cet algorithme excelle dans la recherche de racines pour les fonctions univariables continues au sein d’un intervalle délimité ([a, b]), offrant une stabilité numérique absolue et une garantie formelle de convergence sans risque d’oscillation divergente.
L’implémentation logicielle requiert une structure soignée pour garantir l’efficacité des calculs et minimiser les appels d’API :
function resoudreDichotomie() {
  const feuille = SpreadsheetApp.getActiveSpreadsheet().getSheetByName("Simulation");
  const celluleCible = feuille.getRange("F15");
  const celluleAjustable = feuille.getRange("B4");
  const valeurCible = 3500.0;
  const epsilon = 0.0001;
  const maxIterations = 100;

  let borneInferieure = 0.0;
  let borneSuperieure = 5000.0;
  let iteration = 0;
  let solutionTrouvee = false;

  while (iteration < maxIterations && !solutionTrouvee) {
    let pointMedian = (borneInferieure + borneSuperieure) / 2.0;
    celluleAjustable.setValue(pointMedian);
    SpreadsheetApp.flush(); // Force l'évaluation du graphe cellulaire

    let evaluationCourante = celluleCible.getValue();
    let ecart = evaluationCourante - valeurCible;

    if (Math.abs(ecart) <= epsilon) {
      solutionTrouvee = true;
      Logger.log("Convergence atteinte en " + iteration + " itérations : " + pointMedian);
    } else {
      if (ecart < 0) {
        borneInferieure = pointMedian;
      } else {
        borneSuperieure = pointMedian;
      }
    }
    iteration++;
  }

  if (!solutionTrouvee) {
    throw new Error("L'algorithme n'a pas convergé dans l'intervalle prescrit.");
  }
}
Dans ce segment de code, l’instruction critique SpreadsheetApp.flush() force le moteur de Google Sheets à réévaluer immédiatement l’intégralité du réseau de dépendances cellulaires entre chaque étape de bissection, garantissant que la lecture ultérieure via getValue() retourne la valeur mise à jour du modèle. Pour les systèmes plus complexes, on remplacera avantageusement cette manipulation cellulaire itérative par une encapsulation JavaScript des équations métier au sein d’un tableau vectoriel en mémoire, réduisant le temps d’exécution d’un facteur 100 en éliminant les latences de lecture/écriture réseau.
8.3 Intégration d’interfaces personnalisées et macros déclenchées
L’industrialisation d’une infrastructure d’analyse d’hypothèses requiert que sa manipulation soit rendue ergonomique pour les collaborateurs non techniciens. Pour ce faire, Google Apps Script permet de concevoir des composants d’interface utilisateur intégrés directement au canevas des feuilles de calcul. L’analyste peut insérer des éléments visuels (via Insertion > Dessin), styliser un bouton d’action graphique évocateur (par exemple « Réinitialiser les Scénarios » ou « Calibrer le Seuil de Rentabilité »), et assigner à cet élément le nom de la fonction scriptée correspondante via le menu contextuel du dessin.
Cette interactivité peut être enrichie par le déploiement de menus personnalisés ancrés dans la barre supérieure du classeur en exploitant la fonction événementielle onOpen(). Dès le chargement du document, le script compile un menu sur-mesure exposant l’éventail des simulations automatisées disponibles, guidant l’utilisateur au travers de boîtes de dialogue modales interactives (Browser.inputBox ou formulaires HTML élaborés via le service HtmlService) pour recueillir les paramètres de simulation sans exposer les cellules critiques aux modifications directes.
Enfin, l’écosystème Workspace autorise la mise en place de déclencheurs temporels programmés (time-driven triggers). Cette fonctionnalité permet d’exécuter des analyses de sensibilité de manière récurrente et automatisée — par exemple, chaque nuit après l’importation automatique des cours des devises ou des clôtures logistiques —, recalculant les matrices de risque et consignant les résultats dans des journaux de reporting sans exiger la moindre intervention humaine.
9. Facteurs psychologiques, heuristiques et pièges de la simulation
9.1 L’illusion de contrôle induite par les environnements numériques
L’arsenal technologique et la fluidité de calcul de Google Sheets ne doivent pas masquer un écueil épistémologique redoutable : l’illusion de contrôle qu’engendrent les simulateurs quantitatifs. La prolifération de représentations chiffrées assorties de multiples décimales instille chez les analystes comme chez les destinataires exécutifs un sentiment artificiel de maîtrise et de précision. Ce phénomène psychologique, largement documenté par les travaux en économie comportementale, conduit à confondre la rigueur arithmétique interne du calcul numérique avec la validité réelle des hypothèses fondatrices du modèle.
Cette illusion s’accompagne d’un effet de focalisation (focusing illusion) pernicieux : les modélisateurs ont une propension systémique à concentrer leurs analyses sur les seules variables facilement quantifiables au sein du tableur (telles que les coûts unitaires de production ou les barèmes de transport), tout en occultant les variables qualitatives, hautement imprévisibles mais structurellement déterminantes (telles que l’instabilité réglementaire, les ruptures technologiques disruptives ou les défaillances systémiques de gouvernance). L’univers du tableur, par essence computationnel, tend à créer une cosmologie fermée où tout ce qui ne s’exprime pas sous forme d’équation finit par être considéré comme inexistant.
Pour prévenir cette dérive cognitive, les équipes analytiques doivent cultiver une posture de scepticisme méthodologique permanent. Il convient de rappeler avec constance que le résultat d’une simulation d’hypothèses ne constitue en aucun cas une prédiction oraculaire de l’avenir, mais simplement une projection contingente : l’explicitation tautologique de ce que produirait la réalité si, et seulement si, l’ensemble des postulats formulés dans le modèle se vérifiaient simultanément et sans perturbation externe.
9.2 Résistance cognitive face aux scénarios défavorables (Stress-testing)
Un autre piège psychologique majeur réside dans l’incapacité fréquente des organisations à concevoir et simuler des tests de résistance (stress-testing) suffisamment sévères. Confrontés à l’anxiété que génère l’évocation d’une faillite ou d’un choc d’illiquidité majeur, les analystes manifestent une réticence inconsciente à pousser les curseurs du tableur vers des zones de détresse financière profonde. Les scénarios dits « pessimistes » intégrés dans les modèles se réduisent ainsi bien souvent à des ralentissements économiques superficiels (une baisse de 5 % du chiffre d’affaires là où les crises systémiques provoquent fréquemment des effondrements de 30 à 50 %).
Ce phénomène découle directement du biais de confirmation, qui pousse les modélisateurs à sélectionner des paramètres de simulation calibrés pour conforter les décisions stratégiques déjà arrêtées implicitement par le management. Dans l’usage de Goal Seek, ce biais se manifeste par le choix de valeurs cibles socialement valorisantes, suivi de l’ajustement forcé de variables secondaires jusqu’à ce que le résultat visé apparaisse formellement documenté sur la feuille de calcul, transformant le tableur en un simple instrument de légitimation politique a posteriori.
Une méthodologie efficace pour neutraliser ces distorsions cognitives réside dans l’application formalisée de l’autopsie préalable (pre-mortem analysis), formalisée par le psychologue Gary Klein. Avant de figer les intervalles de sensibilité dans Google Sheets, l’équipe d’analystes est réunie et confrontée au postulat suivant : « Nous sommes dans deux ans, le projet d’investissement s’est soldé par une catastrophe financière absolue ; identifiez les mécanismes mathématiques et les inducteurs exogènes qui ont provoqué cette défaillance. » Cette inversion de la perspective psychologique autorise la libération de la parole critique, légitime l’exploration de scénarios de stress extrêmes (tels qu’un doublement des coûts énergétiques ou un effondrement brutal de la solvabilité sectorielle) et garantit que les marges de manœuvre simulées au sein du tableur intègrent des chocs économiques réellement déstabilisateurs.
9.3 Biais d’ancrage et manipulation involontaire des résultats
L’utilisation des outils de simulation itérative expose l’analyste au biais d’ancrage, un phénomène cognitif où l’esprit s’arrime excessivement à la première information disponible pour former ses jugements ultérieurs. Dans Google Sheets, la valeur scalaire initiale inscrite dans la cellule modifiable au moment où Goal Seek est amorcé constitue une ancre psychologique puissante. Si cette valeur de départ se situe dans un registre conservateur, les résultats itérés découverts lors de la convergence seront implicitement jugés comme des seuils extrêmes ou acceptables, même si le modèle sous-jacent autoriserait une dynamique économique radicalement différente.
Ce biais favorise l’apparition de la dérive d’optimisation (ou data snooping décisionnel), qui consiste pour l’opérateur à réitérer les calculs en modifiant imperceptiblement les hypothèses de base jusqu’à ce que la trajectoire projetée atteigne un niveau jugé politiquement ou managérialement confortable. L’analyste se livre alors, souvent de manière involontaire, à une sélection opportuniste des résultats de sensibilité, en ne présentant à sa direction que les simulations confirmant la robustesse du plan opérationnel initial et en reléguant les extrapolations problématiques dans des onglets masqués du document.
La préservation de la neutralité scientifique de l’analyste exige la formalisation de protocoles de simulation préenregistrés. Les intervalles de variation des paramètres critiques, la granularité des pas d’ajustement et les critères de succès doivent impérativement être consignés dans une charte méthodologique d’évaluation avant le déclenchement des expérimentations sur le tableur. Cette formalisation élimine l’arbitraire humain dans l’interprétation des résultats et garantit que la simulation contrefactuelle conserve son intégrité d’instrument d’aide à la décision objective.
10. Résolution des anomalies, convergence et limites mathématiques
10.1 Diagnostic des échecs de convergence de Goal Seek
Lors de la manipulation intensive de l’extension Goal Seek, l’analyste est régulièrement confronté à des échecs algorithmiques caractérisés par un message d’infaisabilité ou une errance itérative sans fin du panneau de calcul. Diagnostiquer l’étiologie de ces anomalies requiert une analyse fine du comportement mathématique du modèle modélisé par rapport aux présupposés de la méthode de la sécante. La cause la plus fréquente réside dans la présence de discontinuités fonctionnelles au sein du réseau de calcul.
Ces ruptures de continuité émergent typiquement de l’utilisation de fonctions de seuil ou de discrétisation telles que SI, ARRONDI, PLANCHER ou PLAFOND. Si l’équation maîtresse déclenche un changement de palier discret — par exemple, un barème de commissionnement qui bondit brutalement de 5 % à 10 % au franchissement exact du seuil de 100 000 € de ventes —, la dérivée numérique locale devient indéterminée ou infinie au point de bascule. L’algorithme de la sécante, incapable de modéliser ce saut quantique, oscille indéfiniment entre les deux rives du seuil sans jamais pouvoir stabiliser la cellule cible à la tolérance requise.
Une autre pathologie numérique découle de la non-linéarité prononcée des équations, générant des polynômes de degré élevé comportant de multiples optima locaux ou des points d’inflexion où la pente de la sécante s’annule (( f(x_k) – f(x_{k-1}) approx 0 )). Dans une telle configuration, la formule de projection implique une division par une valeur infinitésimale, propulsant la variable d’ajustement vers des valeurs aberrantes situées à des ordres de grandeur disproportionnés de la zone de validité du modèle. La stratégie de remédiation cardinale consiste à réinitialiser manuellement la valeur de départ au plus près de la racine plausible recherchée, ou à assouplir temporairement les équations en substituant aux fonctions d’arrondi discontinues des formulations linéaires continues équivalentes pendant toute la phase de résolution algorithmique.
10.2 Précision numérique et accumulation d’erreurs d’arrondi
L’exécution de milliers de calculs séquentiels par un moteur de tableur soulève la question fondamentale de la fidélité de l’arithmétique binaire en virgule flottante. Comme la quasi-totalité des logiciels informatiques modernes, Google Sheets encode les nombres réels conformément à la norme internationale IEEE 754 en double précision (sur 64 bits). Cette architecture technique garantit environ 15 à 17 décimales significatives de précision, mais présente une faiblesse structurelle intrinsèque : l’impossibilité de représenter de manière exacte certaines fractions décimales élémentaires en base binaire (telles que 0,1 ou 0,2).
Dans une analyse d’hypothèses comportant des boucles de récursion ou des chaînes matricielles profondes, ces inexactitudes infinitésimales s’additionnent et s’amplifient, provoquant un phénomène d’accumulation d’erreurs d’arrondi susceptible de parasiter la convergence numérique. L’analyste pourra ainsi observer qu’une cellule calculée refuse obstinément d’égaler la valeur cible 0, affichant à la place un résidu microscopique de l’ordre de 1.421085e-14. Si le seuil d’epsilon programmé dans l’extension ou le script est configuré avec une sévérité excessive, le solveur rejettera cette solution parfaitement valide sur le plan macroéconomique et continuera de diverger inutilement.
Il est donc crucial d’aligner les exigences de tolérance mathématique sur la réalité physique et comptable des données manipulées. Dans un rapport financier d’entreprise, exiger une précision supérieure au centime d’unité monétaire (( 10^{-2} )) n’apporte aucune valeur décisionnelle et accroît exponentiellement le risque d’échec de terminaison d’algorithme. L’intégration judicieuse de la fonction ARRONDI aux étapes clés d’affichage, ou l’utilisation d’opérateurs de comparaison tolérants du type ABS(Valeur - Cible) < 0.01 au sein des scripts de vérification, garantit une congruence logique irréprochable entre l’extrant chiffré et les standards de conformité de l’industrie.
10.3 Contournement des limites intrinsèques du cloud
À la différence des solutions logicielles de bureau compilées nativement sur le matériel hôte, l’exécution d’analyses d’hypothèses massives dans Google Sheets est encadrée par les restrictions inhérentes aux architectures distribuées en nuage. L’infrastructure de Google applique des mécanismes d’étranglement (throttling) et des plafonds stricts pour préserver l’intégrité de ses serveurs partagés : une formule personnalisée ou une exécution Apps Script ne peut excéder une durée limite continue (généralement 6 minutes par déclencheur unitaire), sous peine d’interruption unilatérale avec renvoi d’une erreur d’expiration temporelle (Exceeded maximum execution time).
De plus, la latence inhérente aux allers-retours réseau entre le navigateur web et les centres de données distants pénalise lourdement les flux transactionnels sollicitant excessivement l’interface de programmation. L’exécution d’un balayage de 500 scénarios via des commandes individuelles setValue() sur Google Sheets peut exiger plusieurs minutes, là où un processeur local exécuterait la même opération en quelques millisecondes dans un environnement mémoire compact.
Pour contourner ces plafonds structurels lors de modélisations prospectives de grande envergure, l’analyste chevronné déploiera des stratégies d’architecture distribuée :
- La vectorisation maximale en mémoire : Comme détaillé précédemment, charger l’ensemble des plages d’hypothèses dans une structure matricielle JavaScript en une seule requête
getValues(), exécuter l’ensemble des itérations mathématiques en mémoire vive interne, puis restituer le résultat complet en un appel terminal unique viasetValues(). - Le partitionnement de la charge : Scinder les espaces de simulation volumineux en plusieurs blocs distincts exécutés séquentiellement au moyen de déclencheurs d’événements programmés qui reprennent le calcul là où le cycle antérieur s’est interrompu.
- L’hybridation des calculs : Pour les simulations stochastiques à très haute intensité (telles que des modèles de Monte-Carlo à 100 000 itérations), déléguer le moteur d’évaluation mathématique à des microservices externes dédiés programmés en Python (via Google Cloud Functions ou Google Colab) et utiliser l’API REST de Google Sheets exclusivement pour la restitution finale et la visualisation synthétique auprès des utilisateurs métiers.
11. Visualisation avancée et communication des espaces d’hypothèses
11.1 Cartographie visuelle par mise en forme conditionnelle dynamique
L’extraction de valeur d’une analyse d’hypothèses ne s’achève pas à la convergence des calculs : elle dépend de la capacité du modélisateur à en communiquer les enseignements de manière fluide et intuitive. Au sein des matrices de sensibilité bidimensionnelles, la prolifération de dizaines de coordonnées numériques denses peut engendrer une saturation cognitive chez les observateurs non initiés, masquant les points d’inflexion critiques sous une surcharge de données. L’application maîtrisée d’une mise en forme conditionnelle dynamique (via Format > Règle de mise en forme conditionnelle) transforme cette grille arithmétique en une cartographie thermique (heatmap) immédiatement déchiffrable.
La mise en place d’échelles de couleurs continues s’avère particulièrement efficace pour cartographier les métriques continues telles que les marges brutes ou les retours sur investissement. En configurant un gradient chromatique associant, par exemple, un vert profond pour les centiles supérieurs, un jaune neutre pour le point mort d’équilibre et un rouge carmin pour les zones de destruction de valeur, l’analyste fait émerger visuellement la géographie des risques du projet. Le comité de direction peut ainsi appréhender en un coup d’œil l’étendue spatiale du domaine de viabilité financière et mesurer la proximité des zones de péril d’exploitation.
Cependant, la conception ergonomique impose de proscrire la surcharge sensorielle. Il est essentiel d’éviter les contrastes trop vifs et la démultiplication anarchique de palettes chromatiques incompatibles sur une même feuille de calcul. L’utilisation de formules personnalisées dans les critères de conditionnement permet par ailleurs de concevoir des règles binaires élégantes : surligner sélectivement la cellule unique correspondant au scénario actuellement actif ou encadrer de bordures contrastées l’intervalle exact où le ratio d’endettement demeure conforme aux engagements bancaires contractuels (covenants).
11.2 Graphiques de sensibilité et diagrammes tornado
Pour hiérarchiser l’impact relatif des différents facteurs exogènes sur une métrique cible, le diagramme tornado constitue l’outil visuel de référence en modélisation financière et en gestion des risques. Ce composant graphique à barres horizontales bidirectionnelles met en scène, pour chaque paramètre clé oscillant entre ses bornes d’incertitude prédéfinies (par exemple (pm 10,%) autour du niveau nominal), l’amplitude consécutive de l’écart généré sur la métrique de résultat (comme la VAN ou le résultat net).
La morphologie caractéristique en entonnoir — où les barres les plus larges trônent au sommet du graphique et les inducteurs les plus marginaux sont alignés vers la base — découle d’un ordonnancement décroissant rigoureux fondé sur la valeur absolue de la variance induite. Google Sheets ne proposant pas de modèle graphique intitulé nativement « Tornado », sa confection repose sur une technique astucieuse de composition : l’élaboration d’un graphique à barres empilées intégrant une série de calage transparente masquée (invisible base series) dont la longueur repousse la barre visible d’écart de part et d’autre d’une ligne d’axe central zéro.
Cette armature graphique peut être enrichie par des représentations sous forme de courbes de niveau ou de graphiques de surface croisant deux paramètres simultanés, matérialisant visuellement les courbures de rendement marginal décroissant. L’adjonction visuelle de bandes de dispersion ou d’intervalles de confiance construits à partir des percentiles calculés (( P_{10} ), ( P_{50} ), ( P_{90} )) confère une dimension probabiliste indispensable pour rappeler aux décideurs que les estimations modélisées ne constituent pas des certitudes rigides, mais des plages d’expectative assujetties à la variance naturelle des marchés.
11.3 Restitution didactique auprès des parties prenantes non techniques
La responsabilité ultime de l’analyste d’hypothèses réside dans la traduction de structures matricielles austères en un récit stratégique intelligible et opérationnel (data storytelling). Présenter à une assemblée générale d’actionnaires ou à un conseil d’administration un ensemble indigeste de formules imbriquées ou un tableau de sensibilité de 500 cases constitue une erreur pédagogique majeure qui suscite la défiance et complique l’arbitrage exécutif.
L’exposé didactique doit déplacer la focale du détail arithmétique vers la confrontation des choix stratégiques fondamentaux. L’analyste structurera son intervention autour de la balance des compromis (trade-offs) révélés par la modélisation : quel gain additionnel de marge nette justifie la prise d’un risque opérationnel accru de 20 % sur la chaîne d’approvisionnement ? Quelle est l’épaisseur exacte du coussin de sécurité protégeant le flux de trésorerie disponible en cas d’effondrement imprévu de la demande de 15 % ?
Pour concrétiser cette restitution, la construction d’un tableau de bord de synthèse exécutif (executive dashboard) représente l’aboutissement du projet. Ce tableau de bord rassemble, sur une page unique rigoureusement calibrée, les commutateurs de scénarios interactifs, les quelques métriques d’impact fondamentales mises en exergue par des typographies agrandies, et le diagramme tornado synthétisant la hiérarchie des risques. En manipulant eux-mêmes les curseurs de simulation au sein d’une interface dépouillée de toute complexité technique, les décideurs s’approprient les dynamiques du modèle et fondent leurs arbitrages sur une compréhension intime des équilibres sous-jacents.
12. Gouvernance, audit et pérennisation des modèles décisionnels
12.1 Protocoles d’audit et vérification de la chaîne causale
La sophistication technique croissante des feuilles de calcul Google Sheets utilisées pour les analyses d’hypothèses amplifie proportionnellement le risque d’erreurs logiques invisibles. Les conséquences de décisions prises sur la base de modèles non audités peuvent se révéler dévastatrices sur le plan économique. La gouvernance impose donc la mise en place d’un protocole d’audit méthodique et régulier de l’intégralité du classeur.
La première étape de cette vérification s’appuie sur le mode d’affichage universel des formules (activable instantanément par la combinaison de touches Ctrl + ' ou via le menu Afficher > Afficher les formules). Ce basculement déploie la syntaxe sous-jacente au sein de chaque cellule, permettant à l’auditeur de vérifier la symétrie dimensionnelle des formules sur l’ensemble des colonnes. Toute rupture dans la continuité syntaxique d’une série uniforme — par exemple, une cellule qui basculerait accidentellement d’une somme dynamique à une constante brute écrasée manuellement — devient instantanément visible.
La cartographie de la chaîne causale requiert ensuite l’inspection méthodique des dépendances directes et indirectes. Si Google Sheets ne dispose pas nativement d’un système de flèches graphiques aussi élaboré que celui de tableurs historiques sur desktop, il permet d’exploiter des extensions spécialisées d’audit ou de remonter manuellement le graphe de dépendance via la barre de formule en examinant les mises en surbrillance chromatique des plages sources. Enfin, chaque formule maîtresse combinatoire doit être accompagnée de commentaires de cellules documentant précisément les fondements économiques de la règle de calcul, garantissant ainsi le transfert d’intelligibilité en cas de rotation du personnel au sein de l’équipe d’analystes.
12.2 Sécurité, gestion des droits et intégrité collaborative
La nature nativement collaborative de Google Sheets représente un atout exceptionnel pour la mise à disposition des classeurs décisionnels, mais constitue simultanément une vulnérabilité majeure pour l’intégrité des modèles d’hypothèses si les permissions d’accès ne sont pas cadenassées avec une extrême rigueur. Le risque qu’un utilisateur distrait modifie involontairement une constante structurelle ou supprime une règle matricielle lors d’une session de simulation partagée impose un cloisonnement rigide des habilitations.
La mise en œuvre de la protection granulaire des cellules (via Données > Protéger les feuilles et les plages) constitue la règle d’hygiène logicielle cardinale. L’administrateur du modèle doit verrouiller systématiquement en mode lecture seule (avec avertissement ou interdiction stricte de modification pour les collaborateurs) l’ensemble des feuilles hébergeant la tuyauterie mathématique, les constantes de référence et les tableaux de bord consolidés. Seules les cellules strictement réservées à la saisie des variables de simulation (les champs d’entrée identifiés ou la cellule abritant le menu déroulant du commutateur de scénario) doivent demeurer éditables par les utilisateurs finaux.
Parallèlement, la fonction d’historique des versions doit être érigée en outil de surveillance continue. Lors de campagnes de simulation impliquant de multiples intervenants simultanés, le journal d’activité détaillé permet d’identifier avec précision quel utilisateur a injecté telle hypothèse à quel instant T, d’analyser les deltas arithmétiques engendrés et, le cas échéant, de restaurer l’intégrité du document à son état antérieur en cas de corruption avérée de l’architecture du classeur.
12.3 Établissement d’une charte de modélisation prévisionnelle
Pour assurer la pérennité institutionnelle des analyses d’hypothèses à travers le temps et les services d’une organisation, la pratique de la modélisation ne saurait reposer sur les idiosyncrasies esthétiques et techniques de chaque individu. Il est impératif d’édicter et de faire respecter une charte de modélisation prévisionnelle unifiée, inspirée des meilleurs standards industriels tels que les méthodologies FAST (Flexible, Appropriate, Structured, Transparent) ou BPMS.
Cette charte doit en premier lieu imposer une normalisation chromatique stricte et uniforme pour l’ensemble des classeurs décisionnels de l’organisation :
- Les cellules d’entrée (inputs) : Systématiquement signalées par une police bleue sur fond blanc ou jaune très pâle, réservées exclusivement aux valeurs scalaires brutes modifiables par les utilisateurs.
- Les cellules de calcul intermédiaire : Rédigées en police noire standard sur fond transparent, hébergeant les équations algorithmiques strictes.
- Les cellules de liaisons externes : Repérées par une police verte ou violette, indiquant que la donnée est issue d’un autre onglet ou d’une source externe via
IMPORTRANGE. - Les cellules de résultat final (outputs) : Identifiées par un encadrement renforcé et une mise en valeur typographique grasse soulignée.
En second lieu, la gouvernance doit instaurer un cadre institutionnalisé d’évaluation périodique des écarts entre les projections simulées par le passé et les réalisations effectives constatées dans les bilans comptables ultérieurs. Ce travail de retour d’expérience (backtesting systématique) mesure la qualité prédictive des modèles, met en lumière les biais de surestimation récurrents et permet de recalibrer les coefficients d’incertitude pour les exercices futurs. Enfin, tout modèle de simulation ayant servi de justification formelle à une décision d’investissement ou d’arbitrage budgétaire majeur doit être figé, étiqueté dans sa version définitive, et archivé sous une forme non modifiable dans un référentiel sécurisé, garantissant une traçabilité documentaire irréprochable face aux auditeurs externes et aux autorités de régulation financière.
Références
- FAST Standard Organisation. (2019). The FAST Standard: Financial modelling standard for spreadsheet design (Version 02c). FAST Organisation. https://www.fast-standard.org/
- Google Workspace. (2024). Goal Seek add-on for Google Sheets. Google Workspace Marketplace. https://workspace.google.com/marketplace/app/goal_seek/396622416049
- Google Workspace. (2024). Utiliser des formules matricielles et la fonction MAKEARRAY dans Google Sheets. Centre d’aide Google Docs. https://support.google.com/docs/answer/12569202
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://ieeexplore.ieee.org/document/8766229
- Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263–291. https://www.jstor.org/stable/1914185
- Klein, G. (2007). Performing a project premortem. Harvard Business Review, 85(9), 18–19. https://hbr.org/2007/09/performing-a-project-premortem
- Powell, S. G., & Baker, K. R. (2017). Management science: The art of modeling with spreadsheets (5th ed.). John Wiley & Sons.
- Press, W. H., Teukolsky, S. A., Vetterling, W. T., & Flannery, B. P. (2007). Numerical recipes: The art of scientific computing (3rd ed.). Cambridge University Press.
- Weisstein, E. W. (2024). Secant method. MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/SecantMethod.html