
Dans le champ épistémologique des sciences contemporaines, et tout particulièrement au sein des disciplines comportementales, psychologiques et sociales, l’investigation empirique repose sur la modélisation rigoureuse des relations unissant les phénomènes observés. Si l’analyse descriptive univariée constitue le point d’ancrage indispensable de toute démarche quantitative en caractérisant la distribution, la tendance centrale et la dispersion de métriques isolées, elle demeure fondamentalement impuissante à révéler l’architecture interactionnelle du réel. Dès lors que le chercheur formule une hypothèse relative à l’interdépendance de deux construits — qu’il s’agisse de mesurer l’impact du stress perçu sur la performance cognitive, d’évaluer la concordance entre deux instruments psychométriques ou de sonder l’association entre des variables socio-démographiques et des comportements de santé —, le recours à l’analyse bivariée s’impose comme une nécessité méthodologique incontournable.
L’environnement statistique R, soutenu par son architecture modulaire et la richesse exponentielle de son écosystème de paquetages spécialisés, s’est imposé comme la plateforme computationnelle de référence pour exécuter de telles investigations. Alliant une flexibilité algorithmique sans égale à des capacités graphiques de pointe via la grammaire des graphiques, R permet de dépasser les approches mécaniques et routinières pour déployer un flux d’analyse exhaustif. Ce flux articule l’exploration visuelle préliminaire, le calcul métrique standardisé, la validation formelle des postulats distributionnels sous-jacents, l’inférence probabiliste et la modélisation prédictive. L’analyse bivariée ne se résume pas à l’extraction brute d’un indice de corrélation ou d’une valeur de probabilité critique ; elle exige une lecture critique et contextualisée des données, attentive aux artefacts d’échantillonnage, aux ruptures de linéarité et aux influences asymétriques.
L’objectif de cet ouvrage est de fournir un guide méthodologique, théorique et appliqué exhaustif pour mener à bien une analyse bivariée complète sous le logiciel R. En ancrant le propos dans une perspective psychométrique et expérimentale exigeante, ce document explore pas à pas la chaîne analytique, depuis la formalisation des types d’échelles de mesure jusqu’à la transition vers les modèles multivariés complexes, en passant par le traitement des données atypiques, l’inférence non paramétrique et la régression linéaire simple. Chaque étape méthodologique est étayée par des explications conceptuelles approfondies et des directives programmatiques claires, garantissant la reproductibilité computationnelle intégrale des démarches présentées selon les standards académiques internationaux.
1. Introduction à l’analyse bivariée et fondements méthodologiques dans R
1.1 Définition conceptuelle et pertinence de l’analyse bivariée
L’analyse bivariée se définit au plan épistémologique comme l’étude statistique simultanée de deux variables distinctes mesurées sur une même unité d’observation ou au sein d’échantillons appariés. Elle se distingue fondamentalement de l’approche univariée, dont la vocation exclusive est de résumer les propriétés distributionnelles intrinsèques d’une seule série de données (à travers des paramètres tels que l’espérance mathématique, l’écart-type ou la kurtose), sans chercher à établir un quelconque pont relationnel avec un facteur externe. À l’autre extrémité du continuum analytique, l’analyse multivariée prend en charge trois variables ou davantage afin de capturer des dynamiques de médiation, de modération, d’ajustement statistique ou de structure latente. L’analyse bivariée occupe ainsi une position charnière : elle constitue le premier niveau formel de complexité relationnelle, servant de passerelle entre la simple description phénoménologique et la modélisation des systèmes dynamiques multifactoriels.
Dans l’étude des comportements humains et des processus cognitifs, l’analyse conjointe de deux variables s’avère indispensable pour déceler des patterns de covariation signifiants. La variabilité interindividuelle, inhérente aux sciences psychologiques, rend illusoire l’analyse de métriques isolées : une mesure d’anxiété n’acquiert sa pleine signification scientifique que lorsqu’elle est mise en relation avec un temps de réaction, une fréquence cardiaque, un trait de personnalité connexe ou un contexte environnemental documenté. Les objectifs fondamentaux poursuivis par l’analyste se structurent autour de trois axes cardinaux : la description de la géométrie relationnelle unissant les variables (linéarité, monotonie, courbure), la quantification précise de la force et de la direction de cette association via des métriques standardisées, et la formulation d’inférences sur la population parente.
Il importe toutefois de souligner une précaution épistémologique cruciale : l’identification empirique d’une covariance, si robuste et statistiquement significative soit-elle, ne saurait à elle seule fonder une inférence causale valide. Dans le cadre des devis observationnels transversaux, l’absence de manipulation expérimentale et de contrôle sur l’ordonnancement temporel expose inévitablement l’analyse bivariée au risque de confusion étiologique. Néanmoins, en établissant l’existence d’une dépendance stochastique, elle pose la condition nécessaire — bien que non suffisante — à l’échafaudage de théories explicatives rigoureuses au sein des sciences comportementales.
1.2 Typologie des variables et choix des démarches analytiques
La sélection rigoureuse d’une procédure d’analyse bivariée dépend en premier lieu de la taxonomie des échelles de mesure postulée par le cadre psychométrique formalisé par Stanley Smith Stevens. On distingue classiquement quatre niveaux d’échelles : nominale (catégories qualitatives discrètes sans ordre hiérarchique, telles que le statut clinique ou le groupe expérimental), ordinale (catégories ordonnées hiérarchiquement mais à intervalles non mesurables, comme les échelles de Likert ou les classements de sévérité symptomatique), d’intervalle (mesures continues possédant une unité constante mais un zéro arbitraire, telles que la température en degrés Celsius ou certains scores standardisés de quotient intellectuel) et de rapport (variables quantitatives continues disposant d’un zéro absolu représentant l’absence totale de la propriété, à l’instar du temps de réaction en millisecondes ou du taux de cortisol plasmatique).
Cette caractérisation définit une matrice de décision méthodologique stricte guidant l’analyste vers le choix de la procédure statistique adéquate. Le croisement de deux variables purement quantitatives (d’intervalle ou de rapport) relève préférentiellement de l’analyse de corrélation linéaire ou de la régression linéaire simple, sous réserve du respect des postulats distributionnels. L’association entre deux variables qualitatives catégorielles (nominales ou ordinales) requiert l’examen de tables de contingence via des tests du Chi-deux ou des procédures exactes combinatoires. Enfin, les structures mixtes combinant une variable catégorielle indépendante et une variable quantitative dépendante nécessitent l’usage de tests de comparaison de moyennes (tests t de Student, analyse de variance univariée) ou de corrélations bisériales de point.
Dans ce processus décisionnel, l’identification du statut théorique des variables s’avère déterminante. Bien que la corrélation soit une métrique symétrique traitant les deux vecteurs de façon indifférenciée, l’analyste doit conceptuellement désigner la variable indépendante (le prédicteur ou facteur explicatif) et la variable dépendante (le critère ou variable réponse) dès lors qu’une perspective de modélisation directionnelle est envisagée. Par ailleurs, la robustesse de l’inférence dépend intimement du plan d’échantillonnage mobilisé : un échantillonnage probabiliste aléatoire simple garantit une représentativité optimale et limite les biais de sélection, tandis qu’un échantillon de convenance ou stratifié exige des ajustements pondéraux pour préserver la validité écologique et externe des estimations bivariées obtenues.
1.3 Configuration de l’environnement de calcul R
Pour mener à bien des analyses bivariées exhaustives et reproductibles, l’analyste doit préalablement configurer un environnement computationnel adapté. Le cœur du système statistique R fournit un ensemble substantiel de fonctions natives (telles que les procédures de base pour la corrélation et les graphiques primitifs), mais l’adjonction d’écosystèmes logiciels spécialisés optimise considérablement l’efficience, la manipulation des structures de données et la lisibilité du code. La suite de paquetages regroupée sous le nom de tidyverse (comprenant notamment dplyr pour la manipulation de données, readr pour l’importation et ggplot2 pour la visualisation avancée) constitue le socle opérationnel moderne, complétée par le paquetage psych développé par William Revelle pour les analyses psychométriques approfondies.
L’installation de ces modules s’effectue au moyen de la directive standardisée d’installation des bibliothèques logicielles depuis les serveurs du Comprehensive R Archive Network (CRAN), suivie de leur invocation dans la session active de travail. Afin de garantir une stricte reproductibilité des calculs — aspect fondamental lors de l’exécution de simulations d’échantillonnage, de rééchantillonnage de type bootstrap ou de génération de jeux de données synthétiques —, il est impératif d’initialiser le générateur de nombres pseudo-aléatoires au moyen de la commande fixant une graine déterministe (via la fonction de paramétrage de la graine du générateur). De surcroît, le réglage fin des options globales de R, comme le formatage de l’affichage des décimales ou l’inhibition de la notation scientifique automatique pour les valeurs de p-valeurs modérées, favorise une interprétation immédiate des sorties numériques.
Une fois les bibliothèques chargées et l’espace de travail assaini par la purge d’éventuels objets résiduels en mémoire vive, l’importation du jeu de données constitue la première manipulation opérationnelle. Qu’il provienne d’un fichier textuel délimité par des virgules (CSV), d’un format propriétaire issu d’un logiciel commercial ou d’une source relationnelle, le conteneur de données doit subir une inspection préliminaire impérative. L’application systématique des fonctions d’inspection de la structure interne permet de cartographier la dimension du tableau de données (nombre de lignes et de colonnes), la typologie interne de chaque vecteur (entiers, réels, facteurs, chaînes de caractères) et d’identifier sans délai les discordances entre le format théorique attendu et le typage effectif opéré par l’interpréteur de code.
2. Préparation et structuration des données bivariées dans R
2.1 Création du jeu de données empirique de référence
Pour illustrer de manière concrète et didactique les concepts exposés au long de ce traité, nous procédons à la construction programmatique d’un jeu de données synthétique, mais rigoureusement calibré sur les propriétés empiriques observables en psychologie de l’éducation. Cet ensemble d’observations modélise la relation entre l’investissement temporel consacré à l’étude hebdomadaire (exprimé en heures) et la performance finale obtenue lors d’un examen standardisé d’évaluation des compétences méthodologiques (score étalonné variant sur une échelle continue de 0 à 100). Nous y adjoignons une variable catégorielle binaire matérialisant l’assignation des participants à un module d’entraînement aux techniques d’apprentissage métacognitif versus un groupe contrôle recevant le cursus standard.
La génération du tableau de données s’appuie sur la création de vecteurs numériques corrélés afin de simuler une structure de dépendance plausible observée dans les populations réelles. La programmation sous R fait appel aux générateurs de distributions gaussiennes standardisées combinés algébriquement pour induire une covariance contrôlée, évitant ainsi le recours à des données purement aléatoires indépendantes qui videraient l’analyse bivariée de sa substance démonstrative. Une fois le tableau structuré sous la forme d’un data frame ou d’un tibble, nous procédons à une validation exhaustive de ses dimensions à travers les primitives du langage dédiées au dimensionnement matriciel.
L’examen dimensionnel est immédiatement complété par l’évaluation scrupuleuse de l’intégrité des vecteurs numériques. Il s’agit de vérifier que les plages de valeurs obtenues respectent rigoureusement les contraintes théoriques et physiologiques des construits mesurés : l’investissement temporel ne peut en aucun cas afficher des grandeurs négatives ni excéder la limite physique des heures hebdomadaires disponibles, de même que les scores académiques doivent strictement s’inscrire dans les bornes délimitées par le protocole d’évaluation. Cette étape de validation logique conditionne l’ensemble de la validité interne des estimations ultérieures, prévenant l’injection d’artéfacts de saisie au sein des algorithmes de calcul bivarié.
2.2 Nettoyage des données et gestion des valeurs manquantes
Aucun protocole expérimental ou observationnel réel n’échappe à l’écueil de la dégradation des données, qu’elle se manifeste par la présence d’observations atypiques ou de cellules vides consécutives à des abandons d’études ou des refus de réponse. La détection des valeurs extrêmes ou aberrantes requiert la mise en œuvre de critères statistiques formels plutôt qu’une inspection visuelle informelle sujette à des biais de confirmation. On privilégie généralement la règle des barrières interquartiles formalisée par John Tukey, qui identifie comme atypique toute observation située au-delà de 1,5 fois l’écart interquartile calculé à partir du premier ou du troisième quartile, ou l’évaluation des scores standardisés z-scores, en retenant le seuil conventionnel de trois écarts-types par rapport à la moyenne arithmétique.
Face aux valeurs manquantes, l’analyste bivarié est confronté à un arbitrage méthodologique de premier ordre. La suppression par liste complète (connue sous l’appellation d’analyse sur cas complets ou complete-case analysis) représente la stratégie par défaut la plus fréquemment adoptée dans les procédures standards de calcul sous R. Toutefois, cette modalité d’exclusion systématique ne demeure non biaisée que sous l’hypothèse très restrictive selon laquelle le mécanisme générateur de données manquantes s’avère complètement aléatoire (Missing Completely at Random, MCAR). Si la perte de données dépend des variables à l’étude (Missing at Random, MAR, ou Missing Not at Random, MNAR), l’élimination des lignes incomplètes altère mécaniquement la variance bivariée et engendre une distorsion substantielle de l’estimation de l’association réelle au sein de la population cible.
Une alternative pragmatique réside dans l’imputation statistique, qu’elle soit déterministe simple (par la moyenne ou la médiane) ou multivariée sophistiquée par équations chaînées (MICE). L’imputation déterministe univariée présente cependant le risque critique de comprimer artificiellement la variance d’échantillonnage et de distordre la corrélation bivariée entre les paires de variables en créant des grappes artificielles sur l’axe concerné. Dès lors, si l’exclusion par observation complète est retenue pour préserver la transparence du calcul didactique, elle doit s’accompagner d’une documentation méticuleuse du nombre d’unités soustraites à l’analyse et d’une discussion sur le biais d’échantillonnage résiduel susceptible d’en découler.
2.3 Statistiques descriptives préliminaires pour variables continues
Avant d’engager le croisement formel des métriques, une exploration descriptive approfondie de chacune des variables continues prises isolément est requise pour appréhender leur profil distributionnel. L’évaluation de la tendance centrale ne doit pas se confiner au seul calcul de la moyenne arithmétique : celle-ci présentant une hypersensibilité notoire aux valeurs distales, il convient de lui associer systématiquement la médiane (point milieu partageant la distribution en deux segments égaux) ainsi que la moyenne tronquée (généralement à hauteur de 5 % ou 10 % à chaque extrémité). La concordance étroite entre ces trois indices fournit un premier indice de la symétrie distributionnelle de la variable examinée.
L’estimation de la dispersion requiert également une pluralité de métriques complémentaires. La variance et son extraction sous forme d’écart-type quantifient l’étalement moyen quadratique autour de la moyenne arithmétique, formant les paramètres de base des statistiques paramétriques classiques. Pour parer au risque de surévaluation de la dispersion provoqué par d’éventuelles observations aberrantes, l’écart interquartile (différence absolue entre le 75e et le 25e centile) offre une mesure d’étalement robuste d’une haute fidélité. L’amplitude globale (différence entre le maximum et le minimum absolus) vient compléter ce tableau pour fixer les bornes extrêmes du spectre empirique observé.
Enfin, l’examen des moments statistiques d’ordre supérieur constitue un prérequis incontournable pour anticiper le respect des postulats d’inférence bivariée. Le coefficient d’asymétrie (skewness) mesure l’écart à la symétrie spéculaire d’une loi normale théorique : une valeur significativement positive dénote un étalement de la queue de distribution vers la droite (valeurs élevées), tandis qu’une valeur négative traduit une accumulation de données dans les valeurs fortes avec une traîne vers les valeurs faibles. Le coefficient d’aplatissement (kurtosis, ou plus rigoureusement l’excès de kurtose) évalue l’épaisseur des queues de distribution et la leptocurticité du profil par rapport à la loi normale standard. Des déviations majeures de ces indices (classiquement au-delà de la plage de -1 à +1) constituent une alerte méthodologique majeure contre l’emploi irréfléchi de procédures d’association linéaires paramétriques strictes.
3. Analyse exploratoire visuelle : Les diagrammes de dispersion de base
3.1 Génération de graphiques de dispersion avec la fonction plot()
L’analyse empirique de deux variables continues exige impérativement une immersion visuelle initiale avant toute abstraction mathématique. Le diagramme de dispersion (scatterplot) constitue l’outil fondamental de cette phase exploratoire, matérialisant chaque unité statistique par un point cartésien dont les coordonnées horizontales et verticales correspondent scrupuleusement aux valeurs prises sur les deux variables respectives. Au sein de l’environnement R de base, la fonction polyvalente graphique standard offre le moyen le plus direct et épuré pour générer cette représentation sans dépendance externe logicielle.
L’utilisation rigoureuse de cette fonction fondamentale repose sur le respect de conventions sémiotiques immuables : l’axe des abscisses (axe X) est invariablement assigné à la variable théoriquement considérée comme explicative, prédictive ou indépendante, tandis que l’axe des ordonnées (axe Y) reçoit la variable réponse, critère ou dépendante. Le paramétrage syntaxique de la fonction permet d’affiner l’esthétique par l’attribution de libellés d’axes explicites (incluant les unités de mesure physiques ou psychométriques), l’ajustement du symbole de traçage typographique (l’argument numérique désignant le type de point pour remplacer le cercle évidé par défaut par un point plein offrant une meilleure visibilité lors de superpositions légères) et le calibrage de l’échelle colorimétrique.
L’inspection du nuage ainsi matérialisé permet d’opérer une première inférence intuitive mais fondamentale quant à la nature de la relation. L’observateur traque l’orientation générale des points : une tendance ascendante caractérise une covariance positive, tandis qu’une inclinaison descendante signale une association inverse. Surtout, cette exploration oculaire primitive permet de discerner immédiatement si la forme relationnelle globale se conforme à une trajectoire rectiligne ou si elle trahit des patterns curvilinéaires (paraboliques, logarithmiques ou sigmoïdes) qui invalideraient de facto l’application non corrigée d’un indice de liaison purement linéaire.
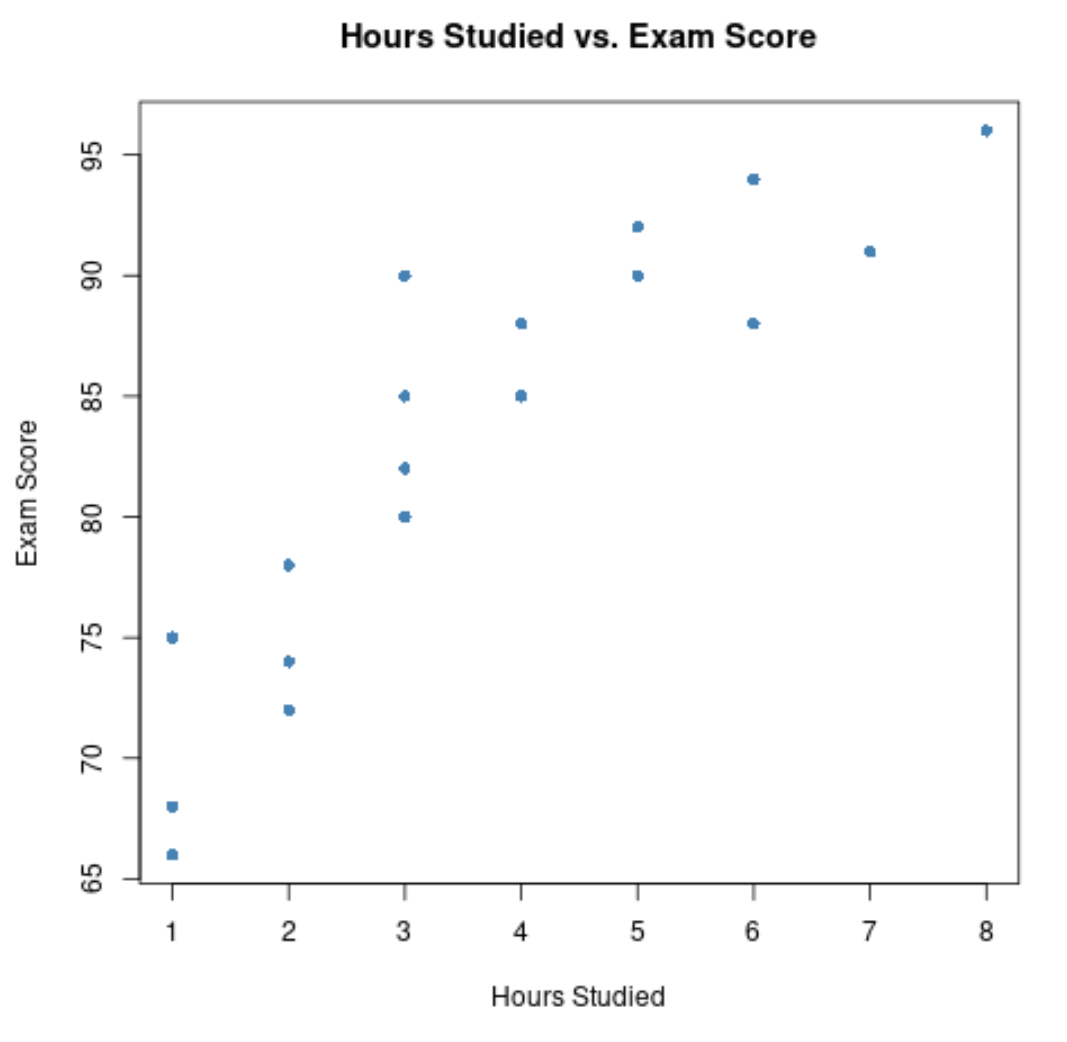
3.2 Détection visuelle des observations influentes et des ruptures de tendance
Au-delà de la forme relationnelle dominante, le diagramme de dispersion primitif excelle dans l’identification sans délai des singularités structurales du jeu de données. La présence d’observations isolées situées à grande distance du corps principal du nuage de points attire immédiatement l’attention de l’analyste. Ces points atypiques peuvent résulter de deux mécanismes distincts : il peut s’agir de valeurs aberrantes sur l’une des dimensions marginales, ou plus insidieusement de combinaisons bivariées anormales où les valeurs prises sur X et Y restent modérées individuellement, mais dont l’association s’avère hautement discordante par rapport à la tendance globale du collectif.
Le tracé permet également d’évaluer intuitivement le respect de la condition d’homoscédasticité, définie comme la constance de la variance de la variable réponse le long de l’axe de la variable prédictive. Une dispersion verticale des points qui s’évase progressivement vers la droite pour dessiner un profil en entonnoir ou en éventail signale l’existence d’une hétéroscédasticité sous-jacente. Cette configuration indique que l’incertitude ou la variabilité du phénomène mesuré en ordonnée n’est pas homogène selon le niveau du facteur en abscisse, situation fréquemment rencontrée lors de l’étude de performances complexes où l’hétérogénéité interindividuelle s’accroît avec le niveau d’expertise.
Il importe enfin de prévenir le chercheur contre les biais perceptifs induits par la manipulation arbitraire des échelles graphiques. Un étirement ou une contraction excessive des limites des axes (via les paramètres de délimitation d’intervalles) est susceptible d’amplifier ou d’atténuer artificiellement l’impression visuelle de pente ou de dispersion. Une observation critique exige donc d’associer systématiquement au graphique une échelle proportionnée aux unités réelles du phénomène, et de ne jamais conclure à la présence ou à l’absence d’une relation sans avoir soumis l’impression graphique à une quantification statistique standardisée.
3.3 Enrichissement du graphique de base avec des lignes de référence
Afin de transformer le diagramme de dispersion en un véritable instrument d’analyse diagnostique, l’analyste peut superposer des repères géométriques directement sur la fenêtre graphique native. L’adjonction la plus fondamentale consiste à tracer la droite de tendance empirique des moindres carrés ordinaires. L’instruction primitive de tracé de lignes droites, prenant en argument un modèle d’ajustement linéaire bivarié calculé à la volée, permet d’inscrire la trajectoire optimale au sens mathématique, offrant un ancrage géométrique clair pour juger de la déviation relative des points par rapport à la linéarité parfaite.
Toutefois, contraindre la visualisation à une ligne purement droite risque d’occulter des inflexions locales significatives de la relation. Pour pallier cet écueil, l’intégration d’une courbe de lissage non paramétrique de type LOWESS (Locally Weighted Scatterplot Smoothing) s’avère particulièrement éclairante. Cet algorithme calcule une succession de régressions locales pondérées en accordant un poids prépondérant aux points voisins dans un voisinage délimité, traçant une trajectoire flexible et lisse qui s’affranchit de toute hypothèse fonctionnelle a priori. La concordance étroite entre la droite des moindres carrés et la courbe de lissage local confirme la stricte linéarité de la relation, tandis qu’une divergence marquée alerte sur une courbure ou une rupture structurelle de pente.
L’enrichissement graphique peut être complété par l’adjonction de lignes orthogonales pointillées matérialisant les coordonnées moyennes univariées des deux variables. L’intersection de ces deux repères orthogonaux découpe l’espace graphique en quatre quadrants cardinaux distincts : les quadrants supérieur-droit et inférieur-gauche regroupent les observations où les deux variables varient de conserve dans le même sens par rapport à leurs moyennes respectives, tandis que les quadrants croisés regroupent les contributions négatives à la covariance globale. Ce découpage spatial matérialise directement la dérivation algébrique de l’association statistique.
4. Visualisation bivariée avancée avec le formalisme ggplot2
4.1 Grammaire des graphiques appliquée à l’analyse bivariée
Bien que les fonctionnalités graphiques natives de R conservent une utilité indéniable pour des inspections exploratoires rapides, l’élaboration de figures destinées à la publication scientifique de haut rang nécessite une flexibilité de composition et une cohérence visuelle supérieures. La bibliothèque logicielle ggplot2, articulée autour des préceptes théoriques de la grammaire des graphiques formalisée par Leland Wilkinson, déconstruit chaque visualisation en un assemblage modulaire de couches sémantiques indépendantes : les données sous-jacentes, les correspondances esthétiques (aesthetics mappings), les objets géométriques (geoms), les transformations statistiques (stats), les systèmes de coordonnées et les thèmes typographiques.
Dans ce cadre formel, l’analyse bivariée de deux variables continues s’initie par la déclaration d’une base graphique liant les colonnes d’intérêt aux coordonnées d’abscisse et d’ordonnée dans l’espace euclidien. La première couche géométrique fondamentale projette les points élémentaires du nuage de dispersion. Par-dessus cette matrice de points, une couche de modélisation statistique superpose un ajustement relationnel lissé. L’analyste peut spécifier un modèle linéaire formel pour visualiser la pente théorique tout en instruisant le système d’afficher l’enveloppe de dispersion matérialisant l’intervalle de confiance calculé au seuil standard de 95 % autour de la trajectoire estimée.
La puissance du formalisme réside également dans le contrôle exhaustif de la grammaire de mise en page. L’application de thèmes graphiques épurés (tels que le thème minimal ou le thème classique éliminant les grilles de fond grisâtres souvent décriées dans les manuels de diffusion académique) assure une lisibilité sans faille. La typographie des axes, la taille relative des étiquettes et la gestion de la transparence des points par le paramètre d’opacité (alpha) permettent de résoudre élégamment les problèmes d’amassement et d’occlusion visuelle lorsque des dizaines de mesures s’accumulent sur des coordonnées rigoureusement identiques.
4.2 Superposition de densités marginales et visualisations conjointes
L’un des défis majeurs de l’analyse bivariée réside dans la difficulté à appréhender simultanément la covariance globale des deux variables et la distribution univariée propre à chacune d’entre elles. Pour surmonter ce cloisonnement perceptif, le couplage de représentations marginales en bordure du diagramme de dispersion principal apporte une solution méthodologique de premier ordre. L’extension ggExtra offre une implémentation computationnelle remarquable via une fonction dédiée permettant d’insérer des tracés de densité continue marginale, des histogrammes ou des diagrammes en boîte le long des axes X et Y.
Cette visualisation synoptique permet de contrôler en un coup d’œil si l’association linéaire globale s’articule sur des distributions univariées symétriques ou si elle subit la déformation asymétrique d’une variable qui comprime ses observations vers un plancher ou un plafond de mesure. L’observation conjointe de la densité marginale prévient des erreurs courantes d’interprétation où une forte pente de régression apparente ne repose en réalité que sur la présence d’une seconde modalité marginale faiblement peuplée à l’extrémité supérieure de l’espace d’échantillonnage.
Dans les contextes impliquant des bases de données volumineuses (macro-échantillons comportementaux ou données massives d’enregistrements en ligne), le diagramme de dispersion traditionnel devient totalement saturé et illisible en raison du chevauchement de plusieurs milliers d’observations. L’analyste recourt alors à des représentations de densité conjointe bidimensionnelle, notamment le pavage hexagonal (geom_hex) ou les cartes d’isolignes de contour de densité 2D. En segmentant l’espace bivarié en alvéoles régulières dont la tonalité colorimétrique traduit l’effectif local d’observations condensées, ces techniques permettent de cartographier la structure topologique fine de la covariance sans aucune perte de discernement visuel.
4.3 Stratification visuelle et modération graphique
L’analyse relationnelle isolant deux métriques court en permanence le danger de l’abstraction réductionniste en ignorant l’influence d’éventuels facteurs modérateurs ou contextuels. Le formalisme graphique sous R autorise l’intégration immédiate d’une troisième variable catégorielle au sein de la dynamique bivariée, transformant le graphique bidimensionnel en un espace d’investigation conditionnelle hautement informatif. Cette intégration s’opère par le mappage de la variable de stratification sur des attributs esthétiques discriminants tels que la couleur de contour, la forme du symbole géométrique ou le type de trait de lissage.
Au-delà de la différenciation chromatique sur un tracé unique, la technique du facettage (faceting) consiste à décomposer la figure en une matrice de sous-graphiques indépendants partageant des échelles coordonnées uniformes, chaque panneau représentant un sous-groupe ou une condition expérimentale spécifique. Cette approche permet de comparer visuellement la stabilité de la pente de dispersion d’une strate à l’autre : l’observation de trajectoires linéaires parallèles témoigne de l’absence d’interaction entre le prédicteur continu et le facteur de stratification, tandis que des pentes divergentes ou croisées révèlent l’existence manifeste d’un effet de modération statistique.
Cette décomposition graphique systématique constitue le rempart le plus efficace contre l’un des pièges méthodologiques les plus insidieux de la recherche quantitative : le paradoxe de Simpson. Ce phénomène émerge lorsqu’une tendance associative observée au niveau global de l’échantillon agrégé s’inverse purement et simplement ou disparaît lorsque les données sont segmentées au sein de leurs sous-populations constitutives. La stratification visuelle préliminaire garantit que l’analyste n’inférera pas une relation linéaire univoque trompeuse qui masquerait des structures contradictoires au sein de strates démographiques, cliniques ou expérimentales distinctes.
5. Quantification de l’association linéaire : Le coefficient de Pearson
5.1 Cadre mathématique et conditions d’application
Le coefficient de corrélation linéaire produit-moment, formalisé mathématiquement par Karl Pearson à la fin du XIXe siècle, représente la mesure paramétrique standardisée de référence pour quantifier la force et le sens de la relation unissant deux variables continues. Algébriquement, le coefficient r de Pearson est défini comme le rapport de la covariance empirique des deux variables au produit de leurs écarts-types respectifs. En divisant la somme des produits des écarts à la moyenne par les normes euclidiennes correspondantes, la formule standardise la covariance — métrique brute dépendante des échelles d’unités de mesure initiales — en un indice adimensionnel strictly contraint dans l’intervalle fermé [-1 ; +1].
L’application légitime du coefficient de Pearson repose sur un corpus strict de postulats distributionnels. Le plus contraignant stipule que les deux variables doivent suivre conjointement une loi normale bivariée. Ce postulat implique non seulement la normalité marginale univariée de chaque composante, mais également l’exigence que la distribution conditionnelle de l’une des variables pour n’importe quelle valeur fixée de l’autre suive une loi normale homoscédastique. En outre, la relation sous-jacente doit être rigoureusement linéaire : Pearson mesure uniquement l’adéquation des observations à une trajectoire rectiligne. Si l’association réelle est de nature quadratique ou exponentielle, le coefficient affichera une valeur proche de zéro, masquant une relation déterministe parfaite mais non rectiligne.
Deux vulnérabilités critiques du coefficient doivent impérativement guider la vigilance du méthodologue. Premièrement, sa sensibilité extrême aux valeurs distales : l’inclusion d’une unique observation atypique positionnée loin du centre de gravité peut faire basculer artificiellement un coefficient nul vers une significativité fallacieuse, ou inversement dissimuler une association prégnante. Deuxièmement, le phénomène de restriction de l’étendue (range restriction), théorisé par Robert Thorndike : lorsqu’un échantillon est sélectionné sur une fraction tronquée de la variabilité d’une variable (par exemple, tester des étudiants exclusivement admis dans un programme d’élite), la variance artificielle réduite compresse drastiquement la magnitude apparente de r, conduisant à une sous-estimation systématique de l’intensité du lien réel existant dans la population générale.
5.2 Mise en œuvre numérique sous R avec cor()
L’extraction numérique du coefficient de Pearson s’effectue sous R au moyen de la fonction générique d’évaluation de la corrélation. Dans sa syntaxe la plus élémentaire, la fonction reçoit en entrée les deux vecteurs numériques à croiser et retourne l’estimation ponctuelle du paramètre empirique. Par défaut, la procédure applique l’algorithme de Pearson sans nécessiter de spécification explicite de la méthode. Toutefois, l’opération échouera systématiquement — en renvoyant une valeur indéterminée (NA) — dès lors que le moindre élément manquant est présent au sein de l’un ou l’autre des vecteurs d’entrée, ce qui exige un paramétrage scrupuleux de l’argument de gestion des lacunes.
Le paramètre contrôlant le traitement des données incomplètes offre deux options principales : le mode d’exclusion complète (complete.obs) qui élimine toute ligne comportant au moins une valeur manquante sur l’ensemble du jeu de données, et le mode d’appariement par paires (pairwise.complete.obs) qui ne supprime les observations incomplètes qu’au regard exclusif des deux vecteurs précisément mobilisés dans le calcul ponctuel en cours. Bien que cette seconde approche maximise la taille d’échantillon effective pour chaque paire bivariée distincte, elle engendre le risque de produire des matrices de corrélation non semi-définies positives, ce qui peut bloquer des calculs multivariés ultérieurs tels que les analyses factorielles.
Lorsque l’investigation s’étend à un ensemble élargi de variables métriques, l’application de la fonction sur un tableau entier génère instantanément une matrice carrée symétrique documentant l’ensemble des covariations bivariées standardisées du système. Dans ce cadre, des précautions computationnelles s’imposent : si une colonne affiche une variance quasi-nulle ou une quasi-invariance d’échelle, l’algorithme se heurtera à une division par zéro lors de la normalisation par l’écart-type, provoquant des avertissements système et l’émission de valeurs non numériques qu’il conviendra de purger ou de régulariser préalablement.
5.3 Le coefficient de détermination R² dans le cadre bivarié
Pour dépasser l’interprétation purement ordinale de l’amplitude du coefficient de Pearson et lui conférer une résonance substantielle, les statisticiens recourent universellement au coefficient de détermination, obtenu par l’élévation au carré de la valeur de r. Désigné par le symbole R², cet indice fournit une quantification directe et hautement intuitive de la magnitude de l’association en exprimant la proportion de la variance totale de la variable critère qui se trouve directement partagée avec la variable prédictive, ou expliquée par elle dans le cadre de l’approximation linéaire.
Sur le plan conceptuel, le coefficient de détermination se visualise élégamment à travers la logique ensembliste d’un diagramme de Venn : si l’on matérialise la variabilité globale de chaque construit par une aire géométrique unitaire, la surface d’intersection mutuelle où les deux disques se recouvrent correspond scrupuleusement au ratio R². Ainsi, un coefficient de corrélation empirique de 0,50 ne signifie nullement que 50 % du comportement de la variable dépendante est capturé par le prédicteur, mais exactement 25 % (soit 0,50 au carré), les 75 % restants relevant d’autres sources de variabilité non contrôlées, d’influences idiosyncrasiques ou de l’erreur pure de mesure psychométrique.
Il est fondamental de maintenir une distinction rigoureuse entre la capacité d’explication statistique fournie par le R² et l’explication mécanistique ou ontologique du phénomène. Affirmer que 30 % de la variance des performances aux examens est expliquée par les heures d’étude constitue un énoncé strictement descriptif portant sur la réduction de l’incertitude prédictive au sens de l’analyse de régression ; cela ne valide en aucun cas l’hypothèse selon laquelle le temps d’étude produirait mécaniquement un tiers du score obtenu sans le concours d’autres composantes cognitives, sociologiques et didactiques médiatrices.
6. Mesures non paramétriques d’association : Spearman et Kendall
6.1 Le coefficient de corrélation des rangs de Spearman (rho)
Lorsque les données empiriques violent délibérément les postulats drastiques de normalité bivariée ou lorsqu’elles sont collectées au moyen d’échelles ordinales (telles que des évaluations graduées de Likert à intervalles inégaux), l’application du coefficient de Pearson expose l’analyste à des estimations fortement biaisées et instables. Le coefficient de corrélation des rangs de Spearman, désigné par la lettre grecque rho, résout cette contrainte en opérant une transformation non linéaire simple mais radicale : il substitue aux valeurs métriques brutes leurs rangs hiérarchiques respectifs au sein de chaque distribution ordonnée.
Le calcul du rho de Spearman revient formellement à appliquer la formule de Pearson sur les rangs d’échantillons ainsi convertis. De par sa nature mathématique, cette métrique n’évalue plus la stricte linéarité de la trajectoire empirique, mais sa monotonie fonctionnelle. Une relation est dite parfaitement monotone si toute augmentation de la variable explicative s’accompagne d’une progression systématique (ou d’une régression systématique s’il s’agit d’une monotonie inverse) de la variable réponse, quelle que soit la régularité ou la constance du rythme d’accroissement le long de l’échelle. Par conséquent, Spearman conserve une stricte invariance face à toute transformation monotone croissante appliquée aux variables d’origine (comme les transformations logarithmiques ou exponentielles).
La robustesse du coefficient de Spearman en présence d’observations extrêmes constitue l’un de ses atouts majeurs. Un point aberrant localisé à dix écarts-types de la moyenne arithmétique globale reçoit simplement le rang maximal séquentiel disponible, ce qui jugule immédiatement son influence disproportionnée sur le calcul de la somme des écarts. Sous R, la génération du rho de Spearman s’obtient avec une simplicité déconcertante en spécifiant la méthode ad hoc au sein de la fonction d’estimation de corrélation standardisée.
6.2 Le tau de Kendall pour données ordinales et petits échantillons
En tant qu’alternative non paramétrique concurrente de Spearman, le coefficient tau formalisé par Maurice Kendall repose sur une approche probabiliste et combinatoire de l’association, fondée sur la comparaison méthodique de toutes les paires d’observations possibles au sein de l’échantillon. Pour une série de n unités expérimentales, l’espace d’analyse englobe n*(n-1)/2 paires uniques de données bivariées. Deux paires sont qualifiées de concordantes si la différence d’ordre observée entre les deux sujets sur la variable X va dans le même sens que leur différence d’ordre sur la variable Y ; elles sont déclarées discordantes si le sens des différences s’inverse.
Le tau de Kendall est substantiellement défini comme la différence normalisée entre la proportion de paires concordantes et la proportion de paires discordantes. Par rapport au rho de Spearman, le tau de Kendall présente des propriétés mathématiques et statistiques indiscutablement supérieures lorsque l’échantillon d’étude est de taille modeste. D’une part, son erreur-type d’échantillonnage converge bien plus rapidement vers une distribution asymptotique normale que celle du rho, rendant les inférences probabilistes significativement plus fiables. D’autre part, Kendall a élaboré des corrections combinatoires rigoureuses pour traiter la présence de rangs ex æquo (liens ou ties) inhérents aux échelles de mesure courtes.
L’exécution computationnelle du test de Kendall s’effectue également via l’interpréteur R en spécifiant la clé de méthode adéquate dans l’appel de corrélation. L’interprétation substantielle du tau est particulièrement élégante et compréhensible pour des auditoires non spécialistes : une valeur de tau égale à 0,40 indique que si l’on tire aléatoirement deux individus au sein de la population, la probabilité que leur classement relatif concorde sur les deux critères étudiés excède de 40 points de pourcentage la probabilité que leurs classements soient discordants.
6.3 Critères comparatifs pour l’arbitrage entre démarches paramétriques et non paramétriques
Face au pluralisme méthodologique offert par R, le statisticien doit formuler un arbitrage méthodologique raisonné pour sélectionner l’indice de liaison le plus adapté à ses données empiriques. Bien que séduisantes par leur absence de postulats restrictifs, les procédures non paramétriques fondées sur l’assignation de rangs paient leur robustesse au prix d’une perte de puissance statistique par rapport au coefficient de Pearson lorsque les conditions de la normalité gaussienne sont effectivement satisfaites. Cette efficacité relative asymptotique (ARE) tourne autour de 91 % pour les indices de rangs face au test paramétrique optimal, ce qui signifie qu’un échantillon légèrement plus grand est nécessaire pour déceler un effet réel de même magnitude.
Pour étayer cette décision sur des fondements quantitatifs solides, l’analyste doit soumettre ses séries de données à une batterie de tests diagnostiques formels de normalité univariée et bivariée. Le test de normalité d’Anderson-Darling ou le classique test de Shapiro-Wilk (implémenté nativement sous R) fournissent des critères probabilistes stricts : le rejet de l’hypothèse nulle d’adéquation gaussienne (typiquement pour une p-valeur inférieure au seuil conventionnel de 0,05) incite fermement à abandonner la démarche de Pearson au profit de Spearman ou de Kendall.
Le guide d’arbitrage méthodologique peut se synthétiser autour de règles décisionnelles limpides : si les variables continues respectent la normalité et présentent une trajectoire linéaire apparente, le coefficient de Pearson doit être priorisé pour maximiser la puissance de généralisation et autoriser le calcul du R² ; si les données comportent des violations modérées de normalité, des distributions asymétriques ou des échelles ordinales étendues avec un large effectif d’échantillonnage, le rho de Spearman constitue la solution idéale ; enfin, en présence d’échantillons de taille réduite (par exemple inférieure à 30 unités) ou de grilles d’évaluation présentant un nombre massif d’ex æquo, le tau de Kendall s’impose sans conteste comme l’estimateur le plus stable et le plus rigoureux.
7. Inférence statistique et tests d’hypothèses sur les coefficients d’association
7.1 Formulation formelle des hypothèses nulle et alternative
L’estimation ponctuelle d’un coefficient de corrélation au sein d’un échantillon ne saurait suffire à clore l’investigation empirique : la valeur calculée demeure une réalisation stochastique soumise aux fluctuations de l’échantillonnage aléatoire. L’inférence statistique permet de déterminer si l’amplitude de l’association observée s’avère suffisamment robuste pour rejeter l’hypothèse selon laquelle elle résulterait d’un simple concours de circonstances probabilistes au sein d’une population parente au sein de laquelle les deux construits seraient en réalité totalement indépendants.
La démarche formelle impose la formulation a priori d’un couple d’hypothèses statistiques mutuellement exclusives. L’hypothèse nulle fondamentale (notée H0) postule l’absence intégrale de corrélation linéaire au sein de la population générale, affirmant que le paramètre théorique sous-jacent est rigoureusement égal à zéro. Face à elle, l’analyste spécifie l’hypothèse alternative (notée H1). Dans une démarche bilatérale classique (two-sided), H1 postule simplement que le paramètre théorique diffère de zéro, sans présumer de sa trajectoire directionnelle. Si des justifications théoriques préexistantes imposent une orientation précise, l’analyste formule une hypothèse alternative unilatérale (one-sided) affirmant que la corrélation est strictement positive ou strictement négative.
Cette formalisation engage le contrôle méthodique de deux catégories d’erreurs inférentielles fondamentales. L’erreur de première espèce (le risque alpha, conventionnellement fixé à 5 %) correspond au risque de rejeter indûment l’hypothèse nulle alors qu’elle est vérifiée dans la réalité ontologique, aboutissant à la proclamation fallacieuse d’une découverte scientifique. L’erreur de seconde espèce (le risque bêta) désigne la probabilité d’échouer à rejeter l’hypothèse nulle alors qu’il existe une véritable relation au sein de la population. La puissance statistique d’un test d’association bivarié, égale au complément à un de bêta, s’accroît directement avec l’augmentation de la taille d’échantillon et l’amplitude théorique de l’effet à déceler.
7.2 Exécution et interprétation de cor.test()
Dans l’environnement de calcul R, la transition de l’estimation purement descriptive à l’inférence probabiliste s’opère au moyen de la fonction d’évaluation de la significativité de la corrélation. Contrairement à la fonction basique qui ne renvoie qu’une grandeur scalaire, cette procédure exécute un test d’hypothèse formel complet et compile les résultats sous une structure d’objet enrichie. Pour tester une hypothèse linéaire paramétrique, la fonction transforme le r de Pearson calculé en une statistique de test empirique suivant une loi théorique de Student à n – 2 degrés de liberté.
L’exécution de la commande fournit en sortie un diagnostic synthétique comportant la valeur de la statistique t empirique, les degrés de liberté exacts, la valeur de probabilité critique (p-valeur), l’estimation ponctuelle du paramètre et son intervalle de confiance bilatéral calculé à 95 %. L’intervalle de confiance est ici déterminé au moyen de la transformation z formalisée par Ronald Fisher, qui stabilise la variance asymptotique du coefficient de corrélation pour pallier l’asymétrie de sa distribution d’échantillonnage lorsque la valeur absolue de r s’écarte de zéro. Cet intervalle est infiniment plus informatif que la seule p-valeur : il indique précisément la plage des valeurs populationnelles plausibles et permet de juger de la précision de la métrique mesurée.
Le rapportage académique de ces sorties computationnelles doit obéir scrupuleusement aux conventions formelles des sociétés savantes, notamment les normes de l’American Psychological Association (normes APA 7e édition). L’analyste synthétise le résultat sous une formulation canonique articulant le symbole de l’indice calculé, les degrés de liberté entre parenthèses, la magnitude exacte de la valeur ponctuelle, le positionnement de la p-valeur vis-à-vis des seuils critiques et les bornes explicites de l’intervalle de confiance. Ce formalisme strict garantit la standardisation et la comparabilité des connaissances au sein de la littérature scientifique internationale.
7.3 Méthodes computationnelles de rééchantillonnage (Bootstrapping)
Lorsque les postulats distributionnels fondamentaux sont violés et que les transformations mathématiques habituelles se révèlent inefficaces, l’analyste peut recourir aux méthodes de rééchantillonnage computationnel intensif, formalisées initialement par Bradley Efron sous la théorie du bootstrap non paramétrique. Cette approche révolutionnaire ne repose sur aucun a priori quant à la forme de la distribution théorique sous-jacente de la population : elle érige l’échantillon empirique lui-même en une population modèle miniature au sein de laquelle elle procède à un tirage aléatoire répété avec remise.
La mise en œuvre pratique sous R s’appuie classiquement sur les fonctionnalités puissantes offertes par le paquetage de rééchantillonnage boot. L’analyste commence par coder une fonction personnalisée qui extrait l’indice de liaison d’intérêt pour chaque sous-échantillon indicé, puis injecte cette routine au sein de l’algorithme générique en lui intimant de réaliser un nombre substantiel de réplications (généralement entre 1 000 et 10 000 itérations). À l’issue du processus, l’algorithme compile la distribution empirique des coefficients de corrélation recalculés sur chaque réplique virtuelle.
À partir de cette distribution d’échantillonnage simulée, le statisticien peut extraire des intervalles de confiance bootstrappés d’une remarquable robustesse. L’utilisation d’intervalles ajustés pour le biais et l’accélération (intervalles BCa) permet de corriger automatiquement les asymétries distributionnelles et les biais d’estimation inhérents aux échantillons modestes. La comparaison métrique entre les intervalles de confiance asymptotiques issus de la transformation z de Fisher et ceux issus de l’approche par rééchantillonnage non paramétrique renseigne de manière éclatante sur la stabilité de l’inférence statistique face aux imperfections des données.
8. Modélisation prédictive : La régression linéaire simple
8.1 Formulation théorique de l’équation des moindres carrés ordinaires (MCO)
Tandis que la corrélation bivariée traite les deux grandeurs dans une symétrie mathématique absolue en ignorant toute directionnalité causale ou prédictive, la régression linéaire simple opère une asymétrie structurante en érigeant explicitement une variable X au statut de prédicteur pour anticiper le comportement d’une variable réponse continue Y. Le modèle probabiliste postule que la réponse observée résulte de la sommation d’une composante déterministe linéaire et d’un terme stochastique résiduel d’erreur non observée.
L’équation formelle s’écrit conventionnellement : Y = bêta-0 + bêta-1 * X + epsilon. Dans cette formulation algébrique, le paramètre bêta-0 représente l’ordonnée à l’origine (ou intercept), c’est-à-dire l’espérance mathématique conditionnelle de la variable dépendante lorsque la variable explicative prend une valeur strictement nulle. Le paramètre bêta-1 désigne la pente de la droite de régression (ou coefficient de régression), quantifiant l’amplitude et le sens de la variation attendue de la réponse Y pour chaque accroissement d’une unité scalaire sur la variable X. Le terme d’erreur résiduelle capture l’ensemble des déviations individuelles non expliquées par l’ajustement linéaire.
L’estimation empirique de ces paramètres inconnus de la population s’effectue quasi universellement au moyen de la méthode des moindres carrés ordinaires (MCO). Cet algorithme d’optimisation analytique vise à déterminer la droite unique qui minimise la somme des carrés des écarts verticaux séparant chaque point de données réel de sa projection théorique prédite sur la trajectoire. Cette procédure géométrique assure que la moyenne arithmétique des résidus d’ajustement est strictement égale à zéro et confère aux estimateurs des propriétés d’optimalité statistique exceptionnelles (meilleur estimateur linéaire sans biais, théorème de Gauss-Markov).
8.2 Estimation empirique du modèle avec la fonction lm()
L’opérationnalisation computationnelle de la régression linéaire bivariée sous R s’appuie sur la fonction fondamentale de modélisation linéaire. La syntaxe repose sur l’écriture d’une formule symbolique standardisée dans laquelle la variable réponse est positionnée à gauche d’un tilde, le prédicteur explicatif étant disposé sur le flanc droit de l’opérateur, assorti de la spécification explicite du jeu de données mobilisé.
L’inspection analytique de l’objet de régression produit est accessible via l’application de la fonction de synthèse textuelle générale. Ce récapitulatif structure les données en plusieurs blocs informatifs décisifs : il détaille la distribution quartilique des résidus empiriques, dresse un tableau des paramètres estimés consignant leur valeur ponctuelle, leur erreur-type standard, la statistique t de Student associée testant la nullité de chaque coefficient, ainsi que la p-valeur correspondante. La significativité de la pente atteste formellement que la variable prédictive contribue à la prédiction de la réponse au-delà du simple hasard d’échantillonnage.
À partir du modèle ainsi calibré, l’analyste peut générer des prédictions ciblées pour de nouvelles observations au moyen de l’opérateur générique d’inférence prédictive. Il convient ici de distinguer soigneusement deux types d’intervalles calculables par la fonction : l’intervalle de confiance pour l’espérance conditionnelle (qui délimite l’incertitude entourant l’estimation de la moyenne de Y pour une valeur de X donnée) et l’intervalle de prédiction individuel. Ce dernier, intégrant à la fois l’incertitude d’estimation des paramètres et la variance intrinsèque de l’erreur aléatoire, s’avère considérablement plus large et définit la fourchette au sein de laquelle se situera le score d’un sujet singulier spécifique avec un degré de confiance fixé.
8.3 Décomposition de la variance et métriques d’ajustement global
L’évaluation de la performance d’un modèle de régression linéaire bivariée repose sur le principe fondamental de la décomposition de la variance totale, formalisé dans le cadre de l’analyse de variance (ANOVA). L’écart quadratique global de chaque observation par rapport à la moyenne arithmétique générale de la variable dépendante (Somme des Carrés Totale, notée SST) est mathématiquement scindé en deux composantes orthogonales et additives : la variabilité capturée par la trajectoire de régression (Somme des Carrés du Modèle ou Expliquée, SSM) et la variabilité résiduelle inexpliquée issue de la dispersion des observations autour de la droite (Somme des Carrés des Résidus, SSR).
Le ratio rapportant la somme des carrés expliquée à la somme des carrés totale correspond rigoureusement au coefficient de détermination R². Dans le cadre strict d’une régression linéaire bivariée simple sans termes d’ordre supérieur, cette métrique coïncide à la perfection avec le carré exact du coefficient de corrélation produit-moment de Pearson liant les deux variables. L’ajustement global est par ailleurs validé par le test F de Fisher-Snedecor, qui évalue le rapport des carrés moyens expliqués aux carrés moyens résiduels pour attester que le modèle dans son intégralité produit une réduction de variance statistiquement significative par rapport à un modèle nul ne contenant que la constante.
Une métrique fondamentale complémentaire est constituée par l’erreur standard résiduelle (Residual Standard Error, ou RSE). Contrairement au R² qui représente un indice relatif sans unité, la RSE exprime l’écart-type d’échantillonnage des résidus dans la métrique originale de la variable dépendante mesurée. Elle s’interprète comme la marge d’erreur typique d’ajustement : une RSE de 4,5 points sur une échelle d’évaluation continue signale que les prédictions générées par l’équation linéaire s’écartent typiquement de 4,5 unités des scores réels observés sur le terrain clinique ou éducatif.
9. Diagnostic statistique approfondi et validation des postulats du modèle
9.1 Examen de la linéarité et de la moyenne nulle des résidus
La validité des inférences probabilistes issues d’une modélisation par régression linéaire simple dépend de manière irréductible de la stricte tenue des postulats du modèle linéaire généralisé. Toute défaillance de ces conditions préalables expose l’analyste à des estimations biaisées, à une surévaluation dramatique de la précision des coefficients ou à l’inflation des erreurs inférentielles de type I. L’évaluation de ces conditions s’effectue au moyen d’une analyse systématique des résidus d’ajustement.
Le premier diagnostic crucial consiste à examiner le graphique des résidus en fonction des valeurs ajustées (Residuals vs Fitted plot). Cette interface graphique permet d’auditer l’hypothèse de linéarité globale et le postulat imposant que l’espérance mathématique des erreurs soit nulle pour toute valeur du continuum prédictif. Les résidus doivent se distribuer de manière aléatoire, symétrique et homogène au sein d’une bande horizontale entourant la ligne zéro, sans dessiner la moindre tendance structurelle apparente.
La présence d’une courbure en forme de parabole ou de U inversé trahit l’incapacité du modèle linéaire simple à rendre compte de la véritable dynamique liant les deux phénomènes. Face à un tel constat de rupture de linéarité, l’analyste ne doit pas forcer l’interprétation d’une pente biaisée : il doit opérer une reconfiguration analytique soit par l’intégration d’un terme polynomial quadratique au sein de la formule de régression sous R, soit par l’application préalable d’une transformation mathématique non linéaire adéquate (transformation logarithmique, racine carrée ou approche systématique de Box-Cox) sur l’une des variables du couple.
9.2 Vérification de l’homoscédasticité et de la normalité des erreurs
Le second diagnostic structural s’attaque au postulat d’homoscédasticité, postulant que les termes d’erreur résiduelle possèdent une variance strictement identique quel que soit le niveau des prédictions calculées. Pour détecter visuellement des déviations à cette invariance d’étalement, l’examen du tracé d’échelle-localisation (Scale-Location plot), qui projette la racine carrée des résidus standardisés en fonction des valeurs ajustées, s’avère particulièrement sensible. Une ligne de lissage horizontale signale une stabilité optimale de la variance d’erreur, tandis qu’une inclinaison ascendante continue révèle une amplification de l’hétérogénéité des résidus sur les segments élevés du modèle.
Cette inspection visuelle doit être corroborée par un test d’hypothèse formel d’homoscédasticité, au premier rang desquels figure le test de Breusch-Pagan, facilement mobilisable via des extensions de diagnostic économétrique telles que lmtest. Le rejet de l’hypothèse nulle d’homoscédasticité invalide le calcul conventionnel des erreurs-types standards de la pente de régression. Pour pallier cette distorsion sans abandonner le modèle, l’analyste programme sous R l’extraction d’erreurs-types robustes à l’hétéroscédasticité (estimateurs sandwich de White ou de type HC3 via le paquetage sandwich), rétablissant l’intégrité de l’inférence statistique sur les coefficients estimés.
Enfin, l’inférence exacte sur de petits échantillons exige que les erreurs suivent une loi normale théorique. Cette condition est rigoureusement évaluée au moyen du diagramme quantile-quantile (Q-Q plot), qui confronte les quantiles empiriques des résidus standardisés aux quantiles théoriques d’une loi normale unitaire. Tout alignement rigoureux sur la droite diagonale à 45 degrés valide l’adéquation distributionnelle. Une discordance marquée aux extrémités (queues lourdes ou concavités prononcées), corroborée par un test formel de Shapiro-Wilk appliqué sur les vecteurs résiduels, avertit le chercheur que l’approximation gaussienne des p-valeurs devient précaire.
9.3 Détection des points d’influence et de levier
Un modèle de régression par les moindres carrés peut être profondément déstabilisé par l’influence démesurée d’une poignée d’observations singulières. En analyse bivariée, l’influence d’un point est le produit conjoint de son effet de levier (sa singularité dans l’espace de la variable explicative X) et de son caractère discordant (la magnitude de son écart résiduel sur la variable dépendante Y). L’analyse diagnostique moderne sous R fournit des métriques spécifiques pour dissocier et évaluer ces mécanismes d’impact.
L’effet de levier se quantifie au moyen des éléments diagonaux de la matrice de projection orthogonale (matrice chapeau ou hat values). Ces coefficients mesurent à quel point la valeur observée d’un sujet dicte sa propre valeur prédite par le modèle. La littérature méthodologique retient généralement le seuil critique d’alerte fixé à deux ou trois fois la valeur moyenne du levier (défini par le ratio 2*(k+1)/n, où k représente le nombre de régresseurs et n la taille d’échantillon). Un sujet possédant une valeur extrême sur la variable X dispose d’un bras de levier potentiel immense sur l’orientation angulaire de la droite.
Pour mesurer l’influence effective globale exercée par chaque unité sur l’intégralité du modèle estimé, la distance de Cook constitue la métrique standardisée par excellence. Elle mesure la distance euclidienne multidimensionnelle de décalage qu’enregistreraient les coefficients du modèle si l’observation concernée était purement et simplement soustraite de l’échantillon. Un seuil opérationnel conventionnel d’influence majeure est atteint lorsque la distance de Cook excède la valeur unitaire, ou de façon plus conservatrice le ratio 4/n. En présence d’observations influentes identifiées, l’analyste se doit d’exécuter une analyse de sensibilité systématique en comparant rigoureusement les estimations issues du jeu complet à celles obtenues après retrait ciblé des points critiques afin de documenter la stabilité des conclusions scientifiques tirées.
10. Analyse bivariée impliquant des variables qualitatives
10.1 Croisement de deux variables qualitatives : Le test du Chi-deux d’indépendance
Lorsque le protocole de recherche implique l’étude relationnelle de deux variables nominales ou catégorielles (par exemple, croiser l’appartenance à un groupe thérapeutique avec l’évolution de la rémission clinique codée en modalités discrètes), les méthodologies linéaires fondées sur les moyennes s’avèrent inapplicables. La structure empirique de base est alors constituée par un tableau de contingence croisant les effectifs conjoints observés pour chaque combinaison de modalités. Sous R, la génération de cette matrice s’opère instantanément à l’aide de la fonction de tabulation native, complétée par les calculs de proportions marginales et conditionnelles.
Le test du Chi-deux d’indépendance de Pearson représente la démarche inférentielle fondamentale pour éprouver la dépendance stochastique de ces deux attributs qualitatifs. Le test compare terme à terme les effectifs empiriques réellement dénombrés dans chaque cellule du tableau aux effectifs théoriques (attendus sous l’hypothèse nulle d’indépendance absolue), ces derniers étant calculés comme le produit des totaux marginaux de la ligne et de la colonne rapporté à la taille globale de l’échantillon. La statistique globale synthétise la somme normalisée des écarts quadratiques entre observés et attendus.
Toutefois, la validité asymptotique de l’approximation du Chi-deux repose sur le strict respect des conditions de Cochran relatives aux effectifs attendus par case : aucune cellule théorique ne doit comporter un effectif nul et au moins 80 % des cellules doivent afficher un effectif théorique supérieur ou égal à 5 unités. Lorsque ces exigences sont satisfaites et que le test conclut au rejet de l’indépendance, la quantification de la force de l’association exige le calcul d’une taille d’effet standardisée. Le coefficient V de Cramér, dérivé de la racine carrée de la statistique du Chi-deux normalisée par l’effectif total et la dimension minimale du tableau, fournit un indice standardisé variant strictement entre 0 et 1, permettant de situer l’intensité de la dépendance catégorielle.
10.2 Alternative exacte de Fisher pour faibles effectifs
Lorsque l’échantillonnage s’avère restreint ou que la distribution des modalités catégorielles présente une forte dissymétrie marginale, les effectifs attendus dans certaines cases du tableau de contingence chutent fréquemment sous le seuil d’admissibilité statistique de Cochran. Dans cette conjoncture défavorable, l’utilisation de la loi continue du Chi-deux pour approximer une distribution discrète engendre des distorsions majeures de la p-valeur calculée, gonflant artificiellement le taux d’erreur de type I. La méthodologie statistique commande alors d’abandonner l’approximation asymptotique au profit du test exact formalisé par Ronald Fisher.
Le test exact de Fisher ne repose sur aucune loi statistique approximée : il s’appuie sur la loi de distribution hypergéométrique pour calculer la probabilité combinatoire exacte d’obtenir la configuration observée des données conditionnellement aux marges fixées du tableau de contingence. Conçu initialement pour les matrices binaires de dimension deux par deux (2×2), l’algorithme a été étendu sous R aux tableaux rectangulaires d’ordre R x C grâce à des implémentations de calcul combinatoire de pointe exécutées sans faillir par la fonction d’analyse exacte.
Dans le cadre privilégié des tableaux de contingence croisant deux facteurs dichotomiques, la procédure fournit une métrique étiologique fondamentale : le rapport de cotes (odds ratio, OR). Cet indice rapporte la cote d’apparition de l’événement étudié dans le premier groupe à la cote de ce même événement dans le second sous-ensemble. Un rapport de cotes strictement égal à 1 traduit une parfaite absence d’association ; une valeur supérieure à 1 signale une surreprésentation du phénomène au sein de la catégorie cible. L’interpréteur R accompagne systématiquement cette taille d’effet d’un intervalle de confiance exact à 95 %, fournissant un outil décisionnel d’une grande valeur clinique et épidémiologique.
10.3 Association entre une variable quantitative et une variable dichotomique
Un cas de figure récurrent dans les devis de recherche comportementale concerne l’analyse de dépendance unissant une métrique quantitative continue (par exemple, un indice d’anxiété) et un facteur qualitatif dichotomique naturel ou provoqué (tel que le genre biologique ou l’assignation à un groupe témoin versus un groupe d’intervention). Deux démarches méthodologiques d’apparence dissemblable s’offrent alors à l’analyste, mais convergent vers une équivalence mathématique parfaite : la corrélation bisériale de point et le test t de Student pour échantillons indépendants.
Le coefficient de corrélation bisériale de point (rpb) s’obtient simplement en codant la variable binaire sous la forme d’un indicateur numérique fictif valant zéro et un, puis en soumettant la paire à la formule standard de corrélation produit-moment de Pearson. La grandeur scalaire obtenue mesure directement le degré d’association entre l’appartenance de groupe et la dispersion du trait quantitatif. De façon remarquable, la statistique t de Student évaluant la différence des moyennes d’échantillons est mathématiquement liée de manière bijective au coefficient bisérial par une équation algébrique directe dépendant exclusivement de la magnitude de l’indice et des degrés de liberté associés.
Au-delà de la confirmation probabiliste d’une divergence entre les deux moyennes de groupes, le rapportage scientifique exige la quantification standardisée de la distance séparant les deux distributions sous la forme d’une taille d’effet de groupe. Le d de Cohen, qui rapporte la différence absolue des moyennes arithmétiques à l’écart-type groupé pondéré de l’échantillon, constitue la référence canonique. Sur des cohortes de taille modeste, le chercheur privilégiera la correction non biaisée proposée par Larry Hedges (g de Hedges), prévenant toute surestimation systématique de la taille d’effet lors de la diffusion des résultats empiriques.
11. Interprétation contextuelle et implications psychométriques des résultats
11.1 Distinction fondamentale entre covariation statistique et causalité
L’exploitation automatisée d’environnements computationnels puissants comme R tend parfois à occulter l’exigence d’une réflexion épistémologique sur la nature réelle des régularités statistiques observées. L’un des écueils majeurs de la recherche empirique réside dans la tentation quasi irrésistible d’ériger une corrélation bivariée substantielle et statistiquement significative au rang d’une validation de causalité ontologique univoque. Or, une liaison empirique robuste entre deux variables X et Y peut émaner d’une pluralité d’architectures causales totalement étanches à l’influence mutuelle directe des construits.
Le mécanisme le plus pernicieux est constitué par l’interférence d’une troisième variable confondante non mesurée, génératrice d’une corrélation fallacieuse ou illusoire (selon le principe de la cause commune formalisé par Hans Reichenbach). Deux phénomènes peuvent fluctuer de concert simplement parce qu’ils subissent simultanément l’action motrice d’un déterminant latent sous-jacent : à titre d’illustration, la corrélation bien connue entre la taille des pieds et les compétences de lecture chez les enfants disparaît intégralement dès lors que l’on contrôle la variable d’âge chronologique. L’analyse bivariée brute est par définition aveugle à ce type de triangulation contextuelle.
De surcroît, les devis de recherche transversaux se révèlent incapables de trancher l’énigme de la causalité inverse, à savoir déterminer si c’est la variable X qui suscite l’émergence de la variable Y ou si c’est la présence précoce de Y qui façonne l’expression de X. Pour échafauder des inférences d’allure causale valides, la corrélation bivariée ne peut agir que comme un point de départ qui doit impérativement s’adosser aux critères de causalité reconnus (antériorité temporelle stricte démontrée par des plans longitudinaux, gradient biologique ou dose-réponse, plausibilité théorique et manipulation expérimentale contrôlée avec randomisation).
11.2 Atténuation de corrélation due à l’erreur de mesure
Dans les sciences psychométriques et du comportement, les construits d’intérêt (intelligence, anxiété, motivation, bien-être) ne font jamais l’objet d’une observation physique directe parfaite : ils sont estimés au travers d’instruments de mesure imparfaits (questionnaires d’auto-évaluation, tests psychologiques) inévitablement contaminés par une part d’erreur de mesure aléatoire. La Théorie Classique des Tests formalise cette contingence en posant que le score observé est la résultante de l’addition du score vrai latent du sujet et d’une composante d’erreur stochastique résiduelle.
L’implication directe de cette imperfection métrologique sur l’analyse bivariée est désignée sous le concept d’atténuation de corrélation. La présence de bruit de mesure aléatoire comprime artificiellement la covariance empirique observable : le coefficient de Pearson calculé sur des scores bruts sous-estime systématiquement et continuellement la magnitude de l’association réelle qui unit les traits latents au sein de la population. Plus la fidélité des instruments mobilisés est fragile, plus l’atténuation de l’indice de liaison empirique s’avère drastique.
Pour restaurer l’estimation du lien latent réel, Charles Spearman a élaboré une formule correctrice analytique dite de correction pour atténuation. Cette formulation divise le coefficient de corrélation empirique observé par la moyenne géométrique des indices de fidélité des deux instruments d’évaluation (généralement mesurés via le coefficient alpha de Cronbach ou le coefficient oméga de McDonald). La mise en œuvre de cette correction sous R permet de dissocier la part d’association structurelle théorique de la perte de précision induite par les déficiences instrumentales du protocole de recueil.
11.3 Traduction des coefficients en implications pratiques
L’expertise du statisticien ne se borne pas à attester de la significativité probabiliste d’un résultat d’analyse bivariée ; elle s’exprime pleinement dans sa capacité à traduire des coefficients d’association abstraits en conséquences pratiques tangibles pour les praticiens, cliniciens ou décideurs institutionnels. L’une des méthodes les plus puissantes pour rendre accessible la signification d’un indice de corrélation linéaire est l’Affichage de la Taille d’Effet Binomiale (Binomial Effect Size Display, BESD), conceptualisé par Robert Rosenthal et Donald Rubin.
Cette technique permet de convertir un modeste coefficient r de Pearson en une modification concrète des taux de succès ou d’amélioration clinique au sein de deux groupes standardisés. Ainsi, une corrélation apparemment modérée de 0,30 unissant la participation à un protocole d’apprentissage et le succès aux examens se traduit de manière spectaculaire dans le formalisme BESD par un passage du taux de réussite moyen de 35 % dans le groupe témoin à 65 % dans le groupe ayant bénéficié de l’intervention. Cette transposition met en exergue l’utilité substantielle d’effets statistiques que des observateurs non avertis qualifieraient abusivement de marginaux sur la foi de coefficients bruts.
Il importe à l’inverse de mettre en garde les analystes contre le mirage de la surinterprétation d’effets minuscules émergeant au sein de macro-échantillons. En vertu des lois de la puissance statistique asymptotique, dès lors qu’une cohorte intègre plusieurs dizaines de milliers d’individus, n’importe quelle liaison bivariée microscopique affichera une p-valeur hautement significative (p < 0,001). Dans un tel contexte, la découverte d’un coefficient de détermination R² expliquant un dixième de pourcent de la variance collective relève de l’artefact de puissance et ne possède aucune pertinence écologique, clinique ou décisionnelle réelle dans le monde tangible.
12. Bonnes pratiques méthodologiques, pièges courants et reproductibilité
12.1 Écueils classiques de l’analyse bivariée et méthodes de remédiation
La pratique quotidienne de l’analyse bivariée sous R expose les chercheurs à des dérives méthodologiques récurrentes susceptibles d’annihiler la validité des inférences publiées. Le premier de ces écueils est le piège redoutable de la pêche aux données ou p-hacking par multiplication non contrôlée des tests d’hypothèses bivariés. Lorsqu’un analyste calcule sans discernement une vaste matrice croisant des dizaines de métriques comportementales pour ne retenir et commenter que les quelques paires affichant une p-valeur inférieure au seuil fatidique de 0,05, il s’expose à une inflation fulgurante du taux global d’erreur de type I (l’aléa d’échantillonnage garantissant des faux positifs systématiques).
La remédiation impérative à cette inflation stochastique impose le paramétrage rigoureux de procédures de correction pour tests multiples. L’environnement R intègre nativement des algorithmes permettant d’ajuster les probabilités critiques observées, qu’il s’agisse de méthodes conservatrices ciblant le contrôle du risque de commettre au moins une erreur dans la famille de tests (comme la procédure séquentielle de Holm-Bonferroni) ou de méthodologies modernes calibrées pour contrôler le taux de fausses découvertes (False Discovery Rate, FDR de Benjamini-Hochberg), particulièrement adaptées aux vastes dépouillements exploratoires.
Un second péché méthodologique consiste en la dichotomisation artificielle de variables initialement continues (par exemple, segmenter arbitrairement un score continu d’extraversion en deux catégories étanches d’introvertis et d’extravertis au moyen d’un split par la médiane). Cette pratique désastreuse mutile la variance bivariée originelle, anéantit une proportion substantielle de la puissance statistique (pouvant équivaloir à la perte d’un tiers de la cohorte expérimentale) et introduit le risque d’engendrer de fausses associations significatives artefactuelles. Les variables quantitatives doivent impérativement être analysées dans la richesse de leur continuum métrique naturel.
12.2 Établissement d’un flux de travail reproductible sous R Markdown ou Quarto
À l’ère de la crise de la reproductibilité scientifique qui traverse les sciences empiriques, l’exécution d’analyses bivariées par bribes de code exécutées de façon désordonnée dans la console d’un logiciel propriétaire appartient à une époque révolue. La rigueur contemporaine exige l’intégration intégrale de la chaîne analytique — de l’ingestion brute des données à la production des figures finales et des tableaux statistiques — au sein d’un document computationnel dynamique unique régi par les préceptes de la programmation lettrée formalisée par Donald Knuth, utilisant des écosystèmes modernes tels que Quarto ou R Markdown.
Cette structuration programmatique garantit une traçabilité totale des manipulations opérées sur les paires de variables. Chaque étape de transformation vectorielle, chaque sélection d’observation et chaque paramétrage d’argument d’imputation y est explicitement consigné sous forme de blocs de code (chunks) reproductibles à l’identique par des auditeurs externes indépendants. L’exportation automatisée des résultats vers des tableaux académiques formatés selon les exigences des comités éditoriaux peut être prise en charge par des bibliothèques logicielles spécialisées comme modelsummary ou flextable, bannissant définitivement les erreurs humaines de recopie manuelle de données numériques.
Le couronnement de cette démarche de transparence méthodologique réside dans la documentation méticuleuse de l’environnement logiciel complet ayant concouru à l’exécution de l’analyse bivariée. L’insertion systématique en clôture de script de l’instruction d’audit de session archive instantanément la version exacte de l’interpréteur R employé, le système d’exploitation hôte, ainsi que les versions matricielles de l’ensemble des paquetages et dépendances logicielles mobilisés. Ce protocole assure la pérennité temporelle de l’infrastructure de calcul et prévient les défaillances algorithmiques susceptibles d’émerger lors d’évolutions futures du langage.
12.3 Transition vers l’analyse multivariée
L’analyse bivariée constitue une étape inaugurale indispensable, mais elle demeure intrinsèquement limitée face à l’enchevêtrement des déterminants qui gouvernent la complexité des comportements humains. Aucun phénomène psychologique, cognitif ou sociétal d’importance ne saurait être appréhendé comme le produit linéaire d’une relation duelle exclusive. Le recours prolongé et isolé aux démarches bivariées expose l’analyste à des explications parcellaires, impuissantes à capturer des boucles de rétroaction, des dynamiques de médiation temporelle ou des régulations conditionnelles complexes.
L’analyste chevronné conçoit donc l’analyse bivariée comme un filtre préparatoire sélectif préparant le saut qualitatif vers les modélisations multivariées intégratives : modèles de régression linéaire multiple, analyses de covariance, modélisations linéaires mixtes hiérarchiques ou modélisations par équations structurelles (SEM). Dans ce cheminement, les coefficients d’association bivariés jouent un rôle diagnostique de première importance en permettant d’inspecter en amont les matrices de corrélation pour repérer les redondances prédictives excessives et prévenir les dysfonctionnements majeurs imputables à la multicolinéarité.
En apprenant à maîtriser le langage R pour disséquer, visualiser, quantifier et questionner la relation unissant deux variables, le chercheur s’approprie les fondations mêmes de l’inférence quantitative. Doté de cette boussole théorique et pratique, attentif aux postulats d’application comme aux résonances substantielles de ses résultats, le praticien dispose de tous les atouts computationnels pour transformer des nuages de données empiriques informes en connaissances scientifiques objectives, solides, contextualisées et pérennes.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3e éd.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2e éd.). The Guilford Press.
- Howell, D. C. (2013). Statistical methods for psychology (8e éd.). Wadsworth, Cengage Learning.
- Revelle, W. (2023). psych: Procedures for psychological, psychometric, and personality research (Version 2.3.9) [Logiciel R]. Comprehensive R Archive Network. https://CRAN.R-project.org/package=psych
- Rosenthal, R., & Rubin, D. B. (1982). A simple, general purpose display of effect size: The binomial effect size display. Journal of Educational Psychology, 74(2), 166–169. https://doi.org/10.1037/0022-0663.74.2.166
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2e éd.). Springer-Verlag. https://ggplot2.tidyverse.org
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science (2e éd.). O’Reilly Media. https://r4ds.hadley.nz