
La visualisation de données contemporaine repose sur un postulat épistémologique fondamental : la transcription graphique d’observations quantitatives doit préserver scrupuleusement la structure stochastique sous-jacente tout en garantissant une lisibilité cognitive optimale pour le chercheur et le lecteur. Dans l’écosystème du langage de programmation statistique R, la bibliothèque ggplot2 s’est imposée comme le paradigme hégémonique de représentation visuelle, matérialisant les concepts théoriques formulés par Leland Wilkinson dans son ouvrage fondateur sur la grammaire des graphiques. Au sein de cette architecture formelle, la manipulation de l’espace géométrique et la fixation des bornes dimensionnelles constituent des opérations d’une sensibilité méthodologique critique, situées à l’intersection exacte du traitement mathématique des données et de la sémiologie graphique.
Définir les limites spatiales d’un repère orthogonal ne se résume pas à un simple arbitrage esthétique ou à une commodité typographique. Selon la méthode logicielle employée, la restriction du champ visuel d’une figure peut induire une modification radicale de la structure des données transmises aux couches d’agrégation et de modélisation statistique. Les analystes inexpérimentés confondent fréquemment la troncature physique de l’échantillon empirique avec l’ajustement optique de la focale d’observation. Cette méprise engendre des dérives analytiques majeures : régularisations fallacieuses de courbes de tendance, amputations d’intervalles de confiance, distorsions non maîtrisées des estimateurs de densité de probabilité et dissimulations perverses de la dispersion réelle des variables à l’étude.
Ce traité exhaustif examine avec une rigueur académique et technique l’ensemble des mécanismes algorithmiques et des fonctions dédiées au bornage des axes sous ggplot2. À travers une confrontation systématique des fonctions d’échelle, des instructions de zoom géométrique cartésien et des modules avancés de gestion des valeurs hors limites, nous fournissons aux statisticiens, chercheurs en sciences cognitives, biométriciens et praticiens de la science des données les clés opérationnelles indispensables pour concilier puissance expressive, exactitude inférentielle et élégance graphique dans leurs publications scientifiques.
1. Fondements théoriques et visualisation de données avec ggplot2
1.1 La grammaire des graphiques appliquée aux dimensions spatiales
L’architecture interne de ggplot2 découle directement des principes structurants théorisés par Leland Wilkinson dans son œuvre séminale, The Grammar of Graphics, puis réinterprétés pour l’environnement R par Hadley Wickham. Au cœur de ce paradigme conceptuel réside l’idée qu’un graphique n’est pas une simple collection de points ou de barres tracés sur un canevas arbitraire, mais une composition rigoureuse de couches sémantiques indépendantes mais coordonnées. Ces couches englobent le jeu de données sous-jacent, les mappages esthétiques qui établissent une correspondance entre variables analytiques et propriétés visuelles, les géométries qui dictent la forme des éléments graphiques, les transformations statistiques qui résument les données brutes, et les systèmes de coordonnées qui projettent ces entités mathématiques dans un espace géométrique plan à deux dimensions.
Dans ce cadre systémique, le repère orthogonal exerce un rôle structurel prépondérant dans la restitution fidèle des distributions empiriques. Les dimensions spatiales, matérialisées par l’axe horizontal des abscisses et l’axe vertical des ordonnées, constituent les ancres perceptuelles primaires au moyen desquelles le système visuel humain décode la magnitude, l’éloignement relatif et les corrélations bivariées. Une distinction primordiale doit être établie dès l’abord entre la transformation géométrique d’un tracé et le filtrage intrinsèque de l’échantillon d’observations. Tandis que la première modifie la matrice de projection sans altérer la masse statistique de référence, le second élimine de facto des vecteurs entiers de données, modifiant les effectifs réels sur lesquels opèrent les algorithmes sous-jacents.
La pertinence méthodologique du cadrage spatial s’avère particulièrement saillante lors de l’exploration de données expérimentales complexes, où des valeurs hors normes peuvent masquer les variations subtiles des groupes d’intérêt ou, inversement, où une compression non contrôlée de la dynamique des axes peut exagérer artificiellement des contrastes négligeables. La maîtrise conceptuelle des systèmes de coordonnées permet ainsi de préserver la validité interne et externe des inférences visuelles formulées tout au long du cycle de recherche empirique.
1.2 Importance de la délimitation des axes dans l’évaluation psychométrique
Dans le domaine spécifique de la psychométrie et des sciences du comportement, la délimitation rigoureuse des repères graphiques constitue un impératif méthodologique de premier ordre. Les instruments d’évaluation, qu’il s’agisse d’échelles de Likert standardisées, de matrices d’aptitudes cognitives ou de batteries de questionnaires de personnalité, reposent sur des échelles de mesure bornées de manière stricte par le protocole expérimental lui-même. Une représentation graphique omettant de respecter ces bornes normatives — par exemple en laissant le moteur graphique ajuster automatiquement l’axe entre la valeur minimale et maximale observées au sein d’une cohorte atypique — induit des distorsions perceptuelles sévères qui faussent l’interprétation clinique des résultats.
La représentation fidèle des intervalles de confiance et des erreurs types de mesure exige que l’espace résiduel autour des estimations ponctuelles traduise la véritable marge d’incertitude théorique sans empiéter sur des scores impossibles hors du domaine de validité du test. De surcroît, la standardisation absolue des repères visuels à travers des protocoles d’expérimentation répétés ou des études longitudinales s’avère indispensable : deux représentations graphiques affichant des pentes visuellement comparables mais possédant des plages d’ordonnées disjointes génèrent inévitablement des conclusions erronées chez les évaluateurs, biaisant l’estimation de l’efficacité thérapeutique ou de la détérioration cognitive.
Ce cadrage minutieux garantit également le maintien d’une cohérence dimensionnelle intangible entre les variables latentes estimées par des modèles d’équations structurelles ou de réponse à l’item et les indicateurs manifestes observés. En ancrant le regard du chercheur sur l’éventail théorique complet du construct psychologique examiné, le statisticien s’assure que la variance graphique reflète la variance du phénomène psychique et non un artifice computationnel de mise à l’échelle automatique.
1.3 Présentation du jeu de données étalon pour les modélisations
Afin de concrétiser les démonstrations formelles tout au long de cet ouvrage et d’assurer une parfaite reproductibilité des expérimentations syntaxiques, nous mobiliserons principalement le jeu de données classique mtcars, extrait des archives de la revue automobile américaine de 1974. Bien que standardisé et intégré nativement au cœur du langage R, ce corpus offre une structure multivariée d’une grande valeur heuristique pour l’étude des tensions entre géométrie spatiale et transformations statistiques. Il comprend trente-deux observations caractérisées par onze variables continues et discrètes décrivant la géométrie mécanique et les performances dynamiques d’une sélection de véhicules thermiques.
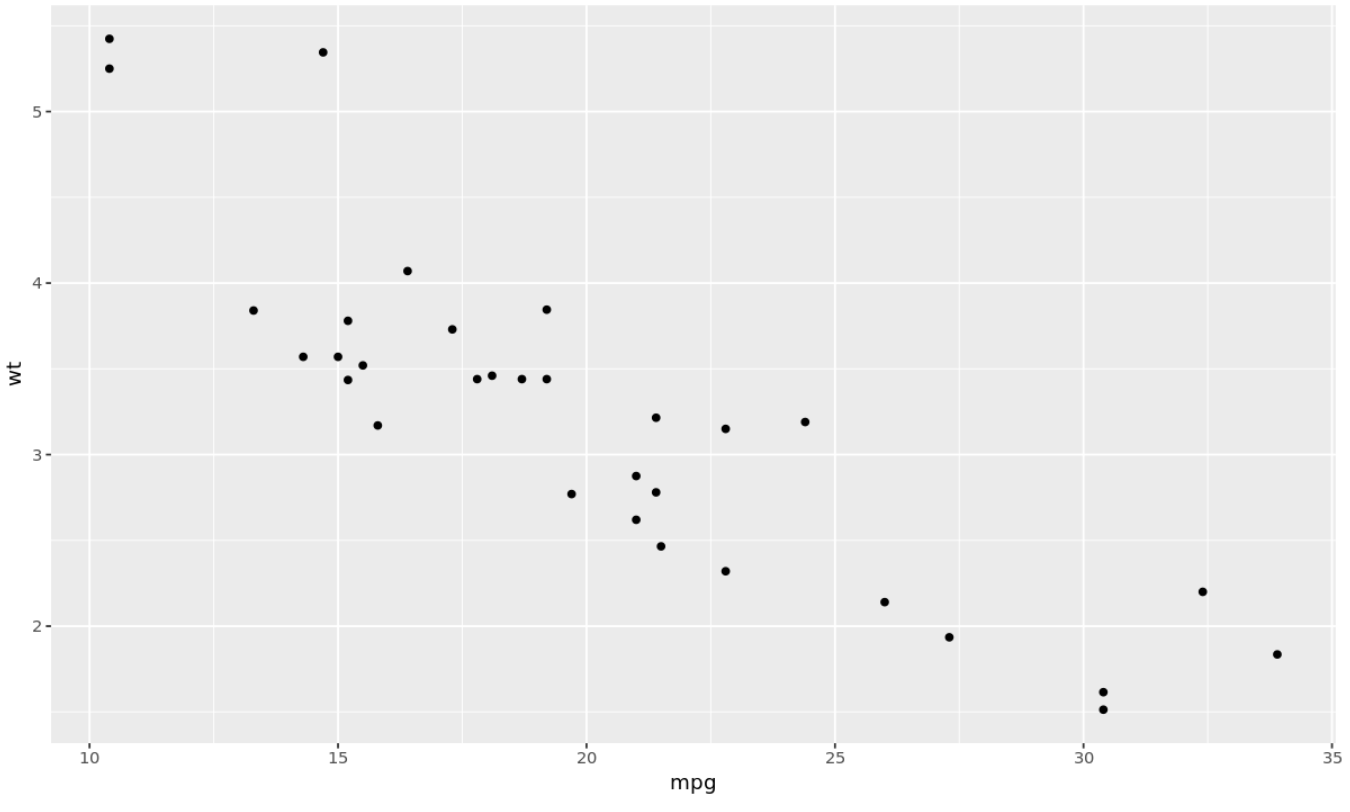
Notre analyse bivariée princeps s’articulera autour de la modélisation de la consommation énergétique, mesurée en miles par gallon par la variable continue mpg, en fonction de la masse globale du véhicule, exprimée en milliers de livres par la variable wt. Cette relation fonctionnelle décroissante et curviligne présente des propriétés statistiques exemplaires pour l’étude des délimitations d’axes : la distribution du poids s’étale de 1,513 à 5,424, tandis que le rendement kilométrique oscille entre 10,40 et 33,90 unités. L’existence d’asymétries distributionnelles et de regroupements périphériques permet d’étudier avec acuité le comportement des fonctions d’ajustement polynomial et de lissage local lorsque les limites géométriques sont contraintes de façon arbitraire.
Le diagnostic exploratoire préliminaire des valeurs extrêmes révèle la présence de modèles particulièrement lourds se détachant nettement du peloton central, générant un étalement asymétrique sur l’axe orthogonal. Ce profil empirique mettra en exergue la différence fondamentale entre les fonctions d’amputation pure de la matière statistique et les algorithmes de zoom optique non invasifs appliqués au niveau des coordonnées spatiales du système graphique.
2. Utilisation basique et syntaxique des fonctions xlim() et ylim()
2.1 Syntaxe formelle et mécanismes d’implémentation
Les outils les plus intuitifs et immédiatement accessibles fournis par l’environnement ggplot2 pour circonscrire l’espace visuel sont les fonctions canoniques xlim() et ylim(). Conçues comme des raccourcis syntaxiques de haut niveau, ces deux directives permettent au praticien de spécifier directement les bornes inférieure et supérieure d’une échelle sans recourir à la formulation plus verbeuse des fonctions de mise à l’échelle formelle. Leur implémentation s’effectue par l’adjonction séquentielle de l’opérateur d’addition binaire, pierre angulaire de la syntaxe additive de ggplot2, qui vient greffer une consigne de délimitation sur un objet graphique préalablement instancié.
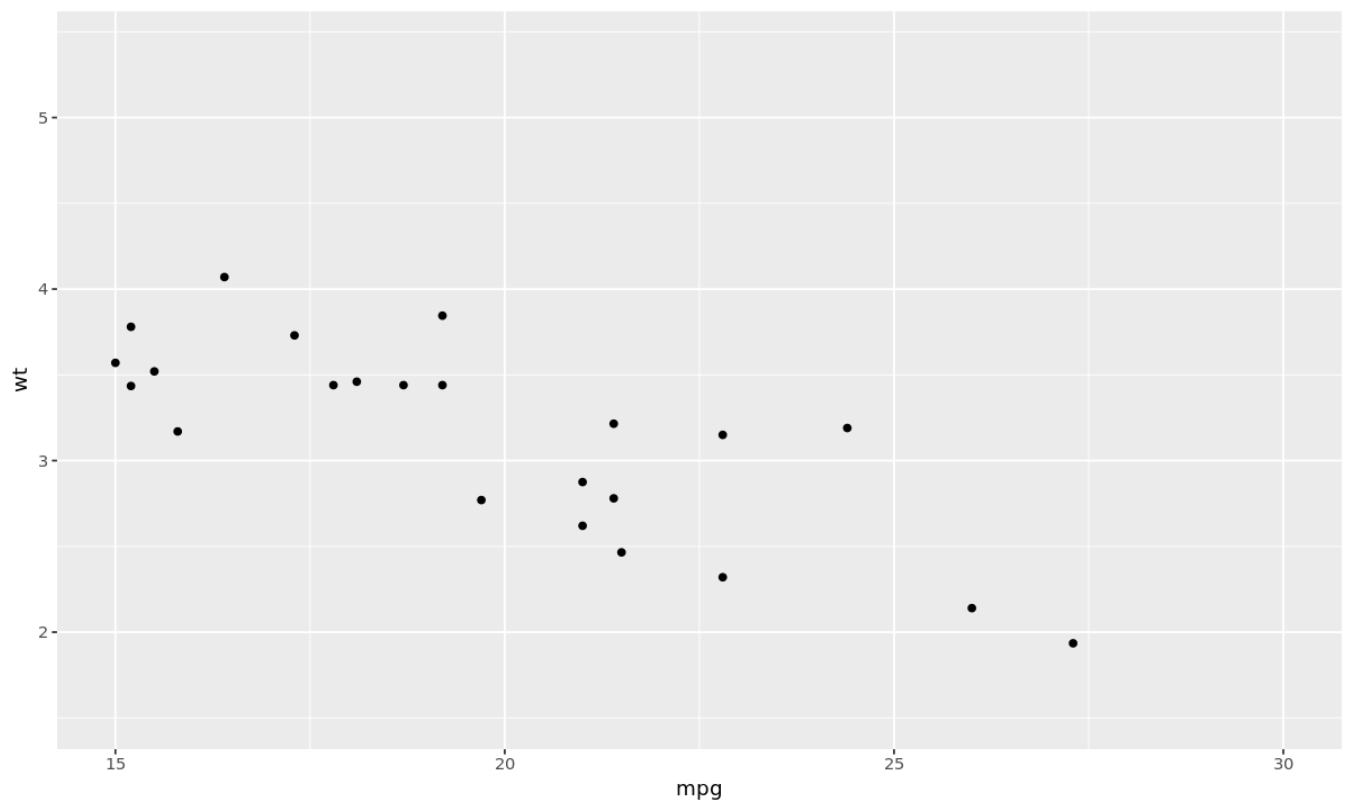
D’un point de vue programmatique, ces fonctions attendent comme arguments un vecteur numérique de longueur deux, formulé sous la forme canonique d’une paire ordonnée représentant le minimum et le maximum admissibles, ou deux scalaires distincts passés consécutivement. Lorsqu’on applique une restriction d’abscisse à l’aide de l’instruction ciblant l’intervalle [2, 4] sur le diagramme de dispersion reliant la masse au rendement énergétique au sein du jeu mtcars, le moteur graphique de ggplot2 intercepte la définition dimensionnelle de l’axe et recalibre l’affichage pour que la surface de projection corresponde exclusivement à la fenêtre numérique demandée.
L’ajustement simultané des deux axes orthogonaux s’opère par la concaténation fluide de xlim() et ylim() au sein du même pipeline d’instructions graphiques. Par cette combinatoire, l’observateur produit un cadrage bidimensionnel ciblé, isolant un rectangle d’intérêt spécifique dans le nuage de points. Néanmoins, cette simplicité d’écriture masque un mécanisme algorithmique invasif, dont la méconnaissance par les analystes débutants constitue l’une des sources les plus fréquentes de biais d’interprétation statistique dans la littérature scientifique contemporaine.
2.2 Gestion des bornes unilatérales avec les valeurs manquantes
Un perfectionnement notable de l’interface syntaxique de ggplot2 réside dans la capacité à formuler des contraintes unilatérales sur les bornes des axes, laissant une extrémité totalement libre de s’ajuster dynamiquement aux distributions observées. Cette prouesse technique s’accomplit par l’injection stratégique de la constante spéciale NA au sein du vecteur numérique définissant le domaine de variation. Lorsqu’une telle valeur manquante est détectée à l’une des positions du vecteur d’encadrement, le compilateur graphique interne délègue automatiquement le calcul de la borne correspondante à l’algorithme d’estimation d’étendue par défaut.
Cette approche est particulièrement vertueuse lorsqu’un impératif méthodologique dicte le plafonnement d’une valeur sans pour autant autoriser le verrouillage de l’origine naturelle des mesures. Par exemple, si l’on souhaite analyser la consommation des véhicules en imposant une borne supérieure maximale de trente unités tout en autorisant l’axe des ordonnées à descendre librement jusqu’au niveau minimal dicté par la physique du système mécanique, la configuration formelle d’un vecteur combinant NA en borne inférieure et 30 en borne supérieure offre une flexibilité calculatoire remarquable.
De façon symétrique, imposer un plancher analytique strict en fixant le seuil inférieur à zéro pour garantir l’ancrage absolu d’une échelle de ratio, tout en laissant le maximum s’étendre organiquement au gré des réalisations empiriques de l’échantillon, préserve l’intégrité de la dynamique naturelle des scores. Cette flexibilité unilatérale évite de coder en dur des extrema rigides qui deviendraient immédiatement obsolètes ou erronés en cas d’actualisation de la table de données source dans un flux analytique automatisé.
2.3 Erreurs courantes d’implémentation chez les praticiens
En dépit de leur apparente simplicité, l’usage empirique de xlim() et ylim() s’accompagne d’une sinistralité élevée chez les chercheurs novices, matérialisée par des erreurs de conception répétées. La méprise la plus élémentaire réside dans l’inversion involontaire des arguments minimaux et maximaux au sein de la séquence numérique transmise. Alors qu’un analyste souhaiterait afficher une plage standard allant de dix à quarante, l’introduction accidentelle d’une séquence décroissante engendre un basculement complet de l’axe, provoquant une inversion de l’orientation spatiale de la courbe et de la lecture perceptuelle du phénomène.
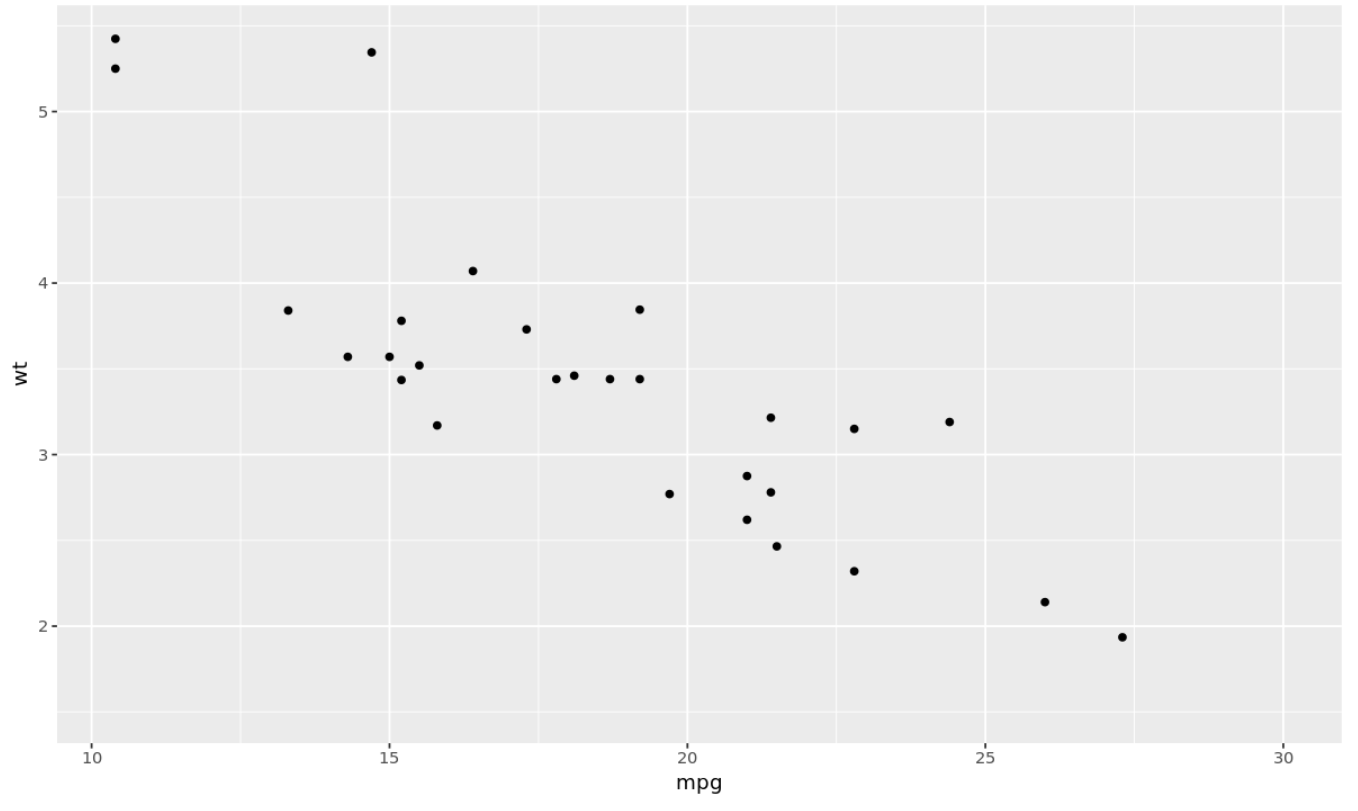
Une autre anomalie récurrente concerne les incompatibilités syntaxiques découlant du passage de structures de données mal conformées. Bien que l’interpréteur tolère à la fois l’argumentation par deux scalaires séparés par une virgule et le passage d’un vecteur composite instancié par la fonction c(), l’injection accidentelle de matrices unidimensionnelles ou de facteurs catégoriels mal convertis génère des interruptions d’exécution immédiates ou des rendus graphiques silencieusement altérés. Cette situation s’aggrave lorsque l’utilisateur tente d’appliquer ces fonctions continues à des variables qualitatives ordonnées sans respecter les typologies attendues par les échelles catégorielles sous-jacentes.
Enfin, la confusion fréquente entre variables continues et niveaux discrets amène souvent des utilisateurs à passer des étiquettes textuelles à xlim(), espérant un réordonnancement implicite des catégories. Cette pratique erronée détruit le mappage de l’axe, soulignant l’obligation méthodologique de bien dissocier le bornage géométrique d’un continuum mathématique réel du filtrage nominal des modalités qualitatives d’un facteur expérimental.
3. Comportement de suppression des données par xlim() et ylim()
3.1 Anatomie de l’avertissement relatif aux valeurs manquantes
Le comportement le plus périlleux associé à l’utilisation non contrôlée de xlim() et ylim() concerne la manière dont le moteur de ggplot2 gère les observations se situant au-delà des frontières stipulées. Lorsqu’un analyste restreint la visibilité d’un graphique via ces fonctions, la console R renvoie invariablement un message d’avertissement caractéristique, stipulant que plusieurs lignes ont été supprimées en raison de la présence de valeurs manquantes. La décomposition clinique de ce message révèle une réalité logicielle fondamentale : les fonctions de raccourci d’échelle ne réalisent pas un recadrage optique de la scène, mais appliquent un filtre booléen strict sur le jeu de données avant toute opération de rendu.
Ce mécanisme d’exclusion préalable des observations modifie profondément la structure de la table de données transmise au pipeline graphique. Toute observation dont la coordonnée spatiale se situe en deçà de la borne inférieure ou au-delà de la limite supérieure est convertie en valeur manquante artificielle NA au niveau de l’étape de transformation d’échelle, puis systématiquement évincée de la mémoire vive assignée à la génération du graphique. L’analyste se trouve alors confronté à une altération invisible de sa cohorte expérimentale.
Il existe une divergence épistémologique cruciale entre une donnée manquante native, résultant d’un écueil lors de la collecte ou du refus de réponse d’un participant à une enquête, et une donnée artificiellement censurée par une directive graphique imprudente. Dans le second cas, la disparition de la donnée échappe souvent au contrôle qualité du statisticien, qui traite l’image finale comme une représentation exhaustive de sa base de travail, alors qu’elle ne figure qu’un sous-échantillon arbitrairement tronqué.
3.2 Altération des estimations statistiques et des géométries d’ajustement
L’impact méthodologique le plus destructeur de ce filtrage structurel réside dans l’altération immédiate de toutes les couches géométriques dépendantes de calculs statistiques inférentiels ou descriptifs agrégés. Dès lors qu’une couche de lissage algorithmique par régression locale ou linéaire via geom_smooth() est superposée au nuage de points, le recalcul mathématique de la trajectoire s’effectue sur les seules données résiduelles autorisées par le bornage d’axe. Par conséquent, les observations extrêmes, qui exercent une influence déterminante sur l’estimation de la pente via le levier qu’elles occupent dans l’espace multidimensionnel, cessent totalement d’agir sur l’équation de la droite.
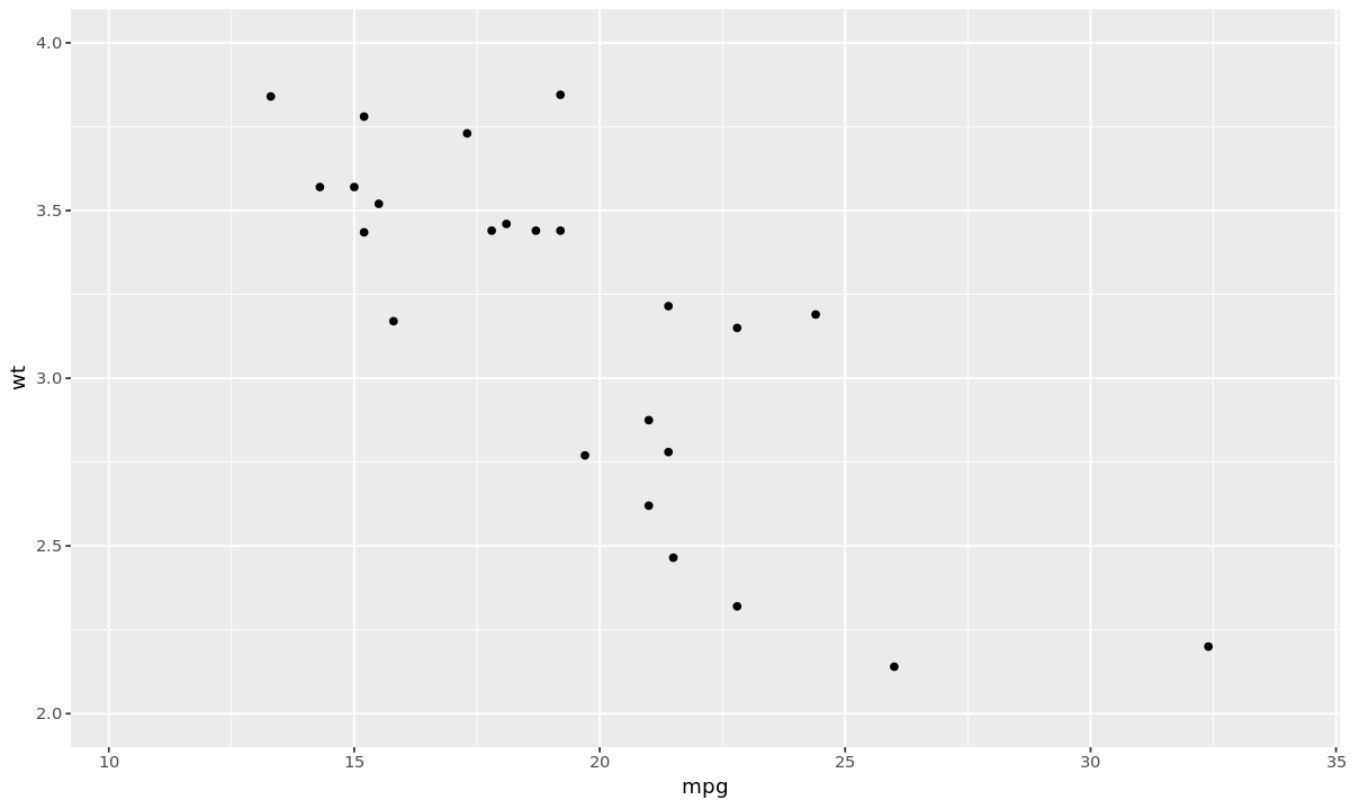
De même, l’exploitation conjointe de geom_boxplot() et de ylim() pour supprimer visuellement des valeurs aberrantes constitue une faute méthodologique majeure. En éliminant ces points en amont du calcul de la boîte à moustaches, le moteur recalcule la médiane, le premier quartile, le troisième quartile ainsi que l’écart interquartile sur une population tronquée. La morphologie entière du diagramme s’en trouve falsifiée, les quartiles dérivant vers l’intérieur et masquant la réalité probabiliste de la distribution étudiée.
Ce phénomène s’étend de façon pernicieuse à l’estimation de densité par noyau gaussien via geom_density(). Le lissage, privé d’une portion de sa queue de distribution, voit son aire totale sous la courbe normalisée artificiellement à l’unité sur l’intervalle restreint, générant des bosses et des renflements de densité totalement factices aux frontières du graphique. Le chercheur court ainsi le risque épistémologique majeur de sous-estimer drastiquement la variance intrinsèque de son échantillon et de publier des modèles statistiques artificiellement surajustés.
3.3 Cas d’usage où le filtrage strict des données s’avère méthodologiquement requis
Bien que la suppression d’observations par xlim() et ylim() soit généralement déconseillée lors de l’application de géométries analytiques complexes, il existe des scénarios scientifiques spécifiques où ce comportement de filtrage strict s’avère non seulement admissible, mais expressément requis sur le plan méthodologique. L’un de ces cas canoniques concerne l’élimination contrôlée d’artéfacts d’enregistrement manifestes, provoqués par des défaillances matérielles de capteurs ou des incohérences de saisie numérique se situant incontestablement hors des limites de validité biologique ou physique du protocole expérimental.
Dans de telles circonstances, l’analyste souhaite intentionnellement que les statistiques d’agrégation, les moyennes pondérées et les estimations de variance ignorent ces aberrations techniques afin de ne pas fausser le signal empirique réel. L’application des raccourcis d’échelle permet alors d’épurer le jeu de données directement au sein de la chaîne de rendu graphique, évitant la multiplication laborieuse de sous-tables filtrées intermédiaires dans l’environnement global de travail sous R.
De surcroît, lors de la phase exploratoire initiale, un chercheur peut délibérément choisir d’opérer une focalisation stricte sur un sous-ensemble théoriquement homogène de données — par exemple en isolant une cohorte d’âge spécifique ou un intervalle de masse critique — pour examiner si les relations de corrélation observées à l’échelle macroscopique se maintiennent de façon robuste au sein de strates plus étroites de la population. L’essentiel réside alors dans la transparence du praticien, qui doit impérativement documenter que les modélisations graphiques résultent d’un filtrage préalable et non d’une simple manipulation optique.
4. Préservation de l’intégrité des données avec coord_cartesian()
4.1 Le concept de zoom optique sans troncature de l’échantillon
Pour résoudre l’impasse méthodologique générée par la suppression structurelle des données lors de la modification des bornes d’affichage, ggplot2 met à disposition un mécanisme architectural d’une élégance absolue : la manipulation directe du système de coordonnées cartésiennes par l’intermédiaire de la fonction coord_cartesian(). Contrairement aux modifications apportées au niveau des échelles primaires, intervenir sur les coordonnées équivaut à placer une lentille d’agrandissement optique au-dessus du canevas graphique intégralement rendu. L’ensemble des calculs statistiques, des modélisations mathématiques et des agrégations géométriques est préalablement exécuté sur la totalité de l’échantillon empirique sans la moindre censure d’observation.
Une fois les géométries calculées dans leur plénitude théorique, le moteur graphique applique la transformation géométrique finale en découpant strictement la zone d’affichage aux coordonnées définies par les arguments formels xlim et ylim imbriqués dans coord_cartesian(). Les observations périphériques situées en dehors du cadre visible continuent d’exister dans la mémoire du graphique ; leurs coordonnées spatiales sont simplement projetées hors du champ perceptuel de l’image finale exportée.
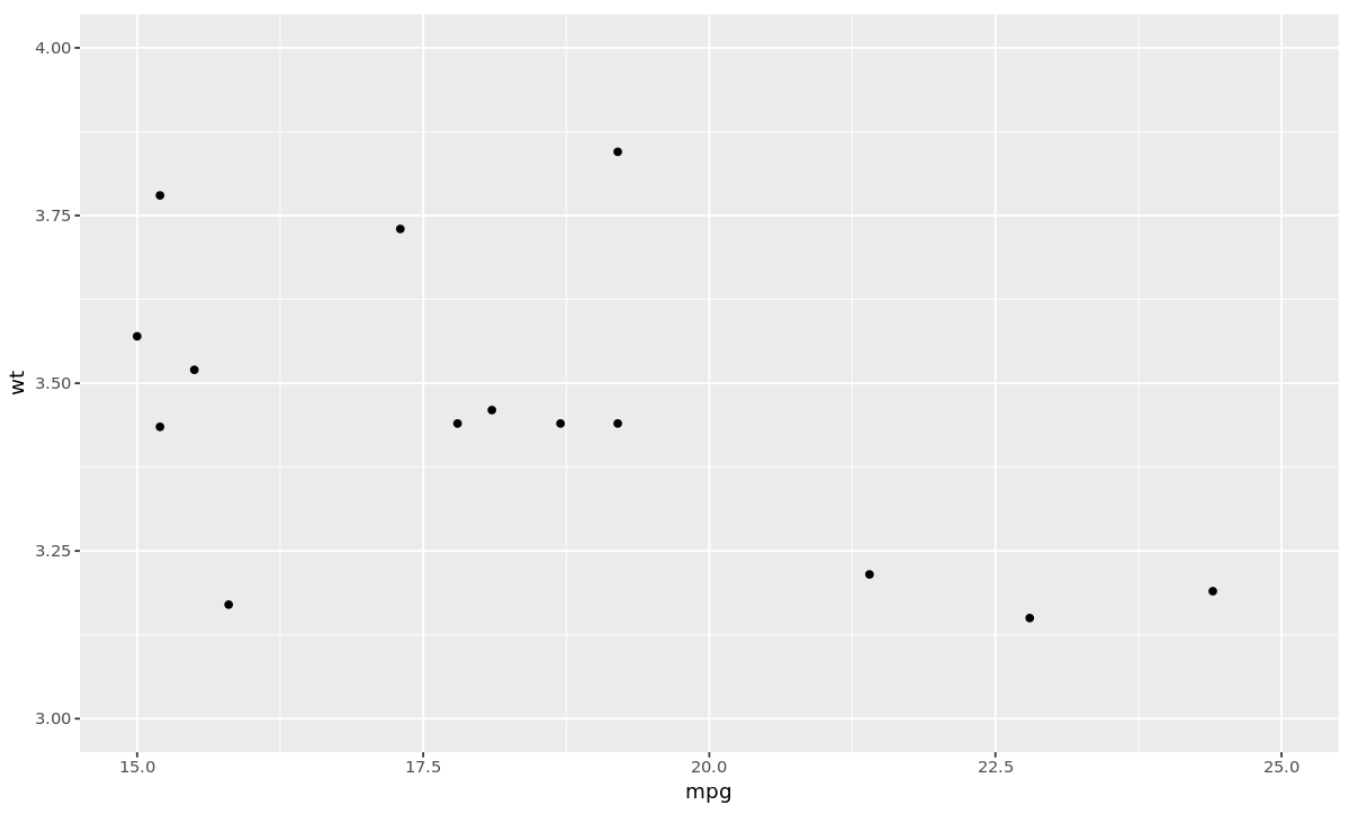
Ce paradigme garantit la stabilité mathématique intégrale des droites d’ajustement, des splines cubiques de lissage et des distributions de quantiles. Une droite de régression linéaire tracée à travers un nuage de points verra sa pente et son ordonnée à l’origine rigoureusement préservées sous coord_cartesian(), quand bien même la lentille de zoom ne capturerait qu’un fragment restreint de la trajectoire globale. C’est l’outil d’excellence pour l’analyse microscopique des données denses sans altération de la vérité inférentielle sous-jacente.
4.2 Comparaison empirique directe : xlim() contre coord_cartesian()
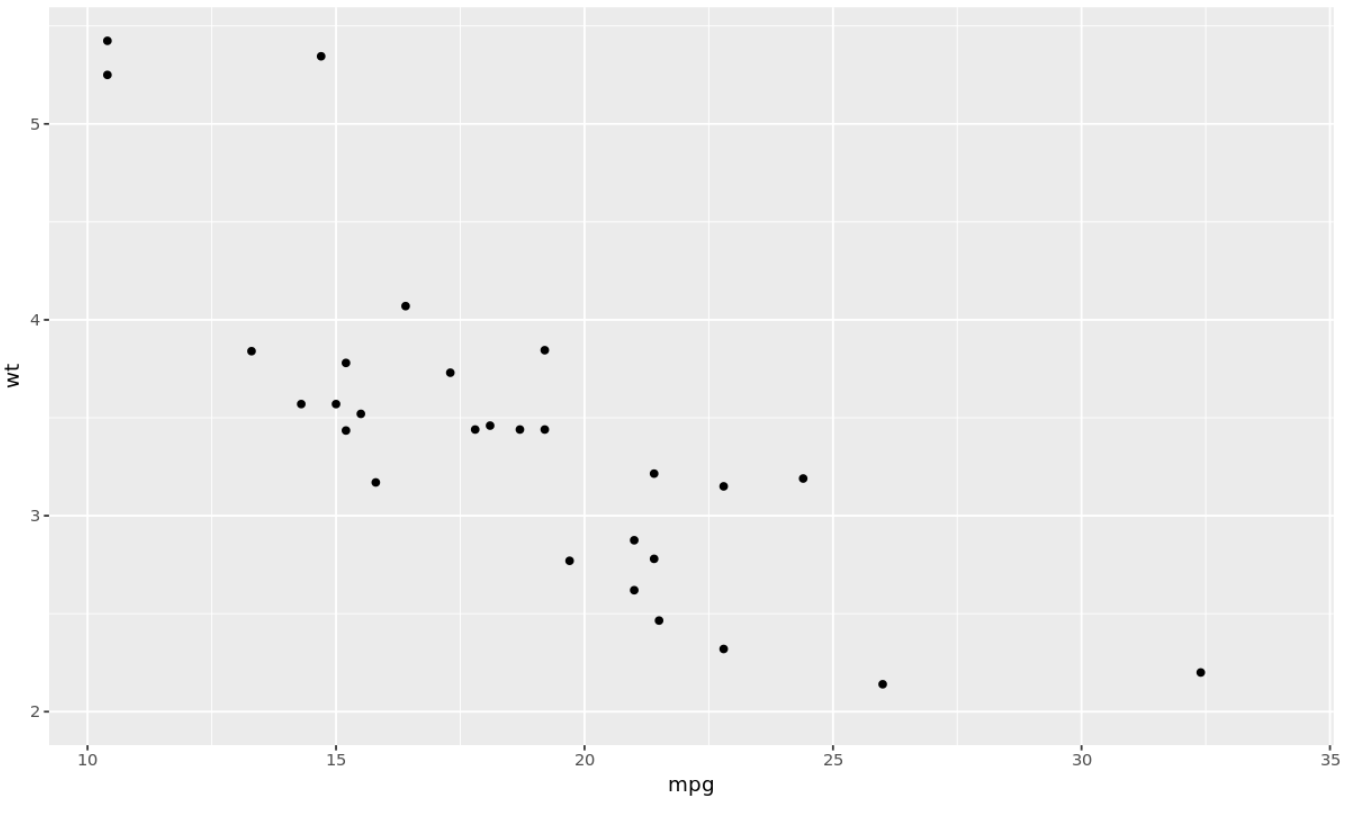
Pour appréhender concrètement la divergence fondamentale entre ces deux philosophies, considérons l’ajustement d’un modèle de régression locale par polynômes locaux de type LOESS ou par régression linéaire simple reliant la puissance au poids au sein de la base mtcars. Si l’on applique l’instruction restrictive xlim(2.5, 4), toutes les automobiles pesant moins de 2 500 livres ou plus de 4 000 livres sont purement et simplement éjectées de la table d’apprentissage de l’algorithme. La fonction de lissage recalcule une nouvelle équation sur les quelques véhicules subsistants, générant une modification drastique de l’inclinaison de la pente et un élargissement artificiel de l’enveloppe d’incertitude représentant l’erreur type résiduelle.
À l’opposé, l’implémentation de la même restriction via l’appel formel coord_cartesian(xlim = c(2.5, 4)) produit un résultat radicalement différent. Le modèle polynomial est estimé sur les 32 observations complètes de la cohorte automobile ; puis, la fenêtre visuelle se resserre sur l’intervalle d’abscisses stipulé. La trajectoire de la courbe et la largeur de l’enveloppe de confiance à 95 % demeurent rigoureusement identiques à celles que l’on observerait sur le graphique grand angle global.
L’analyse comparative du rendu graphique aux abords immédiats des délimitations imposées met en lumière le professionnalisme de cette approche : la courbe de tendance traverse harmonieusement les bordures du cadre d’affichage sans subir de déformations ou de pointes résiduelles provoquées par l’absence subite de points d’ancrage aux extrémités. Le tableau méthodologique qui en découle est limpide : dès lors qu’un graphique intègre une couche de modélisation inférentielle, l’utilisation de coord_cartesian() s’impose impérativement face à toute autre alternative de cadrage.
4.3 Extension aux autres systèmes de coordonnées spécialisés
Le principe du zoom cartésien non destructif ne se cantonne pas au plan orthogonal classique ; il s’étend avec une remarquable cohérence à l’ensemble des systèmes de coordonnées spécialisés proposés par la bibliothèque ggplot2. L’un des cas d’application les plus fréquents concerne la fonction coord_flip(), traditionnellement utilisée pour permuter l’axe horizontal et l’axe vertical afin de faciliter la lecture textuelle d’étiquettes de catégories encombrées ou de profils horizontaux. Au sein de cette fonction, le paramétrage des arguments xlim et ylim conserve son statut de zoom optique souverain, tout en demandant une vigilance cognitive particulière quant à l’attribution spatiale des axes inversés.
Dans le cadre de modélisations spatiales géographiques, morphométriques ou de cartographie factorielle où le rapport d’aspect géométrique porte une signification mathématique intrinsèque, la fonction coord_fixed() impose un ratio d’échelle invariable entre l’axe des ordonnées et celui des abscisses. La fixation conjointe des limites spatiales au sein de coord_fixed() permet de zoomer sur un quadrant d’intérêt anatomique ou géographique tout en interdisant formellement au moteur graphique de distordre les proportions anatomiques ou les distances euclidiennes réelles des entités visualisées.
En revanche, une prudence épistémologique accrue s’impose lors du travail au sein de systèmes non cartésiens, tels que les projections en coordonnées polaires gérées par coord_polar(). L’application de limites rigides sur l’angle ou sur le rayon modifie la topologie même du tore ou du disque d’affichage, risquant de créer des singularités trigonométriques complexes ou des déchirures de surfaces géométriques qu’un analyste non averti pourrait interpréter à tort comme des discontinuités empiriques.
5. Délimitation avancée via scale_x_continuous() et scale_y_continuous()
5.1 L’argument limits au sein de l’écosystème scale_*
Pour le statisticien exigeant qui aspire à un contrôle déterministe de chaque pixel de sa figure, l’approche la plus formelle et la plus puissante pour borner les axes réside dans l’utilisation directe de l’infrastructure des fonctions de mise à l’échelle continue, à savoir scale_x_continuous() et scale_y_continuous(). Ces fonctions incarnent le niveau d’abstraction intermédiaire de la grammaire des graphiques, opérant la transcription formelle des valeurs mathématiques en coordonnées géométriques avant l’étape ultime de projection spatiale. C’est au sein de cette couche que prend place l’argument canonique limits.
La spécification formelle de cet argument requiert un vecteur numérique ordonné composé de deux éléments matérialisant l’infimum et le supremum admissibles sur l’axe considéré. Tout comme les fonctions de commodité xlim() et ylim() — qui ne sont en vérité que des interfaces d’accès déguisées vers ces échelles continues —, l’argument limits appliqué dans scale_*_continuous() procède par défaut à la censure des données hors limites en les transformant en valeurs manquantes. Toutefois, son intégration native au cœur de la fonction d’échelle permet de synchroniser de manière holistique le bornage spatial avec une pléthore d’autres paramètres fondamentaux tels que les étiquettes de graduation, les transformations logarithmiques et l’étalonnage des marges internes.
En inscrivant la délimitation de l’axe au sein de la fonction d’échelle, le chercheur s’assure que la sémiologie graphique globale demeure parfaitement harmonisée : les lignes du quadrillage majeur et mineur, l’ancrage des zéros et l’espacement typographique s’adaptent de concert, évitant ainsi les extrapolations visuelles incohérentes au-delà du domaine couvert par les mesures expérimentales effectives.
5.2 Synchronisation fine entre limits et breaks
L’un des avantages majeurs de l’utilisation conjointe des fonctions scale_x_continuous() et scale_y_continuous() réside dans la capacité à orchestrer une synchronisation mathématiquement parfaite entre les frontières de l’axe, paramétrées par limits, et la disposition géométrique des repères de graduation, régie par l’argument breaks. Lorsque ces deux dimensions sont configurées de façon désynchronisée, des artefacts visuels désastreux surviennent fréquemment, tels que l’affichage d’étiquettes de graduation flottant dans le vide au-delà de la ligne d’axe ou, à l’inverse, une troncature abrupte privant la dernière graduation de son libellé explicatif.
L’exploitation conjointe de la fonction génératrice de séquences seq() constitue la pratique d’excellence pour concevoir des espacements constants, harmonieux et conformes aux préceptes psychophysiques de la lisibilité graphique. Par exemple, sur une échelle d’évaluation allant formellement de 0 à 100 unités, l’analyste peut spécifier un bornage strict via limits = c(0, 100) tout en instanciant un pas régulier d’échantillonnage de vingt unités au moyen de l’expression breaks = seq(0, 100, by = 20). Cette démarche assure que les graduations extrêmes coïncident rigoureusement avec les délimitations physiques du repère graphique.
Cette rigueur programmatique permet également d’adjoindre des étiquettes personnalisées sophistiquées aux points d’arrêt critiques grâce à l’argument labels, garantissant que les seuils théoriques ou cliniques majeurs — tels qu’un score seuil de dépistage ou un niveau critique de toxicité — soient explicitement marqués et nommés précisément sur l’armature de l’axe, sans risque de décalage spatial induit par un recalibrage automatique aléatoire.
5.3 Contrôle des marges internes via le paramètre expand
Par conception par défaut, le moteur de rendu de ggplot2 applique une marge d’expansion automatique de 5 % de part et d’autre des axes continus (et d’environ 0,6 unité sur les axes catégoriels). Cette décision de conception, introduite par Hadley Wickham pour éviter que les glyphes graphiques périphériques situés exactement sur les bornes minimales et maximales ne viennent percuter brutalement les lignes de repère d’axe, peut s’avérer hautement problématique dans certains contextes analytiques rigoureux. Notamment, lors de la création d’histogrammes ou de diagrammes en barres représentant des fréquences absolues, cet espacement automatique laisse flotter les barres au-dessus d’un vide artificiel entre le zéro absolu et la ligne d’abscisse.
L’argument expand, accessible au sein de scale_x_continuous() et de son homologue en ordonnées, permet de neutraliser ou de sculpter ces marges avec une granularité totale. Sa manipulation requiert l’utilisation formelle de la fonction auxiliaire expansion(). Pour éliminer complètement tout espace superflu et contraindre la base des barres à s’ancrer de façon chirurgicale sur la ligne de base d’ordonnée zéro, il suffit de configurer l’expansion sous la forme expansion(mult = c(0, 0)) pour une suppression proportionnelle, ou expansion(add = c(0, 0)) pour une annulation additive absolue.
Dans les publications académiques à haute densité de contenu, où chaque millimètre carré de la grille typographique doit être maximisé pour restituer l’information scientifique, la compression raisonnée de ces marges internes au moyen de coefficients modérés (par exemple mult = c(0, 0.02) pour libérer le haut de la distribution tout en verrouillant la base) optimise la lisibilité tout en garantissant une élégance esthétique digne des meilleures revues internationales.
6. Gestion des observations hors limites avec le package scales
6.1 Le rôle du paramètre oob (Out of Bounds)
Lorsque des limites sont appliquées via les fonctions d’échelle standard, la règle computationnelle par défaut consiste à évincer l’intégralité des observations transgressant ces frontières en leur attribuant la valeur spéciale non disponible NA. Néanmoins, l’écosystème graphique de R offre un raffinement conceptuel remarquable par le truchement du paramètre oob (abréviation de l’anglais Out of Bounds), intégré au sein des fonctions scale_*_continuous(). Ce paramètre attend comme argument une fonction de transformation vectorielle chargée de statuer sur le sort mathématique et visuel réservé aux points excédant le domaine autorisé.
Le package compagnon scales fournit un assortiment de routines hautement spécialisées pour piloter ce comportement avec une rigueur paramétrique totale. Par défaut, le comportement historique correspond à la fonction scales::censor, qui identifie systématiquement les points situés au-delà des limites stipulées et les remplace impitoyablement par des valeurs manquantes. Ce mécanisme engendre la cascade de conséquences précédemment documentée : avertissements d’exécution en console, troncature de données et distorsion des ajustements statistiques non protégés par le système de coordonnées.
L’introduction d’alternatives fonctionnelles à la censure permet au chercheur de repenser la dialectique entre exclusion graphique et intégrité mathématique. En dissociant la contrainte visuelle du canevas de la destruction numérique de la mesure, le paramètre oob confère à l’analyste un levier de contrôle d’une précision inédite, essentiel lors du traitement de distributions hautement asymétriques ou parasitées par des valeurs exceptionnelles mais signifiantes.
6.2 Écrasement aux frontières avec scales::squish
Parmi les stratégies alternatives les plus brillantes figure la fonction scales::squish. Son principe algorithmique ne consiste pas à éliminer les observations hors limites, mais à les comprimer de façon orthogonale directement sur la frontière d’axe la plus proche. Si une limite supérieure est fixée à cent unités et qu’un sujet expérimental présente un score empirique exceptionnel de cent quarante, la routine squish recadre mathématiquement cette coordonnée pour la fixer rigoureusement à cent au moment de la génération géométrique.
Cette approche présente une valeur ajoutée méthodologique considérable dans l’étude de tâches cognitives chronométrées, où des temps de réaction pathologiquement longs — provoqués par des décrochages attentionnels passagers de certains sujets — peuvent étirer indûment l’axe temporel vers des valeurs démesurées. En recourant à scales::squish, l’analyste préserve l’information quant à l’existence de ces réponses déviantes en les matérialisant visuellement sous forme d’un alignement de sentinelles sur la bordure extérieure du graphique, tout en conservant une résolution visuelle optimale pour le corps central de la distribution des temps de réponse normaux.
Une précaution interprétative fondamentale s’impose néanmoins : la légende ou le commentaire textuel accompagnant le graphique doit impérativement expliciter ce mécanisme d’écrasement frontalier. Sans cette mention méthodologique explicite, le lecteur non averti pourrait commettre l’erreur perceptuelle d’interpréter cet empilement linéaire de points marginaux comme un artefact d’effet de plafond intrinsèque à l’instrument d’évaluation, alors qu’il ne s’agit que d’un artifice conscient de cadrage graphique.
6.3 Alternatives fonctionnelles : scales::discard et scales::keep
Au-delà de la censure et de la compression, le package scales met à la disposition des modélisateurs d’autres primitives computationnelles hautement spécialisées, au premier rang desquelles figurent scales::discard et scales::keep. La routine scales::discard opère une élimination totale et immédiate des éléments transgressifs, à la différence de censor qui maintient la position matricielle sous forme d’une case vide NA. Cette divergence de computation prend tout son sens lors du rendu de géométries reliées, telles que des trajectoires temporelles ou des polygones continus, où la présence d’un NA génère une rupture inesthétique de la ligne continue, tandis que l’éviction pure soude directement les segments restants adjacents.
À l’inverse, l’instruction scales::keep conserve scrupuleusement la coordonnée spatiale réelle du point sans altération, tout en autorisant le moteur graphique à tracer les éléments géométriques au-delà des bornes délimitées par les marges intérieures du panneau de tracé. Ce comportement est précieux pour créer des effets graphiques d’échappement contrôlé ou lors de l’intégration de repères flottants au sein de figures multipanneaux complexes.
Le tableau ci-après synthétise les propriétés structurelles, les impacts sur le calcul géométrique et les domaines d’application privilégiés des principales règles de gestion des données hors limites :
| Fonction oob | Transformation de la donnée | Impact sur les statistiques d’ajustement | Usage recommandé en recherche |
|---|---|---|---|
| scales::censor | Conversion en NA | Recalcul complet des modèles sur l’échantillon tronqué | Suppression délibérée d’artefacts physiques aberrants |
| scales::squish | Projection sur la borne (min ou max) | Préserve la présence des cas sans distorsion de l’échelle | Visualisation conjointe de scores sentinelles et du corps central |
| scales::discard | Suppression vectorielle immédiate | Suppression sans maintien des index matriciels | Tracés de lignes continues sans ruptures de segments |
| scales::keep | Conservation de la coordonnée réelle | Données projetées au-delà du cadre d’affichage | Conception d’annotations marginales et d’effets de débordement |
7. Délimitation des axes sur des échelles transformées
7.1 Logarithmes et transformations mathématiques de variables
L’exploration empirique de phénomènes biologiques, économiques ou psychométriques impose couramment le recours à des transformations mathématiques non linéaires, la transition vers l’espace logarithmique décimal via scale_y_log10() ou naturel constituant l’archétype méthodologique pour linéariser des dynamiques exponentielles ou stabiliser des variances hétéroscédastiques. Toutefois, l’interaction entre ces transformations d’échelle et l’argument formel limits recèle une complexité théorique majeure susceptible de compromettre le rendu analytique.
La règle fondamentale régissant ce mécanisme stipule que les valeurs numériques passées au vecteur limits au sein d’une fonction d’échelle transformée comme scale_y_log10() doivent impérativement être exprimées dans l’unité de mesure brute d’origine et non dans l’espace transformé. Si un analyste souhaite délimiter un axe des ordonnées logarithmique entre dix et un million d’unités, il doit spécifier explicitement limits = c(10, 1e6) et non les valeurs des exposants logarithmiques [1, 6]. Le moteur de ggplot2 applique en effet la transformation mathématique en aval de la lecture des paramètres de l’échelle.
Cette distinction s’avère hautement critique lors de la présence de valeurs nulles ou négatives au sein de la base d’observations. Le logarithme de zéro étant mathématiquement indéfini et tendant vers l’infini négatif, l’affectation imprudente d’une borne inférieure inférieure ou égale à zéro engendre l’émission d’erreurs logicielles sévères et l’élimination brutale de pans entiers de la distribution. Le praticien se doit donc de définir avec une précision chirurgicale un plancher strictement positif, fondé sur la limite de détection de l’instrument de mesure employé.
7.2 Ordre de priorité entre transformation et délimitation
Une incompréhension récurrente concerne la divergence d’implémentation entre l’application d’une transformation d’échelle via scale_x_log10() et l’utilisation d’une transformation spatiale de coordonnées au moyen de coord_trans(x = « log10 »). Dans le premier cas, la transformation de la variable est opérée au tout début de la chaîne de traitement graphique : les régressions polynomiales, les lissages et les calculs de densité sont ainsi formellement estimés sur les données préalablement transformées par le logarithme, garantissant des droites de régression parfaites pour des lois de puissance.
Dans le second cas, la transformation est dévolue au système de projection de coordonnées final : les calculs géométriques et statistiques sont initialisés sur l’échelle arithmétique linéaire originale, puis la projection visuelle vient courber spatialement le résultat sur l’espace d’affichage logarithmique. Si un zoom cartésien mal configuré est injecté à cette étape, des courbures inattendues et des déformations des enveloppes de confiance d’intervalles statistiques peuvent survenir de façon impromptue, traduisant visuellement un phénomène mathématiquement incohérent.
Pour la présentation irréprochable de données asymétriques en sciences humaines et comportementales, la recommandation épistémologique dominante consiste à opérer systématiquement la transformation au niveau de l’échelle continue scale_*_log10(), en combinant des bornes brutes naturelles et un étalonnage précis des graduations au format exponentiel lisible, assurant une concordance absolue entre l’intuition visuelle et la rigueur du formalisme mathématique.
7.3 Échelles de pourcentages, probits et standardisations z
L’affichage de proportions, de probabilités cumulées issues de modèles logistiques ou de scores réduits standardisés (scores z) soulève des exigences méthodologiques particulières en matière de bornage spatial. Pour les échelles de proportions bornées intrinsèquement entre 0 et 1, l’analyste doit impérativement résister à la tentation de laisser le compilateur étendre automatiquement les marges au-delà de ces frontières ontologiques. Un graphique présentant un taux de réussite scolaire de 105 % ou une probabilité de récidive négative de -5 % détruit instantanément la crédibilité scientifique du travail de recherche.
Pour autant, le verrouillage strict via limits = c(0, 1) combiné à l’affichage d’intervalles de confiance calculés par approximation asymptotique normale peut générer l’amputation désastreuse des moustaches d’incertitude pour des proportions proches des extrêmes. Dans un tel cas, le recours conjoint à des transformations de type probit ou logit via scales::probability() ou l’utilisation protectrice de coord_cartesian(ylim = c(0, 1)) permet de circonscrire l’espace visuel tout en préservant l’intégrité du calcul inférentiel binomial sous-jacent.
Concernant les distributions standardisées centrées-réduites, il est d’usage académique universel d’imposer des délimitations symétriques rigides d’amplitude équivalente, classiquement fixées à [-3, 3] ou [-4, 4] déviations standard. Cette standardisation visuelle stricte garantit au lecteur une appréciation immédiate de la rareté probabiliste des événements observés, tout dépassement de la frontière des trois sigmas signalant visuellement une anomalie statistique majeure selon les postulats fondamentaux de la loi normale gaussienne.
8. Gestion des limites sur les échelles discrètes et catégorielles
8.1 Filtrage et réordonnancement via scale_x_discrete()
Contrairement aux continuums numériques réels, les axes supportant des variables qualitatives ou catégorielles ordonnées requièrent une approche conceptuelle radicalement distincte. Au sein de la fonction spécialisée scale_x_discrete(), l’argument limits cesse d’accepter une plage continue sous forme d’un vecteur binaire d’extrema pour devenir un vecteur exhaustif de chaînes de caractères énonçant nommément les modalités factorielles autorisées à être projetées sur le graphique.
Cette propriété syntaxique offre au statisticien un double pouvoir de contrôle : le filtrage sélectif et le réordonnancement spatial sans altération de la structure intrinsèque du bloc de données en mémoire vive R. Si l’on dispose d’un facteur expérimental comportant quatre conditions d’exposition (Témoin, Faible, Moyen, Fort), la transmission de l’argument formel limits = c(« Témoin », « Fort ») aura pour effet direct d’évincer les modalités intermédiaires de la surface de tracé, tout en maintenant intacte la table d’origine pour d’autres phases d’investigation statistique.
Simultanément, l’ordre séquentiel d’apparition des modalités au sein de ce vecteur textuel dicte de façon absolue l’ordonnancement géométrique des colonnes ou des boîtes de gauche à droite sur l’axe horizontal. Cette faculté de réorganisation spatiale à la volée est capitale pour aligner la disposition graphique sur des hypothèses expérimentales a priori, facilitant la lecture visuelle immédiate des contrastes planifiés dans des protocoles d’analyse de variance.
8.2 L’expansion des catégories pour l’annotation de contrastes
Une technique avancée, fréquemment mobilisée dans la préparation de figures destinées aux revues biomédicales et psychologiques d’excellence, réside dans l’injection délibérée de modalités nominales factices au sein du vecteur limits d’une échelle discrète. En insérant des chaînes textuelles vides ou des identifiants non présents dans la base empirique (par exemple limits = c(« Témoin », « Traitement_A », » « , « Traitement_B »)), l’analyste force le moteur de ggplot2 à réserver une case spatiale vide d’une largeur géométrique rigoureusement calibrée au milieu du panneau graphique.
Cet intervalle vacant ainsi ménagé au cœur de la figure offre une zone d’ancrage idéale pour l’incrustation manuelle d’annotations statistiques textuelles sophistiquées, de symboles d’accolades marquant des comparaisons multiples par paires ou d’indications précises de significativité inférentielle de type valeurs de p sans jamais surcharger ni masquer les points empiriques des conditions réelles adjacentes.
Cette méthode permet en outre de maintenir un espacement métrique rigoureusement constant entre des familles distinctes de conditions expérimentales présentées sur un même panneau, évitant ainsi le recours laborieux à des montages multipanneaux hétérogènes sous des logiciels tiers de retouche d’images qui brisent la chaîne de reproductibilité numérique du protocole d’analyse.
8.3 Attribution des limites sur des variables combinées
L’investigation de dispositifs factoriels complexes mêlant plusieurs variables catégorielles croisées — tels que des plans d’expérience combinant deux groupes cliniques et trois temps de mesure répétés — engendre fréquemment des étiquettes composites obtenues par l’interaction géométrique des facteurs sous l’instruction d’esthétique interaction(Groupe, Temps). Dans ces contextes à haute densité dimensionnelle, la maîtrise fine des limites discrètes s’avère indispensable pour éviter l’illisibilité du repère d’abscisse.
La formulation explicite du vecteur des limites croisées permet d’imposer un séquençage logique rigoureux, regroupant prioritairement les modalités par proximité conceptuelle (par exemple en alignant tous les temps de mesure d’un premier groupe avant de basculer sur le groupe alternatif) plutôt que de subir le tri alphabétique automatique imposé par défaut par le compilateur interne de R.
Ce cadrage minutieux des modalités combinées garantit la parfaite comparabilité visuelle des profils de réponse longitudinaux entre cohortes divergentes. Il assure que chaque sous-groupe dispose d’une assise géométrique proportionnelle et clairement individualisée, éliminant tout risque de chevauchement typographique et magnifiant la mise en valeur des effets d’interaction statistique révélés par les modèles linéaires mixtes.
9. Interaction entre facettage (faceting) et limites d’axes
9.1 Limites uniformes versus limites libres : facet_wrap et facet_grid
La décomposition d’un corpus multidimensionnel dense en un treillis de sous-graphiques homogènes par facettage spatial via facet_wrap() ou facet_grid() constitue l’une des armes analytiques les plus formidables de la grammaire des graphiques. Par défaut, l’orthodoxie méthodologique de ggplot2 impose une uniformité stricte des limites spatiales sur l’ensemble des panneaux composant la grille : chaque facette partage rigoureusement les mêmes bornes d’abscisses et d’ordonnées, facilitant une comparaison inter-groupes directe et immédiate des magnitudes sans risque de manipulation perceptuelle.
Néanmoins, lorsque les cohortes stratifiées présentent des ordres de grandeur ou des amplitudes de dispersion radicalement dissemblables, cette contrainte d’axes universels stricts peut entraîner l’aplatissement complet des distributions des sous-groupes de faible amplitude, reléguant leurs variations internes au rang de fluctuations invisibles à l’œil nu. L’analyste se voit alors contraint de relâcher cette contrainte globale au moyen du paramètre fonctionnel scales, pouvant accepter les valeurs « free », « free_x » ou « free_y ».
Cette libération des limites spatiales implique toutefois un compromis épistémologique périlleux. Si elle accroît considérablement la résolution morphologique intra-facette, elle brise l’intégrité de la comparabilité inter-facettes : deux pentes visuellement indiscernables au sein de deux panneaux juxtaposés peuvent correspondre à des dynamiques quantitatives divergentes d’un facteur dix. L’analyste doit impérativement réserver cette pratique aux cas où la mise en évidence des structures relationnelles internes prime sur la quantification absolue des écarts de niveau de base.
9.2 Définition de limites distinctes et personnalisées par facette
En dépit de sa remarquable versatilité, la structure native de ggplot2 ne permet pas, par une simple instruction vectorielle, d’assigner des bornes numériques individualisées et asymétriques à chaque sous-panneau issu d’un facettage. Les options se limitent strictement soit à une égalité parfaite d’axe, soit à une libération totale calculée automatiquement au plus près des extrema locaux de chaque facette. Pour contourner cette limite technique historique tout en restant dans le cadre canonique du moteur graphique, les modélisateurs aguerris emploient l’élégante technique du jeu de données fantôme instancié via geom_blank().
Cette approche consiste à concevoir une table de données auxiliaire contenant la variable factorielle de facettage ainsi que les coordonnées minimales et maximales que l’on souhaite expressément forcer sur chaque panneau respectif. En adjoignant cette couche transparente geom_blank(data = table_auxiliaire, aes(x = x_borne, y = y_borne)) à l’intérieur du pipeline de rendu, le compilateur élargit de manière déterministe les dimensions locales de chaque facette sans introduire d’éléments graphiques visibles ni altérer les statistiques réelles de l’échantillon d’étude.
Pour une approche encore plus chirurgicale et programmatique, l’émergence d’extensions modernes de l’écosystème telles que le package ggh4x offre des fonctions spécialisées comme facetted_pos_scales(). Cette interface permet d’injecter une liste hiérarchisée d’échelles continues individuelles ciblant nominativement chaque panneau du treillis, ouvrant la voie à un contrôle déterministe des limites individuelles de facettes indispensables lors de l’étude conjointe de biomarqueurs physiologiques aux variances divergentes.
9.3 Gestion des proportions spatiales via coord_fixed et facettes
L’orchestration simultanée de panneaux de facettage et de contraintes de proportions géométriques unitaire via coord_fixed() engendre des tensions logicielles notables au sein du compilateur graphique. L’architecture de ggplot2 interdit en effet la combinaison directe de coordonnées géométriques fixes avec des échelles libres sur les deux dimensions spatiales (scales = « free »), afin de prévenir des paradoxes computationnels insolubles relatifs au respect du ratio d’aspect sur des rectangles de taille variable.
Pour surmonter cette friction géométrique, le chercheur doit recourir à des stratégies de normalisation d’amplitude graphique en amont du rendu, par exemple en procédant au centrage-réduction méthodique de chaque variable ou en ramenant systématiquement les séries observées sur un intervalle unitaire invariant [0, 1] avant l’application du facettage. Cette harmonisation préalable permet d’appliquer sereinement un système de coordonnées fixes garantissant une comparabilité morphologique irréprochable sans heurter les contraintes internes de dimensionnement spatial.
Le maintien d’une géométrie proportionnelle rigoureuse dans les grilles multipanneaux denses garantit la totale impartialité de l’interprétation scientifique. Il élimine le biais perceptuel induit par l’étirement ou la compression mécanique des sous-graphiques en fonction de la taille variable de la fenêtre d’affichage, assurant la parfaite reproductibilité de l’expérience visuelle quel que soit le support de publication utilisé.
10. Conséquences méthodologiques et perceptuelles de la troncature d’axe
10.1 L’effet d’exagération visuelle des différences de moyennes
L’un des écueils éthiques et méthodologiques les plus sévèrement documentés dans la littérature consacrée à la sémiologie graphique réside dans la pratique trompeuse consistant à tronquer l’origine naturelle d’un axe vertical continu, particulièrement lors de la restitution de contrastes d’amplitudes au moyen de diagrammes en barres ou d’histogrammes de moyennes. Cette altération spatiale viole un principe psychophysique fondamental : dans une représentation en barres, le système cognitif humain décode la magnitude quantitative de la mesure non pas à partir de la position de la ligne sommitale, mais à partir du volume et de la longueur totale de l’aire géométrique tracée au-dessus de la ligne de base.
En resserrant arbitrairement le bas de l’axe des ordonnées au moyen d’un appel malveillant ou inconscient à ylim() pour ne couvrir qu’une bande étroite située juste en dessous des moyennes des groupes expérimentaux, l’analyste génère une amplification factice démesurée des écarts substantiels entre conditions. Deux moyennes empiriques oscillant respectivement entre 95 et 97 unités sur une échelle étalonnée de 0 à 100 — traduisant une différence microscopique de 2 % dans le monde réel — apparaîtront visuellement, sur un axe démarrant fallacieusement à 94, comme un doublement spectaculaire de l’effet, trompant gravement le réviseur ou le décideur institutionnel.
Ces pratiques répréhensibles ont été magistralement formalisées par le statisticien Edward Tufte à travers la formulation du « facteur de distorsion graphique » (Lie Factor), défini comme le ratio entre la magnitude de la variation transmise par la géométrie visuelle et la magnitude de la variation réellement mesurée dans les données empiriques. L’éthique scientifique et les directives de publication contemporaines, à l’instar des standards éditoriaux de l’American Psychological Association (APA), proscrivent rigoureusement la troncature de l’axe du zéro pour les géométries d’amplitudes volumiques continues.
10.2 La perte de visibilité sur la dispersion réelle des données
Au-delà de la manipulation artificielle des tendances centrales, le resserrement excessif des limites spatiales d’un graphique produit un impact destructeur sur la transmission de la dispersion réelle des observations au sein de la cohorte. En focalisant agressivement la caméra graphique sur un intervalle étroit pour isoler l’évolution moyenne d’un traitement, l’analyste censure visuellement les déviations extrêmes de certains individus situés dans les confins de la distribution. Or, en recherche biomédicale ou en pharmacovigilance clinique, ces observations périphériques constituent fréquemment le signal biologique le plus précieux, révélant la présence d’effets indésirables rares mais dévastateurs.
Cette troncature graphique a pour effet mécanique de dissimuler l’hétérogénéité flagrante des variances entre les groupes expérimentaux. Un groupe témoin à la distribution compacte et un groupe expérimental présentant une dispersion chaotique sembleront visuellement équivalents si les bornes de l’axe ont été ajustées de manière à couper les extrémités de la distribution la plus large. Le chercheur annihile ainsi la capacité du lecteur à évaluer intuitivement le respect des postulats d’homosパédasticité indispensables à la validité des tests paramétriques subséquents.
De façon corollaire, ce cadrage myope compromet l’évaluation visuelle de la symétrie des résidus d’estimation dans les modèles de régression. Des erreurs de modélisation systématiques, des hétéroscédasticités structurelles ou des non-linéarités patentes sont gommées de la surface de tracé, entretenant chez l’analyste une confiance aveugle et injustifiée dans la performance prédictive d’un modèle statistique fondamentalement biaisé.
10.3 Recommandations psychophysiques pour un cadrage optimal
Pour concilier transparence scientifique et discernabilité visuelle des contrastes pertinents, les sciences psychophysiques de la vision ont formalisé des lignes directrices objectives pour la détermination des délimitations d’axes optimales. L’une des règles empiriques dominantes préconise de calibrer la fenêtre d’affichage de manière à ce que le nuage central d’observations occupe approximativement 70 % à 85 % de la hauteur et de la largeur utiles du canevas graphique, réservant les 15 % à 30 % résiduels aux marges de contextualisation indispensables à l’ancrage des zéros théoriques ou à l’appréciation des marges de confiance statistique.
Lorsqu’un impératif de granularité microscopique impose sans équivoque de zoomer sur un intervalle restreint non centré sur l’origine absolue — par exemple dans l’analyse de signaux électrophysiologiques fins ou de températures corporelles humaines où des variations d’un dixième de degré revêtent une signification clinique vitale —, l’utilisation de géométries ponctuelles pures (geom_point) ou linéaires (geom_line) doit être systématiquement substituée aux barres volumiques. De plus, la présence d’une rupture d’axe explicite (axis break) matérialisée par un symbole de discontinuité universel doit être formellement incrustée pour rappeler au système perceptuel du lecteur la suspension délibérée du repère nul.
Enfin, pour automatiser la sélection objective des limites dans des processus industriels de traitement de données, la formalisation de bornes probabilistes paramétriques fondées sur des multiples standardisés de l’écart-type ou de l’écart interquartile autour de la médiane offre un compromis irréprochable, assurant une couverture statistique constante et reproductible de l’espace empirique sans intervention discrétionnaire subjective de l’opérateur.
11. Programmation fonctionnelle et automatisation dynamique des limites
11.1 Fonctions personnalisées passées à l’argument limits
L’une des fonctionnalités les plus puissantes, bien que paradoxalement sous-exploitée par la majorité des développeurs R, réside dans la capacité native de l’argument limits au sein des fonctions scale_*_continuous() à accepter en guise de paramètre non pas un simple vecteur fixe codé en dur, mais une véritable fonction mathématique anonyme ou nommée. Cette architecture fonctionnelle ouvre des perspectives d’automatisation dynamique exceptionnelles pour la conception de gabarits graphiques génériques et résilients.
Lorsqu’une fonction est transmise à l’argument limits, ggplot2 lui transmet automatiquement en argument d’entrée l’étendue empirique naturelle des données brutes détectées par l’algorithme (un vecteur numérique de deux éléments représentant le minimum et le maximum réels). La fonction personnalisée peut alors appliquer une règle computationnelle arbitraire sur ces bornes avant de retourner le vecteur définitif qui servira à cadrer l’axe. Par exemple, pour garantir qu’un axe étende systématiquement sa plage de 10 % en deçà du minimum et de 10 % au-delà du maximum observé, il suffit d’injecter une closure fonctionnelle effectuant ce rehaussement proportionnel.
Cette approche s’avère providentielle pour la confection d’axes parfaitement symétriques centrés sur zéro, condition essentielle à la visualisation neutre de coefficients de corrélation, de résidus de régression normalisés ou de logarithmes de ratios d’expression génique (log-fold changes). En transmettant une lambda-fonction calculant l’extremum absolu maximal de l’étendue, l’analyste garantit que la borne inférieure et la borne supérieure afficheront rigoureusement la même amplitude absolue symétrique, prévenant tout décentrement perceptuel asymétrique du zéro focal.
11.2 Création d’un module graphique réutilisable et reproductible
L’industrialisation de la production graphique au sein de départements académiques ou de plateformes biostatistiques exige l’encapsulation de ces règles de délimitation spatiale au sein de wrappers logiciels réutilisables et strictement reproductibles. Plutôt que de disperser des configurations disparates de coord_cartesian() ou de scale_y_continuous() à travers des centaines de scripts de calcul, la méthodologie de pointe consiste à développer des extensions thématiques dédiées intégrant la logique métier de cadrage.
Cette stratégie logicielle repose sur l’écriture de fonctions personnalisées R qui interceptent la distribution de la métrique analysée, évaluent la taille d’effet statistique standardisée associée, et injectent dynamiquement la combinaison appropriée de coordonnées géométriques et d’arguments d’expansion. En dissociant de manière étanche le pipeline de modélisation inférentielle de la couche sémiologique de projection spatiale, le statisticien garantit une uniformité stylistique et méthodologique totale sur l’ensemble des livrables de recherche d’une institution.
De plus, cette modularité logicielle simplifie considérablement les protocoles d’audit de code et de revue par les pairs : toute altération intentionnelle du domaine de visibilité d’une série de graphiques est centralisée dans une routine paramétrique documentée, excluant toute manipulation ad hoc et garantissant une traçabilité intégrale depuis la table de données brutes jusqu’à la figure insérée dans le manuscrit final.
11.3 Gestion des limites dans les visualisations dynamiques et interactives
L’essor des tableaux de bord analytiques interactifs développés sous R Shiny et de l’interopérabilité logicielle avec des bibliothèques JavaScript modernes telles que Plotly via la commande passerelle ggplotly() impose une vigilance technique accrue concernant le comportement des limites spatiales préconfigurées. La traduction d’un objet statique ggplot2 vers un environnement Web dynamique réinterprète en effet la philosophie des coordonnées géométriques en fonction du moteur d’affichage du navigateur client.
Lorsqu’un graphique structuré au moyen de xlim() est converti en canevas interactif, les points censurés sont définitivement perdus pour le moteur JavaScript : l’utilisateur final qui tenterait d’effectuer un zoom arrière dynamique au moyen des outils interactifs de navigation découvrira avec stupeur que l’espace au-delà des bornes initiales est totalement stérile et exempt de données. En revanche, si le cadrage initial a été opéré via les spécifications dimensionnelles de coord_cartesian(), la totalité de la distribution reste matriciellement présente en arrière-plan du flux JSON transmis au navigateur, autorisant un dézoomage fluide et une exploration libre et interactive de l’échantillon complet par l’utilisateur.
Dans l’architecture de tableaux de bord de grande envergure sous Shiny, l’optimisation des temps de latence réseau peut néanmoins justifier l’usage calculé de filtrages d’échelle stricts en amont lorsque la volumétrie atteint des millions d’observations. L’ingénieur de données doit alors arbitrer méthodiquement entre l’intégrité de l’interactivité utilisateur et la bande passante requise pour sérialiser les flux de coordonnées graphiques vers le poste client.
12. Synthèse critique et arbre de décision pour le choix de la méthode
12.1 Grille comparative exhaustive des techniques de limitation
Pour parachever cette étude des mécanismes de délimitation d’axes sous ggplot2, il convient de dresser un bilan analytique confrontant les quatre grandes philosophies computationnelles documentées dans nos travaux. Le choix d’une approche dépend d’un faisceau de contraintes croisées : l’exigence d’intégrité de l’échantillon empirique, la présence de couches géométriques dépendantes de calculs statistiques d’agrégation, la complexité syntaxique tolérée et la nature des interactions dimensionnelles recherchées.
La confrontation objective révèle sans ambiguïté la suprématie opérationnelle de coord_cartesian() dès lors que l’intégrité inférentielle est en jeu. En revanche, la richesse paramétrique des fonctions scale_*_continuous() s’avère incontournable lorsque l’analyste doit coordonner finement les graduations, les libellés typographiques, les compressions de marges d’expansion et les règles spéciales de traitement des anomalies périphériques via les opérateurs oob.
Le tableau synoptique ci-dessous formalise les propriétés discriminantes de chaque dispositif technique afin de guider le statisticien vers le compromis algorithmique le plus adapté à ses contraintes éditoriales :
| Dispositif technique | Niveau d’action logique | Impact sur l’échantillon de données | Calculs statistiques (smooth, boxplot) | Flexibilité sémiologique |
|---|---|---|---|---|
| xlim() / ylim() | Raccourci d’échelle | Censure structurelle (suppression des lignes) | Recalculés sur les données tronquées (biais) | Faible (paramétrage minimaliste) |
| coord_cartesian() | Système de coordonnées | Préservation intégrale (zoom optique) | Estimés sur la totalité de l’échantillon | Moyenne (focalisation et ratios d’aspect) |
| scale_*_continuous() | Échelle primaire continue | Censure par défaut (sauf si oob personnalisé) | Sensibles à la règle oob configurée | Maximale (breaks, labels, expand, oob) |
| scale_*_discrete() | Échelle discrète | Filtrage sélectif des modalités qualitatives | Ajustés aux seules catégories retenues | Élevée (réordonnancement, contrastes) |
12.2 Arbre décisionnel pour les analystes et chercheurs
Face à la pluralité des options logicielles examinées, la démarche méthodologique de l’analyste doit s’ordonner autour d’un algorithme décisionnel séquentiel clair. La première interrogation discriminating porte sur l’objectif de la manipulation spatiale : s’agit-il d’un recadrage optique destiné à scruter des détails morphologiques fins sans altérer la masse statistique, ou d’une volonté délibérée de filtrer l’échantillon d’analyse pour expurger des anomalies physiques avérées ? Si l’objectif relève de la simple observation sans troncature, l’implémentation de coord_cartesian(xlim = …, ylim = …) s’impose d’emblée comme le choix catégorique incontestable.
Si la démarche s’inscrit au contraire dans une refonte de la mise à l’échelle globale de l’expérience, le statisticien doit évaluer la présence de géométries statistiques dépendantes de la distribution globale (régression, quantiles, densités). En présence de telles modélisations, l’éviction brutale par des raccourcis d’échelle de type xlim() doit être formellement rejetée, au profit de transformations d’échelles avancées combinées à des règles de gestion des débordements paramétrées avec soin via oob = scales::squish si la rétention visuelle des cas extrêmes est scientifiquement opportune.
Enfin, lorsque le tracé implique des axes catégoriels ou des compositions de facteurs ordonnés, l’algorithme oriente l’utilisateur vers scale_x_discrete(), complété le cas échéant par des jeux de données auxiliaires vides sous geom_blank() si des asymétries déterministes de facettage multipanneaux doivent être imposées dans le cadre d’un rapport multicritère dense.
12.3 Check-list méthodologique pour la préparation d’articles scientifiques
Avant d’apposer le visa de validation finale sur une figure statistique destinée à la soumission pour publication au sein d’une revue à comité de lecture international, tout chercheur et statisticien devrait s’astreindre à l’exécution de la grille d’audit méthodologique en six points ci-après :
- Vérification de l’intégrité inférentielle : Les couches de lissage statistique, d’intervalles de confiance ou de quartiles ont-elles été calculées sur la population d’observations intégrale sans amputation involontaire induite par des fonctions d’échelle tronquantes ?
- Audit des messages d’avertissement en console : La compilation graphique a-t-elle émis le message d’alerte relatif à la suppression de valeurs manquantes ? Si tel est le cas, cette exclusion découle-t-elle d’un choix délibéré et scientifiquement motivé, ou d’une méprise syntaxique sur les bornes ?
- Explicitation transparente des troncatures : Si l’origine naturelle (zéro) de l’axe vertical a été écartée pour des géométries d’estimation continue, la légende textuelle du manuscrit documente-t-elle clairement cette disposition pour prévenir toute distorsion de lecture ?
- Concordance des graduations et du quadrillage : Les points de rupture breaks coïncident-ils avec les bornes limits, évitant ainsi l’apparition d’espaces fantômes ou d’étiquettes typographiques résiduelles flottant en dehors du panneau utile ?
- Neutralisation des marges indésirables : Pour les diagrammes en barres ou les histogrammes physiques, l’expansion automatique par défaut de 5 % a-t-elle été neutralisée via l’argument formel expand = expansion(mult = c(0, 0.05)) pour garantir l’ancrage des colonnes sur le socle spatial de référence ?
- Audit de reproductibilité du code source : Le pipeline d’instructions graphiques est-il intégralement encapsulé dans un script R autonome et documenté, excluant formellement toute retouche manuelle postérieure susceptible d’altérer la fidélité des projections géométriques ?
Par l’application systématique et rigoureuse de ces canons méthodologiques, les praticiens de la science des données confèrent à leurs restitutions visuelles une autorité scientifique inébranlable, magnifiant la puissance descriptive de la grammaire des graphiques tout en servant scrupuleusement les exigences éthiques de la recherche quantitative contemporaine.
Références
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science (2nd ed.). O’Reilly Media.
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media.
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0