
L’analyse des interrelations au sein d’ensembles complexes de données constitue le socle méthodologique de la recherche contemporaine en sciences humaines, sociales et comportementales. En psychométrie et en psychologie quantitative, la capacité à évaluer simultanément la force, le sens et la configuration des associations linéaires entre plusieurs instruments de mesure représente une étape incontournable avant toute tentative de modélisation causale ou structurelle. L’exploration bivariée systématique permet aux chercheurs de vérifier la cohérence empirique de leurs construits théoriques, d’anticiper les artefacts statistiques et de déceler d’éventuelles redondances conceptuelles au sein de leurs protocoles expérimentaux.
Bien que des progiciels spécialisés tels que IBM SPSS Statistics, R ou SAS soient traditionnellement privilégiés dans les environnements de laboratoire hautement dotés, les outils infonuagiques collaboratifs ont atteint un degré de maturité computationnelle remarquable. Parmi ceux-ci, le tableur Google Sheets s’impose désormais comme une alternative rigoureuse, accessible et hautement collaborative pour le traitement de données multivariées, offrant une flexibilité précieuse pour le travail en réseau interuniversitaire et la reproductibilité des analyses exploratoires.
Le présent guide a pour vocation d’exposer de manière exhaustive et académique les fondements mathématiques, les procédures logicielles et les exigences méthodologiques nécessaires à la construction, la mise en forme visuelle et l’interprétation critique d’une matrice de corrélation au sein de Google Sheets. À travers une démarche progressive articulant théorie de la mesure, manipulation algorithmique et conformité aux standards de publication scientifique de l’American Psychological Association, cet article fournit aux praticiens et chercheurs un cadre opératoire complet pour transformer des données brutes en indicateurs psychométriques exploitables.
1. Introduction aux fondements de la corrélation linéaire et à son rôle en psychométrie
1.1 Définition et propriétés mathématiques du coefficient de corrélation de Pearson
Le coefficient de corrélation produit-moment de Pearson, conventionnellement désigné par la lettre minuscule r pour un échantillon et par la lettre grecque ρ (rho) pour une population parente, formalise l’intensité et l’orientation de la relation linéaire unissant deux variables quantitatives continues. Mathématiquement, cet indice correspond au rapport standardisé entre la covariance des deux variables et le produit géométrique de leurs écarts-types respectifs. En divisant la somme des coproduits des écarts à leurs moyennes respectives par la racine carrée du produit de leurs sommes des carrés déviées, l’équation s’affranchit des unités d’échelle arbitraires pour générer une métrique adimensionnelle universelle.
L’étendue théorique des valeurs permises par cette formulation analytique est strictement bornée au sein de l’intervalle fermé [-1,00 ; +1,00]. Une valeur atteignant exactement +1,00 traduit une association linéaire positive parfaite, signifiant que toute augmentation standardisée de l’une des variables engendre une élévation rigoureusement proportionnelle de la seconde variable le long d’une trajectoire géométrique rectiligne. Réciproquement, une valeur de -1,00 reflète une association linéaire négative absolue, caractérisée par une diminution systématique et proportionnelle de l’une des variables au fur et à mesure que la seconde s’accroît. Une magnitude de 0,00 indique l’absence totale de co-variation linéaire, bien qu’elle n’exclue nullement l’existence de liaisons curvilinéaires complexes ou non monotones.
D’un point de vue vectoriel et algébrique, le coefficient de Pearson peut être conceptualisé comme le cosinus de l’angle formé par deux vecteurs de scores centrés au sein d’un espace euclidien multidimensionnel dont le nombre de dimensions équivaut au nombre d’observations du protocole. Plus l’angle angulaire s’approche de zéro radian, plus le cosinus converge vers l’unité, révélant une colinéarité vectorielle quasi-totale. À l’inverse, une orthogonalité stricte, matérialisée par un angle de quatre-vingt-dix degrés, produit un cosinus nul, confirmant l’indépendance linéaire des deux vecteurs de variables.
Il demeure fondamental de rappeler la distinction épistémologique absolue séparant l’observation d’une corrélation bivariée robuste de l’affirmation d’une relation de causalité univoque. La corrélation n’atteste que d’une simultanéité d’oscillations numériques conjointes au sein d’un échantillon donné. Elle ne permet en aucun cas de statuer sur la direction temporelle de l’effet, ni d’exclure l’action médiatrice ou modératrice de tierces variables non observées, soulevant le risque persistant d’associations spécieuses ou fortuites, particulièrement prononcé dans les protocoles d’observation non expérimentaux.
1.2 Utilité de la matrice de corrélation dans l’analyse multivariée en psychologie
Dans le champ de la psychométrie appliquée et de la psychologie différentielle, l’investigation des traits latents repose rarement sur une mesure isolée. L’administration d’inventaires de personnalité, d’échelles d’attitudes ou de batteries neuropsychologiques génère des matrices multidimensionnelles regroupant un ensemble étendu de sous-échelles ou d’items quantifiés. Dans ce cadre, la matrice de corrélation constitue le premier niveau synthétique de réduction de l’information, permettant aux méthodologistes d’appréhender de façon panoptique l’ensemble des relations bivariées transversales unissant les différentes dimensions évaluées.
Cette condensation tabulaire des interconnexions statistiques s’avère indispensable lors des phases préliminaires de l’analyse factorielle, qu’elle soit exploratoire ou confirmatoire. En examinant les motifs géométriques et numériques au sein de la matrice, le chercheur repère des grappes de corrélations particulièrement denses qui trahissent l’existence probable de facteurs sous-jacents partagés. Des corrélations inter-items uniformément modérées à fortes suggèrent que les questions posées capturent différentes facettes d’un même construit psychologique fondamental, préparant le terrain pour la réduction dimensionnelle par décomposition en composantes principales ou factorisation en axes principaux.
Enfin, la matrice de corrélation représente l’outil privilégié de vérification de la cohérence interne et des formes complémentaires de validité psychométrique d’un instrument de diagnostic ou de recherche. Elle permet d’établir empiriquement la validité convergente, par laquelle une nouvelle échelle doit corréler positivement et substantiellement avec des mesures validées mesurant des construits théoriquement proches. Simultanément, elle autorise le contrôle de la validité discriminante, en vérifiant que les coefficients liant le nouvel instrument à des construits théoriquement distincts demeurent statistiquement faibles ou négligeables, attestant ainsi de la spécificité du domaine psychologique investigué.
2. Structure conceptuelle et propriétés algébriques d’une matrice de corrélation
2.1 Anatomie d’une matrice carrée symétrique
Sur le plan de l’algèbre linéaire, une matrice de corrélation se structure sous la forme d’un tableau bidimensionnel carré noté R, possédant un nombre rigoureusement équivalent de lignes et de colonnes, soit une dimensionnalité formelle k × k, où la variable k correspond à la quantité totale de grandeurs quantitatives introduites dans l’investigation empirique. Chaque intersection positionnelle au sein de cette grille, repérée par l’indice de ligne i et l’indice de colonne j, abrite la valeur scalaire du coefficient de corrélation de Pearson calculé entre la i-ième et la j-ième variable du jeu de données.
La caractéristique fondamentale de cette structure réside dans sa diagonale principale, laquelle s’étend du sommet supérieur gauche à la base inférieure droite du tableau matriciel. Les cellules composant cette diagonale décrivent systématiquement l’autocorrélation d’une variable avec elle-même. Dès lors que toute variable possède une covariance avec sa propre distribution identique à sa variance d’échantillonnage, le coefficient de Pearson calculé à l’intersection d’une dimension avec elle-même atteint invariablement la valeur unitaire de 1,00, constituant ainsi un axe diagonal invariable d’autocorrélation parfaite.
Une seconde propriété géométrique incontournable concerne la symétrie miroir parfaite du tableau par rapport à cette diagonale unitaire, ce qui s’exprime formellement par la relation d’équivalence matricielle R = RT, où RT désigne la transposée de la matrice R. Étant donné que la covariance et le coefficient de Pearson sont par définition des opérateurs commutatifs — le lien statistique unissant la variable A à la variable B étant rigoureusement indiscernable de celui reliant la variable B à la variable A —, l’élément situé à la cellule (i, j) s’avère rigoureusement identique à l’élément logé en position (j, i). Cette redondance mathématique implique que la moitié supérieure droite (triangle supérieur) et la moitié inférieure gauche (triangle inférieur) contiennent des informations strictement dupliquées.
2.2 Propriétés matricielles et pertinence pour les tests psychométriques
Au-delà de sa symétrie géométrique de surface, une matrice de corrélation empirique valide se conforme à une contrainte algébrique fondamentale : elle doit être semi-définie positive, et dans la majorité des situations réelles sans dépendance linéaire exacte, strictement définie positive. Cette caractéristique implique que pour tout vecteur colonne non nul x de dimension k, la forme quadratique résultante xTRx génère un scalaire strictement supérieur ou égal à zéro. En termes probabilistes, cette condition garantit que la variance de toute combinaison linéaire calculée à partir des variables observées demeure positive ou nulle, empêchant l’émergence aberrante de variances estimées négatives.
Dans l’examen exploratoire des batteries de tests, l’analyse des valeurs propres issues de la diagonalisation de cette matrice constitue une étape déterminante pour identifier d’éventuelles singularités ou instabilités numériques. Si le déterminant de la matrice s’effondre vers zéro, cela signale la présence d’une multicolinéarité quasi-parfaite, indiquant qu’au moins une des dimensions psychométriques mesurées ne constitue qu’une réplication linéaire redondante d’autres variables présentes dans l’étude. De telles redondances rendent la matrice non inversible, ce qui interdit le calcul des coefficients de régression standardisés et fausse les algorithmes d’ajustement structurel.
La confirmation de la nature définie positive de la matrice de corrélation est une condition préalable absolue pour l’exécution d’analyses multivariées avancées telles que la modélisation par équations structurelles (SEM) ou l’analyse factorielle confirmatoire (AFC). Les logiciels d’estimation statistique échouent invariablement lorsque les matrices de données brutes, en raison de valeurs manquantes traitées de manière inadéquate ou d’erreurs de calcul bivarié hétérogène, produisent des matrices non semi-définies positives, qualifiées de matrices « non régulières » (non-positive definite matrices). Une compréhension solide de ces fondements matriciels permet d’éviter l’interprétation d’artefacts issus d’approximations de calcul dans les tableurs.
3. Préparation et structuration rigoureuse du jeu de données dans Google Sheets
3.1 Organisation tabulaire conforme aux normes de la recherche académique
L’implémentation rigoureuse d’une analyse corrélationnelle dans Google Sheets débute impérativement par une disposition géométrique disciplinée des observations brutes, conforme aux principes universels du formatage des données tabulaires (tidy data). Dans cette optique, l’architecture de la feuille de calcul doit respecter une règle cardinale : chaque ligne horizontale unique correspond à une unité expérimentale distincte — typiquement un participant anonymisé, un patient ou un sujet d’étude —, tandis que chaque colonne verticale représente exclusivement une variable quantitative, un score composite ou un item d’évaluation standardisé.
La première rangée du tableau, localisée sur la ligne numéro un, doit être réservée sans exception aux libellés d’en-têtes textuels identifiant sans ambiguïté les variables d’intérêt. Il est fortement préconisé d’employer des identifiants concis, syntaxiquement valides et dénués de caractères diacritiques complexes ou d’espaces superflus (par exemple, Anxiete_Etat, Depression_Score ou Extraversion_Total), afin de faciliter leur référencement dans les syntaxes fonctionnelles ultérieures et d’éviter les ruptures accidentelles de chaînes de caractères lors de l’automatisation des calculs.
La colonne inaugurale de l’onglet, généralement la colonne A, devrait accueillir l’identifiant unique d’anonymisation de chaque sujet (par exemple, ID_001, ID_002). Cet agencement sépare nettement les métadonnées nominatives de classification de la zone continue des valeurs strictement métriques, lesquelles occuperont les colonnes adjacentes (B à N). Cette disposition permet de figer facilement la ligne d’en-tête et la colonne d’identification via le menu Affichage > Figer, assurant une navigation confortable à travers les échantillons d’évaluation de grande envergure sans perte de repères visuels.
3.2 Gestion des données manquantes et valeurs aberrantes
L’existence de réponses incomplètes ou omises constitue un défi analytique récurrent dans les protocoles d’administration de questionnaires psychologiques. Face à des cases vides, deux approches computationnelles s’opposent : la suppression par observation (listwise deletion) et la suppression par paire (pairwise deletion). La méthode par observation consiste à purger intégralement de la matrice toute ligne comportant au moins une donnée manquante sur l’ensemble des colonnes investiguées, garantissant ainsi que l’intégralité des coefficients de la matrice finale sera établie sur un effectif strictement constant d’observations, ce qui préserve l’intégrité semi-définie positive de la matrice de corrélation.
Inversement, l’élimination par paire ne neutralise les observations incomplètes que lors du calcul bilatéral spécifique impliquant la variable défaillante. Si Google Sheets opère par défaut une élimination par paire lors de l’application de formules bivariées isolées, cette méthode peut générer des distorsions mathématiques en présence d’un taux d’omission élevé, car chaque coefficient r repose alors sur des sous-échantillons d’effectifs divergents (N hétérogène). Il convient donc de privilégier un filtrage systématique préalable via les filtres natifs de Google Sheets pour constituer une table analytique homogène et complète avant l’extraction des coefficients.
L’inspection des valeurs aberrantes ou extrêmes (outliers) requiert une vigilance méthodologique toute particulière, le coefficient de corrélation de Pearson étant hypersensible aux valeurs distantes en raison de la mise au carré des écarts dans la fonction de variance. Il est vivement conseillé d’insérer des formules d’exploration statistique calculant la moyenne et l’écart-type de chaque colonne pour détecter les scores déviant de plus de trois écarts-types de la moyenne arithmétique. Parallèlement, une étape incontournable en psychométrie consiste à repérer et inverser mathématiquement les items d’échelles formulés de manière négative (reverse-coded items), afin de s’assurer que toutes les dimensions mesurées partagent une valence directionnelle cohérente avant le calcul matriciel.
3.3 Vérification des formats de cellules et typologie des variables
Une source fréquente d’échec ou d’altération silencieuse des calculs statistiques au sein de Google Sheets réside dans l’hétérogénéité des formats assignés aux cellules numériques. Les données issues de plateformes de collecte en ligne (Google Forms, Qualtrics) importent fréquemment des valeurs numériques codées accidentellement en format texte, accompagnées d’espaces insécables ou de séparateurs décimaux incompatibles avec les paramètres régionaux du classeur (différence entre le point anglo-saxon et la virgule continentale européenne).
Pour immuniser l’espace de calcul contre ces dysfonctionnements algorithmiques, l’analyste doit sélectionner la totalité de la plage de scores numériques et lui appliquer explicitement le typage Format > Nombre > Nombre automatique ou Nombre financier. L’utilisation conjointe de la fonction d’audit =ESTNUM() sur quelques cellules tests permet de confirmer que le tableur interprète sans équivoque chaque cellule comme un scalaire arithmétique et non comme une chaîne textuelle passive, laquelle serait ignorée par les routines d’évaluation de variance.
Enfin, la robustesse du protocole gagne à être renforcée en déployant des règles de validation de données (Données > Validation des données). En configurant des contraintes d’intervalles stricts (par exemple, autoriser uniquement des nombres entiers compris entre 1 et 7 pour une échelle de Likert à sept points), le chercheur prévient toute corruption ultérieure de sa base par des fautes de saisie manuelle. Cette hygiène opératoire assure que les distributions empiriques soumises à la corrélation respectent scrupuleusement les postulats d’admissibilité numérique de l’instrument psychométrique déployé.
4. Calcul de la matrice par la fonction COEFFICIENT.CORRELATION
4.1 Syntaxe fondamentale et fonctionnement de la fonction native
Le moteur computationnel de Google Sheets intègre une fonction native dédiée à l’estimation paramétrique bivariée, formalisée en environnement linguistique français sous l’intitulé COEFFICIENT.CORRELATION, laquelle possède une équivalence directe et universellement interchangeable avec la commande canonique anglophone CORREL. La structure syntaxique formelle s’énonce comme suit : =COEFFICIENT.CORRELATION(données_y; données_x), où les deux arguments représentent les plages vectorielles contiguës contenant les observations numériques associées aux deux variables soumises à l’interrogation conjointe.
Sur le plan du comportement algorithmique interne, la fonction exige que les deux plages de données fournies en arguments possèdent rigoureusement une dimensionnalité identique en termes de longueur d’intervalles, c’est-à-dire un nombre identique d’éléments analysés. Si une discordance structurelle existe entre l’étendue de la plage y et celle de la plage x (par exemple, B2:B100 confronté à C2:C95), le système renvoie instantanément un message d’erreur d’incompatibilité de dimension #N/A.
Face aux cellules non renseignées ou contenant des étiquettes textuelles au sein de la plage sélectionnée, la fonction COEFFICIENT.CORRELATION procède de manière autonome à une exclusion ciblée de la paire d’observations concernée. Elle évalue la covariance uniquement à partir des coordonnées où les deux composantes présentent simultanément une valeur numérique valide. Toutefois, si l’une des plages soumises au calcul possède une variance strictement nulle — c’est-à-dire si tous les participants ont consigné une réponse invariante et identique —, la fonction renvoie l’anomalie arithmétique #DIV/0!, traduisant l’impossibilité mathématique d’opérer une division par un écart-type nul dans la normalisation de la covariance.
4.2 Configuration des références relatives et absolues pour le remplissage de la grille
Pour modéliser une matrice de corrélation complète sans avoir à saisir manuellement chaque formule dans les dizaines de cellules composant le tableau croisé, il est impératif d’adopter une stratégie de référencement semi-absolu au moyen du métacaractère dollar ($). Cette technique permet de propager une unique formule mère sur l’ensemble de la surface matricielle par simple étirement horizontal et vertical, réduisant considérablement la durée de paramétrage tout en éliminant les erreurs typographiques de saisie manuelle.
Considérons une configuration où les scores psychométriques de cinq variables s’étendent sur les colonnes B à F de la ligne 2 à la ligne 101 d’une feuille de travail. Sur une feuille de résultats distincte, le chercheur agence sa grille en plaçant les étiquettes de ces mêmes variables en en-tête horizontal sur la plage B1:F1 et en en-tête vertical sur la plage A2:A6. La formule inscrite dans la cellule angulaire supérieure gauche B2 doit lier la première variable colonne à la première variable ligne issue de la feuille source de données.
Pour parvenir à une automatisation robuste garantissant que l’étirement vers la droite conserve la sélection rigoureuse de la ligne de référence et que l’étirement vers le bas préserve la colonne correspondante, le recours aux fonctions d’indirection ou à un ancrage méthodique des plages de données sources est requis. En définissant des plages nommées explicites ou en exploitant les références absolues complètes pour chaque vecteur (par exemple, =COEFFICIENT.CORRELATION('Données'!$B$2:$B$101; 'Données'!C$2:C$101)), le remplissage de la matrice devient fluide, prévenant tout décalage dimensionnel lors de la duplication de la cellule matrice vers les marges périphériques de la grille.
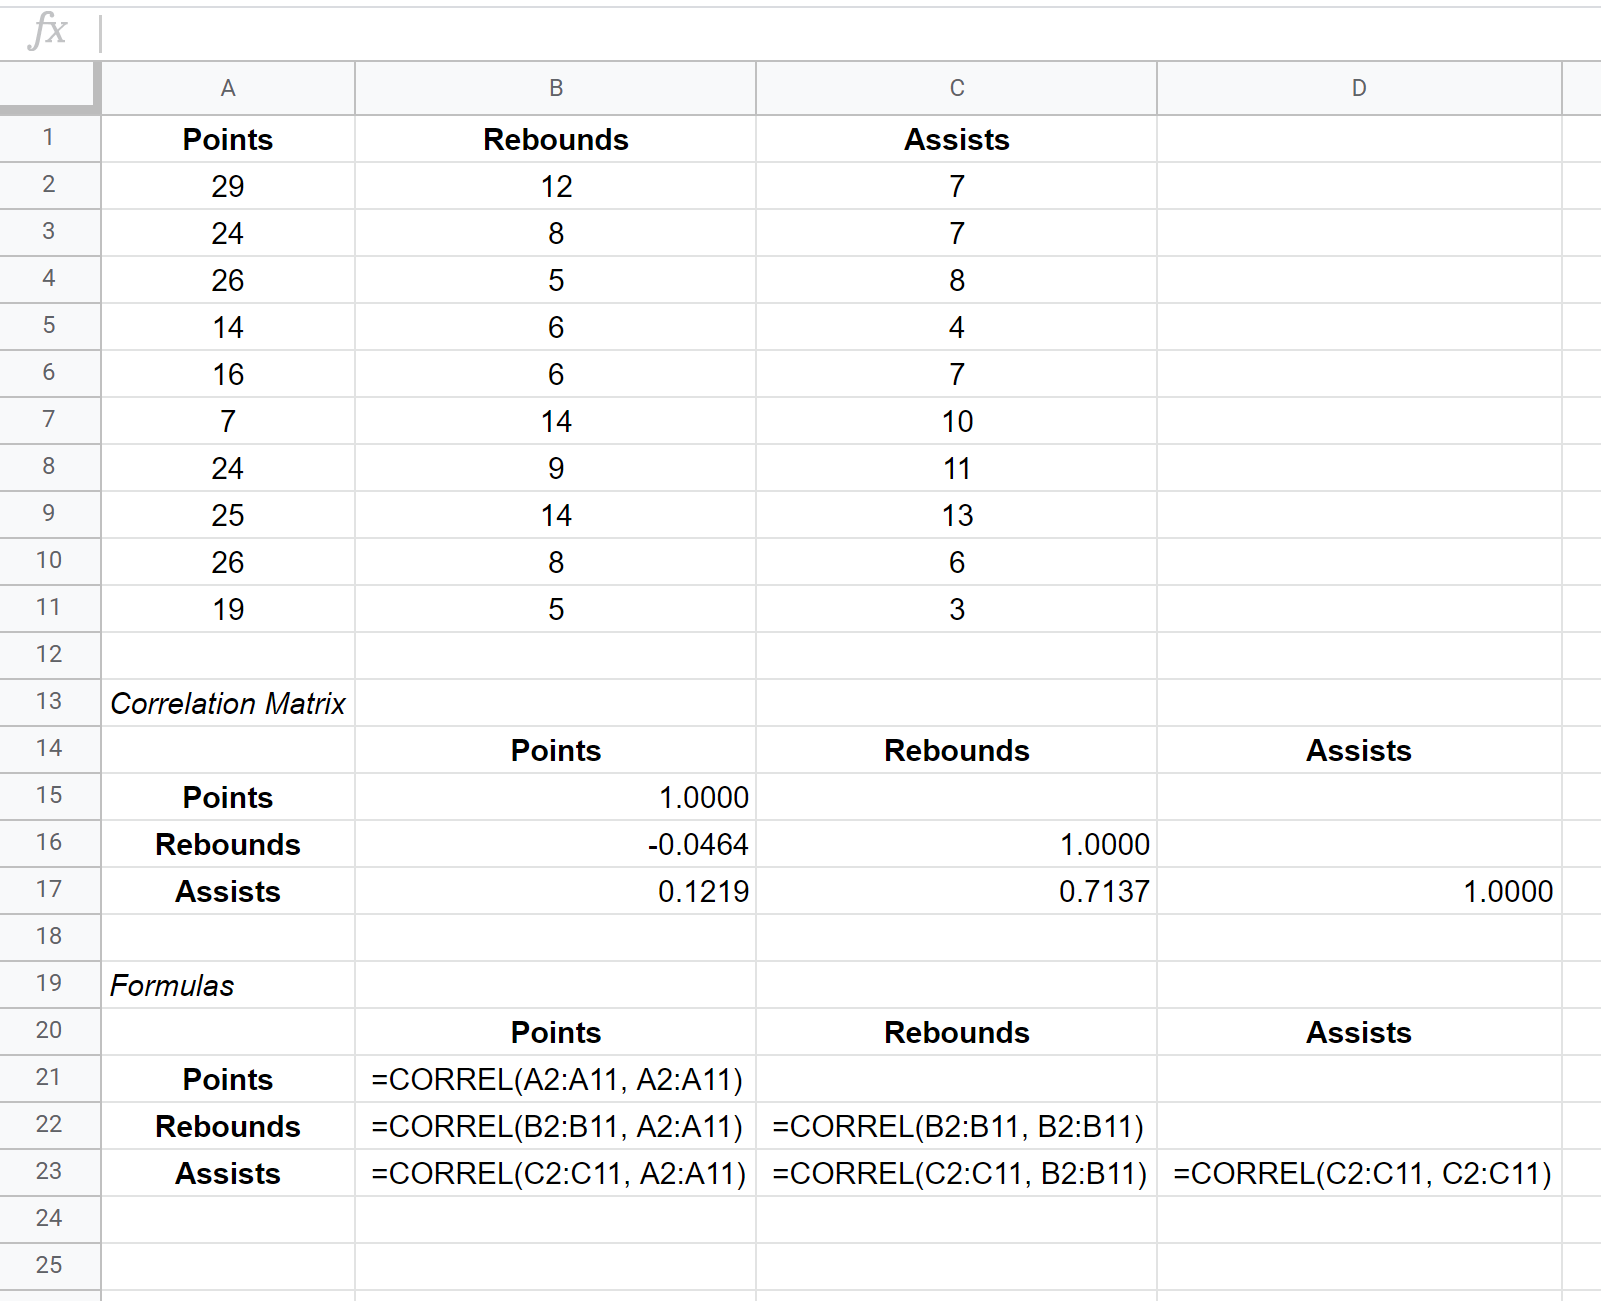
4.3 Contrôle de conformité de la grille générée
Une fois la grille de corrélations intégralement peuplée par le déploiement des formules, une procédure systématique d’audit de conformité s’impose avant toute exploitation des résultats. Le premier indicateur de rectitude computationnelle s’observe le long de l’axe diagonal principal : chaque cellule d’intersection d’une variable avec elle-même (coordonnées B2, C3, D4, etc.) doit impérativement afficher la valeur scalaire de 1,00. L’apparition d’une valeur discordante sur cette diagonale constitue la preuve irréfutable d’une anomalie dans le verrouillage des indices relatifs et absolus de la formule.
Le second verrou méthodologique repose sur le contrôle croisé de la symétrie spéculaire. L’analyste doit vérifier rigoureusement que le coefficient situé en position (Ligne i, Colonne j) correspond au millième près à la valeur enregistrée en position (Ligne j, Colonne i). Par exemple, la corrélation unissant le score de stress au score d’anxiété doit être la réplique exacte de celle joignant le score d’anxiété au score de stress. Toute asymétrie révèle qu’une plage de données a glissé lors du glisser-déposer de la formule originale.
Enfin, l’interception et le diagnostic des anomalies d’exécution évitent les contresens statistiques. L’émergence d’une erreur de typage #VALEUR! signale l’inclusion involontaire d’une cellule de format chaîne ou d’une étiquette textuelle au sein d’une plage opératoire. L’identification rapide de ces erreurs via la fonctionnalité de recherche intégrée garantit que la matrice finale forme une base de calcul parfaitement saine pour les analyses ultérieures.
5. Automatisation du calcul matriciel via les formules matricielles avancées
5.1 Exploitation de la fonction ARRAYFORMULA pour le calcul dynamique
Bien que la méthode d’extension manuelle par glisser-déposer de la fonction COEFFICIENT.CORRELATION offre une prise en main intuitive, elle demeure structurellement statique et vulnérable aux maladresses de manipulation lors de l’insertion ultérieure de nouvelles observations. Pour pallier ces limites, Google Sheets propose le moteur d’évaluation matricielle ARRAYFORMULA, capable de propager dynamiquement un calcul univarié ou multivarié sur un ensemble géométrique étendu de cellules sans exiger la réplication unitaire de la formule.
Cependant, une contrainte computationnelle fondamentale réside dans le fait que la fonction native COEFFICIENT.CORRELATION a été initialement conçue pour agréger deux vecteurs continus en un scalaire unique. Elle résiste par conséquent à l’expansion bidimensionnelle automatique directe au sein d’un bloc ARRAYFORMULA conventionnel. Tenter d’encapsuler directement =ARRAYFORMULA(COEFFICIENT.CORRELATION(Plage_A; Plage_B)) ne produit pas spontanément une matrice croisée, mais résulte en une tentative avortée de synthèse réductionniste renvoyant un coefficient singulier.
Pour contourner cette limitation algorithmique et générer une véritable grille d’expansion dynamique, les modélisateurs chevronnés déploient des formulations combinatoires exploitant la puissance des fonctions de réduction modernes telles que MAP, BYROW ou LAMBDA. En définissant une matrice d’indices où chaque coordonnée croisée déclenche l’exécution itérative de la fonction de corrélation sur les vecteurs correspondants, il devient possible d’instancier un bloc de calcul unitaire s’adaptant de manière totalement fluide et instantanée dès que de nouvelles lignes de participants sont insérées dans les plages sources d’origine.
5.2 Utilisation conjointe des fonctions INDEX et EQUIV pour une matrice dynamique
L’édification d’une matrice de corrélation hautement modulaire gagne à s’appuyer sur le tandem classique des fonctions de recherche INDEX et EQUIV (ou son équivalent moderne XLOOKUP). Cette ingénierie textuelle et positionnelle permet de concevoir une matrice qui identifie dynamiquement les colonnes de données à corréler en se basant exclusivement sur les étiquettes textuelles inscrites dans ses propres en-têtes de lignes et de colonnes, sans dépendre de coordonnées de colonnes codées en dur.
Dans ce schéma, la formule interroge le nom de la variable placé sur l’en-tête de colonne via la fonction EQUIV, laquelle renvoie le numéro d’ordre relatif de cette colonne au sein de la base de données principale. Concomitamment, la même opération est réalisée pour l’en-tête textuel positionné sur la ligne de la matrice. La fonction INDEX utilise ensuite ces index numériques pour extraire et transmettre les deux plages de données dynamiques correspondantes aux arguments de la fonction COEFFICIENT.CORRELATION.
Cette architecture procure une souplesse remarquable : l’utilisateur peut réorganiser l’ordre d’affichage des variables au sein de sa matrice de corrélation, permuter deux colonnes ou supprimer une variable de la présentation simplement en modifiant le texte de l’en-tête, sans jamais altérer l’intégrité fonctionnelle des formules sous-jacentes. Couplée au nommage rigoureux des plages de données (Données > Plages nommées), cette technique confère aux classeurs Google Sheets un statut d’application d’analyse hautement automatisée, pérenne et aisément réutilisable pour différents cycles d’administration de questionnaires psychométriques.
6. Génération assistée d’une matrice à l’aide des modules complémentaires
6.1 Installation et paramétrage d’outils statistiques tiers
Pour les utilisateurs souhaitant s’affranchir de la composition manuelle de formules ou désireux de se rapprocher de l’ergonomie opérationnelle des progiciels académiques dédiés, Google Sheets autorise l’intégration d’extensions analytiques via sa place de marché officielle. Parmi les outils tiers les plus éprouvés et conformes aux protocoles de recherche figure le module complémentaire XLMiner Analysis ToolPak, lequel émule fidèlement les fonctionnalités de l’utilitaire d’analyse historique de Microsoft Excel au sein de l’écosystème infonuagique.
L’installation s’effectue directement depuis l’interface du tableur en accédant au menu Extensions > Modules complémentaires > Télécharger des modules complémentaires, puis en recherchant l’outil désiré. Ce processus requiert la validation d’autorisations de sécurité accordant au script l’accès en lecture et écriture aux feuilles du classeur actif. Dans les contextes universitaires ou institutionnels soumis à des politiques strictes de protection de données confidentielles (RGPD, HIPAA), il incombe au chercheur de s’assurer préalablement que l’utilisation de modules tiers respecte les protocoles éthiques de traitement de données anonymisées.
Une fois le composant activé, son interface se déploie généralement sous la forme d’un volet latéral interactif. L’utilisateur sélectionne l’option intitulée Correlation dans le catalogue des procédures quantitatives disponibles. Cette interface graphique conviviale permet de configurer l’ensemble des paramètres requis — sélection des plages d’entrée, orientation des vecteurs et spécification de la zone de restitution — via de simples clics et sélections à la souris, sans rédaction syntaxique.
6.2 Exécution de l’analyse automatique et exportation des résultats
L’exécution de la routine via un module spécialisé s’avère particulièrement épurée. Dans le champ de sélection Input Range, l’analyste sélectionne en une seule opération continue l’ensemble de la table de données, englobant conjointement toutes les colonnes de scores numériques ainsi que la ligne initiale d’en-tête textuel. Il coche ensuite impérativement la case d’option Labels in first row, instruisant l’algorithme d’utiliser ces libellés comme désignateurs d’axes dans la matrice résultante.
La modalité de regroupement doit être confirmée sur l’option Columns, signifiant que chaque colonne individuelle matérialise une variable psychométrique distincte. Pour achever la configuration, le chercheur désigne l’emplacement spatial destiné à accueillir la matrice finale au sein de la section Output Range, en ciblant soit une cellule libre dans l’onglet en cours de consultation, soit la création automatique d’une nouvelle feuille dédiée aux résultats calculés.
Après validation par un clic sur la commande OK, l’extension exécute l’analyse et génère instantanément une matrice triangulaire inférieure parfaitement étiquetée et dimensionnée. Contrairement aux approches par formules individuelles, le module optimise les flux computationnels, délivrant en une fraction de seconde une synthèse quantitative complète, même face à des matrices d’envergure industrielle intégrant plusieurs dizaines de variables concomitantes.
6.3 Avantages et écueils des modules complémentaires par rapport aux formules
L’arbitrage entre l’emploi de modules complémentaires et l’implémentation de formules natives de tableur repose sur un compromis entre rapidité opérationnelle et dynamisme computationnel. Le principal avantage des extensions telles que XLMiner réside dans l’économie substantielle de temps d’implémentation qu’elles procurent lors du traitement de très grandes matrices (par exemple, 40 items ou plus), tout en éliminant les risques de mauvaise gestion des références relatives et absolues inhérents au copier-coller de formules manuelles.
Néanmoins, le point faible majeur de cette méthode tient au caractère irrémédiablement statique des résultats produits. Les cellules de la matrice générée par un module complémentaire ne contiennent pas des formules de calcul vivantes, mais des valeurs numériques scalaires figées au moment précis de l’exécution. En conséquence, toute modification ultérieure apportée aux données brutes — qu’il s’agisse de la correction d’une erreur de saisie, du recodage d’un item ou de l’adjonction de nouveaux participants — ne sera aucunement répercutée sur la matrice existante, exigeant une réexécution intégrale et manuelle de la procédure d’analyse.
Enfin, sur le plan de la reproductibilité scientifique et du travail collaboratif, la dépendance envers des extensions tierces constitue une vulnérabilité non négligeable. Si le classeur Google Sheets est partagé avec des collaborateurs ne disposant pas des mêmes modules installés ou soumis à des restrictions administratives d’installation au sein de leur réseau académique, ceux-ci se trouveront dans l’incapacité de recalculer ou de vérifier de manière interactive la matrice de données. L’usage des formules natives de Google Sheets demeure de ce fait l’approche la plus universelle, robuste et transparente pour la recherche universitaire.
7. Visualisation et cartographie thermique de la matrice de corrélation
7.1 Configuration des règles de mise en forme conditionnelle
Une matrice de corrélation brute composée exclusivement de valeurs chiffrées condensées présente une lisibilité cognitive restreinte, particulièrement lorsque la dimensionalité excède une demi-douzaine de variables. Pour faciliter la détection rapide des motifs structurels fondamentaux sans contraindre l’observateur à scruter chaque décimale, la transformation de la grille en une cartographie thermique (heatmap) constitue une pratique analytique féconde. Cette technique exploite la mise en forme conditionnelle pour moduler l’apparence chromatique de chaque cellule selon la valeur du coefficient qu’elle contient.
Pour mettre en œuvre cette visualisation au sein de Google Sheets, l’analyste sélectionne précisément la plage rectangulaire délimitant les coefficients calculés — en excluant scrupuleusement les en-têtes textuels et idéalement la diagonale unitaire si l’on souhaite éviter de saturer la dynamique visuelle —, puis se rend dans le menu Format > Mise en forme conditionnelle. Dans le volet latéral qui apparaît, il convient d’activer l’onglet Échelle de couleurs afin de configurer un gradient de teintes continu ajusté sur des seuils statistiques normalisés.
Le paramétrage rigoureux d’une échelle chromatique scientifique requiert une personnalisation méthodique des trois points d’ancrage mathématiques fondamentaux. Le point minimal doit être fixé sur une valeur numérique de -1,00, matérialisant l’intensité théorique maximale d’une liaison inverse. Le point médian doit être obligatoirement contraint à la valeur fixe de 0,00, établissant le point d’équilibre visuel correspondant à la stricte neutralité de co-variation. Enfin, le point maximal est configuré sur une valeur fixe de +1,00, incarnant la borne d’une association linéaire positive absolue.
7.2 Conception d’une carte thermique (Heatmap) divergente
Le choix de la palette chromatique au sein d’une cartographie thermique ne répond pas à des considérations purement ornementales ; il obéit à des conventions sémiotiques strictes visant à préserver l’objectivité de la lecture des données. Les spécialistes recommandent l’usage d’une palette divergente bipolaire, articulée autour d’un ton neutre médian. Les combinaisons classiques associent traditionnellement une teinte froide (tel qu’un bleu acier ou indigo profond) pour désigner les corrélations négatives, une teinte blanche ou crème très claire pour représenter les valeurs gravitant autour de la nullité, et une teinte chaude (rouge carmin, brique ou corail) pour caractériser les coefficients positifs marqués.
Il est impératif d’éviter les gradients agressifs juxtaposant le vert et le rouge vif, particulièrement inadaptés en raison de leur illisibilité fréquente pour les personnes présentant une déficience de la vision des couleurs (daltonisme ou deutéranopie). Une gradation harmonieuse allant du bleu marine au blanc, puis du blanc au vermillon profond, assure une accessibilité universelle tout en offrant une distinction immédiate et intuitive de la valence des associations.
Une attention ergonomique supplémentaire consiste à neutraliser visuellement la diagonale principale. Dans la mesure où les coefficients de valeur 1,00 reflètent une évidence algébrique d’autocorrélation sans intérêt descriptif, leur coloration saturée risque d’attirer indûment l’attention au détriment des interrelations empiriques réelles. Il est donc recommandé d’appliquer une règle de formatage spécifique ou un fond gris neutre uniforme sur les cellules diagonales afin de concentrer l’attention de l’analyste sur les cases hors diagonale.
7.3 Optimisation esthétique de la lisibilité des données psychométriques
L’optimisation finale de l’architecture visuelle de la matrice dans Google Sheets participe directement à la clarté de la communication scientifique. Une première intervention indispensable consiste à uniformiser la précision décimale affichée en utilisant les commandes de réduction de décimales de la barre d’outils, afin d’arrondir rigoureusement l’ensemble des coefficients à deux ou trois chiffres après la virgule, conformément aux standards en vigueur dans les publications savantes.
Une seconde retouche concerne le dimensionnement géométrique des conteneurs. Pour conférer à la matrice un aspect équilibré et professionnel, il convient d’harmoniser la largeur des colonnes de données pour qu’elles épousent une forme sensiblement carrée, évitant ainsi l’aspect étiré ou compressé des cellules par défaut. L’alignement horizontal et vertical des données numériques doit être rigoureusement centré au sein de chaque cellule pour assurer une lisibilité optimale au cœur des fonds colorés.
Enfin, le contraste typographique nécessite un ajustement fin : lorsque le fond d’une cellule s’assombrit sous l’effet d’un coefficient tendant vers -1,00 ou +1,00, la police de caractères noire standard devient difficilement perceptible. L’application d’une règle de mise en forme conditionnelle complémentaire modifiant automatiquement la couleur de police en blanc pur pour les cellules dont la valeur absolue du coefficient excède un certain seuil (par exemple, |r| > 0,60) garantit un ratio de contraste irréprochable et un confort de lecture optimal.
8. Interprétation statistique des coefficients dans le contexte des sciences psychologiques
8.1 Critères de magnitude selon les conventions de Cohen et leurs adaptations
L’attribution d’une signification empirique à la valeur absolue d’un coefficient de corrélation repose historiquement sur les lignes directrices proposées par Jacob Cohen dans son ouvrage de référence sur l’analyse de puissance statistique. Selon les repères théoriques canoniques de Cohen, une valeur de coefficient r comprise entre 0,10 et 0,29 (en valeur absolue) qualifie un effet de faible magnitude ; une valeur se situant entre 0,30 et 0,49 reflète un effet de magnitude moyenne ; enfin, tout coefficient atteignant ou dépassant le seuil de 0,50 est considéré comme manifestant une magnitude forte, signalant un lien substantiel entre les deux construits investigués.
Toutefois, la communauté psychologique contemporaine nuance fortement ces seuils conventionnels, les jugeant fréquemment surévalués au regard de la complexité inhérente aux phénomènes mentaux et comportementaux. Les méta-analyses contemporaines en psychologie sociale et en psychologie de la personnalité soulignent qu’un coefficient de corrélation de l’ordre de 0,20 à 0,30 possède déjà une importance théorique et pratique majeure lorsqu’il s’applique à des comportements humains multifactoriels déterminés par une multiplicité de causes concurrentes.
Il est donc essentiel d’interpréter la grandeur des coefficients à la lumière spécifique du domaine d’investigation : en matière de fidélité test-retest d’un instrument psychométrique ou de validité parallèle, des coefficients inférieurs à 0,70 ou 0,80 sont souvent considérés comme insuffisants. À l’inverse, dans le cadre de l’évaluation du lien liant un trait de personnalité diffus à un comportement professionnel ou de santé à long terme, une corrélation de 0,25 traduit une association robuste et remarquable qu’il serait méthodologiquement erroné de qualifier de négligeable.
8.2 Signification statistique et calcul de la valeur p (p-value)
L’observation d’un coefficient non nul au sein d’un échantillon ne saurait suffire à attester de la présence d’une association réelle au niveau de la population parente globale ; il est indispensable d’écarter l’hypothèse nulle (H0) selon laquelle cette relation ne résulterait que des fluctuations de l’échantillonnage aléatoire. Pour tester la significativité statistique de chaque coefficient de Pearson, ce dernier est converti en une statistique t de Student suivant une loi de Student à (N – 2) degrés de liberté, où N désigne la taille de l’échantillon complet analysé.
La formulation algébrique de cette transformation s’énonce : t = r * RACINE((N - 2) / (1 - r^2)). Google Sheets offre la possibilité de dériver analytiquement la probabilité critique bilatérale (la valeur p) associée à ce score standardisé en exploitant la fonction de probabilité LOI.STUDENT.BILATERALE. La syntaxe opérationnelle s’écrit formellement : =LOI.STUDENT.BILATERALE(ABS(t); N - 2).
Traditionnellement, la significativité s’évalue au regard de seuils alpha préétablis : une valeur p < 0,05 indique une association statistiquement significative (rejetant l’hypothèse nulle avec un risque d’erreur de première espèce inférieur à 5 %), tandis que des seuils plus rigoureux tels que p < 0,01 et p < 0,001 apportent des preuves encore plus concluantes contre l’absence d’effet. La construction d’une seconde matrice parallèle affichant les probabilités critiques constitue ainsi un complément hautement instructif pour valider méthodologiquement chaque intersection de la grille de Pearson.
8.3 Différenciation rigoureuse entre significativité statistique et importance pratique
L’un des écueils majeurs dans l’interprétation des matrices de données réside dans la confusion fréquente entre la significativité statistique d’une corrélation et sa portée substantielle dans la pratique clinique ou théorique. La valeur p ne constitue aucunement un indicateur de la puissance intrinsèque d’une relation ; elle mesure exclusivement la probabilité d’observer de telles données sous l’hypothèse d’une nullité stricte dans la population parente. Dès lors qu’une cohorte d’étude rassemble un échantillon de très grande taille (par exemple, N > 1 000), des coefficients d’une faiblesse extrême, tels qu’un r de 0,07, franchiront sans peine le seuil de significativité conventionnel de p < 0,01, tout en demeurant dénués de toute signification fonctionnelle réelle.
Pour jauger adéquatement la pertinence empirique d’un coefficient, le chercheur doit calculer son coefficient de détermination, matérialisé par r^2 (le carré de la corrélation). Cette métrique quantifie précisément la proportion de variance partagée ou expliquée entre les deux variables mesurées. Ainsi, un coefficient de Pearson de 0,30, bien que hautement significatif sur un échantillon moyen, n’explique en réalité que 0,30^2 = 0,09, soit seulement 9 % de la variance totale du phénomène, laissant 91 % de la variance résiduelle sous l’influence d’autres facteurs non captés par le protocole.
Cette distinction appelle à la retenue lors de la formulation des conclusions psychométriques : une corrélation formellement validée par le calcul des probabilités ne valide pas automatiquement l’équivalence de deux construits ou l’efficacité diagnostique d’un indicateur. L’analyste se doit de systématiquement mettre en perspective la grandeur du coefficient de détermination avec les coûts, les risques et les décisions réelles que l’instrument psychologique ambitionne d’éclairer.
9. Vérification empirique des postulats préalables à la corrélation de Pearson
9.1 Évaluation de la normalité univariée et bivariée des distributions
L’estimation paramétrique du coefficient de corrélation de Pearson repose sur un postulat mathématique formel : la distribution conjointe des deux variables doit suivre une loi normale bivariée, ce qui présuppose que chaque variable considérée isolément présente une distribution univariée gaussienne symétrique. Lorsque les données s’écartent substantiellement de cette morphologie en cloche, la variance empirique est faussée, ce qui dégrade la précision et la robustesse des tests de significativité dérivés.
Dans Google Sheets, l’évaluation préliminaire de la normalité univariée s’opère par le calcul des coefficients de dissymétrie (skewness) et d’aplatissement (kurtosis). La fonction native =COEFFICIENT.ASYMETRIE(plage) permet de mesurer le défaut de symétrie de la distribution, tandis que la fonction =KURTOSIS(plage) évalue la lourdeur des queues de distribution par rapport à la loi normale standard. En règle générale, des indices oscillant au-delà de l’intervalle [-1,00 ; +1,00] traduisent une déviation non négligeable de la normalité, justifiant une inspection graphique approfondie.
La génération d’histogrammes de fréquence (via le menu Insertion > Graphique > Type d’histogramme) complète cette vérification numérique en visualisant l’allure des distributions de chaque sous-échelle. Si un construit psychologique souffre d’un effet plancher marqué (accumulation massive de réponses sur les valeurs les plus basses) ou d’un effet plafond prononcé, la structure bivariée est inévitablement compromise, induisant une sous-estimation artificielle de la véritable intensité de la corrélation de Pearson.
9.2 Inspection de la linéarité et de l’homoscédasticité
Le coefficient de Pearson possède une cécité mathématique structurelle : il est exclusivement configuré pour quantifier l’adéquation d’une relation rectiligne. Dès lors qu’une relation empirique s’exprime selon une géométrie non linéaire — à l’instar de la célèbre loi de Yerkes-Dodson décrivant une relation en U inversé entre le niveau d’éveil attentionnel et la performance cognitive —, le coefficient de Pearson s’effondre vers zéro, masquant une relation réelle sous une apparence trompeuse d’indépendance.
Pour prévenir cette défaillance interprétative, l’inspection visuelle par nuages de points croisés (scatter plots) est indispensable. Dans Google Sheets, il convient de générer des graphiques de dispersion croisant deux à deux les variables suspectées de manifester des dynamiques non linéaires, en insérant systématiquement une ligne de tendance linéaire (menu de personnalisation des séries graphiques). Cet examen permet de vérifier d’un coup d’œil si la trajectoire centrale des points s’infléchit de façon curviligne le long du continuum de mesure.
Simultanément, cet examen graphique permet d’évaluer le postulat d’homoscédasticité, qui requiert que la dispersion des résidus demeure constante tout au long de la droite d’ajustement. Si le nuage de points adopte une silhouette en entonnoir ou en éventail — reflétant une variabilité nettement plus forte pour les valeurs élevées que pour les scores faibles (hétéroscédasticité) —, les estimations des intervalles de confiance et des valeurs p s’en trouvent perturbées, exigeant l’application de corrections de variance ou l’adoption d’estimateurs statistiques non paramétriques.
9.3 Alternatives non paramétriques applicables sous Google Sheets
Lorsque les distributions violent manifestement les postulats de normalité bivariée ou lorsque les variables mesurées reposent sur des échelles strictement ordinales ne garantissant pas des intervalles arithmétiques constants entre les échelons, l’emploi de la corrélation de Pearson devient méthodologiquement discutable. Dans ces circonstances, le recours au coefficient de corrélation par rangs de Spearman (noté ρ ou rho) s’impose comme l’alternative non paramétrique de référence.
Le coefficient de Spearman correspond au coefficient de Pearson calculé non pas sur les données brutes, mais sur les rangs relatifs de chaque observation au sein de sa série. Google Sheets permet d’implémenter cette transformation de façon fluide : il suffit de créer des colonnes intercalaires appliquant la fonction =RANG(valeur; plage; [ordre]) sur chaque variable d’origine, convertissant ainsi l’échelle métrique continue en une série monotone de rangs ordinaux croissants.
Une fois cette conversion opérée pour chaque variable, il ne reste plus qu’à appliquer la fonction usuelle =COEFFICIENT.CORRELATION() sur ces nouvelles colonnes transformées en rangs. Le coefficient résultant capture avec fidélité la monotonie globale de la relation — c’est-à-dire la propension d’une variable à croître lorsque la seconde s’élève —, indépendamment de sa linéarité stricte, tout en offrant une résistance accrue à l’influence perturbatrice des valeurs extrêmes ou des distributions asymétriques couramment rencontrées dans les populations cliniques.
10. Gestion des pièges statistiques et considérations méthodologiques
10.1 Le danger des corrélations illusoires et variables confondantes
L’interprétation hâtive des coefficients d’une matrice bivariée expose le chercheur à l’illusion du lien direct, omettant l’action invisible de variables confondantes ou de facteurs latents communs. Deux variables psychométriques peuvent présenter une corrélation positive très substantielle (par exemple, r = 0,65) sans qu’aucun mécanisme causal ne les unisse, simplement parce que toutes deux constituent les manifestations collatérales d’un troisième déterminant sous-jacent non contrôlé dans le protocole descriptif.
Pour illustrer ce phénomène classique de spéciosité, l’observation d’une association étroite entre le niveau de stress perçu et la fréquence des troubles psychosomatiques peut être fortement médiée ou confondue par un trait latent plus général de névrosisme ou de négativité affective. Si ce dernier n’est pas mesuré ou maintenu mathématiquement constant, l’intensité du lien direct reliant le stress aux symptômes somatiques s’en trouve artificiellement amplifiée.
Bien que Google Sheets ne propose pas de fonction native directe pour le calcul des corrélations partielles — qui permettent de quantifier la relation résiduelle entre deux variables en neutralisant l’effet d’une ou plusieurs autres —, il est possible de calculer cette métrique au moyen de formules matricielles combinées. La formule de corrélation partielle de premier ordre s’énonce : r_xy.z = (r_xy - (r_xz * r_yz)) / (RACINE(1 - r_xz^2) * RACINE(1 - r_yz^2)). Cette manipulation analytique permet de contrôler rigoureusement les inférences théoriques tirées de la matrice d’origine.
10.2 Problématique de la multicolinéarité dans les batteries de tests
Dans l’analyse approfondie d’une matrice de corrélation, l’observation d’associations extrêmement intenses (conventionnellement définies par r > 0,85 ou r > 0,90) ne constitue pas nécessairement un indicateur de validité satisfaisant ; elle signale au contraire l’émergence d’un problème méthodologique majeur qualifié de multicolinéarité. Cette situation traduit une redondance conceptuelle aiguë entre deux échelles, indiquant qu’elles mesurent en réalité exactement le même construit théorique sous des appellations nominales différentes.
Cette redondance fragilise l’application ultérieure de modèles explicatifs multivariés, tels que la régression multiple ou la modélisation structurelle. La présence de variables quasi-colinéaires déstabilise l’inversion de la matrice de covariance, faisant exploser les erreurs-types associées aux coefficients de régression. Il en résulte des estimations instables, des signes de régression contre-intuitifs et une perte de puissance statistique majeure lors de la tentative d’isoler l’apport prédictif spécifique de chaque dimension.
Dans un contexte d’optimisation psychométrique, le repérage de ces corrélations excessives au sein de la matrice Google Sheets constitue un signal d’alerte incitant à l’élagage des instruments de mesure. Le chercheur pourra décider rationnellement de fusionner les dimensions redondantes en un score composite unique ou d’écarter l’une des deux sous-échelles de son protocole, réduisant ainsi la durée de passation pour les répondants sans aucune perte d’information explicative substantielle.
10.3 Effet de la restriction d’étendue sur la valeur des coefficients
Un mécanisme d’altération statistique fréquemment méconnu lors de l’examen des données empiriques réside dans le phénomène d’atténuation par restriction d’étendue (range restriction). Le coefficient de corrélation de Pearson dépend fondamentalement de la variabilité des scores observés au sein de l’échantillon. Si le recrutement des participants s’effectue au sein d’une population excessivement homogène sur le plan des variables mesurées, la variance d’échantillonnage s’effondre, comprimant mécaniquement la valeur calculée du coefficient de corrélation par rapport à son intensité réelle dans la population globale.
Ce biais méthodologique se manifeste avec une acuité particulière dans les recherches universitaires recrutant exclusivement des cohortes d’étudiants en psychologie pour valider des tests d’efficience intellectuelle ou des échelles de capacités cognitives. Chez ces sujets présentant tous un niveau de scolarité et d’aptitudes homogène, la corrélation observée entre deux compétences cognitives apparaîtra modeste (par exemple, r = 0,20), alors qu’elle atteindrait une magnitude élevée (par exemple, r = 0,60) si la mesure était administrée à un échantillon représentatif de l’ensemble de la population générale adulte.
Pour remédier conceptuellement à cette distorsion lors de la restitution des résultats, il est envisageable d’appliquer la formule de correction d’atténuation pour restriction d’étendue de Thorndike, à condition de disposer d’une estimation fiable de la variance de la population générale de référence. Les chercheurs doivent documenter cette limitation avec transparence dans leurs rapports, afin de prévenir des interprétations réductrices quant à la validité opérationnelle réelle de leurs instruments d’évaluation.
11. Étude de cas pas à pas : Analyse corrélationnelle d’un inventaire psychologique
11.1 Présentation du jeu de données synthétique : Modèle des Big Five
Pour ancrer ces concepts dans une perspective appliquée concrète, nous développons ici une étude de cas pas à pas portant sur un échantillon empirique simulé de cent cinquante étudiants universitaires (N = 150) ayant complété une version abrégée de l’inventaire de personnalité des Big Five. Ce modèle théorique éprouvé capture cinq macro-dimensions fondamentales de la personnalité humaine : le Névrosisme (tendance à ressentir des affects négatifs et instabilité émotionnelle), l’Extraversion (orientation vers le monde extérieur, sociabilité et dynamisme), l’Ouverture à l’expérience (curiosité intellectuelle et sensibilité esthétique), l’Agréabilité (comportements prosociaux, empathie et coopération) et la Conscienciosité (rigueur, sens du devoir et autodiscipline).
Les données brutes ont été saisies au sein d’une feuille de calcul Google Sheets intitulée Donnees_BigFive. Les colonnes B, C, D, E et F accueillent respectivement les scores composites standardisés (variant de 10 à 50 points) des cinq dimensions susmentionnées, s’étendant de la rangée 2 à la rangée 151. La ligne inaugurale réunit les étiquettes abréviatives conventionnelles : NEVR, EXTR, OUVE, AGRE et CONS, assurant une indexation claire des données d’entrée.
À la lumière de la littérature psychologique contemporaine, nos hypothèses de travail prédisent : premièrement, l’existence d’une corrélation négative statistiquement significative d’intensité modérée à forte reliant le Névrosisme à l’Extraversion ; deuxièmement, une association positive statistiquement significative entre l’Agréabilité et la Conscienciosité ; et troisièmement, une relative indépendance de l’Ouverture face au Névrosisme, matérialisée par un coefficient non significatif proche du zéro statistique.
11.2 Implémentation complète de la matrice sous Google Sheets
Pour concevoir la matrice de restitution, nous ouvrons un second onglet vierge dans le classeur, que nous désignons par l’étiquette Matrice_Correlation. La structure du tableau croisé est déployée en disposant les cinq acronymes en en-têtes horizontaux sur la plage B1:F1 et en les dupliquant verticalement sur la plage A2:A6. Cet agencement orthogonal crée une grille de 25 cellules d’intersection prêtes à recevoir les formules bivariées.
Dans la première cellule d’intersection B2, croisant la variable NEVR avec elle-même, nous saisissons la formule : =COEFFICIENT.CORRELATION(Donnees_BigFive!$B$2:$B$151; Donnees_BigFive!$B$2:$B$151). Pour propager le calcul de manière efficace sans rupture de référence, nous appliquons un ancrage semi-absolu méticuleux sur les plages de la feuille source, permettant d’étendre la formule horizontalement jusqu’à la colonne F, puis de dupliquer cette rangée de formules vers le bas jusqu’à la ligne 6.
Une fois le calcul matriciel stabilisé, nous appliquons une règle d’arrondi numérique universelle pour fixer la présentation à deux décimales exactes. Enfin, une mise en forme conditionnelle en échelle de couleurs divergente à trois points d’ancrage (-1,00 en bleu acier ; 0,00 en blanc ; +1,00 en rouge carmin) est appliquée sur l’ensemble de la plage B2:F6, transformant la grille en une cartographie thermique exploitable d’un simple coup d’œil.
11.3 Rédaction du compte-rendu analytique et synthèse des résultats
L’observation des coefficients calculés au sein de notre matrice révèle les configurations relationnelles suivantes : l’intersection entre le Névrosisme et l’Extraversion affiche un coefficient r = -0,42. L’application de la formule de conversion en loi de Student confirme la significativité bilatérale de ce résultat (t = -5,63 ; p < 0,001), corroborant solidement notre première hypothèse relative à la dissociation fonctionnelle entre instabilité émotionnelle et dynamisme social au sein de la cohorte évaluée.
Parallèlement, la corrélation liant l’Agréabilité à la Conscienciosité atteint une valeur scalaire de r = +0,34, franchissant également le seuil de significativité conventionnel (t = 4,41 ; p < 0,001). Ce coefficient confirme l’existence d’une convergence positive modérée entre ces deux dispositions prosociales et organisationnelles, confirmant notre deuxième hypothèse empirique. Enfin, la liaison entre le Névrosisme et l’Ouverture s’établit à r = -0,06 (p = 0,46) ; ce résultat dénué de significativité statistique soutient notre troisième hypothèse quant à l’indépendance de la curiosité cognitive face au niveau d’anxiété générale.
En synthèse, la matrice atteste de la fidélité structurelle de notre batterie d’évaluation synthétique. Les dimensions captées manifestent une indépendance relative suffisante — aucun coefficient n’excédant le seuil critique de multicolinéarité de 0,85 —, garantissant que chaque facette de l’inventaire apporte une part d’information spécifique pour l’exploration de la personnalité individuelle.
12. Exportation, mise aux normes APA et intégration dans les publications universitaires
12.1 Mise en forme typographique selon le manuel de publication APA (7e édition)
L’intégration d’un tableau de résultats dans une thèse de doctorat, un mémoire académique ou une revue à comité de lecture affiliée aux sciences psychologiques impose une stricte conformité aux conventions typographiques du Publication Manual of the American Psychological Association (7e édition). La première règle fondamentale prescrite par l’APA stipule la suppression intégrale de la moitié supérieure droite de la matrice de corrélation, ainsi que de sa diagonale unitaire, afin d’éliminer les redondances visuelles. Seul le triangle inférieur strict est conservé.
Une seconde particularité typographique concerne la notation formelle des nombres bornés par construction mathématique au sein de l’intervalle [-1,00 ; +1,00]. Étant donné qu’un coefficient de corrélation de Pearson ne peut en aucun cas excéder la valeur absolue de 1, la norme APA exige l’omission du zéro initial précédant la virgule ou le point décimal. Dès lors, une valeur empirique de 0,42 doit impérativement être retranscrite sous la forme allégée .42 (ou -.42 pour une valeur négative), tant dans les corps de tableaux que dans le texte narratif des résultats.
Enfin, la composition des bordures d’un tableau de normes APA répond à un dépouillement minimaliste : aucun quadrillage vertical n’est toléré au sein du tableau. L’architecture graphique n’admet que trois lignes horizontales continues d’un point d’épaisseur : une bordure délimitant le sommet supérieur de la table, une ligne intermédiaire isolant la rangée des en-têtes de colonnes, et une bordure inférieure scellant la base du tableau avant l’insertion des notes textuelles explicatives.
12.2 Ajout des annotations de significativité par astérisques
Dans la tradition psychométrique, la restitution visuelle des seuils de significativité statistique s’opère par l’adjonction d’astérisques directement accolés aux valeurs des coefficients dans les cellules du tableau. Le système de codification probabiliste universel s’articule comme suit : un astérisque singulier (*) pour attester d’un niveau d’erreur de première espèce p < ,05 ; un double astérisque (**) signalant un seuil renforcé p < ,01 ; et un triple astérisque (***) réservé aux associations hautement fiables franchissant le seuil critique p < ,001.
Dans Google Sheets, l’insertion automatisée de ces marqueurs sans altérer la nature numérique des cellules de calcul sous-jacentes peut s’avérer complexe si l’on souhaite conserver la réactivité de la feuille. Deux voies méthodologiques sont envisageables : soit la conception d’un tableau d’exportation secondaire convertissant les valeurs en chaînes textuelles enrichies au moyen de formulations logiques combinant les conditions =SI() et la concaténation de texte &, soit l’application d’un format de nombre personnalisé sous la structure Format > Nombre > Format de nombre personnalisé pour les cellules dont la valeur p est préalablement tabulée.
Sous la bordure inférieure finale de la table APA, une note explicative standardisée doit être obligatoirement insérée. Cette mention débute invariablement par l’étiquette en italique Note. suivie d’une phrase stipulant l’effectif global d’échantillonnage, la nature bilatérale du test statistique exécuté et la légende exhaustive des seuils de probabilité : Note. N = 150. Tests bilatéraux. * p < ,05. ** p < ,01. *** p < ,001.
12.3 Liaison dynamique et intégration dans les outils de traitement de texte académiques
L’intégration finale de la matrice mise en forme dans l’environnement de traitement de texte représente la dernière étape de la chaîne de travail de publication. L’un des atouts déterminants de l’écosystème infonuagique réside dans la liaison dynamique native unissant Google Sheets à Google Docs. En sélectionnant la grille mise en forme dans le tableur, puis en réalisant un simple copier-coller dans le document texte de recherche, l’utilisateur se voit proposer l’option Lier à la feuille de calcul.
Cette interconnexion algorithmique permanente offre un avantage de productivité substantiel : si un ajustement ultérieur de la base d’échantillonnage ou la correction d’une donnée manquante modifie les coefficients dans Google Sheets, un bouton interactif Mettre à jour apparaît automatiquement au-dessus du tableau dans Google Docs, répercutant instantanément les nouveaux calculs sans exiger une reconstruction manuelle de la mise en page scientifique.
Pour les auteurs composant leurs manuscrits au sein de Microsoft Word ou préparant des documents typographiques complexes sous LaTeX, l’exportation vers ces environnements nécessite une rigueur accrue. Pour Word, un collage spécial sous forme de tableau formaté HTML préserve les bordures horizontales APA sans déstructurer les tabulations. Pour LaTeX, l’extraction de la plage Google Sheets sous forme de fichier délimité par des virgules (CSV) permet, via des convertisseurs dédiés ou des packages tels que booktabs et tabularx, de générer un code source irréprochable garantissant une qualité d’impression de niveau éditorial pour les revues scientifiques internationales.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Google Workspace. (2023). Fonction COEFFICIENT.CORRELATION – Aide Éditeurs Google Docs. Support Google. https://support.google.com/docs/answer/3093990
McCrae, R. R., & Costa, P. T., Jr. (2008). The five-factor theory of personality. In O. P. John, R. W. Robins, & L. A. Pervin (Eds.), Handbook of personality: Theory and research (3rd ed., pp. 159–181). The Guilford Press.
Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.