
Dans le paradigme contemporain des technologies de l’information et de la communication, le traitement structuré des données constitue une compétence fondamentale pour les analystes, gestionnaires et chercheurs. L’application infonuagique Google Sheets s’est imposée comme un environnement de premier plan pour l’orchestration, l’agrégation et la sémiotique visuelle des ensembles de données quantitatifs et qualitatifs. Toutefois, la simple saisie d’informations éparses au sein d’une grille de calcul ne saurait équivaloir à la constitution d’un tableau au sens épistémologique et fonctionnel du terme. Un tableau véritablement opérant repose sur des conventions formelles rigoureuses, une ségrégation rigide entre les dimensions sémantiques et une architecture visuelle optimisant la charge cognitive de l’observateur.
Trop souvent, l’utilisateur non averti confond la surface matricielle continue offerte par le tableur avec une structure tabulaire aboutie. Cette méprise engendre des dérives méthodologiques majeures : prolifération de fusions de cellules anarchiques, rupture de l’atomicité des données, ruptures computationnelles lors des calculs matriciels et vulnérabilités critiques lors de l’exportation vers des systèmes relationnels ou des modèles statistiques tiers. L’élaboration d’un tableau dans Google Sheets doit impérativement s’inscrire dans une démarche méthodologique ascendante, partant de l’épuration du substrat informationnel brut jusqu’à la restitution visuelle régie par les principes fondamentaux du design informationnel et de l’accessibilité universelle.
Le présent traité méthodologique expose, selon une granularité exhaustive et une progression didactique rigoureuse, l’ensemble des étapes nécessaires à la conception, au formatage, à la dynamisation et à la sécurisation d’un tableau au sein de Google Sheets. En conjuguant les apports théoriques de la modélisation des données avec les fonctionnalités natives les plus récentes de l’environnement de Google Workspace, ce guide fournit le cadre analytique indispensable pour transformer une accumulation hétéroclite de cellules en un instrument décisionnel pérenne, robuste et hautement intelligible.
1. Fondements méthodologiques et préparation de l’environnement Google Sheets
1.1 Compréhension de la structure matricielle de la feuille de calcul
La feuille de calcul hébergée sur Google Sheets s’articule intrinsèquement autour d’un espace bidimensionnel orthogonal, régi par des coordonnées cartésiennes univoques. Dans cet agencement spatial, chaque cellule représente l’intersection discrète d’une colonne vectorielle — identifiée par un index alphabétique séquentiel — et d’une rangée horizontale — repérée par un indice numérique incrémental. Cette abstraction matricielle offre un degré de liberté absolu qui constitue paradoxalement sa principale vulnérabilité structurelle. En l’absence de contraintes prédéfinies, la surface de travail autorise la juxtaposition désordonnée de blocs d’informations disparates, induisant une confusion dommageable entre l’espace de stockage, l’espace d’analyse et l’espace de restitution visuelle.
Il convient d’établir une distinction fonctionnelle irréductible entre la grille de calcul indifférenciée et le tableau relationnel structuré. La grille universelle est un canevas permissif au sein duquel les coordonnées n’entretiennent aucune relation hiérarchique ou logique a priori. À l’opposé, le tableau relationnel s’apparente à une relation mathématique au sens de Edgar F. Codd, où chaque colonne formalise un attribut invariable du domaine d’étude et chaque ligne consigne un enregistrement individuel strictement délimité. Cette rigueur morphologique interdit la dispersion des données et garantit l’invariance structurelle indispensable aux traitements algorithmiques ultérieurs.
L’impact de l’architecture tabulaire sur l’efficience du traitement cognitif de l’information s’avère considérable. L’esprit humain, confronté à une masse désordonnée de valeurs scalaires, subit une surcharge mentale immédiate qui entrave la détection de tendances, de ruptures de pente ou d’anomalies distributionnelles. Un tableau convenablement articulé agit comme un dispositif de médiation sémiotique : il convertit la complexité brute en un schéma d’ordonnancement prévisible où l’œil de l’analyste peut balayer les axes de comparaison sans solliciter inutilement sa mémoire de travail. La clarté topologique devient ainsi le vecteur direct de la perspicacité décisionnelle.
1.2 Configuration des paramètres régionaux et typographiques de base
Avant d’initier la moindre saisie documentaire, la maîtrise de l’environnement applicatif impose un calibrage strict des paramètres régionaux de la feuille. Accessible par le menu contextuel des paramètres du classeur, ce réglage détermine la manière dont Google Sheets interprète les séparateurs de décimales, les délimiteurs de milliers et les structures calendaires. Dans l’écosystème francophone continental, l’usage de la virgule comme séparateur décimal et de l’espace fine insécable comme délimiteur de milliers constitue une norme conventionnelle impérative. Une disparité de paramétrage régional entre le poste émetteur et le classeur hôte peut engendrer des erreurs dramatiques de conversion, où des données quantitatives sont arbitrairement requalifiées en chaînes de caractères inertes par le moteur d’évaluation.
Parallèlement, la sélection de la police de caractères typographique doit faire l’objet d’une réflexion ergonomique approfondie, rompant avec les tentations esthétisantes néfastes à la lisibilité. Il est préconisé d’adopter des familles typographiques sans empattement (sans-serif) hautement optimisées pour le rendu sur écran, telles que Roboto, Inter ou Arial. Ces fontes se distinguent par une hauteur de x généreuse, une différenciation morphologique nette entre les glyphes ambigus (comme le chiffre zéro et la lettre majuscule O, ou le chiffre un et la lettre minuscule l) et une neutralité stylistique favorisant la concentration analytique.
Enfin, la définition du facteur d’agrandissement ou zoom d’affichage conditionne le confort de manipulation durant les phases de saisie et d’inspection prolongée. Bien que le paramètre par défaut soit fixé à 100 %, l’hétérogénéité des densités de pixels des moniteurs contemporains (notamment les dalles haute résolution HiDPI ou Retina) justifie fréquemment une adaptation proportionnelle comprise entre 90 % et 110 %. L’objectif ergonomique consiste à maximiser la surface utile visible sans contraindre l’opérateur à un effort d’accommodation oculaire continu, tout en prévenant les défilements horizontaux superflus qui fragmentent la perception globale de la matrice.
1.3 Définition préalable de l’objectif analytique du tableau
La genèse d’un tableau performant ne saurait être subordonnée à une démarche empirique improvisée ; elle requiert une phase essentielle de formalisation conceptuelle. Cette étape liminaire exige l’identification exhaustive des variables d’intérêt ainsi que la théorisation de leurs relations structurelles. L’analyste doit classifier avec certitude les variables qualitatives ordinales, les variables nominales et les dimensions purement métriques continues ou discrètes. De cette typologie découle directement l’agencement relatif des colonnes, les descripteurs universels devant systématiquement précéder les métriques calculées ou dépendantes dans l’ordre de lecture conventionnel.
L’anticipation du volume global des données et de leur fréquence de rafraîchissement régit de manière déterminante l’architecture de la feuille. Un tableau dimensionné pour héberger quelques dizaines d’occurrences statiques autorise des libertés stylistiques qui deviendraient catastrophiques au sein d’une matrice transactionnelle vouée à ingérer des dizaines de milliers d’enregistrements mensuels. Si des expansions massives sont attendues, l’analyste doit proscrire l’insertion de totaux statiques en fond de grille et privilégier des plages dynamiques, assurant ainsi la pérennité structurelle des modèles de calcul face aux fluctuations volumétriques.
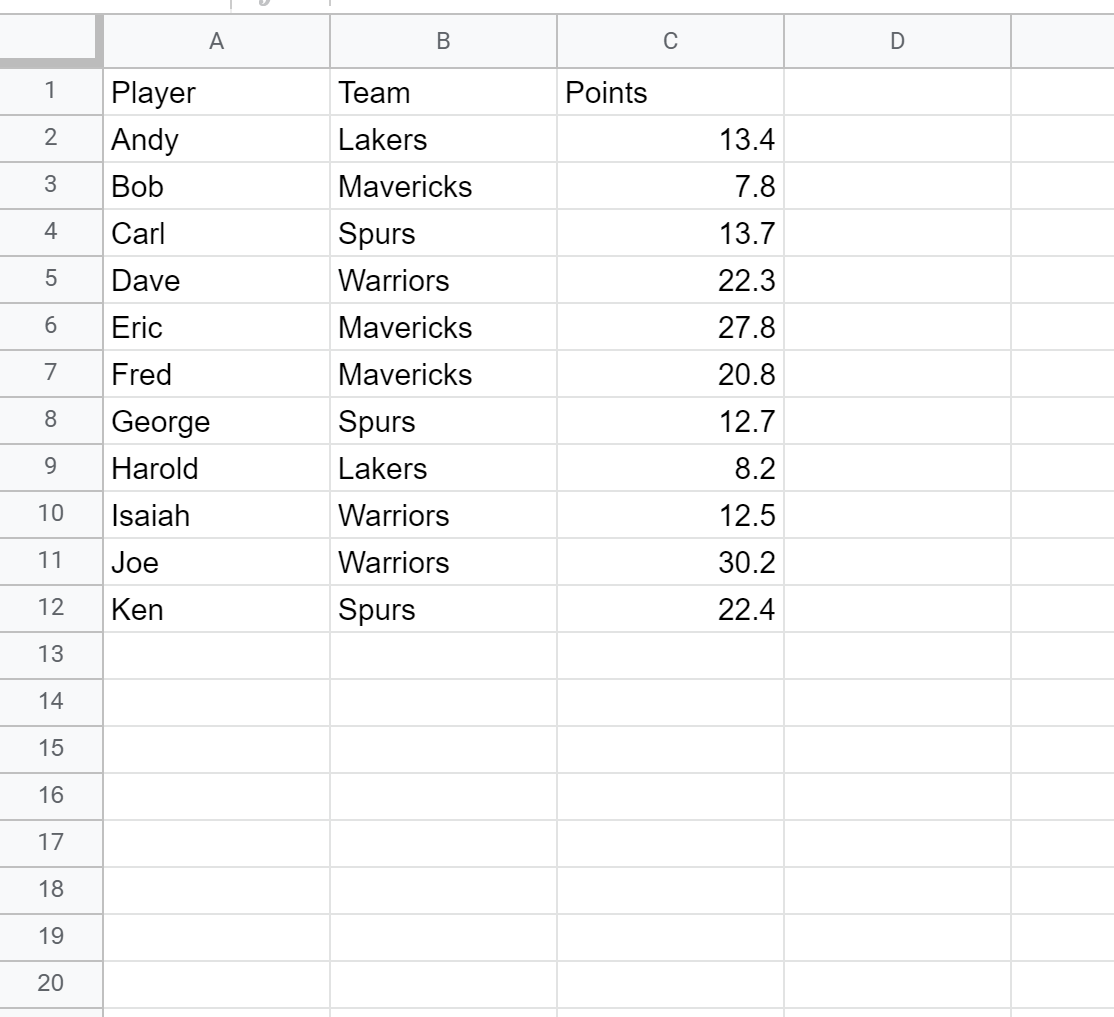
Il s’avère tout aussi capital d’instituer une nomenclature normalisée pour désigner chaque dimension observée. La normalisation sémantique des libellés de colonnes prévient les quiproquos interprétatifs au sein des équipes de travail pluridisciplinaires. L’adoption de conventions syntaxiques uniformes (telles que le bannissement des acronymes opaques, l’usage maîtrisé de la casse ou la spécification explicite des unités de mesure entre parenthèses dans l’en-tête) garantit l’autonomie documentaire du tableau. L’artefact informationnel ainsi produit devient intrinsèquement intelligible, affranchissant l’observateur de tout recours à un guide de lecture annexe.
2. Étape 1 : Saisie et organisation rigoureuse des données brutes
2.1 Principes de saisie univoque et d’atomicité des données
La première règle de gouvernance d’une matrice tabulaire réside dans le précepte d’atomicité, hérité de la première forme normale des bases de données relationnelles. Chaque cellule individuelle de Google Sheets doit impérativement héberger une valeur scalaire unique et indivisible. La tentation fréquente de consigner au sein d’une même coordonnée spatiale un nom patronymique et un prénom, ou une valeur financière conjointe à son unité monétaire textuelle, sabote irrémédiablement les capacités ultérieures de tri, d’agrégation, de filtrage algorithmique et d’interrogation dynamique via le langage de requête interne.
Dans cette même optique de salubrité architecturale, la fusion de cellules au sein de la zone opérationnelle de données constitue une faute méthodologique rédhibitoire. Si la fusion peut superficiellement séduire par ses vertus cosmétiques d’agencement visuel, elle corrompt profondément l’adressage sous-jacent de la matrice. Lorsqu’un groupe de cellules est fusionné, seule la coordonnée située à l’extrême supérieur gauche conserve la valeur sous-jacente, tandis que les cellules satellites sont réduites à des entités nulles. Dès lors, toute tentative d’application de formules vectorielles, de tris séquentiels ou de tables de contingence sur cette zone se heurte à des distorsions mathématiques incontrôlables.
La normalisation syntaxique des enregistrements s’impose comme le rempart ultime contre les ambiguïtés sémantiques. Chaque variable textuelle désignant une même entité du monde réel doit présenter une graphie strictement identique au fil des lignes successives. Des variations infimes causées par des coquilles typographiques, des fautes d’accord ou des abréviations discordantes fragmentent artificiellement les sous-ensembles lors des consolidations statistiques. L’intégrité référentielle dépend intégralement de la discipline imposée lors de la saisie primitive des jetons lexicaux.
2.2 Structuration bidimensionnelle standardisée
L’implantation spatiale des données au sein de la feuille Google Sheets doit respecter une géométrie standardisée intangible. La première rangée du tableau, ou ligne sommitale, est exclusivement dévolue à l’alignement horizontal des attributs ou variables d’observation, constituant le vecteur des métadonnées de structure. Les rangées subséquentes accueillent la séquence ordonnée des observations unitaires, chaque ligne incarnant une entité singulière dotée des caractéristiques définies par les colonnes correspondantes. Cette orientation vectorielle est le standard universel attendu par l’ensemble des algorithmes de calcul et d’intelligence décisionnelle.
Il est indispensable de vérifier méticuleusement l’absence totale de lignes ou de colonnes intercalaires entièrement vides au cœur de la zone matricielle. De nombreux utilisateurs novices introduisent des rangées vierges dans le dessein d’aérer artificiellement la composition visuelle de leur tableau. Cette pratique perturbe gravement la détection automatique des plages continues par Google Sheets, tronque le comportement des raccourcis de navigation clavière et provoque la rupture prématurée des séries lors de l’application de filtres automatiques ou de fonctions matricielles dépendantes de la contiguïté spatiale.
La séparation des différentes dimensions analytiques doit être exclusivement assurée par le cloisonnement des colonnes. Si plusieurs typologies d’informations coexistent au sein du même document de travail, elles ne doivent en aucun cas être empilées de manière anarchique le long de l’axe vertical sans une séparation formelle et autonome. Le respect scrupuleux de cette topologie plane conditionne l’efficacité des traitements automatisés et l’interopérabilité des structures informationnelles générées.
2.3 Prétraitement et nettoyage des scories textuelles
L’étape de saisie brute s’accompagne inévitablement de l’introduction d’impuretés textuelles invisibles à l’œil nu lors d’une lecture cursive, mais dévastatrices pour les moteurs logiques. Au premier rang de ces scories figurent les espaces résiduels, qu’ils soient situés en tête, au cœur ou à la terminaison des chaînes de caractères. Deux valeurs paraissant identiques à l’écran, telles que « Paris » et « Paris », sont traitées par le système comme des entités logiquement disjointes en raison du caractère d’espacement terminal. Il convient d’assainir systématiquement le corpus de données en appliquant des fonctions de nettoyage comme SUPPRESPACE (ou TRIM), capable d’éradiquer ces artéfacts pernicieux.
L’uniformisation de la casse typographique représente une dimension complémentaire du prétraitement. Les disparités aléatoires d’emploi des majuscules et minuscules créent un sentiment de négligence documentaire préjudiciable à la crédibilité de l’analyse, tout en compliquant les appariements stricts dans certaines fonctions logiques sensibles à la casse. Le recours systématique aux transformations programmatiques au moyen des fonctions NOMPROPRE, MAJUSCULE ou MINUSCULE permet de restaurer instantanément une parfaite cohésion esthétique et technique sur l’ensemble des colonnes textuelles.
Enfin, un contrôle méthodique de la cohérence dimensionnelle et du typage primitif des données doit être opéré. L’opérateur doit s’assurer qu’aucune valeur textuelle n’a été insérée par inadvertance au sein d’une série purement quantitative, et que les valeurs temporelles respectent une syntaxe exploitable par le moteur d’horodatage. Cet assainissement liminaire des données garantit que le tableau repose sur un socle d’une robustesse computationnelle irréprochable avant d’aborder les phases de mise en forme et de stylisation visuelle.
3. Étape 2 : Conception et mise en valeur typographique de l’en-tête
3.1 Application de la mise en gras et contraste hiérarchique
L’en-tête d’un tableau remplit une fonction sémiotique fondamentale : il définit l’ontologie des données réparties dans les colonnes sous-jacentes. Pour instaurer une hiérarchie visuelle indiscutable entre ces descripteurs métanarratifs et le corpus des données factuelles, l’application d’un poids typographique gras sur la première ligne s’avère indispensable. Cette densification optique des glyphes signale instantanément au cortex visuel de l’utilisateur le statut supérieur de cette rangée directrice, l’isolant de la masse des enregistrements ordinaires.
Cette différenciation hiérarchique peut être subtilement renforcée par l’ajustement du corps de la police de caractères. L’attribution d’une taille légèrement amplifiée (par exemple un corps de 11 ou 12 points pour l’en-tête, confronté à un corps standard de 10 points pour les cellules de données) accentue la prééminence des libellés de variables. Néanmoins, la modération stylistique doit prévaloir : un écart d’échelle excessif romprait l’équilibre géométrique global de la feuille et contraindrait à un élargissement démesuré de la hauteur des lignes, altérant l’harmonie matricielle d’ensemble.
Il est primordial d’évaluer le ratio de contraste textuel afin de préserver l’accessibilité universelle de l’artefact. Selon les recommandations internationales formulées par le consortium W3C à travers les directives WCAG 2.1, le ratio de contraste entre la teinte du texte de l’en-tête et son arrière-plan doit atteindre au strict minimum une valeur de 4,5:1 pour un texte normal, et de 3:1 pour un texte gras de grande dimension. L’usage de combinaisons chromatiques faiblement contrastées, à l’instar d’un gris moyen apposé sur un fond gris clair, constitue une entrave sévère à l’ergonomie visuelle qui doit être rigoureusement proscrite.
3.2 Alignement spatial et centrage des descripteurs
L’alignement spatial des descripteurs au sein des cellules de l’en-tête participe de manière décisive à l’ordonnancement visuel global du document. Alors que les données brutes sous-jacentes répondent à des règles d’alignement différentielles fondées sur leur nature typologique, les intitulés de colonnes gagnent fréquemment à être centrés horizontalement lorsqu’ils chapeautent des colonnes de codes courts, de dates ou de métriques numériques homogènes. Cet ancrage centralise le point focal de l’observateur au sommet de la colonne, instaurant un repère stable à partir duquel le regard plonge vers les valeurs correspondantes.
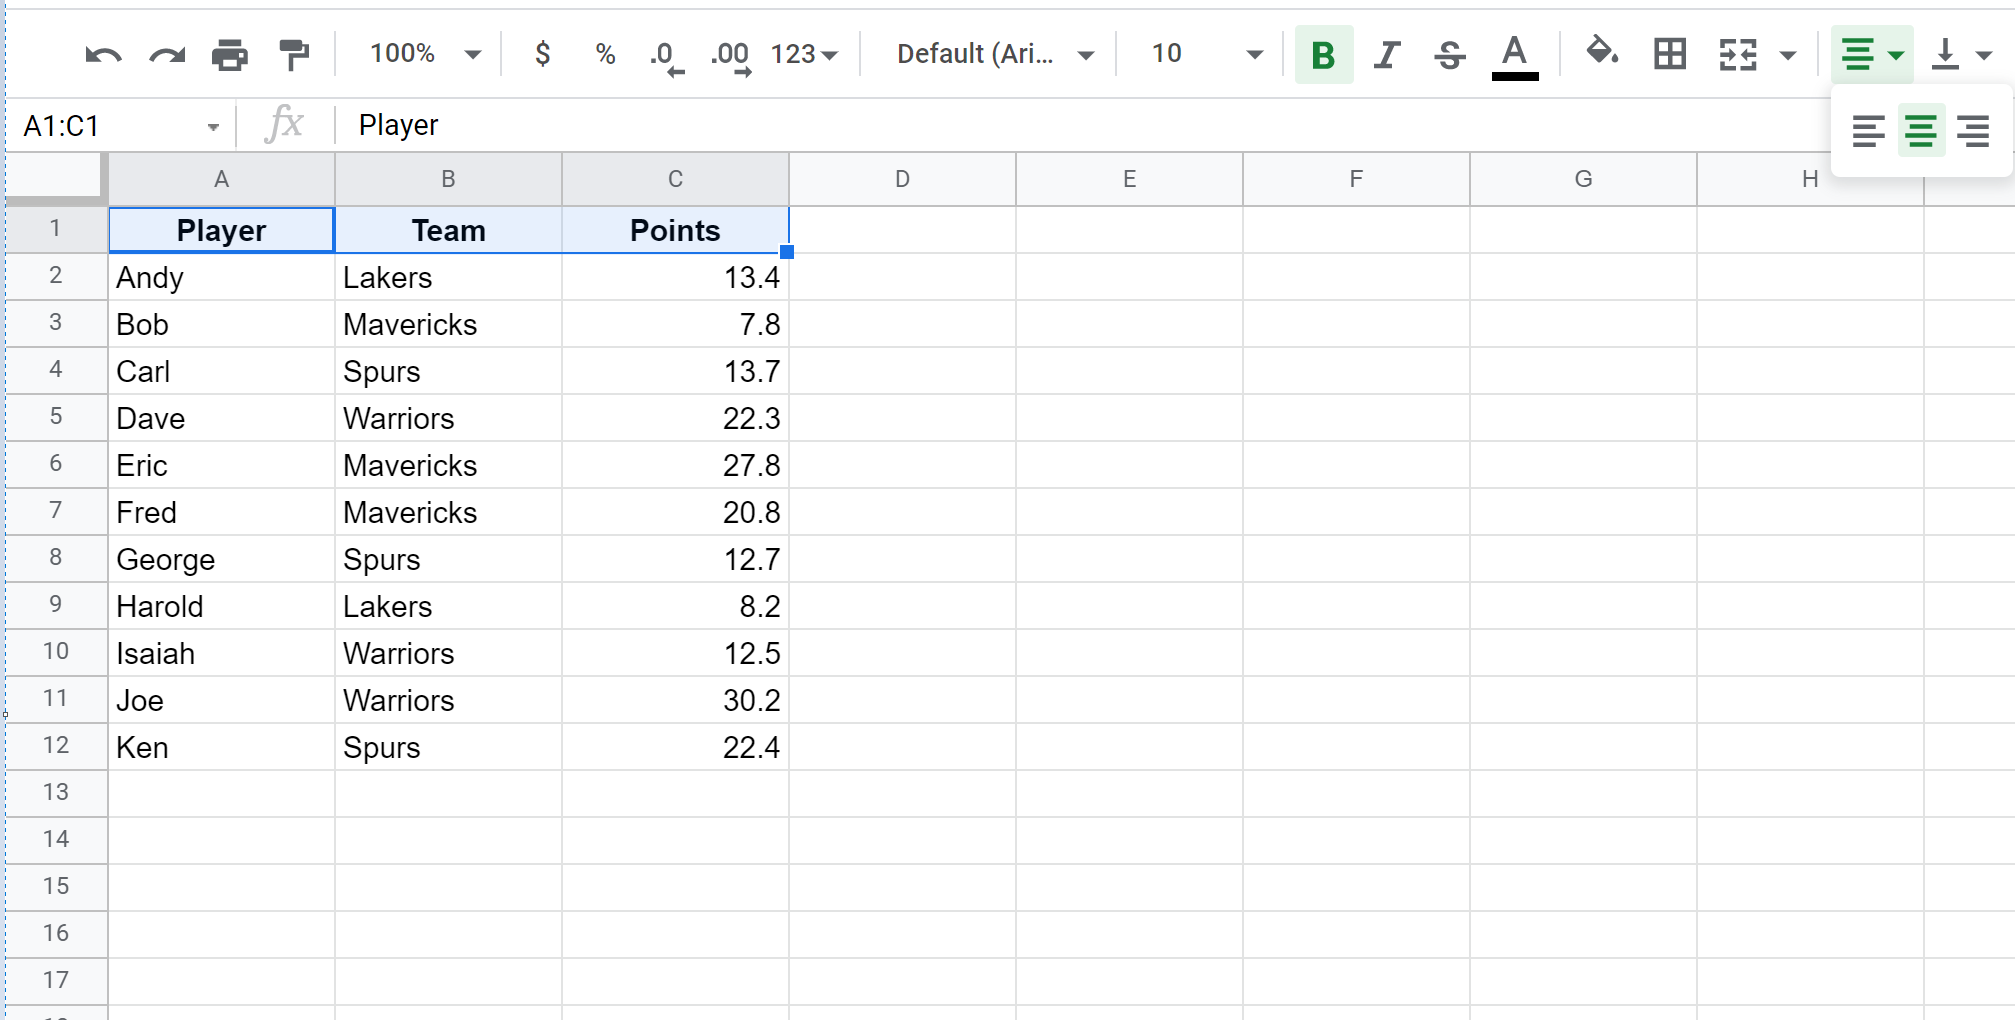
L’ajustement vertical de l’alignement au sein de la cellule d’en-tête constitue un paramètre tout aussi déterminant, bien que fréquemment négligé. Par défaut, Google Sheets positionne les chaînes textuelles en bas de cellule. Il est hautement recommandé de reconfigurer cet attribut pour adopter un alignement vertical centré. Cette disposition garantit une répartition équidistante des marges supérieures et inférieures au-dessus et en dessous du texte, prévenant l’effet visuel disgracieux d’écrasement sur la bordure inférieure qui survient dès que la hauteur de ligne excède l’encombrement strict du glyphe.
Dans cette même perspective de respiration visuelle, l’accroissement mesuré de la hauteur de la première rangée s’impose comme un raffinement ergonomique de premier ordre. En distendant manuellement la frontière inférieure de la ligne 1 pour lui conférer une hauteur de 30 à 40 pixels (au lieu des 21 pixels attribués par défaut), l’analyste insuffle une aération spatiale bienvenue. Cette zone tampon périphérique délimite plus solennellement le statut de métadonnée propre à l’en-tête, éliminant tout sentiment de compression claustrophobique au sommet du tableau.
3.3 Figeage de la ligne d’en-tête pour l’exploration continue
L’un des écueils majeurs inhérents à la manipulation de corpus de données massifs réside dans la déperdition du contexte sémantique lors du défilement vertical prolongé. Dès lors que le nombre d’enregistrements dépasse la capacité d’affichage instantané de l’écran, le glissement vers le bas entraîne l’occultation mécanique de la première ligne. L’observateur se retrouve alors confronté à des alignements de nombres et de codes anonymes, ce qui le contraint à des allers-retours verticaux constants pour vérifier la signification de chaque colonne, augmentant exponentiellement sa charge mémorielle.
L’activation du figeage de la ligne d’en-tête constitue la parade ergonomique définitive à cette vulnérabilité cognitive. Opérée avec une aisance remarquable via le menu Affichage, sous-rubrique Figer, puis en sélectionnant la commande 1 ligne (ou alternativement par la translation manuelle de l’épaisse ligne de démarcation grise nichée au sommet gauche de la grille), cette manipulation ancre définitivement la première rangée au sommet de l’interface visuelle. Quelles que soient l’amplitude et la profondeur du défilement vertical à travers des milliers de lignes, la ligne d’en-tête demeure imperturbablement stationnaire.
Ce figeage structurel optimise l’interaction homme-machine en pérennisant la lisibilité immédiate du référentiel descriptif. Il procure à l’analyste un sentiment de fluidité et de contrôle continu sur son environnement analytique, transformant la feuille de calcul en une interface dynamique hautement interactive. Pour les tableaux à forte expansion horizontale, le même protocole méthodologique peut être appliqué au figeage de la première colonne, sanctuarisant les identifiants primaires face aux défilements horizontaux.
4. Étape 3 : Formatage directionnel et typologique des colonnes
4.1 Règles ergonomiques d’alignement différentiel
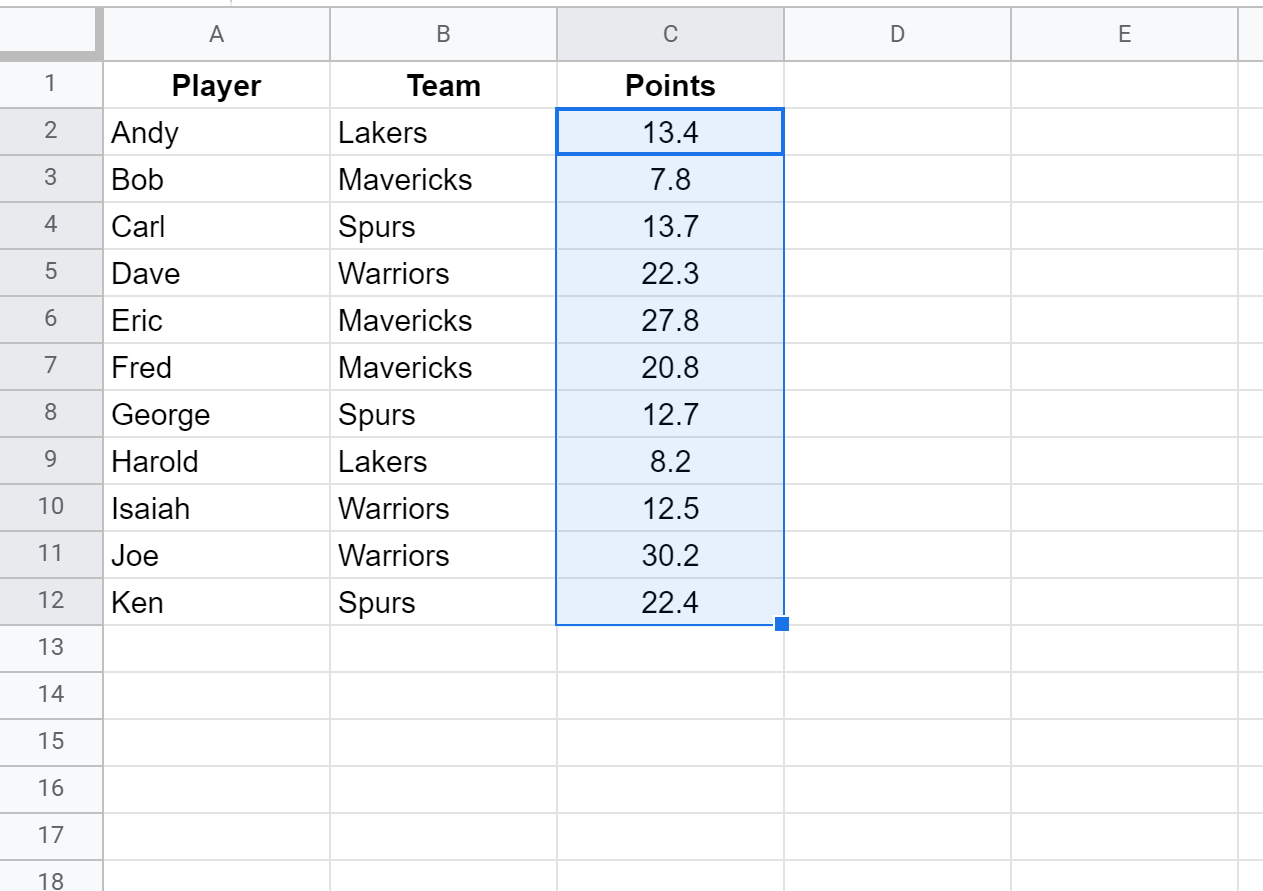
L’alignement spatial des contenus cellulaires ne répond pas à des impératifs décoratifs arbitraires ; il obéit à des conventions psychophysiques précises visant à maximiser l’efficience de lecture de l’appareil oculaire humain. Pour les colonnes textuelles narratives ou nominatives, l’alignement strict à gauche s’impose comme une norme universelle inébranlable dans les cultures occidentales. Le balayage oculaire occidental progressant de gauche à droite, cet ancrage régulier du bord gauche procure à la fovéa un point de départ spatialement prévisible pour chaque nouvel enregistrement textuel, réduisant ainsi la fatigue visuelle.
À l’inverse fondamental, les données numériques quantitatives, scalaires ou monétaires requièrent un alignement absolu sur le bord droit de la cellule. Cette disposition géométrique possède une justification mathématique fondamentale : elle assure la superposition verticale exacte des ordres de grandeur. Les unités se trouvent alignées sous les unités, les dizaines sous les dizaines et les décimales sous les décimales. Cette verticalité parfaite autorise une estimation perceptive quasi instantanée de la magnitude relative des nombres en présence sans nécessiter la lecture analytique décomposée de chaque chiffre, favorisant la détection rapide des valeurs d’échelle aberrantes.
L’alignement centré horizontalement doit être réservé avec une grande parcimonie sélective. Son application se révèle optimale pour des identifiants alphanumériques courts de longueur invariante, des codes d’état normalisés (tels que les codes ISO de pays à deux ou trois lettres), ou des indicateurs d’état binaires (Oui/Non). L’attribution d’un alignement centré à des chaînes de longueurs très divergentes engendre des contours visuels dentelés et chaotiques, perturbant la trajectoire de balayage linéaire de l’œil et altérant l’harmonie géométrique du tableau.
4.2 Assignation stricte des formats numériques et temporels
Une source fréquente de dysfonctionnements calculatoires dans Google Sheets découle de l’absence de formalisation typologique explicite des cellules. Par défaut, le moteur assigne le format général automatique qui tente d’inférer la nature de la donnée saisie. Cette heuristique est faillible et peut engendrer des confusions catastrophiques, notamment en tronquant les zéros initiaux de codes postaux ou d’identifiants séquentiels requalifiés en entiers, ou en opérant des conversions temporelles non désirées. L’analyste rigoureux doit forcer l’assignation de formats précis sur l’ensemble du vecteur de données de chaque colonne.
Pour les grandeurs monétaires, l’application du format financier ou devise s’impose impérativement. Cette configuration garantit l’affichage constant de l’unité monétaire appropriée, l’insertion automatique des séparateurs de milliers et le verrouillage invariable d’une précision fixée à deux décimales, prévenant la disparité inesthétique de longueurs de nombres causée par l’omission des zéros décimaux terminaux. Dans le registre des pourcentages, l’assignation formelle du format idoine convertit les ratios scalaires (de 0 à 1) en affichage fractionnaire normalisé de 0 % à 100 %, évitant des erreurs de calcul grossières lors de l’application manuelle de facteurs multiplicatifs superfétatoires.
En ce qui concerne les grandeurs calendaires, la standardisation absolue selon le référentiel international de la norme ISO 8601 (format AAAA-MM-JJ) ou la forme conventionnelle française étendue (JJ/MM/AAAA) doit être strictement verrouillée. Ce verrouillage neutralise les ambiguïtés d’interprétation chronologique qui surgissent fréquemment lors du partage international de fichiers entre utilisateurs coutumiers de la syntaxe américaine (MM/JJ/AAAA) et ceux régis par la syntaxe européenne, préservant ainsi l’intégrité séquentielle absolue des séries temporelles.
4.3 Gestion des débordements et dimensionnement des largeurs
L’esthétique et la fonctionnalité d’un tableau se trouvent lourdement compromises lorsque des libellés textuels étendus débordent anarchiquement sur les cellules adjacentes inoccupées, ou se trouvent inversement tronqués de manière brutale dès lors que la cellule voisine est dotée d’un contenu. Ce phénomène de troncature nuit gravement à la lisibilité et oblige l’utilisateur à pointer manuellement chaque cellule pour inspecter la barre de formule sous-jacente afin de lire le libellé intégral. La configuration méthodique du comportement de débordement textuel constitue un levier d’optimisation spatial indispensable.
Dans la barre d’outils de Google Sheets, l’outil de retour à la ligne automatique offre trois modes distincts : le débordement, le retour à la ligne et la coupure nette. Pour les colonnes hébergeant des intitulés descriptifs longs, des commentaires qualitatifs ou des désignations d’articles complexes, il convient d’activer résolument le Retour automatique à la ligne (Wrap). Cette commande contraint le flux textuel à s’enrouler au sein des limites latérales de la colonne en ajustant automatiquement la hauteur de la rangée concernée, maintenant l’intégralité du message visible dans le champ de vision direct.
Enfin, le dimensionnement des largeurs de colonnes doit être calibré avec une grande minutie pour éviter tant l’étalement inutile de l’espace que la compression visuelle étouffante. L’exécution d’un double-clic précis sur la ligne de séparation verticale logée entre les en-têtes alphabétiques de deux colonnes déclenche l’ajustement automatique de la largeur sur l’enregistrement le plus long de la série. Toutefois, pour préserver un équilibre visuel harmonieux, l’analyste veillera à harmoniser les largeurs des colonnes hébergeant des données de nature similaire, créant ainsi une régularité rythmique qui apaise le champ perceptif de l’utilisateur.
5. Étape 4 : Implémentation des couleurs en alternance pour la lisibilité
5.1 Activation de la fonction native des couleurs alternées
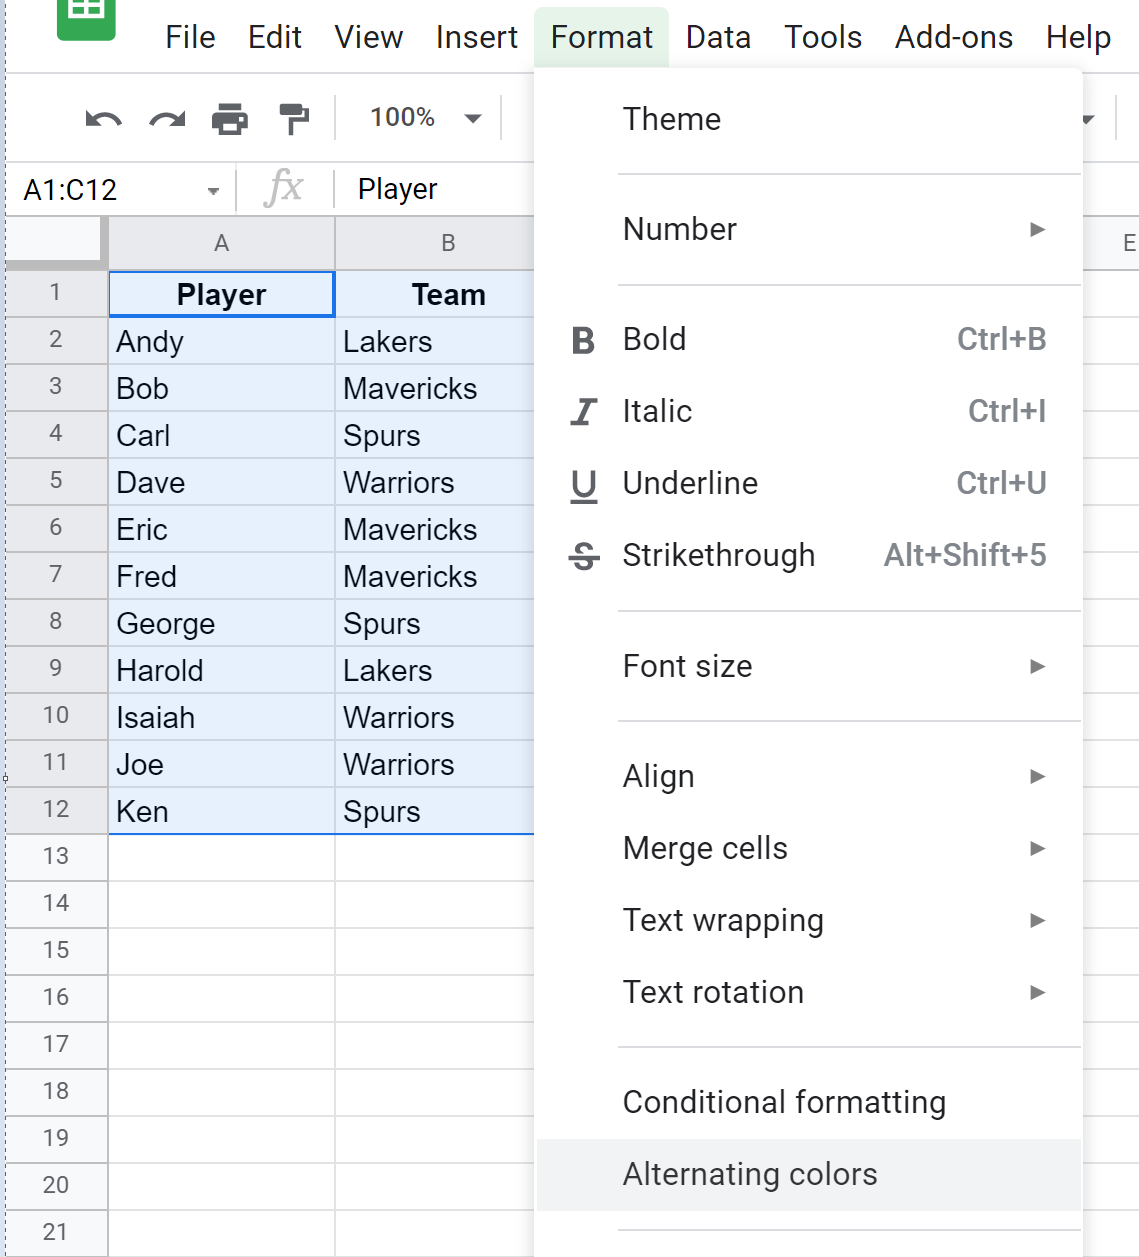
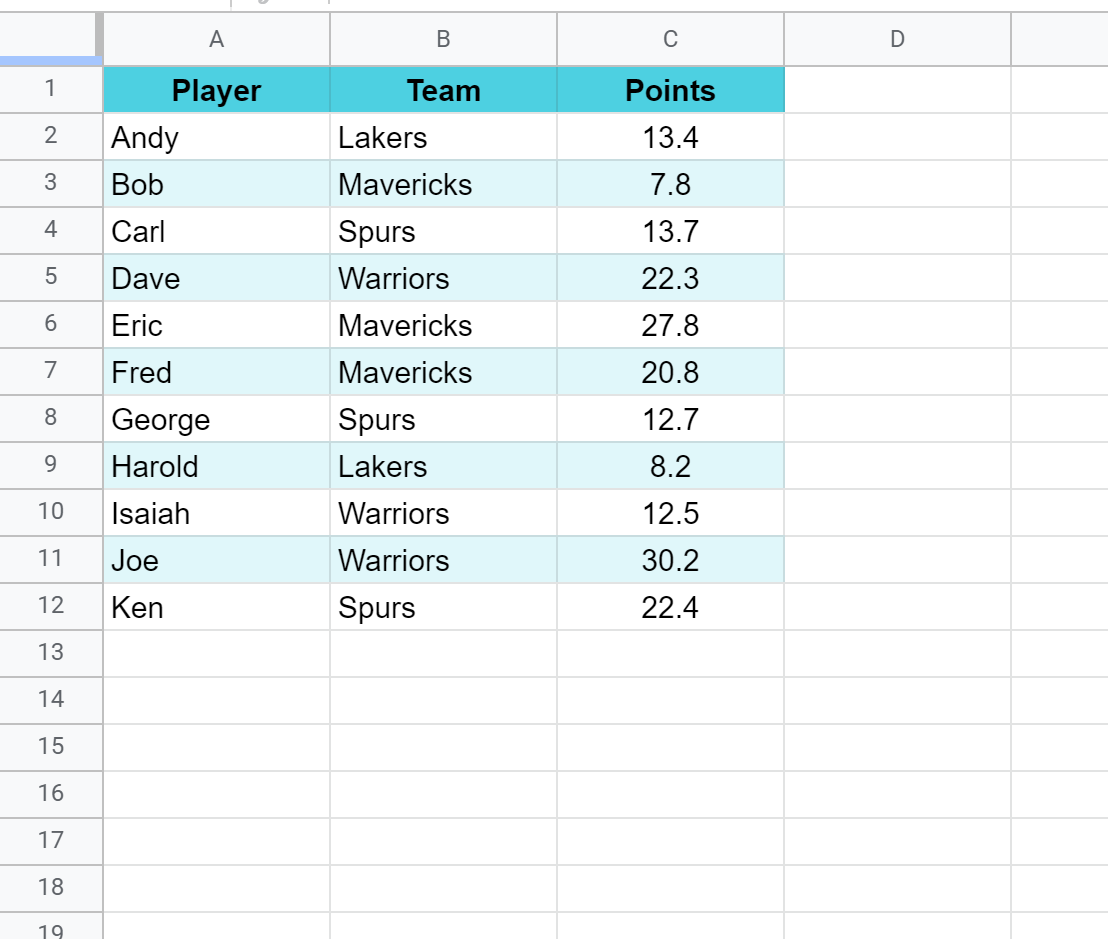
La lecture continue de matrices denses renfermant de multiples colonnes expose l’analyste à un risque de dérive de balayage ophtalmique, l’œil sautant fréquemment d’une ligne à sa voisine supérieure ou inférieure lors du transit horizontal d’un bout à l’autre de la feuille. Pour juguler cette fatigue perceptive, le recours à la zébrure chromatique des lignes constitue un dispositif ergonomique éprouvé. Google Sheets intègre une fonctionnalité native dédiée, accessible via le menu Format, option Couleurs en alternance, qui automatise cette mise en œuvre sans altérer la logique sous-jacente des cellules.
La procédure débute par la délimitation rigoureuse de la plage matricielle constituant l’entité tabulaire. Une fois le panneau de configuration latéral déployé, l’application détecte automatiquement la structure de la sélection et applique un agencement bicolore séquentiel. L’opérateur doit impérativement s’assurer que la case à cocher « En-tête » est active, ce qui signale au moteur d’affichage la nécessité de dédier une nuance chromatique substantiellement plus sombre ou distincte à la première rangée, formalisant explicitement sa primauté sémantique.
L’avantage cardinal de l’utilisation de cet outil natif réside dans son dynamisme structurel immanent. Contrairement à une coloration manuelle cellule par cellule qui impose des rectifications fastidieuses lors de chaque manipulation, le moteur des couleurs en alternance réactualise automatiquement la zébrure lors de l’insertion, de la suppression ou du déplacement de lignes au sein de la plage. L’intégrité de la séquence chromatique est ainsi préservée en permanence, affranchissant l’analyste d’une maintenance cosmétique chronophage et récurrente.
5.2 Sélection chromatique et modération de la saturation
L’application de la couleur au sein d’un tableau analytique doit répondre à une éthique de la sobriété fonctionnelle, inspirée par les travaux fondamentaux d’Edward Tufte sur le design informationnel. L’écueil le plus pernicieux réside dans l’utilisation de teintes hyper-saturées ou criardes qui agressent la rétine et accaparent indûment l’attention visuelle au détriment des données elles-mêmes. L’analyste doit privilégier des nuances pastel atténuées, des dégradés de gris neutres ou des tonalités bleu acier très désaturées pour la trame alternée des rangées.
Le rôle de la zébrure n’est pas d’exhiber une créativité graphique extravagante, mais de matérialiser un rail visuel subtil guidant la trajectoire de lecture horizontale. Une alternance discrète entre un fond blanc pur et un fond teinté d’une luminosité résiduelle de 95 % suffit amplement à accomplir cet objectif physiologique sans alourdir le ratio encre-données de la composition. L’arrière-plan doit demeurer un support silencieux, laissant émerger avec une clarté limpide la typographie noire des valeurs scalaires.
La sélection de la palette doit également satisfaire de manière inflexible aux exigences d’accessibilité visuelle, particulièrement en prévision des déficiences de la vision chromatique telles que le daltonisme (deutéranopie, protanopie). Il est impératif d’éviter l’usage de couples chromatiques conflictuels tels que le rouge et le vert pour distinguer des lignes ou des états alternatifs dans un même ensemble. L’emploi de variations de luminance et de luminosité plutôt que de simples contrastes de teintes pures garantit une universalité d’interprétation pour l’ensemble des collaborateurs consultant le document.
5.3 Personnalisation fine des nuances d’en-tête et de fond
Bien que Google Sheets propose un assortiment étendu de thèmes prédéfinis, l’élaboration de documents d’entreprise ou de rapports institutionnels requiert souvent une personnalisation pointue des nuances chromatiques afin de s’aligner harmonieusement sur une charte graphique corporate. Le panneau latéral des couleurs alternées met à disposition des sélecteurs de nuances hexadécimales personnalisables pour la ligne d’en-tête, la couleur numéro un et la couleur numéro deux des lignes de données.
Pour l’en-tête sommital, l’usage d’une couleur directrice profonde et feutrée (comme un bleu nuit, un vert forêt profond ou un anthracite sombre) autorise le basculement de la typographie textuelle vers le blanc pur. Ce contraste négatif (texte clair sur fond sombre) confère un impact architectural saisissant à la ligne directrice et délimite fermement l’espace supérieur du tableau. L’analyste veillera à ce que le code hexadécimal sélectionné garantisse un contraste maximal avec le texte blanc, évitant les fonds mi-teinte qui diluent la netteté des caractères.
Dans l’hypothèse où le tableau comporterait une ligne récapitulative finale de totaux, le panneau permet également d’activer et de formater un « Pied de page » chromatique distinct. L’application d’une nuance analogue ou légèrement plus dense que celle des lignes courantes, complétée d’un renforcement typographique, marque la clôture solennelle du corpus de données. Cette personnalisation stylistique, consignée de manière cohérente au sein du classeur, insuffle un niveau de finition et de professionnalisme remarquable aux restitutions décisionnelles.
6. Étape 5 : Structuration géométrique et application des bordures
6.1 Hiérarchisation fonctionnelle des épaisseurs et tracés
L’application inconsidérée de bordures épaisses et noires autour de chaque cellule transforme fréquemment les feuilles de calcul en d’étouffantes cages grillagées, où le bruit visuel supplante la lisibilité des chiffres. Dans un tableau méticuleusement conçu, la bordure n’a d’autre raison d’être que d’indiquer des limites spatiales et des hiérarchies logiques là où les seuls espacements typographiques et variations chromatiques s’avèrent insuffisants. La maîtrise des styles et des épaisseurs de trait constitue donc une composante décisive du design de l’information.
Pour le cloisonnement intérieur horizontal et vertical des données, la règle absolue consiste à recourir à la bordure la plus fine disponible, tout en délaissant systématiquement le noir absolu (#000000) au profit d’une nuance de gris médian adoucie (telle que #d1d5db ou #e5e7eb). Ce traçage ténu délimite les alvéoles de calcul sans imposer de coupure visuelle brutale, offrant un soutien discret au regard sans encombrer la scène perceptive de traits graphiques proéminents et superflus.
En revanche, la séparation spatiale entre la ligne d’en-tête et la première occurrence de données gagne à être solidifiée par un tracé d’épaisseur supérieure ou par une double ligne inférieure spécifique. Cette démarcation structurelle renforce le basculement sémiotique entre le domaine métanarratif des descripteurs et le domaine empirique des données factuelles. De façon symétrique, une double bordure inférieure fine sous la rangée de clôture finale signale conventionnellement, dans les normes comptables universelles, l’achèvement définitif de la consolidation mathématique du tableau.
6.2 Application des bordures intégrales via la barre d’outils
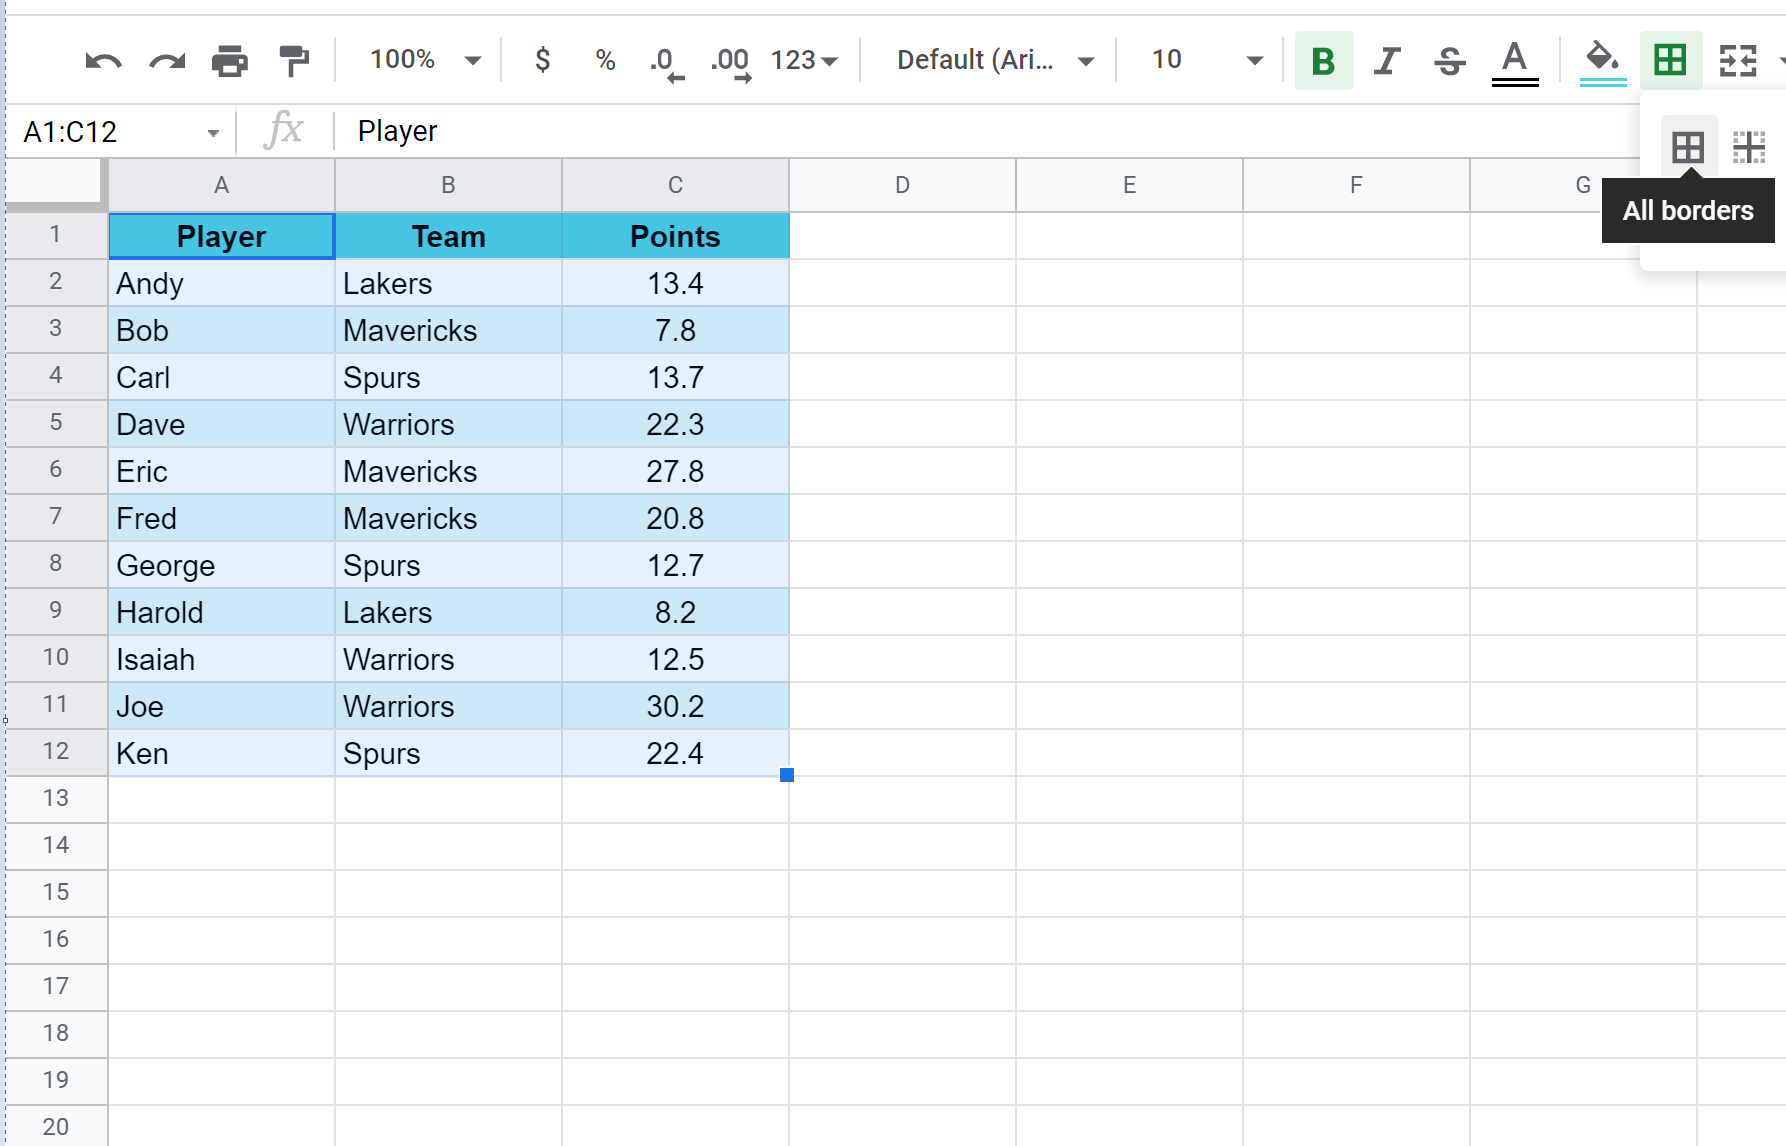
L’orchestration des bordures s’effectue avec une remarquable efficacité opérationnelle au moyen de la palette dédiée située dans la barre d’outils contextuelle de Google Sheets. L’analyste procède préalablement à la sélection exhaustive de l’espace matriciel dévolu au tableau. L’activation du sous-menu Bordures déploie un sélecteur matriciel offrant dix configurations de découpage géométrique distinctes, permettant d’adresser de façon découplée les contours extérieurs, les maillages intérieurs, les séparatrices verticales ou les cloisons horizontales.
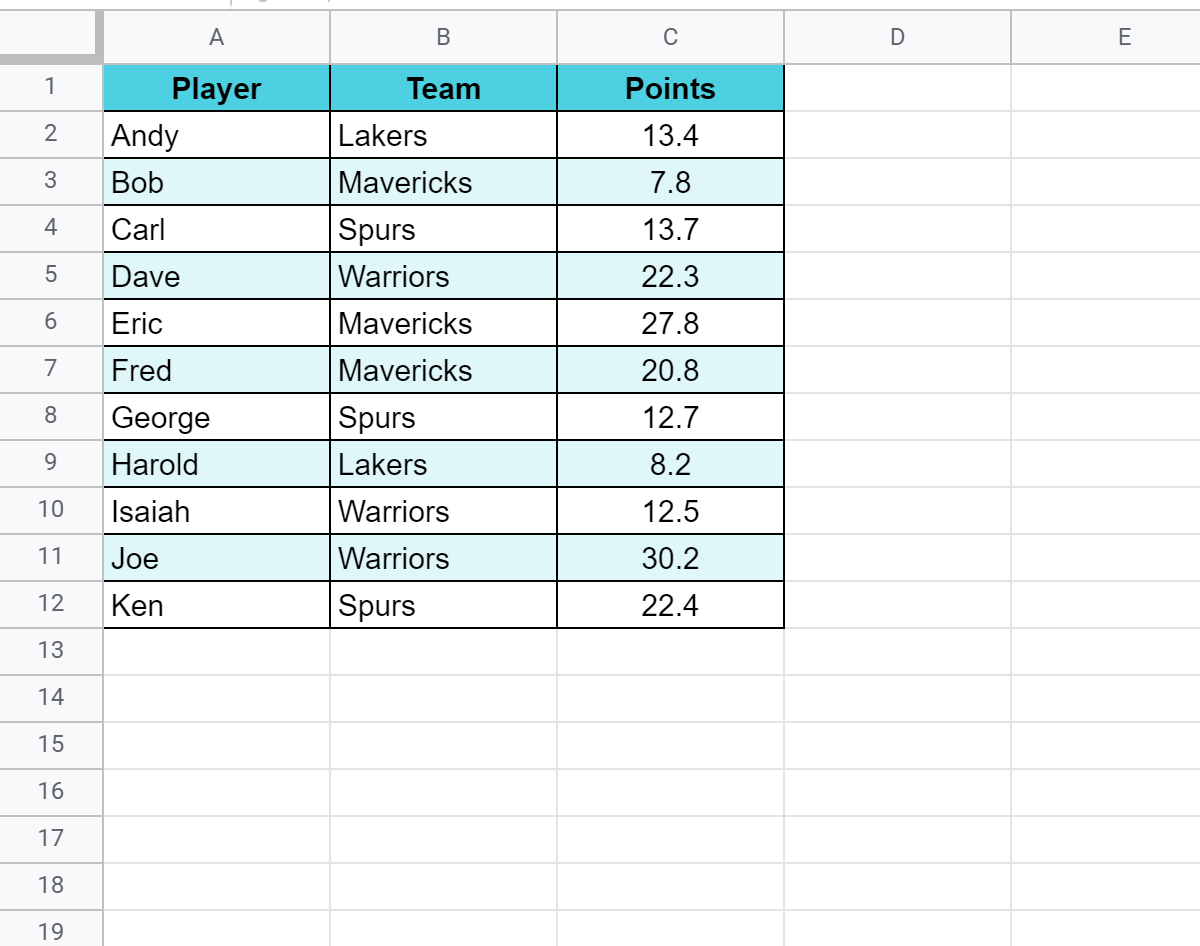
La séquence méthodologique optimale débute par le paramétrage préventif des deux attributs d’influence : la teinte chromatique du trait et son style typologique (ligne pleine fine, moyenne, épaisse, pointillée ou double). Une fois ces paramètres étalonnés sur une nuance de gris modérée et une épaisseur minimale, l’utilisateur applique le mode Toutes les bordures pour instaurer le maillage basal sur la plage sélectionnée. Cette approche systématique prévient l’hétérogénéité accidentelle des tracés qui découle trop souvent d’assignations fragmentaires et non coordonnées.
Dans un second temps, l’opérateur affine la structure géométrique en sur-sélectionnant des zones ciblées du tableau pour leur appliquer des attributs distinctifs. La rangée sommitale d’en-tête fait l’objet d’une sélection isolée afin d’appliquer à sa seule frontière inférieure une bordure renforcée. Ce raffinement modulaire progressif assure une homogénéité formelle impeccable sur l’intégralité du contour matriciel, écartant toute rupture de continuité géométrique le long des périphéries fonctionnelles de la table.
6.3 Équilibre entre quadrillage natif et bordures explicites
Une interrogation récurrente en ergonomie de l’information porte sur la cohabitation entre le quadrillage natif de la feuille de calcul et l’adjonction de bordures explicites façonnées par l’utilisateur. Le quadrillage grisâtre déployé par défaut par Google Sheets sur l’infinité de l’espace de travail possède un caractère purement utilitaire : il sert de guide d’alignement durant la saisie opérationnelle, mais dilue l’identité autonome des entités tabulaires closes qui se trouvent immergées au sein d’un océan indéfini d’alvéoles vides.
Pour sublimer la mise en scène finale d’un tableau et focaliser impérieusement l’attention de l’audience sur les données consolidées, il est hautement profitable de désactiver totalement l’affichage du quadrillage général. Cette opération s’exécute avec une extrême simplicité en décochant l’option Quadrillage logée dans le menu Affichage. La disparition instantanée des lignes d’alvéoles périphériques transforme l’arrière-plan du classeur en une surface immaculée d’une grande pureté visuelle, conférant au tableau autonome une stature documentaire semblable à celle d’une publication éditoriale de haute facture.
Toutefois, ce masquage du quadrillage général impose une rigueur accrue dans l’application des bordures internes explicites du tableau. Dès lors que l’arrière-plan général est neutralisé, le tableau doit posséder sa propre logique de cohérence topologique. L’analyste doit veiller à ce que l’alternance des couleurs de lignes et les tracés de bordures légers suffisent amplement à matérialiser la structure interne des cellules, évitant ainsi que les colonnes adjacentes ne semblent dériver de façon désordonnée sur un fond blanc indifférencié.
7. Exploitation de la fonctionnalité native « Tableau » de Google Sheets
7.1 Conversion d’une plage matricielle en tableau dynamique officiel
Pendant de nombreuses années, Google Sheets a contraint ses utilisateurs à façonner manuellement l’illusion graphique d’un tableau par l’application conjointe de bordures, de couleurs alternées et de filtres superposés sur de simples plages de cellules passives. Une avancée majeure de l’environnement collaboratif réside désormais dans le déploiement d’un objet computationnel autonome et officiel : le composant natif Tableau. Cette mutation technologique rapproche substantiellement Google Sheets des capacités de modélisation orientée objet traditionnellement associées aux bases de données relationnelles.
La conversion d’une plage matricielle préexistante en un tableau dynamique formel s’opère instantanément. Après avoir surligné l’ensemble de la plage continue intégrant les en-têtes et les données brutes, l’utilisateur actionne le menu Format et sélectionne l’instruction explicite Convertir en tableau. Le système analyse automatiquement la périphérie dimensionnelle du bloc, identifie sans ambiguïté la première ligne comme constituant le vecteur d’en-tête métanarratif et drape la structure entière d’une entité logique cohérente dotée de propriétés computationnelles avancées.
Ce nouveau statut ontologique se traduit visuellement par l’encapsulation de la matrice au sein d’un cadre interactif bordé d’éléments d’interface spécifiques. L’entité nouvellement promue se voit attribuer une dénomination symbolique globale (telle que Tableau1), qui transcende la notation de coordonnées cartésiennes classique de type A1:G50. Cette dénomination unifiée simplifie drastiquement la manipulation référentielle de la structure au sein des formules et des scripts d’automatisation, tout en sanctuarisant ses limites dimensionnelles face aux dégradations structurelles accidentelles.
7.2 Gestion automatisée des types de colonnes et contrôles intégrés
L’apport le plus décisif de la fonctionnalité native réside dans la typologie rigide et la gouvernance automatisée des attributs de colonnes. Dès qu’une plage accède au rang de tableau officiel, chaque colonne acquiert un typage sémantique précis visible au sommet de son en-tête via un pictogramme interactif. Google Sheets infère intelligemment si le vecteur relève d’une typologie textuelle, d’une métrique quantitative, d’une dimension temporelle, d’une liste énumérative de statuts ou d’une composante de géolocalisation.
Cette typification native confère à chaque colonne des mécanismes d’interaction hautement ergonomiques. Un simple clic sur l’en-tête déploie des menus contextuels d’inspection, des contrôles de filtrage calibrés spécifiquement sur le type de données sous-jacent (comme des sélecteurs calendaires interactifs pour les dates ou des curseurs de plages pour les nombres) et des utilitaires de réordonnancement sans risque de rupture d’alignement avec les colonnes mitoyennes. L’intégrité de la base de données s’en trouve puissamment consolidée face aux manipulations des utilisateurs inexpérimentés.
Par ailleurs, la propagation des formats et des formules au sein d’un tableau natif s’exécute de manière totalement automatisée lors de l’adjonction séquentielle de nouveaux enregistrements. L’utilisateur qui tape une nouvelle valeur immédiatement sous la dernière rangée du tableau constate l’incorporation instantanée de cette ligne dans le giron de l’entité : les bordures, les formats conditionnels, les couleurs en alternance et surtout les formules de calcul récurrentes sont immédiatement dupliqués vers le bas sans exiger la moindre recopie manuelle, assurant une pérennité absolue des protocoles de saisie.
7.3 Activation et personnalisation de la ligne de totaux synthétiques
Dans la configuration traditionnelle des feuilles de calcul, l’implantation d’une rangée récapitulative au bas d’un bloc de données constituait une source permanente d’erreurs computationnelles. L’insertion manuelle d’enregistrements intercalaires imposait de reconfigurer perpétuellement les bornes dimensionnelles des formules de sommation, au risque d’exclure les occurrences récentes de l’agrégation finale ou de provoquer des références circulaires dramatiques en pointant malencontreusement vers la cellule du total elle-même.
Le composant natif « Tableau » éradique définitivement cette fragilité architecturale grâce à son mécanisme paramétrable de ligne de totaux synthétiques. Directement accessible via la barre d’outils supérieure du tableau ou par l’intermédiaire des options de configuration de la structure, l’activation de cette commande insère un pied de tableau dynamique solidement amarré à la base de la matrice. Cette rangée terminale conserve automatiquement sa position sous le dernier enregistrement, s’ajustant de façon élastique à chaque extension ou contraction du volume des données sous-jacentes.
Chaque cellule constitutive de cette ligne de totaux se transforme en une interface d’agrégation modulaire. Un simple clic sur l’icône contextuelle de la cellule déploie une liste fermée de fonctions statistiques et arithmétiques fondamentales : Somme, Moyenne, Comptage, Max, Min, ou Écart-type. Le moteur applique automatiquement la fonction SOUS.TOTAL appropriée, calculant la métrique retenue exclusivement sur les enregistrements visibles. Lorsque l’analyste applique un filtre sélectif sur le tableau, la ligne de totaux réévalue instantanément ses grandeurs synthétiques pour refléter la seule sous-population affichée, alliant une justesse mathématique absolue à une flexibilité d’analyse hors pair.
8. Sécurisation et standardisation par la validation des données
8.1 Création de listes déroulantes de saisie contrôlée
La pérennité analytique d’un tableau dépend directement de la propreté sémiotique des informations injectées au fil du temps. Lorsque plusieurs collaborateurs interagissent sur un même support partagé, la prolifération de fautes d’orthographe, de variantes de saisie, d’abréviations aléatoires ou de synonymies approximatives détériore inévitablement la valeur informationnelle des variables catégorielles. La mise en œuvre de protocoles de validation des données s’avère indispensable pour restreindre la liberté d’écriture de l’opérateur et contraindre les entrées au sein d’un répertoire taxinomique scrupuleusement maîtrisé.
La matérialisation la plus aboutie de cette standardisation réside dans l’intégration de listes déroulantes contextuelles au cœur des cellules de données. Configurable par l’intermédiaire du menu Données, option Validation des données, ce dispositif permet d’assujettir la valeur de la cellule soit à une énumération d’éléments textuels explicitement renseignés dans l’interface de paramétrage, soit à une plage dynamique d’éléments logée sur une feuille de nomenclature dédiée. L’analyste écarte ainsi toute dérive lexicale en interdisant à la racine l’insertion d’intitulés non répertoriés.
Dans les versions contemporaines de Google Sheets, l’ergonomie des listes déroulantes a bénéficié d’une avancée sémiotique majeure à travers l’introduction des « puces de sélection » (chips). Ces éléments graphiques encapsulent le choix textuel validé dans un cartouche aux angles arrondis, doté d’une couleur d’identification propre à chaque modalité de la variable. Cette stylisation enrichit significativement le tableau : elle guide intuitivement la manipulation des opérateurs, accélère l’identification visuelle des différents états du système observé et prémunit durablement la base de données contre toute entropie textuelle.
8.2 Établissement de bornes et restrictions numériques
Au-delà de la normalisation des chaînes de caractères catégorielles, la sécurisation des grandeurs quantitatives et calendaires exige l’édification de barrières computationnelles infranchissables face aux valeurs manifestement aberrantes. Une coquille typographique consistant en l’adjonction d’un zéro surnuméraire sur une valeur de transaction financière ou la saisie d’un millésime erroné fausse de manière irrémédiable l’ensemble des modélisations mathématiques récapitulatives. La validation de données offre une palette d’opérateurs relationnels conçus pour circonscrire les valeurs acceptables au sein d’intervalles théoriques stricts.
L’analyste a la faculté de contraindre les entrées cellulaires au moyen de critères prédéterminés : validation de la nature purement numérique du contenu, vérification de l’appartenance de la grandeur saisie à une plage close définie par une borne inférieure et une borne supérieure (par exemple, une marge commerciale impérativement comprise entre 0 % et 100 %), ou interdiction de dates situées antérieurement au début de l’exercice comptable courant. Toute tentative d’enregistrement d’une grandeur violant ces postulats logiques est immédiatement interceptée par le système.
Il est fondamental de paramétrer le niveau de sévérité de la règle d’interdiction sur l’option Refuser la saisie, plutôt que sur le simple Afficher un avertissement. La notification d’un avertissement passif tolère l’injection effective de la donnée corrompue dans la matrice en se contentant d’apposer un discret marqueur orange dans le coin supérieur de la cellule, ce qui expose les calculs globaux à des déformations insidieuses. Le rejet catégorique et bloquant de la saisie invalide garantit que la zone de calcul demeure un sanctuaire mathématiquement vierge de toute hétérogénéité aberrante.
8.3 Configuration des messages contextuels d’aide et d’erreur
Le durcissement des protocoles de validation des données, s’il n’est pas accompagné d’un travail soigné de restitution ergonomique, peut susciter une forte incompréhension et une vive frustration auprès des intervenants chargés de la saisie documentaire. Être confronté à un blocage applicatif brutal formulant un refus sans explication claire génère des interruptions de productivité dommageables. Pour fluidifier l’expérience utilisateur, l’analyste doit impérativement exploiter les fonctionnalités d’assistance textuelle contextuelle intégrées aux règles de validation.
Le panneau de configuration autorise la rédaction de textes d’aide personnalisés qui se déploient élégamment au survol ou à la sélection de la cellule concernée. Ces infobulles préventives doivent être formulées avec une concision et une précision chirurgicales, en explicitant sans ambiguïté les contraintes d’admissibilité imposées (par exemple : « Veuillez renseigner une valeur numérique entière comprise strictement entre 10 et 500 » ou « Renseignez la date au format standardisé AAAA-MM-JJ »). Cette transparence sémiotique désamorce les maladresses en guidant proactivement l’action de l’opérateur avant même la survenance de l’erreur.
Parallèlement, la personnalisation du message d’erreur consécutif à une saisie rejetée parachève cette démarche d’ergonomie cognitive. En substituant aux notifications d’erreur génériques du système un diagnostic explicite détaillant la nature de l’infraction commise et les démarches correctives à engager, le tableau devient un artefact auto-pédagogique. Cette bienveillance algorithmique favorise l’appropriation rapide des standards de rigueur documentaire par l’ensemble des parties prenantes, consolidant ainsi durablement la gouvernance des données.
9. Intégration de formules de calcul et d’automatisation structurelle
9.1 Application des opérateurs arithmétiques et fonctions récapitulatives de base
L’utilité analytique d’un tableau se déploie pleinement lorsque la masse des données empiriques brutes est transcendée par la puissance des formules arithmétiques et des fonctions de synthèse. L’adjonction de colonnes calculées permet d’extraire de la valeur incrémentale à partir des variables natives par l’application d’opérateurs linéaires classiques : soustractions pour quantifier des écarts différentiels, multiplications pour appliquer des barèmes tarifaires ou ratios de pondération pour établir des structures relatives de charges.
Au sommet de l’édifice computationnel figurent les fonctions récapitulatives universelles telles que SOMME, MOYENNE, NB et NB.SI. Lors de l’écriture de ces fonctions au sein d’une feuille classique, une exigence méthodologique fondamentale réside dans l’utilisation méthodique des plages ouvertes. Au lieu de borner rigidement un intervalle de calcul à une coordonnée statique telle que SOMME(C2:C50), il est hautement profitable de rédiger la syntaxe sous la forme élastique SOMME(C2:C). Cette notation délibérément tronquée englobe l’infinité de l’espace vertical descendant sous la ligne 2, assurant l’incorporation automatique et transparente des enregistrements futurs sans réécriture des formules.
Il importe également d’auditer avec rigueur le comportement intrinsèque de ces fonctions de synthèse face à des cellules laissées accidentellement vierges ou abritant des valeurs nulles. Alors que la fonction SOMME neutralise naturellement les cellules nulles sans corrompre son résultat vectoriel, l’opérateur MOYENNE se montre hautement sensible à la nuance sémantique entre une cellule vide (exclue du dénominateur du calcul de la moyenne arithmétique) et une cellule hébergeant le chiffre zéro (comptabilisée comme une occurrence valide, pesant mécaniquement sur la distribution). La maîtrise de ces subtilités computationnelles est indispensable pour conjurer tout risque de biais statistique.
9.2 Emploi méthodique des références relatives et absolues
La diffusion fluide d’une formule sur l’intégralité d’un vecteur de colonne constitue un pilier de l’efficience dans Google Sheets, mais elle expose l’analyste inexpérimenté à des désastres computationnels en cas de mauvaise gestion des références spatiales. Par défaut, toute référence de cellule intégrée à une syntaxe algorithmique est une référence relative (par exemple, B2). Lorsque la formule est recopiée ou propagée verticalement le long des lignes inférieures, les indices de colonnes et de rangées s’incrémentent proportionnellement au déplacement, ce qui est précisément l’effet recherché lorsqu’il s’agit d’appliquer un calcul ligne par ligne sur des grandeurs homologues.
Cependant, de multiples modélisations requièrent l’ancrage invariable d’un facteur multiplicatif ou d’un paramètre externe logé dans une cellule unique et stationnaire à l’écart de la table (tel qu’un taux de taxe sur la valeur ajoutée ou un objectif budgétaire global). Dans cette configuration, le recours impérieux à l’opérateur dollar ($) permet de convertir la référence relative en une référence absolue sanctuarisée. La syntaxe $B$1 fige de façon intangible la colonne et la ligne, neutralisant tout incrément lors de la descente de la formule le long de l’axe vertical.
La gymnastique intellectuelle de l’analyste doit s’étendre à la manipulation experte des références mixtes, formalisées par des notations semi-bloquées comme $B2 ou B$2. Dans le premier cas, seul l’axe horizontal des colonnes se trouve verrouillé tandis que les lignes demeurent élastiques ; dans le second, la rangée est immobilisée tandis que les colonnes s’adaptent au glissement latéral. La parfaite maîtrise de ces ancrages différentiels est la condition sine qua non pour bâtir des tables de calcul bidirectionnelles complexes sans générer de décalages d’indices destructeurs.
9.3 Automatisation vectorielle via la fonction ARRAYFORMULA
Bien que la poignée de recopie incrémentale offre un moyen séduisant de propager une formule le long d’une colonne, cette pratique induit des faiblesses structurelles majeures au fil du cycle de vie du classeur. Dupliquer physiquement une formule à l’identique au sein de dizaines de milliers d’alvéoles individuelles alourdit la charge computationnelle du navigateur client, accroît exponentiellement la mémoire vive consommée et expose la matrice à un risque critique : l’écrasement accidentel ou l’altération involontaire de la formule au sein d’une cellule intercalaire par un collaborateur inattentif.
Pour s’affranchir définitivement de ces vulnérabilités, l’environnement Google Sheets déploie une arme architecturale d’une élégance suprême : la fonction matricielle ARRAYFORMULA. Immanquablement positionnée dans la première alvéole supérieure du vecteur de données (généralement en rangée 2), cette méta-fonction prend en charge l’exécution itérative d’un calcul sur une plage vectorielle continue tout entière, sans qu’aucune formule n’ait besoin d’être inscrite dans les cellules sous-jacentes. La formule maîtresse projette littéralement ses résultats le long de la colonne, transformant les cellules filles en récepteurs virtuels passifs.
La syntaxe canonique d’une telle construction gagne à être systématiquement conjuguée avec une clause conditionnelle de sécurité visant à masquer les lignes encore inoccupées : =ARRAYFORMULA(SI(ESTVIDE(A2:A); ""; B2:B * C2:C)). Grâce à cette formulation matricielle hautement sophistiquée, le calcul ne s’exécute que pour les rangées dotées d’un contenu effectif, maintenant un néant propre sur les lignes inférieures vierges. Dès lors qu’un nouvel enregistrement est dactylographié au sein de la colonne source, l’évaluation s’actualise en temps réel de manière instantanée, conférant au tableau un dynamisme et une invulnérabilité logicielle dignes des systèmes de production les plus exigeants.
10. Accentuation visuelle sélective via la mise en forme conditionnelle
10.1 Établissement de règles de surbrillance basées sur des seuils critiques
L’exploration visuelle d’un corpus quantitatif volumineux peut rapidement saturer la mémoire de travail de l’observateur si l’ensemble des grandeurs est restitué avec une uniformité typographique stricte. Pour accélérer la détection des signaux faibles, des ruptures opérationnelles ou des dépassements d’objectifs, la mise en forme conditionnelle se présente comme un puissant amplificateur perceptif. Ce mécanisme algorithmique évalue dynamiquement le contenu de chaque cellule au regard d’un postulat booléen, lui assignant un formatage stylistique spécifique dès lors que le critère logique est satisfait.
L’analyste configure ces protocoles via le menu Format, option Mise en forme conditionnelle. L’édification de règles de surbrillance déterministes repose sur l’exploitation d’opérateurs relationnels rigoureux : égalité, exclusion, supériorité stricte ou positionnement chronologique par rapport à une date mobile. Par exemple, l’affectation d’un arrière-plan écarlate atténué sur les créances clients affichant une ancienneté supérieure à soixante jours focalise immédiatement la vigilance du gestionnaire sur les foyers de risque financiers majeurs sans nécessiter un audit laborieux de chaque enregistrement individuel.
Il est impératif d’assigner des encodages chromatiques dotés d’une sémiologie univoque et universellement partagée : des nuances de rouge pastel pour les ruptures critiques ou les variations négatives, de l’ambre ou du jaune discret pour les avertissements d’imminence ou les valeurs approchant les seuils d’alerte, et des tonalités de vert doux pour les validations de conformité ou les progressions positives. La retenue dans la saturation est fondamentale pour éviter que la feuille de calcul ne se métamorphose en une mosaïque criarde et illisible, contre-productive pour l’analyse cognitive.
10.2 Déploiement d’échelles de couleurs continues
À côté des règles discrètes de surbrillance binaire, Google Sheets offre un mode d’expression visuelle continu d’une grande valeur heuristique : les échelles de couleurs, souvent qualifiées de cartes thermiques cellulaires (heatmaps). Cette modalité chromatique ne tranche pas arbitrairement entre le vrai et le faux ; elle évalue la position relative de chaque valeur scalaire au sein de la distribution statistique globale de la colonne, lui assignant une nuance interpolée le long d’un gradient bicolore ou tricolore harmonieusement étalonné.
La conception d’une échelle thermique exige une rigueur méthodologique sans faille pour prévenir les fausses interprétations analytiques. L’analyste doit proscrire l’échelle tricolore par défaut « Rouge – Jaune – Vert » dès lors qu’elle est appliquée à des métriques dépourvues de polarité axiologique morale (des volumes de ventes ne sont pas « mauvais » intrinsèquement parce qu’ils sont plus bas que d’autres au sein d’une gamme d’articles standard). Il est préférable d’adopter des palettes perceptuellement uniformes et monochromatiques, articulant une couleur directrice unique déclinée de sa forme la plus claire pour le centile le plus bas vers sa forme la plus dense pour le centile culminant.
L’étalonnage des points d’inflexion (minimum, point médian et maximum) gagne fréquemment à être indexé sur des grandeurs statistiques descriptives robustes (telles que le 10e centile, la médiane arithmétique et le 90e centile) plutôt que sur les extremums purs. Ce calibrage percentile protège l’échelle chromatique contre la distorsion d’écrasement provoquée par une valeur aberrante isolée, laquelle concentrerait l’intégralité du gradient sur son seul écart démesuré en réduisant le reste de la population à une teinte parfaitement homogène et inexploitable.
10.3 Prévention de la saturation cognitive et de l’encombrement visuel
L’utilisation de la mise en forme conditionnelle est soumise à la loi des rendements décroissants : plus le nombre de signaux graphiques simultanés prolifère sur un espace restreint, plus l’efficacité perceptive de chaque signal individuel s’effondre. Lorsque chaque alvéole se met à clignoter d’une nuance propre sous la contrainte d’une dizaine de règles enchevêtrées et conflictuelles, l’esprit humain est submergé par une cacophonie visuelle qui neutralise toute capacité d’arbitrage et d’action.
Le principe de parcimonie sémiotique doit impérativement guider l’action du concepteur de tableaux. Une matrice analytique ne devrait jamais héberger plus de deux ou trois règles conditionnelles concurrentes au sein d’une même perspective de lecture. Chaque règle ajoutée doit subir un test d’utilité opérationnelle rigoureux : quelle décision concrète cette surbrillance permet-elle de déclencher immédiatement ? Si la mise en forme ne débouche pas sur un choix d’action tangible, elle relève du bruit décoratif parasitaire et doit être purement éliminée.
Il est en outre fondamental d’auditer continuellement le gestionnaire des règles conditionnelles afin d’éradiquer la gangrène des duplications fantômes. Lors des opérations courantes de copier-coller de fragments de plages de cellules, Google Sheets a la fâcheuse tendance de fragmenter les règles globales existantes en une multitude de sous-règles disjointes pointant vers des coordonnées éclatées. Ce phénomène d’entropie dégrade silencieusement les performances de calcul du moteur et engendre des conflits d’application qu’un nettoyage régulier et consolidé permet d’éviter.
11. Organisation dynamique des flux : Tris, filtres et vues filtrées
11.1 Application de filtres multidimensionnels natifs
L’ordonnancement statique des lignes d’un tableau est impuissant à répondre à la diversité des interrogations analytiques qui émergent au fil de l’exploitation des données. La capacité à isoler dynamiquement des sous-ensembles spécifiques de la population observée, sans altérer ni mutiler la structure pérenne de la matrice, est garantie par le déploiement des filtres natifs. Activée au moyen de l’icône en entonnoir de la barre d’outils générale, cette commande implémente un bouton de contrôle triangulaire interactif au sein de chaque cellule constitutive de l’en-tête sommital.
L’arborescence des options de filtrage offre une flexibilité de requêtage remarquable. L’utilisateur peut solliciter des filtres par condition logique, mobilisant des opérateurs de filtrage textuel (« commence par », « contient »), des critères quantitatifs (« supérieur à », « compris entre ») ou des restrictions calendaires temporelles. Cette modularité permet de disséquer des cohortes complexes avec une rapidité d’exécution instantanée, masquant temporairement le bruit de fond des enregistrements périphériques pour focaliser l’analyse sur l’échantillon d’intérêt.
Un mode de sélection complémentaire permet de filtrer manuellement d’après les valeurs distinctes répertoriées ou même d’isoler les éléments en fonction de leur couleur d’arrière-plan ou de police, capitalisant avec pertinence sur les étapes antérieures de mise en forme conditionnelle. L’analyste doit cependant garder à l’esprit que l’activation d’un filtre natif conventionnel sur une feuille partagée altère la perception visuelle de l’ensemble des collaborateurs consultant simultanément le document, ce qui exige des égards méthodologiques spécifiques en environnement multi-utilisateurs.
11.2 Déploiement des vues filtrées pour les environnements collaboratifs
Dans un contexte de travail contemporain marqué par l’hyper-collaboration synchrone, le filtre natif conventionnel devient rapidement une source d’irritation et d’anarchie opérationnelle. Lorsqu’un analyste applique un filtre restrictif pour isoler les ventes d’une division spécifique, il tronque instantanément l’affichage du document pour l’ensemble des autres collaborateurs connectés à cet instant précis, sabotant involontairement leurs opérations d’audit en cours. Pour désamorcer définitivement ce risque de conflit, Google Sheets intègre une prouesse d’ingénierie collaborative : les Vues filtrées (Filter Views).
Accessible par le menu Données, option Vues filtrées, puis Créer une vue filtrée, cette fonctionnalité bascule l’interface de travail dans une dimension spatiale autonome, signalée par l’apparition d’un cadre périphérique gris sombre encadrant la zone tabulaire. Tout filtre, tri ou réagencement appliqué au sein de cet espace sanctifié est strictement confiné à la perception unique de l’utilisateur qui l’a instancié. Les collègues connectés sur la même feuille continuent d’observer la matrice dans sa plénitude intégrale ou selon leurs propres filtres respectifs sans la moindre interférence perturbatrice.
L’attrait des vues filtrées ne s’arrête pas à cette isolation collaborative. Chaque vue filtrée générée peut être explicitement baptisée d’une désignation sémantique claire (par exemple, « Clients Grands Comptes – En Attente ») et demeure sauvegardée de manière permanente au sein du classeur pour un réemploi instantané ultérieur. Mieux encore : le système génère un identifiant d’adresse web unique (URL) se terminant par un paramètre de type fvid=... propre à cette vue. Il devient ainsi possible de partager un lien direct renvoyant précisément vers cette perspective analytique filtrée, révolutionnant les méthodologies d’échange et de restitution entre équipes de direction.
11.3 Hiérarchisation des tris séquentiels et imbriqués
L’inspection analytique exige fréquemment de dépasser le simple masquage d’enregistrements pour orchestrer un réordonnancement séquentiel exhaustif de la base selon un ou plusieurs axes prioritaires. Bien que le tri alphabétique univarié soit trivial, les analyses granulaires nécessitent l’ordonnancement coordonné de critères concurrents via l’exécution de tris multi-niveaux. Cette opération ne doit jamais être improvisée au risque de dissocier de façon catastrophique des colonnes mal sélectionnées, corrompant définitivement l’intégrité relationnelle des lignes.
Pour exécuter un tri hiérarchisé dans les règles de l’art, l’analyste procède à la sélection intégrale de la matrice tabulaire, ouvre le menu Données et sollicite la commande formelle Trier une plage, sous-menu Options avancées de tri des plages. L’interface contextuelle impose en premier lieu de cocher la mention « Les données ont une ligne d’en-tête », ce qui préserve l’intégrité de la première rangée au sommet de la feuille en évitant son absorption indue dans le flot du tri alphabétique des données factuelles.
L’analyste configure ensuite la clé de tri primaire (par exemple, un regroupement catégoriel par région administrative de A à Z), puis clique sur le bouton d’adjonction pour greffer une clé de tri secondaire imbriquée (telle que le montant des commandes en ordre décroissant de Z à A). Le moteur algorithmique procède alors à un arbitrage parfaitement séquentiel : les occurrences sont prioritairement réparties par ensembles régionaux homogènes, et au sein de chaque région, les transactions sont classées selon leur valeur financière. Cet étagement méthodique offre une structure de lecture limpide qui met instantanément en exergue les disparités de performance interne au sein de chaque segment d’observation.
12. Audit de qualité, accessibilité ergonomique et exportation du tableau
12.1 Protocole de vérification de l’intégrité globale et détection d’erreurs
L’ultime étape méthodologique préalablement à la diffusion d’un tableau décisionnel consiste en un audit de qualité rigoureux destiné à traquer les impuretés computationnelles et les distorsions de logique interne. La présence d’alvéoles polluées par des codes d’erreur bruts générés par l’interpréteur — tels que #N/A, #VALEUR!, #DIV/0! ou le redoutable #REF! — témoigne d’une négligence structurelle inacceptable qui anéantit la crédibilité de l’analyste. Ces artéfacts doivent être impérativement interceptés et neutralisés à la source en encapsulant les syntaxes à risque dans des fonctions de capture comme SIERREUR ou SI.NON.DISP.
Parallèlement à la résorption des erreurs déclarées, l’analyste doit engager une traque méthodique des doublons intempestifs qui auraient pu corrompre la base lors d’imports de données hétérogènes. L’exploitation de l’outil natif de suppression des doublons (logé dans le menu Données, sous-rubrique Nettoyage des données) permet de scanner l’ensemble des clés primaires pour élaguer les répétitions parasitaires tout en consignant un rapport d’audit transparent sur le volume d’enregistrements expurgés.
Enfin, une vérification scrupuleuse de la cohérence comptable des agrégations doit être opérée. L’auditeur confronte la somme transversale des colonnes partielles avec les totaux généraux verticaux pour s’assurer de l’absence absolue de tout écart d’arrondi ou de biais de double comptage résultant de plages de calcul qui se chevaucheraient. L’exactitude formelle des relations mathématiques doit être totale avant d’autoriser la publication ou l’exploitation décisionnelle de l’artefact.
12.2 Optimisation de l’ergonomie visuelle finale et repos cognitif
L’excellence dans la modélisation informationnelle ne réside pas uniquement dans l’exactitude des chiffres ; elle s’exprime avec une égale intensité dans le soin apporté à la psychologie cognitive de l’observateur. Un tableau surchargé, encombré de notes hétéroclites et saturé d’artéfacts visuels induit une usure mentale rapide. L’analyste doit opérer une décontamination esthétique finale en appliquant le principe d’épuration informationnelle : chaque pixel affiché à l’écran doit remplir une fonction sémantique irremplaçable.
Le contrôle de la fluidité de lecture horizontale et verticale constitue un paramètre d’audit capital. L’observateur doit pouvoir parcourir une ligne entière sans jamais éprouver l’obligation d’interrompre son regard pour repositionner son index sur la première colonne. Si une telle dérive survient, c’est l’indice certain que les bordures directrices sont trop diffuses ou que l’écartement spatial entre les colonnes est démesurément étiré. Le resserrement calibré des largeurs et le renforcement subtil de la zébrure chromatique rétablissent instantanément la fluidité cinétique du regard.
Enfin, l’autonomie documentaire du tableau doit être formellement validée. Un observateur tiers, totalement étranger à l’équipe conceptrice du classeur, doit être en mesure d’interpréter sans équivoque la totalité des informations affichées sans solliciter la moindre assistance orale ou textuelle extérieure. Les en-têtes doivent être auto-explicatifs, les unités de mesure impérativement formalisées, les dates univoques et les méthodologies de calcul synthétique immédiatement compréhensibles. L’artefact informationnel atteint alors son statut d’excellence : un instrument de travail indépendant, intelligible et pérenne.
12.3 Procédures de restitution, partage et formats d’exportation
L’ultime horizon du tableau réside dans son extraction vers des canaux de communication externes ou sa conversion en livrables figés destinés à des collèges de direction. La configuration des paramètres d’impression et de conversion vers le format PDF constitue une étape critique où s’effondrent fréquemment les compositions les plus soignées par suite d’une mauvaise maîtrise de la pagination spatiale. L’analyste doit proscrire l’éclatement arbitraire des colonnes sur de multiples pages blanches consécutives.
Au sein de l’interface d’impression avancée de Google Sheets (accessible via le raccourci conventionnel Ctrl+P ou le menu Fichier, puis Imprimer), il convient de sélectionner l’option d’ajustement à la largeur de la page. Ce réglage comprime proportionnellement l’échelle dimensionnelle du tableau pour contraindre l’intégralité du faisceau de colonnes à résider au sein d’une largeur de page unique en mode Paysage. L’analyste prendra également soin de cocher la répétition automatique des lignes d’en-tête sur chaque page subséquente dans l’onglet des en-têtes et pieds de page, garantissant la permanence du contexte sémantique lors de la lecture d’un document imprimé multipage.
Dans la perspective d’une réutilisation des données par des systèmes tiers d’intelligence d’affaires ou des bases relationnelles, l’exportation vers des formats textuels bruts normalisés (tels que les formats délimités par des virgules CSV ou par des tabulations TSV) doit être maîtrisée. L’analyste vérifiera préalablement que la feuille sélectionnée pour l’exportation est expurgée de tout élément périphérique textuel hors-matrice (titres flottants, notes de bas de page informelles) qui corromprait la structure du fichier plat généré. En combinant la robustesse du format source avec une gouvernance exemplaire des autorisations de partage cloud (lecture seule, commentaire ou édition restreinte), le tableau conçu s’impose comme une référence exemplaire d’ingénierie et d’intégrité informationnelle.
Références
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377–387. https://dl.acm.org/doi/10.1145/362384.362685
- Google. (2024). Aide Google Sheets : Utiliser des couleurs en alternance et créer des tableaux. Centre d’aide Google Docs. https://support.google.com/docs/answer/63728
- Google. (2024). Aide Google Sheets : Valider des données dans une feuille de calcul. Centre d’aide Google Docs. https://support.google.com/docs/answer/186103
- Google. (2024). Aide Google Sheets : Guide des formules et fonctions de calcul (ARRAYFORMULA, SOUS.TOTAL, SIERREUR). Centre d’aide Google Docs. https://support.google.com/docs/answer/3093275
- International Organization for Standardization. (2019). Date and time — Representations for information interchange (ISO Standard No. 8601-1:2019). https://www.iso.org/iso-8601-date-and-time-format.html
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press. https://www.edwardtufte.com/tufte/books_vdqi
- World Wide Web Consortium. (2018). Web content accessibility guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/WAI/standards-guidelines/wcag/