
L’analyse empirique des données quantitatives et qualitatives constitue le socle méthodologique fondamental des sciences sociales contemporaines, de la recherche épidémiologique, des études de marché et des sciences de gestion. Face à l’accumulation massive d’enregistrements observationnels ou expérimentaux, le chercheur ou l’analyste se trouve confronté à une exigence incontournable : condenser la complexité d’une population statistique sans en altérer la structure sous-jacente. Au sein de cet impératif de synthèse, le tableau croisé — historiquement et formellement désigné sous le terme de matrice de contingence — s’impose comme l’instrument pivot de l’exploration descriptive bivariée. En révélant la distribution conjointe de deux ou plusieurs variables catégorielles, cette structure matricielle permet de dépasser la simple quantification unidimensionnelle pour investiguer la nature, la force et les configurations singulières des associations inter-variables.
Au cours des quatre dernières décennies, l’informatique appliquée à la gestion et aux sciences analytiques a démocratisé les outils de traitement statistique. Parmi ces instruments, le tableur Microsoft Excel a développé une composante algorithmique particulièrement sophistiquée : l’outil de tableau croisé dynamique (TCD), ou PivotTable. Bien plus qu’une simple fonctionnalité d’affichage, cet algorithme de traitement analytique en ligne (OLAP) redéfinit la manière dont les praticiens manipulent, restructurent et interrogent de vastes bases de données relationnelles ou planes. La capacité d’Excel à réorganiser instantanément des milliers d’observations individuelles en fréquences croisées, en profils relatifs et en distributions marginales offre un environnement computationnel d’une flexibilité remarquable pour quiconque souhaite extraire du sens à partir du bruit informationnel.
Néanmoins, la puissance opérationnelle du tableau croisé dans Excel dissimule fréquemment des pièges méthodologiques et des écueils de modélisation. La constitution d’une matrice croisée scientifiquement irréprochable exige une compréhension rigoureuse des échelles de mesure, une normalisation scrupuleuse des données sources, une maîtrise fine des options d’agrégation numérique et une vigilance accrue quant à l’interprétation des pourcentages conditionnels. Ce guide magistral propose une déconstruction exhaustive, séquentielle et théoriquement ancrée de la création, du paramétrage, de l’optimisation et de l’extension inférentielle des tableaux croisés sous Excel, assurant ainsi une transition fluide entre la rigueur académique et l’application pratique en laboratoire ou en entreprise.
1. Introduction conceptuelle aux tableaux croisés dans Excel
1.1 Définition et rôle fondamental en analyse quantitative
D’un point de vue épistémologique, un tableau croisé se définit comme une matrice mathématique bidimensionnelle organisée pour représenter simultanément la fréquence conjointe de deux attributs qualitatifs ou discrets mesurés sur un même échantillon d’unités statistiques. Les lignes de la matrice correspondent aux modalités mutuellement exclusives de la première variable, tandis que les colonnes matérialisent les modalités de la seconde. À l’intersection de chaque ligne et de chaque colonne se trouve une cellule élémentaire dont la valeur numérique indique l’effectif observé, c’est-à-dire le dénombrement précis d’individus partageant concurremment les deux états d’attributs considérés. Cette formalisation permet de cartographier la structure sous-jacente d’une cohorte en condensant un espace multidimensionnel en un plan immédiatement intelligible pour l’esprit humain.
Le rôle fondamental de cette représentation réside dans la réduction drastique de la dimensionnalité des données brutes. Dans les sciences humaines et sociales, un protocole d’enquête standard peut facilement générer un registre composé de plusieurs centaines de variables documentées sur des milliers de répondants. Sous sa forme brute, ce jeu de données constitue un tableau plat ou un ensemble de vecteurs individuels indéchiffrables par simple inspection visuelle. La construction de la matrice de contingence opère une synthèse sélective en projetant cette masse d’informations sur un espace restreint à deux dimensions analytiques. Elle permet ainsi d’observer immédiatement si la répartition des modalités de la variable d’intérêt varie de manière substantielle en fonction des catégories de la variable de stratification, jetant ainsi les bases préliminaires de la détection de dépendances statistiques.
Il convient d’établir une distinction opératoire rigoureuse entre le concept abstrait de tableau croisé simple et l’implémentation logicielle connue sous l’appellation de tableau croisé dynamique (TCD) au sein de l’environnement Excel. Le tableau croisé simple désigne l’objet statistique théorique, souvent figé sous forme de matrice textuelle ou de tableau statique non recalculable. En revanche, le tableau croisé dynamique représente un moteur de calcul interactif qui virtualise la base de données source, permettant la reconfiguration immédiate des axes d’analyse, l’application de filtres multidimensionnels à la volée, la permutation des variables explicatives et dépendantes, et la dérivation instantanée de métriques agrégées complexes sans modifier l’intégrité de la structure source sous-jacente.
1.2 Pertinence méthodologique dans la recherche empirique
Dans le cadre de la démarche empirique, l’utilisation systématique des tableaux croisés intervient au stade exploratoire de l’analyse des données. Avant même d’envisager le déploiement de modèles économétriques complexes, de régressions logistiques multivariées ou d’analyses factorielles des correspondances, le chercheur doit procéder à un examen méticuleux des distributions marginales et conjointes. Le tableau croisé facilite l’identification rapide des profils comportementaux atypiques, la mise en évidence des concentrations d’effectifs sur certaines trajectoires spécifiques et la détection précoce d’asymétries structurelles dans les patrons de réponses collectés sur le terrain.
Cette étape exploratoire conditionne directement la validité des inférences statistiques ultérieures. En examinant la matrice de contingence, le statisticien évalue la viabilité de l’échantillonnage et vérifie si la structure observée des effectifs respecte les postulats théoriques requis pour les tests paramétriques ou non paramétriques. Par exemple, une matrice révélant des cellules vides ou des effectifs extrêmement réduits signale immédiatement un risque d’instabilité numérique pour les tests d’indépendance classiques, incitant l’investigateur à regrouper certaines modalités ou à privilégier des procédures de rééchantillonnage bootstrap ou des tests exacts de Fisher.
L’intégration de cette procédure au sein d’un outil universel tel qu’Excel offre un avantage méthodologique considérable : la standardisation des observations. Grâce à des protocoles de saisie et de manipulation largement partagés au sein de la communauté scientifique et industrielle, l’usage d’Excel démocratise la traçabilité des transformations opérées sur les données. Il devient aisé de confronter la structure empirique d’un échantillon aux distributions théoriques ou aux données de recensement nationales, permettant de corriger d’éventuels biais d’auto-sélection par l’application ultérieure de coefficients de redressement pondérés directement au sein de la matrice croisée.
1.3 Architecture computationnelle d’Excel appliquée aux fréquences
Pour appréhender pleinement l’efficacité des tableaux croisés dans Excel, il est indispensable de comprendre le moteur computationnel qui orchestre ces opérations en arrière-plan. Lorsqu’un utilisateur initialise un tableau croisé dynamique, Excel ne se contente pas d’exécuter une série d’itérations linéaires ou de fonctions conditionnelles telles que NB.SI.ENS. Le tableur instancie dans la mémoire vive de l’ordinateur une structure optimisée appelée le cache de tableau croisé dynamique (PivotCache). Ce cache constitue un clone hautement compressé et indexé de la source de données, conçu selon les principes des moteurs de traitement analytique en ligne (OLAP, On-Line Analytical Processing).
Cette virtualisation interne découple la zone d’affichage matricielle des données brutes stockées dans la grille de cellules. L’architecture OLAP d’Excel organise les données sous la forme de dimensions (les variables catégorielles) et de mesures (les agrégats numériques tels que les dénombrements ou les moyennes). Lors des permutations de champs opérées par l’utilisateur, le moteur n’interroge pas la feuille de calcul initiale ligne par ligne, mais recalcule les intersections directement au sein du PivotCache via des opérations de découpage en dés (slicing and dicing). Ce mécanisme garantit des temps de réponse quasi instantanés, même lorsque l’échantillon comprend des centaines de milliers de lignes, préservant ainsi la réactivité de l’analyse exploratoire.
Cette architecture assure une interopérabilité sans faille entre les structures tabulaires rectangulaires traditionnelles (les tables plates ou flat tables) et les restitutions matricielles croisées. Toutefois, cette organisation implique que toute modification effectuée sur la grille de saisie originelle n’est pas répercutée de façon synchrone dans la matrice croisée. La mise à jour requiert un déclenchement explicite d’actualisation afin que le cache réindexe les observations modifiées. La maîtrise de cette dissociation conceptuelle entre la couche de stockage physique des données, le cache relationnel intermédiaire et la couche de présentation visuelle est indispensable pour éviter les erreurs d’interprétation chronologiques lors du cycle d’analyse.
2. Fondements théoriques : variables qualitatives et matrices de contingence
2.1 Typologie des échelles de mesure applicables
L’application rigoureuse du croisement de variables repose sur la taxonomie des échelles de mesure formalisée par le psychologue et statisticien Stanley Smith Stevens. Les tableaux croisés s’appliquent en premier lieu aux variables qualitatives nominales. Ces variables décrivent des états discrets sans relation d’ordre hiérarchique intrinsèque, telles que la catégorie socioprofessionnelle, l’appartenance géographique, le statut matrimonial ou le choix d’un produit. Pour ces données, l’ordonnancement des lignes et des colonnes au sein du tableau relève d’un choix arbitraire ou alphabétique, n’altérant en rien la validité formelle des fréquences conjointes observées.
En second lieu, les variables ordinales s’intègrent parfaitement à la construction matricielle, tout en exigeant une contrainte d’agencement stricte. Ces variables intègrent un ordre naturel ou un gradient implicite, à l’image des échelles d’évaluation psychométrique de type Likert (allant de « tout à fait en désaccord » à « tout à fait d’accord »), des niveaux de qualification académique ou des tranches d’intensité de consommation. Dans ce cas, les modalités doivent impérativement respecter cette séquence logique au sein de la matrice sous peine de détruire la cohérence visuelle et d’entraver la détection d’éventuelles relations monotones, linéaires ou curvilignes lors de l’inspection des cases de croisement.
Enfin, les variables quantitatives continues peuvent être adaptées au format de contingence sous réserve d’une opération de discrétisation préalable, souvent désignée sous le terme d’agrégation par intervalles ou de binning. De même, les items polytomiques complexes font fréquemment l’objet d’une binarisation méthodique afin de contraster des populations spécifiques. Dans l’ensemble de ces transformations, le chercheur doit veiller scrupuleusement à préserver la validité de construit de la variable : un regroupement abusif de modalités sous prétexte de grossir les effectifs cellulaires peut gommer des singularités empiriques réelles et introduire des distorsions méthodologiques majeures.
2.2 Formalisation mathématique de la contingence
Pour dépasser l’empirisme intuitif et fonder l’analyse sur des bases quantitatives irréprochables, il est nécessaire de formaliser mathématiquement l’espace de contingence. Considérons un échantillon de taille totale N, sur lequel sont mesurées deux variables catégorielles aléatoires, notées conventionnellement X et Y. La variable X présente r modalités distinctes indexées par i (avec i variant de 1 à r), définissant le nombre de lignes de la matrice. La variable Y présente c modalités distinctes indexées par j (avec j variant de 1 à c), définissant le nombre de colonnes.
L’intersection d’une ligne i et d’une colonne j contient l’effectif conjoint noté nij, représentant le nombre d’observations qui possèdent simultanément la modalité i de X et la modalité j de Y. La sommation des effectifs le long d’une ligne donnée produit le total marginal de ligne, noté ni• :
ni• = ∑j=1..c nij
Symétriquement, la sommation des effectifs le long d’une colonne donnée engendre le total marginal de colonne, noté n•j :
n•j = ∑i=1..r nij
La sommation globale de l’ensemble des cases ou la sommation de l’un ou l’autre des vecteurs marginaux permet de retrouver la taille exhaustive de l’échantillon N :
N = ∑i=1..r ni• = ∑j=1..c n•j = ∑i=1..r ∑j=1..c nij
Cette structure matricielle matérialise l’estimation empirique de la loi conjointe des probabilités. La probabilité conjointe observée est donnée par le ratio pij = nij / N, tandis que les probabilités marginales respectives s’écrivent pi• = ni• / N et p•j = n•j / N. L’hypothèse fondamentale testée ultérieurement lors de l’inférence statistique est celle de l’indépendance stochastique, qui stipule que la survenue d’un état de la variable X n’influence en rien la probabilité de survenue d’un état de la variable Y. Sous cette hypothèse nulle (H₀), la probabilité conjointe théorique équivaut au produit strict des probabilités marginales correspondantes :
P(X = i ∩ Y = j) = P(X = i) × P(Y = j)
Toute déviation systématique et substantielle entre les effectifs empiriques nij relevés dans les cellules d’Excel et les effectifs attendus sous l’hypothèse d’indépendance constituera la preuve tangible d’une association statistique entre les dimensions analysées.
3. Étape 1 : Préparation et saisie rigoureuse des données dans Excel
3.1 Normalisation de la structure tabulaire
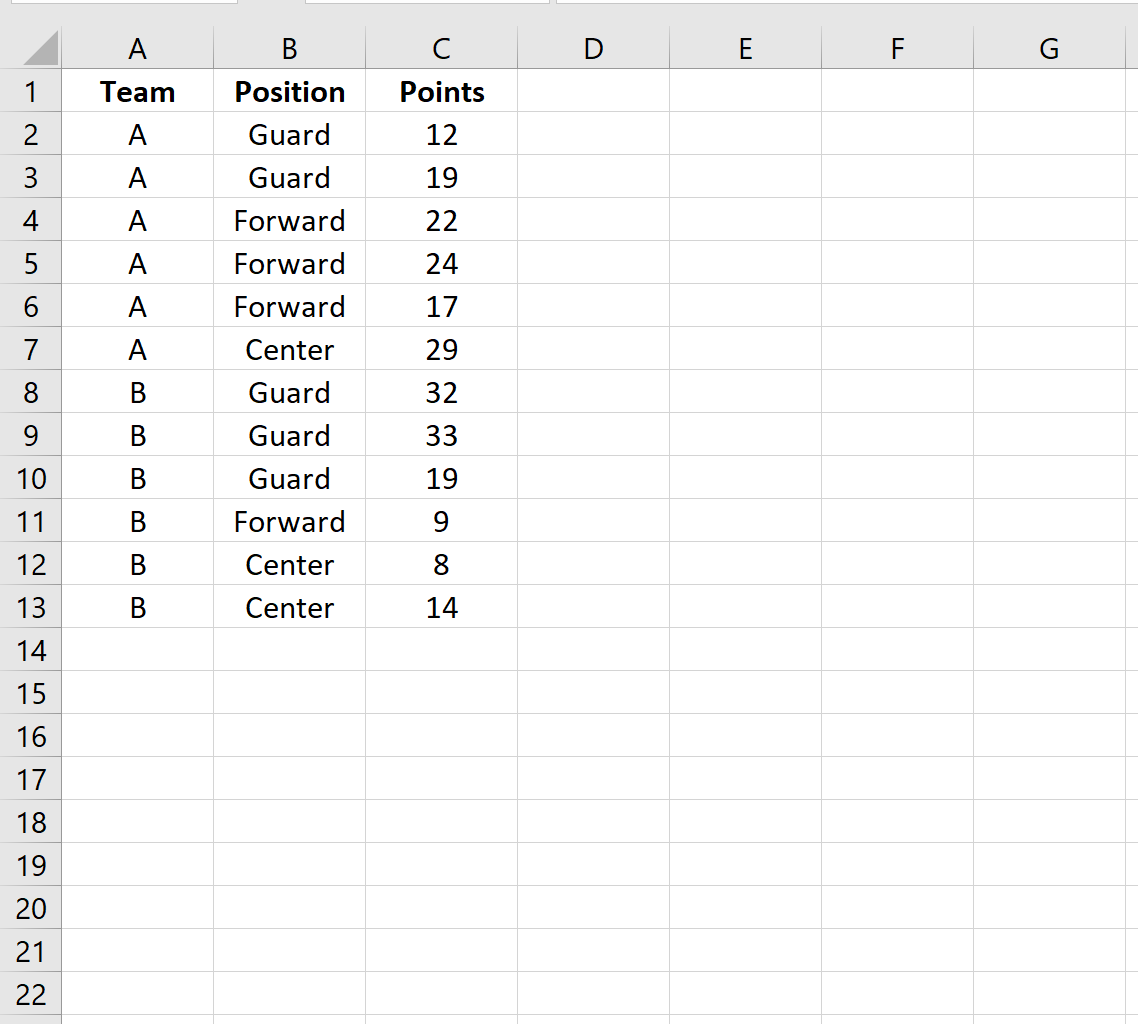
L’échec de la création d’un tableau croisé dans Excel ou la production de résultats erronés résulte, dans l’immense majorité des cas, d’une mauvaise préparation de la base de données source. Pour que l’algorithme d’agrégation d’Excel puisse parser et catégoriser les enregistrements sans distorsion, les données brutes doivent impérativement respecter les règles strictes de la forme normale relationnelle, souvent qualifiée de structure tabulaire rectangulaire ou de données bien rangées (tidy data). Chaque ligne du tableau doit représenter de manière univoque une et une seule unité statistique d’observation (un répondant, une transaction, un patient, une entité géographique), et chaque colonne doit correspondre à une variable distincte et invariante dans sa définition.
La première ligne de la plage de données doit être strictement réservée aux en-têtes descriptifs des variables. Ces étiquettes doivent être courtes, univoques, informatives et dénuées de tout saut de ligne forcé ou de caractères de ponctuation ambigus. Il est formellement prohibé d’empiler plusieurs lignes d’en-têtes superposées, pratique courante mais catastrophique pour les outils d’ingestion analytique. De même, l’existence de cellules fusionnées constitue la faute structurelle la plus critique : la fusion de cellules détruit la relation d’appartenance matricielle, incitant Excel à attribuer la valeur uniquement à la cellule supérieure gauche de la zone fusionnée, laissant les cellules adjacentes dans un état de vacuité informationnelle susceptible de biaiser tous les décomptes ultérieurs.
Enfin, le tableau de données ne doit contenir aucun sous-total préliminaire ni aucune ligne de totalisation générale insérée manuellement au milieu ou au bas du registre. L’algorithme du tableau croisé dynamique prend en charge l’intégralité des mécanismes d’accumulation numérique. L’inclusion accidentelle de totaux intermédiaires au sein des données brutes entraînerait un double comptage immédiat et fausserait la somme totale de l’échantillon. De surcroît, l’analyste doit inspecter l’ensemble de la plage pour vérifier qu’aucune ligne ou colonne entièrement vide n’interrompt la contiguïté des enregistrements.
3.2 Nettoyage et codage des modalités catégorielles
Une fois l’architecture rectangulaire établie, un travail minutieux d’assainissement textuel s’impose. Le moteur du tableau croisé traite les chaînes de caractères de manière quasi littérale. Par conséquent, des disparités typographiques apparemment insignifiantes créent des catégories distinctes indésirables. Par exemple, les chaînes « Cadre supérieur », « cadre superieur », « Cadre Supérieur » et « Cadre supérieur » (avec un espace insécable ou un espace final résiduel) seront interprétées par le moteur OLAP comme quatre modalités distinctes et concurrentes, fragmentant ainsi artificiellement les effectifs d’un même groupe sociologique.
Pour éradiquer ces anomalies, il est recommandé d’appliquer systématiquement les fonctions de nettoyage de texte d’Excel sur des colonnes temporaires avant de figer les valeurs. L’imbrication des fonctions SUPPRESPACE et EPURAGE permet d’éliminer les espaces initiaux, terminaux et consécutifs ainsi que les caractères invisibles non imprimables issus d’extractions de bases de données SQL ou de formulaires Web. Par ailleurs, la normalisation de la casse à l’aide de NOMPROPRE ou MAJUSCULE garantit une uniformité syntaxique absolue à travers tout le fichier :
=NOMPROPRE(SUPPRESPACE(A2))
Le traitement des données manquantes constitue un autre arbitrage méthodologique déterminant. Une cellule laissée vide dans une colonne catégorielle sera classifiée sous l’étiquette générique « (vide) » dans le tableau croisé. Si cette vacuité correspond à un refus de réponse délibéré, à une omission par inadvertance ou à une non-applicabilité structurelle de la question, il est scientifiquement préférable d’imputer explicitement une étiquette de traçabilité, telle que « Non renseigné », « Refus » ou « Ne sait pas ». Cette démarche prévient l’exclusion silencieuse d’observations et permet d’intégrer le taux de non-réponse comme dimension analytique à part entière dans la lecture de la contingence.
3.3 Conversion de la plage en tableau officiel Excel
L’une des pratiques professionnelles les plus déterminantes dans la construction de systèmes d’analyse reproductibles consiste à convertir la plage de cellules standard en un Tableau structuré officiel d’Excel (également appelé objet ListObject). Pour opérer cette transformation, il suffit de sélectionner n’importe quelle cellule active située au cœur du périmètre des données nettoyées, puis d’exécuter la combinaison de touches du clavier Ctrl + L (ou Ctrl + T selon la configuration régionale du système d’exploitation), ou de naviguer vers le ruban Accueil et de sélectionner la commande Mettre sous forme de tableau.
La boîte de dialogue contextuelle invite l’analyste à confirmer l’intervalle spatial des cellules et exige impérativement de cocher l’option Mon tableau comporte des en-têtes. Dès cette validation opérée, la plage se colore d’une mise en forme par bandes contrastées, mais c’est sur le plan fonctionnel que la modification s’avère fondamentale. Le jeu de données se voit attribuer un identifiant unique modifiable dans l’onglet contextuel Création de tableau, qu’il est vivement conseillé de renommer de manière explicite (par exemple Tbl_Enquete_2026) plutôt que de conserver le libellé par défaut Tableau1.
L’utilisation d’une table structurée dynamique résout définitivement la question de la mise à jour des données :
- Extension dimensionnelle automatique : Tout nouvel enregistrement saisi ou collé immédiatement sous la dernière ligne du tableau est automatiquement agrégé au périmètre source sans nécessiter de redéfinition manuelle des plages d’adresses.
- Formules propagées et références structurées : Les éventuelles colonnes calculées utilisent une syntaxe explicite basée sur le nom des variables (ex.
[@Age]) et se propagent instantanément sur l’ensemble des lignes. - Sécurisation du cache OLAP : Le tableau croisé dynamique pointera désormais vers le nom logique du tableau et non vers un adressage absolu rigide de type
$A$1:$Z$5000, éliminant ainsi le risque d’omettre des données lors des expansions ultérieures de la cohorte.
4. Étape 2 : Initialisation du tableau croisé via l’assistant de synthèse
4.1 Sélection du périmètre des données sources
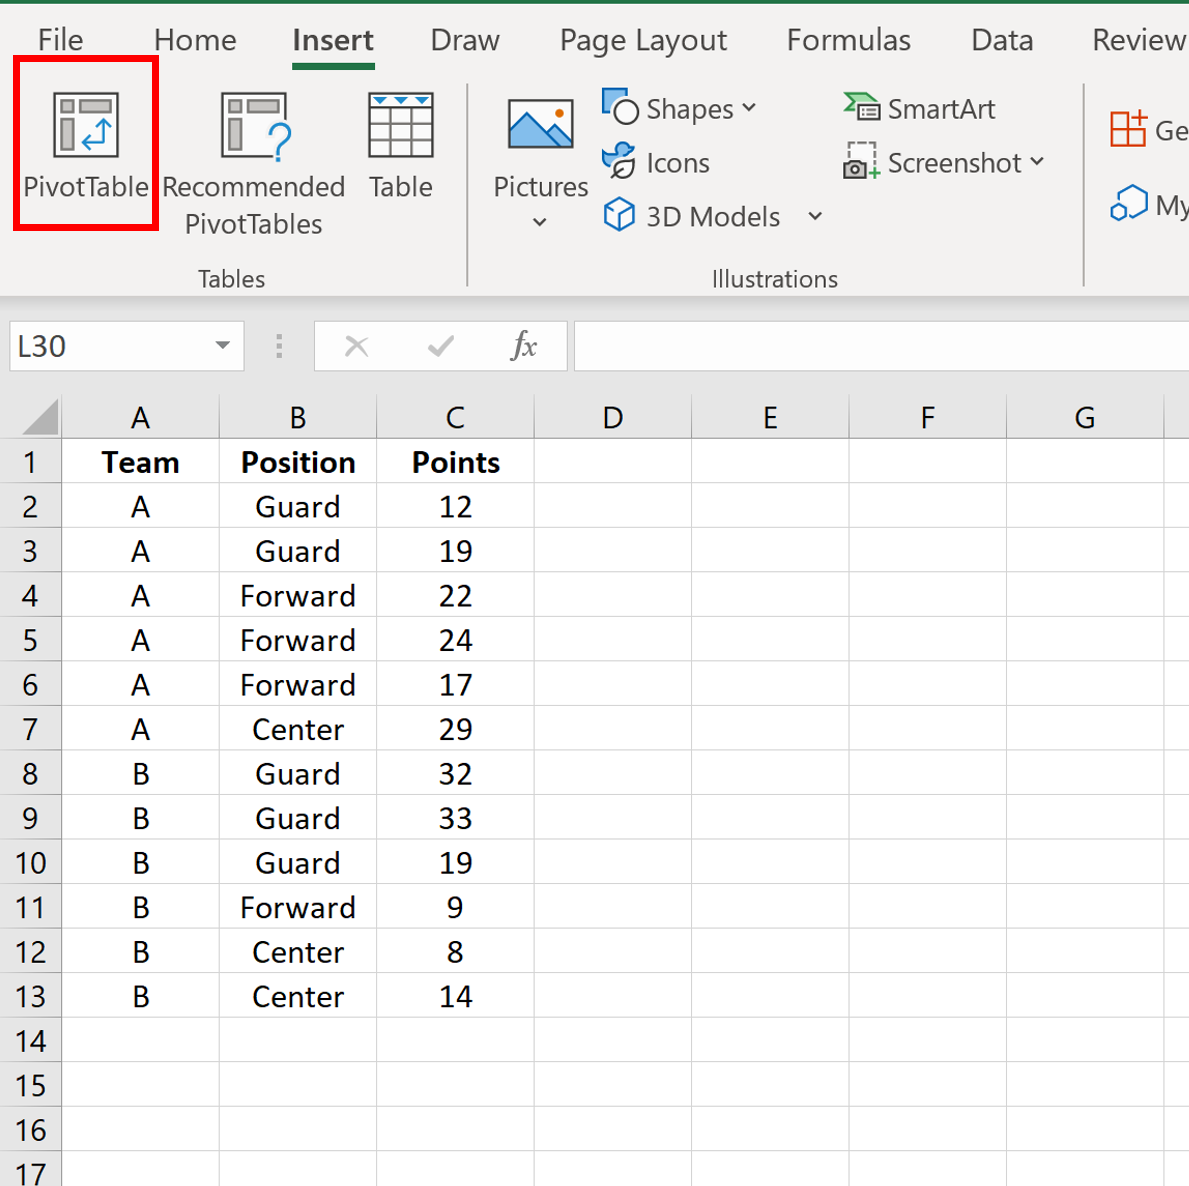
Une fois les données rigoureusement normalisées et encadrées au sein d’une table structurée, l’initialisation du tableau croisé s’exécute à partir de l’interface principale d’Excel. L’utilisateur positionne le curseur sur n’importe quelle cellule interne à la table source. Cette action contextuelle permet à l’application d’identifier immédiatement l’ensemble des limites physiques du tableau. Il convient ensuite de diriger le pointeur vers le ruban supérieur d’Excel, de cliquer sur l’onglet Insertion, puis de sélectionner l’icône intitulée Tableau croisé dynamique, située à l’extrême gauche dans le groupe de commandes Tableaux.
Une boîte de dialogue nodale intitulée Créer un tableau croisé dynamique surgit au premier plan. Le premier segment de cette interface concerne la sélection des données à analyser. Si la normalisation préalable a été effectuée dans les règles de l’art, le champ radio Sélectionner un tableau ou une plage affiche automatiquement le nom d’entité structurée attribué à l’étape précédente (par exemple Tbl_Enquete_2026). Si une plage traditionnelle avait été employée, elle apparaîtrait sous la notation absolue figée, ce qui nécessiterait une vérification manuelle scrupuleuse des coordonnées des cellules limites.
Dans la section inférieure de cette même boîte de dialogue se trouve une option particulièrement puissante : la case à cocher Ajouter ces données au modèle de données. Cette option mobilise le moteur relationnel interne d’Excel (Power Pivot, basé sur la technologie xVelocity VertiPaq). L’activation de cette case est recommandée lorsque le jeu de données dépasse plusieurs centaines de milliers d’enregistrements, lorsqu’il s’avère nécessaire d’établir des relations jointes entre plusieurs tables distinctes sans recourir à RECHERCHEX, ou lorsque l’analyste envisage d’utiliser des métriques avancées telles que le dénombrement distinct univoque (Distinct Count).
4.2 Définition de l’emplacement de destination de la matrice
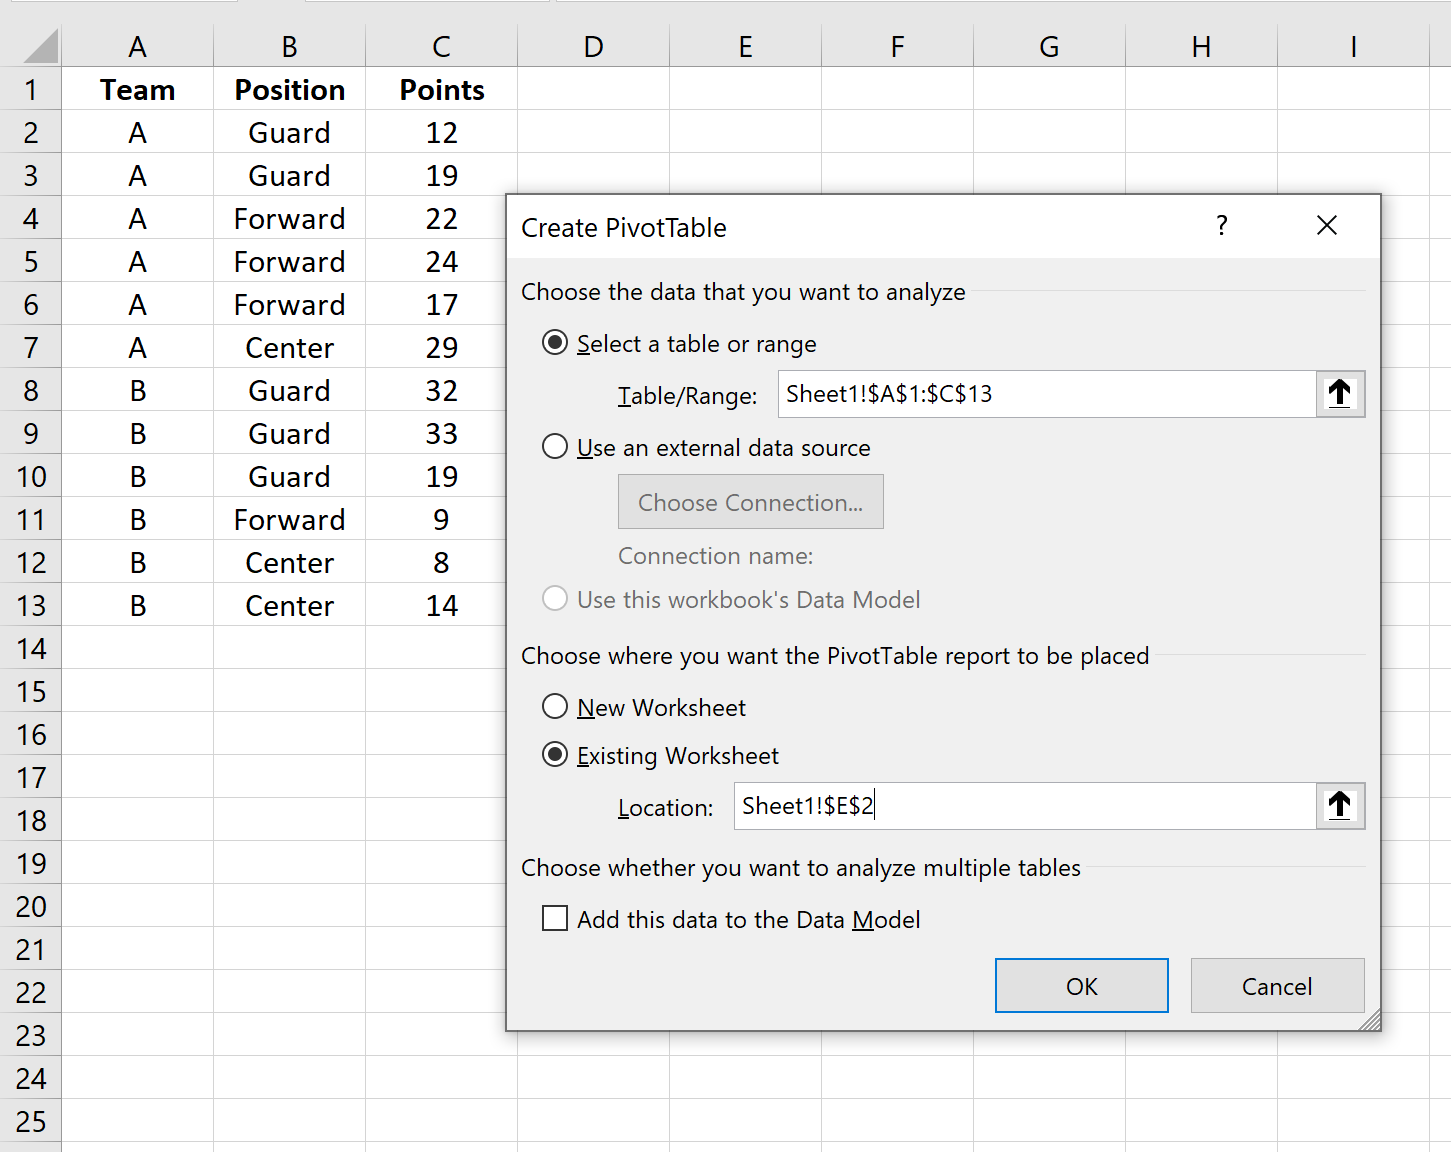
Le second segment décisionnel de la boîte de dialogue d’initialisation porte sur l’ancrage spatial de la matrice de contingence à générer. Excel soumet un arbitrage binaire : héberger le tableau au sein d’une Nouvelle feuille de calcul ou l’implanter dans la Feuille de calcul existante. Dans le cadre de recherches scientifiques ou de rapports professionnels complexes, le consensus méthodologique prescrit d’opter résolument pour l’affectation sur une nouvelle feuille de calcul.
Ce choix garantit une séparation architecturale nette entre la couche de stockage des micro-données primaires et la couche de synthèse analytique. L’implantation sur une feuille dédiée prévient tout risque de collision spatiale. En effet, un tableau croisé dynamique est une entité extensible : selon les filtres appliqués ou les regroupements déployés, sa dimension matricielle peut varier de façon substantielle. S’il est positionné sur la même feuille à proximité d’autres plages de données, toute expansion de colonnes ou de lignes risque de générer une erreur de chevauchement critique et d’altérer la lisibilité de la feuille de travail.
Si des contraintes ergonomiques spécifiques imposent d’insérer le tableau sur une feuille préexistante (par exemple dans le cadre de la construction d’un tableau de bord de synthèse décisionnelle), il convient de sélectionner le bouton radio correspondant et de désigner une cellule cible unique via la zone d’adresse. Cette cellule constituera l’angle supérieur gauche précis où s’ancrera l’étiquette de la première ligne et de la première colonne du futur tableau croisé. Il est alors primordial de réserver un espace libre suffisant vers la droite et vers le bas pour accueillir le volume maximal prévisible de la matrice de contingence.
5. Étape 3 : Configuration structurelle des zones d’analyse
5.1 Attribution des dimensions de lignes et de colonnes
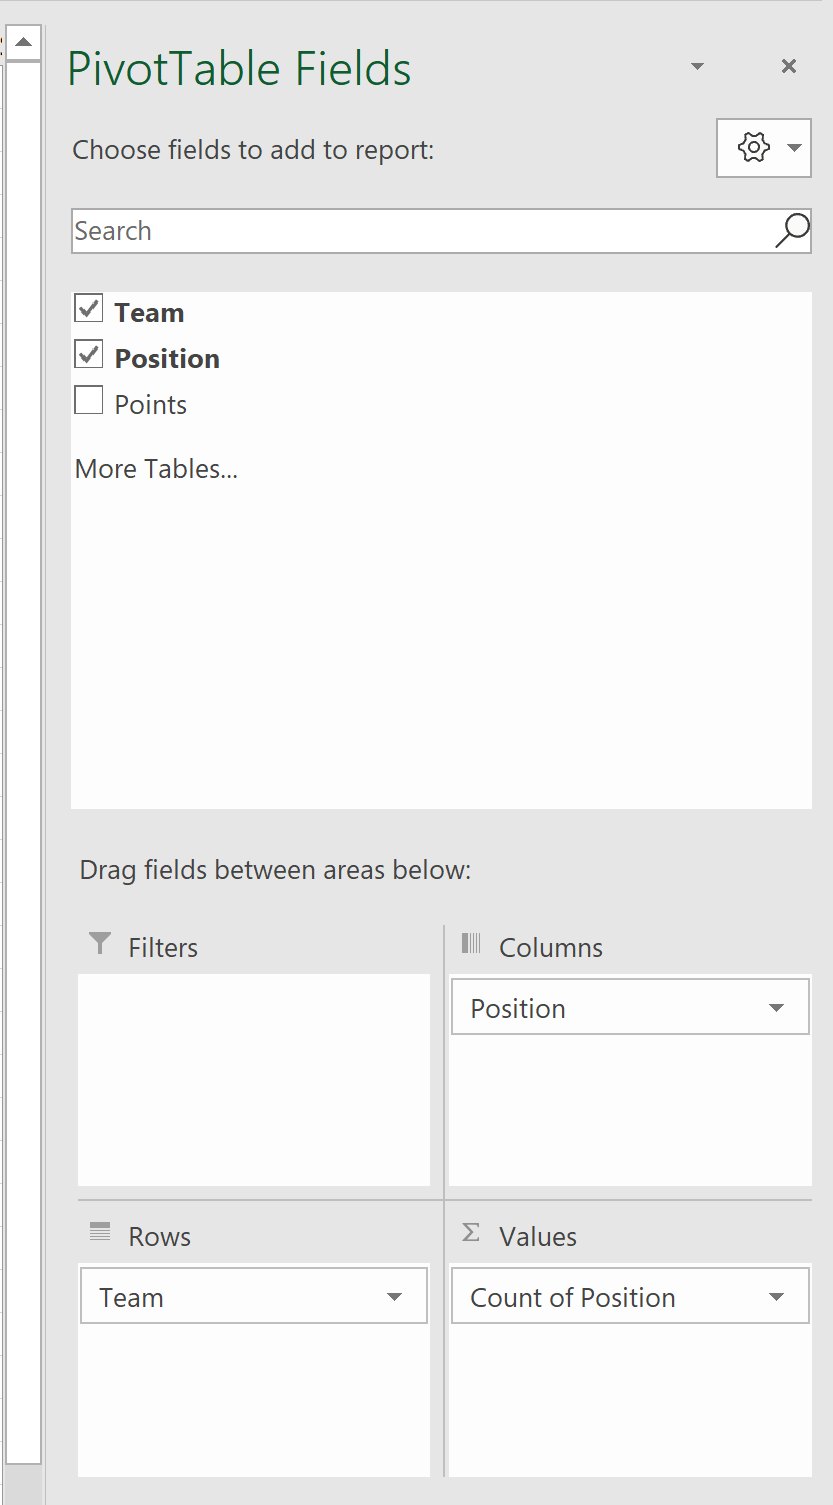
La validation de la boîte de dialogue d’initialisation provoque l’affichage d’un nouvel espace de travail constitué de deux éléments complémentaires : à gauche, une zone rectangulaire vierge réservée à la restitution de la matrice ; à droite, le panneau contextuel intitulé Champs de tableau croisé dynamique. Ce volet latéral d’ingénierie présente la liste exhaustive des variables disponibles dans la table source, surmontant une grille partitionnée en quatre zones fonctionnelles opérationnelles : Filtres, Colonnes, Lignes et Valeurs.
La configuration de la matrice de contingence repose sur une technique élémentaire de glisser-déposer (drag-and-drop). Pour construire une table bivariée standard, l’analyste sélectionne la première variable catégorielle et la fait glisser dans la zone Lignes, puis saisit la seconde variable catégorielle pour la déposer dans la zone Colonnes. Dès ce geste accompli, la matrice s’amorce : les différentes modalités de la première variable s’alignent le long de l’axe vertical, tandis que les modalités de la seconde s’étirent le long de l’axe horizontal, créant ainsi les coordonnées matricielles (i, j) prêtes à accueillir les effectifs empiriques.
Le choix de l’affectation spatiale — quelle variable placer en ligne et quelle variable positionner en colonne — obéit à des conventions sémiologiques et cognitives éprouvées en statistique descriptive :
- Règle de la variable causale ou indépendante : Par convention usuelle, la variable explicative, prospective ou de traitement (variable indépendante, souvent notée X) est fréquemment positionnée en ligne, tandis que la variable de résultat, d’effet ou de réponse (variable dépendante, notée Y) est affectée en colonne.
- Principe de cardinalité et de lisibilité : Si l’une des variables comporte un nombre substantiellement plus élevé de modalités que l’autre, il est ergonomiquement préférable de l’affecter à la zone des lignes. L’œil humain parcourt un défilement vertical avec une aisance cognitive bien supérieure à celle d’un défilement horizontal infini.
- Hiérarchisation multivariée : Excel permet d’empiler plusieurs variables au sein de la zone des lignes ou des colonnes. Ce mécanisme génère une imbrication hiérarchique arborescente particulièrement féconde pour contrôler l’effet d’une variable de confusion ou pour conduire une analyse en sous-strates démographiques successives.
5.2 Paramétrage de la zone des valeurs empiriques
Une matrice de contingence ne prend son sens opératoire que lorsque les cellules de croisement sont peuplées par le dénombrement effectif des observations. Pour concrétiser cette mesure, l’analyste doit sélectionner un champ d’identification au sein de la liste des variables et le glisser dans la zone Valeurs située dans l’angle inférieur droit du panneau contextuel. Si le champ sélectionné contient des données purement textuelles (telles qu’un identifiant alphanumérique d’observation ou une variable catégorielle quelconque), Excel applique automatiquement l’opérateur d’agrégation Nombre (ou décompte des fréquences).
Une attention technique scrupuleuse doit être portée à la nature de la fonction d’agrégation attribuée par défaut par le logiciel. Si le champ glissé dans la zone Valeurs est de nature numérique (par exemple un identifiant numérique de répondant codé 1, 2, 3... ou une variable d’âge), Excel commet fréquemment l’erreur systématique d’appliquer la fonction d’agrégation Somme. Dans ce cas de figure, la matrice n’affiche plus l’effectif nij d’individus dans chaque case, mais la somme arithmétique de leurs identifiants, produisant un résultat totalement aberrant sur le plan de la statistique descriptive.
Pour corriger ou verrouiller ce paramètre, il convient de cliquer sur la petite flèche déroulante adossée au champ présent dans la zone Valeurs, de sélectionner l’option Paramètres des champs de valeurs, puis, dans l’onglet Synthétiser les valeurs par, de sélectionner expressément la commande Nombre. L’analyste valide ensuite la commande. Le tableau restitue alors rigoureusement le comptage des occurrences observationnelles. La dernière vérification préliminaire consiste à confronter le total général situé dans le coin inférieur droit de la matrice avec l’effectif global N de l’échantillon répertorié dans la table source : ces deux métriques doivent concorder de manière rigoureuse.
6. Étape 4 : Interprétation descriptive et analyse marginale des résultats
6.1 Décomposition des totaux marginaux
Dès que la matrice de contingence est générée avec ses décomptes bruts, la première phase de l’investigation analytique consiste à scruter avec acuité les distributions marginales. Ces distributions sont représentées par les vecteurs de sommation situés à l’extrémité droite de chaque rangée (totaux marginaux de lignes ni•) et à la base de chaque colonne (totaux marginaux de colonnes n•j). L’examen de ces marges fournit un panorama synthétique et immédiat de la prévalence intrinsèque de chaque modalité, considérée isolément de toute interaction croisée.
L’analyse des totaux de lignes permet d’évaluer la représentativité et l’équilibre de l’échantillonnage au regard de la variable primaire. Par exemple, si l’on croise le statut d’adoption d’une technologie avec la catégorie d’âge, les totaux marginaux de lignes renseignent sur la distribution démographique globale de la population étudiée. Une asymétrie trop marquée — telle qu’une sous-représentation critique d’une tranche d’âge donnée par rapport aux paramètres de la population mère — est immédiatement détectée à cette étape. Ce diagnostic évite de tirer des conclusions abusives sur des sous-populations marginales dont la taille d’échantillon s’avérerait insuffisante pour garantir la robustesse statistique.
De la même façon, les totaux marginaux de colonnes permettent de quantifier l’incidence globale du phénomène investigué à travers l’ensemble du corpus. La confrontation des différentes marges permet également de détecter la présence éventuelle de cellules d’intersection caractérisées par des effectifs extrêmement faibles (inférieurs à 5 unités). Cette détection précoce est capitale : elle avertit le chercheur que l’application mécanique ultérieure d’un test d’hypothèse asymptotique classique, tel que le Khi-deux de Pearson, risquerait d’être invalidée en raison de la violation des conditions de validité de Cochran.
6.2 Interprétation contextuelle des cellules conjointes
Après l’audit des totaux marginaux, le regard analytique doit se porter sur le cœur de la matrice : les cellules de croisement contenant les effectifs conjoints nij. L’interprétation descriptive de ces intersections catégorielles spécifiques vise à identifier des patterns d’attraction ou de répulsion entre modalités. Une cellule d’intersection donnée matérialise la concrétisation empirique de la rencontre de deux trajectoires attributives.
Il est impératif de relier ces distributions observées aux hypothèses de travail ou au cadre conceptuel guidant la recherche. L’analyste recherche des écarts perceptibles par rapport à une situation d’homogénéité apparente :
- Surreprésentation empirique : Une concentration inattendue d’individus dans une cellule spécifique (par exemple, une modalité de formation professionnelle associée massivement à un niveau élevé d’adoption d’un outil numérique) suggère une affinité positive entre ces deux dimensions.
- Sous-représentation empirique : Inversement, la quasi-absence d’observations dans une case théoriquement plausible (cellule quasi-vide ou nulle) constitue une information tout aussi précieuse, témoignant d’un phénomène d’éviction ou d’incompatibilité empirique entre les catégories sous observation.
- Limites du décompte brut : L’interprétation fondée exclusivement sur les effectifs absolus s’avère trompeuse dès lors que les totaux marginaux sont inégaux. Si une modalité regroupe 80 % de l’échantillon global, il est mathématiquement prévisible que toutes ses cellules conjointes affichent des valeurs numériques élevées sans que cela ne traduise la moindre association statistique réelle. D’où la nécessité méthodologique absolue de basculer vers des métriques relatives normalisées.
7. Étape 5 : Personnalisation des calculs et normalisation relative
7.1 Affichage des pourcentages du total général
Pour neutraliser l’effet d’échelle imposé par la taille absolue de la cohorte et rendre les comparaisons immédiatement intelligibles, Excel propose une palette de métriques relatives via son moteur de calcul interne. La transformation la plus globale consiste à exprimer chaque effectif cellulaire en tant que fraction relative de l’ensemble des observations du tableau, formalisant ainsi l’estimation empirique de la distribution des probabilités conjointes pij = nij / N.
Pour implémenter cette normalisation globale, l’utilisateur exécute un clic droit sur n’importe quelle cellule numérique à l’intérieur de la matrice de contingence. Dans le menu contextuel qui se déploie, il convient de survoler l’option Afficher les valeurs, puis de sélectionner explicitement la commande % du total général. Instantanément, l’ensemble des effectifs bruts est converti en pourcentages. Les totaux marginaux de lignes et de colonnes s’ajustent pour refléter les probabilités marginales respectives, tandis que la cellule située à l’intersection ultime des totaux généraux affiche rigoureusement la valeur de 100,00 %.
Sur le plan interprétatif, cette perspective offre une vision panoramique de la composition de l’échantillon. Elle permet de répondre sans ambiguïté à des interrogations de nature macro-descriptive, telles que : « Quelle proportion globale de l’ensemble de notre population d’étude est constituée de cadres supérieurs ayant manifesté une intention d’achat favorable ? » Cette métrique s’avère particulièrement adaptée aux communications institutionnelles et aux synthèses exécutives destinées à des publics non spécialistes de l’économétrie.
7.2 Calcul des profils-lignes et profils-colonnes
Bien que le pourcentage du total général fournisse une vue d’ensemble macroscopique, il demeure méthodologiquement insuffisant pour analyser la nature conditionnelle des relations entre variables. L’investigateur doit alors recourir aux distributions conditionnelles, incarnées par les profils-lignes et les profils-colonnes. Cette opération correspond formellement au calcul des probabilités conditionnelles selon le théorème de Bayes, en neutralisant l’inégalité de volume existant entre les différents sous-groupes.
L’activation de ces calculs s’effectue avec la même fluidité au sein d’Excel. En cliquant avec le bouton droit sur la zone de données matricielles, puis en naviguant dans Afficher les valeurs, l’analyste peut sélectionner l’un des deux modes fondamentaux de conditionnement :
- Pourcentage du total de la ligne (Profil-ligne) : Chaque cellule (i, j) est divisée par le total marginal de sa propre ligne (nij / ni•). La somme de chaque rangée horizontale totalise ainsi rigoureusement 100 %. Cette approche répond à la question : « Sachant qu’un individu appartient à la modalité i de la variable de ligne, quelle est la probabilité qu’il présente la modalité j de la variable de colonne ? » Ce paramétrage est idéal lorsque la variable indépendante est positionnée en ligne, permettant d’évaluer directement l’impact de différents traitements ou conditions démographiques sur la distribution des réponses.
- Pourcentage du total de la colonne (Profil-colonne) : Chaque cellule (i, j) est divisée par le total marginal de sa colonne d’appartenance (nij / n•j), conférant à chaque vecteur vertical une sommation exacte de 100 %. Cette configuration répond à une logique rétrospective ou étiologique : « Parmi les individus présentant le comportement de résultat j, quelle est la proportion de ceux qui proviennent de la catégorie i ? »
La distinction entre profil-ligne et profil-colonne est d’une portée méthodologique décisive. Confondre le conditionnement direct P(B | A) avec le conditionnement inverse P(A | B) — écueil classique connu sous le nom d’illusion conditionnelle ou sophisme du procureur — conduit à des erreurs d’interprétation désastreuses. L’analyste doit impérativement choisir son mode de calcul en fonction de la direction causale postulée par son protocole de recherche.
7.3 Gestion de la précision numérique et des décimales
L’affichage par défaut des calculs de pourcentages au sein d’Excel intègre fréquemment deux décimales, voire bascule vers un affichage flottant générateur de surcharge cognitive. Sur le plan des standards de publication académique, notamment ceux édictés par l’American Psychological Association (APA), la précision numérique doit faire l’objet d’une standardisation rigoureuse. L’affichage systématique d’un trop grand nombre de décimales donne une illusion de précision trompeuse, particulièrement lorsque la taille de l’échantillon ne justifie pas une telle finesse de mesure.
Pour harmoniser durablement le formatage numérique sans altérer les calculs de précision sous-jacents, il ne faut pas employer les boutons d’arrondi du ruban Accueil de manière superficielle. Il convient plutôt d’intervenir à la source du champ dynamique :
- Ouvrez la boîte de dialogue contextuelle Paramètres des champs de valeurs.
- Cliquez sur le bouton Format de nombre situé dans le coin inférieur gauche de l’interface.
- Dans la catégorie Pourcentage, configurez précisément le paramètre des décimales sur 1 (ou 2 selon les normes strictes imposées par la revue cible de destination).
- Validez en cliquant sur OK sur les deux fenêtres successives.
Cette standardisation garantit que l’arrondi d’affichage sera préservé de façon pérenne, même en cas de restructuration dynamique des axes du tableau. De surcroît, elle permet de prévenir les artefacts visuels d’arrondi dans les sommations marginales. Dans certaines publications imprimées, la somme mécanique de pourcentages arrondis à une seule décimale peut parfois totaliser 99,9 % ou 100,1 % ; la maîtrise du formatage numérique permet de documenter cette convention mathématique usuelle dans les notes de bas de tableau sans susciter de doutes sur la rigueur du traitement computationnel.
8. Étape 6 : Optimisation visuelle, mise en page et sémiotique graphique
8.1 Sélection de la disposition académique du tableau
Par défaut, lors de la genèse d’un tableau croisé dynamique, Excel applique une disposition visuelle dite « compacte ». Bien qu’économique en matière d’encombrement spatial, la disposition compacte superpose souvent les étiquettes de lignes hiérarchiques au sein d’une seule et même colonne, ce qui complique l’extraction automatisée des résultats et enfreint les critères de clarté prescrits par les manuels de rédaction scientifique. Pour conférer à la matrice de contingence une allure académique professionnelle, il est primordial de modifier son architecture de présentation.
Pour ce faire, l’analyste sélectionne une cellule quelconque au sein du tableau pour faire apparaître les deux onglets contextuels dédiés dans le ruban : Analyse de tableau croisé dynamique et Création. En accédant à l’onglet Création, à l’extrême gauche, se trouve le groupe de commandes Disposition. Il convient de cliquer sur le menu déroulant Disposition du rapport et de sélectionner impérativement l’option Afficher sous forme tabulaire.
Cette commande réorganise instantanément la structure visuelle en conférant à chaque dimension catégorielle une colonne distincte et exclusive, munie de son propre en-tête de champ clairement identifié. Dans ce même menu, il est fréquemment judicieux de choisir l’option Répéter toutes les étiquettes d’éléments si l’on projette d’exporter ensuite les résultats vers un autre logiciel d’analyse ou de programmation (tel que R ou Python), évitant ainsi la présence de cellules vides sur les lignes d’occurrences multiples. Enfin, dans le groupe adjacent, l’analyste peut moduler ou désactiver l’affichage des Sous-totaux et des Totaux généraux afin d’épurer la matrice de tout parasite graphique inutile à la démonstration.
8.2 Application du formatage conditionnel discret
L’exploration visuelle de grandes matrices de contingence (par exemple, un tableau croisant 10 classes socioprofessionnelles avec 8 typologies d’usages numériques) peut s’avérer laborieuse face à une grille dense d’effectifs ou de pourcentages. L’incorporation d’une sémiotique graphique par le biais de la mise en forme conditionnelle permet d’orienter le regard de l’évaluateur vers les gradients de concentration statistique, transformant la matrice en une carte thermique (heatmap) synthétique.
Cependant, l’application du formatage conditionnel sur un tableau croisé dynamique obéit à des règles de ciblage strictes pour ne pas perturber l’interprétation marginale. Il ne faut jamais sélectionner manuellement une plage de cellules à la souris pour lui appliquer une règle brute. La procédure correcte consiste à :
- Sélectionner une cellule de valeur interne (hors totaux marginaux).
- Naviguer vers Accueil > Mise en forme conditionnelle > Nuances de couleurs.
- Sélectionner une palette monochromatique sobre (par exemple, un dégradé allant du blanc au bleu ardoise), proscrivant les palettes multicolores criardes de type « feu tricolore » (vert-jaune-rouge), jugées non conformes aux chartes graphiques académiques et problématiques pour les lecteurs atteints de daltonisme.
- Cliquer sur la petite icône d’options contextuelles de mise en forme qui apparaît à côté de la cellule modifiée, et cocher le bouton radio : Appliquer à toutes les cellules affichant les valeurs de « Effectif » pour « Ligne » et « Colonne ».
Cette précaution méthodologique garantit que la mise en forme conditionnelle s’appliquera exclusivement et dynamiquement aux cellules d’intersection empirique, en excluant formellement les colonnes et lignes de totaux marginaux. Si les totaux marginaux étaient inclus par erreur dans le spectre colorimétrique, leur valeur nécessairement plus élevée saturerait l’échelle de couleur, réduisant les contrastes internes des cellules conjointes à une uniformité chromatique illisible.
9. Étape 7 : Filtrage avancé, segmentation et sous-échantillonnage
9.1 Intégration de la zone Filtre de rapport
Dans de nombreuses situations expérimentales ou quasi-expérimentales, l’investigateur doit tester la persistance ou la robustesse d’une relation bivariée à travers différentes strates d’une troisième variable modératrice (par exemple, contrôler la relation entre formation et adoption en fonction du genre ou de la taille de l’entreprise). Excel répond à ce besoin de stratification multivariée grâce à la zone fonctionnelle Filtres (anciennement désignée sous le terme de Filtre de rapport) du panneau des champs.
En glissant une variable de contrôle dans cette zone, Excel insère une série de lignes de commande au sommet de la matrice de contingence. Cette interface déroulante permet d’isoler instantanément une modalité singulière de la variable modératrice. Dès la sélection d’une modalité spécifique, l’intégralité du tableau croisé dynamique recalcule ses effectifs, ses profils-lignes et ses distributions marginales pour ne restituer que la sous-population répondant strictement à ce critère de stratification.
Ce mécanisme permet d’évaluer la stabilité des patrons de contingence à travers les différents sous-échantillons. Toutefois, l’utilisation des listes déroulantes de filtres classiques présente une limite ergonomique majeure dans le cadre de présentations interactives ou d’audits d’équipes de recherche : l’état actif du filtre demeure peu lisible au premier coup d’œil lorsque plusieurs critères de sélection sont superposés. De surcroît, la sélection multiple au sein d’un menu déroulant classique exige plusieurs clics fastidieux, limitant l’agilité de l’investigation exploratoire.
9.2 Utilisation des segments interactifs pour l’exploration de données
Pour pallier les rigidités des filtres classiques, Excel intègre depuis sa version 2010 une interface visuelle de sous-échantillonnage de haute volée : les Segments (ou Slicers). Les segments transforment le filtrage statique en un ensemble de modules graphiques interactifs pourvus de boutons cliquables affichant en permanence l’état d’inclusion ou d’exclusion de chaque modalité catégorielle.
L’insertion d’un segment s’opère de manière intuitive :
- Positionnez le curseur actif à l’intérieur du tableau croisé dynamique.
- Accédez au ruban supérieur contextuel intitulé Analyse de tableau croisé dynamique.
- Dans le groupe Filtrer, cliquez avec force sur la commande Insérer un segment.
- Une boîte de dialogue répertorie toutes les dimensions du jeu de données : cochez la ou les variables de stratification désirées (par exemple,
Région,Genre,Année d'observation) et validez.
Les blocs de segments apparaissent alors en surimpression au-dessus de la feuille de calcul. Un simple clic sur l’un des boutons filtre instantanément la matrice croisée sur cette sous-population. La sélection disjointe ou continue s’effectue en maintenant la touche Ctrl ou Maj enfoncée. En outre, une fonctionnalité structurelle fondamentale réside dans les Connexions de rapports : en effectuant un clic droit sur l’en-tête d’un segment et en sélectionnant cette commande, il est possible de coupler ce segment unique à plusieurs tableaux croisés dynamiques distincts disséminés dans le classeur. Ainsi, une seule manipulation sur le segment synchronise l’ensemble des matrices de contingence associées, offrant un environnement d’exploration multidimensionnelle d’une efficacité comparable à des progiciels de Business Intelligence dédiés.
10. Étape 8 : Extension inférentielle : implémentation du test du Khi-deux dans Excel
10.1 Construction de la table des effectifs théoriques
L’observation empirique d’écarts au sein d’une matrice de contingence ne permet pas, à elle seule, de conclure à l’existence d’une relation statistiquement significative au sein de la population parente. Ces variations peuvent résulter des simples fluctuations d’échantillonnage aléatoire. Pour dépasser le registre purement descriptif et aborder l’inférence statistique, il est de pratique courante de soumettre la table au test d’indépendance du Khi-deux (χ²) de Pearson. Bien qu’Excel ne propose pas d’option native en un clic au sein de l’interface des TCD pour calculer automatiquement cette statistique, il est aisé de construire une matrice satellite d’effectifs théoriques (ou attendus) adossée au tableau croisé.
Rappelons que sous l’hypothèse nulle (H₀) d’indépendance stricte entre les deux dimensions, l’effectif théorique d’une cellule (i, j) — noté eij — correspond au produit de son total marginal de ligne par son total marginal de colonne, divisé par la taille totale de l’échantillon :
eij = (ni• × n•j) / N
Pour matérialiser cette équation dans la feuille de calcul, l’analyste reproduit à côté ou sous le tableau croisé dynamique une grille vide présentant rigoureusement les mêmes en-têtes de lignes et de colonnes. Dans la première cellule active de cette matrice théorique, une formule combinant adressages absolus et relatifs est saisie pour pointer vers les marges du tableau croisé dynamique :
=($M4 * N$8) / $M$8
(où $M4 représente la cellule du total marginal de la ligne courante avec colonne verrouillée, N$8 figure le total marginal de la colonne courante avec ligne verrouillée, et $M$8 désigne l’ancrage absolu de la cellule de totalisation générale N).
Cette formulation judicieuse des symboles dollars permet d’étirer la formule horizontalement et verticalement sur l’ensemble de la grille sans la moindre altération relationnelle. Une fois cette matrice d’effectifs théoriques complétée, l’analyste doit impérativement auditer la conformité aux critères de Cochran : aucun effectif théorique eij ne doit être strictement inférieur à 1, et au maximum 20 % des cellules théoriques peuvent afficher une valeur inférieure à 5. Si cette condition est violée, les conclusions du test du Khi-deux risquent d’être invalides.
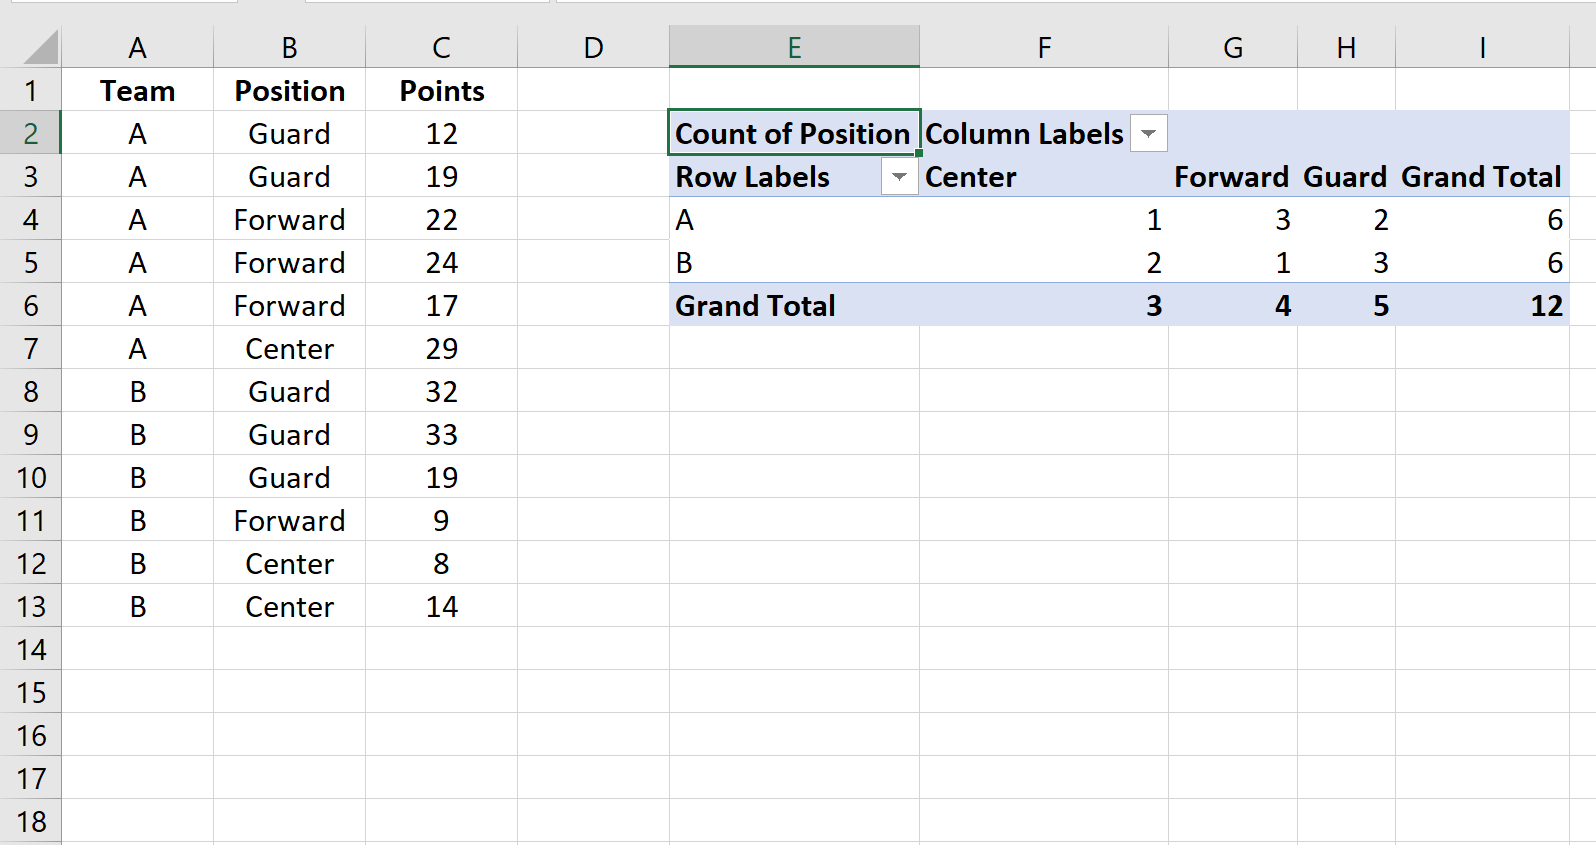
10.2 Calcul de la statistique du test et de la p-valeur
Dès que les deux matrices homologues — la matrice des effectifs réels observés nij issue du tableau croisé et la matrice des effectifs théoriques attendus eij calculée algébriquement — sont finalisées, le calcul de la probabilité critique (p-value) associée au test d’indépendance s’exécute directement à l’aide de la fonction statistique native d’Excel : TEST.KHIDEUX.
Dans une cellule d’analyse distincte, l’utilisateur formule l’appel de fonction suivant :
=TEST.KHIDEUX(plage_reelle; plage_theorique)
L’argument plage_reelle référence précisément le bloc rectangulaire des cellules d’intersection du tableau croisé dynamique (en excluant formellement les lignes et colonnes de totaux marginaux). L’argument plage_theorique sélectionne le bloc homologue correspondant au sein de la matrice calculée à l’étape précédente. La fonction retourne instantanément la probabilité critique asymptotique p sous la distribution théorique du Khi-deux à (r – 1)(c – 1) degrés de liberté.
La règle de décision statistique standard s’applique alors sans ambiguïté au seuil de significativité conventionnel fixé a priori (habituellement α = 0,05) :
- Si p < α : L’hypothèse nulle d’indépendance stochastique est rejetée au profit de l’hypothèse alternative (H₁). L’analyste conclut avec un risque d’erreur contrôlé qu’il existe une association statistiquement significative entre les deux variables étudiées.
- Si p ≥ α : L’hypothèse nulle ne peut être rejetée. Les variations constatées au sein de l’échantillon doivent être attribuées aux simples aléas de l’échantillonnage.
Toutefois, la significativité statistique ne doit pas être confondue avec l’intensité pratique de la relation. Pour quantifier la force substantielle du lien indépendamment de la taille N de l’échantillon, il est recommandé de calculer le coefficient de contingence normalisé intitulé le V de Cramer. Celui-ci s’exprime mathématiquement par l’équation suivante :
V = √[ χ² / (N × min(r – 1, c – 1)) ]
où la statistique globale χ² peut être retrouvée via la fonction inverse LOI.KHIDEUX.INVERSE(p_valeur; ddl). Le V de Cramer oscille strictement entre 0 (absence totale d’association) et 1 (association déterministe parfaite), fournissant une métrique standardisée de la taille d’effet indispensable à toute publication scientifique rigoureuse.
11. Diagnostics des erreurs fréquentes et limites méthodologiques dans Excel
11.1 Résolution des anomalies techniques récurrentes
Même chez les utilisateurs chevronnés d’Excel, la manipulation des tableaux croisés dynamiques se heurte régulièrement à des dysfonctionnements logiciels perturbants mais aisés à diagnostiquer. L’anomalie la plus exaspérante réside dans l’agrégation intempestive en Somme au lieu de Nombre lors du glisser-déposer d’une variable dans la zone des valeurs. Ce comportement se déclenche automatiquement dès qu’Excel identifie ne serait-ce qu’une seule cellule vide ou une seule valeur textuelle au sein d’une colonne majoritairement composée de nombres. La résolution exige d’assainir la colonne source en s’assurant que l’ensemble des cellules partagent un typage numérique homogène, ou de forcer manuellement le paramètre de synthèse sur Nombre comme explicité en section 5.2.
Une seconde pathologie technique fréquente concerne le gel apparent des résultats lors de la modification des données brutes. Contrairement aux formules matricielles classiques qui recalculent leurs sorties de façon synchrone, le tableau croisé dynamique dépend exclusivement de son cache interne statique. Toute injection, modification ou suppression d’enregistrements dans la table source demeure rigoureusement invisible dans la matrice tant que l’utilisateur n’exécute pas une commande explicite d’actualisation. Celle-ci s’opère par le raccourci Alt + F5, ou via un clic droit sur la matrice suivi de la sélection de la commande Actualiser.
Enfin, un désagrément ergonomique récurrent réside dans le réajustement automatique de la largeur des colonnes lors de chaque actualisation, venant anéantir le travail de mise en page manuelle conduit par l’analyste. Pour juguler ce comportement intrusif, il suffit d’effectuer un clic droit dans le tableau croisé dynamique, de sélectionner Options du tableau croisé dynamique, puis, dans l’onglet Disposition et mise en forme, de décocher scrupuleusement la case intitulée Ajuster automatiquement la largeur des colonnes lors de la mise à jour. Dès lors, le formatage spatial demeure invariant au fil des rafraîchissements computationnels.
11.2 Pièges méthodologiques et interprétatifs
Au-delà des incidents purement logiciels, la restitution d’un tableau croisé expose l’analyste à des illusions statistiques graves si l’interprétation s’affranchit d’une épistémologie rigoureuse. Le piège le plus universel consiste à inférer un lien de causalité directe et fonctionnelle à partir d’une simple corrélation de contingence observée. Le fait que deux modalités soient statistiquement associées avec une p-valeur infinitésimale n’implique en aucun cas que la première produise mécaniquement la seconde. Une telle association peut résulter d’une corrélation fortuite ou être entièrement gouvernée par une tierce variable sous-jacente non mesurée (facteur de confusion).
L’illustration la plus spectaculaire de cette vulnérabilité analytique est formalisée par le paradoxe de Simpson. Ce phénomène contrefactuel survient lorsqu’une association observée au sein d’une table de contingence globale bivariée s’inverse totalement ou disparaît dès lors que les données sont stratifiées selon les modalités d’une troisième variable pertinente. Par exemple, un traitement médical peut sembler afficher un taux de guérison supérieur pour le groupe B par rapport au groupe A sur la matrice générale ; or, lorsqu’on segmente le tableau par tranche de sévérité de la pathologie, le groupe A s’avère systématiquement supérieur dans chaque sous-strate. L’omission d’une variable de confusion majeure au sein d’un simple tableau croisé bivarié peut donc conduire à des décisions stratégiques ou cliniques radicalement erronées.
Un autre écueil méthodologique réside dans le morcellement excessif de l’échantillon par l’accumulation inconsidérée de variables imbriquées en lignes et en colonnes. À mesure que l’on croise trois, quatre ou cinq dimensions simultanément, le nombre total de cellules croisées explose de façon combinatoire, tandis que la taille de l’échantillon global N demeure constante. La matrice se retrouve alors criblée de cellules structuralement vides ou à effectifs anecdotiques, détruisant tout pouvoir de généralisation et rendant caduque toute tentative de modélisation inférentielle sérieuse.
11.3 Frontières fonctionnelles d’Excel face aux logiciels statistiques dédiés
Bien qu’Excel constitue un instrument remarquable de flexibilité pour l’ingestion, le nettoyage et l’exploration préliminaire de contingence, il atteint rapidement des frontières structurelles infranchissables dès lors que l’on aborde l’analyse avancée des données catégorielles. La première déficience majeure d’Excel réside dans l’absence de calcul automatisé natif des résidus ajustés standardisés (ou résidus d’Haberman). En l’absence de ces indices indispensables, le chercheur sait que la matrice globale rejette l’indépendance, mais Excel ne lui fournit aucun outil direct pour identifier mathématiquement quelles cellules d’intersection spécifiques contribuent de façon statistiquement significative à la déviation globale du Khi-deux.
En second lieu, dès que le nombre de variables catégorielles à croiser simultanément dépasse deux ou trois, l’analyse descriptive matricielle doit s’effacer au profit de modélisations statistiques supérieures, telles que les modèles log-linéaires ou l’Analyse des Correspondances Multiples (ACM). Ces techniques sophistiquées visent à décomposer géométriquement les inerties et à estimer les interactions d’ordre supérieur sans subir l’aplatissement matriciel contraignant imposé par un tableur. Excel ne propose aucun algorithme natif d’algèbre linéaire capable de projeter ces coordonnées factorielles sur des plans orthogonaux.
Par conséquent, lorsque l’investigateur identifie ces besoins au fil de son exploration sur Excel, la démarche scientifique la plus saine consiste à opérer une migration contrôlée vers des environnements statistiques dédiés tels que R (avec des packages tels que vcd, FactoMineR ou epitools), Python (avec pandas et scipy.stats), IBM SPSS Statistics ou encore Jamovi. Excel conserve alors sa place légitime d’outil amont de saisie, de contrôle de cohérence et de préparation tabulaire des données, tandis que l’inférence complexe et la modélisation multidimensionnelle sont déléguées à des moteurs computationnels conçus spécifiquement pour la statistique mathématique.
12. Synthèse procédurale et bonnes pratiques de documentation scientifique
12.1 Protocole standardisé de vérification en sept points
Afin de garantir l’intégrité absolue des résultats issus d’un tableau croisé avant toute communication institutionnelle ou publication académique, il est vivement recommandé d’exécuter de manière systématique le protocole d’audit méthodologique en sept points synthétisé ci-dessous :
- Conformité de l’échelle : Vérifier que les variables affectées aux axes de contingence sont strictement qualitatives ou discrétisées par intervalles rationnels, en veillant au respect de l’ordonnancement séquentiel pour les variables ordinales.
- Étanchéité et exhaustivité de la source : S’assurer que la plage d’origine est encadrée par une table structurée officielle Excel et qu’elle englobe 100 % des unités d’observation prévues, sans exclusion silencieuse ni tronquage spatial.
- Audit de la fonction d’agrégation : Contrôler expressément dans les paramètres de champs que la fonction opératoire déployée dans la zone Valeurs est bien le dénombrement (Nombre) et non une sommation indésirable (Somme).
- Concordance du volume global : Valider formellement que l’effectif total N situé à l’intersection ultime des marges coïncide à l’unité près avec le volume de lignes de micro-données présentes dans la table brute.
- Règle de conditionnement : Arbitrer sans ambiguïté entre pourcentage du total général, profil-ligne et profil-colonne, en s’assurant que la direction mathématique du conditionnement correspond à la causalité théorique investiguée.
- Évaluation de la viabilité des cases : Examiner attentivement la présence de cellules à très faibles effectifs (inférieurs à 5 unités) et juger de l’opportunité d’un regroupement rationnel de modalités pour éviter l’instabilité numérique.
- Verrouillage de l’actualisation : Exécuter une actualisation générale finale (Alt + F5) immédiatement avant l’extraction ou le figement des tableaux pour neutraliser toute distorsion liée à une désynchronisation du cache OLAP.
12.2 Exportation et intégration des tableaux selon les normes académiques
La transmission des résultats vers des manuscrits scientifiques, des thèses ou des rapports d’expertise exige de s’affranchir de la présentation visuelle brute générée par le tableur. Un tableau croisé dynamique ne doit jamais être copié-collé de façon brute avec ses boutons d’interfaces, ses poignées de menus déroulants et ses trames colorées vers un traitement de texte comme Microsoft Word ou un compilateur LaTeX. Cette pratique nuit à la crédibilité scientifique du document.
La procédure d’exportation rigoureuse impose de sélectionner la matrice de contingence finalisée, de la copier via Ctrl + C, puis d’effectuer un Collage spécial > Valeurs sur une zone neutre ou directement dans l’éditeur de texte. Dès cet instant, le tableau devient une matrice statique débarrassée de son cache logiciel sous-jacent. Il convient ensuite d’appliquer scrupuleusement les directives de mise en page standardisées, notamment celles de l’APA (7ᵉ édition) :
- Bordures épurées : Le tableau ne doit comporter aucune ligne verticale. Seules trois bordures horizontales majeures sont tolérées : une bordure fermant le haut du tableau au-dessus des en-têtes, une bordure séparant les en-têtes des données empiriques, et une bordure finale fermant la base du tableau après la ligne des totaux généraux.
- Typographie et alignement : Les en-têtes de colonnes et les libellés de lignes sont rigoureusement justifiés à gauche, tandis que l’ensemble des données numériques (effectifs et pourcentages) est systématiquement aligné à droite pour faciliter la lecture verticale comparative des grandeurs scalaires.
- Notes de bas de tableau exhaustives : Tout tableau de contingence doit impérativement être surmonté d’un titre numéroté en italique décrivant avec précision l’échantillon et les variables en présence. Sous le tableau, une note de bas de page exhaustive (introduite par le terme générique Note.) doit expliciter la taille totale de l’échantillon N, la signification précise des pourcentages affichés (profils-lignes ou profils-colonnes), la convention de traitement des valeurs manquantes, ainsi que les résultats formels du test inférentiel le cas échéant (statistique du χ², degrés de liberté ddl, p-valeur et V de Cramer).
En respectant scrupuleusement cette chaîne opératoire — depuis l’hygiène méthodologique de la saisie matricielle sous forme rectangulaire dans Excel jusqu’à l’épuration sémiotique finale conforme aux canons internationaux —, l’analyste garantit la reproductibilité totale de ses investigations, assurant ainsi la transition harmonieuse entre la collecte empirique brute et la production d’un savoir scientifique irréprochable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Microsoft Corporation. (2024). Créer un tableau croisé dynamique pour analyser des données de feuille de calcul. Support Microsoft. https://support.microsoft.com/fr-fr/office/créer-un-tableau-croisé-dynamique
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10