
L’analyse exploratoire de données au sein des sciences comportementales et de la psychologie quantitative repose fondamentalement sur la capacité du chercheur à discerner des régularités empiriques, des configurations latentes et des anomalies morphologiques au sein d’échantillons complexes. Alors que l’inférence statistique formelle — matérialisée par les modèles linéaires généralisés, les régressions hiérarchiques ou les équations structurelles — fournit des indices synthétiques d’association et de causalité, elle risque d’occulter des phénomènes distributionnels fondamentaux lorsqu’elle n’est pas précédée d’une étape minutieuse de sémiotique graphique. Dans cette perspective, la représentation visuelle bivariée et multivariée constitue bien plus qu’une simple commodité descriptive : elle incarne une véritable démarche épistémologique visant à confronter les hypothèses théoriques à la matérialité des faits empiriques.
Le nuage de points (ou scatterplot) représente l’outil cardinal pour examiner la relation fonctionnelle entre deux métriques continues. Toutefois, l’investigation contemporaine en psychologie s’aventure rarement dans le cadre restreint de deux variables isolées. L’intégration simultanée de multiples prédicteurs, de variables modératrices qualitatives ou quantitatives, ainsi que la stratification par cohortes cliniques imposent d’enrichir le nuage de points conventionnel. L’enjeu méthodologique consiste à représenter sur un plan bidimensionnel — contraint par les dimensions d’une page de publication ou d’un écran — un hyperespace relationnel complexe sans introduire d’artéfacts visuels, sans dénaturer les propriétés géométriques de l’espace métrique et sans surcharger l’attention cognitive du lecteur.
L’écosystème statistique du langage R, développé initialement par Ross Ihaka et Robert Gentleman d’après le langage S de John Chambers, offre une flexibilité sans équivalent pour relever ce défi d’ingénierie visuelle. À travers son moteur graphique natif de base (Base R graphics) ainsi que ses extensions matricielles et grammaticales spécialisées, R autorise une manipulation chirurgicale de chaque composante du tracé. Ce guide exhaustif a pour vocation d’analyser en détail les fondements conceptuels, les contraintes algorithmiques et les protocoles de programmation requis pour élaborer des nuages de points multivariés d’une rigueur scientifique irréprochable, alignés sur les standards éditoriaux les plus stricts des revues internationales de psychologie et de sciences cognitives.
1. Fondements théoriques et pertinence du nuage de points multivarié en psychologie quantitative
1.1 Rôle de la visualisation bivariée et multivariée dans l’analyse de données comportementales
L’exploration visuelle des associations entre construits psychologiques constitue le premier garde-fou contre les conclusions erronées déduites d’indicateurs de synthèse globaux. Dans le champ de la psychométrie, deux variables peuvent présenter un coefficient de corrélation de Pearson statistiquement significatif et identique alors que leurs dynamiques sous-jacentes diffèrent radicalement. Comme l’illustre magistralement le célèbre quatuor d’Anscombe — étendu plus récemment au concept du Datasaurus Dozen —, des distributions bivariées présentant des moyennes, des variances et des coefficients d’association identiques peuvent recouvrir des réalités géométriques antinomiques, allant de relations parfaitement curvilinéaires à des concentrations d’observations artificiellement tirées par un point aberrant isolé. Dans l’investigation de processus psychologiques tels que la relation entre le niveau d’anxiété état et la performance mnésique, la détection empirique précoce d’une relation en U inversé, postulée par la loi de Yerkes-Dodson, requiert une inspection visuelle directe plutôt qu’un ajustement linéaire mécanique qui conclurait prématurément à une absence d’effet.
Au-delà de l’appréciation des trajectoires fonctionnelles, la visualisation multivariée joue un rôle déterminant dans l’identification des sous-populations au sein d’échantillons cliniques supposés homogènes. L’hétérogénéité des troubles psychiatriques ou neurodéveloppementaux — par exemple, le spectre de l’autisme ou les sous-types de dépression majeure — se traduit fréquemment par des agrégats distincts dans l’espace des variables observées. Une représentation visuelle multidimensionnelle permet d’identifier l’émergence d’îlots de densité distincts, suggérant l’existence de classes latentes ou de profils cognitifs spécifiques que des analyses univariées marginales échoueraient à révéler. L’identification visuelle des cas aberrants univariés ou multivariés (calculés théoriquement par la distance de Mahalanobis) offre également l’opportunité d’examiner la validité écologique de certains profils de réponse avant d’engager des procédures de nettoyage de données plus formelles.
La transition conceptuelle entre une approche descriptive bidimensionnelle et la modélisation statistique multivariée repose sur cette compréhension spatiale des données. En réduisant prématurément la variance d’un ensemble de variables comportementales à un tableau de corrélations ou à des métriques globales, l’analyste fait l’économie d’une compréhension intuitive des interactions d’ordre supérieur. Les limites inhérentes à la réduction univariée dans l’évaluation psychométrique complexe se manifestent dès lors que l’on omet de considérer l’effet de masquage ou le paradoxe de Simpson, où la direction d’une association observée au niveau agrégé s’inverse totalement lorsque les observations sont décomposées selon les strates d’une troisième variable critique, telle que l’âge chronologique ou le niveau socio-économique.
1.2 Intérêt méthodologique de la superposition de séries de données distinctes
La superposition de multiples séries de données au sein d’un repère cartésien partagé offre un avantage comparatif déterminant par rapport à la démultiplication de graphiques isolés. En psychologie expérimentale, l’objectif fondamental consiste régulièrement à comparer des trajectoires comportementales entre des groupes soumis à des protocoles distincts (par exemple, groupe exposé à une remédiation cognitive versus groupe témoin sous placebo) ou à évaluer des conditions de test intra-sujets. La projection des observations sur un même système d’axes permet au système perceptif humain d’effectuer des comparaisons instantanées et précises des centroïdes, des pentes de dispersion et des étendues de variabilité sans exiger le déplacement continu du regard d’une figure à une autre, préservant ainsi la mémoire de travail de l’évaluateur.
Dans l’évaluation conjointe de trajectoires longitudinales de réactivité cognitive, la superposition visuelle autorise l’analyse conjointe des réponses individuelles et des tendances agrégées au fil des sessions d’évaluation répétées. Cette démarche permet d’observer directement si la variabilité interindividuelle tend à se résorber ou au contraire à s’amplifier sous l’effet du temps ou d’une intervention thérapeutique. L’analyste peut ainsi appréhender d’un seul coup d’œil si un traitement cognitif induit une homogénéisation des performances ou s’il exacerbe les écarts de départ, un phénomène d’interaction classique qualifié d’effet Matthieu.
En outre, la mise en concurrence visuelle de plusieurs prédicteurs continus sur une variable dépendante commune offre une vision d’ensemble de leurs forces prédictives relatives. Plutôt que de juxtaposer des coefficients standardisés au sein d’un tableau aride, la confrontation conjointe des nuages de dispersion respectifs — éventuellement enrichis de courbes de tendance distinctes — confère une transparence accrue aux résultats. Cette approche optimise la densité informationnelle de l’article empirique en condensant des relations factorielles complexes sur une surface restreinte, évitant la fragmentation éditoriale souvent imposée par les limites de pagination des revues académiques de premier rang.
1.3 Présentation du cadre technique de R pour la sémiotique graphique
L’architecture graphique de base du système R constitue l’un des piliers historiques de l’analyse statistique informatique. Conçue selon une logique modulaire inspirée du modèle de la table traçante, elle repose sur une séparation nette entre les fonctions dites de « haut niveau » et les fonctions dites de « bas niveau ». Les fonctions de haut niveau, à l’instar de l’incontournable commande d’initialisation, créent un nouveau graphique ex nihilo, calculent l’étendue des coordonnées cartésiennes, dessinent les axes primaires et secondaires, et positionnent les premiers symboles. À l’opposé, les fonctions de bas niveau viennent enrichir, par couches successives et cumulatives, le canevas graphique déjà ouvert, sans jamais en réinitialiser la géométrie fondamentale ni écraser les éléments préexistants.
Cette logique d’accumulation par calques successifs confère au chercheur une maîtrise absolue de chaque millimètre de l’espace d’affichage. Contrairement à des logiciels hermétiques fournissant des figures préconfigurées selon des gabarits rigides, le moteur natif de R permet d’orchestrer la superposition précise d’éléments géométriques distincts (points, segments, polygones, étiquettes textuelles). Cette personnalisation minutieuse est indispensable pour respecter scrupuleusement la sémiotique graphique définie par Jacques Bertin dans ses travaux fondateurs sur la sémiologie graphique, en calibrant de façon optimale les variables visuelles : position, forme, taille, couleur, valeur et texture.
Enfin, la rigueur du moteur graphique de R garantit la conformité stricte avec les normes de publication des organismes savants internationaux, notamment l’American Psychological Association (APA). La standardisation rigoureuse de la taille des polices de caractères, des marges extérieures, de la finesse des traits d’axes et de la disposition des légendes peut être programmée de manière reproductible et automatisée au sein de scripts réutilisables. Cette programmation explicite garantit que les figures produites soutiennent une démarche de science ouverte et reproductible, éliminant toute incertitude liée aux manipulations manuelles dans des interfaces graphiques propriétaires.
2. Préparation des structures de données et gestion de l’environnement sous R
2.1 Formatage des vecteurs et des data frames pour l’analyse multivariée
La structuration rigoureuse de l’espace de données conditionne l’efficacité des procédures de traçage sous le moteur graphique de base de R. Lors de la manipulation d’observations issues de plusieurs conditions expérimentales ou de mesures répétées, l’analyste se trouve confronté à deux paradigmes structurels : la structure large (wide format) et la structure longue (long format). Dans une structure large, chaque modalité expérimentale ou variable dépendante distincte occupe une colonne dédiée au sein du data frame, ce qui implique que chaque ligne correspond à une unité statistique unique (par exemple, un participant spécifique). Cette disposition est particulièrement commode pour les fonctions graphiques de base, car elle permet d’appeler directement des vecteurs indépendants pour chaque strate que l’on souhaite projeter successivement sur le canevas.
Néanmoins, la manipulation de vecteurs distincts exige une vérification drastique de la concordance dimensionnelle et de la distribution des données manquantes. La présence de valeurs non attribuées (identifiées par le symbole conventionnel NA dans l’environnement R) peut tronquer les séquences d’observations et fausser l’indexation lors des boucles itératives de traçage. Il est impératif d’évaluer la typologie des données manquantes — qu’elles soient manquantes de manière totalement aléatoire (MCAR), aléatoire (MAR) ou non aléatoire (MNAR) — avant d’opérer une suppression par liste entière (listwise deletion) ou d’appliquer des techniques modernes d’imputation multiple, afin d’éviter tout biais de sélection dans le graphique final.
De surcroît, le typage strict des variables au sein du tableau de données ne tolère aucune approximation. Les covariables catégorielles destinées à stratifier les séries de points doivent impérativement être instanciées sous forme de facteurs stricts (factors), dotés de niveaux (levels) explicitement étiquetés. Ce typage formel évite les confusions syntaxiques lors de l’extraction conditionnelle de sous-ensembles vectoriels. Simultanément, les variables continues quantitatives doivent être vérifiées quant à leur nature numérique élémentaire (numeric ou double), et standardisées (centrées et réduites sous forme de scores Z) si l’objectif comparatif impose d’annuler les effets d’échelle métrique disparates entre deux instruments de mesure hétérogènes.
2.2 Importation et nettoyage de jeux de données psychologiques simulés
Afin d’illustrer concrètement la démarche méthodologique tout au long de cette monographie, considérons un cadre empirique classique en neurosciences cognitives et en psychologie clinique : l’évaluation de l’impact de l’anxiété état sur l’efficacité de la mémoire de travail au sein de populations distinctes. Supposons une cohorte stratifiée en trois groupes distincts : un groupe témoin sain, un sous-groupe clinique présentant un trouble d’anxiété généralisée, et un troisième sous-groupe composé d’individus diagnostiqués avec un trouble dépressif majeur comorbide. La simulation computationnelle de ces données garantit la parfaite reproductibilité des figures tout en modélisant des propriétés distributionnelles hautement représentatives des observations psychométriques réelles.
Pour assurer la reproductibilité absolue de nos expérimentations numériques, il est primordial d’initialiser le générateur pseudo-aléatoire sous-jacent via la fixation déterministe d’une graine computationnelle (au moyen de la fonction d’ancrage aléatoire de R, couramment appelée par l’instruction d’assignation de graine numérique). Les distributions marginales sont ensuite générées en spécifiant des moyennes différentielles et des matrices de covariance réalistes. Par exemple, au sein du groupe témoin, la relation entre anxiété et performance de rappel mnésique peut présenter une corrélation modérée négative mais stable, alors que dans le groupe souffrant de trouble panique, l’association peut afficher une pente d’atténuation beaucoup plus abrupte, assortie d’une dispersion accrue traduisant une vulnérabilité cognitive accrue face au stress expérimental.
Le nettoyage de cette matrice synthétique nécessite un filtrage minutieux destiné à garantir que l’ensemble des scores générés s’inscrit dans les limites théoriques des échelles psychométriques sous-jacentes (par exemple, des scores bornés entre 0 et 100 pour l’inventaire d’anxiété, et des nombres entiers strictement positifs pour les empan de mémoire de travail). La vérification de ces bornes prévient l’apparition d’artefacts d’échantillonnage qui nuiraient à l’interprétabilité du tracé multivarié ultérieur.
2.3 Configuration des paramètres graphiques globaux avec la fonction par()
Le contrôle de l’environnement graphique natif de R passe impérativement par la maîtrise de la fonction de paramétrage global du dispositif d’affichage. Cette fonction régente l’ensemble des propriétés topologiques et typographiques du canevas, depuis la dimension des marges périphériques jusqu’aux conventions d’orientation des étiquettes numériques. Avant d’exécuter la moindre commande de traçage, l’analyste rigoureux se doit d’interroger et d’ajuster les marges internes du graphique (désignées par l’argument d’ajustement vectoriel à quatre dimensions spécifiant l’espace alloué en bas, à gauche, en haut et à droite de la zone de traçage proprement dite). Un espace insuffisant sur les bordures résultera inévitablement en une troncature mutilante des titres d’axes ou de la boîte de légende externe.
La dimension des marges s’exprime conventionnellement en lignes de texte. Une configuration typique adaptée aux publications académiques allouera un espacement suffisant au bas et à gauche pour accueillir respectivement le nom complet du construit évalué, ses unités métriques et les graduations chiffrées, tout en réduisant les marges supérieure et droite si aucun titre redondant ne vient surcharger le sommet de la figure (les légendes figuratives étant généralement reléguées dans la légende textuelle accompagnant l’article dans le corps éditorial). En outre, la possibilité d’organiser l’espace en panneaux multiples — via la subdivision matricielle de l’affichage en un agencement ordonné de lignes et de colonnes — offre une flexibilité considérable pour juxtaposer des nuages de points multivariés par cohortes d’âge ou conditions d’expérimentation croisées.
Un impératif programmatique souvent négligé réside dans la sauvegarde systématique de l’état initial des paramètres graphiques globaux avant toute modification. Dans la mesure où les altérations appliquées demeurent persistantes tout au long de la session active de travail sous R, omettre de restaurer la configuration originale expose l’utilisateur à des effets de bord indésirables lors de l’exécution ultérieure de tracés non apparentés. L’analyste prendra donc soin de stocker la liste des paramètres d’origine dans un objet temporaire dédié, pour la réinjecter méthodiquement à l’issue du pipeline de génération de la figure.
3. Construction pas à pas avec le moteur graphique de base : la méthode plot() et points()
3.1 Initialisation du canevas principal avec la fonction plot()
La construction méthodique d’un nuage de points multivarié selon l’approche fondamentale de R débute invariablement par l’appel à la fonction générique d’initialisation de haut niveau. Cette commande a pour responsabilité première de créer le repère cartésien en établissant la métrique d’affichage sur la base des données du premier couple de variables quantitatives soumises à son évaluation. Par exemple, si l’on projette en premier lieu les scores d’anxiété et de performance mnésique issus du groupe témoin, cette commande analyse instantanément les distributions respectives, détermine les coordonnées extrêmes et matérialise l’armature structurelle : le cadre rectangulaire, les encoches de graduation et les étiquettes numériques associées.
Dès cette étape inaugurale, l’analyste confère au premier sous-groupe ses propriétés morphologiques et chromatiques distinctives. L’argument de coloration permet de spécifier la teinte exacte attribuée aux marqueurs de cette série pionnière, tandis que l’argument de typologie géométrique détermine la forme spatiale du symbole. Il est particulièrement recommandé d’opter d’emblée pour des attributs visuels contrastés qui serviront de référence comparative aux séries ultérieures. La fonction assure également l’étiquetage provisoire ou définitif des axes d’abscisses et d’ordonnées, qu’il convient de libeller avec un soin scrupuleux en intégrant la terminologie psychométrique appropriée et l’unité de mesure retenue.
Toutefois, une pratique méthodologique avancée consiste parfois à initialiser ce canevas primaire en neutralisant volontairement le tracé effectif des symboles (en configurant l’argument de modalité de traçage sur l’option d’invisibilité totale). Cette technique permet de dresser un cadre vierge, parfaitement calibré au millimètre près en termes d’emprise spatiale, sur lequel viendront ensuite se déposer équitablement l’ensemble des couches de données sans accorder de primauté structurelle au premier groupe sur les suivants.
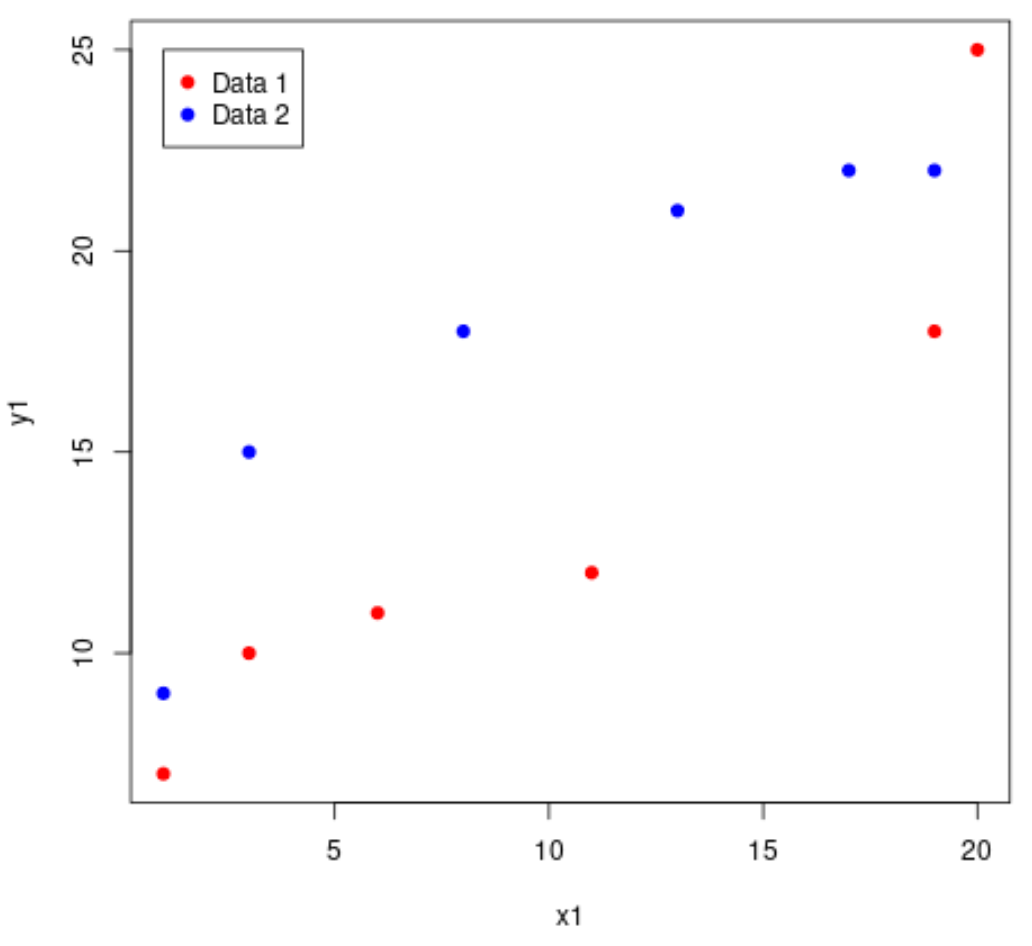
3.2 Superposition de couches de données secondaires au moyen de points()
Dès lors que le cadre de coordonnées cartésiennes se trouve solidement ancré par le tracé inaugural, l’adjonction de nouvelles strates empiriques s’opère exclusivement par le truchement de la fonction de bas niveau dédiée à l’injection de coordonnées ponctuelles. Contrairement à son homologue d’initialisation, cette commande est structurellement incapable d’engendrer un nouveau système d’axes ou de modifier les limites dimensionnelles préétablies du repère ; son exécution se borne à lire l’espace actif et à y projeter une nouvelle constellation de coordonnées vectorielles sans altérer la trame sous-jacente.
L’introduction du second groupe — par exemple, les patients présentant un trouble d’anxiété généralisée — fait ainsi appel à cette fonction en lui transmettant leurs vecteurs respectifs de scores d’abscisse et d’ordonnée. Pour prévenir toute ambiguïté sémiotique, il est absolument capital d’assigner à cette nouvelle série une combinaison chromatique et morphologique strictement différenciée de la première strate. Si le groupe témoin a été figuré par des disques pleins de couleur bleu nuit, le groupe clinique sera avantageusement représenté par des triangles ou des carrés écarlates, instaurant de facto un double encodage visuel (forme et couleur) garantissant une discrimination immédiate, y compris en contexte de reprographie monochrome ou pour les observateurs présentant des déficiences de la vision des couleurs.
Ce protocole itératif se déploie sans restriction pour accueillir un troisième, un quatrième ou un cinquième groupe expérimental. Chaque appel successif à la fonction de bas niveau superpose un calque informationnel additionnel. La lisibilité globale de la composition repose alors sur la discipline de l’analyste, qui doit veiller à ne pas saturer l’espace métrique par une profusion désordonnée de strates concurrentes, sous peine de transformer une visualisation diagnostique éclairante en un enchevêtrement illisible d’encres disparates.
3.3 Pièges courants liés à la séquence d’exécution des commandes graphiques
L’apprentissage du moteur graphique natif de R est fréquemment jalonné de déconvenues techniques imputables à une incompréhension de la chronologie opératoire de ses instructions. L’écueil le plus trivial, mais le plus récurrent chez l’expérimentateur novice, réside dans l’appel réitéré de la fonction d’initialisation lors de la tentative d’adjonction d’une seconde série de données. En lieu et place de la superposition attendue, cet appel intempestif a pour conséquence immédiate d’anéantir le canevas précédent, réinitialisant brutalement le dispositif d’affichage pour ne présenter que la dernière série invoquée, effaçant de facto le travail de composition préliminaire.
Un piège méthodologique bien plus insidieux concerne la troncature invisible des observations périphériques. Lorsque le tracé primaire est initialisé sur la seule base du premier sous-échantillon sans paramétrage explicite des étendues spatiales globales, le moteur ajuste automatiquement ses axes pour circonscrire précisément les valeurs extrêmes de ce groupe inaugural. Si le second groupe clinique — injecté ultérieurement via la fonction de bas niveau — manifeste des scores d’anxiété sensiblement plus élevés ou des effondrements mnésiques plus sévères excédant les coordonnées du premier groupe, ces points marginaux seront impitoyablement exclus du champ visuel visible. Ils continueront d’exister dans la mémoire du système, mais se trouveront projetés au-delà des bordures physiques du graphique, induisant une censure visuelle grave et faussant radicalement l’évaluation clinique de la dispersion réelle.
Enfin, la nature impérative du moteur graphique de base exige une exécution parfaitement synchrone et séquentielle des lignes d’instructions. Toute interruption dans le fil de transmission du script au sein de la console R risque de rompre le lien vers le périphérique actif ou d’intercaler des éléments textuels parasites, corrompant l’intégrité de l’empilement des calques. Une rigueur absolue dans la construction de blocs de code unitaires et auto-suffisants s’avère indispensable pour garantir l’entière reproductibilité de la composition visuelle.
4. Définition rigoureuse des échelles et synchronisation des limites d’axes
4.1 Calcul dynamique de l’étendue globale avec range()
Pour immuniser définitivement le graphique contre le péril de troncature périphérique évoqué précédemment, la détermination rigoureuse et automatisée des bornes extrêmes de chaque axe dimensionnel constitue un impératif programmatique non négociable. L’analyste ne doit jamais présumer des frontières spatiales de ses données ni procéder à des estimations arbitraires codées en dur dans le script, pratiques hautement vulnérables aux erreurs lors de l’actualisation ultérieure des bases d’échantillons. La démarche d’ingénierie statistique consiste à calculer en amont l’enveloppe globale englobant la totalité des sous-groupes appelés à coexister sur la figure.
L’opération repose sur l’extraction synchronisée des valeurs minimales et maximales au moyen de la commande d’identification de l’étendue vectorielle disponible nativement dans R. En regroupant au sein d’une même concaténation temporaire les vecteurs d’abscisses de l’ensemble des conditions expérimentales — tout en veillant à neutraliser les éventuelles valeurs manquantes via l’argument d’exclusion formelle approprié —, la fonction renvoie un vecteur binaire contenant l’infimum et le supremum absolus de l’échelle horizontale. La même procédure d’évaluation exhaustive est appliquée rigoureusement aux vecteurs d’ordonnées, garantissant ainsi l’appréhension mathématique exacte des frontières du nuage de points global.
L’impact psychologique d’une échelle mal calibrée sur la perception des résultats scientifiques est considérable. Une distorsion de l’espace métrique — qu’elle résulte d’une troncature accidentelle ou d’un resserrement artificiel des axes — altère profondément la perception intuitive de la magnitude des effets. Dans les sciences comportementales, où l’évaluation visuelle des forces de corrélation oriente souvent les interprétations qualitatives préliminaires, garantir l’intégrité géométrique intégrale du nuage constitue une condition sine qua non d’honnêteté intellectuelle et de rigueur scientifique.
4.2 Paramétrage explicite de xlim et ylim dans la fonction plot()
Une fois les coordonnées extrêmes rigoureusement déterminées pour chaque dimension, ces vecteurs de limites doivent être injectés de manière programmatique au sein de l’instruction d’initialisation du graphique, via l’attribution explicite des arguments définissant les bornes horizontales et verticales. Cette prescription contraint impérieusement le moteur graphique à étalonner la géométrie de son cadre non pas sur la base restreinte des premières données projetées, mais sur l’étendue inclusive embrassant l’intégralité du corpus d’observations futures.
Cependant, borner le système de coordonnées sur les stricts minima et maxima observés engendre une promiscuité visuelle indésirable : les observations périphériques viennent alors se heurter directement contre les bordures rectangulaires du cadre de traçage, rendant la lecture des symboles marginaux particulièrement délicate. Une bonne pratique méthodologique en psychométrie consiste à implémenter un coussin d’aération périphérique (un padding proportionnel) en dilatant artificiellement les bornes calculées d’une fraction déterminée (typiquement entre 4 % et 8 % de l’étendue totale). Cet élargissement délibéré confère une élégance aérée à la composition et prévient toute confusion entre un marqueur géométrique excentré et le trait structurel du repère d’axe.
Par ailleurs, la question de l’ancrage du point d’origine à zéro versus la troncature d’axe doit être tranchée avec discernement en fonction de la sémiotique des construits évalués. Tandis que des métriques physiques ou des temps de réaction bénéficient d’un ancrage naturel au zéro absolu, des scores standardisés (tels que des scores factoriels centrés-réduits, des quotients intellectuels ou des scores d’échelles de personnalité sans zéro psychologique réel) justifient pleinement un centrage d’échelle focalisé exclusivement sur la zone empiriquement habitée de la distribution, sous réserve que cette focalisation soit explicitement signalée sur les graduations pour prévenir toute tromperie interprétative.
4.3 Personnalisation des graduations et du formatage des axes
La configuration par défaut des axes générés automatiquement par R ne répond que rarement aux exigences esthétiques et fonctionnelles d’une publication de haut niveau. Pour instaurer un contrôle complet sur la sémiotique du tracé, l’analyste chevronné procède régulièrement à la désactivation explicite de la génération automatique des axes lors de l’appel d’initialisation, en spécifiant les arguments de neutralisation d’axes dédiés pour l’abscisse et l’ordonnée. Cette manœuvre dépouille le canevas de toute annotation numérique préfabriquée, autorisant une reconstruction minutieuse de la structure de repérage.
La matérialisation personnalisée des axes s’accomplit subséquemment au moyen de la fonction de bas niveau dédiée à la construction des bordures et graduations. Cette commande autorise la sélection précise de l’emplacement physique de chaque marque de graduation (tick marks), la spécification textuelle exacte de chaque étiquette numérique associée, ainsi que le contrôle de l’orientation spatiale de ces caractères typographiques. Dans les conventions de publication psychologiques, il est éminemment préférable d’orienter l’ensemble des chiffres de manière strictement horizontale, y compris sur l’axe vertical, afin d’épargner au lecteur la contrainte inconfortable d’une rotation de la tête ou d’un déchiffrement vertical préjudiciable à la fluidité cognitive.
Cette approche permet en outre d’imposer un formatage scientifique strict sur les valeurs numériques affichées, garantissant une uniformité impeccable du nombre de décimales significatives selon les directives de l’APA. L’analyste peut ainsi harmoniser les conventions d’arrondi, insérer des symboles de pourcentage ou intégrer des annotations qualitatives directement en regard de seuils de coupure clinique standardisés (par exemple, marquer ostensiblement la frontière d’un score de dépression sévère sur l’axe des ordonnées par un repère typographique spécifique).
5. Personnalisation avancée des marqueurs visuels : symboles, tailles et couleurs
5.1 Sélection typologique des formes géométriques via l’argument pch
Le paramètre structural régissant la typologie géométrique des marqueurs au sein du moteur graphique de R est désigné par l’argument historique de sélection de motif ponctuel. Cet argument accepte une valeur entière indexée de 0 à 25, correspondant chacune à un glyphe graphique spécifique au sein du répertoire standard du système. L’univers de ces vingt-six symboles fondamentaux se scinde en trois catégories taxonomiques majeures, dont la compréhension est indispensable pour une utilisation sémiotique efficiente : les symboles filaires creux (codes 0 à 14), les symboles géométriques pleins unifiés (codes 15 à 20), et les symboles combinés bicolores hautement sophistiqués (codes 21 à 25).
Les symboles combinés (du cercle indexé 21 au losange indexé 25) présentent la propriété architecturale exceptionnelle de dissocier formellement la ligne de contour périphérique de la zone de remplissage intérieur. Cette dualité offre une liberté sémiotique inégalée : la bordure peut être affectée d’une nuance sombre garantissant le contraste sur fond blanc, tandis que l’intérieur peut recevoir une teinte distinctive translucide. Cette configuration est particulièrement efficiente pour préserver l’intégrité visuelle des observations lorsque de multiples points viennent à se chevaucher dans les zones de haute densité distributionnelle.
Dans une perspective méthodologique inclusive et universelle, le choix des formes géométriques attribuées aux différentes cohortes expérimentales doit impérativement respecter les règles élémentaires d’accessibilité visuelle. Un observateur atteint de dyschromatopsie ou confronté à une impression en niveaux de gris doit être en mesure de discriminer instantanément le statut des observations sur la base exclusive de leur signature morphologique. Associer systématiquement un cercle (code 21) au groupe contrôle, un carré (code 22) au groupe clinique modéré et un triangle pointé vers le haut (code 24) au groupe clinique sévère assure une redondance sémiotique robuste qui immunise le graphique contre toute ambiguïté interprétative liée aux contraintes de restitution chromatique.
5.2 Gestion de la chromométrie scientifique avec col et les palettes spécialisées
La sélection chromatique dans une figure scientifique ne saurait être subordonnée à des considérations esthétiques arbitraires ou à des préférences subjectives non étayées. L’assignation de couleurs via l’argument chromatique dédié doit obéir aux lois de la perception visuelle humaine établies par les recherches en psychophysique de Cleveland et McGill. Les palettes arc-en-ciel conventionnelles (à l’instar de la sinistre palette rainbow ou jet historiquement prédominante) sont unanimement condamnées par la communauté scientifique contemporaine : leurs gradients d’intensité non linéaires introduisent de fausses frontières perceptives et des illusions d’optique délétères quant à la proximité ou la divergence des groupes représentés.
Il est dès lors primordial de recourir à des palettes de couleurs perceptuellement uniformes, telles que celles issues des recherches sur les modèles de vision humaine, désormais intégrées nativement dans l’environnement R moderne à travers la famille des palettes viridis (incluant les déclinaisons plasma, magma ou cividis). Ces nuanciers garantissent que la progression mathématique des valeurs statistiques correspond rigoureusement à une progression monotone de la luminosité perçue, tout en conservant une lisibilité sans faille pour les lecteurs atteints des formes les plus prévalentes de daltonisme (deutéranopie et protanopie).
Un levier technique de premier ordre réside dans la gestion de la transparence chromatique grâce à l’incorporation d’un canal alpha. Au sein du moteur de base de R, la manipulation des nuances peut s’opérer par l’usage de codes hexadécimaux à huit caractères ou via la fonction d’ajustement dynamique de couleur. L’injection d’un coefficient de transparence — variant conventionnellement de 0 pour l’invisibilité totale à 1 pour l’opacité absolue — transforme radicalement le comportement visuel des séries superposées. La translucidité permet aux points sous-jacents de transparaître sous les couches supérieures, révélant la densité cumulative par saturation chromatique progressive aux endroits d’interpénétration massive des groupes expérimentaux.
5.3 Modulation de la taille des points au moyen de l’argument cex
L’expansion scalaire des marqueurs s’administre sous R au moyen du paramètre multiplicateur d’échelle des caractères et symboles. Fixé à une valeur unitaire neutre de 1 par défaut, ce paramètre peut être calibré pour moduler la granularité de l’affichage. Dans les protocoles impliquant de petits effectifs cliniques (par exemple des études de cas multiples ou des échantillons de neuro-imagerie fonctionnelle à forte contrainte logistique), il est judicieux d’accroître substantiellement cette valeur (vers des ratios de 1.4 à 1.8) afin de conférer une présence physique tangible à chaque observation singulière. Inversement, lors du traitement de volumineuses cohortes épidémiologiques ou de passations psychométriques en ligne regroupant des milliers de participants, l’abaissement drastique de ce facteur (à des valeurs oscillant entre 0.4 et 0.7) prévient l’étouffement visuel du graphique par agglutination massive d’encre.
La puissance expressive de ce paramètre scalaire prend une dimension multivariée supérieure lorsqu’il est non plus fixé à une constante globale, mais asservi dynamiquement à une troisième variable quantitative continue. Cette démarche donne naissance au paradigme analytique du diagramme à bulles (bubble plot). L’analyste peut ainsi encoder le niveau de certitude diagnostique, la durée de l’intervention thérapeutique ou l’âge chronologique de chaque patient en faisant varier directement le diamètre des points en regard de la métrique sous-jacente.
Toutefois, une précaution psychophysique fondamentale doit être impérativement respectée : le système visuel humain ne décode pas la magnitude d’un objet géométrique bidimensionnel à travers son rayon ou son diamètre, mais à travers la perception globale de sa surface. Si l’on applique une liaison strictement linéaire entre la variable d’intérêt et le paramètre multiplicateur de taille, on induit une distorsion cognitive sévère, le lecteur surestimant exponentiellement les écarts entre les petites et les grandes valeurs. Il est donc méthodologiquement obligatoire d’asservir le facteur scalaire à la racine carrée de la variable cible, restaurant ainsi la fidélité de l’évaluation perceptive de la grandeur représentée.
6. Intégration et optimisation sémiotique de la légende avec legend()
6.1 Positionnement stratégique et coordonnées dans l’espace graphique
Un tracé multivarié sophistiqué demeure parfaitement inutilisable sans une clé sémiotique assurant le décodage sans faille des attributs graphiques mobilisés. Dans l’écosystème graphique natif de R, l’incorporation de cette composante indispensable s’opère par l’appel à la fonction d’annotation de légende. L’implantation géographique de cette boîte textuelle au sein du canevas obéit à deux méthodologies distinctes : l’usage de mots-clés d’ancrage topologique conventionnels ou la spécification millimétrée par coordonnées cartésiennes directes.
L’ancrage topologique simplifié s’appuie sur des descripteurs spatiaux intuitifs — tels que les positions canoniques en haut à gauche, en haut à droite, ou au centre bas — que le moteur de rendu traduit immédiatement en coordonnées relatives calées sur l’intérieur des axes actifs. Si cette approche garantit une exécution rapide, elle comporte le risque inhérent de venir recouvrir précisément la zone du nuage de points hébergeant des observations marginales mais hautement informatives. L’analyste consciencieux évaluera donc la topographie de son nuage empirique pour choisir l’antre spatiale la plus dégagée.
Lorsque la dispersion des données sature l’intégralité du rectangle de traçage, la seule alternative méthodologique viable consiste à déporter la boîte de légende en dehors de la surface de données, typiquement au sein de la marge externe supérieure ou latérale droite. Cette manœuvre requiert au préalable un élargissement proportionné des marges globales du dispositif via la configuration initiale des paramètres d’affichage, combiné à l’activation de l’argument de désactivation de la troncature graphique, autorisant les éléments de la fonction de bas niveau à franchir impunément le périmètre intérieur des axes pour s’épanouir dans la marge externe sans être masqués par le moteur de rendu.
6.2 Synchronisation rigoureuse des attributs graphiques
L’infaillibilité de la légende repose sur une conformité mathématique absolue entre les paramètres morphologiques assignés aux données et ceux injectés dans l’instruction de déclaration sémiotique. Une discordance, même infime — comme l’attribution dans la légende d’une couleur légèrement décalée par rapport au code hexadécimal effectif des points du groupe cible, ou la substitution accidentelle d’un losange à un carré —, détruit instantanément la validité interne du document graphique et jette le discrédit sur l’ensemble de la démarche empirique.
L’analyste doit ainsi veiller à ce que les vecteurs d’arguments passés à la fonction de légende — spécifiant les intitulés textuels clairs, les formes géométriques de référence, les nuances chromatiques et les facteurs d’échelle — reflètent fidèlement la structure ordonnée des appels successifs réalisés lors de la construction du graphique. Les étiquettes verbales doivent abandonner le jargon cryptique des noms de colonnes de bases de données informatisées pour adopter une nomenclature psychologique irréprochable et explicite, indiquant clairement le groupe diagnostique ou la condition expérimentale désignée.
Dans les configurations avancées combinant la présence simultanée de nuages de dispersion et de trajectoires d’ajustement modélisées, la fonction offre la souplesse d’entremêler des symboles ponctuels et des segments linéaires au sein de la même boîte récapitulative. En assignant des vecteurs concordants de styles de traits et d’épaisseurs de lignes en vis-à-vis des formes géométriques correspondantes, l’analyste synthétise en un seul cartel l’intégralité du code de lecture requis pour interpréter tant les données brutes sous-jacentes que les inférences statistiques dérivées.
6.3 Habillage esthétique et encadrement de la boîte de légende
L’impact visuel final de la boîte de légende dépend pour beaucoup de son intégration harmonique au sein de la composition globale. Les options stylistiques de base imposent par défaut un encadrement rectangulaire opaque à contour noir épais, qui tend à monopoliser indûment l’attention visuelle au détriment des données scientifiques elles-mêmes. Suivant les préceptes cardinaux d’Edward Tufte sur l’optimisation du ratio données/encre, il est vivement conseillé d’alléger cette matérialité graphique superflue.
La neutralisation pure et simple du contour géométrique s’obtient aisément en configurant le paramètre de bordure de boîte sur l’option d’invisibilité, conférant un statut d’éléments flottants aux descripteurs textuels et à leurs marqueurs associés. Si l’hétérogénéité du fond visuel impose néanmoins de maintenir une démarcation pour garantir la lisibilité des caractères textuels, l’application d’une couleur d’arrière-plan semi-transparente — générée par une fonction de modulation chromatique avec canal alpha — constitue un compromis ergonomique de premier ordre. Cette translucidité tamise subtilement les points situés sous la légende sans les masquer totalement à l’inspection analytique.
Enfin, la géométrie structurelle de la légende peut être modulée en abandonnant l’agencement vertical classique au profit d’une répartition horizontale des rubriques descriptives. En déployant les modalités textuelles côte à côte le long d’une bande horizontale positionnée élégamment au sommet du repère cartésien, l’expérimentateur dégage l’intégralité de la hauteur du graphique pour le déploiement vertical des dispersions empiriques, optimisant ainsi l’usage de la surface utile de la page académique.
7. Ajout de couches analytiques : droites de régression et tendances non paramétriques
7.1 Modélisation et traçage de droites de régression linéaire via abline()
L’adjonction de modèles mathématiques sur un nuage de dispersion multivarié enrichit considérablement le potentiel diagnostique de la visualisation en matérialisant l’intensité et le sens des associations postulat-effet. Dans le cadre de l’évaluation des associations linéaires au sein de sous-groupes comportementaux, l’estimation conjointe de régressions linéaires ordinaires distinctes permet d’apprécier visuellement l’existence potentielle d’interactions de modération — identifiables graphiquement par la divergence ou le croisement des pentes de régression respectives.
La mise en œuvre algorithmique sous R s’articule élégamment par l’estimation préliminaire des coefficients du modèle via la fonction standard de modélisation linéaire, appliquée séparément aux données de chaque strate expérimentale. Les objets statistiques résultants encapsulent l’ensemble des paramètres d’ajustement, dont l’ordonnée à l’origine et le coefficient de pente. L’injection directe de ces objets modélisés au sein de la fonction de bas niveau dédiée au tracé de droites infinies projette instantanément les trajectoires linéaires idéales sur le repère cartésien en cours d’exploitation.
Chaque droite d’ajustement doit impérativement arborer la même grammaire chromatique que le nuage de points dont elle synthétise la trajectoire, assurant un continuum perceptif sans équivoque. En outre, la modulation des attributs de typologie de ligne (ligne continue, tiretée, ou pointillée) combinée à une calibration précise de l’épaisseur du trait confère une hiérarchisation esthétique claire, évitant que les représentations paramétriques ne viennent écraser sous leur masse graphique les observations empiriques réelles qui doivent demeurer le cœur informatif premier de la figure.
7.2 Intégration de lissages non paramétriques avec lowess() ou loess()
L’hypothèse d’une stricte linéarité des mécanismes psychologiques constitue bien souvent une simplification réductrice, dictée davantage par la commodité mathématique des modèles statistiques conventionnels que par la nature réelle des phénomènes mentaux et comportementaux. Dans l’exploration de processus caractérisés par des dynamiques de saturation, des seuils de réactivité minimale ou des rendements cognitifs décroissants, l’imposition aveugle d’une droite de régression risque de masquer des inflexions fonctionnelles critiques. L’intégration de courbes de lissage non paramétrique localement pondéré — via les algorithmes éprouvés de régression polynomiale locale — apporte une réponse méthodologique rigoureuse à cette contrainte.
L’application de la fonction d’ajustement non paramétrique extrait une trajectoire souple directement guidée par la densité locale des points, sans assumer d’a priori contraignant quant à l’équation mathématique globale sous-jacente. Les coordonnées résultantes sont ensuite injectées sur le graphique actif au moyen de la fonction de bas niveau de traçage séquentiel de lignes continues. Le comportement de cette courbe d’exploration s’avère particulièrement sensible au paramètre d’amplitude de la fenêtre locale (le coefficient de lissage) : un paramètre trop étroit engendre un surajustement bruité reflétant les aléas d’échantillonnage locaux, tandis qu’un paramètre excessivement large efface les réelles ruptures de pente.
La superposition conjointe de ces trajectoires lissées pour l’ensemble des sous-groupes cliniques autorise des comparaisons morphologiques d’une finesse remarquable. L’analyste peut ainsi démontrer avec une clarté éclatante que la baisse de flexibilité cognitive en réponse à l’élévation du stress ne suit pas une dynamique linéaire homogène entre le groupe témoin et les patients cliniques, mais opère selon un effondrement brutal au-delà d’un seuil critique d’anxiété uniquement observable chez les individus diagnostiqués, documentant ainsi visuellement un phénomène d’allostasie psychologique d’un grand intérêt théorique.
7.3 Représentation visuelle des intervalles de confiance et de dispersion
Conformément aux normes contemporaines de transparence méthodologique et d’évaluation de l’incertitude promues par l’APA et le mouvement de la science ouverte, une courbe d’ajustement — qu’elle soit linéaire ou non paramétrique — ne devrait jamais être présentée comme une trajectoire d’une certitude absolue dénuée d’erreur d’échantillonnage. La figuration formelle des enveloppes d’incertitude (les intervalles de confiance à 95 % entourant la prédiction moyenne) est capitale pour tempérer l’enthousiasme interprétatif face à des pentes spectaculaires établies sur des effectifs clairsemés.
La génération computationnelle de ces enveloppes d’inférence statistique sous R s’opère en sollicitant la fonction générique de prédiction appliquée à une grille séquentielle régulière de nouvelles valeurs d’abscisse, en exigeant explicitement le calcul de l’erreur type associée à la prédiction moyenne. Dès lors que les bornes inférieures et supérieures de l’intervalle sont isolées mathématiquement pour chaque groupe expérimental, la matérialisation graphique de ces bandes de dispersion continue s’accomplit magistralement au moyen de la fonction de bas niveau dédiée au remplissage de polygones géométriques.
Pour que cette stratification spatiale demeure parfaitement opérationnelle sans masquer les points empiriques individuels disséminés dans le repère, l’usage d’une coloration polygonale hautement translucide (assortie d’un coefficient alpha très bas, typiquement situé aux alentours de 0.15 à 0.25) est absolument indispensable. Les rubans d’incertitude des différents groupes peuvent alors s’entrecroiser librement : leurs zones de conjonction chromatique révèlent visuellement les plages d’abscisses où les réponses moyennes des populations ne se distinguent pas statistiquement, tandis que leur décrochage spatial sans recouvrement atteste visuellement de l’émergence d’une divergence empirique hautement significative.
8. Modélisation visuelle d’une troisième variable continue : gradient de couleur et diagramme à bulles
8.1 Encodage d’une variable quantitative supplémentaire par l’intensité de la teinte
Lorsque le dessein analytique ne se limite plus à la comparaison de groupes catégoriels étanches mais ambitionne d’examiner l’influence régulatrice d’une troisième métrique quantitative pure — à l’instar de l’âge chronologique des participants, d’un niveau d’exposition traumatique ou d’un indice continu de sommeil —, la morphologie conventionnelle du nuage bivarié doit se muer en un système d’encodage thermique ou chromatique continu. Au lieu de classifier les observations en teintes discrètes contrastées, l’ensemble des points est alors unifié sous une même trajectoire spectrale reflétant rigoureusement l’intensité de la covariable continue sous-jacente.
Ce déploiement algorithmique requiert la confection d’une fonction de conversion d’une échelle continue en une gradation chromatique ordonnée. Le moteur de base de R dispose pour cela de constructeurs de palettes par interpolation, permettant de définir des transitions fluides entre deux ou plusieurs nuances sémantiquement neutres et distinctes. La variable modératrice continue est ensuite subdivisée ou standardisée sous forme d’indices entiers discrets mappés directement sur les tranches correspondantes du vecteur de teintes généré, produisant un vecteur chromatique individualisé dont chaque élément s’injecte de manière transparente dans l’argument de coloration de la fonction de traçage.
Pour parachever l’intégrité sémiotique d’une telle représentation, il est impératif d’adjoindre en marge externe une barre d’étalonnage chromatique (un color bar ou gradient de référence). Cette échelle visuelle, matérialisée par un empilement contigu de rectangles infinitésimaux via des fonctions de bas niveau combinées à des graduations textuelles d’axe dédiées, confère au lecteur la grille de conversion absolue requise pour associer instantanément la température de teinte d’un point isolé à sa valeur métrique réelle sur la troisième dimension évaluée.
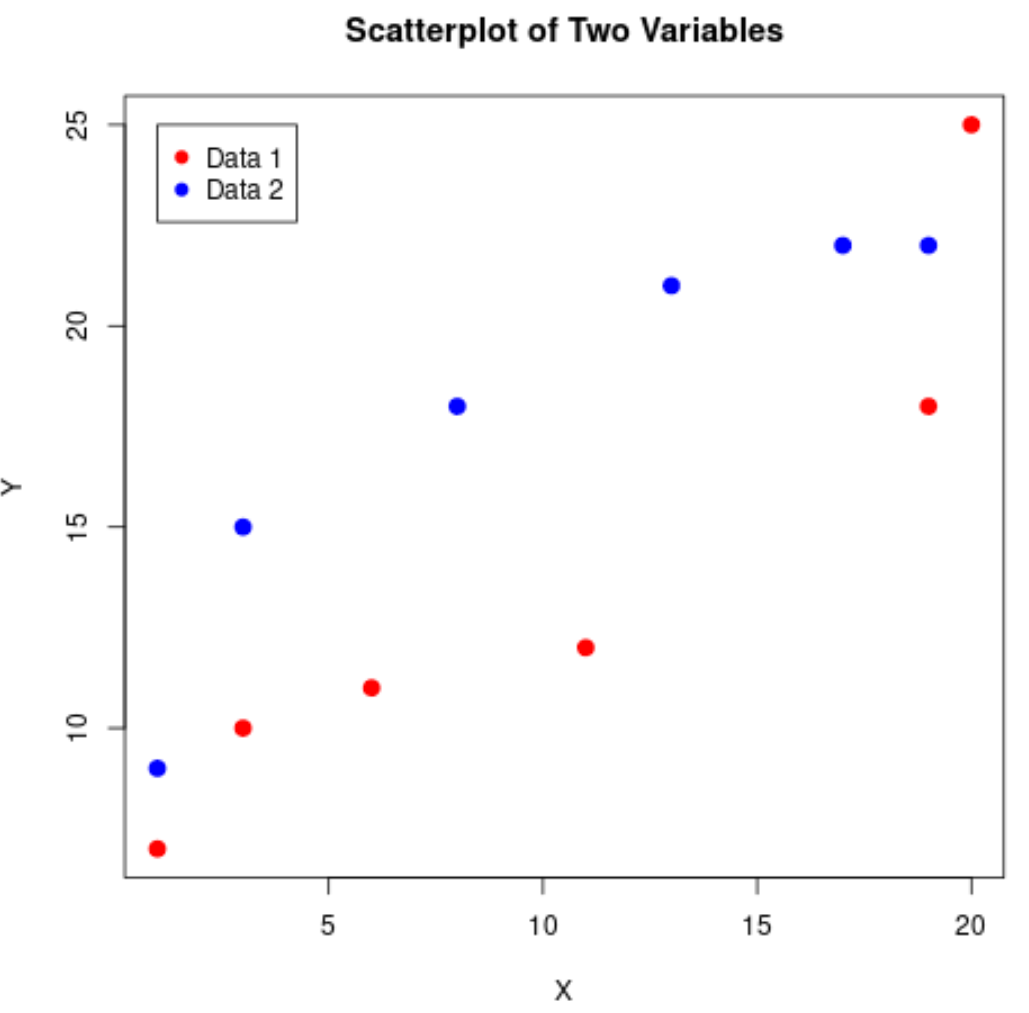
8.2 Technique du diagramme à bulles pour les interactions complexes
Une stratégie concurrente ou complémentaire pour intégrer une dimension quantitative additionnelle repose sur la variation dimensionnelle des marqueurs, matérialisant ce que la sémiologie graphique qualifie universellement de diagramme à bulles. Cette architecture s’avère particulièrement fertile lorsque la troisième variable d’intérêt possède une interprétation concrète en termes de magnitude physique, de volume d’activité ou de taille d’échantillonnage associé à une unité d’agrégation écologique (par exemple, le nombre d’élèves testés au sein de chaque établissement scolaire participant à une vaste évaluation psychométrique multicentrique).
Comme énoncé lors de l’analyse théorique préliminaire des propriétés perceptives, la mise en œuvre rigoureuse de cette technique proscrit l’asservissement direct du rayon des symboles à la métrique brute. Une standardisation préalable est requise pour contraindre la dispersion des surfaces au sein d’une enveloppe visuelle ergonomique : les valeurs de la variable de taille sont d’abord recalibrées entre zéro et un, puis soumises à une transformation par racine carrée avant d’être multipliées par un coefficient d’ajustement global adapté à la résolution du graphique. Cette précaution garantit que les observations de grande magnitude ne viennent pas coloniser l’intégralité du repère au détriment de la visibilité des scores adjacents.
Dans ce contexte géométrique expansif, la gestion de l’occultation devient l’enjeu prépondérant. La superposition de multiples disques de diamètres disparates crée inévitablement des phénomènes de masquage partiel ou total des plus petits éléments par les géométries dominantes. L’attribution impérative de contours nets associée à une translucidité prononcée des zones de remplissage — conjuguée à une séquence de traçage méthodique projetant prioritairement les plus grandes bulles en fond pour déposer ensuite les plus petites en surface — constitue la parade technique indispensable pour préserver la totale transparence des données.
8.3 Considérations ergonomiques et limites de la densité informationnelle
Bien que l’arsenal technique de R autorise la conjonction théoriquement illimitée des dimensions d’encodage visuel — en agençant simultanément les abscisses, les ordonnées, les couleurs de remplissage, les teintes de contours, les formes géométriques et la surface des bulles —, l’analyste doit s’imposer une stricte ascèse ergonomique guidée par la théorie de la charge cognitive. La capacité d’intégration multidimensionnelle du cerveau humain face à un stimulus visuel unique présente des limites physiologiques infranchissables : au-delà de trois dimensions d’encodage concurrentes sur un même espace cartésien, l’effort d’attention sélective requis pour décrypter les interactions complexes neutralise les bénéfices intuitifs de la visualisation au profit d’une confusion intellectuelle contre-productive.
Les principes fondateurs formulés par Edward Tufte concernant l’économie sémiotique rappellent que toute fioriture graphique dénuée de fonction statistique univoque (le fameux chartjunk) doit être impitoyablement bannie. Si un nuage de points enrichi exige une légende labyrinthique de multiples paragraphes pour que le lecteur parvienne péniblement à démêler l’imbrication croisée des diamètres, des teintes et des symboles, la figure s’éloigne de son statut d’outil de communication scientifique pour devenir une énigme visuelle stérile.
Dans de telles configurations de complexité factorielle élevée, la décomposition méthodologique d’une figure unique encombrée en une collection ordonnée de graphiques élémentaires bivariés coordonnés — matérialisant le principe éprouvé des petits multiples (small multiples) — s’avère infiniment supérieure sur le plan heuristique. En maintenant constantes deux dimensions d’analyse et en stratifiant systématiquement la troisième variable selon des panneaux contigus partageant une échelle unifiée, l’analyste offre à l’esprit humain la stabilité comparative requise pour identifier sans effort les modérations et interactions déterminantes.
9. Matrices de dispersion et visualisation conjointe de multiples variables
9.1 Exploration simultanée de multiples dimensions avec la fonction pairs()
Lorsque la batterie d’évaluation psychométrique comporte un ensemble étendu d’instruments de mesure continus — par exemple, l’investigation conjointe des cinq grands facteurs de personnalité du modèle Big Five, ou une constellation d’indices cognitifs évaluant la mémoire de travail, l’inhibition, la flexibilité et la vitesse de traitement —, la construction séquentielle de nuages de dispersion isolés s’avère vite fastidieuse. L’analyste recourt alors avec profit au paradigme des matrices de nuages de points (scatterplot matrices), magistralement instrumenté dans le système de base de R par l’incontournable fonction dédiée aux projections croisées par paires.
Cette commande exécute une combinatoire exhaustive de l’ensemble des paires de variables quantitatives soumises dans le tableau de données, dressant une grille matricielle carrée où chaque cellule intersecte deux dimensions distinctes. Les cellules hors-diagonale matérialisent les projections bivariées respectives, permettant une inspection panoramique instantanée de la topologie globale des associations au sein du système de variables. Une telle vue d’ensemble accélère de façon spectaculaire le diagnostic préliminaire des colinéarités excessives — péril majeur pour la stabilité des régressions multiples ultérieures — tout en révélant les ruptures d’hétéroscédasticité disséminées dans le réseau nomologique des construits.
La véritable puissance de cette fonction réside dans sa totale modularité : elle autorise l’injection de fonctions utilisateur personnalisées pour régir le comportement spécifique des panneaux diagonaux, des panneaux supérieurs et des panneaux inférieurs. L’analyste peut ainsi programmer l’affichage des histogrammes de distribution ou des densités univariées le long de la diagonale principale, réserver le triangle inférieur à l’affichage des nuages de dispersion enrichis de courbes de tendance locales, et consacrer le triangle supérieur à l’inscription textuelle directe des coefficients de corrélation paramétriques de Pearson ou non paramétriques de Spearman, dont la typographie scalaire peut elle-même être asservie proportionnellement à la magnitude mathématique de l’association observée.
9.2 Différenciation de sous-groupes cliniques au sein de la matrice de dispersion
L’utilité diagnostique d’une matrice de dispersion se trouve démultipliée lorsqu’on y injecte une stratification catégorielle reflétant l’appartenance des sujets à des cohortes diagnostiques distinctes. La fonction permet d’assigner de manière vectorielle les arguments de coloration et de morphologie des symboles directement indexés sur les niveaux d’un facteur qualitatif sous-jacent, propageant instantanément la différenciation chromatique et géométrique à travers la totalité des cellules de l’échiquier graphique.
Cette approche synoptique permet d’observer simultanément si la séparation spatiale des sous-groupes cliniques s’opère uniformément sur l’ensemble des dimensions psychométriques ou si elle demeure confinée à un sous-espace spécifique de variables cognitives. Dans une étude explorant des profils neuropsychologiques consécutifs à des traumatismes crâniens, une telle matrice permet de discerner en un instant si le groupe de patients s’écarte des témoins de manière homogène sur la vitesse d’inhibition et la mémoire à long terme, ou si l’on assiste à une dissociation simple ou double — marqueur par excellence de la modularité des fonctions cérébrales.
La détection de configurations multivariées atypiques s’en trouve également grandement facilitée. Un profil de patient apparaissant parfaitement ordinaire et fondu dans la norme lorsqu’il est examiné isolément sur chacune des distributions marginales univariées peut émerger de manière éclatante comme un cas aberrant multivarié singulier lorsqu’il est projeté dans l’espace croisé de deux variables spécifiques. La matrice de dispersion agit alors comme un tamis diagnostique complet, révélant la structure fine des relations factorielles transversales.
9.3 Alternatives et extensions avancées pour l’inspection multivariée
Bien que le moteur graphique de base fournisse l’armature algorithmique fondamentale pour générer ces matrices d’exploration, la communauté des psychométriciens et des statisticiens des sciences du comportement a développé des extensions spécialisées étendant remarquablement ces capacités fonctionnelles. Parmi celles-ci, le paquetage méthodologique psych, élaboré par William Revelle pour les sciences comportementales, figure comme une référence académique incontournable, notamment à travers sa fonction de restitution matricielle enrichie.
Cette fonction spécialisée automatise avec une élégance exemplaire des intégrations sémiotiques qui exigeraient des dizaines de lignes de programmation sous le moteur graphique brut. D’un simple appel syntaxique, elle génère sur la diagonale les tracés de densité non paramétrique accompagnés des histogrammes univariés ; elle enrichit systématiquement les nuages de dispersion bivariés d’ellipses de concentration statistique modélisant la dispersion bivariée normale (dont l’excentricité et l’orientation résument visuellement la force et le sens de la covariance) ; et elle superpose d’autorité une trajectoire de lissage non paramétrique locale couplée à une droite de régression linéaire.
Sur les panneaux supérieurs opposés, la fonction appose les coefficients d’association accompagnés de leur significativité statistique matérialisée par les conventions d’étoiles académiques standardisées, tout en ajustant automatiquement la taille des caractères numériques en fonction de la taille de l’effet. Cette condensation informationnelle magistrale en fait l’outil d’inspection exploratoire multivariée par excellence pour l’analyse d’échelles psychologiques, la validation de construits et l’évaluation préliminaire de matrices factorielles exploratoires ou confirmatoires.
10. Traitement du chevauchement des observations et de la densité dans les grands échantillons
10.1 Diagnostic du problème d’occultation des données (overplotting)
L’expansion technologique des protocoles de recueil de données comportementales — incluant les évaluations écologiques momentanées (EMA) par ordiphones, l’exploitation de registres de santé publique dématérialisés et les passations d’enquêtes à grande échelle sur internet — confronte régulièrement l’analyste à des corpus d’observations regroupant plusieurs milliers, voire dizaines de milliers d’unités statistiques. Dans de telles conditions volumétriques, le nuage de points standard se heurte à une limitation physique critique désignée sous le terme d’occultation massive des données (overplotting).
Ce phénomène d’empilement destructeur se manifeste avec une acuité particulière lors de la manipulation de variables quantitatives discrètes ou pseudo-continues, telles que les scores agrégés issus d’échelles de Likert conventionnelles (par exemple des échelles d’évaluation ordonnées de 1 à 5 ou de 1 à 7). Dans ce contexte métrique borné, des centaines de participants distincts partagent rigoureusement des coordonnées numériques strictement identiques. La projection graphique standard dépose aveuglément ces marqueurs multiples exactement sur le même pixel d’affichage, réduisant visuellement une masse impressionnante de données empiriques à la simple apparition d’un point unique anonyme.
Les conséquences interprétatives de cet artéfact sont méthodologiquement dévastatrices. L’observateur sous-estime tragiquement la densité réelle des sous-populations concentrées au cœur de l’espace métrique, tout en accordant une importance visuelle disproportionnée à des cas périphériques clairsemés mais spatialement isolés. Cette distorsion perceptive fausse l’appréciation intuitive de la force de la relation, masque l’asymétrie potentielle des distributions conjointes et peut inciter le chercheur à poser des inférences totalement déconnectées de la densité de probabilité bivariée effective de son échantillon.
10.2 Application de la gigue aléatoire contrôlée avec la fonction jitter()
Pour décongestionner les concentrations d’observations discrètes et restituer visuellement la masse effective des données agglutinées sur des coordonnées identiques, l’une des solutions algorithmiques les plus immédiates et éprouvées réside dans l’application d’une gigue aléatoire contrôlée, opérée nativement sous R par la fonction de perturbation aléatoire. Cette démarche d’ingénierie mathématique consiste à inoculer un bruit aléatoire infinitésimal et contrôlé aux coordonnées exactes des vecteurs originaux préalablement à leur projection sur le canevas.
L’injection de cette micro-dispersion artificielle — applicable sélectivement aux abscisses, aux ordonnées ou simultanément aux deux dimensions — dissocie les coordonnées confondues et déploie les observations superposées sous la forme d’un halo ou d’une petite constellation locale. L’épaisseur et la nébuleuse de chaque agrégat révèlent alors instantanément l’effectif sous-jacent : un nœud de coordonnées partagé par trois individus n’engendrera qu’un frémissement discret, tandis qu’un nœud regroupant quatre cents participants se matérialisera par un essaim dense et texturé d’une grande expressivité visuelle.
Néanmoins, la calibration de cette perturbation artificielle requiert un dosage rigoureux via les arguments de contrôle de facteur d’amplitude intégrés à la fonction. L’analyste doit veiller scrupuleusement à ce que l’ampleur du déplacement aléatoire ne dépasse jamais la moitié de l’intervalle séparant deux échelons discrets successifs de l’échelle sous-jacente. Une gigue démesurée introduirait une distorsion métrique inacceptable, dissolvant la structure ordonnée des données discrètes dans un brouillard informe et détruisant la signification psychométrique des catégories de mesure originales.
10.3 Cartographie de densité alternative et tracés hexagonaux
Lorsque la taille de l’échantillon atteint des proportions épidémiologiques massives excédant plusieurs dizaines de milliers d’observations, l’application de la simple gigue aléatoire — même tempérée par des transparences chromatiques — atteint ses limites géométriques : le repère cartésien entier se transforme rapidement en une surface d’encre saturée interdisant toute distinction fine. Il devient alors indispensable d’abandonner la représentation des points individuels au profit d’une cartographie de densité de probabilité bivariée continue.
Le moteur de base de R met à disposition une alternative fonctionnelle remarquable à travers la commande de dispersion lissée. Cette fonction estime la densité bivariée par application d’un noyau gaussien bidimensionnel sur le champ des observations, puis matérialise l’intensité de cette concentration à l’aide d’un dégradé continu de textures chromatiques évoquant les courbes de niveau d’une carte topographique. Les zones d’extrême confluence des observations comportementales s’illuminent d’une teinte vive et contrastée, tandis que les bordures de faible dispersion s’estompent doucement vers l’arrière-plan neutre, les cas atypiques isolés continuant d’apparaître sous la forme de points ponctuels discrets.
Dans cette même perspective d’ingénierie graphique des volumineux corpus de données, le compartimentage hexagonal — popularisé par le paquetage spécialisé hexbin — constitue une méthodologie d’agrégation spatiale d’une efficacité redoutable. L’espace bidimensionnel du graphique est découpé selon un pavage régulier d’alvéoles hexagonales régulières, au sein desquelles le nombre exact d’observations tombant dans chaque cellule est décompté mathématiquement. La valeur de ce comptage régit ensuite la tonalité chromatique attribuée à chaque hexagone, offrant une restitution géométriquement intègre et d’une remarquable élégance visuelle de la surface de densité multivariée sans subir la moindre surcharge matérielle lors du rendu numérique.
11. Transition vers l’écosystème ggplot2 pour la gestion déclarative du multivarié
11.1 Fondements de la grammaire des graphiques appliquée aux variables multiples
Bien que le moteur graphique de base de R demeure un monument d’efficacité technique, d’autonomie logicielle et de contrôle chirurgical pour l’élaboration de figures multivariées, l’avènement de l’écosystème ggplot2, conçu par Hadley Wickham d’après les théories formalisées par Leland Wilkinson dans son ouvrage séminal The Grammar of Graphics, a profondément révolutionné la pratique de la visualisation scientifique contemporaine. La transition conceptuelle fondamentale réside dans l’abandon du paradigme impératif — où l’analyste dicte pas à pas au système chaque opération matérielle de traçage — au profit d’un paradigme déclaratif et structural.
Dans ce cadre méthodologique moderne, l’expérimentateur ne manipule plus des coordonnées isolées via des appels successifs de bas niveau, mais déclare formellement des correspondances esthétiques (les fameux aesthetic mappings) reliant les colonnes substantielles d’un tableau de données (obligatoirement structuré au format long) aux canaux visuels du graphique : les axes dimensionnels horizontaux et verticaux, la teinte chromatique de remplissage, la forme morphologique des marqueurs ou le calibre des symboles. Dès lors que ce couplage fonctionnel est formulé, le moteur d’inférence graphique prend en charge de façon totalement automatisée la synchronisation inclusive des étendues spatiales, l’application de palettes coordonnées et — avantage comparatif considérable — la génération matricielle d’une boîte de légende exhaustive rigoureusement alignée sur les propriétés physiques du nuage.
L’enrichissement analytique s’opère par l’empilement modulaire de couches géométriques unifiées selon une syntaxe additive intuitive. L’adjonction d’une couche ponctuelle combinée à une couche de régression paramétrique ou non paramétrique s’exécute avec une économie de code spectaculaire, les trajectoires d’ajustement héritant spontanément de la stratification multivariée déclarée au niveau supérieur sans exiger la moindre itération scripturale fastidieuse de la part du chercheur.
11.2 Décomposition en facettes avec facet_wrap() et facet_grid()
L’un des atouts méthodologiques majeurs consacrant la suprématie opérationnelle de la grammaire des graphiques pour l’analyse multivariée complexe réside dans sa capacité native à déployer instantanément des architectures en petits multiples via les commandes de décomposition en facettes. Lorsque l’espace cartésien bidimensionnel menace d’être submergé par l’entrecroisement anarchique d’un trop grand nombre de sous-groupes ou par l’imbrication de facteurs qualitatifs croisés, la séparation physique des nuages de dispersion sur des panneaux contigus devient la démarche la plus rigoureuse.
L’opérateur de facettage univarié enroulé autorise l’analyste à ventiler automatiquement une relation bivariée — enrichie de ses couleurs et courbes de tendance propres — à travers les multiples strates d’une variable de classification clinique, en agençant harmonieusement les fenêtres résultantes selon une disposition matricielle optimisée. Pour les protocoles expérimentaux hautement élaborés impliquant des devis factoriels croisés complets (par exemple, croisant deux types d’interventions thérapeutiques avec trois paliers chronologiques d’évaluation post-traitement), la commande de facettage matriciel bidimensionnel déploie les nuages de dispersion au sein d’une grille cartésienne orthogonale stricte dont les lignes et les colonnes reflètent respectivement chaque modalité factorielle.
Ce partitionnement spatial préserve scrupuleusement la synchronisation métrique des axes de coordonnées par défaut (garantissant que tous les panneaux partagent strictement la même échelle dimensionnelle pour préserver la comparabilité visuelle directe des dispersions), tout en offrant l’option de libérer les bornes de manière contrôlée si l’investigation empirique exige d’explorer l’architecture interne propre à des sous-échantillons présentant des variances hautement divergentes. L’interprétabilité des interactions de modération triple ou quadruple atteint alors un degré de clarté sémiotique inaccessible à la simple superposition manuelle.
11.3 Comparaison critique de productivité entre Base R et ggplot2
Le choix stratégique entre le recours au moteur graphique de base de R et l’adoption de l’environnement de la grammaire des graphiques ne doit pas être posé en termes de dogme technologique, mais résolu selon une analyse rationnelle des contraintes opérationnelles du projet de recherche. Le moteur natif de base brille par sa vitesse d’exécution pure, son absence totale de dépendance logicielle extérieure — garantissant une pérennité computationnelle absolue des scripts à travers les décennies — et sa souplesse inégalée pour concevoir des mises en page atypiques sortant délibérément des canons géométriques standards.
À l’inverse, dès lors qu’il s’agit d’explorer rapidement un volume important de données multivariées, d’expérimenter des combinaisons factorielles multiples sans devoir reprogrammer manuellement le recalcul des limites, ou de produire des visualisations contemporaines répondant immédiatement aux exigences esthétiques des revues scientifiques de référence, l’environnement de la grammaire des graphiques fait preuve d’une rentabilité méthodologique sans équivalent. La construction d’une figure multivariée complexe intégrant stratifications chromatiques, bandes de confiance ombrées et facettages multiples s’accomplit en une dizaine de lignes élégantes là où le moteur de base réclame plusieurs pages d’un code minutieux articulant calculs d’étendues, boucles conditionnelles et paramétrages chirurgicaux de légendes externes.
L’analyste de données quantitatives en psychologie gagne donc immensément à cultiver une parfaite maîtrise bilingue de ces deux approches complémentaires. L’approche impérative de base constitue le socle indispensable pour appréhender l’architecture intime du système graphique de R et concevoir des visualisations personnalisées hautement spécifiques, tandis que l’approche déclarative offre la vélocité cognitive et l’élégance structurelle requises pour le prototypage rapide et l’exploitation systématique des corpus comportementaux complexes.
12. Exportation haute résolution et conformité aux standards éditoriaux académiques
12.1 Génération de fichiers vectoriels et matriciels haute définition
L’aboutissement ultime de la démarche de sémiotique graphique réside dans la compilation matérielle de la figure au sein d’un fichier informatique autonome destiné à la chaîne éditoriale de la revue scientifique cible. Cette étape technique ne tolère aucun laxisme : l’analyste ne doit en aucun cas se contenter de simples captures d’écran manuelles ou de copies directes depuis la fenêtre graphique interactive du logiciel, pratiques désastreuses qui dégradent irrémédiablement la netteté des tracés et compressent arbitrairement les métriques typographiques.
La génération de figures à usage de publication impose d’invoquer formellement les pilotes graphiques natifs de R au sein du script de programmation. Deux grandes familles de formats s’offrent au choix méthodologique du chercheur : les formats vectoriels et les formats matriciels. Les périphériques vectoriels — au premier rang desquels figure le format de document portable (PDF) et le format PostScript encapsulé (EPS) — constituent l’étalon d’excellence absolu pour les diagrammes de dispersion. En encodant mathématiquement chaque point, segment, contour et caractère typographique sous forme d’équations géométriques scalables, ils garantissent une résolution infinie : le graphique conserve une netteté microscopique absolue quel que soit le taux d’agrandissement opéré par l’imprimeur ou le lecteur.
Si la revue exige impérativement un format matriciel (généralement le format TIFF ou PNG pour les figures complexes), l’analyste paramétrera scrupuleusement la résolution physique via l’argument de densité d’échantillonnage, en fixant un standard minimal absolu de 300 points par pouce (DPI), voire de 600 DPI pour les compositions combinant des trames de demi-teintes et des caractères fins. Il convient également de spécifier de manière programmatique les dimensions spatiales absolues (la largeur et la hauteur en pouces ou centimètres) pour calibrer précisément l’encombrement de la figure en regard de la maquette typographique de la revue (largeur d’une colonne simple ou d’une page double). Enfin, la fermeture rigoureuse du dispositif de rendu via l’instruction de clôture de périphérique est obligatoire pour purger la mémoire tampon et sceller l’écriture du fichier sans risquer de corrompre sa structure binaire.
12.2 Alignement strict sur les normes de présentation de l’APA (7e édition)
L’intégration d’un graphique multivarié au sein d’un manuscrit soumis aux revues de psychologie régies par les directives éditoriales de l’American Psychological Association (APA, 7e édition) requiert une stricte conformité à un ensemble de canons visuels standardisés. Ces directives visent à préserver une sobriété absolue et une lisibilité maximale en éliminant impitoyablement tout artéfact graphique distrayant non porteur de sens scientifique.
Sur le plan typographique, les normes de l’APA proscrivent les polices fantaisistes ou excessivement contrastées au profit de typographies sans empattement nettes et éprouvées, telles qu’Arial, Calibri ou Helvetica, maintenues dans un calibre homogène compris entre 8 et 14 points sur l’ensemble de la composition. L’ornementation interne du graphique doit être dépouillée de tout quadrillage superflu : les grilles d’arrière-plan denses et les fonds colorés ou grisâtres doivent être éliminés pour laisser place à un espace intérieur blanc immaculé, délimité uniquement par les lignes d’axes indispensables.
En outre, la légende d’une figure au format APA ne doit jamais comporter de titre principal incrusté en lettres grasses au sommet du canevas ; le titrage et la numérotation formelle de la figure sont relégués au-dessus du corps de l’image, tandis qu’une note explicative dense et exhaustive est positionnée sous le graphique. Cette note de figure doit définir explicitement chaque acronyme, détailler la signification de chaque code chromatique et géométrique, préciser la taille des effectifs par groupe, et expliciter la nature statistique des barres d’erreur ou des rubans d’incertitude affichés (par exemple en mentionnant explicitement s’il s’agit d’écarts-types, d’erreurs-types de la moyenne ou d’intervalles de confiance à 95 %). Enfin, l’analyste effectuera systématiquement une épreuve de conversion en niveaux de gris pour s’assurer que les contrastes morphologiques demeurent infaillibles même en cas d’impression monochrome.
12.3 Reproductibilité computationnelle et flux de travail documenté
La crédibilité contemporaine de la recherche scientifique en psychologie quantitative repose désormais sur le respect inconditionnel des impératifs de reproductibilité computationnelle et de transparence méthodologique. L’élaboration d’une figure multivariée sophistiquée ne saurait constituer un acte graphique isolé, accompli manuellement de manière éphémère dans une interface logicielle opaque, mais doit s’inscrire au sein d’un flux de travail documenté de bout en bout, archivable et auditable par les pairs.
L’idéal méthodologique consiste à encapsuler l’intégralité du pipeline de données — depuis l’ingestion brute des scores psychométriques, les procédures d’imputation et de transformation métrique, jusqu’au code de traçage et d’exportation de la figure — au sein d’environnements d’édition dynamique tels que R Markdown ou le système de publication scientifique moderne Quarto. Ces cadres computationnels entrelacent harmonieusement le texte narratif de l’article académique, les blocs d’instructions exécutables et les sorties graphiques générées, garantissant que la moindre modification apportée au jeu de données source ou aux paramètres d’échelle se répercute instantanément et automatiquement sur la figure finale compilée.
Dans le cadre d’un engagement en faveur de la science ouverte (Open Science), le script complet de génération graphique, accompagné du jeu de données anonymisé et d’un inventaire précis de l’environnement informatique d’exécution (incluant la version exacte de R et des paquetages mobilisés), doit être déposé sur des répertoires institutionnels pérennes tels que l’Open Science Framework (OSF) ou Zenodo. Cette traçabilité absolue garantit non seulement l’intégrité de la communication scientifique, mais permet également à la communauté des chercheurs de capitaliser sur ces développements méthodologiques, assurant ainsi la diffusion et la pérennité des meilleures pratiques de sémiotique graphique au sein des sciences du comportement.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Chambers, J. M., Cleveland, W. S., Kleiner, B., & Tukey, P. A. (1983). Graphical methods for data analysis. Wadsworth & Brooks/Cole.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
- Revelle, W. (2024). psych: Procedures for psychological, psychometric, and personality research (R package version 2.4.3). Northwestern University. https://cran.r-project.org/package=psych
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0