
L’analyse de régression linéaire constitue l’un des piliers fondamentaux de la modélisation statistique moderne, mobilisée de manière ubiquitaire dans les sciences sociales, l’économétrie, la biomédecine et l’apprentissage automatique supervisé. Lorsqu’un chercheur ou un analyste ajuste un modèle prédictif ou explicatif sur un ensemble de données, l’estimation des paramètres par la méthode des moindres carrés ordinaires ne représente que l’étape préliminaire d’une démarche scientifique rigoureuse. La validité des conclusions dérivées de ces modèles dépend impérativement du respect d’un ensemble d’hypothèses stochastiques sous-jacentes, parmi lesquelles la distribution normale des perturbations aléatoires occupe une position stratégique déterminante. L’investigation empirique de cette normalité ne saurait se limiter à des indicateurs synthétiques agrégés ; elle exige une auscultation visuelle minutieuse, capable de révéler des singularités distributionnelles que les métriques scalaires dissimulent fréquemment.
Au sein de cet arsenal diagnostique, l’histogramme des résidus s’impose comme une représentation graphique cardinale, offrant une vue directe, intuitive et exhaustive sur la morphologie empirique des écarts du modèle. Réalisé dans l’environnement statistique R, ce tracé permet de confronter la dispersion réelle des erreurs d’ajustement à l’idéal théorique incarné par la courbe de Gauss. Maîtriser la confection, la personnalisation et l’interprétation d’un tel graphique dans R représente une compétence méthodologique indispensable pour tout praticien soucieux de garantir l’intégrité de ses inférences. Qu’il soit généré via les primitives graphiques historiques du moteur de base ou par l’intermédiaire de la grammaire élégante et modulaire implémentée dans la bibliothèque ggplot2, l’histogramme constitue un rempart incontournable contre les conclusions statistiques fallacieuses induites par des distributions tronquées, bimodales ou lourdement asymétriques.
Ce guide encyclopédique se propose d’explorer de façon exhaustive et approfondie la théorie, la programmation et l’interprétation diagnostique des histogrammes de résidus sous R. À travers un cheminement méthodique débutant par les fondements mathématiques de l’erreur résiduelle pour aboutir à la rédaction académique de comptes-rendus de modélisation conformes aux standards internationaux, chaque étape sera minutieusement explicitée. Vous découvrirez comment extraire avec précision les résidus, calibrer les classes d’histogrammes selon les critères optimaux de l’échantillonnage, superposer des densités paramétriques et non paramétriques, croiser ces observations avec d’autres diagnostics incontournables et déployer des stratégies correctives performantes face aux pathologies distributionnelles avérées.
1. Introduction aux résidus de régression et à l’hypothèse de normalité en modélisation statistique
1.1 Définition théorique des résidus ordinaires
Dans le cadre formel du modèle linéaire général, la relation unissant une variable dépendante continue aux prédicteurs s’exprime à travers une équation structurelle où chaque observation observée résulte d’une composante déterministe et d’un terme d’erreur stochastique inobservable. Les résidus ordinaires, couramment désignés sous la lettre e, représentent l’écart algébrique calculé entre la valeur empirique mesurée pour un individu statistique donné et la valeur prédite par l’hyperplan de régression ajusté. Mathématiquement, pour la i-ème observation d’un échantillon, le résidu d’ajustement se définit rigoureusement par la différence simple entre la réalisation de la variable réponse et son espérance conditionnelle estimée par l’algorithme d’optimisation.
Il est impératif d’établir une distinction conceptuelle fondamentale entre le terme d’erreur théorique, couramment noté epsilon, et le résidu empirique calculé. L’erreur théorique constitue une variable aléatoire purement conceptuelle, inaccessible à l’observateur, qui traduit l’ignorance totale du modèle quant aux mécanismes non capturés dans la réalité physique ou sociale. En revanche, le résidu empirique est une quantité déterministe calculable, conditionnée à l’échantillon prélevé et aux coefficients estimés par le chercheur. Cette nuance épistémologique s’avère décisive : les propriétés théoriques idéales postulées sur la population parente ne se répercutent jamais de façon intégrale et automatique sur les résidus calculés au sein d’une série limitée de données.
Le rôle des résidus est au cœur même du critère d’optimisation des moindres carrés ordinaires. Cette approche algorithmique vise précisément à minimiser la somme des carrés de ces écarts individuels. Par construction géométrique au sein de l’espace vectoriel engendré par les variables explicatives, le vecteur résiduel résultant de cette projection orthogonale satisfait des propriétés strictes, telles qu’une somme algébrique rigoureusement nulle dès lors qu’un terme d’ordonnée à l’origine figure dans la spécification du modèle. Les résidus ordinaires capturent ainsi l’intégralité de la variance de la variable cible que les descripteurs n’ont pas été en mesure d’expliquer mathématiquement.
1.2 Importance fondamentale de l’hypothèse de normalité
L’hypothèse selon laquelle les erreurs d’un modèle linéaire suivent une loi normale multidimensionnelle de moyenne nulle et de matrice de covariance scalaire ne constitue pas une simple coquetterie technique, mais le socle de toute la théorie inférentielle classique. Si l’ajustement des paramètres par les moindres carrés demeure sans biais et convergent même en l’absence de normalité, la validité formelle des tests d’hypothèses statistiques dépend étroitement de cette condition distributionnelle. Notamment, les tests de Student appliqués à la significativité individuelle de chaque coefficient de régression et le test global de Fisher-Snedecor reposent analytiquement sur le quotient de formes quadratiques de variables gaussiennes indépendantes.
Dès lors que la loi normale gouvernant les perturbations n’est plus respectée, la dérivation analytique exacte de la loi de Student des estimateurs s’effondre dans les échantillons de taille modérée. En conséquence, les intervalles de confiance construits pour encadrer la valeur des paramètres inconnus de la population perdent leur garantie de couverture nominale, exposant l’analyste à des taux d’erreur de première espèce substantiellement distordus. De surcroît, la délimitation des intervalles de prédiction, qui visent à anticiper la réalisation d’une future observation individuelle avec un degré de certitude défini, devient particulièrement vulnérable aux déviations de la normalité, ces intervalles dépendant directement de la forme géométrique des queues de la distribution des erreurs.
Il convient de rappeler que le théorème de Gauss-Markov garantit que les estimateurs des moindres carrés sont les meilleurs estimateurs linéaires sans biais (BLUE) uniquement sous les hypothèses de moyenne nulle, d’homoscédasticité et d’absence d’autocorrélation, sans requérir expressément la normalité. Néanmoins, l’adjonction de l’hypothèse gaussienne confère à ces estimateurs le statut supérieur de meilleurs estimateurs sans biais tout court (BUE), atteignant la borne inférieure de Cramér-Rao. Bien que le théorème central limite offre une bouée de sauvetage asymptotique assurant la normalité limite des estimateurs lorsque la taille de l’échantillon croît vers l’infini, cette convergence peut s’avérer excessivement lente en présence d’asymétries sévères ou de valeurs aberrantes répétées, rendant le contrôle empirique de la normalité irremplaçable.
1.3 Pertinence du diagnostic résiduel dans la recherche empirique
Dans la pratique scientifique appliquée, l’analyse des résidus s’apparente à une véritable autopsie méthodologique du modèle statistique. Dans les échantillons finis, particulièrement ceux couramment traités en psychologie, en écologie ou dans les études cliniques où les effectifs oscillent entre quelques dizaines et quelques centaines d’unités, l’invocation systématique de la robustesse asymptotique relève d’une négligence épistémologique majeure. Les petites perturbations de la structure distributionnelle peuvent générer des fluctuations drastiques de la p-valeur, altérant potentiellement la trajectoire des conclusions substantielles et la reproductibilité des protocoles de recherche.
Face à ce défi, l’inspection visuelle des distributions résiduelles occupe une place de choix, surpassant à bien des égards les tests d’adéquation formels. En effet, des procédures inferentielles telles que le test de Shapiro-Wilk ou celui de Kolmogorov-Smirnov présentent des limites pratiques bien connues : une propension néfaste à rejeter l’hypothèse nulle pour des écarts infinitésimaux sans portée clinique dans les très grands jeux de données, doublée d’un manque criant de puissance statistique pour déceler des déviations critiques dans les échantillons restreints. L’examen graphique apporte une contextualisation spatiale et morphologique directe que nul indicateur binaire ne peut synthétiser adéquatement.
Par ailleurs, le diagnostic visuel de la distribution des résidus constitue une modalité d’investigation incomparable pour identifier des artefacts méthodologiques profonds. Une forme résiduelle s’écartant drastiquement de la symétrie gaussienne peut trahir l’omission d’une variable explicative non linéaire, une mauvaise spécification fonctionnelle de la relation unissant la réponse aux prédicteurs, ou encore des biais de mesure systématiques tels que des effets de plancher ou de plafond dans les instruments de collecte de données. L’histogramme devient ainsi un révélateur des imperfections structurelles du protocole expérimental autant que du modèle mathématique lui-même.
2. Fondements mathématiques et extraction des résidus dans l’environnement R
2.1 Typologie des résidus disponibles dans l’analyse de régression
L’environnement statistique R fournit une architecture computationnelle particulièrement sophistiquée pour la manipulation des différentes catégories de résidus développées par la littérature économétrique. La forme la plus élémentaire est le résidu ordinaire, calculé directement par l’application de la fonction générique residuals() à un objet représentant un modèle ajusté. Bien que conceptuellement direct, ce résidu présente l’inconvénient d’hériter de l’unité de mesure de la variable dépendante d’origine, ce qui entrave les comparaisons objectives entre des modèles portant sur des échelles hétérogènes et masque l’ampleur relative des déviations statistiques individuelles.
Afin de pallier cette limitation métrologique, les résidus standardisés sont obtenus en divisant chaque résidu ordinaire par une estimation de son écart-type individuel. Contrairement à une intuition naïve, les résidus ordinaires n’ont pas une variance constante sur l’ensemble de l’échantillon : celle-ci est fonction de la distance entre les coordonnées d’un point et le barycentre des prédicteurs, matérialisée par les éléments diagonaux de la matrice de projection orthogonale, souvent désignée comme la matrice chapeau. Dans l’écosystème R, la commande spécialisée rstandard() procède à cet ajustement mathématique rigoureux, produisant des résidus dont la variance empirique est normalisée à l’unité, autorisant ainsi l’application immédiate de règles de décision universelles basées sur la loi normale centrée réduite.
À un niveau de raffinement statistique supérieur, les résidus studentisés, également dénommés résidus jackknife ou supprimés, sont générés à l’aide de la fonction rstudent(). Pour calculer le résidu studentisé d’une observation spécifique, le modèle linéaire est ré-estimé virtuellement en omettant cette observation particulière du jeu de données, ce qui empêche une valeur aberrante potentiellement influente de biaiser la variance résiduelle globale vers le haut. Cette métrique constitue l’étalon diagnostique le plus sensible pour détecter les points atypiques capables d’exercer un effet de levier destructeur sur l’estimation de la pente ou d’altérer artificiellement l’allure de la distribution globale visualisée sur un histogramme.
2.2 Propriétés statistiques des résidus estimés
Sur le plan mathématique, les résidus calculés par les moindres carrés ordinaires obéissent à un cadre algébrique contraint par les conditions de premier ordre du programme de minimisation quadratique. Lorsque le modèle statistique intègre une constante, l’annulation formelle des dérivées partielles par rapport à ce paramètre garantit que la moyenne arithmétique exacte des résidus ordinaires est rigoureusement égale à zéro au sein de l’échantillon d’estimation. Cette propriété n’est pas le fruit d’une hypothèse probabiliste spontanée, mais une conséquence directe de la projection du vecteur de la variable réponse sur l’espace vectoriel sous-tendu par les régresseurs incluant le vecteur unité.
La variance résiduelle de l’échantillon, quant à elle, s’obtient en divisant la somme des carrés des résidus par les degrés de liberté résiduels, calculés comme la différence entre l’effectif total d’observations et le nombre total de paramètres estimés par le modèle, constante comprise. Ce diviseur correcteur assure le caractère sans biais de l’estimateur de la variance du terme d’erreur stochastique. L’évaluation de cette dispersion empirique autour de la droite d’ajustement permet de quantifier l’imprécision inhérente au processus de modélisation et constitue la métrique d’échelle essentielle à l’étalonnage de toute courbe théorique de normalité superposée à un tracé d’histogramme.
Toutefois, une propriété souvent sous-estimée dans l’interprétation diagnostique concerne la structure de covariance des résidus estimés. Même lorsque les termes d’erreur théoriques sont postulés mutuellement indépendants et identiquement distribués, les résidus calculés exhibent inévitablement une corrélation linéaire interne induite par le mécanisme de projection matricielle. En d’autres termes, la matrice de variance-covariance des résidus n’est pas strictement diagonale, mais proportionnelle à la matrice identité minorée de la matrice chapeau. Cette légère dépendance induite implique que l’histogramme des résidus reflète une suite de variables très faiblement corrélées, sans que cette particularité ne compromette son utilité pratique dans l’évaluation de la forme générale de la loi sous-jacente.
2.3 Manipulation des structures d’objets résiduels dans R
L’un des atouts déterminants du langage de programmation statistique R réside dans sa flexibilité orientée objet pour l’extraction et la transformation des résultats numériques. L’invocation d’une fonction d’extraction résiduelle renvoie initialement un vecteur numérique à une dimension, doté d’attributs de nommage correspondant aux identifiants textuels ou numériques des lignes de la table d’entrée. Ce vecteur autonome se prête immédiatement à des opérations scalaires élémentaires, telles que le calcul de quantiles, le dénombrement d’occurrences ou l’insertion directe dans les arguments des fonctions graphiques primitives du moteur de base.
Cependant, dans le cadre d’un flux de travail analytique moderne et rigoureux, il est vivement préconisé d’intégrer sans délai ces vecteurs résiduels au sein du tableau de données matriciel originel. Cette fusion structurelle s’effectue couramment par le truchement de la création d’une nouvelle colonne dédiée au sein du data.frame contenant les prédicteurs et la réponse. Cette démarche garantit une traçabilité sans faille : chaque valeur résiduelle demeure indéfectiblement couplée à l’ensemble de ses covariables d’origine, empêchant toute permutation accidentelle d’indices et facilitant des investigations transversales ultérieures, telles que l’analyse conditionnelle des résidus selon des sous-groupes catégoriels.
Pour les utilisateurs adoptant la syntaxe et la philosophie du tidyverse, la conversion de la structure tabulaire sous la forme d’un tibble enrichi représente une pratique d’excellence. Par l’entremise de fonctions de modélisation contemporaines comme celles disponibles au sein du paquetage broom, il est possible de générer une table augmentée intégrant de manière standardisée les valeurs ajustées, les résidus bruts, standardisés et studentisés, ainsi que les distances de levier et de Cook. Cette formalisation algorithmique prépare idéalement le terrain pour les étapes de visualisation avancée, assurant une compatibilité sans friction avec les exigences d’entrée de la bibliothèque graphique ggplot2.
3. Préparation de l’environnement R et génération des données d’exemple
3.1 Configuration du cadre de travail et reproductibilité expérimentale
La reproductibilité constitue le fondement épistémologique de toute démarche scientifique computationnelle. Lorsque l’on procède à des démonstrations méthodologiques impliquant des tirages stochastiques dans des lois de probabilité sous R, l’initialisation explicite du générateur de nombres pseudo-aléatoires s’impose comme un impératif méthodologique incontournable. L’instruction standardisée set.seed(), recevant un entier arbitraire comme paramètre, permet de figer l’état interne de l’algorithme sous-jacent, généralement le générateur de Mersenne-Twister, garantissant ainsi que chaque itération du script produira rigoureusement la même séquence de données synthétiques sur n’importe quel ordinateur.
Outre l’initialisation de la graine aléatoire, la préparation soignée de l’environnement de développement impose une vérification de la session R active, notamment la compatibilité des versions installées et la gestion des bibliothèques nécessaires à l’exécution complète du flux de travail. Bien que l’affichage d’un histogramme élémentaire ne nécessite aucune dépendance externe grâce au moteur de base intégré, l’exploitation pleine et entière des représentations modernes exige l’importation de bibliothèques éprouvées du tidyverse, au premier rang desquelles figure ggplot2, complétée idéalement par des extensions d’agencement graphique.
L’adoption d’un espace de travail propre et dénué d’objets résiduels parasites issus de sessions antérieures prévient tout risque de collision de variables lors des phases d’affectation matricielle. L’organisation du code source selon une architecture modulaire et linéaire, documentée par des commentaires explicatifs détaillés, s’inscrit dans les standards actuels de la science ouverte et reproductible. Cette rigueur initiale assure que le cheminement logique, de la génération des nombres stochastiques à l’exportation des visualisations haute résolution, s’exécutera de manière fluide et transparente sans aucune intervention manuelle discontinue.
3.2 Simulation paramétrique des variables explicatives et dépendante
Afin d’illustrer la mécanique diagnostique de manière contrôlée, la création d’un jeu de données synthétique paramétré offre un cadre pédagogique idéal. Ce procédé autorise l’expérimentateur à définir avec une précision chirurgicale les vraies valeurs des coefficients de régression ainsi que la nature distributionnelle exacte du terme d’erreur stochastique. Pour concevoir un modèle de régression linéaire multiple réaliste, nous pouvons générer un échantillon d’une taille représentative, par exemple cinq cents observations indépendantes, assurant une puissance statistique confortable pour l’examen des propriétés morphologiques de l’histogramme.
La génération des prédicteurs continus s’effectue au moyen de tirages dans des distributions normales diversifiées grâce à la fonction rnorm(). Nous pouvons ainsi simuler une première variable explicative continue dotée d’une moyenne et d’une variance spécifiques, susceptible d’émuler un indicateur psychométrique ou physiologique, et un second prédicteur indépendant caractérisé par des paramètres distincts. L’indépendance ou la faible colinéarité artificielle entre ces régresseurs garantit que les matrices de conception ne souffriront d’aucune instabilité numérique lors de l’inversion algébrique nécessaire à l’obtention des coefficients.
La clé de voûte de cette simulation réside dans la modélisation explicite de la variable réponse continue, configurée comme une combinaison linéaire stricte des prédicteurs générés, augmentée d’un terme d’ordonnée à l’origine et sommée à un vecteur d’erreurs aléatoires. En attribuant à cette perturbation stochastique une distribution gaussienne de moyenne zéro et d’écart-type calibré, nous bâtissons délibérément un scénario théorique parfait où l’hypothèse de normalité résiduelle est rigoureusement satisfaite dans le processus générateur de données. Cette configuration de référence servira de jalon d’étalonnage pour analyser la façon dont l’histogramme empirique parvient à refléter cette normalité programmée.
3.3 Exploration descriptive préliminaire du jeu de données
Avant de procéder à la moindre tentative de modélisation inférentielle, une investigation descriptive des vecteurs simulés s’avère indispensable pour s’assurer de l’intégrité de la structure tabulaire constituée. L’inspection des premières lignes du data.frame au moyen de la commande head() permet de corroborer visuellement le bon ordonnancement des variables, la conformité de leur étiquetage et l’absence apparente de valeurs corrompues ou de discordances d’indexation numérique.
Cette vérification morphologique préliminaire doit être immédiatement complétée par un contrôle de la cohérence des dimensions géométriques du tableau, notamment en s’assurant par la commande dim() que le nombre total de lignes correspond rigoureusement au volume d’observations planifié et que le typage des colonnes relève exclusivement du domaine numérique continu. La moindre anomalie typologique, telle que la conversion accidentelle d’un prédicteur en facteur textuel lors de la manipulation, altérerait l’exécution de la fonction d’ajustement ultérieure.
Enfin, l’application de la fonction summary() sur l’ensemble de la table fournit un panorama synthétique irremplaçable sur les descripteurs fondamentaux de position et de dispersion. L’examen attentif des minima, maxima, médianes et quartiles pour chaque variable permet de s’assurer que les échelles observées correspondent aux ordres de grandeur théoriques insufflés lors de la phase stochastique. Ce diagnostic liminaire confirme la stabilité de l’environnement de données avant de soumettre les vecteurs aux algorithmes d’optimisation mathématique.
4. Ajustement du modèle de régression linéaire multiple avec la fonction lm()
4.1 Spécification de l’équation de régression
L’estimation des paramètres de la relation linéaire reliant la variable dépendante continue à l’ensemble des prédicteurs s’effectue dans l’environnement R par l’intermédiaire de la commande standardisée lm(), acronyme direct de linear models. Cette fonction utilise un formalisme syntaxique déclaratif particulièrement expressif, formalisé par une formule symbolique où la variable réponse se positionne à gauche d’un opérateur tilde, tandis que l’expression additive des variables explicatives se déploie sur son flanc droit.
Sur le plan algorithmique, l’appel à lm() déclenche une séquence de calculs matriciels hautement optimisés, s’appuyant principalement sur la décomposition QR de la matrice des régresseurs pour déterminer les coefficients d’ajustement sans devoir calculer directement l’inverse potentiellement mal conditionné de la matrice de produit croisé. L’attribution du résultat de cette routine à un objet nommé dans l’espace de travail R crée une structure de données composite complexe de classe lm, renfermant l’ensemble des métadonnées de l’ajustement, les coefficients estimés, les rangs mathématiques, ainsi que les vecteurs de valeurs ajustées et de résidus bruts.
Lors de cette phase de modélisation, il convient de porter une attention vigilante à l’absence de valeurs manquantes résiduelles qui auraient pu être introduites par inadvertance dans les vecteurs d’entrée. Bien que la fonction lm() dispose d’un gestionnaire par défaut supprimant automatiquement les paires incomplètes, cette pratique peut modifier subrepticeusement la taille effective de l’échantillon analysé et rompre l’alignement dimensionnel entre le tableau de bord initial et les vecteurs diagnostiques produits en sortie.
4.2 Examen critique du résumé d’ajustement
L’évaluation des performances du modèle ajusté se déploie traditionnellement par le truchement de l’instruction summary() appliquée à l’objet de régression. Cette restitution textuelle synthétique regroupe une densité considérable d’indicateurs inférentiels, débutant par la table des coefficients qui consigne pour chacun d’eux son estimation ponctuelle, son erreur-type asymptotique, la statistique t de Student associée et la p-valeur bilatérale correspondante. Ces valeurs permettent de vérifier immédiatement si les relations injectées artificiellement lors de la phase de simulation sont fidèlement restituées par la machine statistique.
Au-delà de la significativité individuelle des coefficients, le coefficient de détermination usuel R-carré, ainsi que sa déclinaison ajustée pénalisant la complexité paramétrique, fournissent une estimation globale de la proportion de variance de la variable cible expliquée conjointement par l’ensemble des prédicteurs. Une valeur substantielle de cette métrique atteste que l’hyperplan d’ajustement structure efficacement le nuage de points multidimensionnel, laissant une part de variance inexpliquée mesurée par l’erreur standard résiduelle globale de la régression.
Un aspect fréquemment négligé de cette sortie standardisée réside dans la présence, au tout début du compte-rendu, d’une synthèse en cinq points de la distribution des résidus ordinaires, détaillant leur minimum, premier quartile, médiane, troisième quartile et maximum. Cet encart textuel offre un premier aperçu diagnostique capital : si la médiane des résidus s’écarte significativement de zéro, ou si les valeurs absolues du premier et du troisième quartile affichent une dissymétrie flagrante, l’analyste dispose d’un indice précurseur immédiat signalant une violation probable de l’hypothèse de normalité ou d’homoscédasticité bien avant d’avoir tracé le moindre graphique.
4.3 Extraction programmatique des résidus du modèle ajusté
Pour procéder à la construction d’un histogramme des résidus, l’analyste doit isoler avec rigueur le vecteur numérique représentant les écarts d’ajustement. Deux approches programmatiques coexistent dans l’écosystème R pour mener à bien cette opération. La méthode la plus directe consiste à interroger directement la liste interne de l’objet de classe lm par le truchement de l’opérateur dollar en accédant à l’élément model$residuals. Bien que largement répandue dans les scripts élémentaires en raison de sa concision, cette pratique d’accès direct est généralement déconseillée dans le cadre du génie logiciel statistique rigoureux.
L’approche préconisée par les concepteurs du langage repose sur l’emploi systématique des fonctions d’extraction génériques, spécifiquement l’instruction residuals(model). Cette dernière garantit une sécurité d’exécution supérieure, gérant de manière appropriée les méthodes associées aux différentes classes de modèles linéaires et assurant la bonne transmission des attributs, notamment en présence de pondérations spécifiques ou d’options avancées de traitement des données omises. Le résultat est stocké au sein d’une variable autonome expressément dédiée aux manipulations graphiques subséquentes.
Une fois cette extraction réalisée, un contrôle de conformité dimensionnelle élémentaire doit être systématiquement opéré à l’aide de la commande length() appliquée au vecteur résiduel extrait. Il est fondamental de vérifier que cette longueur équivaut précisément au nombre d’observations effectives ayant concouru à l’ajustement du modèle. Cette précaution liminaire garantit qu’aucune désynchronisation structurelle ne viendra corrompre les étapes ultérieures de mise en forme tabulaire et de restitution visuelle.
5. Construction d’un histogramme des résidus avec les fonctions graphiques de base (Base R)
5.1 Syntaxe minimale et premier tracé avec hist()
L’environnement historique de R, couramment désigné sous l’appellation de Base R, dispose d’un moteur graphique vectoriel natif particulièrement rapide et universellement disponible sans nécessiter le chargement d’aucun paquetage tiers. La commande archétypale pour générer un histogramme s’incarne dans la fonction hist(). En passant simplement le vecteur des résidus ordinaires précédemment extrait en paramètre unique de cette instruction, R engendre instantanément une fenêtre graphique affichant la distribution des fréquences des écarts sous forme de rectangles verticaux contigus.
Ce premier tracé brut remplit une fonction diagnostique immédiate lors des phases exploratoires préliminaires d’un projet de modélisation. En quelques millisecondes, le statisticien peut apprécier la dispersion globale des résidus, localiser approximativement le centre de gravité de la distribution et vérifier l’absence d’aberrations numériques majeures issues d’un dysfonctionnement de la phase d’optimisation. Cette accessibilité instantanée confère au moteur de base une valeur inestimable pour les vérifications rapides au fil du code.
Cependant, le comportement algorithmique par défaut de la fonction hist() repose sur des choix automatiques qui ne correspondent pas nécessairement aux exigences esthétiques et méthodologiques des publications scientifiques. Par défaut, la routine applique l’algorithme de Sturges pour déterminer le nombre optimal de classes de découpage et attribue des étiquettes textuelles sommaires issues du nom du vecteur d’entrée. Bien que fonctionnelle, cette visualisation brute requiert une optimisation substantielle de ses arguments pour se muer en un outil de communication scientifique rigoureux.
5.2 Optimisation des paramètres visuels de base
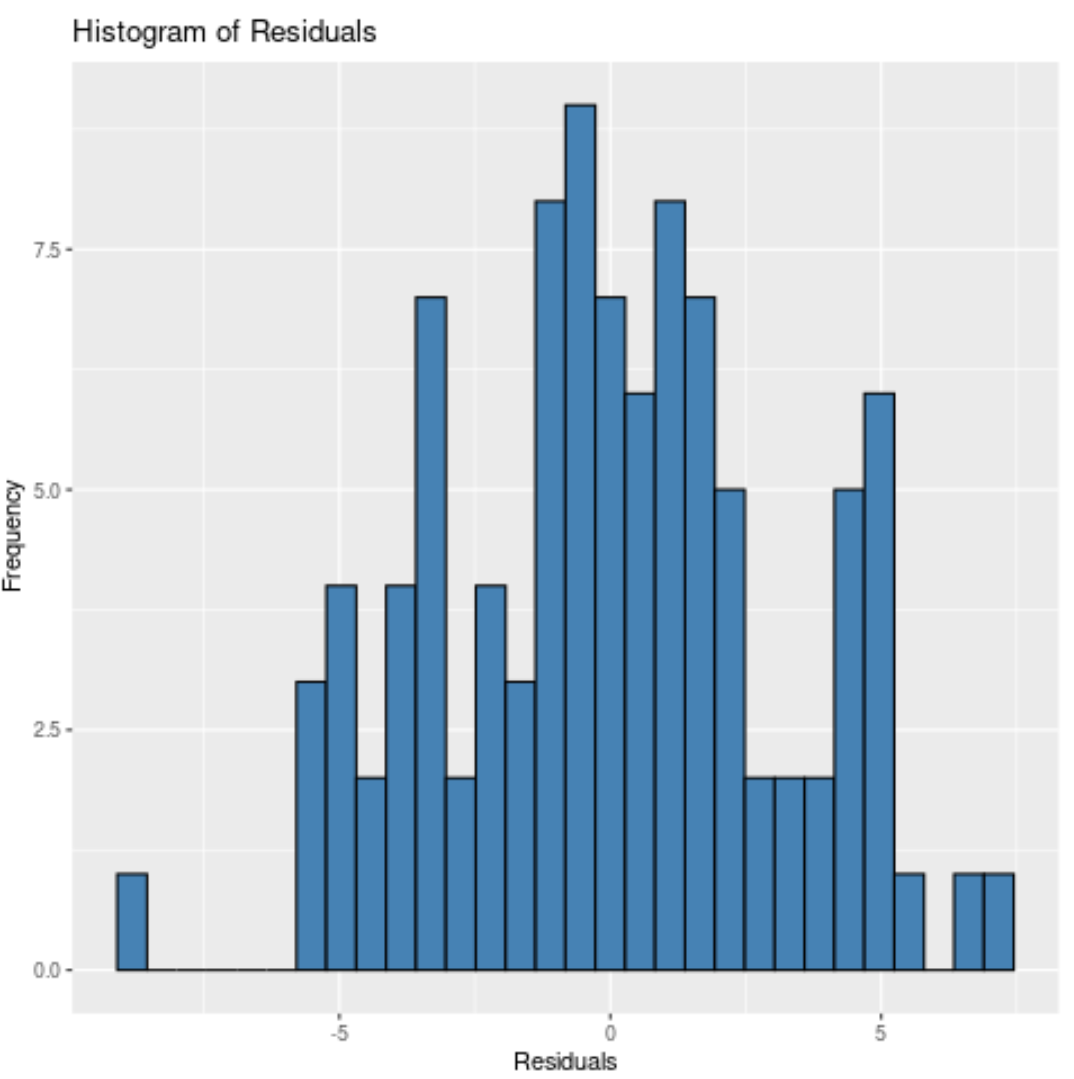
Pour transformer une esquisse graphique rudimentaire en une figure d’analyse rigoureuse, la commande hist() propose un riche éventail d’arguments formels permettant de piloter finement sa structure et son aspect extérieur. L’argument crucial breaks régit le partitionnement de l’axe des abscisses. Au lieu de s’en remettre au partitionnement automatique de Sturges, souvent trop conservateur et lissant excessivement les détails dans les échantillons moyens à grands, l’analyste peut spécifier un entier explicite pour forcer un nombre supérieur d’intervalles ou désigner des algorithmes de discrétisation alternatifs reconnus pour leur robustesse mathématique, tels que ceux de Scott ou de Freedman-Diaconis.
La lisibilité formelle du tracé dépend également de la personnalisation méticuleuse de son titrage et de l’habillage de ses axes de coordonnées. L’utilisation de l’argument main permet de substituer au titre automatique une formulation scientifique explicite contextualisant le modèle examiné, tandis que les paramètres xlab et ylab doivent être impérativement mobilisés pour assigner des descriptions techniques claires, précisant notamment si l’ordonnée matérialise des fréquences absolues d’occurrences ou des densités relatives.
L’harmonie esthétique globale gagne à être affinée par le choix réfléchi des teintes de remplissage et de délimitation géométrique des rectangles de distribution. Par l’entremise de l’argument col, on privilégiera des nuances douces, telles qu’un bleu acier ou un gris perle, évitant ainsi l’agressivité visuelle du blanc pur par défaut. Parallèlement, le paramètre border permet d’appliquer un contour net et contrasté, comme un gris anthracite profond ou un noir classique, afin d’individualiser sans équivoque chaque bac d’observation face au regard de l’évaluateur.
5.3 Superposition d’éléments de référence analytiques
Un histogramme résiduel isolé ne saurait suffire à porter un jugement diagnostique définitif : il exige l’adjonction de repères géométriques permettant d’ancrer la lecture dans le cadre formel des hypothèses du modèle linéaire. L’élément de référence le plus fondamental réside dans la matérialisation explicite de la valeur zéro sur l’axe des abscisses, point d’équilibre théorique de l’espérance mathématique des perturbations. L’environnement graphique de base permet de concrétiser cet ajout par l’appel immédiat de la fonction abline() immédiatement après le tracé de l’histogramme principal.
En configurant l’argument v de la commande abline() sur la valeur zéro, le moteur graphique trace une droite verticale sécante traversant l’intégralité du champ de dispersion. L’attribution d’un style discontinu via le paramètre lty, couplé à une teinte vive telle qu’un rouge carmin et à un épaississement du trait via lwd, offre un contraste visuel puissant. Ce dispositif permet d’évaluer en un coup d’œil si le barycentre de la distribution empirique est parfaitement aligné avec l’origine ou si une asymétrie locale tire la masse résiduelle vers une polarité indésirable.
Bien que cette combinaison de fonctions primitives permette d’atteindre un niveau d’information analytique tout à fait honorable pour l’exploration de bureau, le moteur graphique standard de R bute sur des limites intrinsèques dès lors que l’on ambitionne de superposer des couches analytiques multiples ou d’intégrer des légendes dynamiques complexes. La gestion rigide des marges, l’absence de système de couches empilables réutilisables et la difficulté de standardiser les dimensions typographiques incitent la communauté des statisticiens à se tourner vers des solutions contemporaines plus élaborées pour la production de figures destinées à l’impression académique.
6. Élaboration d’histogrammes des résidus avancés avec ggplot2
6.1 Principes de la grammaire des graphiques appliquée aux résidus
La bibliothèque ggplot2, développée par Hadley Wickham, repose sur les fondements théoriques de la grammaire des graphiques conceptualisée par Leland Wilkinson. Cette approche révolutionnaire s’affranchit du paradigme traditionnel des tracés monolithiques au profit d’une philosophie déclarative où chaque figure se construit par la superposition successive de couches sémantiques indépendantes : les données sources, les correspondances esthétiques (aesthetics), les représentations géométriques (geoms), les transformations statistiques et les systèmes de coordonnées cartésiennes.
Pour appliquer ce paradigme à l’analyse résiduelle, la première étape impose de formater le vecteur des résidus sous la forme d’un conteneur de données tabulaire adapté, généralement un data.frame ou un tibble. Contrairement aux primitives de base qui acceptent des vecteurs numériques décontextualisés, ggplot2 exige impérativement que toute information visuelle soit encapsulée dans une structure rectangulaire relationnelle. Cette contrainte architecturale, loin d’être un obstacle, garantit une traçabilité rigoureuse et standardise l’interopérabilité des scripts au sein des chaînes de traitement de données contemporaines.
L’initialisation du graphique s’opère par l’appel de la fonction maîtresse ggplot(), au sein de laquelle on déclare explicitement la source tabulaire et l’application esthétique aes() assignant la variable résiduelle à l’axe spatial horizontal x. À ce stade primaire, le système génère un canevas mathématique vide mais parfaitement étalonné sur les étendues minimales et maximales des résidus, prêt à accueillir les différentes couches d’expression géométrique qui viendront matérialiser la distribution empirique.
6.2 Configuration précise de geom_histogram()
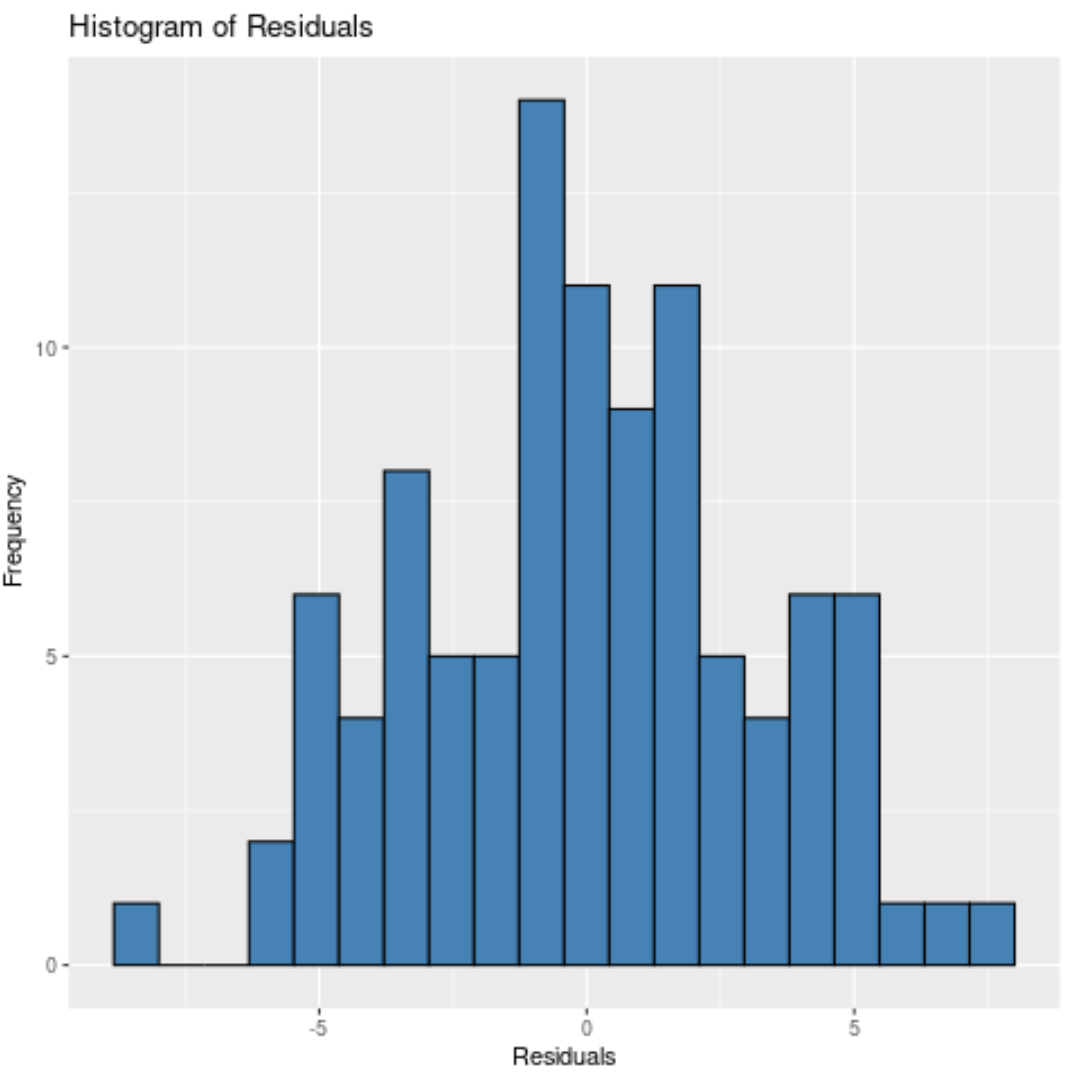
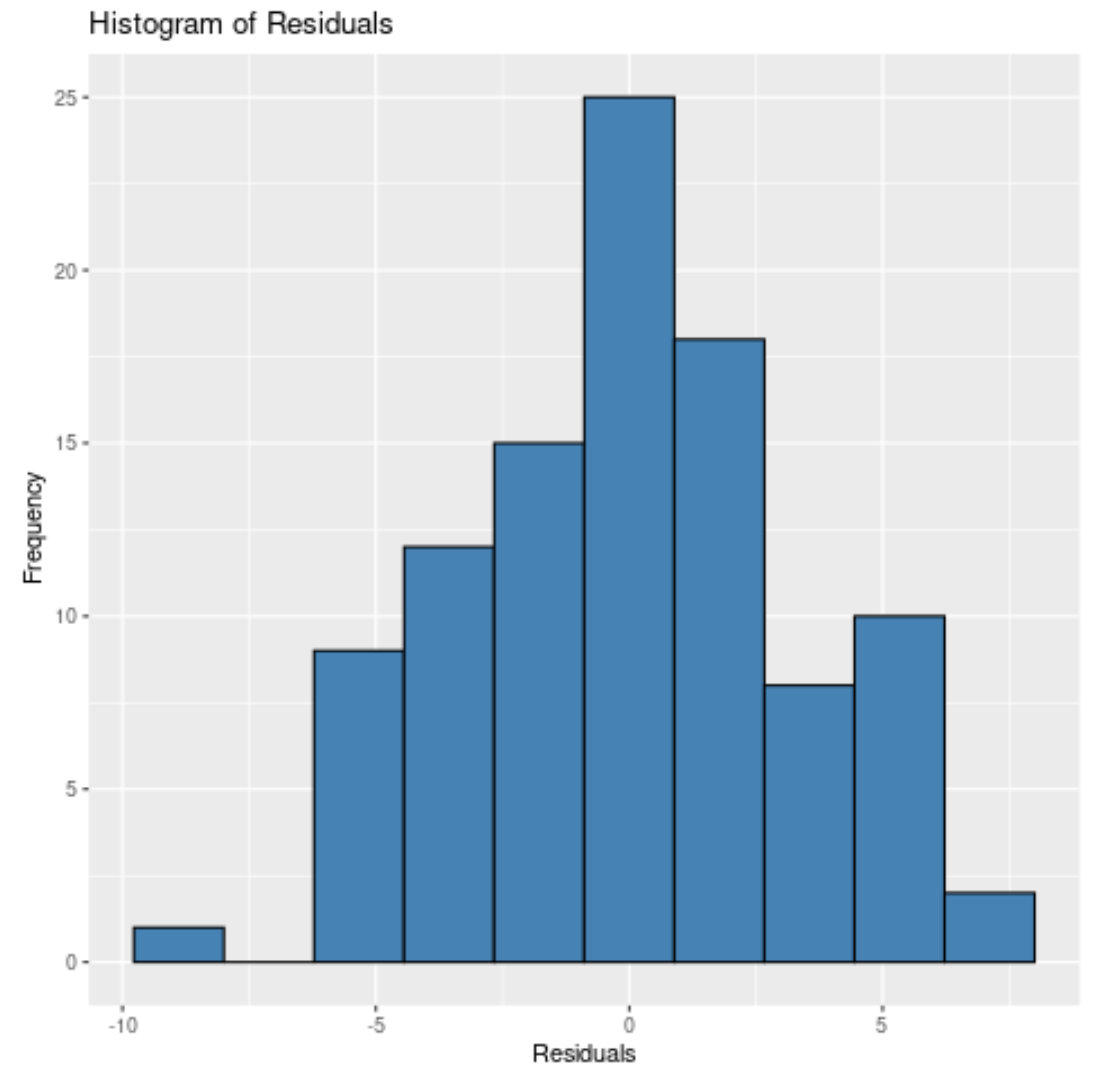
La concrétisation de l’histogramme au sein de l’architecture ggplot2 procède de l’adjonction de la couche géométrique geom_histogram() au moyen de l’opérateur arithmétique d’addition, qui matérialise l’empilement des strates fonctionnelles. Le paramétrage de cette couche requiert une vigilance méthodologique extrême quant au découpage des classes de valeurs. L’utilisateur se voit confronter à un arbitrage technique fondamental entre deux paramètres exclusifs : binwidth, qui fixe une largeur d’intervalle métrique absolue invariable, et bins, qui impose un nombre total fixe de classes sur l’étendue des résidus.
Le choix inconsidéré du partitionnement peut induire des biais d’interprétation cognitifs majeurs. Un paramètre de granularité binwidth trop élevé lisse artificiellement les aspérités de la distribution, dissimulant de facto des bimodalités critiques ou des trous de densité révélateurs d’anomalies structurelles du modèle. Inversement, un partitionnement excessivement fin fragmente la distribution en une myriade d’intervalles clairsemés, générant un bruit visuel stochastique qui obscurcit la perception de la forme globale en cloche recherchée par le statisticien.
Sur le plan chromatique, la géométrie geom_histogram() déploie une expressivité graphique supérieure en permettant de dissocier hermétiquement la couleur du corps des rectangles, régie par l’attribut fill, de celle de leur périphérie linéaire, assignée par l’attribut color. L’insertion judicieuse d’un coefficient de transparence via le paramètre alpha, oscillant idéalement entre 0.6 et 0.8, confère une translucidité élégante indispensable dès lors que l’on projette de superposer ultérieurement des fonctions de densité lissées sans obstruer la visibilité des frontières de classes sous-jacentes.
6.3 Mise en œuvre d’un style visuel épuré et académique
L’apparence par défaut de ggplot2, caractérisée par sa célèbre grille de coordonnées blanche sur fond gris anthracite, bien que fonctionnelle pour l’exploration interactive, est généralement jugée inadaptée aux contraintes de clarté des revues scientifiques internationales à fort facteur d’impact. L’application d’un thème stylistique épuré constitue ainsi une phase incontournable de la préparation visuelle d’un diagnostic résiduel destiné à l’évaluation par les pairs.
Le recours à des thèmes intégrés sobres tels que theme_minimal(), theme_classic() ou theme_bw() permet de purger instantanément la composition graphique des éléments décoratifs superflus. Conformément au principe directeur d’Edward Tufte préconisant la maximisation du ratio données-encre, la suppression de l’arrière-plan opaque et l’atténuation sélective des lignes de quadrillage secondaires concentrent l’attention cognitive du lecteur exclusivement sur la géométrie de la distribution résiduelle.
Cette démarche de raffinement s’achève par la personnalisation détaillée des composantes typographiques et structurelles via l’instruction modulaire theme(). L’uniformisation des familles de polices de caractères, l’ajustement millimétrique de la taille des caractères des étiquettes d’axes, l’adjonction de marges harmonieuses autour de la zone de traçage et l’ajustement du positionnement des axes contribuent à conférer à l’histogramme une finition professionnelle irréprochable répondant scrupuleusement aux conventions graphiques de l’American Psychological Association (APA).
7. Superposition d’une courbe de densité théorique et empirique sur l’histogramme
7.1 Normalisation de l’axe des ordonnées en échelle de densité
Par conception initiale, un histogramme standard affiche sur l’axe vertical le décompte absolu du nombre d’unités statistiques chutant dans chaque classe délimitée. Cette échelle en fréquences simples, bien qu’instinctivement accessible, soulève une impossibilité mathématique absolue dès lors que l’on projette de lui superposer une fonction de densité continue, qu’elle soit issue d’un estimateur par noyau ou d’une loi paramétrique normale. En effet, l’intégrale d’une fonction de densité de probabilité sur son domaine de définition est rigoureusement égale à un, tandis que la surface cumulée des rectangles d’un histogramme de fréquences équivaut au produit de l’effectif total par la largeur de classe.
Pour rendre la géométrie discrète de l’histogramme spatialement commensurable avec l’aire unitaire des courbes de probabilité continues, il est indispensable de normaliser la hauteur des barres de façon à ce que la surface globale de l’histogramme totalise exactement un. Au sein de la bibliothèque ggplot2, cette mutation scalaire s’opère au niveau de la correspondance esthétique du geom_histogram() en assignant à l’ordonnée y l’expression de calcul différé after_stat(density). Cette syntaxe ordonne au moteur graphique de substituer au simple comptage d’effectifs la densité empirique calculée.
Cette transformation modifie en profondeur la grille de lecture quantitative de la figure. La hauteur individuelle d’un rectangle ne désigne plus le nombre absolu d’observations recensées dans cet intervalle, mais la densité relative de probabilité associée à cette tranche de l’étendue résiduelle. La conformité géométrique étant ainsi rétablie, l’analyste peut procéder à la superposition harmonieuse et scientifiquement rigoureuse de profils de distribution continus sur le même système de coordonnées cartésiennes.
7.2 Intégration de la courbe de densité empirique par noyau
La première courbe à juxtaposer sur l’histogramme normalisé est la distribution empirique lissée des résidus, matérialisée graphiquement par l’adjonction de la couche geom_density(). Cette représentation non paramétrique repose sur l’estimation de densité par la méthode du noyau (Kernel Density Estimation), qui associe à chaque point d’observation une fonction de poids gaussienne centrée, avant de sommer l’intégralité de ces contributions individuelles pour produire une trajectoire continue parfaitement lissée.
Le comportement de cet estimateur par noyau dépend au premier chef d’un paramètre d’ajustement hyper-critique : la largeur de bande (bandwidth). Un paramètre de lissage trop étendu tend à écraser la véritable morphologie des données, masquant des anomalies asymptotiques réelles, tandis qu’une largeur de bande sous-dimensionnée génère une courbe tourmentée reflétant les simples fluctuations de l’échantillonnage plutôt que la régularité du processus stochastique sous-jacent. Par défaut, ggplot2 mobilise des règles d’optimisation basées sur l’écart-type et l’intervalle interquartile (notamment la méthode de Silverman), garantissant un compromis de lissage généralement performant.
L’intérêt diagnostique de cette couche empirique réside dans sa capacité à révéler les inflexions subtiles du profil distributionnel que le découpage en blocs rigides de l’histogramme tend inévitablement à morceler ou déformer. En appliquant à geom_density() une teinte distincte, un tracé continu épaissi et éventuellement un remplissage délicatement transparent, l’analyste visualise instantanément la forme effective des résidus sans les artefacts optiques induits par le positionnement arbitraire des frontières de bacs.
7.3 Tracé de la courbe normale théorique de référence
L’aboutissement méthodologique de l’histogramme de diagnostic réside dans la confrontation directe entre la distribution empirique observée et la loi normale théorique idéale postulée par les conditions de Gauss-Markov. Cette modélisation paramétrique de référence s’implémente au moyen de la fonction statistique stat_function(), configurée pour évaluer la fonction de densité gaussienne dnorm() sur l’ensemble du domaine de variation des résidus calculés.
Le calibrage des paramètres de cette loi normale théorique impose une rigueur absolue : la fonction dnorm() doit recevoir pour argument d’espérance mathématique la moyenne exacte des résidus (qui est structurellement nulle) et pour argument de dispersion l’écart-type empirique des résidus observés, extrait au moyen de la fonction sd(). Ainsi calibrée, la courbe théorique représente rigoureusement la distribution gaussienne parfaite qui posséderait la même étendue de dispersion globale que notre modèle d’ajustement.
Le contraste graphique bicolore ainsi déployé—opposant généralement une teinte froide pour l’estimation de densité empirique et un tracé contrasté (tel qu’un trait rouge pointillé ou tireté) pour la référence théorique de Gauss—constitue un instrument d’une remarquable puissance cognitive. Tout écart morphologique substantiel entre ces deux trajectoires continues signale visuellement et sans ambiguïté une violation localisée de l’hypothèse de normalité, qu’il s’agisse d’un décalage du pic modal, d’un déficit d’observations sur les flancs ou d’une surcharge anormale des extrémités de distribution.
8. Diagnostic visuel : identifier les asymétries, l’aplatissement et les valeurs aberrantes
8.1 Évaluation de la symétrie de distribution (skewness)
L’asymétrie résiduelle, formalisée dans la théorie statistique par le troisième moment centré normalisé ou coefficient de Fisher-Pearson (skewness), constitue la première distorsion géométrique observable sur un histogramme diagnostique. Dans une situation idéale de conformité aux postulats de la modélisation linéaire, la distribution des résidus doit exhiber une symétrie parfaite autour de son axe vertical passant par zéro, traduisant une probabilité strictement équivalente de sous-estimer ou de surestimer la valeur de la réponse conditionnellement aux prédicteurs.
Une asymétrie positive, communément qualifiée d’étirement vers la droite, se manifeste sur l’histogramme par une accumulation prononcée de la masse des observations sur le versant des résidus négatifs, tandis qu’une longue traîne de valeurs résiduelles positives s’étire vers les valeurs élevées de l’abscisse. Une telle configuration géométrique révèle que le modèle statistique sous-estime systématiquement et parfois très lourdement les réalisations extrêmes de la variable réponse. À l’inverse, une asymétrie négative étirée vers la gauche témoigne d’une concentration des résidus dans les valeurs positives couplée à une traîne prolongée de fortes erreurs négatives, signalant une tendance du modèle à surestimer considérablement certains profils expérimentaux.
Sur le plan méthodologique, la présence avérée d’une asymétrie résiduelle significative compromet sérieusement l’exactitude des prédictions ponctuelles et dissymétrise l’efficacité réelle des intervalles de prédiction bilatéraux traditionnels. L’analyste doit impérativement discriminer s’il est confronté à un artefact échantillonnal imputable à une taille de groupe insuffisante ou à une propriété intrinsèque du phénomène physique analysé, telle qu’une variable dépendante bornée à zéro présentant une dynamique multiplicative naturelle (ex. revenus financiers, temps de réaction chronométrique ou concentrations biochimiques).
8.2 Analyse du degré d’aplatissement et des queues épaisses (kurtosis)
Le second axe fondamental d’investigation morphologique concerne le degré d’aplatissement relatif de la distribution résiduelle, capturé mathématiquement par le quatrième moment centré ou kurtosis de Pearson. La loi normale théorique sert d’étalon universel avec un coefficient d’aplatissement brut égal à 3 (ou une valeur d’excès de kurtosis nulle). L’examen attentif du sommet de l’histogramme et de l’épaisseur de ses extrémités permet de classifier instantanément la typologie d’écart à cette norme.
Une structure qualifiée de leptokurtique se reconnaît graphiquement à la présence d’un sommet central particulièrement étroit, pointu et surélevé par rapport à la courbe de Gauss théorique, combiné à des queues de distribution épaissies et surchargées en observations aux extrémités distantes. Ce profil distributionnel constitue une alerte méthodologique majeure dans les études inférentielles : les queues épaisses révèlent une probabilité d’occurrence d’erreurs massives nettement supérieure à ce que postule la théorie normale classique. Les estimateurs des moindres carrés demeurent alors excessivement sensibles à ces chocs extrêmes, fragilisant la stabilité globale des coefficients.
À l’opposé, une distribution platykurtique se caractérise par un sommet écrasé, tronqué ou arrondi, assorti d’une dispersion résiduelle étalée et d’un déficit presque total d’observations dans les zones distantes des queues. Bien que moins pénalisante pour la validité des tests inférentiels que la leptokurticité, cette configuration peut trahir l’existence de mécanismes de troncature ou de saturation au sein du processus de mesure, incitant l’expérimentateur à interroger la pertinence des instruments d’évaluation mobilisés sur le terrain.
8.3 Repérage des résidus atypiques et points aberrants
L’histogramme des résidus s’avère être un filtre visuel particulièrement efficient pour détecter les points de données atypiques qui parsèment fréquemment les bases de données empiriques. Ces singularités statistiques se signalent sur le tracé par l’apparition de rectangles isolés, disjoints du corps continu de la distribution, positionnés de façon satellite à plusieurs largeurs de classe de la masse centrale. Ces occurrences périphériques matérialisent des observations pour lesquelles l’ajustement du modèle linéaire a produit une erreur d’une magnitude inhabituellement élevée.
Pour qualifier objectivement le caractère pathologique d’une barre périphérique sur l’histogramme, l’utilisation préalable de résidus standardisés ou studentisés fournit un seuil conventionnel rigoureux. En vertu des propriétés de la loi normale centrée réduite, moins de 0.3% des observations théoriques sont censées excéder une valeur absolue de 3 écarts-types. Ainsi, la présence de classes occupées au-delà des bornes critiques de -3 ou +3 sur un histogramme de résidus standardisés permet d’isoler quasi-instantanément des anomalies méritant une inspection individuelle approfondie.
Néanmoins, une prudence épistémologique stricte s’impose : un résidu de forte magnitude n’est pas obligatoirement synonyme de point d’influence destructeur. Il est indispensable de distinguer un point aberrant vertical (qui s’écarte fortement de la droite tout en se situant à l’intérieur du champ de variation classique des prédicteurs) d’un point à fort effet de levier (dont les coordonnées des prédicteurs sont extrêmes). Si le premier distord l’histogramme résiduel sans nécessairement altérer substantiellement l’estimation de la pente globale, le second peut basculer l’hyperplan de régression tout en affichant paradoxalement un résidu calculé trompeusement modeste par suite d’une attraction mécanique de la droite vers sa position.
9. Complémentarité avec d’autres outils diagnostiques graphiques et tests statistiques
9.1 Confrontation avec le diagramme quantile-quantile (Q-Q plot)
Bien que l’histogramme des résidus offre une vision d’ensemble holistique inégalable sur la distribution des erreurs, son pouvoir de résolution analytique tend à décroître sensiblement au niveau des extrémités ultimes de la distribution. En effet, l’agrégation spatiale des observations au sein d’intervalles discrets dissimule les variations ponctuelles dans les zones où la densité d’échantillonnage s’amenuise. C’est précisément à cet endroit que le diagramme quantile-quantile, ou Q-Q plot normalisé, intervient comme le complément visuel indispensable de l’histogramme.
Généré nativement dans R par la commande plot(model, which = 2) ou via la géométrie stat_qq() sous ggplot2, le diagramme Q-Q projette graphiquement les quantiles empiriques des résidus triés en ordre croissant contre les quantiles théoriques attendus d’une loi normale de référence. Dans l’hypothèse d’une conformité gaussienne parfaite, l’ensemble des points d’observation s’aligne rigoureusement sur une trajectoire rectiligne diagonale à quarante-cinq degrés matérialisée par la droite de Henry.
L’articulation croisée de ces deux dispositifs graphiques permet de lever toute incertitude d’interprétation. Alors que l’histogramme permet de percevoir immédiatement la forme globale, la bimodalité et la dérive du pic modal, le diagramme Q-Q isole avec une sensibilité microscopique le moindre décrochage des quantiles dans les queues de distribution. Une courbure en forme de cloche inversée sur le tracé Q-Q vient confirmer de manière irréfutable une asymétrie perçue sur l’histogramme, tandis qu’une déviation en esse (S) corrobore sans ambiguïté une anomalie d’aplatissement (kurtosis).
9.2 Contrôle simultané de l’homoscédasticité des erreurs
L’évaluation de la distribution résiduelle ne peut être dissociée de l’investigation de l’homoscédasticité, qui postule que la variance des termes d’erreur demeure constante quelle que soit la valeur prédite par le modèle ou le niveau des prédicteurs. Une violation de cette hypothèse fondamentale, connue sous le terme d’hétéroscédasticité, interfère directement avec l’allure de l’histogramme des résidus, pouvant générer une apparence artificielle de queues lourdes qui ne résulte pas d’une véritable loi non gaussienne, mais d’un mélange latent de distributions à variances hétérogènes.
Le tracé diagnostique incontournable pour surveiller cette propriété consiste à projeter les résidus ordinaires ou standardisés en ordonnée contre les valeurs ajustées (fitted values) en abscisse. Dans un modèle parfaitement régulier, le nuage de points résultant forme une bande horizontale homogène et dénuée de motif géométrique structurel. L’émergence d’une morphologie conique ou en entonnoir, où l’amplitude de dispersion des résidus s’élargit ou se resserre au fur et à mesure que les valeurs prédites s’élèvent, atteste d’une dépendance directe entre la dispersion stochastique et le niveau de la réponse.
Lorsqu’une hétéroscédasticité sévère pollue le jeu de données, l’histogramme marginal des résidus regroupe indifféremment des points générés sous des régimes de variance divergents. Cette agrégation produit un aplatissement composite de l’histogramme, illustrant de manière magistrale l’impérieuse nécessité d’une démarche diagnostique systémique : aucun graphique résiduel ne doit être interprété de manière étanche et décontextualisée sans une inspection croisée de l’ensemble de la panoplie des visualisations de régression.
9.3 Apport des tests formels d’adéquation à la normalité
Dans la pratique de la recherche académique, l’inspection visuelle par histogramme est fréquemment confrontée à l’arbitrage d’un test d’hypothèse formel d’adéquation à la normalité. L’outil le plus largement employé et le plus puissant d’un point de vue statistique est le test de Shapiro-Wilk, accessible de façon native sous l’interpréteur R par la fonction shapiro.test(). Ce test évalue formellement l’hypothèse nulle selon laquelle l’échantillon des résidus provient d’une population parente normalement distribuée.
Cependant, l’interprétation aveugle de la p-valeur issue de ce type de test formel recèle des écueils méthodologiques bien documentés dans la littérature statistique contemporaine. Dans les échantillons de grand volume (dépassant plusieurs centaines ou milliers d’individus), la puissance statistique du test devient tellement écrasante que le moindre écart microscopique et substantiellement insignifiant par rapport à la normalité mathématique parfaite conduit inexorablement au rejet brutal de l’hypothèse nulle à un seuil alpha de 5%, induisant l’analyste en panique pour des déviations qui n’altèrent en rien la solidité de ses estimateurs.
À l’inverse, au sein d’échantillons très réduits, la puissance de Shapiro-Wilk s’avère insuffisante pour rejeter formellement l’hypothèse nulle en présence d’asymétries ou de contaminations pourtant bien tangibles sur l’histogramme. C’est pourquoi la communauté statistique internationale s’accorde aujourd’hui à conférer une primauté épistémologique à l’évaluation graphique qualitative. L’histogramme et le Q-Q plot ne sont pas de simples subalternes de la p-valeur ; ils en constituent le contexte sémantique indispensable sans lequel toute décision algorithmique automatisée relève de l’illusion de rigueur.
10. Gestion et résolution des violations de normalité observées sur l’histogramme
10.1 Transformations mathématiques de la variable dépendante
Lorsque l’inspection méthodique de l’histogramme des résidus révèle une asymétrie positive persistante et structurelle, la réponse méthodologique la plus classique consiste à appliquer une transformation fonctionnelle monotone à la variable dépendante avant de réajuster l’équation de régression. La transformation logarithmique, qu’elle soit déployée en base népérienne via log() ou en base dix via log10(), s’impose comme l’outil privilégié pour stabiliser la variance et restaurer la symétrie gaussienne des perturbations stochastiques lorsque la variable cible présente une dynamique d’échelle multiplicative.
Le mécanisme opératoire de la fonction logarithmique agit en compressant de façon différentielle les valeurs élevées de l’échelle tout en étirant les intervalles entre les faibles valeurs numériques. Cette compression asymétrique ramène la longue queue droite observée sur l’histogramme vers le barycentre de la distribution, métamorphosant un profil distributionnel étiré en une morphologie en cloche harmonieuse satisfaisant les critères des moindres carrés. Pour les variables présentant des déviations plus modérées, la transformation par la racine carrée via sqrt() offre une correction plus subtile particulièrement efficace sur des données de dénombrement.
Après l’application de toute transformation mathématique, il est méthodologiquement impératif de ré-estimer intégralement le modèle de régression linéaire et d’extraire le nouveau vecteur résiduel pour tracer un second histogramme de validation. Cette itération confirme si la distorsion initiale a été efficacement résorbée sans introduire une asymétrie inverse pernicieuse. Par ailleurs, l’analyste ne devra pas perdre de vue que le passage à l’échelle logarithmique modifie l’interprétation substantielle des coefficients de régression, qui cessent de traduire des variations additives directes pour exprimer des élasticités ou des variations relatives semi-proportionnelles.
10.2 Optimisation paramétrique par la méthode de Box-Cox
Plutôt que de procéder à des essais empiriques successifs et arbitraires de transformations fonctionnelles (logarithme, racine carrée, inverse), la démarche d’inférence statistique moderne favorise l’automatisation analytique via la transformation de puissance de Box-Cox. Cette méthode paramétrique formalise une famille continue de transformations de puissance indexée par un coefficient scalaire lambda, embrassant l’inversion pure lorsque lambda vaut moins un, le logarithme népérien lorsque lambda tend vers zéro, la racine carrée à un demi, et la stricte linéarité initiale lorsque lambda équivaut à un.
L’implémentation algorithmique de cette technique sous R est facilitée par la fonction boxcox(), hébergée au sein de la bibliothèque de référence MASS. En lui fournissant en entrée l’objet du modèle linéaire original, la routine calcule et trace la courbe de log-vraisemblance profilée associée à un continuum de valeurs candidates de lambda, délimitant visuellement un intervalle de confiance à 95% encadrant la valeur optimale qui maximise mathématiquement la conformité des perturbations stochastiques à l’idéal de la distribution gaussienne.
Dès lors que le paramètre lambda optimal est identifié et estimé, l’analyste applique la puissance correspondante à sa variable réponse, sous réserve que toutes ses composantes soient strictement positives. La ré-évaluation consécutive du modèle permet de générer un histogramme résiduel corrigé qui, dans l’immense majorité des cas empiriques, témoigne d’un réalignement spectaculaire sur la courbe théorique de normalité, annihilant simultanément l’asymétrie résiduelle et une fraction significative de l’hétéroscédasticité sous-jacente.
10.3 Approches alternatives lorsque la normalité résiduelle est inaccessible
Il survient fréquemment des situations expérimentales complexes où aucune transformation fonctionnelle ne parvient à redresser une distribution résiduelle profondément réfractaire aux postulats gaussiens. C’est notamment le cas lorsque la variable dépendante est intrinsèquement binaire, multinomiale, strictement ordinale ou constituée d’occurrences rares dénombrées selon un processus de Poisson. S’acharner à ajuster un modèle linéaire ordinaire dans ces conditions relève d’une hérésie méthodologique que l’histogramme des résidus ne manquera pas de sanctionner par des profils fragmentés ou multimodaux insolubles.
La solution paradigmatique réside alors dans l’abandon des moindres carrés ordinaires au profit des Modèles Linéaires Généralisés (GLM), mobilisables sous R par la fonction maîtresse glm(). Ces architectures statistiques sophistiquées s’affranchissent totalement de l’hypothèse de normalité en autorisant le terme de réponse à suivre une loi appartenant à la vaste famille exponentielle (loi binomiale, poissonienne, gamma ou gaussienne inverse), reliée à la combinaison linéaire des régresseurs par une fonction de lien appropriée (logit, probit, log). L’analyse diagnostique résiduelle se déploie alors via les résidus de déviance ou de Pearson, dotés de leurs propres critères géométriques d’adéquation.
Lorsque la structure des données demeure continue mais se trouve contaminée par une proportion irréductible d’observations extrêmes engendrant une distribution résiduelle lourdement leptokurtique, le recours à la régression robuste offre une alternative performante. Les fonctions telles que rlm() du paquetage MASS mobilisent des estimateurs de type M ou des algorithmes itératifs par moindres carrés repondérés (IRLS) qui neutralisent le poids d’influence des queues épaisses sans exclure arbitrairement les observations atypiques. Enfin, les démarches non paramétriques basées sur le rééchantillonnage par bootstrap permettent d’engendrer des distributions d’échantillonnage empiriques pour les coefficients de régression, garantissant des inférences et des tests d’hypothèses d’une robustesse absolue sans requérir le moindre postulat de normalité résiduelle.
11. Personnalisation avancée et exportation de graphiques de résidus prêts pour publication
11.1 Titrage rigoureux et annotations scientifiques contextuelles
La transition d’une visualisation exploratoire de laboratoire vers une planche graphique digne de figurer dans une revue académique internationale à comité de lecture requiert un travail d’enrichissement sémantique et typographique rigoureux. Au sein de la bibliothèque ggplot2, la couche labs() permet de structurer la hiérarchie textuelle de la figure avec une clarté irréprochable, en stipulant un titre descriptif synthétique, un sous-titre contextualisant le modèle (par exemple, en explicitant la nature de la variable dépendante modélisée) et des étiquettes d’axes libellées selon les standards métrologiques internationaux.
Pour parfaire l’exhaustivité informative du graphique, il est d’usage d’intégrer des annotations textuelles directes positionnées stratégiquement au sein du champ de coordonnées sans obstruer la visibilité des barres de distribution. L’instruction annotate() permet d’ancrer des fragments textuels aux coordonnées spatiales exactes souhaitées, affichant par exemple la valeur numérique précise de l’écart-type résiduel, le coefficient d’asymétrie calculé ou la p-valeur issue du test de Shapiro-Wilk préalablement calculé dans la session d’analyse.
L’intégration d’une légende explicative rigoureuse constitue un impératif lorsque des couches de densité multiples sont superposées. En articulant adéquatement les paramètres aes(color = …) au sein des couches de densité empirique et théorique, ggplot2 engendre une clé de lecture dynamique unifiée. Il est alors aisé d’assigner par la commande scale_color_manual() des libellés scientifiques irréprochables précisant sans ambiguïté la nature de la distribution observée par rapport au modèle gaussien de référence.
11.2 Composition multi-panneaux pour un diagnostic complet
Dans le formatage des articles scientifiques modernes, l’espace d’impression constitue une ressource rare et hautement optimisée. Il est rarement envisageable de consacrer une figure entière à un histogramme de résidus isolé. L’excellence méthodologique commande d’élaborer une planche multi-panneaux intégrée, regroupant de concert l’histogramme de distribution, le diagramme quantile-quantile normalisé, et le graphique de dispersion des résidus en fonction des valeurs prédites, fournissant ainsi en un coup d’œil synoptique l’intégralité du panorama diagnostique des hypothèses de Gauss-Markov.
L’assemblage spatial de ces sous-figures distinctes s’opère aujourd’hui avec une fluidité exceptionnelle grâce à des extensions spécialisées de l’écosystème R, au premier rang desquelles brille le paquetage patchwork, supplantant par son élégance syntaxique les routines historiques de gridExtra. Par l’intermédiaire de simples opérateurs arithmétiques tels que le signe d’addition ou la barre oblique de division, l’analyste peut orchestrer un agencement spatial complexe juxtaposant un panneau d’histogramme supérieur à un diptyque inférieur combinant tracé Q-Q et homoscédasticité.
Ce chaînage déclaratif garantit un alignement parfait des marges extérieures, une uniformisation automatique des échelles typographiques et permet l’adjonction d’une numérotation normalisée des sous-panneaux au moyen de lettres capitales alphabétiques (A, B, C) via l’instruction plot_annotation(tag_levels = ‘A’). La composition résultante atteint une cohérence formelle répondant aux exigences graphiques les plus intransigeantes des éditeurs scientifiques internationaux.
11.3 Exportation haute résolution pour revues à comité de lecture
L’ultime maillon de la chaîne de production graphique réside dans la matérialisation physique du fichier image sous forme numérique pérenne. L’utilisation hasardeuse des fonctions de capture d’écran ou du menu d’exportation standard de l’environnement graphique interactif de RStudio est formellement proscrite pour un travail à vocation académique, car elle engendre des fichiers matriciels à basse résolution de 72 à 96 points par pouce (DPI), notoirement flous et inacceptables pour l’impression typographique professionnelle.
L’outil d’exportation de référence incontournable au sein de l’environnement R moderne est la fonction ggsave(). Cette commande dédiée permet d’intercepter la dernière composition graphique active et de la compiler vers un fichier externe dont on maîtrise souverainement l’ensemble des spécifications dimensionnelles. Il est primordial d’y déclarer explicitement la largeur width et la hauteur height en unités physiques absolues telles que les centimètres ou les pouces, en adéquation stricte avec les gabarits de mise en page imposés par la revue ciblée (par exemple, 18 centimètres pour une composition pleine page sur deux colonnes).
La pérennité de l’exportation repose sur le choix stratégique du format d’encapsulation numérique et du paramètre de résolution dpi. Pour les publications formelles, l’analyste privilégiera impérativement les formats vectoriels purs tels que le Portable Document Format (PDF) ou le Scalable Vector Graphics (SVG), qui garantissent un redimensionnement parfait des polices et des tracés géométriques à l’infini sans la moindre pixelisation. Si des spécifications éditoriales contraignent à fournir des fichiers matriciels, l’exportation au format TIFF ou PNG non compressé doit être calibrée à une résolution minimale absolue de 300 DPI pour les dégradés complexes, et idéalement de 600 DPI pour les planches de tracés au trait, assurant une netteté visuelle absolue sous presse.
12. Étude de cas empirique complète : analyse des résidus d’une régression pas à pas
12.1 Présentation du cadre expérimental et simulation des données de recherche
Afin de concrétiser l’ensemble des concepts théoriques et méthodologiques abordés dans cet ouvrage, déployons une étude de cas empirique intégralement contextualisée. Imaginons une investigation biomédicale contemporaine portant sur les facteurs déterminants de la pression artérielle systolique mesurée en millimètres de mercure chez une cohorte de patients adultes. Notre cadre conceptuel postule que la tension artérielle d’un individu est modulée par trois prédicteurs continus majeurs : l’âge chronologique exprimé en années, l’indice de masse corporelle (IMC) évalué en kilogrammes par mètre carré, et le score moyen d’activité physique aérobie hebdomadaire mesuré en équivalents métaboliques.
Pour asseoir la démonstration sur une base méthodologique parfaitement transparente et reproductible, nous construisons un générateur stochastique modélisant une cohorte réaliste de quatre cents sujets indépendants. Nous paramétrons les prédicteurs de façon à refléter des distributions cliniques crédibles : une moyenne d’âge oscillant autour de 52 ans avec un écart-type de 12 ans, un indice de masse corporelle centré sur 27.5 avec une variabilité modérée, et un niveau d’activité physique décroissant légèrement avec l’avancée en âge afin d’injecter une corrélation croisée réaliste au sein de la matrice de conception.
La variable réponse relative à la pression systolique est ensuite calculée par la sommation d’une constante de base, des contributions linéaires pondérées de chaque prédicteur physiologique et de l’adjonction finale d’un terme d’erreur stochastique résiduel délibérément calibré selon une loi normale d’écart-type égal à 8. Ce protocole assure la création d’un système mathématique intègre dont nous allons inspecter le comportement diagnostique résiduel de bout en bout.
12.2 Pipeline de code complet et reproductible
L’exécution de cette analyse s’ordonne selon un flux de traitement séquentiel strict au sein de l’interpréteur R. La démarche débute par l’initialisation de la graine aléatoire via l’instruction set.seed(42), garantissant la stricte reproductibilité des tirages ultérieurs. On procède ensuite à la création matricielle des régresseurs au moyen de la fonction rnorm() et au calcul vectoriel de la variable tensionnelle, avant de condenser l’ensemble de ces colonnes synchronisées au sein d’un tableau data.frame unifié.
L’étape suivante engage l’ajustement du modèle de régression linéaire multiple via la fonction lm(), spécifiant la relation fonctionnelle formelle reliant la réponse tensionnelle aux trois covariables physiologiques déclarées. Le résultat de cette estimation est immédiatement stocké dans un objet nommé de classe lm. Dès cette affectation complétée, l’extraction des résidus ordinaires s’effectue par l’appel formel de residuals(), dont le vecteur numérique de sortie est réinjecté comme nouvelle composante de la table originelle pour sécuriser les couplages relationnels.
La construction de la planche diagnostique s’articule ensuite au sein du moteur ggplot2. En mobilisant aes(x = residus) combiné à after_stat(density) au sein de la couche géométrique geom_histogram(), nous bâtissons un histogramme aux classes finement partitionnées, orné d’un remplissage doux et d’un contour distinct. Sur cette fondation discrète se greffent successivement la couche geom_density() modélisant la densité empirique par noyau et la fonction stat_function(fun = dnorm) calibrée sur la variance empirique de nos résidus. Le script se clôt par l’application d’un habillage textuel exhaustif via labs(), de retouches ergonomiques avec theme_minimal() et de l’exportation du graphique en haute résolution vectorielle par l’instruction ggsave().
12.3 Rédaction académique du compte-rendu de diagnostic
L’aboutissement ultime de la démarche réside dans la restitution rédactionnelle rigoureuse des constats diagnostiques au sein de la section méthodologique du manuscrit scientifique destiné à la publication. Les comités de rédaction des revues de premier rang exigent une justification explicite de la validité des postulats de modélisation, qui ne saurait se cantonner à une mention lapidaire stipulant simplement que les hypothèses ont été vérifiées.
Une formulation académique exemplaire, conforme aux directives rédactionnelles de l’APA, s’articule typiquement de la manière suivante : « L’examen diagnostique des résidus de l’équation de régression linéaire multiple a été conduit afin de s’assurer du respect des hypothèses fondamentales d’ajustement. L’histogramme des résidus ordinaires, confronté à la fonction de densité gaussienne théorique, révèle une symétrie satisfaisante centrée sur zéro (moyenne = 0.00, écart-type = 7.89), dénuée d’asymétrie notable (skewness = -0.04) ou d’aplatissement pathologique (excess kurtosis = 0.11). Aucune concentration anormale d’observations n’est décelable dans les queues de distribution et la totalité des résidus standardisés s’inscrit à l’intérieur de l’intervalle critique de délimitation [-2.85 ; +2.74]. La concordance visuelle étroite entre l’estimation non paramétrique de densité par noyau et la courbe normale paramétrique confirme l’adéquation empirique à la loi normale, corroborée par la conservation de l’hypothèse nulle au test de Shapiro-Wilk (W = 0.996, p = .42). Dès lors, les inférences dérivées des tests de significativité de Student et l’estimation des intervalles de confiance associés peuvent être tenues pour hautement fiables et robustes. »
Ce modèle d’argumentation textuelle illustre parfaitement la symbiose féconde qui doit s’opérer entre l’inspection visuelle détaillée de l’histogramme, l’évaluation des moments empiriques de la distribution et les tests d’adéquation formels. En documentant avec ce degré de transparence et de précision le diagnostic des résidus sous R, le chercheur confère à ses travaux une crédibilité scientifique inattaquable, garantissant l’intégrité pérenne de ses conclusions au regard des exigences les plus élevées de la communauté scientifique internationale.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications. https://socialsciences.mcmaster.ca/jfox/Books/Companion/
- Gelman, A., & Hill, J. (2006). Data analysis using regression and multilevel/hierarchical models. Cambridge University Press. https://doi.org/10.1017/CBO9780511790942
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0